今日 AIGC 论文速览
今日共 10 篇 · 参考视频重拍与相机控制 2 篇 · 图像编辑与透明素材 3 篇 · 图像生成模型 1 篇 · 旋律音频生成 1 篇 · 音频驱动三维头像 1 篇 · 多参考图生成评测 1 篇 · 城市三维生成 1 篇
重点论文标题列表
SyncVid (高通):换机位也让同一动作对齐WorldForge V2 (西湖大学):换镜头时少带进重建破绽LOCI (Meta):同图每个人都有独立编辑旋钮AlphaAnything (字节):透明素材不用另造一套潜空间EditJev (北京大学):先挑合适的改图模型再开工
选读入口:要把已有视频换机位并对齐人物动作,先读 SyncVid,再读 WorldForge V2 比较噪声同步与轨迹参考两条路。合照里不同人改不同程度,读 LOCI;做玻璃、发丝等透明素材读 AlphaAnything。部署多个编辑器先看 EditJev 的路由与估算时延;想研究扩散之外的图像生成,读 TEM 并留意持续采样链。已有音频模型想跟旋律走,读 Melody Guidance;照片做可转头数字人,接 AudioLift。多张参考总串细节,借 MDMR-Bench 拆验收项;做可逐栋编辑的城市三维资产,再读 CityLift 及掩码和数据域边界。
今日论文速览
1. SyncVid:换机位也让同一动作对齐
SyncVid: World-Equivariant Diffusion for Synchronized Video Generation | 高通 AI Research | arXiv:2610.31765
关键词 :参考视频重拍, 跨视角同步, 结构化噪声, 近似白化
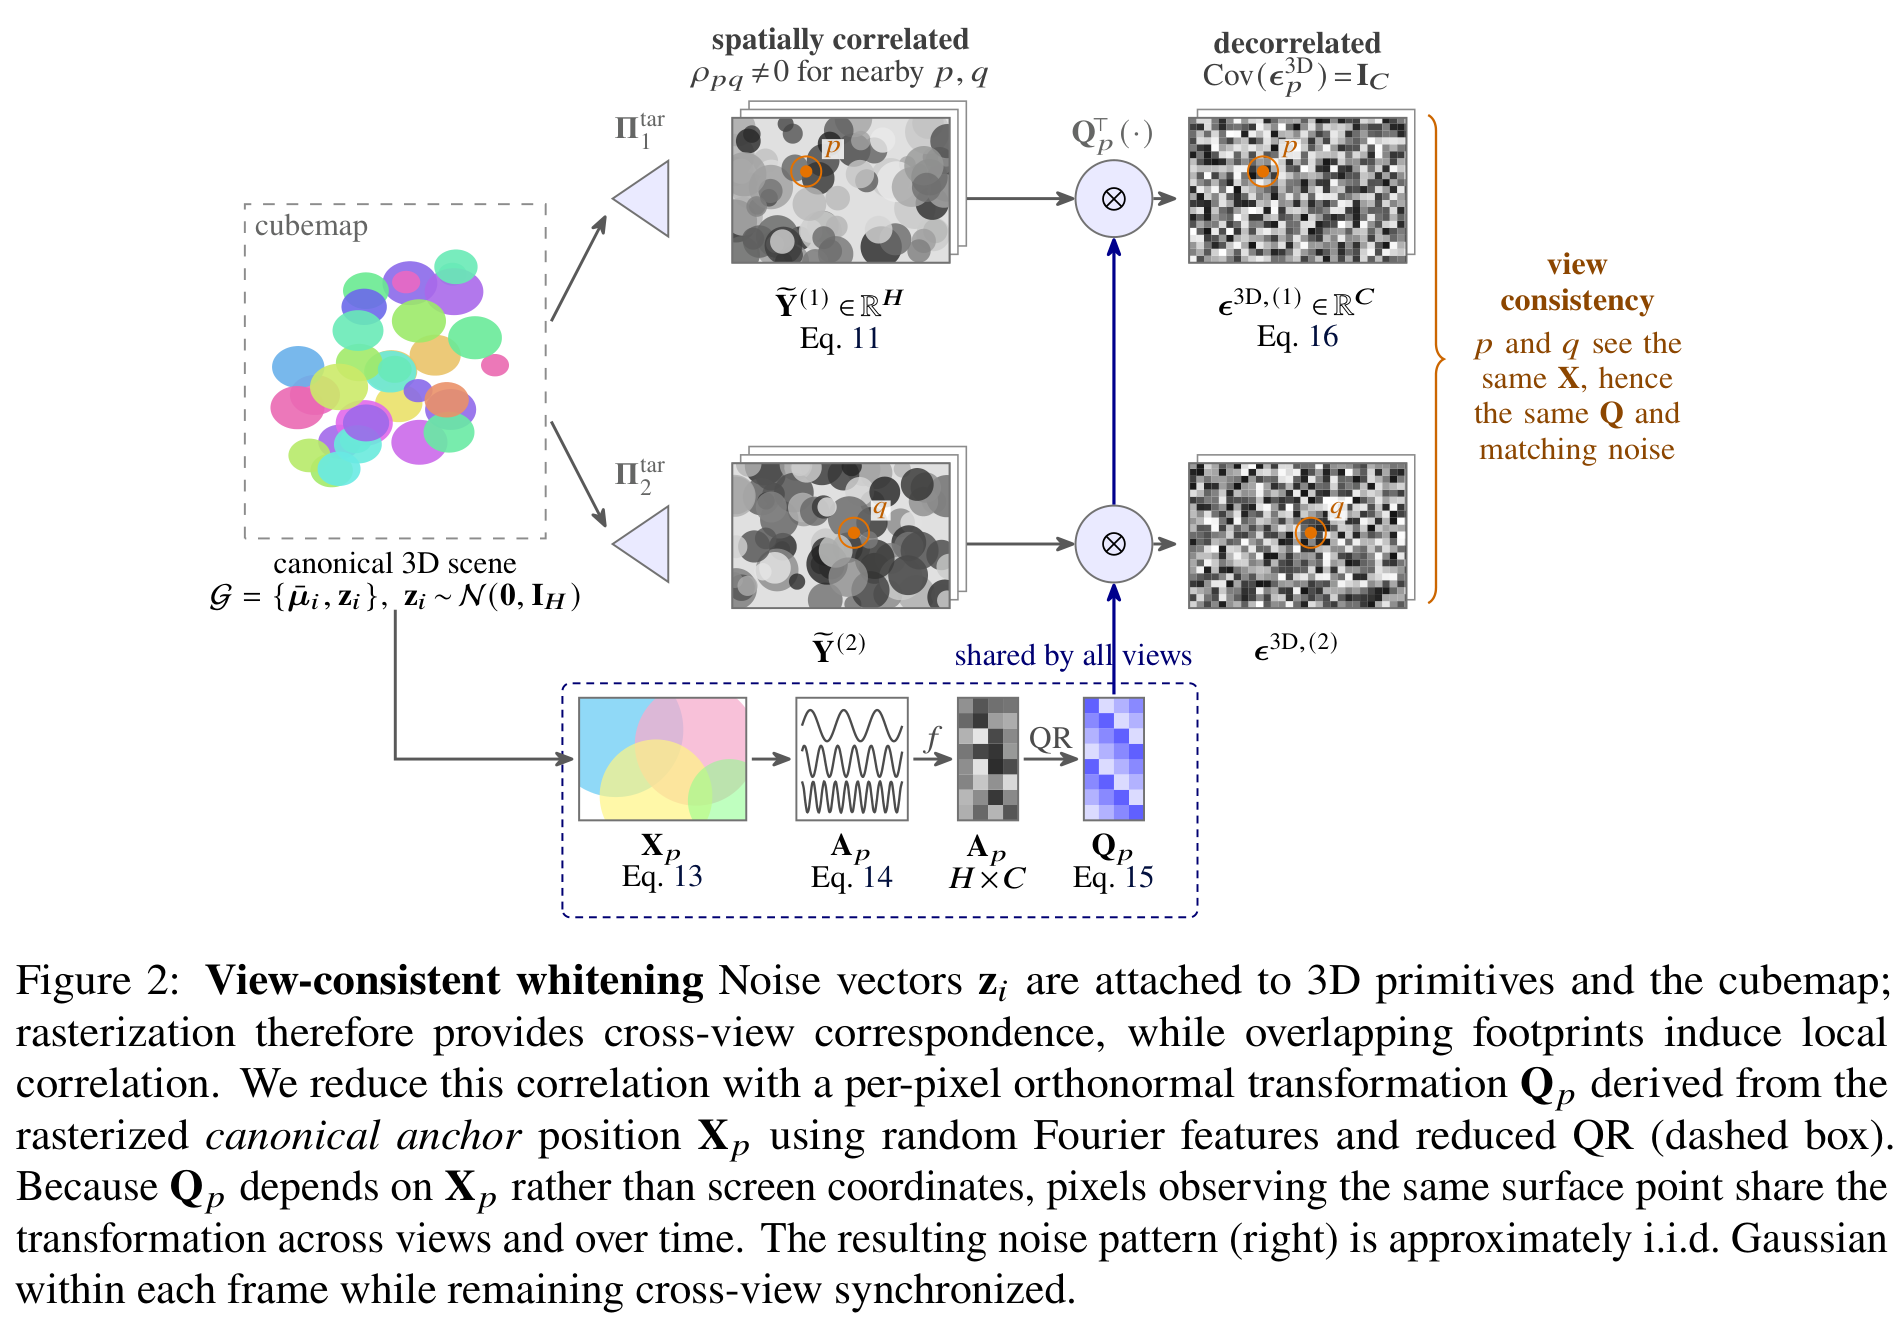
前序问题 :给同一段舞蹈换两个机位,人物可能在左视角抬手、右视角却已经转身。每个视角各自生成得通顺,不代表它们描绘的是同一时刻、同一个动作。怎样让遮挡后露出的部分也尽量一致?方法直觉 :别让各机位从互不相干的随机噪声开始:先给场景里的三维小颗粒各分配一份固定噪声,再按新机位投影。不同机位看见同一个颗粒,就拿到相关的随机起点;生成器负责把不完整的投影补成画面。本文贡献 :NoPo4D 将单目视频重建成随时间变化的高斯点,噪声绑定不随时间变化的规范坐标锚点;未观察背景用包围场景的立方体补足。投影会使邻像素过度相关,于是用规范三维位置的随机傅里叶特征及 QR 正交分解(构造正交方向的局部变换)做近似白化:降低局部相关,同时保留跨视角对应。源视频和渲染视频作为条件,以秩 256 的 LoRA 低秩适配微调 Wan2.2-14B;36000 组合成视频对,加 2000 条真实静态视频折叠出的约 13500 对,八张 H100 训练 10000 次更新。
原文 PDF 图 2|跨视角一致的近似白化:噪声向量绑定三维高斯点与背景立方体,栅格化使不同机位共享对应关系,但重叠足迹带来局部相关。虚线框用规范锚点 X 的位置经随机傅里叶特征及约化 QR 分解得到逐像素正交变换 Q;它依赖三维位置而非屏幕坐标,同一表面跨视角、跨时间共享变换。右侧噪声在帧内近似独立高斯,视角间仍同步;这种白化不是严格独立性保证。
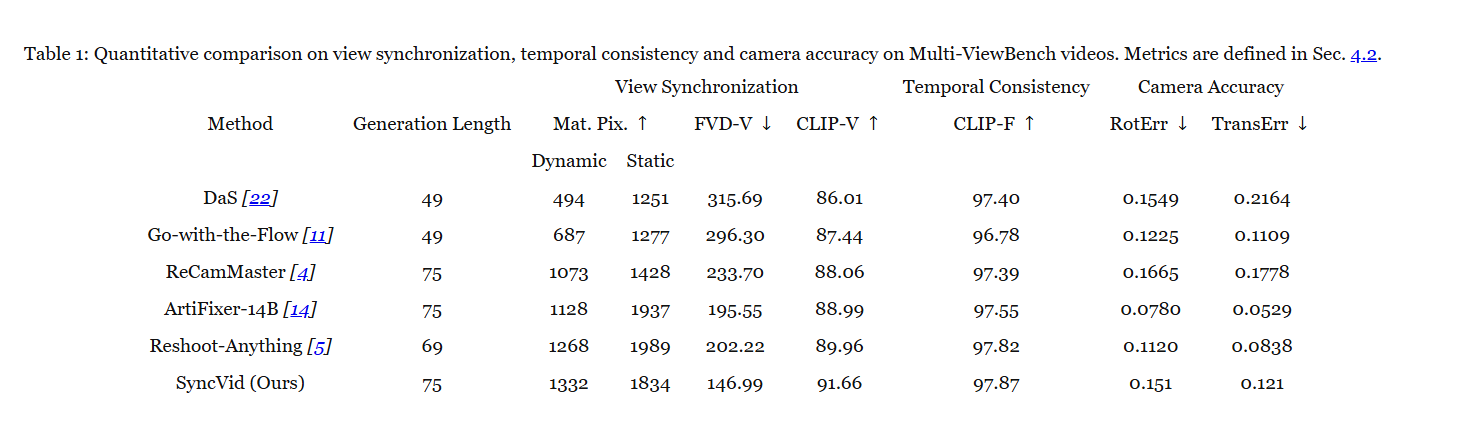
实验效果 :Multi-ViewBench 含 200 片段,统一 5 秒、15 帧/秒、480p,方法输出 75 帧。相对 Reshoot-Anything,动态区域可信匹配点 1268→1332,跨视角 FVD(视频特征分布距离,越低越好)202.22→146.99;跨视角 CLIP 相似度按百分制 89.96→91.66。相机旋转/平移误差 0.151/0.121,逊于 ArtiFixer 的 0.0780/0.0529。单 H100、480×832、50 步生成耗时 1203.1 秒,另有 4D 重建 4.18 秒、噪声渲染 6.44 秒、白化 0.53 秒;未报峰值显存。
原文表 1|Multi-ViewBench 上的视角同步、时间一致性及相机精度比较。Generation Length 为实际生成帧数,49 至 75 帧不等;Mat. Pix.为动态/静态区域的高置信匹配点数,越高越好;FVD-V 为跨视角视频分布距离,越低越好;CLIP-V、CLIP-F 分别为跨视角和时间相似度,越高越好;RotErr、TransErr 为相机旋转和平移误差,越低越好。SyncVid 输出 75 帧、动态匹配 1332、FVD-V146.99,但相机误差 0.151/0.121 未领先。
批判点评 :三维跟踪或遮挡出错仍会破坏同步;白化仅近似,不能保证像素独立或真实世界几何正确。200 片段由视觉语言模型筛选,且不同对照输出长度不同,不能把匹配点当严格同帧数胜率。原文所列项目主页本次返回 404,未确认代码或权重已公开;机构由四位作者的高通公司邮箱及原 PDF 核验。
2. WorldForge V2:换镜头时少带进重建破绽
WorldForge V2: Eliciting Camera-Trajectory Alignment in Video Diffusion Models | 西湖大学;北京航空航天大学;新加坡管理大学 | arXiv:2610.31640
关键词 :相机轨迹控制, 视频重渲染, 速度缓存, 轨迹低秩适配
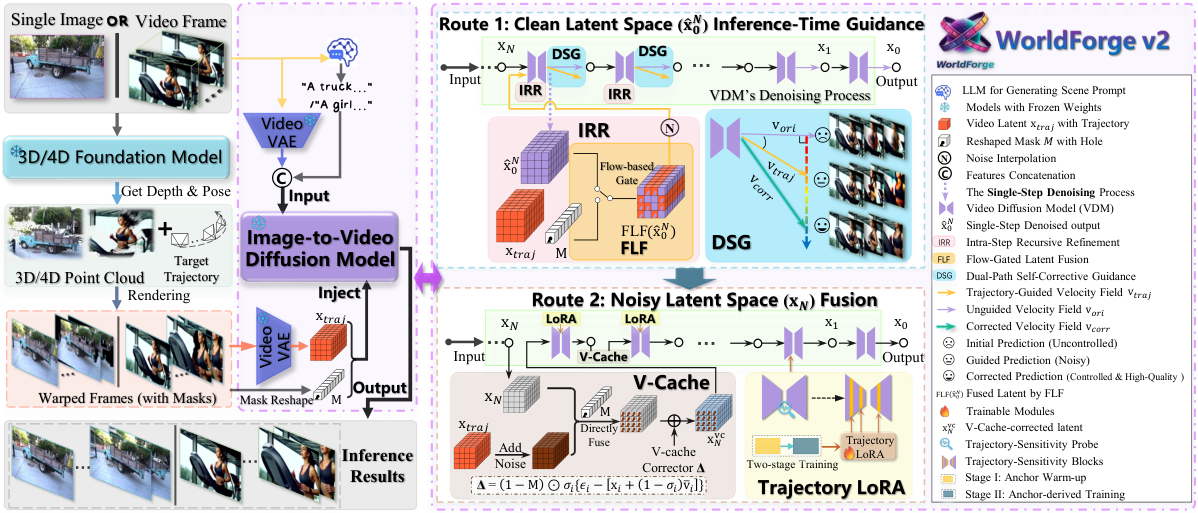
前序问题 :把一段实拍改成绕物体转动,深度重建的孔洞和错位很容易一起变成视频里的浮空结构。直接强塞参考帧会伤画质,完全交给模型又可能不按指定机位走。方法直觉 :先把画面按目标相机路径粗略投影,再挑适合承载运动信息的潜变量通道施加约束;保留原生成器的预测作校正。重拍指导可以带路,但不应把错误参考当成必须照抄的真值。本文贡献 :IRR(步内递归精修)在预测的干净潜变量中融合参考,再统一加噪;FLF(光流门控潜变量融合)比较位移、方向和异常流,筛选运动相关通道;DSG(双路径自校正引导)比较有无轨迹引导的预测,以角度自适应投影校正。v-cache 复用上一步速度预测,少算额外前向。进一步按 Shapley 贡献筛选网络块训练 Trajectory LoRA:LongCat 用 48 块中的 36 块、8 场景 50 视频、1200 次更新;H3 用 50 块中的 38 块、1 场景 50 视频、1500 次更新,均含 200 次锚点预热,再混合引导状态训练。
原文图 2|WorldForge V2 总览:单张图或视频帧与目标相机路径先经几何重建,渲染对齐轨迹的参考帧。无训练路径在预测干净潜空间依次执行 IRR 步内精修、FLF 运动通道筛选和 DSG 双路径校正;高效路径用 V-Cache 在带噪潜空间融合轨迹,结合对轨迹敏感块的轻量 LoRA,仅少量训练数据学习相机控制。目标是在沿指定路径变化时保留底座生成能力。
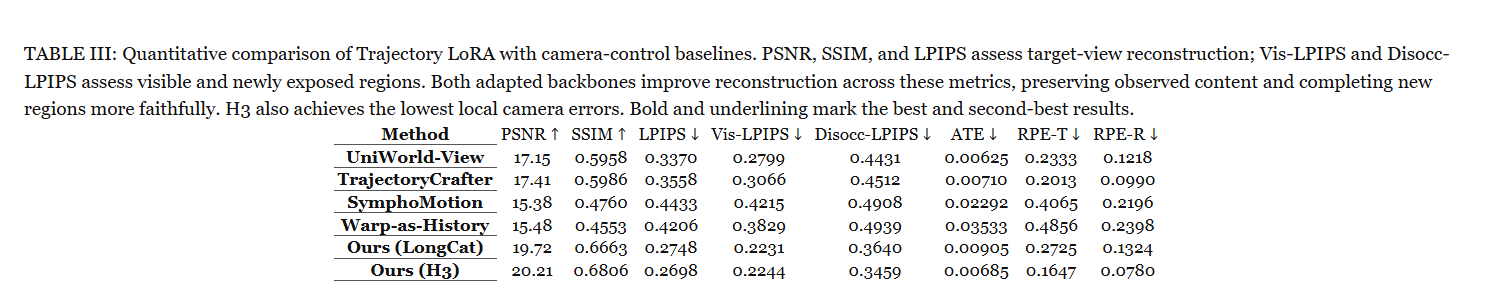
实验效果 :无训练动态重渲染覆盖超过 30 源视频:相对 TrajectoryCrafter,FVD 视频分布距离 97.31→93.17,但 ATE(全局相机位置误差)0.431→0.527,反而更差。学习版在 40 个留出场景、200 条轨迹比较,统一 640×360 评分;H3 的 PSNR 像素信噪比 20.21 分贝、LPIPS 感知距离 0.2698,对照 UniWorld-View 为 17.15/0.3370。单 A100 估算均时 H3 为 707.3 秒,叠加公开加速 LoRA 后 139.0 秒;各方法使用原生配置,非严格等结构提速。
原文表 III|Trajectory LoRA 与相机控制方法对比。PSNR、SSIM 衡量目标视角像素和结构重建,越高越好;LPIPS 衡量感知距离,Vis/Disocc 分别限于可见与新露出区域,越低越好;ATE 为全局轨迹误差,RPE-T/R 为局部平移/旋转误差。两底座改善重建与新区域补全;H3 局部相机误差最低,但 ATE0.00685 仍高于 UniWorld-View0.00625。粗体和下划线分别标示最优与次优。
批判点评 :无训练引导与学习版是两条路径,不能把单场景训练说成整个系统免训练;更新数不含底座预训练。单场景有泛化价值,但大幅度深度错误、人群遮挡仍会留下破绽;全局轨迹指标也非全胜。代码 含 Wan、LongCat 和 H3 相关实现,未实际运行模型。
3. LOCI:同图每个人都有独立编辑旋钮
LOCI: Localized Continuous Control for Multi-Subject Image Editing | Meta AI 研究团队 | arXiv:2610.31950
关键词 :多主体图像编辑, 区域低秩适配, 注意力绑定, 连续强度控制
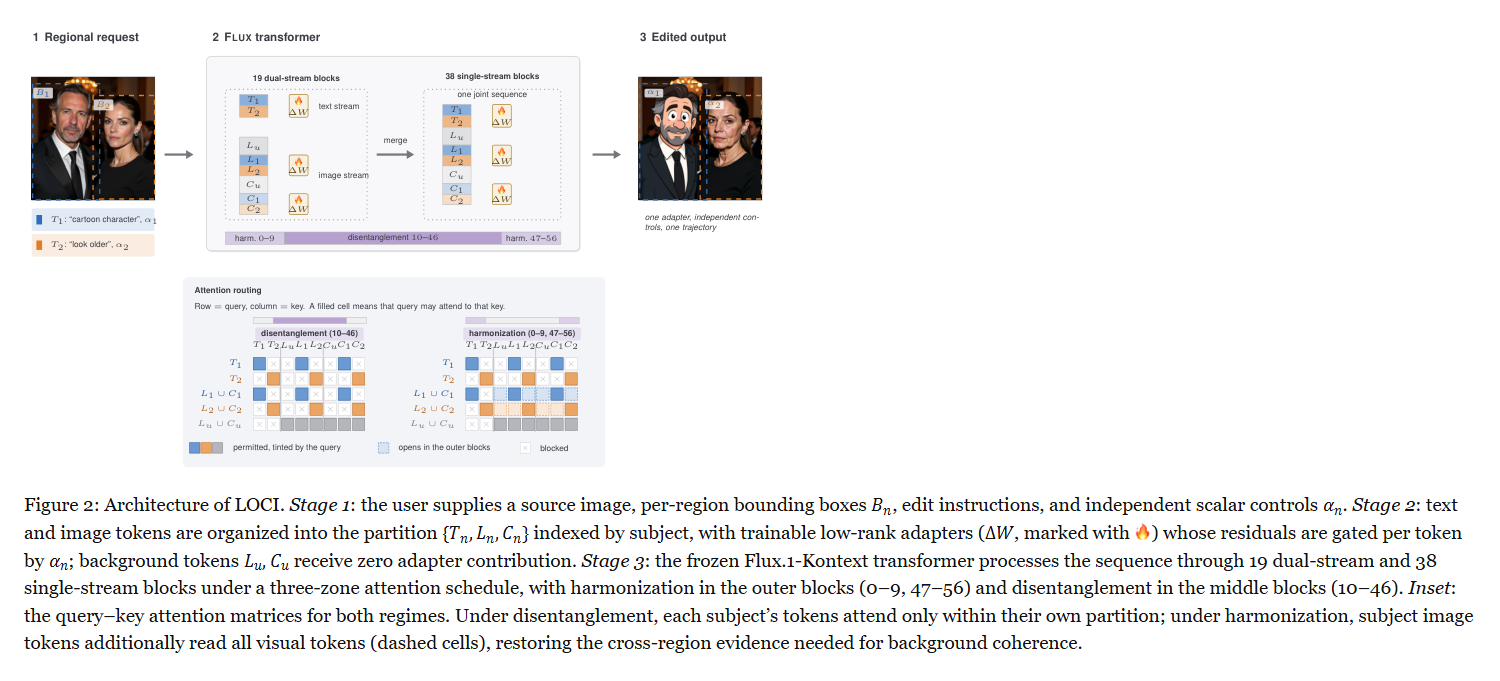
前序问题 :合照里想让左边的人渐渐变老、右边的人只添胡须,调大某个编辑旋钮却可能把所有人一起改。只框定区域解决不了改多少,只调全局强度也解决不了改谁。方法直觉 :让每条指令只和自己的主体绑定,再把低秩适配器原来统一的强度拆成逐个图文片段(token)的强度。训练时先学会把指定编辑完全压回原图,推理时缩放这条抑制方向,得到连续的编辑幅度。本文贡献 :冻结 FLUX.1-Kontext,将文字、待编辑图及源图 token(模型处理的文字或图像片段)按主体分组;区域框或掩码决定写入范围,重叠区域取更强抑制值。IDAttn(主体解耦注意力)在中间块隔离主体,首尾块允许视觉信息互通以协调光照;训练和推理使用同样路由。α为抑制量:1 不改、0 为名义编辑、负数进一步外推。秩 16 适配器仅用 22482 个单区域例,八张 H200 训练 10000 次;不用针对多人数量再训练。
原文图 2|LOCI 架构。阶段 1 由用户提供源图、逐区域框 B、指令及独立控制α;阶段 2 把文字、目标与源图 token 分成主体分组 T/L/C,低秩残差按α逐 token 门控,背景 L_u/C_u 无适配残差。阶段 3 冻结 Flux.1-Kontext 的 19 个双流与 38 个单流块:0–9 及 47–56 块协调视觉信息,10–46 块隔离主体。插图为两种查询—键注意力矩阵;协调阶段主体图像 token 可读取所有视觉 token,补足背景连续性证据。
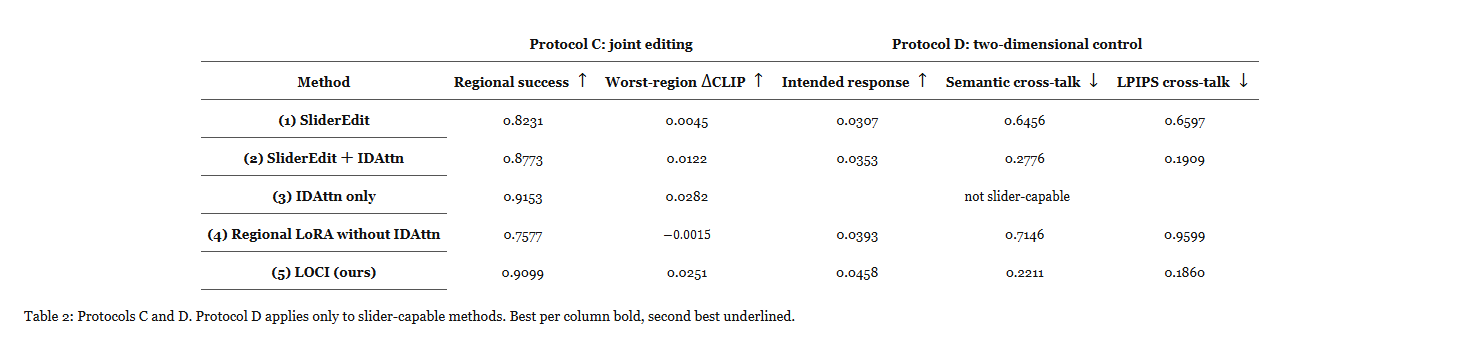
实验效果 :128 个合成多主体场景、427 主体编辑对,每图 2–7 主体;统一 1024×1024、28 去噪步。双旋钮 7×7 网格中,相对事后拼接 SliderEdit 与 IDAttn,语义串扰 0.2776→0.2211,感知串扰 0.1909→0.1860;串扰是非目标变化相对目标变化的比值,越低越好。多区域同时编辑成功率 0.9099,略低于无连续控制的 IDAttn 单独版 0.9153。未报告额外墙钟时延和显存,单次联合编辑仍需要 28 步,不是一次网络调用。
原文表 2|协议 C 让各主体同时名义编辑,区域成功率及最差区域 CLIP 增益越高越好;协议 D 在双旋钮网格分别测目标响应和串扰,仅适用于有连续控制的方法。语义与 LPIPS 感知串扰越低越好。LOCI 区域成功率 0.9099,IDAttn 单独版 0.9153;LOCI 串扰 0.2211/0.1860,事后拼接 0.2776/0.1909。粗体、下划线为最优与次优,不能将无滑块方法当作协议 D 的零串扰。
批判点评 :合成场景的框/掩码已提供,不能外推自动定位和任意拥挤合照。背景虽不写入适配器残差,注意力仍可能传播变化,不能保证背景完全不变。感知串扰相对事后拼接只小幅改善;若框重叠,最强抑制优先也会影响旋钮独立性。原文没有本方法代码入口,不把引用的 FLUX 仓库当 LOCI 代码。
4. AlphaAnything:透明素材不用另造一套潜空间
AlphaAnything: Extending Pretrained RGB Generators to RGBA | 清华大学;字节跳动;北京大学 | arXiv:2610.32413
关键词 :透明图像生成, 共享潜空间, 单向特征传递, 透明度端点损失
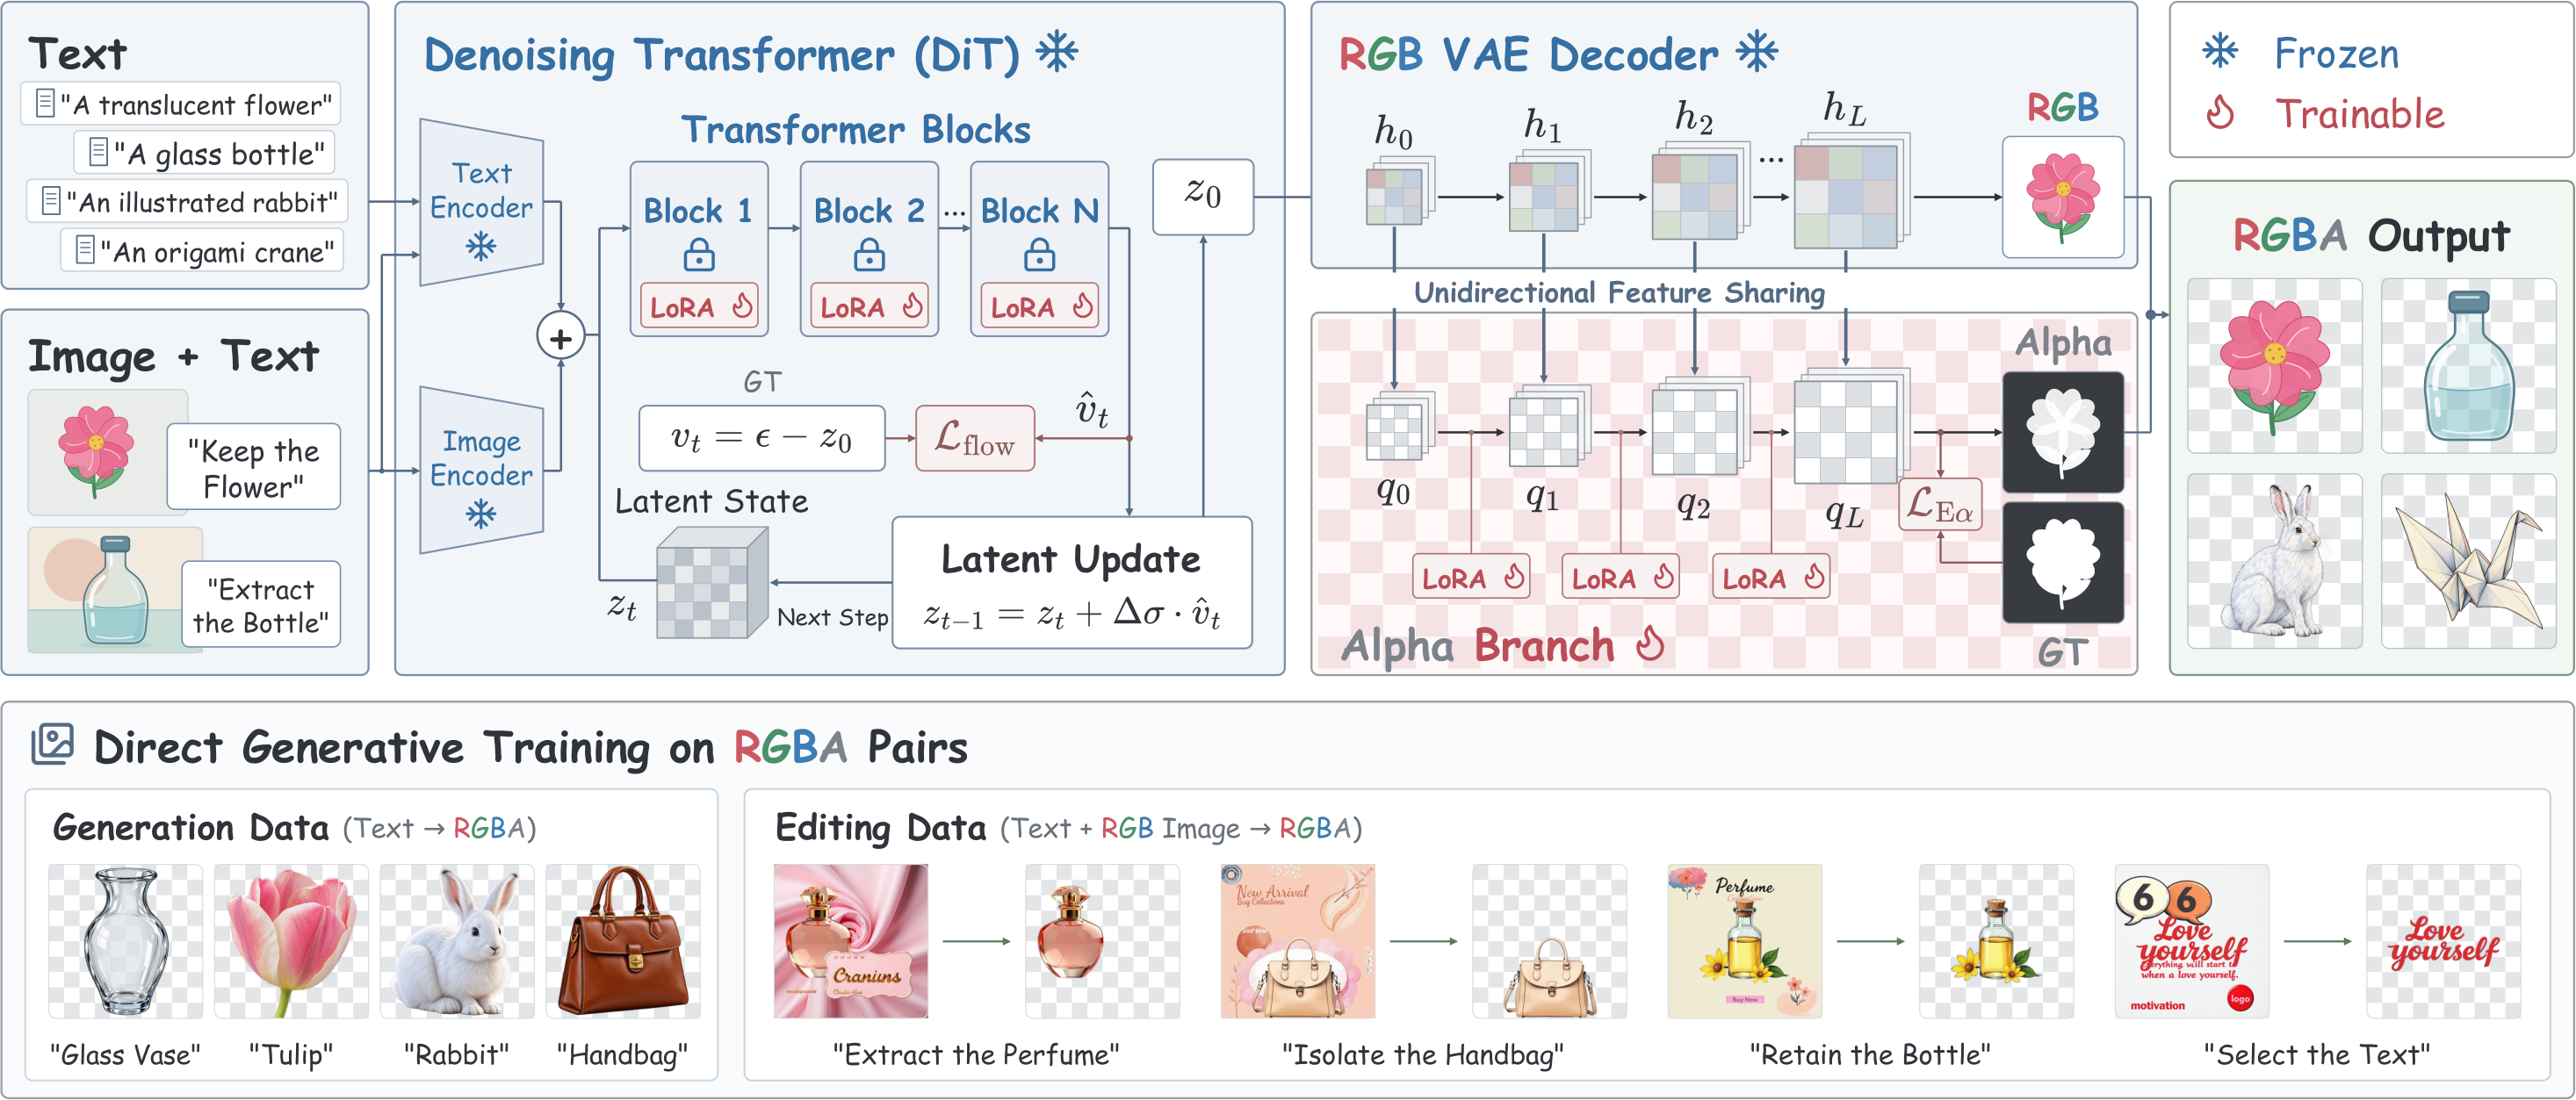
前序问题 :生成玻璃、烟雾或发丝后再抠图,边界容易灰一圈;重新训练透明图像编码器,又可能损失原模型的小字和颜色。能不能让原彩色生成器直接产生透明素材?方法直觉 :在原有 RGB 三色解码器旁加一条预测透明度的支路,支路只能读取彩色特征,不能改回彩色解码过程。同时把透明度误差传回生成器,让它生成的潜变量本身更适合解码透明边界。本文贡献 :RGBA 比 RGB 多一个 alpha 不透明度通道:0 全透明、1 全不透明,中间值半透明。冻结原 VAE(变分自编码器)的编码与 RGB 解码,训练生成 Transformer 的秩 64 LoRA 及 alpha 支路,固定同一潜变量时 RGB 解码严格不变。EA(端点感知)损失按前景/背景混合权重的 Fisher–Rao 弧长衡量误差,可精确表示 0 和 1,错误饱和时仍有梯度;再对前景与背景误差分别开方聚合,增强小片错误的影响。各变体 20000 次更新、全局批量 16,文字生成训练有 8963 份 RGBA 样本。
原文图 2|AlphaAnything 总览:Transformer 的 LoRA 与嵌在 VAE 中的 alpha 分支,仅经生成式训练学习 RGBA。RGB 到 alpha 的单向特征共享,使给定同一潜变量时 RGB 解码保持原样;透明度监督仍可通过冻结但可微的解码器回传生成器,因此最终生成的潜变量允许改变。
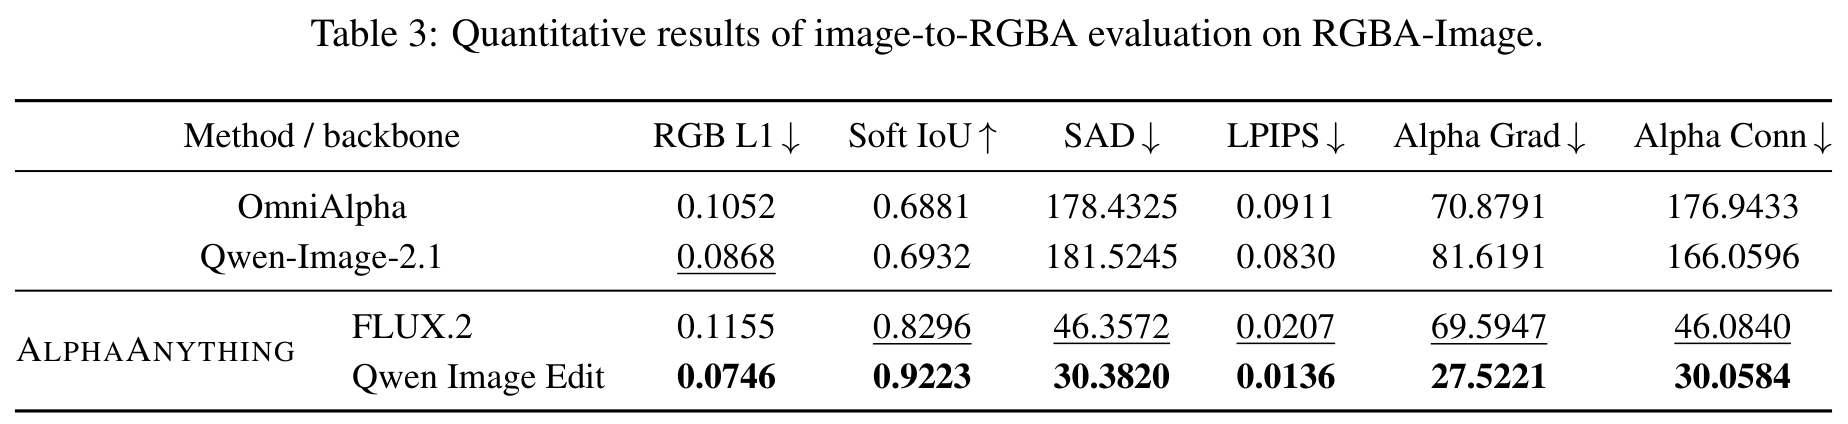
实验效果 :图像转 RGBA 测试为 295 源图中的 735 目标层;Qwen-Image-Edit 底座相对 OmniAlpha,Soft IoU(软透明度交并比)0.6881→0.9223,LPIPS 感知距离 0.0911→0.0136。文字生成在白底/黑底合成图上平均评分;AlphaTest 的 FID 分布距离却不领先,例如 FLUX.2 版 75.1796,对照 Qwen-Image-2.1 为 72.2720。FLUX.2 隔离解码 0.148→0.249 秒,端到端附加 0.244%;2.299→2.386GiB 是 VAE 单独峰值,非完整模型显存。
原文表 3|RGBA-Image 的图像转 RGBA 比较。RGB L1 为颜色绝对误差;Soft IoU 为软透明度交并比,越高越好;SAD 为透明度绝对差总量;LPIPS 为合成图感知距离;Alpha Grad 与 Alpha Conn 分别评透明度边缘梯度与连通误差,后五类距离/误差越低越好。AlphaAnything 比较 FLUX.2 与 Qwen-Image-Edit 底座,不能把后者更高成绩完全归因于统一方法。
批判点评 :固定潜变量的 RGB 解码不变,不保证适配后的生成结果与原模型逐像素相同,潜变量已经被训练改变。透明数据和指标仍有限,文字生成的分布质量未全面胜出。仓库 本次只有 README、素材和忽略文件,不能称实现或权重已开源。
5. EditJev:先挑合适的改图模型再开工
EditJev: System One Routing for Image Editing Models | 北京大学;清华大学 | arXiv:2610.32635
关键词 :图像编辑路由, 偏好排序, 质量时延权衡, 单次评分
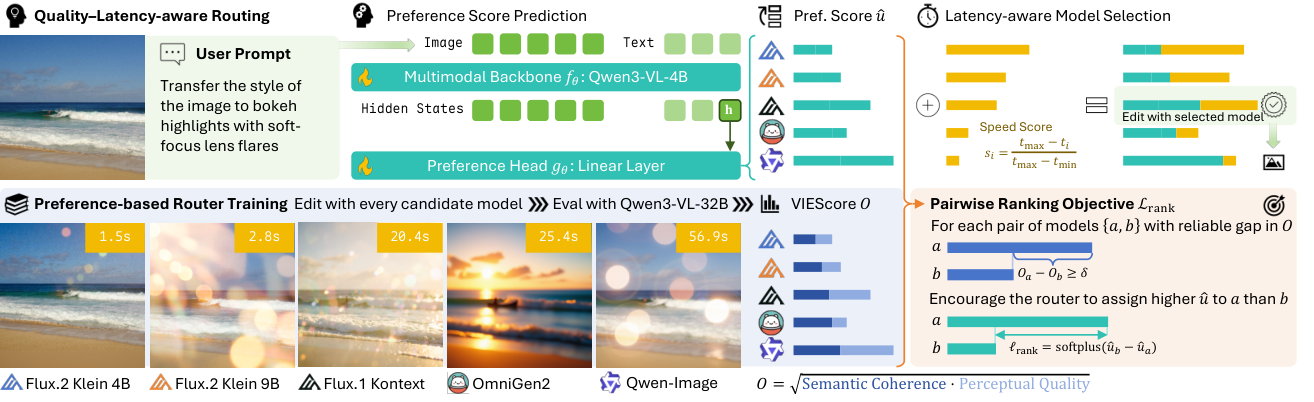
前序问题 :换背景、提衣服、擦汽车,各家编辑器的强弱不同。所有请求都交给平均成绩最高的模型,既可能改错对象,也可能为简单操作等太久;每次先把所有模型都跑一遍又更贵。方法直觉 :先让一个小裁判只看源图和指令,预测五个编辑器谁更合适;把它的质量偏好与事先测好的速度分合起来,只执行被选中的一个。裁判直接输出五维分数,省去逐字生成模型名。本文贡献 :Qwen3-VL-4B 多模态底座冻结主参数,只训练 LoRA 与线性偏好头,读取最后一个非填充 token。候选为 FLUX.2 Klein 4B/9B、FLUX.1-Kontext、OmniGen2 及 Qwen-Image-Edit。离线对每条训练请求运行全部候选,分别评编辑、保留、自然度、伪影;前两项与后两项各取较差值,再取几何平均,仅用差至少 0.5 的模型对训练排序。推理用β权衡质量与归一化速度,ImgEdit 取 0.7、GEdit-En 取 0.02,测试无需看到生成结果。
原文图 2|EditJev 总览:原图注把离线候选出图、自动评估及路由器训练写作上半部,把质量时延推理写作下半部;实际图面顺序相反,上部为在线选择,下部为离线偏好训练,本稿按图面解读。离线阶段运行所有候选用于偏好监督,在线并非先把所有输出生成后再筛选。
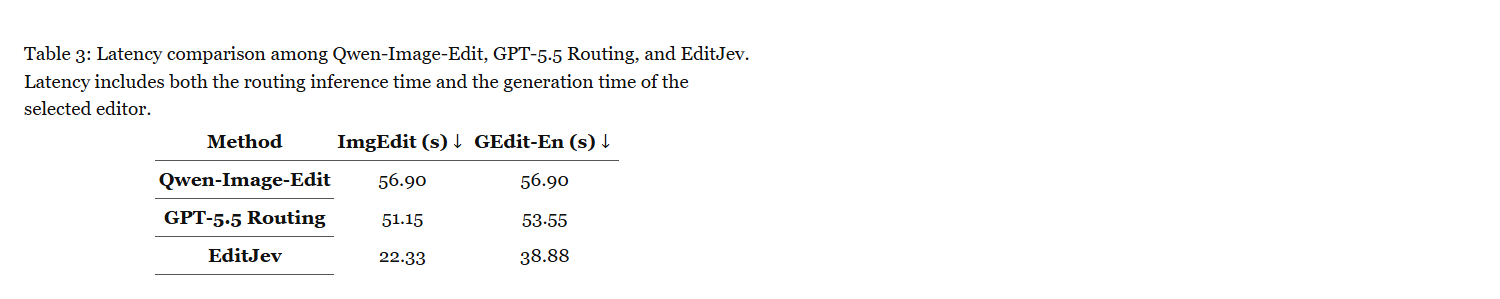
实验效果 :737 个 ImgEdit 与 606 个 GEdit-En 请求,按各自官方协议和 GPT-5.1 裁判评分;相对固定 Qwen-Image-Edit,总分 4.540→4.592、8.194→8.255。RTX PRO 6000 上候选各测 20 请求均时,按选中模型频率加路由开销,估算总时延 56.90→22.33 秒、56.90→38.88 秒;不是每条请求端到端重测。路由单独平均 0.094 秒,依据 5 次本地请求。20 案例、20 人共 400 次判断,人类选择一致 327 次,即 81.75%。
原文表 3|固定 Qwen-Image-Edit、GPT-5.5 路由和 EditJev 的时延比较,含路由推理与选中编辑器生成,越低越好。ImgEdit 分别 56.90/51.15/22.33 秒,GEdit-En 分别 56.90/53.55/38.88 秒;按各模型实测均时与选择频率估算平均总时延,不表示每条请求都做同样端到端重测。
批判点评 :质量提升较小,依赖固定候选池和自动评判偏好;新增编辑器不等于现有评分头自动适配。离线全部候选出图及标注成本未消失,论文也未给完整多模型驻留显存账单。两数据集β不同,不能把省 60.8%时延直接套到任意负载;人评只覆盖 20 案例。原文未提供本方法代码地址。
6. TEM:让图像沿低能量方向慢慢成形
Scaling Transformer Energy-based Models For High Quality Image Synthesis | 麻省理工学院;伊利诺伊大学厄巴纳香槟分校;哈佛大学 | arXiv:2610.31889
关键词 :能量图像生成, 多层能量头, 正样本表征对齐, 持续采样链
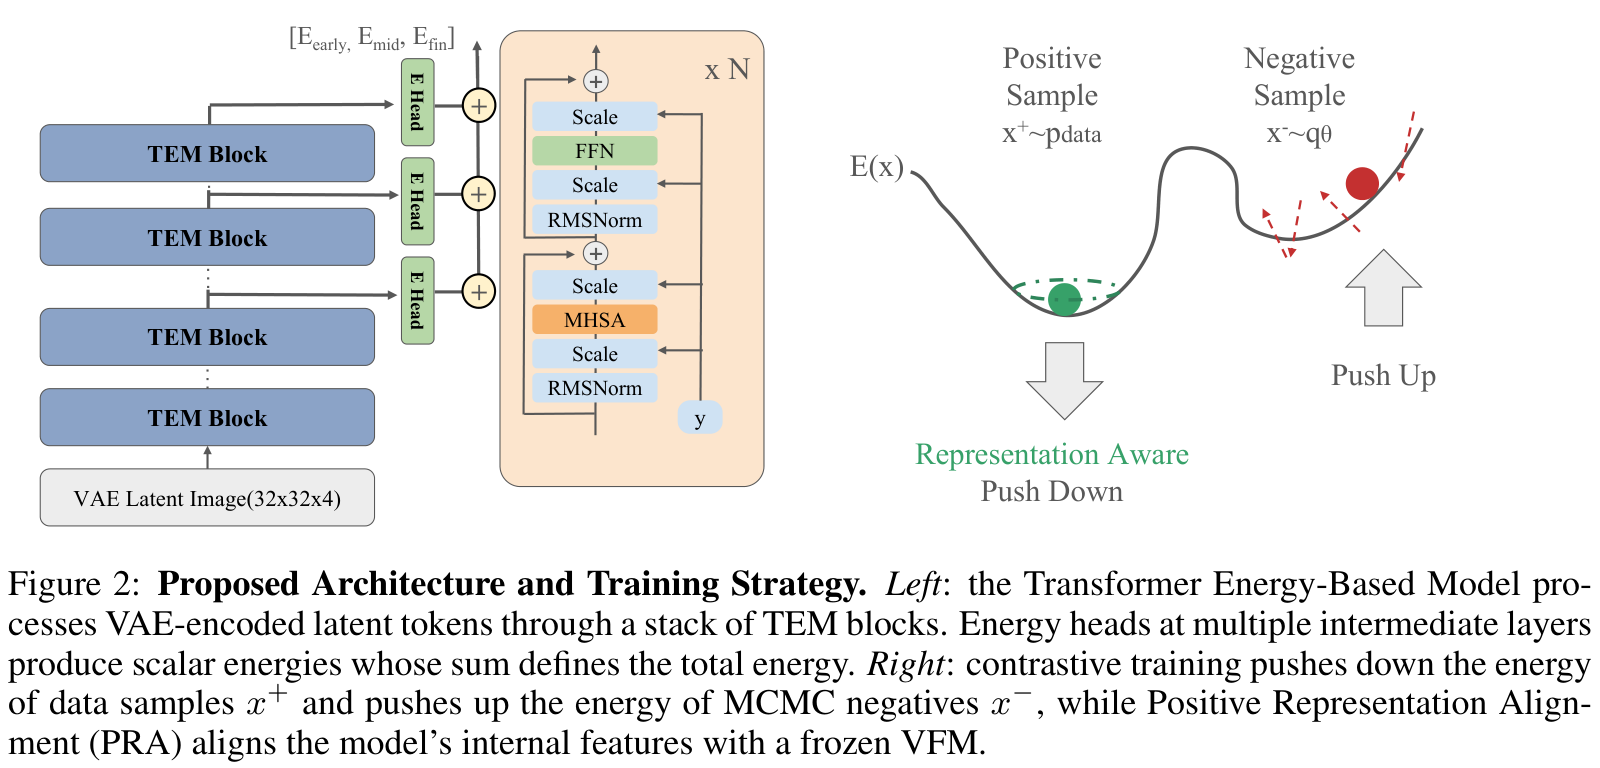
前序问题 :能量模型给每张候选图打一个越低越合理的分数,再沿梯度修图,理论上很灵活;现实中高维采样费算力、训练不稳定,常只能做小图。怎样把这条路线带到现代图像生成规模?方法直觉 :在压缩后的潜空间里打分,让不同深度的评分头分别看纹理、结构和语义,最后加总。只给真实图像补上视觉教师的密集特征监督,避免把错误生成样本也强行拉向同一特征目标。本文贡献 :TEM(Transformer 能量模型)用视觉 Transformer 输出标量能量,多个中间层能量头求和。训练压低真实图能量、抬高自身 MCMC(马尔可夫链蒙特卡洛)负样本能量;采样匹配损失兼顾低能量和多样性,PRA(正样本表征对齐)只对真实图对齐冻结 DINOv2 特征。图像经 Stable Diffusion 自编码器压成 32×32×4 潜变量;训练每次 40 次 Langevin 梯度更新,批量 256,共 50000 次优化,训练缓冲区容量 16000、复用概率 0.99。
原文图 2|架构与训练:左边 TEM 用 Transformer 块处理 VAE 编码的潜变量 token,多层标量能量头相加成总能量;右边对比训练降低真实样本 x+能量、提高 MCMC 生成负样本 x−能量,PRA 只将真实样本内部表征对齐冻结视觉基础模型 VFM。不同深度能量头共同约束纹理、布局和语义。
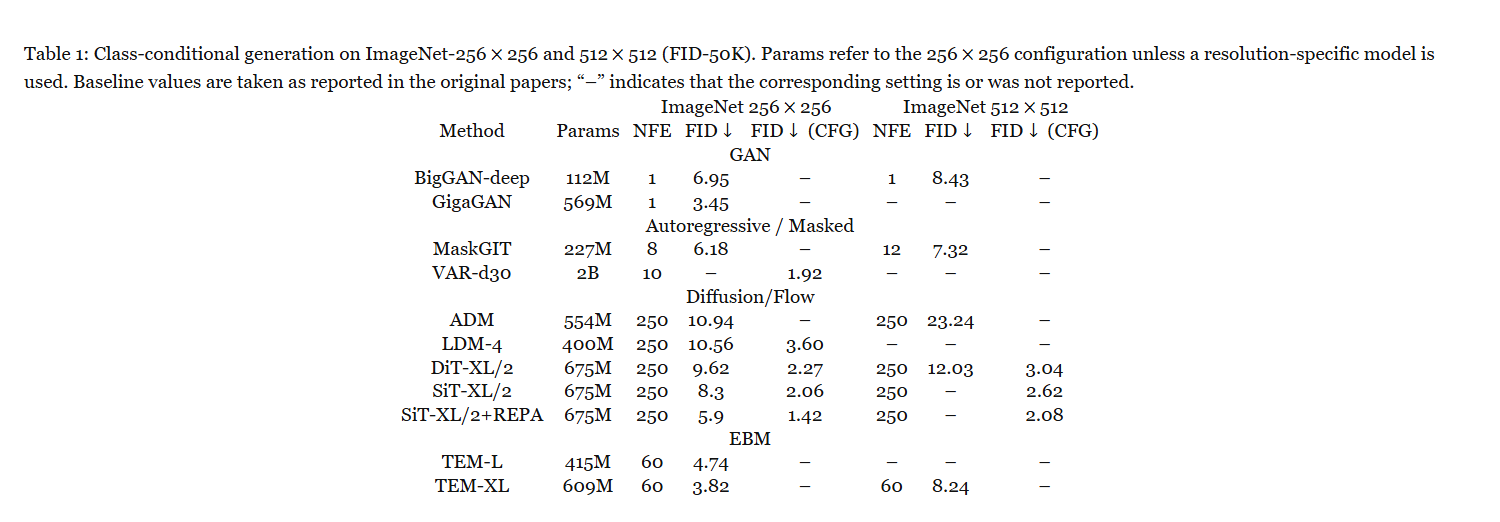
实验效果 :ImageNet 类别条件生成,6.09 亿参数 TEM-XL、60 次采样更新、50000 张图计算 FID(特征分布距离,越低越好):256×256 为 3.82,512×512 为 8.24。同尺寸 DiT-XL 无分类器自由引导为 9.62,有引导为 2.27,不能称全面超过扩散。评估前 5000 条链从高斯噪声起步,后续复用 40 步缓冲状态,再各追加 60 步。附录 256 图采样 14.48 万亿浮点操作/份,DiT 为 29.66 万亿;这是计算量,非墙钟或显存实测。
原文表 1|ImageNet 256×256 与 512×512 类别条件生成,FID 由 50000 样本计算、越低越好;Params 主要按 256 配置,NFE 是论文列出的采样网络评估口径,能量梯度更新成本需另参附录。CFG 列表示分类器自由引导,空线是未报告。TEM-XL 6.09 亿参数、60 步、FID3.82/8.24,主结果无 CFG;各 baseline 数字取原论文,不是全部同机重跑。
批判点评 :步数包含能量梯度,不能与普通去噪前向调用一一等价。持续链复用是成绩协议的重要部分,不代表每图独立 60 步从纯噪声开始。多算未必让分布更好:60→80 步,FID3.82→4.72、召回 0.57→0.51,清晰度换来模式覆盖下降。项目 与代码 有训练、采样实现,未执行模型。
7. Melody Guidance:不用重训也能照旋律生成声音
Melody Guidance for Audio Diffusion Models Without Retraining | 德国埃尔朗根纽伦堡大学;International Audio Laboratories Erlangen | arXiv:2610.32211
关键词 :旋律音频生成, 推理期引导, 可微音高估计, 三角波初始化
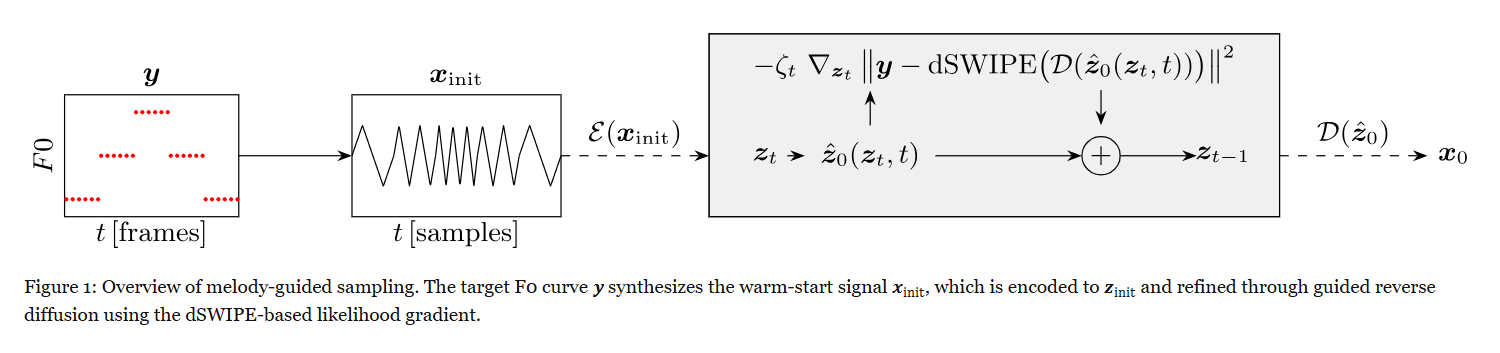
前序问题 :手里有无条件音频扩散模型,想让它按一条旋律唱或弹,通常得重新准备旋律配对数据。只在推理时用音高误差硬拽,又容易得到音准对了、音色却变假的声音。方法直觉 :先用目标音高合成有泛音的三角波作草稿,再让生成器把草稿修成真实音色;每步用可求梯度的音高检测器纠偏。草稿减轻纠偏负担,扩散先验负责声音自然,两者要一起调。本文贡献 :F0 是基频、决定主音高;dSWIPE 是可微音高估计器,用候选音高相关性的 softmax 代替硬选最大值,使音高误差可反传。在每步预测的干净波形上计算误差,经解码器传回潜变量,并按噪声量和梯度范数归一化;波形模型可直接引导。λ为纠偏强度,t_init 为开始去噪的噪声位置;目标音高用标准差 50 音分平滑,100 音分为一个半音,保留颤音空间。唱声 LOUDAR 取λ=2.5、t_init=0.8;吉他为 2/0.7,两钢琴模型为 0.3/0.65。
原文图 1|旋律引导采样:目标 F0 基频曲线 y 先合成三角波热启动信号 x_init,按需编码成 z_init;反向扩散逐步细化,同时经 dSWIPE 可微音高检测器的似然梯度拉向目标旋律。热启动与梯度引导共同减少音准与真实音色的冲突。
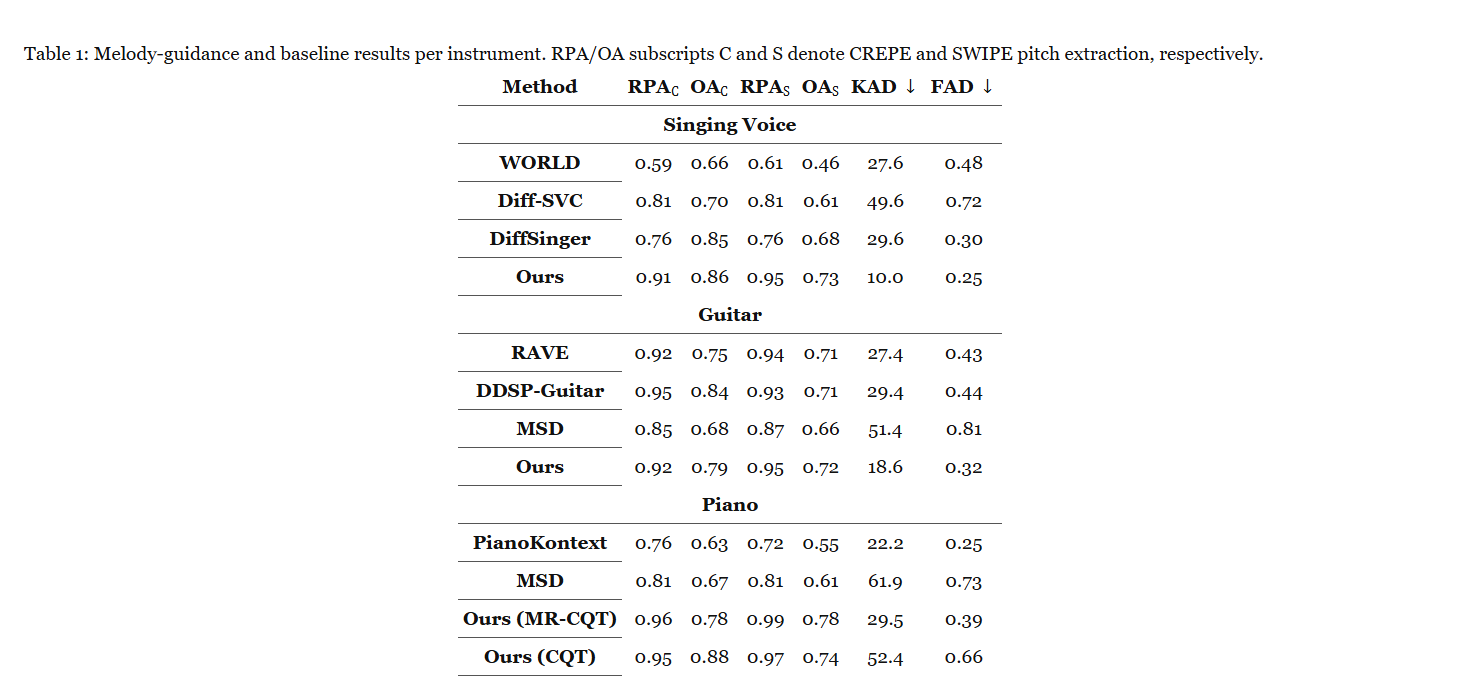
实验效果 :100 条 POP909 旋律、四个底座。唱声用 CREPE 独立提音高,RPA(发声帧原始音高准确率)0.91、OA(含清浊音判断的总体准确率)0.86,DiffSinger 为 0.76/0.85。吉他 OA0.79 低于 DDSP-Guitar0.84;钢琴 MR-CQT 的 OA0.78 优于 PianoKontext0.63,但同为 MAESTRO 训练的 FAD(音频特征分布距离)0.39 较 0.25 差。无需旋律专属重训仍要逐步反传,论文没给墙钟、采样步数总账和峰值显存。
原文表 1|唱声、吉他和钢琴分组结果。RPA 为发声帧原始音高准确率,OA 还计入清浊音识别;下标 C/S 分别指 CREPE/SWIPE 音高提取,准确率越高越好。KAD 与 FAD 分别为核音频距离、Fréchet 音频距离,越低越好;唱声和吉他对照训练数据不同,只能指示相对质量,钢琴同为 MAESTRO 才较可比。不同提音高器下准确率不应混写。
批判点评 :唱声和吉他对照训练数据不同,不能按 FAD 或 KAD 音频分布距离直接排统一音质榜;钢琴对照同数据才较可比。音素、拨弦动作、音头和衰减仍由无条件先验决定,不能据旋律控制推断歌词或演奏法可控。试听项目 可访问,未确认本方法代码已公开。
8. AudioLift:一张照片先补五机位再成头像
AudioLift: Audio-Driven Single Image to Full-Head Gaussian Avatar via Multi-view Video Generation | 耶鲁大学;加州大学默塞德分校;卡内基梅隆大学 | arXiv:2610.31747
关键词 :音频驱动头像, 多视角视频生成, 高斯重建, 后脑补全
前序问题 :单张照片驱动数字人说话,正面看着不错,一转到侧后方就可能头颈断开、帽子消失。参数化人脸的运动空间也难覆盖夸张张嘴,能否借视频生成能力补全完整头部?方法直觉 :先让同一声音驱动五个同步机位,再把每个时刻的五张图拼成三维高斯头像。生成的机位不完全一致,所以重建器训练时就故意看些错位侧视图,学会以清晰正面作锚点。本文贡献 :第一阶段基于 13 亿参数 StableAvatar,四斜机位排成 2×2 画布,另加正面流;同一时刻的视觉 token 读取相同音频窗口,全局注意力共享五视角信息。第二阶段微调 FaceLift 逐帧前馈重建,侧视输入加网格畸变与相机扰动,正面保持干净;活动体积正则压低头部范围外高斯的不透明度,后方三个角度区间用冻结教师低权重蒸馏。训练 2641 条语音序列、328 身份,第二阶段 648 片段各 16 帧,共 10368 多视角场景;两阶段分别 6800 和 7328 次更新,八张 48GB RTX 6000 Ada。
原文图 2|AudioLift 两阶段:(a)音频驱动多视角生成,四个斜视角拼成 2×2 画布,另加正面流,同一时刻的五视角共享音频上下文及跨视角注意力;(b)三维高斯序列重建,微调的前馈重建器逐帧把生成的五机位提升为三维高斯头像,得到可从任意机位、任意时刻渲染的高斯序列。干净参考视图为去噪器提供条件,侧面与正面按时间交错成同一 token 序列,以共享自注意力连接各视角。
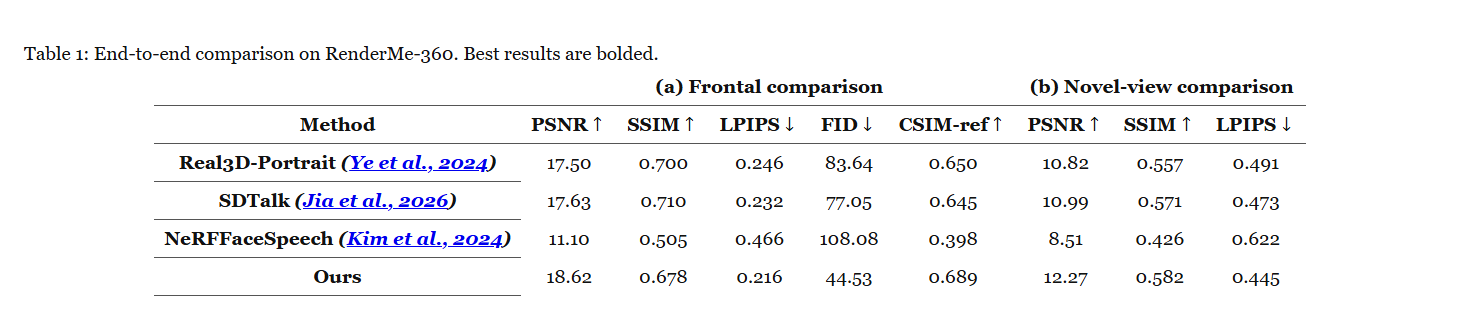
实验效果 :RenderMe-360 测试 42 片段、21 身份,HDTF 另 21 对照片语音;81 帧、25 帧/秒,统一 512×512 白底计分。前者相对 SDTalk,正面 FID 分布距离 77.05→44.53,但 SSIM 结构相似度 0.710→0.678;新机位 PSNR 像素信噪比 10.99→12.27 分贝。新视角只评第 0 帧五个未见相机,正面评 1–80 帧,不能混成全动态新视角定量。第一阶段五视角各 416×608、30 步;未报端到端耗时与实际峰值显存。
原文表 1|RenderMe-360 端到端比较,(a)正面、(b)新视角。PSNR 像素信噪比、SSIM 结构相似度及 CSIM-ref 参考身份余弦相似度越高越好,LPIPS 感知距离与 FID 特征分布距离越低越好。正面评 1–80 帧,新视角仅第 0 帧五个未见相机;AudioLift 正面 FID44.53,但 SSIM0.678 低于 SDTalk0.710,不是所有指标都更优。
批判点评 :后脑来自教师的合理补全,不能声称恢复照片未拍到的真实发型;逐帧前馈重建也不是对整段做显式时间优化。无逐人优化不等于无训练或实时。演示超过 20 秒,但主定量仅 3.24 秒窗口。项目 和所链接仓库 已列出,仓库含两阶段推理、配置与说明,未执行模型。
9. MDMR-Bench:多张参考图要逐项查有没有串
MDMR-Bench: A Multi-Dimensional Benchmark for Multi-Reference Image Generation | 南京大学;华为研究;香港大学 | arXiv:2610.32459
关键词 :多参考生成评测, 检查清单, 非目标保留, 裁判一致性
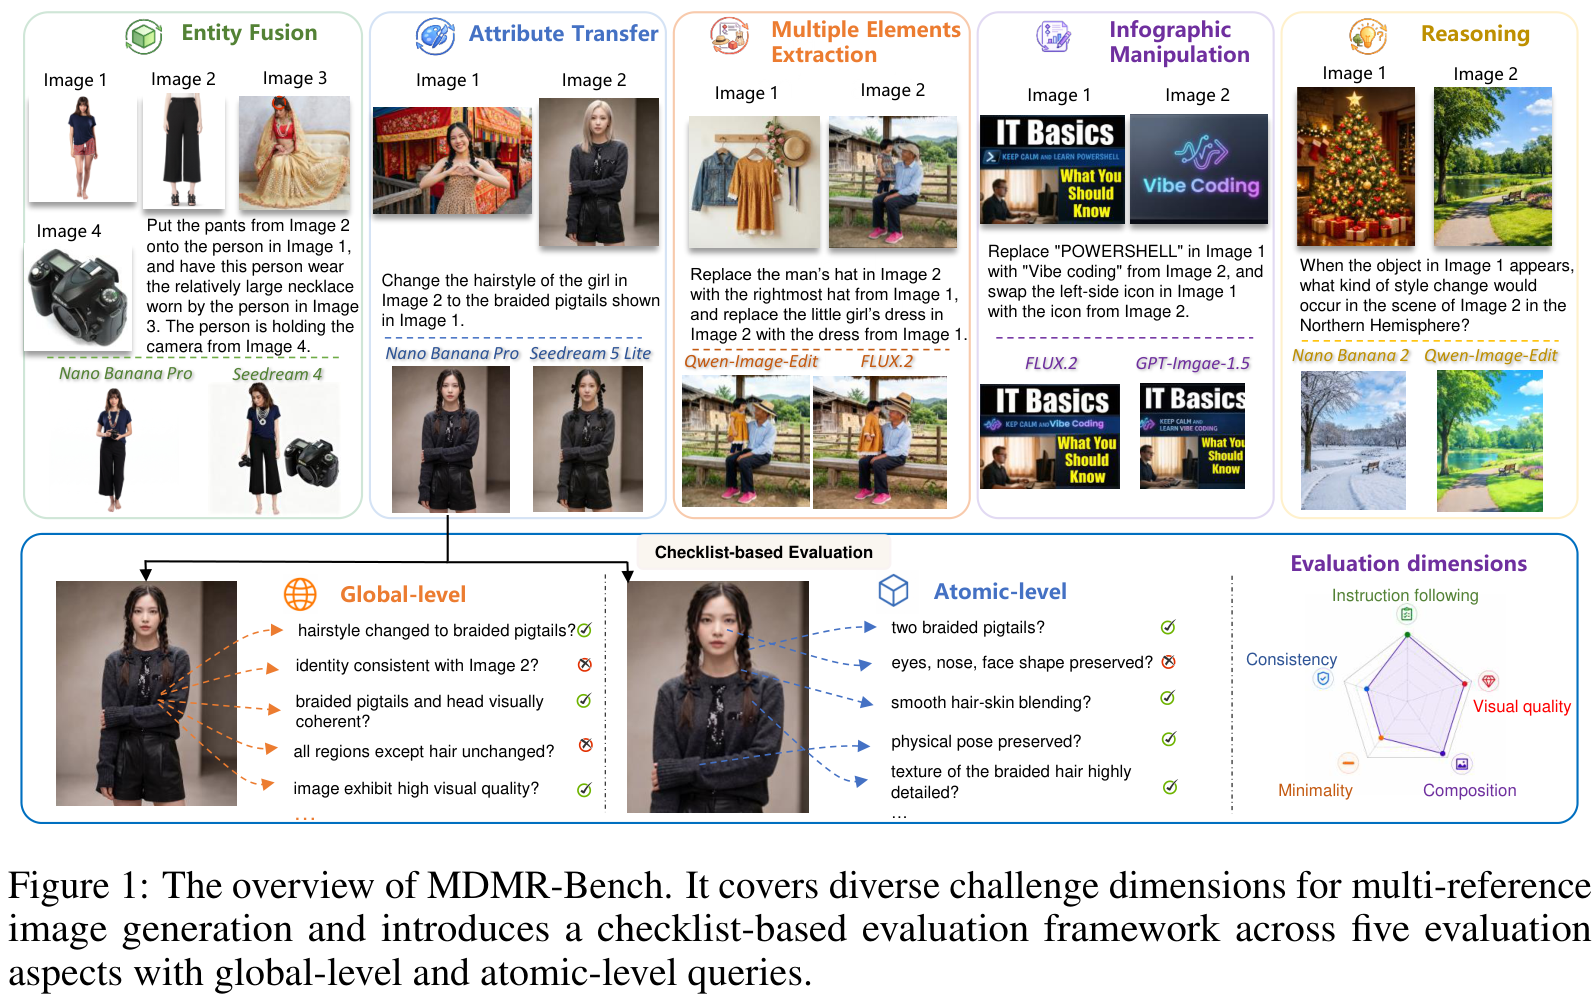
前序问题 :给三张人物、服装和场景参考,结果看着漂亮却把衣服纹理抄错,或者换衣时连脸也变。一个笼统美学分不容易指出是哪条约束没满足,多参考生成需要更细的验收。方法直觉 :把每个要求拆成可回答“是/否”的检查项,既问整体有没有完成,也问某个人、某个属性是否保留。任务家族等权汇总,避免数量最多的容易题把分数撑高。本文贡献 :2390 案例覆盖实体融合、属性转移、单图多元素提取、信息图操作与视觉推理;前两类各 936 和 982 例,常有 2–4 参考图。约 50 万图图库经模型打标签、任务分桶、自动验证及人工筛查;48.2%案例至少含一张合成参考。五维按指令/一致/组合/最小改动/质量分别权重 0.20/0.25/0.25/0.20/0.10,维内整体与原子问题等权;先按子任务平均,最后五任务家族等权。默认 Gemini-3-Pro 裁判,非把各样本简单平均。
原文图 1|MDMR-Bench 概览:多参考图生成覆盖实体融合、属性转移、多元素提取、信息图操作及视觉推理等挑战。五个评估方面均使用整体问题与原子细节问题组成的检查清单,分开诊断指令满足、参考保留、组合、额外修改及画质,而不是只给笼统总分。
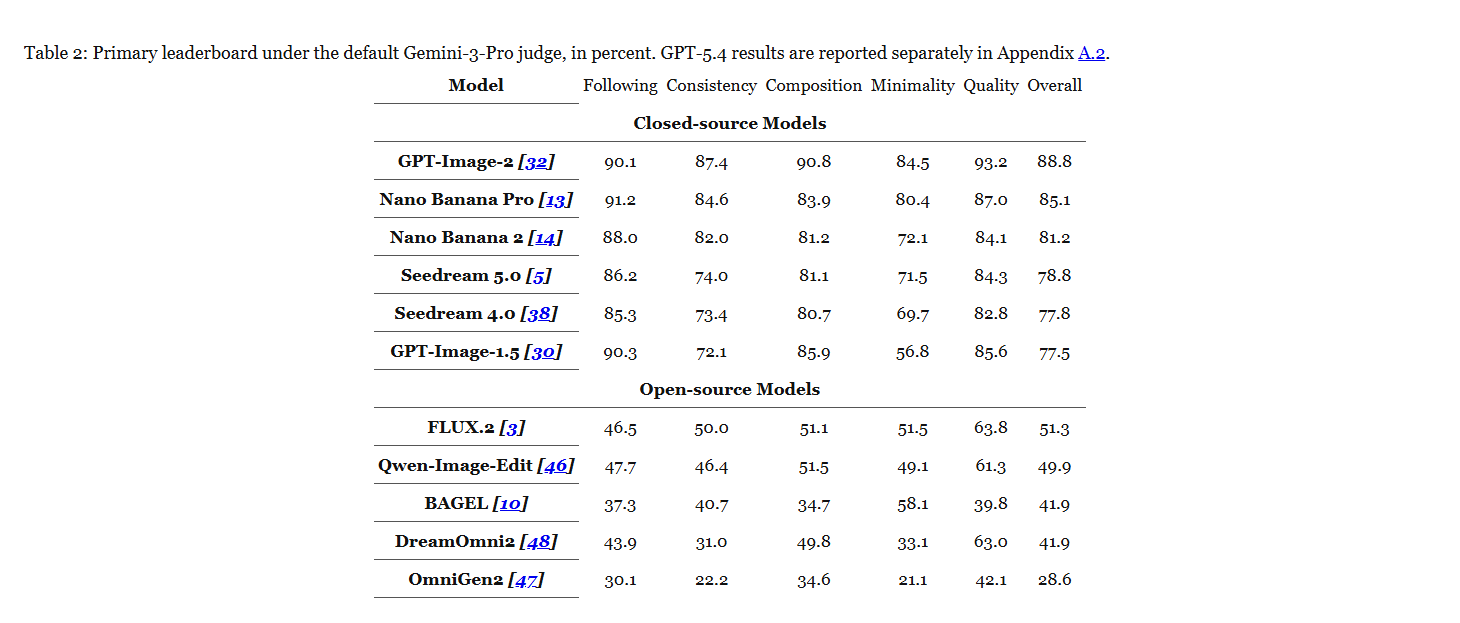
实验效果 :主榜百分制:GPT-Image-2 总分 88.8,Nano Banana Pro85.1,开源组 FLUX.2 为 51.3;这是本基准指定裁判和原生支持分辨率下的分数。GPT-Image-1.5 指令分 90.3,但最小改动仅 56.8,揭示过度编辑。200 案例 800 输出的人评形成 5924 项判断,默认裁判与人类一致率 0.853,Cohen κ(扣除随机一致后的指标)0.642。逐项裁判增加 API 调用成本,未报告统一评测时延或峰值显存。
原文表 2|默认 Gemini-3-Pro 裁判的主榜,百分制;GPT-5.4 裁判另列附录。Following/Consistency/Composition/Minimality/Quality 分别为遵循指令、参考一致、合理组合、最小额外改动和画质,Overall 按既定权重与任务家族等权汇总。闭源与开源模型分组,GPT-Image-2 为 88.8,FLUX.2 为 51.3;这些是指定协议下评分,不是普适成功率。
批判点评 :合成参考、人工维度权重与裁判偏好会影响榜单;属性任务中参考数多的子集更难,不是同一案例只改参考数的因果实验。主榜与任务表对 GPT-Image-2 总分分别 88.8 和 88.7,本稿按主榜口径保留差异。arXiv 评论明确接收 NeurIPS 2026 评测与数据集轨道;代码 本次 404,数据 尚无法确认公开下载,不沿用摘要“已公开”的断言。
10. CityLift:一张城市图补成可拆分楼群
CityLift: Compositional 3D Urban Generation from a Single Image | 西安交通大学;中关村学院 | arXiv:2610.32728
关键词 :城市三维生成, 场景骨架, 空间特征继承, 独立楼宇网格
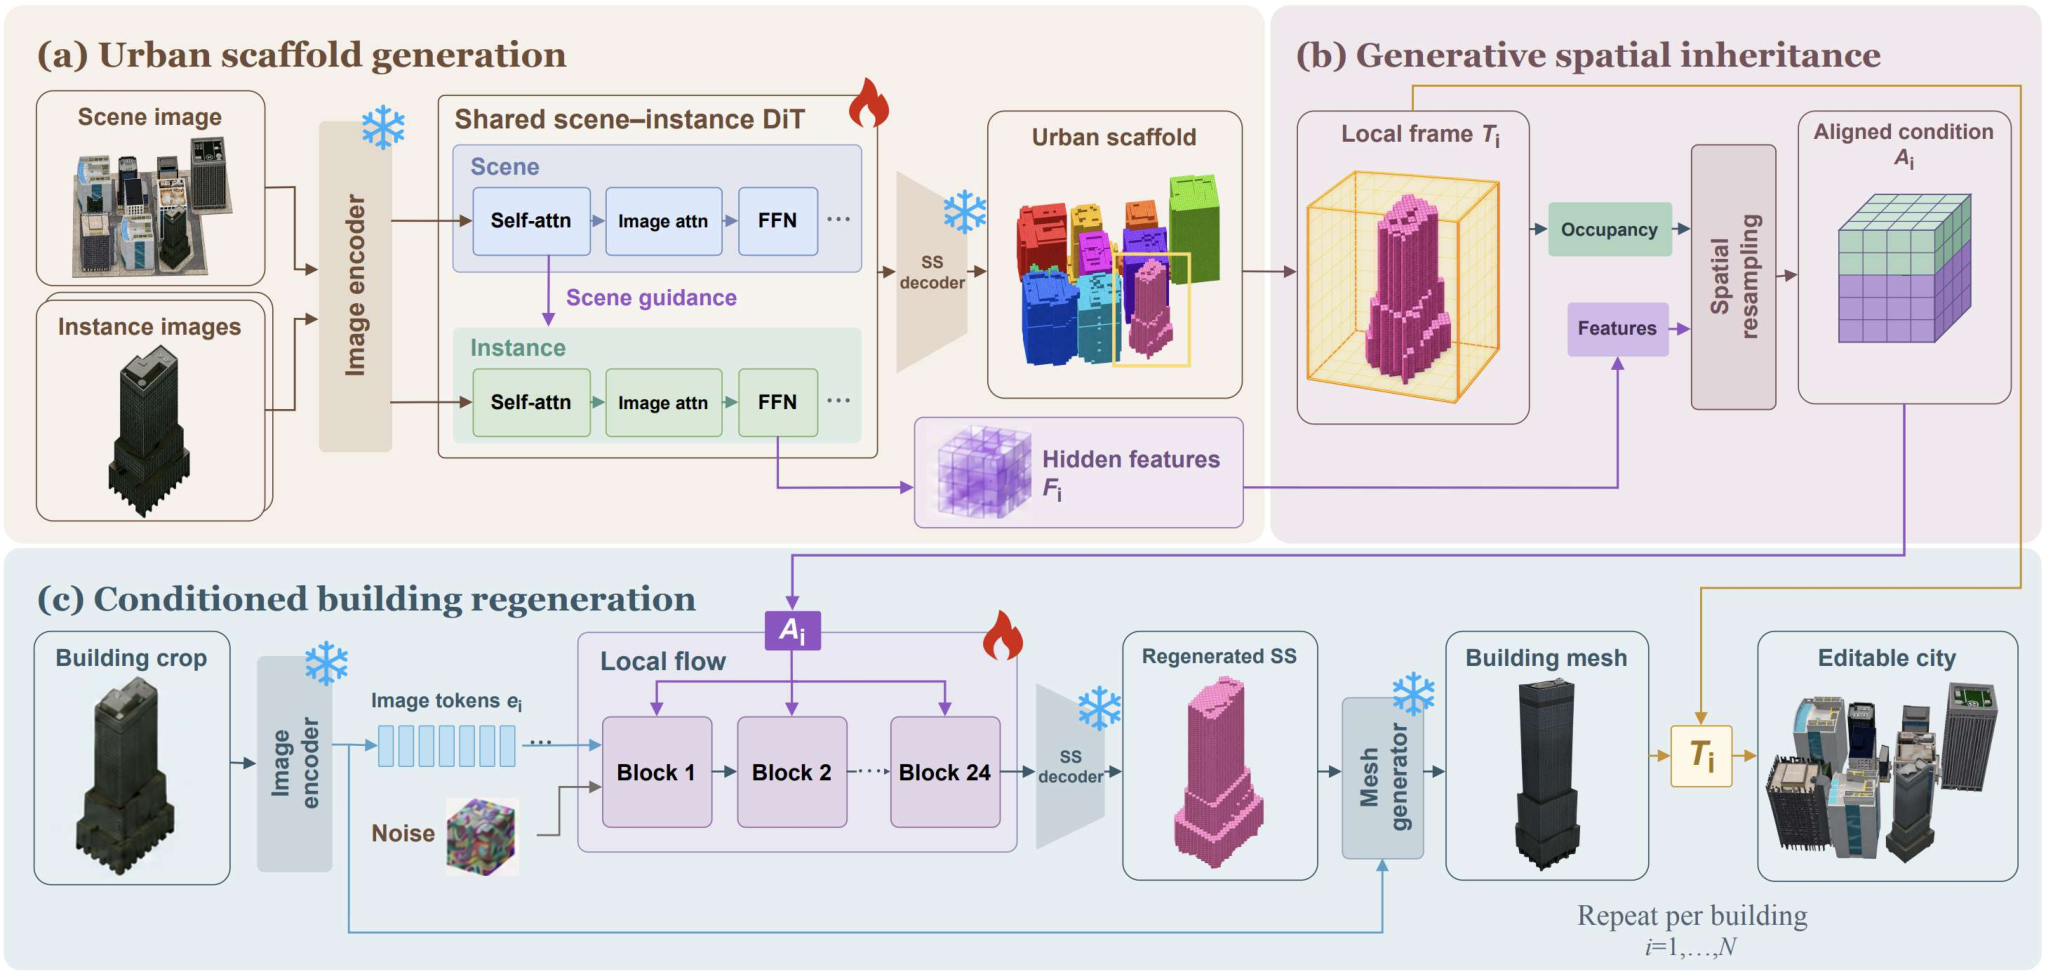
前序问题 :从城市斜拍图做三维资产,逐栋生成容易楼高不对、楼群互撞;整城一次生成又难单独编辑一栋。遮挡让完整几何与相对布局都难猜,怎样同时照顾?方法直觉 :先在同一坐标系搭一份楼群粗骨架,再给每栋楼分自己的细化空间。楼在哪里、有多大,以及从整体读到的三维特征,都随同一坐标变换送进局部生成器,最后按原变换放回。本文贡献 :输入除了单张图,还需要每栋楼实例掩码。共享参数的场景/单楼双流稀疏结构 Transformer 交互,生成 64³占用骨架和隐藏特征;确定性局部坐标映射同时用于占用、特征、训练目标与最终组装。TRELLIS 流模型从噪声重生成局部结构,再由预训练 SAM 3D 生成纹理网格;低噪声阶段另约束占用重叠、质心和轴向分布。CityLift-5K 有 4997 合成场景、36338 栋,训练 4497/验证 250/测试 250;训练用两张 80GB A100,局部模块 18000 次更新。
原文图 2|CityLift 总览:输入单张城市图与逐栋楼掩码,在共同坐标系生成可独立编辑网格。(a)共享的场景/单楼生成器联合预测粗占用,隐式包含位置、尺度和几何;(b)骨架坐标映射 T 把占用及上下文特征 F 重采样进单楼局部空间,得到对齐条件 A;(c)局部流模型依据 A 及楼图特征 e 从噪声重建细稀疏结构,指导网格生成,再沿继承变换放回场景。
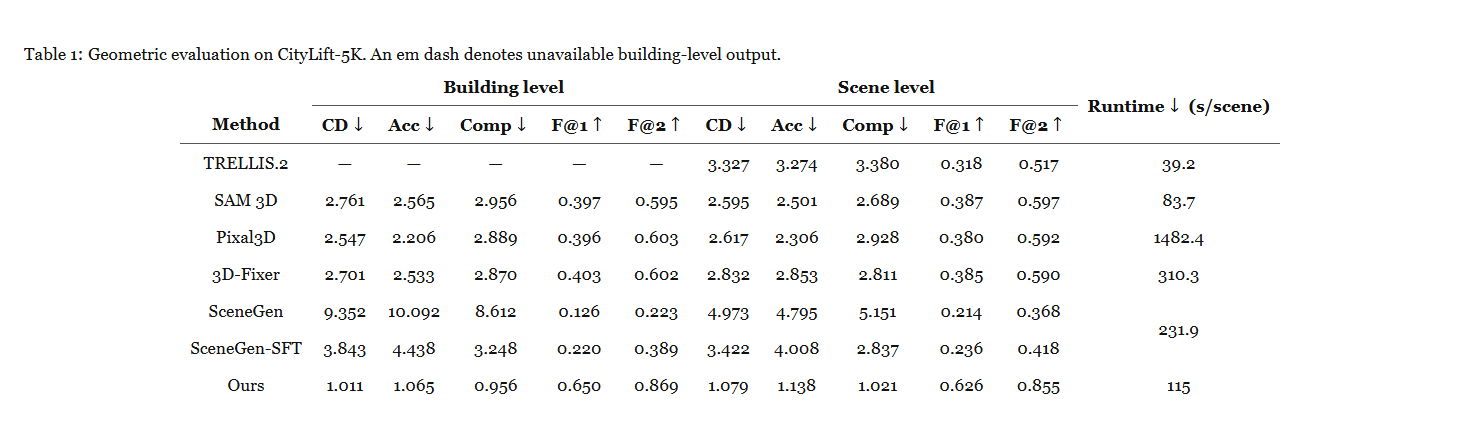
实验效果 :250 个留出场景平均 7.8 栋,楼与场景均隔离。CD(双向表面最近点平均距离,以网格单元计)单楼相对 Pixal3D 由 2.547→1.011;场景相对 SAM 3D 由 2.595→1.079,F@2(两格阈值内精确率召回率的调和平均)0.597→0.855。每场景 115 秒,比 Pixal3D1482.4 秒快,但慢于 SAM 3D83.7 秒和整场景 TRELLIS.2 的 39.2 秒;未报实际峰值显存。真实 InstanceBuilding 来源渲染测试场景 CD2.012→1.531,收益较合成集小。
原文表 1|CityLift-5K 的单楼与场景几何比较,距离以网格单元计。CD 为双向倒角距离,Acc 为生成到参考的单向距离,Comp 为参考到生成的完整性误差,均越低越好;F@1/F@2 为一格/两格阈值 F 分数,越高越好。横线表示没有独立楼输出;末列为秒/场景。CityLift 场景 CD1.079、F@2 为 0.855、115 秒,并非表中最快。
批判点评 :外部真实来源也是从已重建网格再渲染 RGB 与掩码,不能说直接验证任意无人机实拍。外部数据单楼阈值 F 分数和单向精度仍落后 Pixal3D,改善主要来自覆盖与组装。不可见立面是生成性补全,不等于测量真值。项目 可查,本次未发现可确认的方法代码入口。
趋势观察
先定义哪些东西必须保持
SyncVid保持动作的跨机位对应,LOCI限制区域串扰,AlphaAnything只保证固定潜变量的RGB解码;三种保持各有不同对象。
控制常从表示入口开始
场景级噪声、逐token适配强度、原潜空间的透明度监督,比再加一段笼统指令更明确地约束干预位置。
省下的计算要按实际协议计
EditJev报告频率加权估算,TEM复用持续采样链,WorldForge叠加加速LoRA;它们的数字不是同一种时间账单。
完成感不能替代验收清单
MDMR-Bench分开指令与非目标保持,AudioLift区分正面动态与首帧新视角,CityLift分开单楼与整场景质量。
今日讨论
SyncVid 的跨视角 FVD 从 202.22 降到 146.99,相机旋转误差却比 ArtiFixer 更大。若同步收益主要来自把噪声绑定三维锚点,你会怎样用等帧数、同底座实验,分别改变遮挡程度和几何误差,收集哪些独立证据,区分动作同步、轨迹准确与新露出内容的真实一致性?
人工智能炼丹君 整理 | 2026-10-27






评论 (0)