今日 AIGC 论文速览
今日共 10 篇 · 视频编辑与可控重渲染 4 篇 · 单步图像编辑 1 篇 · 视频训练与音视频加速 2 篇 · 场景语音生成 1 篇 · 全景与3D部件生成 2 篇
重点论文标题列表
UniVOE (腾讯混元):删物添物时连阴影一起改FAPL (港科大):只换人物时别把动作也换了Latent Space Jam (Lightricks):先按框走再补回视频质感AnyGameRenderer (Alaya实验室):游戏换画风先数清每个小人ECT (浙江大学):一个噪声时刻改图仍要校准
选读入口:真实视频删物或添物且要一起改阴影、倒影,先读UniVOE;只换人物却连动作也变,接FAPL。要规定每帧位置读Latent Space Jam,要把粗糙游戏录像换画风又数清角色读AnyGameRenderer。单张图低延迟局部改动读ECT;训练流式视频模型读Direct Forcing,已有声画联合生成服务再读CAVC,对照它们的步数与墙钟账单。做数字人口播读HeyGen Voice,看场景声音和音色如何拆开;全景接缝问题读CubeAtlas,图片转可编辑3D资产读FlexPart,注意提示粒度和遮挡边界。
今日论文速览
1. UniVOE:删物添物时连阴影一起改
UniVOE: A Removal-Driven Framework for Interaction-Aware Universal Video Object Editing | 腾讯混元;北京大学深圳研究生院;香港中文大学 | arXiv:2610.31641
关键词 :视频对象编辑, 交互效应, 移除监督, 奖励后训练
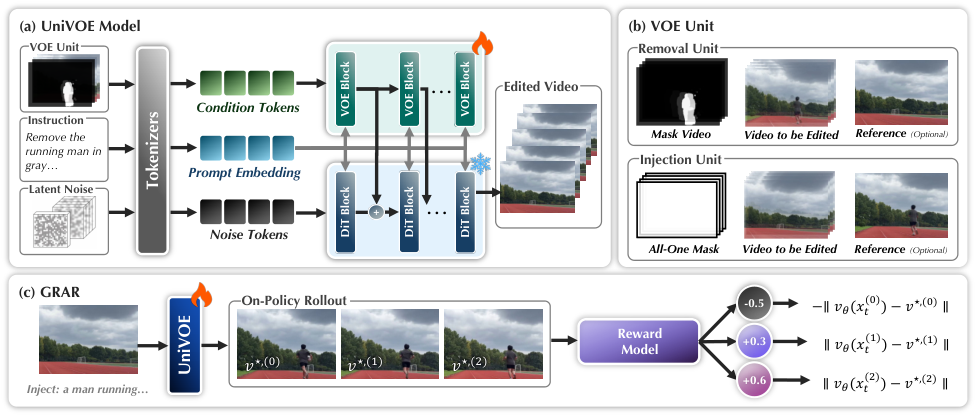
前序问题 :把视频里的烤箱删掉,披萨仍躺在烤箱留下的阴影里;往街道添辆车,地面却没有倒影。视频编辑不能只改物体轮廓,还要处理它对环境造成的光照、接触和反射变化。真实的有物体/无物体配对视频又很难拍到。方法直觉 :先学会把物体和它的痕迹擦干净,再把擦掉后的片段当输入、原始实拍当目标,倒过来教模型添物体。插入结果的运动与交互来自真实片段,减少完全合成监督的失真。本文贡献 :移除器先用超过63000段视频学习补洞,再用68000对视频微调交互效应;应用后筛得69000对,与原68000对合成137000对插入训练数据。两模型结构相同、分别训练,各230亿参数,含冻结140亿参数 Wan2.1 主干及30亿参数控制分支。移除输入膨胀对象掩码,插入用全一掩码允许全局修改;可追加由外部图像编辑器生成的首帧参考。GRAR(组相对优势回归)每个条件生成16份结果,以经人工偏好微调的 Qwen3-VL 奖励模型排序,按组内中位数分正负回归,不另存冻结参考策略。
原文图3|UniVOE流程。(a)移除器与插入器共享网络结构,指令与视频对象编辑单元不同。(b)移除输入源视频与膨胀二值掩码;插入用全一掩码,允许全局交互效应变化。两任务参考图均可选,由外部图像编辑模型生成以提供更明确指导。(c)GRAR组相对优势回归把预训练插入器向人类偏好调整,以改善物理真实感。
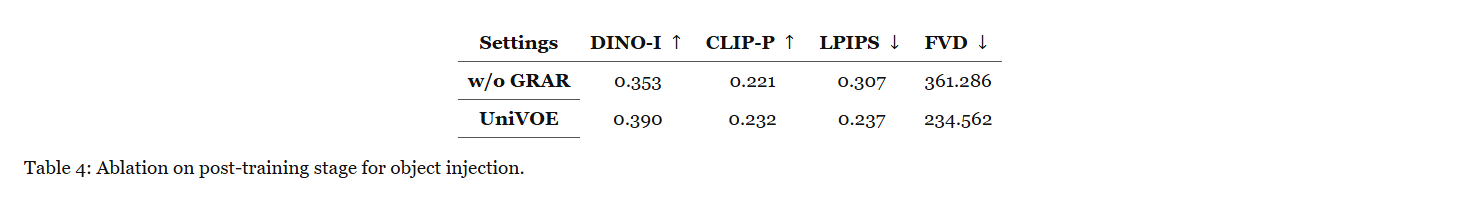
实验效果 :训练片段为97帧、832×480;评测 VOR100对、ROSE56对且剔出训练集。移除仅给文字,插入给文字与参考图。VOR移除的 PSNR(像素信噪比)23.752分贝,EffectErase23.210;插入相对不做GRAR,FVD(视频分布距离,越低越好)361.286→234.562,LPIPS(感知距离,越低越好)0.307→0.237。移除由50步缩到12步,但未报完整推理时间及峰值显存,不能按步数直接宣称提速4倍。
原文表4|对象插入后训练消融。相同设置不做/做GRAR,DINO身份相似度0.353/0.390,CLIP指令相似度0.221/0.232,感知距离LPIPS0.307/0.237,视频分布距离FVD361.286/234.562;前两项越高越好、后两项越低越好。
批判点评 :筛选仍会漏过移除器偏差,插入能力受保留配对与自有奖励模型上限约束;省去参考策略不意味着免除奖励偏移。论文称支持超过200帧编辑,但定量范围仍是97帧480p,不能外推长片稳定性。项目 可查,权重 可查;项目主页标出的代码地址本次返回404,尚未确认代码公开。未据会议模板推断接收。
2. FAPL:只换人物时别把动作也换了
Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation | 香港科技大学;腾讯视频;法国巴黎综合理工学院 LIX | arXiv:2610.30926
关键词 :因子视频编辑, 多模态表征, 动作顺序, 多镜头一致性
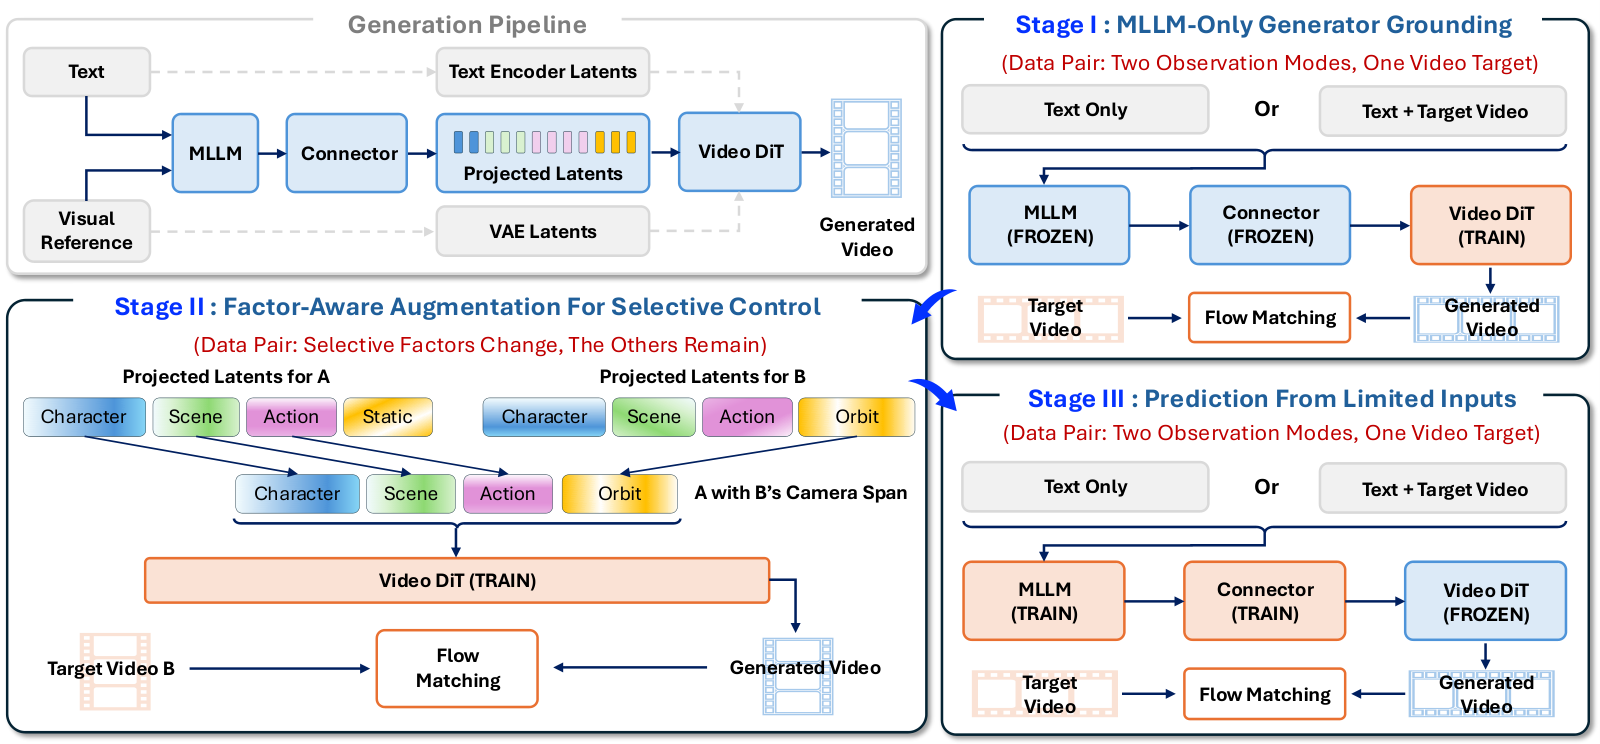
前序问题 :给视频系统接上多模态大语言模型,换个人物仍可能把动作和镜头一起改。原因可能更早:生成器依赖自己的文字和图像条件,根本没认真使用大语言模型的隐藏表征。怎样让这些表征既有用,又能按人物、场景、动作、相机分别控制?方法直觉 :先暂时关掉更容易走的条件捷径,让生成器必须读懂大语言模型的表征;再只换一个因素对应的片段,用成对视频教它哪些该变、哪些该保留。最后反过来固定生成器,让理解端学会提供能生成视频的信息。本文贡献 :FAPL即因子感知预测学习,基于 UniVideo 的130亿参数 DiT(用 Transformer 做视频扩散的生成器)。第一阶段冻结多模态模型及连接器,仅以其潜表征训练DiT;第二阶段在连接器输出后替换结构化描述中某个因子的完整token区间,监督双向编辑,区间可不同长,并不假定完全解耦。第三阶段冻结DiT,梯度经它更新多模态模型及连接器;仅文字、文字加完整视频两种观察以1:1抽样、共用目标。100000对视频每因素25000对,三阶段分别10000、15000、10000步。
原文图3|因子感知预测学习FAPL。阶段一冻结多模态大语言模型和原连接器,用其潜表征训练视频扩散Transformer;阶段二保留这一冻结配置,在成对样本间交换因子对应输出区间,监督特定因素改变;阶段三冻结训练好的生成器,以视频重建共同更新多模态模型与连接器,只有文字、文字加完整视频的观察共用一个生成目标。
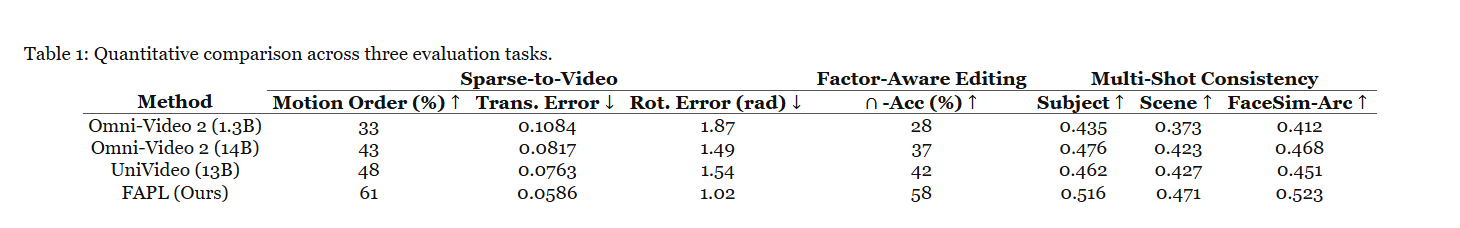
实验效果 :CineFactor-10K按源视频隔离:5000例仅文字生成、5000例因子编辑,另测100组多镜头。相对同底座,动作顺序正确率48%→61%,编辑交集准确率42%→58%;交集要求是非题与选择题同时通过。相机旋转误差1.54→1.02弧度,越低越好。等数据和优化预算下,第二阶段做因子替换比不替换48%→57%,较能隔离机制收益。推理50步、分类器自由引导系数5.0;未报墙钟时延或峰值显存,三阶段训练有额外成本。
原文表1|三个任务定量比较:稀疏输入生成评动作顺序与相机平移/旋转误差;因子编辑交集准确率要求两种问答检查都过;多镜头评主体、场景和ArcFace人脸相似度。FAPL对应61%、0.0586、1.02弧度、58%、0.516、0.471、0.523;不是同一指标的七次测量。
批判点评 :第三阶段完整视频是训练观察,文字分支推理时并未偷看目标视频。多镜头仍独立生成,主要靠共享人物/场景参考,没有跨镜头记忆;隐藏区间受上下文混合,不能称四个因素已经数学解耦。实验支持这些受控任务的改进,尚非任意复杂剪辑都能准确保留。原文未给本方法代码入口。
3. Latent Space Jam:先按框走再补回视频质感
Latent Space Jam: Layout Guided Video Synthesis | Lightricks;独立研究者;莱赫曼大学 CANVAS 实验室 | arXiv:2610.30390
关键词 :布局视频生成, 潜变量优化, 轨迹控制, 两阶段精修
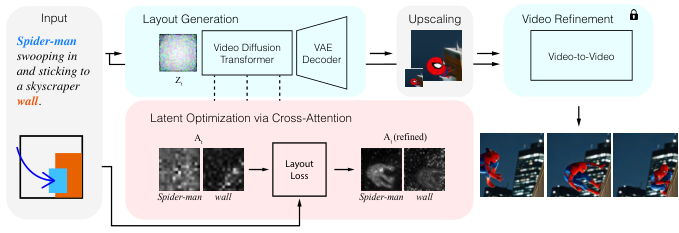
前序问题 :让山羊沿指定路线下山,只写“向左下走”常常不听;强压每帧目标框又会毁掉外观。位置必须准、动作还得连贯,能否把这两个要求放在不同阶段完成?方法直觉 :先生成一条画质粗但位置准的引导视频,再把它当草稿修清楚。草稿也由视频模型产生,保留运动和接触关系,比逐帧贴上独立生成的物体更合适。本文贡献 :冻结文生视频模型,优化潜变量而非模型权重;让指定文本token的交叉注意力分布贴近各帧二值框,使用 KL 散度衡量两分布差异。只在选定去噪时刻和早期三层做梯度优化。草稿可先时空上采样,再按当前噪声量加噪、插入第二次去噪的早期,恢复纹理。Wan2.2与LTX-2均有验证;静态/动态/多物体约40/40/20套布局,共约100套。
原文图2|无需训练的布局引导视频流程。输入文字与时空布局,先用交叉注意力布局损失优化冻结文生视频模型的潜变量,使指定token注意力对应目标框,生成粗糙但遵循布局的潜空间视频;可做空间和时间上采样,再在去噪早期注入引导视频。第二阶段保留布局与运动、改善外观细节,得到最终视频。
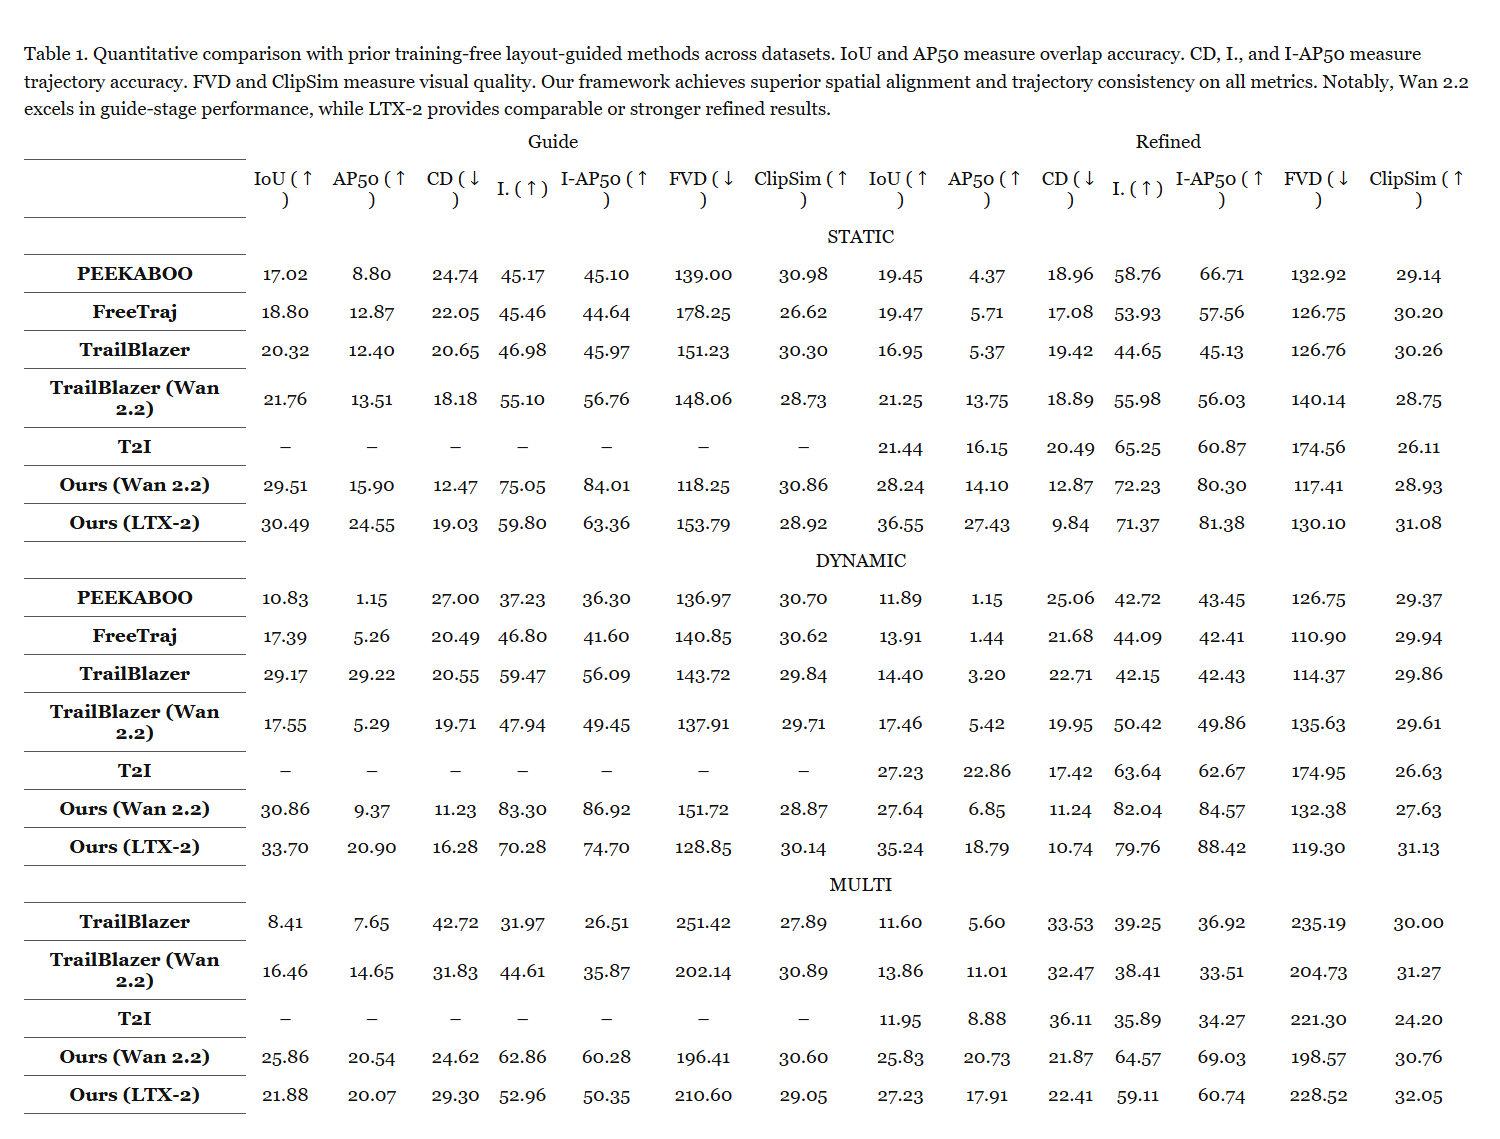
实验效果 :多物体设置,同为Wan2.2并精修后,相对重实现的 TrailBlazer,IoU(预测与目标区域交并比,按百分制显示)13.86→25.83,目标中心距离32.47→21.87,越低越好;FVD视频分布距离204.73→198.57。这里比较的是同底座,不能把LTX与Wan差异全归方法。低分辨率草稿高160像素49帧,再精修到高480像素81帧,耗时36秒+5分58秒,底座6分20秒;高480像素81帧草稿自身要10分24秒,无训练仍有推理优化成本。
原文表1|静态、动态、多物体三类布局比较;IoU交并比与AP50重叠阈值精度评空间重合,CD是中心距离,I.为原始交叠面积、I-AP50基于该面积评轨迹;FVD视频分布距离越低越好、CLIP图文相似度越高越好。左为引导、右为精修;原图注总结Wan2.2引导较强、LTX-2精修相当或更强,但具体条目存在指标取舍,不能理解为每个格子全胜。
批判点评 :框约束不区分物体移动和相机运动,拥挤、多物体交互仍困难;主结果动态场景的部分AP50分数没有胜过早期方法,不能沿用图注“全指标更好”的泛化表述。IoU与中心距离衡量位置,不证明物理正确。耗时表未明确卡型与显存,项目 与代码 可查,未执行;不能仅凭TOG排版认定接收。
4. AnyGameRenderer:游戏换画风先数清每个小人
AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark | Alaya 实验室 | arXiv:2610.31466
关键词 :视频重渲染, 实体对应, 游戏生成, 低秩微调
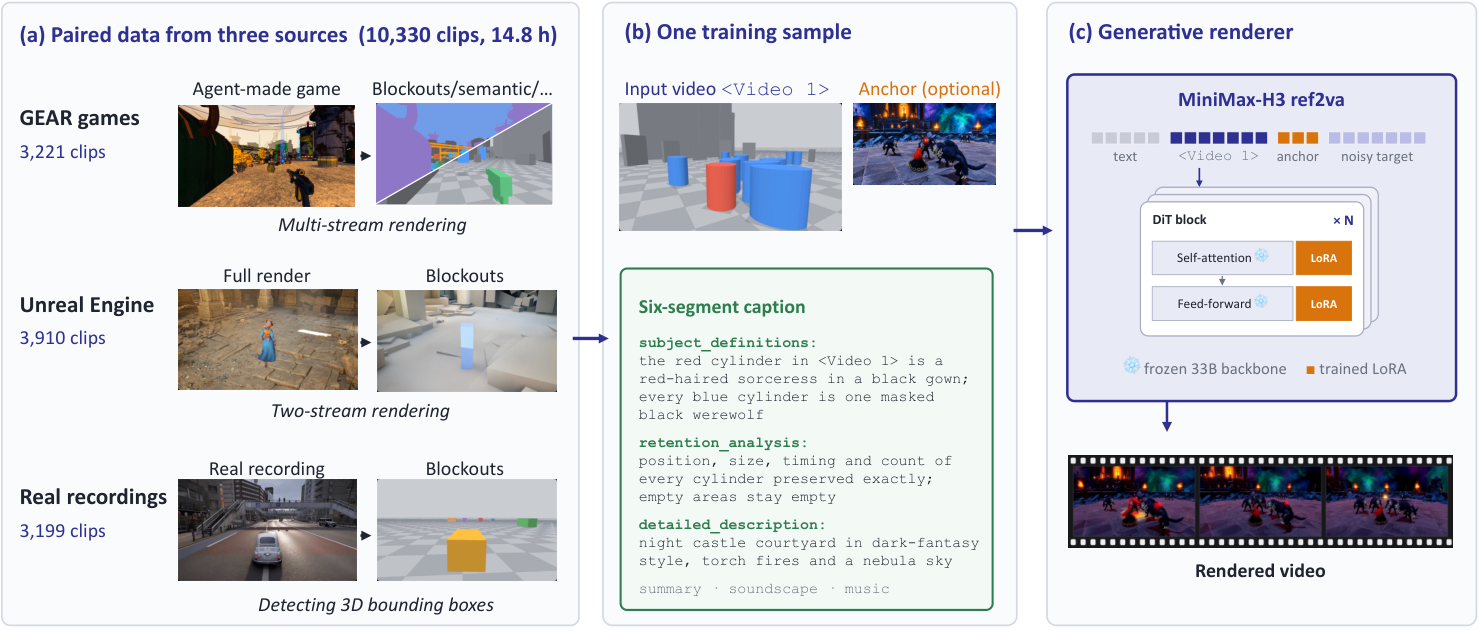
前序问题 :把满屏几何小人换成精致游戏人物,生成器可能留下方块、凭空多出敌人,或把俯视镜头改成正面。游戏的画面可换,角色数量、出场时刻与位置不能随意重写。方法直觉 :直接把粗糙游戏录像作为结构参考,再明确每种形状代表谁。训练描述故意列入没出现的角色,迫使模型根据视频判断实体存在,而不是见到名字就添一个。本文贡献 :基于330亿参数 MiniMax-H3 的参考视频编辑模式,仅训练秩128的 LoRA(低秩适配参数),关闭音频损失、推理丢弃音频。10330段配对由38个GEAR游戏、虚幻引擎和真实录像检测框重建三路组成;统一124帧、24帧/秒、1344×768。六段描述固定身份映射、位置、大小、时机和数量,首帧锚图可选。16张141GB H200训练约48小时;推理20步Euler采样,未报生成耗时或峰值显存。
原文图2|AnyGameRenderer。(a)三路配对:GEAR将完整游戏渲染与方块/语义图等多个粗糙流对齐,虚幻引擎配完整图与方块图,真实录像用检测3D框转粗糙图。(b)每例粗视频作输入,目标首帧可作锚点,六段描述明确粗形状与真实实体对应及保持要求。(c)文字、参考视频、锚图与带噪目标token构成冻结MiniMax-H3生成器输入,只训练自注意力和前馈层的LoRA低秩适配,按指定风格重渲染。
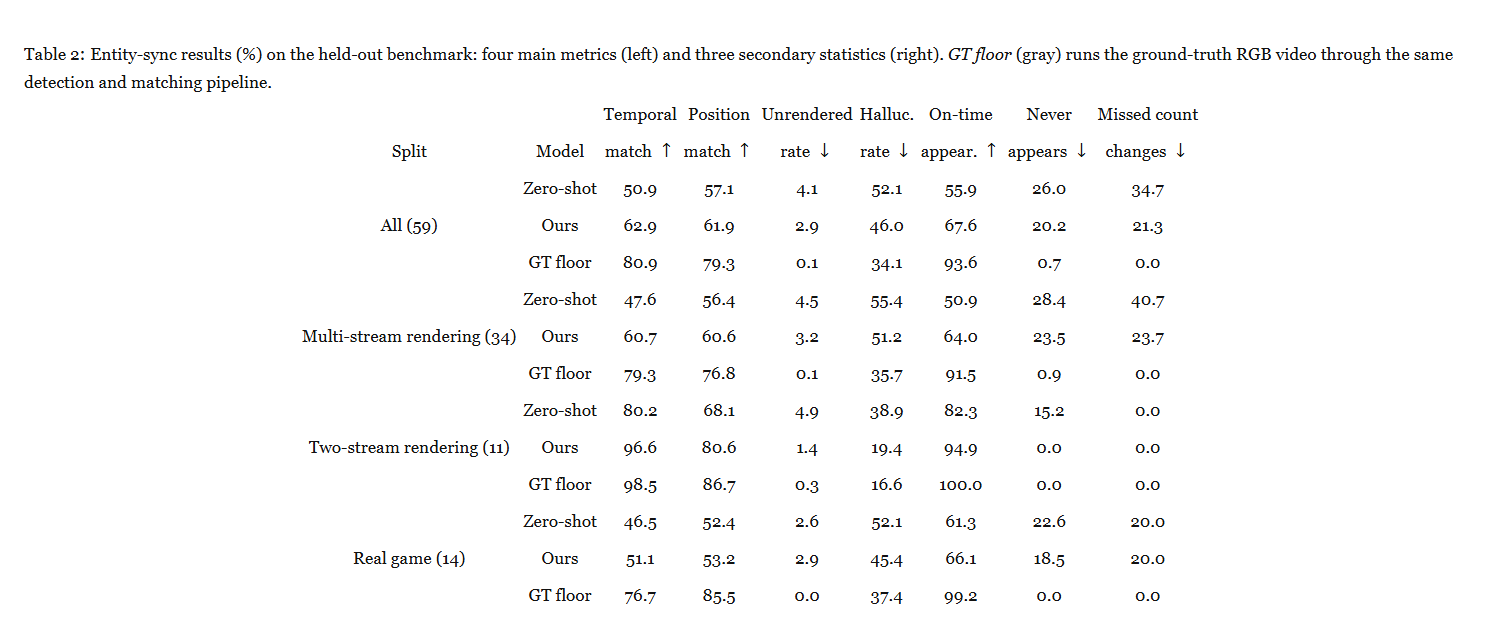
实验效果 :59个隔离案例共753实体,同种子、步数和描述:时间匹配50.9%→62.9%,位置匹配57.1%→61.9%,漏掉数量变化34.7%→21.3%。时间匹配是“输入存在帧集合”和“输出在位帧集合”的交并比;活不足12帧的实体不计。数量统计只覆盖75次规定幅度变化,允许60帧窗口内达标;不是逐帧精确计数。真实录像子集时间匹配仅46.5%→51.1%,未渲染率还由2.6%升至2.9%。
原文表2|隔离测试集实体同步结果,单位%。左侧四主指标为时间匹配、位置匹配、未渲染率与幻觉率;右侧三辅助量为及时出场、从未出现及漏掉数量变化。灰色GT floor把真实RGB视频送进同一检测匹配流程,表示该评估器的可测上限/误差底,而不是人工标注完全无噪声。
批判点评 :总体幻觉率仍46.0%,真值视频经过同一检测匹配流程也有34.1%,说明检测器本身存在误差,不能把46.0%直接当肉眼错画比例。24帧/秒是输出播放率,不是实时生成速度;跨域无锚图风格建议减LoRA系数至0.7,仍待用户实际验收。项目 与代码 、模型 可查;数据仓库 本次只有占位文件,尚未提供样本。未执行模型。
5. ECT:一个噪声时刻改图仍要校准
One Evaluation Is Enough: Inversion-Free Image Editing with Trajectory Correction | 浙江大学;蚂蚁集团;重庆邮电大学 | arXiv:2610.30827
关键词 :单次图像编辑, 端点校准, 无需反演, 计数口径
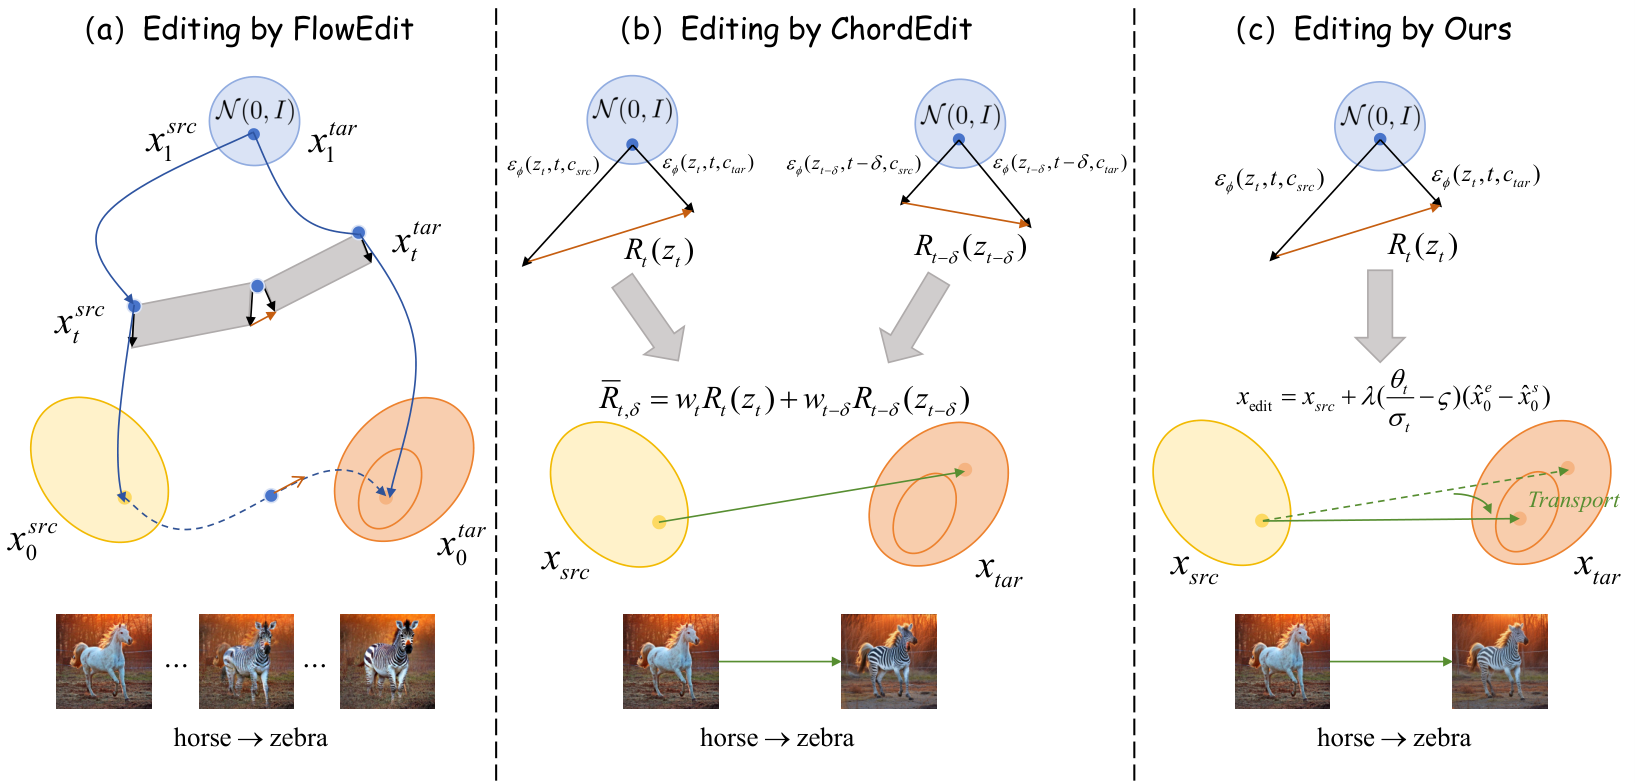
前序问题 :单步图像编辑看似只跑一次,但常在多个噪声时刻分别求源/目标指令差,再合成一步。能否只观察一个时刻,也保住没要求修改的背景?方法直觉 :同一个带噪状态下,源指令和目标指令的预测差同时提供“往哪改”和“干净结果差多少”;先按剩余噪声角度推一把,再用端点差收回过度外推。二者在同一编辑轴上调幅,不是凭空生成新方向。本文贡献 :ECT(端点校准输运)适用于预测噪声的 VP(方差保持)单步生成器。把两种文字条件打包进一次去噪批调用,得到角度切向量与干净端点位移;解析输运后做受约束投影,再更新一次潜变量。不反演、不中途积分、不迭代优化。默认噪声时刻t=0.75、校准系数ζ=0.7、编辑强度λ=1;t是噪声日程位置,ζ收缩外推幅度,λ控制整体编辑量。一个时刻、两条条件分支、一次批调用和一次更新,是四种不同计数。
原文图2|以马变斑马说明编辑流程。(a)FlowEdit沿多步路径累积源/目标场差。(b)ChordEdit把t与t−δ两时刻残差合成一次更新,含四条条件时间分支。(c)ECT在同一带噪状态只算两文字条件;同一预测确定角度残差gₜ与端点位移dₜ,先输运âₜ=−θₜgₜ,再校准u*ₜ=âₜ−ζdₜ,一次更新x_edit=x_src+λu*ₜ。θₜ为剩余噪声角、ζ为校准强度、λ为编辑强度;示意图只表示同一编辑轴调幅。
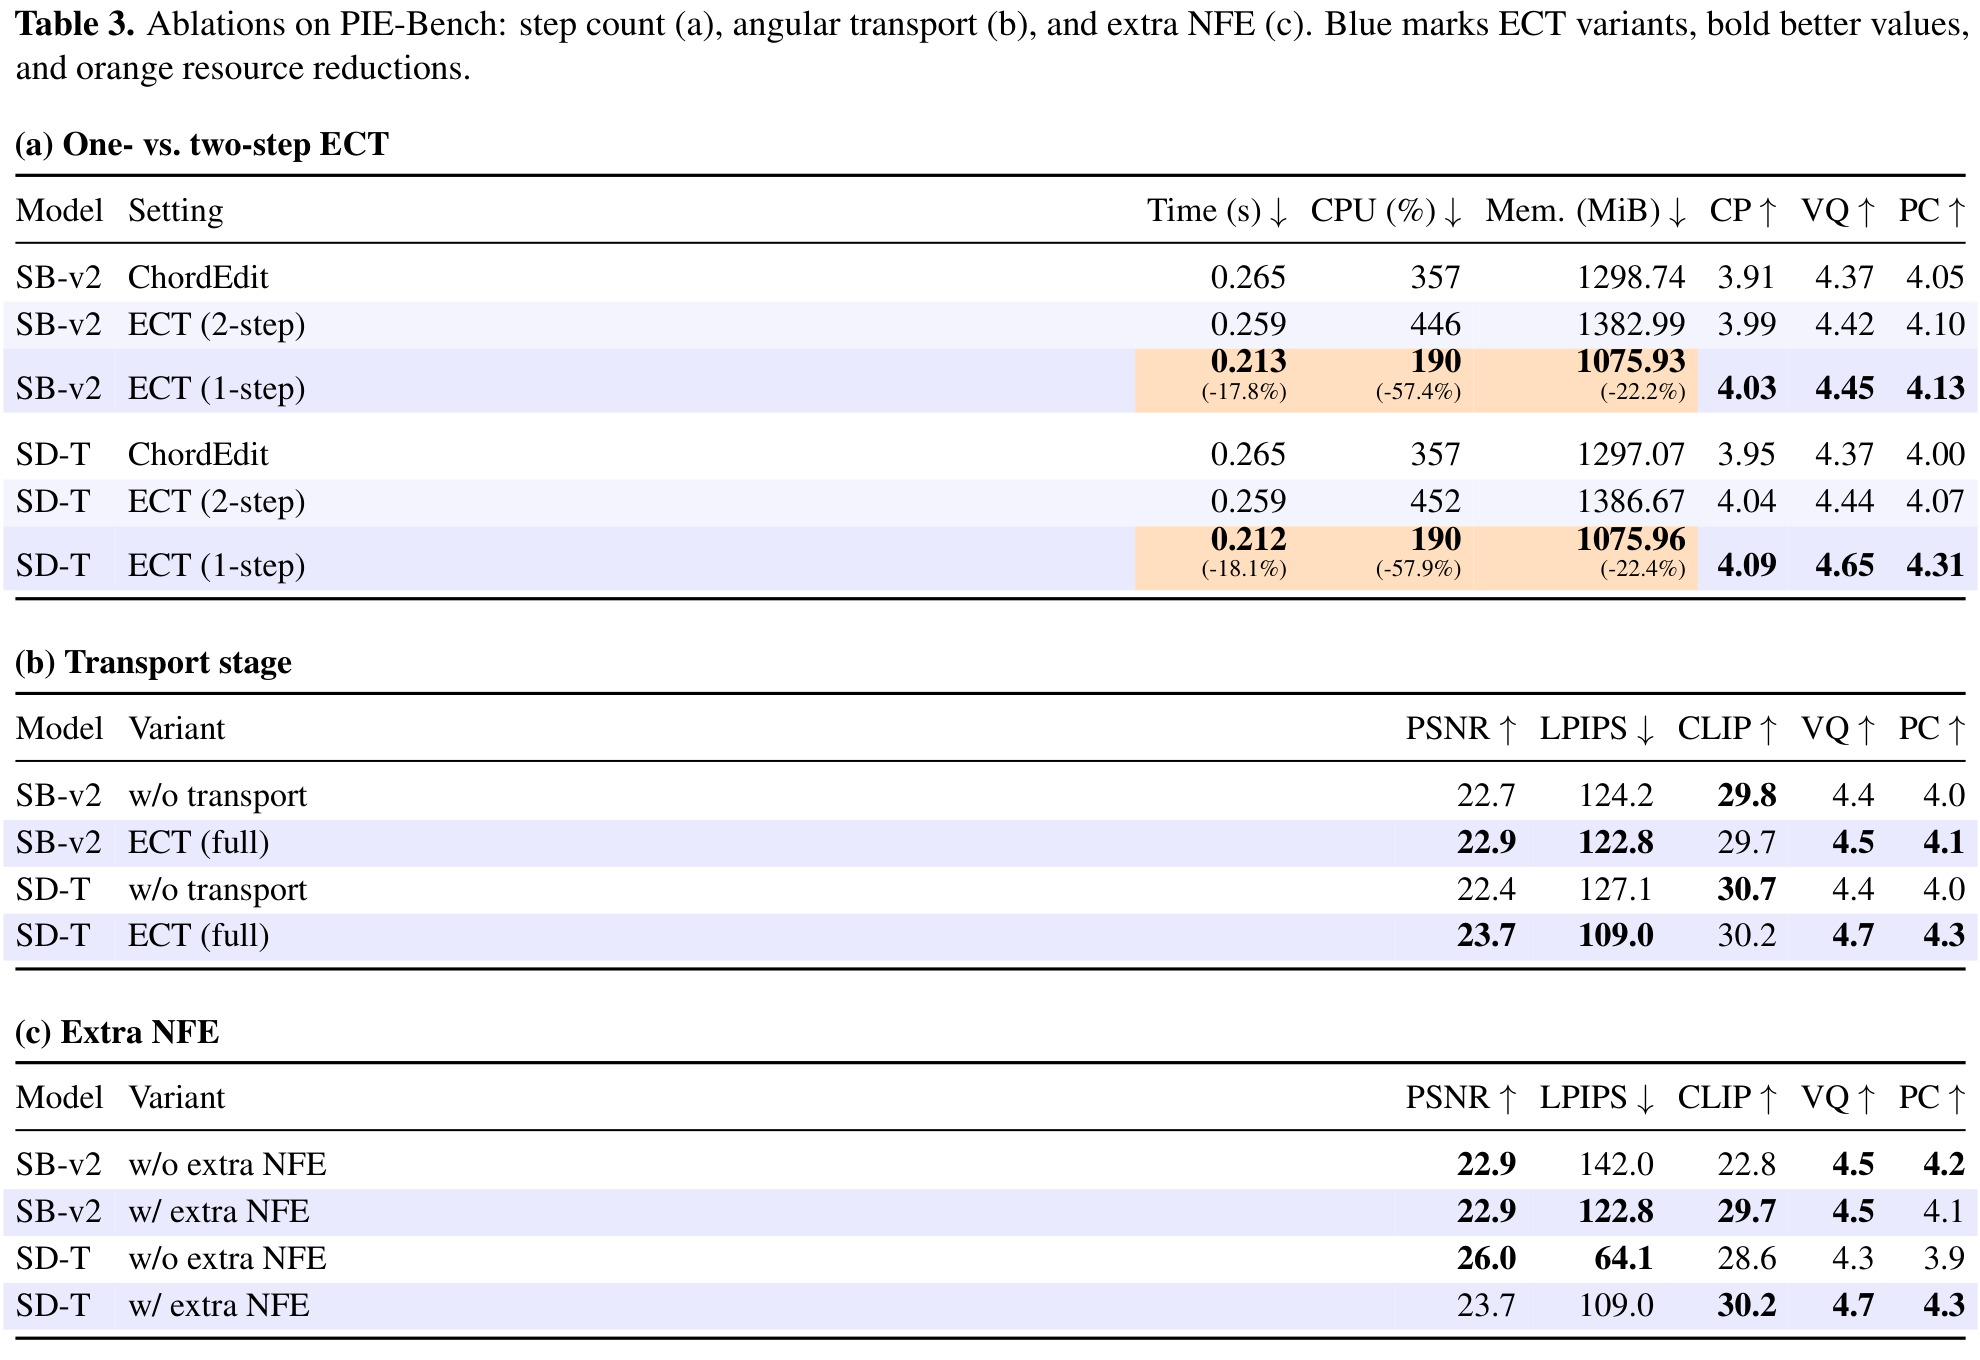
实验效果 :H20、同SD-Turbo底座的PIE-Bench,相对ChordEdit,背景PSNR(像素信噪比)22.63→23.74分贝,LPIPS感知距离按1000倍显示122.64→109.04,越低越好;整图CLIP图文相似度按100倍显示30.60→30.20,编辑对齐略降。同步推理计时0.265→0.212秒,但排除文件读写和指标计算;峰值PyTorch预留显存7498→7480MiB,只省0.24%,不是内存大幅下降。
原文表3|PIE-Bench消融:(a)一步与两步ECT比较;(b)角度输运的作用;(c)额外神经网络评估NFE的作用。蓝色为ECT变体,粗体为较好值,橙色为资源减少;额外NFE是独立变体,不属于严格单时刻主结果。时间为秒、主机内存为MiB,CP/VQ/PC分别评内容身份保持、视觉质量、物理感知协调。
批判点评 :同SwiftBrush-v2的PIE背景均方误差与感知距离有小幅退步;保持更好不等于指令全做对,例如加花仍未准确放到嘴里。主结果严格单时刻,附录额外网络评估变体另算,不能混写。推导尚不覆盖非VP日程、速度预测或空间自适应约束;原文未给本方法代码入口。
6. Direct Forcing:四步视频不再先做初始化
Direct Forcing: A Single-Stage Training Recipe for Few-Step Autoregressive Text-to-Video Generation | 北京航空航天大学;京东未来研究院 | arXiv:2610.30861
关键词 :自回归视频, 单阶段训练, 分布匹配, 梯度平衡
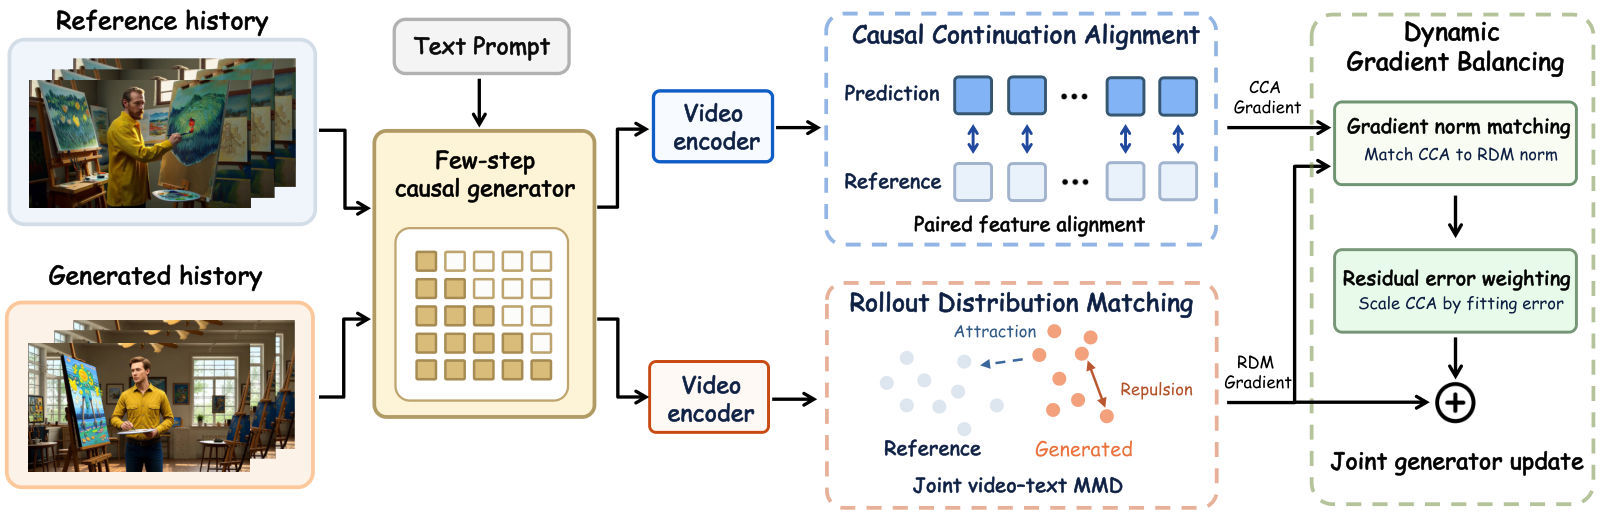
前序问题 :把双向视频扩散模型改成边看历史边出下一块,常先蒸馏因果初始化、再匹配生成分布。只做后者容易在块边界突然换物体,能否一次训练同时学会接得上和整体像真视频?方法直觉 :一组练习在真实历史上续写,约束相邻块;另一组让模型接着自己生成的历史走,检查整批视频的分布。两种练习的梯度强弱动态配平,避免续写损失压住分布学习。本文贡献 :从13亿参数Wan2.1双向底座出发。CCA(因果续写对齐)用冻结视频编码器对齐预测与参考的时空token余弦距离;噪声块只能看之前真块和自己,阻断未来泄漏。RDM(rollout分布匹配)用MMD(最大均值差异,比较特征分布的统计距离)匹配整条生成视频与参考,并用文字相似度配对;每条完整视频算一个分布样本。梯度先等范数,再按续写残差调权。八张B200、6505对参考视频、250次联合更新;每次128生成例做RDM、32参考对做CCA。
原文图3|Direct Forcing用共享少步因果生成器同时学习:在参考历史上做因果续写对齐CCA,在自生成历史上做rollout分布匹配RDM。冻结编码器提供配对余弦对齐及视频文字最大均值差异MMD;动态梯度平衡先匹配梯度范数,再按拟合误差加权CCA,合并为一次共享更新。
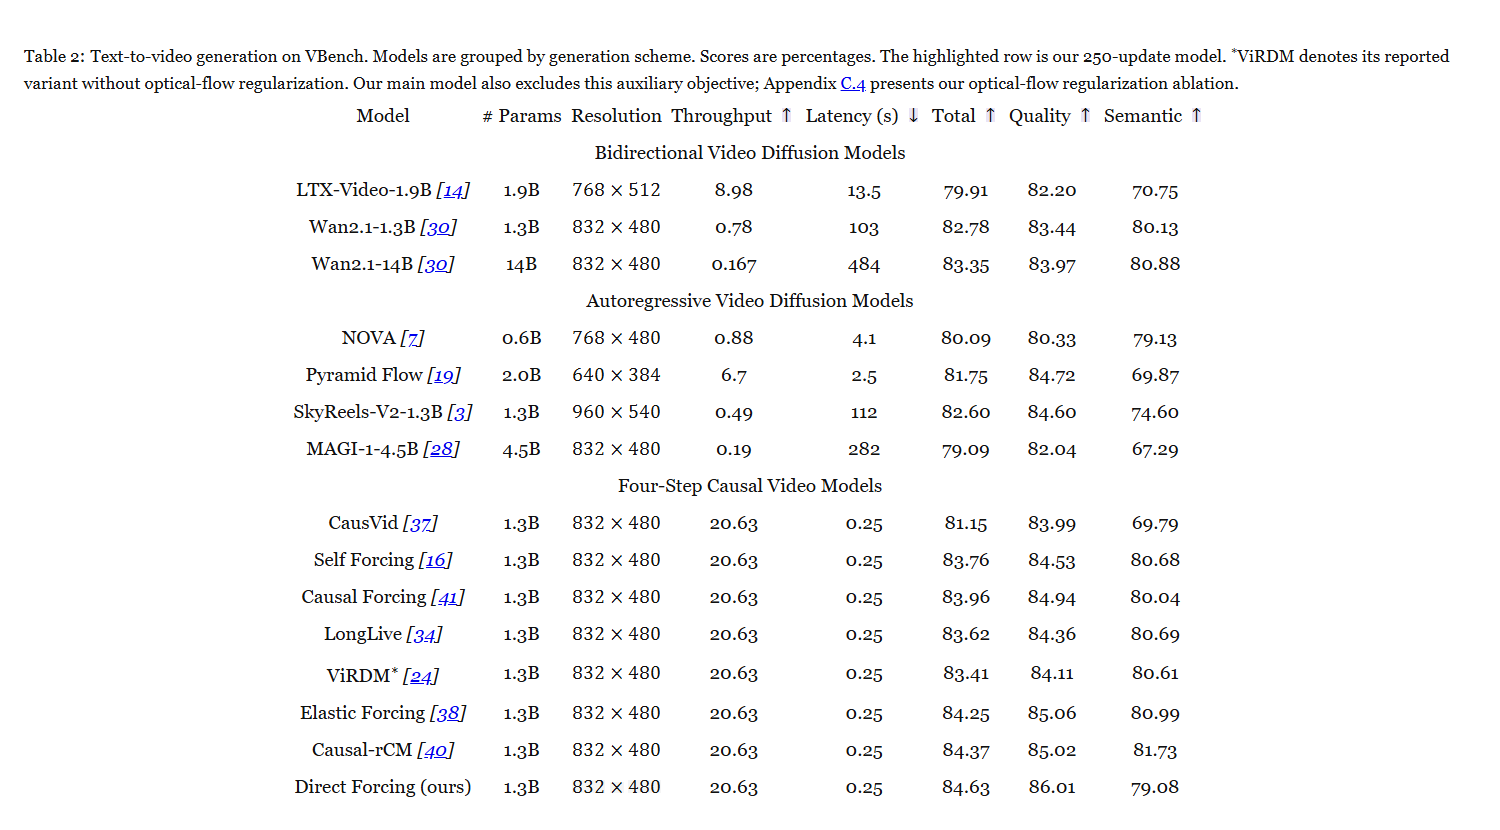
实验效果 :832×480、81帧、每块3个潜帧且去噪4步;944提示各5份共4720视频。VBench总体/质量得分84.63/86.01,相比Elastic Forcing84.25/85.06,但语义79.08低于80.99。单B200吞吐20.63帧/秒、首帧0.25秒,与列出的其他四步模型相同;训练变化未增加推理结构。250次不含底座预训练、离线特征及数据准备,步数也不是统一GPU小时账单。
原文表2|VBench文生视频比较,按生成方式分组,分数用百分制。高亮行是250次更新模型;星号ViRDM不使用光流正则,本方法主模型也未使用这一辅助目标,另在附录消融。吞吐为帧/秒,延迟指首帧秒数,四步因果模型时延在单B200测量;其他时延与部分质量指标沿用原报告。
批判点评 :所谓无在线扩散教师,仍用冻结Wan14B等编码器提取训练特征;不能说不依赖大模型。仅验证13亿参数及最多50秒视频,长视频六指标赢四项、动态与画质两项较差。不同公开baseline的质量得分并非全部本次同机重跑;原文未给本方法代码入口。
7. CAVC:缓存声音后还要重新对齐画面
CAVC: Convergence-Adaptive Audio-Visual Cache for Modality-Asymmetric Diffusion Generation | 浙江大学;蚂蚁集团 | arXiv:2610.30854
关键词 :音视频生成, 非对称缓存, 末端重耦合, 推理加速
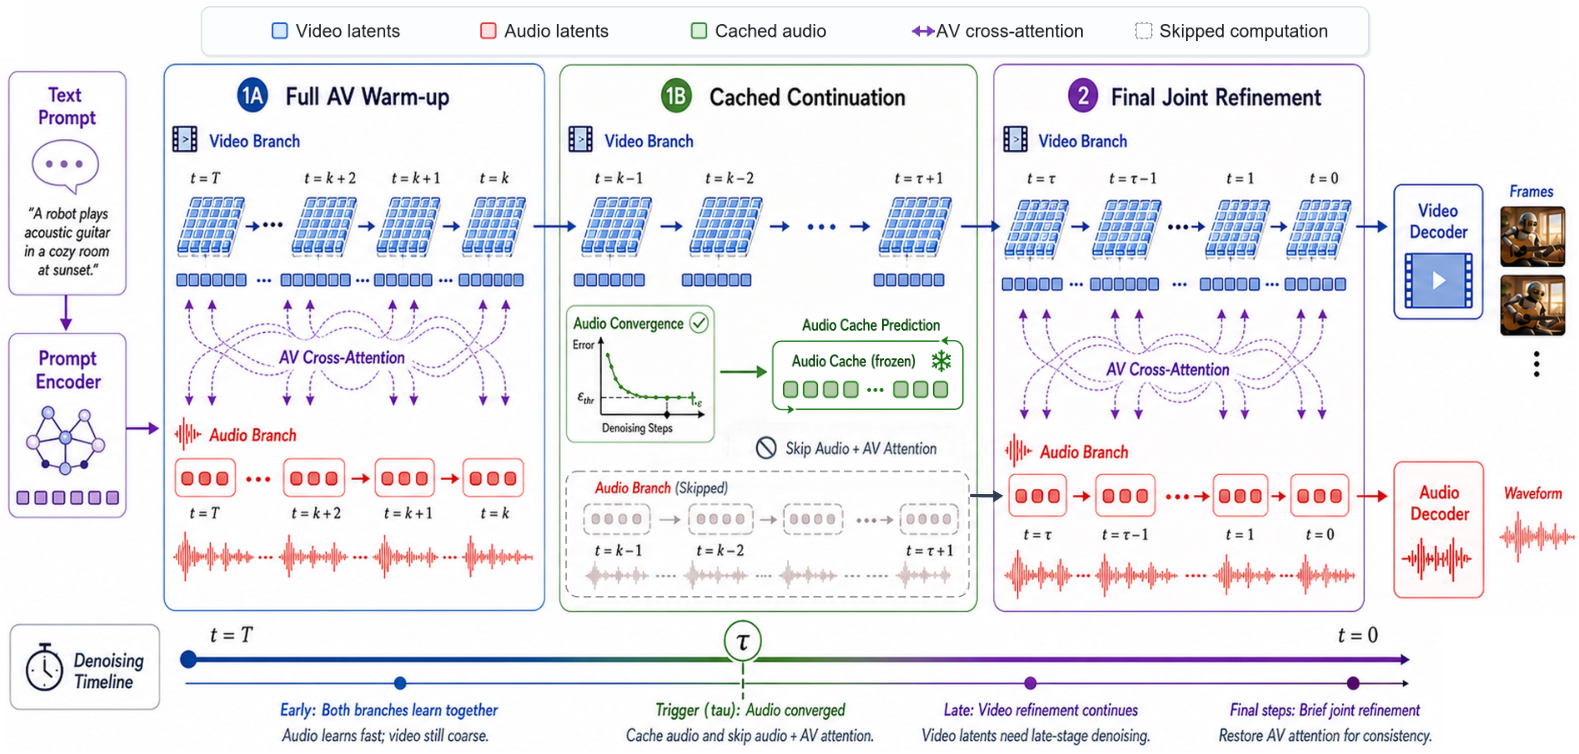
前序问题 :声画联合生成每步都算音频、视频和交叉注意力,很费时。但把两边都缓存,视频动作会停住;只缓存声音又可能让敲击和音效对不上。哪些计算能省,哪些必须一直做?方法直觉 :声音中段偏了,末尾联合细化还能补回不少;视频中段少算丢掉的运动却难补。于是保留完整视频去噪,声音稳定后暂用旧预测,最后再让声画一起校准。本文贡献 :CAVC(收敛自适应音视频缓存)不训练模型:前段完整联合去噪,在线监测音频预测变化,默认阈值0.30、窗口3;触发后重用音频去噪输出、绕过音频分支和声画交叉注意力,但音频潜变量仍按调度器推进。末段恢复原生3步联合细化。基于LTX-2.3-22B-dev及官方蒸馏LoRA,全部方法启用CPU卸载、单样本单并发,在96GB H20测试;不是只删几条Python语句就可忽略传输成本。
原文图2|CAVC按模态收敛动态分配从T到0的去噪轨迹。(1A)高噪声初段完整运行音频、视频及交叉注意力,建立语义绑定;监测器在音频预测稳定的τ时触发缓存。(1B)中段复用音频预测,跳过音频分支和声画注意力,让视频继续独立细化时空结构,避免静态声音过度约束。(2)末尾数步恢复联合计算,解码前减少累计声画偏移、改善同步。
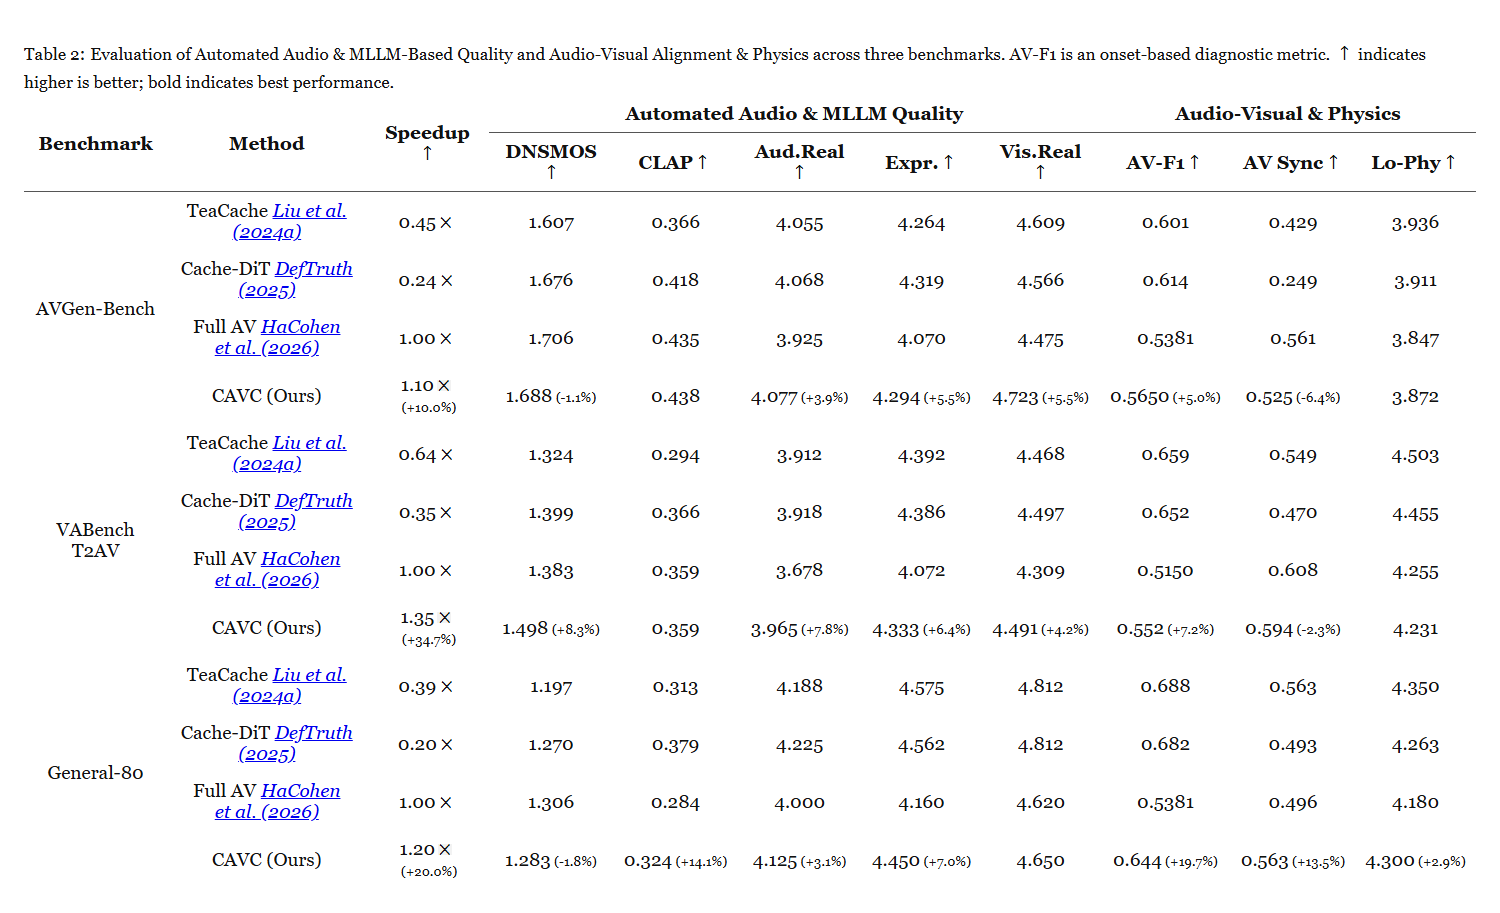
实验效果 :AVGen-Bench/VABench为1280×704、241帧24帧/秒,General-80为1536×1024、121帧24帧/秒,报告墙钟加速1.10–1.35倍。General-80动态程度(光流超过阈值的片段占比)0.380→0.512;AVGen-Bench的AV-F1(起音匹配,容许正负3帧)0.5381→0.5650,但细粒度同步分数0.561→0.525,DNSMOS预测音质1.706→1.688。默认参数消融217.2→184.8秒,是该配置结果,不能把最大加速套到每个提示。
原文表2|三个基准的自动音频、视觉语言模型质量、声画对齐及物理性评估。AV-F1是起音事件匹配诊断分,越高越好;粗体为最优。DNSMOS为预测音质、CLAP为音频文字相似度;声画同步分是时间偏移的变换值,不是人工听评。AVGen-Bench同步分0.561降至0.525,起音F1改善不代表所有同步指标都改善。
批判点评 :结尾重耦合只在测试设置补回约81.5%–91.3%的音频文本相似度缺口,不是数学保证完全恢复;同步分数也非人评。快速连续声学事件触发晚,收益趋近原采样;视频分支始终运行,加速上限受它限制,未报峰值显存下降。原文未给本方法代码入口。
8. HeyGen Voice:声音像本人也要像在这个房间
HeyGen Voice: Scene-Aware Voice Cloning for Talking Videos | HeyGen 研究团队 | arXiv:2610.30470
关键词 :场景语音合成, 音色克隆, 声学锚点, 跨场景适配
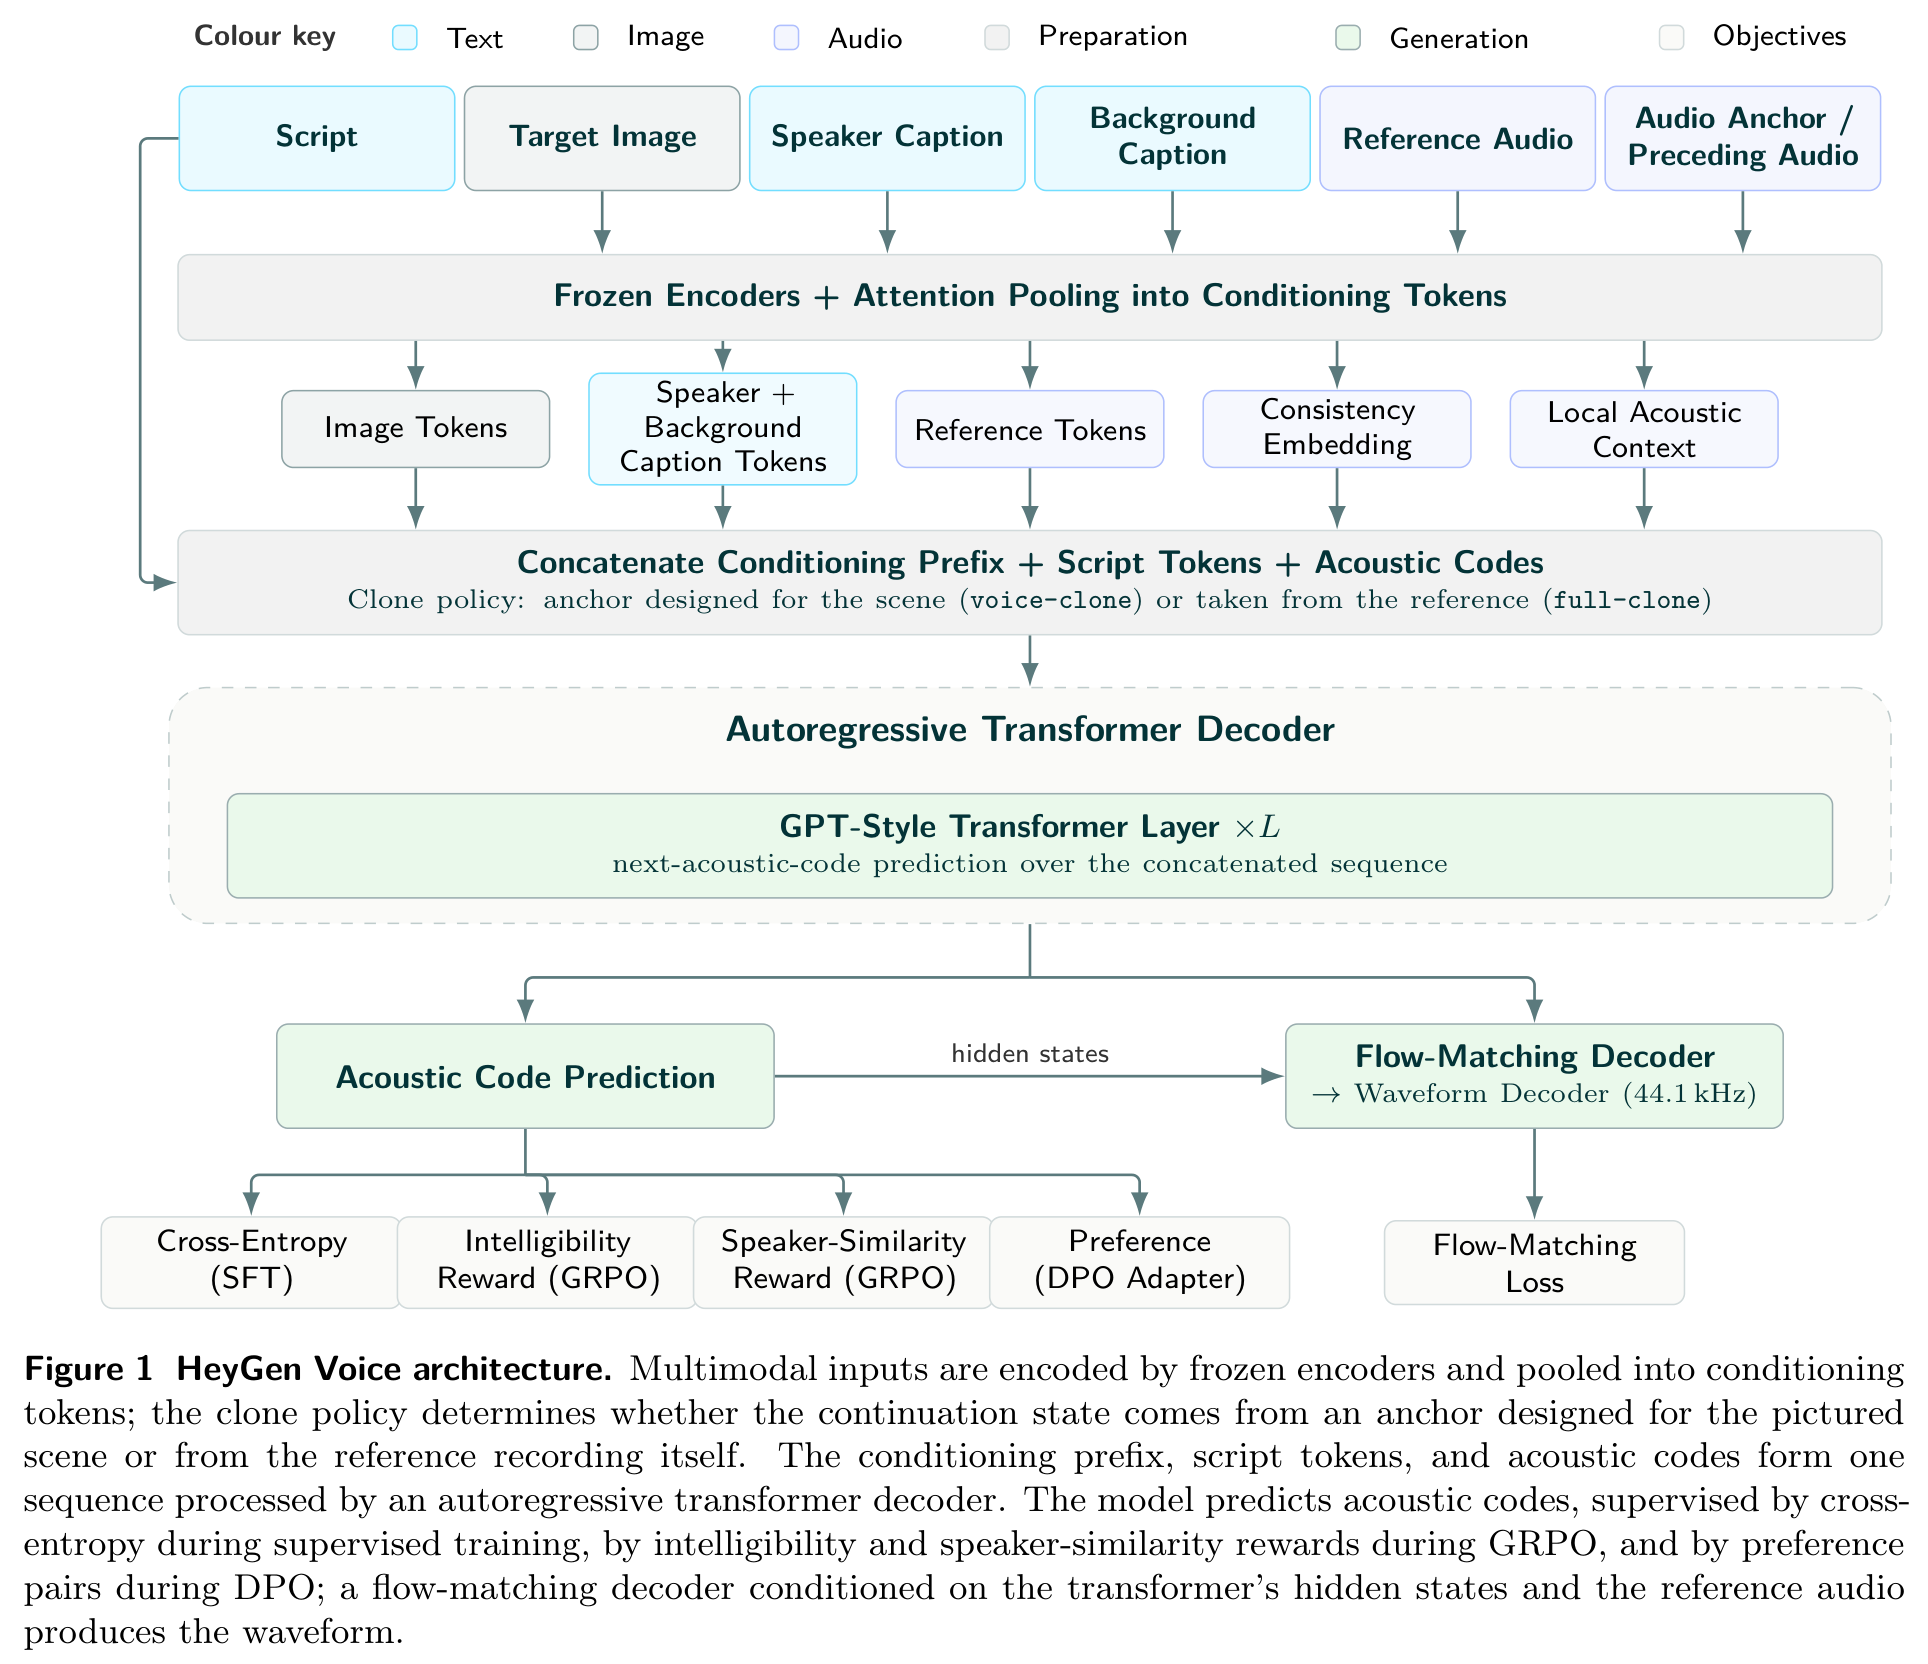
前序问题 :用手机录音克隆本人声音,画面换成录音棚或教堂,声音却仍像手机录的。说话人身份、说话方式和房间声学绑在一起,长稿分段还会一段一间房。方法直觉 :参考录音提供“谁在说”,图片与两段描述提供“怎么说、在哪说”;选定一段生成声音作锚点,后面各段都沿用这套声学状态,另外读取上一段结尾保持衔接。本文贡献 :冻结视觉、文字、音频编码器,分别把图片、说话人描述、环境描述与音色压成少量条件token;自回归Transformer按脚本预测离散声学码,再由流匹配及波形解码器输出44.1千赫声音。五阶段依次为多语种文字转语音预训练、模拟跨场景、真实同人跨场景、组相对策略优化GRPO、直接偏好优化DPO表达适配器。voice-clone保音色并随场景适配,full-clone更多沿用原录音;锚点一致性嵌入与滑动局部上下文分工不同。
原文图1|HeyGen Voice架构。冻结编码器把多模态输入池化为条件token;克隆策略决定延续状态来自为目标场景设计的声音锚点,还是原参考录音。条件前缀、脚本文字和声学码组成同一自回归序列。监督训练用交叉熵,GRPO组相对策略优化用可懂度及音色奖励,DPO直接偏好优化用偏好对;流匹配解码器以隐藏状态和参考音频合成波形。
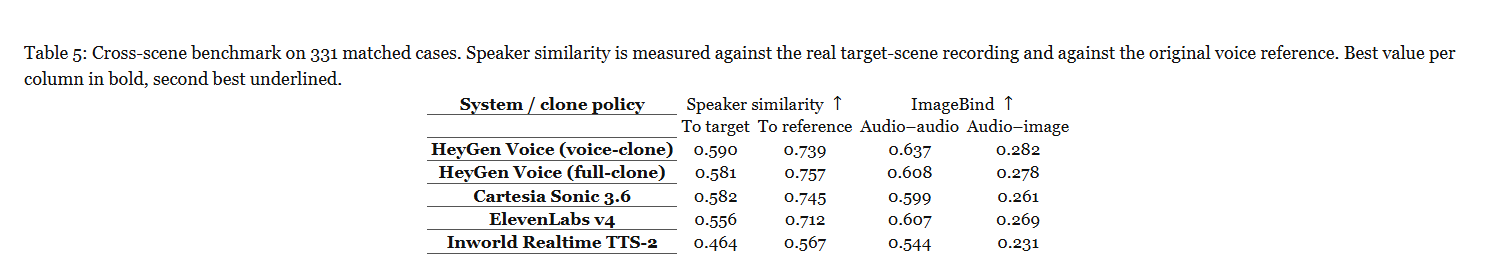
实验效果 :331个英语同人异源案例、155说话人簇,voice-clone目标音色相似度0.590,Cartesia0.582;音画嵌入相似度0.282对0.261。full-clone对原参考相似度0.757,高于voice-clone0.739,体现取舍。此测试额外给HeyGen目标图片、从真实目标录音生成的描述及信噪比,其他语音API没有这些输入,不能归结为纯模型同条件领先。报告单并发实时因子约0.1,即合成耗时/音频时长约十分之一;未报首包时延与峰值显存。
原文表5|331个跨场景配对案例,音色相似度分别参照真实目标录音和原参考录音,ImageBind两列为音频对音频、音频对目标图像的嵌入相似度。粗体最佳、下划线次佳。voice-clone偏目标场景,full-clone偏保留参考声学;HeyGen还接收目标图、由真实目标录音导出的描述与信噪比,不是各系统完全同输入。
批判点评 :十语言文字错误率使用双评审都确认才计错的规则,分歧算零但保留分母,不能当常规自动转写错误率;因此这里主要关注场景迁移证据。听评与生产投票有不同样本池,报告中10月榜单名次也不是永久结论。产品与样例 可查,未见开放权重或本方法训练代码。
9. CubeAtlas:全景六个面放一张画布里生成
Squaring-the-Sphere: Distortion-Free and Seamless Panorama Generation via CubeAtlas | 腾讯 | arXiv:2610.31565
关键词 :全景生成, 立方体表示, 稀疏注意力, 透视超分
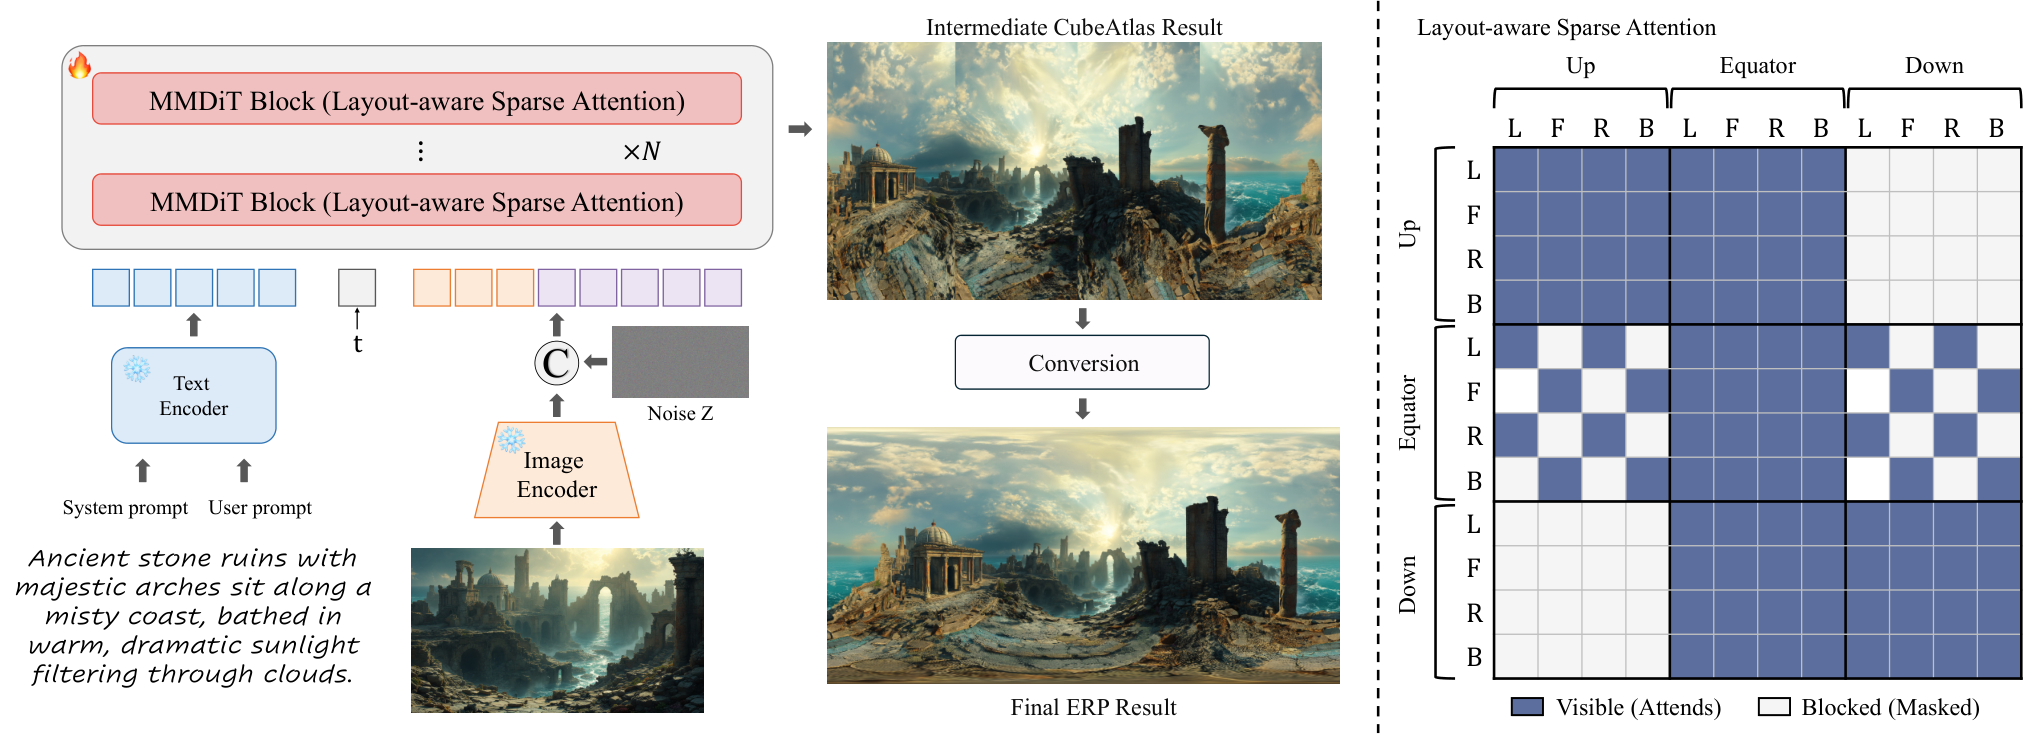
前序问题 :普通照片扩成全景,顶部被拉长;六个透视面分别生成,又在接缝处对不上。如何保留普通图像模型熟悉的透视几何,同时把一整圈场景连起来?方法直觉 :把四个侧面排成一带,上下极面旋转后各取一半,紧挨对应侧面,形成一张紧凑画布。接缝两边能一起去噪,再把互补极面融合回球面。本文贡献 :CubeAtlas是Squaring-the-Sphere的表示:侧面边长S,中央S×4S、上下各S/2×4S,合计2S×4S,S指潜空间边长;不算边缘padding时与ERP(经纬展开)token量相同。输入单张透视图与文字,无需给相机内外参;冻结图像编码器与变分自编码器,完整微调图像编辑DiT8000步。布局稀疏注意力保留目标间75%连接,文字和图像条件仍全连。解码后方向加权融合极面,基图1280×2560;六个92.79度重叠视图经冻结4倍超分得到5120×10240。
原文图3|Squaring-the-Sphere流程。输入透视图和文字,扩散Transformer在同一画布上联合去噪完整CubeAtlas;布局稀疏注意力保留带内连接、限制跨纬度交互。对每个极区,赤道面只关注能组成完整极面的两块同轴半极区;生成后融合拼接为ERP经纬展开全景。联合一次画布不表示只有一个去噪时间步。
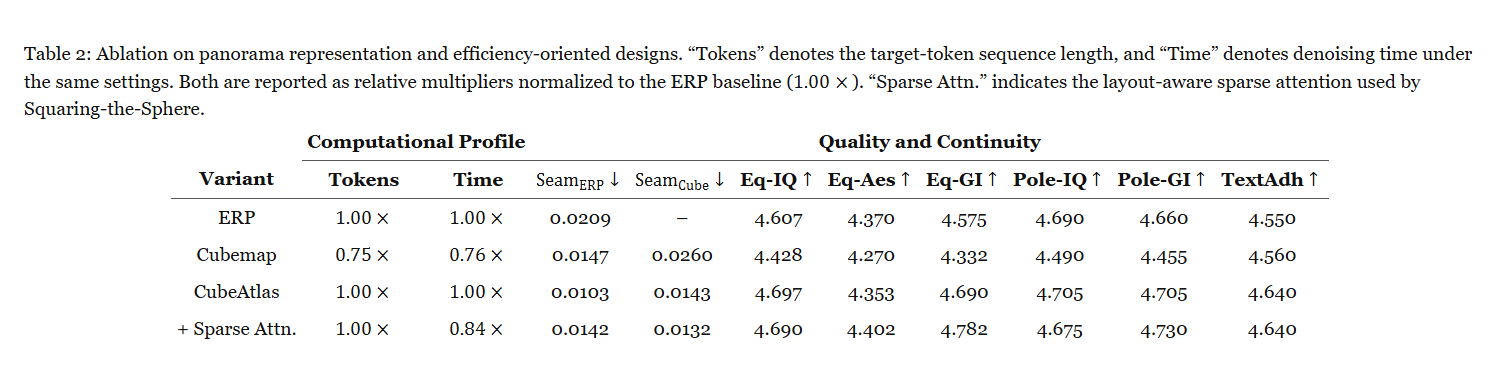
实验效果 :100自采图及三个公开集100/100/118例,主比较均在未超分基图。RealSee3D立方面边缘误差Seam-Cube从CubeDiff0.0229降至0.0064,越低越好;稀疏版同token量去噪时间为ERP的0.84倍,非端到端10K图总时间。相对密集CubeAtlas,立方接缝0.0143→0.0132,但ERP接缝0.0103→0.0142,不能称所有边界指标都更好。
原文表2|全景表示与效率设计消融。Tokens是目标token序列长度,Time为相同设置的去噪时间,均以ERP=1.00倍归一;Sparse Attn.为布局感知稀疏注意力。半极区CubeAtlas token量不变,稀疏版时间0.84倍;各接缝、赤道与极区质量及文字遵循列须分别看,不能把相对时间当完整超分总耗时。
批判点评 :“一次生成”指六面同画布联合处理,不是一次网络评估就出图;10K由透视超分得到,不是原生10K去噪。质量/几何部分由视觉语言模型打分,30全景、各3人验证排序相关,仍是有限评审。SUN360的FID分布距离也未胜过全部对照;未报绝对墙钟或显存,原文未给本方法代码入口。
10. FlexPart:点一下也能指定要生成的部件
A Unified Framework for Image-to-3D Part Generation via Variable Granularity | 同济大学;Chongqing Afari Intelligent Drive Co., Ltd;华中科技大学 | arXiv:2610.31671
关键词 :3D部件生成, 多粒度提示, 几何引导, 最优输运
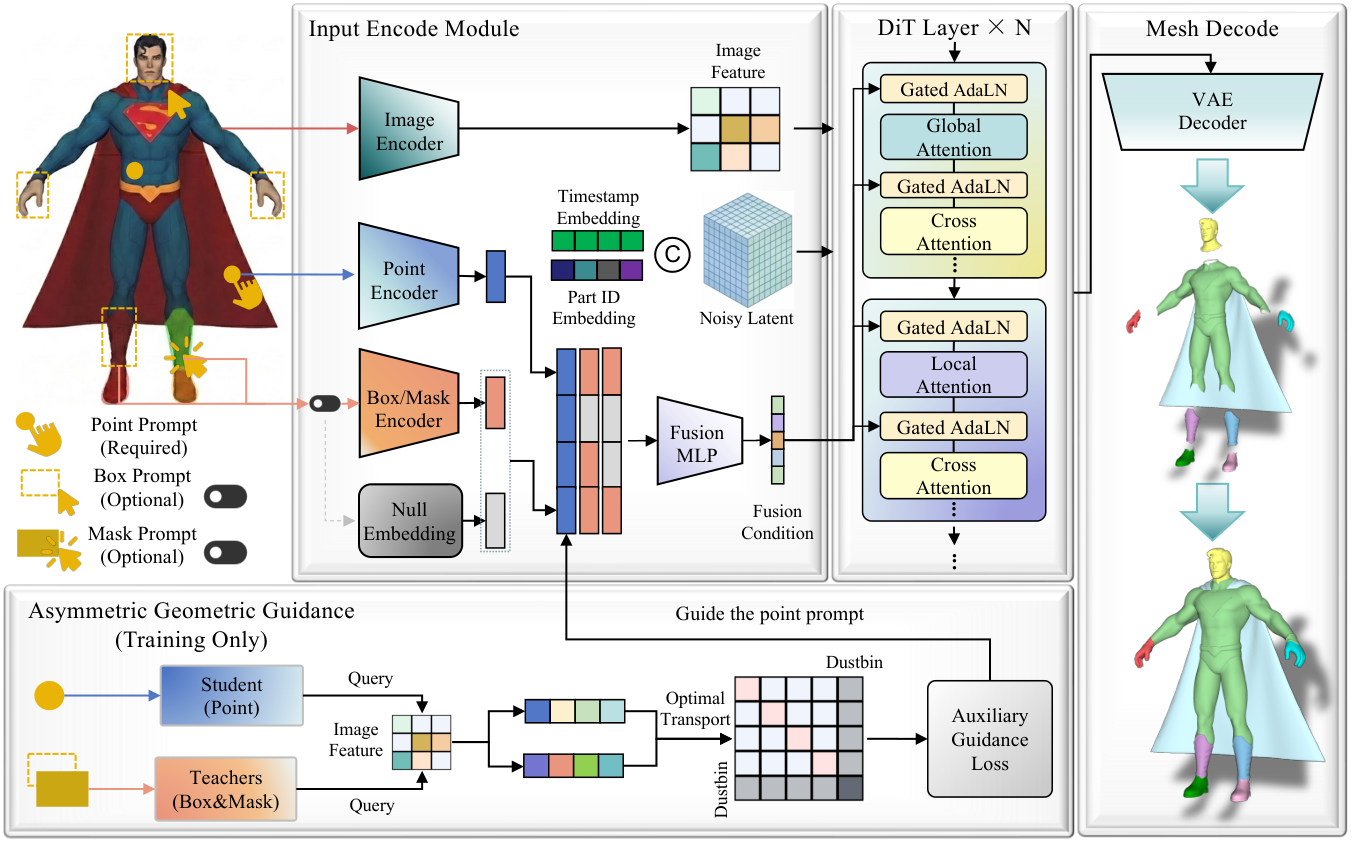
前序问题 :从图片造一把椅子,想分别改椅背和椅腿:有时愿意精描掩码,有时只想点一下。为点、框、掩码各训练一套模型费事,先分割再投到3D也可能把部件切碎。方法直觉 :让详细边界在训练时教会稀疏点击“这个点代表多大一块”,推理时用户再少画一点,也能借到学过的几何常识;详细提示仍可追加,控制精细度更灵活。本文贡献 :FlexPart用TripoSG预训练权重及3D变分自编码器,分别编码点、框、掩码,融合后以带门控的自适应层归一化调制DiT;DINOv2图像特征提供全局语义,部件注意力兼顾局部几何和整体关系。非对称几何引导用部分最优输运对齐点与框/掩码表征,强提示嵌入停止梯度,50次Sinkhorn归一化求匹配,缺失提示用可学习空向量。训练从1–8部件、每部件512token扩到2–16部件、每部件1024token,8张H20;推理至少需要点,框和掩码可逐级加上。
原文图2|FlexPart支持点、框、掩码,点是最低输入。带噪潜变量、部件ID及时间步共同接收提示编码,缺失提示由可学习空向量替代;融合条件经带门控的自适应层归一化调制每层3D扩散Transformer,生成部件。训练专用多粒度几何引导分支以最优输运对齐弱、强几何先验。
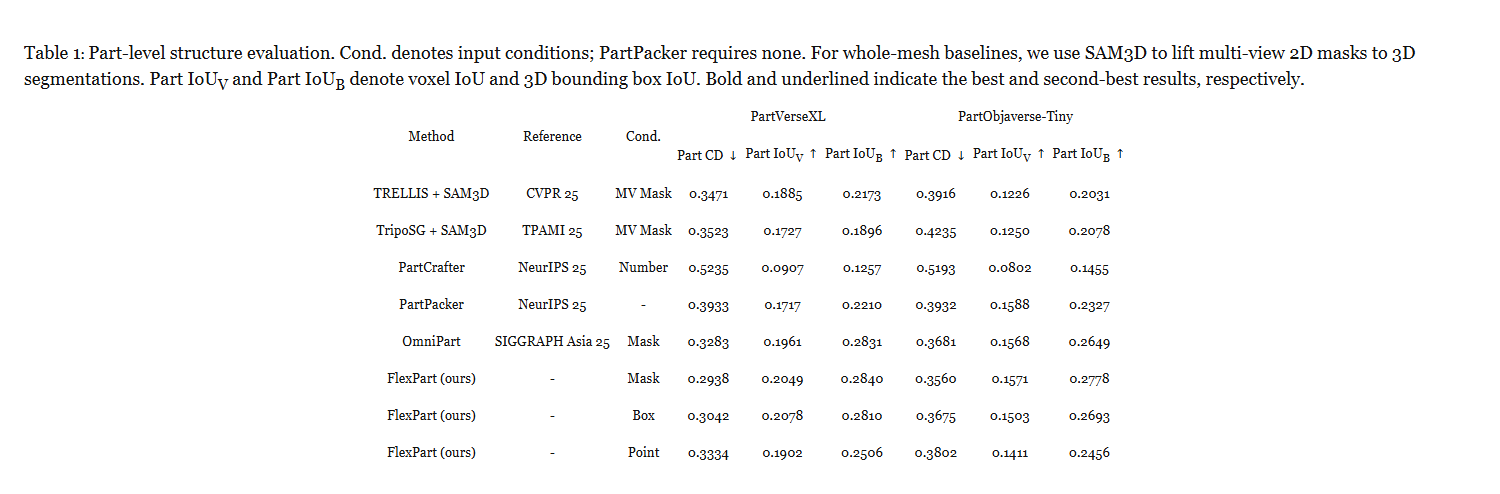
实验效果 :PartVerseXL同掩码条件,部件CD(倒角距离,点集相互最近距离,越低越好)OmniPart0.3283→0.2938,降10.5%;换成框为0.3042,仅比掩码差约3.5%。统一训练相对仅点训练,点条件CD0.3550→0.3334。辅助分支只用于训练;H20的8部件1024token配置,前向8.9毫秒对DiT525毫秒约1.70%,不是整体训练吞吐代价。A800推理峰值约6–8GB,随部件数改变,未给正文可直接引用的统一总时延。
原文表1|部件结构评测,Cond.表示输入条件,PartPacker不需要几何条件。完整网格对照用SAM3D把多视角二维掩码提升到3D分割;Part IoU-V/B分别是体素与三维包围盒交并比,CD为倒角距离、越低越好;粗体/下划线为最优/次优。FlexPart的Mask/Box/Point仍按原文层级保留最低点输入,不能称三种完全孤立推理接口。
批判点评 :点的位置很关键:另一个放点消融中中心改边缘,CD0.3302→0.4190,不能和主表0.3334混为同一协议。遮挡部件仍可能长到可见位置;部件质量改善不等于整体网格全指标最佳,PartObjaverse-Tiny整体CD0.1587也略差于OmniPart0.1585。arXiv评论明确接收NeurIPS 2026;代码 可查,未运行。
趋势观察
控制先要说清保持什么
UniVOE保护对象之外的交互合理性,FAPL检查非目标因素,AnyGameRenderer直接数实体;同叫保持,却需要不同验收对象。
无训练不等于免费
Latent Space Jam在推理时优化草稿,CAVC需要末段重新对齐;ECT批调用次数与条件分支数也不能互换。
监督的入口比接口数量重要
UniVOE倒用移除配对,FAPL关闭条件捷径,Direct Forcing同时看真实与自生成历史,FlexPart让强几何提示教弱提示。
统一表示仍有局部取舍
CubeAtlas减少跨面裂缝却不包办所有ERP边界指标;HeyGen两种克隆策略在目标场景与原录音相似度之间选择。
今日讨论
UniVOE加入GRAR后,VOR插入FVD由361.286降到234.562。若只对奖励模型高分样本做测试,这个改善还能代表真实使用吗?你会如何按移除残影强弱、参考图是否提供分层留出样本,需要哪些独立证据,同时检查非目标区域和阴影变化?
人工智能炼丹君 整理 | 2026-10-26





评论 (0)