
版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

原文:Spark-H3: Adaptive Block Sparse Attention for MiniMax-H3
作者署名:SparkH3 Team。项目博客首发于 2026-09-23,技术正文更新于 2026-10-08。
阅读与代码核对日期:2026-10-24。源码固定在 502ef356,避免后续版本变化影响理解。
代码:Spark-H3 仓库。仓库标注 Apache-2.0;模型权重及依赖的许可应分别查看。
阅读提示:先建立整体直觉,再推导 Reblock 与 Reweight,最后对照源码和运行实验。文中自制实验只验证数学性质,未在本机复现 H3 视频质量或 GPU 加速比。
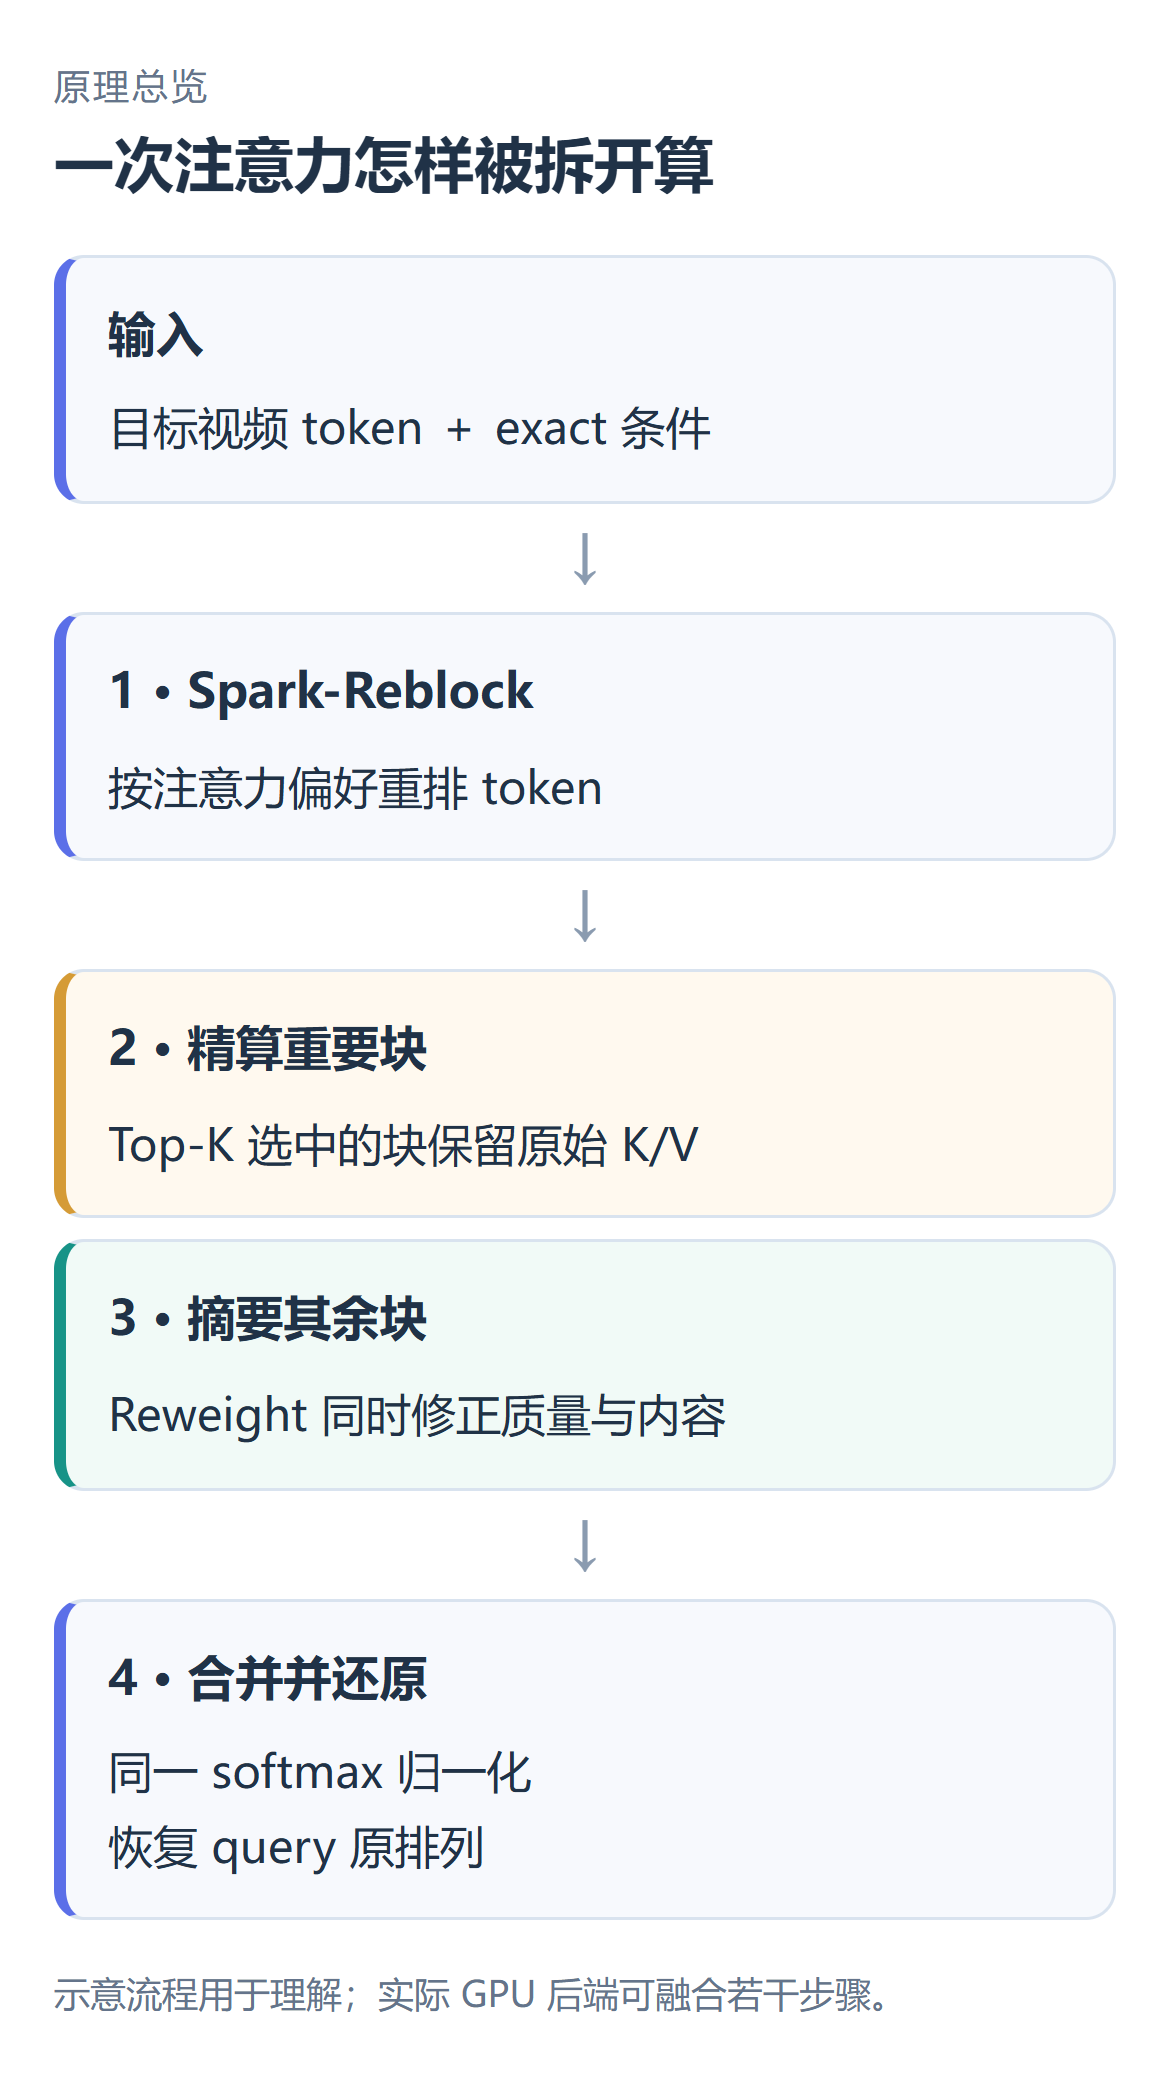
自制原理图:Reblock 改善布局,Top-K 选择精算块,Reweight 覆盖其余块,最后统一归一化并恢复 query 顺序。
Spark-H3 给 MiniMax-H3 视频生成模型替换了一段计算量很大的注意力运算。它保留模型已有权重,在推理时选择一部分 token 之间的交互精确计算,再用便宜的近似覆盖剩余交互。
视频生成会把时空内容编码成 latent token。每一层、每一个注意力头,都要让 query 判断应当从哪些 key 对应的 value 取信息。token 数变长,所有两两关系的数量按平方增长。
降低采样步数可以少运行几次模型;Spark-H3 则降低每次运行内部的注意力成本,两者可以叠加。
这里的目标包含两个层次。一个是输出视频看起来合理;另一个是尽可能接近同一 prompt、同一 seed 下的 dense 原始输出。
后者更严格:即使两段视频都很好看,人物姿态或镜头轨迹不同,逐像素保真指标也会下降。
这篇博客最有价值的地方,是把近似误差拆成了两个可以分别改进的问题。
Spark-Reblock 处理前者,Spark-Reweight 处理后者。把这两条线分开,后面的公式和代码就容易读了。
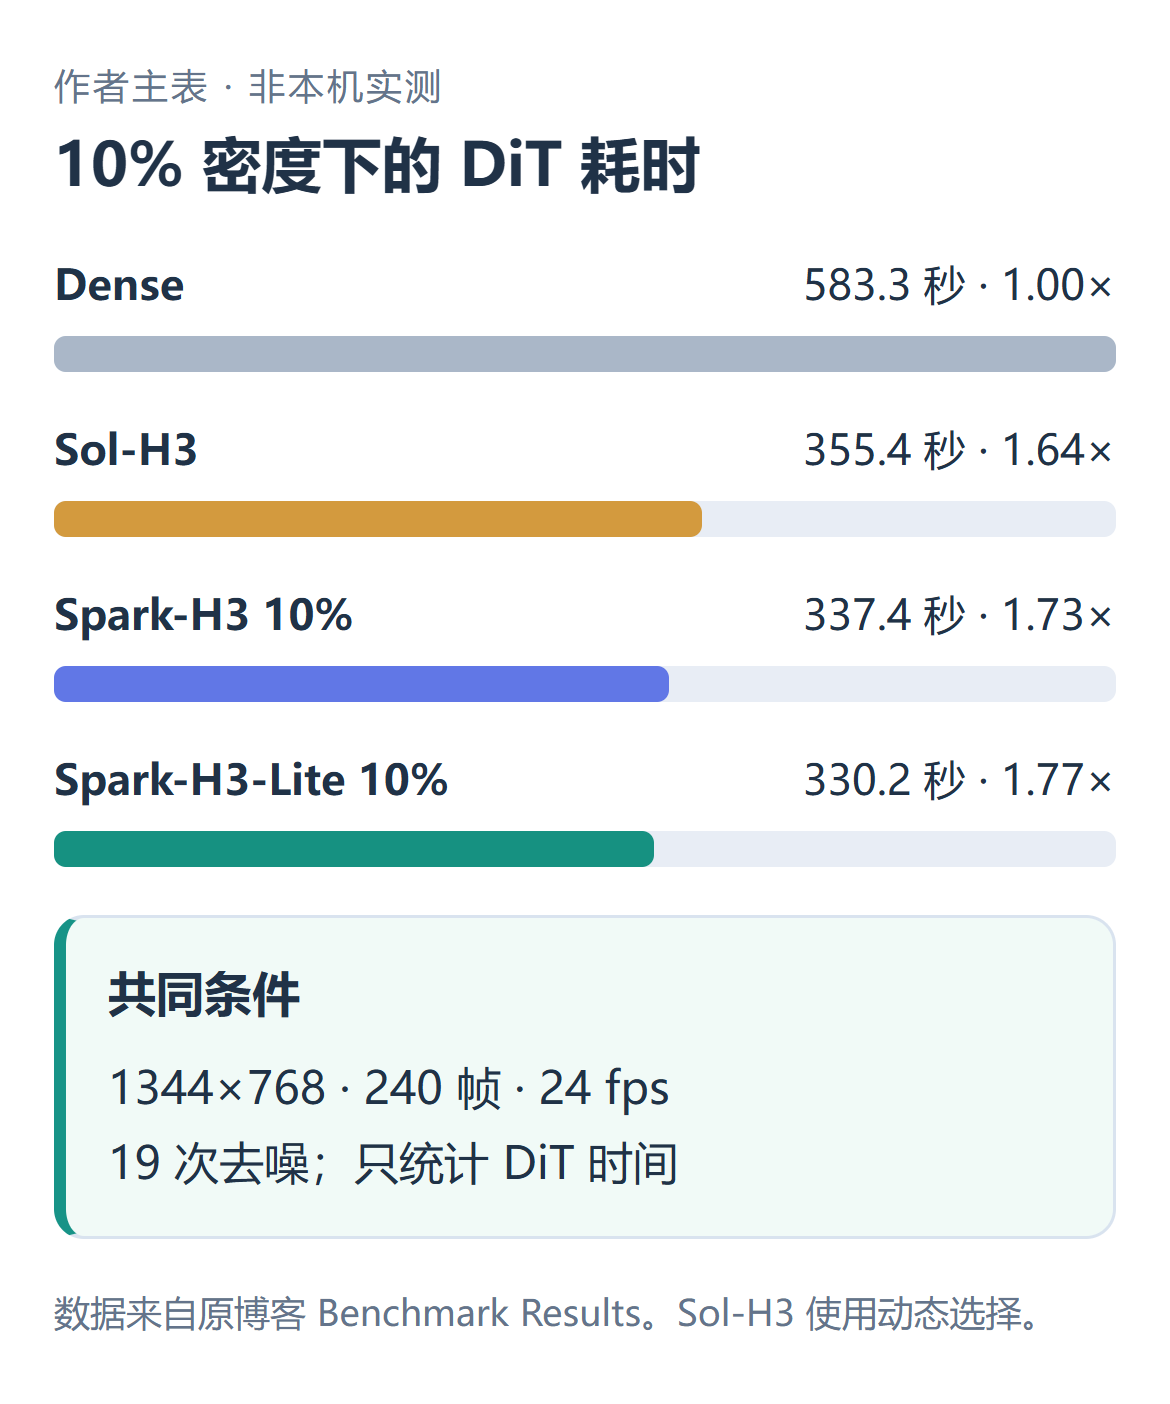
据原博客 Benchmark Results 数据重绘:1344×768、240 帧、24 fps、19 次去噪。只计 DiT;Spark 与 Lite 均为 10% 视频块精算密度,非本机实测。
原博客 Benchmark Results 使用 1344×768、240 帧、24 fps、VBench prompts,以及 20 个调度点对应的 19 次去噪。
质量比较采用相同 prompt、seed 的 dense 输出作为参考。以下只摘出支持主要判断的几行。
| 方法 | 视频块精算密度 | DiT 时间 | 相对 dense 加速 | PSNR / LPIPS |
|---|---|---|---|---|
| Dense | 100% | 583.3 秒 | 1.00× | ∞ / 0.00 |
| Sol-H3 | 动态选择 | 355.4 秒 | 1.64× | 20.36 / 0.20 |
| Spark-H3 | 10% | 337.4 秒 | 1.73× | 23.30 / 0.14 |
| Spark-H3 | 20% | 371.1 秒 | 1.57× | 25.38 / 0.09 |
| Spark-H3 | 30% | 404.1 秒 | 1.44× | 27.07 / 0.07 |
| Spark-H3-Lite | 10% | 330.2 秒 | 1.77× | 23.34 / 0.14 |
来源:原博客 Benchmark Results。这是作者报告的数据,未在本机重跑。
博客的集成实验明确写了 RTX PRO 6000 Blackwell Server Edition 96GB 与 per-block compile;主表段落没有完整重述全部硬件和 warmup 条件,不能自行把另一组实验配置全部搬过来。
10% 是候选视频 K/V 块的精算预算。 它不表示只保留 10% 的视频 token,不表示总 FLOPs 下降 90%,也不表示整条视频生成流程提速十倍。文本、音频等 exact 内容、warmup、分组、摘要和 MLP 仍然有成本。
PSNR 越高、LPIPS 越低,表示相对 dense 参考更接近;SSIM 则主要衡量结构相似。它们回答“改动有多大”,无法单独回答“哪个视频更好”。
VBench 的一致性、平滑度和画质指标补充另一个视角,但也不能证明所有 prompt 上没有损失。
例如作者报告 Spark-H3 10% 的 VBench imaging quality 为 71.81,dense 为 72.14;aesthetic quality 为 68.22,dense 为 67.59。
几个维度接近且互有高低,适合表述为“这些已测维度整体接近”,不应扩写成全面无损。
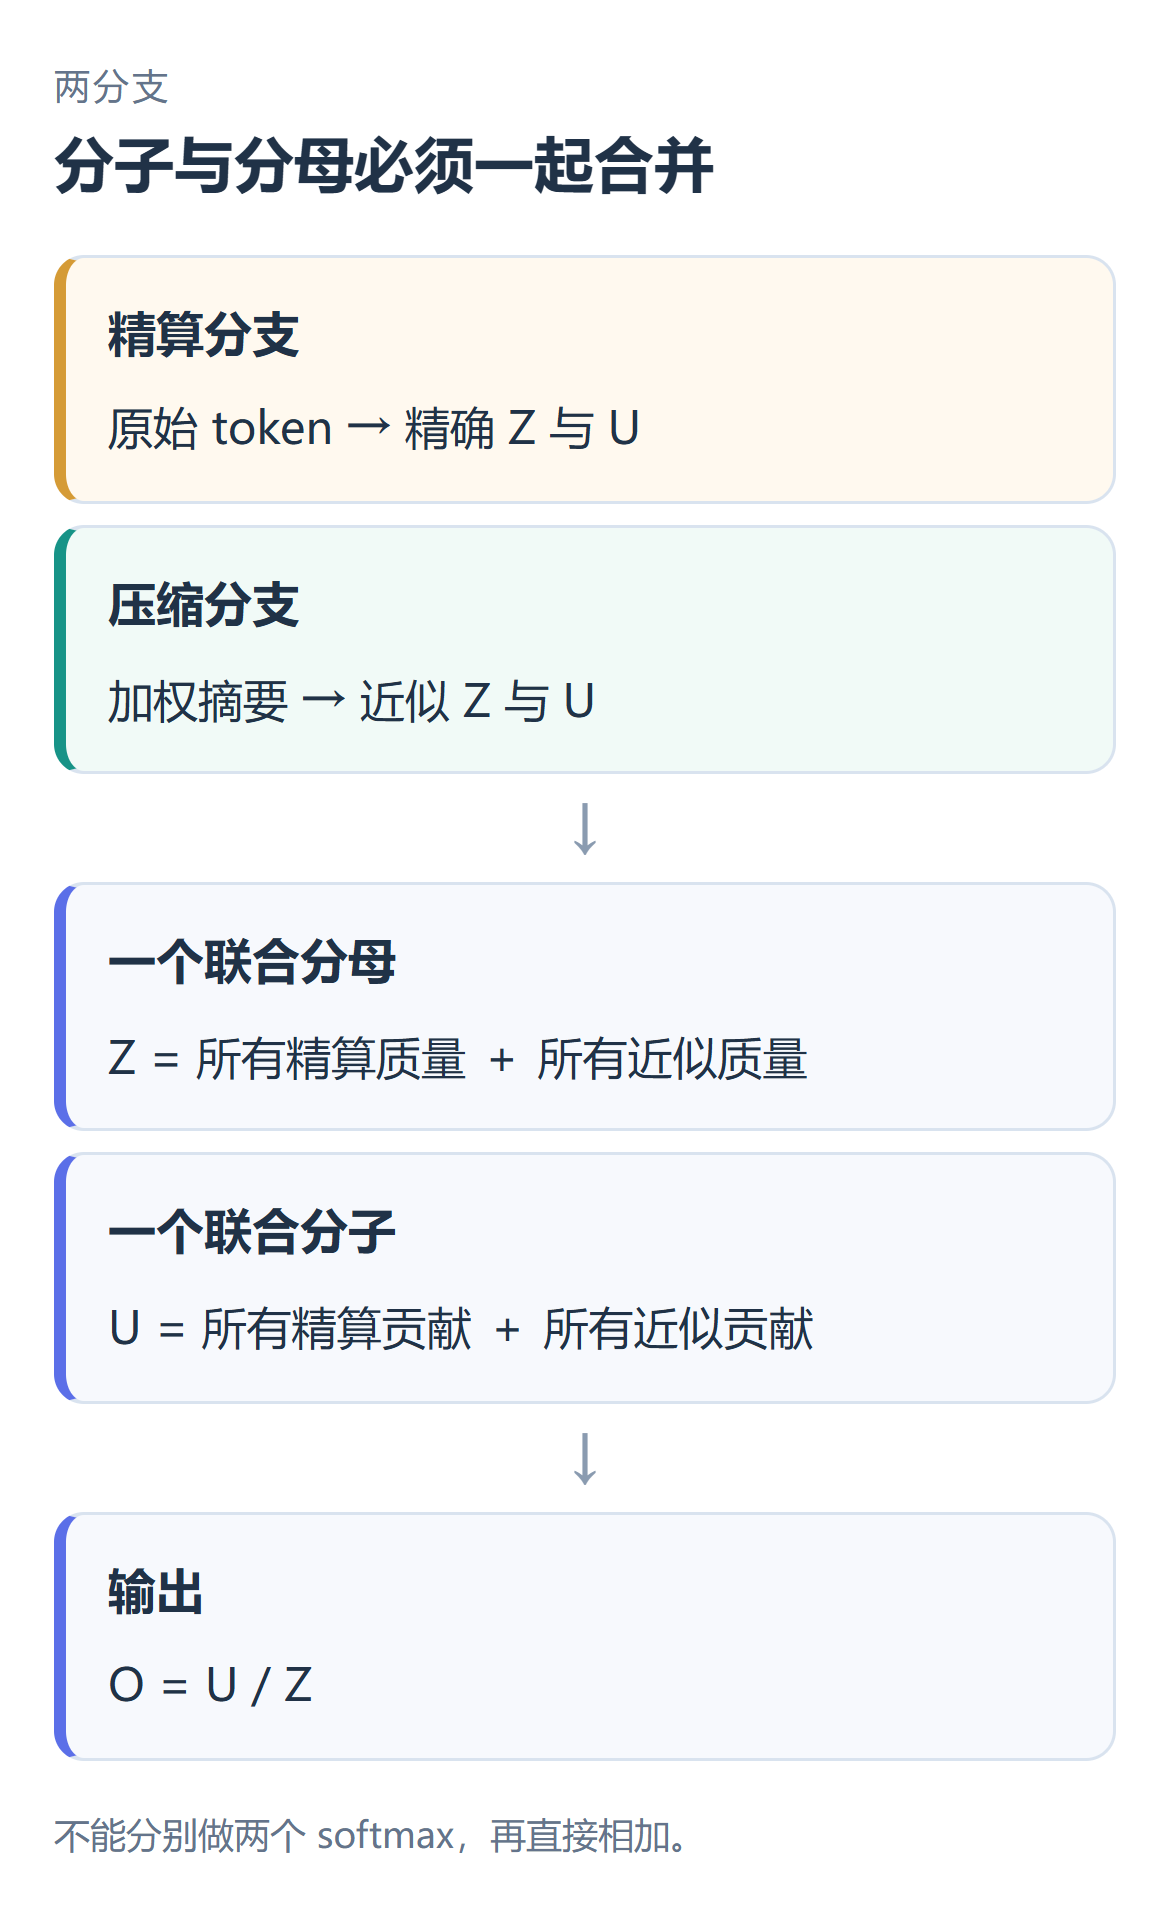
自制原理图:两条分支先合并未归一化分子与指数质量,再得到输出;不能把两个独立 softmax 输出直接相加。
这一节开始进入推导。只想了解部署的读者,可以先读第 11 节源码地图和第 13 节使用说明。
记一个 query 为 q,块 B 内的 key、value 为 k 和 v,head dimension 为 d。注意力先算缩放点积,再指数化,最后统一归一化。
$$s_j(q)=q^T k_j/\sqrt{d}$$
$$Z_B(q)=\sum_{j\in B}e^{s_j(q)}$$
$$U_B(q)=\sum_{j\in B}e^{s_j(q)}v_j$$
Z 是这个块的注意力总质量,U 是还没归一化的内容贡献。全体块的 U 相加,再除以全体块的 Z 相加,得到最终输出。这里把“分子”和“分母”分开,是理解压缩分支的关键。
对精算集合内的块,逐 token 计算 Z 和 U。对剩下的块,用一个 key、一个 value 和一个质量修正项近似整块。这样,昂贵的 token 对 token 交互只发生在少量选中块中。
朴素均值压缩会取块内平均 key 和平均 value。块内有 m 个 token 时,摘要 logit 还要加 log(m)。
原因很直接:把同一个均值重复 m 次,指数质量就乘 m;改成一个虚拟 token 后,必须补回这个数量。
$$\widehat{Z}_B(q)=m e^{q^T\bar{k}_B/\sqrt{d}}$$
因此,把一整个块压成一个 token,却不给它 log(m),会额外漏掉块大小这一项。 这个问题和 Jensen gap 是两回事,应先保证数量语义正确,再讨论怎样让近似更准。
两条分支最终共享同一套分母。不能分别算两个 softmax 输出,再直接加起来,或者各乘 0.5。正确合并时,哪一条分支带来更多指数质量,哪一条就分到更多权重。
实际内核通过 online softmax 维护行最大值、指数和、加权输出。这避免显式生成完整注意力矩阵,也让精算 token 与压缩摘要可以在同一个归一化过程中合并。
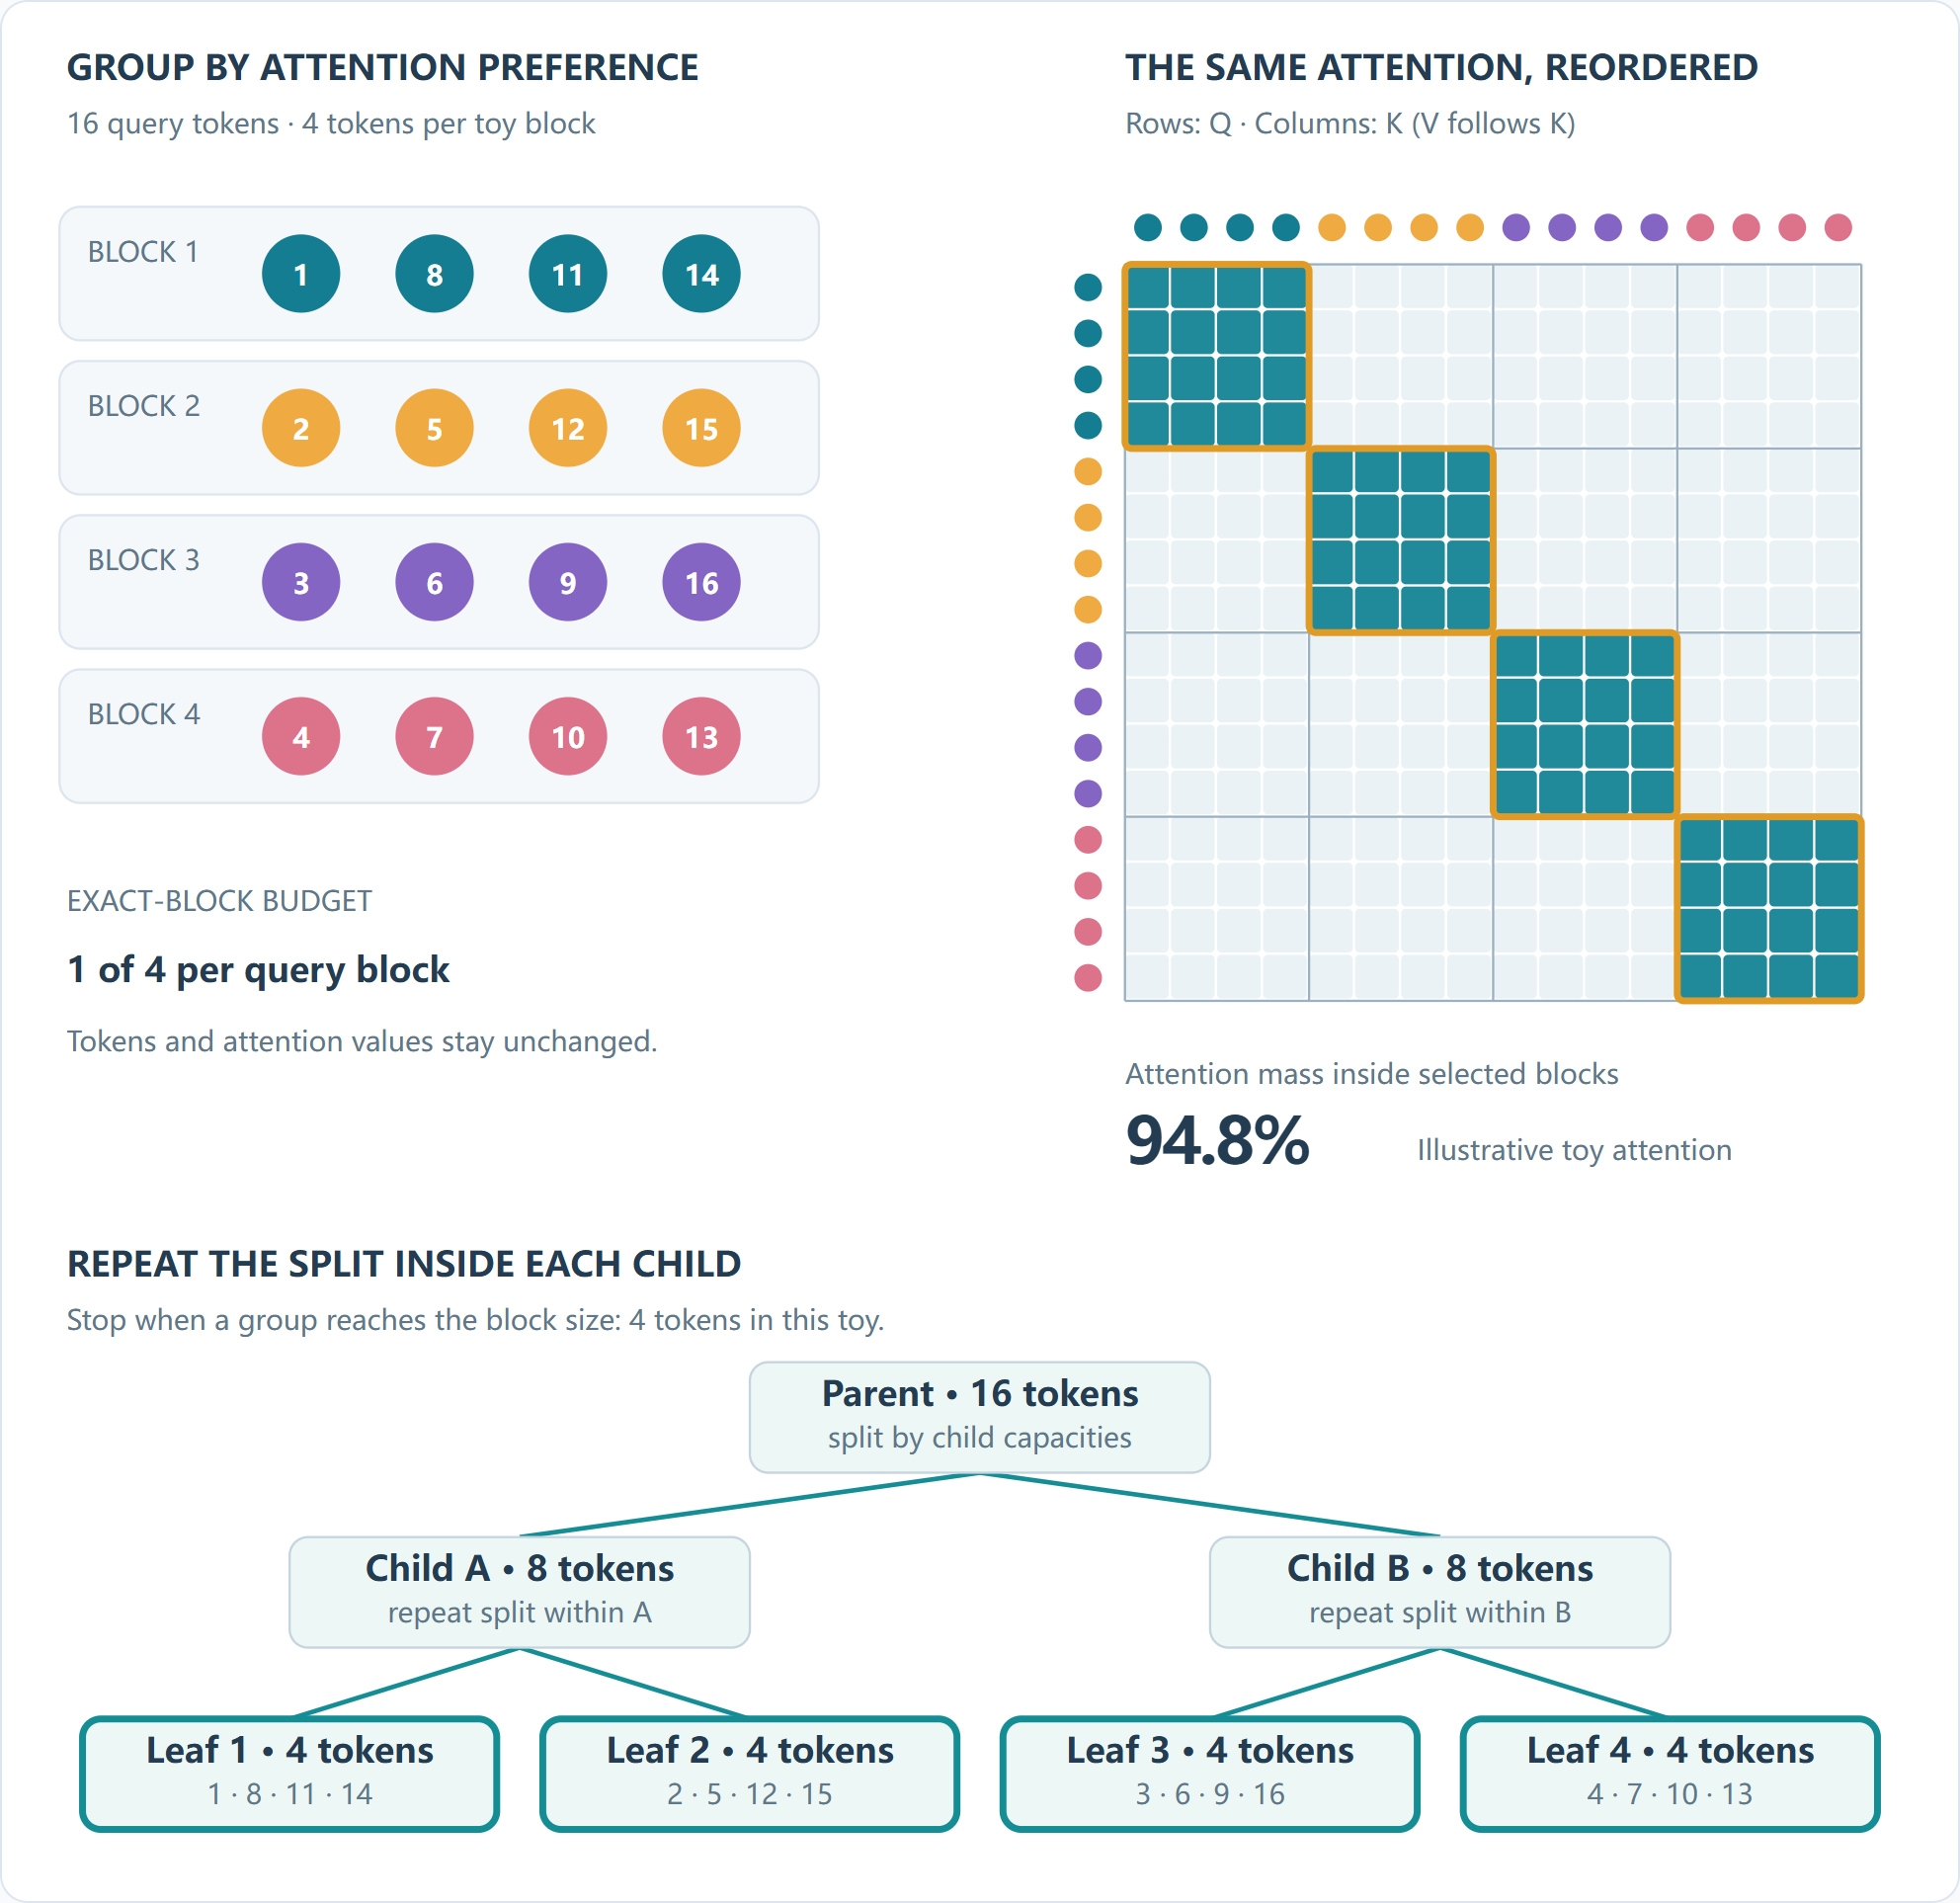
来源:SparkH3 Team 原博客的 Spark-Reblock 动画。截取末帧;16 个 token、每叶 4 个 token 及图中召回数值均为动画玩具示例,不是 H3 消融实验。手机端将原图的分组与矩阵区域纵向排列;博客保留完整帧。
块稀疏注意力需要规则块:GPU 擅长计算整齐的矩阵 tile,不擅长逐个处理四散的 token。但“地址相邻”与“应该一起被注意”不总是一回事。
同一个视频里,一个人物可能跨帧移动。两个空间相近的位置,也可能分别属于人物和背景。扩散早期噪声更强,干净画面里的局部相似性会进一步减弱。
固定时空分组仍然有工程价值,只是未必符合当前层、当前 head 的注意力偏好。
假设一个块里混有几个极重要 token 和大量无关 token。均值打分会把重要成员稀释。预算有限时,整个块可能排不到 Top-K;即使入选,也花了大部分计算在无关成员上。
Reblock 的做法是改变打包方式:把注意力偏好相近的成员放在一起。这样块均值更有代表性,选中一块时,“整块都值得算”的概率更高。
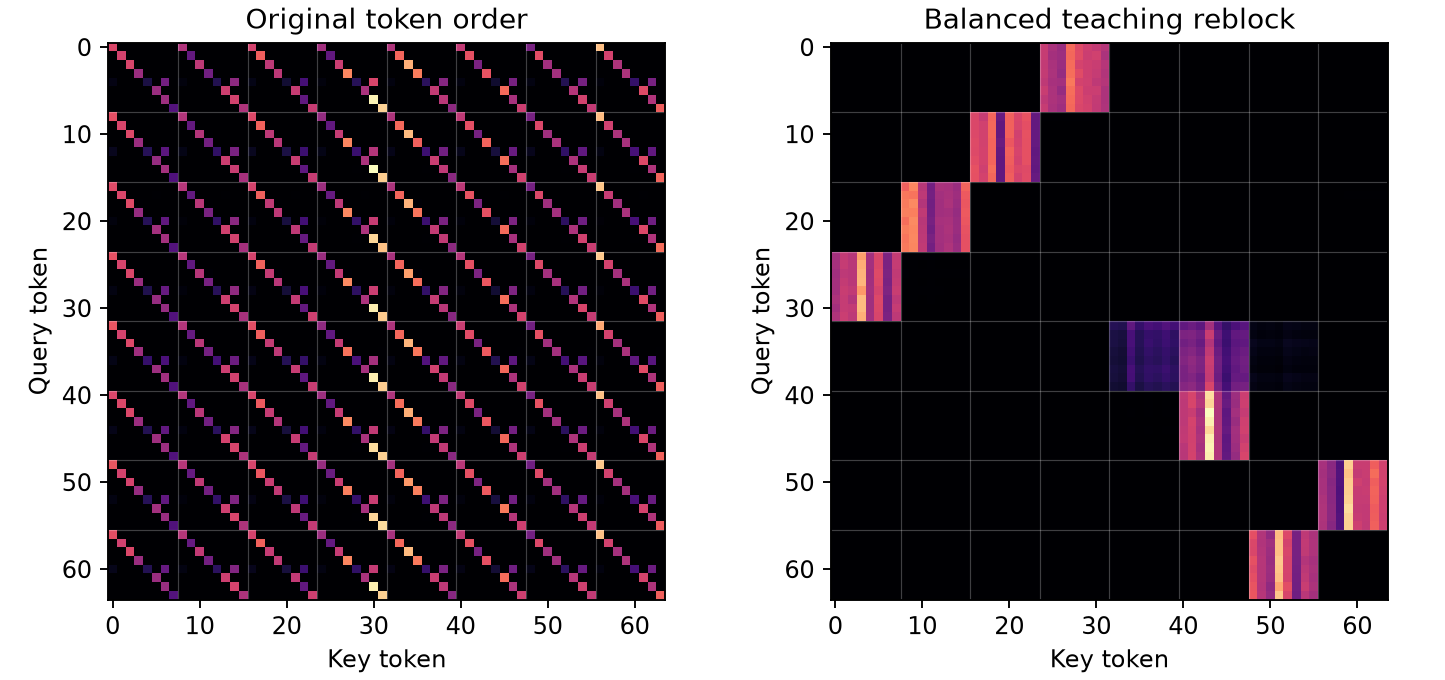
图 1:自制教学实验。左图为交错排列的合成 token,右图按二阶矩特征做等容量二叉分组;亮区域更集中。这里只演示分组几何,未使用作者的 landmark/fanout-16 生产算法,也不代表真实 H3 的质量收益。
单纯重排不会丢信息。对 Q 重新排序,对 K/V 使用同一套 key 排列,计算后恢复 query 顺序,dense attention 的输出在精确算术下保持一致。
真正引入近似的是后续块选择和摘要替代,而不是 permutation 本身。
这也解释一个实现要求:Q 和 K 可以独立分组;但 K 与 V 必须绑定重排,输出必须按 Q 的逆排列恢复。哪怕公式写对,只要其中一处索引错位,就会把别人的内容写到当前 token 上。
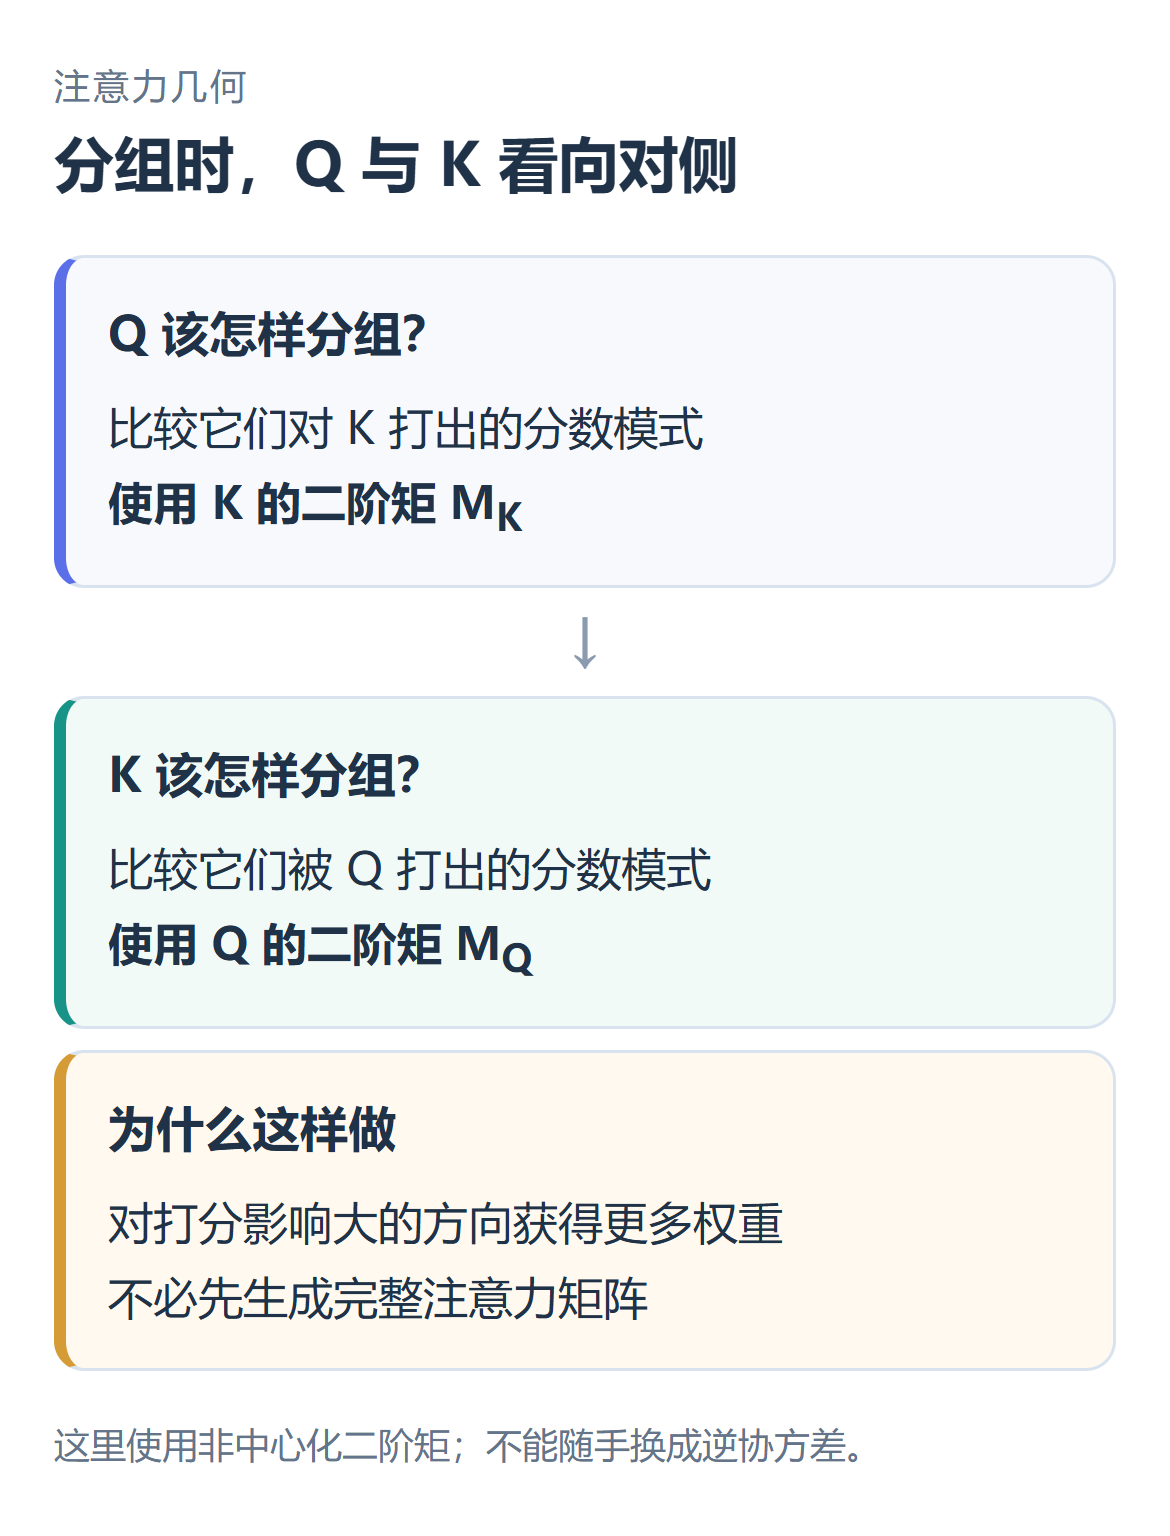
自制原理图:Q 的分组由 K 的非中心化二阶矩诱导,K 的分组则参考 Q;对应比较的是打分模式的相似性。
直接比较两个 query 的欧氏距离,不一定能判断它们对 key 的偏好是否相近。更合理的办法,是比较它们对所有 key 打出的分数模式。
把 query 的完整打分向量写成 Kq。对两个 query,打分向量的内积可以改写为:
$$\langle Kq_i,Kq_j\rangle=q_i^T K^T Kq_j$$
定义 key 的非中心化二阶矩:
$$M_K=K^T K/N$$
于是两个打分向量的 cosine,可以不用真的构建长度为 N 的打分向量,转而在变换后的 d 维空间计算。博客把对应距离写成:
$$d_Q(i,j)=1-\cos(M_K^{1/2}q_i,M_K^{1/2}q_j)$$
这不是凭空添加的“统计技巧”:它来自对 attention logit profile 的比较。
某个方向如果在 key 分布里几乎不出现,query 在这个方向上的差异,对打分影响就很小;key 经常变化的方向,则应得到更多关注。
对 key 做分组时,同理使用 query 的二阶矩。Q 的分组看 K,K 的分组看 Q。 源码中的交叉命名容易绕晕,抓住这个关系就不会读反。
这里有三处边界要说明。
第一,M 是 E[kkᵀ],没有减均值,不能随手改成协方差 Cov(k)。后者会改变几何含义。源码还引入采样、ridge 等数值处理,因此数学等式与实际估计器要分开看。
第二,这是对原始打分模式的 cosine,不是对 softmax 后概率分布的精确距离。cosine 会忽略向量整体尺度,但尺度可能改变 softmax 的尖锐程度。
它是有依据的分组标准,不能宣称“同组 query 的注意力分布完全相同”。
第三,不需要显式求一个对称平方根。只要找到因子 L,使 LLᵀ 近似 M,对行向量使用 qᵀL 就能得到同一内积几何。
不要把“Mahalanobis”习惯性理解成必须乘逆协方差;这里采用的是对侧二阶矩诱导的度量。
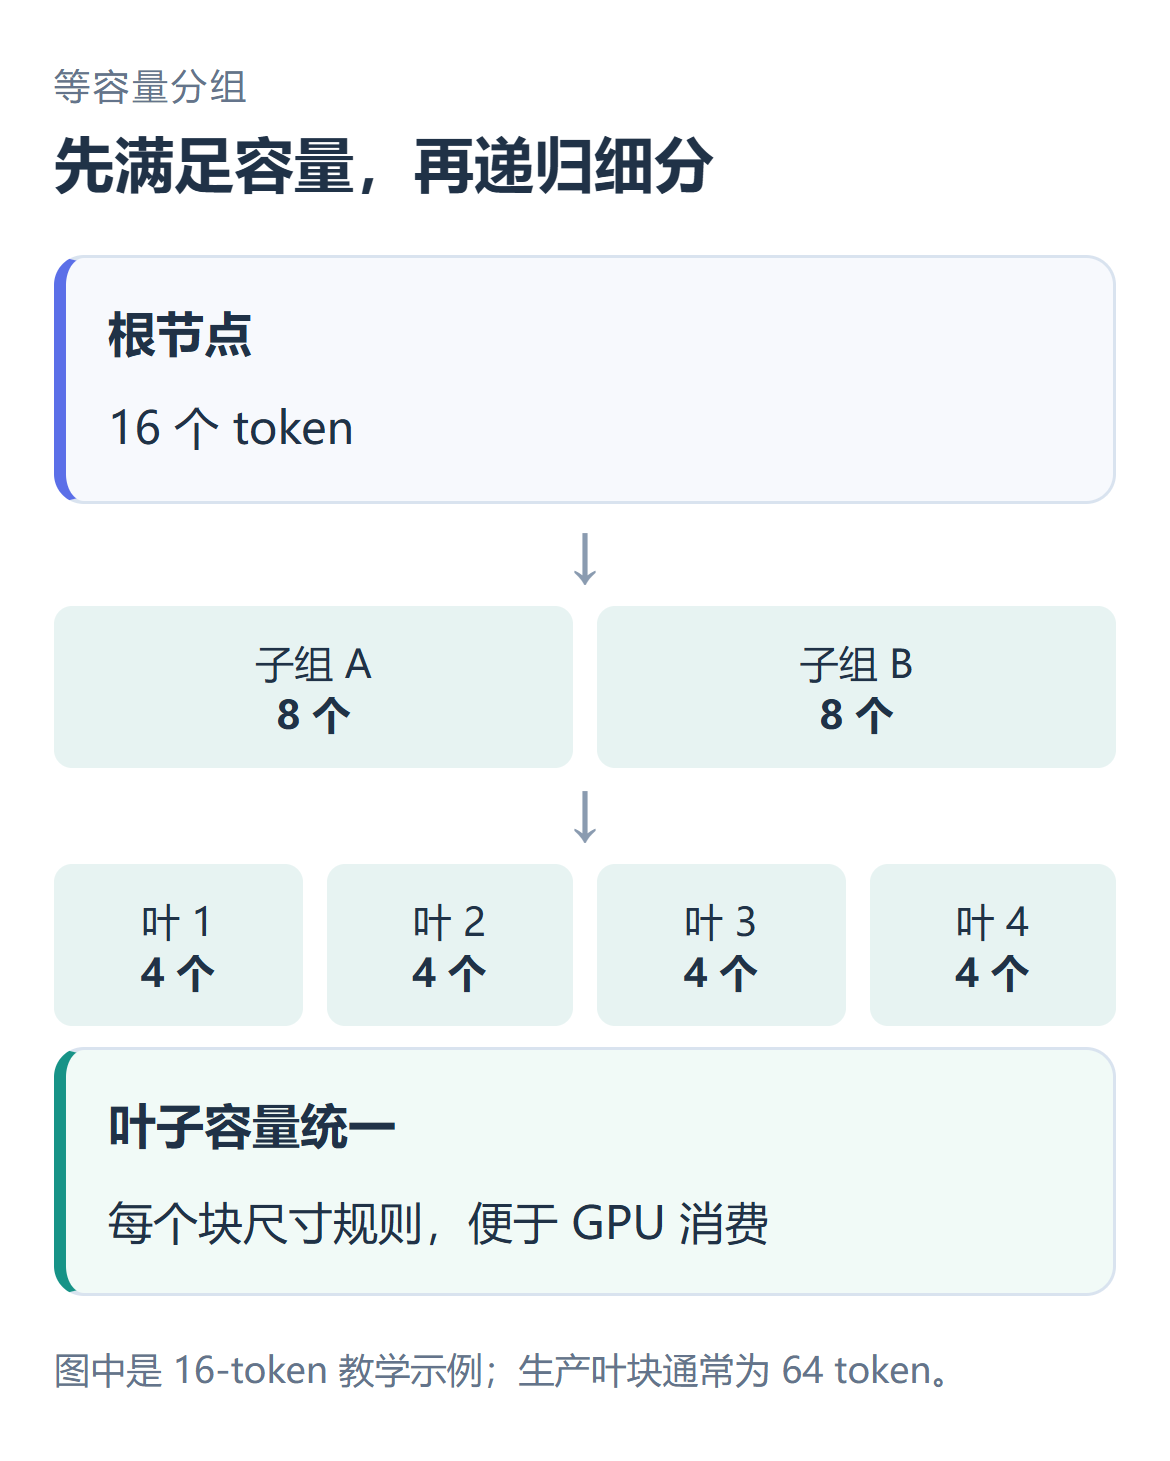
自制教学图:16 个 token 逐级分成容量相等的子组,最终每叶 4 个 token。真实生产路径通常使用 64-token 叶块,图中分叉仅用于解释容量约束。
知道相似度,还不足以得到 GPU 好用的稀疏块。普通 k-means 的簇大小会不相等:有的簇很多 token,有的很少。如果再硬切成固定块,边界可能切断簇,或者混入别的簇。
Spark-Reblock 通过层次划分处理容量约束。从整组 token 开始,按指定子节点容量分配成员,然后在子组内继续细分,直到叶子是目标块大小。当前生产路径通常面向 64-token 叶块。
固定版本的默认设置包括 fanout 16、32 个 midpoint landmarks、group size 1,以及 power-of-two fanout 调度。
landmarks 帮助估计节点内划分方向,再用容量约束产生规则块。它不是对每一对 token 都计算相似度,也不是全局最优聚类的保证。
博客给出的分组复杂度是 O(N log N),这个判断需要把 head dimension、landmark 数量和分叉数视为固定参数。
每一层处理当前 token,层数随序列长度对数增长,因而避免直接枚举所有 token 对。
但 Spark 整套注意力不因此变成 O(N log N)。 如果始终精算固定比例 ρ 的视频块,精算部分仍有约 ρN² 个交互。逐 query 消费 N/64 个尾部摘要,也保留二次量级,只是常数更小。Reblock 的复杂度与整个注意力的复杂度必须分开说。
源码还有一个值得注意的优化:ComfyUI 当前默认 reblock_layout=q_reuse_k,只构建 K 布局,让 Q 复用;independent 则分别构建两侧布局。
两者会带来不同的布局成本与分组结果,不能只凭博客的抽象描述推断当前节点必然独立分组。
原博客 Spark-Reblock 消融在 10% 预算下,把 attention-mass recall 从 68.66% 提升到 81.54%,增加 12.88 个百分点;PSNR 从 18.61 提升到 22.41 dB。
这个实验只替换分组,其他设置保持不变,因而支持“更好的块布局有帮助”这一判断。
attention-mass recall 统计选中交互覆盖了 dense 的多少概率质量。它不是视频语义召回率,也不表示丢掉了其余概率:压缩分支仍会近似剩余部分。
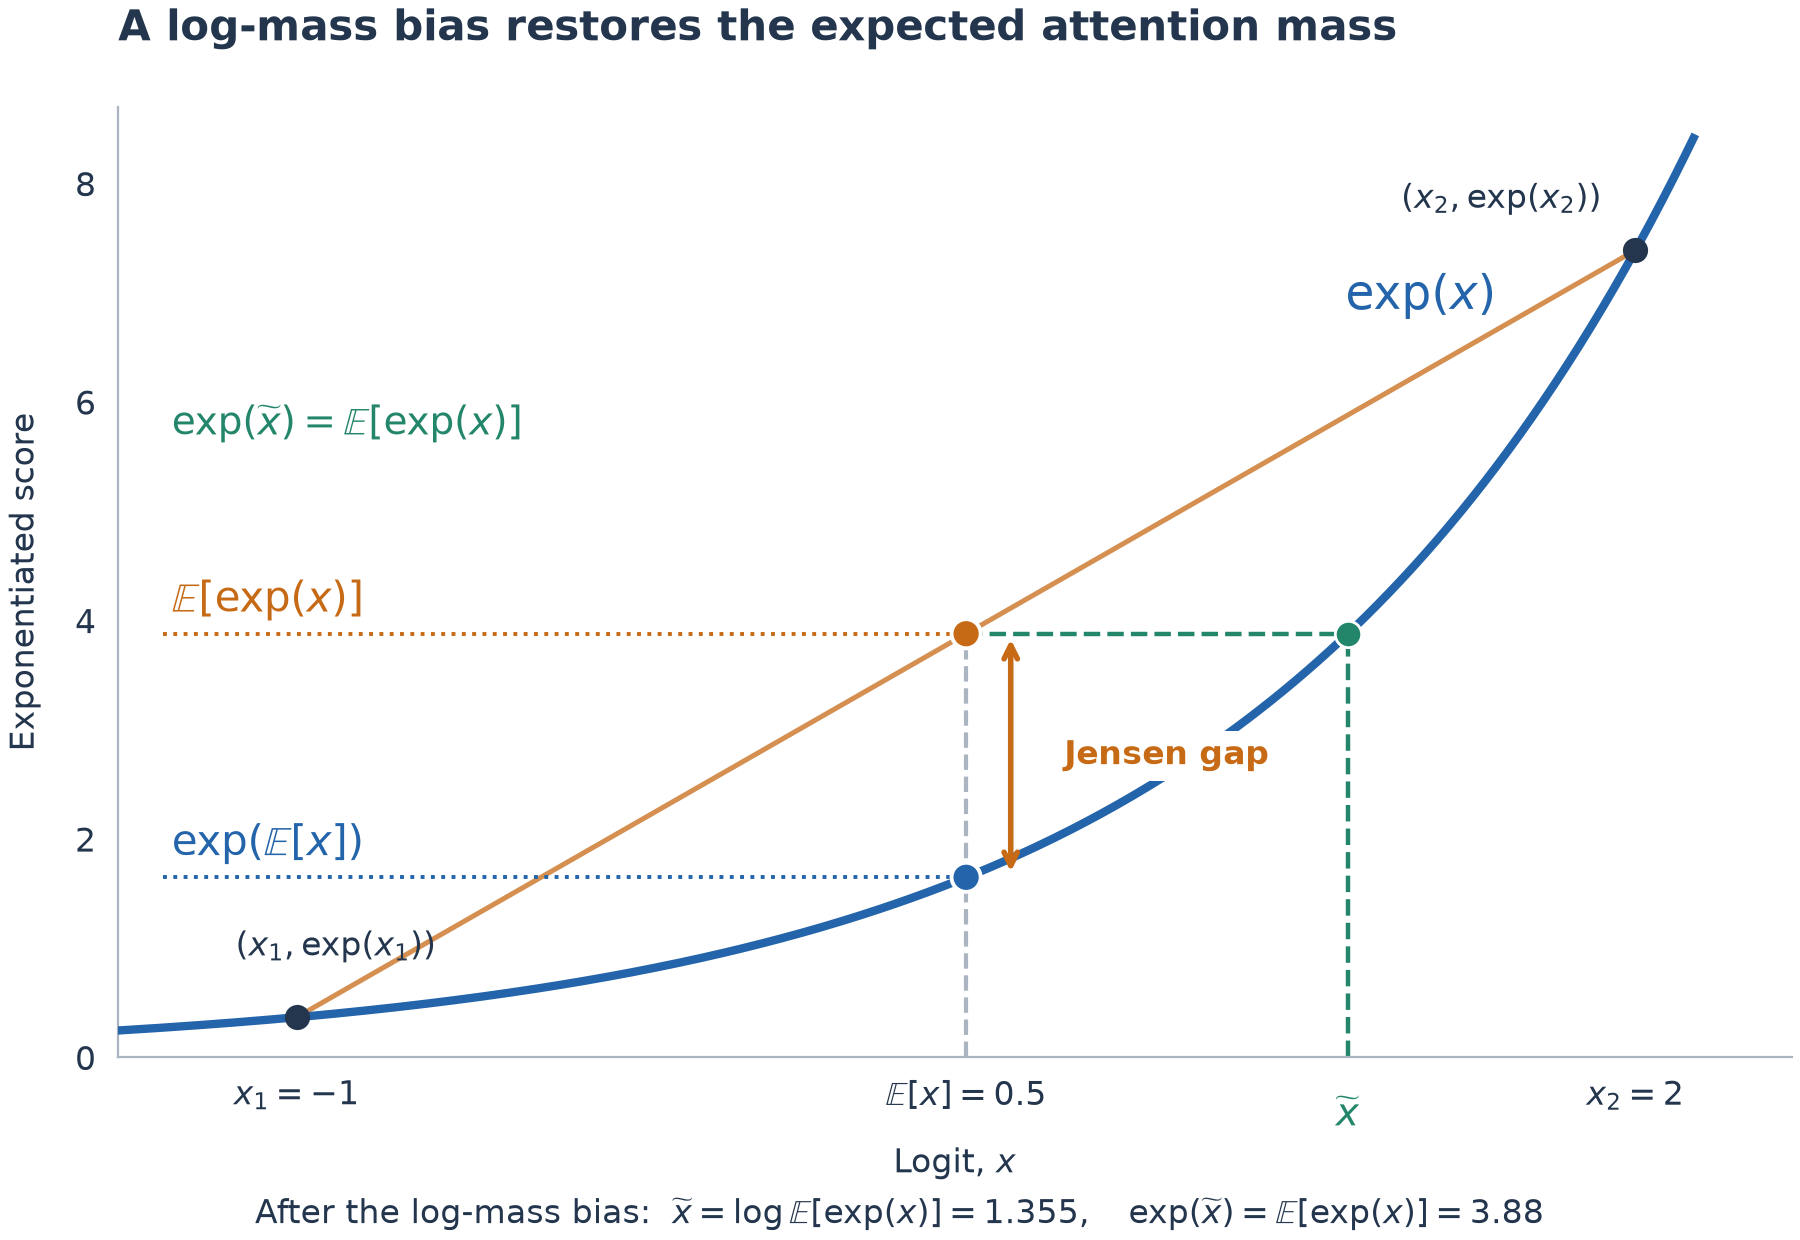
来源:SparkH3 Team 原博客的 reweight_correction 图。蓝色为先平均再 exp,橙色为先 exp 再平均,绿色表示修正后的等效 logit。原图用 x₁=−1、x₂=2;手机端按相同数据重绘并配中文说明。这张图解释质量偏差,完整加权 K/V 构造见第 08 节。
注意力是先 exp,再求和。均值压缩把一组不同的 logit 替换成平均值,再 exp。由于指数是凸函数,这两个顺序通常不等价。
$$E[e^x]\ge e^{E[x]}$$
这就是博客提到的 Jensen gap。同一块内部的 logit 越分散,先平均再指数化就越容易遗漏高分成员带来的质量。
压缩块与 exact 块放在一个 softmax 中竞争时,压缩块可能因此被系统性压低。
拿一个只有两个 token 的块看得最清楚。令 d=1、q=1、key 为 −2 和 2,value 为 0 和 1。两个 logit 就是 −2 和 2。
所以需要补的有两件事:这个块该分到多少权重,以及它拿到权重后应当输出什么内容。只修分母、不修 value,仍可能把块的主要内容算错。
Reweight 采用一个代表 query,为每个块重新计算摘要。默认代表点是当前 head 内所有目标视频 query 的均值。
只用一个代表点给所有 K 打分,新增摘要构建可保持线性复杂度;若每个 query 都重新生成专属摘要,就回到了昂贵的全量交互。
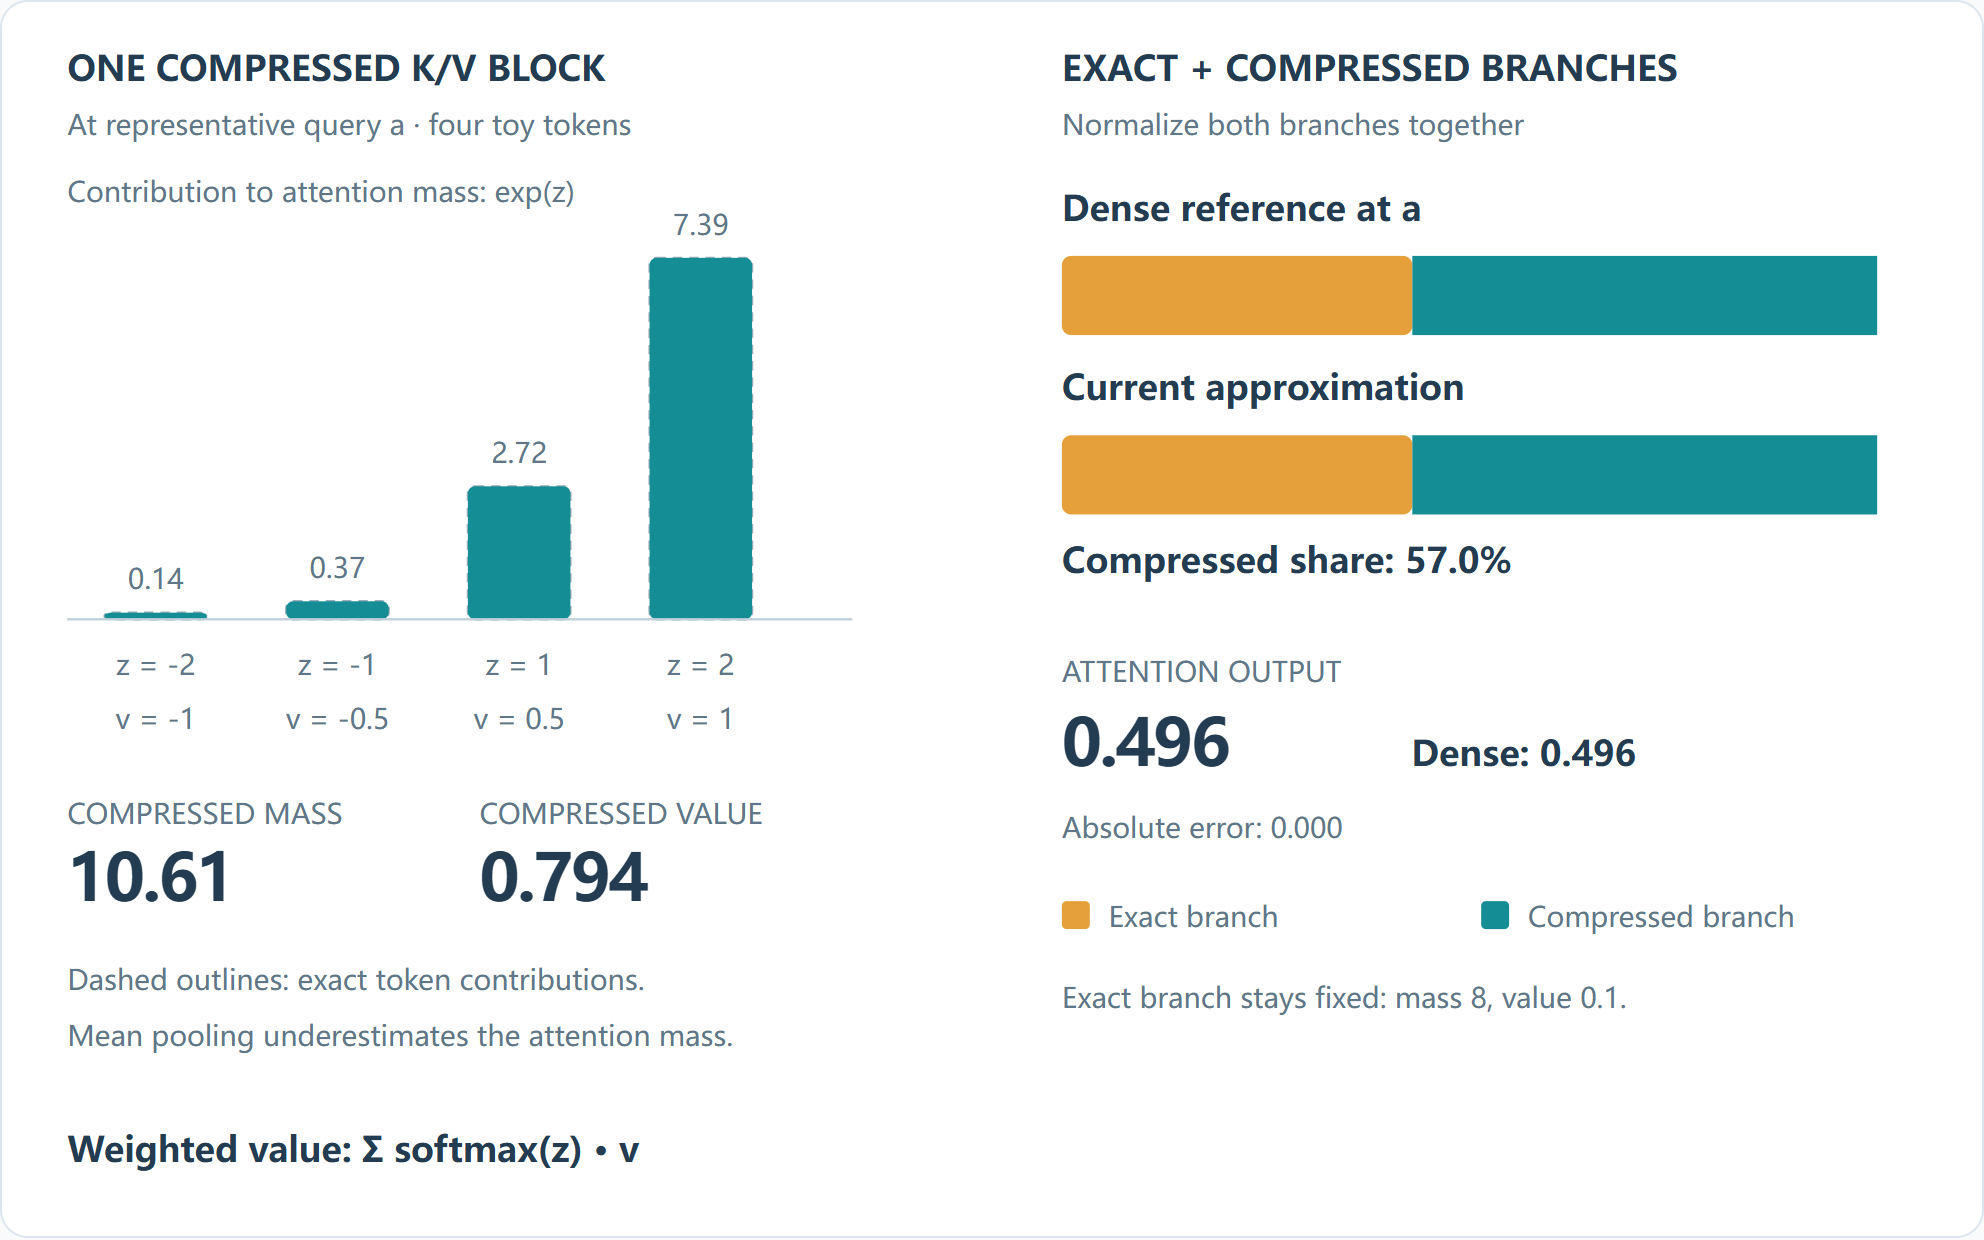
来源:SparkH3 Team 原博客的 Spark-Reweight 动画。截取末帧;四个玩具 token 的 logit 为 −2、−1、1、2,图示依次修正压缩质量与加权 value,并与固定 exact 分支联合归一化。它展示代表 query 处的匹配,不表示任意 query 都精确。手机端将两侧面板纵向排列。
记代表 query 为 a。先在块内计算相对 a 的 softmax 权重:
$$p_j(a)=\operatorname{softmax}_j(a^T k_j/\sqrt{d})$$
再同时加权 K 和 V:
$$\widetilde{k}_B=\sum_{j\in B}p_j(a)k_j$$
$$\widetilde{v}_B=\sum_{j\in B}p_j(a)v_j$$
最后构造质量修正。为了手机阅读,把它拆成两条短式子:
$$\ell_B=\log Z_B(a)$$
$$b_B=\ell_B-a^T\widetilde{k}_B/\sqrt{d}$$
对于实际 query q,用如下一个虚拟 token 近似整块:
$$\widehat{z}_B(q)=q^T\widetilde{k}_B/\sqrt{d}+b_B$$
$$\widehat{U}_B(q)=e^{\widehat{z}_B(q)}\widetilde{v}_B$$
在 q=a 时,这个摘要能恢复整块的真实 Z 和 U。 将 q=a 代入,第一项正好被 bias 中的减法消掉,留下 log Z;再乘加权 value,就回到原始未归一化分子。多个压缩块与任意 exact 块一起合并时,这个性质仍然成立。
这是理想精确算术下的性质,真实 BF16/FP32 实现会有舍入误差。
当前源码默认还会用存储后的 BF16 摘要 key 计算 bias 中的减项,使下游实际消费的 key 与质量校正相配合;可选 pre_round 是不同的数值消融。
回到上面的两-token 例子,a=1 时,加权 key 为 1.928055,加权 value 为 0.982014,bias 为 0.090095。
虚拟 logit 为 2.018150,指数后正好是 7.524391。
这里容易出现一个反直觉的误读:bias 比 log(2) 小,不意味着补偿方向错了。 加权 key 已经提高了 logit,bias 必须扣除这部分变化。
不能保留均值 key,却直接套用加权 key 对应的 bias;也不能换了加权 key,还继续无条件加 log(m)。
事实上,在未舍入的数学定义下,这个 b 就是代表点块内权重的熵 H(p),介于 0 和 log(m) 之间。全块近似均匀时,它接近 log(m);权重集中到一个成员时,它接近 0。
补偿的含义取决于“key 和 bias 的组合”。
下面这一层是根据定义推导出的解释,原博客并未把它写成完整定理。
把一个块的精确 log-mass 记为 f(q)=log Z_B(q)。它对 q 的梯度就是按当前注意力加权的 key,再除以 √d。
$$\nabla f(a)=\widetilde{k}_B/\sqrt{d}$$
所以 Spark 的虚拟 logit 等价于 f 在 a 处的一阶展开:
$$\widehat{z}_B(q)=f(a)+(q-a)^T\nabla f(a)$$
这样可以看清它为什么比均值更贴近局部真实分布:它同时对齐了代表点上的函数值和梯度。也可以看清它的局限:q 走远了,一条切线无法描述整个曲面。
log-sum-exp 是凸函数,因此理想算术下,这条切线不会高于真实块 log-mass。局部二阶误差由注意力权重下 key 的协方差控制,方向上越分散,偏离代表点时误差越大。
这个性质只讨论单块质量,不意味着最终视频误差有同样简单的单调关系。
value 的限制更直接:摘要 value 对所有 q 固定,而真实块内加权 value 会随 q 改变。就算某处质量近似得不错,内容贡献也可能不准。
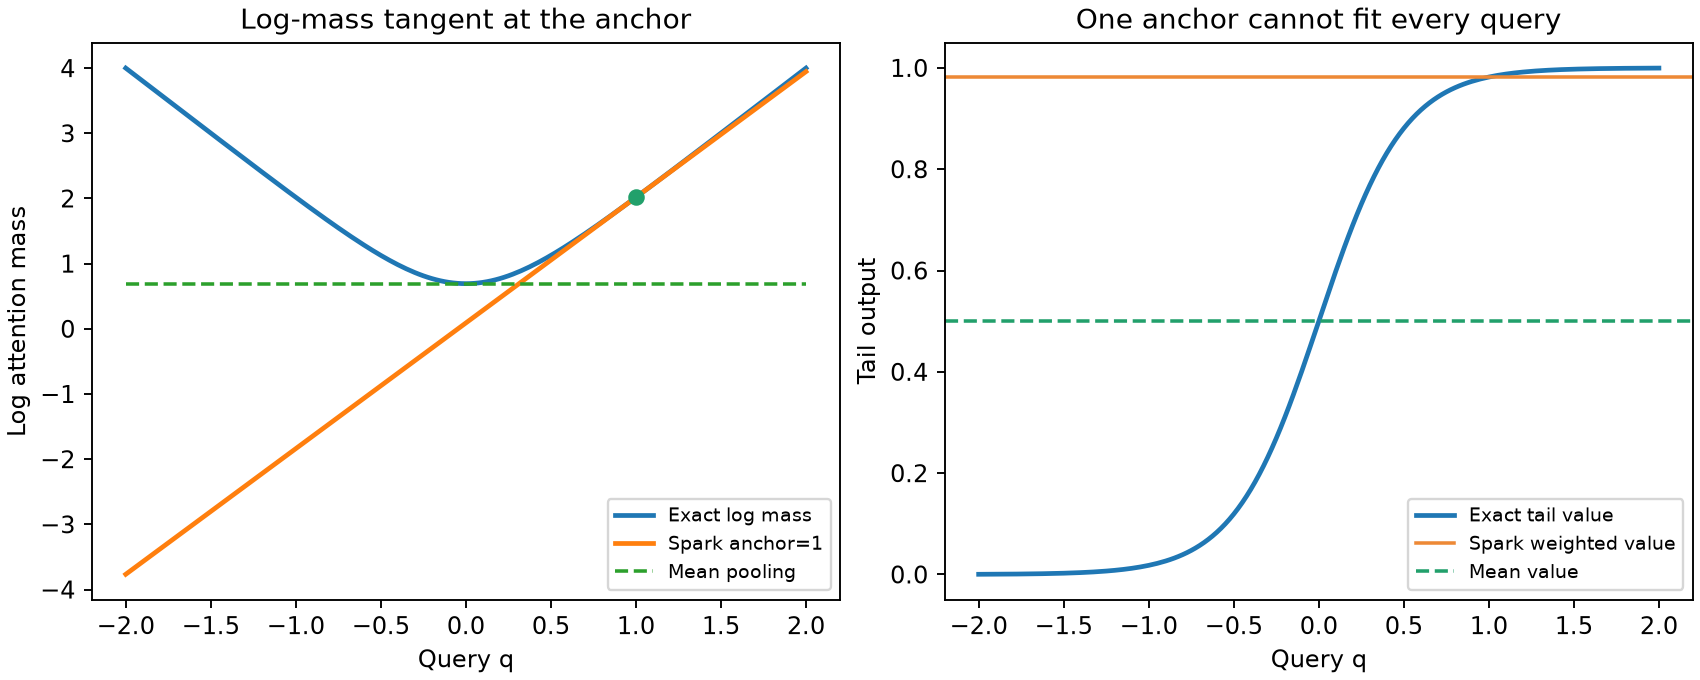
图 2:自制两-token 实验,key 为 −2 和 2,value 为 0 和 1,代表点 a=1。左图显示 log-mass 在代表点相切;右图显示固定加权 value 无法跟随全部 query。远离代表点时,Reweight 也可能比均值更差,应按实际分布评估。
这也解释了 Reblock 与 Reweight 为什么互补。前者让需要一起处理的成员更集中,也改善重要块的选择;后者尽量提高剩余块的摘要质量。
但不能由此推出它们误差必然相加,或者任何输入下组合都严格更优。
原博客 Reweight 单独消融保持固定分组,将绝对 log-mass 误差从 3.86 降到 2.78 nats,约下降 28%;PSNR 从 18.61 到 19.17 dB。
它的独立收益小于 Reblock 那组,但它修的是另一处误差,不能拿两组数字直接做联合归因。
下面是独立编写的 NumPy 教学实现,采用稳定 softmax,输入一个块的 K/V 和代表 query。它与作者内核的数学目标对应,省略了多 head、混合布局和 GPU 调度。
import numpy as np

def softmax(x):
    z = np.exp(x - np.max(x, axis=-1, keepdims=True))
    return z / z.sum(axis=-1, keepdims=True)

def summary(anchor, keys, values):
    scale = keys.shape[-1] ** -0.5
    logits = keys @ anchor * scale
    weights = softmax(logits)
    key = weights @ keys
    value = weights @ values
    peak = logits.max()
    lse = peak + np.log(np.exp(logits - peak).sum())
    bias = lse - anchor @ key * scale
    return key, value, bias

def mixed(query, keys, values, exact_ids,
          block=4, anchor=None):
    logits, vals = [], []
    scale = keys.shape[-1] ** -0.5
    for bid, start in enumerate(range(0, len(keys), block)):
        kb = keys[start:start + block]
        vb = values[start:start + block]
        if bid in exact_ids:
            logits.extend(query @ kb.T * scale)
            vals.extend(vb)
        else:
            if anchor is None:
                ak, av = kb.mean(0), vb.mean(0)
                bias = np.log(len(kb))
            else:
                ak, av, bias = summary(anchor, kb, vb)
            logits.append(query @ ak * scale + bias)
            vals.append(av)
    return softmax(np.asarray(logits)) @ np.asarray(vals)

rng = np.random.default_rng(20261024)
k = rng.normal(size=(32, 8))
v = rng.normal(size=(32, 5))
a = rng.normal(size=8)
dense = softmax(a @ k.T / np.sqrt(8)) @ v
out = mixed(a, k, v, {1, 5}, anchor=a)
print(np.max(np.abs(out - dense)))
assert np.allclose(out, dense, atol=1e-12, rtol=0)
exact_ids 是本例手动指定的精算块集合;生产代码会由路由生成。选中块只贡献原始 token;未选中块只贡献摘要,避免重复记账。
最后只有一次 softmax,这一行承担了分子与分母的正确合并。
运行最后一段,最大绝对误差约为 1.25×10⁻¹⁶。同样随机输入与 exact 集合下,将尾部改成均值摘要,最大绝对误差约为 0.240925。
这个数字用于检验构造,不能当作 H3 指标或普适收益。
配套实验还做了三个独立检查:全部块精算时回到 dense;Q/K 重排后恢复输出保持不变;对侧二阶矩空间的 cosine 与完整打分向量 cosine 一致。三个最大误差均低于 1.1×10⁻¹⁵。
完整脚本位于本项目 tools/spark_h3_lab.py,会保存实验数字和两张图。它的等容量二叉 PCA 分组仅用于解释 Reblock 直觉,不冒充作者的分区算法。
复现生产性能需要跑真实 H3、正确的 CUDA 后端和相同评测协议。
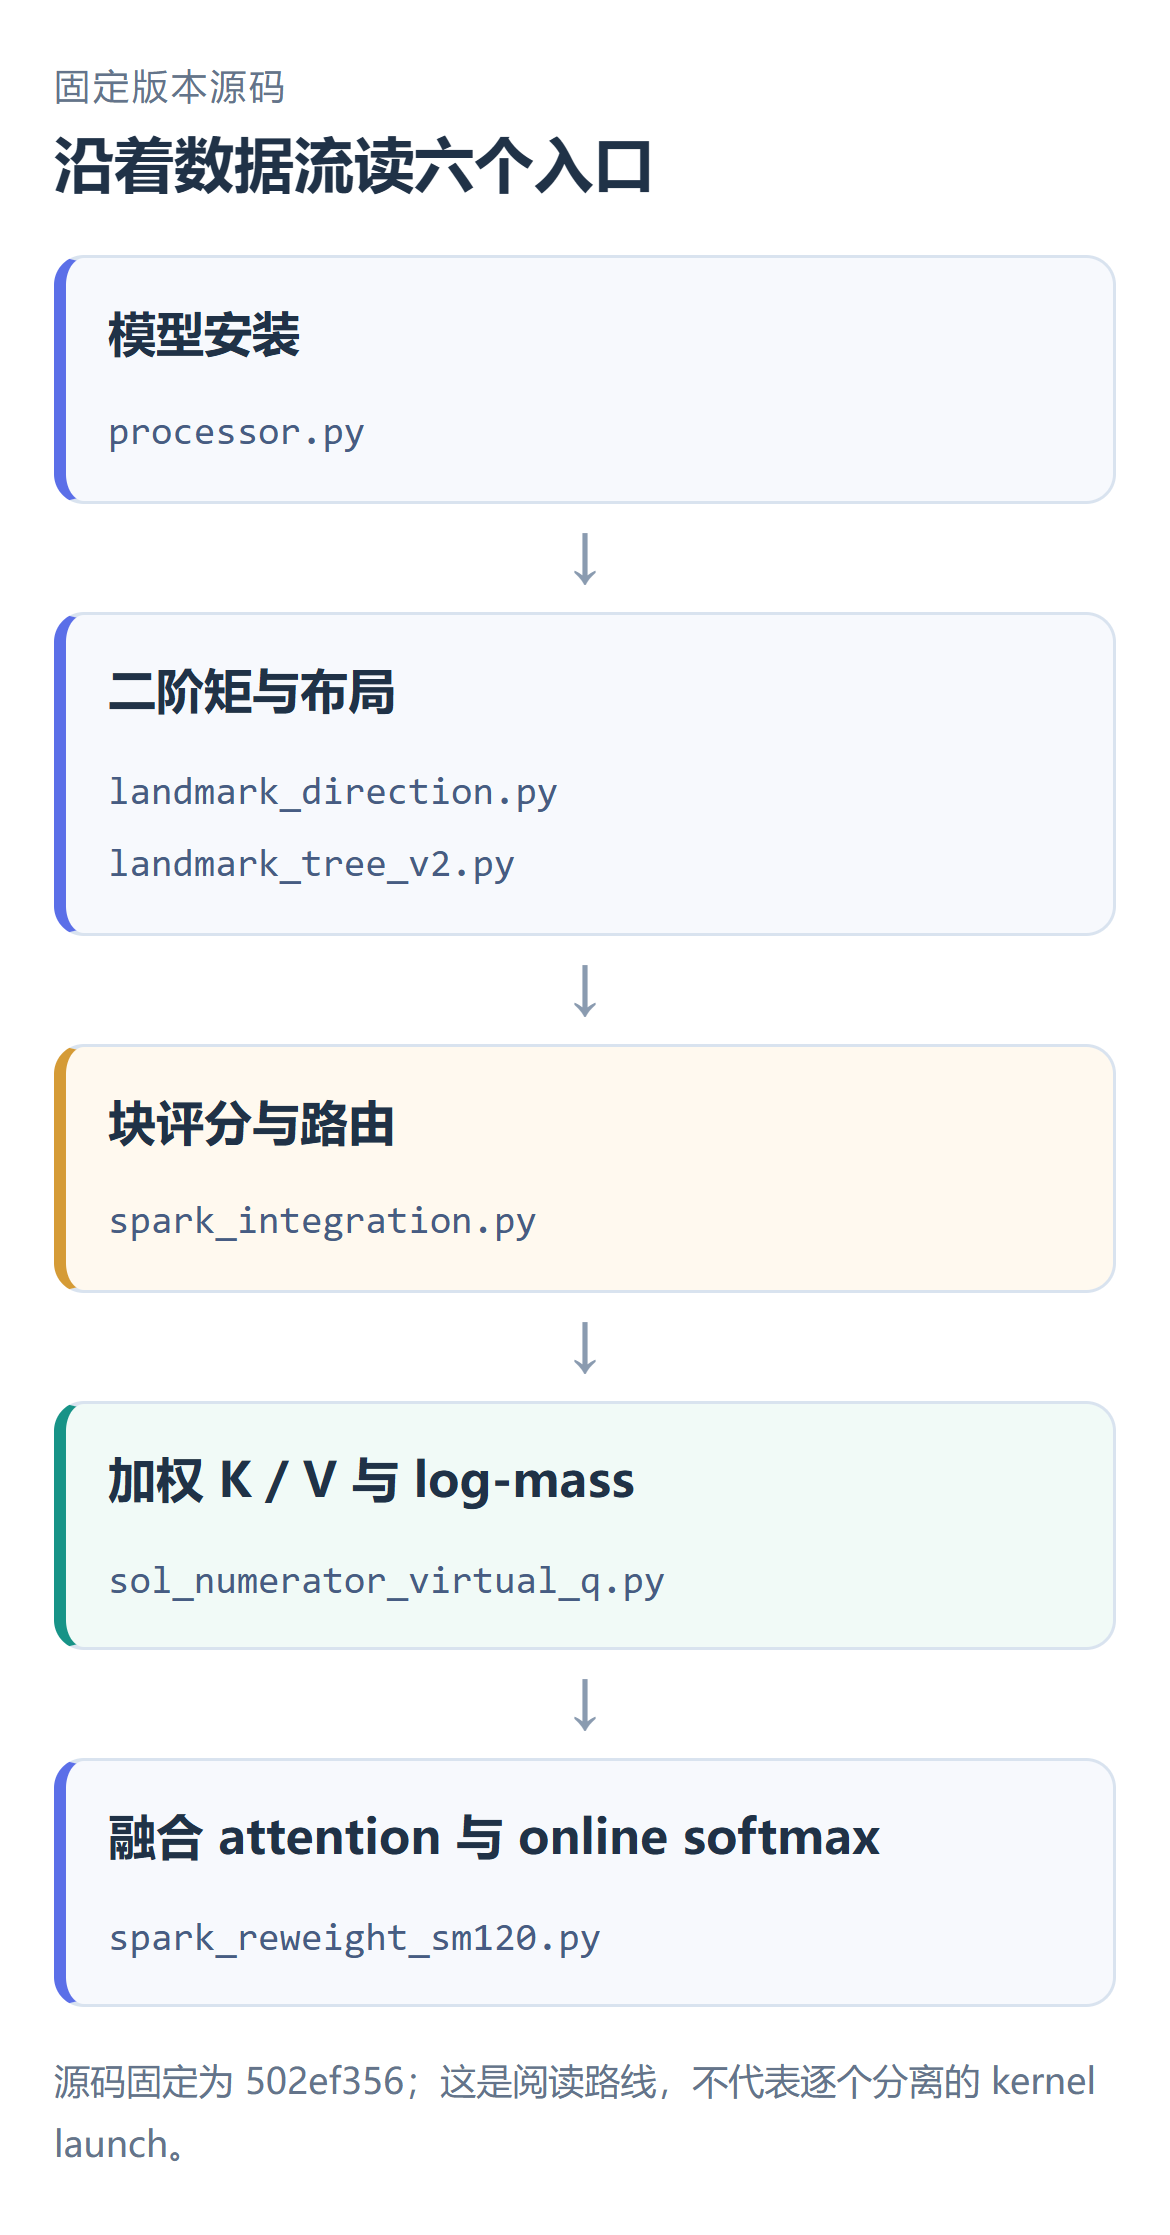
自制源码路线图;文件与当前解读固定的 502ef356 版本对应。图中的顺序用于阅读理解,实际后端可以融合若干步骤。
固定版本源码中,公开入口、布局、路由与内核分得比较清楚。阅读时建议沿着下面的顺序走,避免从一个叫 Spark 的辅助实验文件误入非默认路径。
第一站:公开入口。 spark.py 把 spark_reblock 直接别名到 recursive_landmark_tree_v2_blocks,把 spark_reweight 别名到 virtual_summaries。后者只构建加权 K/V 与 bias,不负责生成代表点、路由、精算或合并输出。
第二站:模型安装器。 processor.py 的 install_h3_spark_attn 构建控制器,安装 attention processors 和布局 hook。上下文退出时恢复原状态;同一个安装上下文中再次调用 pipeline 前,需要 reset,避免沿用上一次去噪计数与缓存。
第三站:二阶矩与分组。 landmark_direction.py 中的 landmark_direction_factors 处理交叉度量;landmark_tree_v2.py 构建等容量层次与 permutation。指标估计、landmark 策略和树分割是独立选择,别把它概括成一次普通 sort。
第四站:Top-K。 spark_integration.py 的 _sol_topk_policy_scores 提供了很直观的参考路径:计算 query 块均值与 key 块质心点积,再按候选视频块数确定预算。它不是先构建全 token 注意力矩阵再取 Top-K。
相邻位置的强制 exact 带,在重排默认设置下关闭。独立排列 Q/K 后,块号相邻已不表示原时空邻近。exact context 则单独加入,不挤占候选视频块预算。
spark_route.py 明确标为 experimental,不能仅凭名字把它当作默认路由。
第五站:摘要。 sol_numerator_virtual_q.py 的 _summaries 和 virtual_summaries 对应第 8 节。核对重点是三个输出:加权 key、加权 value、log-mass;它们必须来自同一套权重和尺度。
底层用 exp2/log2,是 GPU 数值实现选择。点积先乘 1/√128,再换到以 2 为底的指数单位,写回 bias 时再换回自然对数。
看到 1.442695... 与 0.693147...,不要误以为模型换了定义;它们分别是 log₂e 和 ln2。
第六站:融合计算。 spark_reweight_sm120.py 包含路由 mask、online softmax 与摘要质量合并等实现。生产路径还包含 packed route 导出,尽量避免在注意力内核里再次算路由 QK。
整体数据流可以理解为:QKV 投影与位置处理 → 确认 packed token 范围 → 重排规划 → 块路由和尾部摘要 → exact 与近似联合归一化 → 恢复 query 排列 → 输出投影。
某些后端将其中几步融合,未必存在对应的中间大张量。
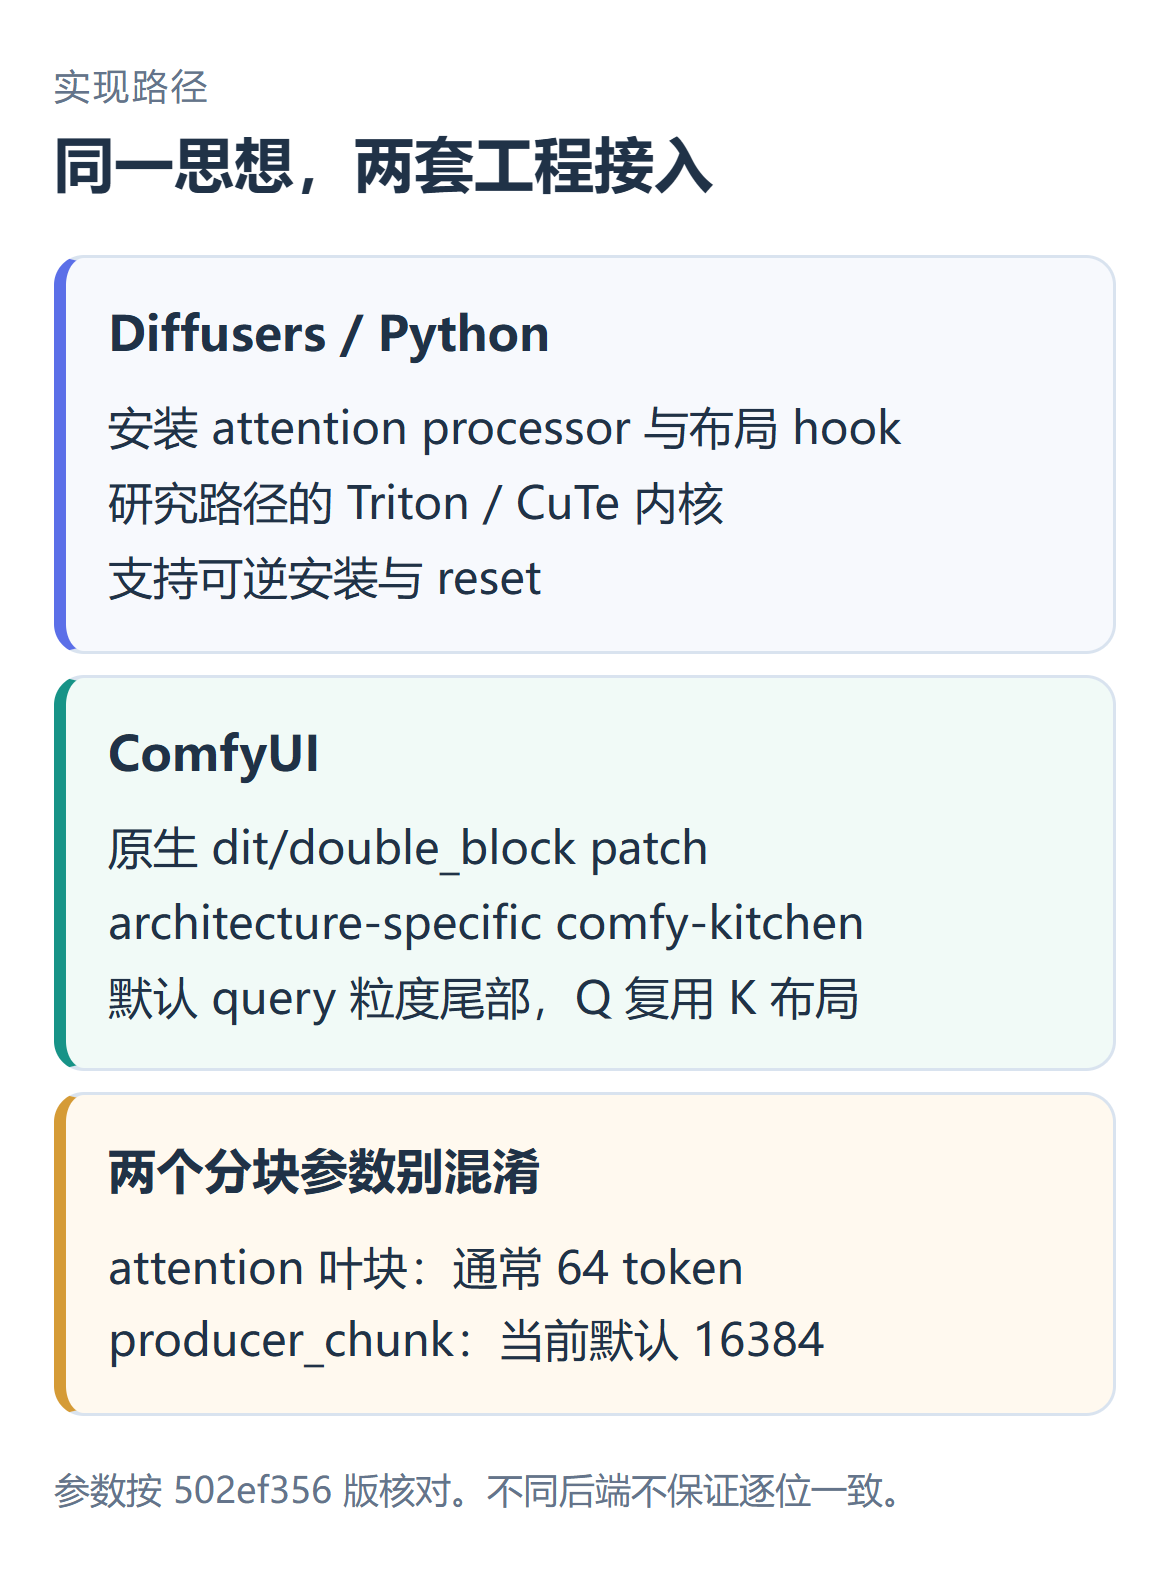
根据固定版本源码整理:算法思想相通,安装方式、内核与默认值分别核对。ComfyUI 的 producer_chunk 是 QKV 生产端分块,不是 64-token 注意力块。
Diffusers/Python 与 ComfyUI 是两条集成路径。它们共享算法思想,但 hook 位置、内核、默认参数和布局实现会变化。
不能在 Python 路径复现一个结果,就认为 ComfyUI 所有配置都会逐位一致。
ComfyUI 的 comfyui_nodes.py 在原生 dit/double_block patch 结构接入;comfyui_backend.py 连接 architecture-specific comfy-kitchen CUDA 后端。
它没有在运行时调用研究路径的 Triton/CuTe attention 内核。
一个很实在的优化,是把排列索引直接交给前后处理:读入 Q/K/V 时按布局消费,输出时按逆排列 scatter,减少四次实体 gather 带来的额外显存读写。
数学上等价的流程,在长序列下可能有完全不同的内存成本。
固定版本节点的默认参数还包括:topk_ratio=0.2、dense_layers=0、min_tokens=12288、tail_granularity=query、producer_chunk=16384。
其中 producer chunk 是 QKV 生产端分块大小,不是 attention block size;后者仍通常为 64。较早文档出现的 4096 不能当成当前默认值。
tail_granularity=query 保留每一条真实 q 来消费摘要;block 则同一个 query 块共享近似结果。exact 分支仍使用真实 query。
只看“都有 Reweight”无法判断这两种配置的误差是否相同。
默认 sparse_scope=target-video,目标视频以外的参考视频、图像、文本和音频按 exact 条件处理。
Ref2VA 可以显式选择 joint-video,将目标与参考视频共同放入稀疏域;静态参考图、文本和音频仍 exact。这是功能范围变化,应独立评价参考一致性。
混合尾块也需要小心。视频边界如果不是 64 的倍数,不能把后面的文本 token 当成视频一起聚类。默认 dense-tail 路径把这一段按 exact 处理。
布局来自模型提供的元数据,比猜测 token span 可靠。
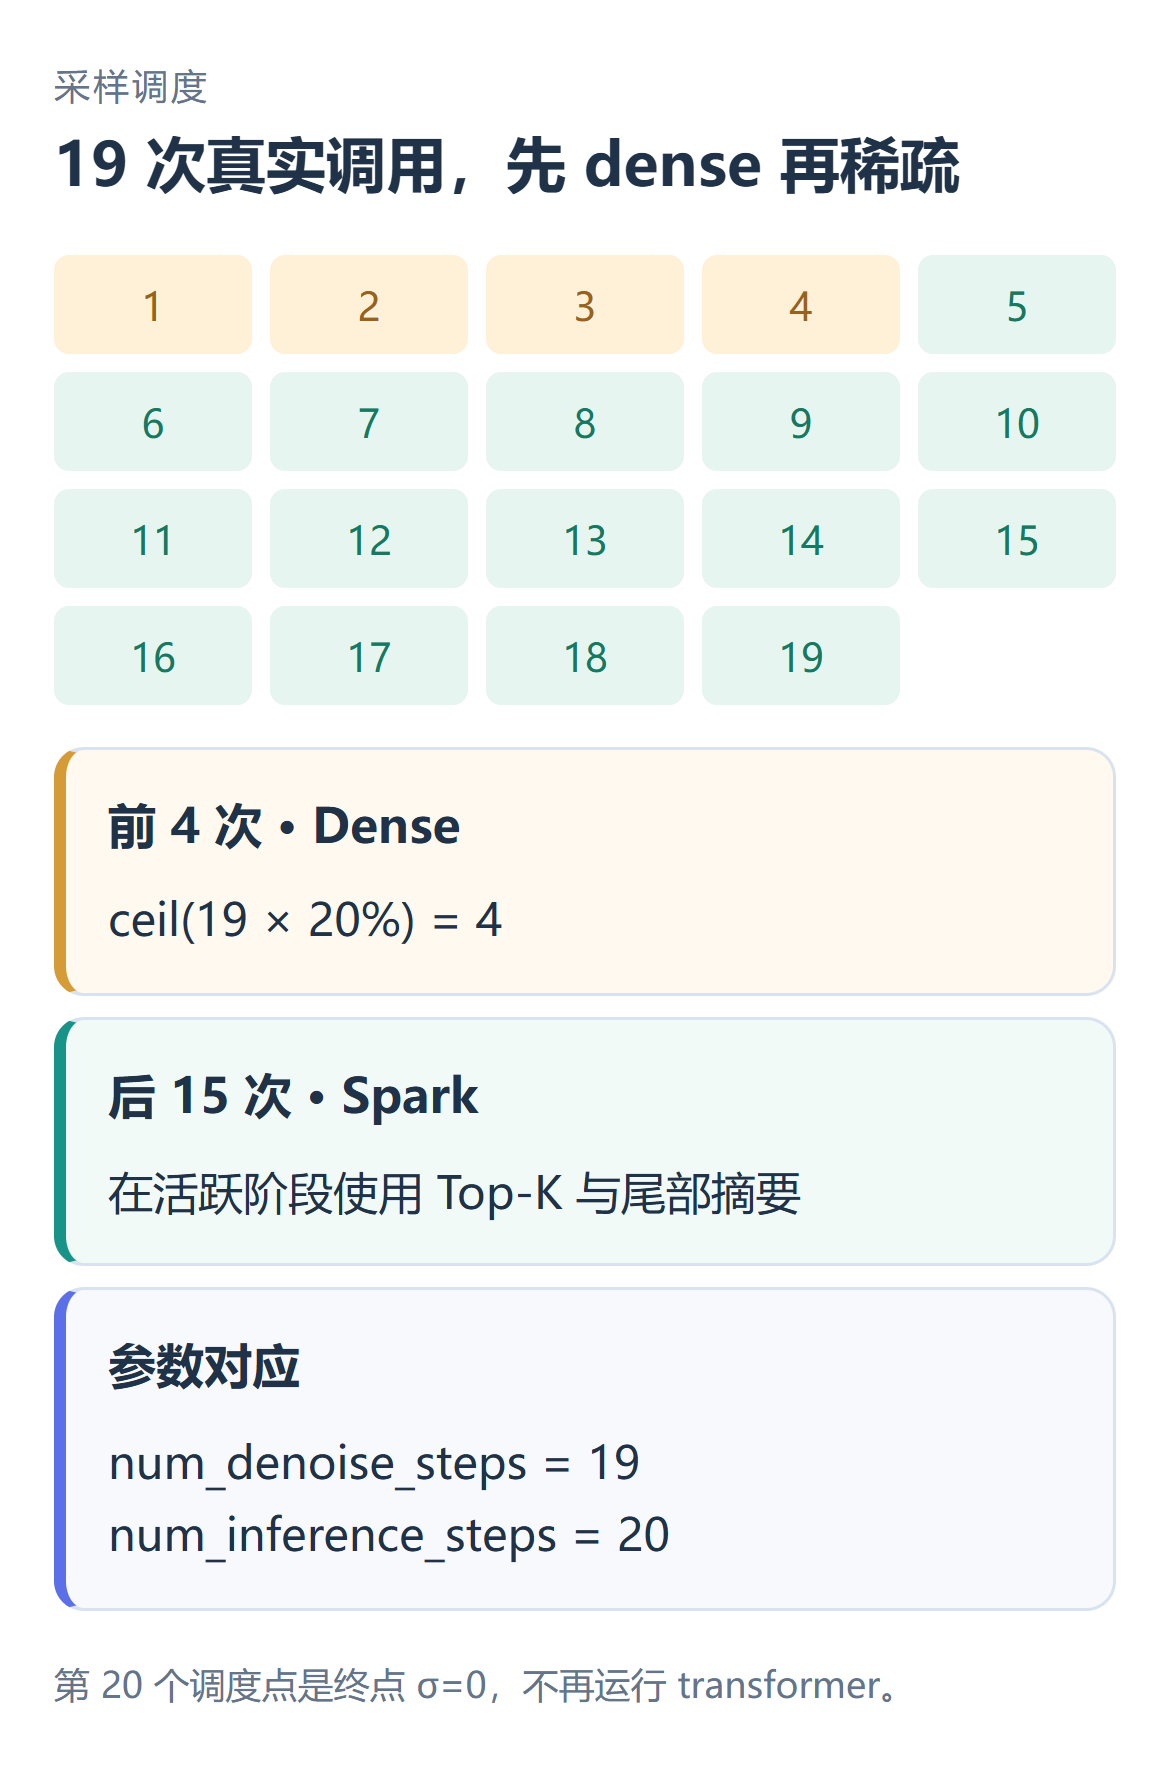
自制调度图:19 次真实去噪、20% warmup 向上取整为 4 次 dense;随后 15 次启用 Spark。调度器另含最终 σ=0 端点。
截至核对日期,作者 v0.1.5 发布说明 提供 Linux/Windows x86_64、SM86/SM89/SM120 的 CUDA 13.0 安装包,并增加 ComfyUI 0.42.x 的 comfy-kitchen 0.2.39 支持;包内同时提供面向 0.38.x–0.40.x 的 wheel。
Python 3.12+、PyTorch CUDA 13.0+ 等要求应以当前安装包为准。
SM86、SM89、SM120 大致对应这批发布包中的 RTX 30、RTX 40、RTX 50/相关 Blackwell 设备。
不要把研究代码中的 SM90/SM100 dispatch 分支,等同于这些架构已完成生产验证。硬件支持、融合实现完成度和发布包可用性,是三项不同事实。
如果走 ComfyUI,先下载符合操作系统与 GPU 架构的 ZIP,连同 SHA256SUMS 校验;将节点目录放到 custom_nodes,用启动 ComfyUI 的同一个 Python 执行安装器,再重启。
权重和 LoRA 不包含在节点包中。
参数建议从 fidelity、20% Top-K 和默认 exact 条件范围开始。
fidelity 在前 20% 模型调用使用 dense;speed 从第一次调用起稀疏;dense 用于旁路对照。
这三个模式不是博客主表里按 10%/20%/30% 密度命名的同一组标签。 模式控制 warmup,Top-K 控制活跃阶段的精算预算,需要分别记录。
例如 19 次真实去噪调用,20% warmup 按向上取整得到 4 次。
MiniMax-H3 的调度器还包含最终 σ=0 端点,因此 Python pipeline 的 num_inference_steps=20 对应 19 次真实去噪;安装器的 num_denoise_steps 应传 19。
少步 LoRA 的调度规则则按各自官方说明处理。
Python 集成可以写成下面的最小改动。这里假定 pipe、模型权重和 inputs 已按 MiniMax-H3 官方流程准备完成;它不是一份独立模型加载脚本。
from h3_sparse_attention import install_h3_spark_attn

n_denoise = 19
with install_h3_spark_attn(
    pipe.transformer,
    num_denoise_steps=n_denoise,
    warmup_mode="warmup_steps",
    warmup_steps=4,
    dense_layers=0,
    topk_ratio=0.2,
) as attention:
    result = pipe(
        **inputs,
        num_inference_steps=n_denoise + 1,
    )
    stats = attention.summary()
调参时先固定模型、prompt、seed、scheduler、帧数与分辨率,对比 dense 和 fidelity。
然后只改变 Top-K,观察脸部细节、快速运动、跨镜头一致性与参考保持;确认误差可接受,再减少 warmup。
计时至少同时记录模型去噪时间与整条 pipeline 时间。第一次编译、模型加载、权重 offload、VAE 解码和音频处理应明确计入或排除。
RTX 4090 与 96GB Blackwell 上的显存策略不一样,不能直接平移博客中的秒数。
若配合 KJNodes 低显存节点,作者建议模型连接顺序为:加载器 → Low VRAM Attention → Chunk FeedForward → Spark → 采样器。
小 chunk 可以降低临时显存,但会增加调用开销。双阶段 LBH 工作流中,高分辨率第二阶段应按作者说明关闭 dense warmup,避免再次支付预热成本。
先看 Amdahl 定律。设原始流程里可被这项优化影响的比例为 p,该部分加速 r 倍,那么整体加速由两部分共同决定:
$$S=1/((1-p)+p/r)$$
原主表 Spark-H3 10% 的 attention 加速是 2.33×,DiT 加速是 1.73×。
将两者粗略代入简化模型,可反推出约 74% 的可加速占比;这只帮助理解未加速部分的约束,不是作者提供的 profiler 分解,更不能据此精确拆出 Reblock、MLP 各用了多少时间。
Spark-H3-Lite 在博客中被描述为重排延迟减半,主表 10% 时比标准版快 7.2 秒。
不要仅凭这个描述,把源码里的任意 q_reuse_k 或相邻层复用开关直接认定为 Lite 的唯一实现;复现实验还需要相应配置与完整记录。
再看与 Video DeltaNet 的比较。
博客在 345 帧、14.4 秒设置下报告,无 warmup 的 Spark-H3 达到 BF16 2.49×、FP8 2.86× 的每步 DiT 加速;相应 VDN 为 2.28×、2.60×。
这组数字不能证明 Spark 在同质量下胜过 VDN。两者没有可直接对齐的相同 dense 权重;作者也明确把无 warmup 结果看成乐观速度上界。
采用旨在保真度的 warmup 时,VDN 仍更快。FP8 行还必须与 FP8 dense 比,不能拿 BF16 dense 做分母放大加速。
Few-step LoRA 和 Spark 可以分别减少“运行几次”与“每次算多少”,但组合收益通常不是两个宣传加速倍数直接相乘。
warmup、第一层保留 dense、CPU–GPU 传输以及 latent 分辨率变化都会改变结果。
技术定位可以这样对照:
| 方法 | 改进重点 | 剩余内容如何处理 | 使用代价与边界 |
|---|---|---|---|
| 固定布局 BSA | 规则分块与选择精算块 | 取决于具体实现;博客消融带均值尾部 | 易接内核,分组可能不匹配当前内容 |
| Sol-Attn | 动态阈值选择与融合归一化 | 均值压缩分支 | 稀疏率随内容变化 |
| Veda | 训练更准确的块选择评分 | 博客讨论的方案丢弃未选块 | 需要相应训练或适配权重 |
| Spark-Attn | 自适应布局与加权尾部摘要 | 代表 query 条件下的加权 K/V 加 bias | 重排成本、代表点近似与后端兼容 |
| Video DeltaNet | 精算局部规则加训练适配的 DeltaNet | 通过学习的线性分支覆盖其余关系 | 模型适配与权重不能直接等同 dense |
BSA 在不同项目里可能只表示一个宽泛的算子家族。有些实现丢弃尾部;这篇博客的消融基线保留均值尾部。讨论横向比较前,应先确认具体算子,避免同名不同义。
Spark-H3 最值得学习的地方,是它把三个常常混在一起的层次接上了:先定义注意力偏好的几何,再构造 GPU 能消费的规则块,最后为未精算部分建立同时考虑质量与内容的摘要。
Reblock 的对侧二阶矩有明确的打分向量解释;Reweight 的摘要可以推导出代表点匹配和 log-mass 切线性质;内核再把这些运算融合进真实推理流程。
读懂其中任意一层,都能回头检查另两层是否实现了同一件事。
工程上也要保留几个现实判断。
当前证据主要围绕 MiniMax-H3,不能外推到所有 DiT;单代表点会有结构性误差;保真度和主观质量不能互相替代;长序列的节省要抵消重排与摘要成本,短序列可能更适合 dense。
作者博客尚不能替代完整可复现实验报告。
如果你已经在做 H3 工作流,这是一条值得实测的推理替换路径。若做稀疏注意力研究,更值得跟进的是代表点怎样选择、块质量误差怎样界定,以及能否让路由预算随层和内容变化,同时保留高效内核。
读代码时可以一直带着三个检查:这个块为什么值得精算?这个摘要的质量和内容是否配套?这些优化最终有没有省下真实墙钟时间? 这三个问题,比单看一个稀疏率更接近方法是否可用。
原理图与数值验证为本次独立编写的 CPU 实验;原博客实验值均已注明来源和条件。未运行模型权重、未测本机 GPU 性能。解读与推导:人工智能炼丹君,2026-10-24。

评论 (0)