今日 AIGC 论文速览
今日共 10 篇 · 视频演化训练 1 篇 · 驾驶与人物视频编辑 2 篇 · 图像编辑与少步对齐 2 篇 · 视频几何纠偏 1 篇 · 长视频记忆与计算分配 2 篇 · 语音生成表征 1 篇 · 交互视频压缩 1 篇
重点论文标题列表
FCP (南京大学):别只接下一段还要预测更远HorizonComposer (西蒙菲莎):换天气时保住车辆和车道JointLight (中科院计算所):先滤掉几何伪影再给人物换光ER-Chord (新加坡国立):单步改图把力气用在可靠位置
AdvFidelity (阿里淘天):少步奖励训练也盯住网格伪影
选读入口:想知道逐段视频生成为什么能接得顺、却未必学会场景如何演化,先读FCP:训练时增加未来块预测监督,推理仍按原流程逐块生成。若要编辑已有视频,再按场景选HorizonComposer的驾驶天气改写或JointLight的人物重打光;单张图局部编辑看ER-Chord,少步生成纹理瑕疵看AdvFidelity。镜头几何漂移读CausalAlign,一分钟视频忘前文读Attn-Forcing,稀疏算力分配读ALLOT;语音事件编码读RubatoCodec,交互视频压缩读CADRE。
今日论文速览
1. FCP:别只接下一段还要预测更远
Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation | 南京大学;腾讯互娱 ARC 实验室;浙江大学 | arXiv:2610.29989
关键词 :自回归视频, 未来块预测, 物理合理性, 辅助监督
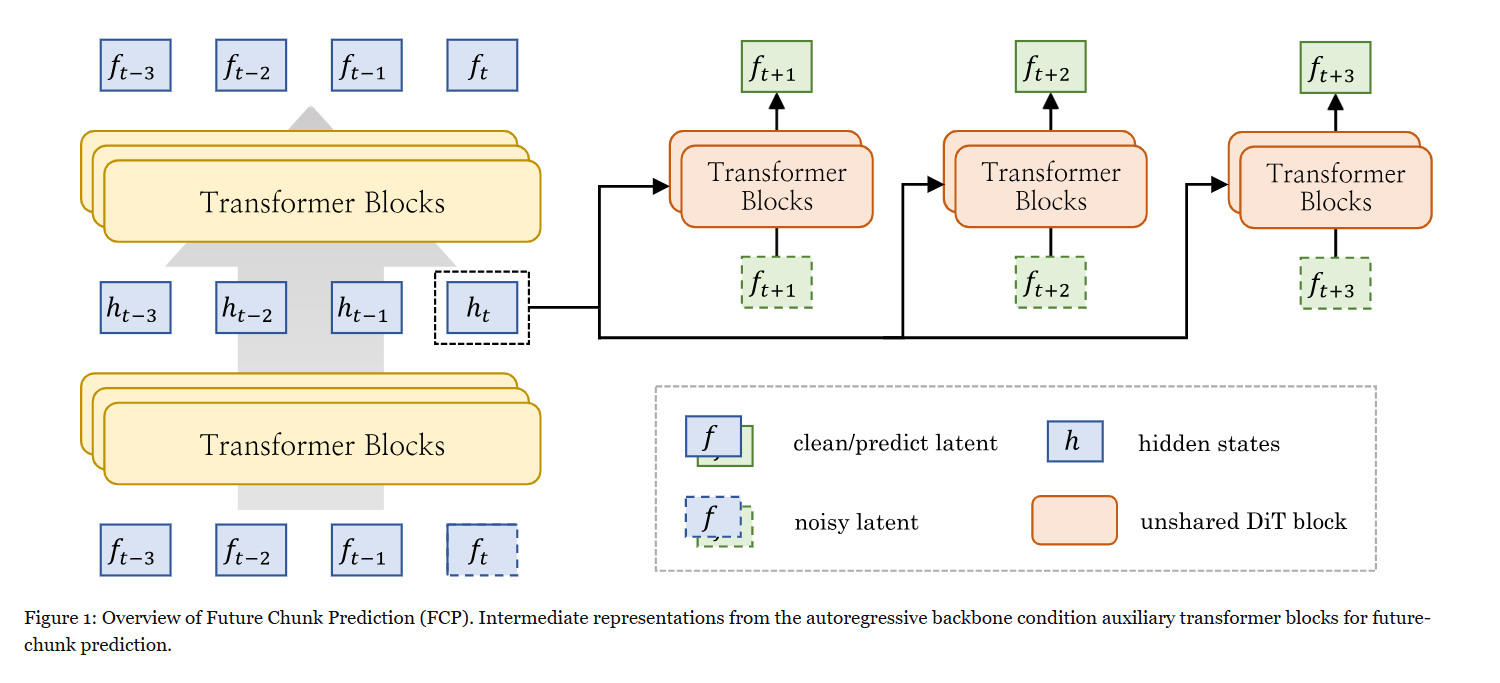
前序问题 :前一秒画面没断,不代表后一秒运动合理。训练总给真实相邻历史,模型可能靠几乎不变的画面就完成去噪;怎样逼它学习更远的变化?方法直觉 :把中间几段挡住,让模型仅凭当前内部特征预测更远的片段。辅助预测器不能互相偷看未来,也不给文字捷径;主模型因此要在特征里留下时间演化信息。本文贡献 :Future Chunk Prediction 即未来块预测,在标准教师强制训练上增加独立辅助分支;教师强制指以真实历史而非生成历史作条件。Wan 主干抽取干净历史与带噪目标的多层特征,经多层感知机融合后逐 token 调制每个三层扩散Transformer预测器;token是网络处理的特征单元。各未来偏移并行、互不串接,省略文字跨注意力,辅助梯度回到主干。推理删除这些分支,仍按原流程逐块生成。
原文图1|未来块预测FCP概览。自回归主干的中间表征作为辅助Transformer块的条件,预测更远未来片段;训练梯度回到主干,推理移除辅助预测分支。
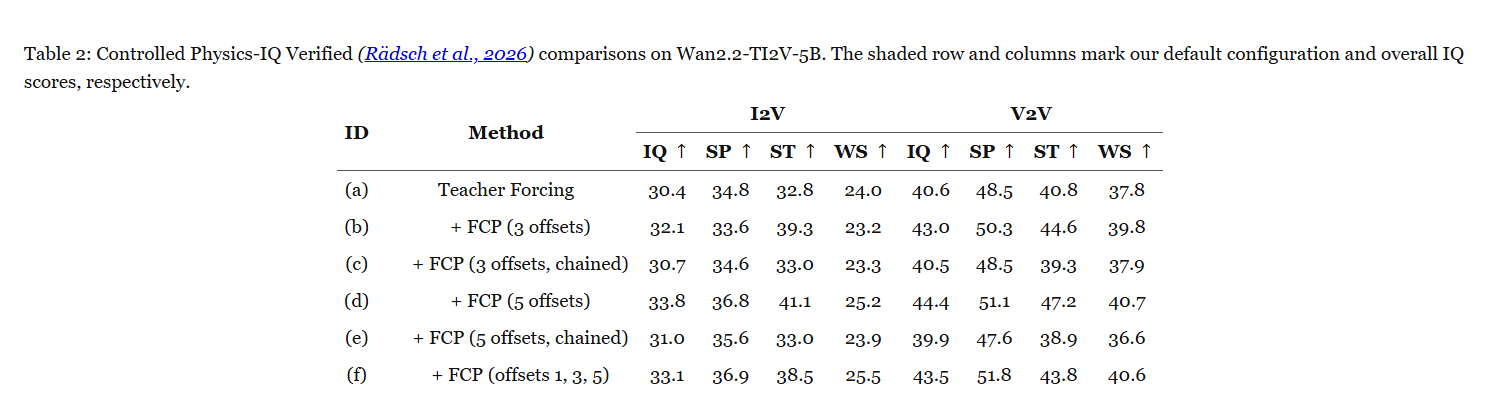
实验效果 :匹配训练数据/设置的 Wan2.2-TI2V-5B 对照,Physics-IQ Verified 的总体 IQ 评分在图生视频30.4→33.8,视频续写40.6→44.4;这是与真实录像对比的物理合理性评分,不是成功率。1.3B消融中,监督干净/带噪特征兼用时30.9,仅干净28.8、仅带噪29.9、原训练27.6。达到 IQ=30 的估算训练计算比全历史特征辅助版少50.7%,不能写成比基础训练省50.7%。
原文表2|Wan2.2-TI2V-5B受控比较。图生视频I2V与视频续写V2V分别报告Physics-IQ Verified总体IQ及SP、ST、WS分项;灰色行列为默认配置与总体分。偏移是未来块的整数距离,chained表示串联预测,不能与彼此独立并行分支混同。
批判点评 :5B训练首阶段32张GPU、25000步、121帧1024×576,另有后续阶段,辅助网络增加训练成本;推理路径相同不构成实测零时延。不同公开模型的数据和训练不同,横榜不用于归因;部分补充评测依赖视觉语言裁判,细微动力学未必敏感。项目 与代码 可查,未复现。
2. HorizonComposer:换天气时保住车辆和车道
HorizonComposer: Spatiotemporally Consistent Driving Video Editing with Enriched Traffic Semantics | 西蒙菲莎大学;NEC 美国研究院 | arXiv:2610.28829
关键词 :驾驶视频编辑, 交通语义, 像素奖励, 参考帧过渡
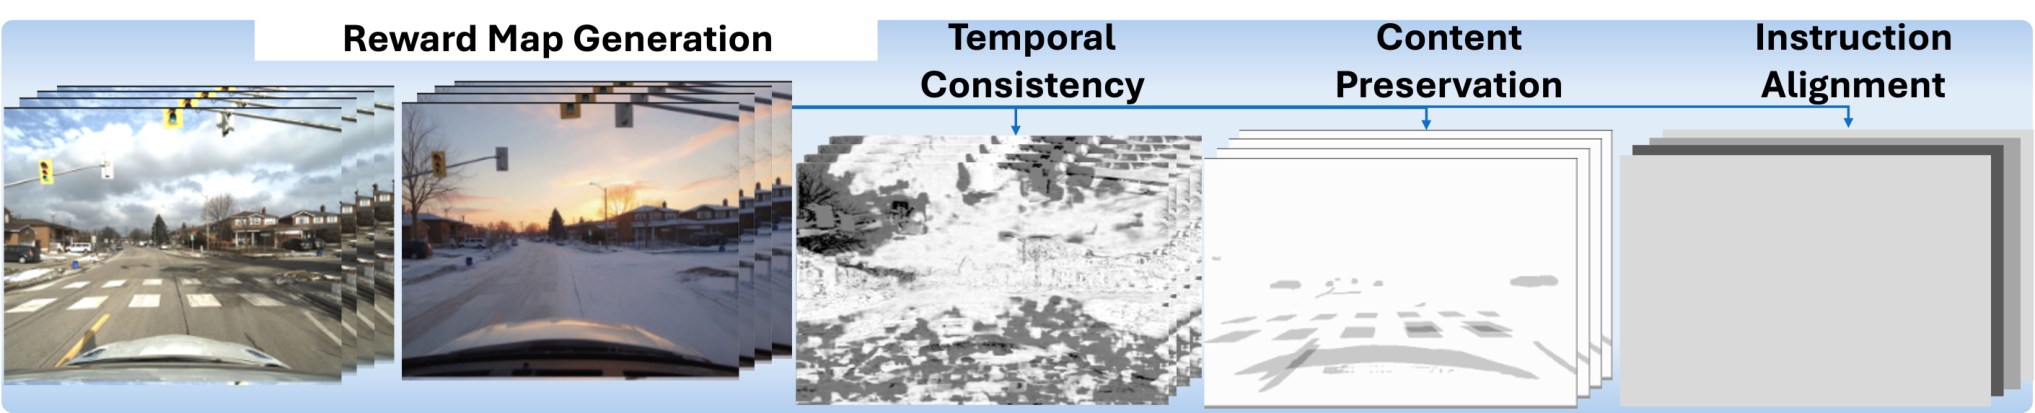
前序问题 :把晴天行车记录改成雪夜,车道线弯了、前车消失了,生成片就不能再用于验证原场景。天气和光线要变,车辆身份、位置与运动却必须尽量保留,怎样让编辑器分清这两件事?方法直觉 :不把整段训练视频一概判好坏,而是逐像素标出哪些变化可信;另外给参考图片与动态视频留一段内部过渡,先消化参考里错位的车,再输出正式片段。本文贡献 :在 Cosmos-Transfer2.5 上冻结深度控制分支、微调视觉分支。混合重复路线实拍配对与合成编辑配对,以场景变化检测、车道/车辆分割、光流及指令评分形成内容、时序、对齐三路奖励,转为逐像素二值条件;离线强化训练时以0.3概率丢弃它,推理设为全正。前置2个思考潜帧并镜像反转开头控制序列,完成后裁掉;按时间压缩4倍,它们对应8帧过渡,生成93帧后保留85帧。这里的思考指时序缓冲。
原文图3|细粒度奖励图生成。对每对视频,结合帧级编辑指标、像素级场景变化掩码和驾驶语义检查生成稠密奖励图;以可信外观修改为监督,同时保护车道和车辆等关键交通语义,具体实现见原文附录H。
实验效果 :44位参与者给出429条准则级回答,内容保持偏好46%,SyntheticPip 为33%,约39%是相对增幅,不是增加39个百分点。SeRM 车道分割的平均交并比 mIoU 为37.48%→40.27%。BDD100K 从200真视频增补200生成视频,整体平均精度 mAP 为0.167→0.175;严格定位阈值0.75的 mAP@75 为0.154→0.165,才对应相对7.14%。训练2张80GB H100、48 GPU小时;推理35步,未报完整耗时/峰值显存。
原文表4|BDD100K下游多对象检测。真实200视频与同样真视频加200生成视频比较;mAP为跨交并比阈值平均精度,mAP@50/75分别在0.50/0.75阈值下计算。三项从0.167/0.316/0.154升至0.175/0.324/0.165,相对增幅4.79%/2.53%/7.14%,不是百分点。
批判点评 :150例域内、150例域外评测中,结构保持有收益,但域外指令成功指标较 SyntheticPip 低4.52%,画质指标低3.10%。局部轨迹修改需先由 HorizonForge 完成,不是本模型直接控制任意车辆。额外8帧和外部参考编辑器有成本;86,614总视频与28,348合成训练片不是同一统计单位。原文未给本方法代码入口,不作会议接收推断。
3. JointLight:先滤掉几何伪影再给人物换光
JointLight: Human-Centric Video Relighting with Asynchronous RGB-Irradiance Joint Modeling | 中科院计算所;中国科学院大学;卡迪夫大学;快手 | arXiv:2610.29780
关键词 :视频重打光, 辐照度, 异步去噪, 几何误差
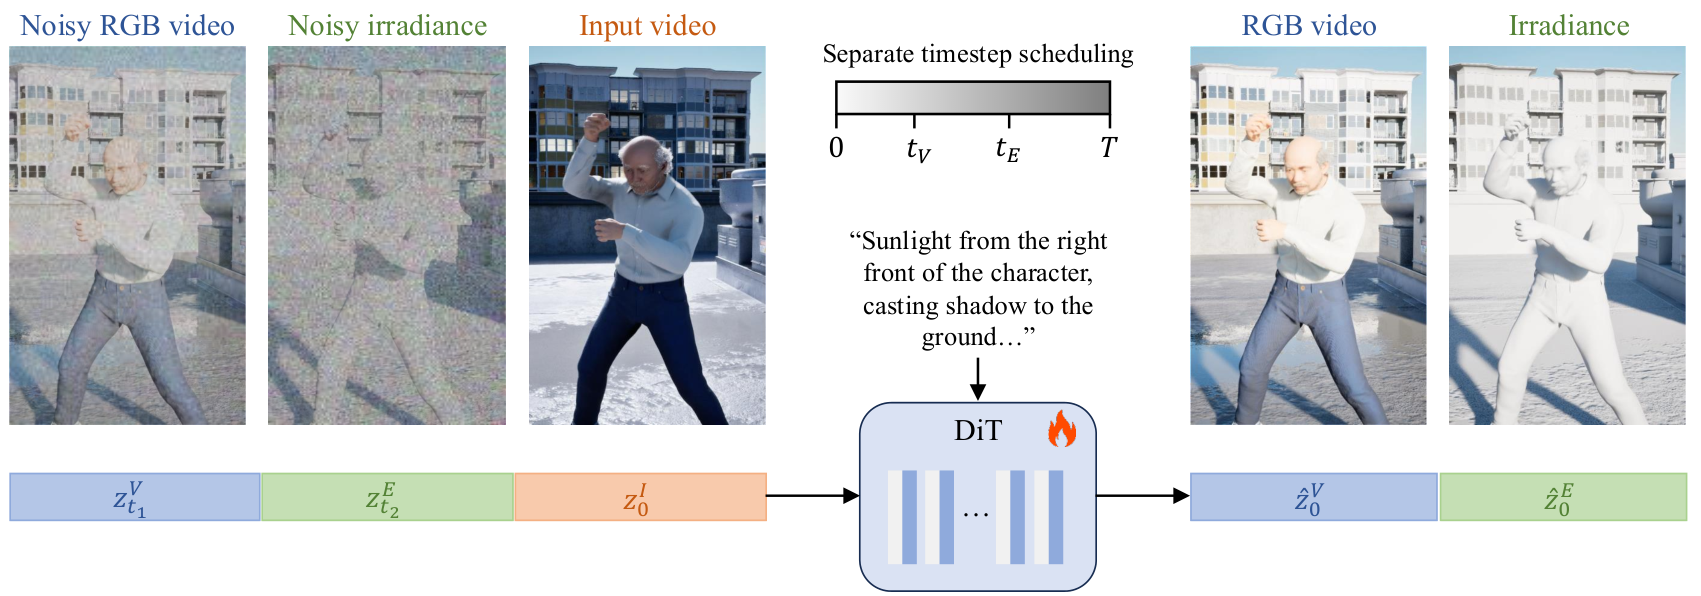
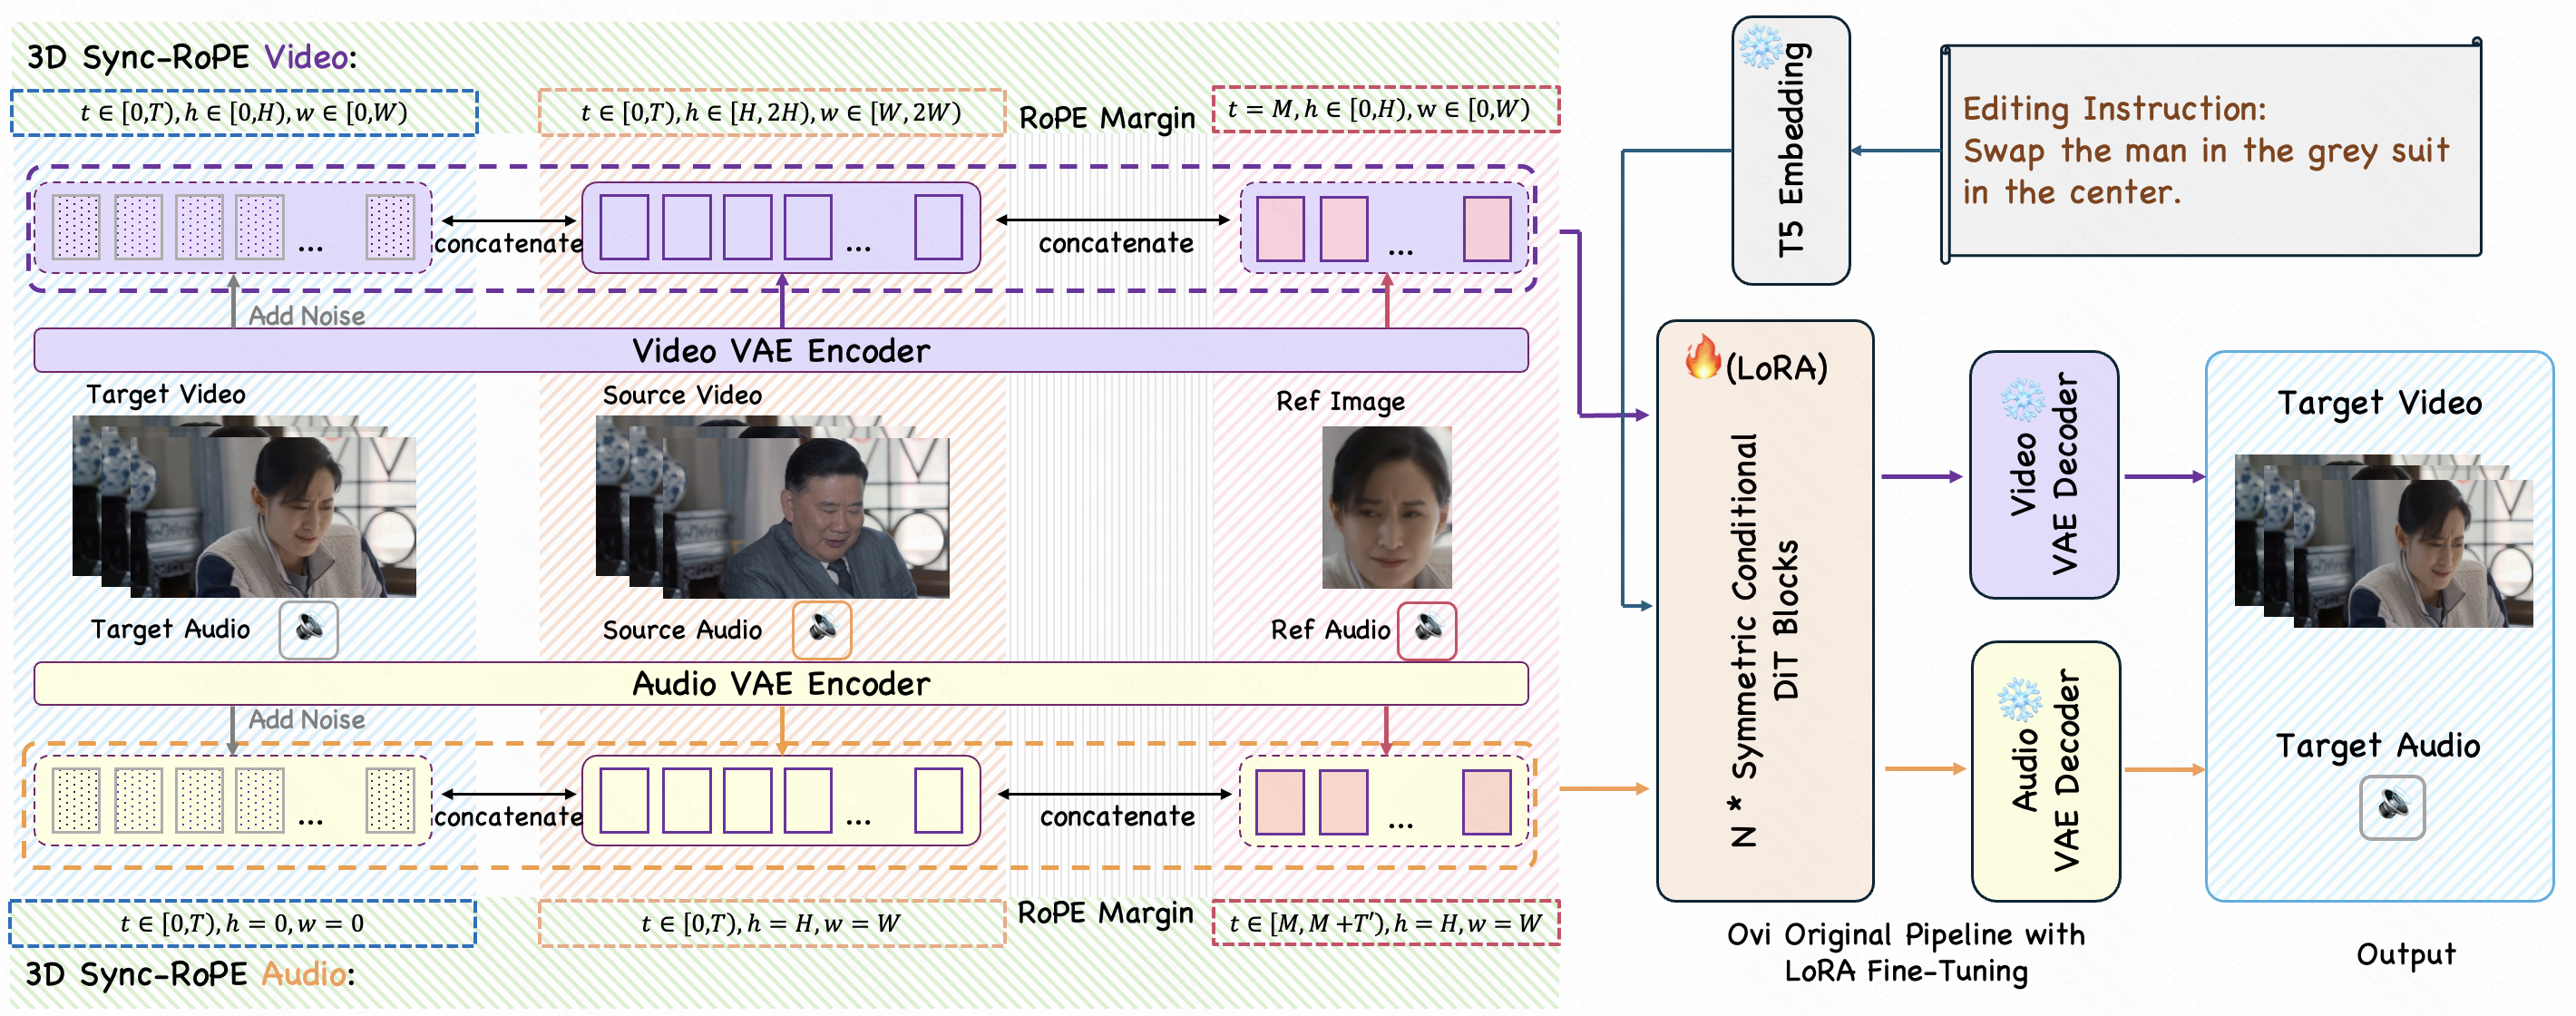
前序问题 :人物视频想把阳光从左边转到右边,改色调不等于改光照。先估几何再渲染光照虽可控制方向,网格孔洞和锯齿又会变成漏光,怎样用粗几何而不照搬其错误?方法直觉 :把粗光照加噪,让细碎伪影先消失,保留大尺度亮暗分布;再让彩色视频与光照图互相修复。二者处于不同噪声阶段,避免把不可靠光照当作干净真值。本文贡献 :逐帧从单目点云构网格,赋白色漫反射材质,在 Mitsuba 3 中用目标高动态范围环境图渲染辐照度,即表面接收的照明分布。Wan2.2-TI2V-5B 把源视频、带噪彩色视频与辐照度沿时间拼接,共享旋转位置编码、用模态嵌入区分。训练12000步,最后4000步以估计光照替换真值做域匹配。推理将光照固定在0.6T噪声阶段,T为完整去噪日程,彩色支路到该阶段后两路一起去噪。
原文图2|完整训练流程。带噪彩色视频、带噪辐照度视频及源视频编码后沿帧维拼接,输入全量微调的扩散Transformer;彩色与辐照度token分配各自噪声时间,支持异步推理。
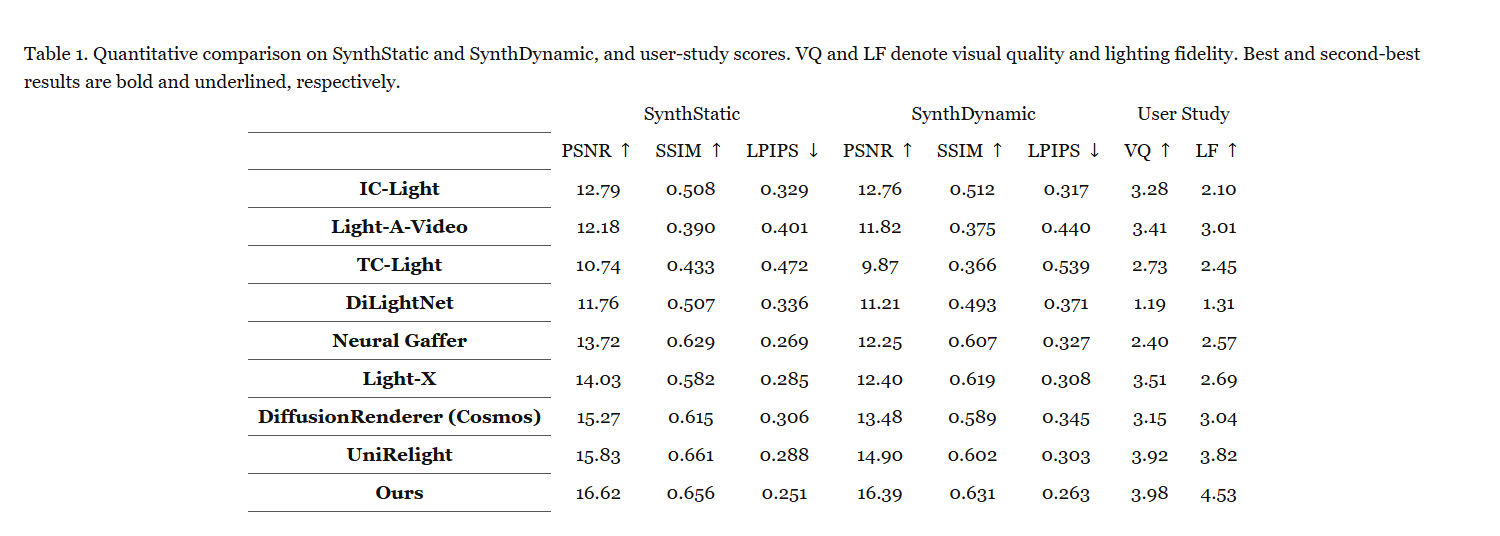
实验效果 :训练用UE5合成6.8万段、每段94帧、832×480视频及配对光照;测试静态光/旋转光各50例。旋转光下 PSNR 像素信噪比16.39分贝,对照 UniRelight14.90;LPIPS 感知距离0.263/0.303,越低越好。静态光结构相似度 SSIM 为0.656,低于对照0.661。单张 A800、81帧、50步完整流程223秒,含点云/深度22.8秒、网格38.2秒、渲染18.8秒、神经生成141.9秒;未报峰值显存。
原文表1|SynthStatic静态光、SynthDynamic动态光及用户评分。PSNR像素信噪比、SSIM结构相似度越高越好,LPIPS感知距离越低越好;VQ/LF分别是视觉质量/光照忠实度,13位用户对15例按1至5评分。粗体/下划线为最好/次好。静态SSIM仍由UniRelight领先。
批判点评 :真实视频主要作定性和13人15例评分;HumanOLAT 独立测试是前景掩码后的静态图,不能当作真实动态视频定量证明。光照图只管漫反射,镜面、金属和玻璃的高光不保证正确,强运动及深度断层仍可能漏光,脸部细节也可能过平。论文首页给出 SIGGRAPH Asia 2026 会议及DOI证据;代码、数据仅承诺公开,未见本方法下载入口。
4. ER-Chord:单步改图把力气用在可靠位置
ER-Chord: Spatially Consistent One-Step Image Editing via Equal-Energy Reliability Redistribution | 新加坡国立大学;快手;大连理工;天津大学;哈尔滨工业大学;腾讯 | arXiv:2610.29248
关键词 :单步编辑, 空间分配, 等能量, 无需训练
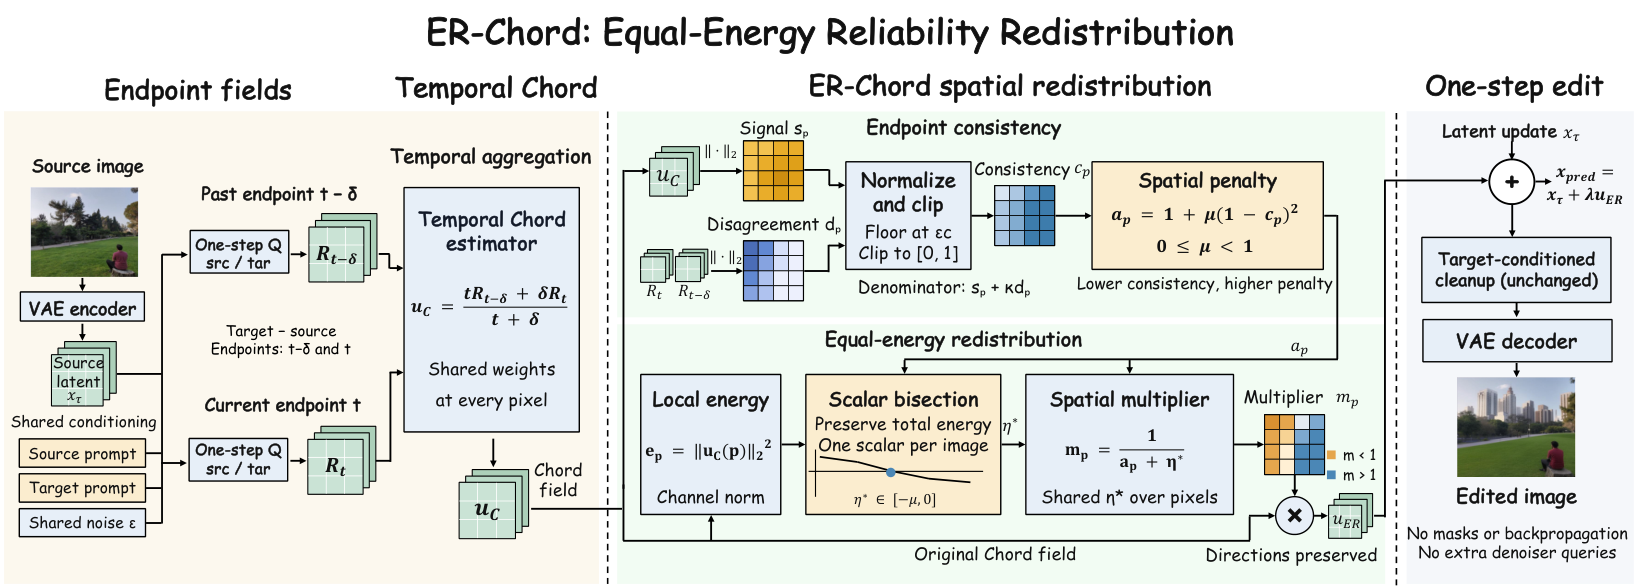
前序问题 :只把沙发换颜色,单步编辑器却连墙面一起改。把整体编辑强度调小能保背景,但目标也改不动;能否总力度不减,只把它放到更可信的位置?方法直觉 :比较相邻噪声水平给出的编辑方向:局部越一致,越值得分配更新幅度。保留每处原方向和全图总能量,用一个共同的调节量重新分配幅度。本文贡献 :复用 ChordEdit 的两个端点预测,以端点差异相对局部控制幅度定义可靠度;它表示预测一致,不表示语义一定正确。目标是在接近原编辑场的同时惩罚低可靠位置,约束清理前控制向量平方和不变。强度参数小于1且原能量非零时有唯一方向保持解;用最多32次二分求共同标量,CPU开销小于0.01秒,不加去噪网络调用、训练、反演或反向传播。
原文图1|ER-Chord方法概览。从时间聚合的编辑控制场出发,测量局部端点一致性,在方向不变、总控制能量固定的前提下重新分配空间幅度;不需辅助引导、训练、反演、额外去噪评估或反向传播。
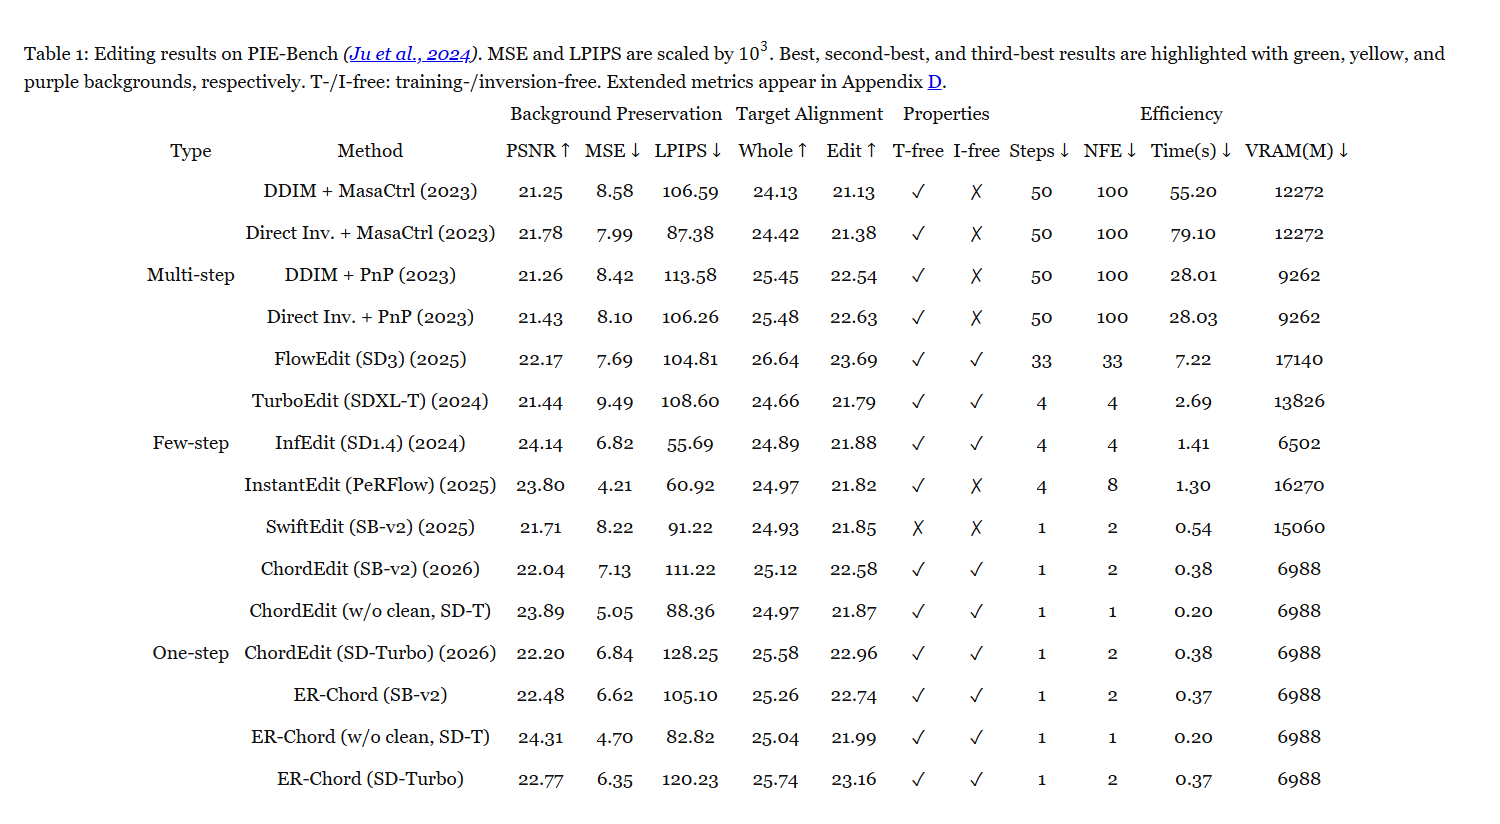
实验效果 :PIE-Bench 全700例,SD-Turbo、相同目标文本/噪声/种子:背景 PSNR 为22.20→22.77分贝,LPIPS 感知距离按1000倍标度128.25→120.23,目标编辑区图文相似度22.96→23.16。完整法为1次输运更新加1次清理,网络评估次数 NFE=2;无清理 NFE=1,不能将单步写成全流程只调用网络一次。报告0.37秒/图,对照0.38,峰值均6988 MiB;所读原文未说明具体测速卡型。
原文表1|PIE-Bench编辑比较。MSE均方误差及LPIPS感知距离按1000倍显示;PSNR与整图/编辑区图文相似度越高越好。绿/黄/紫分别为前三名;T-/I-free表示无需训练/反演。Steps为输运步数,NFE为网络评估次数;完整ER-Chord还含清理,NFE=2。时间为秒,峰值内存MiB。
批判点评 :外部 TEdBench 100例的方向相似度0.25与对照持平,不能概括为全指标上涨。等能量只约束清理前,不能证明最终图片改动量一样;低可靠点也不必全部减弱,约束在全图耦合。若底座方向就错,重新分力度仍救不了。代码 已有作者入口,本稿未运行模型。
5. AdvFidelity:少步奖励训练也盯住网格伪影
AdvFidelity: Unifying Preference Alignment and Few-Step Image Generation within Reinforcement Learning | 阿里淘天集团;上海交通大学 | arXiv:2610.29380
关键词 :图像生成编辑, 少步强化学习, 对抗奖励, 参考配对
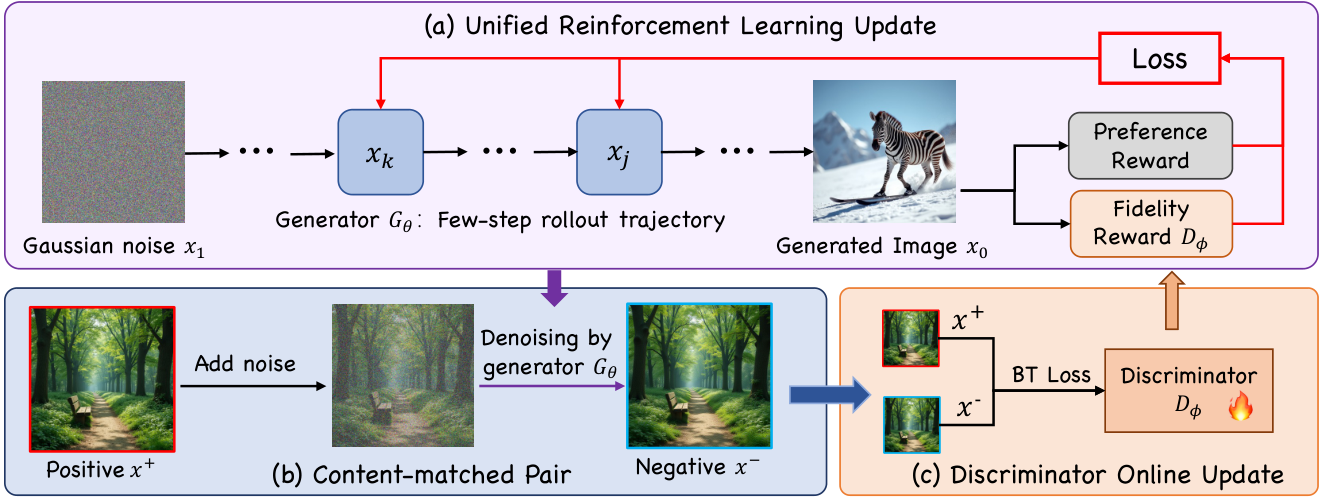
前序问题 :图像符合文字、奖励得分也高,放大却满是网格和纹理噪点;先强化对齐再蒸馏加速,又可能丢掉对齐收益。怎样在少步训练里同时检查这些低层缺陷?方法直觉 :找高质量参考图,加适量噪声再由当前模型重建,做成内容接近、细节质量不同的一对。判别器不容易靠题材或色调取巧,而要学着分辨生成器眼下的伪影。本文贡献 :基于 LeapAlign,让任务奖励和在线保真奖励的梯度穿过实际4或8步采样轨迹,共同训练 LoRA 低秩适配器,不使用分布匹配蒸馏损失。判别器冻结 DINOv2 视觉主干,只训练全局特征上的多层感知机,并用随机裁块放大局部问题。参考加0.3或0.5噪声后用一两步重建负例;每次生成器更新后更新判别器,正负配对用排序损失。参考按任务选原底座样本、目标风格模型样本或真实训练图。
原文图2|AdvFidelity。(a)少步生成器从噪声采样,任务与保真奖励共同更新。(b)高质参考加中等噪声,由当前模型重建成内容匹配的负样本。(c)判别器按Bradley–Terry配对排序损失在线更新,再提供保真奖励。每轮先更新一次生成器,再重复构造配对及判别更新。
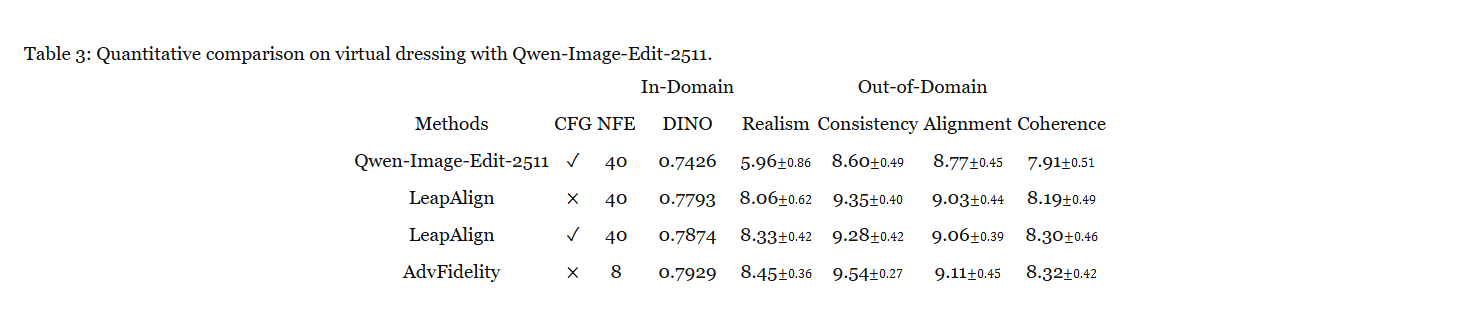
实验效果 :FLUX.1-dev 在 GenEval553条提示、每条4图上,组合生成总分4步0.7535、8步0.7759,50步 LeapAlign0.7420。Qwen-Image-Edit-2511 换装124例,8步、无分类器自由引导 CFG,服饰特征相似度0.7929;40步且带CFG对照0.7874。外域四项1至10分由 Gemini 三次评价同一组生成图,误差条表示裁判重复波动,不是多次模型训练。训练新增参考重建及判别器更新,未给完整耗时显存账单。
原文表3|Qwen-Image-Edit-2511换装定量比较。域内用DINO服饰特征相似度,域外用真实感、一致性、对齐、协调性四项模型裁判评分;CFG标明是否用分类器自由引导,NFE为报告的采样网络评估口径。8步法不使用CFG;均值和标准差来自对同一组图三次裁判评分。
批判点评 :不做显式蒸馏,不等于不用强模型参考:偏好任务准备5万张50步、已对齐模型样本;GenEval另用5000张底座参考,不能混为同一设置。消融按组件累加,尚非所有因素独立随机对照;奖励风格依赖所选参考,少步数也不能直接换算同倍加速。当前未核实方法代码链接,不宣称可立即复现。
6. CausalAlign:镜头运动别在去噪后段忘掉
CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion | 北京大学;北京通用人工智能研究院;英伟达;清华大学;威斯康星大学麦迪逊分校 | arXiv:2610.29915
关键词 :视频几何, 相机运动, 因果诊断, 变化特征对齐
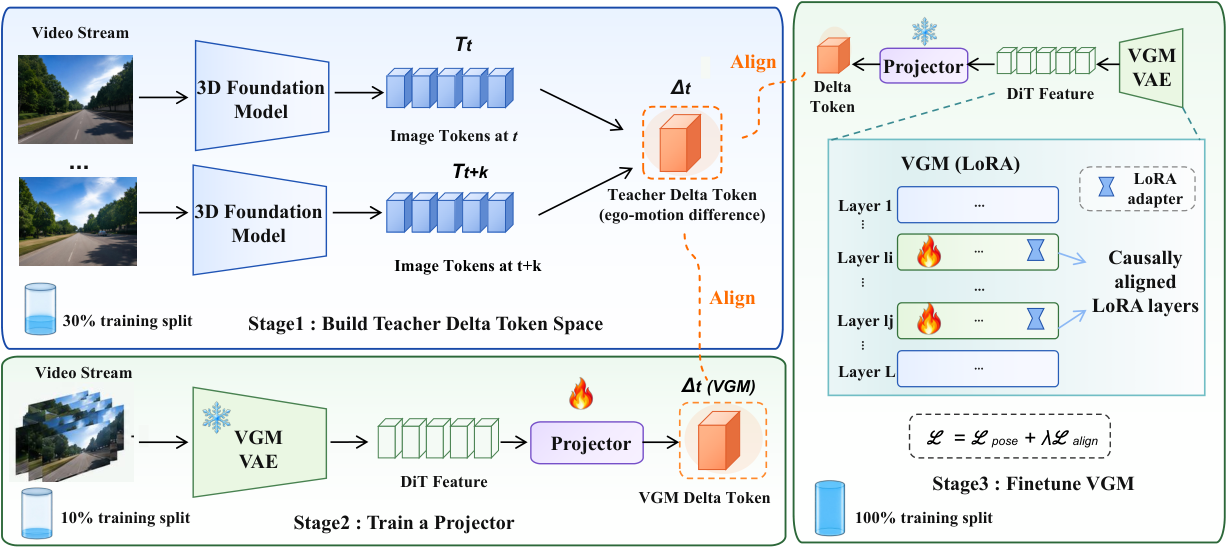
前序问题 :视频刚开始镜头绕物体转得合理,越往后几何却漂移。模型内部能解码相机运动,不代表生成时真正使用或保留它,怎样找到该补强的层和去噪阶段?方法直觉 :既做读出测试,也主动遮掉、打乱、替换或注入运动特征,看生成是否受影响;只在运动信息开始衰退的位置,教模型保存前后帧的变化,而不是死记静态场景。本文贡献 :用冻结的 LingBot-Map 三维教师学习128维 delta token,即帧间变化特征,其中64维运动、40维几何、24维视觉。三阶段先训教师变化编码器,再训主干到该空间的投影器,最后冻结教师与投影器,只调目标层 LoRA。Wan2.2-14B-I2V 选14、10、12、20层和噪声索引398、799,以变化对齐及相对位姿监督训练;位置由线性探针和相同范数随机干预对照共同确定。推理只需首帧与文字,无额外三维缓存。
原文图2|CausalAlign三阶段训练。第一阶段把流式三维教师连续帧特征编码成帧间变化token;第二阶段用训练集小子集学习主干到变化空间的投影器,随后冻结;第三阶段用完整训练划分仅优化已诊断目标层的LoRA,投影器仍冻结。
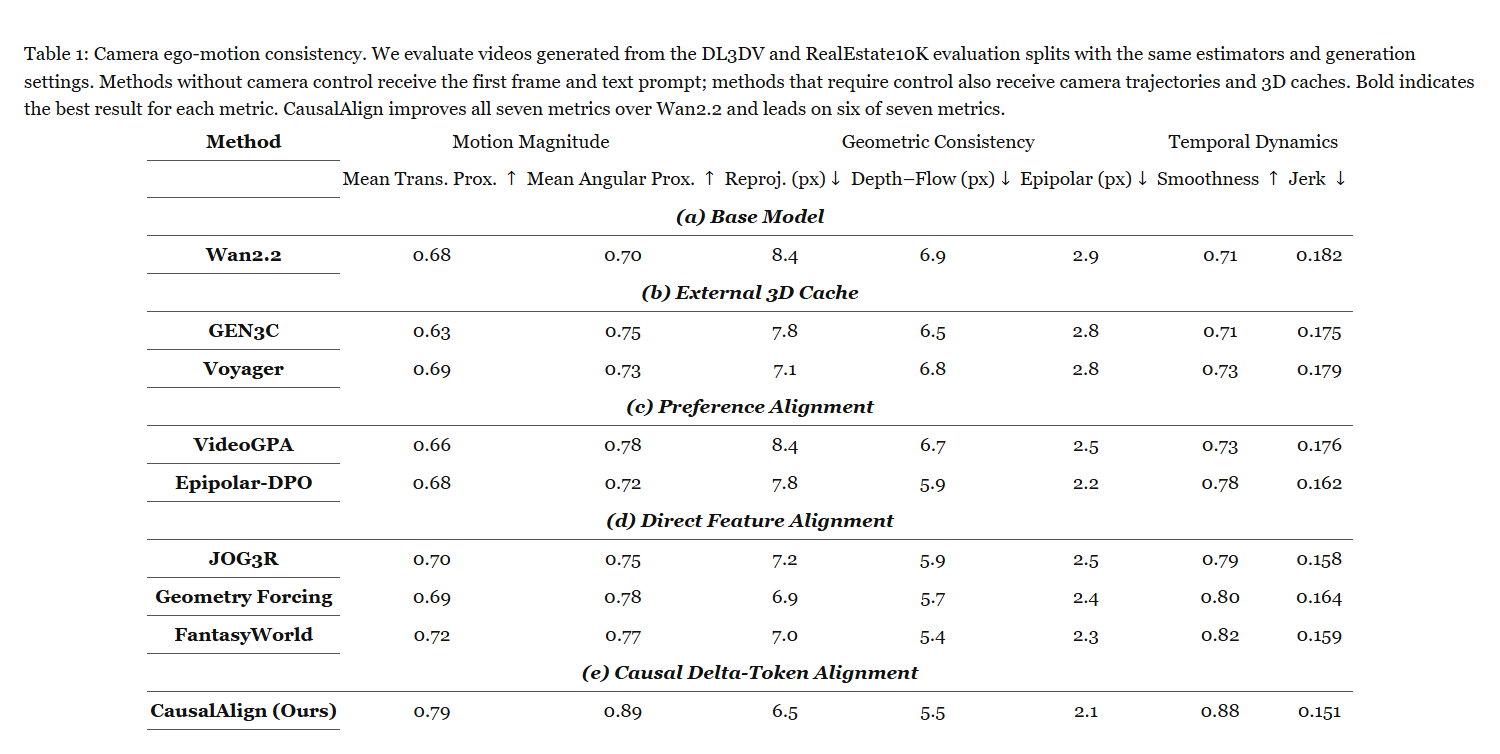
实验效果 :DL3DV、RealEstate10K 各90%训练/10%评测,同采样/种子:重投影误差8.4→6.5像素,降22.6%;深度-光流误差6.9→5.5像素,对照 FantasyWorld 为5.4,仍更低。视频分布距离 FVD 为182.4→182.7,越低越好,不能称画质全指标改善。迁移 Fast-WAM 后任务组平均成功43.5%→54.2%,提高10.7个百分点;原子已见任务703/900成功,对应78.1%。
原文表1|相机自身运动一致性,同划分、估计器及生成设置。无相机控制的方法只收首帧和文字,有控制的方法额外收轨迹及三维缓存。平移/角速度接近度、平滑度越高越好;重投影、深度-光流、极线误差单位像素,越低越好;Jerk度量加速度突变。CausalAlign七项均优于底座、六项列首。
批判点评 :相机未来并非唯一,主榜评内部几何一致,不是逐帧命中给定轨迹;显式相机控制对照还拿到轨迹与三维缓存,输入条件不同。运动姿态与深度均由冻结估计器恢复,估计误差仍在。教师、干预诊断及三阶段适配有额外训练成本,未给完整耗时显存,推理移除辅助网络不代表已实测加速。核心是视频生成,机器人迁移只是补充;未核实方法代码入口。
7. Attn-Forcing:旧画面删掉后仍记住它的作用
Attn-Forcing: Learning Full-Context Attention Proxies for Streaming Video Generation | 同济大学;腾讯;南洋理工大学;香港科技大学 | arXiv:2610.30036
关键词 :流式视频, 注意力代理, 历史压缩, 注意力监督
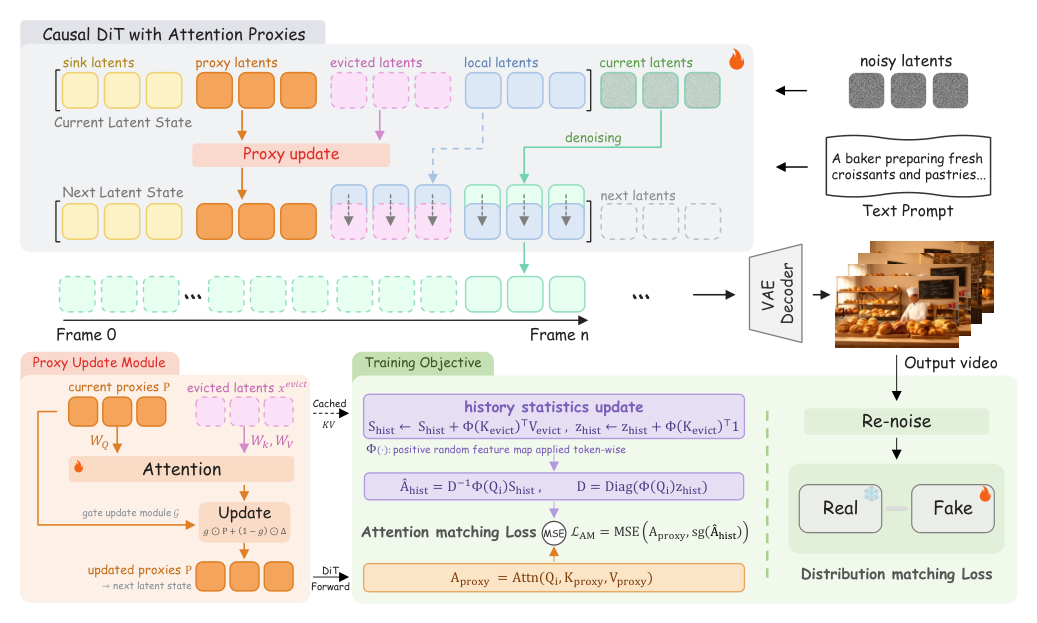
前序问题 :流式生成一分钟视频,缓存旧帧会越来越贵,删掉又容易忘记前面。直接延长窗口还可能让运动变僵,怎样在固定内存里保住历史对当前画面的影响?方法直觉 :把将要移出窗口的内容交给少量可学习代理,并教代理回答“当前查询看旧历史会得到什么”,而不只要求它把旧画面压缩得像。本文贡献 :Wan2.1-T2V-1.3B 上保留3个起始潜帧、9个局部潜帧和3个代理潜帧;这些是压缩视频帧,不是3个标量或文本token。门控跨注意力用被移出的视觉潜变量更新代理,再经主干形成逐层键值缓存。128维随机特征在线累计历史键值统计,近似历史注意力响应,停止梯度后只作监督目标;最后6层的匹配损失仅优化代理参数。与分布匹配蒸馏联合训练,短初始化700步、60秒流式长训2300步,16张H20、总批量32。
原文图2|Attn-Forcing。训练时,把将从局部窗口移出的视觉潜变量经代理更新模块写入可学习代理。注意力匹配损失让代理响应接近由在线累积统计近似的历史响应;统计只作监督,推理用代理产生的正常键值。
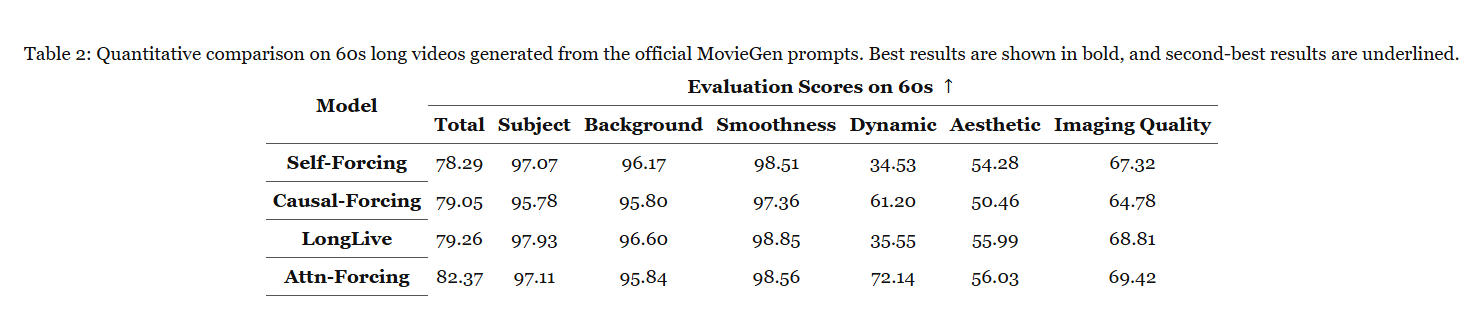
实验效果 :946条VBench提示各5种子评5秒/30秒,60秒另用128条 MovieGen 提示。60秒六维加权总分82.37,LongLive79.26,动态程度72.14/35.55;但主体一致性97.11/97.93、背景95.84/96.60,保持不是全胜。自有消融仅加代理总分80.03→80.16,再加注意力监督到82.37,收益主要在监督。每块4去噪步;H20端到端生成时间额外约13%,还多一次主干前向,未报完整峰值显存。
原文表2|官方MovieGen提示生成60秒视频,128条提示,用VBench-Long六维评总分、主体/背景一致性、运动平滑、动态程度、美学及画质,均越高越好。粗体/下划线为最好/次好;总分更高不等于每项一致性最好。
批判点评 :固定大小历史统计只用于训练监督;推理直接使用该近似会逐渐模糊,不能把线性注意力替换与代理法混为一谈。LongLive窗口从12扩到120时总分79.26→75.01,可能受训练窗口失配影响,并非长上下文天然更差。动态指标上升也不能替代精确回忆任务,尚无无限时长证据;未核实作者方法仓库。
8. ALLOT:按最终视频误差分配稀疏预算
Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers | 中国科学院大学;中科院自动化所;快手可灵;北京大学 | arXiv:2610.29441
关键词 :视频扩散加速, 稀疏注意力, 离线校准, 延迟预算
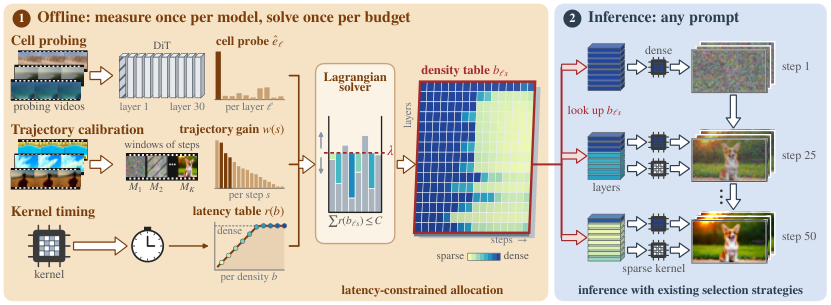
前序问题 :视频注意力每层都删相同比例,某个关键层一稀疏就变形;只看本层误差,又低估早期小误差向最终视频传播的影响。怎样把有限的注意力时间花对位置?方法直觉 :先逐个测“层×去噪步”被简化后最终损失多少,再按真实计时分配预算。像给关键工序留全量检查,对容错位置多省一点,而不是只按理论算量平均删。本文贡献 :ALLOT 全称 Allocating Layer-step Latency by Output Tests。先单层稀疏探测一步速度预测误差,再用每5步一窗的稀疏完整生成,校准误差向最终画面的传播增益;四段真实探测视频、八条校准提示。测量部署内核在各密度下的延迟,二分拉格朗日权重求每格密度表,超出稀疏内核交叉点就保留密集计算。推理查表,保留既有块排序与内核,但密度截断替代原逐头/逐输入阈值自适应。
原文图3|ALLOT流程。(1)离线测逐层单步误差、去噪轨迹传播增益、不同稀疏密度的内核延迟,为每个延迟预算C求密度表。(2)推理逐层逐步查密度,密度1调用密集注意力,否则使用既有稀疏内核。
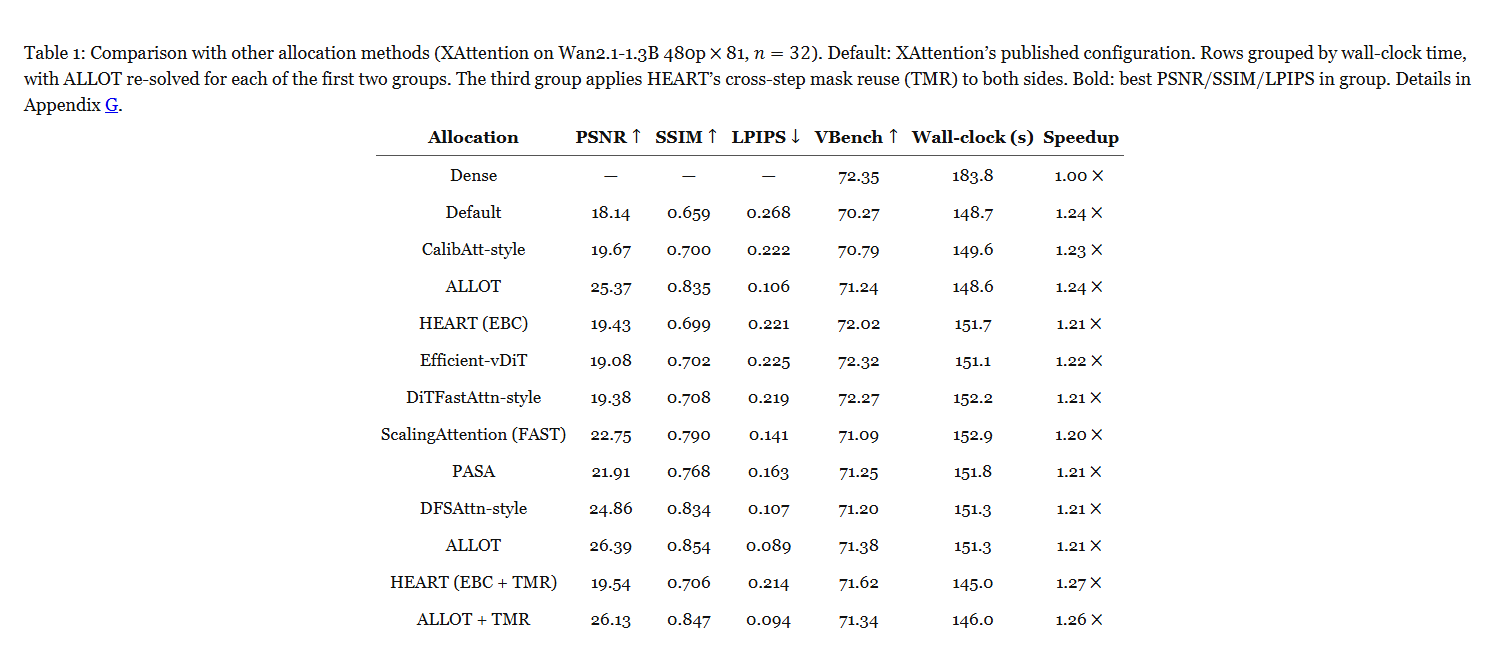
实验效果 :XAttention、Wan2.1-1.3B、480p81帧、50步、32提示,同种子相对密集视频的 PSNR 为18.14→25.37分贝;耗时148.7→148.6秒,密集183.8秒。这是贴近密集输出,不是绝对生成质量。四类公开管线九设置,按成对95%区间与感知距离共同判六胜三平;并非九项都更好。离线测量约6至23 GPU小时,Wan2.2双专家超过30;换 Radial/HunyuanVideo 的探测另报57 GPU小时,调预算CPU重求约4秒。
原文表1|XAttention、Wan2.1-1.3B、480p81帧、32提示的分配比较。Default为公开配置;按墙钟时间分组,前两组各重求ALLOT表,第三组双方都使用HEART跨步掩码复用TMR。粗体为组内PSNR/SSIM/LPIPS最好,保真指标参照同种子密集输出,Speedup为密集总时间除以该行时间。
批判点评 :输出误差可加与传播增益跨层共享都是近似,求解器最优只针对离散估计目标及对应预算,不保证真实视频全局最优。部分设置 VBench 或感知距离退步,例如 SVG2 感知距离0.151→0.156。更换模型、选择策略和部署硬件需重新核对探测与计时;多次生成才能摊薄校准成本。未核实作者代码入口。
9. RubatoCodec:语音token留给变化快的地方
RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding | 第三智能公司(Third Intelligence) | arXiv:2610.29434
关键词 :语音生成, 自适应编码, 事件预算, 流式解码
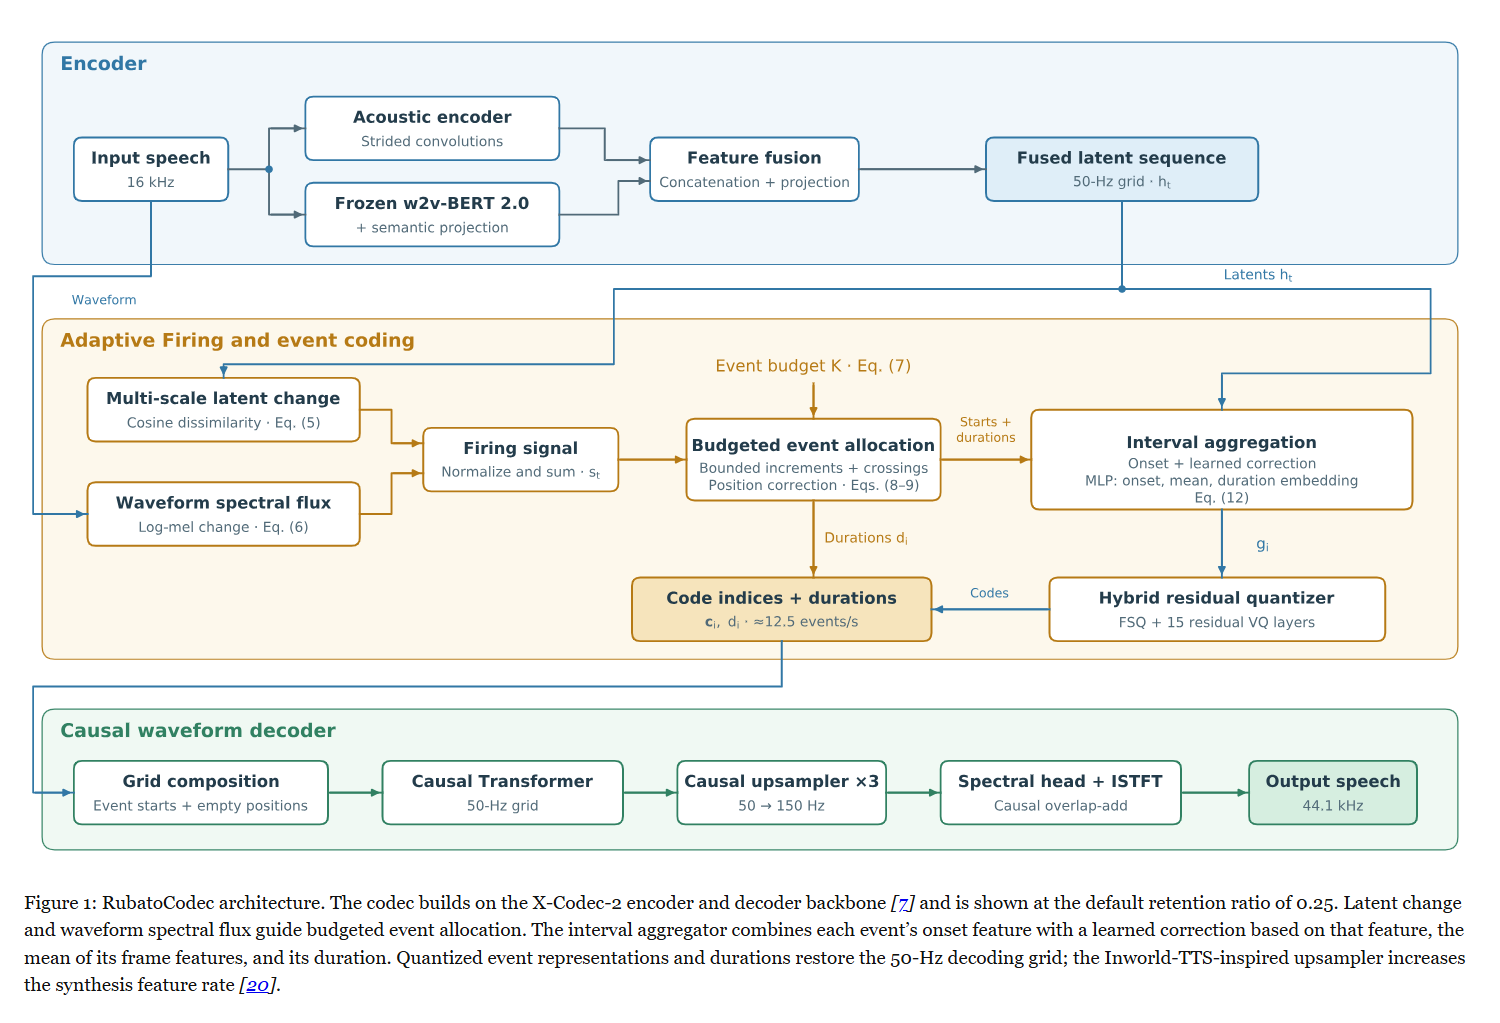
前序问题 :语音生成每秒只留少量token,停顿和爆破音却分到一样多位置,短音节容易丢。若每句话的token总数又任意浮动,生成长度更难预测,能否总量固定、局部分得灵活?方法直觉 :同样长的一句话给同样事件预算,变化快的地方切得密,近静音切得疏;每个事件同时存内容码和持续时间,生成器按事件而非固定时钟输出。本文贡献 :基于 X-Codec-2,将16千赫输入编码到50赫兹、每格20毫秒;用潜特征变化与频谱通量定边界,K=round(RT),T为编码格数、R为保留比例,默认R=0.25,即约12.5事件/秒。二分和单调校正保证恰好K个非空事件。聚合起始特征、区间均值和时长,默认每事件16层量化,每层4096个码值;事件不是单个码索引。内容与时长恢复50赫兹网格,因果解码输出44.1千赫音频。TTS先生成各码层,再生成时长,可逐事件解码。
原文图1|RubatoCodec,默认保留比例0.25,沿用X-Codec-2编解码主干。潜特征变化和波形频谱通量分配固定预算事件;聚合器把事件起点特征与由起点、区间均值、时长得到的可学习修正相加。量化内容和时长恢复50赫兹网格,再经受Inworld TTS启发的上采样提高合成特征率。
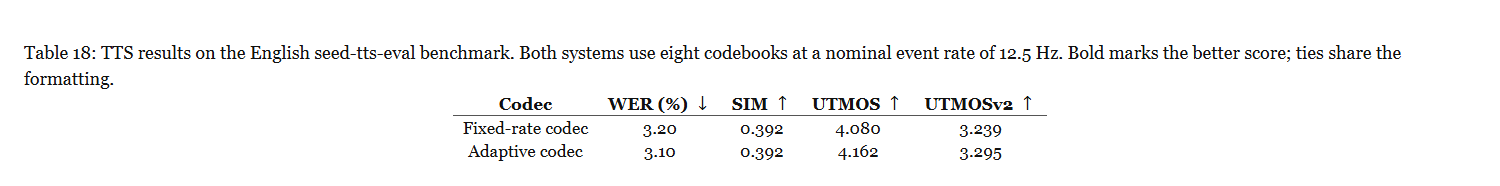
实验效果 :匹配 Qwen3-0.6B 主干、8码本、12.5事件/秒,English seed-tts-eval1088句零样本音色克隆:逐句平均词错误率 WER 为3.20%→3.10%,音色余弦相似度均0.392,预测音质 UTMOS 为4.080→4.162,非人工听评分。H200上另测250个合成代码事件,解码平均11.07毫秒/事件,对应平均约80毫秒声音;不包含文本模型生成、首包等待及在线编码,不能称11毫秒端到端语音响应。
原文表18|English seed-tts-eval语音合成。两系统同为八码本、标称12.5事件/秒。WER为逐句平均词错误率,越低越好;SIM为参考音色余弦相似度;UTMOS/UTMOSv2为预测音质,越高越好,非听评。粗体为较优值,并列共同标记。
批判点评 :全句归一化、双向语义编码和未来特征用于分配,当前编码不是在线因果;流式成立于已给事件的解码。TTS生成88.3%句子恰中预算、99.9%差不超过1事件,并非全数严格满足。长事件偶有不自然停顿;码层与时长都计入比特率,不能把12.5事件/秒当12.5索引/秒。代码 与权重 可查,未运行。
10. CADRE:静止镜头与移动镜头压法不同
Rethinking Video Autoencoders for Interactive World Models | Kyutai;巴黎路桥学院 LIGM、巴黎理工学院、法国国家科研中心、古斯塔夫埃菲尔大学;加州大学伯克利分校 | arXiv:2610.30129
关键词 :视频自编码器, 交互生成, 时空压缩, 动作延迟
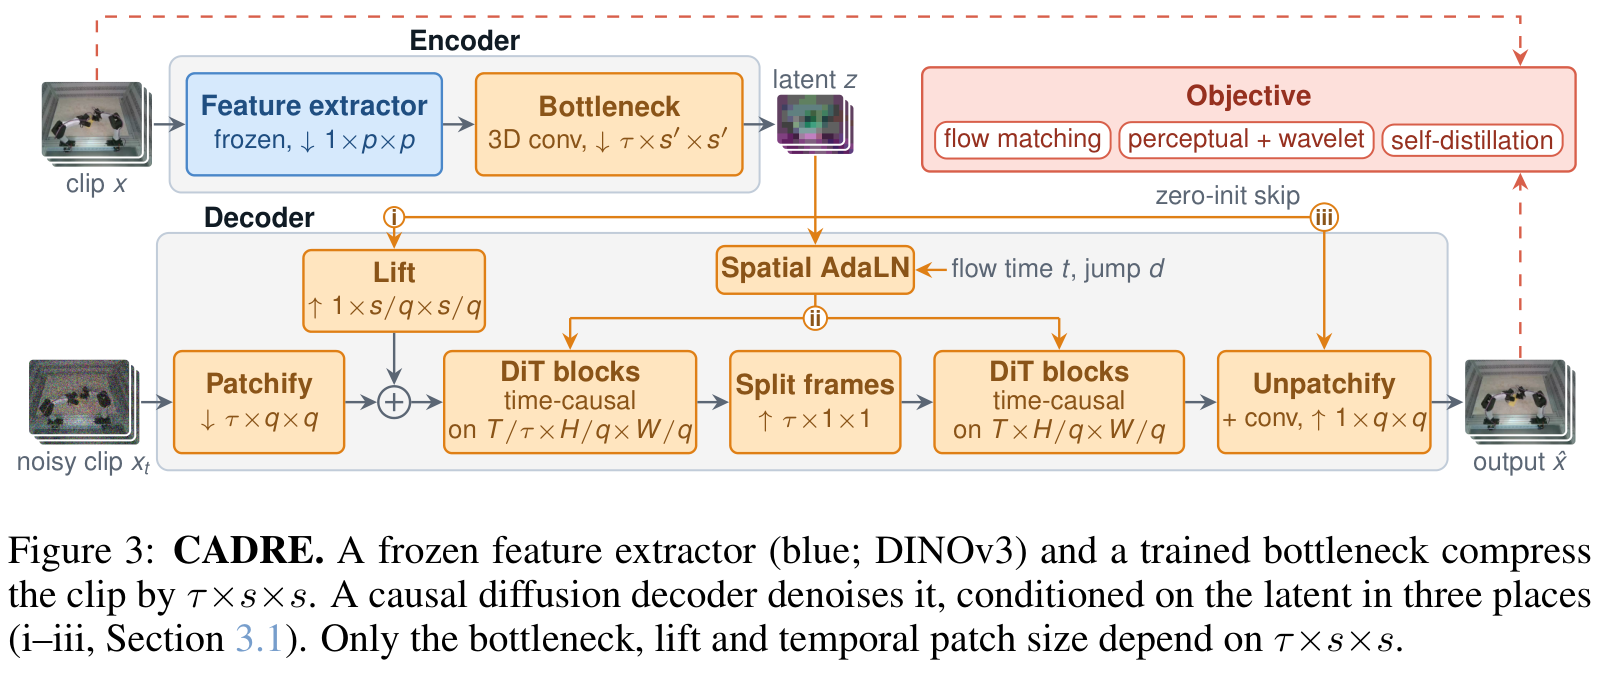
前序问题 :交互视频模型帧率够高,按键后却等很久才有反应;重建图像看着清晰,手里小物体的运动又丢了。该压时间还是压空间,不能只凭单帧画质决定。方法直觉 :每多合并几帧,模型少算几次,但动作也要等这几帧凑齐。静止镜头的时间重复多,移动镜头每帧都见新内容,两者应把压缩预算放在不同轴。本文贡献 :冻结 DINOv3 逐帧特征,训练三维卷积瓶颈;用因果扩散解码器、空间自适应归一化和零初始化跳接恢复像素。自蒸馏让一次大步匹配两次小步,得到一或二步解码。七种自编码器只改变时间因子τ和空间因子s,τ×s×s分别表示合并帧数与两轴压缩;潜变量由同一12亿参数、动作条件世界模型生成。训练自编码器用7.6万小时混合视频,比较另含五种既有自编码器。
原文图3|CADRE。冻结DINOv3提取器与训练瓶颈按τ×s×s压缩,τ为时间帧数、s为空间压缩因子;因果扩散解码器在输入、逐层空间调制及零初始化跳接三处接收潜变量。仅瓶颈、升维及时间分块随压缩点变化;训练结合感知、三维小波、流匹配及自蒸馏目标。
实验效果 :机器人/人体操作、驾驶/室内导航四环境,统一20帧/秒、288×512,每环境2048例;给40真帧后生成96帧,评最后16帧。相同2×32×32压缩,单步扩散解码相对回归版将 FVD 视频分布距离降低1.4至2.5倍,越低越好;回归版像素PSNR反而更高,可能来自模糊。单H100、世界模型8步,仅若干配置达到20帧/秒且动作延迟小于230毫秒,不是所有压缩点。
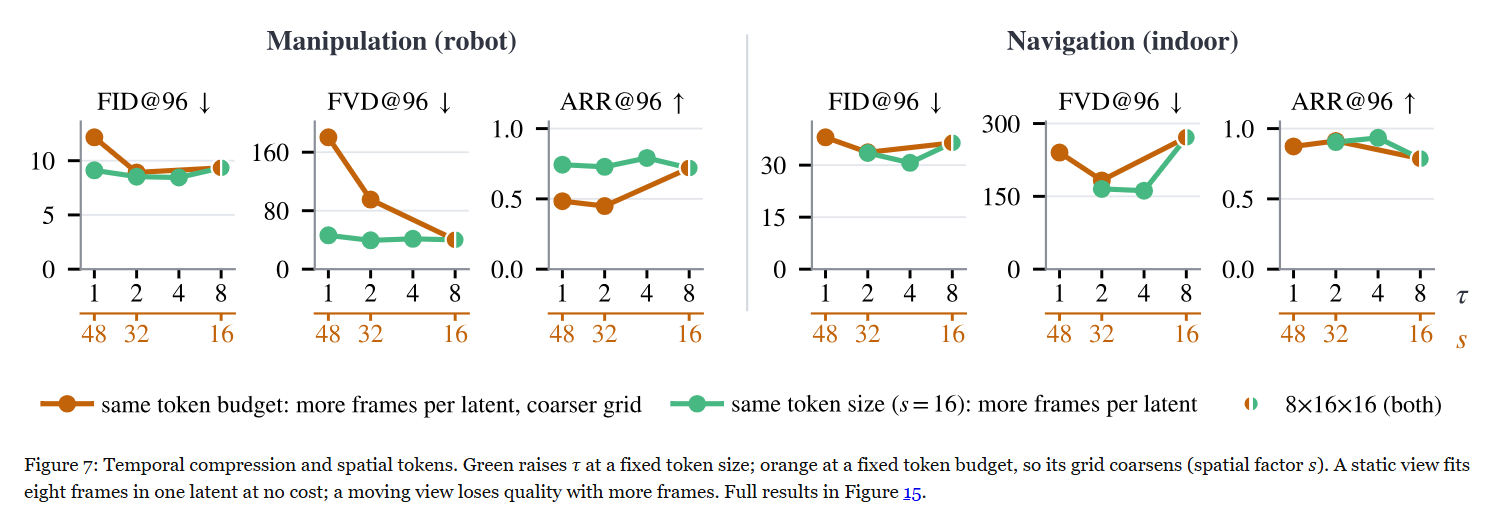
原文图7|时间压缩和空间token的取舍。绿色固定空间块尺寸增加时间合并τ,橙色固定token总预算,空间格随之变粗。静止视角允许更多时间合并,移动视角合并过多会伤运动质量;完整结果在原文图15,不能仅凭图像清晰度选择压缩。
批判点评 :动作可恢复比 ARR 是冻结探针读回动作的决定系数,再除以真视频探针分数,不等于机器人成功率。固定约1100个token/16帧时,移动镜头偏2×32×32、操作偏8×16×16;粗空间格会使操作FVD变差2.4倍而图像分布几乎不变。相机运动只是主要解释,场景/动作也随域变化,不能当严格单因子因果结论。项目 与代码 可查,未复现。
趋势观察
辅助监督要阻断捷径
FCP不让未来分支串看并去掉文字条件;CausalAlign以干预诊断找层;Attn-Forcing直接约束历史注意力响应,训练目标决定留下何种信息。
保持不是把编辑力度调小
HorizonComposer把可靠监督细化到像素,ER-Chord固定清理前总能量,JointLight先处理几何提示的噪声;各自保护的对象不同。
收益必须和成本放在一起
Attn-Forcing约多13%推理时间,ALLOT需离线探测,JointLight完整223秒含几何与渲染;少步骤、少缓存都不直接等于端到端更快。
压缩的计数单位影响结论
RubatoCodec每事件有多个码层和时长;CADRE同时压时间与空间;HorizonComposer的2潜帧对应8输出过渡帧,先说明单位再读数字。
今日讨论
FCP在标准教师强制训练上增加未来块预测;匹配训练数据与设置的Wan2.2-TI2V-5B图生视频对照中,Physics-IQ总体评分从30.4提高到33.8。若要检验收益是否来自隔开中间画面的未来块监督,而不是额外分支容量或训练计算,哪些证据能说明等数据、等计算的消融成立,并同时排除推理质量与成本退步?
人工智能炼丹君 整理 | 2026-10-23


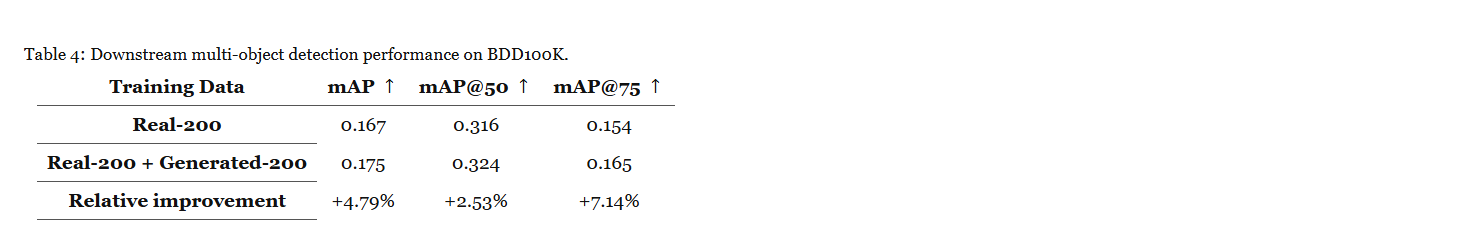

评论 (0)