今日 AIGC 论文速览
今日共 10 篇 · 参考视频与统一编辑 2 篇 · 文字与生成轨迹编辑 2 篇 · 数值编辑评测 1 篇 · 视频渲染与计算分配 2 篇 · 语音合成训练 1 篇 · 骨架与四维生成 2 篇
重点论文标题列表
AVE (快手):换人换声一起对上口型VitronEdit (新加坡国立):几何监督只加给多视角TextRIRO (复旦):打乱真文字学会保留字形Dancing Diffusion (中科院自动化所):接着同一生成过程改下半场ABACUS (CEA LIST):加三个物体到底加对几个
选读入口:要把视频中的人连声音一起替换,先读AVE;图像、参考视频和多视角编辑想共用模型,接着读VitronEdit。真实招牌换字读TextRIRO,已生成图片想保留街景再改对象读Dancing Diffusion;验收“加三个”是否真加三个,用ABACUS。把灰模或骨架渲成视频读SolarRenderer,研究算力分配读MoDDiT。语音只错几个字时看LoCA的局部训练;三维资产需要可重放动作看JCA,生成场景需要换镜头和时间看AEON。
今日论文速览
1. AVE:换人换声一起对上口型
Edit in Sync: Unified End-to-End Audio-Visual Editing for Human-Centric Videos | 快手可灵;北京大学;香港中文大学;清华大学;香港大学;国防科技大学 | arXiv:2610.27947
关键词 :参考视频编辑, 音画同步, 人物替换, 双向监督
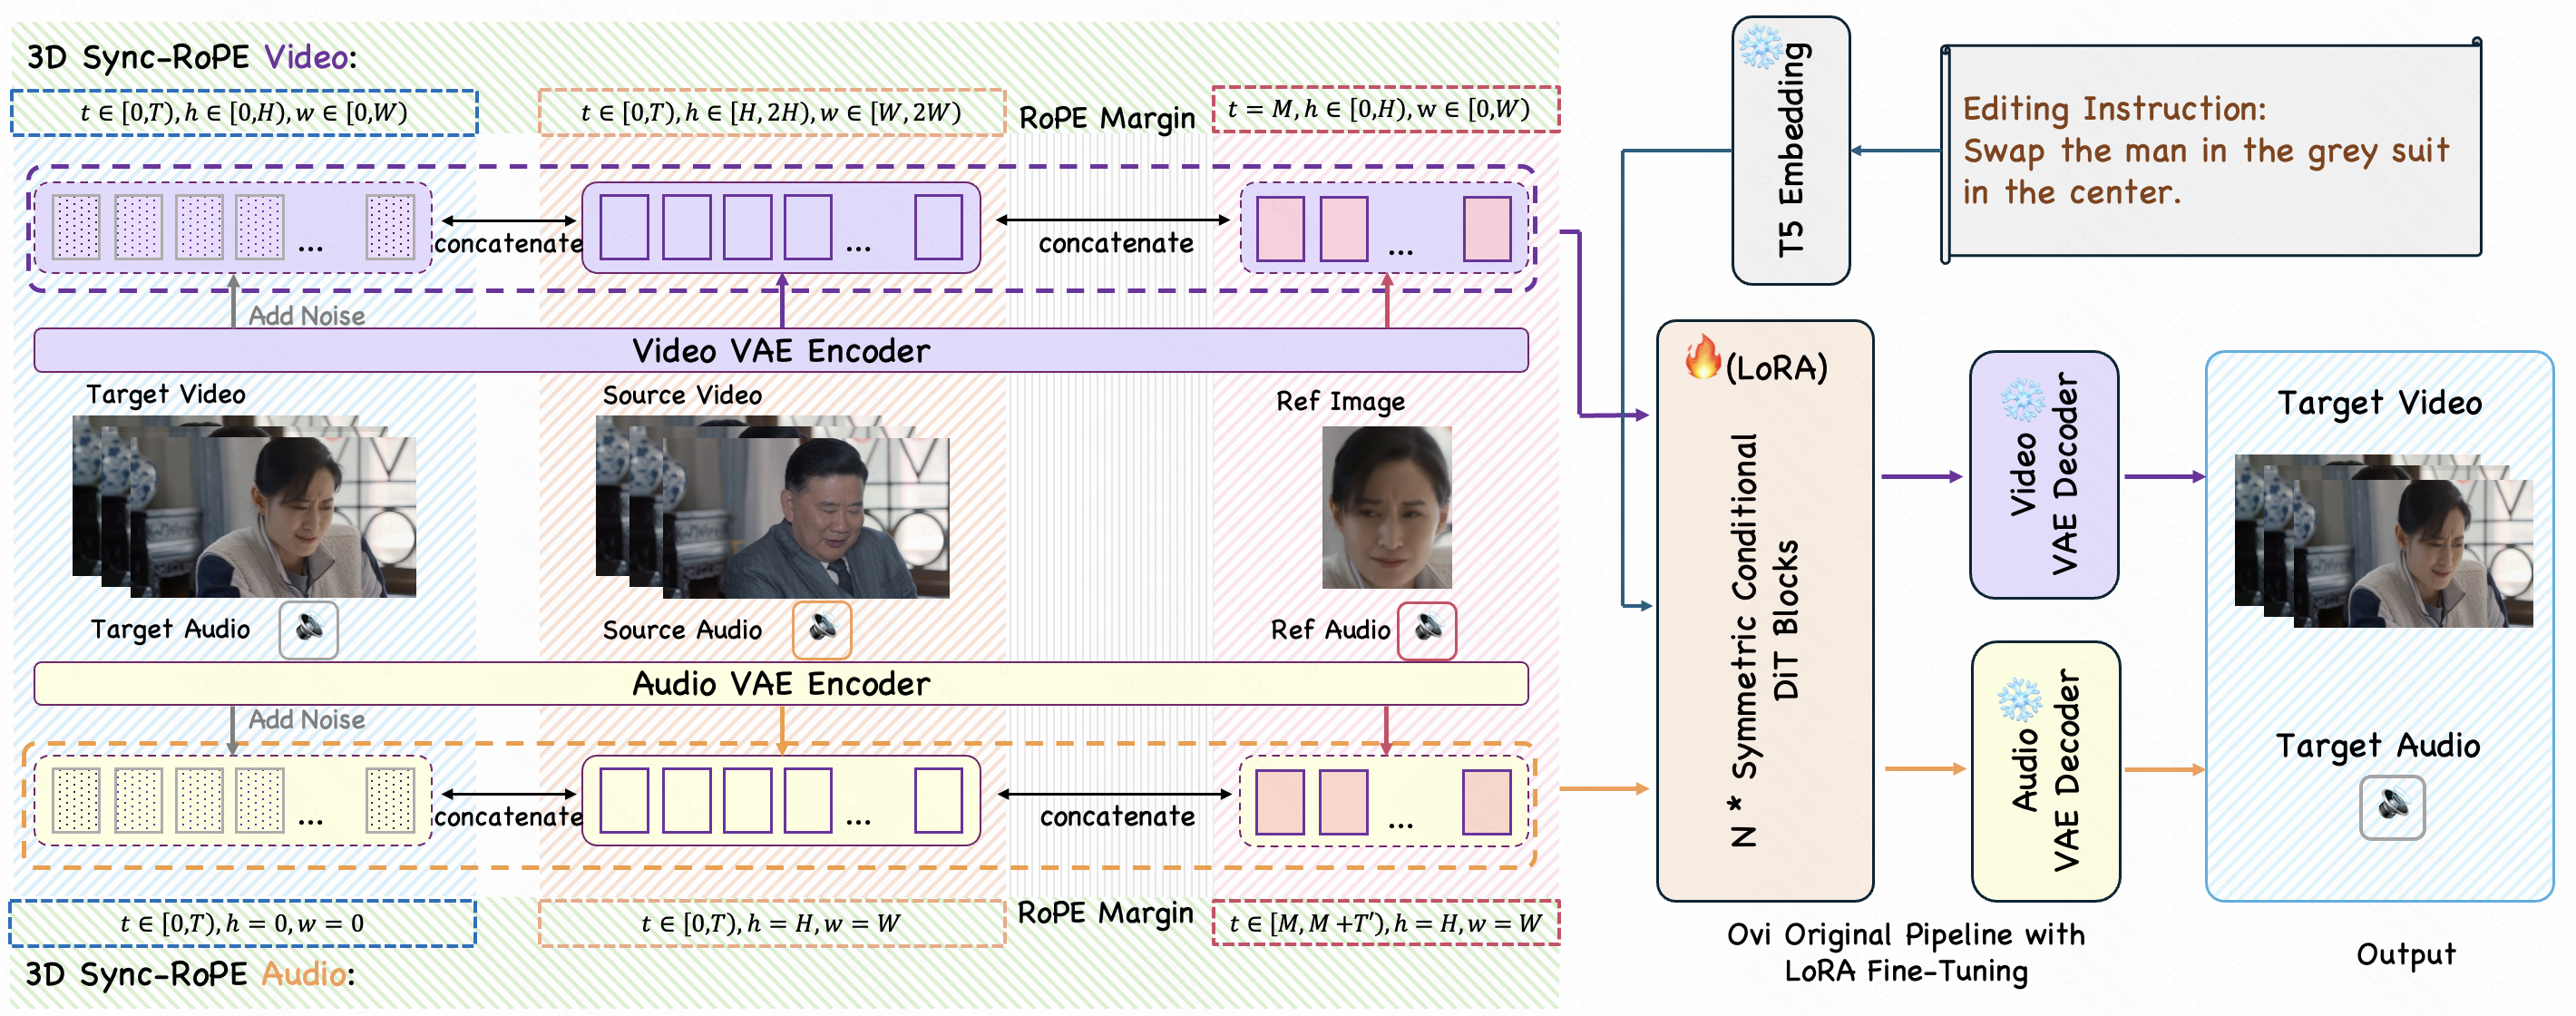
前序问题 :把视频里的人换成参考人物,外观对了,声音却还像原人,重新配音又对不上嘴。人物插入和删除也必须同时处理画面与声音,怎样保住原动作、说话时序和背景?方法直觉 :让声音和画面在每一层互相参考,而不是先换脸再配音;把源片、目标和参考放在共同时间轴,又用不同坐标标明它们的角色,避免把参考当成待生成内容。本文贡献 :以 Ovi 音视频联合主干为基础,自编码器将音画压到潜空间,两路扩散 Transformer 用双向跨注意力交换信息。Modality-Aware Sync-RoPE 是区分角色的旋转位置编码:源与目标共享时间坐标,空间轴偏移区分角色,参考隔开固定距离;音频时间频率按长度比缩放。先预热音频,再联合适配,最后精修高质子集;正向学合成编辑,反向以真实片为目标,降低合成痕迹。所有阶段用秩256的 LoRA 低秩适配器,基础权重冻结。
原文图4|AVE总览。模态感知同步旋转位置编码通过角色专属的三维坐标偏移,区分源、目标与参考特征,同时维持共同时间轴上的对应关系。
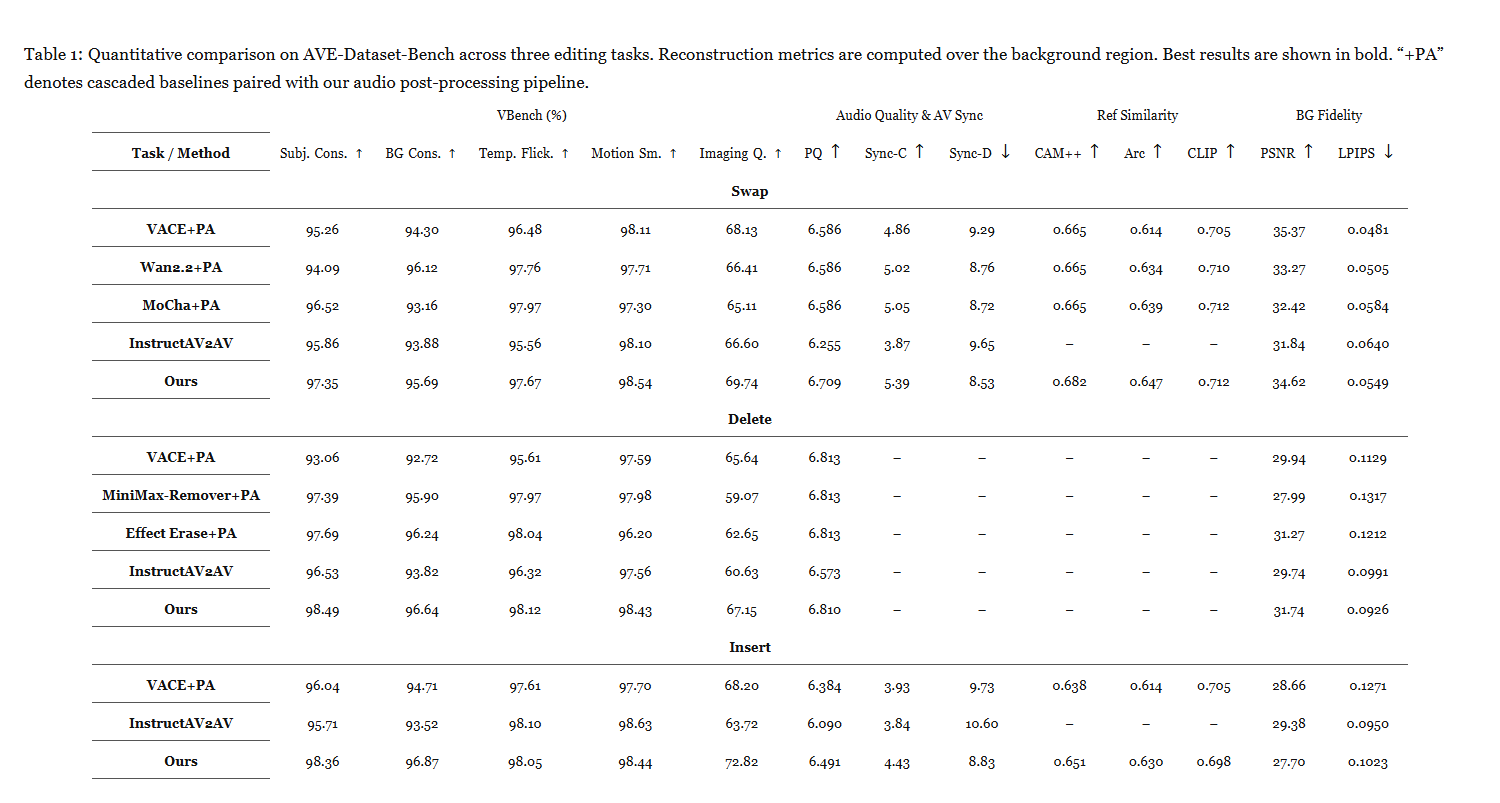
实验效果 :评测192例,替换、插入、删除各64例;片长121帧、24帧/秒、480×832,音频16千赫。替换时,口型同步置信度 Sync-C 为5.39,对照 Wan2.2+音频后处理为5.02;同步特征距离 Sync-D 为8.53/8.76,越低越好。音色相似度 CAM++ 为0.682/0.665,人脸相似度 ArcFace 为0.647/0.634;原文正文曾把两项名称写反,此处按指标定义校正。替换背景像素信噪比 PSNR 为34.62,低于 VACE 对照35.37。
原文表1|AVE-Dataset-Bench三种编辑任务的定量比较。重建指标仅在背景区域计算,粗体标最好结果;+PA表示串联基线接入作者音频后处理。音色/人脸相似度以表头CAM++/Arc为准,正文有名称互换。
批判点评 :无掩码指模型推理不要求空间掩码,数据合成与背景评分仍用分割。自建数据约10万对;阶段1约12万对含外部真实移除子集,不能混算。联合阶段用24张 H800,未报端到端推理耗时与峰值显存;背景保持并非全面领先。原文仅承诺后续开放代码、权重和基准,尚无核实的下载入口;不作会议背书。
2. VitronEdit:几何监督只加给多视角
VitronEdit: Universal Visual Editing across Images, Videos, and 3D Scenes | 新加坡国立大学;牛津大学 | arXiv:2610.27049
关键词 :统一编辑, 参考视频, 几何后训练, 跨模态迁移
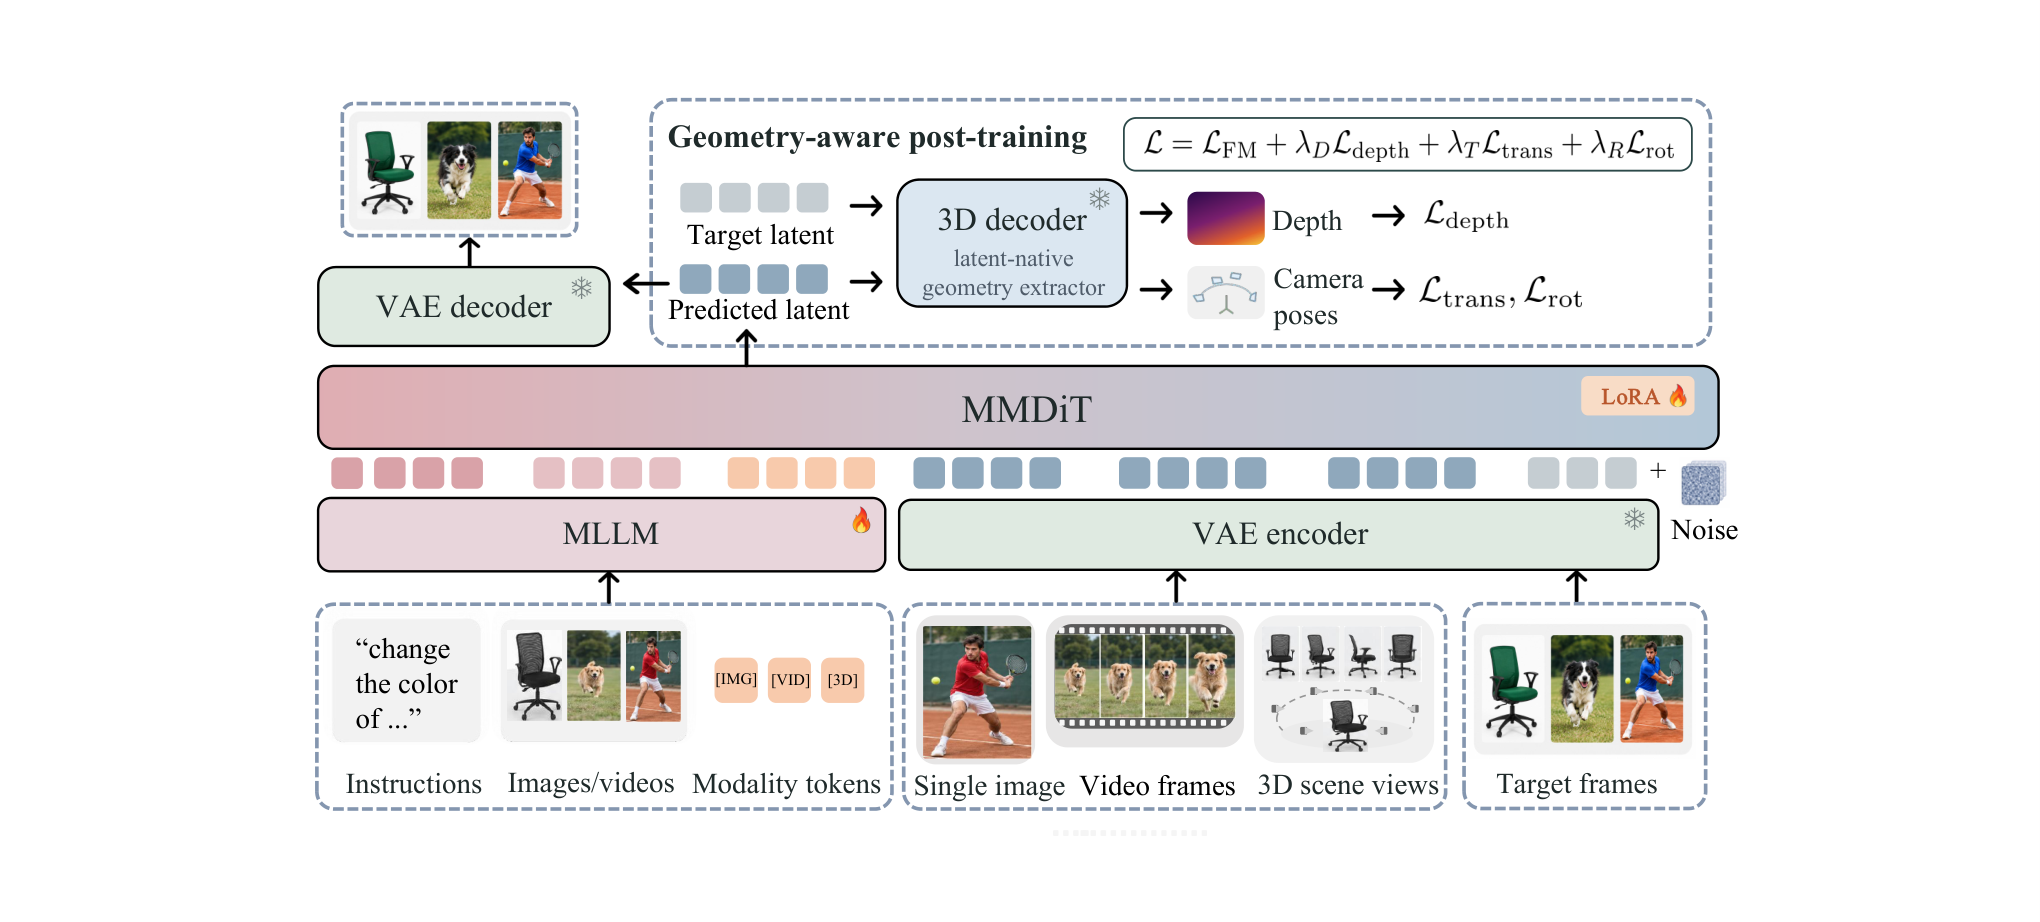
前序问题 :图像、视频编辑有大量配对数据,三维场景却缺。把每个视角单独改好,转动镜头时颜色、材质又不一致;能否借图像和视频的编辑经验,再学会跨视角保持?方法直觉 :把图像看成静止序列、视频看成时间序列、三维看成多视角序列,用同一模型编辑;几何老师只管真正有多视角约束的三维样本,让共享主干吸收这种约束。本文贡献 :从 OmniWeaving 初始化,主干为 HunyuanVideo-1.5,Qwen2.5-VL 多模态语言模型编码指令与参考;用模态 token 即模态标记区分三类序列。先图像、再视频、后加入三维数据训练,约253万样本;秩32 LoRA 适配后再训练500步。冻结几何提取器从预测及目标潜变量估深度、相机,约束归一化深度、相对旋转及局部/全局位移。默认仅三维样本用几何损失。图像复制5帧,多视角首帧保留、其余各重复4次,减轻时间压缩损失。
原文图2|VitronEdit总览。几何后训练以冻结的三维解码器,从预测与目标潜变量估计深度和相机姿态,作为几何监督。
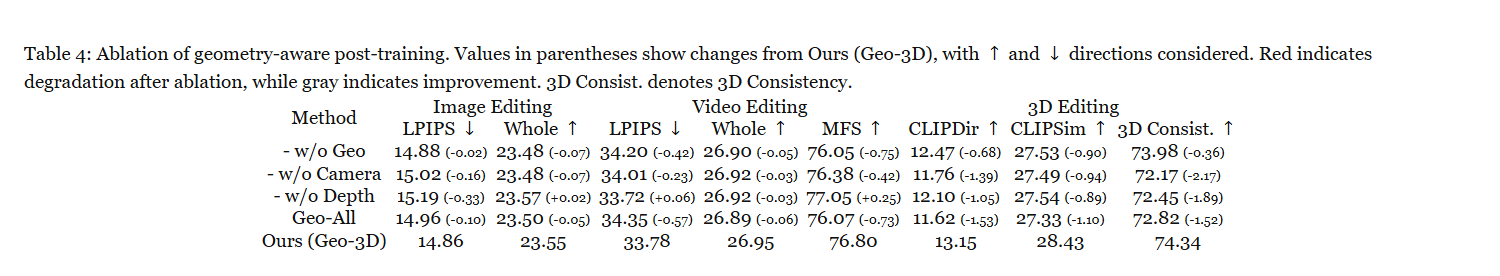
实验效果 :消融中,仅三维加几何监督相比不加:跨视角编辑方向一致性73.98→74.34,图像感知距离 LPIPS 为14.88→14.86、视频34.20→33.78;距离越低越好,这些分数沿用原文100倍标度。三维主榜一致性74.34,对照 EditSplat 为66.30。视频指令/参考混合榜的整帧图文语义相似度26.95高于初始化26.50,但源内容 PSNR 为17.32低于19.57;不能称所有编辑指标提升。
原文表4|几何后训练消融。括号为相对仅三维加几何监督Geo-3D的变化,按指标上升/下降方向判优劣;红色表示移除后退步、灰色表示改善。3D Consist.为跨视角编辑方向一致性。
批判点评 :三维评测16项任务,26个编辑视图经50步生成后重新训练三维高斯30000次;评分8视图来自重建训练视图,并非留出新视角。额外几何网络与序列复制有训练/内存代价,训练用8张 H200,缺完整推理账单。只覆盖静态场景多视角编辑。项目 与代码 可查,仓库内称UniVEdit,本稿未运行。
3. TextRIRO:打乱真文字学会保留字形
Real In, Real Out: What If We Only Use Real Data for Scene Text Editing? | 复旦大学可信具身智能研究院;上海市多模态具身智能重点实验室;腾讯微信视觉团队 | arXiv:2610.27592
关键词 :场景文字编辑, 真实数据, 自配对, 长文本识别
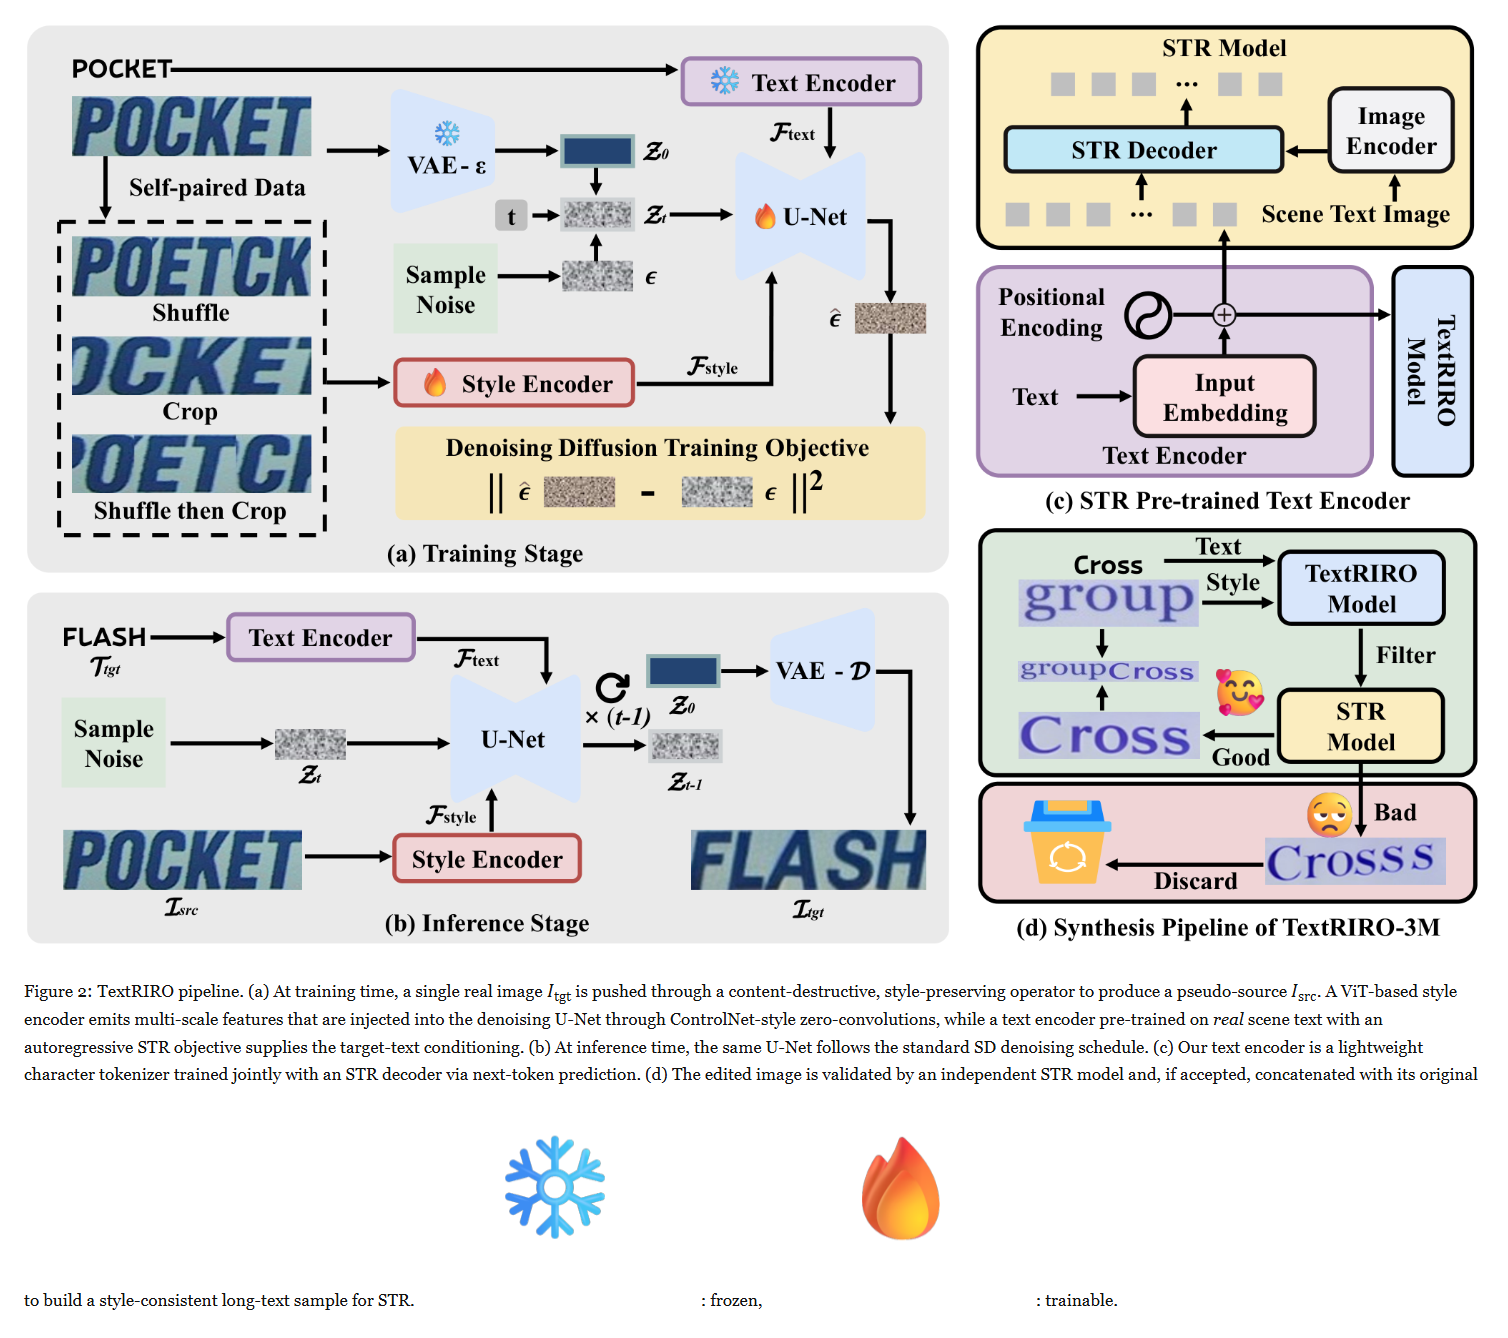
前序问题 :把招牌上的词换掉,字体、透视和灯光却像贴纸。真实的改字前后配对图很少,合成字训练又容易带来不自然风格,能否让一张真图自己提供监督?方法直觉 :沿文字长轴按字符数切条,打乱再裁一段:原来写什么被破坏,笔画、材质与局部弯曲仍在。模型拿这份残缺风格和目标文字,重建完整真实原图。本文贡献 :Shuffle&Crop 按概率先打乱字符列,再连续裁剪,也保留只裁剪分支。ViT 视觉 Transformer 提取多尺度风格,经 ControlNet 式零初始化卷积注入去噪 U-Net;文字编码器先在真实场景做下一字符预测,学习字符辨认。冻结 SD2.1 自编码器与文字编码器,训练 SD1.5 U-Net 和风格编码器。输入64×256;识别器过滤生成图,再与原图拼成长文字,构建 TextRIRO-3M。
原文图2|(a)训练时对一张真实目标图破坏文字内容但保留风格,构成伪源图;视觉Transformer风格编码器输出多尺度特征,经ControlNet式零卷积注入U-Net,真实文字识别预训练的文字编码器提供目标文字。(b)推理沿稳定扩散标准去噪日程。(c)轻量字符分词器与识别解码器共同做下一字符预测。(d)独立文字识别器检验编辑结果,通过后与原图拼成长文本。图标分别表示冻结和可训练。
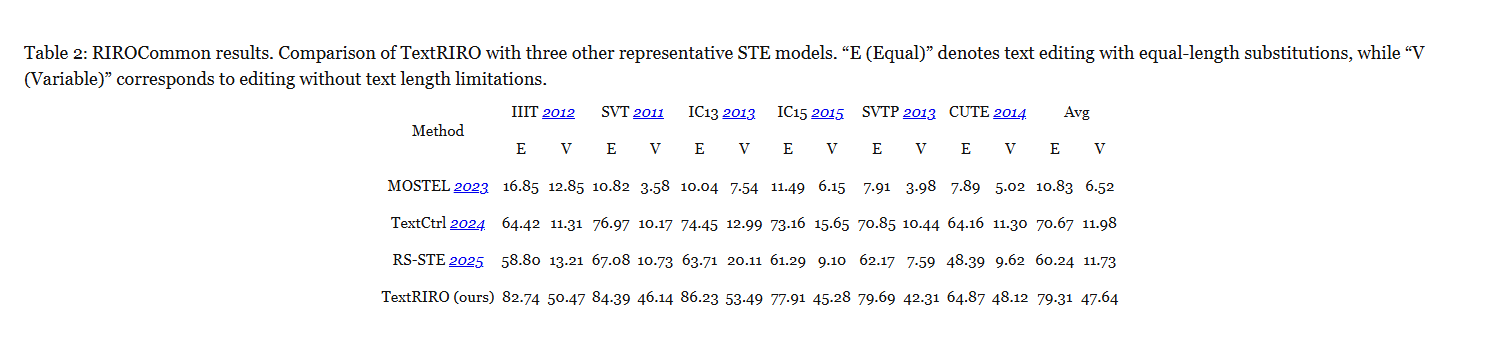
实验效果 :ScenePair 整词识别准确率85.23%,TextCtrl 为84.67%、RS-STE 为91.80%;FID 生成分布距离41.53,优于后二者43.78/49.59,越低越好。RIROCommon 六数据集平均,等长改字79.31%、不限长度47.64%,对照 RS-STE 为60.24%/11.73%。V100、20步、批量32报告平均0.20秒/图,是批处理摊销;文字预训练36 GPU小时、编辑微调180 GPU小时。
原文表2|RIROCommon结果,与三种场景文字编辑模型比较。E为等长替换,V为不限制文字长度的编辑;每个数据集分别统计,Avg为六集平均,不能把两类任务混算。
批判点评 :不等于识别准确率全面最好;识别器偏好和图像真实感是两回事。混合打乱裁剪也未在每种曲线布局上胜出。长文本对称拼接产生偶数长度偏置,附录混入非对称拼接缓解;对极长文本仍应单验。arXiv 备注明确已被 NeurIPS 2026 接收。代码 已提供入口,本稿未运行模型。
4. Dancing Diffusion:接着同一生成过程改下半场
Dancing Diffusion: Learning Continuous Programs for Image Generation and Editing | 中国人民大学;中国科学院自动化研究所 | arXiv:2610.28003
关键词 :图像编辑, 条件编译, 前缀复用, 保持取舍
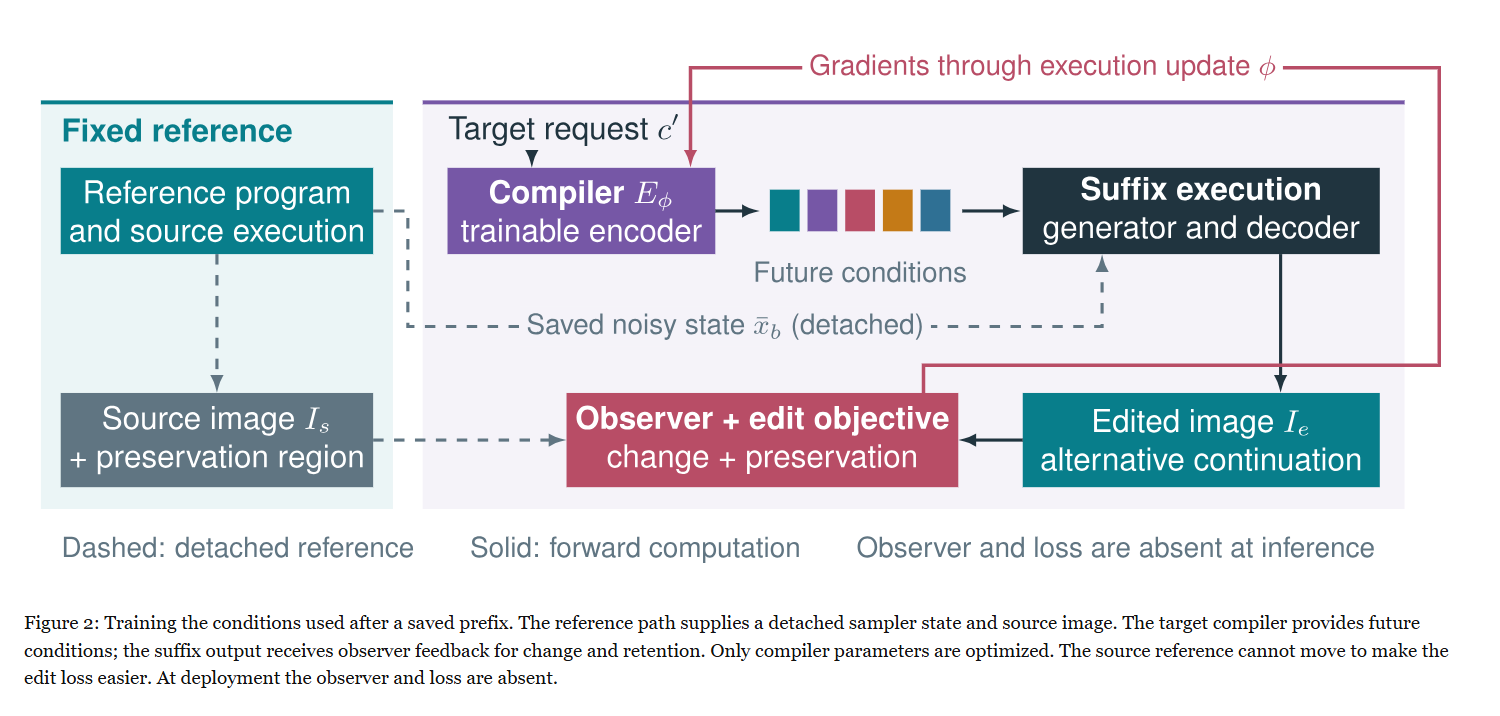
前序问题 :把生成的红公交改成红卡车,从噪声重画会连街道也换掉;太晚切换指令,背景保住了,车又改不动。能否把生成的前半段保存,再只改后续操作?方法直觉 :把一条指令编成按时间执行的连续条件块,像安排分段任务。保存已经走过的采样状态,再替换尚未执行的条件;前史相同,但未来像素仍可能改变。本文贡献 :冻结 SANA-600M 生成器,以2.731亿参数编译器输出3个条件块及有效位置掩码;总采样30步。训练时参考图与前缀状态停止梯度,固定视觉观察器同时评价目标变化与非编辑区保持,梯度穿过去噪后缀只更新编译器。上线不调用观察器。6/12/12 表示三块各执行6、12、12步;它含40次更新的联合热身,其他日程初始化不同,不能当严格单变量比较。
原文图2|训练已保存前缀之后的条件。参考路径给出停止梯度的采样状态和源图;目标编译器提供未来条件,后缀输出接受关于变化与保留的观察器反馈。仅优化编译器,源参考不能跟着移动降低损失;部署不含观察器和损失。
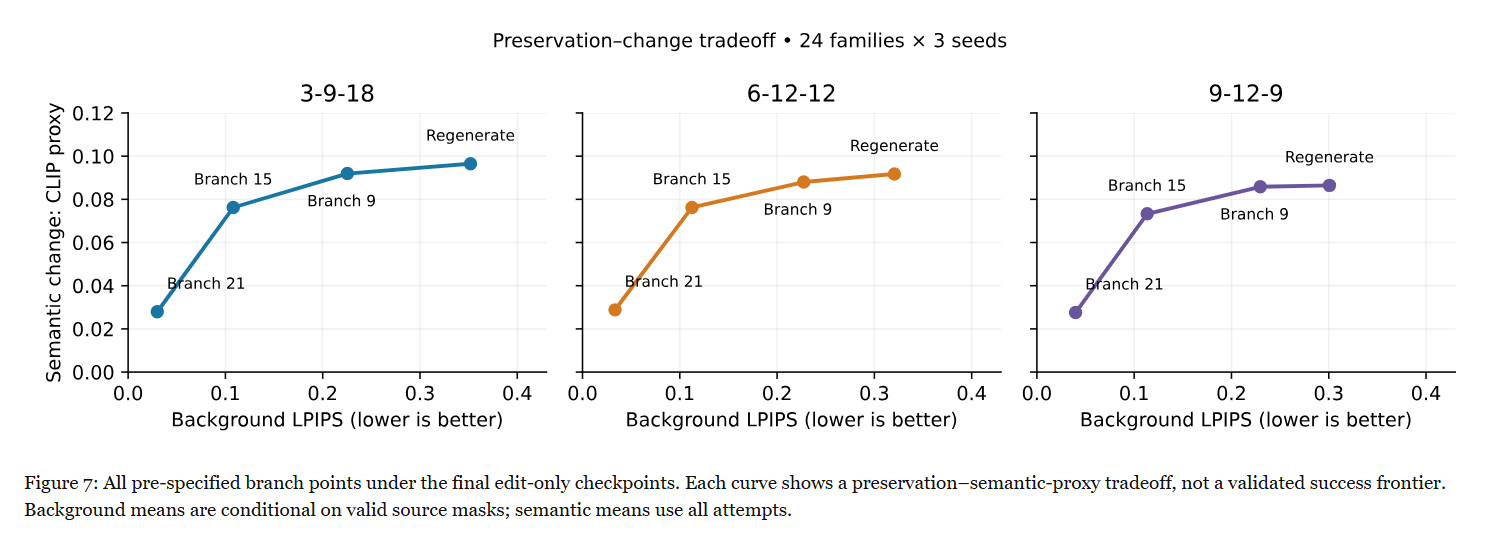
实验效果 :24类请求、每类3个种子,在6/12/12日程第9步分支,背景 LPIPS 感知距离由重新生成的0.321降到0.227,越低越好;图文目标差值变化0.092→0.088,保持更多但编辑略弱。第21步分支距离0.033、语义变化0.029,编辑进一步受限。A800上4个后续版本,重算9.20秒、缓存7.18秒,省22.0%;不含加载和写文件,每份潜状态32 KiB。
原文图7|最终仅编辑目标检查点上的全部预先规定分支点。每条曲线表示背景保持与语义代理之间的取舍,并非已经验证的成功率前沿;背景均值只计有效源掩码,语义均值用全部尝试。
批判点评 :三种日程各仅一次训练;背景均值只覆盖有效源掩码,语义均值用全部尝试。原生指令切换同样能缓存,省时不全来自学习。操作可寻址不证明语义完全解耦,类别替换也不等于完整指令成功。主要研究生成轨迹,未建立真实照片编辑或推理能力结论;原文无核实的方法代码入口。
5. ABACUS:加三个物体到底加对几个
ABACUS: A Benchmark for Image Editing Models to Assess Object Category and Counting Under Scene Conservation | 巴黎萨克雷大学;法国原子能与替代能源委员会LIST实验室 | arXiv:2610.28316
关键词 :图像编辑评测, 对象计数, 场景保持, 实例核验
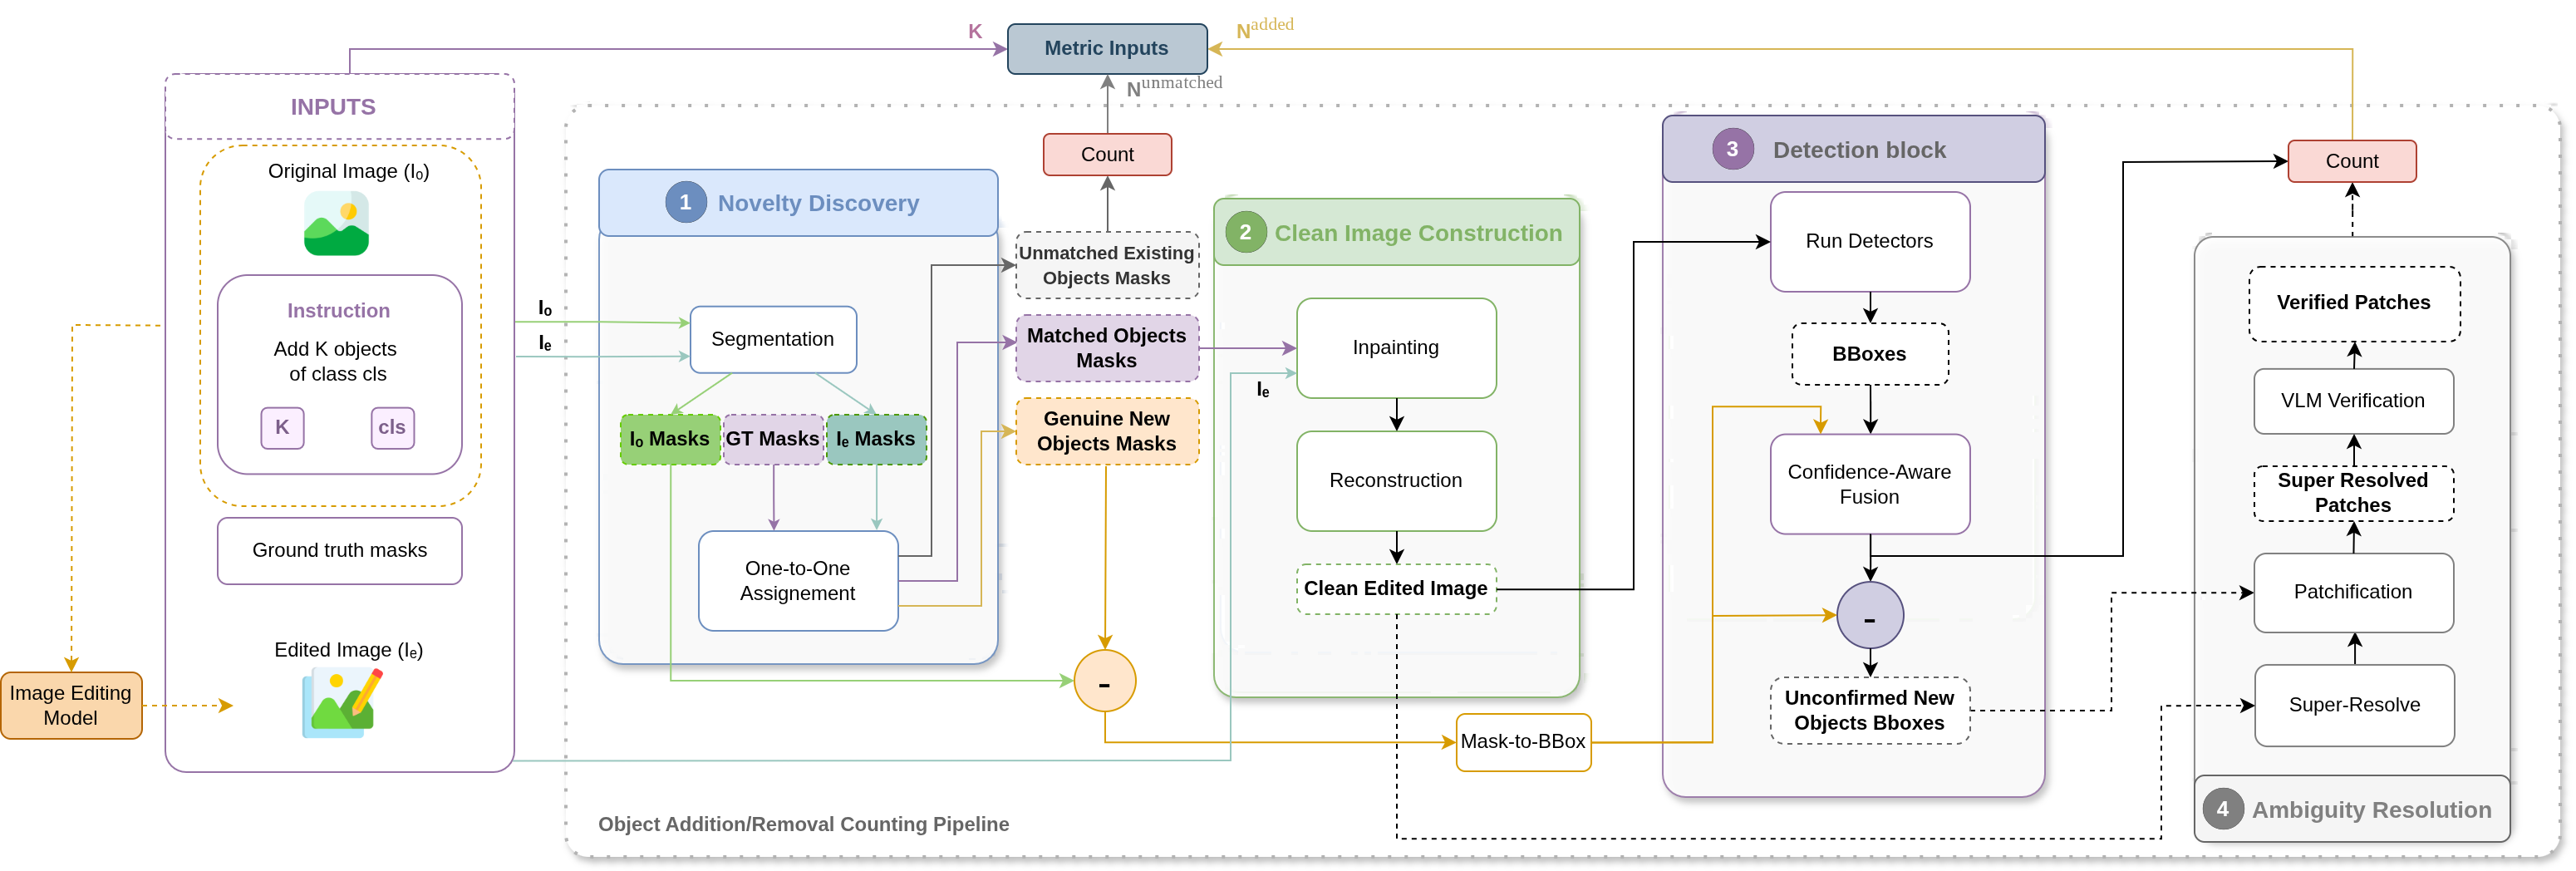
前序问题 :让编辑器加三把椅子,画面很漂亮却只多两把,甚至把旧椅子挪过去充数。再找视觉语言模型打分,它自己也可能数错,该怎样验证新增了什么?方法直觉 :先把每个旧物体和编辑后的对应物匹配,再把保留对象遮掉,只数真正新增的;同时检查旧物体和背景是否被破坏,三件事缺一不可。本文贡献 :在 COCO 的80类可数物体上,经双检测器与人工检查构造3845张图、10944条加/删/改指令。评测用 SAM 分割定位、实例一一匹配、非生成式修补去掉保留内容,再由 RF-DETR 与 Co-DETR 双检测确认。仅6.4%的歧义实例交给 Qwen3.6-27B 回答类别是否正确,不让它计数。CF 为数量符合度,按实际数与请求数的调和口径;SC 为光流位移与多尺度结构相似度的背景保持;OC 为旧类别保留度。先分别取均值,再把三因子相乘。
原文图3|添加与删除共享四阶段管线:输入原图Io、编辑图Ie及全景分割真值,依次做新实例发现、干净图构建、双检测器检测与视觉语言模型歧义消解,输出确认新增数和未匹配原实例数;在添加/删除任务中,这两个输出互换用途。
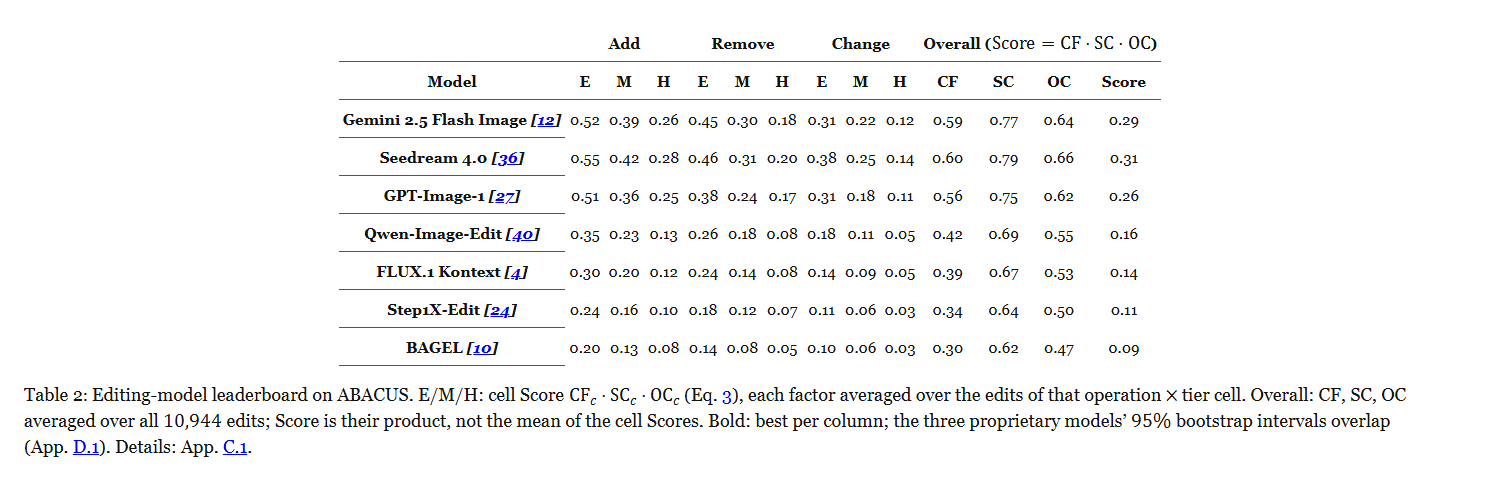
实验效果 :600张人工计数图上,精确计数一致率0.82,单视觉语言模型0.55、单检测器0.28;困难档0.76而非满分。七编辑器主榜 Seedream4.0 总分0.31,Gemini2.5为0.29、GPT-Image-1为0.26;这是三项均值的乘积,不是成功率,也不是各难度格子总分的平均。三个商业模型的95%自助采样区间重叠,不能据点估计断言显著排名。
原文表2|ABACUS编辑模型榜。E/M/H为易/中/难,每个操作与难度格先对数量CF、场景SC、旧类别OC分别取均值,再相乘;整体在10944次编辑上同样先均值后相乘,并非格子分数平均。粗体为列最好;三个商业模型95%自助采样区间重叠。
批判点评 :只覆盖80类固定词表,不评艺术风格,也不约束“必须改哪一把”。检测与匹配有偏差,源图筛选偏向可检测对象;多工具评测另有运行成本,未报端到端时延显存。arXiv 明确 WACV 2027 数据集评测轨接收。代码与数据 可查,未在本稿重跑。
6. SolarRenderer:粗略结构四步变成写实视频
SolarRenderer: Few-Step Generative Reference Rendering | 新加坡国立大学;LIGHTSPEED;香港中文大学(深圳);SLAI;香港科技大学(广州) | arXiv:2610.28630
关键词 :生成式渲染, 结构参考, 四步蒸馏, 流式视频
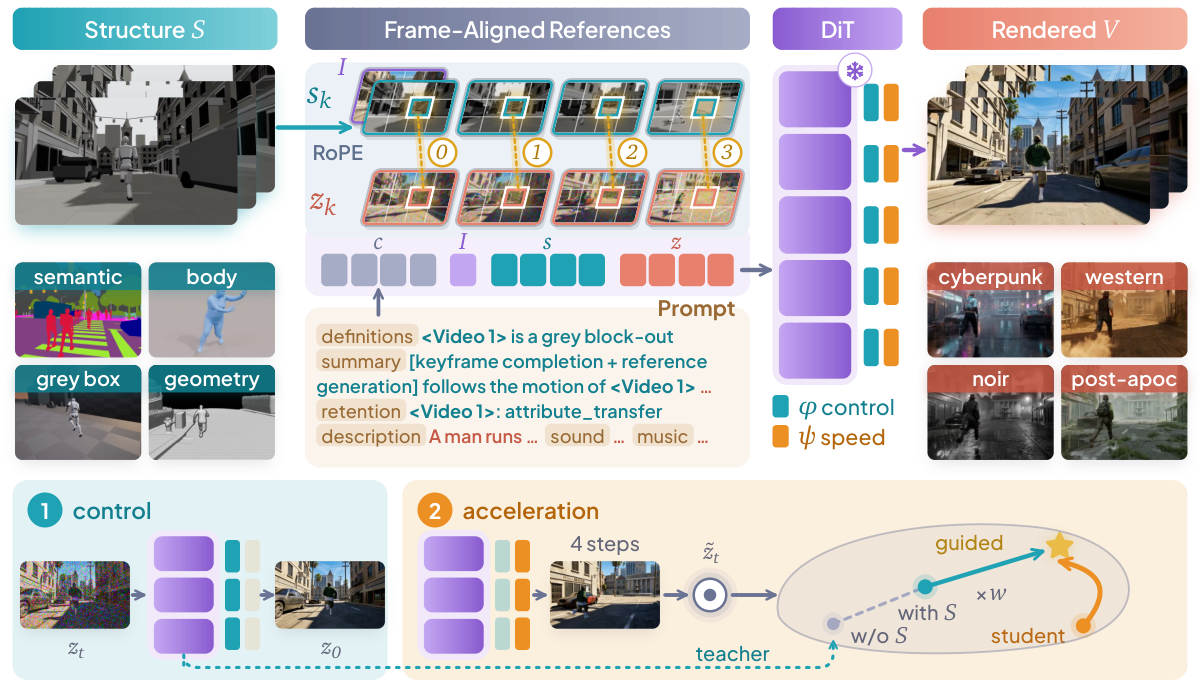
前序问题 :游戏引擎给出灰模、骨架或深度,布局和动作是对的,缺少真实材质与灯光。生成模型把结构当宽松参考,又容易改镜头;怎样既听结构又少跑几十步?方法直觉 :让每个结构特征与要生成的那一帧占据相同位置,用文字说明该继承布局而不要继承灰色外观;先学会控制,再单独训练四步加速,避免速度目标毁掉控制。本文贡献 :冻结330亿参数 MiniMax-H3,结构视频进入原生参考通路,不加类型标记,旋转位置编码逐帧对齐;参考近干净、目标带噪,区分二者。秩384控制 LoRA 用流匹配训练后冻结;加速 LoRA 的前128秩取自 DMAD,扩到384秩。分布匹配教师比较有/无结构预测,以1.5倍方向引导加强结构,再监督学生;另有五次分布估计更新对应一次生成器更新。训练含13.6万片段、约243小时。
原PDF图2(HTML图1)|冻结扩散Transformer通过原生参考通路读结构视频,序列包含文字、可选首帧I、结构潜变量sk及带噪潜变量zk;sk使用对应zk的时间/空间旋转位置,首帧位置为0。(1)控制LoRA以流匹配训练。(2)加速LoRA向结构引导教师蒸馏,教师由有/无结构S预测差、按强度w外推。
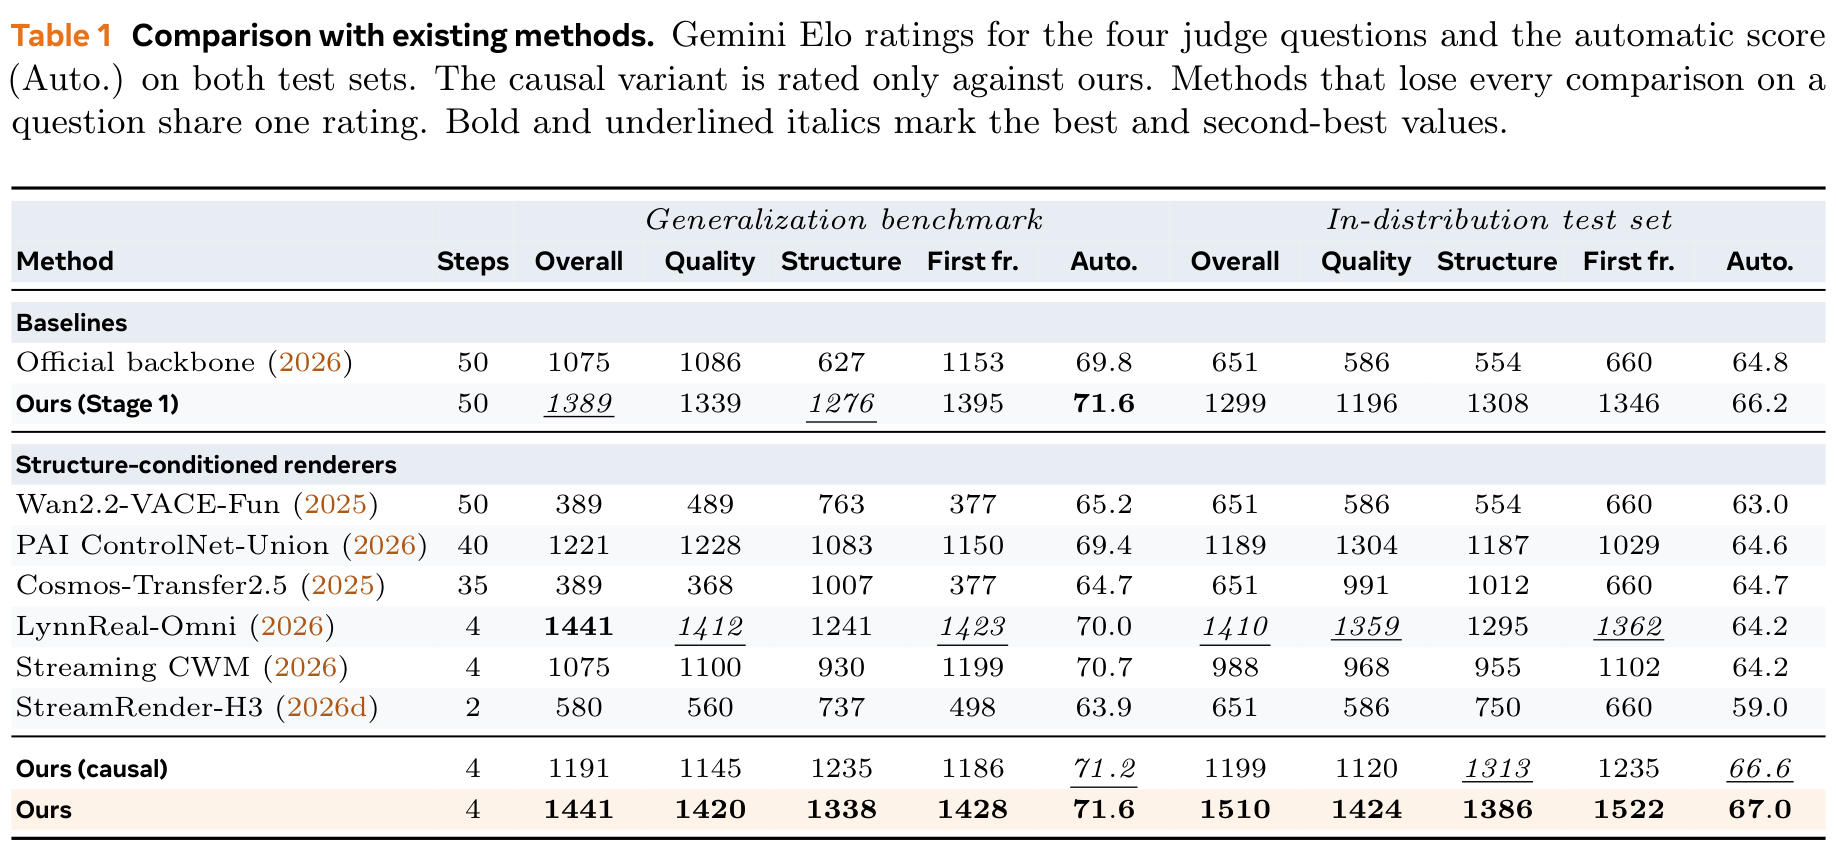
实验效果 :泛化集208例、57段结构视频、16种表示,其中11种训练未见;另有53段有真值测试。四步生成158帧约209秒,对照50步2562秒,为12.3倍;原文只注明单 GPU,未给该测速的具体卡型。泛化总体偏好 Elo 为1441,与 LynnReal-Omni 持平,结构评分1338高于1241;Elo 是成对模型裁判拟合,不是准确率。
原PDF表1|在泛化与分布内两测试集上比较四个问题的Gemini成对偏好Elo及自动分。因果版只与本法比较;某问题全部对局失利的方法共用一个评分。粗体与下划线斜体分别为最好和次好。不同测试集的评分分别拟合。
批判点评 :分块因果版另报768p最高28帧/秒,具体硬件、首块延迟与峰值内存不完整,不能与209秒拼成同一配置。仓库另有4张B200的社区流式集成,不能反推论文测速条件。因果版偏好较低且颜色会漂移;快速镜头四步也不总胜50步。项目 与代码 含推理、权重及训练入口,未复现。网页与PDF图号不同,配图按PDF。
7. MoDDiT:把算力留给真正难画的块
MoDDiT: Simple Token Routing in Diffusion Transformers | BOLD(British Open-ended Learning and Discovery,英国开放式学习与发现团队) | arXiv:2610.28086
关键词 :扩散Transformer, token路由, 动态计算, 视频蒸馏
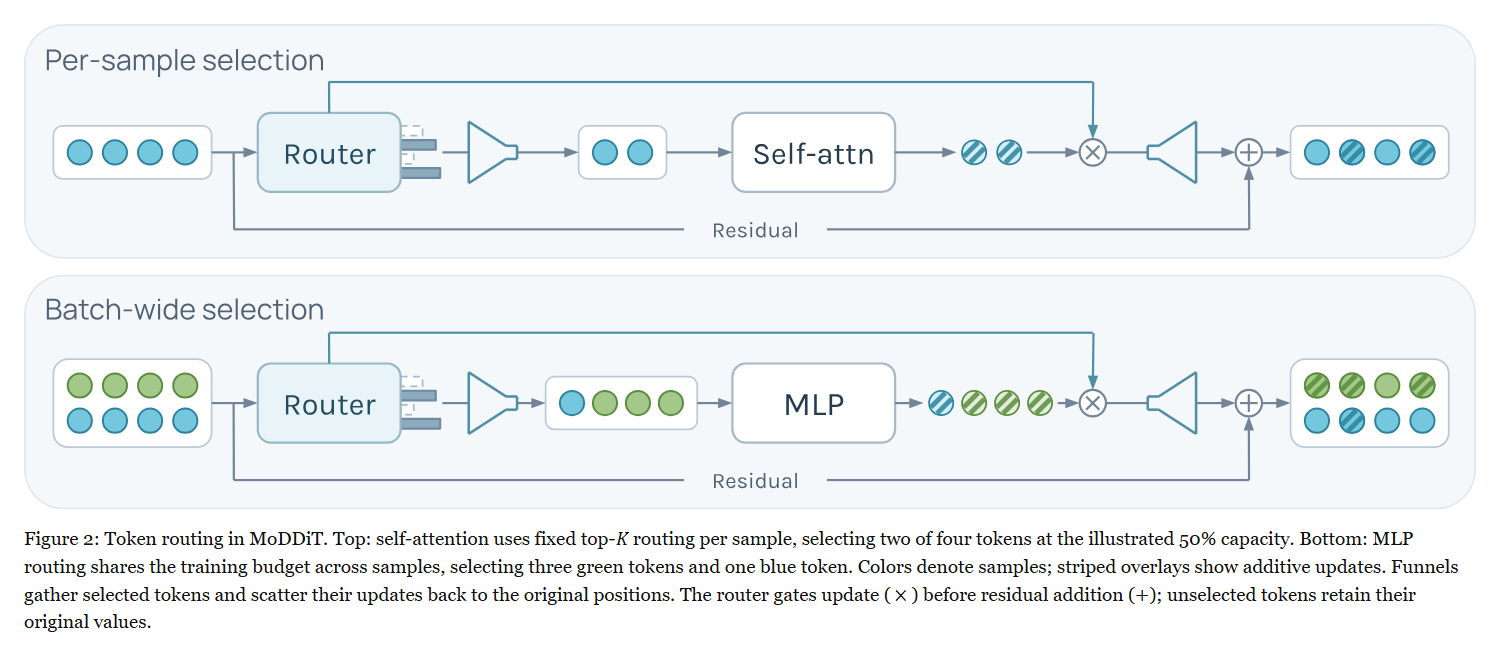
前序问题 :天空和背景很容易,细纹和运动边缘很难,扩散网络却让每个特征块经过同样多计算。能否绕过不需要更新的 token,把预算留给困难部分?方法直觉 :像分诊一样先给特征块打分:自注意力每图固定选一部分,前馈网络则让不同样本共享总预算;未选中的内容直接沿残差通路保留。本文贡献 :两层小网络为 token 即网络处理的特征单元打路由分;训练加 Gumbel 随机扰动探索,渐退为确定性选择。自注意力每样本选前K项,K是被选数量;MLP 多层感知机把批次与 token 合并分配预算,推理用训练跟踪阈值估计分配。图像模型从零训练100万步,交替把一层密集块换成两层稀疏块,因此12.5%容量不是只花12.5%总计算。
原文图2|上:自注意力逐样本固定选前K个特征,50%容量示例选四个中的两个。下:MLP前馈路由跨样本共享训练预算,选三个绿色和一个蓝色特征;颜色表示样本,条纹表示加性更新。漏斗收集被选特征并将更新散回原位置,路由门控先乘更新再做残差相加,未选特征保持原值。
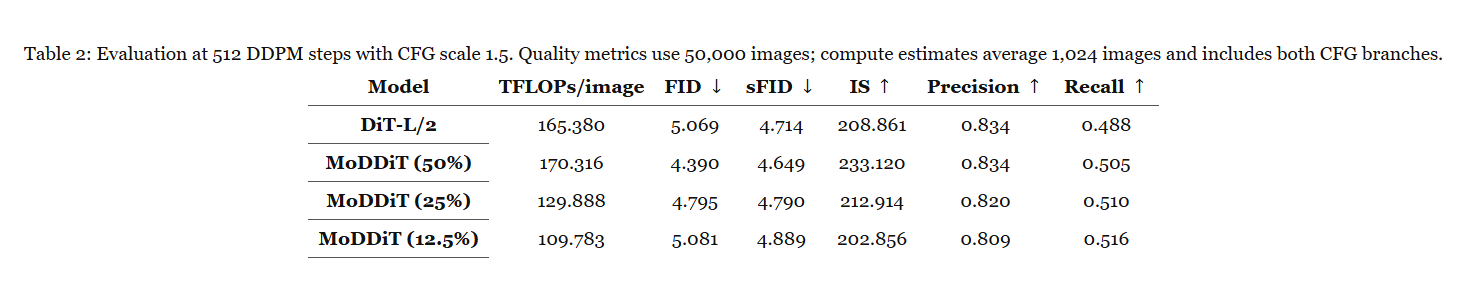
实验效果 :ImageNet 256×256、512次去噪更新、引导强度1.5、50000图:25%容量模型 FID 分布距离4.795,对照 DiT-L/2 为5.069;每图去噪算量129.888/165.380万亿浮点运算,含条件与无条件两支,不含解码。空间版 FID 为4.790/4.714,反而略差。视频四步学生 Funnel20 的 VBench 总分77.69低于密集82.07,算量省23.98%。
原文表2|512次DDPM去噪更新、无分类器引导强度1.5。质量用50000张图;算量估计平均1024张,含条件和无条件两支,不含自编码器解码;FID为生成分布距离,sFID为空间版,IS为Inception评分,Precision/Recall为生成精度和覆盖率。
批判点评 :图像批量32只测得1.64对1.55图/秒,小批量反而更慢,收集/散回特征的开销抵消省算;未报硬件对应的全面延迟优势。1X视频预测的稀疏/密集训练批量256/217,等更新次数并非等数据量。BOLD 是PDF列出的机构,邮箱含牛津域名不能直接当牛津机构背书;未核实方法代码入口。
8. LoCA:一句话错在哪里就改哪里
LoCA: Local Credit Assignment for Reinforcement Learning of Autoregressive Flow-Matching TTS | 灵光乍现科技(上海) | arXiv:2610.28035
关键词 :语音合成, 局部信用, 流匹配, 强化学习
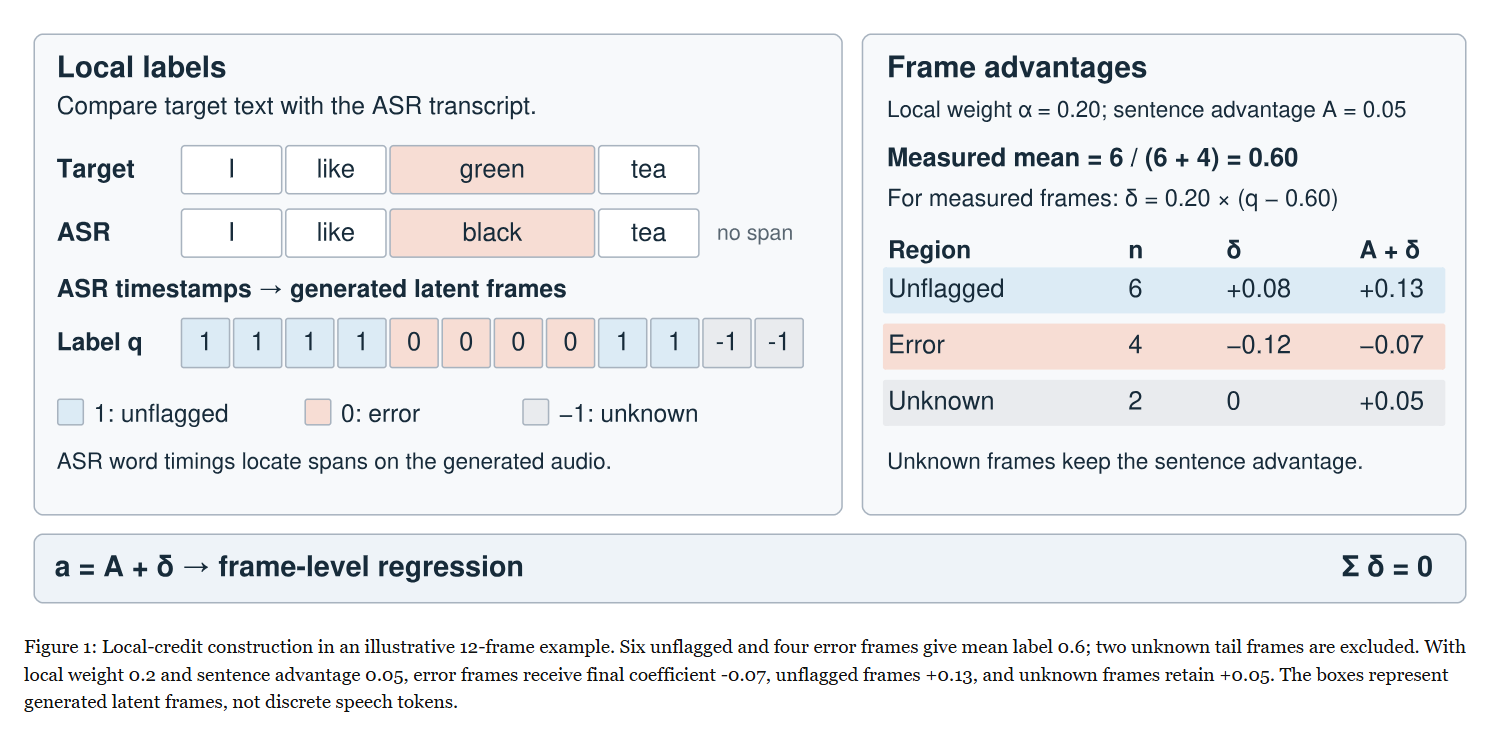
前序问题 :合成一句话只错一个词,整句奖励却一起惩罚,正确片段也被推走;负奖励持续排斥同一个输出,还可能把训练推得过头。怎样只针对可靠的局部错误调整?方法直觉 :先把识别出的错字对齐到声音时间段,给错误与未报错片段不同增量,未知尾部不判错;再给正向拟合和负向排斥各设停止线,够了就停。本文贡献 :在20亿参数 VoxCPM2 自回归流匹配语音主干上,每条件采8个候选,以识别内容误差和说话人相似度计算句级优势,即样本相对组内平均的好坏。自动语音识别 ASR 与强制对齐定位错误,映射到生成潜帧;已测标签在句内中心化,局部权重0.2,保持系数均值,未知帧增量为零。正负回归阈值相对冻结参考误差计算,另加参考锚定;只控制固定重放目标,不保证参数不会漂移。
原文图1|12个生成潜帧的局部信用示例,非离散语音token。6个未报错帧、4个错误帧的标签均值0.6,另2个未知尾帧排除;局部权重0.2、句级优势0.05时,错误/未报错/未知帧最终系数为-0.07/+0.13/+0.05。
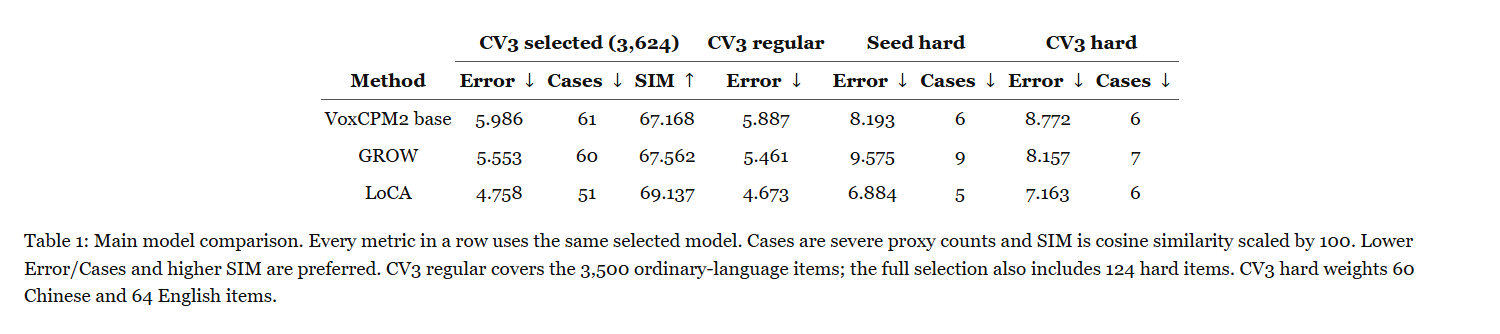
实验效果 :固定 CV3 子集3624条,含3500普通及124困难例;相同选定模型整行比较:内容错误率4.758%,原模型5.986%、GROW 5.553%;严重失败代理51/61/60条,音色余弦相似度乘100为69.137/67.168/67.562。中文按字符、其余语言按词算逐句错误率,再按样本数加权。均10个流匹配步、引导强度2、固定种子,无重试或多次挑最好。
原文表1|主模型比较,每行所有指标来自同一选定模型。Cases为严重失败代理数量,SIM为余弦相似度乘100;错误率/数量越低越好,相似度越高越好。CV3普通集3500条,加124条困难例组成完整选择集;困难中文60、英文64条按样本数加权。
批判点评 :去阈值变体严重失败仅44条,比完整法少,但错误率及音色更差;不能称所有风险均下降。俄语未进本次强化训练池,错误率6.219%→4.723%,严重代理却5→6;不代表底座没见俄语。训练多候选、ASR和对齐有额外成本,缺完整耗时显存表。单主干单种子,严重代理不是人工听评;未核实方法代码入口。
9. JCA:视频动作也能导出骨架动画
Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs | NVIDIA;以色列理工学院;巴伊兰大学 | arXiv:2610.28632
关键词 :运动视频联合生成, 任意骨架, 相机对齐, 交叉注意力
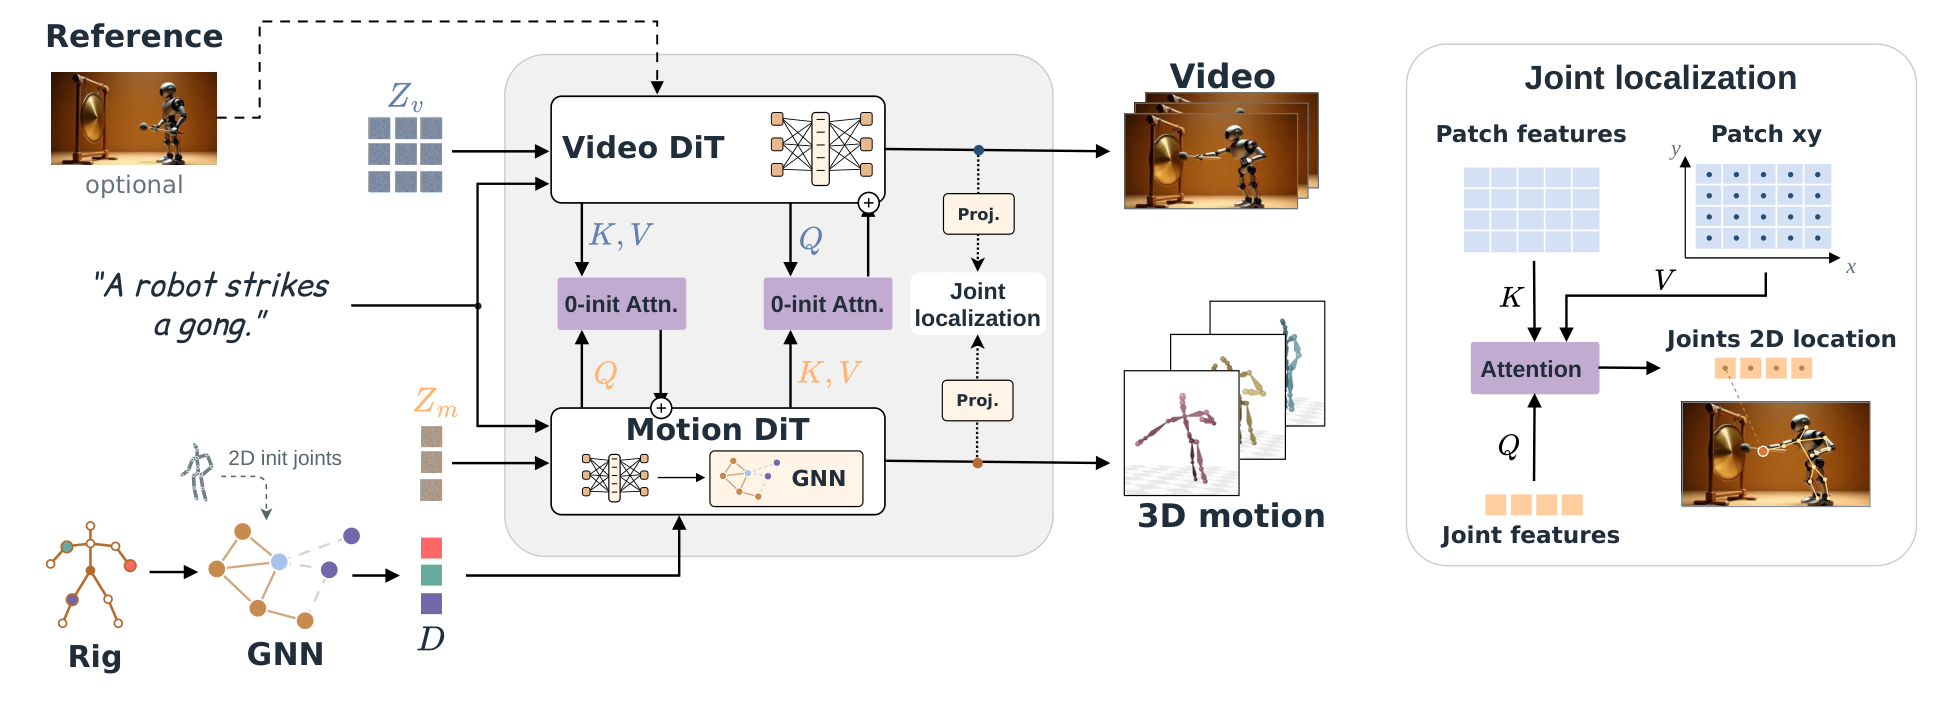
前序问题 :视频里猴子跳得很自然,三维资产却拿不到可重放动作;先生成视频再估骨架,动作可能超出这只猴子的关节结构。能否从一开始就让指定骨架参与生成?方法直觉 :让懂视频的模型和懂骨架的模型一起去噪,相互通报动作进度;再找出每个三维关节投影到画面的哪里,拟合把两者对齐的相机。本文贡献 :图网络按关节名、静止几何、可选参考图二维位置和骨骼连接编码;每关节每帧18通道,含旋转、位置及变化。独立运动去噪器与 Wan2.2-I2V-A14B 图生视频主干通过零初始化双向跨注意力桥耦合,附加模块共1.78亿参数。定位头将关节对视频块的注意力加权成二维坐标,再拟合每片一台静态透视相机。数据约20万视频/运动对,含11.8万资产视频、6万人体、2.7万机器人;运动单独预训另用12.5万序列。
原文图2|输入文字、骨架及可选参考图,同时去噪视频潜变量Zv与运动特征Zm。图网络把骨架及图中关节二维位置编码成逐关节描述D;运动块沿骨骼边传播图注意力。零初始化双向跨注意力桥让两路交换特征,训练起点保留各自预训练行为。右侧定位头用关节查询视频块,按块坐标加权得到二维关节,与三维运动形成对应点以拟合相机。
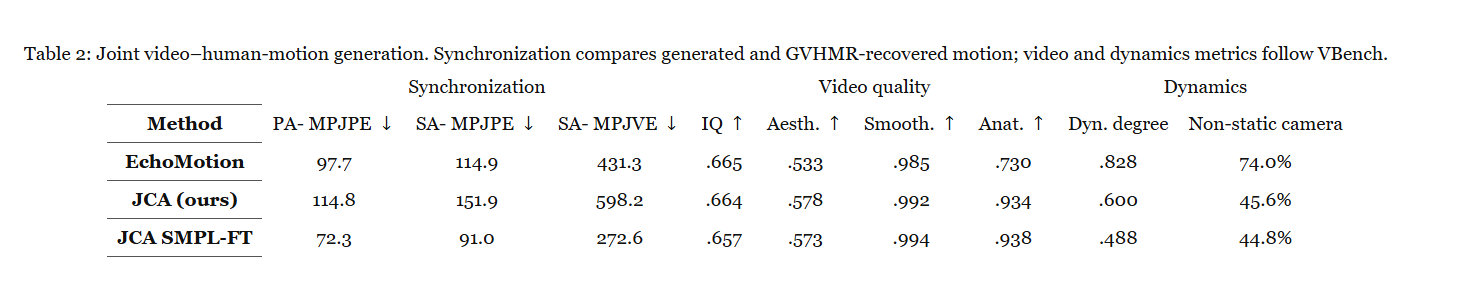
实验效果 :20资产×5指令共100对,模型裁判0至100分的指令遵循58.4,对照 ActionMesh43.4;网格边长相对变化中位数0.20%/7.07%,越低越好。人体250条指令,通用版对齐后平均关节位置误差114.8毫米,差于 EchoMotion97.7;专门人体微调10000步后72.3。引导每去噪步需4次前向,附加参数少不等于运行便宜。
原文表2|视频与人体运动联合生成。同步指标比较生成动作和GVHMR恢复的动作;视频与动态指标按VBench。PA-MPJPE为逐帧刚性对齐后关节位置误差,SA-MPJPE/MPJVE为全序列单旋转对齐后位置/速度误差;位置毫米、速度毫米/秒。通用版和人体微调版须区分。
批判点评 :人体对照使用文本生成,本法有生成的参考图,输入条件不同;同步参考来自另一个恢复模型,并非动作捕捉。相机拟合假定静态,训练偏双足;模型不直接看到三维场景几何,接触与穿透没有硬约束,交互对象也未恢复三维。缺完整延迟显存表。作者项目页 展示结果,当前未见方法代码链接。
10. AEON:把生成视频解成持续四维场景
AEON: Unifying Video and 3D World Models | 清华大学软件学院 | arXiv:2610.28631
关键词 :四维生成, 高斯场景, 潜空间适配, 持续表示
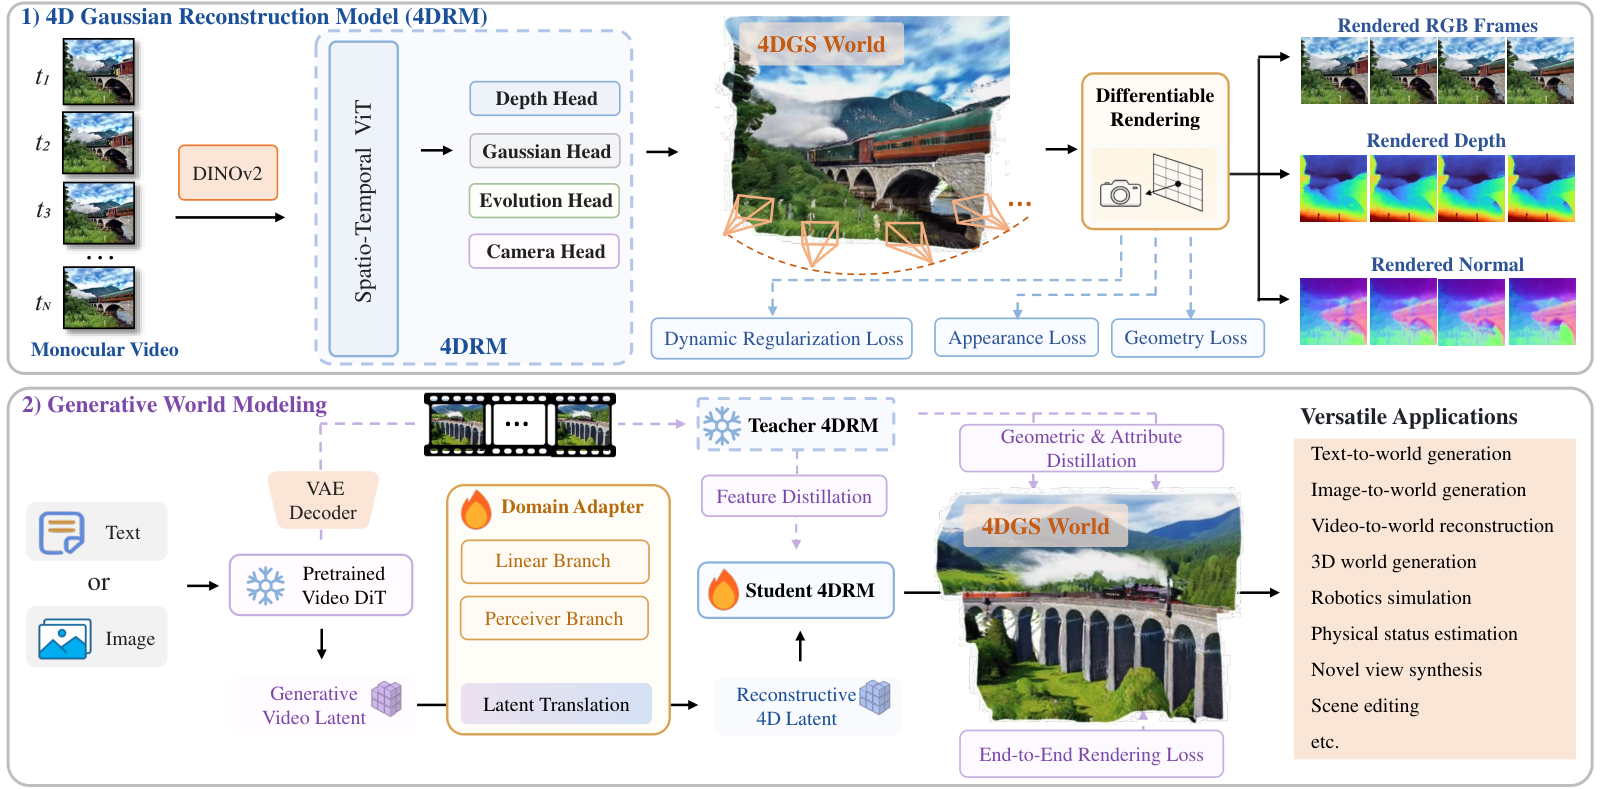
前序问题 :生成视频能看,换个视角却容易变形;逐帧重建得到的三维结构也不一定属于同一个世界。怎样把视频生成先验变成可以反复换镜头的显式动态场景?方法直觉 :让生成模型先给出压缩视频,再翻译成一个持续存在、会移动和显隐的高斯集合;换镜头时渲染同一份场景,而不是重新猜一组画面。本文贡献 :4DGS 即带时间变化的三维高斯表示,每个基元含位置、形状、颜色、不透明度、线速度、角速度及可见持续时间。先训四维重建器,四个头估深度、外观、动态和相机;再用线性岭回归初始化的卷积支路与零门控 Perceiver 跨注意力支路,把 Wan 视频潜变量映射到 视觉表征模型 DINOv2 第4层特征空间。冻结重建教师监督基元、几何与特征,最后加可微渲染精修;蒸馏后两阶段可用无几何标注的视频。
原文图2|上(1):四维重建器4DRM用深度、高斯外观、动态演化和相机四头,把单目视频解成4DGS场景,再渲染RGB、深度和法线作端到端监督。下(2):冻结视频扩散模型(如Wan2.2)提供生成先验,教师重建器提供四维重建能力,经域适配器和可学习学生4DRM蒸馏,形成显式动态场景。
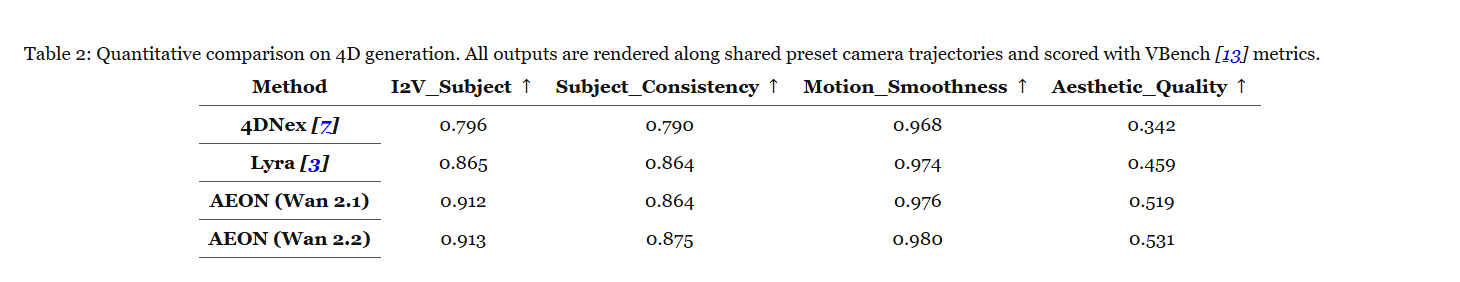
实验效果 :30个图文场景的相同预设镜头上,Wan2.2版主体一致性0.875、运动平滑0.980、美学0.531,对照 Lyra 为0.864/0.974/0.459,均越高越好。视频转四维重建的 DaVis 结果:PSNR像素信噪比24.661,对照 NeoVerse23.929;LPIPS感知距离0.243/0.283,越低越好。生成、重建和新轨迹评测是三类任务,不混作同一组成绩。
原文表2|四维生成的定量比较。全部输出沿共同预设相机轨迹渲染,使用VBench主体参考相似度、主体一致性、运动平滑及美学评分;比较基于同一图文条件,不应当作任意视角几何真值。
批判点评 :实时指已得到高斯后的渲染,不等于文本到四维场景实时;16张 H200 训练,未给完整生成延迟、显存预算。世界时长受视频窗口限制,未见区域会露洞,跨窗口融合只是未来方案;显式渲染不证明几何真实。arXiv 备注明确 NeurIPS 2026 接收。项目 与推理代码 可查,仓库目前列Wan2.1生成路线,不能据Wan2.2主榜声称全部版本已开放。
趋势观察
保留目标应进入机制
AVE共享时间轴,TextRIRO保风格破文字,Dancing Diffusion固定已执行状态;三者分别约束同步、样式与生成前史。
几何约束要放对位置
VitronEdit只对三维样本加几何监督,JCA显式读骨架,AEON输出持续高斯;一致性与物理正确仍需区分。
平均数字必须说清分母
ABACUS先均值后乘积,LoCA逐句误差按样本加权,SolarRenderer不同测试集Elo分别拟合,不能把评分写成成功率。
少算与更快需要两份证据
MoDDiT算量下降可能抵不过小批量路由开销;SolarRenderer四步整段与流式实时是两个版本,Dancing前缀省时也适用于原生切词。
今日讨论
AVE人物替换的Sync-C从Wan2.2串联对照5.02提高到5.39,Sync-D从8.76降到8.53,但背景PSNR为34.62,低于另一对照VACE的35.37。若你在做参考人物视频编辑,会收集哪些指标和失败样本,结合口型同步、参考身份、背景保持与实际耗时来决定联合编辑是否值得,而不把不同对照的最优数值拼成一次全面胜出?
人工智能炼丹君 整理 | 2026-10-22



评论 (0)