今日 AIGC 论文速览
今日共 10 篇 · 视频编辑与透明素材 3 篇 · 多轮与分层图像编辑 2 篇 · 音视频联合创作 1 篇 · 多镜头布局生成 1 篇 · 文生图与推理效率 2 篇 · 可控歌曲翻唱 1 篇
重点论文标题列表
DeOverlay (字节):从原片出发擦掉遮挡字幕Wan-Alpha++ (天津大学):让透明特效从出现走到消失ColorModern (延世大学):四格关键帧带动长片调色MT Forcing (商汤):用单轮老师稳住八轮编辑LayerEditor (华南理工):编辑完顺手交付可复用图层
选读入口:原片被字幕或标题遮住,先读DeOverlay;手头是单张透明素材、要做出现消失动画,读Wan-Alpha++。老彩色长片只想换色调,读ColorModern。连续改图漂移看MT Forcing,成品还要拆成可复用层看LayerEditor;只修声音或画面其中一条看UniAVC。需要人物按三维站位跨镜头转身看MeV;考虑训练预算读Halcyon,已有扩散模型要省推理读SpecKCast;想保留旋律却改速度和唱法读MuLaCover。
今日论文速览
1. DeOverlay:从原片出发擦掉遮挡字幕
DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal | 字节跳动;南方科技大学 | arXiv:2610.26081
关键词 :视频编辑, 叠层移除, 流匹配, 场景保持
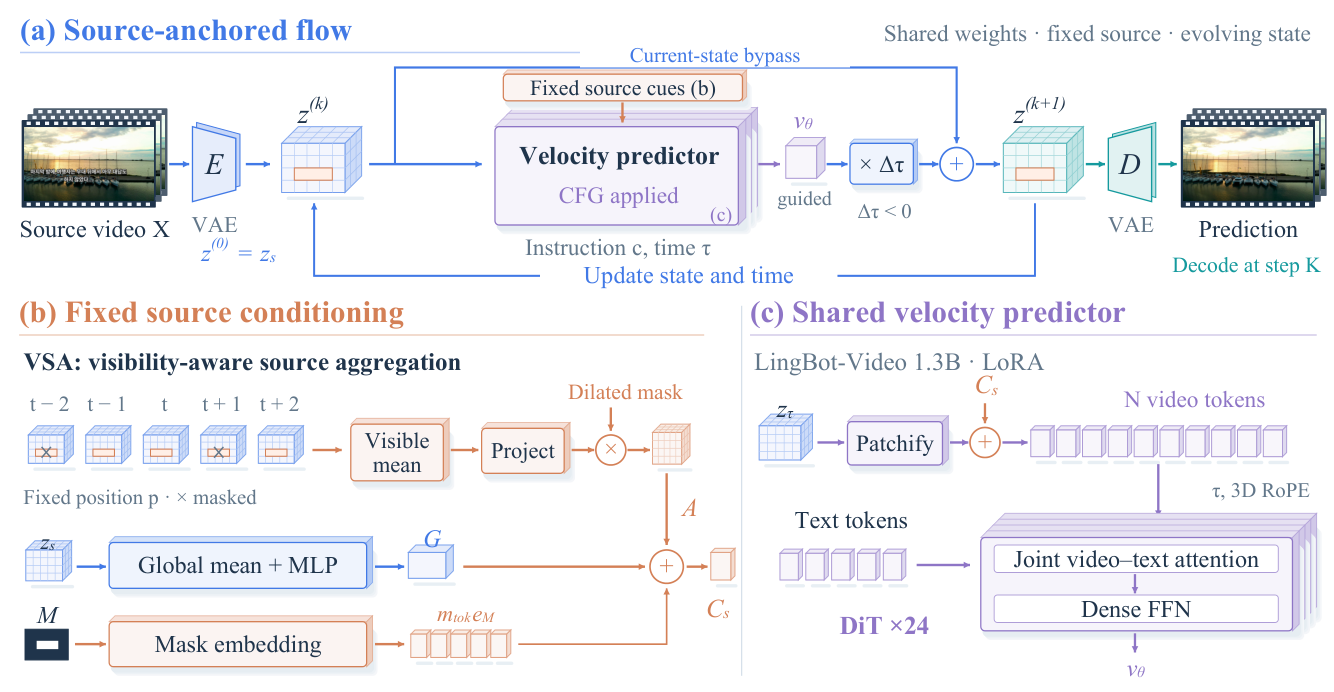
前序问题 :擦掉字幕后,背景也被重新画了一遍;旁边帧能看到的细节没用上,始终被遮挡的区域又必须靠生成补全。怎样同时利用原片和生成先验?方法直觉 :从带字幕的原视频开始小步修正,每一步都重新参考同一份原片;局部只汇总没被遮住的位置,让字幕本身不混进背景线索。本文贡献 :以13亿参数 LingBot-Video 为主干,训练350000对叠层/干净片段,用秩256的 LoRA 低秩适配器微调。视频自编码器先压到潜空间,在原片与干净片之间学习流匹配,即预测沿两者连线移动的速度;遮挡区损失权重6、外部1。对前后共5个潜时间位置,在固定空间坐标排除掩码区并按可见数平均,另加全局源特征与编辑区域嵌入;逐元素相加维持一条视频token序列,token即网络处理的特征单元。推理共享同一网络反复更新,使用12像素无缝贴回。
原文图3|DeOverlay总览。(a)共享权重Euler更新从源潜变量开始,上方通路传当前状态,下方循环在固定源线索下更新状态与时间;(b)可见性感知源汇总VSA、全局源条件GSC与掩码嵌入组成源条件;(c)源线索先加到当前状态token,再联合处理视频与文字。张量网格和中间状态为示意,RGB为配对源片/输出。
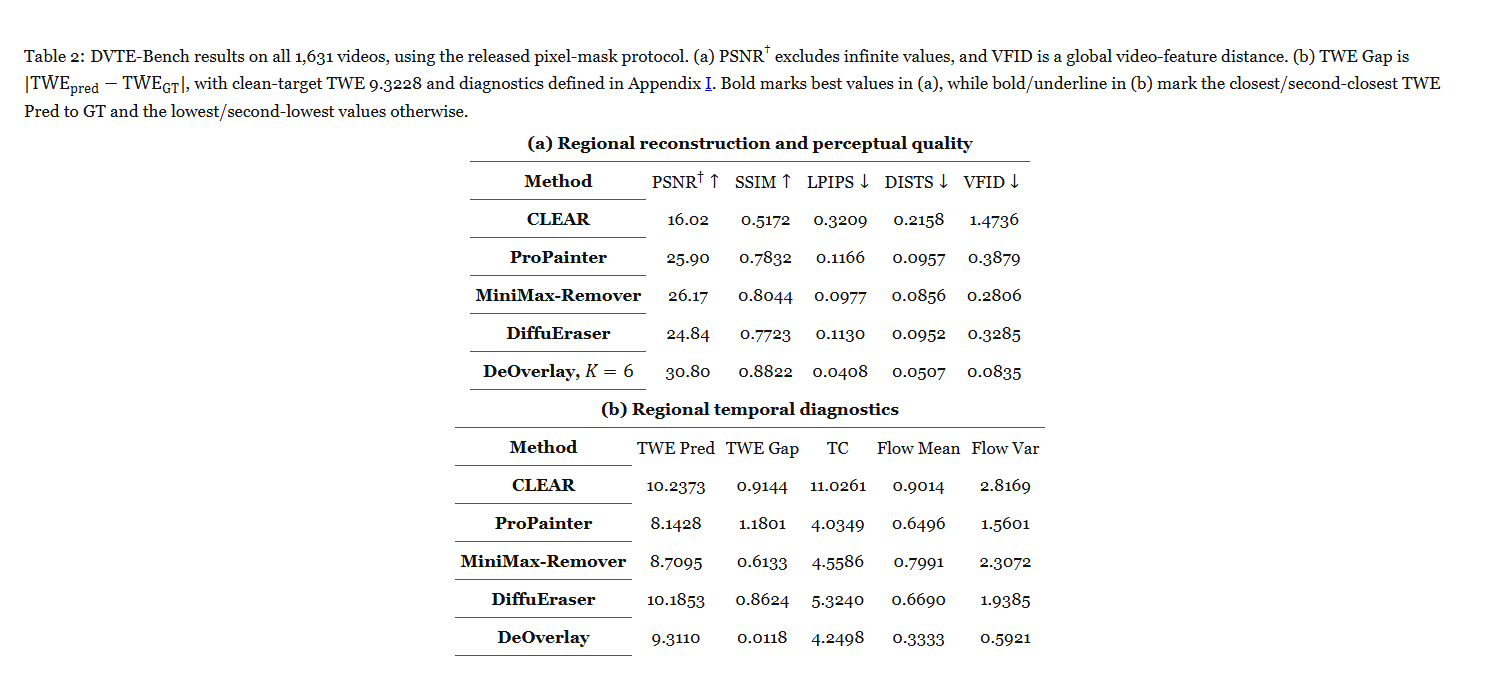
实验效果 :DVTE-Bench含8类、1631对视频,原干净目标经文字识别筛查;输入真值外接框掩码,评分用像素掩码。六步、引导强度2实际调用网络12次:遮挡区PSNR像素保真信噪比30.80,对照MiniMax-Remover为26.17,越高越好;LPIPS感知距离0.0408/0.0977,视频特征分布距离VFID为0.0835/0.2806,均越低越好。单A100另测8段650帧:四步端到端2.0712帧/秒、峰值12.236GiB,排除初始化;六步主榜没有对应速度行。
原文表2|全部1631条视频采用发布的像素掩码协议。(a)PSNR排除无限值,VFID为全局视频特征分布距离;(b)TWE Gap是预测与干净目标平均时间变形误差的绝对差,目标TWE为9.3228,诊断定义见原文附录I。粗体标(a)最佳值,(b)粗体/下划线标预测TWE最接近/次接近目标及其余诊断最低/次低值。
批判点评 :适合已知叠层位置的场景,不能把合成叠层评测当真实遮挡全恢复。固定坐标汇总会混合运动物体;完全遮住的内容仍是推断。目标筛掉天然文字,保留路牌文字需另测;四步也慢于MiniMax-Remover的2.6405帧/秒。作者项目页 承诺开放基准与输出,尚未核实方法代码;不作会议接收背书。
2. Wan-Alpha++:让透明特效从出现走到消失
Wan-Alpha++: Animating a Single RGBA Asset into Controllable Transparent Video Effects | 天津大学;香港理工大学;大连理工大学;莫纳什大学;中国科学技术大学;独立研究者 | arXiv:2610.26189
关键词 :参考动画, RGBA生成, 透明特效, 时间控制
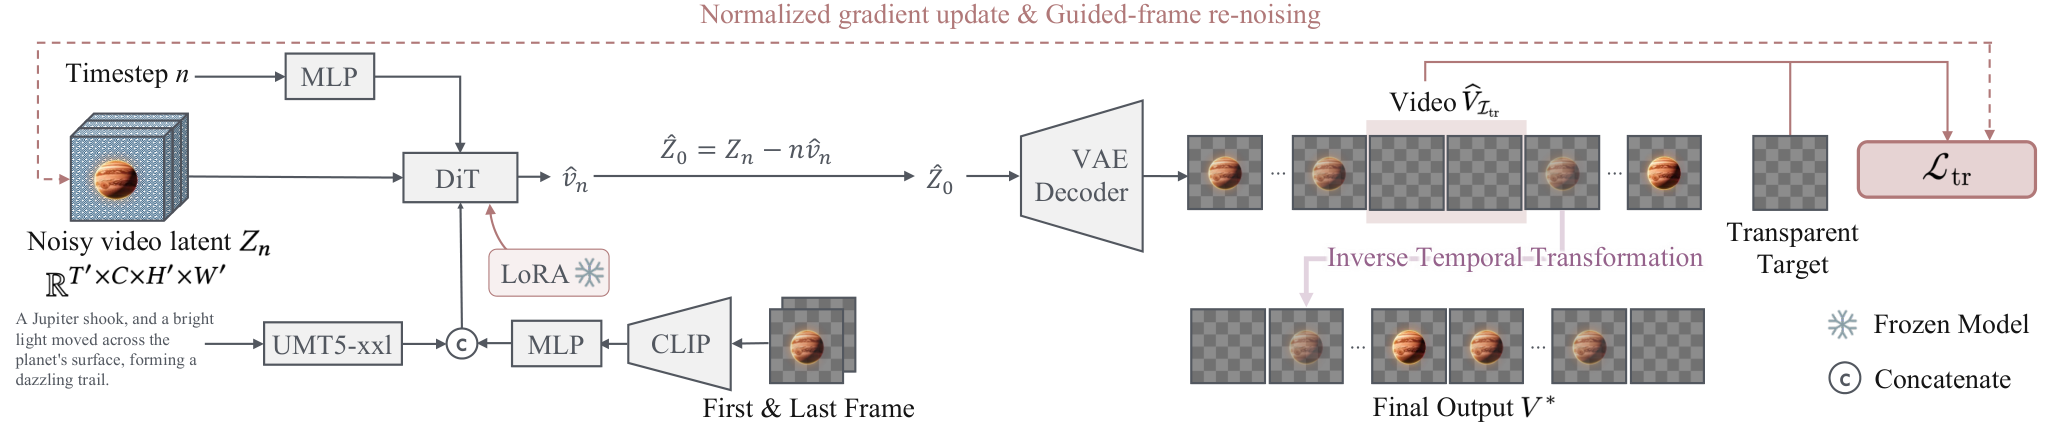
前序问题 :拿一张带透明度的火焰素材做“先出现、再消失”的动画,首尾都是全透明,传统首帧或首尾帧控制就看不到素材本身;先生成再抠像还会丢掉烟雾的半透明边缘。方法直觉 :把时间轴循环平移,让原来位于中间的可见素材跑到两端,借用已有首尾条件能力;生成后再移回时间轴,恢复出现到消失的过程。本文贡献 :RGBA是RGB颜色加alpha不透明度。共享视频潜空间分别编码颜色与alpha,通过透明感知双向扩散保持预训练颜色分布并区分alpha;透明度引导的噪声均值偏移控制粗略位置。新增图像条件路线先适配Wan2.1-I2V-14B,再用196条特效视频学习时间相位重参数化,把零/正/零alpha模式变为正/零/正。推理对指定透明区间做归一化梯度更新,再逆变换;同一参考RGBA图约束两端。
原文图4|时间相位重参数化的图像到RGBA视频推理。同一RGBA输入约束时间两端;透明状态引导对用户指定不可见区间施加归一化梯度更新,最后做时间变换,恢复需要的出现/消失特效。
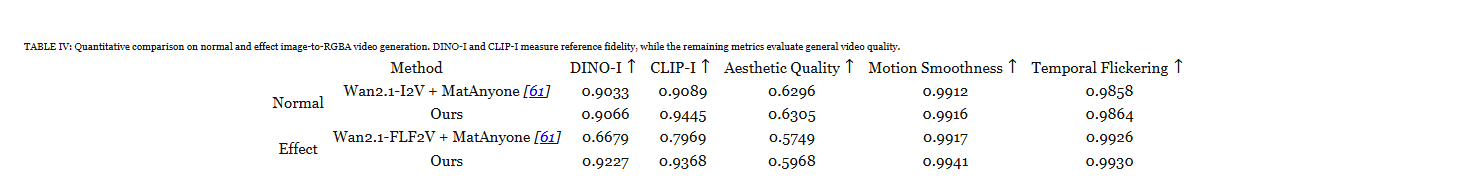
实验效果 :图像条件视频为81帧、480×832、40步;前32步每步另做2至3次梯度迭代,不能沿用文生版四步加速。文本训练/验证集为77237/4066条,基础图生路线另用429条,特效适配用196条。效果类评测对照Wan2.1-FLF2V加MatAnyone:DINO-I结构特征相似度0.9227/0.6679,CLIP-I语义外观相似度0.9368/0.7969,均越高越好;这类依赖外观的分数只统计足够可见的帧。
原文表IV|普通与特效两类图像到RGBA视频定量比较。DINO-I和CLIP-I衡量参考保持,其余指标衡量通用视频质量,均按原表方向解读;效果类DINO-I由0.6679到0.9227。
批判点评 :收益主要针对透明出现/消失和输入素材保持,不等同修改任意既有视频。两阶段生成加抠像对照与端到端RGBA路线的能力不同;只用少量特效数据,复杂多阶段透明变化仍待验证。40步及梯度引导增加推理成本,论文未给完整耗时或峰值显存;尚无核实的方法代码入口。原Wan-Alpha会议版不代表本扩展已被接收。
3. ColorModern:四格关键帧带动长片调色
From Legacy to Contemporary: Scalable Color Modernization for Long Videos | 延世大学 | arXiv:2610.26391
关键词 :视频调色, 关键帧编辑, 颜色传播, 镜头一致性
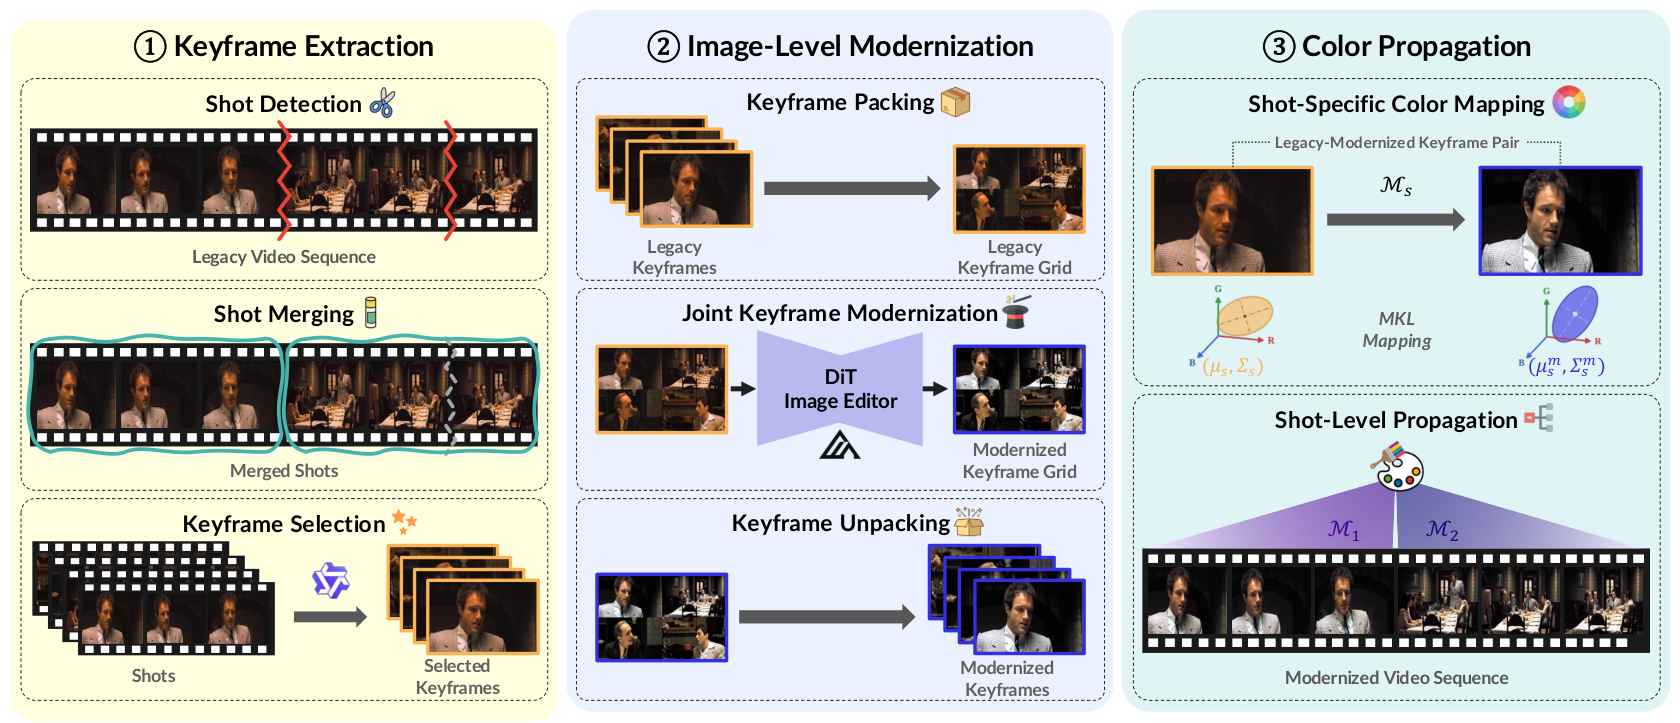
前序问题 :老彩色视频偏色、灰暗,逐帧让生成模型重画会改脸、闪烁;每镜头各调各的,又可能让相邻镜头像来自两部电影。方法直觉 :先把相邻镜头的代表帧放到一张四格图里一起调色,再只把学到的颜色变换传播给原帧。生成模型负责审美参考,原片保住空间细节。本文贡献 :先检测并合并镜头,从每镜头16个候选中用Qwen3-VL-8B选关键帧。最多4张相邻关键帧拼成2×2,FLUX.1-Kontext-dev按同一自然现代色调指令编辑30步。拆开后估计每镜头的MKL(Monge–Kantorovitch线性)颜色映射:用完整3×3矩阵匹配RGB均值和协方差,保留颜色通道间关联;高亮处用平滑压缩防止硬截断,再固定应用于该镜头全部帧,无需训练新模型。
原文图1|长视频调色流程:先将输入分成镜头,各取代表关键帧,再联合现代化相邻镜头的关键帧,最后从原帧/编辑帧对估计每镜头颜色映射,应用于该镜头全部帧。
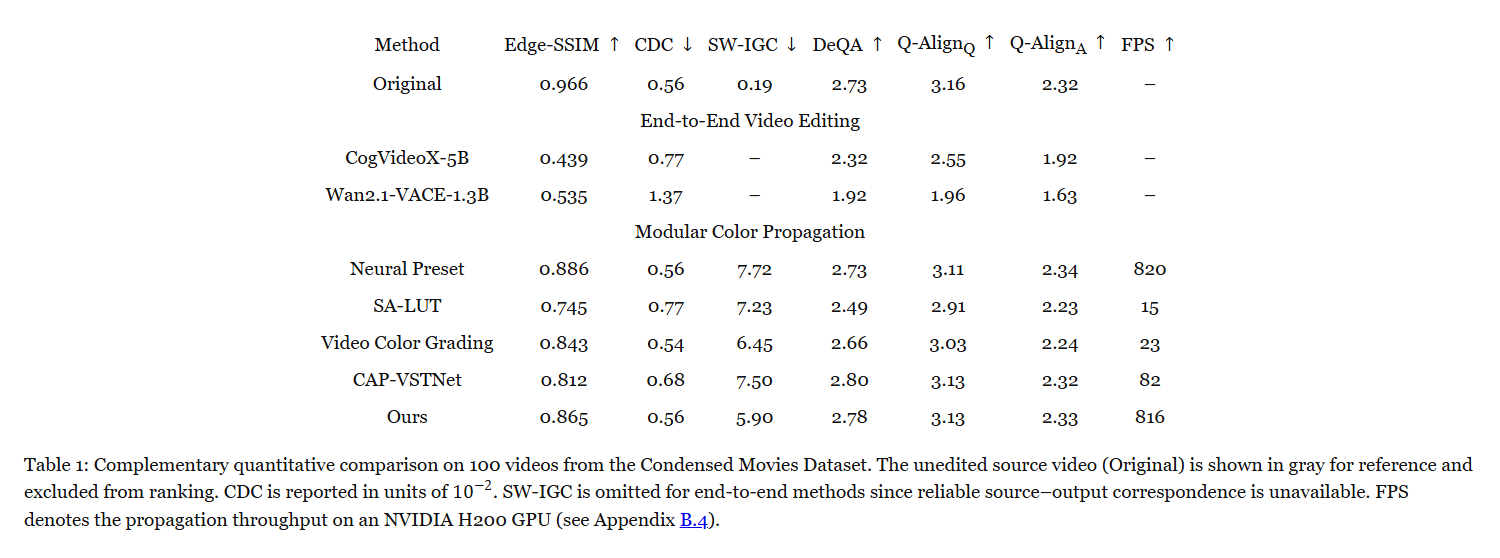
实验效果 :100段1960至2000年代电影片段共3.9小时、3390镜头,每段2至4分钟。65人对15段作975份完整排序,平均名次2.31,对照CAP-VSTNet为3.02,越低越好;第一名占37.9%/17.6%。边缘结构相似度0.865,不及Neural Preset的0.886;相似源镜头的颜色变换差异SW-IGC为5.90/7.50,越低越好。H200颜色传播816帧/秒,只是末段;完整流程还需约13秒/镜头选帧、14秒/四格编辑,CPU含视频读写传播约80帧/秒;抽样10段端到端平均每段10.9分钟。
原文表1|Condensed Movies数据集100段视频的补充定量比较。灰色原视频仅供参考且不计排名;CDC以百分之一为单位。端到端方法缺可靠源/输出对应,故未报SW-IGC;FPS仅为H200上的颜色传播吞吐。
批判点评 :它修改已有彩色视频的色调,不能补黑白片缺失颜色,也不处理划痕与几何修复。静态全局映射可能跟不上镜头内照明变化。SW-IGC用24标准色评估映射相似度,过度平滑能得更低4.46却产生不自然色彩,因此低分不等于审美最佳。作者代码仓库 可访问;未运行完整流程。
4. MT Forcing:用单轮老师稳住八轮编辑
MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion | 商汤研究院;香港科技大学;斯坦福大学;清华大学AIR | arXiv:2610.25404
关键词 :多轮编辑, 分布蒸馏, 历史监督, 质量漂移
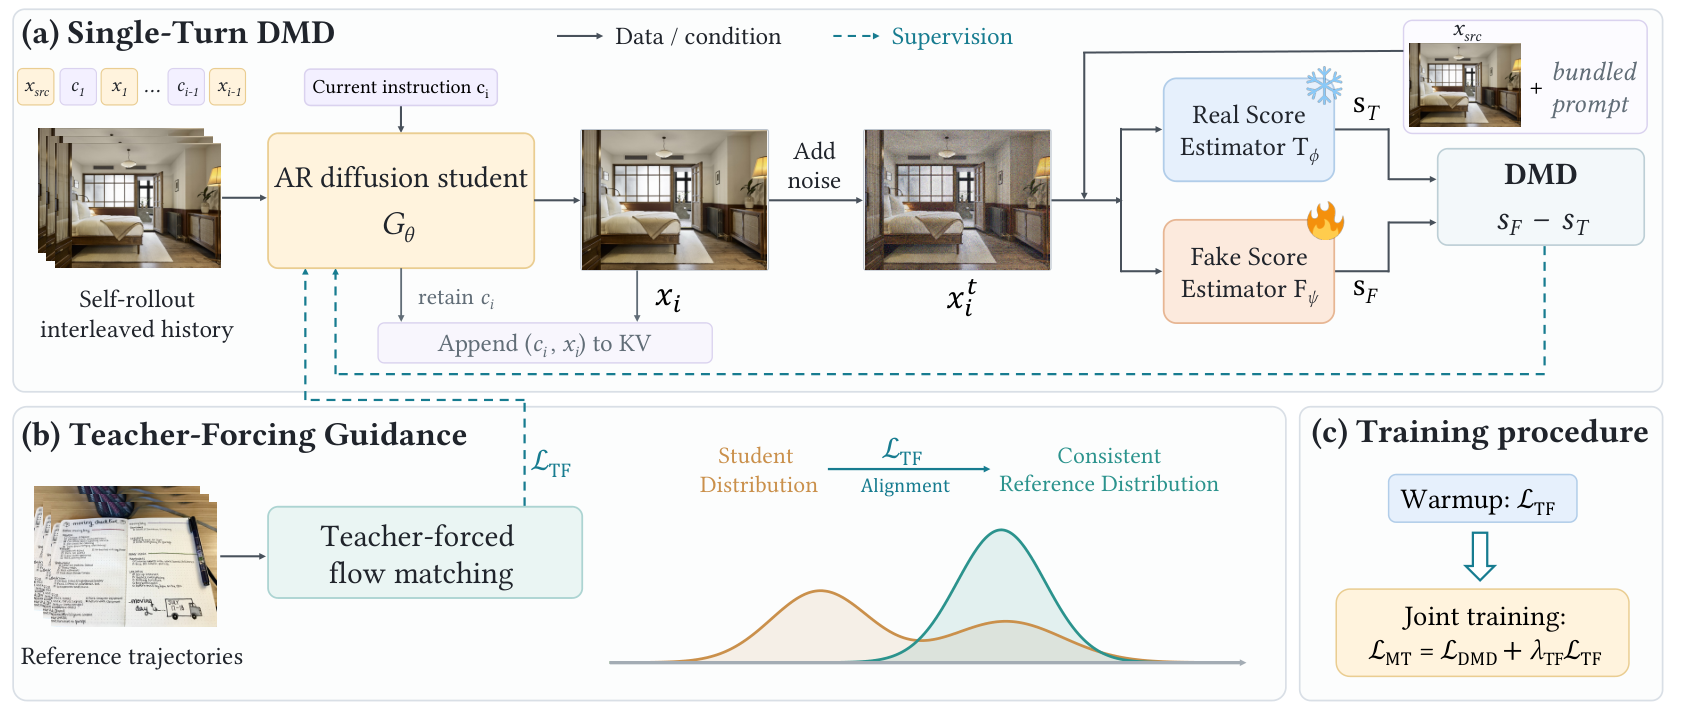
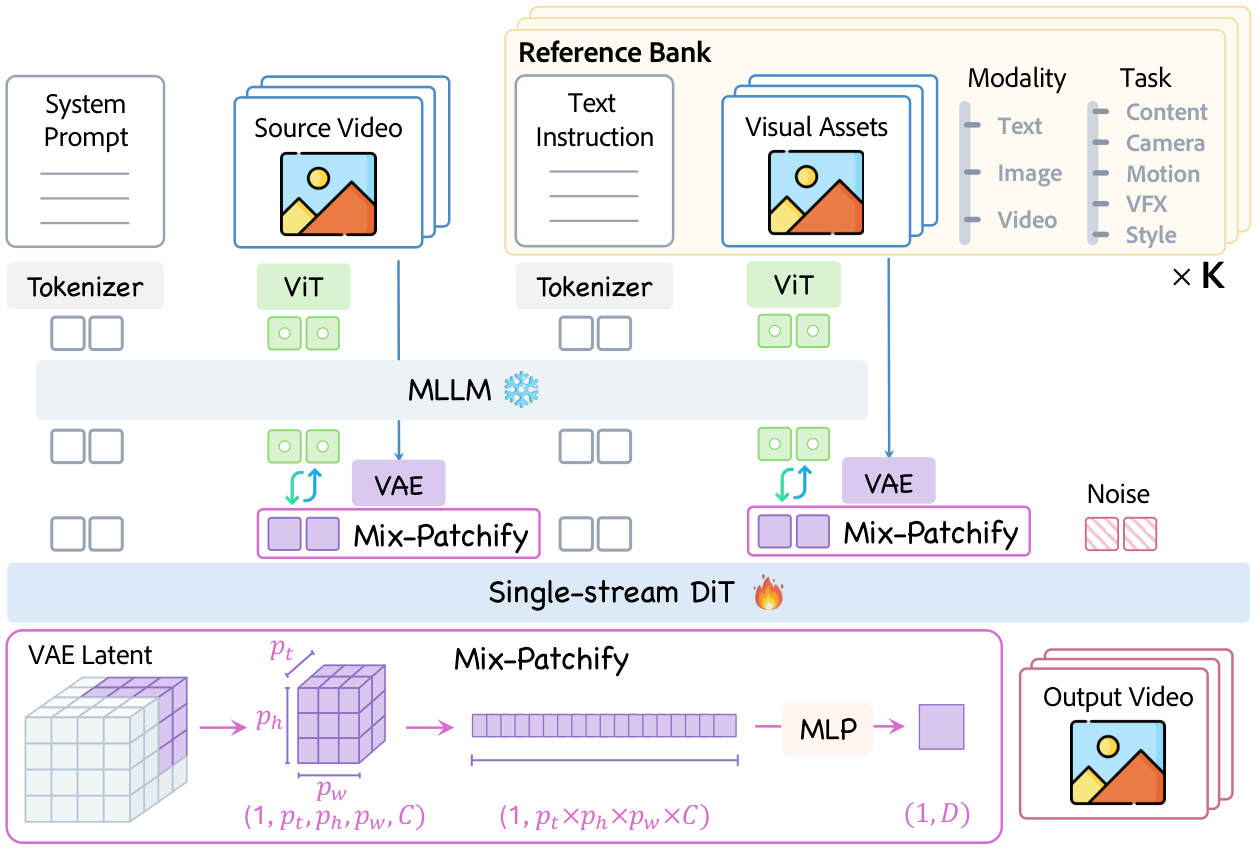
前序问题 :一张图连续改八次,前面几轮还清晰,后来纹理变脏、先前保留的花纹也丢了。只用正确历史训练,模型上线后却只能接着自己的错误继续改。方法直觉 :让学生在自己生成的历史上练习,但老师每次都从最初原图执行累积指令,避免老师也越改越坏;再用一致的参考轨迹约束“哪些细节必须延续”。本文贡献 :Single-Turn DMD即单轮分布匹配蒸馏:把截至当前轮的指令合成一次编辑请求,由固定单轮老师从源图给出目标分布,监督学生自回归生成的每轮输出。仅匹配各轮分布不能保证前后同一细节,因此Teacher-Forcing Guidance先在参考轨迹上预热,之后仍用较小权重的流匹配监督历史到下一图的转移。它改训练过程,无需在每次用户编辑时再生成老师结果。
原文图2|MT Forcing。(a)单轮DMD将学生自生成轨迹的逐轮边缘分布匹配到单轮老师;(b)参考轨迹上用流匹配监督依赖历史的转移;(c)总体训练先teacher-forcing预热,之后DMD联合teacher-forcing正则,分别维护画质与跨轮一致性。
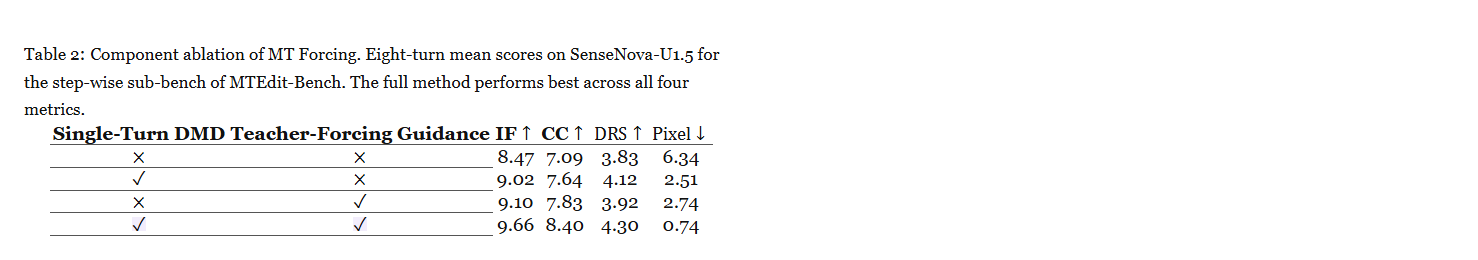
实验效果 :在MTEdit-Bench的100条八轮逐步编辑会话,对同一SenseNova-U1.5前后比较:第八轮IF指令遵循4.52→9.17、CC累积内容一致性3.22→7.68,二者为Qwen3.5-Plus的0至10分;DRS抗画质漂移分3.03→4.35,取两个画质评分平均、0至5分。八轮平均匹配点位移Pixel为6.34→0.74像素;同时使用两项训练目标的消融均分IF/CC为9.66/8.40。
原文表2|SenseNova-U1.5在MTEdit-Bench逐步子集的八轮均分组件消融。完整方法在IF、CC、DRS和Pixel四指标均最好,分别为9.66、8.40、4.30及0.74像素。
批判点评 :Pixel度量前后图像匹配点移动,只有本应保持的区域才宜越小越好,不能替代编辑是否正确。第一轮部分内容分下降,第八轮改善不等于每轮全面领先;DMD还需教师、生成器及分布估计网络,训练与参考轨迹成本没有完整账单。不同裁判或多轮指代任务仍需另验。作者项目与代码 可访问,本稿未复现实验。
5. LayerEditor:编辑完顺手交付可复用图层
Editing Images into Reusable Layers via Compositional Edit-Prior Distillation | 华南理工大学;清华大学;中国科学技术大学;鹏城实验室;京东 | arXiv:2610.24738
关键词 :图像编辑, RGBA图层, 组合蒸馏, 图层控制
前序问题 :改完电商海报只得到一张扁平图,下一次想单独移动商品或改字又要重画;先编辑再拆层还会把文字、边缘和半透明内容拆坏。方法直觉 :让模型一起画最终效果和按顺序排列的独立图层,再把图层合成回去请原编辑老师检查;这样“每层可用”与“合起来编辑正确”同时受约束。本文贡献 :基于FireRed-Image-Edit-1.1,把编辑画布以及有序图层的颜色/alpha特征放进一条序列;alpha是连续不透明度,单独解码以保住细边和半透明。C-EPD为组合编辑先验蒸馏,在学生实际走到的去噪状态查询冻结教师:直接画布接受速度监督,解码后的图层合成图接受像素监督,梯度能传回颜色与alpha。每5次更新做一次蒸馏,使用10节点轨迹、每次选2个查询;基础流匹配继续训练所有输出。
原文图2|LayerEditor同时生成直接编辑画布D及有序RGBA图层堆栈S。组合编辑先验蒸馏C-EPD使用冻结老师,同时监督直接预测与解码图层重新合成的图像。
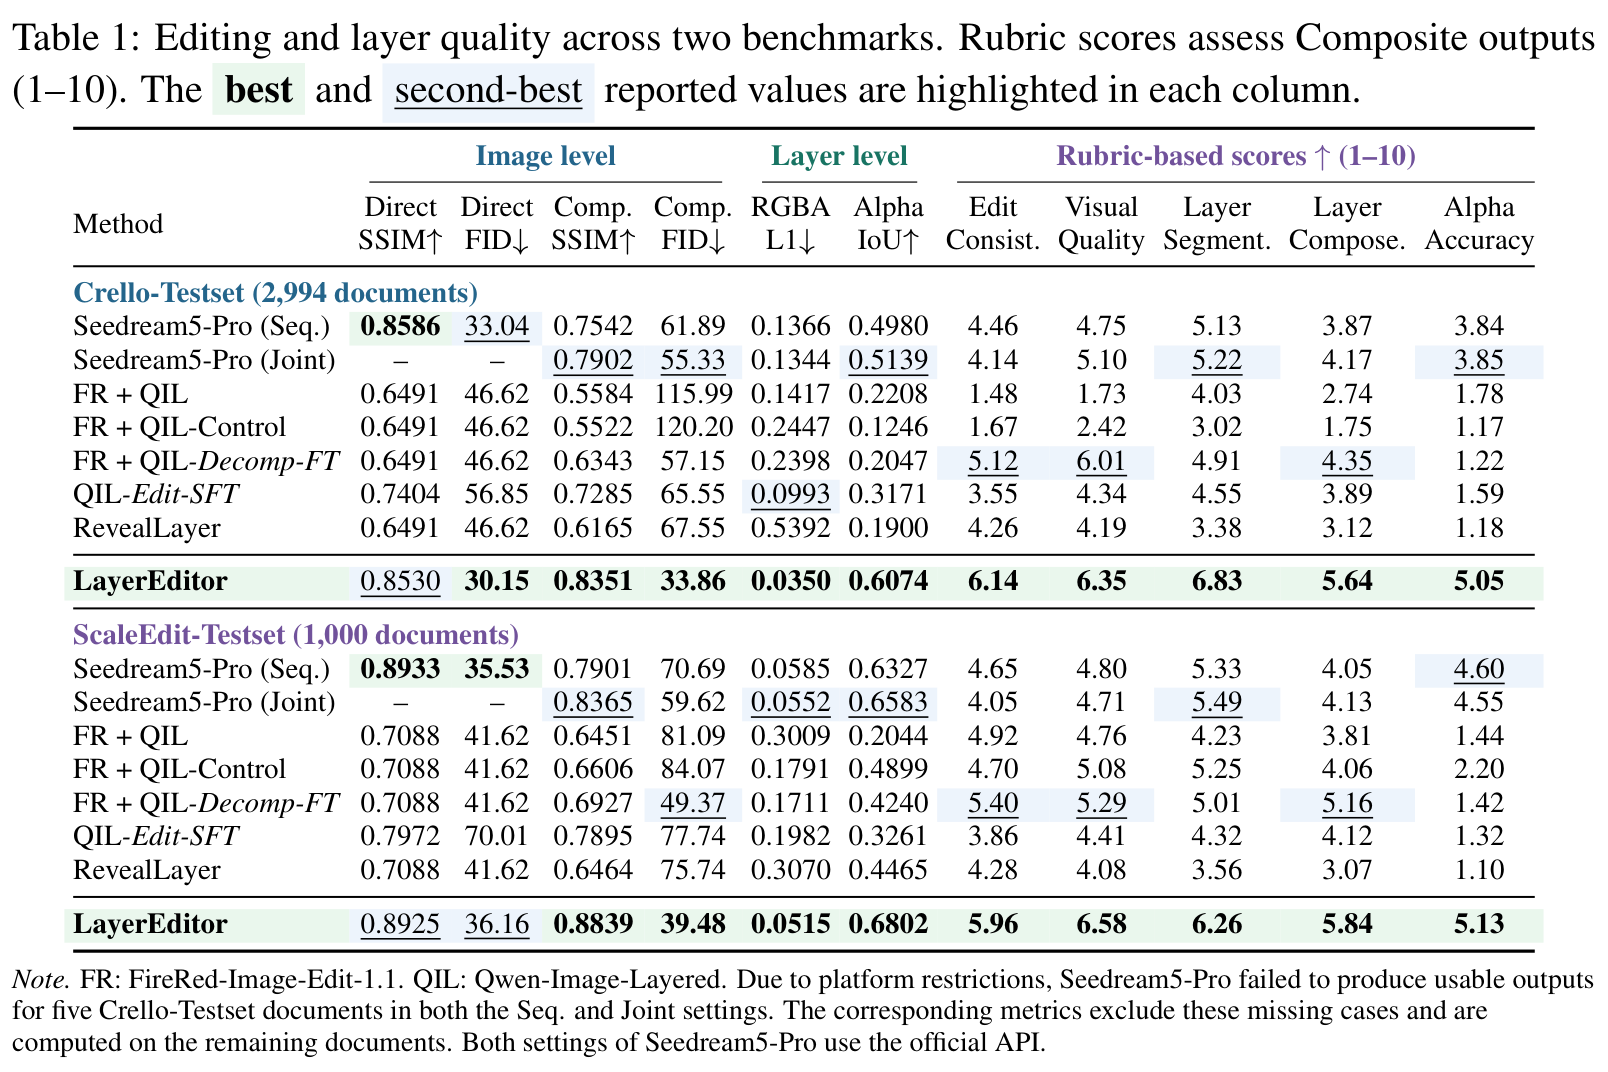
实验效果 :LayerEditor-100K提供约10万编辑/有序图层样本。独立Crello测试2994例、ScaleEdit测试1000例;后者合成图结构相似度SSIM为0.8839,对照Seedream5-Pro联合版0.8365,越高越好;alpha交并比IoU为0.6802/0.6583。Crello合成图FID分布距离33.86/55.33,越低越好。消融去C-EPD后编辑一致性评分6.14降至4.67,分数来自1至10分模型裁判。主干秩256适配,推理30步,另训练alpha解码器。
原文表1|两个基准上的编辑与图层质量。规则式模型评分针对合成输出,范围1至10;每列最佳与次佳标出。图像层指标分别检查直接输出和图层合成结果,图层指标检查RGBA误差及alpha重合。
批判点评 :联合输出和可微解码增加训练与长序列成本,没有完整推理时延、峰值显存证明。重合图层先做一一匹配再算误差,不代表语义拆分唯一正确;完全被遮住内容仍靠逐层监督。Seedream有5例无有效输出被其指标排除,比较分母并非完全一致;模型裁判分也不是人类认可率。尚无核实的方法代码入口。
6. UniAVC:保留一条音画分支只改另一条
UniAVC: Unified Audio-Video Creation via Progressive Training and Asymmetric Scheduling | 香港科技大学;华为研究 | arXiv:2610.24791
关键词 :音视频编辑, 联合生成, 非对称去噪, 分阶段训练
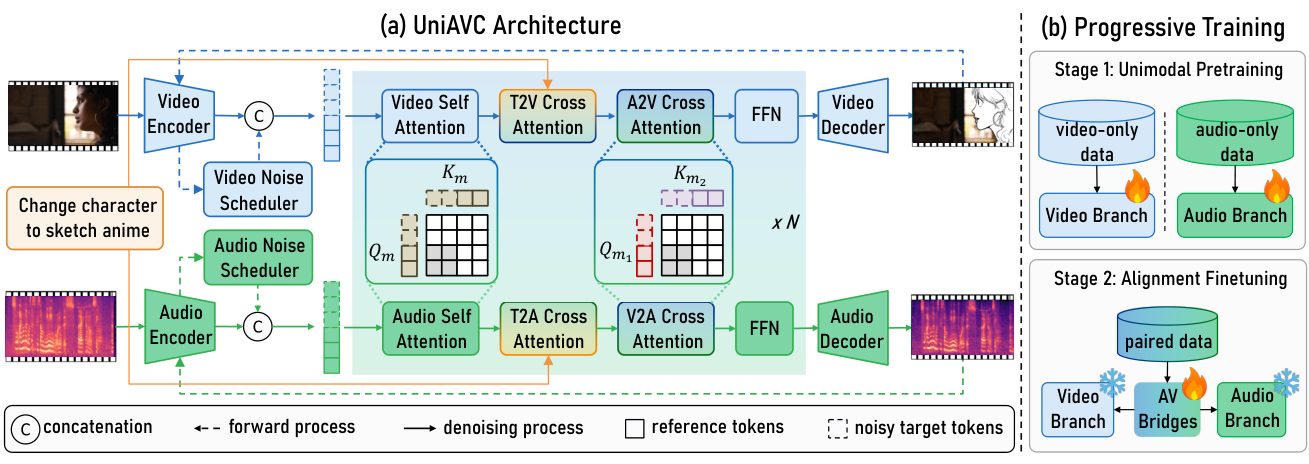
前序问题 :只想换画面却把满意的声音也重做了;只想修音频,统一噪声进度又逼两种信息一起变化。稀缺音画配对数据还要从头教模型各自怎么生成,太浪费。方法直觉 :先分别练好视频和音频,再用配对数据只训练两者的交流通道;共享时间索引下各走各的去噪进度,想保留哪条就把哪条固定为干净条件。本文贡献 :从LTX-2.3初始化两套Transformer,以每层跨注意力桥交流,桥的调制读取对方噪声等级。参考潜变量与目标特征拼接,掩码禁止参考读取噪声目标。先独立训练两分支,再冻结分支、仅训练跨模态桥;视频/音频各消费3430万/5490万次样本,配对对齐消费67万次,次数不等于独立数据量。额外训练一条分支无噪声且不计损失的任务,支持单模态编辑及固定满意分支后的自修正。
原文图3|UniAVC。(a)音视频两套Transformer仅通过每块跨注意力桥交互,调制由对方噪声等级驱动;参考潜变量作为上下文token与目标拼接,掩码阻止参考在自/跨注意力中读取噪声目标。(b)先并行用单模态数据练好各自生成编辑,再冻结两分支,只用配对数据训练跨模态桥。
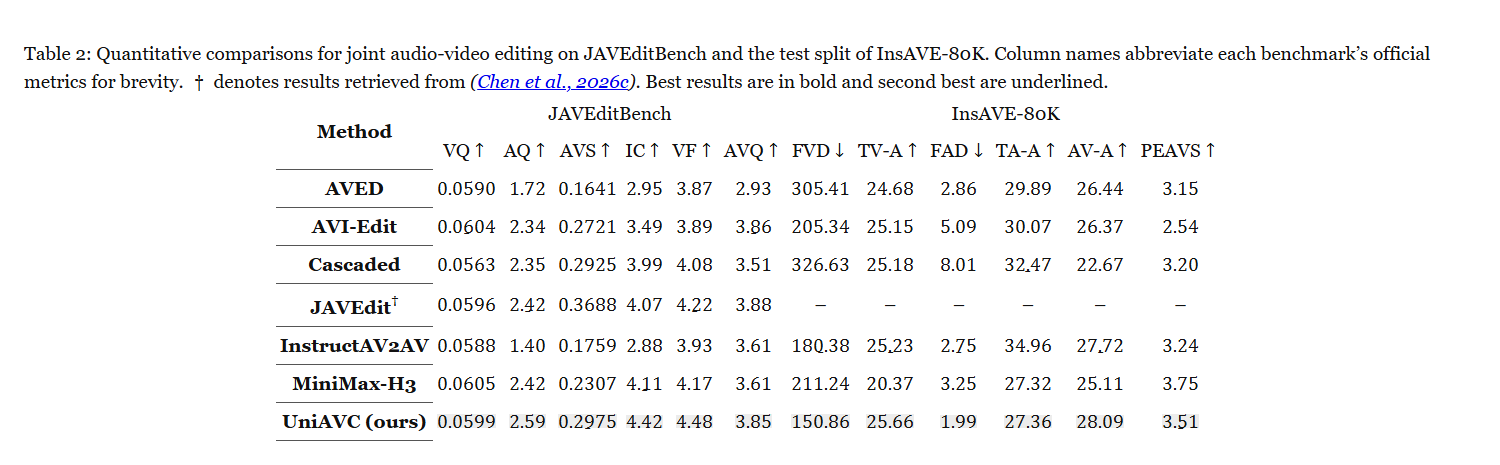
实验效果 :720P、121帧、24帧/秒、16kHz单声道训练,推理30步,视频/音频噪声偏移参数9/2。InsAVE-80K测试集对照InstructAV2AV:FVD视频分布距离150.86/180.38、FAD音频分布距离1.99/2.75,均越低越好;但文本音频对齐27.36/34.96,越高越好,对照更佳。JAVEditBench指令一致性分4.42,对照MiniMax-H3为4.11;音画同步分0.2975却低于JAVEdit的0.3688。
原文表2|JAVEditBench与InsAVE-80K测试集联合音视频编辑比较。列名缩写各基准官方指标,剑号表示取自引用论文的结果;粗体/下划线分别为最好/次好。本法分布距离更低,但部分音画同步与文本音频对齐仍落后对手。
批判点评 :它支持编辑既有音画,故放在创作效率部分;并非所有生成或同步指标最优。自修正需额外去噪,30步不能当全部请求的统一时延。分阶段节约的是配对样本消耗,3430万与5490万次单模态训练不能忽略;部分视频来自内部数据,且论文附录对InsAVE训练/测试划分表述有歧义,复现须核对划分。作者项目与代码 可访问,未跑模型。
7. MeV:先在三维里排好每个镜头
Mise-en-Video: Fine-Grained 3D Control for Multi-Shot Video Generation | 香港科技大学;可灵AI研究;香港中文大学;西北工业大学;大连理工大学 | arXiv:2610.26801
关键词 :多镜头生成, 三维布局, 朝向控制, 分层注意力
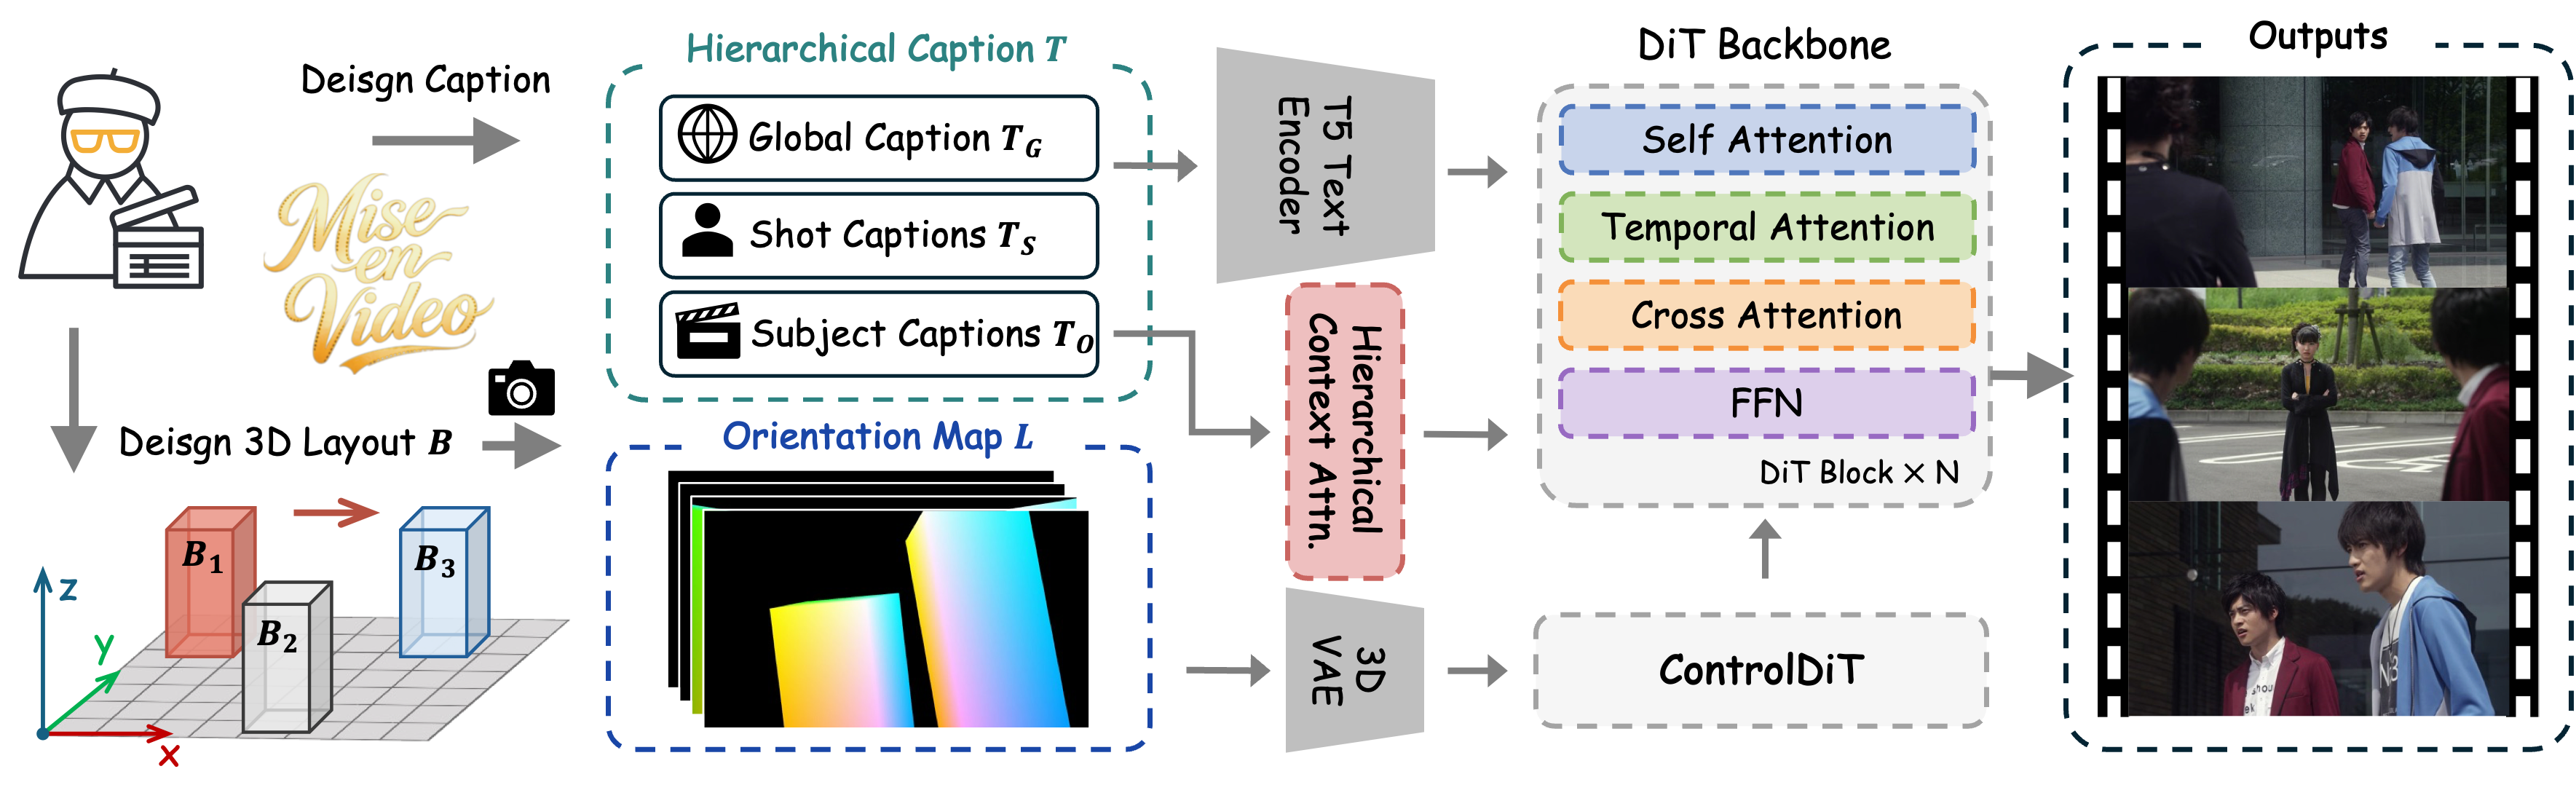
前序问题 :同一个人物跨镜头还在,却不按要求转身、位置也不对;一句长提示同时描述整片、每镜头和人物属性,信息容易串到别处。方法直觉 :先用三维盒子安排人物站位和朝向,再把整体剧情、镜头说明和人物属性分别送到该看的区域,让控制信号既有空间也有作用范围。本文贡献 :Mise-en-Video简称MeV。给有朝向的三维边界框涂NOCS标准物体坐标颜色,即用固定颜色编码物体自身坐标,投影成逐帧二维布局。控制分支复制主干前一半Transformer块,经零初始化卷积逐层注入。层级上下文注意力让全局文本对所有视频特征可见、镜头文本只对所属镜头可见、主体文本只对盒子覆盖区域可见。先训练层级文本,再冻结主干训练布局分支;16万条、每条2至6镜头、最多250帧,1B即10亿参数基础主干,使用32张GPU。
原文图2|MeV总览。创作者先设计三维场景并给分层描述;布局投影为NOCS标准物体坐标颜色编码,作为ControlDiT引导;文本分成全局、镜头、主体三级,通过层级上下文注意力融合,改善跨镜头叙事及主体一致性。
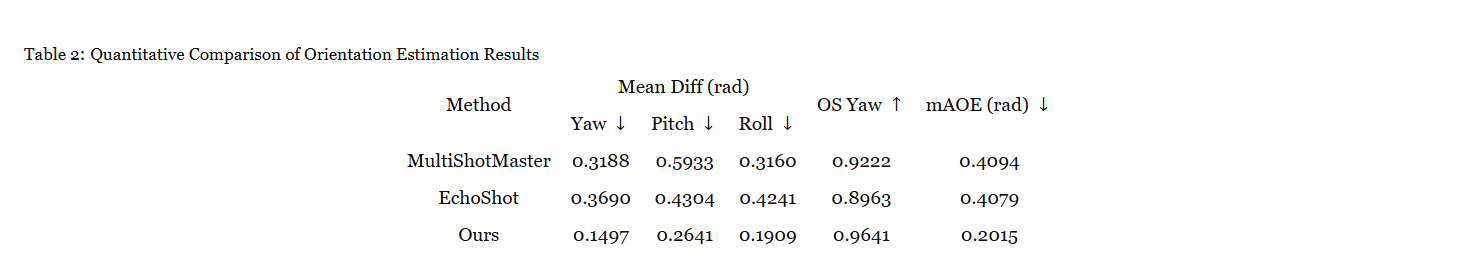
实验效果 :100组多镜头提示比较中,MeV/EchoShot跨镜头主体一致性0.5499/0.4492,越高越好;对MultiShotMaster,平均朝向角误差0.2015/0.4094弧度,越低越好。去三维布局后同误差升到0.4194。14B即140亿参数HoloCine的主体一致性0.5955仍高于MeV,不能称跨规模全面领先;主表与层级注意力消融的完整模型数字也不同,不能混算。
原文表2|朝向估计定量比较:偏航、俯仰、翻滚角平均差及mAOE平均朝向误差以弧度计,越低越好;偏航朝向相似度OS Yaw越高越好。MeV的mAOE为0.2015,对照MultiShotMaster为0.4094。
批判点评 :粗盒子便于导演控制,但不能表达手指等精细形变,额外半主干控制分支与布局制作均有成本,未给完整速度显存结果。去注意力掩码反而提高表面一致性,却让多镜头塌成连续镜头,说明指标必须结合叙事。作者项目页 标注SIGGRAPH Asia 2026,本稿仅将其作为作者声明;机构身份按原文;当前仓库开放数据标注与布局渲染管线,不能当完整视频生成权重已开放。
8. Halcyon:不用语言预训练也能学文生图
Text-to-Image Generative Modeling Without Language Pretraining | 斯坦福大学;Radical Numerics | arXiv:2610.26863
关键词 :文生图, 从零训练, 早期融合, 训练预算
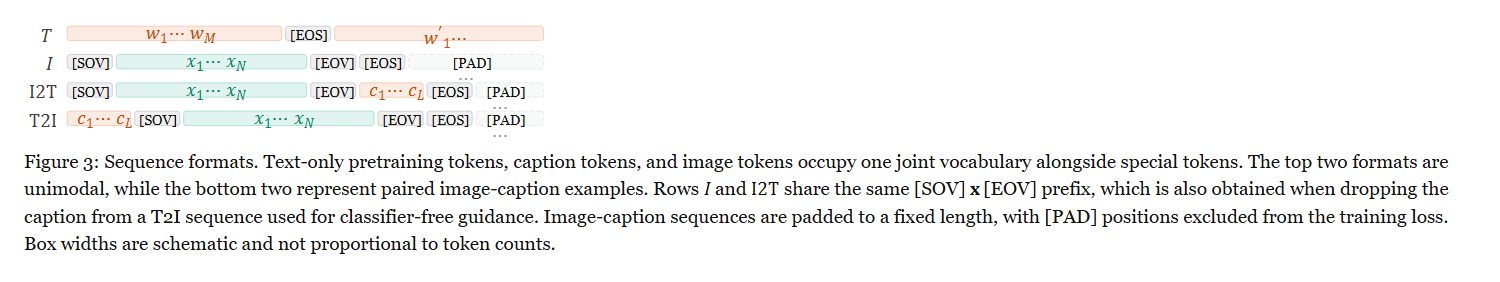
前序问题 :训练文生图模型,是否必须先花大成本学一个通用语言模型?语言预测更强,并不保证更会把文字变成图像。方法直觉 :把文字和图像都切成离散token,在同一模型里直接学习“这段话之后应该出现哪些图像单元”,让图文配对负责教文字的视觉含义。本文贡献 :早期融合的自回归Transformer统一预测文字与图像序列。文本分词器、图像分词器及生成器均从头训练;256×256图像用8倍下采样得到32×32、共1024个图像token,文字/图像/特殊符号合计80640词表。GPIC约1亿图文对训练一轮。以图生文序列替换部分丢弃描述的样本,仍保留无条件图像前缀,可在相同预算附带学图像描述。另用固定计算预算和预训练初始化作受控实验。
原文图3|序列格式。纯文本预训练、描述和图像token与特殊符号共享词表;前两行是单模态,后两行是配对图文。图像I与图生文I2T共享图像开始/结束包围的图像前缀,文生图T2I丢弃描述作无分类器引导时也得到此前缀。序列补到固定长度,PAD填充不计训练损失;框宽仅示意,不代表token数量。
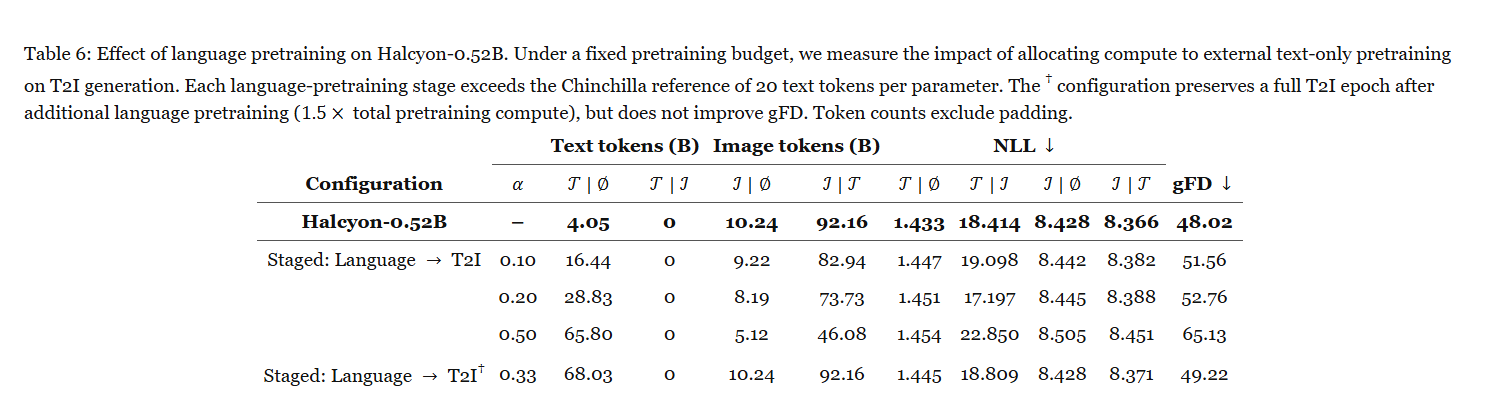
实验效果 :GPIC测试50000条描述,每条一张256×256图;gFD为生成与真实图像特征的Fréchet分布距离,越低越好。16亿参数Halcyon为35.28,对照JiT-T2I-XXL/8++为40.97;总预训练运算量约少275倍,包含语言、分词器和图像生成器训练,非采样加速。5.2亿参数在额外语言预训后仍完整训练一轮图文、总预算1.5倍时gFD为49.22,未优于从头的48.02;构图问答GenEval在16亿参数时53.48,对照43.17,越高越好。
原文表6|Halcyon-0.52B固定预训练预算下,分配外部纯文本训练对文生图的影响。各语言阶段均超过每参数20文本token的Chinchilla参考量;剑号配置在额外语言训练后保留完整一轮文生图,总计算1.5倍,gFD仍未改善。token计数不含填充。
批判点评 :结论限GPIC、256分辨率和已测模型;受控干预集中小型自回归模型,不能推广为所有生成任务都不需要语言。无语言模型权重预训不等于不用文字:文本分词还使用OpenWebText。1024token逐个生成的延迟没有端到端证明。项目页 提供模型集合,但代码标coming soon;网页模板仓库不是方法代码。
9. SpecKCast:预测不同频带何时需要重算
SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration | 多伦多大学;Vector研究所;三星电子多伦多AI中心 | arXiv:2610.26837
关键词 :扩散加速, 频域预测, 卡尔曼滤波, 不确定性
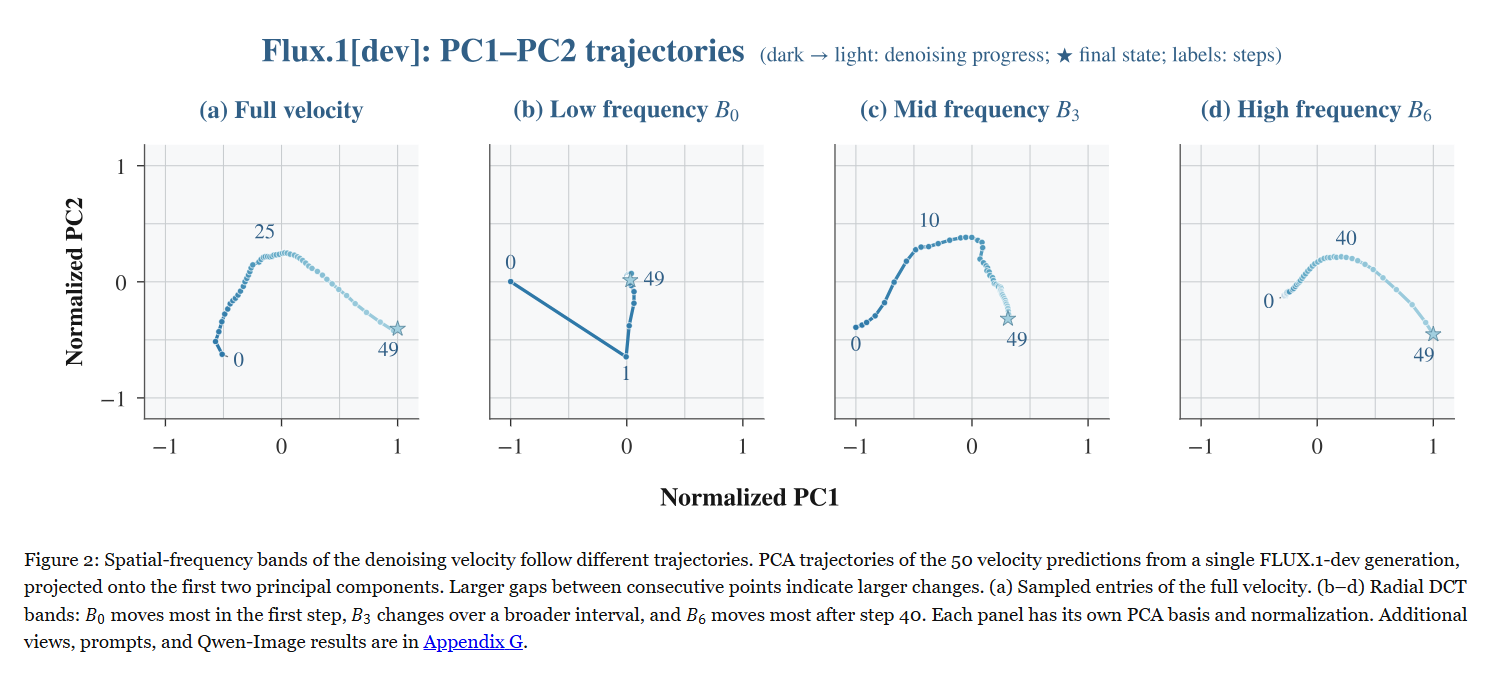
前序问题 :缓存上一去噪步能省算,但跳得越远越失真;画面大轮廓和细纹在不同阶段变化,整块特征用同一预测规则并不合适。方法直觉 :把去噪输出拆成低频轮廓与高频细节,各自记住数值和变化速度;预测越来越不确定时再真正调用大网络纠正,平稳时直接用预测。本文贡献 :二维离散余弦变换DCT把每个输出通道分解为空间频率,分7个频带。卡尔曼滤波作为递推状态估计器,为每个系数追踪值与速度,为频带共享不确定性;按噪声信噪比扭曲各带时间轴,阻尼外推避免越跳越远。实验先用12提示×50步轨迹校准频带功率,取后25步统计,参数不训练但校准有成本。跳过时逆变换得到采样器所需速度,不确定性过阈值才重算。
原文图2|去噪速度各空间频带轨迹不同。一次FLUX.1-dev生成的50次速度预测分别做PCA主成分投影,点间更大间隔表示变化更大。(a)完整速度采样分量;(b至d)径向DCT频带B0首步变化最大、B3较宽区间持续变化、B6在40步后最活跃。各面板分别拟合PCA与归一化,不能把跨面板距离直接比较;更多提示与Qwen-Image原文附录G提供。
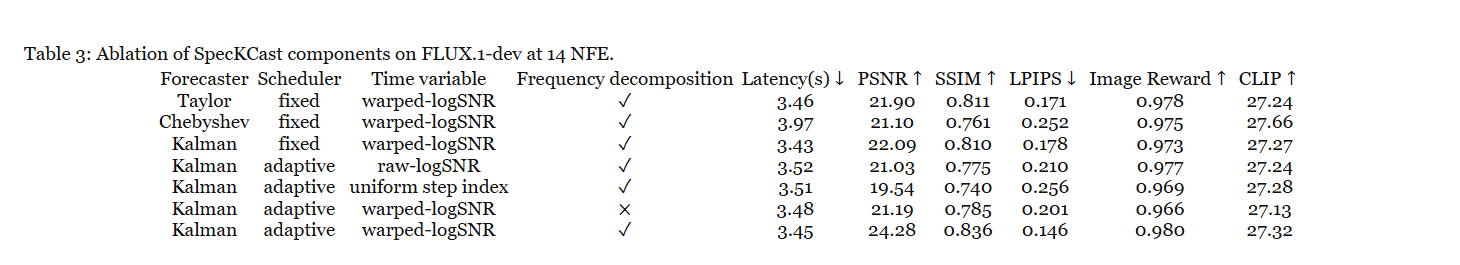
实验效果 :H100上,以50步为完整参考。Qwen-Image 1328×1328约8次有效求值配置,从52.22到8.70秒、6.00倍,额外0.01GiB;与参考图感知距离LPIPS为0.267,越低越好,绝非无损。Wan2.1-14B约14次配置由370到105.2秒、3.52倍,视频质量分80.86对参考81.11。NFE按论文表记有效去噪求值预算,是跨样本平均,单样本可变;使用双分支引导的模型每次实际还需条件/无条件两次Transformer前向。
原文表3|FLUX.1-dev约14次有效求值下的SpecKCast组件消融。频率分解、按频带扭曲时间和不确定性自适应调度共同带来最佳参考保真,完整模型PSNR24.28、LPIPS0.146、耗时3.45秒。
批判点评 :PSNR、SSIM与LPIPS主要衡量贴近50步参考,不自动代表用户更喜欢;6倍是图像特定设置,不能套给全部视频。Wan额外内存表中约0.05GiB,摘要“低于0.05”不宜当所有模型严格上界。已计算步仍处理全部空间token;离线校准和自适应耗时需纳入部署预算,尚无核实方法代码入口。
10. MuLaCover:给旋律和弦换速度与唱法
MuLaCover: Flexible Cover Song Generation via Symbolic Tonal Control | 穆罕默德·本·扎耶德人工智能大学;北京大学;MuLa Labs Vera Praxis Lab;香港中文大学;南京艺术学院 | arXiv:2610.26684
关键词 :歌曲生成, 符号乐谱, 翻唱控制, 部分参考
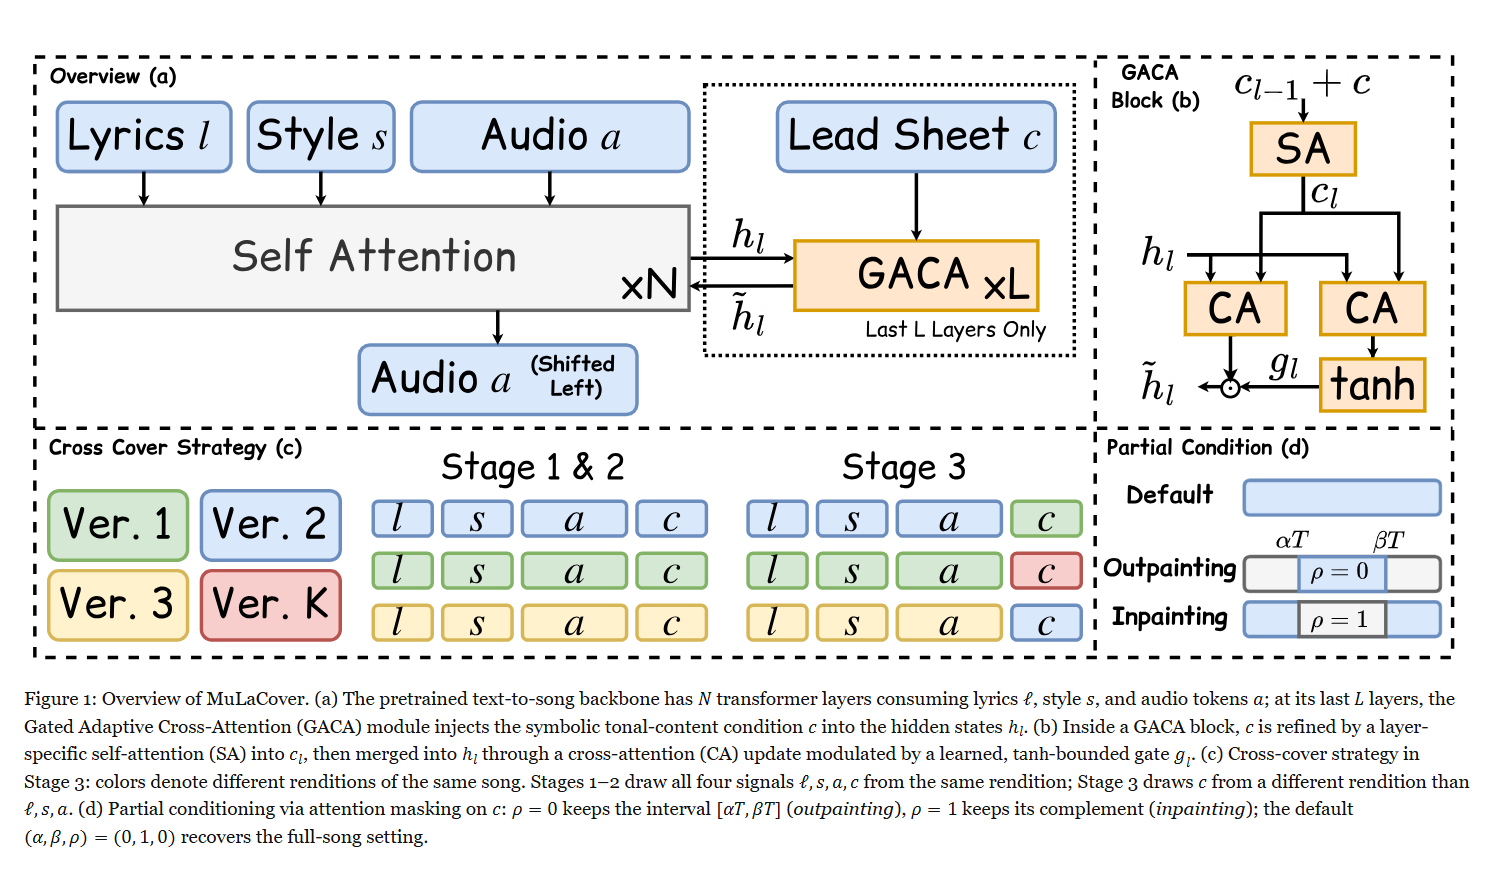
前序问题 :想保留一首歌的旋律和和弦,却换成另一种风格、速度,逐帧音频条件容易把新版本也锁在原节拍上;只给一段副歌时更加受限。方法直觉 :保留“唱什么旋律、配什么和弦”的简谱骨架,把原录音时间先归一化;让文字指定新歌词与风格,生成器自己决定新版本如何铺开。本文贡献 :从参考录音抽取旋律与和弦,统一到每分钟120拍、十六分音符网格。旋律用128个音高各自的起音/延音状态共256维,和弦用12音级;投影后通过门控自适应跨注意力接入HeartMuLa-3B的28层中最后8层。先30秒片段预热,再全曲训练,最后用同一歌不同版本的“内容/歌词风格音频”交叉配对微调。掩蔽乐谱区间支持续写、向前后扩展和补副歌;前两阶段仅训新模块,最后加低秩适配。
原文图1|MuLaCover。(a)N层歌曲主干输入歌词l、风格s和音频token a,最后L层以GACA门控自适应跨注意力注入乐谱内容c;(b)c先经各层自注意力细化,再以tanh限制的可学门控合入隐藏状态;(c)前两阶段四信号取同版本,第三阶段c取同曲另一版本;颜色区分版本。(d)内容序列掩码支持部分参考:rho=0保留alpha T到beta T区间以向外生成,rho=1保留其补集以填内部,T为乐谱长度;默认alpha=0、beta=1、rho=0为全曲。
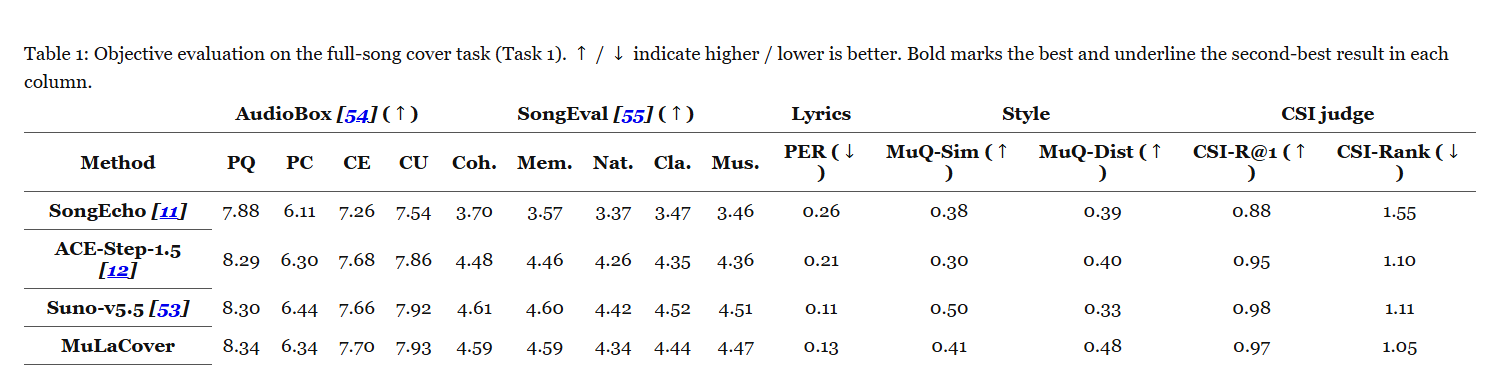
实验效果 :约20万合成歌曲用于数据构造,16张A100 80GB训练,新增可训参数约3亿至4亿而非整个模型规模。完整翻唱任务在32首源歌检索库中,本法/Suno-v5.5的CSI首位找回率为0.97/0.98,越高越好;音素错误率0.13/0.11,越低越好,后者更佳。22名有效参与者对8首抽样歌给出95个完整人歌组合、1520次五分评分,本法整体音乐性3.75±0.22,对照3.88±0.21,区间为95%置信区间。
原文表1|全曲翻唱任务的客观评测,箭头标指标优劣方向,粗体为最好、下划线为次好。比较音频审美、歌词、风格和原曲检索;本法与商业对照各有优劣,不能用单列概括全部音乐性。
批判点评 :可控性不等于逐音符精确复制,自动旋律和和弦转录错误会传递;小检索库与听评也不足证明所有风格等价商业系统。部分参考任务的SongEcho掩蔽与ACE-Step串联是作者适配,不能当原生能力公平等同。未报告完整推理时延显存,训练新模块也有成本。项目与代码 可访问,项目副标题写Lead Sheet Control,原文保留Tonal Control;仓库标权重与输出限非商业用途。
趋势观察
编辑应先想哪些信息不能丢
DeOverlay固定源引导,ColorModern只传播颜色,UniAVC固定满意分支;三者都把保留目标放进具体操作。
监督对象要对准失败阶段
MT Forcing练学生自己生成的历史,LayerEditor检查图层重新合成,Wan-Alpha++把可见参考搬到有效条件位置。
计算预算必须有分母
Halcyon的275倍算总预训练,SpecKCast的6倍是特定采样设置,ColorModern的816帧/秒仅末段传播。
多维指标共同决定是否可用
MuLaCover旋律检索与歌词精度不同步,MeV表面一致性不能取代分镜控制,UniAVC分布距离好也不保证所有同步指标领先。
今日讨论
DeOverlay同一检查点的四步/六步消融,遮挡区PSNR仅从32.461到32.467,相对时延却从1.00到1.25;速度表四步为2.0712帧/秒,主榜六步尚无对应端到端行。若你要做批量视频字幕移除,会收集哪些指标,结合遮挡区感知距离、运动边界残影、天然文字保留率与实际耗时,判断这两步是否值得,而不直接拿六步质量和一步3.0847帧/秒拼成一个配置?
人工智能炼丹君 整理 | 2026-10-21



评论 (0)