今日 AIGC 论文速览
今日共 10 篇 · 多参考视频编辑 1 篇 · 多轮图像编辑 1 篇 · 视频几何纠错与视频配音 2 篇 · 像素生成与推理效率 2 篇 · 语音与个性化生成 2 篇 · 可控3D头像与世界模型 2 篇
重点论文标题列表
OmniXRef (Adobe):多段参考各取所需再改视频MTEdit (商汤):先拼好编辑轨迹再拆训练对VGC (加州默塞德):生成完再修镜头下的几何MFlow (Adobe):按数据方向学该预测什么Sink-Sparse (西安交大):保留重要注意力再补全局
选读入口:要用多段参考改视频,先读 OmniXRef;连续修图越改越脏读 MTEdit,生成视频已有几何变形读 VGC。训练像素生成器读 MFlow,长序列注意力慢读 Sink-Sparse;动作细节配错音读 SCR-V2A,语音首响预算紧读 DriftTTS。两图合成准备慢读 Kingfisher;表情带偏镜头读 VDAs,镜头回访忘场景读 PPMem。
今日论文速览
1. OmniXRef:多段参考各取所需再改视频
OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing | Adobe Research;布朗大学 | arXiv:2610.22744
关键词 :视频编辑, 多模态参考, 属性迁移, 位置编码
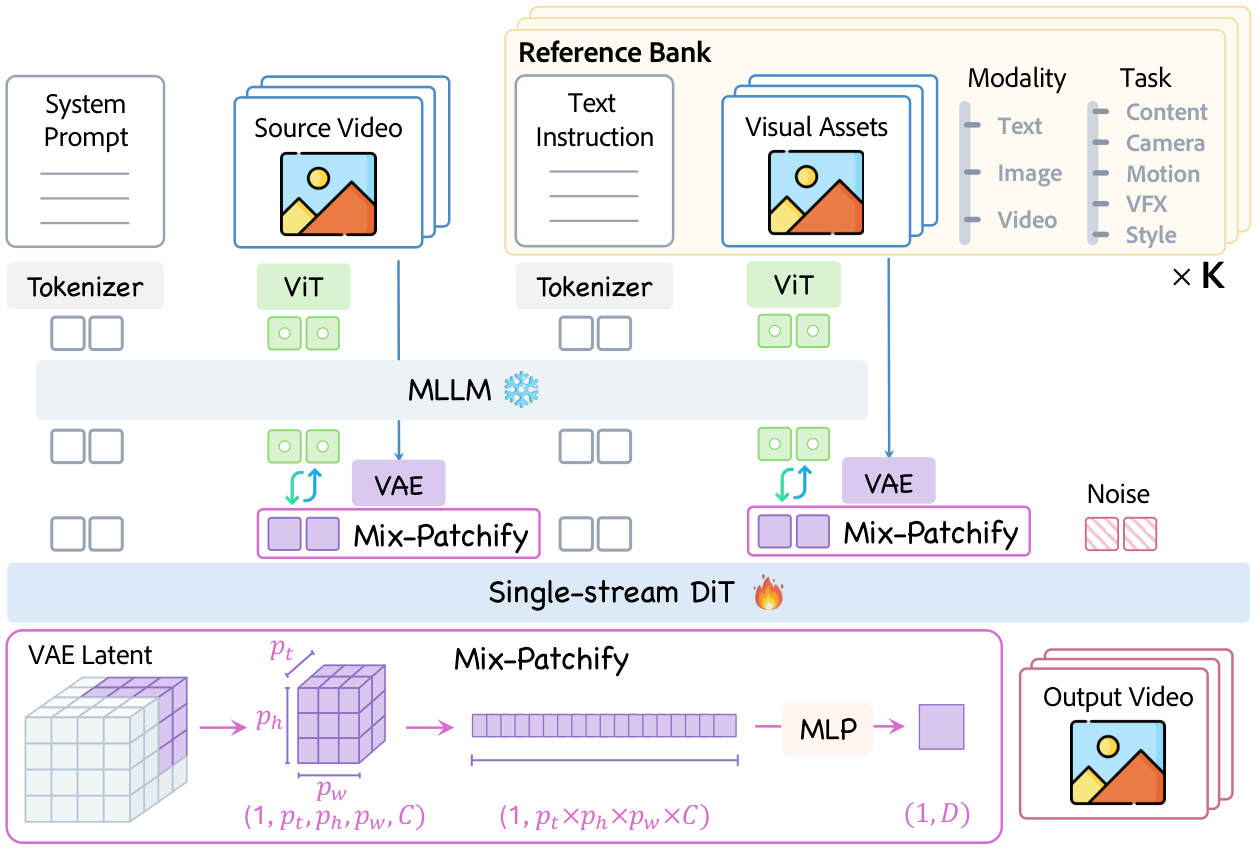
前序问题 :想让原视频沿参考片的镜头运动,再套另一段的灯光,模型却把参考人物也搬了进来。多个参考不仅要“都看到”,还要分清每段只允许借什么。方法直觉 :把每个参考做成一个带任务和编辑说明的小包,再给这些包预留固定位置。网络可同时比较全部输入,而不把参考数量改变误当成位置含义改变。本文贡献 :冻结 Qwen3-VL-8B 多模态语言模型提取交错文本/视觉上下文,视觉位置换成视频编码潜变量,单流扩散 Transformer 联合去噪。Mix-Patchify按任务压缩参考的空间 token,源/目标保持细粒度、参考时间轴不压缩。R²-RoPE 是预留参考槽的旋转位置编码:为参考预留8槽,训练随机分配不重复位置,避免增加参考时越出训练坐标范围。约1000万训练样本经272P单参考、272P双参考、480P精调逐级学习;主要文字编辑数据约700万为内部数据。
图2|OmniXRef-Model整体结构。参考包统一承载文本、图像和视频参考。多模态语言模型从交错输入提取语义上下文;单流扩散Transformer通过完整自注意力联合处理上下文文本、视觉token及噪声,使多个参考包同时约束编辑结果。下方Mix-Patchify将视频潜变量按所需粒度切块,再映射为扩散token。
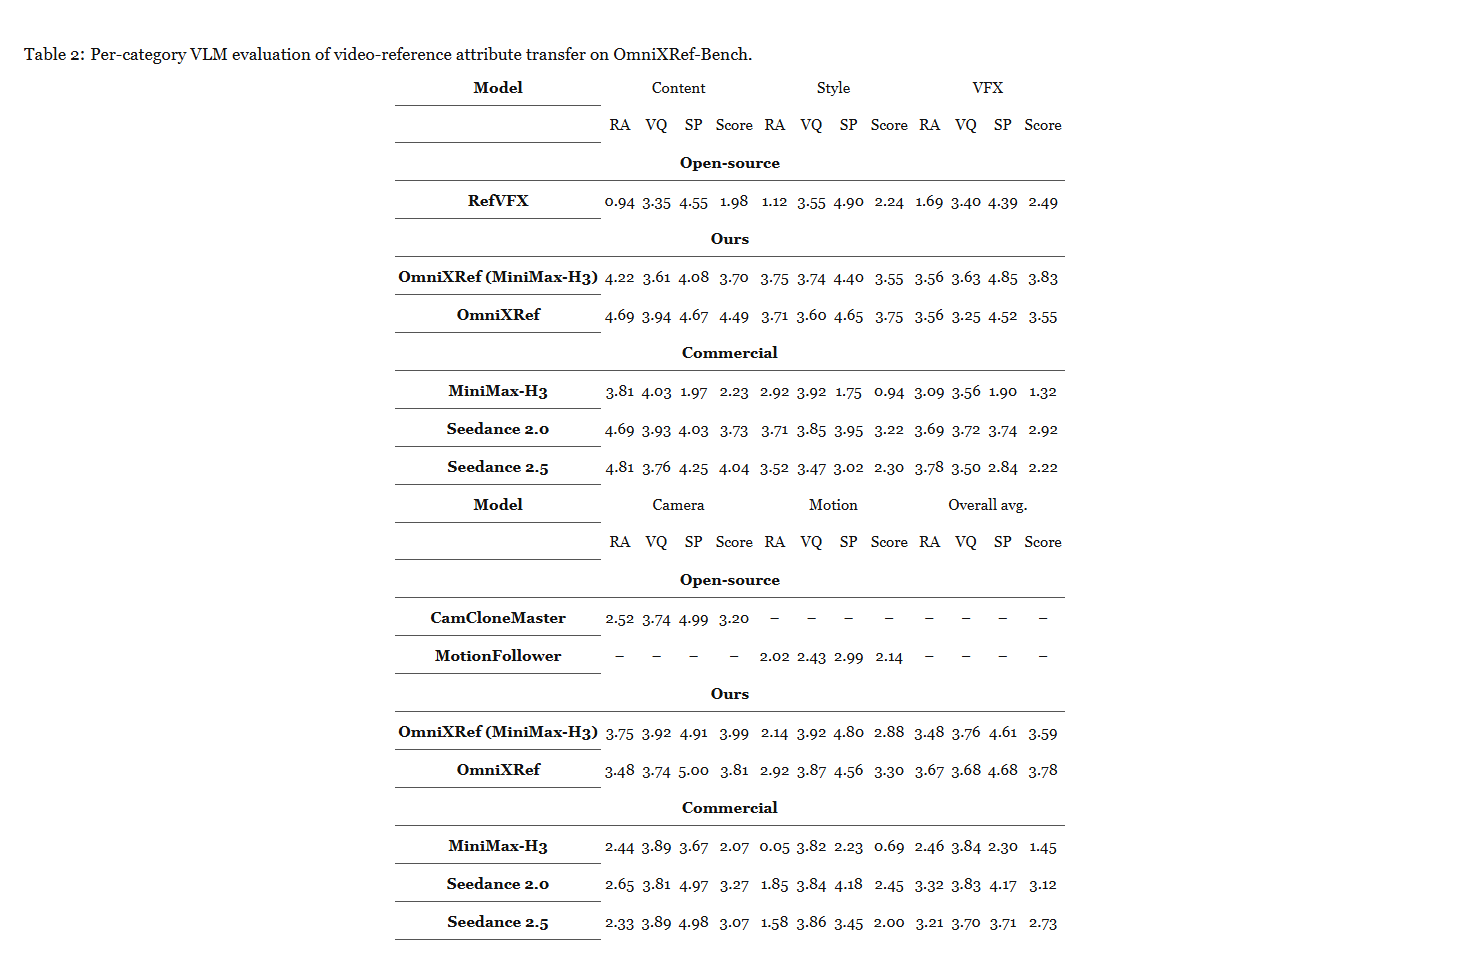
实验效果 :OmniXRef-Bench 共125例,覆盖镜头、动作、内容、风格、视觉特效五类,用 Gemini 3.8 Flash 裁判。RA参考遵循、VQ画质、SP源内容保留各按0至5分评估;综合分另惩罚参考泄漏,非简单均值。总体综合分OmniXRef/Seedance 2.5为3.78/2.73,SP为4.68/3.71;但VQ为3.68/3.70,画质并未胜过该商用对照。支持三参考的展示来自双参考训练后的组合泛化,不能据8槽宣称8参考质量已充分评测。
表2|OmniXRef-Bench视频参考属性迁移的逐类别语言模型裁判评估,含内容、风格、特效、镜头、动作及五类总体均值。RA为参考遵循,VQ为视觉质量,SP为源内容保留,三者均为0至5分且越高越好;Score按原协议综合并惩罚参考泄漏,不能按三分算术平均解释。商用模型为参考,粗体只标其余方法最优;横线表示缺少结果。
批判点评 :训练与推理要付多参考 token 及全注意力开销;局部压缩并不消除随参考数增加的计算。有限125例及语言模型裁判适合看属性迁移趋势,非普遍产品排名。主表和消融表的完整模型数值略异,正文统一用主表;项目页 仍标Code Soon,没有已开源证据。
2. MTEdit:先拼好编辑轨迹再拆训练对
MTEdit: Packed Trajectories Beat Rollouts for Multi-Turn Image Editing | 商汤研究院;香港科技大学;斯坦福大学;清华大学AIR | arXiv:2610.23751
关键词 :多轮编辑, 轨迹数据, 上下文学习, 质量漂移
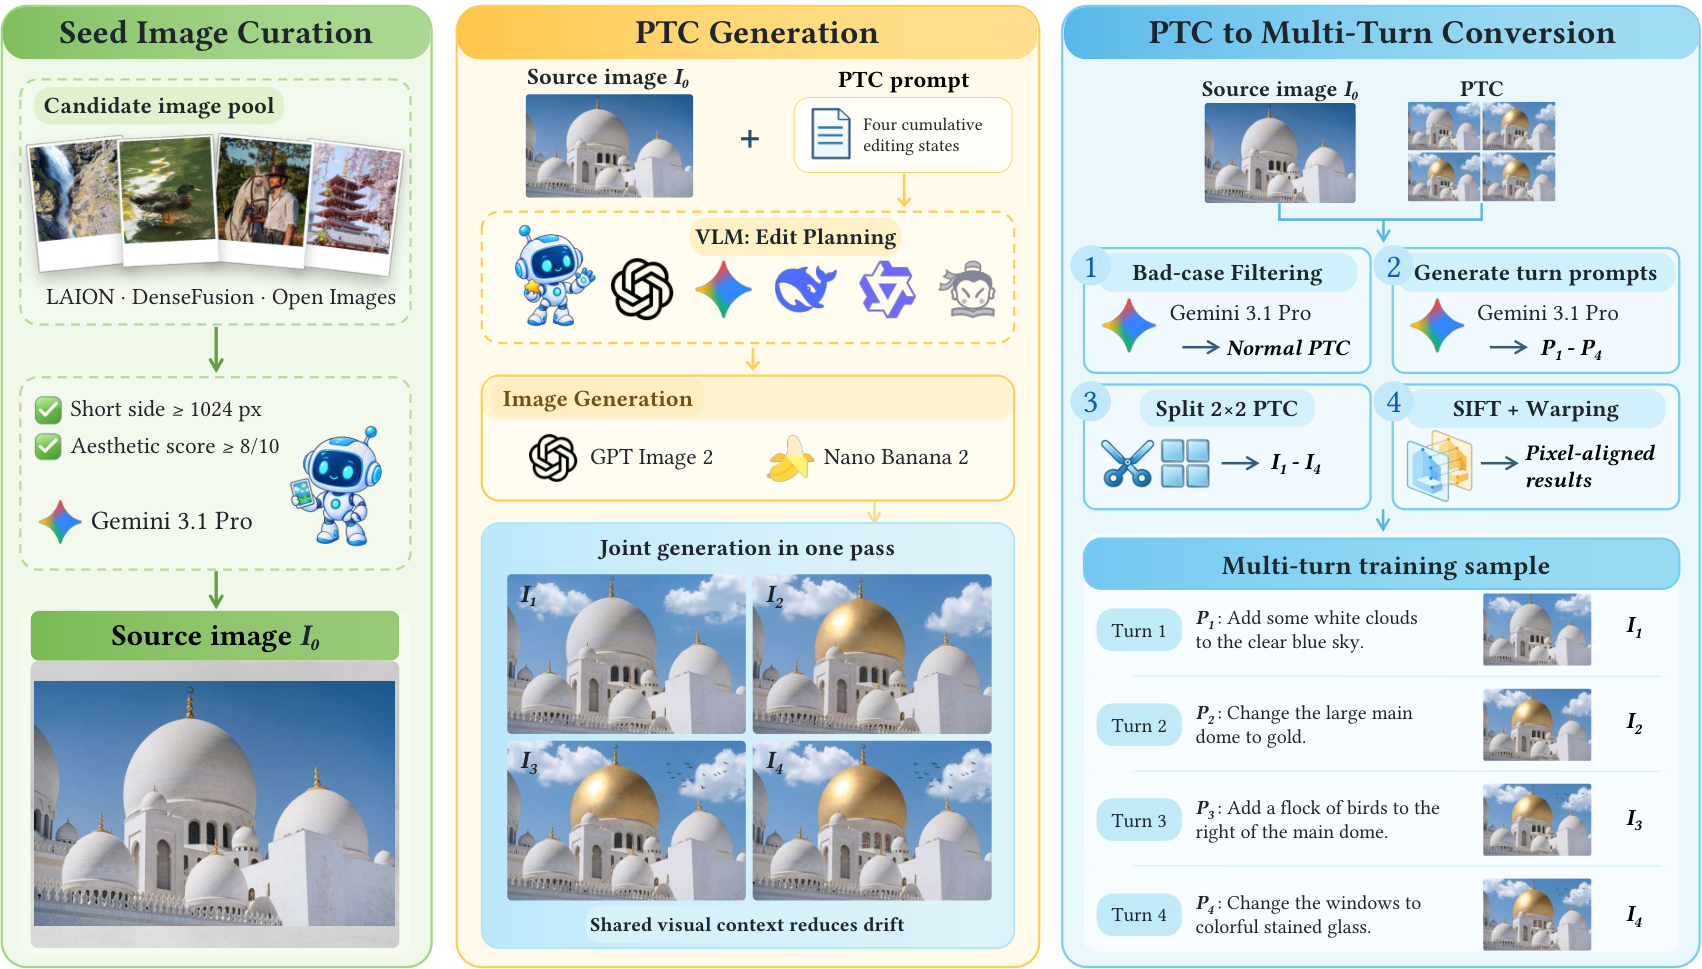
前序问题 :连续改八次图,第八次可能已经脏了;若训练数据本身也靠逐轮改图获得,模型会学到这种累积退化。怎样得到既遵循连续指令、又不越改越坏的训练链?方法直觉 :先在同一画布里共同生成多个编辑状态,再把画布拆成轨迹。共享视觉上下文让各状态互相约束,比每轮只承接上一次的误差更稳。本文贡献 :PTC(packed trajectory canvas,打包轨迹画布)流程先筛高分辨率美学种子图,再用视觉语言模型规划画布提示,让闭源图像模型一次生成多个状态。随后做坏例过滤、拆格、局部特征匹配与几何对齐,并补逐轮指令,得到50万条轨迹、269万次编辑,最多8轮、平均5.38轮。既包含只执行当前指令,也包含需记住历史的约束、指代和简短指令。用块因果注意力及交错位置编码联合训练多轮,微调 Qwen-Image-Edit-Causal。
图2|MTEdit数据构造。(a)筛选高分辨率与高美学质量种子图。(b)视觉语言模型依据种子图规划PTC画布提示,指导闭源图像模型在共享视觉上下文中共同生成多个编辑状态。(c)过滤坏例、生成逐轮提示,拆分画布并做局部特征匹配和几何对齐,将状态转换为含指令与目标图的多轮编辑轨迹。
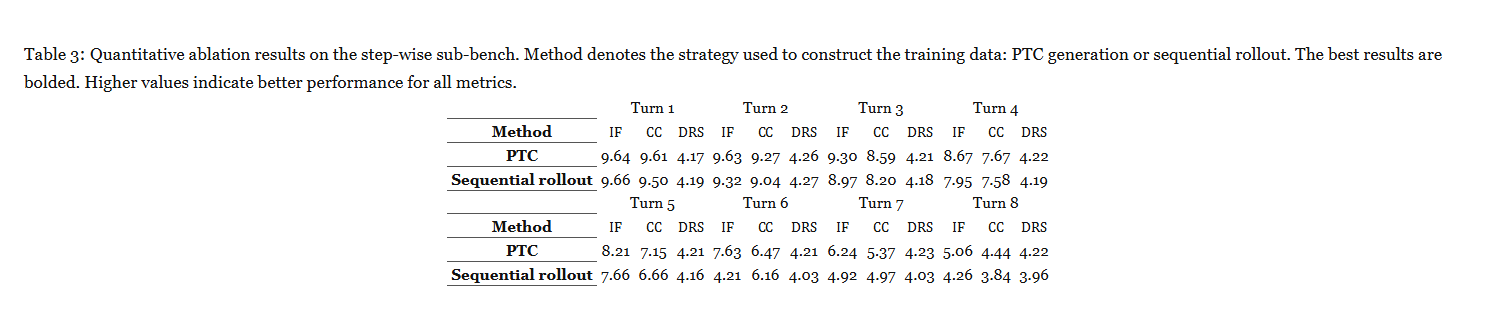
实验效果 :MTEdit-Bench 含100条8轮逐步编辑链,另有三类各50条4轮上下文任务。受控消融用相同图像/提示、相同教师,各造1万条8轮链,再让同一主干训练5000步:第8轮 PTC/逐轮生成的 IF 指令遵循分为5.06/4.26,CC 内容一致性分为4.44/3.84,DRS 抗画质漂移分为4.22/3.96。IF/CC 是视觉语言裁判0至10分,低于6的首次失败后后续轮置零;DRS是两种画质评分平均、0至5分,不随失败清零。
表3|逐步编辑子基准上的受控消融。Method表示训练数据用PTC共同生成还是逐轮生成;每种构造各1万条八轮轨迹、同主干同超参数训练5000步。逐轮报告IF指令遵循、CC内容一致性与DRS抗画质漂移,均越高越好,粗体标最优。IF/CC为0至10分且首个失败之后后续归零;DRS为0至5分并保留实际分数。
批判点评 :结果支持数据构造方式,不代表闭源教师可被低成本替代;画布生成、筛选与对齐成本仍须支付。完整模型第8轮DRS为4.33,但指令遵循仍落后最强闭源模型,不能把画质稳定等同编辑正确。低分置零会放大早期失败影响,比较时应沿用同协议;未核实MTEdit专属代码或数据下载入口,也无会议接收证据。
3. VGC:生成完再修镜头下的几何
Learning to Correct Geometry in Generated Videos | 加州大学默塞德分校;南洋理工大学;北京大学;卡内基梅隆大学 | arXiv:2610.23856
关键词 :视频修正, 几何一致性, 配对监督, 光流
前序问题 :镜头移动时,灯杆变成两根、门框扭曲;换一个视频生成器又要重新解决。能否在成片后统一修正,而不修改原生成模型?方法直觉 :拿真实视频当正确答案,让现有补帧生成器制造“同场景但几何出错”的版本,再训练一个专门纠错的视频模型。难点是错片仍要走原镜头路线。本文贡献 :VG-Pairs按相机旋转和平移量决定分段数,在运动方向转折处选关键帧,分段用 Wan 2.1-Fun-InP 补中间帧并拼接,避免只给首尾时走捷径。VGC以 Wan 2.1-1.3B 做视频到视频去噪,输入错片、文本和从错片计算的光流;光流是相邻帧运动场,用于区分全局相机移动与局部物体运动,推理时同样可得。训练使用约8000条DL3DV及6.3万条SpatialVID视频,81帧、832×480,32张H100训练1万步。
图3|VGC流程。从真实视频中按相机运动选自适应关键帧,图生视频补全器合成有几何扭曲的片段作训练输入;纠错器学习还原几何一致的目标视频。光流由错片计算并作辅助条件,帮助区分镜头移动与场景动态。中央三维重建仅用于示意,实际流程不使用该重建。
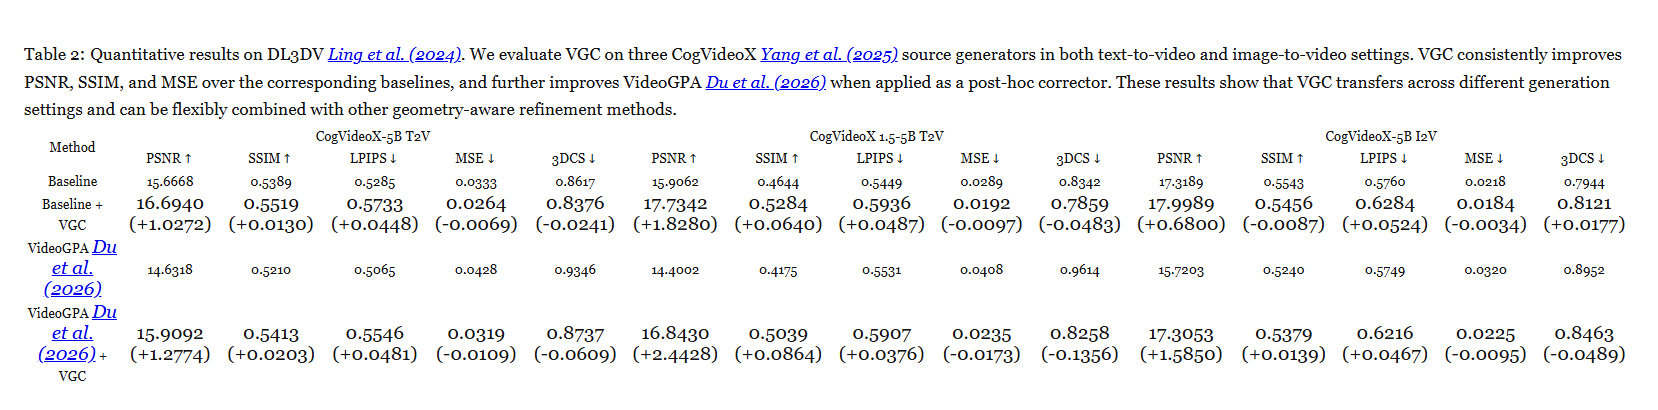
实验效果 :在200条保留DL3DV提示、CogVideoX-5B文生视频上,用独立三维重建再投影衡量一致性:PSNR由15.6668到16.6940,像素均方误差MSE由0.0333到0.0264,均改善;LPIPS感知距离却由0.5285升至0.5733,反而变差。图生视频的3DCS三维一致性误差亦由0.7944到0.8121,越低越好,不能宣称所有几何指标均提高。大模型14B扩展到动态场景和720P,属于另一配置。
表2|DL3DV中三种CogVideoX来源生成器的文生/图生视频几何修正。通过独立三维重建与再投影计算PSNR、结构相似度SSIM、感知距离LPIPS、均方误差MSE和三维一致性误差3DCS;前两者越高越好,后三者越低越好。括号是加VGC后的变化,亦展示与VideoGPA叠加。PSNR和MSE多改善,但LPIPS均变差,图生视频的部分SSIM、3DCS也退化,不能据原表概括所有指标改善。
批判点评 :改进主要来自配对监督;加光流的增益有限,额外纠错生成、视频编码及光流计算均增加延迟,论文未给完整部署耗时。重投影自洽也不保证忠于真实场景。已核实NeurIPS 2026接收;代码 现释放14B无光流版,不能直接等同上述1.3B含光流实验。项目页作者与arXiv有一名作者差异,本稿保留arXiv原始名单与机构。
4. MFlow:按数据方向学该预测什么
Rethinking the design space of Vanilla Pixel Diffusion Transformers | Adobe Research;马里兰大学帕克分校 | arXiv:2610.23854
关键词 :像素生成, 流匹配, 参数化, 高频细节
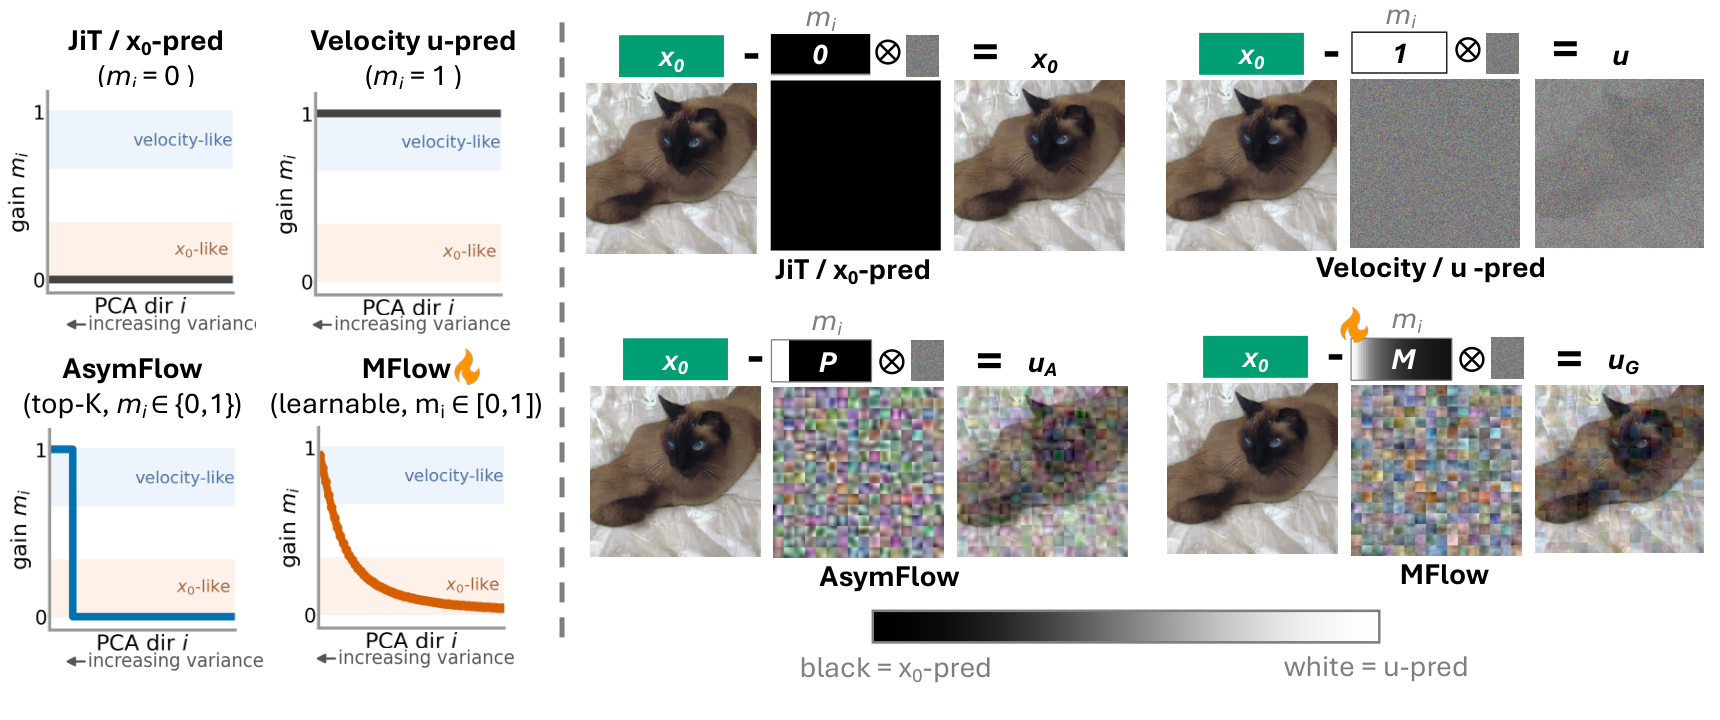
前序问题 :直接在像素上生成时,预测干净图像有时比预测变化速度容易,但换大模型、换视频就未必。固定一种目标,还可能让整套训练都在迁就不合适的表示。方法直觉 :不同数据方向的难度不同:轮廓和细纹不必用同一种预测目标。让模型为每个方向学习“更像图像还是更像速度”,再统一还原成采样需要的速度。本文贡献 :先用 PCA 主成分分析计算固定的图像块或视频块正交方向,再学习各方向的系数 m_i,范围0至1。目标为 x₀−Mε:x₀是干净信号,ε是噪声,M按这些系数重加权噪声;m_i=0对应干净预测,1对应速度预测。将输出解析恢复为速度后计算流匹配损失,避免系数靠缩小目标投机。另加 ConvRefiner:冻结主干,用轻量卷积残差和对抗损失补细节,专门处理 JiT 类大图像块模型的高频缺失。
图3|MFlow预测参数化。按PCA数据主方向比较固定干净预测、固定速度预测、低秩二值分配的AsymFlow,以及连续可学习的MFlow。左侧曲线展示各方向的系数m_i,0偏向干净图像、1偏向速度;右侧用干净图像减去重加权噪声展示不同目标。黑色表示干净预测,白色表示速度预测。
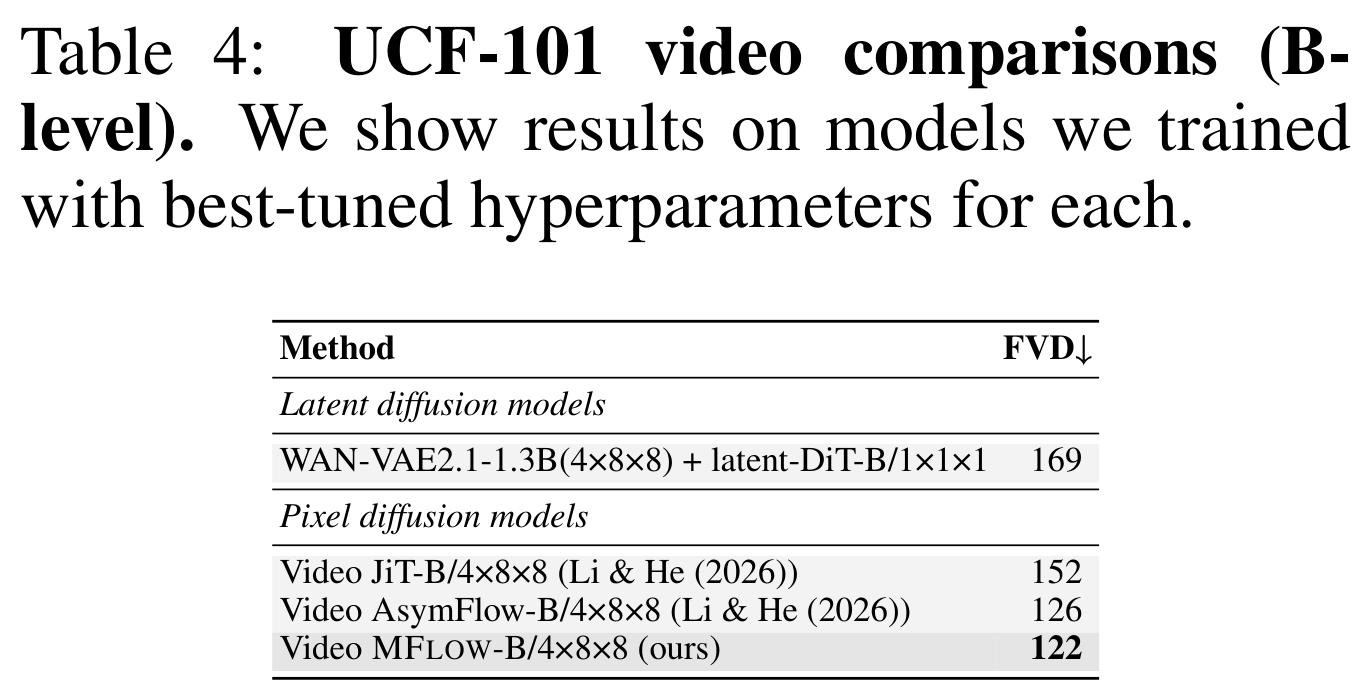
实验效果 :UCF-101 类别条件视频为16帧、128×128;各模型独立调采样参数,B级 MFlow/JiT/AsymFlow 的 FVD(视频特征分布距离,越低越好)为122/152/126。ImageNet 256×256、H级加相同感知损失时,FID(图像分布距离,越低越好)为1.81/1.82/1.79,并非全面最优。卷积细化器在冻结训练600轮的主干上另练30轮,恢复每像素0.5至0.7周期的径向高频能量,FID基本保持;文生图另有5000步细化训练。
表4|UCF-101类别条件视频生成B级模型比较。作者分别训练并独立调优每个模型的采样超参数,视频为16帧、128×128;FVD以1万生成视频估计分布距离,越低越好。潜空间基线为Wan视频编码器加latent-DiT;像素JiT、AsymFlow、MFlow分别为152、126、122。表内编码器名中的1.3B不是所比较生成器的参数规模。
批判点评 :价值是减少人工选择预测子空间,不是推理必然更快。小模型、是否加入感知损失会改变排名;高频统计改善也不等同细节真实。大规模文生图用了内部预训练与微调数据,复现门槛需单算;额外卷积、训练和显存没有完整端到端量化。作者项目页 未提供方法代码入口,不能把网页模板仓库当代码;论文仍在审稿。
5. Sink-Sparse:保留重要注意力再补全局
Sink-Sparse Hybrid Attention for Efficient Inference in T2I/T2V Diffusion Transformers | 西安交通大学;厦门大学;上海交通大学 | arXiv:2610.22975
关键词 :生成加速, 稀疏注意力, 离线校准, 全局补偿
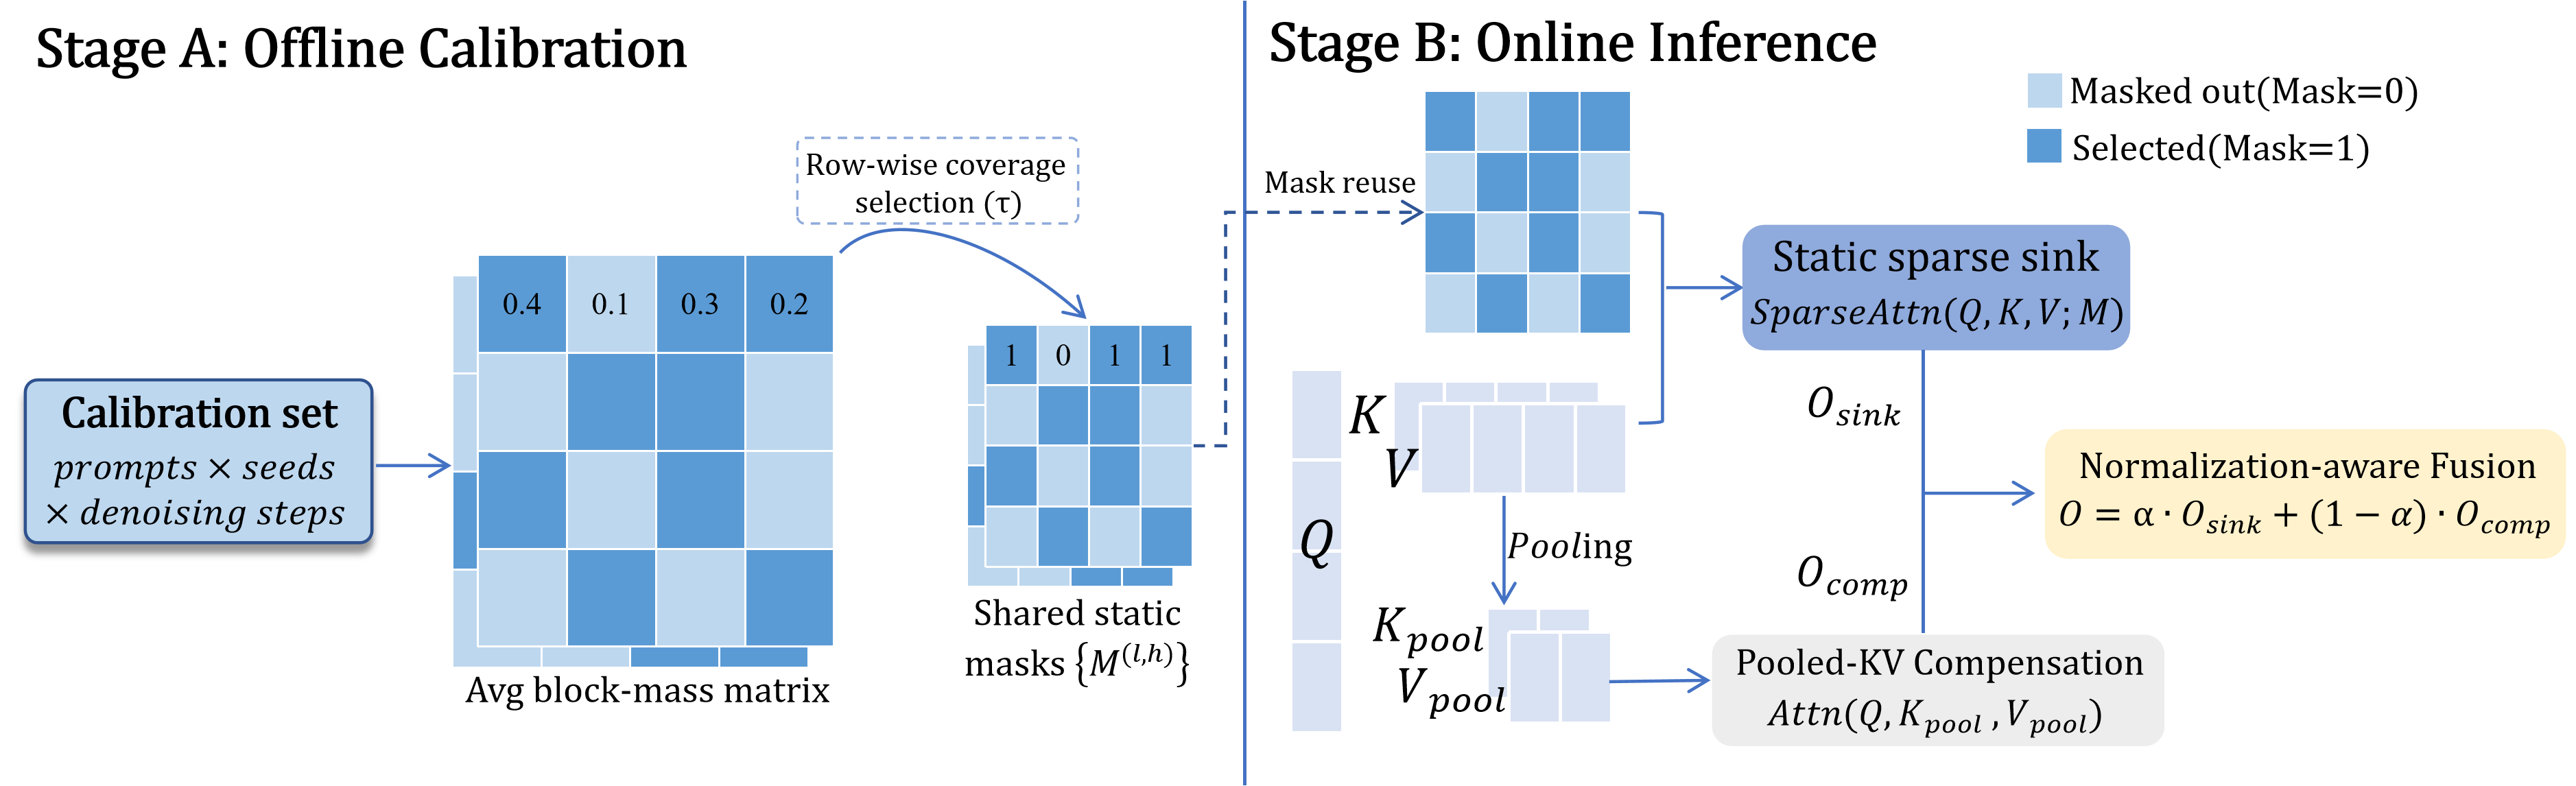
前序问题 :视频token越多,反复计算全连接注意力越慢;每一步再搜索该留哪些关联,也可能吃掉稀疏化收益。能否一次找好,以后重复利用?方法直觉 :同一层同一注意力头常反复关注相似位置。保留这个稳定骨架,再用低分辨率全局摘要补上弱关联,兼顾省算与上下文。本文贡献 :离线在每个主干分别跑4提示×2噪声种子的完整轨迹,汇总精确块级注意力概率质量;每行选能覆盖阈值τ的最少块,固定掩码跨步复用。在线稀疏分支保留重要块,补偿分支只将key/value(供查询读取的键和值)按30个token均值池化,query仍保持原长;依据两支归一化常数自适应融合。模型权重、采样步数不变,免训练不等于免校准。
图4|Sink-Sparse Hybrid Attention两阶段流程。离线对少量提示、种子及去噪步采集稠密注意力,精确汇总块级概率质量并按行覆盖阈值τ选出每层每头固定掩码。在线各步复用掩码,稀疏分支保留稳定高质量关联;全长query读取均值池化的key/value以补全局信息,最后按归一化常数融合两分支。
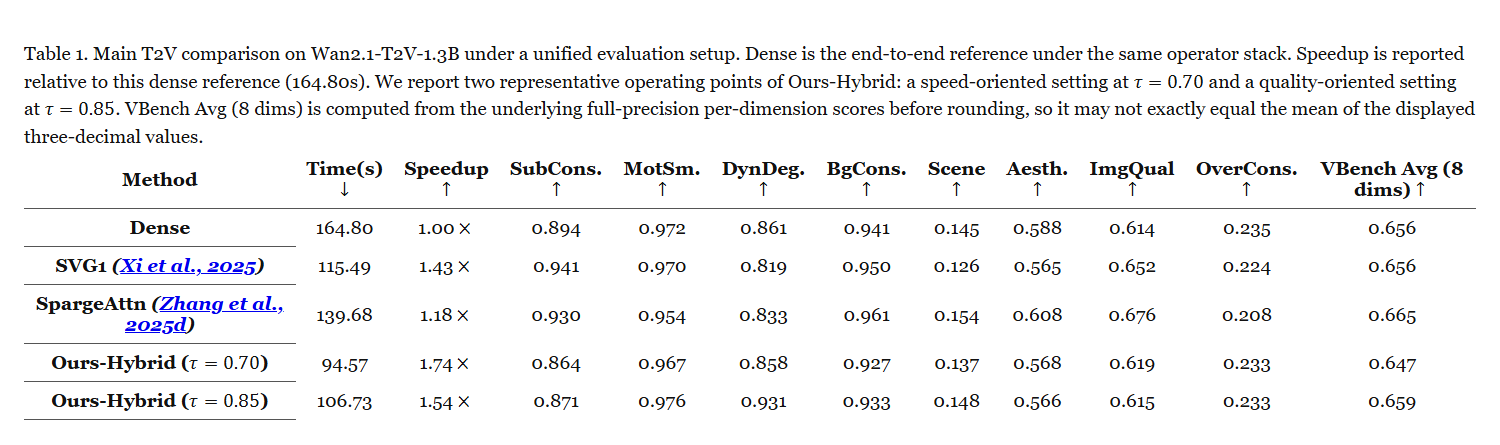
实验效果 :单A800 80GB,Wan2.1-1.3B、832×480、81帧、50步:τ=0.85时由164.80降到106.73秒、1.54倍;VBench八维均分0.656到0.659,越高越好,非官方完整总分。τ=0.70可到94.57秒、1.74倍,但均分降为0.647。Z-Image-Turbo 2048×2048、8步由23.39到14.88秒、1.57倍;GenEval2中各属性问答软分的几何均值Soft-TIFA GM由16.38降至15.21,越高越好。计时排除初始化和写文件;默认离线校准约22分钟为按稠密耗时估算。
表1|Wan2.1-1.3B文生视频主比较,832×480、81帧、50步、单A800 80GB。Dense为同一优化算子栈的稠密基准164.80秒,加速倍数以它为分母;计时不含模型初始化和视频写入。τ=0.70/0.85为速度/质量档。八列分别评主体、运动平滑、动态幅度、背景、场景、美学、成像及总体一致性,均越高越好;八维均分由未四舍五入值计算,非完整VBench总分。
批判点评 :这是已测两主干上的质量与速度取舍,图像设置并非无损。固定掩码可能遗漏罕见或分布变化下的关系,不应跨主干直接复用;稀疏率只统计主分支,不包含补偿分支。尚未核实作者代码入口,也未报告完整峰值显存,不把免训练写成零部署成本。
6. SCR-V2A:盯住真正发声的局部来配音
Semantic-Critical Regions for Video-to-Audio Generation | 悉尼大学 | arXiv:2610.23021
关键词 :视频配音, 局部语义, 适配控制, 音画对齐
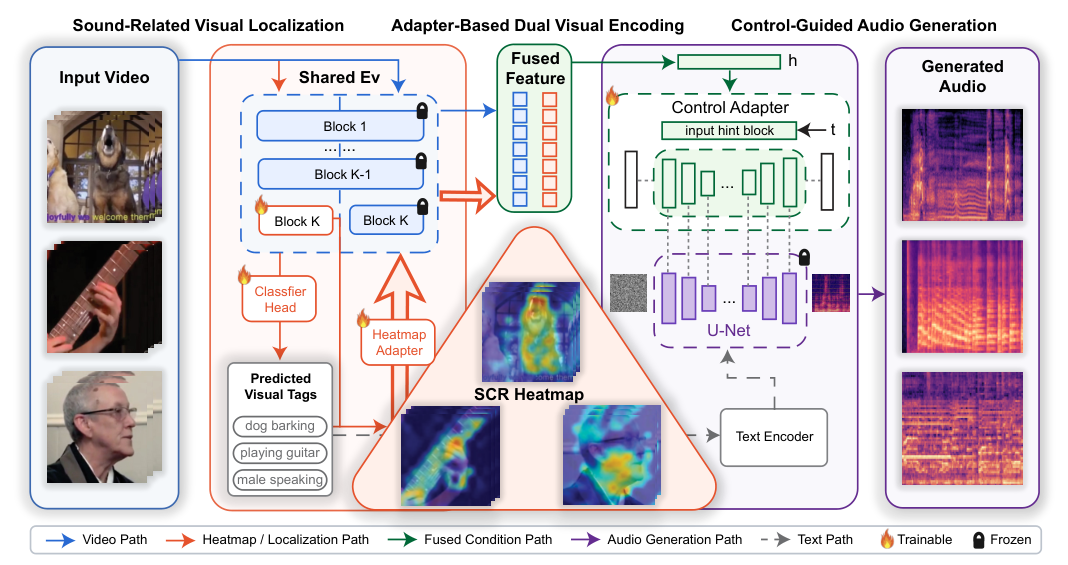
前序问题 :画面里人和乐器都很大,真正发声的却是手与琴弦接触处。只用整帧语义,配音可能听着像那个场景,却错过细小动作和节奏。方法直觉 :先找“哪里最能解释声音”,把局部热图与原视频同时送入生成器:局部提示事件,全局保住场景,标签补声音类别。本文贡献 :SCR指语义关键区域。用MotionFormer视频编码器预测声音标签,只微调最后块与分类头;保留概率高于0.65、最多5个标签,通过类别梯度加权的激活图定位区域,跨标签取最大,再与原帧各占50%叠加。热图适配器弥合热图和自然视频的差别,二者由共享视觉编码器编码后拼接,经控制适配器注入预训练音频扩散U-Net(带跨层跳接的去噪网络),标签作辅助语义条件,最后解码频谱与波形。
图2|SCR-V2A整体结构。声音相关视觉定位预测标签并提取语义关键区域热图;原始视频与经热图适配器处理的热图由共享编码器编码,融合后经控制适配器注入冻结音频扩散U-Net,并联合声音标签的文本特征生成频谱与波形。彩色箭头区分视频、定位、融合、音频及文本路径,火焰/锁表示可训练/冻结组件。
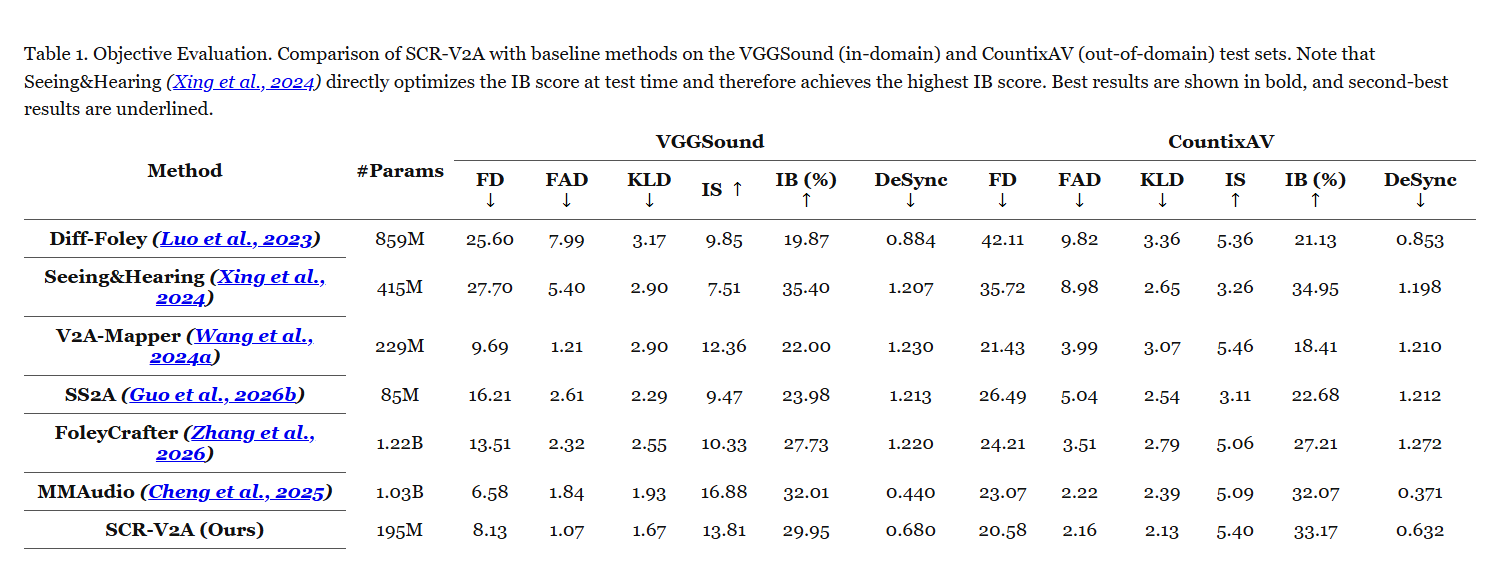
实验效果 :在VGGSound约20万条10秒片、310类上训练,并用CountixAV测跨域。域内SCR-V2A/MMAudio 的FAD(VGGish特征上的音频分布距离,越低越好)为1.07/1.84,DeSync音画时间不同步分为0.680/0.440、越低越好,后者更强。跨域FAD为2.16/2.22。30人对20视频的5秒音频作五分评价,本法总体音质3.93±0.94、语义对齐4.10±0.88、时间对齐3.50±0.97;MMAudio时间对齐3.87±0.94。195M指可训练参数,非整模型参数或推理内存。
表1|VGGSound域内和CountixAV域外客观比较。FD、FAD为不同音频特征空间的分布距离,KLD为类别概率分布差异,DeSync为时间不同步分,均越低越好;IS为音频质量/多样性分,IB为ImageBind音画语义相似度%,均越高越好。Seeing&Hearing直接在测试时优化IB,比较需注意该条件。#Params按文中说明计可训练参数,非总推理参数;粗体/下划线标最优/次优。
批判点评 :局部区域有助分布质量和语义,不保证时序最佳。梯度热图、双路视觉编码和扩散本身均需计算,缺端到端时延与峰值显存证据,不能只凭可训练参数宣称部署轻。标签误判也会把注意力引向错处;这些差异不由小规模听评自动证明显著。arXiv明确写ACM Multimedia Asia 2026已接收,未核实专属代码入口。
7. DriftTTS:把迭代搬到训练来一步发声
DriftTTS: One-stage Single Step Text-to-Speech via Generative Drifting | 首尔市立大学人工智能系 | arXiv:2610.22960
关键词 :语音生成, 生成漂移, 单步采样, 片段监督
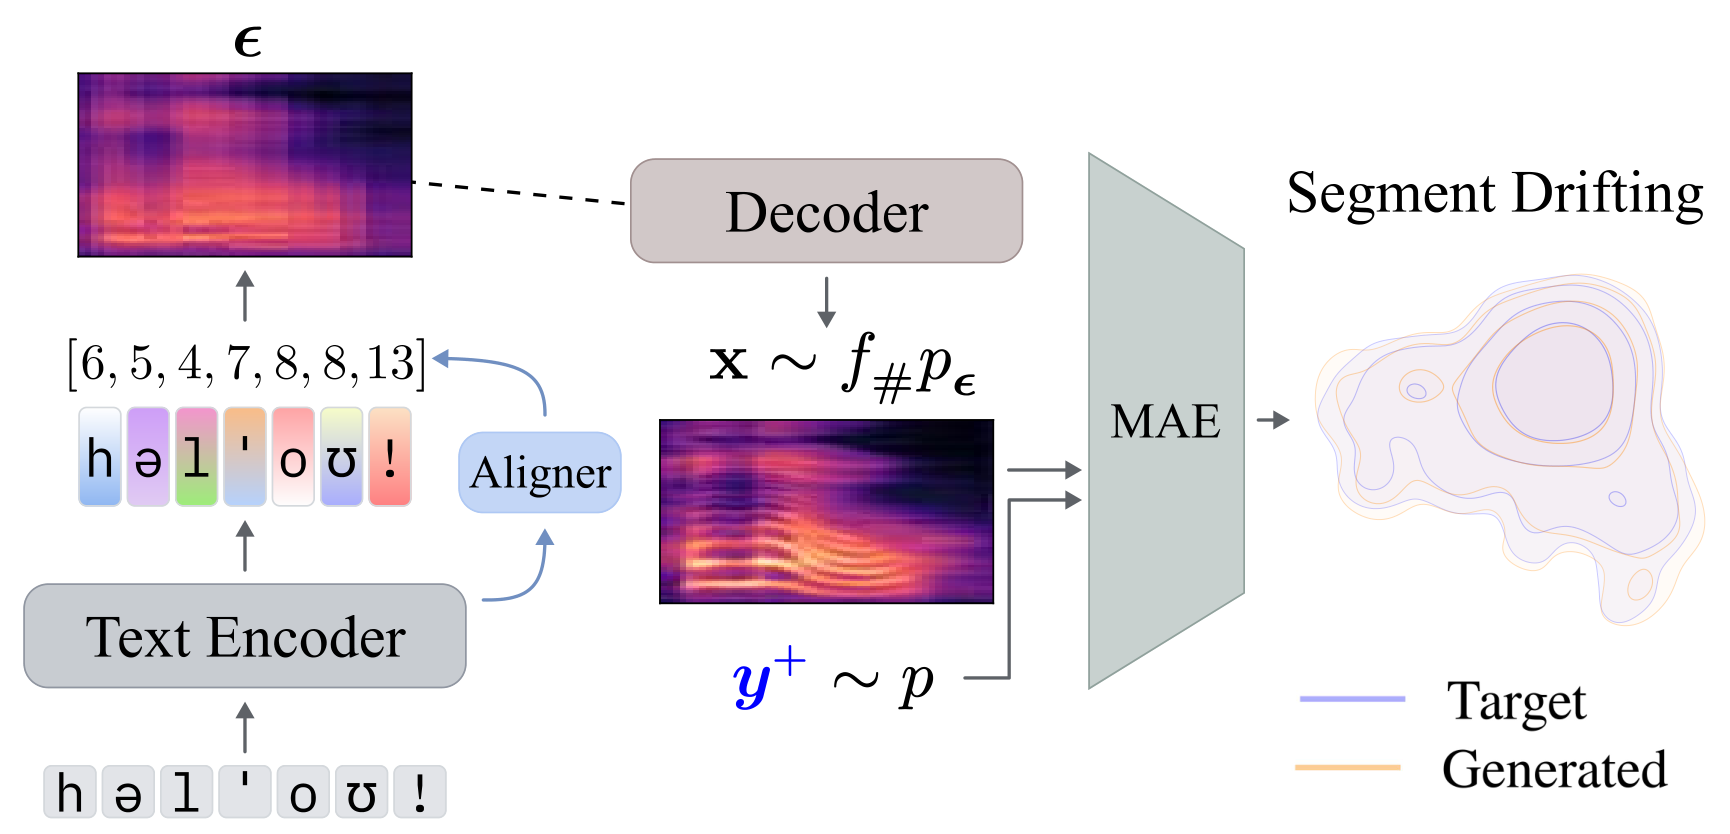
前序问题 :语音生成器要反复调用解码器,交互响应变慢;蒸馏虽能减步,却通常先付一遍多步教师训练。能否从头训练一个只调用一次的模型?方法直觉 :让生成结果在训练中靠近真实语音片段、远离当前错误分布,推理时就直接落到目标附近;片段一起比较还能避免单帧“对了、拼起来却不顺”。本文贡献 :沿用Matcha-TTS文本编码器和时长预测器,用MAS单调对齐搜索把每个文字token的表示按持续时间展开,形成接近目标梅尔频谱(声学能量随时间与频带变化)的先验。解码器接先验与随机噪声,一次预测频谱,无时间步嵌入。训练随机裁80帧约0.93秒片段,以掩码自编码器MAE提取特征;真实批次作吸引样本、生成批次作排斥样本且排除自身,三个温度共同计算漂移损失。
图1|DriftTTS训练流程。文本编码器与MAS单调对齐搜索依据每个token持续时间重复其表示,构造先验ε=μ;解码器单次把先验映为生成片段。片段漂移在MAE掩码自编码器的特征空间中比较生成与真实目标片段,将训练中的生成分布推向目标;推理无需重复该漂移优化。
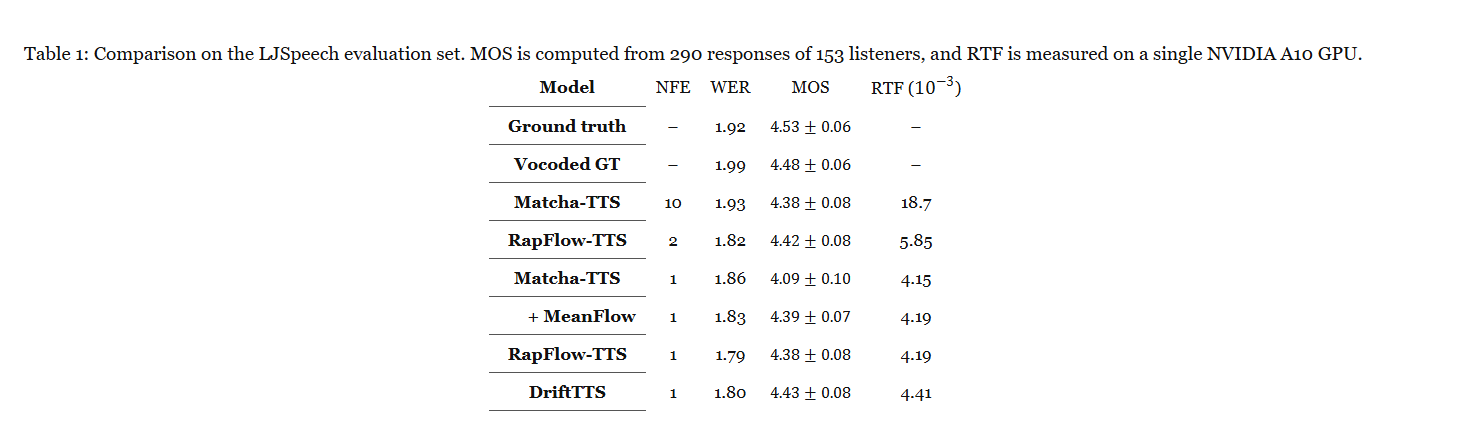
实验效果 :LJSpeech单说话人训练2000轮、4张A10,每GPU批量64;另训练MAE,波形仍由HiFi-GAN声码器合成。500条评测、单A10、批量1:NFE即解码器调用次数,DriftTTS为1;WER单词错误率1.80%,MOS五分听感均分4.43±0.08,对照Matcha-TTS十次调用为1.93%、4.38±0.08。RTF为模型推理秒数/音频秒数,排除声码器:0.00441对0.0187,约4.2倍;单步RapFlow为0.00419,仍略快。MOS来自153人290份响应。
表1|LJSpeech评测。NFE为推理解码器调用次数;WER为单词错误率%、越低越好;MOS为五分主观听感均值及所报区间、越高越好,来自153名听者的290份响应。单A10测RTF即推理秒数除音频秒数,表中单位10⁻³且不含声码器,越低越好。Ground truth为真实语音,Vocoded GT为声码器重建。
批判点评 :“从头单阶段”限定TTS模型,不代表没有预训练声码器或额外特征网络。去MAE后WER升至20.03%,片段与特征空间是必要条件;训练大批量和2000轮的成本不能隐去。多说话人、零样本与长语音尚待验证,MOS区间重叠也不能声称听感显著胜过多步。作者音频页 可访问,尚无代码入口;机构是首尔市立大学,非首尔大学。
8. Kingfisher:重组前四级图码来换风格
Kingfisher: Fast Personalized Visual Autoregressive Generation via Scale-Aware Prompt-Conditioned Scale Decomposition | 越南胡志明市科学大学;越南国家大学胡志明市分校;日本国立情报学研究所 | arXiv:2610.23238
关键词 :个性化生成, 视觉自回归, 风格迁移, 尺度分解
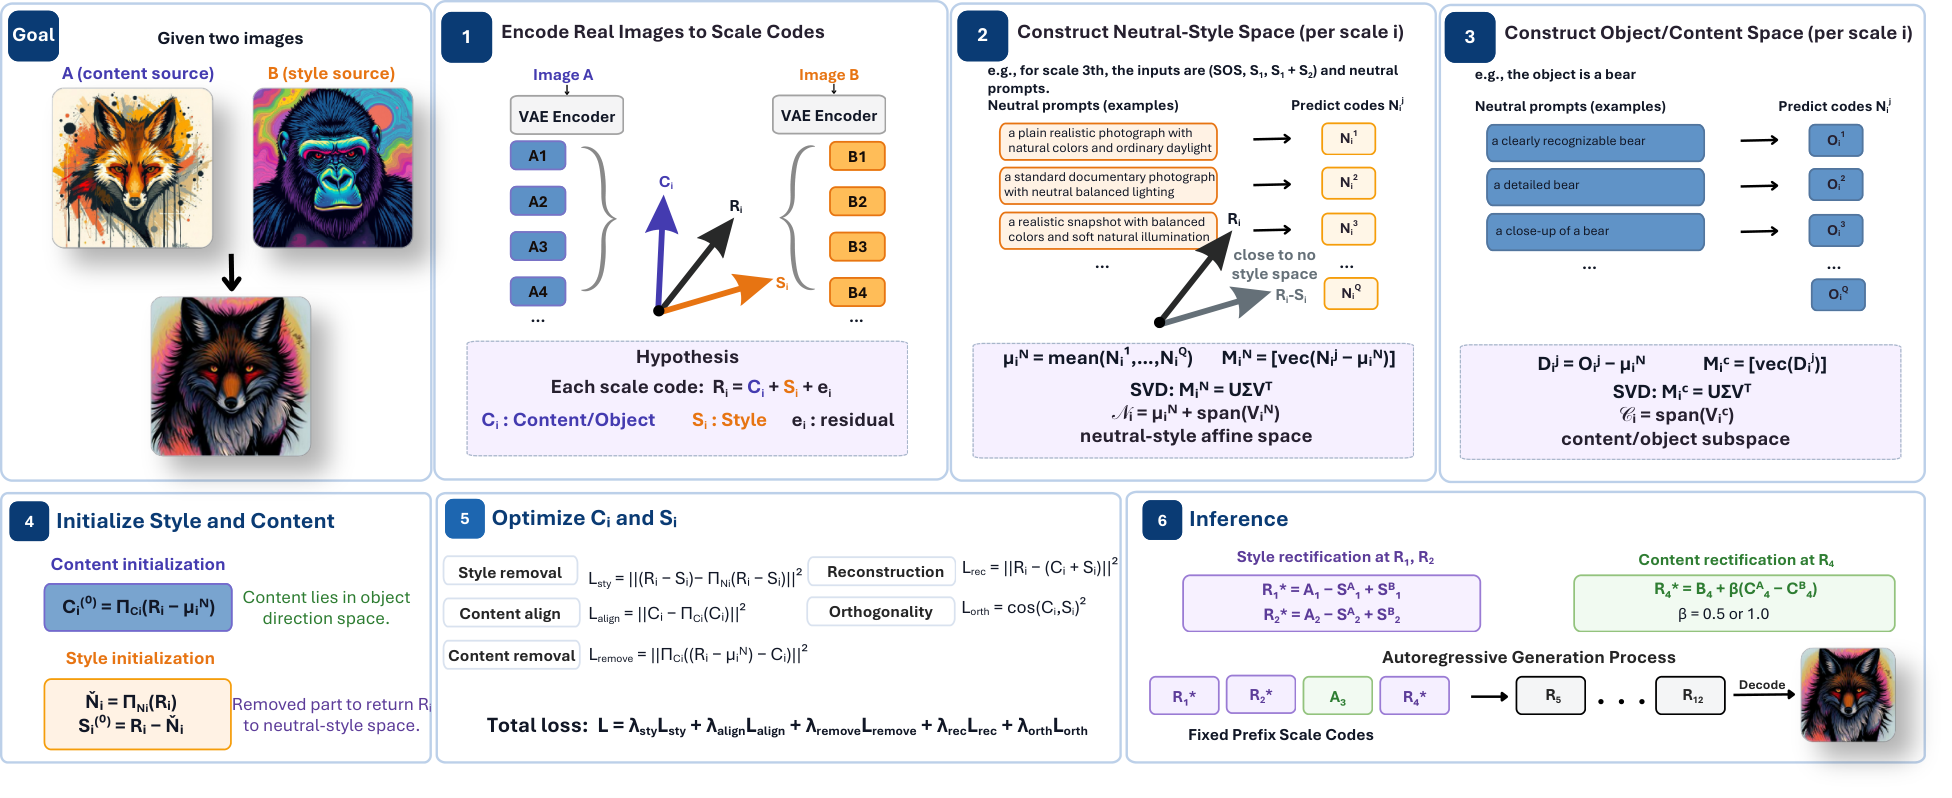
前序问题 :想保留一张实拍的主体、借另一张的画风,逐对训练LoRA适配器太慢;直接混合图像表示又容易把主体和风格一起换掉。方法直觉 :视觉自回归生成先画粗结构再补细节。抓住最早几级里决定主体与外观的部分,拆开后重新组合,再让冻结的生成器补完后续。本文贡献 :在冻结的 Infinity 多尺度生成器上,只处理前四级残差码。用中性外观提示和物体提示查询生成器,SVD奇异值分解提取“中性外观仿射空间”与“物体内容子空间”,据此投影并联合优化内容、风格及残差。重组时前两级换外观、第三级保留内容语义锚、第四级补内容方向;其余级由原生成器按位自校正生成。无需更新模型权重,但每对图片仍有图码优化。
图3|Kingfisher整体流程。将内容图A和风格图B用冻结编码器变为多尺度残差码,通过中性与物体提示分别构造外观仿射空间、物体内容子空间;在选定早期尺度将图码拆为内容、风格和残差并优化约束,再重组成语义前缀。冻结Infinity生成器按位自校正补剩余尺度,保留A结构并引入B外观。
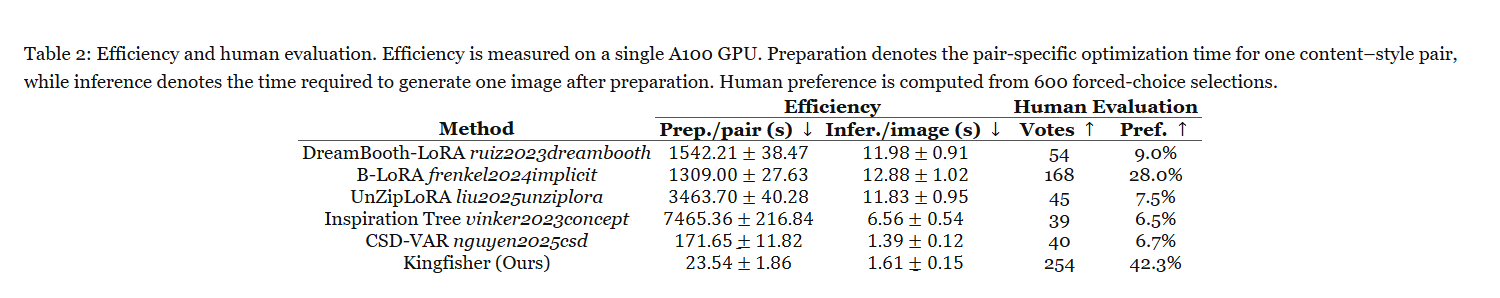
实验效果 :CSD-100的100张图各配5张不同类别风格图,共500个有序组合,每法一图,固定种子2026。Kingfisher/UnZipLoRA 的内容相似度CSD-C为0.5519/0.5782,后者更好;风格相似度CSD-S为0.5222/0.3673,本法更好,二者均为特征余弦相似度。单A100每对准备23.54±1.86秒,对照CSD-VAR为171.65±11.82秒;准备后每图1.61±0.15秒,对照1.39±0.12秒。20人600次强制选择中获254票、42.3%,是相对偏好。
表2|单A100效率与人工偏好。Prep./pair是每对内容/风格图的准备优化秒数;Infer./image是准备完成后单张生成秒数,两者不可混用。数值为均值与所报告离散度。人工偏好来自20参与者共600次强制选择:Votes为票数、Pref.为占比;这不是开放用户群的绝对满意率。
批判点评 :加速集中在准备阶段,并非每图推理最快。171.65除23.54约7.29倍,与摘要7.5倍和正文“超过10倍”不一致,本稿保留原秒数;也不沿用未明确分母的54倍宣传。仅单张内容/风格、固定种子协议,不足证明开放场景通用解耦;项目页 标代码即将开放。
9. VDAs:表情与镜头分开驱动头像
Video Diffusion Avatars: Taming Video Diffusion Models into Controllable 3D Avatars | 慕尼黑工业大学;Woven by Toyota;Toyota Motor Europe | arXiv:2610.23772
关键词 :可控头像, 视频扩散, 表情解耦, 多视角
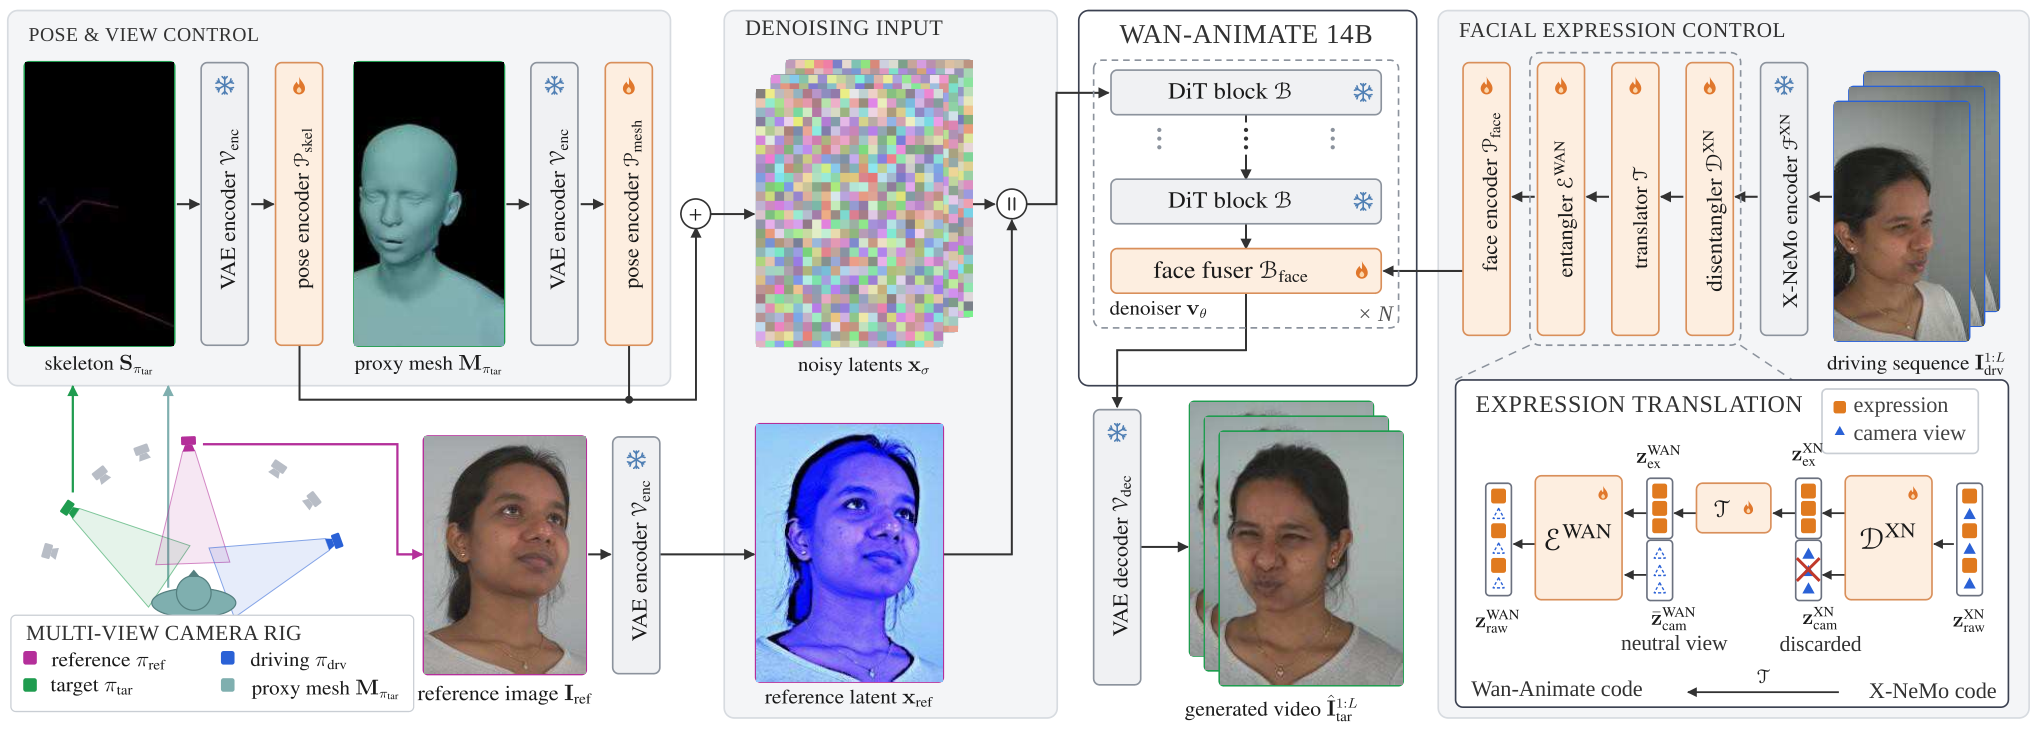
前序问题 :拿一段正脸表情去驱动侧面头像,表情编码里夹带的原镜头会把新视角拉回去;仅靠传统三维脸模又难表达舌头与嘴内细节。方法直觉 :把“做什么表情”和“从哪儿看”分开,再用不同相机的参考、驱动和目标三元组训练,迫使模型不能偷用驱动镜头。本文贡献 :在 WAN-Animate-14B 上使用 X-NeMo 学习式表情码,经解耦器分成表情与相机部分,再翻译回原模型可接受的条件格式,相机部分取中性值。代理网格将头部/躯干局部坐标方向与明暗编码成图像,联合控制镜头、颈部及上身,三维骨架补姿态。冻结去噪主干,只微调条件相关组件;公开多视角数据上的相机三元组进一步去掉视角捷径。
图2|Video Diffusion Avatar结构。镜头、上身姿态与表情作为独立控制信号进入WAN-Animate-14B。解耦的X-NeMo表情码翻译成原生条件格式,并配视角中性相机码;代理网格渲染编码镜头和姿态。多视角数据的参考、驱动、目标相机三元组训练多视角一致性,主扩散块冻结而条件相关组件微调。
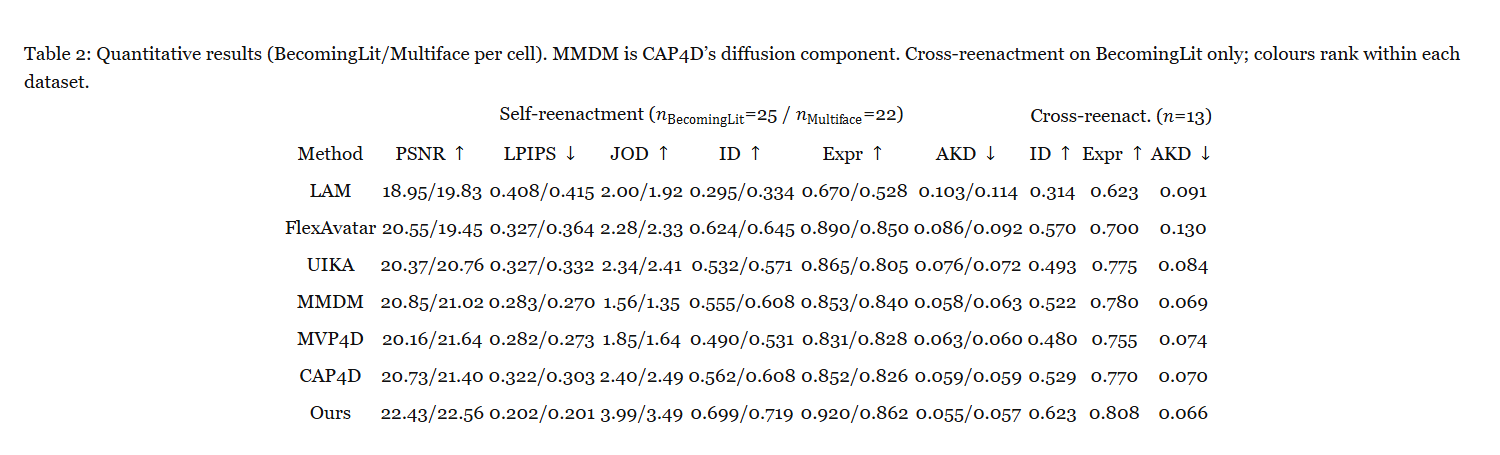
实验效果 :单张A100训练34小时,推理20步。BecomingLit 的25条同人驱动测试中,VDAs/MVP4D 的脸部LPIPS感知距离为0.202/0.282,越低越好;JOD感知质量预测分为3.99,对照中最高CAP4D为2.40,越高越好。另测22条Multiface同人和13条BecomingLit跨人驱动。完整模型在单A100生成77帧、576×1024约12分钟;四步蒸馏原型改为288×512可达论文所报4.8帧/秒,但降低画质。
表2|定量结果:每格左/右依次为BecomingLit和Multiface;同人驱动各25和22例,跨人驱动仅BecomingLit的13例。MMDM为CAP4D的扩散组件。PSNR、JOD感知质量、ID身份相似度、Expr表情一致性越高越好;LPIPS和AKD平均关键点距离越低越好。跨人无逐像素真值,故仅评身份、表情及关键点;颜色在各数据集内部排序。
批判点评 :完整模型适合离线制作,不能把34小时训练或低分辨率原型速度当作高清实时渲染能力。作者当前仓库对快速版写约3.5帧/秒,与论文4.8的原型口径分开;长序列仍可能漂移,光照烘在参考中。静态三维高斯重建只是多视角一致性探针,视频输出不等于直接交付可实时渲染的三维资产。代码 已有推理脚本与权重说明。
10. PPMem:把场景记成平面再转镜头
Persistent Planar Memory for Video World Models | 清华大学;蚂蚁集团;香港科技大学 | arXiv:2610.23795
关键词 :视频生成, 世界模型, 平面记忆, 相机控制
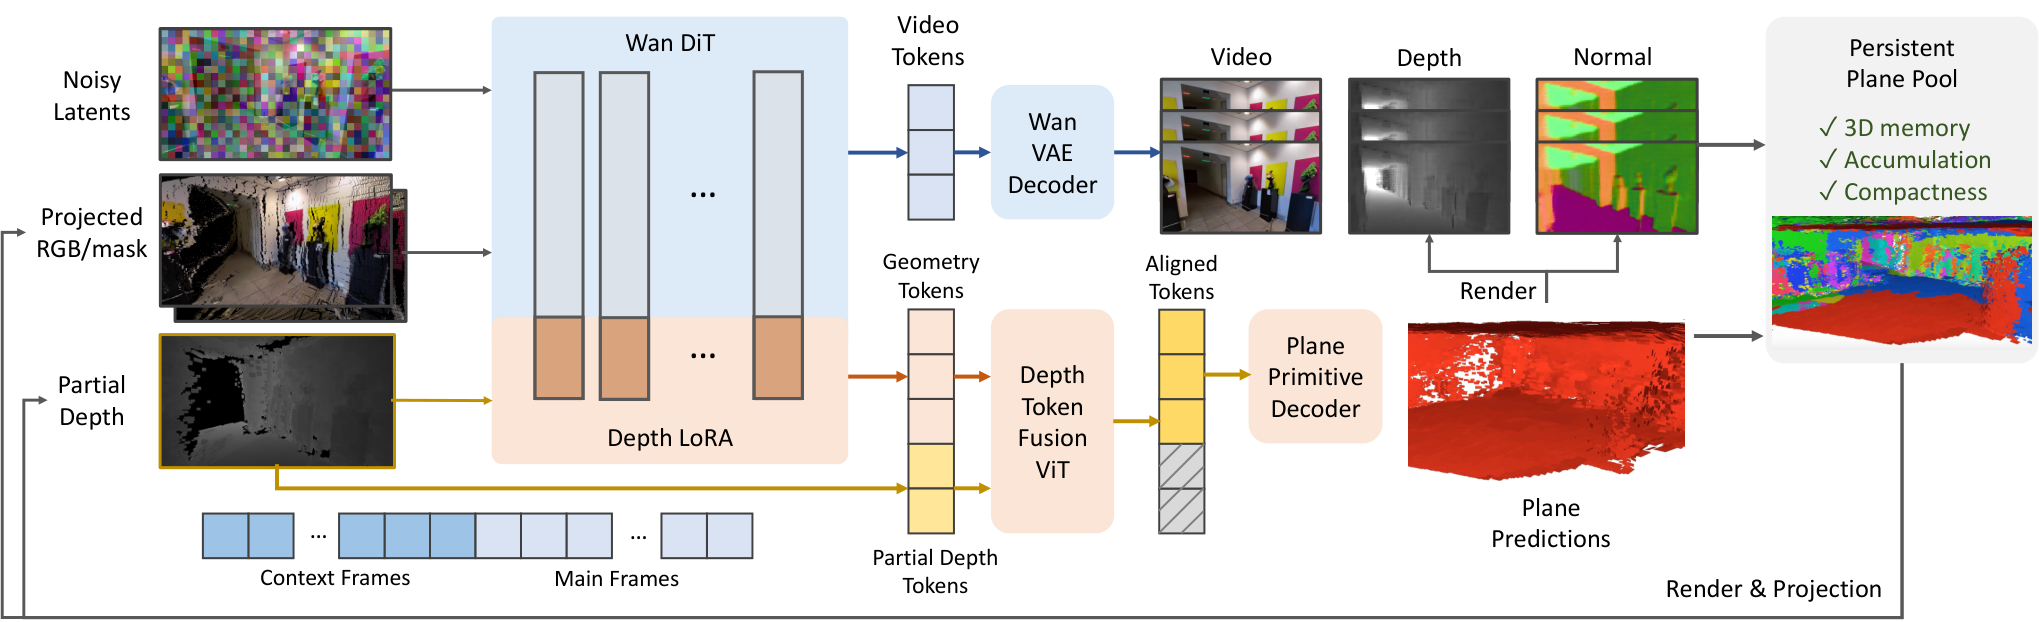
前序问题 :镜头绕回刚才的房间,墙和门却换了位置;只看最近几帧不够,逐像素累积三维点又让场景记忆膨胀。怎样在连续生成中保存可再投影的空间结构?方法直觉 :墙、地板和立面大多接近平面。把这些面记住,再从下一段的目标相机渲染深度,相当于让生成器沿着同一份场景草图继续画。本文贡献 :在 Wan 2.2 TI2V 5B 扩散 Transformer(用注意力网络逐步去噪的视频生成器)上,每段生成约25帧,并预测平面。每面用7个参数表示:中心深度、两个矩形尺度、四元数(四维旋转表示)。旧面通过遮挡投票删除,近邻按观测质量去重,再与新面合并。深度既作为输入通道,也经 DTF(把深度切成网络处理的特征单元token再融合)补入几何特征;先训练视频主干,再冻结主干训练几何头及 LoRA 低秩适配器。推理去噪后另做一次启用几何适配器的前向来提取平面。
图2|PPMem整体结构。带噪视频潜变量与源视图投影RGB、可见掩码、平面池渲染的部分深度按通道拼接,前序上下文帧在时间上前置。Wan扩散主干的两路token分别由视频解码器恢复RGB,或经几何LoRA及ViT深度token融合后解码成逐帧平面。平面合并进持久池,再按下一段目标相机渲染并回馈条件。
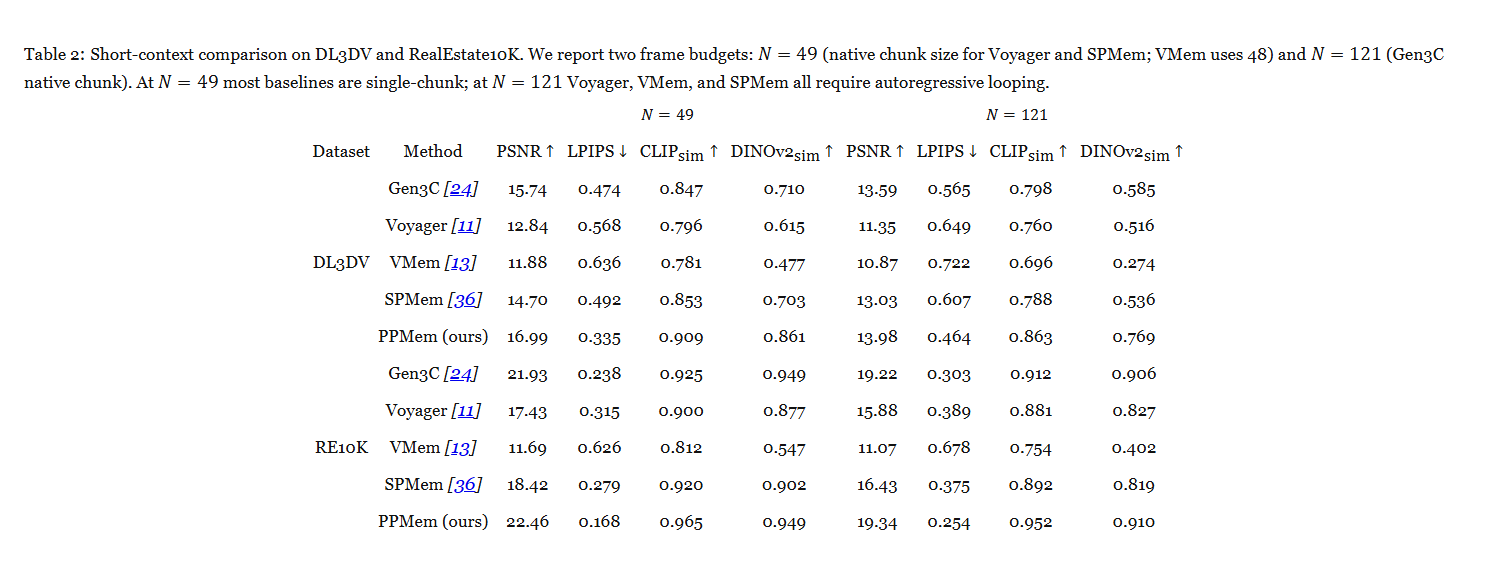
实验效果 :主实验训练使用 DL3DV 与 RealEstate10K 超过8万片段,576×1024;两测试集各100场景。DL3DV 的121帧完整系统对照中,PPMem/Gen3C 的 PSNR(像素保真信噪比,越高越好)为13.98/13.59,LPIPS(感知距离,越低越好)为0.464/0.565。各模型按自身原生分辨率评测,不能把差异全部归给记忆。同主干、低分辨率消融中,预测深度/真值及其倒数均小于1.25的比例由无持久记忆64.0%升至70.3%。约400帧后10万个平面约5MB,仅为几何记忆;额外深度编码器约8700万参数,非零推理成本。
表2|DL3DV和RealEstate10K上的短程完整系统比较。两种帧预算N=49与N=121;N指输出帧数,VMem短档用48帧。49帧时多数基线只生成一段,121帧时Voyager、VMem、SPMem需自回归衔接。PSNR、CLIP语义及DINOv2结构相似度越高越好,LPIPS感知距离越低越好。每种方法按自身原生分辨率与画幅评测,输入及真值相应裁剪缩放。
批判点评 :适合静态、平面丰富且相机路径已知的环境;作者亦承认动态内容与非平面细节受限。5MB不能当整机显存,作者仓库默认设置约需19GiB GPU内存。主榜是跨系统比较,消融才控制主干;深度 token 融合的阈值准确率也未优于仅通道拼接。已核实 NeurIPS 2026 接收;项目与代码 可访问,未运行模型。
趋势观察
控制先分清信息该进哪里
MTEdit共享画布防止训练轨迹漂移,OmniXRef按参考包限定属性,VDAs把表情与镜头分开;保持内容不能靠泛泛加大条件强度。
记忆与纠错处理不同时间点
PPMem把几何记忆带入下一段生成,VGC在视频生成后修正;前者不能代替后者的成片检查,后者也没有持久世界状态。
省算需要保留成本账
Sink-Sparse要离线校准并付全局补偿,Kingfisher要逐对优化图码,DriftTTS把多步推理的工作搬到训练;同叫免训练或一步,账本并不相同。
主指标无法代替全部验收
MFlow补高频而FID变化小,VGC重投影改善却有感知退化,SCR-V2A音频分布质量与时间对齐也有取舍。
今日讨论
OmniXRef 在125例多参考编辑测试中的综合分为3.78,Seedance 2.5为2.73;源内容保留分为4.68/3.71,但画质分为3.68/3.70,并未领先。如果要给真实剪辑流程选模型,你会用哪些指标同时检查参考属性迁移、源内容保留、参考泄漏、画质和参考数增加后的计算成本,而不只看综合分?
人工智能炼丹君 整理 | 2026-10-20



评论 (0)