今日 AIGC 论文速览
今日共 10 篇 · 图像表征与统一生成 2 篇 · 图像编辑与蒸馏 2 篇 · 视频计算与采样加速 2 篇 · 视频时序控制 1 篇 · 三维材质生成 1 篇 · 音乐与长语音生成 2 篇
重点论文标题列表
FeaTok (Meta):图像token先学特征再画图Intern Lumina U2 (上海AI Lab):一个视觉位置装八本码表ACEdit (特拉维夫大学):连续改十次也守住原图细节FocusOPD (中科大):只在早期深层补蒸馏监督Speculative Forcing (KAIST):画好的视频token提前交卷
选读入口:想重新训练图像表示,先读 FeaTok,关心统一图像理解与生成再接 Intern Lumina U2;连续改图会漂移,直接看 ACEdit,要合并多个教师看 FocusOPD。视频算得慢,按位置早停读 Speculative Forcing,按时间缓存读 SoftCache;事件先后不对读 TSG。商品三维小字丢失看 SUPRA-Tex,低预算文生音乐看 MIDI-REPA,语音超过50秒开始跳读或变声看 VoXtend。
今日论文速览
1. FeaTok:图像token先学特征再画图
FeaTok: Feature-Loss Tokenization for Image Generation | Meta FAIR;Mila;蒙特利尔大学;哥伦比亚大学;牛津大学;麦吉尔大学 | arXiv:2610.22060
关键词 :图像生成, 特征重建, 离散编码, 全局条件
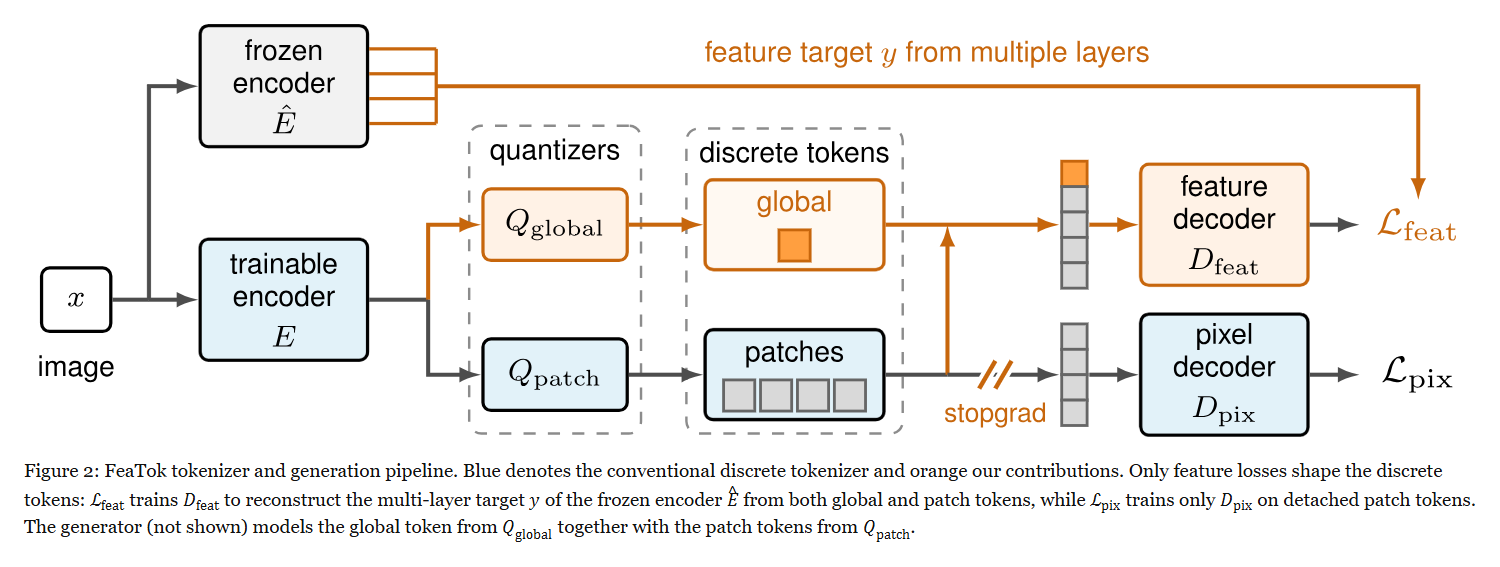
前序问题 :把图片压成离散token后,重建得像,不代表后面的生成器容易学。逐像素还原会迫使编码器保留许多局部细节,却未必组织好物体与场景的关系;token就是供模型预测的离散视觉单元。方法直觉 :先教编码器抓住视觉特征中的结构,再单独教解码器把这些单元画回像素。生成器先决定全局内容,再补局部,减少每一步从零猜整幅画的负担。本文贡献 :FeaTok用冻结视觉编码器四个等间隔层的归一化特征均值作目标,通过特征重建训练编码器、量化器与特征解码器;像素解码器仍训练,但在输入处截断梯度,像素损失不能反过来塑造token。全局特征和局部图块各用一个量化器,生成时先预测全局token,再以其为条件预测图块。SigLIP、SigLIP2、DINOv2、DINOv3均做受控实验;只换特征目标时SigLIP2并不获益,加入全局token才超过像素版。
图2|FeaTok的编码及生成流程。蓝色为传统离散编码器,橙色为本方法:特征损失L_feat只训练特征解码器D_feat,从全局及局部图块token重建冻结编码器的多层目标y;像素损失L_pix仅训练像素解码器D_pix,输入的图块token已截断梯度。图中未画出的生成器联合建模全局量化器Q_global与图块量化器Q_patch的token。
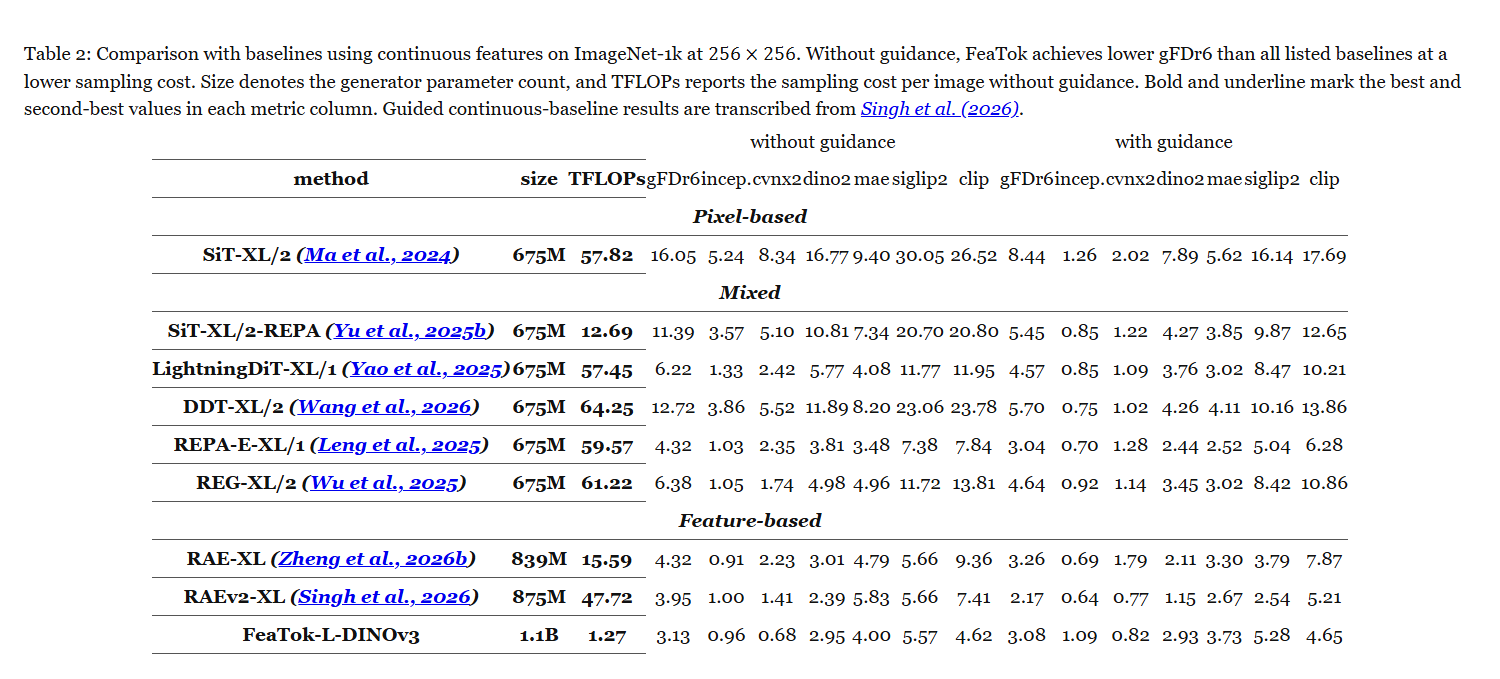
实验效果 :ImageNet-1k、256×256、五万张生成样本,无引导FeaTok-L-DINOv3的gFDr6为3.13,离散基线VFMTok2为4.38;它平均六种特征空间中以固定参考距离归一化的Fréchet距离比,越低越好。对连续RAEv2为3.13对3.95,采样运算量1.27对47.72 TFLOPs,TFLOPs指每图万亿次浮点运算,约38倍是算量比。单L40S、批量256、含像素解码的实测吞吐14.36对1.09图/秒,峰值22.0对13.4 GiB。
表2|ImageNet-1k 256×256上的连续特征基线对比。无引导时FeaTok以更低采样运算量取得所列模型最低gFDr6;Size为生成器参数量,TFLOPs为无引导每图采样浮点运算量。各指标列以粗体和下划线表示最优、次优。有引导连续基线转录自Singh等人2026论文;有引导RAEv2仍优于FeaTok,不能把无引导结论扩到整表。gFDr6为六特征空间归一化Fréchet距离比均值,越低越好。
批判点评 :有引导RAEv2仍以2.17优于FeaTok的3.08,不能称全面超越连续模型。DINOv3特征监督使重建PSNR从20.61降至17.45,PSNR是逐像素重建信噪比、越高越好,说明细节存在代价。文生图还需预训练75000次后微调500次,不是从零500次。项目页 明确代码与权重待开源审批。
2. Intern Lumina U2:一个视觉位置装八本码表
Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation | 上海AI Lab;华为;上海交大;大连理工;清华;上海创智学院;悉尼大学;港科大(广州);中科院深圳先进院;中科大;港中文 | arXiv:2610.20818
关键词 :统一生成理解, 多码本, 掩码扩散, 稳定性感知采样
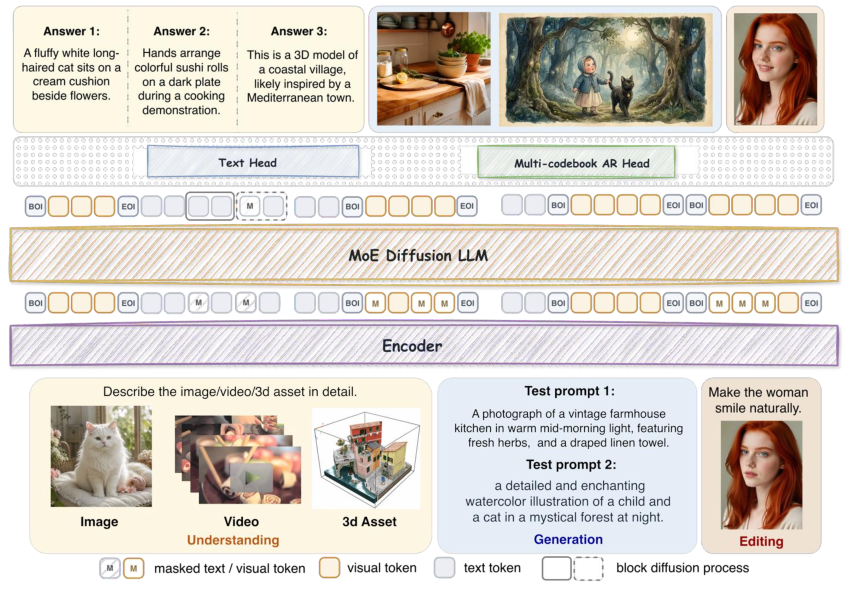
前序问题 :统一模型既要读懂图片,又要生成纹理。一处画面只用一个离散编号,容量受限;直接把连续图像特征接入文本模型,又要协调不同表示和训练目标。方法直觉 :每个视觉位置用八个互补编号描述,主干同时推理所有位置,小预测头在每个位置内依次补齐八个编号,把空间并行与局部依赖分工。本文贡献 :冻结AToken编码器将图像、视频、三维输入转成统一离散表示,每处有8个码本、每码本4096项。各码本独立嵌入后在同一位置拼接、投影成一个主干token;掩码扩散主干预测缺失位置,多码本自回归头依次预测该位置的8个码。文本按块扩散生成,图像全画布迭代;MoE即混合专家,只激活部分参数。整机约16.9B参数、每token激活约1.4B,B为十亿。
图3|Intern Lumina U2整体结构:视觉输入由AToken编码成视觉token,文本编码为文本token;MoE混合专家扩散语言主干通过文本头恢复掩码文本、以块扩散生成回答,通过多码本自回归头恢复掩码视觉位置。每个视觉token的K个码按顺序预测;本模型K=8,不同位置由主干并行处理。
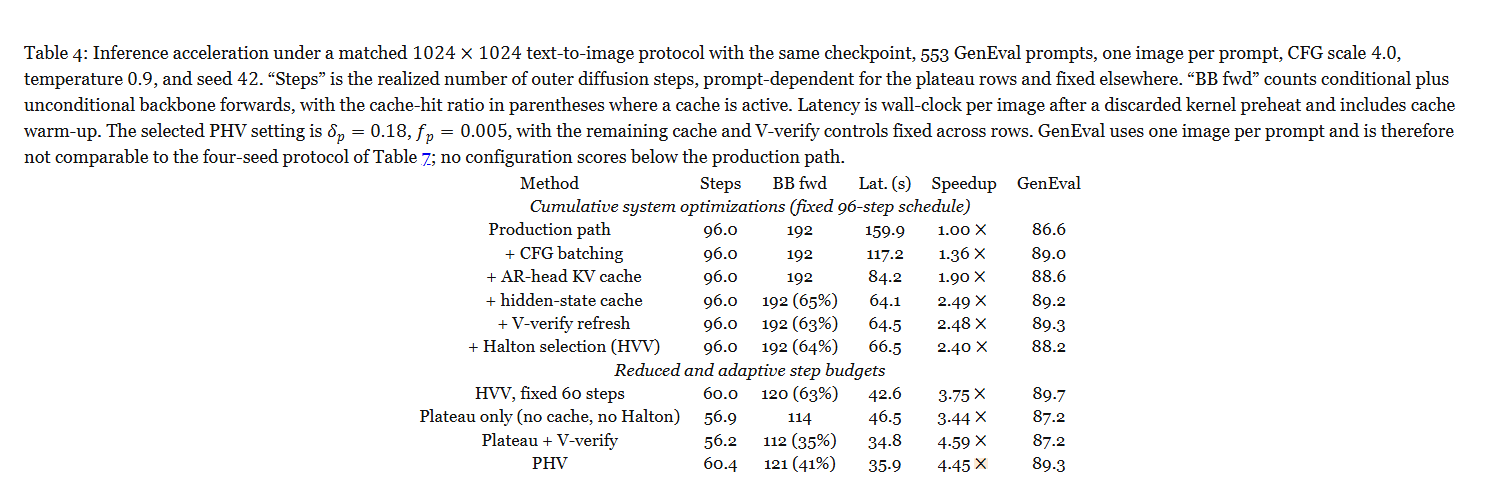
实验效果 :主模型在1024张昇腾910B上训练,另有训练token预算不同的NVIDIA参考线。同一检查点、1024×1024、553条GenEval提示、每提示1图、引导强度4.0的加速实验,默认96个外层扩散步需159.9秒;PHV即Plateau-Halton sampling with V-verify,以置信度平台决定解掩码、Halton顺序选位置,再由验证器按隐状态漂移刷新缓存,合用后平均60.4步、35.9秒,4.45倍。主干前向次数由192降至121,含有条件和无条件两支;相应GenEval物体属性组合分86.6至89.3;原文该计时表未清楚注明卡型,不把35.9秒视作指定910B的单卡性能。
表4|同一检查点1024×1024文生图推理加速:553条GenEval提示,每条一图,引导4.0、温度0.9、随机种子42。Steps为实际外层扩散步数,平台自适应行随提示变化;BB fwd同时计有条件及无条件主干前向,括号为缓存命中率。时间为去掉首次内核预热后的每图墙钟时间,含缓存预热。选定PHV使用δ_p=0.18、f_p=0.005,其余缓存和验证参数固定。单图GenEval不能与表7四种子协议直接对比,所列配置均未低于production path。
批判点评 :该加速表是单种子协议,不能与四种子主榜的89分混算;60.4步也不是60.4次主干前向。多码本头本身仍有解码开销。当前生成能力限图像生成和编辑,视频与三维是理解输入,尚未验证视频或三维生成。代码 可访问,本次未运行模型。
3. ACEdit:连续改十次也守住原图细节
ACEdit: Stable Multi-Turn Image Editing via Asymmetric Conditioning | 特拉维夫大学 | arXiv:2610.22328
关键词 :多轮图像编辑, 自生成轨迹, 非对称条件, 分数蒸馏
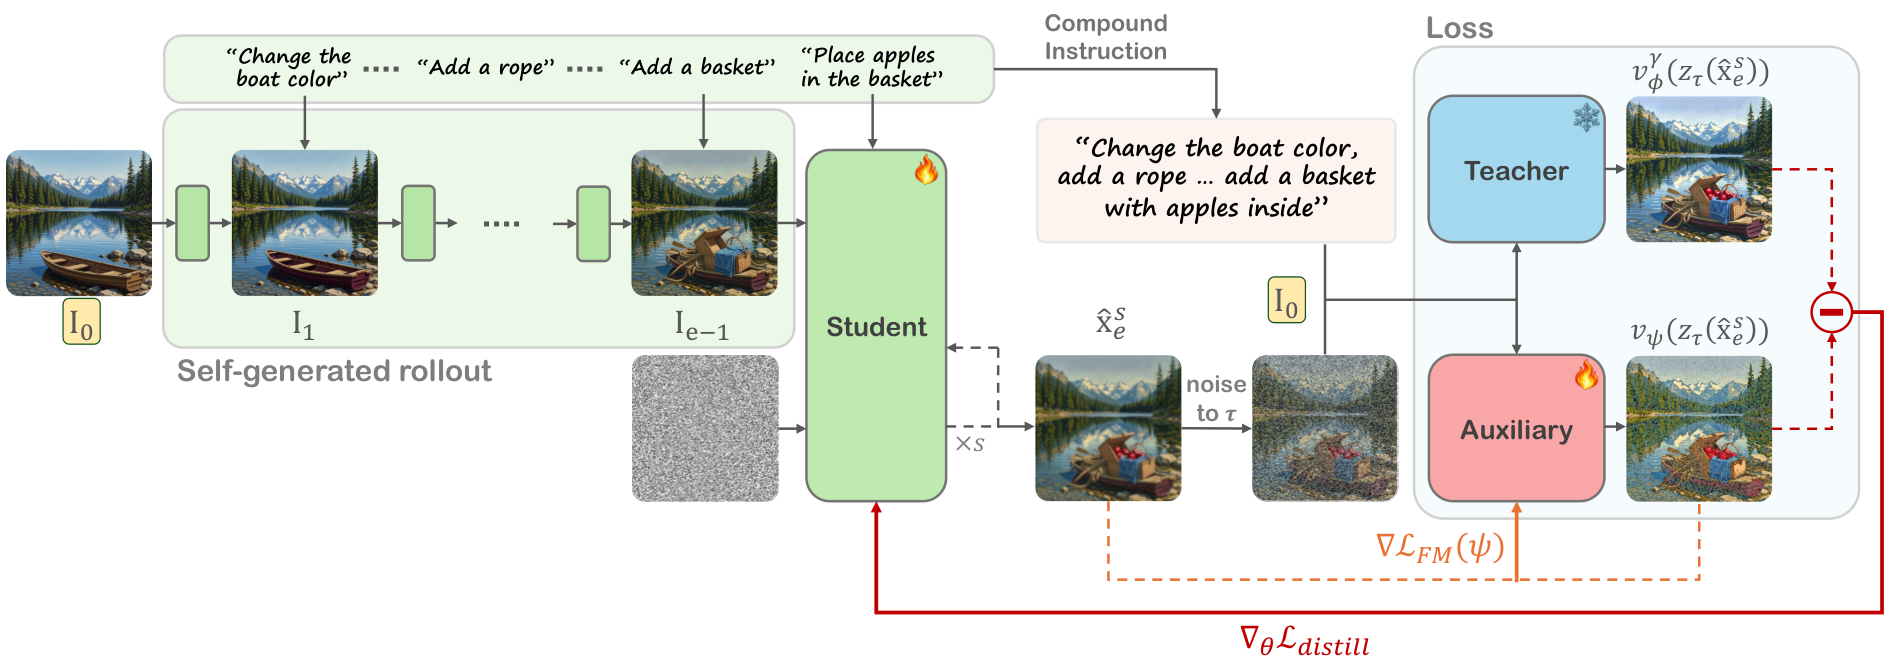
前序问题 :先换衣服,再加道具,改到后面人脸和背景一起漂移。训练时看干净原图,使用时却不断编辑自己的输出;误差逐轮累积,用固定配对目标硬教也会错位。方法直觉 :学生照常在自己的上一轮结果上编辑,老师始终看干净原图与累计指令。学生走一条可能出错的长路,老师从源头判断现在该变成什么,避免把旧错误当成要保留的细节。本文贡献 :学生为四步FLUX.2-klein-9B,冻结教师与可训练辅助编辑器为同系列base版。教师和辅助器都看原图及合并指令,二者预测差形成分数蒸馏梯度,辅助器拟合学生当前输出分布。训练以10轮自生成编辑轨迹暴露真实输入,仅对抽中的当前轮当前去噪步回传梯度,轮间直接传潜变量,省去反复像素编解码。学生只训练rank16的LoRA低秩适配权重,共27.8M参数,M为百万。
图2|ACEdit方法。左:学生沿自身生成轨迹逐轮编辑,上一轮图像I_(e-1)和当前指令产生当前去噪步的干净估计。右:估计加噪至τ,同时送入冻结教师及可训练辅助编辑器;两者都以干净原图I_0和截至第e轮的累计指令为条件。教师表示期望的干净条件分布,辅助器拟合学生实际生成分布,二者预测差给出蒸馏梯度,把多轮输出推向不退化的目标分布。
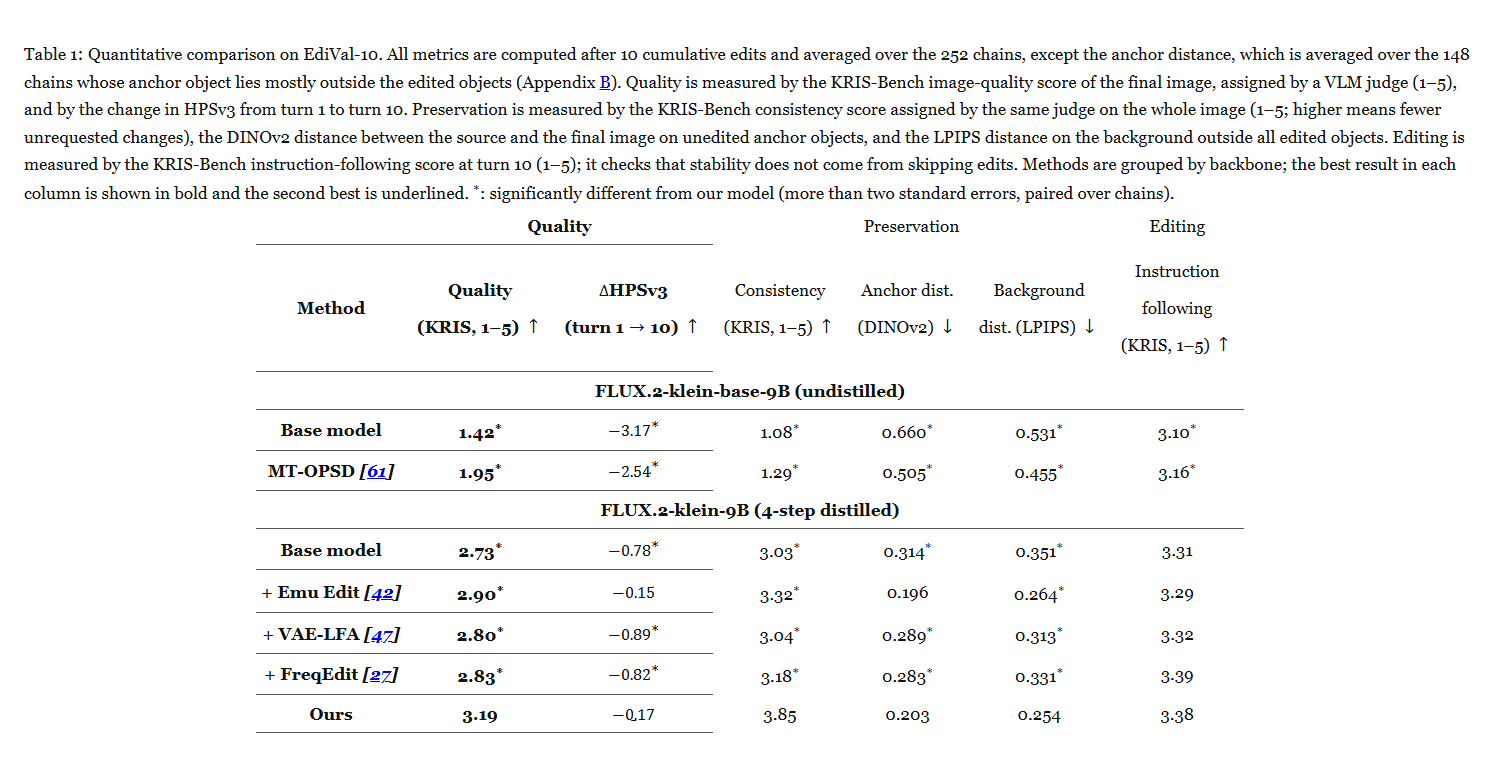
实验效果 :96张合成图、每图10条局部指令,共960条;单B200约4.4 GPU小时,505次迭代中只有100次学生更新,推理仍为4步。EdiVal-10测试252条真实照片编辑链,十轮末KRIS视觉语言裁判质量分2.73至3.19、一致性3.03至3.85,均为1至5分;指令遵循3.31至3.38未标显著差异。未编辑背景LPIPS感知距离由0.351降至0.254,越低越好;未编辑锚点DINOv2距离只在148条有效链统计。
表1|EdiVal-10定量对比。除锚点距离外,均在252条编辑链累计十轮后计算;锚点距离只统计148条锚对象大部分位于编辑区外的链。质量为KRIS视觉语言裁判的1至5分和第1至10轮HPSv3变化;保留性为同裁判一致性、未编辑锚点DINOv2距离及背景LPIPS距离;编辑性用第10轮指令遵循分检查是否偷懒不编辑。模型按主干分组,粗体及下划线为列最优和次优,星号表示与本方法配对差异超过两个标准误。
批判点评 :稳定性改善不等于永不忘记旧编辑,论文仍出现“让登山者微笑”时抹掉先前墨镜的失败。Emu Edit的HPSv3质量变化-0.15还略优于本方法-0.17,不应每列都称第一。与30步MT-OPSD的主干和分辨率不同。作者项目 代码仍标Coming soon。
4. FocusOPD:只在早期深层补蒸馏监督
FocusOPD: Structure-Guided On-Policy Distillation for Diffusion Models | 中科大;港科大(广州);华为诺亚方舟实验室 | arXiv:2610.21250
关键词 :图像生成, 多教师蒸馏, 方向对齐, 监督预算
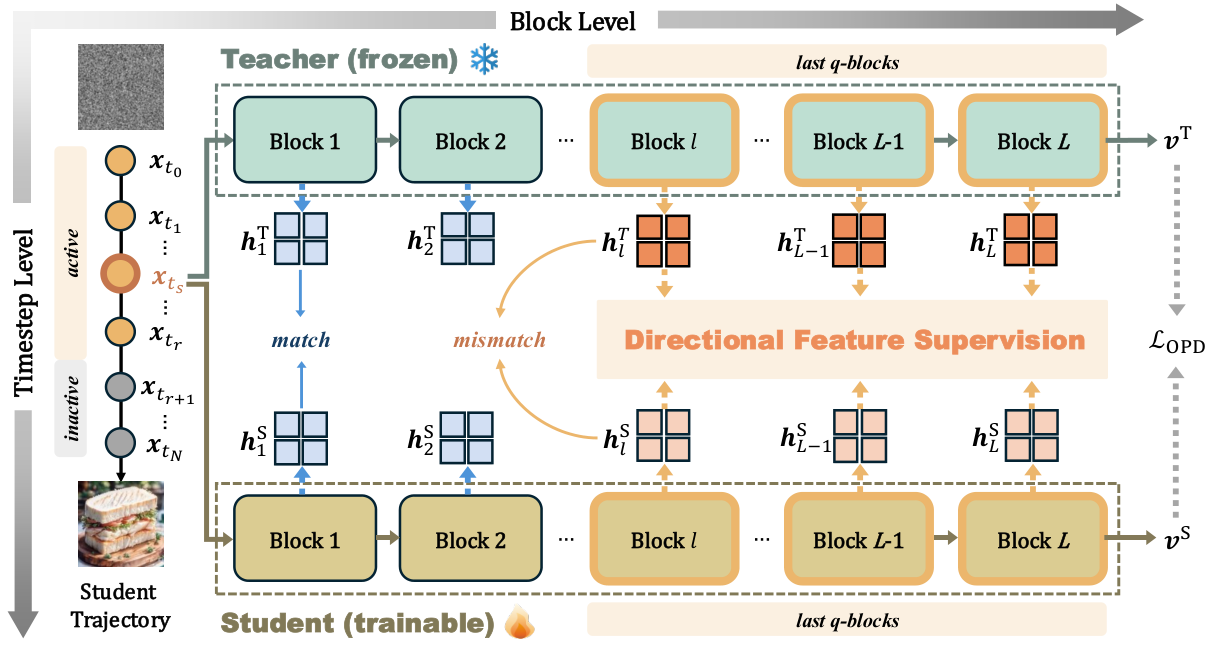
前序问题 :把构图、画字和审美三个教师合进一个生成器,只匹配最后输出,学生内部特征仍可能接不住教师能力。全层全时刻强行对齐,又增加训练开销。方法直觉 :先定位差距集中在哪些层、哪些去噪阶段,再把额外监督花在那里。高噪声早期负责搭结构,深层负责落实语义,方向一致可能比把所有特征数值抄齐更有用。本文贡献 :在学生自己的10步轨迹上抽取并截断梯度的状态,让学生和同架构教师读取同一输入。保留原OPD即在策略分布上的输出蒸馏,再对选定深层和早期步骤的逐token特征归一化,最小化余弦方向差;只更新学生的LoRA适配权重。SD3.5-M受控配置选最后12层、前40%去噪段,推理只保留学生,不增加教师。
图4|FocusOPD流程:教师与学生读取来自学生轨迹的相同状态,输出监督遵循原有OPD协议,额外特征方向监督集中在早期去噪与深层。推理只使用训练后的学生,没有额外教师调用。
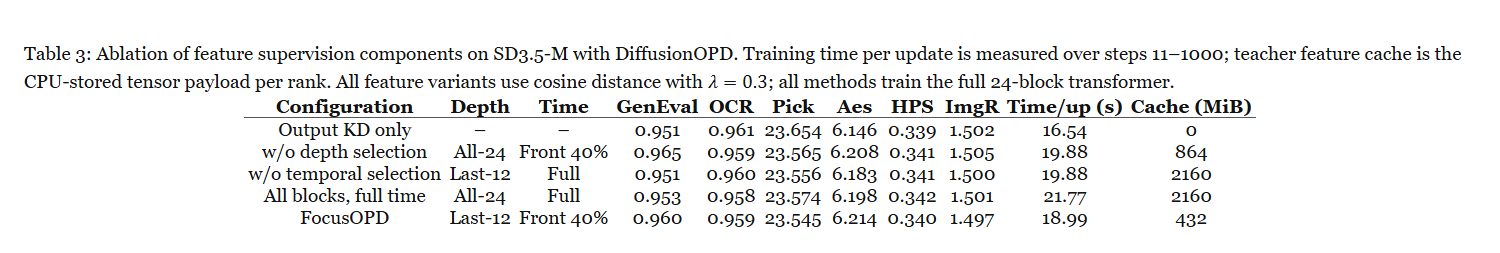
实验效果 :512×512、训练至检查点1000,SD3.5-M加在DiffusionOPD上,GenEval组合正确率0.953至0.967,PickScore偏好奖励23.797至23.944,LAION审美分6.052至6.199,均越高越好。独立监督预算消融中,选择12层及早期40%的更新耗时18.99秒,全24层全轨迹21.77秒,纯输出监督16.54秒;每个并行进程的CPU教师缓存分别432、2160和0 MiB,不能说是GPU显存。
表3|SD3.5-M和DiffusionOPD上的特征监督消融。单次更新耗时统计第11至1000步;教师缓存是每个并行进程存于CPU的张量负载,不是GPU显存。特征变量都用余弦距离、权重λ=0.3;所有方法训练完整24层Transformer,Last-12只限制监督位置而非只训练12层。Time列标监督覆盖范围,Time/up为秒,缓存为MiB。
批判点评 :主表与开发集消融数字不同,不能把消融的0.960当主榜0.967的同一运行。各指标并非单调:DanceOPD加监督后的文字识别准确率0.952降至0.945,STEP-OPD的PickScore也稍降。论文对两个主干选窗是否完全一致有文字出入;本期12层/40%只指明示的SD3.5-M配置。额外监督比纯输出训练更贵,未确认独立公开实现。
5. Speculative Forcing:画好的视频token提前交卷
Speculative Forcing for Efficient Autoregressive Video Generation | 韩国科学技术院(KAIST AI);NAVER AI Lab | arXiv:2610.22347
关键词 :视频生成加速, token早停, 收敛验证, 上下文缓存
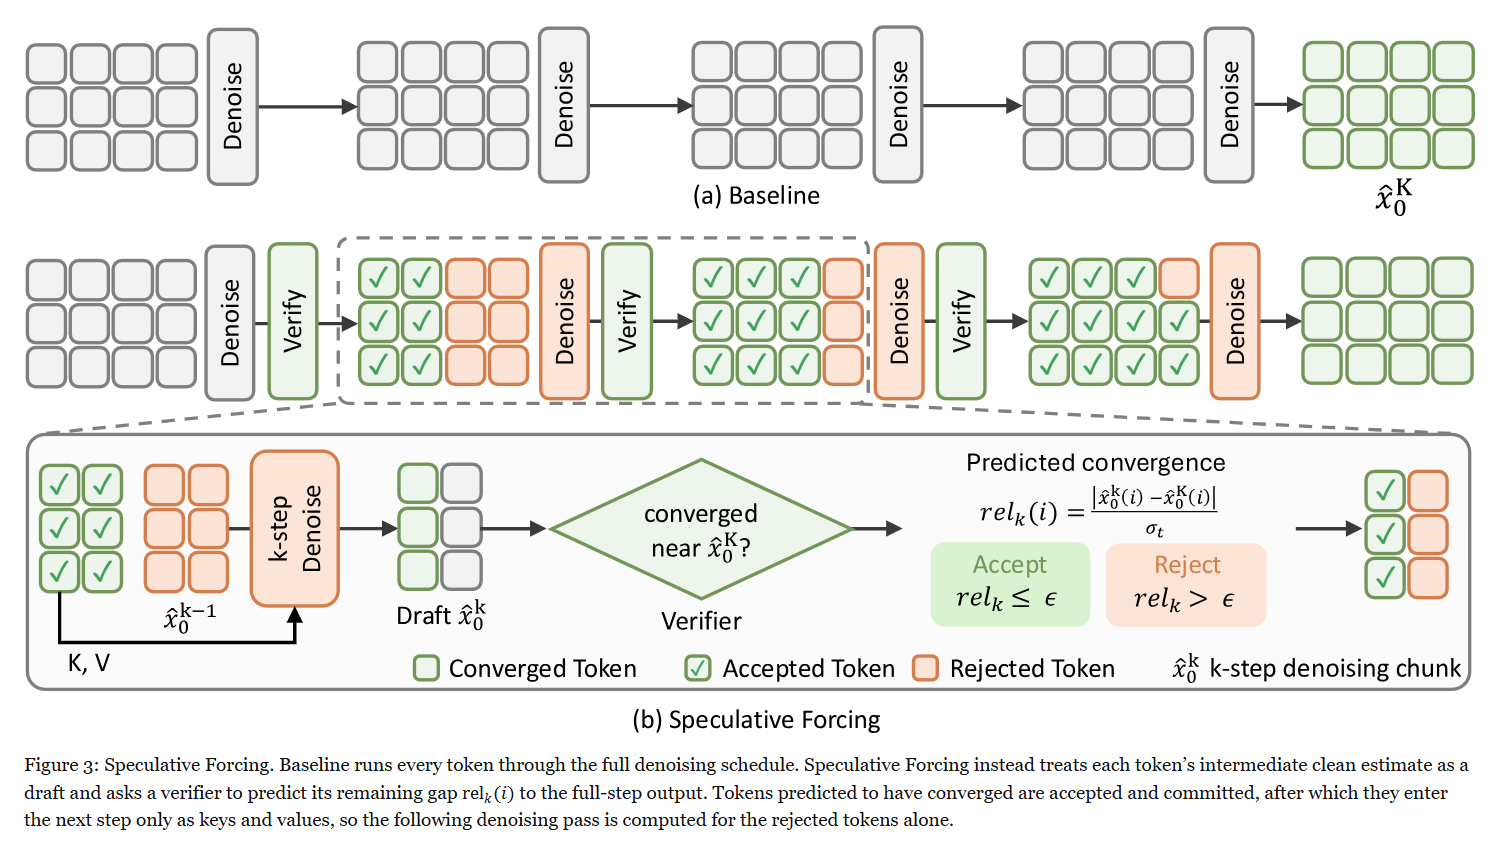
前序问题 :少步视频模型仍让每个视觉token完整跑四步,即使静态背景早已接近最终结果,也要陪着运动区域继续算。把整块一起早停又会把未修好的细节带入后续视频。方法直觉 :逐个检查中途的干净估计,足够接近四步结果的token先定稿;后续只更新还没完成的部分。已交卷的内容仍能作为上下文被其他位置读取。本文贡献 :提供两种验证器:免训练版使用与干净历史内容的相似性及跨步稳定性;学习版读取冻结生成器的中间特征,用三层三维卷积预测每token相对完整结果的剩余误差,再做局部时空平滑。接受后冻结该token,只保留key/value供注意力匹配和取回内容。学习头分别用1000条提示或1000个初始场景的完整轨迹训练,阈值控制提前接受程度。
图3|Speculative Forcing:基线让每个token走完整去噪表;本方法把中间干净估计当草稿,验证器预测其相对完整结果的剩余差距rel_k(i)。预测已收敛者接受定稿,后续只作为注意力的key和value参与上下文,因此下一次去噪仅更新尚未接受的token。
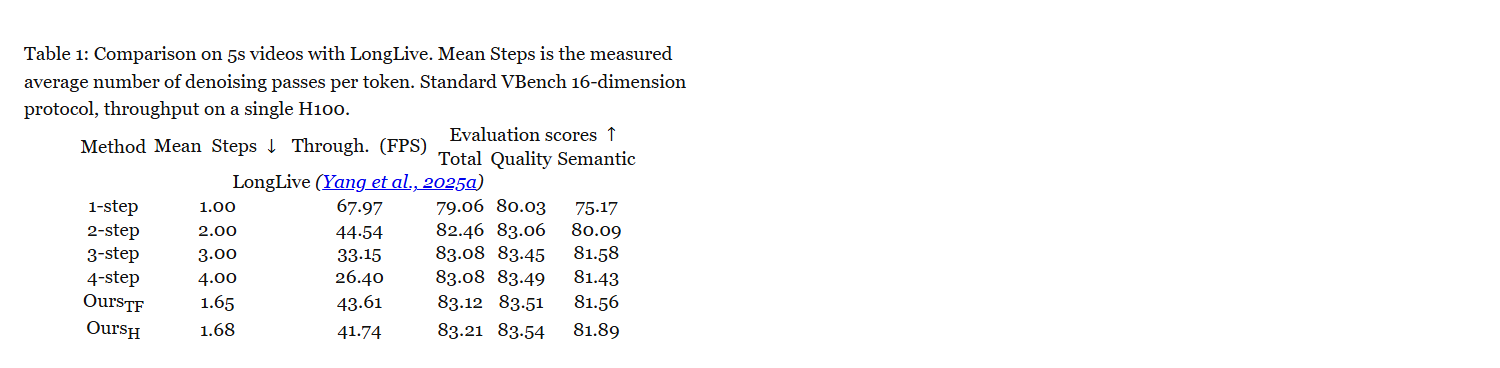
实验效果 :单H100、LongLive 1.3B、5秒VBench视频,学习版平均每token去噪1.68次,吞吐26.40至41.74帧/秒,总分83.08至83.21;这不是整机只调用1.68次。30秒VBench-Long为1.72次、24.5至37.8帧/秒。Lingbot-World 2.0相机运动测试200场景、每段253帧,平均2.55次、18.1至24.5帧/秒;质量随时间波动的Drift由3.094降至2.839,越低越好。
表1|LongLive生成5秒视频。Mean Steps是每个token平均实际去噪次数,不是完整网络调用次数;标准VBench的16个维度汇总为总分、质量与语义分,均越高越好,吞吐在单张H100上测量。TF为免训练验证器,H为学习头验证器;与1至4步统一采样分别对照。
批判点评 :阈值放松并非免费:世界生成阈值从0.24提至0.32,虽到28.3帧/秒,Drift却升至3.398。定稿是不可撤回的,错误接受会影响后续上下文;训练版还要先采完整轨迹。它研究token去噪早停,与上期交付缓存的Speculative Sampling是不同机制。代码仓库 当前仅说明内部审查后发布,尚未确认实现可用。
6. SoftCache:缓存还够用就往前多走一步
SoftCache: Adaptive Step Size Caching for Diffusion Transformers | 特拉维夫大学;莱赫曼大学 | arXiv:2610.22369
关键词 :扩散加速, 自适应步长, 特征缓存, 网格重排
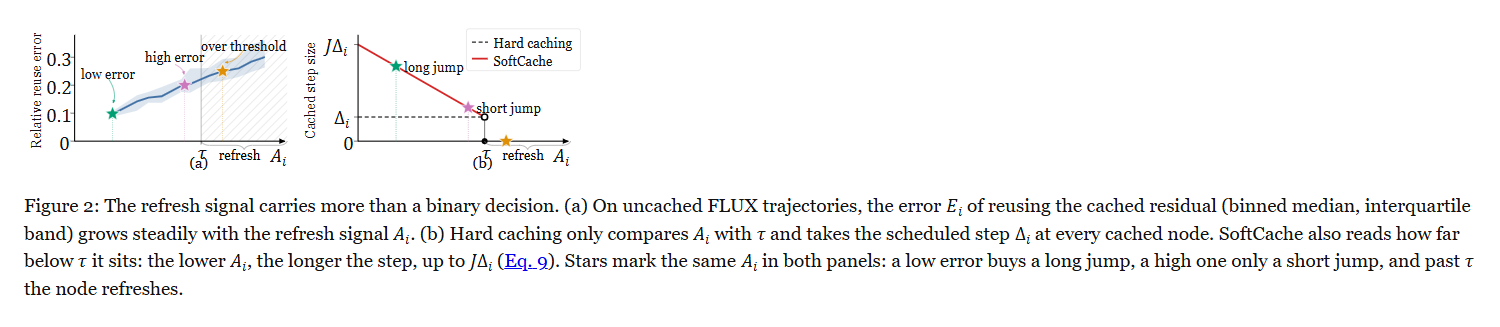
前序问题 :缓存加速通常只决定“重算还是复用”,但一次刚刷新的缓存与即将过期的缓存,仍按相同步长前进,没把剩余精度余量用于减少采样节点。方法直觉 :缓存越新、估计误差越小,就允许走得远些;快到刷新阈值时收回原步长。跳到原网格之间后,还要同步调整后面的节点,否则会浪费一次计算走极短的路。本文贡献 :用输入廉价探针累计的陈旧信号与阈值之间的归一化余量设置复用步长;轨迹开始及探针突变时禁跳。为支持离网格时刻,用最近两次新算残差沿时间线性外推,并在大加速时阻尼;跳后将剩余节点重新均匀分布到终点。无需训练,但多保存一个历史残差张量,刷新阈值仍需按速度目标选择。
图2|刷新信号包含的不只是二值决定。(a)无缓存FLUX轨迹上,复用残差相对误差E_i的分箱中位数与四分位带随累计刷新信号A_i上升。(b)硬缓存只将A_i与阈值τ比较,并在缓存节点使用原步长Δ_i;SoftCache还读取距阈值的余量,A_i越低步长越长,上限JΔ_i。星号表示两面板同一A_i:低误差允许长跳,高误差只短跳,越过τ则重算刷新。
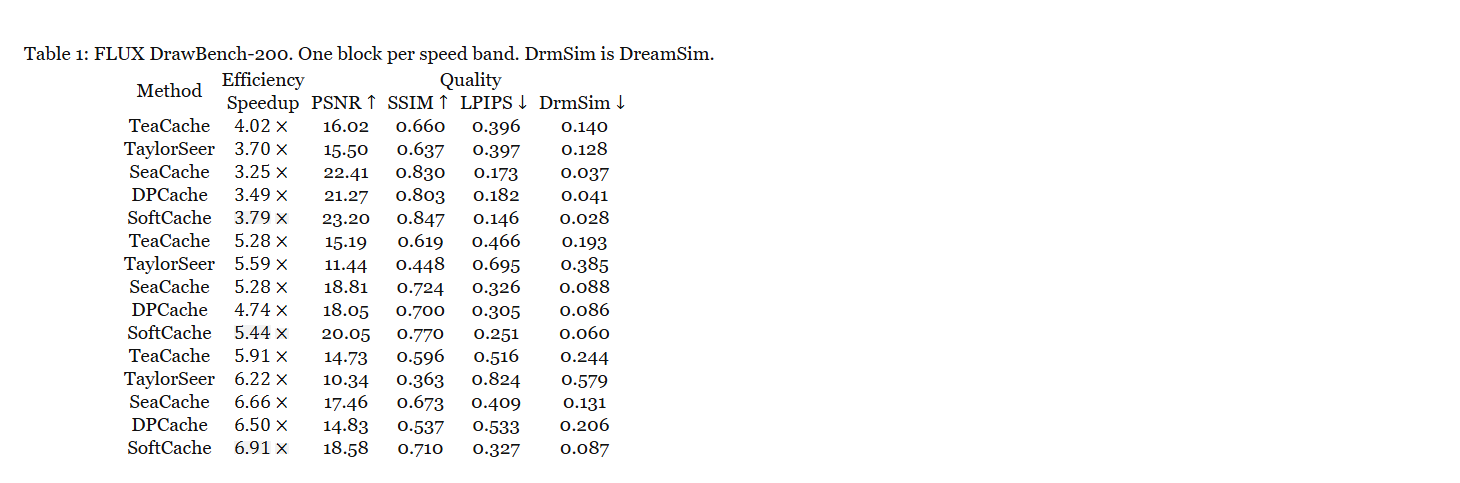
实验效果 :FLUX.1-dev、1024×1024、DrawBench 200提示、原50步Euler、单H100 NVL,与同提示同随机种子的无缓存结果比较。最快档去噪环节15.49至2.24秒、6.91倍,PSNR18.58对SeaCache17.46,LPIPS0.327对0.409;PSNR信噪比越高、LPIPS感知距离越低表示更接近原采样。峰值分配内存均33.8 GB。混元视频65帧640×480、946提示最快档6.05倍;Wan2.1另在RTX A5000,不能跨设备比较绝对耗时。
表1|FLUX、DrawBench 200提示,每个分块对应一个速度档,逐行报告实际加速比。DrmSim为DreamSim感知距离;PSNR信噪比、SSIM结构相似度越高越好,LPIPS和DreamSim距离越低越好,四者均衡量与同提示同种子无缓存采样的保真度,不能读成绝对生成质量或人类偏好。
批判点评 :6.91倍计同步后的去噪循环,不是含全部编解码的端到端服务时间。四个保真指标衡量接近无缓存结果,不能等同人类更喜欢;随预算收紧它自身也会变差,FLUX慢档PSNR23.20、快档18.58。需验证新主干的刷新信号是否仍可靠。代码 入口可访问。
7. TSG:把视频先后顺序写成可执行约束
Temporal Specification Guidance for Text-to-Video Generation | 宾夕法尼亚大学;丰田北美研发 | arXiv:2610.20822
关键词 :可控视频生成, 时序逻辑, 注意力引导, 生成验收
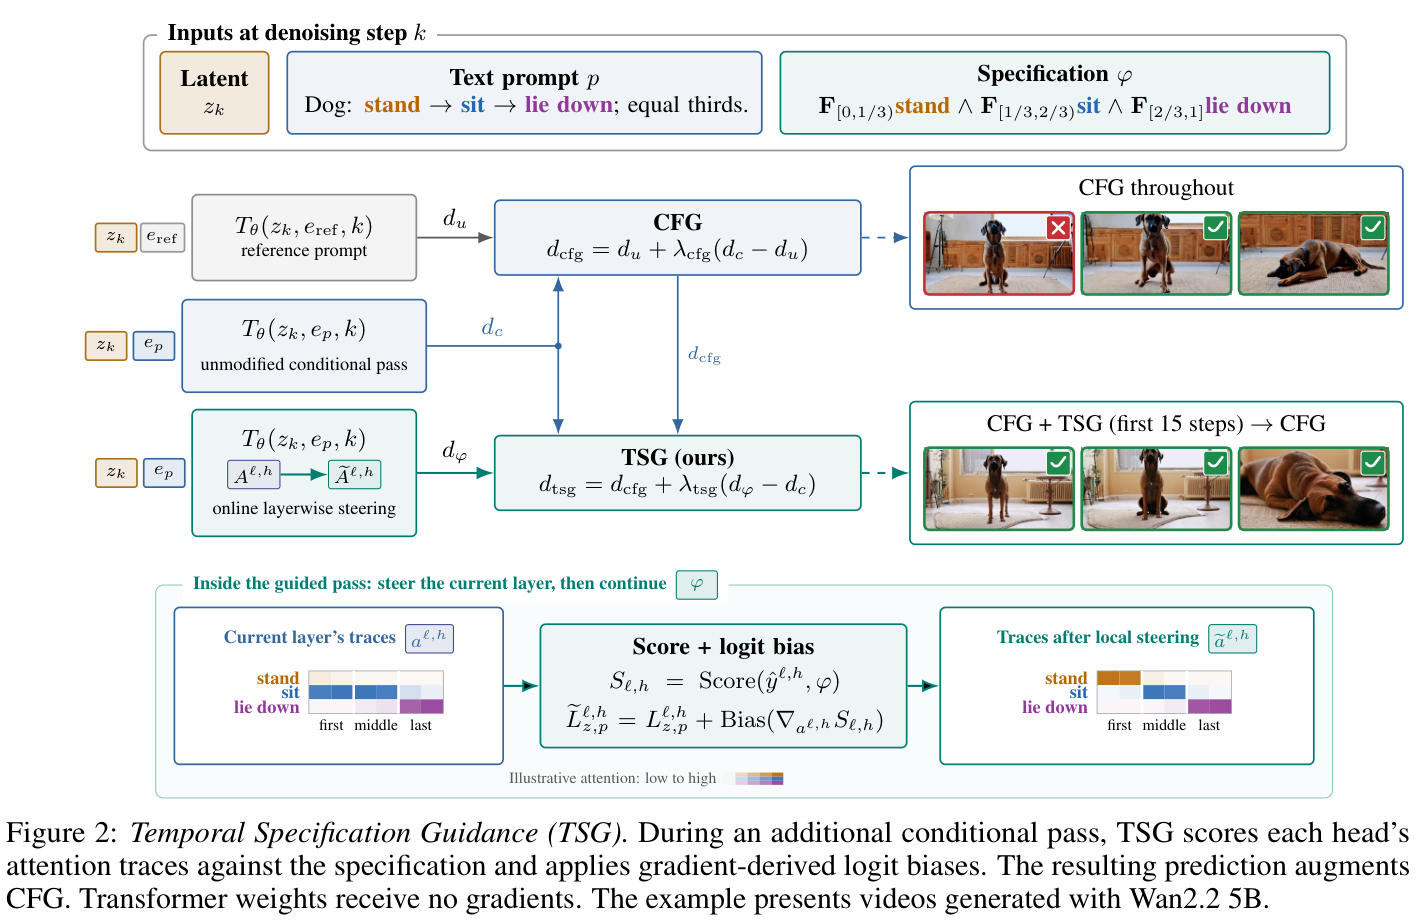
前序问题 :要求红灯变绿,模型可能两种颜色都画到了,却顺序错了;要求一个物体先进入、另一个持续存在,文字出现不代表时序要求真的满足。方法直觉 :把“先发生、持续到、在某段时间出现”写成机器可检查的时间规则,再沿着增加规则满足度的方向调整生成过程。本文贡献 :TSG即Temporal Specification Guidance,用带时间区间的时序逻辑表达事件约束,从视频对文本的注意力提取每个概念随时间的证据。LogSTOP在对数空间计算可微满足分,将其对注意力的梯度改写为注意力偏置,额外条件前向得到引导方向,叠加CFG无分类器引导;CFG通过有条件和无条件预测差加强提示。无需外部概念分类器,也不对视频Transformer权重反向传播;默认前15采样步启用。
图2|时序规格引导TSG。额外条件前向中,逐注意力头对时序证据按规格评分,并应用由梯度得到的logit偏置,再以得到的预测扩充无分类器引导CFG。Transformer权重不接收梯度。示例视频由Wan2.2 5B生成。
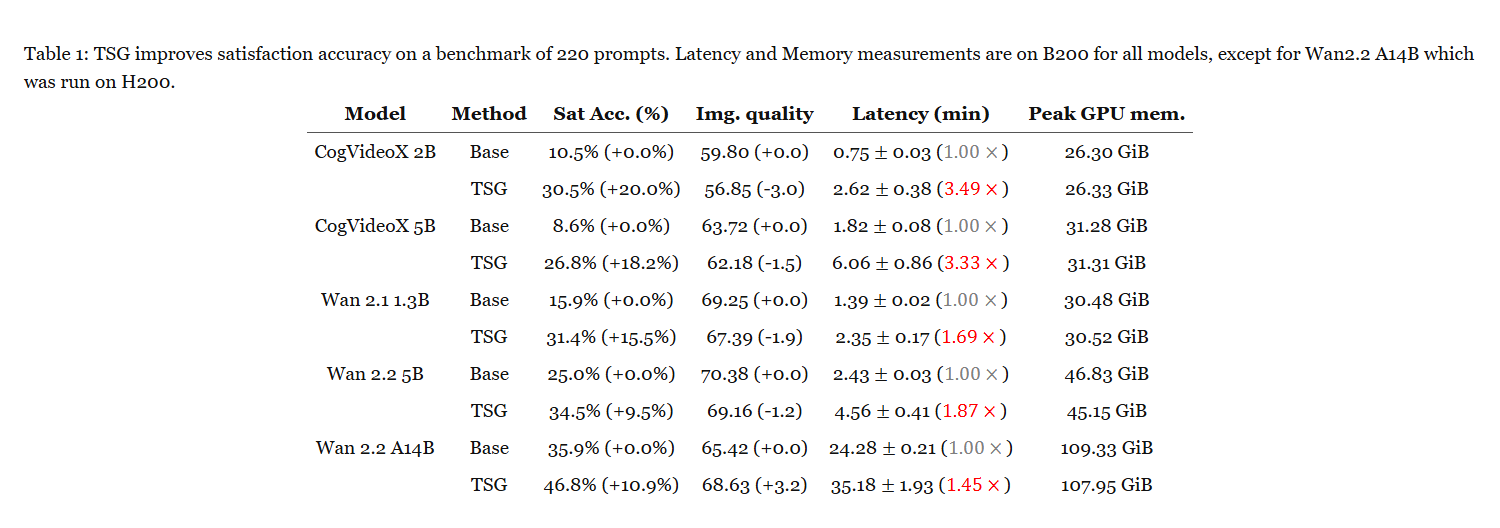
实验效果 :220提示、11类约束、5至6秒视频、五种主干,规则满足准确率提高9.5至20个百分点。单B200、Wan2.1-1.3B为15.9%至31.4%,时间1.39至2.35分钟,峰值30.48至30.52 GiB;画质分69.25降至67.39。A14B另用H200,满足率35.9%至46.8%,耗时24.28至35.18分钟。评测均匀抽21帧,Qwen2.5-VL-7B判概念是否存在后才按规则计分。
表1|220提示基准上的时序约束满足率、画质、时间和峰值内存。除Wan2.2 A14B在H200测量外,其余时间与内存均在B200测量;时间单位分钟,内存GiB。Base为仅CFG,TSG为加入规格引导;满足率变化应读为百分点,附带倍数为各自基线时间比,跨设备绝对时间不能直接排序。
批判点评 :免训练也付出额外前向时延,低显存增量不能写成低计算代价。最强配置仍只有46.8%满足率,注意力只是概念代理,视觉语言裁判和21帧抽样也可能漏掉短事件。其优势是可检查的约束接口,还不能宣称视频已严格满足形式化保证;原文未确认可用独立代码入口。
8. SUPRA-Tex:三维表面也能保住小字纹理
SUPRA-TEX: 3D Generation with Super-Aligned Texture | 华为;上海交大;华中科大 | arXiv:2610.22352
关键词 :三维纹理生成, 物理材质, 可见锚定, 不可见面补全
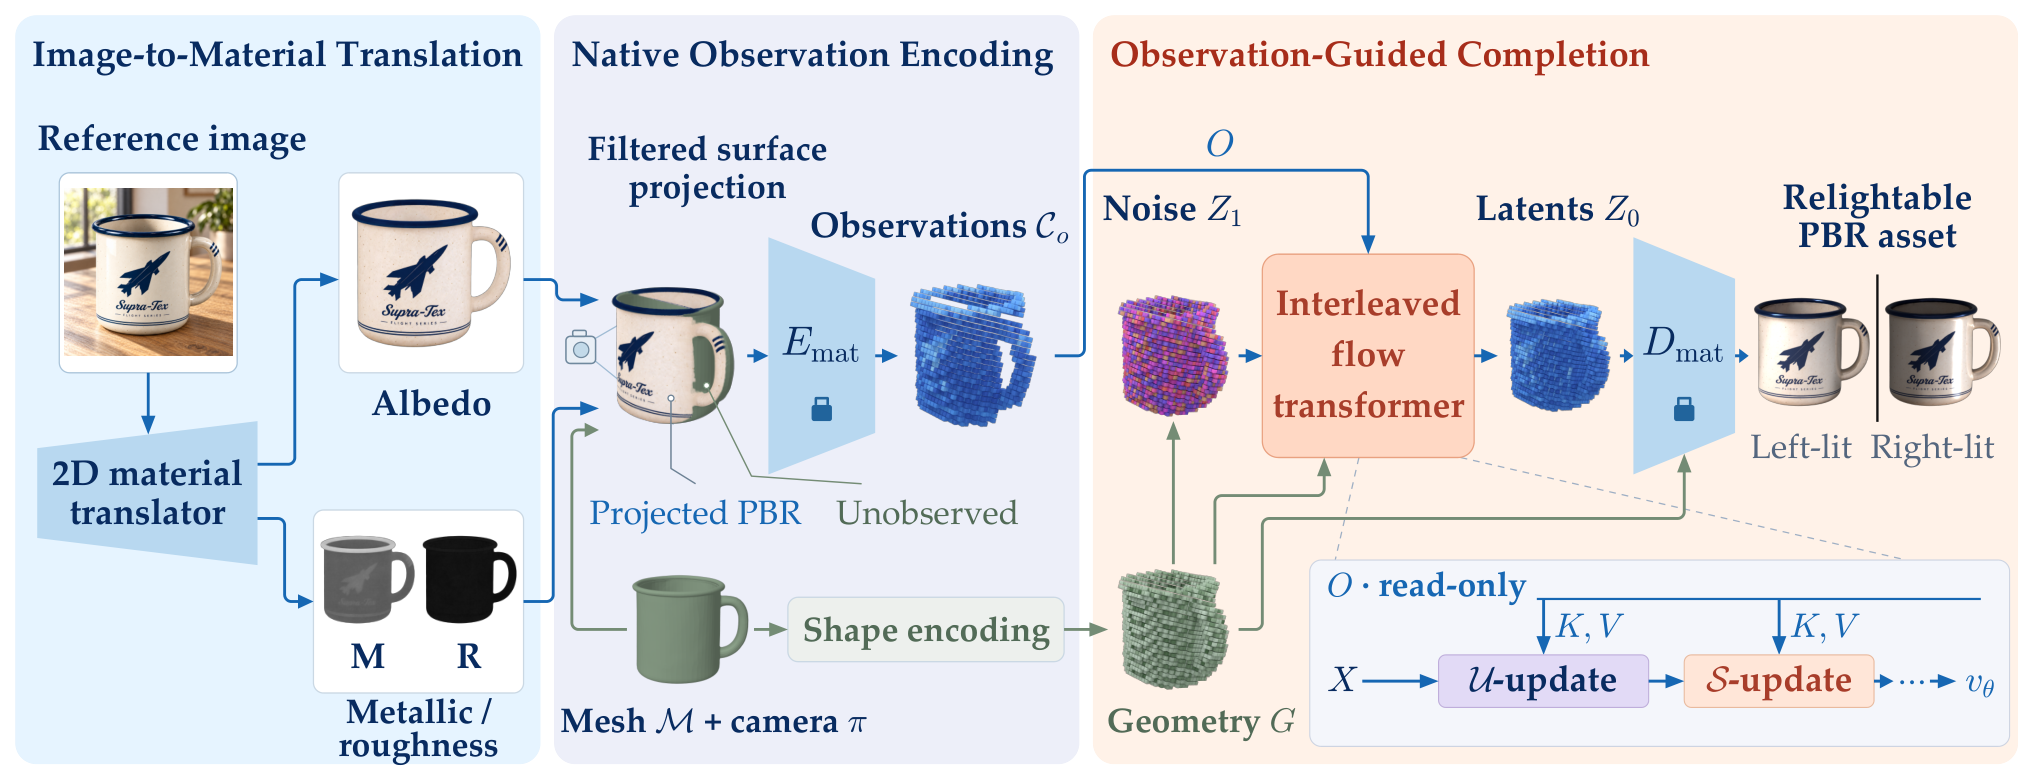
前序问题 :给商品照片生成三维资产,正面标签变糊、背面纹理接不上;光照烘进颜色后,换个灯源就显得不真实。可见面细节与不可见面补全需要分开处理。方法直觉 :先把照片中可信的颜色和材质投到三维表面,当作固定参考;生成器集中补看不到的区域,再协调全表面,减少反复改写已经观察到的小字和图案。本文贡献 :二维编辑模型估计去光照的反照率、金属度、粗糙度,即物理渲染PBR材质;有效观测投到可见表面体素,未观察处不以虚构填充值冒充证据。冻结材质编码器将观测编码到目标生成潜空间,另附覆盖范围与边界距离;交错流Transformer把观测作为只读key/value,交替更新未观察单元与全表面。60层生成器在64张GPU训练,推理25步Euler、不用CFG。
图1|SUPRA-Tex。左:二维转换器从单参考图估计去光照的反照率、金属度、粗糙度。中:利用网格M与相机投影π将有效估计投到可见体素,部分PBR输入省略不可见体素;冻结材质编码器E_mat将其映到目标潜空间,连同覆盖与边界元数据组成观测C_o。右:以几何潜变量G为条件,交错流Transformer从噪声Z_1生成完整材质Z_0。插图中固定只读流O提供key/value,生成流X交替更新未观察单元U与全表面S;冻结解码器D_mat输出表面PBR材质,分别从左右打光展示。
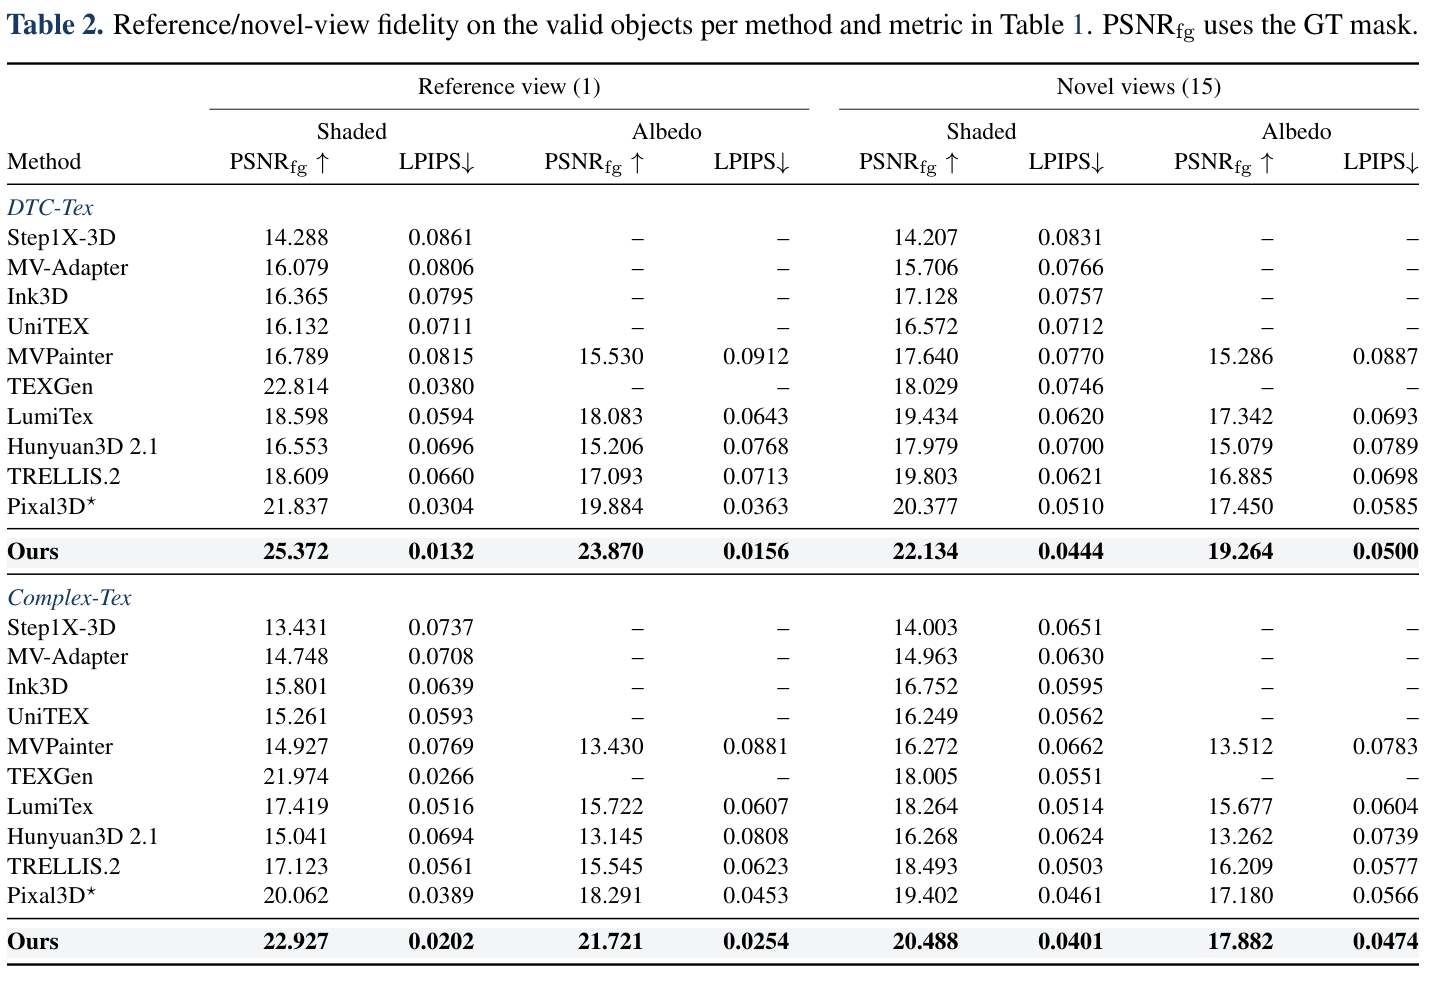
实验效果 :给定真实网格与单张参考图,在DTC-Tex的100个商品及Complex-Tex的110个网格,以同光照同相机渲染参考视角和15个新视角。新视角前景PSNR为22.134对Pixal3D的20.377、20.488对19.402,PSNR越高越接近真实像素。另在两者共享预测几何的端到端实验,DTC-Tex四视角PSNR28.65对26.88;几何生成与贴纹理协议必须分开看。
表2|在表1各方法各指标的有效对象上,分开报告一个参考视角及15个新视角的保真度;PSNR_fg使用真实前景掩码,PSNR越高、LPIPS感知距离越低越好。Shaded为带光照渲染,Albedo为反照率。新视角先对每个对象平均、再跨对象平均,包含已观察和未观察表面;缺少PBR输出的方法对应反照率为横线。
批判点评 :新视角同时包含已见和未见表面,不能把它称为纯背面准确率。几何是固定条件,形状或相机错位无法靠纹理修复;二维金属度估错也会被保留下来。商业系统对比另用两视图,不能与此处单图实验混算。代码与权重入口 已读,未实跑。
9. MIDI-REPA:用音符结构教小模型作曲
MIDI-REPA: Improving Text-to-Music Generation with Symbolic Representation Alignment | 台湾大学;加州大学圣迭戈分校 | arXiv:2610.20967
关键词 :文生音乐, 符号监督, 表征对齐, 低成本训练
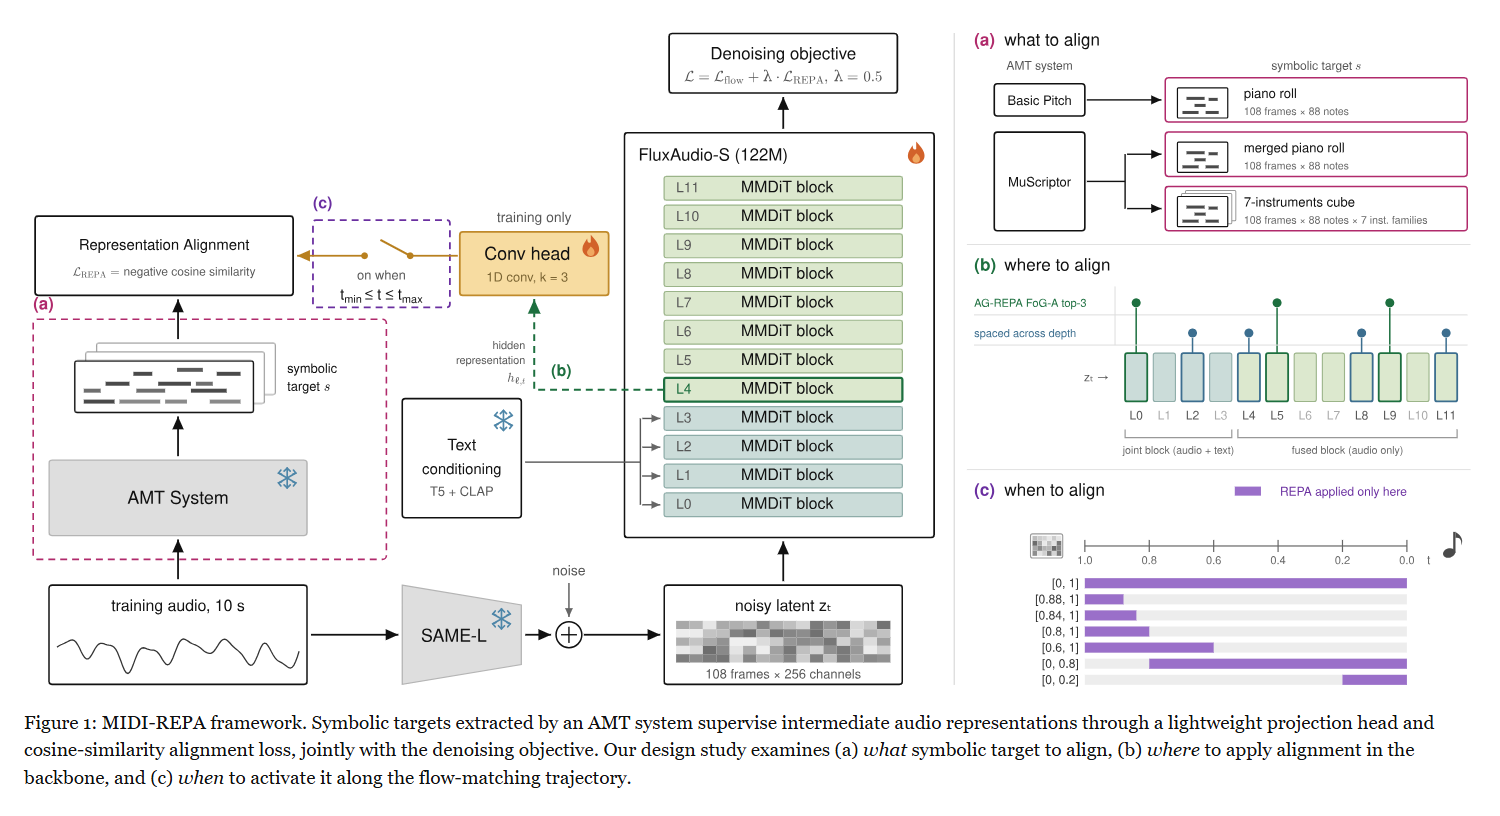
前序问题 :音乐生成器直接从密集波形学旋律与节奏,有限预算下容易学到音色却抓不住音符结构。扩大参数并非唯一办法,训练目标本身也可以更明确。方法直觉 :先让现成转谱器把训练音频写成简化音符表,训练时要求生成器的中间特征也能读出这张表;推理时撤掉老师,仍按文本生成声音。本文贡献 :在122M参数FluxAudio-S上,用自动音乐转录AMT提取与音频潜变量时间对齐的MIDI音符目标,轻量时间卷积头以余弦相似度辅助流匹配训练。MuScriptor音符卷帘表是108时间帧×88音高的二值矩阵;与分7乐器族的立方目标、Basic Pitch目标对比。最稳配置对齐第L2层、覆盖完整去噪轨迹,冻结SAME-L音频编码器处理10秒44.1kHz立体声。
图1|MIDI-REPA框架:自动音乐转录AMT提取的符号目标通过轻量投影头与余弦相似度对齐损失监督中间音频表征,同时保留去噪目标。设计研究分别检查(a)对齐哪一种符号目标、(b)在主干哪一层对齐、(c)在流匹配轨迹的哪一段启用对齐。
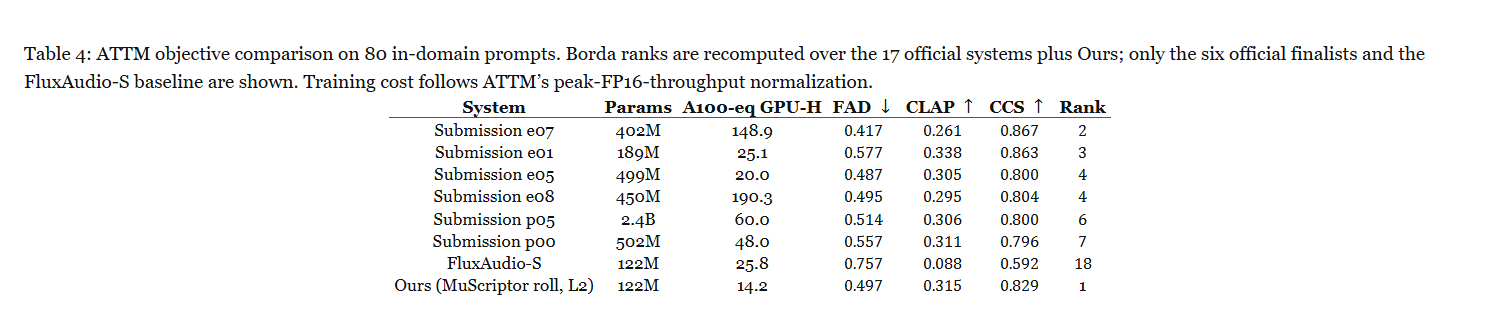
实验效果 :筛选后的JamendoMIDI有51077曲,排除验证及重叠参考后训练49034曲、约3161小时,30万次更新,单RTX3090约31.3 GPU小时;该时间未单独覆盖全量离线转谱成本。Song Describer Dataset(SDD)受控实验,Fréchet音频距离FAD从0.5275降至0.4947,越低越好;CLAP音频与文本嵌入相似度从0.2220至0.2686,越高越好。ATTM另80条提示为FAD0.497、CLAP0.315;推理25步Euler和4.5引导,不增加转谱器或对齐头。
表4|80条域内提示上的ATTM客观比较。Borda排名在17个官方系统加本方法的集合上重算,表中仅展示六个官方决赛系统和FluxAudio-S基线。训练成本按ATTM峰值FP16吞吐换算,A100-eq为等效GPU小时,不是实际设备时间;FAD音频分布距离越低、CLAP音频文本相似度和CCS字幕一致性分越高越好。重算Rank并非新增官方比赛名次。
批判点评 :14.2 A100等效GPU小时是按峰值半精度吞吐换算,不是实际在A100训练;ATTM重算综合排名也不是比赛官方新名次。MIDI监督取决于转谱质量,Basic Pitch在同一测试FAD0.5363还差于基线。这里只验证短片段,未证明完整歌曲结构。arXiv明确Submitted to ICASSP 2027,不能写已接收。代码 入口已核验。
10. VoXtend:短语音模型连续读到四分钟
Speaking Longer Than Learned: Training-Free Long-Form Generation for Full-Stream Text-to-Speech | 首尔市立大学 | arXiv:2610.19553
关键词 :长语音合成, 窗口限制, 说话人保持, 免训练外推
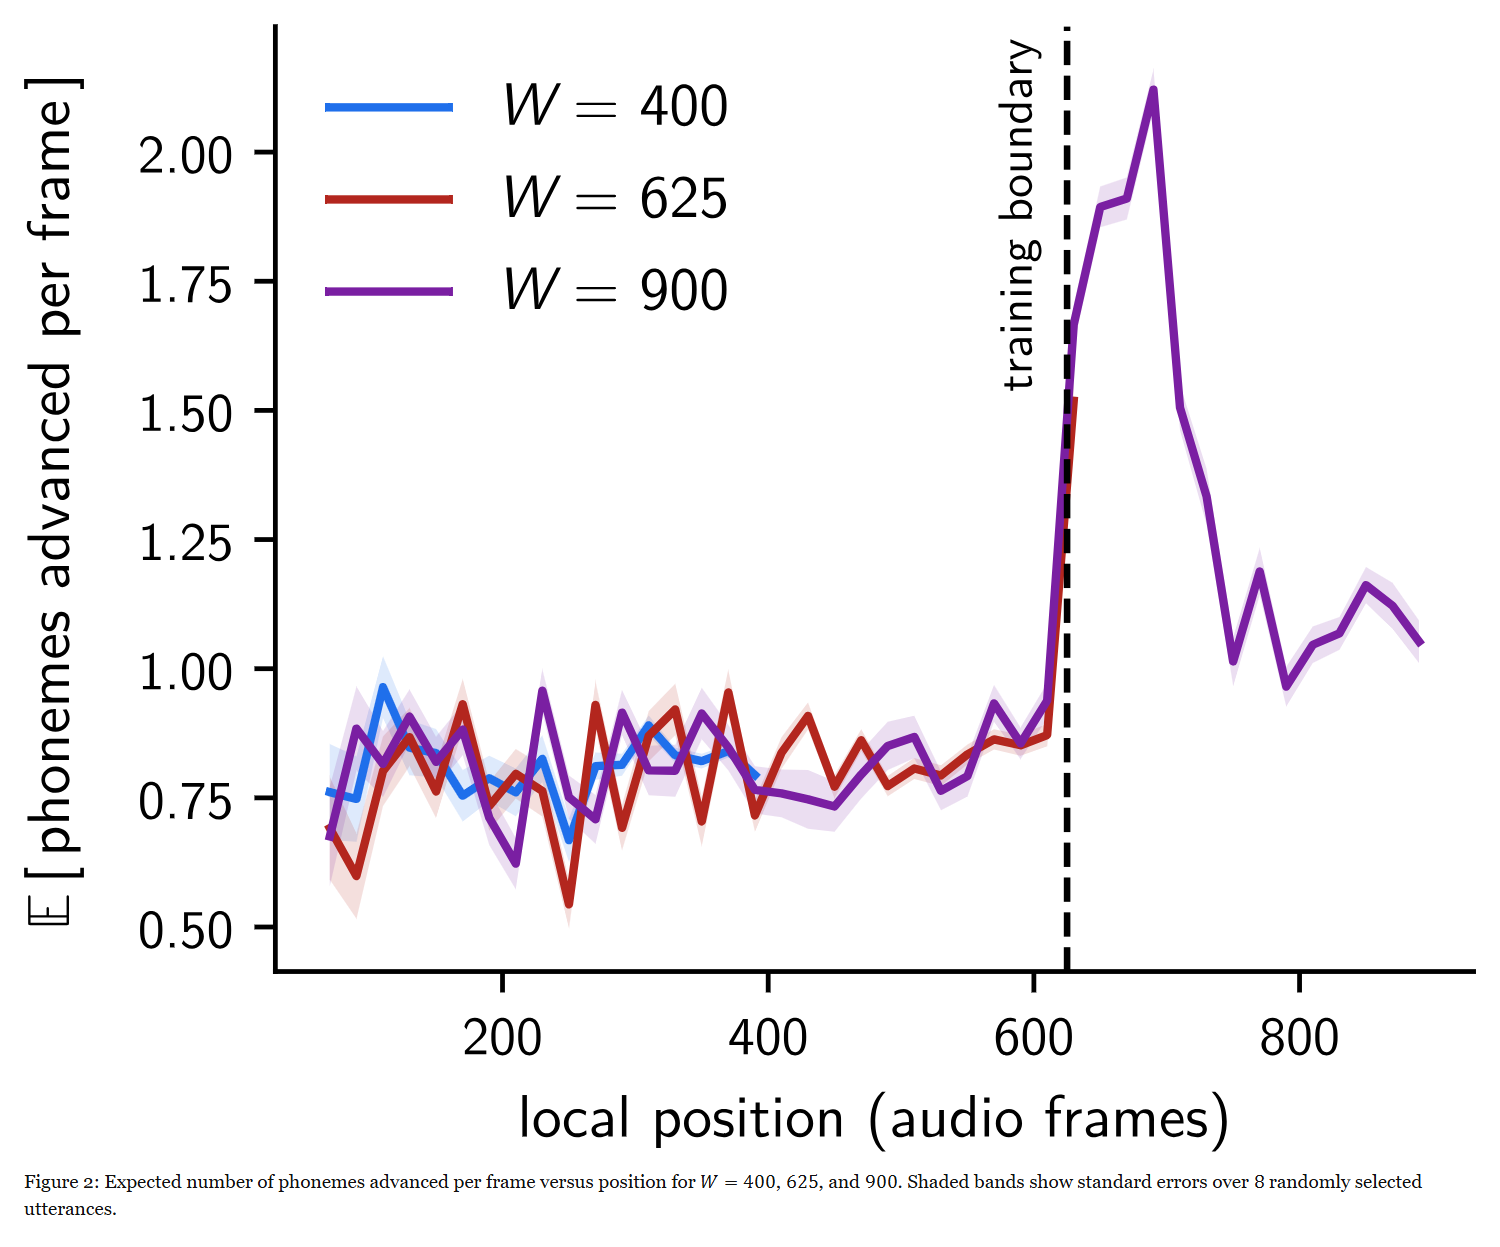
前序问题 :只见过50秒语音的流式模型,读长文时会跳音、越读越不像同一个人。持续保留开头的参考声音并清理旧缓存,也没有消除这种退化。方法直觉 :先让模型反复工作在熟悉的位置区间,再持续提醒它“声音像开头这个人”。缩短窗口解决发音位置偏差,给参考声音加注意力偏置解决身份漂移。本文贡献 :在VoXtream2上定位:把缓存重置推迟到900帧,发音加速仍在训练边界625帧附近出现,说明不是简单丢历史。于是把时间Transformer的缓存窗口W从625缩为375帧,帧率12.5Hz,相当50秒与30秒窗口;重置仍保留声学提示和近期帧并重算key/value。再向参考音频对应的注意力logit即归一化前分数加常量b=1.5,强化声纹条件,无需追加训练。
图2|音频生成的局部位置与每帧预期推进音素数,分别取窗口W=400、625、900帧。阴影为随机8段语句的标准误。把缓存重置推迟到900帧仍在625附近异常推进,用来区分位置范围问题与重置丢失历史;这是方法诊断图,非生成系统结构图。
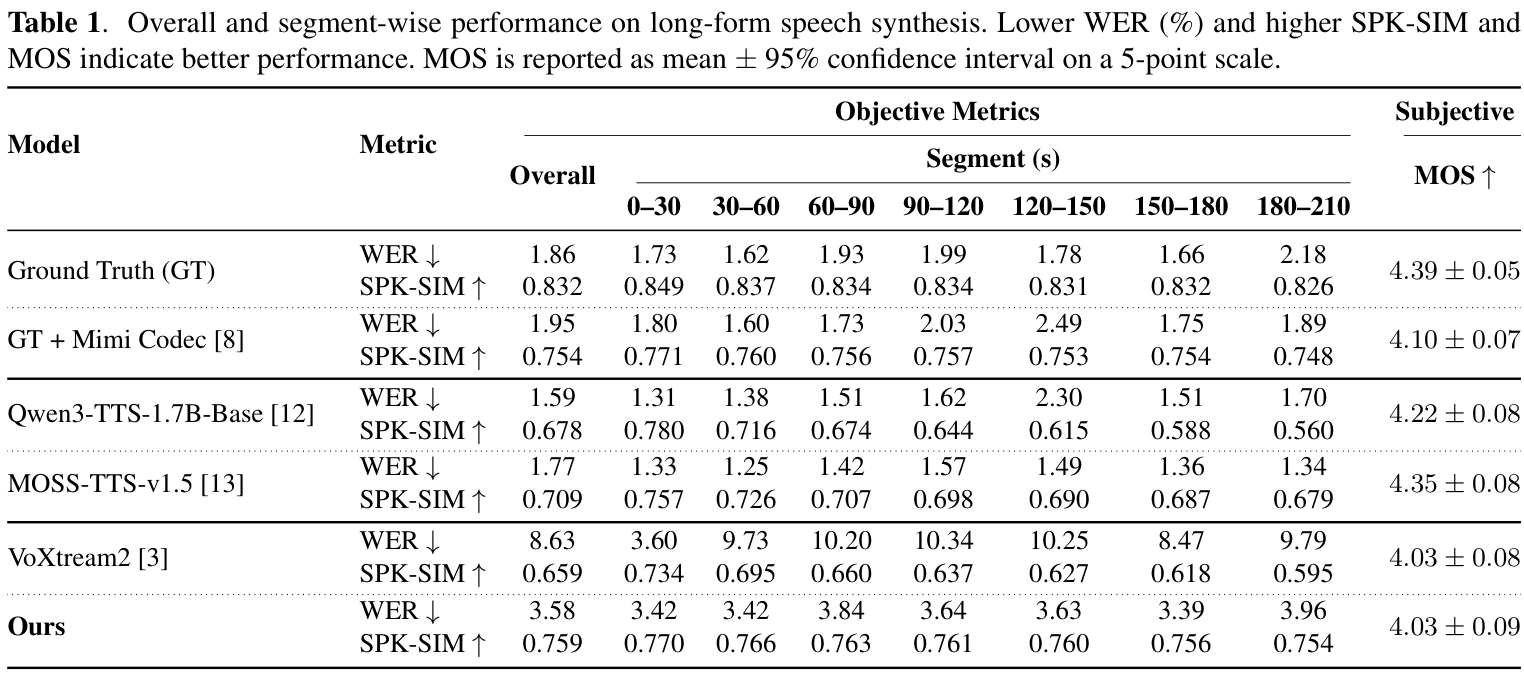
实验效果 :LibriSpeech-Long dev-clean的281段、15.89小时、最长约4分钟,平均7.88秒开头作声学提示。整体单词错误率WER8.63%至3.58%,越低越好;说话人嵌入余弦相似度SPK-SIM0.659至0.759,越高越好。158名听众评自然度,每模型325次评分,五分制MOS均4.03。仅缩窗口至375的RTX3090实时因子RTF由0.415至0.433,RTF是计算时长除音频播放时长、小于1表示快于播放;不是完整双改动的计时。
表1|长语音整体及分段表现。WER为单词错误率(%)、越低越好,SPK-SIM为说话人特征余弦相似度、MOS为五分主观评分,均越高越好。MOS按均值与95%置信区间报告;GT为真实语音,GT+Mimi为编解码重建。按0至210秒分段与整体分别比较,不能把单段变化当整段平均。
批判点评 :Qwen3-TTS与MOSS-TTS错误率仍更低,不能称长语音整体最强。窗口太小至250帧,WER反升6.51%;声学提示占用和重置重算也构成成本。证据来自特定主干与英语朗读,未验证多人对话或跨语言;VoXtend是本期沿用作者项目域名的短标签。作者音频样例 可访问,尚未确认公开代码。
趋势观察
先决定表示要服务谁
FeaTok限制像素梯度,Intern Lumina U2给每处八个码;重建、生成和理解的表示目标需要明确分工。
把监督花在实际输入上
ACEdit让学生面对自己的编辑输出,FocusOPD沿学生轨迹补早期深层监督,MIDI-REPA则在音乐中间特征补音符结构。
加速要区分计算粒度
Speculative Forcing按token早停,SoftCache按缓存余量跳时间节点;前者平均token次数、后者去噪循环加速都不能替代服务端到端计时。
保持与改变要有具体条件
TSG约束事件时间,SUPRA-Tex固定可信观测,VoXtend调整位置窗口并保留声纹条件;它们各有额外计算与失效场景。
今日讨论
FeaTok无引导采样为1.27 TFLOPs,对照RAEv2为47.72,但批量256的端到端吞吐是14.36对1.09图/秒,显存则22.0对13.4 GiB。若你要选择线上图像表示,哪种证据能够支持你在同显存预算、同质量目标且含像素解码的条件下采用FeaTok,并验证算量优势能兑现多少请求吞吐?
人工智能炼丹君 整理 | 2026-10-19


评论 (0)