


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练目标与采样流程(ddpm)、潜空间扩散(latent_diffusion)、自注意力(attention_basics)
关键词:DiT、Diffusion Transformer、adaLN-Zero、patchify、Gflops 缩放、条件注入
读者先掌握 DDPM 的加噪与噪声预测目标、潜空间压缩和多头注意力即可。本文把 $z_t$ 记作加噪后的 VAE 潜变量;$T$ 是空间 token 数,时间步用 $t$,二者不要混淆。LayerNorm 对每个 token 的特征维归一化,后文给出其条件调制。MAC 是乘加次数;一次乘加常按 2 FLOPs 折算,既不是耗时也不是吞吐。
先给三组数字。论文结果来自 DiT 原文 Table 4:256×256 ImageNet、400K 训练步、batch 256、EMA 权重、无 CFG、50K 样本 FID、250 步 DDPM、ft-MSE VAE 解码器;不包含 VAE 的参数和前向成本。本文没有重训该 ImageNet 实验。文中 NumPy toy 与解析账本另有完整可运行脚本。
第一组:参数量相差约 4 倍的两个模型,FID 几乎相同;第三个大模型却差得多。 DiT-S/2 用 33M 参数、6.06 Gflops 得到 FID 68.40,DiT-B/4 用 130M、5.56 Gflops 得到 68.38;DiT-L/8 用 459M、5.01 Gflops 得到 118.87。三者的预算只是接近,并非严格相等。图 1 虚线连接的是这三种配置,第三点并未与前两点重合。它说明参数量不足以预测这些配置的质量;更小 patch 可以让小模型增加 token 计算,得到有竞争力的结果。三个点同时改变宽度、深度和 patch,不能单独证明“买 token 永远优于买宽度”。UNet 也能调整通道、层数或下采样设计,DiT 的优势在于用统一 block 更方便地组织这些缩放实验。
第二组:DiT-XL/2 的主要矩阵 MAC 中,注意力两次矩阵乘约占 3.57%。 对 $T=256,d=1152$,qkv、输出投影和 MLP 合计是 $12Td^2$,注意力分数与加权是 $2T^2d$。线性项占这两类主项的约 96.43%;若以包含调制、输入和输出等简化项的 118.646 G 账本为分母,则分别约 96.21% 与 3.56%。不要混用分母。两类主项相等时 $T=6d$,即 XL 的 6912。这个算式解释运算量分配;实际瓶颈仍受访存、kernel 和硬件影响,注意力的二次存储也不能从 MAC 比例中排除。论文在指定配置网格和训练预算中观察到更多 Gflops 与更低 FID 的相关性,不是对任意任务的单调保证。
第三组:同样 118.6 Gflops,只换条件注入方式,FID 从 25.21 掉到 19.47。 论文 Table 4 中四种 block 的 400K 步对照是同一个 DiT-XL/2 骨架:in-context 35.24、cross-attention 26.14、vanilla adaLN 25.21、adaLN-Zero 19.47。其中 vanilla adaLN 与 adaLN-Zero 的 Gflops 只差 0.08,差别包括新增残差门控与零初始化,不能把整个增益归因于初始化一个因素。这组 5.74 分差距对应门控与初始化等结构选择的联合比较,不能视为只改一个初始化变量的因果效应。下文逐行说明其前向和梯度路径。
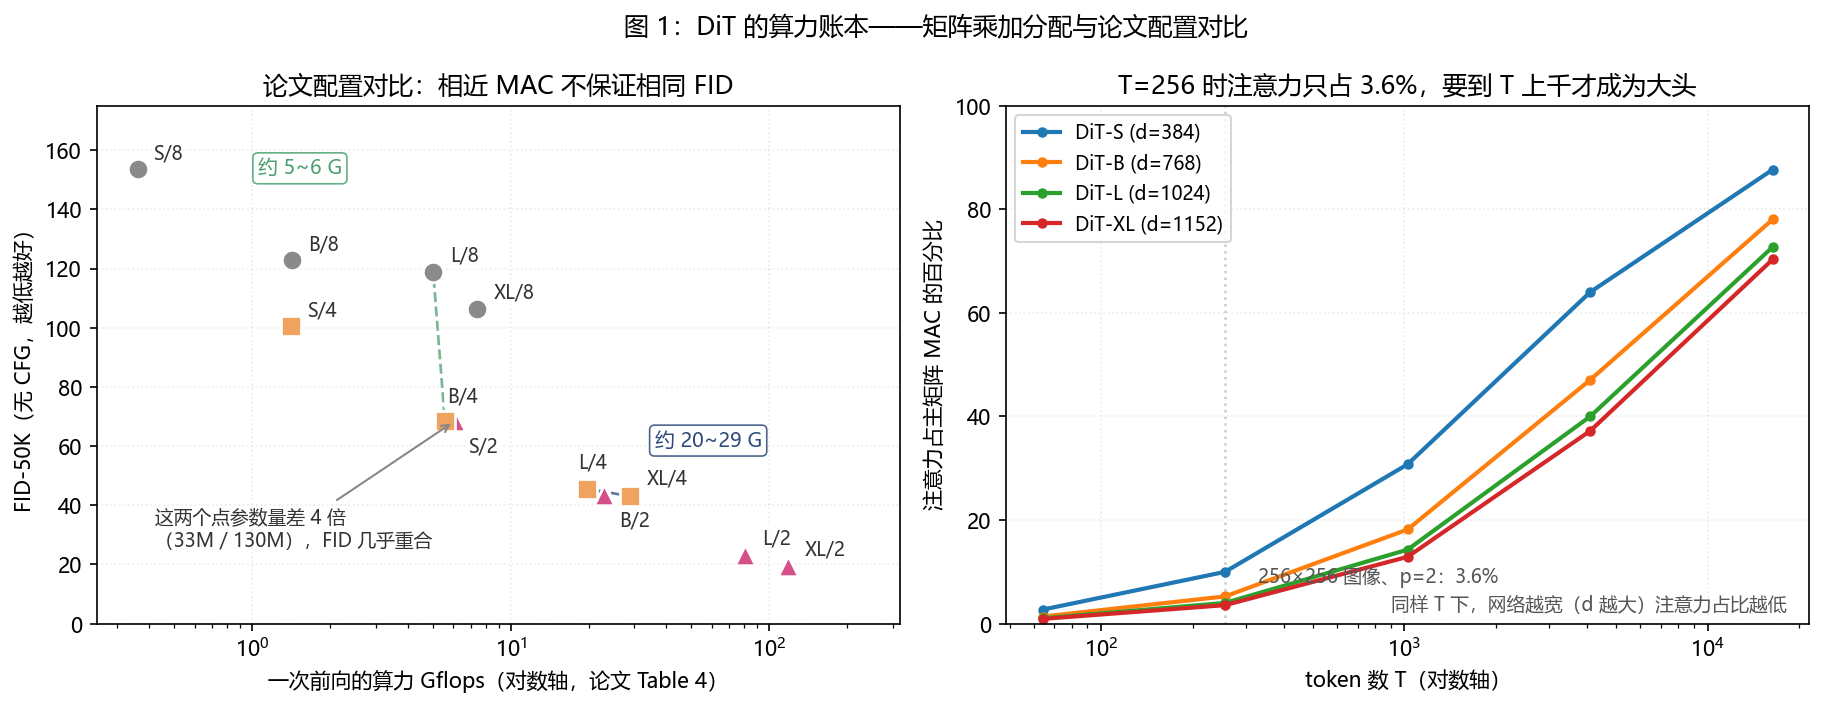
这张图要看什么:左图使用论文 Table 4 的预算和 FID,虚线只是连接预算接近的配置。S/2 与 B/4 的 FID 接近,L/8 明显更高,不能读成三者等高。右图只比较注意力矩阵 MAC 与主干线性 MAC,竖线为 T=256;随 token 增加,二次项逐渐变得重要。
所以这篇文章回答三个问题:DiT 的算力账本是怎么记的、adaLN-Zero 的「恒等初始化」在数学上意味着什么、以及它换来的到底是什么。
三句话讲完:
把潜变量切成 patch 序列,再接条件化的 ViT 风格骨干。 32×32×4 的潜变量按 p=2 切成 (32/2)²=256 个 token,每个 token 原始 16 维,线性嵌入到 d 维,加固定的 2D sin-cos 位置编码,过 N 个 block,最后一层线性投回 p²×2C 维(原始 learn_sigma=True,同时输出噪声与方差参数)再拼回空间形状。patch size p 是 DiT 沿用 ViT 的缩放旋钮:p 减半,token 数翻四倍,主干线性 MAC 翻四倍、注意力矩阵 MAC 翻十六倍;总预算还含每样本固定项,参数量近似不变。
条件(时间步 + 类别)不进序列,而是变成每个 block 的 LayerNorm 参数。 具体做法是调制:先算出 $c = t_{\text{emb}} + y_{\text{emb}}$,再用一个 $\text{SiLU} \to \text{Linear}(d, 6d)$ 把它变成 6 段 d 维向量,分别是注意力分支与 MLP 分支的 $(\beta_1, \gamma_1, \alpha_1)$ 与 $(\beta_2, \gamma_2, \alpha_2)$。前两个做 shift/scale,第三个是残差门控:$x \leftarrow x + \alpha \odot f(\cdot)$。
Zero 指的是整个调制层零初始化,于是每个 block 在初始化时是恒等函数。 关键点在 DiT 的 modulate 写法:它是 $x(1 + \gamma_{\text{out}}) + \beta_{\text{out}}$ 而不是 $x\gamma_{\text{out}} + \beta_{\text{out}}$。调制层输出全零时,$\gamma_{out}=0$(有效缩放为 $1+\gamma_{out}=1$)、$\beta = 0$、$\alpha = 0$,三件事同时成立,整个 block 变成 $x \mapsto x$。实测:28 层叠完之后 $\|x_{28} - x_0\|_\infty = 0$(图 2 左)。
代价也很清楚:门关着的时候,block 内部除门控之外的参数梯度精确为零——在独立 block 接非零上游梯度时,门控可能先获得梯度;完整 DiT 的输出头也为零,第一步首先更新输出头。
记潜变量 $z \in \mathbb{R}^{I \times I \times C}$(256×256 图像过 VAE 后是 $I=32, C=4$)。patchify 把每个 $p \times p \times C$ 的方块摊平成一个 $p^2C$ 维向量,共
$$T = (I/p)^2$$
个,再用一个线性层 $\mathbb{R}^{p^2C} \to \mathbb{R}^d$ 嵌入。实测的形状(附录 dit_flops.py):
输入潜变量 z: (2, 32, 32, 4)
p=8: patchify -> (2, 16, 256)   T=16,  每 token 256 维
p=4: patchify -> (2, 64, 64)    T=64,  每 token 64 维
p=2: patchify -> (2, 256, 16)   T=256, 每 token 16 维
$T$ 之外的一切($d$、block 数、头数)都与 $p$ 无关,所以在其余配置固定时,$p$ 主要改变 token 运算量,但输入和输出投影的参数也随之改变:$p$ 从 8 减到 2,DiT-S 的 Gflops 从 0.36 涨到 6.06(17 倍),论文取整均为 33M,并非每个参数完全相同。
数一个 block 的主要矩阵乘加次数(MAC,一次 $ab+c$ 记 1)。这一口径能近似解释论文的 Gflops;论文没有给出足以完全复现所有逐元素算子的统一 profiler 定义,本文不声称逐 FLOP 完全一致。
| 部件 | 每个 token 的 MAC | 说明 |
|---|---|---|
| qkv 投影 | $3d^2$ | $d \to 3d$ |
| 注意力分数 $QK^\top$ | $Td$ | 每个 token 对 T 个位置各做 d 次乘加 |
| 注意力加权 $AV$ | $Td$ | 同上 |
| 输出投影 | $d^2$ | $d \to d$ |
| MLP($d \to 4d \to d$) | $8d^2$ | 两层各 $4d^2$ |
| adaLN 调制 | $6d^2$ / 样本 + $3d$ / token | 每个样本只算一次;3d 是简化的逐元素计数,未穷尽两分支全部操作 |
忽略调制与逐元素项,一个 block 的算力是
$$\mathrm{MAC}_{\text{block}} \approx T(12d^2 + 2Td)$$
其中 $12d^2=3d^2+d^2+8d^2$。仅乘 $N=28,T=256,d=1152$ 的两类主项得到 118.380 G MAC;再加每层 $6d^2$ 的条件投影、输入/输出和时间嵌入以及简化逐元素项,脚本得到 118.646194176 G,论文报告 118.64 G。两者很接近,但不是同一个精确计数。LayerNorm、softmax、SiLU/GELU 的实际算子成本与偏置操作未完整计入。一次乘加按 2 FLOPs 折算时,主矩阵项可约乘二,不能把所有逐元素项也机械当成两次运算。
参数账本则可以精确核对:原始源码的两个 block LayerNorm 和最终 LayerNorm 均无仿射参数;类别表含 1000 个类别与 1 个 null 行;输出头含 $2C$ 通道。因此每块可训练参数为 $18d^2+15d$,XL/2 的可训练参数共 674,834,720,冻结位置编码另有 294,912 个数;将冻结参数也算入模型 Parameter,总数是 675,129,632。下面表格的“本篇参数量”统一取可训练参数。12 种配置均已用固定官方 DiT 类在 PyTorch meta 设备上逐参数数目核对,不执行这些大模型的前向或训练。
这张对账表本身就是文章的一半结论,值得整张贴出来:
| 模型 | N / d / T | 本篇 GMAC | 论文 Gflops | 可训练 M | 论文 FID |
|---|---|---|---|---|---|
| DiT-S/8 | 12 / 384 / 16 | 0.358 | 0.36 | 33.142 | 153.60 |
| DiT-S/4 | 12 / 384 / 64 | 1.413 | 1.41 | 32.920 | 100.41 |
| DiT-S/2 | 12 / 384 / 256 | 6.059 | 6.06 | 32.865 | 68.40 |
| DiT-B/8 | 12 / 768 / 16 | 1.418 | 1.42 | 130.869 | 122.74 |
| DiT-B/4 | 12 / 768 / 64 | 5.567 | 5.56 | 130.426 | 68.38 |
| DiT-B/2 | 12 / 768 / 256 | 23.012 | 23.01 | 130.316 | 43.47 |
| DiT-L/8 | 24 / 1024 / 16 | 5.013 | 5.01 | 458.578 | 118.87 |
| DiT-L/4 | 24 / 1024 / 64 | 19.700 | 19.70 | 457.988 | 45.64 |
| DiT-L/2 | 24 / 1024 / 256 | 80.716 | 80.71 | 457.841 | 23.33 |
| DiT-XL/8 | 28 / 1152 / 16 | 7.394 | 7.39 | 675.665 | 106.41 |
| DiT-XL/4 | 28 / 1152 / 64 | 29.050 | 29.05 | 675.001 | 43.01 |
| DiT-XL/2 | 28 / 1152 / 256 | 118.646 | 118.64 | 674.835 | 19.47 |
横着读这张表,三个旋钮的作用各不相同:
值得注意的是「同样算力下单块算力都是 12d² 主导」这件事在表里也看得出来:DiT-S/2 与 DiT-B/4 的算力(6.06 / 5.56 G)落在同一档,说明一个 12 层 384 宽、切到 p=2 的小模型,和 12 层 768 宽、切到 p=4 的大模型,在算力上是可以互换的;两者的 FID 也确实只差 0.02。这条「算力等价」的直觉,是后面理解缩放实验的前提。
注意力占比是两种项的比值:
$$\frac{2Td}{12d^2 + 2Td} = \frac{2T}{12d + 2T}$$
代入 $T=256, d=1152$ 得 3.57%。令两者相等解出临界点 $T = 6d$:固定 T 时,d 越大,注意力矩阵 MAC 在这两类主项中的占比越小;这不判定实际延迟或显存占比。图 1 右图画的是各档模型在 $T$ 从 64 到 16384 上扫过的这条曲线。
标准 LayerNorm 之后接仿射变换:
$$h = \gamma \odot \mathrm{LN}(x) + \beta$$
其中 $\mathrm{LN}$ 对最后一维做归一化(DiT 里 elementwise_affine=False,仿射参数不是 LN 自带的)。 具体对一个 d 维 token,均值 $\mu=d^{-1}\sum_jx_j$,方差 $v=d^{-1}\sum_j(x_j-\mu)^2$,使用总体方差而非无偏样本方差:
$$\mathrm{LN}(x)_j=\frac{x_j-\mu}{\sqrt{v+\epsilon_{LN}}},\qquad \epsilon_{LN}=10^{-6}$$
其中稳定常数防止零方差时除零;它与扩散噪声 $\varepsilon$ 是两个不同量。adaLN 的做法是把 $\gamma, \beta$ 变成条件的函数:
$$(\beta_1, \gamma_1, \alpha_1, \beta_2, \gamma_2, \alpha_2) = \mathrm{Linear}_{d \to 6d}\big(\mathrm{SiLU}(c)\big), \qquad c = t_{\text{emb}} + y_{\text{emb}}$$
DiT 源码里的 modulate 是这样写的:
$$\mathrm{modulate}(x, \beta, \gamma) = x \odot (1 + \gamma) + \beta$$
用 $1+\gamma$ 时,调制层输出 $\gamma=0$ 对应有效缩放为 1,$\beta=0$ 对应不平移。注意“调制输出”与“有效缩放”是两个量,不能把同一个 $\gamma$ 同时写成 0 与 1。没有这项偏移未必数学上完全无法学习,但会改变初始特征与梯度路径。
DiT block 的两条残差分支都带门:
$$x' = x + \alpha_1 \odot \mathrm{Attn}\big(\mathrm{modulate}(\mathrm{LN}_1(x), \beta_1, \gamma_1)\big)$$
$$x'' = x' + \alpha_2 \odot \mathrm{MLP}\big(\mathrm{modulate}(\mathrm{LN}_2(x'), \beta_2, \gamma_2)\big)$$
调制层零初始化时 $\beta=0$、$\gamma=0$(有效缩放 $1+\gamma=1$)、$\alpha=0$。只要两个门控为零且分支输出有限,block 就是恒等映射,即使 shift/scale 非零也成立。把整层调制器置零进一步让分支内部从不平移、单位缩放开始,但这不是恒等的必要条件。
实测(附录 adaln_zero.py,DiT-XL 宽度 d=1152、T=256、16 头;随机 float64 教学 block,不是预训练模型):
adaln_zero   单块 |out - x| 最大值 = 0.000e+00
             叠 28 层后 |out - x| 最大值 = 0.000e+00
adaln        单块 |out - x| 最大值 = 2.985e+00
             单块相对扰动 std(out-x)/std(x) = 0.6105
             叠 28 层后残差流漂移 std(x_28 - x_0) = 4.3497
对照组 vanilla adaLN(无门控且调制层非零初始化):单块就给残差流叠上 std 为 0.61 的随机扰动,28 层随机游走之后漂移达到 4.35——该 seed 下输出相对输入有较大扰动;漂移标准差不能证明输入信息已经丢失。零初始化这一侧,漂移严格是 0,连浮点误差都没有。图 2 左图画的就是这两条曲线。
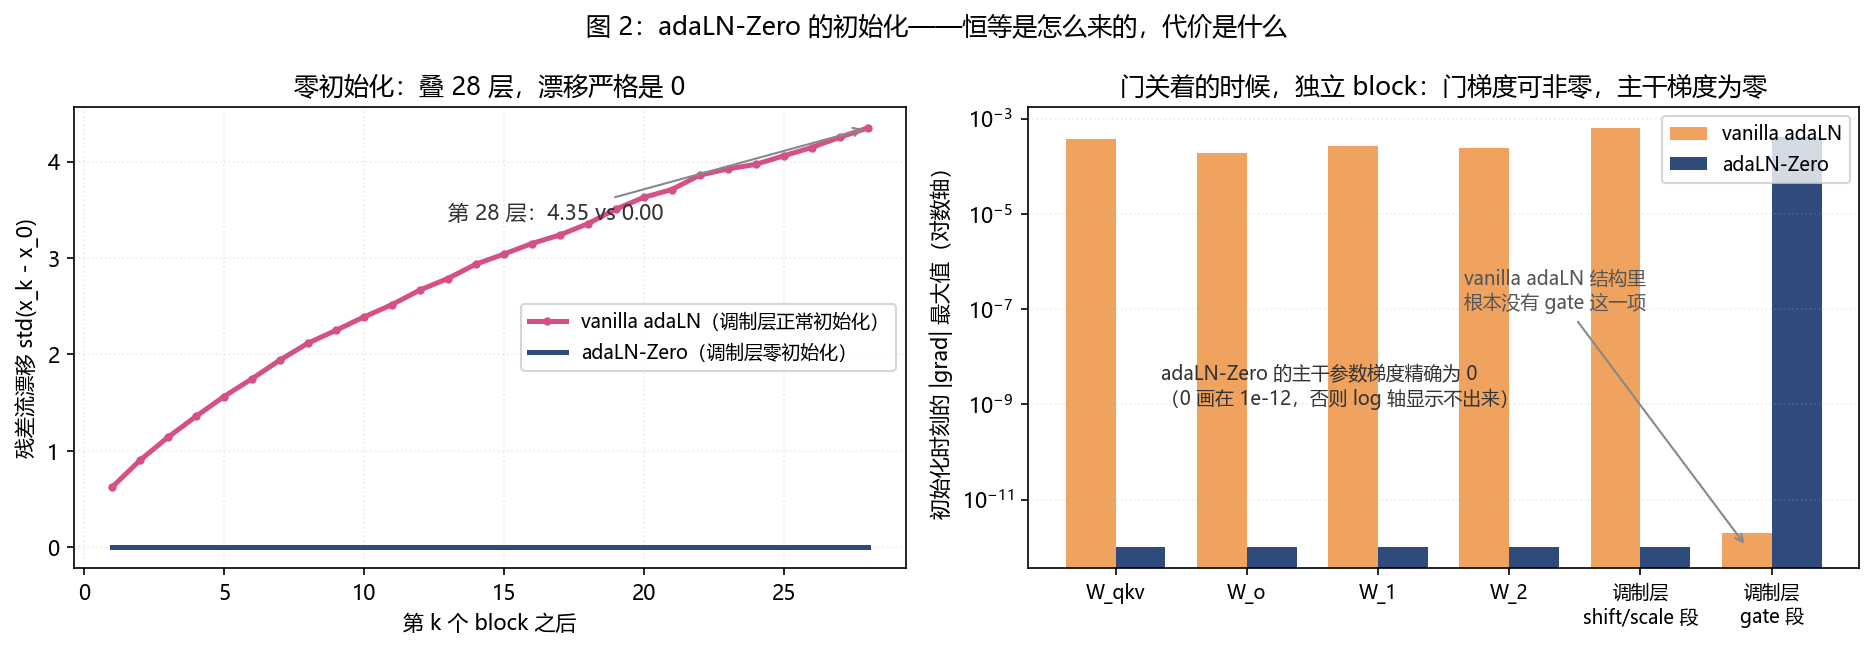
这张图要看什么:左图比较相同深度宽度的两种 block;差别包含门控及调制初始化——蓝线恒等于 0,粉线一路爬到 4.35。右图是初始化那一刻各部件的梯度大小(对数轴):蓝柱的主干部分趴在底部,真实值就是精确的 0(画在 1e-12 只是为了让 log 轴显示得出),只有最后一组「调制层 gate 段」立起来;粉柱则所有部件都有梯度。注意最右一组的对比是不对称的:vanilla adaLN 结构里压根没有 gate 这一项,所以那条柱子是空的——零初始化不只是「让某些梯度变成 0」,它同时给网络装上了一组原本不存在的门。
先看单条残差分支 $y=x+\alpha\odot f(h;\theta_f)$,其中 $h=(1+\gamma)\odot\mathrm{LN}(x)+\beta$。对每个样本 b,三个调制向量均为 d 维,并广播到所有 token;$g=\partial L/\partial y$ 与 x 同形状。令 $J_f$ 是 f 对其输入的完整雅可比,$J_{\theta_f}$ 是对分支参数的雅可比,链式法则给出:
$$\frac{\partial L}{\partial\alpha_{bj}}=\sum_{t=1}^{T}g_{btj}f(h)_{btj}$$
$$r=J_f(h)^\top(\alpha\odot g),\qquad \frac{\partial L}{\partial\theta_f}=J_{\theta_f}^\top(\alpha\odot g)$$
$$\frac{\partial L}{\partial\beta_{bj}}=\sum_t r_{btj},\qquad \frac{\partial L}{\partial\gamma_{bj}}=\sum_t r_{btj}\mathrm{LN}(x)_{btj}$$
这里 $\alpha\odot g$ 隐含 token 广播,雅可比转置乘向量是完整矩阵运算,不能把它写成没有收缩指标的逐元素乘积。于是有限分支值且 gate=0 时,分支参数、shift 和 scale 的梯度为零;gate 的梯度可以非零,但若上游 g 为零或求和抵消,它也可能为零。共享调制线性层的权重和偏置还须对样本 b 累加。残差输入 x 的梯度仍可通过恒等路径传播,并不是整个 block 的所有梯度都为零。
下面独立 block 的线性损失实际为 mean(out*w),w 是固定随机数组,均值归一化已包含在 g 中:
adaLN-Zero: W_qkv=0.000000e+00, W_o=0.000000e+00, W_1=0.000000e+00, W_2=0.000000e+00
调制层各段: shift_msa=0.000000e+00, scale_msa=0.000000e+00, gate_msa=6.521017e-05, shift_mlp=0.000000e+00, scale_mlp=0.000000e+00, gate_mlp=4.136085e-04
vanilla adaLN: W_qkv=3.751596e-04, W_o=1.960228e-04, W_1=2.736421e-04, W_2=2.435175e-04
调制层各段: shift_msa=6.434247e-04, scale_msa=7.563427e-05, shift_mlp=3.578871e-04, scale_mlp=3.251636e-04
完整 DiT 还将最终输出线性层置零。写成 $o=W_{out}h+b_{out}$,首次反传的上游为 $W_{out}^\top\partial L/\partial o=0$,所以更早的 block gates 暂时也没有损失梯度。固定官方小模型的真实 CPU 实验(输入 2×4×8×8、输出 2×8×8×8、两块 d=32、SGD 学习率 0.1)得到:
step 0: 输出 max=0;输出头 grad max=0.0414984;首块调制/注意力 grad=0/0
step 1: 首块调制 grad max=9.09985e-5;注意力 grad=0
step 2: 首块注意力 grad max=1.65495e-9
这是一个具体更新过程的验证,不是保证任意优化器和数据都按固定步数打开门。权重衰减、显式正则或其他损失会另添更新路径。
零输出头的初始 MSE 等于当前这批样本噪声平方的平均值,不保证恰为总体期望 1;learned-variance 的完整训练损失还含另一项,不能只报噪声 MSE 就称完整训练 loss。NumPy 小模型的实跑见下一段:
当前批 mean(eps²)=1.0083085178;零头 MSE=1.0083085178;输出 max=0.0
随机打开输出头后 MSE=3.1357716071;输出 max=4.954960论文那组数字(DiT-XL/2、400K 步、ImageNet)在本机复现不了——没有 ImageNet,也没有 TPU。但同一个问题可以搬到跑得完的 toy 上:8 个朝向的二维条纹、潜变量 8×8×2、patch p=2 得到 $T=16$、$d=64$、6 层,各方案使用相同宽度、深度、训练样本流、优化器、学习率计划与步数,每种跑 3 个 seed。结构、参数量、初始化规则及随机数消费顺序不同,不能称为只改初始化的配对消融。脚本就是附录里的 cond_ablation.py。
结果以最终代码真实重跑,训练统计是最后 200 步各 batch MSE 的均值;“±”是 3 次结果的总体标准差(ddof=0),只作描述性统计。另在每次训练结束后,用新噪声和新时间采样的 256 个样本计算评估 MSE;8 类条纹模板仍与训练相同,不是新语义类别的泛化评估。
| 方案 | 参数量 | 训练 MSE 均值 ± std | 新加噪评估 MSE 均值 ± std |
|---|---|---|---|
| adaLN-Zero | 464,328 | 0.031844 ± 0.002636 | 0.022255 ± 0.003168 |
| vanilla adaLN | 414,408 | 0.073483 ± 0.001623 | 0.068328 ± 0.000756 |
| in-context | 307,912 | 0.073493 ± 0.002453 | 0.064545 ± 0.003234 |
| cross-attention | 408,520 | 0.071401 ± 0.001369 | 0.067276 ± 0.006353 |
三个 seed 各自的最后200步训练 MSE:
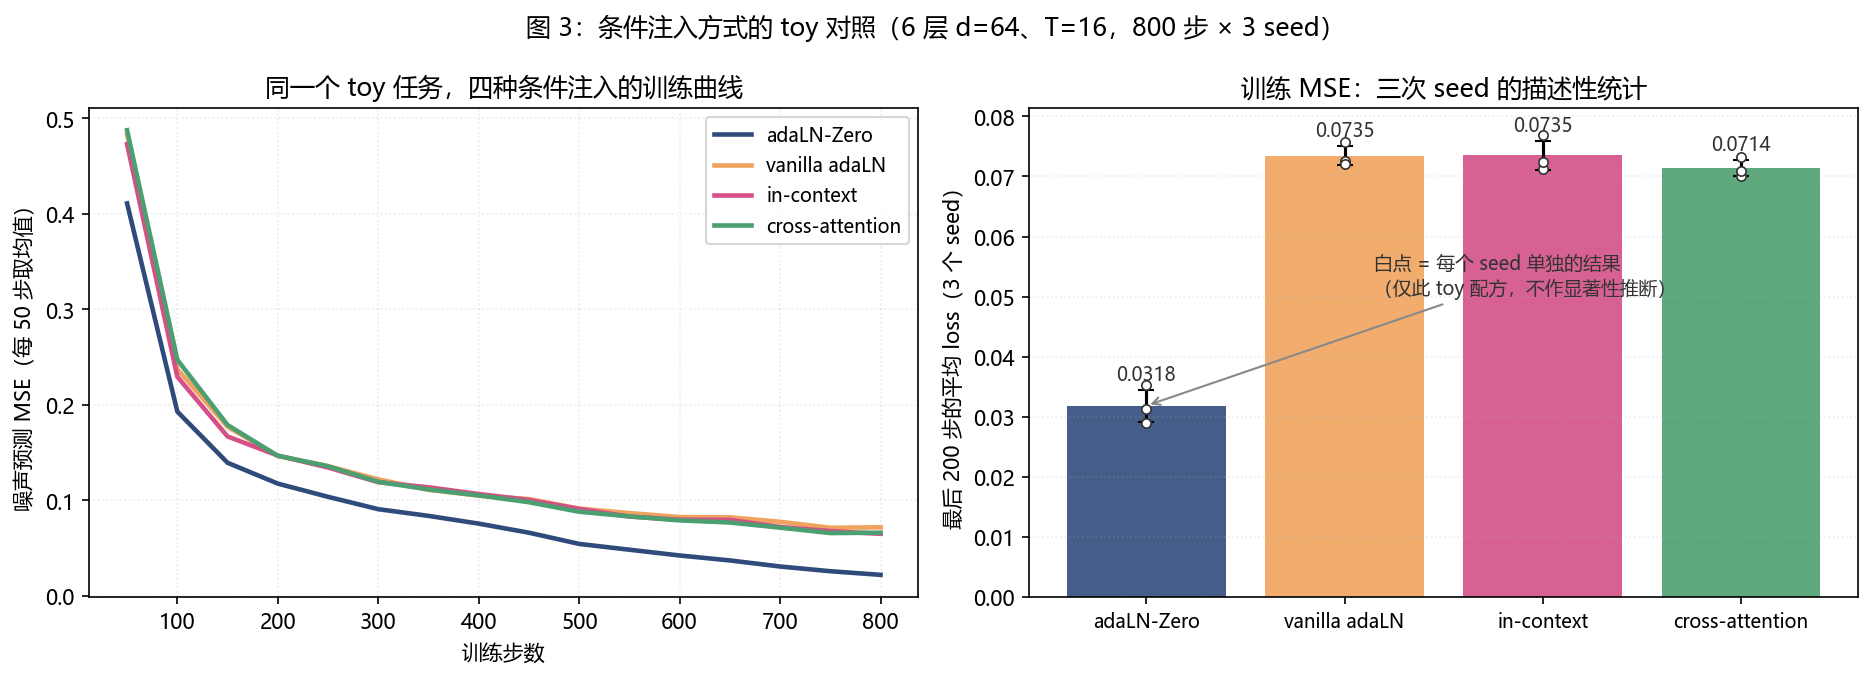
这张图要看什么:左图仅画 seed=0 的训练曲线,右图画三个 seed 的最终训练 MSE 和离散点。曲线及数值均来自本轮完整档缓存;完整参数与代码哈希绑定在缓存元数据中,修改代码或 batch/depth/seed 后不会沿用旧结果。
在这一次完整重跑中,按平均训练 MSE 从低到高依次为:adaLN-Zero、cross-attention、vanilla adaLN、in-context。这是此教学结构、8 个固定条纹模板和三个训练 seed 的结果,不是对所有条件注入方法的排序定理。新加噪评估值不必等于最后 200 步训练均值:两者既使用不同噪声,也对应不同阶段的参数。
这个实验保留了自注意力、条件注入与噪声预测的机制,但不含 VAE、learned variance、CFG 或图像 FID。评估只检查同一组条纹模板下新的加噪样本;三 seed 的区间或排序不能证明不存在随机波动,也不能解释 ImageNet 上其他方案的排序为何不同。in-context 多两个 token 的成本、条件交互的难度都可能随任务变化;本文没有用这个实验分别识别这些原因。vanilla adaLN 与 adaLN-Zero 的每层参数差为 2d²+2d,d=64、6 层时差 49,920,来自多出的两个调制门段;这个参数差可以精确解释,质量差不能据此单因归因。
论文比较了四种把条件塞进 Transformer 的办法,它们的差别全部集中在「条件从哪里进入 block」这一件事上:
| 方案 | 条件怎么进去 | 代价 |
|---|---|---|
| in-context | 把 $t_{\text{emb}}, y_{\text{emb}}$ 当成两个额外 token 加入序列(本教学实现拼在末尾),走的还是同一套 self-attention | 序列变长,token 数从 $T$ 变 $T+2$;每个 block 都要为这两个 token 做一次全量 attention |
| cross-attention | 主干只放图像 token,另加一层交叉注意力,条件 token 当 key/value | 多一套 $d \to d$ 的注意力参数,算力上涨最多 |
| vanilla adaLN | 条件不进序列,变成 LayerNorm 的 shift/scale($\gamma, \beta$),没有门 | 每层另加约 4d² 的条件投影参数,MAC 只对每样本算一次;无额外 gate |
| adaLN-Zero | 同上,再多两个门 $\alpha_1, \alpha_2$,并把整个调制层零初始化 | 每层比 vanilla adaLN 多 $2d^2+2d$ 的调制参数(含偏置) |
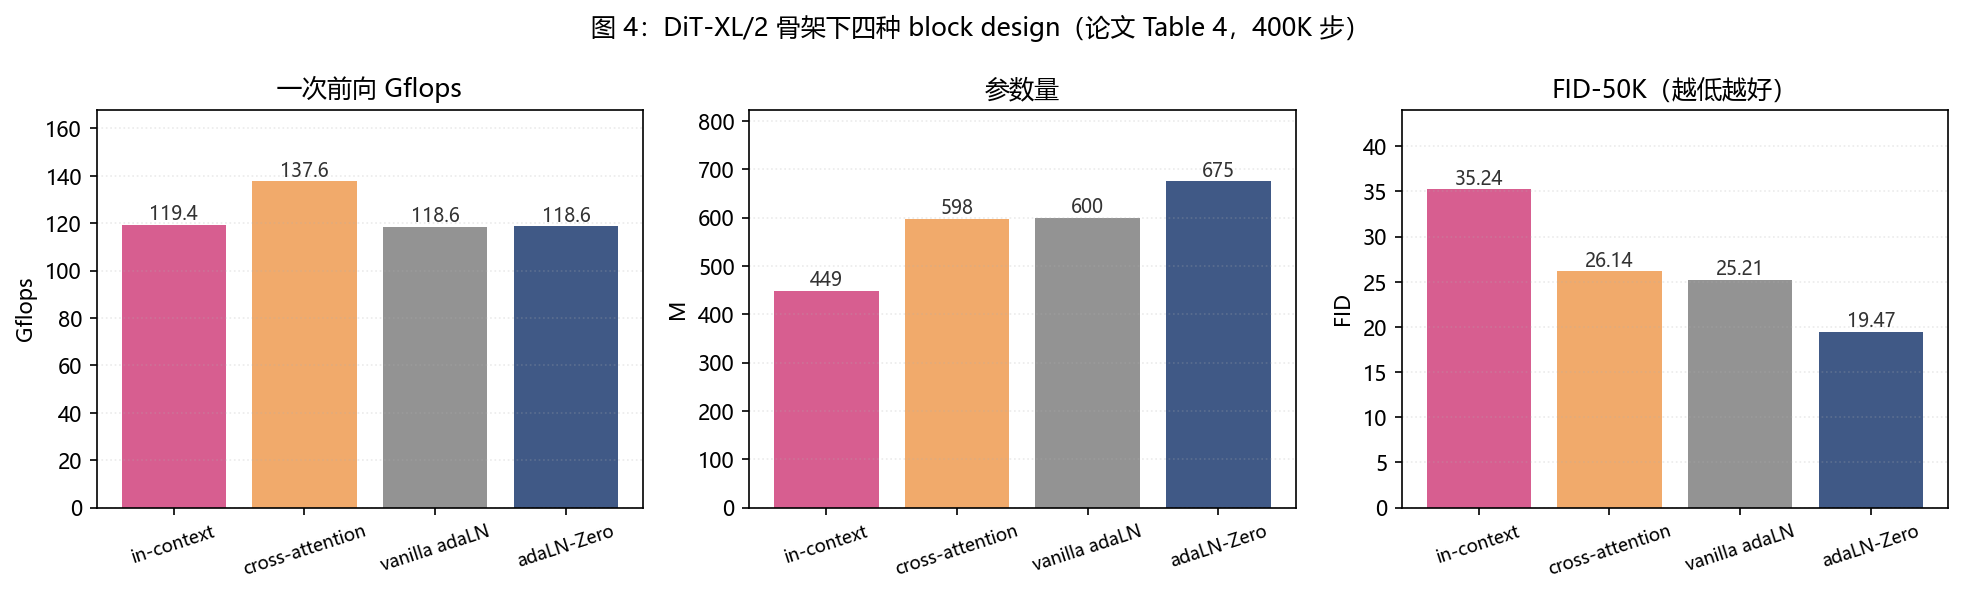
这张图要看什么:三根柱子分别是算力、参数量、FID,四组从左到右对应上表的四种方案。先看中间那张参数量图:in-context 参数最少(449M,因为它没有额外的注意力参数,只是把序列变长),cross-attention 为约 598M 总参数,不能把它与另一方案的 600M 相加,adaLN-Zero 是 675M,比 vanilla adaLN 多了 75M——近似差来自每块新增的 $2d^2+2d$ 个调制参数。再看右边那张 FID 图:参数最少的 in-context 质量最差(35.24),参数最多的 adaLN-Zero 质量最好(19.47)。最后看左边的算力:四种方案的算力其实都挤在 118~138 G 这个窄区间里(in-context 因为序列长了一点反而是 119.37,cross-attention 因为多一套注意力到 137.62),这约 16 分的差距出现在相近但并不完全相同的前向预算下,表明这个训练设置对条件结构选择敏感;它不把算力、参数量与初始化的因果贡献完全拆开。
一个容易看漏的对照:vanilla adaLN 与 adaLN-Zero 的算力只差 0.08 G(118.56 vs 118.64),参数量差 75M,FID 差 5.74 分。门取常数 1 时可包含无门控的行为,但条件相关门控也增加了函数自由度;该对照同时改变参数与初始化,不能证明函数类完全相同,更不能把 5.74 分全部归因为优化路径。
完整脚本在文末附录,这里放三段核心代码与它们的真实输出。
def patchify(z, p):
    """z: [B, I, I, C] -> [B, (I/p)^2, p*p*C]"""
    B, I, _, C = z.shape
    g = I // p
    z = z.reshape(B, g, p, g, p, C)
    z = z.transpose(0, 1, 3, 2, 4, 5)       # [B, g, g, p, p, C]
return z.reshape(B, g * g, p * p * C)跑一遍(batch=2、32×32×4):p=8 -> (2, 16, 256)、p=4 -> (2, 64, 64)、p=2 -> (2, 256, 16),逆变换的最大误差 0.00e+00。
def modulate(h, shift, scale):
    """DiT 源码的 modulate: x * (1 + scale) + shift"""
    sh = tg.reshape(shift, (shift.v.shape[0], 1, -1))
    sc = tg.reshape(scale, (scale.v.shape[0], 1, -1))
    return tg.add(tg.add(h, tg.mul(h, sc)), sh)

class DiTBlock:
    def __call__(self, x, c, store, ctx=None):
        B, T, d = x.v.shape
        sh_a, sc_a, gate_a, sh_m, sc_m, gate_m = tg.chunk_last(
            self.w_mod(tg.silu(c), store), 6)
        h = self._modulate(tg.layernorm(x), sh_a, sc_a)
        a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store)
        x = tg.add(x, tg.mul(tg.reshape(gate_a, (B, 1, d)), a))
        h2 = self._modulate(tg.layernorm(x), sh_m, sc_m)
        u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store)
        return tg.add(x, tg.mul(tg.reshape(gate_m, (B, 1, d)), u))
逐项对一下变量名与 03 节的符号:sh_a/sc_a/gate_a 就是 $(\beta_1, \gamma_1, \alpha_1)$,w_mod 是那个 $\text{Linear}(d, 6d)$,注意它前面接的是 silu 而不是别的激活。w_mod 在 mode="adaln_zero" 时用 zero=True 初始化——weight 和 bias 全是 0,另外 vanilla adaLN 调制四段且没有残差门控;两者并非只差初始化。
dit_flops.py 的真实输出中,XL/2 的可训练参数为:
patch 嵌入                         19,584
时间嵌入                        1,624,320
类别嵌入(含 null)              1,153,152
28 × 23,905,152                669,344,256
FinalLayer(含方差输出)         2,693,408
合计                          674,834,720
冻结位置编码另计                  294,912
近似主矩阵账本中,逐 token 线性项是 114.152177664 G,注意力两次乘法为 4.227858432 G,完整简化账本 118.646194176 G。所有 12 个配置与论文 Gflops 的偏差小于 1%,但这只是计数模型接近论文,不是测出了相同 GPU 延迟。参数数目则与官方类的真实注册参数精确相等。
手写自动微分不能在零输出头下检验主干:那样主干梯度全为零,错误的反向也可能“通过”。本次修正 gradcheck_report,在中心差分前把输出头设为非零,真正让 LayerNorm、注意力、MLP 和条件路径接到梯度。另把同一套 NumPy block 权重复制给固定官方 DiTBlock 与 timm Attention/Mlp,打开非零调制,比较输出、输入/条件及全部五组线性层的权重和偏置梯度;float64 的最大误差见第 09 节。官方完整小模型还验证了第 3.5 节的分阶段梯度路径。
对照官方 固定提交的 models.py,提交为 ed81ce2(完整提交链接可点开核查)。本文实际执行原始 AST 类与方法,依赖选用 timm v0.6.12 的原始 Attention/Mlp/PatchEmbed;官方 environment.yml 并未固定 timm 版本。两项简单辅助函数提供等价的 tuple 转换和断言,未改写这些类的数学实现。使用 PyTorch 2.10 CPU,未声称复现原 JAX/TPU 训练或 GPU 性能。
modulate 就是那个 $1+\gamma$。 源码原样:
def modulate(x, shift, scale):
    return x * (1 + scale.unsqueeze(1)) + shift.unsqueeze(1)
每个 block 内用一层 SiLU + Linear,一次算 6 段再 chunk;不同 block 的调制器不共享权重。 不是给六个分支各配一个线性层:
self.adaLN_modulation = nn.Sequential(nn.SiLU(), nn.Linear(hidden_size, 6 * hidden_size, bias=True))
# 上面这个 Sequential 的输出一次是 6d 维,再切成六段
shift_msa, scale_msa, gate_msa, shift_mlp, scale_mlp, gate_mlp = self.adaLN_modulation(c).chunk(6, dim=1)
初始化分三步,顺序不能乱。 先 xavier_uniform_ 初始化所有 Linear,再把每个 block 的调制层整体置零,最后把 FinalLayer 的调制层和输出线性层置零:
self.apply(_basic_init)                             # 1. 全模型 xavier_uniform
for block in self.blocks:                           # 2. 每个 block 的 adaLN 调制层归零
    nn.init.constant_(block.adaLN_modulation[-1].weight, 0)
    nn.init.constant_(block.adaLN_modulation[-1].bias, 0)
nn.init.constant_(self.final_layer.adaLN_modulation[-1].weight, 0)   # 3. 输出层归零
nn.init.constant_(self.final_layer.adaLN_modulation[-1].bias, 0)
nn.init.constant_(self.final_layer.linear.weight, 0)
nn.init.constant_(self.final_layer.linear.bias, 0)
注意第 2 步是整层置零,不是只置零 gate 那两段——这就是 3.4 节说的「一次拿到 $\gamma=0$(有效缩放为 1)、$\beta=0, \alpha=0$ 三件事」。
与最小实现的差异,以及为什么:
| 差异 | 源码里的做法 | 为什么 |
|---|---|---|
| 位置编码 | 2D sin-cos,requires_grad=False 冻结 |
沿用 MAE 风格;冻结的是位置 Parameter,仍占存储,不能由此推得所有任务质量或外推优势 |
| 时间步编码 | 256 维正弦 → Linear → SiLU → Linear | 原始 DiT 采用该频率嵌入,不是所有扩散模型的唯一选择;toy 使用归一化时间且 t_freq=32 |
| 类别嵌入 | nn.Embedding(1000 + 1, d),多一个位置 |
多出来的那一行是 CFG 的 null token,token_drop 把标签换成它 |
| 输出通道 | learn_sigma=True 时输出 $2 \times 4 = 8$ 通道 |
一半预测噪声、一半预测方差(可学习的 $\Sigma_\theta$),采样时用后者做各时间步的方差 |
| CFG 的作用范围 | forward_with_cfg 只把引导作用在前 3 个通道 |
该固定代码注释说明这是为了精确复现做的选择,常规做法是引导所有噪声预测通道,而不是把学习方差通道也一起外推;这是复现 DiT 数值时最容易踩的坑之一 |
| 激活函数 | nn.GELU(approximate="tanh") |
固定代码采用此近似;本文不以它推出跨硬件速度或 FID 不变的保证 |
还有一个容易被忽略的点:unpatchify 用的是 torch.einsum('nhwpqc->nchpwq', x),不是简单的 reshape。它要把 token 里的 $p \times p \times C$ 重新摆回空间位置,通道维要提到最前面。
整条前向的调用顺序(DiT.forward)值得记住,因为后面拆视频版 DiT 时这几步会变成瓶颈点:
x = self.x_embedder(x) + self.pos_embed   # 1. patchify + 位置
t = self.t_embedder(t)                                   # 2. 时间步 → 256 → d
y = self.y_embedder(y, self.training)                    # 3. 类别 → d(training 时才做 label dropout)
c = t + y                                                # 4. 两个条件相加,不是拼接
for block in self.blocks: x = block(x, c)                # 5. N 个 block,条件从 c 进来
x = self.final_layer(x, c)                               # 6. 也是调制出来的 shift/scale
x = self.unpatchify(x)                                   # 7. 回到空间形状
第 4 步相加后 c 仍为 d 维,每个 block 的调制参数沿 token 广播;这是条件注入的形式约束,不是对含位置编码和注意力的整个网络表达能力给出绝对上界。
分类器无关引导(CFG)是在 forward 外面拼的。 forward_with_cfg 复制输入 batch 的前半份为两份,但不会替调用者改标签。调用者需传入偶数 batch、成对一致的时间步,以及前半条件标签、后半 null 标签,最后再合成:
half = x[: len(x) // 2]
combined = torch.cat([half, half], dim=0)          # 前半、后半的条件由调用者传入的 y 决定
model_out = self.forward(combined, t, y)
eps, rest = model_out[:, :3], model_out[:, 3:]
cond_eps, uncond_eps = torch.split(eps, len(eps) // 2, dim=0)
half_eps = uncond_eps + cfg_scale * (cond_eps - uncond_eps)
eps = torch.cat([half_eps, half_eps], dim=0)
return torch.cat([eps, rest], dim=1) # 其余通道原样保留这里有两个复现时必须知道的细节:其一,引导公式用无条件分支做基准(uncond + w·(cond − uncond)),不是把有条件分支当基准;其二,eps, rest 的拆分把引导限制在前 3 个通道,返回时仍拼回其余通道(含方差),该固定代码注释说这是为了精确复现而做的选择,常规做法是引导所有噪声预测通道,而不是把学习方差通道也一起外推。照着论文数值复现时如果忘了这一条,采样协议会改变;本文没有测出这个修改会令 FID 改变多少。
learn_sigma 是输出通道翻倍的原因。 当它为真时 out_channels = 2 * in_channels,网络一半预测噪声 $\varepsilon$、另一半预测 learned-range 的方差插值参数,经同提交扩散代码映射为对数方差。该映射不自动将插值参数裁到 [-1,1],网络超出该区间时也可能发生外插。采样时前者进 DDPM/DDIM 的更新公式,后者可用于学习方差的 DDPM 更新;DDIM 的随机方差由其调度与 η 决定,通常不使用该头。这也是为什么 DiT 的输出头看起来比「预测噪声」该有的形状大一号。
代价一:$O(T^2)$ 迟早会来找你。 T=256 时注意力只占 3.6%,那是 256×256 图像。512×512 的 DiT-XL/2 有 T=1024,一次前向 524.6 Gflops(是 256 分辨率的 4.4 倍);再往视频走,时间维一加,token 数轻易上万。长视频常采用序列并行、稀疏/窗口或时空分解等方案,但不是由该公式得出的唯一必选实现。T 远小于 6d 只说明 MAC 主项中线性层更大,不能据此保证注意力不是实际瓶颈。
代价二:adaLN 对所有 token 施加同一个函数。 论文原话:adaLN 是四种方案里唯一「被限制成对所有 token 应用同一个函数」的。$\beta, \gamma, \alpha$ 是 d 维向量,在整个序列上广播,没有空间维度。所以凡是条件本身带空间结构的任务——局部编辑、inpainting 的 mask、逐区域控制——单靠一个广播的全局调制向量不便保留空间对应关系,通常还需空间输入、条件 token 或 cross-attention;不能据此断言整体网络表达不了局部任务。SD3 的 MM-DiT 为图像和文本保留不同权重并做联合注意力;它给出另一种条件交互设计,本文不将其历史动机归因于单一原因。
代价三:patch size 减半,主要 token 算力约四倍起,参数仅小幅变化。 这是好事也是陷阱:在论文所测配置中,小模型 + 小 patch 可获得接近某些大模型的 FID(01 节);不保证任意模型可互换;坏消息是部署成本还取决于硬件、batch、访存和采样步数;Gflops 是其中一项,论文前向 Gflops 约相差 17 倍,参数取整相同;这不是测得 17 倍延迟,部署时容易误判。
代价四:丢掉了 UNet 的多尺度归纳偏置。 UNet 的下采样-上采样结构天然假设「图像有局部性、有尺度层次」,这个先验在小数据集上是白送的。原始 DiT 用平铺 token 网格和全局注意力,也有 patch 结构和固定位置编码;不能说完全没有空间归纳偏置。论文的结论主要来自 ImageNet 规模;它没有给出这里所说“几万张图”场景的普遍收敛比较,因此小数据集需另做受控验证。
代价五:初始化决定最初的梯度路径。 独立 block 实验验证门控阻断分支梯度;完整模型还需先打开零输出头。不能据此指定“前几步只有门在动”的固定持续时间,或无依据地推荐给调制器更大学习率。
论文中的 ADM 1983 Gflops 与 DiT-XL/2 118.64 Gflops 是像素空间 UNet 与潜空间 Transformer 的跨系统比较,分辨率、表示和训练预算都不同。它说明整套 DiT 系统有竞争力,不能把约 16.7 倍单次前向差全归因于更换骨干,也不包含完整采样步数与 VAE 成本。
| 论文 | 原文 | 在本文中的作用 |
|---|---|---|
| ADM | 2105.05233 | UNet 扩散与引导的强基线;跨像素/潜空间预算不能全归因于骨干 |
| LDM | 2112.10752 | 在压缩潜空间训练扩散,为 DiT 的 32×32×4 输入提供表示基础 |
| U-ViT | 2209.12152 | 探索带长跳连的 ViT 扩散骨干,将时间和条件作为 token;整体结构不等于 DiT 的 in-context 变体 |
| DiT | 2212.09748 | 在指定 ImageNet 配置网格研究深度、宽度、patch 和条件注入,adaLN-Zero 在所测对照中较优 |
| PixArt-α | 2310.00426 | 结合文本 cross-attention 与时间调制;文中训练预算比较绑定其数据与训练方案 |
| SD3 | 2403.03206 | 用图文不同权重的 MM-DiT 和 rectified flow,不能等同于只改原始类别嵌入 |
| Latte | 2401.03048 | 探索视频潜空间 Transformer 的四种时空建模设计,不代表所有视频骨干都采用同一结构 |
这条阅读线把潜空间表示、Transformer 骨干、文本交互与时间建模分开理解:ADM/LDM 提供扩散与潜空间背景,U-ViT/DiT 探索骨干,PixArt-α/SD3 研究文本交互,Latte 研究视频。它是按问题组织的阅读顺序,不是所有后继工作的一条单向继承史。可以从固定 DiT 代码确认时间/类别调制与恒等残差这套设计;不能把“后继几乎都沿用零初始化”当成已逐模型验证的事实。
误解一:adaLN-Zero 只是把 scale 零初始化。 实现把整个调制线性层置零;调制输出 scale=0,而有效缩放为 1。残差恒等主要由 gate=0 保证,单独关门已经足够。
误解二:注意力 MAC 比例小,就不会成为瓶颈。 XL/2、T=256 的两类主矩阵 MAC 中注意力约占 3.57%,但实际耗时取决于算子效率与访存;显式注意力矩阵存储仍是二次项。长视频的 T 可远大于图像,不能把几百 token 的结论泛化。$T=6d$ 只是两类 MAC 主项相等的点。
误解三:patch size 只影响 token 数,是个「免费的」结构选择。 参数量只是近似不变(DiT-S 三档取整都是 33M),对算力一点也不免费(0.36 → 1.41 → 6.06 G,17 倍)。论文里那句「changing $p$ has no meaningful impact on downstream parameter counts」说的是参数,别顺手读成「没有代价」。
误解四:Gflops、GMAC 和实测速度可以互换。 论文预算数值接近按一次乘加计 1 的主要矩阵账本。若按乘、加各计一次,主矩阵 FLOPs 约是 MAC 的两倍;逐元素函数仍需自己的计数规则。本文明确给出近似项和遗漏,不把接近 118.64 写成逐 FLOP 复现,更不从预算直接推出硬件速度。
误解五:零初始化让整个模型不能训练。 零输出头仍能先收到非零梯度;随后 gate 和主干逐步接到信号。独立 block 的梯度实验不能替代完整 DiT 首次反传的检查。
误解六:DiT 就是「把 UNet 换成 ViT」,拿一个标准 ViT 直接接上就行。 差的不是一点:DiT 没有 [CLS] token、没有分类头、位置编码是冻结的 2D sin-cos(这是原始实现的选择,不能由此保证所有任务中都优于可学习编码);最关键的是它的 block 不是标准 ViT block——多了一条 adaLN 调制支路和两个门,FinalLayer 也是「调制 + 线性」而不是「LN + 线性」。把 torchvision 里的 ViT 拿来改,能跑起来,但那不是 DiT,也复现不出 19.47 的 FID。
附录保留六个完整脚本,其中 dit_core.py、tiny_grad.py 是公共件,另四个是实验入口。只需 NumPy、matplotlib;主体脚本与绘图实跑环境是 Windows、Python 3.11.9、NumPy 2.4.3、matplotlib 3.10.7;官方 CPU 参考使用已有局部运行依赖,确切版本见实跑证据。进程内 OpenBLAS/OMP 各 1 线程。官方参考另用 PyTorch 2.10.0+cpu,不安装系统包,不将 CPU 结果外推为 GPU、TPU 性能。
python dit_flops.py:打印 patchify 与逆变换的真实形状、可训练参数和近似 MAC;预期 XL/2 为 674,834,720 可训练参数、约 118.646 G 简化预算。冻结位置编码另计 294,912,12 配置与官方注册参数精确一致。python adaln_zero.py:真实执行 d=1152、T=256 的单块/28 层前向和独立 block 梯度,恒等误差为 0。非零输出头下中心差分检查实际激活的主干梯度,最大相对误差 1.110e-03(分母下限 1e-8;近零梯度的相对值受消减误差放大)。另以三步长独立检查 702 个参数探点,步长 1e-6 时最大绝对差为 3.217e-10,步长从 1e-4 降低时的误差收敛与独立官方对照支持反向实现;同权重官方 block 的 float64 前向最大差 2.220e-16,输入/条件/所有参数梯度最大差 1.388e-17。python cond_ablation.py:快速档为 150 步、1 seed,只检查这套小实验的训练行为。python cond_ablation.py --full --rerun 强制重跑 800 步 × 3 seed × 4 方案;正常 --full 仅在源码哈希、NumPy、seed、batch、depth 与完整元数据均一致时复用缓存。学习率从 0.003 按 0.25**(step/steps) 衰减,batch=32,训练时间均匀取 [0.05,0.95],用余弦加噪。完整档耗时随机器而异,以本机运行证据为准。python make_figures.py:生成四张原图;图 3 使用完整档缓存,若缺失则触发完整训练。图 1/4 的 FID 来自原论文,不是本机测得;图 2/3 的数值是本文实跑。想验证零 gate 的边界,可在 adaln_zero.py 中分别换随机 c、给 shift/scale 非零值但保持两个 gate=0,有限分支下仍为恒等。反例是分支出现 NaN 或无穷时,浮点的零乘它并不保证有限输出。再把输出头随机打开后做梯度检查,便能避免“全零梯度让错误反向看似正确”的假通过。
直接后继:自回归视频生成、跨步缓存复用。本篇不改变这些节点。
09 节用到的脚本全文如下(dit_flops.py、adaln_zero.py、cond_ablation.py、dit_core.py、tiny_grad.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
# -*- coding: utf-8 -*-
"""DiT 账本(一):patchify 的形状、参数量与 Gflops,逐项对账。

DiT 这篇论文最反直觉的一点是:**它把「模型大小」和「一次前向的算力」拆开了**。
改 patch size p 几乎不动参数量,却能让 Gflops 翻四倍;改 hidden size d
不动 token 数,参数量与逐 token 线性 MAC 都近似按 d² 增长。

这个脚本做三件事:
  1. 真的做一次 patchify,打印每一步的形状(不是嘴上说 T=(I/p)^2);
  2. 按 DiT 的实际结构逐项数参数,与论文 Table 4 的 Params(M) 对账;
  3. 用同一套结构数 Gflops,与论文 Table 4 的 Flops(G) 对账。

计数说明:主要矩阵乘法按一次乘加记 1 的 MAC 口径;另含简化逐元素项。
该预算接近论文 Gflops,未完整计数 LN/softmax/非线性,不是逐 FLOP 或延迟复现。
"""

import numpy as np

# ─────────────── 论文 Table 1 的四档配置:(深度 N, hidden d, 头数) ───────────────
DIT_CONFIGS = {
    "S":  (12, 384, 6),
    "B":  (12, 768, 12),
    "L":  (24, 1024, 16),
    "XL": (28, 1152, 16),
}

# 论文 Table 4 的真实数字,用来对账:(Gflops, 参数量 M, FID-50K 无引导)
PAPER_TABLE4_256 = {
    ("S", 8): (0.36, 33, 153.60), ("S", 4): (1.41, 33, 100.41), ("S", 2): (6.06, 33, 68.40),
    ("B", 8): (1.42, 131, 122.74), ("B", 4): (5.56, 130, 68.38), ("B", 2): (23.01, 130, 43.47),
    ("L", 8): (5.01, 459, 118.87), ("L", 4): (19.70, 458, 45.64), ("L", 2): (80.71, 458, 23.33),
    ("XL", 8): (7.39, 676, 106.41), ("XL", 4): (29.05, 675, 43.01), ("XL", 2): (118.64, 675, 19.47),
}

# 四种条件注入在 DiT-XL/2 上的对照:论文 Table 4 的四种 block 在 400K 步时的行
PAPER_BLOCK_DESIGN = {
    # 名字: (Gflops, Params M, FID)
    "in-context":     (119.37, 449, 35.24),
    "cross-attention": (137.62, 598, 26.14),
    "adaLN":          (118.56, 600, 25.21),
    "adaLN-Zero":     (118.64, 675, 19.47),
}


# ─────────────── 1. patchify:真的做一遍 ───────────────
def patchify(z, p):
    """z: [B, I, I, C] -> [B, (I/p)^2, p*p*C]。

    把 I×I 切成 (I/p)×(I/p) 个格子,每个格子里的 p*p*C 个数直接摊平成
    一个 token 的原始特征。论文里这一步是一个 nn.Linear(p*p*C, d)。
    """
    B, I, _, C = z.shape
    assert I % p == 0, f"I={I} 必须被 p={p} 整除"
    g = I // p
    z = z.reshape(B, g, p, g, p, C)
    z = z.transpose(0, 1, 3, 2, 4, 5)       # [B, g, g, p, p, C]
    return z.reshape(B, g * g, p * p * C)


def unpatchify(x, p, I, C):
    """patchify 的逆:[B, T, p*p*C] -> [B, I, I, C]。"""
    B = x.shape[0]
    g = I // p
    x = x.reshape(B, g, g, p, p, C)
    x = x.transpose(0, 1, 3, 2, 4, 5)       # [B, g, p, g, p, C]
    return x.reshape(B, I, I, C)


# ─────────────── 2. 参数账本 ───────────────
def count_params(cfg="XL", p=2, C=4, n_classes=1000, t_freq=256,
                 I=32, learn_sigma=True, class_dropout=True, include_frozen=False):
    """固定官方 DiT 参数;默认统计可训练参数,冻结位置编码另计。"""
    N, d, _ = DIT_CONFIGS[cfg]
    out_C = 2 * C if learn_sigma else C
    items = {"patch 嵌入": p*p*C*d+d,
             "时间嵌入": t_freq*d+d+d*d+d,
             "类别嵌入(含 null 行)": (n_classes+int(class_dropout))*d}
    # 两个 LN 均 elementwise_affine=False,不含任何可训练 scale/bias。
    per_block = 18*d*d + 15*d
    items[f"{N} 个 block × {per_block:,}"] = N*per_block
    items["FinalLayer(含方差输出)"] = 2*d*d+2*d+d*p*p*out_C+p*p*out_C
    if include_frozen:
        items["冻结 2D 位置编码"] = (I//p)**2*d
    return sum(items.values()), items, per_block


# ─────────────── 3. 近似 MAC 账本(不等同实际 FLOP 或延迟)───────────────
def count_gflops(cfg="XL", p=2, I=32, C=4, t_freq=256, learn_sigma=True):
    """一次前向(batch=1)的主要矩阵 MAC + 简化逐元素计数;非完整 profiler。"""
    N, d, _ = DIT_CONFIGS[cfg]
    T = (I // p) ** 2
    # 每个 block:qkv 3d²、attn 分数 T²d、attn 加权 T²d、out d²、mlp 8d²
    # 调制层对整条样本只算一次(6d²),逐 token 的 γ/β/α 逐元素乘加记 3Td
    per_block_token = 12 * d * d                 # 3(qkv) + 1(out) + 8(mlp)
    per_block_attn = 2 * T * d                   # 摊到每个 token 上是 2*T*d
    per_block_elem = 3 * d                       # γ⊙h、+β、α⊙Δ
    block_macs = T * (per_block_token + per_block_attn + per_block_elem) + 6 * d * d
    patch_macs = T * (p * p * C) * d             # patchify 的线性嵌入
    final_macs = T * d * (p * p * C * (2 if learn_sigma else 1)) + 2 * d * d
    cond_macs = t_freq * d + d * d               # t 嵌入 MLP,算一次
    total = N * block_macs + patch_macs + final_macs + cond_macs
    return total / 1e9, {
        "T": T,
        "block 内逐 token 线性(12d²)": N * T * per_block_token / 1e9,
        "block 内注意力(2T²d)": N * T * per_block_attn / 1e9,
        "调制与逐元素(3Td + 6d²)": N * (T * per_block_elem + 6 * d * d) / 1e9,
        "patchify + FinalLayer": (patch_macs + final_macs) / 1e9,
        "t 嵌入": cond_macs / 1e9,
    }


def scaling_ledger():
    """把 12 个模型的解析账本与论文数字并排打印。"""
    rows = []
    for cfg in ["S", "B", "L", "XL"]:
        for p in [8, 4, 2]:
            g, _ = count_gflops(cfg, p)
            tot, _, _ = count_params(cfg, p)
            pg, pm, fid = PAPER_TABLE4_256[(cfg, p)]
            rows.append((f"DiT-{cfg}/{p}", DIT_CONFIGS[cfg][0], DIT_CONFIGS[cfg][1],
                         (32 // p) ** 2, g, pg, tot / 1e6, pm, fid))
    return rows


def main():
    rng = np.random.default_rng(0)

    print("=" * 78)
    print("1. patchify 的真实形状(256×256 图像 → 32×32×4 潜变量,batch=2)")
    print("=" * 78)
    z = rng.standard_normal((2, 32, 32, 4))
    print(f"  输入潜变量 z: {z.shape}")
    for p in [8, 4, 2]:
        x = patchify(z, p)
        back = unpatchify(x, p, 32, 4)
        ok = np.abs(back - z).max()
        print(f"  p={p}: patchify -> {x.shape}"
              f"   (T={(32//p)**2}, 每个 token 原始维度 {p*p*4})"
              f"    逆变换最大误差 {ok:.2e}")

    print()
    print("=" * 78)
    print("2. 参数账本(DiT-XL/2 逐项)")
    print("=" * 78)
    tot, items, per_block = count_params("XL", 2)
    for k, v in items.items():
        print(f"  {k:<34s} {v:>14,d}  ({v/tot*100:5.1f}%)")
    print(f"  {'合计':<34s} {tot:>14,d}  = {tot/1e6:.1f} M"
          f"   (论文 Table 4: 675 M)")

    print()
    print("=" * 78)
    print("3. Gflops 账本(DiT-XL/2,按 MAC 记)")
    print("=" * 78)
    g, parts = count_gflops("XL", 2)
    for k, v in parts.items():
        if k == "T":
            print(f"  token 数 T                              {v:>10d}")
        else:
            print(f"  {k:<38s} {v:>10.2f} G  ({v/g*100:5.1f}%)")
    print(f"  {'合计':<38s} {g:>10.2f} G   (论文 Table 4: 118.64 G)")

    print()
    print("=" * 78)
    print("4. 12 个模型:解析账本 vs 论文数字")
    print("=" * 78)
    hdr = f"{'模型':<12s}{'N':>4s}{'d':>6s}{'T':>6s}{'Gflops算':>10s}{'Gflops论文':>11s}{'差':>8s}{'M算':>8s}{'M论文':>7s}{'FID':>8s}"
    print(hdr)
    for name, N, d, T, g, pg, m, pm, fid in scaling_ledger():
        print(f"{name:<12s}{N:>4d}{d:>6d}{T:>6d}{g:>10.2f}{pg:>11.2f}{(g-pg)/pg*100:>7.1f}%"
              f"{m:>8.1f}{pm:>7d}{fid:>8.2f}")

    print()
    print("=" * 78)
    print("5. 同算力下:把预算花在 token 上还是花在宽度/深度上?")
    print("=" * 78)
    print("  取自论文 Table 4,挑 Gflops 接近的组:")
    for tag, keys in [("~5-6 G", [("S", 2), ("B", 4), ("L", 8)]),
                      ("~20-29 G", [("B", 2), ("L", 4), ("XL", 4)]),
                      ("~80-119 G", [("L", 2), ("XL", 2)])]:
        print(f"  {tag}:")
        for k in keys:
            pg, pm, fid = PAPER_TABLE4_256[k]
            print(f"    DiT-{k[0]}/{k[1]}: {pg:6.2f} G  {pm:4d} M  FID {fid:6.2f}")


if __name__ == "__main__":
main()# -*- coding: utf-8 -*-
"""DiT 账本(二):adaLN-Zero 的初始化到底做了什么,逐个数出来。
adaLN-Zero 通常被一句话带过——「把每个 block 初始化成恒等函数」。
这句话里有三个可以量出来的事实,本脚本一个一个验:
A. 恒等是真的恒等:out - x 的最大绝对误差是 0.0,不是「很小」。
B. 门控关着的时候,block 里除门控之外的参数梯度**精确为 0**;
连 shift/scale 那两段的梯度也是 0——只有 gate 那两段有梯度。
这是独立 block 接非零上游梯度的实验;完整零输出头模型第一步先更新输出头。
C. 不零初始化会怎样:block 在初始化时给残差流叠上一层随机扰动,
28 层叠下来 std 会漂。零初始化则一层都不漂。
D. 输出层也零初始化:模型第一天的预测是全 0,初始 loss 就是噪声的
二阶矩,可以被事先算出来,而不是一个随机的数。
另有一个 gradcheck,用中心差分核对手写 autograd,正文里报的最大相对误差来自它。
"""
import numpy as np
import tiny_grad as tg
from dit_core import DiTBlock, MicroDiT, COND_MODES
D_BIG = 1152 # DiT-XL 的 hidden size
T_BIG = 256 # 32×32 潜变量、p=2 时的 token 数
DEPTH = 28 # DiT-XL 的深度
def _fresh_block(mode, seed=0, d=D_BIG, n_heads=16):
rng = np.random.default_rng(seed)
return DiTBlock(d, n_heads, rng, mode=mode)
# ─────────────── A + C:恒等性与深度漂移 ───────────────
def identity_and_drift(depth=DEPTH, seed=0, d=D_BIG, T=T_BIG, n_heads=16):
rng = np.random.default_rng(seed)
x0 = rng.standard_normal((1, T, d))
c = rng.standard_normal((1, d))
out = {}
for mode in ("adaln_zero", "adaln"):
x = tg.leaf(x0.copy())
drift = []
for i in range(depth):
blk = _fresh_block(mode, seed=seed + i, d=d, n_heads=n_heads)
x = blk(x, tg.leaf(c), [])
tg.reset()
drift.append(float(np.std(x.v - x0)))
out[mode] = {
"identity_err": float(np.abs(x.v - x0).max()),
"drift": drift,
"std_ratio": [float(np.std(x.v) / np.std(x0))],
}
# 单块的恒等性单独再报一次(28 层叠完还是 0 才说明真的恒等)
blk = _fresh_block("adaln_zero", seed=3, d=d, n_heads=n_heads)
tg.reset()
y = blk(tg.leaf(x0.copy()), tg.leaf(c), [])
out["adaln_zero"]["single_block_err"] = float(np.abs(y.v - x0).max())
blk = _fresh_block("adaln", seed=3, d=d, n_heads=n_heads)
tg.reset()
y = blk(tg.leaf(x0.copy()), tg.leaf(c), [])
out["adaln"]["single_block_err"] = float(np.abs(y.v - x0).max())
out["adaln"]["single_block_rel"] = float(np.std(y.v - x0) / np.std(x0))
tg.reset()
return out
# ─────────────── B:初始化那一刻的梯度结构 ───────────────
def grad_at_init(mode="adaln_zero", seed=0, d=D_BIG, T=T_BIG, n_heads=16):
rng = np.random.default_rng(seed)
x0 = rng.standard_normal((1, T, d))
c = rng.standard_normal((1, d))
w = rng.standard_normal((1, T, d)) # 线性损失 L = mean(out*w)
blk = _fresh_block(mode, seed=seed, d=d, n_heads=n_heads)
store = []
tg.reset()
out = blk(tg.leaf(x0), tg.leaf(c), store, ctx=None)
loss = tg.mean_all(tg.mul(out, tg.leaf(w)))
tg.backward(loss)
names = {
"W_qkv": blk.w_qkv.W, "W_o": blk.w_o.W, "W_1": blk.w_1.W, "W_2": blk.w_2.W,
}
res = {}
for k, arr in names.items():
node = [n for n in store if n.v is arr]
res[k] = float(np.abs(node[0].g).max()) if node else 0.0
# 调制层按 6 段(或 4 段)拆开看:哪几段真的拿到了梯度
mod_node = [n for n in store if n.v is blk.w_mod.W][0]
g = mod_node.g # [d, n_mod*d]
n_mod = 6 if mode == "adaln_zero" else 4
cols = [float(np.abs(g[:, i * d:(i + 1) * d]).max()) for i in range(n_mod)]
res["mod_chunks"] = cols
res["mod_name"] = (["shift_msa", "scale_msa", "gate_msa",
"shift_mlp", "scale_mlp", "gate_mlp"] if n_mod == 6
else ["shift_msa", "scale_msa", "shift_mlp", "scale_mlp"])
tg.reset()
return res
# ─────────────── D:初始 loss 是不是可预测的 ───────────────
def init_loss(mode="adaln_zero", seed=0, B=32):
rng = np.random.default_rng(seed)
m = MicroDiT(mode=mode, seed=seed)
z = rng.standard_normal((B, m.T, 8))
t = rng.uniform(0.05, 0.95, B)
y = rng.integers(0, m.n_classes, B)
oh = np.zeros((B, m.n_classes))
oh[np.arange(B), y] = 1.0
eps = rng.standard_normal((B, m.T, 8))
store = []
tg.reset()
pred = m.forward(z, t, oh, store)
mse_zero = float(((pred.v - eps) ** 2).mean())
pmax_zero = float(np.abs(pred.v).max())
# 把输出层换成正常 xavier 初始化再测一次
lim = np.sqrt(6.0 / (m.d + 8))
m.w_out.W = rng.uniform(-lim, lim, m.w_out.W.shape)
store = []
tg.reset()
pred = m.forward(z, t, oh, store)
mse_rand = float(((pred.v - eps) ** 2).mean())
pmax_rand = float(np.abs(pred.v).max())
tg.reset()
return float((eps ** 2).mean()), mse_zero, mse_rand, pmax_zero, pmax_rand
# ─────────────── autograd 自检 ───────────────
def gradcheck_report(seed=0):
"""手写 autograd 对不对:拿中心差分逐个参数核。
adaln_zero 初始化下大部分参数梯度恒为 0(B 节已证),核不出东西,
所以核 adaln 与 cross_attn 两种结构——它们把所有算子都走到了。
"""
rng = np.random.default_rng(seed + 7)
z = rng.standard_normal((4, 16, 8))
t = rng.uniform(0.05, 0.95, 4)
oh = np.zeros((4, 8))
oh[np.arange(4), rng.integers(0, 8, 4)] = 1.0
tgt = rng.standard_normal((4, 16, 8))
worst = 0.0
for mode in ("adaln", "cross_attn", "in_context"):
mm = MicroDiT(d=32, n_heads=4, depth=2, mode=mode, seed=seed)
# 必须打开输出头,否则上游全为零,无法检验主干的反向。
mm.w_out.W[:] = rng.normal(0, 0.1, mm.w_out.W.shape)
def build(mm=mm):
s = []
p = mm.forward(z, t, oh, s)
diff = tg.sub(p, tg.leaf(tgt))
return tg.mean_all(tg.mul(diff, diff)), s
tg.reset()
worst = max(worst, tg.gradcheck(build, seed=seed))
return worst
def main():
print("=" * 78)
print("A. 恒等性:DiT-XL 配置(d=1152, 16 头, T=256)")
print("=" * 78)
r = identity_and_drift()
for mode in ("adaln_zero", "adaln"):
d = r[mode]
print(f" {mode:<12s} 单块 |out - x| 最大值 = {d['single_block_err']:.3e}")
if mode == "adaln":
print(f" {'':<12s} 单块相对扰动 std(out-x)/std(x) = {d['single_block_rel']:.4f}")
print(f" {'':<12s} 叠 {DEPTH} 层后 |out - x| 最大值 = {d['identity_err']:.3e}")
dr = d["drift"]
pick = [0, 6, 13, 20, 27]
print(f" {'':<12s} 残差流漂移 std(x_k - x_0):"
+ " ".join(f"k={k+1}:{dr[k]:.4f}" for k in pick))
print()
print("=" * 78)
print("B. 初始化那一刻,block 里谁拿到了梯度(L = mean(out*w),w 固定随机)")
print("=" * 78)
for mode in ("adaln_zero", "adaln"):
g = grad_at_init(mode)
nz = [g[k] for k in ("W_qkv", "W_o", "W_1", "W_2")]
print(f" {mode:<12s} 主干参数 |grad|max: "
+ " ".join(f"{k}={v:.3e}" for k, v in zip(("W_qkv", "W_o", "W_1", "W_2"), nz)))
print(f" {'':<12s} 调制层各段 |grad|max: "
+ " ".join(f"{n}={v:.3e}" for n, v in zip(g["mod_name"], g["mod_chunks"])))
print()
print("=" * 78)
print("D. 初始 loss 能不能事先算出来(FinalLayer 零初始化 vs 正常初始化)")
print("=" * 78)
e2, mse_z, mse_r, pz, pr = init_loss()
print(f" 样本噪声平方均值 mean(eps^2) = {e2:.4f} <- 理论上就是初始 loss")
print(f" 零初始化输出层,实测初始 MSE = {mse_z:.4f}")
print(f" 零初始化时模型输出的最大绝对值 = {pz:.3e} (就是全 0)")
print(f" 正常初始化输出层,实测初始 MSE = {mse_r:.4f} <- 高出 {mse_r/mse_z:.2f} 倍")
print(f" 正常初始化时模型输出的最大绝对值 = {pr:.3e}")
print()
print("=" * 78)
print("自检:非零输出头下 autograd vs 中心差分(三种非门控结构)")
print("=" * 78)
print(f" 最大相对误差 = {gradcheck_report():.2e}")
if __name__ == "__main__":
main()# -*- coding: utf-8 -*-
"""四种条件注入的 NumPy toy 对照;不是 ImageNet FID 复现。
8 个固定条纹模板,8×8×2 潜变量,p=2、T=16、d=64、4 头、6 层。
各方案共享采样流和训练超参数,结构、参数数目与初始化不同。
默认150步×1seed;--full为800步×3seed,--rerun强制重算,实际耗时依机器。
源码哈希及完整元数据一致时才复用缓存;同时评估256个新加噪样本。
"""
import json
import hashlib
import tempfile
import os
import sys
import numpy as np
import tiny_grad as tg
from dit_core import (MicroDiT, Adam, COND_MODES, make_patterns, patchify_imgs,
alpha_bar_cosine)
SIDE, P, C = 8, 2, 2
PATCH_DIM = P * P * C # 8
T = (SIDE // P) ** 2 # 16
K = 8 # 类别数
DEPTH = 6
HERE = os.path.dirname(os.path.abspath(__file__))
NODE_DIR = os.path.dirname(HERE)
# 完整档的参数(文章里的数字就是这一组)
STEPS_FULL, SEEDS_FULL = 800, (0, 1, 2)
# 快速档:只为「脚本能跑通」而存在(体检会真的执行每个脚本),
# 结果同样会缓存,不会覆盖完整档。
STEPS_QUICK, SEEDS_QUICK = 150, (0,)
def _cache_path(steps, seeds):
return os.path.join(NODE_DIR, "_cache",
f"cond_results_s{steps}_n{len(seeds)}.json")
CACHE = _cache_path(STEPS_FULL, SEEDS_FULL)
def sample_batch(rng, pats, B):
"""采一批 (z_t, t, y_onehot, eps)。"""
y = rng.integers(0, K, B)
x0 = pats[y] # [B,8,8,2]
eps = rng.standard_normal((B, SIDE, SIDE, C))
t = rng.uniform(0.05, 0.95, B)
ab = alpha_bar_cosine(t)[:, None, None, None]
z = np.sqrt(ab) * x0 + np.sqrt(1.0 - ab) * eps
oh = np.zeros((B, K))
oh[np.arange(B), y] = 1.0
return patchify_imgs(z, P), t, oh, patchify_imgs(eps, P)
def make_model(mode, seed, depth=DEPTH):
return MicroDiT(d=64, n_heads=4, depth=depth, n_classes=K, patch_dim=PATCH_DIM,
T=T, mode=mode, seed=seed, out_dim=PATCH_DIM)
def train_one(mode, seed=0, steps=800, batch=32, lr=3e-3, log_every=50, depth=DEPTH):
rng = np.random.default_rng(seed)
pats = make_patterns(SIDE, C, K)
m = make_model(mode, seed, depth)
opt = Adam(m.arrays())
curve, gnorms, losses = [], [], []
for s in range(1, steps + 1):
z, t, oh, eps = sample_batch(rng, pats, batch)
store = []
tg.reset()
pred = m.forward(z, t, oh, store)
diff = tg.sub(pred, tg.leaf(eps))
loss = tg.mean_all(tg.mul(diff, diff))
tg.backward(loss)
gn = opt.step(store, lr * (0.25 ** (s / steps)), s)
losses.append(float(loss.v))
gnorms.append(gn)
if s % log_every == 0:
curve.append([s, float(np.mean(losses[-log_every:]))])
# 新噪声/时间采样;同 seed 各方案使用相同 256 个评估样本。
eval_rng = np.random.default_rng(10000 + seed)
vals = []
for _ in range(8):
z,t,oh,eps = sample_batch(eval_rng,pats,32)
tg.reset()
pred = m.forward(z,t,oh,[])
vals.append(float(np.mean((pred.v-eps)**2)))
tg.reset()
return {
"evaluation_mse": float(np.mean(vals)), "evaluation_examples": 256,
"mode": mode, "curve": curve, "final": float(np.mean(losses[-200:])),
"grad1": gnorms[0], "grad10": float(np.mean(gnorms[:10])),
"gradmax": float(np.max(gnorms)),
"params": int(sum(a.size for a in m.arrays())),
}
def _meta(steps,seeds,batch,depth):
names = ["cond_ablation.py","dit_core.py","tiny_grad.py"]
return dict(steps=steps,seeds=list(seeds),batch=batch,depth=depth,
code_sha256={n:hashlib.sha256(open(os.path.join(HERE,n),"rb").read()).hexdigest() for n in names},
numpy=np.__version__,schema=2,lr=3e-3,evaluation_examples=256)
def _write_cache(data, path=CACHE):
"""原子保存,防止中断留下半份 JSON。"""
os.makedirs(os.path.dirname(path), exist_ok=True)
fd,tmp=tempfile.mkstemp(dir=os.path.dirname(path),suffix=".tmp")
try:
with os.fdopen(fd,"w",encoding="utf8") as stream:
json.dump(data,stream,ensure_ascii=False,indent=1)
stream.flush();os.fsync(stream.fileno())
os.replace(tmp,path)
finally:
if os.path.exists(tmp):os.unlink(tmp)
def run_all(seeds=(0, 1, 2), steps=800, batch=32, depth=DEPTH, resume=True):
"""跑四种条件注入的对照。resume=True 时复用缓存里已经跑完的模式。"""
cache = _cache_path(steps, seeds)
out = {}
if resume and os.path.exists(cache):
try:
with open(cache, encoding="utf-8") as f:
old = json.load(f)
if old.get("_meta") == _meta(steps,seeds,batch,depth):
out = {k: v for k, v in old.items() if not k.startswith("_")}
if "_sweep" in old:
out["_sweep"] = old["_sweep"]
except Exception:
out = {}
for mode in COND_MODES:
if mode in out:
print(f" [skip] {mode}(缓存里已有,跳过)", file=sys.stdout)
continue
rs = [train_one(mode, seed=sd, steps=steps, batch=batch, depth=depth)
for sd in seeds]
fin = [r["final"] for r in rs]
out[mode] = {
"final_mean": float(np.mean(fin)),
"final_std": float(np.std(fin)),
"finals": fin,
"evaluation_mses": [r["evaluation_mse"] for r in rs],
"evaluation_mean": float(np.mean([r["evaluation_mse"] for r in rs])),
"evaluation_std": float(np.std([r["evaluation_mse"] for r in rs])),
"curve": rs[0]["curve"],
"grad1": rs[0]["grad1"],
"grad10": rs[0]["grad10"],
"gradmax": rs[0]["gradmax"],
"params": rs[0]["params"],
}
out["_meta"] = _meta(steps,seeds,batch,depth)
_write_cache(out, cache)
print(f" [done] {mode}", file=sys.stdout)
out["_meta"] = _meta(steps,seeds,batch,depth)
return out
def sweep_depth(modes=("adaln_zero", "adaln"), depths=(2, 4, 6, 8, 10),
steps=400, seed=0, batch=32):
"""深度变化时,两种 adaLN 的差距怎么变。"""
res = {}
for mode in modes:
row = []
for dep in depths:
rng = np.random.default_rng(seed)
pats = make_patterns(SIDE, C, K)
m = make_model(mode, seed, dep)
opt = Adam(m.arrays())
losses = []
for s in range(1, steps + 1):
z, t, oh, eps = sample_batch(rng, pats, batch)
store = []
tg.reset()
pred = m.forward(z, t, oh, store)
diff = tg.sub(pred, tg.leaf(eps))
loss = tg.mean_all(tg.mul(diff, diff))
tg.backward(loss)
opt.step(store, 3e-3 * (0.25 ** (s / steps)), s)
losses.append(float(loss.v))
row.append([dep, float(np.mean(losses[-200:]))])
print(f" [done] {mode} depth={dep}", file=sys.stdout)
res[mode] = row
return res
def load_or_run(seeds=SEEDS_FULL, steps=STEPS_FULL, batch=32, depth=DEPTH,
sweep=False):
"""缓存优先(完整档)。sweep=True 时才额外跑深度扫描(很慢,默认不跑)。"""
cache = _cache_path(steps, seeds)
data = None
if os.path.exists(cache):
try:
with open(cache, encoding="utf-8") as f:
data = json.load(f)
except Exception:
data = None
if data and data.get("_meta") == _meta(steps,seeds,batch,depth) \
and all(m in data for m in COND_MODES):
if sweep and "_sweep" not in data:
data["_sweep"] = sweep_depth(steps=steps // 2, batch=batch)
_write_cache(data, cache)
return data
data = run_all(seeds=seeds, steps=steps, batch=batch, depth=depth)
if sweep:
data["_sweep"] = sweep_depth(steps=steps // 2, batch=batch)
_write_cache(data, cache)
return data
def _show(res, steps, n_seeds):
print(f"{'mode':<14s}{'参数量':>10s}{'最终 loss(均值±std)':>24s}"
f"{'首步梯度范数':>14s}{'峰值梯度':>12s}")
for mode in COND_MODES:
r = res[mode]
print(f"{mode:<14s}{r['params']:>10d}"
f"{r['final_mean']:>16.4f} ± {r['final_std']:<7.4f}"
f"{r['grad1']:>14.3e}{r['gradmax']:>12.3e}")
print()
print(f" loss 曲线(seed=0,{steps} 步,每 {max(1, steps // 20)} 步取一次均值):")
for mode in COND_MODES:
c = res[mode]["curve"]
picks = [c[i] for i in range(0, len(c), max(1, len(c) // 6))]
print(f" {mode:<14s} " + " ".join(f"{s}:{v:.4f}" for s, v in picks))
if n_seeds > 1:
print()
print(" 每个 seed 的最终 loss(看排序稳不稳):")
for mode in COND_MODES:
print(f" {mode:<14s} "
+ " ".join(f"{v:.4f}" for v in res[mode]["finals"]))
if res.get("_sweep"):
print()
print("=" * 78)
print("深度扫描:两种 adaLN 在不同深度下的最终 loss")
print("=" * 78)
for mode, row in res["_sweep"].items():
print(f" {mode:<12s} " + " ".join(f"d={d}:{v:.4f}" for d, v in row))
if __name__ == "__main__":
full = "--full" in sys.argv
steps, seeds = (STEPS_FULL, SEEDS_FULL) if full else (STEPS_QUICK, SEEDS_QUICK)
tag = "完整档" if full else "快速档"
print("=" * 78)
print(f"四种条件注入在 toy 任务上的训练对照({tag}:{steps} 步 × "
f"{len(seeds)} 个 seed)")
print("=" * 78)
res = (run_all(seeds=seeds,steps=steps,resume=False) if "--rerun" in sys.argv
else load_or_run(seeds=seeds, steps=steps, sweep="--sweep" in sys.argv))
_write_cache(res,_cache_path(steps,seeds))
_show(res, steps, len(seeds))
if not full:
print()
print(f" 想复现文章里的那组数字:python cond_ablation.py --full"
f"({STEPS_FULL} 步 × {len(SEEDS_FULL)} 个 seed,约十分钟)")# -*- coding: utf-8 -*-
"""DiT 的最小可运行复刻(numpy):一个 block、四种条件注入方式、一个 toy 训练集。
教学结构参考 facebookresearch/DiT;不复现完整方差头、CFG、VAE 或训练配方。models.py:
modulate(x, shift, scale) = x * (1 + scale) + shift
block: x = x + gate_msa * attn(modulate(norm1(x), shift_msa, scale_msa))
x = x + gate_mlp * mlp(modulate(norm2(x), shift_mlp, scale_mlp))
初始化采用同类规则(随机数消费顺序与官方不同)::所有 Linear 走 xavier_uniform,然后把每个 block 的 adaLN 调制层
(SiLU → Linear(d, 6d))的 weight 与 bias 整个置零;FinalLayer 的调制层与输出
线性层同样置零。
四种条件注入(对应论文 Figure 3 与 Table 4 末尾四行):
adaln_zero : adaLN-Zero,调制层零初始化
adaln : 无门控、四段调制,调制层用 xavier 初始化(vanilla adaLN 教学版)
in_context : t 与 y 当作两个额外 token 塞进序列,标准 ViT block
cross_attn : 标准 ViT block + 一层对条件向量的 cross-attention
"""
import numpy as np
import tiny_grad as tg
COND_MODES = ("adaln_zero", "adaln", "in_context", "cross_attn")
# ─────────────── 线性层 ───────────────
class Linear:
def __init__(self, fan_in, fan_out, rng, zero=False, std=None):
if zero:
self.W = np.zeros((fan_in, fan_out))
elif std is not None:
self.W = rng.normal(0.0, std, (fan_in, fan_out))
else:
lim = np.sqrt(6.0 / (fan_in + fan_out)) # xavier_uniform
self.W = rng.uniform(-lim, lim, (fan_in, fan_out))
self.b = np.zeros(fan_out)
def __call__(self, x, store=None):
Wn = tg.leaf(self.W)
bn = tg.leaf(self.b)
if store is not None:
store.append(Wn)
store.append(bn)
return tg.add(tg.matmul(x, Wn), bn)
def _to_heads(a, B, T, n_heads, dh):
return tg.transpose(tg.reshape(a, (B, T, n_heads, dh)), 0, 2, 1, 3)
def _attend(q, k, v, scale):
s = tg.scale(tg.matmul(q, tg.transpose(k, 0, 1, 3, 2)), scale)
return tg.matmul(tg.softmax(s, axis=-1), v)
def mh_self_attention(x, n_heads, w_qkv, w_o, store):
B, T, d = x.v.shape
dh = d // n_heads
q, k, v = tg.chunk_last(w_qkv(x, store), 3)
q = _to_heads(q, B, T, n_heads, dh)
k = _to_heads(k, B, T, n_heads, dh)
v = _to_heads(v, B, T, n_heads, dh)
y = _attend(q, k, v, 1.0 / np.sqrt(dh)) # [B,H,T,dh]
y = tg.reshape(tg.transpose(y, 0, 2, 1, 3), (B, T, d))
return w_o(y, store)
def mh_cross_attention(x, ctx, n_heads, w_q, w_kv, w_o, store):
B, T, d = x.v.shape
Tc = ctx.v.shape[1]
dh = d // n_heads
q = w_q(x, store)
k, v = tg.chunk_last(w_kv(ctx, store), 2)
q = _to_heads(q, B, T, n_heads, dh)
k = _to_heads(k, B, Tc, n_heads, dh)
v = _to_heads(v, B, Tc, n_heads, dh)
y = _attend(q, k, v, 1.0 / np.sqrt(dh))
y = tg.reshape(tg.transpose(y, 0, 2, 1, 3), (B, T, d))
return w_o(y, store)
# ─────────────── DiT block ───────────────
class DiTBlock:
def __init__(self, d, n_heads, rng, mode="adaln_zero", mlp_ratio=4):
assert mode in COND_MODES, mode
assert d % n_heads == 0
self.mode = mode
self.d = d
self.n_heads = n_heads
self.w_qkv = Linear(d, 3 * d, rng)
self.w_o = Linear(d, d, rng)
hid = int(d * mlp_ratio)
self.w_1 = Linear(d, hid, rng)
self.w_2 = Linear(hid, d, rng)
if mode == "cross_attn":
self.w_cq = Linear(d, d, rng)
self.w_ckv = Linear(d, 2 * d, rng)
self.w_co = Linear(d, d, rng)
if mode == "adaln_zero":
self.w_mod = Linear(d, 6 * d, rng, zero=True)
elif mode == "adaln":
self.w_mod = Linear(d, 4 * d, rng)
else:
# 标准 ViT block:LayerNorm 带仿射参数,初始化成 γ=1、β=0
self.ln1_g, self.ln1_b = np.ones(d), np.zeros(d)
self.ln2_g, self.ln2_b = np.ones(d), np.zeros(d)
self.ln3_g, self.ln3_b = np.ones(d), np.zeros(d)
def _modulate(self, h, shift, scale):
"""DiT 源码的 modulate: x * (1 + scale) + shift,展平成 [B,1,d] 再广播。"""
sh = tg.reshape(shift, (shift.v.shape[0], 1, -1))
sc = tg.reshape(scale, (scale.v.shape[0], 1, -1))
return tg.add(tg.add(h, tg.mul(h, sc)), sh)
def _vi_norm(self, x, g, b, store):
gn, bn = tg.leaf(g), tg.leaf(b)
store.append(gn)
store.append(bn)
return tg.add(tg.mul(tg.layernorm(x), gn), bn)
def __call__(self, x, c, store, ctx=None):
B, T, d = x.v.shape
if self.mode == "adaln_zero":
sh_a, sc_a, gate_a, sh_m, sc_m, gate_m = tg.chunk_last(
self.w_mod(tg.silu(c), store), 6)
h = self._modulate(tg.layernorm(x), sh_a, sc_a)
a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store)
x = tg.add(x, tg.mul(tg.reshape(gate_a, (B, 1, d)), a))
h2 = self._modulate(tg.layernorm(x), sh_m, sc_m)
u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store)
return tg.add(x, tg.mul(tg.reshape(gate_m, (B, 1, d)), u))
if self.mode == "adaln":
sh_a, sc_a, sh_m, sc_m = tg.chunk_last(self.w_mod(tg.silu(c), store), 4)
h = self._modulate(tg.layernorm(x), sh_a, sc_a)
a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store)
x = tg.add(x, a)
h2 = self._modulate(tg.layernorm(x), sh_m, sc_m)
u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store)
return tg.add(x, u)
# ── 标准 ViT block(in-context / cross-attn)──
h = self._vi_norm(x, self.ln1_g, self.ln1_b, store)
x = tg.add(x, mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store))
if self.mode == "cross_attn":
h2 = self._vi_norm(x, self.ln2_g, self.ln2_b, store)
x = tg.add(x, mh_cross_attention(h2, ctx, self.n_heads,
self.w_cq, self.w_ckv, self.w_co, store))
h3 = self._vi_norm(x, self.ln3_g, self.ln3_b, store)
else:
h3 = self._vi_norm(x, self.ln2_g, self.ln2_b, store)
u = self.w_2(tg.gelu_tanh(self.w_1(h3, store)), store)
return tg.add(x, u)
def arrays(self):
out = [self.w_qkv.W, self.w_qkv.b, self.w_o.W, self.w_o.b,
self.w_1.W, self.w_1.b, self.w_2.W, self.w_2.b]
if self.mode in ("adaln_zero", "adaln"):
out += [self.w_mod.W, self.w_mod.b]
else:
out += [self.ln1_g, self.ln1_b, self.ln2_g, self.ln2_b]
if self.mode == "cross_attn":
out += [self.ln3_g, self.ln3_b,
self.w_cq.W, self.w_cq.b, self.w_ckv.W, self.w_ckv.b,
self.w_co.W, self.w_co.b]
return out
# ─────────────── 位置编码与时间步编码 ───────────────
def sincos_pos_embed(side, d):
"""2D sin-cos 位置编码(DiT 直接抄 MAE 的,固定不可学习)。
两个空间轴各占一半维度:每轴的 d/2 维里再对半分成 sin 与 cos。
"""
assert d % 4 == 0, "d 必须是 4 的倍数才能两轴对半分"
def emb1d(pos, dim):
half = dim // 2
omega = 1.0 / (10000 ** (np.arange(half, dtype=np.float64) / half))
out = np.asarray(pos, dtype=np.float64).reshape(-1, 1) * omega[None]
return np.concatenate([np.sin(out), np.cos(out)], axis=-1)
gy, gx = np.meshgrid(np.arange(side), np.arange(side), indexing="ij")
emb = np.concatenate([emb1d(gy.reshape(-1), d // 2),
emb1d(gx.reshape(-1), d // 2)], axis=-1)
return emb[None, :, :]
def timestep_embedding(t, dim, max_period=10000):
"""DiT 抄 GLIDE 的正弦时间步编码。t: [B] -> [B, dim]。"""
half = dim // 2
freqs = np.exp(-np.log(max_period) * np.arange(half, dtype=np.float64) / half)
args = np.asarray(t, dtype=np.float64)[:, None] * freqs[None]
return np.concatenate([np.cos(args), np.sin(args)], axis=-1)
# ─────────────── 一个能训的小 DiT ───────────────
class MicroDiT:
def __init__(self, d=64, n_heads=4, depth=8, n_classes=8, patch_dim=8,
T=16, t_freq=32, mode="adaln_zero", seed=0, out_dim=8):
rng = np.random.default_rng(seed)
self.mode = mode
self.d, self.T, self.n_classes = d, T, n_classes
self.w_in = Linear(patch_dim, d, rng)
self.pos = sincos_pos_embed(int(round(np.sqrt(T))), d)
self.w_t0 = Linear(t_freq, d, rng, std=0.02)
self.w_t1 = Linear(d, d, rng, std=0.02)
self.y_emb = rng.normal(0.0, 0.02, (n_classes, d))
self.blocks = [DiTBlock(d, n_heads, rng, mode=mode) for _ in range(depth)]
# FinalLayer:adaLN 调制(零初始化)+ 输出线性层(零初始化)
if mode in ("adaln_zero", "adaln"):
self.w_fmod = Linear(d, 2 * d, rng, zero=True)
self.fin_g, self.fin_b = np.ones(d), np.zeros(d)
self.w_out = Linear(d, out_dim, rng, zero=True)
def forward(self, z, t, y_onehot, store):
"""z:[B,T,patch_dim] t:[B] y_onehot:[B,K] -> pred:[B,T,out_dim]"""
B = z.shape[0]
d = self.d
x = tg.add(self.w_in(tg.leaf(z), store), tg.leaf(self.pos))
tf = timestep_embedding(t, self.w_t0.W.shape[0])
tv = self.w_t1(tg.silu(self.w_t0(tg.leaf(tf), store)), store)
ytab = tg.leaf(self.y_emb)
store.append(ytab)
yv = tg.matmul(tg.leaf(y_onehot), ytab)
c = tg.add(tv, yv)
t_tok = tg.reshape(tv, (B, 1, d))
y_tok = tg.reshape(yv, (B, 1, d))
if self.mode == "in_context":
x = tg.concat_tokens(x, tg.concat_tokens(t_tok, y_tok))
ctx = tg.concat_tokens(t_tok, y_tok)
for blk in self.blocks:
x = blk(x, c, store, ctx=ctx)
if self.mode == "in_context":
x = tg.take_tokens(x, self.T)
if self.mode in ("adaln_zero", "adaln"):
sh, sc = tg.chunk_last(self.w_fmod(tg.silu(c), store), 2)
hn = tg.layernorm(x)
h = tg.add(tg.add(hn, tg.mul(hn, tg.reshape(sc, (B, 1, d)))),
tg.reshape(sh, (B, 1, d)))
else:
g, b = tg.leaf(self.fin_g), tg.leaf(self.fin_b)
store.append(g)
store.append(b)
h = tg.add(tg.mul(tg.layernorm(x), g), b)
return self.w_out(h, store)
def arrays(self):
out = [self.w_in.W, self.w_in.b,
self.w_t0.W, self.w_t0.b, self.w_t1.W, self.w_t1.b,
self.y_emb, self.w_out.W, self.w_out.b]
if self.mode in ("adaln_zero", "adaln"):
out += [self.w_fmod.W, self.w_fmod.b]
else:
out += [self.fin_g, self.fin_b]
for blk in self.blocks:
out += blk.arrays()
return out
# ─────────────── Adam ───────────────
class Adam:
def __init__(self, arrays):
self.idx = {id(a): i for i, a in enumerate(arrays)}
self.m = [np.zeros_like(a) for a in arrays]
self.v = [np.zeros_like(a) for a in arrays]
def step(self, nodes, lr, step, b1=0.9, b2=0.999, eps=1e-8):
gnorm = 0.0
for n in nodes:
i = self.idx.get(id(n.v))
if i is None or n.g is None:
continue
g = n.g
gnorm += float((g * g).sum())
self.m[i] = b1 * self.m[i] + (1 - b1) * g
self.v[i] = b2 * self.v[i] + (1 - b2) * g * g
mh = self.m[i] / (1 - b1 ** step)
vh = self.v[i] / (1 - b2 ** step)
n.v -= lr * mh / (np.sqrt(vh) + eps)
return float(np.sqrt(gnorm))
# ─────────────── toy 训练数据:8 个方向的条纹 ───────────────
def make_patterns(side=8, C=2, K=8):
"""K 个不同朝向的二维条纹,当作 K 类「图像」。"""
yy, xx = np.meshgrid(np.arange(side), np.arange(side), indexing="ij")
pats = np.zeros((K, side, side, C))
for k in range(K):
th = k * np.pi / K
phase = 2 * np.pi * 2.0 * (xx * np.cos(th) + yy * np.sin(th)) / side
pats[k, :, :, 0] = np.cos(phase)
pats[k, :, :, 1] = np.sin(phase)
return pats / np.std(pats)
def patchify_imgs(imgs, p):
"""imgs:[B,I,I,C] -> [B,(I/p)^2,p*p*C]"""
B, I, _, C = imgs.shape
g = I // p
z = imgs.reshape(B, g, p, g, p, C).transpose(0, 1, 3, 2, 4, 5)
return z.reshape(B, g * g, p * p * C)
def alpha_bar_cosine(t):
"""余弦 schedule 的 ᾱ_t:t=0 时 1(干净),t=1 时 0(纯噪声)。"""
return np.cos(np.pi * np.asarray(t, dtype=np.float64) / 2.0) ** 2# -*- coding: utf-8 -*-
"""NumPy reverse-mode 自动微分,仅供本文小型实验。
训练使用解析反向;中心差分在非零输出头下检查实际活跃的主干,
近零梯度需同时报告绝对误差和相对误差,不能以旧零输出头检查推断全部反向正确。
"""
import numpy as np
_TAPE = []
class Node:
__slots__ = ("v", "g", "ins", "bwd")
def __init__(self, v, ins=(), bwd=None):
self.v = np.asarray(v, dtype=np.float64)
self.g = None
self.ins = ins
self.bwd = bwd
_TAPE.append(self)
@property
def shape(self):
return self.v.shape
def reset():
_TAPE.clear()
def leaf(v):
return Node(v)
def _unbc(g, shape):
"""把广播出去的梯度还原成 shape(求和 + 去掉被广播的轴)。"""
if g.shape == shape:
return g
while g.ndim > len(shape):
g = g.sum(axis=0)
for ax, s in enumerate(shape):
if s == 1 and g.shape[ax] != 1:
g = g.sum(axis=ax, keepdims=True)
return g.reshape(shape)
def _mk(v, ins, fn):
def bwd(g, a=ins, f=fn):
for node, gv in zip(a, f(g)):
if node.g is None:
node.g = np.zeros_like(node.v)
node.g += _unbc(gv, node.v.shape)
return Node(v, ins, bwd)
def add(a, b):
return _mk(a.v + b.v, (a, b), lambda g: (g, g))
def sub(a, b):
return _mk(a.v - b.v, (a, b), lambda g: (g, -g))
def mul(a, b):
return _mk(a.v * b.v, (a, b), lambda g: (g * b.v, g * a.v))
def neg(a):
return _mk(-a.v, (a,), lambda g: (-g,))
def matmul(a, b):
"""支持 [m,k]@[k,n]、[... ,m,k]@[k,n]、[m,k]@[B,k,n]、[... ,m,k]@[... ,k,n]。"""
av, bv = a.v, b.v
v = av @ bv
def f(g):
# 一律走 BLAS 的 batched matmul:比 einsum 快一个量级
if av.ndim <= 2 and bv.ndim <= 2:
return (g @ bv.T, av.T @ g)
if bv.ndim == 2: # [..., m,k] @ [k,n]
da = g @ bv.T
p = int(np.prod(av.shape[:-2]))
a2 = av.reshape(p, *av.shape[-2:]).swapaxes(-1, -2) # [p,k,m]
g2 = g.reshape(p, *g.shape[-2:]) # [p,m,n]
return (da, (a2 @ g2).sum(axis=0))
if av.ndim == 2: # [m,k] @ [..., k,n]
p = int(np.prod(bv.shape[:-2]))
b2 = bv.reshape(p, *bv.shape[-2:]).swapaxes(-1, -2) # [p,n,k]
g2 = g.reshape(p, *g.shape[-2:]) # [p,m,n]
return ((g2 @ b2).sum(axis=0), av.T @ g)
return (g @ bv.swapaxes(-1, -2), av.swapaxes(-1, -2) @ g)
return _mk(v, (a, b), f)
def transpose(a, *axes):
inv = np.argsort(axes)
return _mk(a.v.transpose(axes), (a,), lambda g: (g.transpose(inv),))
def reshape(a, shape):
return _mk(a.v.reshape(shape), (a,), lambda g: (g.reshape(a.v.shape),))
def scale(a, c):
return _mk(a.v * c, (a,), lambda g: (g * c,))
def chunk_last(a, n):
"""把最后一维等分成 n 份(adaLN 的 6 路调制输出就是这么切的)。"""
k = a.v.shape[-1] // n
out = []
for i in range(n):
v = a.v[..., i * k:(i + 1) * k]
def f(g, i=i, k=k):
full = np.zeros_like(a.v)
full[..., i * k:(i + 1) * k] = g
return (full,)
out.append(_mk(v, (a,), f))
return out
def split3(a):
"""把最后一维等分三份(qkv)。"""
d = a.v.shape[-1] // 3
out = []
for i in range(3):
v = a.v[..., i * d:(i + 1) * d]
def f(g, i=i, d=d):
full = np.zeros_like(a.v)
full[..., i * d:(i + 1) * d] = g
return (full,)
out.append(_mk(v, (a,), f))
return out
def take_tokens(a, n):
"""取前 n 个 token,其余位置梯度补零(in-context 读回图像 token 用)。"""
v = a.v[:, :n, :]
def f(g):
full = np.zeros_like(a.v)
full[:, :n, :] = g
return (full,)
return _mk(v, (a,), f)
def concat_tokens(a, b):
"""沿 token 维拼接(in-context 把条件 token 接在序列末尾)。"""
v = np.concatenate([a.v, b.v], axis=1)
def f(g):
return (g[:, :a.v.shape[1], :], g[:, a.v.shape[1]:, :])
return _mk(v, (a, b), f)
def tanh(a):
t = np.tanh(a.v)
return _mk(t, (a,), lambda g: (g * (1.0 - t * t),))
def sigmoid(a):
s = 1.0 / (1.0 + np.exp(-a.v))
return _mk(s, (a,), lambda g: (g * s * (1.0 - s),))
def silu(a):
s = 1.0 / (1.0 + np.exp(-a.v))
v = a.v * s
return _mk(v, (a,), lambda g: (g * (s + v * (1.0 - s)),))
def gelu_tanh(a):
"""GELU 的 tanh 近似,DiT 源码里用的就是这个(nn.GELU(approximate='tanh'))。"""
k = np.sqrt(2.0 / np.pi)
s = a.v * a.v
inner = k * (a.v + 0.044715 * a.v * s)
t = np.tanh(inner)
v = 0.5 * a.v * (1.0 + t)
dv = 0.5 * (1.0 + t) + 0.5 * a.v * (1.0 - t * t) * k * (1.0 + 0.134145 * s)
return _mk(v, (a,), lambda g: (g * dv,))
def softmax(a, axis=-1):
e = np.exp(a.v - a.v.max(axis=axis, keepdims=True))
p = e / e.sum(axis=axis, keepdims=True)
def f(g):
s = (g * p).sum(axis=axis, keepdims=True)
return (p * (g - s),)
return _mk(p, (a,), f)
def layernorm(a, eps=1e-6):
"""对最后一维做归一化,无仿射参数(DiT 的缩放/平移由 adaLN 给出)。"""
mu = a.v.mean(axis=-1, keepdims=True)
xc = a.v - mu
var = (xc * xc).mean(axis=-1, keepdims=True)
inv = 1.0 / np.sqrt(var + eps)
v = xc * inv
def f(g):
gm = g.mean(axis=-1, keepdims=True)
gv = (g * v).mean(axis=-1, keepdims=True)
return (inv * (g - gm - v * gv),)
return _mk(v, (a,), f)
def mean_all(a):
n = a.v.size
return _mk(a.v.mean(), (a,), lambda g: (np.full(a.v.shape, g / n),))
def backward(loss):
for node in _TAPE:
node.g = np.zeros_like(node.v)
loss.g = np.ones_like(loss.v)
for node in reversed(_TAPE):
if node.bwd is not None:
node.bwd(node.g)
return loss
def gradcheck(build, eps=1e-5, seed=0, n_probe=6):
"""中心差分逐参数核对,返回最大相对误差。
build() 每次调用要返回 (loss Node, 参数 Node 列表)。差分直接扰动 Node 底层
的 ndarray——Node.v 与模型里那块内存是同一块,所以扰动后重新 forward
就能拿到扰动后的 loss。
"""
rng = np.random.default_rng(seed)
worst = 0.0
_, store = build()
for node in store:
flat = node.v.reshape(-1)
idx = rng.choice(flat.size, size=min(n_probe, flat.size), replace=False)
for i in idx:
old = flat[i]
flat[i] = old + eps
reset()
lp = float(build()[0].v)
flat[i] = old - eps
reset()
lm = float(build()[0].v)
flat[i] = old
num = (lp - lm) / (2 * eps)
reset()
loss, s2 = build()
backward(loss)
cur = [n for n in s2 if n.v is node.v]
ana = cur[0].g.reshape(-1)[i] if cur and cur[0].g is not None else 0.0
denom = max(abs(num), abs(ana), 1e-8)
worst = max(worst, abs(num - ana) / denom)
reset()
return worst# -*- coding: utf-8 -*-
"""画配图。数字全部来自同目录的实验脚本,不另算一遍。
运行: python make_figures.py [--only 图名]
"""
import os
import sys
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
sys.path.insert(0, os.path.dirname(os.path.abspath(__file__)))
import dit_flops as F # noqa: E402
import adaln_zero as AZ # noqa: E402
import cond_ablation as CA # noqa: E402
HERE = os.path.dirname(os.path.abspath(__file__))
FIGDIR = os.path.join(os.path.dirname(HERE), "figures")
os.makedirs(FIGDIR, exist_ok=True)
C0 = "#2f4b7c"
C1 = "#d45087"
C2 = "#f0a35e"
C3 = "#4c9f70"
CGREY = "#8a8a8a"
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False
def _save(fig, name):
p = os.path.join(FIGDIR, name)
fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white")
plt.close(fig)
print(f" [ok] {name} ({os.path.getsize(p)} bytes)")
# ─────────────── 图 1:算力账本 ───────────────
def fig_ledger():
fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.8))
# 左:相近 Gflops 的三个配置,FID 并不都相等
ax = axes[0]
marks = {8: "o", 4: "s", 2: "^"}
cols = {8: CGREY, 4: C2, 2: C1}
# 手工微调标号偏移,避免同算力组里三个点叠在一起看不清
offs = {("S", 2): (7, -15), ("B", 4): (1, 9), ("L", 8): (8, 5),
("S", 4): (8, 5), ("B", 8): (8, 5), ("B", 2): (7, -15),
("L", 4): (-4, 10), ("XL", 4): (8, 6), ("L", 2): (8, 5),
("XL", 2): (8, 5), ("S", 8): (8, 5), ("XL", 8): (8, 5)}
for cfg in ["S", "B", "L", "XL"]:
for p in [8, 4, 2]:
g, pm, fid = F.PAPER_TABLE4_256[(cfg, p)]
ax.scatter(g, fid, marker=marks[p], s=95, color=cols[p], zorder=3,
edgecolor="white", linewidth=1.3)
ax.annotate(f"{cfg}/{p}", (g, fid), textcoords="offset points",
xytext=offs[(cfg, p)], fontsize=9, color="#333333",
bbox=dict(boxstyle="round,pad=0.15", fc="white",
ec="none", alpha=0.75))
ax.set_xscale("log")
ax.set_xlim(0.25, 320)
ax.set_ylim(0, 175)
ax.set_xlabel("一次前向的算力 Gflops(对数轴,论文 Table 4)")
ax.set_ylabel("FID-50K(无 CFG,越低越好)")
ax.set_title("论文配置对比:相近 MAC 不保证相同 FID")
ax.grid(alpha=0.25, ls=":")
for tag, keys, col, tx, ty in [
("约 5~6 G", [("S", 2), ("B", 4), ("L", 8)], C3, 1.05, 152),
("约 20~29 G", [("B", 2), ("L", 4), ("XL", 4)], C0, 36, 60)]:
xs = [F.PAPER_TABLE4_256[k][0] for k in keys]
ys = [F.PAPER_TABLE4_256[k][2] for k in keys]
ax.plot(xs, ys, ls="--", lw=1.3, color=col, alpha=0.75, zorder=1)
ax.text(tx, ty, tag, color=col, fontsize=9.5, ha="left",
bbox=dict(boxstyle="round,pad=0.25", fc="white", ec=col,
alpha=0.85, lw=0.8))
ax.annotate("这两个点参数量差 4 倍\n(33M / 130M),FID 几乎重合",
xy=(6.06, 68.40), xytext=(0.42, 26), fontsize=9,
color="#333333", ha="left",
arrowprops=dict(arrowstyle="->", color="#888888", lw=1))
# 右:注意力占多少算力,随 token 数怎么变
ax = axes[1]
Ts = np.array([64, 256, 1024, 4096, 16384])
ds = {"DiT-S (d=384)": 384, "DiT-B (d=768)": 768, "DiT-L (d=1024)": 1024,
"DiT-XL (d=1152)": 1152}
for name, d in ds.items():
lin = 12 * d * d # 每 token 的线性部分(qkv+out+mlp)
attn = 2 * Ts * d # 每 token 摊到的注意力部分
ax.plot(Ts, attn / (lin + attn) * 100, marker="o", lw=2, ms=4,
label=name)
ax.set_xscale("log")
ax.set_ylim(0, 100)
ax.set_xlabel("token 数 T(对数轴)")
ax.set_ylabel("注意力占主矩阵 MAC 的百分比")
ax.set_title("T=256 时注意力只占 3.6%,要到 T 上千才成为大头")
ax.grid(alpha=0.25, ls=":")
ax.legend(fontsize=9, loc="upper left")
ax.axvline(256, color="#cccccc", lw=1.2, ls=":", zorder=0)
ax.annotate("256×256 图像、p=2:3.6%", xy=(256, 3.6), xytext=(330, 8),
fontsize=9, color="#555555")
ax.text(900, 2.5, "同样 T 下,网络越宽(d 越大)注意力占比越低",
fontsize=9, color="#555555")
fig.suptitle("图 1:DiT 的算力账本——矩阵乘加分配与论文配置对比",
fontsize=12)
fig.tight_layout()
_save(fig, "fig1_compute_ledger.png")
# ─────────────── 图 2:初始化恒等 ───────────────
def fig_identity():
r = AZ.identity_and_drift()
drift_zero = r["adaln_zero"]["drift"]
drift_plain = r["adaln"]["drift"]
ks = np.arange(1, len(drift_plain) + 1)
fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.4))
ax = axes[0]
ax.plot(ks, drift_plain, color=C1, lw=2.4, marker="o", ms=3,
label="vanilla adaLN(调制层正常初始化)")
ax.plot(ks, drift_zero, color=C0, lw=2.4, label="adaLN-Zero(调制层零初始化)")
ax.set_xlabel("第 k 个 block 之后")
ax.set_ylabel(r"残差流漂移 std(x_k - x_0)")
ax.set_title("零初始化:叠 28 层,漂移严格是 0")
ax.legend(fontsize=9)
ax.grid(alpha=0.25, ls=":")
ax.annotate(f"第 28 层:{drift_plain[-1]:.2f} vs {drift_zero[-1]:.2f}",
xy=(28, drift_plain[-1]), xytext=(13, 3.4), fontsize=10,
color="#333333",
arrowprops=dict(arrowstyle="->", color="#888888", lw=1))
ax = axes[1]
labels = ["W_qkv", "W_o", "W_1", "W_2", "调制层\nshift/scale 段", "调制层\ngate 段"]
gz = AZ.grad_at_init("adaln_zero")
gp = AZ.grad_at_init("adaln")
def pick(r, kind):
"""按名字取,避免把 vanilla adaLN 的 shift_mlp 误当成 gate。"""
vals = [v for nm, v in zip(r["mod_name"], r["mod_chunks"])
if (("gate" in nm) if kind == "gate"
else ("shift" in nm or "scale" in nm))]
return max(vals) if vals else None
v_zero = [gz["W_qkv"], gz["W_o"], gz["W_1"], gz["W_2"],
pick(gz, "ss"), pick(gz, "gate")]
v_plain = [gp["W_qkv"], gp["W_o"], gp["W_1"], gp["W_2"],
pick(gp, "ss"), pick(gp, "gate")]
# vanilla adaLN 结构里没有 gate:画在最底部,并单独标注
FLOOR = 1e-12
v_plain = [FLOOR if v is None else v for v in v_plain]
v_zero = [FLOOR if v is None else v for v in v_zero]
x = np.arange(len(labels))
w = 0.38
ax.bar(x - w / 2, np.array(v_plain) + FLOOR, w, color=C2, label="vanilla adaLN")
ax.bar(x + w / 2, np.array(v_zero) + FLOOR, w, color=C0, label="adaLN-Zero")
ax.set_yscale("log")
ax.set_xticks(x)
ax.set_xticklabels(labels, fontsize=9)
ax.set_ylabel("初始化时刻的 |grad| 最大值(对数轴)")
ax.set_title("门关着的时候,独立 block:门梯度可非零,主干梯度为零")
ax.legend(fontsize=9)
ax.grid(alpha=0.25, ls=":", axis="y")
ax.annotate("adaLN-Zero 的主干参数梯度精确为 0\n(0 画在 1e-12,否则 log 轴显示不出来)",
xy=(x[0] + w / 2, FLOOR), xytext=(0.35, 1e-9), fontsize=9,
color="#333333")
ax.annotate("vanilla adaLN 结构里\n根本没有 gate 这一项",
xy=(x[-1] - w / 2, FLOOR), xytext=(3.35, 1e-7), fontsize=9,
color="#555555", ha="center",
arrowprops=dict(arrowstyle="->", color="#888888", lw=1))
fig.suptitle("图 2:adaLN-Zero 的初始化——恒等是怎么来的,代价是什么",
fontsize=12)
fig.tight_layout()
_save(fig, "fig2_identity.png")
# ─────────────── 图 3:四种条件注入的 toy 训练对照 ───────────────
def fig_ablation():
res = CA.load_or_run()
fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.6))
cols = {"adaln_zero": C0, "adaln": C2, "in_context": C1, "cross_attn": C3}
names = {"adaln_zero": "adaLN-Zero", "adaln": "vanilla adaLN",
"in_context": "in-context", "cross_attn": "cross-attention"}
ax = axes[0]
for mode in CA.COND_MODES:
c = res[mode]["curve"]
ax.plot([p[0] for p in c], [p[1] for p in c], lw=2.2, color=cols[mode],
label=names[mode])
ax.set_xlabel("训练步数")
ax.set_ylabel("噪声预测 MSE(每 50 步取均值)")
ax.set_title("同一个 toy 任务,四种条件注入的训练曲线")
ax.legend(fontsize=9)
ax.grid(alpha=0.25, ls=":")
ax = axes[1]
x = np.arange(len(CA.COND_MODES))
means = [res[m]["final_mean"] for m in CA.COND_MODES]
stds = [res[m]["final_std"] for m in CA.COND_MODES]
ax.bar(x, means, yerr=stds, capsize=4,
color=[cols[m] for m in CA.COND_MODES], alpha=0.9)
# 把 3 个 seed 的最终 loss 直接点到柱子上:看排序有没有重叠
for i, m in enumerate(CA.COND_MODES):
vals = res[m]["finals"]
ax.scatter([i] * len(vals), vals, s=20, color="white",
edgecolor="#333333", linewidth=0.8, zorder=4)
ax.set_xticks(x)
ax.set_xticklabels([names[m] for m in CA.COND_MODES], fontsize=9)
ax.set_ylabel("最后 200 步的平均 loss(3 个 seed)")
ax.set_title("训练 MSE:三次 seed 的描述性统计")
ax.grid(alpha=0.25, ls=":", axis="y")
top = max(means) + max(stds) * 3
ax.set_ylim(0, top)
for i, (m, s) in enumerate(zip(means, stds)):
ax.text(i, m + s + top * 0.02, f"{m:.4f}", ha="center", fontsize=9,
color="#333333")
ax.annotate("白点 = 每个 seed 单独的结果\n(仅此 toy 配方,不作显著性推断)",
xy=(0, means[0]), xytext=(1.15, top * 0.62), fontsize=9,
color="#333333",
arrowprops=dict(arrowstyle="->", color="#888888", lw=1))
fig.suptitle("图 3:条件注入方式的 toy 对照(6 层 d=64、T=16,800 步 × 3 seed)",
fontsize=12)
fig.tight_layout()
_save(fig, "fig3_cond_ablation.png")
# ─────────────── 图 4:四种 block design 的算力-质量对照 ───────────────
def fig_design():
order = ["in-context", "cross-attention", "adaLN", "adaLN-Zero"]
names = ["in-context", "cross-attention", "vanilla adaLN", "adaLN-Zero"]
g = [F.PAPER_BLOCK_DESIGN[k][0] for k in order]
pm = [F.PAPER_BLOCK_DESIGN[k][1] for k in order]
fid = [F.PAPER_BLOCK_DESIGN[k][2] for k in order]
fig, axes = plt.subplots(1, 3, figsize=(13.2, 4.0))
cols = [C1, C2, CGREY, C0]
for ax, vals, title, ylab, fmt in [
(axes[0], g, "一次前向 Gflops", "Gflops", "{:.1f}"),
(axes[1], pm, "参数量", "M", "{:d}"),
(axes[2], fid, "FID-50K(越低越好)", "FID", "{:.2f}"),
]:
bars = ax.bar(np.arange(4), vals, color=cols, alpha=0.92)
ax.set_xticks(np.arange(4))
ax.set_xticklabels(names, fontsize=8.5, rotation=18)
ax.set_title(title)
ax.set_ylabel(ylab)
ax.grid(alpha=0.25, ls=":", axis="y")
for b, v in zip(bars, vals):
ax.text(b.get_x() + b.get_width() / 2, v, fmt.format(v), ha="center",
va="bottom", fontsize=9, color="#333333")
if title.startswith("FID"):
ax.set_ylim(0, max(vals) * 1.25)
else:
ax.set_ylim(0, max(vals) * 1.22)
fig.suptitle("图 4:DiT-XL/2 骨架下四种 block design(论文 Table 4,400K 步)",
fontsize=12)
fig.tight_layout()
_save(fig, "fig4_block_design.png")
FIGURES = {
"ledger": fig_ledger,
"identity": fig_identity,
"ablation": fig_ablation,
"design": fig_design,
}
if __name__ == "__main__":
only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None
for name, fn in FIGURES.items():
if only and name != only:
continue
print(f"[draw] {name}")
fn()
评论 (0)