今日 AIGC 论文速览
今日共 10 篇 · 视频生成与推理加速 4 篇 · 蒸馏与一步生成 3 篇 · 统一模型与自我反思 1 篇 · 音乐与音频生成 1 篇 · 数据集与评测 1 篇
重点论文标题列表
YuE2 (港科大):先写谱再唱出来,49.3%胜WorldAttention (阿里巴巴达摩院):单卡22帧,内核快14倍PDMD (加州大学圣迭戈分校):一行代码,VBench 涨 1.03GeoShrink (香港科技大学(广州)):两行代码换五倍,PSNR+3.10MGFlow (清华大学):一步打赢四步,FDr 1.45
今日论文速览
1. YuE2:先写谱再唱出来,49.3%胜
YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality | 香港科技大学;M-A-P;HKGAI;Tokenwave.AI;纽约大学;斯坦福大学;MBZUAI;Noiz;ACE Studio | arXiv:2609.33757
关键词 :音乐生成, 符号音乐, 音频生成, 可控创作, 多模态
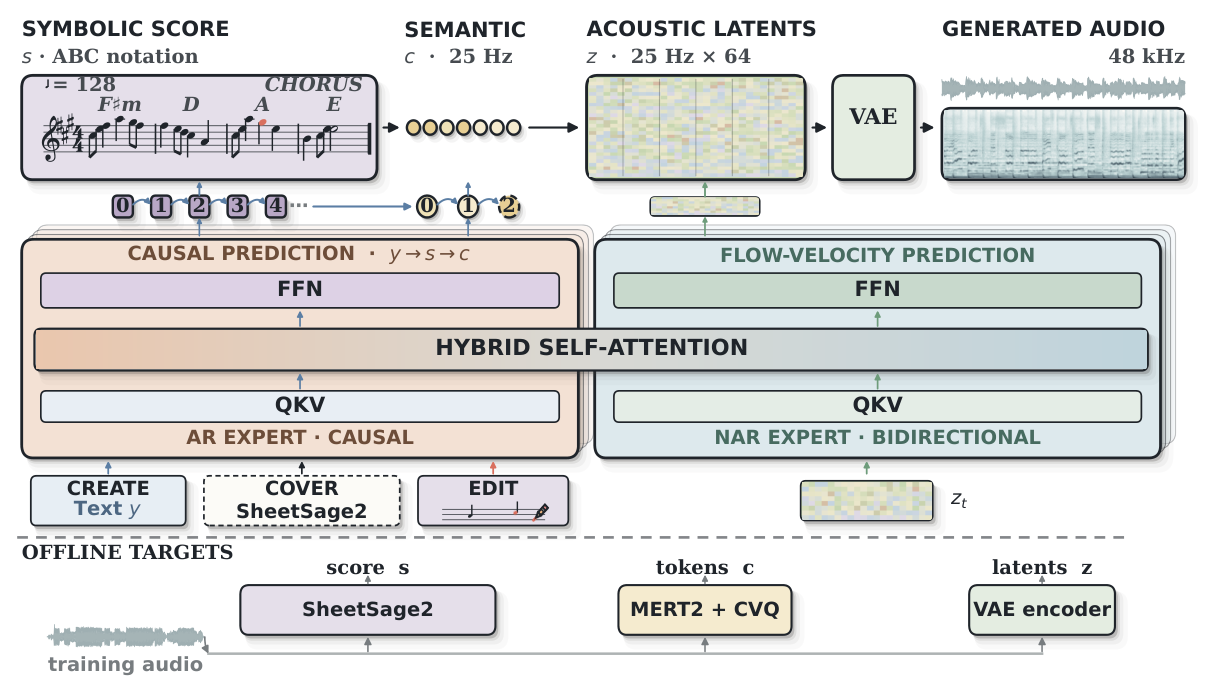
前序问题 :符号音乐模型把旋律、和声、节奏、曲式写得很清楚,但通常停在「谱」这一步,出不了成品录音;音频模型能吐出完整歌曲,作曲过程却完全隐式,用户没法改。真正可用的创作工具要的是「先看懂谱、再决定怎么唱」。更麻烦的是训练数据:现成录音没有对齐的乐谱,符号监督和语义监督双双缺失。本文贡献 :用一个 AR-NAR 混合的 Mixture-of-Transformers 把两件事接成一条链:先写出可读的乐谱(指定旋律与和声),展开成 25 Hz 语义音乐 token,最后落成 25 Hz 连续声学 latent,由 48 kHz 立体声 VAE 解码成整首歌。为从「没有对齐乐谱的录音」里学会这套流程,配套提出 MERT2 提供语义监督、SheetSage2 提供符号监督。由于中间产物是人类可读的乐谱,同一 checkpoint 能跟着谱面编辑改动并保住未改动部分,还能零样本翻唱,外部大模型也可把反馈译成谱面修订,实现 agentic 改曲。
Composing in symbols, performing in audio.
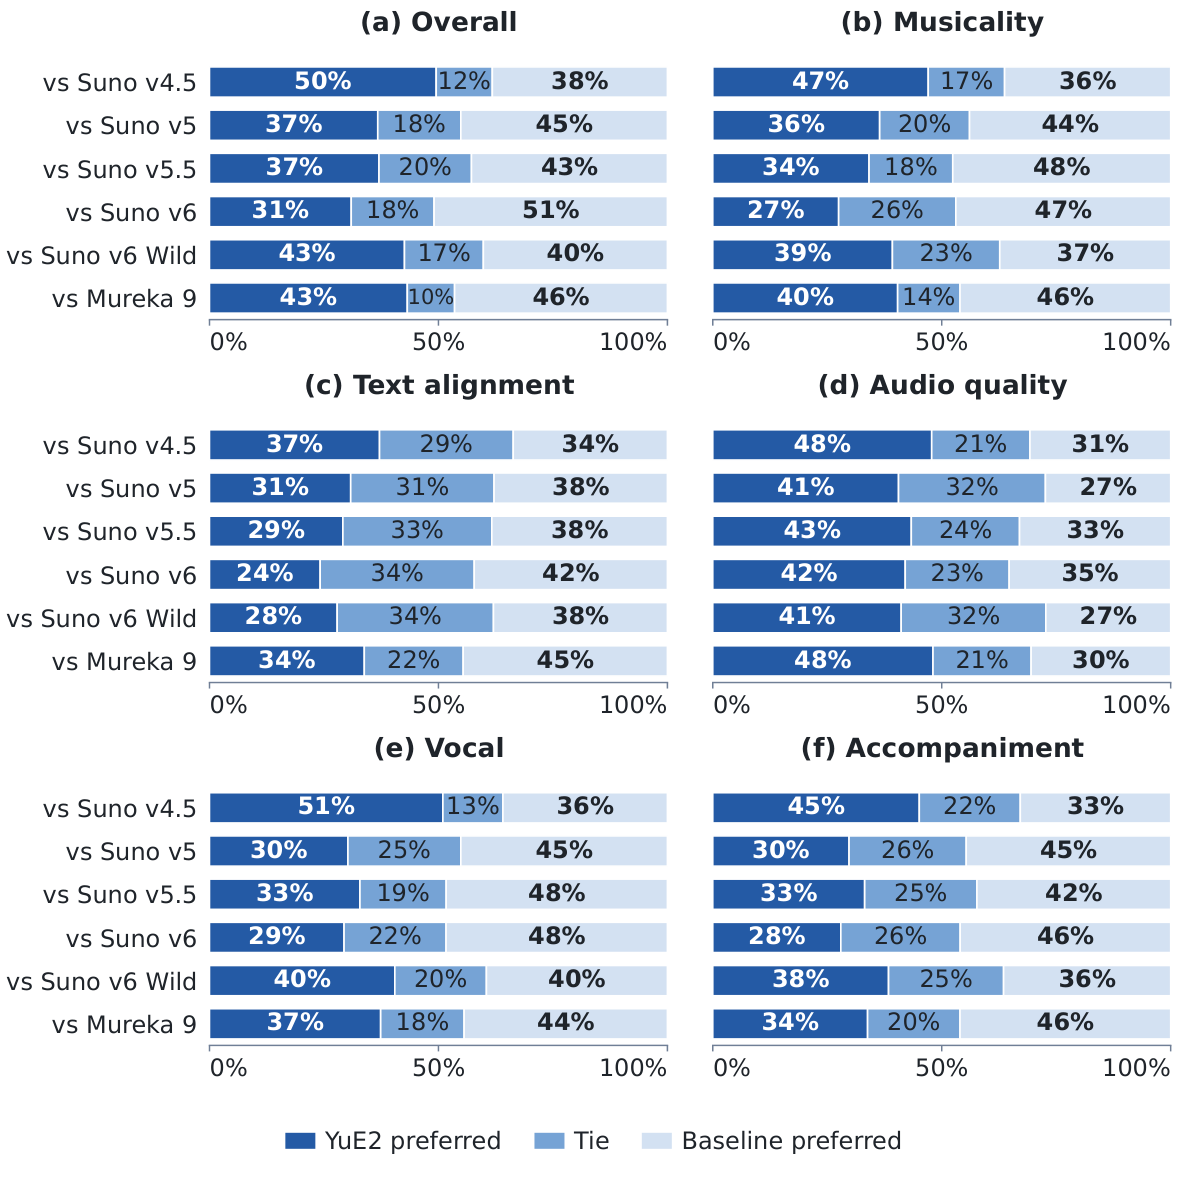
实验效果 :同一 checkpoint 下,专家对「带符号规划」的整体偏好为 49.3%,不规划只有 34.6%。WildSongBench 上 SongBench Global Avg 得 6.73,超过所有受评公开基线;best-of-8 取 6.96,是全部受评系统中的最高均值。专家听测中 best-of-8 优于 Suno v4.5,对 v5 接近持平。MERT2 在 MARBLE 的 15 项指标中 14 项刷新最佳;SheetSage2 在 lead-sheet 转录对比的 15 组指标对中 12 组领先。
Expert preferences for YuE2 versus six proprietary song generators across all six criteria.
批判点评 :49.3% 对 34.6% 看着是压倒性优势,其实只是同一套系统的两种采样策略互相比,净增益不到 15 个百分点。真正硬的对标是 Suno v6:论文自己给的专家偏好里对 v6 的 overall 胜率只有 31.6%、败率 59.3%,是明显劣势——「frontier quality」只在 v4.5 / v5 这一档站得住。另外 best-of-8 的 6.96 需要 8 倍采样成本,56 页技术报告也没有同行评审背书。
2. WorldAttention:单卡22帧,内核快14倍
WorldAttention: An Efficient Attention Architecture for Interactive Video World Models | 阿里巴巴达摩院;浙江大学;香港科技大学;湖畔实验室;阿里巴巴 TRE | arXiv:2609.34606
关键词 :视频世界模型, 稀疏注意力, KV 缓存, 推理加速, 长视频生成
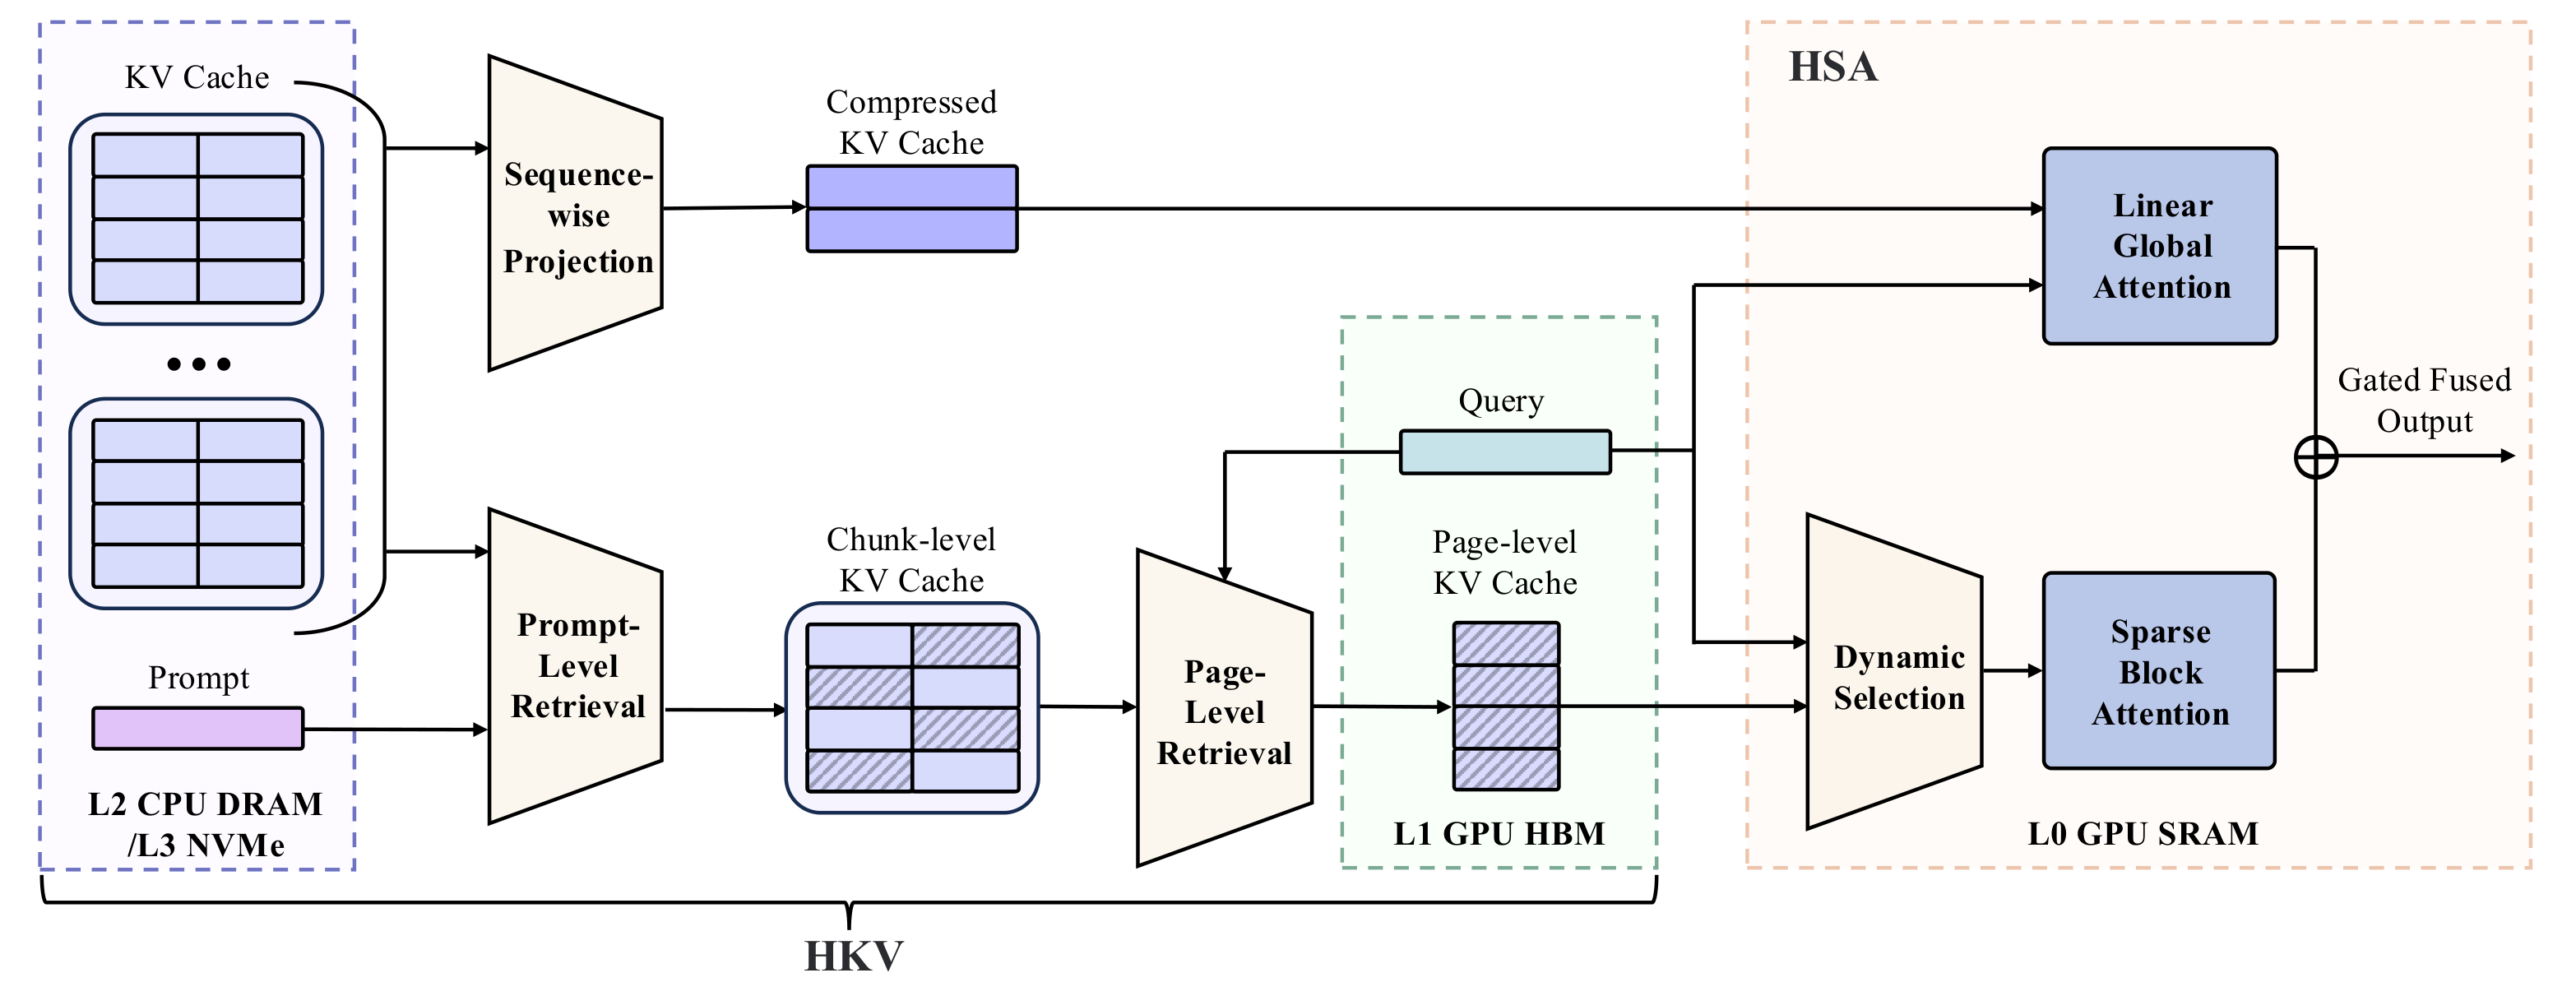
前序问题 :交互式视频世界模型要按文本指令持续生成长时间、时间连贯的视频。滑动窗口能把计算量封住,代价是历史上下文被直接砍掉,长程交互能力塌掉;而保留全历史 KV 缓存在计算和显存上都不可行——注意力的二次复杂度让开销爆掉,KV 缓存的线性增长迟早把显存吃满。两条路都不通,问题落在「既要长历史,又要低延迟」上。本文贡献 :提出系统级协同设计的注意力架构,两手一起改:一是 Hybrid Sparse Attention(HSA),把线性全局注意力和头自适应稀疏注意力并在双分支里,按注意力头动态决定稀疏度;二是 Hierarchical KV Cache(HKV),把历史 KV 组织成跨多层存储的语义索引页,先做 prompt 级检索再做 page 级检索,粗到细地把需要的页取回并控制 GPU 驻留量。两项设计都配了定制 kernel,把理论上的效率真正落到硬件上。
Overall architecture of WorldAttention.
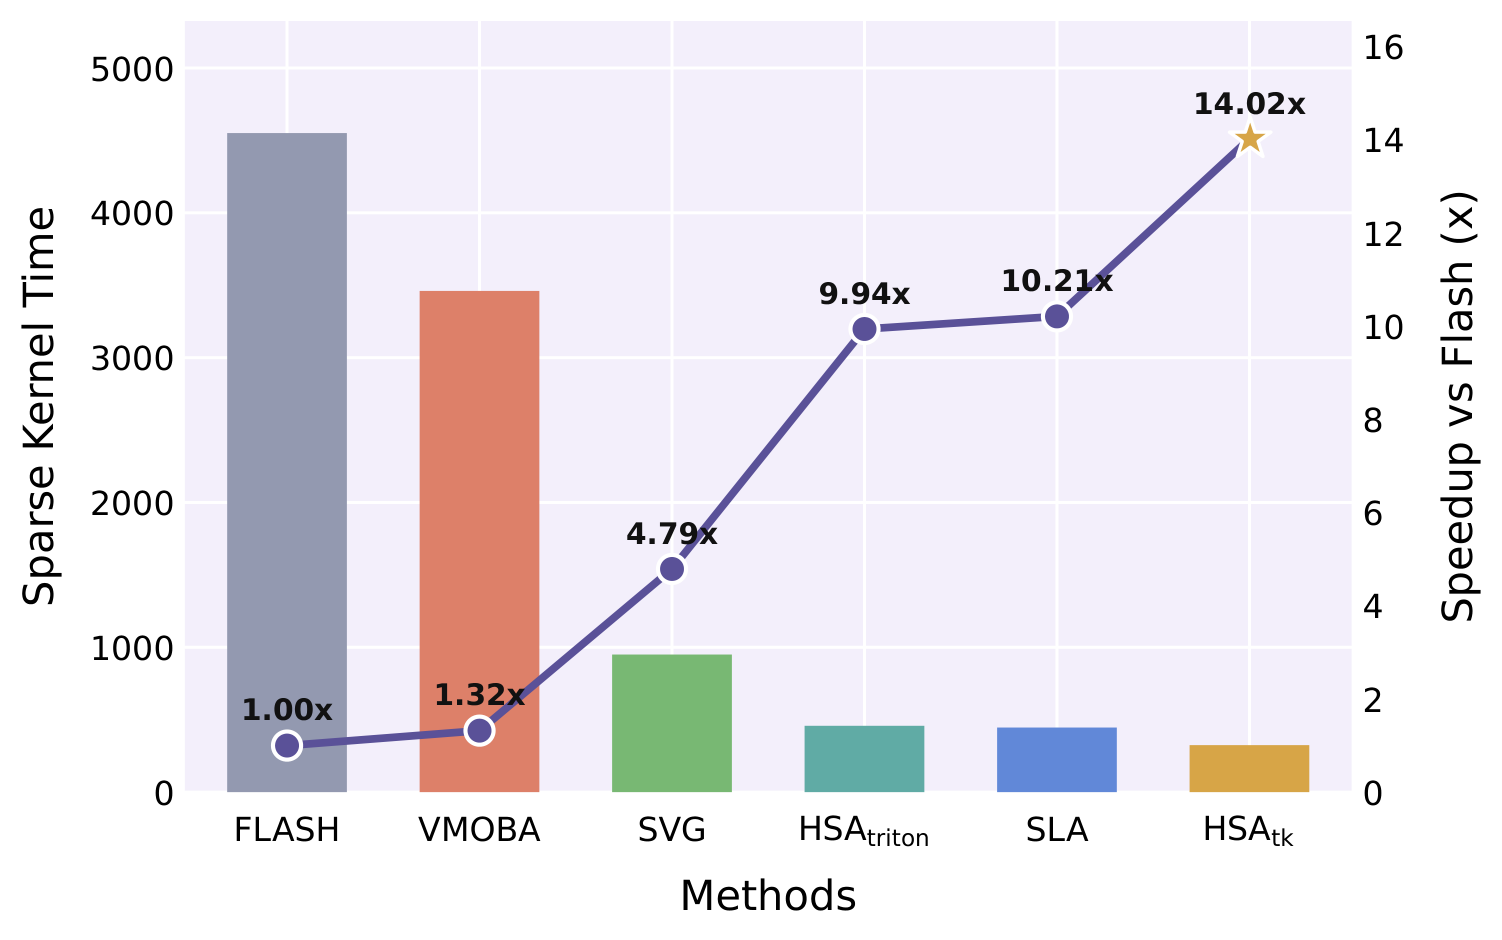
实验效果 :定制 kernel 相对 FlashAttention-3 带来 14.02 倍 kernel 级加速,叠加 HKV 后端到端加速 2.21 倍;单张 NVIDIA H100 上维持 22.0 FPS。VBench-Long 上质量得分 86.55 且吞吐最快,主体一致性 0.9472;InterVBench 上主体一致性 0.9668。B200 上跨模型规模与分辨率的端到端加速为 2.06 到 2.46 倍。
Attention kernel speedup.
批判点评 :14.02 倍是 attention kernel 这一层的数字,端到端只剩 2.21 倍,落差本身就是论文的自我交代:HSA 单次执行 633 微秒里,稀疏 block 注意力 kernel 只占 11.78 微秒(1.86%),大头是 KV 连续拷贝(31.00%)和线性分支(39.78%)。也就是说 kernel 做得再快,杠杆也被内存搬运和线性分支吃掉。另外质量侧的「超越此前 SOTA」只给了主体一致性等少数几项,没有给出相对最强基线的完整指标表。
3. PDMD:一行代码,VBench 涨 1.03
PDMD: Projected Distribution Matching Distillation for Video Diffusion Models | 加州大学圣迭戈分校;字节跳动 | arXiv:2609.35768
关键词 :视频生成, 扩散蒸馏, 分布匹配, 少步生成, 批评者误差
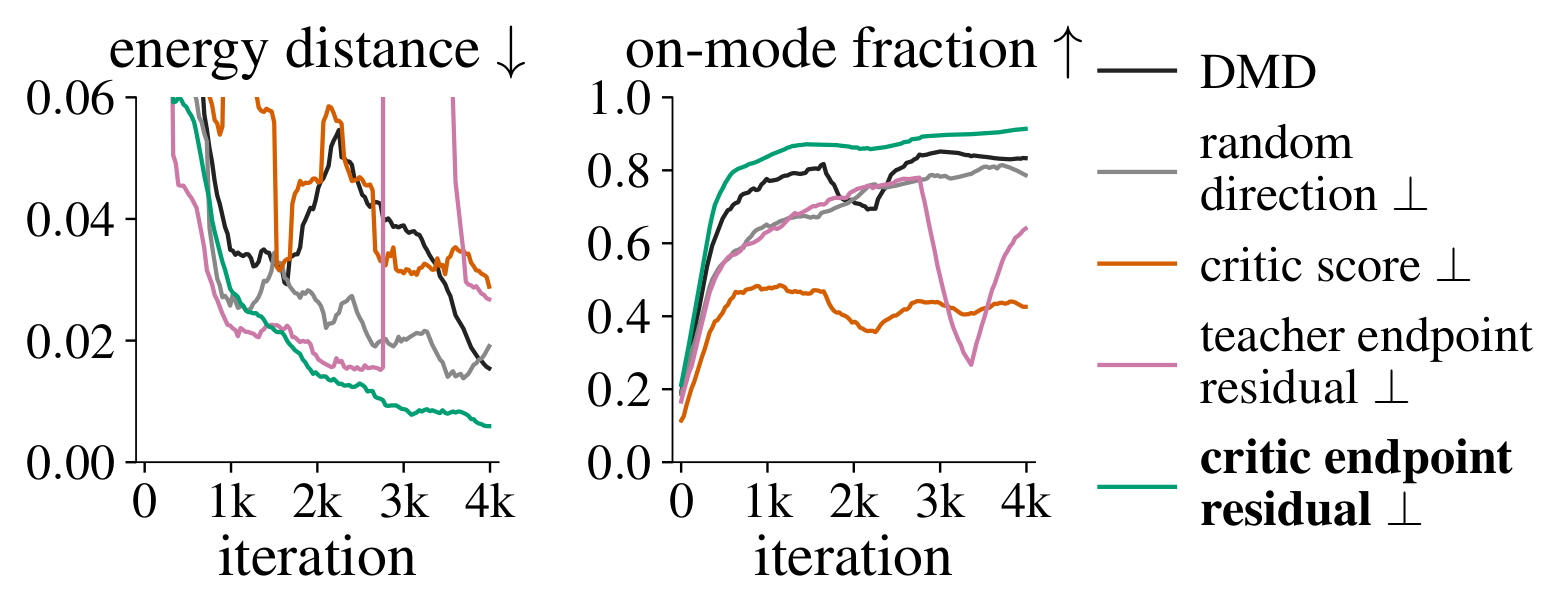
前序问题 :视频扩散模型动辄要几十次去噪评估,DMD 能把 NFE 压到个位数,但蒸馏出来的样本会在训练过程中逐步退化:画面越来越过饱和、纹理出现不自然的伪影。作者把根因定位到 critic 误差——它混进学生更新之后会随训练步数累积,而 DMD 本身没有任何机制把这个误差拦下来。本文贡献 :提出 PDMD:把 DMD 更新中「与学生-critic 端点残差平行」的那个分量投影掉。作者证明,在固定噪声查询点上,这个残差正是 critic 端点误差的无偏估计;在高维假设下,投影能移除恒定比例的 critic 误差,同时只丢掉可忽略比例的 ideal DMD 信号。整个改动对 DMD 只动一行代码,不引入额外损失、额外网络、额外数据、额外模型前向,也不需要多阶段训练。
2D comparison of projection directions (20-point moving average).
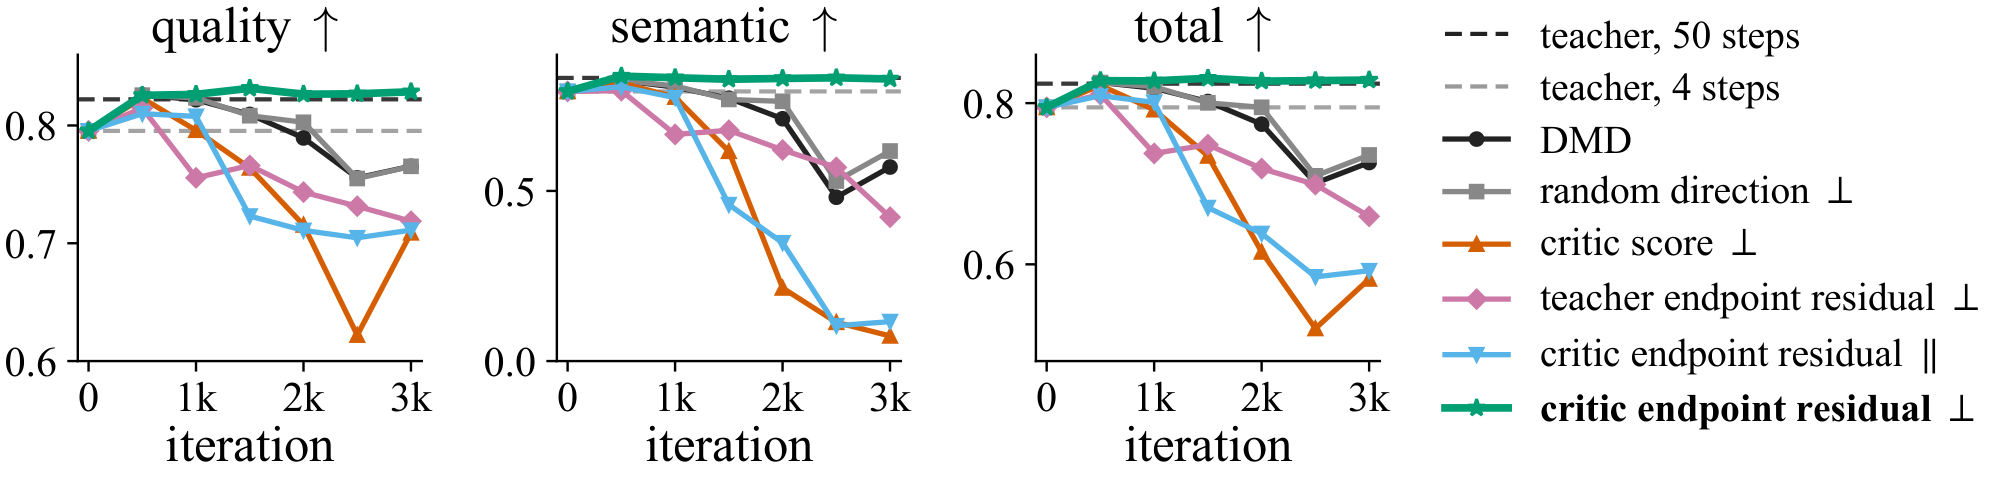
实验效果 :Wan2.1 上 4 NFE 取得 VBench 总分 83.73,比对齐设置的 DMD 高 1.03 分。MiniMax-H3 音视频联合生成上,VideoGen-Eval 视觉总分 83.17,比最强蒸馏基线高 0.41 分,且在受评的 4-NFE 模型中 6 项音频指标全部拿到最好成绩。定性对比与用户研究在视觉质量、运动、音频质量上都偏向 PDMD。
Quality, semantic, and total scores on the 387 VideoGen-Eval prompts.
批判点评 :1.03 和 0.41 都是小数点后两位的量级提升,放在 VBench 总分 80 多的量级上更像「修退化」而不是「提上限」——它的价值本来就在于 DMD 已经开始崩的那段区间,基线越健康收益越小。MiniMax-H3 的 0.41 分是相对「最强蒸馏基线」而非 teacher,论文没给与未蒸馏模型的差距。另外投影只保证移除「恒定比例」误差,这个结论建立在高维假设之上,实际有限维下的常数有多大并未量化。
4. GeoShrink:两行代码换五倍,PSNR+3.10
GeoShrink: Accelerating Diffusion Transformers with Two Lines of Code | 香港科技大学(广州);格里菲斯大学;CSIRO Data61;JITRI 深度感知研究所 | arXiv:2609.33723
关键词 :推理加速, 扩散Transformer, 免训练, 采样求解器, 特征预测
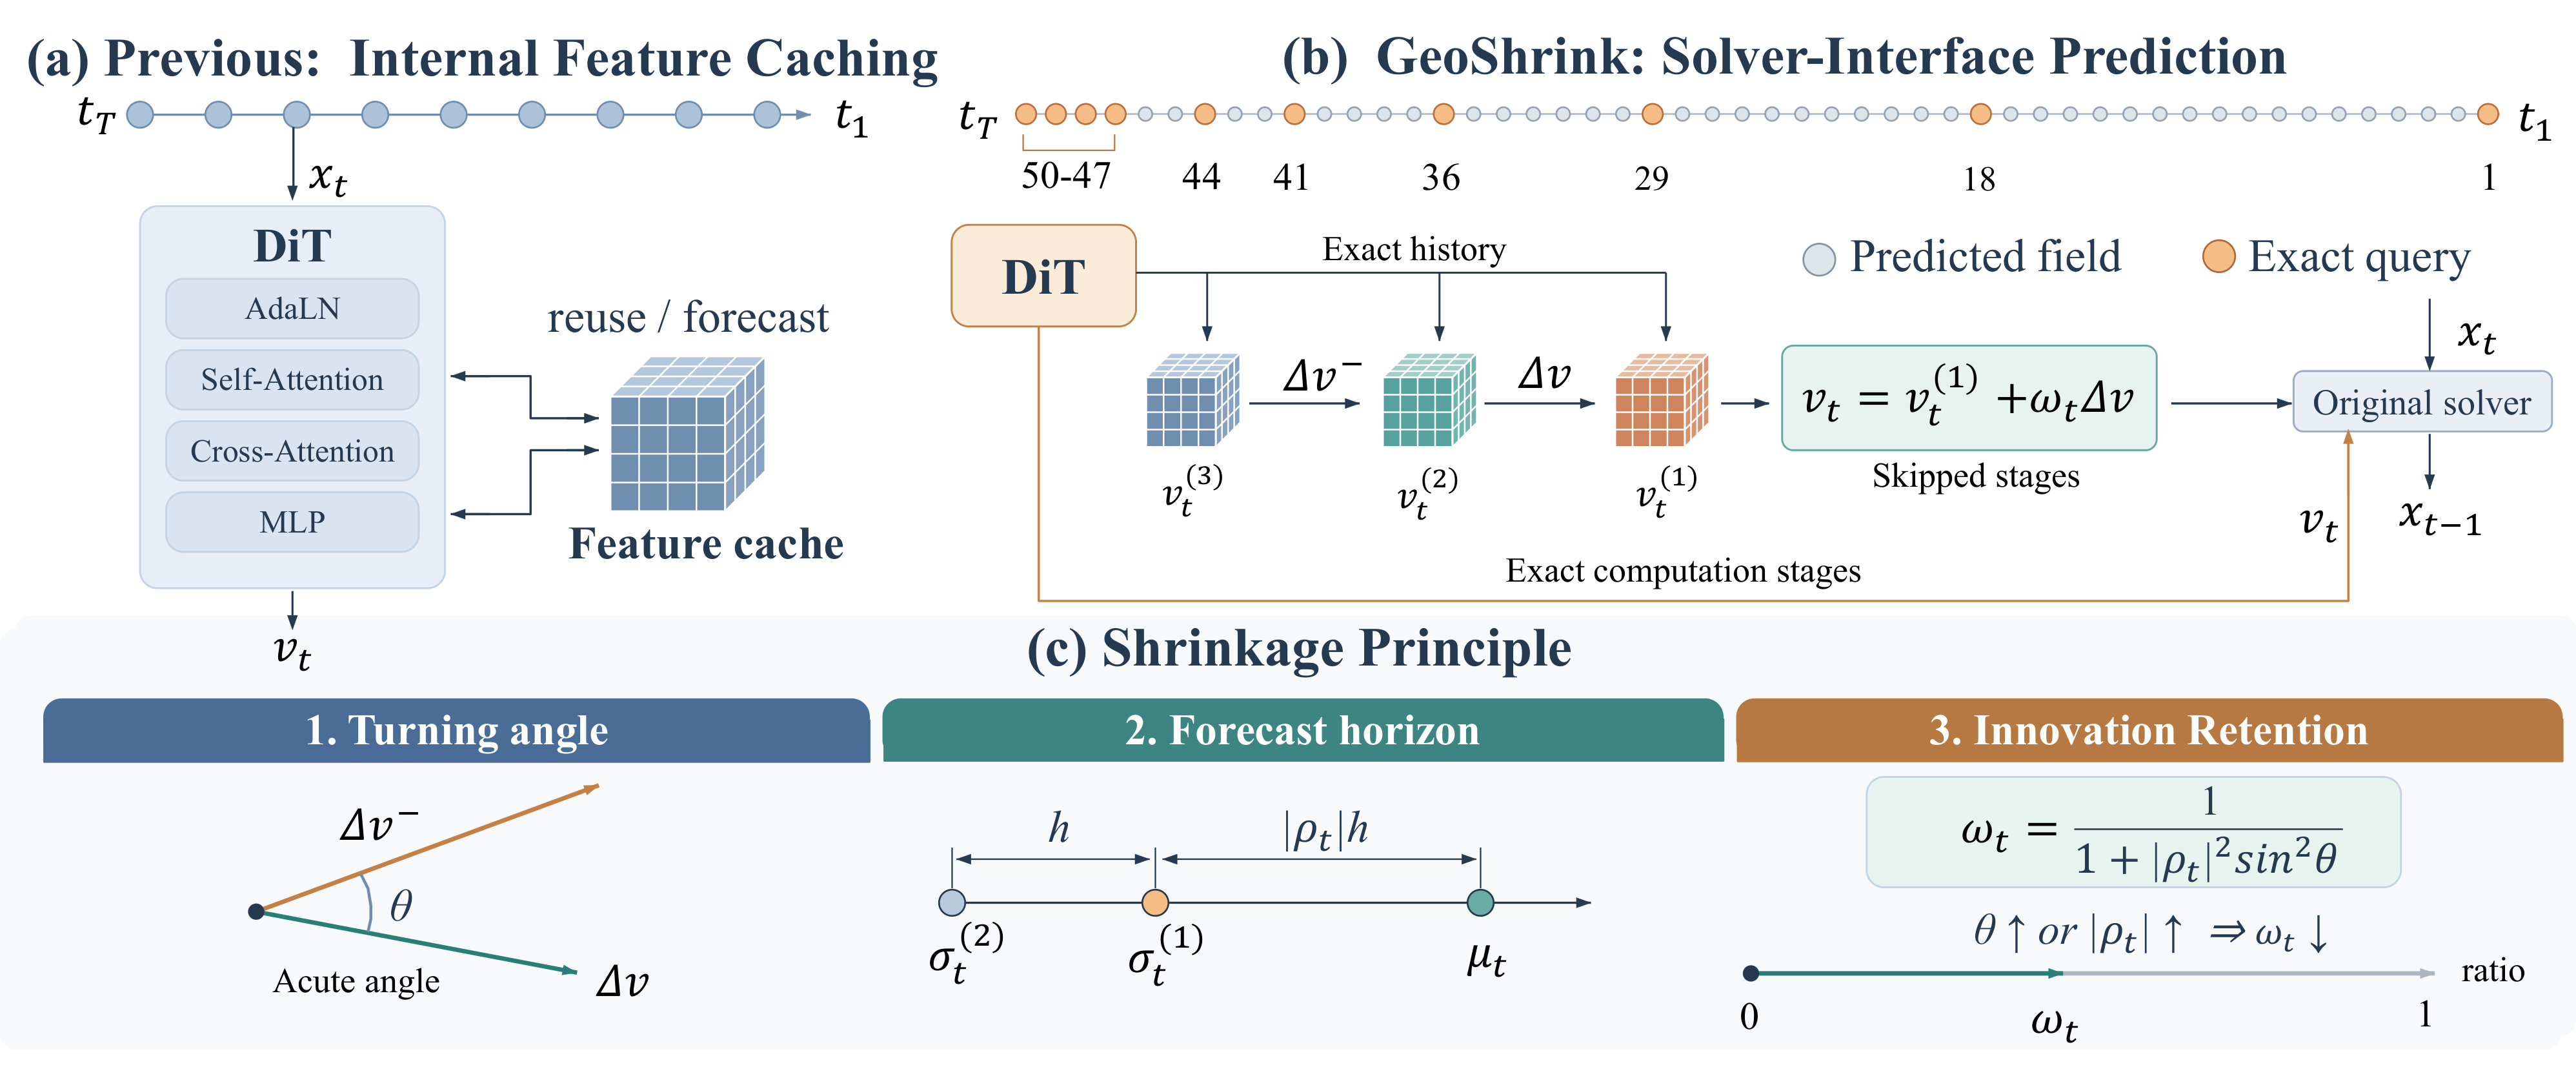
前序问题 :扩散 Transformer 的推理成本几乎全部来自沿采样轨迹反复调用模型。已有的免训练加速多走特征缓存路线,在不同去噪步之间复用或预测中间表示;但这类方法动的是模型内部结构,接入成本高,而且缓存什么、什么时候更新都要重新调。能不能完全不碰模型,只在求解器接口上做文章。本文贡献 :提出 GeoShrink:保留原始求解器网格,只在预先规定的一组锚点上真正调用模型。被跳过的阶段,它把「最近一次观测到的增量」按几何保留比例加回最近的精确输出,作为求解器要的那个场。这个规则从弦切线传输和往返线投影推出来,并给出一条几何锚间距原则:在固定覆盖率和首段跨度下,让相邻最大间隔的扩张最小。误差分析刻画了预测误差的几何闭合与传播,全程不假设能拿到未来模型输出。改动只需两行代码。
Overview of GeoShrink.
实验效果 :在约 5 倍加速下,FLUX 的 PSNR 比所列最强基线高 3.10 dB。HunyuanVideo 上报告 4.99 倍加速,ChronoMagic-Bench-150 的 PSNR 比最强保真基线高 5.44 dB。在固定评估预算下对比,运动、音频、音乐、3D 生成上也都有明显增益,实验覆盖图像、视频、动作、音频以及适配后的 3D 后端。
Speed-quality trade-off: GeoShrink yields a better Pareto frontier on SD3.5 Medium.
批判点评 :全文主打指标是 PSNR,这是保真度指标而不是感知质量指标——5.44 dB 的 PSNR 增益可以对应肉眼几乎无差别的画面,也可以对应明显更糊的结果,论文没有补 FID 或人类偏好。另外「比所列最强基线高」里的基线集合是作者自选的,到底是跟哪些缓存类方法比、有没有包含最新的同类工作,从摘要看不出来。锚间距原则也只在给定覆盖率和首段跨度这组约束下最优。
5. MGFlow:一步打赢四步,FDr 1.45
Unifying Distributional Training for One-Step Visual Generation | 清华大学;复旦大学;西安交通大学;北京大学;浙江大学;DeepSeek;字节跳动 Seed;加州大学伯克利分校;智源研究院 | arXiv:2609.35763
关键词 :一步生成, 分布匹配, 高斯混合, Wasserstein梯度流, 文生图
前序问题 :一步生成器的分布训练有很多条彼此看起来不相干的路线:FD-Loss 用高斯矩匹配,Drifting 用核密度做 KL 匹配,各自都能work,但没人说清楚它们之间的关系是什么,也说不清「分布建模」和「匹配差异」这两件事哪一件在起作用。缺少统一视角的直接后果是,新方法只能靠试,无法判断某一处改动到底改的是哪一环。本文贡献 :给出一个统一的理论框架:把「分布建模」与「匹配差异度」拆开,再用 Wasserstein 梯度流把全局目标和逐点特征更新连起来。在这个框架下,FD-Loss 和 Gaussian-kernel Drifting 分别被还原为高斯最优传输和基于核密度的 KL 匹配两个特例。框架进一步催生 MGFlow:用高斯混合来建模特征分布,粒度可调,介于全局矩和逐样本表示之间;它同时支持最优传输和基于分数的匹配,并用带质量约束的样本分配配成对分量更新,专门解决「混合模型表达力提升」本身解决不了的 mode collapse。
A unified view of distributional training.
实验效果 :ImageNet 256×256 上大幅超过 FD-Loss 基线,pMF-H 取得 FDr⁶ 1.45、JiT-H 取得 1.64,均为当前最佳。文生图方面,把 FLUX.2 [klein] 4B 后训练成一步生成器,在 GenEval 和 PickScore 两个指标上都超过了原始的四步模型。
One-step text-to-image samples from FLUX.2 [klein] 4B post-trained with MGFlow.
批判点评 :FDr⁶ 是论文自报指标,对比表里的基线也是作者自己跑的,跨论文可比性存疑;ImageNet-256 是类条件生成的老基准,没有在更大规模或更高分辨率上验证。文生图部分只报了 GenEval 和 PickScore 两个自动指标,没给人类偏好,而「一步超过四步」这种反直觉结论恰恰最需要人工评测背书。另外九家机构联合署名,真正的方法贡献集中在统一框架和高斯混合这两点上,工程验证面其实偏窄。
6. REPI:16万步追平700万步
Scaffold Then Internalize: Representation Injection for Diffusion Transformers | 中山大学;Video Rebirth;香港理工大学 | arXiv:2609.35292
关键词 :扩散Transformer, 表示对齐, 训练加速, 表示注入, 图像生成
前序问题 :REPA 类方法靠「把扩散 Transformer 的隐状态投影到预训练视觉编码器空间」来加速训练,方向是单向的:扩散模型被迫去迎合编码器。反过来那条路没人走过——让编码器表示直接参与去噪过程。问题在于直接注入会破坏扩散模型自身的表示结构,注入之后模型到底学到了什么、推理时还要不要带着编码器,都没人回答。本文贡献 :提出 REPI(REPresentation Injection),走 scaffold-then-internalize 两段式:第一阶段「搭脚手架」,用投影后的编码器 K/V 临时替换扩散 Transformer 原生的 K/V,只保留它自己的 Query,让外部表示先替模型把去噪这件事撑起来;第二阶段「内化」,模型恢复到使用自己的 K/V,同时用一个内化目标把自身 K/V 对齐到投影后的编码器表示。推理时编码器和投影层全部丢掉,不留下任何额外开销。
Overview of REPI. (a) Scaffold. (b) Internalization.
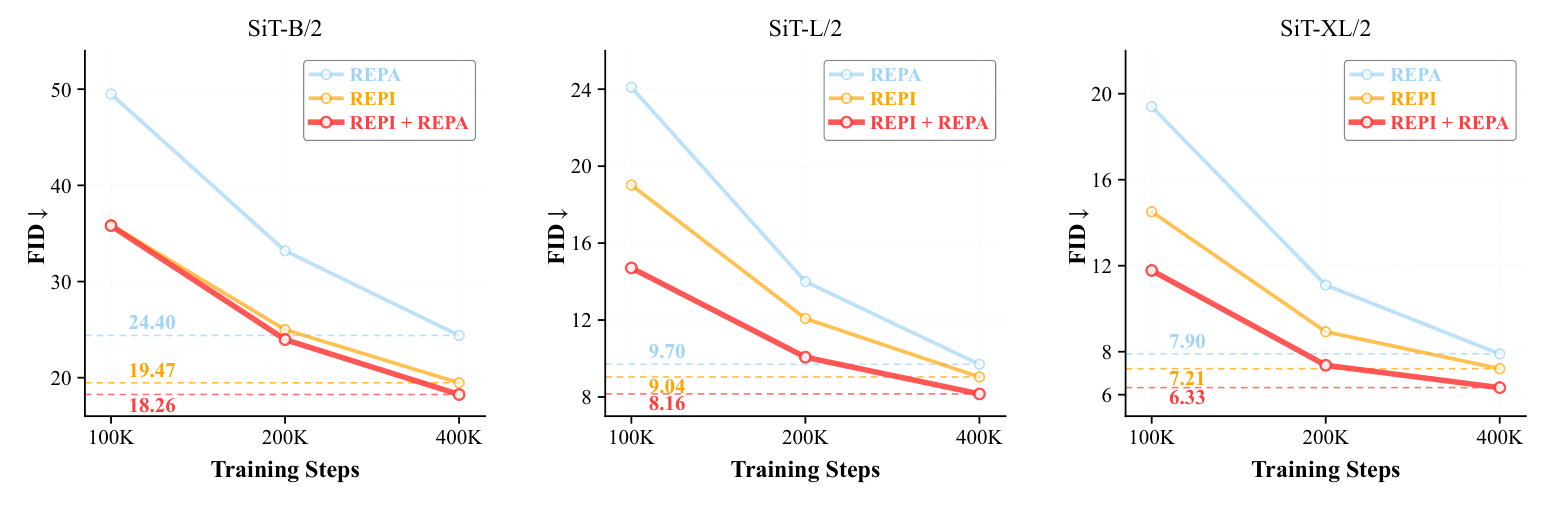
实验效果 :在 SiT-B、SiT-L、SiT-XL 等多种骨干上一致优于 REPA,且两者高度互补——叠加后收益远超任一单独使用。SiT-XL 上,REPI + REPA 训练 200K 步就已经超过 REPA 训练 400K 步的结果。最亮眼的是:仅用 160K 步,REPI + REPA 就能匹配 vanilla SiT 训练 7M 步的效果,相当于 43.5 倍以上的提速。
REPI accelerates diffusion transformer training across model scales.
批判点评 :43.5 倍的对照物是「什么都不加的 vanilla SiT」,这个基线本身不含任何加速手段,比值因此被放大;更有信息量的是和 REPA 的等步数对比,那部分增益要小得多。另外从 FID-步数曲线看,REPI 做的是把曲线「提前」,并没有把收敛上限抬高——训练足够久之后差距会收窄。论文也明确指出最大收益来自与 REPA 叠加,单独用 REPI 的绝对提升要看主表才清楚。代码目前标注为即将开源。
7. UMM-Reflection:自己改自己图,GenEval+12
Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning | 南洋理工大学;上海交通大学;东京大学 | arXiv:2609.35767
关键词 :统一多模态模型, 强化学习, 自我反思, 图像编辑, 文生图
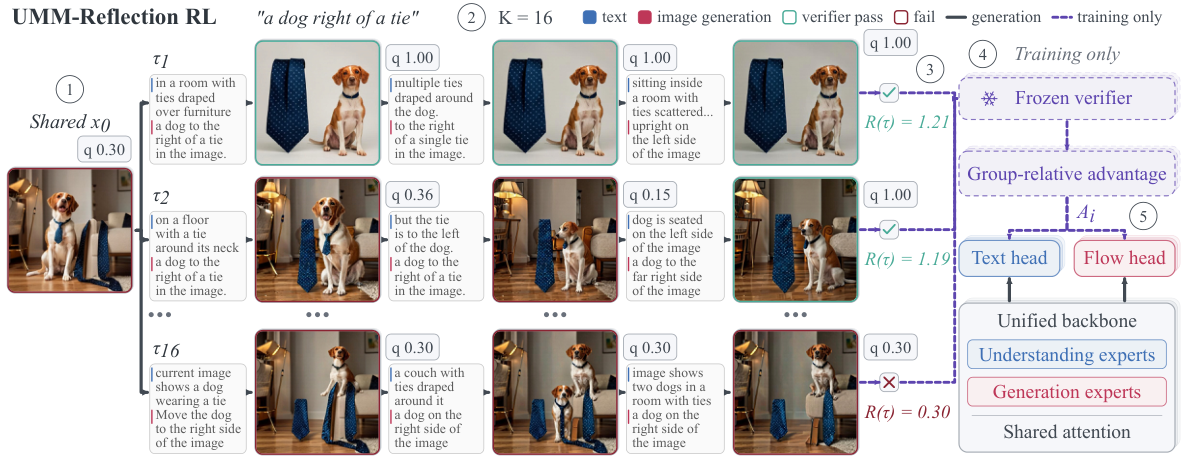
前序问题 :统一多模态模型既能看图又能画图,理论上应该能自己修自己的输出:先诊断这张图错在哪,再改,看着改完的结果继续诊断。但「这次修改到底有没有用」只有渲染出来才知道,所以反思文本和图像生成必须沿着整条回路联合学习。SFT 冷启动能学会走流程却找不到高成功率的修复路径;而只优化渲染器或只优化某一个头的朴素 RL,又把大部分收益留在桌上。本文贡献 :提出 UMM-Reflection,在同一个统一模型内部对完整反思轨迹做 RL。关键设计是 sibling trajectories 共享同一张初始图像,这样 group-relative advantage 比较的就是不同「反思策略」而不是不同起点;再用一个轨迹级 advantage 同时更新反思 token 和基于 flow 的修订,避免逐轮信用分配带来的组合爆炸。信用跨轮次流动、同时流向同一模型的两种角色,推理时不需要任何 verifier。
UMM-Reflection RL.
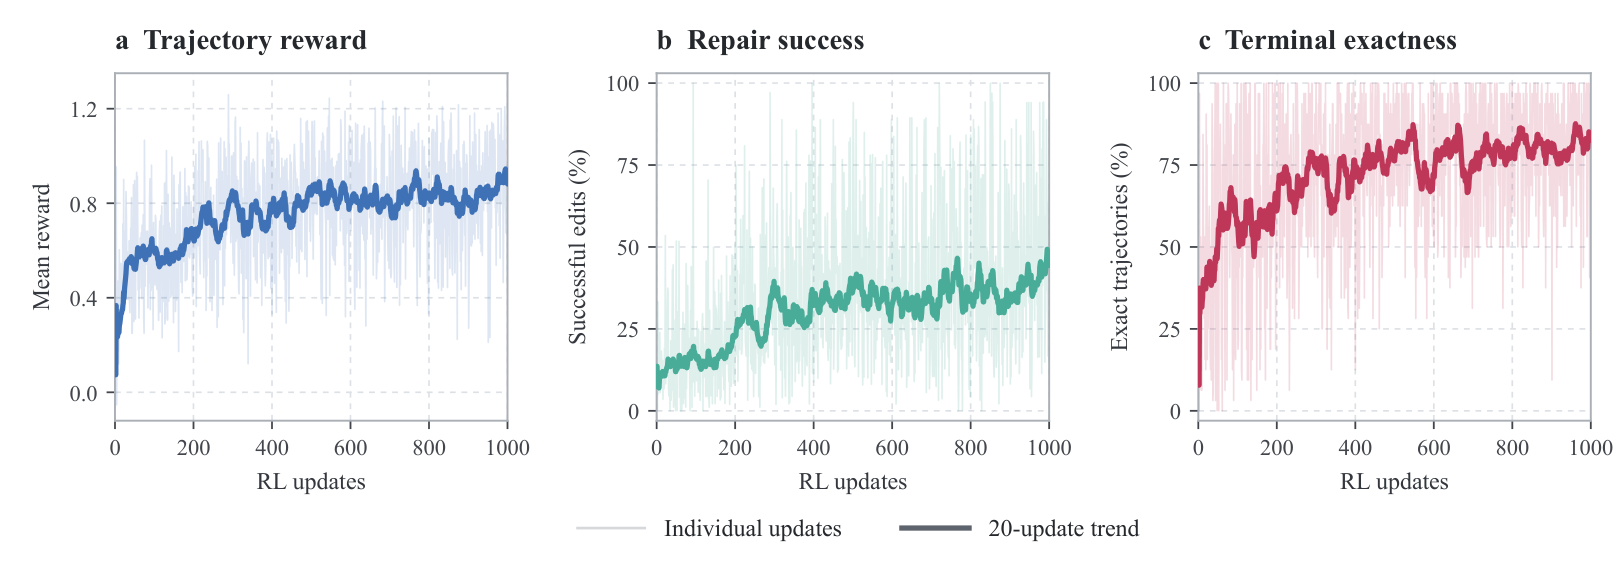
实验效果 :在 BAGEL 上相对 SFT 把 GenEval 提升 12.05 分,且增益能迁移到训练中完全没用过的 WISE(+10.97)、OneIG-Bench(+3.48)、T2I-CompBench++(+4.63)。
Learning dynamics of the 1,000-update RL run.
批判点评 :+12.05 分是相对 SFT 冷启动版本,不是相对原始 BAGEL 或当前 SOTA 生成模型,绝对值要在主表里才看得清。整套实验只在一个统一模型(BAGEL)上做,换骨干是否成立未知。训练侧每条轨迹最多三轮反思、每组 16 条 rollout,为了拿到稳定的 group-relative advantage 开销不小;而三轮上限本身就意味着更长链条的迭代修复能力没有被验证——尽管推理免 verifier 是实打实的优势。
8. Elastic Forcing:扔掉两个打分模型,84.64
From Scores to Samples: Elastic Forcing for Autoregressive Video Generation | 清华大学人工智能学院;西安交通大学 IAIR;复旦大学相辉研究院;北京大学 | arXiv:2609.35491
关键词 :视频生成, 自回归生成, 蒸馏, MMD, 后训练
前序问题 :少步自回归视频生成基本都挂在 DMD 上,而 DMD 需要两样重资产:一个双向扩散 teacher,和一个在线更新的 fake-score 模型。前者限制了「能学什么」——必须有一个现成的目标分布 teacher;后者让后训练的内存和计算开销居高不下,模型一大就跑不动。两者的存在使得「直接向参考视频学」这条路一直没走通。本文贡献 :提出 Elastic Forcing:不学 teacher 给出的真假分数,而是直接从参考视频学 rollout 分布,后训练阶段两个 score model 全部去掉。做法是在冻结的自监督视频表示空间里最小化 MMD(最大均值差异),并用 Nyström–Monte Carlo 混合估计器在近似偏差与采样方差之间取平衡;再配合省内存的 replay 和梯度子采样让这个目标变得可训练。移除辅助 score model 之后,14B 后训练可以放进 8 张 H200。
Demonstration of Elastic Forcing.
实验效果 :在与 Self-Forcing 完全相同的架构和初始化下,1.3B 模型把 VBench 总分从 83.80 提到 84.64,同时保持 17 FPS。去掉辅助 score model 使 14B 规模的后训练在 8 张 H200 GPU 上成为可能。除了蒸馏,直接从参考视频学习还能在没有目标专用扩散 teacher 的情况下习得新的视觉风格、语义概念和空间先验。
Additional demonstrations of our 14B model.
批判点评 :83.80 到 84.64 只有 0.84 分,而且这个对照是与 Self-Forcing 同架构同初始化的自体基线,不是与当前最强少步方法比。14B 那部分论文只说「使后训练成为可能」,没有给出 14B 的量化评测结果,也没有和带 score model 的同等规模方案做效率对比——省下来的显存到底换来多少质量,读者看不到。MMD 估计器本身还需要在 Nyström 近似偏差和 Monte Carlo 方差之间调参,这个权衡的敏感度没在摘要里交代。
9. GEAR:几何只当地址,12项全第一
Geometry as Address: Routing Attention to Visual Memory for Long-Horizon Camera-Controlled Video Generation | 浙江大学 CAD&CG 国家重点实验室;香港科技大学(广州);LIGHTSPEED | arXiv:2609.34722
关键词 :视频生成, 相机控制, 长程记忆, 几何先验, 记忆检索
前序问题 :长程相机可控视频生成要从不断膨胀的视觉历史里把之前看过的内容取回来。现有做法要么在历史上下文里隐式检索,要么把历史重建成持久的 3D 记忆:前者检索低效、token 越堆越多,后者会因为全局融合不断累积几何误差,跑几十秒之后画面就漂了。矛盾在于几何信息到底该被用来「解释场景」还是只用来「定位」。本文贡献 :核心洞察是:几何不需要解释场景,它只需要决定「视觉记忆该从哪里读」,而「该恢复什么」交给注意力去判断。GEAR 据此把几何当作视觉记忆的显式 token 级地址——不把历史观测融进一个持久的全局 3D 表示,而是保留为逐帧 latent,只用逐帧几何与目标视角建立 token 级对应关系,从而避开全局融合的误差累积。由这些对应关系引导,Geometric Correspondence Attention(GCA)在去噪时把几何匹配上的历史特征选择性注入到噪声目标 patch。另外用 Invisible Octree 累积可见性证据,把几何上合理但实际被遮挡的对应关系剔掉。
System overview.
实验效果 :在 DL3DV 与 WorldScore 的全部 12 项指标上取得最佳:SSIM 0.3645、LPIPS 0.4459、FVD 837.59、TransErr 0.0116、RotErr 0.1228、ATE 0.0436、Content Alignment 0.7423、Photo Consistency 0.9732、Style Consistency 0.8700、主观分 0.5018、Revisit SSIM 0.6489、Revisit LPIPS 0.2019。支持沿高难度轨迹生成分钟级视频。
Out-of-domain qualitative comparison for minute-long generation.
批判点评 :主观分只有 0.5018,刚过一半,说明「12 项全第一」里最贴近人的那一项优势最薄。FVD 837.59 的绝对值也谈不上低。对比集合是「带 memory 机制的近期方法」,没有与不带记忆的强基线在同等时长下对照,因此无法判断这套地址机制相对「干脆不记忆」的净收益。此外整套方法依赖每帧几何(位姿与深度)可用,相机轨迹是外部给定的,几何估计本身的误差如何传导到地址精度只做了定性讨论。
10. ORAV:380题9种角色,人机86%
ORAV: Benchmarking Audio-Video Generation from Multimodal Contexts | 清华大学人工智能学院;腾讯混元 | arXiv:2609.34843
关键词 :音视频生成, 多模态参考, 基准评测, 组合式生成, 评测协议
前序问题 :用异构多模态参考(图、视频、音频混着给)去生成音视频成了一个新课题,它同时要求两件事:对生成结果有组合式控制,对多模态上下文有 grounded 理解。但现有基准基本只覆盖单参考或同构参考,评测协议也沿用通用视频质量指标,无法判断「模型有没有照着指令把指定参考里的指定内容取出来并正确组合」。没有基准,就没法追踪这一方向的进展。本文贡献 :提出 ORAV Bench,包含 380 个任务实例,每个实例带 2 到 10 个参考,覆盖 9 种语义角色和 30 种角色组合;指令负责说明各参考之间的关系,媒体本身提供要被落实的身份、动态和音频特征。评测上设计了一套参考感知的成对比较协议:先分别准备视觉和听觉证据,再逐个比较每个参考「本应贡献什么」,最后在两种呈现顺序下核对总体裁决,以消解顺序偏差。
Omni-reference audio-video generation requires selectively composing information from heterogeneous references.
实验效果 :在留出实例上,该协议与人类判断的有效一致率达到 86.08%。对 5 个前沿系统的评测显示,总体排名掩盖了各系统在不同参考组合上的能力差异;暴露出的一个反复出现的失败模式是:模型生成了与某个参考高度相似、但并非指令所要求的内容。可复现的逐点诊断在质量、参考亲和度、语音三个维度上揭示出彼此独立的行为差异。
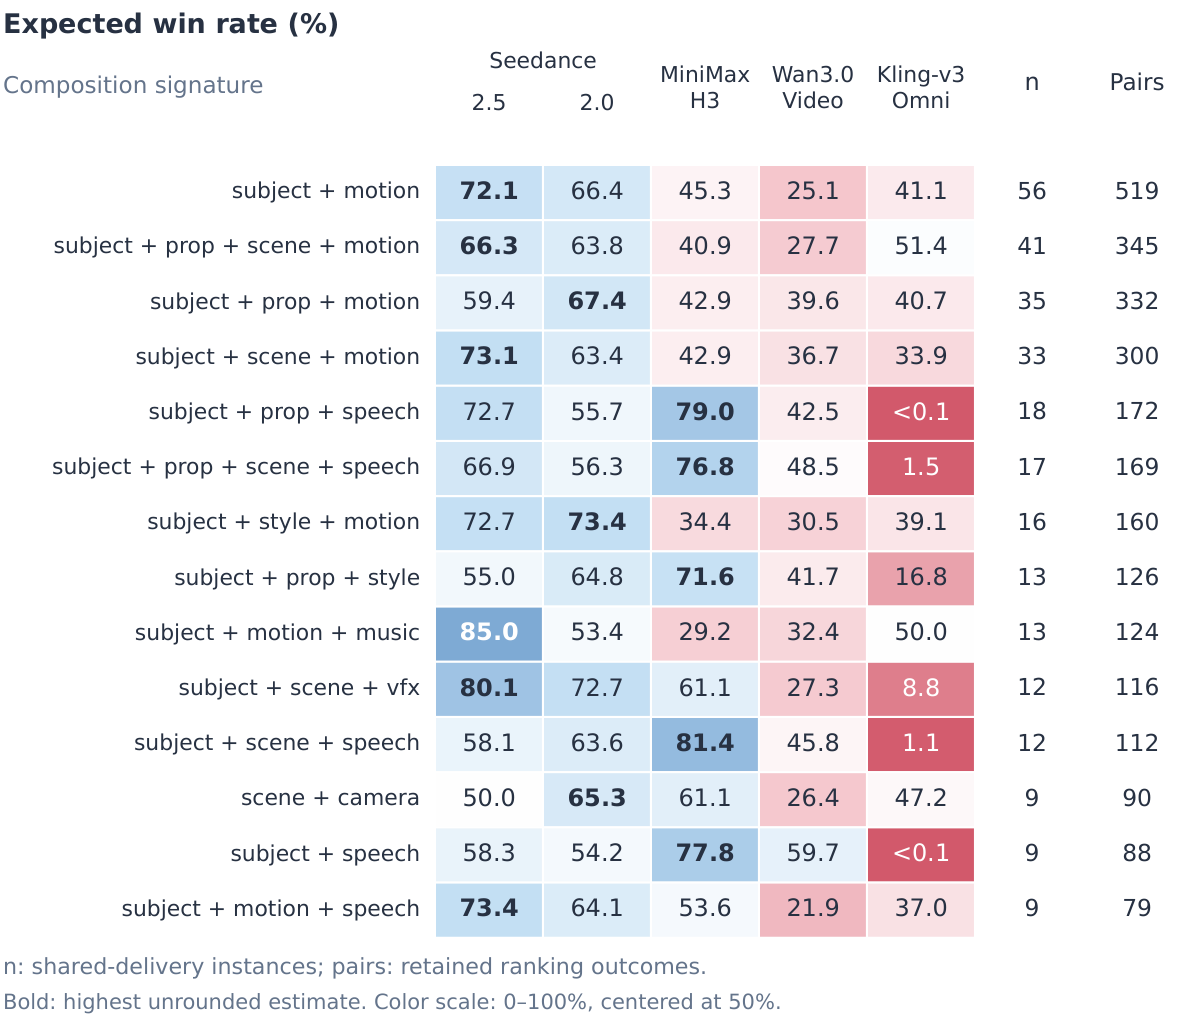
Performance across composition signatures.
批判点评 :86.08% 是「有效一致率」,已经剔除了不可用判断和顺序冲突的样本,分母比全部配对要小,实际一致性更接近的下界没有给出。5 个受评系统在摘要里被匿名处理为 frontier systems,读者无法核对评测对象;380 个实例摊到 30 种角色组合后每种只剩十几个,论文也承认只有共享实例数不少于 8 个的 14 个 signature 才重拟合了胜率。作为纯基准工作,它不提供任何模型或训练方案,落地价值取决于社区是否跟进。
趋势观察
加速的战场从算法层下移到系统层
今天十篇里有三篇在跟计算成本较劲,但下手的层级完全不同:WorldAttention 直接写定制 kernel 并重排 KV 的内存层级,GeoShrink 干脆绕开模型、只在求解器接口上抠掉五分之四的调用,Elastic Forcing 则是把两个 score model 整个删掉换来 14B 后训练的可行性。共同点是单纯改注意力数学已经不够,谁把内存搬运和调用次数一起管起来谁才拿到真实收益。
「先搭脚手架再拆掉」成了训练范式的共识动作
REPI 用编码器 K/V 临时替换扩散 Transformer 的原生 K/V,等模型内化之后在推理时把编码器整体丢弃;PDMD 只对 DMD 动一行代码、不加任何额外网络或损失;UMM-Reflection 在训练时用冻结 verifier 打分、推理时一个 verifier 都不需要。三篇方向毫不相干,却都在做同一件事:把复杂度全部留在训练期,交付一个结构不变、开销不增的推理模型。
人工智能炼丹君 整理 | 2026-09-30
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注













评论 (0)