


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 训练目标与采样流程($\bar{\alpha}$ 记号、DDIM 单步更新直接沿用)、DiT 架构拆解(潜空间 patch 化成 token 的约定)
关键词:自回归视频、Diffusion Forcing、Self-Forcing、teacher forcing、曝光偏差、KV cache、流式生成
设想一个采用固定整段去噪的视频产品,等了3秒才出第一帧。若主要耗时来自采样循环,就需要先检查范式的交付粒度。
本文先以全序列双向扩散为对照:21 个潜帧(对应约 5 秒成片)拼成一条 3 万多 token 的序列,帧和帧之间双向可见,整段一起降噪。在这个循环里,最后一帧没去噪完,第一帧就不交付。这描述的是固定整段、无额外交付机制的采样循环:未来帧作为带噪状态已在张量里,并非“不存在”;当前帧依赖这些状态,须等当前整块完成。滑窗、分块或因果化会改变交互方式。
我按 Wan2.1-T2V-1.3B 的真实拓扑和 Self-Forcing 的默认配置,把这笔账算成了 MAC 数(第 06 节有完整过程):在假设有效算力 400 TFLOPS、只计 Transformer 的理想算术估算中,5 秒视频的全序列扩散整段 latent 就绪约 2.83 秒;换成因果自回归加 KV cache,首块去噪加缓存刷新折算 0.20 秒——账本中的 13.98 倍差距(不是实测 GPU 延迟)。而总算力几乎没变(比值 0.875,自回归反而略省)。
但把「一帧一帧往后生成」这条路走通,会立刻撞上一个语言模型社区早就算过的老账:训练时模型看的上下文是真值帧(teacher forcing),推理时上下文只能换成模型自己的输出。这两件事不是一回事,误差会顺着自回归链条滚雪球——这就是曝光偏差(exposure bias)。
Forcing 系列就是围着这两个问题打转的:Diffusion Forcing 把「下一帧预测」和「扩散去噪」缝成一个目标,让每帧带独立噪声级;Self-Forcing 干脆在训练时就用模型自己的 rollout 当上下文,缩小训练与推理的上下文分布差异。这篇把两个问题都算成数:流式的账用真实拓扑算,曝光偏差的坑用一个能完整复现的玩具实验拆开看。
把三种范式并排放,差别其实只有一句话:每一帧能看什么、历史从哪里来、以什么噪声级被看到。
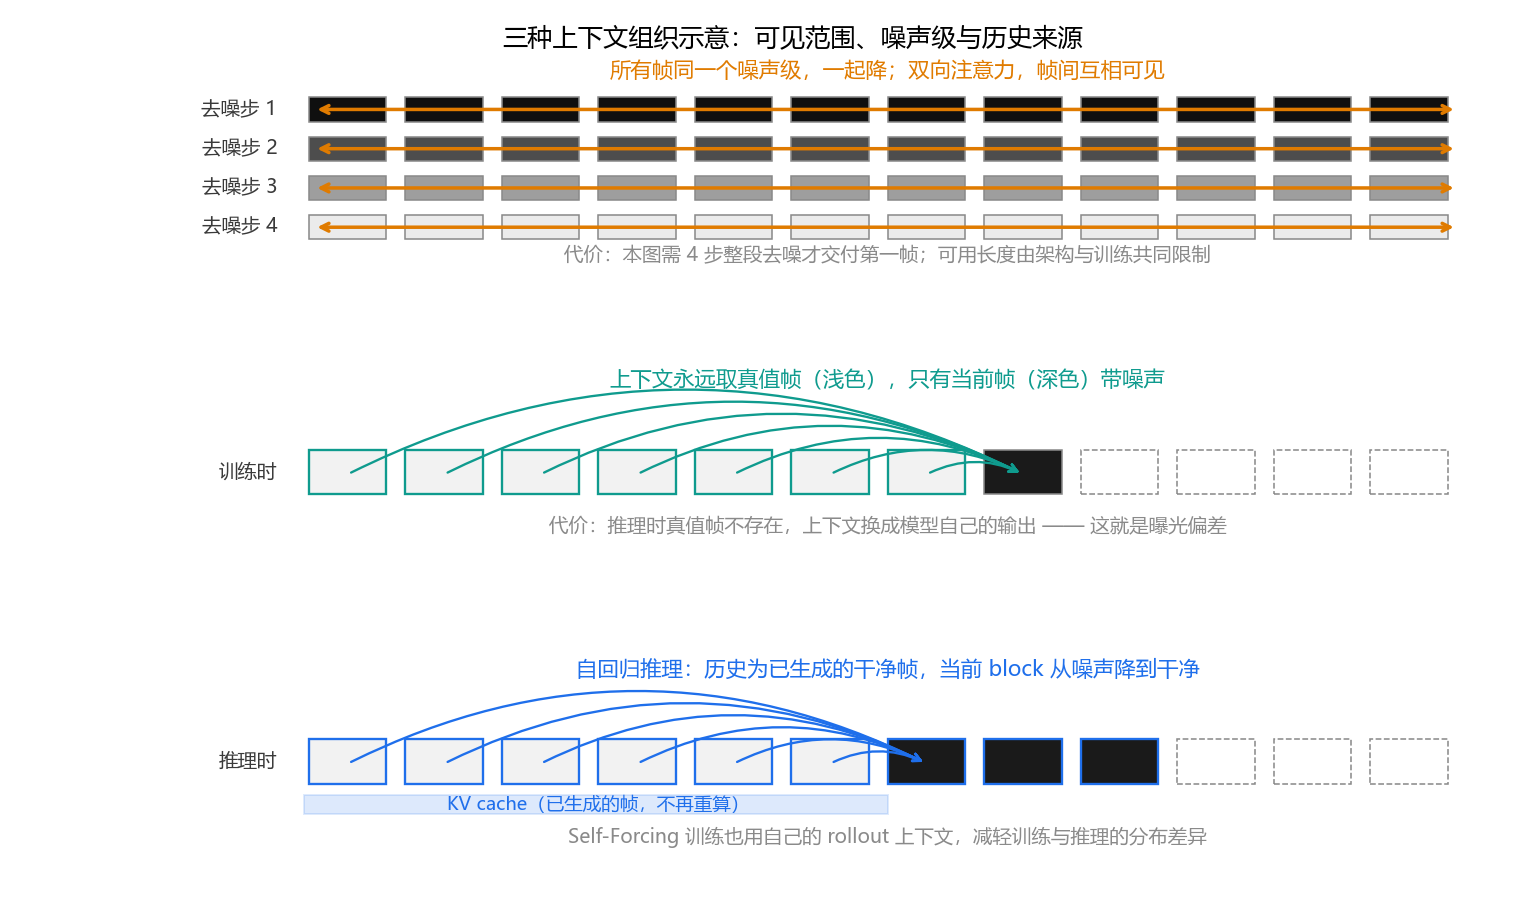
这张图要看什么:上行是全序列扩散——所有帧共用同一个噪声级、一起降、双向注意力互相可见,代价是 4 步全部算完才有第一帧;中行是 teacher forcing——只有当前帧带噪声,上下文全是浅色真值帧,而推理时真值帧不存在,误差就从这里的「换上下文」进来;下行是因果自回归采样;训练时使用自身 rollout 对应 Self-Forcing,而独立噪声的 Diffusion Forcing 训练上下文仍来自数据——图示的历史帧以干净预测构建缓存(真实刷新路径见05节),当前 block 从高噪声一路降到干净,其中“训练用自身 rollout”是 Self-Forcing 的额外设计。
这里的帧指潜帧,block是一次生成的潜帧组;KV缓存保存历史各层key/value向量,并非原视频帧。03节需用到条件概率、均值与方差,额外假设将逐项说明。
三个要点:
顺带把「Forcing」这个词的出处交代掉。它来自语言模型的 teacher forcing:训练 RNN 语言模型时,每一步的输入都用数据集里的真值 token「强行喂入」(force),而不是模型上一步的输出。在采用因果掩码的Transformer中,这允许训练位置并行;RNN本身仍按时间递推,但也埋下了训练-测试分布错位的种子——语言模型社区管它叫 exposure bias,几十年里试过 scheduled sampling、DAgger 各种解法。Forcing 系列的谱系就是围绕这个错位逐步收紧的过程:Diffusion Forcing 先把「下一帧预测」的接口扩展成「每帧带独立噪声级的条件去噪」,让自回归的骨架里能塞进扩散的表达力;Self-Forcing 再把训练时的上下文从真值换成模型自己的 rollout,缩小这项错位(截断梯度、长度与采样设定仍有差异)。视频把这个问题变得更尖锐:语言模型一步错一个 token,视频一步错的是一整帧,而且帧与帧之间还有时间维度上的积分效应(下一节的主角)。
为展示上下文错位,令x_t为第t个干净潜帧、k_t为噪声步、epsilon_t为独立标准高斯,z_t(k_t)为按3.3节加噪的输入;f_theta为参数theta的干净帧预测器,gt是真值历史,向量范数对潜帧全部分量求平方和。期望覆盖数据、噪声步和噪声,可用简化目标:
$$\mathcal L_{TF}=E_{x,k,\epsilon}\sum_t\|x_t-f_\theta(z_t(k_t),k_t,x_{\lt t}^{gt})\|^2.$$
推理时把真值历史换成模型生成历史 $\hat x_{\lt t}$,但通常不在推理现场优化损失。用同样的去噪回归在生成历史上评测,只是本文的受控诊断量,不是视频生成质量的完整定义;任意生成视频与某条真值逐帧 MSE 也不是 Self-Forcing 的训练目标。
训练和评测使用同一个 $f_\theta$ 时,上下文从数据历史换成模型历史即可造成分布偏移。充分容量下精确学习每个条件分布可得到正确联合分布;现实中的估计误差、有限容量和长时 rollout 会放大这一差异。
令 $e_t$ 是第 $t$ 步的标量误差,$a$ 是有效传递系数,$\delta_t$ 是本步新增误差。先假设 $e_0=0$,增量独立、零均值、方差为 $v$。展开递推 $e_t=ae_{t-1}+\delta_t$ 得 $e_T=\sum_{j=0}^{T-1}a^j\delta_{T-j}$;独立性令交叉协方差消失,所以
$$\operatorname{Var}(e_T)=v\sum_{j=0}^{T-1}a^{2j}=v\frac{1-a^{2T}}{1-a^2},\qquad a^2\ne1.$$
最后一步是等比数列求和。$a=1$ 或 $a=-1$ 时直接用有限和得到 $Tv$;$|a|\lt1$ 时极限为 $v/(1-a^2)$;$|a|\gt1$ 才有指数增长。$a=0.97$ 与0.85的极限放大系数约16.9和3.60,前者更晚饱和:慢和快在这里都是有界的。
若增量均值为 $m$,均值误差还含 $m\sum_j a^j$,MSE是方差加均值平方;相关增量还带交叉协方差。矩阵情形需检查 $A^j$ 的范数,不能只报谱半径。例如 $A=\begin{pmatrix}0.5&10\\0&0.5\end{pmatrix}$ 的谱半径只有0.5,却把单位向量 $(0,1)$ 一步放大到范数10.0125。
toy数据慢矩阵是0.97倍正交矩阵、快矩阵是0.85倍正交矩阵再过tanh;它们不等于学习器闭环误差的传递系数。耦合、非线性、初始误差与估计偏差会改变结果。下文只报告快慢分量曲线,不把实测倍数接近16.9当作上述公式的证明。forcing_checks.py 独立检查30个有限和与非正规矩阵反例。
标准全序列噪声训练通常共享 $k$;Diffusion Forcing 对各帧独立采噪声级,并把带噪历史一起作为条件。例如噪声预测形式为:
$$\mathcal L_{DF}=E_{x,k_{1:T},\epsilon_{1:T}}\sum_t w(k_t)\|\epsilon_t-\epsilon_\theta(z_{\le t},k_{\le t})\|^2,$$
w(k_t)是非负时间权重,epsilon_theta是噪声预测器;此目标显式输入噪声级,与toy不同。其中 $z_t=\sqrt{\bar\alpha_{k_t}}x_t+\sqrt{1-\bar\alpha_{k_t}}\epsilon_t$;也可等价改写成带相应权重的 $x_0$ 预测。历史 $z_{\lt t}$ 通常也带各自的噪声,不能只在公式里写干净的 $x_{\lt t}$。
统一噪声级可恢复共享噪声训练形式,但不会自动把因果遮罩变成双向注意力;把历史噪声降到 0、仅对当前块去噪,则给出自回归采样接口。当前块仍从高噪声逐步降噪,不是“把当前噪声取最小就等于 next-token prediction”。
Self-Forcing 第 3.3 节 用自身自回归 rollout 产生整段视频,再做视频级分布匹配。以 DMD 为例,目标可写为
$$\mathcal L_{SF}=E_k\big[D_{KL}(p_{\theta,k}(x^{1:T})\|p_{data,k}(x^{1:T}))\big].$$
这里k是对整段视频施加的评估噪声级,p_theta,k与p_data,k分别是生成/数据经该加噪核后的联合密度。这里比较生成与数据的加噪联合分布,借助教师/学生 score 估计更新;论文还考察 SiD、GAN 损失。它不是逐帧配对 MSE,也不是 DAgger 的同义词。二者都关注自生成上下文,但经典 DAgger 需要专家对学习器访问状态提供标签,Self-Forcing 不以这种标签循环定义。
本文下面的线性回归 toy 诊断历史替换,并在自身历史特征上做配对标签重拟合。目标仍是原配对轨迹下一帧;既没有DAgger的访问状态专家重标注,也没有累计数据集,因此只借用了“收集自身历史”的想法。它没有实现DMD,不能用它的失败证明Self-Forcing失败。
Self-Forcing 为控制显存,每个序列随机选一个去噪退出步,只保留最终被选步骤的反传,并阻断先前帧 KV cache 的梯度;这比笼统说“回传最近几帧”更准确。普通一阶反传并不自动产生 Hessian 的二阶交叉项。
本文toy不对rollout链反传。岭回归后从0.3起最多五次折半,按独立验证集前24帧MSE选步;外推测试末帧超过初始50倍的保护仅是探索性停止规则,故不声称选择后的长时测试有无偏泛化保证。日志现打印真正接受的alpha。
完整实验在 forcing_lab.py(附录有全文,numpy 单文件可跑)。比较两种局部特征模型,以及同一因果模型替换历史后的表现:
双向与因果模型的信息分布、特征定义和采样过程不同,等维数不保证公平架构比较。更窄的干预是:同一个TF权重分别读真值历史与自身历史,测试样本i两端均重置种子32000+i,每帧初始噪声配对,因此无历史的第0帧应逐元素相同。x_true只作标签,不再泄漏进生成初始状态。TF是使用测试真值的oracle诊断;逐帧MSE还含不可预测过程噪声,不是视频分布质量。
核心特征函数如下;完整采样器和训练循环保留在附录:
def feat_causal(z_t, hist, c):
    if len(hist) == 0:
        prev = np.zeros(D)
        past_mean = np.zeros(D)
    else:
        prev = hist[-1]
        past_mean = np.asarray(hist[-4:]).mean(axis=0)
    return np.concatenate([z_t, prev, past_mean, c, np.ones(1)])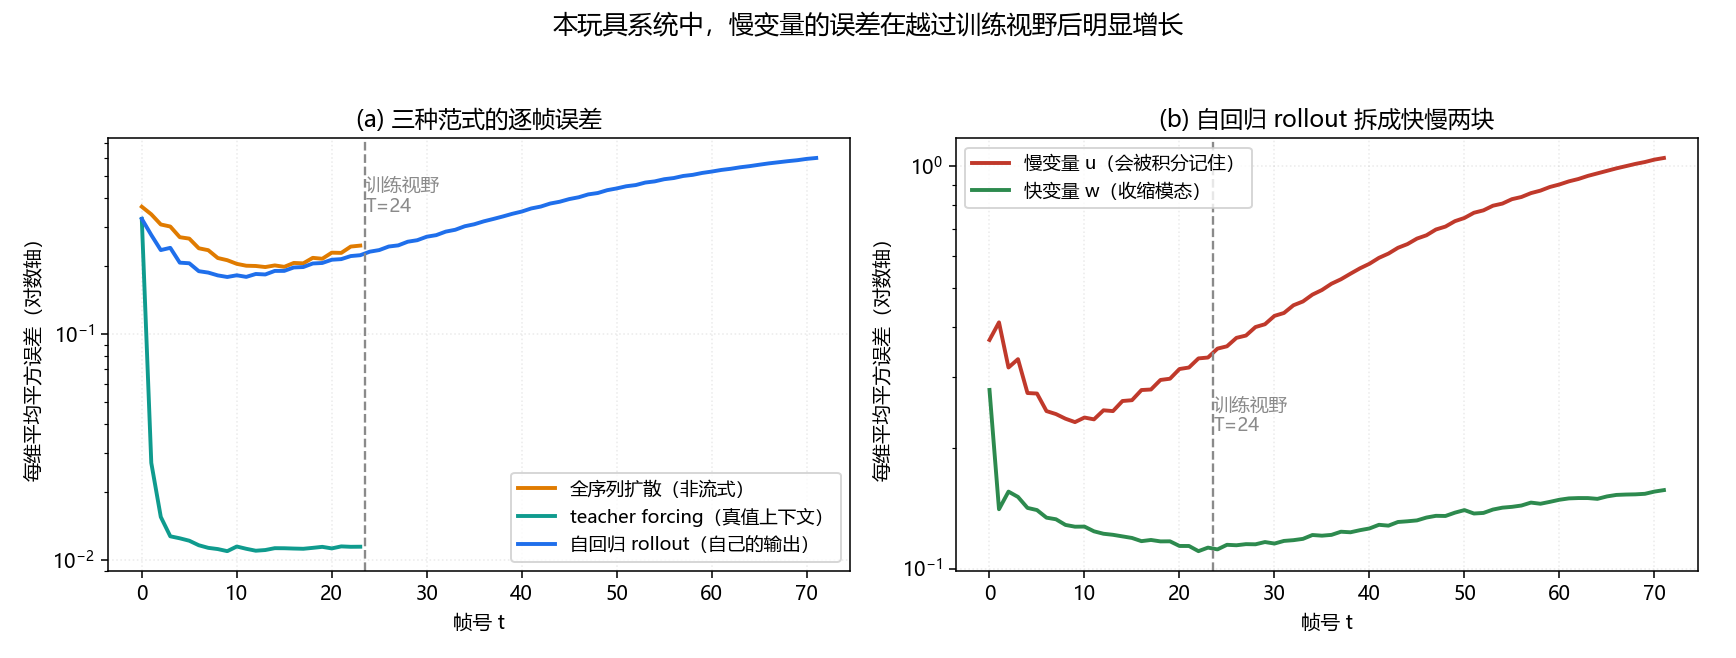
这张图要看什么:左图三条曲线在训练视野边界(第 24 帧,竖虚线)附近的分叉——teacher forcing 平在 0.01 附近,但它测试时不可得;自身历史曲线与TF分开,越过视野后慢分量误差明显增大,曲线并非处处单调。右图把 rollout 的误差拆成快慢两块:慢变量(红)在所测 72 帧窗口内继续增大,不能据此证明无限长度发散,快变量(绿)基本是平的——这仅描述当前模型与有限长度,不验证独立增量方差假设。
真实输出(逐帧 MSE,每维平均平方误差):
| 零起始帧号 | 双向局部特征 | TF真值历史 | 自身历史rollout |
|---|---|---|---|
| 0 | 0.36699 | 0.32436 | 0.32436 |
| 1 | 0.33968 | 0.02699 | 0.27516 |
| 11 | 0.20119 | 0.01125 | 0.17958 |
| 23 | 0.24698 | 0.01149 | 0.22396 |
| 47 | —(本次只采24帧) | — | 0.41614 |
| 71 | —(本次只采24帧) | — | 0.60306 |
本次视野内MSE分别为0.23990、0.02535、0.20947;同权重历史替换对应约8.26倍误差比。它诊断当前弱模型的上下文依赖,不能换算成真实视频质量降低多少。
把 rollout 的误差按 3.2 节拆开:
| 状态分量 | TF视野内 | rollout视野内 | 二者比值 | rollout视野外/内 |
|---|---|---|---|---|
| 慢变量u | 0.01863 | 0.28621 | 15.36 | 2.45 |
| 快变量w | 0.03207 | 0.13272 | 4.14 | 1.01 |
这些倍数仅是当前拟合器的分量统计;数据转移系数、误差相关和配对过程噪声不同,不能把它们与16.9或3.6做一一理论拟合。有限区间内增长也不是无限长度发散证据。
Q3现在称“配对标签重拟合”:自身历史配原序列标签,独立验证集选混合步长;没有专家重新标注、数据聚合或DMD。Q4固定真值历史只改加噪,Q5改训练历史的噪声级,再用干净真值/自身历史评测。
训练先对每条历史帧独立加噪,再用同一组帧构造prev和past_mean;评测同样只加一次,并在四次当前帧去噪之间保持历史固定。空历史仍为零。四帧均值噪声方差、prev与均值的噪声协方差都为 $(1-\bar\alpha_k)/4$,分别给两个汇总特征加独立同方差噪声会破坏这两项。此toy只用一个全局历史噪声级且未显式输入网络,不等于独立逐帧噪声的Diffusion Forcing。
固定到官方Self-Forcing提交 33593df3e81fa3ec10239271dd2c100facac6de1,检查日期2026-10-29。锚点为 CausalInferencePipeline、SelfForcingTrainingPipeline、self_forcing_dmd.yaml、default_config.yaml、WanDiffusionWrapper与FlowMatchScheduler。
学生和教师必须分开。 包装器默认 model_name="Wan2.1-T2V-1.3B";配置中的 real_name: Wan2.1-T2V-14B 是real score教师,并非生成器尺寸。生成器学习率2e-6,DMD目标,形状[1,21,16,60,104]、每块3潜帧,默认不单独生成首帧。四步列表[1000,750,500,250]开启warp。本文账本只数学生生成,不含教师/critic训练。
同提交Wan 1.3B配置给出宽1536、FFN8960、30层、12头,每头128;patch=(1,2,2),VAE stride=(4,8,8)。60×104是潜空间宽高,每帧(60/2)(104/2)=1560个token,通道16进入patch特征,不再乘token数。21潜帧对应1+4(21-1)=81像素帧,16fps约5.06秒;首块3潜帧对应9像素帧,之后每块增加12帧。
四次预测加一次刷新,但不是四步确定性DDIM。 官方相邻预测之间调用flow加噪器,使用新标准高斯重新污染预测的干净结果,而非沿用同一个噪声估计。形式 $z=(1-\sigma)x+\sigma\epsilon$ 不等于toy VP的 $\sqrt{\bar\alpha}x+\sqrt{1-\bar\alpha}\epsilon$。warp用shift=5的1000点表,通过1000-step索引映射,因此名义750不是线性beta表的第750步。
四次后,普通推理用干净的 denoised_pred 输入、context_noise时间标签再跑一次,覆盖当前块K/V;刷新前没有再加噪。训练管线则先scheduler.add_noise,再在no_grad内刷新。表设置sigma_min=0且extra_one_step=True,排除了精确零;时间步0的最近点sigma约0.00498008,所以固定版本的训练刷新仍有小量污染。不能把toy“上下文多少VP噪声”当作通用官方参数契约。
缓存的实际分配不同于理想动态账本。 K/V每层形状[B,capacity,12,128];普通推理无局部窗时一开始预分配32760容量,局部窗时为local_attn_size×1560。30层bf16共5.623627GiB,非逐帧从零分配。文本K/V每层[B,512,12,128],合计0.087891GiB;512是固定文本槽位数。块内彼此可见、块间因果,不是块内逐token三角遮罩。滚动窗口还受sink token、位置编码和训练局部注意力影响,不能无条件截断。
普通 inference() 最后才调用以下解码,再返回整段:
vae.decode_to_pixel(output, use_cache=False)它可以逐块算latent,调用这个函数仍不能逐块收到像素帧;流式产品还需要分块VAE、交付接口和传输。本文MAC不含这些成本。
梯度和实跑边界。 训练随机选退出去噪步,之前步不记录梯度、退出步反传、缓存刷新不反传;same_step_across_blocks控制共享索引,超过21帧时更早块也关闭梯度。它是截断估计,不是完整BPTT。DMD用整段加噪分布的score差,非配对MSE。
本次未经改写执行原始完整方法AST:CPU四种退出位置均验证前步无梯度/退出步有梯度/刷新无梯度;两块推理共10次前向,刷新输入等于干净预测。原始分配方法在meta设备核对真实shape与字节;flow加噪float32/64四组输入通过。生成器、文本、VAE用小张量回调,退出索引由夹具指定,未加载权重、未跑真实CUDA/NCCL/完整DMD或视频质量。论文第4节与附录A报告DMD约1.5小时/64张H100,属于原论文训练预算;本机CPU核验不支持推断训练收敛或GPU吞吐。
流式不是免费的,把账算干净。
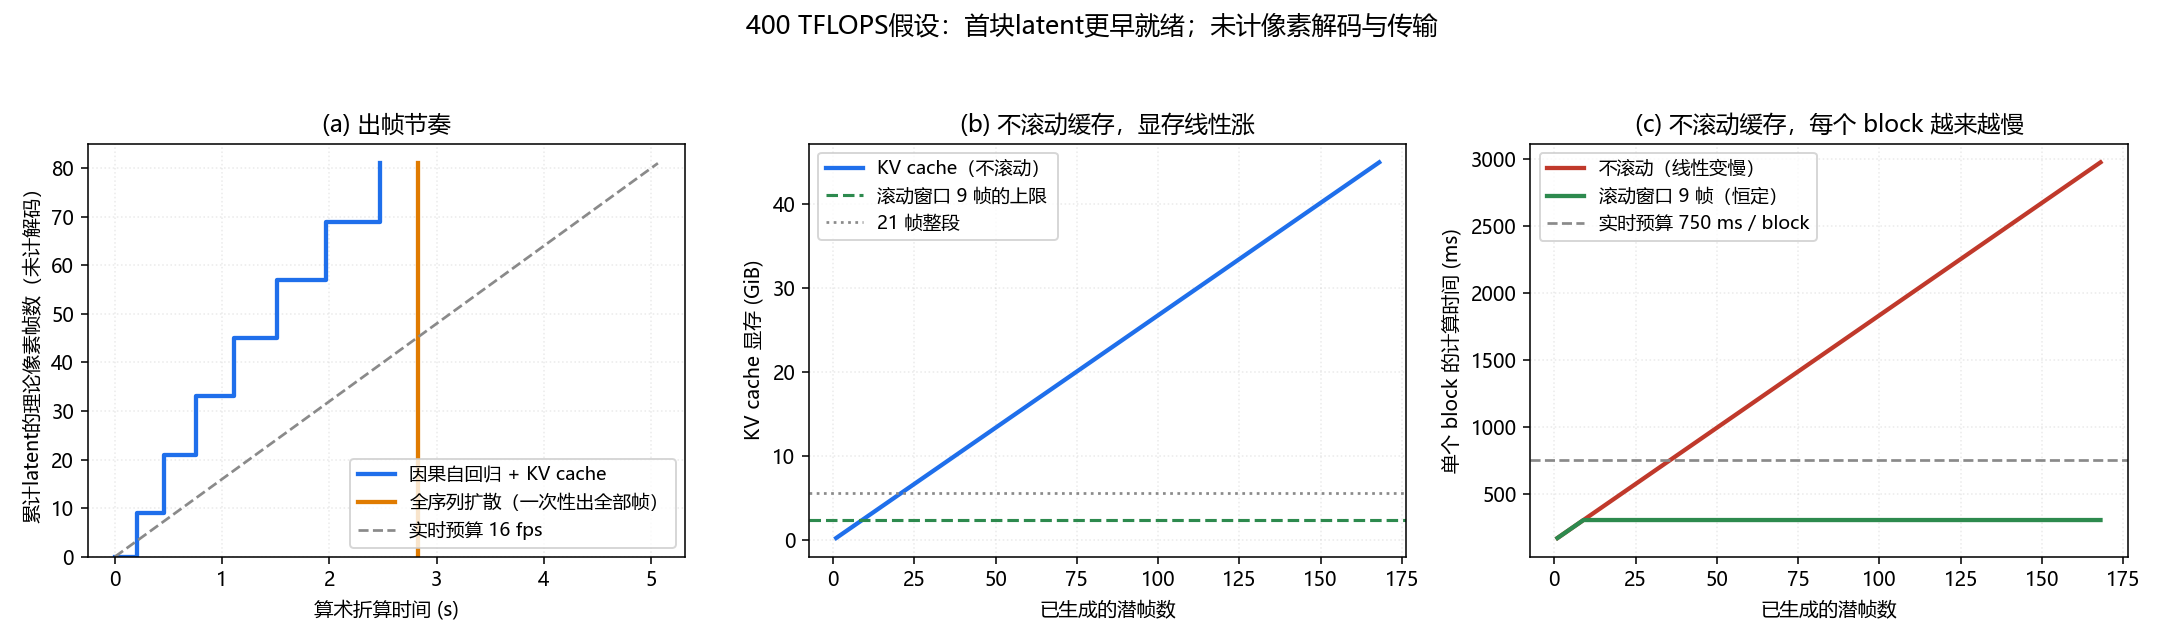
这张图要看什么:左图台阶是按顺序完成预测与刷新的latent就绪点,像素轴按压缩率理论换算:首块9帧、之后每块12帧;没有计入解码或实际GPU时间,橙色竖线是全序列扩散一次性交付的时刻;中图和右图是一对警告——不滚动缓存时显存和单 block 时间都随长度线性涨,无sink的理想9潜帧有效窗口限制这两项;非官方整应用显存测量。
口径先交代清楚(逐项对齐公开配置,代码在附录 streaming_ledger.py):每层每 token 的 MAC = 注意力分数(对每个可见 key 做两次内积,$2 \times n_{\text{key}} \times d$)+ 四个注意力投影($4 d^2$)+ FFN($2 \times d \times 8960$)+ 一次 cross-attention(对 512 个文本 token 的分数与投影)。KV cache 每潜帧的字节数按以下乘积计算,折合0.267792GiB:
$$2 \times30\times1560\times1536\times2=287539200\text{ B}.$$
(十进制0.287539GB)——K、V 两份,乘 30 层、每帧 1560 token、$d = 1536$、bf16 两字节——21帧合计5.623627GiB,即6.0383232GB。时间按假设有效400 TFLOPS折算(1 MAC = 2 FLOP),只算 transformer 主体,不含 VAE 解码与文本编码。
算力账(400 TFLOPS 有效算力折算,MAC 计入注意力 QKV 与投影):
| 全序列扩散 | 因果 + KV cache | |
|---|---|---|
| 单步去噪 MAC | 1.4142e+14 | 首块 8.09e+12 → 末块 2.02e+13 |
| 四次全序列 / 每块四次加刷新总MAC | 5.6567e+14 | 4.9514e+14(比值 0.875) |
| 总时间 | 2.828 s | 2.476 s |
| 首块含刷新折算(非像素交付) | 2.828 s | 0.202 s(13.98×) |
| 末块算术节奏 | 一次性交付 | 末块505.1ms,实时预算 750 ms,余量 1.48× |
首块四次预测完成即有干净latent,算术折算约0.162秒;表中0.202秒额外计一次刷新,二者对应整段/首块比约17.48与13.98。四步后最后块的刷新也按原循环计入。norm、激活、调制、patch输入输出、文本K/V首次投影、VAE、随机数、数据搬移与kernel launch均未计入。固定400TFLOPS速率未随shape或瓶颈变化,不能推断实际实时。
两点容易被误读:其一,自回归并不显著省总算力(0.875 倍,注意力遮罩少算的钱被 KV cache 刷新的额外前向花掉了大半),它主要改变latent交付粒度和后续块节奏;其二,若每层稠密保存 32760×32760×12 个 bf16 分数,约 25.76 GB(24.0 GiB)(32760 token 的平方 × 12 头 × bf16),精确IO优化注意力可避免物化这项;并不减少全部二次算术(前置阅读见那篇)。
显存账(bf16 KV cache,30 层全量):21帧有效容量5.624GiB,理想9帧窗口2.410GiB(43%)。不滚动的话,生成到 336 潜帧(336 个潜帧按 4 倍时间解码约 1341 帧,在 16 fps 下约 83.8 秒)时单 block 要 5.8 秒、缓存89.98GiB——两头都爆炸;9 帧滚动窗口下恒定 303.2ms、2.41GiB(仅理想有效注意力窗口)。固定可见窗口可限制这两项工作量,但会丢弃远程直接信息。官方普通函数预分配缓存并保存整段latent,所以不能据此宣称整个应用空间恒定或长时语义稳定。
质量与稳定性的账,用两个受控实验说:
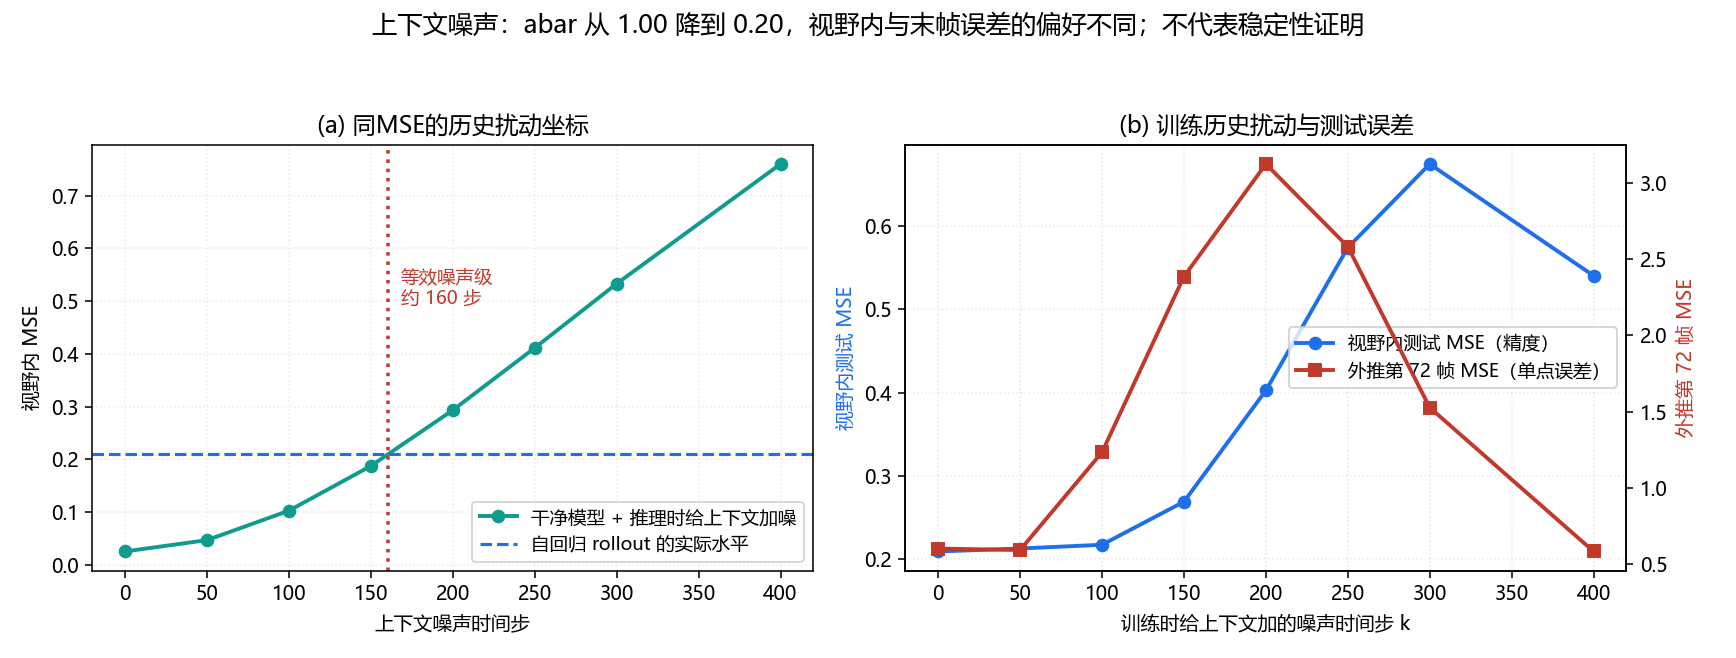
这张图左侧以一个MSE坐标校准历史扰动,右侧给不同训练历史加噪的视野内与末帧测试误差;曲线和标注来自本次统一加噪方式后的完整实跑,
这条脉络同时改变历史来源、噪声条件、后训练目标和采样成本,不能压成“加噪后再做DAgger”。相关推导见DDIM、流匹配与潜空间扩散。
误解一:“自回归必然省总算力,0.20秒就是产品首帧。” 当前0.875倍只属于该shape、可见范围及每块四次预测加刷新;0.20秒是含刷新算术折算,VAE、接口和传输未计入。官方普通函数还在末尾整段解码。
误解二:“谱半径决定一切,0.97意味着无限发散。” 理想独立零均值标量模型在绝对系数小于1时有界;偏置、相关增量和非正规矩阵另查。数据转移0.97不等于学习器误差闭环0.97。
误解三:「在自生成上下文上逐帧重拟合,轮次越多就越稳。」 看配对标签重拟合用验证集视野内误差选步时发生了什么:
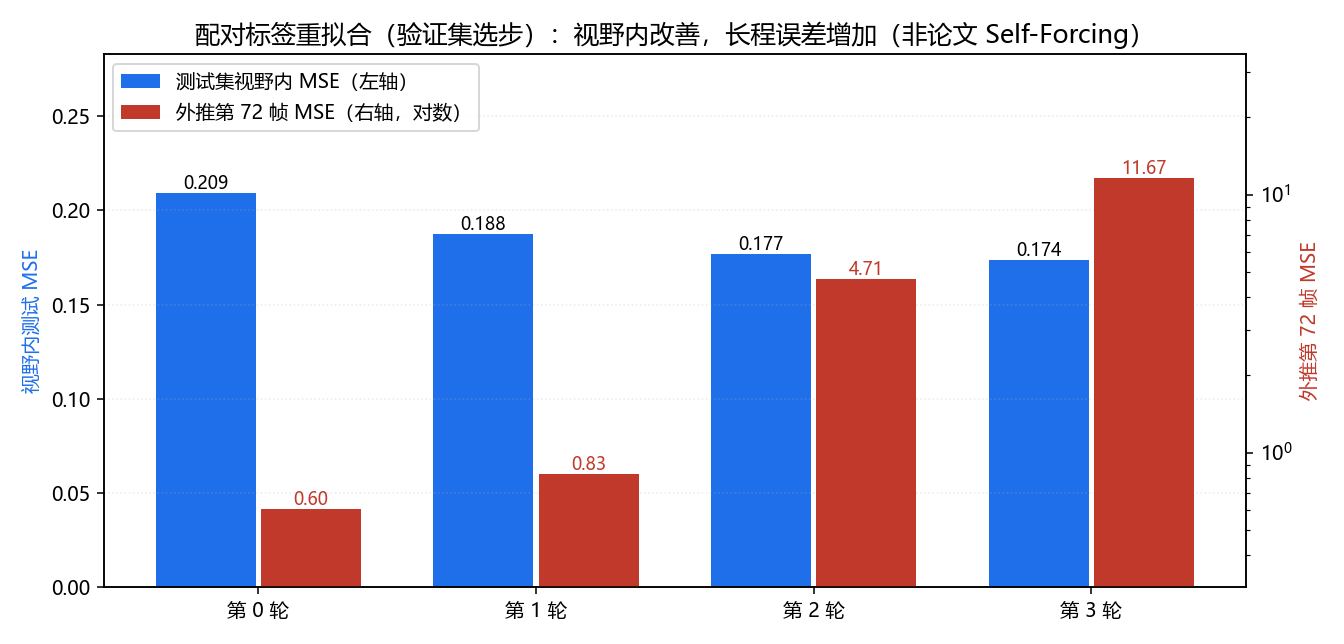
蓝柱读左轴视野内MSE,红柱读右侧对数轴末帧MSE。Q3按独立验证集选步,真值不参与生成初始状态;它既不是完整DAgger,也不是Self-Forcing消融。以下给本次完整实跑:
| 轮次 | 测试视野内MSE | 测试t=71MSE |
|---|---|---|
| round0 | 0.20947 | 0.60306 |
| round1 | 0.18767 | 0.82679 |
| round2 | 0.17684 | 4.70642 |
| round3 | 0.17357 | 11.66893 |
误解四:「训练时给上下文加噪越多越鲁棒。」 右图(06 节)的折中曲线明确说不是,Q5 的原始数据在这里:
| 训练历史噪声步 | TF诊断 | rollout视野内 | rollout末帧t=71 |
|---|---|---|---|
| 0 | 0.02535 | 0.20909 | 0.60274 |
| 50 | 0.02723 | 0.21259 | 0.59302 |
| 100 | 0.03301 | 0.21712 | 1.23368 |
| 150 | 0.04476 | 0.26883 | 2.38543 |
| 200 | 0.06276 | 0.40246 | 3.12273 |
| 250 | 0.08539 | 0.57413 | 2.58114 |
| 300 | 0.11001 | 0.67454 | 1.52668 |
| 400 | 0.15310 | 0.54038 | 0.58389 |
Q5用训练噪声种子24重新拟合,测试初始噪声按90000+i配对;Q1用训练种子22、测试种子32000+i,因此两个k=0基线略有差异。
本次八点只展示这个弱模型的精度取舍,视野内和末帧可以偏好不同超参。不要混算TF与rollout列,也不能把单条MSE下降解释为长时稳定性证明;这里没有实现独立逐帧噪声且输入噪声级的Diffusion Forcing。
误解五:“因果注意力必须丢质量,或一定不丢质量。” 本toy不支持任何一项普遍结论。双向信息、架构容量、后训练与采样误差都需真实模型实验,不能用配对MSE替代视频分布评测。
四脚本全文见附录;教学实验依赖NumPy,制图另需matplotlib,无权重或GPU要求。快速版样本较少,写独立fast缓存,不能拿其数字配完整实验图。
python forcing_lab.py --fast
python forcing_lab.py
python streaming_ledger.py
python forcing_checks.py
python make_figures.pyforcing_checks.py 独立检查30个误差有限和、DDIM约2.22e-16误差、非正规矩阵一步10.0125放大;传标签不改变生成、同随机数首帧相等。10万条历史夹具验证均值方差与prev/mean协方差,理论值0.118979。pipeline/causal_inference.py、configs/self_forcing_dmd.yaml)互补阅读是少步蒸馏与下游世界模型;流式出帧不自动等于可交互环境。少步数蒸馏(DMD / 蒸馏到 1~4 步)——Forcing 解决了「怎么流式地生成」,蒸馏解决「每块少算几步」,两者拼起来才是实时视频生成的完整拼图。
读原论文的建议顺序:先读 Self-Forcing 的第 3 节(推理管线那五步,对照本文 05 节的表),再回头读 Diffusion Forcing 的第 3 节(目标函数的统一形式,对照本文 3.3 节)——反过来读会被「每帧独立噪声级」的抽象描述卡住,先看到具体的采样循环再回头抽象,会顺很多。玩具实验(04 节)建议在读论文之前跑一遍,数字先在手里,论文里每一句关于 exposure bias 的表述都能对号入座。
09 节用到的脚本全文如下(forcing_checks.py、forcing_lab.py、streaming_ledger.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""Independent arithmetic checks for the article (NumPy only)."""
import json
from pathlib import Path
import numpy as np
import forcing_lab as f
import streaming_ledger as s


def main():
    rng = np.random.default_rng(77)
    errors = []
    for a in [0.0, 0.85, 0.97, 1.0, -1.0, 1.02]:
        for length in [1, 2, 24, 72, 200]:
            # Independent impulse response versus iterated covariance.
            v = 0.0
            for _ in range(length):
                v = a*a*v + 0.04
            direct = 0.04 * sum(a**(2*j) for j in range(length))
            errors.append(abs(v-direct))
    assert max(errors) < 1e-9
    transient = np.array([[0.5, 10.0], [0.0, 0.5]])
    assert max(abs(np.linalg.eigvals(transient))) == 0.5
    assert np.linalg.norm(transient @ [0., 1.]) > 10
    # DDIM: exact x0 and shared epsilon reproduce every intermediate.
    x, noise = rng.normal(size=(2, 6)), rng.normal(size=(2, 6))
    ddim_errors = []
    for t, u in [(1000, 750), (750, 500), (500, 250), (250, 0)]:
        a, b = f.abar_of(t), f.abar_of(u)
        z = np.sqrt(a)*x + np.sqrt(1-a)*noise
        expected = np.sqrt(b)*x + np.sqrt(1-b)*noise
        ddim_errors.append(float(np.max(abs(f.ddim_step(z, x, a, b)-expected))))
    assert max(ddim_errors) < 1e-14
    W = rng.normal(0, 0.02, size=(f.F_DIM, f.D))
    truth, cond = f.sample_sequences(rng, f.make_system(), 2, 8)
    free = f.sample_causal(W, np.random.default_rng(9), 8, cond[0])
    labelled, features, labels = f.sample_causal(
        W, np.random.default_rng(9), 8, cond[0], collect=True, x_true=truth[0])
    assert np.array_equal(free, labelled)  # labels cannot leak into generation
    teacher = f.sample_causal(W, np.random.default_rng(9), 8, cond[0], hist_true=truth[0])
    assert np.array_equal(free[0], teacher[0])
    # Correct joint history covariance, rather than two independently noised features.
    level = 250
    data = np.tile(truth[:1], (100000, 1, 1))
    X, Y = f.build_gt_dataset(data, np.tile(cond[:1], (len(data), 1)),
                              np.random.default_rng(17), levels=[500], ctx_ts=level)
    n = len(data)
    assert not X[:n, f.D:3*f.D].any()  # empty history remains exactly zero
    t = 4
    prev = X[t*n:(t+1)*n, f.D:2*f.D]
    mean = X[t*n:(t+1)*n, 2*f.D:3*f.D]
    covariance = float(np.cov(prev[:, 0], mean[:, 0], ddof=0)[0, 1])
    variance = float(mean[:, 0].var())
    expected = (1-f.abar_of(level))/4
    assert abs(covariance-expected) < 0.002
    assert abs(variance-expected) < 0.002
    # Enumerate visible token pairs independently from the algebraic ledger.
    pairs = sum((min(i+3,21)-i)*min(i+3,21) for i in range(0,21,3))
    expected_pairs = 3*3*sum(range(1,8))
    assert pairs == expected_pairs == 252
    ledger = s.ledger_numbers()
    bytes_per_latent = 2*30*1560*1536*2
    assert ledger['kv_all_gb']*2**30 == bytes_per_latent*21
    assert s.gbyte(bytes_per_latent*42) == 2*ledger['kv_all_gb']
    assert [4*(3*i-1)+1 for i in range(1,8)] == [9,21,33,45,57,69,81]
    result = dict(passed=True, recurrence_cases=len(errors), recurrence_max_error=max(errors),
                  nonnormal_spectral_radius=.5, nonnormal_one_step_norm=float(np.linalg.norm(transient@[0.,1.])),
                  ddim_max_error=max(ddim_errors), labels_do_not_change_generation=True,
                  first_frame_paired_exact=True, noisy_history_covariance=covariance,
                  noisy_mean_variance=variance, covariance_theory=expected,
                  block_pairs=pairs, kv_bytes_per_latent=bytes_per_latent,
                  kv_21_gib=ledger['kv_all_gb'], latency_ratio=ledger['t_full']/ledger['t_blocks'][0],
                  toy_vp_terminal_alpha=f.abar_of(1000), errors=[], warnings=[])
    Path(__file__).with_name('validation_results.json').write_text(
        json.dumps(result,ensure_ascii=False,indent=2)+'\n',encoding='utf8')
    print(json.dumps(result,ensure_ascii=False,indent=2))


if __name__ == '__main__':
main()# -*- coding: utf-8 -*-
"""
forcing_lab.py —— 自回归视频生成 / Forcing 范式的玩具实验(只依赖 numpy)
跑法: python forcing_lab.py # 全量
python forcing_lab.py --fast # 小样本快速迭代
python forcing_lab.py --rounds 4 # 多做几轮配对标签重拟合
python forcing_lab.py --ctx 0 100 250 # 只扫这几个上下文噪声级
数据是一段"带条件的 6 维视频",分成两块,故意让它们的时间尺度不同:
u(前 3 维)慢变量:u_t = Lam u_{t-1} + G w_{t-1} + 噪声,Lam 的谱半径 0.97
—— 一条会被积分记住的轨迹,误差会累积(相机轨迹、主体位置)
w(后 3 维)快变量:w_t = tanh(Aw w_{t-1} + Bw c) + 噪声
—— 收缩模态,误差会被动力学忘掉(纹理、局部细节)
输出顺序与正文表格一一对应:
Q1 三种范式的逐帧误差:全序列扩散 / teacher forcing / 自回归 rollout
Q2 当前拟合器的误差分量;不把数据生成谱半径当闭环误差的系数
Q3 配对标签线性重拟合;不是 Self-Forcing 的 DMD 实现
Q4 历史加噪扫描;与官方flow context_noise不是相同接口
"""
import argparse
import os
import numpy as np
# ═══════════════════════════════ 0. 配置 ═══════════════════════════════
DU = 3 # 慢变量 u 的维度(会被积分记住的分量)
DW = 3 # 快变量 w 的维度(收缩的分量)
D = DU + DW # 每帧"潜向量"的总维度
DC = 4 # 条件向量维度(类比文本 embedding)
T_TRAIN = 24 # 训练时的序列长度(horizon)
T_ROLL = 72 # 推理外推到 3 倍长度
N_STEPS_DIFF = 1000
STEPS = [1000, 750, 500, 250] # 对齐 Self-Forcing 的 4 步去噪
LAM_SLOW = 0.97 # 慢变量的自回归系数(谱半径)
RHO_FAST = 0.85 # 快变量转移矩阵的谱半径
G_SCALE = 0.09 # 快变量驱动慢变量的耦合强度
SIG_U = 0.02 # 慢变量的过程噪声
SIG_W = 0.10 # 快变量的过程噪声
LAMBDA = 3e-3 # ridge 系数(压住上下文权重,防止 rollout 重训时正反馈发散)
ALPHA = 0.3 # toy 重拟合 每轮的权重更新步长(1.0 = 完全换成新解)
SEED_SYS = 20250608
CACHE = os.path.join(os.path.dirname(os.path.abspath(__file__)), "forcing_lab_cache.npz")
# ═══════════════════════ 1. 噪声表:线性 beta 调度(DDPM 原版)═══════════════════════
def build_schedule(n_steps=N_STEPS_DIFF, beta0=1e-4, beta1=0.02):
beta = np.linspace(beta0, beta1, n_steps)
return np.concatenate([[1.0], np.cumprod(1.0 - beta)]) # 下标 = 时间步 t
ABAR = build_schedule()
def abar_of(timestep):
t = min(max(int(round(timestep)), 0), N_STEPS_DIFF)
return float(ABAR[t])
# ═══════════════════════ 2. 数据:慢变量 + 快变量 + 条件 ═══════════════════════
def _ortho(rng, n, rho):
q, _ = np.linalg.qr(rng.standard_normal((n, n)))
return rho * q
def make_system():
rng = np.random.default_rng(SEED_SYS)
return dict(
Lam=_ortho(rng, DU, LAM_SLOW),
G=rng.standard_normal((DU, DW)) * G_SCALE,
Aw=_ortho(rng, DW, RHO_FAST),
Bw=rng.standard_normal((DW, DC)) * 0.9,
H=rng.standard_normal((DU, DC)) * 0.9,
)
def sample_sequences(rng, S, n, T):
"""采样 n 条长度为 T 的序列。c 是每条序列固定、模型可见的条件(类比文本)。"""
c = rng.standard_normal((n, DC))
cb = c @ S["Bw"].T # (n, DW)
hb = c @ S["H"].T # (n, DU)
u = np.tanh(hb) + SIG_U * rng.standard_normal((n, DU))
w = np.tanh(cb) + SIG_W * rng.standard_normal((n, DW))
out = np.empty((n, T, D))
for t in range(T):
out[:, t, :DU] = u
out[:, t, DU:] = w
w_new = np.tanh(w @ S["Aw"].T + cb) + SIG_W * rng.standard_normal((n, DW))
u_new = u @ S["Lam"].T + w @ S["G"].T + SIG_U * rng.standard_normal((n, DU))
u, w = u_new, w_new
return out, c
# ═══════════════════════════ 3. 两种特征(因果 / 双向)═══════════════════════════
#
# 两边都是"自己的观测 + 两个邻居/汇总向量 + 条件 + 偏置",维数完全相同 = 3D+DC+1。
# 两个受控特征构造不同;不是完整视频范式之间的性能比较:
# 因果 causal:上一帧的上下文 + 过去 4 帧均值(只看过去)
# 双向 bidir :前一帧 + 后一帧的噪声观测(能看未来)
F_DIM = 3 * D + DC + 1
def feat_causal(z_t, hist, c):
if len(hist) == 0:
prev = np.zeros(D)
past_mean = np.zeros(D)
else:
prev = hist[-1]
past_mean = np.asarray(hist[-4:]).mean(axis=0)
return np.concatenate([z_t, prev, past_mean, c, np.ones(1)])
def feat_bidir(z_seq, t, c):
zp = z_seq[t - 1] if t > 0 else np.zeros(D)
zn = z_seq[t + 1] if t + 1 < len(z_seq) else np.zeros(D)
return np.concatenate([z_seq[t], zp, zn, c, np.ones(1)])
def fit_ridge(X, Y, lam=LAMBDA):
F = X.shape[1]
return np.linalg.solve(X.T @ X + lam * np.eye(F), X.T @ Y)
# ═══════════════════════════ 4. 采样器 ════════════════════════════
def ddim_step(z, xhat, a, a_next):
"""DDIM (eta=0):固定噪声估计,只把噪声水平降到下一档。"""
eps = (z - np.sqrt(a) * xhat) / np.sqrt(max(1e-12, 1.0 - a))
return np.sqrt(a_next) * xhat + np.sqrt(1.0 - a_next) * eps
def sample_bidir(W, z_init, c, steps=STEPS):
"""全序列扩散:整条序列一起走 4 步,每步所有帧互相可见。非流式。"""
T = z_init.shape[0]
z = z_init.copy()
xhat = np.zeros_like(z)
for i, ts in enumerate(steps):
a = abar_of(ts)
xhat = np.stack([feat_bidir(z, t, c) for t in range(T)]) @ W
if i + 1 < len(steps):
z = ddim_step(z, xhat, a, abar_of(steps[i + 1]))
return xhat
def sample_causal(W, rng, T_out, c, steps=STEPS, ctx_ts=0, hist_true=None,
ctx_rng=None, collect=False, x_true=None):
"""因果自回归 rollout。
ctx_ts VP教学加噪级;历史帧各自加噪一次后固定,0为干净。
官方flow缓存刷新另见实现对照,二者不是相同的调度器。
hist_true 给定时上下文永远取真值 —— teacher forcing 评测(测试时不可得)。
ctx_rng 给定时,连真值上下文也按 ctx_ts 加噪(Q4 用的受控实验)。
"""
a_ctx = abar_of(ctx_ts)
if T_out < 1 or hist_true is not None and len(hist_true) < T_out:
raise ValueError("Invalid output/history length")
# 固定一次每条历史帧的噪声;求均值时保留与prev的协方差。
history_source = None
if hist_true is not None:
history_source = np.asarray(hist_true[:T_out]).copy()
if ctx_rng is not None and a_ctx < 1.0:
history_source = (np.sqrt(a_ctx) * history_source
+ np.sqrt(1-a_ctx) * ctx_rng.standard_normal(history_source.shape))
out = np.empty((T_out, D))
hist = []
rows_X, rows_Y = [], []
for t in range(T_out):
# 生成初始噪声不依赖真值标签;VP末端仍近似N(0,I)。
z = rng.standard_normal(D)
for i, ts in enumerate(steps):
a = abar_of(ts)
if hist_true is not None:
ctx = history_source[:t]
else:
ctx = np.array(hist) if len(hist) else np.zeros((0, D))
feat = feat_causal(z, ctx, c)
xhat = feat @ W
if collect and x_true is not None:
rows_X.append(feat.copy())
rows_Y.append(x_true[t].copy())
if i + 1 < len(steps):
z = ddim_step(z, xhat, a, abar_of(steps[i + 1]))
out[t] = xhat
if hist_true is None:
if a_ctx >= 1.0 - 1e-12:
hist.append(xhat.copy())
else:
hist.append(np.sqrt(a_ctx) * xhat
+ np.sqrt(1.0 - a_ctx) * rng.standard_normal(D))
if collect:
return out, np.array(rows_X), np.array(rows_Y)
return out
# ═══════════════════════════ 5. 数据集构造 ════════════════════════════
def build_gt_dataset(seqs, conds, rng, levels=STEPS, ctx_ts=0):
"""teacher forcing 数据集:上下文用真值帧(可按 ctx_ts 加噪)。"""
n, T, _ = seqs.shape
a_ctx = abar_of(ctx_ts)
Xs, Ys = [], []
context = seqs
if a_ctx < 1.0:
context = np.sqrt(a_ctx) * seqs + np.sqrt(1-a_ctx) * rng.standard_normal(seqs.shape)
for t in range(T):
if t == 0:
prev, pm = np.zeros((n, D)), np.zeros((n, D))
else:
prev = context[:, t-1, :]
pm = context[:, max(0,t-4):t, :].mean(axis=1)
for ts in levels:
a = abar_of(ts)
z = np.sqrt(a) * seqs[:, t, :] + np.sqrt(1.0 - a) * rng.standard_normal((n, D))
Xs.append(np.concatenate([z, prev, pm, conds, np.ones((n, 1))], axis=1))
Ys.append(seqs[:, t, :])
return np.concatenate(Xs, 0), np.concatenate(Ys, 0)
def build_bidir_dataset(seqs, conds, rng, levels=STEPS):
n, T, _ = seqs.shape
Xs, Ys = [], []
for ts in levels:
a = abar_of(ts)
z = np.sqrt(a) * seqs + np.sqrt(1.0 - a) * rng.standard_normal((n, T, D))
for t in range(T):
zp = z[:, t - 1, :] if t > 0 else np.zeros((n, D))
zn = z[:, t + 1, :] if t + 1 < T else np.zeros((n, D))
Xs.append(np.concatenate([z[:, t, :], zp, zn, conds, np.ones((n, 1))], axis=1))
Ys.append(seqs[:, t, :])
return np.concatenate(Xs, 0), np.concatenate(Ys, 0)
# ═══════════════════════════ 6. 度量 ════════════════════════════
def mse_curve(pred, truth, sl=None):
"""每帧每维的平均平方误差。sl 是维度切片,用来把快慢变量分开看。"""
e = (pred - truth) if sl is None else (pred[..., sl] - truth[..., sl])
return (e ** 2).mean(axis=(0, -1))
USL, WSL = slice(0, DU), slice(DU, D)
def ctx_gain(W):
"""模型对上下文的依赖强度:上下文两块特征对应权重的 Frobenius 范数。"""
return float(np.linalg.norm(W[D:3 * D, :]))
def doubling_length(curve, t0=2, t1=None):
t1 = t1 or len(curve) - 1
y = np.log(np.maximum(curve[t0:t1 + 1], 1e-12))
b = np.polyfit(np.arange(t0, t1 + 1), y, 1)[0]
return float(np.log(2.0) / b) if b > 0 else float("inf")
def fmt_row(tag, cur, cur_u, cur_w, T=T_TRAIN):
return (f" {tag:<12}{cur[:T].mean():>12.5f}{cur_u[:T].mean():>12.5f}"
f"{cur_w[:T].mean():>12.5f}{cur[min(23, len(cur) - 1)]:>12.5f}"
f"{cur[min(47, len(cur) - 1)]:>12.5f}{cur[-1]:>12.5f}")
# ═══════════════════════════ 7. 主流程 ════════════════════════════
def main():
ap = argparse.ArgumentParser()
ap.add_argument("--rounds", type=int, default=3)
ap.add_argument("--n-train", type=int, default=6000)
ap.add_argument("--n-test", type=int, default=1500)
ap.add_argument("--alpha", type=float, default=ALPHA)
ap.add_argument("--fast", action="store_true")
ap.add_argument("--ctx", type=int, nargs="*",
default=[0, 50, 100, 150, 200, 250, 300, 400])
args = ap.parse_args()
if args.fast:
args.n_train, args.n_test = 2500, 500
S = make_system()
seqs_train, c_train = sample_sequences(np.random.default_rng(11), S,
args.n_train, max(T_TRAIN, T_ROLL))
seqs_test, c_test = sample_sequences(np.random.default_rng(12), S,
args.n_test, max(T_TRAIN, T_ROLL))
var_u = seqs_test[..., USL].var(axis=(0, 1)).mean()
var_w = seqs_test[..., WSL].var(axis=(0, 1)).mean()
print("=" * 78)
print(f"数据:u_t = Lam u_{{t-1}} + G w_{{t-1}} + {SIG_U} xi (慢变量,谱半径 {LAM_SLOW})")
print(f" w_t = tanh(Aw w_{{t-1}} + Bw c) + {SIG_W} xi (快变量,谱半径 {RHO_FAST})")
print(f"D={D}(u:{DU} + w:{DW}) DC={DC} 训练集 {seqs_train.shape} 测试集 {seqs_test.shape}")
print(f"慢变量边缘方差 {var_u:.4f} 快变量边缘方差 {var_w:.4f}")
print(f"训练视野 T={T_TRAIN},外推到 T={T_ROLL};去噪步 {STEPS}")
print(f"特征维数 F = 3D+DC+1 = {F_DIM}(因果与双向完全相同)")
print(f"最后一步的输入噪声级 abar({STEPS[-1]}) = {abar_of(STEPS[-1]):.4f}")
print("=" * 78)
# ── 基线 0:全序列扩散(非因果,整段一起解)─────────────────────
Xb, Yb = build_bidir_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(21))
Wb = fit_ridge(Xb, Yb)
rng_b = np.random.default_rng(31)
pred_bi = np.stack([sample_bidir(Wb, rng_b.standard_normal((T_TRAIN, D)), c_test[i])
for i in range(args.n_test)])
cur_bi = mse_curve(pred_bi, seqs_test[:, :T_TRAIN])
cur_bi_u = mse_curve(pred_bi, seqs_test[:, :T_TRAIN], USL)
cur_bi_w = mse_curve(pred_bi, seqs_test[:, :T_TRAIN], WSL)
# ── 基线 1:teacher forcing(上下文用真值帧)────────────────────
Xg, Yg = build_gt_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(22))
W_tf = fit_ridge(Xg, Yg)
rng_tf = np.random.default_rng(32)
pred_tf = np.stack([sample_causal(W_tf, np.random.default_rng(32000+i), T_TRAIN, c_test[i],
hist_true=seqs_test[i, :T_TRAIN])
for i in range(args.n_test)])
cur_tf = mse_curve(pred_tf, seqs_test[:, :T_TRAIN])
cur_tf_u = mse_curve(pred_tf, seqs_test[:, :T_TRAIN], USL)
cur_tf_w = mse_curve(pred_tf, seqs_test[:, :T_TRAIN], WSL)
# ── 基线 2:同一个权重做自回归 rollout ──────────────────────────
rng_sf = np.random.default_rng(33)
pred_sf0 = np.stack([sample_causal(W_tf, np.random.default_rng(32000+i), T_ROLL, c_test[i], ctx_ts=0)
for i in range(args.n_test)])
cur_sf0 = mse_curve(pred_sf0, seqs_test[:, :T_ROLL])
cur_sf0_u = mse_curve(pred_sf0, seqs_test[:, :T_ROLL], USL)
cur_sf0_w = mse_curve(pred_sf0, seqs_test[:, :T_ROLL], WSL)
print("\n【Q1】三种范式的逐帧 MSE(每维平均平方误差)")
print(f"{'帧号':>6}{'全序列扩散':>14}{'teacher forcing':>16}{'自回归 rollout':>16}")
for t in [0, 1, 2, 3, 5, 7, 11, 15, 19, 23]:
print(f"{t:>6}{cur_bi[t]:>14.5f}{cur_tf[t]:>16.5f}{cur_sf0[t]:>16.5f}")
print("\n【Q2】曝光偏差拆成快慢两块看")
print(f" {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}"
f"{'t=23':>12}{'t=47':>12}{'t=71':>12}")
print(fmt_row("全序列", cur_bi, cur_bi_u, cur_bi_w) + " 非流式,长度固定")
print(fmt_row("teacher", cur_tf, cur_tf_u, cur_tf_w) + " 上下文用真值,测试时不可得")
print(fmt_row("rollout0", cur_sf0, cur_sf0_u, cur_sf0_w))
print(f"\n 快变量 w:teacher {cur_tf_w[:T_TRAIN].mean():.5f} -> "
f"rollout {cur_sf0_w[:T_TRAIN].mean():.5f} "
f"放大 {cur_sf0_w[:T_TRAIN].mean() / cur_tf_w[:T_TRAIN].mean():.2f} 倍(有限窗口统计)")
print(f" 慢变量 u:teacher {cur_tf_u[:T_TRAIN].mean():.5f} -> "
f"rollout {cur_sf0_u[:T_TRAIN].mean():.5f} "
f"放大 {cur_sf0_u[:T_TRAIN].mean() / cur_tf_u[:T_TRAIN].mean():.2f} 倍")
print(f" 慢变量误差 t=1 -> t=23 增长 "
f"{cur_sf0_u[23] / max(cur_sf0_u[1], 1e-12):.2f} 倍,"
f"翻倍长度 {doubling_length(cur_sf0_u, 1, T_TRAIN - 1):.2f} 帧")
print(f" 快变量误差 t=1 -> t=23 变化 "
f"{cur_sf0_w[23] / max(cur_sf0_w[1], 1e-12):.3f} 倍(有限窗口统计)")
print(f" 越过训练视野(t>={T_TRAIN})后:慢变量是视野内的 "
f"{cur_sf0_u[T_TRAIN:].mean() / cur_sf0_u[:T_TRAIN].mean():.2f} 倍,"
f"快变量 {cur_sf0_w[T_TRAIN:].mean() / cur_sf0_w[:T_TRAIN].mean():.2f} 倍")
print(f" 模型对上下文的依赖强度 |W_ctx| = {ctx_gain(W_tf):.4f}")
# ── Q3:Self-Forcing 轮次 ─────────────────────────────────────
print(f"\n【Q3】配对标签重拟合(非Self-Forcing/完整DAgger)轮次(每轮用自己 rollout 的上下文重训,步长 alpha={args.alpha})")
print(f" {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}"
f"{'t=23':>12}{'t=47':>12}{'t=71':>12}")
W = W_tf.copy()
curves, us, ws = {"round0": cur_sf0}, {"round0": cur_sf0_u}, {"round0": cur_sf0_w}
rng_roll = np.random.default_rng(41)
rng_eval = np.random.default_rng(61)
n_sub = min(3000, args.n_train)
def eval_rollout(Wm, rng):
p = np.stack([sample_causal(Wm, rng, T_ROLL, c_test[i], ctx_ts=0)
for i in range(args.n_test)])
return p, mse_curve(p, seqs_test[:, :T_ROLL])
# 注意:这里故意只按训练视野内的指标接受更新。Self-Forcing 的论文强调用
# "视频级整体损失",下面会看到只盯视野内会发生什么。
seqs_val, c_val = sample_sequences(np.random.default_rng(13), S, min(300,args.n_test), T_ROLL)
def validation_score(Wm):
pv = np.stack([sample_causal(Wm,np.random.default_rng(44000+i),T_TRAIN,c_val[i])
for i in range(len(c_val))])
return float(mse_curve(pv,seqs_val[:,:T_TRAIN]).mean())
best_score = validation_score(W)
tail0 = cur_sf0[-1]
for r in range(1, args.rounds + 1):
Xs, Ys = [], []
for i in range(n_sub):
_, Xr, Yr = sample_causal(W, rng_roll, T_TRAIN, c_train[i], ctx_ts=0,
collect=True, x_true=seqs_train[i, :T_TRAIN])
Xs.append(Xr)
Ys.append(Yr)
W_new = fit_ridge(np.concatenate(Xs, 0), np.concatenate(Ys, 0))
# 折半线搜索:rollout 重训容易形成正反馈,只接受真的变好的更新
picked = None
a = args.alpha
for _ in range(5):
W_try = (1.0 - a) * W + a * W_new
rng_try = np.random.default_rng(61)
p_try, c_try = eval_rollout(W_try, rng_try)
sc = validation_score(W_try)
if np.isfinite(sc) and sc < best_score:
picked = (W_try, p_try, c_try, sc, a)
best_score = sc
break
a *= 0.5
if picked is None:
print(f" round {r}: 折半线搜索到 alpha={a:.4f} 仍没有变好的更新,提前停止")
break
if picked[2][-1] > 50.0 * tail0:
print(f" round {r}: 外推末帧已发散到 {picked[2][-1]:.3g}(round0 的 "
f"{picked[2][-1] / tail0:.1f} 倍),停止")
curves[f"round{r}"] = picked[2]
us[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], USL)
ws[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], WSL)
break
W = picked[0]
curves[f"round{r}"] = picked[2]
us[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], USL)
ws[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], WSL)
print(fmt_row(f"round{r}", curves[f"round{r}"], us[f"round{r}"], ws[f"round{r}"])
+ f" alpha={picked[4]:.5f}")
print(f"\n {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}"
f"{'t=23':>12}{'t=47':>12}{'t=71':>12}")
print(fmt_row("teacher", cur_tf, cur_tf_u, cur_tf_w))
print(fmt_row("全序列", cur_bi, cur_bi_u, cur_bi_w))
keys = ["round0"] + [k for k in curves if k != "round0"]
for k in keys:
print(fmt_row(k, curves[k], us[k], ws[k]))
best = min(keys, key=lambda k: curves[k][:T_TRAIN].mean())
print(f"\n 最好一轮 {best}:快变量 {ws['round0'][:T_TRAIN].mean():.5f} -> "
f"{ws[best][:T_TRAIN].mean():.5f}"
f"(降 {100 * (1 - ws[best][:T_TRAIN].mean() / ws['round0'][:T_TRAIN].mean()):.1f}%),"
f"慢变量 {us['round0'][:T_TRAIN].mean():.5f} -> "
f"{us[best][:T_TRAIN].mean():.5f}"
f"(降 {100 * (1 - us[best][:T_TRAIN].mean() / us['round0'][:T_TRAIN].mean()):.1f}%)")
# ── Q4:上下文噪声必须与训练对齐 ──────────────────────────────
print("\n【Q4】固定历史来源,只扫描历史加噪级")
print(" (受控实验:上下文一律取真值帧,只改加噪级别,把曝光偏差排除掉)")
W_noisy = fit_ridge(*build_gt_dataset(seqs_train[:, :T_TRAIN], c_train,
np.random.default_rng(23), ctx_ts=250))
print(f" {'训练噪声步':<12}{'推理噪声步':<12}{'abar':>8}{'视野内MSE':>12}{'慢变量u':>12}")
ctx_rows = {}
for tag, Wm in [("clean(0)", W_tf), ("noisy(250)", W_noisy)]:
row = {}
for cts in args.ctx:
rng_e = np.random.default_rng(70)
p = np.stack([sample_causal(Wm, rng_e, T_TRAIN, c_test[i], ctx_ts=cts,
hist_true=seqs_test[i, :T_TRAIN], ctx_rng=rng_e)
for i in range(args.n_test)])
cc = mse_curve(p, seqs_test[:, :T_TRAIN])
cu = mse_curve(p, seqs_test[:, :T_TRAIN], USL)
row[cts] = cc
print(f" {tag:<12}{cts:<12}{abar_of(cts):>8.4f}{cc.mean():>12.5f}{cu.mean():>12.5f}")
ctx_rows[tag] = row
print(f" -> {tag} 的最优推理噪声步 = {min(row, key=lambda k: row[k].mean())}")
print("\n 同样的扫描放到自回归 rollout 上(此时上下文是模型自己的输出)")
row_sf = {}
for cts in args.ctx:
rng_e = np.random.default_rng(80)
p = np.stack([sample_causal(W, rng_e, T_TRAIN, c_test[i], ctx_ts=cts)
for i in range(args.n_test)])
cc = mse_curve(p, seqs_test[:, :T_TRAIN])
row_sf[cts] = cc
print(f" {'selfroll':<12}{cts:<12}{abar_of(cts):>8.4f}{cc.mean():>12.5f}"
f"{mse_curve(p, seqs_test[:, :T_TRAIN], USL).mean():>12.5f}")
print(f" -> 自回归 rollout 的最优推理噪声步 = {min(row_sf, key=lambda k: row_sf[k].mean())}")
# ── Q5:等效噪声级 + 训练时给上下文加噪换鲁棒性 ──────────────────
print("\n【Q5】曝光偏差的等效噪声级,以及训练时给上下文加噪能不能换来自回归的鲁棒性")
line_tf = np.array([ctx_rows["clean(0)"][k].mean() for k in args.ctx])
if not np.all(np.diff(line_tf) > 0):
raise ValueError("Equivalent-noise interpolation requires a strictly increasing measured curve")
target = cur_sf0[:T_TRAIN].mean()
grid = np.array(args.ctx, dtype=float)
eq = float(np.interp(target, line_tf, grid)) if line_tf[0] <= target <= line_tf[-1] else float("nan")
print(f" 自回归 rollout 的视野内 MSE = {target:.5f}")
if np.isfinite(eq):
print(f" 在 Q4 那条『干净模型 + 加噪上下文』曲线上插值,它等效于给真值上下文加 "
f"{eq:.1f} 个时间步的噪声(abar 约 {abar_of(eq):.4f})")
else:
print(" 超出 Q4 的扫描范围,无法插值出等效噪声级")
print(f"\n {'训练ctx噪声':<14}{'TF评测':>12}{'自回归(视野内)':>16}{'自回归t=71':>14}{'慢变量u':>12}")
q5 = {}
for k in args.ctx:
Wk = fit_ridge(*build_gt_dataset(seqs_train[:, :T_TRAIN], c_train,
np.random.default_rng(24), ctx_ts=k))
rng_a = np.random.default_rng(90)
p_tf = np.stack([sample_causal(Wk, np.random.default_rng(90000+i), T_TRAIN, c_test[i],
hist_true=seqs_test[i, :T_TRAIN])
for i in range(args.n_test)])
rng_b2 = np.random.default_rng(91)
p_sf = np.stack([sample_causal(Wk, np.random.default_rng(90000+i), T_ROLL, c_test[i], ctx_ts=0)
for i in range(args.n_test)])
c_tfk = mse_curve(p_tf, seqs_test[:, :T_TRAIN]).mean()
c_sfk = mse_curve(p_sf, seqs_test[:, :T_ROLL])
c_sfu = mse_curve(p_sf, seqs_test[:, :T_ROLL], USL)
q5[k] = (c_tfk, c_sfk[:T_TRAIN].mean(), c_sfk[-1], c_sfu[:T_TRAIN].mean())
print(f" {k:<14}{c_tfk:>12.5f}{c_sfk[:T_TRAIN].mean():>16.5f}"
f"{c_sfk[-1]:>14.5f}{c_sfu[:T_TRAIN].mean():>12.5f}")
best_k = min(q5, key=lambda k: q5[k][1])
print(f" -> 自回归 rollout 最好的训练上下文噪声步 = {best_k}"
f"(视野内 {q5[best_k][1]:.5f},对照 k=0 的 {q5[args.ctx[0]][1]:.5f})")
cache_path = CACHE.replace(".npz", "_fast.npz") if args.fast else CACHE
np.savez(cache_path,
cur_bi=cur_bi, cur_bi_u=cur_bi_u, cur_bi_w=cur_bi_w,
cur_tf=cur_tf, cur_tf_u=cur_tf_u, cur_tf_w=cur_tf_w,
var_u=np.array([var_u]), var_w=np.array([var_w]),
**{f"cur_{k}": v for k, v in curves.items()},
**{f"u_{k}": v for k, v in us.items()},
**{f"w_{k}": v for k, v in ws.items()},
ctx_clean=np.array([ctx_rows["clean(0)"][k].mean() for k in args.ctx]),
ctx_noisy=np.array([ctx_rows["noisy(250)"][k].mean() for k in args.ctx]),
ctx_sf=np.array([row_sf[k].mean() for k in args.ctx]),
ctx_list=np.array(args.ctx),
q5_tf=np.array([q5[k][0] for k in args.ctx]),
q5_sf=np.array([q5[k][1] for k in args.ctx]),
q5_sf_end=np.array([q5[k][2] for k in args.ctx]),
q5_sf_u=np.array([q5[k][3] for k in args.ctx]),
eq_noise=np.array([eq]))
print(f"\n[cached] {cache_path}")
if __name__ == "__main__":
main()# -*- coding: utf-8 -*-
"""
streaming_ledger.py —— 流式生成 vs 全序列扩散的算力 / 显存账本(纯算术,numpy 只用来算)
跑法: python streaming_ledger.py
拓扑全部取自公开配置,不是估的:
Wan2.1-T2V-1.3B(wan/configs/wan_t2v_1_3B.py):
dim=1536, ffn=8960, num_heads=12, num_layers=30, patch_size=(1,2,2), vae_stride=(4,8,8)
Self-Forcing(configs/self_forcing_dmd.yaml):
image_or_video_shape=[1,21,16,60,104]
denoising_step_list=[1000,750,500,250] # 4 步
num_frame_per_block=3
Self-Forcing(pipeline/causal_inference.py):
每个 block 走完 4 步之后,还要用 context_noise 时间步再跑一次 forward 刷新 KV cache
口径:MAC = 一次乘加(1 MAC = 2 FLOP)。时间按 假设有效算力 400 TFLOPS 折算,
只算 transformer 主体,不含 VAE 解码与文本编码。
"""
import numpy as np
# ── 拓扑 ──────────────────────────────────────────────────────────
D = 1536 # dim
FFN = 8960 # ffn_dim
LAYERS = 30
HEADS = 12
D_HEAD = D // HEADS
N_TEXT = 512 # T5 文本 token 数(cross-attn 的 K/V 长度)
LAT_FRAMES = 21 # 潜空间帧数
LAT_H, LAT_W = 60, 104
PATCH = (1, 2, 2)
TOK_PER_FRAME = (LAT_H // PATCH[1]) * (LAT_W // PATCH[2]) # 1560
N_TOK = LAT_FRAMES * TOK_PER_FRAME # 32760
BLOCK = 3 # num_frame_per_block
N_STEPS = 4 # len(denoising_step_list)
EXTRA_KV_REFRESH = 1 # 每个 block 结束后刷新 KV cache 的那次 forward
PIXEL_PER_LATENT = 4 # vae_stride[0],潜帧映射: 81 像素帧
FPS = 16
BYTES = 2 # bf16
EFF_TFLOPS = 400e12
def mac_per_layer(n_new, n_key):
"""一层 transformer 的 MAC。n_new = 本次参与计算的 token 数,n_key = 可见的 key 数。"""
attn = 2.0 * n_new * n_key * D # QK^T + AV
proj = 4.0 * n_new * D * D # q, k, v, o
ffn = 2.0 * n_new * D * FFN
cross = 2.0 * n_new * N_TEXT * D + 2.0 * n_new * D * D # 注意力 + q/o 投影
return attn + proj + ffn + cross
def gbyte(x_bytes):
return x_bytes / 1024.0 ** 3
def sec(mac):
return 2.0 * mac / EFF_TFLOPS
def main():
print("=" * 78)
print("拓扑:Wan2.1-T2V-1.3B + Self-Forcing 默认配置")
print(f" dim={D} ffn={FFN} layers={LAYERS} heads={HEADS} head_dim={D_HEAD}")
print(f" 潜空间 {LAT_FRAMES}x16x{LAT_H}x{LAT_W} patch={PATCH} -> "
f"每帧 {TOK_PER_FRAME} token,整段 {N_TOK} token")
print(f" block={BLOCK} 帧,每 block {N_STEPS} 步去噪 + {EXTRA_KV_REFRESH} 次 KV cache 刷新")
print(f" 潜帧映射: {LAT_FRAMES * PIXEL_PER_LATENT - 3} 像素帧 @ {FPS}fps ≈ "
f"{(LAT_FRAMES * PIXEL_PER_LATENT - 3) / FPS:.2f} 秒")
print(f" 时间按 {EFF_TFLOPS/1e12:.0f} TFLOPS 有效算力折算(1 MAC = 2 FLOP)")
print("=" * 78)
# ── A. 全序列扩散:4 步,每步整段双向 ────────────────────────────
mac_full_step = LAYERS * mac_per_layer(N_TOK, N_TOK)
mac_full = N_STEPS * mac_full_step
print("\n【A】全序列扩散(非流式,整段一起解)")
print(f" 单步 MAC {mac_full_step:.4e} 时间 {sec(mac_full_step)*1000:.1f} ms")
print(f" 4 步合计 MAC {mac_full:.4e} 时间 {sec(mac_full):.3f} s")
print(f" 第一帧延迟 必须等 {N_STEPS} 步全部算完 = {sec(mac_full):.3f} s")
attn_bytes_full = HEADS * N_TOK * N_TOK * BYTES
print(f" 注意力矩阵要是真存下来:{HEADS} 头 x {N_TOK}^2 x {BYTES}B = "
f"{gbyte(attn_bytes_full):.1f} GiB(稠密物化很贵;精确IO优化可避免物化)")
# ── B. 因果自回归 + KV cache ────────────────────────────────────
n_blocks = (LAT_FRAMES + BLOCK - 1) // BLOCK
print(f"\n【B】因果自回归 + KV cache({n_blocks} 个 block,每 block {BLOCK} 帧)")
print(f" {'block':>6}{'新token':>9}{'可见key':>9}{'单步MAC':>14}{'block合计MAC':>16}{'时间(ms)':>11}")
mac_blocks = []
for i in range(n_blocks):
n_new = min(BLOCK, LAT_FRAMES-i*BLOCK) * TOK_PER_FRAME
n_key = min((i+1)*BLOCK,LAT_FRAMES) * TOK_PER_FRAME
m_step = LAYERS * mac_per_layer(n_new, n_key)
n_fwd = N_STEPS + EXTRA_KV_REFRESH
# 4 步去噪:每步的 key 数就是 n_key(含当前 block 内部的因果可见部分)
m_block = n_fwd * m_step
mac_blocks.append(m_block)
print(f" {i:>6}{n_new:>9}{n_key:>9}{m_step:>14.4e}{m_block:>16.4e}"
f"{sec(m_block)*1000:>11.1f}")
mac_blocks = np.array(mac_blocks)
mac_causal = mac_blocks.sum()
print(f" 合计 MAC {mac_causal:.4e} 时间 {sec(mac_causal):.3f} s")
print(f" 第一帧延迟 = 第 0 个 block = {sec(mac_blocks[0])*1000:.1f} ms"
f"(比全序列快 {sec(mac_full)/sec(mac_blocks[0]):.1f} 倍)")
print(f" 稳态每个 block {sec(mac_blocks[-1])*1000:.1f} ms,"
f"实时预算 {BLOCK * PIXEL_PER_LATENT / FPS * 1000:.0f} ms "
f"-> 余量 {BLOCK * PIXEL_PER_LATENT / FPS / sec(mac_blocks[-1]):.2f} 倍")
# ── C. 总账对比 ────────────────────────────────────────────────
print(f"\n【C】总账({LAT_FRAMES} 潜帧)")
print(f" 全序列扩散 MAC {mac_full:.4e} 时间 {sec(mac_full):.3f} s "
f"首帧延迟 {sec(mac_full):.3f} s")
print(f" 因果+KVcache MAC {mac_causal:.4e} 时间 {sec(mac_causal):.3f} s "
f"首帧延迟 {sec(mac_blocks[0]):.3f} s")
print(f" 总算力比 因果 / 全序列 = {mac_causal / mac_full:.3f}")
print(f" 首帧延迟比 全序列 / 因果 = {sec(mac_full) / sec(mac_blocks[0]):.2f}")
# ── D. KV cache 显存 ───────────────────────────────────────────
print("\n【D】KV cache 显存(bf16)")
kv_all = 2 * LAYERS * N_TOK * D * BYTES
print(f" 完整 21 帧 2 x {LAYERS} x {N_TOK} x {D} x {BYTES}B = {gbyte(kv_all):.3f} GiB")
for w in [3, 6, 9, 12, 21]:
kv_w = 2 * LAYERS * w * TOK_PER_FRAME * D * BYTES
print(f" 滚动窗口 {w:>2} 帧 {gbyte(kv_w):.3f} GiB (占完整缓存 {w/LAT_FRAMES*100:.0f}%)")
cross_cache = 2 * LAYERS * N_TEXT * D * BYTES
print(f" cross-attn 缓存(文本 {N_TEXT} token,只算一次){gbyte(cross_cache):.3f} GiB")
# ── E. 无限长:不滚动缓存会怎样 ─────────────────────────────────
print("\n【E】继续往下生成(不滚动缓存 vs 滚动窗口 9 帧)")
print(f" {'已生成潜帧':>10}{'无滚动:单block时间(ms)':>24}{'滚动9帧(ms)':>16}{'无滚动:累计GB':>16}")
cum = 0.0
for nlat in [21, 42, 84, 168, 336]:
i = nlat // BLOCK - 1
n_new = min(BLOCK, LAT_FRAMES-i*BLOCK) * TOK_PER_FRAME
n_key = min((i+1)*BLOCK,LAT_FRAMES) * TOK_PER_FRAME
m_noroll = (N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer(n_new, n_key)
m_roll = (N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer(
n_new, min(n_key, 9 * TOK_PER_FRAME))
cum = 2 * LAYERS * nlat * TOK_PER_FRAME * D * BYTES
print(f" {nlat:>10}{sec(m_noroll)*1000:>24.1f}{sec(m_roll)*1000:>16.1f}"
f"{gbyte(cum):>16.3f}")
# ── F. 出帧节奏 ────────────────────────────────────────────────
print("\n【F】出帧节奏(首块3潜帧对应9像素帧,后续每块增加12帧;仅latent就绪,不含解码)")
t_full = sec(mac_full)
t_blocks = np.cumsum(sec(mac_blocks))
print(f" 全序列:t={t_full:.3f} s 时一次性拿到全部 {LAT_FRAMES * PIXEL_PER_LATENT - 3} 帧")
for i, tb in enumerate(t_blocks):
print(f" 因果 :t={tb:.3f} s 时拿到第 {(i+1)*BLOCK*PIXEL_PER_LATENT-3:>3} 像素帧")
print(f" 实时预算:{FPS} fps 下应该在 "
f"{np.arange(1, n_blocks+1)*BLOCK*PIXEL_PER_LATENT/FPS} 秒处出帧")
print("\n[cached] 数值直接被 make_figures.py 引用(本文件被 import 时用函数取)")
def ledger_numbers():
"""给 make_figures.py 用的结构化数值。"""
n_blocks = (LAT_FRAMES + BLOCK - 1) // BLOCK
mac_blocks = []
for i in range(n_blocks):
n_new = min(BLOCK, LAT_FRAMES-i*BLOCK) * TOK_PER_FRAME
n_key = min((i+1)*BLOCK,LAT_FRAMES) * TOK_PER_FRAME
mac_blocks.append((N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer(n_new, n_key))
mac_blocks = np.array(mac_blocks, dtype=float)
mac_full = N_STEPS * LAYERS * mac_per_layer(N_TOK, N_TOK)
return dict(
mac_full=float(mac_full), mac_causal=float(mac_blocks.sum()),
mac_blocks=mac_blocks, t_full=sec(mac_full), t_blocks=np.cumsum(sec(mac_blocks)),
kv_all_gb=gbyte(2 * LAYERS * N_TOK * D * BYTES),
kv_per_frame_gb=gbyte(2 * LAYERS * TOK_PER_FRAME * D * BYTES),
n_blocks=n_blocks, block=BLOCK, lat_frames=LAT_FRAMES,
tok_per_frame=TOK_PER_FRAME, n_tok=N_TOK,
attn_gb_if_materialized=gbyte(HEADS * N_TOK * N_TOK * BYTES),
pixel_frames=LAT_FRAMES * PIXEL_PER_LATENT - 3, fps=FPS,
)
if __name__ == "__main__":
main()
print()
for k, v in ledger_numbers().items():
if not isinstance(v, np.ndarray):
print(f" {k:>28} = {v}")# -*- coding: utf-8 -*-
"""
make_figures.py —— 本文配图(matplotlib,中文字体 PingFang SC)
跑法: python make_figures.py
所有数字都从 forcing_lab_cache.npz(forcing_lab.py 实跑产出)和
streaming_ledger.ledger_numbers() 里取,不手写,避免图文漂移。
注意:matplotlib 的 mathtext 标签一律写 raw 字符串,且反斜杠后只跟字母
(beta 这种字母命令没问题,逗号、百分号等非字母不要跟在反斜杠后面)。
"""
import os
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle, FancyArrow
HERE = os.path.dirname(os.path.abspath(__file__))
FIGDIR = os.path.join(os.path.dirname(HERE), "figures")
CACHE = os.path.join(HERE, "forcing_lab_cache.npz")
import forcing_lab as FL
import streaming_ledger as SL
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False
# 颜色常量(写图注前先对照这里,别凭印象写颜色)
C_BLUE = "#1f6feb" # 自回归 rollout
C_TEAL = "#0f9b8e" # teacher forcing
C_ORANGE = "#e07b00" # 全序列扩散
C_RED = "#c0392b" # 慢变量 u / 恶化
C_GREEN = "#2d8a4e" # 快变量 w / 改善
C_GRAY = "#8a8a8a" # 参照线、未生成
C_DARK = "#3a3a3a" # 噪声最重的格子
C_LIGHT = "#f2f2f2" # 干净的格子
def load():
return dict(np.load(CACHE, allow_pickle=True))
# ══════════════════════════ 图 1:三种范式的噪声级与因果结构 ══════════════════════════
def _box(ax, x, y, w, h, level, edge=C_GRAY, lw=0.8, ls="-"):
"""level: 1 = 干净(浅),0 = 纯噪声(深)"""
facecolor = str(max(0.0, min(1.0, float(level))))
ax.add_patch(Rectangle((x, y), w, h, facecolor=facecolor, edgecolor=edge,
linewidth=lw, linestyle=ls, zorder=2))
def fig_paradigm(path):
n = 12
bw, bh = 0.86, 0.62
fig, axes = plt.subplots(3, 1, figsize=(11.0, 6.6))
fig.subplots_adjust(left=0.06, right=0.97, top=0.93, bottom=0.07, hspace=0.34)
# (a) 全序列扩散:整段一起降噪,帧与帧之间双向可见
ax = axes[0]
steps_lv = [0.06, 0.30, 0.62, 0.92]
for r, lv in enumerate(steps_lv):
y = (len(steps_lv) - 1 - r) * 1.0
for i in range(n):
_box(ax, i * 1.07, y, bw, bh, lv)
ax.annotate("", xy=(n * 1.07 - 0.1, y + bh / 2), xytext=(0.05, y + bh / 2),
arrowprops=dict(arrowstyle="<->", color=C_ORANGE, lw=1.8))
ax.text(-0.35, y + bh / 2, r"去噪步 %d" % (r + 1), ha="right", va="center",
fontsize=10, color=C_DARK)
ax.text(n * 1.07 / 2, len(steps_lv) + 0.15,
"所有帧同一个噪声级,一起降;双向注意力,帧间互相可见",
ha="center", fontsize=11, color=C_ORANGE)
ax.text(n * 1.07 / 2, -0.55, "代价:本图需 4 步整段去噪才交付第一帧;可用长度由架构与训练共同限制",
ha="center", fontsize=10, color=C_GRAY)
# (b) teacher forcing:真值上下文,只看过去
ax = axes[1]
y = 0.0
cur = 7
for i in range(n):
if i < cur:
_box(ax, i * 1.07, y, bw, bh, 0.95, edge=C_TEAL, lw=1.2)
elif i == cur:
_box(ax, i * 1.07, y, bw, bh, 0.10)
else:
_box(ax, i * 1.07, y, bw, bh, 1.0, edge=C_GRAY, lw=0.8, ls="--")
for i in range(cur):
ax.annotate("", xy=(cur * 1.07 + bw * 0.5, y + bh * 0.45),
xytext=(i * 1.07 + bw * 0.5, y + bh * 0.45),
arrowprops=dict(arrowstyle="->", color=C_TEAL, lw=1.2,
connectionstyle="arc3,rad=-0.25"))
ax.text(-0.35, y + bh / 2, "训练时", ha="right", va="center", fontsize=10, color=C_DARK)
ax.text(n * 1.07 / 2, y + 1.50,
"上下文永远取真值帧(浅色),只有当前帧(深色)带噪声",
ha="center", fontsize=11, color=C_TEAL)
ax.text(n * 1.07 / 2, y - 0.52,
"代价:推理时真值帧不存在,上下文换成模型自己的输出 —— 这就是曝光偏差",
ha="center", fontsize=10, color=C_GRAY)
# (c) Self-Forcing 风格的生成上下文:自己的输出进 KV cache,逐 block 走
ax = axes[2]
done, blk = 6, 3
for i in range(n):
if i < done:
_box(ax, i * 1.07, y, bw, bh, 0.95, edge=C_BLUE, lw=1.2)
elif i < done + blk:
_box(ax, i * 1.07, y, bw, bh, 0.10, edge=C_BLUE, lw=1.2)
else:
_box(ax, i * 1.07, y, bw, bh, 1.0, edge=C_GRAY, lw=0.8, ls="--")
for i in range(done):
ax.annotate("", xy=(done * 1.07 + bw * 0.5, y + bh * 0.45),
xytext=(i * 1.07 + bw * 0.5, y + bh * 0.45),
arrowprops=dict(arrowstyle="->", color=C_BLUE, lw=1.2,
connectionstyle="arc3,rad=-0.25"))
ax.add_patch(Rectangle((-0.05, y - 0.42), done * 1.07 + 0.05, 0.26,
facecolor=C_BLUE, alpha=0.15, edgecolor=C_BLUE, lw=1.0))
ax.text(done * 1.07 / 2, y - 0.29, "KV cache(已生成的帧,不再重算)",
ha="center", va="center", fontsize=9.5, color=C_BLUE)
ax.text(-0.35, y + bh / 2, "推理时", ha="right", va="center", fontsize=10, color=C_DARK)
ax.text(n * 1.07 / 2, y + 1.50,
"自回归推理:历史为已生成的干净帧,当前 block 从噪声降到干净",
ha="center", fontsize=11, color=C_BLUE)
ax.text(n * 1.07 / 2, y - 0.82,
"Self-Forcing 训练也用自己的 rollout 上下文,减轻训练与推理的分布差异",
ha="center", fontsize=10, color=C_GRAY)
for ax in axes:
ax.set_xlim(-2.4, n * 1.07 + 0.3)
ax.set_ylim(-1.05, len(steps_lv) + 0.45 if ax is axes[0] else 1.95)
ax.axis("off")
axes[0].set_title("三种上下文组织示意:可见范围、噪声级与历史来源",
fontsize=13, pad=10)
fig.savefig(path, dpi=140)
plt.close(fig)
# ══════════════════════════ 图 2:误差随帧号怎么长 ══════════════════════════
def fig_rollout(d, path):
T = FL.T_TRAIN
fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.7))
ax = axes[0]
xs = np.arange(T)
ax.plot(xs, d["cur_bi"][:T], color=C_ORANGE, lw=2.0, label="全序列扩散(非流式)")
ax.plot(xs, d["cur_tf"][:T], color=C_TEAL, lw=2.0, label="teacher forcing(真值上下文)")
xr = np.arange(len(d["cur_round0"]))
ax.plot(xr, d["cur_round0"], color=C_BLUE, lw=2.0, label="自回归 rollout(自己的输出)")
ax.axvline(T - 0.5, color=C_GRAY, ls="--", lw=1.2)
ax.text(T - 0.4, ax.get_ylim()[1] * 0.55, "训练视野\nT=24", fontsize=9.5, color=C_GRAY)
ax.set_yscale("log")
ax.set_xlabel("帧号 t")
ax.set_ylabel("每维平均平方误差(对数轴)")
ax.set_title("(a) 三种范式的逐帧误差", fontsize=12)
ax.legend(fontsize=9.5, loc="lower right")
ax.grid(alpha=0.25, ls=":")
ax = axes[1]
ax.plot(xr, d["u_round0"], color=C_RED, lw=2.0, label=r"慢变量 u(会被积分记住)")
ax.plot(xr, d["w_round0"], color=C_GREEN, lw=2.0, label=r"快变量 w(收缩模态)")
ax.axvline(T - 0.5, color=C_GRAY, ls="--", lw=1.2)
ax.text(T - 0.4, 0.22, "训练视野\nT=24", fontsize=9.5, color=C_GRAY)
ax.set_yscale("log")
ax.set_xlabel("帧号 t")
ax.set_ylabel("每维平均平方误差(对数轴)")
ax.set_title("(b) 自回归 rollout 拆成快慢两块", fontsize=12)
ax.legend(fontsize=9.5, loc="upper left")
ax.grid(alpha=0.25, ls=":")
fig.suptitle("本玩具系统中,慢变量的误差在越过训练视野后明显增长",
fontsize=13)
fig.tight_layout(rect=[0, 0, 0.99, 0.94])
fig.savefig(path, dpi=140)
plt.close(fig)
# ══════════════════════════ 图 3:Self-Forcing 轮次的取舍 ══════════════════════════
def fig_rounds(d, path):
keys = sorted([k[4:] for k in d if k.startswith("cur_round")],
key=lambda s: int(s.replace("round", "")))
lbl = [("round0" if k == "round0" else k) for k in keys]
inh = [float(d[f"cur_{k}"][:FL.T_TRAIN].mean()) for k in keys]
tail = [float(d[f"cur_{k}"][-1]) for k in keys]
x = np.arange(len(keys))
fig, ax = plt.subplots(figsize=(9.6, 4.6))
ax2 = ax.twinx()
b1 = ax.bar(x - 0.19, inh, 0.36, color=C_BLUE, label="测试集视野内 MSE(左轴)")
b2 = ax2.bar(x + 0.19, tail, 0.36, color=C_RED, label="外推第 72 帧 MSE(右轴,对数)")
for b in b1:
ax.text(b.get_x() + b.get_width() / 2, b.get_height(),
f"{b.get_height():.3f}", ha="center", va="bottom", fontsize=9)
for b in b2:
ax2.text(b.get_x() + b.get_width() / 2, b.get_height(),
f"{b.get_height():.2f}", ha="center", va="bottom", fontsize=9,
color=C_RED)
ax.set_xticks(x)
ax.set_xticklabels([k.replace("round", "第 ") + " 轮" if k != "round0" else "第 0 轮"
for k in keys])
ax.set_ylabel("视野内测试 MSE", color=C_BLUE)
ax2.set_ylabel("外推第 72 帧 MSE", color=C_RED)
ax2.set_yscale("log")
ax.set_ylim(0, max(inh) * 1.35)
ax2.set_ylim(min(tail) * 0.5, max(tail) * 3.0)
ax.grid(alpha=0.25, ls=":", axis="y")
ax.set_title("配对标签重拟合(验证集选步):视野内改善,长程误差增加(非论文 Self-Forcing)",
fontsize=13)
h1, l1 = ax.get_legend_handles_labels()
h2, l2 = ax2.get_legend_handles_labels()
ax.legend(h1 + h2, l1 + l2, fontsize=10, loc="upper left")
fig.tight_layout()
fig.savefig(path, dpi=140)
plt.close(fig)
# ══════════════════════════ 图 4:上下文噪声的取舍 ══════════════════════════
def fig_context(d, path):
ks = [int(v) for v in d["ctx_list"]]
ab = [FL.abar_of(k) for k in ks]
tf = [float(v) for v in d["q5_tf"]]
end = [float(v) for v in d["q5_sf_end"]]
inh = [float(v) for v in d["q5_sf"]]
fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.7))
ax = axes[0]
ax.plot(ks, d["ctx_clean"], "o-", color=C_TEAL, lw=2.0,
label="干净模型 + 推理时给上下文加噪")
ax.axhline(float(d["cur_round0"][:FL.T_TRAIN].mean()), color=C_BLUE, ls="--", lw=1.6,
label="自回归 rollout 的实际水平")
ax.axvline(float(d["eq_noise"][0]), color=C_RED, ls=":", lw=1.8)
ax.text(float(d["eq_noise"][0]) + 8, ax.get_ylim()[1] * 0.62,
f"等效噪声级\n约 {float(d['eq_noise'][0]):.0f} 步", fontsize=9.5, color=C_RED)
ax.set_xlabel("上下文噪声时间步")
ax.set_ylabel("视野内 MSE")
ax.set_title("(a) 同MSE的历史扰动坐标", fontsize=12)
ax.legend(fontsize=9.5)
ax.grid(alpha=0.25, ls=":")
ax = axes[1]
ax.plot(ks, inh, "o-", color=C_BLUE, lw=2.0, label="视野内测试 MSE(精度)")
ax.set_xlabel("训练时给上下文加的噪声时间步 k")
ax.set_ylabel("视野内测试 MSE", color=C_BLUE)
ax2 = ax.twinx()
ax2.plot(ks, end, "s-", color=C_RED, lw=2.0, label="外推第 72 帧 MSE(单点误差)")
ax2.set_ylabel("外推第 72 帧 MSE", color=C_RED)
ax.set_title("(b) 训练历史扰动与测试误差", fontsize=12)
h1, l1 = ax.get_legend_handles_labels()
h2, l2 = ax2.get_legend_handles_labels()
ax.legend(h1 + h2, l1 + l2, fontsize=9.5, loc="center right")
ax.grid(alpha=0.25, ls=":")
fig.suptitle(f"上下文噪声:abar 从 {ab[0]:.2f} 降到 {ab[-1]:.2f},"
f"视野内与末帧误差的偏好不同;不代表稳定性证明", fontsize=13)
fig.tight_layout(rect=[0, 0, 0.99, 0.93])
fig.savefig(path, dpi=140)
plt.close(fig)
# ══════════════════════════ 图 5:流式账本 ══════════════════════════
def fig_ledger(path):
L = SL.ledger_numbers()
fig, axes = plt.subplots(1, 3, figsize=(15.6, 4.6))
# (a) 出帧节奏
ax = axes[0]
pix = (np.arange(1, L["n_blocks"] + 1) * L["block"] * 4 - 3)
ax.step(np.concatenate([[0], L["t_blocks"]]),
np.concatenate([[0], pix]), where="post", color=C_BLUE, lw=2.2,
label="因果自回归 + KV cache")
ax.plot([L["t_full"], L["t_full"]], [0, L["pixel_frames"]], color=C_ORANGE, lw=2.2,
label="全序列扩散(一次性出全部帧)")
tt = np.linspace(0, L["pixel_frames"] / L["fps"], 50)
ax.plot(tt, tt * L["fps"], color=C_GRAY, ls="--", lw=1.4, label="实时预算 16 fps")
ax.set_xlabel("算术折算时间 (s)")
ax.set_ylabel("累计latent的理论像素帧数(未计解码)")
ax.set_title("(a) 出帧节奏", fontsize=12)
ax.legend(fontsize=9.5)
ax.grid(alpha=0.25, ls=":")
ax.set_ylim(0, L["pixel_frames"] * 1.05)
# (b) KV cache 显存
ax = axes[1]
nf = np.arange(1, 169)
ax.plot(nf, nf * L["kv_per_frame_gb"], color=C_BLUE, lw=2.2, label="KV cache(不滚动)")
ax.axhline(9 * L["kv_per_frame_gb"], color=C_GREEN, ls="--", lw=1.6,
label="滚动窗口 9 帧的上限")
ax.axhline(L["kv_all_gb"], color=C_GRAY, ls=":", lw=1.4, label="21 帧整段")
ax.set_xlabel("已生成的潜帧数")
ax.set_ylabel("KV cache 显存 (GiB)")
ax.set_title("(b) 不滚动缓存,显存线性涨", fontsize=12)
ax.legend(fontsize=9.5)
ax.grid(alpha=0.25, ls=":")
# (c) 单 block 计算时间
ax = axes[2]
nkey = np.arange(1, 169) * SL.TOK_PER_FRAME
t_noroll = 2.0 * (SL.N_STEPS + SL.EXTRA_KV_REFRESH) * SL.LAYERS * np.array(
[SL.mac_per_layer(SL.BLOCK * SL.TOK_PER_FRAME, k) for k in nkey]) / SL.EFF_TFLOPS
t_roll = 2.0 * (SL.N_STEPS + SL.EXTRA_KV_REFRESH) * SL.LAYERS * np.array(
[SL.mac_per_layer(SL.BLOCK * SL.TOK_PER_FRAME,
min(k, 9 * SL.TOK_PER_FRAME)) for k in nkey]) / SL.EFF_TFLOPS
ax.plot(np.arange(1, 169), t_noroll * 1000, color=C_RED, lw=2.2, label="不滚动(线性变慢)")
ax.plot(np.arange(1, 169), t_roll * 1000, color=C_GREEN, lw=2.2, label="滚动窗口 9 帧(恒定)")
ax.axhline(SL.BLOCK * 4 / SL.FPS * 1000, color=C_GRAY, ls="--", lw=1.4,
label="实时预算 750 ms / block")
ax.set_xlabel("已生成的潜帧数")
ax.set_ylabel("单个 block 的计算时间 (ms)")
ax.set_title("(c) 不滚动缓存,每个 block 越来越慢", fontsize=12)
ax.legend(fontsize=9.5)
ax.grid(alpha=0.25, ls=":")
fig.suptitle("400 TFLOPS假设:首块latent更早就绪;未计像素解码与传输",
fontsize=13)
fig.tight_layout(rect=[0, 0, 0.99, 0.93])
fig.savefig(path, dpi=140)
plt.close(fig)
def main():
os.makedirs(FIGDIR, exist_ok=True)
d = load()
fig_paradigm(os.path.join(FIGDIR, "paradigm.png"))
fig_rollout(d, os.path.join(FIGDIR, "rollout_error.png"))
fig_rounds(d, os.path.join(FIGDIR, "selfforcing_rounds.png"))
fig_context(d, os.path.join(FIGDIR, "context_noise.png"))
fig_ledger(os.path.join(FIGDIR, "streaming_ledger.png"))
for f in sorted(os.listdir(FIGDIR)):
p = os.path.join(FIGDIR, f)
print(f" {f:<28} {os.path.getsize(p)/1024:.0f} KB")
if __name__ == "__main__":
main()
评论 (0)