


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练与采样、扩散过程与 score
关键词:流匹配、flow matching、rectified flow、速度场、直线路径、reflow、NFE
先给三个数字,全部来自文末附录里能直接跑的脚本。
数字一:换个回归目标,预测误差幅度系数差 100 倍,对应平方损失权重差 10000 倍。 把「干净图估计」上的误差记为 $\delta$,在 $t=0.99$(几乎纯噪声)这一时刻:如果模型输出的是噪声 $\epsilon$,loss 看到的误差是 $0.0101\,\delta$;如果输出的是速度 $v$,loss 看到的是 $1.0101\,\delta$。在固定干净图误差的比较下,速度目标给予高噪声端更大的相对权重。 这是速度参数化与噪声参数化的一个权重差异;采用何种目标还取决于路径、预条件、训练时间分布与架构,不能把所有模型选择归因为这一个系数(03 节推导,图 1 画出整条曲线)。
数字二:「直线路径」的 ODE 轨迹一点都不直。 Rectified Flow 最常被转述成"路径是直的,所以快"。实测:把二维八模高斯混合推到数据端,用附录 reflow_lab.py 的 10 万个起点、64 步 RK2(128 NFE)轨迹账本,精确场的弧长/弦长均值为 1.6499(图 2 另用 300 步 RK4 示意)——轨迹比两点连线多走了 65% 的路。训练时那条 $(1-t)x+t\epsilon$ 插值线确实是直线,但模型实际采样走的是边缘速度场的积分曲线,两者不是一回事(02 节的图 2 把这件事画出来了)。
数字三:reflow 一轮,2 步采样的误差降 11.1 倍。 用第 1 轮训好的模型把噪声推到数据端、拿得到的配对重训一轮,配对插值上的归一化回归残差 $S_{pair}$ 从 $0.6229$ 掉到 $0.0027$(前者用精确场,后者用训练模型;对应不同耦合,也包含学习误差,不能据此声称不可约误差降低 231 倍),NFE=2 的终点偏差从 $0.04469$ 降到 $0.00402$,已经低于方差保持路径 2 步的 $0.0105$。但高 NFE 下的终点偏差没有因此继续下降:生成质量仍受教师分布、重训误差和有限样本评估影响,06 节展开。
所以这篇文章要回答三个问题:流匹配到底在训练什么、它和 DDPM 是不是两个东西、以及"直线路径"这个卖点真实兑现了多少。
三句话讲完:
流匹配训练的是一个速度场,不是噪声。 采样是解一条 ODE:从噪声端 $t=1$ 出发,跟着 $v_\theta$ 走到数据端 $t=0$。训练只是回归:给定当前点 $z_t$,预测条件速度 $u_t$;在线性 Rectified Flow 路径上,它就是这一对端点的相对位移。最优解是条件期望 $E[u_t \mid z_t = z]$,而由连续性方程,在可积性、正则性及解唯一性成立、场学习与积分均精确时(03 节证),这个期望场把 $p_1$ 运到 $p_0$——所以不需要知道任何密度,样本对就够。
高斯路径提供了统一描述,但不同路径不等于同一个模型。 把路径统一写成 $z_t=\alpha_t x+\sigma_t\epsilon$:DDPM 的单时刻加噪边缘可对应 $\alpha_t=\sqrt{\bar\alpha_t}$、$\sigma_t=\sqrt{1-\bar\alpha_t}$;这里需将离散噪声表连续化,Rectified Flow 取 $\alpha_t=1-t$、$\sigma_t=t$。两者可以使用相同的网络架构。三种预测目标(干净图 $x$、噪声 $\epsilon$、速度 $v$)在同一条已知路径及非退化时间内可以代数换算输出(无需重训网络);不同路径的模型不能仅换公式就变成彼此,04 节把换算残差验到 $10^{-15}$。
"直"的是训练插值线,不是采样轨迹。 在本文独立配对的平滑数据分布上,线性路径边缘场满足 $v(z,0)=-z$、$v(z,1)=z-\mu$,其中 $\mu=E[x]$。采样从 1 积分到 0,时间步为负,因此噪声端先朝数据均值走,数据端局部向外走;中间还有模式分流。实际积分轨迹可以弯曲,reflow 用模型生成的端点配对重训,可在理想条件下改善速度沿轨迹的恒定程度。本文以下采用数据 $t=0$、噪声 $t=1$;RF 原论文常用噪声到数据的正向时间。令 $s=1-t$ 后,速度也要变号,不能只倒置时间标签。
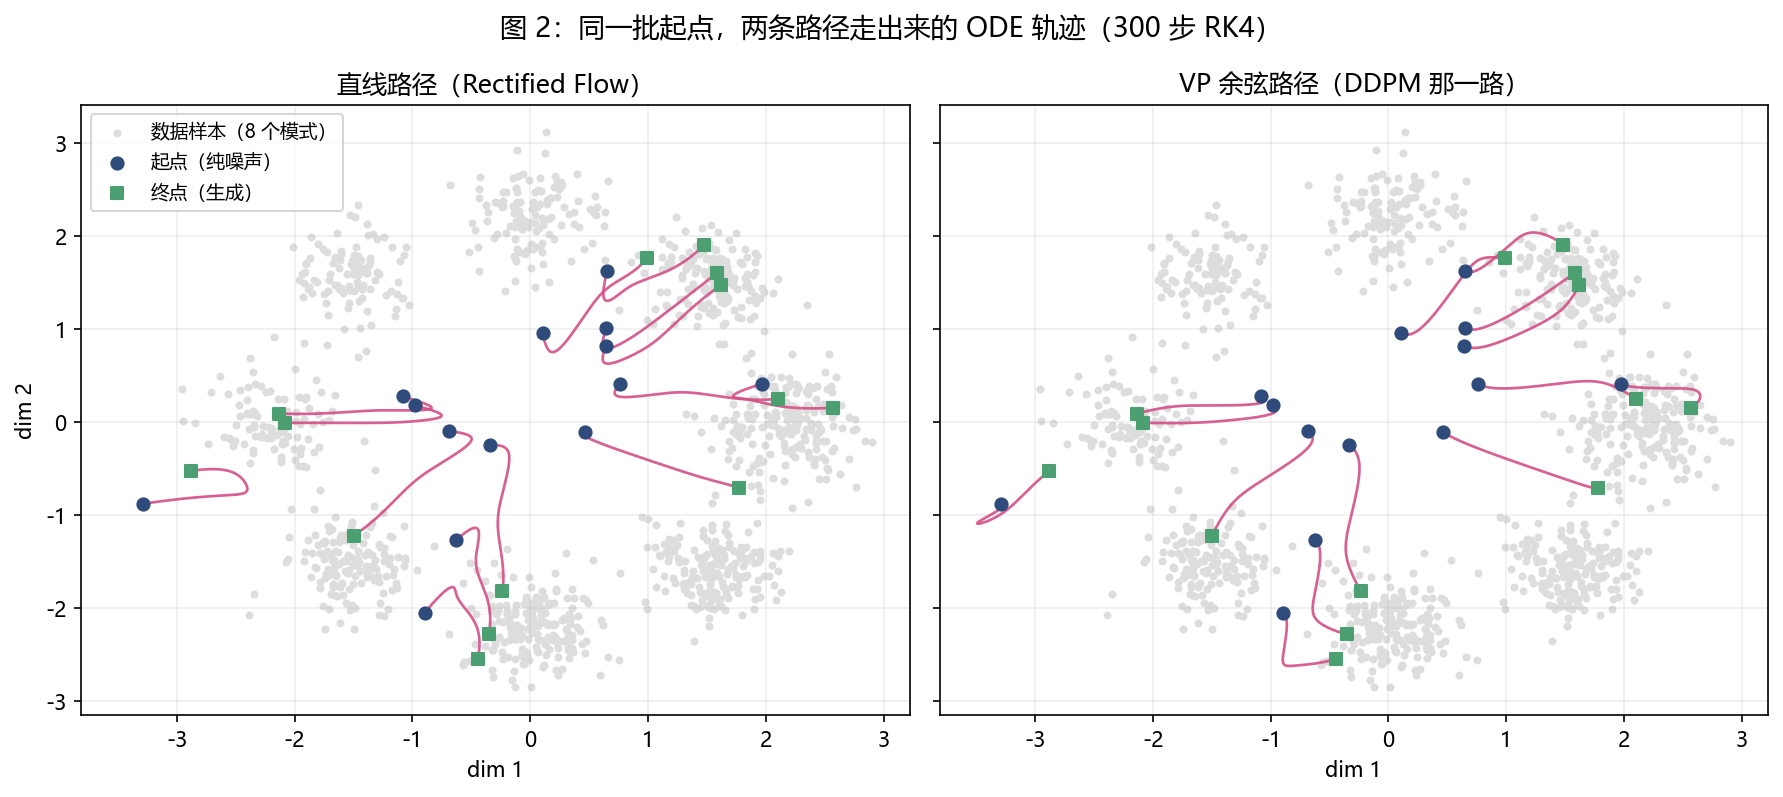
这张图要看什么:在这 14 个共同起点上,左图(直线路径)出现明显回转,右图(VP 余弦路径)较平缓。灰点是 8 个数据模式,蓝圆是噪声起点,绿方是生成终点。两图使用相同的精确场计算方式和 300 步 RK4,只改变路径;其形状是本分布上的实验结果。VP 数据端速度为零,但由于数据均值不为零,噪声端速度并不为零,见 3.4 节。
把常见高斯插值类扩散/流方法统一成一条路径。取数据样本 $x\sim p_{\text{data}}$、独立噪声 $\epsilon\sim N(0,I)$,令
$$z_t=\alpha_t x+\sigma_t\epsilon,\qquad t\in[0,1]$$
约定 $t=0$ 是数据端、$t=1$ 是噪声端,即 $\alpha_0=1,\sigma_0=0$、$\alpha_1=0,\sigma_1=1$。各符号的含义:$\alpha_t$ 是数据分量的幅度,$\sigma_t$ 是噪声分量的幅度,两者是标量函数,选不同的曲线就得到不同的方法:
| 方法 | $\alpha_t$ | $\sigma_t$ | 备注 |
|---|---|---|---|
| VP / DDPM | $\sqrt{\bar\alpha_t}$ | $\sqrt{1-\bar\alpha_t}$ | 满足 $\alpha_t^2+\sigma_t^2=1$,当数据协方差也为单位阵时保持单位方差;一般数据协方差仍随 t 改变 |
| Rectified Flow | $1-t$ | $t$ | 线性插值,中间分布方差会缩水(06 节) |
对固定的一对 $(x,\epsilon)$,$z_t$ 是一条确定的曲线,它对时间的导数是
$$u_t=\dot\alpha_t x+\dot\sigma_t\epsilon$$
每个符号:$\dot\alpha_t$、$\dot\sigma_t$ 是两条幅度曲线的导数;$u_t$ 叫条件速度——它说的是"这一对端点对应的粒子此刻在往哪走"。直线路径下 $\dot\alpha_t=-1$、$\dot\sigma_t=1$,所以 $u_t=\epsilon-x$,与 $t$ 无关:整条插值线是匀速直线。这就是"直线"的全部含义,它只说了这条以 $(x,\epsilon)$ 为参数的曲线,没说采样时走的那条。
这里的“高斯”指给定数据后的加噪分布。单时刻边缘并不指定随机过程的联合分布:固定一份 $\epsilon$ 画出的插值曲线,与 DDPM 每步注入新噪声的马尔可夫链可以有相应的单时刻边缘,却有不同的路径联合分布与采样器。本文积分的是确定性 ODE;不能把它称为原 DDPM 逆链的逐路径复现。有限 DDPM 噪声表的最后时刻一般也只是接近标准高斯;本文的纯噪声端是连续路径的理想端点。
后文 reflow 改变端点耦合(coupling,即两个端点的联合分布),不改变线性插值公式。3.2 节的条件期望证明允许相关端点;本节的独立高斯条件式、4.1 节的 GMM 精确场以及 3.4 节独立配对的端点公式,只用于第 1 轮。第 2 轮端点由教师相关配对,不能继续套用同一 GMM 闭式。
采样时我们手里没有那对 $(x,\epsilon)$,只有 $z_t$。所以要用的是边缘速度场:
$$v^{\star}(z,t)=E\left[u_t \mid z_t=z\right]$$
读法:在所有"此刻恰好经过 $z$ 的粒子对"里,平均下来往哪走。要证它是"对的场",也就是用它解 ODE 确实把 $p_1$ 运到 $p_0$。对任意光滑测试函数 $\phi$,沿条件路径求导再取期望:
$$\frac{d}{dt}E\left[\phi(z_t)\right]=E\left[\nabla\phi(z_t)\cdot u_t\right]=E\left[\nabla\phi(z_t)\cdot E[u_t\mid z_t]\right]=\int \nabla\phi(z)\cdot v^{\star}(z,t)\,p_t(z)\,dz$$
第二步是把里层的条件期望提出来(塔性质)。最后那个积分正是连续性方程 $\partial_t p_t+\nabla\cdot(v^{\star}p_t)=0$ 的弱形式,在速度场和密度满足适当正则性、相应 ODE 与连续性方程有唯一解的条件下,$v^{\star}$ 生成的流在每个时刻匹配既定的 $p_t$,从 $p_1$ 走到 $p_0$。这里 $p_t$ 本身随时间变化,并不是保持某个固定分布不变。这一步就是"marginalization trick":条件场逐对可得,边缘场取个条件期望就行。
于是在线性路径下,训练目标可以完全绕开密度(一般路径把目标换成 $u_t$):
$$\min_\theta\;E_{t,x,\epsilon}\left\|v_\theta(z_t,t)-(\epsilon-x)\right\|^2$$
这里 $t$ 在训练时按指定密度采样,本文 toy 使用均匀分布;$E$ 表示对时间和端点配对取期望。对每个有正训练密度的 $t$,平方回归的逐点最优解是 $v^{\star}(z,t)$;改变时间采样而不补重要性权重,会改变有限容量模型的误差分配。没有任何一项需要 $p_t$ 的表达式——这是流匹配在工程上能起飞的根本原因:它把"学分布"变成了"学一个回归"。
设 $m(z,t)=E[x\mid z_t=z]$(干净图估计)、$e(z,t)=E[\epsilon\mid z_t=z]$(噪声估计)。对 $z_t=\alpha_t x+\sigma_t\epsilon$ 两边取条件期望(条件期望是线性的,$z_t$ 在条件下是常数):
$$z=\alpha_t m+\sigma_t e$$
这是贯穿全文的恒等式,$\alpha m+\sigma e=z$。再配合速度的定义 $v=\dot\alpha_t m+\dot\sigma_t e$,两个方程、两个未知数,解出
$$m=\frac{\sigma_t v-\dot\sigma_t z}{\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t},\qquad e=\frac{\dot\alpha_t z-\alpha_t v}{\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t}$$
分母 $\Delta_t=\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t$ 是个行列式;一般路径必须满足 $\Delta_t\ne0$ 才能从 $(z,v)$ 唯一恢复两个估计。若数据与噪声幅度以同一比例变化,两行方程相关,换算就不可逆。直线路径下它恒等于 $-1$($(-1)\cdot t-1\cdot(1-t)=-1$),于是换算干净得没有任何除法:
| 已知 | 求 $m$(干净图) | 求 $e$(噪声) |
|---|---|---|
| 速度 $v$ | $m=z-t\,v$ | $e=z+(1-t)\,v$ |
| 噪声 $\epsilon$ | $m=(z-t\,e)/(1-t)$ | — |
| 干净图 $m$ | — | $e=(z-(1-t)m)/t$ |
第一行值得盯一眼:从速度换算到干净图和噪声都不需要除以 $\alpha$ 或 $\sigma$,而第二、三行各有一个会趋奇的除法。这说明线性路径下由速度到两个端点估计的系数有界;并不保证网络误差、训练梯度或完整采样算法都更稳定。该线性换算在端点仍有定义,但从噪声反推干净图要求 $1-t\ne0$,从干净图反推噪声要求 $t\ne0$。
那为什么不能说"三种参数化完全等价"? 真值层面等价(上表),loss 层面不等价。假设模型在 $m$ 上有误差 $\delta$,把它代入三种目标的误差:
$$\text{x0 目标:}\ \|\delta\|,\qquad \text{噪声目标:}\ \frac{\alpha_t}{\sigma_t}\|\delta\|,\qquad \text{速度目标:}\ \left|\dot\alpha_t-\frac{\dot\sigma_t\alpha_t}{\sigma_t}\right|\|\delta\|$$
来历:$e=(z-\alpha_t m)/\sigma_t$ 对 $m$ 求导得 $-\alpha_t/\sigma_t$;$v=\dot\alpha_t m+\dot\sigma_t e$ 对 $m$ 求导得 $\dot\alpha_t-\dot\sigma_t\alpha_t/\sigma_t$。直线路径代入,得到三条曲线
$$\text{x0:}1,\qquad \text{噪声:}\frac{1-t}{t},\qquad \text{速度:}\frac{1}{t}$$
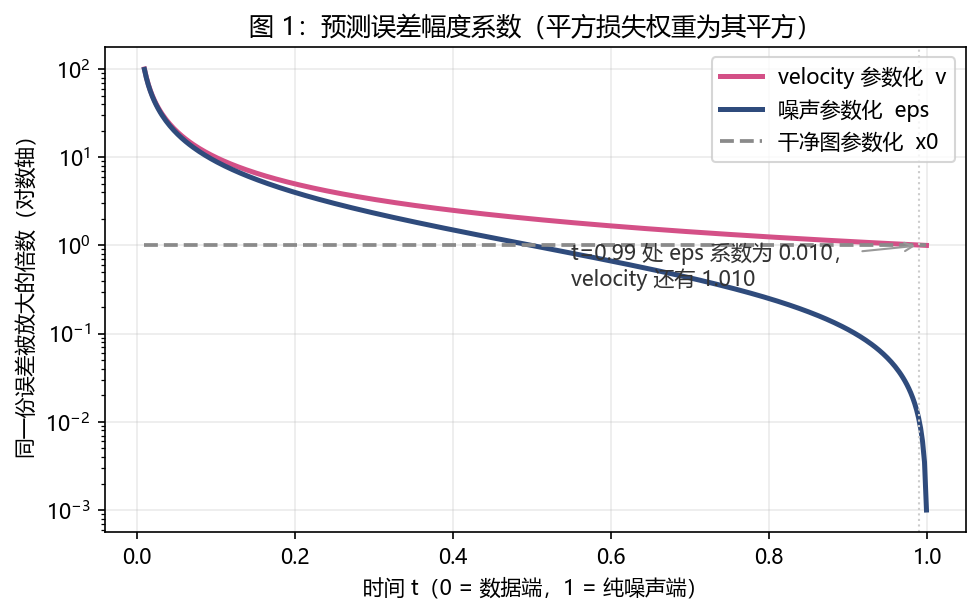
这张图要看什么:横轴是时间 $t$,纵轴是对数刻度的放大倍数。$t=0.99$(接近纯噪声端)噪声参数化的曲线是 $0.0101$——在高噪声端,噪声目标对"你把干净图猜错了"几乎无感,因为 $z$ 里本来就几乎没有 $x$ 的信息;而速度目标的系数是 $1.0101$;真正取 $t\to1$ 的极限时,二者分别趋于 0 和 1。反过来在 $t\to 0$(数据端)二者对固定干净图误差的换算系数都增大,速度系数比噪声系数加法上大 1;这不等于直接 velocity 训练的目标或梯度必然发散。这里能直接推出的是高噪声端对干净图估计误差的相对损失权重不同,不能单凭它保证真实网络的梯度大小或学习效率。
还可以把这条链接回先修中的 score。仅在独立高斯加噪、$\sigma_t>0$ 时,对加噪密度求空间导数给出 $\nabla\log p_t(z)=-e(z,t)/\sigma_t$。再在 $\alpha_t>0$ 时用 $m=(z-\sigma_t e)/\alpha_t$ 消元:
$$v^{\star}(z,t)=\frac{\dot\alpha_t}{\alpha_t}z+\left(\frac{\dot\alpha_t}{\alpha_t}\sigma_t^2-\dot\sigma_t\sigma_t\right)\nabla\log p_t(z).$$
这就是与同边缘扩散的概率流 ODE 对接的一种写法;在可构造相应扩散的条件下,它与随机反向采样共享边缘目标,轨迹不必相同。式中除法的非退化条件不能省略;直线路径的 $v=\epsilon-x$ 监督本身不需要计算 score,也不需要在退化端点执行这些除法。相关端点的 reflow 不具有上述独立加噪条件,不能直接照搬此 score 恒等式。原始推导讨论了概率路径、条件场与边缘场的关系。
先看端点行为。本文数据是平滑的高斯混合,数据与噪声独立;因此在数据端,$m(z,0)=z$、$e(z,0)=E[\epsilon\mid x=z]=0$;在噪声端,$m(z,1)=\mu=E[x]$、$e(z,1)=z$。这些关系来自端点的条件独立性,不能用 $(z-\alpha m)/\sigma$ 中的“分子趋零”来推断一个 $0/0$ 极限。
make_data 的 8 个分量权重与 $1+0.35\cos(\cdot)$ 成正比,并不均匀。精确加权均值为
$$\mu=(0.294464,\,-0.248024).$$
线性路径 $\dot\alpha=-1,\dot\sigma=1$ 的端点速度是
$$v(z,0)=-z,\qquad v(z,1)=z-\mu.$$
采样沿负时间方向积分,所以噪声端局部朝 $\mu$ 走,数据端局部沿 $z$ 向外走。中间的模式分流也会影响轨迹,端点公式本身不能决定全程弯曲程度;01 节的弧长比是实际积分测得的结果,不是由端点方向推出的普遍定理。
VP 余弦路径取 $\alpha=\cos(\pi t/2)$、$\sigma=\sin(\pi t/2)$,因此
$$v_{\rm VP}(z,0)=0,\qquad v_{\rm VP}(z,1)=-\frac{\pi}{2}\mu=(-0.462543,\,0.389595).$$
只有数据均值为零时,这条 VP 路径的两个端点速度才都为零。本实验不满足该条件。
需要区分两个诊断量。本文脚本 straightness_of 实际计算的是原始端点配对插值上的归一化回归残差:
$$S_{pair}=\frac{\int_0^1 E\|v((1-t)z_0+t z_1,t)-(z_1-z_0)\|^2dt}{E\|z_1-z_0\|^2}.$$
当 $v=v^{\star}$ 时,分子是条件回归的不可约误差。下式的期望同时包含均匀时间与端点配对,并且 $S_{pair}$ 用 $v^{\star}$ 计算:
$$E\|v_\theta-u\|^2=E\|v_\theta-v^{\star}\|^2+S_{pair}E\|z_1-z_0\|^2.$$
Rectified Flow 论文沿实际 ODE 轨迹 $Z_t$ 定义的 straightness 则比较 $v(Z_t,t)$ 与 $Z_1-Z_0$。这不是在独立原始配对插值线上评估,不能直接把本文 $S_{pair}$ 当成论文的同名量。本文另用实际积分轨迹的弧长/弦长检测几何变直,两个指标应分别报告。论文的零 straightness 要求速度沿轨迹恒定,比“几何上落在一条直线”更强:标量轨迹 $Z_t=t^2$ 的弧长/弦长是 1,但 $\int_0^1(2t-1)^2dt=1/3$;从 0 到 1 用一步 Euler 得到 0,精确终点却是 1。几何直线仍可能需要更好的时间参数化或积分格式。弧长的离散计算必须是 $\sum_j\|Z_{t_{j+1}}-Z_{t_j}\|_2$,不能先分别累加坐标上的绝对位移再取范数。
path_lab.py 另取 1500 个起点、400 步 RK4(1600 NFE):线性路径的平均弧长/弦长为 1.6232,VP 为 1.2915。沿实际轨迹的速度偏差再除以平均弦长平方,得到归一化 $S_{traj}$ 分别为 1.2293、0.5317。这与原始配对插值上的 $S_{pair}$ 不同。01 节的 1.6499 来自 reflow_lab.py 的另一批 10 万个起点和 64 步 RK2;样本与积分精度不同,诊断数值也会不同。
全部代码在文末附录,保留原有五个实验脚本,另补一份独立校验脚本;数值实验依赖 numpy、画图另需 matplotlib:fm_oracle.py(实验台与精确场)、param_lab.py(三种参数化)、path_lab.py(路径对比与 NFE)、reflow_lab.py(reflow 两轮)、make_figures.py(配图)。实验台是一个二维八模高斯混合,噪声是 $N(0,I)$。选它的原因是:高斯混合经过任何高斯路径之后仍是高斯混合,于是 $m$、$e$、$v^{\star}$ 全都有闭式解,不用训练也不用采样近似。
分量 $k$ 的中间方差是 $V_k(t)=\alpha_t^2 s_k^2+\sigma_t^2$($s_k$ 是该分量的标准差),后验责任是给定当前点后属于分量 $k$ 的概率,贝叶斯公式给出未归一化权重:
$$r_k(z,t)\propto w_k V_k(t)^{-d/2}\exp\left[-\frac{\|z-\alpha_t\mu_k\|^2}{2V_k(t)}\right].$$
最后对 $k$ 归一化;本文维数 $d=2$。三个量都是"责任加权的条件均值":
def m(self, z, t):                      # E[x | z_t = z]
    a = self.path.alpha(t)
    r, V, diff = self._post(z, t)
    ex = self.data.mu[None,:,:] + (a * self.data.s**2 / V)[None,:,None] * diff
    return (r[:,:,None] * ex).sum(1)

def e(self, z, t):                      # E[eps | z_t = z]
    sg = self.path.sigma(t)
    r, V, diff = self._post(z, t)
    ee = (sg / V)[None,:,None] * diff
    return (r[:,:,None] * ee).sum(1)

def v(self, z, t):                      # 边缘速度场
    return self.path.dalpha(t) * self.m(z, t) + self.path.dsigma(t) * self.e(z, t)
先验两个恒等式。第一个是 3.3 节的 $\alpha m+\sigma e=z$,第二个是把 $v^{\star}$ 用另一种方式算一遍——直线路径下 3.3 节的表给出 $v^{\star}=(z-m)/t$:
=== 恒等式自检:alpha*m + sigma*e 应等于 z(残差 ~1e-15)===
path        t     |a*m+s*e-z|    |v-(da*m+ds*e)|
linear      0.05        2.66e-15          0.00e+00
linear      0.95        1.78e-15          0.00e+00
cosine_vp   0.05        1.78e-15          0.00e+00
cosine_vp   0.95        1.78e-15          0.00e+00

=== 直线路径下 v* 的两种算法是否一致:(z-m)/t 与 alpha' m + sigma' e ===
  t=0.1  最大绝对差 = 1.332e-14
  t=0.9  最大绝对差 = 1.776e-15
第一条验证了条件均值的一致性;第二条直接复用了 v() 的定义,只能作接口检查,不能算独立证明。新增 fm_checks.py 直接对混合密度有限差分核验 score 和连续性方程,并用单高斯的均值/方差导数另算速度;还检查 MLP 梯度及积分器实际 NFE。数值残差验证具体实现,推导正确性仍依赖 03 节的假设与证明。
把 3.3 节的换算写成代码并逐点验真值(注意残差随 $t\to 1$ 变大——那是除以 $(1-t)$ 的数值放大,不是推导错):
def v_to_me(z, v, path, t):
    a, sg = path.alpha(t), path.sigma(t)
    da, ds = path.dalpha(t), path.dsigma(t)
    det = da * sg - ds * a               # 直线路径恒等于 -1
    m = (sg * v - ds * z) / det
    e = (da * z - a * v) / det
    return m, e
path t v->m v->e eps->m eps->v
linear 0.10 1.78e-15 1.33e-15 1.78e-15 1.78e-15
linear 0.90 1.22e-15 8.88e-16 1.30e-14 1.29e-14
linear 0.99 1.78e-15 1.78e-15 2.04e-13 2.03e-13放大倍数不靠公式背,用数值扰动直接量:给 $m$ 加一个长度固定为 $0.01$ 的随机扰动,看三种预测误差范数各被放大多少;平方损失对应这些系数的平方。实测与解析式在小数点后四位完全一致($t=0.1$ 时噪声目标 $9.0000$ 对 $9.0000$、速度目标 $10.0000$ 对 $10.0000$),整条曲线就是图 1。
误差尺子值得单独说一句。常用做法是"拿一条很高步数的参考解当真值",但那条参考解自己也有截断误差。这里利用 $p_t$ 仍是高斯混合这一点,取一组中心为 $c$、带宽为 $h>0$ 的 RBF 特征:
$$\phi_c(z)=\exp\left(-\frac{\|z-c\|^2}{2h^2}\right).$$
它在高斯下的期望有闭式,于是参照侧没有任何采样噪声。生成样本一侧仍有有限样本误差:一批 4000 个真实样本对精确 $p_{\text{data}}$ 的偏差是 $0.00211$,这里只把它画成参考线,既不是误差下限,也不是显著性阈值。更换随机种子后,这个参考偏差也会变化。要判断小差异是否稳定,应对方法使用共同起点并重复多个种子。有限组 RBF 特征只是分布诊断,特征偏差小不能证明两个分布相同。
NFE 统计实际速度场评估次数:Euler 每步 1 次,RK2 每步 2 次。所以 NFE=8 时分别运行 8 步 Euler 或 4 步 RK2,表中按这一预算公平比较。
=== NFE-误差:直线路径 vs VP 余弦路径(同一批起点、同一批随机数)===
  NFE   linear/euler  linear/rk2   vp/euler     vp/rk2
    2       0.04074      0.04113     0.01047    0.04603
    4       0.01491      0.00736     0.00562    0.00318
    8       0.00802      0.00202     0.00329    0.00236
   16       0.00466      0.00183     0.00234    0.00194
   32       0.00307      0.00184     0.00199    0.00186
  256       0.00194      0.00183     0.00184    0.00183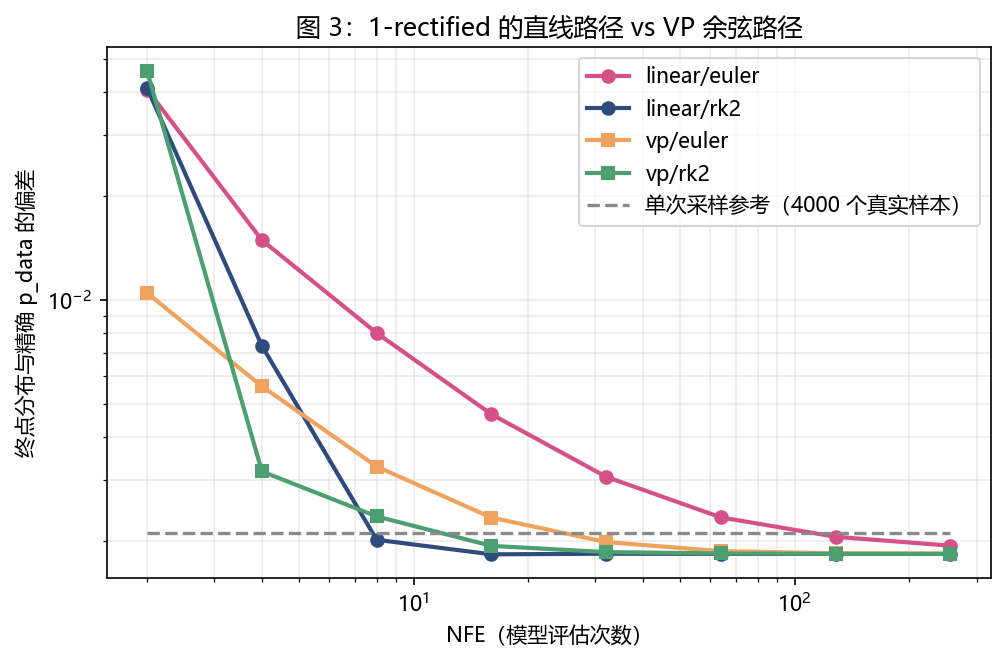
这张图要看什么:高 NFE 时,四条线都接近同一量级的小偏差,与有限样本误差并存;这不能单独证明场正确。低 NFE 的差异依赖路径和积分器:在 Euler、NFE=8 这一点,线性路径误差是 VP 的约 2.4 倍($0.00802$ 对 $0.00329$),不是“需要 2.4 倍步数”。要比较所需步数,应先规定相同误差阈值。RK2 在 NFE=2 时只有一个积分步,误差甚至大于 Euler;较高阶也不保证每个极低预算下都更好。
数值积分误差受速度场的空间与时间变化、时间网格和积分器共同影响,不能仅用“曲线弯”或错误的“两端速度为零”解释。时间 shift 也可能改变弯曲轨迹的积分精度;这里只能报告本次测试:Euler、NFE=8 时,shift=1、3、6 的误差分别为 $0.00802$、$0.00864$、$0.01843$,这两个非均匀网格没有带来改善。
reflow 的实现出奇地短:用第 1 轮模型从噪声端积分到数据端,得到新配对,再训一轮。
def round1_pairs(n, seed=0):
    rng = base_rng(seed)
    data = make_data()
    z0 = data.sample(n, rng)              # 数据端(t=0)
    z1 = rng.standard_normal((n, D))      # 噪声端(t=1),独立配对
    return z0, z1

def generate_pairs(model, z1, n_steps=100):
    sched = make_schedule(n_steps)        # RK2:100 步 = 200 次场评估
    z0, _ = integrate(lambda z, t: model(z, t), z1, sched, "rk2")
    return z0                             # 新配对就是 (z0, z1)
模型是 NumPy 实现的两个 128 宽 tanh 隐层 MLP,两轮各 6000 次更新、batch=512、训练 seed=0。第 1 轮从 10 万个固定数据样本有放回抽取,并每步重采独立噪声和时间;这仍是有限经验数据池,不等于每步重新抽总体数据。第 2 轮拟合 10 万个数值教师配对;教师使用 100 步 RK2,即每条配对 200 NFE。第 1 轮在 10 万条独立配对上训练(每步从数据样本池抽样并重采独立噪声),末 200 个训练 minibatch 的逐坐标 MSE 均值为 $2.1853$——按样本平方范数是 $4.3706$,而估计的不可约回归误差 $S_{pair}\cdot E\|z_1-z_0\|^2\approx4.3702$(未舍入计算;两个因子分别约为 $0.6229$、$7.0162$)。训练 minibatch 均值与配对池上 32 时刻求积的估计口径不同;还含有限数据/时间采样误差,略低或略高都可能发生,不能证明模型已达精确最优;在分布内查询点上它与精确场的相对均方误差是 $1.28\%$。
然后是关键的一步——量两轮的归一化配对残差和 NFE:
=== 归一化配对回归残差(另用弧长/弦长量轨迹)===
  第 1 轮配对 + 精确场   S_pair = 0.6229
  第 1 轮配对 + 第1轮模型 S_pair = 0.6289
  第 2 轮配对 + 第2轮模型 S_pair = 0.0027
  弧长/弦长:精确场 1.6499 | 第1轮 1.6463 | 第2轮 1.0027

=== NFE-误差(直线路径;精确场 / 第1轮模型 / 第2轮模型)===
  NFE    精确场    第1轮    第2轮
    2   0.04012   0.04469   0.00402
    4   0.01469   0.01789   0.00401
    8   0.00785   0.00927   0.00402
   16   0.00427   0.00563   0.00402
   64   0.00182   0.00389   0.00403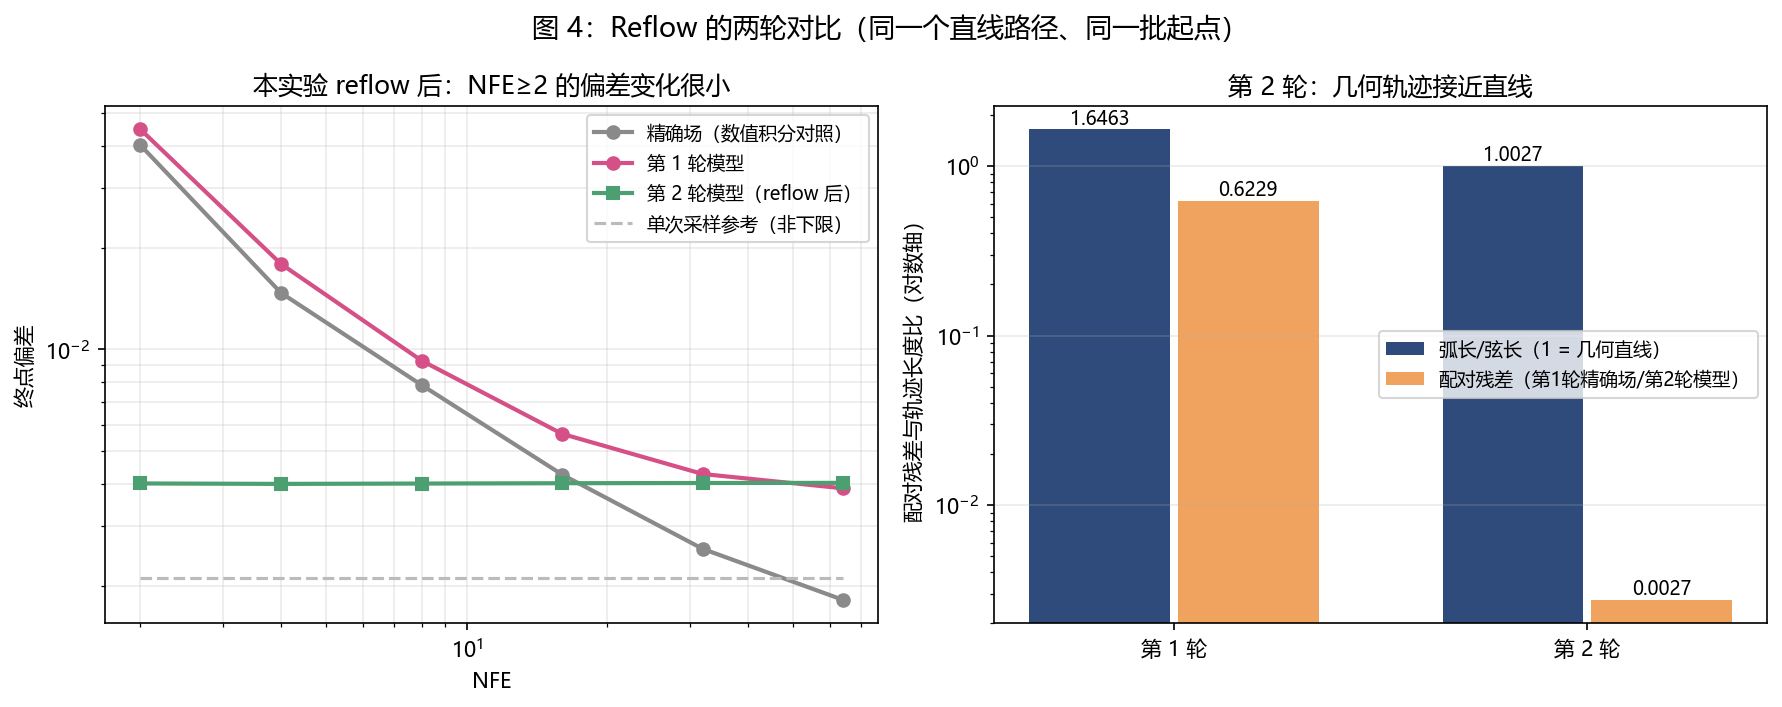
这张图要看什么:左图是三条 NFE-误差曲线,绿色(reflow 后)从 NFE=2 起就是一条平线——步数不再是瓶颈;右图分别比较配对回归残差与实际轨迹弧长/弦长:配对残差第 1 轮用精确场、第 2 轮用重训模型;弧长柱均用对应训练模型。第 2 轮的弧长/弦长 $1.0027$,这批数值轨迹在几何上接近两点连线;速度是否均匀还需另看沿轨迹的诊断。第 1 轮配对残差用精确场(估计不可约误差),第 2 轮用训练模型(包含不可约误差与学习误差),而且耦合不同,不能用二者比值定量声称不可约误差降低多少倍。两者均以 32 等距时刻近似时间积分。另外注意第 2 轮配对的弦长平方从 $7.0162$ 掉到 $1.2410$:reflow 之后噪声端和数据端被强相关地配对了,这种配对改变也体现在实际轨迹变直上;不能把较小的配对残差本身称为曲率。
本次在同一对训练模型上新增独立评估:留出 4000 个新噪声,经同一 100 步 RK2 教师生成配对,第 2 轮模型的配对残差为 0.002772(训练配对池为 0.002749)。再固定模型,仅更换五个噪声 seed;每个 seed 两轮共享 4000 个起点,均用 NFE=2 的 Euler:
| 评估 seed | 第 1 轮偏差 | 第 2 轮偏差 |
|---|---|---|
| 999 | 0.04469 | 0.00402 |
| 1000 | 0.04497 | 0.00584 |
| 1001 | 0.04399 | 0.00307 |
| 1002 | 0.04504 | 0.00519 |
| 1003 | 0.04461 | 0.00553 |
五次均观察到第 2 轮偏差更低,但数值随评估采样变化;这只支持这两个固定 toy 模型的少步结果,不是五次独立训练,也不是图像质量或所有数据分布的保证。完整训练配置、源码 SHA256、结果与权重写入同目录快照。
以 Diffusers v0.35.1 的 调度器源码为准。对照的是标量时间、默认确定性分支,关闭 inverted sigma、终点拉伸及其他 sigma 重排;逐 token 等分支不在这里的公式覆盖范围。model_output 是模型输出的本文方向速度 $\epsilon-x$,不是 VP 路径中另有定义的 $v$ 目标。网络时间标签通常是 $1000\sigma$,积分步长仍使用 $\sigma$,两者不可混用。
Euler 更新。 原类的 step() 在该分支执行:
dt = sigma_next - sigma
prev_sample = sample + dt * model_output
$\sigma$ 就是本文线性路径的 $t$,表从 1 递减到 0,因此负步长负责从噪声生成数据。函数先把 sample 升到 FP32,再按模型输出 dtype 返回;不要从文档中的泛称“预测噪声”反推这条分支的实际参数化。本文对原类 AST 做 18 次 CPU step 对照,覆盖 FP32、FP16、BF16 和 shift=1/3,结果与同精度更新逐位一致;这是调度器公式验证,没有运行完整文生图模型或 GPU 性能测试。
干净图估计与随机分支。 stochastic_sampling=True 时,源码先算 $\widehat x_0=z-\sigma v_\theta$,再以新噪声 $\eta\sim N(0,I)$ 构造下一状态:
$$z_{next}=(1-\sigma_{next})\widehat x_0+\sigma_{next}\eta.$$
干净图公式正是 3.3 节第一格,但整个随机更新并非默认 Euler ODE 步;不能只摘第一行就说两条采样路径等价。本文固定随机种子实跑这一分支,与完整式逐位核对。
最后评估点与最终落点。 shift=1 的默认 1000 训练时间表,最后非零模型评估点为约 0.001,set_timesteps 另在 sigma 表末尾追加 0。最后一步从正 sigma 积分到 0,不在 0 再评估网络;其他配置/自定义表应查看实际 sigmas。网络调用所需的是表内时间值,不能把 enumerate 的整数索引传进 step()。
静态与动态 shift。 静态变换是 $t'=st/[1+(s-1)t]$,其中 $s>0$ 是配置中的 shift。它重新安排模型评估时刻;本文未将位移速度换成 $dz/dt'$ 后再统一网格求解,而是在改变后的原时间点上用其差值积分。动态指数分支使用
$$t'=\frac{\exp(\mu)}{\exp(\mu)+(1/t-1)}.$$
序列长度到 $\mu$ 的线性插值发生在 pipeline 调用者中:FLUX 调用代码、SD3 调用代码先由实际 token 数 $L$ 计算
$$\mu(L)=\mu_b+\frac{L-L_b}{L_m-L_b}(\mu_m-\mu_b),$$
再传给调度器;调度器在启用动态 shift 却没收到 $\mu$ 时会报错。以显式配置 $L_b=256$、$L_m=4096$、$\mu_b=0.5$、$\mu_m=1.15$ 为例,中点 $L=2176$ 得 $\mu=0.825$。它不自动截断,$L=8192$ 会外推到约 1.8433;默认值需以具体模型配置为准,不能把所有 SD3/FLUX 模型概括成同一策略。SD3 原论文第 5.3.2 节用常量图像与分辨率相关的信噪比作动机,这不是“每张真实图都按像素数精确缩放信息”的定理。04 节的 toy shift 测试也只报告该分布上的数值结果。
训练时间分布。 SD3 原论文第 3.1 节比较多种时间采样,包含 logit-normal:先采 $a\sim N(m,s^2)$,再取 $t=1/(1+\exp(-a))$;本文关注的 $m=0,s=1$ 在中间时刻权重较大。该形状依赖参数,不能说所有 logit-normal 都只有一个居中众数。固定训练辅助函数按此变换实现,CPU 实跑与同 seed 的 normal→sigmoid 逐位相同。改变时间密度相当于改变有限模型的训练权重;这与推理侧改变离散时间网格是两个设计选择,也不能用噪声目标在高噪声端的系数直接解释 velocity 模型选择这一密度。
直线路径不是免费的午餐。 在这组实验的 Euler、NFE=8 处,线性路径的误差约为 VP 余弦路径的 2.4 倍;这个误差比不等于达到同一质量所需的步数比。需要诚实标注边界:这是一个二维、数据尺度(标准差 1.56)与噪声尺度(1)不匹配的 toy,不能据此断言"VP 路径普遍更省步数";但至少说明直线插值不保证少步积分准确。实际轨迹接近直线有助于理解 reflow 的效果,积分难度仍取决于沿轨迹的速度变化与数值格式。真实模型里路径选择还和训练分布、模型容量、蒸馏方案纠缠在一起,单独归因很难。
reflow 仍受教师分布与学习误差限制。 本次第 2 轮的高 NFE 偏差约为 $0.00403$;第 1 轮模型用于训练的 10 万个生成端点偏差为 $0.00328$。二者评估样本量不同,不能据此定量断言“误差几乎全部继承自教师”。在理论条件满足、回归和积分精确的理想 reflow 中,端点边缘分布保持为教师的分布;有限模型还会增加重训和积分误差。图 4 显示的是少步曲线被压平,不能当作重训自动改善真实数据拟合的证据。
reflow 的账单。 它需要用第 1 轮模型做一次全量生成,生成量要够训第 2 轮。其成本由配对生成量、教师步数和重训步数共同决定,不能固定说成翻倍,所以工程上要么只在最后的精调阶段做,要么直接换成少步蒸馏(已发布的少步蒸馏)。
$\sigma\to0$ 的数值边界。 需要避免在端点进行会除以零的参数化转换;速度场 Euler 更新自身不含该除法。最后从 $\sigma>0$ 到 0 的 Euler 步正是 $x_0=x-\sigma v$,两种说法在直线路径下是同一操作。
误解一:"流匹配与扩散完全相同,或完全无关。" Flow Matching 是训练速度场的框架,可以采用扩散的连续高斯边缘路径,也可以采用其他插值路径。DDPM 另有离散马尔可夫链和随机逆过程;同边缘概率流 ODE 不等于相同的随机路径。相同架构和可换算输出不意味着训练损失、模型分布及采样器完全等价。Rectified Flow 在本文取 $\alpha=1-t,\sigma=t$,还需指定端点耦合、时间采样和数值求解器。
误解二:"路径是直的,所以一两步就能出图。" 直的是训练时的插值线;采样走的是边缘场的积分曲线。实测 1-rectified 的弧长/弦长是 $1.65$,NFE=2 误差 $0.04469$。要两步出图,靠的是 reflow 之后的第 2 轮($0.00402$),不是第 1 轮的"直线路径"。
误解三:"reflow 之后质量和速度都变好了。" 只对了一半。步数-精度曲线确实被压平(NFE=2 就到位),但精度仍受教师样本分布与重训误差限制:第 2 轮在本次实验中停在约 $0.00403$,教师生成端点的参考偏差为 $0.00328$。理想 reflow 保持教师端点边缘,有限训练下则需另外评估分布偏差,不能保证质量自动提高。
误解四:"velocity 预测只是把回归目标换了个写法。" 真值层面是,loss 层面不是。$t=0.99$ 处噪声目标对干净图误差的放大倍数是 $0.0101$,速度目标是 $1.0101$,幅度系数差 100 倍、平方权重差 10000 倍;这只描述固定干净图误差的相对权重,不代表高噪声端一半训练样本都无用。
误解五:"流匹配需要知道边缘密度或 score。" 3.2 节的推导全程只用了条件期望和塔性质,训练目标里没有任何一项含 $p_t$。若评估 NLL,需要概率密度或其可计算表示;沿可逆 ODE 跟踪散度是一种做法,并不要求已知数据密度。本文的 RBF 指标之所以有解析参照,是因为选了可计算的 GMM;真实图像任务通常没有这个条件。
三个可以自己跑的小实验,按顺序:
python fm_oracle.py。应该看到 $\alpha m+\sigma e=z$ 的残差在 $10^{-15}$ 量级,$v^{\star}$ 的两种算法差约 $10^{-14}$。这些是 float64 和本例尺度下的数值,不是所有 dtype 的固定门槛。较大残差也可能来自精度、端点除法或索引错误;应定位原因,不能仅凭残差认定缺 log-sum-exp。python param_lab.py。看解析式与数值扰动两列是否完全一致,再看 $t=0.99$ 那一行——噪声目标 $0.0101$ 对速度目标 $1.0101$。python reflow_lab.py(完整两轮 6000 步和十万配对,纯 NumPy;耗时取决于 CPU、BLAS 与线程数)。确认三件事:第 1 轮逐坐标平均 loss 乘以维数 2 后,接近估计的 $S_{pair}\cdot E\|z_1-z_0\|^2$;第 2 轮弧长/弦长 $\approx 1.00$;第 2 轮 NFE 曲线近乎平坦,但仍存在相对真实数据的偏差。另跑 python fm_checks.py,可复核密度有限差分、连续性、MLP 梯度、真实 NFE 和几何直但非匀速的反例。make_figures.py 复用本次 reflow 实跑结果;快照绑定源码 SHA256、模型权重哈希与训练配置,缺失或过期就完整重算。它不是拿旧图上的数字反填正文。
想改实验设置的话:make_data 里的 radius 控制数据尺度(默认 2.2)。改变它后重新运行 path_lab.py,比较不同路径在相同实际 NFE 下的误差。半径改变会同时影响数据协方差、模式间距和路径难度;不要把某一次误差比当作固定的步数收益。
09 节用到的脚本全文如下(reflow_lab.py、path_lab.py、fm_oracle.py、param_lab.py、make_figures.py、fm_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
# -*- coding: utf-8 -*-
"""flow_matching 实验台(四):Reflow —— 用模型自己造的配对再训一轮。

Rectified Flow 最容易被转述错的一句话是「它的路径是直的」。
真的是直的,但直的是**训练时那条插值线** (1-t)x + t*eps;
ODE 真正走出来的轨迹是边缘速度场 v*(z,t) = E[eps - x | z_t = z] 的积分曲线,
本例的积分轨迹会弯曲,弧长须把每一小段的欧式长度相加后再与弦长比较。

Reflow 做的事是:用第 1 轮训好的模型把噪声推到数据端,得到一批**配对**
(z_1, z_0) = (起点噪声, 模型生成的终点),再拿这批配对重训一轮。
理想化 reflow 的性质有理论条件;本实验另外测量有限模型的轨迹长度比和采样误差。

这一份用 numpy 手搓一个小 MLP 当"模型",分别报告配对插值上的归一化回归残差 S_pair、实际 ODE 轨迹弧长/弦长和 NFE-误差。
"""

import hashlib
import json
import os
import platform
from pathlib import Path
import numpy as np

from fm_oracle import (
    D, base_rng, make_data, LinearPath, OracleFlow,
    make_rbf_centers, discrepancy, make_schedule, integrate,
)

C, BW = make_rbf_centers()
PATH = LinearPath()


# ─────────────────── 一个小 MLP(numpy 手写) ───────────────────
class MLP:
    def __init__(self, sizes, rng):
        self.W, self.b = [], []
        for i in range(len(sizes) - 1):
            lim = np.sqrt(6.0 / (sizes[i] + sizes[i + 1]))
            self.W.append(rng.uniform(-lim, lim, (sizes[i], sizes[i + 1])))
            self.b.append(np.zeros(sizes[i + 1]))
        self.m = [np.zeros_like(w) for w in self.W]
        self.v = [np.zeros_like(w) for w in self.W]
        self.mb = [np.zeros_like(x) for x in self.b]
        self.vb = [np.zeros_like(x) for x in self.b]

    def forward(self, X):
        A = [X]
        H = X
        for i in range(len(self.W) - 1):
            H = np.tanh(H @ self.W[i] + self.b[i])
            A.append(H)
        A.append(H @ self.W[-1] + self.b[-1])
        return A[-1], A

    def step(self, X, Y, lr, tstep, beta1=0.9, beta2=0.999, eps=1e-8):
        pred, A = self.forward(X)
        g = 2.0 * (pred - Y) / pred.size
        for i in range(len(self.W) - 1, -1, -1):
            gW = A[i].T @ g
            gb = g.sum(0)
            self.m[i] = beta1 * self.m[i] + (1 - beta1) * gW
            self.v[i] = beta2 * self.v[i] + (1 - beta2) * (gW * gW)
            self.mb[i] = beta1 * self.mb[i] + (1 - beta1) * gb
            self.vb[i] = beta2 * self.vb[i] + (1 - beta2) * (gb * gb)
            mh = self.m[i] / (1 - beta1 ** tstep)
            vh = self.v[i] / (1 - beta2 ** tstep)
            # 先用本次前向的旧权重传播梯度,再更新参数。
            g_prev = (g @ self.W[i].T) * (1 - A[i] ** 2) if i > 0 else None
            self.W[i] -= lr * mh / (np.sqrt(vh) + eps)
            bmh = self.mb[i] / (1 - beta1 ** tstep)
            bvh = self.vb[i] / (1 - beta2 ** tstep)
            self.b[i] -= lr * bmh / (np.sqrt(bvh) + eps)
            if i > 0:
                g = g_prev
        return float(((pred - Y) ** 2).mean())

    def __call__(self, z, t):
        tt = np.full((z.shape[0], 1), float(t))
        return self.forward(np.concatenate([z, tt], axis=1))[0]


def train(pairs_z0, pairs_z1, n_step=4000, batch=512, lr=3e-3, seed=0, fresh=False):
    """在给定配对上训练速度场:目标 u = z_1 - z_0,z_t = (1-t) z_0 + t z_1。

    fresh=True 时重采噪声和时间,数据仍从有限样本池有放回抽取。
    这不是每步重新抽取总体数据;独立留出样本用于检查泛化。
    """
    rng = base_rng(seed)
    net = MLP([D + 1, 128, 128, D], np.random.default_rng(seed + 1))
    n = pairs_z0.shape[0]
    losses = []
    for s in range(1, n_step + 1):
        if fresh:
            idx = rng.integers(0, n, batch)
            z1 = rng.standard_normal((batch, D))
            z0 = pairs_z0[idx]          # 有限经验数据池,不能当作总体新样本
        else:
            idx = rng.integers(0, n, batch)
            z0 = pairs_z0[idx]
            z1 = pairs_z1[idx]
        t = rng.uniform(0.0, 1.0, (batch, 1))
        zt = (1 - t) * z0 + t * z1
        u = z1 - z0
        X = np.concatenate([zt, t], axis=1)
        cur_lr = lr * (0.3 ** (s / n_step))     # 余弦退火换成简单指数退火
        l = net.step(X, u, cur_lr, s)
        losses.append(l)
    return net, float(np.mean(losses[-200:]))


# ─────────────────── 两轮的配对 ───────────────────
def round1_pairs(n, seed=0):
    """第 1 轮:数据与噪声独立配对(这就是 Rectified Flow 原始的训练配对)。"""
    rng = base_rng(seed)
    data = make_data()
    z0 = data.sample(n, rng)              # 数据端(t=0)
    z1 = rng.standard_normal((n, D))      # 噪声端(t=1)
    return z0, z1


def generate_pairs(model, z1, n_steps=100):
    """用 RK2 的 n_steps 个积分步生成配对,实际场评估次数为 2*n_steps。"""
    sched = make_schedule(n_steps)
    z0, _ = integrate(lambda z, t: model(z, t), z1, sched, "rk2")
    return z0


# ─────────────────── 评价指标 ───────────────────
def straightness_of(pairs_z0, pairs_z1, vfun, nstep=32):
    """配对插值上的归一化回归残差;不是论文沿实际 ODE 轨迹定义的 straightness。"""
    ts = np.linspace(1.0, 0.0, nstep + 1)[:-1]
    dev = 0.0
    for t in ts:
        zt = (1 - t) * pairs_z0 + t * pairs_z1
        dev += float(np.mean(np.sum((vfun(zt, t) - (pairs_z1 - pairs_z0)) ** 2, axis=1)))
    dev /= len(ts)
    return dev / float(np.mean(np.sum((pairs_z1 - pairs_z0) ** 2, axis=1)))


def arc_over_chord(pairs_z1, vfun, nstep=64):
    """真走一遍:从 z_1 出发积分到 t=0,量轨迹弧长与端点弦长之比。"""
    sched = make_schedule(nstep)
    z0, traj = integrate(vfun, pairs_z1, sched, "rk2")
    seg = np.linalg.norm(np.diff(traj, axis=0), axis=2).sum(0)
    chord = np.linalg.norm(z0 - pairs_z1, axis=1)
    return float(np.mean(seg / np.maximum(chord, 1e-12))), z0


def nfe_curve(pairs_z1, vfun, nfe_list, data):
    flow = OracleFlow(data, PATH)
    out = []
    for nfe in nfe_list:
        sched = make_schedule(nfe)
        z0, _ = integrate(vfun, pairs_z1, sched, "euler")
        out.append(discrepancy(z0, 0.0, flow, C, BW))
    return np.array(out)


def field_error(model, flow, n=4000, seed=3):
    """训练出来的场与精确场差多少(相对均方)。

    查询点取自真实边缘 p_t(与第 1 轮训练分布一致),并在五个时刻汇总平方误差。
    """
    rng = base_rng(seed)
    data = make_data()
    num = 0.0
    den = 0.0
    for t in (0.1, 0.3, 0.5, 0.7, 0.9):
        x = data.sample(n, rng)
        eps = rng.standard_normal((n, D))
        zt = (1 - t) * x + t * eps
        v = flow.v(zt, t)
        num += float(np.mean(np.sum((model(zt, t) - v) ** 2, axis=1)))
        den += float(np.mean(np.sum(v ** 2, axis=1)))
    return num / den


def chord_scale(pairs_z0, pairs_z1):
    """E||z_1 - z_0||^2,配对残差 S_pair 的分母。"""
    return float(np.mean(np.sum((pairs_z1 - pairs_z0) ** 2, axis=1)))


def state():
    data = make_data()
    flow = OracleFlow(data, PATH)
    z0_1, z1 = round1_pairs(100000, seed=0)
    net1, loss1 = train(z0_1, z1, n_step=6000, seed=0, fresh=True)
    z0_2 = generate_pairs(net1, z1, n_steps=100)
    net2, loss2 = train(z0_2, z1, n_step=6000, seed=0)

    nfe_list = [2, 4, 8, 16, 32, 64]
    eval_z1 = base_rng(999).standard_normal((4000, D))
    out = {
        "nfe": np.array(nfe_list),
        "loss1": loss1,
        "loss2": loss2,
        "ferr1": field_error(net1, flow),
        "ferr2": field_error(net2, flow),
        "S1_oracle": straightness_of(z0_1, z1, lambda z, t: flow.v(z, t)),
        "S1_learned": straightness_of(z0_1, z1, lambda z, t: net1(z, t)),
        "S2_learned": straightness_of(z0_2, z1, lambda z, t: net2(z, t)),
        "arc1_oracle": arc_over_chord(z1, lambda z, t: flow.v(z, t))[0],
        "arc1_learned": arc_over_chord(z1, lambda z, t: net1(z, t))[0],
        "arc2_learned": arc_over_chord(z1, lambda z, t: net2(z, t))[0],
        "nfe_oracle": nfe_curve(eval_z1, lambda z, t: flow.v(z, t), nfe_list, data),
        "nfe_learned1": nfe_curve(eval_z1, lambda z, t: net1(z, t), nfe_list, data),
        "nfe_learned2": nfe_curve(eval_z1, lambda z, t: net2(z, t), nfe_list, data),
        "chord1": chord_scale(z0_1, z1),
        "chord2": chord_scale(z0_2, z1),
        "teacher_discrepancy": discrepancy(z0_2, 0.0, flow, C, BW),
    }
    # 留出噪声经同一教师生成配对;只量回归/数值教师,不假称精确 reflow。
    held_z1 = base_rng(1234).standard_normal((4000, D))
    held_z0 = generate_pairs(net1, held_z1, n_steps=100)
    out["S2_heldout"] = straightness_of(held_z0, held_z1, net2)
    out["evaluation_seeds"] = []
    for seed in [999, 1000, 1001, 1002, 1003]:
        z = base_rng(seed).standard_normal((4000, D))
        vals = [float(nfe_curve(z, net, [2], data)[0]) for net in [net1, net2]]
        out["evaluation_seeds"].append({"seed": seed, "round1_nfe2": vals[0], "round2_nfe2": vals[1]})
    arrays = {}
    for name, net in [("net1", net1), ("net2", net2)]:
        for i, (w, b) in enumerate(zip(net.W, net.b)):
            arrays[f"{name}_W{i}"] = w
            arrays[f"{name}_b{i}"] = b
    here = Path(__file__).resolve().parent
    tmp = here / '_reflow_models.tmp.npz'
    np.savez(tmp, **arrays)
    os.replace(tmp, here / '_reflow_models.npz')
    def serial(v):
        if isinstance(v, np.ndarray): return v.tolist()
        if isinstance(v, dict): return {k: serial(x) for k, x in v.items()}
        if isinstance(v, list): return [serial(x) for x in v]
        return v
    payload = {"results": serial(out), "inputs": snapshot_inputs(),
               "numpy": np.__version__, "python": platform.python_version(),
               "models_sha256": hashlib.sha256((here / '_reflow_models.npz').read_bytes()).hexdigest(),
               "config": {"pairs": 100000, "steps_per_round": 6000, "batch": 512,
                          "hidden": [128, 128], "teacher_steps": 100, "teacher_method": "rk2",
                          "training_seed": 0, "evaluation_particles": 4000,
                          "S_pair_quadrature": "32 equal intervals, right endpoints in increasing time"}}
    tmp = here / '_reflow_results.tmp.json'
    tmp.write_text(json.dumps(payload, ensure_ascii=False, indent=2), encoding='utf8')
    os.replace(tmp, here / '_reflow_results.json')
    return out


def snapshot_inputs():
    here = Path(__file__).resolve().parent
    return {n: hashlib.sha256((here / n).read_bytes()).hexdigest()
            for n in ['fm_oracle.py', 'reflow_lab.py']}


def reviewed_state():
    """配图复用当前代码的真实实跑;缺失/过期时完整重算,不接受旧实验缓存。"""
    here = Path(__file__).resolve().parent
    p = here / '_reflow_results.json'
    if p.exists():
        obj = json.loads(p.read_text('utf8'))
        if obj['inputs'] == snapshot_inputs() and obj['models_sha256'] == hashlib.sha256((here / '_reflow_models.npz').read_bytes()).hexdigest():
            return obj['results']
    return state()


if __name__ == "__main__":
    result = state()
print(json.dumps(result, default=lambda v: v.tolist(), ensure_ascii=False, indent=2))# -*- coding: utf-8 -*-
"""flow_matching 实验台(三):路径的选择到底值多少 NFE。
直线路径(Rectified Flow)和 VP 余弦路径(DDPM 那一路)通向**同一个**目标分布,
中间分布不同,ODE 的轨迹与时间参数化也会不同。这一份把这件事量成三条曲线:
1. NFE-误差曲线:同一批起点,比较路径和积分器;Euler/RK2/RK4 每步分别评估 1/2/4 次场。
2. 欧式弧长 / 弦长,以及沿实际 ODE 轨迹的归一化速度偏差 S_traj;
后者对 Rectified Flow 的轨迹 straightness 再除以 E||Z_1-Z_0||^2,
不等于 reflow_lab 在原始配对插值上计算的 S_pair。
3. 时间 shift(SD3/FLUX 的做法)在直线路径上到底省不省步数。
误差尺子是 fm_oracle.discrepancy:拿精确边缘 p_t 的 RBF 特征矩当参照,
参照侧没有采样噪声,生成粒子一侧仍有有限样本误差。共享起点可减轻比较方差,
小差异是否稳定仍应更换随机种子验证;单次真实样本偏差不是硬下限。
"""
import numpy as np
from fm_oracle import (
D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow,
make_rbf_centers, discrepancy, make_schedule, integrate,
)
NPART = 4000
C, BW = make_rbf_centers()
def start_particles(n, rng):
"""t=1 端的粒子:精确就是 N(0, I)。"""
return rng.standard_normal((n, D))
def sampling_reference(data, n=NPART):
"""固定一次真实样本与精确 p_data 的偏差,仅作有限采样参考,不是误差下限。"""
rng = base_rng(12345)
x = data.sample(n, rng)
flow = OracleFlow(data, LinearPath())
return discrepancy(x, 0.0, flow, C, BW)
def run_sweep(path, method, nfe_list, npart=NPART):
rng = base_rng()
z1 = start_particles(npart, rng)
flow = OracleFlow(make_data(), path)
out = []
calls_per_step = {"euler": 1, "rk2": 2, "rk4": 4}[method]
for nfe in nfe_list:
if nfe < calls_per_step or nfe % calls_per_step:
raise ValueError(f"{method}: NFE must be a positive multiple of {calls_per_step}")
sched = make_schedule(nfe // calls_per_step)
z0, _ = integrate(lambda z, t: flow.v(z, t), z1, sched, method)
out.append(discrepancy(z0, 0.0, flow, C, BW))
return np.array(out)
def straightness(path, npart=1500, nstep=400):
"""细步长积分出真实轨迹,量它离弦有多远。"""
rng = base_rng(777)
z1 = start_particles(npart, rng)
flow = OracleFlow(make_data(), path)
sched = make_schedule(nstep)
z0, traj = integrate(lambda z, t: flow.v(z, t), z1, sched, "rk4")
# traj: [nstep+1, npart, 2],index 0 是 t=1
arc = np.linalg.norm(np.diff(traj, axis=0), axis=2).sum(axis=0) # [npart],各段欧式长度相加
chord = np.linalg.norm(z0 - z1, axis=1)
ratio = float(np.mean(arc / np.maximum(chord, 1e-12)))
# S_traj = mean_t ||v(z_t,t) - (z_1 - z_0)||^2 / mean ||z_1 - z_0||^2
chord_dir = (z1 - z0)[None, :, :] # [1,npart,2]
ts = sched[:-1]
dev = 0.0
for i, t in enumerate(ts):
v = flow.v(traj[i], t)
dev += float(np.mean(np.sum((v - chord_dir[0]) ** 2, axis=1)))
dev /= len(ts)
scale = float(np.mean(np.sum((z1 - z0) ** 2, axis=1)))
return ratio, dev / scale
def shift_sweep(path, nfe_list, shifts, npart=NPART):
rng = base_rng()
z1 = start_particles(npart, rng)
flow = OracleFlow(make_data(), path)
res = {}
for sh in shifts:
errs = []
for nfe in nfe_list:
sched = make_schedule(nfe, shift=sh)
z0, _ = integrate(lambda z, t: flow.v(z, t), z1, sched, "euler")
errs.append(discrepancy(z0, 0.0, flow, C, BW))
res[sh] = np.array(errs)
return res
def state():
"""给画图脚本复用:返回与上面打印完全一致的数字。"""
data = make_data()
nfe_list = [2, 4, 8, 16, 32, 64, 128, 256]
out = {
"nfe": np.array(nfe_list),
"sampling_reference": sampling_reference(data),
"sweep": {},
"straight": {},
"shift": {},
}
for path in (LinearPath(), CosineVPPath()):
for method in ("euler", "rk2"):
out["sweep"][(path.name, method)] = run_sweep(path, method, nfe_list)
out["straight"][path.name] = straightness(path)
out["shift"] = shift_sweep(LinearPath(), [4, 8, 16, 32, 64], [1.0, 3.0, 6.0])
out["shift_nfe"] = np.array([4, 8, 16, 32, 64])
return out
if __name__ == "__main__":
data = make_data()
print(f"=== 单次采样参考:{NPART} 个真实样本 vs 精确 p_data 的偏差 = "
f"{sampling_reference(data):.5f} ===")
print("(这不是硬下限或显著性阈值;评估小差异需重复采样)")
print()
nfe_list = [2, 4, 8, 16, 32, 64, 128, 256]
print("=== NFE-误差:直线路径 vs VP 余弦路径 ===")
print(" NFE linear/euler linear/rk2 vp/euler vp/rk2")
lin_e = run_sweep(LinearPath(), "euler", nfe_list)
lin_r = run_sweep(LinearPath(), "rk2", nfe_list)
vp_e = run_sweep(CosineVPPath(), "euler", nfe_list)
vp_r = run_sweep(CosineVPPath(), "rk2", nfe_list)
for i, n in enumerate(nfe_list):
print(f"{n:>5}{lin_e[i]:>14.5f}{lin_r[i]:>13.5f}{vp_e[i]:>12.5f}{vp_r[i]:>11.5f}")
print()
print("=== 轨迹指标(400 步 RK4,即 1600 NFE;数值近似 ODE 轨迹)===")
for path in (LinearPath(), CosineVPPath()):
ratio, s = straightness(path)
print(f" {path.label:<28} 弧长/弦长 = {ratio:.4f} 归一化 S_traj = {s:.4f}")
print()
print("=== 时间 shift(仅直线路径,Euler)===")
res = shift_sweep(LinearPath(), [4, 8, 16, 32, 64], [1.0, 3.0, 6.0])
print(" NFE shift=1 shift=3 shift=6")
for i, n in enumerate([4, 8, 16, 32, 64]):
print(f"{n:>5}{res[1.0][i]:>11.5f}{res[3.0][i]:>11.5f}{res[6.0][i]:>11.5f}")# -*- coding: utf-8 -*-
"""flow_matching 实验台(一):任意高斯路径下的精确速度场。
这一份是整个文章所有数字的来源。思想是:
数据分布取二维高斯混合 p_data(K 个各向同性分量),噪声取 N(0, I)。
对任意「高斯路径」 z_t = alpha_t * x + sigma_t * eps(t=1 是纯噪声,t=0 是数据),
p_t 仍然是高斯混合(分量均值 alpha*mu_k,方差 alpha^2 s_k^2 + sigma^2),
于是下面四样东西全都有闭式解,不需要训练、不需要采样近似:
m(z,t) = E[x | z_t = z] 去噪均值(x0 预测的真值)
e(z,t) = E[eps | z_t = z] 噪声均值(epsilon 预测的真值)
v(z,t) = alpha' m + sigma' e 边缘速度场(速度预测的真值)
score = grad log p_t(z)
有了这些,三种参数化(x0 / eps / v)可以逐点互相换算并验到浮点误差,
ODE 的 NFE-误差曲线可以用「精确边缘 p_t」当尺子,不需要跑一条高精参考解。
误差尺子:取一组 RBF 特征 phi_c(z) = exp(-||z-c||^2 / (2h^2)),
它在高斯分布下的期望有闭式,于是
disc(粒子云, t) = mean_c | (1/N) sum_i phi_c(z_i) - E_{p_t}[phi_c] |
经验侧仍有有限样本误差,解析侧不额外引入采样噪声。单次真实样本参考值既不是硬地板,
也不是统计显著性阈值;有限组 RBF 特征矩一致也不能证明两个分布完全一致。
"""
import numpy as np
D = 2 # 二维,画图方便;公式与代码对任意维都成立
# ─────────────────────────── 随机流 ───────────────────────────
def base_rng(seed=20260928):
"""所有脚本与画图共用同一条随机流,保证正文数字与图上的数字一致。"""
return np.random.default_rng(seed)
# ─────────────────────────── 数据分布 ───────────────────────────
class GMM2D:
"""二维各向同性高斯混合。"""
def __init__(self, means, stds, weights=None):
self.mu = np.asarray(means, dtype=float) # [K, 2]
self.s = np.asarray(stds, dtype=float) # [K]
K = self.mu.shape[0]
if weights is None:
self.w = np.full(K, 1.0 / K)
else:
self.w = np.asarray(weights, dtype=float)
self.w = self.w / self.w.sum()
@property
def K(self):
return self.mu.shape[0]
def sample(self, n, rng):
k = rng.choice(self.K, size=n, p=self.w)
return self.mu[k] + self.s[k][:, None] * rng.standard_normal((n, D))
def mean_cov(self):
m = (self.w[:, None] * self.mu).sum(0)
c = (self.w[:, None, None] * (
(self.s ** 2)[:, None, None] * np.eye(D)[None]
+ (self.mu - m)[:, :, None] * (self.mu - m)[:, None, :]
)).sum(0)
return m, c
def make_data(K=8, radius=2.2, std=0.28):
"""8 个分量摆在半径 2.2 的圆上,每个分量标准差 0.28。"""
ang = np.arange(K) * 2 * np.pi / K
mu = np.stack([radius * np.cos(ang), radius * np.sin(ang)], axis=1)
s = np.full(K, std)
# 权重做成确定性的非均匀(1 + 0.35 cos),让混合更不像"一圈一样的点"
w = 1.0 + 0.35 * np.cos(ang + 0.7)
return GMM2D(mu, s, w / w.sum())
# ─────────────────────────── 路径 ───────────────────────────
class LinearPath:
"""Rectified Flow 的直线插值路径:z_t = (1-t) x + t eps。"""
name = "linear"
label = "直线路径(Rectified Flow)"
def alpha(self, t):
return 1.0 - t
def sigma(self, t):
return t
def dalpha(self, t):
return -1.0
def dsigma(self, t):
return 1.0
class CosineVPPath:
"""方差保持(VP)路径:z_t = cos(pi t/2) x + sin(pi t/2) eps。
alpha^2 + sigma^2 = 1,也就是 DDPM 那一路 cosine schedule 的连续化版本。
"""
name = "cosine_vp"
label = "VP 余弦路径(DDPM 那一路)"
def alpha(self, t):
return np.cos(0.5 * np.pi * t)
def sigma(self, t):
return np.sin(0.5 * np.pi * t)
def dalpha(self, t):
return -0.5 * np.pi * np.sin(0.5 * np.pi * t)
def dsigma(self, t):
return 0.5 * np.pi * np.cos(0.5 * np.pi * t)
# ─────────────────────────── 精确场 ───────────────────────────
class OracleFlow:
"""给定数据与路径后的精确边缘速度场。"""
def __init__(self, data: GMM2D, path):
self.data = data
self.path = path
# 后验responsibility r_k(z,t) 与分量方差 V_k(t)
def _post(self, z, t):
a = self.path.alpha(t)
sg = self.path.sigma(t)
V = a * a * self.data.s ** 2 + sg * sg # [K]
diff = z[:, None, :] - a * self.data.mu[None, :, :] # [N,K,2]
d2 = (diff ** 2).sum(-1) # [N,K]
logp = -0.5 * d2 / V[None, :] - np.log(V)[None, :] + np.log(self.data.w)[None, :]
logp = logp - logp.max(1, keepdims=True)
r = np.exp(logp)
r = r / r.sum(1, keepdims=True)
return r, V, diff
def m(self, z, t):
"""E[x | z_t = z],也就是 x0 预测的真值。"""
a = self.path.alpha(t)
r, V, diff = self._post(z, t)
ex = self.data.mu[None, :, :] + (a * self.data.s ** 2 / V)[None, :, None] * diff
return (r[:, :, None] * ex).sum(1)
def e(self, z, t):
"""E[eps | z_t = z],也就是 epsilon 预测的真值。"""
sg = self.path.sigma(t)
r, V, diff = self._post(z, t)
ee = (sg / V)[None, :, None] * diff
return (r[:, :, None] * ee).sum(1)
def v(self, z, t):
"""边缘速度场 v*(z,t) = alpha' m + sigma' e。"""
da = self.path.dalpha(t)
ds = self.path.dsigma(t)
return da * self.m(z, t) + ds * self.e(z, t)
def score(self, z, t):
"""grad log p_t(z)。"""
r, V, diff = self._post(z, t)
return -(r[:, :, None] * diff / V[None, :, None]).sum(1)
def marginal(self, t):
"""p_t 的分量参数(仍是 GMM):均值 [K,2]、标准差 [K]、权重 [K]。"""
a = self.path.alpha(t)
sg = self.path.sigma(t)
return a * self.data.mu, np.sqrt(a * a * self.data.s ** 2 + sg * sg), self.data.w
# ─────────────────────────── 误差尺子 ───────────────────────────
def make_rbf_centers(n=9, extent=3.6, bw=0.9):
g = np.linspace(-extent, extent, n)
C = np.stack(np.meshgrid(g, g, indexing="ij"), axis=-1).reshape(-1, D)
return C, bw
def rbf_expectation(means, sds, weights, C, bw):
"""E_{p_t}[phi_c],phi_c(z)=exp(-||z-c||^2/(2 bw^2)),p_t 为各向同性 GMM。
单个高斯分量 N(m, v I) 下:E[phi_c] = (bw^2/(bw^2+v))^{d/2} * exp(-||m-c||^2/(2(bw^2+v)))
"""
v = sds ** 2 # [K]
coef = (bw ** 2 / (bw ** 2 + v)) ** (D / 2.0) # [K]
d2 = ((means[:, None, :] - C[None, :, :]) ** 2).sum(-1) # [K, M]
val = coef[:, None] * np.exp(-0.5 * d2 / (bw ** 2 + v)[:, None])
return (weights[:, None] * val).sum(0) # [M]
def discrepancy(z, t, flow: OracleFlow, C, bw):
"""粒子云 z 与精确边缘 p_t 的 RBF 特征矩偏差(越小越好)。"""
mu_t, sd_t, w_t = flow.marginal(t)
exact = rbf_expectation(mu_t, sd_t, w_t, C, bw)
d2 = ((z[:, None, :] - C[None, :, :]) ** 2).sum(-1)
emp = np.exp(-0.5 * d2 / bw ** 2).mean(0)
return float(np.abs(emp - exact).mean())
# ─────────────────────────── 积分器 ───────────────────────────
def make_schedule(n_steps, shift=1.0):
"""含 n_steps 个积分区间(不是统一 NFE 预算)的时刻表。shift>1 是 SD3/FLUX 那套把时间往高噪声端推的做法。"""
t = np.linspace(1.0, 0.0, n_steps + 1)
if shift != 1.0:
t = shift * t / (1.0 + (shift - 1.0) * t)
return t
def integrate(vfun, z, schedule, method="euler"):
"""从 t=1 走到 t=0。vfun(z, t) 返回对递增时间定义的 dz/dt;负步长负责反向积分。"""
z = z.copy()
traj = [z.copy()]
for i in range(len(schedule) - 1):
t = schedule[i]
h = schedule[i] - schedule[i + 1] # >0
if method == "euler":
dz = vfun(z, t)
elif method == "rk2":
zm = z - 0.5 * h * vfun(z, t)
dz = vfun(zm, t - 0.5 * h)
elif method == "rk4":
k1 = vfun(z, t)
k2 = vfun(z - 0.5 * h * k1, t - 0.5 * h)
k3 = vfun(z - 0.5 * h * k2, t - 0.5 * h)
k4 = vfun(z - h * k3, t - h)
dz = (k1 + 2 * k2 + 2 * k3 + k4) / 6.0
else:
raise ValueError(method)
z = z - h * dz
traj.append(z.copy())
return z, np.stack(traj) # traj: [S+1, N, 2]
# ─────────────────────────── 自测 ───────────────────────────
def selfcheck():
rng = base_rng()
data = make_data()
out = []
for path in (LinearPath(), CosineVPPath()):
flow = OracleFlow(data, path)
z = rng.standard_normal((4000, D)) * 1.6
for t in (0.05, 0.25, 0.5, 0.75, 0.95):
a = path.alpha(t)
sg = path.sigma(t)
m = flow.m(z, t)
e = flow.e(z, t)
v = flow.v(z, t)
# 恒等式 1:alpha*m + sigma*e == z
r1 = float(np.abs(a * m + sg * e - z).max())
# 恒等式 2:v == alpha' m + sigma' e(定义,顺手确认没写反导数)
r2 = float(np.abs(v - (path.dalpha(t) * m + path.dsigma(t) * e)).max())
out.append((path.name, t, r1, r2))
return out
if __name__ == "__main__":
print("=== 恒等式自检:alpha*m + sigma*e 应等于 z(残差 ~1e-15)===")
hdr = "path t |a*m+s*e-z| |v-(da*m+ds*e)|"
print(hdr)
for name, t, r1, r2 in selfcheck():
print(f"{name:<12}{t:>6.2f}{r1:>16.2e}{r2:>18.2e}")
rng = base_rng()
data = make_data()
flow = OracleFlow(data, LinearPath())
print()
print("=== 直线路径下 v* 的两种算法是否一致:(z-m)/t 与 alpha' m + sigma' e ===")
for t in (0.1, 0.3, 0.5, 0.7, 0.9):
z = rng.standard_normal((2000, D)) * 1.6
lhs = (z - flow.m(z, t)) / t
rhs = flow.v(z, t)
print(f" t={t:.1f} 最大绝对差 = {np.abs(lhs - rhs).max():.3e}")# -*- coding: utf-8 -*-
"""flow_matching 实验台(二):三种参数化(x0 / eps / v)的换算与 loss 权重。
要回答两个问题:
1. 固定同一条高斯路径和非退化时间,eps / x0 / v 输出能否代数换算?
可以换算同一路径上的输出,但不能据此把 VP 模型直接变成另一条 RF 路径的模型。
三种参数化的真值来自同一个去噪均值 m:
z = alpha*m + sigma*e (路径定义,恒等)
v = alpha'*m + sigma'*e (速度定义)
两式联立解出 m、e,就得到「速度 -> 噪声/干净图」的换算;
反过来也成立。下面把这些换算逐点验到 1e-14。
2. 输出可换算,为什么不同训练目标仍会产生差异?
因为「等价」指的是**真值**等价,**loss 不等价**:同一个 m 上的误差 delta,
在三种 loss 里被放大的倍数不同:
x0 : 1
eps : alpha / sigma
v : |alpha' - sigma' * alpha / sigma|
这里列的是误差幅度系数,平方损失权重还需平方。直线路径 t→1 时,
eps 系数趋于 0,v 系数趋于 1;这比较固定 m 误差的相对权重,
不等于真实网络的所有梯度或质量。t=1 的 eps->m 换算本身退化。
"""
import numpy as np
from fm_oracle import (
D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow,
)
# ─────────────────── 换算表的通用形式 ───────────────────
def v_to_me(z, v, path, t):
"""由 (z, v) 反解 (m, e)。
解 [[alpha', sigma'], [alpha, sigma]] @ [m, e] = [v, z]
行列式 det = alpha'*sigma - sigma'*alpha
"""
a, sg = path.alpha(t), path.sigma(t)
da, ds = path.dalpha(t), path.dsigma(t)
det = da * sg - ds * a
m = (sg * v - ds * z) / det
e = (da * z - a * v) / det
return m, e
def eps_to_me(z, eps_hat, path, t):
"""由 eps 预测反解 (m, e)。"""
a, sg = path.alpha(t), path.sigma(t)
m = (z - sg * eps_hat) / a
return m, np.broadcast_to(eps_hat, m.shape).copy()
def me_to_v(m, e, path, t):
return path.dalpha(t) * m + path.dsigma(t) * e
def check_conversions():
"""真值层面三种参数化互转,误差应到浮点量级。"""
rng = base_rng()
data = make_data()
rows = []
for path in (LinearPath(), CosineVPPath()):
flow = OracleFlow(data, path)
z = rng.standard_normal((3000, D)) * 1.6
for t in (0.1, 0.3, 0.5, 0.7, 0.9, 0.99):
m = flow.m(z, t)
e = flow.e(z, t)
v = flow.v(z, t)
# 真值 v -> (m,e)
m2, e2 = v_to_me(z, v, path, t)
# 真值 eps -> m -> v
m3, _ = eps_to_me(z, e, path, t)
v3 = me_to_v(m3, e, path, t)
rows.append((
path.name, t,
float(np.abs(m2 - m).max()),
float(np.abs(e2 - e).max()),
float(np.abs(m3 - m).max()),
float(np.abs(v3 - v).max()),
))
return rows
# ─────────────────── 放大倍数 ───────────────────
def weights(path, ts):
"""返回三种参数化下「m 上的单位误差」被放大的倍数(振幅,非平方)。"""
wx = np.ones_like(ts)
we, wv = [], []
for t in ts:
a, sg = path.alpha(t), path.sigma(t)
da, ds = path.dalpha(t), path.dsigma(t)
we.append(a / sg)
wv.append(abs(da - ds * a / sg))
return wx, np.array(we), np.array(wv)
def numeric_weight_check():
"""不靠公式,直接用数值扰动验证放大倍数:给 m 加一个固定扰动,看 loss 变化。"""
rng = base_rng()
data = make_data()
flow = OracleFlow(data, LinearPath())
path = LinearPath()
z = rng.standard_normal((4000, D)) * 1.6
out = []
for t in (0.1, 0.3, 0.5, 0.7, 0.9, 0.99):
m = flow.m(z, t)
e = flow.e(z, t)
v = flow.v(z, t)
delta = rng.standard_normal((4000, D))
delta = delta / np.linalg.norm(delta) * 0.01 # 固定长度 0.01 的扰动
mp = m + delta
ep = (z - path.alpha(t) * mp) / path.sigma(t)
vp = me_to_v(mp, ep, path, t)
r_eps = np.linalg.norm(ep - e) / np.linalg.norm(delta)
r_v = np.linalg.norm(vp - v) / np.linalg.norm(delta)
_, we, wv = weights(path, np.array([t]))
out.append((t, r_eps, float(we[0]), r_v, float(wv[0])))
return out
if __name__ == "__main__":
print("=== 换算残差(真值层面互转,应为 1e-14 量级)===")
print("path t v->m v->e eps->m eps->v")
for name, t, r1, r2, r3, r4 in check_conversions():
print(f"{name:<11}{t:>5.2f}{r1:>12.2e}{r2:>12.2e}{r3:>12.2e}{r4:>12.2e}")
print()
print("=== 放大倍数:解析式 vs 数值扰动(直线路径)===")
print(" t eps实测 eps解析 v实测 v解析")
for t, re_, we_, rv_, wv_ in numeric_weight_check():
print(f"{t:>5.2f}{re_:>10.4f}{we_:>10.4f}{rv_:>10.4f}{wv_:>10.4f}")
print()
print("=== 放大倍数随 t 的变化(直线路径 vs VP 余弦路径)===")
ts = np.array([0.01, 0.05, 0.1, 0.2, 0.4, 0.6, 0.8, 0.9, 0.95, 0.99])
for path in (LinearPath(), CosineVPPath()):
wx, we, wv = weights(path, ts)
print(f"-- {path.label}")
print(" t x0 eps v")
for i, t in enumerate(ts):
print(f"{t:>7.2f}{wx[i]:>8.3f}{we[i]:>10.3f}{wv[i]:>10.3f}")# -*- coding: utf-8 -*-
"""画配图。数字全部来自同目录的实验脚本,不另算一遍。
运行: python make_figures.py [--only 图名]
"""
import os
import sys
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
sys.path.insert(0, os.path.dirname(os.path.abspath(__file__)))
from fm_oracle import ( # noqa: E402
D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow,
make_schedule, integrate,
)
from param_lab import weights # noqa: E402
import path_lab # noqa: E402
import reflow_lab # noqa: E402
HERE = os.path.dirname(os.path.abspath(__file__))
FIGDIR = os.path.join(os.path.dirname(HERE), "figures")
os.makedirs(FIGDIR, exist_ok=True)
C0 = "#2f4b7c"
C1 = "#d45087"
C2 = "#f0a35e"
C3 = "#4c9f70"
CGREY = "#8a8a8a"
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False
def _save(fig, name):
p = os.path.join(FIGDIR, name)
fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white")
plt.close(fig)
print(f" [ok] {name} ({os.path.getsize(p)} bytes)")
# ─────────────── 图 1:三种参数化的放大倍数 ───────────────
def fig_weights():
ts = np.linspace(0.01, 0.999, 400)
wx, we, wv = weights(LinearPath(), ts)
fig, ax = plt.subplots(figsize=(7.4, 4.2))
ax.plot(ts, wv, color=C1, lw=2.4, label="velocity 参数化 v")
ax.plot(ts, we, color=C0, lw=2.4, label="噪声参数化 eps")
ax.plot(ts, wx, color=CGREY, lw=1.8, ls="--", label="干净图参数化 x0")
ax.set_yscale("log")
ax.set_xlabel("时间 t(0 = 数据端,1 = 纯噪声端)")
ax.set_ylabel("同一份误差被放大的倍数(对数轴)")
ax.set_title("图 1:预测误差幅度系数(平方损失权重为其平方)")
ax.axvline(0.99, color="#cccccc", lw=1, ls=":")
ax.annotate("t=0.99 处 eps 系数为 0.010,\nvelocity 还有 1.010",
xy=(0.99, 1.0), xytext=(0.55, 0.35), fontsize=10, color="#333333",
arrowprops=dict(arrowstyle="->", color="#999999", lw=1))
ax.legend(loc="upper right", fontsize=10)
ax.grid(alpha=0.25)
_save(fig, "fig1_param_weights.png")
# ─────────────── 图 2:两条路径的真实 ODE 轨迹 ───────────────
def fig_trajectories():
data = make_data()
rng = base_rng(4242)
z1 = rng.standard_normal((600, D))
xs = data.sample(1200, base_rng(11))
fig, axes = plt.subplots(1, 2, figsize=(12.0, 5.4), sharex=True, sharey=True)
sched = make_schedule(300)
for ax, path in zip(axes, (LinearPath(), CosineVPPath())):
flow = OracleFlow(data, path)
z0, traj = integrate(lambda z, t: flow.v(z, t), z1, sched, "rk4")
ax.scatter(xs[:, 0], xs[:, 1], s=8, color="#dddddd", label="数据样本(8 个模式)")
for i in range(14):
ax.plot(traj[:, i, 0], traj[:, i, 1], color=C1, lw=1.3, alpha=0.9)
ax.scatter(z1[:14, 0], z1[:14, 1], s=34, color=C0, zorder=5, label="起点(纯噪声)")
ax.scatter(z0[:14, 0], z0[:14, 1], s=34, color=C3, marker="s", zorder=5, label="终点(生成)")
ax.set_title(path.label)
ax.set_xlabel("dim 1")
ax.grid(alpha=0.2)
axes[0].set_ylabel("dim 2")
axes[0].legend(fontsize=9, loc="upper left")
fig.suptitle("图 2:同一批起点,两条路径走出来的 ODE 轨迹(300 步 RK4)", fontsize=13)
fig.tight_layout()
_save(fig, "fig2_trajectories.png")
# ─────────────── 图 3:NFE-误差 ───────────────
def fig_nfe():
nfe_list = [2, 4, 8, 16, 32, 64, 128, 256]
floor = path_lab.sampling_reference(make_data())
cur = {
"linear/euler": path_lab.run_sweep(LinearPath(), "euler", nfe_list),
"linear/rk2": path_lab.run_sweep(LinearPath(), "rk2", nfe_list),
"vp/euler": path_lab.run_sweep(CosineVPPath(), "euler", nfe_list),
"vp/rk2": path_lab.run_sweep(CosineVPPath(), "rk2", nfe_list),
}
fig, ax = plt.subplots(figsize=(7.6, 4.6))
for (k, v), col, mk in zip(cur.items(), [C1, C0, C2, C3], ["o", "o", "s", "s"]):
ax.loglog(nfe_list, v, marker=mk, color=col, lw=2, label=k)
ax.loglog(nfe_list, [floor] * len(nfe_list), color=CGREY, ls="--", lw=1.6,
label="单次采样参考(4000 个真实样本)")
ax.set_xlabel("NFE(模型评估次数)")
ax.set_ylabel("终点分布与精确 p_data 的偏差")
ax.set_title("图 3:1-rectified 的直线路径 vs VP 余弦路径")
ax.grid(alpha=0.25, which="both")
ax.legend(fontsize=10)
_save(fig, "fig3_nfe_paths.png")
return {"nfe": nfe_list, "curves": {k: v.tolist() for k, v in cur.items()}}
# ─────────────── 图 4:Reflow ───────────────
def fig_reflow():
snapshot = reflow_lab.reviewed_state()
nfe_list = snapshot['nfe']
o = np.asarray(snapshot['nfe_oracle'])
a = np.asarray(snapshot['nfe_learned1'])
b = np.asarray(snapshot['nfe_learned2'])
floor = path_lab.sampling_reference(make_data())
arc1, arc2 = snapshot['arc1_learned'], snapshot['arc2_learned']
s1, s2 = snapshot['S1_oracle'], snapshot['S2_learned']
fig, axes = plt.subplots(1, 2, figsize=(12.0, 4.8))
ax = axes[0]
ax.loglog(nfe_list, o, marker="o", color=CGREY, lw=2, label="精确场(数值积分对照)")
ax.loglog(nfe_list, a, marker="o", color=C1, lw=2, label="第 1 轮模型")
ax.loglog(nfe_list, b, marker="s", color=C3, lw=2, label="第 2 轮模型(reflow 后)")
ax.loglog(nfe_list, [floor] * len(nfe_list), color="#bbbbbb", ls="--", lw=1.5,
label="单次采样参考(非下限)")
ax.set_xlabel("NFE")
ax.set_ylabel("终点偏差")
ax.set_title("本实验 reflow 后:NFE≥2 的偏差变化很小")
ax.grid(alpha=0.25, which="both")
ax.legend(fontsize=9)
ax = axes[1]
names = ["第 1 轮", "第 2 轮"]
x = np.arange(2)
ax.bar(x - 0.18, [arc1, arc2], width=0.34, color=C0, label="弧长/弦长(1 = 几何直线)")
ax.bar(x + 0.18, [s1, s2], width=0.34, color=C2, label="配对残差(第1轮精确场/第2轮模型)")
ax.set_xticks(x)
ax.set_xticklabels(names)
ax.set_yscale("log")
ax.set_ylabel("配对残差与轨迹长度比(对数轴)")
ax.set_title("第 2 轮:几何轨迹接近直线")
ax.grid(alpha=0.25, axis="y")
ax.legend(fontsize=9)
for i, (av, sv) in enumerate([(arc1, s1), (arc2, s2)]):
ax.text(i - 0.18, av * 1.08, f"{av:.4f}", ha="center", fontsize=9)
ax.text(i + 0.18, sv * 1.08, f"{sv:.4f}", ha="center", fontsize=9)
fig.suptitle("图 4:Reflow 的两轮对比(同一个直线路径、同一批起点)", fontsize=13)
fig.tight_layout()
_save(fig, "fig4_reflow.png")
return {"nfe1": a.tolist(), "nfe2": b.tolist(), "S1": s1, "S2": s2,
"arc1": arc1, "arc2": arc2}
if __name__ == "__main__":
only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None
jobs = {
"weights": fig_weights,
"trajectories": fig_trajectories,
"nfe": fig_nfe,
"reflow": fig_reflow,
}
for k, fn in jobs.items():
if only and k != only:
continue
print(f"[draw] {k}")
fn()
print("done")"""Independent numerical checks of the article's mathematics and NumPy MLP."""
import json
from pathlib import Path
import numpy as np
from fm_oracle import (GMM2D, make_data, OracleFlow, LinearPath, CosineVPPath,
make_schedule, integrate)
from reflow_lab import MLP
def density(z, t, data, path):
# Direct mixture density, independent of OracleFlow._post/score.
var = path.alpha(t)**2 * data.s**2 + path.sigma(t)**2
d = z[:, None, :] - path.alpha(t) * data.mu[None]
return (data.w[None] * np.exp(-np.sum(d*d, axis=2)/(2*var[None]))
/ (2*np.pi*var[None])).sum(1)
def main():
rng = np.random.default_rng(7)
data = make_data()
points = rng.normal(size=(32, 2))
score_error = continuity_error = gaussian_error = 0.0
step = 1e-5
for path in [LinearPath(), CosineVPPath()]:
flow = OracleFlow(data, path)
for t in [.05, .2, .5, .8, .95]:
p = density(points, t, data, path)
fd = np.zeros_like(points)
div = np.zeros(len(points))
for j in range(2):
dz = np.zeros_like(points); dz[:, j] = step
pp = density(points+dz, t, data, path)
pm = density(points-dz, t, data, path)
fd[:, j] = (np.log(pp)-np.log(pm))/(2*step)
div += (pp*flow.v(points+dz, t)[:, j]
- pm*flow.v(points-dz, t)[:, j])/(2*step)
score_error = max(score_error, float(np.max(abs(fd-flow.score(points, t)))))
pt = (density(points, t+step, data, path)-density(points, t-step, data, path))/(2*step)
continuity_error = max(continuity_error, float(np.max(abs(pt+div))))
gaussian = GMM2D([[.3, -.8]], [.7])
gf = OracleFlow(gaussian, path)
a, s, da, ds = path.alpha(t), path.sigma(t), path.dalpha(t), path.dsigma(t)
var = a*a*.7**2+s*s
exact = da*gaussian.mu[0]+(a*da*.7**2+s*ds)/var*(points-a*gaussian.mu[0])
gaussian_error = max(gaussian_error, float(np.max(abs(gf.v(points, t)-exact))))
assert score_error < 2e-7 and continuity_error < 2e-8 and gaussian_error < 1e-12
# Numerical gradients versus moment buffers from one real Adam update.
net = MLP([3, 4, 2], np.random.default_rng(11))
x = rng.normal(size=(5, 3)); y = rng.normal(size=(5, 2))
fdw = []; fdb = []
for params, target in [(net.W, fdw), (net.b, fdb)]:
for param in params:
g = np.empty_like(param)
for idx in np.ndindex(param.shape):
old = param[idx]; param[idx] = old+1e-6
lp = ((net.forward(x)[0]-y)**2).mean()
param[idx] = old-1e-6
lm = ((net.forward(x)[0]-y)**2).mean()
param[idx] = old; g[idx] = (lp-lm)/2e-6
target.append(g)
net.step(x, y, .001, 1)
grad_error = max(float(np.max(abs(g-m/.1))) for g,m in zip(fdw+fdb,net.m+net.mb))
assert grad_error < 2e-9
orders = []; nfe = []
for method, calls in [('euler',1),('rk2',2),('rk4',4)]:
errs = []
for n in [8,16]:
counter = [0]
def velocity(z,t):
counter[0] += 1
return z
z,_ = integrate(velocity,np.ones((1,2)),make_schedule(n),method)
assert counter[0] == n*calls
errs.append(float(abs(z[0,0]-np.exp(-1))))
nfe.append(dict(method=method,steps=n,calls=counter[0]))
orders.append(dict(method=method,errors=errs,observed_order=float(np.log2(errs[0]/errs[1]))))
assert all(r['observed_order'] > k-.15 for r,k in zip(orders,[1,2,4]))
# One geometric line can have nonuniform velocity: z_t=t^2, z'_t=2t.
ts = np.linspace(0,1,10001)
nonuniform = float(np.trapezoid((2*ts-1)**2,ts))
assert abs(nonuniform-1/3) < 1e-8
report = dict(passed=True,score_fd_max_error=score_error,continuity_max_residual=continuity_error,
gaussian_closed_form_error=gaussian_error,mlp_gradient_fd_error=grad_error,
integrator_orders=orders,nfe_counts=nfe,
straight_line_nonuniform_speed=dict(arc_over_chord=1,velocity_residual=nonuniform,one_step_euler_endpoint=0,exact_endpoint=1),
dependent_coupling_counterexample='x=epsilon implies z_t=x and v=0; independent endpoint formulas do not apply',
errors=[],warnings=[])
Path(__file__).with_name('validation_results.json').write_text(json.dumps(report,indent=2),encoding='utf8')
print(json.dumps(report,indent=2))
if __name__ == '__main__':
main()
评论 (0)