今日 AIGC 论文速览
今日共 10 篇 · 视频生成与推理加速 4 篇 · 图像生成与编辑 3 篇 · 语音与动作生成 2 篇 · 数据集与评测 1 篇
重点论文标题列表
Qwen-Audio-Agent (阿里巴巴 Token Foundry):双Agent并行,座舱91.04%DyMD (北航):14B 压成 1.3B 四步HetA-DiT (高通 AI 研究院):两成 token 走全注意力Routed Forcing (清华大学):动力学+45%,嘴部不动RWTD (字节跳动 Seed):一步模型 GenEval 0.80
今日论文速览
1. Qwen-Audio-Agent:双Agent并行,座舱91.04%
Qwen-Audio-Agent Technical Report | 阿里巴巴 Token Foundry | arXiv:2609.25195
关键词 :全双工语音, 智能体架构, 任务委派, 语音助手, 异步执行
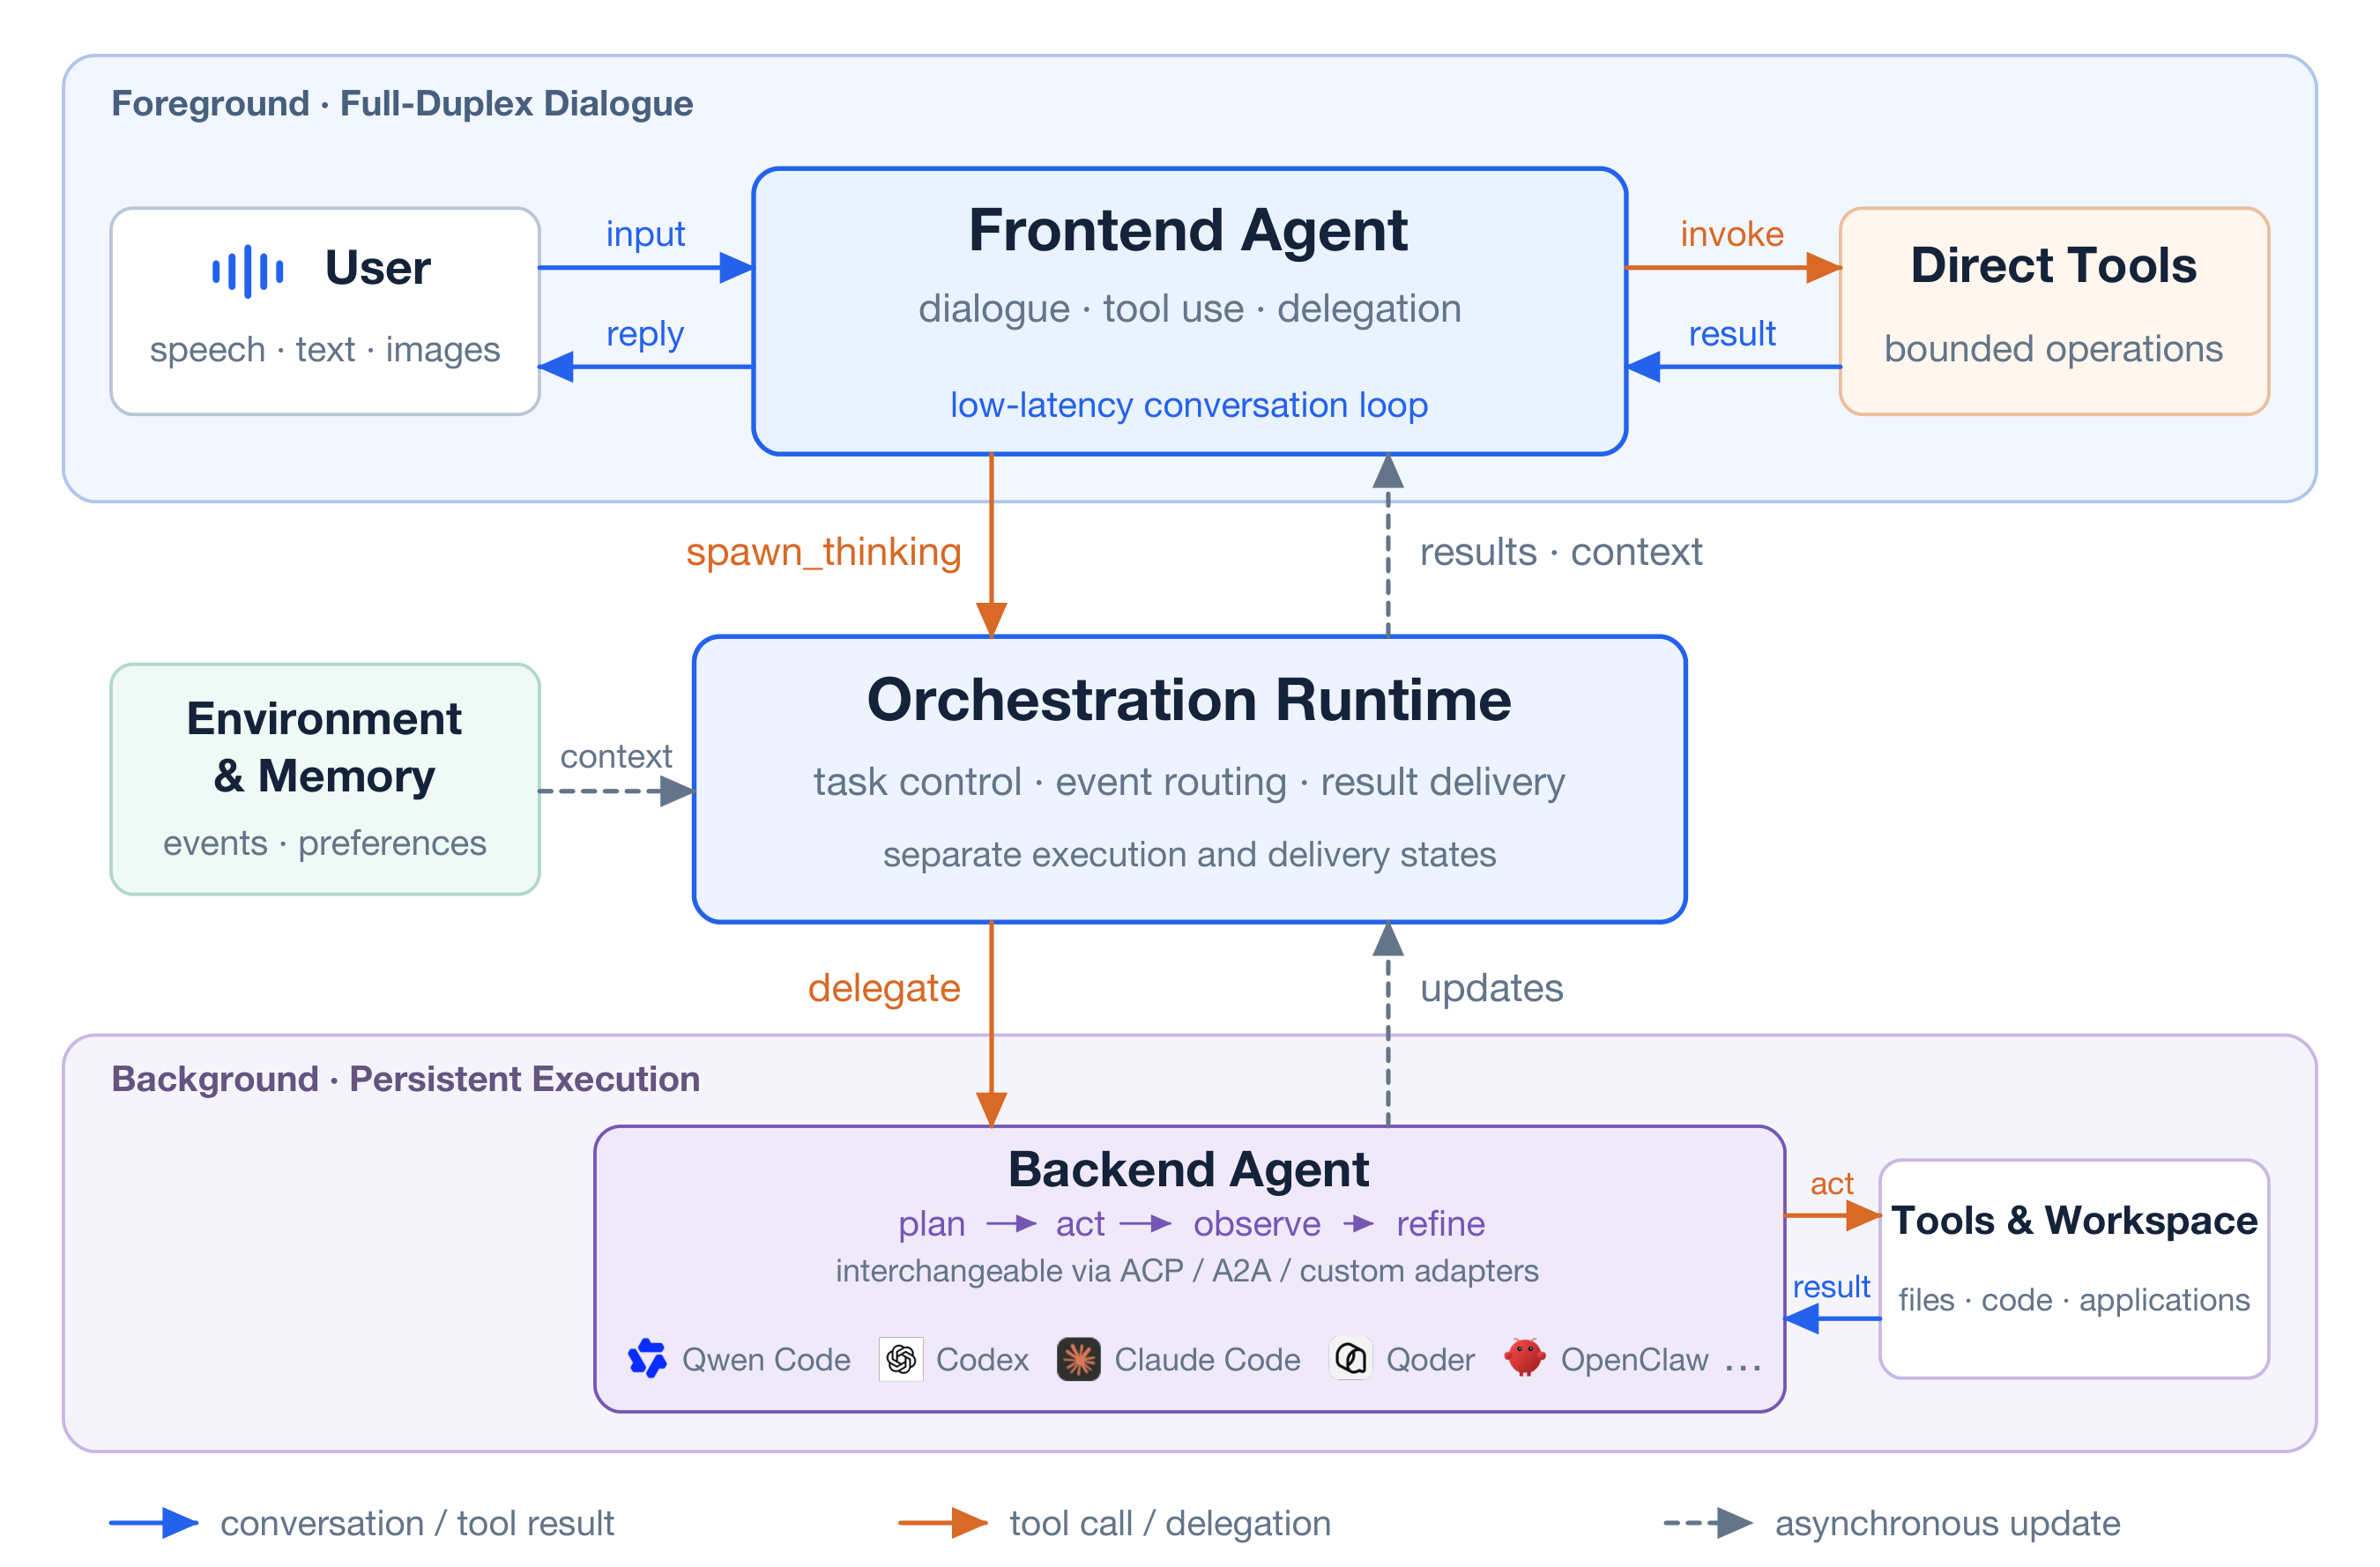
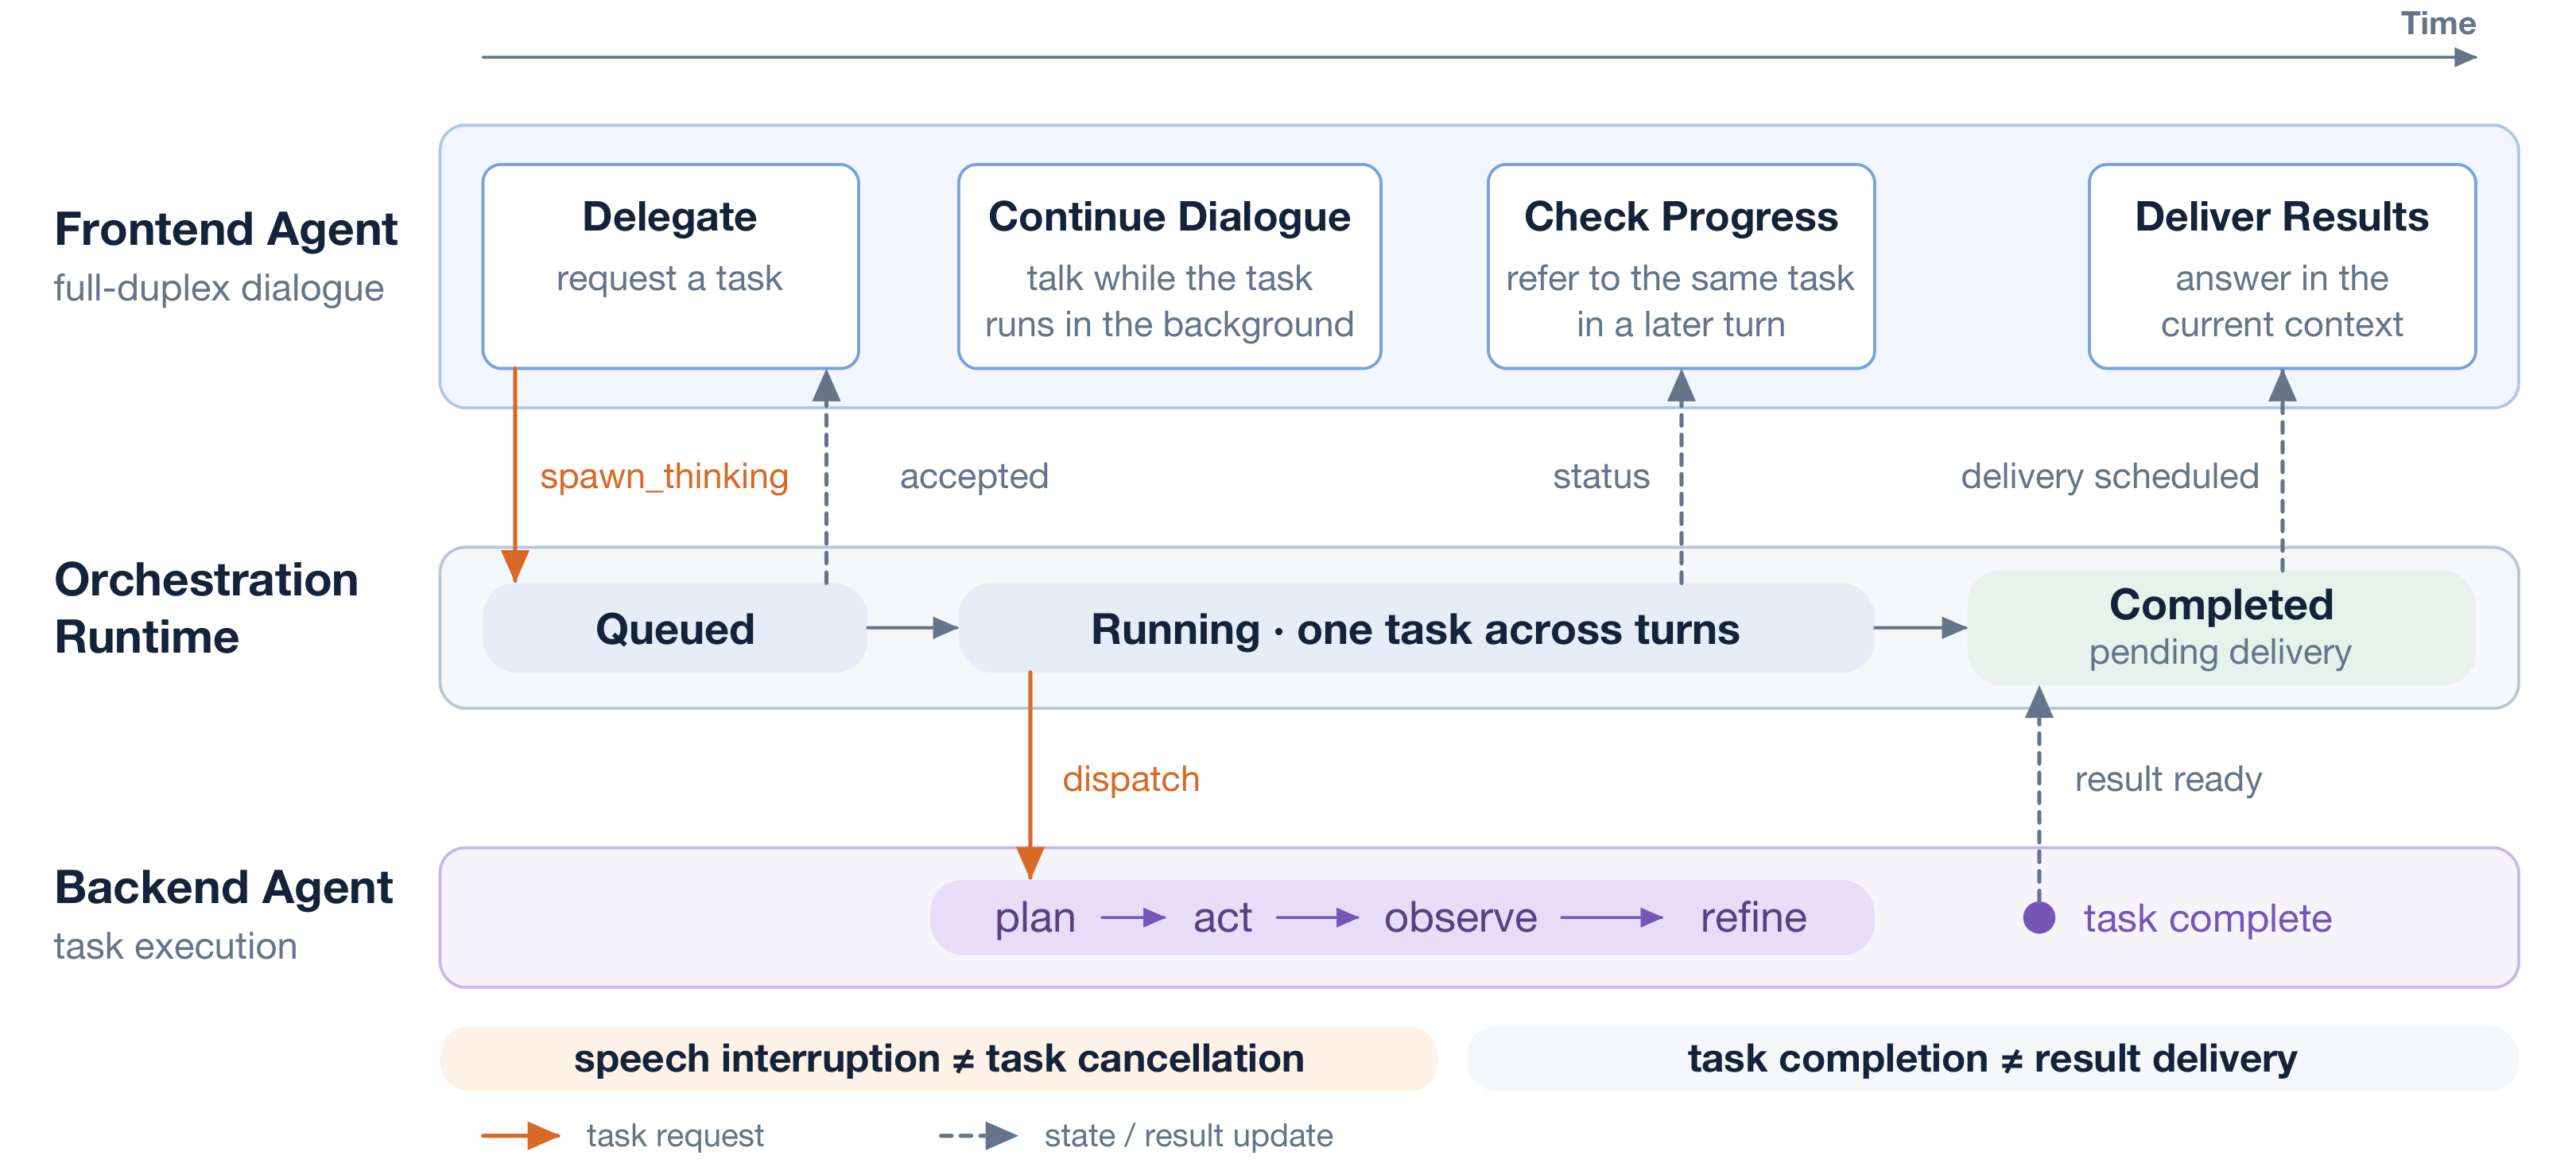
前序问题 :全双工语音助手要一边聊天一边干活,但一段对话里既混着「马上能答」的即时操作,也混着「要跑好几步」的长任务。现有做法要么让前台模型自己把工具全调完(长任务把对话卡死),要么整段委托给后台(用户干等,中途插一句还会把任务一起取消)。语音打断与任务取消、执行完成与结果回传被绑成一根绳,是这套系统要解决的核心矛盾。本文贡献 :提出前后台双 Agent 架构:Frontend Agent 只负责对话,并判断这一步是直接调工具还是委派出去;Backend Agent 在独立上下文里跑被委派的任务;Orchestration Runtime 负责维护任务状态、协调向用户要授权,并把结果排回对话。关键设计是把「语音打断」和「任务取消」解耦,把「执行完成」和「结果投递」解耦,所以后台在跑的时候对话还能继续往下聊。独立适配器让前台模型、后台 Agent、客户端可以分别替换,已在桌面助手、智能座舱、语音客服三类场景落地。
Foreground-background architecture of Qwen-Audio-Agent.
实验效果 :内部座舱基准 134 个用例上,混合执行的任务成功率 91.04%,直接执行 72.39%、全部委派 80.60%。另在「三种配置都成功」的同一批轮次上做延迟评测,混合执行的平均任务执行延迟比这两个基线分别低 26.73% 和 30.91%。
Illustrative timeline of a delegated task.
批判点评 :两个数字其实来自两个不同的评测集合:成功率是 134 个座舱用例,延迟只统计三种配置都跑成功的轮次——也就是说最难的那批(只有混合执行成功、基线直接失败)根本没进延迟统计,26.73% 的降幅是在对自己有利的子集上算出来的。另外 91.04% 比的是同一套系统的两种退化配置,没有跟任何外部语音智能体对照,报告也没给后台任务的绝对耗时。
2. DyMD:14B 压成 1.3B 四步
DyMD: Preserving Interaction Dynamics through Distribution Matching Distillation in Few-Step Video World Models | 北京航空航天大学;京东未来学院 | arXiv:2609.31349
关键词 :视频世界模型, 分布匹配蒸馏, 少步生成, 具身智能, 交互动力学
前序问题 :大视频扩散模型是很强的具身预测先验,但多步采样对交互式下游太贵。DMD 能把采样压到几步,代价却是机器人与物体之间的交互运动被抹掉:画面看着没问题,机械臂却基本不动,生成出来的世界对规划毫无用处。本文贡献 :从 teacher 信号和 fake-score 信号两头定位问题:弱重加噪让 teacher 后验一直集中在「没动作」的 rollout 附近,而动作更强的 rollout 又带来更大的 fake-score 拟合误差,反过来拖住生成器学动力学。DyMD 给两个自适应机制——temporal affinity 条件下的重加噪采样,按每条 rollout 当前交互保真度混合基础时间步表与 teacher 先验;dynamics-guided fake-score tracking,用噪声条件预测器估计每条 rollout 的拟合难度并上调其 critic 权重。14B teacher 蒸成 4 步 1.3B 学生,推理时不加任何辅助模块。
Overview of DyMD.
实验效果 :具身视频基准上,相对 Base DMD 把 R-Bench 任务遵循度提 9.6 个百分点、PAI-Bench-G 的 Domain 分提 5.1 分,视觉质量基本持平。作为下游动作规划骨干,在两个 WorldArena 任务上平均成功率 34%,Base DMD 为 16%。
Visual comparison of interaction dynamics between Base DMD and DyMD at four NFE.
批判点评 :34% 对 16% 看着翻倍,但绝对值仍只有三分之一,而且只在两个任务上测;全文反复验证的其实是主表那两个更朴素的数(9.6 / 5.1)。另外整套收益建立在「先用 V-JEPA 类特征算 temporal affinity」之上,这个额外前向的开销并没有计进推理成本。
3. HetA-DiT:两成 token 走全注意力
Where Compute Matters: Heterogeneous Attention for Efficient Video Diffusion | 高通 AI 研究院;波恩大学 | arXiv:2609.31050
关键词 :视频扩散, 稀疏注意力, 推理加速, token 路由, DMD
前序问题 :视频扩散的自注意力在长时空 token 序列上是二次开销。现有高效注意力基本对所有 token 一视同仁,但去噪难度在不同视频区域、不同时间步上差异极大,均匀省算力必然在最难的地方翻车。本文贡献 :提出 HetA-DiT:一个轻量不确定度分支预测每个 token 的去噪难度,据此把不确定的 token 送进稠密全局注意力、把更可信的 token 交给便宜的局部注意力。路由同时随内容和时间步自适应,并保留全局上下文,还留了一个参数控制质量-效率权衡。关键工程点是推理时不新增 Transformer 前向——不确定度估计直接复用上一个去噪步的结果,也因此能和少步 DMD 蒸馏兼容。
HetA-DiT. Heterogeneous self-attention computation assigned to tokens with different denoising complexities.
实验效果 :在 DMD 蒸馏后的 Wan2.2-5B 与 Wan2.1-1.3B 上评测,VBench、VBench-2.0 和人工偏好上质量与基线可比,但只有约 20% 的 token 走稠密注意力。
Qualitative comparison of HetA-DiT to baseline DMD.
批判点评 :摘要只说「维持可比质量」,没给 VBench 总分的具体差值;而「约 20% 走稠密」是路由比例、不是端到端加速比,局部注意力在真实硬件上能兑现多少要看实现,论文里也没有 wall-clock 延迟表。此外不确定度复用上一步估计,意味着第一个去噪步的路由其实是盲的。
4. Routed Forcing:动力学+45%,嘴部不动
Where and When to Force: Routed Forcing for Streaming Avatars | 清华大学;京东未来学院;东南大学 | arXiv:2609.30963
关键词 :流式数字人, 蒸馏, DMD, 多样性塌缩, 区域路由
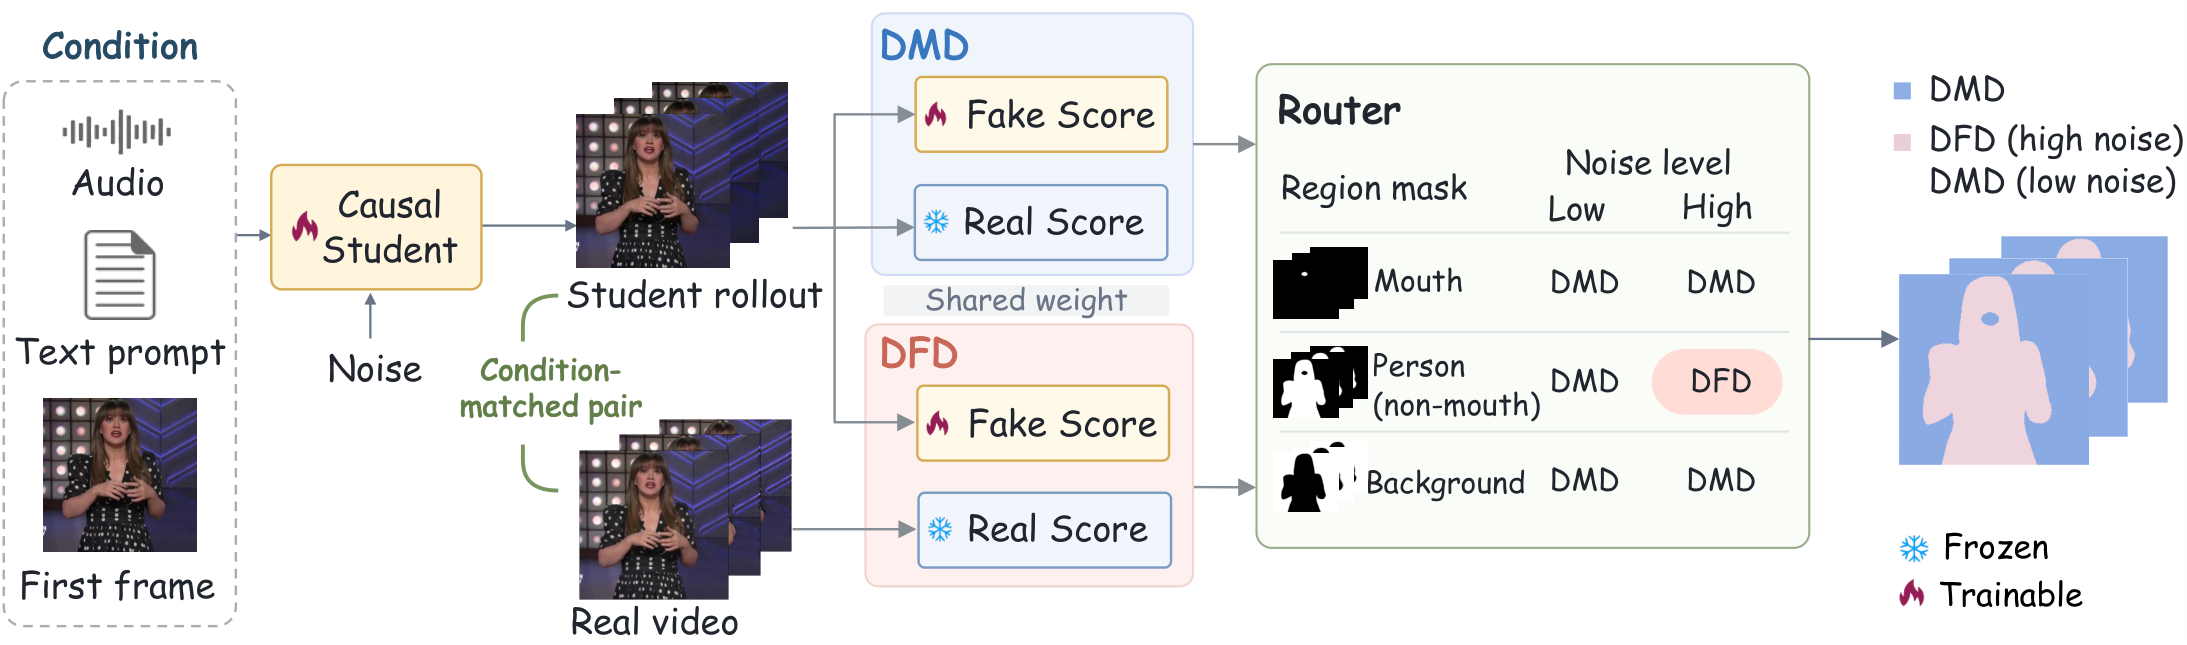
前序问题 :Self Forcing 用 DMD 把双向视频扩散模型蒸成因果、少步的流式生成器,但 DMD 最小化的是 reverse KL,本质是 mode-seeking:学生会丢掉高动态模态、塌到静止输出上,把生成视频的动态和多样性一起压扁。本文贡献 :先把这种塌缩量化成一张区域异质图:人物区域(姿态、手势)多样性损失最大,音频驱动的嘴部损失很小,背景几乎不变。据此提出两维路由——Where:人物区域改用 Data-Forcing Distillation(拿真实视频当监督),嘴部与背景保留 DMD 以保口型和场景稳定;When:高噪声阶段开 DFD 注入真实动态,低噪声阶段切回 DMD 修细节,避免真实视频与学生 rollout 的空间差异带来模糊与伪影。
Routed Forcing routes distillation by semantic region and noise stage.
实验效果 :相对 Self Forcing,动态最高提升 45%,多样性提升 7–25%,视频质量与口型同步基本保持。
Qualitative comparison of different training strategies.
批判点评 :45% 是「最高」值,7–25% 的多样性区间跨了不同指标,主表里并不是每项都赢。更重要的是整套方法依赖先用分割模型对学生 rollout 抽人物 mask、用面部关键点抽嘴部 mask,这些前处理在流式实时场景里的开销没有被计入收益。
5. RWTD:一步模型 GenEval 0.80
Aligning One-Step Generative Models with Reward-Weighted Transport Distillation | 字节跳动 Seed;加州大学伯克利分校 | arXiv:2609.30840
关键词 :一步生成, 奖励对齐, 最优传输, 蒸馏, 后训练
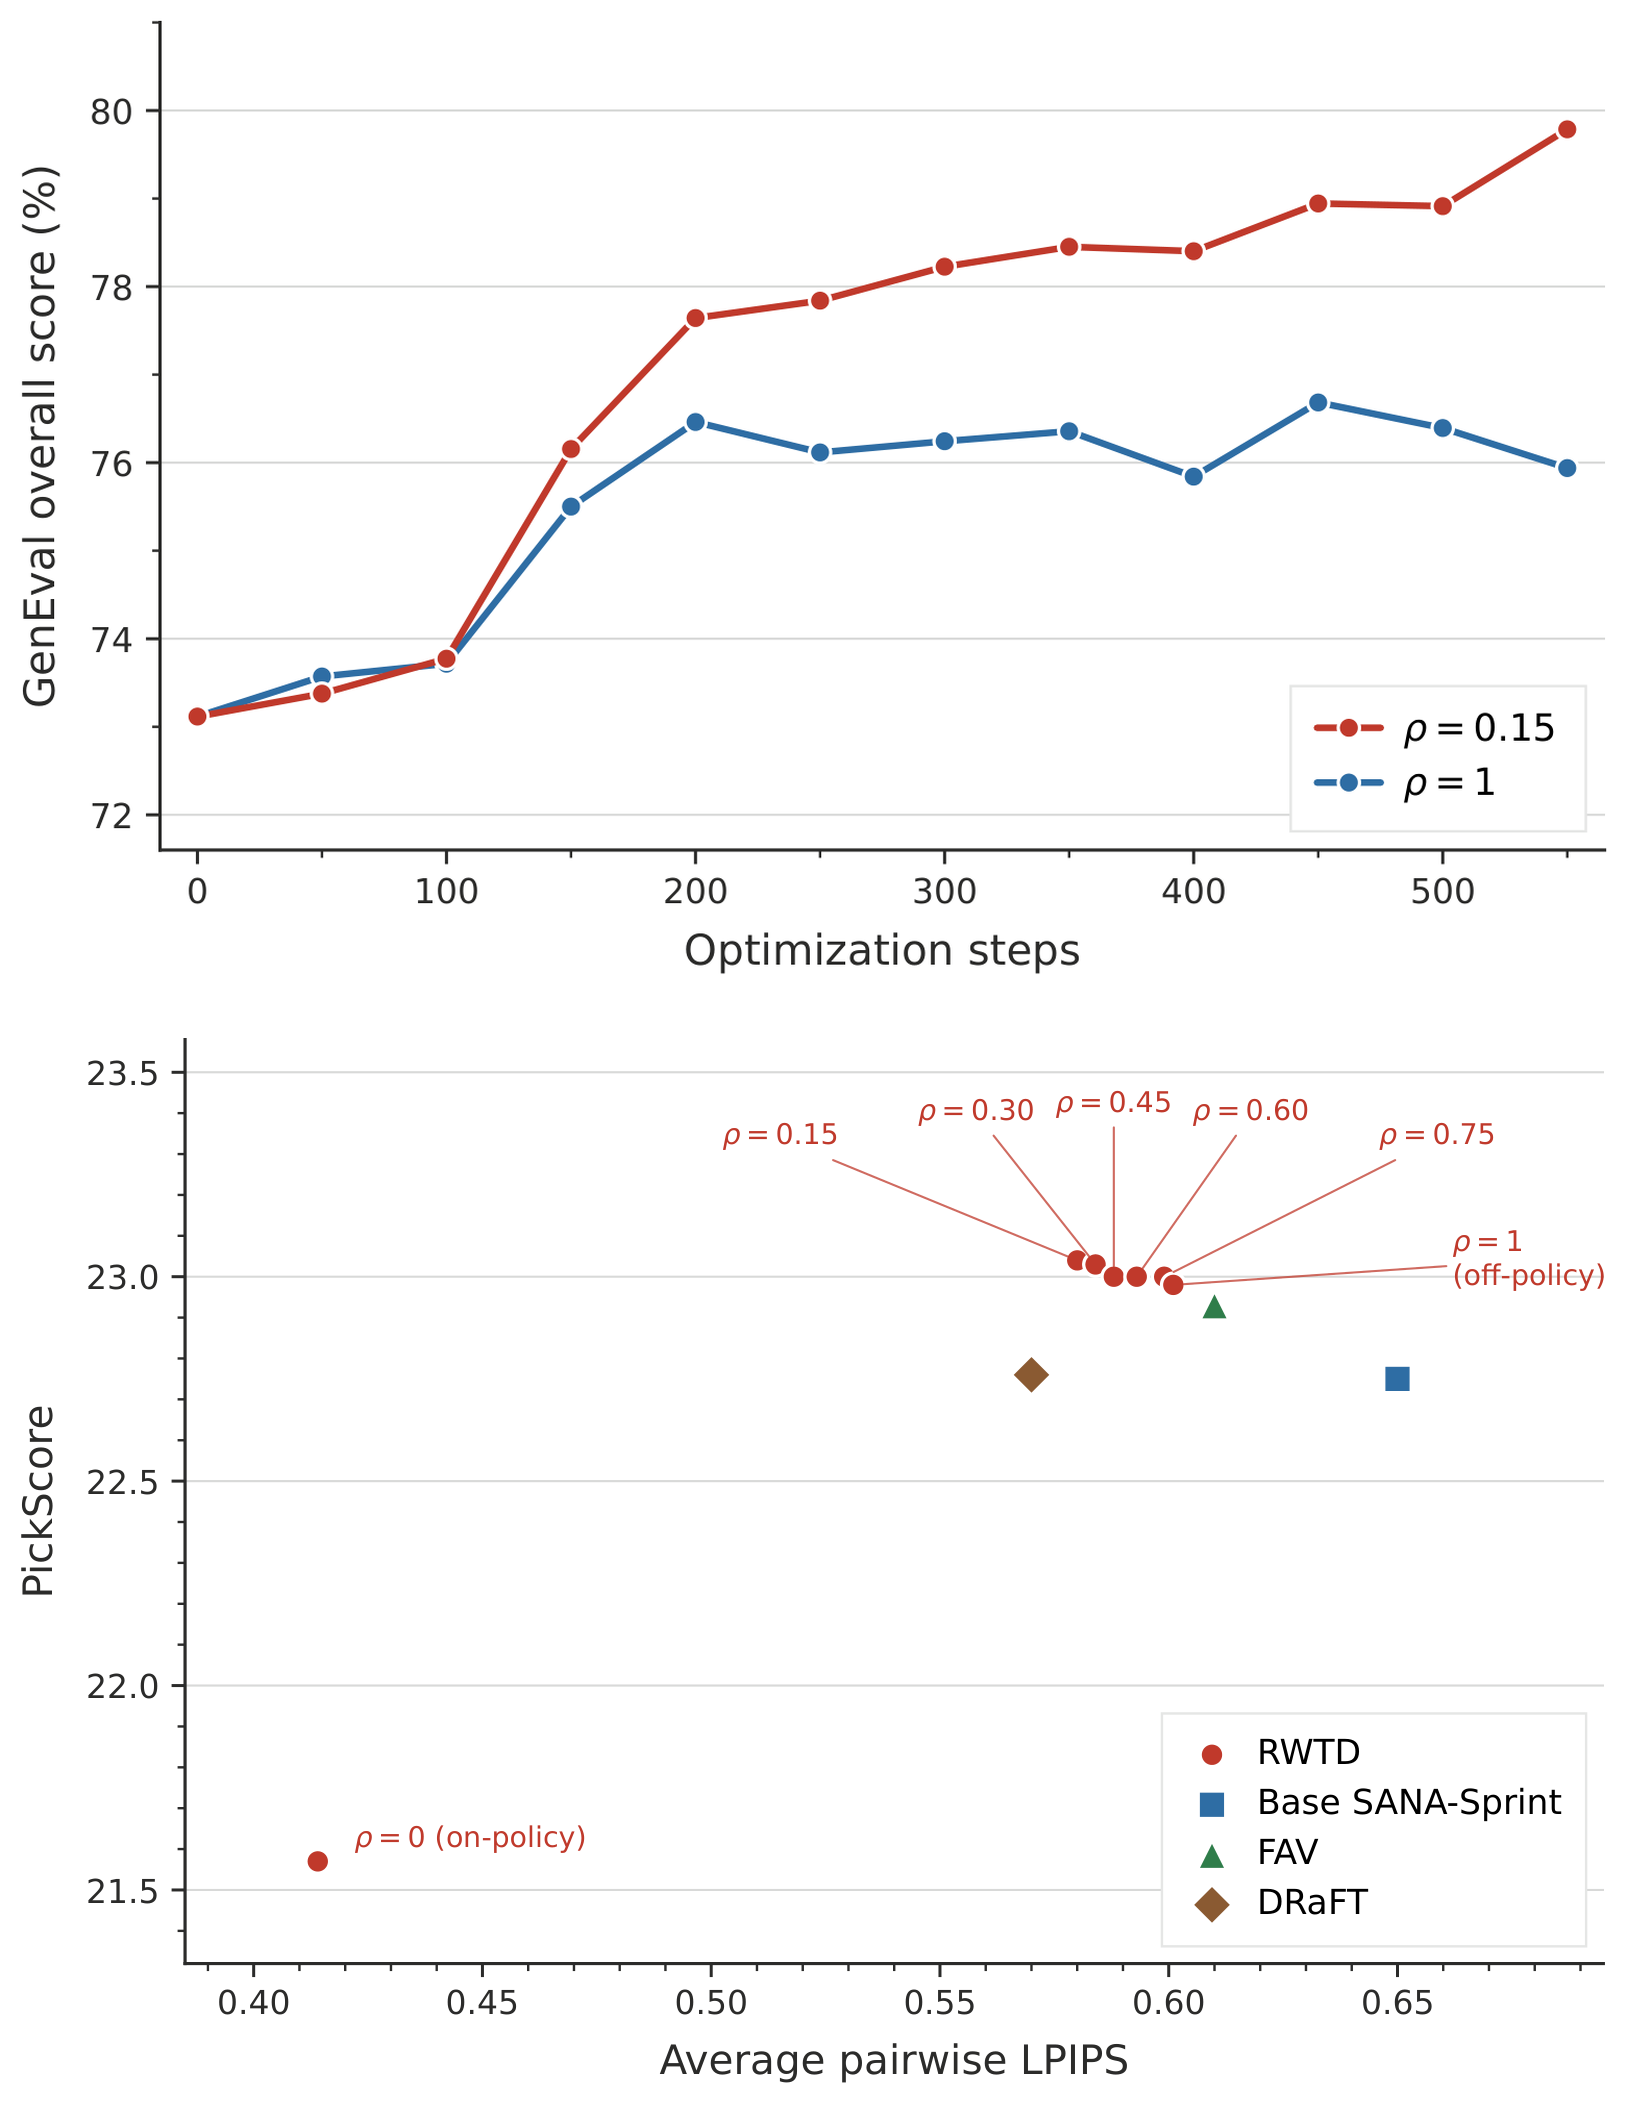
前序问题 :一步生成器推理便宜,但后训练极难:通用隐式生成器既没有可算的似然,也没有去噪轨迹可借,而 GenEval、HPSv2 这类奖励往往根本不可导,梯度类方法又容易把图改得过度风格化。本文贡献 :提出 Reward-Weighted Transport Distillation,只要采样和标量奖励分数。它没有直接对齐常规的 reward-tilted 参考分布,而是构造自适应目标:把「当前分布」与「参考分布」分别倾斜后再混合——当前项吸收训练中已发现的改进,参考项把目标锚回预训练生成器。实现上用特征空间最优传输加不动点回归完成对齐。理论分析表明其不动点分布在 off-policy 倾斜参考与 on-policy 倾斜当前模型之间插值,给出了「适应奖励」与「保留先验」的权衡解释。
SANA Sprint 1.6B comparisons. RWTD improves alignment on difficult position prompts.
实验效果 :把一步模型 SANA Sprint 1.6B 的 GenEval 从 0.73 提到 0.80;单独的偏好对齐实验显示跨奖励泛化良好,HPSv2 后训练在涨分的同时基本保住了组合能力与真实感。
Effect of mixed reward tilting on GenEval and held-out PickScore / diversity.
批判点评 :0.73→0.80 是 GenEval 单项,摘要没说明其他指标是否同步变好。论文自己指出梯度类基线 FAV、DRaFT 在 HPSv2 上出现明显风格化、属于奖励过优化,而 RWTD 只是「大体保留真实感」——这说明 RWTD 同样在往奖励方向偏,只是偏得慢。另外最优传输做在特征空间,编码器选谁会直接影响结论。
6. SAP-DMD:两步采样救回高频细节
Spectral Amplitude Purification in Distribution Matching for Diffusion Distillation | 浙江大学;加州大学伯克利分校 | arXiv:2609.29116
关键词 :扩散蒸馏, DMD, 频域分析, 一步生成, 细节恢复
前序问题 :DMD 能让扩散模型几步出图,但优化动态长期被低频信号主导:方向误差的幅度谱高度集中在低频,弱的中高频信号被压住,细结构和纹理迟迟回不来。本文贡献 :提出 SAP-DMD,一个即插即用模块:自适应地调制 DMD 方向场的幅度谱,压掉幅度谱的支配性长尾,削弱低频主导,让中高频结构更快恢复。改动只在方向场上做,不替换骨干、不加参数。
2-step performance evolution during training on SD3.5 Medium.
实验效果 :在 PixArt-α、SD3、SD3.5 上,2 步与 4 步采样下都更快收敛、生成质量更好。
Qualitative comparison of 4-step (top) and 2-step (bottom) generation.
批判点评 :摘要通篇是定性表述——「更快收敛」「质量更好」,没有给任何一个具体数字,FID/CLIP 的实际对比全在正文表里。所谓「即插即用」也只在这三个文生图模型上验过,视频与编辑类任务没测。另外压低频本身是经验操作,压到什么程度靠阈值超参,论文没有给出选参依据。
7. FuseReg:换解码器 gFID 降 27%
FuseReg: Regularizing Layer Fusion Mitigates the Reconstruction-Generation Gap in Representation Autoencoders | 布朗大学;南加州大学;莱斯大学;阿伯丁大学;圣母大学;马里兰大学;宾夕法尼亚大学 | arXiv:2609.31620
关键词 :表征自编码器, 层融合, 正则化, 图像生成, 重建生成鸿沟
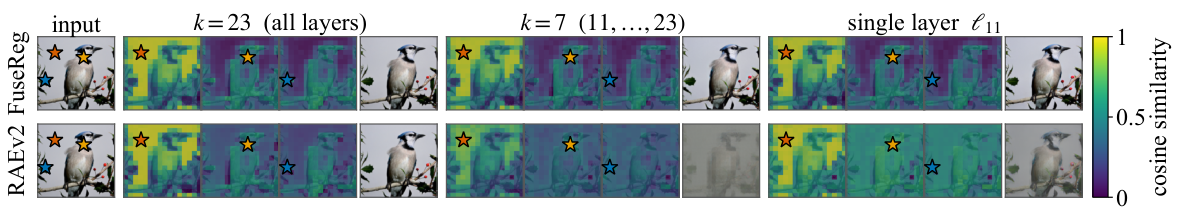
前序问题 :表征自编码器(RAE)直接把预训练视觉编码器的特征当重建与扩散潜变量用。但要选哪些编码器层组成这个共享潜空间是个两难:浅层保像素细节更好,深层生成指标更好。固定启发式的层融合把两个本该分开优化的目标硬绑在了一起。本文贡献 :提出 FuseReg:不挑层,改为在随机采样的编码器层子集上训练。理论分析给出机制解释——子集采样显式惩罚了对跨层不一致的敏感性。结果是同一个解码器可以不重训地同时处理完整、稀疏、单层三种融合方式。
Cosine-similarity maps of decoder intermediate-block features under different layer fusions.
实验效果 :ImageNet-256 + DINOv3-L 上,单个 FuseReg 解码器在三种融合下的 PSNR 都高于为固定融合专门训的解码器;只换解码器、生成器完全不动,RAEv2 DiT-XL 的无引导 gFID 降 27%;生成与扩散两阶段一起正则化,DiT-Base 的 gFID 降 29%。
One FuseReg decoder supports both sparse and single-layer fusions.
批判点评 :27% 和 29% 都是相对自身基线的相对降幅,不是 gFID 绝对值,也没跟非 RAE 路线(如 SD-VAE)的潜空间横向比。另外随机子集训练要求训练时多跑几种融合,成本靠「一次训练多处可用」摊平——这个账只在论文自己的设定下成立。
8. Timo:40K 动作片段六维评测
Timo: $\textbf{T}$aming Mult$\textbf{i}$modal Diffusion Transformer for Human $\textbf{Mo}$tion Generation | 逐际动力 | arXiv:2609.30761
关键词 :人体动作生成, MMDiT, flow matching, 运动学监督, 评测基准
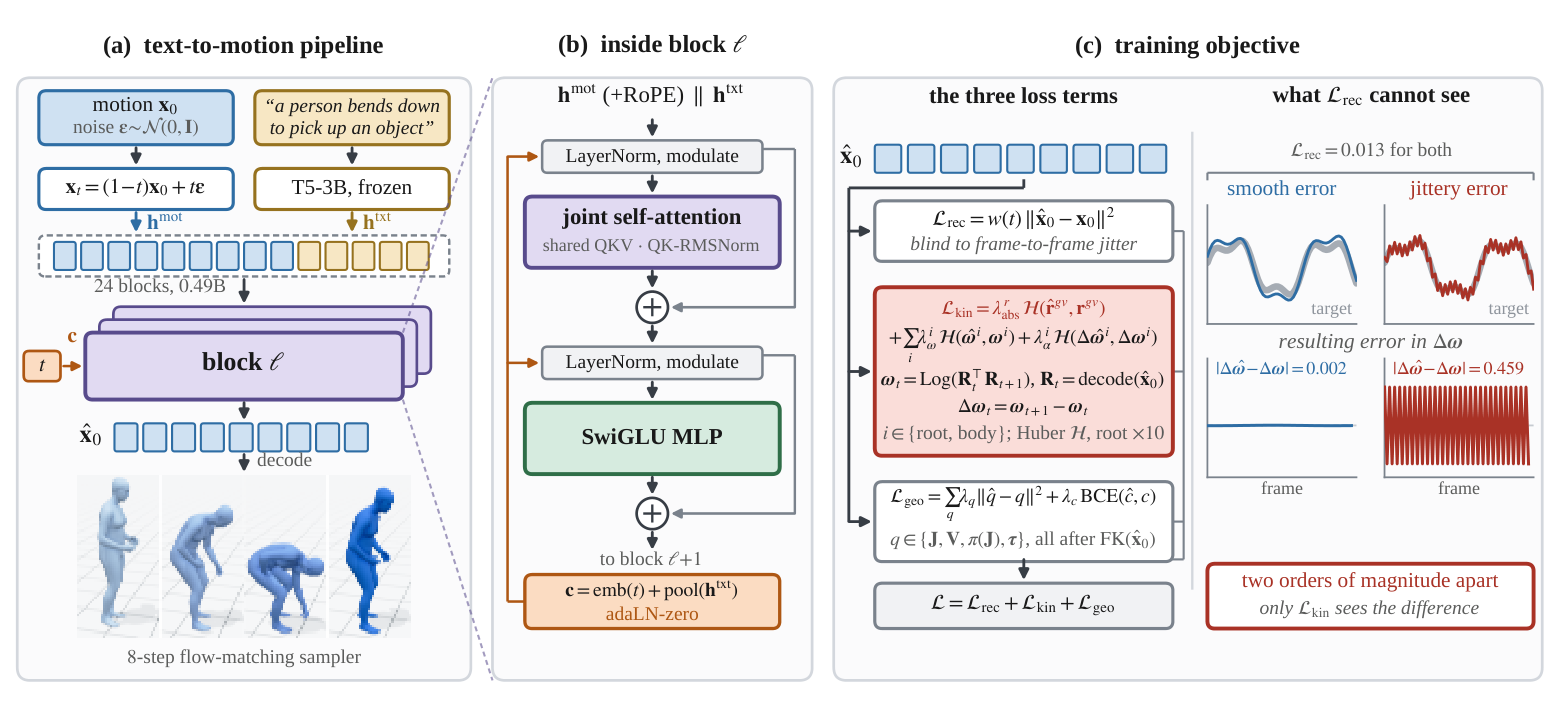
前序问题 :现有人体动作生成大多用 cross-attention 注入文本语义,忽略了动作与文本 token 之间的双向建模。直接把视觉生成里好用的 MMDiT 搬过来也不行:关节运动时间上连贯、跨关节相关性却很弱,MMDiT 配 flow matching 直接上会产出不协调、抖动严重的动作。本文贡献 :提出 kinematics-aware 的 MMDiT 框架 Timo:用全共享的多模态注意力做文本-动作双向建模,配合 flow matching、几何与旋转运动学监督(直接比较真实旋转及其随时间的变化),以及从「广泛动作学习」到「细节字幕对齐」的两阶段课程。同时构建了 6 个公开数据集、40,025 条留出片段的基准,在同一评测器与评分协议下测六个互补维度。
Kinematics-aware multimodal generation with a shared 24-block stack.
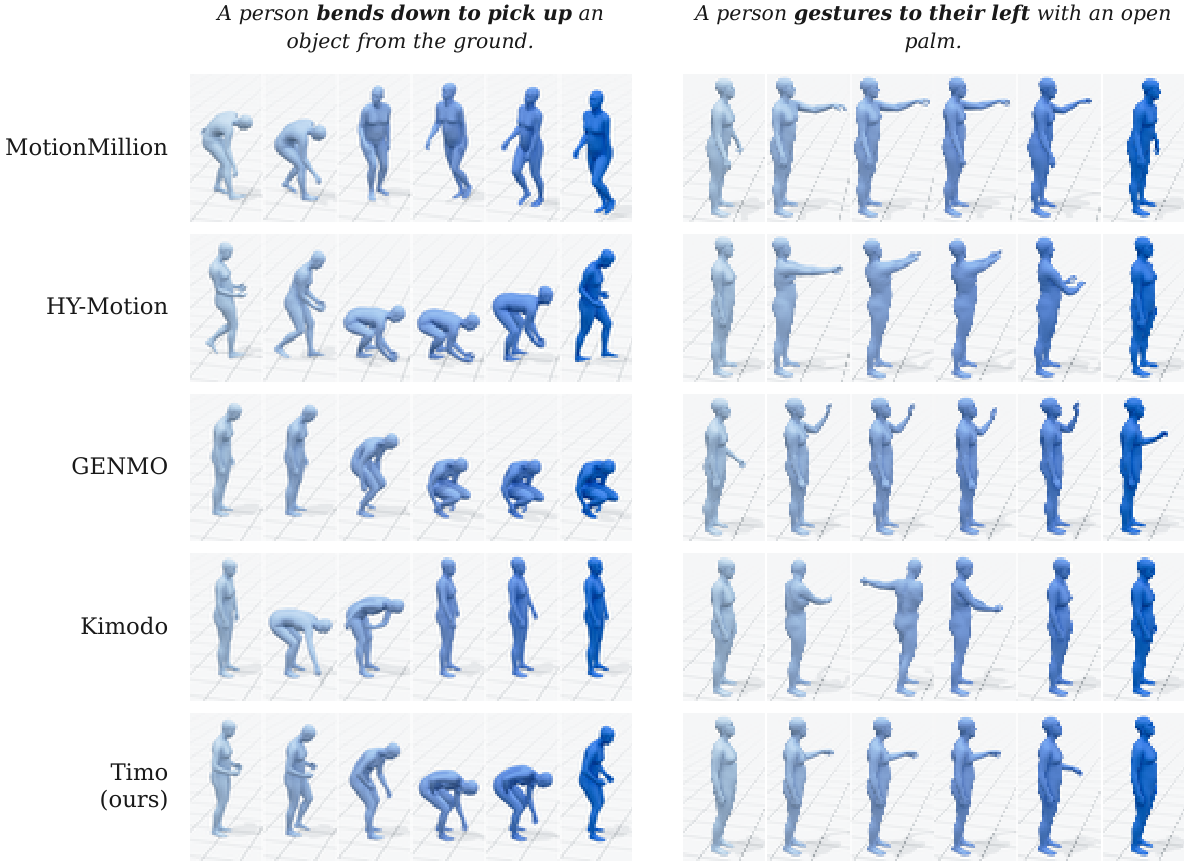
实验效果 :定量与定性均明显超过现有方法,在六个维度中的五个上超过 Kimodo,基准平均分相对提升 40.8%。并在 LimX Luna、LimX Oli 两台实体人形机器人上完成重定向与跟踪执行。
Qualitative comparison across models and prompts.
批判点评 :40.8% 是「基准平均分」的相对提升,而这个基准的作者就是本论文自己:六个维度、统一评测器都是他们定的,被比较的四个系统是「重新评测而非引用原文数字」,训练数据与表示各不相同,文中也承认自家数据含内部采集。机器人演示只做到重定向跟踪,没有闭环控制指标。
9. HyperErase:超网络一次前向出 LoRA
HyperErase: Scale-Calibrated Hypernetwork for Multi-Concept Erasure in Text-to-Image Models | 哈尔滨工业大学(深圳);清华大学深圳国际研究生院;吉林大学;鹏城实验室;华南理工大学 | arXiv:2609.31154
关键词 :概念擦除, 超网络, LoRA, 文生图, 模型安全
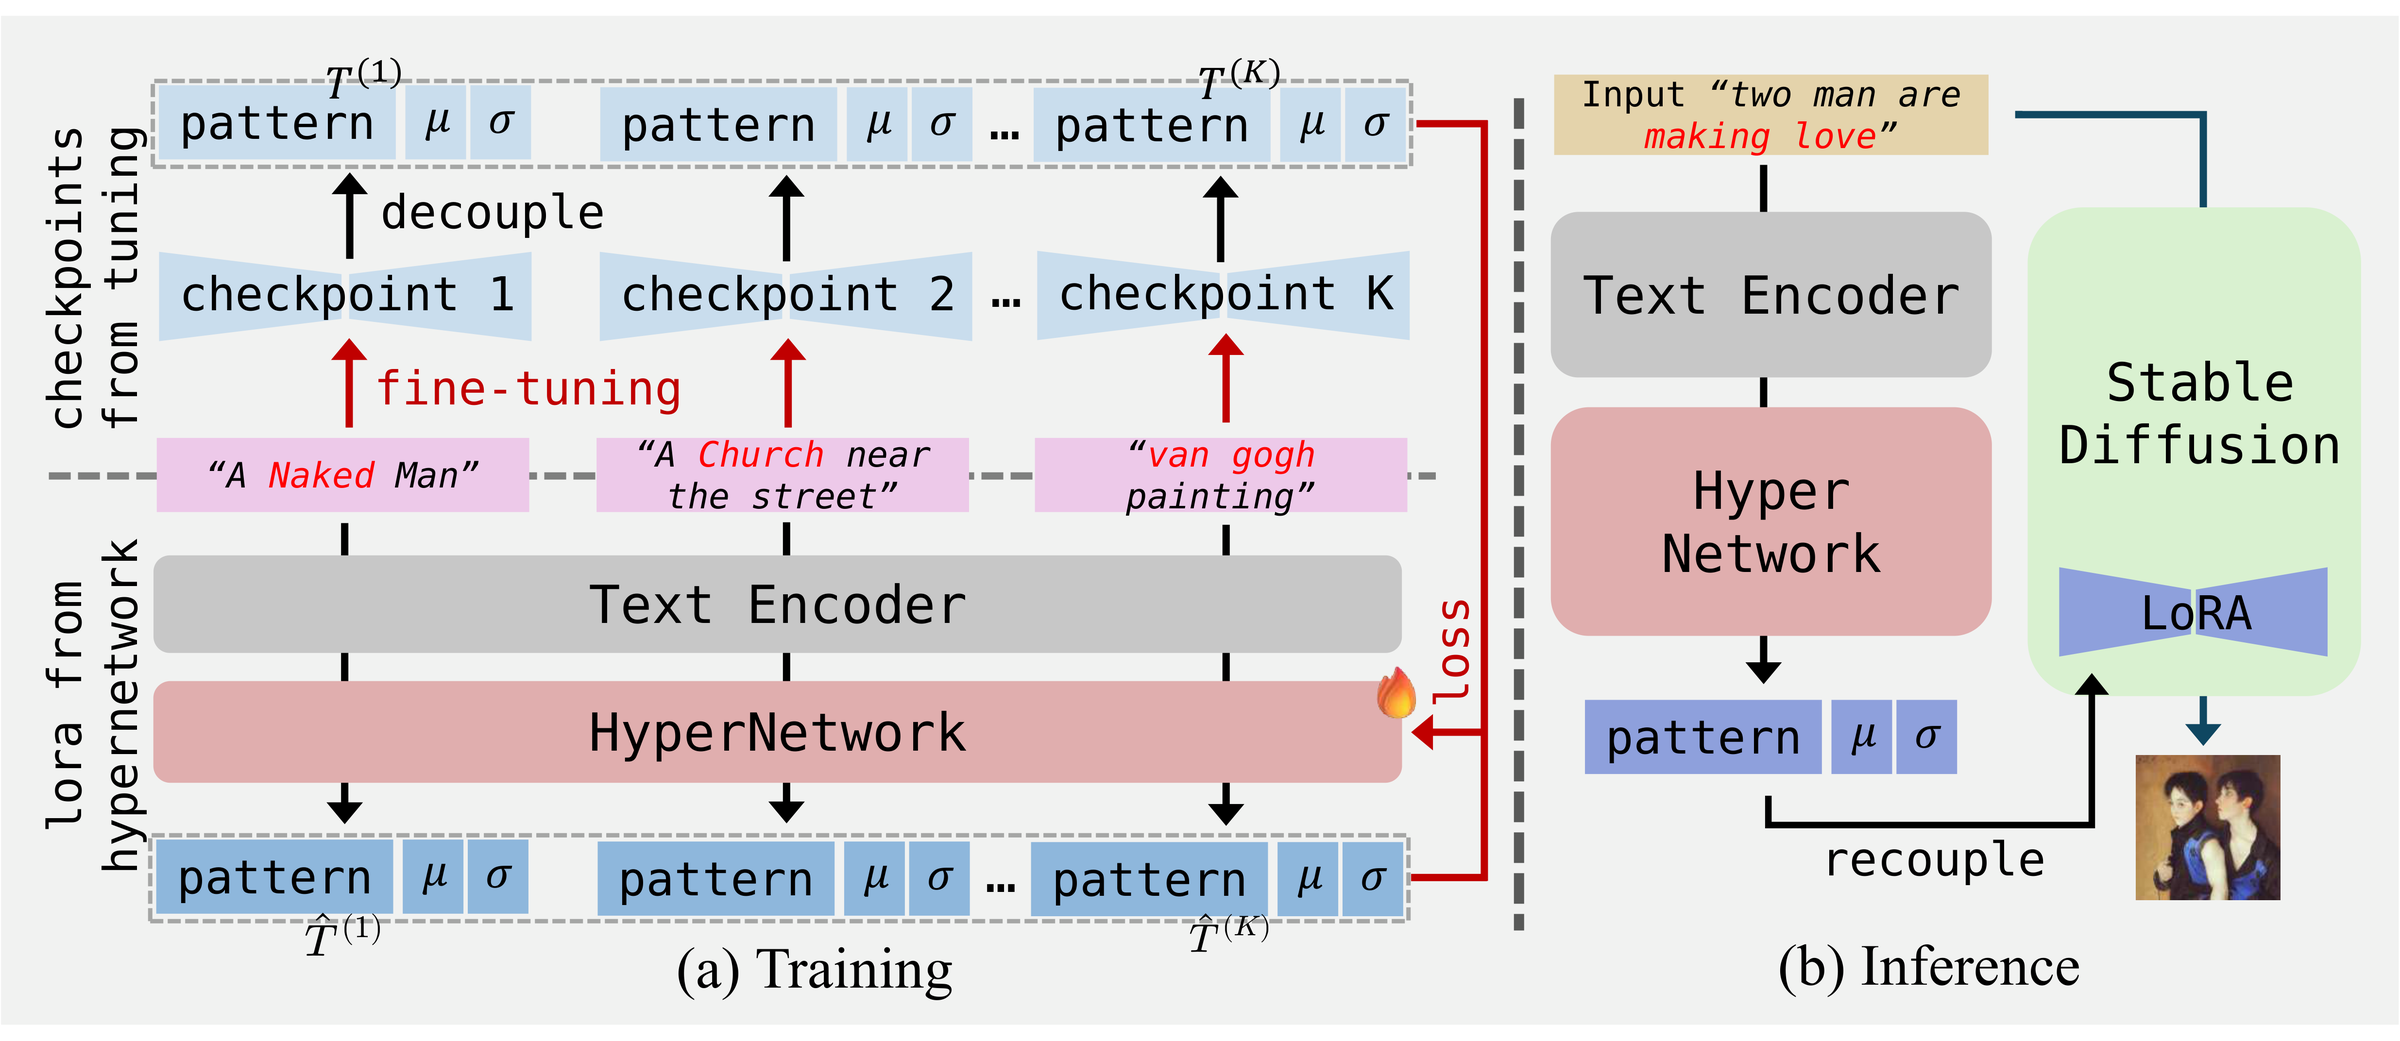
前序问题 :概念擦除的主流做法是静态权重:训一个冻结的 adapter,遇到不同 prompt 变体就不好使,多概念叠加时还会发生参数互相干扰。本文贡献 :把概念擦除重构成「prompt 条件的参数摊销」:训一个超网络,把文本描述直接映射为该 prompt 专属的 LoRA 更新,不需要逐 prompt 做梯度优化,也免去手工合并 LoRA。为了让合成出的 adapter 稳且准,又提出 decoupled rectification——把 LoRA token 拆成 pattern 与 scale 两个子空间,对 scale 用平方根变换抑制乘性过缩放,并在推理时用教师给出的规范先验做校正。
Overview of HyperErase: hypernetwork-driven prompt-conditioned parameter synthesis.
实验效果 :在主要概念类别上,擦除有效性、图像质量、语义对齐三者的权衡全面改善,性能接近「金标准」的单概念基线;一次前向就能为每个 prompt 变体产出专属 LoRA,推理期无需梯度更新。
Visual results of artist style erasure.
批判点评 :摘要里「接近金标准单概念基线」是自我定位,实际是在 I2P / NudeNet 这类检测指标上逼近,而 FID、CLIP 的对比分散在不同概念类别的表里,没有一张表把三个维度同时摆在一起。另外超网络本身要先跑完 gold baseline 的擦除流程、收集 checkpoint-prompt 对,这个前置成本并没有被算进「免优化」的收益里。
10. TrafficImag:31K 样本的反事实路口
TrafficImag: A Benchmark for Counterfactual Roadside Traffic Video Generation | 德克萨斯大学奥斯汀分校;杜克大学 | arXiv:2609.30722
关键词 :反事实生成, 路侧交通, 视频生成, 评测基准, 世界模型
前序问题 :现成路侧交通数据集支持感知、预测和视觉问答,但不评「反事实视频生成」:改掉某一个交通参与者的行为之后,生成的未来既要符合道路拓扑,又不能扰动其余交通参与者。本文贡献 :TrafficImag 把大规模路侧数据(9,022 张标注图、7,043 段去重视频、31,145 条以参与者为中心的历史-未来样本)和一套可执行协议绑在一起,覆盖行为推理、干预感知的图像编辑、条件视频生成三类任务。每次干预都用「参与者级程序」来描述:目标参与者、意图行为、合法路线、交互顺序、时间约束,从而给异构基础模型提供统一评测接口。评测四个互补的有效性维度,端到端反事实只有四项全过才算成功。
Overview of the TrafficImag benchmark.
实验效果 :在多个 SOTA 基础模型上,最强推理器的 macro F1 为 80.4%;完整条件接口把最好生成器的端到端成功率从 23.3% 拉到 55.0%。Oracle 研究显示条件视频执行仍是剩余的主要瓶颈。
Matched 8-second rollouts for a programmed left-turn counterfactual.
批判点评 :55.0% 已经是最好的数,意味着接口给全后仍有近一半反事实做不成;而 20 个场景 × 3 次重复对百分比类指标来说置信区间很宽。论文自己也承认瓶颈在视频执行,也就是说这个基准当下更多是在给生成器记分,还没真正定位到路侧场景的语义难题。
趋势观察
少步蒸馏开始为「丢掉的东西」买单
今天十篇里有四篇在修蒸馏的副作用:DyMD 修的是机器人不再和物体交互,Routed Forcing 修的是数字人塌成静态,SAP-DMD 修的是低频把高频细节吃掉,RWTD 则换了个方向——先承认一步生成器的后训练很难做,再用最优传输把奖励塞进去。共同点是 NFE 已经不是瓶颈,蒸馏完之后「还剩什么」才是。
「对所有东西一视同仁」正在被放弃
HetA-DiT 只让约两成 token 走稠密注意力,Routed Forcing 按人物、嘴部、背景分区域换监督信号,FuseReg 干脆不挑层而是在随机层子集上训练。三篇方法毫不相干,但都在拒绝均匀处理——按 token、按区域、按层做差异化分配,成了这一批论文共享的默认动作。
人工智能炼丹君 整理 | 2026-09-29
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注

















评论 (0)