


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:表征与压缩 | 难度:进阶 | 前置知识:VAE 结构与训练目标(
vae_basics)
关键词:视频VAE、3D因果卷积、时间压缩、分块推理、闪烁伪影、潜变量 token
先给四个数字,全部来自文末附录里能直接跑的脚本。
数字一:不压时间维,潜变量序列会长到做不了全注意力。 同样一段 121 帧、768×512 的视频,用逐帧图像 VAE(空间 8×8、4 通道)编码出来是 743,424 个 token;改成 4×8×8(时间再压 4 倍、16 通道,CogVideoX / Wan / HunyuanVideo 这一档)是 190,464 个;再激进一点到 8×32×32(LTX-Video 这一档)只剩 6,144 个。自注意力的代价是 $O(N^2)$,所以相对第一档,注意力分别便宜 15.2 倍和 14641 倍(04 节算账,图 4 画出来)。这个差距决定了视频 DiT 能不能做「全时空自注意力」——做不了就只能在空间上做注意力、时间维另想办法,而「时间维另想办法」正是早期视频模型帧间闪烁的根源之一。
数字二:对称时间卷积可能读取未来,本 toy 的每个输出都有这种依赖。 把编码器里的时间填充从「只补前面」换成「前后对称补」,实测 12 个潜变量帧全部都依赖未来帧,最多超前 8 帧。这意味着你没法一边生成一边往外吐——潜变量位置 $j$ 最多要等到输入位置 $4j+8$(与本 toy 总步距 4 对齐),而不是把两侧帧索引直接相加。因果卷积把这个数字压到 0(03 节证明,图 1 左右两栏对比)。
数字三:分块解码不补够上下文,一整块都是错的,不是只有接缝那一帧。 把 24 个潜变量帧切成 3 块、每块 8 帧逐块解码:上下文带 0 帧时,两块合计 64 个输出帧里有 48 帧和整段解码的结果对不上;每块每多带 1 帧上下文,就少错 4 个输出帧(两块合计 8 帧);带到 6 帧时误差精确归零(不是变小,是浮点意义上完全相等)。6 这个数字不是经验值,它等于解码器的时间感受野减 1(03 节推导,图 3 是整条曲线)。
数字四:时间压缩的额度取决于画面运动有多快。 把一个匀速移动的高斯斑点压 8 倍时间再还原,运动速度 0.25 像素/帧时重建 PSNR 是 40.81 dB,速度提到 4 像素/帧掉到 24.92 dB,差 15.9 dB。而且会交叉:压时间 2 倍的曲线在约 2 像素/帧处掉到「压空间 2 倍」这条与速度无关的基线之下——过了这个点,继续压时间不如改压空间(06 节展开,图 5)。
所以这篇文章回答四件事:时间维到底怎么压、何时需要因果卷积、逐块推理要带多少上下文才不接缝、以及时间压缩比能推到多大。
三句话讲完:
视频 VAE 相对图像 VAE 只多一件事:在时间轴上再压 $s_T$ 倍。 潜变量形状从 $T \times H' \times W' \times C$ 变成 $T' \times H' \times W' \times C$,其中 $T' = \lfloor (T-1)/s_T \rfloor + 1$。token 数直接除以 $s_T$,注意力代价除以 $s_T^2$。
需要严格流式处理时,时间运算应满足因果性。 无膨胀、核长 $k_t$ 的卷积可只在前面补 $k_t-1$ 帧,边界可补零或复制首帧。离线视频 VAE 也可以采用非因果结构;卷积因果还不够,归一化、注意力、池化等其他时间运算也须检查。
代价有两笔,都要记账。 一是时间压缩等价于给运动物体糊上一条长度 $(s_T - 1) \cdot v$ 像素的运动模糊($v$ 是运动速度);二是因果卷积的感受野有限,逐块推理时每块必须额外带「感受野 − 1」帧上下文,带不够就不是接缝难看,是整块算错。
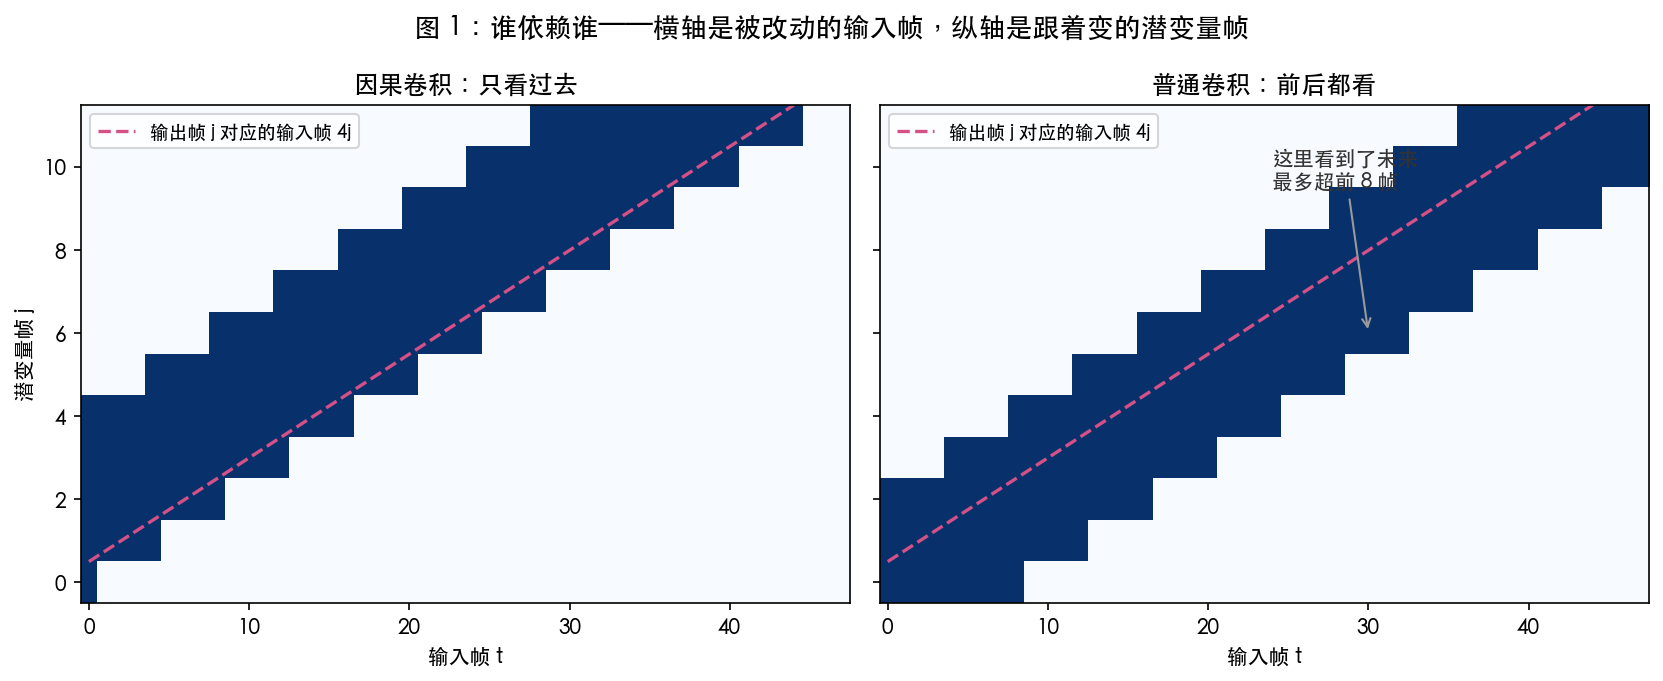
这张图要看什么:横轴是被人为改动的输入帧,纵轴是跟着发生变化的潜变量帧,蓝点表示「这一对有依赖关系」。左图所有蓝点都落在虚线(输入帧 $= 4j$)左边或线上——没有任何一个潜变量帧看到未来;右图蓝点越过虚线,右侧那团就是泄漏的未来信息,实测最多超前 8 帧。两张图除了时间填充方式,其余完全相同。
一维卷积(时间轴)在输入长度 $T_{\text{in}}$、核 $k_t$、步距 $s_t$、两端填充 $p_{\text{front}}$ 和 $p_{\text{back}}$ 下的输出长度是
$$T_{\text{out}} = \left\lfloor \frac{T_{\text{in}} + p_{\text{front}} + p_{\text{back}} - k_t}{s_t} \right\rfloor + 1$$
每个符号:$T_{\text{in}}$ 是进入这一层的帧数,$p_{\text{front}}$ 是时间轴前面补的帧数,$p_{\text{back}}$ 是后面补的,$k_t$ 是时间维核长,$s_t$ 是时间步距。
因果卷积取 $p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$,代进去:
$$T_{\text{out}} = \left\lfloor \frac{T_{\text{in}} - 1}{s_t} \right\rfloor + 1$$
减 1 加 1 这一对不是凑出来的,它有物理含义:首帧被单独保留下来了。 前面补的那 $k_t - 1$ 帧全是零,所以第一个输出位置看到的是「$k_t - 1$ 个零 + 第 0 帧」,它天生就是第 0 帧的专属输出位。剩下 $T_{\text{in}} - 1$ 帧才按步距 $s_t$ 分组。
许多视频模型约定输入帧数为 $1+k s_T$,但要以完整实现为准。 本文 stride-conv toy 两次时间步距 2 时,49 帧的链路为:
$$49 \to \lfloor 48/2 \rfloor + 1 = 25 \to \lfloor 24/2 \rfloor + 1 = 13$$
得到 13 个 latent 帧。对本 toy,100 帧得到 25 个,最后输出所对齐的输入位置为 96,因此尾部 97—99 没被覆盖;真实模型也可能通过补帧、裁剪或专门的池化分支处理。下面引用的 CogVideoX 对奇偶长度有不同池化逻辑,不能把单层 stride-conv 公式不加条件地替代完整模型。
设时间填充后第 $i$ 个输入帧落在下标 $i + k_t - 1$ 上。步距为 $s_t$ 的第 $j$ 个输出取的是填充后区间 $[j s_t,\; j s_t + k_t - 1]$,对应原始输入下标
$$[j s_t - (k_t - 1),\; j s_t]$$
上界恰好是 $j s_t$——第 $j$ 个输出能用到的最新输入帧就是第 $j s_t$ 帧,未来的帧一个都进不来。这就是因果性的全部证明,它只依赖「$p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$」这一条。
堆多层时把每层的时间步距连乘,记到第 $l$ 层输入为止的累积步距为 $S_l = \prod_{m<l} s_m$,则最终第 $j$ 个潜变量帧能用到的最新输入帧是 $S_{\text{total}} \cdot j$。脚本 causality_check() 用扰动法验过:把第 $t$ 帧之后的所有输入都改掉,凡是满足 $S_{\text{total}} \cdot j < t$ 的潜变量帧,变化量精确等于 0——不是小,是零,因为根本没连过来。
换成对称填充($p_{\text{front}} = p_{\text{back}} = (k_t - 1)/2$),上界变成 $j s_t + \lfloor (k_t - 1)/2 \rfloor$,未来的帧就漏进来了。实测 12 个潜变量帧全部泄漏,最多超前 8 帧。
$t$ 时刻的输出能看到多长的历史,叫时间感受野。标准公式是
$$\mathrm{RF} = 1 + \sum_l (k_l - 1) \cdot S_l,\qquad S_l = \prod_{m<l} s_m$$
每个符号:$k_l$ 是第 $l$ 层的时间核长,$S_l$ 是走到第 $l$ 层输入时已经累积的时间步距。关键点在 $S_l$:第 $l$ 层的一个核长 $k_l$,在原始输入上跨的是 $k_l \times S_l$ 帧,因为它的每一个位置本身就代表了 $S_l$ 个原始帧。
本工程的 toy 编码器是 4 层 $k = 3$、步距 $[1, 2, 2, 1]$:
$$\mathrm{RF} = 1 + 2\cdot 1 + 2\cdot 1 + 2\cdot 2 + 2\cdot 4 = 17$$
注意最后两项:同样一个 $k = 3$ 的核,在第 3 层贡献 4 帧,到第 4 层就贡献 8 帧——因为前面已经把时间压了 4 倍。这就是「层数不变、压缩比一上去感受野暴涨」的原因,也是下面那条上下文公式的来源。
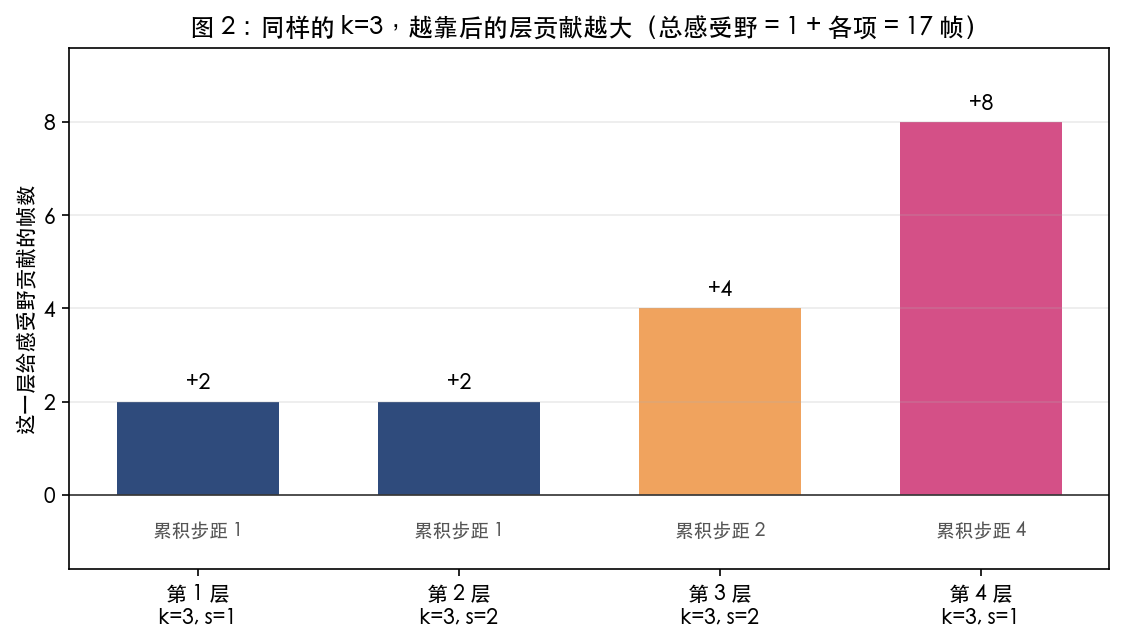
这张图要看什么:四根柱子的核长全都是 3,但贡献从 2 帧一路涨到 8 帧,涨的唯一原因是柱底标注的「累积步距」从 1 变成 4。要控制感受野和分块开销,就要一起考虑各层的核长与累计步距。
脚本 receptive_field() 用逐帧扰动实测了同一个数:最大跨度 17 帧,与公式逐项吻合;同时验了因果上界(潜变量帧 $j$ 能看到的最新输入帧 $\le 4j$)零次违反。
由 3.3,输出(或潜变量)帧 $j$ 依赖的输入区间长度是 $\mathrm{RF}$,右端点是 $S_{\text{total}} \cdot j$,所以左端点是 $S_{\text{total}} \cdot j - \mathrm{RF} + 1$。
现在做分块:要正确算出第 $j_0$ 块,就必须拿到它左端点往前的全部输入。缺掉的部分在普通卷积里是被零填充替掉的——零不是正确的值,于是结果错。所以:
$$\text{所需上下文} = \mathrm{RF} - 1 \quad \text{(以该侧的时间单位为帧)}$$
注意单位随你在哪一侧算:
两条都被脚本验到了:解码侧 ctx 从 0 加到 6,误差在 6 处精确归零;编码侧 ctx 从 0 加到 16,误差在 16 处精确归零。这不是调参调出来的,是感受野直接算出来的。
把时间下采样简化成最朴素的「$s$ 帧取平均」(CogVideoX 的下采样层真的就是 avg_pool1d,见 05 节)。一个以速度 $v$ 像素/帧平移的物体,在 $s$ 帧内走过的距离是 $(s-1)v$,所以 $s$ 帧平均等价于把它和一条长度 $L = (s-1)v$ 的盒式核做卷积。
这实际上是 $s$ 个离散平移位置的均匀平均,位移取 $0,v,\ldots,(s-1)v$,其方差为 $v^2(s^2-1)/12$。不是把端点距离直接代入连续盒核的 $L^2/12$。因此,无限画布上按二阶矩定义的宽度满足
$$\sigma_{\text{new}} = \sqrt{\sigma^2 + \frac{v^2(s^2-1)}{12}}$$
当 $s=8,v=4,\sigma=3$ 时,解析宽度是 $\sqrt{9+84}=\sqrt{93}\approx9.644$ 像素;带微噪声并截去噪声底的代码测得约 9.640。差别来自有限画布和阈值测宽,而不是神经网络实验。这只是“时间平均 + 最近邻还原”的模型,不是学习型视频 VAE 的必然误差或压缩下界。
环境只要 numpy。全部脚本在文末附录,这里放最核心的三段。
def causal_pad(x, k_t):
    """时间轴前面补 k_t-1 帧零,后面不补。这是「因果」二字的全部实现。"""
    if k_t <= 1:
        return x
    pad = np.zeros((x.shape[0], k_t - 1, x.shape[2], x.shape[3]), dtype=x.dtype)
    return np.concatenate([pad, x], axis=1)


def conv3d_causal(x, w, stride=(1, 1, 1), time_pad="causal"):
    """3D 卷积,时间填充方式可选:

    time_pad="causal"     前面补 k_t-1 帧、后面不补(只看过去)
    time_pad="symmetric"  前后各补 (k_t-1)//2 帧(会看到未来)
    """
    kt, kh, kw = w.shape[2], w.shape[3], w.shape[4]
    if time_pad == "causal":
        x = causal_pad(x, kt)
    else:
        pad = ((0, 0), ((kt - 1) // 2, (kt - 1) // 2), (0, 0), (0, 0))
        x = np.pad(x, pad, mode="constant")
    x = sym_pad_hw(x, kh, kw)
    return conv3d_valid(x, w, stride)


def out_frames(t_in, k_t=3, s_t=1):
    """因果卷积的时间输出帧数。注意不是 floor(T_in / s_t)。"""
    return (t_in - 1) // s_t + 1
toy 使用无 batch 的 [C,T,H,W];PyTorch Conv3d 常用带 batch 的 [B,C,T,H,W],也支持无 batch 输入。真实输出:
  T_in=  49 -> s_t=1: 预测  49 / 实测  49 OK  s_t=2: 预测  25 / 实测  25 OK  s_t=4: 预测  13 / 实测  13 OK
两级时间压缩 2(CogVideoX 口径):49 帧 -> 25 -> 13 潜变量帧def causality_check():
"""改未来的帧,看过去的潜变量有没有跟着变。变了就是漏了未来信息。"""
net = ToyVideoVAE()
v = make_video(t=48)
z_ref = net.encode(v)
worst = 0.0
for t_edit in range(0, 48, 4):
v2 = v.copy()
v2[:, t_edit:] += 3.0 # 从第 t_edit 帧起全部改动
z2 = net.encode(v2)
# 总时间步距 4,所以潜变量帧 j 只应该看到输入帧 <= 4j
for j in range(z2.shape[1]):
if 4 * j < t_edit:
diff = np.abs(z2[:, j] - z_ref[:, j]).max()
worst = max(worst, diff)
print(f" 应该完全不受影响的潜变量帧上,最大变化量 = {worst:.3e}")真实输出:
应该完全不受影响的潜变量帧上,最大变化量 = 0.000e+00把 ToyVideoVAE() 换成 ToyVideoVAE(time_pad="symmetric") 再跑一次 dependency_matrix,会得到「12 个潜变量帧全部泄漏、最多超前 8 帧」——这是 09 节留给读者的第一个动手验证。
def decode_chunked(net, z, chunk=CHUNK, ctx=0):
    """按 chunk 个潜变量帧一块解码,每块前面带 ctx 帧上下文。"""
    nz = z.shape[1]
    pieces, starts = [], []
    n_chunks = (nz + chunk - 1) // chunk
    for i in range(n_chunks):
        lo = i * chunk
        hi = min(lo + chunk, nz)
        lo_in = max(0, lo - ctx)
        out = net.decode(z[:, lo_in:hi])
        keep = (hi - lo) * T_STRIDE        # 上下文部分的输出要丢掉
        pieces.append(out[:, -keep:])
        starts.append(lo * T_STRIDE)
    return np.concatenate(pieces, axis=1), starts
96 帧输入 $\to$ 24 个潜变量帧 $\to$ 切 3 块,真实输出(误差按输出标准差归一):
  ctx | 块头误差 | 块尾误差 | 块内被污染帧数 | 边界跳变放大
  ----+---------+---------+----------------+------------
     0 | 2.550e+00 | 3.206e+00 |             48 | 1.90x
     1 | 2.094e+00 | 1.814e+00 |             40 | 2.19x
     2 | 1.658e+00 | 1.399e+00 |             32 | 1.88x
     3 | 1.313e+00 | 8.267e-01 |             24 | 2.19x
     4 | 8.700e-01 | 4.549e-01 |             16 | 1.15x
     5 | 4.051e-01 | 0.000e+00 |              8 | 1.07x
     6 | 0.000e+00 | 0.000e+00 |              0 | 1.00x
三件事要读出来:
编码侧同理,真实输出(每块 32 个输入帧,误差按潜变量标准差归一):
  ctx | 块头潜变量误差 | 块尾潜变量误差 | 被污染潜变量帧数
  ----+----------------+----------------+--------------
     0 | 3.245e+00 | 2.984e+00 |              4
     8 | 1.297e+00 | 0.000e+00 |              2
    12 | 6.090e-01 | 0.000e+00 |              1
    16 | 0.000e+00 | 0.000e+00 |              0
阈值 16,正是编码器感受野 $17 - 1$。
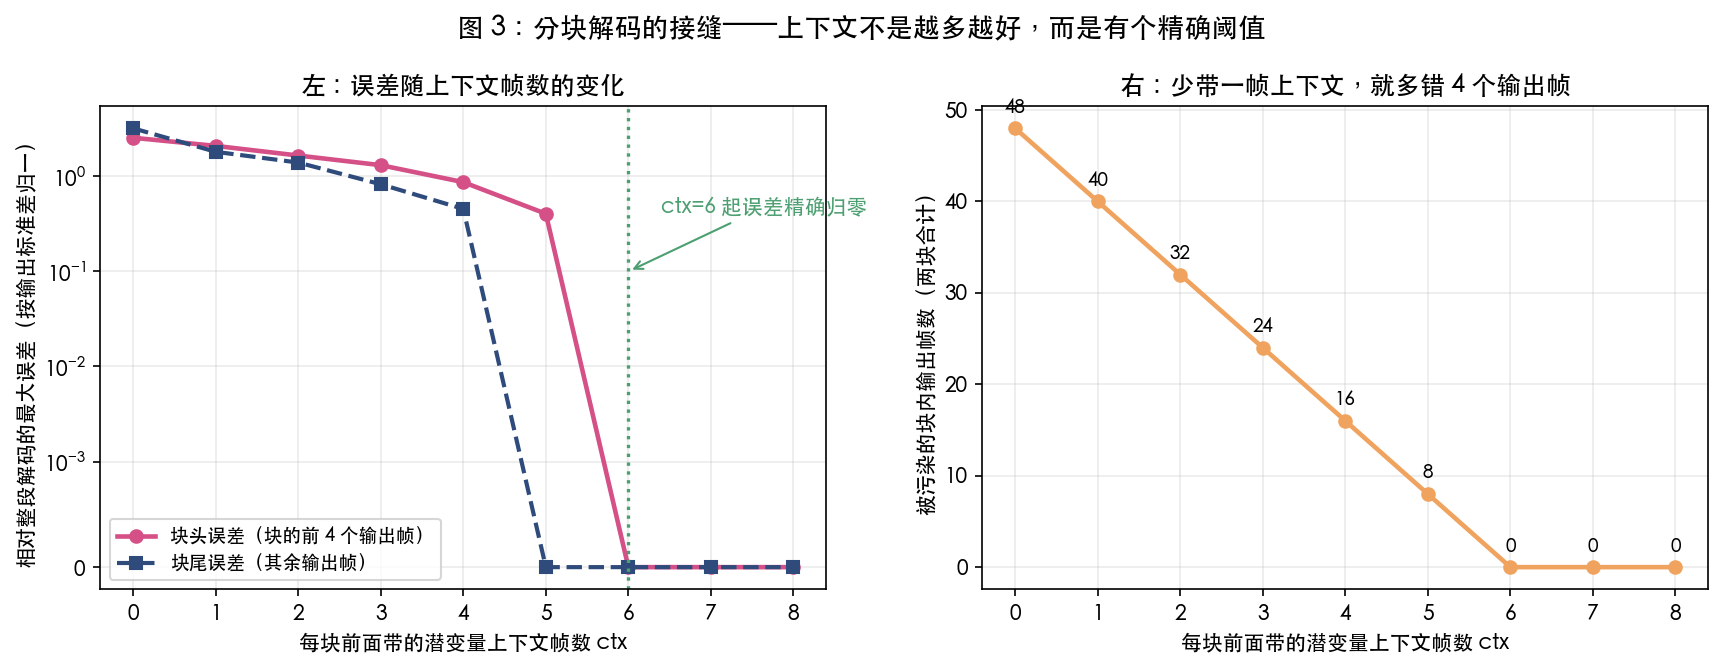
这张图要看什么:左图两条线(块头、块尾)在 ctx = 6 处一起掉到 0,纵坐标是对数轴——前面那段下降看着平缓,其实是从「两个标准差」这种肉眼可见的错误降到零。右图的阶梯更直白:被污染帧数每块减少 4 帧、图中两块合计减少 8 帧,斜率就是 $s_T$。
def latent_frames(t_in, s_t):
    """因果卷积下的潜变量帧数:首帧单独占位,所以是 floor((T-1)/s)+1。"""
    return (t_in - 1) // s_t + 1
121 帧 / 768×512 / RGB 的真实输出:
  配置                                  | 潜变量形状 (T'xH'xW'xC) | token 数 N | N^2 相对代价 | 便宜倍数 | 每 token 覆盖像素
  图像 VAE 逐帧(SVD / AnimateDiff 口径)| 121 x  64 x  96 x   4 |    743,424 |   1.000e+00 |     1.0x |      192
  CogVideoX / Wan / HunyuanVideo(4x8x8)|  31 x  64 x  96 x  16 |    190,464 |   6.564e-02 |    15.2x |      768
  LTX-Video(8x32x32)                  |  16 x  16 x  24 x 128 |      6,144 |   6.830e-05 | 14641.0x |   24,576
只动时间维的对照(固定空间 8×8、通道 16):时间压缩 1→2→4→8,token 数 743,424→374,784→190,464→98,304,长序列下近似每翻一倍注意力代价降到 1/4,首帧保留会带来取整差异。
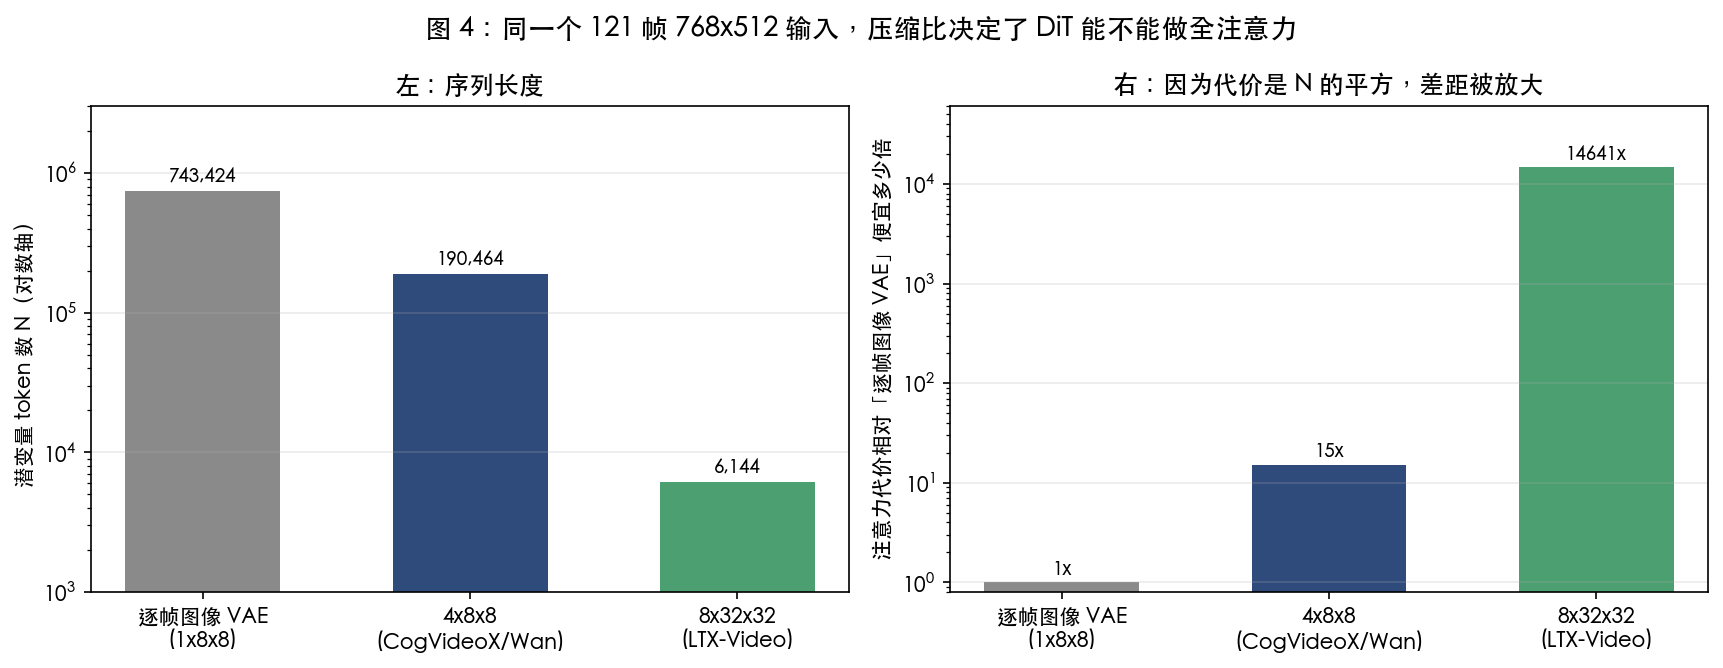
这张图要看什么:左图是序列长度(对数轴),右图是注意力的相对代价——右图的差距比左图大得多,因为代价是 $N^2$。6,144 个 token 意味着 LTX-Video 可以在这个分辨率上直接做全时空自注意力,而 743,424 个 token 连存 attention map 都存不下。
最小实现只有一条时间前补零,生产代码多了五处,每处都有原因。以下均以 huggingface/diffusers 2026-09 的实现为准(上游会重构,引用时请对照 repo/path#symbol):
src/diffusers/models/autoencoders/autoencoder_kl_cogvideox.py#CogVideoXCausalConv3dsrc/diffusers/models/autoencoders/autoencoder_kl_wan.py#WanCausalConv3dsrc/diffusers/models/downsampling.py#CogVideoXDownsample3Dsrc/diffusers/models/upsampling.py#CogVideoXUpsample3Dsrc/diffusers/models/autoencoders/autoencoder_kl_cogvideox.py#CogVideoXCausalConv3d:
time_pad = time_kernel_size - 1
self.time_causal_padding = (width_pad, width_pad, height_pad, height_pad, time_pad, 0)
F.pad 的元组是从最后一维往前写的,所以这六个数的含义是 $(W_{\text{left}}, W_{\text{right}}, H_{\text{left}}, H_{\text{right}}, T_{\text{left}}, T_{\text{right}})$。最后两个是 $(k_t - 1,\ 0)$——和 3.2 节推导的 $p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$ 完全一致。空间两维是对称的,只有时间轴不对称。
Wan 的 WanCausalConv3d(autoencoder_kl_wan.py)写成另一种形式:
self._padding = (self.padding[2], self.padding[2], self.padding[1], self.padding[1],
                 2 * self.padding[0], 0)
self.padding = (0, 0, 0)
它先把 nn.Conv3d 自带的 padding 清零,改成自己手动 pad。$k_t = 3$ 时 padding[0] = 1,于是 $2 \cdot 1 = 2 = k_t - 1$,和 CogVideoX 殊途同归。
CogVideoX 的 fake_context_parallel_forward:
kernel_size = self.time_kernel_size
if kernel_size > 1:
    cached_inputs = [conv_cache] if conv_cache is not None else [inputs[:, :, :1]] * (kernel_size - 1)
    inputs = torch.cat(cached_inputs + [inputs], dim=2)
return inputs读法:有缓存就把上一块最后 $k_t - 1$ 帧拼到前面;是第一块(没缓存)就把第 0 帧复制 $k_t - 1$ 次。这正好对应 3.4 节的两种情形——「缺上下文就用别的东西填」,而复制首帧比补零更合理(这是 pad_mode 的一个选项)。紧接着:
conv_cache = inputs[:, :, -self.time_kernel_size + 1:].clone()把拼接后输入的最后 $k_t - 1$ 帧存起来,给下一块用。整个编码器把这些缓存收进一个以层名索引的字典(conv_in、down_block_0……)逐层传递。Wan 的对应逻辑更紧凑,直接把缓存长度从待补的填充里减掉:
if cache_x is not None and self._padding[4] > 0:
    x = torch.cat([cache_x, x], dim=2)
    padding[4] -= cache_x.shape[2]
这就是 04 节那个 ctx 在生产代码里的样子。 这里有个容易看错的地方:工业实现每层只缓存 $k_t - 1 = 2$ 帧,而 04 节实测需要 6 帧,直觉上会觉得「2 帧不够」。其实够——因为每层缓存的是该层自己输入分辨率下的帧,越往后的层分辨率越高,同样 2 帧折回潜变量帧单位就越小。把解码器 d0…d4 逐层折算后累加:
| 层 | 输入相对潜变量的帧间距 | 缓存 $(k_t - 1)$ 帧折回潜变量帧 |
|---|---|---|
| d0 | 1.00 | 2.00 |
| d1 | 1.00 | 2.00 |
| d2 | 0.50 | 1.00 |
| d3 | 0.25 | 0.50 |
| d4 | 0.25 | 0.50 |
| 合计 | 6.00 |
逐层累加 = 6.00,和 04 节实测需要的 6 帧完全吻合——逐层缓存本来就等价于整条链路的感受野减 1,前提是每一层都缓存。真正的陷阱是只在网络入口缓存一次,那样只有 2 帧,接缝一定在。
src/diffusers/models/downsampling.py#CogVideoXDownsample3D:
x = x.permute(0, 3, 4, 1, 2).reshape(batch_size * height * width, channels, frames)
if x.shape[-1] % 2 == 1:
    x_first, x_rest = x[..., 0], x[..., 1:]
    x_rest = F.avg_pool1d(x_rest, kernel_size=2, stride=2)
    x = torch.cat([x_first[..., None], x_rest], dim=-1)
else:
    x = F.avg_pool1d(x, kernel_size=2, stride=2)
两个细节值得记住:
avg_pool1d,不是 stride 卷积。 空间维倒是用 nn.Conv2d(stride=2)(注意它把 (B, T, C, H, W) 折叠成 (B*T, C, H, W) 后用 2D 卷积做的,目的是省 Conv3d 的显存)。所以 3.5 节把时间下采样建模成平均池化不是偷懒,它就是这个实现。上采样端(upsampling.py#CogVideoXUpsample3D)对称地用 F.interpolate 做时间 2 倍、空间 2 倍,并且同样对首帧单独处理。
另外编码器里有一行决定「在哪几层压时间」:
temporal_compress_level = int(np.log2(temporal_compression_ratio))
compress_time = i < temporal_compress_level
压缩比 4 → level = 2 → 只有前两个下采样块压时间。这也解释了图 2 那件事:压缩集中在前段时,后段的层会以更大的累积步距去看历史,感受野涨得最快。
| 差距 | 生产代码 | 为什么 |
|---|---|---|
| 归一化 | GroupNorm / CogVideoXSpatialNorm3D |
调节中间激活的尺度;不能代替 KL,也不保证 latent 标准正态。若统计量跨时间,还须单独检查因果性 |
| 激活与结构 | ResNet block + SiLU,不是单层卷积 | 单层卷积的表达能力撑不起 8×8 的空间压缩 |
| 卷积实现 | CogVideoXSafeConv3d(分块跑的 Conv3d) |
避免长视频上 Conv3d 一次性分配大显存 |
| 缓存粒度 | 每层一个 key 的字典 | 分块推理要逐层续接,不是只在入口续接 |
| 精度与缓存 | dtype 由模型配置决定;缓存可 .clone() |
bf16 降低存储,clone 控制缓存所有权;二者是不同问题 |
数值个数、序列长度与信息量是三件事。 这张表最容易看错:
  配置                                  | 潜变量数值总数 | 压缩比(像素值 / 潜变量数值)
  图像 VAE 逐帧(SVD / AnimateDiff 口径)|      2,973,696 |     48.0 : 1
  CogVideoX / Wan / HunyuanVideo(4x8x8)|      3,047,424 |     46.8 : 1
  LTX-Video(8x32x32)                  |        786,432 |    181.5 : 1
4×8×8 这一档的数值元素压缩比和逐帧图像 VAE 几乎一样(46.8 vs 48.0)。它在这个数值元素口径下没有更小,但并非无损重排:学习型编码器把 743,424 个 token 重排成 190,464 个更「厚」的 token(通道 4 → 16)。数值个数接近不代表信息容量相同;这张表直接说明的是序列长度。 真正开始省容量的是 8×32×32 这一档,代价是 LTX-Video 摘要里自己写的那句:"the high compression inherently limits the representation of fine details"(高压缩本质上限制了细节的表达)。
时间压缩的额度由运动速度决定。 图 5 的三组曲线:
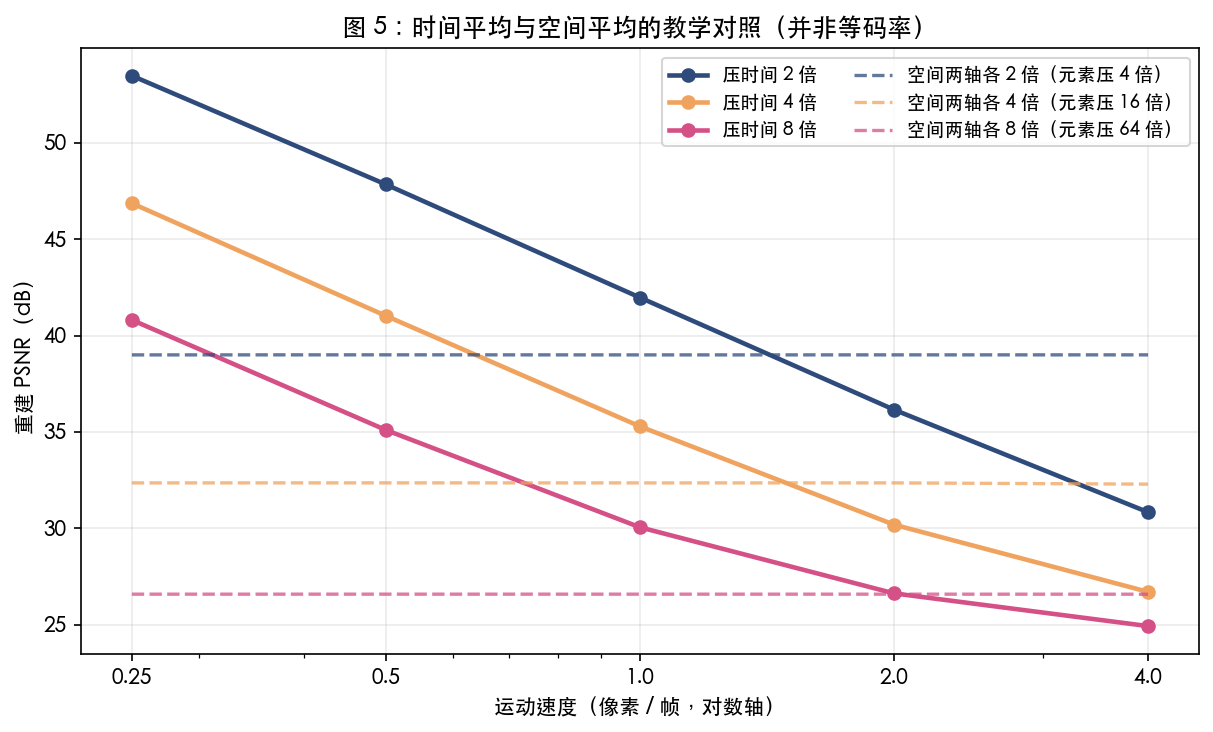
这张图要看什么:实线是压时间,虚线是压空间(与速度无关,当基线用)。同一颜色实线往下掉、虚线不动,交叉之后「再压时间」就不如「改压空间」。实测交叉点:压 2 倍和 4 倍在约 2 像素/帧处,压 8 倍在约 4 像素/帧处。
  速度 v |  时间 2x / 空间 2x    时间 4x / 空间 4x    时间 8x / 空间 8x
   0.25  |   53.49 /  39.00      46.87 /  32.35      40.81 /  26.58
   1.00  |   41.97 /  39.00      35.28 /  32.35      30.05 /  26.58
   2.00  |   36.15 /  39.00      30.18 /  32.35      26.62 /  26.58
   4.00  |   30.83 /  39.00      26.69 /  32.29      24.92 /  26.57
这些交叉点只属于本实验的斑点、尺寸、噪声和滤波器。尤其“时间 s 倍”减少 s 倍元素,而“空间两轴各 s 倍”减少 s² 倍元素,并非等码率比较,不能据此给出“超过 2 像素/帧就不能压缩”的部署阈值。真实 VAE 需在相同码率、动作数据和感知/时序指标下做验证。
首帧总是吃亏的。 因果卷积前面补的是零(或复制首帧),第一个输出位置天然只能看到 1 帧输入。图 1 左图第 0 行只有一个蓝点就是这个意思。所以「图生视频」任务里把首帧单独处理、或者编码时多给一帧,是常见做法。
上下文是纯开销。 带够 $\mathrm{RF} - 1$ 帧上下文,意味着每块要多算:
  解码块大小 | 需要上下文 | 额外算力占比
     8 潜变量帧 |   6 帧 | 42.9%
    16 潜变量帧 |   6 帧 | 27.3%
    24 潜变量帧 |   6 帧 | 20.0%
  编码块大小 | 需要上下文 | 额外算力占比
    32 输入帧 |  16 帧 | 33.3%
128 输入帧 | 16 帧 | 11.1%上下文的绝对量是固定的,块越大摊得越薄。这就是「块不能切太小」的定量理由:块切成 8 帧,42.9% 的算力花在重复计算上,此时「分块省显存」的收益已经被吃掉了三分之一。
离线场景可以考虑非因果结构。 它能使用前后帧,但是否提高质量要由实验决定。非因果网络也能分块,只是需要左右上下文或接受输出延迟。因果性本身不保证无闪烁,也不保证完整模型严格流式:跨时间归一化或全局注意力仍可能破坏性质。
五篇,每篇一句话说清它对「时间维怎么处理」的贡献:
还有一条不压时间的路线:Stable Video Diffusion 使用空间压缩的图像自编码器并加入时序解码层;Align your Latents 是较早的 Video LDM 工作,不能把两个标题和论文 ID 混在一起。逐帧 latent 的长度更大,但生成器是否采用全时空、分离式注意力或其他结构会改变真实成本。
误解一:「时间压缩 4 倍时,48 帧一定输出 13 帧。」 本文单侧填充 stride-conv 公式给出 $\lfloor47/4\rfloor+1=12$,49 帧才给 13。许多真实模型限定 $1+k s_T$ 帧,其他输入长度会经过补齐、裁剪或不同池化分支,必须核对代码,不能把帧数规则泛化。
误解二:「只要卷积前补零,整个 VAE 就严格因果。」 单层卷积的因果范围可以逐项证明,但还要检查膨胀、池化对齐、归一化和注意力的时间依赖。分块既可逐层缓存中间特征,也可在入口重叠足够大的上下文后裁剪;后者在本 toy 需要 6 个 latent 帧,而不是只缓存 2 帧。两种方式都可正确,只是计算和内存开销不同。
误解三:「分块解码只要重叠 1 帧就够,接缝最多难看一点点。」 实测:缺上下文时不是接缝那一帧错,是整块错。块大小 8 个潜变量帧、上下文 0 帧时,32 个输出帧里 24 帧是错的;每少带 1 帧上下文多错 4 个输出帧。而且这个错误不是「视觉上略糊」,是数值上完全跑偏(相对标准差 2.55 倍)。
误解四:「压缩比越高越好,反正都是 VAE 重建。」 4×8×8 相对逐帧图像 VAE 的数值元素压缩比几乎没变(46.8:1 vs 48.0:1),它省的是序列长度(06 节第一张表)。真正省容量的是 8×32×32 那一档,而论文自己承认细节受限。所以「压缩比」这个词在这件事上有两个含义,混着用会得出完全相反的结论。
误解五:「视频 VAE 就是把图像 VAE 的 2D 卷积换成 3D 卷积。」 三处不一样:(a)CogVideoX 的时间池化本身没有可学习参数,但其前后的 3D 时间卷积有;(b)空间卷积被折叠成 2D 卷积做,为的是省 Conv3d 的显存;(c)temporal_compress_level = int(log2(ratio)) 决定只有前几层压时间,不是每层都压。想从图像 VAE 权重 inflate 一个视频 VAE,这三处都得单独处理。
五个脚本都在文末附录;数值实验依赖 numpy,make_figures.py 还依赖 matplotlib。运行时间取决于机器。
python causal_conv3d.py     # 形状公式 + 因果性 + 感受野(约 11 秒)
python chunk_decode.py      # 分块编解码的接缝(约 8 秒)
python temporal_budget.py   # 运动速度 vs 时间压缩
python token_ledger.py      # token 账本
python make_figures.py      # 重画本文 5 张图
预期结果:
causal_conv3d.py:形状公式 6 组输入、3 组步距预测值全部等于实测值;49 -> 25 -> 13;因果性违反量 0.000e+00;感受野公式 17 = 实测 17,因果上界 0 次违反。chunk_decode.py:解码侧 ctx = 6 时误差 0.000e+00;编码侧 ctx = 16 时误差 0.000e+00;被污染帧数随 ctx 每 +1 减 8(两块合计)。temporal_budget.py:s=8 那一列 PSNR 从 40.81 dB 掉到 24.92 dB;宽度增幅实测约 3.24 倍,修正离散方差后的解析值也约 3.24 倍;交叉点报在 2 / 2 / 4 像素/帧。三个可以自己改的小实验:
dependency_matrix(t_in=48, time_pad="symmetric"),看所有 12 个潜变量帧都越过 $4j$ 那条线,最多超前 8 帧。chunk_decode.py 会看到阈值跟着移动。这条最能验证「上下文 = 感受野 − 1」不是巧合。按依赖顺序:
vae_basics(VAE 结构与训练目标) — 本文默认你已经知道 KL 项和重参数化在干什么。若要接着问「潜变量为什么要近似标准正态」,看它。vae_losses(视频 VAE 的常见 loss 组合) — 本文只讲了结构没讲训练目标。L1 + KL + LPIPS + GAN 四项权重怎么配、谁在管伪影,是那篇的话题;帧间闪烁的根因有一半在那儿,不在本文的因果性里。latent_diffusion(潜空间扩散) — 潜变量一旦定了,扩散过程就全在它上面做,包括那个 scaling factor。dit(DiT:用 Transformer 替掉 UNet) — 01 节那个 $N^2$ 账单最后是要 DiT 来付的,token 数直接决定它能不能做全时空注意力。autoregressive_video(自回归视频生成与 Forcing 范式) — 本文讲的是「逐块解码不接缝」;那篇讲的是更进一步:干脆按帧自回归地生成,因果性从 VAE 一路贯穿到生成模型。09 节用到的脚本全文如下(make_figures.py、causal_conv3d.py、chunk_decode.py、temporal_budget.py、token_ledger.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
# -*- coding: utf-8 -*-
"""画配图。所有数字都来自同目录的实验脚本,不另算一遍。

运行: python make_figures.py [--only 图名]

标签一律用 Unicode(σ、×)而不是 mathtext,省得反斜杠踩到转义检查。
"""

import os
import sys

import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

sys.path.insert(0, os.path.dirname(os.path.abspath(__file__)))

import causal_conv3d as cc                            # noqa: E402
import chunk_decode as cd                             # noqa: E402
import token_ledger as tl                             # noqa: E402
import temporal_budget as tb                          # noqa: E402

HERE = os.path.dirname(os.path.abspath(__file__))
FIGDIR = os.path.join(os.path.dirname(HERE), "figures")
os.makedirs(FIGDIR, exist_ok=True)

C0 = "#2f4b7c"
C1 = "#d45087"
C2 = "#f0a35e"
C3 = "#4c9f70"
CGREY = "#8a8a8a"

plt.rcParams["font.sans-serif"] = ["Heiti TC", "Arial Unicode MS", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False


def _save(fig, name):
    p = os.path.join(FIGDIR, name)
    fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white")
    plt.close(fig)
    print(f"  [ok] {name}  ({os.path.getsize(p)} bytes)")


# ─────────────── 图 1:因果 vs 非因果的依赖矩阵 ───────────────
def fig_dependency():
    dep_c = cc.dependency_matrix(t_in=48, time_pad="causal")
    dep_n = cc.dependency_matrix(t_in=48, time_pad="symmetric")
    fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.6), sharey=True)
    for ax, dep, title in ((axes[0], dep_c, "因果卷积:只看过去"),
                           (axes[1], dep_n, "普通卷积:前后都看")):
        ax.imshow(dep.T, aspect="auto", cmap="Blues", interpolation="nearest",
                  origin="lower")
        nz = dep.shape[1]
        jj = np.arange(nz)
        ax.plot(4 * jj, jj + 0.5, color=C1, lw=1.6, ls="--",
                label="输出帧 j 对应的输入帧 4j")
        ax.set_xlabel("输入帧 t")
        ax.set_title(title, fontsize=12)
        ax.legend(loc="upper left", fontsize=9)
    axes[0].set_ylabel("潜变量帧 j")
    # 标一处「未来泄漏」
    leak = []
    for j in range(dep_n.shape[1]):
        idx = np.where(dep_n[:, j])[0]
        if len(idx) and idx.max() > 4 * j:
            leak.append(int(idx.max()) - 4 * j)
    if leak:
        axes[1].annotate(f"这里看到了未来\n最多超前 {max(leak)} 帧",
                         xy=(30, 6), xytext=(24, 9.5), fontsize=10, color="#333333",
                         arrowprops=dict(arrowstyle="->", color="#999999", lw=1))
    fig.suptitle("图 1:谁依赖谁——横轴是被改动的输入帧,纵轴是跟着变的潜变量帧",
                 fontsize=13)
    fig.tight_layout()
    _save(fig, "fig1_dependency.png")
    return dep_c, dep_n


# ─────────────── 图 2:感受野为什么会被步距放大 ───────────────
def fig_rf():
    kernels = [3, 3, 3, 3]
    strides = [1, 2, 2, 1]
    contrib, cum = [], []
    c = 1
    for k, s in zip(kernels, strides):
        contrib.append((k - 1) * c)
        cum.append(c)
        c *= s
    rf = 1 + sum(contrib)
    fig, ax = plt.subplots(figsize=(7.6, 4.4))
    x = np.arange(len(kernels))
    ax.bar(x, contrib, color=[C0, C0, C2, C1], width=0.62)
    for i, (v, cu) in enumerate(zip(contrib, cum)):
        ax.text(i, v + 0.25, f"+{v}", ha="center", fontsize=10)
        ax.text(i, -0.9, f"累积步距 {cu}", ha="center", fontsize=9, color="#555555")
    ax.axhline(0, color="#333333", lw=0.8)
    ax.set_xticks(x)
    ax.set_xticklabels([f"第 {i + 1} 层\nk={k}, s={s}"
                        for i, (k, s) in enumerate(zip(kernels, strides))])
    ax.set_ylabel("这一层给感受野贡献的帧数")
    ax.set_ylim(-1.6, max(contrib) + 1.6)
    ax.set_title(f"图 2:同样的 k=3,越靠后的层贡献越大(总感受野 = 1 + 各项 = {rf} 帧)",
                 fontsize=12)
    ax.grid(alpha=0.25, axis="y")
    fig.tight_layout()
    _save(fig, "fig2_rf.png")
    return contrib, rf


# ─────────────── 图 3:分块解码的接缝 ───────────────
def fig_chunk():
    net, v, z, ref = cd.build()
    scale = float(ref.std())
    ctxs = list(range(0, 9))
    head, tail, contam = [], [], []
    for ctx in ctxs:
        got, starts = cd.decode_chunked(net, z, cd.CHUNK, ctx)
        diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale
        hi, ti, cn = [], [], 0
        for s in starts[1:]:
            hi += list(range(s, s + cd.T_STRIDE))
            ti += list(range(s + cd.T_STRIDE, s + cd.CHUNK * cd.T_STRIDE))
            cn += int((diff[s:s + cd.CHUNK * cd.T_STRIDE] > 1e-9).sum())
        head.append(float(diff[hi].max()))
        tail.append(float(diff[ti].max()))
        contam.append(cn)

    fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.5))
    ax = axes[0]
    ax.plot(ctxs, head, "o-", color=C1, lw=2.2, label="块头误差(块的前 4 个输出帧)")
    ax.plot(ctxs, tail, "s--", color=C0, lw=2.0, label="块尾误差(其余输出帧)")
    ax.set_yscale("symlog", linthresh=1e-3)
    ax.set_xlabel("每块前面带的潜变量上下文帧数 ctx")
    ax.set_ylabel("相对整段解码的最大误差(按输出标准差归一)")
    ax.axvline(6, color=C3, lw=1.6, ls=":")
    ax.annotate("ctx=6 起误差精确归零", xy=(6, 1e-1), xytext=(6.4, 4e-1),
                fontsize=10, color=C3,
                arrowprops=dict(arrowstyle="->", color=C3, lw=1))
    ax.set_title("左:误差随上下文帧数的变化", fontsize=12)
    ax.legend(fontsize=9)
    ax.grid(alpha=0.25)

    ax = axes[1]
    ax.plot(ctxs, contam, "o-", color=C2, lw=2.2)
    ax.set_xlabel("每块前面带的潜变量上下文帧数 ctx")
    ax.set_ylabel("被污染的块内输出帧数(两块合计)")
    for i, c in enumerate(contam):
        ax.annotate(str(c), (ctxs[i], c), textcoords="offset points",
                    xytext=(0, 7), ha="center", fontsize=9)
    ax.set_title("右:少带一帧上下文,就多错 4 个输出帧", fontsize=12)
    ax.grid(alpha=0.25)
    fig.suptitle("图 3:分块解码的接缝——上下文不是越多越好,而是有个精确阈值",
                 fontsize=13)
    fig.tight_layout()
    _save(fig, "fig3_chunk.png")
    return ctxs, head, tail, contam


# ─────────────── 图 4:token 账本 ───────────────
def fig_ledger():
    rows = [tl._row(n, a, b, c) for n, a, b, c in tl.REAL]
    labels = ["逐帧图像 VAE\n(1x8x8)", "4x8x8\n(CogVideoX/Wan)", "8x32x32\n(LTX-Video)"]
    ns = [r["n"] for r in rows]
    rel = [(r["n"] / ns[0]) ** 2 for r in rows]
    fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.5))
    ax = axes[0]
    bars = ax.bar(labels, ns, color=[CGREY, C0, C3], width=0.58)
    ax.set_yscale("log")
    ax.set_ylabel("潜变量 token 数 N(对数轴)")
    for b, n in zip(bars, ns):
        ax.text(b.get_x() + b.get_width() / 2, n * 1.15, f"{n:,}",
                ha="center", fontsize=9)
    ax.set_ylim(1e3, 3e6)
    ax.set_title("左:序列长度", fontsize=12)
    ax.grid(alpha=0.25, axis="y")

    ax = axes[1]
    bars = ax.bar(labels, [1.0 / r for r in rel], color=[CGREY, C0, C3], width=0.58)
    ax.set_yscale("log")
    ax.set_ylabel("注意力代价相对「逐帧图像 VAE」便宜多少倍")
    for b, r in zip(bars, rel):
        ax.text(b.get_x() + b.get_width() / 2, (1.0 / r) * 1.15,
                f"{1.0 / r:.0f}x", ha="center", fontsize=9)
    ax.set_ylim(0.8, 6e4)
    ax.set_title("右:因为代价是 N 的平方,差距被放大", fontsize=12)
    ax.grid(alpha=0.25, axis="y")
    fig.suptitle("图 4:同一个 121 帧 768x512 输入,压缩比决定了 DiT 能不能做全注意力",
                 fontsize=13)
    fig.tight_layout()
    _save(fig, "fig4_ledger.png")
    return ns, rel


# ─────────────── 图 5:运动速度 vs 时间压缩 ───────────────
def fig_motion():
    speeds = tb.SPEEDS
    p_t = {2: [], 4: [], 8: []}
    p_s = {2: [], 4: [], 8: []}
    for v in speeds:
        x = tb.moving_blob(v)
        for s in (2, 4, 8):
            p_t[s].append(tb.psnr(x, tb.repeat_time(tb.avg_pool_time(x, s), s)))
            p_s[s].append(tb.psnr(x, tb.repeat_space(tb.avg_pool_space(x, s), s)))
    fig, ax = plt.subplots(figsize=(8.2, 5.0))
    colors = {2: C0, 4: C2, 8: C1}
    for s in (2, 4, 8):
        ax.plot(speeds, p_t[s], "o-", color=colors[s], lw=2.2,
                label=f"压时间 {s} 倍")
    for s in (2, 4, 8):
        ax.plot(speeds, p_s[s], ls="--", color=colors[s], lw=1.6, alpha=0.75,
                label=f"空间两轴各 {s} 倍(元素压 {s*s} 倍)")
    ax.set_xscale("log")
    ax.set_xticks(speeds)
    ax.set_xticklabels([str(v) for v in speeds])
    ax.set_xlabel("运动速度(像素 / 帧,对数轴)")
    ax.set_ylabel("重建 PSNR(dB)")
    ax.set_title("图 5:时间平均与空间平均的教学对照(并非等码率)",
                 fontsize=12)
    ax.legend(fontsize=9, ncol=2)
    ax.grid(alpha=0.25)
    fig.tight_layout()
    _save(fig, "fig5_motion.png")
    return p_t, p_s


if __name__ == "__main__":
    only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None
    jobs = {
        "dependency": fig_dependency,
        "rf": fig_rf,
        "chunk": fig_chunk,
        "ledger": fig_ledger,
        "motion": fig_motion,
    }
    for k, fn in jobs.items():
        if only and k != only:
            continue
        print(f"[draw] {k}")
        fn()
print("done")# -*- coding: utf-8 -*-
"""3D 因果卷积的 numpy 最小实现,以及形状公式、因果性、感受野的实测。
运行: python causal_conv3d.py
约定张量布局 [C, T, H, W](通道优先,和 torch 的 Conv3d 一致)。
因果卷积的全部秘密只有一条:时间轴**只在前面**补 k_t - 1 帧,后面一帧都不补。
"""
import numpy as np
def base_rng(seed=20260930):
"""全工程的种子入口。所有随机权重都从这里分叉,保证数字可复现。"""
return np.random.default_rng(seed)
# ─────────────── 基本算子 ───────────────
def causal_pad(x, k_t):
"""时间轴前面补 k_t-1 帧零,后面不补。这是「因果」二字的全部实现。"""
if k_t <= 1:
return x
pad = np.zeros((x.shape[0], k_t - 1, x.shape[2], x.shape[3]), dtype=x.dtype)
return np.concatenate([pad, x], axis=1)
def sym_pad_hw(x, k_h, k_w):
"""空间轴对称补零,和 torch 的 Conv3d 默认行为一致。"""
pad = ((0, 0), (0, 0),
((k_h - 1) // 2, k_h // 2), ((k_w - 1) // 2, k_w // 2))
return np.pad(x, pad, mode="constant")
def conv3d_valid(x, w, stride=(1, 1, 1)):
"""x [C_in,T,H,W] × w [C_out,C_in,kT,kH,kW] -> [C_out,To,Ho,Wo],只做 valid 部分。"""
c_in, t, h, wd = x.shape
c_out, c_in2, kt, kh, kw = w.shape
assert c_in == c_in2, "通道数对不上"
st, sh, sw = stride
to = (t - kt) // st + 1
ho = (h - kh) // sh + 1
wo = (wd - kw) // sw + 1
out = np.zeros((c_out, to, ho, wo), dtype=np.float64)
for o in range(c_out):
wo_kernel = w[o]
for i in range(to):
for j in range(ho):
for k in range(wo):
patch = x[:, i * st:i * st + kt,
j * sh:j * sh + kh,
k * sw:k * sw + kw]
out[o, i, j, k] = np.sum(patch * wo_kernel)
return out
def conv3d_causal(x, w, stride=(1, 1, 1), time_pad="causal"):
"""3D 卷积,时间填充方式可选:
time_pad="causal" 前面补 k_t-1 帧、后面不补(只看过去)
time_pad="symmetric" 前后各补 (k_t-1)//2 帧(会看到未来)
"""
kt, kh, kw = w.shape[2], w.shape[3], w.shape[4]
if time_pad == "causal":
x = causal_pad(x, kt)
else:
pad = ((0, 0), ((kt - 1) // 2, (kt - 1) // 2), (0, 0), (0, 0))
x = np.pad(x, pad, mode="constant")
x = sym_pad_hw(x, kh, kw)
return conv3d_valid(x, w, stride)
def out_frames(t_in, k_t=3, s_t=1):
"""因果卷积的时间输出帧数。
T_out = floor((T_in - 1) / s_t) + 1
注意不是 floor(T_in / s_t):因为首帧被保留下来单独占了一个输出位。
"""
return (t_in - 1) // s_t + 1
# ─────────────── 一个可复用的 toy 视频 VAE ───────────────
class CausalConv3d:
"""带激活的因果卷积层。权重由 base_rng 派生,fix 住后所有实验共用。
act 默认用 tanh 而不是 ReLU:随机权重下 ReLU 会把一大半通道关死,
实测感受野会被「死通道」削小,接缝误差也随之小到 1e-7 量级,看不出问题。
真实 VAE 里有 GroupNorm 兜着,绝大多数通道是活的,tanh 更接近那个状态。
"""
def __init__(self, c_in, c_out, k=(3, 3, 3), s=(1, 1, 1), seed=0, act="tanh",
time_pad="causal"):
rng = base_rng(1000 + seed)
scale = 0.9 / np.sqrt(c_in * k[0] * k[1] * k[2])
self.w = rng.normal(0.0, scale, size=(c_out, c_in) + tuple(k))
self.b = rng.normal(0.0, 0.02, size=c_out)
self.k = tuple(k)
self.s = tuple(s)
self.act = act
self.time_pad = time_pad
def __call__(self, x):
y = conv3d_causal(x, self.w, self.s, time_pad=self.time_pad)
y = y + self.b.reshape(-1, 1, 1, 1)
if self.act == "tanh":
y = np.tanh(y)
elif self.act is True or self.act == "relu":
y = np.maximum(y, 0.0)
return y
def time_upsample(x, factor=2):
"""时间维最近邻上采样:每个潜变量帧重复 factor 次。
这是纯复制,不引入新的时间依赖,所以不改感受野的「帧数」,
只改感受野在输出帧单位下的跨度。
"""
return np.repeat(x, factor, axis=1)
class ToyVideoVAE:
"""一个能跑的因果视频自编码器(权重是随机的,不追求重建质量)。
编码器把时间压 4 倍、空间压 4 倍;解码器用最近邻上采样还原。
它的唯一用途是让「谁依赖谁」这件事可以被实测。
"""
def __init__(self, time_pad="causal"):
self.e0 = CausalConv3d(1, 4, k=(3, 3, 3), s=(1, 1, 1), seed=1,
time_pad=time_pad)
self.e1 = CausalConv3d(4, 8, k=(3, 3, 3), s=(2, 2, 2), seed=2,
time_pad=time_pad)
self.e2 = CausalConv3d(8, 8, k=(3, 3, 3), s=(2, 2, 2), seed=3,
time_pad=time_pad)
self.e3 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=4,
time_pad=time_pad)
self.d0 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=5)
self.d1 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=6)
self.d2 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=7)
self.d3 = CausalConv3d(8, 4, k=(3, 3, 3), s=(1, 1, 1), seed=8)
self.d4 = CausalConv3d(4, 1, k=(3, 3, 3), s=(1, 1, 1), seed=9, act=None)
def encode(self, x):
x = self.e0(x)
x = self.e1(x)
x = self.e2(x)
return self.e3(x)
def decode(self, z):
x = self.d0(z)
x = self.d1(x)
x = time_upsample(x, 2)
x = self.d2(x)
x = time_upsample(x, 2)
x = self.d3(x)
return self.d4(x)
def __call__(self, x):
return self.decode(self.encode(x))
def make_video(t=48, h=16, w=16, seed=7):
"""一段有运动的合成视频:一个高斯斑点匀速横移 + 缓慢明暗变化。"""
rng = base_rng(seed)
ys, xs = np.mgrid[0:h, 0:w]
frames = []
speed = 0.6
cy = h / 2.0 + rng.normal(0, 0.3)
for ti in range(t):
cx = (w / 4.0 + speed * ti) % w
blob = np.exp(-(((ys - cy) ** 2 + (xs - cx) ** 2) / 6.0))
bg = 0.15 * np.sin(2 * np.pi * ti / 24.0) * np.ones_like(blob)
frames.append(blob + bg + 0.02 * rng.normal(size=blob.shape))
v = np.stack(frames)[None] # [1, T, H, W]
return v.astype(np.float64)
# ─────────────── 实验 1:形状公式 ───────────────
def shape_table():
print("── 实验 1:因果卷积的时间帧数公式 ──")
print("公式:T_out = floor((T_in - 1) / s_t) + 1 (因果,前补 k_t-1)")
rows = []
for t_in in (16, 17, 32, 48, 49, 121):
row = [t_in]
for s_t in (1, 2, 4):
pred = out_frames(t_in, s_t=s_t)
w = np.zeros((2, 1, 3, 3, 3))
w[:] = 0.1
x = np.zeros((1, t_in, 8, 8))
got = conv3d_causal(x, w, stride=(s_t, 1, 1)).shape[1]
row.append((s_t, pred, got))
rows.append(row)
print(f" T_in={t_in:4d} -> " +
" ".join(f"s_t={s}: 预测 {p:3d} / 实测 {g:3d} {'OK' if p == g else 'FAIL'}"
for s, p, g in row[1:]))
# CogVideoX 的真实数字:49 帧进,两级时间压缩 2
t = 49
t1 = out_frames(t, s_t=2)
t2 = out_frames(t1, s_t=2)
print(f" 两级时间压缩 2(CogVideoX 口径):49 帧 -> {t1} -> {t2} 潜变量帧")
return rows, (t, t1, t2)
# ─────────────── 实验 2:因果性 ───────────────
def causality_check():
"""改未来的帧,看过去的潜变量有没有跟着变。变了就是漏了未来信息。"""
print("\n── 实验 2:因果性检验(改未来,看过去)──")
net = ToyVideoVAE()
v = make_video(t=48)
z_ref = net.encode(v)
worst = 0.0
for t_edit in range(0, 48, 4):
v2 = v.copy()
v2[:, t_edit:] += 3.0 # 从第 t_edit 帧起全部改动
z2 = net.encode(v2)
# 总时间步距 4,所以潜变量帧 j 只应该看到输入帧 <= 4j
for j in range(z2.shape[1]):
if 4 * j < t_edit: # 这个潜变量帧不该看到第 t_edit 帧及之后
diff = np.abs(z2[:, j] - z_ref[:, j]).max()
worst = max(worst, diff)
print(f" 应该完全不受影响的潜变量帧上,最大变化量 = {worst:.3e}")
print(f" 判据:等于 0 则因果性成立(浮点意义上 < 1e-12 即通过)")
return worst
# ─────────────── 实验 3:感受野 ───────────────
def encoder_rf_formula(kernels, strides):
"""RF = 1 + sum_l (k_l - 1) * prod_{m<l} s_m
prod_{m<l} s_m 是「到第 l 层输入为止累积的时间步距」,
所以越靠后的层,一个 kernel 覆盖的原始帧数越多。
"""
rf = 1
cum = 1
for k, s in zip(kernels, strides):
rf += (k - 1) * cum
cum *= s
return rf, cum
def encoder_rf_measured():
"""扰动法实测:逐帧加扰动,看哪些潜变量帧跟着动。"""
net = ToyVideoVAE()
v = make_video(t=48)
z_ref = net.encode(v)
nz = z_ref.shape[1]
depends = np.zeros((48, nz), dtype=bool)
for t_edit in range(48):
v2 = v.copy()
v2[:, t_edit:t_edit + 1] += 2.0
z2 = net.encode(v2)
depends[t_edit] = np.abs(z2 - z_ref).max(axis=(0, 2, 3)) > 1e-12
return depends, z_ref
def receptive_field():
kernels = [3, 3, 3, 3]
strides = [1, 2, 2, 1]
rf_pred, cum = encoder_rf_formula(kernels, strides)
print("\n── 实验 3:编码器的时间感受野 ──")
print(f" 公式:RF = 1 + sum (k_l - 1) * prod_(m<l) s_m")
print(f" 本 toy 的层配置 k={kernels}, s={strides}")
print(f" 公式预测 RF = {rf_pred} 帧,累积时间步距 = {cum}")
depends, z_ref = encoder_rf_measured()
nz = z_ref.shape[1]
spans = []
for j in range(nz):
idx = np.where(depends[:, j])[0]
if len(idx) == 0:
spans.append((j, None, None, 0))
continue
spans.append((j, int(idx.min()), int(idx.max()), int(idx.max()) - int(idx.min()) + 1))
print(" 实测(逐帧扰动):潜变量帧 j -> 受影响的输入帧区间")
for j, lo, hi, sp in spans[:6]:
if lo is None:
print(f" j={j:2d}: 无任何输入帧影响它(权重恰好全被 ReLU 关掉)")
else:
print(f" j={j:2d}: 输入帧 [{lo:2d}, {hi:2d}],跨度 {sp:2d} 帧")
# 因果性上界:潜变量帧 j 能看到的最新输入帧
print(" 因果性上界检查:潜变量帧 j 能看到的最新输入帧应当 <= 步距 * j")
bad = 0
for j, lo, hi, sp in spans:
if hi is not None and hi > cum * j:
bad += 1
print(f" 违反次数 = {bad}(0 表示因果性严格成立)")
max_span = max(s for _, _, _, s in spans)
print(f" 实测最大跨度 = {max_span} 帧,公式预测 = {rf_pred} 帧")
return rf_pred, cum, spans, max_span
def dependency_matrix(t_in=48, time_pad="causal"):
"""扰动法得到「输入帧 t 是否影响潜变量帧 j」的布尔矩阵 [T_in, n_z]。
这张矩阵就是因果性的可视化:因果卷积下它必须落在 j*s_t 这条对角线以下。
"""
net = ToyVideoVAE(time_pad=time_pad)
v = make_video(t=t_in)
z_ref = net.encode(v)
dep = np.zeros((t_in, z_ref.shape[1]), dtype=bool)
for t_edit in range(t_in):
v2 = v.copy()
v2[:, t_edit:t_edit + 1] += 2.0
dep[t_edit] = np.abs(net.encode(v2) - z_ref).max(axis=(0, 2, 3)) > 1e-12
return dep
if __name__ == "__main__":
shape_table()
causality_check()
receptive_field()# -*- coding: utf-8 -*-
"""分块编解码的接缝实验:到底要带多少帧上下文,逐块跑才能和整段跑一模一样。
运行: python chunk_decode.py
这是整篇文章最核心的一个实验。设置:
- 96 帧输入 -> 编码器压成 24 个潜变量帧(时间步距 4)
- 整段编解码得到参考输出
- 然后把潜变量切成 3 块,每块前面额外喂 ctx 个潜变量帧当上下文,
解码后把上下文那部分输出丢掉,只留本块
- 比较「分块结果」与「整段结果」在每个位置的差
编码侧同样要分块(长视频不可能一次装进显存),所以下面两件事都测:
1. 解码侧:需要几个潜变量帧上下文
2. 编码侧:需要几个输入帧上下文
"""
import numpy as np
from causal_conv3d import ToyVideoVAE, make_video
T_FRAMES = 96 # 输入帧数
T_STRIDE = 4 # 编码器总时间步距:1 个潜变量帧对应 4 个输出帧
CHUNK = 8 # 每块 8 个潜变量帧 = 32 个输出帧
def build():
net = ToyVideoVAE()
v = make_video(t=T_FRAMES)
z = net.encode(v) # [8, 24, 4, 4]
ref = net.decode(z) # [1, 96, 16, 16]
return net, v, z, ref
# ─────────────── 解码侧 ───────────────
def decode_chunked(net, z, chunk=CHUNK, ctx=0):
"""按 chunk 个潜变量帧一块解码,每块前面带 ctx 帧上下文。"""
nz = z.shape[1]
pieces, starts = [], []
n_chunks = (nz + chunk - 1) // chunk
for i in range(n_chunks):
lo = i * chunk
hi = min(lo + chunk, nz)
lo_in = max(0, lo - ctx)
out = net.decode(z[:, lo_in:hi])
keep = (hi - lo) * T_STRIDE # 上下文部分的输出要丢掉
pieces.append(out[:, -keep:])
starts.append(lo * T_STRIDE)
return np.concatenate(pieces, axis=1), starts
def decode_sweep():
net, v, z, ref = build()
scale = float(ref.std())
print("── 解码侧:上下文帧数 vs 接缝误差 ──")
print(f" {T_FRAMES} 帧输入 -> {z.shape[1]} 个潜变量帧(时间步距 {T_STRIDE})"
f" -> {ref.shape[1]} 帧输出")
print(f" 误差已按输出标准差归一化(std = {scale:.4f})")
print("")
print(" ctx | 块头误差 | 块尾误差 | 块内被污染帧数 | 边界跳变放大")
print(" ----+---------+---------+----------------+------------")
table = []
for ctx in range(0, 9):
got, starts = decode_chunked(net, z, CHUNK, ctx)
diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale
head_idx, tail_idx, contam = [], [], 0
for s in starts[1:]:
head_idx += list(range(s, s + T_STRIDE))
tail_idx += list(range(s + T_STRIDE, s + CHUNK * T_STRIDE))
contam += int((diff[s:s + CHUNK * T_STRIDE] > 1e-9).sum())
head = float(diff[head_idx].max())
tail = float(diff[tail_idx].max())
jump = boundary_jump(ref, got, starts)
table.append((ctx, head, tail, contam, jump))
print(f" {ctx:4d} | {head:.3e} | {tail:.3e} | {contam:14d} | {jump:.2f}x")
return table
def boundary_jump(ref, got, starts):
"""同一位置处,分块结果的帧间跳变相对整段结果放大了多少倍。
分母取「整段解码在同一帧的跳变」而不是全场平均——视频在某些帧本来就变化快,
拿全场平均当分母会把正常内容误判成接缝。
"""
ratios = []
for s in starts[1:]:
j_got = float(np.abs(got[:, s] - got[:, s - 1]).max())
j_ref = float(np.abs(ref[:, s] - ref[:, s - 1]).max())
if j_ref > 1e-12:
ratios.append(j_got / j_ref)
return max(ratios) if ratios else float("nan")
def decode_profile():
"""误差在块内是怎么衰减的:看第 2 块前 24 个输出帧。"""
net, v, z, ref = build()
scale = float(ref.std())
print("")
print("── 第 2 块内的误差衰减(输出帧 32 起,取前 12 帧,按 std 归一)──")
out = {}
for ctx in (0, 2, 4, 6):
got, starts = decode_chunked(net, z, CHUNK, ctx)
diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale
seg = diff[32:32 + 24]
out[ctx] = seg
print(f" ctx={ctx}: " + " ".join(f"{x:.1e}" for x in seg[:12]))
return out
# ─────────────── 编码侧 ───────────────
def encode_chunked(net, v, chunk_in=32, ctx=0):
"""按 chunk_in 个输入帧一块编码,每块前面带 ctx 个输入帧上下文。"""
t = v.shape[1]
pieces = []
n_chunks = (t + chunk_in - 1) // chunk_in
for i in range(n_chunks):
lo = i * chunk_in
hi = min(lo + chunk_in, t)
lo_in = max(0, lo - ctx)
z_i = net.encode(v[:, lo_in:hi])
keep = (hi - lo) // T_STRIDE # 上下文换来的多余潜变量帧要丢掉
pieces.append(z_i[:, -keep:] if keep > 0 else z_i[:, :0])
return np.concatenate(pieces, axis=1)
def encode_sweep():
net, v, z, ref = build()
scale = float(z.std())
print("")
print("── 编码侧:上下文帧数 vs 潜变量误差 ──")
print(f" 每块 32 个输入帧(= 8 个潜变量帧),误差按潜变量标准差归一"
f"(std = {scale:.4f})")
print("")
print(" ctx | 块头潜变量误差 | 块尾潜变量误差 | 被污染潜变量帧数")
print(" ----+----------------+----------------+--------------")
table = []
for ctx in (0, 4, 8, 12, 16, 20, 24):
zh = encode_chunked(net, v, 32, ctx)
if zh.shape[1] != z.shape[1]:
print(f" ctx={ctx}: 潜变量帧数对不上 {zh.shape[1]} vs {z.shape[1]},跳过")
continue
d = np.abs(zh - z).max(axis=(0, 2, 3)) / scale
head = float(d[8:10].max())
tail = float(d[10:16].max())
contam = int((d[8:16] > 1e-9).sum())
table.append((ctx, head, tail, contam))
print(f" {ctx:4d} | {head:.3e} | {tail:.3e} | {contam:14d}")
return table
# ─────────────── 直接问:谁依赖谁 ───────────────
def dependency_table():
"""扰动法:直接问「输出帧 o 依赖哪些潜变量帧」,从而算出必需的上下文帧数。"""
net, v, z, ref = build()
nz = z.shape[1]
z_ref = net.decode(z)
dep = np.zeros((nz, z_ref.shape[1]), dtype=bool)
for j in range(nz):
z2 = z.copy()
z2[:, j] += 1.0
dep[j] = np.abs(net.decode(z2) - z_ref).max(axis=(0, 2, 3)) > 1e-12
print("")
print("── 直接问:块头输出帧依赖哪些潜变量帧 ──")
print(" 块起点(输出帧) | 依赖的最早潜变量帧 | 需要的上下文帧数")
need = []
n_chunks = (nz + CHUNK - 1) // CHUNK
for i in range(1, n_chunks):
j0 = i * CHUNK
o0 = j0 * T_STRIDE
idx = np.where(dep[:, o0])[0]
if len(idx) == 0:
continue
need.append((o0, int(idx.min()), j0 - int(idx.min())))
print(f" {o0:3d} | {int(idx.min()):3d} | {j0 - int(idx.min())}")
widths = []
for o in range(z_ref.shape[1]):
idx = np.where(dep[:, o])[0]
widths.append(int(idx.max()) - int(idx.min()) + 1 if len(idx) else 0)
rf_dec = max(widths)
print(f" 解码器时间感受野(潜变量帧数,取所有输出帧的最大值)= {rf_dec}")
print(f" 推论:所需上下文 = 感受野 - 1 = {rf_dec - 1} 个潜变量帧")
return need, rf_dec
def context_decomposition():
"""逐层只缓存 (k_t - 1) 帧,折算回潜变量帧单位后累加起来等于什么?
这是检验「工业实现里每层只缓存 k_t-1 帧够不够」的关键一笔:
够不够取决于你把缓存折算回哪一级的单位。逐层缓存时,第 l 层的
k_t-1 = 2 帧是该层输入分辨率下的 2 帧,折回潜变量帧要乘上该层
相对潜变量的帧间距(上采样会把间距缩小)。
"""
# 解码器 d0..d4 的输入相对潜变量的时间帧间距
spacing = {"d0": 1.0, "d1": 1.0, "d2": 0.5, "d3": 0.25, "d4": 0.25}
k_t = 3
print("")
print("── 逐层缓存 (k_t - 1) 帧,累加起来是多少 ──")
print("")
print(" 层 | 输入相对潜变量的帧间距 | 缓存 (k_t-1) 帧折回潜变量帧")
print(" ----+------------------------+----------------------------")
total = 0.0
for name, sp in spacing.items():
c = (k_t - 1) * sp
total += c
print(f" {name} | {sp:22.2f} | {c:12.2f}")
print(f" 合计 | {'':22} | {total:12.2f}")
print("")
print(f" 实测需要的上下文(dependency_table)= 6 个潜变量帧")
print(f" 逐层缓存累加 = {total:.2f} 个潜变量帧 -> "
f"{'完全吻合' if abs(total - 6) < 1e-9 else '不吻合'}")
print("")
print(" 结论:工业实现里「每层只缓存 k_t-1 帧」是**正确的**,因为逐层")
print(" 累加后恰好等于感受野 - 1。真正的陷阱是只在网络入口缓存一次——")
print(" 那样只有 (k_t-1) = 2 帧,差得远。")
return total
def overhead(rf_dec=7, rf_enc=17):
"""带上下文要多算多少:额外算的量占本块的比例。"""
print("")
print("── 上下文的开销 ──")
print(" 解码块大小 | 需要上下文 | 额外算力占比")
rows = []
for chunk in (8, 12, 16, 24):
ctx = rf_dec - 1
frac = ctx / (chunk + ctx)
rows.append(("decode", chunk, ctx, frac))
print(f" {chunk:3d} 潜变量帧 | {ctx:3d} 帧 | {frac * 100:.1f}%")
print(" 编码块大小 | 需要上下文 | 额外算力占比")
for chunk in (32, 64, 128):
ctx = rf_enc - 1
frac = ctx / (chunk + ctx)
rows.append(("encode", chunk, ctx, frac))
print(f" {chunk:3d} 输入帧 | {ctx:3d} 帧 | {frac * 100:.1f}%")
return rows
def state():
net, v, z, ref = build()
return dict(z=z, ref=ref)
if __name__ == "__main__":
decode_sweep()
decode_profile()
dependency_table()
context_decomposition()
encode_sweep()
overhead()# -*- coding: utf-8 -*-
"""时间压缩比的预算:运动多快的时候,压 s 倍时间就开始糊。
运行: python temporal_budget.py
把「时间下采样」简化成最朴素的 s 帧平均 + 最近邻还原(CogVideoX 的下采样层
真的就是 avg_pool1d,见 05 节)。学习到的时间卷积会比平均聪明,但这个教学模型
只演示量级和规律,不是神经 VAE 的误差下界,而且它有一条可以验的解析预期:
平均 s 帧 == 给运动物体糊上一条长度 (s-1) * v 像素的运动模糊
"""
import numpy as np
from causal_conv3d import base_rng
# 画布要够宽:最快的斑点(4 px/帧 x 32 帧 = 128 px)必须全程留在画面内,
# 否则斑点在后面几帧整个飘出去,加权宽度会因为分母趋于 0 而算成 nan。
T, H, W = 32, 32, 192
SIGMA = 3.0 # 斑点的高斯半径(像素)
SPEEDS = [0.25, 0.5, 1.0, 2.0, 4.0]
FACTORS = [1, 2, 4, 8]
def moving_blob(speed, t=T, h=H, w=W, sigma=SIGMA, seed=11):
"""一个匀速横移的高斯斑点。不环绕,避免边界跳变污染 PSNR。"""
rng = base_rng(seed)
ys, xs = np.mgrid[0:h, 0:w]
cy = h / 2.0
cx0 = w * 0.25
frames = []
for ti in range(t):
cx = cx0 + speed * ti
frames.append(np.exp(-(((ys - cy) ** 2 + (xs - cx) ** 2) / (2 * sigma ** 2))))
v = np.stack(frames)[None] # [1, T, H, W]
return v + 0.001 * rng.normal(size=v.shape) # 微量噪声,避免除零
def avg_pool_time(x, s):
"""每 s 帧平均成 1 帧(非重叠分组)。"""
n = x.shape[1] // s
return x[:, :n * s].reshape(x.shape[0], n, s, H, W).mean(axis=2)
def repeat_time(z, s, t_out=T):
"""最近邻还原:每个潜变量帧重复 s 次。"""
return np.repeat(z, s, axis=1)[:, :t_out]
def avg_pool_space(x, s):
"""空间 sxs 块平均。"""
n_h, n_w = H // s, W // s
y = x[:, :, :n_h * s, :n_w * s]
y = y.reshape(x.shape[0], T, n_h, s, n_w, s)
return y.mean(axis=(3, 5))
def repeat_space(z, s):
"""空间最近邻还原。"""
return np.repeat(np.repeat(z, s, axis=2), s, axis=3)
def psnr(a, b, peak=1.0):
mse = float(np.mean((a - b) ** 2))
return 99.0 if mse <= 1e-20 else 10.0 * np.log10(peak ** 2 / mse)
def width_along_x(x):
"""斑点沿运动方向的强度加权标准差,用来量「被糊成多宽」。
两个坑都踩过:
1. 只能在空间维度上归约(沿 y 求和、保留 x)。把所有轴一起归约会把 x
也压掉,得到一个不随压缩变化的常数。
2. 要先掐掉噪声底。加权方差里 (x - mean)^2 是杠杆,画面远端一个
-0.026 的噪声像素能贡献 -9 的「方差」,把真实值直接打成负数。
"""
xs = np.arange(W)[None, None, :] # [1, 1, W]
prof = x.sum(axis=2) # [1, T, W],沿 y 归约
prof = np.clip(prof, 0.0, None)
thr = 0.005 * prof.max(axis=2, keepdims=True) # 掐掉噪声底,保留斑点
prof = np.where(prof < thr, 0.0, prof)
wsum = prof.sum(axis=2, keepdims=True) + 1e-12 # [1, T, 1]
mx = (prof * xs).sum(axis=2, keepdims=True) / wsum
var = (prof * (xs - mx) ** 2).sum(axis=2, keepdims=True) / wsum
return float(np.sqrt(var).mean())
def psnr_table():
print("── 时间压缩 s 倍之后,运动速度 vs 重建 PSNR(dB)──")
print("")
print(" 速度 v |" + "".join(f" s={s:<2d} " for s in FACTORS))
print(" --------+" + "".join("---------------" for _ in FACTORS))
table = {}
for v in SPEEDS:
x = moving_blob(v)
row = []
for s in FACTORS:
row.append(psnr(x, repeat_time(avg_pool_time(x, s), s)))
table[v] = row
print(f" {v:5.2f} |" + "".join(f" {p:8.2f} dB " for p in row))
print("")
print(" 读法:s=1 是原图(噪声极小,PSNR 到顶);同一列往下看,运动越快越糊。")
print(f" s=8 那一列从最慢到最快掉了 "
f"{table[SPEEDS[0]][-1] - table[SPEEDS[-1]][-1]:.1f} dB。")
return table
def blur_law():
"""验那条解析规律:糊掉的长度应该是 (s-1) * v。"""
print("")
print("── 验规律:平均 s 帧 ≈ 加一条长度 (s-1)*v 的运动模糊 ──")
print("")
print(" 速度 v | s | 斑点宽度 原图 -> 压缩后 | 实测增幅 | 解析预期")
print(" --------+-----+-------------------------+----------+----------")
rows = []
for v in (1.0, 2.0, 4.0):
x = moving_blob(v)
w0 = width_along_x(x)
for s in (2, 4, 8):
r = repeat_time(avg_pool_time(x, s), s)
w1 = width_along_x(r)
pred = np.sqrt(SIGMA ** 2 + v ** 2 * (s ** 2 - 1) / 12.0)
rows.append((v, s, w0, w1, w1 / w0, pred / w0))
print(f" {v:5.2f} | {s:2d} | {w0:7.3f} -> {w1:7.3f} "
f"| {w1 / w0:7.3f}x | {pred / w0:7.3f}x")
print("")
print(" 解析预期 = sqrt(sigma^2 + v^2*(s^2-1)/12) / 实测原宽度:")
print(" 平均 s 个等间隔平移量,其离散方差是 v^2*(s^2-1)/12。")
return rows
def time_vs_space():
"""时间压 s 倍与空间两轴各压 s 倍(总 s^2 倍),并非等码率对照。"""
print("")
print("── 不同元素压缩率:时间 s 倍 vs 空间 s^2 倍(PSNR,dB)──")
print("")
print(" 速度 v |" + "".join(f" 时间 {s}x / 空间 {s}x " for s in (2, 4, 8)))
print(" --------+" + "".join("-----------------------" for _ in (2, 4, 8)))
rows = []
for v in SPEEDS:
x = moving_blob(v)
cells = []
for s in (2, 4, 8):
p_t = psnr(x, repeat_time(avg_pool_time(x, s), s))
p_s = psnr(x, repeat_space(avg_pool_space(x, s), s))
cells.append((p_t, p_s))
rows.append((v, cells))
line = " {:5.2f} |".format(v)
for p_t, p_s in cells:
line += f" {p_t:6.2f} / {p_s:6.2f} "
print(line)
print("")
print(" 读法:空间那一列基本与速度无关(压空间就是把细节磨掉,一视同仁);")
print(" 时间那一列随运动变快而下降。两条线会交叉,交叉之后")
print(" 这只比较两种滤波失真,不能从非等码率交叉点推出实际压缩策略。")
crossings = []
for si, s in enumerate((2, 4, 8)):
prev_sign = None
for v, cells in rows:
p_t, p_s = cells[si]
sign = p_t > p_s
if prev_sign is not None and sign != prev_sign:
crossings.append((s, v))
prev_sign = sign
if crossings:
print("")
print(" 交叉点(压时间开始不如压空间的速度):")
for s, v in crossings:
print(f" s={s}x:约 {v} px/帧 附近")
return rows
def state():
return dict(psnr=psnr_table(), blur=blur_law(), ts=time_vs_space())
if __name__ == "__main__":
psnr_table()
blur_law()
time_vs_space()# -*- coding: utf-8 -*-
"""潜变量 token 账本:不同的时空压缩比,到底把 Transformer 的序列变成多长。
运行: python token_ledger.py
自注意力的代价是 O(N^2),所以真正决定「视频 DiT 能不能做全时空注意力」的
不是像素总量,而是**潜变量 token 数 N**。这个脚本只做算术,但它是选压缩比的依据。
"""
# 统一的输入:121 帧(5 秒 @ 24fps)、768 x 512、RGB
T_IN, H_IN, W_IN, C_IN = 121, 512, 768, 3
# 表一:真实模型在用的配置(通道数取各模型公开权重的值)
REAL = [
("图像 VAE 逐帧(SVD / AnimateDiff 口径)", 1, 8, 4),
("CogVideoX / Wan / HunyuanVideo(4x8x8)", 4, 8, 16),
("LTX-Video(8x32x32)", 8, 32, 128),
]
# 表二:固定空间 8x8、通道 16,只扫时间压缩比——把时间这一维的贡献单独拎出来
TIME_SWEEP = [(s_t, 8, 16) for s_t in (1, 2, 4, 8)]
def latent_frames(t_in, s_t):
"""因果卷积下的潜变量帧数:首帧单独占位,所以是 floor((T-1)/s)+1。"""
return (t_in - 1) // s_t + 1
def _row(name, s_t, s_h, s_c):
t_out = latent_frames(T_IN, s_t)
h_out = H_IN // s_h
w_out = W_IN // s_h
n = t_out * h_out * w_out
return dict(name=name, s_t=s_t, s_h=s_h, ch=s_c,
shape=(t_out, h_out, w_out), n=n, vals=n * s_c,
cover=s_t * s_h * s_h * C_IN)
def table_real():
pix = T_IN * H_IN * W_IN * C_IN
print(f"输入:{T_IN} 帧(5 秒 @ 24fps)、{W_IN} x {H_IN}、RGB,"
f"像素值总数 = {pix:,}")
rows = [_row(n, a, b, c) for n, a, b, c in REAL]
base = rows[0]["n"]
print("")
print("── 表一:三个真实档位 ──")
print("")
print(" 配置 | 潜变量形状 (T'xH'xW'xC) "
"| token 数 N | N^2 相对代价 | 便宜倍数 | 每 token 覆盖像素")
print(" --------------------------------------+-----------------------"
"+------------+-------------+---------+----------------")
for r in rows:
rel = (r["n"] / base) ** 2
r["rel"] = rel
t, h, w = r["shape"]
print(f" {r['name']:<38} | {t:3d} x {h:3d} x {w:3d} x {r['ch']:3d} "
f"| {r['n']:10,d} | {rel:11.3e} | {1 / rel:7.1f}x | {r['cover']:8,d}")
return rows
def table_time_sweep():
print("")
print("── 表二:固定空间 8x8 / 通道 16,只动时间压缩比 ──")
print("")
print(" 时间压缩 | 潜变量帧数 | token 数 N | 相对上一步便宜 | 相对 1x 累计")
print(" ---------+------------+------------+----------------+-------------")
rows = []
base = None
for s_t, s_h, s_c in TIME_SWEEP:
r = _row(f"s_t={s_t}", s_t, s_h, s_c)
if base is None:
base = r["n"]
r["rel"] = (r["n"] / base) ** 2
rows.append(r)
for i, r in enumerate(rows):
step = (rows[i - 1]["n"] / r["n"]) ** 2 if i > 0 else 1.0
print(f" {r['s_t']:3d} x | {r['shape'][0]:10d} | {r['n']:10,d} "
f"| {step:13.1f}x | {1 / r['rel']:11.1f}x")
print("")
print(" 规律:时间压缩每翻一倍,token 数减半,注意力代价降到 1/4。")
return rows
def why_channels_grow():
"""压缩的是序列长度,不是信息量——通道数必须补回来。"""
pix = T_IN * H_IN * W_IN * C_IN
print("")
print("── 为什么压缩比上去了,潜变量通道数也要跟着涨 ──")
print("")
print(" 配置 | 潜变量数值总数 | 压缩比(像素值 / 潜变量数值)")
print(" --------------------------------------+----------------+----------------------------")
for name, s_t, s_h, s_c in REAL:
r = _row(name, s_t, s_h, s_c)
print(f" {name:<38} | {r['vals']:14,d} | {pix / r['vals']:8.1f} : 1")
print("")
print(" 数字要看懂:4x8x8 那一行和「逐帧图像 VAE」的压缩比几乎一样(46.8 vs 48.0),")
print(" 它省下的不是信息量,而是**序列长度**——190464 个 token 变成能做注意力的规模。")
print(" LTX-Video 摘要里自述总压缩比 1:192,和上表最后一行的 181.5:1 是同一量级")
print(" (差别来自它把 patchify 挪进 VAE 的口径)。")
def frame_count_rule():
"""帧数必须满足什么条件,才能整除不被裁掉。"""
print("")
print("── 帧数该怎么选:T = 1 + k * s_T ──")
for s_t in (4, 8):
print(f" 时间压缩 {s_t}x:合法帧数 1, {1 + s_t}, {1 + 2 * s_t}, ... 即 T = 1 + k*{s_t}")
print(f" 例:121 帧 -> {latent_frames(121, s_t)} 个潜变量帧"
f"({'整除,不丢帧' if (121 - 1) % s_t == 0 else '不整除,会向下取整'})")
print(f" 例:100 帧 -> {latent_frames(100, s_t)} 个潜变量帧"
f"({'整除,不丢帧' if (100 - 1) % s_t == 0 else '不整除,会向下取整'})")
def state():
return dict(real=table_real(), sweep=table_time_sweep())
if __name__ == "__main__":
table_real()
table_time_sweep()
why_channels_grow()
frame_count_rule()
评论 (0)