


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

论文:Improving Video Sparse Attention with Fine-grained Router and Sparse Rebasing
机构:UC San Diego · 字节跳动 Seed · UC Berkeley · Georgia Tech
作者:Peiyuan Zhang、Guoqiang Wei、Yilong Zhao、Zixiang Zhang、Wei Zhou、Will Lin、Heng Zhang、Xiaonan Nie、Yan Zeng、Hao Zhang(Peiyuan Zhang 与 Yilong Zhao 的工作完成于字节 Seed 实习期间)
日期:2026-09-26(arXiv 2609.32882)
代码:截至发稿未见 VSA2 的代码与权重;前代 VSA、STA 的 kernel 在 FastVideo 仓库(hao-ai-lab/FastVideo)开源
论文状态:arXiv 预印本,comment 字段为空,暂无接收信息
视频 DiT 越做越长、越做越清晰,最先扛不住的是注意力。
论文开头给了一个量级:一段 5 秒的高清视频,展开成 token 就超过 10 万个。3D 全注意力的计算量随序列长度平方增长,训练和推理的大头都落在注意力上。作者后面测速用的 720p、10 秒视频,是 22 万 token。
UCSD 这个组在更早的 STA 论文里给过一个更直观的数:HunyuanVideo 生成一段 5 秒 720P 视频总共要 945 秒,其中注意力就占了 800 秒。
大家早就知道注意力矩阵里大部分元素贡献很小,于是有了一大批稀疏注意力方法。但这里有一道分水岭:
VSA2 想做的是后一类的"完整版":一个能从预训练中途接入、一路用到 RL 和推理的可训练稀疏注意力。它在前代 VSA 的基础上改了两处结构,外加一套训练配方:
结果是这样的(论文 Table 2 与 Figure 8):
| 设置 | 注意力稀疏度 | 加速 | 质量 |
|---|---|---|---|
| 480p 预训练,训练/推理都用 top64 | 90% | 端到端 2.09× | 人评与全注意力互有胜负 |
| 720p 预训练,训练/推理都用 top64 | 95% | 端到端 4.62× | 人评与全注意力基本持平 |
| 注意力算子,22 万 token(单卡 H800,对比 FlashAttention-3) | top64 | 注意力 8.9× | — |
作者团队也值得一提。UCSD 这边是 Hao Zhang 组,STA、VSA 和 FastVideo 都出自这里,一作 Peiyuan Zhang 同时是 STA 和 VSA 的一作;另一半作者来自字节 Seed。所以这篇可以看成 VSA 这条路线第一次在完整的视频 DiT 训练流程里走通——从预训练、RL 到推理。

(图片来源:论文 Figure 3。样本来自 Table 2 中 Exp 6 的 checkpoint,每组上行是全注意力、下行是 VSA2;第一组和第三组是图生视频,中间一组是文生视频)
值得关注的地方:
需要冷静看的地方:
先把 VSA2 放回坐标系里。视频 DiT 的稀疏注意力大致分三拨。
第一拨:免训练,只管推理。 拿一个用全注意力训好的模型,推理时找出不重要的注意力块跳过。代表是 Sparse VideoGen(在线判断每个头是"空间头"还是"时间头",在 CogVideoX-v1.5 和 HunyuanVideo 上端到端最高 2.28 倍和 2.33 倍),以及 SpargeAttn、XAttention、Radial Attention 等。STA 算半只脚在这里:它用固定的 3D 滑动 tile 窗口,免训练时 HunyuanVideo 从 945 秒降到 685 秒,允许微调后降到 268 秒。
这一拨的共同问题是模型没见过稀疏,稀疏度一高就容易掉质量,而且预训练成本一分没省。
第二拨:微调之后稀疏。 在已有模型上用少量步数把稀疏注意力"训进去"。清华的 SLA 把注意力权重分成关键、边缘、可忽略三类,关键部分走稀疏注意力、边缘部分走线性注意力,在 Wan2.1-1.3B 上注意力计算省 95%,端到端 2.2 倍;后续的 SLA2 加上可学习 router 和量化感知训练,把稀疏度推到 97%。VSA 也做过类似的改造:把 Wan-2.1 换成稀疏注意力后,注意力提速 6 倍,端到端从 31 秒降到 18 秒。
第三拨:预训练就稀疏。 DSV、VSA 都尝试过从预训练阶段就用稀疏注意力。VSA 当时从 6000 万参数一路做到 14 亿参数的 scaling 实验,找到一个训练 FLOPs 降 2.53 倍、diffusion loss 不掉的点。但正如 VSA2 自己指出的,这些实验规模偏小,评价主要看 loss,没有人评和视觉对比。
LLM 那边的两条线也是 VSA2 的直接参照:
VSA2 的不少消融实验,就是在回答"LLM 这套设计搬到视频上还成不成立"。
所以 VSA2 的位置很清楚:沿着 VSA 的 coarse-to-fine 框架,把"预训练就稀疏"推进到完整的视频 DiT 训练流程里,并重新设计了 router。
先把 coarse-to-fine 框架讲清楚,VSA2 的改动都在它上面动刀。
以 VSA 为例,一层稀疏注意力分两步:
为了让 GPU 算得快,block-sparse attention 的块大小 B 通常取 64 或 128,这是硬件决定的。问题在于,以往的 router 顺手把池化步长也设成了 B——一个 cube 的 128 个 token 被压成一个向量去算分数。
作者认为这带来两个结构性天花板。
天花板一:池化太粗,看不清关键 token。 128 个 token 的平均值会把 $\mathbf{QK}^\top$ 里的细节抹平。长视频、高分辨率下,这种"混叠"要么让真正关键的 token 漏选、质量下降,要么逼着你多选块、稀疏度上不去。
天花板二:每个 query 分到的预算一样多。 标准的 per-token TopK 要求每个 query 看同样数量的 KV。简单的 query 浪费算力,难的 query 又吃不饱。稀疏度一往上推,最先饿着的恰恰是最需要上下文的那些 query。
从公式上看更清楚。假如算力无限,最理想的选块分数应该是先算完整的 token 级注意力 $\mathbf{A}$,再按块求平均:
$$\mathbf{A}=\mathrm{Softmax}\big(\mathbf{Q}\mathbf{K}^\top/\sqrt{D}\big)$$
$$\mathbf{P}_{oracle}=\mathrm{MeanPool}_{B\times B}(\mathbf{A})$$
VSA 的 coarse branch 则是把池化挪到了 softmax 前面,先按整个 cube 池化出 $\mathbf{Q}_c=\mathrm{MeanPool}_B(\mathbf{Q})$、$\mathbf{K}_c=\mathrm{MeanPool}_B(\mathbf{K})$,再算注意力:
$$\mathbf{P}_c=\mathrm{Softmax}\big(\mathbf{Q}_c\mathbf{K}_c^\top/\sqrt{D}\big)$$
如果注意力是线性的,两者相等;但 softmax 是非线性的,所以这只是近似,精度取决于"cube 内部的 token 足够相似"这个局部性假设。cube 越大,这个假设越站不住。
VSA2 的解法,一句话就是:只在 router 里把 cube 切得更细。下图左边是以往的 router,右边是 VSA2 的细粒度 router,细节放到第 07 段讲。
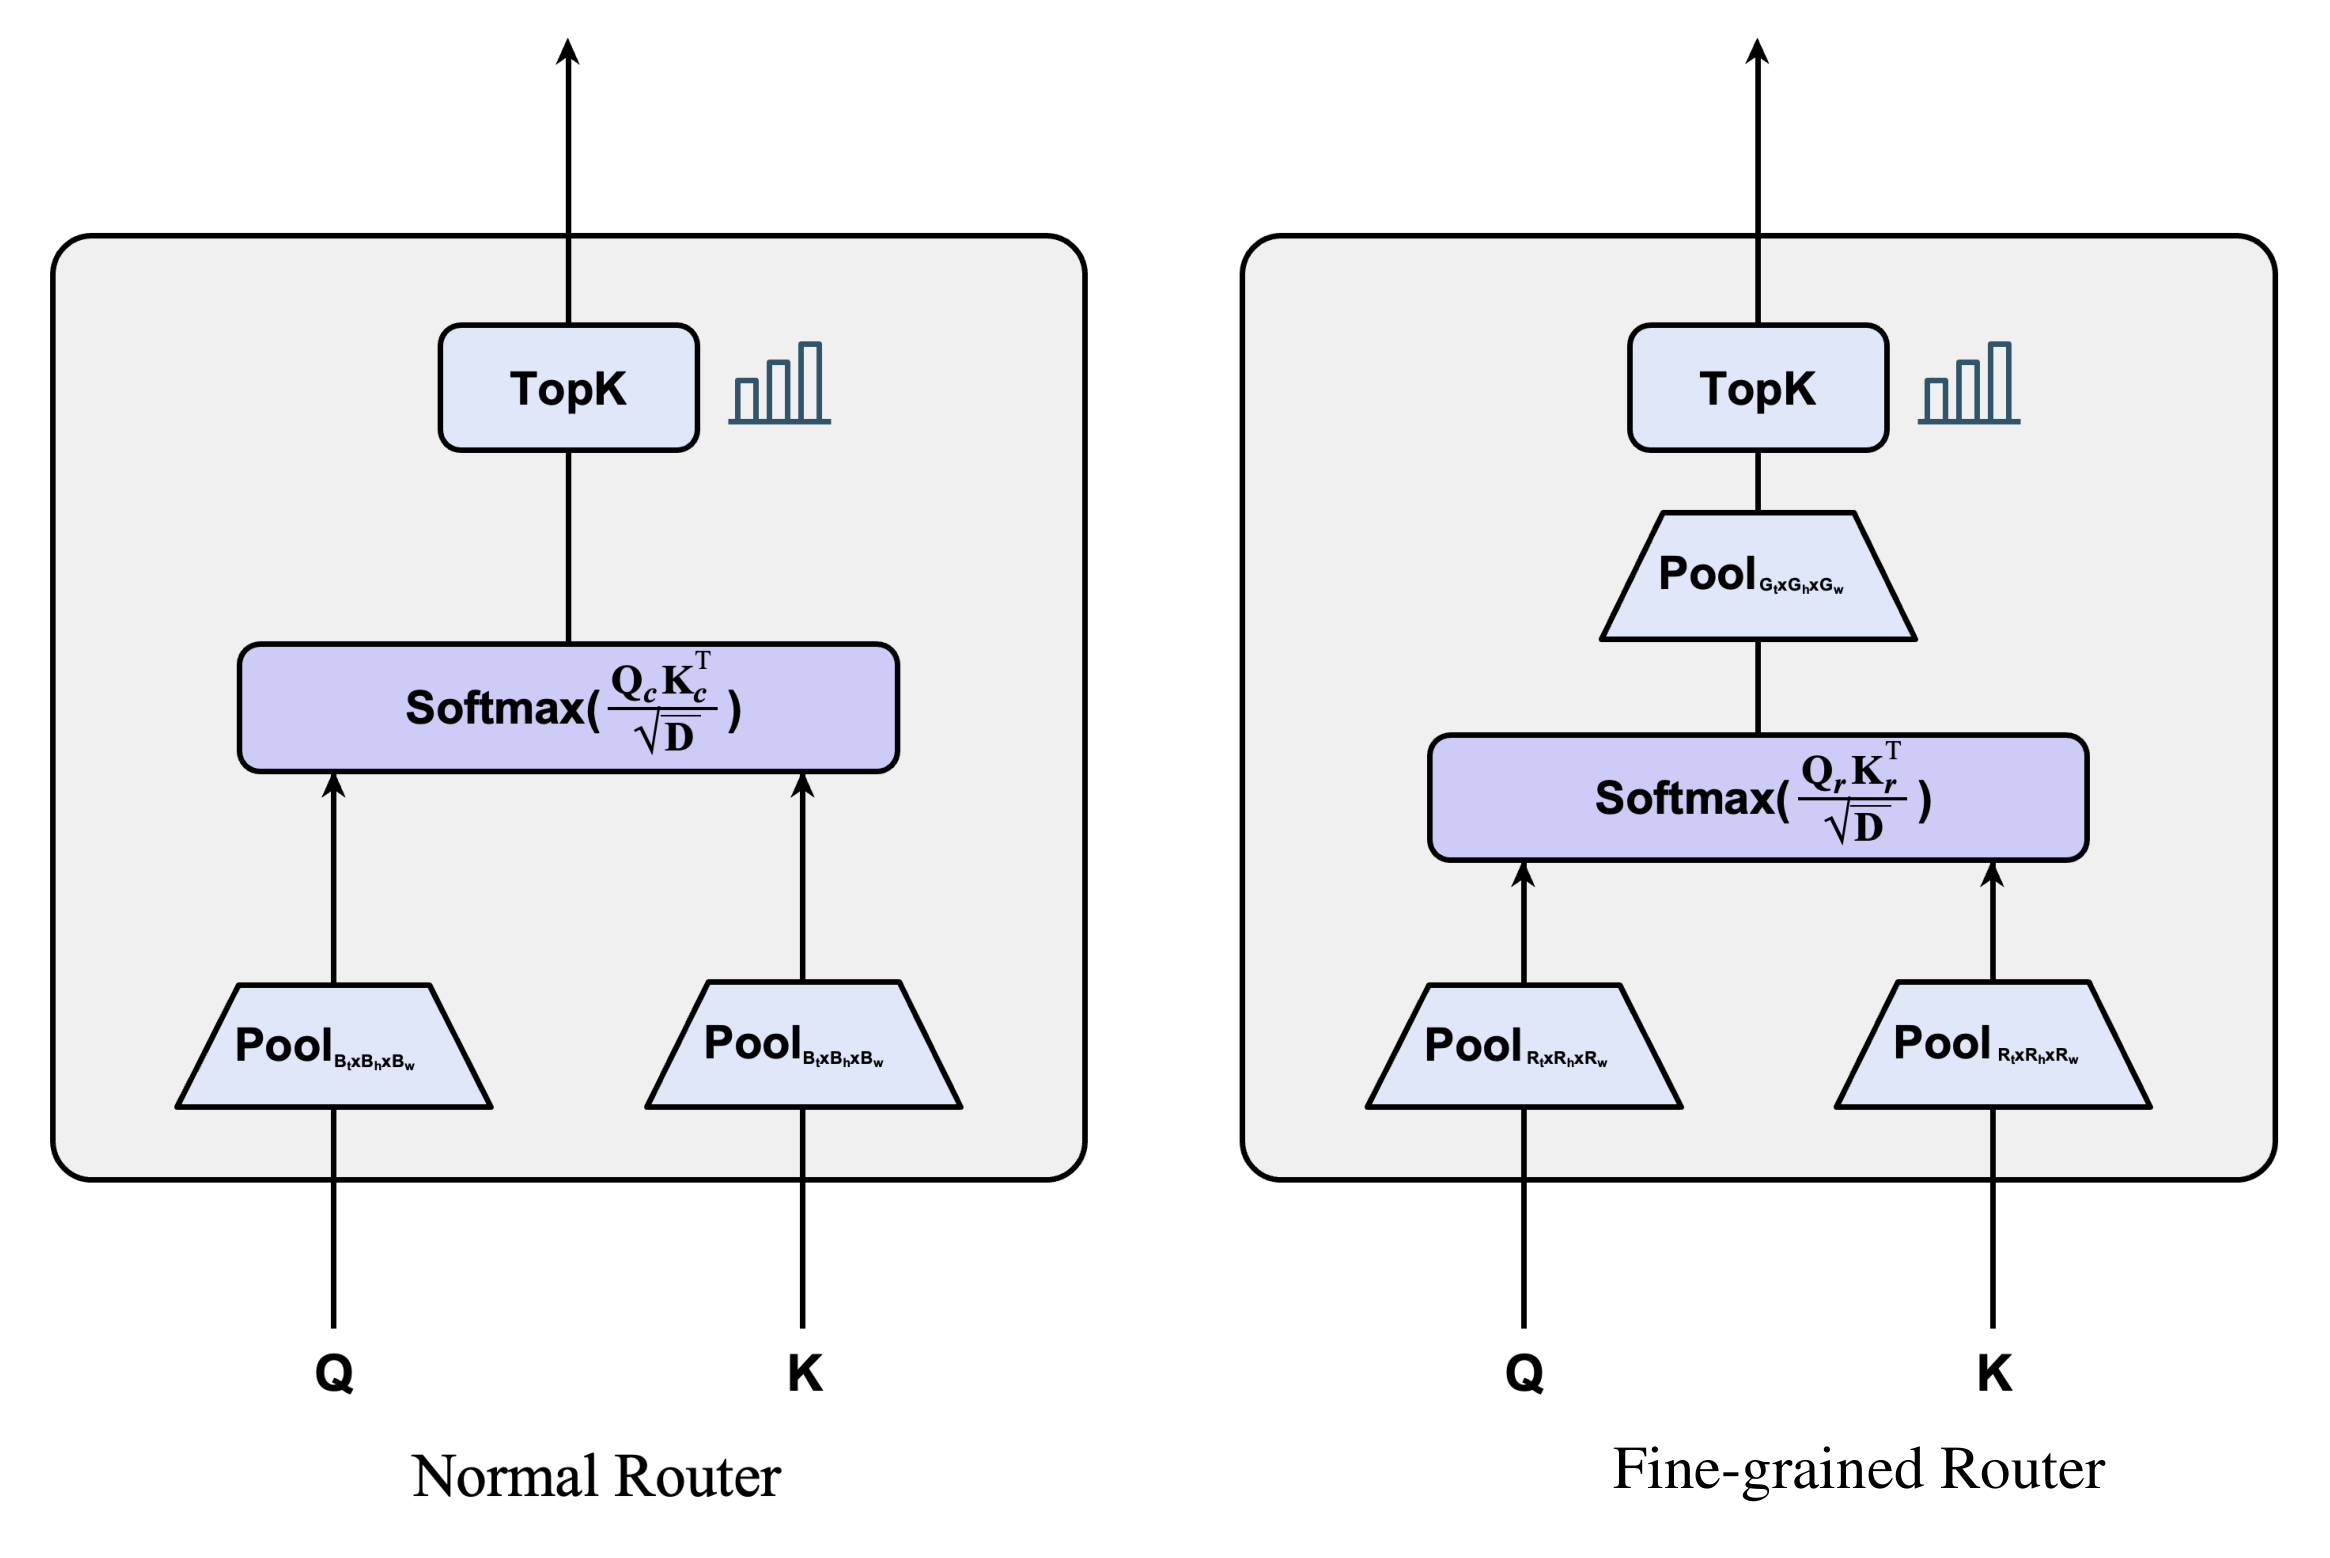
(图片来源:论文 Figure 1。左:VSA 等方法使用的常规 router,Q、K 都按整个 cube 池化,softmax 之后直接 TopK;右:VSA2 的细粒度 router,先按小得多的尺寸 R 池化 Q、K,softmax 之后再按 G×G 做分数池化,最后 TopK)
(05~07 三段偏技术,只想看结果的可以直接跳到 08。)
改 router 之前,作者先回答了一个更根本的问题:router 的选块能力到底从哪来?
这件事在 MoE 里很明确:router 的打分会乘到专家输出上,梯度能流回来,router 是学出来的。但在稀疏注意力里,TopK 选出的是一张布尔 mask,fine branch 的梯度流不回 router。VSA 的 coarse branch 虽然有梯度(来自它自己的输出 $\mathbf{O}_c$),但这份梯度并不来自选块结果。
于是有两种假说:
作者设计了几组参数量对齐的消融:

(图片来源:论文 Figure 7。(a) 全注意力设置下 GQA(4 组)与 MHA 的训练 loss;(b) "按头分组 + 按邻域分组"的混合方案与纯"按邻域分组"对比;(c) router 的 QKV 绑定 coarse branch 还是 fine branch;(d) MoE 式可反传 router 与 VSA 对比;(e) 有无细粒度 router、top64 与 top128 对比;(f) per-token 与 per-sequence TopK 对比。除 (f) 从 256p 视频 checkpoint 初始化外,其余都从头训练;(b)(e)(f) 的放大插图是训练末段)
先看 router 相关的两组:
结论是:在视频扩散模型里,复杂的可学习 router 没必要,无梯度 router 就够了,效果还更好。 既然 router 不学,能改进的就只剩"无梯度 router 本身的精度",这就引出了细粒度 router。
同一张图里还有两组是针对 NSA 设计的:
我的看法:这组实验的结论很干脆,但有两点要留个心眼。一是 (a)~(d) 和 (f) 都只训了 1 万步,(e) 也只有 3 万步,全是单次运行,没给多随机种子的方差;二是 (e)(f) 两组的差距要靠放大插图才分得清,曲线大部分时候是重叠的。结论的方向我倾向于相信,但"显著更低"的说法要打个折。
另一个有意思的对照是 SLA2。SLA2 的核心卖点恰恰是可学习 router,VSA2 却说 router 不用学,两篇结论看似相反。不过场景不同:SLA2 是在训好的 Wan2.1 上做短程微调,router 要在很少的步数里适配一个现成的全注意力模型;VSA2 是数万步的预训练,网络的其他部分有足够时间去适应一个固定的 router。我的理解是,在预训练尺度上,与其让 router 学会挑块,不如让模型学会适应 router。
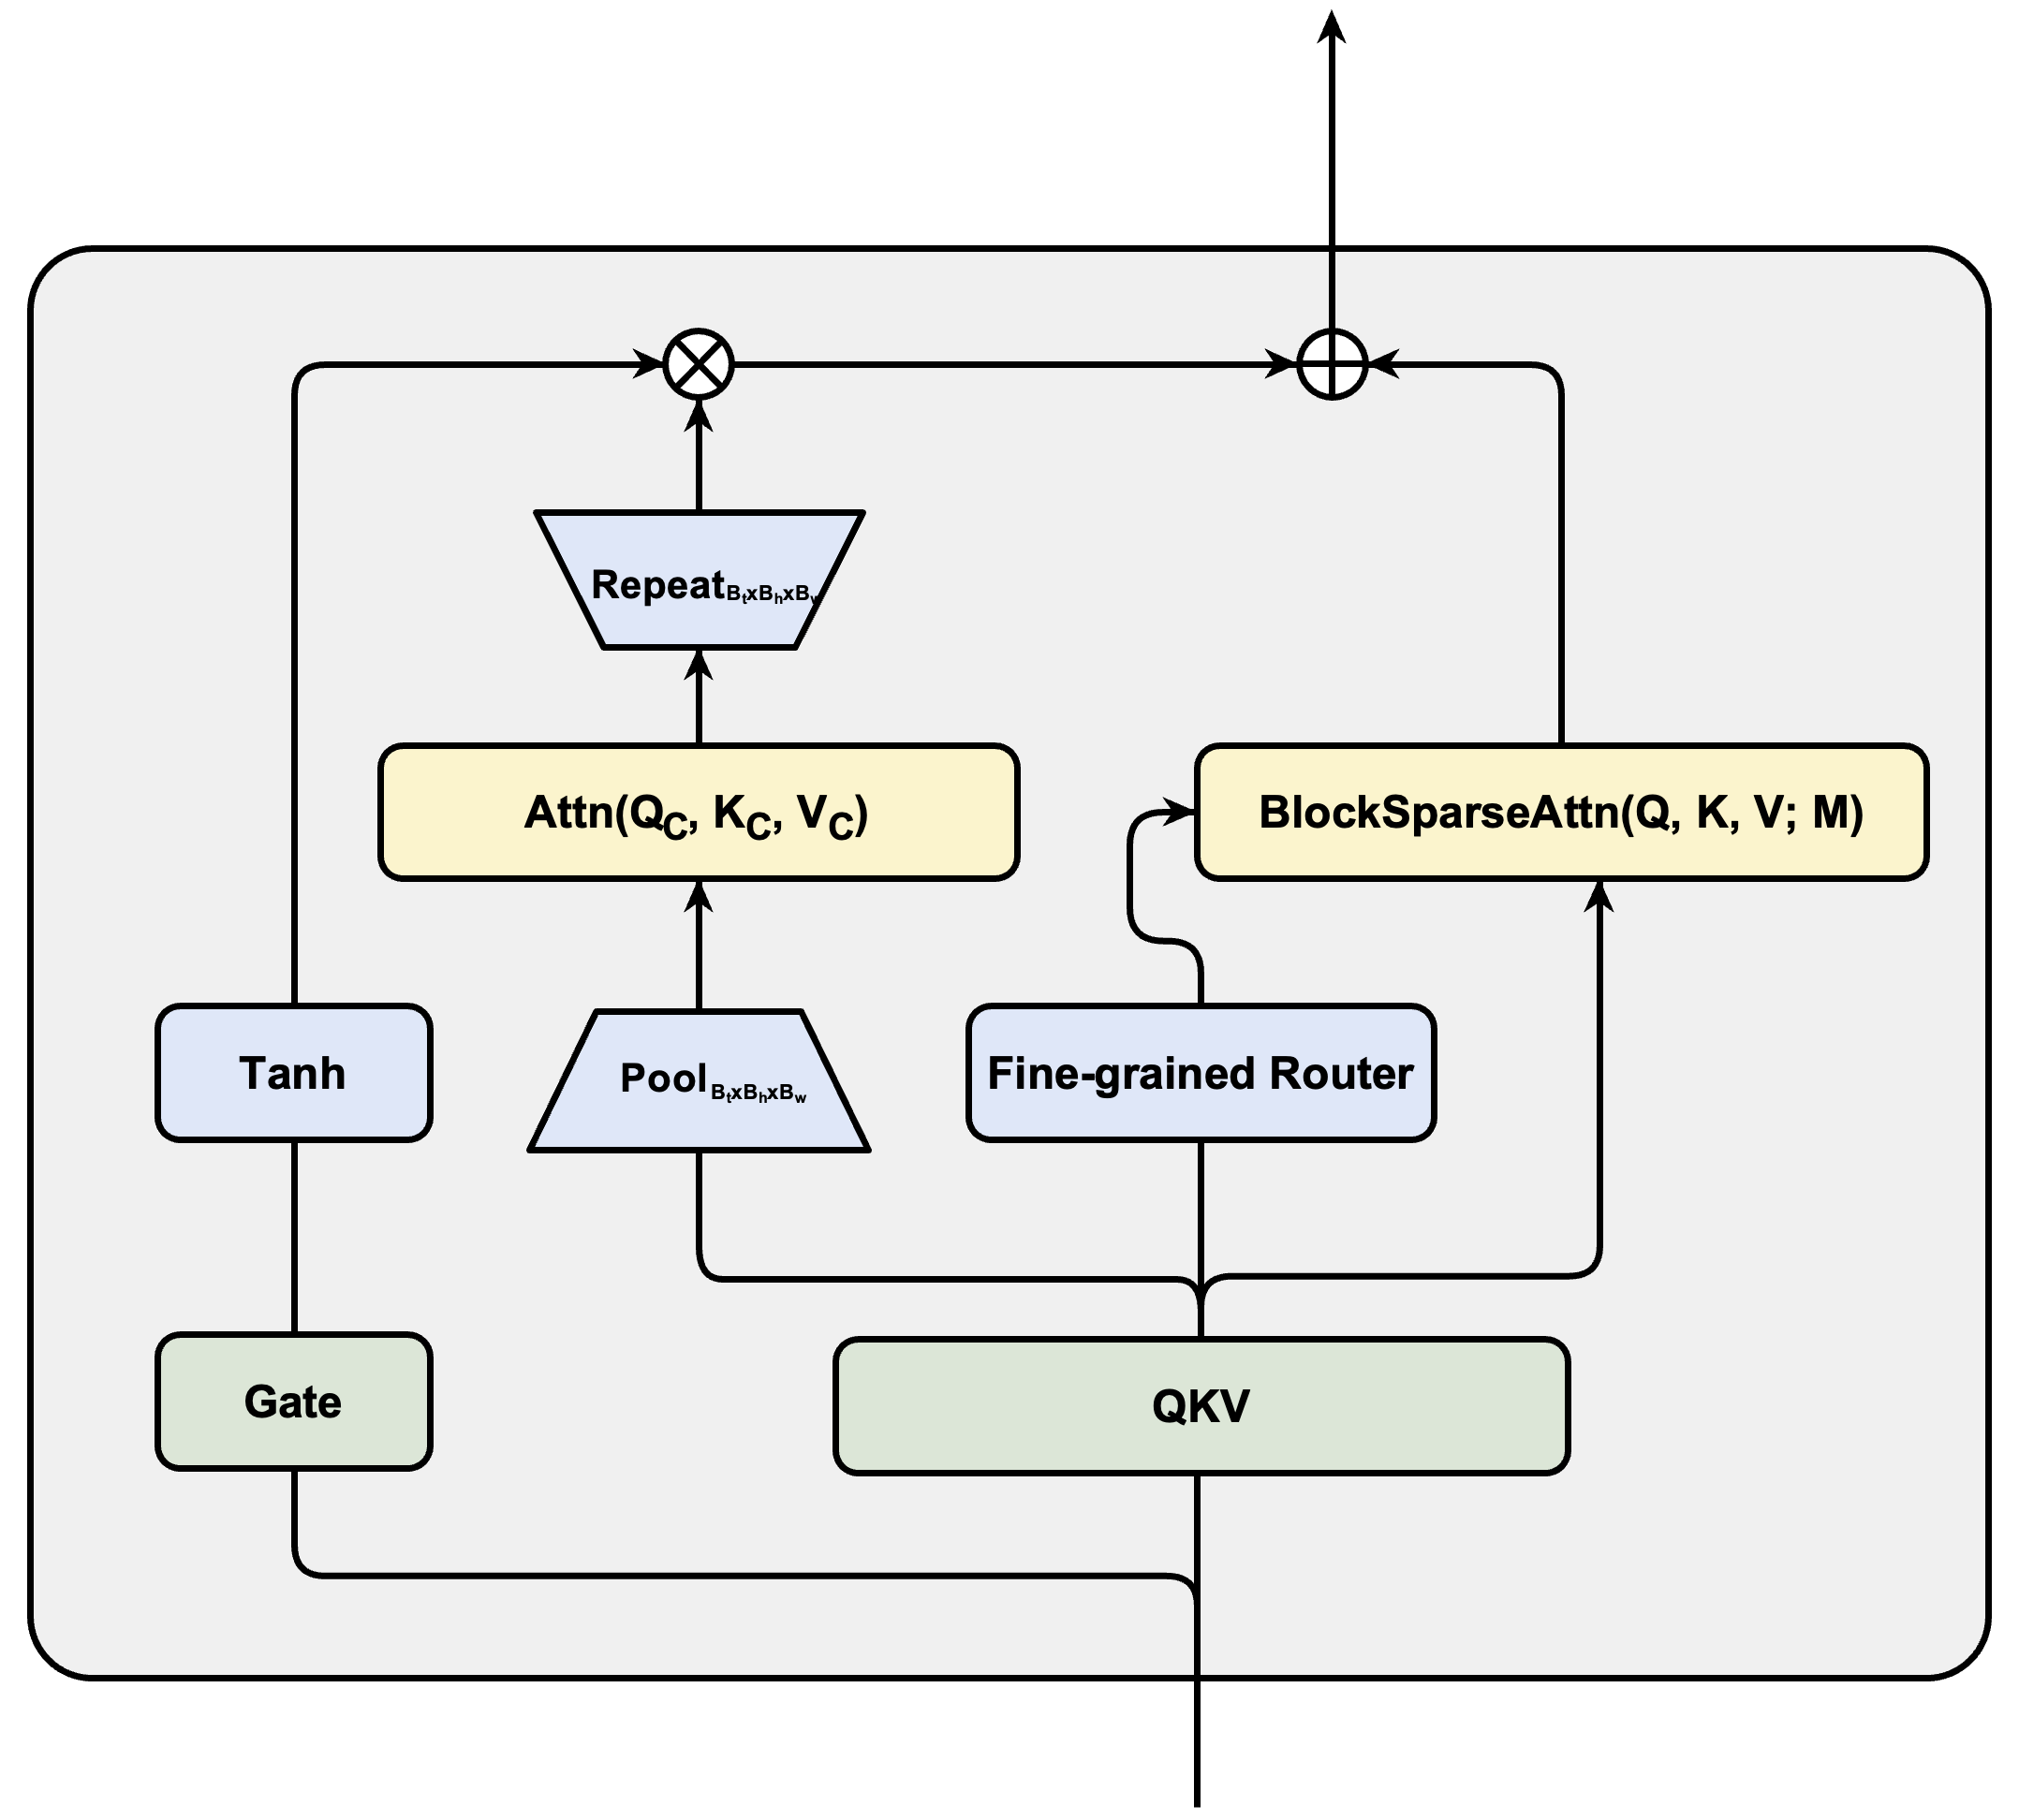
(图片来源:论文 Figure 2。左侧 coarse branch 把 Q、K、V 按 cube 池化后做 cube 级全注意力,再 Repeat 回原分辨率,乘上由 Gate 投影经 Tanh 得到的门控值;右侧细粒度 router 产出块级 mask M,交给 BlockSparseAttn 计算 fine branch;两路输出相加得到最终结果)
按数据流走一遍。
第 0 步:重排。 把 token 从逐行扫描的顺序重排成逐 cube 的顺序,让同一个 cube 里的 token 在内存里挨着。注意力是整个 Transformer 里唯一依赖 token 顺序的算子,所以这个重排只需在网络开头做一次,RoPE 位置编码跟着一起重排即可。
coarse branch:和 VSA 一样。 按 cube 做均值池化,在 $L/B$ 长度的序列上做全注意力,再把输出复制回每个 token。作者也试过 NSA 式的池化和基于注意力的池化,都没比简单的均值池化更好。
fine branch:只算选中的块。 用 router 给出的 mask 做 block-sparse attention。文本条件部分照 MMDiT 的做法处理:视频到文本、文本到视频的注意力保持完整,不做稀疏。
门控合并:
$$\mathbf{O}=\tanh(\mathbf{X}\mathbf{W}_g)\odot\mathbf{O}_c+\mathbf{O}_f$$
$\mathbf{X}$ 是这一层的隐状态,$\mathbf{W}_g$ 是一个单通道投影,每个 token、每个头算出一个门控值,用来调节 coarse branch 的贡献;fine branch 的输出直接加上去。
这扇门的初始化很关键,第 08 段会讲到:$\mathbf{W}_g$ 是 VSA2 唯一新增的参数,初始化为零。
router 是 VSA2 相对 VSA 真正动刀的地方,单独拿出来讲。
VSA2 把 router 从 coarse branch 里拆了出来,单独用一个小得多的池化尺寸 R(见第 04 段的 Figure 1 右图)。记 $\mathbf{Q}_r=\mathrm{MeanPool}_R(\mathbf{Q})$、$\mathbf{K}_r=\mathrm{MeanPool}_R(\mathbf{K})$,router 的块级分数是:
$$\hat{\mathbf{P}}=\mathrm{Softmax}\big(\mathbf{Q}_r\mathbf{K}_r^\top/\sqrt{D}\big)$$
$$\mathbf{P}_r=\mathrm{MeanPool}_{G\times G}(\hat{\mathbf{P}})$$
拆开是三步,作者叫它 pool-softmax-pool:
它夹在两个极端之间:比 oracle 便宜得多(序列只有 L/R 长),又比 VSA 的 coarse branch 保留了更多 cube 内部的差异。换个说法,池化有一部分挪到了 softmax 之后,非线性造成的失真就小一部分。
论文没给具体的 B 和 R,但可以反推。 附录给了稀疏度的估算公式:
$$\text{Sparsity}\approx 1-\Big(\frac{1}{R^2}+\frac{KB}{L}\Big)$$
其中 $1/R^2$ 是 router 的开销(相对全注意力),$KB/L$ 是 fine branch 的开销(平均每个 query block 看 K 个 KV block),coarse branch 的 $1/B^2$ 小到可以忽略。
把 Table 2 的三组数代进去:480p(约 9.9 万 token)top64 时稀疏度 0.90、top128 时 0.82,720p(约 22 万 token)top64 时 0.95。两个 480p 的数一减,$64B/99\text{K}\approx0.08$,B 应该是 128;再代回去,R 取 8 时三个数都能对上(算出来是 0.902、0.819、0.947),取 4 或 16 都对不上。所以我推断 VSA2 用的是 B = 128、R = 8、G = 16——这是我的推算,论文正文没有写。
这组参数能说明几件事:
per-sequence TopK:预算按整条序列分。 传统做法是每个 query block 各挑 K 个;VSA2 把 N×N 的分数矩阵拉平,在整条序列上一次挑出 N×K 个块对,各个头的预算相同。总计算量不变,但每个 query block 分到的 KV 块数可以差很多。Figure 7(f) 显示这样做的 loss 比 per-token 低一点;作者也试过按累计概率截断的 top-p 类方法,没有正向结果。
下面是按论文公式写的示意代码,方便对照理解(不是官方实现,真实 kernel 不会物化中间的注意力矩阵):
import torch


@torch.no_grad()  # router 不接收梯度
def fine_grained_router(q, k, R, topk):
    # q, k: [H, N, B, D],已按 cube-major 重排;
    # 假设每个 block 内按 G 个大小为 R 的子立方体连续存放
    H, N, B, D = q.shape
    G = B // R
    # MeanPool_R -> [H, L/R, D]
    qr = q.reshape(H, N * G, R, D).mean(dim=2)
    kr = k.reshape(H, N * G, R, D).mean(dim=2)
    # softmax -> [H, L/R, L/R]
    scores = qr @ kr.transpose(-1, -2) / D ** 0.5
    p_hat = scores.softmax(dim=-1)
    # MeanPool_{GxG} -> [H, N, N]
    p = p_hat.reshape(H, N, G, N, G).mean(dim=(2, 4))
    # per-sequence TopK:整条序列一起挑 N * topk 个块对
    idx = p.reshape(H, N * N).topk(N * topk, dim=-1).indices
    mask = torch.zeros(H, N * N, dtype=torch.bool,
                       device=q.device)
    mask.scatter_(1, idx, True)
    # 每行(query block)选中的块数可以不同
    return mask.reshape(H, N, N)
融合 kernel:中间矩阵不能写出来。 上面代码里的 p_hat 是 (L/R)×(L/R) 大小。按我反推的 R = 8,22 万 token 时每个头约有 7.6 亿个元素,BF16 下约 1.5 GB,20 个头就是约 30 GB,物化出来显存和带宽都扛不住。
所以作者用 CuTe DSL 写了一个融合 kernel,把 GEMM、softmax 和 G×G 池化合在一起:

(图片来源:论文 Figure 5。Q、K 先按 R 池化成 Qr、Kr;第一遍在 SRAM 上逐块计算 softmax 之前的注意力分数并累积 log-sum-exp;第二遍重新计算注意力块、做 softmax,并直接在 SRAM 上完成 G×G 池化,只把 L/B × L/B 的块级分数写回 HBM)
$\mathbf{Q}_r\mathbf{K}_r^\top$ 要算两遍,多了一次计算,但换来 I/O 大幅减少。作者称比不融合的版本明显更快,但没给具体倍数。这是典型的用计算换访存,和 FlashAttention 的思路一脉相承。
结构讲完,再看怎么训。对想在自家训练流程里用的人来说,这部分可能比结构本身更有参考价值。
先交代训练设置。 模型结构大体沿用 MMDiT,目标是 flow matching(预测速度),文生视频和图生视频联合训练;时间步采样用 logit-normal 分布,并按分辨率做偏移;工程上用了 FSDP、序列并行、激活重计算和 torch.compile。训练分三段:480p 预训练、720p 预训练,以及从 480p checkpoint 出发的 RL。所有阶段的训练片段都是 5~12 秒、多种长宽比。参数量、数据集、VAE 配置,论文都没有写。
Sparse Rebasing:只在最贵的阶段切换。 现在的视频 DiT 普遍走渐进式训练:先图像,再低分辨率短视频,最后高分辨率长视频。VSA2 从一个用全注意力训到 256p 的视频 checkpoint 出发,到 480p、720p 预训练和 RL 阶段才换成 VSA2。
切换之所以平滑,靠的是那扇门:$\mathbf{W}_g$ 零初始化,刚切换时 $\mathbf{O}=\mathbf{O}_f$,输出只来自 fine branch,也就是用同一套 Q、K、V 做的稀疏注意力,对原模型的扰动最小。coarse branch 的贡献之后再慢慢学出来。
这个思路和 MoE 从稠密模型 upcycling 很像(这是我的类比)。好处有两个:一是可以直接复用全注意力训好的文生图、低分辨率视频 checkpoint;二是低分辨率阶段序列本来就短,稀疏注意力省不了多少,没必要在那里折腾。
Hard-to-Easy Curriculum:训得难,测得松。 训练时用更激进的稀疏度(top-K 小),推理时放宽(top-K 大)。Table 2 的 Exp 1~4 对比了 top32/top64 训练与 top64/top128 推理的几种组合,规律很一致:推理时的 top-K 比训练时大,运动质量就更好。 最突出的是 Exp 2(top64 训、top128 推),文生视频运动质量人评净胜 22.1%。
但代价也很一致:指令跟随和美学变差。 Exp 3(top32 训、top128 推)的文生视频指令跟随净输 15.4%。
作者对这两个现象的解释是:
对应的补救办法是:拿 top64 预训练好的 checkpoint,在 RL 阶段改用 top128 再训一轮(Exp 6)。结果文生视频的指令跟随和美学基本拉回持平(−2.01%、0.00%),运动质量仍然保持优势(文生 +7.38%、图生 +8.05%)。
RL 用的是 reward feedback learning,不是 GRPO 或 DPO。 模型直接预测干净视频 $x_0$,由一个基于 VLM 的奖励模型和一个基于 CLIP 的奖励模型打分,梯度直接穿过奖励模型回传给 DiT。一个值得肯定的细节:奖励权重是在全注意力 checkpoint 上调的,VSA2 直接沿用、不做任何调整。这对 VSA2 来说是偏保守的比较方式。
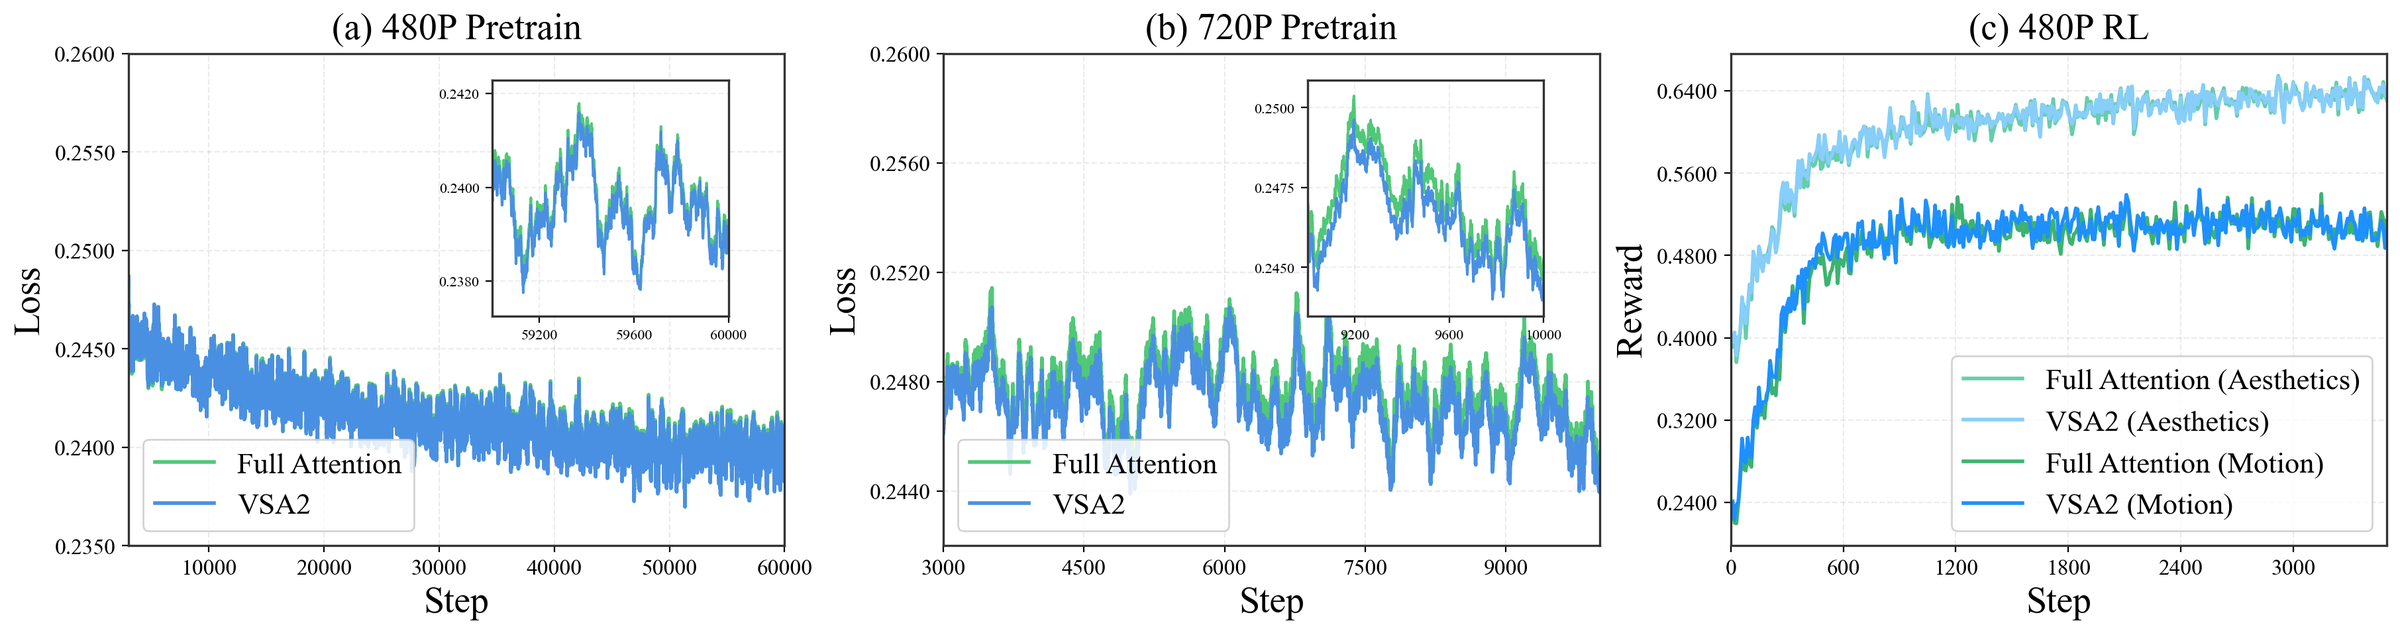
(图片来源:论文 Figure 4。(a) 480p 预训练和 (b) 720p 预训练的训练 loss,VSA2(蓝)整体略低于全注意力(绿),放大插图里才看得清差距;(c) 480p RL 阶段的美学 reward 与运动 reward,两种注意力的曲线基本重合)
90%~95% 稀疏度下 loss 反而略低于全注意力,这一点值得多想一下。我的一个猜测是:VSA2 并不是全注意力的"子集",coarse branch 额外提供了一条带门控的全局汇总通路,相当于多了一点结构上的归纳偏置。论文没有做去掉 coarse branch 的消融,这个问题目前没有答案。
VSA2 的质量评估主要靠两样:训练 loss(作者引用 Movie Gen 的结论,认为它和人类偏好相关性好),以及 149 条人工挑选的高难度 prompt 上的成对人评。
人评规则是:同一条 prompt 下 VSA2 和全注意力各生成一个 10 秒视频,评分员判"更好、一样、更差",最后报告(更好 − 更差)/ 149。评测分辨率是 480×864(约 9.9 万 token)和 720×1280(约 22 万 token),用的是 EMA checkpoint。
这意味着表里的每个百分比都能换算回"净多赢了几条":1/149 ≈ 0.67%。先看七组实验的配置:
| Exp | 阶段 | 训练 / 推理 top-K | 注意力稀疏度 | 端到端加速 |
|---|---|---|---|---|
| 1 | 480p | 64 / 64 | 0.90 | 2.09× |
| 2 | 480p | 64 / 128 | 0.82 | 1.92× |
| 3 | 480p | 32 / 128 | 0.82 | 1.92× |
| 4 | 480p | 32 / 64 | 0.90 | 2.09× |
| 5 | 480p RL | 64 / 64 | 0.90 | 2.09× |
| 6 | 480p RL | 64+128 / 128 | 0.82 | 1.92× |
| 7 | 720p | 64 / 64 | 0.95 | 4.62× |
再看人评结果,括号里是我按 ×149 换算的净条数:
| Exp | 文生·运动 | 文生·指令跟随 | 文生·美学 | 图生·运动 | 图生·指令跟随 |
|---|---|---|---|---|---|
| 1 | −1.34%(−2) | +1.34%(+2) | −0.67%(−1) | +8.72%(+13) | +1.34%(+2) |
| 2 | +22.1%(+33) | −3.36%(−5) | −4.7%(−7) | +6.71%(+10) | −8.72%(−13) |
| 3 | +7.38%(+11) | −15.4%(−23) | −4.7%(−7) | +11.4%(+17) | −9.4%(−14) |
| 4 | +12.1%(+18) | −10.1%(−15) | −7.38%(−11) | +4.03%(+6) | −4.03%(−6) |
| 5 | −4.03%(−6) | +1.34%(+2) | −2.01%(−3) | +8.05%(+12) | −4.7%(−7) |
| 6 | +7.38%(+11) | −2.01%(−3) | 0.00%(0) | +8.05%(+12) | −2.69%(−4) |
| 7 | +6.71%(+10) | −2.01%(−3) | +1.34%(+2) | +0.67%(+1) | −1.34%(−2) |
(数据来源:论文 Table 2,正数表示 VSA2 优于同阶段的全注意力模型;括号内的净条数是我的换算)
几个读法:
第一,720p 那一行才是标题数字对应的质量。 95% 稀疏、端到端 4.62 倍的情况下,五项指标里净差最大的是文生视频运动 +10 条,其余都在 3 条以内。说"与全注意力基本持平"是站得住的。
第二,多数格子在噪声范围内。 论文没报告平票比例。我粗算了一下:假如 VSA2 和全注意力其实一样好,且有一半是平票,那么净胜条数的标准差约为 8.6 条,也就是 ±5.8%。按这把尺子量,超出两个标准差的只有 Exp 2 的文生运动(+22.1%)和 Exp 3 的文生指令跟随(−15.4%),Exp 4 的文生运动(+12.1%)刚好擦线。也就是说,Hard-to-Easy 对运动的提升和对指令跟随的损害是可信的信号,其余的正负差别大多分辨不出来。
第三,正文有一处表述不严谨。 论文说 Exp 2 中"评分员认为 22.1% 的 VSA2 文生视频样本运动更好",但按它自己的计分规则,22.1% 是净胜率(更好减更差),不是"更好"的比例。实际被判为更好的比例只会更高。
第四,图生视频的运动几乎全线为正。 7 组实验里只有 Exp 7 接近 0,其余都在 +4%~+11.4%。单看每格都不算显著,但方向一致,值得后续验证。
作者还做了一个挺有说服力的分析:把 Exp 1 里两个分别训练的 checkpoint(一个 VSA2、一个全注意力)的注意力图并排对比,训练 6 万步之后两者的注意力模式仍然高度相似(论文 Figure 6)。以往的分析一般是拿全注意力模型推理时的注意力图做 profiling,这里是两个独立训练的模型直接对比,更能说明稀疏训练没有把模型带偏。
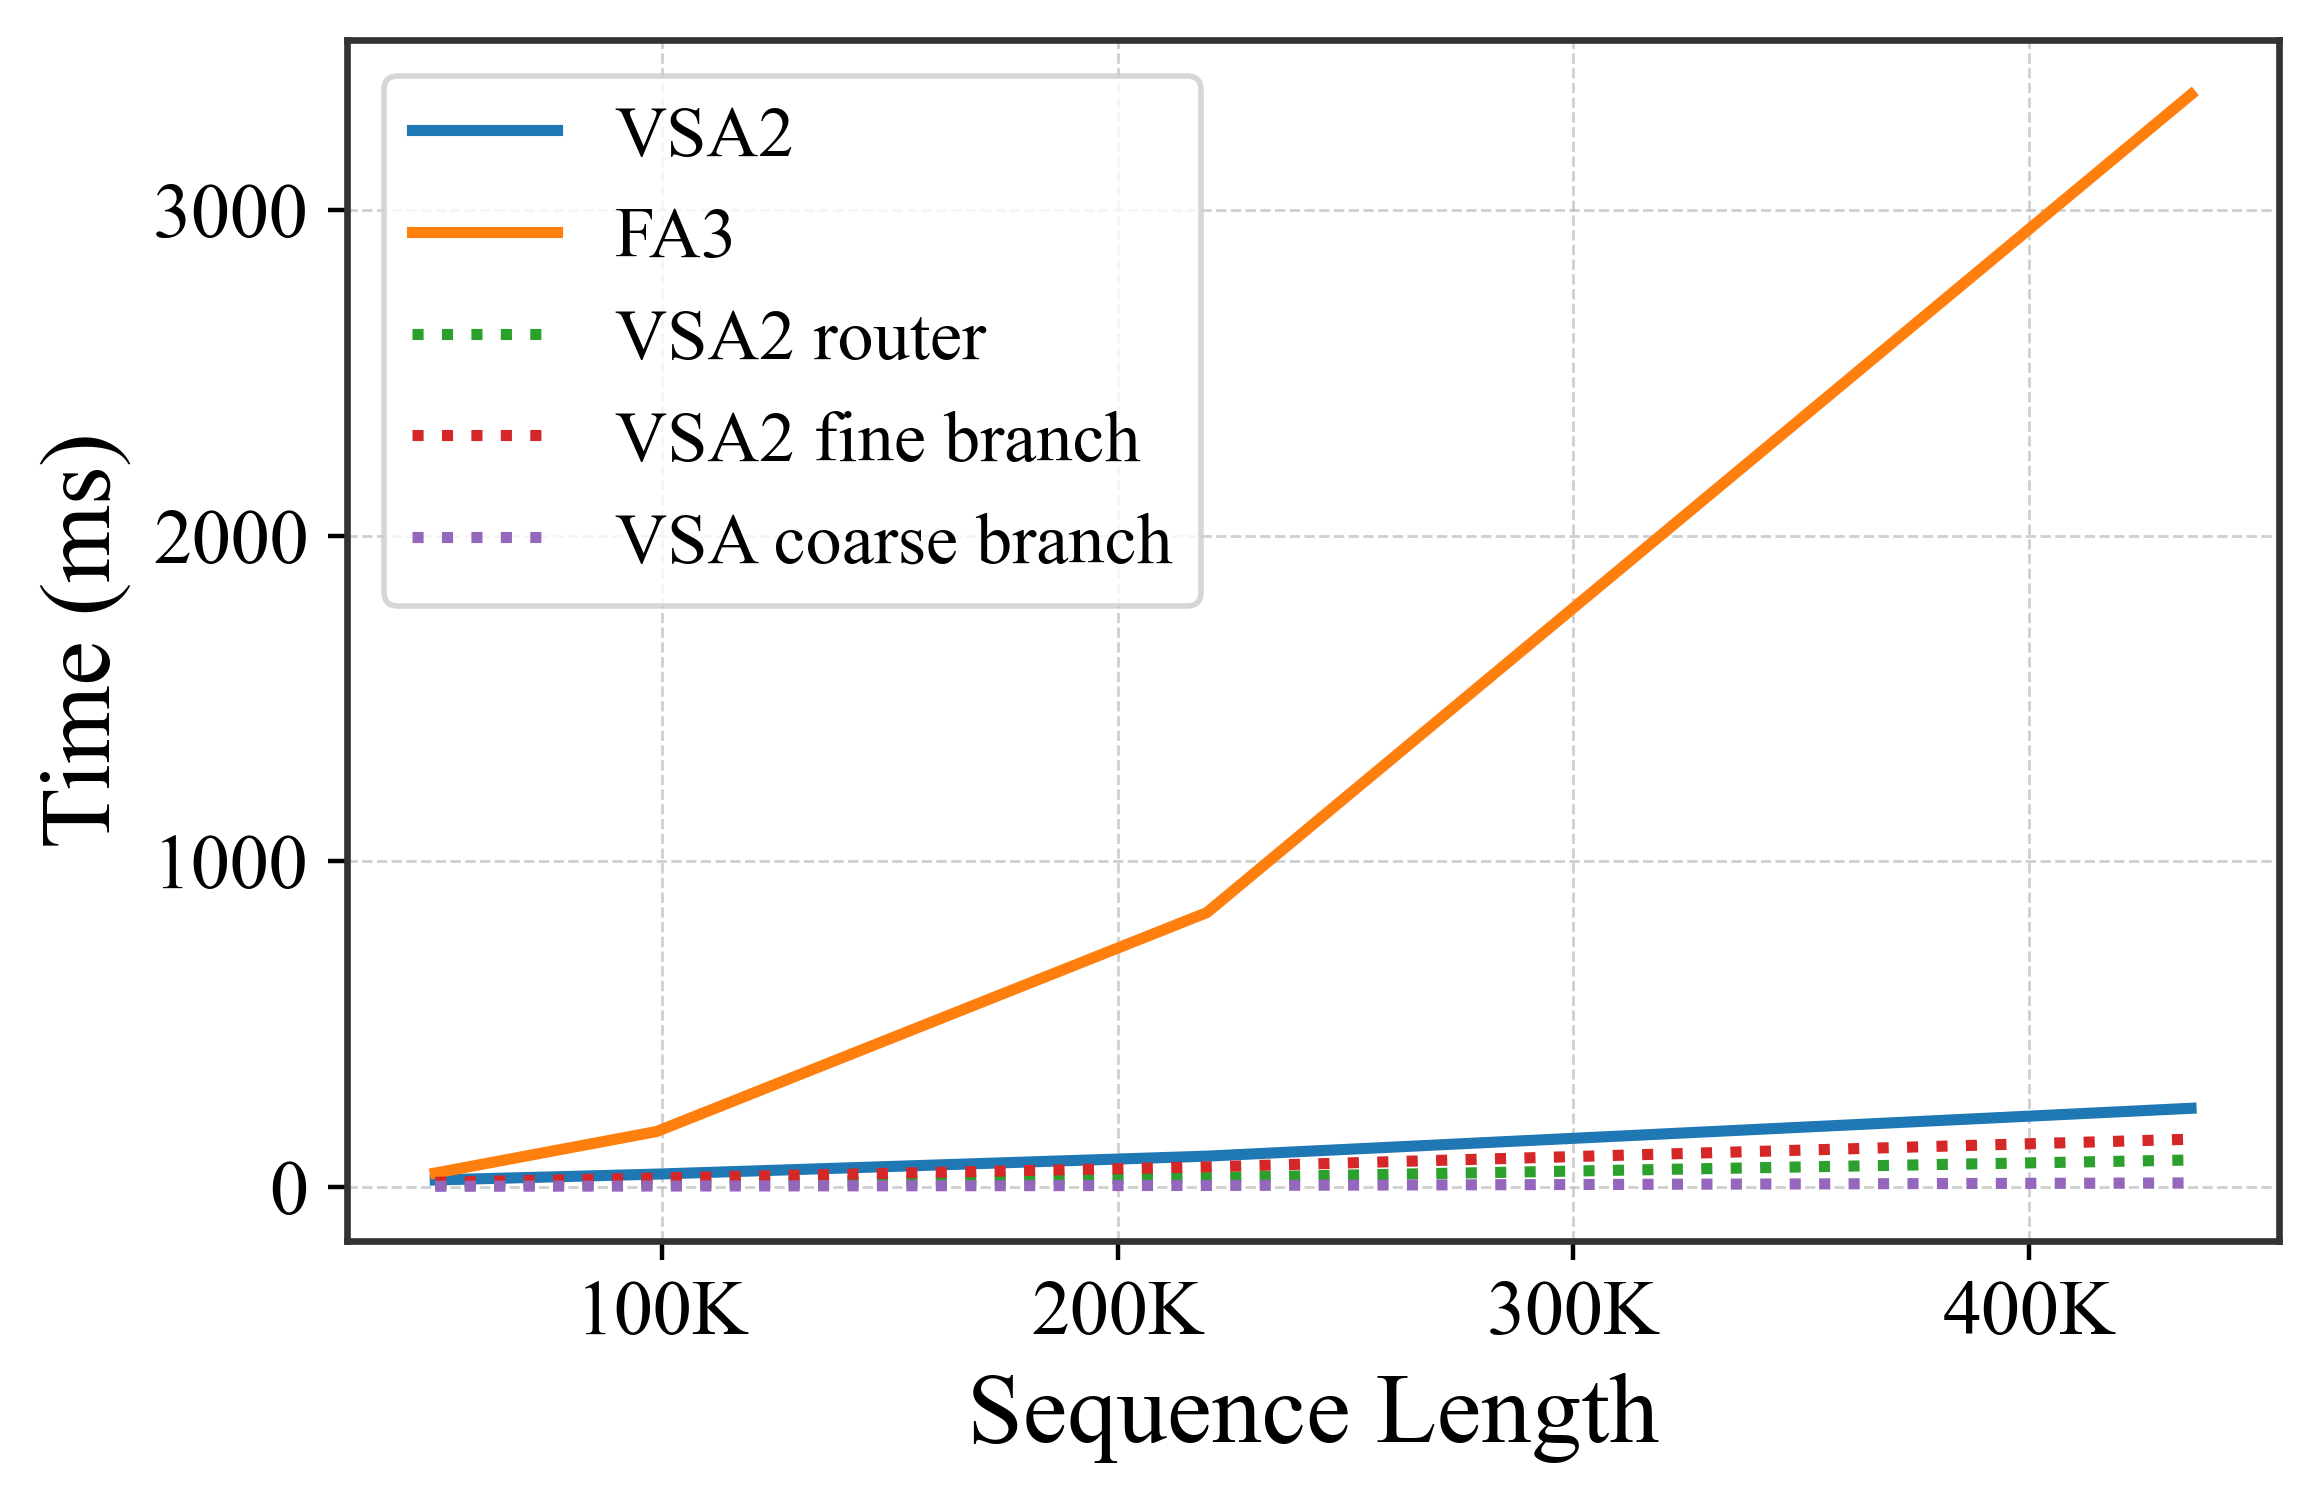
(图片来源:论文 Figure 8。单张 H800、batch 1、20 个头、head dim 128、top64;统计的是 Figure 2 中除 QKV 投影之外所有算子的总耗时。橙线是 FlashAttention-3,蓝线是 VSA2,虚线是 VSA2 的 router、fine branch、coarse branch 分项耗时)
算子层面:22 万 token(对应 720p、10 秒)时,VSA2 的注意力比 FlashAttention-3 快 8.9 倍。序列越长差距越大,图里 43.6 万 token 处 FA3 已经超过 3000 毫秒,VSA2 仍在几百毫秒以内。
router 的开销不小:22 万 token 时占注意力总耗时的 22%,43.6 万 token 时升到 30%。
理想与实测之间还有空间。 95% 稀疏意味着计算量只剩约 5%,按 FLOPs 算理想加速接近 20 倍,实测是 8.9 倍。差出来的部分,一块是 router 自己(22%),另一块我推测来自 block-sparse 的访存开销,以及每个 query block 选中块数不等带来的负载不均。论文没有给 fine branch 单独的 MFU,没法细拆。
端到端层面:720p 端到端 4.62 倍,比注意力的 8.9 倍低一截,因为 DiT 里还有线性层、归一化,以及文本编码、VAE 解码等开销。论文没有说明端到端计时具体包含哪些环节、用了几张卡、多少步。
用 Amdahl 定律倒推一下(我的粗算,假设 8.9 倍对端到端里的所有注意力都成立):全注意力时,注意力约占 720p 端到端时间的 88%;换成 VSA2 之后,注意力只剩端到端时间的 46% 左右,非注意力部分反而占了一半以上。
这有一个直接推论:在 720p 这个量级,继续压注意力的边际收益已经在变小,下一步的大头在步数蒸馏、特征缓存、量化这些手段上。论文也提到,稀疏注意力和这些方法基本正交。
"计算量减半"要打个折。 摘要说 VSA2 比 VSA "注意力计算减半、loss 还更低",依据是 Figure 7(e):细粒度 router 配 top64 优于粗粒度 router 配 top128,fine branch 的计算量确实减半。但 router 本身不是免费的。
按论文给的 22% router 耗时占比粗算:VSA2 的注意力耗时里,fine branch(连同很小的 coarse branch)约占 78%;换成 VSA 的 top128,这部分翻倍,总耗时约为 VSA2 的 1.56 倍。也就是说,VSA2 相对 VSA 实际省下的注意力时间约 36%,大约三分之一。如果改按附录的 FLOPs 公式和我反推的参数算,720p 省 29%、480p 省 41%。数字依然可观,但不是一半。
router 的开销会越来越显眼。 按稀疏度公式,router 的相对开销固定在 $1/R^2$,fine branch 的相对开销 $KB/L$ 随序列变长而下降。按我反推的 B = 128、R = 8、K = 64,两者在 $L=KBR^2\approx52$ 万 token 时持平。作为参照,1080p、10 秒视频按 720p 的 22 万 token 等比例换算约 49.5 万 token,已经贴着这个拐点,而 1080p 正是作者在附录里写的下一步。到那时,要么把 R 调大(router 更便宜,但也更粗),要么就得换一种分层的 router。

(图片来源:论文 Figure 11,附录。样本来自 Exp 6 的 checkpoint,四组 30 秒视频的抽帧:雪山滑雪、水中追球的小狗、乡间土路上开旧卡车的男人、客厅里弹钢琴的男人)
论文附录展示了一组 30 秒视频:训练数据最长只有 12 秒,模型直接生成了 30 秒,作者称"没有明显退化",并把它当作 VSA2 能往分钟级视频扩展的早期证据。
这组结果值得看,但证据力度有限:
不过有一点是确定的:30 秒视频的 token 数是 10 秒的三倍左右,全注意力的计算量就是九倍。越是这种长度,稀疏注意力的收益越大。 作者在附录里写了两个后续方向:一是做 1080p,二是和 Self-Forcing 这类自回归视频生成方法结合。后者逐块生成视频,天然需要高效的长上下文注意力。
现状:截至发稿,VSA2 的代码和权重都没有公开。前代 VSA、STA 的 kernel 在 FastVideo 仓库里开源,VSA2 的 fine branch 和 VSA 一样用 ThunderKittens 实现 block-sparse attention,复现有现成的起点;需要自己补的是细粒度 router 的融合 kernel,以及支持每个 query block 选中块数不等的调度。
如果想照着复现,关键配置是这些(B、R 为我的反推):
训练配方上的建议:
如果你手上是开源模型、只想加速推理:VSA2 需要训练,不是即插即用的方案。在 Wan2.1 这类开源模型上,SLA、VSA 这类微调方案,或者 Sparse VideoGen 这类免训练方案,代码都已经开源,现在就能用。
硬件:测速只在 H800 上做过,kernel 依赖 ThunderKittens 和 CuTe DSL,换到其他架构的卡上需要重新评估。
前面零散提过,这里集中说。
1. 人评样本少、粒度粗。 149 条 prompt,每格的分辨率是 0.67%。论文没报告评分员人数、是否盲评、平票比例和评分一致性。除了 Hard-to-Easy 带来的运动提升和指令跟随下降,其余多数差异都在统计噪声以内。"与全注意力持平"的结论站得住,"部分场景超过全注意力"需要更大的评测集来确认。
2. 没有外部 baseline,没有公开 benchmark。 对比对象只有同条件训练的全注意力,以及 VSA/NSA 的设计变体。没有在同一个模型上比 SLA、SLA2、VMoBA、Sparse VideoGen,也没有 VBench 之类的公开指标。
3. 无法复现。 模型参数量、数据集、VAE、训练算力都没公开,代码和权重也没放出,外部读者只能相信内部实验。
4. 训练加速没有量化。 论文的出发点是预训练成本,但所有加速数字都来自推理。Sparse Rebasing 到底省了多少 GPU 小时、训练吞吐提升多少,没有给。
5. "计算量减半"没算 router。 算上 router,720p 下相对 VSA 实际省下约三分之一(见第 10 段)。
6. 消融的统计强度一般。 Figure 7 的消融是 1 万到 3 万步的单次运行,(e)(f) 的差距要靠放大插图才看得见,没有多随机种子。
7. Hard-to-Easy 的代价要靠额外训练来补。 运动质量的提升伴随着指令跟随和美学的下降,要再做一轮更高 top-K 的 RL 才能恢复。工程上意味着训练和推理要维护两套 top-K 配置。
8. 扩展性隐患。 router 的相对开销固定在 $1/R^2$,按反推参数在约 52 万 token(接近 1080p、10 秒)时会追平 fine branch;动态稀疏和 Ring-Attention 不好配合。这两点作者都在附录里承认了。
9. 长视频证据薄弱。 30 秒生成只有抽帧展示,没有全注意力对照和量化指标。
10. 端到端测速条件不透明。 端到端加速用的硬件、GPU 数、采样步数、是否包含文本编码与 VAE 解码,论文都没交代。
下面这张表是我按各论文公开信息整理的,不是论文原表。各方法的模型、硬件、分辨率、baseline 都不同,加速倍率跨行不能直接比较。
| 方案 | 何时引入稀疏 | 怎么选块 | 选块器是否学习 | 报告的稀疏度 | 论文报告的加速 |
|---|---|---|---|---|---|
| VSA2(2026.09) | 预训练中途接入,覆盖 RL 与推理 | 细粒度 pool-softmax-pool,per-sequence TopK | 否,无梯度 | 90%~95% | 注意力 8.9×(H800,对比 FA3);720p 端到端 4.62× |
| VSA(2025.05,NeurIPS 2025) | 从头预训练,或改造已有模型 | cube 级 coarse attention 的分数,逐 query block TopK | 与 coarse branch 共享参数 | — | 训练 FLOPs 降 2.53×;Wan-2.1 注意力 6×,端到端 31 秒→18 秒 |
| SLA(2025.09) | 微调 | 按注意力权重分关键、边缘、可忽略,边缘部分走线性注意力 | 启发式划分 | 注意力计算省 95% | 注意力 13.7×;Wan2.1-1.3B 端到端 2.2× |
| SLA2(2026.02) | 微调 + 量化感知训练 | 可学习 router 决定走稀疏还是线性 | 是 | 97% | 注意力约 18.6×;Wan2.1-14B-720P 端到端 4.35×(RTX 5090,排除 CPU offload 开销) |
| STA(2025.02,ICML 2025) | 免训练或微调 | 固定的 3D 滑动 tile 窗口 | 无选块器 | — | HunyuanVideo 端到端 945 秒→685 秒(免训练)、268 秒(微调) |
| Sparse VideoGen(2025.02) | 仅推理 | 在线 profiling,把头分成空间头和时间头 | 不需要训练 | — | 端到端最高 2.28×(CogVideoX-v1.5)、2.33×(HunyuanVideo) |
| NSA / MoBA(2025.02,LLM) | 预训练 | NSA:压缩分支打分,GQA 组内共享;MoBA:key 块均值池化做门控 | NSA 借道压缩分支获得梯度;MoBA 无参数 | — | 语言模型,不直接可比 |
几点解读:
我觉得这篇论文最大的价值,是把"可训练稀疏注意力"从一个小规模、只看 loss 的研究结论,变成了一个在完整视频 DiT 训练流程里走通的工程方案。预训练、RL、推理都换成 90%~95% 稀疏的注意力,人评还能和全注意力打平,这件事本身就是一个很强的信号。
具体的技术结论里,有三条我认为会被后续工作反复引用:
但也要清醒地看到,这篇论文的证据几乎全是内部的:内部模型、内部数据、149 条 prompt 的人评、没有外部 baseline,也没有代码。它更像一份高质量的工业实践报告,而不是一篇可以被独立验证的方法论文。
给不同读者的建议:
如果你在训练自己的视频 DiT:这篇是目前最值得参考的稀疏注意力训练配方。Sparse Rebasing 和"高分辨率阶段才切换"的思路可以直接借鉴;Hard-to-Easy 能换来运动质量,但要为指令跟随留一轮 RL。
如果你做推理部署、用的是开源模型:VSA2 暂时用不上,SLA、VSA 改造版或 Sparse VideoGen 这些有代码的方案更现实。另外记住,在 720p 量级上注意力被砍掉之后,非注意力部分就成了大头,步数蒸馏和缓存可能比继续压注意力更划算。
如果你是研究者:有几个问题这篇论文没有回答。稀疏训练为什么能让 loss 低于全注意力,是 coarse branch 带来的额外通路,还是正则效应?router 在 1080p 以上怎么扩展?每个 query 选中的块数不等时,序列并行的负载怎么均衡?
VSA2 把视频稀疏注意力的讨论,从"推理时怎么少算"推进到了"训练时就不算"。它能不能撑到 1080p 和分钟级视频,取决于 router 开销和序列并行这两个问题怎么解决,这也是这条路线接下来最值得期待的地方。
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)