今日 AIGC 论文速览
今日共 10 篇 · 视频与图像生成模型 5 篇 · 世界模型与音视频联合生成 1 篇 · 推理加速与模型压缩 2 篇 · 生成理解一体化与奖励模型 2 篇
重点论文标题列表
- LongLive-Plug(NVIDIA):蒸馏一次,插遍54个模型
- SplitMoE(国科大):专家拆两拨,人像涨9分
- HelixWorld(港科大):24帧实时出声的世界
- LDM-is-AE(港理工):不用分词器,FID 1.80
- NesTok(华北电力大学):变长 token,gFID 1.46
今日论文速览
1. LongLive-Plug:蒸馏一次,插遍54个模型
LongLive-Plug: Once-for-All Distillation for Video Generation | NVIDIA | arXiv:2609.38154
关键词:视频生成, 扩散蒸馏, LoRA 复用, 少步采样, 免训练部署
- 前序问题:视频扩散模型每做一次下游特化就要重跑一遍蒸馏:要么为少步采样,要么为长视频补误差修正。论文在 Wan2.2-TI2V-5B 上算了账——四个任务各自的专用蒸馏再花 83.9、150.0、86.8、56.1 H100 卡时,合计 376.8,加上一次性底座蒸馏约 80 卡时,总共 456.8 卡时。能力是通用的,钱被重复付了四遍。
- 本文贡献:把「单遍 CFG」「少步采样」「自回归长时误差修正」各蒸馏成一个 LoRA 挂在底座上,之后插到任何结构兼容的下游模型即可用,下游不再重训。CFG LoRA 只在 w=5 的固定引导强度下训练,推理时靠调 LoRA 权重换引导强度;与少步 LoRA 叠加,下游同时保住少步生成和 CFG 可控。作者称下游新增条件分支、扩展输出通道后适配器仍可复用。
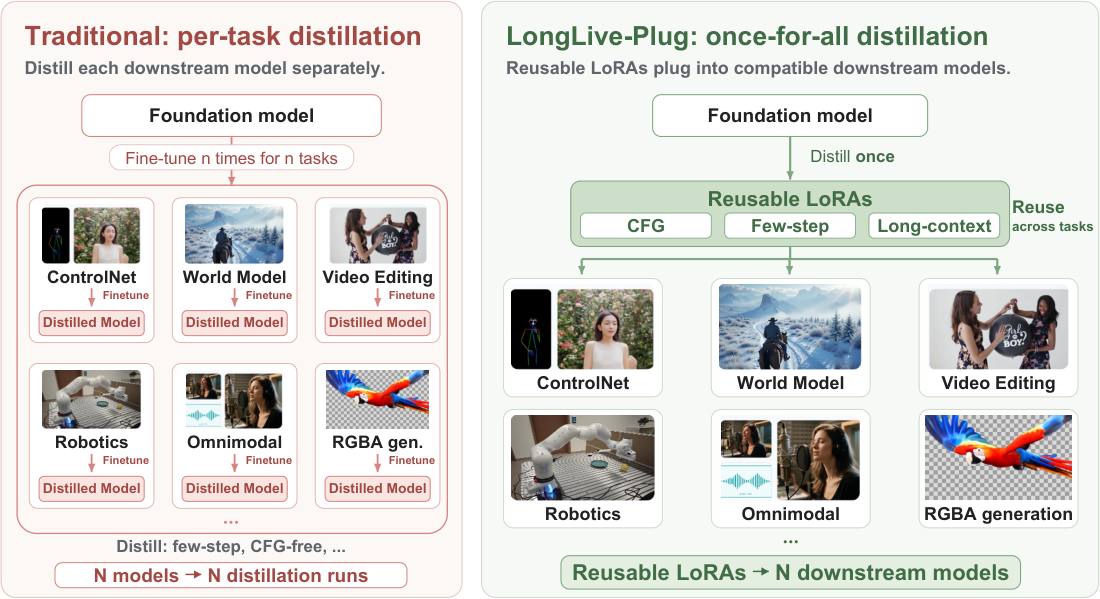 Once-for-all distillation: reusable LoRAs plug into compatible downstream models.
- 实验效果:在 Wan2.1-14B、Wan2.2-TI2V-5B、MiniMax-H3 三个底座家族、八个任务类别共 54 个下游模型上验证免训练部署。世界模型 SCOPE 上把朴素四步的 FVD 从 805.5 拉回 478.7,优于专用蒸馏的 502.1;ControlNet 上六项全优于朴素四步,深度 si-RMSE 从 2.135 降到 1.641、DOVER 从 8.90 升到 10.11;原生 20–50 步调度降到 1/5–1/12.5。
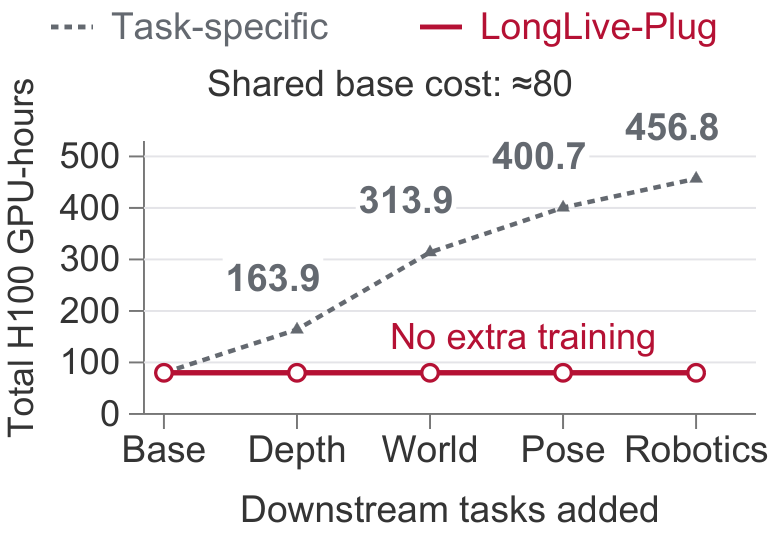 Downstream distillation cost: task-specific distillation accumulates while LongLive-Plug stays flat.
- 批判点评:省的是专用蒸馏的钱,80 卡时的一次性底座蒸馏照付,且只对同一底座家族有效。更关键的取舍藏在正文一句「相对任务专用蒸馏存在按指标而异的取舍」——插拔版不是全面反超,而是用 80 卡时换一个接近 456.8 卡时的结果。CFG LoRA 的引导控制是推理权重外推出来的,训练只见过 w=5 这一个点。
2. SplitMoE:专家拆两拨,人像涨9分
Breaking the Uniformity Trap: Scaling Video Diffusion Model via SplitMoE | 中国科学院大学;字节跳动;Canva Research;北京科技大学 | arXiv:2609.38140
关键词:视频生成, 混合专家, 稀疏路由, DiT 规模化, 负载均衡
- 前序问题:MoE 从 LLM 搬到视频生成上一直水土不服:token 级路由各自为政,再用负载均衡损失把使用率往均匀方向压,结果语义连贯的一块画面被拆到互不相关的专家里,作者称之为「均匀性陷阱」。视频数据时空冗余、语义长尾,本来就不该被均匀分配。
- 本文贡献:把专家池显式劈成两拨:语义专家抓高层语义抽象,通用专家兜住残差视觉信息和生成自由度。路由用原型引导,配合 pull-push 正则——pull 把原型锚在有意义的视觉语义上,push 防止原型塌缩冗余。两条 sigmoid 独立打分,一个 token 可以同时选中一个语义专家和一个通用专家,不必在所有专家间做全局 softmax 竞争。
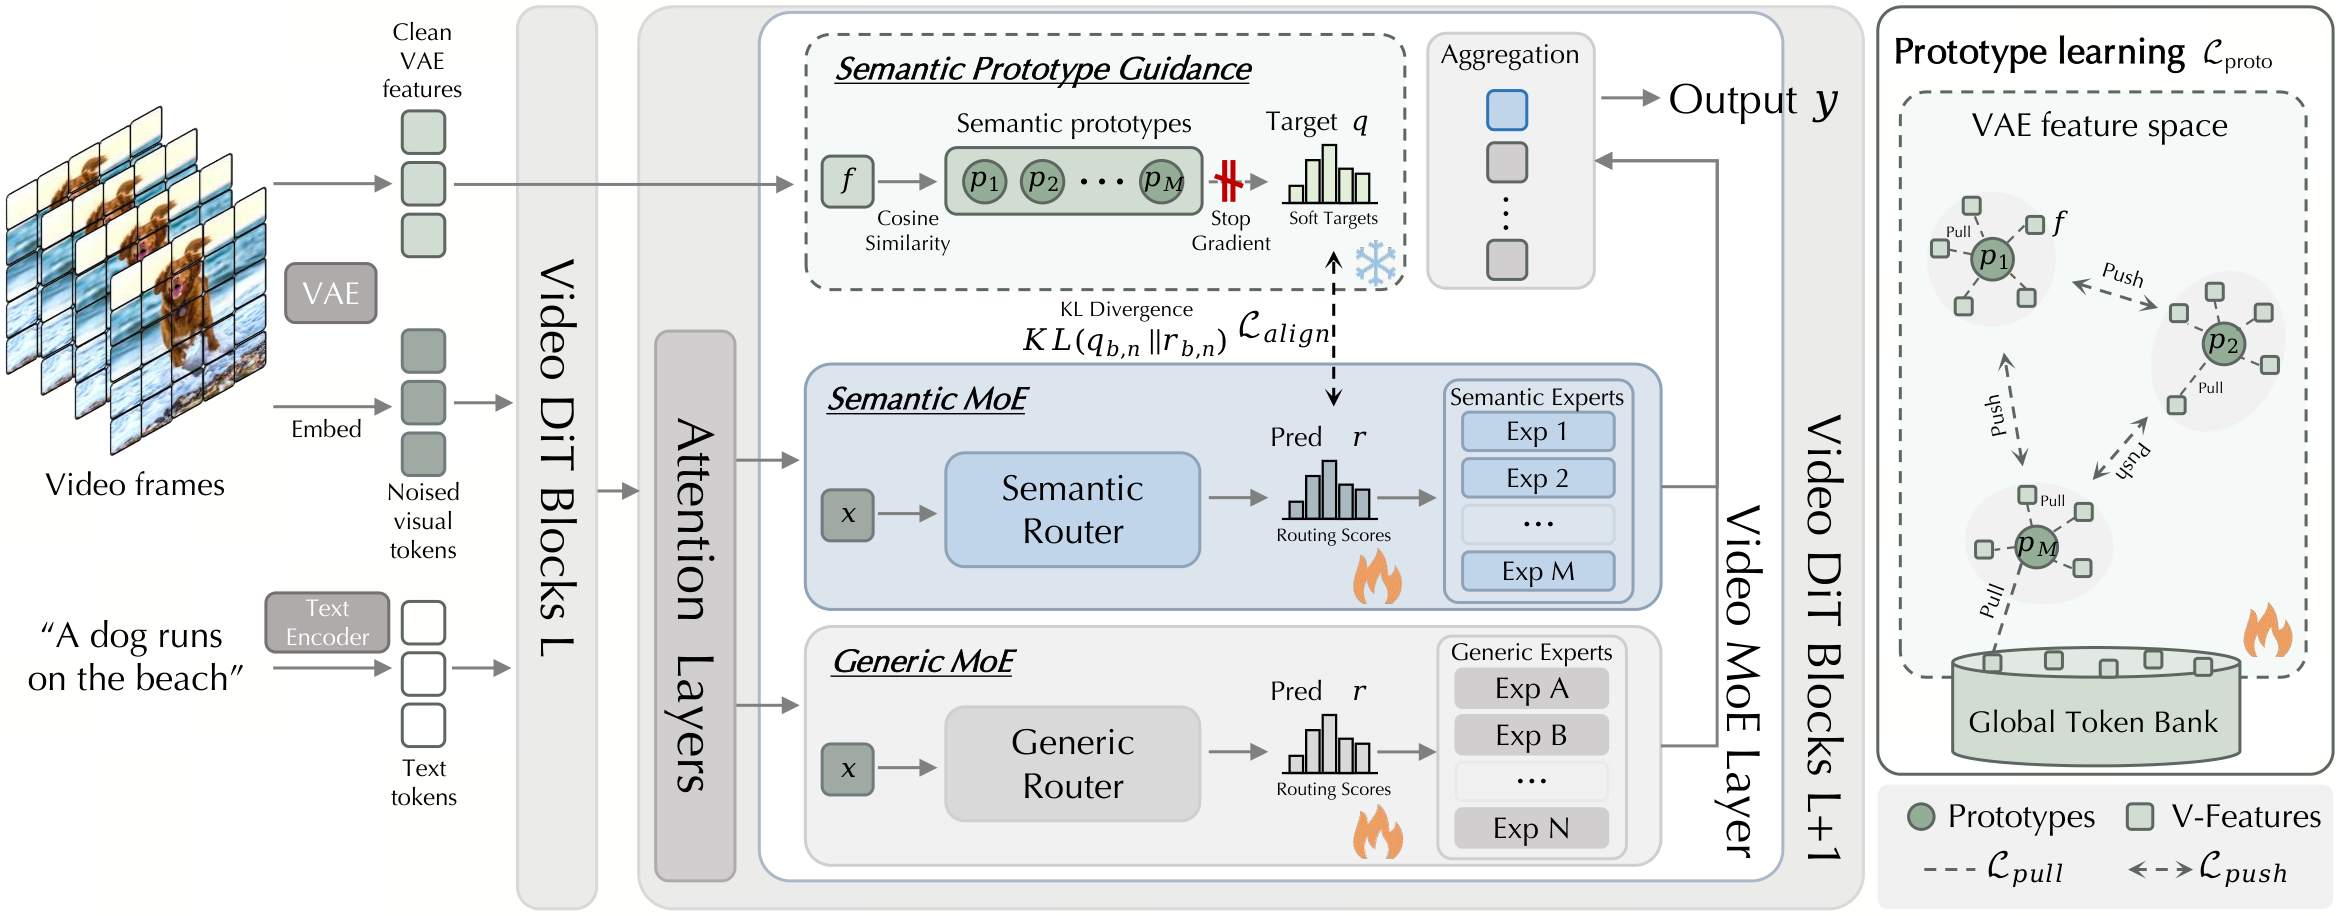 Pipeline of SplitMoE: each Video MoE layer splits into Semantic and Generic branches with VAE-prototype induced semantic routing.
- 实验效果:在同等激活参数预算(A14B)下对比 Wan2.2 系列:Creativity 58.46%、Human Fidelity 84.47%、T2V-CompBench 属性一致性 84.63% 三项拿到全场第一,人像保真比 Wan2.2 的 75.33% 高出 9 个多点。对比同数据微调的密集 Wan2.2-FT 全维领先,且收敛更快——约 70% 训练步数就达到可比的验证扩散损失。
 Qualitative comparison with baseline methods.
- 批判点评:「打破均匀性陷阱」的措辞比结果激进。它自己的表里 Physics 69.41% 输给 LTX-2 的 76.71%,Interaction 69.98% 输给 Wan2.2 的 73.29% 和 OmniWeaving 的 73.94%,Commonsense 64.89% 离 LongCat-Video 的 70.94% 差 6 个点。消融也显示去掉原型引导的 w/o PG 版本在 Commonsense 上 63.22% 与完整版 64.89% 差距很小,语义路由的主要收益其实集中在物理和人像两项。
3. HelixWorld:24帧实时出声的世界
HelixWorld: A Real-time Interactive Audio-Visual World Model | 香港科技大学;Noiz AI | arXiv:2609.38123
关键词:世界模型, 音视频生成, 实时交互, 空间音频, 因果蒸馏
- 前序问题:主流交互式世界模型全是哑巴:只管画面渲染和操控,声音这一维整个缺失。级联的视频转音频模型拿不到相机轨迹和用户动作,声场对不上自运动,串行延迟也谈不上实时;而把它们硬改成因果自回归,历史误差会迅速累积成灾难性多模态漂移。训练数据同样缺——现有世界模型数据集基本无声,视频语料里的音轨又常被后期配乐和旁白污染。
- 本文贡献:先用一个双向教师模型在自建的高保真空间音视频数据(真立体声 + 度量级相机位姿)上学 6-DoF 轨迹与动作条件,再用在线轨迹蒸馏把它压成少步因果学生,配合长程流式微调压掉曝光偏差。块内注意力保持双向以维持音视频交互,跨块注意力严格因果并配滑动 KV 缓存。同时提出 HelixBench,首次把空间声学一致性纳入世界模型评测。
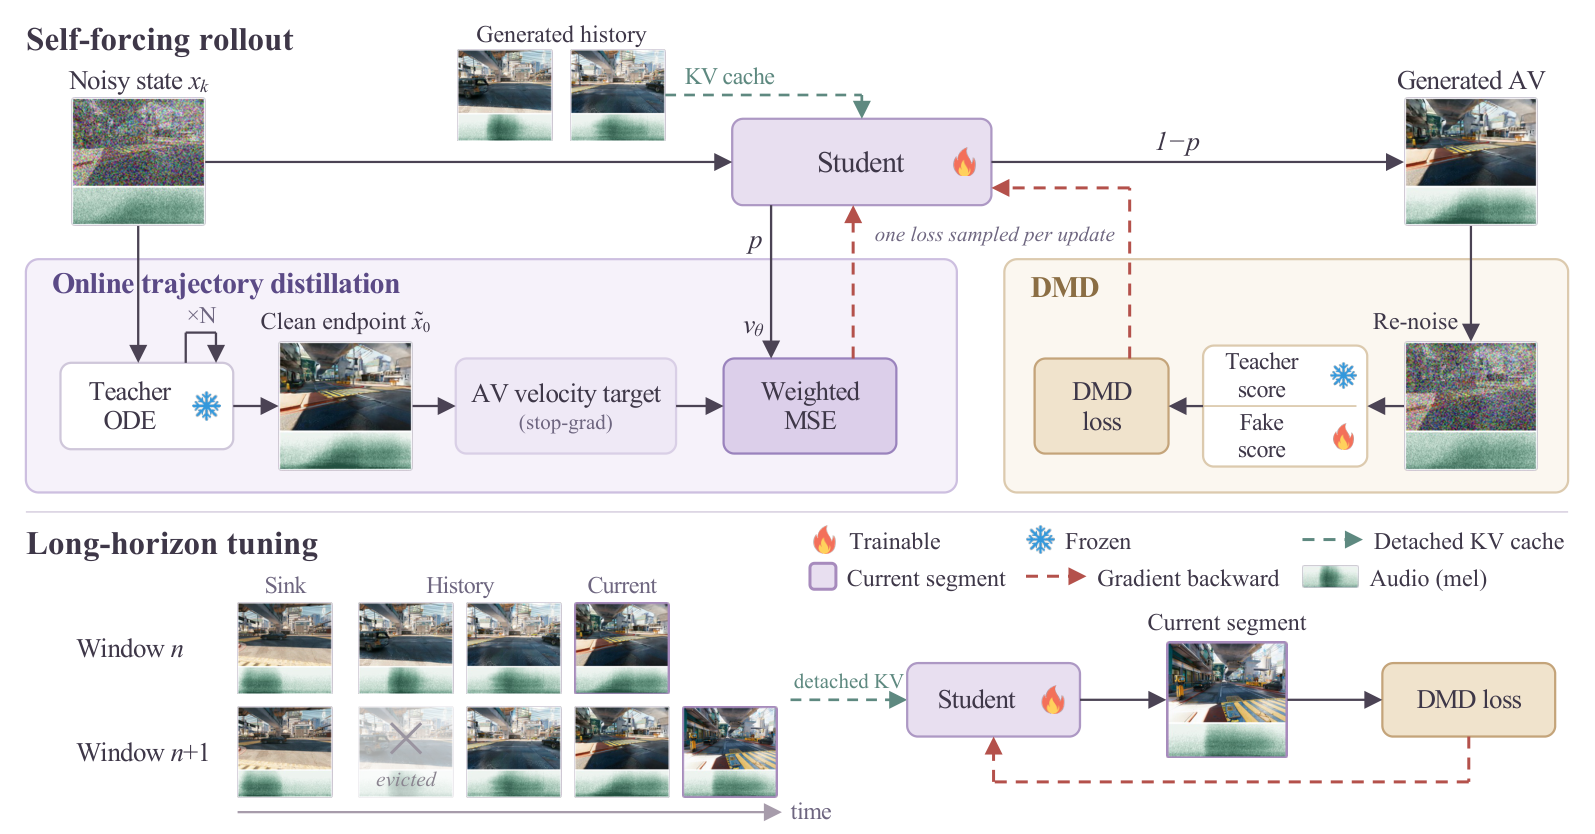 Causal distillation pipeline: self-forcing rollout, online trajectory distillation, DMD, and long-horizon tuning.
- 实验效果:单张 NVIDIA H800 上稳态 RTF 0.77,768×512、24 FPS,含视频与音频解码。HelixBench 上因果学生 KL 1.3934、FAD 2.3872、IB 0.2987、Spatial 41.7583 全部第一;级联配音路线(HelixWorld+AudioX / ThinkSound / PrismAudio)的空间分甚至是负的,说明分离式生成根本抓不住声源位置。
 Visual comparison under interactive control.
- 批判点评:WBench 导航榜上它平均 79.9 只排第 4,落后 Alaya-EVOKE-Turbo 82.0、EchoWM 81.0、Zing-0.5 81.0——「比肩 SOTA 无声世界模型」是有选择的比法。更反直觉的是音画同步:学生的 DeSync 0.5867 秒反而差于 LTX-2.3 base 的 0.4042 秒,CLAP 0.3016 也略低于级联的 HelixWorld+AudioX 0.3094,联合生成在语义对齐上没打赢「先出画面再配音」。
4. LDM-is-AE:不用分词器,FID 1.80
LDM-is-AE: Latent Diffusion Model is an Auto-Encoder for End-to-End Image Generation | 香港理工大学;OPPO 研究院 | arXiv:2609.37080
关键词:图像生成, 潜在扩散, 自编码器, 一阶段训练, 表示学习
- 前序问题:LDM 的两段式流程先训一个自编码器定住 latent 空间,再在里面训扩散。问题在于这个空间是为重建优化的,训练扩散时它是冻住的,天然与去噪动力学不匹配。而两阶段里最强的那批又几乎都挂着 DINOv2 这类外部视觉基础模型做监督,等于把表示学习的成本挪到表外。
- 本文贡献:核心观察是:LDM 骨干每一步去噪其实都在做 latent→feature→latent 的变换,这本身就是一次内部「解码—编码」。于是把 DiT 劈成互逆的两半 DiT-D 与 DiT-E,在中间特征上加一个轻量 MLP 头对齐到像素空间并施加图像域监督,把这条 latent→image→latent 路径显式化;零噪声时它自然等价于一次自编码。另配时间感知的辅助特征混合,避免对齐吃掉去噪容量。
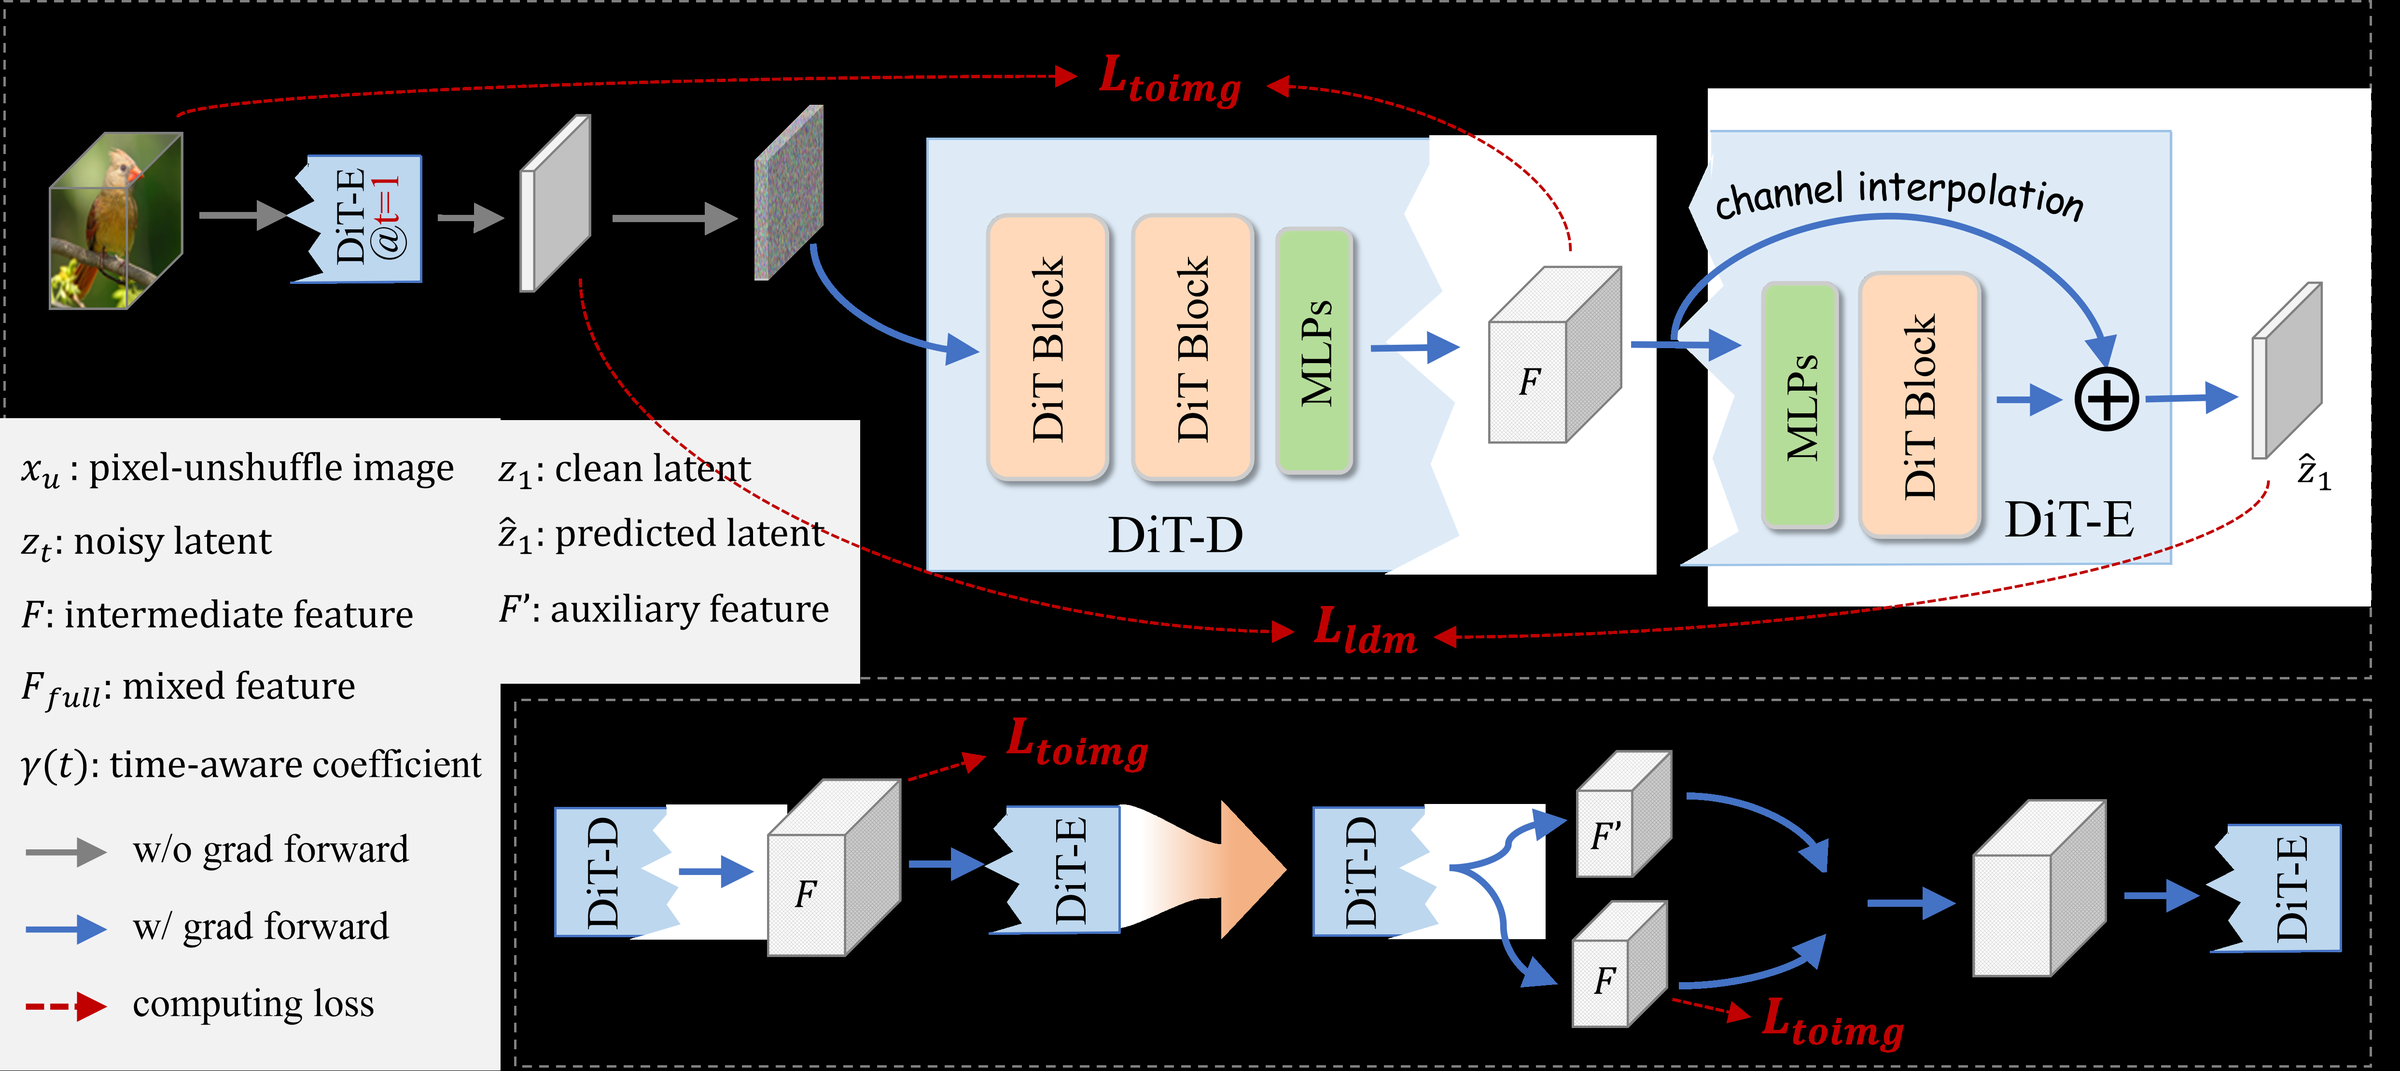 Architecture and training design of LDM-is-AE: (a) network architecture and training pipeline; (b) time-aware auxiliary feature mixing.
- 实验效果:ImageNet 256×256 上 FID 1.80、IS 314,512×512 上 FID 1.90、IS 320——512 这一档超过了 JiT-H/32 的 1.94、REPA-SiT-XL/2 的 2.08。生成器训练 FLOPs 7.02,低于 JiT-H/16 的 14.0。自编码路径上 PSNR 27.57 高于 VAVAE 的 26.59 和 SDVAE 的 25.94。
 Class-conditional ImageNet samples generated by LDM-is-AE at 256x256 resolution.
- 批判点评:FID 1.80 这个数得放在「不用 VFM 的一阶段方法」这个限定里看:两阶段挂 DINOv2 的 LightningDiT、REPA-SiT 仍然更好。更值得玩味的是它自己的重建口径——rFID 0.7879 明显差于 VAVAE 的 0.2650 和 REPA-E 的 0.4980,PSNR 最高却 rFID 最差,说明这个 latent 是奔着自然图像分布去的,压根不为「还原输入」负责,论文把这叫 diffusion-native,换个说法就是不忠于输入。
5. NesTok:变长 token,gFID 1.46
NesTok: Nested Self-Aligned 1D Tokenizer for Autoregressive Image Generation | 华北电力大学;中国科学技术大学;斯坦福大学 | arXiv:2609.36756
关键词:图像生成, 视觉分词器, 变长 token, 自回归生成, 嵌套对齐
- 前序问题:变长 1D 分词器想用一个 tokenizer 覆盖不同算力预算,主流做法是嵌套 dropout——随机截断 latent 序列并保留前缀,逼着前面的 token 装下最重要的信息。但「长度灵活」不等于「token 用得好」:已有工作发现序列加长后下游 AR 生成质量收益递减甚至倒退,尾部 token 基本成了摆设。
- 本文贡献:提出嵌套自对齐:跨长度联合优化重建,同时用全长序列去指导短序列,让短前缀逼近全长的重建质量,而不是只让前缀独立地「更重要」。配套的动机实验很直白——嵌套 dropout 训出来的码本在靠后位置归一化熵很低,码本多样性塌了,gFID 只有 2.46。
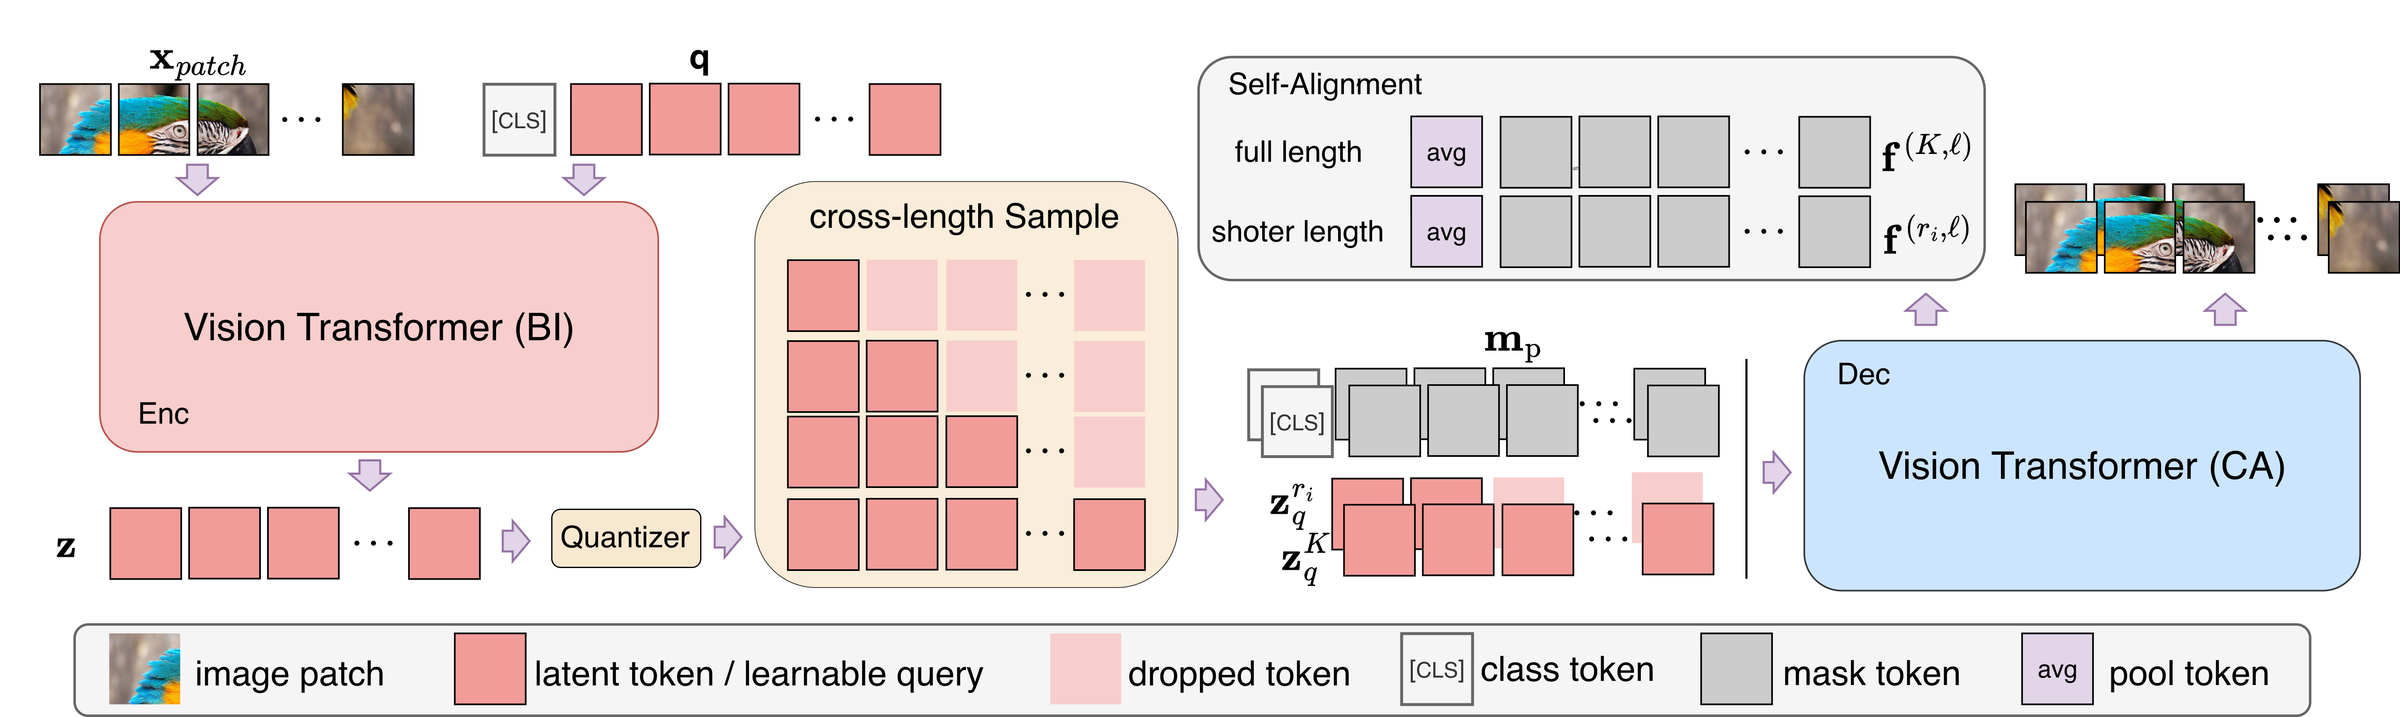 Overview of the nested self-aligned training pipeline.
- 实验效果:ImageNet 上 rFID 0.98,下游 AR 生成 gFID 1.46(带引导)、IS 295.9,在变长自回归图像生成这一档里是当前最好,优于 ReTok 的 2.27、One-D-Piece 的 2.35、DetailFlow-32 的 2.75,也远好于嵌套 dropout 基线的 2.46。
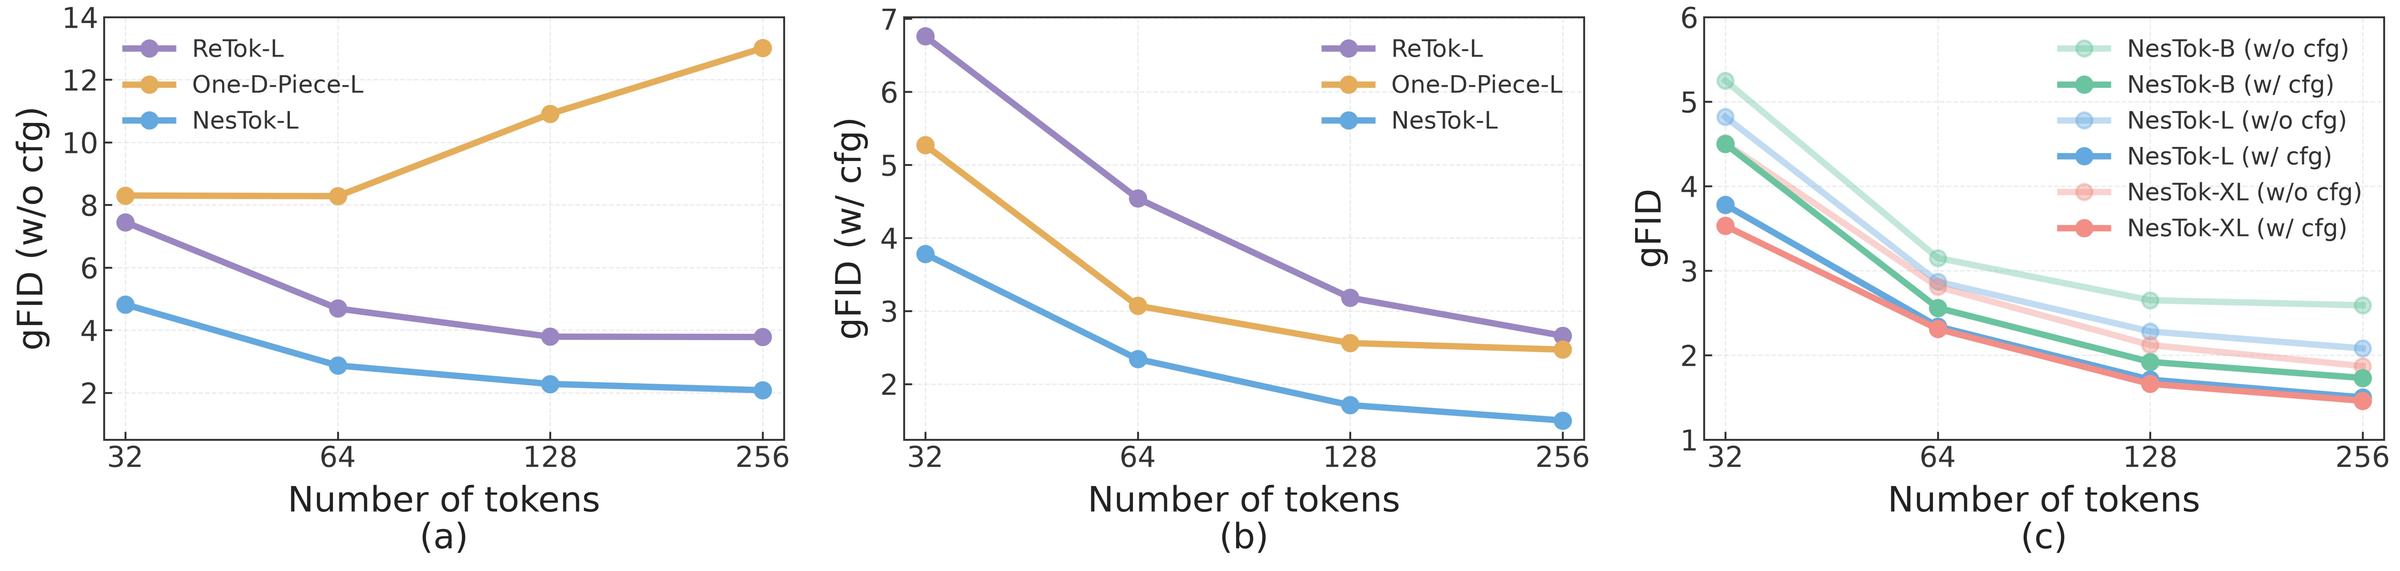 gFID with and without classifier-free guidance across different methods, model sizes, and token lengths.
- 批判点评:1.46 这个 SOTA 是「变长自回归」这个小池子里的 SOTA:同一张表上扩散路线的 Lightning-DiT-XL 带引导 gFID 1.35、REPA-XL/2 1.42 都更好。而重建口径更尴尬——rFID 0.98 远差于 LightningDiT 用的 KL tokenizer 0.28 和 SD-VAE 的 0.62,等于用重建质量换了生成质量。另外它仍是 VQ 分词器,390M 参数不算轻。
6. PixelDiff-GAN:加判别器,FID 降到28.6
Adversarial Training for Pixel Diffusion | Adobe Research;加州大学圣地亚哥分校;加州大学默塞德分校 | arXiv:2609.38170
关键词:图像生成, 像素扩散, 对抗训练, 后训练, 频谱分析
- 前序问题:像素扩散直接在 RGB 上出图,绕开了自编码器这个瓶颈,但产出的图像在细尺度自然图像统计上系统性偏低——说白了就是高频细节不够。这是个老问题,却一直没人系统性地验证对抗训练能不能补。
- 本文贡献:保留预训练模型原来的扩散/流匹配目标不动,只在非高噪声时间步上对预测输出额外加一个对抗损失,架构和采样流程一行不改。作者还做了归因:频带与幂律分析显示原模型系统性地欠产高频,对抗后训练正好把这部分谱功率补回来。
 Noise-gate rationale: structure settles early, detail settles late.
- 实验效果:两个像素骨干上同时改善分布保真、覆盖率、提示对齐和感知质量。DeCo 上 FID 从 33.27 降到 28.59、pFID 27.9→24.4、CMMD 0.836→0.736、recall 0.361→0.406、DPG 81.6→83.3、TOPIQ 0.71→0.77、MANIQA 0.64→0.71;PixelGen 上 DPG 从 78.4 提到 80.8。1065 组配对样本的胜率也明显高于 latent 扩散的同类做法。
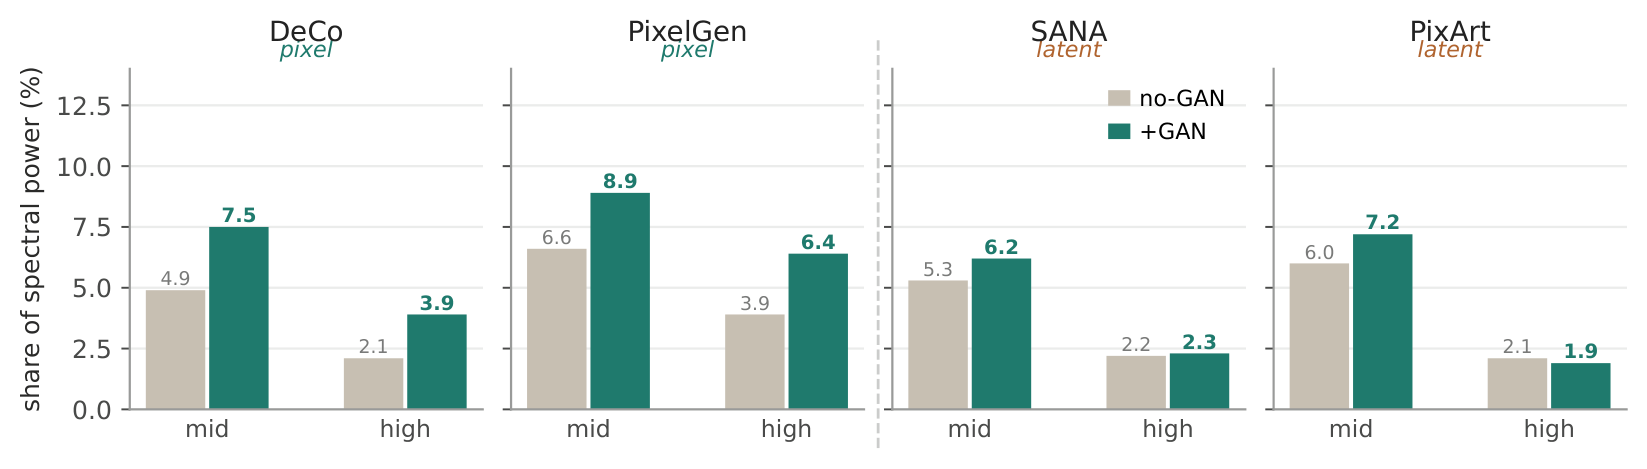 Pixel radial-profile band share over 30,000 images per model; gray = no-GAN, green = +GAN.
- 批判点评:FID 28.59 的绝对值放在今天并不好看,它赢的是「相对自己」这一档。真正有价值的是边界实验:同样的流程搬到 latent 扩散(PixArt / SANA)上没有可比增益,也几乎没加回解码后的高频功率——作者据此认为「能否直接触达被修正的图像统计」才是对抗后训练成不成立的关键。另外论文自己提到真实照片在 TOPIQ 上只拿 0.57,比生成的还低,等于承认无参考指标不足以单独作证。
7. DIET:砍半专家,57GB 变 30GB
DIET: Deletion-response Expert Trimming for Video Diffusion Transformers | 西安交通大学;上海交通大学;阿里巴巴 Token Hub;阿里云 | arXiv:2609.37829
关键词:视频生成, MoE 剪枝, 专家裁剪, 免微调压缩, 推理加速
- 前序问题:MoE 的稀疏激活只省算力不省显存——所有专家的参数一个不少地躺在 checkpoint 里。整块删掉专家是最直接的瘦身办法,但现有一次性剪枝判据靠静态激活或路由频率打分,看不见「删掉某个专家、token 重新路由之后」这一层到底发生什么。而在这个规模上穷举多种删除组合,代价根本付不起。
- 本文贡献:用一次 all-expert 标定把条件/无条件 token 下所有专家输出和 router 状态全部录下来,之后重放任何单专家删除及其成组重路由,退化成对缓存状态的张量运算,零额外前向。在此基础上把「保留哪些专家」写成整体多样性损失:每个被删专家匹配到最近的保留专家,求和最近邻余弦距离作集合级覆盖损失。求解分两层——层内贪心+单交换+模拟退火,层间用回归指导的预算分配。
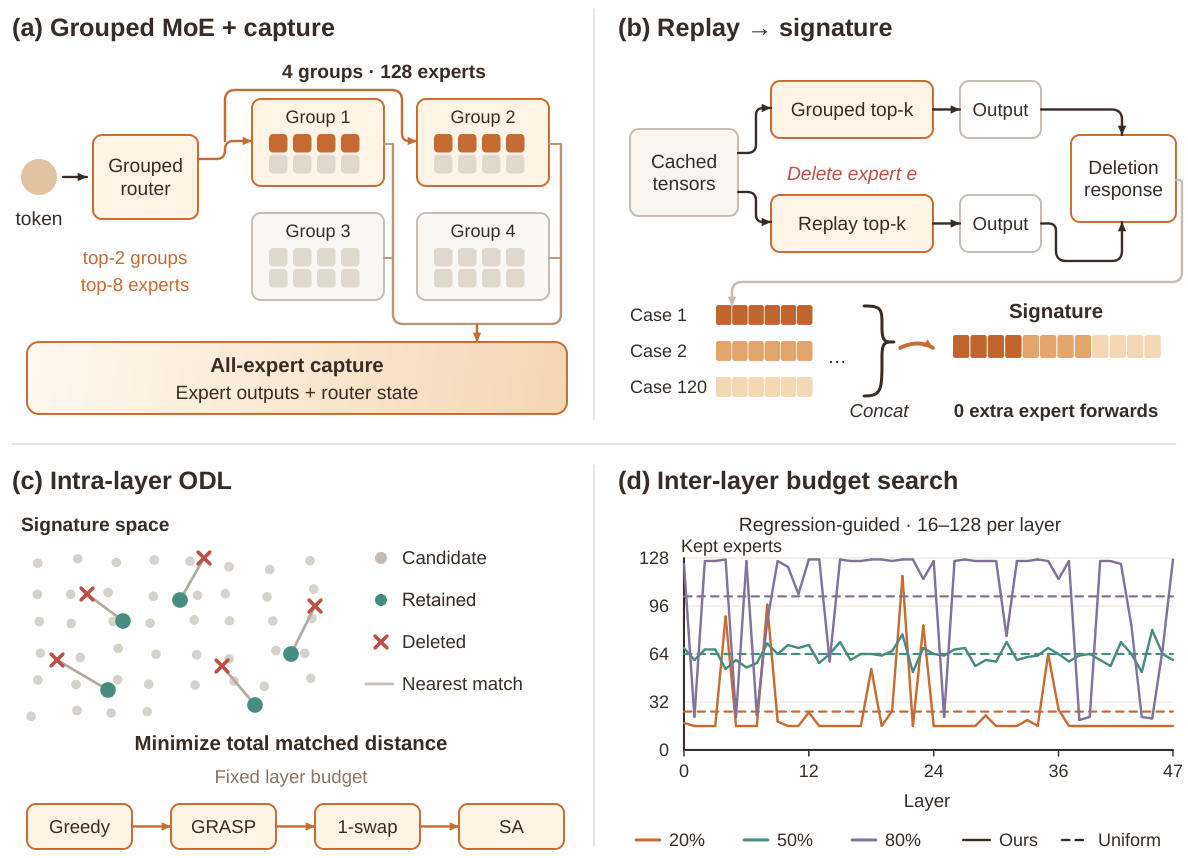 DIET overview: grouped MoE capture, replay-to-signature, intra-layer ODL, and inter-layer budget search.
- 实验效果:在 LingBot-Video 30B-A3B 上免微调剪掉 50% 专家(6144→3072),checkpoint 从 57GB 降到 30GB,48GB 单卡可部署;284 条固定用例上 VBench Total 反而从 0.7941 升到 0.8115。层间非均匀预算分配比均匀分配多拿 1.2 个点。所有保留预算下都优于从 LLM 移植过来的剪枝基线。
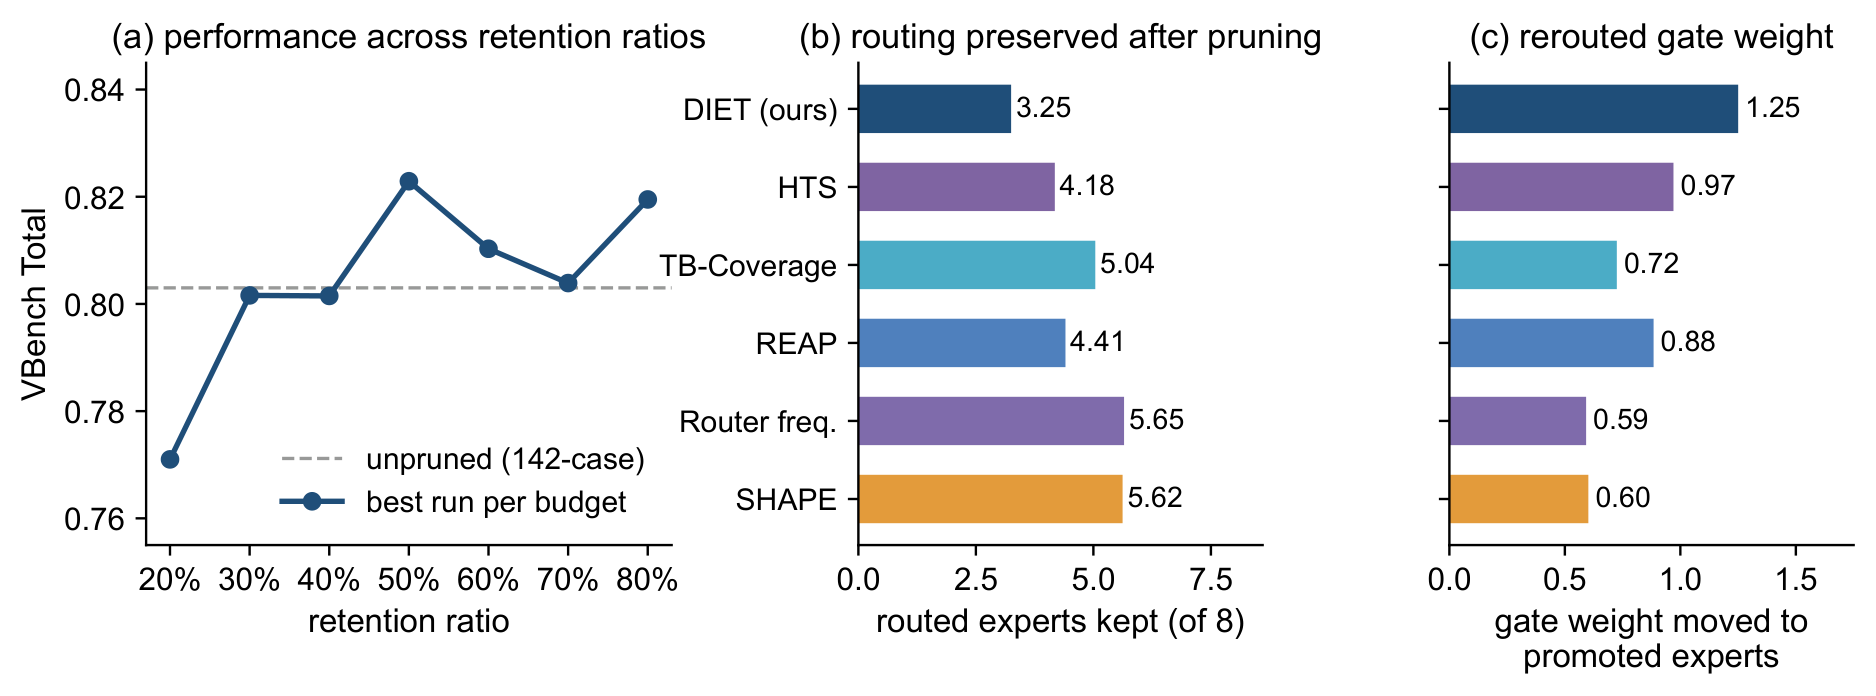 Primary evaluation and routing dynamics across candidate retention budgets.
- 批判点评:VBench 从 0.7941 涨到 0.8115 是这条工作最抓眼的数字,但幅度只有 1.7 个百分点,且出自自家固定的 284 条协议,更像「没掉点」而不是「变好了」。省下的是 27GB 存储,激活算力并没少——稀疏激活本来就只算一部分。另外这套标定缓存的前提是条件/无条件 token 可配对,CFG 之外的采样路径能否同样成立没有验证。
8. SoL-Refiner:一步上 4K,快 8.91 倍
SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video | NVIDIA | arXiv:2609.37969
关键词:视频生成, 超分辨率精修, 一步蒸馏, 强化学习后训练, 推理加速
- 前序问题:高分辨率视频生成的代价随时空 token 数暴涨。实用做法是先在低分辨率出片再用 refiner 精修,但常规 refiner 本身要跑好几个目标分辨率的去噪步,等于引入第二个采样瓶颈。而且多数 refiner 只针对自家基模型开发,换一个生成器还灵不灵几乎没人测。
- 本文贡献:从 LTX-2.3 出发走三步:高分辨率续训学精修映射、帧级奖励模型做 RL 后训练提升感知质量、最后一步蒸馏压成单步。推理侧配 TAE 小自编码器降低编解码开销,用 latent 上采样初始化,再由 Sol Video Inference Engine 执行单次 NFE。同时建了 Refiner-Bench——150 条对齐视频、统一输入协议,专门横向比 refiner。
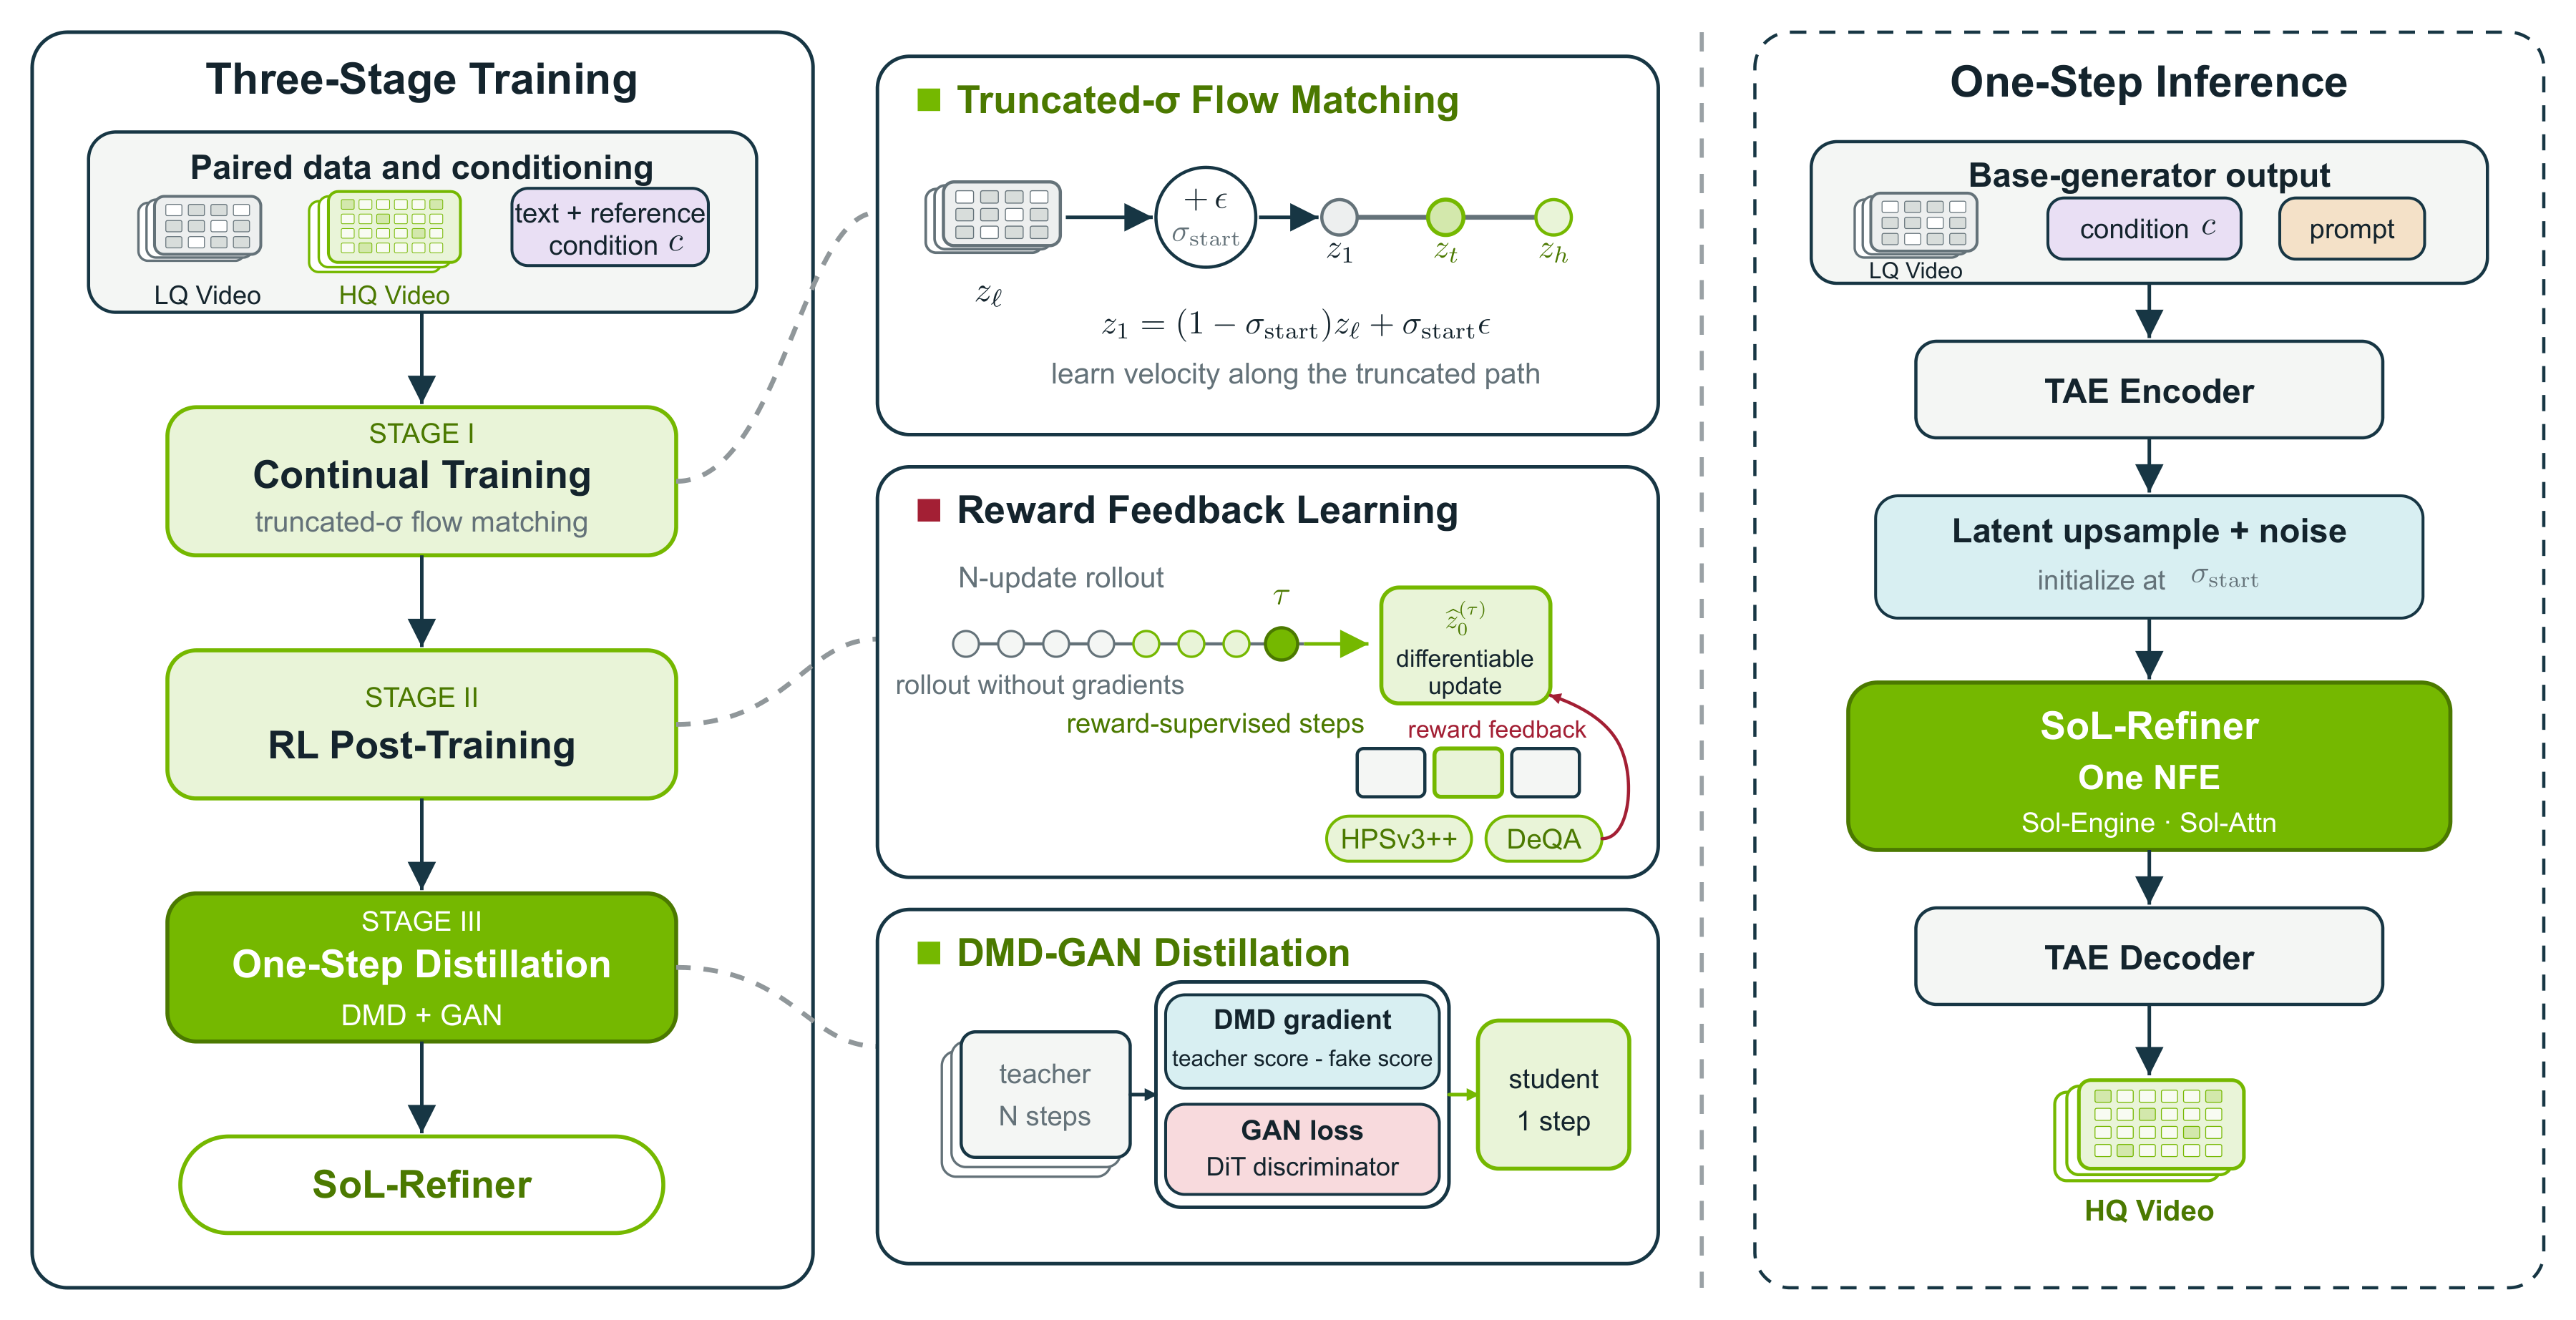 Training and inference pipeline of SoL-Refiner.
- 实验效果:一步版在 Refiner-Bench 上 VBench 均值 0.81048、UniPercept 均值 60.4150,超过同为一档步数的 SEEDVR2 和三步的 LTX-2.3 Refiner。4K 上相对三步 LTX-2.3 Refiner,VBench 与 UniPercept 均值分别提升 3.86% 和 22.79%。叠满加速栈后 2K 延迟档精修提速 8.91 倍;配四步 MiniMax H3 基模型,整条两级流水线比直接全分辨率生成快 27 倍。
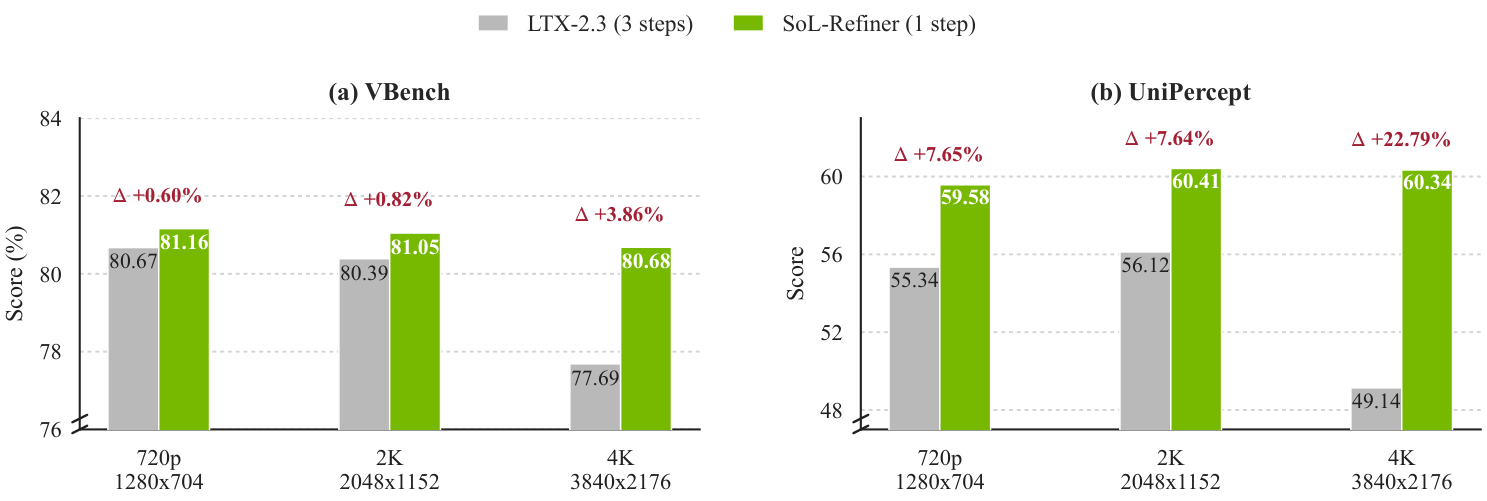 Performance across output resolutions: three-step LTX-2.3 Refiner vs one-step SoL-Refiner.
- 批判点评:一步版输给自家多步版——0.81048 对 23 步的 0.81691,主体一致性 0.92191、动态度 0.71333 都被多步版和 LTX-2.0 Refiner 压过。8.91 倍是「精修阶段」的加速,不是端到端;27 倍那个数则是把基模型也换成低分辨率四步 H3 之后的联合结果。另外 Refiner-Bench 是自建集,起点又是 LTX-2.3,公平性靠 shared-input 协议兜着。
9. OmniTaskonomy:19个生成任务换25项能力
OmniTaskonomy: When Does Visual Generation Improve Visual Understanding? | 加州大学伯克利分校;杜克大学;卡内基梅隆大学;华盛顿大学;Elorian;Impossible Research | arXiv:2609.38079
关键词:统一多模态, 生成理解一体化, 任务迁移, 梯度对齐, 训练课程
- 前序问题:生成能给理解带来多少好处,一直是笔糊涂账:已有工作普遍认为理解反哺生成容易,反过来收益微弱。但这在直觉上说不通——生成提供的是像素级稠密监督,覆盖外观、空间关系、几何,而这些恰恰也是识别、计数、空间推理、3D 感知需要的。
- 本文贡献:用「同一个底层视觉问题、两种输出模态」的受控配对来做因果分离:I2I 生成任务和 I2T 理解任务表达同一个问题,只换监督形式。再搭一个覆盖 19 个 I2I 生成任务与 25 项 I2T 理解能力的统一分类法 OmniTaskonomy(按识别、重建、重组三个基础问题组织),画出完整的迁移图谱。机制上用梯度对齐解释:生成与理解在理解分支 pre-attention RMSNorm 参数上的梯度对齐越强,迁移增益越大。
 OmniTaskonomy: a unified taxonomy of I2I tasks and understanding capabilities under the three Rs.
- 实验效果:先做 I2I 再做 I2T 的课程能稳定提升理解表现,且增益随 I2I 数据量单调增长;混合训练则没有一致的规模收益。I2I 训练还能减少达到同一理解水平所需的 I2T 监督量,在 I2T 数据稀缺时收益最大。迁移图谱里既有直觉对应的组合(深度预测→度量 3D 推理、物体指向→计数、拼图重建→2D 排序),也有反直觉的(2.5D 分割→类别识别、Z-depth 预测→定位)。
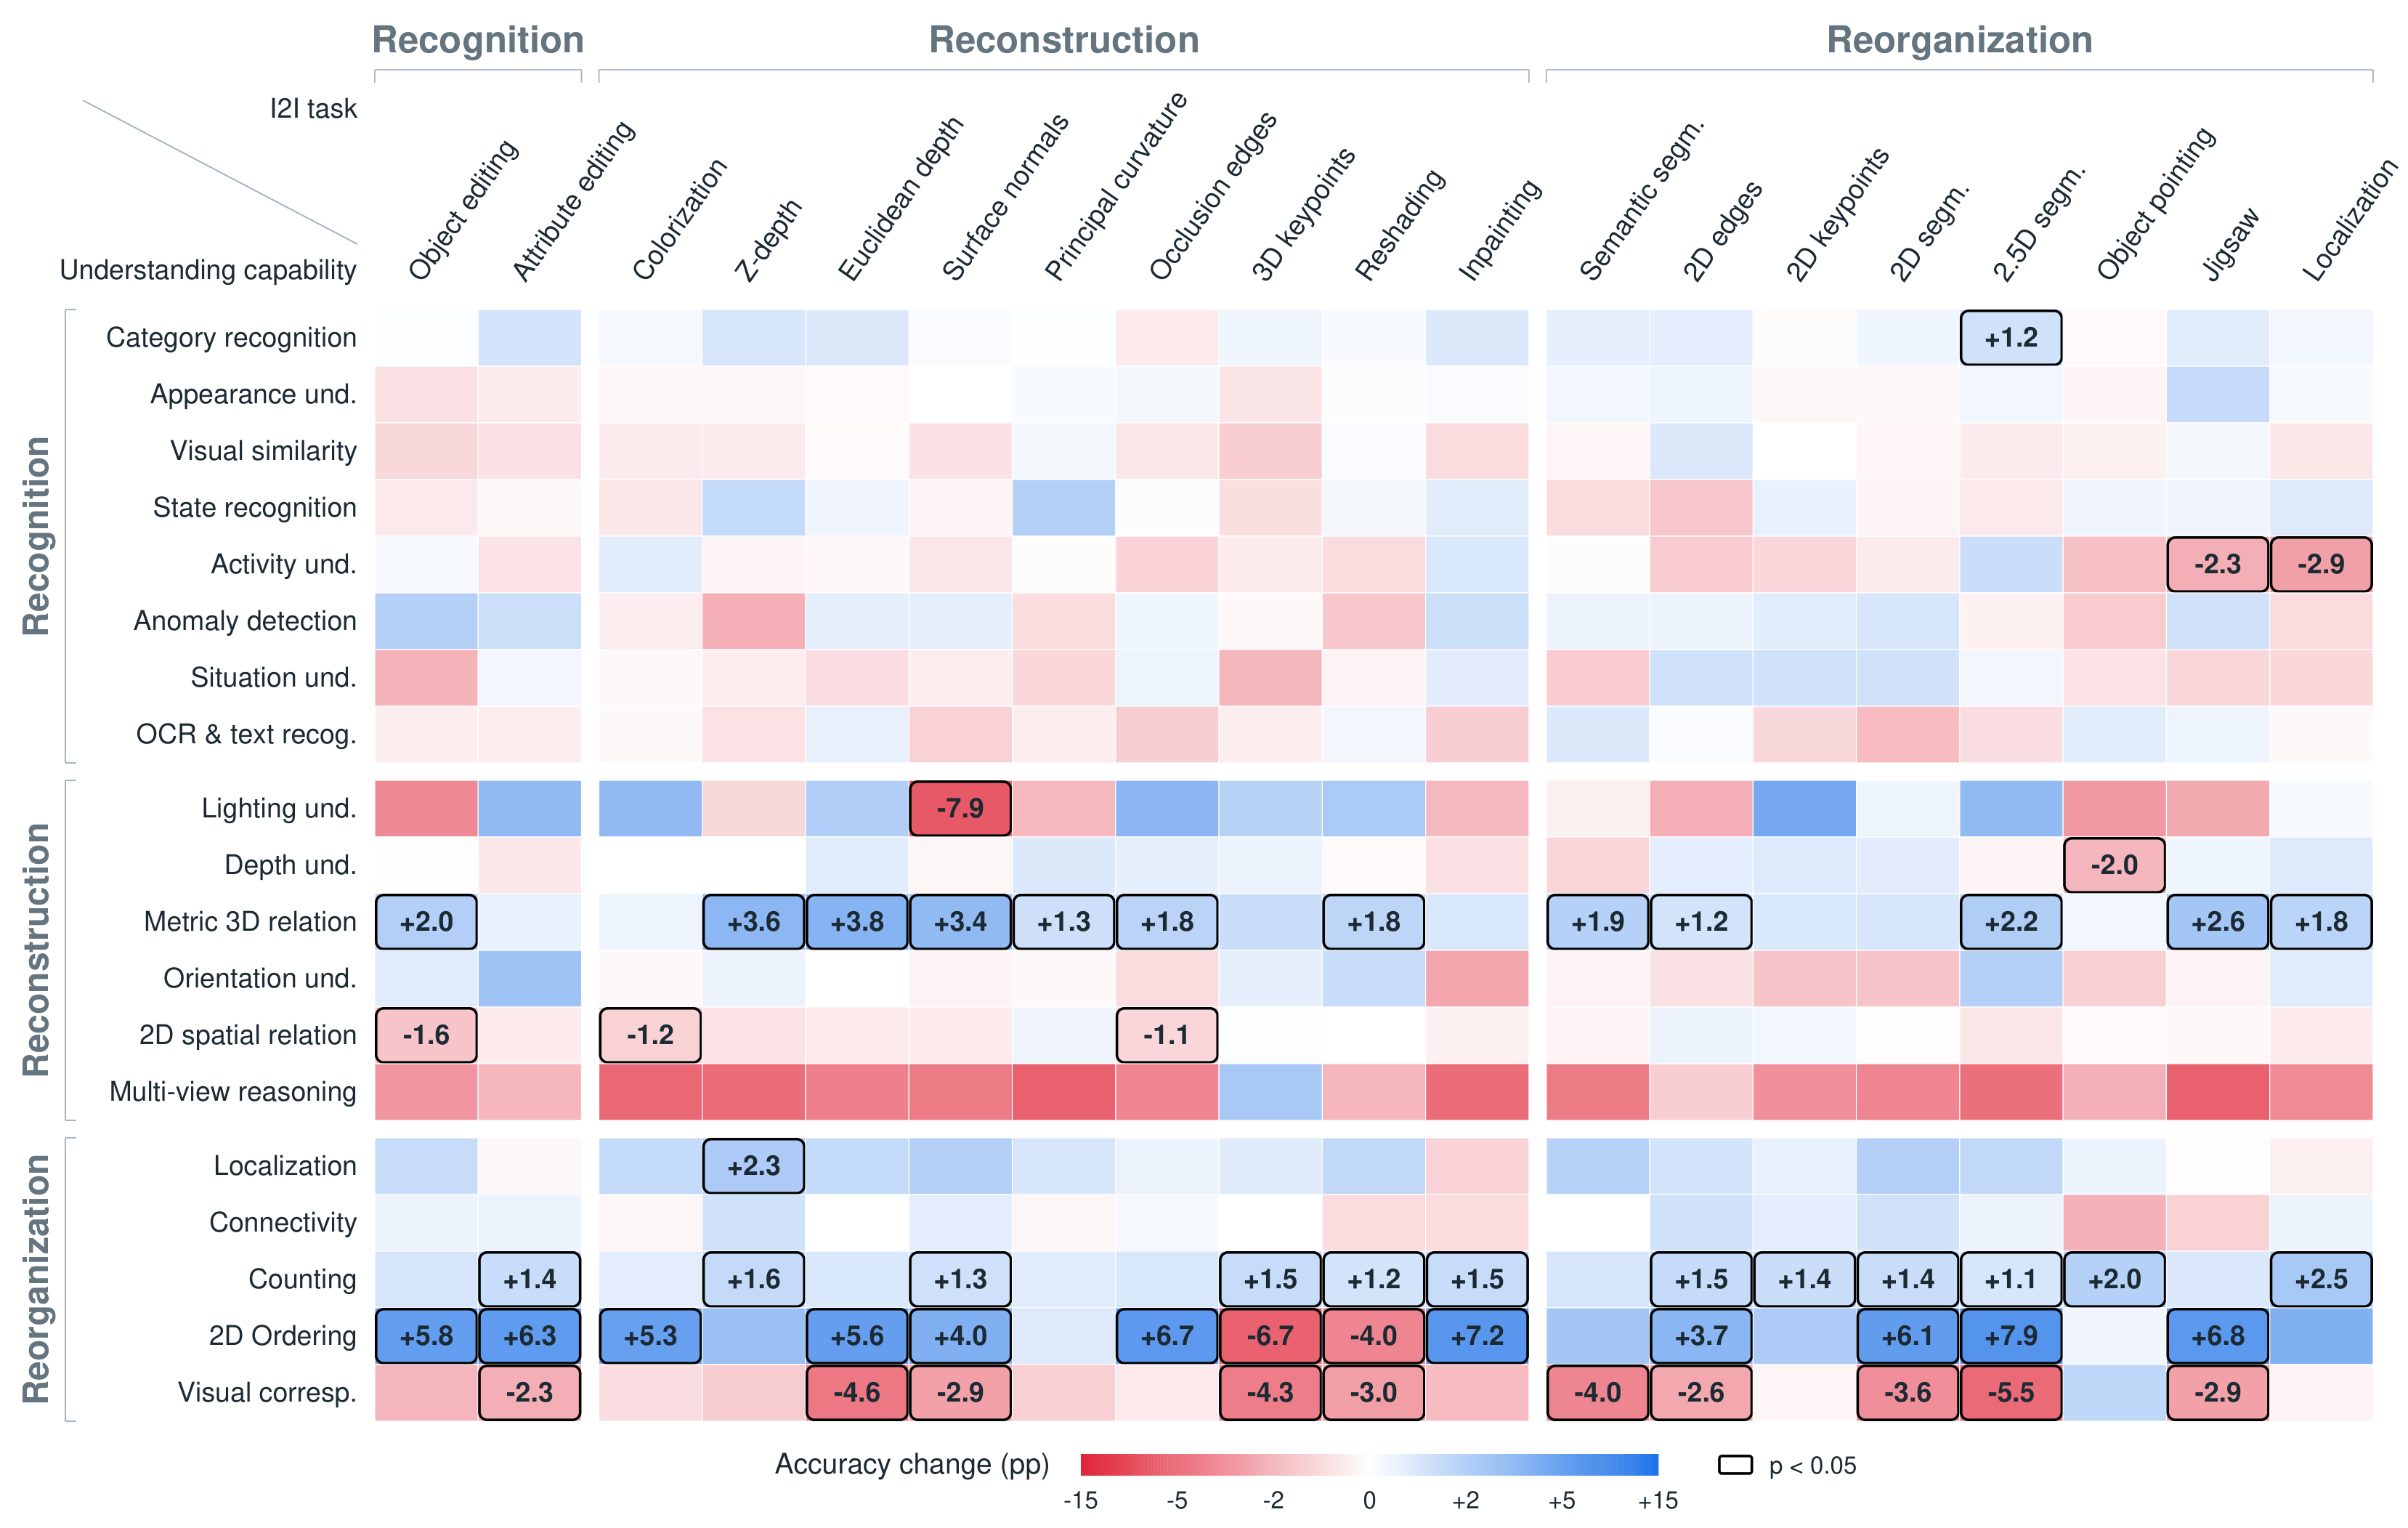 Generation-to-understanding transfer across visual capabilities.
- 批判点评:结论的成立高度依赖课程顺序——先 I2I 后 I2T 才有效,混合训练就没有一致的规模收益,这更像是「课程设计」而非「生成天然有益」。迁移图谱是选择性的:作者自己也说收益 task-dependent,图里有多少格子是负增益论文没有全列。梯度对齐目前只是相关性分析,拿它做任务选择的先验还缺因果验证。
10. ThinkRM:先定评分表,9B 超 GPT-4.1
Think Before You Score: Thinking Reward Model for Visual Generation | 杭州电子科技大学;中国科学院自动化研究所;北京大学;商汤科技;复旦大学;西北工业大学;南洋理工大学;清华大学 | arXiv:2609.37372
关键词:奖励模型, 视觉生成评测, 评分细则, 偏好优化, 强化学习
- 前序问题:视觉奖励模型通常把任务条件和候选输出直接映射成一个标量分数,至于「这个 case 到底该评什么」完全隐在黑箱里。图像生成和图像编辑的评判标准差异极大,用一套固定标准硬套,细粒度区分能力必然上不去。
- 本文贡献:提出「先想清楚再打分」:为每个 case 先自适应地生成评分细则(rubric),再按细则做逐条评估,最后产出细粒度 pointwise 分数。训练上先做结构化 SFT 冷启动,再用成对偏好优化;作者发现常规成对偏好优化会引起分数极化,于是提出 Pairwise Dual-Group Relative Policy Optimization,在保留细粒度打分能力的同时提升判别力。
 Thinking Reward Model (TRM) follows the Think-Before-You-Score paradigm, with RM and RL performance.
- 实验效果:9B 模型在 GenAI-T2I 上从基线的 58.9% 提到 71.2%、MMRB2-T2I 从 59.4% 提到 67.9%,两个榜上都超过 GPT-4.1;编辑侧 EditScore-ERB 0.750/0.639/0.743、EditReward-ERB 67.8%、MMRB2 从 53.0% 提到 58.2%。用它做奖励去优化 BAGEL、FLUX.1-dev、SD3.5-M 等多个生成模型,跨架构跨规模一致有提升。
 Qualitative comparison of SenseNova-U1.5 before and after RL fine-tuning with TRM.
- 批判点评:「超过 GPT-4.1」是在特定榜单和特定打分协议下的结果,且作者明说 pointwise 模型只统计非平局预测的准确率,平局样本另算——这个口径会显著抬高数字。冷启动 SFT 已经把 58.9% 拉到 70.1%,后面的成对优化只再加 1.1 个点,说明真正吃重的是 rubric 监督数据本身。另外 8 家单位联合、训练只用约 4000 条偏好对,规模偏小。
趋势观察
蒸馏的计价单位从「每个模型」变成「每个底座家族」
LongLive-Plug 把少步采样、单遍 CFG、长时误差修正各做成一只 LoRA,一次 80 卡时的底座蒸馏换掉四个任务 376.8 卡时的专用蒸馏;SoL-Refiner 把多步精修压成一步再叠 TAE 与推理引擎拿到 8.91 倍;DIET 直接免微调砍掉一半专家把 57GB 压到 30GB。三篇下手的地方完全不同——一只 LoRA、一次 NFE、一半专家——但都在问同一个问题:这份能力到底要不要为每个落点重付一遍钱。
生成与理解之间的账开始被逐项结算
OmniTaskonomy 用 19 个生成任务对 25 项理解能力画出迁移图谱,结论是收益 selective 且强依赖「先 I2I 后 I2T」的课程;Think Before You Score 则反过来问评估侧——给每个 case 先拟一份评分细则再打分,9B 模型在两个榜上压过 GPT-4.1。前者说明「生成有益理解」不能当口号用,后者说明奖励模型缺的不是参数量而是「该评什么」这一步显式化。
人工智能炼丹君 整理 | 2026-10-01
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注









评论 (0)