


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:分布式训练 | 难度:进阶 | 前置知识:梯度、向量范数与 Adam;本文会补齐加权平均、集体通信和优化器状态的必要定义
关键词:数据并行、DDP、ZeRO、优化器状态切分、FSDP、显存占用估算
先算一笔会让很多人意外的账:训练一个 75 亿参数模型,模型权重明明只有 15 GB,为什么放进 80 GB 显存的 GPU 还会爆?
假设用混合精度 Adam 训练。每个参数除了 2 字节的 FP16/BF16 权重,还要留下 2 字节梯度、4 字节 FP32 主权重、4 字节一阶动量和 4 字节二阶动量。合计不是 2 字节,而是 16 字节/参数:
$$7.5\times10^9\times16\ \mathrm{bytes}=120\ \mathrm{GB}$$
这 120 GB 还没有算激活、临时通信缓冲区、CUDA context 和显存碎片。换句话说,模型甚至没开始处理一帧视频,单是“为了训练而保存的状态”就已经放不下。
自然的反应是:“那我上 64 张卡。”可如果只用普通数据并行,每张卡都会保留完整的参数、完整的梯度和完整的 Adam 状态。64 张卡只是把不同 mini-batch 同时算得更快,每张卡看到的仍然是同一份 120 GB。总显存从 80 GB 变成 5120 GB,但单卡瓶颈一点没松,模型照样启动不了。
这就是 ZeRO 要解决的矛盾:数据并行已经拥有整个集群的总显存,却因为每张卡都复制同样的训练状态,只能使用其中一张卡的容量。ZeRO 不改变模型的数学计算,而是按顺序切掉三种冗余副本:
把刚才的 75 亿参数模型放到 64 个数据并行 rank 上,三阶段的模型状态显存分别是 31.41 GB、16.64 GB 和 1.88 GB。最后一个数字正好是 $120/64$。这些数字不是宣传页上的模糊“最高节省多少”,而是本文后面会逐项推出来、再用代码复现的结果。
对视频生成尤其要补一句:视频 DiT 的 token 数很长,激活往往比模型状态还大。ZeRO 能拆掉模型状态冗余,但不会自动消灭激活。先分清是哪一类显存爆了,再决定用 ZeRO、激活重计算还是序列并行,比盲目把配置改成 stage 3 更重要。
三句话先建立框架:
如果只记一件事:DDP 在不同数据上复制模型,ZeRO 再切分训练状态;在同一全局目标和正确归约下,切分本身不改变梯度的数学值。
这里的 rank 可以先理解为一个独立训练进程,通常一个 rank 独占一张 GPU。$N$ 表示数据并行进程数,world_size 就是 $N$。每个 rank 处理本地 batch,DDP 的参数副本在同步更新后应一致;ZeRO-3 则让不同 rank 持有同一个全局参数向量的不同分片,不能要求它们的本地张量相同。
设全局 batch 有 $B$ 个样本,均匀切给 $N$ 个 rank,每个 rank 得到 $b=B/N$ 个样本。模型参数记作 $w$,第 $i$ 个样本的损失是 $\ell(x_i;w)$。
第 $r$ 个 rank 的局部平均损失为:
$$L_r(w)=\frac{1}{b}\sum_{i\in\mathcal{B}_r}\ell(x_i;w)$$
其中 $\mathcal{B}_r$ 是 rank $r$ 拿到的样本集合,$b$ 是本地 batch size。对参数求导,得到局部梯度:
$$g_r=\nabla_w L_r(w)=\frac{1}{b}\sum_{i\in\mathcal{B}_r}\nabla_w\ell(x_i;w)$$
同步数据并行对所有局部梯度取平均:
$$g=\frac{1}{N}\sum_{r=1}^{N}g_r=\frac{1}{Nb}\sum_{r=1}^{N}\sum_{i\in\mathcal{B}_r}\nabla_w\ell(x_i;w)=\frac{1}{B}\sum_{i=1}^{B}\nabla_w\ell(x_i;w)$$
右边正是把所有样本放在一张卡上算全局平均损失所得到的梯度。等价成立依赖四个前提:损失能按样本分解且样本计算不因分组改变(如本地 BatchNorm 统计会破坏这一条件);各 rank 从同一个参数 $w$ 出发;样本权重一致;更新前完成同步。若最后一个 batch 在各 rank 上不等长,仍然机械地“先本地平均再按 rank 平均”,样本就会被赋予错误权重。这也是分布式数据加载器必须谨慎处理尾 batch 的原因。
DDP 的核心任务由此非常明确:它不替你切输入,而是在 autograd 产生梯度后,把各 rank 的 $g_r$ 聚合成相同的 $g$。
不等长时要把“按 rank 平均”改成“按目标中的有效元素加权”。记 rank $r$ 有 $b_r$ 个样本,总数 $B=\sum_r b_r$,则:
$$L=\sum_r\frac{b_r}{B}L_r,\qquad g=\sum_r\frac{b_r}{B}g_r$$
默认 DDP 对梯度按 $N$ 平均;因此把每个本地平均损失乘以 $Nb_r/B$,归约后才等于全局样本均值。若目标是有效 token 的平均,$b_r$ 就应换成有效 token 数,并在同一个累计更新窗口内求总分母;每条回答平均再平均,是另一个目标。自定义通信 hook 或 DDP join 的除数可能改变,不能继续套默认 $N$。
一个可手算的反例:两个 rank 的局部梯度均值为 2 和 8,分别代表 2 和 1 个样本。rank 平均是 5,样本平均是 $(2\times2+8)/3=4$。下文真实 CPU MSE 例子中,错误 rank 平均的最大梯度误差为 0.4166667,正确加权误差仅 $2.22\times10^{-16}$。
DistributedSampler 让各 rank 迭代数相同,不能自动保持原始数据集的严格样本均值。固定 PyTorch v2.10.0 源码实跑:5 个样本、2 个 rank、不打乱时,默认得到 [0,2,4] 与 [1,3,0],样本 0 被补一次;drop_last=True 得 [0,2] 与 [1,3],样本 4 被丢掉。它们各自定义了实际处理的数据多重集。要对原始 5 个样本严格平均,仍需显式处理重复/丢弃和有效权重,并保持各 rank 集体调用顺序一致;只改本地权重而让某 rank 提前退出可能挂起。
设模型有 $P$ 个可训练参数,采用低精度前后向和 FP32 Adam 更新。每个参数对应:
后面三项统称优化器状态,共 12 字节。普通 DDP 每个 rank 的模型状态显存是:
$$M_{\mathrm{DDP}}=(2+2+12)P=16P$$
注意这是该训练状态布局的理想常驻账本,没有包含激活等剩余显存;它不是所有混合精度实现的通用下界。它的价值不是预测 nvidia-smi 到个位数,而是先回答“哪一类状态值得切”。
实际套公式时,$P$ 应取需要优化器更新的参数量,不是配置文件里笼统写出的模型总参数量。冻结的视觉编码器通常仍要保存推理权重,却不产生梯度和 Adam 状态;共享 embedding 在参数统计中也只能算一次。优化器同样会改常数:SGD 无动量时几乎没有 $m,v$,8-bit Adam 会压缩这两份状态,某些纯 BF16 配置也不保留 FP32 主参数。所以正确动作不是背住“训练恒等于 16 字节/参数”,而是先列出当前训练栈真正持有的张量,再把每一项的元素数乘 dtype 字节数。本文使用 16 字节,是为了与 ZeRO 原论文的混合精度 Adam 假设严格对齐。
原生 PyTorch autocast 的另一种常见布局是 FP32 参数 4 字节、FP32 梯度 4 字节、两个 FP32 矩 8 字节,也可能合计 16 字节,但没有另算一份 FP32 主权重。把两种布局混在一起,会重复计算主参数。Adam 的状态通常在首次产生梯度并更新时才创建,初始化后直接读显存也会低估训练稳定阶段。
若有 $P_f$ 个冻结参数,还要加其实际权重字节 $d_fP_f$;它们没有梯度和 Adam 状态,不代表权重不占空间。只有确实参加相同分片方案的冻结权重才能除以 $N$。共享权重按底层存储去重,分片填充、对齐、桶和副本则单列;小模型和不能整除的分片不一定恰好达到 $1/N$。
ZeRO-1:只切优化器状态。 参数和梯度仍然每卡各有一份,12 字节的 FP32 主参数与 Adam 两个矩按 $N$ 份切开:
$$M_{\mathrm{Z1}}=4P+\frac{12P}{N}$$
当 $N$ 很大,第二项趋近于 0,但第一项中的 2 字节参数和 2 字节梯度仍然复制,所以 ZeRO-1 的极限是 $4P$,相对 $16P$ 最多节省 4 倍。
ZeRO-2:再切梯度。 常驻的完整副本只剩 2 字节低精度参数;梯度与优化器状态合计 14 字节一起分片:
$$M_{\mathrm{Z2}}=2P+\frac{14P}{N}$$
当 $N$ 很大,极限是 $2P$,相对普通 DDP 最多节省 8 倍。这里的常驻值不包含反向产生和归约中的临时梯度。所谓“切梯度”不是说某个 rank 永远见不到别人的梯度,而是 reduce-scatter 聚合后,每个 rank 只保留自己负责更新的那一片结果,其余梯度用完即释放。
ZeRO-3:参数也切。 参数、梯度和优化器状态全部只保留 $1/N$:
$$M_{\mathrm{Z3}}=\frac{16P}{N}$$
这时单卡模型状态随卡数线性下降,理论上终于可以使用整个数据并行组的聚合显存。代价是某层计算前必须 all-gather 出完整参数,计算后再 reshard。这里的“完整”通常只针对一个 FSDP unit 或若干层,而不是一次把全模型永远拼回显存;包装粒度如果选错,峰值仍然可能爆掉。
代入 $P=7.5\times10^9$、$N=64$:
这与 ZeRO 原论文表 1中的 120、31.4、16.6、1.88 GB 对上了。论文使用十进制 GB;如果监控工具显示 GiB,同一字节数的 GiB 数值会比 GB 数值小约 6.9%,比较数字前先统一单位。
先固定口径:$W$ 是完整参数的通信字节数,$G$ 是完整梯度的通信字节数,$a=(N-1)/N$。以下数值是理想 ring 每个 rank 的发送字节;接收量相同,若把发送和接收相加要再乘 2。它既不是整个集群的字节总和,也不是实测网卡流量。
ring reduce-scatter 有 $N-1$ 轮,每轮发送张量的 $1/N$,所以每 rank 发送 $aG$;all-gather 同理发送 $aW$。DDP 的 all-reduce 可拆成梯度 reduce-scatter 与梯度 all-gather:
$$V_{\mathrm{DDP}}=2aG$$
ZeRO 论文的理想 Stage 1/2 调度把平均梯度送到状态所有者,再让所有者更新参数,最后聚合参数片:
$$V_{\mathrm{Z1/Z2}}=a(G+W)$$
Stage 1 可在这一调度下不长期释放梯度,Stage 2 进一步释放非所属梯度;二者的通信账不因此翻倍。Stage 3 在前向后释放完整参数,反向前再聚合一次,然后归约梯度:
$$V_{\mathrm{Z3}}=a(G+2W)$$
若参数、梯度通信都为两字节,$W=G=2P$,Stage 3/DDP 比为 $3/2$;但 7.5B/64 卡的精确发送量为 DDP/Stage 1/2 29.53125 GB、Stage 3 44.296875 GB。30/45 GB 是省略 $a$ 的大 $N$ 近似。1.5B/8 卡则为 5.25/7.875 GB,直接用 6/9 GB 会高估约 14.3%。$N=1$ 时所有通信量应为零。
通信 dtype 不同会改变比例。保持两字节参数,改用四字节梯度,7.5B/64 卡下 $W=15$ GB、$G=30$ GB,DDP/Stage 1或2/Stage 3 分别发送 59.0625/44.296875/59.0625 GB;此时 Stage 3 相对 DDP 为 1,而非 1.5。驻留梯度与通信梯度在真实框架中也可能不同,脚本为简单起见让它们共用一个 dtype 参数。
实现名不能代替通信时间轴。 PyTorch v2.10.0 的 DDP + ZeroRedundancyOptimizer 默认先执行 DDP 完整梯度 all-reduce,再由各状态所有者广播更新后的参数。它不能直接套上述 Stage 1 的 $a(G+W)$;若把参数广播理想化为相同带宽的分片聚合,应另算 $2aG+aW$。实际广播树、NCCL 算法、融合及 overlap 路径均会改变流量与时间。这些式子只比较指定调度的带宽项,不是训练时间预测。
实际峰值更接近:
$$M_{\mathrm{peak}}=\max_t\left[S(t)+A(t)+U(t)+R(t)+F(t)\right]$$
这里 $t$ 是训练时间,$S,A,U,R,F$ 分别是同一时刻的模型状态、激活、临时物化/通信/算子空间、运行时和未被前项计入的分配器开销。它们必须按底层存储互不重复;不能把各类在不同时间的峰值直接相加当作实测峰值。
第一项是前面推导的参数、梯度和优化器状态。激活由 batch、序列长度、空间分辨率、层数和 checkpoint 策略决定;临时项包含 all-gather bucket、梯度 bucket 和算子工作区;runtime 包含 CUDA context、通信库等;碎片则取决于张量生命周期和分配器状态。
例如上面的 ZeRO-3 常驻状态是 1.875 GB。若一个 unit 就包含全部 7.5B 参数,完整两字节参数缓冲本身为 15 GB;当它与常驻分片共存时,仅这两项就约 16.875 GB。若实现复用存储,增量需按实际存活缓冲重算;预取下一个 unit 还可能让两个完整缓冲共存。用 $16P/N$ 断言“2 GB 就能训练”会漏掉决定能否启动的窗口。
ZeRO 原论文给过一个很有提醒意义的例子:15 亿参数 GPT-2 的模型状态至少 24 GB;序列长度 1024、batch 32 时,激活约 60 GB,即使用激活重计算降到约 8 GB,临时 FP32 扁平缓冲还可能再占 6 GB。只看 $16P$ 判断“32 GB 正好能放下”会直接翻车。
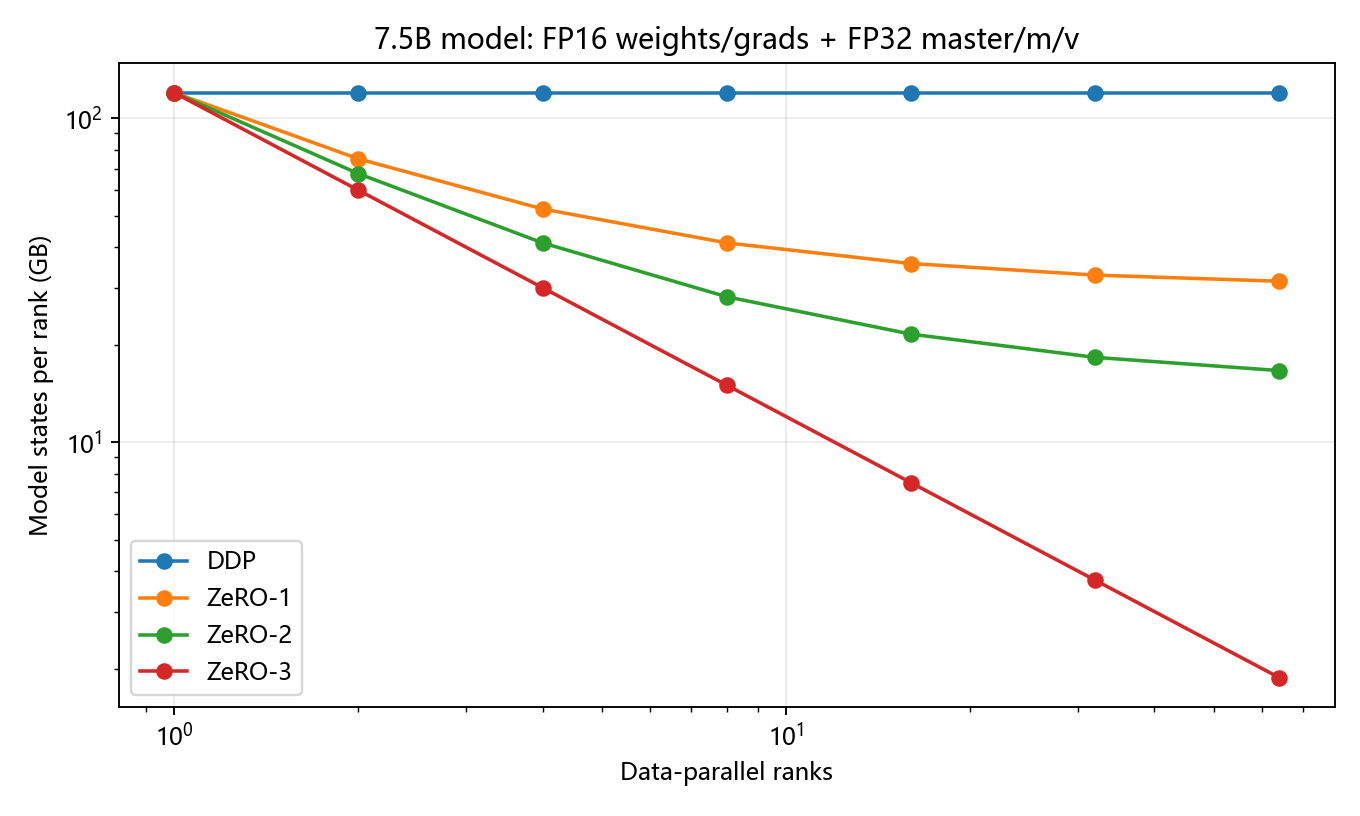
模型状态随数据并行卡数的变化。固定 FP16 参数/梯度与 FP32 主权重及 Adam 状态,纵轴为十进制 GB;不含激活、临时聚合缓冲和运行时。
本节保留两个标准库脚本,并增加一份 NumPy/PyTorch CPU 参考脚本。第一个复现论文显存表;第二个把 DDP all-reduce 与 ZeRO-2 的 reduce-scatter + all-gather 拆开,先验证一次更新,再用混合正负梯度验证连续 12 次 Adam 更新及恢复。完整代码在文末附录。
zero_memory_ledger.py 把每个阶段写成“每卡复制多少字节 + 分片多少字节”:
STAGES = (
    Stage("DDP", 16.0, 0.0),
    Stage("ZeRO-1", 4.0, 12.0),
    Stage("ZeRO-2", 2.0, 14.0),
    Stage("ZeRO-3", 0.0, 16.0),
)

def bytes_per_parameter(self, world_size: int) -> float:
    return self.replicated_bytes + self.sharded_bytes / world_size
replicated_bytes 是每个 rank 必须完整保留的部分,sharded_bytes 是可以除以 $N$ 的部分。默认参数就是论文的 7.5B/64 卡案例。实际运行:
model=7.5B, world_size=64
assumption: params 2B + grads 2B + fp32 master/m/v 12B = 16 bytes/parameter
stage    bytes/param    model-state GB    vs DDP    comm/step GB
DDP         16.0000            120.00      1.00x           29.53
ZeRO-1       4.1875             31.41      3.82x           29.53
ZeRO-2       2.2188             16.64      7.21x           29.53
ZeRO-3       0.2500              1.88     64.00x           44.30
note: activation, temporary buffers and fragmentation are excluded
为什么 64 卡的 ZeRO-1 只有 3.82 倍而不是宣传里的 4 倍?因为 4 倍是 $N\to\infty$ 的上限,有限卡数下 $12P/N$ 还没有消失。ZeRO-2 的 7.21 倍同理。ZeRO-3 没有复制项,所以恰好获得 64 倍。通信列已包含 $(N-1)/N$,是每 rank 发送的理论 GB;表格保留两位小数,精确值见 3.4。用 --grad-bytes 4 可重算四字节梯度的账本;参数通信仍为两字节。
再换成 1.5B/8 卡:
model=1.5B, world_size=8
assumption: params 2B + grads 2B + fp32 master/m/v 12B = 16 bytes/parameter
stage    bytes/param    model-state GB    vs DDP    comm/step GB
DDP         16.0000             24.00      1.00x            5.25
ZeRO-1       5.5000              8.25      2.91x            5.25
ZeRO-2       3.7500              5.62      4.27x            5.25
ZeRO-3       2.0000              3.00      8.00x            7.88
note: activation, temporary buffers and fragmentation are excluded
这组数字揭示一个选型习惯:模型状态只差几 GB 时,ZeRO-1/2 往往已经够用;不必为了追求最低常驻显存直接承担 Stage 3 的参数聚合。
zero_update_simulator.py 构造 4 个 rank、8 个参数。每个 rank 看见不同数据,因此产生不同局部梯度。DDP 路径先得到完整平均梯度,再完整执行 Adam;ZeRO-2 路径只把平均梯度对应的两元素分片交给各 rank,每个 rank 维护自己的 $m,v$,更新后再把四个参数片聚合起来。
核心区别只有分片发生的位置:
reduced_full_grad = average_columns(local_grads)
ddp_params, ddp_m, ddp_v = adam_first_step(PARAMS, reduced_full_grad)

param_shards = shard(PARAMS, WORLD_SIZE)
grad_shards = shard(reduced_full_grad, WORLD_SIZE)
updated_shards = []
for params_for_rank, grads_for_rank in zip(param_shards, grad_shards):
    updated, local_m, local_v = adam_first_step(params_for_rank, grads_for_rank)
    updated_shards.append(updated)
zero_params = [value for part in updated_shards for value in part]
真实运行输出:
world_size=4, parameter_count=8, shard_width=2
local gradient matrix shape=(4, 8)
reduce-scatter result shape=(4, 2)
averaged gradient: [0.02, 0.045, 0.07, 0.095, 0.12, 0.145, 0.17, 0.195]
DDP updated params: [0.099, -0.201, 0.299, -0.401, 0.499, -0.601, 0.699, -0.801]
ZeRO-2 gathered params: [0.099, -0.201, 0.299, -0.401, 0.499, -0.601, 0.699, -0.801]
max_abs_diff=0.000000000000
Adam m/v scalars per rank: DDP=16, ZeRO-2=4, reduction=4.00x
max_abs_diff=0 是本文最重要的代码结果:同一份平均梯度、同一优化器规则下,把参数更新分给不同 rank 并不会改变更新后的模型。每卡 Adam 的 $m,v$ 元素数则从 16 降到 4,正好是 4 倍。真实系统还需要 bucket、异步通信、混合精度和异常恢复,但数学骨架就是这几十行。
不过,Adam 第一步不是足够强的聚合验收。初始 $m=v=0$ 时,偏差修正后更新为:
$$\Delta w=-\eta\frac{g}{|g|+\varepsilon}$$
若梯度全同号且远大于 $\varepsilon$,把 $g$ 错乘一个正数,参数改变量仍几乎只是 $-\eta$。因此保留上面例子作入门,不把它当完整正确性证据。
新补的 multistep() 连续 12 步改变梯度符号与幅度,并直接按目标分片聚合,避免先算全量平均再切片的同源验证。它在每一步分别比较参数、一阶矩和二阶矩;从第 5 步保存的参数、两个矩和全局 step 恢复,再续跑到第 12 步。实跑最大参数/m/v 差和恢复参数差均为 0。故意让 rank 0 漏除以 4,一阶矩最大差为 0.0807017083,验收能够抓住故障。
Adam 每一步的规则是 $m_t=\beta_1m_{t-1}+(1-\beta_1)g_t$、$v_t=\beta_2v_{t-1}+(1-\beta_2)g_t^2$,然后用 $m_t/(1-\beta_1^t)$ 与 $v_t/(1-\beta_2^t)$ 更新对应参数。$m,v$ 都按参数元素独立计算,所以同一归约梯度下可分别更新分片;保存矩却丢掉 $t$,也会改掉偏差修正。这里的 $\eta$ 是学习率,$\varepsilon$ 是开方之后的稳定项,$\beta_1=0.9,\beta_2=0.999$。脚本不使用 weight decay。
两个反例说明哪些操作不能随便交换顺序:
zero_reference.py 在 Python 3.11.9、NumPy 2.4.6、PyTorch 2.10.0+cpu 下实跑。它把同样 12 步梯度送给真实 torch.optim.Adam,逐步检查参数和两个矩,最大误差 $4.16\times10^{-17}$;保存并恢复优化器状态后,后七步结果逐位一致。再对真实线性模型的 MSE 做 autograd,验证 3.1 的不等 batch 加权。
审核时还通过脚本可选参数加载了下载的 PyTorch v2.10.0 原始 Adam 源码与原始采样器源码,整份加载,没有改写函数;原始 Adam 与安装版本结果完全一致。读者日常运行只需 python zero_reference.py,不需要下载目录、GPU、模型权重或进程组。源码下载属于额外审阅证据,不是基本运行的前提。
这是单进程 CPU 的数值与 API 参考核验。没有执行真实 DDP 集体通信、DeepSpeed、FSDP GPU 分片,也没有实测 NCCL 带宽或模型显存;不能把脚本的 0 误差换算成多机吞吐或浮点归约逐位一致的保证。
最小实现为了看懂“切什么”,生产实现要解决的则是“什么时候切、什么时候聚合、怎么让网络传输藏在计算后面”。本轮核对固定 PyTorch v2.10.0 文档/源码与 DeepSpeed v0.18.0 配置定义(2026-10-17 审阅);原理与这些版本的默认调度分开讨论。
PyTorch 的 DistributedDataParallel 常见 GPU 用法是一进程一卡,也支持 CPU 模型;本文的数值验证在 CPU 上完成。它不会自动切分输入;应用通常用 DistributedSampler 保证不同 rank 读取不同样本。模型参数在每卡完整复制,autograd hook 在反向过程中把就绪梯度装进 bucket,并尽早发起 all-reduce,以便通信和后续层反向计算重叠。
这解释了两个常见现象:第一,DDP 通常比单进程 DataParallel 快,因为没有主卡收集和 Python 线程瓶颈;第二,DDP 加卡能缩短时间,却不会降低模型状态的单卡显存。它首先是一种吞吐扩展方案,不是大模型装载方案。
ZeroRedundancyOptimizer:最小改动的 Stage 1 思路PyTorch 的 ZeroRedundancyOptimizer 可以和 DDP 组合。每个 rank 只为大约 $1/N$ 的参数维护本地优化器状态,更新自己负责的参数后广播结果,让所有 DDP 副本重新一致。这对应 ZeRO-1 的核心思想;参数仍完整复制,所以不能把它当成 FSDP 的替代品。
官方文档还标记该 API 为 experimental,并提示启用 overlap_with_ddp=True 时,最初若干迭代可能因为梯度 bucket 尚未稳定而不做参数更新。工程上不能只看“少了多少 GB”,还要读清 API 的更新时序、checkpoint 聚合和版本状态。
DeepSpeed 官方 ZeRO 教程把三个阶段定义得很直接:Stage 1 切优化器状态,Stage 2 再切梯度,Stage 3 再切参数。一个典型配置是:
{
  "zero_optimization": {
    "stage": 2,
    "contiguous_gradients": true,
    "overlap_comm": true,
    "reduce_bucket_size": 500000000
  }
}
contiguous_gradients 针对碎片与通信连续性,overlap_comm 尝试把通信藏进计算,reduce_bucket_size 在“消息大到能吃满带宽”和“临时 bucket 不要撑爆显存”之间取舍。这些开关没有脱离前面的公式,只是在控制公式之外的临时项和时间轴。固定 DeepSpeed v0.18.0 配置源码把 reduce_bucket_size 定义为元素数;500000000 是五亿个元素,不是五亿字节:两字节缓冲约 1 GB、四字节约 2 GB,重叠时还可能同时存活多个缓冲。这个教学配置不是对任意显存容量的推荐值。
如果 GPU 显存仍不够,ZeRO-Offload 可以把优化器状态与计算移到 CPU,ZeRO-Infinity 进一步使用 CPU 和 NVMe。但 官方 ZeRO-Offload 教程 展示的 10B 单 V100 案例并不意味着 offload 免费:PCIe 传输、CPU Adam 吞吐、NUMA 与磁盘带宽会变成新的瓶颈。
知识树里的代码锚点 FullyShardedDataParallel 类 在固定 PyTorch v2.10.0 中存在,已实际读取该类源码;下列为 FSDP1 策略。FSDP1 的 ShardingStrategy 可以这样理解:
NO_SHARD:参数、梯度、优化器状态都复制,行为接近 DDP;SHARD_GRAD_OP:梯度和优化器状态分片,参数在计算窗口内保持完整,接近 ZeRO-2;FULL_SHARD:参数、梯度和优化器状态全分片,接近 ZeRO-3;HYBRID_SHARD:节点内全分片、节点间复制,减少低带宽跨节点通信。另一个代际是 PyTorch 2.10 FSDP2 API 的 fully_shard:FSDP2 以 DTensor 做逐参数分片,不再依赖 FSDP1 的扁平参数;reshard_after_forward=True 对应 FULL_SHARD,设为 False 则更像 SHARD_GRAD_OP。文章或配置里只写“用了 FSDP”已经不够,必须同时说明代际和策略。在本版默认 reshard_after_forward=None 下,非根 unit 通常前向后重新分片,根 unit 默认保留完整参数到反向以省一次聚合;显式布尔值可以覆盖这一行为。因此下面七步生命周期对应显式前向后 reshard 的 full-shard unit,不能宣称所有默认 FSDP2 unit 都反向前再 all-gather。只包装根模块也容易把全模型聚在一起,应从各 block 到根模块逐层应用;优化器须在完成分片后创建。
以 full shard 为例,一个 FSDP unit 在一次训练步里大致经历:
真正决定峰值的不是“最终只存 $1/N$”,而是同一时刻有多少 unit 正在 all-gather、预取队列有多深、最大 unit 有多大。如果把整个模型只包成一个巨型 unit,那么计算前仍要暂时物化全模型;如果把每个很小的算子都单独包起来,又会制造大量小消息,延迟和调度开销反而吞掉吞吐。Transformer 常按 block 包装,就是在这两端之间折中。
FSDP2 的公开契约仍是同一个时间逻辑:前向/反向前由 hook unshard,之后 reshard,梯度用 reduce-scatter 汇聚。实现细节从 flat parameter 变成 DTensor,不代表 ZeRO 的“按需物化”思想变了。
先测量,再逐级加复杂度:
ZeroRedundancyOptimizer;切分不省去同一全局 batch 的模型前向与反向。 集群仍要完成这些数学运算,但原 DDP 在每 rank 重复的完整 Adam 更新可改成各 rank 只更新所属片,因而不能笼统说所有优化器计算也完全不减少。它让每个 rank 少存状态,并通过通信在需要时恢复视图。若模型原本就能舒适放下,Stage 3 很可能只是增加通信和 hook 调度,吞吐反而下降。
通信字节相同,不代表时间相同。 ZeRO-2 与 DDP 在论文模型里都是约 $2G$,但一次大 all-reduce 和许多 layer-wise reduce-scatter/all-gather 的延迟特征不同。NVLink 节点内、InfiniBand 节点间、普通以太网的最优 bucket 大小不会一样;跨节点带宽不足时,1.5 倍 Stage 3 通信尤其明显。
平均显存很低,峰值仍可能 OOM。 参数 all-gather、预取、梯度归约、算子 workspace 可能同时在场。只看稳定阶段的 memory_allocated 会漏掉峰值;要记录 max_memory_allocated,并逐步调 wrap 粒度、prefetch 和 bucket。
ZeRO 解决不了激活随序列长度增长。 视频 DiT 中,时间、宽、高一起扩张,token 数可能成倍增加,注意力和 MLP 保存的激活随之增长。参数切到 1 GB 后仍然爆显存,并不说明 ZeRO 失效,而是瓶颈已经从模型状态转移到激活。
checkpoint 变复杂。 每个 rank 手里只有一片状态,保存时要选择 full、sharded 或 local state dict。把完整 checkpoint 聚合到 rank 0 可能让 CPU 内存瞬间成为瓶颈;只保存分片又要求恢复时正确处理 world size 和布局。训练能跑并不等于容灾链路可用,上线前至少做一次“保存—退出—换步数恢复”的演练。
全局操作必须认识分片。 梯度范数裁剪、参数检查、EMA、冻结部分参数、权重共享都不能默认“当前 rank 能看到完整张量”。例如 FSDP1 提供自己的 clip_grad_norm_,就是因为全局范数需要跨分片归约。绕开框架直接遍历本地 .grad,算到的只是局部值。
offload 是拿带宽换容量。 CPU 内存比显存大,NVMe 又比 CPU 内存大,但层级越远,带宽越低、延迟越高。小模型或计算密度不够的模型会被数据搬运压垮;只有“不 offload 根本跑不了”或计算足以覆盖传输时,这个交换才划算。
大 batch 会改变优化问题。 增加数据并行度时,如果每卡 batch 不变,全局 batch 会随 $N$ 增长。ZeRO 保证同一全局 batch 下更新等价,却不保证扩大 batch 后收敛曲线不变。学习率、warmup、梯度累计和数据采样仍要一起调整。
什么时候不该用 ZeRO-3:模型与激活在单卡尚有充足余量、网络较慢、模型由大量极小模块组成且难以形成高效 bucket,或者你更看重最低延迟和调试简单性。此时 DDP 或 ZeRO-1/2 往往是更好的工程答案。
这条路线不是“突然发明一种分布式训练”,而是一步步把数据并行里的冗余拆掉:
主线可以压缩成一句话:all-reduce 证明“计算可以复制、结果可以同步”,ZeRO 进一步问“既然结果会同步,状态为什么还要复制”。 后续 Offload、Infinity、FSDP 都是在回答状态放在哪、何时出现、以什么粒度搬运。
“数据并行会把模型切到多张卡上。” 不会。普通 DDP 是每卡一个完整模型,只切数据。能把吞吐从一张卡扩到八张,不代表能装下超过单卡容量的参数。
“ZeRO-3 后每卡永远只有 $1/N$ 参数。” 常驻状态是 $1/N$,计算某个 FSDP unit 前仍需临时 all-gather 完整参数。忽略这个瞬时窗口,就会得到理论显存能放、实际 forward 前仍 OOM 的配置。
“ZeRO-2 比 DDP 少传一半梯度,所以一定更快。” ZeRO-2 用 reduce-scatter 只留下梯度片,但更新后还要 all-gather 参数片。按论文的理想字节模型,总通信量与 DDP all-reduce 相同;快慢来自重叠、bucket、拓扑与实现,而非简单少一半。
“用了 ZeRO 就不用 activation checkpointing。” 两者切的是不同账本。ZeRO 处理模型状态冗余;activation checkpointing 用额外重算减少前向激活保存。长视频训练经常需要两者同时用。
“参数是 BF16,所以 Adam 也只占 2 字节。” 常见混合精度训练会保留 FP32 主参数与 FP32 的 $m,v$,优化器部分仍是 12 字节/参数。不同优化器、8-bit optimizer 或纯 BF16 更新会改变常数,因此使用 $16P$ 前必须先列出真实 dtype 与状态。
“64 卡 ZeRO-1 就一定省 4 倍。” 4 倍是 $N$ 很大时的渐近上限。64 卡的精确值是 $16/(4+12/64)=3.82$ 倍;8 卡只有 2.91 倍。宣传中的“up to”不能替代自己的显存账本。
“只要 loss 一样,所有数据并行更新都严格一致。” 浮点归约顺序会改变末位误差,随机数、dropout、数据尾 batch 和非确定性 kernel 也会影响复现。数学上等价不等于 bitwise identical;本文模拟得到 0 误差,是因为使用同一确定性顺序与双精度标量。
下面前四项可在没有 GPU 的机器上完成,第五项需要你自己的真实训练日志。三个数值脚本及配图脚本全文在附录,标准库例子直接用 Python 3 运行;真实参考脚本需安装 NumPy 和 PyTorch,配图另需 matplotlib。
实验一:复现原论文表格。
python zero_memory_ledger.py预期看到 7.5B/64 卡下 DDP、ZeRO-1/2/3 分别为 120.00、31.41、16.64、1.88 GB。如果结果差约 7%,检查自己是不是把 GiB 和十进制 GB 混用了。
实验二:观察有限卡数离理论上限有多远。
python zero_memory_ledger.py --params-b 1.5 --world-size 8预期 ZeRO-1 只省 2.91 倍,ZeRO-2 只省 4.27 倍,ZeRO-3 才精确省 8 倍。再把 world-size 改成 2、4、16、64,观察 Stage 1 向 4 倍、Stage 2 向 8 倍收敛。
实验三:验证更新等价性。
python zero_update_simulator.py预期 DDP 与 ZeRO-2 的八个新参数完全相同,max_abs_diff=0;每 rank 的 Adam $m,v$ 标量数从 16 降为 4。把 local_gradient() 的公式改掉,只要两条路径仍使用同一平均梯度,完整平均与直接分片聚合的更新、两个矩应继续一致;再运行脚本自带的 12 步检查和故障注入,避免只检查第一步。
实验四:核对不等 batch 与真实优化器。 运行 python zero_reference.py,应看到正确加权梯度误差约 2.22e-16、错误 rank 平均误差约 0.4167、12 步 Adam 参数/状态最大误差约 4.16e-17,以及恢复后逐位相同。也可以在标准库模拟器中修改 rank 代表的样本数,观察 5 与 4 的反例。采样器的补齐/丢弃决定实际数据多重集,不能把 drop_last 当成无损修复。
实验五:给自己的模型补全账本。 从训练日志记录参数量、每种状态 dtype、峰值激活与临时 buffer。先用脚本算指定布局的常驻状态,再结合 profiler、分配器快照及 all-gather 时间轴定位额外存储。随序列长度或分辨率增长的差值可能来自激活,也可能来自 attention workspace 和算法选择;输入无关的峰值还可能是参数聚合。改变一个因素再复测,峰值相减只能提供线索,不能单独确定因果。
读完这篇可以沿分布式训练知识树继续:
本文的核心资料均来自原始论文与官方实现:ZeRO 的显存和通信公式以 ZeRO 原论文为准;三阶段配置参考 DeepSpeed ZeRO 官方教程;DDP、优化器分片和 FSDP 策略分别核对了 PyTorch DDP 文档、ZeroRedundancyOptimizer 文档 与 FSDP 文档。代码路径和 API 会随上游重构,工业实现部分注明的日期就是版本边界。
09 节用到的脚本全文如下(zero_memory_ledger.py、zero_update_simulator.py、zero_reference.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
"""复现 ZeRO 论文中的混合精度 Adam 模型状态显存账本。

这里只计算参数、梯度和优化器状态,不包含激活、临时通信缓冲区、
CUDA context 与内存碎片。单位同时使用十进制 GB,便于和论文表格对照。
"""

from __future__ import annotations

import argparse
import math
from dataclasses import dataclass


@dataclass(frozen=True)
class Stage:
    name: str
    replicated_bytes: float
    sharded_bytes: float

    def bytes_per_parameter(self, world_size: int) -> float:
        return self.replicated_bytes + self.sharded_bytes / world_size


STAGES = (
    Stage("DDP", 16.0, 0.0),
    Stage("ZeRO-1", 4.0, 12.0),
    Stage("ZeRO-2", 2.0, 14.0),
    Stage("ZeRO-3", 0.0, 16.0),
)


def gb(byte_count: float) -> float:
    """转为十进制 GB;ZeRO 原论文的 120 GB 使用这个口径。"""
    return byte_count / 1_000_000_000


def communication_bytes(stage: str, params: float, world_size: int,
                        grad_bytes: int = 2) -> float:
    """理想 ring:每 rank 发送字节数;不再加一份接收,未算延迟。"""
    alpha = (world_size - 1) / world_size
    weights, grads = 2 * params, grad_bytes * params
    if stage == "DDP":
        return alpha * 2 * grads
    if stage in ("ZeRO-1", "ZeRO-2"):
        return alpha * (grads + weights)
    return alpha * (grads + 2 * weights)


def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--params-b", type=float, default=7.5,
                        help="参数量,单位十亿;默认复现论文的 7.5B 示例")
    parser.add_argument("--world-size", type=int, default=64,
                        help="数据并行进程数")
    parser.add_argument("--grad-bytes", type=int, choices=(2, 4), default=2,
                        help="驻留及通信梯度的每元素字节数;参数通信固定2字节")
    args = parser.parse_args()
    if not math.isfinite(args.params_b) or args.params_b <= 0 or args.world_size <= 0:
        raise ValueError("params-b 与 world-size 必须为正数")

    params = args.params_b * 1_000_000_000
    print(f"model={args.params_b:g}B, world_size={args.world_size}")
    print(f"assumption: params 2B + grads {args.grad_bytes}B + "
          f"fp32 master/m/v 12B = {14 + args.grad_bytes} bytes/parameter")
    print("stage    bytes/param    model-state GB    vs DDP    comm/step GB")
    ddp_bytes = 14 + args.grad_bytes
    for stage in STAGES:
        extra = args.grad_bytes - 2
        bpp = stage.bytes_per_parameter(args.world_size)
        bpp += extra if stage.name in ("DDP", "ZeRO-1") else extra / args.world_size
        state_gb = gb(params * bpp)
        saving = ddp_bytes / bpp
        comm_gb = gb(communication_bytes(stage.name, params, args.world_size, args.grad_bytes))
        print(f"{stage.name:<8} {bpp:>10.4f} {state_gb:>17.2f} "
              f"{saving:>9.2f}x {comm_gb:>15.2f}")

    print("note: activation, temporary buffers and fragmentation are excluded")
    print("comm: ideal ZeRO schedule, per-rank sent bytes, finite-N ring factor included")
    print("not measured network traffic; PyTorch ZRO+DDP may use a different schedule")


if __name__ == "__main__":
main()#!/usr/bin/env python3
"""用单进程模拟 DDP 与 ZeRO-2 的单步及多步 Adam 更新。
脚本不依赖 GPU、PyTorch 或分布式运行时。四个“rank”先各自产生一份局部
梯度,再比较两条路径:DDP 对完整梯度做 all-reduce;ZeRO-2 对梯度做
reduce-scatter、每个 rank 只更新自己的参数片,最后 all-gather 参数。
"""
from __future__ import annotations
import math
import copy
import json
WORLD_SIZE = 4
PARAMS = [0.10, -0.20, 0.30, -0.40, 0.50, -0.60, 0.70, -0.80]
LEARNING_RATE = 1e-3
BETA1 = 0.9
BETA2 = 0.999
EPSILON = 1e-8
def local_gradient(rank: int, width: int) -> list[float]:
"""构造确定性的局部梯度,模拟每个 rank 看见不同数据。"""
return [((rank + 1) * (index + 2) - 3) / 100.0 for index in range(width)]
def average_columns(rows: list[list[float]]) -> list[float]:
return [sum(column) / len(rows) for column in zip(*rows)]
def shard(vector: list[float], world_size: int) -> list[list[float]]:
if len(vector) % world_size:
raise ValueError("为了让示例清楚,参数量必须能被 world_size 整除")
width = len(vector) // world_size
return [vector[rank * width:(rank + 1) * width]
for rank in range(world_size)]
def adam_first_step(params: list[float], grads: list[float]) -> tuple[list[float], list[float], list[float]]:
"""执行 Adam 的第 1 步,并返回新参数、m、v。"""
new_params: list[float] = []
m_state: list[float] = []
v_state: list[float] = []
for value, grad in zip(params, grads):
m = (1.0 - BETA1) * grad
v = (1.0 - BETA2) * grad * grad
m_hat = m / (1.0 - BETA1)
v_hat = v / (1.0 - BETA2)
updated = value - LEARNING_RATE * m_hat / (math.sqrt(v_hat) + EPSILON)
new_params.append(updated)
m_state.append(m)
v_state.append(v)
return new_params, m_state, v_state
def adam_step(params, grads, m, v, step):
"""逐元素 Adam,无weight decay;epsilon在开方之后,使用全局step。"""
m = [BETA1 * a + (1 - BETA1) * g for a, g in zip(m, grads)]
v = [BETA2 * a + (1 - BETA2) * g * g for a, g in zip(v, grads)]
p = [a - LEARNING_RATE * (mi / (1 - BETA1 ** step)) /
(math.sqrt(vi / (1 - BETA2 ** step)) + EPSILON)
for a, mi, vi in zip(params, m, v)]
return p, m, v
def mixed_gradients(step):
return [[math.sin((r + 1) * (j + 1) * 0.73 + step * 0.47) +
0.2 * math.cos(j + step) for j in range(len(PARAMS))]
for r in range(WORLD_SIZE)]
def reduce_scatter_direct(rows):
"""直接聚合每个目标分片;不先构造完整平均梯度。"""
width = len(rows[0]) // WORLD_SIZE
return [[sum(row[j] for row in rows) / WORLD_SIZE
for j in range(r * width, (r + 1) * width)]
for r in range(WORLD_SIZE)]
def multistep(steps=12):
p = PARAMS[:]; m = [0.] * len(p); v = m[:]
parts = shard(p, WORLD_SIZE); ms = shard(m, WORLD_SIZE); vs = shard(v, WORLD_SIZE)
wrong_parts = copy.deepcopy(parts); wrong_ms = copy.deepcopy(ms); wrong_vs = copy.deepcopy(vs)
max_p = max_m = max_v = resume_error = 0.
saved = None
for t in range(1, steps + 1):
rows = mixed_gradients(t)
p, m, v = adam_step(p, average_columns(rows), m, v, t)
gs = reduce_scatter_direct(rows)
for r in range(WORLD_SIZE):
parts[r], ms[r], vs[r] = adam_step(parts[r], gs[r], ms[r], vs[r], t)
# 故障注入:某rank漏了平均中的除以world_size。
bad = [g * WORLD_SIZE for g in gs[r]] if r == 0 else gs[r]
wrong_parts[r], wrong_ms[r], wrong_vs[r] = adam_step(
wrong_parts[r], bad, wrong_ms[r], wrong_vs[r], t)
flat = lambda xs: [a for x in xs for a in x]
diff = lambda a, b: max(abs(x - y) for x, y in zip(a, b))
max_p = max(max_p, diff(p, flat(parts)))
max_m = max(max_m, diff(m, flat(ms)))
max_v = max(max_v, diff(v, flat(vs)))
if t == 5:
saved = json.loads(json.dumps(dict(step=t,params=parts,m=ms,v=vs)))
# 从第5步保存的参数、矩和全局step恢复;继续到同一第12步。
for t in range(saved['step'] + 1, steps + 1):
gs = reduce_scatter_direct(mixed_gradients(t))
for r in range(WORLD_SIZE):
saved['params'][r],saved['m'][r],saved['v'][r] = adam_step(
saved['params'][r],gs[r],saved['m'][r],saved['v'][r],t)
resume_error = diff(p, flat(saved['params']))
bad_m = diff(m, flat(wrong_ms))
# 先各rank做本地Adam再平均参数,与先平均梯度再Adam不交换。
rows = [[1.] * 8, [1.] * 8, [1.] * 8, [-2.] * 8]
correct = adam_first_step(PARAMS, average_columns(rows))[0]
local = average_columns([adam_first_step(PARAMS,g)[0] for g in rows])
local_adam_error = diff(correct, local)
# 两分片梯度[3,4],阈值1。全局裁剪为[.6,.8];分别裁剪为[1,1]。
local_clip_norm = math.sqrt(2.)
# rank平均2与8,各代表2和1样本。
unweighted, weighted = (2 + 8) / 2, (2 * 2 + 8) / 3
result=dict(steps=steps,max_parameter_error=max_p,max_m_error=max_m,max_v_error=max_v,
resume_parameter_error=resume_error,wrong_reduce_m_error=bad_m,
local_adam_then_average_error=local_adam_error,
independently_clipped_global_norm=local_clip_norm,
uneven_rank_mean=unweighted,uneven_sample_mean=weighted)
assert max(max_p,max_m,max_v,resume_error) < 1e-14
assert bad_m > 0.01 and local_adam_error > 0.0004 and unweighted != weighted
return result
def main() -> None:
local_grads = [local_gradient(rank, len(PARAMS))
for rank in range(WORLD_SIZE)]
# DDP:每个 rank 经 all-reduce 得到同一份完整平均梯度,并完整更新参数。
reduced_full_grad = average_columns(local_grads)
ddp_params, ddp_m, ddp_v = adam_first_step(PARAMS, reduced_full_grad)
# ZeRO-2:reduce-scatter 的结果等价于先平均,再只保留所属分片。
param_shards = shard(PARAMS, WORLD_SIZE)
grad_shards = shard(reduced_full_grad, WORLD_SIZE)
updated_shards: list[list[float]] = []
state_sizes: list[int] = []
for params_for_rank, grads_for_rank in zip(param_shards, grad_shards):
updated, local_m, local_v = adam_first_step(params_for_rank, grads_for_rank)
updated_shards.append(updated)
state_sizes.append(len(local_m) + len(local_v))
# all-gather 后每个 rank 都能拿到同一份新参数;这里拼接一次代表该结果。
zero_params = [value for part in updated_shards for value in part]
max_abs_diff = max(abs(a - b) for a, b in zip(ddp_params, zero_params))
shard_width = len(PARAMS) // WORLD_SIZE
print(f"world_size={WORLD_SIZE}, parameter_count={len(PARAMS)}, "
f"shard_width={shard_width}")
print(f"local gradient matrix shape=({WORLD_SIZE}, {len(PARAMS)})")
print(f"reduce-scatter result shape=({WORLD_SIZE}, {shard_width})")
print("averaged gradient:", [round(x, 4) for x in reduced_full_grad])
print("DDP updated params:", [round(x, 6) for x in ddp_params])
print("ZeRO-2 gathered params:", [round(x, 6) for x in zero_params])
print(f"max_abs_diff={max_abs_diff:.12f}")
print(f"Adam m/v scalars per rank: DDP={len(ddp_m) + len(ddp_v)}, "
f"ZeRO-2={state_sizes[0]}, reduction={WORLD_SIZE:.2f}x")
print("multistep:", json.dumps(multistep(), sort_keys=True))
if __name__ == "__main__":
main()"""真实CPU Adam/梯度加权对照:Python3.11、NumPy、PyTorch2.10。
不启动进程组、不需要GPU;不声称测量了DDP/ZeRO网络或显存。
可选 --official-dir 指向已下载的v2.10.0官方adam.py与sampler源码目录。
"""
import argparse
import copy
import importlib.util
import json
from pathlib import Path
import numpy as np
import torch
from zero_update_simulator import PARAMS, average_columns, mixed_gradients, multistep, adam_step
def load_original(name, file):
spec = importlib.util.spec_from_file_location(name, file)
module = importlib.util.module_from_spec(spec)
spec.loader.exec_module(module)
return module
def probe(adam_class):
p = torch.tensor(PARAMS, dtype=torch.float64, requires_grad=True)
optimizer = adam_class([p], lr=1e-3, betas=(.9,.999), eps=1e-8,
foreach=False, fused=False)
q=PARAMS[:]; m=[0.] * 8; v=m[:]; saved=None; error=0.
for step in range(1,13):
g=average_columns(mixed_gradients(step))
p.grad=torch.tensor(g,dtype=torch.float64); optimizer.step()
q,m,v=adam_step(q,g,m,v,step)
state=optimizer.state[p]
for actual,expected in [(p.detach().tolist(),q),(state['exp_avg'].tolist(),m),
(state['exp_avg_sq'].tolist(),v)]:
error=max(error,max(abs(a-b)for a,b in zip(actual,expected)))
if step==5:saved=(p.detach().clone(),copy.deepcopy(optimizer.state_dict()))
p2=saved[0].clone().requires_grad_(True)
o2=adam_class([p2],lr=1e-3,foreach=False,fused=False)
o2.load_state_dict(saved[1])
for step in range(6,13):
p2.grad=torch.tensor(average_columns(mixed_gradients(step)),dtype=torch.float64);o2.step()
assert torch.equal(p,p2)
return dict(max_state_parameter_error=error,resume_bitwise_equal=True,final_parameters=p.detach().tolist())
def weighted_gradients():
x=torch.tensor([[1.,0.],[0.,1.],[2.,1.]],dtype=torch.float64)
y=torch.tensor([1.,-2.,.5],dtype=torch.float64)
w=torch.tensor([.2,-.3],dtype=torch.float64,requires_grad=True)
full=torch.autograd.grad(((x@w-y)**2).mean(),w)[0]
gs=[]
for indices in [slice(0,2),slice(2,3)]:
gs.append(torch.autograd.grad(((x[indices]@w-y[indices])**2).mean(),w)[0])
correct=(2*gs[0]+gs[1])/3;wrong=(gs[0]+gs[1])/2
# DDP默认按rank平均:每个rank的局部mean乘 N*b_r/B。
ddp_scaled=(gs[0]*(2*2/3)+gs[1]*(2*1/3))/2
return dict(global_gradient=full.tolist(),correct_max_error=float((full-correct).abs().max()),
ddp_scaled_max_error=float((full-ddp_scaled).abs().max()),
wrong_max_error=float((full-wrong).abs().max()))
def main():
parser=argparse.ArgumentParser();parser.add_argument('--official-dir',type=Path);a=parser.parse_args()
torch.set_num_threads(1)
result=dict(torch=torch.__version__,numpy=np.__version__,device='cpu',simulator=multistep(),
installed_adam=probe(torch.optim.Adam),weighted_mse=weighted_gradients())
if a.official_dir:
original=load_original('torch.optim.reviewed_adam',a.official_dir/'adam_v2.10.0.py')
result['official_adam']=probe(original.Adam)
assert result['official_adam']==result['installed_adam']
sampler=load_original('reviewed_sampler',a.official_dir/'sampler_v2.10.0.py')
dataset=list(range(5))
result['sampler']={}
for drop in [False,True]:
parts=[list(sampler.DistributedSampler(dataset,num_replicas=2,rank=r,
shuffle=False,drop_last=drop))for r in range(2)]
result['sampler'][str(drop)]=parts
assert result['sampler']=={'False':[[0,2,4],[1,3,0]],'True':[[0,2],[1,3]]}
assert result['installed_adam']['max_state_parameter_error']<1e-14
assert result['weighted_mse']['correct_max_error']<1e-14
assert result['weighted_mse']['wrong_max_error']>0.1
output='reference_official_results.json' if a.official_dir else 'reference_results.json'
Path(__file__).with_name(output).write_text(json.dumps(result,indent=2),encoding='utf8')
print(json.dumps(result,indent=2))
if __name__=='__main__':
main()"""Regenerate this article's deterministic teaching figure (numpy + matplotlib)."""
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
OUT=Path(__file__).resolve().parents[1]/"figures"
OUT.mkdir(exist_ok=True)
plt.rcParams.update({"font.sans-serif":["Microsoft YaHei","DejaVu Sans"],"axes.unicode_minus":False})
n=np.array([1,2,4,8,16,32,64]); p=7.5e9
fig,ax=plt.subplots(figsize=(8,4.8))
for name,y in [("DDP",np.full(n.shape,16.)),("ZeRO-1",4+12/n),("ZeRO-2",2+14/n),("ZeRO-3",16/n)]:
ax.plot(n,y*p/1e9,"o-",label=name)
ax.set(xscale="log",yscale="log",xlabel="Data-parallel ranks",ylabel="Model states per rank (GB)",title="7.5B model: FP16 weights/grads + FP32 master/m/v")
ax.legend();ax.grid(alpha=.25);fig.tight_layout()
fig.savefig(OUT/'zero_states.png',dpi=170)
plt.close(fig)
print(OUT/'zero_states.png')

评论 (0)