今日 AIGC 论文速览
今日共 10 篇
重点论文标题列表
Video DeltaNet (UC Berkeley × Impossible Inc. × UT Austin):线性注意力让H3快14.5倍dQwen3.5 (University of Texas at Austin):混合骨干省一半适配tokenEdit-VAR (中山大学 × 华南理工大学 × 清华大学 × 山东大学 × 南开大学 × 湖南大学):免训练免反演改视频Paint-Anything (ByteDance Seed × 浙江大学 × 南京大学):写个十六进制就能上色StepAudio 3 Music (StepFun(阶跃星辰)× ACE × 香港中文大学 × UC San Diego):先写ABC谱再生成5分半歌
今日论文速览
1. Video DeltaNet:线性注意力让H3快14.5倍
Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation | UC Berkeley × Impossible Inc. × UT Austin | arXiv:2609.20744
关键词 :视频扩散模型,线性注意力,混合注意力,推理加速
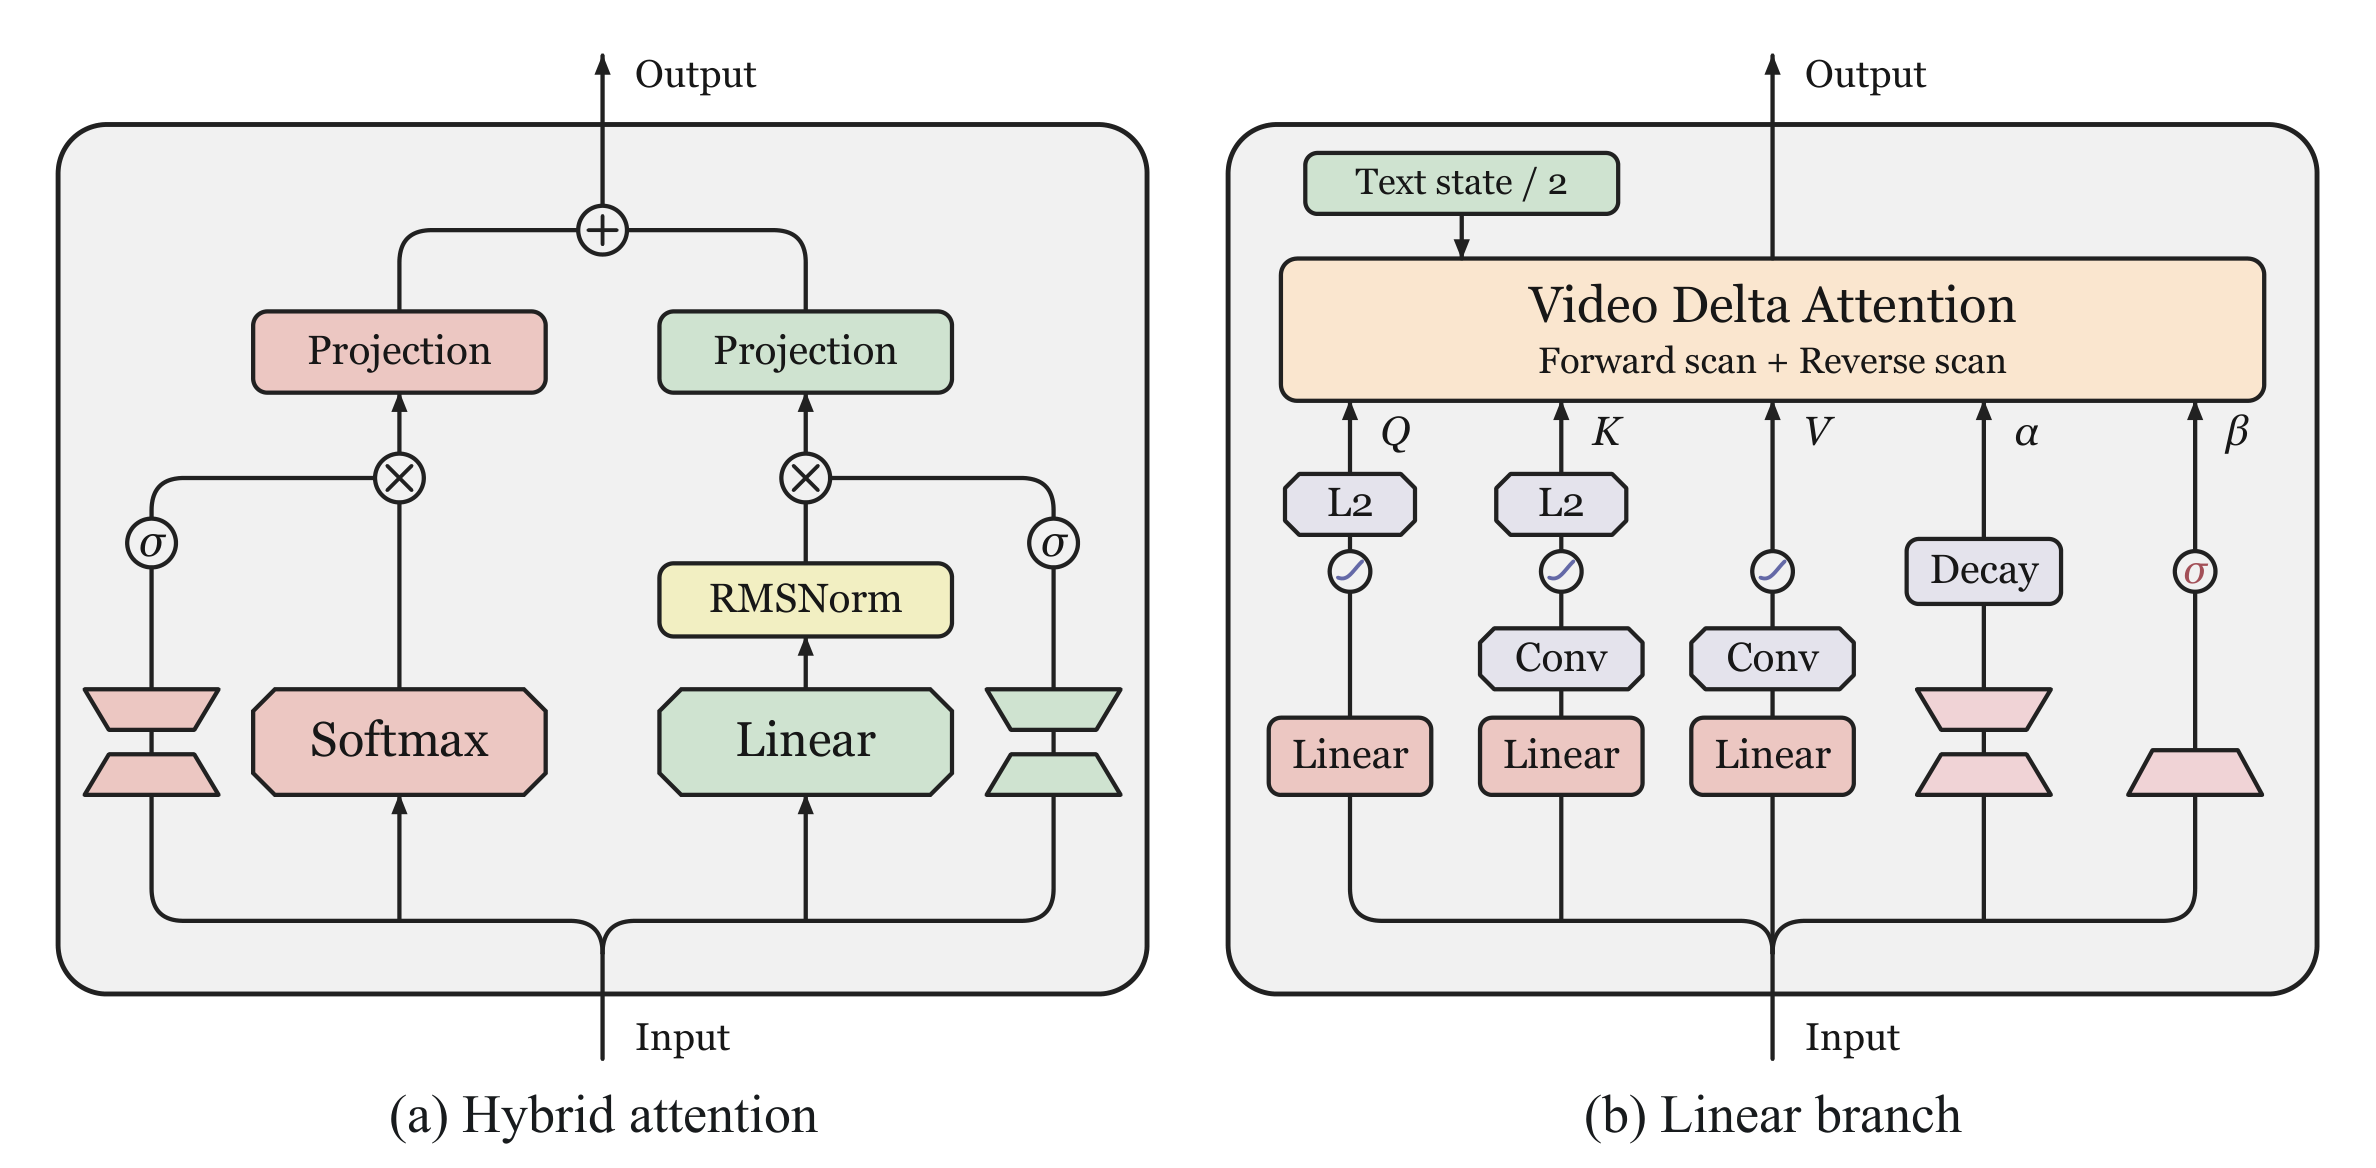
前序问题 :视频扩散模型每一步去噪都要把又长又宽的时空 token 序列过一遍注意力,算力全压在这里。线性注意力在大语言模型里已经被验证好用,但直接搬到视频模型上会丢掉细粒度交互,画面质量跟着掉——于是「省算力」和「保质量」一直是二选一。本文贡献 :论文提出 Video DeltaNet(VDN),不做纯替换而是双分支并存:局部 Softmax 注意力管近处的细粒度交互,双向线性记忆管长程视频上下文。线性分支的核心是 Video Delta Attention(VDA),它不按 token 逐个更新记忆,而是以「帧」为单位、把该帧的全部空间 token 一起吸收进去,一帧只更新一次。两个分支各有独立的输出投影和可学习门控来校准配比;适配则走分阶段的教师对齐配方(Stage A1 先单独对齐每个线性分支,A2 再端到端训练组装后的混合层),把新通路渐进地塞进已预训练的模型里。作者把 VDN 落在 MiniMax H3 上,只对 video-to-video 这类交互用混合注意力,凡是牵涉文本或音频的交互仍然保留 Softmax。
实验效果 :配合八步蒸馏和优化过的 SGLang 服务栈,VDN-H3 在 8 张 NVIDIA B200 上生成 14.3 秒 768p 视频,DiT 去噪只用 6.70 秒,相对同样 8 卡、50 步的 dense H3 基线提速 14.5 倍。质量方面:50 步时 Stage B 后的 VDN-H3 与蒸馏前的 Dense H3 基本持平(美学、技术、学习质量、FIRM 各项接近,仅两个端点保真度指标略降);八步时在五项无参考质量指标上全部最高,VQA_T 比 FastH3 v2 高 10.78 分;四步时同样在五项上超过 Dense H3 加 Larry 适配器与 FastH3 v1,VQA_T 领先 FastH3 v1 达 12.64 分。
批判点评 :这篇的价值在于把「线性注意力用于视频」从整体替换改成了按交互类型分流:视频与视频之间用线性,涉及文本、音频的跨模态交互留给 Softmax,承认了不同交互对精度的敏感度本就不一样,比一刀切务实得多。以帧为单位更新记忆也和视频 tokenizer 的时间结构对齐(H3 的 VAE 按五个连续潜帧为一个时间块解码,窗口顺着它走以免 Softmax 边界切断 tokenizer 的自然时间单元)。要留意的是 14.5 倍里混进了八步蒸馏和服务栈优化的贡献,架构本身的净收益要看 50 步那组对照;论文也明确说八步那组的显著性标记是各变体与 Dense 50 比,并非 VDN-H3 直接对 FastH3。另外全部结论都长在 MiniMax H3 这一个骨干上,换模型是否还成立尚无证据。
2. dQwen3.5:混合骨干省一半适配token
dQwen3.5: Hybrid-Attention Diffusion Language Models | University of Texas at Austin | arXiv:2609.20751
关键词 :扩散语言模型,混合注意力,模型适配,并行解码
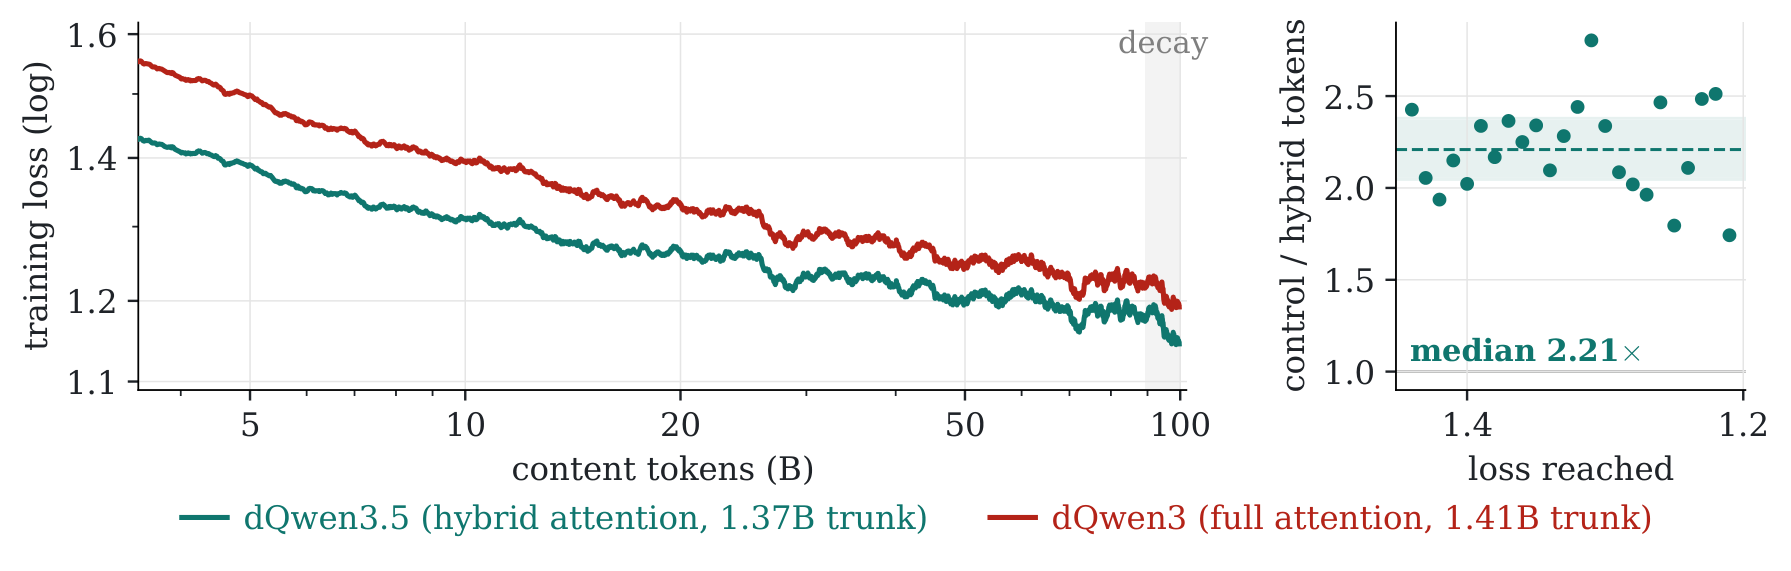
前序问题 :把预训练好的自回归模型改造成扩散语言模型(DLM)是条省钱路线,但几乎所有现成改造都从全注意力 Transformer 出发。问题是自回归这边早就转向了注意力与 RNN 层交错的混合架构,而 RNN 结构上就是因果的,要把它双向化并不容易——骨干和目标范式对不上。本文贡献 :作者索性直接试:以 Qwen3.5 为起点,在 0.8B、2B、4B、9B 四个规模上做自回归到扩散的适配,得到 dQwen3.5 系列,并拿一个全注意力模型做对照,专门回答两个问题——混合骨干是否是高效的适配起点,适配出来的模型还保不保留定义 DLM 的并行与任意序解码行为。评测统一用同一套解码方案(默认画布 1024)而非各家自带的推理配方,并用 trunk(去掉 embedding 与输出头)参数量作为容量口径对齐比较组。
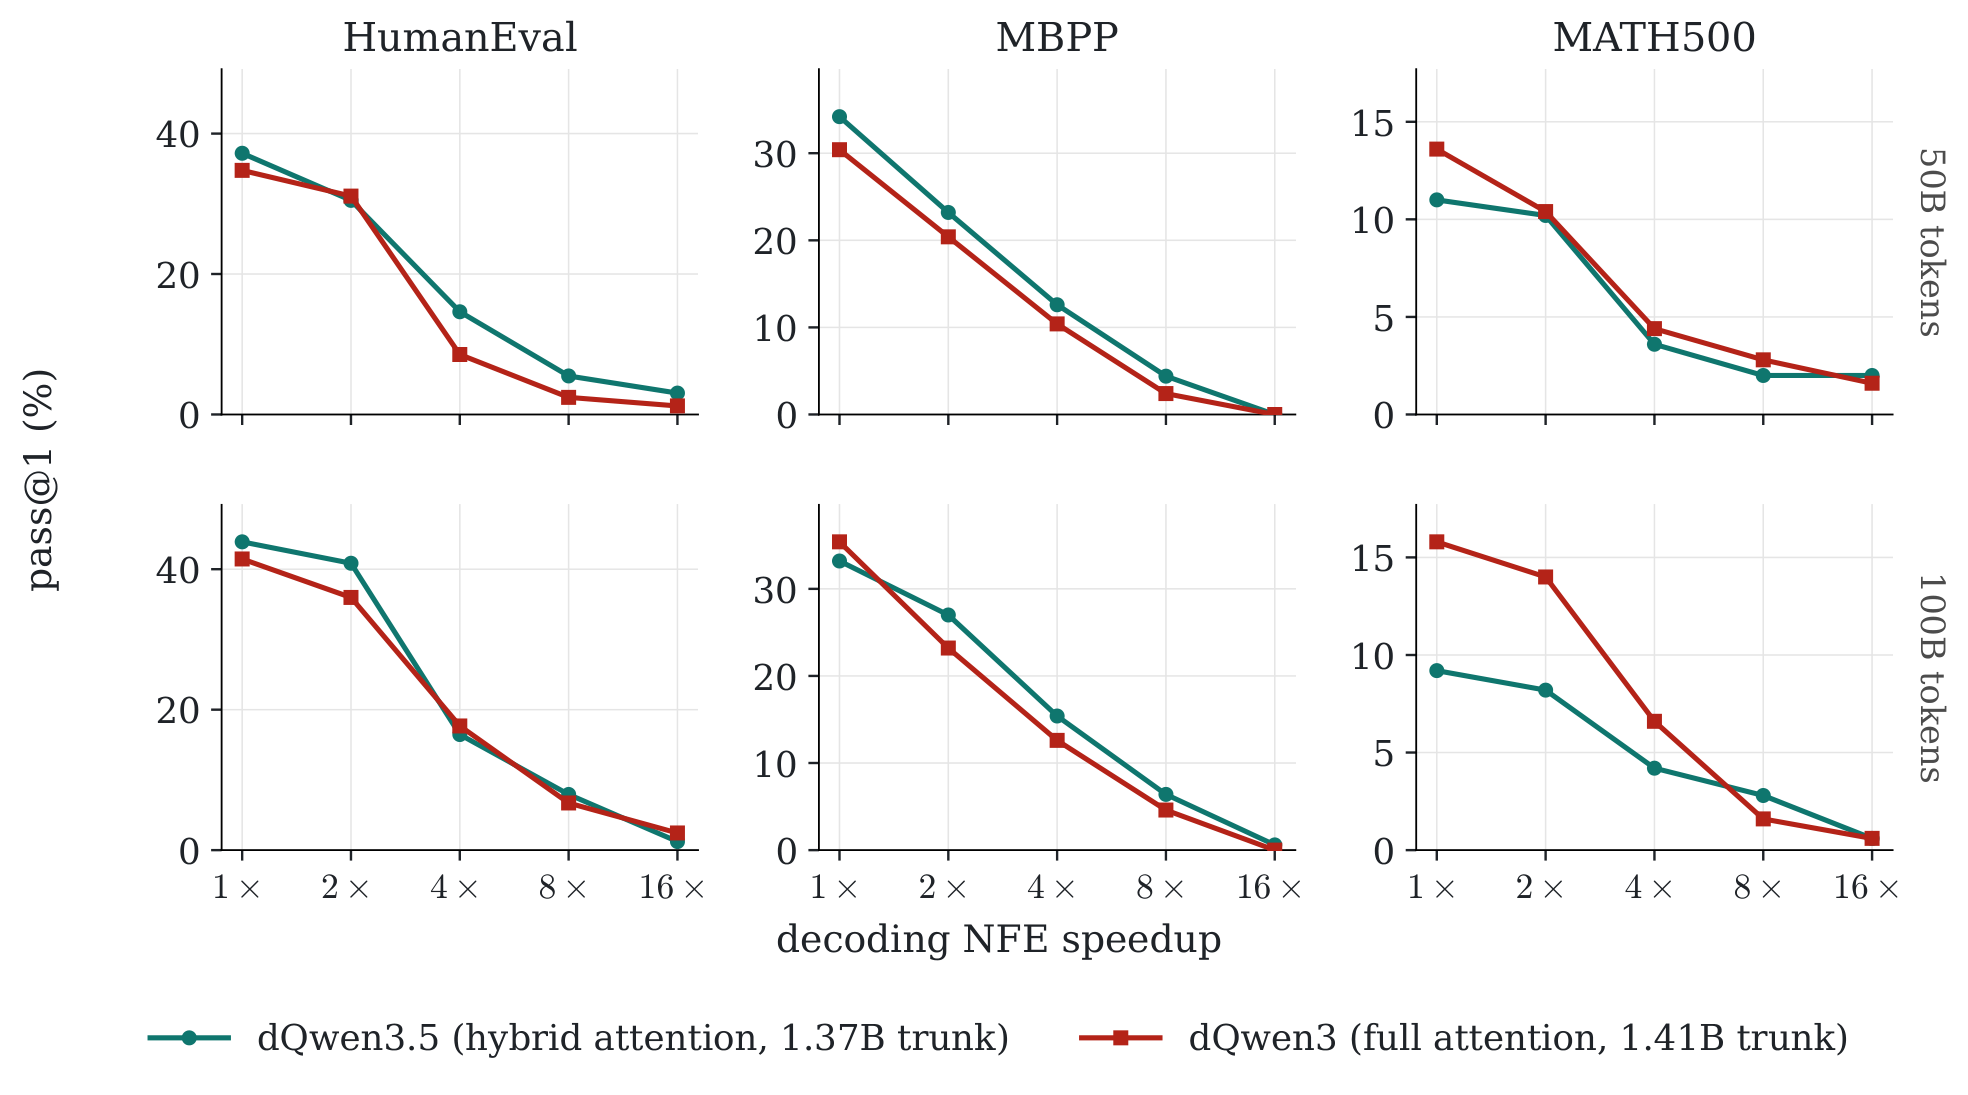
实验效果 :混合骨干确实更省:达到同一训练 loss 所需的 token 量大约只要全注意力对照的一半,配图上逐个 loss 档位统计的中位数是 2.21 倍 token 效率差。跨规模看,dQwen3.5 在任意序解码行为上与全注意力 DLM 相似,并行解码下表现强劲——HumanEval 与 MBPP 上 1× 到 8× 加速区间基本压住全注意力对照。
批判点评 :结论有用且反直觉:结构上「不适合」双向化的混合骨干,反而是更划算的 DLM 起点,这对想复用现成混合架构权重的人是直接的好消息。但配图暴露了摘要没提的代价——在 MATH500 上,100B token 档的混合版明显落后全注意力对照(1× 时约 9.3% 对 15.8%),数学推理这一块的损失不小,只有在 4× 以上高加速区间才靠后者衰减更快而追平。作者自己在注释里也怀疑退化可能来自训练数据混合不如 Qwen3/Qwen3.5 原始配方,这等于承认「骨干差异」和「数据差异」还没被干净地分离。另外全部比较都在基座 checkpoint 上做,后训练被明确排除在外,而后训练对下游表现影响很大,所以这套结论离「能直接上线」还有距离。
3. Edit-VAR:免训练免反演改视频
Edit-VAR: Taming Visual Autoregressive Model for Precise Video Editing | 中山大学 × 华南理工大学 × 清华大学 × 山东大学 × 南开大学 × 湖南大学 | arXiv:2609.21268
关键词 :视频编辑,视觉自回归,免训练,token替换
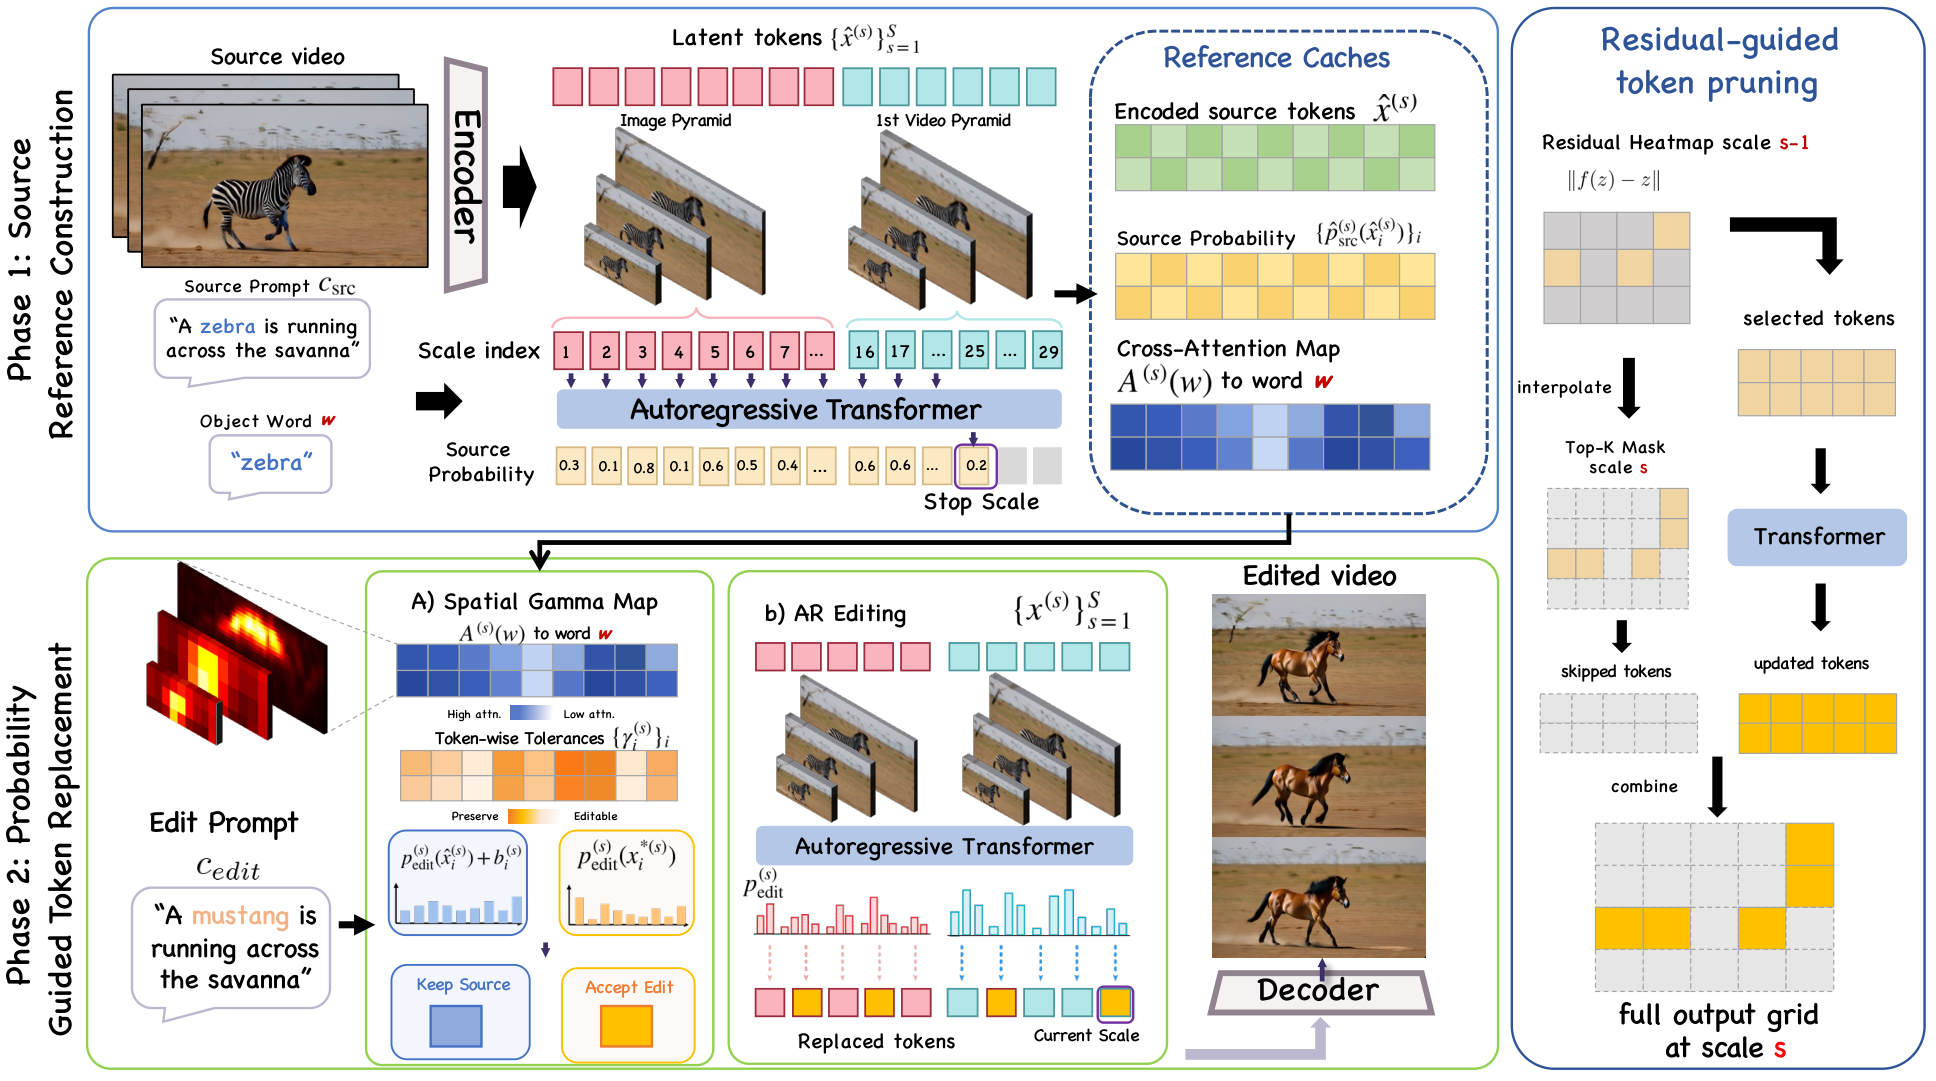
前序问题 :文本引导的视频编辑要改对目标内容,同时保住没被编辑区域的外观和时间连贯。训练型方法控制力强但吃数据吃算力;免训练方法分两条路,免反演的不用恢复轨迹,可它那套保源引导会限制编辑强度、让语义改动做不彻底;反演型先恢复潜轨迹再重生成,近似误差会累积,导致源内容漂移和时间不一致。本文贡献 :Edit-VAR 是第一个基于预训练视觉自回归视频模型、既免训练又免反演的文本引导视频编辑框架。它把源视频直接编码成多尺度离散 token,用概率引导的条件 token 替换来保源;再用注意力引导的 token 级与尺度感知调制,只在与编辑相关的位置和生成阶段选择性放松源约束。Scale-Decoupled Generation 以「晚期尺度解除约束」的形式实现,负责重新生成运动一致的细节、减少纹理碎裂。另有残差引导的 token 剪枝,利用最后两个高分辨率尺度上的冗余来压推理开销。
实验效果 :大量实验加一项盲测用户研究显示,Edit-VAR 在编辑保真度、源内容保持、时间连贯性和推理效率上整体优于现有免训练视频编辑方法。定性对比里,同样把「red boat hull」改成「dark blue boat hull」、把「tree frog」改成「poison dart frog」,VACE 会连船型和背景一起改,RAVE 整片色调偏移、青蛙变成纯绿,Edit-VAR 则只换掉目标物的颜色与纹理,港口的其他船、水面倒影和叶片细节都留住了。
批判点评 :把编辑搬到离散多尺度 token 上做,绕开了连续扩散反演的误差累积,这个切换是这篇最实在的地方——问题定位在「反演」而不是泛泛的「一致性」,配套的概率引导替换也把「保源还是接受编辑」变成了可按 token 判定的显式比较。但摘要通篇只给「整体优于」的定性结论,没有一个具体数字,编辑保真与源保持之间的权衡到底移动了多少无从判断;残差剪枝说是降推理成本,省了多少、掉不掉质量也没披露。更根本的限制是它绑在视觉自回归视频模型上,而这类骨干的开源生态和画质上限目前都不如主流扩散视频模型,方法再好也受骨干天花板约束。
4. Paint-Anything:写个十六进制就能上色
Paint-Anything: Unified Any-Color Control for Image Generation and Editing | ByteDance Seed × 浙江大学 × 南京大学 | arXiv:2609.20816
关键词 :图像生成,图像编辑,颜色控制,数据管线
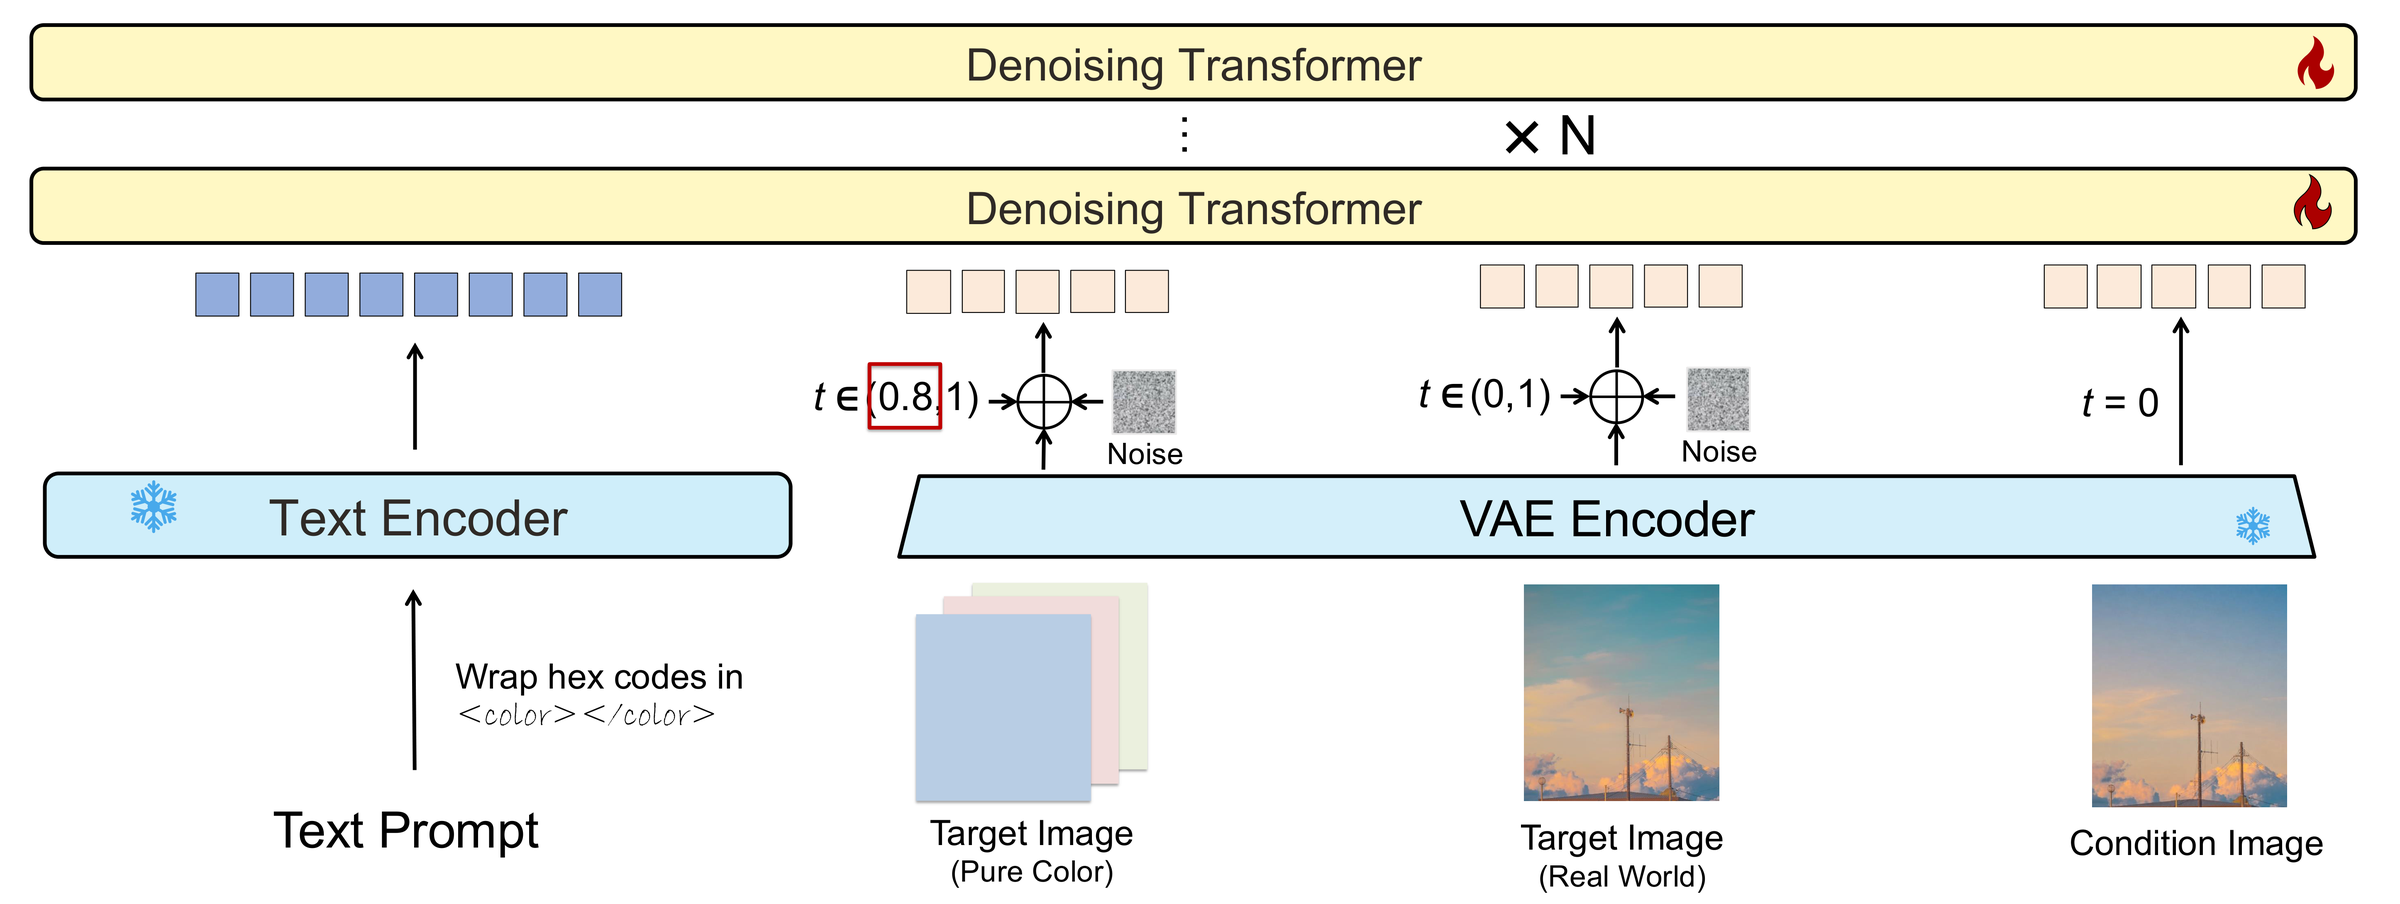
前序问题 :专业设计需要的是任意颜色控制:用任一 24 位十六进制值指定某个物体的目标颜色,生成和编辑都得听话。以往工作在颜色生成、编辑、上色上各做一块,却往往依赖专门的颜色表示或特制的推理流程,不通用。而大语言模型这边提供了一个更简单的起点——连小模型都已经能把十六进制值和颜色语义对上。本文贡献 :Paint-Anything 直接把十六进制写进文本提示(包在 color 标签里)由文本编码器编码,通过物体级颜色监督学出一套生成与编辑共享的 hex-prompt 接口。配套数据管线从真实图像构建 Paint-500K:经 VLM 定位、SAM3 掩码、CIE 空间颜色提取、编辑对合成、过滤与重新描述而成。关键设计是:真实图像有阴影,标签只能算近似颜色,所以再补一批纯色锚点——它们的像素与配对的十六进制严格一致;而这些锚点只在高噪声时间步参与训练,低噪声阶段仍交给自然图像,避免把纯色的平坦质感带进成品。论文还提出 Any Color Benchmark(ACBench),含 ACBench-T2I 与 ACBench-Edit 两部分,专门量物体级十六进制颜色保真度。
实验效果 :在 FLUX.2-4B 上,Paint-Anything 把 ACBench-T2I 和 ACBench-Edit 分数相对基座分别提升 85.3% 和 28.3%,并在参与比较的方法中取得最高的平均 CompColor 分。消融实验支持这套训练配方。定性对比里基座 FLUX.2-4B 常给出「语义上说得通但数值上离要求很远」的颜色——要 #FF5634 的车身给成偏红、要 #000080 的沙漠绿洲给成亮蓝,Paint-Anything 则能贴住指定色值。
批判点评 :「纯色锚点只在高噪声时段用」这个细节是全文最值得抄的一笔:它承认了监督信号在不同噪声尺度上的可信度不同,用时间步做分工而不是简单混数据,比多数「加一路干净监督」的做法更讲究。把十六进制塞进文本提示、不引入专门颜色编码器,也让它能直接挂在现成模型上。但 85.3% 是相对基座的提升,基座本身在这项上分数低,相对增幅容易放大;编辑侧只有 28.3%,两者差距说明编辑任务里颜色约束和内容保持的冲突还没解决好。更要紧的是 ACBench 是作者自建的评测,「在自家基准上提升最多」这件事需要外部复现才能定性。另外全部结果都在 FLUX.2-4B 上,跨骨干的可迁移性未验证。
5. StepAudio 3 Music:先写ABC谱再生成5分半歌
StepAudio 3 Music Technical Report | StepFun(阶跃星辰)× ACE × 香港中文大学 × UC San Diego | arXiv:2609.16034
关键词 :音乐生成,音频tokenizer,MoE,流匹配DiT
前序问题 :长篇音乐生成要同时满足两件事:既能按开放域文本指令走,又得让和声、节奏、旋律结构立得住。以重建为导向的音频 tokenizer 会把音乐结构和精细声学细节混在一起,产出高熵 token 不好建模;而模型若只是端到端硬生,编曲结构就成了隐式的、不可控的副产物。本文贡献 :StepAudio 3 Music 走离散与连续混合的设计。StepAudio Music Tokenizer 把音频表示成 50 Hz 的单码本流(码本 65536 条),靠语义引导的自监督与多任务训练同时保住音乐结构和重建所需信息;论文用受控对比(统一 25 Hz 帧率)比较了单码本 VQ、Semantic RVQ、Acoustic RVQ 三种离散瓶颈,以及不同 DiT 配置,才定下这个方案。渲染侧由流匹配 DiT 预测连续的 StepAudio VAE 潜变量,再由 VAE 解码器还原 48 kHz 音频。显式规划则交给一个 MoE 自回归模型:它先用 ABC 记谱法产出中间编曲方案(ABC-CoT),再去预测音乐 token,让和声、节奏、旋律结构成为生成上下文的一部分。渐进式训练课程加监督微调支撑歌曲与纯器乐生成、由干声生成伴奏、翻唱合成,最长 5 分 30 秒。
实验效果 :经 DPO 强化学习后,模型在 AudioBox 的 Content Enjoyment、Content Usefulness、Production Quality 三项以及 MuQ-MuLan 相似度上取得所评系统中的最高分,SongBench 结果具备竞争力。在 Artificial Analysis Music Arena Vocals 初步榜上 Quality Elo 为 1105。
批判点评 :「先写 ABC 谱再生成音频」把编曲从隐式副产物提成了显式可读的中间态,这既是可控性抓手也是可调试性抓手,是这篇最有辨识度的设计;单码本 50 Hz 加流匹配 DiT 的分工,也把「离散好建模」和「连续好还原」各自的长处分开用了。但榜单要看细账:Vocals 榜上它实际是第 4 名(前面是 Suno V5.5 的 1170、Mureka V9 的 1159、Mureka V8 的 1140),摘要里「仅次于 Suno V5.5 和 Mureka」的说法把 Mureka 两个版本折叠了,读起来比实际名次靠前。更关键的是它的投票样本只有 2119,而同榜 Suno、MiniMax 等都在 1 万以上,95% 置信区间也宽到 ±14,和第 5 名 Suno V5(1097,±6)的差距在统计上并不稳。论文自己也说明这些评测衡量的是生成质量,并不直接度量对单个 ABC 音符、和弦、小节的遵循程度——也就是说 ABC-CoT 到底被执行得多准,目前没有直接证据。
6. PhysStream:边生成边推物理的流式视频
PhysStream: Streaming Physics-Grounded Video Generation with Structured Scene Memory and Fine-Grained Motion Control | University of Pennsylvania × Snap Inc. × KAUST | arXiv:2609.17521
关键词 :视频生成,物理一致性,自回归,交互控制
前序问题 :视频生成的交互控制正从粗糙提示走向对动态场景做细粒度、物理上有意义的操纵。但现有可控方法要么要求生成开始前就给出完整控制时间表,要么用像素空间信号去规定物体位置——那是在指派位置,而不是在指定物理动力学。本文贡献 :PhysStream 是面向物理接地的图生视频的自回归模型,带两样东西。一是结构化场景记忆:位置图与物体跟踪图都从已生成的帧里在线导出,边生成边更新。二是用稀疏的速度增量信号做细粒度运动控制,这些信号编码的是物理量,让模型去学底层动力学而不是背位置。训练分两阶段:先用运动控制条件微调一个双向模型,再训练一个因果自回归模型并额外接入结构化场景记忆,进一步提升物理一致性。
实验效果 :PhysStream 支持对多物体桌面刚体场景做交互式的、生成中途的控制——这是此前方法不具备的能力。合成基准上运动分布距离(FVMD)比最强基线降低 33%,轨迹误差降低 12%;野外对比中超过 85% 的情况被人类评估者更偏好。长时程上,配图里一只玉色茶杯在桌面随机走动,从 t=0 一路走到 t=180 帧,远超 49 帧的训练窗口,仍持续跟随随机注入的速度增量交互并保持外观不崩。
批判点评 :「控制信号编码物理量而非像素位置」这个取舍是关键:它把可控性问题从「让模型听话地摆物体」改成「让模型学会动力学然后自己推演」,这也是它能支持生成中途插入交互、而不需要预先排好完整控制表的根因。结构化场景记忆从已生成帧在线导出,避免了额外的外部状态追踪,工程上干净。但作者自己单列了一张图说明一致性指标的局限——FlashMotion 的一致性分数和本方法相当,却有明显伪影和幻觉物体,DragStream 生成近乎静止的画面也能拿高分,这等于承认 33% 和 12% 这两个提升所依赖的指标体系本身可信度有限,真正支撑结论的是那 85% 的人类偏好。适用范围也偏窄:主战场是多物体桌面刚体,非刚体只给了弹跳球和布料两个微调后的演示,离通用物理场景还远。
7. DeepSeek-V4.1-Flash:每token只留890字节KV
DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression | DeepSeek-AI | arXiv:2609.19969
关键词 :KV cache压缩,MoE,长上下文,推理成本
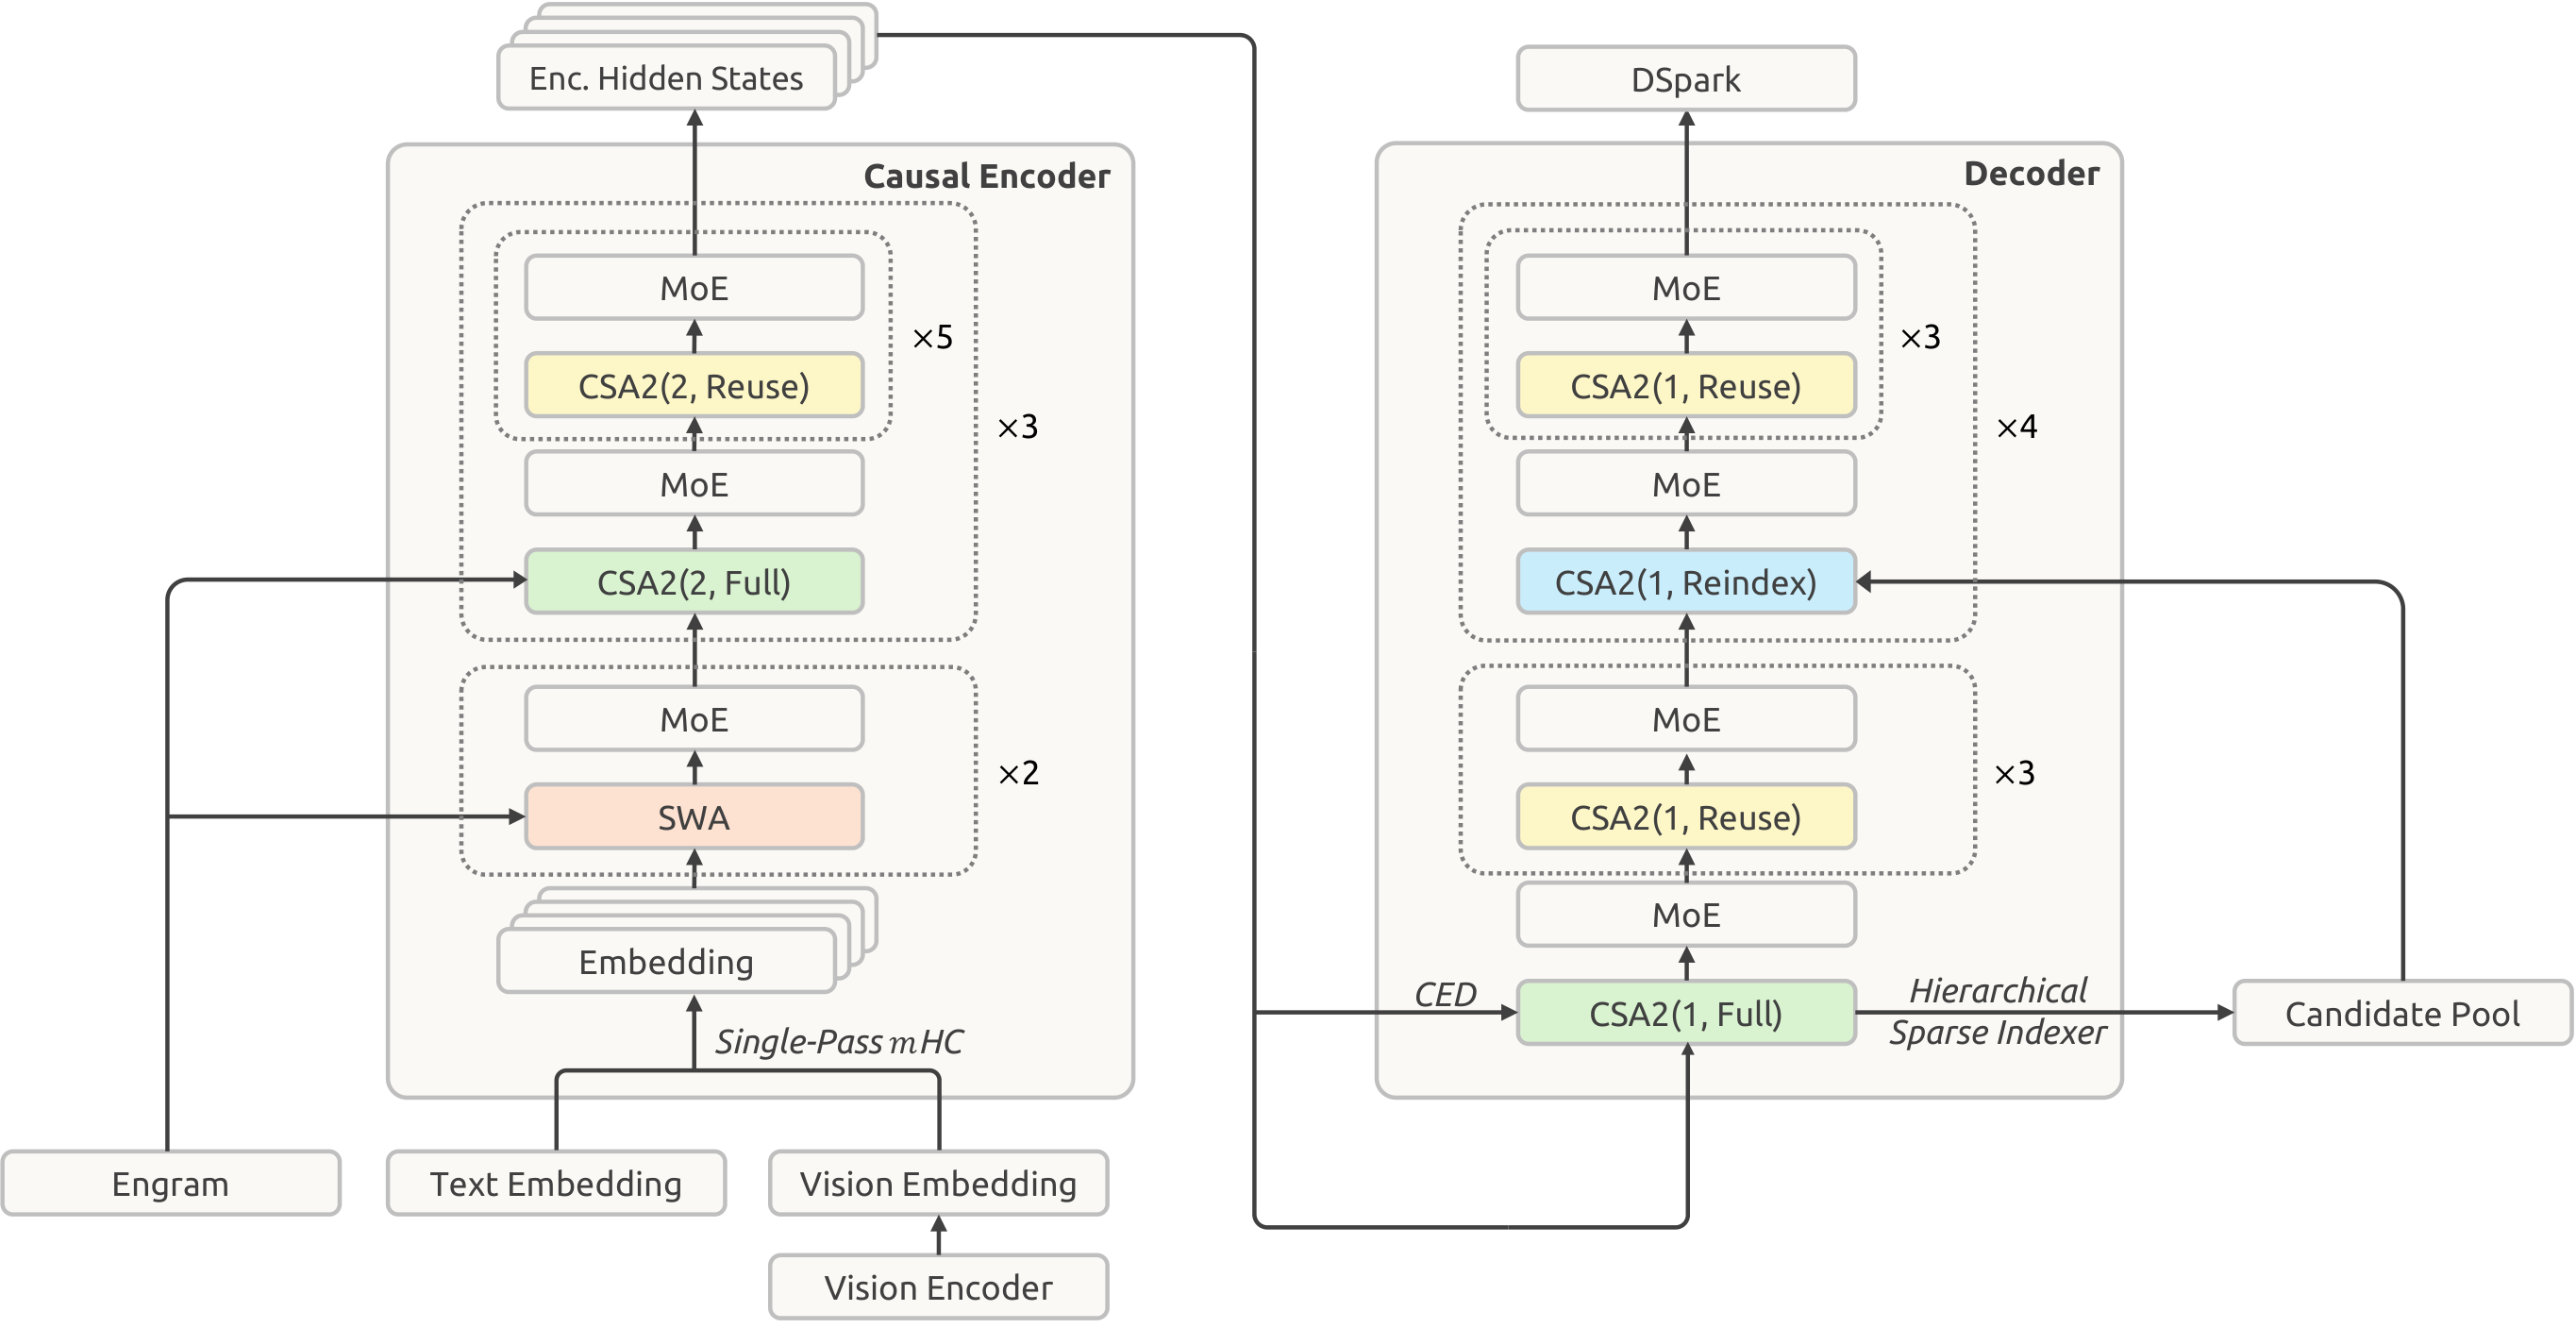
前序问题 :长时程智能体大规模铺开后,模型负载越来越偏输入重。尽管此前工作已大幅降低长上下文计算成本,prefill 仍然很贵,而庞大的 KV cache 继续挤占 HBM 与 SSD 容量、吃掉数据传输带宽。算力、存储、带宽这三份需求合起来,构成了进一步压低部署成本的主要瓶颈。本文贡献 :DeepSeek-V4.1-Flash 是一个多模态 MoE 模型,骨干 552B 参数,支持最长 100 万 token 上下文。它采用因果编码器-解码器(CED)架构:解码时每 token 激活 16B 参数,prefill 时只激活 8B,这对智能体这类输入重负载显著改善成本效率。为把 KV cache 压缩推到极限,模型把 Compressed Sparse Attention 2(CSA2)里的跨层 KV cache 复用与 FP4 KV 缓存结合起来,使常驻 HBM 的全局 KV cache 降到每 token 890 字节,约为 DeepSeek-V4-Flash 的四分之一。再通过名为 SWA Bounded Replay 的部署优化,把常驻 SSD 或主机内存的持久 KV cache 压到约八分之一。论文另外精简了 V4 架构并引入若干高效扩展,在 45T token 的多模态语料上预训练并做了完整后训练。
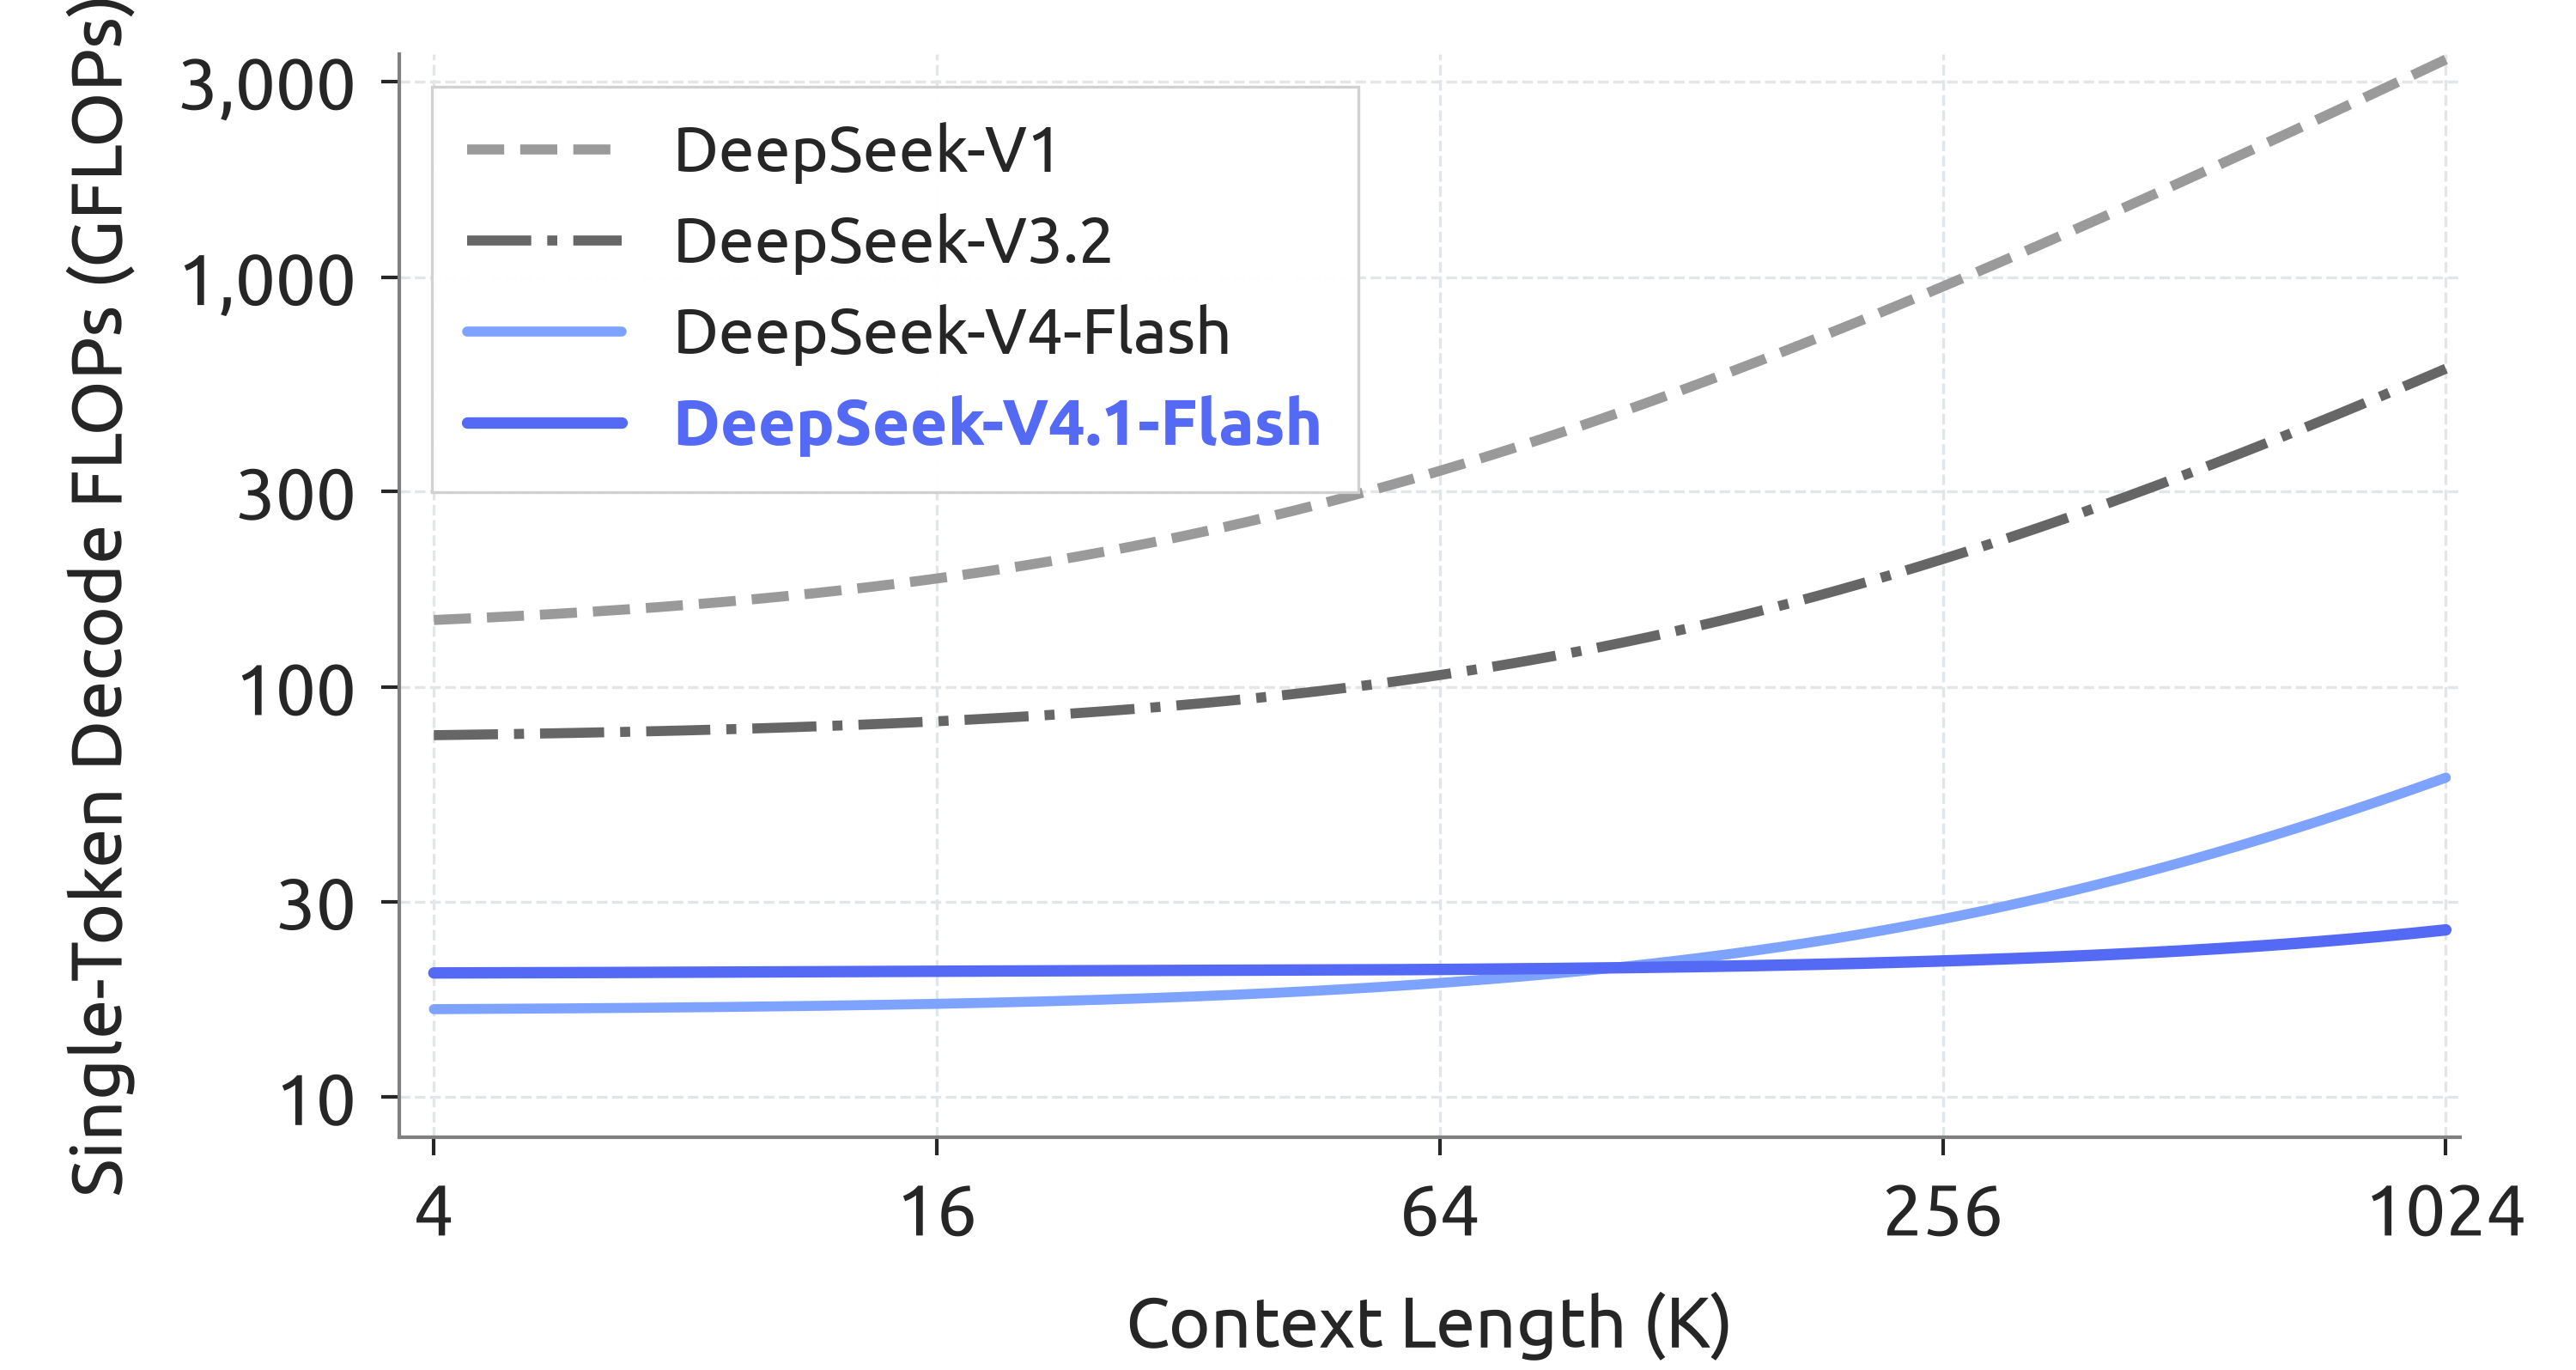
实验效果 :KV cache 占用大幅缩小的同时,性能明显好于基线。单 token decode FLOPs 随上下文增长的曲线上,V4.1-Flash 到 1024K 仍基本持平在 25 GFLOPs 上下,而 V4-Flash 已升到约 55、V3.2 约 600、V1 超过 3000。预训练阶段在自建留出集上,V4.1-Flash-Base 的 BPB 在所有任务上均低于 V4-Flash-Base 与 V4-Pro-Base。代码智能体基准上性能随 RL 训练规模持续提升,把最大上下文进一步扩到 1M token 后,在极长时程任务上还能继续涨。模型权重已在 HuggingFace 放出。
批判点评 :890 字节每 token 这个数字值得记住:它把长上下文的讨论从「模型记不记得住」彻底拽到了「cache 放不放得下、搬不搬得动」,而 prefill 8B、decode 16B 的非对称激活更是直接冲着智能体负载「输入远大于输出」的真实形状去的,属于按负载画像改架构。但 FLOPs 曲线也显示,在约 100K 以下的上下文里 V4.1-Flash 反而略高于 V4-Flash(约 23 对 19 GFLOPs),这套设计是拿短上下文的一点效率换长上下文的大幅收敛,主要跑短请求的场景未必划算。另外 FP4 KV 缓存在什么任务上会先露出精度问题、SWA Bounded Replay 对首 token 延迟的影响如何,摘要都没交代;593 位作者的技术报告里工程优化与架构贡献高度耦合,外部想复现出同样的 890 字节与同等质量,难度不低。
8. The Weight Is Over:12GB显卡跑亚秒出图
The Weight Is Over - Interactive Diffusion on Consumer GPUs | Adobe × NVIDIA | arXiv:2609.21849
关键词 :端侧推理,扩散加速,文本编码器蒸馏,显存预算
前序问题 :端侧推理正在爆发,但势头几乎全在语言模型那边。扩散管线吃显存、对延迟敏感,还要编排文本编码器、Transformer、解码器以及后处理若干环节,这套流程远没有大模型推理循环那么标准化,落到消费级设备上格外难办。本文贡献 :论文在性能、质量、模型体积这个三角里找可落地的点,给出三项贡献:一个嵌入翻译器,把小文本编码器映射到大编码器的表示空间,从而砍掉权重与延迟;一套可复现的扫参配方,用来在扩散管线的速度/质量/显存三角里做导航;以及一个端侧交互式图像生成编辑器,在较新的 GPU 上实现亚秒级首图时间(TTFI)。
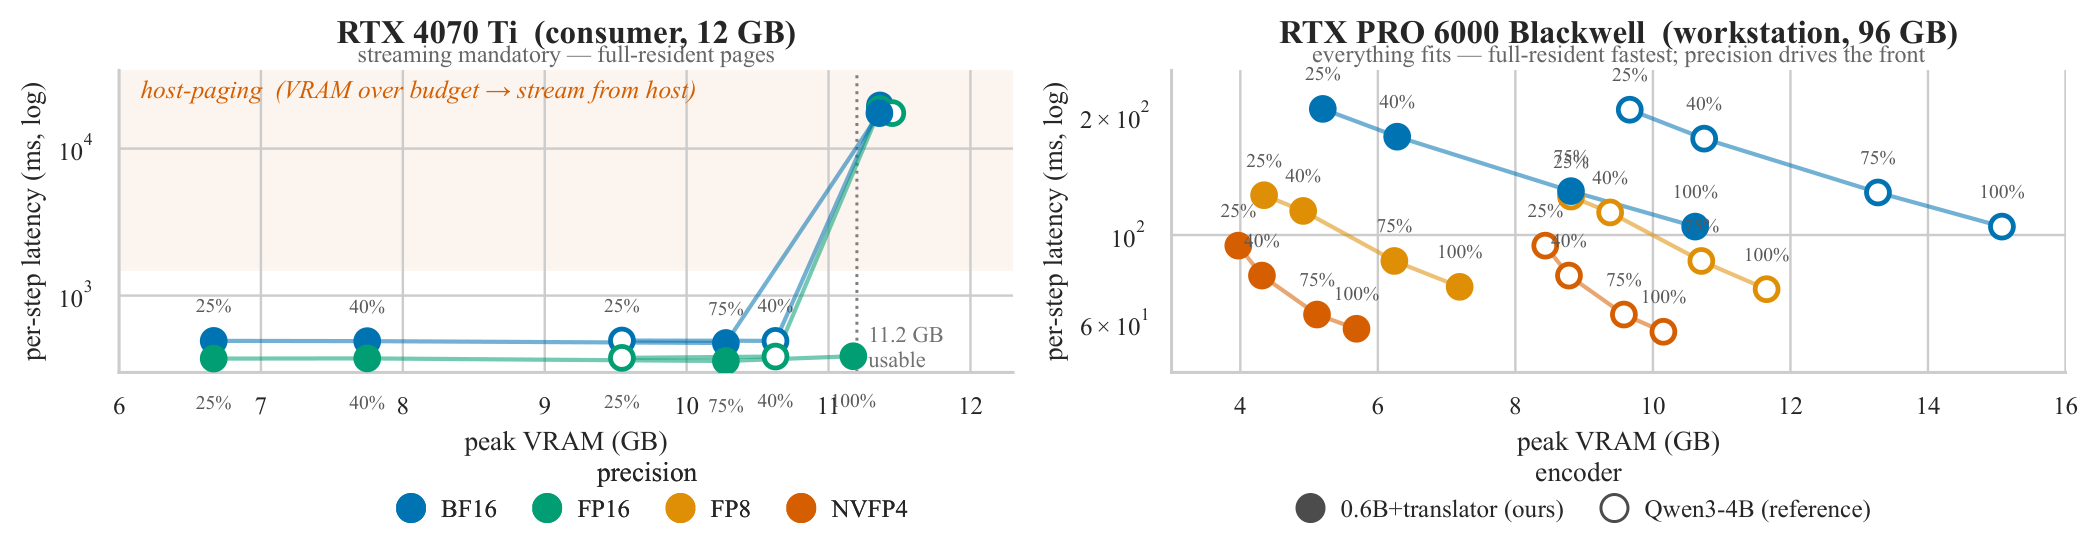
实验效果 :跨设备扫参结果最能说明问题。RTX 4070 Ti(12 GB,可用约 11.2 GB)上,只要常驻权重预算没超出可用显存,每步延迟稳定在数百毫秒量级;一旦越过 11.2 GB 就触发 host-paging、必须从主机流式取权重,每步延迟直接跳到 10^4 毫秒级,相当于一个断崖。工作站级 RTX PRO 6000 Blackwell(96 GB)上「什么都放得下」,此时主导排序的就变成精度——NVFP4 最快,FP8 次之,FP16/BF16 落后。嵌入翻译器的容量门槛也量出来了:187M 的翻译器能紧跟 4B 参考编码器,29M 就会漂到「看着合理但内容不对」(要狐狸给猫、要拉面给黄色玩偶),3.5M 则塌缩成一种同质的暗黑森林风格。
批判点评 :这篇的实用价值不在某个新模块,而在把「显存预算」立成了一等约束并画出了那条断崖:越过可用显存的惩罚不是线性变慢而是一到两个数量级,这意味着端侧调优的第一目标应该是「压进预算」而不是「提高吞吐」,顺序搞反了后面全是白做。把翻译器容量与语义保真的关系摸到 187M/29M/3.5M 三个档,也给了很实际的选型下界。但工作偏工程报告:只有两位作者、两台设备,没有跨更多消费级显卡的统计;质量评价主要靠定性图,缺少 FID 之类的量化指标,「187M 紧跟 4B」到底差多少无法量化。亚秒 TTFI 也限定在「较新的 GPU」上,对更老的消费级卡是什么表现没有交代。
9. MuSeC:语义声学分流的音乐codec
Rethinking Music Tokenization: A Semantic Codec toward High-Fidelity LLM Music Generation | 西北工业大学 ASLP × 吉利汽车研究院(宁波) | arXiv:2609.21240
关键词 :音乐tokenizer,语义codec,残差量化,音乐信息检索
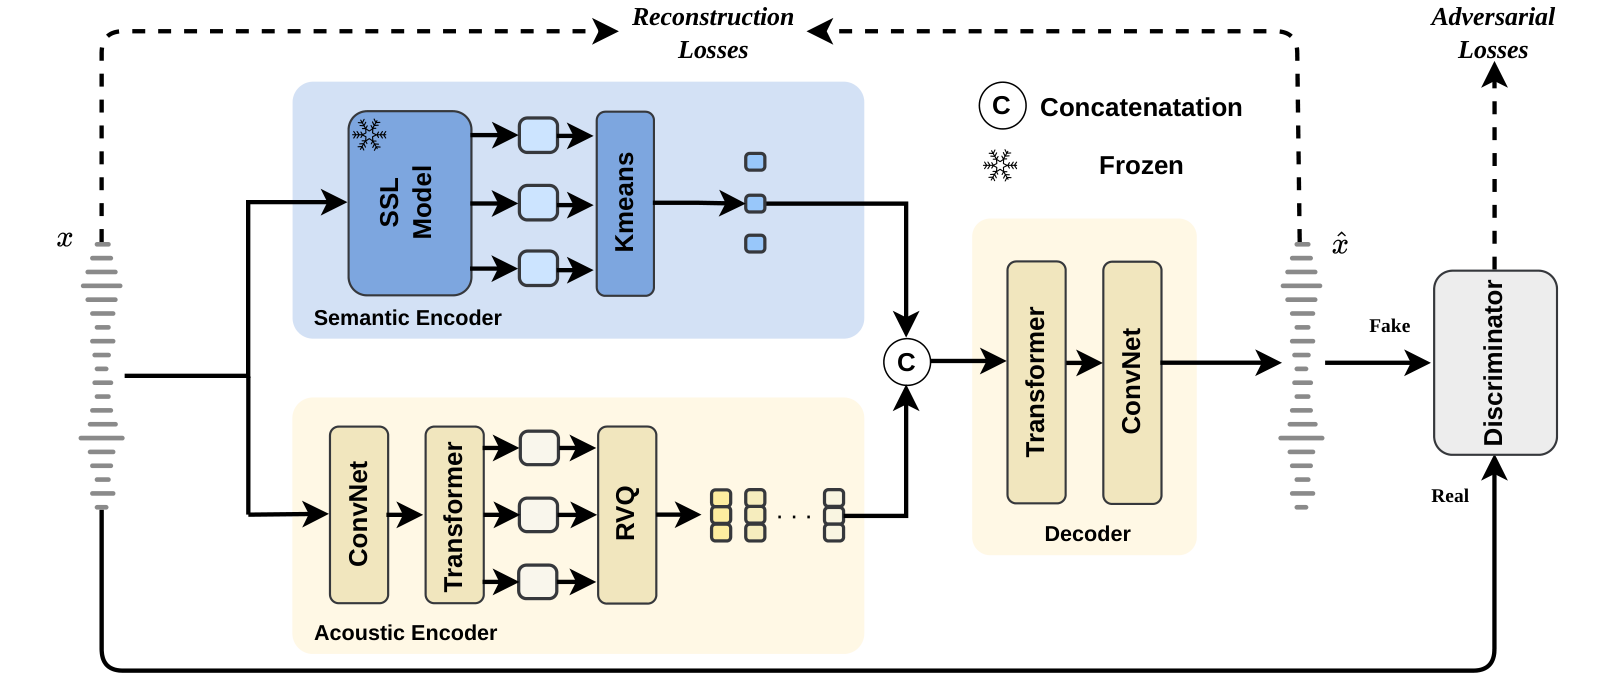
前序问题 :离散音频 tokenization 已成为原始波形与自回归建模之间的关键接口,所以音乐 tokenizer 得同时做到两件互相拉扯的事:支持高保真重建,又要产出适合语言建模的离散序列。以重建为导向的 tokenizer 常把音乐结构和精细声学细节混在一起,产出高熵 token 难建模;而语义引导的替代方案本是为语音设计的,套到音乐上不合身,往往还伤重建质量。本文贡献 :论文先把「音乐语义内容」重新定义成一个可度量的概念——以下游音乐信息检索(MIR)任务表现为锚。循着这个定义提出 MuSeC:一个音乐语义 codec,直接从混合信号里把语义与声学内容解耦,不需要做源分离。结构上,冻结的 SSL 编码器加 k-means 提供语义 token,另一路声学 RVQ 流捕捉细粒度声学信息,两路拼接后送解码器做高保真重建,训练时还有判别器提供对抗损失。
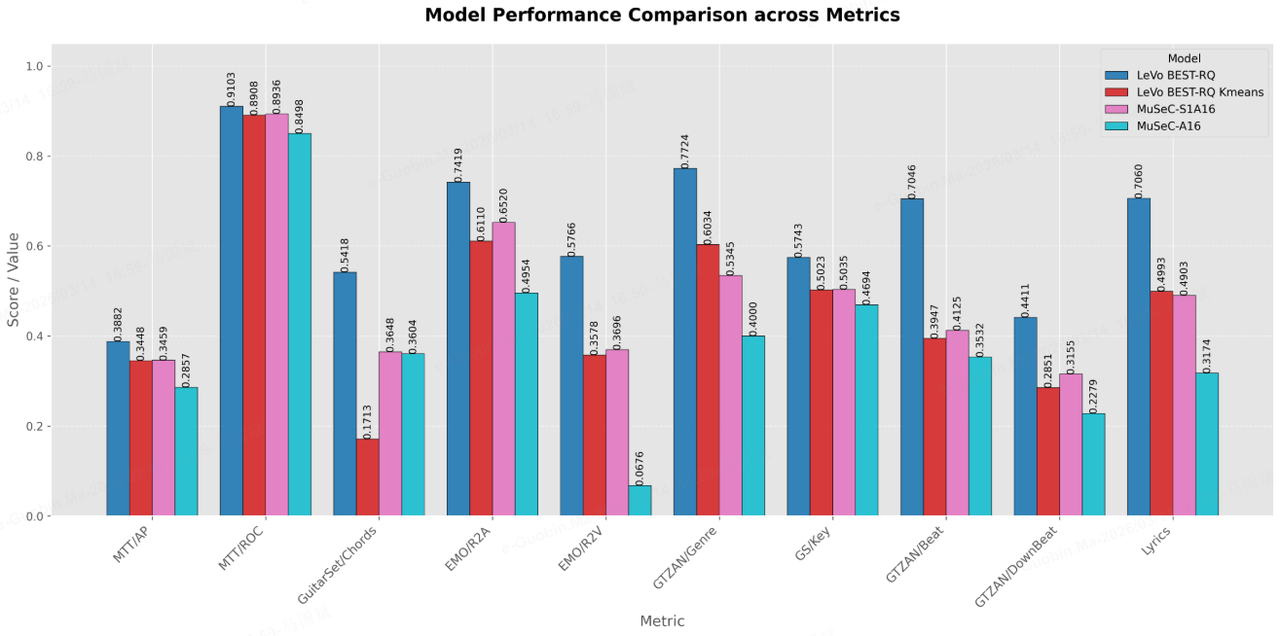
实验效果 :MuSeC 在保住高保真重建所需信息的同时,产出对语言模型更友好的离散单元,重建质量有提升,token 序列也更可预测,为高保真 LLM 音乐生成提供了实际基础。MIR 任务上的自消融显示,完整 MuSeC(S1A16)在 GuitarSet/Chords(0.3648 对 0.1713)、EMO/R2A(0.6520 对 0.6110)、EMO/R2V(0.3696 对 0.3578)等任务上明显好于纯 k-means 量化版本,也普遍好于只有声学的 A16 变体。
批判点评 :把「语义」从形容词变成以 MIR 任务表现为锚的可测量量,是这篇方法论上最扎实的一步——有了口径,语义与声学的分流才有得优化,而不是凭感觉设计码本。不做源分离直接从混合信号解耦,也省掉了一个容易引入误差的前置环节。但消融图显示优势并不一致:GTZAN/Genre 上 MuSeC-S1A16 是 0.5345,反而低于 k-means 的 0.6034,Lyrics 上两者基本持平(0.4903 对 0.4993);更重要的是全部设置都明显低于连续 LeVo BEST-RQ 这条语义上限(多数任务差 0.1 以上),说明离散化的语义损失远未补齐。另外论文标题指向「高保真 LLM 音乐生成」,但实际只做到 codec 这一层,接上语言模型后端到端能好多少并没有验证,「更可预测的 token 序列」目前也缺少熵或困惑度之类的直接数字支撑。
10. OmniVBench:1.2万条清单查参考跑没跑偏
OmniVBench: A Benchmark and Large-Scale Dataset for Omni Reference-to-Video Generation | 腾讯 × 香港科技大学(广州) | arXiv:2609.22069
关键词 :视频生成评测,参考到视频,数据集,因子级评估
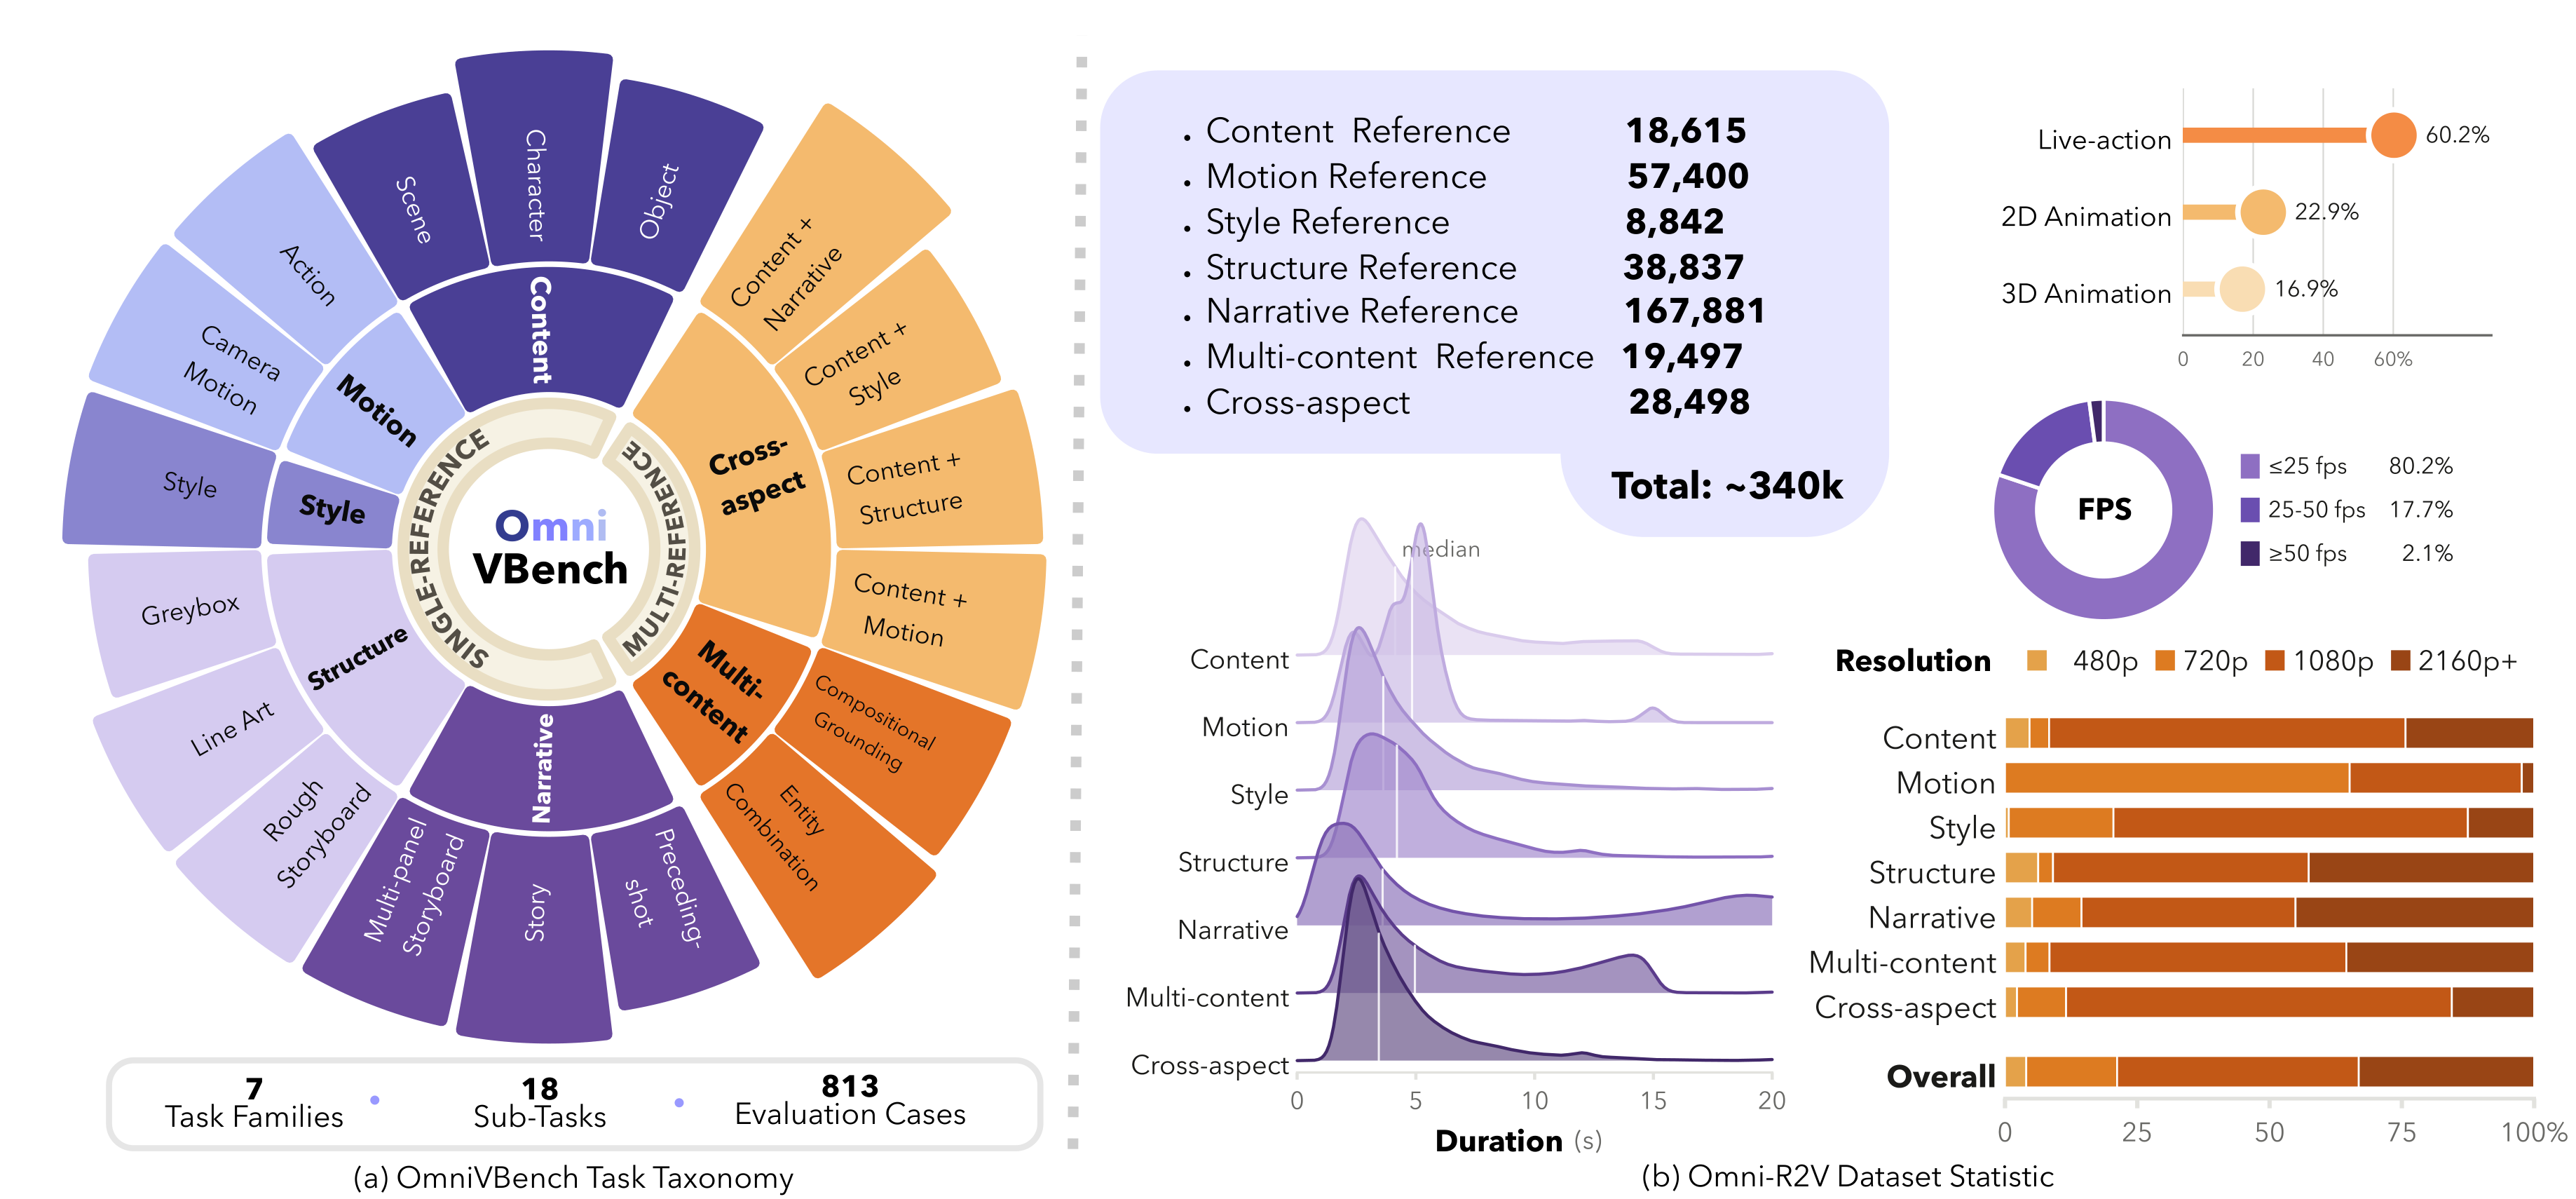
前序问题 :参考到视频(R2V)生成正朝着越来越通用、越来越多样的参考控制演进,催生了所谓全模态 R2V 这一范式。但现有基准跟不上:测试用例覆盖的参考类型与组合都有限,评估协议大多只看整体参考一致性,忽略了参考因子是否被正确保留、解耦并路由到对应目标。同时全模态 R2V 训练数据构建成本高,合适的训练资源很稀缺。本文贡献 :论文同时给出 OmniVBench 与 Omni-R2V Dataset,一个管评测一个管训练。OmniVBench 把 R2V 评测扩展到更广的参考类型、更细的控制任务和更丰富的参考组合,覆盖 7 个任务族、18 个细粒度任务,横跨内容、运动、风格、结构、叙事与多参考设定,共 813 个评测用例。核心是因子级评估:用 12172 条针对具体用例的检查清单条目,逐条判断意图中的参考因子是否被忠实保留、是否被正确解耦并绑定到目标、是否按指令实现。Omni-R2V Dataset 主要取材于大规模专业视频素材库,包含 34 万条处理好的训练样本,覆盖多种参考类型与多参考组合,并给出各任务专用的参考-目标配对构建管线。
实验效果 :对先进的开源与闭源 R2V 模型做的大范围评测显示,各任务族和各评估维度上都存在明显性能差距,暴露了当前 R2V 模型的残留局限。配图给出的多参考用例里,RF(参考保真)/IR(指令遵循)两项分数分化极大:UniVideo 只有 33.2/14.8,LoomVideo 43.1/36.7,OmniWeaving 48.0/56.0,Kling 3.0 Omni 62.9/100,Bernini 85.2/69.7,Gemini Omni 91.2/100,而 MiniMax H3、Seedance 2.0 与 Seedance 2.5 在该用例上拿到 100/100。
批判点评 :把「参考一致性」拆成保留、解耦、路由三件事,是这套基准最有价值的判断——多参考场景真正容易错的不是「像不像」,而是把 A 参考的属性贴到了 B 目标上,而整体一致性分数恰恰看不出这类串台。12172 条逐用例清单让这种错误变得可指认。数据侧 34 万条专业素材样本对社区也是实打实的补给。但代价是清单法对判定器的依赖很重:谁来回答这 1.2 万条问题、判定器自身的偏差和一致性如何,摘要没有交代,而这直接决定分数可信度。813 个评测用例摊到 18 个细粒度任务上平均每任务仅四十余例,统计功效对细分结论偏弱;配图那个用例里三个模型同时打满 100/100,也提示清单在强模型区间容易饱和、区分度下降。另外基准与数据集同源、且出自同一团队,用该数据训练的模型在该基准上的成绩需要额外小心解读。
趋势观察
注意力的省法,从「换掉它」变成「按交互类型分流」
Video DeltaNet 只在视频与视频之间用线性注意力,凡涉及文本或音频的交互仍留给 Softmax;dQwen3.5 则把注意力与 RNN 交错的混合骨干当成扩散语言模型的适配起点。两篇的共同前提是承认不同交互对精度的敏感度本来就不同,一刀切替换必然在某处付出代价。
长上下文的成本,已经从算力转到显存和带宽
DeepSeek-V4.1-Flash 把常驻 HBM 的全局 KV 压到每 token 890 字节、持久部分再压到八分之一,并用 prefill 8B、decode 16B 的非对称激活去贴合智能体负载的真实形状;The Weight Is Over 则量出消费级显卡越过可用显存后延迟跳升两个数量级的断崖。两者都在说:放不放得下、搬不搬得动,已经比算得快不快更决定部署成本。
生成过程正在被拆出显式的中间态
StepAudio 3 Music 先用 ABC 记谱产出编曲方案再预测音乐 token,PhysStream 把位置图与跟踪图作为结构化场景记忆在线维护,Edit-VAR 缓存源概率与交叉注意力图再逐 token 决定保源还是改。把过去隐含在权重里的东西显式化,换来的是可控性与可调试性。
评测开始追问「参考有没有被放对位置」
OmniVBench 把参考一致性拆成保留、解耦、路由三件事,用 1.2 万条逐用例清单指认把 A 的属性贴到 B 上的串台;Paint-Anything 自建 ACBench 专量物体级十六进制色值保真;MuSeC 干脆把「音乐语义」定义成下游 MIR 任务表现。三者都不再满足于一个整体相似度分数。
人工智能炼丹君 整理 | 2026-09-21
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注















评论 (0)