


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:评测与指标 | 难度:工程实战 | 前置知识:无
关键词:音频质量、音频评测、MOS、PESQ、STOI、SI-SDR、FAD、Fréchet Audio Distance、感知评测、语音合成、音频codec、无参考评测
先看一个教学假设:团队比较两个音频 codec 版本,一个版本对齐更准,SI-SDR 更高,却同时新增了低能量的高频纯音。波形误差下降和听感变差可以同时发生。第 04 节用可复现合成信号展示这个指标盲区;本文没有受试者听测,因此不把「刺耳」或「无差别」写成测得的事实。7~7.5 kHz 的窄带成分可能可闻,其显著程度取决于响度、掩蔽、设备和听者;不能把这一段称为人耳最敏感频段。
这个问题不是「评测做少了」,而是指标回答的问题和团队想问的问题不是同一个。SI-SDR 回答的是「输出波形和参考波形逐采样点对得上吗」,团队想问的是「用户听着难受吗」。这两个问题之间的距离,就是这篇要讲的东西。
更麻烦的是,音频指标的「鄙视链」比图像指标更长、更碎:PESQ 面向语音质量,含窄带与宽带版本;STOI 面向语音可懂度,音乐生成用的是分布级的 FAD,而人工 MOS 需要组织听测,并报告受试者、协议与置信区间。没有一个指标是免费的午餐——先搞清楚每个指标在测什么,再决定用哪个,比记住任何一行数字都重要。
先把这篇要用的缩写认全——音频圈的缩写比图像圈更碎,不先对齐名词,后面每个数字都容易理解错:
| 缩写 | 全称 | 中文 | 一句话 |
|---|---|---|---|
| MOS | Mean Opinion Score | 平均意见分 | 找一群人听、打分取平均。按指定听测协议汇总主观评分,有成本和统计不确定性 |
| PESQ | Perceptual Evaluation of Speech Quality | 语音质量感知评估 | 语音有参考质量指标,P.862 为窄带、P.862.2 为宽带扩展 |
| STOI | Short-Time Objective Intelligibility | 短时客观可懂度 | 只测「内容听不听得清」,不测好不好听 |
| SI-SDR | Scale-Invariant Signal-to-Distortion Ratio | 尺度不变信号失真比 | 允许整体缩放后再比波形,衡量逐采样点对齐程度 |
| FAD | Fréchet Audio Distance | Fréchet 音频距离 | 不需逐条配对参考,仍需参考音频集合,比较两堆特征分布,思想来自图像的 FID |
| STFT | Short-Time Fourier Transform | 短时傅里叶变换 | 把波形切帧做 FFT,得到随时间变化的频谱 |
| SSL | Self-Supervised Learning | 自监督学习 | UTMOS 这类 MOS 预测器用来提特征的预训练模型 |
| DNSMOS / UTMOS | — | — | 用模型预测 MOS 的两种常见方案(前者微软、后者东京大学 SaruLab) |
三句话讲完框架:
每个指标只回答一个具体的问题:「波形逐点对齐了吗」(SI-SDR/SNR)、「频谱形状像吗」(对数梅尔距离)、「这两堆音频听起来像同一个世界来的吗」(FAD)、「人听着舒服吗」(MOS,以及预测它的 UTMOS/DNSMOS)。问题不同,答案就不同——不存在「最好的指标」,只存在「问对了问题的指标」。
有参考和无参考是两大阵营。有参考指标(SI-SDR、PESQ、梅尔距离)需要对应的参考信号,适合 codec、增强、分离等任务;逐条无参考指标(UTMOS、DNSMOS)不需要对应参考;FAD 不需要逐条配对,但需要代表目标分布的参考集合。是否适合音乐或音效仍取决于训练域和特征器。
客观指标是 人耳的代理,代理就有失真。失真最大的地方往往是「在部分听测条件下不显著、指标却敏感」的维度(波形相位、时移、整体音量),和「人耳一耳朵就听出来、指标却毫无反应」的维度(高频毛刺、音色瑕疵)。第 04 节会用一张表把这两类失真都造出来给你看。
信号处理里的「失真」最朴素的定义是信噪比:
$$\mathrm{SNR} = 10 \log_{10} \frac{\| s \|^{2}}{\| \hat{s} - s \|^{2}}$$
其中 $s$ 是参考信号、$\hat{s}$ 是待测信号,范数就是逐采样点的能量。它有一个明显的不合理之处:如果输出和参考只差一个整体音量($\hat{s} = 0.95\,s$),按理说听感几乎没差别,但 SNR 会把它记成 $20\log_{10}(1/0.05) \approx 26$ dB 的「失真」。
SI-SDR 的解法是先做最优缩放,再算残差——这也是它名字里 Scale-Invariant 的来历:
$$\alpha = \frac{\langle \hat{s}, s \rangle}{\langle s, s \rangle}$$
$$\mathrm{SI\text{-}SDR} = 10 \log_{10} \frac{\| \alpha s \|^{2}}{\| \hat{s} - \alpha s \|^{2}}$$
$\alpha$ 是把待测信号投影到参考方向上的最小二乘系数:分子是内积 $\langle \hat{s}, s \rangle$(两个波形逐点相乘再求和,衡量「同相程度」),分母是参考信号的能量,用来归一化。缩放完再算残差,整体音量的差异就被精确抵消了。
但这个设计同时埋了雷。SI-SDR 衡量的是逐采样点的对齐程度,而波形对齐对时间平移极端敏感:把信号往后挪 8 个采样点(16 kHz 采样率下只有 0.5 毫秒,单独播放时通常不易觉察),波形的峰谷就全部错开了,内积 $\langle \hat{s}, s \rangle$ 急剧下降、残差急剧上升,SI-SDR 可以从正几十分贝直接掉到负值——第 04 节的实验里,0.5 毫秒的时移让 SI-SDR 掉到了 $-6.25$ dB。
所以使用 SI-SDR 前要确认与参考的对齐约定(降噪、回声消除、codec 重建),并且要明白它测的是去掉全局增益后的波形误差,对齐只是影响因素之一。
因为这个指标不是从「信噪比」这棵树上长出来的,而是从盲源分离那套评价体系里长出来的。2006 年的 BSS_eval 工具箱(Vincent / Gribonval / Févotte,Performance measurement in blind audio source separation)把估计信号相对参考的总误差拆成四类:
对应地给出 SIR / SAR / ISR 三个分项,以及一个总指标——SDR(Signal-to-Distortion Ratio)。
关键就在 Distortion 这个词:它涵盖上面四类,而 SNR 的「噪声」只对应其中一类。在盲源分离里,最伤听感的往往不是噪声,而是别的源串进来的干扰和算法自己的伪影,叫「信噪比」会名不副实。
后来 2019 年 Le Roux 等人在 SDR – half-baked or well done?(arXiv:1811.02508)里指出 BSS_eval 版 SDR 有两个致命问题:bss_eval_sources 允许用 512 阶滤波器去「修改参考信号」来拟合估计值,于是把某些频段直接置零也能拿到近乎无穷的 SDR;bss_eval_images 的 SDR 又退化成了普通 SNR,不允许全局缩放,反被一些算法无意间靠调音量刷了分。他们给出的修法就是本文用的 SI-SDR——误差项与参考信号严格正交,彻底去掉对幅度缩放的依赖,命名沿袭 SDR 保持与社区的连续性。
SDR 的 distortion 可以包括噪声、串扰和伪影等误差。SNR 与 SI-SDR 是否数值相等还取决于缩放、投影和预处理约定,不能仅凭「只有加性噪声」判定。工程上 SI-SNR 常用于同类投影指标,比较实现时须检查是否先去均值、如何处理静音。
梅尔刻度近似描述感知音高与频率的非线性关系,不能据此断言某两个高频纯音「人耳几乎分不清」。本文采用 HTK 风格的映射:
$$m(f) = 2595 \log_{10}\left(1 + \frac{f}{700}\right)$$
其中 $f$ 的单位为 Hz。短时傅里叶变换(STFT)得到幅度谱后,用三角滤波器聚合到梅尔频带,再取对数。本文的最小实现是梅尔幅度谱,不是常见的梅尔功率谱;两者必须区分。令 $M(k,t)$ 为第 $k$ 带、第 $t$ 帧的幅度,以每条音频的谱峰值 $M_{\max}$ 归一化,定义:
$$L(k,t)=\ln\max\left(M(k,t)/M_{\max},10^{-4}\right)$$
$$D_{\mathrm{mel}} = \frac{1}{KT}\sum_{k,t}\left|L(k,t)-\hat L(k,t)\right|$$
$K,T$ 分别为梅尔带数和帧数。这里的单位是自然对数幅度差,不是 dB;换成 dB 要乘 $20/\ln 10$。独立归一化是为了在本实验里忽略整体增益,若任务关心响度,就不能先把这类差异消掉。幅度下限 $10^{-4}$ 对应峰值下 80 dB,防止对接近零的值取对数;若使用功率谱,同样的 80 dB 下限应是 $10^{-8}$。窗口、hop、滤波器、幅度/功率约定、floor 和归一化都会改变数值,需完整报告。
前面两个指标都需要一条参考音频。但音乐生成、音效生成没有「正确答案」——你没法说这段生成的钢琴曲应该长什么样。这类任务需要无参考指标,FAD 是其中最常用的一个。
FAD 的思路借自图像领域的 FID:不比较单条音频,而是比较两堆音频的分布。把每条音频过一个特征提取器(原论文用 VGGish,得到 128 维特征),每堆音频的特征就变成了高维空间里的一团点云,然后近似成高斯分布,问:这两个高斯离得多远?
FAD 使用两个拟合高斯之间的 2-Wasserstein 距离平方(沿用 Fréchet distance 名称):
$$\mathrm{FD} = \left\| \mu_{r} - \mu_{t} \right\|^{2} + \mathrm{Tr}\left( \Sigma_{r} + \Sigma_{t} - 2 \left( \Sigma_{r} \Sigma_{t} \right)^{1/2} \right)$$
$\mu_{r}, \mu_{t}$ 是参考集和测试集的特征均值(每维上特征的平均),$\Sigma_{r}, \Sigma_{t}$ 是协方差矩阵(特征之间的联合波动结构),$\mathrm{Tr}$ 是矩阵的迹(对角线元素之和)。直觉上:均值差衡量「两团云的中心差多远」,协方差项衡量「两团云的形状差多远」。
样本量会影响均值和协方差的估计。当样本数不超过特征维度时,中心化样本协方差必然秩亏;但秩亏不表示距离无法计算。更关键的是估计偏差和方差,其大小取决于特征谱、独立样本数和参考集,而非单由维度决定。第 04 节的 16 维合成例子中,同分布两组的距离从 8 个样本时的 13.1390 降到 300 个样本时的 0.1844;这是一组随机种子的结果,不是通用阈值。
原始 FAD 论文 与 后续 FAD 评测研究 讨论了特征器和样本量偏差。本次修订移除了缺少原始音频与评测脚本的历史「真实案例」图表;下面保留可由附录完整复现的合成实验,避免把不可复核的数值当作结论依据。
完整脚本在文末附录,这里只看核心片段与真实输出。数值脚本只用 numpy;配图脚本另需 matplotlib,不依赖音频模型权重。
第一段:构造三种不同机制的退化(metric_disagreement.py)。干净信号用「基频 + 6 个谐波 + 慢包络」合成;三种退化分别是音量 ×0.95、叠 7/7.5 kHz 纯音、循环时移 0.5 ms:
def degrade(x, kind, sr=SR):
    if kind == "A":
        return 0.95 * x                      # 音量差 5%
    if kind == "B":
        # 7/7.5 kHz 纯音,均低于 16 kHz 采样率的 Nyquist 频率
        t = np.arange(len(x)) / sr
        buzz = 0.02 * (
            np.sin(2 * np.pi * 7000 * t) + np.sin(2 * np.pi * 7500 * t)
        )
        return x + buzz
    if kind == "C":
        return np.roll(x, 8)                 # 时移 8 采样 = 0.5ms
    raise ValueError(kind)
第二段:SI-SDR 的最小实现(缩放抵消就三行):
def si_sdr(ref, est):
    """Scale-Invariant SDR。

    先把 est 投影到 ref 上(找一个最优缩放 alpha),剩下的残差才算失真。
    所以「整体音量变了」在 SI-SDR 里被完全抵消——这是设计意图,
    但也意味着它测不出增益错误。
    """
    if np.dot(ref, ref) <= 0 or np.dot(est, est) <= 0:
        raise ValueError("SI-SDR needs non-silent reference and estimate")
    alpha = np.dot(est, ref) / np.dot(ref, ref)
    e_target = alpha * ref
    e_res = est - e_target
    num = np.dot(e_target, e_target)
    den = np.dot(e_res, e_res)
    if den <= 1e-24 * num:
        return float("inf"), alpha
return 10 * np.log10(num / den), alpha真实运行输出(16 kHz、1 秒合成乐音):
操作           SI-SDR(dB) SNR(dB)  梅尔距离(ln幅度) 高频占比    高频谱平坦度
A 音量×0.95          inf   26.02       0.0000      3.808e-14    0.3256
B 7/7.5kHz纯音     26.58   26.58       0.3472      2.188e-03    近0
C 循环时移0.5ms -6.25 -0.51 0.0187 3.836e-14 0.3272np.roll 是循环时移,会把尾部搬到开头;它只是对齐敏感性的演示,真实系统延迟应在共同有效区间评测。谱平坦度描述所选频带的谱能量是否集中。纯音通常低、平坦噪声通常高,但音乐本来就含纯音,白噪声也可能是缺陷,因此不能用统一的 0.05 阈值判好坏。本实验干净信号的高频能量约为 $10^{-14}$ 量级,已几乎为空;此时平坦度主要由窗函数泄漏和数值 floor 决定,0.3256 不是「健康音频标准」。高频能量占比与平坦度在理想非零计算下都对全局增益不变,实际小能量频带则应先做绝对能量门控。
第三段:FAD 与样本量(fad_sample_size.py)。没有 VGGish,就用 16 维归一化对数梅尔幅度均值当特征——Fréchet 距离这一步的数学完全一样。核心实现采用对称半正定夹心矩阵。不能把一般非对称的 $\Sigma_r\Sigma_t$ 直接交给只处理对称矩阵的 eigh;通用矩阵平方根算法可以处理乘积,但不是这里的最小实现。附录检查非半正定输入,并仅把容差内的负舍入误差截为零。
真实运行输出(每行重新抽取样本,固定随机种子):
每堆样本数    同分布距离    带纯音距离
     8        13.1390       47.5224
    16         3.8499       49.1996
    32         1.6452       46.6619
    64         0.9992       46.3322
   128         1.1044       45.4964
   300         0.1844       45.4057
总体分布相同才有理论距离零,两个有限样本的估计值不必为零,也不必随样本量严格单调下降。这里是自定义 16 维梅尔特征的高斯距离演示,不是标准 VGGish FAD。
配图由 mel_spectrogram.py 重绘,单位为 dB,和表中自然对数单位相差固定倍数。B 的两条纯音均低于 Nyquist 频率;旧实现的 sin(2π·8000t) 在 16 kHz 采样时落在零点,不能用它模拟一个存在的 8 kHz 纯音。
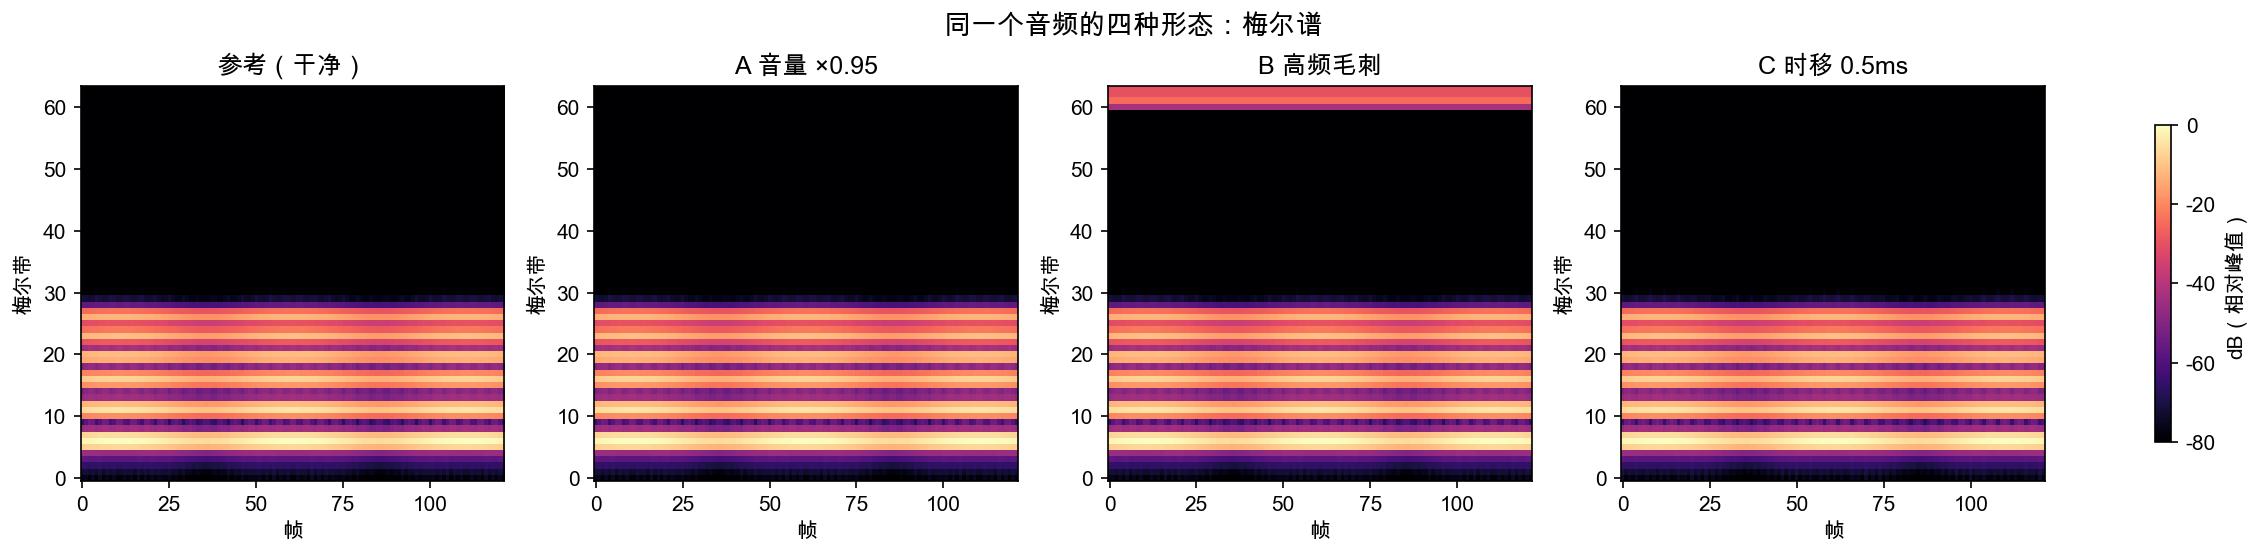
图要看什么:B 在高频多出亮带;A 因独立归一化与参考重合;C 的谱形状变化较小。色谱只能证实频谱结构变化,不能代替主观听测。
最小实现是为了讲清原理,生产里的实现多出的主要是「工程鲁棒性」:
FrechetAudioDistance(以 2026-09 的实现为准)把特征提取抽象成 preproc + model 两个可插拔组件,with_vggish() 一行构建官方配置;Microsoft 的 fadtk 则把 CLAP、MERT、HuBERT、Whisper 等十来种特征提取器都接了进来——FAD 的数值和特征提取器强绑定,换提取器等于换了一把尺子,不同论文的 FAD 数字不能直接比。另外它用流式更新(update/compute 两段式),避免一次把全部音频载入内存。facebookresearch/encodec/encodec/model.py 的 EncodecModel 提供 encode/decode 与可调目标码率的残差量化器,评测 codec 时要用它官方的 24 kHz / 48 kHz 配置,因为不同采样率下量化器的带宽分配不同,失真谱型也不同。pesq / pystoi,使用时仍须核对模式与预处理。| 指标 | 适合的问题 | 什么时候会骗你 |
|---|---|---|
| SI-SDR | 时间严格对齐的重建任务 | 对时移和相位差敏感;对单个全局增益不敏感 |
| SNR | 同上,且关心音量 | 对感知无感的相位问题同样过敏 |
| 对数梅尔距离 | 音色/频谱保真度 | 归一化会消除整体增益;逐帧比较仍对时序变化敏感,时间聚合又会丢失结构 |
| PESQ / STOI | 语音质量 / 语音可懂度 | 需按版本匹配带宽;不能直接推广为音乐或音效质量指标 |
| FAD | 生成系统的分布级评价 | 样本量不足时严重虚高;绑定特征提取器;对单条样本没有意义 |
| MOS(人工) | 指定协议下的主观评价 | 有采样不确定性;跨批次比较需要协议、样本与评分锚点控制 |
| UTMOS / DNSMOS | MOS 的廉价代理 | 排序与绝对值都需校准,域外泛化尤其容易失败 |
两条总原则:
(具体缺陷怎么查、该看哪个数字,见下面「诊断手册:按症状选指标」。)
前面几节讲的是「每个指标测什么」,这一节反过来——从你听到或收到的问题出发,倒推该看哪个数字。(它和上面的边界表是一体两面:表说「指标会骗你」,这里说「那该看谁」。)
有对应参考波形时,可算 SI-SDR、SNR、谱距离以及适用的语音指标。没有逐条参考时,MOS 预测器仍可逐条打分,文本条件模型也可以计算文本与音频相似度。经典 FAD 是集合统计,不直接定位单条缺陷;研究中的单样本扩展有另外的定义与边界。
比较两个生成器时,优先固定 prompt 分布、后处理、时长和测试规模。若确实有一一对应的 prompt 与样本,可以做配对分析;非配对设计同样可以成立,但需要匹配设计的统计方法。报告效应量和置信区间,必要时使用置换检验或按独立音频单位重采样;多指标检验还要考虑多重比较。p=0.02 不能因为只有 24 条样本就改称「勉强」,p=0.2 也不能证明没有差异。单个集合级 FAD 更不能直接塞进逐条配对 t 检验。
先检查格式、采样率、声道、时长、绝对电平,再检查相对谱、局部异常和整体统计。接近静音时,按自身峰值归一化会把噪声放大得像正常内容,平坦度也可能很高;此时应单独报告静音比例及条件质量,不能默默删掉静音样本来提高总分。
浮点信号超过 0 dBFS 说明超出常见满刻度约定,但尚不能证明已发生硬削波。真峰值与采样峰值也要区分,是否压限应依据目标交付规范;不能假设流媒体平台的响度归一化会自动修复过载。THD+N 通常需要规定的测试信号,不是对任意音乐直接测 50/60 Hz 哼声的万能工具,后者应在谱上检查基频、谐波与背景的相对强度。
最后把可疑样本与 prompt、参考和听测对照:可视化说明信号发生了什么,不能单独决定这种变化是否符合内容要求。附录实验能验证增益、时移和新增纯音如何影响指标;实际产品的合格线需要自己的数据与听测来确定。
PESQ(ITU-T P.862,2001):通信时代的遗产。把心理声学掩蔽模型塞进了客观指标,第一次让「机器预测听感」在窄带语音上有了可信度——也把「只适用语音」的边界刻进了骨子里。
SDR – half-baked or well done? (arXiv:1811.02508)(ICASSP 2019):指出 BSS_eval 那版 SDR 在单通道场景下会被滥用(改参考信号、靠调音量刷分),给出本文用的 SI-SDR 定义——误差与参考正交、不依赖幅度缩放。读它是理解「为什么偏偏叫 SDR」的最短路径。
Fréchet Audio Distance: A Metric for Evaluating Music Enhancement Algorithms (arXiv:1812.08466):把 FID 的思想搬到音频,提出基于背景集特征统计的音乐质量指标,解决了生成式音乐「没有正确答案可比」的问题;留下的问题是 FAD 数值绑定特征提取器、且强依赖样本量。
High Fidelity Neural Audio Compression (arXiv:2210.13438)(EnCodec):神经音频 codec 的代表作,结合客观指标与主观听测评价低码率重建。不能由这篇论文推导出「SI-SDR + PESQ + 梅尔距离」是所有 codec 的固定验收标准。
UTMOS: UTokyo-SaruLab System for VoiceMOS Challenge 2022 (arXiv:2204.02152):用 SSL 特征 + 集成学习预测 MOS,拿了 VoiceMOS Challenge 2022 多项第一。它代表的方向是「用模型替代昂贵的人工听测」——可行,但域外泛化仍是软肋。
一条暗线贯穿始终:指标的演进一直在追赶生成能力的演进。信号指标管不了感知,感知指标管不了分布,分布指标管不了单条样本——每一代生成技术把旧指标逼失效一次,然后逼出下一代指标。
先安装 numpy matplotlib,把文末三个脚本存到同一目录,分别运行。它们不下载音频或权重;可复现的结论来自数值输出,不包括主观听感结论。
metric_disagreement.py 的 7000/7500 Hz 改成 200/250 Hz,重跑。高频占比应基本不变,但低频梅尔谱会改变。记录实际距离,不能预设「一定更小」或「一定同样刺耳」。这说明频带指标有明确的观测范围。np.roll(x, 8) 改成 np.roll(x, 1),比较 SI-SDR 与谱距离。变化取决于波形自相关,不存在通用于所有音频的固定分数;真实延迟应在共同有效区间对齐,避免循环边界干扰。image_metrics):FAD 的直系前身。FID 的样本量陷阱、特征提取器绑定问题在图像侧一模一样,先读它再看本文会有「同一个故事换了个领域」的感觉。video_metrics):评测的维度从音频扩展到视频,多维度分解 + 人工验收的思路一脉相承。vq_tokenizer):音频 codec(EnCodec、SoundStream)就是 VQ-VAE 思想在波形上的应用,想理解被评测的对象,从这篇进。09 节用到的脚本全文如下(metric_disagreement.py、fad_sample_size.py、mel_spectrogram.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""同一个音频退化,四个指标给出四种排名。

这篇文章的核心论点就是这张表:指标不是「音质分数」,每个指标只回答一个
很具体的问题。用错了就会得到自欺欺人的结论。

三种退化分别是整体增益、窄带纯音和循环时移。
表中听感仅是待验证的假设,本文没有执行受试者听测。

干净的语音/音乐可以看成「基频 + 一串谐波」,这里就按这个造,
省得读者还要去找音频文件。只用 numpy。
"""

import numpy as np

SR = 16000
DUR = 1.0
N = int(SR * DUR)
rng = np.random.default_rng(0)


def make_clean(n=N, sr=SR):
    """基频 220Hz + 前 6 个谐波,加一点慢包络,听起来像有起伏的乐音。"""
    t = np.arange(n) / sr
    x = np.zeros(n)
    for k in range(1, 7):
        x += (1.0 / k) * np.sin(2 * np.pi * 220 * k * t)
    # 慢包络:2.5Hz 的轻微起伏,避免信号看起来像死板的稳态正弦
    x *= 0.75 + 0.25 * np.sin(2 * np.pi * 2.5 * t)
    return x / np.abs(x).max()


def degrade(x, kind, sr=SR):
    if kind == "A":
        return 0.95 * x                      # 音量差 5%
    if kind == "B":
        # 7/7.5 kHz 的窄带纯音:是否刺耳需听测,且两者均低于 Nyquist 频率
        t = np.arange(len(x)) / sr
        buzz = 0.02 * (
            np.sin(2 * np.pi * 7000 * t) + np.sin(2 * np.pi * 7500 * t)
        )
        return x + buzz
    if kind == "C":
        return np.roll(x, 8)                 # 时移 8 采样 = 0.5ms
    raise ValueError(kind)


def si_sdr(ref, est):
    """Scale-Invariant SDR。

    先把 est 投影到 ref 上(找一个最优缩放 alpha),剩下的残差才算失真。
    所以「整体音量变了」在 SI-SDR 里被完全抵消——这是设计意图,
    但也意味着它测不出增益错误。
    """
    if np.dot(ref, ref) <= 0 or np.dot(est, est) <= 0:
        raise ValueError("SI-SDR needs non-silent reference and estimate")
    alpha = np.dot(est, ref) / np.dot(ref, ref)
    e_target = alpha * ref
    e_res = est - e_target
    num = np.dot(e_target, e_target)
    den = np.dot(e_res, e_res)
    if den <= 1e-24 * num:
        return float("inf"), alpha
    return 10 * np.log10(num / den), alpha


def snr(ref, est):
    """不做缩放对齐的信噪比。音量差会被算成失真。"""
    res = est - ref
    den = np.dot(res, res)
    if den == 0:
        return float("inf")
    return 10 * np.log10(np.dot(ref, ref) / den)


def stft_mag(x, n_fft=512, hop=128):
    win = np.hanning(n_fft)
    n_frames = 1 + (len(x) - n_fft) // hop
    frames = np.stack([x[i * hop:i * hop + n_fft] * win for i in range(n_frames)])
    return np.abs(np.fft.rfft(frames, n_fft, axis=1)).T   # [freq, time]


def hz_to_mel(f):
    return 2595.0 * np.log10(1.0 + f / 700.0)


def mel_to_hz(m):
    return 700.0 * (10 ** (m / 2595.0) - 1.0)


def mel_filterbank(sr=SR, n_fft=512, n_mels=64, fmin=20.0, fmax=8000.0):
    n_freqs = n_fft // 2 + 1
    hz = mel_to_hz(np.linspace(hz_to_mel(fmin), hz_to_mel(fmax), n_mels + 2))
    bins = np.floor(hz * n_fft / sr).astype(int)
    fb = np.zeros((n_mels, n_freqs))
    for i in range(n_mels):
        left, center, right = bins[i], bins[i + 1], bins[i + 2]
        if center <= left:
            center = left + 1
        if right <= center:
            right = center + 1
        for k in range(left, min(center, n_freqs)):
            fb[i, k] = (k - left) / (center - left)
        for k in range(center, min(right, n_freqs)):
            fb[i, k] = (right - k) / (right - center)
    return fb


def log_mel(x, sr=SR, n_fft=512, hop=128, n_mels=64):
    """归一化梅尔幅度谱的自然对数,单位为 ln 幅度(不是 dB)。

    每条样本独立归一化是本实验为了忽略整体增益所作的选择,
    不是所有音频评测的必需步骤。幅度 floor=1e-4 对应峰值下 80 dB。
    """
    fb = mel_filterbank(sr=sr, n_fft=n_fft, n_mels=n_mels)
    mel = fb @ stft_mag(x, n_fft=n_fft, hop=hop)
    mel = mel / (mel.max() + 1e-12)
    return np.log(np.maximum(mel, 1e-4))     # floor 在 log(1e-4) ≈ -9.2


def log_mel_distance(ref, est):
    """对数梅尔谱的平均绝对误差(单位为自然对数幅度差)。"""
    return float(np.mean(np.abs(log_mel(est) - log_mel(ref))))


def hf_energy_ratio(x, sr=SR, n_fft=512, hop=128, f_lo=6000.0):
    """6kHz 以上能量占总能量的比例——高频毛刺会把它顶起来。"""
    mag = stft_mag(x, n_fft=n_fft, hop=hop)
    freqs = np.fft.rfftfreq(n_fft, 1.0 / sr)
    power = (mag ** 2).mean(axis=1)
    return float(power[freqs >= f_lo].sum() / power.sum())


def spectral_flatness(x, sr=SR, n_fft=512, hop=128, f_lo=4000.0, f_hi=9000.0):
    """高频平均功率谱的几何均值/算术均值,范围 0~1。

    小值表示谱能量集中,不等价于存在缺陷;纯乐音也会很低。
    只在该频带有足够能量时解释,阈值必须按任务和频带校准。
    与高频能量占比一样,理想计算对非零全局增益不变。
    """
    mag = stft_mag(x, n_fft=n_fft, hop=hop)
    freqs = np.fft.rfftfreq(n_fft, 1.0 / sr)
    band = mag[(freqs >= f_lo) & (freqs <= f_hi)]
    power = (band ** 2).mean(axis=1) + 1e-20
    geo = np.exp(np.mean(np.log(power)))
    ari = np.mean(power)
    return float(geo / ari)


def main():
    ref = make_clean()
    print(f"参考信号: {len(ref)} 采样 = {len(ref) / SR:.2f}s @ {SR}Hz")
    print(f"参考信号高频能量占比: {hf_energy_ratio(ref):.3e}")
    print()
    header = (f"{'退化':<18}{'操作':<12}{'SI-SDR(dB)':>12}{'SNR(dB)':>10}"
              f"{'梅尔距离':>10}{'高频占比':>12}{'高频谱平坦度':>14}")
    print(header)
    print("-" * len(header))

    rows = {}
    for kind, feel in (("A", "增益变化"), ("B", "新增纯音"), ("C", "循环时移")):
        est = degrade(ref, kind)
        s, alpha = si_sdr(ref, est)
        d = {
            "si_sdr": s,
            "snr": snr(ref, est),
            "mel": log_mel_distance(ref, est),
            "hf": hf_energy_ratio(est),
            "flat": spectral_flatness(est),
            "alpha": alpha,
        }
        rows[kind] = d
        print(f"{kind + ' ' + {'A': '音量×0.95', 'B': '高频毛刺', 'C': '时移0.5ms'}[kind]:<18}"
              f"{feel:<12}{s:>12.2f}{d['snr']:>10.2f}{d['mel']:>10.4f}"
              f"{d['hf']:>12.3e}{d['flat']:>14.4f}")

    print()
    print("读数(这才是重点):")
    print(f"  A 音量小 5%:SI-SDR = {rows['A']['si_sdr']:.2f} dB(缩放被抵消,几乎满分),"
          f"SNR = {rows['A']['snr']:.2f} dB(老老实实记了一笔)")
    print(f"     → 最优缩放 alpha = {rows['A']['alpha']:.4f},表示估计波形为参考的 0.95 倍")
    print(f"  B 高频毛刺:SI-SDR = {rows['B']['si_sdr']:.2f} dB 看着还行,"
          f"高频占比却从 {hf_energy_ratio(ref):.3e} 涨到 {rows['B']['hf']:.3e}")
    print(f"  C 时移 0.5ms:SI-SDR 掉到 {rows['C']['si_sdr']:.2f} dB,"
          f"但梅尔距离只有 {rows['C']['mel']:.4f} —— 谱几乎没动")
    print()
    print("结论:SI-SDR 衡量的是「波形对不对齐」,梅尔距离衡量的是「频谱像不像」,")
    print("      高频占比描述频带能量分配,是否刺耳还需要听测。")


if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""FAD 到底在比什么,以及为什么样本量不够时它根本不可信。
FAD(Fréchet Audio Distance)是 FID 的音频版:不问「这两条音频像不像」,
而是问「这两堆音频的分布像不像」。这个区别决定了它有两个反直觉的性质:
1. 它不配对。不需要参考音频和测试音频一一对应,
所以能评测「凭空生成」的音乐/音效——这是 PESQ 之类做不到的。
2. 它对样本量极其敏感。协方差是从样本里估的,样本不够时估出来的协方差
本身就是歪的,算出来的 FAD 跟真实值差得离谱。
这里用 16 维归一化对数梅尔幅度均值当特征(真正的 FAD 用 VGGish 的 128 维 embedding,
我们没有那个模型,但 Fréchet 距离这一步的数学完全一样)。
"""
import numpy as np
SR = 16000
N_FFT = 512
HOP = 128
N_MELS = 16
rng = np.random.default_rng(7)
def stft_mag(x, n_fft=N_FFT, hop=HOP):
win = np.hanning(n_fft)
n_frames = 1 + (len(x) - n_fft) // hop
frames = np.stack([x[i * hop:i * hop + n_fft] * win for i in range(n_frames)])
return np.abs(np.fft.rfft(frames, n_fft, axis=1)).T
def hz_to_mel(f):
return 2595.0 * np.log10(1.0 + f / 700.0)
def mel_to_hz(m):
return 700.0 * (10 ** (m / 2595.0) - 1.0)
def mel_filterbank(sr=SR, n_fft=N_FFT, n_mels=N_MELS, fmin=20.0, fmax=8000.0):
n_freqs = n_fft // 2 + 1
hz = mel_to_hz(np.linspace(hz_to_mel(fmin), hz_to_mel(fmax), n_mels + 2))
bins = np.floor(hz * n_fft / sr).astype(int)
fb = np.zeros((n_mels, n_freqs))
for i in range(n_mels):
left, center, right = bins[i], bins[i + 1], bins[i + 2]
if center <= left:
center = left + 1
if right <= center:
right = center + 1
for k in range(left, min(center, n_freqs)):
fb[i, k] = (k - left) / (center - left)
for k in range(center, min(right, n_freqs)):
fb[i, k] = (right - k) / (right - center)
return fb
FB = mel_filterbank()
def embed(x):
"""一段音频 → 16 维特征:各梅尔带的平均对数幅度。"""
mel = FB @ stft_mag(x)
mel = mel / (mel.max() + 1e-12)
return np.log(np.maximum(mel, 1e-4)).mean(axis=1)
def make_tone(f0, n=8000, buzz=False, snr_db=None):
"""一个乐音:基频 f0 + 谐波。buzz=True 时叠高频毛刺。"""
t = np.arange(n) / SR
x = np.zeros(n)
for k in range(1, 6):
x += (1.0 / k) * np.sin(2 * np.pi * f0 * k * t)
if buzz:
x += 0.05 * (np.sin(2 * np.pi * 7000 * t) + np.sin(2 * np.pi * 7500 * t))
if snr_db is not None:
x = x + rng.normal(0, np.sqrt(np.mean(x ** 2) / (10 ** (snr_db / 10))), n)
return x / (np.abs(x).max() + 1e-12)
def sqrtm_psd(A):
"""对称半正定阵的平方根;仅裁掉舍入级负特征值。"""
A = (A + A.T) / 2
w, V = np.linalg.eigh(A)
if w.min() < -1e-10 * max(1.0, np.abs(w).max()):
raise ValueError("matrix is not positive semidefinite")
w = np.clip(w, 0.0, None)
return (V * np.sqrt(w)) @ V.T
def frechet_distance(X, Y):
"""两个特征集合的 Fréchet 距离。
把每堆特征当成一个高斯(只关心均值和协方差),再算这两个高斯之间的
2-Wasserstein 距离的平方。闭式解:
FD = ||mu_x - mu_y||^2 + Tr(S_x + S_y - 2 (S_x S_y)^{1/2})
"""
mu_x, mu_y = X.mean(axis=0), Y.mean(axis=0)
S_x = np.cov(X, rowvar=False)
S_y = np.cov(Y, rowvar=False)
diff = mu_x - mu_y
# 不可把一般非对称的 S_x @ S_y 直接交给 eigh。
# 使用对称半正定夹心矩阵,平方根的迹与原式相同。
s_x_sqrt = sqrtm_psd(S_x)
covmean = sqrtm_psd(s_x_sqrt @ S_y @ s_x_sqrt)
fd = diff @ diff + np.trace(S_x) + np.trace(S_y) - 2 * np.trace(covmean)
tol = 1e-7 * max(1.0, np.trace(S_x) + np.trace(S_y))
if fd < -tol:
raise ArithmeticError("negative distance exceeds numerical tolerance")
return float(max(fd, 0.0)) # 仅容差内的负舍入误差截到 0
def main():
# 参考集:干净乐音,基频在 200~400Hz 之间随机
# 测试集 A:同分布(只是另一批采样)→ FAD 应该接近 0
# 测试集 B:带高频毛刺 → FAD 应该明显大于 0
def make_set(n, buzz=False):
return np.stack([
embed(make_tone(rng.uniform(200, 400), buzz=buzz)) for _ in range(n)
])
print("特征维度: 16(各梅尔带的平均对数幅度)")
print()
print("样本量对 FAD 的影响(同一个分布对,只是抽的样本数不同):")
print(f"{'每堆样本数':>10}{'同分布 FAD':>14}{'带毛刺 FAD':>14}{'相对基线':>10}")
print("-" * 50)
big_ref = make_set(600)
for n in (8, 16, 32, 64, 128, 300):
ref = big_ref[:n]
same = np.stack([
embed(make_tone(rng.uniform(200, 400))) for _ in range(n)
])
buzz = make_set(n, buzz=True)
fd_same = frechet_distance(ref, same)
fd_buzz = frechet_distance(ref, buzz)
ok = f"{fd_buzz / max(fd_same, 1e-6):.1f}x"
print(f"{n:>10}{fd_same:>14.4f}{fd_buzz:>14.4f}{ok:>10}")
print()
print("注意最上面几行:样本只有 8 或 16 个时,「同分布」的 FAD 就已经不是 0 了,")
print("这是均值与协方差估计误差;16 维、16 个样本的中心化协方差必然奇异。")
print("真实 VGGish 特征为 128 维,但所需样本数还取决于谱结构、独立性和精度——")
print("这就是为什么论文里报的 FAD 必须同时报样本数,否则数字不可比。")
print()
print("另一面:")
print(f" 300 个样本时,同分布 FAD 与带毛刺 FAD 差了 "
f"{frechet_distance(big_ref[:300], make_set(300, buzz=True)) / max(frechet_distance(big_ref[:300], np.stack([embed(make_tone(rng.uniform(200, 400))) for _ in range(300)])), 1e-9):.1f} 倍")
print(" → 倍数只是描述量,不是统计检验;需多次抽样或按音频做 bootstrap。")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""把「指标打架」画出来看:三种退化的梅尔谱。
波形指标(SI-SDR)分不清的三件事,在谱上一眼就能看出来:
音量 ×0.95 —— 本图每条单独归一化,整体增益被抵消
高频毛刺 —— 谱的中上部多出一条亮带(听感需另行验证)
时移 0.5ms —— 几乎看不出差别(但 SI-SDR 可能明显下降)
产出 figures/mel_compare.png,文章里用  引用。
"""
import os
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib import font_manager
# matplotlib 默认字体没有中文,标题会渲染成一排豆腐块。
# 按 macOS / Linux 常见字体逐个试,找一个系统里真有的。
_AVAILABLE = {f.name for f in font_manager.fontManager.ttflist}
for _cand in ["PingFang SC", "Heiti SC", "Arial Unicode MS", "Songti SC",
"STHeiti", "Noto Sans CJK SC", "WenQuanYi Zen Hei"]:
if _cand in _AVAILABLE:
plt.rcParams["font.sans-serif"] = [_cand]
break
plt.rcParams["axes.unicode_minus"] = False # 负号不要用中文缺字替代
SR = 16000
N_FFT = 512
HOP = 128
N_MELS = 64
OUT_DIR = os.path.join(os.path.dirname(os.path.abspath(__file__)), "..", "figures")
def make_clean(n=16000, sr=SR):
t = np.arange(n) / sr
x = np.zeros(n)
for k in range(1, 7):
x += (1.0 / k) * np.sin(2 * np.pi * 220 * k * t)
x *= 0.75 + 0.25 * np.sin(2 * np.pi * 2.5 * t)
return x / np.abs(x).max()
def degrade(x, kind, sr=SR):
t = np.arange(len(x)) / sr
if kind == "A":
return 0.95 * x
if kind == "B":
return x + 0.02 * (np.sin(2 * np.pi * 7000 * t) + np.sin(2 * np.pi * 7500 * t))
if kind == "C":
return np.roll(x, 8)
raise ValueError(kind)
def stft_mag(x, n_fft=N_FFT, hop=HOP):
win = np.hanning(n_fft)
n_frames = 1 + (len(x) - n_fft) // hop
frames = np.stack([x[i * hop:i * hop + n_fft] * win for i in range(n_frames)])
return np.abs(np.fft.rfft(frames, n_fft, axis=1)).T
def hz_to_mel(f):
return 2595.0 * np.log10(1.0 + f / 700.0)
def mel_to_hz(m):
return 700.0 * (10 ** (m / 2595.0) - 1.0)
def mel_filterbank(sr=SR, n_fft=N_FFT, n_mels=N_MELS, fmin=20.0, fmax=8000.0):
n_freqs = n_fft // 2 + 1
hz = mel_to_hz(np.linspace(hz_to_mel(fmin), hz_to_mel(fmax), n_mels + 2))
bins = np.floor(hz * n_fft / sr).astype(int)
fb = np.zeros((n_mels, n_freqs))
for i in range(n_mels):
left, center, right = bins[i], bins[i + 1], bins[i + 2]
if center <= left:
center = left + 1
if right <= center:
right = center + 1
for k in range(left, min(center, n_freqs)):
fb[i, k] = (k - left) / (center - left)
for k in range(center, min(right, n_freqs)):
fb[i, k] = (right - k) / (right - center)
return fb
FB = mel_filterbank()
def log_mel_db(x):
mel = FB @ stft_mag(x)
mel = mel / (mel.max() + 1e-12)
return 20 * np.log10(np.maximum(mel, 1e-4)) # 归一化后取 dB,floor 在 -80dB
def main():
ref = make_clean()
cases = [
("参考(干净)", ref),
("A 音量 ×0.95", degrade(ref, "A")),
("B 高频毛刺", degrade(ref, "B")),
("C 时移 0.5ms", degrade(ref, "C")),
]
specs = [log_mel_db(x) for _, x in cases]
# 每条谱已独立按峰值归一化,共用色标只用于比较相对谱形状。
vmin = min(s.min() for s in specs)
vmax = max(s.max() for s in specs)
fig, axes = plt.subplots(1, 4, figsize=(15, 3.6), constrained_layout=True)
for ax, (name, _), s in zip(axes, cases, specs):
im = ax.imshow(s, origin="lower", aspect="auto", vmin=vmin, vmax=vmax,
cmap="magma")
ax.set_title(name, fontsize=12)
ax.set_xlabel("帧")
ax.set_ylabel("梅尔带")
fig.colorbar(im, ax=axes, shrink=0.8, label="dB(相对峰值)")
fig.suptitle("同一个音频的四种形态:梅尔谱", fontsize=13)
os.makedirs(OUT_DIR, exist_ok=True)
out = os.path.join(OUT_DIR, "mel_compare.png")
fig.savefig(out, dpi=150, bbox_inches="tight", facecolor="white")
plt.close(fig)
print(f"图已保存: {out}")
print()
print("每张谱的动态范围与「和参考谱的平均绝对差」:")
print(f"{'形态':<16}{'最小值(dB)':>12}{'最大值(dB)':>12}{'与参考的平均差(dB)':>20}")
print("-" * 62)
base = specs[0]
for (name, _), s in zip(cases, specs):
print(f"{name:<16}{s.min():>12.2f}{s.max():>12.2f}"
f"{np.mean(np.abs(s - base)):>20.3f}")
if __name__ == "__main__":
main()
评论 (0)