


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 5 篇 · 文生图生成加速与效率 2 篇 · 可控图生视频 1 篇 · 生成安全与对齐 1 篇 · 多模态视觉推理与评测 1 篇
Multi-Resolution Flow Matching: Training-Free Diffusion Acceleration via Staged Sampling | 北航·ETH苏黎世 | arXiv:2607.01642
关键词:文生图,流匹配,免训练加速,多分辨率,超分辨率
前序问题:文生图扩散/流匹配质量随规模提升而算力暴涨(Qwen-Image-20B 单张 1024² 在 A100 上采样达 47 秒);已有免训练多分辨率加速在潜空间做上采样并选择性修改局部,常带来明显模糊或伪影。
本文贡献:提出 MrFlow——面向预训练流匹配模型的免训练多分辨率加速:分阶段「低分辨率快速生成主结构 → 像素空间用轻量预训练 GAN 超分 → 注入低强度噪声做高频重采样 → 高分辨率精修细节」,利用图像在不同分辨率下的结构一致与细节差异实现由粗到细的高效生成,无需任何训练或运行时动态识别,且可与时间步蒸馏正交叠加。

实验效果:在 FLUX.1-dev 与 Qwen-Image 上端到端加速达 10×,OneIG 指标较加速前差距控制在 1% 以内,显著超越其他免训练加速策略;叠加预训练蒸馏权重后进一步冲到 25× 加速。
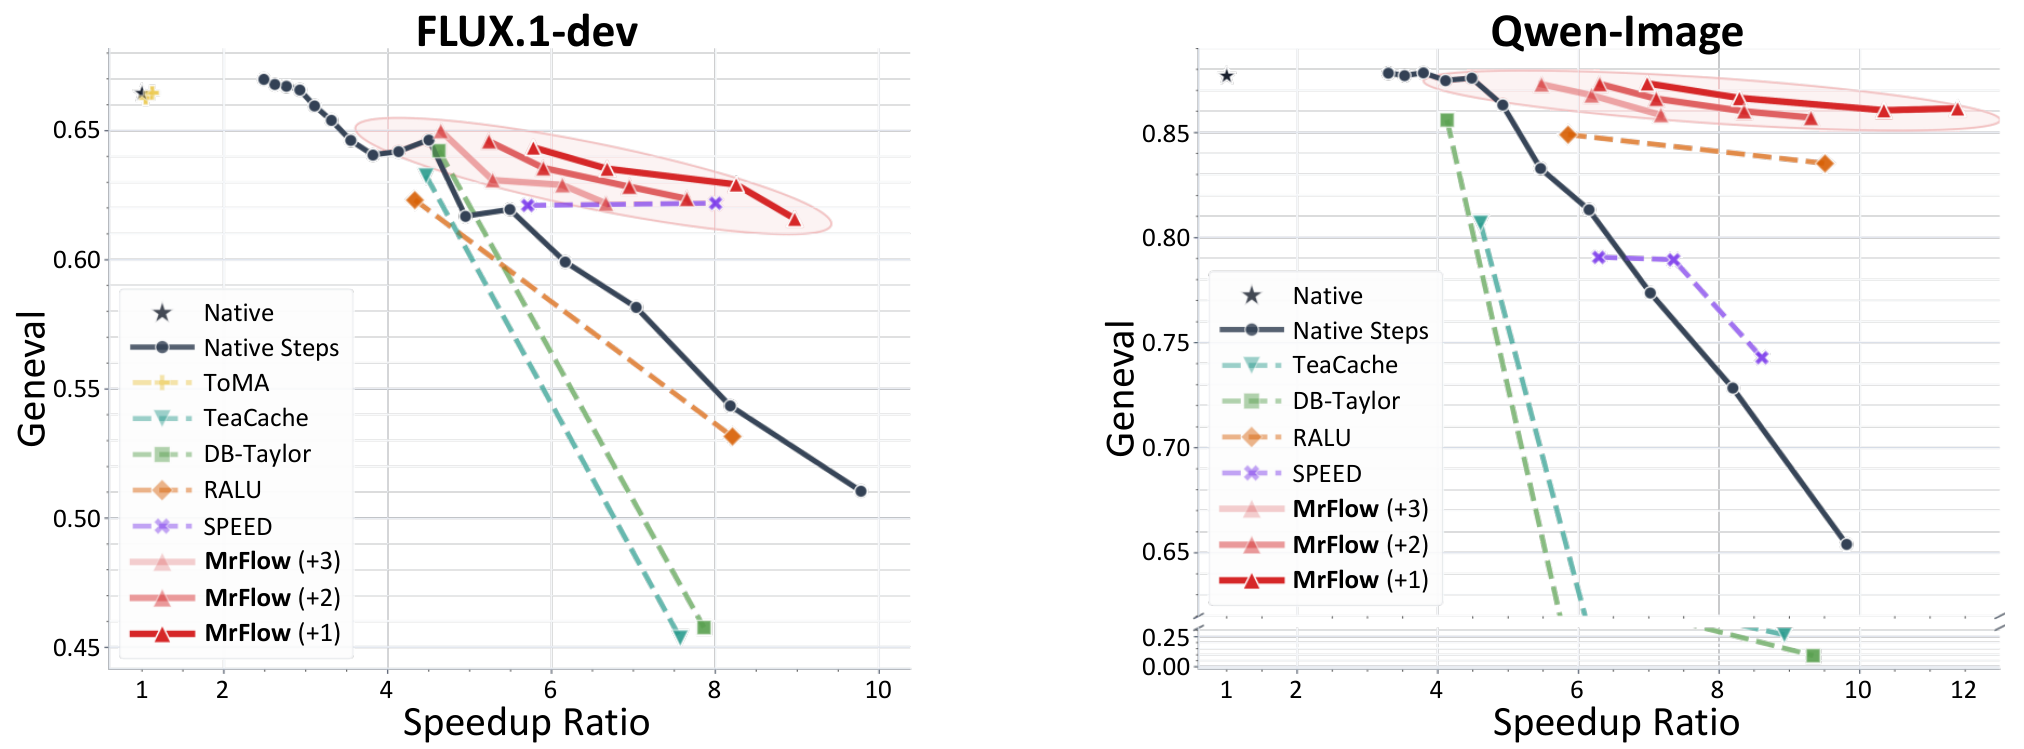
批判点评:把「先低分辨率出结构、再像素超分、最后高分辨率精修」串成免训练流水线,几乎零训练成本换来 10-25× 提速、还能与蒸馏正交叠加,对 FLUX/Qwen-Image 这类主流模型即插即用,工程性价比极高。但收益依赖轻量 GAN 超分网络质量(论文也承认 Real-ESRGAN 最平衡),像素超分对强纹理/文字细节可能引入偏差、需高分辨率步纠正,极端 25× 场景仍要借蒸馏权重、并非纯免训练。
GEAR: Guided End-to-End AutoRegression for Image Synthesis | 北大·腾讯混元 | arXiv:2606.32039
关键词:自回归生成,VQ tokenizer,表征对齐,端到端训练,ImageNet
前序问题:视觉生成通常两阶段训练——先训 tokenizer 做重建再冻结,再在其离散索引/连续潜上训生成器;这种解耦让 tokenizer 完全不知道生成器「什么好建模」,且 VQ 索引不可微、直通估计(STE)会崩,梯度无法回传到 tokenizer。
本文贡献:提出 GEAR,端到端联合训练 VQ tokenizer 与自回归(AR)生成器,用表征对齐引导。关键是对码本分配做「双读出」:硬 one-hot 分支用下一 token 预测训练 AR,可微软分支携带表征对齐损失、只回传去引导 tokenizer——让 AR 主动把 tokenizer 推向自己更易预测的索引分布,把对齐负担从 tokenizer 转移到 AR(与扩散侧「让潜变量本身更语义」的做法正相反)。
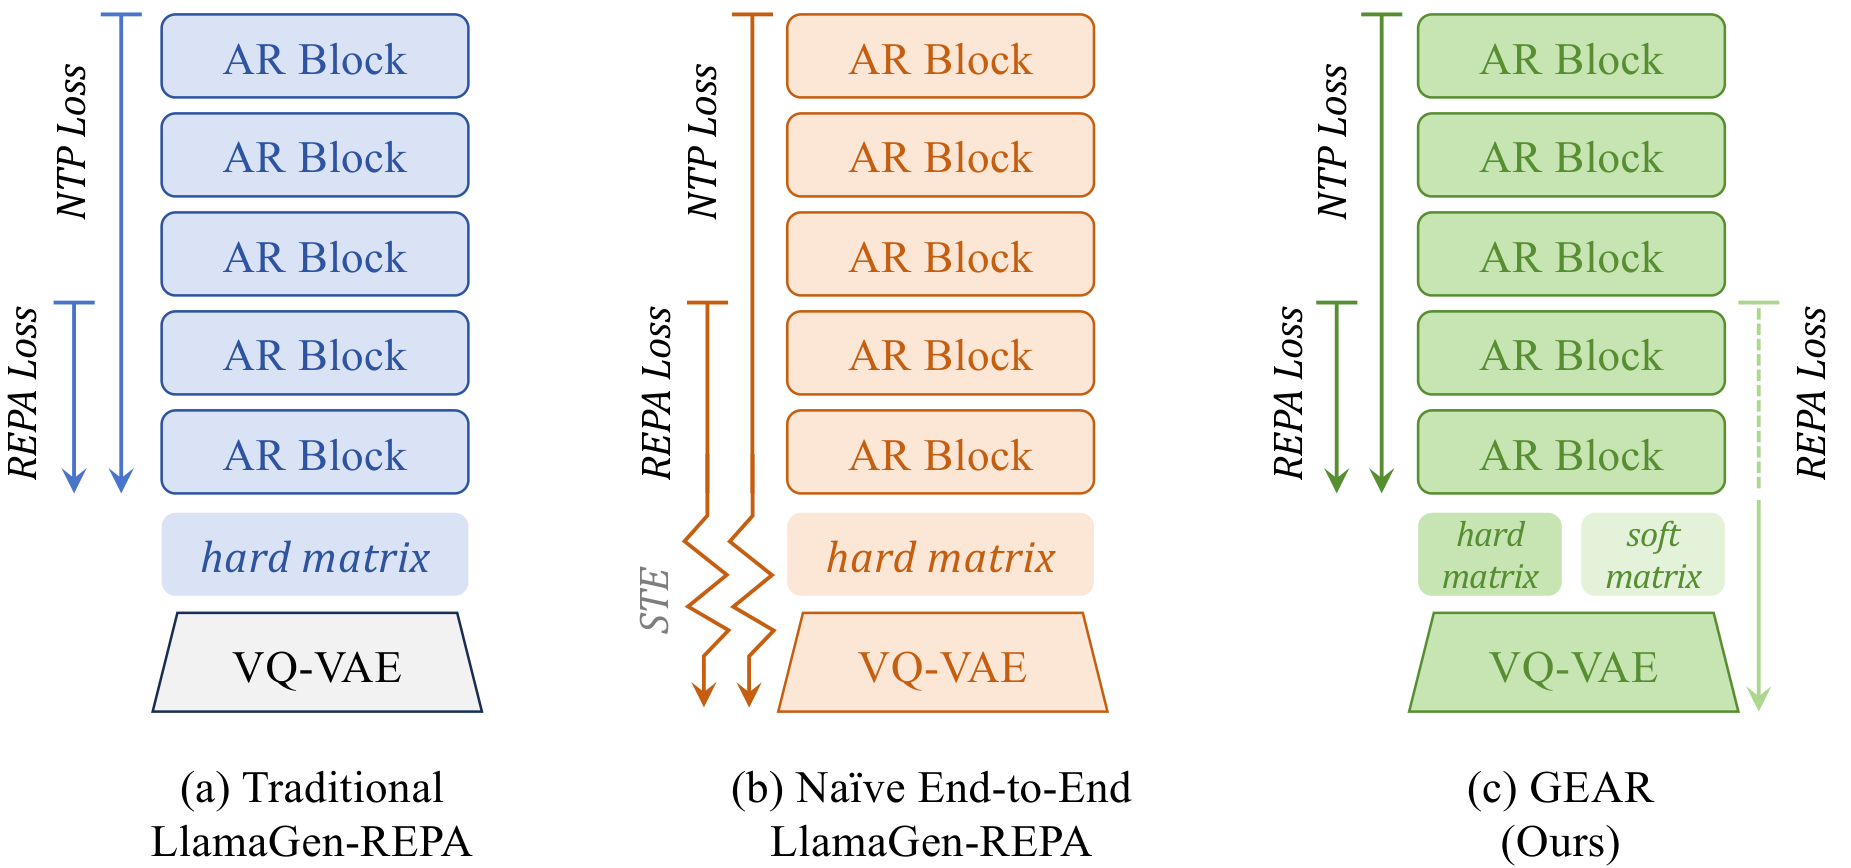
实验效果:相比强基线 LlamaGen-REPA,ImageNet gFID 收敛最高提速 10×,学到明显更好的 patch 级、空间连贯特征,并可泛化到多种量化器(VQVAE/LFQ/IBQ)与文生图任务。
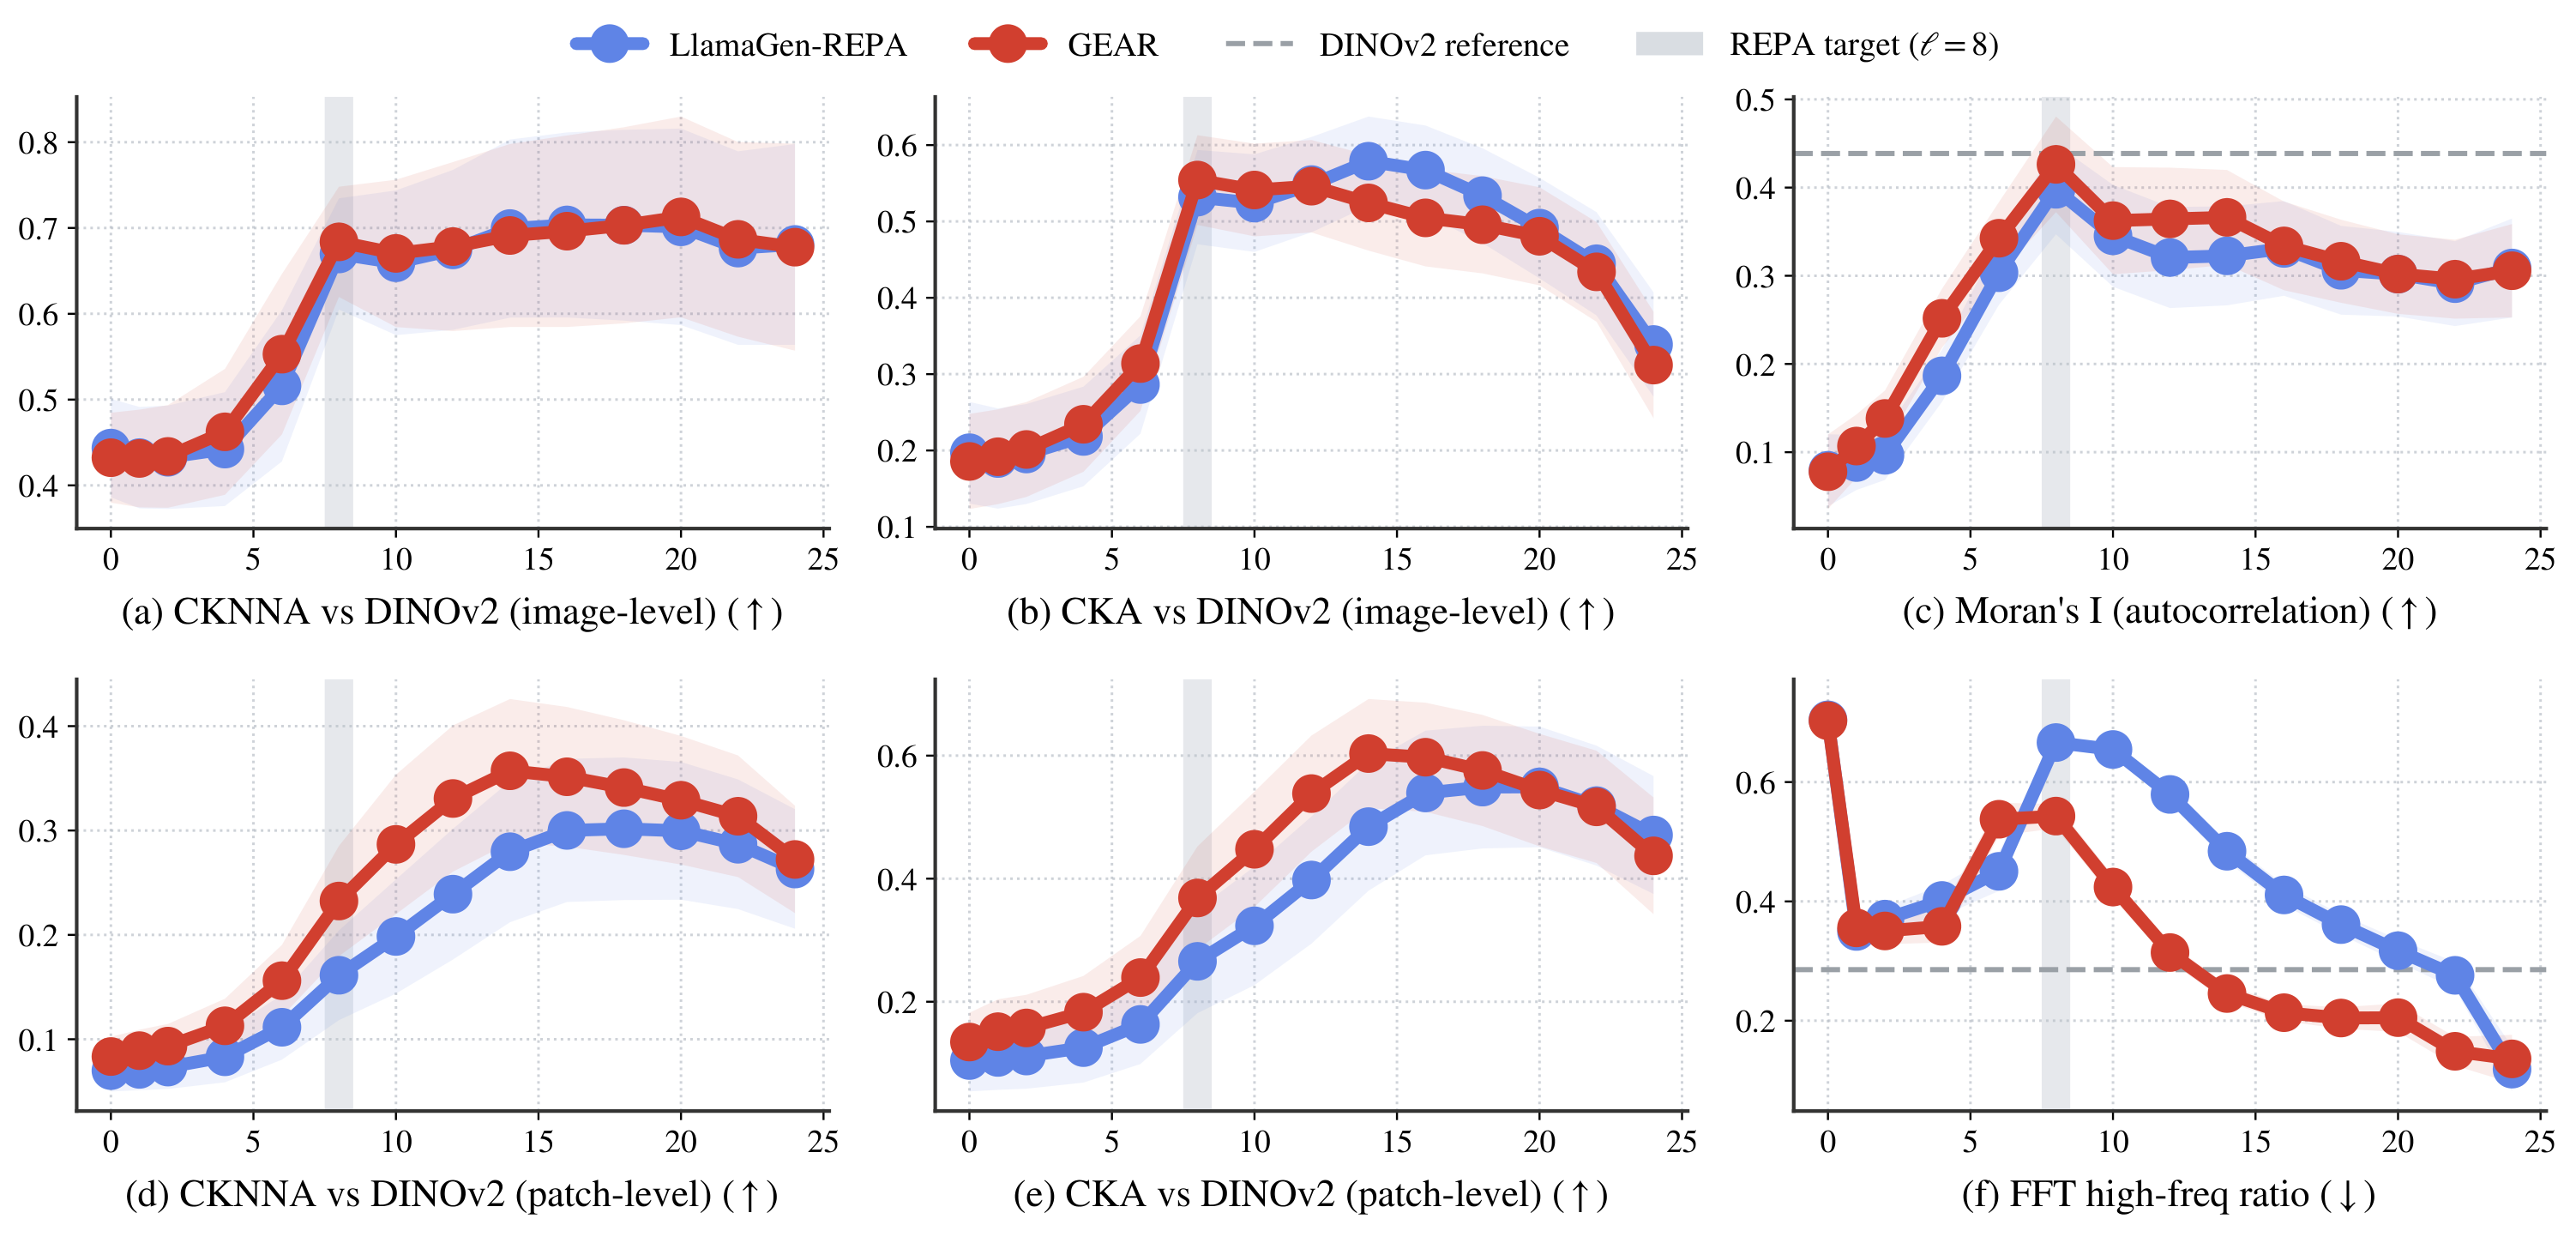
批判点评:用「双读出」优雅绕开 VQ 不可微、把表征对齐负担从 tokenizer 挪到 AR,是对两阶段范式的一次范式级反思,收敛提速 10× 且跨量化器/文生图泛化,北大+腾讯混元背景也更接近落地。但端到端联训的稳定性与显存开销、软分支对齐目标的设计敏感度,以及在更大分辨率/更大码本下能否延续优势仍待验证。
TrajLoc: Trajectory-Attention Localization for Multi-Object Motion Control | Amazon·特拉维夫大学 | arXiv:2607.00861
关键词:图生视频,多物体控制,轨迹控制,交叉注意力,身份保持
前序问题:图生视频(I2V)里控制多物体运动,既要保各自身份、又要遵循不同目标轨迹;已有方法把多条轨迹揉进共享的稠密条件信号,物体越多、路径交叉遮挡时对象级对应越难保持。
本文贡献:提出 TrajLoc,为每个物体施加严格的逐对象空间约束、彼此隔离:直接在注意力层里把每个物体 token 的交叉注意力权重替换为「以其每帧目标位置为中心的高斯热图」;同一套逐对象 token 接口通过可学习嵌入携带轨迹与深度,并以编码首帧外观替代物体 token 来保持身份一致。
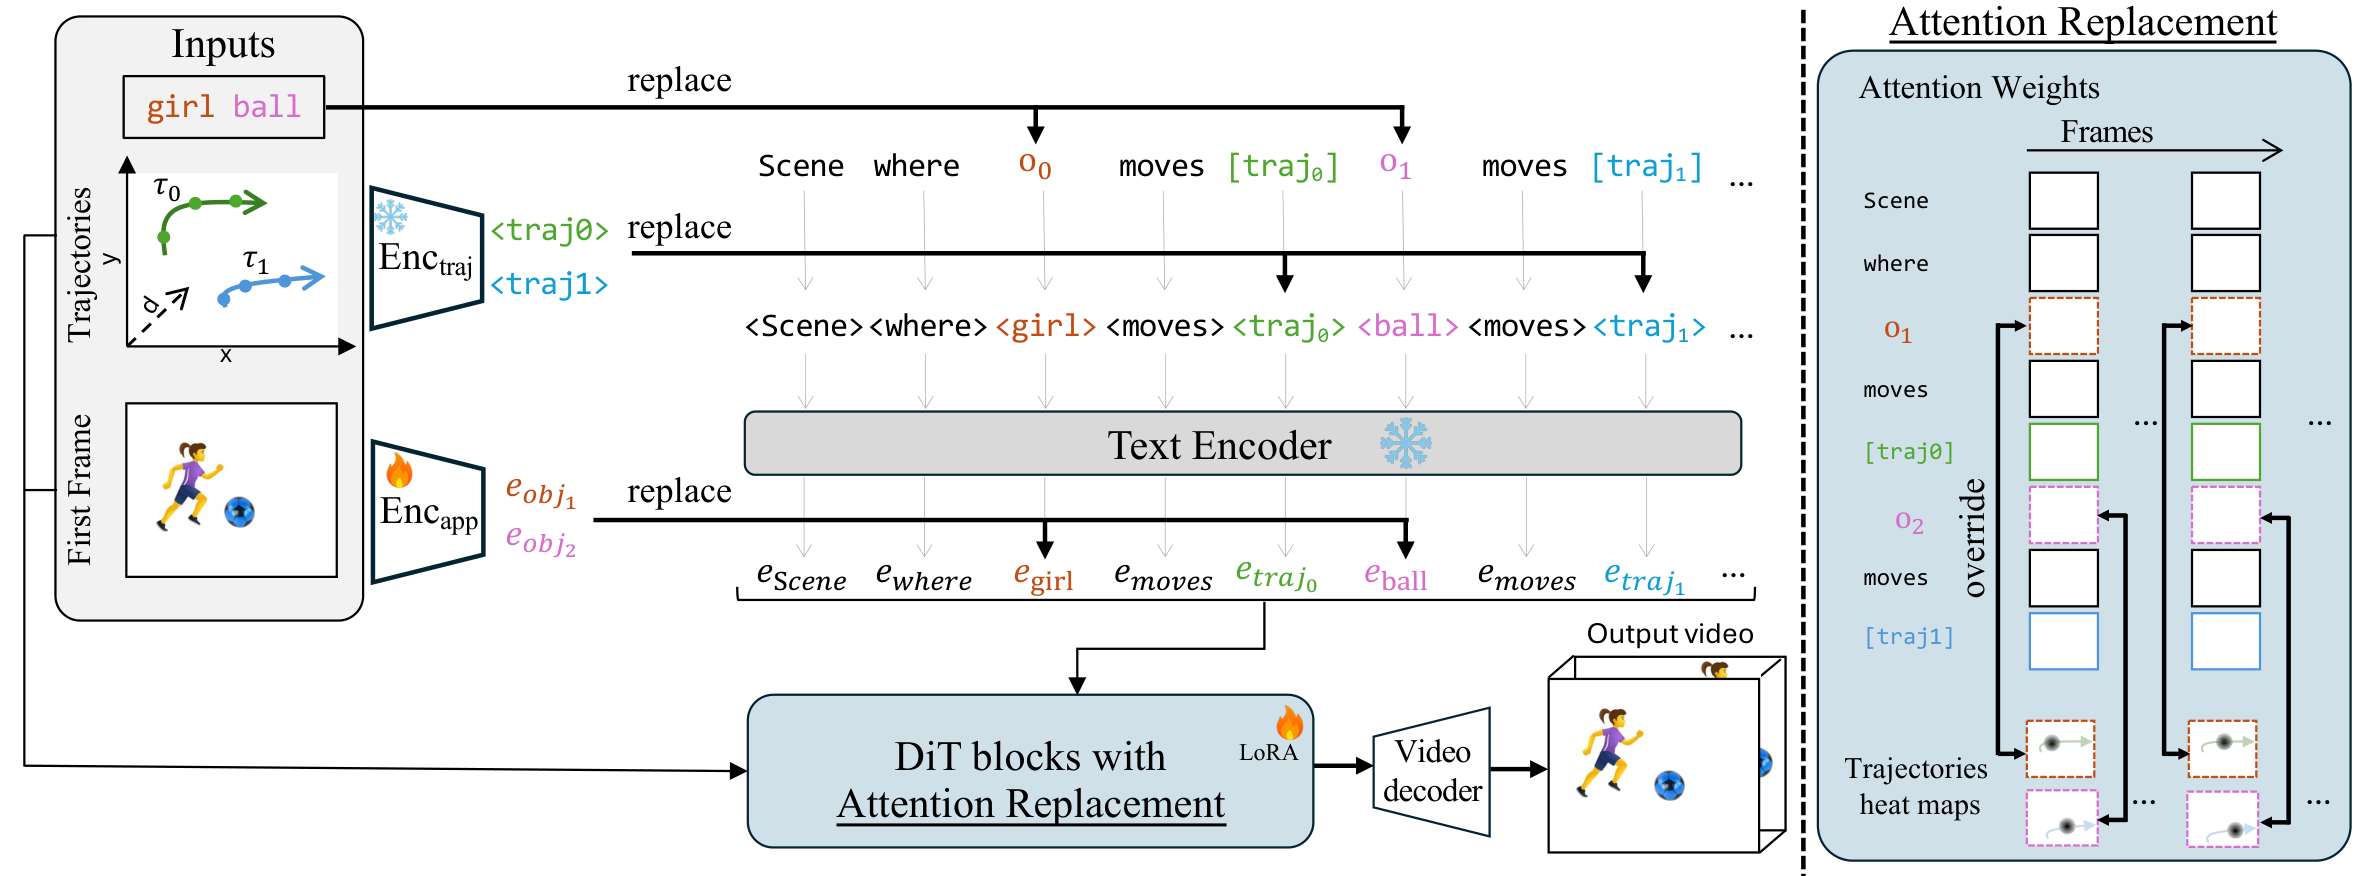
实验效果:在含最多 20 个同时受控物体及分布外真实场景的六个数据集上,视觉保真与轨迹遵循度一致提升;应用于 CogVideoX-5B 与 Wan2.1-14B 两种异构骨干,较最强基线平均 +4.3 dB PSNR、轨迹终点误差降低 51%。
批判点评:用「把交叉注意力权重直接换成高斯热图」实现逐物体硬空间约束,简洁、可跨 CogVideoX/Wan2.1 骨干迁移,20 物体拥挤场景下轨迹终点误差降 51% 很实在。但高斯热图是相对刚性的先验,对形变大/尺度剧变或非刚体运动可能过约束,深度与轨迹共用一套 token 的表达上限、以及热图中心定位对细粒度交互(接触/穿插)的处理仍待观察。
The Illusion of High Utility in Safety Alignment of Text-to-Image Diffusion Models | 中佛罗里达大学 | arXiv:2607.00402
关键词:文生图,安全对齐,语义坍缩,几何正则,TIFA
前序问题:文生图安全对齐要压制有害生成同时保住良性提示的效用,但现有「高安全+高效用」的结论多建立在 FID/CLIPScore 等粗粒度全局指标上,对细粒度语义正确性不敏感,制造了「高效用假象」。
本文贡献:用结构化评测(TIFA 问答式忠实度)戳穿假象——安全对齐模型在物体数量、属性、关系上语义保真明显下滑;进而定位根因为文本编码器嵌入空间的「语义坍缩」(嵌入分布收缩+提示间相似结构扭曲),且与结构化效用损失强相关。据此提出结构感知几何正则(SAGE),在对齐时显式保住嵌入分布展度与提示间关系结构。

实验效果:SAGE 恢复了结构化效用(TIFA 较此前 SOTA +5.0%),同时保持强安全性能与有竞争力的粗粒度效用分数(已被 ECCV 2026 接收)。

批判点评:从「粗指标掩盖语义退化」这一反直觉观察出发、用嵌入几何正则对症「语义坍缩」,视角犀利、从诊断到方案闭环完整,TIFA +5.0% 也证明可恢复细粒度效用。但方案聚焦文本编码器嵌入几何、对更深层去噪网络诱发的语义损失覆盖有限,安全与效用的权衡在更强攻击/更广有害概念下能否稳住、以及 TIFA 之外评测的一致性仍需扩验。
PixelEyes: Decoupling Perception and Reasoning for Pinpoint Visual Evidence Seeking | 武汉大学·UC Merced | arXiv:2607.00115
关键词:多轮视觉推理,MLLM,指代分割,视觉搜索,评测基准
前序问题:多轮视觉推理里,MLLM 反复定位失败导致轨迹又长又冗余;根因是推理与感知纠缠在同一模型内——边推理边定位,定位不准又触发更多推理轮次、把轨迹撑大。
本文贡献:提出 PixelEyes,把推理与感知显式解耦:推理器只决定「找什么」,专用感知工具回答「在哪」。含两招——(1) 掩码引导视觉搜索:调用指代分割模型给出掩码级精确定位,免去推理器补偿粗糙 grounding;(2) 语义区域广度优先搜索(BFS):把探索组织为对语义区域的 BFS,消除反复裁剪错误子区域造成的冗余回路。并通过重合成专家轨迹构建 PixelEyes-6K 数据集,另建零提示视觉搜索基准 Pinpoint-Bench(含实例级掩码/框,区分定位失败与推理失败)。
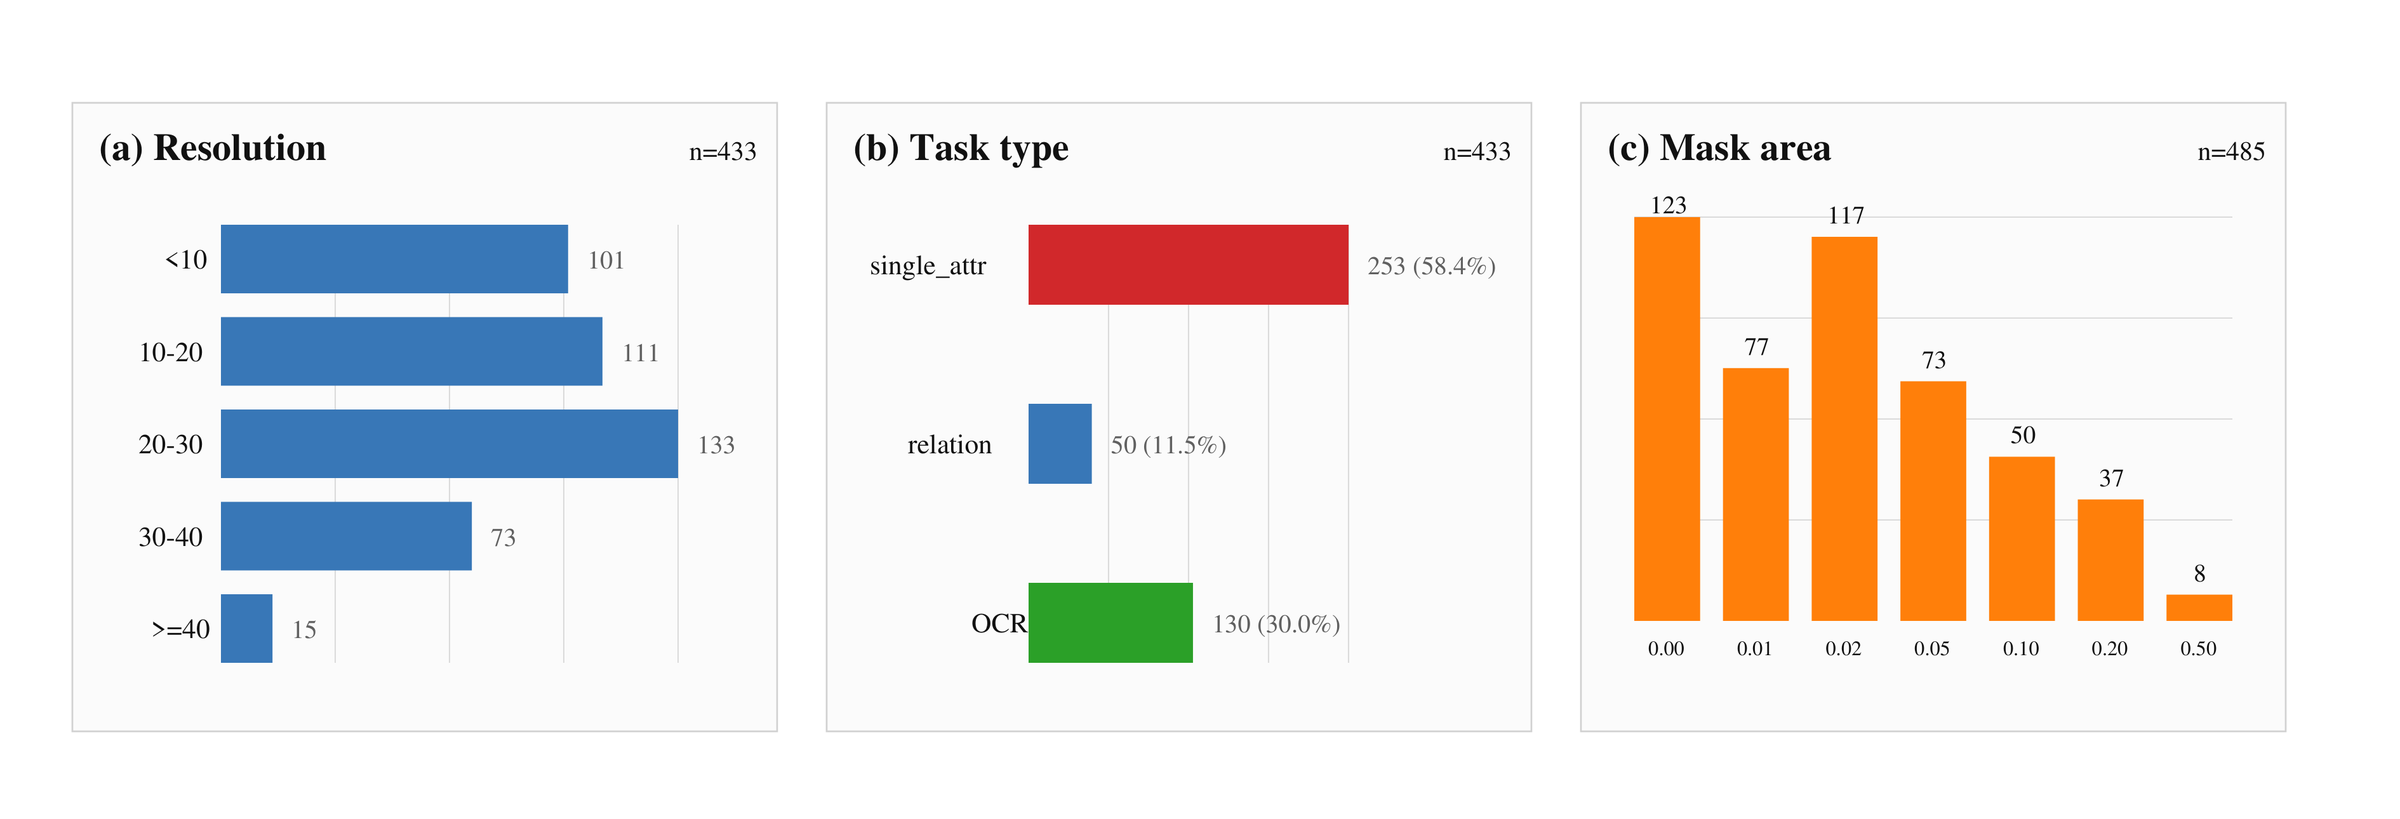
实验效果:近期 SOTA 的 MLLM 与视觉推理智能体在 Pinpoint-Bench 上仍留有很大提升空间,印证其质量与难度;代码与模型已开源。

批判点评:把「推理定位纠缠」拆成「推理器+分割感知工具」两件事、再用语义区域 BFS 剪掉冗余回路,思路清晰且直击多轮视觉搜索的实际痛点,配套 Pinpoint-Bench 也补齐了「定位 vs 推理」失败区分的评测缺口。但方案依赖外部指代分割模型精度、分割错误会直接卡住定位,BFS 在超大图/极多语义区域下的开销,以及它属视觉理解/grounding 而非生成、与生成一体化的结合仍需后续工作。
人工智能炼丹君 整理 | 2026-07-03
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)