


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 生成加速与高效训练 3 篇 · 生成理解一体化 1 篇 · 视频修复与重打光 3 篇 · 音频与语音生成 2 篇 · 生成安全与对齐 1 篇
MobileWan: Closing the Quality Gap for Mobile Video Diffusion | 高通(Qualcomm) | arXiv:2607.06173
关键词:视频扩散,移动端部署,循环蒸馏,注意力剪枝,VBench
前序问题:视频扩散靠把 Transformer 扩到数十亿参数换质量,但手机端模型受限于 0.4-1.8B 小参数预算、生成质量上不去;难点是如何在内存受限的移动硬件上跑服务器级大模型。
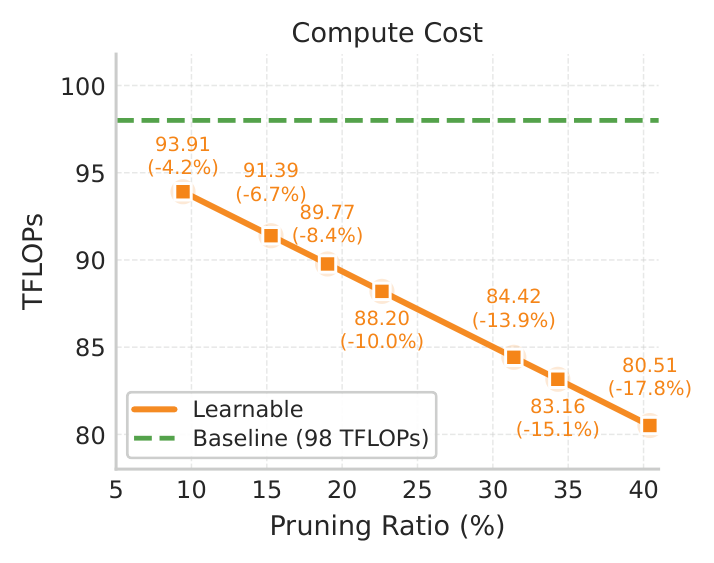
本文贡献:证明高质量移动端视频生成不必用小模型——把服务器级 5B 视频扩散 Transformer 高效部署到手机。以 Wan2.2-5B 为起点,用循环蒸馏把视频生成改造成分块自回归、常数内存注意力;配合因果线性注意力让模型推理时像 RNN 运行且跨块保持时序一致;再提出可学习注意力头剪枝(二值化逐头门控+噪声偏置稀疏目标端到端优化+蒸馏微调),叠加采样步蒸馏与内存优化 VAE 解码。
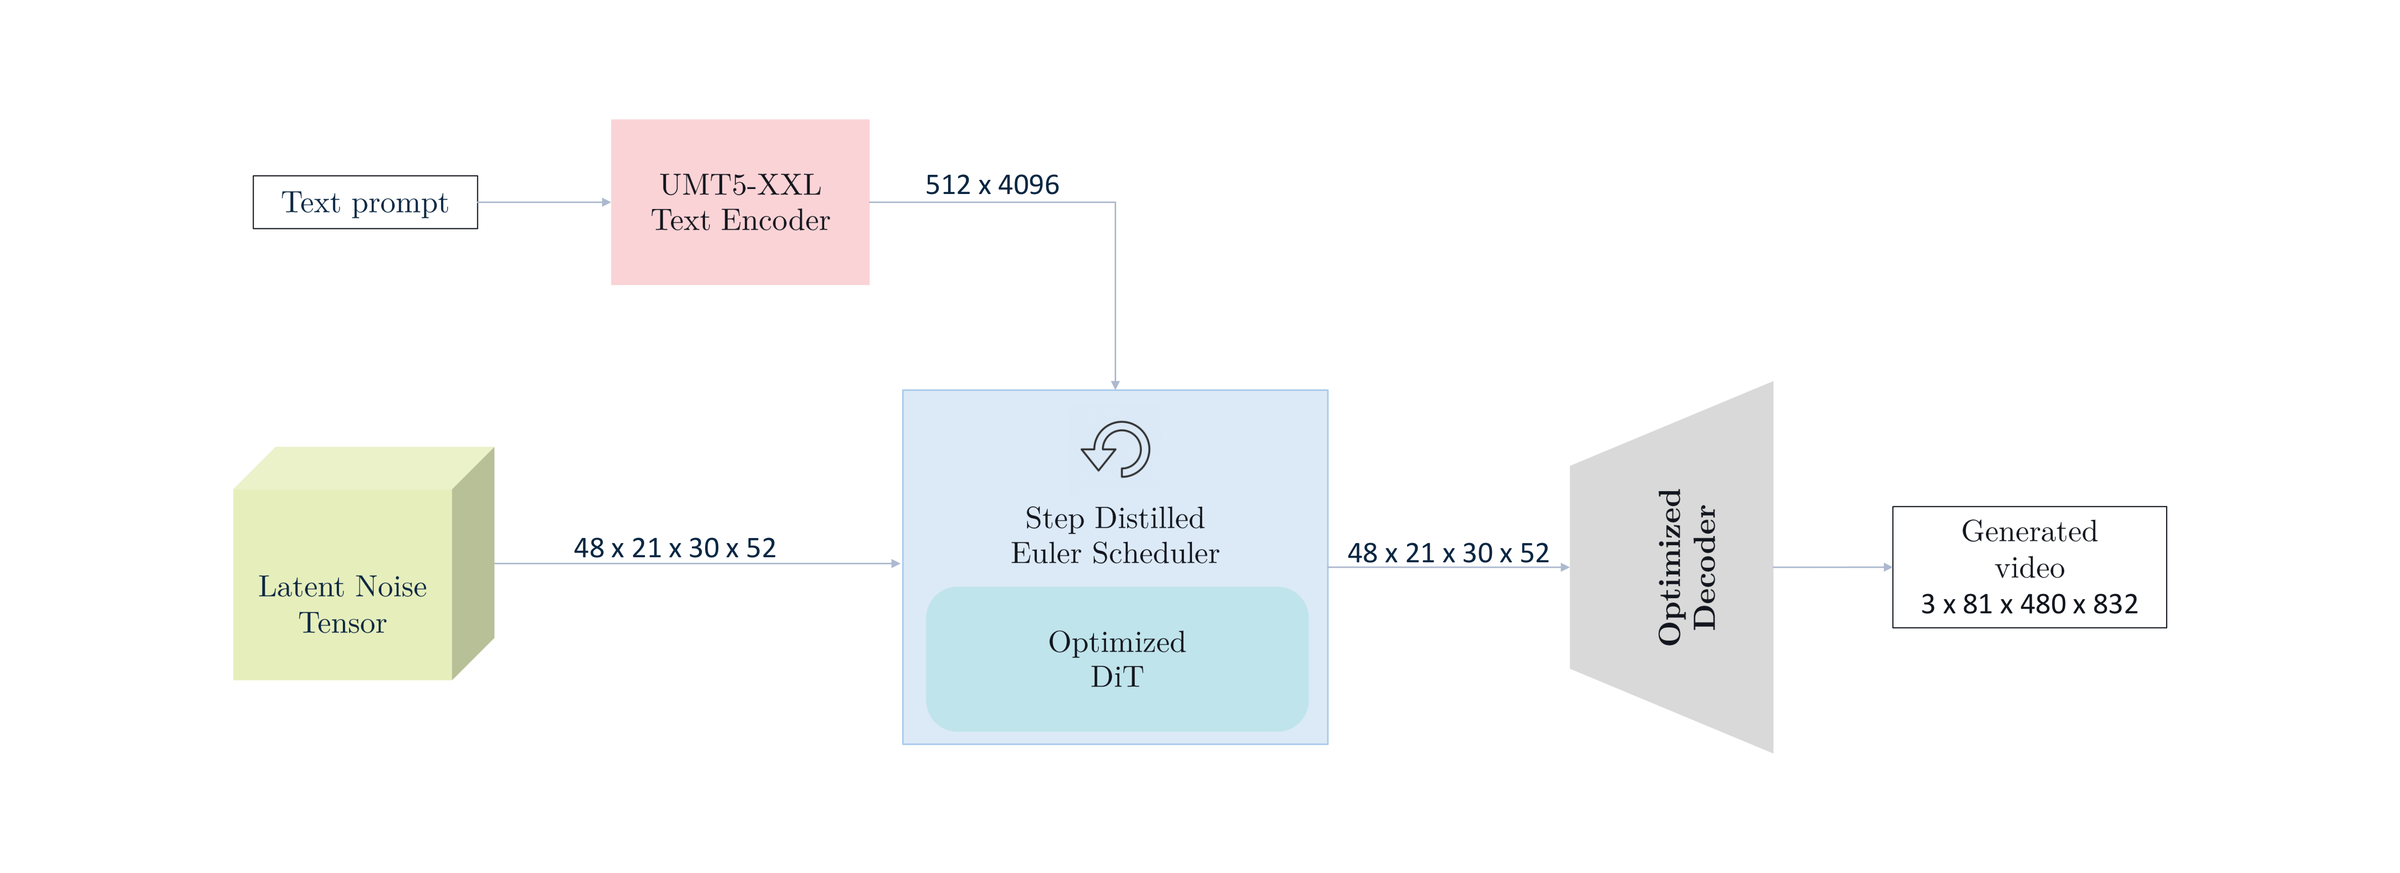
实验效果:成为首个可部署到商用手机的 5B 级视频扩散模型;在 Qualcomm Snapdragon 8 Gen 5 NPU 上以 20 秒端到端延迟生成 5 秒 480×832、16 FPS 视频,VBench 得分 83.79,刷新移动端视频生成 SOTA。
批判点评:用「循环重构+因果线性注意力+逐头剪枝+步蒸馏」组合拳把 5B 大模型压进手机 NPU,是移动端视频生成的一次实打实突破,高通自家 NPU 落地也很硬核。但 480×832/5 秒/16 FPS 仍是受限规格、20 秒延迟离交互式实时尚有距离,多重压缩(剪枝+线性注意力+步蒸馏)对复杂运动/长视频的质量损失、以及对非骁龙硬件的可迁移性仍待观察。
Dynamic-in-Few-Step: Unifying Dynamic Computation and Few-Step Distillation for Efficient Video Generation | 西湖大学·vivo·浙大 | arXiv:2607.06631
关键词:视频扩散,少步蒸馏,动态稀疏,模型混合,后训练加速
前序问题:视频扩散质量高但算力昂贵;少步蒸馏虽提速,却对所有去噪阶段强制统一的静态结构,忽视了不同噪声水平天然不同的算力需求。
本文贡献:提出后训练加速框架,把动态结构稀疏化直接融进蒸馏过程:不同于对固定管线做事后压缩,它联合优化去噪步数与结构稀疏度,把预训练视频扩散变成紧凑的、逐步专用的模型混合(Mixture-of-Models, MoM);并用渐进训练策略+输出回滚机制解决联合优化的训练不稳定,配套专用推理引擎高效部署。

实验效果:与现有加速技术正交且高效:在 Wan-14B 上,在 4 步蒸馏基础上再去掉 24% 的每步 FLOPs、额外带来 1.2× 墙钟加速,相对 50 步教师达到 30× 提速,同时保持有竞争力的生成质量。

批判点评:抓住「不同噪声步算力需求不同」这一被少步蒸馏忽视的冗余,用逐步专用 MoM 把动态稀疏与蒸馏联合优化、且与其它加速正交,思路精准、30× 提速实在。但 MoM 带来路由与部署复杂度、需专用推理引擎,「4 步基础上再省 24% FLOPs」的绝对增益有限,训练稳定性靠渐进策略+回滚机制维持、调参成本与更大规模泛化仍待看。
FourTune: Towards Fully 4-Bit Efficient Post-Training for Diffusion Models | MIT·Stanford·CMU | arXiv:2607.05711
关键词:扩散模型,4-bit量化,后训练,LoRA,FLUX
前序问题:大扩散模型后训练受显存占用大、训练慢制约,现有参数高效微调(PEFT)只能部分缓解,始终困在「省显存却不省算力」的内存-速度权衡里(如 LoRA 全精度骨干仍占大量显存、QLoRA 频繁在线反量化反增开销)。
本文贡献:提出 FourTune,基于端到端 W4A4G4(权重/激活/梯度全 4-bit)的高效后训练框架:三分支混合管线在标准 LoRA 上增设冻结的数值稳定器,隔离对量化敏感的离群值,从而在原生 4-bit 计算下稳定训练;并用硬件友好的分块量化与定制融合算子支持高效量化反向传播、降低显存带宽开销。
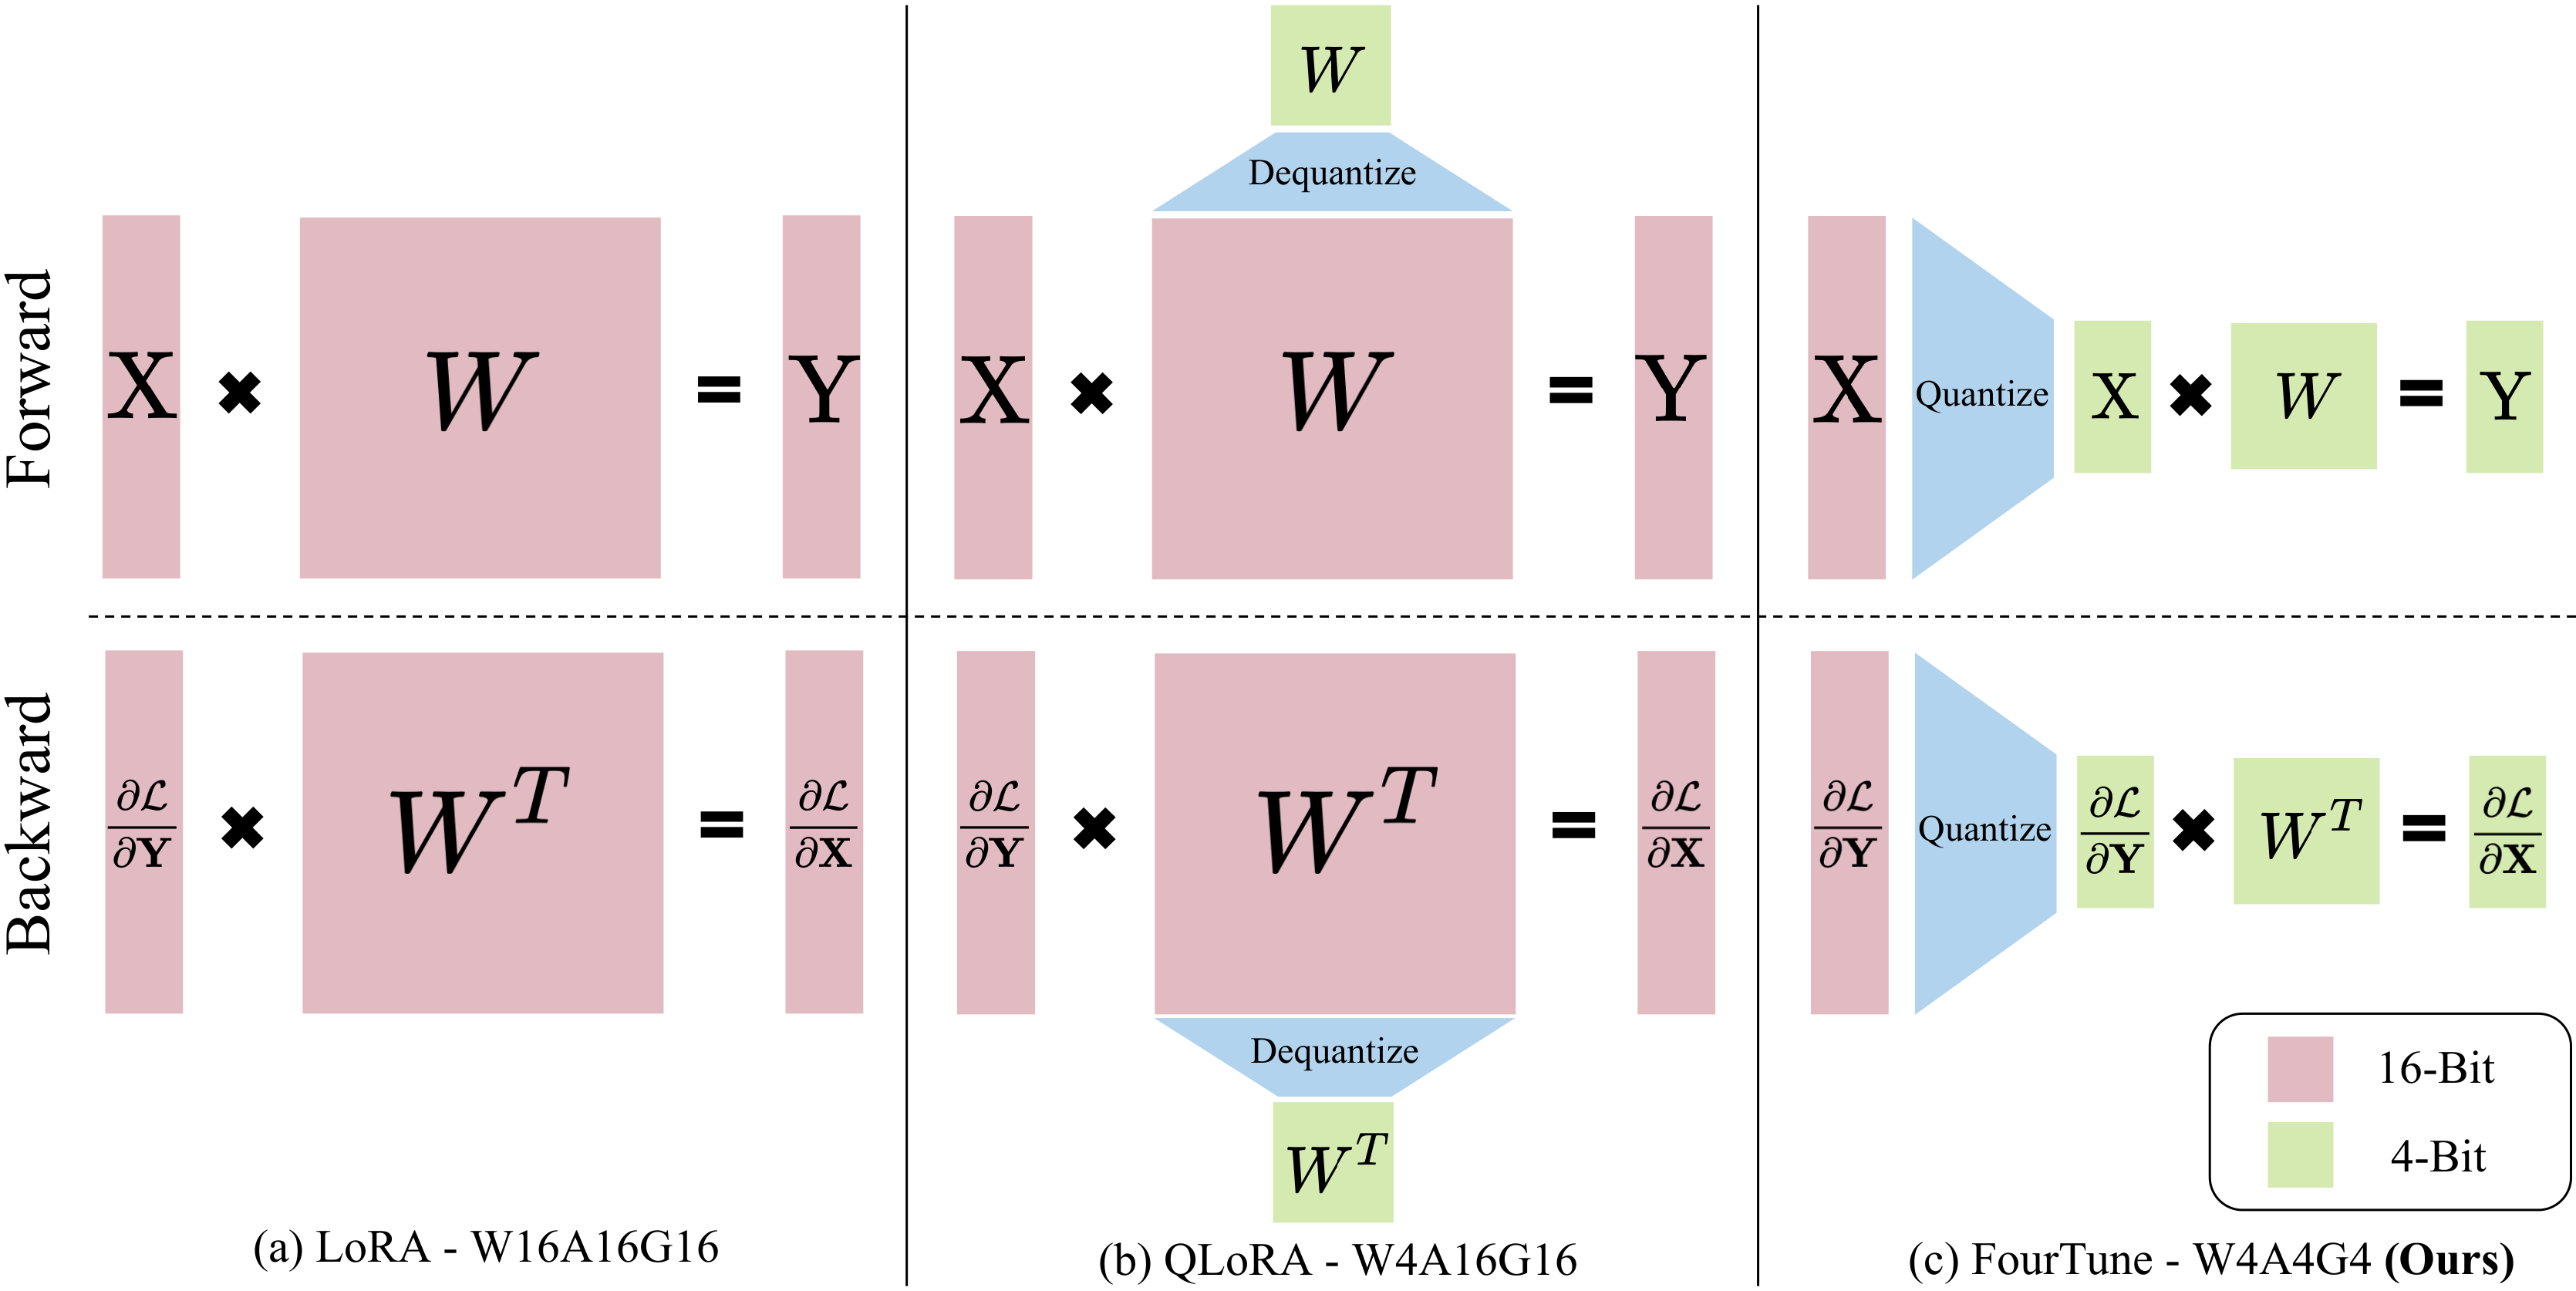
实验效果:在定制化、强化学习、蒸馏三类任务上均可匹配全精度微调质量;在 FLUX.1-dev(12B)上,相比 BF16 LoRA 显存开销降低 2.25×、端到端训练吞吐提升 2.27×。
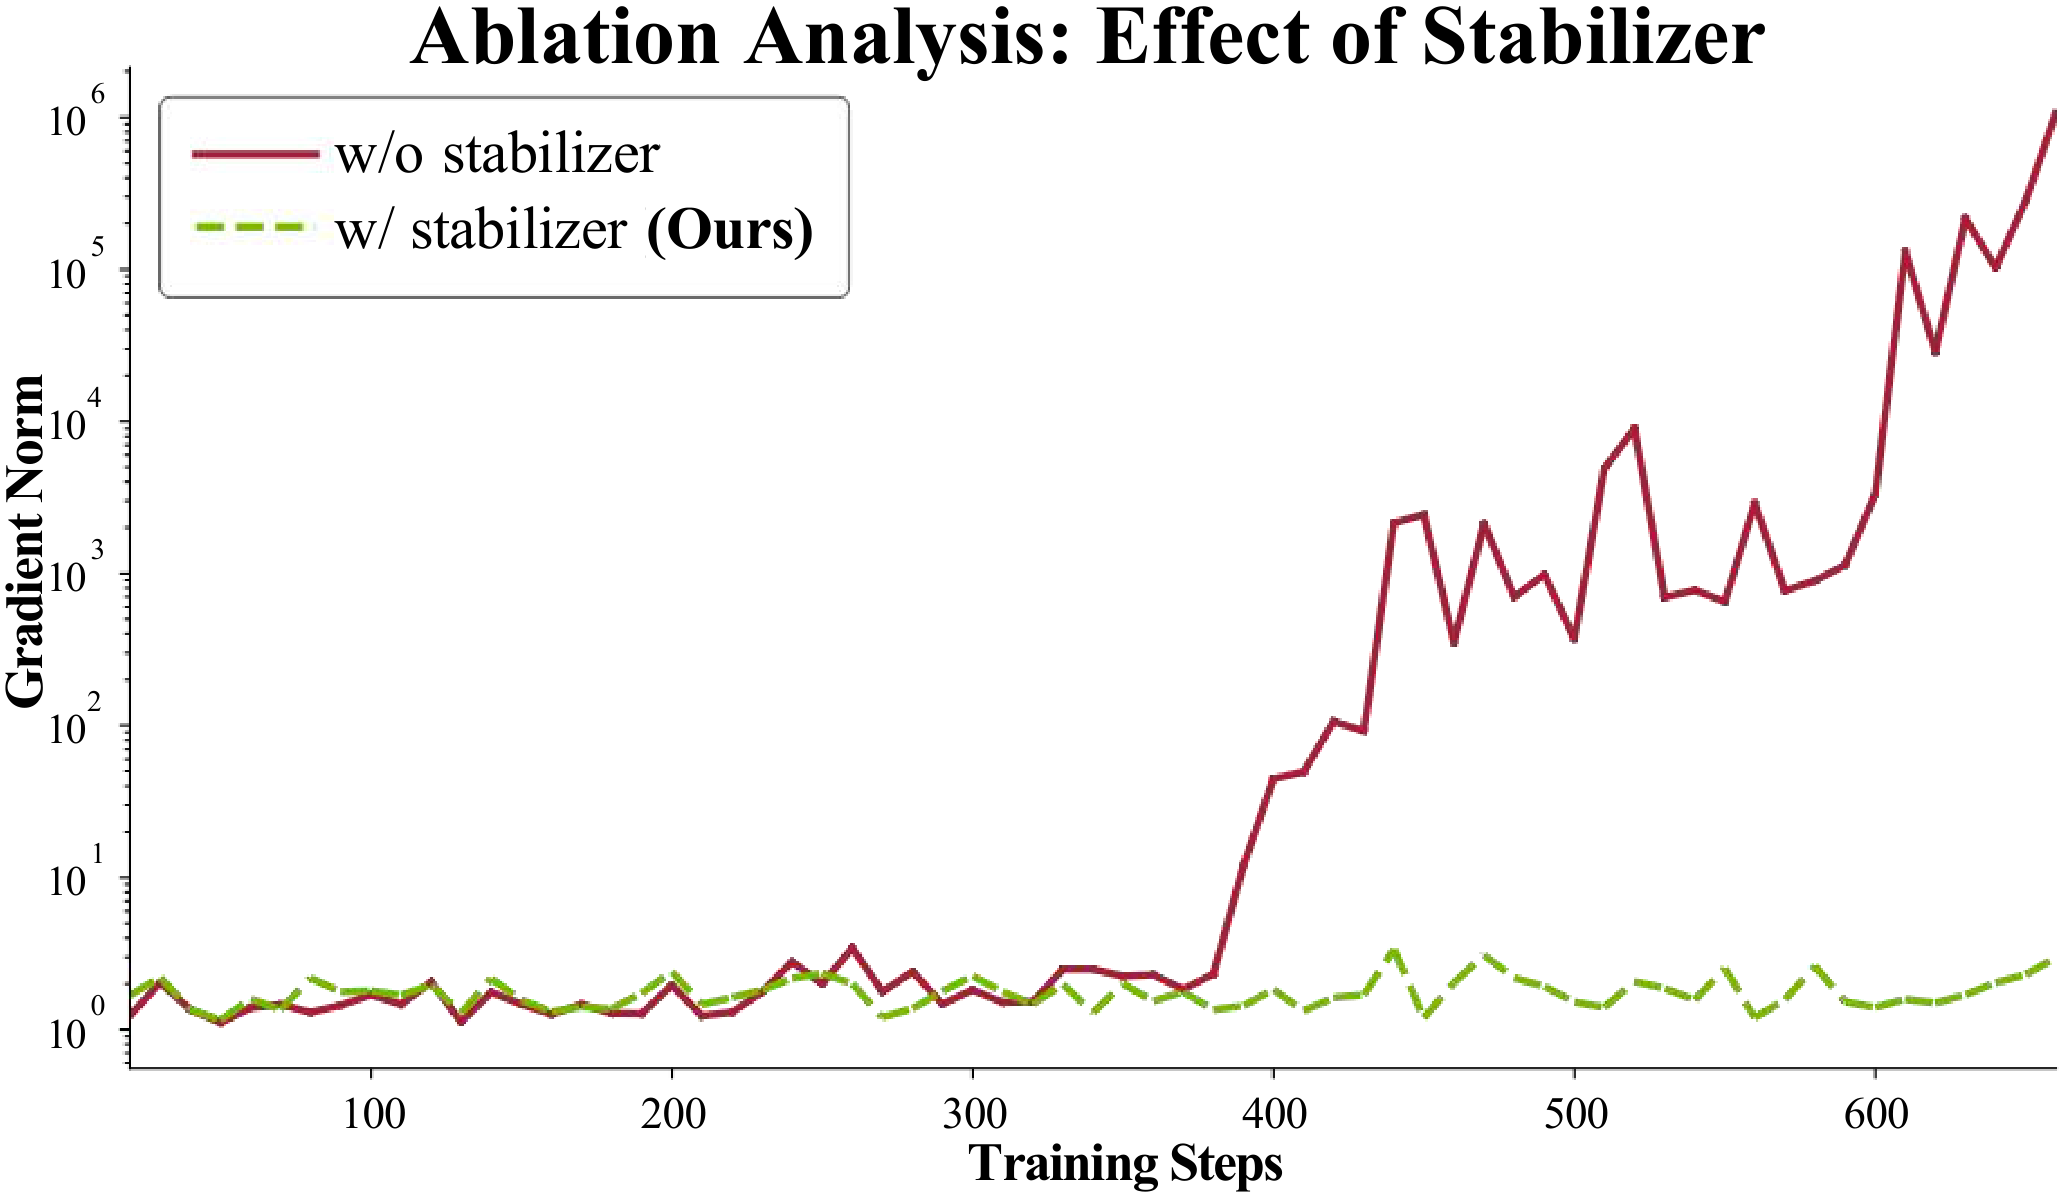
批判点评:把量化从推理推进到「后训练全 4-bit(含梯度)」,用冻结数值稳定器隔离离群值破解 4-bit 训练不稳定,配定制融合算子拿到 2.25× 显存/2.27× 吞吐,MIT/Stanford/CMU 这套量化天团工程含金量高。但 W4A4G4 依赖特定硬件与定制 kernel、通用性受限,数值稳定器额外分支的开销、以及更大模型/更长训练下 4-bit 梯度的精度累积误差仍需更多验证。
Gen4U: Unifying Video Generation and Understanding via Diffusion | Google DeepMind | arXiv:2607.06856
关键词:视频扩散,生成理解一体化,表征探测,视频编码器,零样本
前序问题:以往认为扩散表征只擅长低层几何、拙于高层语义,生成与理解被割裂看待;能否让同一个视频扩散模型既生成又理解,缺乏系统证据。
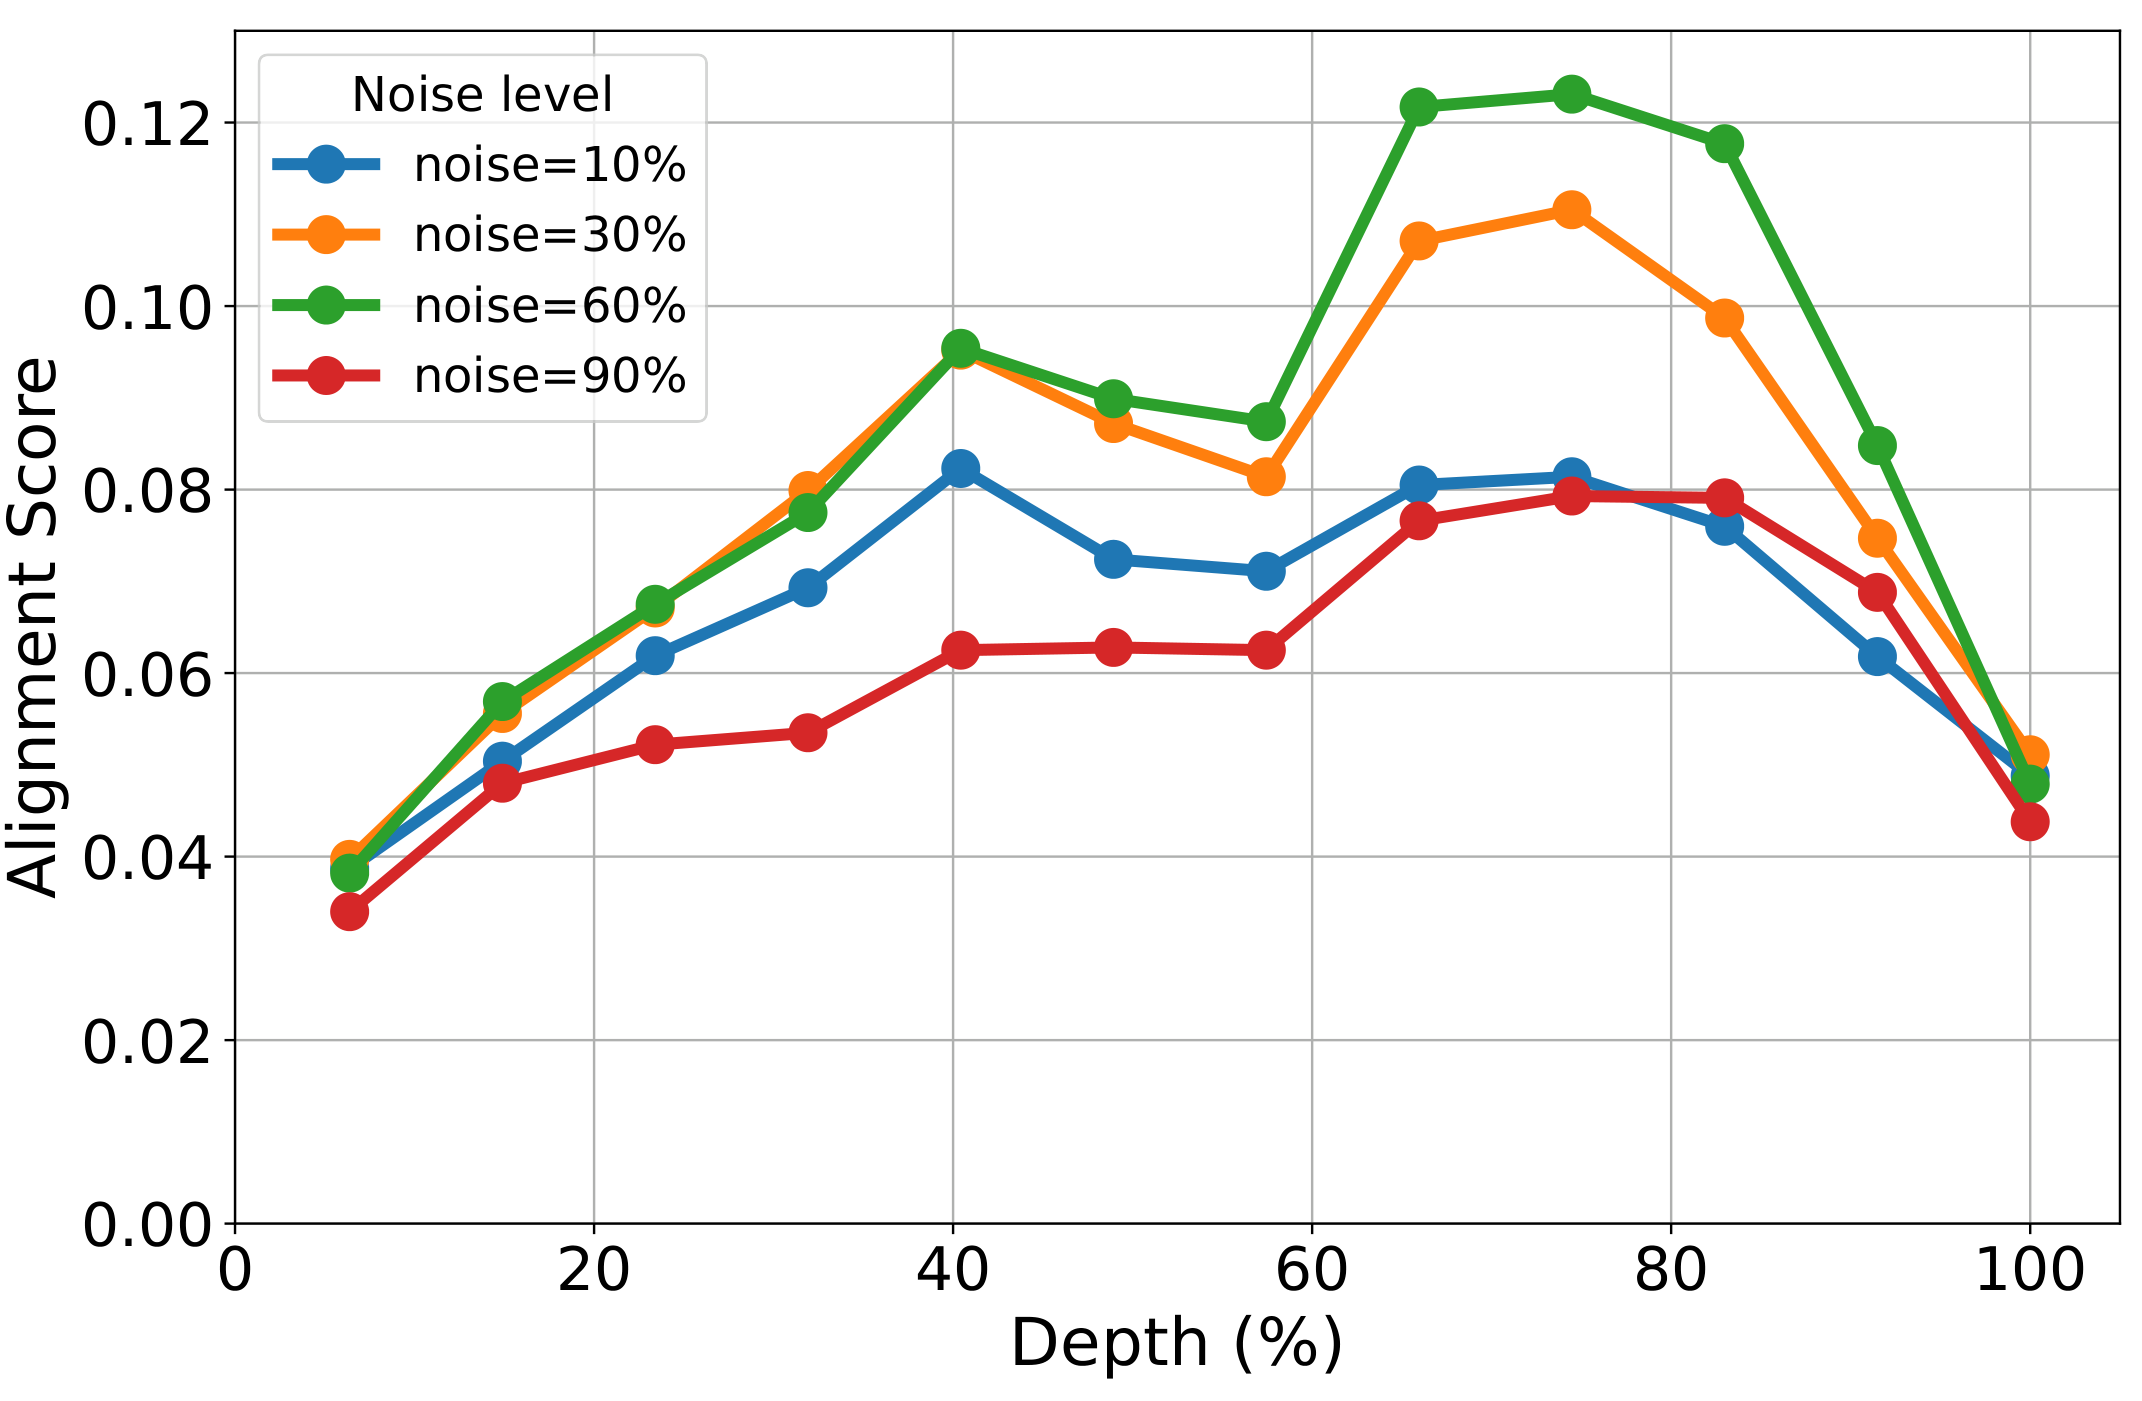
本文贡献:用互近邻(mutual-kNN)对齐度量系统探测 SOTA 视频扩散(Veo3、Wan2.2)的中间激活,揭示其潜空间沿网络深度与噪声水平高度结构化:中等噪声给出线性可分的全局语义,低噪声保留细粒度细节但空间分散、需注意力解码。据此提出 Gen4U,用单次前向复用这些生成表征,把冻结的大规模视频扩散直接当作强视频编码器。
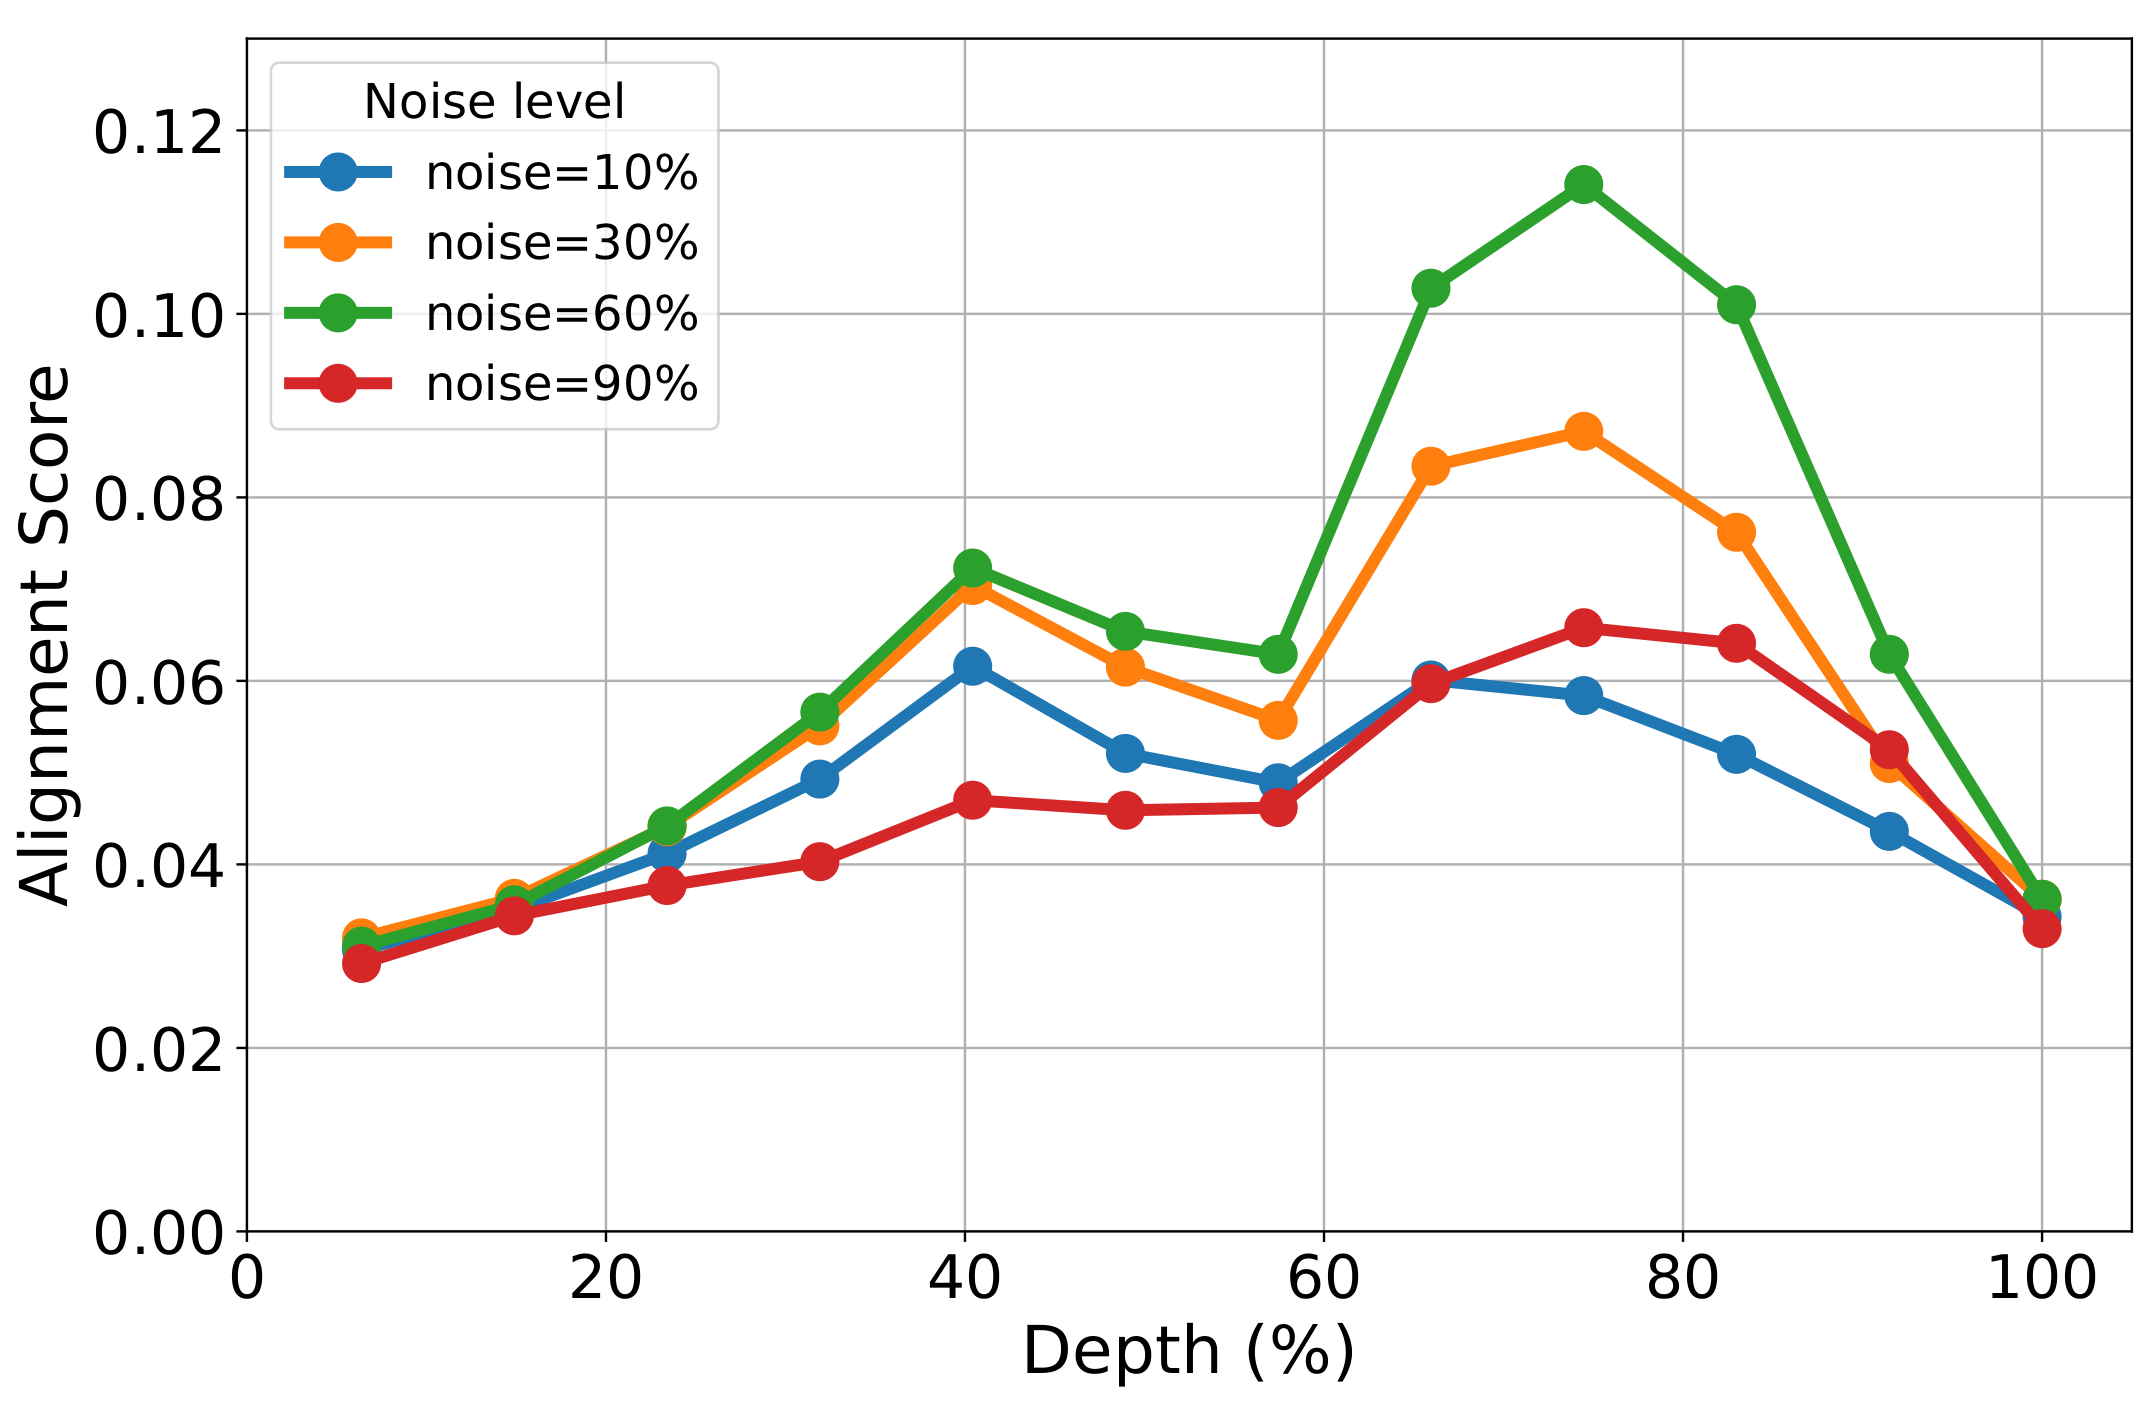
实验效果:冻结、免微调的视频扩散在视频分类、深度估计、相机位姿估计、图像/视频描述等一系列语义与非语义任务上都极具竞争力,在保留原模型高质量生成能力的同时统一了生成与理解两大范式。
批判点评:用对齐度量把「视频扩散潜空间怎样编码语义」讲清楚,并证明冻结模型免微调即是强编码器,是对「生成即理解」的漂亮实证,DeepMind 用 Veo3 背书说服力强。但探针依赖对 mutual-kNN 等度量与噪声/层位的精心选点,下游任务用简单读出头、与专用微调 SOTA 仍有差距,且强依赖顶级视频扩散(Veo3 闭源),可复现与在更弱模型上的普适性存疑。
LightCrafter: PBR-Conditioned Video Diffusion Refinement for Controllable and Consistent Relighting | CMU·多伦多大学·博世 | arXiv:2607.08016
关键词:视频重打光,PBR渲染,视频翻译,时序一致,CogVideoX
前序问题:视频重打光要同时兼顾长时时序一致与基于物理的光传输,依赖对材质/几何/光照等本征属性的准确估计。已有两条路都不理想:逆渲染+正渲染重建噪声大、难处理全局光照;生成式视频到视频翻译则可控性差、时序不稳、且受配对训练数据限制。
本文贡献:提出 LightCrafter 混合管线,把视频重打光重构为「对一段代理视频做视频翻译」:不直接翻译输入视频,而是把「输入在目标光照下的 PBR 渲染」翻译为最终结果——将光照目标烘焙进 PBR 代理,免去教扩散模型理解环境贴图等光照概念,既能实现更精细的光照控制、又天然带来长时时序一致。为补足 PBR 难建模的全局光照,在合成配对视频+真实无配对视频上后训练 CogVideoX 以调用视频生成模型的光度先验。

实验效果:在真实世界重打光基准上超越此前 SOTA,并贡献了一个用于深入分析的合成基准;将开源数据集、基准、指标与代码。

批判点评:用「PBR 代理+视频翻译」把光照控制从难教的生成条件变成可烘焙的物理渲染,兼得可控性与时序一致,思路巧妙、实测超 SOTA。但方案质量受前置 PBR 渲染(依赖本征估计)的上限约束,全局光照仍要靠后训练 CogVideoX 兜底,两阶段管线的复杂度、以及对复杂材质/强动态场景的泛化仍待检验。
FADRA: Frequency-Aware Diffusion with Residual Adaptation for Video Face Restoration | UAE大学·中国海洋大学·MBZUAI | arXiv:2607.06389
关键词:视频人脸修复,频率感知,扩散模型,残差自适应,时序一致
前序问题:视频人脸修复(VFR)要从严重退化的视频里恢复高质量且时序一致的面部细节,现有方法难以在空间保真与时序连贯间取得平衡。
本文贡献:提出 FADRA,频率感知+迭代残差自适应的扩散框架:借预训练文生视频扩散的强时序一致性,用轻量 LoRA 适配器+低质(LQ)像素对齐特征融合高效迁移冻结生成先验;再引入重复残差自适应头(RRAH)在骨干后做逐步残差精修——RRAH 把 LQ 潜变量与当前速度预测一起作输入,在每个流匹配步反复回看 LQ 线索、预测残差更新;另设频率感知损失在多个频段显式监督、强调对感知质量关键且易时序抖动的频率分量。

实验效果:恢复出更好的面部结构、产出比 SOTA 更时序一致的视频,在定量指标与主观感知上均有明显提升。
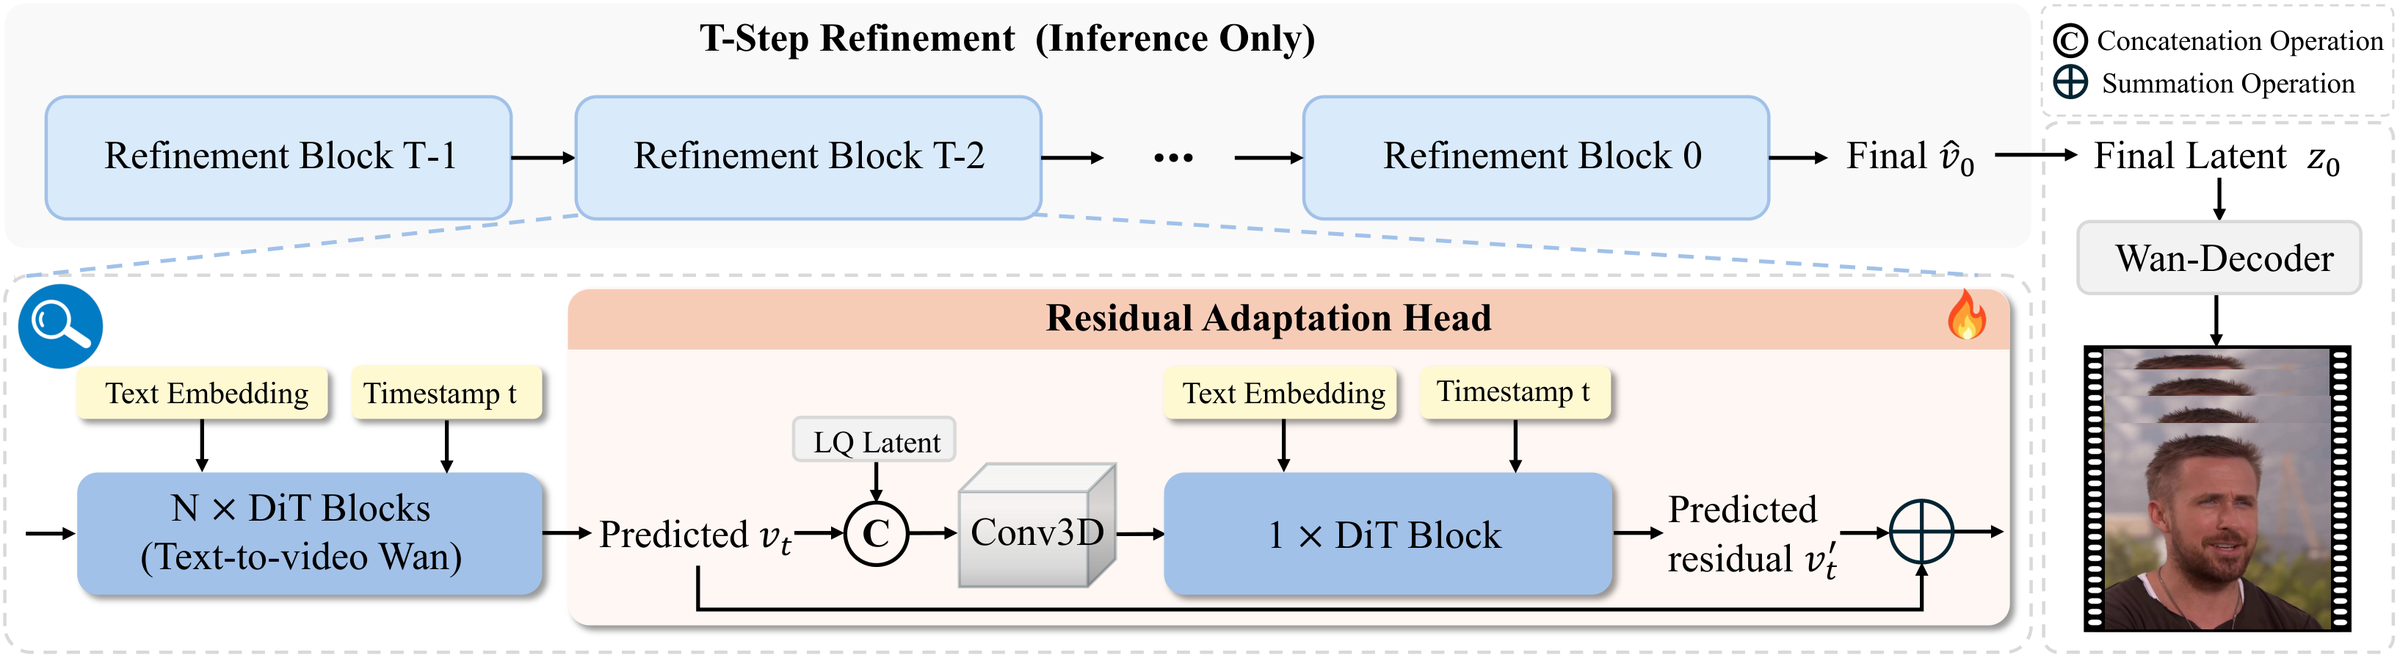
批判点评:用「LoRA 迁移生成先验+RRAH 逐步残差回看 LQ+频率感知损失」三招治 VFR 的空间-时序权衡,把频域监督用在易抖动分量上很对症。但方法叠了多个模块、对预训练文生视频先验依赖强,RRAH 重复精修的推理开销、以及在极端退化或大姿态/遮挡人脸上的鲁棒性仍需更多验证。
DiffCVE: Diffusion-based Compressed Video Enhancement | 武汉大学 | arXiv:2607.07195
关键词:压缩视频增强,编码先验,扩散模型,QP条件,VAE解码
前序问题:严重压缩视频的感知质量增强很难:伪影模式复杂、信息损失大;直接套用扩散模型往往忽视压缩退化特性,还可能引入与结构不一致的幻觉。
本文贡献:提出 DiffCVE:用编码先验增强的双条件(CPDC)分支联合建模压缩视频与编码先验,让残差、运动矢量等编码先验在去噪过程中提供互补的结构与运动引导;用压缩退化语义提示(CDSP)以 QP 条件文本提示+LoRA 微调让扩散过程感知压缩严重程度;再在 VAE 解码器里加入编码先验引导的加权融合(CPWF),用 QP 预测的权重融合 VAE 编码器与编码先验编码器特征。
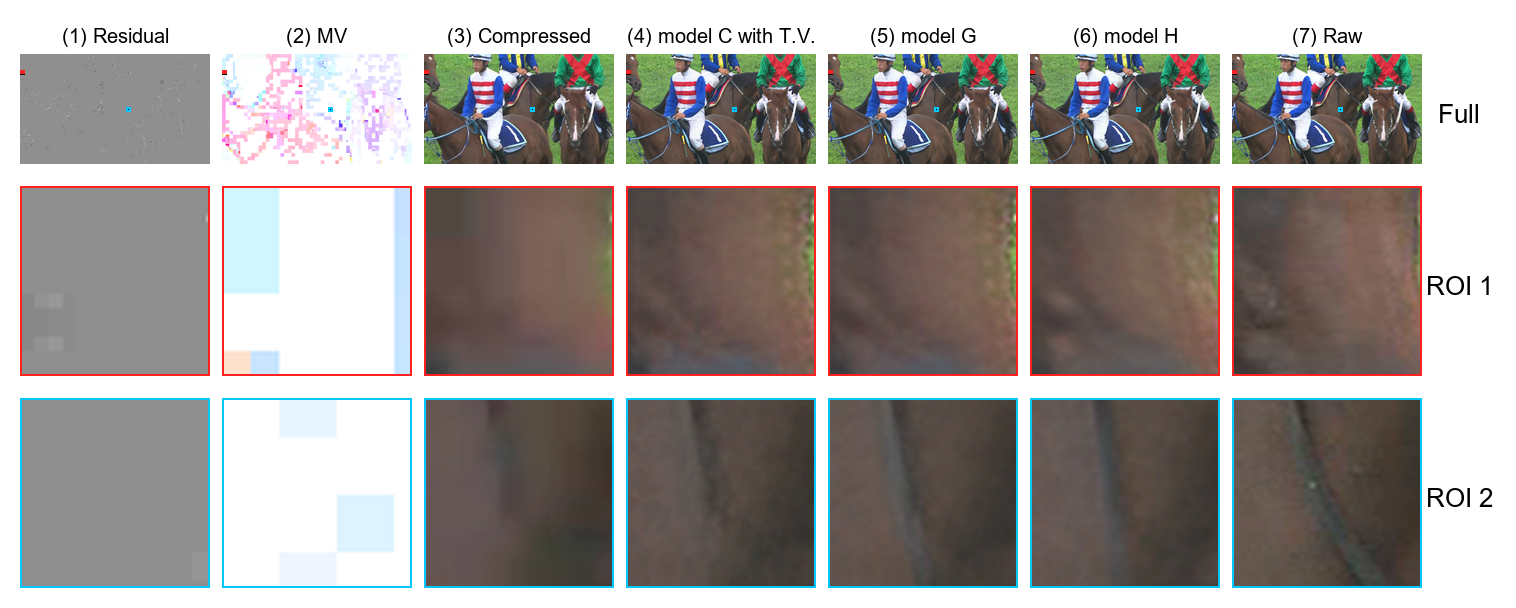
实验效果:在提升感知质量上效果显著,尤其在严重压缩设置下优势明显;项目页提供了增强视频演示。

批判点评:把「编码先验(残差/运动矢量/QP)」这一压缩视频独有信息喂进扩散去噪与解码,对症「忽视退化特性+幻觉」两大痛点,充分利用视频编码域知识很务实。但强依赖可拿到的编码先验(需解码端配合)、QP 条件与三模块叠加的复杂度,以及在跨编码标准/未知码率下的泛化仍待验证。
Precise Video-to-Audio Generation with Cross-Modal Alignment in Latent Space | FPT Software·NVIDIA | arXiv:2607.06405
关键词:视频到音频,端到端,交叉注意力,音视频同步,VGGSound
前序问题:视频到音频(V2A)要为无声视频合成语义一致且时序同步的声音,但许多方法靠多阶段训练(算力高、耗时长),或把视觉转成文本以借用文生音频模型(牺牲细粒度时序线索)。
本文贡献:提出 Flowley,端到端单阶段训练架构,融合视觉特征与文本提示生成配音;核心是渐进软掩码交叉注意力,把音视频同步直接嵌进注意力机制、相较标准注意力零额外算力;并提出即插即用的 SoundCap 管线,为视频生成细粒度、声音导向的描述来引导模型(弥补现有 V2A 基准缺乏声音描述的问题)。
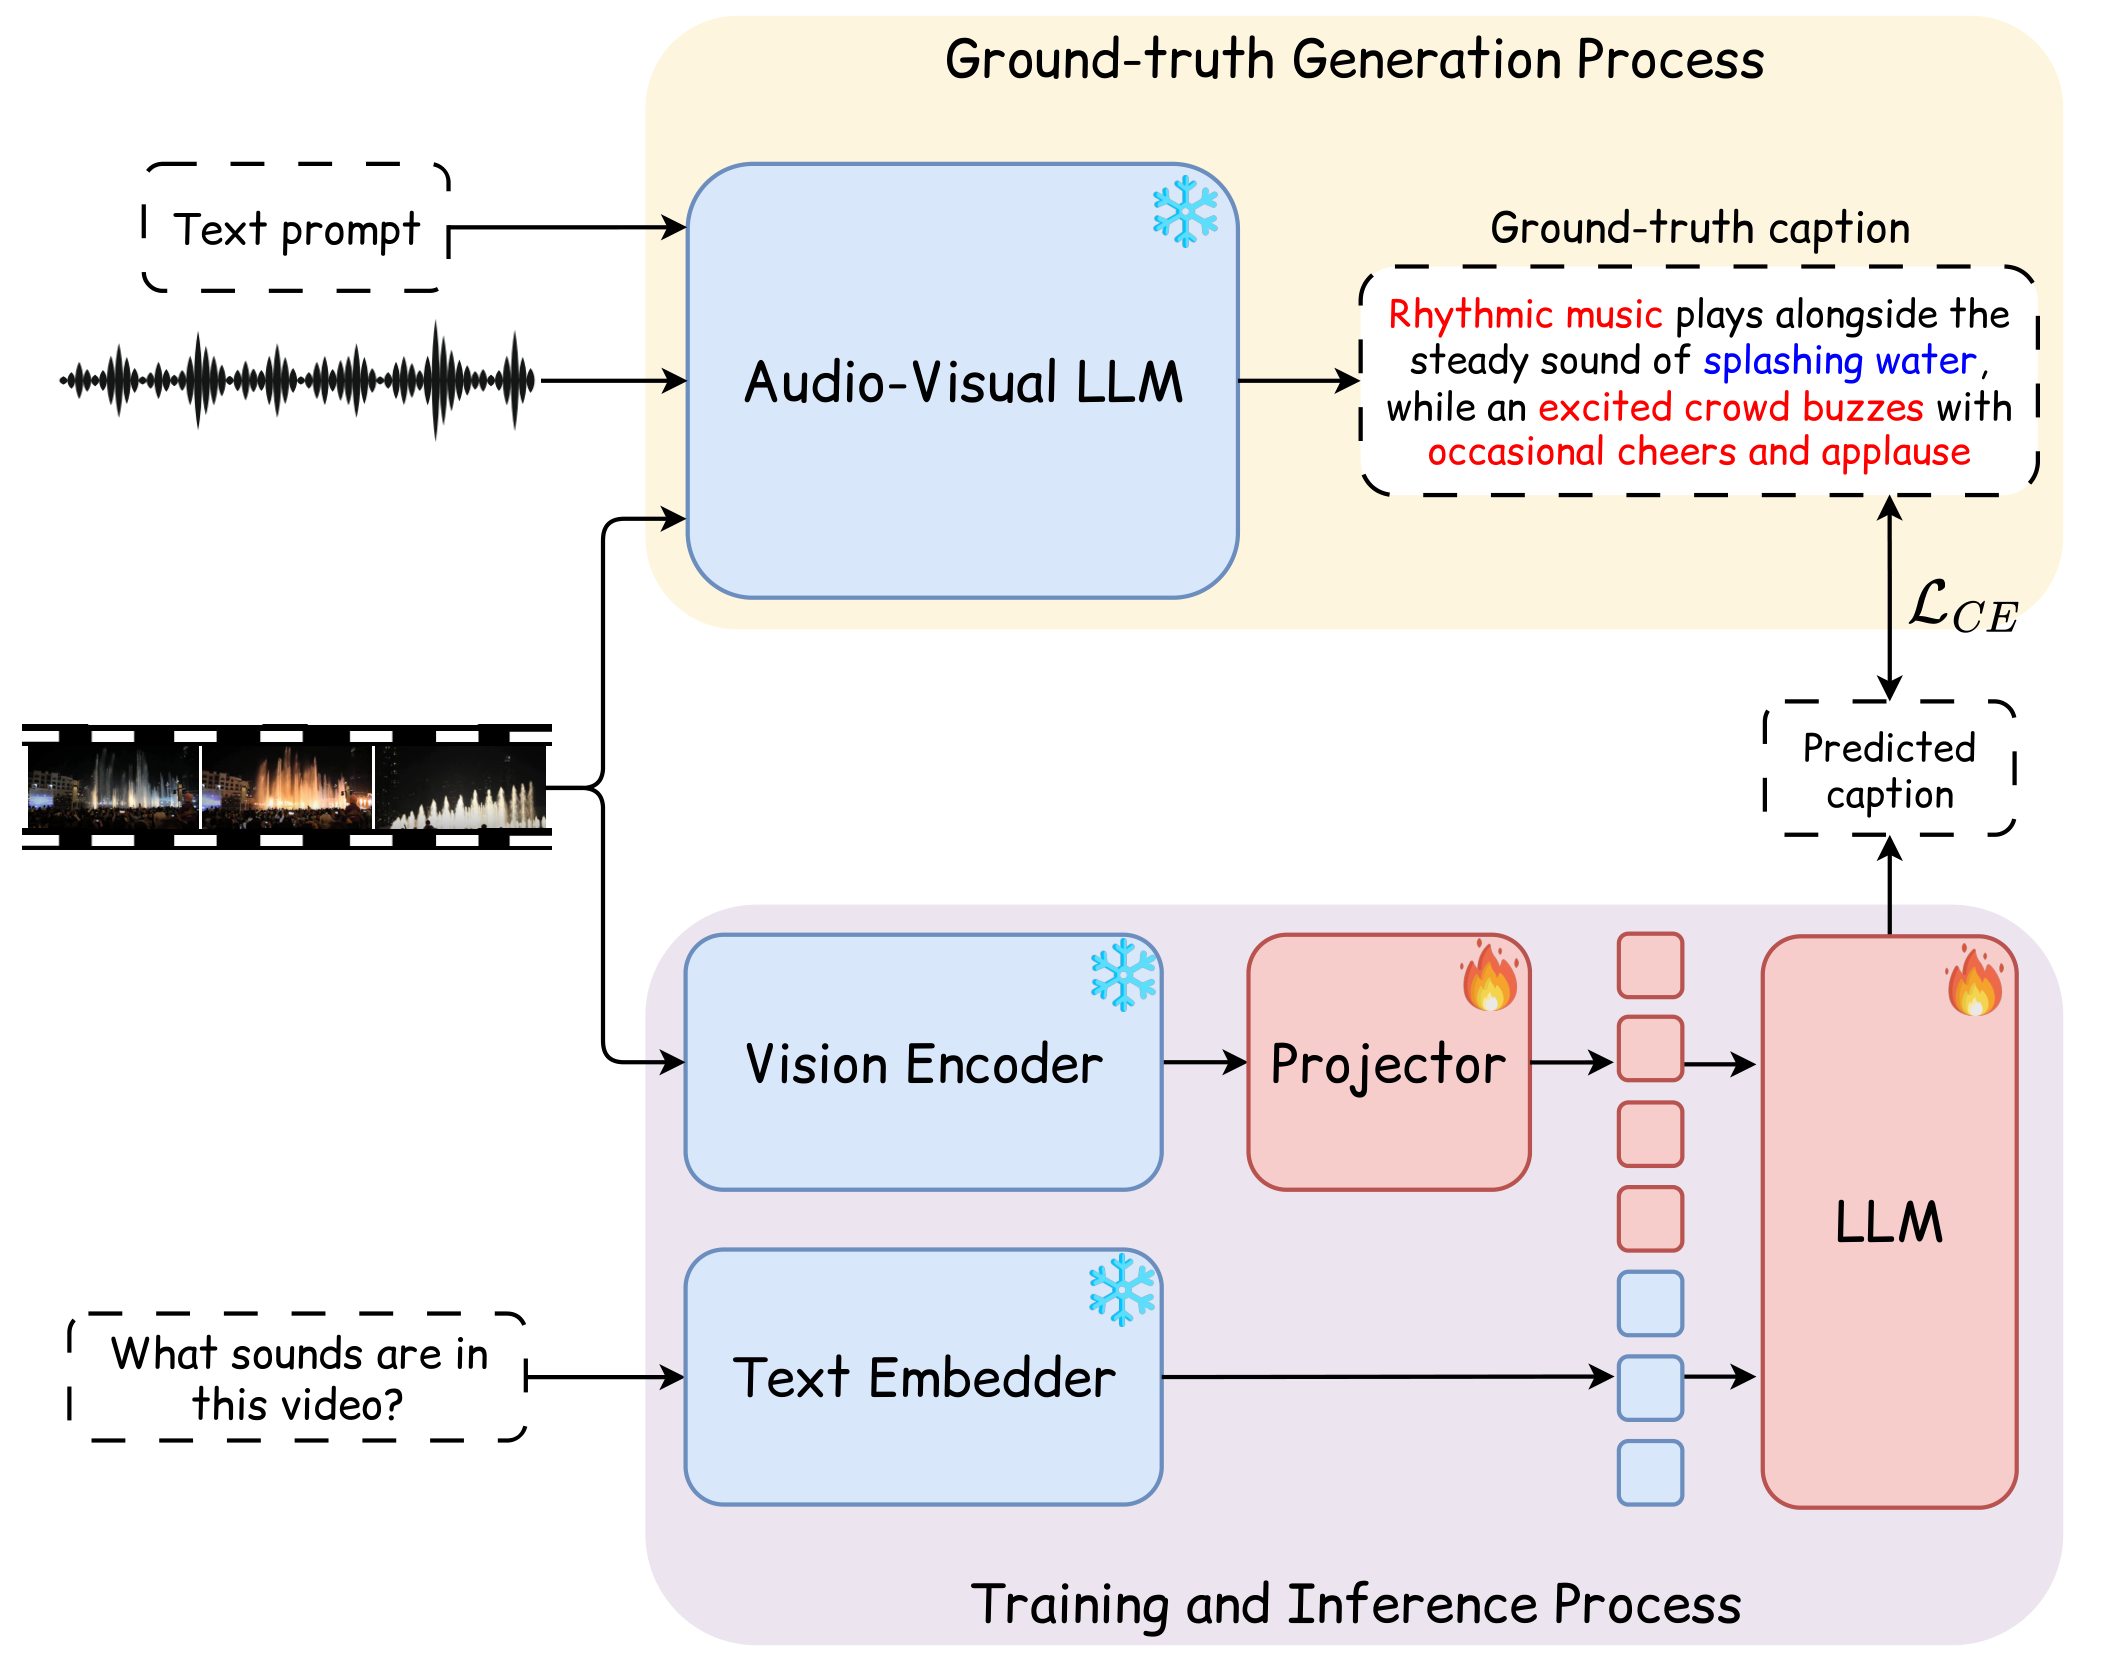
实验效果:不集成任何预训练音视频对齐模块,Flowley 在 VGGSound 多项指标上达到 SOTA;引入 SoundCap 后,零样本设置下音频质量进一步超过最强的闭源方法。
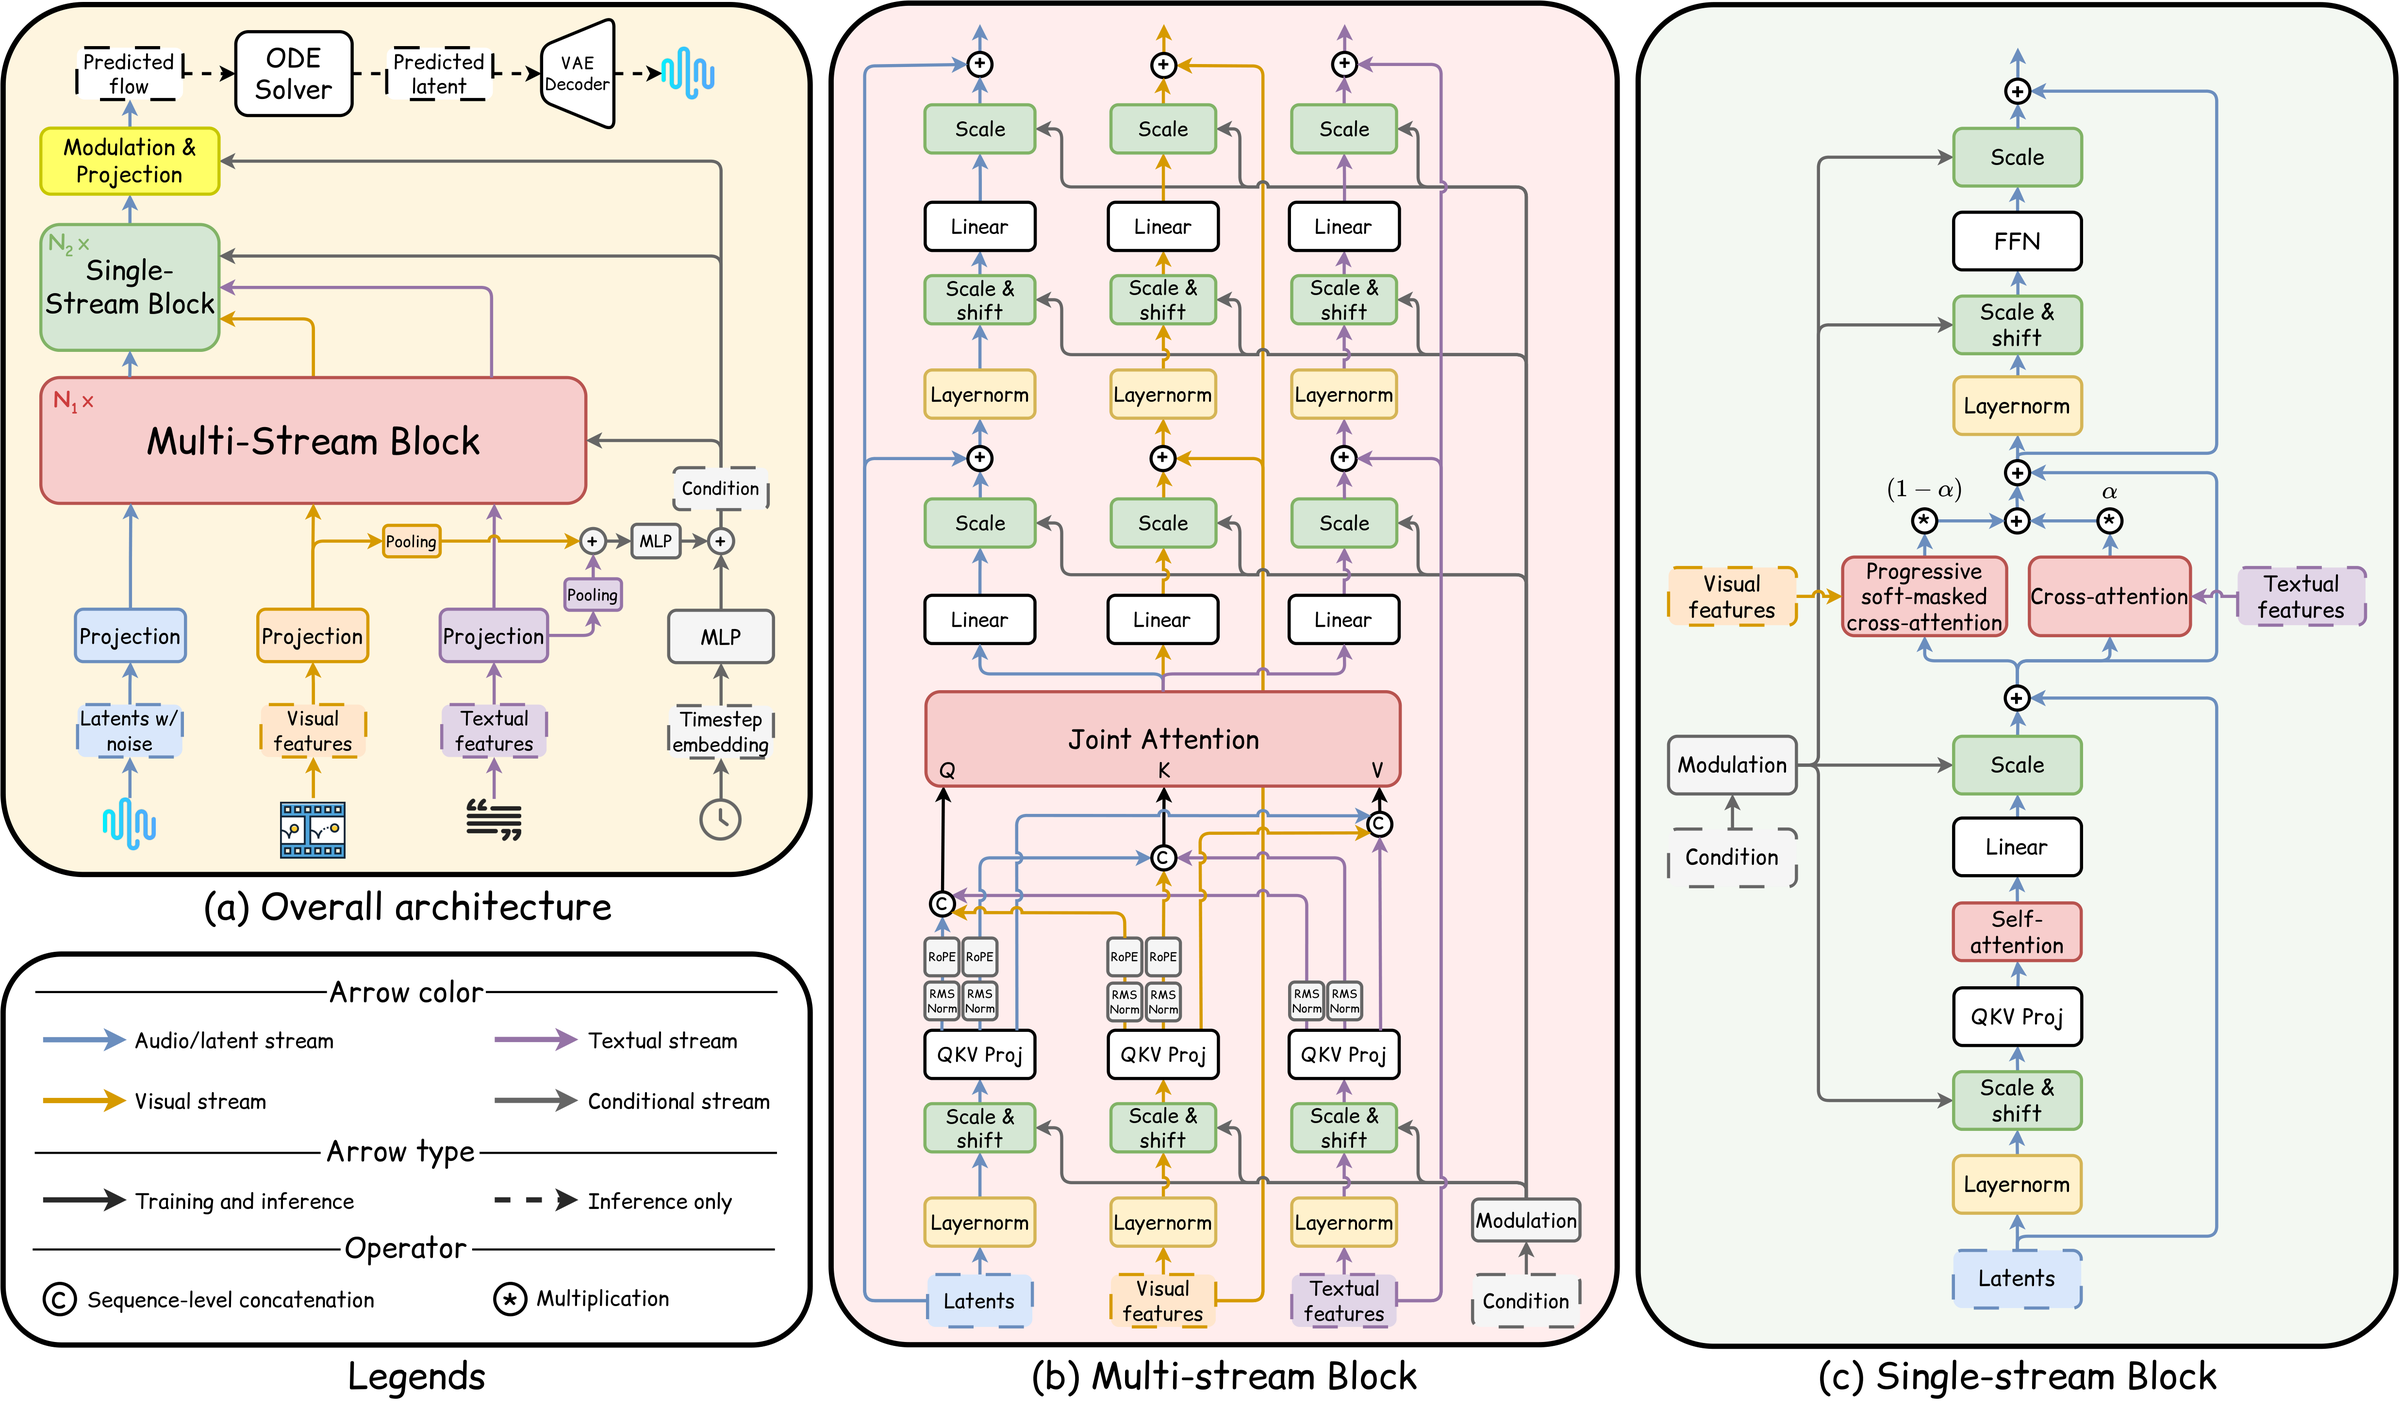
批判点评:用「软掩码交叉注意力零成本内建同步+SoundCap 补声音描述」把 V2A 做成单阶段端到端,免掉专用对齐模块还拿 SOTA,简洁高效。但收益部分来自 SoundCap 描述质量(引入额外描述管线),VGGSound 之外更开放场景的时序精准同步、以及对无明显声源/复杂多声源视频的泛化仍待验证。
Fréchet Distance Loss on Speech Representations for Text-to-Speech Synthesis | 台湾大学·华盛顿大学 | arXiv:2607.06027
关键词:语音合成,流匹配,Fréchet距离,分布正则,少步采样
AEGIS: A Mechanism-Guided Defense against Visual Synonym Jailbreaks in Text-to-Image Models | 复旦·阿里 | arXiv:2607.06120
关键词:文生图,安全对齐,越狱防御,注意力头,推理期干预
前序问题:文生图扩散虽保真度高、应用广,却易被「视觉同义词攻击(VSA)」越狱——看似良性的提示通过隐式视觉联想诱导出违禁图像;现有防御大多围绕过滤/编辑时显式暴露的不安全概念,对 VSA 留有盲区,陷入「防不住 VSA 或误伤相似良性概念」的安全-效用两难。
本文贡献:从「静态压制预设不安全概念」转向「动态追踪不安全语义如何在生成中涌现」。机理分析发现:VSA 与显式不安全提示都通过稀疏的「语义注入注意力头」收敛,这些头是违禁视觉语义的推理期瓶颈。据此提出 AEGIS(经识别与引导的自适应规避防护),一种推理期防御,仅在被识别出的脆弱注意力头上施加相似度感知的排斥。
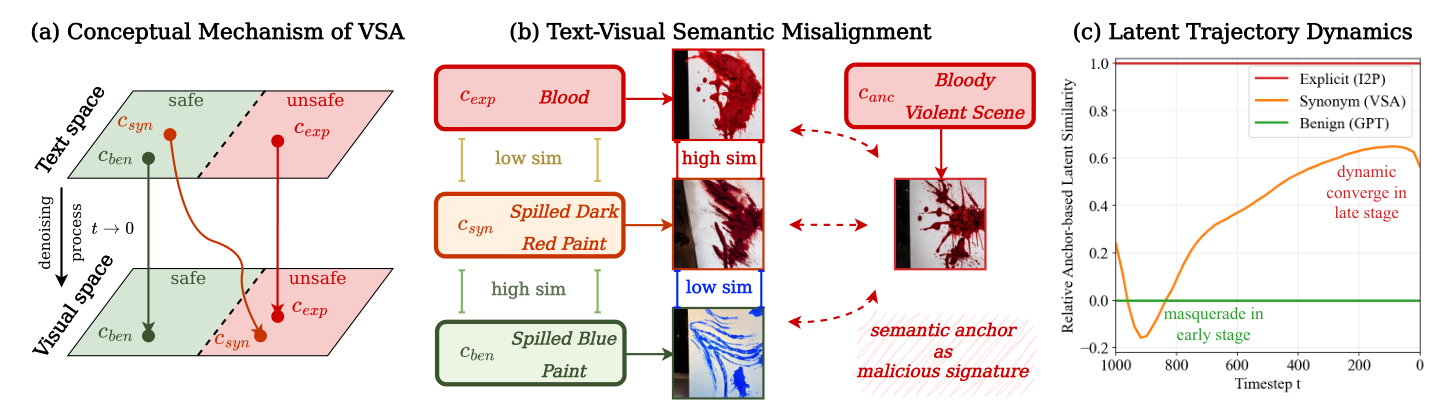
实验效果:对比 16 个基线,AEGIS 同时提升安全与效用:在 SD 1.4 上把域内暴力/裸露 VSA 的攻击成功率(ASR)降到 0.00/0.03、域外显式与对抗攻击 ASR≤0.09;保持良性图像保真、不误伤难负概念,并可在重识别关键头后迁移到 SD 2.1 与 FLUX.1。

批判点评:用机理分析锁定「语义注入注意力头」这一 VSA 瓶颈、只在少数脆弱头做定向排斥,既躲开全局压制的误伤又不需重训,把安全-效用两难做出正收益、还能跨模型迁移,思路犀利。但依赖对脆弱头的准确识别(每个骨干需重识别),面对自适应攻击者绕开这些头、或更强开源模型上的稳健性仍是开放问题,推理期干预对生成多样性的潜在影响也需观察。
人工智能炼丹君 整理 | 2026-07-10
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)