


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 7 篇 · 视频生成基础模型与推理 2 篇 · 高效视频生成与重建 2 篇 · 音乐舞蹈与全景生成 2 篇 · 高效语音合成 1 篇
Video Generation Models are General-Purpose Vision Learners | Google DeepMind | arXiv:2607.09024
关键词:视频生成,视觉基础模型,预训练,深度估计,涌现泛化
前序问题:NLP 靠下一 token 预测从任务专用模型走向强大的通用基础模型;那么计算机视觉要达到通用模型,需要什么等价的催化剂?
本文贡献:主张大规模文生视频是计算机视觉的强预训练范式,能提供通用视觉智能所需的时空先验、视觉-语言对齐与可扩展性。提出 GenCeption:以预训练视频生成扩散骨干定义一个前馈感知模型,可由文本指令引导执行多种视觉任务。

实验效果:在深度、表面法线、相机位姿估计、指代表达分割、3D 关键点预测等多样任务上达 SOTA,常匹配或超过 DepthAnything3、SAM3、VGGT-Omega、Sapiens 等专用模型;视频生成预训练优于 V-JEPA、Video MAE,数据效率极高(用少 7~500 倍数据即可比肩 D4RT/VGGT-Omega);且现涌现行为——仅用合成人像视频训练即可泛化到真实影像与动物/机器人等分布外类别。
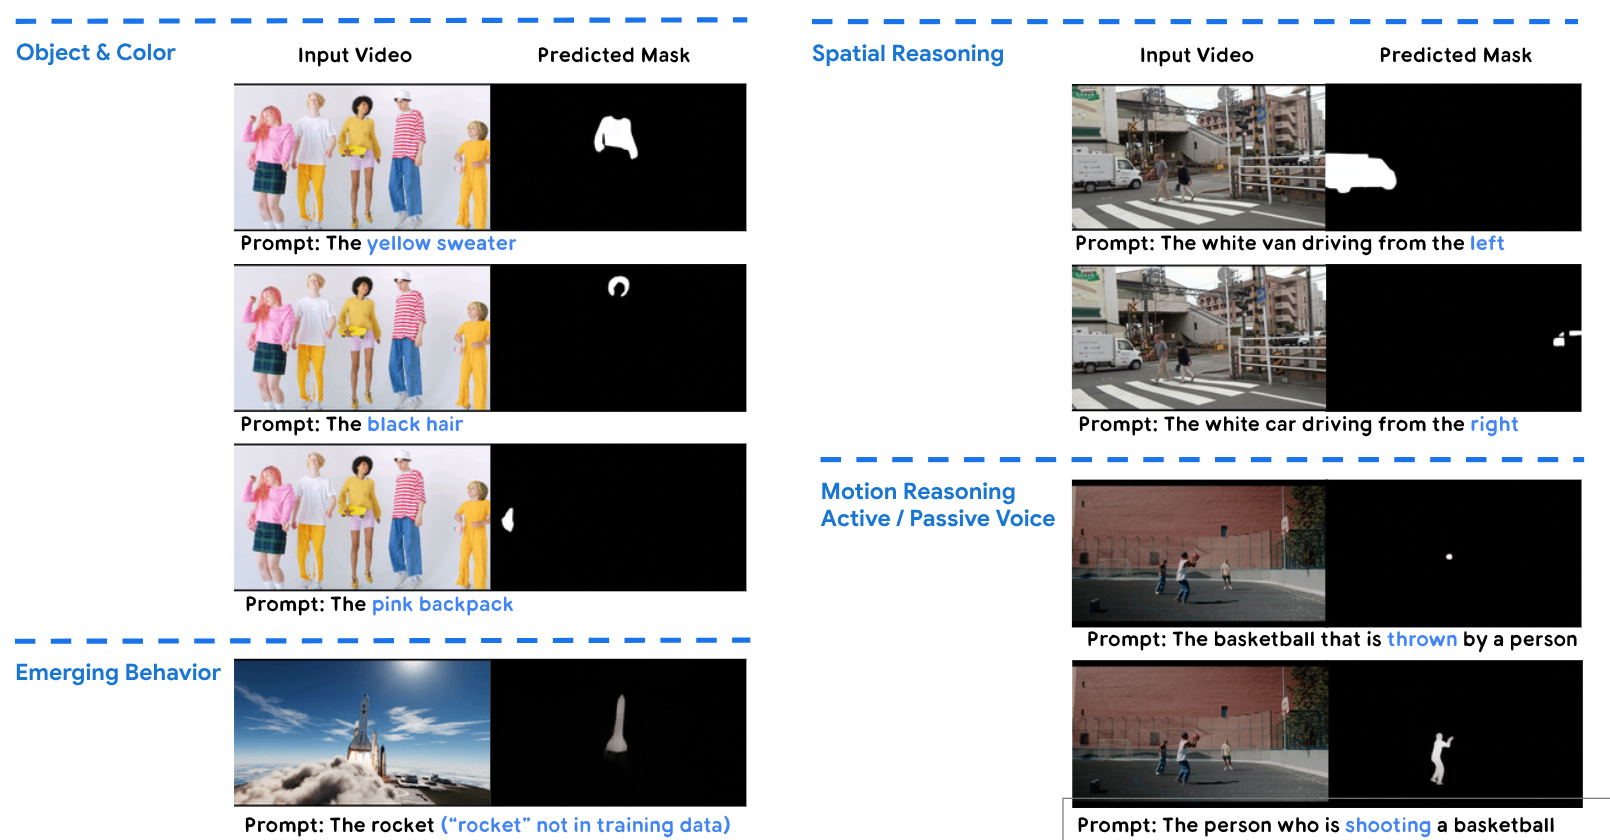
批判点评:用 DeepMind 的分量把「视频生成=通用视觉基础」这一论断做实,跨任务 SOTA+惊人数据效率+涌现泛化,说服力强、方向指引意义大。但依赖大规模视频扩散骨干、算力门槛高,各下游任务仍需文本指令引导与适配,'通用'在更开放任务/真实部署下的稳健性仍需检验。
OPSD-V: On-Policy Self-Distillation for Post-Training Few-Step Autoregressive Video Generators | 美团·港科大·港城大 | arXiv:2607.08766
关键词:视频生成,自回归,自蒸馏,少步采样,长视频
前序问题:少步自回归(AR)视频生成器能低延迟产长视频,但长程 AR 展开时存在误差累积与运动动态减弱。
本文贡献:提出在线(on-policy)自蒸馏范式 OPSD-V 做少步 AR 视频后训练:减少长程退化的同时保持原有少步推理路径。核心是训练时引入真实长视频作时序上下文、提供稠密的轨迹级监督——学生严格按推理时 rollout、以自己此前生成的 KV cache 为条件逐块生成;教师在学生所到的相同去噪状态评估,但用更干净、AR 一致的时序缓存(旧历史可替换为真实视频上下文),从而在在线 AR 缓存动态下给出稠密的去噪级纠正目标,不改采样器/去噪步数/推理时缓存机制。

实验效果:应用于 Self-Forcing、LongLive 等代表性少步 AR 视频模型,视觉质量、运动动态与 VBenchLong 一致提升;10 人用户研究中 66.0% 场景更偏好 OPSD-V(排除平局达 82.5%)。
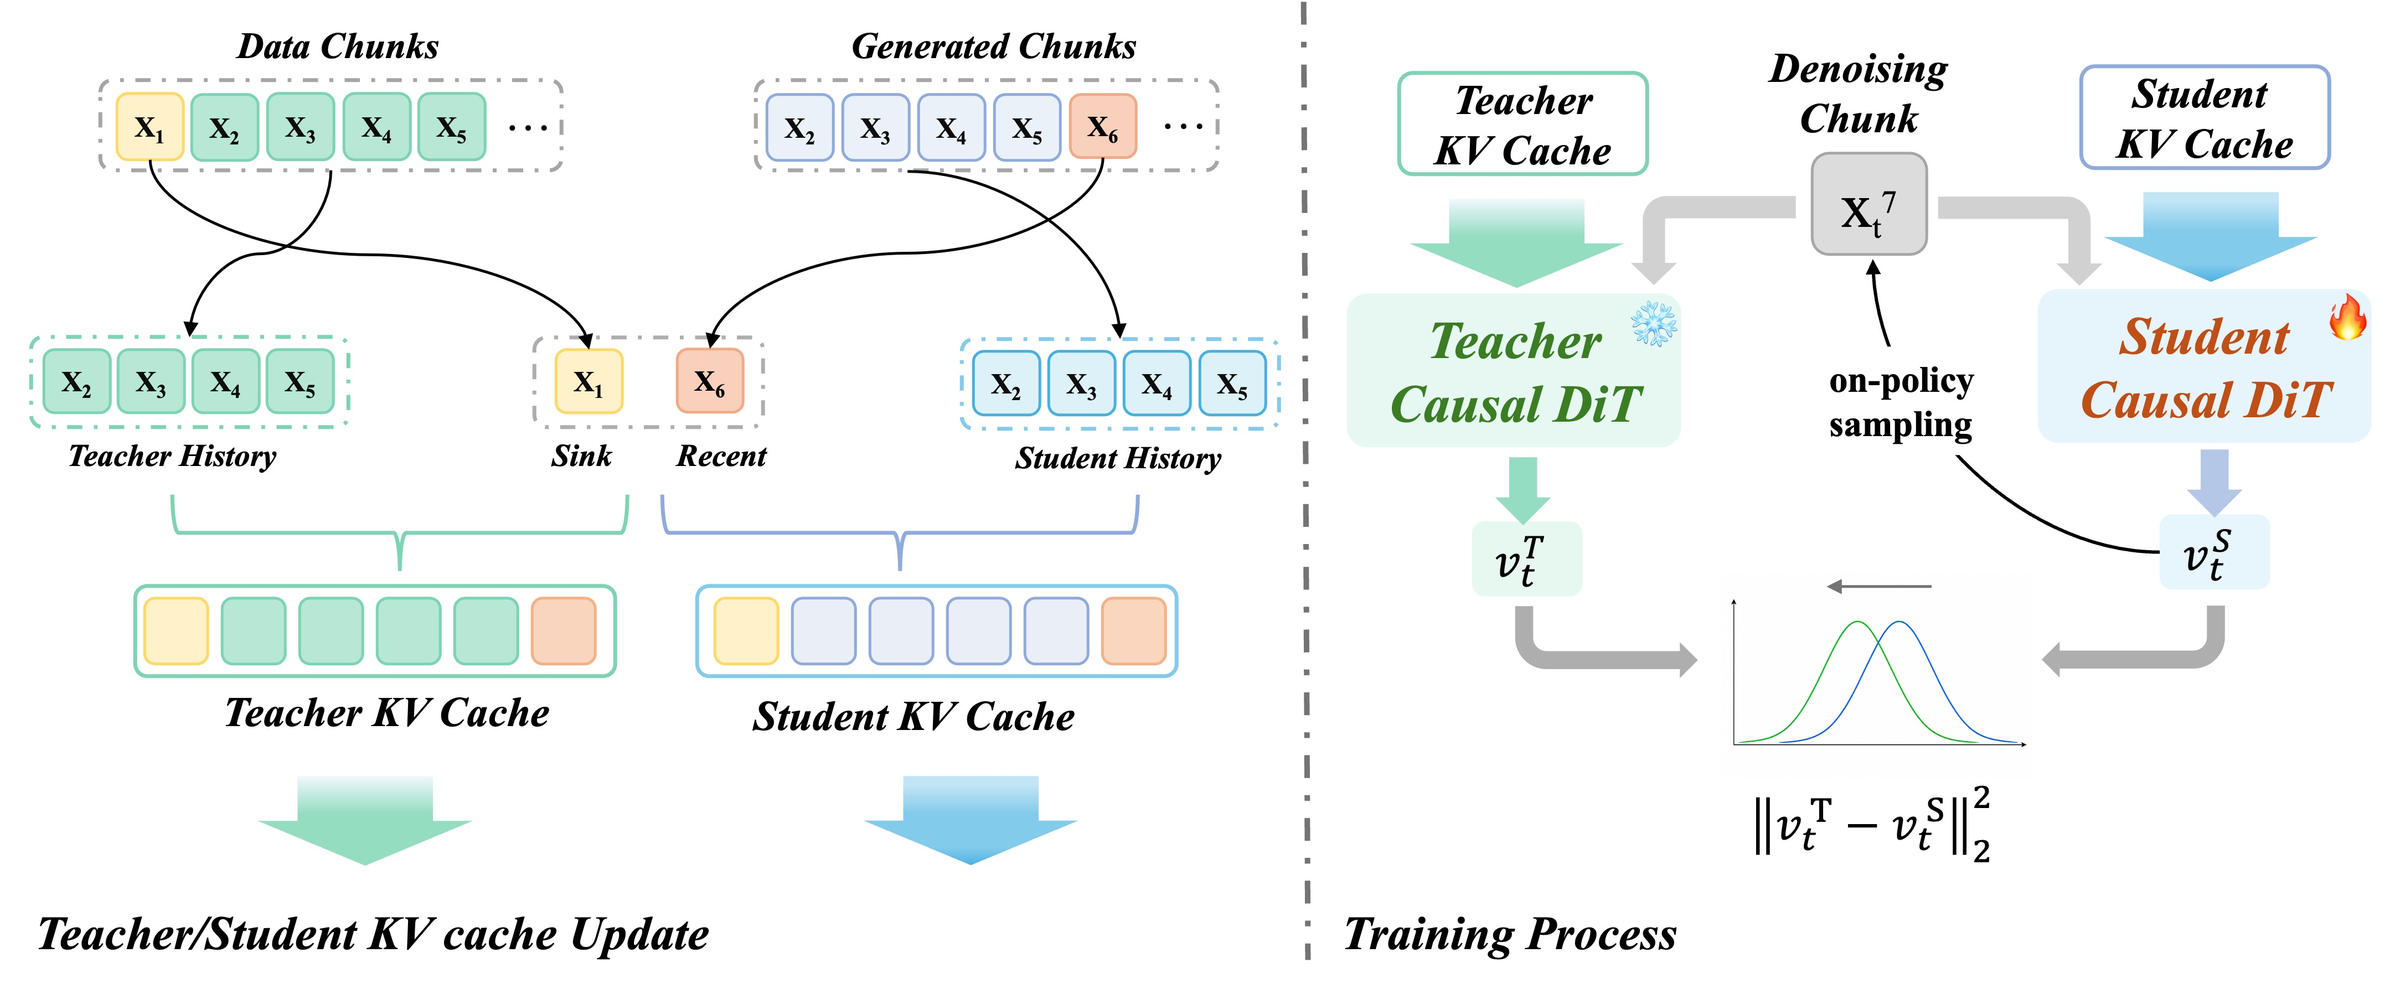
批判点评:「学生走真实推理路径、教师用真实视频上下文给稠密纠正」是对少步 AR 长视频退化的精准手术,且不动推理链、即插即改。但需真实长视频作上下文、训练成本上升,纠正上限受教师与真实上下文质量制约,超长时程的漂移是否彻底解决仍待观察。
OpenCoF: Learning to Reason Through Video Generation | 字节Seed·港中文 | arXiv:2607.08763
关键词:视频生成,视频推理,Chain-of-Frame,数据集,注意力
前序问题:推理已成大模型核心能力;视频生成提供了不同于 Chain-of-Thought 的路径——推理可经时序相连的帧展开(Chain-of-Frame, CoF)。但现有视频生成器多在通用语料上训练,缺乏针对 CoF 推理的多样监督与专门设计。
本文贡献:提出 OpenCoF 框架:含横跨 11 类任务的推理视频数据集 OpenCoF-17K,以及微调视频模型 Wan-CoF 研究多样时序监督能否改善 CoF;并进一步给模型配「视觉+文本推理 token」分别捕捉低层视觉线索与高层语义先验以做空间/时序推理,通过性能对比与注意力分析考察这些 token 在模型深度、去噪步、空间与时间上的贡献。
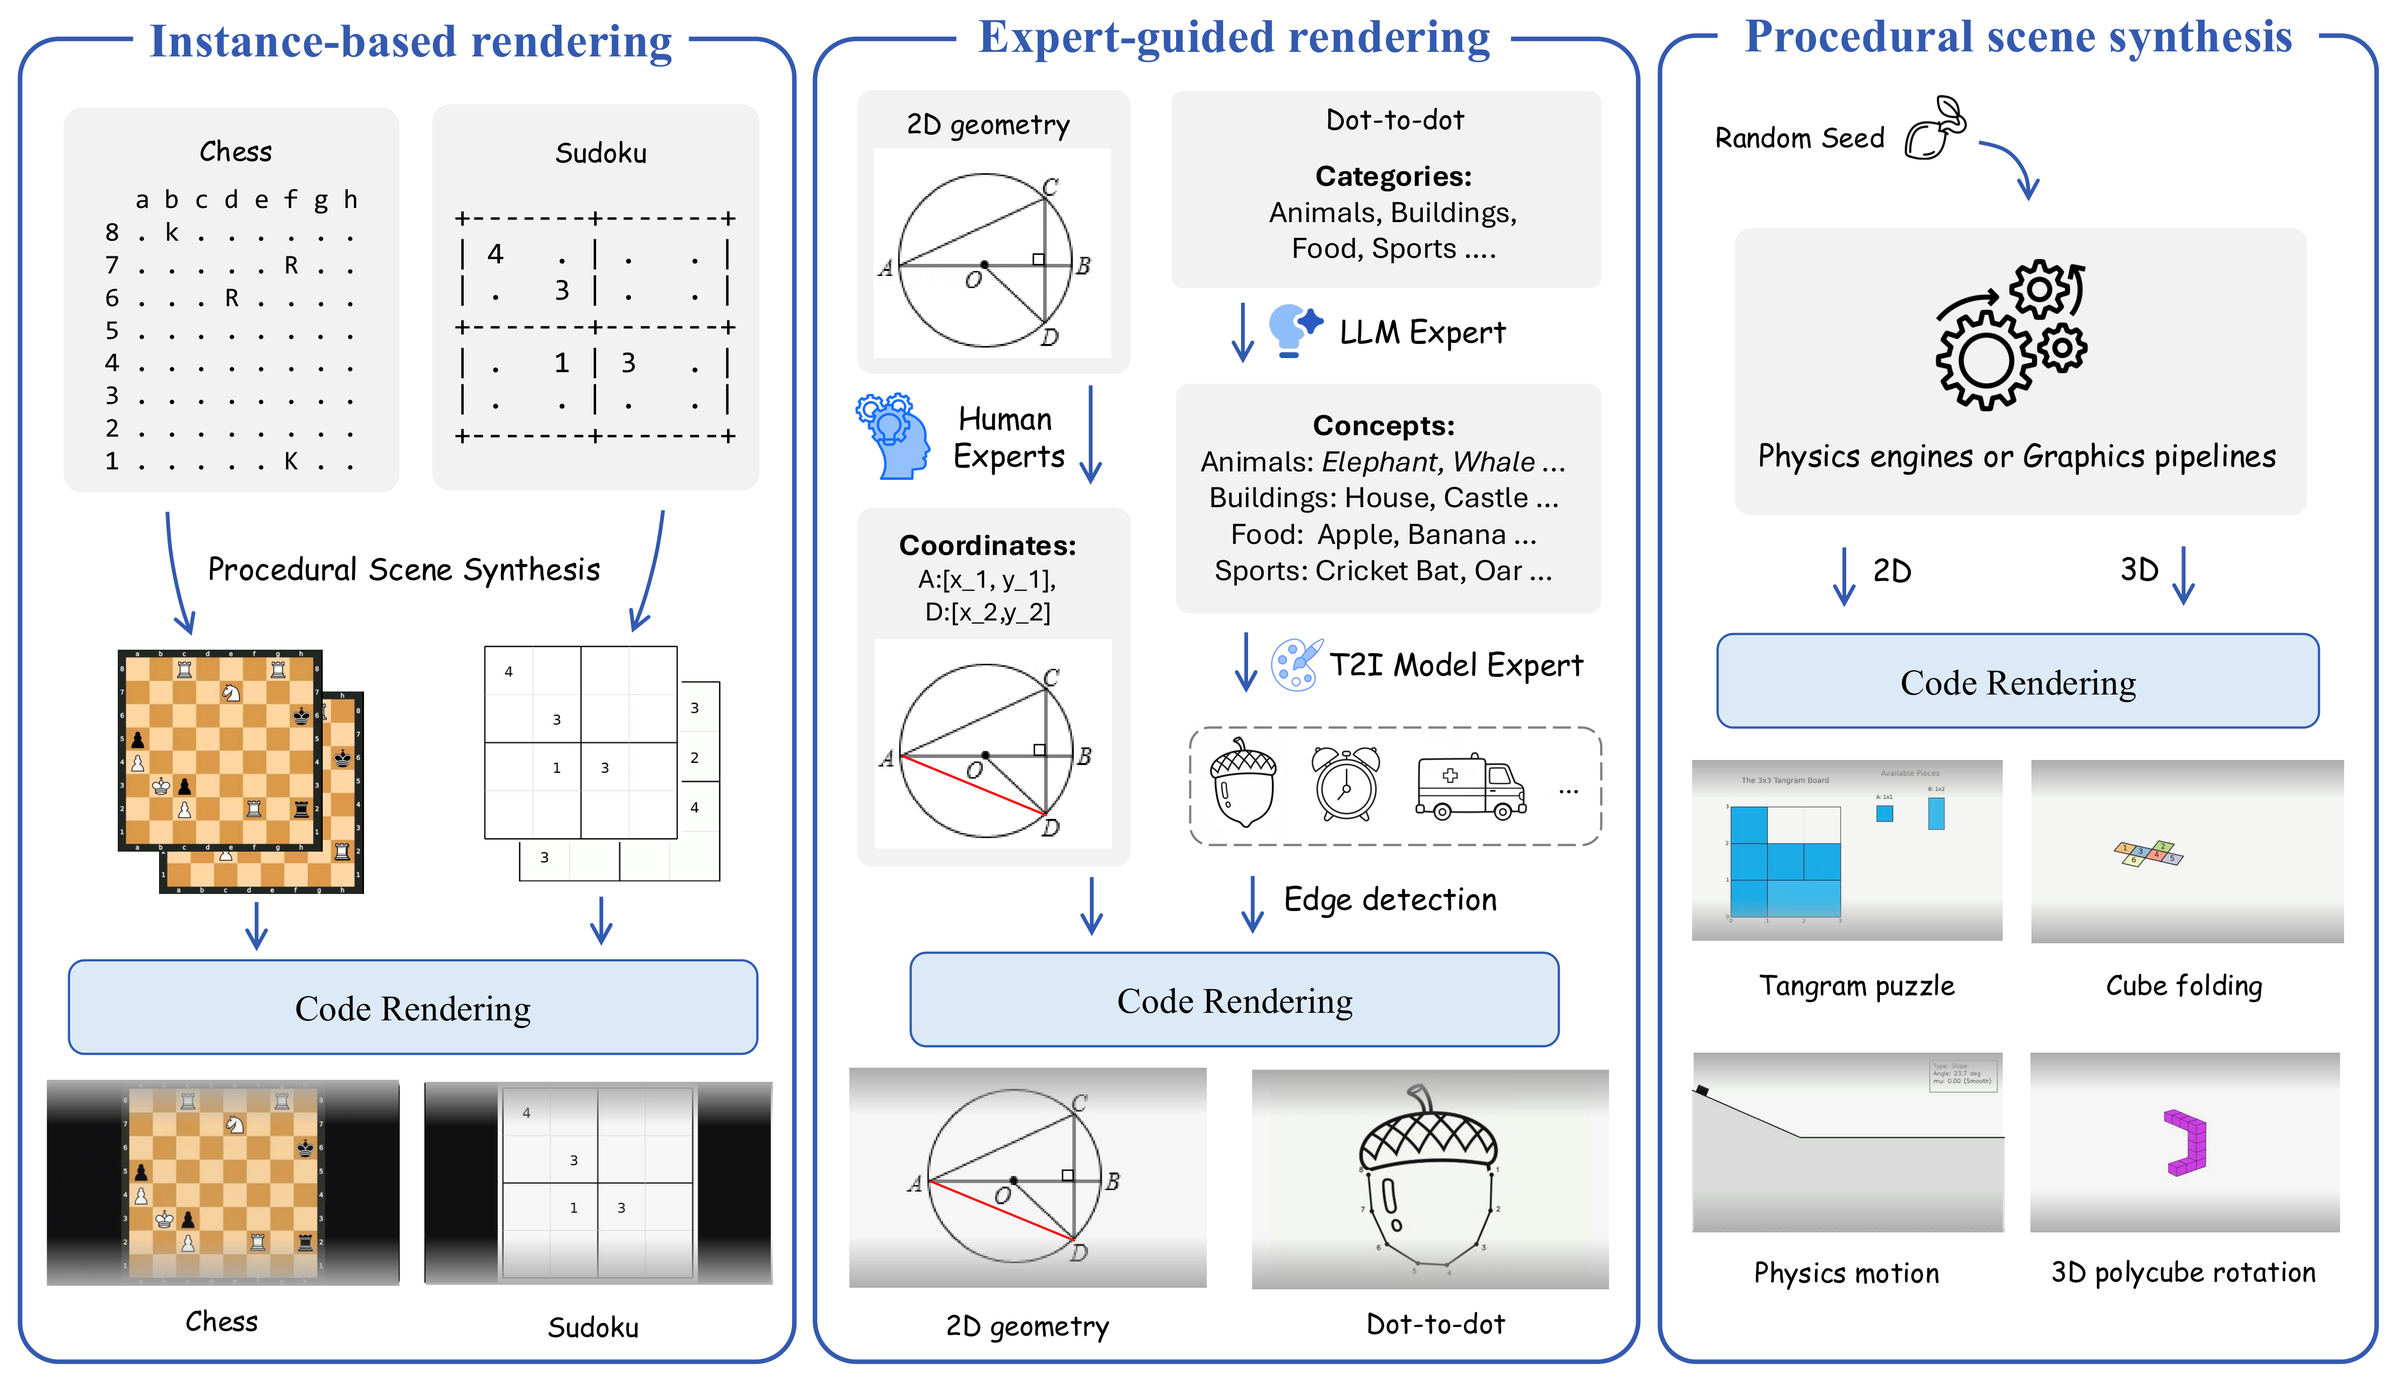
实验效果:在四个视频推理基准上,Wan-CoF 较 Wan2.2-I2V-A14B 基线取得可观提升;数据、模型与代码全开源。

批判点评:把「用连贯帧展开推理」正式化为 CoF 并配数据集+推理 token,为「会推理的视频生成」提供了抓手,开源也利于生态。但视频推理评测仍不成熟、'画面推理'与真实逻辑正确性的关系待厘清,推理 token 带来的额外结构与开销在更复杂任务上的收益仍需验证。
LongE2V: Long-Horizon Event-based Video Reconstruction, Prediction, and Frame Interpolation with Video Diffusion Models | 阳明交大(台湾) | arXiv:2607.08770
关键词:事件相机,视频重建,视频扩散,插帧,时序一致
前序问题:从稀疏事件流恢复高质量视频很难:回归方法常糊化纹理,现有生成模型又难保长期稳定。
本文贡献:提出 LongE2V,用预训练视频扩散先验联合处理事件相机的视频重建、预测与插帧:微调基础视频模型获高数据效率与更优感知质量;用自回归展开(Autoregressive Unrolling)与自适应上下文切换缓解超长序列时序漂移;用重编码对齐+交叉残差校正保证插帧的精确双向一致;用事件体素密度增强确保跨传感器分辨率鲁棒。

实验效果:真实基准上在重建/预测/插帧三任务全面超过 SOTA,时序连贯性突出且具零样本泛化。

批判点评:把视频扩散先验迁到事件相机这一低层重建任务、一套框架吃三任务,数据效率与感知质量兼得,思路新颖。但依赖预训练视频先验与微调、事件-视频域差处理,极端稀疏/高速场景下的重建保真与长程漂移仍是挑战。
Wan-Dancer: A Hierarchical Framework for Minute-scale Coherent Music-to-Dance Generation | 阿里通义 | arXiv:2607.09581
关键词:音乐到舞蹈,长视频,分层生成,RoPE,阿里通义
前序问题:直接从音乐生成长时长、高清、节奏同步的舞蹈视频仍很难——现有扩散模型多在 20 秒后失效,无论走中间 3D 骨架还是端到端合成,长时都有时序漂移、身份不一致与动作重复。
本文贡献:提出分钟级连贯音乐到舞蹈生成的分层框架:把过程解耦为全局关键帧规划与局部时序精修,利用整轨音乐上下文保长程连贯;关键创新含经时间映射 RoPE 的动态帧率自适应(精确对齐)、基于光流的损失(增强动作连续性)、动作速度控制(快速运动保细节)。

实验效果:突破常规时长壁垒,生成稳定、超过一分钟的 720p/30fps 舞蹈视频;跨五种舞种、可由音频与文本共同条件,刷新长时长连贯舞蹈合成 SOTA。
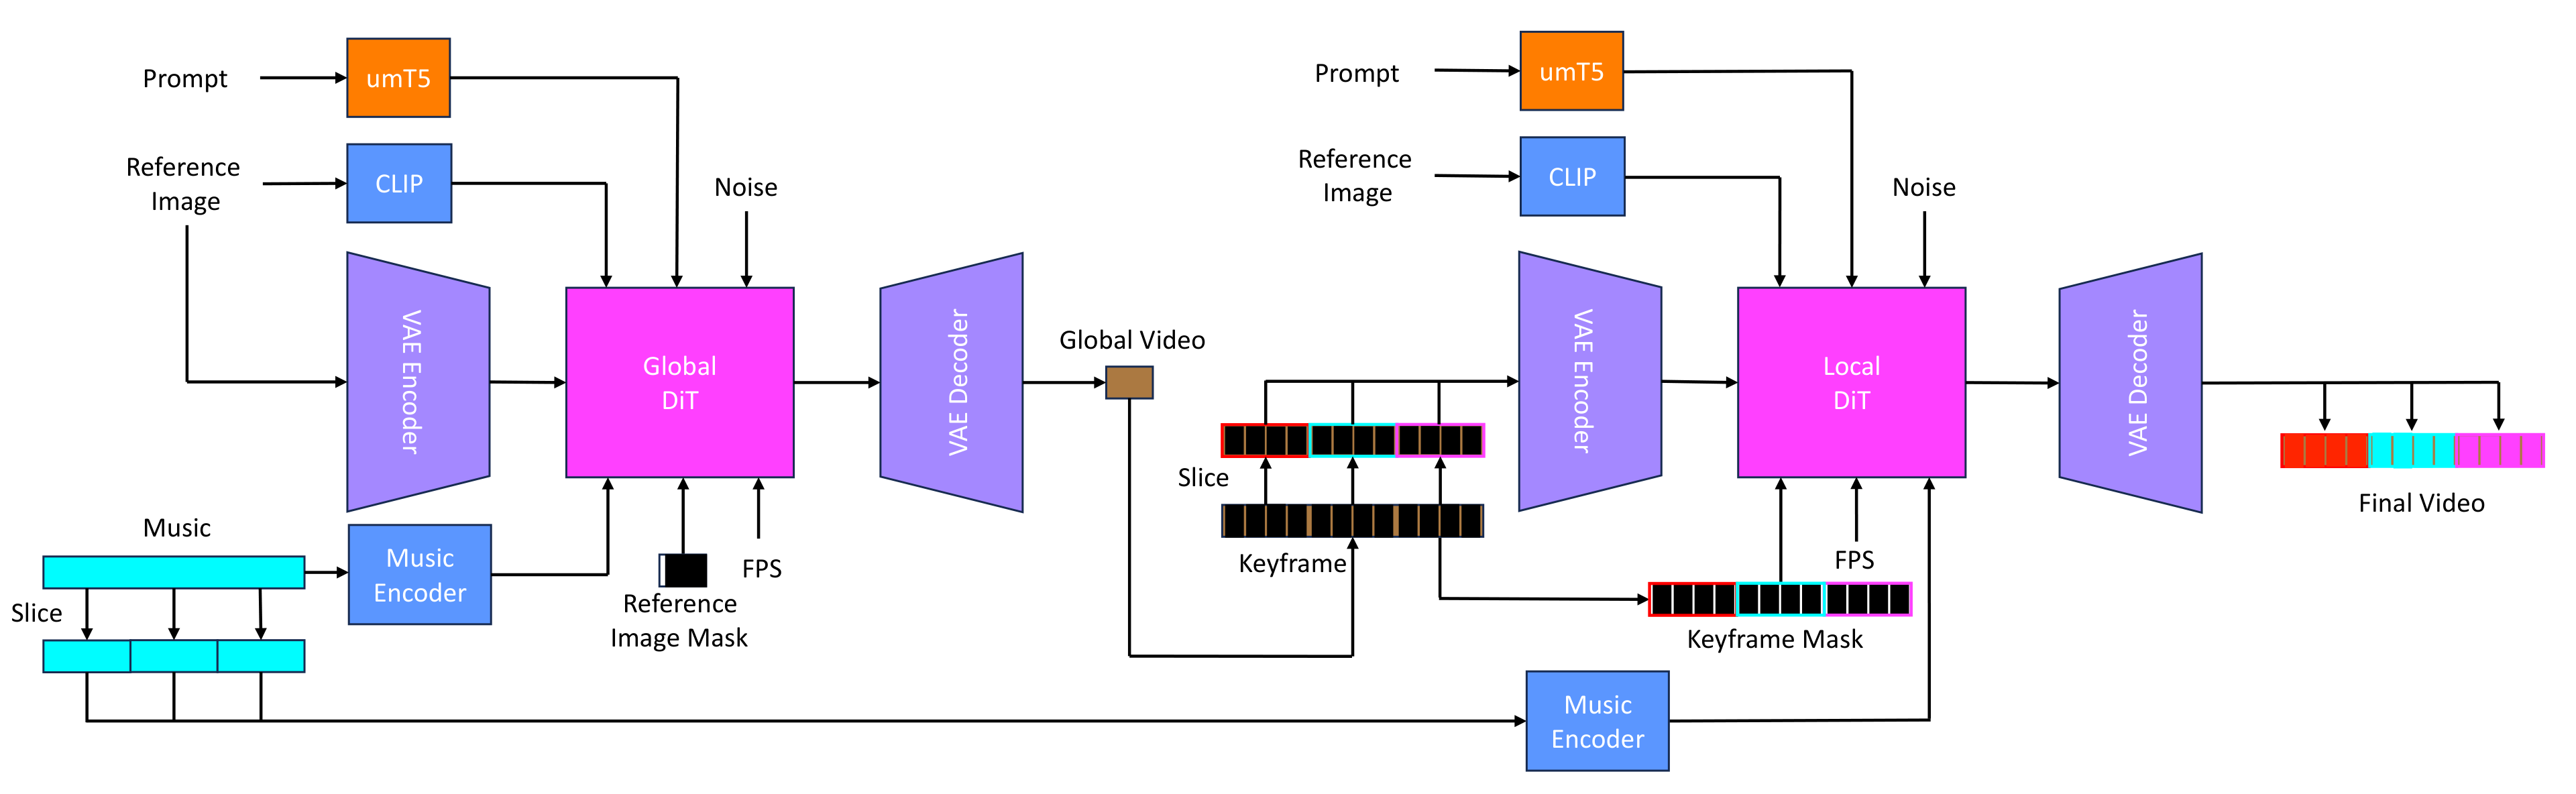
批判点评:「全局规划+局部精修」的分层设计对症长视频漂移,分钟级 720p/30fps 与多舞种适配很有产品感(通义出品)。但舞蹈生成对身份一致与物理合理要求高,分层拼接处的连贯、复杂高速编舞的保真,以及音乐-动作语义对齐的细腻度仍需更多样例检验。
Enhancing In-context Panoramic Generation via Geometric-aware Pretraining | Insta360·清华 | arXiv:2607.08765
关键词:全景生成,上下文生成,几何感知,深度,图像编辑
前序问题:全景文生图快速进步,上下文(in-context)编辑成自然延伸,但缺乏大规模高质量的上下文全景训练数据,且全景几何一致性难保。
本文贡献:提出两阶段框架 Canvas360:几何感知预训练+下游任务微调。构建含 1M 高质量配对全景样本的 Canvas360Dataset(覆盖风格迁移/修补/外扩/编辑);建模上用并行深度生成、速度环形填充与相似度损失正则,学习几何感知表征、捕捉物体畸变细节、提升几何一致与全局连贯;借强全景先验,用 token 级拼接统一支持多种下游上下文全景任务。

实验效果:显著提升全景图像保真,在全景专用 FAED 指标上尤强,其余量化指标具竞争力或领先,任务覆盖与建模灵活性超过此前方法。

批判点评:补齐上下文全景的大规模数据+几何感知预训练,环形填充等针对全景畸变的设计对症,Insta360 背景也贴近实拍应用。但 1M 数据靠深度预测配对、质量受预测器限制,全景特有的极区畸变与跨接缝一致在复杂编辑下仍是难点。
FreyaTTS Technical Report | Freya Team | arXiv:2607.09530
关键词:语音合成,流匹配,免tokenizer,边端部署,土耳其语
前序问题:高可靠、高效的对话式语音合成需要在小模型上同时兼顾质量与部署效率。
本文贡献:推出 FreyaTTS:183.2M 参数、免 tokenizer、土耳其语优先的非自回归条件流匹配 DiT,工作在冻结的 AudioVAE2 连续潜空间(16kHz 编码/48kHz 解码),把容量全用于文本到潜表征映射。三大改进:(1)从 92 个土耳其字符词表端到端建模,无音素器/G2P 前端/离散语音分词器;(2)非自回归并行去噪,一次性预测整段潜序列;(3)面向生产的两阶段后训练(单说话人音色锁定+短句覆盖)提升一致性与短输入鲁棒。
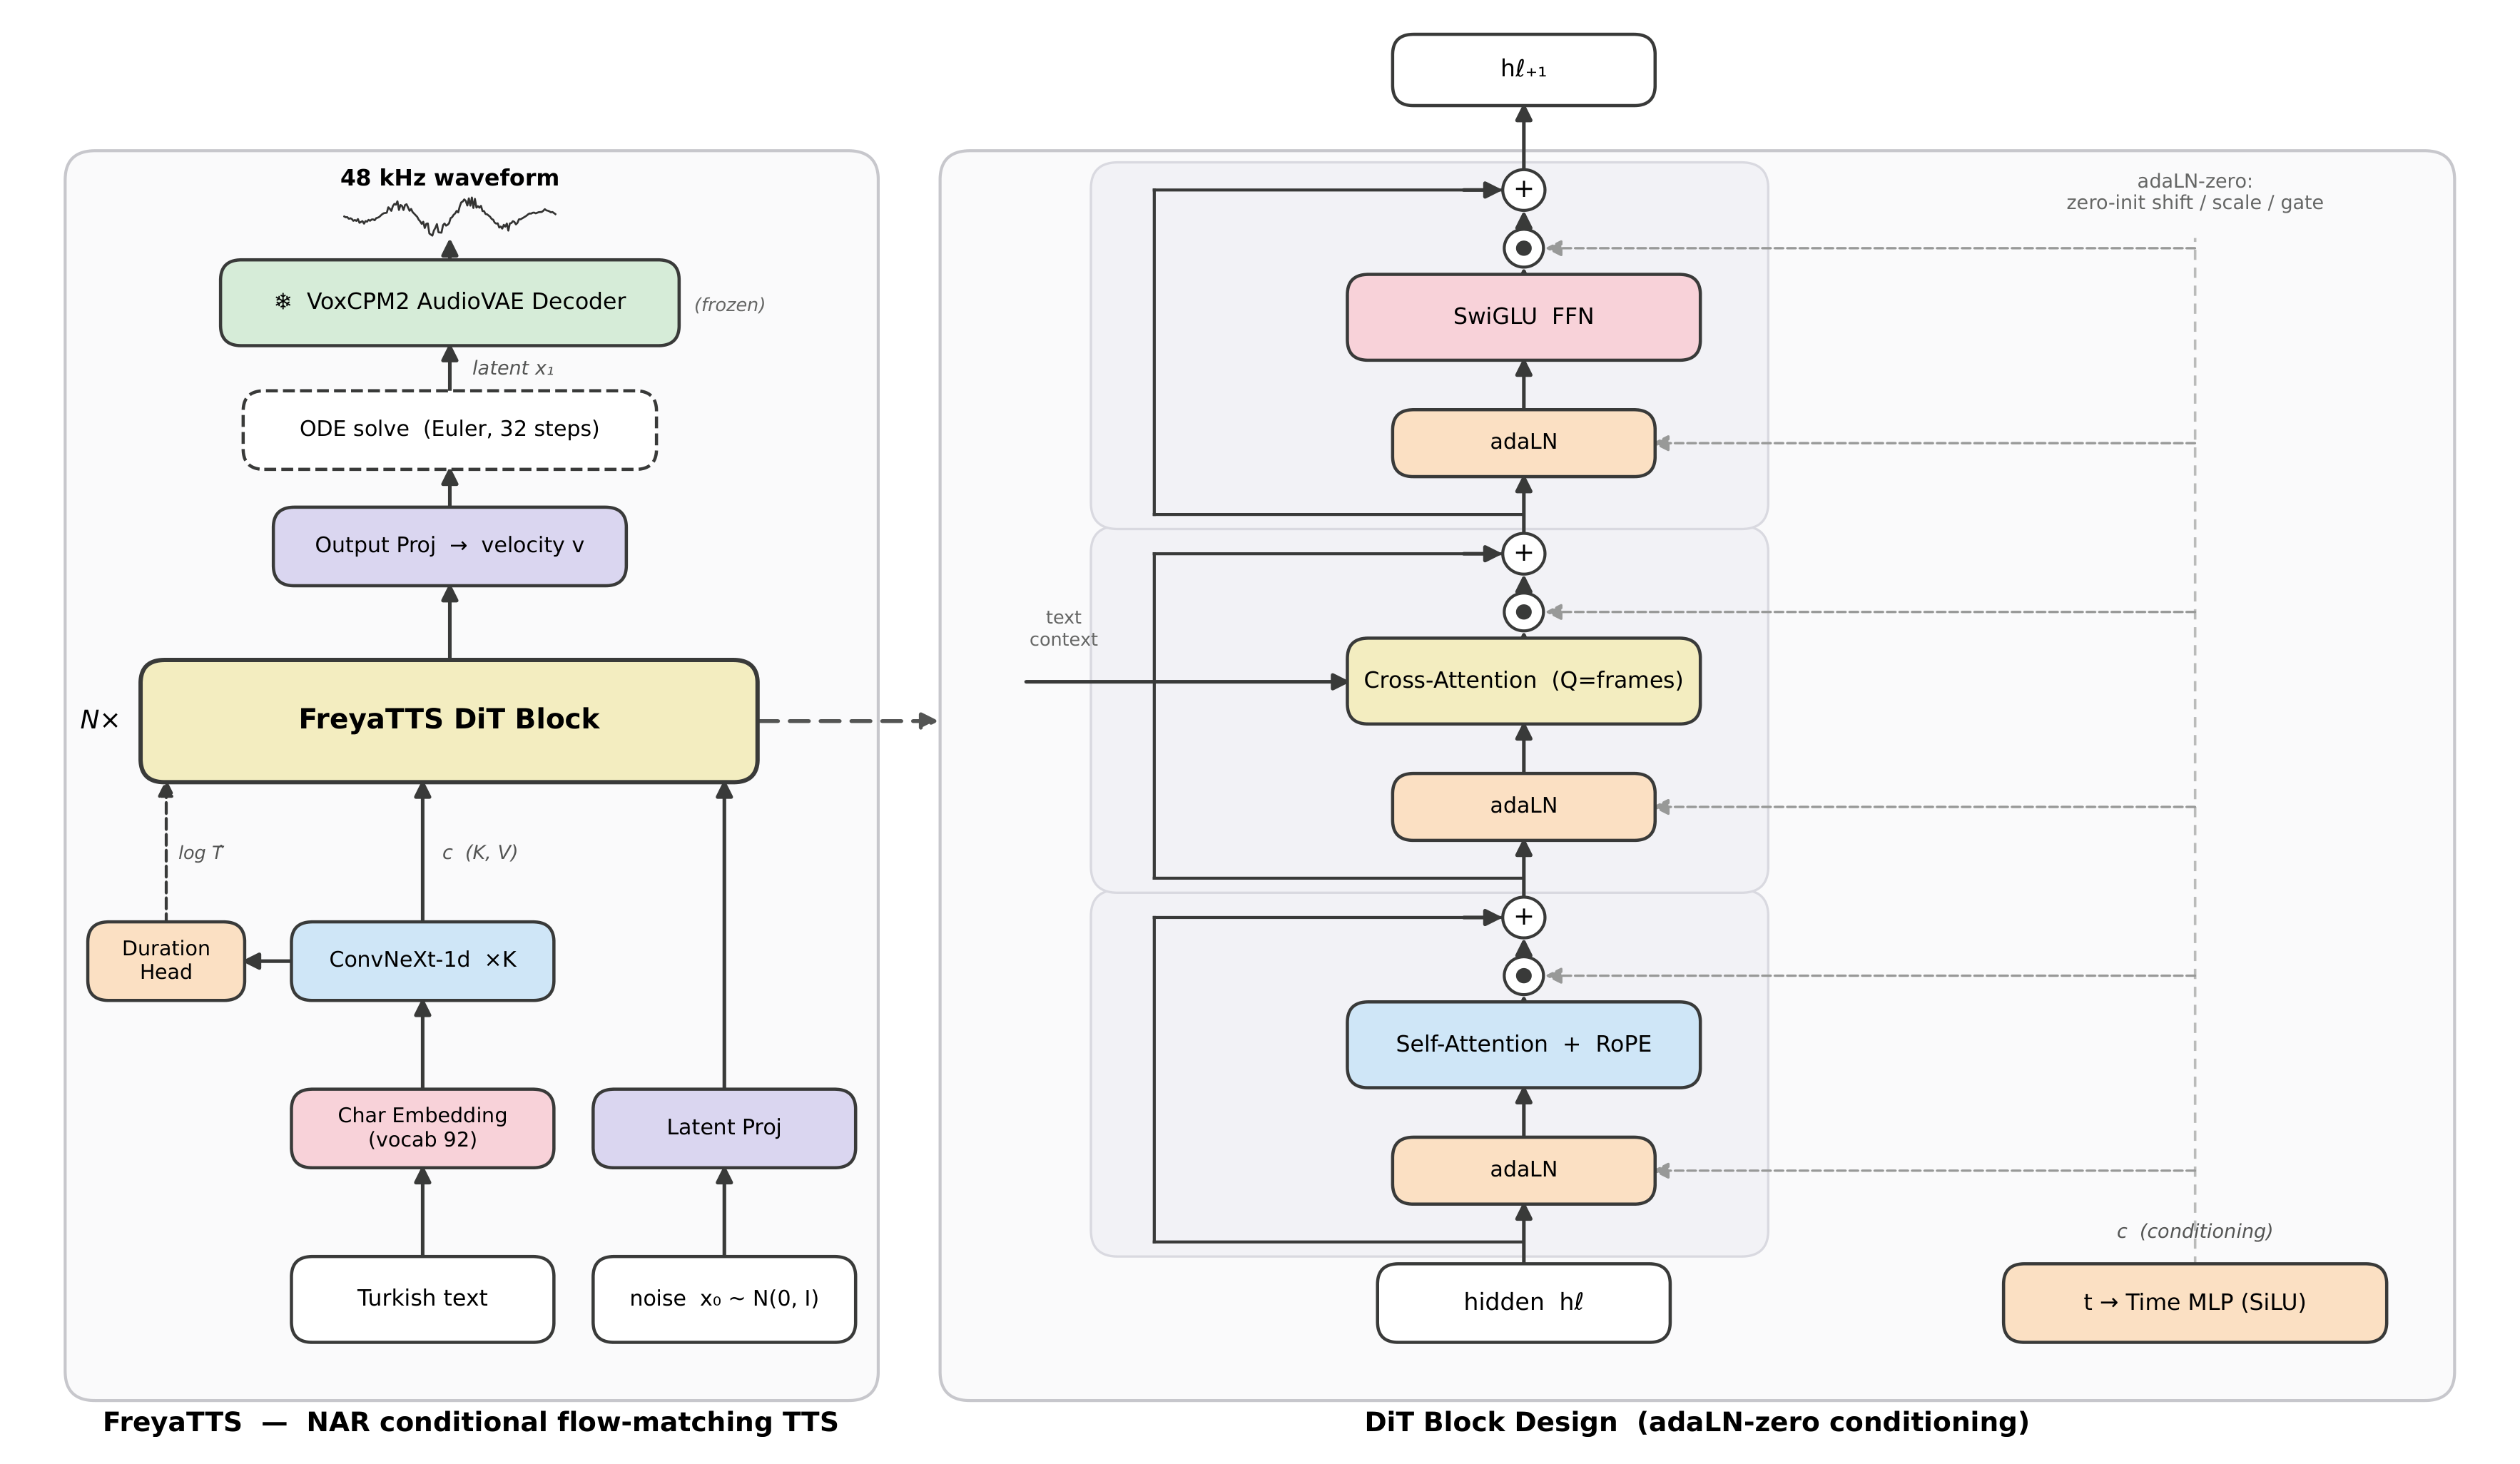
实验效果:在 Freya-TR-Eval 上 WER 8.0%、CER 3.0%,以极小参数超过更大开源系统;消费级 GPU RTF 0.11、笔记本 CPU 也快于实时,适配边端部署;权重/代码/基准以 Apache-2.0 开源。
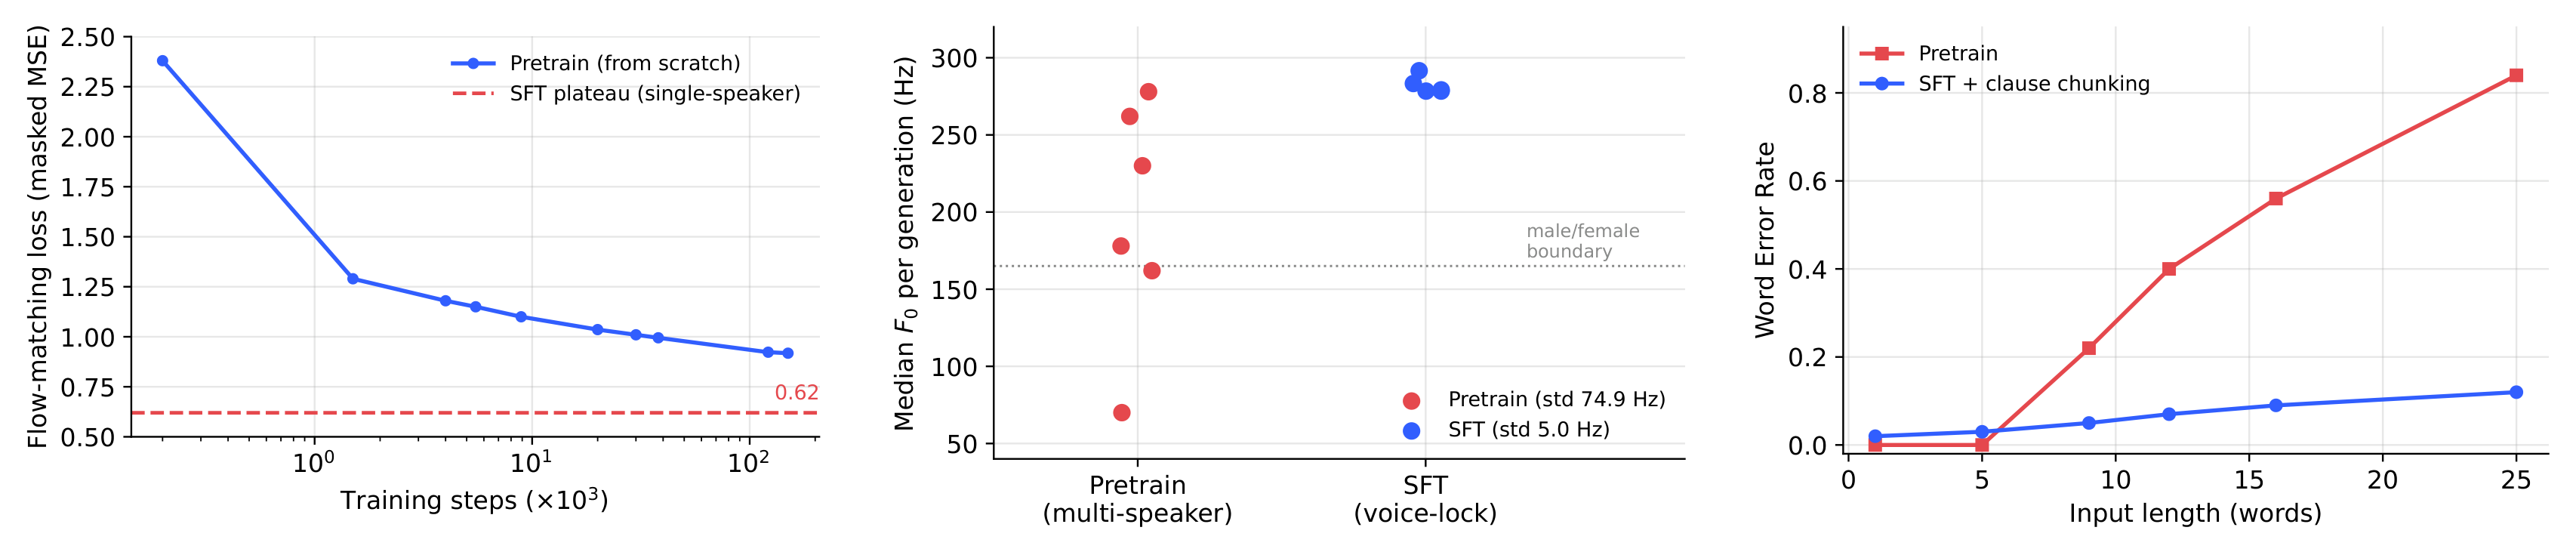
批判点评:免 tokenizer+非自回归+边端友好,把小模型 TTS 的质量与效率平衡做得很实用,开源也友好。但为土耳其语优先,跨语言/多语种泛化未知,183.2M 小模型在情感/多说话人/长文本上的表现天花板仍有限。
人工智能炼丹君 整理 | 2026-07-14
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)