


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 9 篇 · 视频世界模型与人像动画 2 篇 · 图像生成与编辑 3 篇 · 蒸馏加速与模型压缩 2 篇 · 语音合成与生成媒体 2 篇
MemLearner: Learning to Query Context Memory for Video World Models | 港大·快手可灵 | arXiv:2606.31734
关键词:视频世界模型,记忆,上下文查询,一致性,交互生成
前序问题:视频世界模型据用户动作与历史帧预测未来世界状态,但缺乏记忆导致长时生成场景不一致;此前基于规则的上下文帧检索在遮挡与动态物体场景下泛化差。
本文贡献:提出基于学习的自适应上下文查询 MemLearner:用 query token 桥接上下文与预测 token,直接借视频生成模型自身做上下文查询,复用预训练视觉先验、无需从零训额外模块,并含高效训练/推理策略。收集含遮挡与动态物体的长视频数据集(带相机位姿标注),提出兼用带标注渲染与无标注真实视频的多数据集训练策略。

实验效果:在场景一致性与记忆上显著超过此前视频世界模型,尤其在遮挡与动态挑战场景下优势明显。
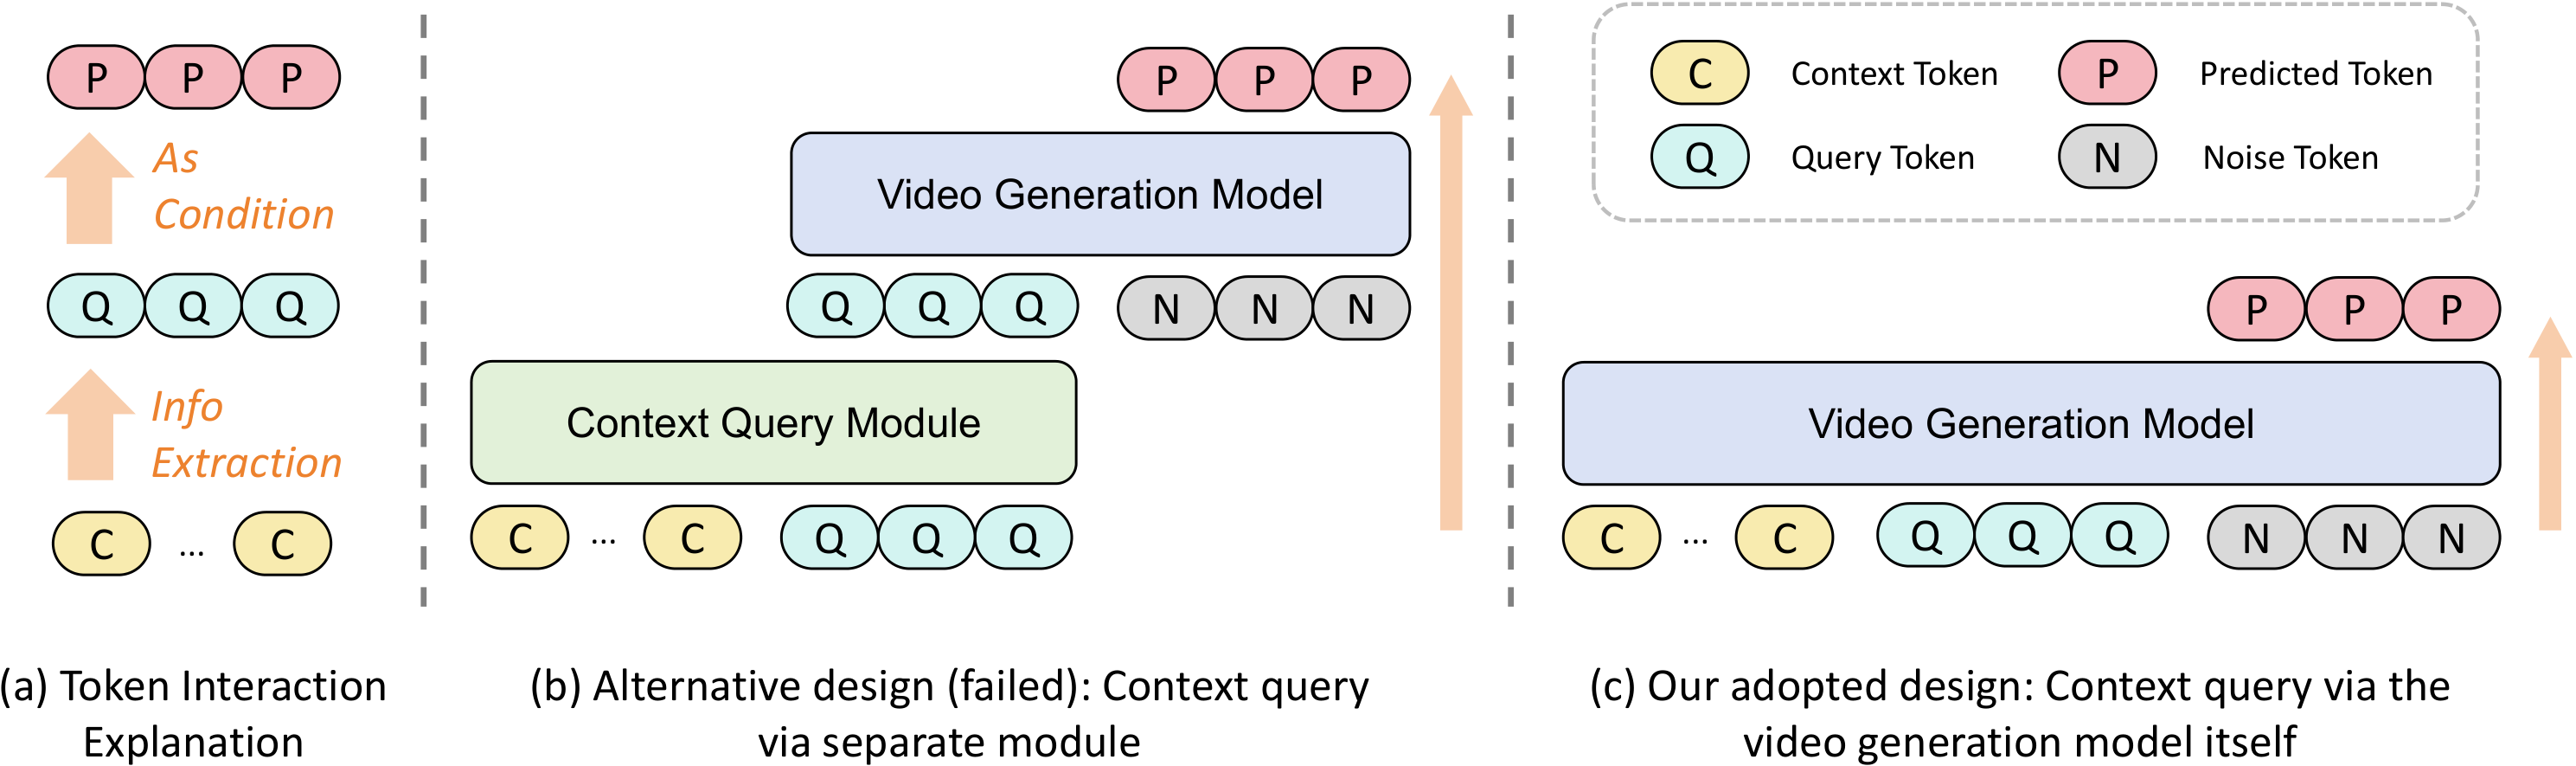
批判点评:把「记忆检索」从规则升级为可学习查询、且复用生成模型自身先验,是对世界模型长程一致性痛点的对症之解,有快手可灵背景更接近落地。但仍依赖带位姿标注数据构建、查询机制在超长时程下的累积漂移,以及对开放世界更复杂交互的泛化仍待检验。
WarpI2I: Image Warping for Image-to-Image Translation | 卡内基梅隆 | arXiv:2606.31018
关键词:图像翻译,重打光,显著性,图像warp,扩散模型
前序问题:图像到图像(I2I)翻译在人像重打光、驾驶场景翻译等任务上已见成效,但紧凑型潜在扩散模型(LDM)的编码器把高分辨率输入压到空间下采样的潜空间,常难保细粒度结构。
本文贡献:提出简单的显著性引导 warp-unwarp 框架:编码前把空间表征向显著区域重分配(warp),在不提高潜空间分辨率的前提下更好保留结构细节;warp 后的图像交给原扩散模型处理,再经逆 warp 映回。另配一个基于 outpainting 的高效合成数据生成管线,为图像重打光产出高质量配对数据。方法与模型无关、无需改架构、几乎零额外算力。

实验效果:在人像重打光、驾驶场景重打光与翻译上,结构保持、光照忠实度与画质均提升;逐帧应用即可自然扩展到视频且时序稳定性好。

批判点评:「warp 到显著区再 unwarp」用几乎零成本换取结构保真,即插即用、跨模型通用,工程性价比高。但显著性估计的质量直接决定收益,非均匀形变对非显著区/大范围全局变化可能引入损失,视频靠逐帧应用而非原生时序建模也限制了强运动场景。
MEPA: Multi-Scale Representation Alignment for Visual Autoregressive Modeling with Mixture of Experts | 西电·华为 | arXiv:2607.00371
关键词:视觉自回归,MoE,多尺度,ImageNet,自监督
前序问题:视觉自回归(VAR)开创由粗到细的多尺度自回归生成,但多尺度表征学习存在固有缺陷:低尺度主要捕全局语义、高尺度关注细节,跨尺度共享架构引发优化冲突;且因果自回归下早期尺度的错误语义会传播并显著劣化最终输出。
本文贡献:提出尺度感知 token 路由的 MoE 架构,允许按尺度自适应选专家、解耦各尺度表征学习;并用外部自监督特征增强早期尺度语义建模——非朴素对齐,而是为 VAR 范式设计残差特征聚合方案。

实验效果:ImageNet 256² 上,仅用默认一半训练轮次、更小参数预算即取得优于稠密基线的 FID,训练成本仅微增;随训练轮次增大差距进一步拉开。
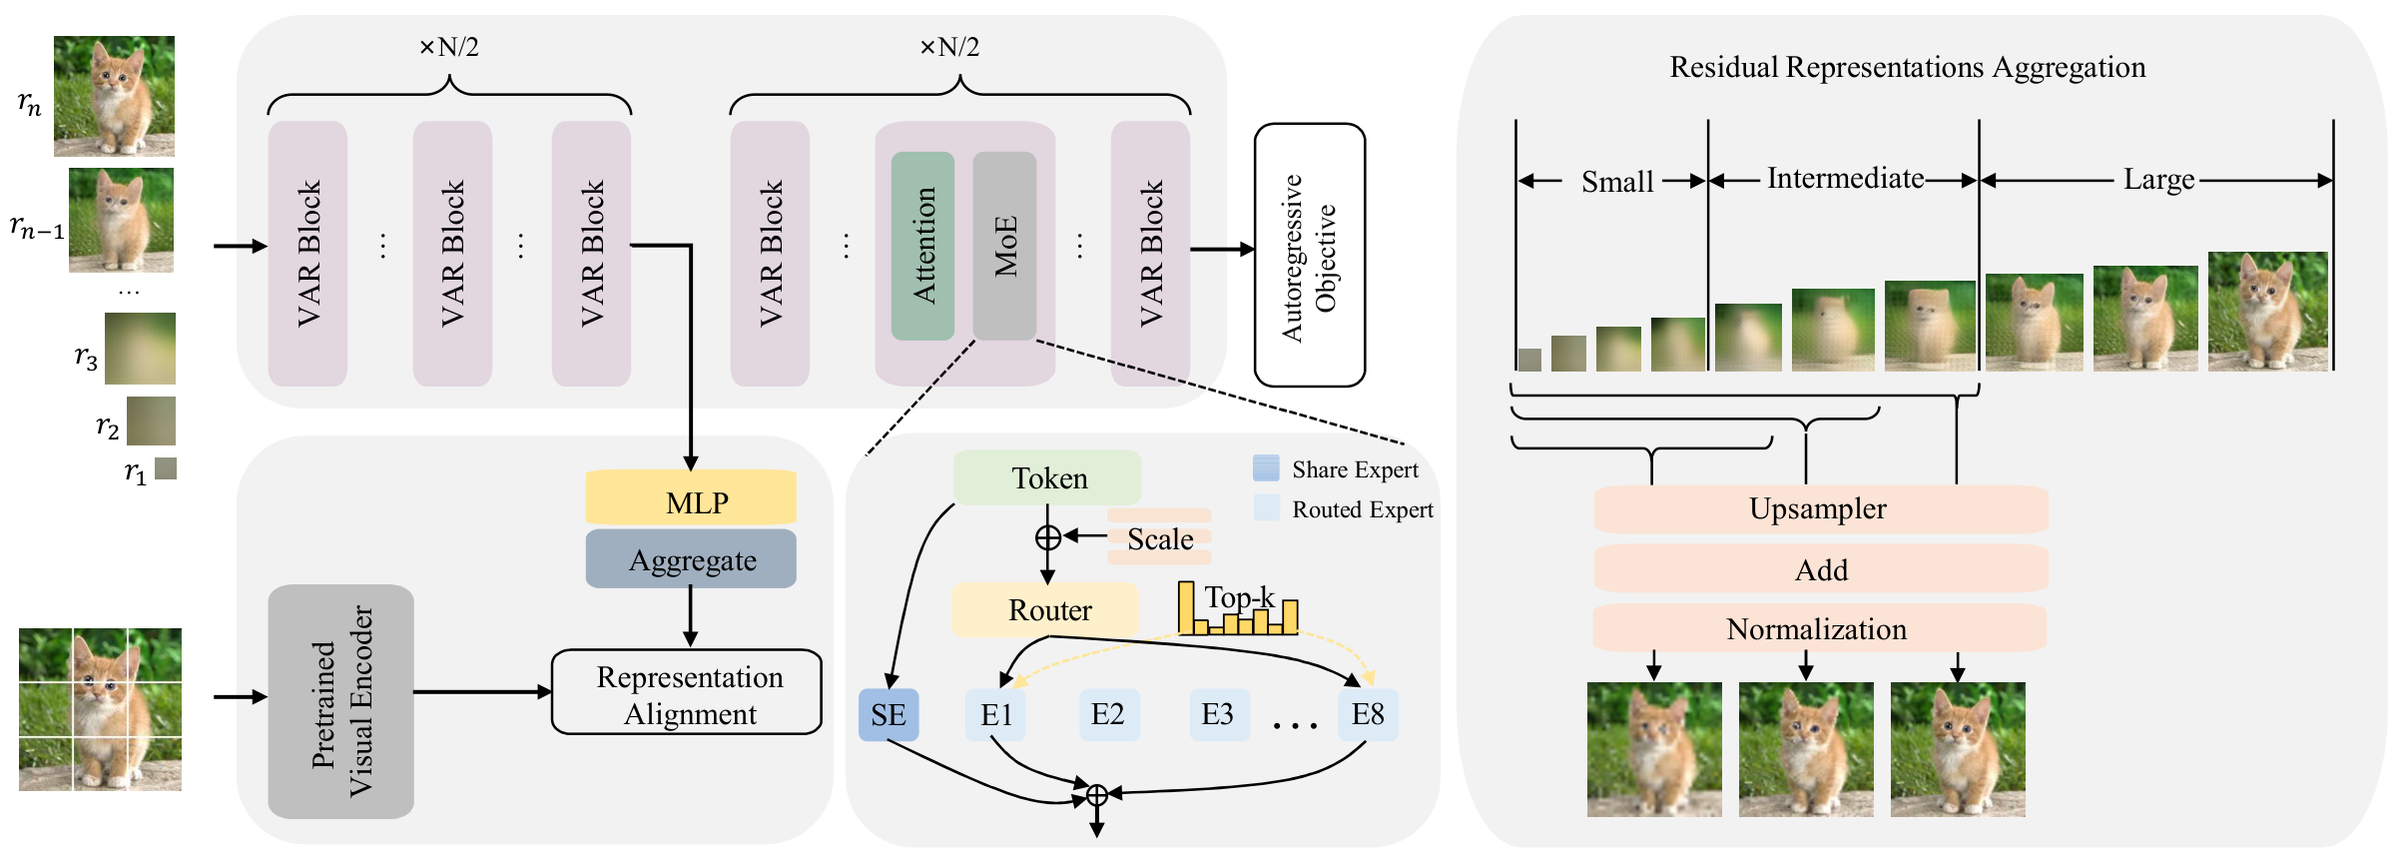
批判点评:用 MoE 按尺度分工+自监督特征补早期语义,精准对症 VAR 的跨尺度冲突与误差传播,训练效率提升实在。但 MoE 带来路由与部署复杂度,「一半轮次超稠密」的优势在更大规模/更高分辨率与文生图场景能否延续仍待验证。
Cross-Space Distillation: Teaching One-Step Students with Modern Diffusion Teachers | VinAI·罗格斯 | arXiv:2606.32020
关键词:扩散蒸馏,一步生成,跨潜空间,SD1.5,部署
前序问题:现代一步扩散靠基于分布的时间步蒸馏获高质量,却依赖「师生须同一潜空间」这一关键假设,阻止把 SD3.5/Flux 等高容量老师的知识迁到潜分辨率与 VAE 参数化都不同的紧凑学生(如 SD1.5)。
本文贡献:形式化提出 Cross-Space Distillation(师生在潜分辨率与 VAE 空间双双不同),并引入 Bridge——轻量潜空间接口,把学生潜变量映到老师空间而不改学生骨干:以冻结的学生 VAE 解码器作空间先验+紧凑可学习投影器,用潜重建与注意力保真目标训练以稳定对齐老师空间(ECCV 2026)。
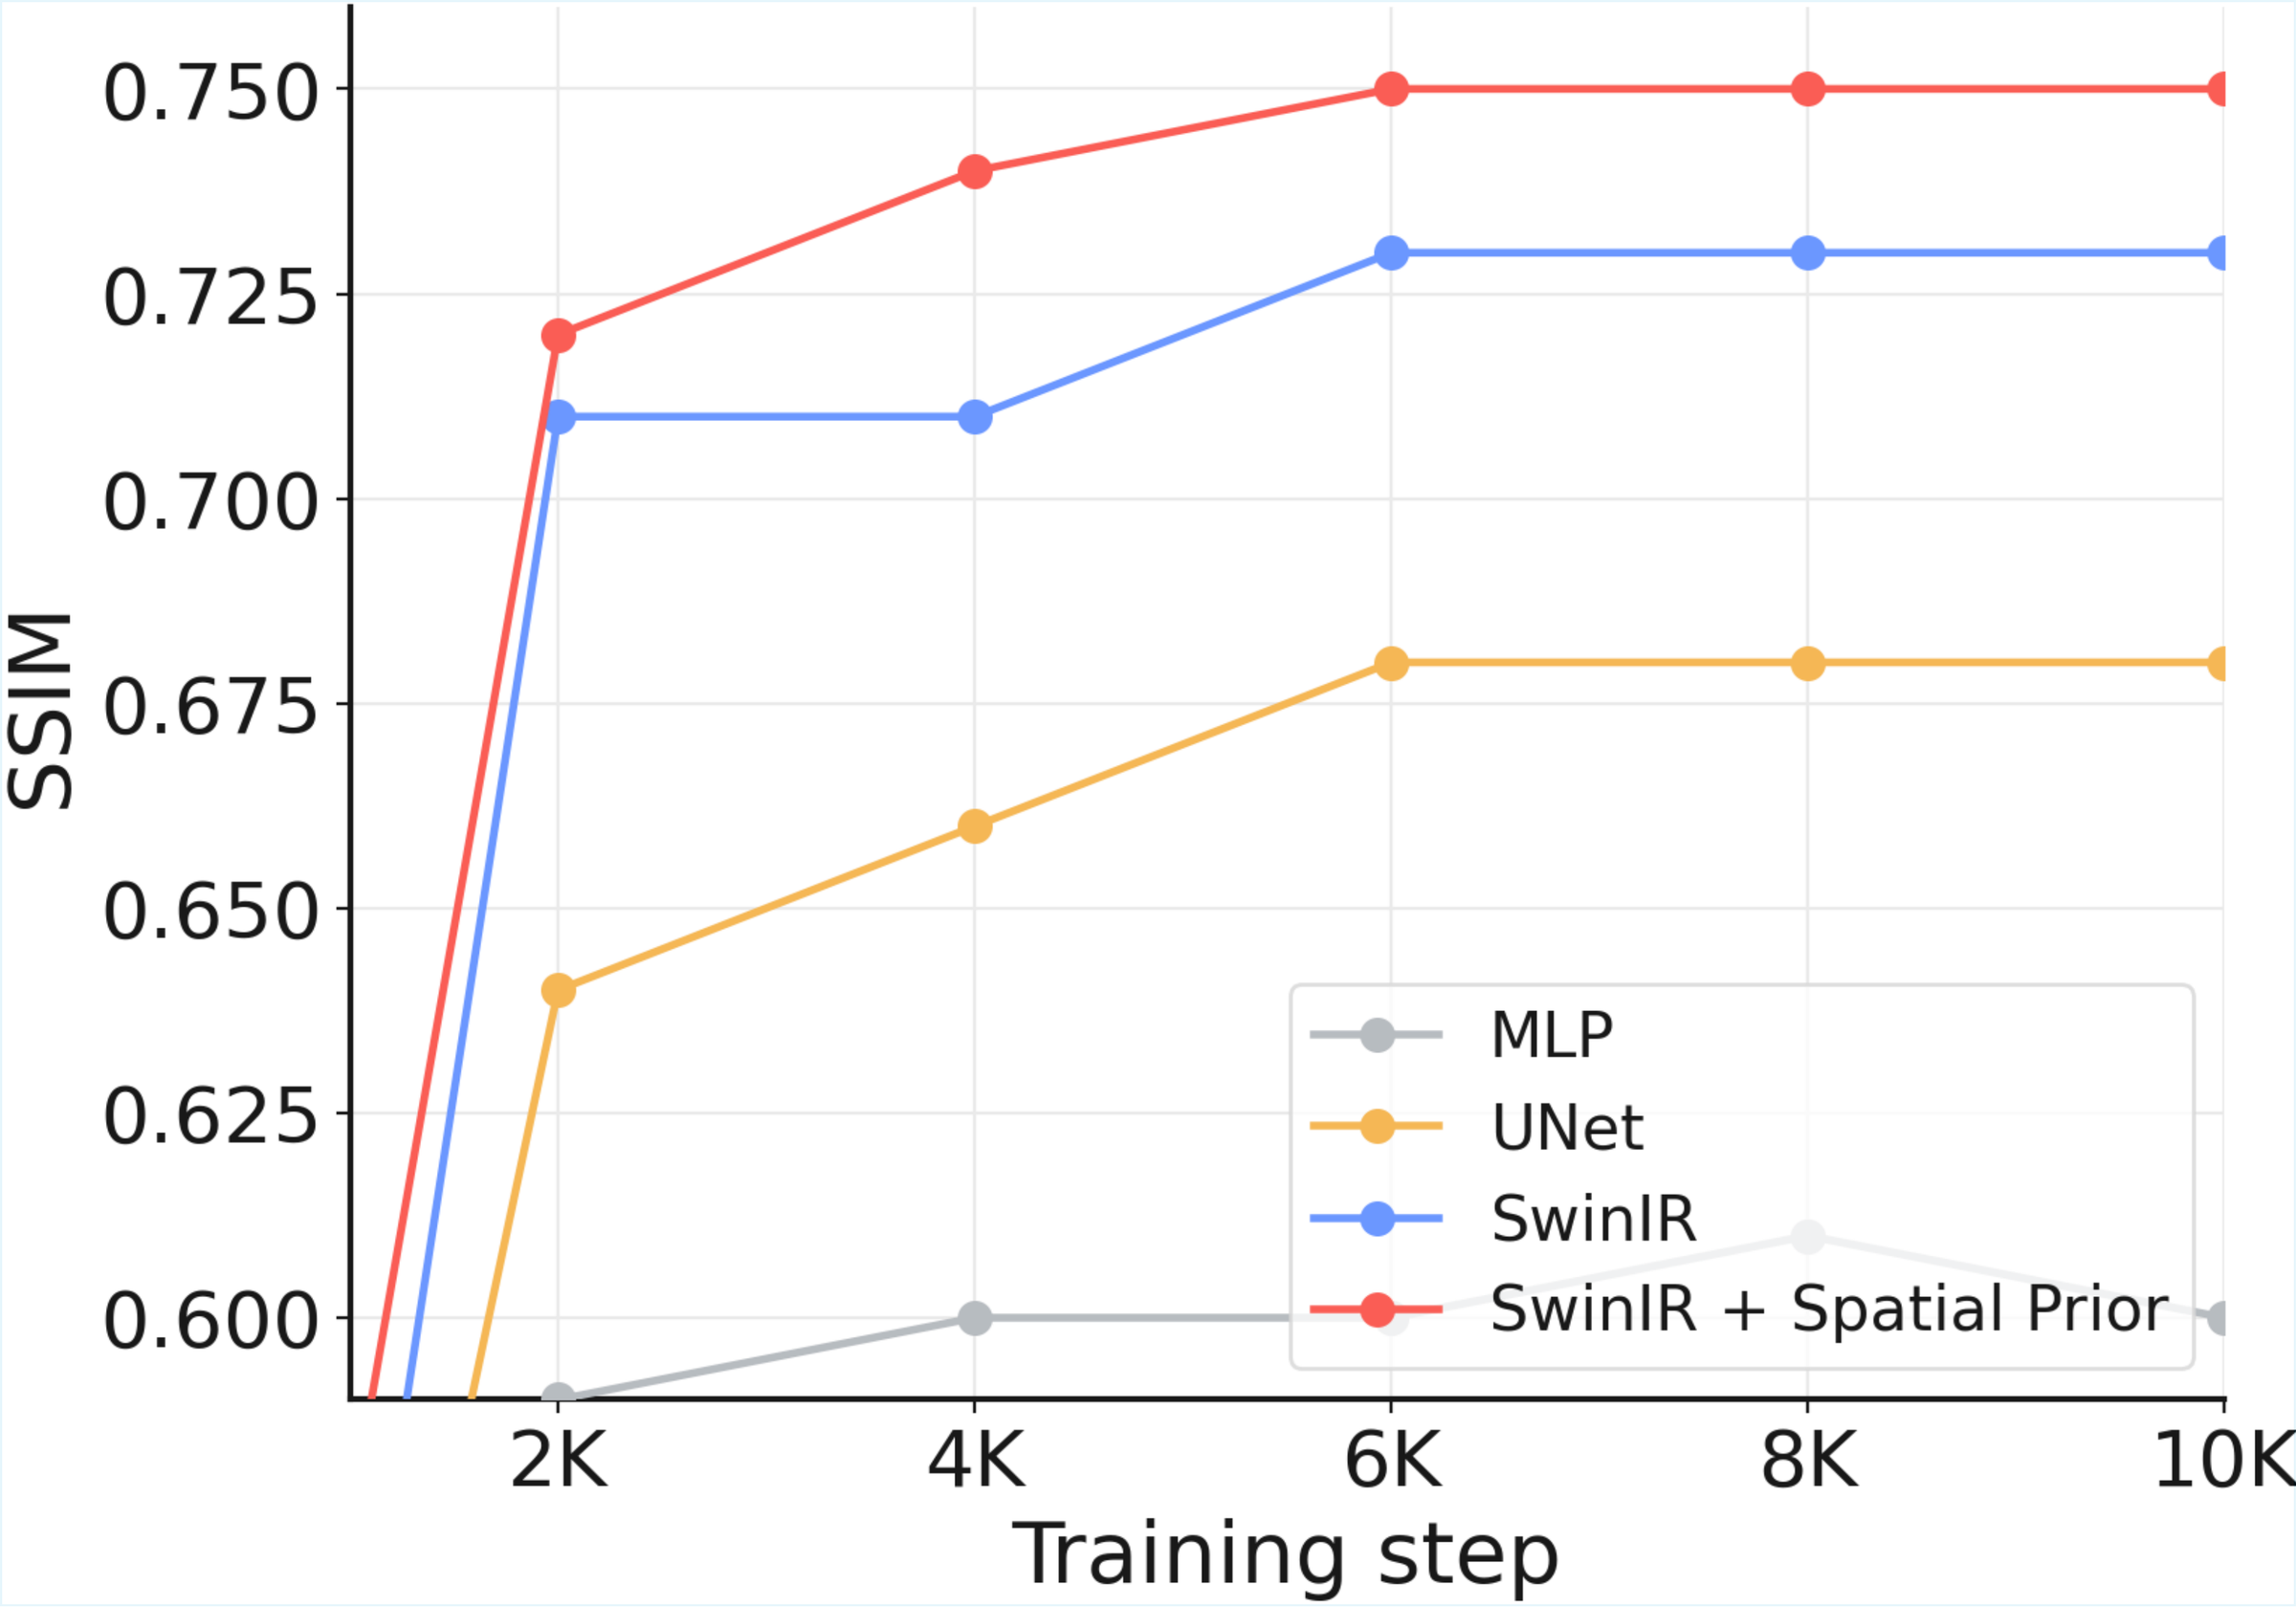
实验效果:跨多种现代老师,Bridge 为紧凑一步学生带来显著增益——如把 SD1.5 从 5.4 提升到 9.4 HPSv3,同时保持一步推理、低延迟与广泛生态兼容。
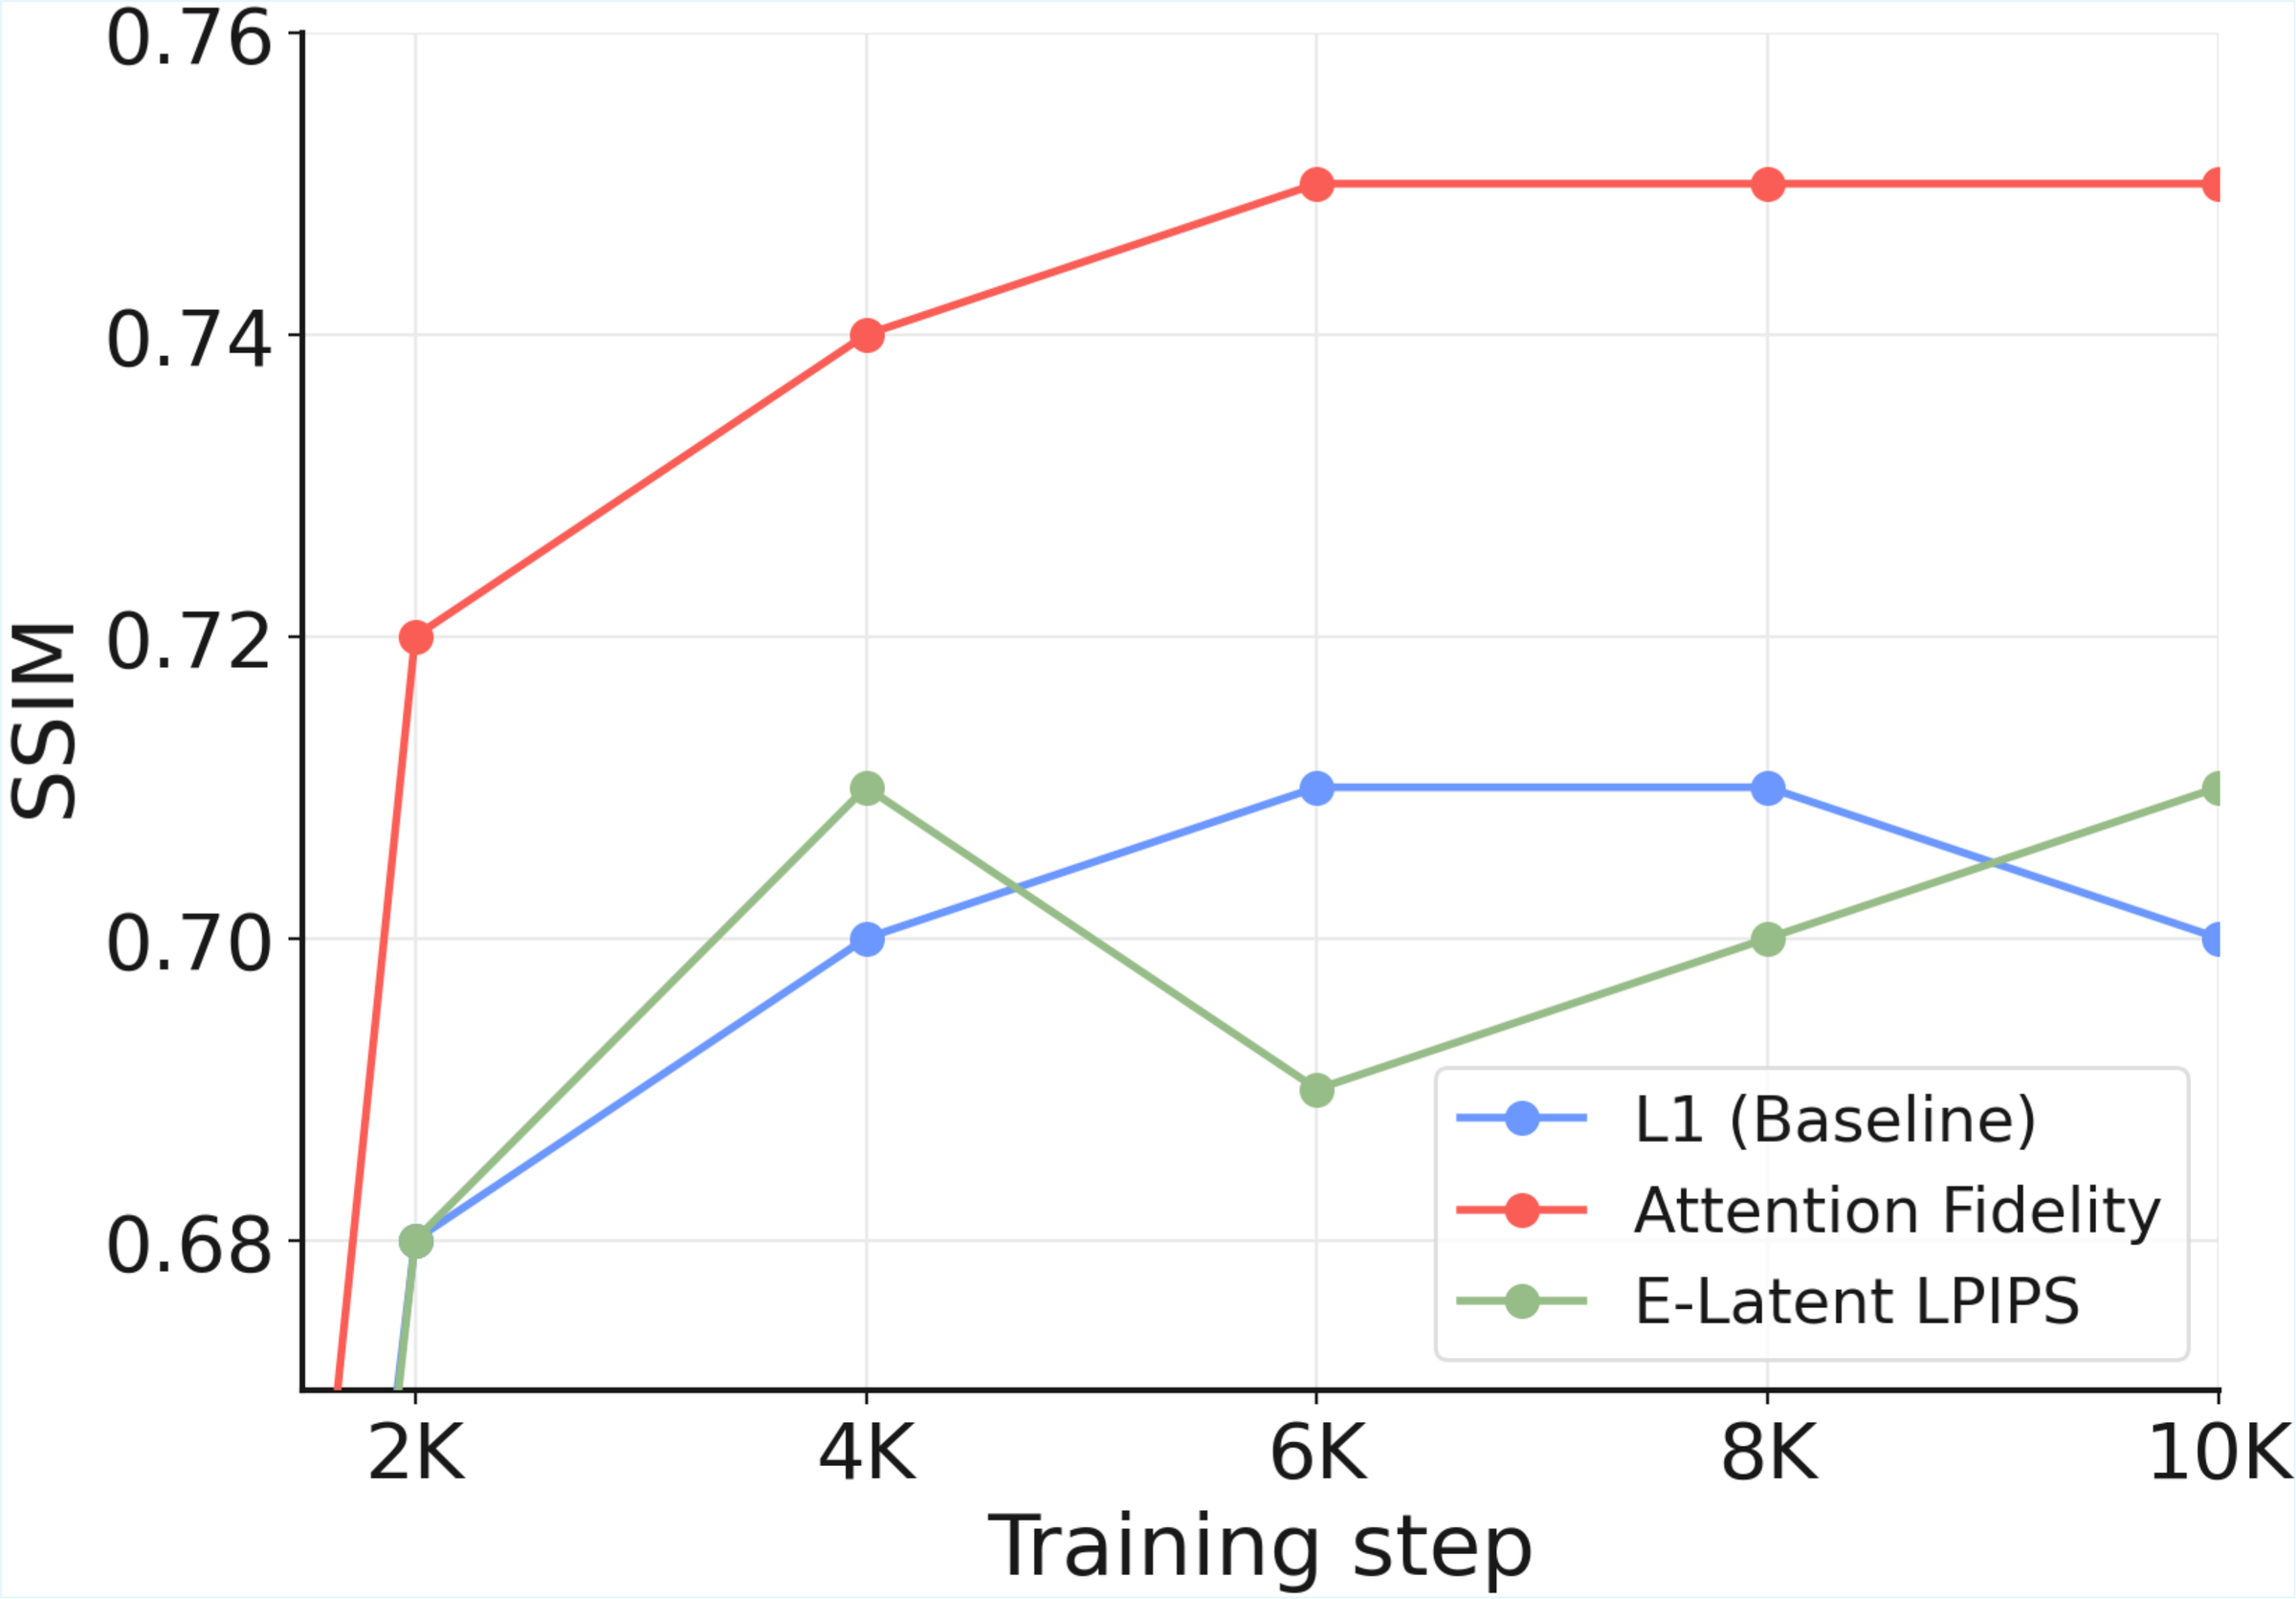
批判点评:打破「师生同空间」限制、用轻量桥接把大老师蒸进小学生,兼顾部署友好与生态兼容,思路清晰、增益明显。但 Bridge 仍需针对师生对训练,跨差异极大的 VAE/分辨率时对齐质量、以及一步学生画质上限能否逼近老师仍是问题。
SyncCache: Exploiting Asymmetric Dynamics for Fast Audio-Driven Portrait Animation | 北大·上海AILab·vivo | arXiv:2606.30849
关键词:人像动画,音频驱动,特征缓存,推理加速,唇同步
前序问题:DiT 大幅推进音频驱动人像动画,但算力高、推理延迟大;现有免训练扩散缓存多为文本条件生成设计,忽视人像动画固有的空间与模态不均衡。
本文贡献:提出免训练、面向 DiT 人像动画的缓存加速 SyncCache,显式利用「非对称动态」:音频驱动、集中在人物区域的高频动态比低频视觉背景更难也更关键。用空间非对称探测优先关注动态人区的误差敏感度;用模态解耦缓存跳过重 DiT 块(复用稳定的块间残差)、同时持续重算轻量音频块以保精确唇同步;并把内存自适应缓存选择建模为离线动态规划、无在线开销。
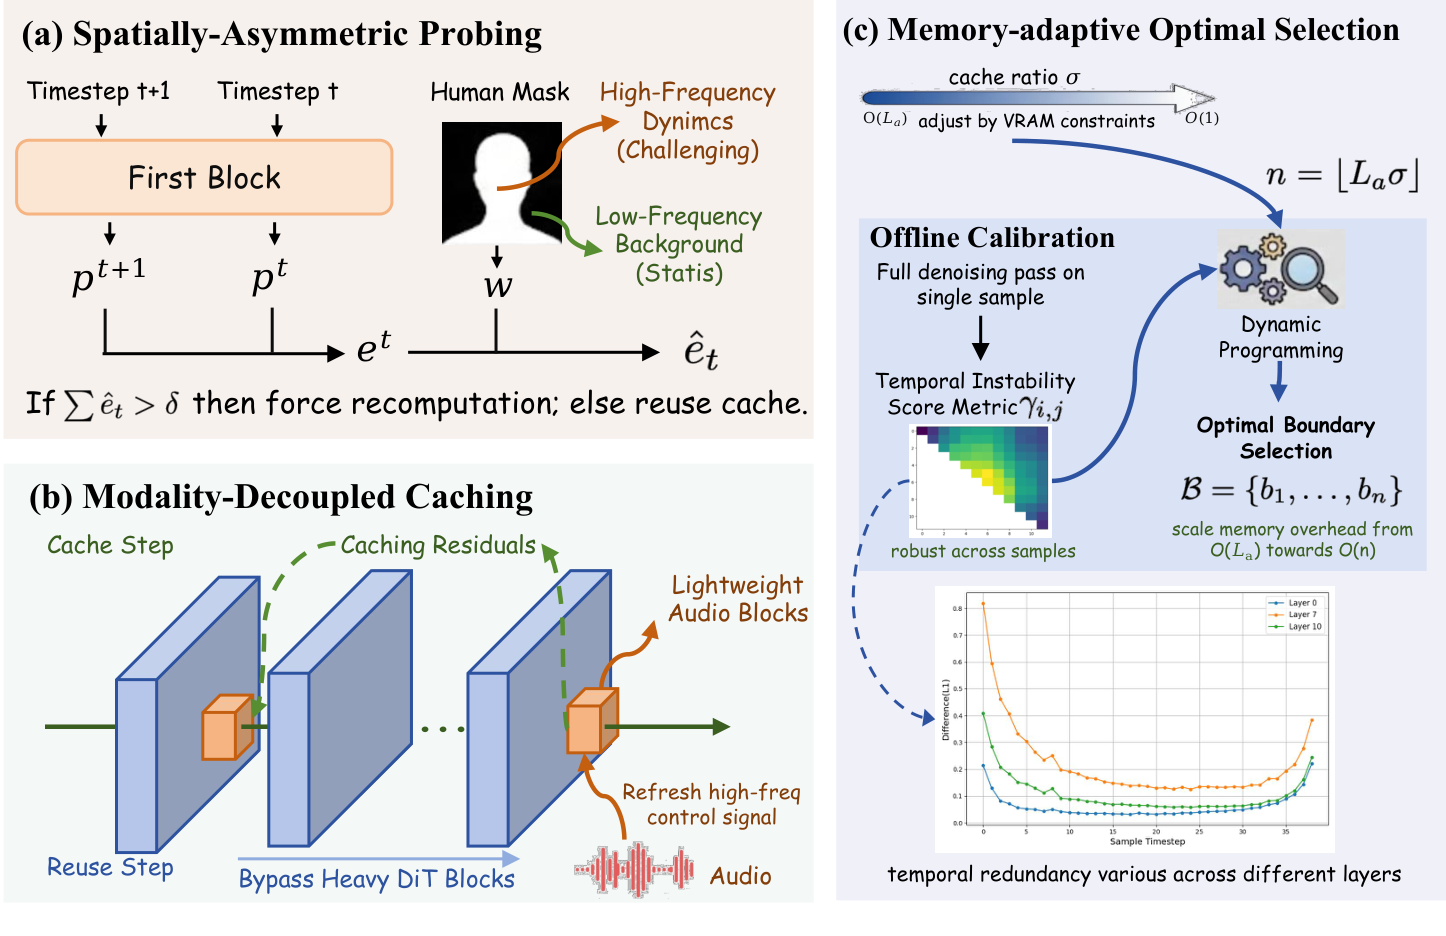
实验效果:在 HunyuanVideo-Avatar 上达 4.12×、Wan-S2V 上 3.75× 加速,视觉近无损且音频对齐精确。

批判点评:抓住「音频高频动态集中在人脸」这一非对称结构做差异化缓存,唇同步与背景分而治之很聪明,加速比可观。但方法针对人像动画定制、跨其他音驱视频任务的通用性有限,缓存比与画质/唇同步的权衡在极端表情/快速语音下仍需验证。
AnyBokeh: Physics-Guided Any-to-Any Bokeh Editing with Optical Fingerprint Transfer | 南洋理工 | arXiv:2606.31959
关键词:虚化编辑,景深,物理引导,弥散圆,图像编辑
前序问题:景深控制是摄影基本工具,但单图拍后虚化(bokeh)编辑仍难;现有方法多假设全对焦输入、或先复原全对焦再渲染,会丢弃源图模糊线索并把复原伪影传到最终结果。
本文贡献:提出物理引导的任意到任意虚化编辑 AnyBokeh:不把源模糊当退化去除,而用带符号弥散圆(CoC)图与视差图估计源模糊状态;通过建模「带符号 CoC 与视差差」的线性关系估计源专属「光学指纹」,把源光学特性迁到目标对焦与光圈设置;生成式编辑器以源/目标 CoC 图为条件做相对模糊合成,实现空间自适应的去模糊、保持与散焦渲染。还构建了带精确深度/对焦距离/完整 EXIF 的高保真合成数据集。
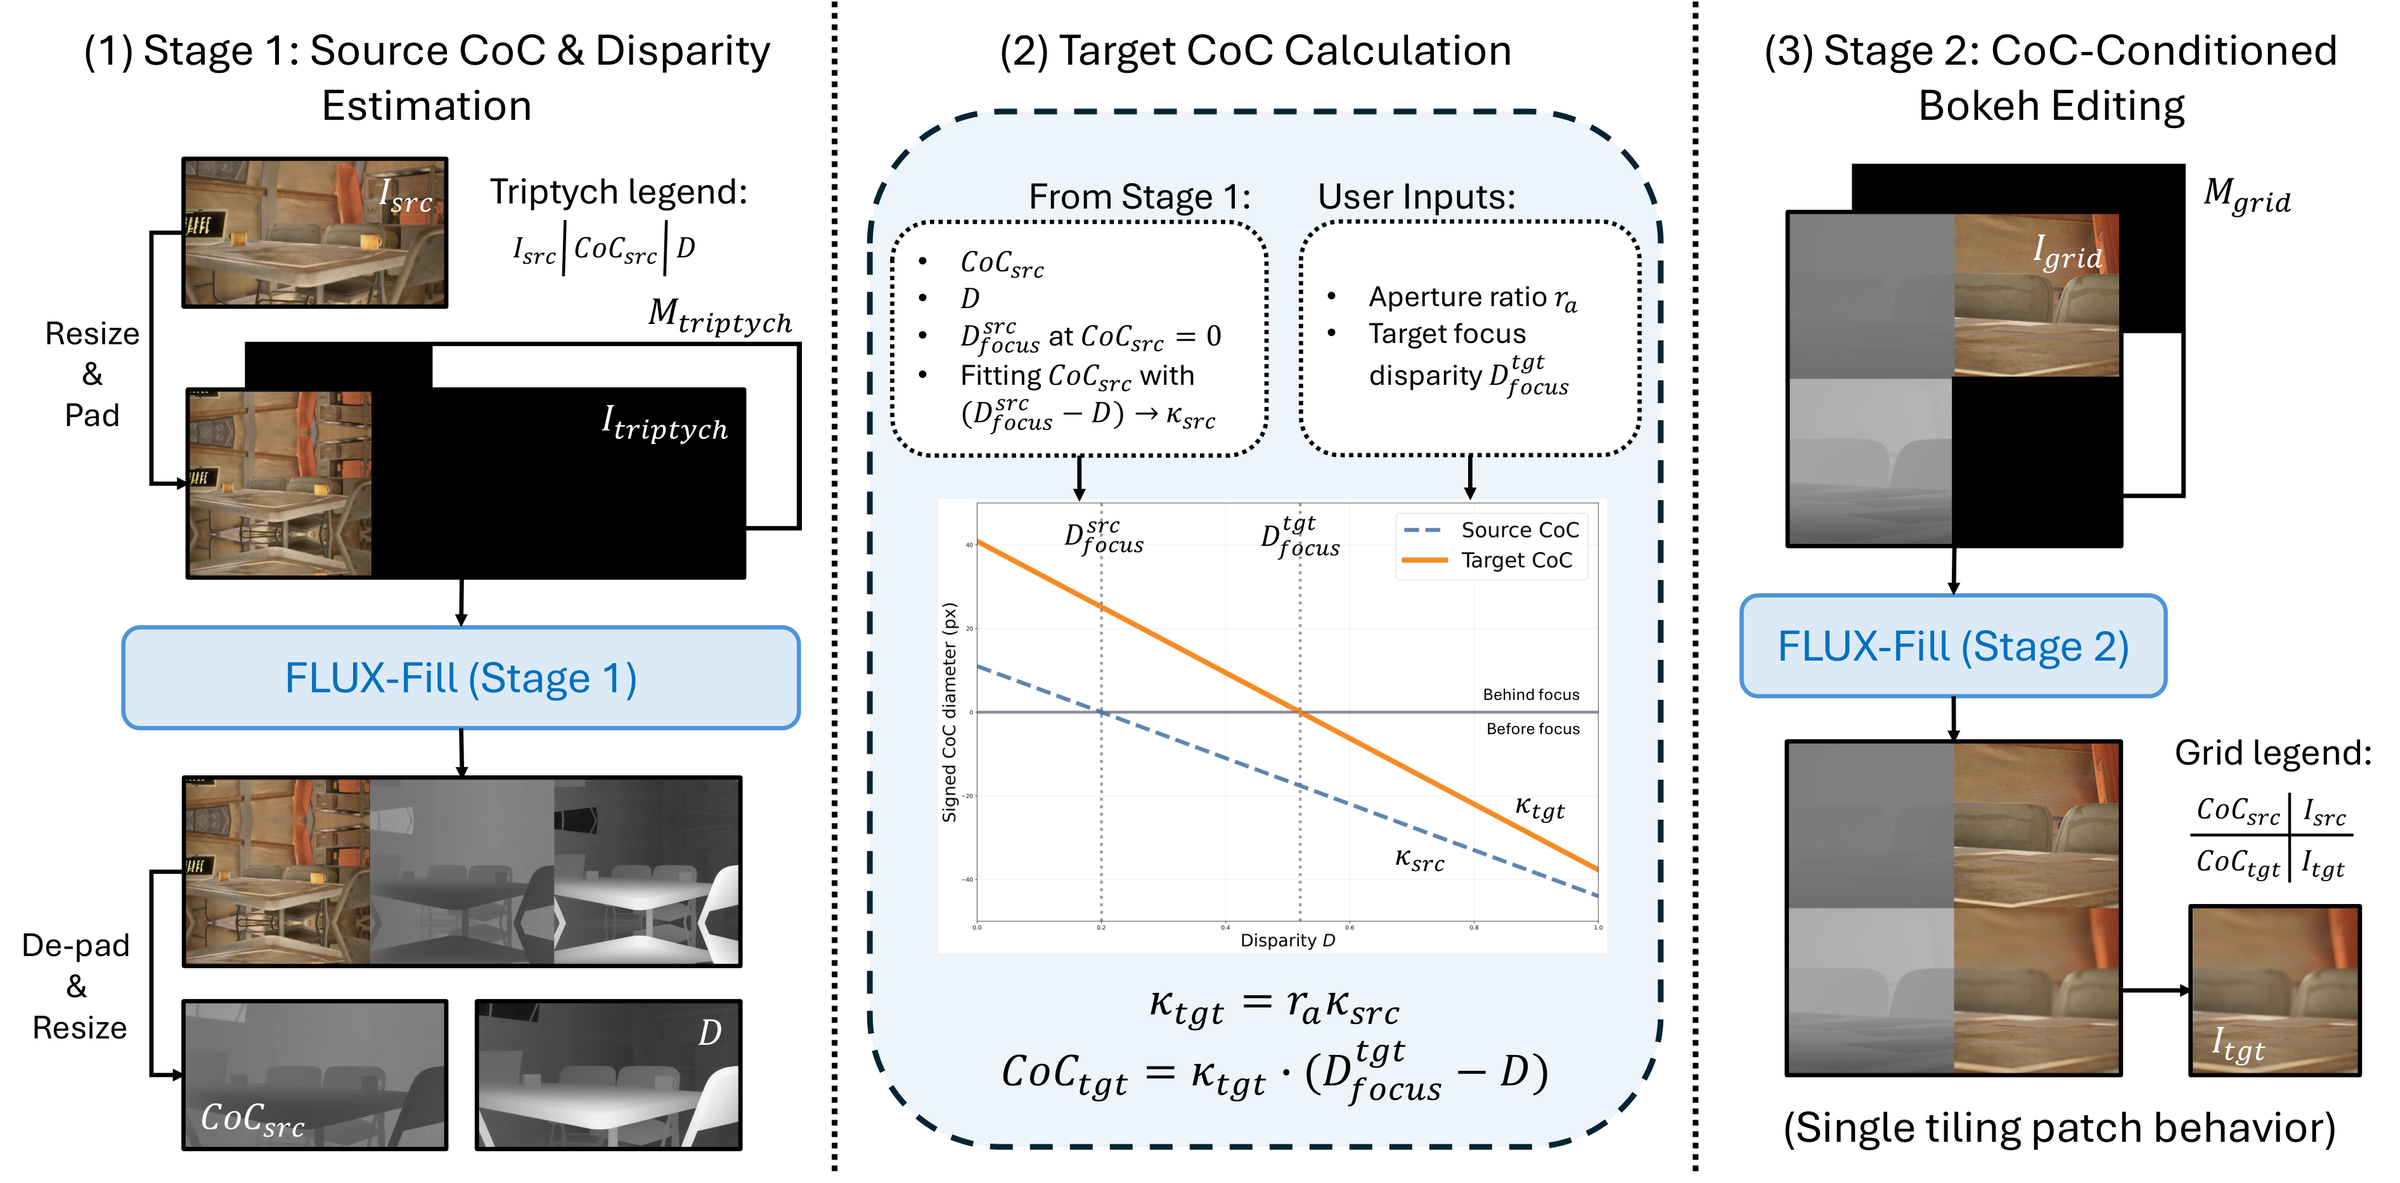
实验效果:真实基准上在任意到任意虚化、全对焦到虚化、散焦去模糊上均忠实可控,且免去现有方法常需的全对焦复原与测试时虚化级标定。

批判点评:用「光学指纹+带符号 CoC」把虚化编辑建在物理量上,避开全对焦复原的伪影链,泛化性与可控性都更好。但依赖对 CoC/视差的准确估计,真实复杂场景(多层景深、透明/高光)下物理假设是否成立、合成到真实的域差仍需关注。
Vitality-Aware Compression for Efficient Image-to-Shape Diffusion Transformers | KRAFTON | arXiv:2607.00382
关键词:3D生成,图像到形状,模型压缩,剪枝量化,DiT
前序问题:3D 形状生成进展显著,但大型 DiT 模型在资源受限场景算力过高;其他域的扩散压缩策略难直接迁到 3D,此前 3D 效率工作又多聚焦推理速度而非骨干压缩。
本文贡献:提出首个面向图像到形状(image-to-shape)DiT 的压缩框架:基于「3D DiT 各层对几何合成重要性非均匀」的观察,构建几何感知、以「活力(vitality)」为引导的框架,融合结构化剪枝、自适应量化与定向微调。
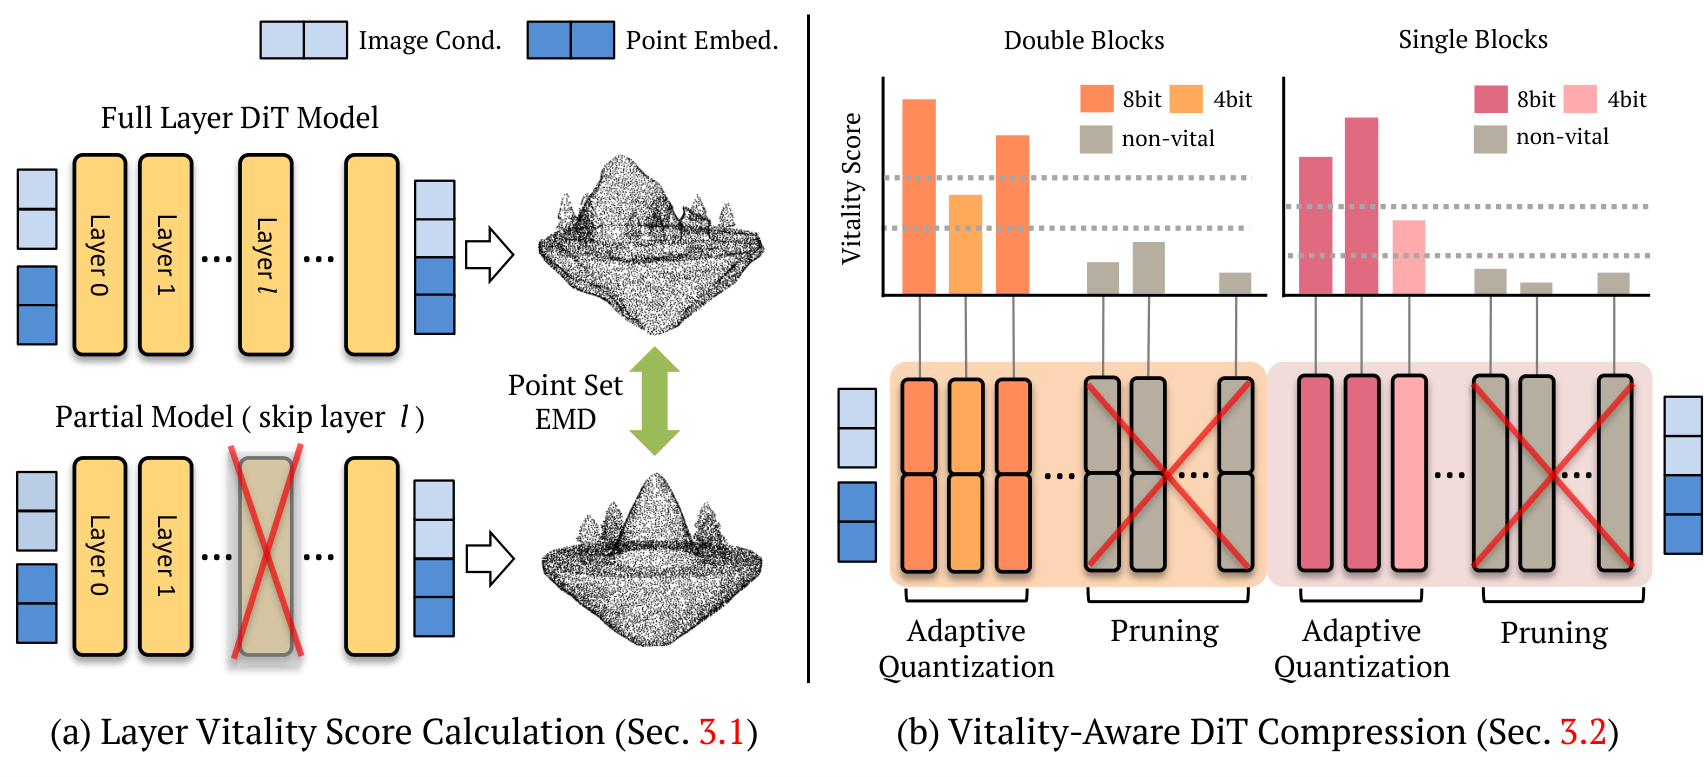
实验效果:在多个 SOTA 图像到 3D 模型上实现最高 66% 模型体积缩减,同时保持与全尺寸相当的合成保真度,可作即插即用的高效 3D 生成方案。
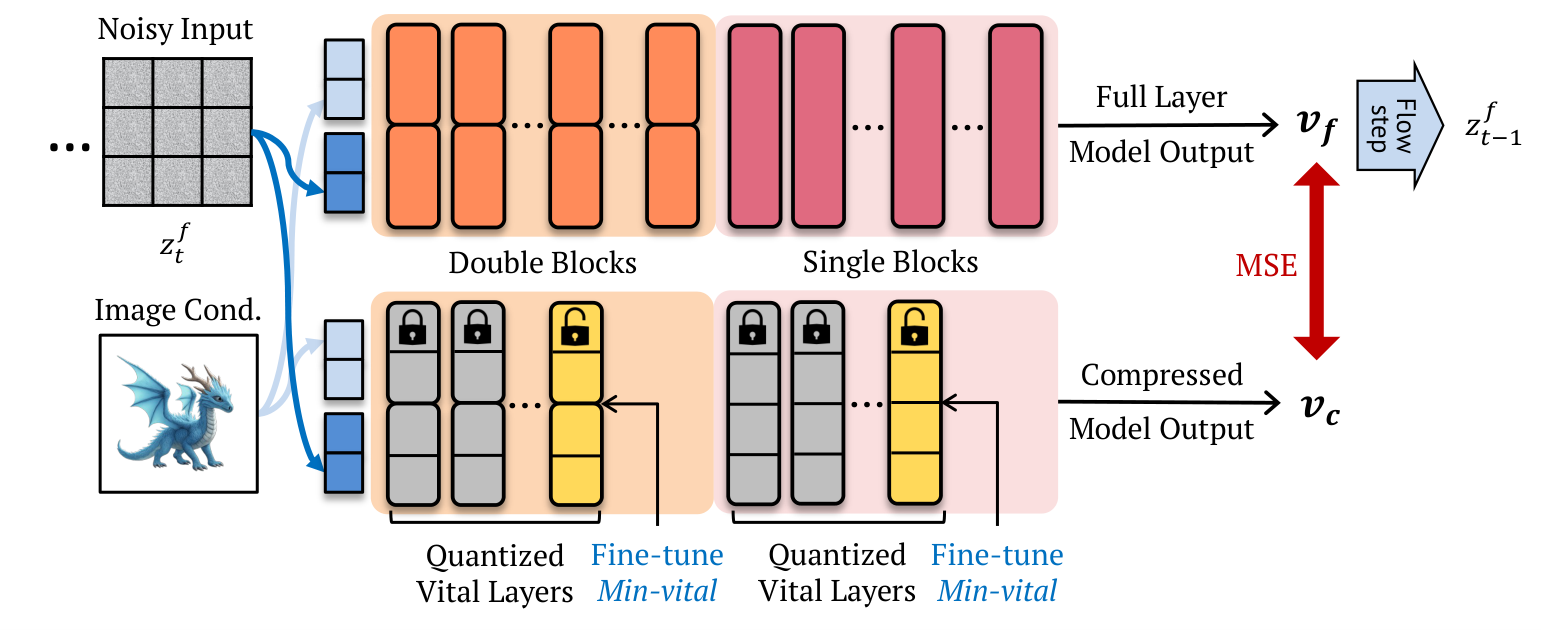
批判点评:把「层重要性非均匀」用于几何感知压缩、剪枝+量化+微调三管齐下,填补 3D 骨干压缩空白,通用性不错。但 66% 缩减下几何细节(薄结构/高频表面)的保真边界、量化实际加速高度依赖硬件/kernel,跨更多 3D 表示的迁移仍待看。
Enhancing Flow Matching with A Unified Guidance Framework for Efficient and Robust Speech Synthesis | 作业帮 | arXiv:2607.00363
关键词:语音合成,流匹配,推理加速,音色泄漏,TTS
前序问题:流匹配(FM)已成语音生成的强范式,但受高推理延迟与音色泄漏制约。
本文贡献:提出统一引导框架,用两条互补策略提升效率与鲁棒:数据侧用异构增强的 Data-guidance 促使模型解耦语言内容与声学残留;模型侧提出增强的 Model-guidance,协同轨迹校正与新颖的内在引导目标,把条件知识蒸进网络权重、拉直推理轨迹,从而免去 Classifier-Free Guidance(CFG)开销。

实验效果:推理提速近 3 倍,同时较 SOTA 基线有效提升说话人相似度(VC 与 TTS 均评)。
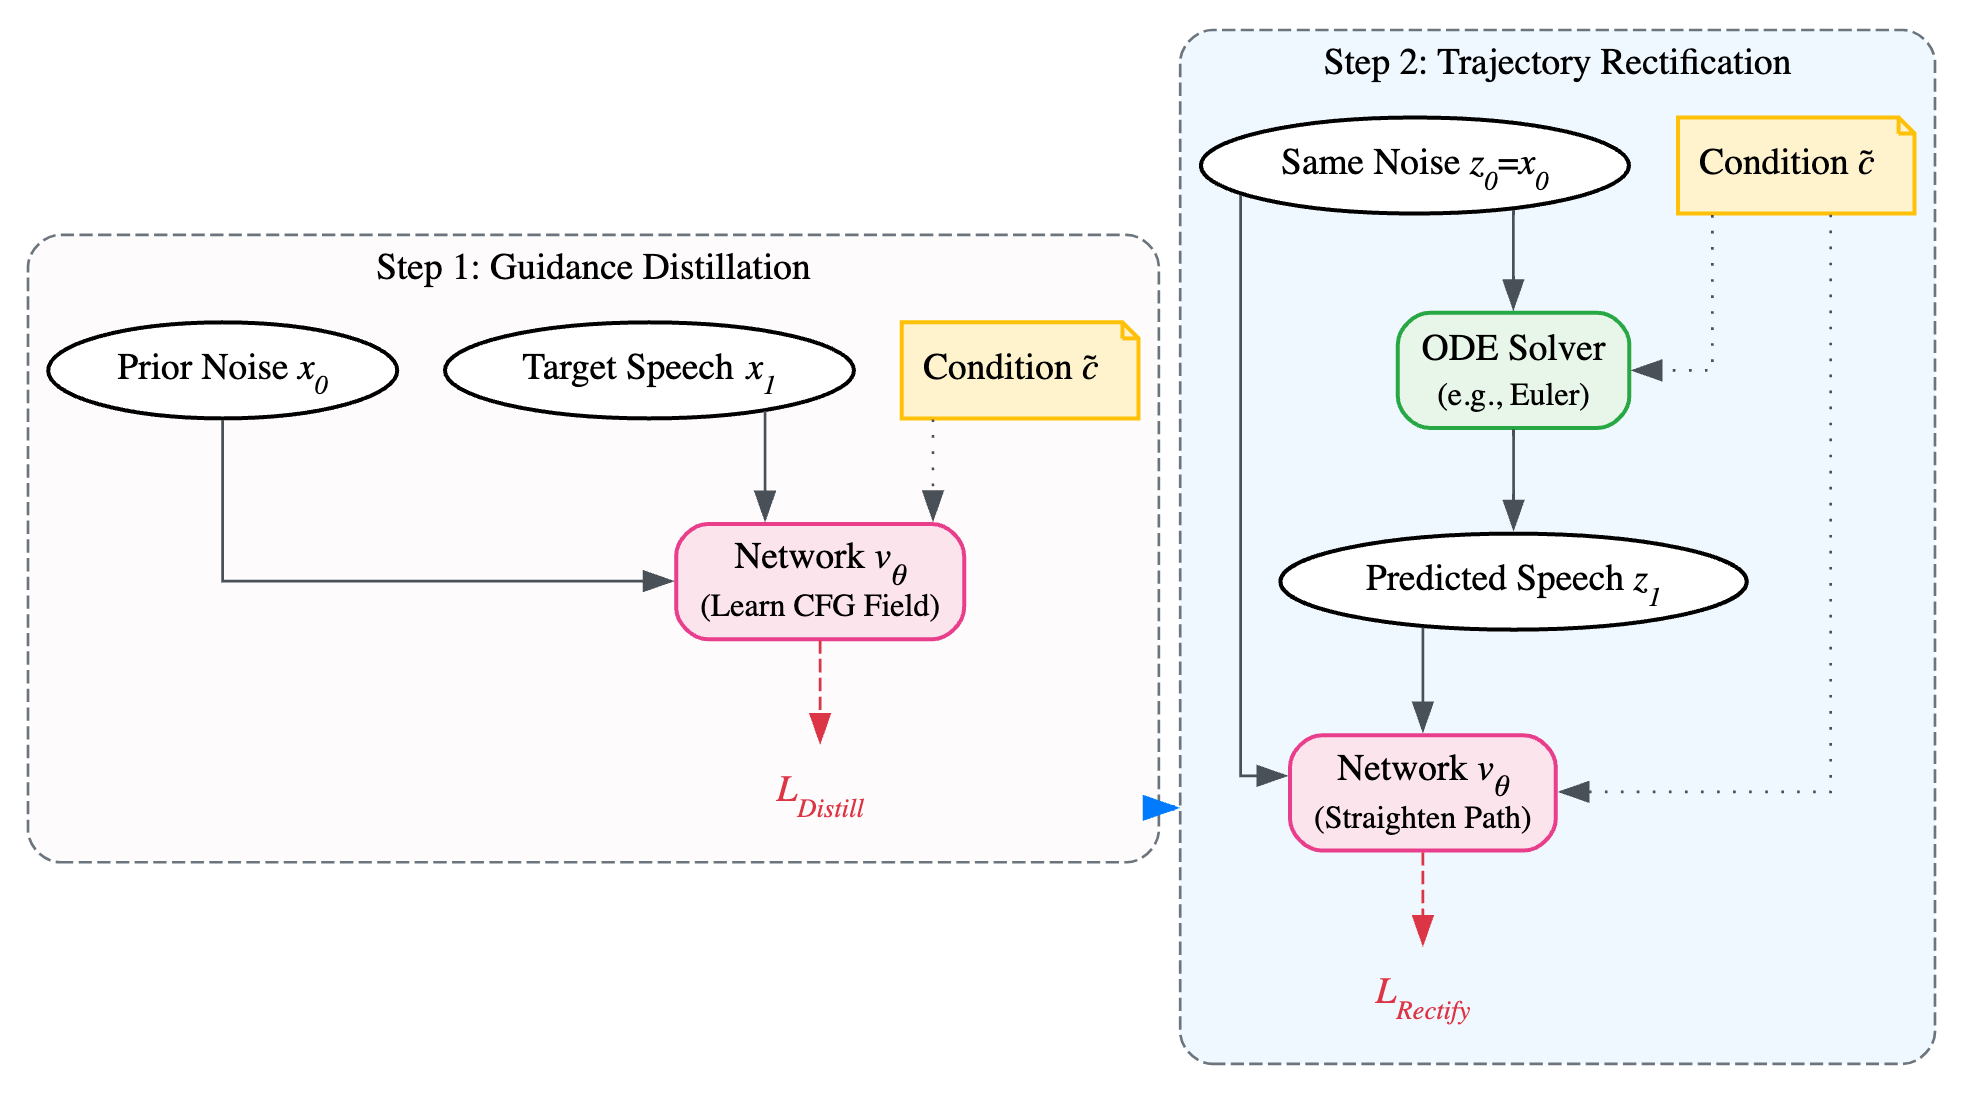
批判点评:把「数据解耦+模型内在引导」统一起来同时治延迟与音色泄漏、还省掉 CFG,思路简洁有效、提速实在。但内在引导蒸掉 CFG 后对强可控性/多样性的影响、音色泄漏在跨语言或极端音色下是否彻底解决仍需更多主观评测。
Vertigo Vertigo: Reconstructing a Cinematic Ideal through its Predictive AI Double | 伦敦艺术大学 | arXiv:2607.00047
关键词:视频生成,关键帧插值,电影重构,潜先验,生成媒体
前序问题:生成式媒体与经典电影的关系是「范式转变」还是「同一逻辑的加速」?缺乏可量化的探针。
本文贡献:Vertigo Vertigo 用仅 2.78% 原片帧作稀疏关键帧锚点,经大型视频扩散模型做首末帧插值,逐场景重构希区柯克《迷魂记》(1958);把这部「关于强迫性重构人造理想」的电影本身当探针,检验生成系统里编码的经典电影规范(入选 Ars Electronica EXPANDED 2026)。
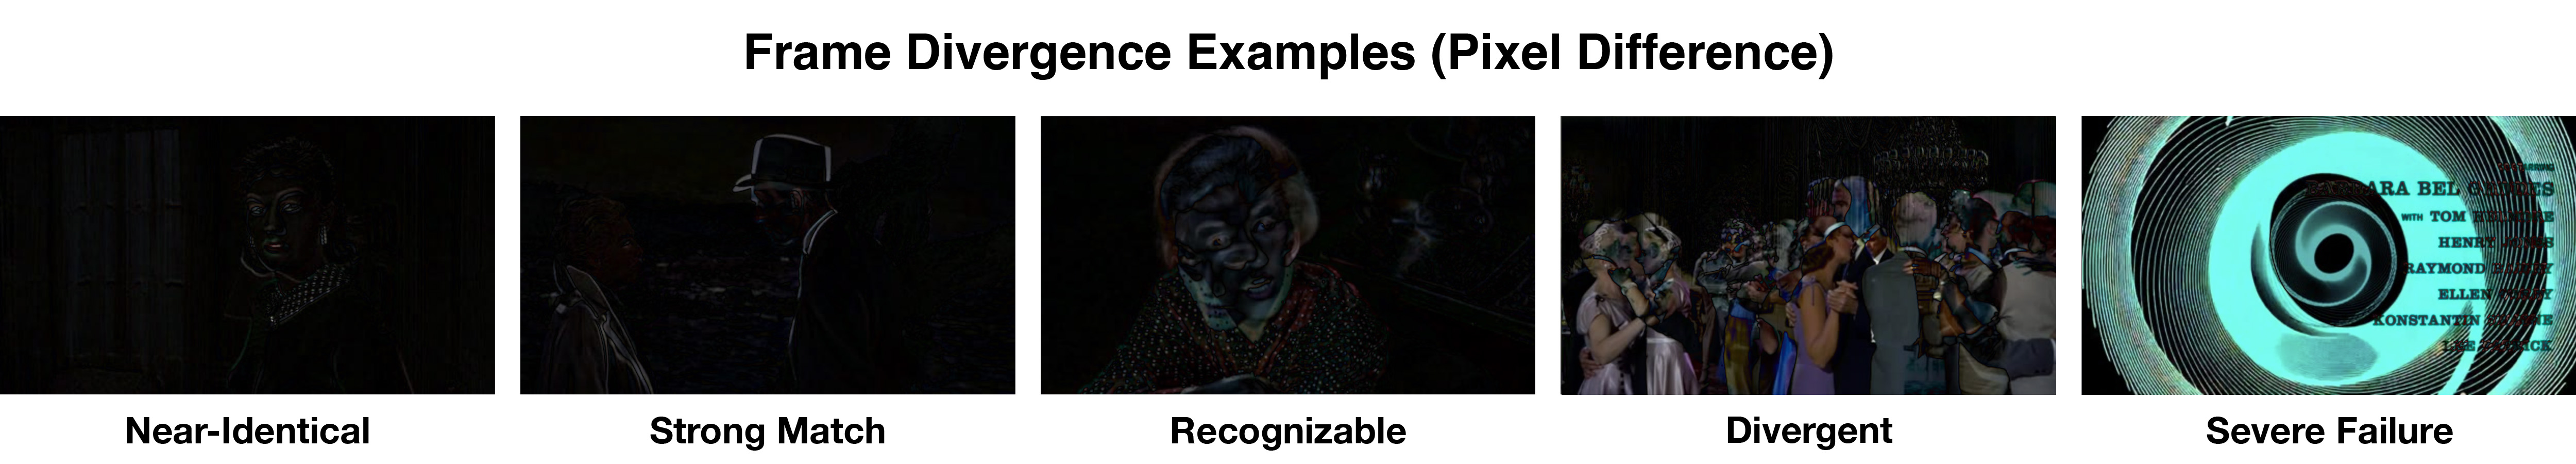
实验效果:经计算分析与媒体理论学者(Manovich 等)评述,73.1% 的帧可辨认为《迷魂记》的合理再现、仅 3.6% 灾难性失败,表明电影规范被深度压缩进模型潜先验;成片以原片与其「预测影子」的不稳定叠影呈现。
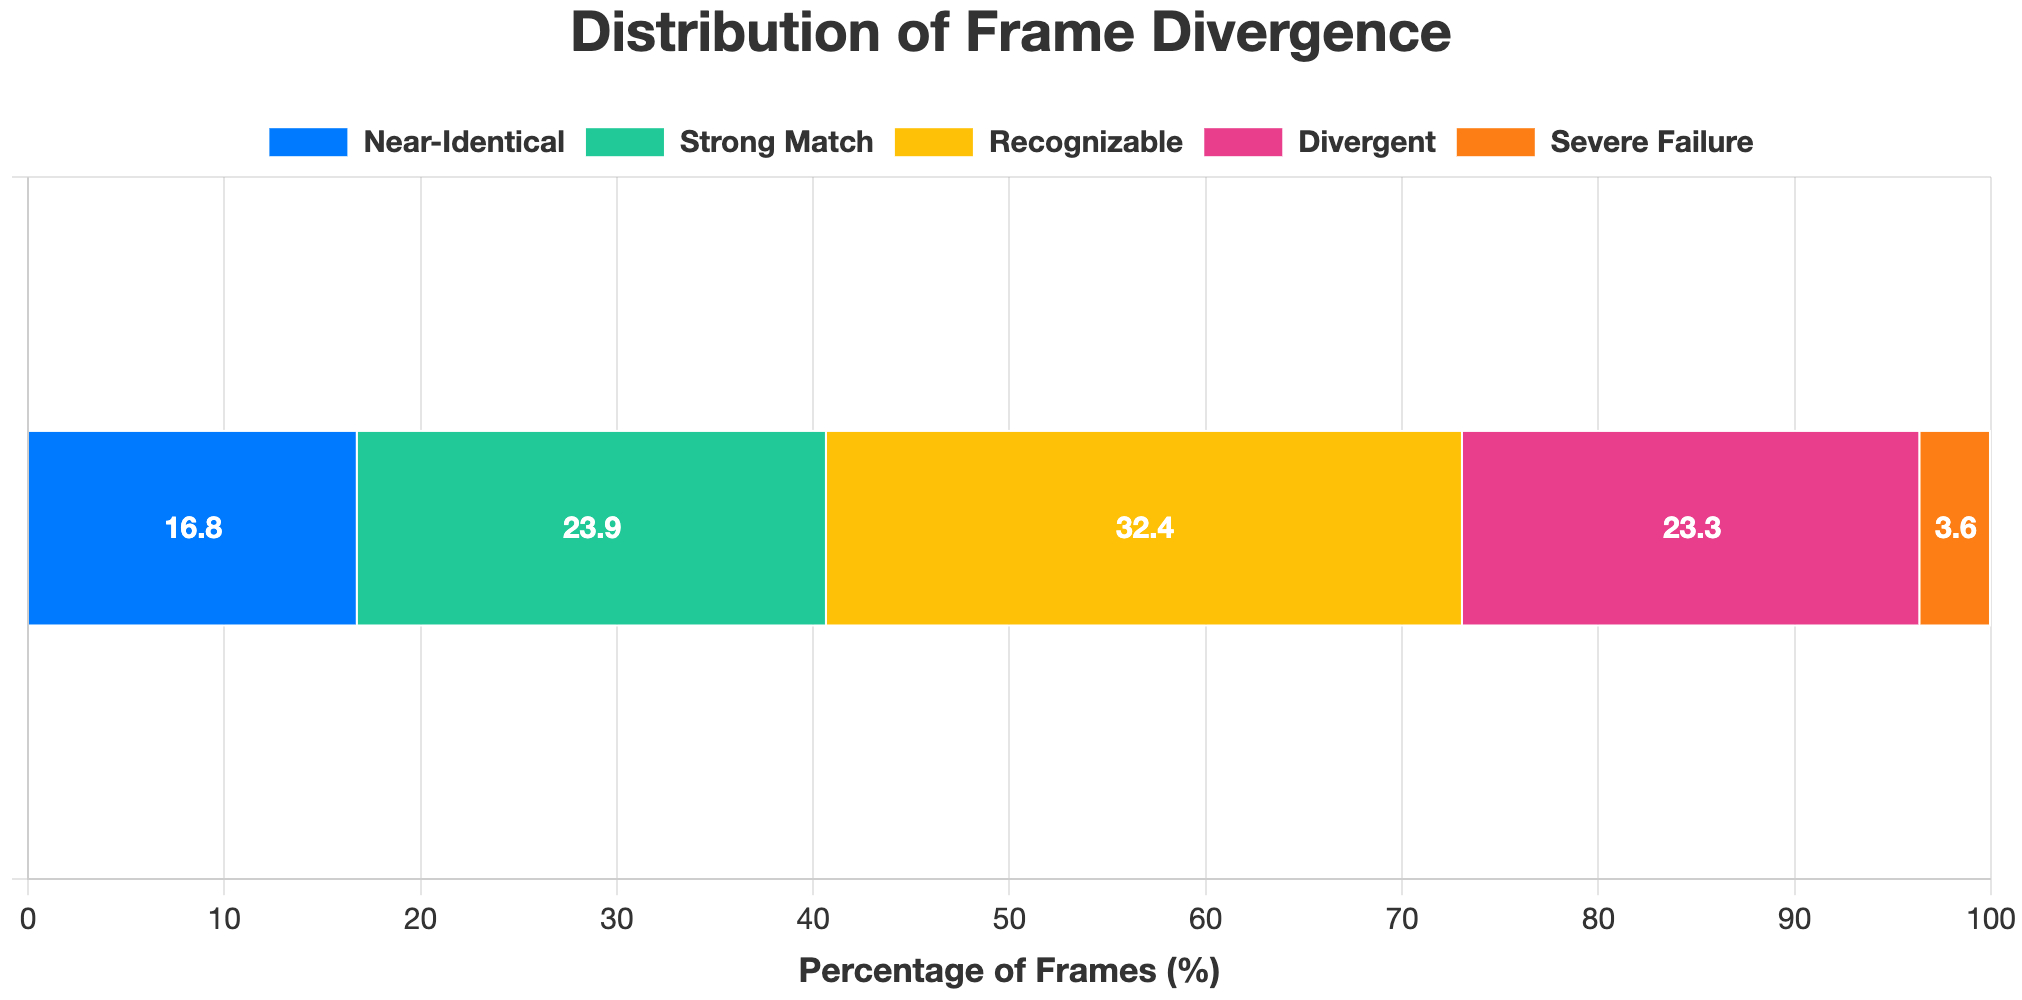
批判点评:把「用 2.78% 帧重构整部经典」做成对生成模型潜先验的文化探针,视角新颖、跨艺术与技术,量化保真数字也有说服力。但本质是艺术/媒体理论作品而非方法创新,'可辨认率'的主观评判、以及结论对不同影片/模型的普适性都有限。
人工智能炼丹君 整理 | 2026-07-02
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)