


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 实时世界模型与未来预测 2 篇 · 图像视频生成加速 2 篇 · 全模态推理与数字人 2 篇 · 语音与图像生成控制 2 篇 · 生成安全与任务修复 2 篇
Wonder: Video World Model Done Better | Adobe Research·约翰霍普金斯 | arXiv:2607.26037
关键词:视频世界模型,实时生成,相机控制,长期记忆,Adobe
前序问题:从一张图构建可交互世界,不仅要按相机控制实时生成新视角,还要在分钟级探索中记住已见区域,允许用户返回旧地点,并维持几何、外观和动态一致。普通视频生成的控制、记忆和训练管线彼此割裂。
本文贡献:提出通用视频世界模型Wonder,联合设计相机控制、稀疏记忆与蒸馏训练。稠密坐标场把相机运动和朝向渲染成空间对齐的视觉证据;稀疏注意力记忆从不断增长的历史中只检索少量相关token,计算不随上下文长度线性增长;多项修正改善Self-Forcing式蒸馏的控制遵循、多样性和长期记忆。

实验效果:可从图片或条件视频构建可玩世界,以16 FPS实时合成分钟级视频,支持相机导航、探索未知区域、重访旧区域和对已有动态场景重新运镜,同时保持长期几何、外观与动态连贯。

批判点评:Adobe把世界模型最关键的实时性、可控相机和长期记忆放进同一系统,16 FPS分钟级结果足以指向交互创作。但“可探索”仍是视频生成而非显式3D模拟,重访一致不代表真实几何闭环;分钟级稳定性的场景复杂度与硬件成本需结合演示判断。
Schrödinger's Cat: Probabilistic Representation and Prediction of Potential Scene Kinematics | ECCV 2026·慕尼黑大学 | arXiv:2607.25984
关键词:运动预测,概率分布,世界模型,ECCV,不确定性
前序问题:从局部观察预测场景未来,本质上存在多条可能轨迹。视频预测往往把算力花在外观,或只采样少量轨迹,既无法显式表示完整运动分布,也难定位“哪个物体、哪个时刻”最不确定。
本文贡献:提出未来运动潜分布的目标感知表示GARFIELD。给定图像和可选稀疏时空约束,模型学习结构化时空潜变量;同一表示既能联合采样全部轨迹,也可由确定性密度解码器直接读取底层运动分布。新增约束可逐步收窄特定物体与时刻的不确定性。
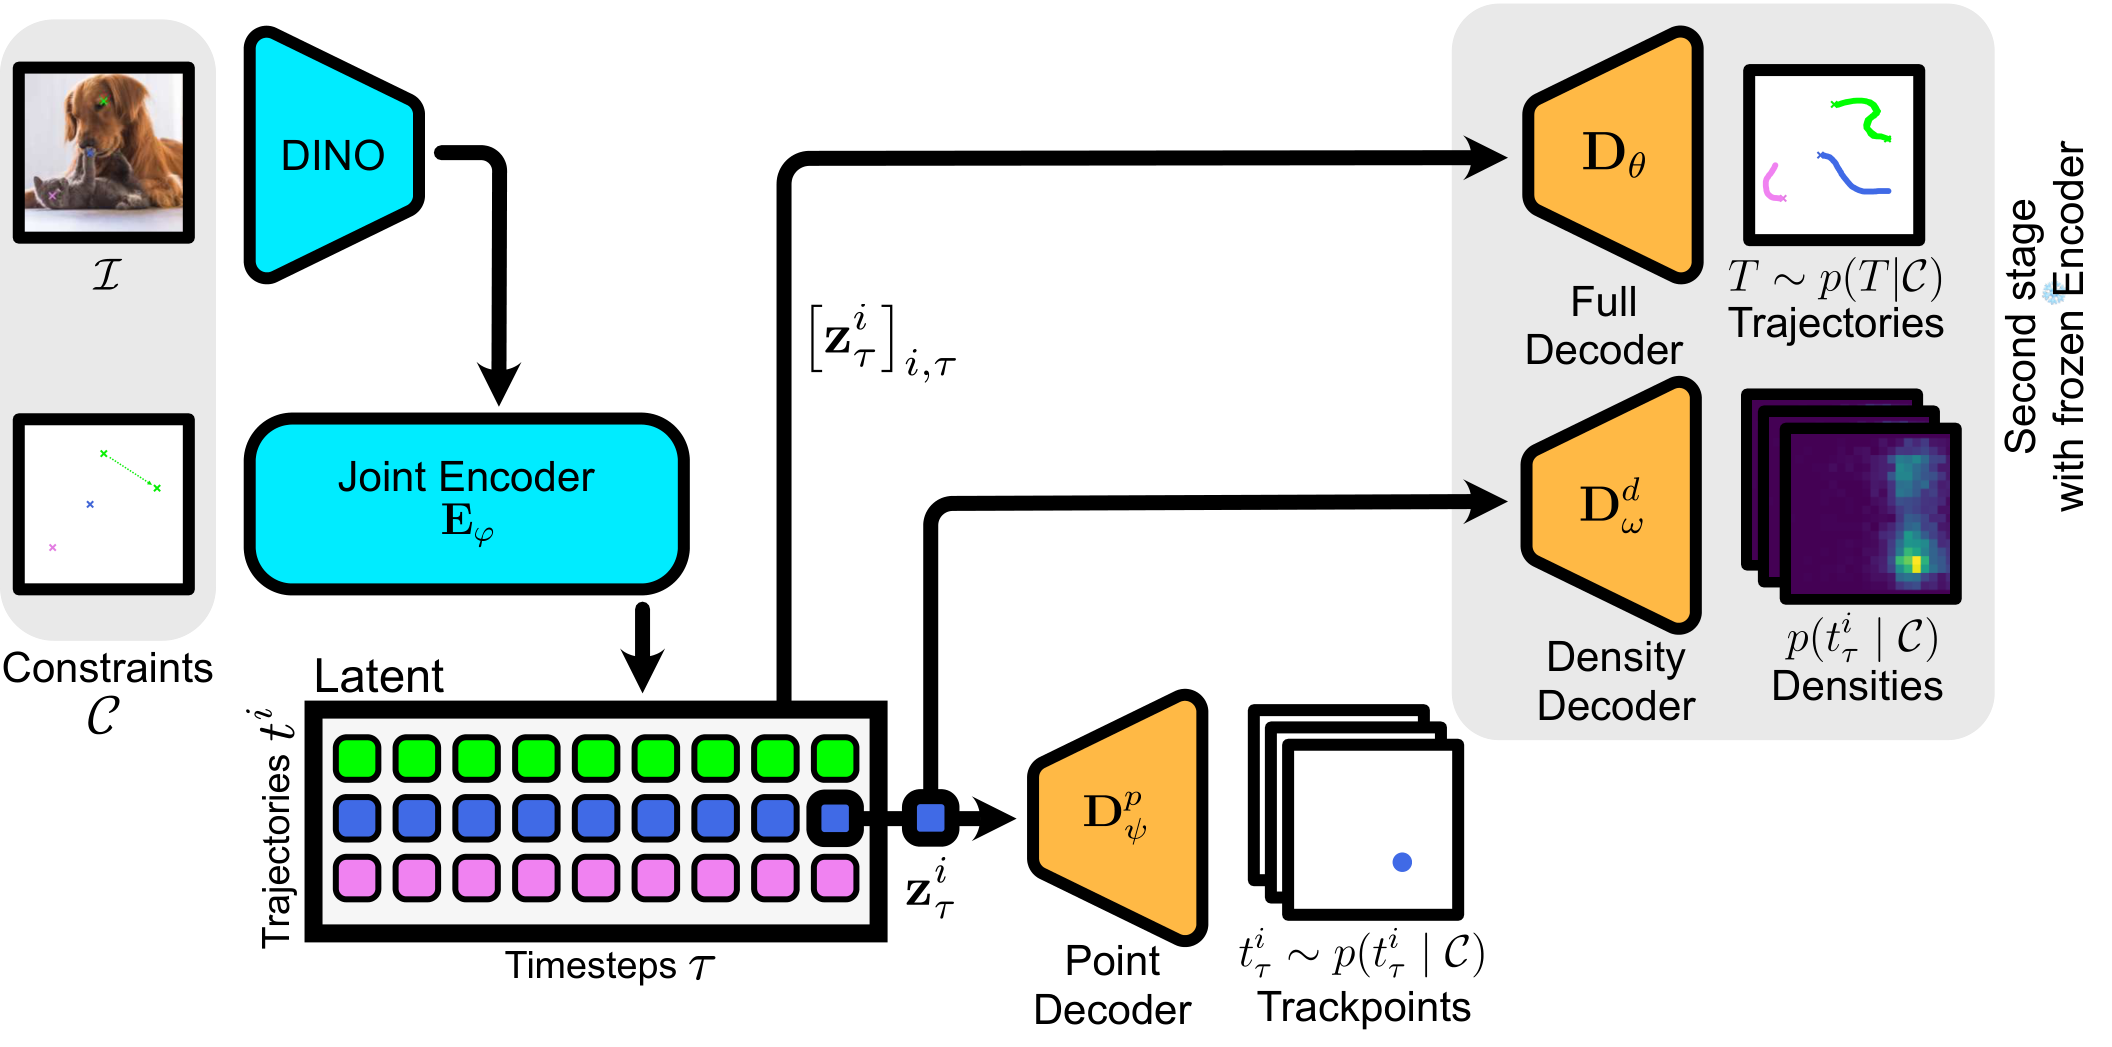
实验效果:运动规划表现可与大型视频生成模型竞争,轨迹采样快97倍;运动密度估计比对生成模型做Monte Carlo采样快两个数量级,可用于交互探索和不确定性感知规划。

批判点评:它把“未来长什么样”拆成“未来可能怎么动”,避免为规划浪费画面生成算力,97倍数字很有说服力。但潜运动分布不直接保证外观、碰撞和语义合理,复杂可变形物体与长时人类行为可能仍需视频级世界知识。
Parallel Decoding Distillation for Fast Image and Video Generation | NVIDIA·魏茨曼研究所 | arXiv:2607.26004
关键词:并行解码,扩散蒸馏,NVIDIA,少步生成,Flow Matching
前序问题:视频扩散和流模型采样迭代慢,主流少步蒸馏依赖VSD与对抗损失,训练难稳定且容易模式坍塌,表现为视频多样性下降和运动不足。
本文贡献:提出并行解码蒸馏PDD,以简化、可扩展的轨迹蒸馏替代复杂对抗训练。每次网络评估同时预测多个去噪步,学习平均速度表示,无需JVP或有限差分回归速度导数;架构兼容任意预训练扩散/flow模型,并允许推理时选择不同NFE。
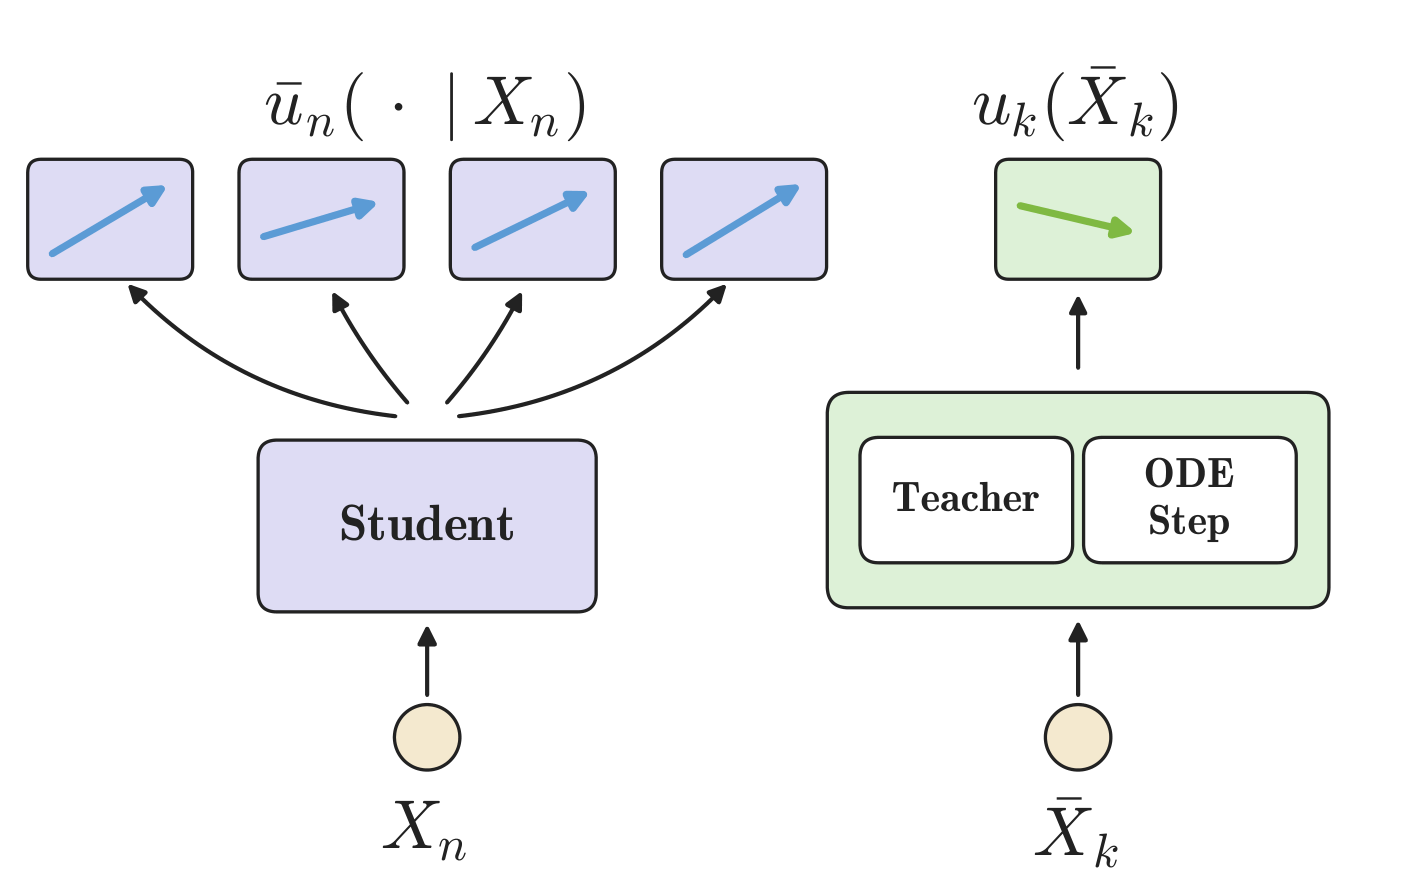
实验效果:在LTX-2.3文生视频/音频、Wan 14B文生视频和Qwen-Image文生图上,仅4到8 NFE即达到SOTA,并显著改善生成视频多样性。
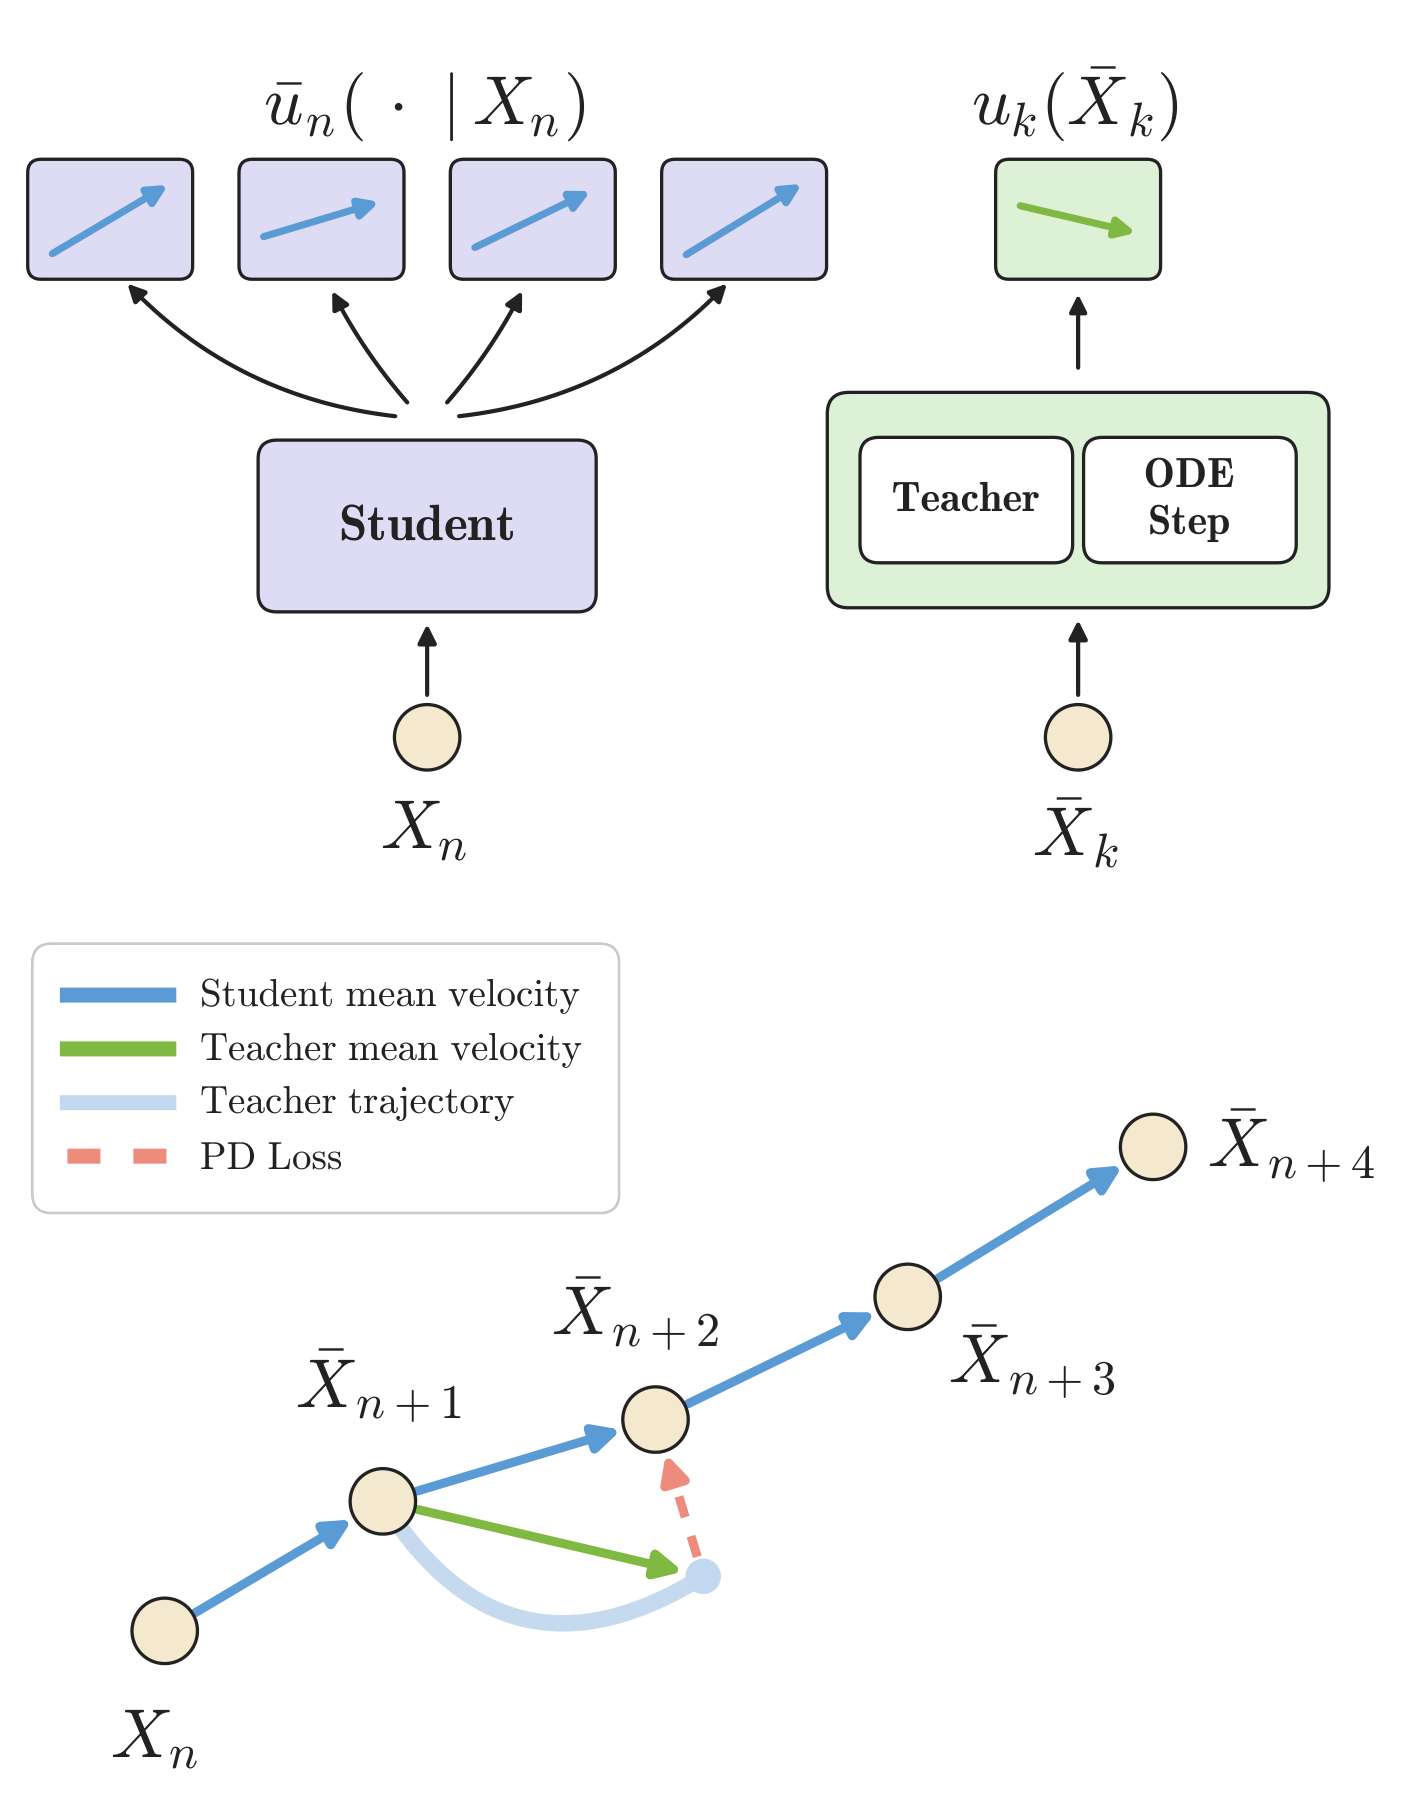
批判点评:PDD横跨图像、视频和音频,说明并行解码可能成为通用少步蒸馏接口;不依赖VSD和GAN也降低训练风险。不过摘要只报4–8步SOTA,缺少相对速度与训练成本;一次预测多步是否会在极端动作中积累轨迹偏差仍需细看。
OmniCache: Multidimensional Hierarchical Feature Caching for Diffusion Models | UT Austin | arXiv:2607.23844
关键词:扩散缓存,免训练,推理加速,视频生成,层级复用
前序问题:高分辨率图像和视频扩散在多步采样中反复计算相似中间特征。现有缓存通常只利用单一维度冗余,或通过token合并求平均,容易破坏位置顺序和时空结构。
本文贡献:提出免训练多维层级缓存OmniCache,系统利用帧内、帧间、运动和去噪步四类冗余,并设计Token、Frame、Block与Layered四级缓存。方法通过相似度选择可缓存特征、跳过重复计算,再恢复位置一致的激活;空间特征可在时间层复用,时间特征也可在空间层复用。

实验效果:在保持视觉保真与运动连贯的同时,SD3、SVD-XT和Latte推理延迟分别最多降低35%、25%和28%,无需改权重或重新训练。
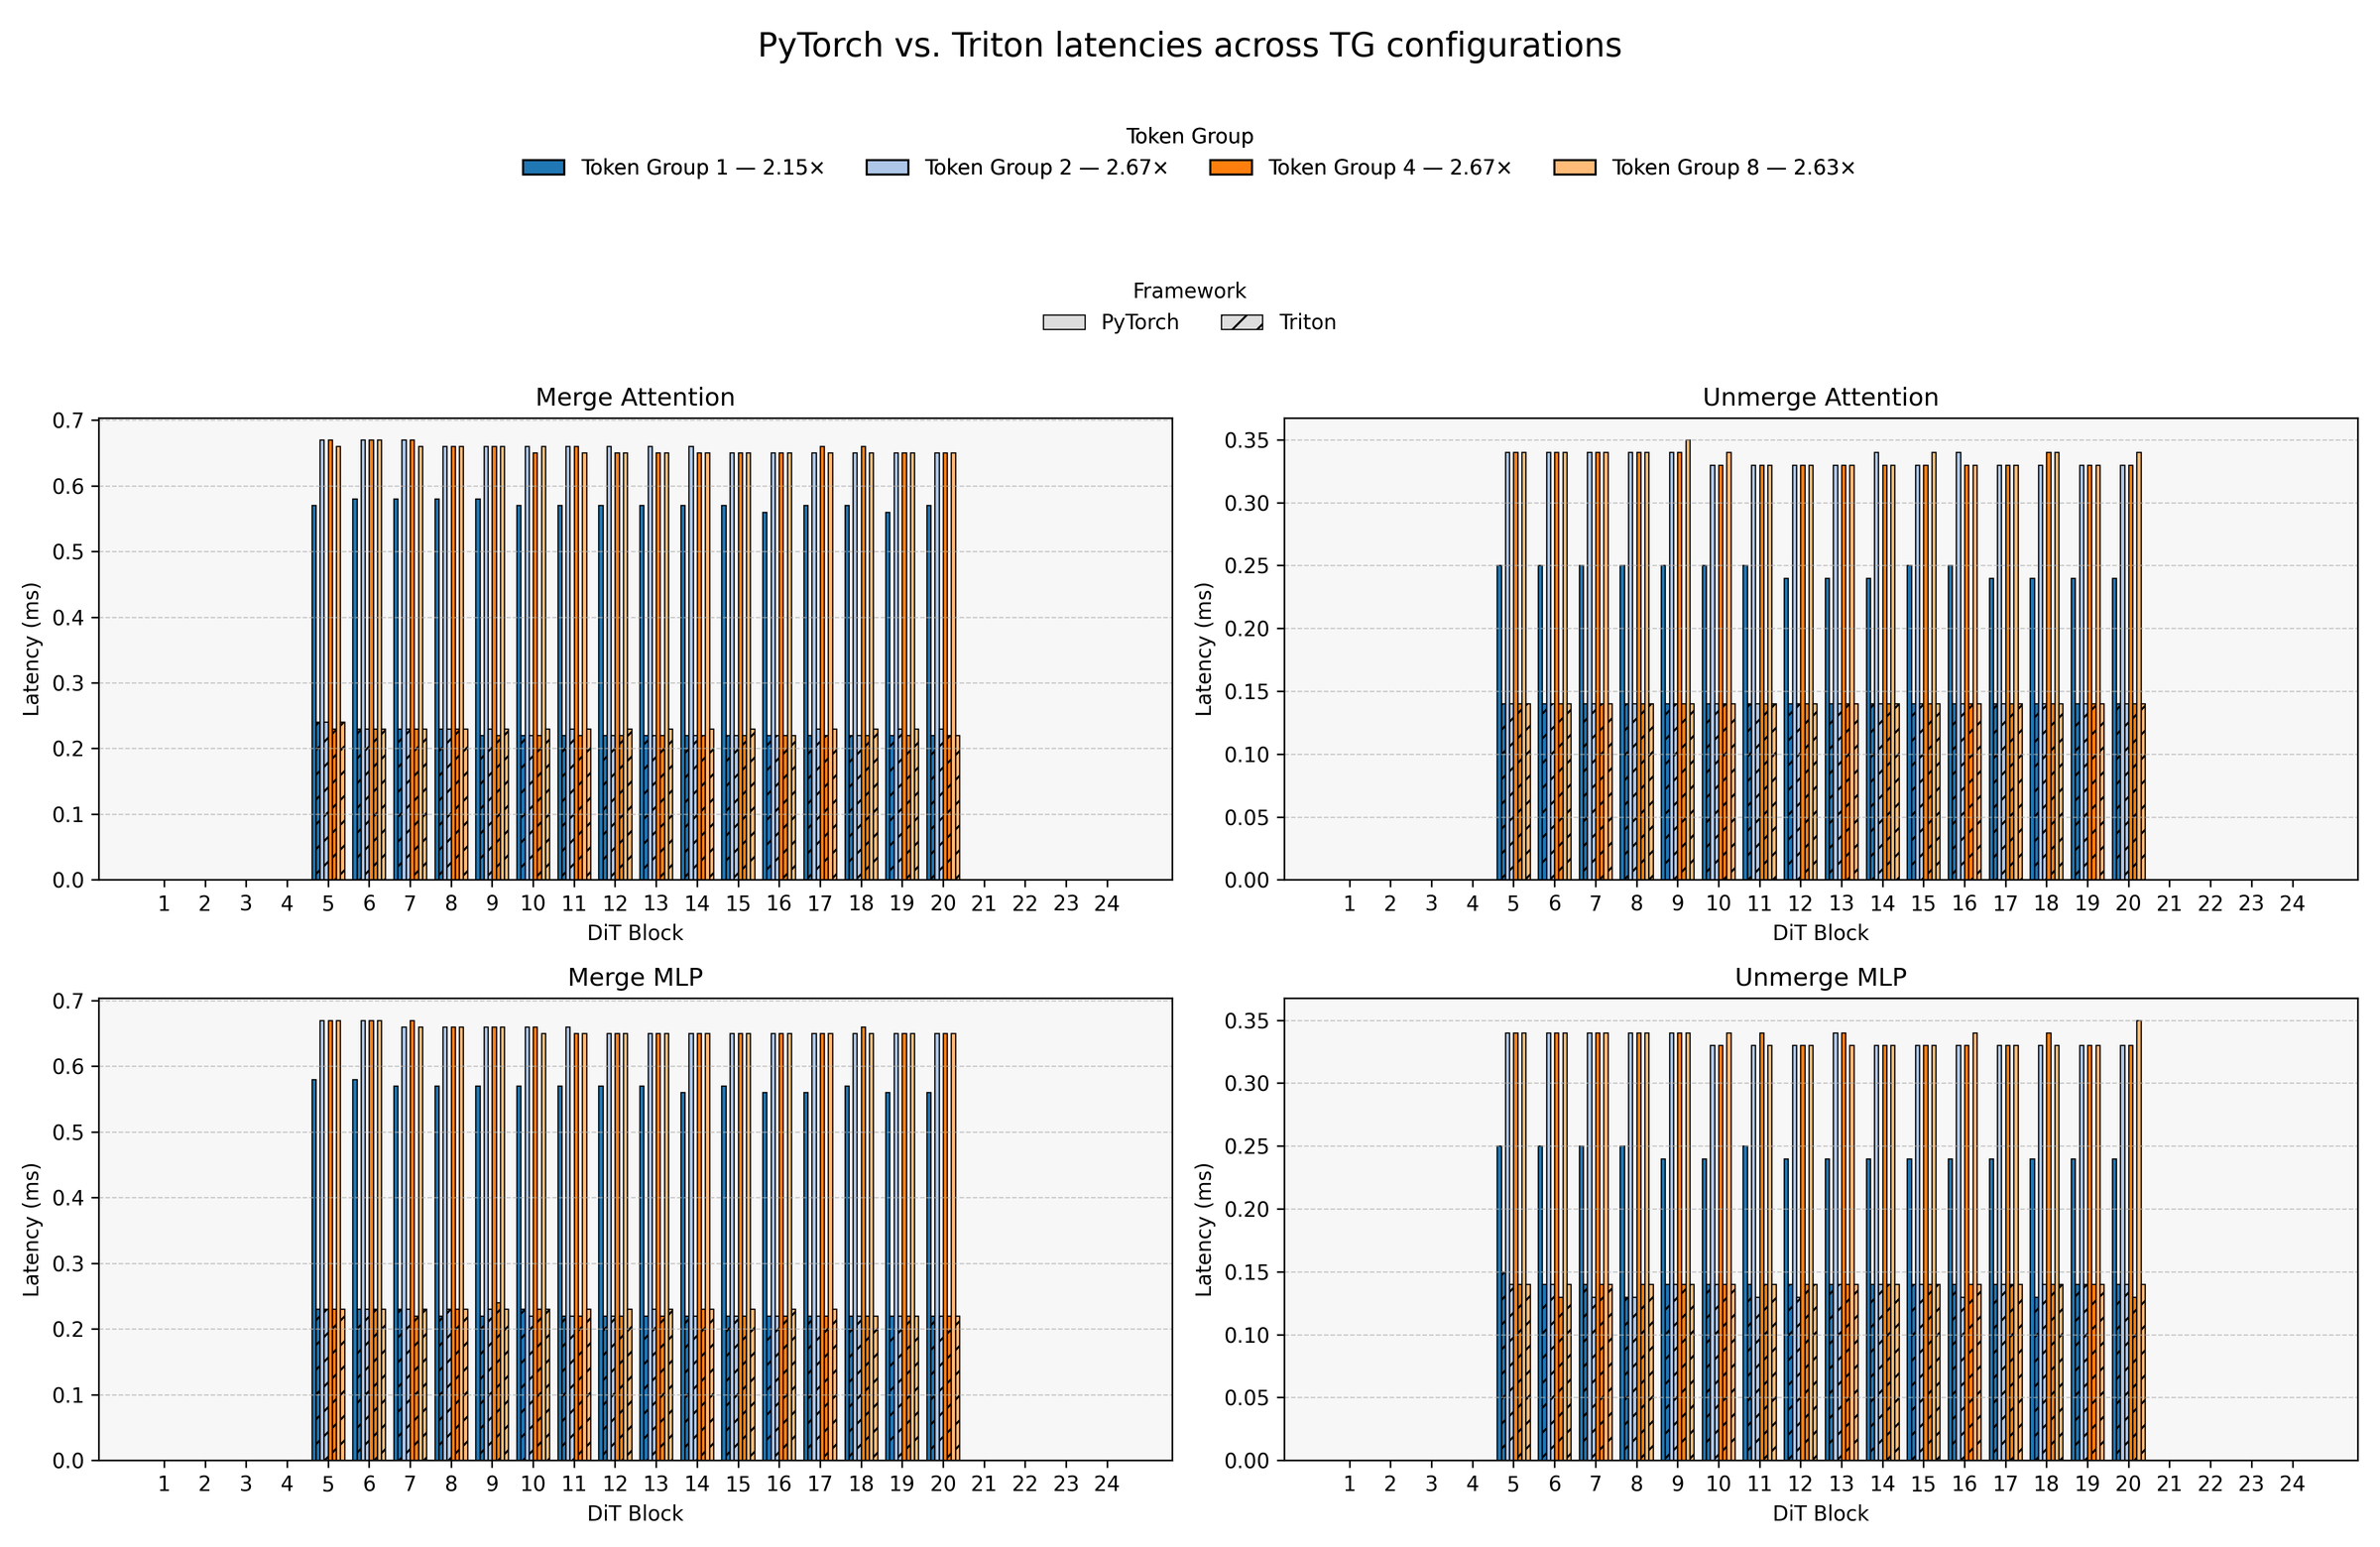
批判点评:OmniCache把缓存从“跨步复用一层”扩成时空、模块与层级协同,覆盖图像和视频骨干。局限是三组模型的最高收益不同,缓存命中率高度依赖内容运动;快速镜头和大形变可能减少复用,四级策略本身也增加调度复杂度。
OmniDelta: Skill-Driven Budget Allocation for Token Compression in OmniLLMs | 阿里Qwen·浙大·CMU·中科院 | arXiv:2607.25669
关键词:全模态LLM,Token压缩,Qwen,预算分配,推理加速
前序问题:全模态LLM的音频和视频token很长,现有压缩多关注“保留哪些token”,却默认模态间和模态内预算固定。查询与音视频的直接相似度难判断该给哪种模态更多预算,均匀切分又会漏掉关键片段。
本文贡献:提出免训练技能驱动框架OmniDelta。音频与视频skill pool先根据查询意图在两种模态间移动固定总预算,再依据局部复杂度和时间冗余,把各模态预算细分到音频片段与视频帧;局部预算可与已有剪枝器组合,总保留率不变,只改变算力花在哪里。

实验效果:在四个音视频基准和两款Qwen2.5-Omni模型上建立新的准确率—效率Pareto前沿。Qwen2.5-Omni-7B仅保留25% token时,GPU内存降低22%,端到端提速1.64倍。

批判点评:OmniDelta抓住了压缩前更上游的问题:先决定预算给谁,再决定删谁。数字实用且无需训练。但skill pool若误判意图,会在剪枝前就饿死关键模态;复杂跨模态推理可能无法被单一预算分配准确刻画。
Let Me Look at You: Advanced Facial Expression Modeling for Conversational Speech Synthesis | 内蒙古大学·港中文深圳 | arXiv:2607.24430
关键词:对话语音,表情建模,DPO,视觉Token,TTS
前序问题:对话语音合成需要生成符合上下文的自然、共情声音,但现有系统常忽略说话人面部表情这一细腻情绪信号;同时缺少大规模自然对话的同步语音—视频数据。
本文贡献:提出基于LLM的表情感知语音系统FacialTalker。AUTokenizer以单码本将逐帧Action Unit组合离散成紧凑视觉token;DualDPO同时对视觉token和语音token施加偏好约束,联合优化表情理解与语音语义。团队还通过自动流水线从真实网络对话构建VSDD-1K。
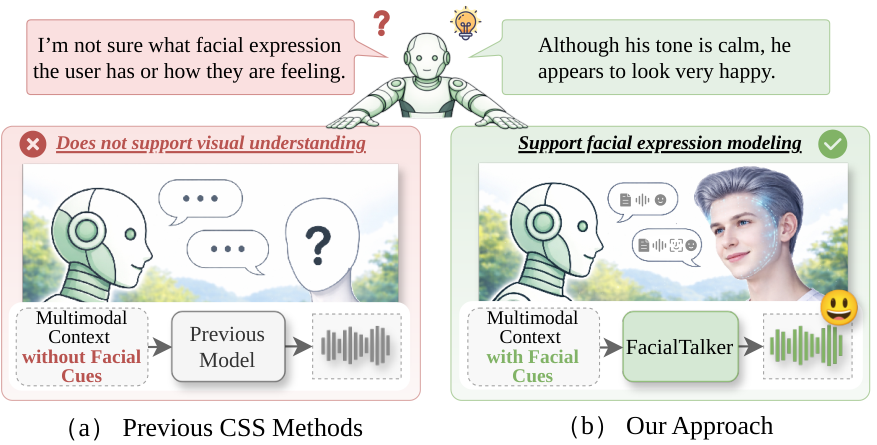
实验效果:VSDD-1K含超过1033小时同步说话人视频与语音,85%以上帧有人脸。客观和主观实验均超过强基线,语音更自然、富表现力且与对话情境更一致。
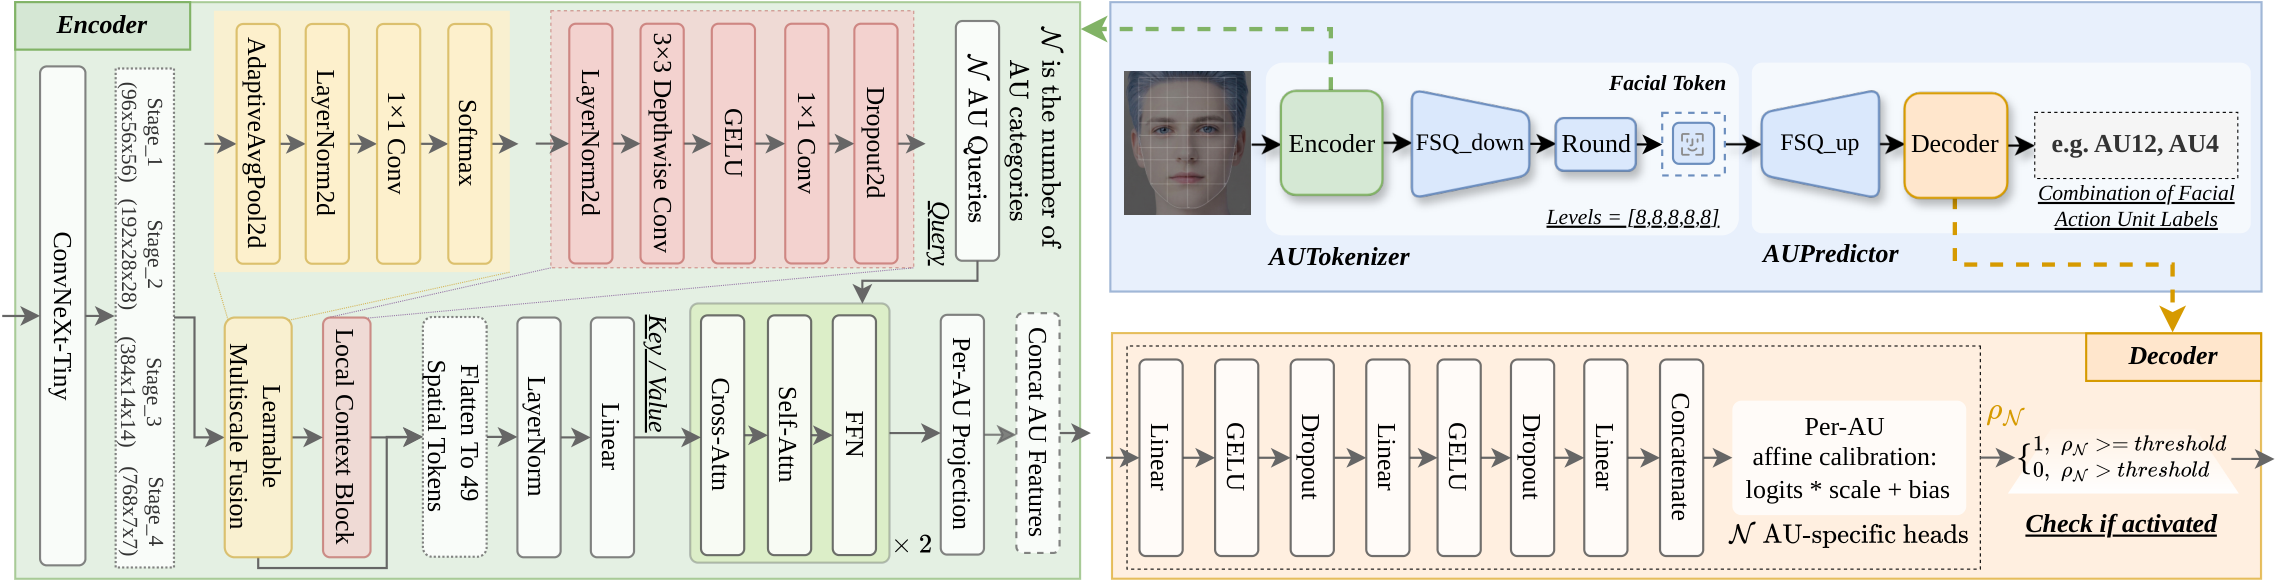
批判点评:从“听上下文”扩展到“看对方表情”,更贴近真实对话Agent;1033小时数据也是重要资产。但网络视频中的表情、声音与身份偏差复杂,自动采集可能带来隐私和标注噪声;Action Unit离散token也未必覆盖微妙文化差异。
TaoMate: Anchor-Guided Memory Bridging Evolving and Reference States for Real-Time Audio-Video Digital Human Generation | 阿里淘天 | arXiv:2607.24359
关键词:数字人,音视频生成,持久记忆,身份锚,阿里
前序问题:长时实时数字人的有界缓存只能保留近期动作和语音,旧身份信息会被遗忘;看完整历史又昂贵且会传播累积错误,导致跨分段外观漂移和音画失步。
本文贡献:提出锚点引导持久记忆TaoMate:保留不可变视觉身份锚,将完成的音视频块压缩成定容动态状态,并用模态专用残差注意力检索,不扩展活动缓存。参考感知调制联合动态与锚点外观统计;保持锚点的因果上下文蒸馏覆盖不同rollout长度、前缀来源和历史可靠性,且支持跨块阶段并行。

实验效果:在自回归长视频延续中保持跨提示分段的稳定外观和强音画同步,并通过阶段并行加速少步联合音视频生成,无需为特定流水线重新训练。

批判点评:AptAvatar解决两步速度,TaoMate则补长期记忆,两者显示淘天正搭建数字人完整栈。不可变锚可稳身份,却可能压制随时间合理变化的发型、光照或服饰;摘要没有绝对FPS和长视频时长,实时结论还需硬件指标。
PRISM: Prompt Refinement via Image-grounded Self-rewarding Mechanism for Text-to-Image Generation | 哈工深·中大·华南理工·广工 | arXiv:2607.24353
关键词:提示优化,文生图,自奖励,VLM,图像诊断
前序问题:文生图对提示词写法高度敏感,现有优化多在文本侧改写、扩写,或依赖外部奖励,缺少对实际生成图的结构化诊断,也难学到可复用的提示优化策略。
本文贡献:提出图像接地自奖励提示优化PRISM,闭合“提示—生成图—视觉诊断—再改提示”反馈环。统一VLM先经多任务监督微调,识别语义一致、审美质量和人类偏好问题;再以理想点与Chebyshev混合奖励进行自奖励优化,学习针对具体视觉缺陷的提示策略。
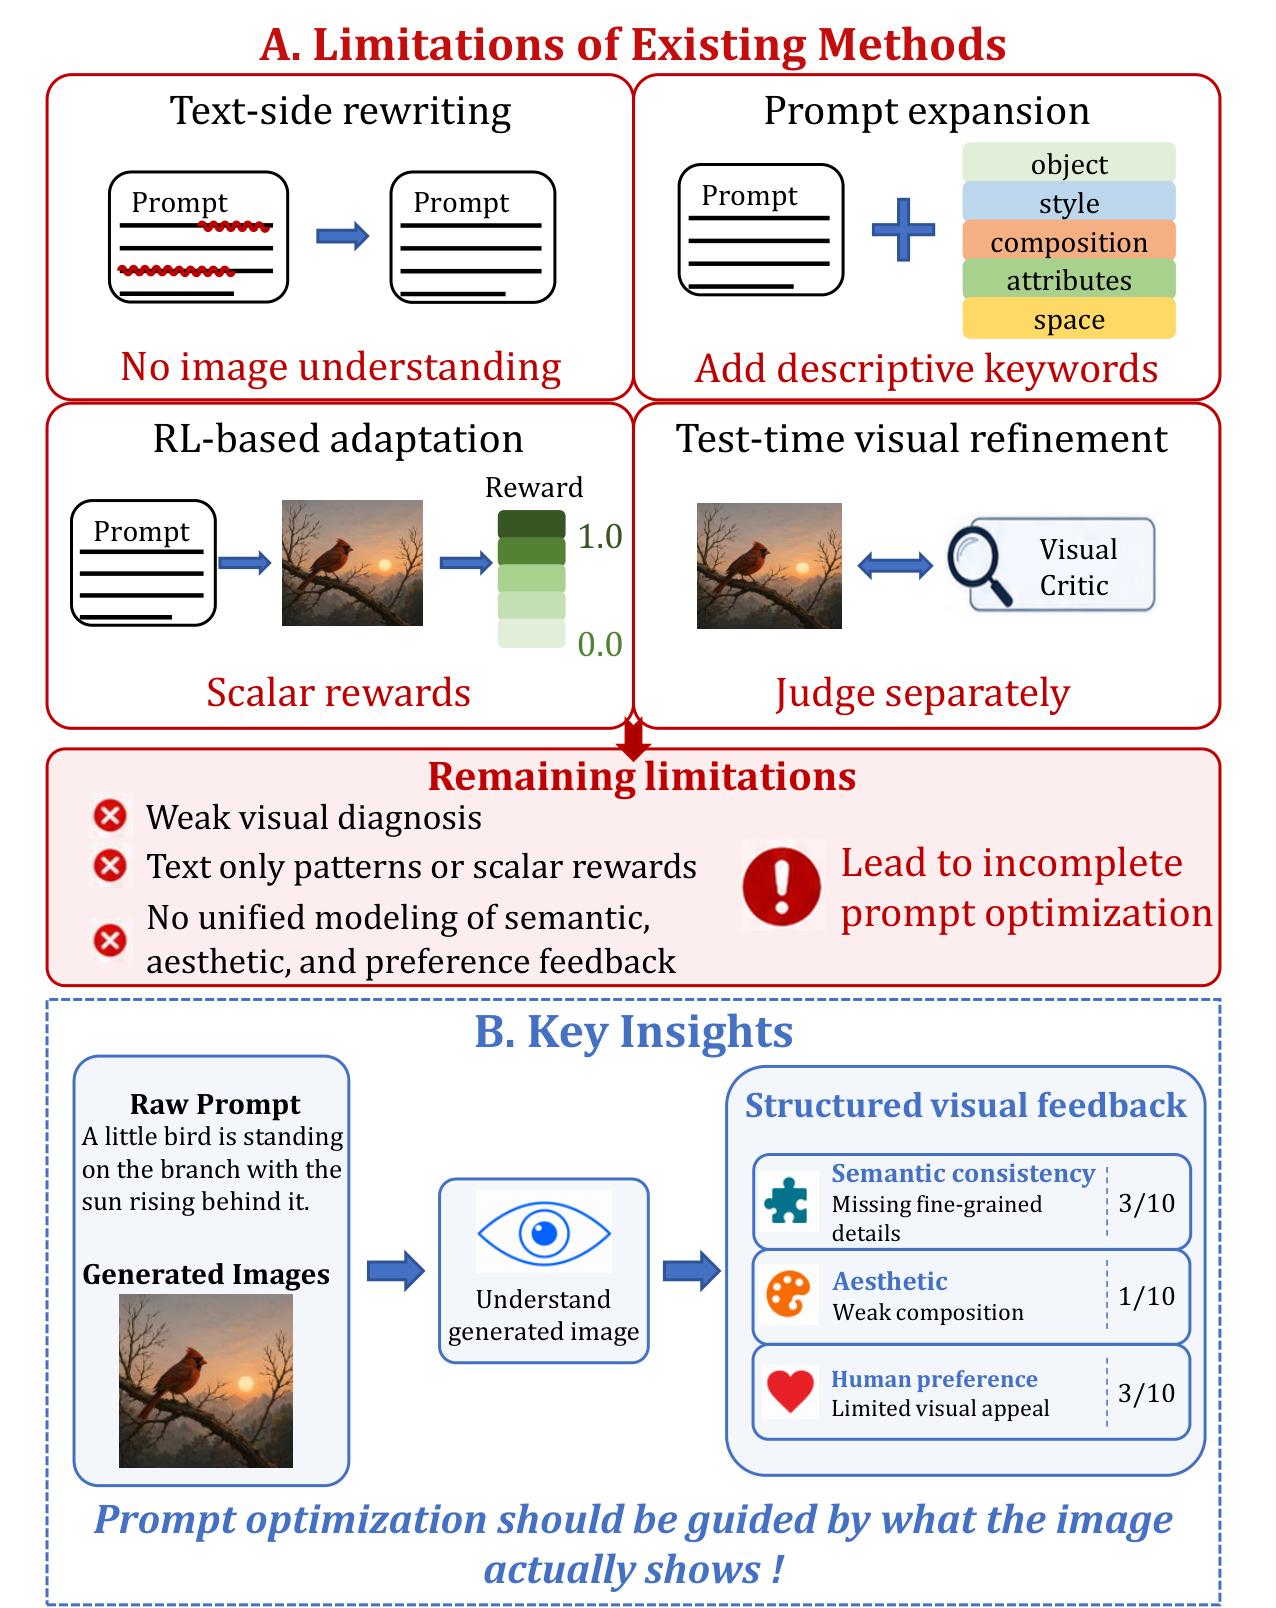
实验效果:实验显示PRISM同时提升整体图像质量与细粒度语义对齐,并能输出可解释的视觉反馈,支持有针对性的提示修正;代码已开放。

批判点评:让模型先看成片再改提示,比盲目扩写更接近人类创作迭代。风险在于VLM既当诊断器又参与自奖励,可能强化自身偏好与评分漏洞;提示变好也可能只是对特定生成器过拟合。
I2VShield: An Efficient Proactive Defense Framework against DiT-based Image-to-Video Models | 中山大学 | arXiv:2607.25522
关键词:图生视频,隐私保护,对抗扰动,DiT,主动防御
前序问题:图生视频被用于未经授权地驱动个人照片。现有主动保护主要针对模型做梯度对抗攻击,防御者自己就需要大显存GPU,普通用户难以使用。
本文贡献:提出面向DiT图生视频的生成式对抗防御I2VShield。文本自适应扰动生成器结合对抗学习,以较低计算产生视觉不可察觉扰动;无目标多模态注意力破坏(MAD)直接放大DiT内部注意力特征与干净输入的偏差,破坏后续时空一致生成。

实验效果:在多个数据集和主流DiT图生视频模型上获得有竞争力的保护效果,尤其能破坏时空连贯,同时显著降低防御扰动生成的计算成本。

批判点评:它把隐私保护从事后检测前移到上传前防御,且试图摆脱大GPU门槛,现实意义强。但扰动可能被平台压缩、裁剪或重编码削弱,跨黑盒模型转移性与对抗升级仍是关键;主动破坏也可能影响合法编辑。
Noise-Free One-Step LoRA for Task-Driven Image Restoration with Diffusion Priors | 首尔大学 | arXiv:2607.25390
关键词:图像修复,一步扩散,LoRA,无噪声,任务驱动
前序问题:任务驱动图像修复既要画面好看,又要提升分类、分割、检测和OCR。扩散先验有帮助,但随机噪声让同一输入输出不稳定,可能破坏下游任务一致性。
本文贡献:论文发现预训练扩散先验可以直接做确定性、无噪声的一步前向,关键在适配器选择:LoRA能稳定提升,而ControlNet式条件并不奏效。在此基础上加入任务保持GAN训练,用感知质量约束与任务目标共同优化,避免修得好看却损伤识别。
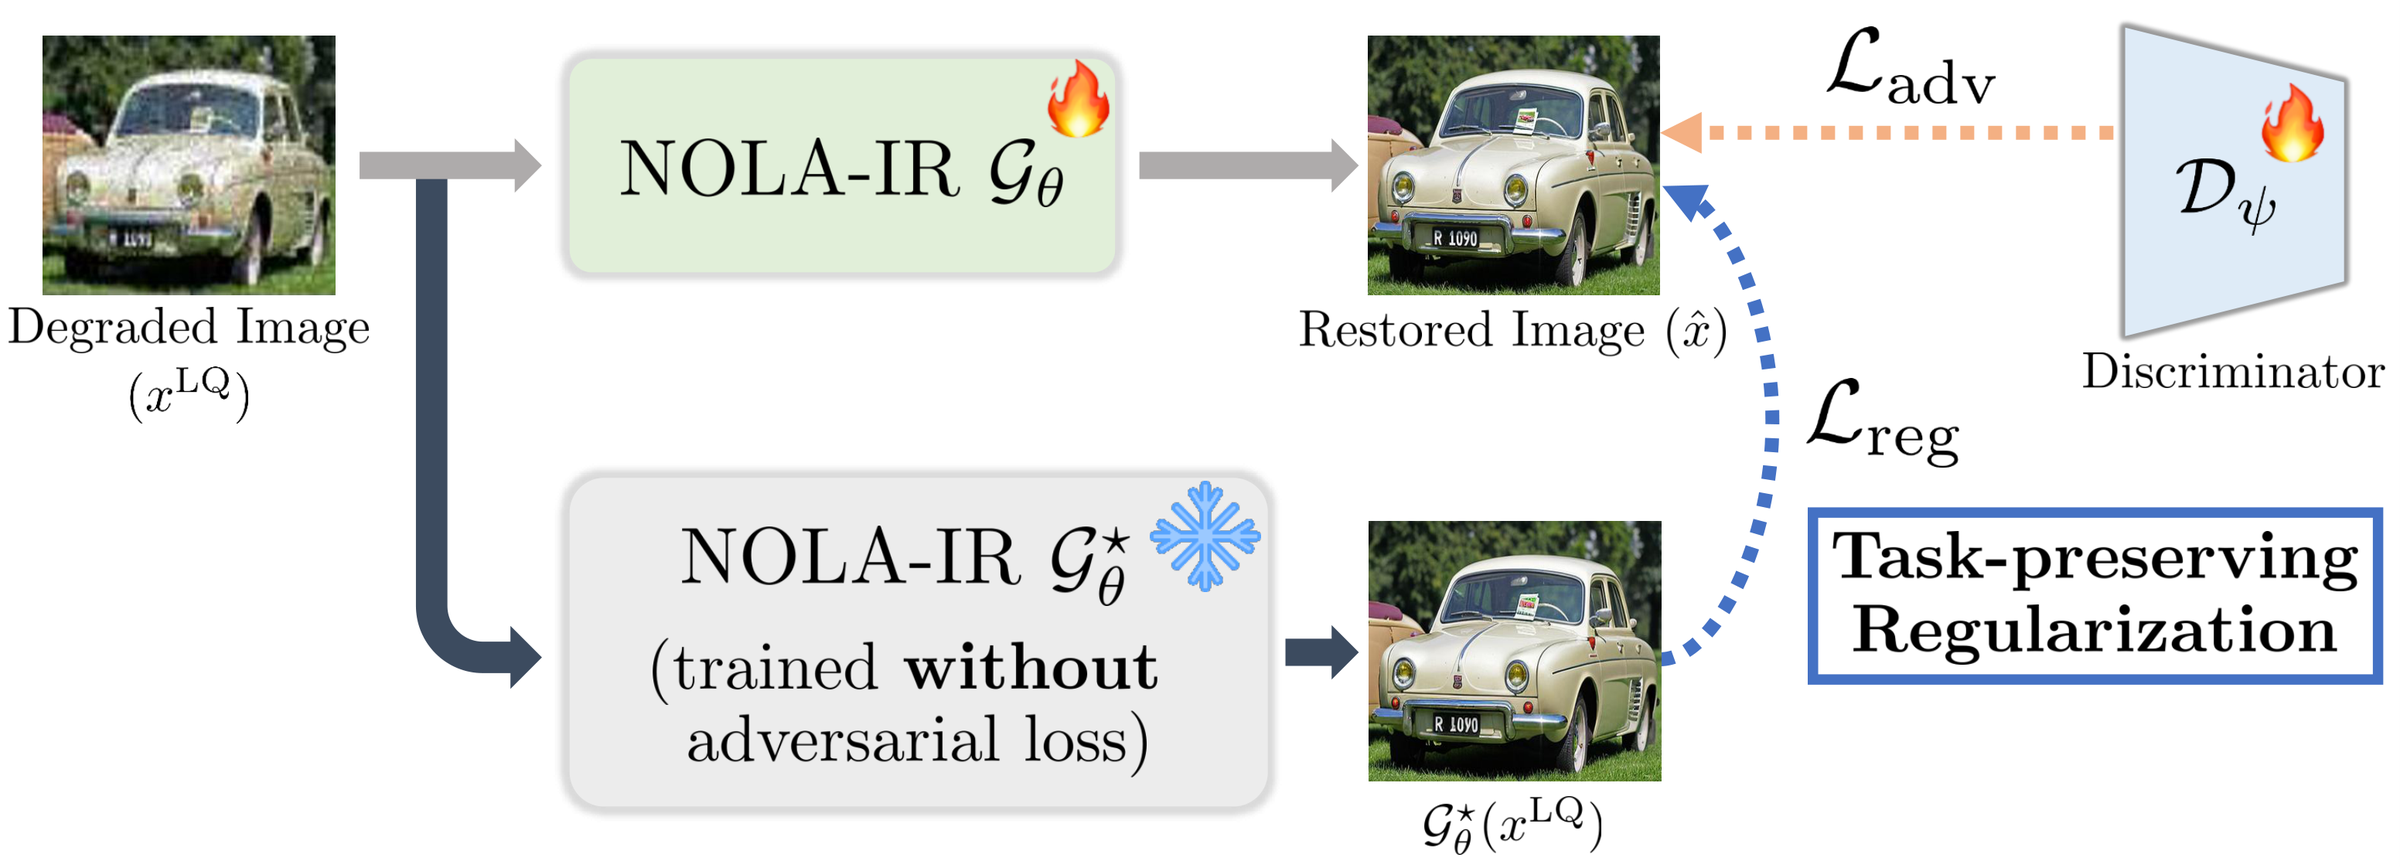
实验效果:无噪声一步LoRA超过传统多步扩散TDIR基线,在分类、分割、检测上持续提升,并在真实退化图像与OCR中验证泛化;GAN阶段进一步改善观感而不牺牲任务表现。
批判点评:“去掉噪声、只跑一步”反而更适合任务修复,说明生成多样性在恢复场景可能是负资产。结论对端侧预处理很有价值,但优势依赖预训练扩散先验与LoRA任务适配;不同退化混合下的确定性输出也可能固化错误细节。
人工智能炼丹君 整理 | 2026-07-30
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)