


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 端侧音频与数字人生成 2 篇 · 视觉生成推理加速 2 篇 · 可控视频编辑与专业评测 3 篇 · 全模态表示与扩散蒸馏 2 篇 · 视频模型视觉推理 1 篇
Memory Efficient Audio Synthesis with Decoupled Temporal Depth Diffusion Transformers | Apple | arXiv:2607.23811
关键词:端侧TTS,Siri,音频DiT,RVQ,Apple
前序问题:Siri Expressive Voices要在设备上实时生成可配置、富表现力的语音,但语义音频token转高保真波形的detokenizer受AMX算力和内存严格限制。传统Transformer或GAN随序列长度线性甚至平方增长,难以持续合成长音频。
本文贡献:Apple提出解耦时间与RVQ深度的三组件架构:流式编码器、时间解码器和深度解码器。单个可复用的DiT式深度解码器通过stage conditioning自回归生成全部RVQ层,取代每层一个解码器;因果滑窗注意力配合固定窗口KV缓存,使运行内存不随语音长度增长。
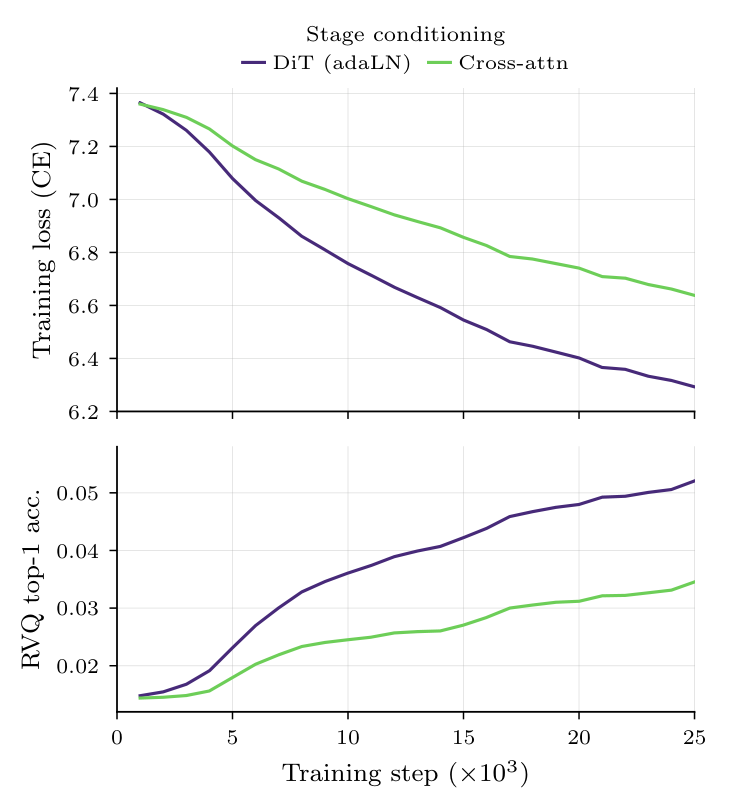
实验效果:部署在Apple Matrix Coprocessor上,每步约10ms、约16倍实时,峰值运行内存仅21MB,端侧资产329MB,可连续合成20到320秒音频。AFM 3 Core Advanced中以10亿参数激活规模运行,相比上一代端侧TTS,整体MOS从3.87升至4.15,对话语音从3.82升至4.24。
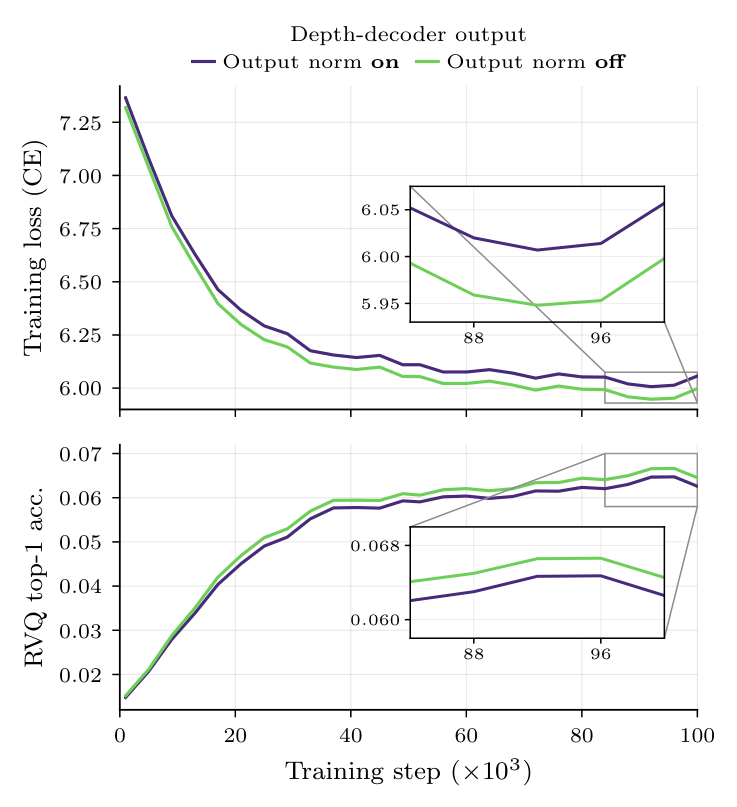
批判点评:这是今日最强工业落地:Apple不仅给结构,还给AMX上的时延、内存、资产和MOS,证明十亿级音频生成可真正驻留端侧。代价是方案深度绑定Apple硬件与AFM token体系,16倍实时不能直接外推到通用CPU/GPU;320秒以上稳定性和多语言覆盖也未披露。
Sol-Attn: Accelerating Video Generation Inference via On-the-Fly Attention Sparsification | NVIDIA | arXiv:2607.24027
关键词:稀疏注意力,视频生成,NVIDIA,免训练,推理加速
前序问题:视频DiT的长token序列让注意力成为推理瓶颈。现有免训练动态稀疏要么固定保留比例、要么按累计概率动态分配,路由预算僵硬或失衡,还要显式生成代理分数图;直接丢掉未选块则在高稀疏率下明显伤质量。
本文贡献:提出免训练Sol-Attn,将动态路由、稀疏计算与近似修正合进同一次online softmax。在线块阈值直接比较代理分数选关键KV块,不物化完整代理图,预算动态且可控;未选块的代理分数被复用来近似其贡献,避免keep-or-drop造成的信息断崖。
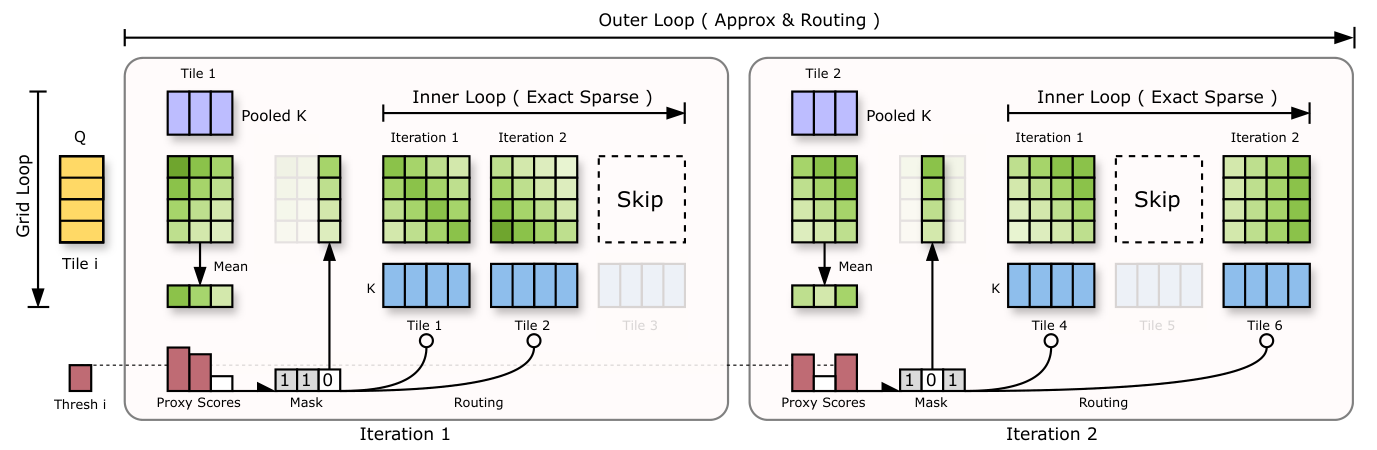
实验效果:在保持视觉质量的同时,视频生成端到端提速2.1倍、视频编辑提速2.3倍,并在图像与视频任务上推进免训练稀疏注意力的质量—效率前沿。
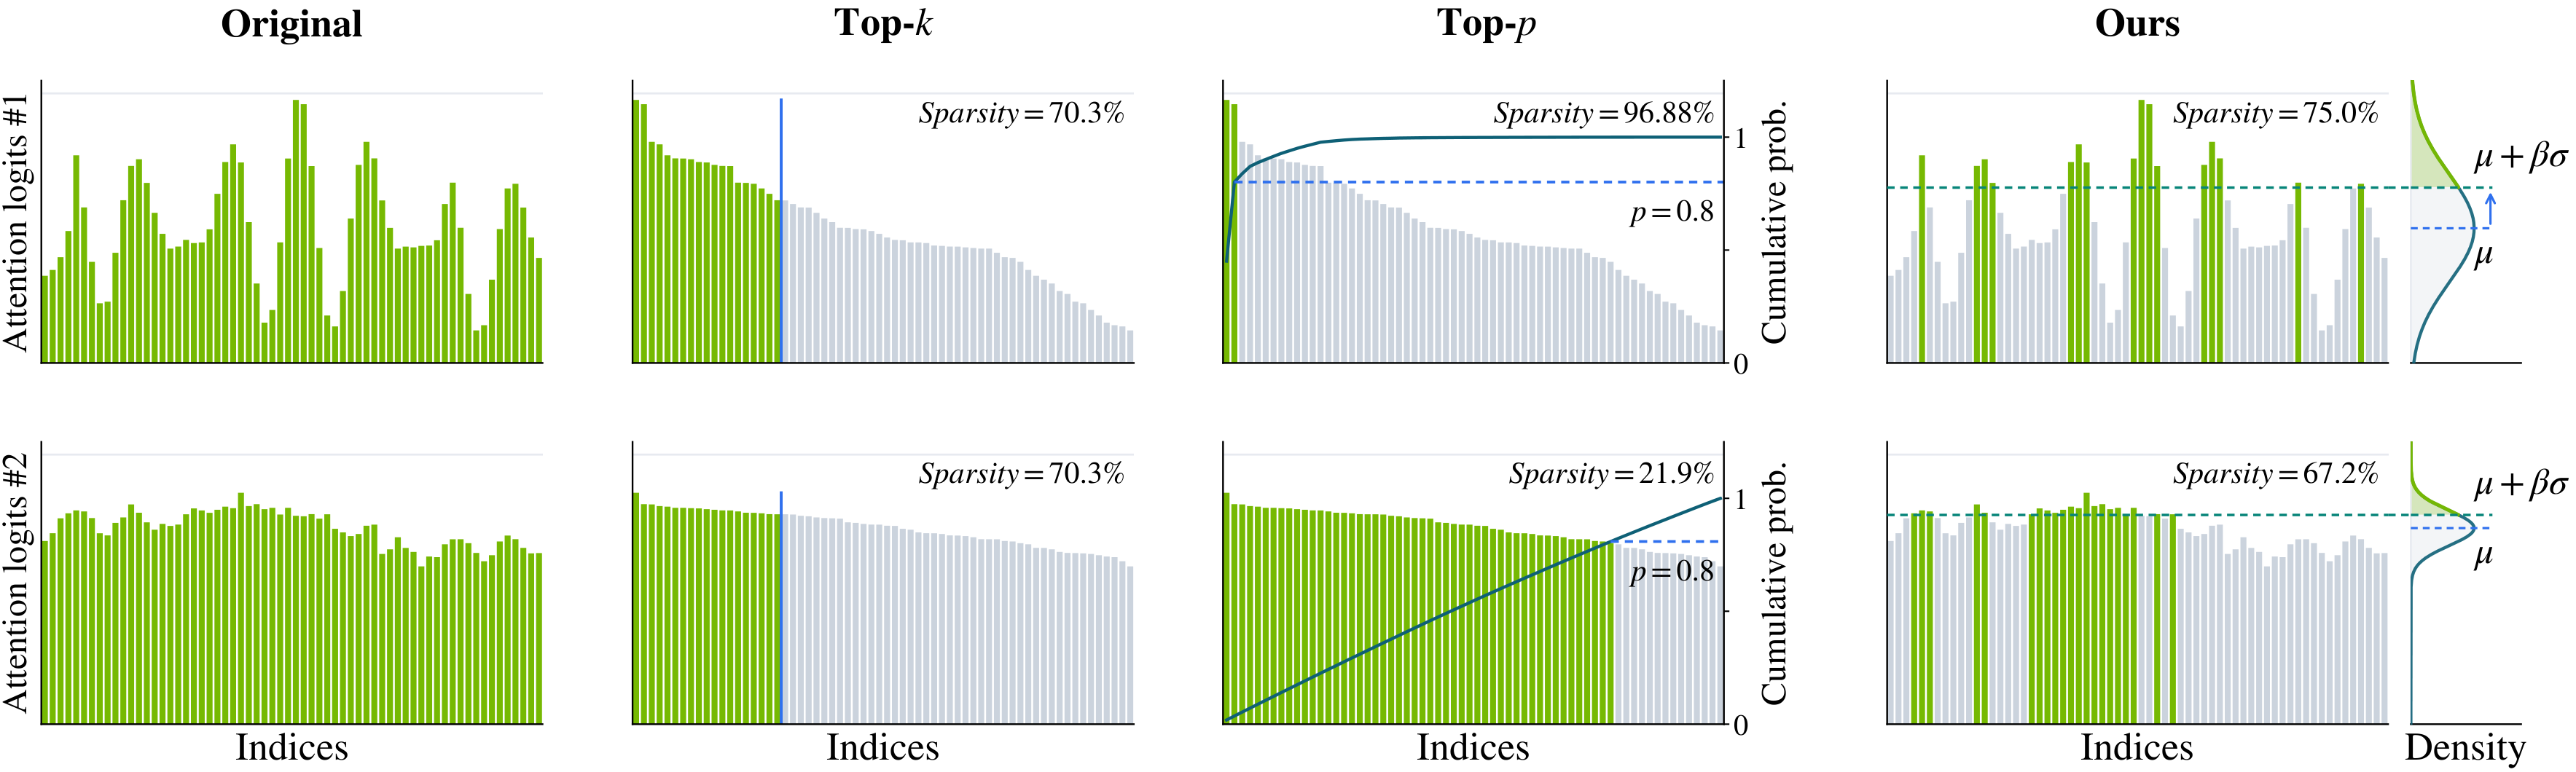
批判点评:Sol-Attn的价值不只是稀疏,而是把路由开销和遗漏补偿塞进online softmax一遍完成,NVIDIA背景也意味着内核可落地。但提速依赖模型、序列长度和阈值;代理分数对被丢块的近似在快速运动、小目标或精细文字场景中仍可能失真。
UniGen-AR: Unifying Visual Generation with Auto-Regressive Modeling | CMU·UIUC·Toyota Research | arXiv:2607.24157
关键词:统一视觉生成,自回归,VAR,MLLM,VQ-VAE
前序问题:文生图、编辑、修复和传统感知仍由不同模型负责;扩散虽能统一多种图像输出,但迭代采样延迟高,限制统一视觉生成在交互场景落地。
本文贡献:提出UniGen-AR,将通用MLLM与next-scale视觉自回归(VAR)解码器结合。MLLM把自由文本指令和控制信号编码为统一序列,VAR用一套权重和统一提示接口生成图像输出,覆盖四大家族15项以上任务且无需任务专用头。消融指出VQ-VAE码本大小和层级是VAR扩展的关键。
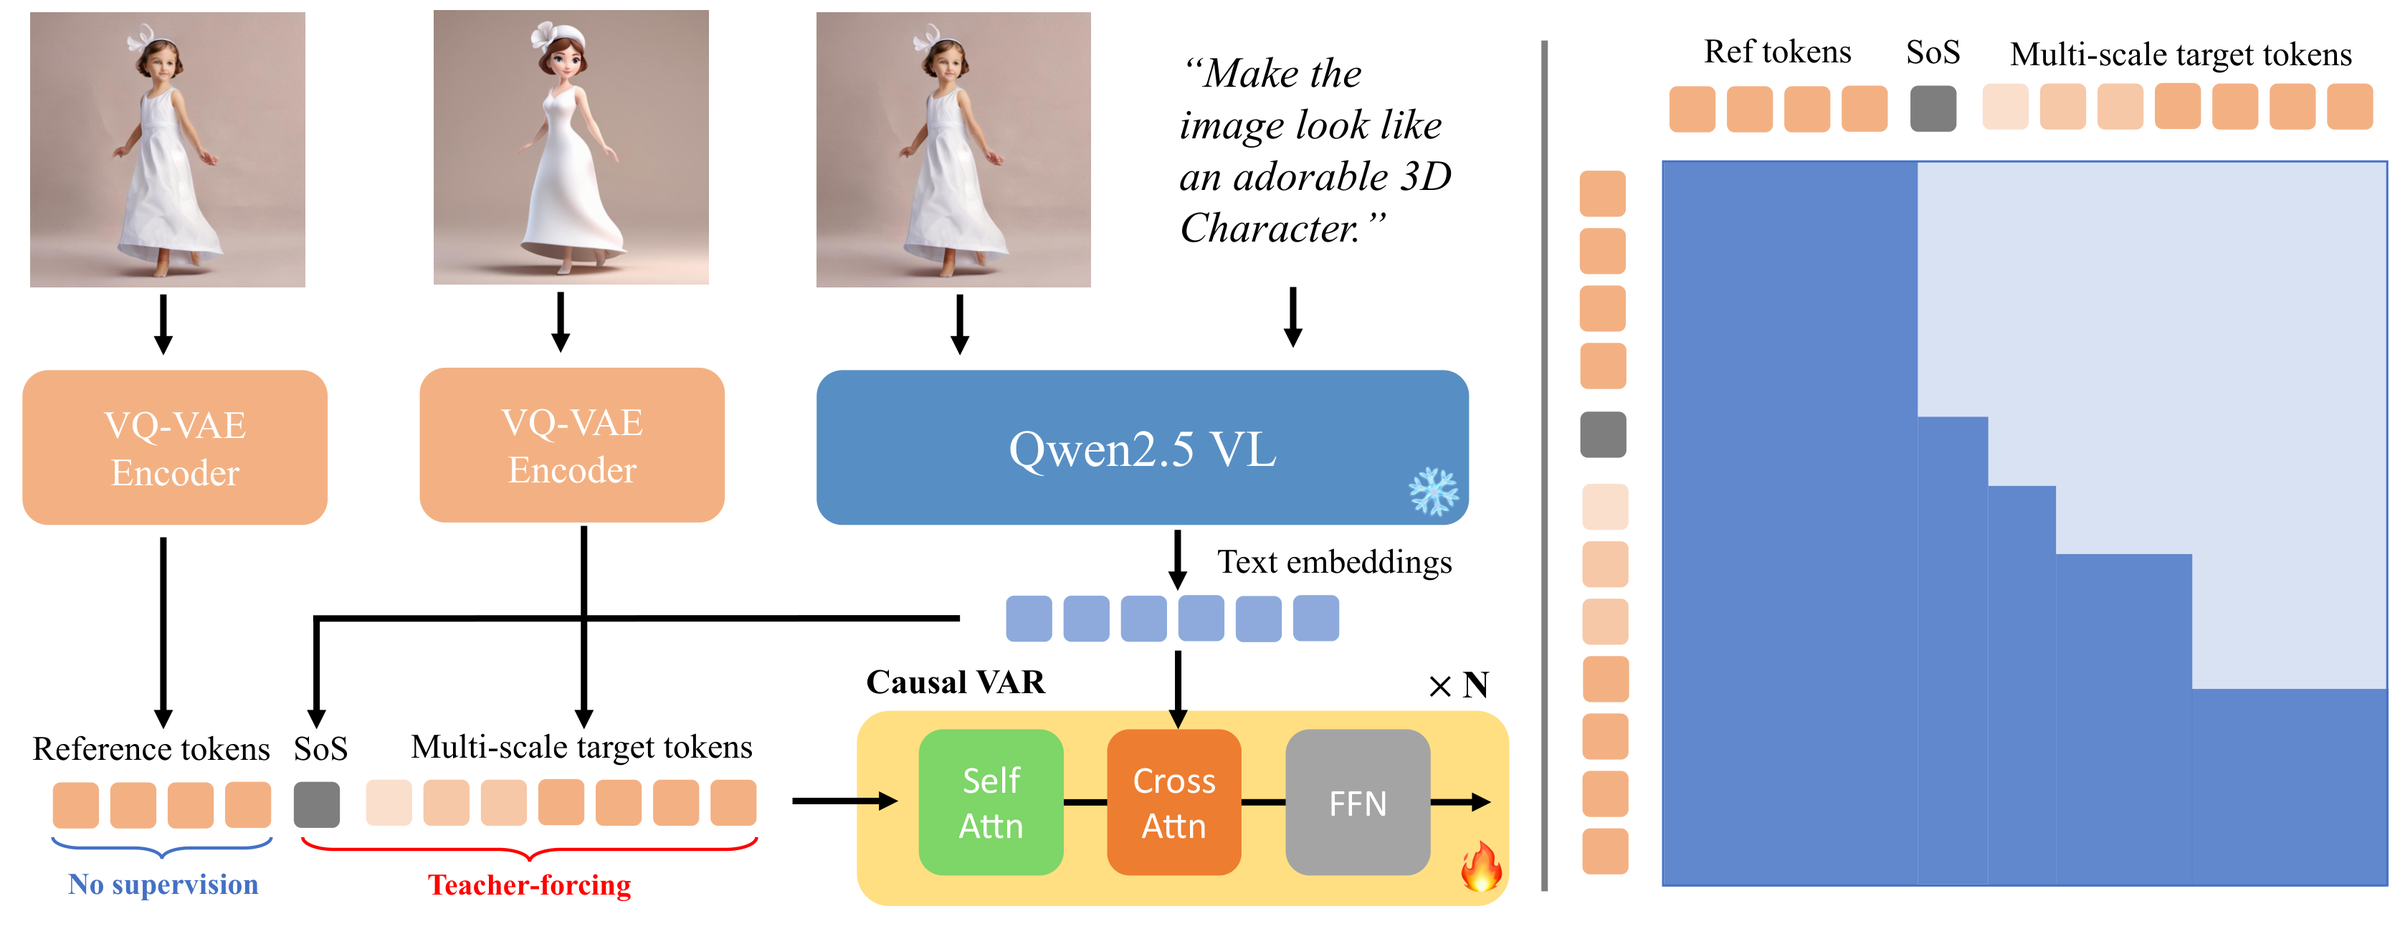
实验效果:相对扩散基线推理延迟最多降低19倍,同时保持或提升输出质量;单模型覆盖文生图、图像编辑、修复、感知等15项以上任务。
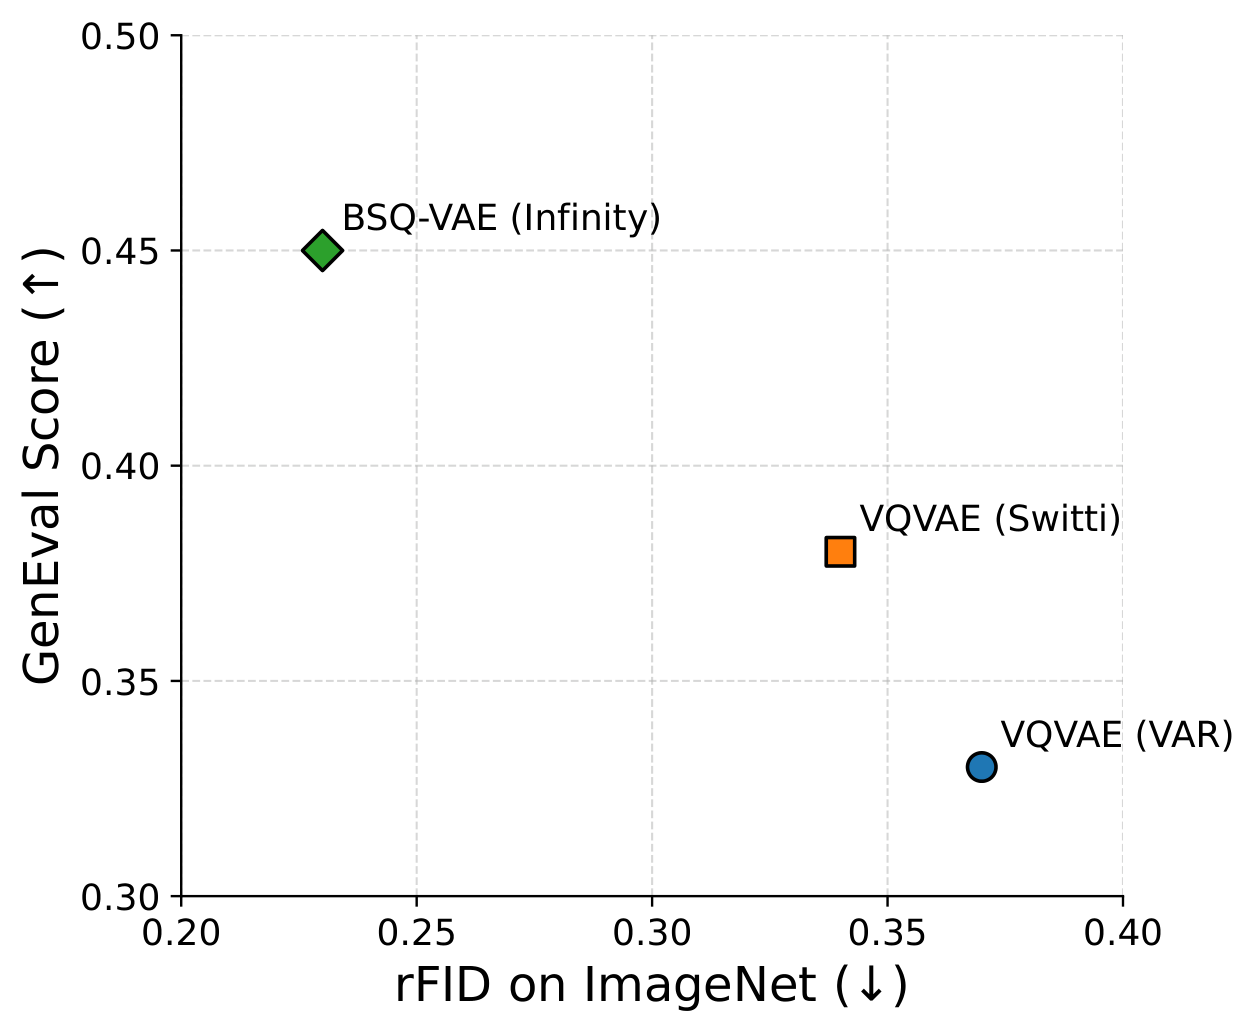
批判点评:用VAR替代扩散解码器,把统一视觉生成的效率问题正面解决,19倍延迟优势非常醒目。但自回归速度会受视觉token数量影响,VQ-VAE码本带来的量化误差仍在;15任务统一不等于每项都超过专用SOTA。
AptAvatar: Fast and Vivid Long-Form Audio-Driven Video Generation for Production-Ready Avatars | 阿里淘天 | arXiv:2607.24013
关键词:数字人,音频驱动,两步生成,分布蒸馏,阿里
前序问题:生产级音频驱动数字人既要快,又要保持身份、动作表现力和长视频稳定。现有加速常靠因果注意力、短时间窗、缩小模型或分辨率换速度,在极端两步生成时质量尤其容易塌。
本文贡献:提出14B长视频数字人AptAvatar。端点锚定分布蒸馏在普通DMD外加入Anchor Score Estimator,用冻结四步桥接生成器定义可达到的轨迹端点,指导两步学生;Self-Generated History Replay复用早期checkpoint输出作为分块训练历史,近似推理时自生成上下文而无需昂贵在线rollout。

实验效果:仅2次函数评估即可生成720P长视频数字人,推理提速60倍,同时保持视觉保真、鲜活动作、长时身份一致和文本动作控制。
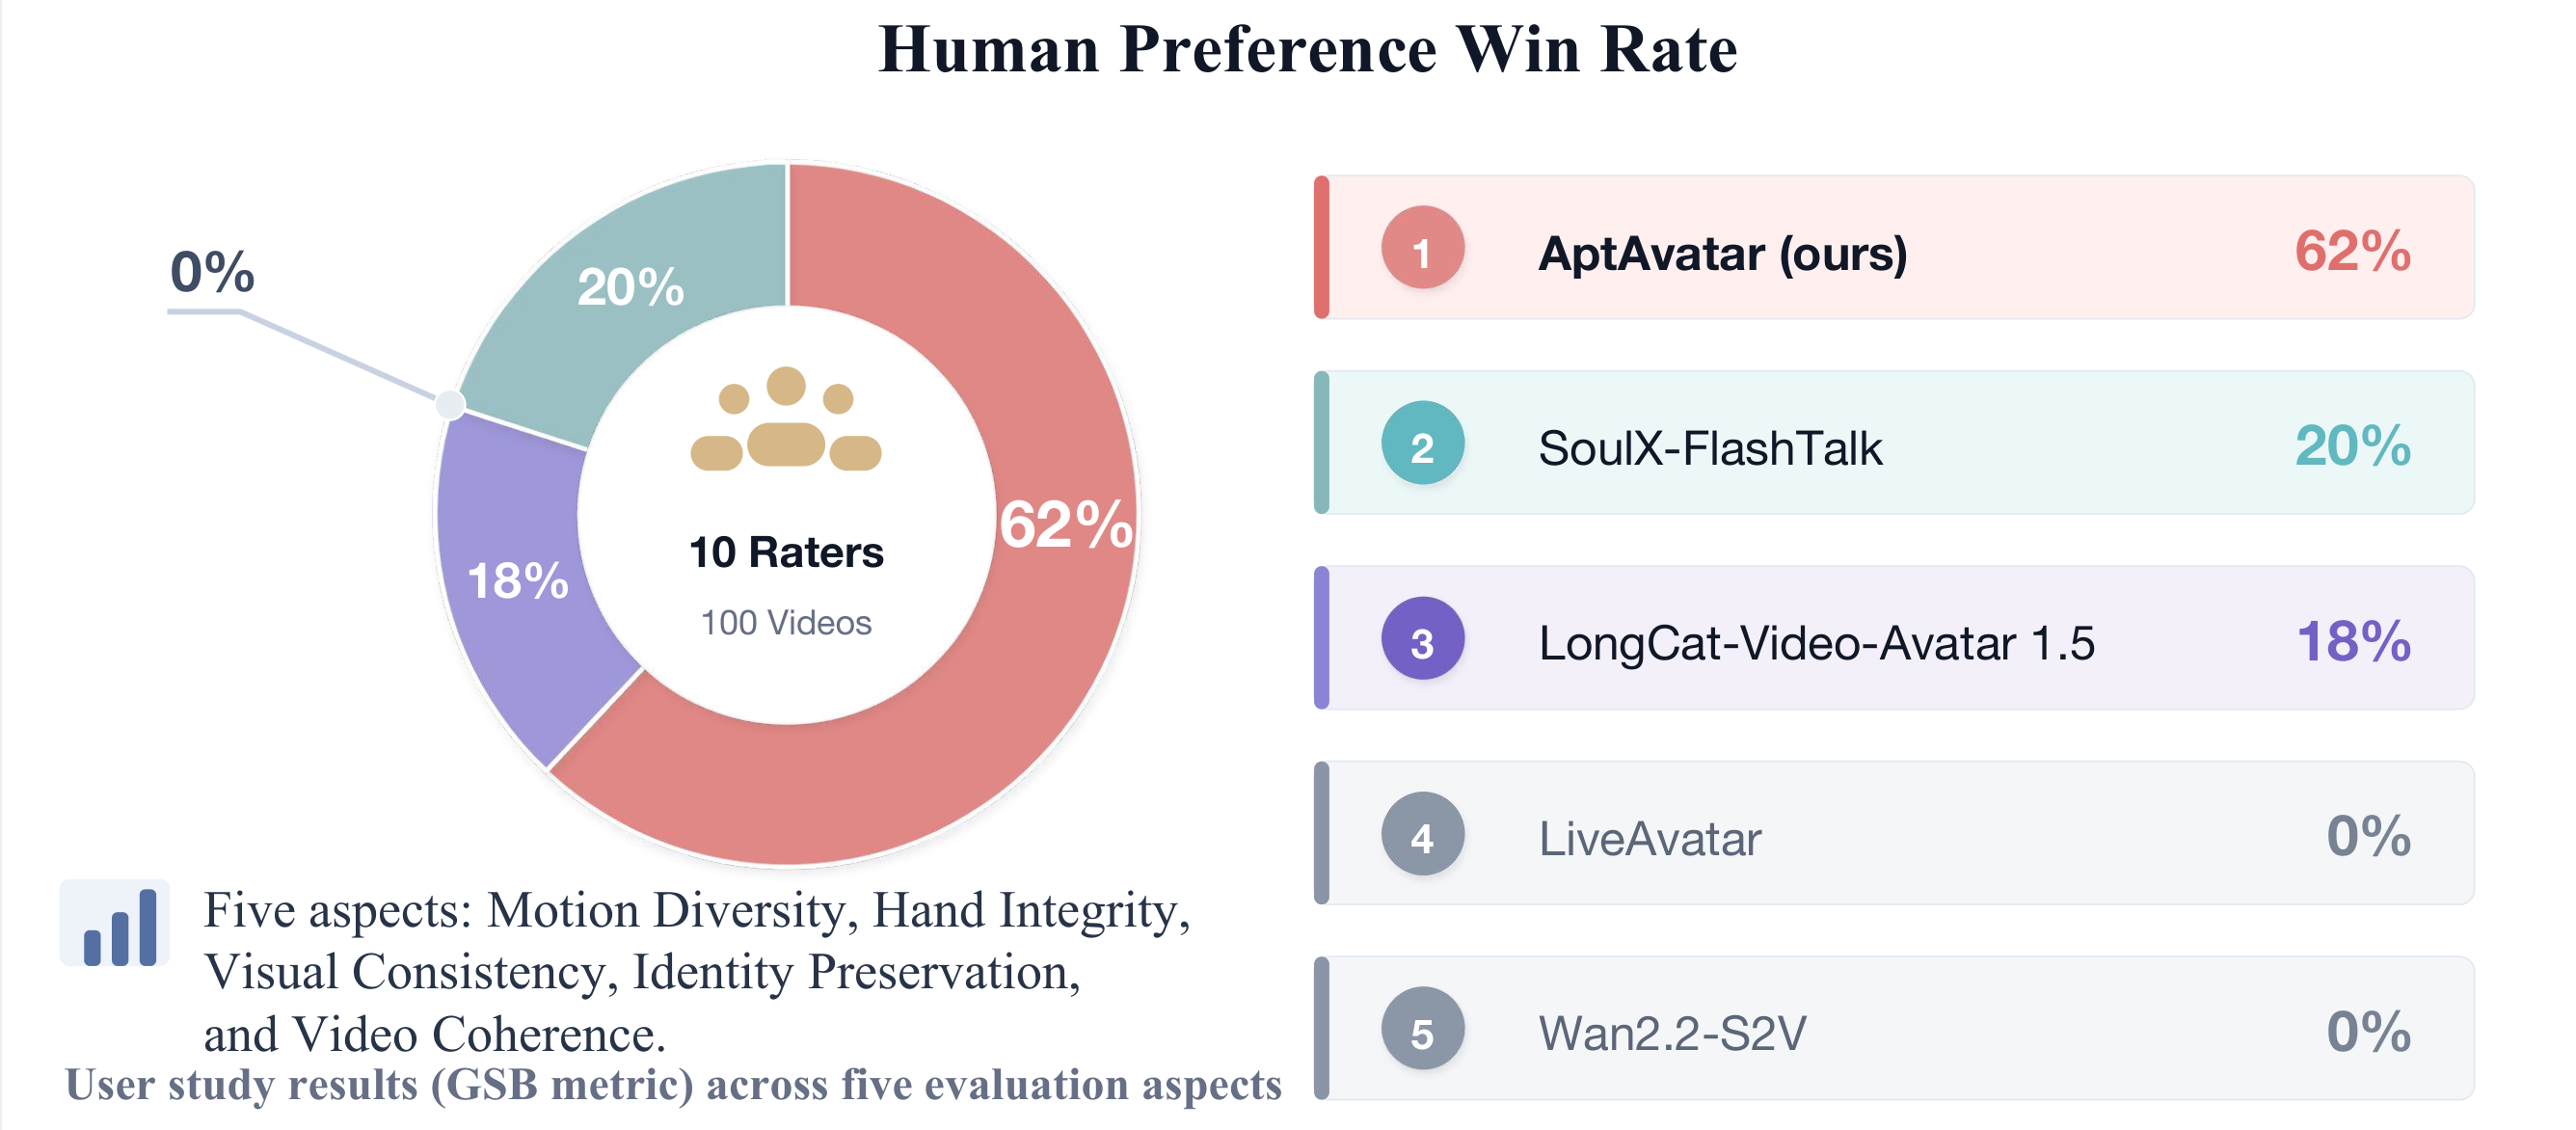
批判点评:14B、720P、两步和60倍同时成立,说明淘天已瞄准直播与营销生产链。端点锚降低了两步蒸馏难度,但训练依赖四步桥接器和历史checkpoint缓存,流水线并不轻;摘要也未给绝对FPS,生产“实时”仍需硬件数据。
EgoPlay: Event-Triggered Video Editing for Egocentric Streams | Snap·KAUST | arXiv:2607.24560
关键词:视频编辑,事件触发,第一视角,Snap,流式生成
前序问题:第一视角连续视频需要“当X发生时再做Y”,模型既要识别事件发生与否和时刻,又必须完整保留事件前画面、只改后续。检测器串联编辑器容易误触发并产生误差传递。
本文贡献:提出端到端事件触发V2V编辑器EgoPlay,在一个视频扩散模型中联合学习事件识别、时间克制和像素编辑,支持未发生事件与多事件提示。团队构建10.6万组事件触发片段—提示数据,训练双向编辑器并导出可逐块流式推理的因果版本;评测拆分触发后质量、触发前保持和假触发鲁棒性。
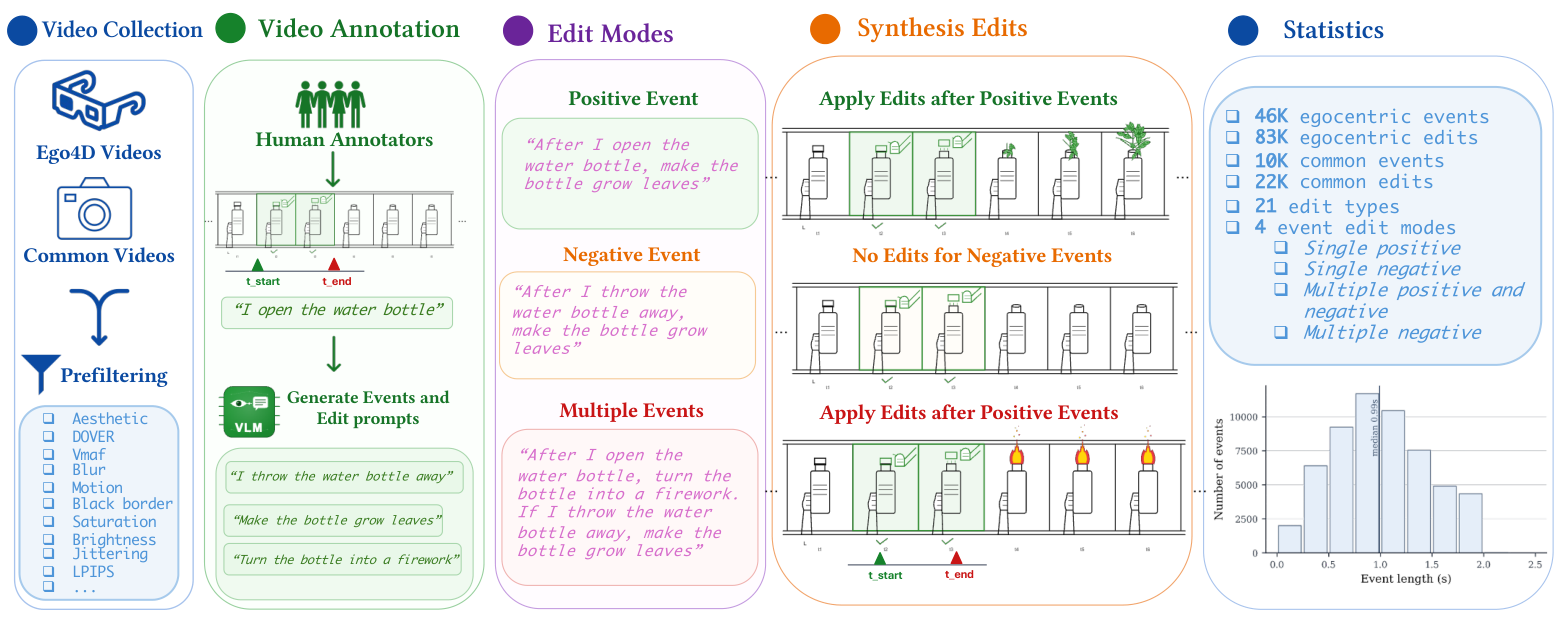
实验效果:相对EgoEdit,编辑质量、视觉质量和背景一致性分别提升17.7%、16.9%、16.4%;相对VLM检测器+编辑器串联基线分别提升15.7%、14.5%、13.5%,GPU内存还不到其一半。

批判点评:EgoPlay把视频编辑从“全片执行指令”升级为事件驱动程序,对AR眼镜和第一视角Agent很关键。风险是模型同时承担检测与生成,触发判断难单独校准;Ego4D里的事件覆盖有限,安全敏感场景不能只依赖生成模型自判。
FilmBench: A Film-Grade Benchmark for Cinematic Video Generation | 阿里·北京电影学院·虎鲸文娱 | arXiv:2607.24241
关键词:视频评测,电影语言,多镜头,阿里,FilmOps
前序问题:多数视频生成基准用网页或LLM提示,并由通用多模态模型打总体画质、文本一致和流畅度,测到的是“像视频”,而非导演真正关心的镜头设计、动态美学和多镜头叙事。
本文贡献:提出电影级T2V/R2V基准FilmBench,与导演、北电教师和制片团队共同设计。1169条提示反推自20类获奖电影片段,其中1056条为多镜头真实shot list;评价体系含3轴、12组件、T2V 35项加R2V 3项子指标,并开放电影语言算子FilmOps和专家级自动评测Agent。

实验效果:评测9个T2V和7个R2V模型,自动评测对人类模型排名的Spearman相关分别达0.95和0.96。现有模型在动态美学上普遍不足,且从单镜头到多镜头性能明显下降,弱模型跌幅更大。
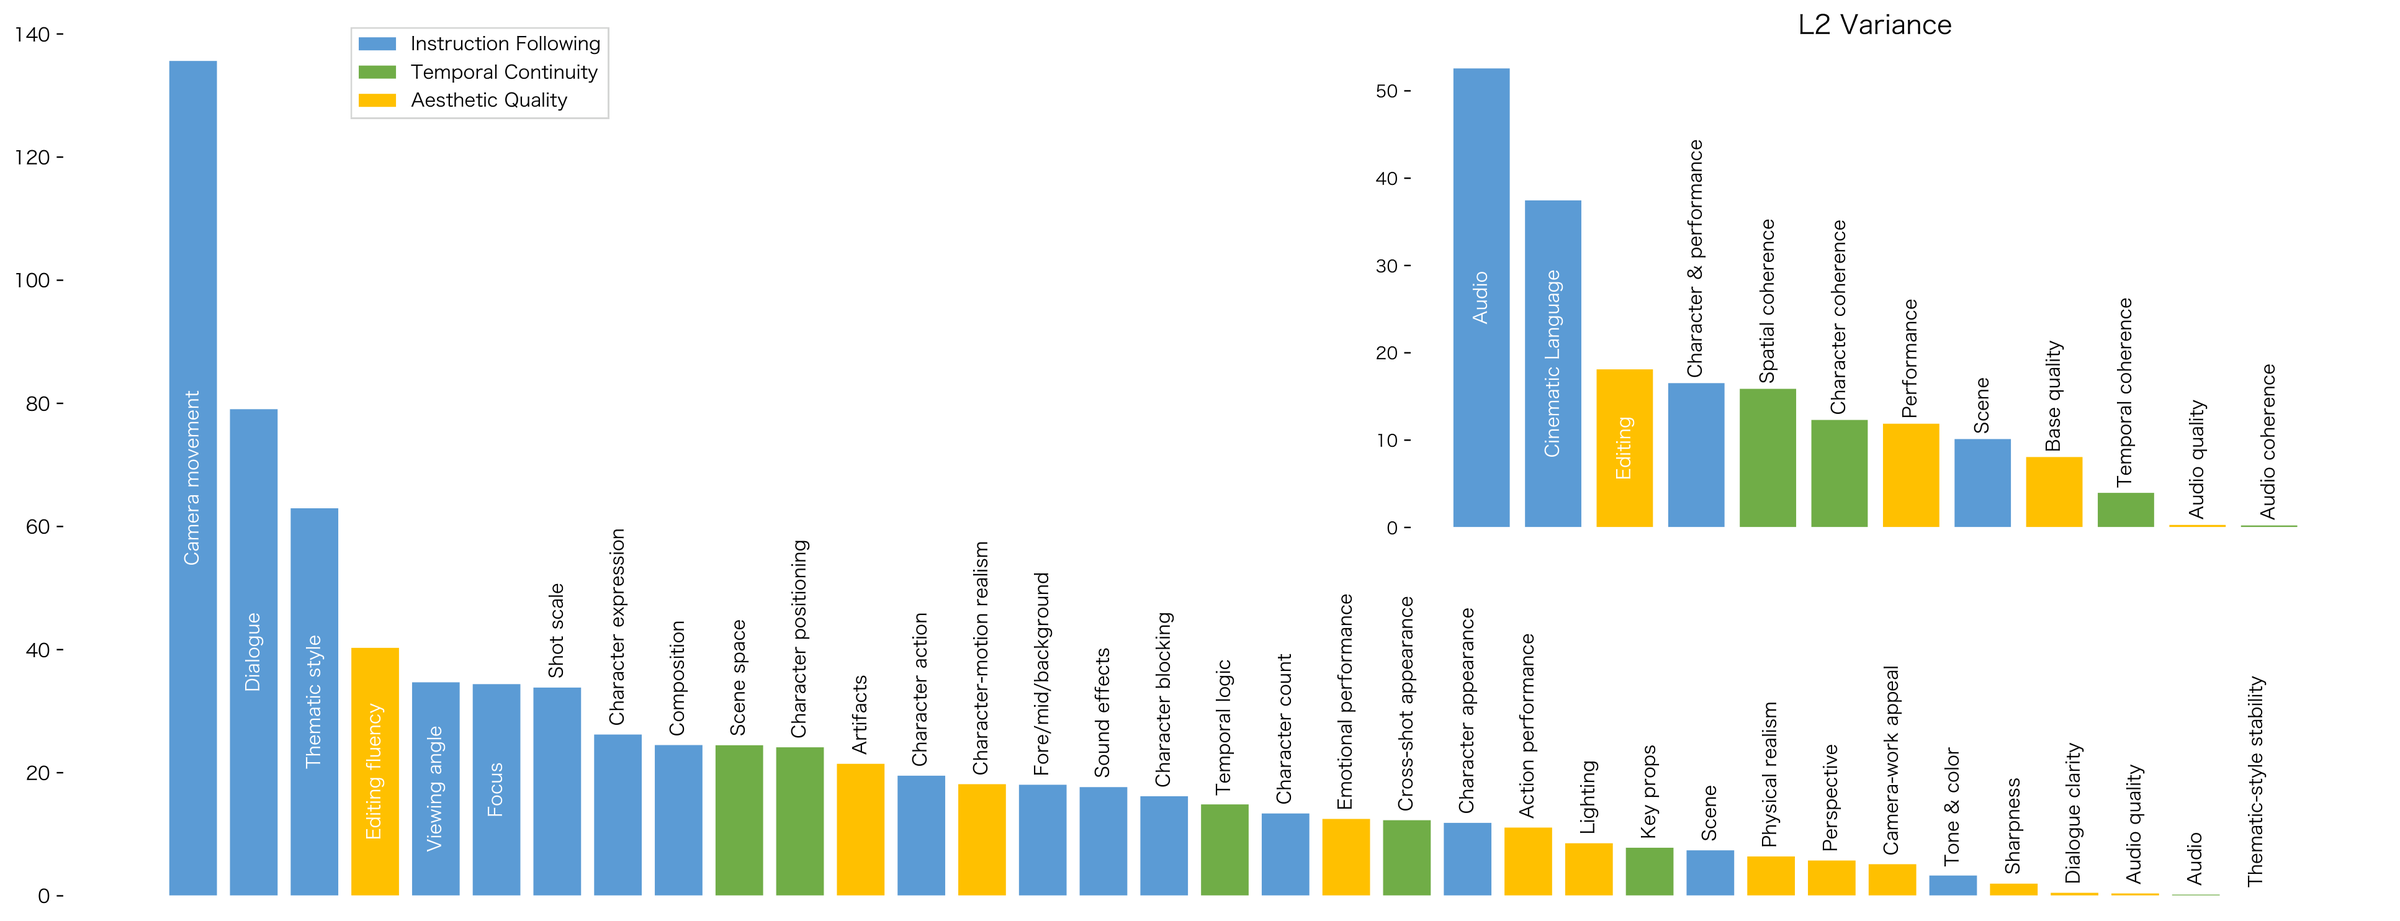
批判点评:FilmBench把视频评测从VBench式通用指标拉到专业电影语言,是生成视频走向影视生产的重要基础设施。但获奖电影反推提示可能偏向成熟电影美学,自动Agent即使排名相关高,也不代表每个镜头级解释都可靠;版权与参考片段可复现性同样重要。
OmniVAE: An Audio-Video VAE with Cross-Modal Alignment for Joint Generation | 复旦·上海创新院·MOSI·上交 | arXiv:2607.23855
关键词:音视频生成,VAE,跨模态对齐,复旦,全模态
前序问题:联合音视频生成通常分别训练音频VAE和视频VAE,两套潜空间没有细粒度对应,下游生成器不得不从零学习“哪个画面该配哪个声音”,增加同步学习难度。
本文贡献:提出联合训练的OmniVAE。除重建目标外,以片段级音视频对比学习捕获时间—语义对应并对齐潜空间;同时把预训练音频和视频语义编码器特征分别蒸馏进对应潜变量,让两种表示既保留重建能力,又更容易被下游联合生成模型学习。
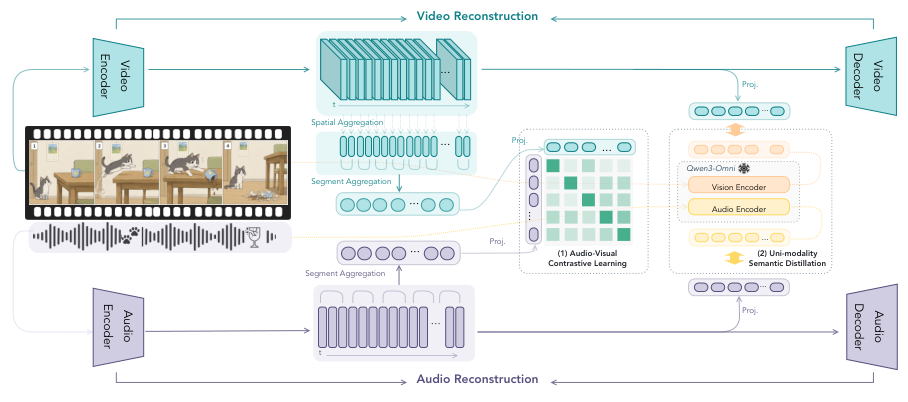
实验效果:两种对齐目标持续提升潜空间可学习性,使下游文生音视频获得更高生成质量与更准确跨模态同步,验证统一表征应从VAE底座开始。
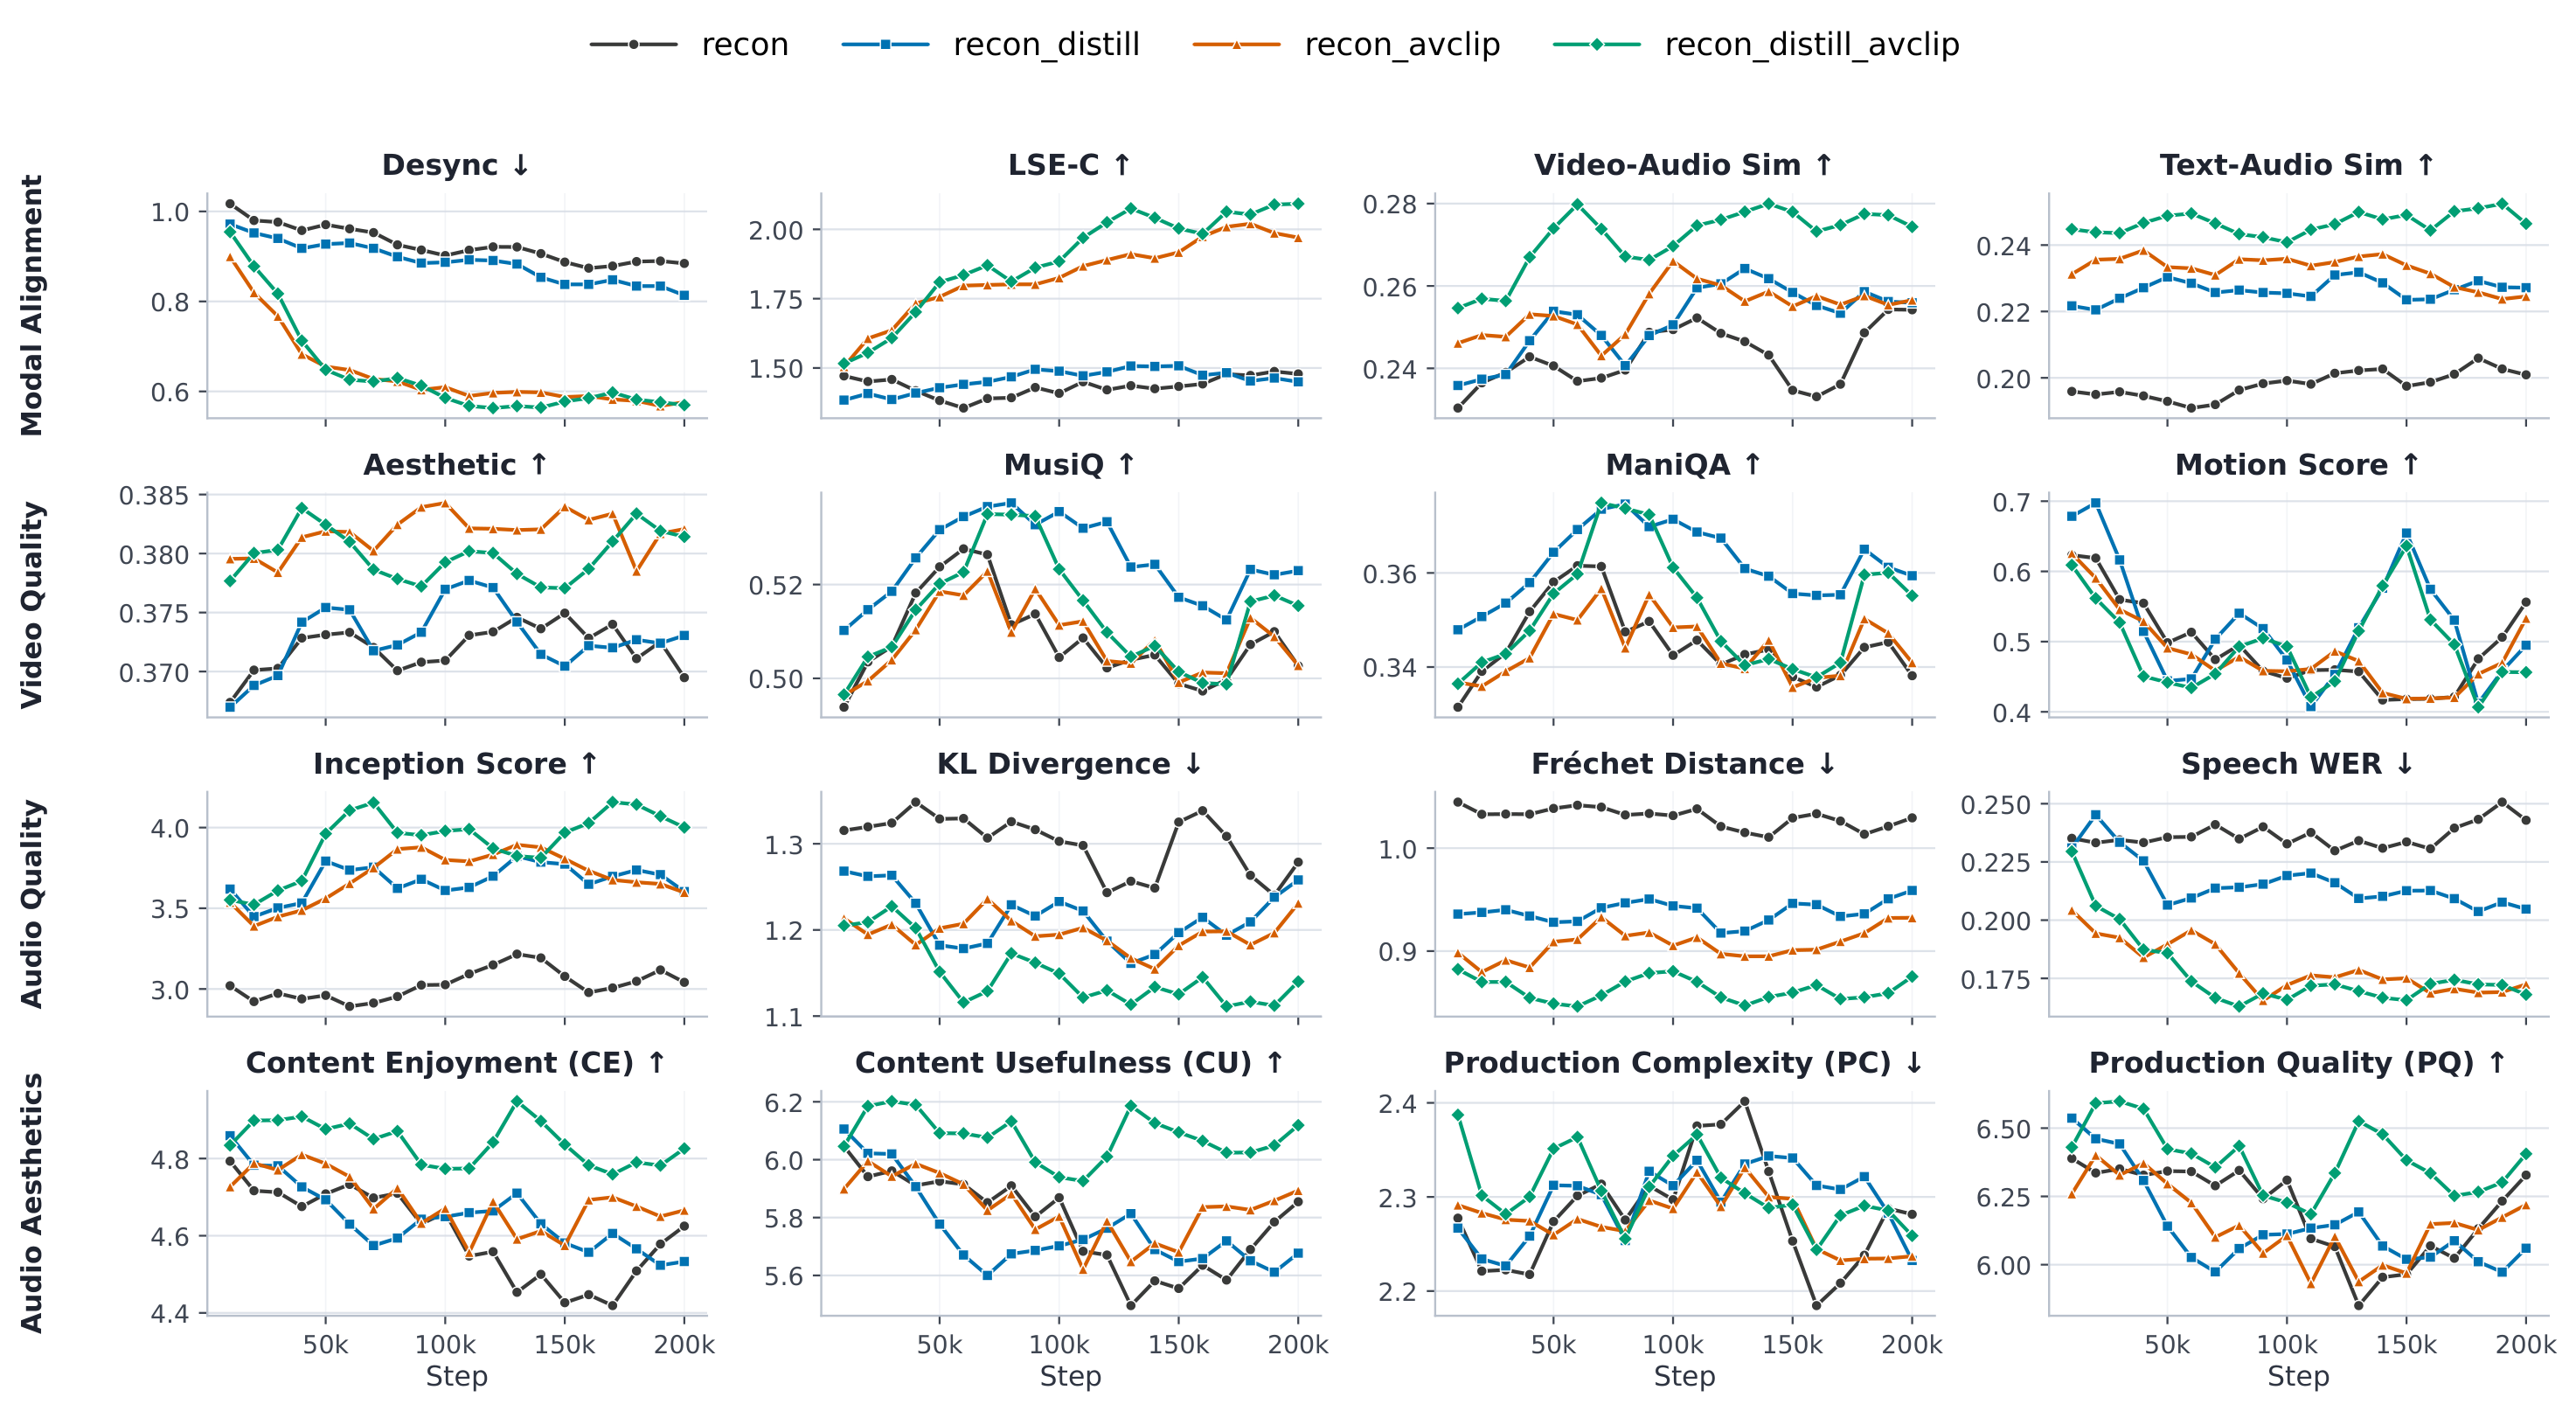
批判点评:多数工作把同步压力全留给生成DiT,OmniVAE提前在tokenizer阶段对齐,方向很对。但对比目标可能把音画关系压成粗语义相似,口型、碰撞声等毫秒级同步仍需生成器建模;联合VAE也会降低替换单一模态编码器的灵活性。
Rethinking Classifier-Free Guidance in On-Policy Diffusion Distillation | 阿里通义千问 | arXiv:2607.24731
关键词:扩散蒸馏,CFG,在线策略,PDM,视频控制
前序问题:在线策略扩散蒸馏通常直接匹配教师与学生经CFG合成后的速度,但这个总目标无法唯一约束正、负两个分支:两边误差可互相抵消。当教师负分支含学生拿不到的特权信息时,正分支变好反而会伴随负分支恶化。
本文贡献:论文将该失败模式命名为负分支不对称(NBA),并提出分支感知的Positive-Direction Matching(PDM):分别约束正条件预测与CFG条件方向,使监督可识别,不再让合成结果掩盖分支错误。方法用于从稠密到稀疏的视频控制蒸馏。

实验效果:朴素CFG匹配对推理guidance scale高度敏感,PDM在不同引导尺度下实现更稳健、有效的知识迁移,修复教师负分支存在特权条件时的对抗误差动态。

批判点评:它揭示了一个容易被总loss掩盖的蒸馏病灶:CFG结果对了,不代表两个分支学对了。分析价值高于单项榜单。不过当前验证集中在稠密到稀疏视频控制,PDM对文生图少步蒸馏、不同负提示schema的普适性仍需实证。
Visual Prompt Engineering for Video Models | Google DeepMind | arXiv:2607.25537
关键词:视觉提示工程,视频模型,视觉推理,Google DeepMind,图像编辑
前序问题:视频生成模型正成为视觉推理基础模型,但用户仍主要优化文字提示。对于迷宫、物理轨迹等任务,原始抽象图像可能不符合模型训练分布,仅改文字无法消除视觉输入本身的表达障碍。
本文贡献:提出视觉提示工程VIPE:调用图像编辑模型自动修改任务图像的呈现方式,例如把抽象草图转成写实场景,再交给视频模型推理。它不改目标问题,只优化视觉prompt,使输入更贴近视频模型容易理解和模拟的分布。
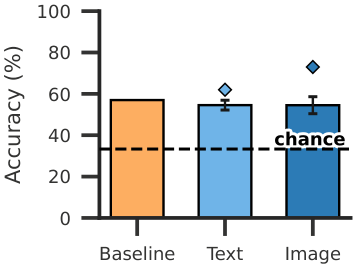
实验效果:VIPE在多种任务上提升视频模型视觉推理,效果甚至可超过传统文本提示工程和测试时扩展,且额外计算较低。
批判点评:“不是改问题文字,而是改给模型看的世界”是很有启发的提示工程范式,Google DeepMind视频模型背景也值得关注。但编辑器可能偷偷改变物理条件或答案线索,提升不一定来自更强推理;必须验证语义与几何约束在改图前后严格等价。
Explicit Layer Modeling for Video Object Insertion and Layer Decomposition | POSTECH | arXiv:2607.25802
关键词:视频编辑,RGBA,图层分解,物体插入,扩散模型
前序问题:多数视频编辑没有显式图层表示,物体插入、复用和后期调整只能隐式推断或逐场景优化。缺少前景RGBA监督,也让阴影、反射等伴随视觉效果难与背景正确合成。
本文贡献:构建TriLayer大规模三元视频数据,逐帧对齐合成画面、背景和含物体外观及视觉效果的前景层。基于此提出双分支DBL-Diffusion,通过共享去噪和跨分支交互联合建模RGB合成与RGBA前景;DBL-Insert生成可后期编辑的插入图层,DBL-Decompose恢复前景与背景。
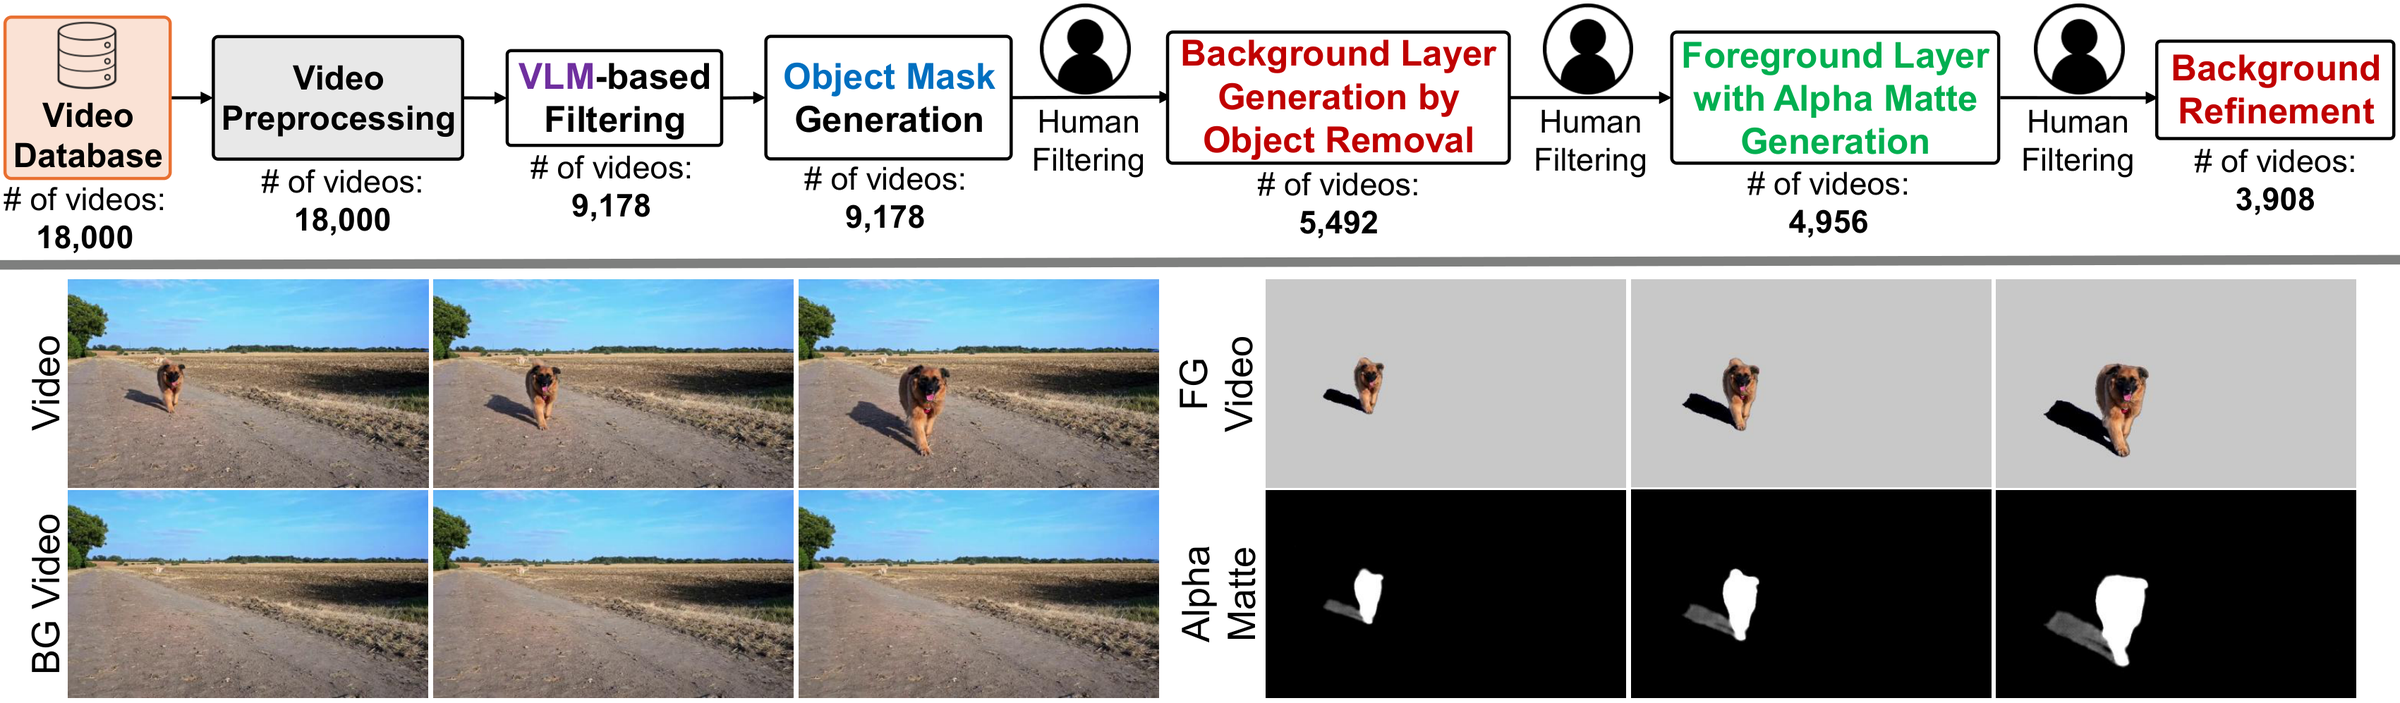
实验效果:显式图层建模显著提升视频物体插入保真度和图层分解质量,并让生成结果可用于真实合成与灵活后期修改。

批判点评:从最终RGB转向可编辑RGBA资产,是视频生成接入专业后期管线的重要一步。难点在于TriLayer数据如何获得真实透明度和复杂光效监督;半透明、运动模糊、反射及跨层光照很难被单一RGBA层完整表达。
人工智能炼丹君 整理 | 2026-07-29
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)