


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 实时与长视频生成 2 篇 · 视频测试时扩展与多人物生成 2 篇 · 理解生成统一表征 1 篇 · 可控视频与图像编辑 3 篇 · 生成部署与音频创作 2 篇
Ms. Forcing: Efficient Streaming Video Generation with Multi-Scale Patchification and Attention | Brown·MIT·Meta | arXiv:2607.20940
关键词:流式视频,实时生成,多尺度Patch,滚动扩散,DMD
前序问题:流式视频扩散虽可支持交互式世界模拟,但传统逐帧生成同时嵌套自回归与多步去噪,难以实时。滚动窗口把不同噪声级的连续帧并行去噪,却仍用同样细的空间粒度处理所有状态,浪费大量计算。
本文贡献:提出 Ms. Forcing:多尺度 Patchification(MSP)按噪声级给高噪状态分配更粗 patch,使活动窗口 token 减少45%;多尺度自注意力(MSSA)按查询尺度匹配可见 KV 密度,继续压低注意力成本。固定窗口位置决定全部尺度,计算图保持静态且硬件友好;同噪声级 DMD(H-DMD)则用来自同一源噪声级的干净预测组装训练视频,缩小训练序列与推理滚动的错位。
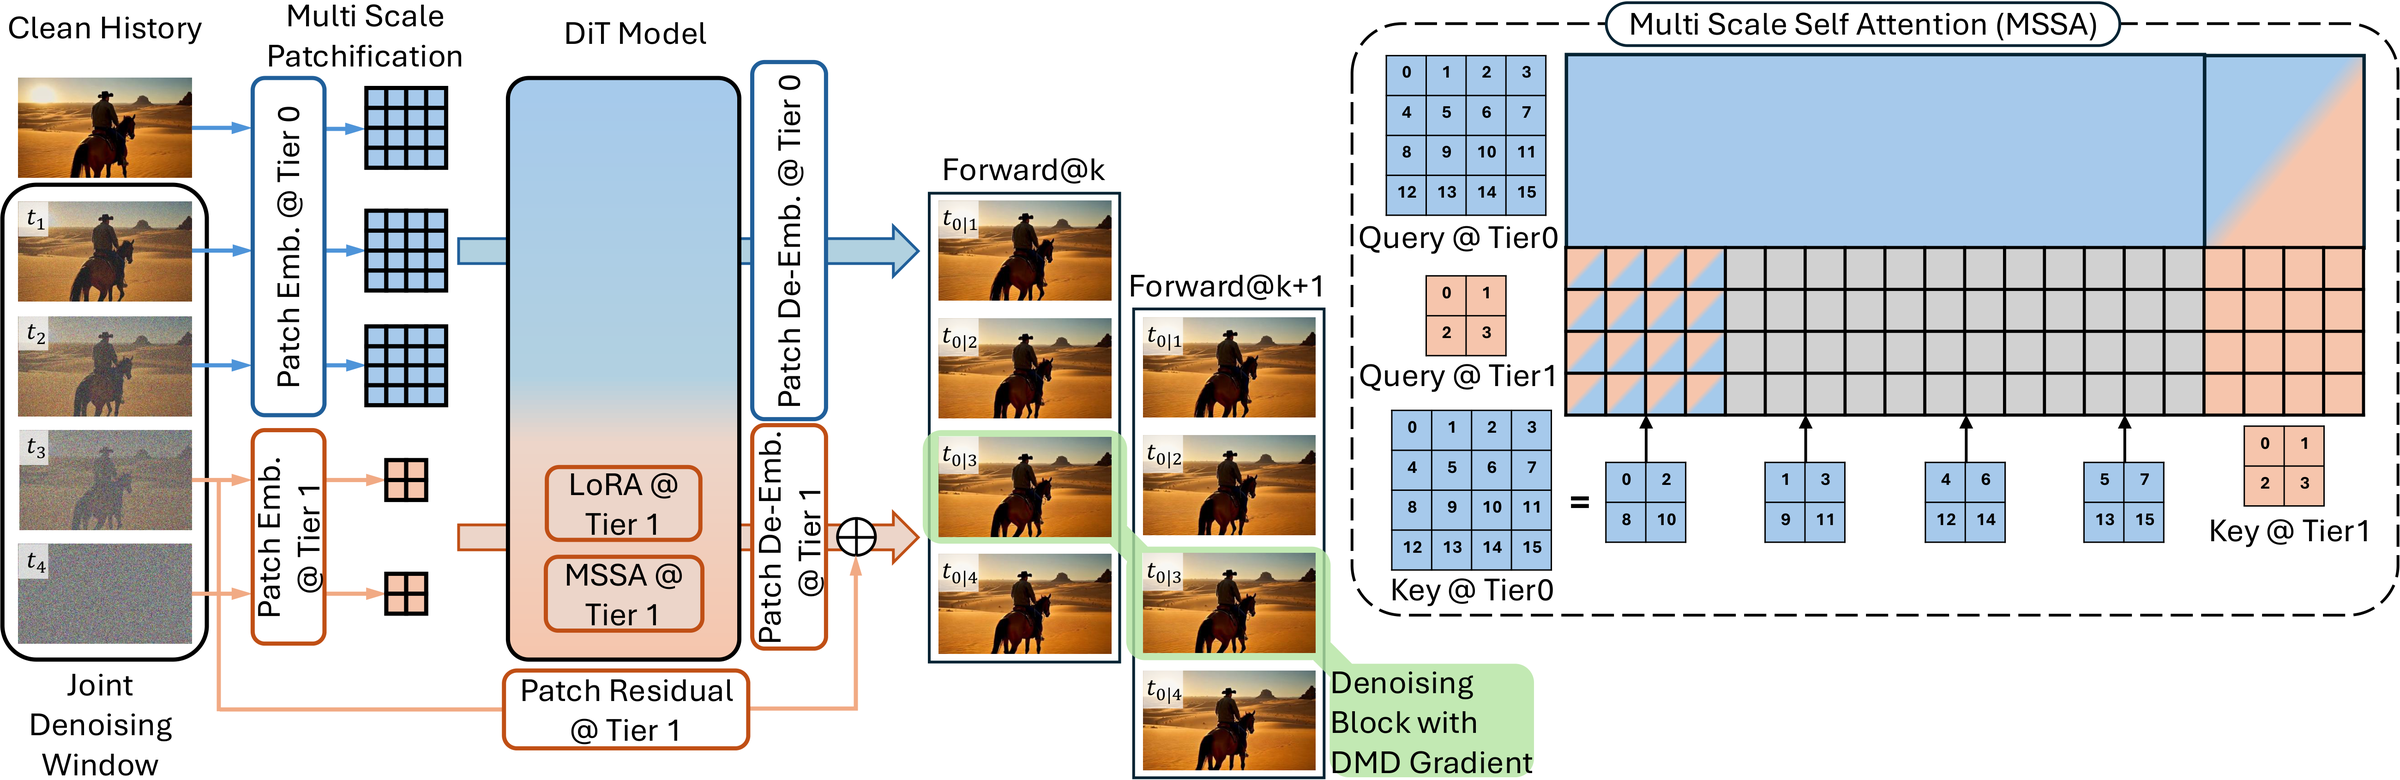
实验效果:单张 H200 上达到22.84 FPS,比 Rolling Forcing 快39.6%;同时在短视频和长视频设置中显著提升 VBench。

批判点评:这是今日最硬的工业数字:单 H200 首次把流式扩散推到实时帧率,而且不是单纯牺牲质量换速度。关键洞察是高噪帧无需看清每个像素。但22.84 FPS依赖H200与固定窗口配置,分辨率、模型规模和端到端编码开销需一并看;高噪粗粒度也可能损伤快速出现的小物体。
Self Gradient Forcing: Native Long Video Extrapolation | 京东探索研究院 | arXiv:2607.20368
关键词:长视频,自回归扩散,Self Forcing,KV缓存,梯度训练
前序问题:Self Forcing让模型在自身生成历史上训练,缓解训练看真值、推理看生成结果的暴露偏差;但历史KV缓存只是冻结状态,未来帧损失无法反向教会早期帧“如何写入更有用的记忆”,形成历史上下文梯度缺口。
本文贡献:提出两遍训练的Self Gradient Forcing(SGF),无需穿过完整串行 rollout 反传。第一遍无梯度执行与推理一致的自回归滚动,在抽样退出步记录自生成上下文与噪声潜变量;第二遍并行重算该步的上下文KV和未来对上下文的因果注意力,让未来视频潜变量损失监督历史记忆的写入方式。
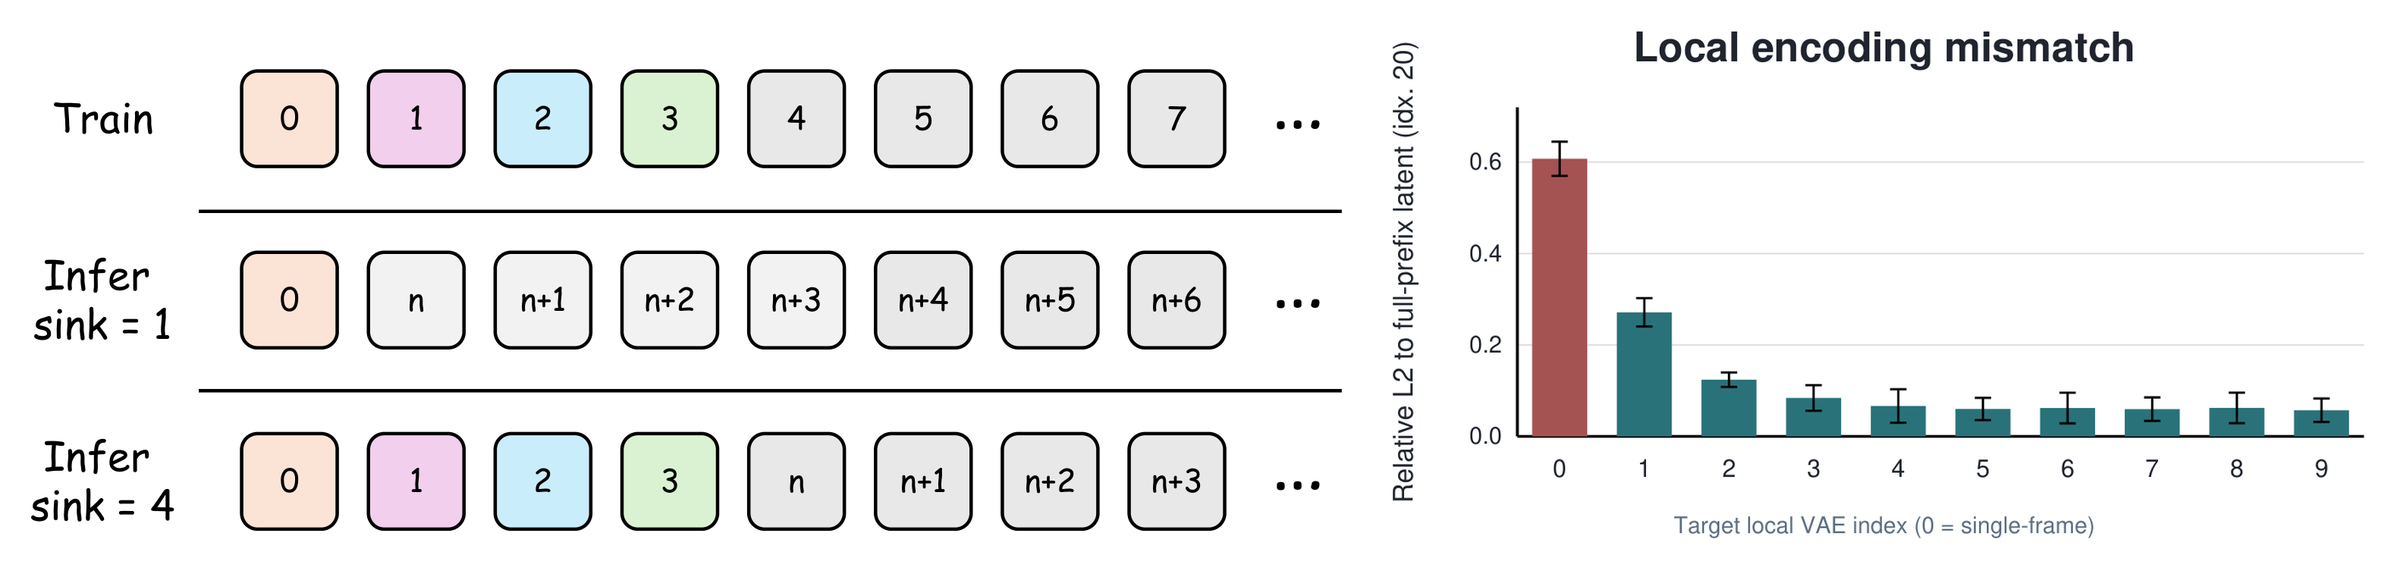
实验效果:在逐帧与分块长时实验、不同初始化下,角色身份、背景布局和时间稳定性均强于Self Forcing;仅用5秒训练窗口即可原生外推到数分钟视频。
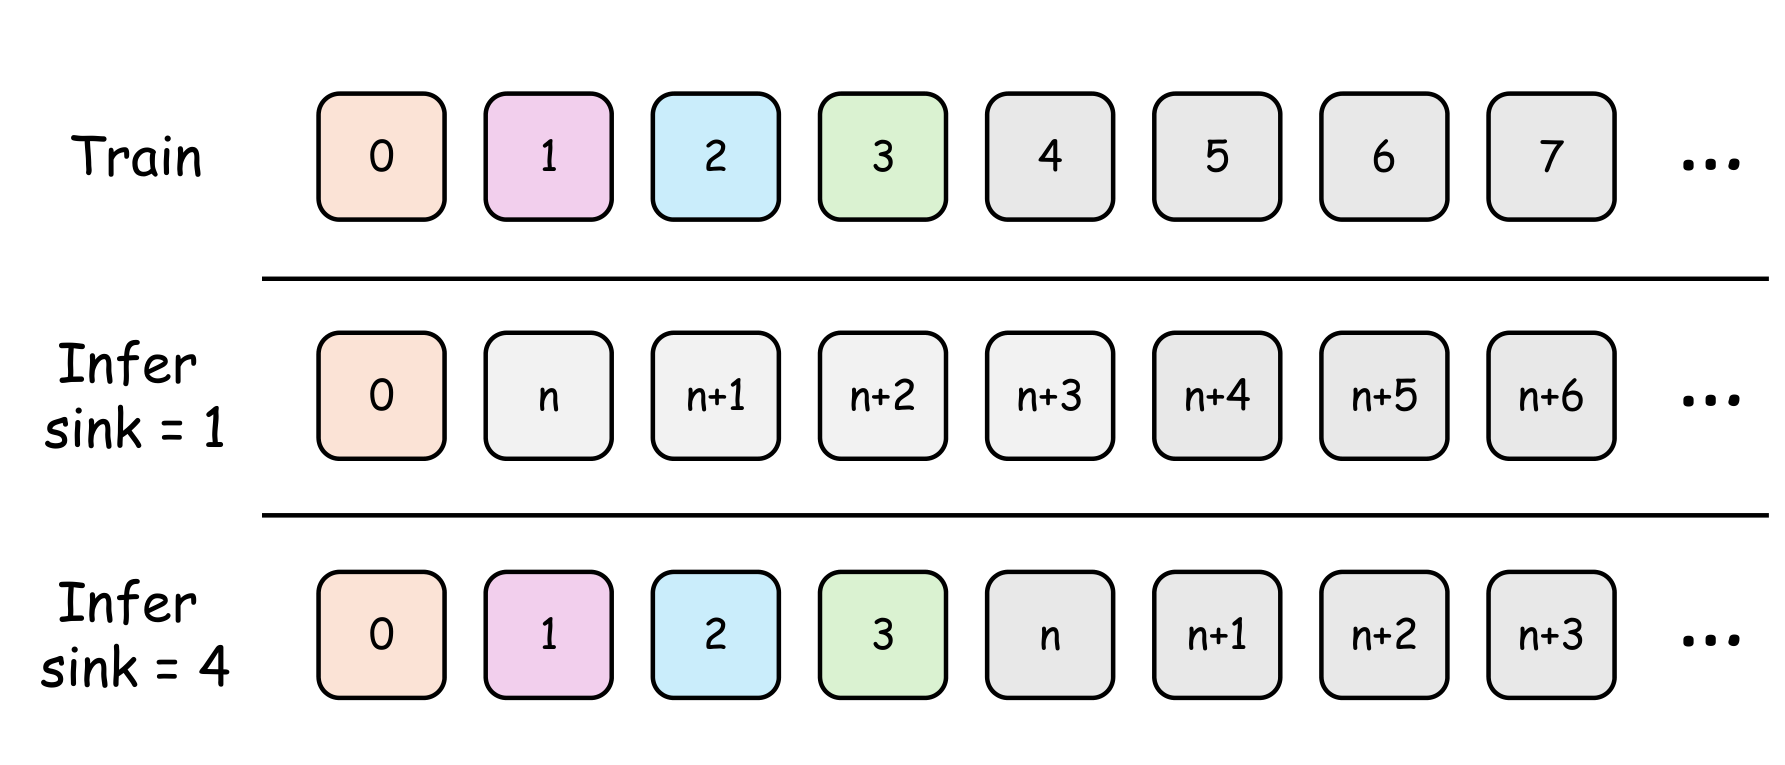
批判点评:它把长视频问题从“怎样读取历史”推进到“怎样写好历史”,5秒训练到数分钟外推非常抓眼。两遍法避免全序列反传,工程上也现实。不过数分钟不等于全程有意义,身份和背景稳定之外,长期叙事、动作因果与新内容丰富度仍可能衰减。
CachedSearch: Training-Free Cached Exploration for Test-Time Search in Video Diffusion | Google·UT Austin·CU Boulder | arXiv:2607.23159
关键词:测试时搜索,视频扩散,缓存加速,Best-of-N,免训练
前序问题:测试时best-of-N搜索能让小视频模型接近大模型,却需2到10倍计算,因为所有候选都完整去噪、最后大多被丢弃。缓存可让单次生成快2到3倍,但若近似误差打乱验证器排序,就可能选错赢家。
本文贡献:首次系统研究缓存对视频候选排序的影响,并提出免训练CachedSearch:用激进缓存低成本探索所有种子,仅把缓存阶段的赢家用全计算重生成。缓存与完整生成的每提示中位Spearman相关达0.905,错误主要集中在分数近乎打平的候选,因而影响自限;方案与验证器和搜索算法解耦。
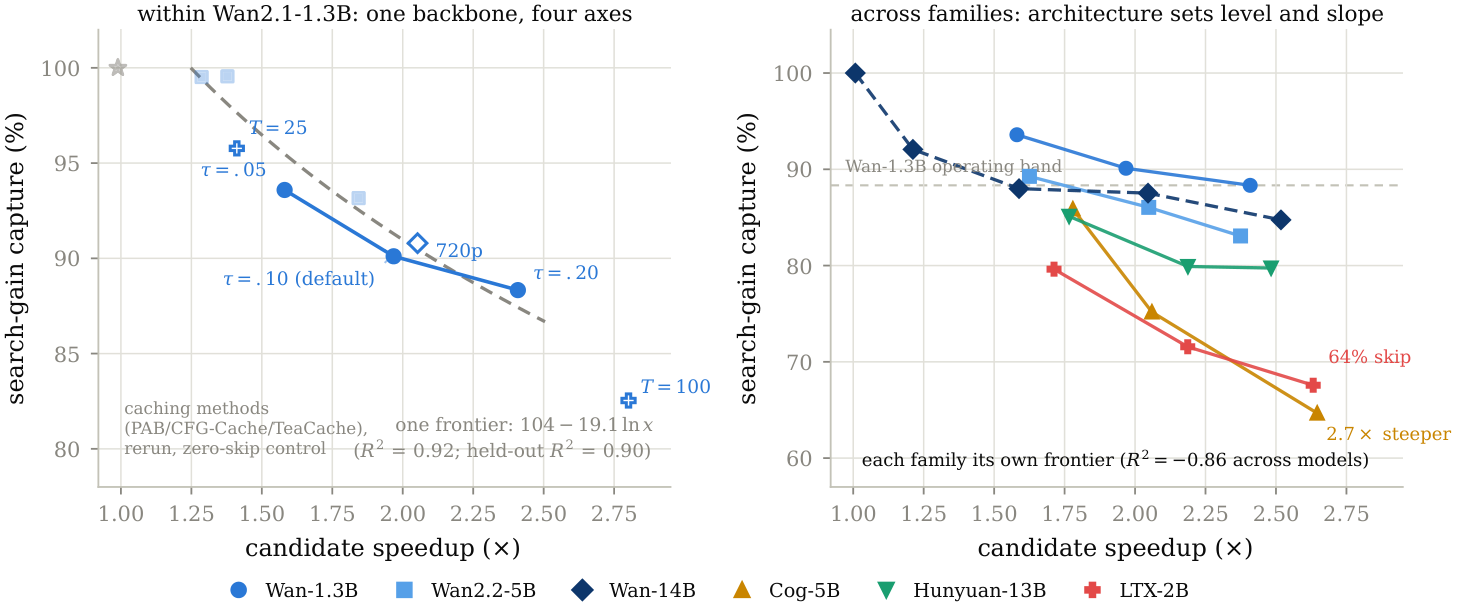
实验效果:N=8时以63%成本保留best-of-N的94.7%收益;同预算可搜索两倍宽度,收益高38%。结论覆盖1.3B到14B、Wan/LTX/CogVideoX/Hunyuan六个模型;叠加中途剪枝可节省3.11倍探索计算并保留88.6%收益。
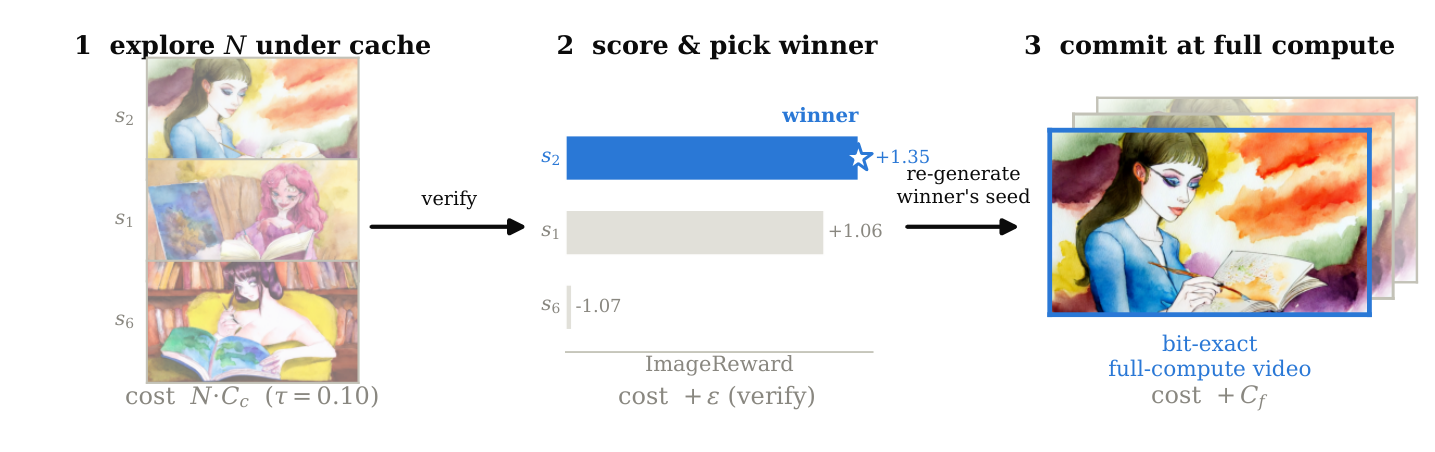
批判点评:“便宜试遍、只精修赢家”是测试时扩展最直接的降本路线,跨四个模型家族也增强了可信度。但它仍依赖奖励器排序是否符合人类偏好,近似搜索会放大奖励黑客;新架构还需重新校准缓存参数,并非完全零配置。
Twins: Learn to Predict Unified Representations with Focal Loss | ICML 2026·腾讯混元·港中文 | arXiv:2607.22531
关键词:统一多模态,视觉Token,ViT,VAE,Flow Matching
前序问题:统一多模态模型常用ViT语义特征做理解、VAE低层潜变量做生成,两套连续表征不一致。直接联合预测时,DiT容易拟合ViT却学不好VAE分布,难以同时满足理解、重建和生成。
本文贡献:提出Twins连续统一表征:在同一token网格按通道拼接SigLIP2 ViT特征与FLUX.2 VAE潜变量,不增加序列长度和注意力成本。团队将失衡归因于频率偏置、内在维度及条件相关/无关不确定性差异,并把Focal Loss思想改造成flow matching焦点回归,重点提升误差大的VAE维度。
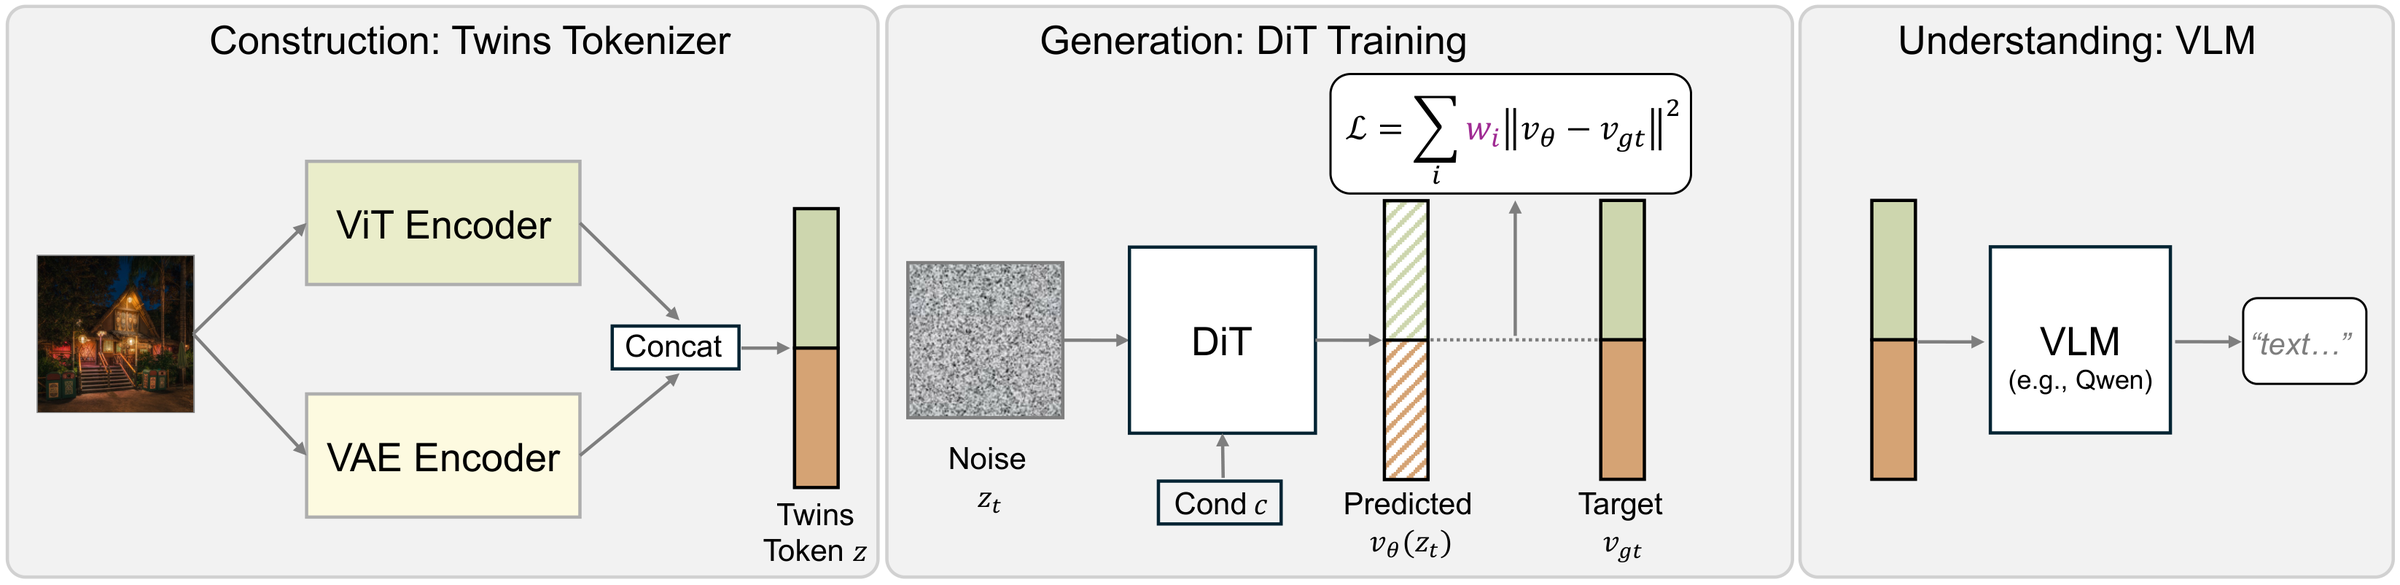
实验效果:ImageNet上相对朴素MSE最高改善10.57 gFID,且不使用classifier-free guidance;多模态理解表现保持竞争力,重建保真度也提升。
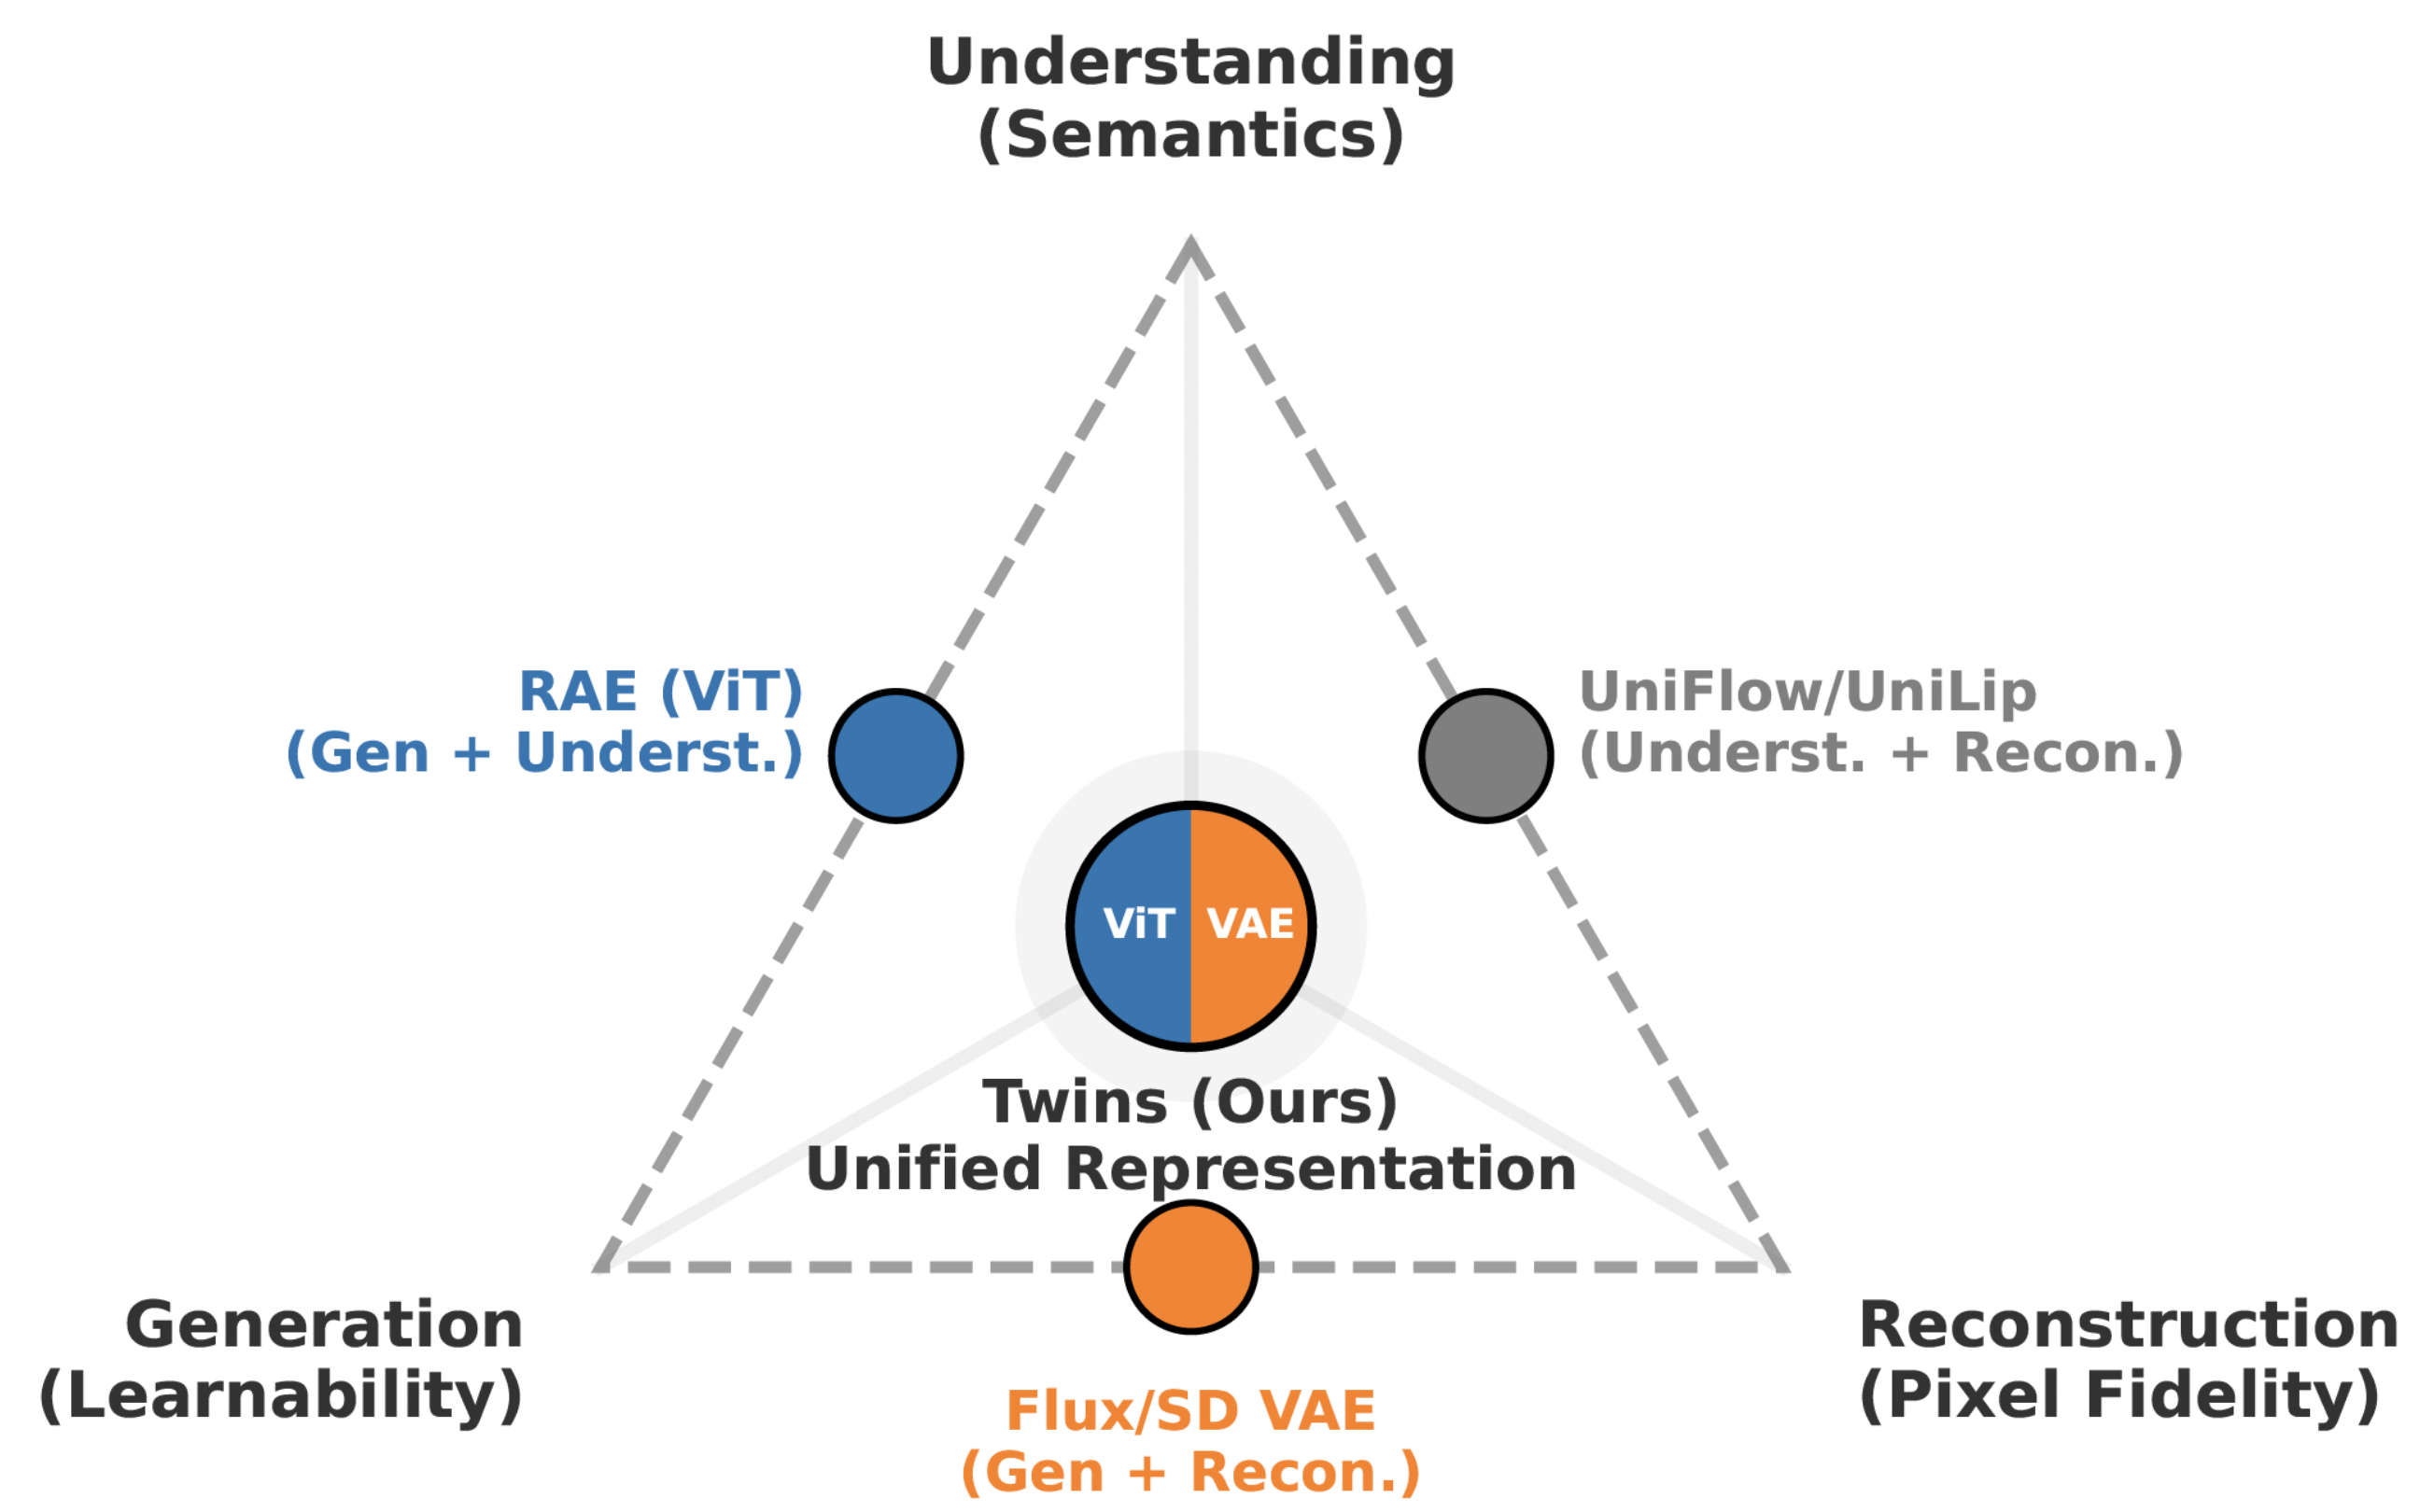
批判点评:它用最简单的通道拼接绕开两套视觉接口,再用损失重加权处理“语义易学、细节难学”,ICML与混元背景值得关注。但共享token仍是两种预训练特征的并置而非真正涌现的统一空间,推理通道宽度和解码链路成本并未消失。
GroupVideo: Multi-Identity Customized Text-to-Video Generation | 中科院自动化所·蚂蚁 | arXiv:2607.21027
关键词:视频生成,多人物,身份保持,Video DiT,定制视频
前序问题:身份定制视频大多只支持单人;把多张人脸简单拼接成条件会造成身份混淆,人物表情与动作像把静态脸“贴”到视频上,缺乏自然性。
本文贡献:提出基于Video DiT的GroupVideo。视觉对齐联合编码多张人脸提供稳健身份参考,语义感知器负责提升动作自然度;带空间引导的ID定位模块配合边界框约束与mask正则,将身份信息限制在对应脸部区域,抑制人物间特征串扰。团队还构建2万条高质量多身份视频数据集。
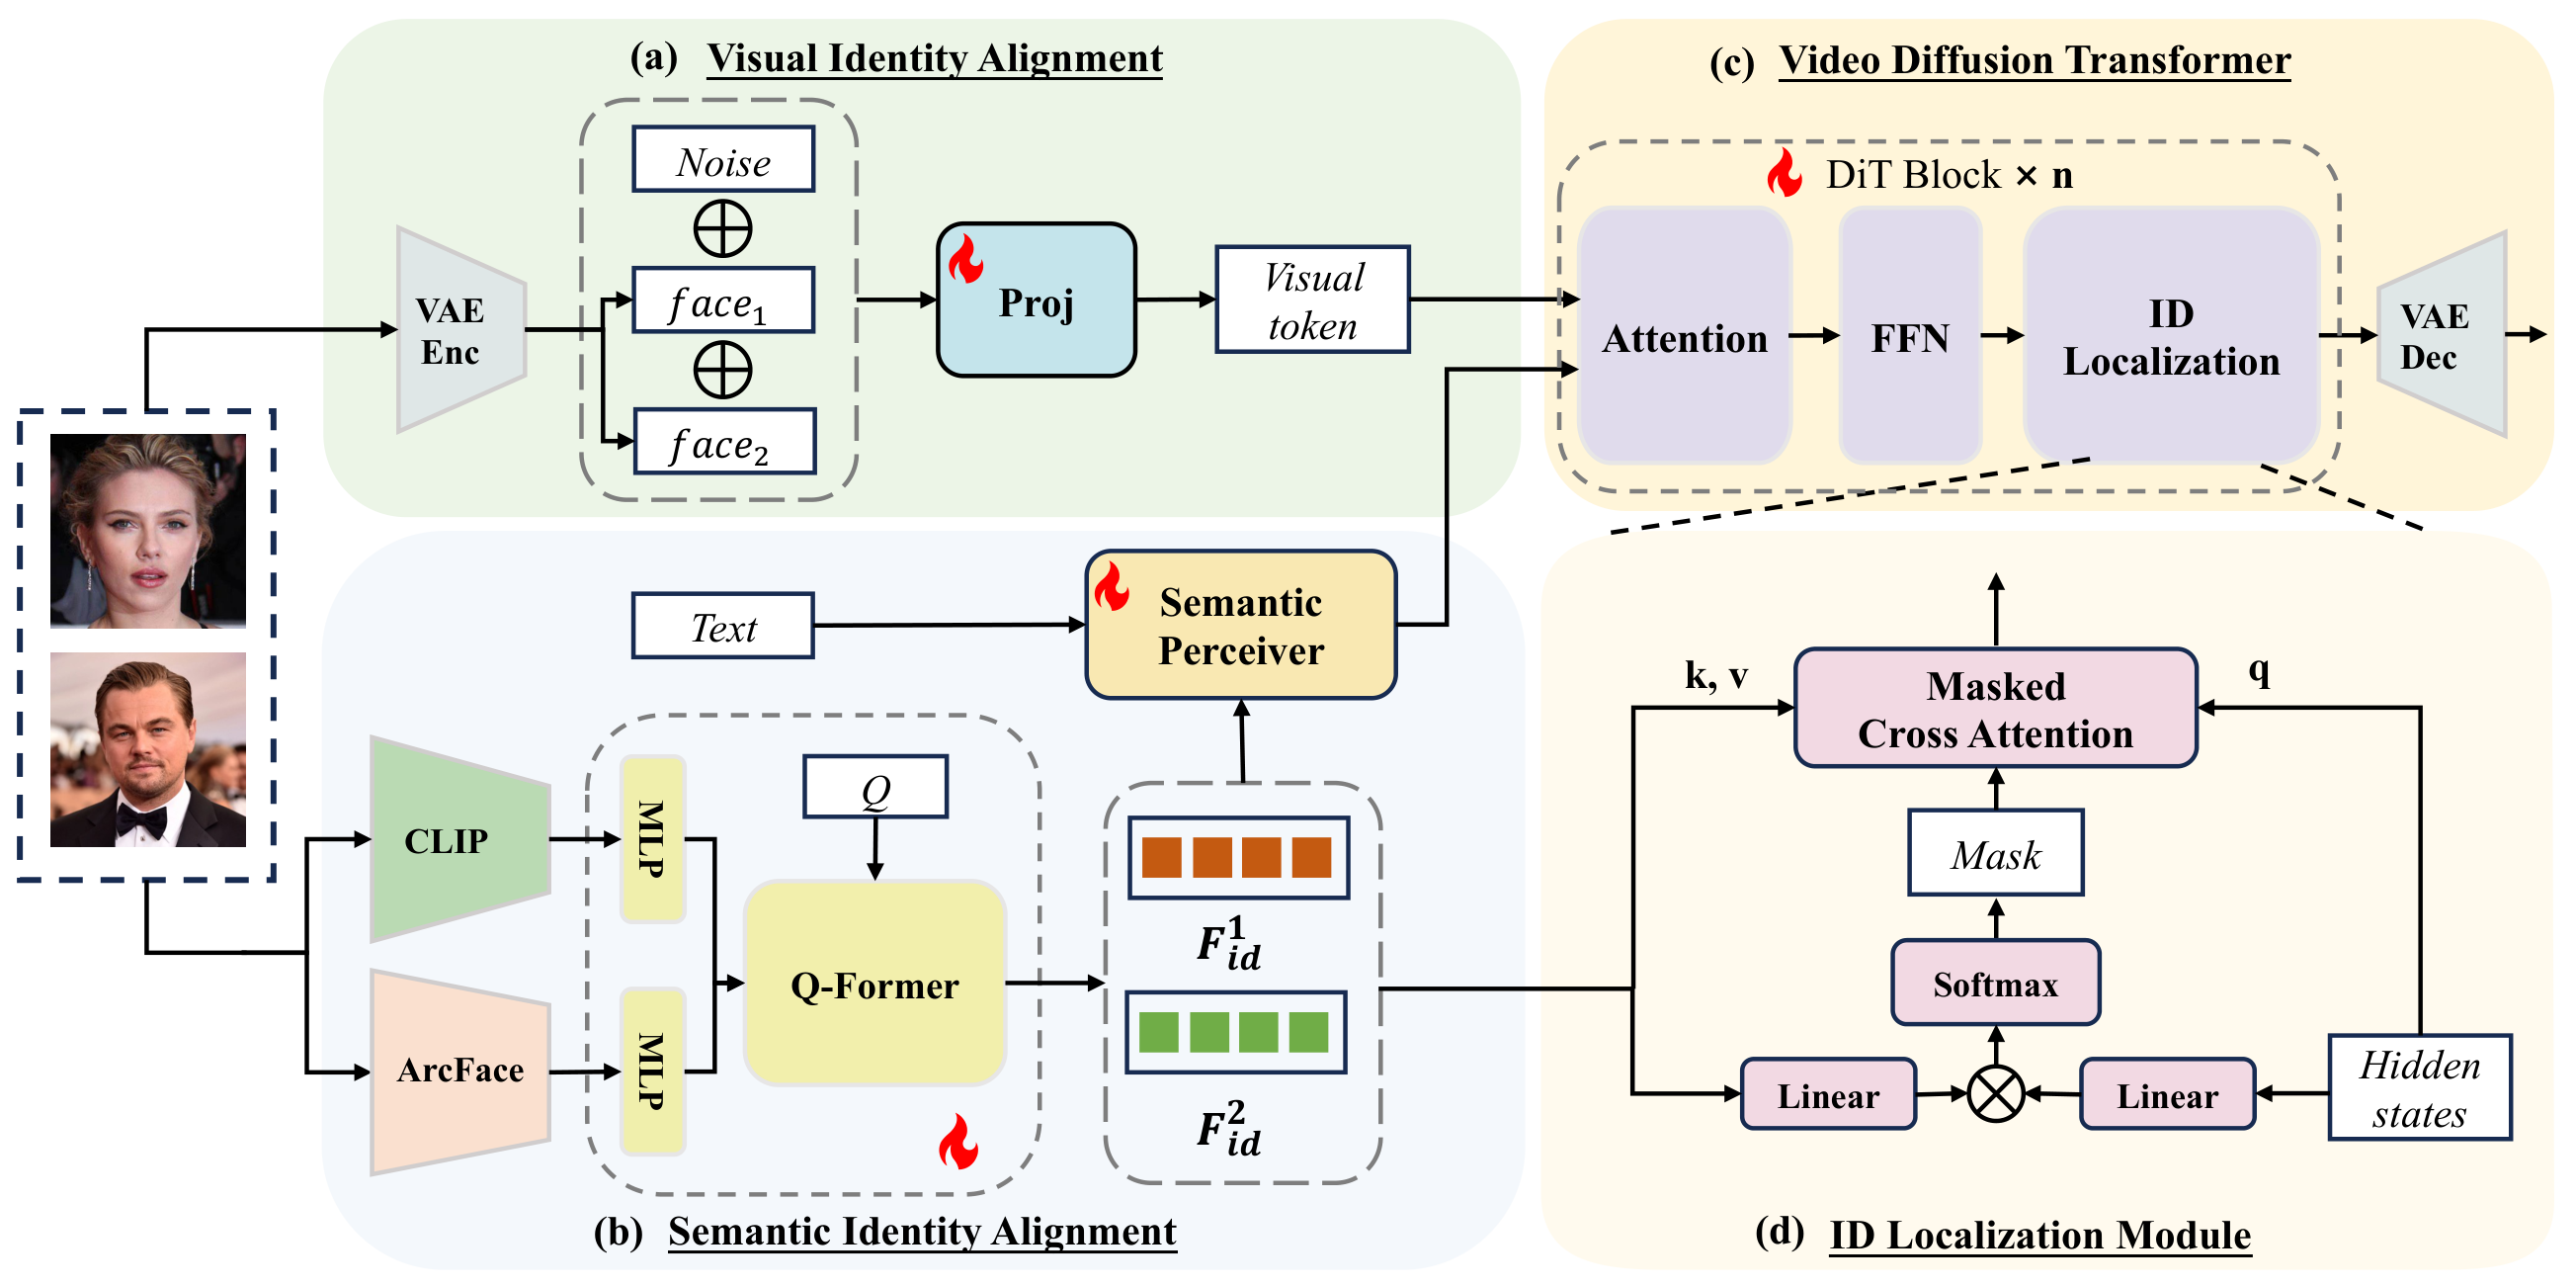
实验效果:在多角色视频中,身份一致性与动作自然度均超过现有方法,并改善多人物同时出现时的身份保真;新增2万条多ID数据为后续研究提供基础。

批判点评:多人物是定制视频迈向真实叙事必须补的一环,显式ID定位比条件拼接更靠谱。局限是训练仍依赖框和mask约束,2万条数据对人物组合、遮挡与长时交互的覆盖有限;多人身份正确也不保证彼此动作逻辑自然。
AgentHOI: Multi-Agent Reasoning for Human-Object-Interaction Video Generation via Implicit Representation Alignment | 腾讯混元·中科院大学 | arXiv:2607.22241
关键词:HOI视频,多Agent,动作规划,腾讯混元,视频扩散
前序问题:人和物体交互视频不仅要让主体动起来,还要理解接触、受力与动作先后。现有方法依赖显式姿态或运动轨迹,扩展到不同物体和复杂指令时成本高、泛化弱。
本文贡献:提出thinking-before-generation的AgentHOI:感知、交互和运动规划多个Agent先把高层文本意图拆成带秒级时间区间的执行计划;再用隐式文本-运动对齐,将文本到动作先验蒸馏进视频扩散模型,使推理时无需额外运动输入。
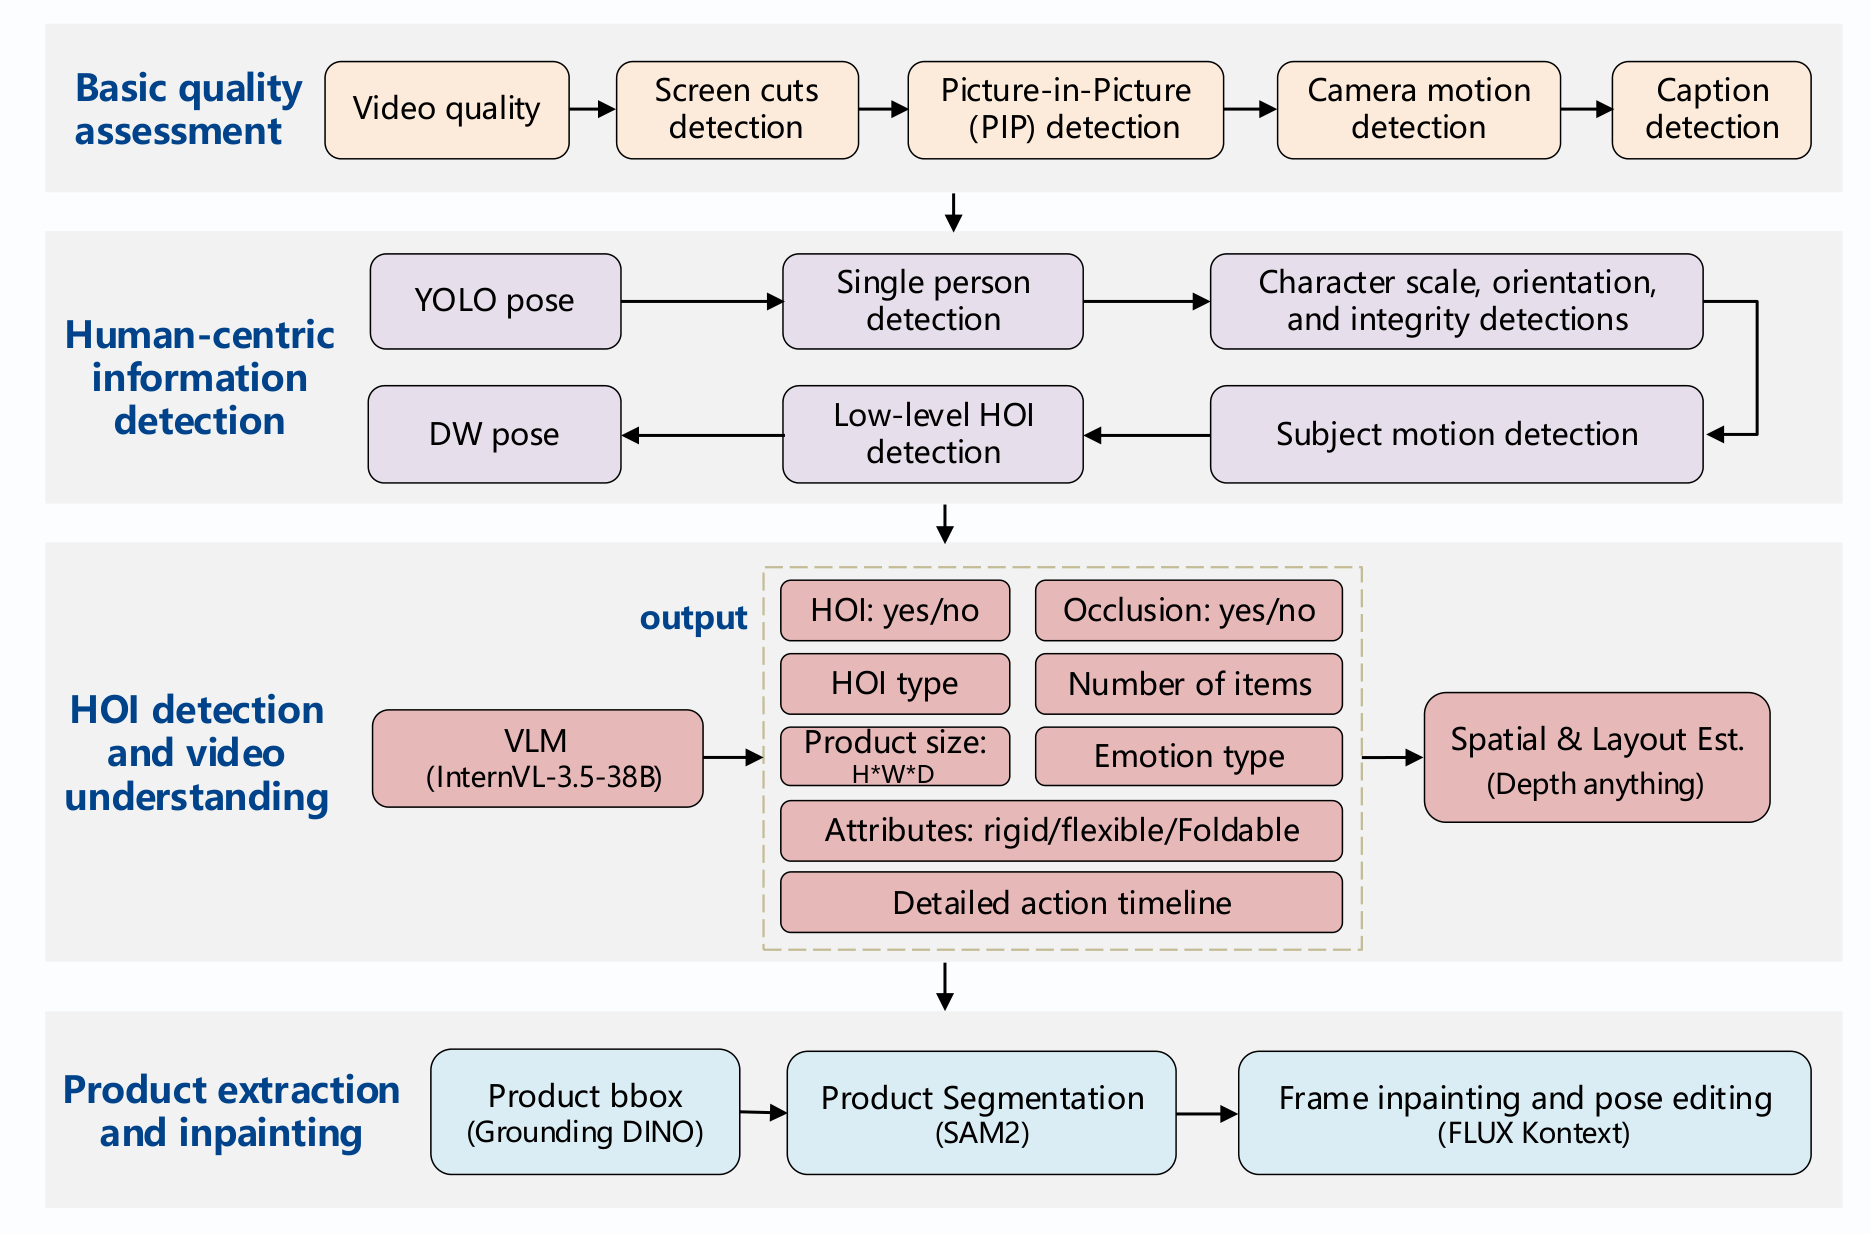
实验效果:在穿戴、骑乘等高难物体中心场景中,显著提升交互自然度、物体外观保持和复杂文本指令遵循;代码已开源。
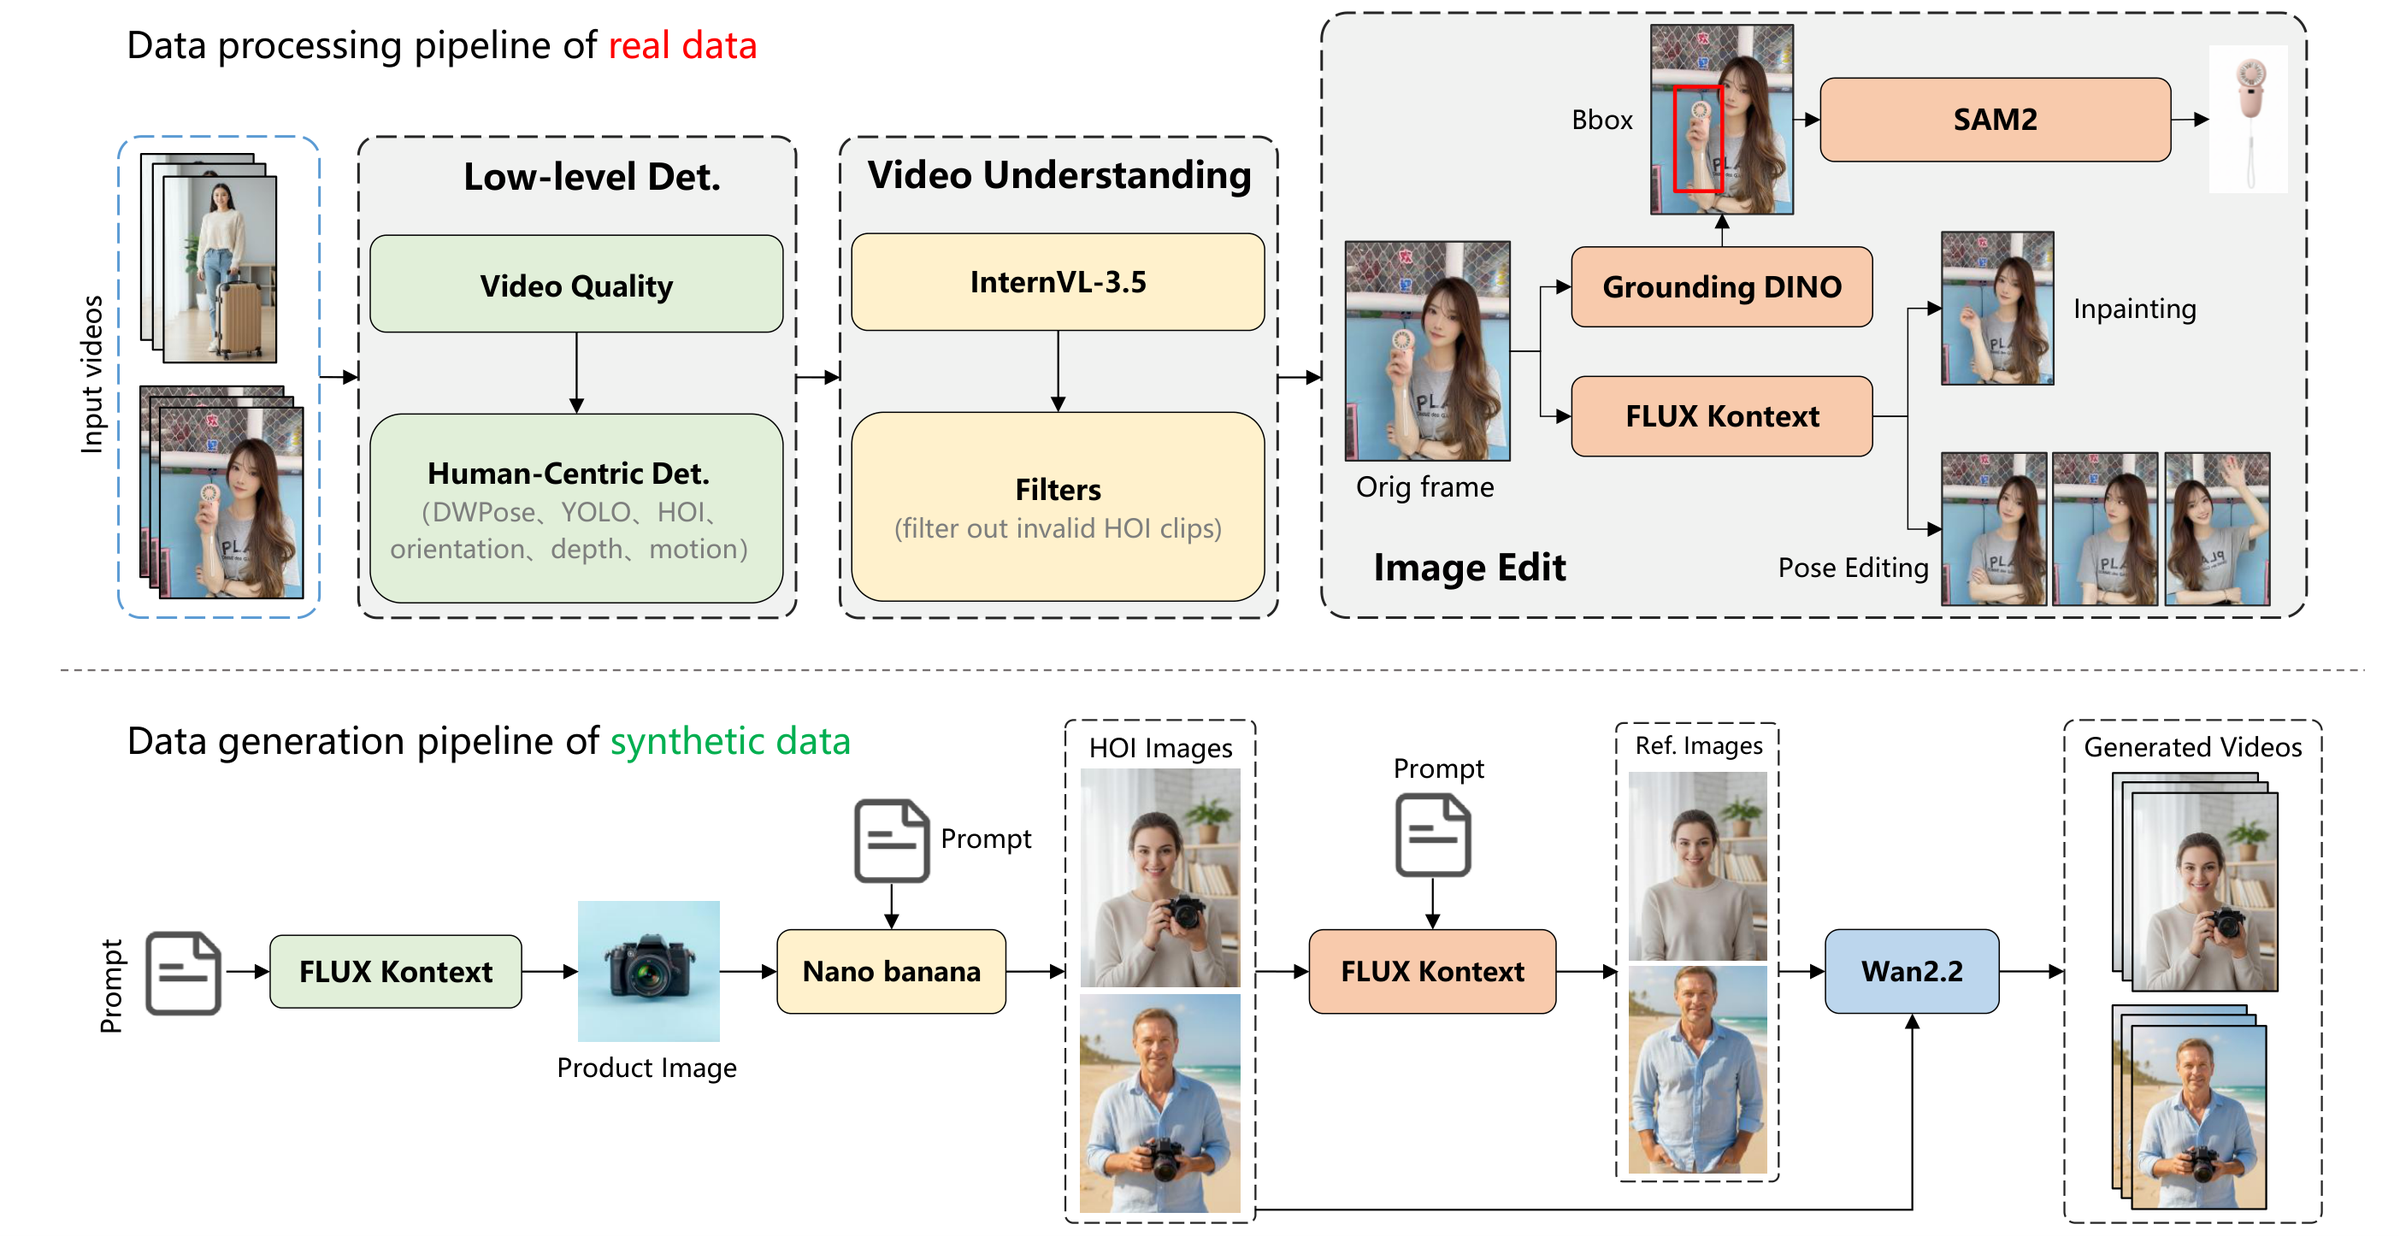
批判点评:混元把Agent推理从提示改写推进到动作规划,适合HOI这种先讲逻辑再画运动的任务。但文本计划无法完整表达连续接触力学,Agent链中的错误会被生成模型忠实放大;“自然”仍主要靠视觉评价而非物理正确性。
InnoText: A Unified Model for Visual Text Generation and Editing | 中山大学·京东·中科院 | arXiv:2607.22101
关键词:视觉文字,DiT,图像编辑,中文生成,统一模型
前序问题:视觉文字既要求字形结构规则又要求可读,小字号和中文尤其困难。UNet常生成乱码,现有DiT又多只做生成或编辑单项任务,造成重复训练、风格不一致和跨任务泛化不足。
本文贡献:提出统一DiT框架InnoText,在单模型内同时完成视觉文字生成与编辑。字体大小感知调制(FSAM)适配不同尺度,小字符感知增强专攻细粒度字形,任务特定区域加权损失按生成/编辑区域自适应优化;同时构建覆盖多字体、字号和背景的高质量中英双语数据集。
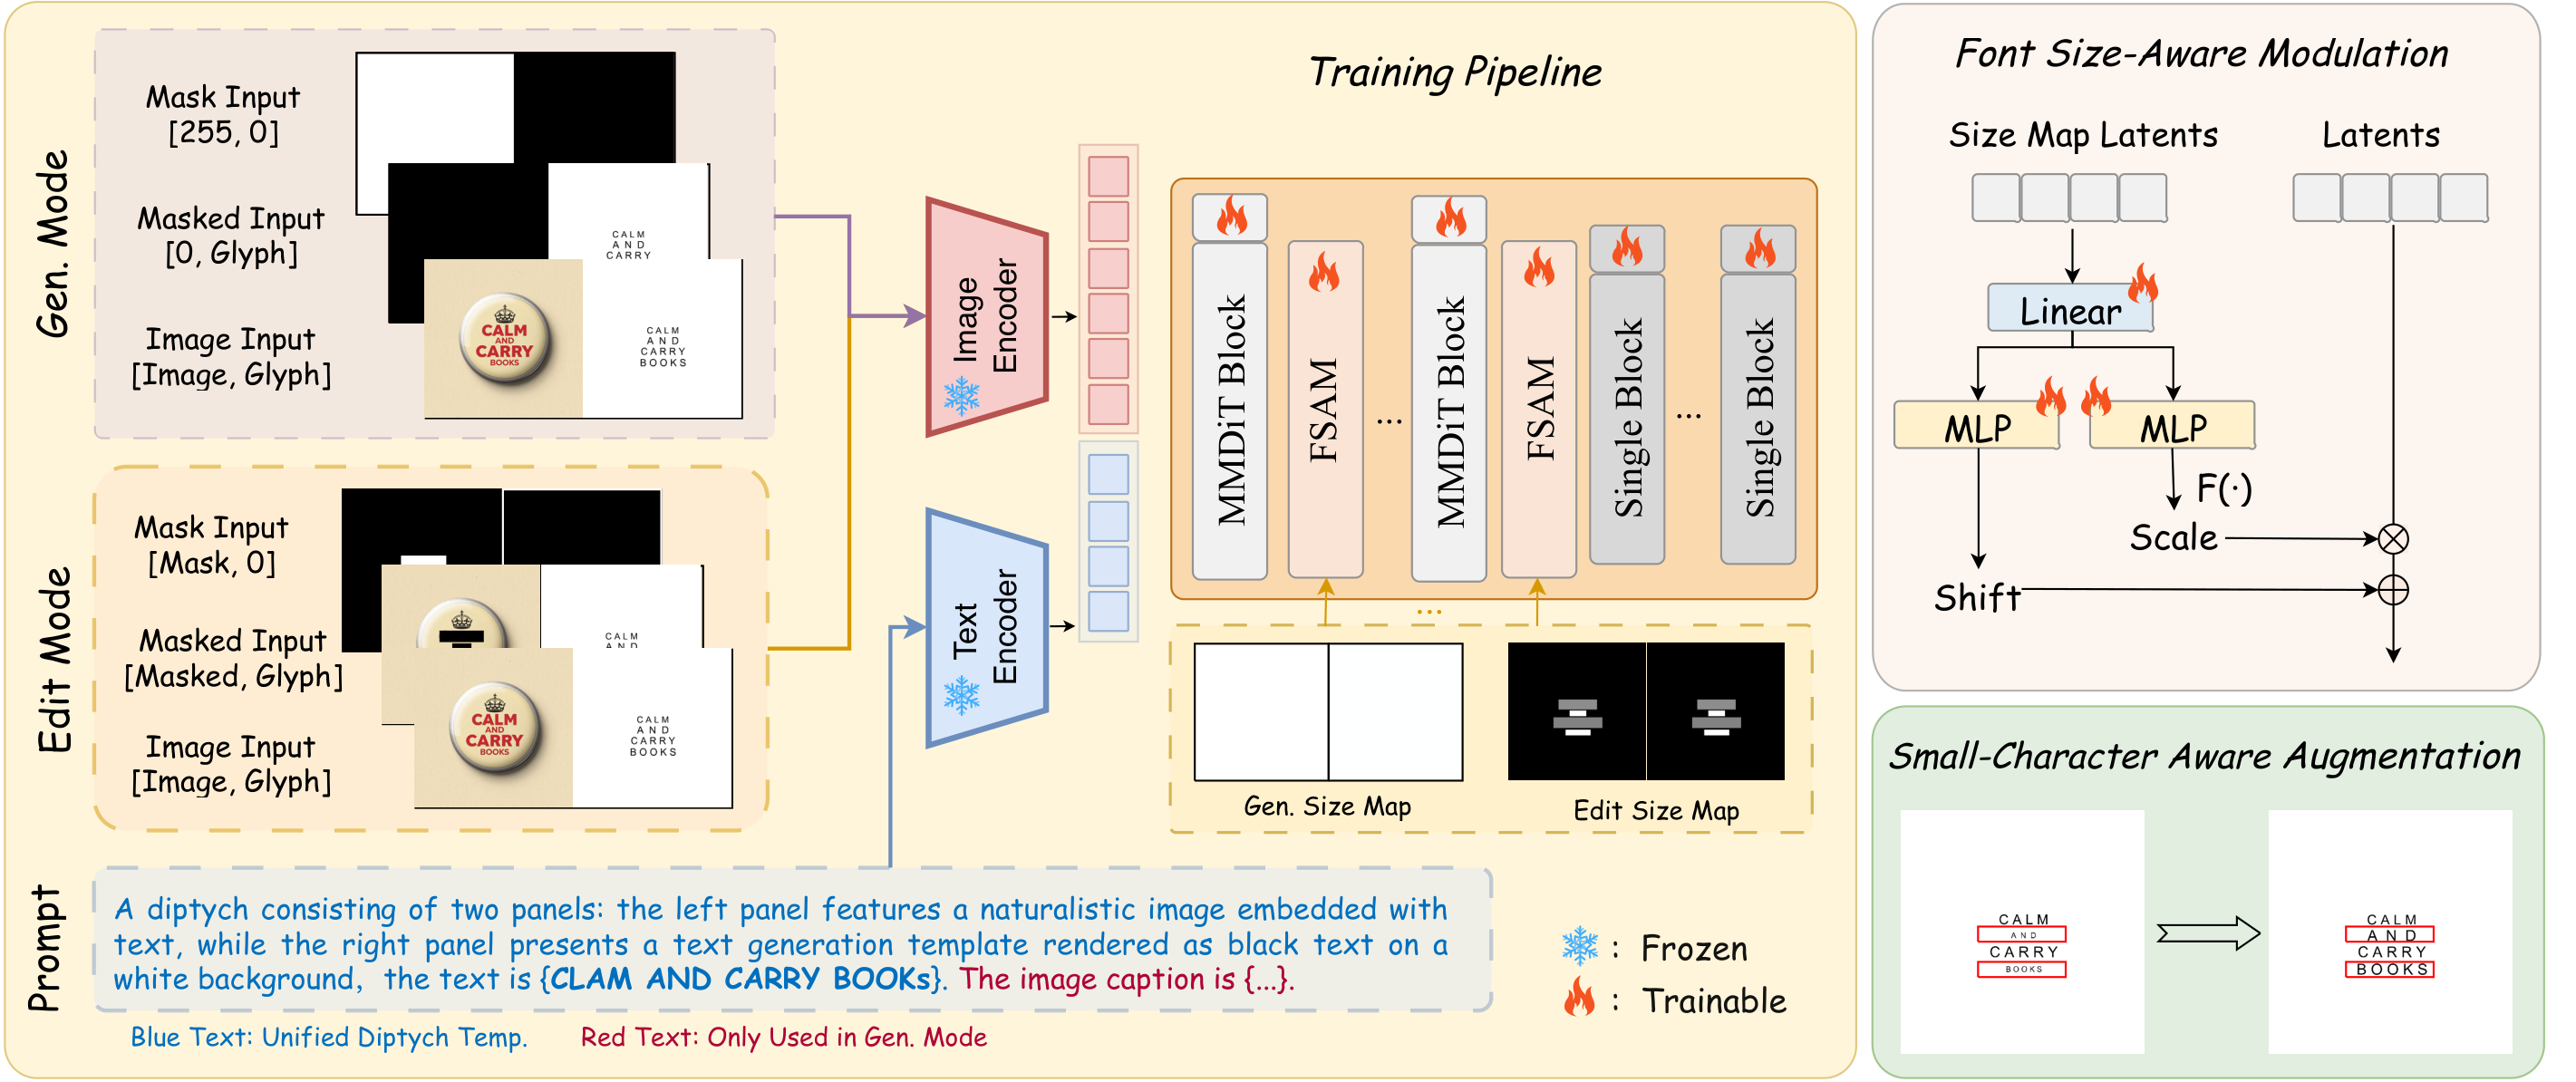
实验效果:实验显示生成准确率和编辑质量均优于对比方法,可输出更清晰、连贯且与背景融合自然的中英文字图像。

批判点评:把生成与编辑合并对海报、电商和本地化设计很实用,中英双语也比只测拉丁字母更有说服力。但摘要缺少量化幅度,视觉文字真正难点还包括长段排版、罕见字和任意语言,当前双语数据的外推边界待验证。
WhereEdit: Mask-aware Local Latent Editing for One-Step Image Editing | 中科院西安光机所·西交·武大 | arXiv:2607.20883
关键词:一步编辑,局部控制,AutoMask,免训练,图像编辑
前序问题:一步文生图模型让实时编辑成为可能,但现有方法主要靠文字做全局语义搬运,缺少“改哪里”的显式空间控制;即便加入区域约束,目标区修改强度也常不够,背景还容易被连带改变。
本文贡献:提出免训练、免反演的WhereEdit,把一步编辑改写为局部自适应语义运输。AutoMask从模型内部token注意力自动发现相关区域,Amplified Conditional Transport只在局部强化条件变化,同时保护非目标区域与结构一致性;额外区域监督实验进一步验证显式空间推理的价值。

实验效果:PIE-Bench上持续超过现有一步图像编辑方法,在保持一步生成效率的同时取得更高编辑质量;使用真值mask还能继续提升。
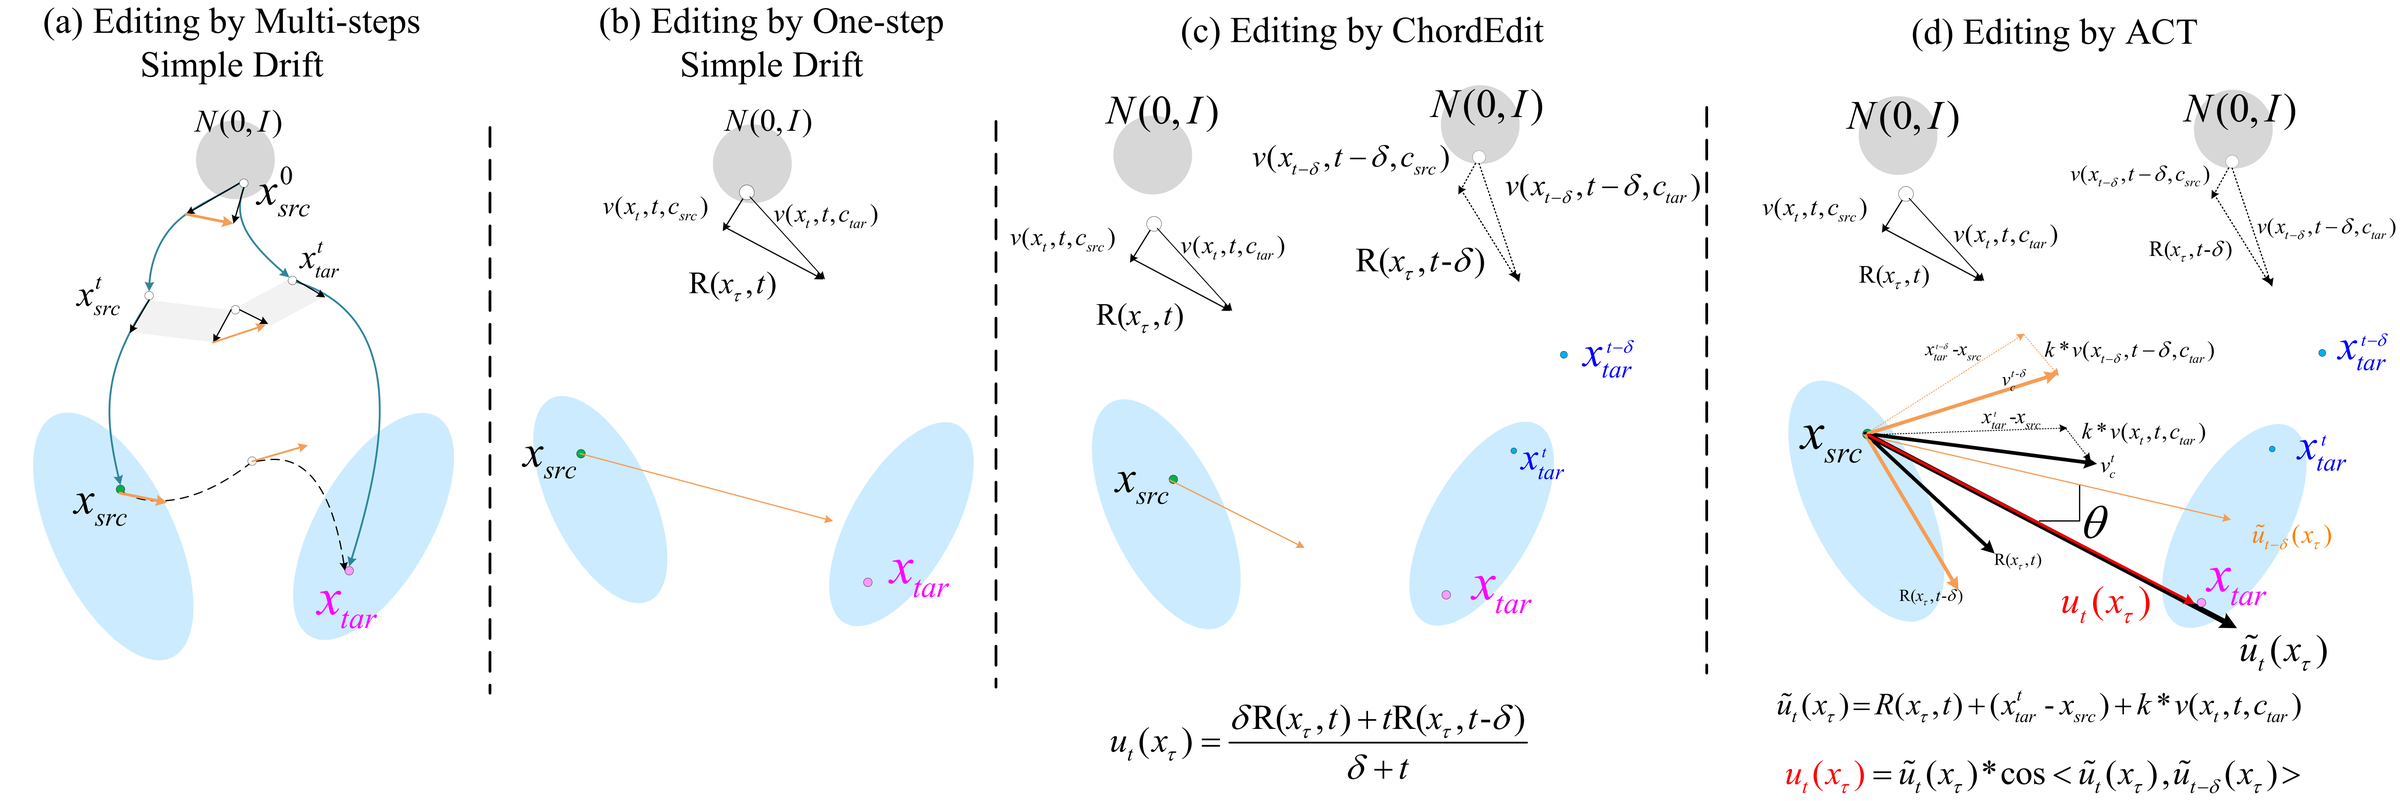
批判点评:WhereEdit补上了一步编辑最关键的空间控制,且无需训练和反演,适合交互产品。但AutoMask依赖模型注意力能正确指向目标,抽象属性、多个同类物体和大范围几何变化时容易选错区域;真值mask继续提升也说明自动定位尚未到顶。
KroQuant: Kronecker-Structured Block Transforms for Efficient Post-Training Quantization of Diffusion Transformers | EPFL·AMD | arXiv:2607.21446
关键词:DiT量化,W4A4,Kronecker变换,AMD,后训练量化
前序问题:DiT做W4A4后训练量化时,线性层输入中的离群激活超出4-bit表示范围,生成质量会严重下降。已有通道缩放损精度,Hadamard变换块大且在线成本高,完整可学习变换又要每层每步执行昂贵矩阵乘。
本文贡献:提出KroQuant,对每32个激活元素应用可学习的Kronecker结构可逆变换,参数不到逐通道缩放一半;块内结构可由tensor core小GEMM执行。离线LoRaQ权重校准再吸收剩余逐权重量化误差,把激活侧变换与权重侧修正结合。
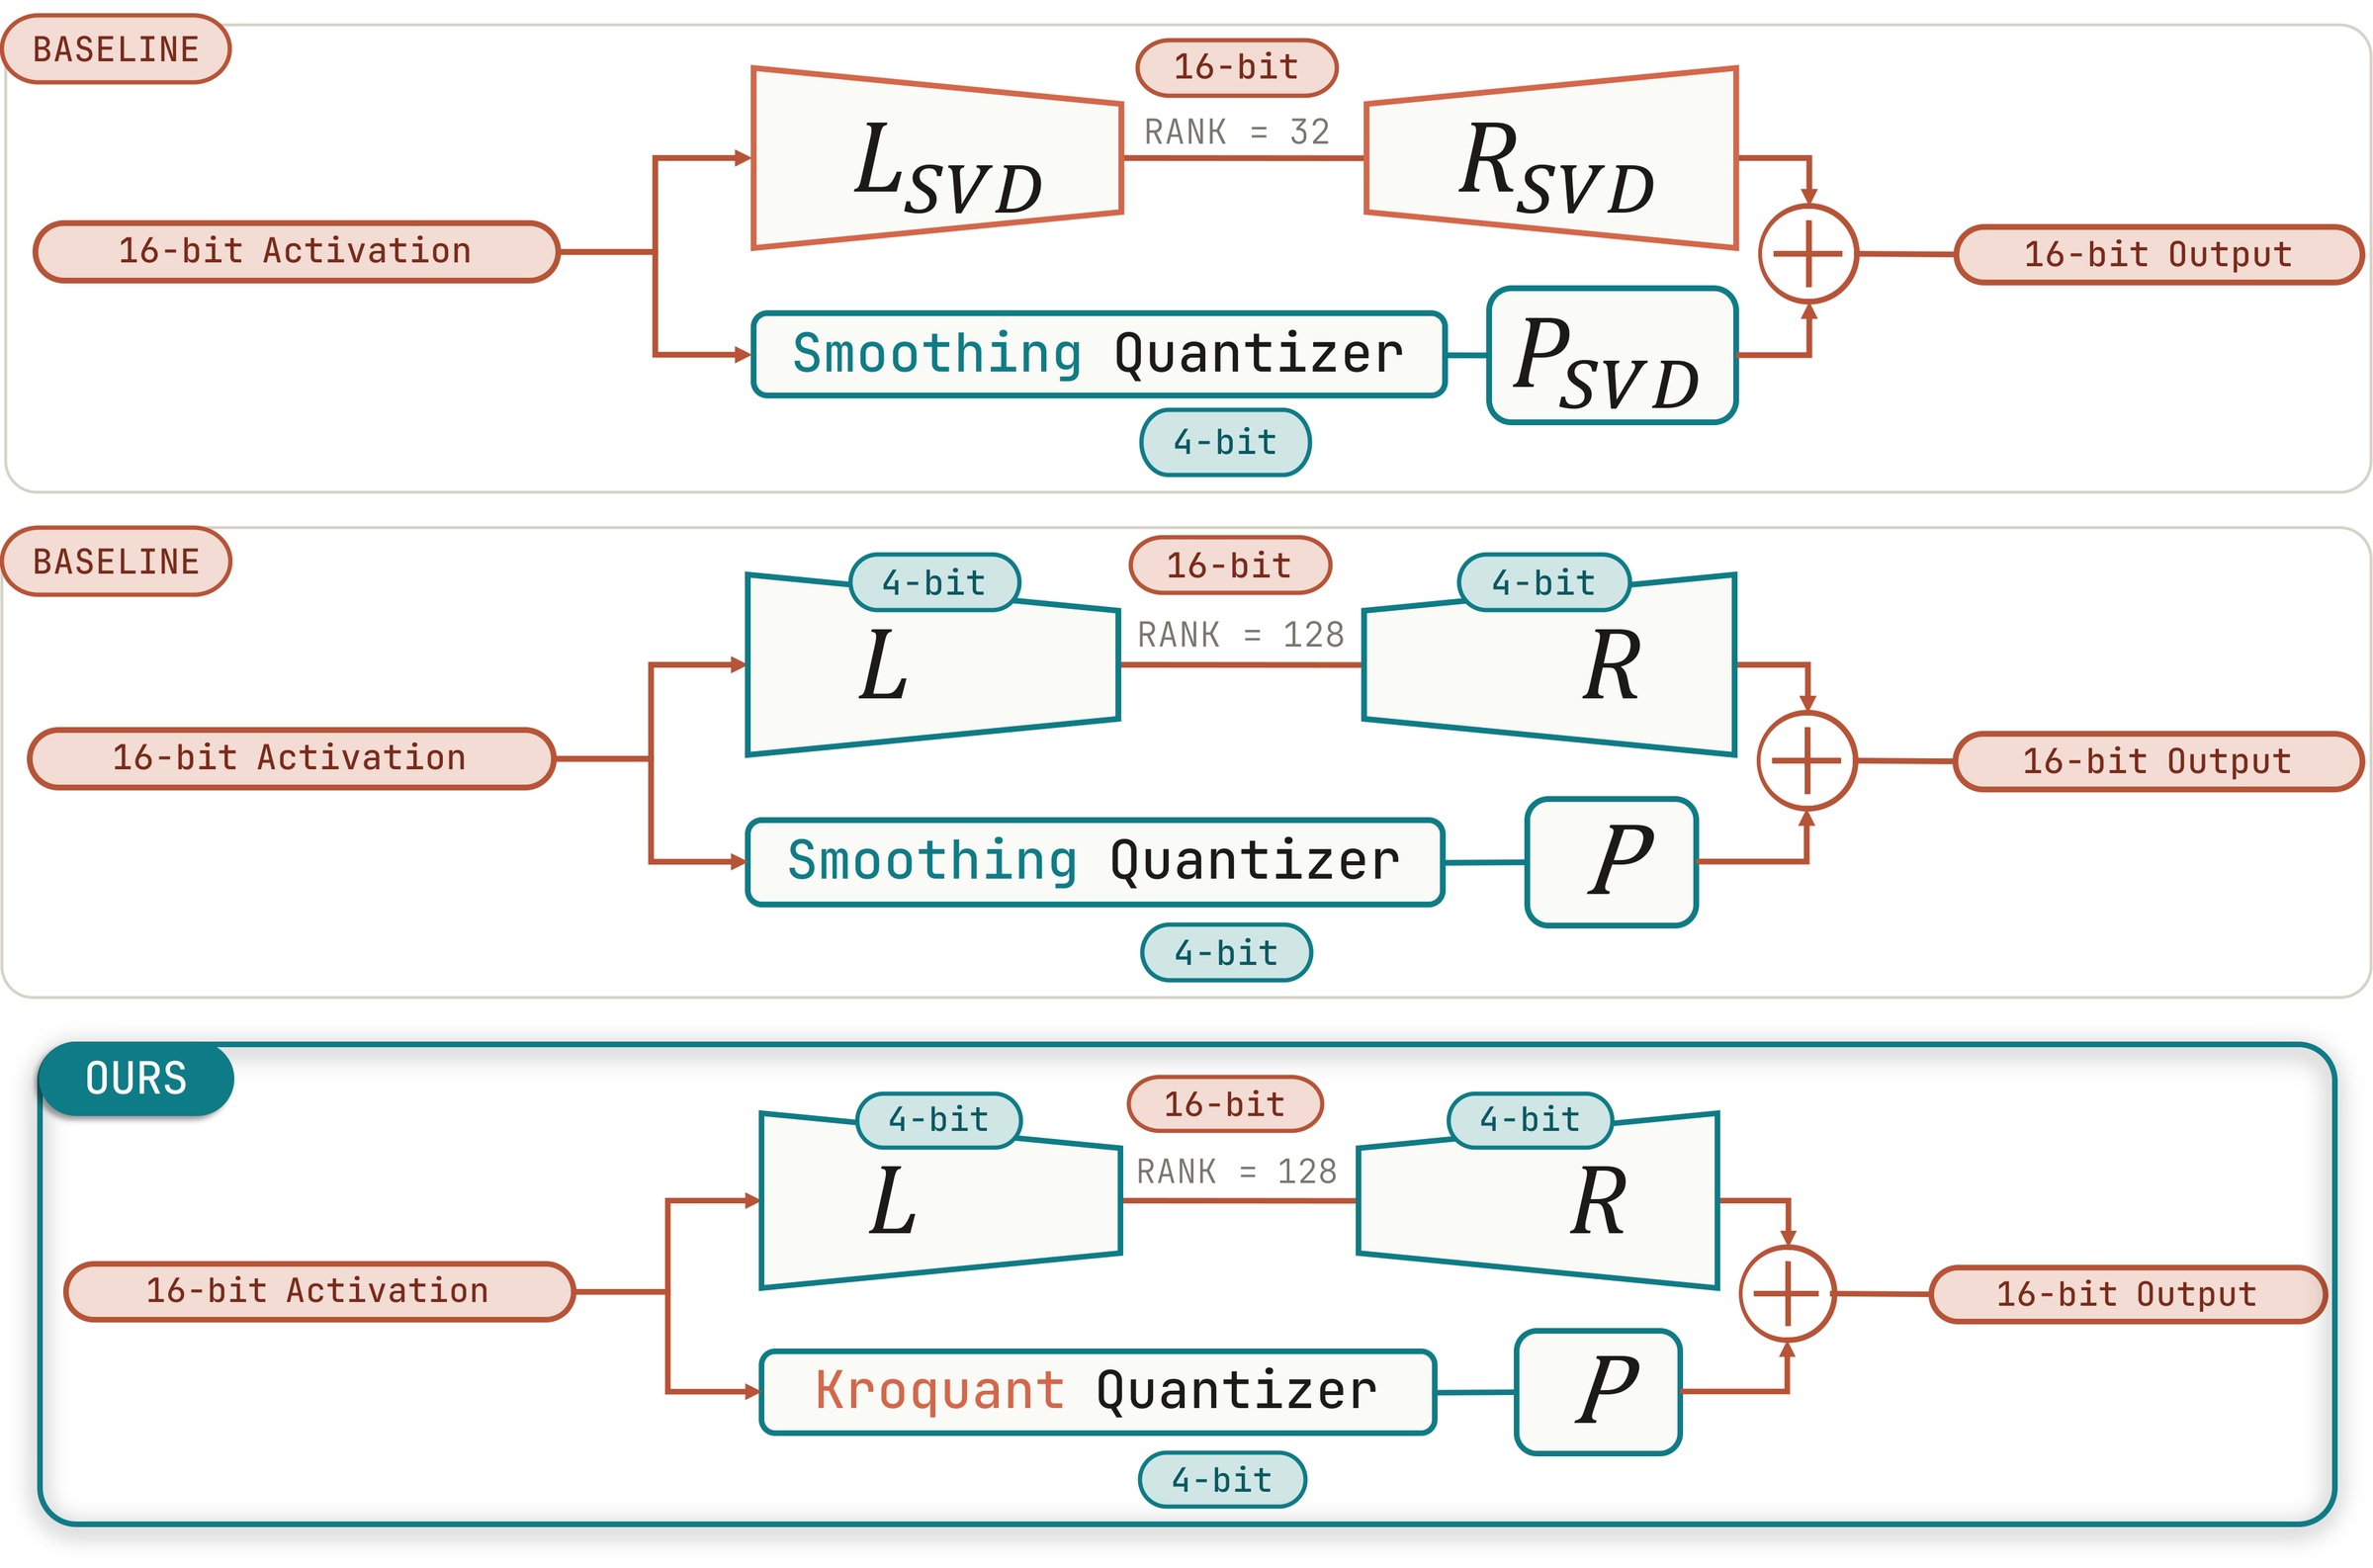
实验效果:MI350 GPU上量化器内核最多比SmoothQuant快14%;PixArt-Σ、SANA、FLUX.1-schnell在W4A4(MXFP4e2)下,比SVDQuant和LoRaQ更接近全精度参考,同时保持或提升图像质量。
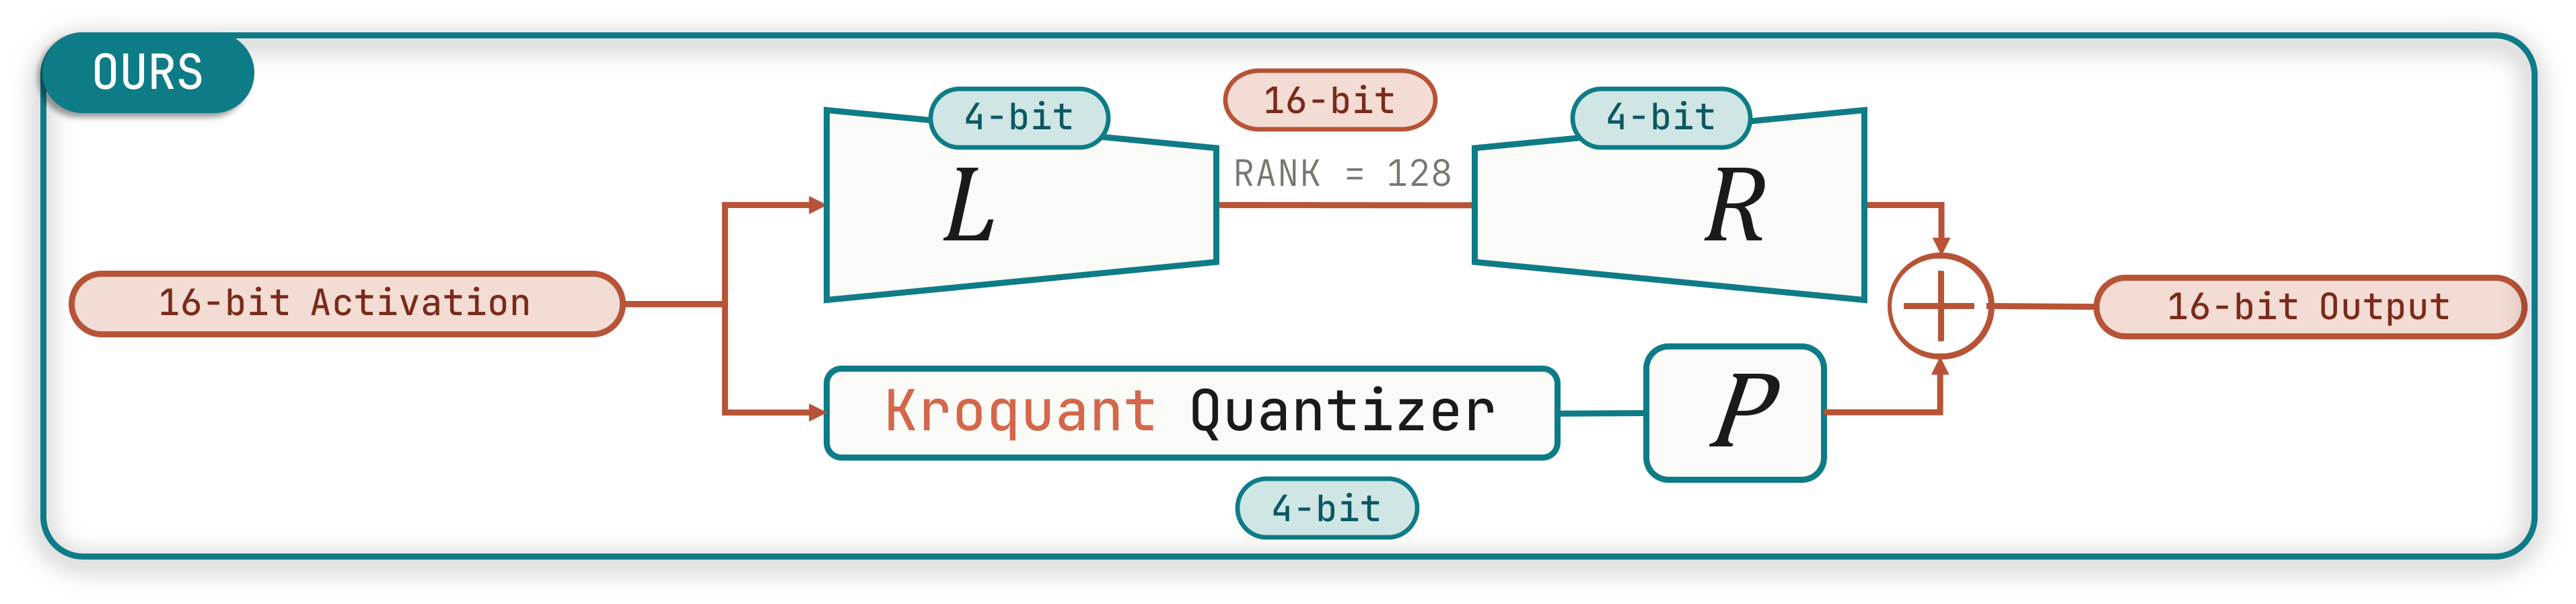
批判点评:权重和激活同时4-bit才真正触及DiT部署成本,AMD与EPFL给出的硬件内核数字比只报离线指标更可信。但14%是量化器kernel而非整条生成链路,端到端提速取决于去噪步数和算子占比;Kronecker块大小也可能需按新架构重调。
SoundscapeAgent: Agentic Soundscape Construction for Controllable Synthesis and Scalable Audio-Language Supervision | 武汉大学·腾讯混元 | arXiv:2607.21857
关键词:音频生成,创作Agent,声景,腾讯混元,音频语言
前序问题:单次文本到音频把规划、音源选择、时间布局和混音都藏在黑盒里,用户难以控制多事件声景,也无法获得包含事件角色与时间关系的结构化音频语言监督。
本文贡献:提出SoundscapeAgent:LLM Agent把用户意图转成可执行场景计划,通过检索和按需生成获取音频素材,再按可控时间线渲染多事件混音并导出对齐元数据。用户可指定工具并直接编辑计划,实现human-in-the-loop;同一流水线还能规模化生成结构化音频语言训练数据。
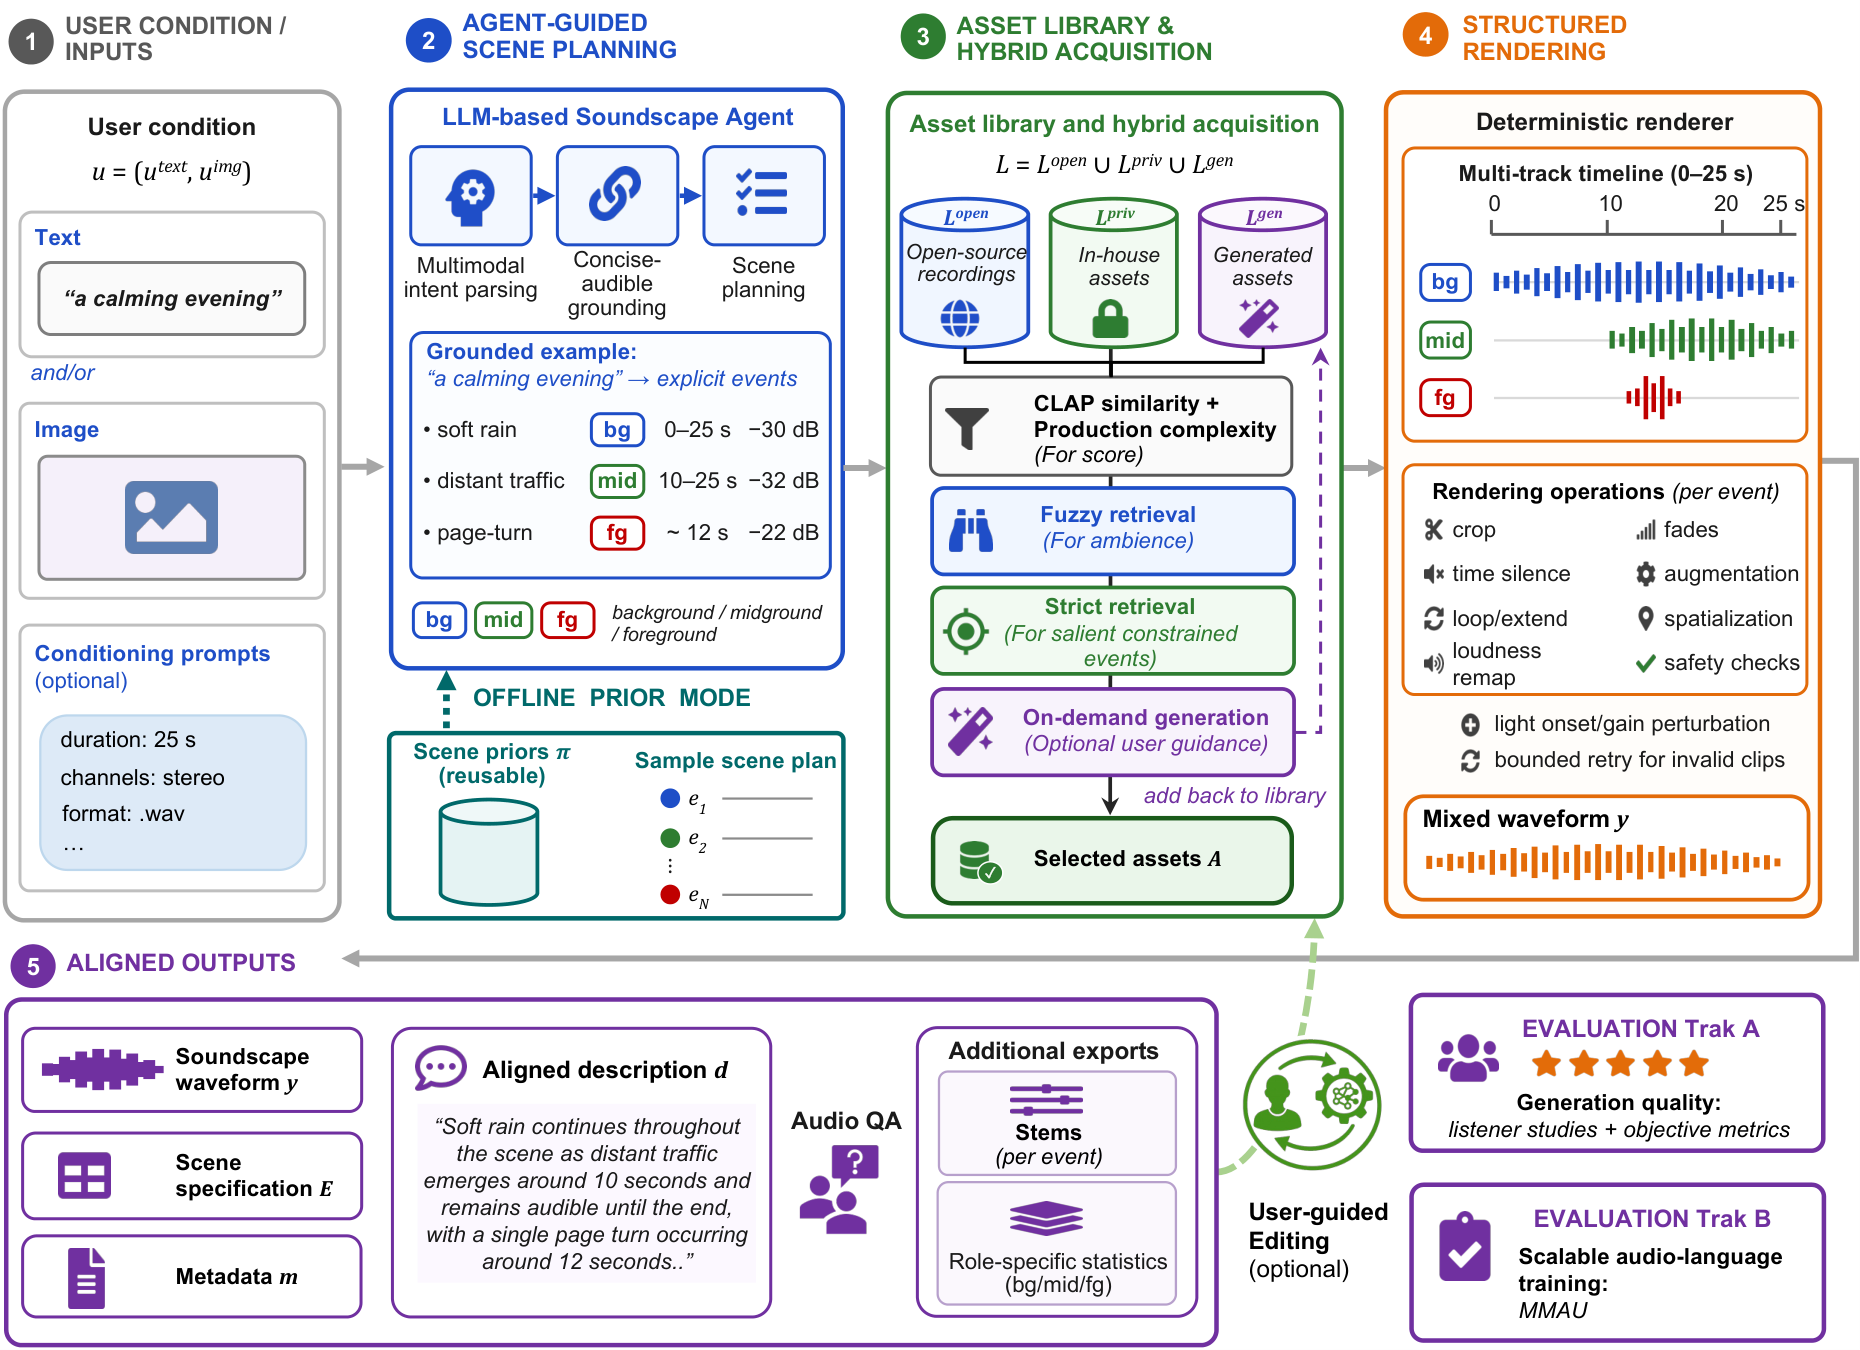
实验效果:听测和客观指标显示其生成质量可与文本到音频基线竞争;使用Agent合成数据训练的模型,在下游音频推理上持续超过仅用真实数据的基线。
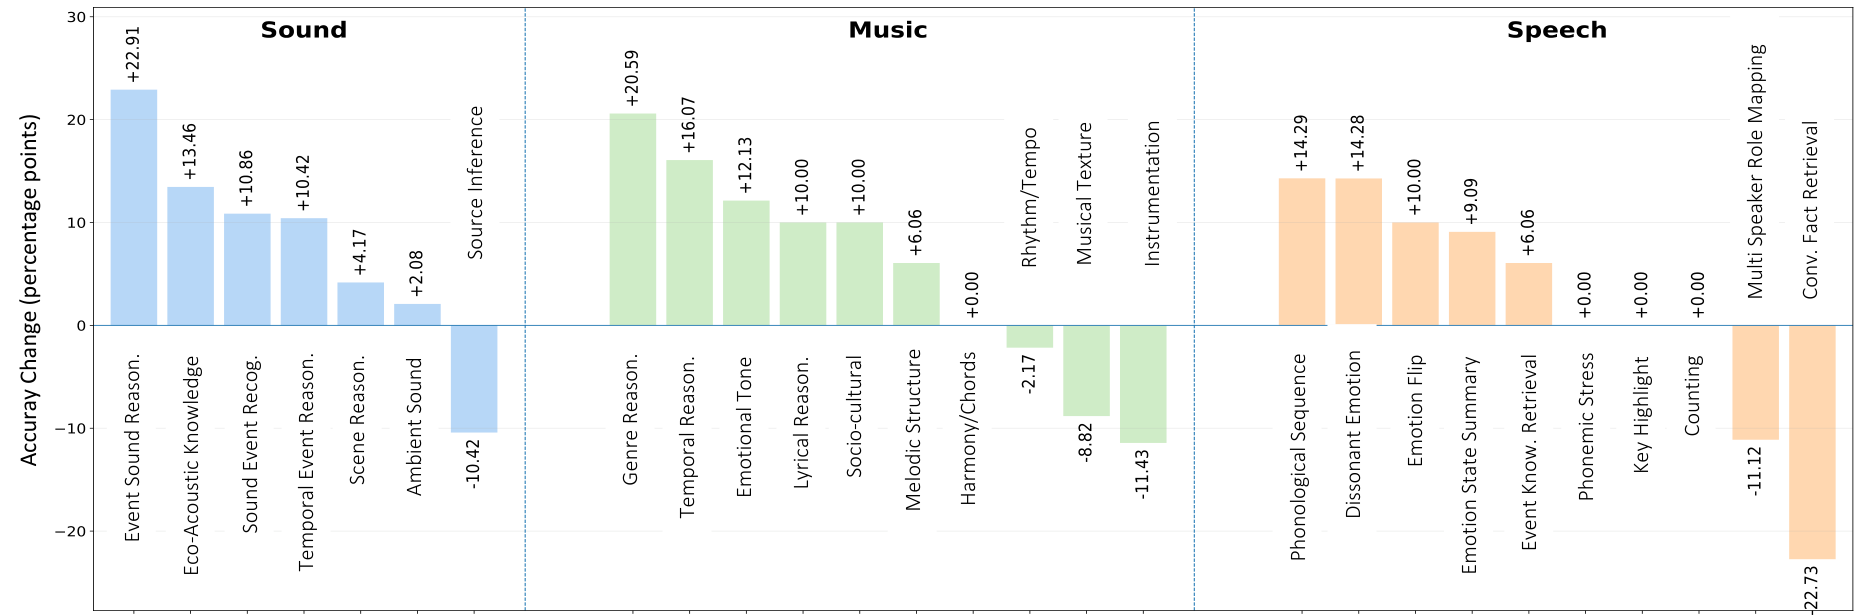
批判点评:它把“生成一段声音”升级为可检查、可修改的音频工程时间线,既服务创作又反哺理解数据。但检索素材的版权、来源域偏差和混音物理真实性会进入训练集;Agent生成元数据规模大不等于监督准确,仍需质量过滤。
人工智能炼丹君 整理 | 2026-07-28
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)