


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 5 篇 · 高效视频生成 1 篇 · 交互式世界模型与生成渲染 2 篇 · 可控视频生成 1 篇 · 人像图像编辑 1 篇
SANA-Video 2.0: Hybrid Linear Attention with Attention Residuals for Efficient Video Generation | NVIDIA | arXiv:2607.21553
关键词:视频生成,线性注意力,扩散Transformer,高效推理,视频DiT
前序问题:视频扩散 Transformer 用全 softmax 注意力质量高但随序列二次增长、长高清视频代价大;纯线性注意力可 O(N) 扩展却缺全秩 token 交互、质量受损。
本文贡献:提出统一架构下 5B/14B 的混合视频扩散 Transformer SANA-Video 2.0:混合线性-softmax 注意力以 3:1 比例把门控线性注意力(O(N) 为主的混合)与周期性门控 softmax 锚点结合,恢复纯线性注意力缺失的全秩交互;块注意力残差(AttnRes)把完成的块摘要路由进后续线性层、复用锚点特征并把深层有效秩提升约 12%;从零训练直接学完整混合(而非线性化预训练模型),降分辨率代理实验确定 25% softmax 为质量-效率最优点。

实验效果:40 步采样下单张 H100、480p 生成 13.2s 达 VBench 84.30,与远大的 softmax 视频 DiT 具竞争力却延迟极低;编译后 DiT 前向在 720p/60s 比匹配全 softmax 基线快 3.2 倍(时长越长差距越大);再加 Sol-Engine 全栈优化(核融合/缓存/稀疏注意力)提速 3.58 倍,5B 管线 720p/5s 达 13.06s,比 Wan2.2-A14B 快 120 倍。
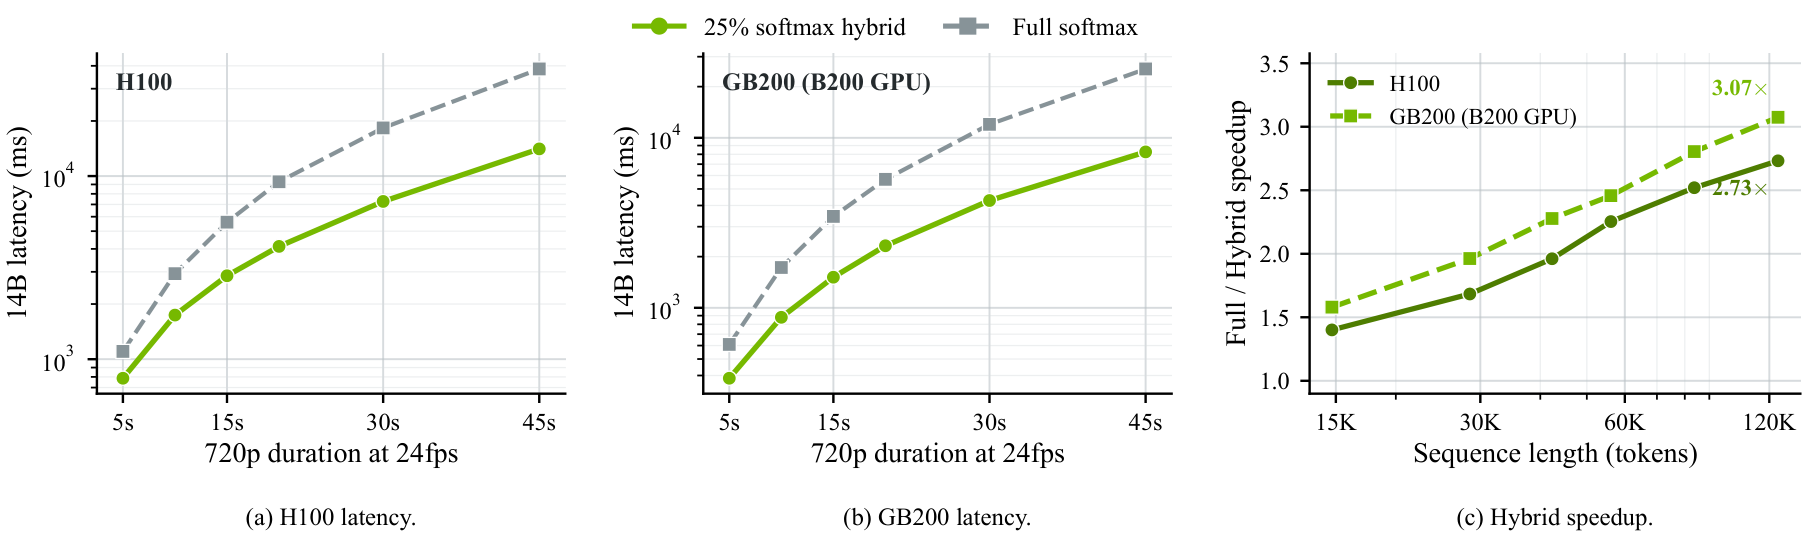
批判点评:用「混合线性-softmax+块注意力残差」在大幅降本下恢复 softmax 级表达力、且从零训得完整混合,单卡 720p 与 120× 提速对长高清视频落地意义大(NVIDIA 出品)。但混合比例/锚点设计的通用性、从零训练的成本、以及极长时长与更高分辨率下质量与效率的平衡仍需更多验证。
Streaming Multi-Agent Autoregressive Diffusion Model with World State Registers | UCLA·Adobe | arXiv:2607.21594
关键词:世界模型,多智能体,自回归扩散,状态寄存器,流式生成
前序问题:多智能体交互世界模型不仅要生成一致观测,还要维持跨智能体持久、随视角演化的世界状态;现有自回归视频扩散把观测历史作条件上下文,难在多智能体/多视角下维持共享状态。
本文贡献:提出流式多智能体视频扩散模型 WorldWeaver(W²),用跨智能体世界状态寄存器增强 rollout:可学习 token 存储共享世界信息、跟踪各智能体状态、并在每生成一块后动态更新;用跨越个体智能体状态、含鸟瞰的全局状态视图与场景文本的监督信号为寄存器提供 grounding;架构上用 Mixture-of-Transformers 让世界状态建模与视觉帧建模各用独立权重。
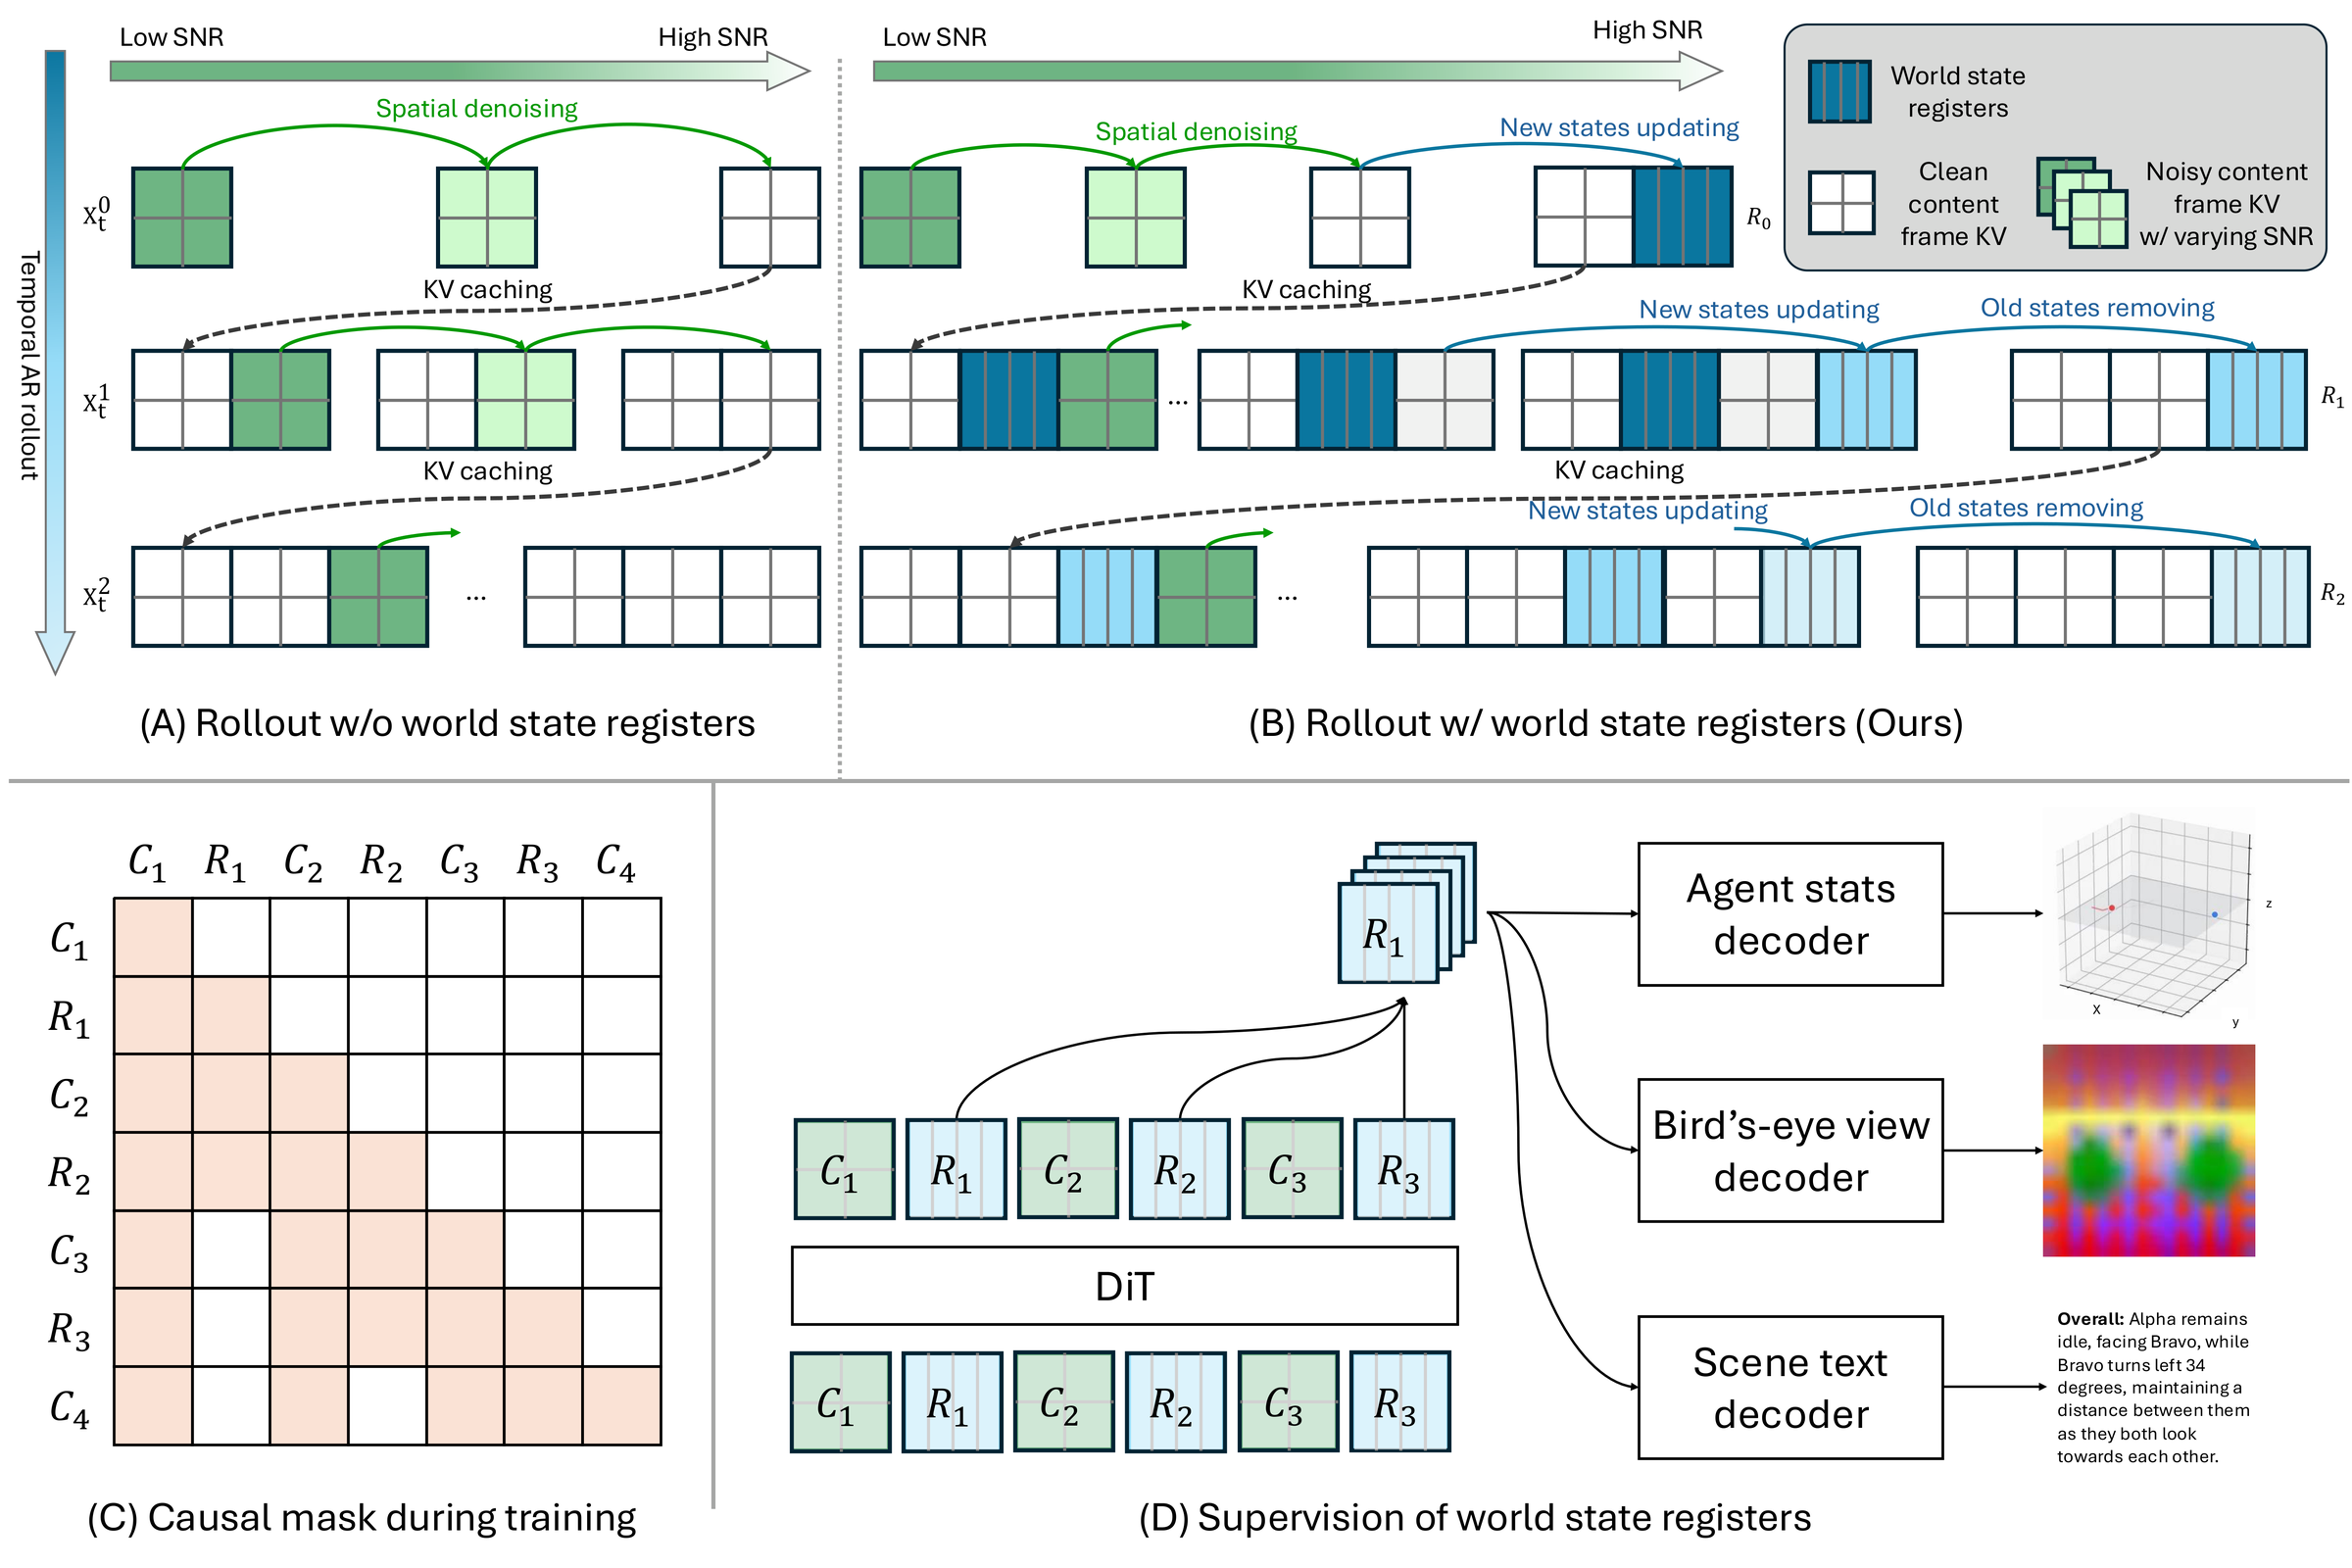
实验效果:在双智能体 Minecraft 视频生成上,显式世界状态建模提升了逻辑一致性与生成质量。

批判点评:用「世界状态寄存器+MoT 分权」把多智能体共享状态显式化,直指现有 AR 世界模型只靠观测历史的短板,UCLA·Adobe 出品思路扎实。但目前主要在 Minecraft 双智能体上验证,真实复杂场景、更多智能体与更长时程下的状态一致与可扩展性仍待检验。
Closing the Loop: Training-Free Revisit Consistency for Autoregressive Generative Rendering | Roblox·宾州州立 | arXiv:2607.21848
关键词:生成渲染,自回归视频,回环一致,免训练,3D世界
前序问题:条件视频生成可把 3D 引擎渲染(深度/无纹理几何)转成写实视频用于游戏与沉浸内容,需长时程自回归持续合成新帧并保持持久 3D 世界;但 AR 生成器用有界 KV cache 分块合成,当相机在上下文被淘汰后回访某地,即使条件渲染仍与几何对齐,模型也常重新生成不一致外观。
本文贡献:提出无需任何后训练的方案,利用 3D 引擎已提供的对应关系解决回访不一致:时间对应把位姿匹配的历史潜块检索回 KV cache 作回环记忆;空间对应用相机位姿与深度重投影,把 token 级注意力偏向检索块中几何对应区域。

实验效果:在从 TartanAir/TartanGround 挖掘的回环轨迹上(贴近复杂真实场景),在回访一致性上超过现有免训练基线,且不损整体视频质量。

批判点评:把 3D 引擎自带的时空对应变成免训练的回环记忆,精准命中 AR 生成渲染的回访漂移,Roblox 背景贴近游戏落地、零后训练很实用。但依赖 3D 引擎提供精确对应(纯生成场景不适用)、检索与重投影的额外开销,以及大幅动态/光照变化下的一致仍需更多验证。
GraphVid: Interactive Graph-Controllable Video Generation | UIUC | arXiv:2607.21580
关键词:图生视频,可控生成,交互图,多主体,数据集
前序问题:可控视频生成难在用文本或主要约束像素移动的运动控制精确指定多物体交互;基于轨迹的控制常需为多物体画准确轨迹,随场景复杂度扩展差、遮挡/重叠下含糊。
本文贡献:提出图条件的图生视频模型 GraphVid,通过结构化交互图实现灵活而精确的多主体交互控制;并构建大规模、以交互为中心、带结构化关系标注的视频数据集 GraphVid-Bench 以训练交互感知的视频生成模型。
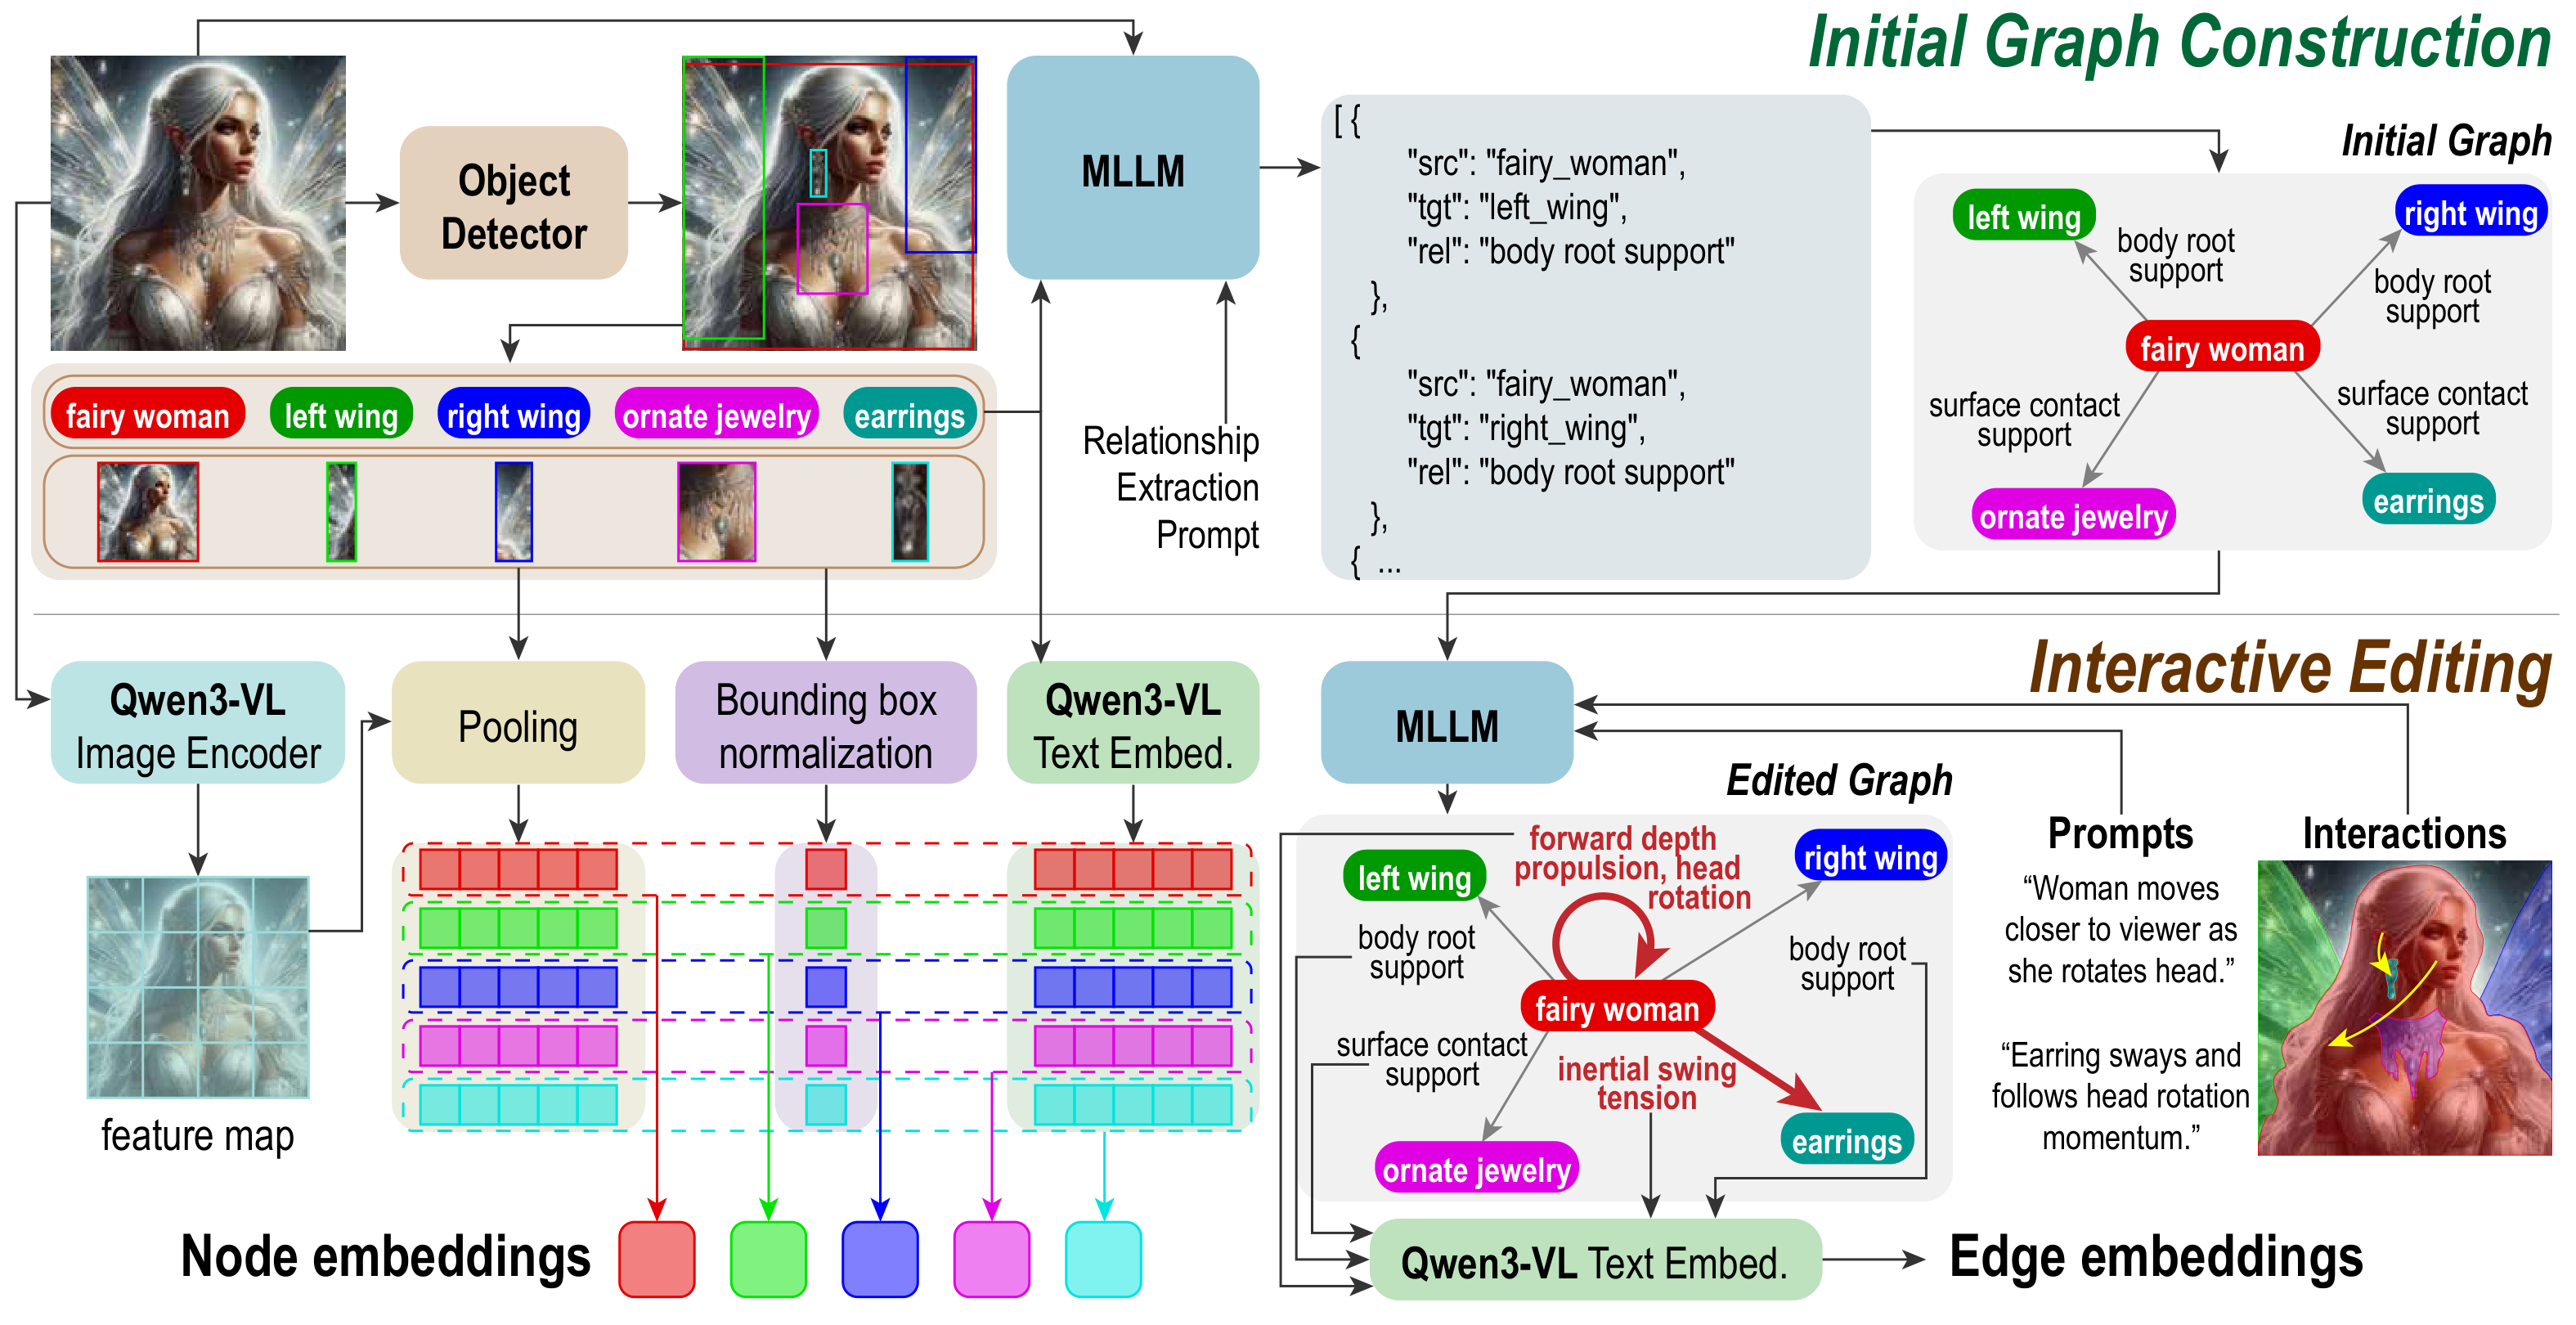
实验效果:尽管训练数据与可训练参数远少于此前运动控制方法,GraphVid 仍具强可控性与画质:相比 Motion-I2V,FID 最多降 39.9%、FVD 降 37.6%,PSNR 从 9.87 升至 15.98、SSIM 从 0.38 升至 0.61。
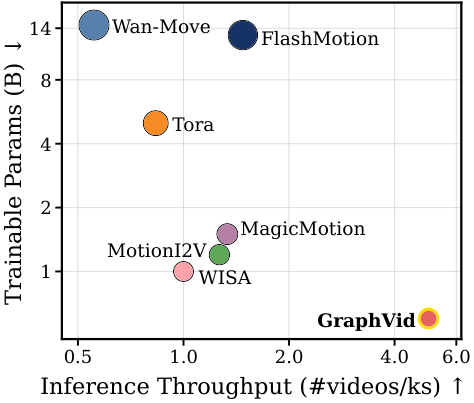
批判点评:用「交互图」作结构化语义接口控制多主体视频,比画轨迹更省数据、更抗遮挡歧义,指标提升明显、范式有启发。但交互图的构建与交互标注成本、复杂/开放场景下图到视频的忠实度,以及相比像素级控制的精细度边界仍需更多检验。
MagicMakeup: A Region-Controllable Diffusion Transformer for High-Fidelity Makeup-Transfer | 浙大·vivo | arXiv:2607.20924
关键词:妆容迁移,图像编辑,扩散Transformer,区域控制,身份保持
前序问题:妆容迁移要把参考妆容迁到源脸同时保源身份;扩散方法虽推进整脸编辑,但强区域可控、妆容保真与身份保持仍难——像素-注意力错位致溢出到非目标区、双图条件下迁移/保持概念不清致妆容属性与身份耦合、且缺身份一致且区域标注的高分辨率数据集。
本文贡献:提出基于扩散 Transformer 的区域可控高保真妆容迁移框架 MagicMakeup,建立在空间约束与概念解耦上:Token 对齐区域门控把像素 mask 与注意力对齐并施加区域特定 logit 门控以实现精确区域编辑并保身份;跨模态感知引导对齐文本与图像特征以厘清迁移与保持概念;并设计经区域特定卸妆生成 1024×1024 数据对的流程、建立合成与真实统一基准。

实验效果:大量定量定性实验表明,MagicMakeup 提升区域可控性、妆容保真与身份保持,且跨风格、种族、姿态具强鲁棒。

批判点评:用「区域门控+概念解耦」对症妆容迁移的溢出与身份耦合,配区域标注高分辨率数据与统一基准,工程扎实、vivo 背景贴近手机影像落地。但依赖卸妆合成的数据对质量、极端妆容/复杂光照下的保真,以及区域门控在细小部位的精度仍有提升空间。
人工智能炼丹君 整理 | 2026-07-27
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)