


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

论文:SLA2: Sparse-Linear Attention with Learnable Routing and QAT
机构:清华大学 · UC Berkeley
作者:Jintao Zhang、Haoxu Wang、Kai Jiang、Kaiwen Zheng、Youhe Jiang、Ion Stoica、Jianfei Chen、Jun Zhu、Joseph E. Gonzalez
日期:2026-02-13(arXiv v1)
相关代码:thu-ml/SLA(仓库已引用 SLA2,但当前公开用法主要对应前代 SLA)
重点对比:DeepSeek-V3.2 技术报告 · DeepSeek-V3.2-Exp 官方实现
论文状态:arXiv 预印本;源码使用 ICML 2026 preprint 模板,不等于已被 ICML 接收
简单讲:SLA2 是给视频扩散模型做的“注意力分流器”。
生成视频时,Transformer 里的每个视觉 token 原本要和大量其他 token 做完整注意力,序列一长,计算量就按平方增长。SLA2 不想把 97% 的连接粗暴删掉,而是把连接分成两路:
在 Wan2.1-1.3B-480P 和 Wan2.1-14B-720P 上,论文把稀疏率推到 97%。此时考虑线性分支后,作者给出的实际计算节省约为 96.7%;RTX 5090 上前向 Attention Kernel 从 FlashAttention2 的 219 TOPS 提高到 4079 TOPS,按图中数字约为 18.6~18.7 倍。
但先别把这个结果理解成“整个视频生成快 18.7 倍”。端到端加速是:
原因很直接:Attention 之外还有 FFN、VAE、调度与数据搬运。Kernel 快 18.7 倍,不代表整条流水线同倍率加速。
主要亮点:
需要冷静看的地方:
传统稀疏注意力的做法比较像裁员:只保留 Top-k 连接,其余直接置零。问题是,视频注意力里被删掉的大量小权重可能单个不重要,但合起来仍承载全局色调、背景一致性和长程运动信息。
SLA 的思路更柔和:
它依赖一个观察:扩散模型的完整注意力矩阵 $P$ 往往可以拆成“高稀疏部分 $P_1$ + 低秩部分 $P_2$”。稀疏分支精确处理尖峰,线性分支近似处理长尾,理论上比纯 Top-k 更适合高稀疏率。
前代 SLA 的 Router 却比较朴素:先对相邻 token 的 $Q$、$K$ 做平均池化,再按池化注意力分数大小选 Top-k。分数最大的一批进稀疏分支,其余进线性分支。这个规则能用,但“权重大”不等于“必须由精确 Softmax 计算”;有些权重搬到线性分支后仍容易被低秩结构表达。
SLA2 的目标不是简单找“大权重”,而是找出“哪一组连接留给线性分支后,整体近似误差最小”。
(这段稍微技术一点,不感兴趣可以跳到 05。)
设完整注意力概率矩阵为:
$$P=\mathrm{softmax}(QK^\top/\sqrt d)$$
给定二值 mask $M$,理想分解是:
$$P_1=P\odot M,\qquad P_2=P\odot(1-M),\qquad P=P_1+P_2$$
直觉上,稀疏分支应该计算 $P_1V$。但实际的 Masked Softmax 会在保留位置上重新归一化。设每一行被 mask 选中的概率质量为:
$$\alpha=P_1\mathbf 1$$
真正由稀疏 Softmax 得到的是:
$$P_s=P_1/\alpha$$
所以目标并不是 $P_sV$,而是:
$$P_1V=\alpha\odot(P_sV)$$
这就是前代 SLA 的尺度错位:稀疏分支每行都被强行归一化到和为 1,把本来只占 $\alpha$ 的概率质量放大了。前代让线性分支后面的投影同时做两件事——近似 $P_2V$,再抵消稀疏分支多出来的缩放误差。一个分支承担两个目标,学习难度自然更高。
SLA2 改成:
$$O=\alpha\odot O_s+(1-\alpha)\odot O_l$$
这里 $O_s$、$O_l$ 都先做行归一化。$\alpha$ 恢复稀疏分支本来应占的概率质量,$1-\alpha$ 给线性分支分配剩余质量,两路相加后仍保持归一化。这个改动看起来只多了一对系数,实际上把“谁负责什么”重新理顺了。
需要留意:理论推导里的 $\alpha$ 是完整注意力在 mask 内的真实概率和;工程实现中的 $\alpha$ 是训练得到的参数。它是对真实比例的学习近似,不是推理时先算完整注意力再精确求和——否则加速就没有意义了。论文也没有说明具体如何把学习参数约束到 $[0,1]$,例如是否经过 Sigmoid。
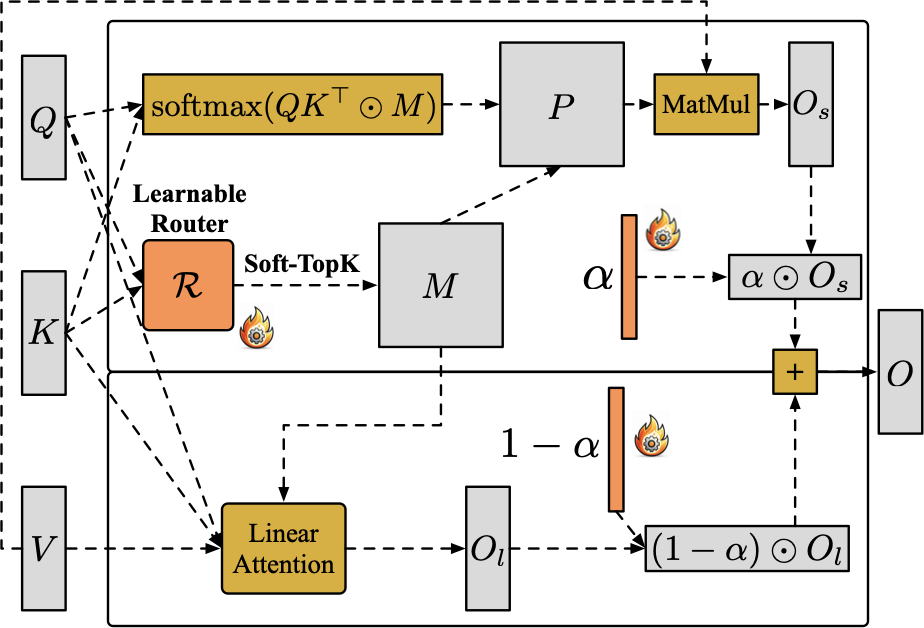
(图片来源:论文 Figure 1。Router 从 Q/K 产生块级 mask;被选块走稀疏低比特 Softmax,未选块进入线性分支,最后由 α 和 1-α 混合。)
(技术细节,可选阅读。)
视频 token 数量很大,如果 Router 自己也计算完整 $N\times N$ 分数,加速收益会被它吃掉。SLA2 先对相邻 token 做块级平均池化:
$$\bar Q=\mathrm{pool}(Q),\qquad \bar K=\mathrm{pool}(K)$$
实验使用的块大小是:
然后加两组可学习投影:
$$P_c=\mathrm{proj}_q(\bar Q)\mathrm{proj}_k(\bar K)^\top$$
每一行选最高的 $k\%$:
$$M_c=\mathrm{Top\mbox{-}k}(k\%,P_c)$$
其中 $k\%=5\%、4\%、3\%$,分别对应大约 95%、96%、97% 的稀疏率。得到的是块级 mask,不是逐 token mask。GPU Kernel 直接按块跳过乘法,不必把 $M_c$ 展开成巨大的 $N\times N$ 矩阵。
可学习的部分不是 Top-k 本身,而是 $\mathrm{proj}_q$ 和 $\mathrm{proj}_k$。它们把 Q/K 映射到一个“更适合做分流”的空间。如果两个投影都设为单位矩阵,就退化成前代 SLA 的启发式 Router。
这也解释了它和 DeepSeek DSA 的第一个共同点:两者都不是直接相信主注意力的原始点积,而是训练一个便宜的旁路打分器,提前预测哪些连接值得进入昂贵注意力。
这里要区分“前向输入”和“训练监督”:SLA2 Router 前向只读取 Q/K,但 Stage 1 用 Full Attention 与 SLA2 最终输出的 MSE 训练,目标经过了 $PV$,所以监督信号间接依赖 V。DeepSeek DSA 的 Indexer 前向和注意力分布 KL 目标都不直接依赖 V。
SLA2 的训练分成两个阶段。
Stage 1:先把 Router 和 $\alpha$ 初始化好
硬 Top-k 不可导,所以训练时换成 SoftTop-k:
$$\mathrm{SoftTop\mbox{-}k}(P_c)_{ij}=\sigma((P_c)_{ij}/\tau+\lambda_i)$$
$\tau=0.1$。$\lambda_i$ 通过二分搜索求解,使每行的软选择总和严格接近目标预算。这个设计不是随便用个 sigmoid,而是让软 mask 仍然保持固定的稀疏预算。
Stage 2:换回硬 Top-k,微调整个视频扩散模型
这个安排很务实:第一阶段解决“Top-k 不可导”,第二阶段解决“软选择和真实部署不一致”。代价是 Router 学到的是第一阶段 Full Attention 输出近似,后续端到端训练不会继续按最终生成损失调整路由边界。
SLA2 只量化稀疏分支的核心矩阵乘法。
前向过程可以拆成两段:
此外,Kernel 先对 K 做列均值平滑,量化/反量化方案沿用 SageAttention2++。整个计算基于 FlashAttention 风格的在线 Softmax,只对 mask 命中的块做 QK 和 PV,不会先生成完整分数矩阵再遮掉 97%。
反向传播则全部使用原始 FP16 Q/K/V 和前向输出计算梯度。也就是说:
Table 2 的消融也支持 QAT 有用:同样做量化推理,去掉 QAT 后,1.3B 模型的 AQ 从 64.62 降到 61.85,Vision Reward 从 0.1039 降到 0.0850。
不过论文没有把最终实验精确采用 INT8 还是 FP8、各张量尺度粒度和完整 Kernel 配置写透。工程复现时,这不是小细节,而是决定误差和速度的关键参数。
SLA2 的高效不只来自“mask 很稀”,还来自两条分支都避免了完整 $N^2$ 物化。
命中 mask 的块:
未命中 mask 的块:
最后按块对应的 $\alpha$ 混合两路。论文算法给出的 $\alpha$ 输入形状是 $N/b_q\times1$,说明工程实现实际上是 Query Block 级混合,而不是每个 Query token 各自一套完全独立比例。
这点很重要:论文正文常把 $\alpha$ 写成 $N\times1$,算法实现则使用 $N/b_q\times1$。两者表达的是同一思路,但粒度不同;复现时应以 Kernel/算法描述为准。
实验底模是 Wan2.1-T2V-1.3B-480P 和 Wan2.1-T2V-14B-720P。训练集是私有的 3000 段公开视频,每段约 5 秒;每种方法微调 500 步,1.3B batch size 64,14B batch size 15。
在 1.3B 模型、97% 稀疏率下:
所以更准确的说法是:SLA2 在图像质量、整体一致性和审美分上高于未微调 Full Attention,但运动平滑、主体一致性与偏好奖励仍略低。不能概括成“所有指标超过 Full Attention”。
14B、97% 稀疏时,SLA2 的 IQ/OC/AQ 为 66.93/21.12/65.14;Full Attention 为 68.01/22.44/64.66。它在审美分更高,但 IQ 和 OC 没超过 Full Attention。相较于 90% 稀疏的 VMoBA、VSA、SLA,SLA2 整体更稳。
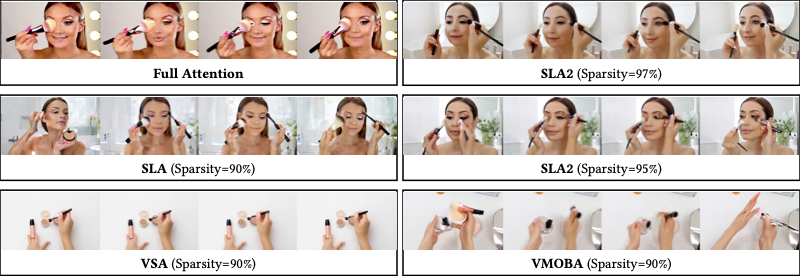
(图片来源:论文 Figure 2。第一人称化妆视频案例;这是作者选择的单个定性样例,不代表平均质量。)
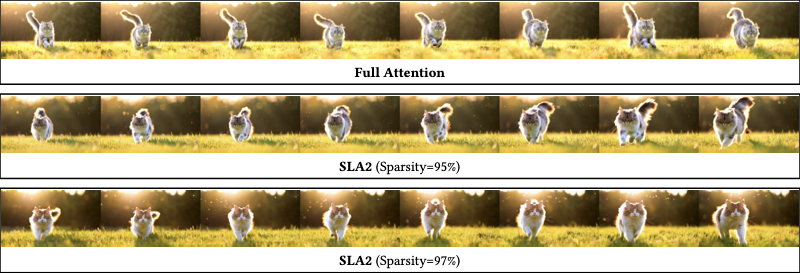
(图片来源:论文 Figure 3。草地奔跑猫咪案例;SLA2 97% 稀疏与 Full Attention 的关键帧接近。)
先说结论:两者共享的是“Learned Retrieval before Attention”范式,不是同一种稀疏注意力实现。
共同点主要有六个:
前向路由都由 Q/K 相关信号驱动,不读取 V。
但训练目标不同:SLA2 的输出 MSE 经过 $PV$,监督间接依赖 V;DSA 的注意力分布 KL 目标不直接依赖 V。
都有独立于主注意力的轻量打分空间。
SLA2 用 $\mathrm{proj}_q(\bar Q)\mathrm{proj}_k(\bar K)^\top$;DSA 用多头 Indexer 的投影 q/k 和门控权重。
最终都执行硬 Top-k。
Router/Indexer 只负责候选检索,真正的主注意力只在选中位置计算。
都先学习近似 Full Attention,再让主模型适应稀疏模式。
SLA2 Stage 1 拟合 Full Attention 输出;DSA Dense Warm-up 对齐主注意力分布,随后稀疏继续训练。
Router/Indexer 自己仍有全局扫描成本。
它们不是让选点免费,而是用便宜打分替代昂贵主注意力。DSA Indexer 的 Prefill 仍是 $O(L^2)$,只是常数远小于主 MLA;收益取决于旁路足够轻、主 Attention 足够重。
都要求 Kernel 真正按索引跳过计算。
只生成 mask、仍调用 Dense Attention 并不会获得论文速度。SLA2 依赖块稀疏 FlashAttention 风格 Kernel;DSA 依赖 Indexer Logit Kernel 与 FlashMLA 稀疏 Kernel。
这个共同范式可以概括成:先花小钱做检索,再花大钱做精算。
这是最重要的区别。
DeepSeek DSA 对每个 Query token 从历史 KV 中选 Top-2048。选中的 token 进入主 MLA Attention,未选中的 token 不参与该 Query 的主注意力计算。
SLA2 则没有把未选连接直接丢掉:
所以两者的 Router 优化目标不同:
这也是为什么 SLA2 不能照搬 DSA 的 KL Attention Map Distillation。它不仅要排序重要性,还要考虑剩余矩阵是否容易被线性分支表达。
(技术细节,可选阅读。)
对 Query token $h_t$ 和历史 token $h_s$,DSA 的分数是:
$$I_{t,s}=\sum_{j=1}^{H_I}w^I_{t,j}\cdot\mathrm{ReLU}\left((q^I_{t,j})^\top k^I_s\right)$$
官方配置为:
Dense Warm-up 时,DSA 把主注意力各 Head 的分数汇总、L1 归一化为目标分布,用 KL 散度训练 Indexer:
稀疏训练阶段:
SLA2 只有两组投影后的块级点积,没有 DSA 的 64 个 Indexer Head、ReLU 聚合和 Query 自适应 Head 权重。它在 Stage 1 通过 SoftTop-k 可微选择,以最终 Attention 输出 MSE 训练 Router 和 $\alpha$。
这个差别可以理解为:
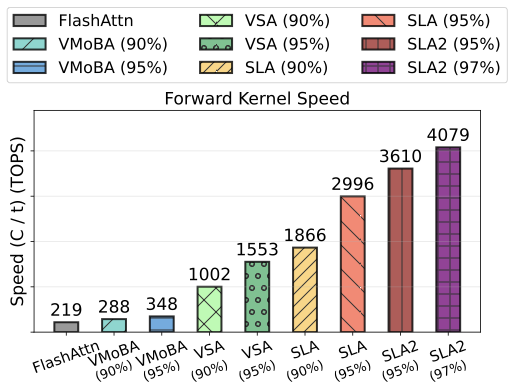
(图片来源:论文 Figure 4。SLA2 97% 稀疏达到 4079 TOPS;FlashAttention2 为 219 TOPS。)
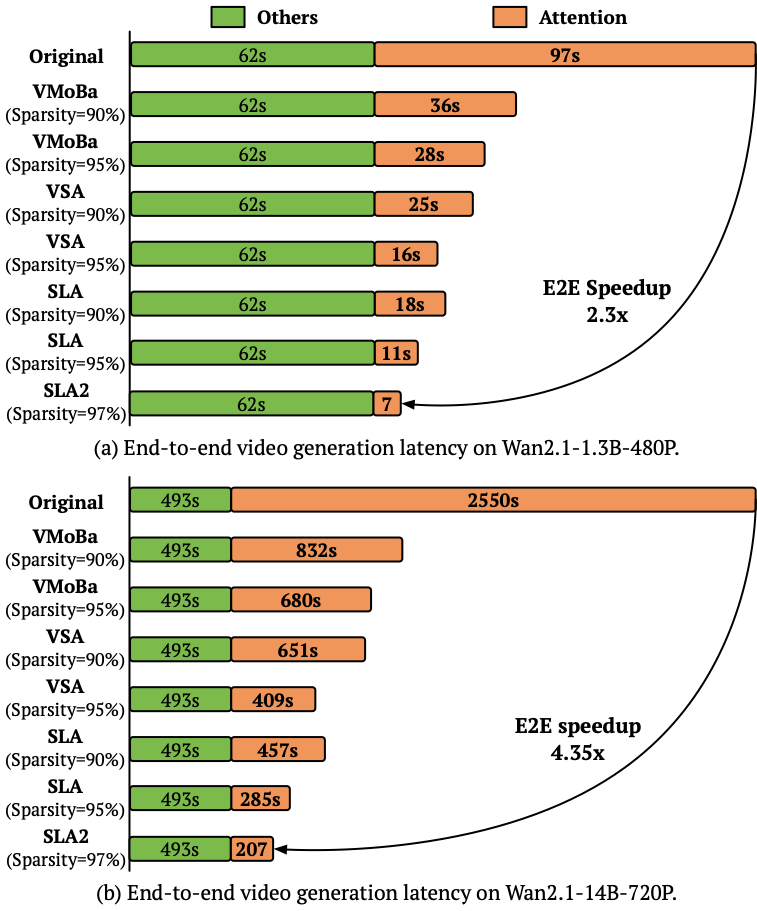
(图片来源:论文 Figure 5。上:1.3B-480P;下:14B-720P,14B 数据排除了 CPU Offload 开销。)
SLA2 报的是 RTX 5090 上视频扩散 Attention Kernel 和视频生成延迟。DeepSeek DSA 报的是 H800 集群上 128K 文本模型的 Prefill/Decode 成本,并用每 GPU 小时 2 美元估算服务成本。
两者至少有五个不可控变量:
因此不能说“SLA2 18.7 倍,比 DSA 更快”,也不能反过来说 DSA 更适合所有场景。能比较的是机制和复杂度,不能把两篇论文的速度数字放在同一排行榜。
| 维度 | SLA2 Learnable Router | DeepSeek DSA Lightning Indexer |
|---|---|---|
| 目标模型 | 视频扩散 Transformer | 自回归大语言模型 |
| 主注意力 | 稀疏 Softmax + 线性 Attention | MLA 的稀疏主注意力 |
| 路由对象 | Query Block × KV Block | Query token × 历史 KV token |
| 未选连接 | 进入线性分支近似 | 不进入该 Query 的主 Attention |
| Router 输入 | 池化后的 Q/K | Hidden/Query Latent 投影出的 q/k |
| V 的角色 | 前向路由不读 V;Stage 1 输出 MSE 经 $PV$ 间接依赖 V | 前向与注意力分布 KL 目标均不直接依赖 V |
| 打分函数 | 两个可学习投影后的点积 | 64 Head、ReLU、Query 门控加权求和 |
| 选择预算 | 每行 3%/4%/5% 块 | 每个 Query 固定 Top-2048 token |
| 训练监督 | Full/SLA2 输出 MSE + 扩散损失 | 主注意力分布 KL + 语言建模损失 |
| Top-k 可微性 | Stage 1 用 SoftTop-k 反传 | 用独立 KL 训练 Indexer,不穿过硬 Top-k |
| 第二阶段 Router | 冻结 | 继续由 KL 单独优化 |
| 分支混合 | 学习 $\alpha$ 与 $1-\alpha$ | 无线性补偿分支,无 $\alpha$ |
| 量化角色 | QAT 直接训练低比特稀疏 Attention | Indexer 可用 FP8;模型本身为 FP8 部署体系 |
| 官方复现状态 | SLA 仓库公开,SLA2 完整训练链尚不明确 | 权重、推理代码与高性能 Kernel 已公开 |
再补一个容易混淆的点:DeepSeek 还有 MoE Expert Router。DSA Lightning Indexer 不是专家路由器,它路由的是“当前 Query 应该看哪些历史 KV”;SLA2 Router 路由的是“某个注意力块应走稀疏 Softmax 还是线性近似”。三者名字相似,但对象不同。
我对 SLA2 的评价是:数学修补比 97% 稀疏这个标题数字更有价值。
它首先把前代 SLA 的缩放错位讲清楚,再用 $\alpha/(1-\alpha)$ 让两条分支各归其位。Learnable Router 和 QAT 是建立在这个正确分解上的工程增强,不是孤立的技巧堆叠。
与 DeepSeek DSA 对比后,技术路线也更清晰:
研究者建议:值得跟进的方向不是单纯继续把稀疏率从 97% 推到 98%,而是验证 Router 是否跨 Prompt、分辨率、时长和模型层稳定;也可以尝试 DSA 式多头 Indexer + SLA2 线性残差,比较 KL 分布蒸馏与输出 MSE 哪个更适合扩散模型。
工程师建议:目前先把 SLA2 当成有潜力的 Kernel/训练方案,不要当作即插即用库。你需要定制块稀疏 Kernel、线性分支、QAT 和两阶段微调;没有官方完整脚本时,复现成本明显高于普通 FlashAttention 替换。
产品侧建议:这项工作真正能带来的不是“同一张卡快 18.7 倍出视频”,而是在 Attention 成为主要瓶颈的高分辨率、长视频场景中,把端到端耗时压到原来的约 43% 或 23%。是否值得接入,要看你的 FFN、VAE 和数据搬运占比。
最后给一句最短判断:
DSA 是学会“该看谁”,SLA2 是学会“谁要精看、谁可以略读”;共同方向是把 Attention 从固定算子变成可学习的计算资源分配器。
作者:人工智能炼丹君
日期:2026-07-25
声明:个人观点,仅供参考。数据来源于 SLA2、DeepSeek-V3.2 原始论文及官方实现,如有偏差以原文为准。



评论 (0)