


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 交互式世界模型 2 篇 · 高效图像/视频生成与编辑 3 篇 · 可控与电影级视频生成 2 篇 · 生成新用途与安全 2 篇 · 音乐生成 1 篇
ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU | 阿里·高德AMAP | arXiv:2607.19191
关键词:世界模型,实时交互,自回归视频,蒸馏,单卡部署
前序问题:交互式视频世界模型要同时具备交互、持久时空一致、稳定长时程生成与高效响应,且此前多依赖重型算力,难在消费级单卡上实时长时程运行。
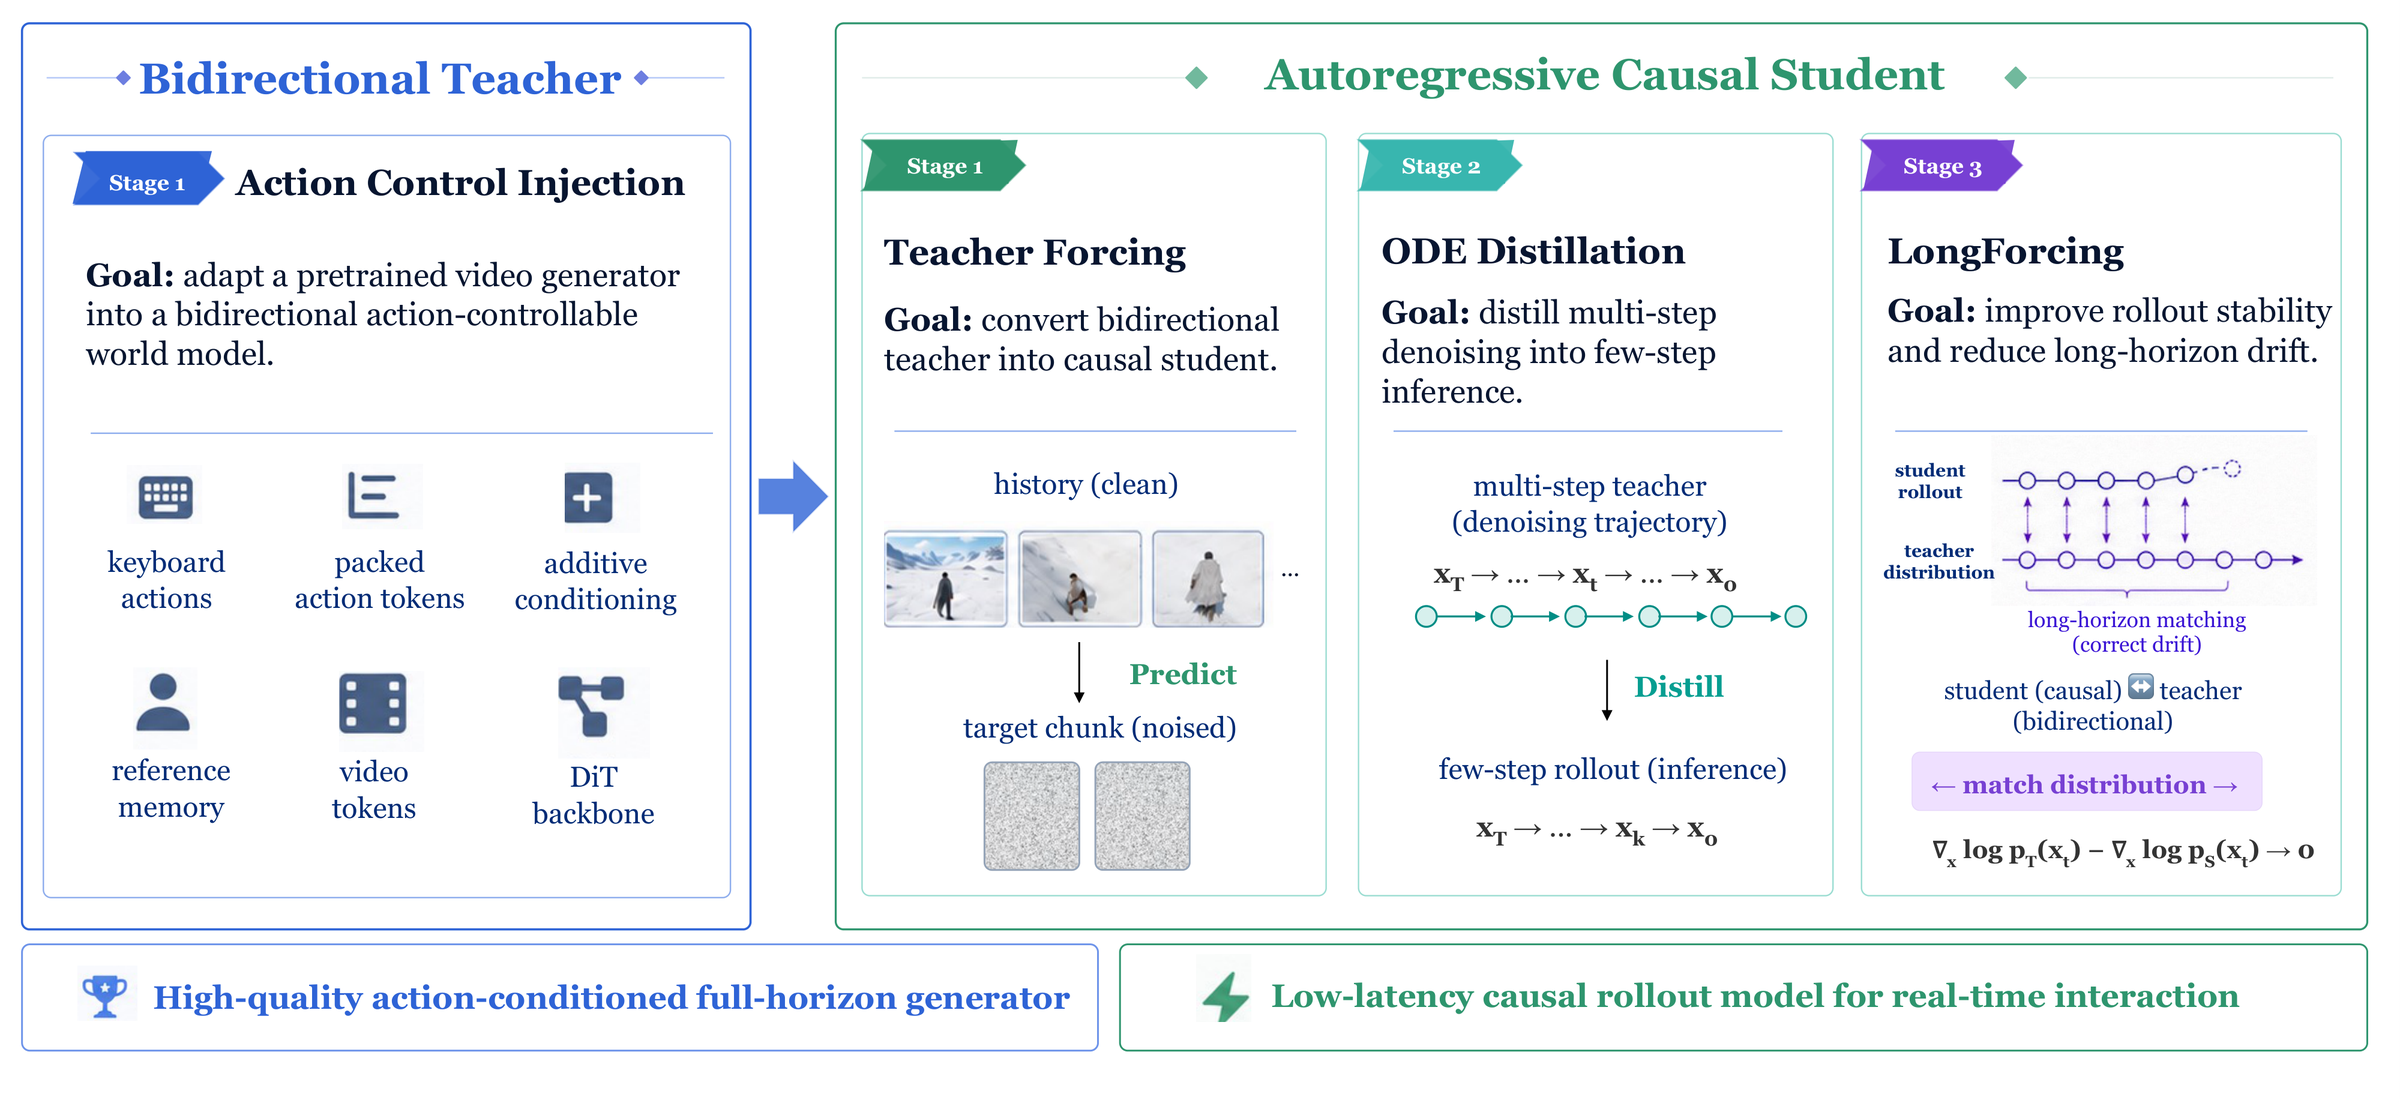
本文贡献:提出动作条件视频世界模型 ABot-World-0,配套横跨 AAA 游戏/仿真引擎/互联网视频的多源数据基建(WorldExplorer 训练反馈驱动采集 + 14 项确定性质检 + VLM 评估 + 动作/文本同步标注);训练上把双向动作条件教师经 teacher forcing 与 ODE 蒸馏渐进蒸成因果学生,并提 LongForcing 对齐长自 rollout 与扩展时程教师、抑制分布与自回归漂移;原始键盘动作作统一控制接口,参考角色记忆保第三人称身份一致;部署上协同设计流式推理栈(轻量 VAE 解码、高效注意力、内存感知调度、低比特 DiT)。
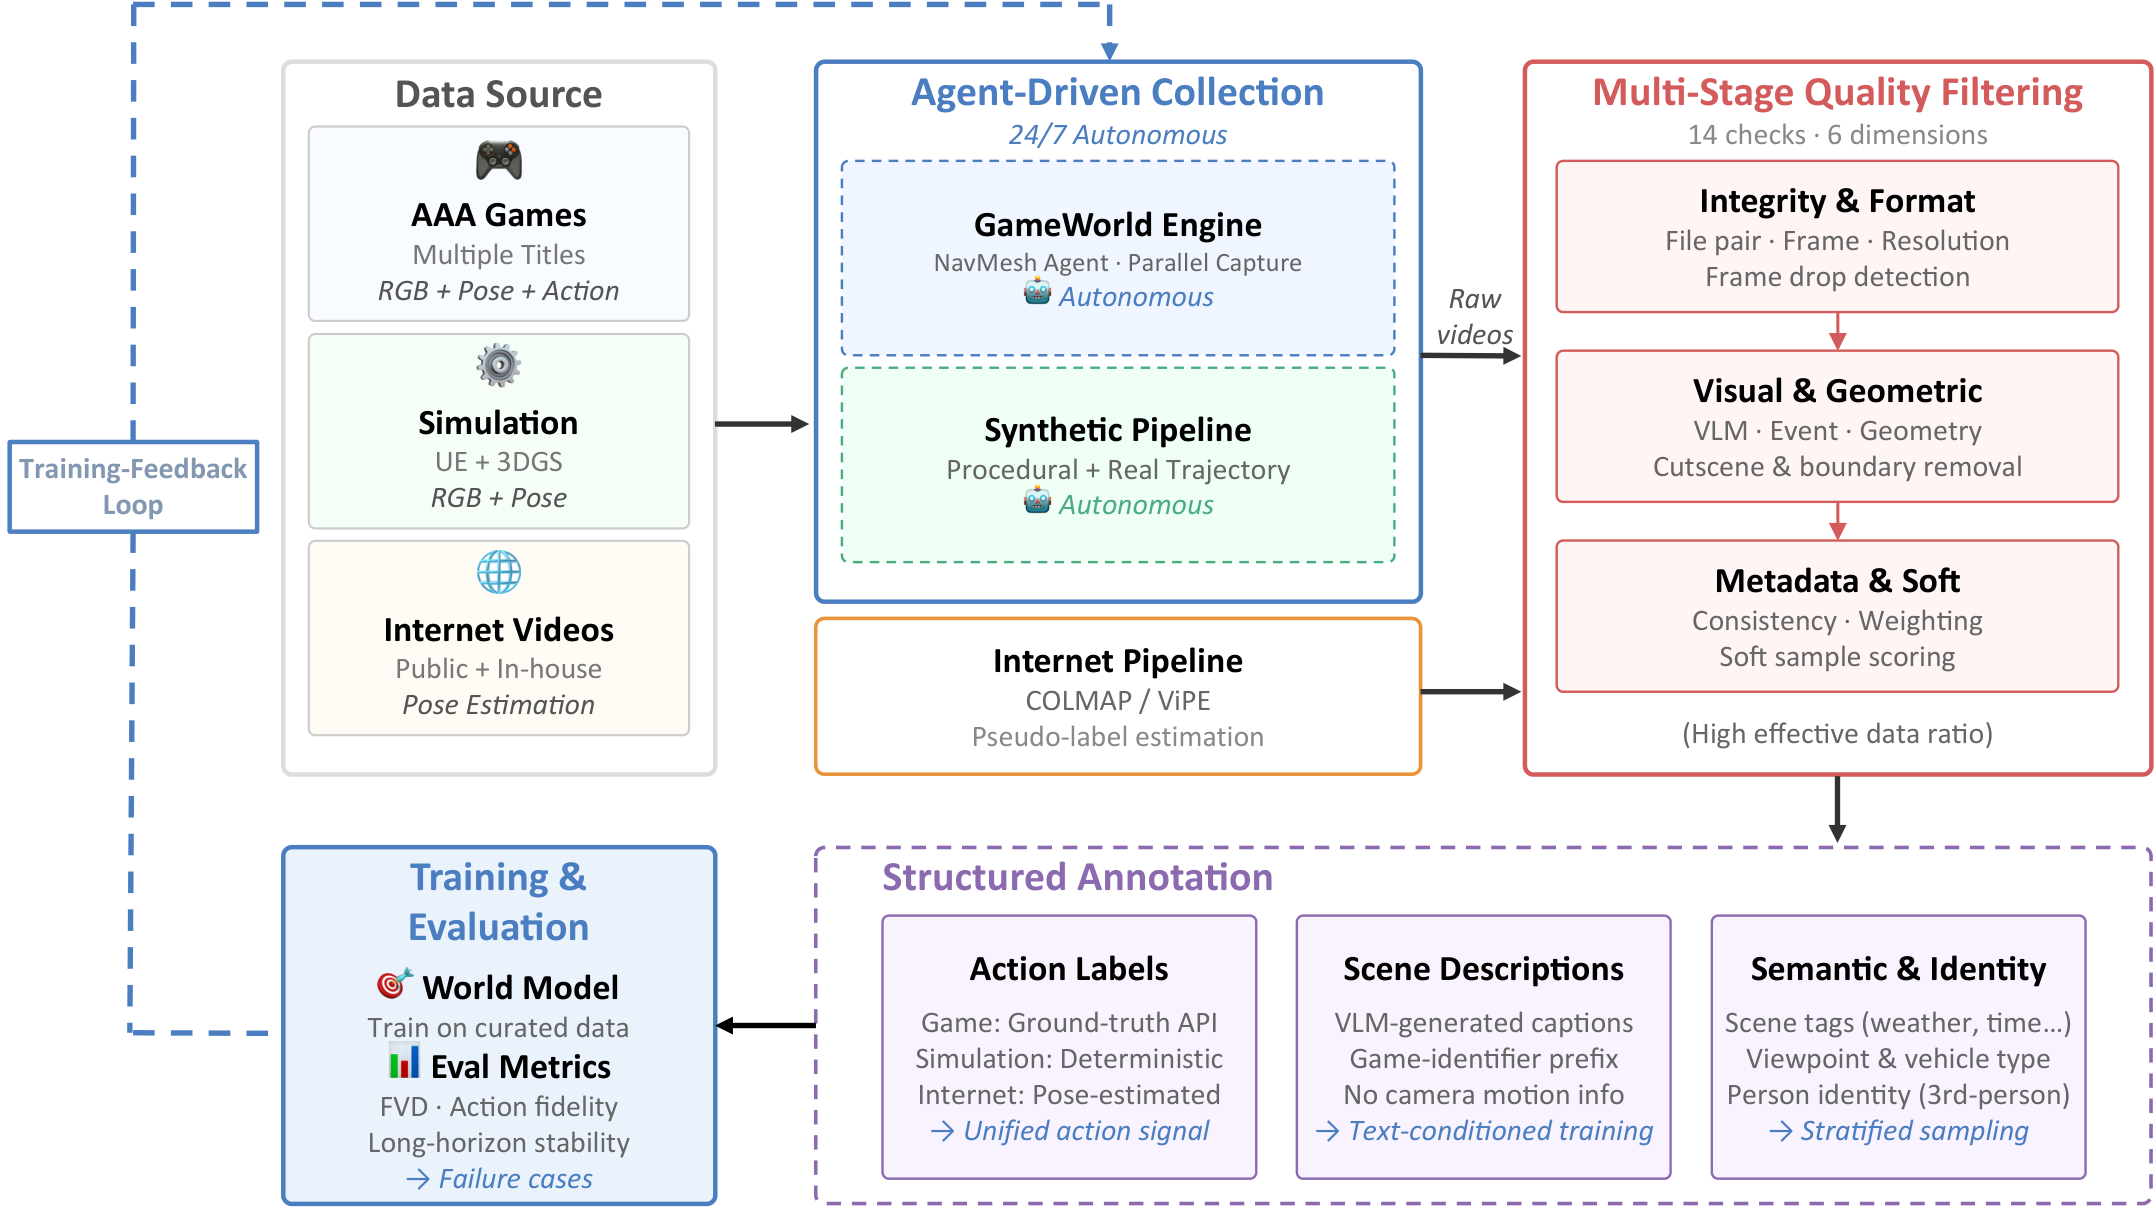
实验效果:在优化的低比特配置下,单张 NVIDIA RTX 5090 桌面 GPU 上以最高 16FPS 流式生成 720P 视频,动作到首帧延迟 1.2s、峰值显存约 19GiB;在 WorldRoamBench 与长交互 rollout 上展现有竞争力的可控性与连贯的长时程世界演化。
批判点评:把交互式世界模型压进消费级单卡(5090/16FPS/19GiB)是极硬的工程落地,多源数据基建+LongForcing 抑漂移思路完整、阿里高德背景也贴近实景重建。但 16FPS/720P 距真正丝滑仍有距离、低比特下的画质代价、超长时程一致与物理合理性、以及对开放动作的泛化仍需检验。
AlayaWorld: Interactive Long-Horizon World Modeling -- Full Technical Report | Alaya Lab | arXiv:2607.18367
关键词:世界模型,交互生成,自回归蒸馏,长时程,开源
前序问题:视频世界模型能即时从文本/图像/视频生成可交互环境,但要落地需同时具备交互、持久时空一致、稳定长时程生成与高效响应四大耦合能力。
本文贡献:提出交互式长时程视频世界模型 AlayaWorld:基于 15B 视频扩散 Transformer,在相机轨迹与可切换文本提示下自回归生成短潜块;有界视觉上下文融合持久 sink 帧、压缩时序历史、几何对齐空间记忆与近帧条件;用自 rollout 收集的损坏历史与预测残差训练以降长期漂移;提出离散自回归蒸馏(结合分布匹配蒸馏、self-forcing++、一致性蒸馏)把推理从约 30 步降到每块 4 步。
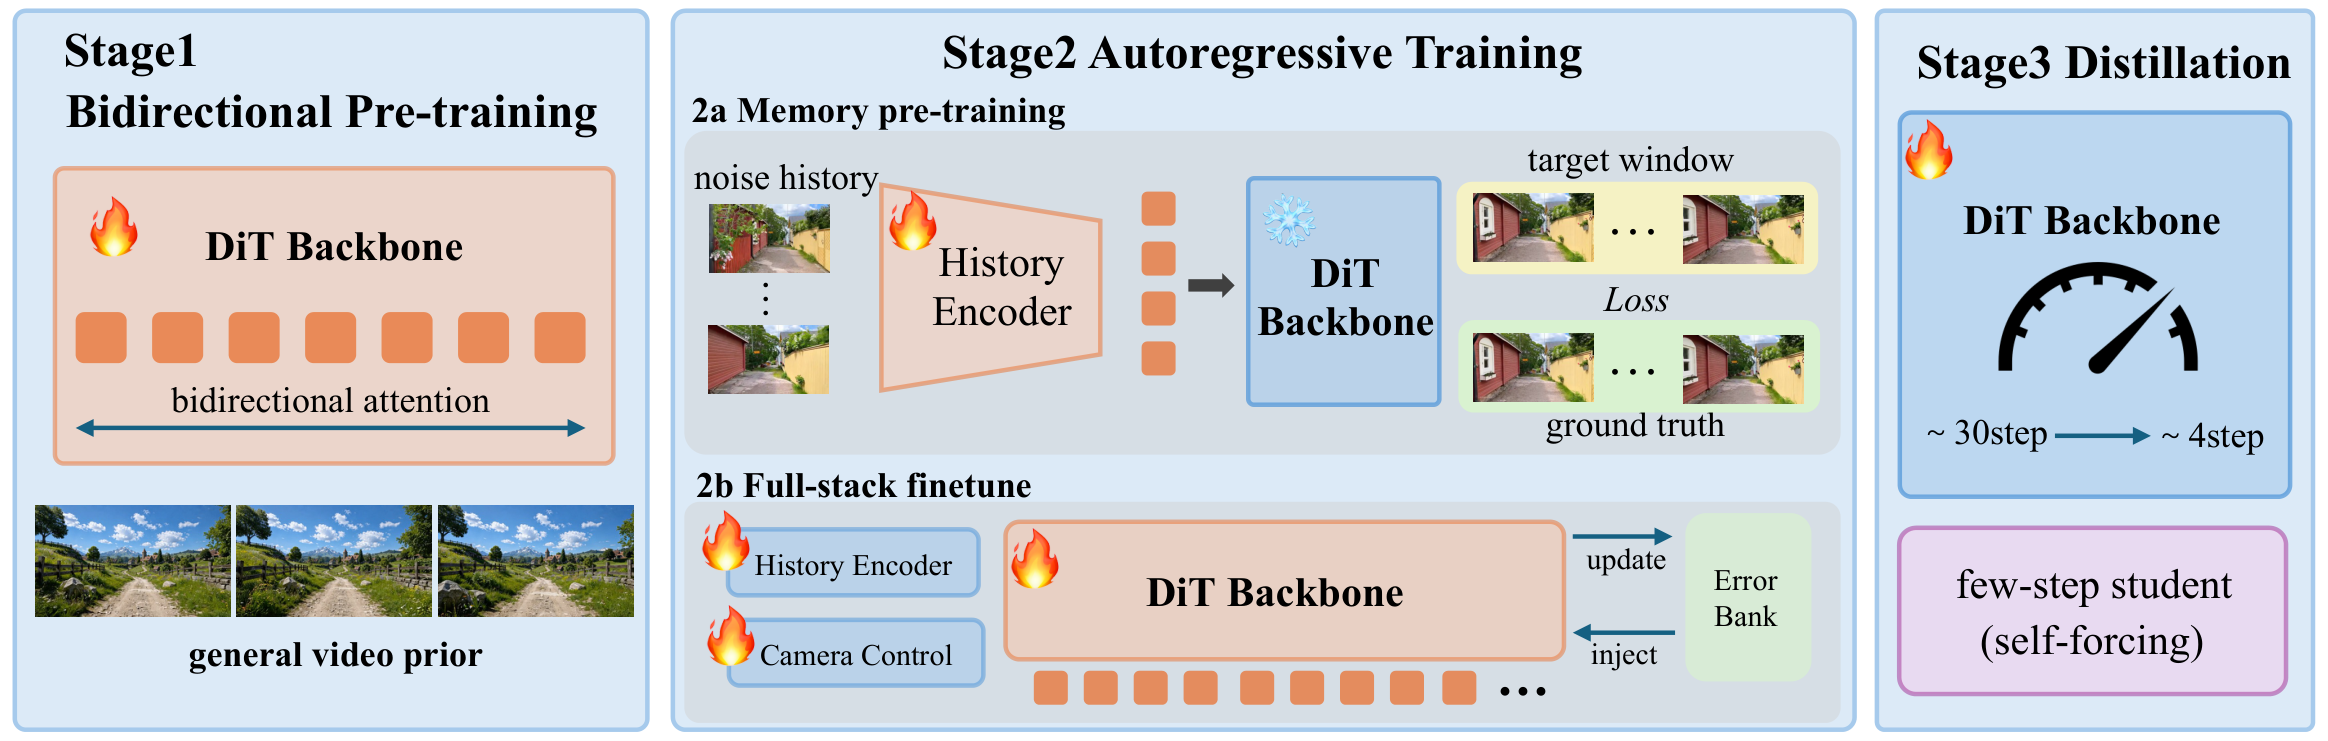
实验效果:生成 540p/720p、24fps 视频,在 iWorld-Bench 上长时程生成最佳;定位为全栈、开源、长期项目,为交互式视频世界模型研究提供可扩展基座。

批判点评:15B 世界模型+四步蒸馏+全栈开源,对社区推进交互式世界模型很有价值,几何对齐空间记忆+损坏历史训练也对症长程漂移。但 24fps/720p 的实时性、复杂交互下的一致与可控、以及开源基座的训练成本与数据获取门槛,仍是从 demo 到产品要迈的坎。
Mage-Flow: An Efficient Native-Resolution Foundation Model for Image Generation and Editing | Microsoft | arXiv:2607.19064
关键词:图像生成,图像编辑,原生分辨率,VAE,少步蒸馏
前序问题:大规模视觉生成器越来越强,但训练、微调与部署成本高昂,难以兼顾高分辨率质量与交互级效率。
本文贡献:推出紧凑 4B 生成栈 Mage-Flow:由轻量高保真潜表征分词器 Mage-VAE 与原生分辨率多模态扩散 Transformer(整流流匹配)协同设计。Mage-VAE 用单步扩散式编解码+锚定潜表征正则,在保持强公开 VAE 重建质量的同时把分词成本降一个数量级以上;配合原生分辨率打包与栈级 CUDA 核融合,端到端训练吞吐提升约 2.5 倍。基于此构建 Base/RL 对齐/Turbo 三档、覆盖生成与编辑:Diffusion-NFT 提升指令遵循/文字渲染/美学/编辑保真,配对抗感知引导的少步蒸馏产出 4 步 Turbo。
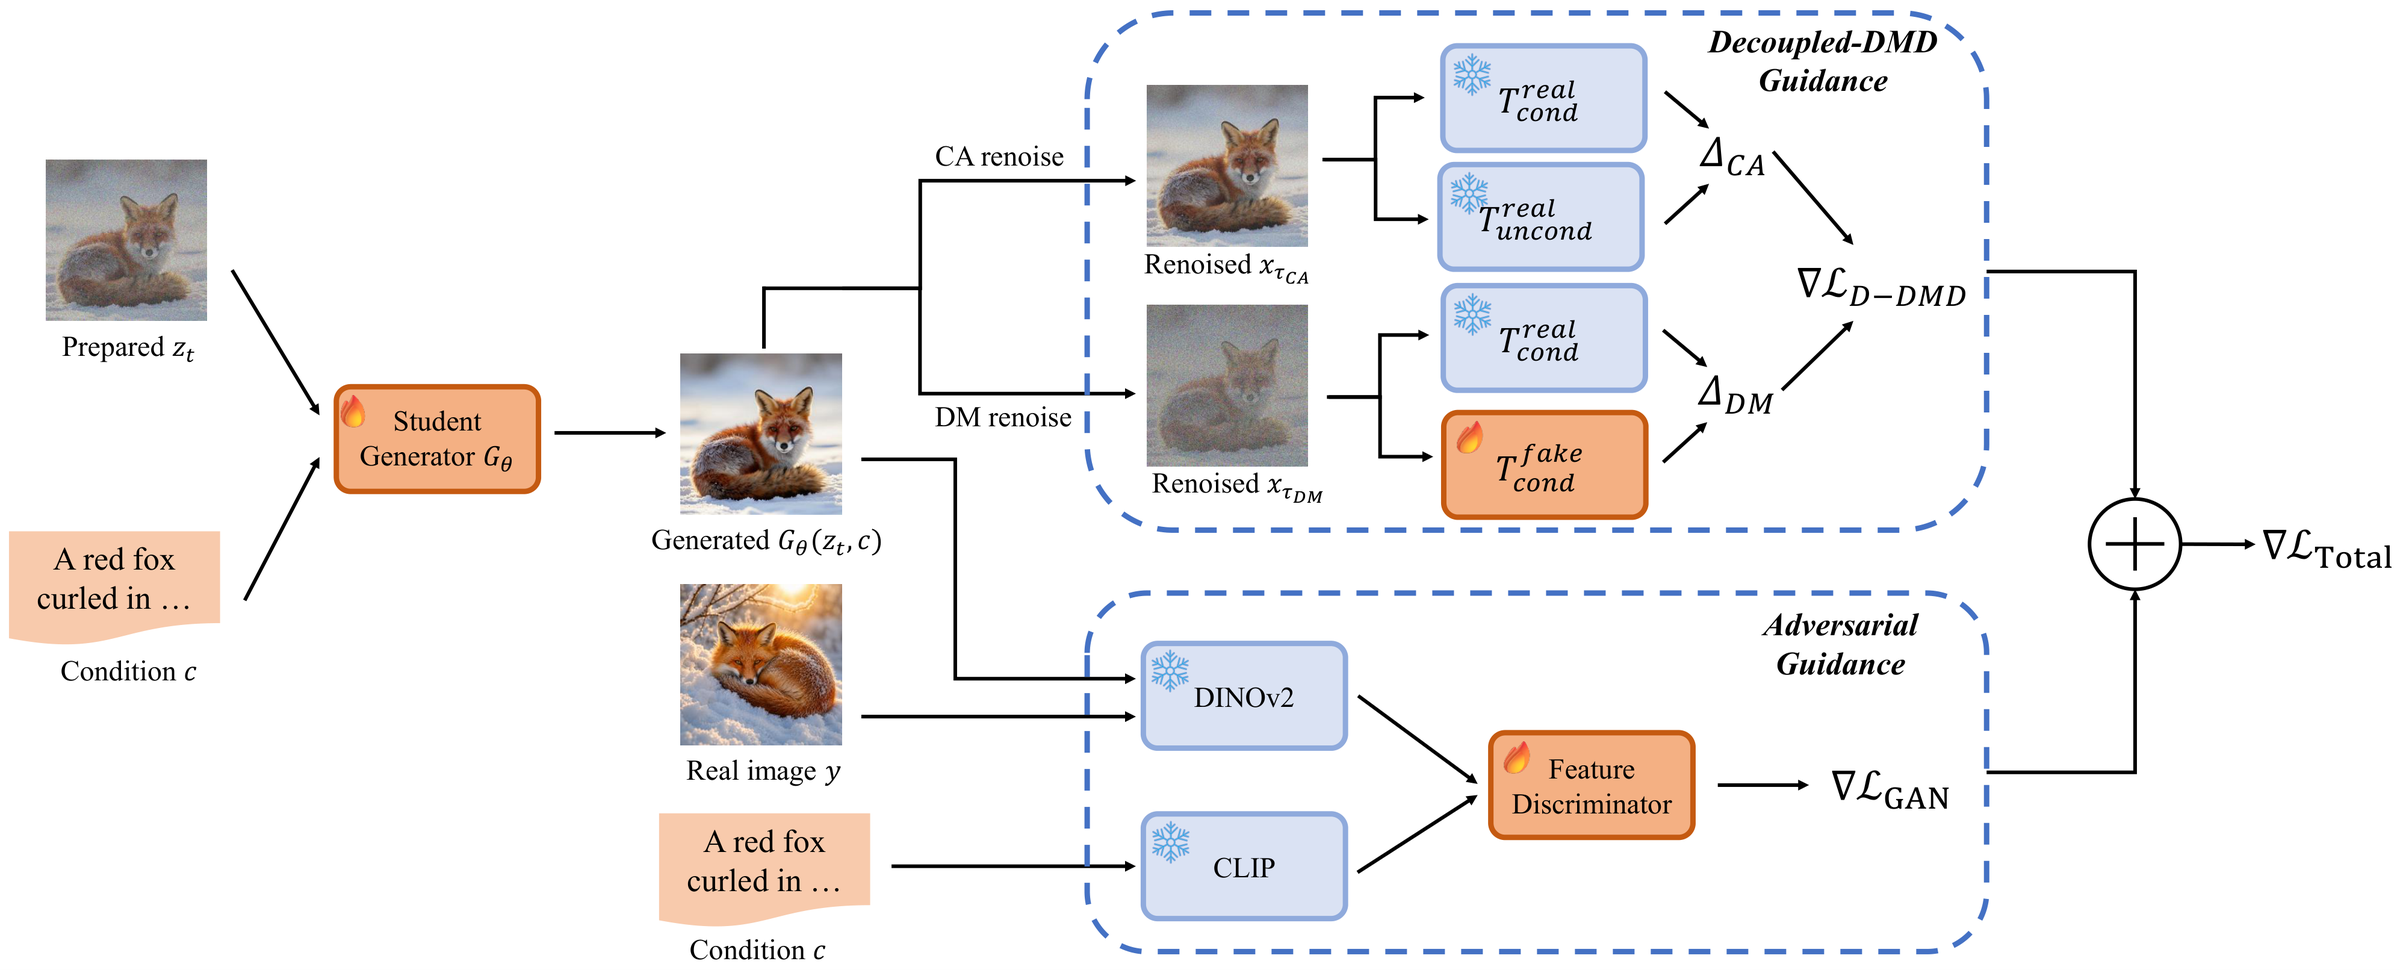
实验效果:尽管规模紧凑,Mage-Flow 与 Mage-Flow-Edit 在标准生成/编辑基准上具竞争力;Turbo 变体让高分辨率交互实用——单张 A100、1024² 下生成仅 0.59s、编辑仅 1.02s,显存占用小。
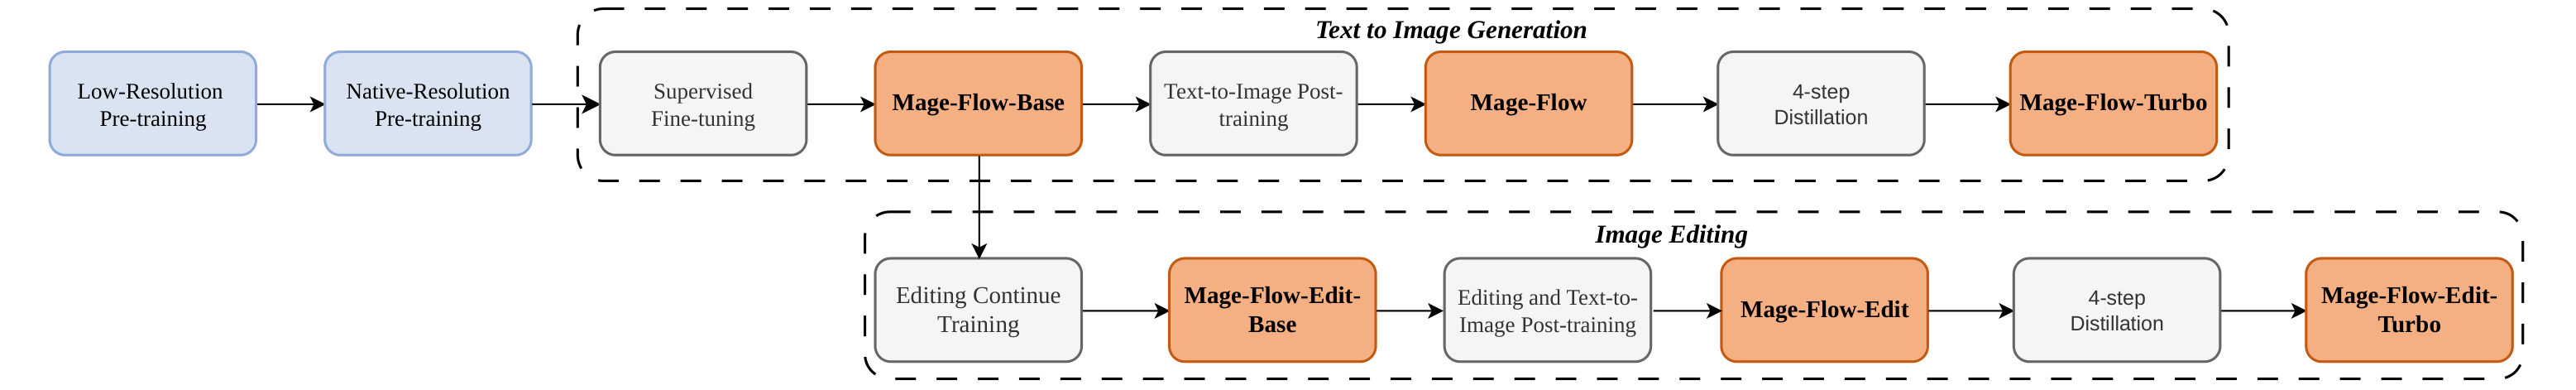
批判点评:微软用「分词器-骨干-系统」协同把 4B 小模型的高分辨率生成/编辑做到 0.59s/1.02s,工业化落地感很强、成本友好。但 4B 规模在极致画质/复杂语义/长文本渲染上的天花板、与十亿级大模型的差距,以及 RL 对齐/蒸馏带来的多样性与保真权衡,仍需在更广场景验证。
OSVE: One Step Video Editing with One Step Diffusion Models | 高丽大学 | arXiv:2607.19895
关键词:视频编辑,单步扩散,噪声预测,时序一致,实时
前序问题:扩散模型的文本引导视频编辑因多步采样与反演而慢得不实用。
本文贡献:提出 OSVE,首个成功把单步文生图(T2I)模型适配到高质量视频编辑的框架,攻克反演、可编辑性与时序一致三大难题:训练一个可学习编码器单次前向预测每帧初始噪声以绕开慢速迭代反演,并用结构感知编辑(SAE)损失在结构对齐图对上训练以在编辑中保留源视频几何;提出统一帧编辑(UFE)拼接帧潜表征在单步生成中促成跨帧注意力保时序连贯;对长视频用带锚帧的滑窗保全局一致。

实验效果:编辑质量匹配或超过 SOTA 多步方法,同时快约 155~171 倍,为实用实时视频编辑铺路;代码开源。

批判点评:把单步 T2I 迁到视频编辑、直接预测初始噪声避开反演,155~171 倍提速+结构保持的设计很漂亮,实时编辑价值大。但依赖结构对齐图对训练编码器、单步生成对大幅/复杂编辑的上限、以及长视频滑窗拼接处的一致,仍需更强样例检验。
HeadCast: Casting Attention Heads for Efficient Autoregressive Video Generation | 快手可灵 | arXiv:2607.20125
关键词:自回归视频,推理加速,KV缓存,注意力头,免训练
前序问题:自回归(AR)视频扩散是长视频/流式合成的有力范式,但持续增长的 KV cache 让注意力成为主导推理成本(高分辨率下每帧 token 众多);现有缓存淘汰用粗糙启发式致帧间闪烁,或需重训。
本文贡献:提出免训练、即插即用的加速框架 HeadCast:基于「预训练 AR 模型注意力头呈稳定异质行为」的观察,短暖机后在最大噪声步一次性把每个注意力头分为 Sink/Dummy/Spatial/Global 四类,并把单体 KV cache 重构为按头分路径;关键是保留维持长程时序一致的 Global 头。因 Spatial 路径在固定网格上运算,其节省随分辨率增长。
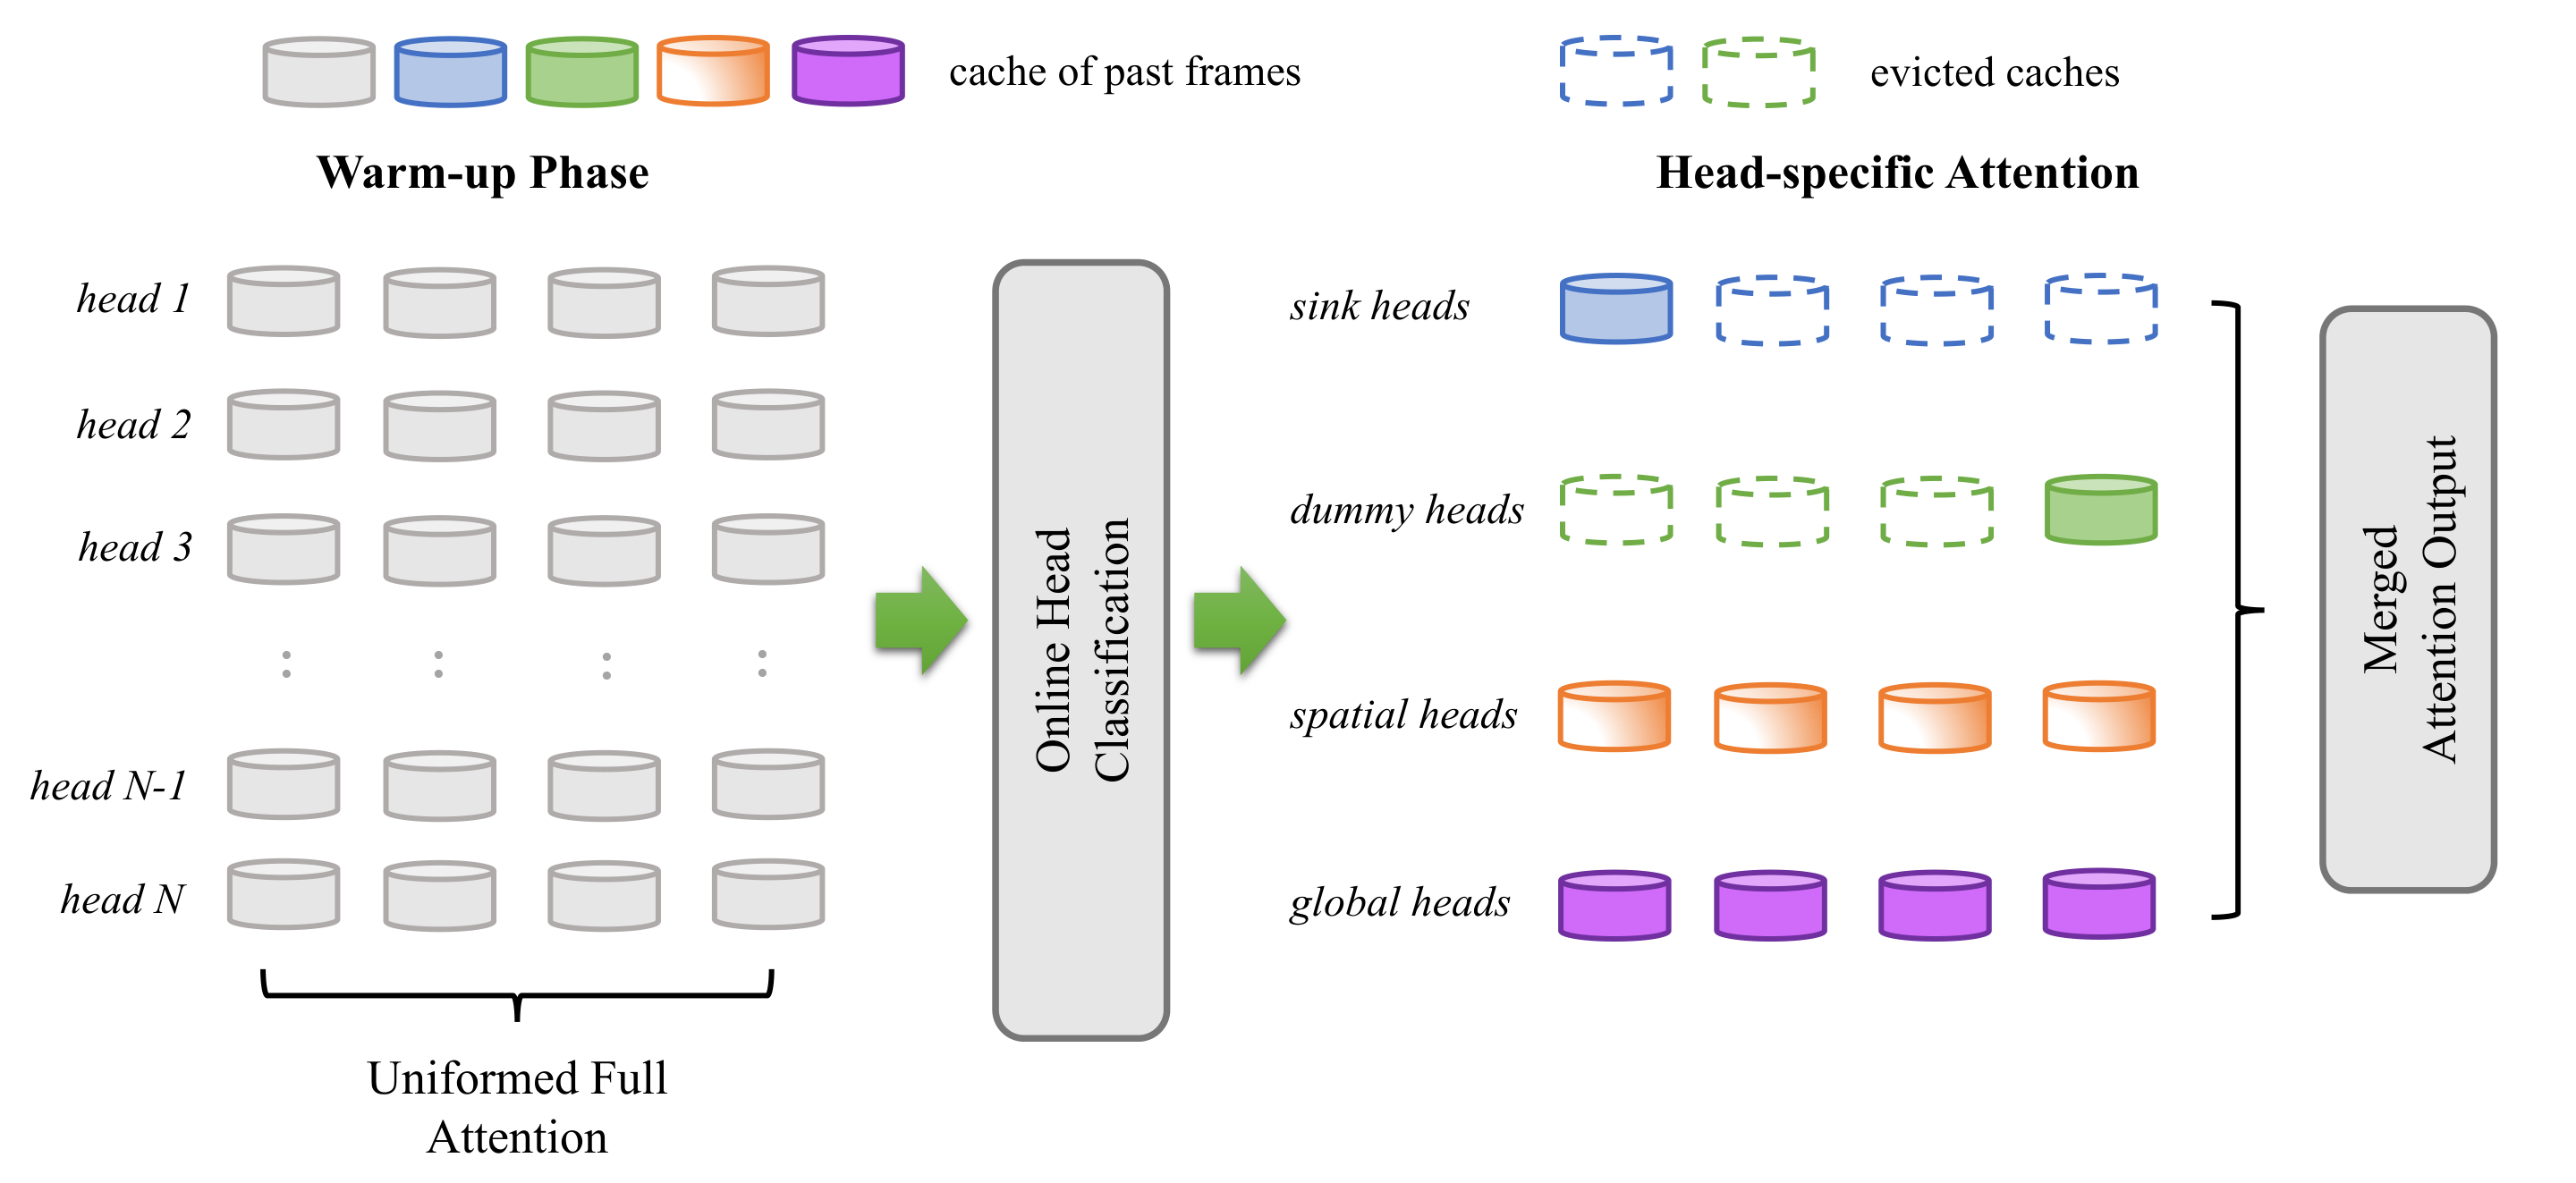
实验效果:在多个 SOTA AR 模型上,720P 加速至多 1.62 倍、1080P 至多 1.95 倍,VBench 质量与全注意力持平且基本无闪烁;代码开源。
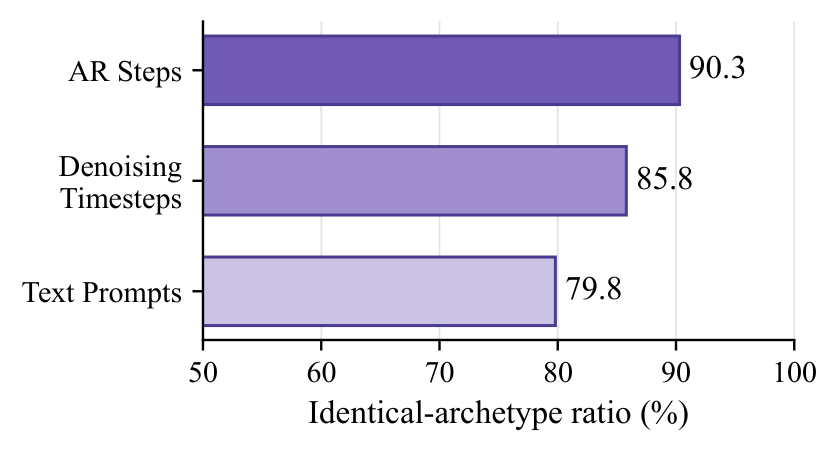
批判点评:「按注意力头功能分类+分路径缓存」免训练即插即用、且分辨率越高越省,对长视频/流式生成的推理成本是很实用的解法(可灵背景更贴落地)。但一次性分类的稳健性、四类原型对不同模型的普适、以及在极长序列/更高分辨率下保真与加速的平衡,仍需更多模型验证。
ShotPlan: Cinematic Video Generation with Learnable Planning Token | 中国电信TeleAI·哈工大 | arXiv:2607.17675
关键词:电影级生成,多镜头,规划token,转场,视频扩散
前序问题:现有视频生成在单镜头上效果惊艳,但电影级生成需要连贯叙事与有效多镜头组合、需显式镜头规划,仍受限。
本文贡献:提出 ShotPlan,在视频扩散基座上做显式多镜头电影级生成:引入可学习规划 token 捕捉镜头级转场线索、可与原视频生成 token 无缝融合以控制转场时间戳;规划 token 配分数时间旋转位置编码(FRoPE),使镜头转场可在帧级建模。

实验效果:显著超过现有电影级视频生成方法,提供更灵活的镜头管理与更强的镜头间一致性。

批判点评:用「可学习规划 token+帧级 FRoPE」把多镜头转场显式化,是对电影级叙事生成痛点的对症设计,中国电信 TeleAI 出品。但多镜头的叙事连贯不止转场时机,人物/场景跨镜头一致、复杂运镜与更长叙事的可控性,以及与专业剪辑的差距仍需更多验证。
The generator is the tracker: Multi-object tracking by painting persistent identity colours | 康奈尔大学 | arXiv:2607.17120
关键词:多目标跟踪,视频生成,身份一致,重识别,LoRA
前序问题:多目标跟踪(MOT)传统被拆成检测+关联,身份靠轨迹缓存、运动模型、外观嵌入等外部状态维护;能否让视频生成器直接用像素维护这种状态?
本文贡献:微调 22B 文生视频扩散模型(LTX-2.3)配轻量上下文 LoRA,把 RGB 片段翻译成 ID-map 片段——每个人被涂成随时间持久的独特纯色(同色=同身份);长视频以链式窗口生成、每窗以上一窗清理后的尾部为条件,短续训教模型延展给定着色,身份便无需跟踪器/运动模型/重识别模块地沿链流动。
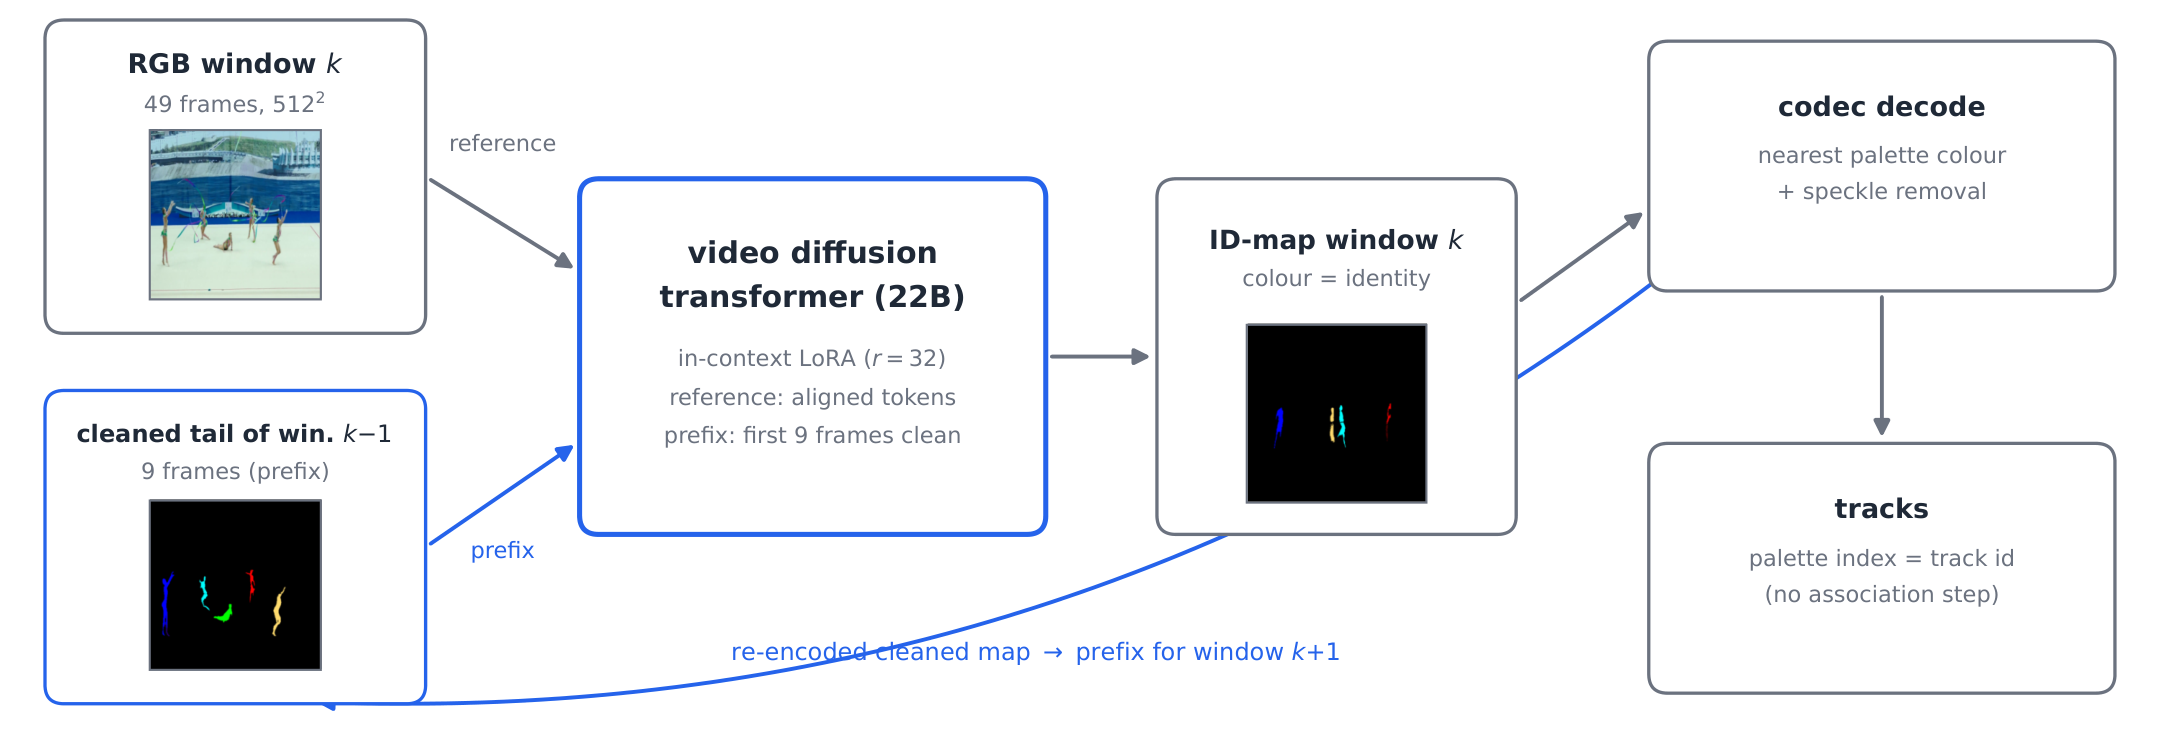
实验效果:DanceTrack 测试榜上达 40.3 HOTA(据称首个上榜且无检测器/无跟踪栈的生成式跟踪器),虽低于专用 SOTA(≥70),但误差画像独特——关联分 AssA 44.1 超原基准全部跟踪器,短板仅在检测;同样生成窗改用经典事后关联得分差一倍(18.2 HOTA);383 个遮挡事件中以 42% 条件率在间隙后重获身份(外观嵌入基线为 0),表明其着色是涌现的重识别信号。
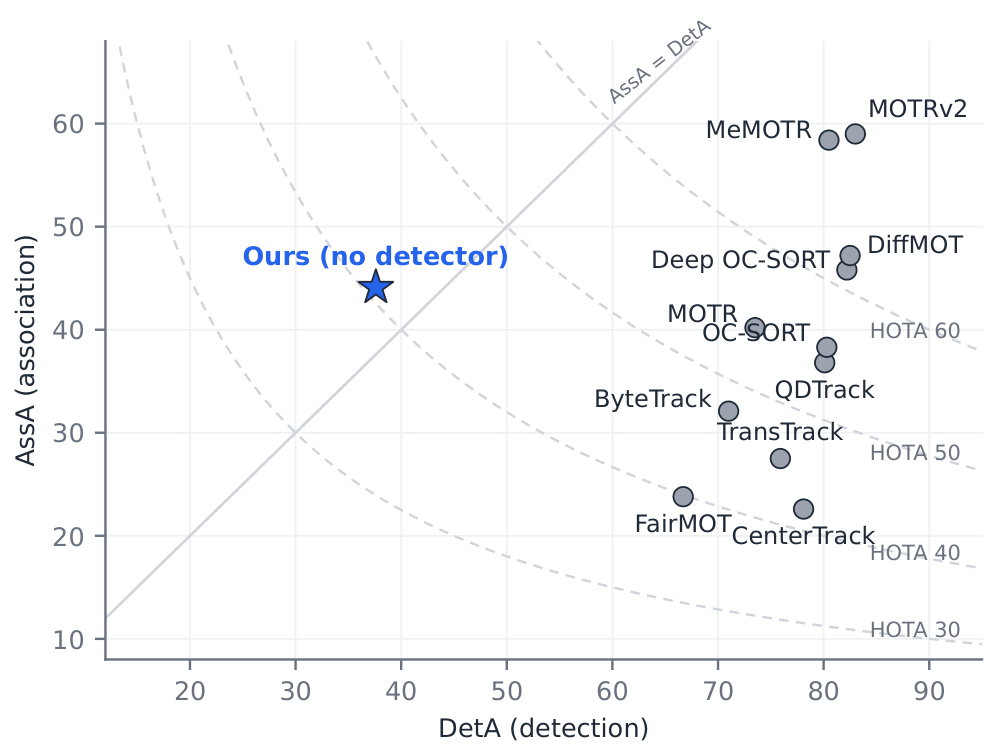
批判点评:「让生成器用像素维护身份」把 MOT 重构为着色生成,关联能力与遮挡重识别的涌现很惊艳、思路极具启发。但 40.3 HOTA 距实用尚远(检测是硬短板)、依赖 22B 大模型链式生成成本高、极密集/快速场景下的可扩展性仍是问题,更像范式验证而非即用方案。
Keyframe-Anchored Identity Preservation for Sequential-Action Video Generation | 中科大 | arXiv:2607.17985
关键词:身份保持,文生视频,关键帧,序列动作,免训练
前序问题:保身份的文生视频要在整段视频中维持指定主体可识别性;IPVG26 挑战把它从单一整体提示扩展到带时间戳的动作序列——主体须按序完成一串不同动作且身份一致,而端到端生成器随运动累积易外观漂移。
本文贡献:提出免训练三阶段流水线:动作感知提示润色阶段先把输入改写为指定每个动作终态的图像生成提示;保身份生成阶段以参考身份与前一帧联合条件产出关键帧序列,从而解耦时不变外观与时变姿态;身份感知推理增强阶段用多参考引导与身份驱动噪声搜索合成中间片段,双重强化采样期身份保真。

实验效果:在 IPVG26 官方 Track 2 榜排名第三,展现有竞争力的性能与较强通用性。

批判点评:用「关键帧锚定+解耦外观与姿态」免训练做序列动作身份保持,工程组合清晰、竞赛第三也证明有效。但依赖关键帧质量与多阶段拼接,中间片段合成的动作流畅、长序列多动作下的累积漂移,以及免训练相对专门训练方法的天花板仍待观察。
Between Safe Boundaries: Exploiting Temporal Consistency for Jailbreaking Text-To-Video Generation Models | 中科大 | arXiv:2607.17279
关键词:文生视频,越狱攻击,时序一致性,MCTS,AI安全
前序问题:文生视频(T2V)模型广泛部署,其对越狱攻击的鲁棒性引发担忧;现有方法多从文生图迁移,未利用视频固有的时序一致性、需大量视频查询优化(黑盒不可行)、且对抗提示搜索靠启发式局部信号缺结构化探索。
本文贡献:提出结构化、查询高效的 T2V 越狱框架 BSB:利用时序一致性,把有害意图编码为两个各自无害的「边界状态」之间的转变,攻击那些插值时易在中间帧产生不安全内容的边界状态对;为避免在视频空间直接评估所有候选的高昂开销,BSB 在更廉价的文本代理空间做蒙特卡洛树搜索(MCTS),并用稀疏视频级评估定期校准。

实验效果:在 Veo 3.1、Sora 2、Seedance、Kling v1 等主流商用 T2V 上,BSB 超越所有现有越狱基线,攻击成功率较最强对手平均相对提升 18.6%;揭示时序一致性是被忽视却关键的攻击面。
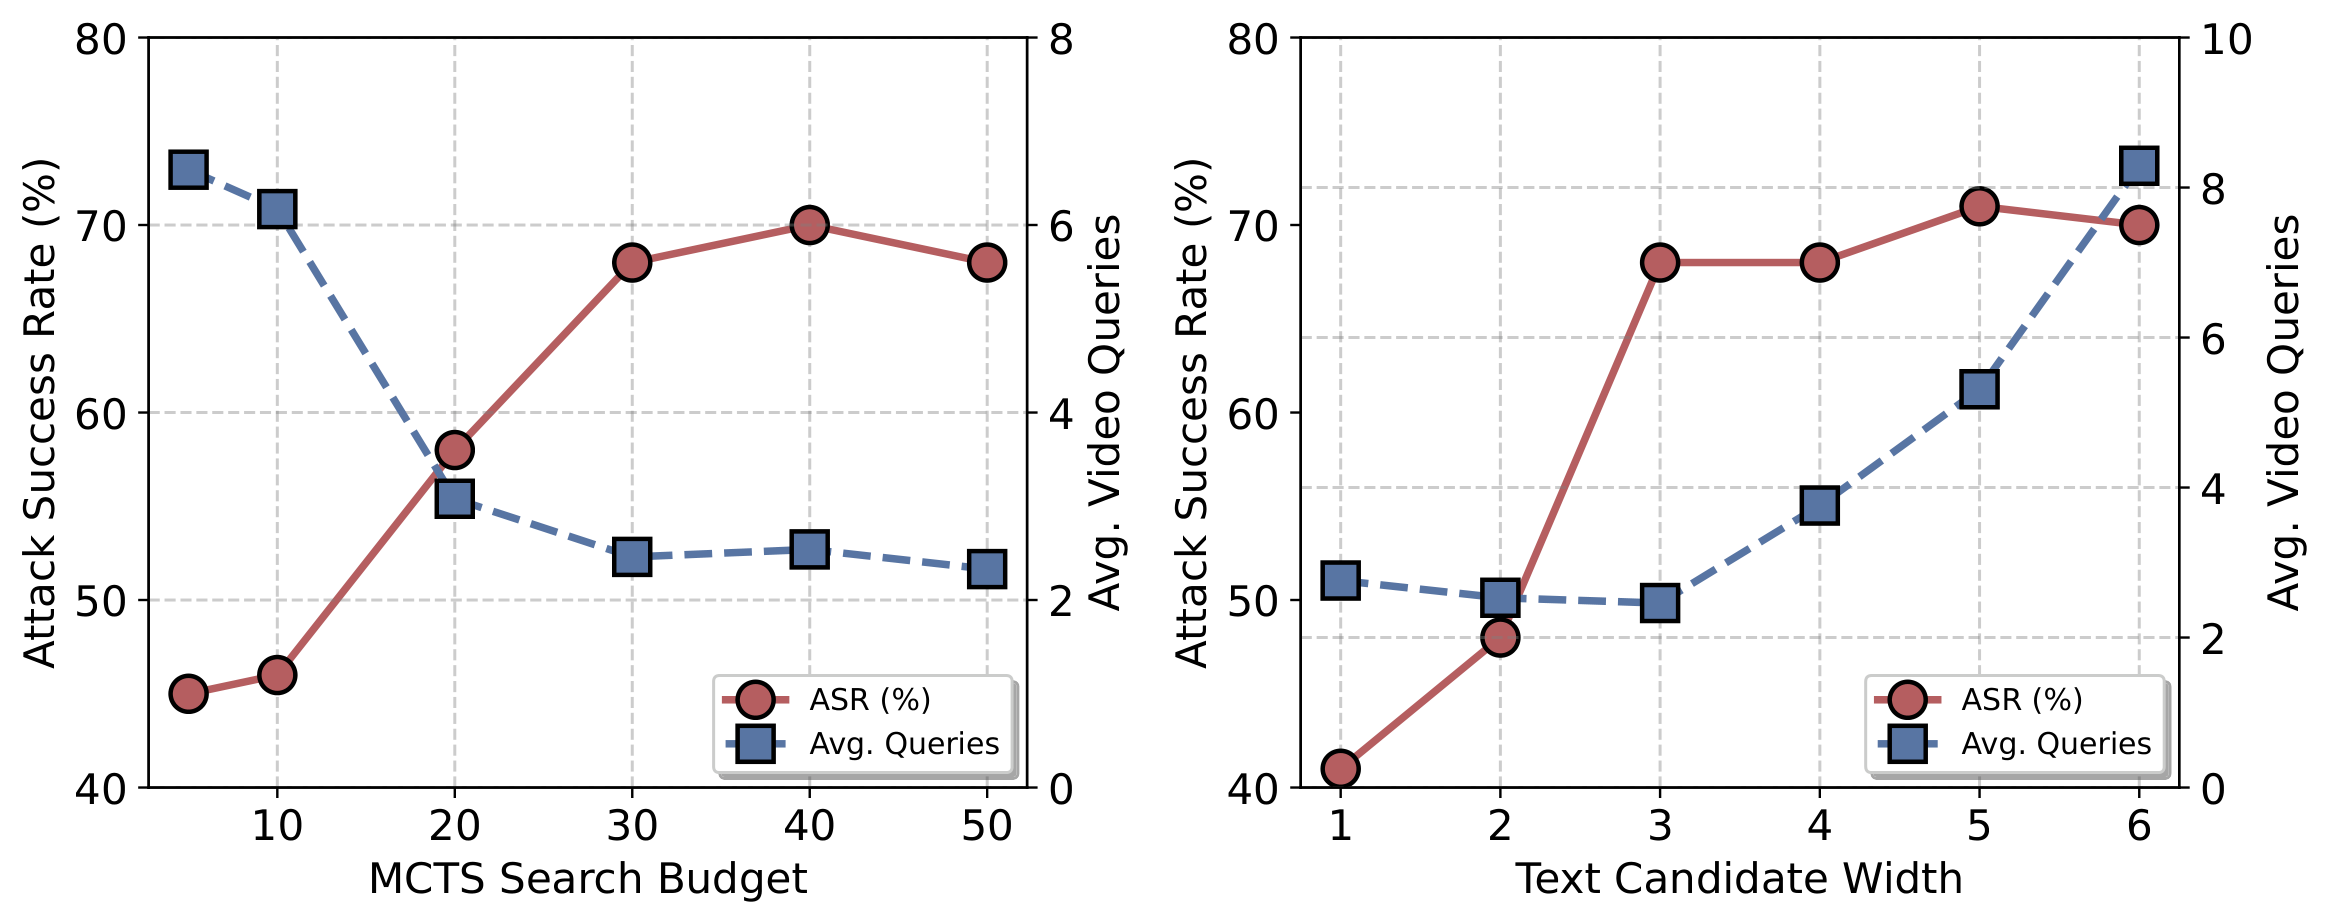
批判点评:把「时序一致性」从能力变成攻击面、用文本代理空间 MCTS 做查询高效黑盒越狱,视角新颖且对主流商用模型有效,安全警示意义大。但作为攻击方法需警惕滥用、防御侧的对应缓解未深入,攻击在持续迭代的商用安全策略下的长期有效性也存疑。
Pushing the Frontier of Full-Song Generation: Hierarchical Autoregressive Planning Meets Flow-Matching Rendering | 阿里(Token Foundry) | arXiv:2607.20253
关键词:歌曲生成,自回归,流匹配,RVQ,翻唱
前序问题:从歌词、文本描述与音乐属性生成高质量全长歌曲仍具挑战,且需统一支持词到歌、纯器乐、翻唱等多任务。
本文贡献:提出统一歌曲生成框架,支持歌词到歌、器乐生成、翻唱三任务:语义感知分词器把音频编码为 8 码本 RVQ token;hybird-LM 在其上做分层自回归音频 token 建模生成全曲;FullDiT 在连续 VAE 潜空间以码本 token/歌词/文本为条件做全曲流匹配以提升保真;翻唱用旋律模块从参考音频抽取并离散化旋律线索、在保留原旋律的同时引导生成;并探索 DPO/GRPO/OPD 做 hybird-LM 后训练、对 FullDiT 用基于流的 GRPO 提升音乐性与渲染质量。

实验效果:在多语种自动基准与 Artificial Analysis 带人声音乐榜上,框架在所评设置下取得有竞争力的表现。
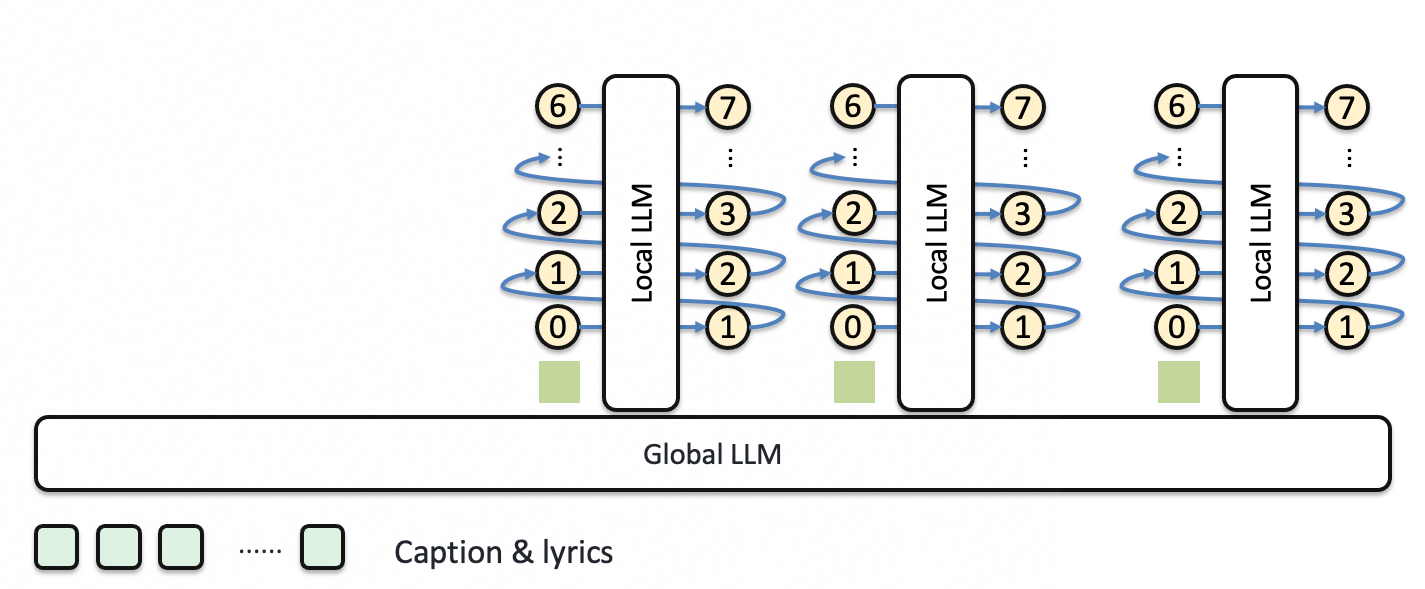
批判点评:「分层自回归规划+流匹配渲染」的双阶段设计兼顾结构与音质、还统一了词到歌/器乐/翻唱三任务(阿里出品),工程完整。但全曲生成对长程结构、人声吐字与音乐性要求极高,多任务统一下各子任务的上限、翻唱的版权与旋律保真边界,以及主观音乐性的稳定性仍需更多盲测检验。
人工智能炼丹君 整理 | 2026-07-23
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)