今日 AIGC 论文速览
今日共 10 篇 · 统一理解生成与三维细节 2 篇 · 推理式与可控视频生成 2 篇 · 音视频联合生成 1 篇 · 视频推理加速 4 篇 · 视频文字编辑评测 1 篇
重点论文标题列表
PixelUMM (NVIDIA):像素直进图像视频同模型BTC3D (香港城市大学(东莞)):分块条件补3D细节ThinkV2V (港中大):先推理再改视频LIFT (加州大学圣迭戈分校):只画终帧也能控未来StereoBind (西电):声源移动立体声跟着走
今日论文速览
1. PixelUMM:像素直进图像视频同模型
PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation | NVIDIA;滑铁卢大学 | arXiv:2609.38597
关键词 :统一多模态, 像素空间, 图像生成, 视频生成, 视觉理解
前序问题 :统一理解与生成模型通常给同一张图准备两套表示:ViT 特征服务理解,VAE latent 服务生成。这不只让视觉上下文变长,也把成熟的视觉语言预训练与生成接口绑在两条管线上。图像还能直接切 patch,视频却要同时兼容理解侧的采样帧与生成侧的连续时空块,统一接口更难。本文贡献 :PixelUMM 取消预训练视觉编码器和 VAE,把图像变成空间 patch、视频变成时空 tubelet,都只用一层线性投影接入 8B Mixture-of-Transformers。理解走自回归文本预测,生成在原始像素上做 flow matching;共享 attention 让干净条件与带噪目标直接交互。论文还系统比较 patch/tubelet 大小、线性头与卷积解码头,发现卷积头能压掉格子伪影。
实验效果 :不使用视觉 encoder/tokenizer 时,PixelUMM 在图像理解 MMMU 得 41.67、视频理解 MVBench 得 70.53;图像生成 GenEval 原始 prompt 为 0.77,用 BAGEL-long 重写后为 0.83,DPG-Bench 为 85.74。视频生成 VBench 总分 83.24,处于统一模型可比区间,但不是各榜第一。
批判点评 :“统一”仍有边界:理解与生成使用两套 Transformer expert,只共享 attention,并非一组参数同时做两件事。原始像素 token 让更小 patch 和 tubelet 虽然降低 loss,却直接抬高序列长度与训练成本。作者也提醒各模型训练数据不同,当前表格不能证明 encoder-free 架构本身更优;MMMU 41.67 与主流 8B VLM 仍有明显差距。
2. BTC3D:分块条件补3D细节
BTC3D: Blended Tile Conditioning for Detail-Enhancing Image-to-3D Generation | 香港城市大学(东莞);SB Intuitions;巴塞罗那自治大学 | arXiv:2609.39709
关键词 :图像生成3D, 免训练, 分块条件, 细节保真, 流匹配
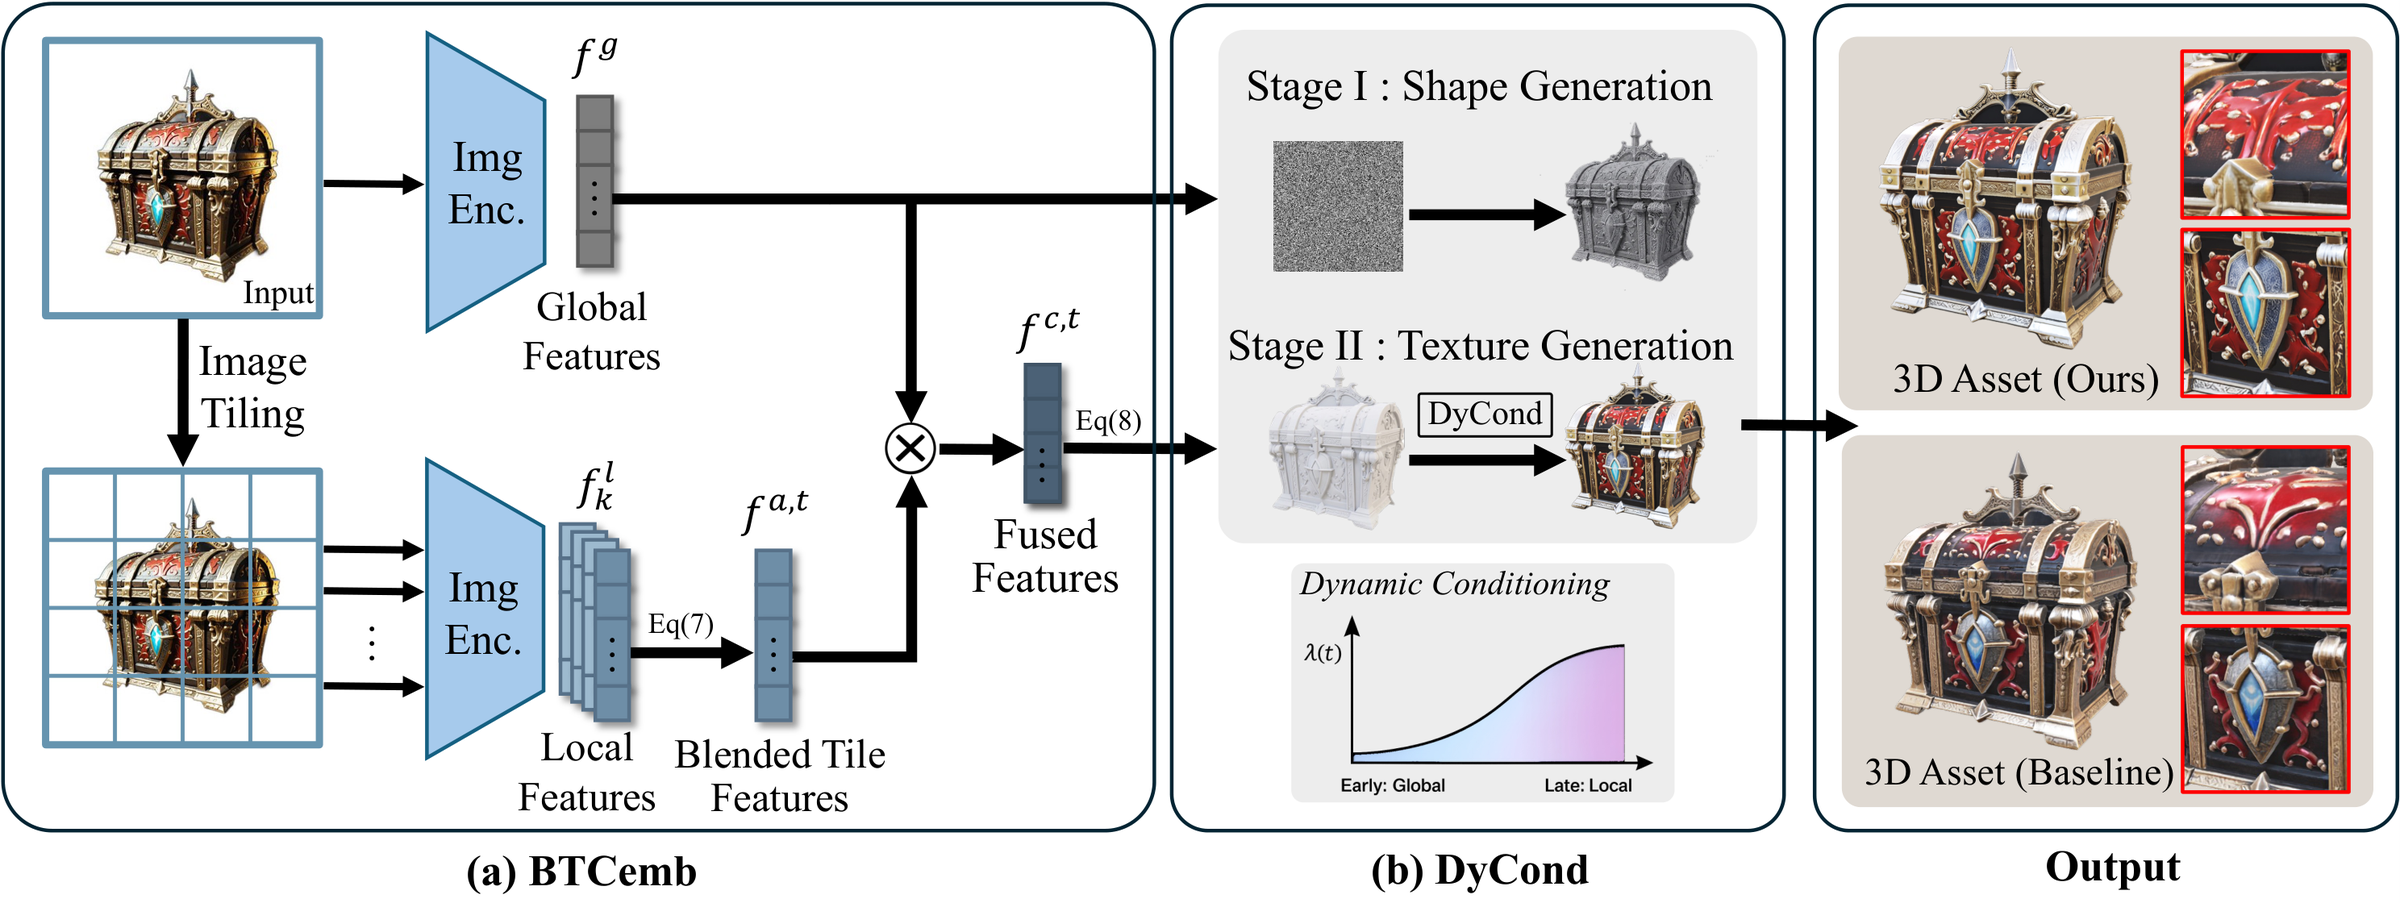
前序问题 :扩散式 image-to-3D 已经能出像样模型,可一旦输入图细节丰富,纹理就糊成一团。主流做法把整张图压成一个全局条件特征,空间信息在这一步被压掉,作者称之为 detail attenuation;而想补细节通常要重训或微调大模型,对 3D 管线代价过高。本文贡献 :BTC3D 是推理时即插即用的免训练框架。它先验证 image-to-3D 模型存在「图像特征可加性」:把局部图块的特征相加,仍能得到语义一致且保留局部细节的 3D 输出。据此把输入图切成若干 tile,各自提取局部条件并按前景权重聚合成 blended tile embedding;再配一个 dynamic conditioning 调度,在扩散后期低噪声阶段逐步加大 tile 条件的权重,早期仍交给全局条件主导结构。
实验效果 :在 3D-Arena 与 Toys4K 上,把 BTC3D 接到 TRELLIS、TRELLIS.2、Hunyuan3D-v2.1 上都提升了纹理与视觉保真,且保持全局结构一致。20 名参与者、400 次两两偏好测试中,接入 BTC3D 的 TRELLIS.2 拿到 67.25% 选票(269 票),基线只有 32.75%(131 票),纹理密集的样本优势最明显。
批判点评 :收益主要靠人眼偏好而非几何或纹理指标说话,67.25% 也是相对自家基线的增幅,缺少跨方法横评;论文同时承认纹理稀疏的样本上两者偏好接近持平,说明方法吃的是「有没有细节可补」。另外 tile 切分与融合系数 α、β 都是人工超参,动态调度只按扩散时间步推进,不看当前生成内容。
3. ThinkV2V:先推理再改视频
ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing | 香港中文大学;字节跳动;浙江大学;俄亥俄州立大学 | arXiv:2609.38541
关键词 :视频编辑, 多模态大模型, 显式推理, DiT, 指令跟随
前序问题 :现有指令视频编辑器多把 MLLM 当语义编码器,直接把 prompt 压成条件。碰到“把会被雨淋湿的东西收起来”这类不直接点名目标的指令,模型必须先理解因果与对象关系,再决定改哪里;只抓关键词往往画面能改,却改错对象或违背真实意图。本文贡献 :ThinkV2V 让 MLLM 先显式分析源视频和指令,再通过 learnable-query connector 把推理结果送给多条件 DiT。训练采用从直接编辑到推理密集样本的 progressive curriculum;推理时生成多份候选编辑 prompt,迭代反思并选择最可靠的一份。团队同时整理 ThinkV2V-150K 与专门考隐式意图、因果编辑的 ThinkV2V-Bench。
实验效果 :5B 编辑器在 ThinkV2V-Bench 上由 Seed-1.6-VL 评测的 Overall 为 2.72,高于 OpenVE-Edit 的 2.09 和 14B DITTO 的 2.02;Gemini-2.5-Pro 评测下为 2.61,也高于 ICVE 的 2.52。模型在 32 卡上分三阶段训练,最终 720p 推理,以小于多条 10B–14B 基线的规模拿到最佳综合分。
批判点评 :核心结论依赖 Seed-1.6-VL 与 Gemini-2.5-Pro 充当裁判,复杂编辑的自动分数仍可能偏向更会“讲意图”的输出。Inference-Time Thinking Scaling 需要多候选生成、反思和筛选,论文没有把新增延迟与算力单独量化。150K 数据由既有模型与筛选流程构建,推理能力有多少来自 MLLM、多少来自数据课程,还缺更严格的因果拆分。
4. LIFT:只画终帧也能控未来
LIFT: Layout-In-Future Video Generation under Large Viewpoint Change via On-Policy Self-Distillation | 加州大学圣迭戈分校;弗吉尼亚大学;Meta;Amazon;Lambda | arXiv:2609.38146
关键词 :视频生成, 相机控制, 未来布局, on-policy self-distillation, 图生视频
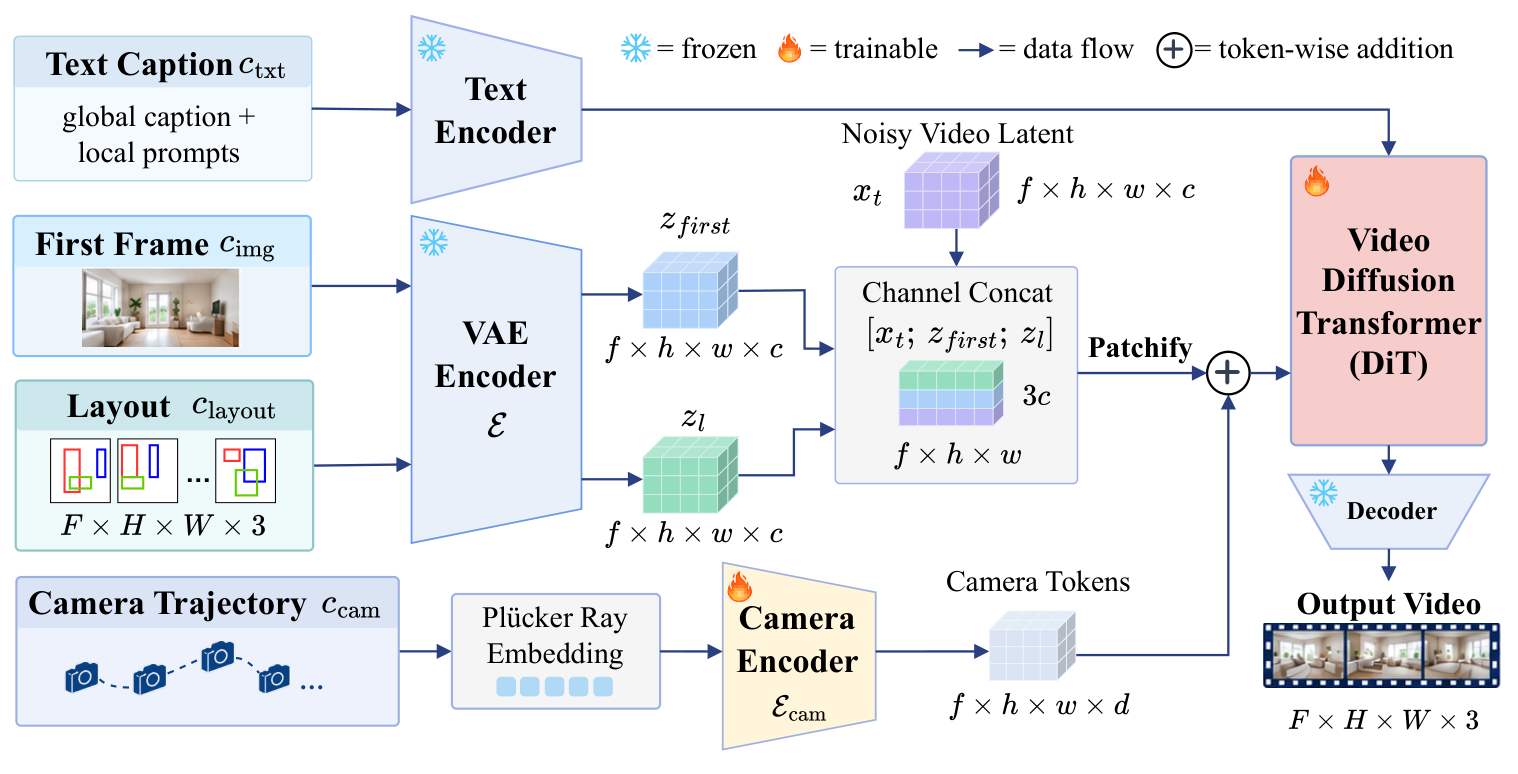
前序问题 :相机大幅移动时,首帧之外会露出全新区域。只给相机轨迹能控制“镜头往哪走”,却不能指定新区域里出现什么;逐帧框轨迹虽然能控布局,标注和交互成本又太高。真正实用的接口应允许用户只在未来关键帧画几个框,同时让中间过程自然长出来。本文贡献 :LIFT 把最后一帧的 bounding box 与局部 prompt 编成稀疏 layout latent,与首帧和噪声视频一起送入 DiT,相机 token 另行注入。训练时用拥有逐帧 dense layout 的冻结教师,在学生自己访问的 ODE 状态上做 on-policy self-distillation,把 dense 轨迹知识蒸馏给只看终帧布局的学生;同一个学生交替学习有布局与仅相机两种模式。
实验效果 :LIFT 1.3B 在终帧布局控制上 mIoU 0.51,高于需要逐帧框的 MagicMotion 0.41;同时相机 RotErr 2.97、TransErr 0.59,视频 FVD 99.35。OPSD 只用 500×16=8000 次样本更新,直接或 dense-to-sparse SFT 都要 4000×32=12.8 万次,训练样本量缩到 1/16。
批判点评 :布局接口仍只是 2D 框加局部文字,没有深度、朝向、遮挡和实例关系;相机一转,两个框在 3D 中究竟谁挡谁并未显式建模。所谓 1/16 训练量比较的是作者设定的更新预算,并不等于端到端数据与教师成本也缩到 1/16;OPSD 还依赖一个先用 dense layout 训练好的教师。
5. StereoBind:声源移动立体声跟着走
Here the World in Stereo: Learning Dynamic Spatial Correspondence for Immersive Joint Video-Audio Generation | 西安电子科技大学;vivo 蓝图影像实验室 | arXiv:2609.38748
关键词 :音视频联合生成, 立体声, 空间音频, 运动轨迹, 跨模态对应
前序问题 :联合音视频模型已经能做到“画面里有什么就听到什么”和大致同步,却很少管声音来自哪里。AR/VR 中声源从左往右移动时,左右声道也应连续变化;只用文本或整段视频条件生成声音,往往知道是汽车声,却无法让声像跟随汽车轨迹。本文贡献 :StereoBind 把可见声源的 motion track 作为共同坐标系:Visual Motion Binding 绑定视觉运动与音频 token,Spatial Track Encoder 提供绝对位置,Residual Track RoPE 编码相对位移。团队用真实视频定位跟踪加合成立体声、再配合可控合成场景,构建 StereoWorld-29K,并用 StereoWorldBench 单独评测动态空间对应。
实验效果 :在 StereoWorldBench 上,StereoBind 的 ILD-W 为 2.754、SELD-Acc 0.757、SMR-Err 14.86、AST-Ang 0.465、AST-Cal 0.314,五项空间指标都优于表中 Ovi、MiniMax-H3、LTX-2.5/2.3 及两条 video-to-spatial-audio 基线;视觉 Subject Consistency 0.955、Motion Smoothness 0.996,整体画面质量没有明显牺牲。
批判点评 :当前条件是一条主要声源轨迹,训练和评测强调水平声像移动;多声源竞争、声源与听者同时运动、遮挡和完整 3D 声场仍被列为未来工作。空间指标全面领先不代表总体音质全面领先,Subject Consistency 0.955 低于 MiniMax-H3 的 0.968,Audio PQ 6.86 也只是略高于 6.81。
6. ReCaVSR:1080p单卡跑21.2FPS
ReCaVSR: One-Step Streaming Diffusion Video Super-Resolution with Recycled Latents and Learned Cache Routing | 中国科学技术大学 | arXiv:2609.37831
关键词 :视频超分辨率, 流式扩散, KV Cache, 一步生成, 实时推理
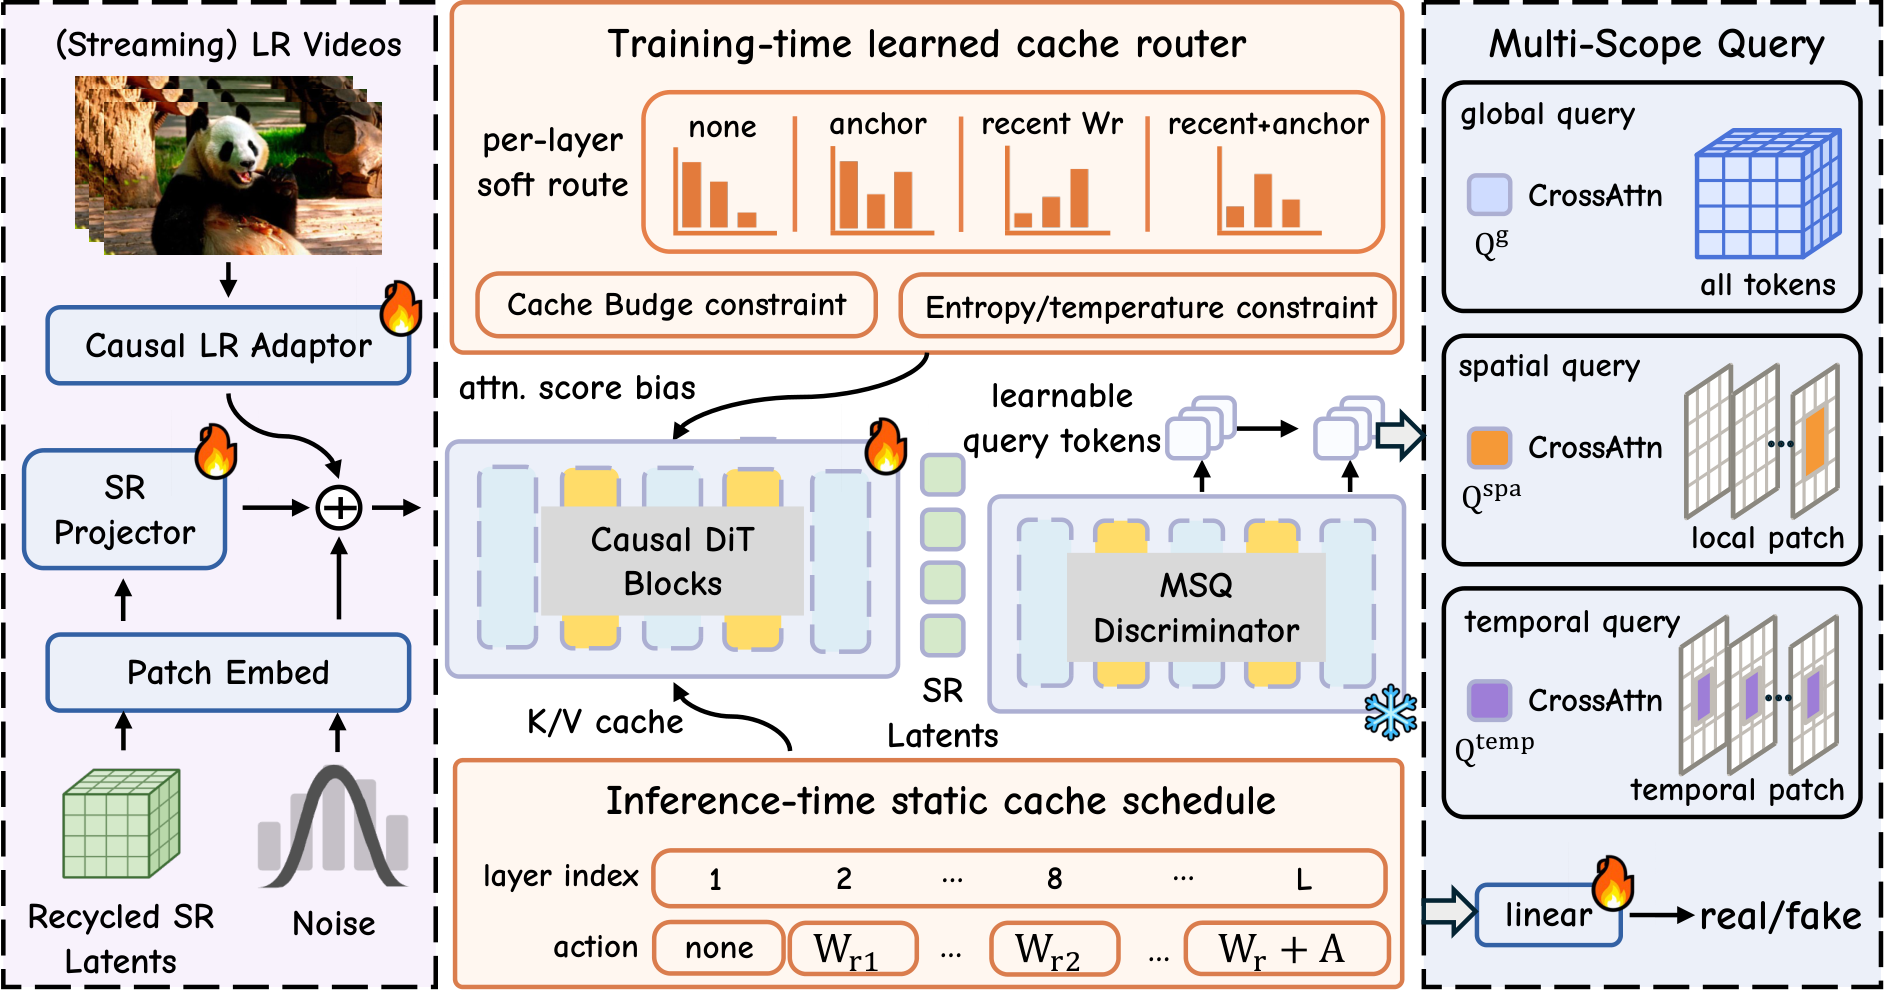
前序问题 :扩散式视频超分画质好,却很难满足直播级延迟。现有流式方案要么多步去噪,要么每层都保留完整历史 KV;但视频超分当前帧已有低清观测,上一块超分 latent 也带着局部时序信息,继续为所有层保存同样长的历史既占显存又拖慢注意力。本文贡献 :ReCaVSR 基于 Wan2.2 做一步流式超分,把上一块生成的 SR latent 直接回收为下一块条件,再为每个 DiT 层学习不同的历史缓存范围,训练完导出固定路由。生成器用 sequential self-rollout 对齐真实因果推理;Multi-Scope Query 判别器同时看全局、空间窗口和时间 tube;LR-conditioned FlashDecoder 在解码时再次利用低清观测。
实验效果 :单张 A100-80GB 输出 1080×1920 时达到 21.20 FPS、峰值显存 15.16GB,相对 FlashVSR Tiny 快 2.72 倍、少用 38.0% 显存,首个完整 RGB 输出的模型时间为 0.982 秒。LongVSR60 上 MUSIQ 57.89、CLIP-IQA 0.4932、DOVER 0.6075,后三项都高于列出的流式基线。
批判点评 :它并非所有重建指标都第一:REDS30 的 PSNR 21.67 明显低于 RealViformer 23.32,说明生成式纹理仍会牺牲逐像素保真。缓存路由在训练后固定,遇到运动强度突变或硬切镜不能自适应;论文的长视频测试还是单段连续镜头,跨场景时旧 latent 和 KV 会不会污染新镜头尚未验证。
7. PARK:稀疏注意力快1.76倍
PARK: Accurate Block Retrieval for Sparse Attention in Video Diffusion Transformers | 华南理工大学 | arXiv:2609.38978
关键词 :视频生成, 稀疏注意力, DiT, block retrieval, 免训练加速
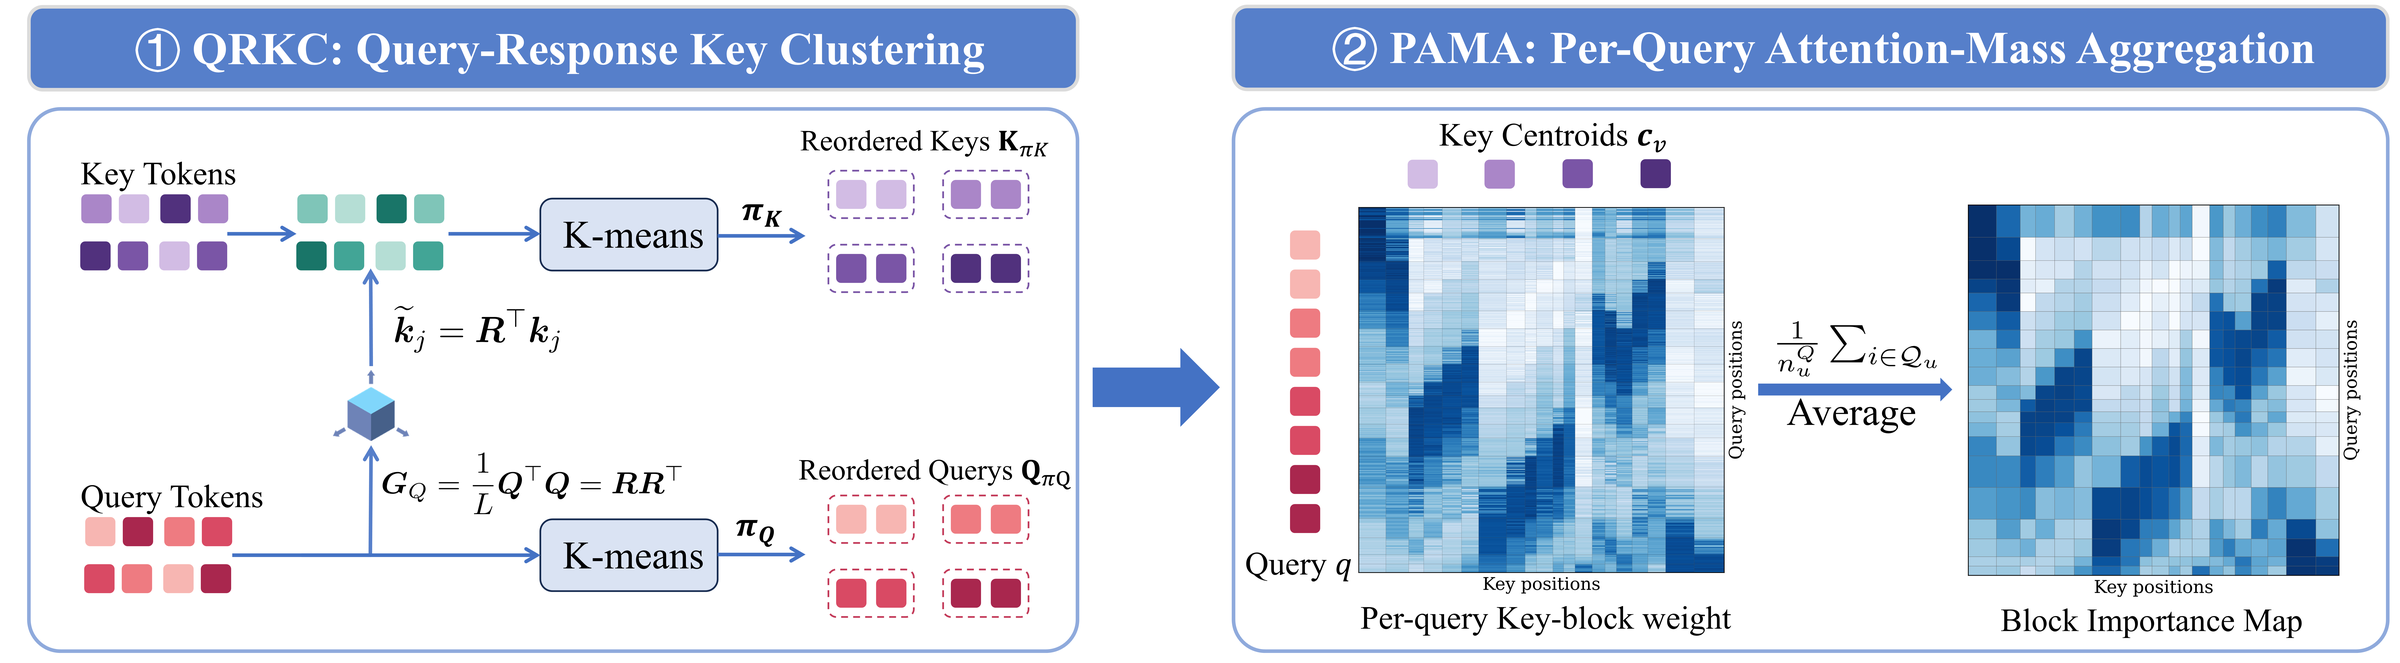
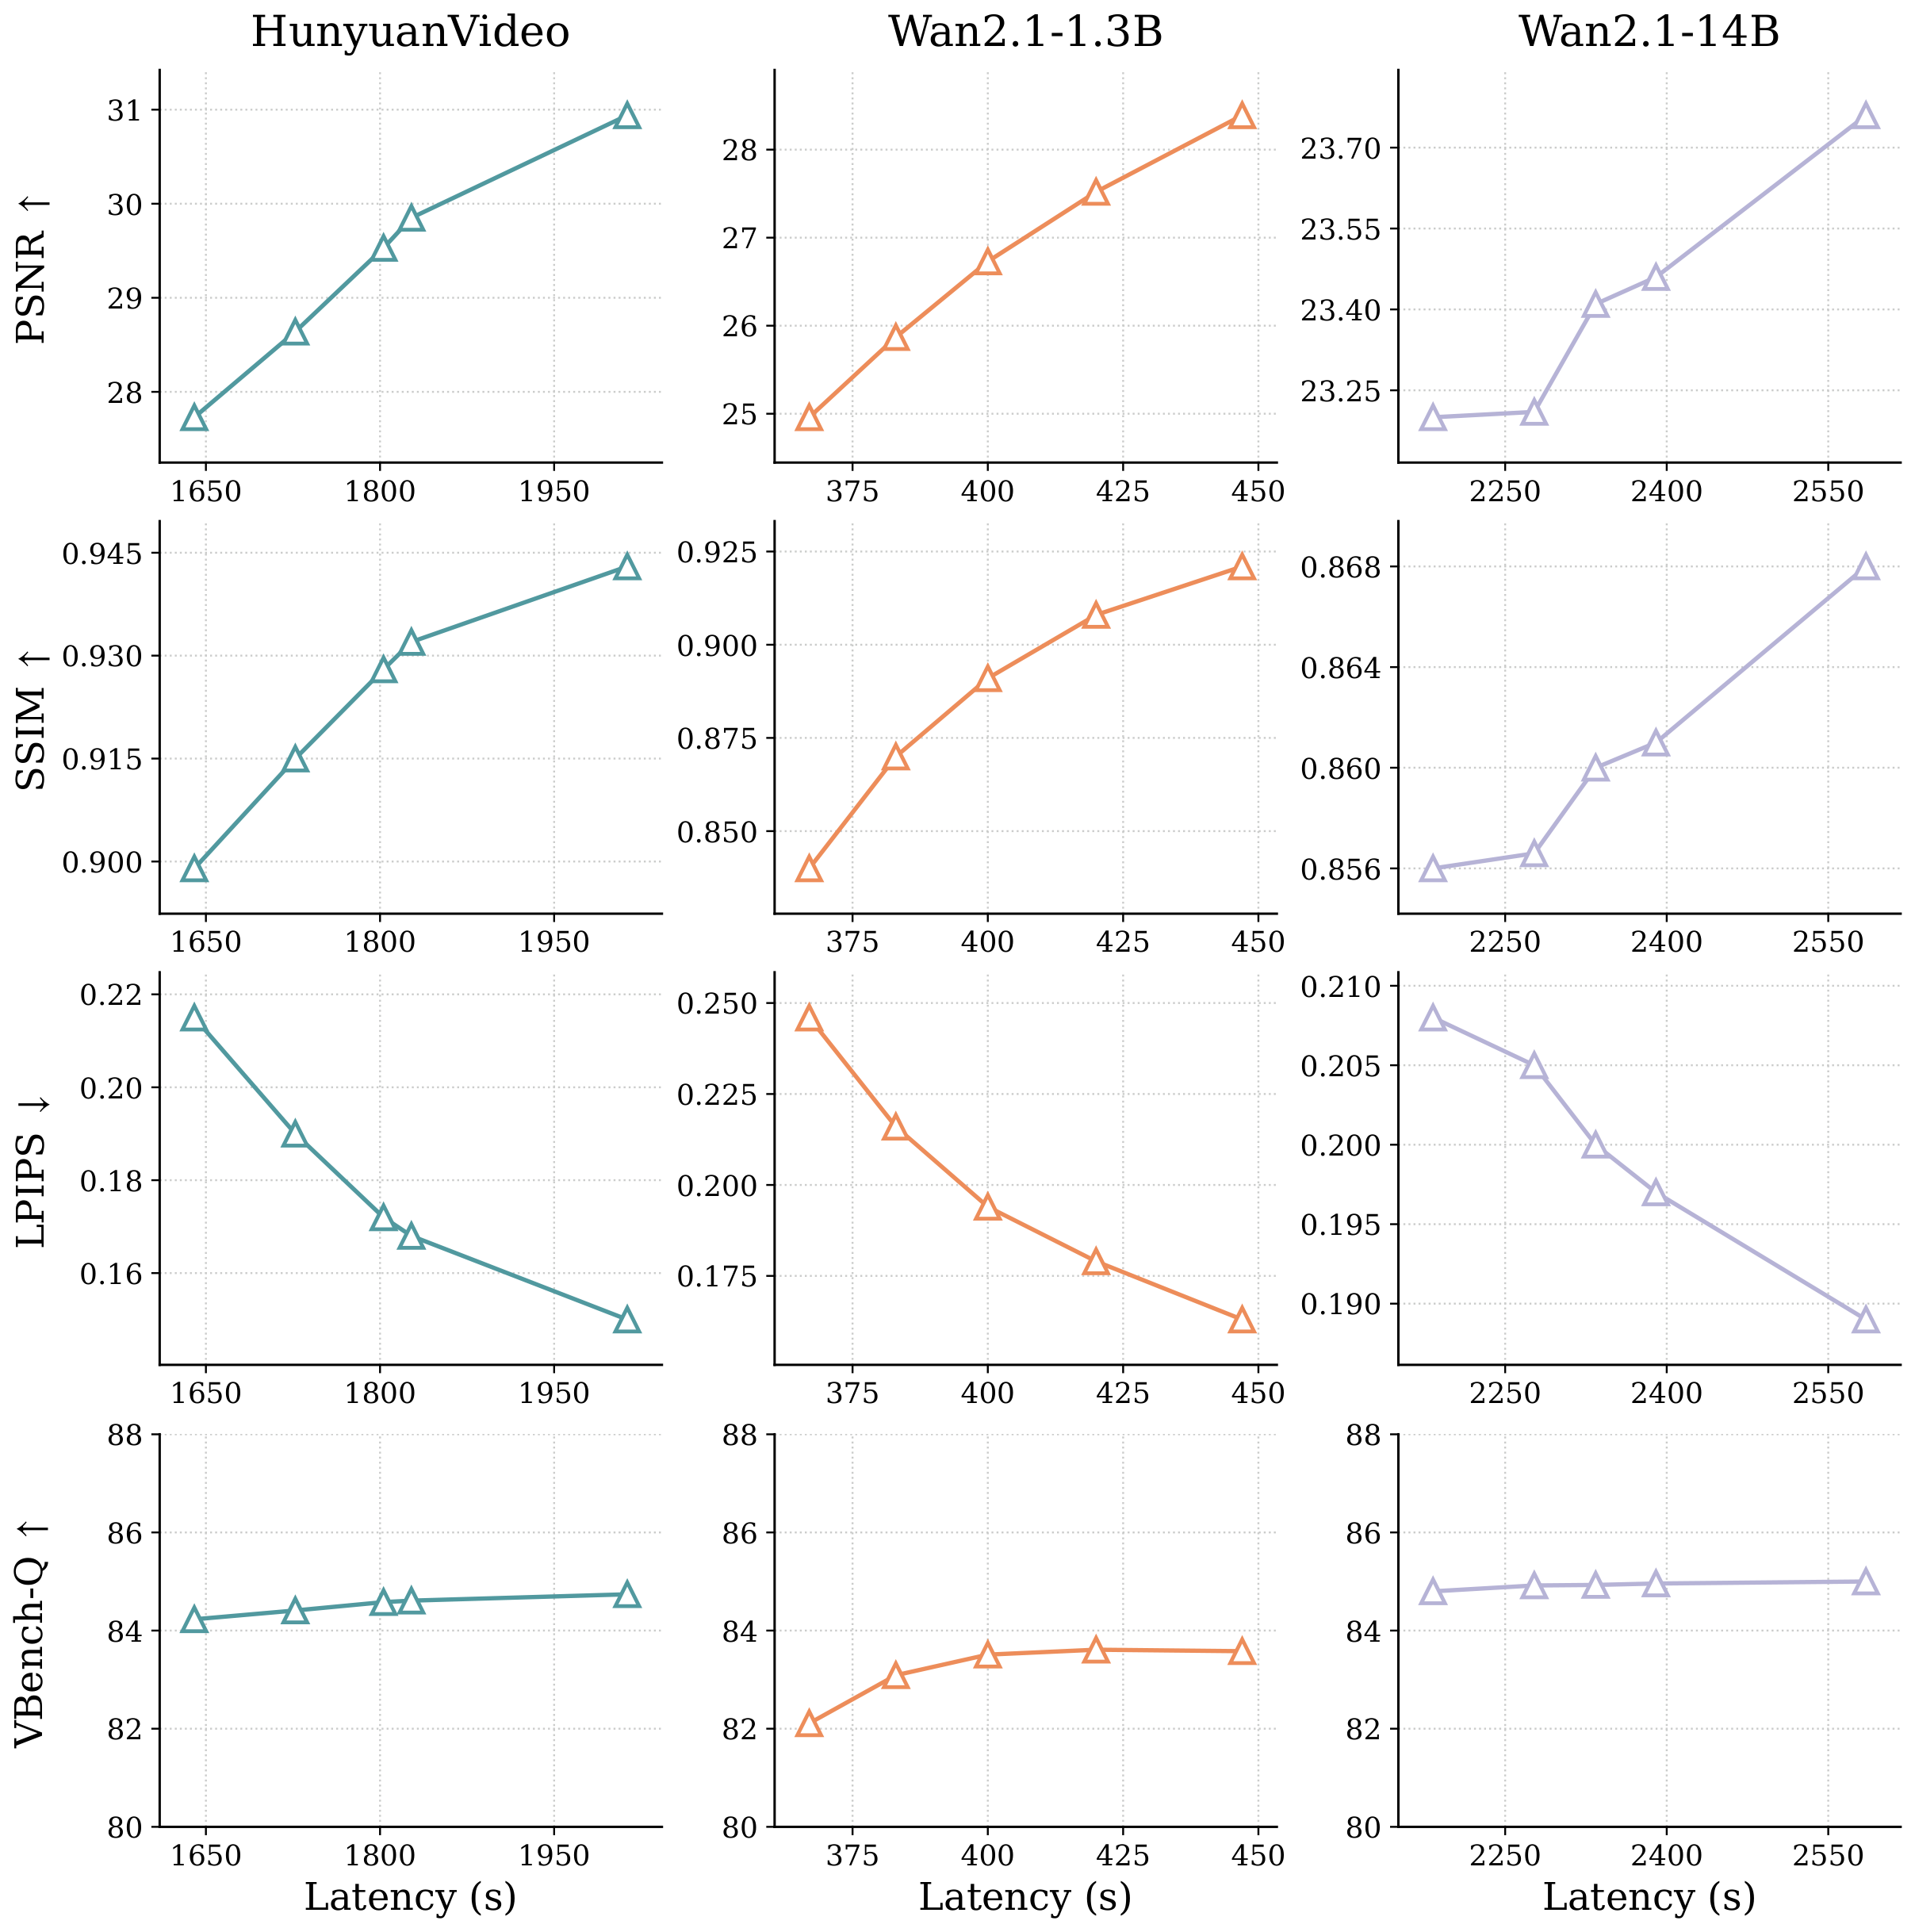
前序问题 :视频 DiT 的稀疏注意力通常先把 query 与 key 分块求均值,再按块检索。这个近似有两重错位:Softmax 前把多个 query 平均会抹掉各自偏好的 key;在原始 key 空间做欧氏聚类,也不保证同一簇的 key 在当前 query 下拥有相似 QK 分数。检索一旦选错块,要么掉画质,要么为了兜底算太多。本文贡献 :PARK 保留块内每一个原始 query,分别对 key block 做归一化后再平均分布,避免 query-centroid 代替整块偏好;key 侧则从当前 query 推导度量,先变换 key 再做 K-means,让欧氏距离对应 QK-score 误差。方法完全免训练,并把 PAMA 检索写成融合 GPU kernel,把准确率收益留住而不让检索开销反噬。
实验效果 :在 Wan2.1-1.3B 上,PARK 将单次测试从 745 秒降到 423 秒,端到端 1.76 倍加速,同时 PSNR 27.52、SSIM 0.908、LPIPS 0.177,优于同表其他稀疏基线。跨 Wan2.2-14B、Wan2.1-14B、Wan2.1-1.3B 和 HunyuanVideo 四个模型,相对 dense 的加速范围为 1.53–1.76 倍。
批判点评 :收益建立在四个视频扩散模型和固定检索配置上,作者明确没有验证 LLM 或其他多模态任务。主表中 Wan2.2 的 Aesthetic Quality 65.29% 仍低于 dense 的 65.56%,Wan2.1-1.3B 的 Background Consistency 96.87% 也低于 dense 的 96.99%;它更像高质量近似,而不是无损替换。
8. UnStep:免训练把视频推到50FPS
UnStep: Training-Free Acceleration of Causal Video Diffusion with Fewer Steps Than Distillation | Meta 超级智能实验室 | arXiv:2609.32518
关键词 :视频生成, 因果扩散, 免训练加速, KV Cache, 推理优化
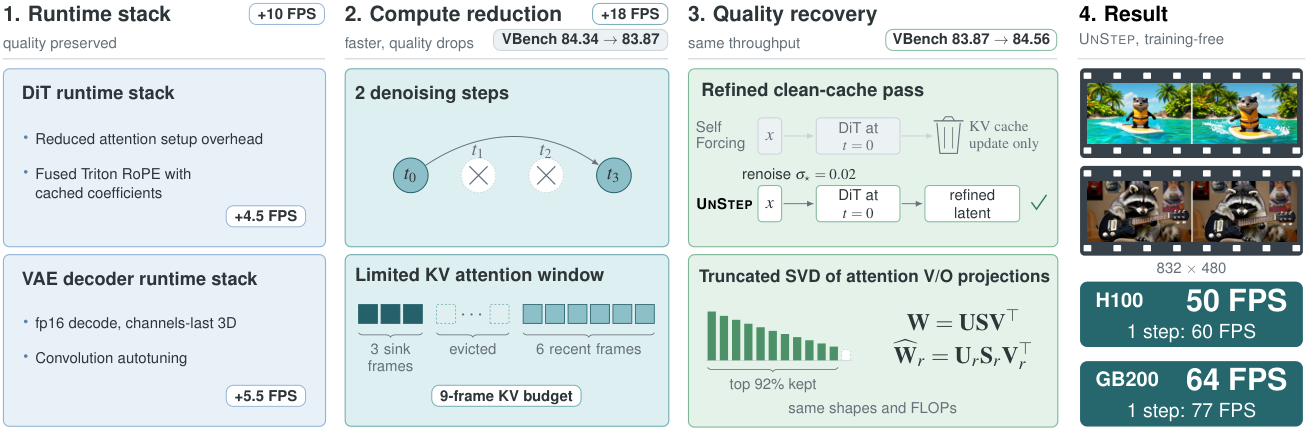
前序问题 :四步因果蒸馏已经比 50 步双向教师快,但 Self Forcing 在 H100 上仍只有 17 FPS。步数继续砍到一两步会掉质量,历史 KV 随视频变长继续膨胀;同时当 DiT 已经很少步,RoPE、cache 索引、attention 调度和 VAE 解码这些过去被遮住的系统开销反而成了瓶颈。本文贡献 :UnStep 是不改权重的推理 wrapper:后续块从四步减到两步,只保留 sink 加最近窗口;把已生成 latent 重新加到近干净噪声,再复用原有 clean-cache pass 做一次修正,并对 attention 的 V/O 投影做截断 SVD 抵消少步误差。系统侧再融合 RoPE、缓存系数、固定长度 attention,并把 VAE 改成 FP16 与 channels-last 卷积。
实验效果 :同一 Self Forcing checkpoint 在 H100 上从 17.0 FPS 提到 49.8 FPS,VBench Total 反而从 84.31 到 84.56;相同 wrapper 套在 Causal Forcing 和 LongLive 1.0 上也都约 49.8 FPS。若推理时改成一步,H100 达 59.6 FPS;GB200 最快报告 77 FPS,全程没有重训。
批判点评 :所有超参数只在 Self Forcing、5 秒 T2V、单张 H100 这一套设置上调过,迁移结果证明“能用”,不代表每个 checkpoint、GPU、任务和长度都最优。50 FPS 的成绩同时叠加算法减步与大量 H100 专用 kernel 优化,不能全部归功于新的生成算法;而训练自由的约束也限制了更激进稀疏或量化后的质量恢复。
9. DeCoPrune:剪85%缓存仍保上下文
DeCoPrune: Efficient KV-Cache Pruning for Autoregressive Video Diffusion via Denoising Consistency | 南洋理工大学;清华大学;普林斯顿大学 | arXiv:2609.39096
关键词 :自回归视频, KV Cache, 训练自由剪枝, 长上下文, 一致性
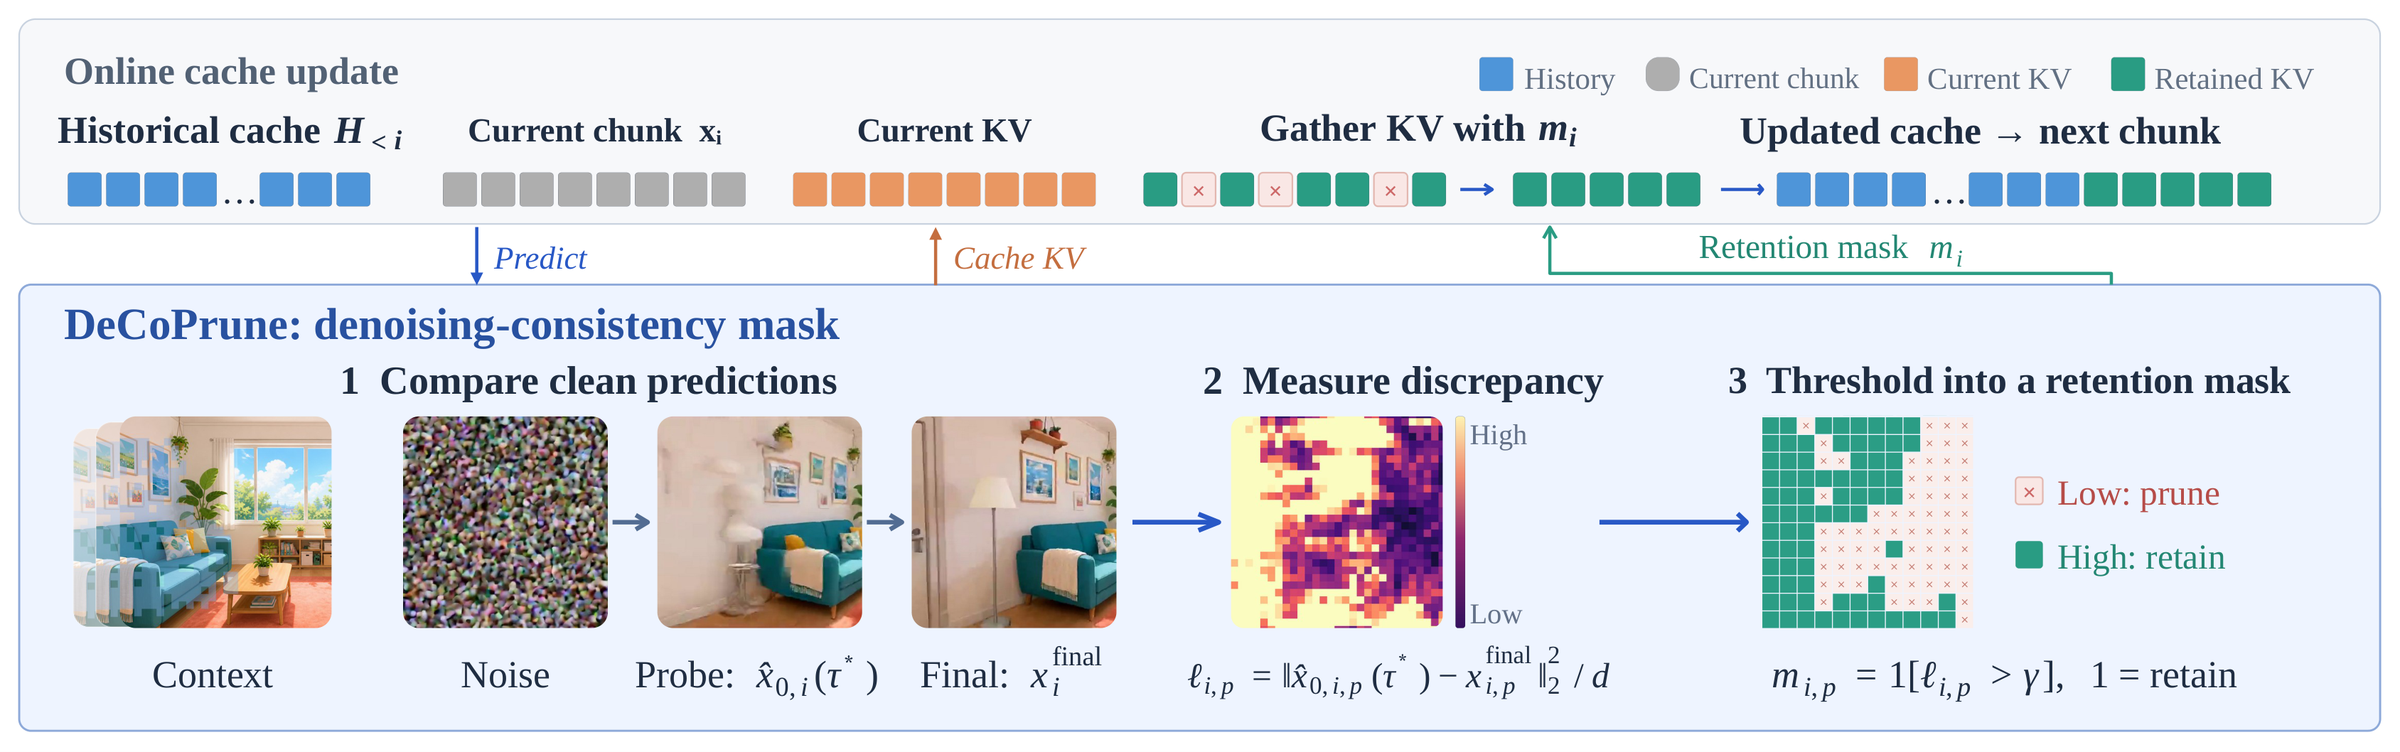
前序问题 :自回归视频扩散把每段历史都塞进 KV Cache,时间越长,显存和 attention 成本越大。固定滑窗只看远近,attention 权重或相似度剪枝又不直接回答“这个历史块是否提供了不可替代的信息”,所以容易把稍后 prompt 才会重新提到的物体细节一起删掉。本文贡献 :DeCoPrune 用同一条去噪轨迹里的中间 probe 与最终预测做差:没有历史支持时难以稳定去噪、step-to-final discrepancy 较大的 token 被判为更需要上下文,因此保留高差异 token,再物理压紧历史 KV。论文同时构建 CMBench,用一分钟上下文中的物体取放、场景恢复等续写任务专测“前文记没记住”,并提供按 attention head 类型分组的 HS 版本。
实验效果 :主设置剪掉 85.43% 历史 KV,续写 FPS 从 FullKV 的 1.568 提到 6.489,快 4.14 倍;CMBench DINO 从 0.6803 只降到 0.6701。head-specialized 版本在 86.19% 剪枝率下 DINO 为 0.6783,几乎追平 FullKV,且 VBench 的图像质量项没有出现系统性崩塌。
批判点评 :“剪掉 85%”并不等于显存有硬上限,作者明确承认剩余缓存仍随视频长度线性增长。Denoising consistency 是 future-agnostic 的:某个细节此刻很好去噪、因此被删掉,但未来指令恰好再次询问它时仍可能失忆。主干又集中在 LingBot World v2,其他开源模型的分钟级 FullKV 本身就不稳定,方法与 backbone 上限难完全拆开。
10. ViTeX-Bench:387段视频检验动态改字
ViTeX-Bench: Benchmarking High-Fidelity Video Scene Text Editing | 得州农工大学 | arXiv:2609.40356
关键词 :视频编辑, 场景文字, 评测基准, 时序一致性, 编辑局部性
前序问题 :视频里的招牌、球衣或屏幕改字,要同时满足字符串正确、跨帧不漂、背景不被改。通用视频编辑指标可能把“画面很稳但根本没改字”的结果评得很高,静态 OCR 又看不见闪烁与字符漂移,现有公开数据也缺少真实视频的成对编辑参考。本文贡献 :ViTeX-Bench 收集 387 段 720p、120 帧、24 FPS 真实视频,其中 230 段提供人工复核的成对训练编辑,157 段冻结测试。评测拆成文字正确性、视觉/时序质量、编辑局部性三轴共 13 个指标,并用 OCR 校准、人评相关性与 Pareto 前沿解释取舍;配套的 ViTeX-Edit-14B 用随运动对齐的 glyph-video 条件微调 VACE。
实验效果 :八条基线中,ViTeX-Edit-14B 在 video-native 编辑器里 CharAcc 最高,为 0.688,text-crop Warp 1.53 也最低;相较 VideoPainter 的 CharAcc 0.619 提升 0.069。但逐帧 FLUX-Text 的 CharAcc 仍达 0.737,代价是 Warpc 13.01、字符跨帧严重漂。人评与 OCR 方法排名的 Spearman 相关系数为 0.95。
批判点评 :这个基准把“漂亮、正确、稳定、局部”拆开是优点,也暴露了参考模型并非全面第一:ViTeX-Edit 的 SeqAcc 0.341 低于 FLUX-Text 0.528。数据以清晰、局部、拉丁文字为主;非拉丁切片里除 AnyText2 外其余编辑器 CharAcc 都低于 0.19,严重运动、曲面文字、密集排版的覆盖仍不足。
趋势观察
加速的战场从「少走几步」挪到了「每层只记该记的」
ReCaVSR 给每个 DiT 层学一个缓存跨度,PARK 修正稀疏注意力的块检索误差,UnStep 把两步采样、限窗 KV 与 kernel 优化叠进同一个免训练 wrapper,DeCoPrune 则用去噪一致性挑出真正依赖历史的 token,四篇都指向同一件事:视频模型已进入少步时代,下一轮效率竞争发生在缓存、检索与运行时细节。另一头,PixelUMM 去掉视觉编码器让像素直进统一模型,说明「统一」正在从拼模块转向砍模块。
人工智能炼丹君 整理 | 2026-10-02
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注

















评论 (0)