


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:表征 | 难度:进阶 | 前置知识:变分下界与重参数化(ELBO)、VAE 结构与训练目标(知道「重参数化」和「KL 项怎么来的」就够了)
关键词:VQ-VAE、VQGAN、码本、straight-through、码本坍缩、感知损失
先算一笔账,这是 VQGAN 原文 的一个重要动机,另一个是让压缩后的局部表征保留可感知的结构。把一张 256×256 的 RGB 图像当成序列直接做自回归:每个像素三个通道各算一个 token,序列长度是 256 × 256 × 3 = 196,608。自回归 Transformer 的注意力矩阵是序列长度的平方,也就是 3.87 × 10¹⁰ 个元素——单张显式 BF16 分数矩阵约 72 GiB,尚未乘 batch、头数和训练保存量。这里比较的是朴素稠密注意力的逻辑矩阵大小,不能等同于 FlashAttention 的实际显存或整网耗时。
我按这个口径把不同下采样率的账都算了一遍(token_budget.py,本机实跑):
| 下采样率 f | 256² 图像的 token 数 | 注意力矩阵规模 | 相对像素级 |
|---|---|---|---|
| 像素级 RGB | 196,608 | 3.87 × 10¹⁰ | 1 |
| f=4 | 4,096 | 1.68 × 10⁷ | 4.3 × 10⁻⁴ |
| f=8 | 1,024 | 1.05 × 10⁶ | 2.7 × 10⁻⁵ |
| f=16 | 256 | 6.55 × 10⁴ | 1.7 × 10⁻⁶ |
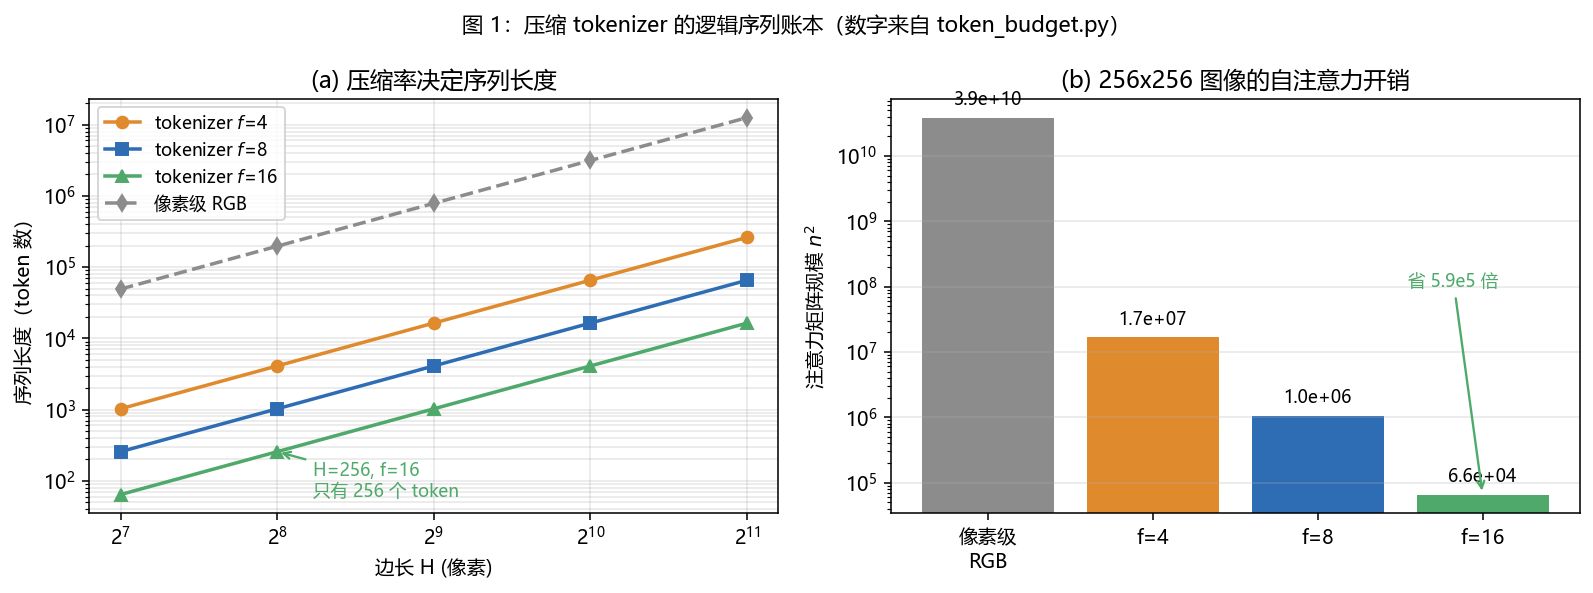
这张图要看的是两件事:左图里三条 tokenizer 曲线与像素级虚线之间的纵向鸿沟——f=16 时 256² 图像只有 256 个 token,是像素级序列的 1/768;右图是同一个事实在注意力开销上的投影,柱子从 3.87 × 10¹⁰ 掉到 6.55 × 10⁴,省了约 59 万倍。分辨率越高鸿沟越陡(1024² 图像在 f=16 下是 4,096 个 token),视频账本还要约定时间边界:这里取 121 个采样时刻,24fps 下首末相距 5 秒;采用「首帧单独保留,其余 120 帧每 4 帧一组」的示意规则,时间长度为 31,空间 f=16 时共有 31×256=7,936 个 token。这是明示的计数约定,并非所有视频 tokenizer 的通用长度公式;实际应读它的卷积、填充和截断规则。
压缩让序列变短,离散化则让下游能够用 K 分类交叉熵预测码字编号,复用离散序列建模设施。这是 VQ 路线的便利,自回归本身并不要求离散变量:MAR 就在连续潜变量上构造条件生成器。不能笼统说连续目标一定病态。原 DALL-E 用 8192 类的 dVAE 和 32×32=1024 个图像 token;VQGAN 的 f=16 配置给出 16×16=256 个 token,MaskGIT 和 VAR 再改变这些离散表征的预测顺序。
不过离散化是有代价的,而且真正容易被忽视的代价不在「码本有多大」,在「码本用得怎么样」。我在 8×8 小块的玩具上训了一个 K=512 的 VQ 自编码器(collapse_lab.py,实跑):512 个码字里只有 17 个被用到,96.7% 的码在最终 4096 样本评估窗口未命中;码本标称 9 bit,边缘使用熵为 log2(14.50)=3.86 bit/token;这不是固定长度索引实际只存了 3.86 bit。这篇就讲三件事:量化怎么写进损失函数、码本怎么训练才不会死、以及为什么追求感知质量时会加入感知损失和对抗损失,而像素保真任务可能继续重视 MSE。
三句话:
VQ-VAE(Neural Discrete Representation Learning)的名字里有 VAE,推导起点也确实是 ELBO:
$$\log p(x) \ge \mathbb{E}_{q(z \mid x)} \big[ \log p(x \mid z) \big] - \mathrm{KL}\big( q(z \mid x) \,\Vert\, p(z) \big)$$
每一项的含义:$q(z \mid x)$ 是编码器给出的「后验」,$p(z)$ 是我们先验地相信 latent 该有的分布,$p(x \mid z)$ 是解码器。VAE 里这三样都是连续分布,KL 项把后验往先验上压,重参数化让采样可导。下面先看原论文第一阶段的简化模型。用 $k$ 表示码字的离散索引,$e_k$ 是其向量值:
把这个确定性后验和均匀先验代进 KL:$q$ 在 $e_k$ 处为 1、其余为 0,求和只剩被选中那一项:
$$\mathrm{KL}\big( q \,\Vert\, p \big) = \sum_{j=1}^{K} q_j \log \frac{q_j}{p_j} = 1 \cdot \log \frac{1}{1/K} = \log K$$
$\log K$ 在 K 固定时为常数;若一张图有 N 个索引、先验对各位置独立均匀,整张图的 KL 为 $N\log K$。因此这个阶段的 KL 不给编码器可用的优化信号,但数学上的离散后验和变分下界仍存在。字典与 commitment 项是处理量化训练的附加代理项,不能说是从常数 KL 严格推出来的。原论文随后另训自回归先验 $p_\psi(k_1,\ldots,k_N)$;学习到的先验通常不均匀,相应 KL 就不再是常数。
量化操作本身是:
$$z_q = e_k, \quad k = \arg\min_{j} \, \Vert z_e - e_j \Vert_2^2$$
符号含义:$z_e \in \mathbb{R}^d$ 是编码器输出(e 指 encoder),$e_j \in \mathbb{R}^d$ 是第 j 个码字,$z_q$ 是替换后的向量(q 指 quantized)。问题出在 $\arg\min$:它是分段常数函数。训练中把 $z_e$ 微动一点点,只要不跨过两个码字的垂直平分面,选中的 $k$ 根本不变,$z_q$ 不变,重建损失也不变。
在不跨越最近邻分区的区域内部,硬量化对输入的导数为零;分区边界可能跳变、不可导。我在训好的 VQ-AE 上用有限差分实测过(vq_core.py 的 [D] 段,512 个样本,沿随机单位方向扰动 $z_e$):
| 扰动步长 eps | 有限差分 $\partial L/\partial z_e$ | argmin 保持不变的样本比例 |
|---|---|---|
| 10⁻¹ | −7.6 × 10⁻⁶ | 0.9941 |
| 10⁻² | 0.0(精确为零) | 1.0000 |
| 10⁻³ | 0.0(精确为零) | 1.0000 |
| 10⁻⁴ | 0.0(精确为零) | 1.0000 |
eps=10⁻¹ 那一行有 0.59% 的样本跨过了平分面,所以差分不为零——这也正是 argmin「分段常数、边界处跳变」的直接展示。而在平分面之间的整片区域里,重建损失对编码器没有任何梯度。VQ-VAE 的解法是 straight-through:假装量化是恒等映射,把解码器对 $z_q$ 的梯度原封不动地抄给 $z_e$:
$$\frac{\partial L}{\partial z_e} \mathrel{:=} \frac{\partial L}{\partial z_q}$$
要强调的是:这不是真实梯度的估计,是替代品。真实梯度是 0,直通梯度实测平均范数 1.49 × 10⁻⁴(同一组权重),它携带的信息是「如果量化不存在,往哪边调编码器能让重建更好」。这是让局部连续优化能推进训练的启发式,并不保证每次更新都选到更好的码字,也不保证沿硬目标下降。commitment 与码本更新帮助两侧协调,具体稳定性仍须验证。
实现上只有一行(taming-transformers 的写法,见 05 节):z_q = z + (z_q - z).detach()。前向时 $z_q$ 是真的码字,反向时梯度绕过 $(z_q - z)$ 这个常量直接流向 $z$。
直通梯度有个致命遗漏:码本自己拿不到任何来自重建损失的梯度。查表本身能对被选中的码字求导,不能对离散索引求导。这里重建梯度不进入码本,是因为 z + (z_q-z).detach() 显式切断了量化分支的反向路径;直通让它转而进入编码器。如果什么都不加,码本会永远停在初始化的位置。我在玩具上实测过这条「什么都不加」的路线(vq_core.py [E] 段,K=64,800 步):码本位移精确为 0.000000,重建 MSE 0.185734,是正常训练的 3 倍多。
所以码本必须有独立的更新机制,VQ-VAE 给了第一条路——字典损失。把编码器输出当成常数(stop-gradient,记作 sg),把码字往它身上拉:
$$L_{\text{codebook}} = \big\Vert \mathrm{sg}[z_e] - e_k \big\Vert_2^2, \qquad \frac{\partial L_{\text{codebook}}}{\partial e_k} = 2\,(e_k - z_e)$$
第二条路是 EMA(原 VQ-VAE 的附录 A.1 已经给出,不是 VQ-VAE-2 才引入):不用梯度,直接对「每个码字被选中样本的均值」做指数滑动。记第 t 步里码字 j 被选中了 $n_j$ 次、被选中样本之和为 $s_j$,则
$$c_j \leftarrow \gamma c_j + (1-\gamma)\, n_j, \quad m_j \leftarrow \gamma m_j + (1-\gamma)\, s_j, \quad e_j \leftarrow \frac{m_j}{c_j + \epsilon_{\text{smooth}}}$$
$\gamma$ 是滑动系数(taming 里 decay=0.99),$c_j$ 是每个码字的滑动计数,$m_j$ 是滑动累加的样本和,$\epsilon_{\text{smooth}}$ 用来防止某个几乎没人用的码字除以接近零的数(taming 的平滑是 $(c_j + \epsilon) \cdot n / (n + K\epsilon)$,其中 $n$ 是全部计数之和)。EMA 的本质是把码字变成「最近被它编码过的那些向量的滑动平均」,不走码本的梯度优化器,但仍有 decay、平滑、初始化和重启阈值等选择;梯度更新与 EMA 两种路线都在使用。本文玩具的计数初始为 1,官方 EmbeddingEMA 初始为 0、累积向量初始非零,二者不能冒充逐步数值等价。未命中码字的计数和向量会一起衰减,平滑也会改变比值;它并非必然立即变成 0/0。
现在把绳子接上另一头。EMA 把码字往编码器输出上拉,但没有任何东西把编码器输出往码字上拉——编码器完全可以漂走,让量化误差 $\Vert z_e - e_k \Vert^2$ 失控。commitment 项就是拴住编码器的那根绳:
$$L_{\text{commit}} = \beta \,\big\Vert z_e - \mathrm{sg}[e_k] \big\Vert_2^2$$
注意方向和字典损失正好相反:字典损失动了 $e_k$($z_e$ 被 stop-gradient 冻住),commitment 动了 $z_e$($e_k$ 被冻住)。字典梯度路线最小化下面的目标;若用 EMA,则以码本更新规则替代字典损失的梯度步骤,不把 EMA 当作额外损失相加:
$$L = \underbrace{-\log p(x \mid z_q)}_{\text{重建,经直通传给编码器}} + \underbrace{\big\Vert \mathrm{sg}[z_e] - e_k \big\Vert_2^2}_{\text{字典损失}} + \underbrace{\beta \big\Vert z_e - \mathrm{sg}[e_k] \big\Vert_2^2}_{\text{commitment}}$$
$\beta$ 不能脱离损失归约方式来比较。本文训练对重建项取 batch×64 的均值,对 commitment 取 batch×d 的均值;两者都要除 batch。原核验漏给 commitment 除 512,错误地产生了「429 倍」。修正后同一工作点的直通梯度平均范数为 1.490013×10⁻⁴,commitment 为 1.249852×10⁻⁴,比值约 0.839。这撤回了原文的梯度量级归因,不改变训练循环本来就正确的归约。$\beta$ 扫描的实测结果(collapse_lab.py [A] 段,K=64,1200 步):
| $\beta$ | 0 | 0.05 | 0.25 | 1.0 | 4.0 |
|---|---|---|---|---|---|
| 重建 MSE | 0.0673 | 0.0484 | 0.0600 | 0.0387 | 0.0385 |
| 活跃码数 | 14 | 14 | 16 | 17 | 18 |
这次单 seed、同训练预算的扫描中,1.0 比 0.25 的 MSE 低约 35%,4.0 的 MSE 还略低;不能把 1.0 宣称为普遍最优。更不能把改善归因于已撤回的 429 倍。改变重建项量纲、均值/求和归约、初始化或训练时长,都可能改变合适的 $\beta$。
若多个真实纹理被映到同一个 latent,逐像素 MSE 的最优确定性解码就会平均它们;当 latent 已保留足够细节时,这个前提未必成立。06 节用刻意丢掉纹理极性的玩具展开。VQGAN 把重建侧换成三件套:
$$L_{\text{VQGAN}} = \underbrace{\big\Vert x - \hat x \big\Vert_1 + \lambda_{\text{lpips}} L_{\text{LPIPS}}(x, \hat x)}_{\text{感知重建}} + \underbrace{\lambda_{\text{GAN}} \big( -\mathbb{E}[D(\hat x)] \big)}_{\text{对抗}} + \underbrace{\lambda_{\text{cb}} L_{\text{codebook}} + \beta L_{\text{commit}}}_{\text{量化}}$$
$\hat x$ 是解码器输出,$D$ 是 PatchGAN 判别器,LPIPS 是在 VGG16 五层特征上算距离再加一层学出来的 1×1 卷积(lpips.py 里五个 NetLinLayer,实读源码确认)。这里按官方代码采用判别器的未归一化 logit,生成器损失为负平均 logit;默认判别器用 hinge:真实项 $\max(0,1-D(x))$ 与生成项 $\max(0,1+D(\hat x))$ 各取均值,再平均两项。它与 sigmoid 概率上的负 log 损失不同。对抗项权重有自适应部分,也仍有手设乘数:对解码器最后一层分别求重建损失和对抗损失的梯度,取范数比 $\lambda_{\text{GAN}} \leftarrow \Vert \nabla L_{\text{rec}} \Vert / \Vert \nabla L_{\text{GAN}} \Vert$,实际分母加 $10^{-4}$,比值截断至 $[0,10^4]$、停止梯度,再乘 disc_weight 和按 disc_start 开启的 disc_factor。这是按最后一层局部范数平衡两种信号,并不保证全网梯度或质量稳定。固定 官方损失源码 与 CPU 原方法核验可对照。
三个从粗到细的指标,别混用:
两个容易踩的坑。第一,perplexity 是分布层面的量:它下降只说明使用分布变尖了,既不告诉你死码落在哪,也不等价于重建质量——要看死码分布得直接画使用次数的直方图(图 4 干的就是这件事)。第二,taming 是在当前 batch 上算 avg_probs 的,batch 越小噪声越大;小 batch 上看到 ppl 上下抖动不等于坍缩,别急着改 decay 或加重启。
最小实现不需要网络,一个「线性编码器 + VQ + 线性解码器」就能把所有机制跑出来。数据是我合成的 8×8 小块:16 个低频类心,类内加连续变化和白噪声(make_patch_data,4096 个样本,种子 0;Python 3.11.9、NumPy 2.4.3、单 BLAS 线程实跑。表格除特别注明留出集外都来自训练分布内评估,不是泛化质量结论)。核心的量化与直通就这几行(完整脚本在附录):
def quantize(z_e, codebook):
    d2 = ((z_e[:, None, :] - codebook[None, :, :]) ** 2).sum(-1)   # [N, K]
    idx = d2.argmin(axis=1)                                        # 最近邻
    return codebook[idx], idx, d2[np.arange(len(idx)), idx]

# 训练循环里(z_q 是查表结果,e_k = z_q):
x_hat = z_q @ params["Wd"] + params["bd"]
dxh = 2.0 * (x_hat - x) / (len(x) * d_in)          # 对 x_hat 的梯度
dz_q = dxh @ params["Wd"].T                        # 解码器传给 z_q 的梯度
dz_e = dz_q + beta * 2.0 * (z_e - z_q) / (len(x) * d_lat)   # 直通 + commitment
# 码本走 EMA(onehot 统计被选中的次数与样本和,见附录 vq_core.py)
第一件事:误差到底由哪几块组成。 用同一组训练后权重,把「走不走量化」作为开关(vq_core.py [C] 段,K=64,d=8):
| 通路 | 重建 MSE/像素 |
|---|---|
| 连续自编码器参考(无 VQ,独立训练 800 步) | 0.011082 |
| 同一组 VQ-AE 权重,绕开量化(直接用 $z_e$ 过解码器) | 0.023360 |
| 同一组 VQ-AE 权重,正常走量化 | 0.060345 |
同一组 VQ-AE 权重下,量化通路比连续通路多 0.036985(+158.3%)MSE。这是开关量化的像素误差差值,不等于潜空间的 $\mathbb{E}\Vert z_e-z_q\Vert^2/d$,后者为 0.158759。定义连续重建残差 $r=z_eW_d+b-x$、量化带来的输出改变量 $\delta=(z_q-z_e)W_d$,逐项展开有:
$$\mathbb{E}\Vert r+\delta\Vert^2=\mathbb{E}\Vert r\Vert^2+\mathbb{E}\Vert\delta\Vert^2+2\mathbb{E}\langle r,\delta\rangle$$
只有证明交叉项为零,才可称正交误差分解;一般不能保证量化后误差一定增加。同样,独立连续模型的 0.011082 与 VQ 模型的 0.023360 来自不同训练目标和参数,体现组合训练的差异,不能单独定位为 commitment 的因果代价。vq_checks.py 对 40 组随机夹具验证了这条带交叉项的恒等式。
第二件事:固定潜分布后看码本容量收益。 固定一个训好的连续编码器,对它的潜变量做 k-means(k-means 就是「给定 K 个码字的最优最近邻量化器」的近似),在留出集上测失真随 K 的变化:
| 码本维度 d | 理论斜率 −2/d | 实测斜率(K≥16 段) | K 从 8 加到 512,失真降多少 |
|---|---|---|---|
| 2 | −1.00 | −0.87 | 66.5 倍 |
| 4 | −0.50 | −0.40 | 33.8 倍 |
| 8 | −0.25 | −0.28 | 13.9 倍 |
| 16 | −0.125 | −0.36 | 12.7 倍 |
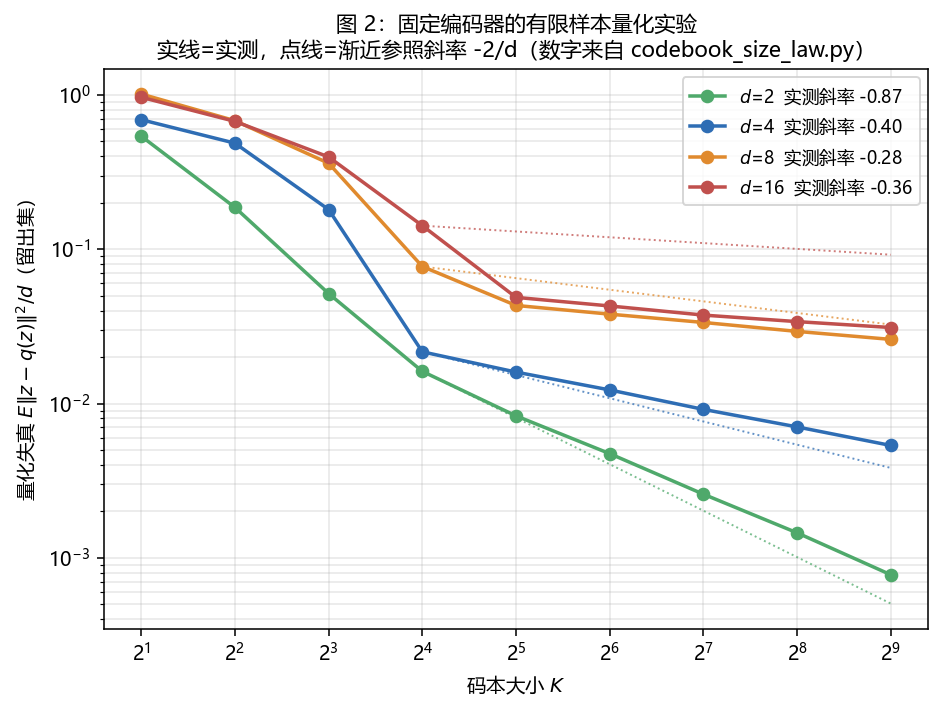
这张图比较实测线与渐近参照,不能当作普适定律的验证。直观上,若 K 个小单元覆盖固定的 d 维体积,每个单元的线性尺度约为 $K^{-1/d}$,平方误差才有 $K^{-2/d}$ 的尺度。这个解释要求足维连续密度、足够大的 K 和接近最优的码本;有限样本的局部 k-means 不满足全部条件。这里 d=16 的数据主要由 9 个低频基方向加噪声产生,潜分布的有效维度也未必是 16。不能把偏离唯一归因于「每码只有 8 个训练样本」。这些数值只描述本次固定编码器和留出集;它们不预测 rFID。
第三件事:码本坍缩与两副解药。 K=512、随机初始化、EMA 更新,训练 1200 步:
| 配置 | 重建 MSE | 活跃码数 | perplexity | 有效 bit(log2 ppl) |
|---|---|---|---|---|
| 随机初始化 | 0.049067 | 17 / 512 | 14.50 | 3.86 |
| 连续 AE 预训练 + k-means | 0.017501 | 512 / 512 | 450.51 | 8.82 |
| 死码重采样重启 | 0.018368 | 500 / 512 | 426.71 | 8.74 |
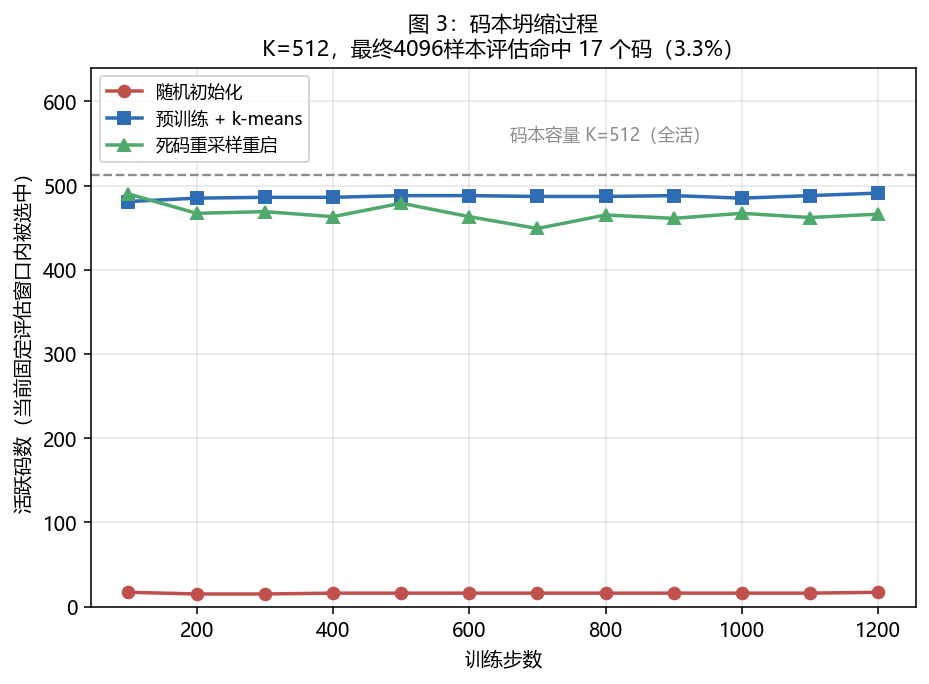
这张图要读两种评估窗口:曲线是固定 2048 样本,表格是最终全部 4096 样本,因此绿线末端 466 与表中 500、蓝线末端 491 与表中 512 并不矛盾。随机初始化早期就只使用少量码字,但「当前未命中」不证明此后永不命中。重启分支将 EMA 计数小于 1 的码替换成当批真实编码向量,改变了训练动力学。预训练分支额外付出 800 步连续 AE 和 20 轮 k-means,随后携带同一编码器/解码器权重进入 1200 步 VQ;原代码把码本初始化在预训练坐标里、却重置了编码器,本轮修正了这一坐标错配。该分支不能当作零额外成本的纯初始化消融。
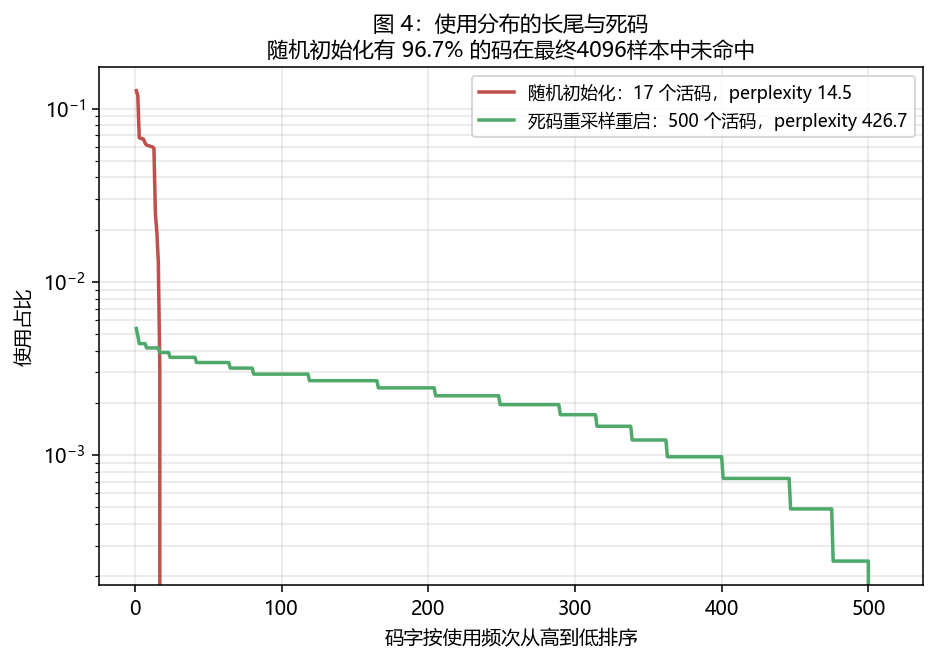
这张图的索引按使用次数排序,零计数无法在对数轴显示,缺席不表示日志丢失。随机分支最终只有 17 个活码;重启分支把很多码带回了当前评估窗口,但利用率不是重建质量的充分条件。两分支训练样本 MSE 为 0.049067 和 0.018368,单次比约 2.67,不推广到真实图像。
字典梯度更新也未被这个实验淘汰:同一玩具、800 步时,码本 SGD 学习率从 0.02 增到 10,MSE 从 0.241819 到 0.053808;后者还低于不重启 EMA 的 0.059999。优化器、初始化和训练预算都影响比较,不能说「主流全部转向 EMA」或「梯度始终追不上 EMA」。
上面是最小实现,以下按 2026-11-01 核对的官方提交 3ba01b2 对照 量化器、损失 和 模型配置。完整原类 AST 在 CPU 实际执行,范围是量化、梯度分流、EMA 更新和局部权重,不是预训练 VQGAN 的图像质量复现。
距离计算用展开式。 教学版广播会物化 N×K×d 的中间数组;官方用平方范数和点积,只构造 N×K 距离表。等价的核心函数如下,完整教学脚本仍在附录:
def squared_distances(z_flattened, weight):
    return (z_flattened.square().sum(1, keepdim=True)
            + weight.square().sum(1)[None, :]
            - 2 * (z_flattened @ weight.T))
这里 N=batch×latent高×latent宽。展开式减轻中间存储,但仍有 N×K 成本,低精度相消也可能改变边界附近最近邻;大码本还可分块检索。
直通就一行,和推导完全一致:z_q = z + (z_q - z).detach()。
taming 保留了一个带 bug 的版本。 VectorQuantizer2 有个 legacy 开关,legacy=True(默认)时损失是 loss = mean((z_q.detach()-z)**2) + beta * mean((z_q - z.detach())**2)——$\beta$ 被加在了码本项上,而不是 commitment 项,与论文公式相反。源码注释直说这是历史 bug,为了兼容旧 checkpoint 保留默认。读老代码、对老权重时要注意这个坑。
官方这份 EMA 基元的权重是 requires_grad=False 的。EmbeddingEMA 里 weight、cluster_size、embed_avg 全是关闭梯度的参数,更新完全靠滑动平均——其平滑公式见 3.3,但初始计数不同。还须指出该提交 EMAVectorQuantizer.__init__ 使用未定义的 codebook_dim、num_tokens,不能直接把这个包装类称作已运行生产实现;本轮执行的是完整、可工作的 EmbeddingEMA 类。原 VectorQuantizer 还计算 perplexity:exp(-sum(avg_probs * log(avg_probs))),这正是我用来诊断坍缩的量。
decay 不是「越接近 1 越稳」,它是一个时间常数。 衰减系数 $\gamma$ 决定码字「记得多久以前的样本」:$\gamma=0.99$ 时一个历史样本的贡献半衰期是 $\log 0.5 / \log 0.99 \approx 69$ 步,458 步后只剩 1%;$\gamma=0.999$ 半衰期拉到 693 步,$\gamma=0.95$ 只有 13.5 步。这个数要和 batch 里的 token 数对着调:VQGAN f=16 时一张 256² 图给 256 个 token,batch=8 一共 2048 个 token,摊到 K=16384 的码本上平均每步每个码字只被选中 0.125 次。也就是说大码本下 EMA 的计数极其稀疏,decay 太小时计数的历史权重快速衰减,平滑或重启更容易影响罕用码;这只是可能的动力学,不能从平均命中数断言必然坍缩。
损失在 losses/vqperceptual.py:L1 + LPIPS + hinge GAN。 三个值得抄的细节:一是 adopt_weight,判别器从第 disc_start 步才介入(先让重建学好,再上对抗);二是 calculate_adaptive_weight,取 $\Vert \nabla_{\text{last}} L_{\text{rec}} \Vert / \Vert \nabla_{\text{last}} L_{\text{GAN}} \Vert$ 并 clamp 到 10⁴;三是判别器是 NLayerPatchGAN,按 patch 判真假,这样高分辨率下判别器参数量不随分辨率爆炸。
官方数字(固定 README 的重建 FID 表):
| 模型 | f | K | rFID 对训练集 | rFID 对验证集 |
|---|---|---|---|---|
| DALL-E dVAE(Gumbel) | 8 | 8192 | 33.88 | 32.01 |
| VQGAN ImageNet | 16 | 1024 | 10.54 | 7.94 |
| VQGAN ImageNet | 16 | 16384 | 7.41 | 4.98 |
| VQGAN OpenImages | 8 | 256 | 未报告 | 1.49 |
| VQGAN OpenImages | 8 | 16384 | 未报告 | 1.14 |
数值逐列来自固定 README 重建表。rFID 比较原图分布与重建分布的特征统计,越低越好,但数值比不是「质量好多少倍」。原文将训练参照的 33.88 与验证参照的 1.49 混除成 22 倍,还把跨模型/训练数据差异归因于某一种损失,本轮撤回这种读法。ImageNet 两行显示该组配置增大 K 后统计指标改善,但并非只改 K 的受控消融;已核实的 1024 配置 embed_dim=256,不能仅因 quant_conv 存在就推断所有 checkpoint 的维度。潜空间欧氏失真幂律也不预测 rFID。
代价一:有损量化与有限容量。 固定连续 AE 的另一个留出实验(codebook_size_law.py,1500 步,d=8)在 K=512 时,连续通路 MSE 为 0.011378,量化通路为 0.020533,增幅 80.5%。这与 04 节的联合 VQ 训练不是同一组权重。可以研究更多码字、较低的有效维度、残差/多级量化等选择,但没有「加 K 必然最差」的通用排序;解码器也会放大量化扰动。
代价二:低利用率的处理有代价。 本玩具随机初始化有 96.7% 的码在最终窗口未命中,但这不是所有 VQ 必然经历的比例。预训练加 k-means 有额外成本;重启改变码字语义,还需考虑下游先验是否已在使用原索引。FSQ 用少量坐标上的固定标量格点,LFQ 用符号二值化产生隐式码,减少学习每个独立向量的负担;它们都不保证任意数据和训练下 100% 命中。把编码器恒定输出一个格点,就是只使用一个码的反例。
代价三:感知重建会「编」细节。 这是 3.5 节埋的伏笔,用一个能算清楚的玩具展开(perceptual_lab.py)。构造:一个 latent 对应两种等概率的纹理 $x = m \pm p$(m 是低频内容,p 是棋盘纹理,纹理相对于正极性样本的梯度能量比约 83.5%,该样本仍有内容/纹理交叉项)。在候选输出 $m + c \cdot p$ 上比较两种损失:
| 候选输出 | MSE | SNR | 梯度能量保留 | 到最近模态的距离 |
|---|---|---|---|---|
| $c=0$(MSE 最优,条件均值) | 0.250000 | 5.30 dB | 18.6% | 0.250 |
| $c=-0.785$(网格上的特征最优) | 0.404056 | 3.22 dB | 70.7% | 0.012 |
| $c=1$(选一个清晰模态) | 0.500000 | 2.29 dB | 97.5% | 0.000 |
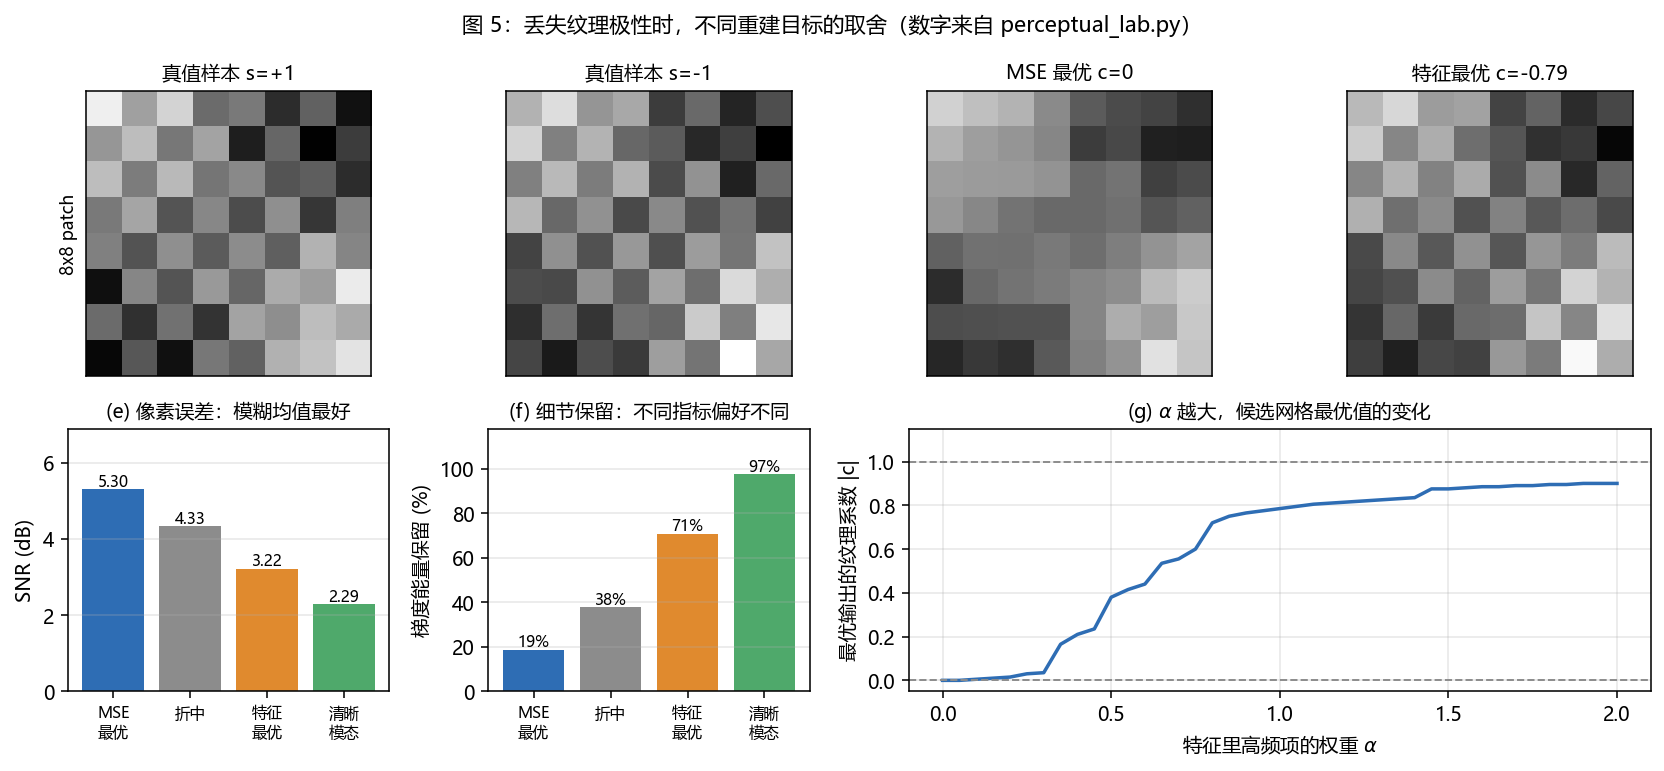
这张图要看条件均值与单个模态的不同偏好。本玩具使用 $\phi(x)=[x,\alpha|\nabla x|]$,不是 LPIPS,也没有训练 GAN;候选为 $m+cp$,在步长 0.005 的有限网格上选最优。按两种真值取期望,MSE 可直接化成 $\Vert p\Vert^2(1+c^2)/64$,所以 $c=0$ 最优;非线性特征距离可偏好非零 c。表中 dB 是 $10\log_{10}(P_{\mathrm{signal}}/\mathrm{MSE})$、信号能量 0.8474 作基准的 SNR,不是峰值固定的 PSNR;这个合成数据也未限定在 [0,1]。
perceptual_lab.py 的 0.7356 阈值只比较两个候选 c=1 与 c=0:记它们的未归一化梯度幅值误差为 G(1)、G(0),则 $\alpha^2>[\Vert p\Vert^2/(G(0)-G(1))]$ 时前者更好,要求分母为正。它不是全体 c 的最优解首次偏离零的阈值,更不是普遍 LPIPS 参数。该实验说明信息丢失时不同目标可作不同取舍,不能说明真实 LPIPS/rFID 一定支持某个输出,也不能宣称此后无人报告 PSNR。
但这笔账的另一面是:对抗训练出来的「细节」不保证是真的。判别器只关心「像不像真图」,不关心「是不是这张图」,所以感知+GAN 的重建会补出数据集里常见的纹理——做压缩、做医学影像这类需要像素保真的任务时,这条路要慎走(GAN 训练不稳的代价也真实存在,05 节的 disc_start 和自适应权重都是为此付的工程税)。
边界:下游是否真正需要离散接口。 若目标是离散先验、掩码预测或可编码索引,VQ 是有意义的候选;连续潜空间扩散通常直接使用连续 VAE,但也有其他表示组合。离散化还服务压缩和表征学习,不能说非自回归就毫无收益。选型需同时看下游接口、率失真、重建质量与训练成本。
最后坦诚标注边界:本文教学训练与感知实验数字来自 8×8 合成小块上的玩具(numpy 实跑,可复现),规模和真实 VQGAN(f=16、d=256、K=16384、百万级图像)差几个数量级;直通的梯度分流与 EMA 更新式可对照源码,但训练稳定性、利用率及感知偏好都不能直接外推;具体数字(比如 $\beta=1.0$ 更好)不能外推,它依赖我的损失量纲。
误解一:「KL 是常数,所以没有变分解释」。 one-hot 仍是离散分布;第一阶段固定均匀先验使 KL 为常数,不等于模型不再有变分下界。另训的自回归先验不是这个均匀先验。
误解二:「查表挡住了所有码本梯度」。 对固定索引,查表可以向码字反传;本实现由 detach 将重建梯度引入编码器,码本再由字典损失或 EMA 更新。
误解三:「straight-through 是硬目标梯度的无偏估计」。 区域内部硬梯度为零、边界处可能不可导;STE 是局部替代方向,不能当作硬目标的无偏梯度。
误解四:「高 perplexity 就代表高质量、低实际码率」。 它衡量指定窗口的边缘分布;固定长度码率、联合熵、率失真和语义质量各有定义。
误解五:「beta=0.25 或 1.0 可以照抄」。 本玩具的最优扫描点不等于其他数据、损失和归约下的最优点。原先 429 倍论据已撤回,修正后的 commitment/直通范数比为 0.839。
下面四个原实验都可以在附录代码里一键复现(numpy only,不需要 GPU):
python vq_core.py,看 [D] 段——把 $z_e$ 沿随机方向扰动 10⁻² 到 10⁻⁴,有限差分精确为 0,argmin 保持不变的样本比例是 1.0000;对比直通梯度平均范数 1.49 × 10⁻⁴。python collapse_lab.py,看 [B][C] 段——K=512 随机初始化最终只有 17 个活码(96.7% 死码)、重建 MSE 0.0491;换死码重采样后 500 个活码、MSE 0.0184。你也可以把 restart_dead=True 关掉再跑一遍,确认结果回到 17。python perceptual_lab.py,把文件顶部的 AMP(纹理幅度)从 0.5 改成 0.1 再跑——你会发现梯度能量保留率对纹理幅度极其敏感,而 MSE 最优解的纹理保留永远是 0(条件均值把 ±纹理精确抵消)。python codebook_size_law.py,读 [A] 段输出——d=16 时 K 从 8 加到 512 只把失真降到 1/12.7,d=2 时同样 64 倍的预算能降到 1/66.5。改变 n_cluster 或噪声后应重新报告整条曲线,不能预先保证斜率变陡。要独立核对梯度归约、熵、121 帧计数与误差交叉项,再跑附录 vq_checks.py,预期 27 组最近邻、40 组误差恒等式和 7 个非法输入通过。09 节用到的脚本全文如下(token_budget.py、collapse_lab.py、vq_core.py、vq_checks.py、codebook_size_law.py、perceptual_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""token_budget.py —— 离散化到底换来多少「序列长度」上的便宜。

显式稠密注意力矩阵随序列长度平方增长;压缩 tokenizer 是降低逻辑成本的一条路线。
本脚本把这笔账算成具体的数:

    [A] 不同分辨率 / 下采样率下的 token 数与注意力规模
    [B] 码本大小 K 决定每个 token 多少 bit,折算成每张图多少 bpp
    [C] 视频的 token 数(时空压缩一起算)
    [D] 码本坍缩要付的比特代价:perplexity 描述边缘使用熵

运行:python token_budget.py
"""

from __future__ import annotations

import numpy as np


def n_tokens(h, w, f, t=1, f_t=1):
    """空间整除;首帧独立、后续按 f_t 分组,无填充的显式约定。"""
    if any(not isinstance(v, (int, np.integer)) or isinstance(v, bool) or v <= 0 for v in (h, w, f, t, f_t)):
        raise ValueError("positive integer dimensions required")
    if h % f or w % f or (t - 1) % f_t:
        raise ValueError("spatial dimensions and remaining frames must divide exactly")
    return (1 + (t - 1) // f_t) * (h // f) * (w // f)


def main():
    print("[A] 图像:边长 H 与下采样率 f 决定 token 数(注意力按 n^2 涨)")
    print("    H      f     token 数      注意力矩阵 n^2      相对像素级")
    for H in (256, 512, 1024):
        base = H * H * 3                      # 像素级(RGB 逐通道)
        for f in (4, 8, 16):
            n = n_tokens(H, H, f)
            print("    %-5d  %-4d  %-12d  %-18.3e  %.4g" % (
                H, f, n, float(n) ** 2, float(n * n) / float(base * base)))
        print("      (像素级 RGB 序列 %d,n^2 = %.3e)" % (base, float(base) ** 2))
    print()

    print("[B] 码本容量 K 决定每个 token 的 bit 数(256x256 图像)")
    print("    K         bit/token   f=8: bit/图   bpp      f=16: bit/图   bpp")
    for K in (256, 512, 1024, 4096, 16384, 262144):
        bit = np.log2(K)
        row = [K, bit]
        for f in (8, 16):
            n = n_tokens(256, 256, f)
            total = n * bit
            row += [total, total / (256 * 256)]
        print("    %-8d  %-10.2f  %-12.0f  %-7.3f  %-12.0f  %.3f" % tuple(row))
    print("    bpp 是固定长度码索引的逻辑 bit/pixel,未含码本、解码器、容器或熵编码。")
    print()

    print("[C] 视频:时间维也要压(121 个采样时刻(24fps 的首末时刻相距 5 秒),256x256)")
    print("    f_t    f     token 数       上下文长度对比(相对 121x256x256x3 像素)")
    pixel = 121 * 256 * 256 * 3
    for f_t in (1, 4, 8):
        for f in (8, 16):
            n = n_tokens(256, 256, f, t=121, f_t=f_t)
            print("    %-5d   %-4d  %-14d  %.5g" % (
                f_t, f, n, float(n) / pixel))
    print()

    print("[D] 码本坍缩的比特代价:边缘使用熵看 perplexity,不是看 K")
    print("    K       perplexity   标称 bit    边缘熵 bit    相对最大熵差")
    for K, ppl in [(512, 14.50), (512, 450.51), (512, 426.71),
                   (16384, 14.50), (16384, 1000.0), (16384, 16384.0)]:
        nominal = np.log2(K)
        eff = np.log2(ppl)
        print("    %-6d  %-11.2f  %-10.2f  %-10.2f  %.1f%%" % (
            K, ppl, nominal, eff, 100 * (nominal - eff) / nominal))
    print("    前3行来自 collapse_lab.py 的实测:K=512 随机初始化只有 17 个码活着,")
    print("    9 bit 的码本边缘熵为 3.86 bit;死码重启后回到 8.74 bit。")
    print()

    print("[E] 一句话总结")
    f16 = n_tokens(256, 256, 16)
    print("    256x256 图像在 f=16 下是 %d 个 token,是像素级 RGB 序列的 1/%.0f;"
          % (f16, (256 * 256 * 3) / f16))
    print("    注意力规模从 %.2e 降到 %.2e,省了 %.0f 倍——这才是采用压缩 tokenizer 的一个动机。"
          % (float(256 * 256 * 3) ** 2, float(f16) ** 2,
             float(256 * 256 * 3) ** 2 / float(f16) ** 2))


if __name__ == "__main__":
main()"""collapse_lab.py —— 码本坍缩(codebook collapse)是怎么发生的,能救回来多少。
码本坍缩指的是:K 个码字里只有一小撮被用到,剩下的在当前评估窗口里没有被选中
(死码)。花了一整个 K×d 的码本,当前边缘码分布的熵为 log2(perplexity) bit。
[A] commitment 权重 beta 怎么影响坍缩程度
[B] 大码本在训练过程中怎么一步步坍缩(活跃码数曲线)
[C] 两种常用解药有多大用:连续AE预训练 + k-means码本 / 死码重采样重启
运行:python collapse_lab.py
"""
from __future__ import annotations
import argparse
import numpy as np
from vq_core import kmeans, make_patch_data, perplexity, quantize, train_ae
BIG_K = 512
def stats(X, params, codebook):
"""给定训练好的权重与码本,算重建误差与使用分布统计量。"""
z_e = X @ params["We"]
z_q, idx, _ = quantize(z_e, codebook)
cnt = np.bincount(idx, minlength=len(codebook)).astype(np.float64)
rec = float((((z_q @ params["Wd"] + params["bd"]) - X) ** 2).mean())
frac = np.sort(cnt / cnt.sum())[::-1]
return {
"rec": rec,
"alive": int((cnt > 0).sum()),
"ppl": perplexity(cnt),
"top1": float(frac[0]),
"bottom_half": float(frac[len(frac) // 2:].sum()),
"counts": cnt,
}
def run_vq(X, K=BIG_K, beta=0.25, steps=1200, seed=0, mode="ema",
init_cb=None, restart=False, log_every=100, init_params=None):
"""跑一次 VQ-AE 训练,返回 (stats, hist)。"""
p, c, h, _ = train_ae(X, 8, mode, K=K, beta=beta, steps=steps, seed=seed,
restart_dead=restart, init_cb=init_cb,
log_every=log_every, init_params=init_params)
return stats(X, p, c), h
def main():
ap = argparse.ArgumentParser()
ap.add_argument("--steps", type=int, default=1200)
ap.add_argument("--K", type=int, default=BIG_K)
ap.add_argument("--seed", type=int, default=0)
args = ap.parse_args()
X, _, _, _ = make_patch_data(n=4096, seed=args.seed)
print("数据 X%s,训练 %d 步" % (X.shape, args.steps))
print()
# ---------------- [A] beta 扫描 ----------------
print("[A] commitment 权重 beta 的影响(K=64,码本 EMA,%d 步)" % args.steps)
print(" beta 重建MSE 活跃码 perplexity")
for beta in (0.0, 0.05, 0.25, 1.0, 4.0):
s, _ = run_vq(X, K=64, beta=beta, steps=args.steps, seed=args.seed)
print(" %-9.2f %.6f %4d %.2f" % (
beta, s["rec"], s["alive"], s["ppl"]))
print(" -> beta=0 时没有commitment约束;改变beta会影响训练,结果还依赖")
print(" 初始化、损失归约和训练预算(不能从单 seed 归纳最优 beta)。")
print()
# ---------------- [B] 大码本的坍缩过程 ----------------
print("[B] 大码本 K=%d 的坍缩过程(beta=0.25,EMA,随机初始化)" % args.K)
s0, h0 = run_vq(X, K=args.K, steps=args.steps, seed=args.seed, log_every=200)
print(" 步数 重建MSE 活跃码 perplexity")
for i in range(len(h0["step"])):
print(" %5d %.6f %4d %.2f" % (
h0["step"][i], h0["recon"][i], h0["alive"][i], h0["ppl"][i]))
print(" 最终:%d 个码字里只有 %d 个活着;perplexity %.2f 对应 %.2f bit,"
"而固定长度索引是 %.2f bit" % (
args.K, s0["alive"], s0["ppl"], np.log2(max(s0["ppl"], 1e-12)),
np.log2(args.K)))
print(" 最热的 1 个码占 %.3f 的使用量,最冷的一半码一共只占 %.4f"
% (s0["top1"], s0["bottom_half"]))
print()
# ---------------- [C] 解药 ----------------
print("[C] 两种解药(同为 K=%d,%d 步)" % (args.K, args.steps))
p_init, _, _, _ = train_ae(X, 8, "continuous", steps=800, seed=args.seed)
init_cb = kmeans(X @ p_init["We"], args.K, seed=args.seed, iters=20)
s1, h1 = run_vq(X, K=args.K, steps=args.steps, seed=args.seed,
init_cb=init_cb, log_every=200, init_params=p_init)
s2, h2 = run_vq(X, K=args.K, steps=args.steps, seed=args.seed,
restart=True, log_every=200)
print(" 配置 重建MSE 活跃码 perplexity 边缘熵bit")
for tag, s in [("随机初始化", s0), ("连续AE预训练 + k-means", s1),
("死码重采样重启", s2)]:
print(" %-16s %.6f %4d/%4d %6.2f %.2f" % (
tag, s["rec"], s["alive"], args.K, s["ppl"],
np.log2(max(s["ppl"], 1e-12))))
print()
print(" 注:本玩具有 16 个类心,但类内连续变化允许超过 16 个活码;")
print(" 活跃数不等于信息质量。预训练分支另付 800 步连续AE及 k-means 成本。")
print()
print("[D] 活跃码数随训练步数的变化(供配图)")
print(" 随机初始化 :", list(zip(h0["step"], h0["alive"])))
print(" 连续AE预训练 + k-means:", list(zip(h1["step"], h1["alive"])))
print(" 死码重采样 :", list(zip(h2["step"], h2["alive"])))
if __name__ == "__main__":
main()"""vq_core.py —— 向量量化器(VQ)的最小实现,外加一个真跑得起来的训练实验。
无 torch 依赖,纯 numpy。使用 Python 3.10+;本轮环境见 quality_report.md。
运行:
/usr/local/bin/python3 vq_core.py
/usr/local/bin/python3 vq_core.py --steps 1200 --K 64 --beta 0.25
输出分五段:
[A] 连续自编码器基线(无量化)——独立优化的参考
[B] VQ-AE 训练结果:重建误差 / 量化误差 / 码本使用率 / perplexity
[C] 固定权重对照:连续通路与量化通路(含交叉项)
[D] straight-through 的梯度核验:真实有限差分 vs 直通梯度
[E] 码本更新方式对照(不更新 / 梯度 / EMA / EMA+死码重启)
"""
from __future__ import annotations
import argparse
import os
import numpy as np
HERE = os.path.dirname(os.path.abspath(__file__))
# ------------------------------------------------------------------ 数据
def cos_basis(patch: int = 8, n_freq: int = 3):
"""8x8 小块的低频余弦基,共 n_freq^2 = 9 个,已按行归一化。"""
t = np.arange(patch) + 0.5
one_d = [np.ones(patch)]
for k in range(1, n_freq):
one_d.append(np.cos(np.pi * k * t / patch))
B = np.stack([np.outer(a, b).ravel() for a in one_d for b in one_d])
return B / np.linalg.norm(B, axis=1, keepdims=True)
def make_patch_data(n=4096, patch=8, n_cluster=16, seed=0,
center_scale=2.0, intra=0.35, noise=0.05):
"""合成一批 8x8 小块:16 个类心 + 类内低频连续变化 + 白噪声。
返回 X[N, 64]、类标、类心、基。类间方差远大于类内,所以码本有机会学到
「块类别」这种离散结构;白噪声部分不可压缩,构成误差地板。
"""
rng = np.random.default_rng(seed)
B = cos_basis(patch) # [9, 64]
dim_b = B.shape[0]
centers = center_scale * (rng.normal(size=(n_cluster, dim_b)) @ B)
labels = rng.integers(0, n_cluster, size=n)
X = centers[labels].copy()
X += intra * (rng.normal(size=(n, dim_b)) @ B) # 类内连续变化
X += noise * rng.normal(size=(n, patch * patch)) # 不可压缩噪声
return X, labels, centers, B
# ------------------------------------------------------------------ 量化
def quantize(z_e, codebook):
"""最近邻量化。z_e [N, d],codebook [K, d]。
返回 z_q[N, d]、索引 idx[N]、量化误差(每样本 d 维平方和)。
"""
z_e, codebook = np.asarray(z_e), np.asarray(codebook)
if (z_e.ndim != 2 or codebook.ndim != 2 or not len(z_e) or not len(codebook)
or z_e.shape[1] != codebook.shape[1] or not z_e.shape[1]
or not np.isfinite(z_e).all() or not np.isfinite(codebook).all()):
raise ValueError("finite nonempty [N,d] and [K,d] arrays required")
d2 = ((z_e[:, None, :] - codebook[None, :, :]) ** 2).sum(-1) # [N, K]
idx = d2.argmin(axis=1)
return codebook[idx], idx, d2[np.arange(len(idx)), idx]
def kmeans(data, k, seed=0, iters=25):
"""Lloyd 迭代 + kmeans++ 初始化。空簇用「当前最差点」补齐。"""
rng = np.random.default_rng(seed)
n, d = data.shape
k = min(k, n)
centers = np.empty((k, d), dtype=data.dtype)
centers[0] = data[rng.integers(n)]
closest = ((data - centers[0]) ** 2).sum(1)
for j in range(1, k):
tot = closest.sum()
if tot <= 0:
centers[j] = data[rng.integers(n)]
else:
centers[j] = data[rng.choice(n, p=closest / tot)]
closest = np.minimum(closest, ((data - centers[j]) ** 2).sum(1))
for _ in range(iters):
_, assign, dist = quantize(data, centers)
dist = dist.copy()
for j in range(k):
mask = assign == j
if mask.any():
centers[j] = data[mask].mean(0)
else: # 空簇:拿当前最差的点填
j_worst = int(np.argmax(dist))
centers[j] = data[j_worst]
dist[j_worst] = -1.0
return centers
def perplexity(counts):
"""码本 perplexity = exp(使用分布的熵),上界是码本大小 K。"""
p = np.asarray(counts, dtype=np.float64)
if p.ndim != 1 or not len(p) or not np.isfinite(p).all() or (p < 0).any() or p.sum() <= 0:
raise ValueError("nonnegative finite counts with positive total required")
p = p / p.sum()
nz = p[p > 0]
return float(np.exp(-(nz * np.log(nz)).sum()))
# ------------------------------------------------------------------ 训练
class Adam:
"""够用的 Adam,只处理一组 numpy 参数。"""
def __init__(self, params, lr=0.02, b1=0.9, b2=0.999, eps=1e-8):
self.p = params
self.m = {k: np.zeros_like(v) for k, v in params.items()}
self.v = {k: np.zeros_like(v) for k, v in params.items()}
self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps
self.t = 0
def step(self, grads):
self.t += 1
for k, g in grads.items():
self.m[k] = self.b1 * self.m[k] + (1 - self.b1) * g
self.v[k] = self.b2 * self.v[k] + (1 - self.b2) * (g * g)
mhat = self.m[k] / (1 - self.b1 ** self.t)
vhat = self.v[k] / (1 - self.b2 ** self.t)
self.p[k] -= self.lr * mhat / (np.sqrt(vhat) + self.eps)
def make_params(d_in, d_lat, seed=0):
rng = np.random.default_rng(seed)
return {
"We": rng.normal(scale=0.1, size=(d_in, d_lat)),
"Wd": rng.normal(scale=0.1, size=(d_lat, d_in)),
"bd": np.zeros(d_in),
}
def evaluate(X, params, codebook, eval_idx):
"""在固定评估集上算重建 MSE、量化误差、活跃码数、perplexity。"""
x = X[eval_idx]
z_e = x @ params["We"]
d_lat = params["We"].shape[1]
if codebook is None:
z_q, qerr, alive, ppl, counts = z_e, 0.0, 0, 0.0, None
else:
z_q, idx, qerr = quantize(z_e, codebook)
counts = np.bincount(idx, minlength=len(codebook)).astype(np.float64)
alive = int((counts > 0).sum())
ppl = perplexity(counts)
x_hat = z_q @ params["Wd"] + params["bd"]
return {
"recon": float(((x_hat - x) ** 2).mean()),
"quant": float(np.mean(qerr)) / d_lat if codebook is not None else 0.0,
"alive": alive,
"ppl": ppl,
"counts": counts,
}
def train_ae(X, d_lat, codebook_mode, K=64, beta=0.25, steps=800, batch=512,
lr=0.02, seed=0, decay=0.99, restart_dead=False, log_every=100,
cb_lr=10.0, init_cb=None, init_params=None):
"""训练「线性编码器 + VQ + 线性解码器」。
codebook_mode:
"continuous" —— 无量化,连续自编码器基线
"none" —— 码本完全不更新(只有 straight-through)
"grad" —— 码本用 ||sg[z_e] - e||^2 的梯度更新
"ema" —— 码本用指数滑动平均更新(cluster_size + embed_avg)
"""
if codebook_mode not in {"continuous", "none", "grad", "ema"} or not 0 <= decay < 1:
raise ValueError("invalid quantizer mode or EMA decay")
if min(steps, batch, K, d_lat, log_every) <= 0 or beta < 0:
raise ValueError("positive sizes/steps and nonnegative beta required")
rng = np.random.default_rng(seed)
eval_rng = np.random.default_rng(1000 + seed)
eval_idx = eval_rng.choice(len(X), size=min(2048, len(X)), replace=False)
n, d_in = X.shape
params = make_params(d_in, d_lat, seed=seed)
if init_params is not None:
if set(init_params) != set(params) or any(init_params[k].shape != v.shape for k, v in params.items()):
raise ValueError("initial parameter shapes differ")
params = {k: np.asarray(v).copy() for k, v in init_params.items()}
opt = Adam(params, lr=lr)
has_vq = codebook_mode != "continuous"
if has_vq:
# 码本初始化:小方差(呼应 taming 里 uniform(-1/n_e, 1/n_e) 的量级)
codebook = (rng.normal(scale=1.0 / K, size=(K, d_lat))
if init_cb is None else np.asarray(init_cb).copy())
if codebook.shape != (K, d_lat) or not np.isfinite(codebook).all():
raise ValueError("initial codebook shape or values invalid")
init_codebook = codebook.copy()
cluster_size = np.ones(K, dtype=np.float64) # EMA 用
embed_avg = codebook.copy() # EMA 用
else:
codebook = init_codebook = None
cluster_size = embed_avg = None
hist = {"step": [], "recon": [], "quant": [], "alive": [], "ppl": []}
for step in range(1, steps + 1):
b = rng.choice(n, size=min(batch, n), replace=False)
x = X[b]
z_e = x @ params["We"] # [B, d]
if has_vq:
z_q, idx, _ = quantize(z_e, codebook)
e_k = z_q
x_hat = z_q @ params["Wd"] + params["bd"]
# 反传:解码器对 z_q 的梯度,原封不动地当作对 z_e 的梯度
dxh = 2.0 * (x_hat - x) / (len(x) * d_in) # [B, d_in]
dz_q = dxh @ params["Wd"].T # [B, d]
dz_e = dz_q + beta * 2.0 * (z_e - e_k) / (len(x) * d_lat)
opt.step({"We": x.T @ dz_e, "Wd": z_q.T @ dxh,
"bd": dxh.sum(0)})
if codebook_mode == "grad":
# d/de ||sg[z_e] - e||^2 = 2 (e - z_e)。注意码本是普通 SGD,
# 不走 Adam,所以它的有效步长要单独调(见 [E] 的 cb_lr 扫描)。
g = 2.0 * (e_k - z_e) / (len(x) * d_lat)
np.add.at(codebook, idx, -cb_lr * g)
elif codebook_mode == "ema":
onehot = np.zeros((len(x), K))
onehot[np.arange(len(x)), idx] = 1.0
cnt = onehot.sum(0)
cluster_size = decay * cluster_size + (1 - decay) * cnt
embed_avg = decay * embed_avg + (1 - decay) * (onehot.T @ z_e)
tot = cluster_size.sum()
smoothed = (cluster_size + 1e-5) / (tot + K * 1e-5) * tot
codebook = embed_avg / smoothed[:, None]
if restart_dead:
dead = np.where(cluster_size < 1.0)[0]
for j in dead: # 死码重采样为真实的编码器输出
codebook[j] = z_e[rng.integers(len(z_e))]
cluster_size[j] = 1.0
embed_avg[j] = codebook[j]
else:
x_hat = z_e @ params["Wd"] + params["bd"]
dxh = 2.0 * (x_hat - x) / (len(x) * d_in)
opt.step({"We": x.T @ (dxh @ params["Wd"].T),
"Wd": z_e.T @ dxh, "bd": dxh.sum(0)})
if step % log_every == 0 or step == steps:
m = evaluate(X, params, codebook, eval_idx)
hist["step"].append(step)
for k in ("recon", "quant", "alive", "ppl"):
hist[k].append(m[k])
shift = None
if has_vq:
shift = float(np.abs(codebook - init_codebook).mean())
return params, codebook, hist, shift
# ------------------------------------------------------------------ 主流程
def main():
ap = argparse.ArgumentParser()
ap.add_argument("--steps", type=int, default=800)
ap.add_argument("--K", type=int, default=64)
ap.add_argument("--d", type=int, default=8)
ap.add_argument("--beta", type=float, default=0.25)
ap.add_argument("--seed", type=int, default=0)
args = ap.parse_args()
X, labels, centers, B = make_patch_data(n=4096, seed=args.seed)
n, d_in = X.shape
print("数据: X%s 样本范数均值 %.4f" % (X.shape, np.linalg.norm(X, axis=1).mean()))
print("码本 K=%d, 潜维度 d=%d, beta=%.2f" % (args.K, args.d, args.beta))
print()
# ---------------- [A] 连续自编码器基线 ----------------
pc, _, hc, _ = train_ae(X, args.d, "continuous", steps=args.steps,
seed=args.seed)
recon_c = hc["recon"][-1]
print("[A] 连续自编码器(无量化,独立训练的线性参考)")
print(" 重建 MSE/像素 = %.6f" % recon_c)
print()
# ---------------- [B] VQ-AE ----------------
pv, cb, hv, _ = train_ae(X, args.d, "ema", K=args.K, beta=args.beta,
steps=args.steps, seed=args.seed)
print("[B] VQ-AE(码本 EMA 更新, decay=0.99)训练曲线")
print(" 步数 重建MSE 量化误差/d 活跃码 perplexity")
for i in range(len(hv["step"])):
print(" %5d %.6f %.6f %5d %.2f" % (
hv["step"][i], hv["recon"][i], hv["quant"][i],
hv["alive"][i], hv["ppl"][i]))
counts = np.bincount(quantize(X @ pv["We"], cb)[1],
minlength=args.K).astype(np.float64)
print(" 最终活跃码 %d / %d,perplexity %.2f(上界 %d)" % (
(counts > 0).sum(), args.K, perplexity(counts), args.K))
print()
# ---------------- [C] 误差分解 ----------------
z_e = X @ pv["We"]
z_q, _, qerr = quantize(z_e, cb)
rec_vq = (((z_q @ pv["Wd"] + pv["bd"]) - X) ** 2).mean()
rec_cont = (((z_e @ pv["Wd"] + pv["bd"]) - X) ** 2).mean()
print("[C] 误差分解(同一组 VQ-AE 权重,只换「走不走量化」)")
print(" 连续通路重建 MSE = %.6f (固定权重的连续通路)" % rec_cont)
print(" 量化后重建 MSE = %.6f" % rec_vq)
print(" 差值(量化引入) = %.6f (%.1f%%)" % (
rec_vq - rec_cont, 100 * (rec_vq - rec_cont) / rec_cont))
print(" [A] 连续基线 = %.6f" % recon_c)
print(" 量化误差 E||z_e-e||^2/d = %.6f" % (qerr.mean() / args.d))
print()
# ---------------- [D] straight-through 梯度核验 ----------------
# 用 [B] 训好的 VQ-AE,在真实工作点上做有限差分。
rng = np.random.default_rng(7)
x0 = X[:512]
z_e0 = x0 @ pv["We"]
z_q0, idx0, _ = quantize(z_e0, cb)
xh0 = z_q0 @ pv["Wd"] + pv["bd"]
L0 = ((xh0 - x0) ** 2).mean()
direction = rng.normal(size=args.d)
direction /= np.linalg.norm(direction)
print("[D] straight-through 梯度核验(512 样本,取 [B] 训好的权重)")
print(" 有限差分:把 z_e 沿随机单位方向微扰 eps,看 L 怎么变")
for eps in (1e-1, 1e-2, 1e-3, 1e-4):
z_p = z_e0 + eps * direction
z_qp, idxp, _ = quantize(z_p, cb)
Lp = ((z_qp @ pv["Wd"] + pv["bd"] - x0) ** 2).mean()
same = float((idxp == idx0).mean())
print(" eps=%.0e : dL/dz_e = %+.10f (argmin 保持不变的样本 %.4f)" % (
eps, (Lp - L0) / eps, same))
dxh = 2.0 * (xh0 - x0) / (len(x0) * d_in)
dz_q = dxh @ pv["Wd"].T
st_grad = float((dz_q * direction).sum())
st_norm = float(np.linalg.norm(dz_q, axis=1).mean())
commit = 2.0 * args.beta * (z_e0 - z_q0) / (len(x0) * args.d)
commit_norm = float(np.linalg.norm(commit, axis=1).mean())
print(" 直通梯度 dL/dz_q 投影到同一方向 = %+.10f" % st_grad)
print(" 直通梯度平均范数 ||dL/dz_q|| = %.6e" % st_norm)
print(" commitment 项平均范数 = %.6e" % commit_norm)
print(" -> Voronoi 区域内部真实梯度为 0(边界处不可导),直通梯度非零;")
print(" 它是「假装量化是恒等映射」的替代品,不是真实梯度的估计。")
print()
# ---------------- [E] 码本更新方式对照 ----------------
print("[E] 码本更新方式对照(同为 %d 步,K=%d,beta=%.2f)" % (
args.steps, args.K, args.beta))
print(" 模式 重建MSE 活跃码 perplexity 码本位移")
for mode, rst, cbl in [("none", False, 10.0), ("grad", False, 10.0),
("ema", False, 10.0), ("ema", True, 10.0)]:
p, c, h, shift = train_ae(X, args.d, mode, K=args.K, beta=args.beta,
steps=args.steps, seed=args.seed,
restart_dead=rst, cb_lr=cbl)
cnt = np.bincount(quantize(X @ p["We"], c)[1],
minlength=args.K).astype(np.float64)
tag = mode + ("+restart" if rst else "")
print(" %-18s %.6f %5d %.2f %.6f" % (
tag, h["recon"][-1], int((cnt > 0).sum()), perplexity(cnt), shift))
print()
print(" 附:grad 模式对码本步长极敏感(码本是普通 SGD,不走 Adam)")
for cbl in (0.02, 0.1, 1.0, 10.0):
p, c, h, _ = train_ae(X, args.d, "grad", K=args.K, beta=args.beta,
steps=args.steps, seed=args.seed, cb_lr=cbl)
cnt = np.bincount(quantize(X @ p["We"], c)[1],
minlength=args.K).astype(np.float64)
print(" cb_lr=%-6.2f 重建MSE %.6f 活跃码 %3d perplexity %.2f" % (
cbl, h["recon"][-1], int((cnt > 0).sum()), perplexity(cnt)))
print()
if __name__ == "__main__":
main()"""独立核验 VQ 的局部梯度、信息熵、量化边界和固定解码器误差恒等式。
运行 python vq_checks.py;只依赖 NumPy,不训练模型、不需要权重。
"""
from pathlib import Path
import json
import numpy as np
from vq_core import quantize, perplexity, train_ae, make_patch_data, make_params
from token_budget import n_tokens
from perceptual_lab import make_toy, evaluate_candidate, phi
def main():
rng = np.random.default_rng(17)
nearest = 0
for n in (1, 3, 11):
for d in (1, 2, 8):
for k in (1, 4, 9):
z, e = rng.normal(size=(n, d)), rng.normal(size=(k, d))
q, idx, err = quantize(z, e)
expected = np.array([min(range(k), key=lambda j: sum((z[i, l]-e[j, l])**2 for l in range(d))) for i in range(n)])
assert np.array_equal(idx, expected)
assert np.allclose(err, ((z-q)**2).sum(1))
nearest += 1
assert quantize(np.array([[0.]]), np.array([[-1.], [1.]]))[1][0] == 0
z = np.array([[.2], [.3]])
e = np.array([[-1.], [1.]])
q, idx, _ = quantize(z, e)
f = lambda v: float(((quantize(v, e)[0]-.4)**2).mean())
hard_fd = (f(z+1e-6)-f(z-1e-6))/2e-6
assert hard_fd == 0
# 对当前量化点构造局部恒等替代目标,验证STE的局部梯度;并不声称它是硬目标真梯度。
assert f(np.full_like(z, -.2)) != f(z)
grad = 2*(q-.4)/q.size
surrogate = lambda v: float(((q+v-z-.4)**2).mean())
surrogate_fd = (surrogate(z+1e-6)-surrogate(z-1e-6))/2e-6
assert abs(surrogate_fd-grad.sum()) < 1e-9
entropy = []
for counts in [np.ones(8), np.array([9, 0, 0]), np.array([1, 2, 3, 0])]:
p=counts/counts.sum();h=-sum(float(v*np.log2(v)) for v in p if v>0)
assert abs(np.log2(perplexity(counts))-h) < 1e-14
entropy.append(h)
# 边缘熵不是序列联合熵:三位完全相同、各位边缘均匀;联合熵1bit而边缘和3bit。
assert np.log2(perplexity([1,1])) == 1
time_counts = [n_tokens(256,256,16,t=t,f_t=4) for t in (1,5,121)]
assert time_counts == [256,512,7936]
invalid = 0
cases=[lambda: perplexity([0,0]),lambda:perplexity([-1,2]),lambda:perplexity([np.nan]),lambda:quantize(np.zeros((2,2)),np.zeros((3,1))),lambda:quantize(np.zeros((0,2)),np.zeros((3,2))),lambda:n_tokens(256,256,16,t=120,f_t=4),lambda:n_tokens(255,256,16)]
for fn in cases:
try: fn()
except ValueError: invalid += 1
else: raise AssertionError('invalid input accepted')
# 解码器放大和交叉项;潜空间距离不是像素误差增量。
errors=[]
for _ in range(40):
x,z,e,w,b=(rng.normal(size=shape) for shape in [(5,7),(5,3),(4,3),(3,7),(7,)])
q,_,_=quantize(z,e);r=z@w+b-x;delta=(q-z)@w
difference=((r+delta)**2).mean()-(r*r).mean()
rhs=(delta*delta).mean()+2*(r*delta).mean();errors.append(abs(difference-rhs))
assert max(errors)<1e-12
# commitment、码本项分别使用均值归约,有限差分验证同一批次量纲。
z=rng.normal(size=(4,3));e=rng.normal(size=(4,3));beta=.25;step=1e-6
commit=lambda a: beta*((a-e)**2).mean();g=2*beta*(z-e)/z.size
fd=[]
for index in np.ndindex(z.shape):
p=z.copy();q=z.copy();p[index]+=step;q[index]-=step
fd.append(abs((commit(p)-commit(q))/(2*step)-g[index]))
assert max(fd)<1e-9
# 暖启动保留同一编码器/解码器坐标;零学习率一步不会偷偷重置参数。
X,*_=make_patch_data(n=64);params=make_params(64,2);cb=(X@params['We'])[:8]
trained,_,_,_=train_ae(X,2,'ema',K=8,steps=1,batch=16,lr=0,init_cb=cb,init_params=params)
assert all(np.array_equal(v,trained[k]) for k,v in params.items())
m,p=make_toy();a=float((p*p).mean());mse_error=0
for c in (-1.,-.79,0.,.5,1.):
result=evaluate_candidate(m,p,c,1.);mse_error=max(mse_error,abs(result['mse']-a*(1+c*c)))
direct=.5*((phi(m+c*p,1)-phi(m+p,1))**2).mean()+.5*((phi(m+c*p,1)-phi(m-p,1))**2).mean()
assert abs(direct-result['feat'])<1e-14
assert mse_error<1e-14
out=dict(passed=True,nearest_cases=nearest,invalid_cases=invalid,hard_fd=hard_fd,ste_surrogate_fd=surrogate_fd,entropy_bits=entropy,video_tokens=time_counts,error_identity_max=max(errors),commitment_fd_max=max(fd),mse_identity_max=mse_error,errors=[],warnings=[])
Path(__file__).with_name('validation_results.json').write_text(json.dumps(out,ensure_ascii=False,indent=2)+'\n',encoding='utf8')
print(json.dumps(out,ensure_ascii=False,indent=2))
if __name__ == '__main__':
main()"""codebook_size_law.py —— 码本容量 K 的收益到底有多大?
核心问题:把码本从 512 加到 16384,重建能好多少?直觉是「容量越大越好」,
但高维量化的经典结论(Zador 定理的渐近形式)说:最优量化失真随码本大小
在足维连续密度、高码率和最优码本等条件下渐近按 K^(-2/d) 衰减。d=256 时指数只有 -1/128,也就是
K 翻一倍、失真只降 0.5%。
本脚本的实测方式:先训一个连续自编码器把潜分布固定住,再对潜变量做 k-means
(k-means 就是「给定 K 个码字的局部优化最近邻量化器」的近似),在**留出集**上
测失真(避免用训练集测失真造成的过拟合假象)。
[A] 不同 d 下,量化失真 vs K 的双对数斜率,与 -2/d 对拍
[B] 像素重建误差怎样随潜量化改变(继续加 K 的收益拐点)
运行:python codebook_size_law.py
"""
from __future__ import annotations
import argparse
import numpy as np
from vq_core import kmeans, make_patch_data, quantize, train_ae
def distortion_curve(z_fit, z_test, k_list, seed=0, iters=20):
"""在 z_fit 上拟合 k-means,在 z_test 上测失真(留出集估计)。"""
out = []
for k in k_list:
c = kmeans(z_fit, k, seed=seed, iters=iters)
_, _, d2 = quantize(z_test, c)
out.append(float(d2.mean()) / z_fit.shape[1])
return np.array(out)
def fit_slope(k_list, dist):
"""双对数线性拟合:log D = a * log K + b,返回斜率 a。"""
lk = np.log(np.asarray(k_list, dtype=np.float64))
ld = np.log(np.asarray(dist, dtype=np.float64))
a, b = np.polyfit(lk, ld, 1)
return float(a), float(b)
def main():
ap = argparse.ArgumentParser()
ap.add_argument("--steps", type=int, default=1500, help="连续自编码器训练步数")
ap.add_argument("--seed", type=int, default=0)
args = ap.parse_args()
X, _, _, _ = make_patch_data(n=8192, seed=args.seed)
d_in = X.shape[1]
# 前一半拟合码本,后一半当留出集测失真
X_fit, X_test = X[:4096], X[4096:]
k_list = [2, 4, 8, 16, 32, 64, 128, 256, 512]
print("数据 X%s(前 4096 拟合码本,后 4096 留出评估)" % (X.shape,))
print()
print("[A] 量化失真 D(K) = E||z - q(z)||^2 / d 的双对数斜率")
print(" d 理论 -2/d 实测斜率(K>=16) D(8) D(512) 衰减倍数")
results = {}
for d in (2, 4, 8, 16):
params, _, hist, _ = train_ae(X_fit, d, "continuous", steps=args.steps,
seed=args.seed)
z_fit = X_fit @ params["We"]
z_test = X_test @ params["We"]
dist = distortion_curve(z_fit, z_test, k_list, seed=args.seed)
slope, _ = fit_slope(k_list[3:], dist[3:]) # 只拟合 K>=16 段,不预设已到渐近区间
results[d] = {"dist": dist, "slope": slope, "params": params,
"z_fit": z_fit, "z_test": z_test}
print(" %-4d %-11.4f %-17.4f %.4e %.4e %.1fx" % (
d, -2.0 / d, slope, dist[2], dist[-1], dist[2] / dist[-1]))
print()
print(" K 从 8 加到 512(64 倍):d=2 失真降 %.1f 倍,d=16 只降 %.1f 倍。"
% (results[2]["dist"][2] / results[2]["dist"][-1],
results[16]["dist"][2] / results[16]["dist"][-1]))
print(" -2/d 仅为高码率、足维连续分布和最优码本的渐近参照;")
print(" 有限样本、非均匀密度、局部 k-means 和有效维度都能改变实测斜率。")
print()
# ---------------- [B] 拐点:量化误差 vs 子空间残差 ----------------
params = results[8]["params"]
z_fit, z_test = results[8]["z_fit"], results[8]["z_test"]
rec_cont = (((z_test @ params["Wd"] + params["bd"]) - X_test) ** 2).mean()
print("[B] 码本大到什么程度,像素误差相对连续通路如何改变(d=8,留出集)")
print(" 连续通路重建 MSE(子空间残差) = %.6f" % rec_cont)
print(" K 量化失真/d 量化后重建MSE 相对残差涨幅")
for k in k_list:
c = kmeans(z_fit, k, seed=args.seed, iters=20)
z_q, _, d2 = quantize(z_test, c)
rec = (((z_q @ params["Wd"] + params["bd"]) - X_test) ** 2).mean()
print(" %-7d %.4e %.6f %+.1f%%" % (
k, d2.mean() / 8, rec, 100 * (rec - rec_cont) / rec_cont))
print()
if __name__ == "__main__":
main()"""perceptual_lab.py —— 为什么 信息丢失时不同重建目标的取舍:一个能算清的玩具。
VQ-VAE 用 MSE(或像素空间的似然)训练解码器。MSE 的最优解是条件均值,
而条件均值会把「同一 latent 对应多种合理细节」平均掉 —— 这就是重建发糊的
数学根源,不是玄学。VQGAN 的解法是换掉重建损失:改成特征空间距离(LPIPS)
外加一个对抗项。
本脚本用一个双模态玩具把这个机制算清楚:
[A] 构造:同一个 latent 对应两种等概率的纹理(+p 和 -p)
[B] MSE 最优 = 条件均值,纹理被平均掉;高频(梯度)能量只剩多少
[C] 换成非线性特征空间后,最优解沿候选网格偏离均值;求阈值 alpha 并与解析式对拍
[D] 三种候选输出的三项指标对比:SNR / 梯度能量保留 / 到最近模态的距离
注意:这里的特征映射 phi(x) = [x, alpha * |grad x|] 是我手工造的非线性特征,
仅演示一个特定非线性特征的偏好;本文对照的LPIPS实现使用VGG16 五层特征加
一层学习的 1x1 卷积,仅是定性类比,不能据此验证真实 LPIPS/GAN 的质量。
运行:python perceptual_lab.py
"""
from __future__ import annotations
import numpy as np
PATCH = 8
AMP = 0.5 # 纹理幅度
SEED = 0
def gradient_magnitude(img):
"""前向差分后取绝对值:|grad x| 的展平向量(水平 56 个 + 垂直 56 个)。"""
gx = np.diff(img, axis=1)
gy = np.diff(img, axis=0)
return np.concatenate([np.abs(gx).ravel(), np.abs(gy).ravel()])
def phi(img, alpha):
"""非线性特征映射:图像本身 + alpha 乘梯度幅值。"""
return np.concatenate([img.ravel(), alpha * gradient_magnitude(img)])
def make_toy():
"""低频内容 m + 等概率的 ±棋盘纹理 p。"""
rng = np.random.default_rng(SEED)
u = np.arange(PATCH) + 0.5
m = np.outer(np.cos(np.pi * u / PATCH), np.cos(np.pi * u / PATCH)) * 1.5
m += 0.3 * rng.normal(size=(PATCH, PATCH)) # 让内容不那么对称
ii, jj = np.meshgrid(np.arange(PATCH), np.arange(PATCH), indexing="ij")
p = AMP * ((-1.0) ** (ii + jj))
return m, p
def evaluate_candidate(m, p, c, alpha):
"""候选输出 x_hat = m + c * p,返回三项指标。"""
x_hat = m + c * p
x_plus, x_minus = m + p, m - p
# MSE(对两种真值取期望)
mse = 0.5 * (((x_hat - x_plus) ** 2).mean() + ((x_hat - x_minus) ** 2).mean())
# 特征空间距离(对两种真值取期望)
f_hat = phi(x_hat, alpha)
feat = 0.5 * (((f_hat - phi(x_plus, alpha)) ** 2).mean()
+ ((f_hat - phi(x_minus, alpha)) ** 2).mean())
# 梯度能量保留(相对真值的期望梯度能量)
g_hat = np.concatenate([np.diff(x_hat, axis=1).ravel(),
np.diff(x_hat, axis=0).ravel()])
g_true = 0.5 * (np.concatenate([np.diff(x_plus, axis=1).ravel(),
np.diff(x_plus, axis=0).ravel()]) ** 2).sum()
g_true += 0.5 * (np.concatenate([np.diff(x_minus, axis=1).ravel(),
np.diff(x_minus, axis=0).ravel()]) ** 2).sum()
grad_keep = float((g_hat ** 2).sum() / g_true)
# 到最近模态的距离(越小说明落在数据流形上)
to_mode = float(min(((x_hat - x_plus) ** 2).mean(),
((x_hat - x_minus) ** 2).mean()))
return {"c": c, "mse": float(mse), "feat": float(feat),
"grad_keep": grad_keep, "to_mode": to_mode}
def best_c(m, p, alpha, grid=None):
if grid is None:
grid = np.linspace(-1.5, 1.5, 601)
losses = np.array([evaluate_candidate(m, p, c, alpha)["feat"] for c in grid])
return float(grid[int(np.argmin(losses))]), grid, losses
def main():
m, p = make_toy()
signal_power = float(((0.5 * ((m + p) ** 2).mean() + 0.5 * ((m - p) ** 2).mean())))
print("[A] 玩具构造:8x8 patch,x = m + s * p,s = +1 / -1 各 0.5")
print(" 低频内容 m: 范数 %.4f,梯度能量 %.4f" % (
np.linalg.norm(m), (np.concatenate([np.diff(m, axis=1).ravel(),
np.diff(m, axis=0).ravel()]) ** 2).sum()))
print(" 棋盘纹理 p: 范数 %.4f,梯度能量 %.4f(纹理占了 %.1f%% 的梯度能量)" % (
np.linalg.norm(p),
(np.concatenate([np.diff(p, axis=1).ravel(),
np.diff(p, axis=0).ravel()]) ** 2).sum(),
100 * (np.concatenate([np.diff(p, axis=1).ravel(),
np.diff(p, axis=0).ravel()]) ** 2).sum()
/ (np.concatenate([np.diff(m + p, axis=1).ravel(),
np.diff(m + p, axis=0).ravel()]) ** 2).sum()))
print()
print("[B] MSE 最优 = 条件均值(c=0,纹理被平均掉)")
c_star, grid, losses = best_c(m, p, 0.0)
r0 = evaluate_candidate(m, p, 0.0, 0.0)
psnr0 = 10 * np.log10(signal_power / r0["mse"])
print(" MSE 最优的 c* = %.3f(理论值 0)" % c_star)
print(" 重建 MSE = %.6f,SNR = %.2f dB" % (r0["mse"], psnr0))
print(" 梯度能量保留 = %.4f(条件均值必然丢高频:E||grad x||^2 = "
"||grad E[x]||^2 + E||grad(x - E[x])||^2)" % r0["grad_keep"])
print()
print("[C] 换成特征空间后,最优解沿候选网格偏离均值")
print(" alpha 最优 c* 该点的 MSE SNR(dB) 梯度能量保留")
for alpha in (0.0, 0.2, 0.3, 0.378, 0.4, 0.5, 1.0, 2.0):
c_a, _, _ = best_c(m, p, alpha)
r = evaluate_candidate(m, p, c_a, alpha)
psnr = 10 * np.log10(signal_power / r["mse"])
print(" %-8.3f %-10.3f %-13.6f %-10.2f %.4f" % (
alpha, c_a, r["mse"], psnr, r["grad_keep"]))
# 解析阈值:alpha^2 > ||p||^2 / ||grad p||^2
gp = np.concatenate([np.diff(p, axis=1).ravel(), np.diff(p, axis=0).ravel()])
thresh = float(np.sqrt((p ** 2).sum() / (gp ** 2).sum()))
print(" 粗略解析估计 alpha* = sqrt(||p||^2 / ||grad p||^2) = %.4f"
"(假设纹理梯度远大于内容梯度)" % thresh)
# 精确的「两个候选」比较:L(c) = (c^2+1)||p||^2 + alpha^2 * G(c),
# 于是「清晰模态 L(1)」优于「模糊均值 L(0)」的条件是 alpha^2 > ||p||^2/(G(0)-G(1))
g0 = 0.5 * ((gradient_magnitude(m) - gradient_magnitude(m + p)) ** 2).sum()
g0 += 0.5 * ((gradient_magnitude(m) - gradient_magnitude(m - p)) ** 2).sum()
g1 = 0.5 * ((gradient_magnitude(m + p) - gradient_magnitude(m - p)) ** 2).sum()
exact = float(np.sqrt((p ** 2).sum() / (g0 - g1)))
print(" 精确阈值:G(0)=%.4f, G(1)=%.4f,L(1)<L(0) 要求 alpha > %.4f"
% (g0, g1, exact))
print(" -> alpha 超过 %.3f 之后,「输出一个清晰模态」在特征损失上严格优于"
"「输出模糊均值」;" % exact)
print(" alpha 继续加大,最优 c 沿坐标轴继续往 ±1 移(不是跳变,"
"因为 |grad(m+c*p)| 关于 c 连续)。")
print()
print("[D] 四种候选输出的指标对比(SNR 用信号能量 %.4f 作基准)" % signal_power)
print(" 候选 MSE SNR(dB) 梯度保留 到最近模态距离")
c_feat, _, _ = best_c(m, p, 1.0)
for tag, c in [("MSE 最优 (c=0)", 0.0), ("折中 (c=0.5)", 0.5),
("特征最优 (c=%.3f)" % c_feat, c_feat), ("清晰模态 (c=1)", 1.0)]:
r = evaluate_candidate(m, p, c, 1.0)
psnr = 10 * np.log10(signal_power / r["mse"])
print(" %-20s %.6f %-10.2f %-9.4f %.6f" % (
tag, r["mse"], psnr, r["grad_keep"], r["to_mode"]))
print()
r_mean = evaluate_candidate(m, p, 0.0, 1.0)
r_sharp = evaluate_candidate(m, p, 1.0, 1.0)
r_feat = evaluate_candidate(m, p, c_feat, 1.0)
print(" SNR 的绝对值很小,是因为这个玩具里纹理完全无法从 latent 预测,")
print(" 要看的是相对差:")
print(" · 特征最优解 (c=%.3f) 的 MSE 是模糊均值的 %.2f 倍(SNR 低 %.2f dB);"
% (c_feat, r_feat["mse"] / r_mean["mse"],
-10 * np.log10(r_mean["mse"] / r_feat["mse"])))
print(" · 但它保留了 %.0f%% 的梯度能量,模糊均值只保留 %.0f%%;"
% (100 * r_feat["grad_keep"], 100 * r_mean["grad_keep"]))
print(" · 完全选一个模态 (c=1) 时 MSE 是均值的 %.1f 倍(SNR 低 %.2f dB),"
"梯度能量保留 %.0f%%,且到最近模态距离为 0 —— 它落在数据流形上。"
% (r_sharp["mse"] / r_mean["mse"],
-10 * np.log10(r_mean["mse"] / r_sharp["mse"]),
100 * r_sharp["grad_keep"]))
print(" 这里是自造特征距离与信号能量 SNR,不是 LPIPS/FID 或峰值 PSNR;")
print(" 不能从本玩具推断真实 tokenizer 的指标排序。")
if __name__ == "__main__":
main()"""make_figures.py —— 画正文用到的五张示意图。
所有数字都现场重算(不读缓存),来源是同目录下的实验脚本:
token_budget.py -> 图 1(序列长度与注意力规模)
codebook_size_law.py-> 图 2(码本容量 K 的收益曲线)
collapse_lab.py -> 图 3、图 4(坍缩过程与使用分布)
perceptual_lab.py -> 图 5(MSE 最优 vs 特征空间最优)
运行:/usr/local/bin/python3 make_figures.py
输出:../figures/*.png
"""
from __future__ import annotations
import os
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import codebook_size_law as CSL
import collapse_lab as CL
import perceptual_lab as PL
import token_budget as TB
from vq_core import kmeans, make_patch_data, quantize, train_ae
HERE = os.path.dirname(os.path.abspath(__file__))
FIGDIR = os.path.join(HERE, os.pardir, "figures")
os.makedirs(FIGDIR, exist_ok=True)
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False
C_A = "#2E6DB4" # 蓝:主曲线 / 基线
C_B = "#C0504D" # 红:第二种配置
C_C = "#4FA96B" # 绿:第三种配置 / 好的一方
C_D = "#E08A2E" # 橙:强调
C_GREY = "#8C8C8C"
def _save(fig, name):
path = os.path.join(FIGDIR, name)
fig.savefig(path, dpi=140, bbox_inches="tight", facecolor="white")
plt.close(fig)
print(" -> %s" % path)
# ---------------------------------------------------------------- 图 1
def fig_token_budget():
sizes = np.array([128, 256, 512, 1024, 2048], dtype=float)
fig, axes = plt.subplots(1, 2, figsize=(11.5, 4.3))
ax = axes[0]
for f, col, mk in [(4, C_D, "o"), (8, C_A, "s"), (16, C_C, "^")]:
n = (sizes / f) ** 2
ax.plot(sizes, n, color=col, marker=mk, lw=1.8,
label=r"tokenizer $f$=%d" % f)
ax.plot(sizes, sizes ** 2 * 3, color=C_GREY, marker="d", lw=1.8, ls="--",
label="像素级 RGB")
ax.set_xscale("log", base=2)
ax.set_yscale("log")
ax.set_xlabel("边长 H (像素)")
ax.set_ylabel("序列长度(token 数)")
ax.set_title("(a) 压缩率决定序列长度")
ax.grid(alpha=0.3, which="both")
ax.legend(fontsize=9)
ax.annotate("H=256, f=16\n只有 256 个 token",
xy=(256, 256), xytext=(300, 60), fontsize=9, color=C_C,
arrowprops=dict(arrowstyle="->", color=C_C, lw=1.2))
ax = axes[1]
labels = ["像素级\nRGB", "f=4", "f=8", "f=16"]
vals = [(256 * 256 * 3) ** 2, ((256 / 4) ** 2) ** 2,
((256 / 8) ** 2) ** 2, ((256 / 16) ** 2) ** 2]
colors = [C_GREY, C_D, C_A, C_C]
bars = ax.bar(labels, vals, color=colors)
ax.set_yscale("log")
ax.set_ylabel(r"注意力矩阵规模 $n^2$")
ax.set_title("(b) 256x256 图像的自注意力开销")
ax.grid(alpha=0.3, axis="y")
for b, v in zip(bars, vals):
ax.text(b.get_x() + b.get_width() / 2, v * 1.6, "%.1e" % v,
ha="center", fontsize=9)
ax.annotate("省 5.9e5 倍",
xy=(3, vals[3]), xytext=(2.55, 1e8), fontsize=9, color=C_C,
arrowprops=dict(arrowstyle="->", color=C_C, lw=1.2))
fig.suptitle("图 1:压缩 tokenizer 的逻辑序列账本(数字来自 token_budget.py)",
fontsize=11)
fig.tight_layout()
_save(fig, "token_budget.png")
# ---------------------------------------------------------------- 图 2
def fig_codebook_law():
X, _, _, _ = make_patch_data(n=8192, seed=0)
X_fit, X_test = X[:4096], X[4096:]
k_list = [2, 4, 8, 16, 32, 64, 128, 256, 512]
fig, ax = plt.subplots(figsize=(7.6, 5.2))
color_map = {2: C_C, 4: C_A, 8: C_D, 16: C_B}
slopes = {}
for d in (2, 4, 8, 16):
params, _, _, _ = train_ae(X_fit, d, "continuous", steps=1500, seed=0)
z_fit = X_fit @ params["We"]
z_test = X_test @ params["We"]
dist = CSL.distortion_curve(z_fit, z_test, k_list, seed=0)
slope, _ = CSL.fit_slope(k_list[3:], dist[3:])
slopes[d] = slope
ax.plot(k_list, dist, color=color_map[d], marker="o", lw=1.8,
label=r"$d$=%d 实测斜率 %.2f" % (d, slope))
# 理论斜率 -2/d,锚定在 K=16 处
anchor = dist[3]
theo = anchor * (np.array(k_list[3:], dtype=float) / 16.0) ** (-2.0 / d)
ax.plot(k_list[3:], theo, color=color_map[d], lw=1.0, ls=":",
alpha=0.75)
ax.set_xscale("log", base=2)
ax.set_yscale("log")
ax.set_xlabel(r"码本大小 $K$")
ax.set_ylabel(r"量化失真 $E\Vert z-q(z)\Vert^2/d$(留出集)")
ax.set_title("图 2:固定编码器的有限样本量化实验\n"
"实线=实测,点线=渐近参照斜率 -2/d(数字来自 codebook_size_law.py)",
fontsize=11)
ax.grid(alpha=0.3, which="both")
ax.legend(fontsize=9)
_save(fig, "codebook_size_law.png")
return slopes
# ---------------------------------------------------------------- 图 3、4
def fig_collapse():
X, _, _, _ = make_patch_data(n=4096, seed=0)
K = CL.BIG_K
s_rand, h_rand = CL.run_vq(X, K=K, steps=1200, seed=0, log_every=100)
p_init, _, _, _ = train_ae(X, 8, "continuous", steps=800, seed=0)
init_cb = kmeans(X @ p_init["We"], K, seed=0, iters=20)
s_km, h_km = CL.run_vq(X, K=K, steps=1200, seed=0, init_cb=init_cb,
log_every=100, init_params=p_init)
s_rs, h_rs = CL.run_vq(X, K=K, steps=1200, seed=0, restart=True,
log_every=100)
fig, ax = plt.subplots(figsize=(7.6, 5.0))
for h, col, mk, tag in [(h_rand, C_B, "o", "随机初始化"),
(h_km, C_A, "s", "预训练 + k-means"),
(h_rs, C_C, "^", "死码重采样重启")]:
ax.plot(h["step"], h["alive"], color=col, marker=mk, lw=1.8, label=tag)
ax.axhline(K, color=C_GREY, ls="--", lw=1.2)
ax.text(max(h_rand["step"]) * 0.55, K * 1.08,
"码本容量 K=%d(全活)" % K, color=C_GREY, fontsize=9)
ax.set_xlabel("训练步数")
ax.set_ylabel("活跃码数(当前固定评估窗口内被选中)")
ax.set_title("图 3:码本坍缩过程\n"
"K=%d,最终4096样本评估命中 %d 个码(%.1f%%)"
% (K, s_rand["alive"], 100.0 * s_rand["alive"] / K),
fontsize=11)
ax.grid(alpha=0.3)
ax.legend(fontsize=9)
ax.set_ylim(0, K * 1.25)
_save(fig, "collapse_curve.png")
fig, ax = plt.subplots(figsize=(7.6, 4.8))
for s, col, tag in [(s_rand, C_B, "随机初始化"), (s_rs, C_C, "死码重采样重启")]:
frac = np.sort(s["counts"] / s["counts"].sum())[::-1]
ax.plot(np.arange(1, len(frac) + 1), frac, color=col, lw=1.8,
label="%s:%d 个活码,perplexity %.1f" % (tag, s["alive"], s["ppl"]))
ax.set_yscale("log")
ax.set_xlabel("码字按使用频次从高到低排序")
ax.set_ylabel("使用占比")
ax.set_title("图 4:使用分布的长尾与死码\n"
"随机初始化有 %.1f%% 的码在最终4096样本中未命中" %
(100.0 * (1 - s_rand["alive"] / K)), fontsize=11)
ax.grid(alpha=0.3, which="both")
ax.legend(fontsize=9)
_save(fig, "usage_hist.png")
return s_rand, s_km, s_rs
# ---------------------------------------------------------------- 图 5
def fig_perceptual():
m, p = PL.make_toy()
signal_power = float(0.5 * ((m + p) ** 2).mean() + 0.5 * ((m - p) ** 2).mean())
c_feat, _, _ = PL.best_c(m, p, 1.0)
cands = [("真值样本 s=+1", m + p), ("真值样本 s=-1", m - p),
("MSE 最优 c=0", m), ("特征最优 c=%.2f" % c_feat, m + c_feat * p)]
fig, axes = plt.subplots(2, 4, figsize=(12.0, 5.6),
gridspec_kw={"height_ratios": [1.0, 0.92]})
vmin = min(a.min() for _, a in cands)
vmax = max(a.max() for _, a in cands)
for ax, (tag, img) in zip(axes[0], cands):
im = ax.imshow(img, cmap="gray", vmin=vmin, vmax=vmax, interpolation="nearest")
ax.set_title(tag, fontsize=10)
ax.set_xticks([])
ax.set_yticks([])
axes[0][0].set_ylabel("8x8 patch", fontsize=9)
rows = [("MSE 最优 c=0", 0.0), ("折中 c=0.5", 0.5),
("特征最优 c=%.2f" % c_feat, c_feat), ("清晰模态 c=1", 1.0)]
psnrs, keeps = [], []
for tag, c in rows:
r = PL.evaluate_candidate(m, p, c, 1.0)
psnrs.append(10 * np.log10(signal_power / r["mse"]))
keeps.append(100 * r["grad_keep"])
xpos = np.arange(len(rows))
ax = axes[1][0]
bs = ax.bar(xpos, psnrs, color=[C_A, C_GREY, C_D, C_C])
ax.set_xticks(xpos)
ax.set_xticklabels(["MSE\n最优", "折中", "特征\n最优", "清晰\n模态"], fontsize=8)
ax.set_ylabel("SNR (dB)")
ax.set_title("(e) 像素误差:模糊均值最好", fontsize=10)
ax.grid(alpha=0.3, axis="y")
ax.set_ylim(0, max(psnrs) * 1.3)
for b, v in zip(bs, psnrs):
ax.text(b.get_x() + b.get_width() / 2, v + 0.08, "%.2f" % v,
ha="center", fontsize=8)
ax = axes[1][1]
bs = ax.bar(xpos, keeps, color=[C_A, C_GREY, C_D, C_C])
ax.set_xticks(xpos)
ax.set_xticklabels(["MSE\n最优", "折中", "特征\n最优", "清晰\n模态"], fontsize=8)
ax.set_ylabel("梯度能量保留 (%)")
ax.set_title("(f) 细节保留:不同指标偏好不同", fontsize=10)
ax.grid(alpha=0.3, axis="y")
ax.set_ylim(0, 118)
for b, v in zip(bs, keeps):
ax.text(b.get_x() + b.get_width() / 2, v + 1.5, "%.0f%%" % v,
ha="center", fontsize=8)
# 右侧两格合并成一条 alpha 扫描曲线(先把占位的两个空轴关掉)
axes[1][2].axis("off")
axes[1][3].axis("off")
ax = plt.subplot2grid((2, 4), (1, 2), colspan=2)
alphas = np.linspace(0.0, 2.0, 41)
cs = [PL.best_c(m, p, a)[0] for a in alphas]
ax.plot(alphas, np.abs(cs), color=C_A, lw=1.8)
ax.axhline(1.0, color=C_GREY, ls="--", lw=1.0)
ax.axhline(0.0, color=C_GREY, ls="--", lw=1.0)
ax.set_xlabel(r"特征里高频项的权重 $\alpha$")
ax.set_ylabel("最优输出的纹理系数 |c|")
ax.set_title(r"(g) $\alpha$ 越大,候选网格最优值的变化", fontsize=10)
ax.grid(alpha=0.3)
ax.set_ylim(-0.05, 1.15)
ax.set_xticks([0.0, 0.5, 1.0, 1.5, 2.0])
fig.suptitle("图 5:丢失纹理极性时,不同重建目标的取舍"
"(数字来自 perceptual_lab.py)", fontsize=11)
fig.tight_layout()
_save(fig, "perceptual_tradeoff.png")
def main():
print("画图:所有数字现场重算,不读缓存")
print("[1/5] token_budget.png")
fig_token_budget()
print("[2/5] codebook_size_law.png")
slopes = fig_codebook_law()
print(" 实测斜率:", {k: round(v, 3) for k, v in slopes.items()})
print("[3/5] collapse_curve.png + usage_hist.png")
s_rand, s_km, s_rs = fig_collapse()
print(" 随机初始化: alive=%d ppl=%.2f rec=%.6f" % (
s_rand["alive"], s_rand["ppl"], s_rand["rec"]))
print(" 预训练 + k-means: alive=%d ppl=%.2f rec=%.6f" % (
s_km["alive"], s_km["ppl"], s_km["rec"]))
print(" 死码重采样: alive=%d ppl=%.2f rec=%.6f" % (
s_rs["alive"], s_rs["ppl"], s_rs["rec"]))
print("[5/5] perceptual_tradeoff.png")
fig_perceptual()
print("完成,图在 %s" % os.path.abspath(FIGDIR))
if __name__ == "__main__":
main()
评论 (0)