


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:推理加速 | 难度:进阶 | 前置知识:性能建模与 Profiling(performance_profiling)、混合精度(mixed_precision)、自注意力机制(attention_basics)
关键词:算子融合、kernel fusion、CUDA Graph、发射开销、访存瓶颈、torch.compile、Inductor
阅读准备:先读性能建模与 Profiling、混合精度与自注意力。kernel 是一次设备端计算程序;ufunc 是 NumPy 的逐元素数组调用,两者的派发路径不同。本文比较它们共有的“调用成本与中间数组”问题,不把 CPU ufunc 计时换算为 CUDA launch 延迟。
数字与验证范围:2026-11-03 在 Windows CPU、Python 3.11.9、NumPy 2.4.3 上重跑,进程线程设为 1。原版 M1 Pro 数字保留在修订基线。本轮 CUDA 不可用;所有 CUDA 微秒时间线和 kernel 数列表都是显式假设,未运行 GPU kernel、capture/replay 或完整模型。工业对照固定到 PyTorch v2.10.0;官方调度评分函数的 CPU 夹具与图 API 的委托契约另行核对,后者不等于 CUDA 实测。
先摆三个不同口径的数,避免把模型输入当成实测。
第一个数:手选的一种 decode lowering 列表合计 1093 个 kernel。 launch_model.py 把一层划为 34 个操作节点,32 层加 5 个输出节点,得到 $34\times32+5=1093$。它借用了常见 8B decoder 的层数,只是练习列表:RMSNorm 拆几次、QKV 是否合并、KV 写入与注意力是否融合,都要由后端决定。它不能验证某个真实 Llama 的 kernel 数,也不靠落进一个宽泛区间证明正确。
第二个数:单独假设 700 个 kernel,CPU 每次提交 3 μs、GPU 执行 2 μs。 单流事件模拟得到 eager 2102 μs,其中从计时起点计算的 GPU 未执行时间为 702 μs。若 Graph 首次提交同样取 3 μs,并假设相对 eager 每节点多 0.5 μs,总时长为 1753 μs,模型加速 1.199 倍。这是 700 节点案例,不能和上面的 1093 混用;微秒输入也不是本机测量。NVIDIA 的官方测试区分 CPU 调用时长、设备运行时长、首次上传与重复回放,实际结果还取决于硬件、CUDA 版本和图拓扑。
第三个数:8 段仿射链,CPU 代数合并后实测快 3.80–6.48 倍。 每段是乘加两个 ufunc,所以原链有 16 次数组调用,合并版仍有 2 次;不能称为 8 次对 1 次真实 GPU kernel 融合。小数组调用成本、大数组内存和算术都可能影响这个比值,第 04 节会保留原实验逐项展开。
还有一个更刺眼的数在注意力上。按 $B=8$、$H=16$、$S=2048$、$d=4096$、bf16 算:输入激活 $[B,S,d]$ 是 128.0 MiB,而 score 矩阵 $[B,H,S,S]$ 是 1.000 GiB,正好是输入的 8 倍。放大倍数是 $H \cdot S / d$——$S$ 翻一倍,它翻一倍;$S=8192$ 时是 32 倍。若这五步分别物化,max 读 1 份、减读写 2 份、exp 读写 2 份、sum 读 1 份、除读写 2 份,共 8 份全尺寸 score 流量,即 8 GiB;忽略逐行 max/sum 向量。若整行能留在片上,融合 softmax 读 score 写概率至少 2 GiB。这里仍物化 score 和概率;mask 可以广播或直接按坐标计算,不能凭形状再强加一张 1 GiB mask。
你以为模型卡在算力上,其实它经常卡在「把中间结果写出去再读回来」和「让 CPU 一次又一次地通知 GPU 开工」这两件事上。
三句话:
cudaGraphLaunch 提交整张图。仅捕获并回放同一组 kernel 时,不改变它们的逻辑数组读写,主要减少逐项的 CPU 提交;设备前端调度也可能变化。这里谈的是同一组 kernel,不排除编译器同时融合或重新安排内存。一句总结:融合省字节,Graph 省发射。把两者混为一谈,是这一块最常见的错误。
前置文章 performance_profiling 已经建过这条判据,这里只取结论。一个算子的耗时下界由两件事里更慢的那个决定:
$$T \ge \max\left(\frac{F}{P_{\text{peak}}},\ \frac{B}{B_{\text{off}}}\right)$$
其中 $F$ 是浮点运算次数(FLOPs),$P_{\text{peak}}$ 是峰值算力(FLOP/s),$B$ 是需要搬动的字节数(含读和写),$B_{\text{off}}$ 是片外内存带宽(字节/秒)。两者的比值就是算术强度:
$$I = \frac{F}{B}$$
$I$ 要与机器的 $P_{\text{peak}}/B_{\text{off}}$ 比较,才能判断理想 roofline 的哪一侧更紧;实际还可能受到派发、并行度、缓存和特殊函数吞吐限制。逐元素算子的 $I$ 是常数:算一个元素做 1 次操作、读 4 字节写 4 字节,$I = 1/8$。在 fp32 下算力峰值除以带宽的量级是每字节几十次操作,所以单次简单加法在足够大的连续数组上常是带宽优化对象。但 exp、三角函数等不能用一次普通 FLOP 的峰值来估计,小数组也可能主要受调用成本限制,不能说逐元素算子永远受带宽限制。
融合可以减少中间全局流量和调用,也可能通过化简减少 $F$,或通过重算增加 $F$ 换取更低存储。后面的账本会注明属于哪一种。
考虑 $K$ 个串起来的逐元素算子,作用在一个 $N$ 元素的张量上($b$ 为每元素字节数)。
不融合:每个算子单独成一个 kernel,各自读一遍输入、写一遍输出。第 $k$ 个 kernel 的访存是 $2Nb$ 字节(因为输入和输出都是 $N$ 个元素),$K$ 个加起来:
$$B_{\text{unfused}} = 2KNb$$
融合:一个 kernel 从头做到尾。读输入 $Nb$、写输出 $Nb$,中间那 $K-1$ 步全在片上:
$$B_{\text{fused}} = 2Nb$$
两式相除,字节比正好是 $K$:
$$\frac{B_{\text{unfused}}}{B_{\text{fused}}} = K$$
这个推导假设每个算子只有一个等尺寸输入、没有其他消费者、不需溢写,也不重复读输入。它是指定模式的逻辑字节账本,不是 DRAM 性能计数器。若中间结果已命中缓存、融合后寄存器不足而 spill、或 occupancy 降低,时延就不会按字节比缩放。
附录 [A] 同时列三种具体账本,不能混用:
还可以做一个条件性两层存储模型:假设融合后仍有 $2(K-1)Nb$ 的中间传输,但全在带宽 $B_{\text{on}}$ 的片上完成,且忽略计算、启动、同步与重叠。令 $\rho=B_{\text{on}}/B_{\text{off}}$,则:
$$T_{\text{fused,model}}=\frac{2Nb}{B_{\text{off}}}+\frac{2(K-1)Nb}{B_{\text{on}}},\qquad T_{\text{unfused,model}}=\frac{2KNb}{B_{\text{off}}}$$
$$S_{\text{model}}=\frac{K}{1+(K-1)/\rho}$$
它在 $\rho=1$ 时为 1,$\rho\to\infty$ 时趋近 $K$,只说明这些假设下的敏感性。寄存器中的中间值不必逐次经历这种“读写”;NumPy 分块则仍逐次执行 ufunc,并新增循环和复制。所以该式既不是融合的硬上限,也不能用任意两组 CPU 吞吐的比值验证 GPU 模型。若融合增加计算、同步或溢写,它完全可能慢于原实现。
一次算子调用的耗时,在规模足够小时和数据量无关。写成仿射形式:
$$t(n) = a + b_{\text{el}} \cdot n$$
$a$ 是固定开销(派发、参数检查、缓冲建立),$b_{\text{el}}$ 是每元素的边际成本。开销和数据各占一半的那个规模是:
$$n^{\ast} = \frac{a}{b_{\text{el}}}$$
本轮 [D] 先预热,再取 7 个批次的中位数,用 $n\le16384$ 的六点拟合:$a=0.476517$ μs,$b_{\text{el}}=61.424$ μs/百万元素,$n^{\ast}=7757.9$ 元素(30.30 KiB)。这些是此 CPU/Python/NumPy 路径的拟合参数,非 CUDA launch 测量,也不要求其他机器出现同一个临界点。
在把每次调用近似成同一个 $a+bn$ 的前提下,16 次调用链里的截距份额是:
$$\mathrm{share}_{\mathrm{model}}=\frac{2Ka}{2K(a+b_{\text{el}}n)}=\frac{1}{1+n/n^{\ast}}$$
这仍是模型分解。拟合误差、ufunc 类型、循环解释器与工作集变化都会影响它,不能把该份额称为实际 GPU 空转率或“实测加速中多少来自访存”。
令 $N\ge1$ 为 kernel 数,$\ell\ge0$ 为每次 CPU 提交耗时,$e\ge0$ 为每个 kernel 的有效设备耗时。假设单流串行、CPU 连续提交、无其他开销,编号从 $i=1$ 开始。CPU 的第 $i$ 次提交在 $i\ell$ 完成,GPU 必须等该提交及前一个 kernel:
$$f_0=0,\qquad s_i=\max(f_{i-1},i\ell),\qquad f_i=s_i+e$$
由递推可得精确的有限 $N$ 结果:若 $\ell\le e$,首个 kernel 等 $\ell$,之后无间隙,总时长为 $\ell+Ne$;若 $\ell>e$,每次等 CPU,总时长为 $N\ell+e$。合成一个式子:
$$T_{\mathrm{eager}}=\ell+e+(N-1)\max(\ell,e)$$
从 $t=0$ 开始计、只把执行 kernel 算忙碌时,未执行时间为 $T_{\mathrm{eager}}-Ne$;它包括开头等待,不能直接称为设备利用率测量。
Graph 一次提交耗时记为 $g$。若把两侧共有的前端成本已计入 $e$,Graph 每节点相对 eager 的有效增量记为 $\delta$,则一个简化模型为:
$$T_{\mathrm{graph}}=g+N(e+\delta),\qquad S=T_{\mathrm{eager}}/T_{\mathrm{graph}}$$
$\delta$ 是待测差值,可以为正、零或负,只要求有效时长非负;它不是 CUDA 必收的一笔额外派发费。原脚本默认 $N=700,\ell=g=3,e=2,\delta=0.5$ μs,故得到 $2102/1753=1.199$。在 CPU 受限分支,解两者相等得到:
$$e_{\mathrm{break}}=\frac{N\ell-g-N\delta}{N-1}=2.499285\ldots\ \mathrm{\mu s}$$
因此原来画在 3 μs 的“盈亏点”并不精确。仍用该组假设,$e=20$ μs 时确实略慢;但换成 $\delta=0$,大 kernel 案例就打平,$\delta=-0.1$ μs 则可稍快。大 kernel 必亏不是普遍规律。 实际图还可能有并行节点、不同的提交成本和设备调度,不能由这张单链模拟包办。
最后把首次录制、实例化、上传等额外成本合计为 $H$,重复回放 $R$ 次。当每轮净节省 $\Delta=T_{\mathrm{eager}}-T_{\mathrm{graph}}>0$ 时,严格回本要求 $R\Delta>H$;本例每轮省 349 μs,若假设 $H=1000$ μs,要至少 3 次。$H$ 也只是演示输入,真实服务还须计入静态输入复制、输出生命周期与必要同步。NVIDIA 官方文档也分别讨论首次运行和重复回放,不能把一次录图成本摊成零。
因果注意力里,第 $i$ 个 query 只能看见前 $i$ 个 key。如果老老实实算满 $S \times S$ 的 score 矩阵,被掩掉的部分是纯浪费。精确的保留比例是:
$$\text{kept} = \frac{S(S+1)/2}{S^2} = \frac{S+1}{2S}$$
$S=2048$ 时是 50.0%——一半的 score 元素算完就扔。逐元素地跳过在硬件上不现实,实际做法是按块跳:块边长 $B_r$ 时共有 $n_b = S/B_r$ 个 query 块,第 $i$ 个 query 块只算前 $i$ 个 key 块,算下来是 $n_b(n_b+1)/2$ 个块:
$$\text{kept}_{\text{block}} = \frac{n_b(n_b+1)/2}{n_b^2} = \frac{n_b+1}{2 n_b} = \frac{1}{2} + \frac{1}{2 n_b}$$
按上述方形整除块模型计算($S=2048$):块边长 64 时 51.6%,128 时 53.1%,256 时 56.2%。这是把对角块也按整块计算的面积比例,不是整次 attention 的实测耗时;尾块、矩形 tile 和对角块内部掩码另算。相对 $1/2$ 的超额为 $1/(2n_b)$,相对精确保留比例的超额是 $1/(2n_b)-1/(2S)$,所以块越小越接近理论上界——但块越小,片上数据被切得越碎,调度开销越大。这是块大小必须折中的原因,不是调参玄学。
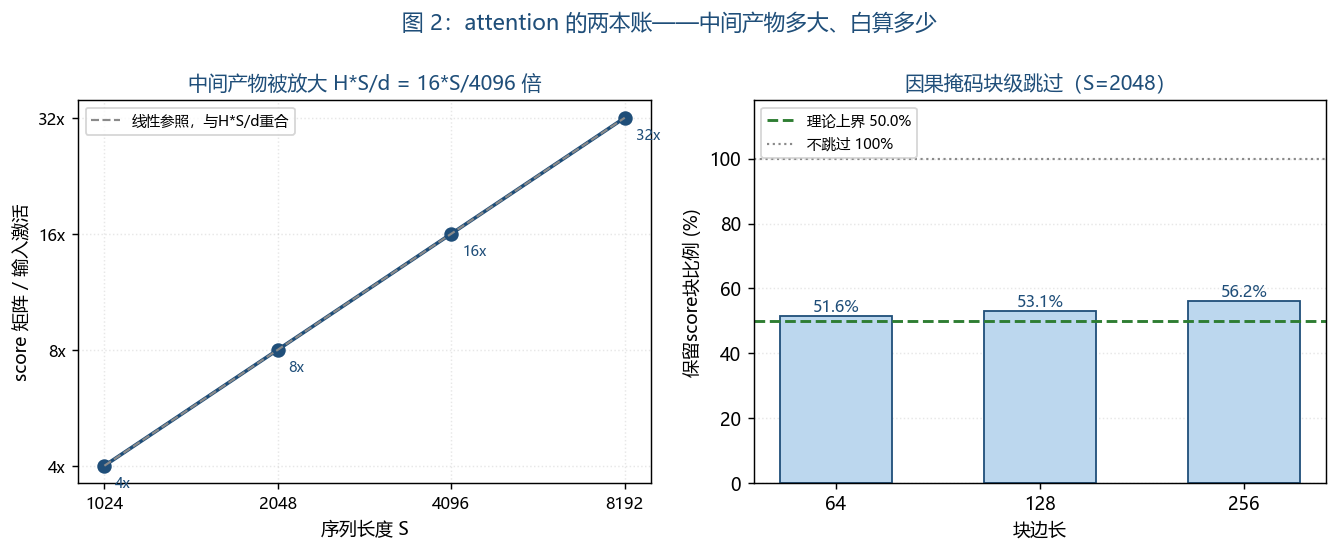
这张图要看什么:左图的 score/输入比例严格按 $HS/d$ 随 $S$ 线性增长,双对数坐标上斜率为 1;灰虚线与它重合。不要把 score 自身的平方增长与这个比例混同。右图展示整除方形块的保留面积比例,64/128/256 块分别为 51.56%/53.13%/56.25%,不是 GPU 时间实测。
保留三个原脚本,新增一个独立数值检查脚本,正文末尾都有完整代码。Python 3 与 NumPy 可跑三个原脚本的计算部分;独立 fusion_checks.py 还需 PyTorch(本轮用 2.10 CPU),生成五图需 matplotlib,图中中文字体需系统支持(本轮使用 Microsoft YaHei)。在任意终端用 python 运行:
fusion_lab.py:[A] 字节账本、[B] 带宽与工作集、[C] 三种融合形态、[D] 固定开销、[E] attention 尾部launch_model.py:[F1] 时间线、[F2] 扫描、[F3] kernel 计数、[F4] 收益分解make_figures.py:把前两脚本落盘的 JSON 画成 5 张图。fusion_checks.py:独立验证事件闭式、字节计数、分块尾部、稳定 softmax、浮点与非仿射反例。我把「融合」拆成三种可测量的形态,这是本篇的核心实验设计:
K = 8                      # 8 段链,每段 h <- A*h + B
A_S, B_S = 1.01, 0.01


def _v1_unfused(x, buf, K=K):
    """V1 不融合:K 段,每段 2 次算子调用,每段结果都写回内存。"""
    np.multiply(x, A_S, out=buf)
    np.add(buf, B_S, out=buf)
    for _ in range(K - 1):
        np.multiply(buf, A_S, out=buf)
        np.add(buf, B_S, out=buf)
    return buf


def _v3_closed(x, out, K=K):
    """V3 代数合并:K 段仿射合成一个仿射,只剩 2 次调用。"""
    Ak = A_S ** K
    Bk = B_S * sum(A_S ** j for j in range(K))
    np.multiply(x, Ak, out=out)
    np.add(out, Bk, out=out)
return out三种形态要按实际执行的代码区分:
先预热,再交替 V1/V3 顺序,9 轮各自取批次中位数;相对误差定义为最大绝对差除以 V1 最大绝对值。本轮快照如下(时间单位 μs):
| 元素数 | V1 | V3 | V1/V3 | 相对误差 |
|---|---|---|---|---|
| 512 | 8.970 | 2.150 | 4.172 | 1.349e-07 |
| 4096 | 9.700 | 2.550 | 3.804 | 1.969e-07 |
| 65536 | 56.430 | 8.710 | 6.479 | 5.115e-07 |
| 262144 | 216.000 | 34.760 | 6.214 | 5.802e-07 |
| 1048576 | 1447.610 | 233.310 | 6.205 | 5.129e-07 |
| 4000000 | 7757.160 | 1672.110 | 4.639 | 6.165e-07 |
误差是这批输入上的观测,不是任意 dtype/幅值/链长都安全的证明。第 6.2 节给反例。
最大规模上,V2 使用同一新输入、V1 基准 7.763 ms,结果如下;每个 tile 输出均与 V1 逐元素相同:
| tile 元素数 | V2 ms | 相对 V1 |
|---|---|---|
| 16384 | 6.932 | 1.120 |
| 65536 | 5.423 | 1.431 |
| 262144 | 5.519 | 1.407 |
| 1048576 | 7.368 | 1.054 |
本机 V2 最快 1.431 倍。把 [B] 的逻辑吞吐比 2.914 机械代入两层模型,会得 2.351 倍;这不是同一物理模型的预测,不能以接近或不同就声称因果成立。tile 分配、复制、Python 循环、ufunc 吞吐和缓存都还存在。
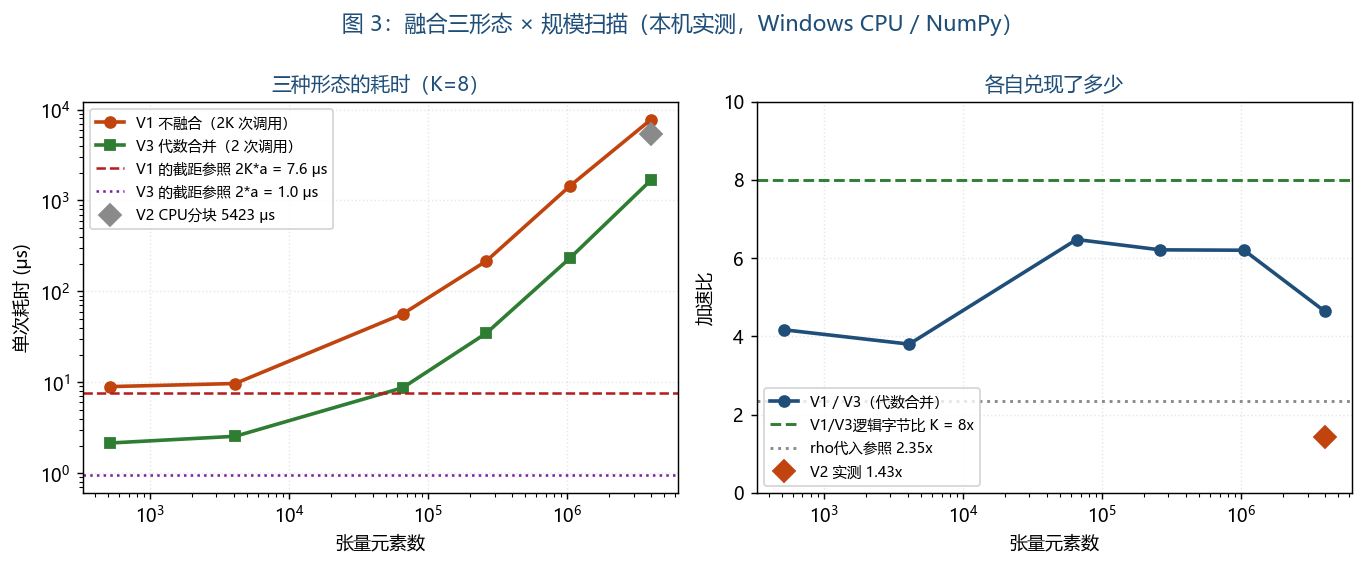
这张图要看什么:左图保留 V1/V3 规模曲线和 V2 最佳点,虚线是单 add 拟合截距的参照,不是所有函数的严格时延下限。右图的 $K=8$ 是 V1/V3 的逻辑字节比,灰线只是 rho 代入算术,两者都不是实测时延上限。
[B] 使用 np.add(x, 1.0, out=y),以 $2n_{\mathrm{bytes}}/t$ 计算逻辑吞吐。$n_{\mathrm{bytes}}$ 仅是一张数组大小,$x$ 与 $y$ 的总存活工作集为两倍;下表保留全部规模:
| 单数组 KiB | 两数组工作集 KiB | 逻辑 GB/s |
|---|---|---|
| 32 | 64 | 46.479 |
| 128 | 256 | 106.131 |
| 512 | 1024 | 97.001 |
| 2048 | 4096 | 56.988 |
| 8192 | 16384 | 49.522 |
| 32768 | 65536 | 19.756 |
| 131072 | 262144 | 19.362 |
人为把单数组不超过 8 MiB 的五点叫 small,其余两点叫 large,中位数为 56.988 和 19.559 GB/s,比值 2.914。这两个键在 JSON 中为兼容旧图仍名为 B_cache_GBs / B_dram_GBs,实际只是分组统计;阈值不证明 L1/L2/DRAM 归属,更不是峰值带宽。硬件缓存行、写分配、预取、SIMD 和频率都没有用计数器隔离,所以该比值不能成为 GPU 的片内/片外参数。
[D] 对每个规模预热后连续调用:小规模每批 20000 次、大规模每批 500 次,做 7 批取中位数。循环成本也计入;[C] 则用交替调用的批次计时,这两者是不同微基准,不要求拟合截距恰好预测整条链。
实测单次时间(μs):$n=1$ 为 0.4646、$n=8$ 为 0.4674、$n=64$ 为 0.4669、$n=512$ 为 0.5373、$n=4096$ 为 0.7370、$n=16384$ 为 1.4798、$n=65536$ 为 4.4078、$n=262144$ 为 21.4532、$n=1048576$ 为 129.5942。小端最小二乘给 $a=0.476517$ μs、$b=61.424$ μs/百万元素。拟合得到的 $n^{\ast}=7757.9$ 是模型交叉点,而非机器的缓存容量;若斜率或截距不为正,应判模型失效,脚本会明确报错。
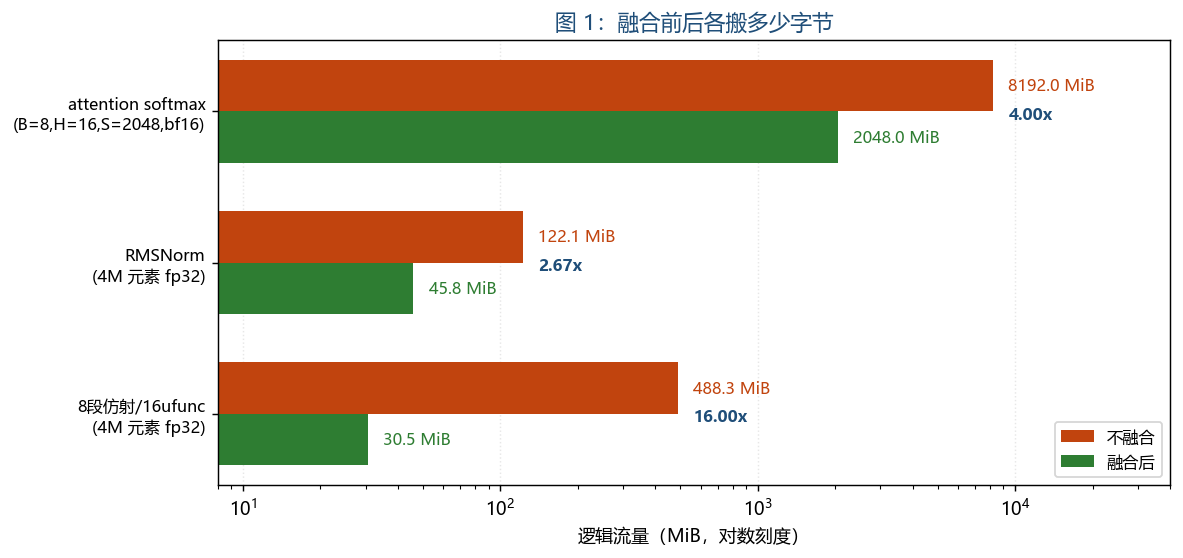
这张图要看什么:三组指定模式的逻辑账本,横轴为 MiB 的对数刻度。第一组的“融合后”是真正单 kernel 的理想流量,并非 V3 实跑;RMSNorm 已计入权重读,softmax 忽略行统计并假设中间 dtype 不变。不同规模的字节不能单独决定优化优先级,还要结合调用频率和端到端 trace。
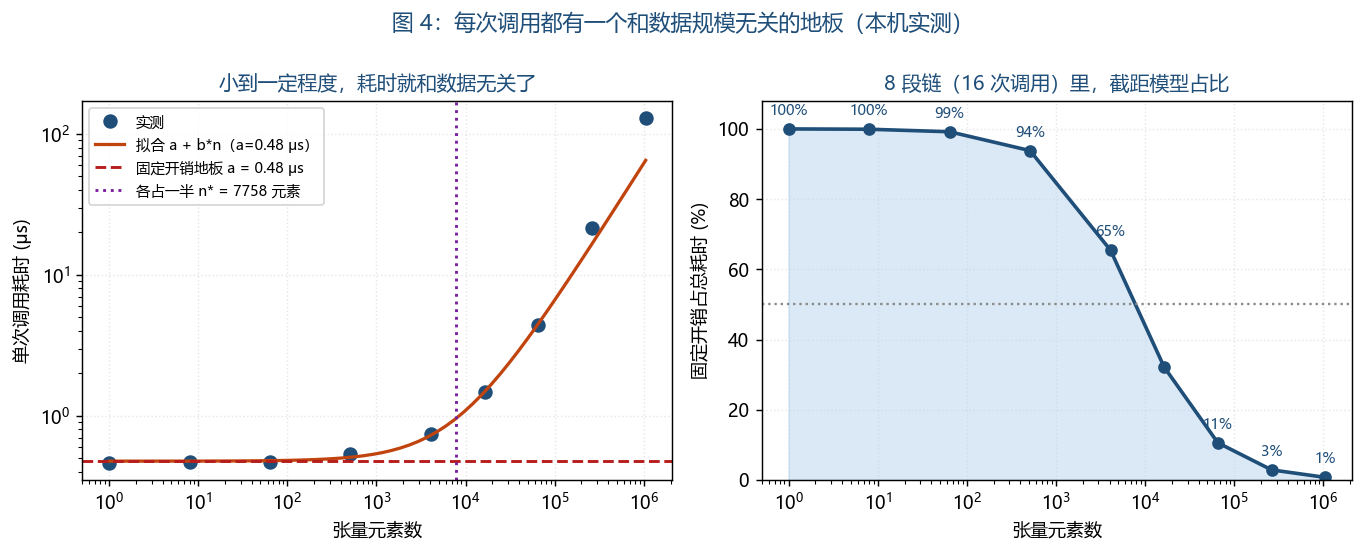
这张图要看什么:左图比较单 add 的实测点和局部拟合,竖线标识模型 $n^{\ast}=7758$;右图是 $1/(1+n/n^{\ast})$ 的模型份额,不是额外测出的 CUDA 发射开销。
[F4] 把 [D] 的同一 add 模型扩到 V1/V3,保留反事实分解练习。由 $t_1=2K(a+bn)$、$t_3=2(a+bn)$,截距节省为 $2(K-1)a$,每元素项节省为 $2(K-1)bn$;两者除以模型总节省,分别得到 $a/(a+bn)$ 与 $bn/(a+bn)$。
| 元素数 | V1实测 μs | V1模型 μs | V3实测 μs | V3模型 μs |
|---|---|---|---|---|
| 512 | 8.970 | 8.127 | 2.150 | 1.016 |
| 4096 | 9.700 | 11.650 | 2.550 | 1.456 |
| 65536 | 56.430 | 72.032 | 8.710 | 9.004 |
| 262144 | 216.000 | 265.254 | 34.760 | 33.157 |
| 1048576 | 1447.610 | 1038.145 | 233.310 | 129.768 |
| 4000000 | 7757.160 | 3938.749 | 1672.110 | 492.344 |
| 元素数 | 模型截距份额 |
|---|---|
| 512 | 93.81% |
| 4096 | 65.45% |
| 65536 | 10.58% |
| 262144 | 2.87% |
| 1048576 | 0.73% |
| 4000000 | 0.19% |
表中差距直接显示模型外推误差。“每元素项”包含算术、缓存和内存成本,不等于访存;“截距项”是 CPU 路径模型,不等于 CUDA 发射。它不能证明加速的 94% 或 100% 来自某种原因。
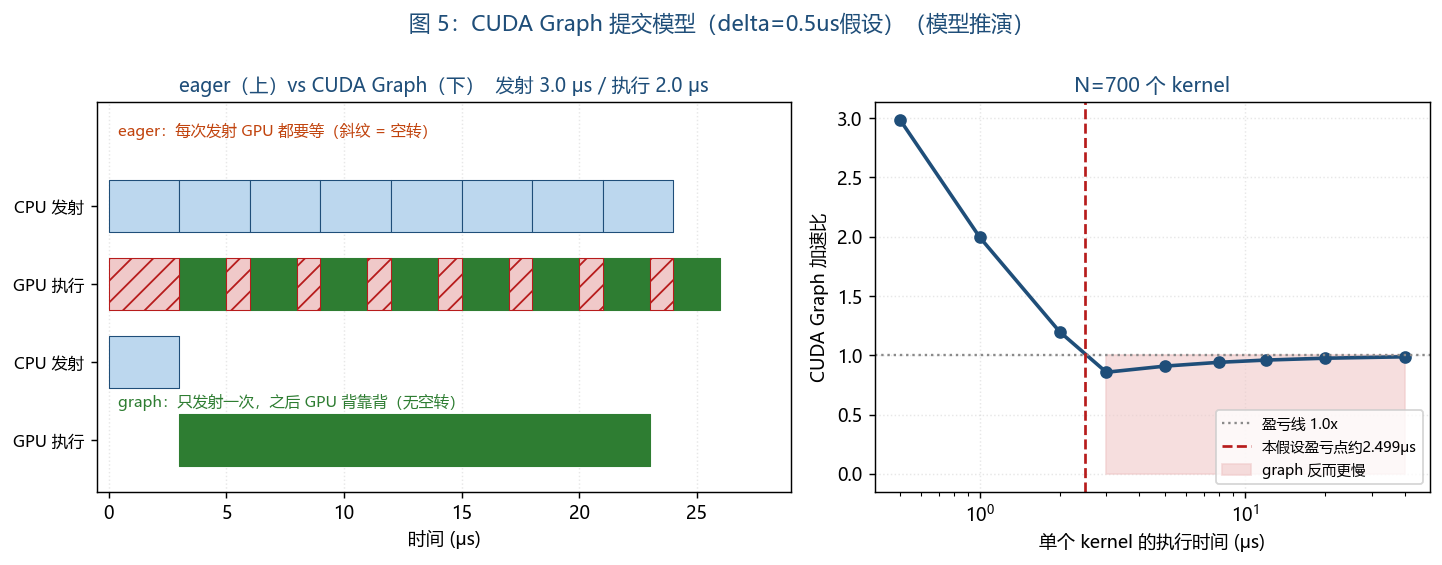
这张图要看什么:左图只画 8 个 kernel 以便看清间隙,蓝条是提交、绿条是执行,Graph 下排的有效设备段包含假设增量 delta,不代表硬件零派发。右图用 700 个 kernel,红线为本组假设的精确盈亏点约 2.499 μs,阴影不是所有 CUDA Graph 的失败区域。
本节固定到 PyTorch v2.10.0。主入口是 torch/_inductor/compile_fx.py#compile_fx:FX 表达计算图,Inductor 负责 lowering、调度与生成后端代码,GPU 常用 Triton,CPU 也有自己的代码生成路径。
torch/_inductor/scheduler.py#Scheduler中,fuse_nodes 组织融合,can_fuse、can_fuse_vertical 与后端合法性检查判断候选能否合并。score_fusion_memory 的参数顺序是 self、node1、node2、count_bytes,不是把 count_bytes 当第一个参数;默认分支估计两个节点共有读写依赖所代表的内存收益,它的文档也仅称融合评分的第一项。混合顺序归约有单独路径,最终策略还要考虑后端、拓扑、资源与实际基准,不能说评分就是全部节省的字节。
本轮直接从该固定源文件抽取完整评分方法,在 CPU 上用小型依赖图夹具执行共享、非共享、大小集合分支,检查字节估计;没有改写函数体,也没有编译 GPU 内核。这验证了评分语义,未验证端到端 Inductor 性能。
归约、随机数、原地写、别名和动态 shape 都可能限制某一种融合,但不是统一的“禁止融合表”。例如行归约 softmax 正是经典融合目标;随机数需要维持合法 RNG 语义;动态 shape 可通过 guard、符号形状或重编译处理。编译器应先保证依赖与数值语义,再判断成本。
最小实现里的融合是「一串逐元素算子合成一个 kernel」。生产实现里最有价值的融合形态是 epilogue fusion:把接在 GEMM 后面的 bias、激活、缩放并进 GEMM 的 kernel 里,让 GEMM 的输出直接以最终形态写出,不经过显存。
仅对 $[M,N]$ 的 fp32 输出流计数:分离的 GEMM 写一次 $4MN$,bias 加法读写 $8MN$,激活再读写 $8MN$,合计 $20MN$;融合后最终结果写一次 $4MN$。这里输出流量少 80%,不能说整个 GEMM 的总访存降到 $1/5$。
若把两边共有的矩阵输入流量记为 $Q_{AB}$、bias 只读一次的理想流量为 $4N$,则总量比为:
$$\frac{Q_{AB}+20MN+4N}{Q_{AB}+4MN+4N}$$
它通常小于 5,并随输入占比改变;真实 bias 广播、缓存命中与 GEMM 分块还会修改物理字节。融合让累加器中的结果接着做 bias/激活再写出,具体能否采用这种 epilogue,要看 GEMM 后端、dtype 与可用资源。
固定版本的 torch/cuda/graphs.py#CUDAGraph暴露 capture_begin、capture_end、instantiate、replay。三个细节需要修正:
graph_pool_handle() 是可选的跨图共享提示。 capture_begin(pool=None) 合法;PyTorch 的 caching allocator 会为捕获管理私有池。通常要保留静态输入/输出和相关内存的生命周期,并不要求所有张量先由用户显式塞进同一个池。keep_graph。 默认 keep_graph=False 在 capture_end 已实例化;True 时可显式 instantiate(),否则首次 replay() 自动实例化。提前实例化以避免第一次 replay 延迟增加,是针对后一种路径的建议,不能当作所有调用的强制步骤。torch/_inductor/cudagraph_trees.py与固定版本说明讨论录制路径、输出存活和内存复用。不同 shape 可能触发新录制;路径分支也不只有前反向形状变化这一种。torch.compile(mode="reduce-overhead") 可以启用相关优化,但不保证任意程序都完整捕获或加速。本轮 CPU 对原 Python CUDAGraph 包装类做委托契约检查,底层 CUDA 基类用显式测试替身记录参数;同时查验原 C++ 实例化条件。它只能验证包装层的可选参数与委托,并没有执行 CUDA capture/replay。
| 差异 | 原因与边界 |
|---|---|
| 合法性与成本分开 | 依赖/别名正确仍不保证融合有收益;寄存器和共享内存可能限制并行度 |
| guard 与形状管理 | 动态输入可能重编译、分桶或重录;并非所有动态 shape 都无法优化 |
| 静态地址与生命周期 | 捕获的地址须在回放时有效;私有池和跨图共享池有不同用途 |
| RNG、原地更新与输出复用 | 支持的语义需按后端和 API 核对,不能只看数学表达式 |
| 单次成本与重复成本 | 编译、录制、实例化、上传、输入复制和稳态回放分别计时 |
$K/(1+(K-1)/\rho)$ 是第 3.2 节所列存储假设的结果,不能当成硬件定律。本轮逻辑吞吐比 2.914 与 V2 最佳 1.431 倍只描述这些 CPU 程序;V2 仍有 tile 内的 16 次数组调用与输出复制,不能说“留片上动作已做对”。
V3 只对仿射复合成立,真实融合通常要保留非线性、归约或随机行为。若改成每段 max(A*h+B,0),再直接用无激活的闭式就会算错;新增检查脚本给出该反例。融合也可能增加寄存器压力、溢写和重算,降低 occupancy,所以即便中间逻辑字节更少,也可能更慢。
本轮 V1/V3 最大相对误差约 $6.17\times10^{-7}$,仅对表中随机 fp32 输入成立。舍入重排不是必然有害,也不是自动无害:例如 fp32 中先算 $(10^{20}+(-10^{20}))+3$ 得 3,换成 $10^{20}+((-10^{20})+3)$ 得 0。低精度、溢出、抵消和长链都能扩大差异。
因此验证应比较形状、dtype、绝对/相对误差及任务敏感性;需要逐位复现时不能只说“在许可范围内”。只改变 kernel 边界也未必改变计算顺序,但代数合并、FMA 与归约重排可能改变结果。
保留原 [E] 的五步稳定 softmax:减去逐行最大值后指数化,按行求和再除;输入形状 [8,1024,1024]、fp32,一份 score 为 32 MiB,五步完整尺寸逻辑流量为 256 MiB。本轮全数组 16.983 ms,64 行分块 13.183 ms,快 1.288 倍,输出逐位相同;这和旧 M1 观测方向不同。
用 [B] 的 large 逻辑吞吐 19.559 GB/s 做除法,得到 13.724 ms 参照;1.237 倍的差距不能证明主要时间全在 exp。add 的逻辑吞吐不是此 shape 的物理带宽上限,归约、广播、缓存、布局和循环都未隔离。要识别瓶颈需分别计时或硬件 profile,当前结果不提供这种因果证据。
真正融合的 softmax 会改变访存和调用;FlashAttention进一步用分块与在线归一化避免保存完整 score/概率,并可在因果模式跳过无用块。它不是因为“融合对计算受限算子完全无效”才需要存在;某些优化也可能同时改变算法、并行与计算量。
.item();普通 CPU Python 逻辑也不会被录下来在 replay 时重跑。RNG 有受支持的状态管理,需要按 API 使用。graph_pool_handle() 不是必需;捕获中原始 cudaMalloc 与框架 allocator 处理的张量分配也不能混为一谈。PyTorch 固定版本 CUDA 说明是接口约束的依据。实践上先看 trace 与稳态/端到端延迟,再决定融合、Graph 或二者组合。列表练习中 1093→355 只是给定手选 lowering 的节点数对照,真实框架不会仅凭模型层数自动得到这个结果。
四篇,按「融合是怎么从手工技巧变成系统能力,又怎么被反过来审视」串起来。
TVM: An Automated End-to-End Optimizing Compiler for Deep Learning(arXiv:1802.04799,2018)。把计算图优化与面向硬件的算子调度、自动搜索组织成端到端编译系统;论文讨论 operator fusion,但不据此声称它是自动融合的起点,也不能把本文简化字节式直接等同于其整个搜索目标。
The Deep Learning Compiler: A Comprehensive Survey(arXiv:2002.03794,2020,本文知识树的锚点)。给出一张完整坐标系:图级优化(融合、常量折叠、CSE)、算子级优化、内存分配、后端代码生成。它把融合明确归到「图级优化」——融合通常结合图与算子层的依赖、布局和数值语义;不能从“图级优化”的分类推成编译器对算子数学一无所知。
FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(arXiv:2205.14135,2022)。把融合推到极致:不只把 softmax 融进注意力,还根本不实例化 $S \times S$ 的 score 矩阵,用在线 softmax 一边遍历一边归一化。这正是本篇 [A] 节那 1.000 GiB 中间产物的解法,因果模式可跳过无用块;精确节省依 tile、尾块和实现而定,不应对所有模式一概声称减少一半算术。
Operator Fusion in XLA: Analysis and Evaluation(arXiv:2301.13062,2023)。反过来审视这件事:作者去读 XLA 的融合 pass 源码,在 Cartpole 的 2048 并行环境、10000 步、RTX 2080 Ti 测试中,将代码改写、融合边界调整与 10 次循环展开等结合,报告相对论文原始 JAX-XLA baseline 最高 10.56 倍。它不是孤立一次 fusion pass 的通用收益。这篇的价值在于它把「融合是好事」这个默认假设变成了可度量的对象——它提醒我们连同 baseline、shape、后端与改写方式报告结果,不能只保留最大倍数。
至于 CUDA Graph,它不是论文,是 CUDA 10 起提供的一项运行时机制(录制-实例化-回放),说明见 CUDA C++ Programming Guide 的 CUDA Graphs 一节。把它和融合并列讨论,是因为它经常被当成融合的替代品——而它其实解决另一个问题。
前三个原脚本计算只需 NumPy(画图另需 matplotlib),独立检查还需 PyTorch CPU,不需要 GPU;按下面顺序运行即可得到本轮同口径的形状与数值,计时随机器和负载变化:
python fusion_lab.py ALL
python launch_model.py
python fusion_checks.py
python make_figures.py
实验一:测调用模型。 python fusion_lab.py D 拟合你自己的 $a,b,n^{\ast}$;本轮约 0.477 μs、7758 元素,不能预设其他机器相同。单独运行 D 会覆盖 _fusion_results.json 为当前部分结果,画全套图前应重新运行 ALL。
实验二:把 K 改成 16。 V1 的调用由 16 次变为 32 次,V3 仍为两次。理想逻辑字节比变为 16;实际加速未必贴着 16,也不受此值作为通用时延上限约束。检查较长链的舍入误差和计时变化,而非预设一定更快。
实验三:改变访问步长。 对相同逻辑元素数分配更大底层数组,再用步长视图测 add。分别报告逻辑字节、底层地址跨度和计时;步长可能增加缓存行流量,但不能据此预设 small/large 比必然趋向 1。两层模型只是要被检验的假设。
实验四:查模型反例。 fusion_checks.py 比较事件闭式与递推,验证 $N=1$、相等提交/执行时间、尾 tile、极端 softmax、非仿射与浮点抵消。把 Graph 的增量改成 0 或负值,看“大 kernel 必亏”如何失效。
实验五:自己列 kernel。 在 launch_model.py 的 per_layer 中改 lowering 情景,再对真实 GPU profiler 的 kernel trace(若有)核对;列表和不能当作实测。要测 CUDA Graph,应另外按官方示例准备 GPU、静态输入、预热和同步,并分别报告录制成本与多次稳态回放;本篇没有把这部分标为已跑。
09 节用到的脚本全文如下(launch_model.py、fusion_checks.py、fusion_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
launch_model.py —— 发射开销、CUDA Graph,以及它们和融合的分工

只捕获回放同一组kernel时逻辑字节不变;融合与代数化简可能改变字节和算术。
这个脚本把两件事分开算:

  [F1] 离散事件时间线:eager 逐个发射 vs CUDA Graph 一次发射
  [F2] 扫描:单个 kernel 执行多久时,CUDA Graph 才赚?
  [F3] 按 Llama-3-8B 架构手数一步 decode 有多少个 kernel
  [F4] 分解:本机实测的 K 段链加速里,截距项和每元素项的条件性分解

所有微秒输入与kernel列表都是教学假设,不是当前机器CUDA实测。
官方背景:https://developer.nvidia.com/blog/cuda-graphs/
固定开销模型不能证明大kernel必亏;td为相对eager的假设增量。

运行:
    python launch_model.py
"""

from __future__ import annotations

import json
import os

import numpy as np

HERE = os.path.dirname(os.path.abspath(__file__))


# ══════════════════════════════════════════════════════════════
# [F1] 离散事件时间线
# ══════════════════════════════════════════════════════════════

def simulate_eager(n_kernel, t_launch, t_exec):
    """eager:CPU 逐个 cudaLaunchKernel,GPU 逐个执行,单流异步。

    CPU 发第 i 个要花 t_launch,发完就不用管了,可以继续发下一个;
    GPU 要等「前一个跑完」且「这个已经被发出去」才能开始。
    两个条件里慢的那个决定 GPU 什么时候开工,差出来的就是 GPU 空转。
    """
    if not isinstance(n_kernel,int) or n_kernel < 1 or t_launch < 0 or t_exec < 0:
        raise ValueError("positive kernel count and nonnegative times required")
    gpu_free = 0.0
    idle = 0.0
    for i in range(n_kernel):
        cpu_done = (i + 1) * t_launch          # CPU 发完第 i 个的时刻
        start = max(gpu_free, cpu_done)        # GPU 能开工的时刻
        idle += start - gpu_free
        gpu_free = start + t_exec
    return {"total": gpu_free, "idle": idle,
            "idle_frac": idle / gpu_free if gpu_free > 0 else 0.0}


def simulate_graph(n_kernel, t_launch, t_exec, t_dispatch):
    """CUDA Graph:一次 cudaGraphLaunch 提交整张图。

    t_launch在此代表整图CPU提交时间;t_dispatch为每节点相对eager
    的设备耗时增量。它可以为零或负,不是CUDA固定派发罚金。
    """
    if not isinstance(n_kernel,int) or n_kernel < 1 or t_launch < 0 or t_exec < 0 or t_exec+t_dispatch < 0:
        raise ValueError("invalid graph model inputs")
    total = t_launch + n_kernel * (t_exec + t_dispatch)
    return {"total": total, "idle": t_launch,
            "idle_frac": t_launch / total if total > 0 else 0.0}


def section_F1():
    print("\n" + "=" * 72)
    print("[F1] 时间线:eager 逐个发射 vs CUDA Graph 一次发射")
    print("=" * 72)

    N, tl, te, td = 700, 3.0, 2.0, 0.5
    e = simulate_eager(N, tl, te)
    g = simulate_graph(N, tl, te, td)
    print(f"\n  设定:N={N} 个 kernel,发射 {tl} us,执行 {te} us,"
          f"graph 内派发 {td} us")
    print(f"  eager      总时长 {e['total']:8.1f} us,GPU 空转 {e['idle']:7.1f} us"
          f"({e['idle_frac']*100:.0f}%)")
    print(f"  CUDA Graph 总时长 {g['total']:8.1f} us,GPU 空转 {g['idle']:7.1f} us"
          f"({g['idle_frac']*100:.0f}%)")
    print(f"  加速比 = {e['total']/g['total']:.2f}x")

    # 换一个大 kernel 场景:执行时间远大于发射
    e2 = simulate_eager(N, tl, 20.0)
    g2 = simulate_graph(N, tl, 20.0, td)
    print(f"\n  换成大 kernel(执行 20 us):")
    print(f"  eager      {e2['total']:8.1f} us,空转 {e2['idle_frac']*100:.0f}%")
    print(f"  CUDA Graph {g2['total']:8.1f} us,空转 {g2['idle_frac']*100:.0f}%")
    print(f"  加速比 = {e2['total']/g2['total']:.2f}x  -> 几乎没用")
    print("这是delta=0.5us的假设案例,大kernel是否收益须测两侧前端及摊销。")

    return {"N": N, "t_launch": tl, "t_exec": te, "t_dispatch": td,
            "eager": e, "graph": g, "speedup": e["total"] / g["total"],
            "big": {"eager": e2, "graph": g2,
                    "speedup": e2["total"] / g2["total"]}}


# ══════════════════════════════════════════════════════════════
# [F2] 扫描:什么时候值得上 CUDA Graph
# ══════════════════════════════════════════════════════════════

def section_F2():
    print("\n" + "=" * 72)
    print("[F2] 扫描:单 kernel 执行时间 t_exec 对加速比的影响")
    print("=" * 72)

    N, tl, td = 700, 3.0, 0.5
    print(f"\n  N={N}, 发射 {tl} us, graph 内派发 {td} us")
    print(f"\n  {'t_exec(us)':>11} {'eager(us)':>11} {'graph(us)':>11} "
          f"{'加速':>7} {'eager空转':>9}")
    rows = []
    for te in [0.5, 1.0, 2.0, 3.0, 5.0, 8.0, 12.0, 20.0, 40.0]:
        e = simulate_eager(N, tl, te)
        g = simulate_graph(N, tl, te, td)
        rows.append({"t_exec": te, "eager_us": e["total"], "graph_us": g["total"],
                     "speedup": e["total"] / g["total"],
                     "idle_frac": e["idle_frac"]})
        print(f"  {te:>11.1f} {e['total']:>11.1f} {g['total']:>11.1f} "
              f"{e['total']/g['total']:6.2f}x {e['idle_frac']*100:8.0f}%")

    crossover=(N*tl- tl-td*N)/(N-1)
    print(f"本假设CPU受限分支精确盈亏点 {crossover:.9f}us;不是通用CUDA边界")
    return {"N": N, "t_launch": tl, "t_dispatch": td, "rows": rows}


# ══════════════════════════════════════════════════════════════
# [F3] 一步 decode 有多少个 kernel(按架构手数)
# ══════════════════════════════════════════════════════════════

# Llama-3-8B 的公开配置
LLAMA3_8B = dict(n_layer=32, d_model=4096, n_head=32, n_kv_head=8,
                 head_dim=128, d_ffn=14336, vocab=128256)


def section_F3():
    print("\n" + "=" * 72)
    print("[F3] 一步 decode 有多少个 kernel(按 Llama-3-8B 架构手数)")
    print("=" * 72)
    print("\n  ⚠ 这是**按架构推导**,不是实测。真实数字取决于编译器怎么 lowering,")
    print("    列表是手选lowering情景,架构不能决定真实kernel数。")

    cfg = LLAMA3_8B
    # 每层:括号里是不融合时这个模块会拆成几个 kernel
    per_layer = [
        ("输入 RMSNorm", 4),        # 平方 / 归约 / 乘 / 缩放
        ("q_proj", 1),
        ("k_proj", 1),
        ("v_proj", 1),
        ("RoPE on q", 3),           # cos/sin 表取 + 旋转 + 拼接
        ("RoPE on k", 3),
        ("KV cache 写入", 2),       # k、v 各一次 scatter
        ("QK^T", 1),
        ("scale + mask", 2),
        ("softmax", 3),             # max / sub+exp / sum+div
        ("@V", 1),
        ("o_proj", 1),
        ("残差加", 1),
        ("后注意力 RMSNorm", 4),
        ("gate_proj", 1),
        ("up_proj", 1),
        ("SiLU", 1),
        ("逐元素乘", 1),
        ("down_proj", 1),
        ("残差加", 1),
    ]
    total_per_layer = sum(k for _, k in per_layer)
    n_layer = cfg["n_layer"]
    total = total_per_layer * n_layer + 5      # + 输出层 norm / lm_head / 采样等
    print(f"\n  每层 {total_per_layer} 个 kernel:")
    for name, k in per_layer:
        print(f"    {name:<22} {k}")
    print(f"\n  x {n_layer} 层 = {total_per_layer*n_layer},加输出头约 5 个")
    print(f"  合计 ≈ {total} 个 kernel / token")
    print("这是列表求和,不是GPU trace,也不构成对真实kernel数的验证。")

    # 融合后:把每层里能合的合掉
    fused_per_layer = [
        ("RMSNorm 融合", 1),
        ("QKV 一次 GEMM", 1),
        ("RoPE 融合", 1),
        ("KV cache 写入", 1),
        ("注意力融合(Flash)", 1),
        ("o_proj", 1),
        ("残差 + RMSNorm 融合", 1),
        ("gate/up 一次 GEMM", 1),
        ("SiLU + 乘 融合", 1),
        ("down_proj", 1),
        ("残差加", 1),
    ]
    fused_pl = sum(k for _, k in fused_per_layer)
    fused_total = fused_pl * n_layer + 3
    print(f"\n  融合后每层 {fused_pl} 个 -> 合计 ≈ {fused_total} 个/token")
    print(f"  kernel 数减少 {total/fused_total:.1f}x")
    print(f"\n  注意:融合减少的是 kernel 数,CUDA Graph 不减少 kernel 数,")
    print(f"  它只是把 {total} 次 CPU 发射合并成 1 次。两者正交,可以同时用。")

    return {"cfg": cfg, "per_layer": per_layer,
            "total_per_layer": total_per_layer, "total": total,
            "fused_per_layer": fused_per_layer, "fused_total": fused_total,
            "reduce": total / fused_total}


# ══════════════════════════════════════════════════════════════
# [F4] 分解:本机实测的加速里,发射和字节各占多少
# ══════════════════════════════════════════════════════════════

def section_F4(fus):
    print("\n" + "=" * 72)
    print("[F4] 分解:本机 K 段链的加速里,多少归于调用截距项、多少归于每元素项")
    print("=" * 72)

    D = fus["D"]
    C = fus["C"]
    a = D["a_us"]                      # 每次调用的固定开销(拟合)
    b = D["b_us_per_elem"]             # 每元素的边际成本(拟合)
    K = C["K"]

    print(f"\n  局部拟合截距 a = {a:.3f} us/次,边际 b = {b*1e6:.2f} us/百万元素")
    print(f"\n  {'n':>9} {'V1 实测':>10} {'V1 模型':>10} {'V3 实测':>10} "
          f"{'V3 模型':>10} {'发射贡献':>9}")

    rows = []
    for c in C["curves"]:
        n = c["n"]
        # V1: 2K 次调用,每次搬 n 个元素;V3: 2 次调用
        t1_model = 2 * K * (a + b * n)
        t3_model = 2 * (a + b * n)
        # 反事实:只把调用次数从 2K 降到 2,数据量不变(纯发射收益)
        t_launch_only = 2 * K * a + 2 * K * b * n - (2 * a + 2 * K * b * n)
        total_gain = t1_model - t3_model
        frac = t_launch_only / total_gain if total_gain > 0 else 1.0
        rows.append({"n": n, "t1_model": t1_model, "t3_model": t3_model,
                     "launch_frac": frac})
        print(f"  {n:>9} {c['t1_us']:9.2f} us {t1_model:9.2f} us "
              f"{c['t3_us']:9.2f} us {t3_model:9.2f} us {frac*100:8.0f}%")

    small = rows[0]
    big = rows[-1]
    print(f"\n  n={small['n']}({small['n']*4/1024:.1f} KiB):"
          f"仿射模型分解的 {small['launch_frac']*100:.0f}% 归于调用截距项,"
          f"只有 {(1-small['launch_frac'])*100:.0f}% 归于每元素项。")
    print(f"  n={big['n']}({big['n']*4/1024/1024:.1f} MiB):"
          f"反过来,{big['launch_frac']*100:.0f}% 归于调用截距项,"
          f"{(1-big['launch_frac'])*100:.0f}% 归于每元素项。")
    print(f"\n  这就是本文最想说的一句话:")
    print(f"    **模型分解不等于实测因果;每元素项含算术、缓存与内存等成本。**")
    print(f"    CUDA Graph 只做前一件,而且做得更彻底(一次发射整张图)。")

    return {"a_us": a, "b_us_per_elem": b, "rows": rows}


# ══════════════════════════════════════════════════════════════

def main():
    res = {}
    res["F1"] = section_F1()
    res["F2"] = section_F2()
    res["F3"] = section_F3()

    p = os.path.join(HERE, "_fusion_results.json")
    if os.path.exists(p):
        with open(p, encoding="utf-8") as f:
            fus = json.load(f)
        if "C" in fus and "D" in fus:
            res["F4"] = section_F4(fus)
    else:
        print("\n[F4] 跳过:先跑 fusion_lab.py ALL 生成 _fusion_results.json")

    p = os.path.join(HERE, "_launch_results.json")
    with open(p, "w", encoding="utf-8") as f:
        json.dump(res, f, ensure_ascii=False, indent=2)
    print(f"\n结果已写入 {p}")


if __name__ == "__main__":
main()"""Independent CPU checks for the article; no CUDA execution is claimed."""
from pathlib import Path
import json,math
import numpy as np
import fusion_lab as f
import launch_model as l
def main():
rng=np.random.default_rng(113)
cases=0;relmax=0.0
for n in [1,7,16,31,257,4097]:
for k in [1,2,8,16]:
x=rng.normal(size=n).astype(np.float32)
a=f._v1_unfused(x,np.empty_like(x),k).copy()
for tile in [1,7,32,10000]:
b=f._v2_tiled(x,np.empty_like(x),tile,k)
assert np.array_equal(a,b);cases+=1
b=f._v3_closed(x,np.empty_like(x),k)
expected=(float(f.A_S)**k)*x.astype(np.float64)+f.B_S*sum(f.A_S**j for j in range(k))
err=float(np.max(np.abs(b-expected))/max(1,np.max(np.abs(expected))))
relmax=max(relmax,err);assert err<1e-6
event=0
for n in [1,2,7,700,1093]:
for launch in [0.0,0.5,3.0]:
for execute in [0.0,0.5,2,3,20]:
r=l.simulate_eager(n,launch,execute)
exact=launch+execute+(n-1)*max(launch,execute)
assert math.isclose(r['total'],exact,abs_tol=1e-9)
assert math.isclose(r['idle'],exact-n*execute,abs_tol=1e-9);event+=1
big={str(d):l.simulate_eager(700,3,20)['total']/l.simulate_graph(700,3,20,d)['total']for d in [.5,0,-.1]}
assert big['0']==1 and big['-0.1']>1 and big['0.5']<1
crossover=(700*3-3-700*.5)/699
assert abs(l.simulate_eager(700,3,crossover)['total']-l.simulate_graph(700,3,crossover,.5)['total'])<1e-9
h=1000;delta=2102-1753
assert 2*delta<=h and 3*delta>h
soft=0;softmaxerr=0.0
import torch
torch.set_num_threads(1)
for shape in [(1,1,3),(2,7,17),(3,9,64)]:
for scale in [1,1000]:
x=(rng.normal(size=shape)*scale).astype(np.float32)
y=f._softmax_unfused(x,np.empty_like(x)).copy()
for rows in [1,4,100]:
z=f._softmax_tiled(x,np.empty_like(x),rows);assert np.array_equal(y,z);soft+=1
ref=torch.softmax(torch.from_numpy(x).double(),dim=-1).numpy()
err=float(np.max(np.abs(y-ref)));softmaxerr=max(err,softmaxerr);assert err<2e-7
assert np.all(np.isfinite(y))and np.all(y>=0)and np.allclose(y.sum(-1),1,atol=2e-7)
blocks=0
for seq in [1,2,7,16,64]:
mask=np.tril(np.ones((seq,seq),dtype=bool));assert mask.sum()==seq*(seq+1)//2
for tile in [1,2,4,8]:
cells=[mask[i:i+tile,j:j+tile].any()for i in range(0,seq,tile)for j in range(0,seq,tile)]
nb=math.ceil(seq/tile);assert sum(cells)==nb*(nb+1)//2;blocks+=1
left=np.float32(np.float32(1e20)+np.float32(-1e20))+np.float32(3)
right=np.float32(1e20)+(np.float32(-1e20)+np.float32(3));assert left==3 and right==0
x=np.array([-10,-1,1],dtype=np.float64);relu=x.copy()
for _ in range(8):relu=np.maximum(f.A_S*relu+f.B_S,0)
affine=f.A_S**8*x+f.B_S*sum(f.A_S**j for j in range(8));assert relu[0]>affine[0]
rejected=0
for fn in [lambda:f._v1_unfused(np.ones(1),np.empty(1),0),lambda:f._v2_tiled(np.ones(1),np.empty(1),0),lambda:f._v3_closed(np.ones(1),np.empty(1),-1),lambda:l.simulate_eager(0,1,1),lambda:l.simulate_graph(1,1,1,-2)]:
try:fn()
except ValueError:rejected+=1
else:raise AssertionError('Invalid input accepted')
# Scalar, full-size stream count under the assumptions in section3.2.
n=4000000;b=4;chain=16*2*n*b;v3=2*2*n*b;ideal=2*n*b
assert chain/v3==8 and chain/ideal==16
assert (2+1+2+3)*n*b/(3*n*b)==8/3
result=dict(passed=True,block_tail_exact_cases=cases,affine_float64_reference_max_relative_error=relmax,event_cases=event,graph_big_kernel_speedups=big,graph_crossover_us=crossover,amortization_min_replays=3,softmax_tiled_cases=soft,softmax_torch_float64_max_error=softmaxerr,causal_block_cases=blocks,float32_reassociation=[float(left),float(right)],nonlinear_counterexample=[relu.tolist(),affine.tolist()],invalid_inputs_rejected=rejected,logical_bytes=dict(v1=chain,v3=v3,ideal_fused=ideal),scope='CPU NumPy, original event simulator and Torch softmax reference; no CUDA or physical memory profiling',errors=[],warnings=[])
p=Path(__file__).with_name('validation_results.json');p.write_text(json.dumps(result,indent=2),encoding='utf8');print(json.dumps(result,indent=2))
if __name__=='__main__':main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
fusion_lab.py —— 算子融合的「字节账本 + 实测校验」
本脚本用 NumPy 在 CPU 上测量调用和逻辑数组流量,不需要 NVIDIA GPU。
历史版本的 M1 结果保留于基线;当前环境与输出由实跑证据另行记录。
本脚本不能识别实际缓存驻留、DRAM 字节或 CUDA launch 成本。
可测的是CPU数组程序在不同规模下的耗时和逻辑吞吐,不能凭此
识别缓存层级或把每次调用的截距当成CUDA launch成本。
五组实验:
[A] 字节账本 —— 几类常见 pattern 融合前后各搬多少字节(所列流量假设下的算术)
[B] 带宽–工作集 —— 不同数组规模下的逻辑吞吐比 rho
[C] 融合三形态 —— 不融合 / CPU分块 / 代数合并,扫规模看各自值多少
[D] 固定开销 —— 拟合出每次调用的固定成本,算它占总耗时的比例
[E] attention尾 —— score 矩阵账本、本机 softmax 对照
运行:
python fusion_lab.py ALL
"""
from __future__ import annotations
import json
import os
import time
import numpy as np
HERE = os.path.dirname(os.path.abspath(__file__))
RNG_SEED = 20261002
MIB = float(1024 ** 2)
GIB = float(1024 ** 3)
# 逐元素链的形态:每段 h <- A*h + B,共 K 段
K_CHAIN = 8
A_S, B_S = 1.01, 0.01
def bench(fn, reps=7):
"""预热后取批次中位数;包括Python调用成本,不是硬件计数器。"""
fn()
ts = []
for _ in range(max(7, min(reps, 21))):
t0 = time.perf_counter()
for _ in range(10):
fn()
ts.append((time.perf_counter() - t0) / 10)
return float(np.median(ts))
def paired_bench(fn1, fn2):
fn1(); fn2()
samples = [[], []]
for r in range(9):
for i in ([0, 1] if r % 2 == 0 else [1, 0]):
samples[i].append(bench((fn1, fn2)[i], reps=7))
return tuple(float(np.median(t)) for t in samples), samples
def passes_to_bytes(n_elem, dtype_bytes, n_passes):
"""1 个 pass = 把整个张量读一遍再写一遍 = 2 * 字节数。"""
return 2.0 * n_elem * dtype_bytes * n_passes
# ══════════════════════════════════════════════════════════════
# [A] 字节账本:融合前后各搬多少字节
# ══════════════════════════════════════════════════════════════
def section_A():
print("\n" + "=" * 72)
print("[A] 字节账本:融合前后各搬多少字节(所列流量假设下的算术)")
print("=" * 72)
out = {}
n = 4_000_000 # 一个中等激活张量,fp32
b = 4
# ── A1. K 段逐元素链 ──────────────────────────────────
K = K_CHAIN
unf = passes_to_bytes(n, b, 2 * K)
fus = passes_to_bytes(n, b, 1)
print(f"\n A1 {K} 段逐元素链({n/1e6:.0f}M 元素,fp32)")
print(f" V1 的 {2*K} 个 ufunc : {unf/MIB:8.1f} MiB")
print(f" 融合成 1 个 kernel : {fus/MIB:8.1f} MiB -> 流量比 {unf/fus:.2f}x")
out["chain"] = {"K": K, "calls": 2*K, "v3_MiB": passes_to_bytes(n,b,2)/MIB, "unfused_MiB": unf / MIB, "fused_MiB": fus / MIB,
"ratio": unf / fus}
# ── A2. RMSNorm ───────────────────────────────────────
# 不融合:x*x(读写) / reduce mean(读) / x*r(读写) / *g(读写)
unf = 8 * n * b
fus = 3 * n * b
# 只计完整尺寸流:平方2N、归约N、乘行尺度2N、乘gamma3N;
# 融合读x/gamma写y共3N,忽略行尺度向量、缓存和溢写。
print(f"\n A2 RMSNorm({n/1e6:.0f}M 元素)")
print(f" 分离完整尺寸流 : {unf/MIB:8.1f} MiB")
print(f" 融合完整尺寸流 : {fus/MIB:8.1f} MiB -> 流量比 {unf/fus:.2f}x")
out["rmsnorm"] = {"unfused_MiB": unf / MIB, "fused_MiB": fus / MIB,
"ratio": unf / fus}
# ── A3. attention 的 score 矩阵 ───────────────────────
Bs, H, S, D = 8, 16, 2048, 4096
dt = 2 # bf16
act_bytes = Bs * S * D * dt
score_bytes = Bs * H * S * S * dt
half = 1 + 2 + 2 + 1 + 2 # softmax 五步各读写几份 score
unf = half * score_bytes
fus = 2 * score_bytes
print(f"\n A3 attention score(B={Bs}, H={H}, S={S}, d={D}, bf16)")
print(f" 输入激活 [B,S,d] : {act_bytes/MIB:8.1f} MiB")
print(f" score 矩阵 [B,H,S,S] : {score_bytes/GIB:8.3f} GiB"
f" = 输入的 {score_bytes/act_bytes:.0f}x")
print(f" softmax 不融合 {half} 份读写 : {unf/GIB:8.3f} GiB")
print(f" softmax 融合 : {fus/GIB:8.3f} GiB -> 省 {unf/fus:.1f}x")
print(" mask可广播或由坐标生成,不假定物化[B,H,S,S];未计mask额外流量")
print(f"\n 放大倍数 = H*S/d = {H}*{S}/{D} = {H*S/D:.0f}x")
print(f" S 翻一倍 -> 放大倍数翻一倍(score 按 S 的平方长,激活按 S 长)")
for s in (1024, 2048, 4096, 8192):
print(f" S={s:>5}: score/激活 = {H*s/D:5.1f}x")
out["softmax"] = {"B": Bs, "H": H, "S": S, "d": D,
"act_MiB": act_bytes / MIB, "score_GiB": score_bytes / GIB,
"blowup": score_bytes / act_bytes,
"unfused_GiB": unf / GIB, "fused_GiB": fus / GIB,
"ratio": unf / fus, "mask_GiB": score_bytes / GIB,
"blowup_curve": [{"S": s, "x": H * s / D}
for s in (1024, 2048, 4096, 8192)]}
# ── A4. 因果掩码:块级跳过能省多少 ────────────────────
total = S * S
kept_exact = S * (S + 1) // 2
rows = []
print(f"\n A4 因果掩码 S={S}:块级跳过 vs 精确跳过")
for br in (64, 128, 256):
nb = S // br
blocks_done = nb * (nb + 1) // 2 # query 块 i 只算 j<=i 的 key 块
rows.append({"br": br, "nb": nb, "frac": blocks_done / (nb * nb)})
print(f" 块边长 {br:>4}: 算 {blocks_done:>4}/{nb*nb:<4} 块"
f" = {blocks_done/(nb*nb)*100:5.1f}% 工作量")
print(f" 理论上界(逐元素精确): {kept_exact/total*100:5.1f}%")
print(f" 完全不跳 : {100.0:5.1f}% -> 白算 "
f"{100-kept_exact/total*100:.1f}%")
out["causal"] = {"S": S, "exact_frac": kept_exact / total, "blocks": rows}
return out
# ══════════════════════════════════════════════════════════════
# [B] 工作集与逻辑吞吐
# ══════════════════════════════════════════════════════════════
def section_B():
print("\n" + "=" * 72)
print("[B] 带宽 vs 工作集(np.add(x, 1, out=y):1 读 1 写)")
print("=" * 72)
rng = np.random.default_rng(RNG_SEED)
print(f"\n {'工作集':>12} {'耗时':>10} {'带宽':>10} 归属")
rows = []
for nbytes in [32 << 10, 128 << 10, 512 << 10, 2 << 20, 8 << 20,
32 << 20, 128 << 20]:
n = nbytes // 4
x = rng.standard_normal(n).astype(np.float32)
y = np.empty_like(x)
bench(lambda: np.add(x, 1.0, out=y), reps=3)
t = bench(lambda: np.add(x, 1.0, out=y), reps=11)
bw = 2 * nbytes / t / 1e9
tag = "small" if nbytes <= (8 << 20) else "large"
rows.append({"KiB": nbytes >> 10, "total_live_KiB": 2*nbytes/1024, "ms": t * 1e3, "GBs": bw, "tag": tag})
print(f" {nbytes>>10:>10} KiB {t*1e3:9.3f} ms {bw:9.1f} GB/s {tag}")
del x, y
b_cache = float(np.median([r["GBs"] for r in rows if r["tag"] == "small"]))
b_dram = float(np.median([r["GBs"] for r in rows if r["tag"] == "large"]))
rho = b_cache / b_dram
print(f"逻辑吞吐small={b_cache:.3f}GB/s large={b_dram:.3f}GB/s rho={rho:.3f}")
print("每行标称是单个数组大小;x与y的存活工作集为两倍。")
print("阈值分组不证明缓存归属;此rho不能用作GPU片内/片外带宽比。")
return {"rows": rows, "B_cache_GBs": b_cache, "B_dram_GBs": b_dram, "rho": rho}
# ══════════════════════════════════════════════════════════════
# [C] 融合三形态 × 规模扫描
# ══════════════════════════════════════════════════════════════
def _v1_unfused(x, buf, K=K_CHAIN):
"""V1 不融合:K 段,每段 2 次算子调用,每段结果都写回内存。"""
if not isinstance(K, int) or K < 1:
raise ValueError("K must be a positive integer")
np.multiply(x, A_S, out=buf)
np.add(buf, B_S, out=buf)
for _ in range(K - 1):
np.multiply(buf, A_S, out=buf)
np.add(buf, B_S, out=buf)
return buf
def _v2_tiled(x, out, tile, K=K_CHAIN):
"""CPU分块ufunc:仍执行2K次完整tile读写,不是真实寄存器融合。"""
if not isinstance(tile, int) or tile < 1 or not isinstance(K, int) or K < 1:
raise ValueError("tile and K must be positive integers")
t = np.empty(tile, dtype=np.float32)
for s in range(0, x.size, tile):
m = min(tile, x.size - s)
v = t[:m]
np.multiply(x[s:s + m], A_S, out=v)
np.add(v, B_S, out=v)
for _ in range(K - 1):
np.multiply(v, A_S, out=v)
np.add(v, B_S, out=v)
out[s:s + m] = v
return out
def _v3_closed(x, out, K=K_CHAIN):
"""V3 代数合并:K 段仿射合成一个仿射,只剩 2 次调用。
h_K = A^K * h_0 + B*(A^K - 1)/(A - 1)
中间结果根本不存在,连「留在片上」都不需要。
"""
if not isinstance(K, int) or K < 1:
raise ValueError("K must be a positive integer")
Ak = A_S ** K
Bk = B_S * sum(A_S ** j for j in range(K))
np.multiply(x, Ak, out=out)
np.add(out, Bk, out=out)
return out
def section_C(rho):
print("\n" + "=" * 72)
print(f"[C] 融合三形态 × 规模扫描(K={K_CHAIN} 段 h <- {A_S}*h + {B_S})")
print("=" * 72)
rng = np.random.default_rng(RNG_SEED)
sizes = [512, 4096, 65536, 262144, 1 << 20, 4_000_000]
curves = []
print(f"\n {'n':>9} {'V1 不融合':>11} {'V3 代数合并':>11} "
f"{'V1/V3':>7} {'相对误差':>10}")
for n in sizes:
x = rng.standard_normal(n).astype(np.float32)
buf, out = np.empty_like(x), np.empty_like(x)
(t1, t3), samples = paired_bench(lambda: _v1_unfused(x, buf),
lambda: _v3_closed(x, out))
rel = float(np.max(np.abs(buf - out)) / np.max(np.abs(buf)))
curves.append({"n": n, "t1_us": t1 * 1e6, "t3_us": t3 * 1e6,
"speedup": t1 / t3, "rel_err": rel, "paired_samples_seconds": samples})
print(f" {n:>9} {t1*1e6:9.2f} us {t3*1e6:9.2f} us "
f"{t1/t3:6.2f}x {rel:10.2e}")
# V2在最大规模上比较不同tile;不据数组大小推断缓存归属。
print(f"\n V2 分块融合(n=4,000,000,扫 tile):")
x = rng.standard_normal(4_000_000).astype(np.float32)
buf, out = np.empty_like(x), np.empty_like(x)
bench(lambda: _v1_unfused(x, buf), reps=3)
t1_big = bench(lambda: _v1_unfused(x, buf), reps=11)
print(f" V1 不融合基准: {t1_big*1e3:.3f} ms")
v2 = []
for tile in [16384, 65536, 262144, 1 << 20]:
bench(lambda: _v2_tiled(x, out, tile), reps=3)
t = bench(lambda: _v2_tiled(x, out, tile), reps=11)
assert np.array_equal(_v1_unfused(x,buf),out)
v2.append({"tile": tile, "ms": t * 1e3, "speedup": t1_big / t, "exact_match": True})
print(f" tile={tile:>8}: {t*1e3:8.3f} ms {t1_big/t:5.2f}x")
best2 = max(v2, key=lambda r: r["speedup"])
K = K_CHAIN
pred = K / (1 + (K - 1) / rho)
print(f"\n V2 最佳 {best2['speedup']:.2f}x(tile={best2['tile']})")
print(f" 模型预测 K/(1+(K-1)/rho) = {K}/(1+{K-1}/{rho:.3f}) = {pred:.2f}x")
print("该rho代入式子仅作敏感性算术,不是V2预测;分块仍有ufunc和拷贝成本。")
print("V3减少算术与调用;K字节比不是普遍延迟上限,不能据此作因果归因。")
return {"K": K, "rho": rho, "curves": curves,
"v2": v2, "v2_best": best2, "v2_pred": pred,
"t1_big_ms": t1_big * 1e3}
# ══════════════════════════════════════════════════════════════
# [D] 固定开销:每次调用的地板成本
# ══════════════════════════════════════════════════════════════
def section_D():
print("\n" + "=" * 72)
print("[D] 单次调用的固定开销(np.add(x, 1, out=y))")
print("=" * 72)
rng = np.random.default_rng(RNG_SEED)
sizes = [1, 8, 64, 512, 4096, 16384, 65536, 262144, 1 << 20]
print(f"\n {'n':>9} {'单次耗时':>11}")
rows = []
for n in sizes:
a = rng.standard_normal(n).astype(np.float32)
b = np.empty_like(a)
reps = 20000 if n <= 4096 else 500
samples = []
for _ in range(7):
np.add(a, 1.0, out=b)
t0 = time.perf_counter()
for _ in range(reps):
np.add(a, 1.0, out=b)
samples.append((time.perf_counter() - t0) / reps)
t = float(np.median(samples))
rows.append({"n": n, "us": t * 1e6, "samples_seconds": samples})
print(f" {n:>9} {t*1e6:9.3f} us")
# 拟合范围限于小数组;不同规模的缓存/算术吞吐可能使仿射模型失效。
ns = np.array([r["n"] for r in rows if r["n"] <= 16384], dtype=float)
ts = np.array([r["us"] for r in rows if r["n"] <= 16384], dtype=float)
A = np.stack([np.ones_like(ns), ns], axis=1)
coef, *_ = np.linalg.lstsq(A, ts, rcond=None)
a_us, slope = float(coef[0]), float(coef[1])
print(f"\n 拟合 t = a + b*n(n <= 16384):")
print(f" 固定开销 a = {a_us:.3f} us / 次")
print(f" 边际成本 b = {slope*1e6:.3f} us / 百万元素")
if a_us <= 0 or slope <= 0:
raise RuntimeError("Affine fit invalid; do not claim a positive crossover")
n_half = a_us / slope
print(f" 开销与数据各占一半的临界规模 n* = a/b = {n_half:.0f} 元素"
f"({n_half*4/1024:.1f} KiB)")
print(f"\n {K_CHAIN} 段链({2*K_CHAIN} 次调用)里固定开销的占比:")
share = []
for r in rows:
n = r["n"]
fixed = 2 * K_CHAIN * a_us
tc = 2 * K_CHAIN * (a_us + slope * n)
frac = fixed / tc if tc > 0 else 1.0
share.append({"n": n, "fixed_frac": frac})
print(f" n={n:>9}: 固定部分占 {frac*100:5.1f}%")
return {"rows": rows, "a_us": a_us, "b_us_per_elem": slope,
"n_half": n_half, "share": share, "K": K_CHAIN}
# ══════════════════════════════════════════════════════════════
# [E] attention 尾部:本机 softmax 对照
# ══════════════════════════════════════════════════════════════
def _softmax_unfused(x, out):
m = np.max(x, axis=-1, keepdims=True) # 读
np.subtract(x, m, out=out) # 读 x + 写 out
np.exp(out, out=out) # 读 + 写
s = np.sum(out, axis=-1, keepdims=True) # 读
np.divide(out, s, out=out) # 读 + 写
return out
def _softmax_tiled(x, out, rows):
for i in range(0, x.shape[1], rows):
sl = slice(i, i + rows)
blk, dst = x[:, sl, :], out[:, sl, :]
m = np.max(blk, axis=-1, keepdims=True)
np.subtract(blk, m, out=dst)
np.exp(dst, out=dst)
s = np.sum(dst, axis=-1, keepdims=True)
np.divide(dst, s, out=dst)
return out
def section_E(b_dram):
print("\n" + "=" * 72)
print("[E] attention 尾部:本机 softmax 分块对照")
print("=" * 72)
rng = np.random.default_rng(RNG_SEED)
H, S = 8, 1024
x = rng.standard_normal((H, S, S)).astype(np.float32)
nbytes = x.nbytes
print(f"\n score 矩阵 [H={H}, S={S}, S={S}] = {nbytes/MIB:.1f} MiB")
out = np.empty_like(x)
bench(lambda: _softmax_unfused(x, out), reps=3)
t_unf = bench(lambda: _softmax_unfused(x, out), reps=11)
ref = out.copy()
o2 = np.empty_like(x)
bench(lambda: _softmax_tiled(x, o2, 64), reps=3)
t_til = bench(lambda: _softmax_tiled(x, o2, 64), reps=11)
diff = float(np.max(np.abs(ref - o2)))
traffic = 8 * nbytes # [A3] 里的 8 份读写
roof = traffic / (b_dram * 1e9) * 1e3
print(f"\n 不融合(5 次 NumPy 调用,共 {traffic/MIB:.0f} MiB 读写): {t_unf*1e3:8.3f} ms")
print(f" 分块融合(rows=64) : {t_til*1e3:8.3f} ms"
f" speedup={t_unf/t_til:.2f}x diff={diff:.1e}")
print(f"\n add逻辑吞吐参照 = {traffic/MIB:.0f} MiB / {b_dram:.0f} GB/s = {roof:.3f} ms")
print(f" 实测 / 参照 = {t_unf*1e3/roof:.2f}x")
print("逻辑字节/实测add吞吐只是参照估计,不是物理访存下界。")
print("耗时比不能隔离exp、归约、缓存、布局、循环或调度;需要分别profile。")
assert np.allclose(ref.sum(axis=-1), 1, atol=2e-7)
assert np.array_equal(ref,o2)
return {"H": H, "S": S, "score_MB": nbytes / MIB,
"t_unfused_ms": t_unf * 1e3, "t_tiled_ms": t_til * 1e3,
"speedup": t_unf / t_til, "diff": diff,
"traffic_MB": traffic / MIB, "roof_ms": roof,
"over_roof": t_unf * 1e3 / roof}
# ══════════════════════════════════════════════════════════════
def main():
import sys
which = sys.argv[1] if len(sys.argv) > 1 else "ALL"
if which not in ("ALL", "A", "B", "C", "D", "E"):
raise ValueError("Expected ALL or A/B/C/D/E")
res = {}
if which in ("ALL", "A"):
res["A"] = section_A()
if which in ("ALL", "B"):
res["B"] = section_B()
if which in ("ALL", "C"):
rho = res.get("B", {}).get("rho")
if rho is None:
res["B"] = section_B()
rho = res["B"]["rho"]
res["C"] = section_C(rho)
if which in ("ALL", "D"):
res["D"] = section_D()
if which in ("ALL", "E"):
bd = res.get("B", {}).get("B_dram_GBs")
if bd is None:
res["B"] = section_B()
bd = res["B"]["B_dram_GBs"]
res["E"] = section_E(bd)
p = os.path.join(HERE, "_fusion_results.json")
with open(p, "w", encoding="utf-8") as f:
json.dump(res, f, ensure_ascii=False, indent=2)
print(f"\n结果已写入 {p}")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
make_figures.py —— 画本文的 5 张配图。
数据全部读已经跑完的实验(_fusion_results.json / _launch_results.json),
不在这里重新算,避免图上的数字和正文漂移。
运行:
python make_figures.py
"""
from __future__ import annotations
import json
import os
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
HERE = os.path.dirname(os.path.abspath(__file__))
FIGDIR = os.path.join(HERE, "..", "figures")
try:
os.makedirs(FIGDIR, exist_ok=True)
except FileExistsError:
pass
# 配色(正文写「这张图要看什么」时按这几个名字描述)
C_MAIN = "#1f4e79" # 深蓝:主曲线
C_ALT = "#c1440e" # 橙红:对照曲线
C_GREEN = "#2e7d32" # 绿:第三组 / 融合后
C_PURPLE = "#7b1fa2" # 紫:标注线
C_GRAY = "#8a8a8a" # 灰:参考线
C_LIGHT = "#bcd7ee" # 浅蓝:填充
C_RED = "#b71c1c" # 红:越界 / 地板
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False
plt.rcParams["figure.dpi"] = 130
plt.rcParams["savefig.dpi"] = 130
MIB = float(1024 ** 2)
def _load(name):
p = os.path.join(HERE, name)
if not os.path.exists(p):
raise SystemExit(f"缺少 {name},先跑 fusion_lab.py ALL / launch_model.py")
with open(p, encoding="utf-8") as f:
return json.load(f)
# ══════════════════════════════════════════════════════════════
# 图 1:字节账本
# ══════════════════════════════════════════════════════════════
def fig_traffic(fus):
A = fus["A"]
items = [
("8段仿射/16ufunc\n(4M 元素 fp32)",
A["chain"]["unfused_MiB"], A["chain"]["fused_MiB"]),
("RMSNorm\n(4M 元素 fp32)",
A["rmsnorm"]["unfused_MiB"], A["rmsnorm"]["fused_MiB"]),
("attention softmax\n(B=8,H=16,S=2048,bf16)",
A["softmax"]["unfused_GiB"] * 1024, A["softmax"]["fused_GiB"] * 1024),
]
labels = [t[0] for t in items]
unf = [t[1] for t in items]
fs = [t[2] for t in items]
fig, ax = plt.subplots(figsize=(9.2, 4.4))
y = np.arange(len(items))
h = 0.34
ax.barh(y + h / 2, unf, height=h, color=C_ALT, label="不融合")
ax.barh(y - h / 2, fs, height=h, color=C_GREEN, label="融合后")
for i, (u, f) in enumerate(zip(unf, fs)):
ax.text(u * 1.15, i + h / 2, f"{u:.1f} MiB", va="center",
fontsize=9, color=C_ALT)
ax.text(f * 1.15, i - h / 2, f"{f:.1f} MiB", va="center",
fontsize=9, color=C_GREEN)
ax.annotate(f"{u/f:.2f}x", xy=(u, i), xytext=(u * 1.15, i - 0.05),
fontsize=9, color=C_MAIN, fontweight="bold")
ax.set_yticks(y)
ax.set_yticklabels(labels, fontsize=9)
ax.set_xscale("log")
ax.set_xlim(8, 40000)
ax.set_xlabel("逻辑流量(MiB,对数刻度)", fontsize=10)
ax.set_title("图 1:融合前后各搬多少字节", fontsize=12, color=C_MAIN)
ax.legend(loc="lower right", fontsize=9)
ax.grid(axis="x", alpha=0.3, linestyle=":")
ax.set_axisbelow(True)
fig.tight_layout()
fig.savefig(os.path.join(FIGDIR, "fig_traffic.png"), bbox_inches="tight")
plt.close(fig)
# ══════════════════════════════════════════════════════════════
# 图 2:score 矩阵的放大倍数 + 因果块级跳过
# ══════════════════════════════════════════════════════════════
def fig_blowup(fus):
A = fus["A"]
sm = A["softmax"]
ca = A["causal"]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.4, 4.2))
# 左:放大倍数随 S 增长
ss = [d["S"] for d in sm["blowup_curve"]]
xx = [d["x"] for d in sm["blowup_curve"]]
ax1.plot(ss, xx, "o-", color=C_MAIN, linewidth=2, markersize=7)
ax1.plot(ss, np.array(ss) * (sm["H"]/sm["d"]), "--", color=C_GRAY, linewidth=1.2,
label="线性参照,与H*S/d重合")
ax1.set_xscale("log", base=2)
ax1.set_yscale("log", base=2)
ax1.set_xticks(ss)
ax1.set_xticklabels([str(s) for s in ss], fontsize=9)
ax1.set_yticks(xx)
ax1.set_yticklabels([f"{v:.0f}x" for v in xx], fontsize=9)
ax1.minorticks_off()
ax1.set_xlabel("序列长度 S", fontsize=10)
ax1.set_ylabel("score 矩阵 / 输入激活", fontsize=10)
ax1.set_title(f"中间产物被放大 H*S/d = {sm['H']}*S/{sm['d']} 倍",
fontsize=11, color=C_MAIN)
ax1.grid(alpha=0.3, linestyle=":")
ax1.legend(fontsize=8, loc="upper left")
ax1.set_axisbelow(True)
for s, v in zip(ss, xx):
ax1.annotate(f"{v:.0f}x", (s, v), textcoords="offset points",
xytext=(6, -12), fontsize=8, color=C_MAIN)
# 右:因果块级跳过
brs = [str(b["br"]) for b in ca["blocks"]]
fr = [b["frac"] * 100 for b in ca["blocks"]]
bars = ax2.bar(brs, fr, color=C_LIGHT, edgecolor=C_MAIN, width=0.55)
ax2.axhline(ca["exact_frac"] * 100, color=C_GREEN, linestyle="--",
linewidth=1.6, label=f"理论上界 {ca['exact_frac']*100:.1f}%")
ax2.axhline(100, color=C_GRAY, linestyle=":", linewidth=1.2,
label="不跳过 100%")
for b, v in zip(bars, fr):
ax2.text(b.get_x() + b.get_width() / 2, v + 1.2, f"{v:.1f}%",
ha="center", fontsize=9, color=C_MAIN)
ax2.set_ylim(0, 118)
ax2.set_xlabel("块边长", fontsize=10)
ax2.set_ylabel("保留score块比例 (%)", fontsize=10)
ax2.set_title(f"因果掩码块级跳过(S={ca['S']})", fontsize=11, color=C_MAIN)
ax2.legend(fontsize=8, loc="upper left")
ax2.grid(axis="y", alpha=0.3, linestyle=":")
ax2.set_axisbelow(True)
fig.suptitle("图 2:attention 的两本账——中间产物多大、白算多少",
fontsize=12, color=C_MAIN, y=1.0)
fig.tight_layout()
fig.savefig(os.path.join(FIGDIR, "fig_blowup.png"), bbox_inches="tight")
plt.close(fig)
# ══════════════════════════════════════════════════════════════
# 图 3:融合三形态 × 规模扫描
# ══════════════════════════════════════════════════════════════
def fig_three_forms(fus):
C = fus["C"]
D = fus["D"]
K = C["K"]
a = D["a_us"]
cur = C["curves"]
ns = [c["n"] for c in cur]
t1 = [c["t1_us"] for c in cur]
t3 = [c["t3_us"] for c in cur]
sp = [c["speedup"] for c in cur]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.6, 4.3))
# 左:耗时 vs 规模
ax1.loglog(ns, t1, "o-", color=C_ALT, linewidth=2, markersize=6,
label="V1 不融合(2K 次调用)")
ax1.loglog(ns, t3, "s-", color=C_GREEN, linewidth=2, markersize=6,
label="V3 代数合并(2 次调用)")
floor = 2 * K * a
ax1.axhline(floor, color=C_RED, linestyle="--", linewidth=1.4,
label=f"V1 的截距参照 2K*a = {floor:.1f} μs")
ax1.axhline(2 * a, color=C_PURPLE, linestyle=":", linewidth=1.4,
label=f"V3 的截距参照 2*a = {2*a:.1f} μs")
# V2 在最大规模上的结果
v2b = C["v2_best"]
ax1.plot([ns[-1]], [v2b["ms"] * 1e3], "D", color=C_GRAY, markersize=9,
label=f"V2 CPU分块 {v2b['ms']*1e3:.0f} μs")
ax1.set_xlabel("张量元素数", fontsize=10)
ax1.set_ylabel("单次耗时 (μs)", fontsize=10)
ax1.set_title(f"三种形态的耗时(K={K})", fontsize=11, color=C_MAIN)
ax1.legend(fontsize=8, loc="upper left")
ax1.grid(alpha=0.3, linestyle=":")
ax1.set_axisbelow(True)
# 右:加速比
ax2.semilogx(ns, sp, "o-", color=C_MAIN, linewidth=2, markersize=6,
label="V1 / V3(代数合并)")
ax2.axhline(K, color=C_GREEN, linestyle="--", linewidth=1.6,
label=f"V1/V3逻辑字节比 K = {K}x")
ax2.axhline(C["v2_pred"], color=C_GRAY, linestyle=":", linewidth=1.6,
label=f"rho代入参照 {C['v2_pred']:.2f}x")
ax2.plot([ns[-1]], [v2b["speedup"]], "D", color=C_ALT, markersize=9,
label=f"V2 实测 {v2b['speedup']:.2f}x")
ax2.set_ylim(0, max(K * 1.25,max(sp)*1.2))
ax2.set_xlabel("张量元素数", fontsize=10)
ax2.set_ylabel("加速比", fontsize=10)
ax2.set_title("各自兑现了多少", fontsize=11, color=C_MAIN)
ax2.legend(fontsize=8, loc="lower left")
ax2.grid(alpha=0.3, linestyle=":")
ax2.set_axisbelow(True)
fig.suptitle("图 3:融合三形态 × 规模扫描(本机实测,Windows CPU / NumPy)",
fontsize=12, color=C_MAIN, y=1.0)
fig.tight_layout()
fig.savefig(os.path.join(FIGDIR, "fig_three_forms.png"), bbox_inches="tight")
plt.close(fig)
# ══════════════════════════════════════════════════════════════
# 图 4:单次调用的固定开销
# ══════════════════════════════════════════════════════════════
def fig_launch(fus):
D = fus["D"]
rows = D["rows"]
ns = np.array([r["n"] for r in rows], dtype=float)
us = np.array([r["us"] for r in rows], dtype=float)
a, b = D["a_us"], D["b_us_per_elem"]
n_half = D["n_half"]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.6, 4.2))
# 左:延迟 vs 规模,含地板
ax1.loglog(ns, us, "o", color=C_MAIN, markersize=7, label="实测")
grid = np.logspace(0, np.log10(ns.max()), 60)
ax1.loglog(grid, a + b * grid, "-", color=C_ALT, linewidth=1.8,
label=f"拟合 a + b*n(a={a:.2f} μs)")
ax1.axhline(a, color=C_RED, linestyle="--", linewidth=1.6,
label=f"固定开销地板 a = {a:.2f} μs")
ax1.axvline(n_half, color=C_PURPLE, linestyle=":", linewidth=1.6,
label=f"各占一半 n* = {n_half:.0f} 元素")
ax1.set_xlabel("张量元素数", fontsize=10)
ax1.set_ylabel("单次调用耗时 (μs)", fontsize=10)
ax1.set_title("小到一定程度,耗时就和数据无关了", fontsize=11, color=C_MAIN)
ax1.legend(fontsize=8, loc="upper left")
ax1.grid(alpha=0.3, linestyle=":")
ax1.set_axisbelow(True)
# 右:一条 K 段链里固定开销的占比
share = D["share"]
sn = np.array([s["n"] for s in share], dtype=float)
sf = np.array([s["fixed_frac"] for s in share]) * 100
ax2.semilogx(sn, sf, "o-", color=C_MAIN, linewidth=2, markersize=6)
ax2.axhline(50, color=C_GRAY, linestyle=":", linewidth=1.3)
ax2.fill_between(sn, 0, sf, color=C_LIGHT, alpha=0.55)
for x, v in zip(sn, sf):
if v > 55 or v < 12:
ax2.annotate(f"{v:.0f}%", (x, v), textcoords="offset points",
xytext=(0, 8), fontsize=8, color=C_MAIN,
ha="center")
ax2.set_ylim(0, 108)
ax2.set_xlabel("张量元素数", fontsize=10)
ax2.set_ylabel("固定开销占总耗时 (%)", fontsize=10)
ax2.set_title(f"{D['K']} 段链({2*D['K']} 次调用)里,截距模型占比",
fontsize=11, color=C_MAIN)
ax2.grid(alpha=0.3, linestyle=":")
ax2.set_axisbelow(True)
fig.suptitle("图 4:每次调用都有一个和数据规模无关的地板(本机实测)",
fontsize=12, color=C_MAIN, y=1.0)
fig.tight_layout()
fig.savefig(os.path.join(FIGDIR, "fig_launch.png"), bbox_inches="tight")
plt.close(fig)
# ══════════════════════════════════════════════════════════════
# 图 5:CUDA Graph 的时间线
# ══════════════════════════════════════════════════════════════
def fig_graph(lnc):
F1 = lnc["F1"]
F2 = lnc["F2"]
tl, te, td = F1["t_launch"], F1["t_exec"], F1["t_dispatch"]
fig, (ax1, ax2) = plt.subplots(
1, 2, figsize=(11.2, 4.3), gridspec_kw={"width_ratios": [1.25, 1]})
# ── 左:甘特图,只画前 8 个 kernel ──
n_show = 8
# eager:CPU 逐个发射,GPU 要等「前一个跑完」且「这个已发出」才能开工。
# 时刻逐事件推算,和图里的条形严格同源。
gpu_free, segs_cpu, segs_gpu, segs_idle = 0.0, [], [], []
for i in range(n_show):
cpu_done = (i + 1) * tl
start = max(gpu_free, cpu_done)
if start > gpu_free:
segs_idle.append((gpu_free, start - gpu_free))
segs_gpu.append((start, te))
segs_cpu.append((i * tl, tl))
gpu_free = start + te
ax1.broken_barh(segs_cpu, (3.4, 0.8), facecolors=C_LIGHT,
edgecolor=C_MAIN, linewidth=0.6)
ax1.broken_barh(segs_gpu, (2.2, 0.8), facecolors=C_GREEN,
edgecolor=C_GREEN, linewidth=0.6)
ax1.broken_barh(segs_idle, (2.2, 0.8), facecolors="#f0c9c9",
edgecolor=C_RED, linewidth=0.6, hatch="//")
# graph:一次发射,之后背靠背
g_cpu = [(0, tl)]
g_gpu = [(tl, n_show * (te + td))]
ax1.broken_barh(g_cpu, (1.0, 0.8), facecolors=C_LIGHT,
edgecolor=C_MAIN, linewidth=0.6)
ax1.broken_barh(g_gpu, (-0.2, 0.8), facecolors=C_GREEN,
edgecolor=C_GREEN, linewidth=0.6)
ax1.set_yticks([3.8, 2.6, 1.4, 0.2])
ax1.set_yticklabels(["CPU 发射", "GPU 执行", "CPU 发射", "GPU 执行"],
fontsize=9)
ax1.set_xlabel("时间 (μs)", fontsize=10)
ax1.set_xlim(-0.5, n_show * tl + te + 3)
ax1.set_ylim(-0.6, 5.4)
ax1.set_title(f"eager(上)vs CUDA Graph(下) "
f"发射 {tl} μs / 执行 {te} μs", fontsize=10.5, color=C_MAIN)
ax1.grid(axis="x", alpha=0.3, linestyle=":")
ax1.set_axisbelow(True)
ax1.text(0.4, 4.95, "eager:每次发射 GPU 都要等(斜纹 = 空转)",
fontsize=8.5, color=C_ALT, va="center")
ax1.text(0.4, 0.78, "graph:只发射一次,之后 GPU 背靠背(无空转)",
fontsize=8.5, color=C_GREEN, va="center")
# ── 右:加速比 vs 单 kernel 执行时间 ──
rws = F2["rows"]
tes = [r["t_exec"] for r in rws]
sps = [r["speedup"] for r in rws]
ax2.plot(tes, sps, "o-", color=C_MAIN, linewidth=2, markersize=6)
ax2.axhline(1.0, color=C_GRAY, linestyle=":", linewidth=1.3,
label="盈亏线 1.0x")
ax2.axvline((F2["N"]*F2["t_launch"]-F2["t_launch"]-F2["N"]*F2["t_dispatch"])/(F2["N"]-1), color=C_RED, linestyle="--", linewidth=1.5,
label="本假设盈亏点约2.499μs")
ax2.fill_between(tes, 0, 1.0, where=np.array(sps) < 1.0,
color="#f0c9c9", alpha=0.6, label="graph 反而更慢")
ax2.set_xscale("log")
ax2.set_xlabel("单个 kernel 的执行时间 (μs)", fontsize=10)
ax2.set_ylabel("CUDA Graph 加速比", fontsize=10)
ax2.set_title(f"N={F2['N']} 个 kernel", fontsize=11, color=C_MAIN)
ax2.legend(fontsize=8, loc="lower right")
ax2.grid(alpha=0.3, linestyle=":")
ax2.set_axisbelow(True)
fig.suptitle("图 5:CUDA Graph 提交模型(delta=0.5us假设)(模型推演)",
fontsize=12, color=C_MAIN, y=1.0)
fig.tight_layout()
fig.savefig(os.path.join(FIGDIR, "fig_graph.png"), bbox_inches="tight")
plt.close(fig)
# ══════════════════════════════════════════════════════════════
def main():
fus = _load("_fusion_results.json")
lnc = _load("_launch_results.json")
fig_traffic(fus)
fig_blowup(fus)
fig_three_forms(fus)
fig_launch(fus)
fig_graph(lnc)
print("已生成 5 张图:")
for f in sorted(os.listdir(FIGDIR)):
if f.endswith(".png"):
p = os.path.join(FIGDIR, f)
print(f" {f} {os.path.getsize(p)/1024:.0f} KiB")
if __name__ == "__main__":
main()
评论 (0)