


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:注意力与位置编码 | 难度:进阶 | 前置知识:自注意力机制的计算与显存账本
关键词:MoE、稀疏激活、专家路由、top-k、负载均衡、容量溢出
本文的算例在 CPU 上用 PyTorch 实际运行;它验证路由与容量机制,并不代表 GPU 集群吞吐。参数量账本只计算专家前馈层,明确排除注意力、优化器状态与通信。两篇锚点论文的标题与编号分别核对了 Shazeer 等人,1701.06538 和 Fedus 等人,2101.03961。
设想你已经把 Transformer 的注意力优化得很好,但还想让模型记住更多视觉对象、动作模式和语言知识。直接把每层前馈网络加宽,参数量和每个 token 的前向计算都会一起涨;训练显存、推理算力也跟着涨。MoE 的出发点是:保留多套前馈参数,让每个 token 只调用其中少数几套。总容量可以长得快,单 token 实际执行的专家计算长得慢。
先看一笔能复算的账。取隐藏宽度 $d=4096$、SwiGLU 中间宽度 $h=14336$。一个专家有 gate、up、down 三块矩阵,忽略偏置后共有 $3dh=176,160,768$ 个参数。放八个专家,总计 $1,409,286,144$ 个专家参数;每个 token 选两个,只触及 $352,321,536$ 个专家参数。在“同样八个专家都计算”的假想稠密基线下,专家矩阵乘的主项是四分之一。这里的“四倍”只属于这一层的专家部分:注意力、路由、分发、合并、跨设备通信一个都没算进去。八套 bf16 专家权重仍占约 2.625 GiB,不会因为每次只用两套就自动缩成四分之一。
真正会让方案失效的是路由。假如 16 个 token 中有 10 个奔向同一专家,其他专家分别只有 3、2、1 个,最忙的卡可能决定整步耗时。若像 Switch Transformer 那样给每个专家固定容量 4,六个 token 会溢出;把容量提到 6,仍有四个溢出。附录的 CPU 实验确实打印了 6/16 与 4/16。容量继续提到 10 才没有溢出,却要为大量空槽留空间。稀疏激活解决了“每个 token 算太多专家”的问题,不能自动解决“专家分工是否均匀”的问题。
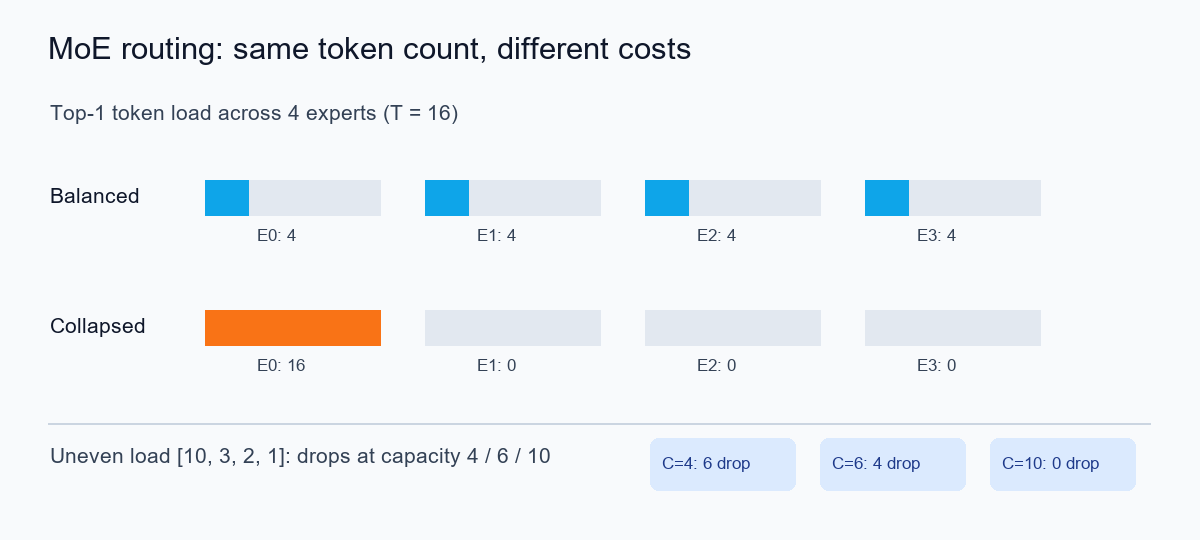
图中上半部分故意把总 token 数保持为 16:均衡分配是 [4,4,4,4],坍缩分配是 [16,0,0,0];下半部分用 [10,3,2,1] 计算容量为 4、6、10 时的溢出。它画的是调度代价,不是模型质量曲线。
第一句:MoE 通常替换 Transformer block 的前馈子层,注意力仍先让 token 互相交换信息,然后每个 token 在前馈阶段自己选专家;Mixtral 原论文明确采用每个 token 选两个 SwiGLU 专家。第二句:路由器先给所有专家打分,再只执行 top-k;参数总数随专家数增加,但单 token 专家计算主要随 $k$ 增加。第三句:专家偏科会造成容量溢出、尾部等待和训练不稳,因此必须把专家负载、溢出率与通信量和任务损失一起看。
它不是“每个专家懂一种人类可命名的技能”的硬分工。专家是网络权重,路由是在每一层、对每个 token 重新做的决定。同一个视频片段里的不同 patch,或同一个句子的不同 token,都可能走不同专家;解释一个专家“负责什么”需要额外分析,不能凭编号想象。
先把一个 token 的隐藏向量记作 $u$,维度为 $d$。SwiGLU 前馈层可写成:
$$F(u)=W_{\mathrm{down}}\bigl(\operatorname{SiLU}(W_{\mathrm{gate}}u)\odot W_{\mathrm{up}}u\bigr)$$
$W_{\mathrm{gate}}$ 和 $W_{\mathrm{up}}$ 各把 $d$ 维映射到 $h$ 维,$W_{\mathrm{down}}$ 再映射回 $d$ 维;$\odot$ 是逐元素乘法。三块矩阵分别有 $dh$、$dh$、$hd$ 个权重,所以主参数量是 $3dh$。一次前向的矩阵乘主项也近似与 $3dh$ 成正比;SiLU、逐元素乘、读写权重及内核发射是额外成本。
现在复制出 $N$ 套这样的前馈层,记作 $F_1,\ldots,F_N$。如果每个 token 都执行全部 $N$ 套,参数量和前馈计算都乘 $N$,这只是昂贵的稠密集成。MoE 的关键是:路由仍观察全部 $N$ 个候选,但只执行其中 $k$ 个专家,通常 $k\ll N$。
路由矩阵 $W_{\mathrm{route}}$ 的形状是 $N\times d$。对 token $u_t$,先得分,再做 softmax:
$$z_{t,i}=(W_{\mathrm{route}}u_t)_i,\qquad p_{t,i}=\frac{\exp z_{t,i}}{\sum_{j=1}^{N}\exp z_{t,j}}$$
$t$ 是 token 序号,$i$ 是专家序号;$z_{t,i}$ 是尚未归一化的偏好,$p_{t,i}$ 是归一化概率。选出概率最大的 $k$ 个专家,形成集合 $S_t$。以 Mixtral 式 top-2 归一化为例,选中专家的合并权重是:
$$a_{t,i}=\frac{p_{t,i}}{\sum_{j\in S_t}p_{t,j}},\quad i\in S_t;\qquad y_t=\sum_{i\in S_t}a_{t,i}F_i(u_t)$$
分母只对已选中的专家求和,故其权重之和是 1。没有选中的专家既不运行前馈网络,也不贡献输出。路由计算本身的矩阵乘大致是 $Nd$,专家计算主项是 $k(3dh)$,所以在 $h$ 很大而 $k$ 很小时路由通常比专家矩阵乘小;实际耗时仍会受到 token 重排和通信影响。top-k 索引是离散的;反向传播在当前选中集合内可以沿连续权重求导,但不能把“换成另一个专家”的离散跳变当成普通连续导数。
这里有个容易漏掉的细节:若 $k=1$ 还把唯一选中的概率除以自己,合并权重恒为 1,主任务损失就无法经这个权重训练路由器。Switch 的 top-1 路由保留了所选概率作为乘数,并另加负载均衡损失;不能把上面的 top-2 归一化公式机械套到所有 top-1 实现上。实现差别要看原论文与代码,而不是只看“top-1”三个字。
专家总参数约为 $P_{\mathrm{all}}=N(3dh)$;单 token 运行的专家参数约为 $P_{\mathrm{active}}=k(3dh)$,因此两者的比值是 $N/k$。这个推导只说明同一 MoE 层内全部专家与激活专家的差异。它没有证明 MoE 相对“参数更少、但充分训练的稠密模型”一定更快或更准;也没有证明端到端延迟会按 $N/k$ 缩短。公平比较要明确横轴是总参数、激活参数、每 token FLOPs、训练吞吐、墙钟时间中的哪一个。
以本文数值为例,$N=8$、$k=2$,所以 $N/k=4$。如果改成 $k=4$,专家计算主项会翻倍而总参数不变;如果把 $N$ 从 8 扩到 16 且保持 $k=2$,激活的专家计算主项近似不变,但权重驻留、路由维度与分布式通信压力会增加。这才是条件计算的交易:用更多存储与更复杂的调度,换更多参数容量与较少的激活计算。
取一批 $T$ 个 token,先讨论 Switch 的 top-1。令 $f_i$ 为实际派给专家 $i$ 的 token 比例,令 $P_i$ 为路由器分给该专家的平均概率。原论文使用下面的辅助项:
$$f_i=\frac{1}{T}\sum_{t=1}^{T}\mathbf{1}[\operatorname{argmax}_j p_{t,j}=i],\qquad P_i=\frac{1}{T}\sum_{t=1}^{T}p_{t,i}$$
$$L_{\mathrm{aux}}=\alpha N\sum_{i=1}^{N}f_iP_i$$
$\mathbf{1}$ 是指示函数;$\alpha$ 控制辅助项相对主任务损失的强度。$f_i$ 是由离散 argmax 得到的实际负载,作为本批次统计量不走梯度;$P_i$ 连续可导,给路由器提供调整信号。若四个专家都恰好分到四分之一 token 且平均概率也是四分之一,则不乘 $\alpha$ 的项是 $4\times4\times(1/4)(1/4)=1$。若 16 个 token 全选第 0 个专家,且它的平均概率是 0.7112,同一项约为 $4\times0.7112=2.8449$。附录代码打印的就是这两个值。
不要把辅助项误认为“越小一定越好”的独立目标。它和语言、图像或视频的主任务损失一起优化;给得太重会强迫本来有意义的专家分化变得机械均匀,给得太轻会让路由坍缩。Shazeer 等人的早期方案分别约束 importance 与 load;Switch 把它简化成一个点积项。Switch 论文第 2.2 节报告了 $\alpha=10^{-2}$ 的实验设置,但这个数不是跨任务的通用常数。
路由概率决定“想去哪里”,硬件要决定“哪里放得下”。Switch 的 top-1 固定容量在概念上是:
$$C=\left\lceil c\frac{T}{N}\right\rceil$$
$C$ 是每个专家本批次最多接收的 token 数,$c$ 是容量因子。若 $T=16$、$N=4$、$c=1$,每个专家只有四个槽;[10,3,2,1] 的第一位会溢出六个。把 $c$ 设成 1.5,容量变六、溢出四个;到 2.5 容量才变十、溢出为零。增加容量会减少丢弃,但静态张量中的空槽也增加。Switch 原论文说明:溢出的 token 跳过该专家层的计算,经残差路径传给下一层;这不是把 token 从整个网络删除。不同生产实现可以使用不同的溢出策略,不能从论文机制推断所有框架都会丢 token。
这一定义专门对应 top-1。top-2 每个 token 会产生两个派发名额,负载与容量的账要按派发次数重新算;直接拿 $T/N$ 给 top-2 算容量会少估。文章后面的代码将 top-2 正确性实验与 top-1 容量实验明确分开。
把一批输入写成张量形状能看出程序为何必须“先拆再合”。设 batch 有 $B$ 条样本,每条 $S$ 个 token,压平后 $T=BS$;输入是 [T,d],路由 logits 是 [T,N],top-k 索引和权重都是 [T,k]。按专家重新排列后,第 $i$ 位专家只拿到自己的 $L_i$ 行,结果是 [L_i,d];再按原 token 索引累加回 [T,d]。只要每个 token 恰好被派发 $k$ 次,就必有 $\sum_i L_i=kT$。附录的 expert_loads=[8,7,8,9] 总和为 32,恰好等于 $16\times2$。这是发现漏派发或重复派发的第一道检查。
第二条关系来自合并权重。对同一个 token,Mixtral 式归一化后 $\sum_{i\in S_t}a_{t,i}=1$;若实测不等于 1,可能把全部专家的 softmax 概率直接拿来加权,却忘了对选中集合重新归一化。第三条关系是输出维度不变:专家前馈网络虽可扩到中间宽度 $h$,最终都要回到 $d$ 维,才能与 Transformer block 的残差相加。三条关系分别守住派发次数、权重尺度和残差形状,比直接观察最终 loss 更容易定位代码错误。
一次反向传播中,把当前 batch 已统计出的 $f_i$ 当作常量。softmax 的导数是 $\partial p_{t,i}/\partial z_{t,j}=p_{t,i}(\mathbf{1}[i=j]-p_{t,j})$:提高专家 $j$ 的 logit,会抬高它自己的概率,同时压低其他专家的概率。代入上一小节的 $L_{\mathrm{aux}}$,得到:
$$\frac{\partial L_{\mathrm{aux}}}{\partial z_{t,j}}=\frac{\alpha N}{T}p_{t,j}\left(f_j-\sum_{i=1}^{N}f_ip_{t,i}\right)$$
若专家 $j$ 的实际负载 $f_j$ 高于这个 token 所见的加权平均负载,梯度为正,梯度下降倾向于压低它的 logit。低负载专家可能得到相反推力。这只是一次梯度步的局部解释:$f_i$ 由 argmax 决定,会在选择边界突然跳变;主任务梯度、容量限制和数据分布也同时影响下一次路由。因此“有可导辅助项”不等于“必然均衡”,更不等于“均衡后质量一定最好”。
若第 $i$ 位专家收到 $L_i$ 个 token、每位静态容量都是 $C$,则溢出数为 $\sum_i\max(L_i-C,0)$,空槽数为 $\sum_i\max(C-L_i,0)$。用前面的 [10,3,2,1] 代入:$C=4$ 时溢出 6、空槽 6;$C=6$ 时溢出 4、空槽 12;$C=10$ 时溢出 0、空槽 24。容量越大,溢出变少,却给静态张量留下更多空位。空槽是否真的造成同等比例的计算浪费,还要看内核能否跳过填充;它至少会影响形状、存储或通信安排。
在多模态场景,整体平均负载还可能掩盖局部高峰。文本、图像 patch 与连续视频帧混在一批时,整批的四位专家统计可能接近均匀,但某一类 token 在某一层仍高度集中;按帧解码时的瞬时负载又可能不同于整段视频的平均。一个实用的诊断表应按层、模态和时间片记录最大 $L_i$、平均 $L_i$、溢出数与通信时间。这里是从路由与队列机制推出的监控建议,并非本文已经做过的多模态训练实测。
完整代码在文末 moe_lab.py,只依赖 PyTorch,CPU 上直接执行:python moe_lab.py。它先生成形状为 [16,4] 的 token 矩阵,以一个线性路由器选择四个专家中的两个。每个专家是一层很小的 Linear → ReLU → Linear,用于验证路由逻辑;前面的大模型参数账本仍按真实 SwiGLU 的三矩阵结构计算,不能把玩具专家误当成生产模型。
核心的稀疏计算可以缩到下面几行。top_idx 的形状是 [token,k],token_id 和 slot_id 一起定位“这个专家接收了哪个 token、占该 token 的第几个席位”;index_add_ 把两路专家结果加回对应 token。
probs = F.softmax(logits.float(), dim=-1)
top_prob, top_idx = probs.topk(k, dim=-1)
top_weight = top_prob / top_prob.sum(dim=-1, keepdim=True)
result = torch.zeros_like(x)
for expert_id, expert in enumerate(experts):
    token_id, slot_id = torch.where(top_idx == expert_id)
    if token_id.numel() == 0:
        continue
    value = expert(x[token_id]) * top_weight[token_id, slot_id, None]
    result.index_add_(0, token_id, value)
print(result.shape, top_idx.shape)
固定随机种子为 7 后,脚本实际输出 input=(16, 4) output=(16, 4) top_idx=(16, 2),四位专家各接到 [8,7,8,9] 次派发,总和为 32,正好是 $16\times2$。它另用“全部专家都算、最后把没选中的输出乘零”的稠密参考结果做正确性对照,最大绝对误差在打印精度内为 0.000000000。参考实现会浪费计算,但适合检验稀疏实现的索引和加权有没有写错。
接着脚本不训练模型,而是构造两组受控路由 logits:一组让四个专家每人接四个 token,另一组让全部 token 偏向同一个专家。这样能把“负载变了”与“训练也变了”分开。打印结果为:均衡时 $f=P=[0.25,0.25,0.25,0.25]$,未乘 $\alpha$ 的辅助项是 1.0000;坍缩时 $f=[1,0,0,0]$、$P=[0.7112,0.0963,0.0963,0.0963]$,辅助项是 2.8449。容量实验又输出 6/16、4/16、0/16 三档溢出。读者可以独立复跑,不需要下载权重或数据集。
这组数字只证明公式、分发与计数代码互相吻合,不证明训练时加辅助项就一定达到均衡。真实训练还要监控各层的负载直方图、丢弃率、主任务损失、路由熵及设备间 all-to-all 的时间;单看一张 token 直方图不足以判断模型质量。
以 2026-10-03 检查的 Hugging Face modeling_mixtral.py 为准,MixtralTopKRouter 先把隐藏状态展平,用 F.linear 得到 [token, expert] logits;它在 float32 中做 softmax,再 top-k,并对选中权重重新归一化。MixtralSparseMoeBlock 负责接路由输出与专家集合,最终还原 batch、sequence、hidden 三维。知识树里的 code_refs 指向这个文件的 MixtralSparseMoeBlock,路径与符号已经实际打开核对。
同一文件中的 MixtralExperts 不为每个 token 单独启动一次专家网络,而是先找出哪些专家被选中,再按专家收集 token,用 index_add_ 汇总。它把多位专家的矩阵存成带专家维的三维权重,并通过 @use_experts_implementation 接入不同执行实现。我们的小脚本保持“每个专家一个模块”,方便看公式;生产代码则必须考虑连续内存布局、分组矩阵乘、编译路径和设备利用率。文件在主分支上会变,正文只核对了本日可见的结构与函数名,没有声称这些细节永久不变。
Mixtral 的 top-2 与 Switch 的 top-1 还不能混成一个实现。前者在路由器里对两个已选概率归一化;后者的论文重点是单专家派发、静态容量、溢出路径与辅助负载损失。Hugging Face 这份 Mixtral 文件的前向代码不是 Switch 论文的 TPU 分布式训练系统,也不能从它有 index_add_ 就断言大集群没有 all-to-all。若专家分布在多卡上,token 必须先到相应设备、计算后再汇总;代价由网络拓扑、批量大小、token 倾斜和实现决定。
还有一个工业层面的数字边界:本文的 3dh 只含 SwiGLU 的三个权重矩阵。真实 Transformer block 还有 Q、K、V、输出投影、归一化、嵌入及可能的共享专家。训练时优化器状态和梯度常比 bf16 权重本身占更多空间;推理时即使每个 token 只用两位专家,服务系统仍需让其他专家随时可访问,或者承担按需调入的时延。因此“激活参数少”不等于“部署内存少”。
收益首先是参数容量对激活计算的比值。 对 $N$ 位同宽专家取 $k$ 位,专家主计算的理想比值是 $N/k$;训练可在近似固定的每 token 专家 FLOPs 下试更多参数。它是否换来更好的任务质量,仍要做同预算、同数据、同训练时长的实验。早期论文报告过优于稠密对照的结果,但不能把某篇任务的收益搬给任意视觉生成模型。
第一笔代价是权重与状态。 参数量按 $N$ 增长,bf16 权重、梯度、优化器状态与检查点大小都要算。只看前向激活的 $k$ 位专家会严重低估训练资源。专家可以并行放在不同设备上,但又引出网络通信。
第二笔代价是路由偏斜。 每个专家的处理时间近似由收到的 token 数决定,整步会等最慢专家。容量限制可以把形状固定,却在溢出时改变有效计算;容量放大又会浪费填充。高平均负载不够,还要检查最忙专家、各层差异、长尾 token 和各设备之间的均衡。附录中的 [10,3,2,1] 正是最小反例。
第三笔代价是通信与小批量。 当专家跨设备切分,派发和合并通常需要集体通信;batch 很小或自回归逐 token 解码时,每位专家分到的 token 少,矩阵乘可能跑不满,固定通信开销更显眼。用单机 CPU 玩具实验不能估算这部分,也不能用“理论 FLOPs 四分之一”宣称端到端四倍加速。
第四笔代价是路由训练本身。 top-k 的硬选择会让专家早期获得的样本不均,冷门专家因训练较少又更难被选中,形成反馈。负载项、噪声、容量因子与专家初始化都会影响稳定性,但也可能伤害有意义的专门化。需要同时报告主任务指标与路由指标,而不是把“每个专家等量接单”当终点。
什么时候不该急着用?模型还小、普通前馈层已足够,或者服务以低 batch、低延迟为主且跨卡通信昂贵时,先用 性能建模与 Profiling 找到实际瓶颈。如果数据与训练预算不足以让多位专家学出差异,多出来的参数只会变成管理负担。这是工程判断,不是 MoE 论文对所有应用的普适否定。
这五篇连起来的主线是:先提出条件计算,再解决大规模分布式派发,接着简化路由与容量控制,最后面对稳定性和实际模型实现。论文里的速度、质量数字都有各自的设备与数据条件;这篇文章只借它们确认机制,不拼接成一个不存在的统一基准。
误解一:“八专家选二就是整个模型快四倍。” 四倍只来自专家矩阵乘的理想主项比值。注意力、路由、all-to-all、token 重排及等待最慢专家都在分母里。实验报告应分别列专家 FLOPs 与端到端时延。
误解二:“只激活两位专家,显存里只需放两套权重。” 路由在运行时根据每个 token 的状态变化,未选中的六位专家下一 token 可能被选到。权重需要驻留、分片或按需加载;哪一种都要付存储或调入成本。
误解三:“softmax 概率均匀就说明负载均衡。” 硬 top-1 派发由 argmax 决定,平均概率 $P_i$ 与实际负载 $f_i$ 是两个量。大量 token 的首选专家仍可能相同,所以要同时观察两者。Switch 的辅助项特意把它们相乘。
误解四:“溢出意味着 token 从模型中消失。” 在 Switch 论文描述的残差结构里,溢出 token 跳过这一专家层,后续层仍能接到它。它确实失去本层的专家变换,但不等于整条序列被删除。
误解五:“专家会自动对应数学、代码、图像等人类类别。” 路由学的是降低训练目标的内部划分,可能依赖位置、频率或更难解释的因素。必须用受控输入、路由统计和质量消融来验证专门化;给专家起名字只是叙事。
先执行文末两份完整脚本:python moe_lab.py 复现数值,python make_figures.py 生成配图。脚本固定随机种子,CPU 不需要模型权重。练习时一次只改一个条件,并把 主计算、路由负载、溢出率 分开记录。
k=2 改为 k=1。top_idx 应从 (16,2) 变成 (16,1),总派发次数从 32 变成 16。注意玩具实现会对唯一概率做归一化,权重恒为 1;这正好验证第 3.2 节提醒的训练梯度陷阱,因此它只能用来做前向路由演示,不能直接拿来训练 Switch。T=16,N=4,把不均匀分配 [10,3,2,1] 改成 [4,4,4,4]。容量因子 1.0 时,溢出应从 6/16 变 0/16。这是不改网络结构、只改路由就改变有效计算的最小实验。若要进一步实验训练效果,可以在小数据集上加入任务损失与 $L_{\mathrm{aux}}$,逐档扫描 $\alpha$,同时画验证损失和各专家负载。预期是过小的 $\alpha$ 可能坍缩、过大的 $\alpha$ 可能牺牲任务目标;具体拐点依赖数据和实现,本文没有训练实验,因此不提供虚构数值。
先复习知识树的 自注意力机制:MoE 一般替换前馈子层,不替读者省去注意力的计算与显存账。然后读 性能建模与 Profiling,把“专家 FLOPs 少了”落到实际延迟账本;跨卡部署时再接 数据并行与 ZeRO,理解参数和状态如何分布。知识树中规划中的“量化:从 INT8 到 FP4”会继续回答:专家权重多、驻留贵时,能否用更低精度换内存与带宽,以及质量会付出什么代价。
把这篇用在自己的模型上时,建议先固定总训练 token、硬件与优化器配置,记录稠密前馈基线的质量和耗时;再逐步加入多专家、top-k 路由、容量限制和均衡项。每加一项都单独保存路由直方图、每层最忙专家、溢出比例及端到端吞吐。这样最后即使质量没有提升,也能判断问题出在专家容量不足、调度不均,还是通信把理论上的稀疏收益吃掉了。只报告总参数和激活参数两个数字,很难让读者复现或比较。另外,比较实验要记录随机种子和路由器初始化。路由决策依赖输入分布,同一个模型换一批数据,专家负载也可能改变;只截取一次顺利的运行,无法说明服务长期稳定。
本文最重要的读法是把三根轴分开:总参数量决定可用容量,激活专家数决定每 token 专家计算,实际路由负载决定系统是否跑得顺。 只有把它们放到同一张账本里,MoE 的收益和代价才不会被一个“四倍”掩盖。
09 节用到的脚本全文如下(moe_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""A small, reproducible MoE routing lab. Requires PyTorch, runs on CPU."""

from __future__ import annotations

import math

import torch
from torch import nn
from torch.nn import functional as F


def sparse_moe(x: torch.Tensor, logits: torch.Tensor, experts: nn.ModuleList, k: int):
    """Route each token to k experts and merge the selected outputs."""
    probs = F.softmax(logits.float(), dim=-1)
    top_prob, top_idx = probs.topk(k, dim=-1)
    top_weight = top_prob / top_prob.sum(dim=-1, keepdim=True)
    result = torch.zeros_like(x)
    for expert_id, expert in enumerate(experts):
        token_id, slot_id = torch.where(top_idx == expert_id)
        if token_id.numel() == 0:
            continue
        value = expert(x[token_id]) * top_weight[token_id, slot_id, None]
        result.index_add_(0, token_id, value)
    return result, probs, top_idx, top_weight


def switch_aux_loss(probs: torch.Tensor) -> tuple[torch.Tensor, torch.Tensor, torch.Tensor]:
    """Switch's top-1 balancing term, without the tunable alpha coefficient."""
    token_count, expert_count = probs.shape
    chosen = probs.argmax(dim=-1)
    fractions = torch.bincount(chosen, minlength=expert_count).float() / token_count
    mean_prob = probs.mean(dim=0)
    return expert_count * (fractions * mean_prob).sum(), fractions, mean_prob


def capacity_drops(assignments: torch.Tensor, expert_count: int, factor: float):
    """Count top-1 overflow with a fixed expert capacity."""
    capacity = math.ceil(assignments.numel() * factor / expert_count)
    loads = torch.bincount(assignments, minlength=expert_count)
    dropped = torch.clamp(loads - capacity, min=0).sum().item()
    return capacity, loads.tolist(), int(dropped)


def main():
    torch.manual_seed(7)
    token_count, dim, hidden, expert_count, k = 16, 4, 8, 4, 2
    x = torch.randn(token_count, dim)
    gate = nn.Linear(dim, expert_count, bias=False)
    experts = nn.ModuleList(
        [nn.Sequential(nn.Linear(dim, hidden), nn.ReLU(), nn.Linear(hidden, dim))
         for _ in range(expert_count)]
    )
    out, probs, chosen, weights = sparse_moe(x, gate(x), experts, k)

    # A dense reference evaluates every expert. It is only a correctness oracle.
    dense_ref = torch.zeros_like(x)
    for expert_id, expert in enumerate(experts):
        contribution = torch.zeros(token_count, 1)
        for slot in range(k):
            contribution += (chosen[:, slot] == expert_id)[:, None] * weights[:, slot, None]
        dense_ref += contribution * expert(x)
    max_error = (out - dense_ref).abs().max().item()
    print(f"input={tuple(x.shape)} output={tuple(out.shape)} top_idx={tuple(chosen.shape)}")
    print(f"expert_loads={torch.bincount(chosen.flatten(), minlength=expert_count).tolist()}")
    print(f"sparse_dense_max_error={max_error:.9f}")

    # Controlled router logits: the difference is caused by routing, not training.
    balanced_logits = torch.zeros(token_count, expert_count)
    balanced_logits[torch.arange(token_count), torch.arange(token_count) % expert_count] = 2.0
    collapsed_logits = torch.zeros_like(balanced_logits)
    collapsed_logits[:, 0] = 2.0
    for name, logits in (("balanced", balanced_logits), ("collapsed", collapsed_logits)):
        loss, fractions, mean_prob = switch_aux_loss(F.softmax(logits, dim=-1))
        print(f"{name}: f={fractions.tolist()} P={[round(v, 4) for v in mean_prob.tolist()]} "
              f"N_sum_fP={loss.item():.4f}")

    uneven = torch.tensor([0] * 10 + [1] * 3 + [2] * 2 + [3])
    even = torch.arange(token_count) % expert_count
    for name, assignments in (("even", even), ("uneven", uneven)):
        for factor in (1.0, 1.5, 2.5):
            capacity, loads, dropped = capacity_drops(assignments, expert_count, factor)
            print(f"{name} factor={factor:.1f}: capacity={capacity} "
                  f"loads={loads} dropped={dropped}/{token_count}")

    width, expansion, model_experts, active = 4096, 14336, 8, 2
    params_one = 3 * width * expansion  # SwiGLU: gate, up, down matrices.
    params_all = model_experts * params_one
    params_active = active * params_one
    print(f"SwiGLU ledger: one={params_one:,} all={params_all:,} "
          f"active_per_token={params_active:,} all_over_active={params_all / params_active:.1f}x")
    print(f"expert_weights_bf16={params_all * 2 / 2**30:.3f} GiB; "
          "this excludes attention, optimizer states, activations and communication")


if __name__ == "__main__":
main()"""Draw the MoE routing/capacity experiment. Requires Pillow only."""
from pathlib import Path
from PIL import Image, ImageDraw, ImageFont
ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "figures"
OUT.mkdir(exist_ok=True)
def font(size):
for path in ("C:/Windows/Fonts/arial.ttf", "/usr/share/fonts/truetype/dejavu/DejaVuSans.ttf"):
if Path(path).is_file():
return ImageFont.truetype(path, size)
return ImageFont.load_default()
im = Image.new("RGB", (1200, 540), "#f8fafc")
d = ImageDraw.Draw(im)
title = font(31)
text = font(21)
small = font(17)
d.text((48, 30), "MoE routing: same token count, different costs", font=title, fill="#0f172a")
d.text((50, 100), "Top-1 token load across 4 experts (T = 16)", font=text, fill="#334155")
for row, (name, counts, color) in enumerate((
("Balanced", [4, 4, 4, 4], "#0ea5e9"),
("Collapsed", [16, 0, 0, 0], "#f97316"),
)):
y = 160 + row * 130
d.text((50, y + 23), name, font=text, fill="#0f172a")
for i, value in enumerate(counts):
x = 205 + i * 220
d.rectangle((x, y + 20, x + 175, y + 55), fill="#e2e8f0")
if value:
d.rectangle((x, y + 20, x + 175 * value // 16, y + 55), fill=color)
d.text((x + 52, y + 65), f"E{i}: {value}", font=small, fill="#334155")
d.line((48, 423, 1150, 423), fill="#cbd5e1", width=2)
d.text((50, 443), "Uneven load [10, 3, 2, 1]: drops at capacity 4 / 6 / 10", font=text, fill="#334155")
for i, (cap, drops) in enumerate(((4, 6), (6, 4), (10, 0))):
x = 650 + i * 170
d.rounded_rectangle((x, 438, x + 145, 490), radius=8, fill="#dbeafe")
d.text((x + 12, 453), f"C={cap}: {drops} drop", font=small, fill="#1e3a8a")
path = OUT / "routing_capacity.png"
im.save(path)
print(path)
评论 (0)