


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:推理加速 | 难度:进阶 | 前置知识:混合精度与数值稳定性、自注意力机制的计算与显存账本
关键词:性能建模、Profiling、Roofline、算术强度、memory bandwidth、FLOPs、MFU、PyTorch Profiler、Nsight
先看本次 CPU 复核得到的两段计算:GEMM 约 98.57 MFLOP,逐元素 add 约 100 MFLOP;二者运算量相近,最短耗时却分别为 1.029 ms 和 23.623 ms,差 22.9 倍。环境为 Windows / AMD64、NumPy 2.4.6、OpenBLAS,线程请求值为 1。machine_probe.py 会记录实际 NumPy 构建配置和全部计时样本。
这里 add 复用 200 万元素的三份 fp32 数组,工作集 24 MB,重复 50 轮;累计逻辑流量 1200 MB,并不等于实测 DRAM 搬运量。GEMM 通过矩阵复用获得更高逻辑算术强度,但本实验没有硬件计数器,不能把 22.9 倍差距全部归因于 DRAM 带宽。它足以提醒我们:只比较 FLOPs,不能预测耗时。
再看一个优化评审:想把 LayerNorm 换成更快的低精度计算单元。若一行数据确实能驻留片上、只读输入并写输出,本文简化账本的强度约为 1.5 个教学操作/Byte;是否由带宽主导,还要核对标量、归约、平方根的执行资源,不能直接与 BF16 Tensor Core 的 ridge point 比较。只有在已确认流量主导、其他资源不变的模型里,单独提高计算峰值的收益才是 1.00。 小 batch GEMM 的权重量化常能减少字节,但反量化、格式元数据和内核效率也要记账。
这篇的目的就是把这套「先算账再动手」的方法补齐:两个账本——速度账(算力 vs 带宽)和容量账(显存四项)——加上一套实测手段(profiler)。量化、算子融合、KV cache 管理、并行切分,所有推理优化节点的收益判断都站在这篇的地基上。
阅读前只需会矩阵形状、乘加计数和单位换算;混合精度一篇解释 dtype 与字节数,注意力一篇解释 Q/K/V。本篇会补足异步计时、缓存层级与活跃 token 的必要背景,不要求先懂 CUDA 内核。
三句话讲完核心:
一个算子要做 $F$ 个浮点运算(FLOP,口径:一次乘加记 2 个 FLOP),硬件每秒最多做 $P_{\text{peak}}$ 个——就算计算单元一刻不停,也至少要 $F/P_{\text{peak}}$ 秒。同理,算子要把 $D$ 字节的数据在内存和计算单元之间搬个来回,总线每秒最多搬 $\beta$ 字节——至少要 $D/\beta$ 秒。无论计算和搬运是否重叠,总时间都不能短于这两个最低时间,所以可取 max 作为下界。若进一步用等号近似真实时间,才需要充分重叠和接近峰值利用率等假设:
$$T \ge \max\left(\frac{F}{P_{\text{peak}}},\ \frac{D}{\beta}\right)$$
注意这是下界:真实 kernel 还有 kernel launch、同步、缓存未命中、TLB miss 等额外开销,只要 $F$、$D$ 和对应物理峰值口径正确,实际耗时不能突破这个下界。后面的实验用经验标定值和逻辑数组流量代入,此时算出的只是参考模型估计;计时波动或缓存会产生超过 100% 的达成率,并不违反物理下界。差距也不能全算成可消除的优化空间。
定义算术强度:
$$I = \frac{F}{D}$$
物理含义:每从内存搬 1 字节数据,能换来多少次浮点运算。它取决于实现与所选存储层级;实际缓存命中和重复加载又与硬件有关,不能视为完全与机器无关。再定义机器的 ridge point:
$$I^{\ast} = \frac{P_{\text{peak}}}{\beta}$$
物理含义:给定指令资源与存储层级下,「算」和「搬」模型时间一样长的分界点,单位都是 FLOP/Byte,所以可以比。把 $I$ 与 $I^{\ast}$ 代回 3.1 的下界:
$P_{\text{peak}}$ 必须匹配运算类型。本文采用 A100 40GB SXM 白皮书 Table 1的 BF16 dense Tensor Core 312 TFLOP/s、HBM2 带宽 1555 GB/s,得到 $I^{\ast}=200.6$;同表 FP32 CUDA core 只有 19.5 TFLOP/s,对应 12.5 FLOP/Byte。A100 的表中没有原生 FP8 Tensor Core。保留这些旧卡作为易复算例子,数字不是对所有算子的统一峰值。
H100 SXM 官方规格给带稀疏脚注的 BF16 1979、FP8 3958 TFLOP/s;除去结构化稀疏的二倍口径后约为 989.5、1979。代码取 BF16 的约数 989、带宽 3.35 TB/s。下面若对 add、LayerNorm、softmax 统一代入 $P=312$ TFLOP/s,只是在演示一个假想统一操作吞吐的教学模型,不能据此诊断 A100 上的标量算子。真实不同资源的写法见 3.6。
GEMM:$A[M,K] \times B[K,N] \to C[M,N]$。每个输出元素要做 $K$ 次乘加,共 $M N K$ 次,乘加各记一次:
$$F_{\text{gemm}} = 2MNK,\qquad D_{\text{gemm}} = b\,(MK + KN + MN)$$
$b$ 是每元素字节数(bf16 取 2)。这是每份输入读一次、输出写一次且不读取旧 C 的最低流量示例,未计分块重读、write allocate 与输出累加。固定 K/N 时增大 M 可摊薄权重读取,提高模型 I;大 batch 更可能接近计算侧、小 batch 更可能受流量影响,但缓存命中、矩阵布局和内核调度可能改变实际瓶颈。
逐元素算子:$n$ 个元素各做 1 次运算,读 2 份写 1 份:
$$F = n,\qquad D = 3 b n,\qquad I = \frac{1}{3b}$$
$I$ 是常数(fp32 下约 0.083,bf16 下约 0.17),与 $n$ 无关。在固定 dtype 与访存模型下,增大 n 本身不会提高 I,因而不会像增加 GEMM 的复用维度那样跨越 roofline 分界。
简化 LayerNorm:共 n 行、每行 d 个元素(本节不加偏置,只保留 gamma),先求均值、减均值、平方后再求均值,最后除标准差并乘 gamma;忽略每行 eps 加法/平方根等小量,按教学规则每个元素约六次操作。若整行及统计量能复用、gamma 读取等小量忽略,最低流量示例为一次读与一次写:
$$F_{\text{ln}}\approx6nd,\qquad D_{\text{ln,min}}\approx2bnd,\qquad I_{\text{ln,min}}\approx\frac{3}{b}$$
bf16 时得到约1.5个教学操作/Byte。本文 NumPy 分步实现会反复读写大数组,共约10遍,fp32 下 $I\approx6/(10\times4)=0.15$;广播 gamma 和行统计量按可复用小数组另计。两种流量口径不同,不应把最低流量模型冒充 NumPy 的物理实测流量。
softmax 的读写口径:本文的三阶段教学实现先读 X 求 max,再读 X、计算并保存指数数组 E(同时归约求和),最后读 E、归一化并写 P。因此是 3 读 2 写,约 $D=5bnd$;这里假设“保存 E 与求和”已融合,并不是第 4.2 节 NumPy 各语句的完整流量。若整行能驻留片上存储,融合实现可约 1 读 1 写,二者的理想流量比为 2.5。
在线归一化原论文 Algorithm 2的 Safe softmax 不保存 E,输出时重新计算 exp,因此是 3 读 1 写;Algorithm 3 的 online 版本先流式求归一化量,再重读输入写概率,为 2 读 1 写,其对照是 4/3 的流量比。它们与本文保存 E 的基线不同,也与 Triton 整行融合示例的驻留前提不同,不能混用这些比值。
本文与 roofline_model.softmax 对保存 E 或整行驻留的模型统一用约 $5nd$ 作为教学操作计数(max、减法、exp、求和、除法各按一次,忽略每行的小量);它不是五类操作都拥有相同吞吐的物理断言。max、exp 与除法并非都能跑在 Tensor Core 上;重新计算 exp 的 Safe 版本、online 递推及实际分块内核都需另数操作。
单头注意力($N$ 是 token 数,$D_{h}$ 是每头维度):两次 $N \times N \times D_{h}$ 的矩阵乘加 softmax:
$$F_{\text{attn}} = 4N^{2}D_{h} + 5N^{2}$$
朴素实现的分数矩阵 $S$ 和概率矩阵 $P$ 都要落显存,二次项访存约 $4N^{2}$;FlashAttention 原论文 Algorithm 1 与 IO 分析只让当前分数/概率瓦片驻留片上,不保存完整 $N^{2}$ 矩阵;若仅统计每份输入读取一次与输出写回一次,可得到不可避免的数据流量下界;真实分块内核会反复读入 K/V 或 Q 等数据:
$$D_{\text{朴素}} = b\,(4N^{2} + 4ND_{h}),\qquad D_{\text{flash,min}} = b \cdot 4ND_{h}$$
代入 $N=4096$、$D_{h}=128$、bf16(脚本 roofline_model.py 实算):朴素 $D = 138.41\ \text{MB}$、$I = 62.7$,落在 A100($I^{\ast} = 200.6$)的带宽受限区;理想最低流量 $D_{\mathrm{flash,min}} = 4.19\ \text{MB}$、$I = 2068$,跳进算力受限区。教学函数令两种路径使用相同操作计数(×1.000),参考模型从 0.089 ms 降到 0.028 ms(×3.2);真实 online softmax 有额外归约/重缩放操作,不能据此说实际 FLOPs 完全不变。这是按最低流量与假想统一吞吐计算的理想示例,33 倍不是实际 FlashAttention 访存或速度的测量;有限片上存储下还需分块 IO 模型。FlashAttention 那篇的完整递推在知识树的下一节点展开,这里先用 roofline 把它的收益定位清楚。
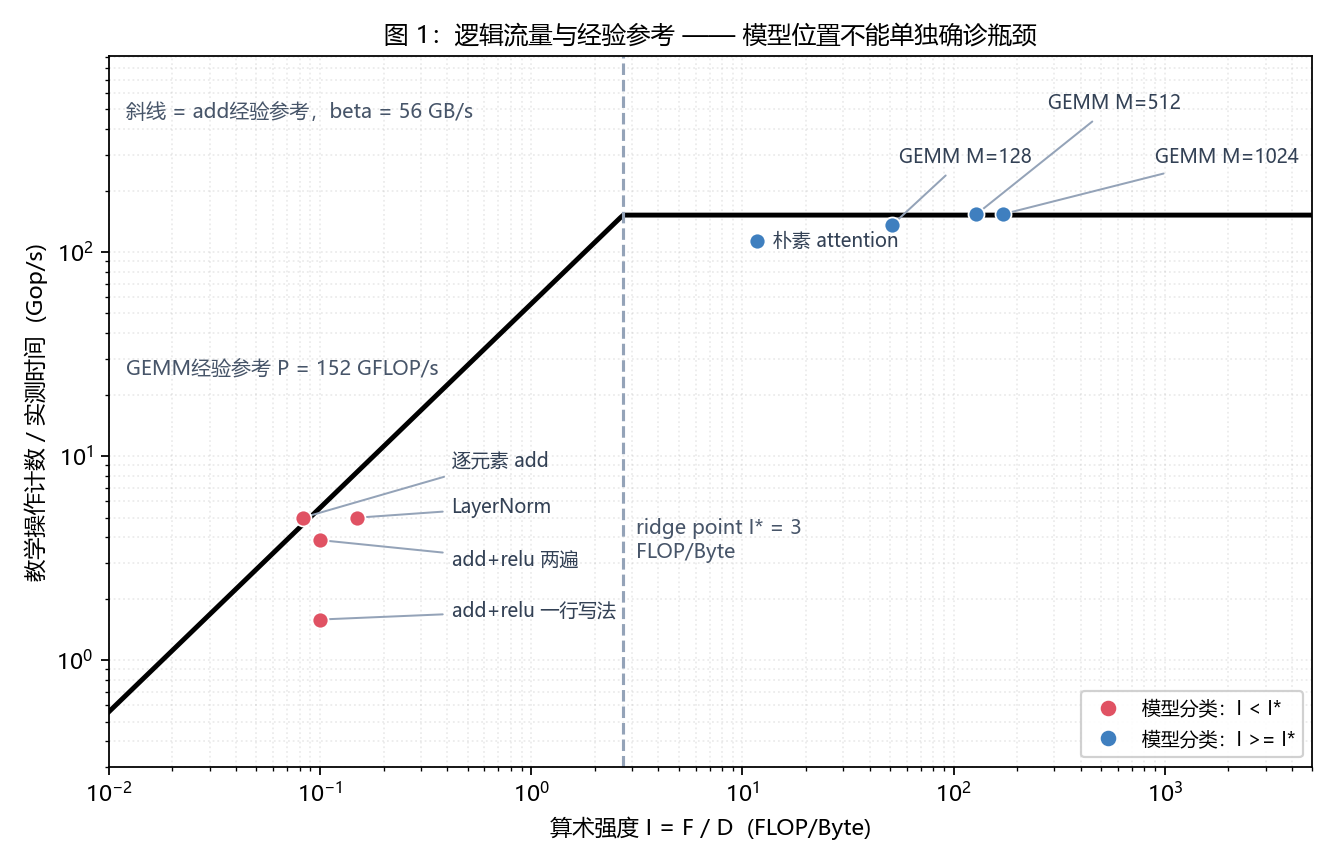
图 1:这张图要看三样——散点的横坐标是各算子的算术强度 $I$,点越靠右越「算得过来」;按 I 与 I 的相对位置给点作模型分类;点到经验参考折线的距离并不能单独证明真实瓶颈;FlashAttention 会改变访存量和横坐标,无法直接把这段垂直差距视为它的加速收益。*
把算力翻倍($P_{\text{peak}} \to 2P_{\text{peak}}$),加速比是:
$$S_{\text{算力}} = \frac{\max(F/P_{\text{peak}},\ D/\beta)}{\max(F/(2P_{\text{peak}}),\ D/\beta)}$$
若模型流量项主导,分子分母都是 $D/\beta$,$S_{\text{算力}} = 1$。算力受限时加速至多为 2;当 $1\lt I/I^{\ast}\lt 2$ 时,算力翻倍会遇到带宽上限,加速为 $I/I^{\ast}$。带宽翻倍对称地反一次。roofline_model.py 第四节用统一教学计数代入 $P=312$ TFLOP/s、$\beta=1555$ GB/s,下面是该假想二资源模型的结果;只有 BF16 dense GEMM 的计算峰值与 A100 规格直接匹配,其他行仍需 3.6 的资源区分:
算子                              I/I*      算力×2 的加速    带宽×2 的加速
逐元素 add [16M]                  0.001          1.00x          2.00x
LayerNorm [4096, 3072]            0.007          1.00x          2.00x
softmax 朴素三遍 [4096, 4096]     0.002          1.00x          2.00x
GEMM 512x4096x4096                2.041          2.00x          1.00x
attention 朴素 [N=4096,D=128]     0.312          1.00x          2.00x
attention ideal-min [N=4096,D=128]   10.307          2.00x          1.00x
这些是模型估计时间的比值,不是对真实优化加速比的无条件上限。一个实现若同时消除了调度开销、缓存重读或中间分配,实际加速可以大于单独改变 P 或 beta 的模型比值;反过来,开销不降也可能达不到该比值。图 2 用于提出测量假设,不能代替 profile。
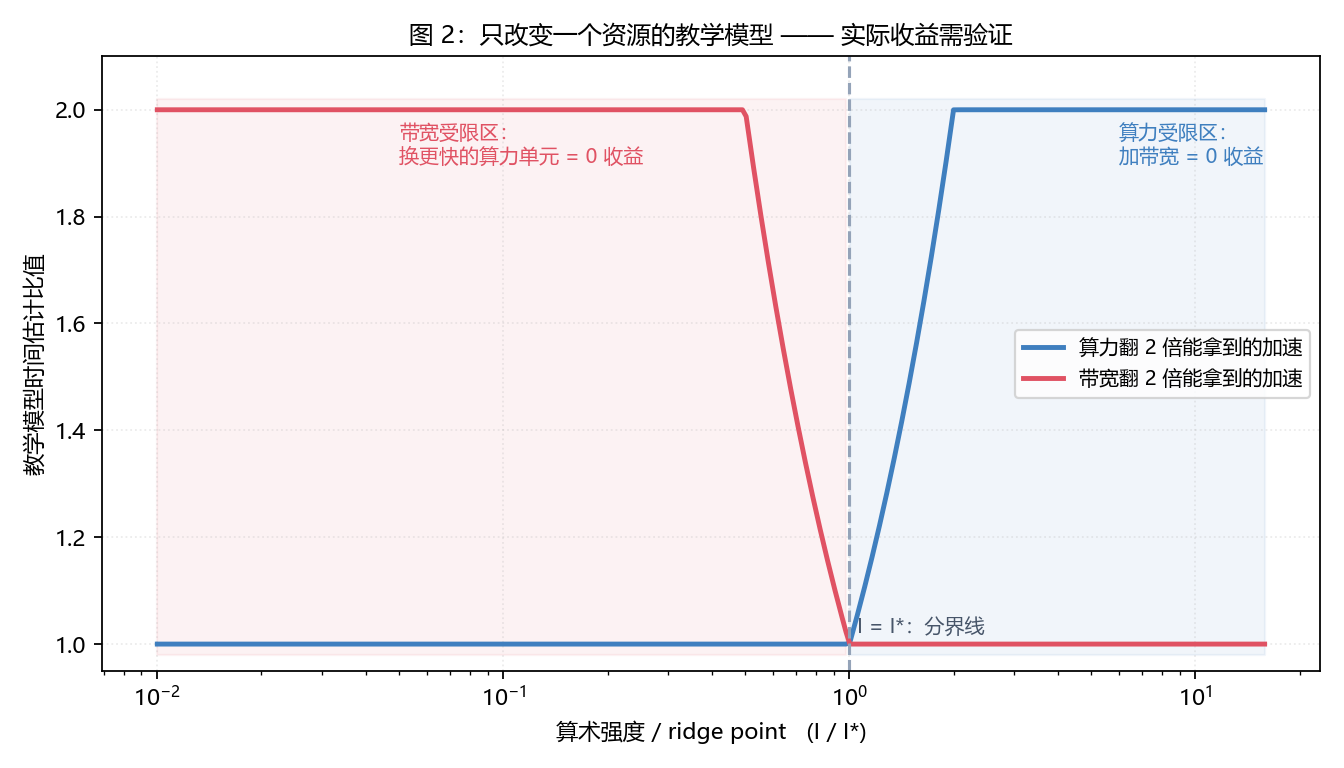
图 2:这张图要看什么——横轴 $I/I^{\ast}=1$ 那条竖线就是分界线:线左边算力翻倍的理想收益为 1,带宽翻倍收益在 1 到 2 之间;只有 I/I≤0.5 时完整得到 2 倍。线右边对称,I/I≥2 才完整得到算力翻倍的 2 倍。投入硬件或投入算子融合之前,先看自己在哪一侧。
速度账之外另有一本容量账。下面以未分块 prefill、同时处理 BS 个 token 为例,显存分四项:
$$M_{\text{total}} = N_{\text{params}} \cdot b_{w} + 2BSLd_{\text{kv}}b_{\text{kv}} + N_{\text{active}}a + \rho M_{\text{sum}}$$
逐项说物理含义:$N_{\text{params}}$ 是参数量、$b_{w}$ 是每参数字节数(fp16 为 2)——这一项与并发无关,是常数;$B$ 是并发序列数、$S$ 是序列长度、$L$ 是层数、$d_{\text{kv}}$ 是每层 KV 总维度(GQA 模型用实际的 KV head 数乘头维度)——KV cache 每个 token 每层都要存一份 K 和一份 V,所以是 $2BSLd_{\text{kv}}b_{\text{kv}}$ 字节;$b_{\text{kv}}$ 是 KV 的每元素字节数,与权重 dtype 独立;KV 总容量随并发线性增长;$a$ 是每 token 的激活峰值(推理不保留整层中间结果,但当前层十几份临时张量要同时活着,$d_{\text{model}}=4096$、fp16 时假设同时存活 16 份这种张量得到 128 KiB/token;这是容量练习的显式假设,未做模型显存峰值测量,不能视为经验通用常数);$\rho$ 是额外开销率,$M_{\text{sum}}$ 是前三项之和。这里 $N_{\text{active}}$ 是同时处理的活跃 token 数:未分块 prefill 取 BS,逐 token decode 通常取 B,分块 prefill 取本轮实际 chunk token 数。KV cache 仍按已保存上下文 token 数计。变长序列应把 BS 换成各序列实际长度之和;权重 fp16 并不要求 KV 也用 fp16,代码显式支持 kv_b 和 active_tokens。第 04 节把未分块 prefill 的教学账本代进一个 7B 模型。
把不同工作量分开:$F_{\text{tc}}$ 为 Tensor Core 的乘加 FLOP,$F_{\text{scalar}}$ 为普通浮点管线 FLOP,$N_{\exp}$ 为指数次数,$D_{\ell}$ 为存储层级 $\ell$ 的实测字节数。分别匹配峰值 $P_{\text{tc}}$、$P_{\text{scalar}}$、指数吞吐 $R_{\exp}$ 和该层带宽 $\beta_{\ell}$,仍可逐项取最大:
$$T\ge\max\left(\frac{F_{\text{tc}}}{P_{\text{tc}}},\frac{F_{\text{scalar}}}{P_{\text{scalar}}},\frac{N_{\exp}}{R_{\exp}},\max_{\ell}\frac{D_{\ell}}{\beta_{\ell}}\right)$$
这是更细的乐观下界;如果操作有依赖或共享执行资源,还可能需要把某些时间相加。没有 $R_{\exp}$ 实测或明确规格时,就不能从 $5nd$ 推出 softmax 的硬件计算时间。Hierarchical Roofline 原文解释为什么每一级存储都需要自己的流量与带宽,不能拿逻辑数组流量直接配 DRAM 带宽。
一个纯算术反例(单位为教学单位,非任何GPU规格):Tensor工作量10、吞吐100,标量工作量90、吞吐10,搬100字节、带宽100。误把100次操作全除以100得到计算时间1;分资源后下界为 max(0.1,9,1)=9。resource_time 实跑验证了这个9倍差距。这说明“运算数少”与“该类资源能做多快”必须一起定义。
保留原来的三个数值脚本与四幅图,并增加可独立运行的 profiler_probe.py。数值实验只需 Python 3.10+ 与 NumPy;图表另外需要 matplotlib,Profiler 对照另需 PyTorch(本次 2.10.0+cpu)。依次运行 machine_probe.py、roofline_model.py、memory_ledger.py、profiler_probe.py、make_figures.py,文末附录包含完整代码。
原稿的大工作集默认占用较多内存,尤其十亿元素 add 还曾通过 float64 临时数组初始化。本版默认用有界工作集;machine_probe.py --large 和 memory_ledger.py --large 保留原 32M 向量、4096 方阵与 64 MiB batch 权重实验,运行前需确认资源。默认模式不能证明 DRAM 流量、GPU 内核瓶颈或服务吞吐。
本次快照时间 2026-10-10 09:12:57;Windows / AMD64、NumPy 2.4.6、OpenBLAS、fp32,BLAS/OpenMP线程请求值均为 1(只设置本次进程)。经验参考 $\beta=55.74$ GB/s、$P=151.75$ GFLOP/s、$I^{\ast}=2.72$ FLOP/Byte。它们是所选 shape 的最短样本结果,不是设备峰值。
add 标定用 200 万个 fp32 元素、三份数组,总工作集 24 MB,累计每轮逻辑读写也是 24 MB;是否触及 DRAM,取决于缓存层级与系统状态。方阵乘用 1024×1024,三份数组工作集 12 MiB,$F=2n^{3}$,不能将这个 shape 的经验参考视作所有矩阵形状的可达峰值。
预热一次后,add 测 8 次,GEMM 测 5 次;代码同时保存全部样本、min、median、max。参考折线采用最短时间,以观察接近最佳状态的实现;端到端延迟应另测典型请求、并发和分位数,不能套用这个 min。
add:最短 0.431 ms,中位数 0.612 ms
GEMM:最短 14.152 ms,中位数 14.367 ms
经验 P = 151.75 GFLOP/s,add 逻辑字节率 beta = 55.74 GB/s,I* = 2.72
比值超过 100% 不代表违反物理定律:逻辑 D 未用硬件计数器测量,而基线 P/beta 只来自一个 shape 和访问模式。本机算子若运行得比参考更好,也会超过这条经验折线。
关键测试对象是 matmul-softmax-matmul 微基准;此处省略 1/√D 缩放,不是完整的生产 attention。下面按 NumPy 语句累计逻辑读写:右侧 1~10 是分数/概率矩阵的累计访问遍数;它不包含 Q/K/V/O 的线性项,也不是十次完整 DRAM 扫描的测量。实际 BLAS 分块、CPU缓存、write allocate 都可能改变物理流量:
def attention_naive():
    np.matmul(q, kt, out=S)                        # 写 S            1 遍
    np.max(S, axis=-1, keepdims=True, out=rowmax)  # 读 S            2 遍
    np.subtract(S, rowmax, out=S)                  # 读写 S          4 遍
    np.exp(S, out=S)                               # 读写 S          6 遍
    np.sum(S, axis=-1, keepdims=True, out=rowsum)  # 读 S            7 遍
    np.divide(S, rowsum, out=S)                    # 读写 S          9 遍
    np.matmul(S, v, out=O)                         # 读 S 写 O      10 遍
本次默认模式的真实输出(经验 $I^{\ast}=2.72$;“模型位置”只指该参考折线):
算子 | I | 模型位置 | 估计 ms | 最短 ms | 中位 ms | 参考比值
逐元素 add(1 遍) | 0.08 | 带宽 | 0.431 | 0.400 | 0.511 | 108%
add+relu 两遍(预分配) | 0.10 | 带宽 | 0.718 | 1.032 | 1.465 | 70%
add+relu 写成一行(有中间数组) | 0.10 | 带宽 | 0.718 | 2.530 | 2.970 | 28%
LayerNorm [1024,1024] 预分配 | 0.15 | 带宽 | 0.753 | 1.261 | 1.290 | 60%
attention 朴素 [N=512,D=128] | 11.75 | 算力 | 0.893 | 1.191 | 1.211 | 75%
GEMM 128x1024x1024 | 51.20 | 算力 | 1.769 | 1.978 | 2.116 | 89%
GEMM 512x1024x1024 | 128.00 | 算力 | 7.076 | 7.020 | 7.320 | 101%
GEMM 1024x1024x1024 | 170.67 | 算力 | 14.152 | 14.017 | 14.306 | 101%
逐元素、LayerNorm 与注意力的 exp/max 被各按一个教学操作计数,因此表中的参考 P 只可作粗略标尺,不能认为这些指令都能达到 GEMM 吞吐。分配与归约是否主导,还需更细的 profile。
本次朴素 attention 的模型位置是“算力”,参考比值 75%;原稿 arm64、大 shape 快照的位置曾是“带宽”。这正好构成反例:同一个算法换 shape、BLAS、线程和经验参考,模型分类便可能改变;仅凭这张总计时表无法确证哪级缓存、哪类指令才是瓶颈。 图 1 画全部 8 行,图文使用同一快照。
未分块 prefill 的容量教学账代一个 7B 模型(32 层、$d_{\text{kv}} = 4096$、权重和 KV 都取 fp16):
模型:7B,fp16 权重 = 13.0 GiB,32 层,d_kv = 4096
KV cache 单价:512 KiB / token (一条 4096 长的序列 = 2.00 GiB)

 batch    权重   KV cache    激活     额外开销     合计    假设 78 GiB 可用预算
     1   13.0G     2.00G    0.50G    4.66G   20.20G     装得下
     8   13.0G    16.00G    4.00G    9.91G   42.95G     装得下
    16   13.0G    32.00G    8.00G   15.91G   68.95G     装得下
    24   13.0G    48.00G   12.00G   21.91G   94.95G     OOM
    32   13.0G    64.00G   16.00G   27.91G  120.95G     OOM
两个读数:权重是常数,batch 再大都是 13.0 GiB;KV cache 按 512 KiB/token 线性涨,batch 16 时(32 GiB)已经是权重的 2.5 倍。此处 30% 是人为设定的额外开销/前三项总量比率,不是实测额外开销率;它也不同于 PagedAttention 论文中 KV cache 已分配容量的浪费比例。同一张卡只把本教学模型的额外开销率改成 4%,batch 24 从 94.95 GiB 降到 75.96 GiB,从 OOM 变装得下:不换卡、不改模型,这个假设账本跨过一个 batch 档位;真实分页收益需只对可优化的 KV 分配项建模,并检查实际可用显存。例如 batch=24 若只把“KV 额外开销/有效KV”从 30% 改为 4%,而权重、激活不加该比例,合计从 87.44 GiB 降到 74.96 GiB;这是另一个显式教学账本,仍不是 PagedAttention 实测复现。
容量账决定“能开多大”,速度账用于比较吞吐与延迟。默认 batch 微基准固定 1024×1024 的 fp32 权重,只有 4 MiB;原稿 4096×4096、64 MiB 可通过 --large 恢复。本次每个 B 预热一次后测 15 次,吞吐是 B 除以最短 GEMM 时间,不包含请求排队、前后处理或完整模型:
B | F MFLOP | D MB | I | 模型位置 | 最短 ms | 中位 ms | 吞吐 K token/s
1 | 2.097 | 4.202 | 0.50 | 带宽 | 0.059 | 0.065 | 16.9
2 | 4.194 | 4.211 | 1.00 | 带宽 | 0.382 | 0.391 | 5.2
4 | 8.389 | 4.227 | 1.98 | 带宽 | 0.346 | 0.347 | 11.6
8 | 16.777 | 4.260 | 3.94 | 算力 | 0.406 | 0.416 | 19.7
16 | 33.554 | 4.325 | 7.76 | 算力 | 0.502 | 0.512 | 31.9
32 | 67.109 | 4.456 | 15.06 | 算力 | 0.711 | 0.802 | 45.0
64 | 134.218 | 4.719 | 28.44 | 算力 | 1.107 | 1.138 | 57.8
128 | 268.435 | 5.243 | 51.20 | 算力 | 1.939 | 2.043 | 66.0
256 | 536.871 | 6.291 | 85.33 | 算力 | 3.604 | 3.722 | 71.0
B=1 到 256,最短延迟增长 61.0 倍,GEMM-only 吞吐增长 4.2 倍;没有理由预设“batch 越大延迟就一定平坦”。B=1 的参考比值 128% 也证明经验折线不是硬件上界。4 MiB 权重可能被缓存复用,D 表只记逻辑流量,不能直接把 D/时间当成 DRAM 带宽。
另作两个容量反例:在 batch=24、4096上下文下,把 KV 从 2 字节改成 1 字节,KV 项从 48 GiB 降至 24 GiB;仅改变权重 dtype 并不会自动改变 KV dtype。相同 KV 上下文做逐 token decode,激活项若按 128 KiB/活跃token 的假设计数,则从 prefill 的 12 GiB 变为约 0.00293 GiB;实际 attention workspace、分配器和运行库仍要另计。memory_ledger.ledger 支持这两种参数,见 09 节。
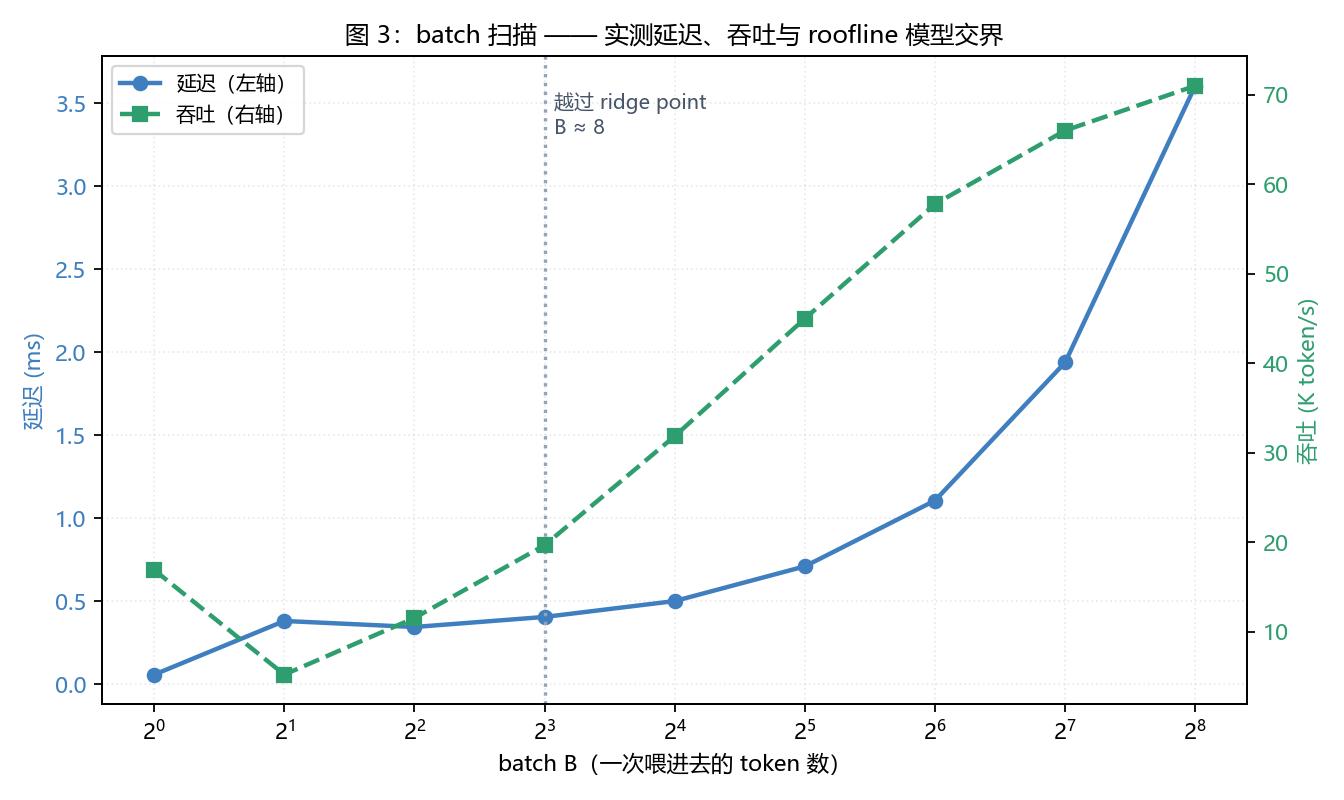
图 3:这张图要看什么——左边是实测延迟,右边是实测吞吐,曲线不保证出现理想平坦段;竖虚线是首个跨过经验 ridge point 的采样 B,模型边界在它与前一采样值之间;延迟变化可能有多个原因,不能从该图猜测具体库路径。
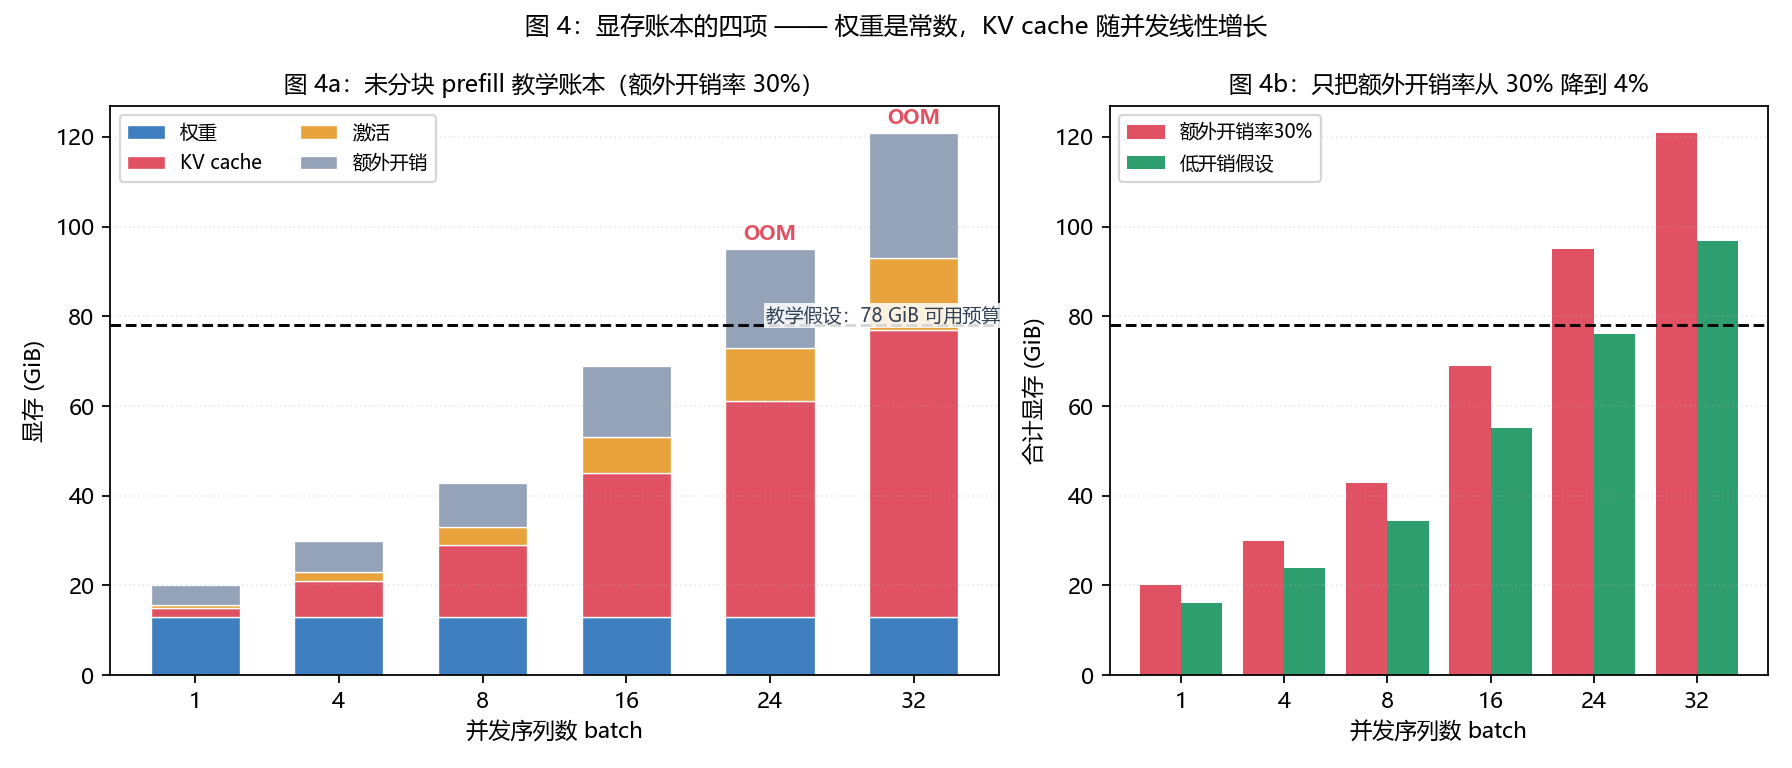
图 4:这张图要看什么——左图是显存四项的堆叠:蓝色权重是常数,红色 KV cache 随并发线性涨,越过黑色可用线就是 OOM;右图是只改一个参数(额外开销率 30%→4%)的效果,batch 24 从 OOM 变装得下。
PyTorch v2.10.0 torch/profiler/profiler.py#profile是本次核验的固定源码版本。附录 profiler_probe.py 定义了完整 x/w,CPU 也能运行;若 CUDA 可用,才加 CUDA activity 并在独立计时前后同步。预热与延迟测量放在采集区外,减少把初始化和采集成本当作 kernel 时间的风险。它和本文账本的对应关系是:
key_averages 聚合算子事件,不等于直接聚合 GPU kernel;嵌套事件的总时间可能重复包含子调用,不能把所有行的 total time 简单相加。CPU 本次按 self_cpu_time_total 排序;CUDA 分支按 self_device_time_total 排序,该分支尚未在本次 CPU 机器实测。with_flops=True 在该版本只估计支持的矩阵乘与二维卷积等算子;本次 aten::mm 报 524288,与 $2\times16\times128\times128$ 一致,输出 shape 为 [16,128]。它不是全模型完整 FLOPs 计数,也不是实测指令数。profile_memory=True 跟踪张量分配/释放。本次 mm 的 self CPU memory 为 8192 字节,恰好等于输出大小;这是该事件的分配增量,不是 CPU RSS 或设备显存峰值,也不涵盖预先创建的权重、KV、allocator reserve 与所有 workspace。record_shapes 等开关会增加开销并保留张量引用,可能影响优化;定位后应关闭采集单独计时。代码导出 Chrome trace,后续才能分析热点、子事件与时间线。PaLM §4.1 与 Appendix B定义的训练 MFU 排除激活重算 FLOPs,只计模型所需前向与反向运算。使用 MFU(Model FLOPs Utilization)时应先定义模型理论运算量、时间窗口、卡数与匹配硬件峰值,典型形式为 $\mathrm{MFU}=F_{\text{model}}/(T_{\text{wall}}N_{\text{gpu}}P_{\text{peak}})$。本文不从这一次 mm 采集计算模型 MFU;分布式通信、并发重叠和计时范围都可能改变分母。
Nsight 工具的分工:Nsight Systems 官方 User Guide对应 kernel 空隙、同步和通信时间线;Nsight Compute 官方 Profiling Guide给热点 kernel 的指令吞吐、缓存层级、occupancy 与 stall 等指标。Speed Of Light 的两个百分比是利用率摘要,不能只比较它们便确证瓶颈。先用时间线选热点,再用与该 kernel 指令/存储层级相匹配的计数器检验模型。本次没有 NVIDIA GPU,不宣称完成 nsys/ncu 实测。
SDPA 会按输入和硬件选择后端,不能断言所有 diffusers/transformers 默认用某个 FlashAttention 实现。本文 2068 个教学操作/Byte 来自理想一次读写与统一计数,真实 FlashAttention 仍有分块重读、标量归约和有限片上容量约束。
roofline 是模型,模型有假设。四条主要假设和不成立时的样子:
什么时候不用它:动态 shape、算子间强耦合(融合边界在变)、通信密集的分布式场景——这些先上 profiler 看时间线,先选热点与明确测量口径,再用 roofline;分层、分资源模型也可以帮助分析这些复杂负载,只是本文简单二资源式不够。坦诚标注:本文当前数值实测来自 Windows CPU 的 NumPy 与一个 PyTorch CPU 小矩阵;原大工作集形状保留为可选模式,数字本身不可迁移,理想分段趋势也可能被缓存、内核选择和调度打破。
五篇连起来是一条线:先有判定工具(roofline),再按受限类型各给一把钥匙——算力侧(混合精度)、带宽侧(FlashAttention)、容量侧(PagedAttention)。
依次执行五个完整脚本,比较快照的最短值、中位数和全部样本;不预设某行参考比值必须低于50%或接近100%。改变工作集、shape与线程设置,每次重新标定并重画四图。若观察到分类或延迟变化,先记录变化,再用工具确认原因。
先运行 machine_probe.py,再用 ledger(..., kv_b=1) 对照 kv_b=2;KV项应分别24/48 GiB。再加 active_tokens=24 比较decode激活,注意它没有改变已保存的KV上下文。
memory_ledger.ledger(
    7e9, 2, 32, 4096, 24, 4096, 131072, 0.30, kv_b=1)
在 roofline_model.py 中只把例子的P改为1979e12、保留beta和字节数,观察模型边界右移;这是控制变量练习,不能称为真实H100换卡结果。真实换卡需要同时核对带宽、指令类型、dtype、缓存和内核。
运行 profiler_probe.py,核对 [16,128]×[128,128]、524288 FLOP和8192字节输出,打开trace查看算子事件;CPU结果不能用来证明CUDA分支或GPU显存表现。
按知识树的依赖关系,从这篇出发有三个方向:
继续阅读 FlashAttention 为什么不需要存下注意力矩阵:本文 3.3 节的最低流量示例省略了真实分块重读,那篇把 online softmax 的递推式一步步推出来。
09 节用到的脚本全文如下(machine_probe.py、roofline_model.py、profiler_probe.py、memory_ledger.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""在同一台机器上把 roofline 的「峰值」和「落点」都实测出来。

只依赖 numpy。直接 `python machine_probe.py` 即可运行,约 20 秒。

为什么要自己测一遍
------------------
roofline_model.py 里的 A100/H100 峰值是厂商标称值,读者手边不一定有 GPU。
本脚本统一记录教学操作数和逻辑数组流量;GEMM乘加按2计数,exp/max各按1。
add有效字节率与GEMM经验算力只构成参考折线,不是所有算子的硬件物理下界。
同一台机器、BLAS和线程设置可以比较本次结果,但仍须硬件计数器才能诊断瓶颈。

每个算子的 D 都按实现里实际的读写遍数来数:
    LayerNorm 预分配版    10 遍(mean / 减均值 / 平方 / 再 mean / 除 / 乘 gamma)
    attention 朴素预分配   10 遍(写 S / max / 减 / exp / sum / 除 / 读 S 写 O)
遍数不是拍脑袋来的,是照着下面每一行 numpy 数出来的。

输出的每个数字都来自 `time.perf_counter()` 的真实计时。
"""

import argparse
import io
import os
import statistics
from contextlib import redirect_stdout
import json
import platform
import time
from pathlib import Path

import numpy as np

FP32 = 4  # 本机跑 fp32,BLAS 后端在快照 environment 中实际记录
_LAST_TIMING = {}

SNAPSHOT = Path(__file__).resolve().parent / "probe_results.json"


def _best(fn, repeat: int):
    """预热后取repeat次最短值,另存全部样本和中位数;不代表请求延迟分位数。"""
    fn()  # 预热:第一次要分配 / 触发缺页
    samples = []
    for _ in range(repeat):
        t = time.perf_counter()
        fn()
        samples.append(time.perf_counter() - t)
    _LAST_TIMING.clear()
    _LAST_TIMING.update(samples_seconds=samples, median_seconds=statistics.median(samples),
                        min_seconds=min(samples), max_seconds=max(samples), repeats=repeat)
    return min(samples)


# ── 一、标定可达带宽:二元 add 模式(读两份写一份)───────────────────
def measure_bandwidth(n: int = 2_000_000, repeat: int = 8) -> float:
    """返回实测可达带宽(Byte/s)。

    默认每份 fp32 数组 8 MB;large模式128 MB;应核对目标机器缓存大小,这里测量此访问模式的有效带宽。
    z = x + y:读 2n、写 n,共 3n 个元素。
    """
    x = np.ones(n, dtype=np.float32)
    y = np.ones(n, dtype=np.float32)
    z = np.empty(n, dtype=np.float32)
    dt = _best(lambda: np.add(x, y, out=z), repeat)
    return 3 * n * FP32 / dt


# ── 二、标定峰值算力:大矩阵乘 ────────────────────────────────────
def measure_matmul_peak(n: int = 1024, repeat: int = 5) -> float:
    """返回实测可达算力(FLOP/s)。

    大方阵乘能摊薄访存;测得的是此shape/BLAS/线程数的经验参考,非物理峰值。
    FLOPs = 2·n³(口径同 roofline_model.py:一次乘加记 2 个浮点运算)。
    """
    rng = np.random.default_rng(0)
    a = rng.standard_normal((n, n), dtype=np.float32)
    b = rng.standard_normal((n, n), dtype=np.float32)
    c = np.empty((n, n), dtype=np.float32)
    dt = _best(lambda: np.matmul(a, b, out=c), repeat)
    return 2 * n ** 3 / dt


def calibrate(verbose: bool = True, large: bool = False):
    n = 32_000_000 if large else 2_000_000
    side = 4096 if large else 1024
    bw = measure_bandwidth(n=n)
    bw_timing = dict(_LAST_TIMING)
    fl = measure_matmul_peak(n=side)
    peak = dict(peak_flops=fl, peak_bw=bw, vector_elements=n, matrix_side=side,
                bandwidth_timing=bw_timing, matmul_timing=dict(_LAST_TIMING))
    if verbose:
        print("=" * 80)
        print(f"本机标定({platform.machine()},numpy {np.__version__},fp32)")
        print("=" * 80)
        print(f"  实测可达带宽 beta  = {bw / 1e9:8.2f} GB/s")
        print(f"  实测可达算力 P     = {fl / 1e9:8.2f} GFLOP/s")
        print(f"  ridge point  I*    = {fl / bw:8.1f} FLOP/Byte")
        print("  注:这是该shape下的经验参考,不是所有算子的物理上限;")
        print("      换 BLAS 后端、换 dtype、换线程数都会变。口径一致才有可比性。")
    return peak


def build_ops(large: bool = False):
    """构造待实测的算子。每个元素 = (名字, F, D, 函数, repeat)。"""
    rng = np.random.default_rng(0)
    ops = []

    # ── 逐元素:1 遍 vs 2 遍 vs「看起来融合了」 ──
    n = 32_000_000 if large else 2_000_000
    a = rng.standard_normal(n, dtype=np.float32)
    b = rng.standard_normal(n, dtype=np.float32)
    o1 = np.empty(n, dtype=np.float32)
    tmp = np.empty(n, dtype=np.float32)

    def add_relu_two_pass():          # 5n 个元素:tmp 读写各一次
        np.add(a, b, out=tmp)
        np.maximum(tmp, 0, out=o1)

    def add_relu_one_line():          # 写法像融合了,numpy 照样分配中间数组
        np.maximum(np.add(a, b), 0, out=o1)

    ops.append(("逐元素 add(1 遍)", 1.0 * n, FP32 * 3 * n,
                lambda: np.add(a, b, out=o1), 8))
    ops.append(("add+relu 两遍(预分配)", 2.0 * n, FP32 * 5 * n,
                add_relu_two_pass, 8))
    ops.append(("add+relu 写成一行(有中间数组)", 2.0 * n, FP32 * 5 * n,
                add_relu_one_line, 8))

    # ── LayerNorm:预分配的 10 遍版 ──
    ln_n, ln_d = (8192, 4096) if large else (1024, 1024)
    x = rng.standard_normal((ln_n, ln_d), dtype=np.float32)
    g = rng.standard_normal(ln_d, dtype=np.float32)
    mu = np.empty((ln_n, 1), dtype=np.float32)
    var = np.empty((ln_n, 1), dtype=np.float32)
    xc = np.empty_like(x)
    xc2 = np.empty_like(x)

    def layernorm_buffered():
        np.mean(x, axis=-1, keepdims=True, out=mu)      # 读 x            1 遍
        np.subtract(x, mu, out=xc)                      # 读 x 写 xc      3 遍
        np.multiply(xc, xc, out=xc2)                    # 读 xc 写 xc2    5 遍
        np.mean(xc2, axis=-1, keepdims=True, out=var)   # 读 xc2          6 遍
        np.sqrt(var + 1e-5, out=var)                    # 小量
        np.divide(xc, var, out=xc)                      # 读 xc 写 xc     8 遍
        np.multiply(xc, g, out=xc)                      # 读 xc 写 xc    10 遍

    ops.append((f"LayerNorm [{ln_n},{ln_d}] 预分配", 6.0 * ln_n * ln_d,
                FP32 * 10 * ln_n * ln_d, layernorm_buffered, 5))

    # ── 朴素注意力:S 落盘,10 遍 N² 访存 ──
    N, D = (2048 if large else 512), 128
    q = rng.standard_normal((N, D), dtype=np.float32)
    k = rng.standard_normal((N, D), dtype=np.float32)
    v = rng.standard_normal((N, D), dtype=np.float32)
    kt = np.ascontiguousarray(k.T)
    S = np.empty((N, N), dtype=np.float32)
    O = np.empty((N, D), dtype=np.float32)
    rowmax = np.empty((N, 1), dtype=np.float32)
    rowsum = np.empty((N, 1), dtype=np.float32)

    def attention_naive():
        # 本微基准省略 1/sqrt(D) 缩放,只测 matmul-softmax-matmul 的执行开销。
        np.matmul(q, kt, out=S)                              # 写 S          1 遍
        np.max(S, axis=-1, keepdims=True, out=rowmax)        # 读 S          2 遍
        np.subtract(S, rowmax, out=S)                        # 读写 S        4 遍
        np.exp(S, out=S)                                     # 读写 S        6 遍
        np.sum(S, axis=-1, keepdims=True, out=rowsum)        # 读 S          7 遍
        np.divide(S, rowsum, out=S)                          # 读写 S        9 遍
        np.matmul(S, v, out=O)                               # 读 S 写 O    10 遍

    ops.append((f"attention 朴素 [N={N},D={D}]", 4.0 * N * N * D + 5.0 * N * N,
                FP32 * (10 * N * N + 4 * N * D), attention_naive, 5))

    # ── GEMM 三个规模 ──
    side = 4096 if large else 1024
    for m in ((512, 2048, 4096) if large else (128, 512, 1024)):
        ma = rng.standard_normal((m, side), dtype=np.float32)
        mb = rng.standard_normal((side, side), dtype=np.float32)
        mc = np.empty((m, side), dtype=np.float32)
        ops.append((f"GEMM {m}x{side}x{side}", 2.0 * m * side * side,
                    FP32 * (m * side + side * side + m * side),
                    lambda ma=ma, mb=mb, mc=mc: np.matmul(ma, mb, out=mc), 5))
    return ops


def probe(peak: dict, verbose: bool = True, large: bool = False):
    ops = build_ops(large=large)
    I_star = peak["peak_flops"] / peak["peak_bw"]
    if verbose:
        print("\n" + "=" * 80)
        print("三、真实算子打到这张 roofline 上:模型估计 vs 实测")
        print("=" * 80)
        hdr = (f"{'算子':<32s}{'I':>9s}{'受限':>8s}{'T估计':>10s}{'T实测':>10s}"
               f"{'达成率':>9s}{'实测算力':>14s}")
        print(hdr)
        print("-" * len(hdr))

    rows = []
    for name, F, D, fn, repeat in ops:
        dt = _best(fn, repeat)
        I = F / D
        bound = "算力" if I >= I_star else "带宽"
        t_pred = max(F / peak["peak_flops"], D / peak["peak_bw"])
        eff = t_pred / dt
        rows.append(dict(name=name, I=I, bound=bound, t_pred=t_pred, t_real=dt,
                         eff=eff, flops=F, bytes=D, gflops=F / dt / 1e9, timing=dict(_LAST_TIMING)))
        if verbose:
            print(f"{name:<32s}{I:>9.2f}{bound:>8s}{t_pred * 1e3:>8.2f}ms"
                  f"{dt * 1e3:>8.2f}ms{eff * 100:>8.0f}%"
                  f"{F / dt / 1e9:>11.1f} GF/s")
    if verbose:
        print("\n  参考比值 = 模型估计 / 实测,回答的是「这个实现离 roofline 还有多远」。")
        print("  低达成率可能来自指令、缓存、调度或同步;单凭此比值不能诊断额外访存。")
    return rows


def demo_same_flops():
    """约100MFLOP,有限工作集重复访问对比,不是DRAM压力测试。"""
    print("\n" + "=" * 80)
    print("四、约100MFLOP,两种算子在有限工作集上差多少时间")
    print("=" * 80)
    rng = np.random.default_rng(3)
    target = 1.0e8

    # GEMM:2·M·K·N = target,取 K=N=1024
    M = int(target / (2 * 1024 * 1024))
    ma = rng.standard_normal((M, 1024)).astype(np.float32)
    mb = rng.standard_normal((1024, 1024)).astype(np.float32)
    mc = np.empty((M, 1024), dtype=np.float32)
    t_gemm = _best(lambda: np.matmul(ma, mb, out=mc), 10)
    f_gemm = 2.0 * M * 1024 * 1024

    # 逐元素:n 个元素各算 1 次,F = n
    # 复用有限工作集,避免十亿元素及float64临时数组造成多GB瞬时分配。
    chunk, rounds = 2_000_000, 50
    n_elem = chunk * rounds
    a = rng.standard_normal(chunk, dtype=np.float32)
    b = rng.standard_normal(chunk, dtype=np.float32)
    o = np.empty(chunk, dtype=np.float32)
    def chunked_add():
        for _ in range(rounds):
            np.add(a, b, out=o)
    t_elem = _best(chunked_add, 5)

    print(f"  GEMM    : F = {f_gemm / 1e9:.3f} GFLOP, "
          f"D = {FP32 * (M * 1024 + 1024 * 1024 + M * 1024) / 1e6:.1f} MB, "
          f"实测 {t_gemm * 1e3:.3f} ms({f_gemm / t_gemm / 1e9:.0f} GFLOP/s)")
    print(f"  逐元素  : F = {n_elem / 1e9:.3f} GFLOP, "
          f"D = {FP32 * 3 * n_elem / 1e6:.1f} MB, "
          f"实测 {t_elem * 1e3:.3f} ms({n_elem / t_elem / 1e9:.0f} GFLOP/s)")
    print(f"  → FLOPs 基本相同,耗时差 {t_elem / t_gemm:.0f} 倍。")
    print("    同样运算量不代表同样时间:这里逐元素算子的运算数并未")
    print(f"    减少;逻辑 I={1 / (FP32 * 3):.2f} FLOP/Byte,24MB工作集反复访问,不能确证DRAM瓶颈。")

    return dict(gemm_flops=f_gemm, gemm_seconds=t_gemm, add_flops=n_elem,
                add_seconds=t_elem, add_working_set_bytes=3 * chunk * FP32,
                add_logical_bytes=FP32 * 3 * n_elem, chunk=chunk, rounds=rounds,
                ratio=t_elem / t_gemm)


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--large", action="store_true", help="恢复原大shape实验;先确认可用内存")
    args = parser.parse_args()
    peak = calibrate(large=args.large)
    rows = probe(peak, large=args.large)
    demo = demo_same_flops()
    config = io.StringIO()
    with redirect_stdout(config):
        np.show_config()
    environment = dict(platform=platform.platform(), numpy=np.__version__,
                       thread_settings={k: os.environ.get(k) for k in
                                        ("OPENBLAS_NUM_THREADS", "OMP_NUM_THREADS", "MKL_NUM_THREADS")},
                       numpy_config=config.getvalue(), preset="large" if args.large else "bounded")

    # 把这次标定存成快照:make_figures / memory_ledger 直接读它,
    # 保证「图上的数字」和「正文引用的数字」来自同一次运行。
    SNAPSHOT.write_text(json.dumps(
        dict(peak=peak, rows=rows, demo=demo, environment=environment,
             note=f"{platform.machine()} / numpy {np.__version__} / fp32",
             timestamp=time.strftime("%Y-%m-%d %H:%M:%S")),
        ensure_ascii=False, indent=1), encoding="utf-8")
    print(f"\n标定快照已存到 {SNAPSHOT.name},make_figures / memory_ledger 会复用它。")
    print(f"这台机器的 roofline:P = {peak['peak_flops'] / 1e9:.0f} GFLOP/s, "
          f"beta = {peak['peak_bw'] / 1e9:.1f} GB/s, "
          f"I* = {peak['peak_flops'] / peak['peak_bw']:.1f} FLOP/Byte")


if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""Roofline 模型的最小实现:把「算力账」和「带宽账」合成一条上界曲线。
只依赖 numpy(其实只是用来排版,算法本身是纯标量运算)。
直接 `python roofline_model.py` 即可运行,约 1 秒。
符号与文章第 03 节一一对应
--------------------------
F 浮点运算数(FLOP)。口径:一次乘加(MAC)记 2 FLOP
D 教学逻辑流量(Byte):按数组读写计;并非硬件DRAM计数器
I 算术强度 I = F / D,单位 FLOP/Byte
P_peak 峰值算力(FLOP/s)
beta 峰值带宽(Byte/s)
I_star ridge point = P_peak / beta,只判定所给模型的主导资源
关键结论(代码算完会打印):
T >= max(F / P_peak, D / beta)
把 F 降为一半或把 D 降为一半时的模型比值,见 optimize_headroom()
"""
import json
from pathlib import Path
def _local_spec():
"""本机实测峰值:优先读 machine_probe.py 存下的标定快照。
快照不存在时明确要求先运行 machine_probe.py。
这样 SPECS 里的「本机实测」永远是同一次标定,不会和正文引用的数字分叉。
"""
snap = Path(__file__).resolve().parent / "probe_results.json"
if snap.exists():
p = json.loads(snap.read_text(encoding="utf-8"))["peak"]
return dict(peak_flops=p["peak_flops"], peak_bw=p["peak_bw"])
raise FileNotFoundError("请先运行 machine_probe.py 生成本机快照;不能用别人的峰值兜底")
# ── BF16/FP8 dense GEMM 厂商峰值;不能视为逐元素/exp吞吐。
# A100 40GB SXM: https://images.nvidia.com/aem-dam/en-zz/Solutions/data-center/nvidia-ampere-architecture-whitepaper.pdf
# H100 SXM: https://www.nvidia.com/en-us/data-center/h100/ (带*稀疏值除2)
# 注意 H100 BF16 dense 算力增幅大于带宽增幅,ridge point 比 A100 高:
# 带宽涨 2.15 倍、bf16 算力涨约 3.17 倍 → 更多 kernel 落在带宽受限区。
SPECS = {
"A100-40GB SXM (bf16)": dict(peak_flops=312e12, peak_bw=1555e9),
"H100-80GB SXM (bf16)": dict(peak_flops=989e12, peak_bw=3350e9),
"H100-80GB SXM (fp8)": dict(peak_flops=1979e12, peak_bw=3350e9),
# 下面这一条不是标称值,是 machine_probe.py 在同一台机器上实测出来的
"本机实测(见 machine_probe.py)": _local_spec(),
}
BF16 = 2 # bytes per element
def roofline_time(F: float, D: float, peak_flops: float, peak_bw: float):
"""roofline 时间下界:算力时间与带宽时间取 max(假设两者完美重叠)。"""
t_compute = F / peak_flops
t_memory = D / peak_bw
return max(t_compute, t_memory), t_compute, t_memory
def resource_time(terms, moved_bytes, bandwidth):
"""按不同资源给下界,terms 为 [(工作量, 同口径峰值), ...]。
例:Tensor Core FLOP、FP32 CUDA-core FLOP、exp次数分别使用对应吞吐。
只取max仍是假定资源可完美重叠的乐观下界,不能冒充实测耗时。
"""
if moved_bytes < 0 or bandwidth <= 0:
raise ValueError("字节数非负、带宽为正")
if any(work < 0 or rate <= 0 for work, rate in terms):
raise ValueError("工作量非负、同口径吞吐为正")
return max([moved_bytes / bandwidth] + [work / rate for work, rate in terms])
def bound_of(F: float, D: float, peak_flops: float, peak_bw: float) -> str:
I = F / D
I_star = peak_flops / peak_bw
return "算力受限" if I >= I_star else "带宽受限"
def optimize_headroom(F: float, D: float, peak_flops: float, peak_bw: float):
"""把运算量 F 或搬运量 D 减半,理想模型可快多少?
答案与算术强度有关:带宽受限时只减少运算量的模型收益为 0,算力受限时最多 2 倍。
返回 (F 减半的加速比, D 减半的加速比),分别等价于只将峰值算力或带宽翻倍。
"""
def speedup(F2, D2):
t0, _, _ = roofline_time(F, D, peak_flops, peak_bw)
t1, _, _ = roofline_time(F2, D2, peak_flops, peak_bw)
return t0 / t1
return speedup(F / 2, D), speedup(F, D / 2)
# ── 几类算子的 F / D 账本 ──────────────────────────────────────────
def gemm(M: int, K: int, N: int, b: int = BF16):
"""矩阵乘 [M,K] @ [K,N] -> [M,N]。读 A、读 B、写 C。"""
F = 2.0 * M * K * N
D = b * (M * K + K * N + M * N)
return F, D
def elementwise(n: int, b: int = BF16, n_pass: int = 1, n_read: int = 1):
"""逐元素算子:读 n_read 份、写 1 份;n_pass 表示这样读写几轮。
二元运算(如 add)是 n_read=2:读两份输入、写一份输出。
"""
F = 1.0 * n * n_pass # 每个元素算 1 次
D = b * (n_read + 1) * n * n_pass
return F, D
def layernorm(n: int, d: int, b: int = BF16):
"""简化 LayerNorm(无 beta):两次归约、减均值、平方、除标准差、乘 gamma,约 6 次/元素。
访存 = 读 x 一遍 + 写 y 一遍(统计量是 O(n) 的小量,忽略)。"""
F = 6.0 * n * d
D = b * 2 * n * d
return F, D
def softmax(n: int, d: int, b: int = BF16, fused: bool = True):
"""softmax:exp / 减最大值 / 归一化,约 5 次运算/元素。
fused=True 假设整行可驻留片上存储,读 1 遍写 1 遍;不是独立 online normalizer 的通用 IO
fused=False 保存 E 的三阶段模型:读X求max;读X写E同时归约和;读E写P,共3读2写
不是原论文 Algorithm 2 的重算 exp、3读1写版本;F=5nd不适用于后者或online递推
"""
F = 5.0 * n * d
D = b * 2 * n * d if fused else b * (3 * n * d + 2 * n * d)
return F, D
def attention(N: int, D: int, b: int = BF16, flash: bool = False):
"""单头注意力。N 是 token 数,D 是每头维度。
flash=False(朴素):分数矩阵 S 和权重 P 都要落 HBM
S = Q K^T 写 N^2
P = softmax(S) 读 N^2 写 N^2
O = P V 读 N^2
→ 二次项访存 ≈ 4 N^2 b
flash=True(强缓存假设下的最低流量,不是真实 FlashAttention IO):Q/K/V 读进来、O 写出去,只保留一块分数/概率瓦片,不分配完整 N^2 矩阵
→ 访存 ≈ 4 N D b
"""
F = 4.0 * N * N * D + 5.0 * N * N # 两个 N×N×D 的矩阵乘 + softmax
if flash:
D_bytes = b * (3 * N * D + N * D) # 读 Q K V,写 O
else:
D_bytes = b * (4 * N * N + 4 * N * D) # 上面再加 S/P 的读写
return F, D_bytes
def fmt(x: float, unit: str = "") -> str:
for u, s in (("T", 1e12), ("G", 1e9), ("M", 1e6), ("K", 1e3)):
if x >= s:
return f"{x / s:.2f} {u}{unit}"
return f"{x:.2f} {unit}"
def main():
print("=" * 78)
print("一、三组 GEMM 规格与本机经验标定(不是所有算子的统一物理峰值)")
print("=" * 78)
print(f"{'设备':<28s}{'P_peak':>14s}{'beta':>14s}{'I* = P/beta':>16s}")
ridges = {}
for name, s in SPECS.items():
I_star = s["peak_flops"] / s["peak_bw"]
ridges[name] = (s, I_star)
print(f"{name:<28s}{fmt(s['peak_flops'], 'FLOP/s'):>16s}"
f"{fmt(s['peak_bw'], 'B/s'):>14s}{I_star:>12.1f} FLOP/B")
a100 = SPECS["A100-40GB SXM (bf16)"]
h100 = SPECS["H100-80GB SXM (bf16)"]
print(f"\n A100 -> H100:带宽 ×{h100['peak_bw'] / a100['peak_bw']:.2f},"
f"算力 ×{h100['peak_flops'] / a100['peak_flops']:.2f},"
f"ridge point {a100['peak_flops'] / a100['peak_bw']:.0f} -> "
f"{h100['peak_flops'] / h100['peak_bw']:.0f}(更高 = 更多算子落入带宽受限区)")
# ── 二、算子账本 ────────────────────────────────────────────────
N, D = 4096, 128 # 一个典型的 DiT / LLM 单头规模
cases = [
("逐元素 add [16M]", elementwise(16_000_000, n_read=2)),
("LayerNorm [4096, 3072]", layernorm(4096, 3072)),
("softmax fused [4096, 4096]", softmax(4096, 4096, fused=True)),
("softmax 朴素三遍 [4096, 4096]", softmax(4096, 4096, fused=False)),
("GEMM 512x4096x4096", gemm(512, 4096, 4096)),
("GEMM 4096x4096x4096", gemm(4096, 4096, 4096)),
("attention 朴素 [N=4096,D=128]", attention(N, D, flash=False)),
("attention ideal-min [N=4096,D=128]", attention(N, D, flash=True)),
]
print("\n" + "=" * 78)
print("二、统一操作计数的教学模型(b=2,P=312T,beta=1555G)")
print("=" * 78)
hdr = (f"{'算子':<32s}{'F (教学操作)':>14s}{'D (Byte)':>14s}"
f"{'I':>10s}{'受限':>10s}{'T_roof':>12s}")
print(hdr)
print("-" * len(hdr))
for name, (F, Db) in cases:
I = F / Db
T, tc, tm = roofline_time(F, Db, a100["peak_flops"], a100["peak_bw"])
print(f"{name:<32s}{fmt(F):>14s}{fmt(Db, 'B'):>14s}"
f"{I:>10.2f}{bound_of(F, Db, a100['peak_flops'], a100['peak_bw']):>10s}"
f"{T * 1e3:>10.3f} ms")
# ── 三、FlashAttention 把算术强度抬了多少 ────────────────────────
print("\n" + "=" * 78)
print("三、物化 S/P 与理想最低 IO 对比(单头 N=4096, D=128, bf16)")
print("=" * 78)
F_naive, D_naive = attention(N, D, flash=False)
F_flash, D_flash = attention(N, D, flash=True)
T_naive, _, _ = roofline_time(F_naive, D_naive, a100["peak_flops"], a100["peak_bw"])
T_flash, _, _ = roofline_time(F_flash, D_flash, a100["peak_flops"], a100["peak_bw"])
print(f" FLOPs : {fmt(F_naive)} -> {fmt(F_flash)} "
f"(×{F_flash / F_naive:.3f},几乎没变)")
print(f" 访存 : {fmt(D_naive, 'B')} -> {fmt(D_flash, 'B')} "
f"(×{D_flash / D_naive:.4f},省 {D_naive / D_flash:.1f} 倍)")
print(f" 算术强度 : {F_naive / D_naive:.1f} -> {F_flash / D_flash:.1f} FLOP/B "
f"(×{(F_flash / D_flash) / (F_naive / D_naive):.1f})")
print(f" 受限类型 : {bound_of(F_naive, D_naive, **a100)} -> "
f"{bound_of(F_flash, D_flash, **a100)}")
print(f" roofline : {T_naive * 1e3:.3f} ms -> {T_flash * 1e3:.3f} ms "
f"(×{T_naive / T_flash:.2f})")
print(f" 注意:模型比值来自「少搬 {D_naive / D_flash:.0f} 倍字节」,"
"此处给各运算统一计数和统一P,仅为教学模型;真实内核的标量吞吐、exp及重读需另计。")
# ── 四、砍算力 vs 砍带宽,谁的收益大 ────────────────────────────
print("\n" + "=" * 78)
print("四、教学资源模型中,只翻倍 P 或 beta 的时间估计比值")
print("=" * 78)
print(f"{'算子':<32s}{'I/I*':>10s}{'算力×2 的加速':>16s}{'带宽×2 的加速':>16s}")
I_star = a100["peak_flops"] / a100["peak_bw"]
for name, (F, Db) in cases:
s_flops, s_bw = optimize_headroom(F, Db, a100["peak_flops"], a100["peak_bw"])
print(f"{name:<32s}{(F / Db) / I_star:>10.3f}"
f"{s_flops:>14.2f}x{s_bw:>14.2f}x")
print("\n 读法:带宽受限的行(I/I* < 1)里「算力×2」那一列几乎都是 1.00——"
"\n 在只改变计算峰值且访存不变的理想模型里,该列为 1。")
# ── 五、GEMM 什么时候从带宽受限翻到算力受限 ─────────────────────
print("\n" + "=" * 78)
print("五、GEMM [M,4096] x [4096,4096]:M 多大才开始算力受限")
print("=" * 78)
K = Nout = 4096
print(f"{'M':>8s}{'I (FLOP/B)':>14s}{'受限':>12s}")
prev = None
for M in (1, 2, 4, 8, 16, 32, 64, 128, 256, 512, 1024, 4096):
F, Db = gemm(M, K, Nout)
b = bound_of(F, Db, a100["peak_flops"], a100["peak_bw"])
print(f"{M:>8d}{F / Db:>14.2f}{b:>12s}")
if prev == "带宽受限" and b == "算力受限":
print(f" ↑ 拐点:M 在 ({M // 2}, {M}] 之间,"
f"I 越过 ridge point {I_star:.0f}")
prev = b
print("\n 推论:小 batch 推理(M=1~8)里的 GEMM 是带宽受限的,"
"这时候做 fp8 量化省的是字节、不是算力。")
if __name__ == "__main__":
main()"""最小 PyTorch Profiler 对照:无需模型权重;默认CPU,可选CUDA。"""
import json
import statistics
import time
from pathlib import Path
import torch
from torch.profiler import ProfilerActivity, profile, record_function
def main():
torch.manual_seed(7)
torch.set_num_threads(1)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
x = torch.randn(16, 128, device=device)
w = torch.randn(128, 128, device=device)
activities = [ProfilerActivity.CPU]
if device.type == "cuda":
activities.append(ProfilerActivity.CUDA)
def synchronize():
if device.type == "cuda":
torch.cuda.synchronize()
with torch.inference_mode():
for _ in range(5):
torch.mm(x, w)
synchronize()
samples = []
for _ in range(10):
synchronize()
start = time.perf_counter()
torch.mm(x, w)
synchronize()
samples.append(time.perf_counter() - start)
# profiler区域用于观察事件;上面单独计时用于延迟,避免混入采集开销。
with profile(activities=activities, record_shapes=True,
profile_memory=True, with_flops=True, acc_events=True) as prof:
with record_function("one_matmul"):
y = torch.mm(x, w)
synchronize()
events = prof.key_averages()
sort = "self_device_time_total" if device.type == "cuda" else "self_cpu_time_total"
print(events.table(sort_by=sort, row_limit=8))
mm = next(event for event in events if event.key == "aten::mm")
expected = 2 * 16 * 128 * 128
assert mm.flops == expected
assert y.shape == (16, 128) and torch.isfinite(y).all()
result = dict(torch_version=torch.__version__, device=str(device),
x_shape=list(x.shape), w_shape=list(w.shape), y_shape=list(y.shape),
estimated_mm_flops=mm.flops, expected_mm_flops=expected,
mm_self_cpu_memory_bytes=mm.self_cpu_memory_usage,
y_bytes=y.numel() * y.element_size(),
standalone_seconds=samples, median_seconds=statistics.median(samples),
event_keys=[event.key for event in events],
note="CPU实跑时不宣称CUDA内核验证;算子分配增量不是设备显存总占用")
here = Path(__file__).resolve().parent
prof.export_chrome_trace(str(here / "profiler_trace.json"))
(here / "profiler_results.json").write_text(json.dumps(result, ensure_ascii=False, indent=2), encoding="utf-8")
print(json.dumps(result, ensure_ascii=False, indent=2))
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""显存账本 + batch 扫描:容量这本账怎么算,以及它怎么反过来决定速度。
只依赖 numpy(第二部分要真跑计时)。直接 `python memory_ledger.py` 即可运行,约 10 秒。
第一部分是「容量账」:权重 / KV cache / 激活 / 额外开销四项加总,看 假设 78 GiB 可用预算
能塞多少条并发请求。第二部分是「速度账」:batch 变大之后,同一份权重被更多
token 摊薄,算术强度抬上去。I与I*仅标记模型分类交界,计时曲线不一定出现相同拐点。
"""
import argparse
import statistics
import json
import time
from pathlib import Path
import numpy as np
GIB = 1024 ** 3
def _load_peak():
"""优先读 machine_probe.py 存下的标定快照(保证口径一致);
未运行时明确报错,避免误用另一台机器的峰值。"""
snap = Path(__file__).resolve().parent / "probe_results.json"
if snap.exists():
peak = json.loads(snap.read_text(encoding="utf-8"))["peak"]
return peak["peak_flops"], peak["peak_bw"]
raise FileNotFoundError("请先运行 machine_probe.py;不使用其他机器标定兜底")
P_PEAK, BETA = _load_peak()
I_STAR = P_PEAK / BETA
def kv_cache_bytes(n_tokens: int, n_layers: int, d_kv: int, b: int = 2) -> int:
"""KV cache 字节数:每个 token 每层都要存一份 K 和一份 V。
n_tokens 序列长度(或并发请求的总 token 数)
n_layers 层数 L
d_kv 每层的 KV 总维度 = n_kv_heads × d_head(GQA 时用实际的 KV head 数)
b 每个元素的字节数(fp16/bf16 = 2,fp8 = 1)
"""
return 2 * n_tokens * n_layers * d_kv * b
def ledger(n_params: float, b_w: int, n_layers: int, d_kv: int,
batch: int, seq: int, act_per_token: int, overhead_rate: float,
kv_b: int = 2, active_tokens: int | None = None):
"""推理显存账本的四项,单位 GiB。
act_per_token 每个 token 的激活峰值(字节)。推理不保留整层的中间结果,
但当前层的十几份临时张量要同时活着:d_model=4096、fp16 时
一份 [d] 张量 8 KiB,取 16 份 ≈ 128 KiB / token。
这是16份张量的教学假设,不是实测或通用经验值。
overhead_rate 教学额外开销 / (权重 + KV + 激活),不是实测碎片率。
本函数按未分块 prefill 计 batch*seq 个活跃 token;
逐 token decode 的激活应改为 batch*act_per_token,KV 仍取 batch*seq。
"""
w = n_params * b_w
if min(n_params, b_w, n_layers, d_kv, batch, seq, act_per_token, overhead_rate, kv_b) < 0:
raise ValueError("容量输入不得为负")
active = batch * seq if active_tokens is None else active_tokens
if active < 0:
raise ValueError("活跃token数不得为负")
kv = kv_cache_bytes(batch * seq, n_layers, d_kv, b=kv_b)
act = active * act_per_token
frag = (w + kv + act) * overhead_rate
return dict(weights=w / GIB, kv=kv / GIB, act=act / GIB, frag=frag / GIB,
total=(w + kv + act + frag) / GIB)
def part1():
print("=" * 80)
print("一、显存账本:一张 假设 78 GiB 可用预算,能塞多少条并发请求")
print("=" * 80)
# Llama-2-7B 的配置:32 层、32 个 KV head、d_head=128 → d_kv = 4096
N_PARAMS, N_LAYERS, D_KV = 7e9, 32, 4096
SEQ = 4096
per_token = kv_cache_bytes(1, N_LAYERS, D_KV)
print(f" 模型:7B,fp16 权重 = {N_PARAMS * 2 / GIB:.1f} GiB,"
f"{N_LAYERS} 层,d_kv = {D_KV}")
print(f" KV cache 单价:{per_token / 1024:.0f} KiB / token "
f"(一条 {SEQ} 长的序列 = {per_token * SEQ / GIB:.2f} GiB)")
print()
hdr = (f"{'batch':>6s}{'权重':>9s}{'KV cache':>10s}{'激活':>9s}"
f"{'额外开销':>9s}{'合计':>9s}{'78GiB预算':>10s}")
print(hdr)
print("-" * len(hdr))
for batch in (1, 4, 8, 16, 24, 32):
# 朴素预分配:按最大长度全预留,教学假设:以权重+KV+激活总和的 30% 估计额外开销,不是实测碎片比例
naive = ledger(N_PARAMS, 2, N_LAYERS, D_KV, batch, SEQ,
act_per_token=131072, overhead_rate=0.30)
ok = "装得下" if naive["total"] < 78 else "OOM"
print(f"{batch:>6d}{naive['weights']:>8.1f}G{naive['kv']:>9.2f}G"
f"{naive['act']:>8.2f}G{naive['frag']:>8.2f}G"
f"{naive['total']:>8.2f}G{ok:>10s}")
# 换成低开销假设(教学假设,非 PagedAttention 实测):额外开销率降到 4%
print("\n 同一张卡,把额外开销率从 30% 降到 4%(低开销假设):")
print(f"{'batch':>6s}{'朴素合计':>11s}{'低开销假设':>11s}{'多出来的并发':>16s}")
for batch in (8, 16, 24, 32):
naive = ledger(N_PARAMS, 2, N_LAYERS, D_KV, batch, SEQ, 131072, 0.30)
low_overhead = ledger(N_PARAMS, 2, N_LAYERS, D_KV, batch, SEQ, 131072, 0.04)
extra = ""
if naive["total"] > 78 >= low_overhead["total"]:
extra = "从 OOM 变装得下"
print(f"{batch:>6d}{naive['total']:>10.2f}G{low_overhead['total']:>10.2f}G"
f"{extra:>16s}")
print("\n 读法:权重那一项是常数,batch 再大也不变;KV cache 才是随并发")
print(" 线性增长的那一项,batch 16 时它已经比权重还大。")
print(" 「显存够放权重就能跑」这句话漏掉了后面三项。")
# 用 roofline_model 里同款口径:下界 = max(F/P, D/beta)。
# P_PEAK / BETA / I_STAR 已在文件顶部从标定快照读出,这里不再覆盖,
# 否则快照刷新后正文引用的数字会和实际跑出来的对不上。
def batch_sweep(repeats: int = 15, d: int = 1024):
"""固定一份「权重」,扫 batch,返回每一档的实测延迟/吞吐/算术强度。"""
rng = np.random.default_rng(0)
W = rng.standard_normal((d, d), dtype=np.float32) # 默认4 MiB,large模式64 MiB的权重
W_bytes = W.nbytes
FP32 = 4
def run(B):
x = rng.standard_normal((B, d), dtype=np.float32)
y = np.empty((B, d), dtype=np.float32)
np.matmul(x, W, out=y) # 预热
samples = []
for _ in range(repeats):
t = time.perf_counter()
np.matmul(x, W, out=y)
samples.append(time.perf_counter() - t)
return min(samples), samples
rows = []
for B in (1, 2, 4, 8, 16, 32, 64, 128, 256):
F = 2.0 * B * d * d
D = W_bytes + 2 * B * d * FP32
I = F / D
dt, samples = run(B)
rows.append(dict(B=B, F=F, D=D, I=I, lat=dt, thr=B / dt,
bound="算力" if I >= I_STAR else "带宽",
t_pred=max(F / P_PEAK, D / BETA),
eff=max(F / P_PEAK, D / BETA) / dt, matrix_side=d,
median_seconds=statistics.median(samples), samples_seconds=samples))
return rows, W_bytes
def part2(d=1024):
"""batch 扫描实测:延迟、吞吐、算术强度,以及拐点在哪。"""
print("\n" + "=" * 80)
print("二、batch 扫描实测:吞吐什么时候不再涨")
print("=" * 80)
rows, W_bytes = batch_sweep(d=d)
(Path(__file__).resolve().parent / "batch_results.json").write_text(
json.dumps(dict(rows=rows, weight_bytes=W_bytes,
peak=dict(peak_flops=P_PEAK, peak_bw=BETA), matrix_side=d), indent=2), encoding="utf-8")
print(f" 固定「权重」W 形状 [{d}, {d}],fp32 = {W_bytes / 2 ** 20:.0f} MiB;"
f"batch B 就是一次喂进去的 token 数")
print(f" 经验参考(来自 machine_probe 的标定快照):"
f"P = {P_PEAK / 1e9:.0f} GFLOP/s,beta = {BETA / 1e9:.1f} GB/s,"
f"I* = {I_STAR:.1f}")
print()
hdr = (f"{'B':>6s}{'F (GFLOP)':>12s}{'D (MB)':>10s}{'I':>9s}{'受限':>8s}"
f"{'延迟 ms':>10s}{'吞吐 K/s':>11s}{'估计 ms':>10s}{'达成率':>9s}")
print(hdr)
print("-" * len(hdr))
prev_bound = None
for r in rows:
print(f"{r['B']:>6d}{r['F'] / 1e9:>12.3f}{r['D'] / 1e6:>10.2f}"
f"{r['I']:>9.2f}{r['bound']:>8s}{r['lat'] * 1e3:>10.3f}"
f"{r['thr'] / 1e3:>9.1f}K{r['t_pred'] * 1e3:>10.3f}"
f"{r['eff'] * 100:>8.0f}%")
if prev_bound == "带宽" and r["bound"] == "算力":
print(f" ↑ 拐点:B 从 {r['B'] // 2} 到 {r['B']} 之间"
f"越过 ridge point {I_STAR:.1f}")
prev_bound = r["bound"]
# 只标记延迟变化;不从总计时猜测库实现路径或实际硬件瓶颈。
for r0, r1 in zip(rows, rows[1:]):
if r1["B"] == 2 * r0["B"] and r1["lat"] > r0["lat"] * 1.5:
print(f" ! 反常:B={r0['B']} 只要 {r0['lat'] * 1e3:.2f} ms,"
f"B={r1['B']} 却要 {r1['lat'] * 1e3:.2f} ms")
base = rows[0]
top = rows[-1]
print(f"\n 延迟:B=1 时 {base['lat'] * 1e3:.3f} ms,B={top['B']} 时 "
f"{top['lat'] * 1e3:.3f} ms(涨 {top['lat'] / base['lat']:.1f} 倍)")
print(f" 吞吐:B=1 时 {base['thr'] / 1e3:.1f} K/s,B={top['B']} 时 "
f"{top['thr'] / 1e3:.1f} K/s(涨 {top['thr'] / base['thr']:.1f} 倍)")
print(f" 单样本成本:B={top['B']} 时把 {W_bytes / 2 ** 20:.0f} MiB 权重的逻辑读取摊薄到 {top['B']} 个样本,"
f"每个样本只摊 {W_bytes / top['B'] / 2 ** 20:.2f} MiB")
print(" → 增大 batch 可摊薄权重访问;延迟是否平坦、吞吐能增加多少仍需实测。")
print(" → 上面标 ! 的行是 roofline 看不见的东西:同样的公式、更大的 batch,"
"可能涉及内核选择、调度或计时波动,单凭本表不能确诊。")
if __name__ == "__main__":
parser = argparse.ArgumentParser()
parser.add_argument("--large", action="store_true", help="batch权重恢复4096x4096")
args = parser.parse_args()
part1()
part2(d=4096 if args.large else 1024)#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""生成「性能建模与 Profiling」一文的四张解释图。
图里的计时优先读取已保存的实测快照,避免重绘时图文使用不同测量:
* roofline.png 峰值与落点来自 machine_probe.calibrate() / probe()
* batch_scaling.png 来自 memory_ledger.batch_sweep()
* memory_ledger.png 来自 memory_ledger.ledger()
* opt_gain.png 来自 roofline_model.optimize_headroom()
只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行,约 40 秒。
改了另外三个脚本,这里要重跑,避免图与正文数字对不上。
"""
import json
import sys
from pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
HERE = Path(__file__).resolve().parent
sys.path.insert(0, str(HERE))
import machine_probe as MP # noqa: E402
import memory_ledger as ML # noqa: E402
import roofline_model as RM # noqa: E402
OUT = HERE.parent / "figures"
try:
# exist_ok=True 是必须的:目录已存在时 pathlib 会抛 FileExistsError,
# 少数沙箱环境连 exist_ok=True 的 mkdir 也一并拦,这里再兜一层。
OUT.mkdir(exist_ok=True)
except PermissionError:
if not OUT.is_dir():
raise
plt.rcParams.update({
"font.sans-serif": ["Microsoft YaHei", "SimHei", "PingFang SC", "DejaVu Sans"],
"axes.unicode_minus": False,
"figure.dpi": 160,
"savefig.dpi": 160,
})
C_MEM = "#e05263" # 带宽受限:红
C_CMP = "#3f7fbf" # 算力受限:蓝
C_ACC = "#2f9e6f" # 好结果:绿
C_GREY = "#94a3b8"
# ── 图 1:roofline 曲线 + 实测落点 ────────────────────────────────
def fig_roofline(peak, rows):
P = peak["peak_flops"] / 1e9 # GFLOP/s
beta = peak["peak_bw"] / 1e9 # GB/s
I_star = P / beta # 因为两个都除过 1e9,比值不变
I = np.logspace(-2, 4, 400)
perf = np.minimum(P, beta * I)
fig, ax = plt.subplots(figsize=(8.4, 5.4))
ax.loglog(I, perf, color="k", lw=2.2)
ax.axvline(I_star, color=C_GREY, ls="--", lw=1.4)
ax.text(I_star * 1.15, 3, f"ridge point I* = {I_star:.0f}\nFLOP/Byte",
color="#475569", fontsize=9, va="bottom")
ax.text(0.012, 25, f"GEMM经验参考 P = {P:.0f} GFLOP/s", fontsize=9,
color="#475569")
ax.text(0.012, P * 3, "斜线 = add经验参考,beta = "
f"{beta:.0f} GB/s", fontsize=9, color="#475569")
# 落点:用实测时间反推实际性能
short = {
"逐元素 add(1 遍)": "逐元素 add",
"add+relu 两遍(预分配)": "add+relu 两遍",
"add+relu 写成一行(有中间数组)": "add+relu 一行写法",
"LayerNorm [8192,4096] 预分配": "LayerNorm",
"attention 朴素 [N=2048,D=128]": "朴素 attention",
"GEMM 512x4096x4096": "GEMM M=512",
"GEMM 2048x4096x4096": "GEMM M=2048",
"GEMM 4096x4096x4096": "GEMM M=4096",
}
offsets = { # 手工调过:右边缘和重叠的标签让位
"GEMM M=4096": (-10, 10),
"GEMM M=2048": (10, -4),
"GEMM M=512": (12, -14),
"朴素 attention": (7, -3),
}
# 左下角四个点挤在一起,用箭头把标签拉到右边的空地上
arrows = {
"逐元素 add": (0.42, 9.5),
"LayerNorm": (0.42, 5.6),
"add+relu 两遍": (0.42, 3.1),
"add+relu 一行写法": (0.42, 1.75),
}
for r in rows:
name = short.get(r["name"], r["name"])
if r["name"].startswith("GEMM "):
name = "GEMM M=" + r["name"].split()[1].split("x")[0]
elif r["name"].startswith("LayerNorm"):
name = "LayerNorm"
elif r["name"].startswith("attention"):
name = "朴素 attention"
y = r["gflops"]
ax.scatter([r["I"]], [y], s=52,
color=C_MEM if r["bound"] == "带宽" else C_CMP,
zorder=5, edgecolor="white", linewidth=0.8)
if name.startswith("GEMM M="):
m = int(name.split("=")[1])
target = {128: (55, P * 1.8), 512: (280, P * 3.3), 1024: (900, P * 1.8)}.get(m)
if target:
ax.annotate(name, (r["I"], y), xytext=target, fontsize=8.5, color="#334155",
arrowprops=dict(arrowstyle="-", color=C_GREY, lw=0.9))
continue
if name in arrows:
tx, ty = arrows[name]
ax.annotate(name, (r["I"], y), xytext=(tx, ty),
fontsize=8.5, color="#334155",
arrowprops=dict(arrowstyle="-", color=C_GREY, lw=0.9),
va="center")
continue
dx, dy = offsets.get(name, (7, -3))
ha = "right" if dx < 0 else "left"
ax.annotate(name, (r["I"], y), textcoords="offset points",
xytext=(dx, dy), fontsize=8.5, color="#334155", ha=ha)
ax.set_xlabel("算术强度 I = F / D (FLOP/Byte)")
ax.set_ylabel("教学操作计数 / 实测时间 (Gop/s)")
ax.set_title("图 1:逻辑流量与经验参考 —— 模型位置不能单独确诊瓶颈",
fontsize=11)
ax.set_xlim(0.01, 5000)
ax.set_ylim(0.3, max(600, P * 6))
ax.grid(alpha=0.25, which="both", ls=":")
handles = [plt.Line2D([], [], marker="o", ls="", color=C_MEM,
label="模型分类:I < I*"),
plt.Line2D([], [], marker="o", ls="", color=C_CMP,
label="模型分类:I >= I*")]
ax.legend(handles=handles, loc="lower right", fontsize=8.5, framealpha=0.9)
fig.tight_layout()
fig.savefig(OUT / "roofline.png")
plt.close(fig)
# ── 图 3:batch 扫描的延迟与吞吐 ──────────────────────────────────
def fig_batch(rows):
B = [r["B"] for r in rows]
lat = [r["lat"] * 1e3 for r in rows]
thr = [r["thr"] / 1e3 for r in rows]
fig, ax1 = plt.subplots(figsize=(8.4, 5.0))
ax1.plot(B, lat, "o-", color=C_CMP, lw=2, label="延迟(左轴)")
ax1.set_xscale("log", base=2)
ax1.set_xlabel("batch B(一次喂进去的 token 数)")
ax1.set_ylabel("延迟 (ms)", color=C_CMP)
ax1.tick_params(axis="y", labelcolor=C_CMP)
ax2 = ax1.twinx()
ax2.plot(B, thr, "s--", color=C_ACC, lw=2, label="吞吐(右轴)")
ax2.set_ylabel("吞吐 (K token/s)", color=C_ACC)
ax2.tick_params(axis="y", labelcolor=C_ACC)
# 拐点:I 越过 ridge point 的地方
cross = next((r for r in rows if r["bound"] == "算力"), None)
if cross:
ax1.axvline(cross["B"], color=C_GREY, ls=":", lw=1.5)
ax1.text(cross["B"] * 1.05, max(lat) * 0.92,
f"越过 ridge point\nB ≈ {cross['B']}", fontsize=9,
color="#475569")
# 库的反常:延迟不随 batch 单调
b8 = next((r["lat"] for r in rows if r["B"] == 8), None)
spike = next((r for r in rows if r["B"] in (2, 4) and
b8 is not None and r["lat"] > 1.5 * b8), None)
if spike:
ax1.annotate(f"B={spike['B']} 延迟为 B=8 的 {spike['lat']/b8:.1f} 倍\n(原因需 profile)",
(spike["B"], spike["lat"] * 1e3),
textcoords="offset points", xytext=(14, -6),
fontsize=8.5, color=C_MEM)
ax1.set_title("图 3:batch 扫描 —— 实测延迟、吞吐与 roofline 模型交界",
fontsize=11)
ax1.grid(alpha=0.25, ls=":")
lines1, lab1 = ax1.get_legend_handles_labels()
lines2, lab2 = ax2.get_legend_handles_labels()
ax1.legend(lines1 + lines2, lab1 + lab2, loc="upper left", fontsize=9)
fig.tight_layout()
fig.savefig(OUT / "batch_scaling.png")
plt.close(fig)
# ── 图 4:显存账本 ────────────────────────────────────────────────
def fig_ledger():
batches = [1, 4, 8, 16, 24, 32]
naive = [ML.ledger(7e9, 2, 32, 4096, b, 4096, 131072, 0.30) for b in batches]
low_overhead = [ML.ledger(7e9, 2, 32, 4096, b, 4096, 131072, 0.04) for b in batches]
fig, (ax, ax2) = plt.subplots(1, 2, figsize=(11.2, 4.8),
gridspec_kw={"width_ratios": [1.35, 1]})
x = np.arange(len(batches))
keys = [("weights", "权重", "#3f7fbf"), ("kv", "KV cache", "#e05263"),
("act", "激活", "#e8a33d"), ("frag", "额外开销", "#94a3b8")]
bottom = np.zeros(len(batches))
for k, label, color in keys:
vals = np.array([d[k] for d in naive])
ax.bar(x, vals, bottom=bottom, label=label, color=color, width=0.62,
edgecolor="white", linewidth=0.6)
bottom += vals
ax.axhline(78, color="k", ls="--", lw=1.3)
ax.text(len(batches) - 0.4, 79, "教学假设:78 GiB 可用预算", fontsize=8.5,
ha="right", color="#334155", bbox=dict(facecolor="white", alpha=0.85, edgecolor="none", pad=1))
for i, d in enumerate(naive):
if d["total"] > 78:
ax.text(i, d["total"] + 2, "OOM", ha="center", fontsize=9,
color=C_MEM, fontweight="bold")
ax.set_xticks(x)
ax.set_xticklabels(batches)
ax.set_xlabel("并发序列数 batch")
ax.set_ylabel("显存 (GiB)")
ax.set_title("图 4a:未分块 prefill 教学账本(额外开销率 30%)", fontsize=10.5)
ax.legend(fontsize=8.5, ncol=2)
ax.grid(axis="y", alpha=0.25, ls=":")
w_naive = [d["total"] for d in naive]
w_low_overhead = [d["total"] for d in low_overhead]
ax2.bar(x - 0.2, w_naive, width=0.4, label="额外开销率30%", color="#e05263")
ax2.bar(x + 0.2, w_low_overhead, width=0.4, label="低开销假设", color="#2f9e6f")
ax2.axhline(78, color="k", ls="--", lw=1.3)
ax2.set_xticks(x)
ax2.set_xticklabels(batches)
ax2.set_xlabel("并发序列数 batch")
ax2.set_ylabel("合计显存 (GiB)")
ax2.set_title("图 4b:只把额外开销率从 30% 降到 4%", fontsize=10.5)
ax2.legend(fontsize=8.5)
ax2.grid(axis="y", alpha=0.25, ls=":")
fig.suptitle("图 4:显存账本的四项 —— 权重是常数,KV cache 随并发线性增长",
fontsize=11)
fig.tight_layout()
fig.savefig(OUT / "memory_ledger.png")
plt.close(fig)
# ── 图 2:砍算力 vs 砍带宽,各有多少钱 ────────────────────────────
def fig_opt_gain():
a100 = RM.SPECS["A100-40GB SXM (bf16)"]
ratio = np.logspace(-2, 1.2, 300)
sp_flops, sp_bw = [], []
for r in ratio:
# 造一个算术强度恰好是 r × I* 的算子:固定 D,F 由 r 决定
D = 1e8
F = r * (a100["peak_flops"] / a100["peak_bw"]) * D
s_f, s_b = RM.optimize_headroom(F, D, a100["peak_flops"], a100["peak_bw"])
sp_flops.append(s_f)
sp_bw.append(s_b)
fig, ax = plt.subplots(figsize=(8.4, 4.8))
ax.semilogx(ratio, sp_flops, color=C_CMP, lw=2.2,
label="算力翻 2 倍能拿到的加速")
ax.semilogx(ratio, sp_bw, color=C_MEM, lw=2.2,
label="带宽翻 2 倍能拿到的加速")
ax.axvline(1.0, color=C_GREY, ls="--", lw=1.4)
ax.text(1.05, 1.02, "I = I*:分界线", fontsize=9, color="#475569")
ax.fill_between(ratio, 0.98, 2.02, where=np.array(ratio) < 1,
color=C_MEM, alpha=0.07)
ax.fill_between(ratio, 0.98, 2.02, where=np.array(ratio) >= 1,
color=C_CMP, alpha=0.07)
ax.text(0.05, 1.9, "带宽受限区:\n换更快的算力单元 = 0 收益",
fontsize=9, color=C_MEM)
ax.text(6, 1.9, "算力受限区:\n加带宽 = 0 收益", fontsize=9, color=C_CMP)
ax.set_xlabel("算术强度 / ridge point (I / I*)")
ax.set_ylabel("教学模型时间估计比值")
ax.set_ylim(0.95, 2.1)
ax.set_title("图 2:只改变一个资源的教学模型 —— 实际收益需验证",
fontsize=11)
ax.grid(alpha=0.25, ls=":")
ax.legend(fontsize=9, loc="center right")
fig.tight_layout()
fig.savefig(OUT / "opt_gain.png")
plt.close(fig)
def main():
# --only <图名>:只重画指定一张(roofline / batch / ledger / gain),
# 避免为了改一张图的标签把所有实测算子重跑一遍、数字跟正文引用分叉。
only = None
if "--only" in sys.argv:
only = sys.argv[sys.argv.index("--only") + 1]
# 优先读 machine_probe.py 存的标定快照,保证图上数字与正文引用同源
if MP.SNAPSHOT.exists():
snap = json.loads(MP.SNAPSHOT.read_text(encoding="utf-8"))
peak = snap["peak"]
print(f"读取标定快照({snap['timestamp']},{snap['note']}):")
else:
print("没找到标定快照,现场标定一遍…")
peak = MP.calibrate(verbose=False)
MP.SNAPSHOT.write_text(json.dumps(
dict(peak=peak, rows=MP.probe(peak, verbose=False),
note="fresh", timestamp="")))
print(f" P = {peak['peak_flops'] / 1e9:.0f} GFLOP/s, "
f"beta = {peak['peak_bw'] / 1e9:.1f} GB/s, "
f"I* = {peak['peak_flops'] / peak['peak_bw']:.1f}")
if only in (None, "roofline"):
rows = snap.get("rows") if MP.SNAPSHOT.exists() and "snap" in locals() else None
if not rows:
rows = MP.probe(peak, verbose=False)
fig_roofline(peak, rows)
if only in (None, "batch"):
batch_snap = HERE / "batch_results.json"
if batch_snap.exists():
sweeps = json.loads(batch_snap.read_text(encoding="utf-8"))["rows"]
else:
sweeps, weight_bytes = ML.batch_sweep()
batch_snap.write_text(json.dumps(dict(rows=sweeps, weight_bytes=weight_bytes, peak=peak), indent=2))
fig_batch(sweeps)
if only in (None, "ledger"):
fig_ledger()
if only in (None, "gain"):
fig_opt_gain()
if only and only not in ("roofline", "batch", "ledger", "gain"):
raise ValueError("unknown figure: " + only)
print(f"\n图已写入 {OUT}")
if __name__ == "__main__":
main()
评论 (0)