今日 AIGC 论文速览
今日共 10 篇 · 图像编辑与生成安全 2 篇 · 统一预训练与视频运动 2 篇 · 多模态联合生成 2 篇 · 音频生成与后训练 2 篇 · 推理加速与视频评测 2 篇
重点论文标题列表
KwaiMind (快手):180万对数据炼电商修图UVU (清华大学):视觉监督前移,RefCOCO涨7.7⚡ Unite-Audio (东京科学大学):117M音频生成,CLAP登顶
MotionSpec (卡迪夫大学):频谱轨迹约束视频运动RecCAR (巴伊兰大学):反向注意力补齐,音画更同步
今日论文速览
1. KwaiMind:180万对数据炼电商修图
KwaiMind Technical Report | 快手 | arXiv:2609.26375
关键词 :图像编辑,电商,CTR奖励,Ecom-Bench,在线强化学习
⚠️ 前序问题 :电商修图不是通用编辑:商品主体要一模一样、促销文字要渲染准确、图还得有点击欲。通用编辑模型在这三件事上都没专门优化,而电商数据的采集清洗又贵又杂,缺一套能稳定产出高质量配对数据的流水线。
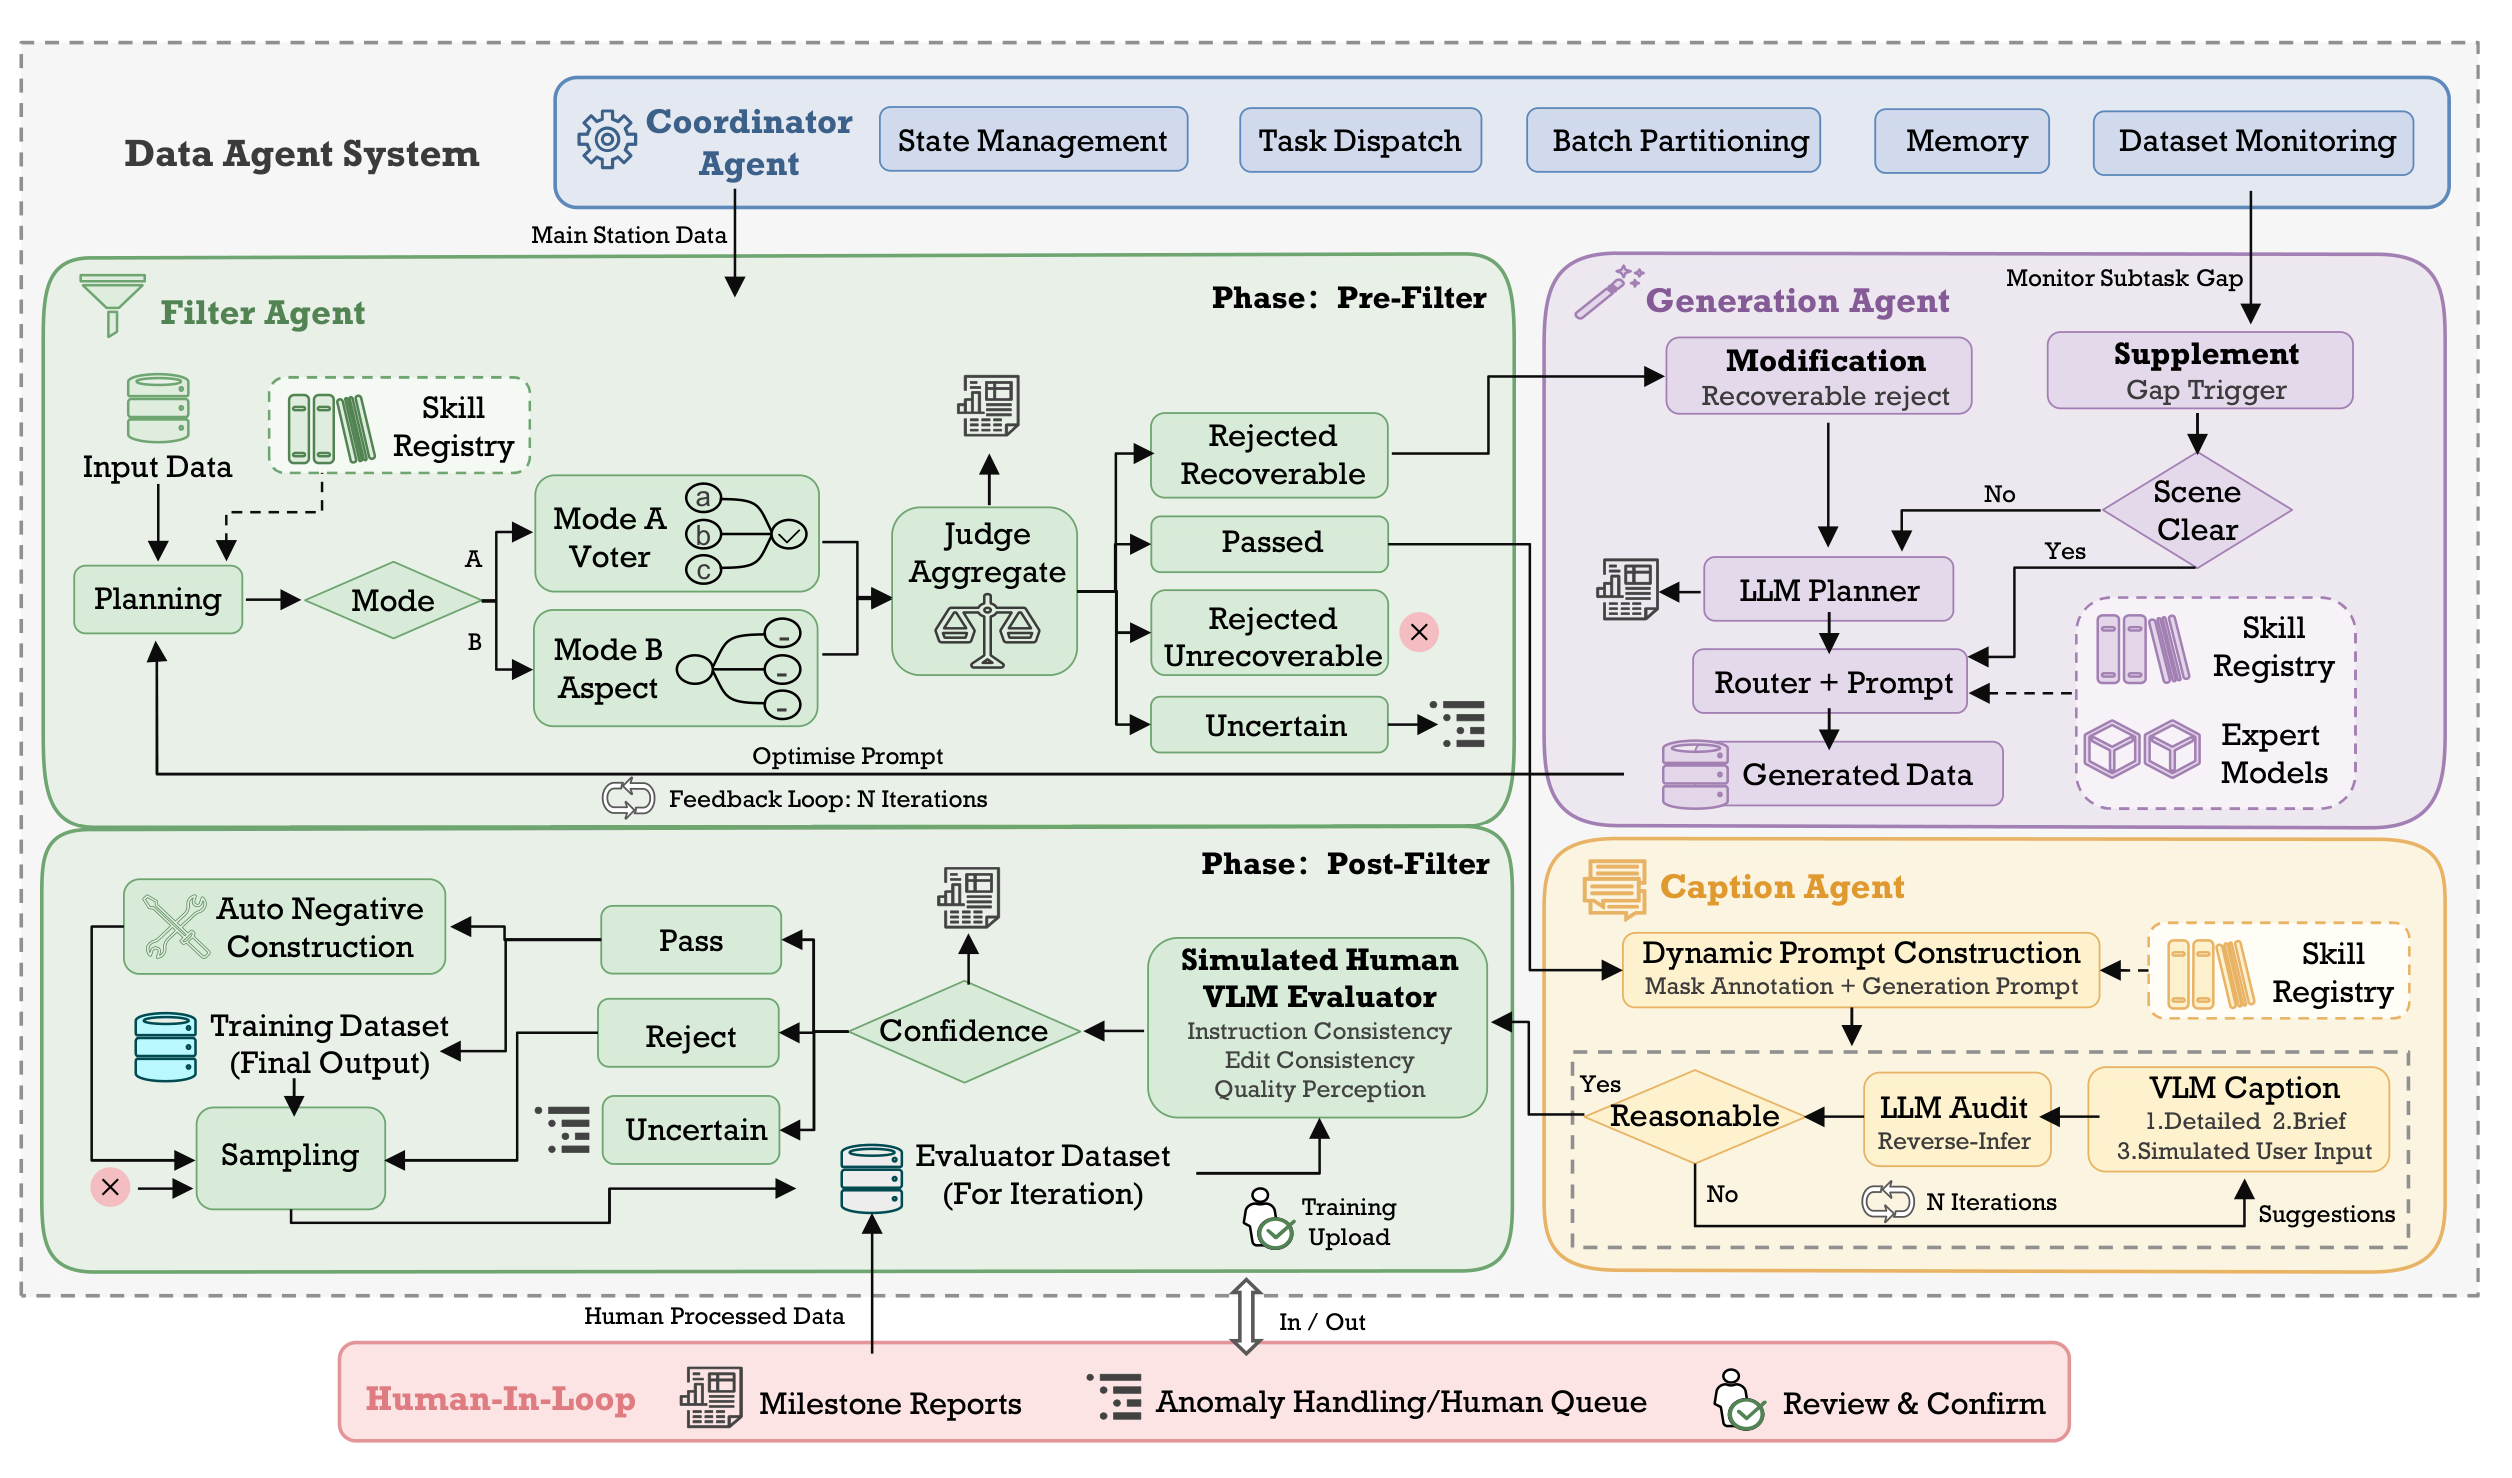
本文贡献 :快手发布 KwaiMind:多模态 DiT 底座,Agent 数据引擎维护约 180 万高质量编辑对;继续预训练加 SFT 后走偏好优化与在线 RL,用 VLM 通用裁判加 CTR、文字渲染、商品一致性三类专用奖励训练专精策略,再经 on-policy 蒸馏合并成单一模型;配套发布覆盖 11 类商业编辑任务的 Ecom-Bench。
Overview of the end-to-end data pipeline. Coordinator Agent routes samples through filtering, generation, captioning, and post-filtering with bounded feedback loops and human review.
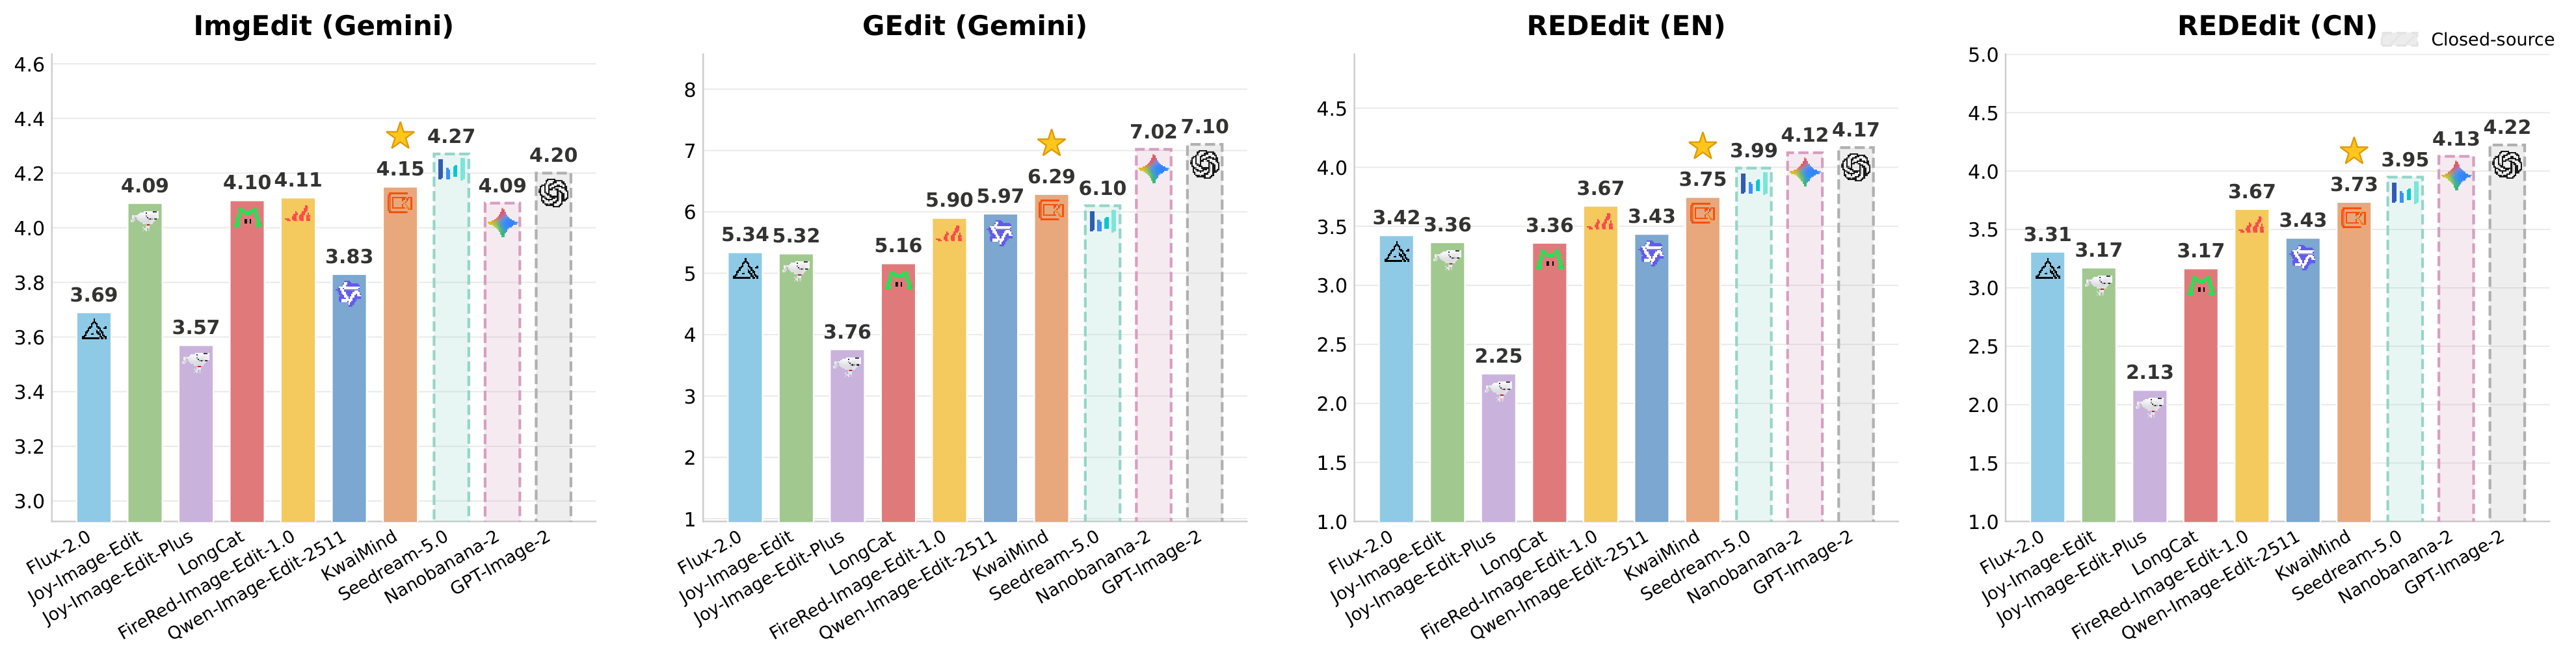
实验效果 :开源编辑器里综合最强:ImgEdit 4.15、GEdit 5.79、REDEdit 英/中 3.75/3.73,Ecom-Bench 视觉质量第一;CTR 引导优化把生成图预测 CTR 超过原图的比例从 12.16% 提到 37.41%,线上 A/B 实际 CTR 相对提升约 2.44%。
Overall comparison on general image editing benchmarks: ImgEdit, GEdit, and the English and Chinese splits of REDEdit. Hatched bars denote closed-source models.
批判点评 :最强的限定词是开源:图上闭源模型全面更高——ImgEdit 被 Seedream 4.0 的 4.27 和 GPT-Image-2 的 4.20 压着,GEdit 上 Nano Banana 2 拿 7.02、GPT-Image-2 拿 7.10,比 KwaiMind 的 5.79 高出一大截,REDEdit 两个语种同样如此。真正立住的卖点其实是 CTR 这条商业指标,而不是编辑质量本身。
2. UVU:视觉监督前移,RefCOCO涨7.7
UVU: Improving Multimodal Understanding via Vision-Language Unified Autoregressive Paradigm | 清华大学;腾讯优图实验室;南京大学;格拉斯哥大学 | arXiv:2609.27915
关键词 :统一自回归,像素级codebook,连续视觉编码,视觉监督,预训练
⚠️ 前序问题 :多模态大模型的细粒度视觉理解长期靠稀疏文本监督撑着,已有的视觉监督大多加在后训练阶段,那时视觉表征已基本定型,监督信号只能当辅助约束。要重塑感知骨干,得把视觉监督搬进预训练。
本文贡献 :提出 UVU 视觉语言统一自回归范式:不用向量量化,SigLIP-2 连续视觉特征直接进 LM 解码器做下一 token 预测;设计大规模迭代层次聚类算法构建 20 万词表的像素级视觉 codebook,让图像 patch 与文本 token 在预训练期共享统一监督,模型由此内化视觉重建能力。
Overview of the UVU vision-language unified autoregressive framework. Continuous visual features from SigLIP-2 are projected and integrated with textual embeddings for autoregressive next-token prediction in an LM decoder, generating pixel-level image tokens.
实验效果 :同为 3B/Qwen2.5 底座,RefCOCO 从 84.1 涨到 91.8、LISA 57.4→71.7、CVBench-3D 71.9→76.6、BLINK 46.9→52.8;相对去掉视觉监督的自版 UVU*,RefCOCO +6.2、LISA +12.1。注意力热图显示 UVU 更聚焦目标区域。
Comparison of visual attention heatmaps under three paradigms: from left to right, without visual supervision, AR + VQ, and UVU (Ours).
批判点评 :对手没输干净:SEEDB 74.1 仍低于 LLaVA-OV 的 75.4,MMStar 55.0 输给 56.7,ScienceQA 91.3 远低于 GLM-4v 的 96.7;MME 2201.9 对 LLaVA-OV 2146.3 的领先也只有 2.6%。统一目前只覆盖理解侧,生成侧数据还没进训练,作者自己也在文中承认。
3. Unite-Audio:117M音频生成,CLAP登顶
UNITE-AUDIO: Joint Learning of Continuous Tokenization and Latent Flow Matching for Text-to-Audio Generation | 东京科学大学;清华大学;武汉大学;东京大学;蚂蚁集团 | arXiv:2609.28206
关键词 :文本生成音频,联合训练,flow matching,Flow-GRPO,连续表征
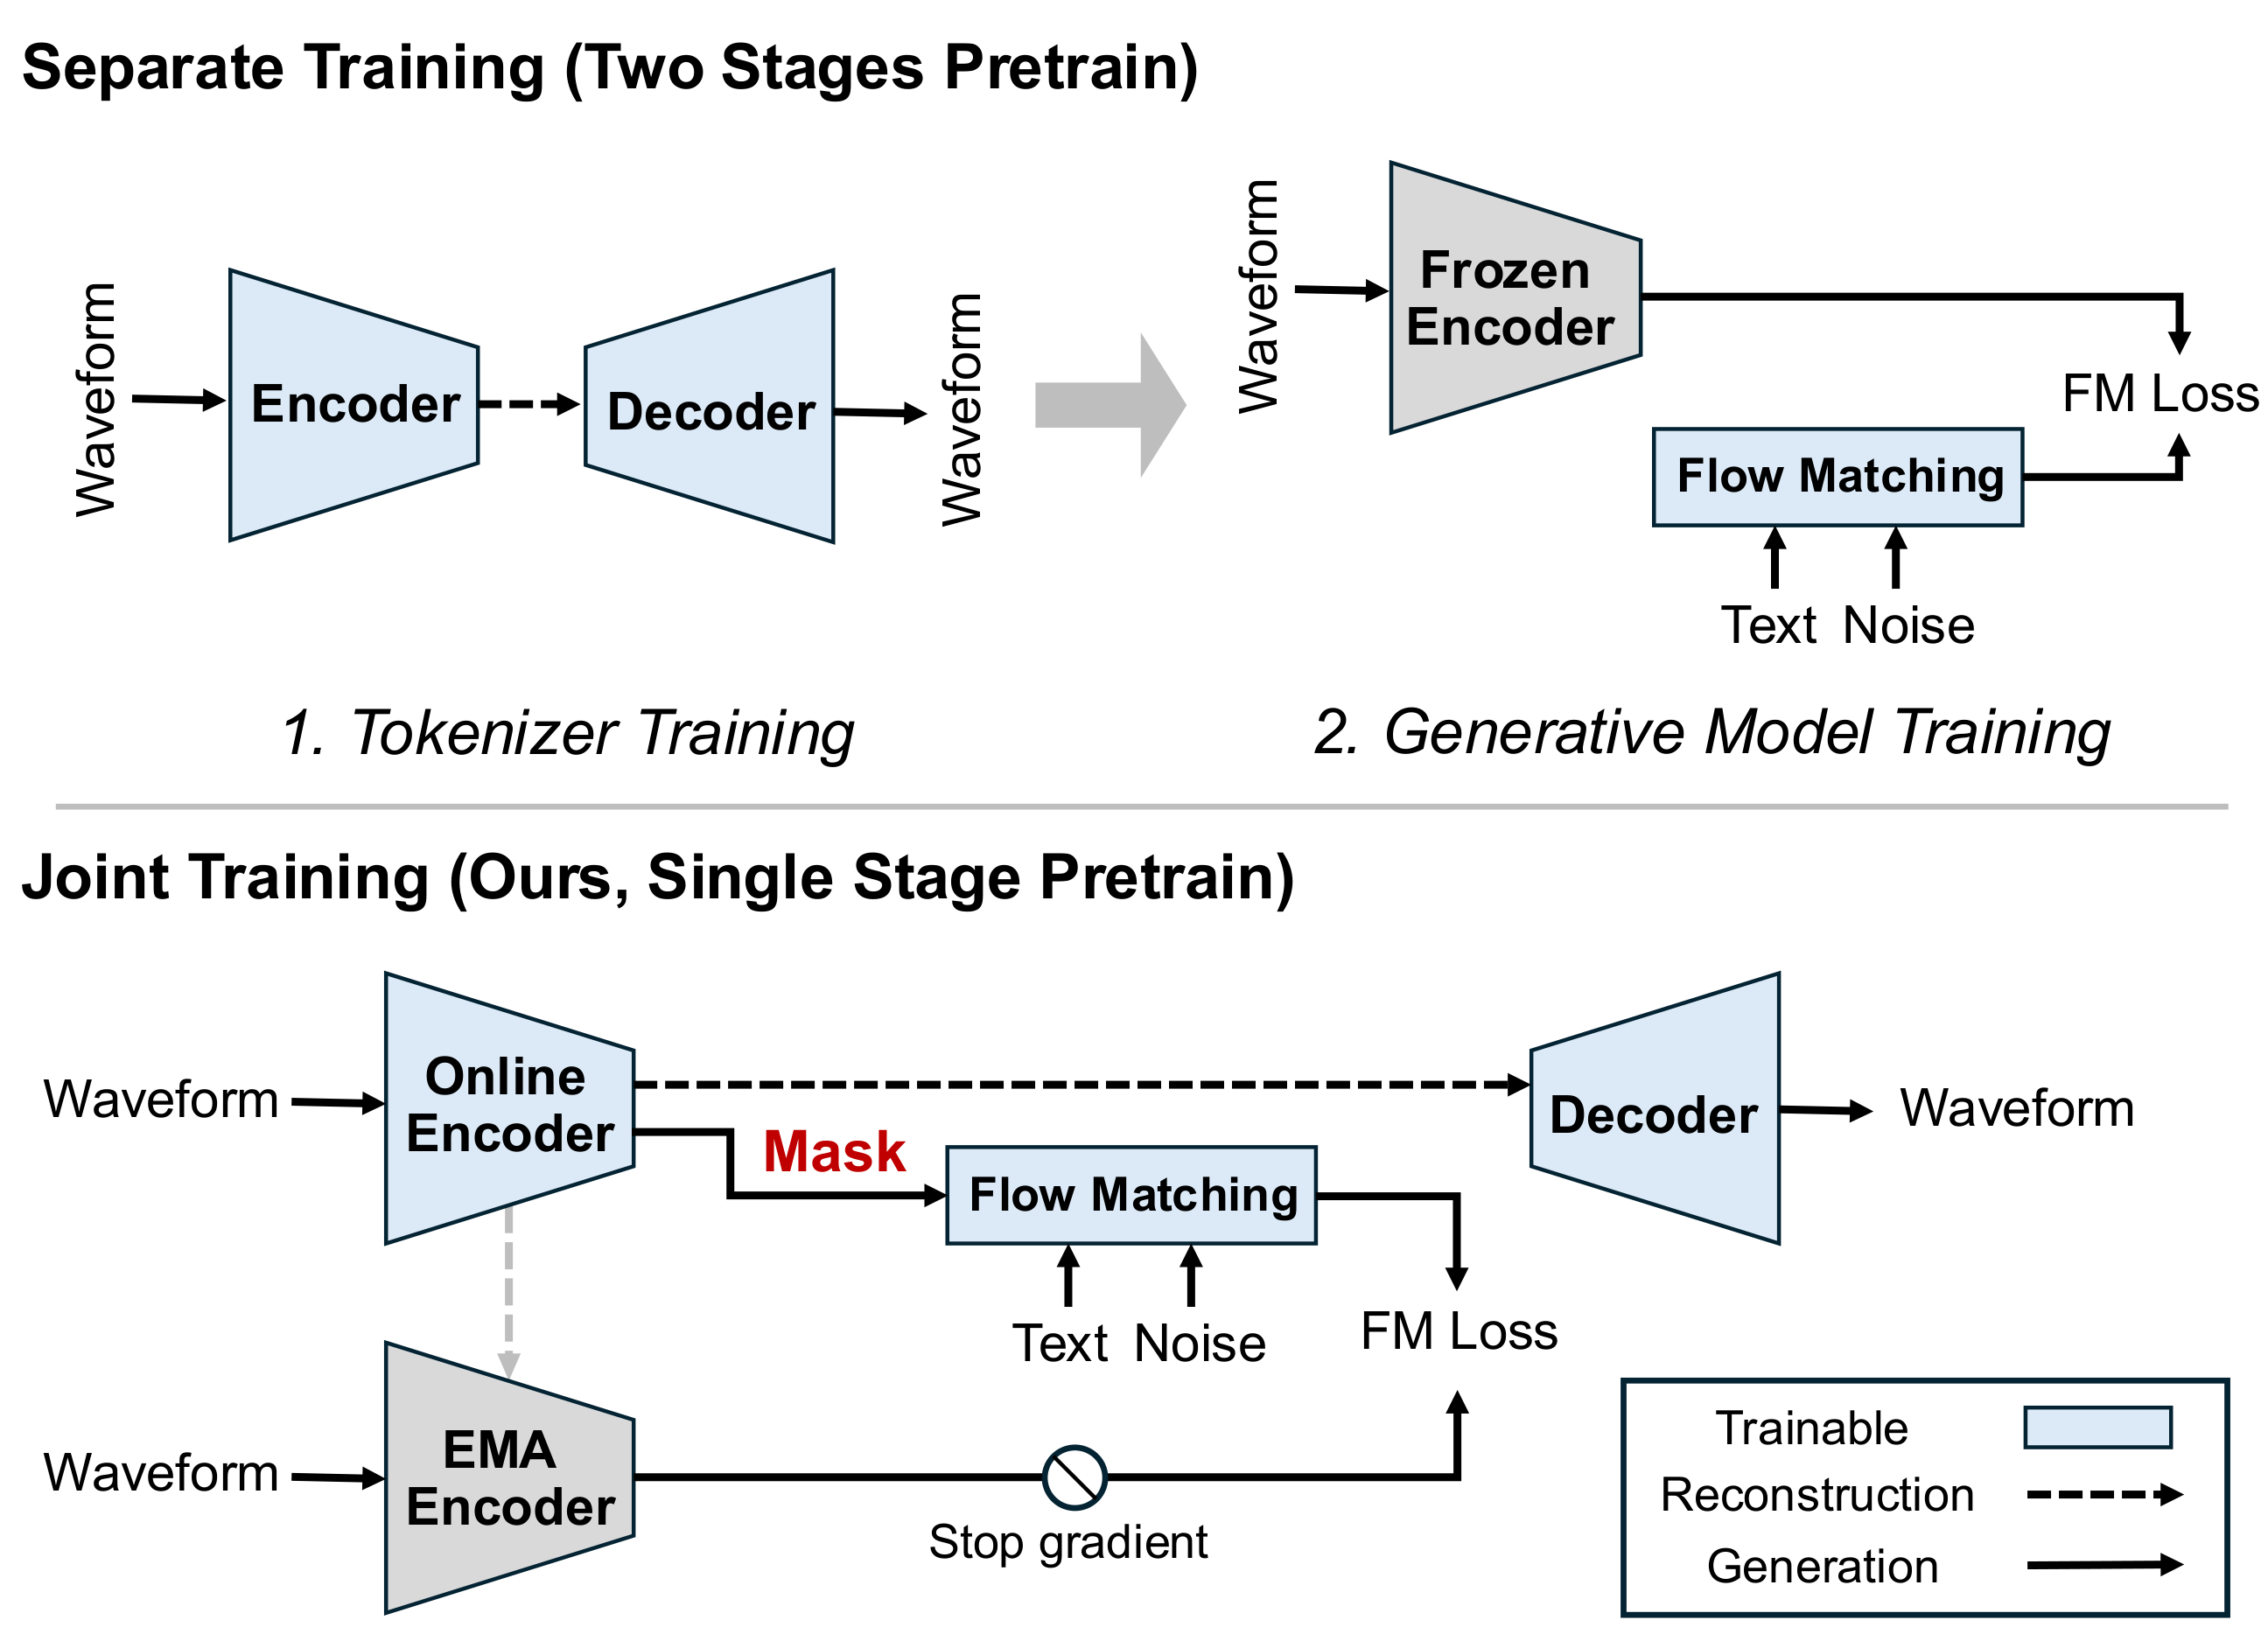
⚠️ 前序问题 :文本生成音频的主流做法是两阶段:先训重建导向的音频 tokenizer 再冻结,然后在固定隐空间训生成模型。但为重建优化的表征未必适合生成,生成目标无法反过来塑造隐空间。
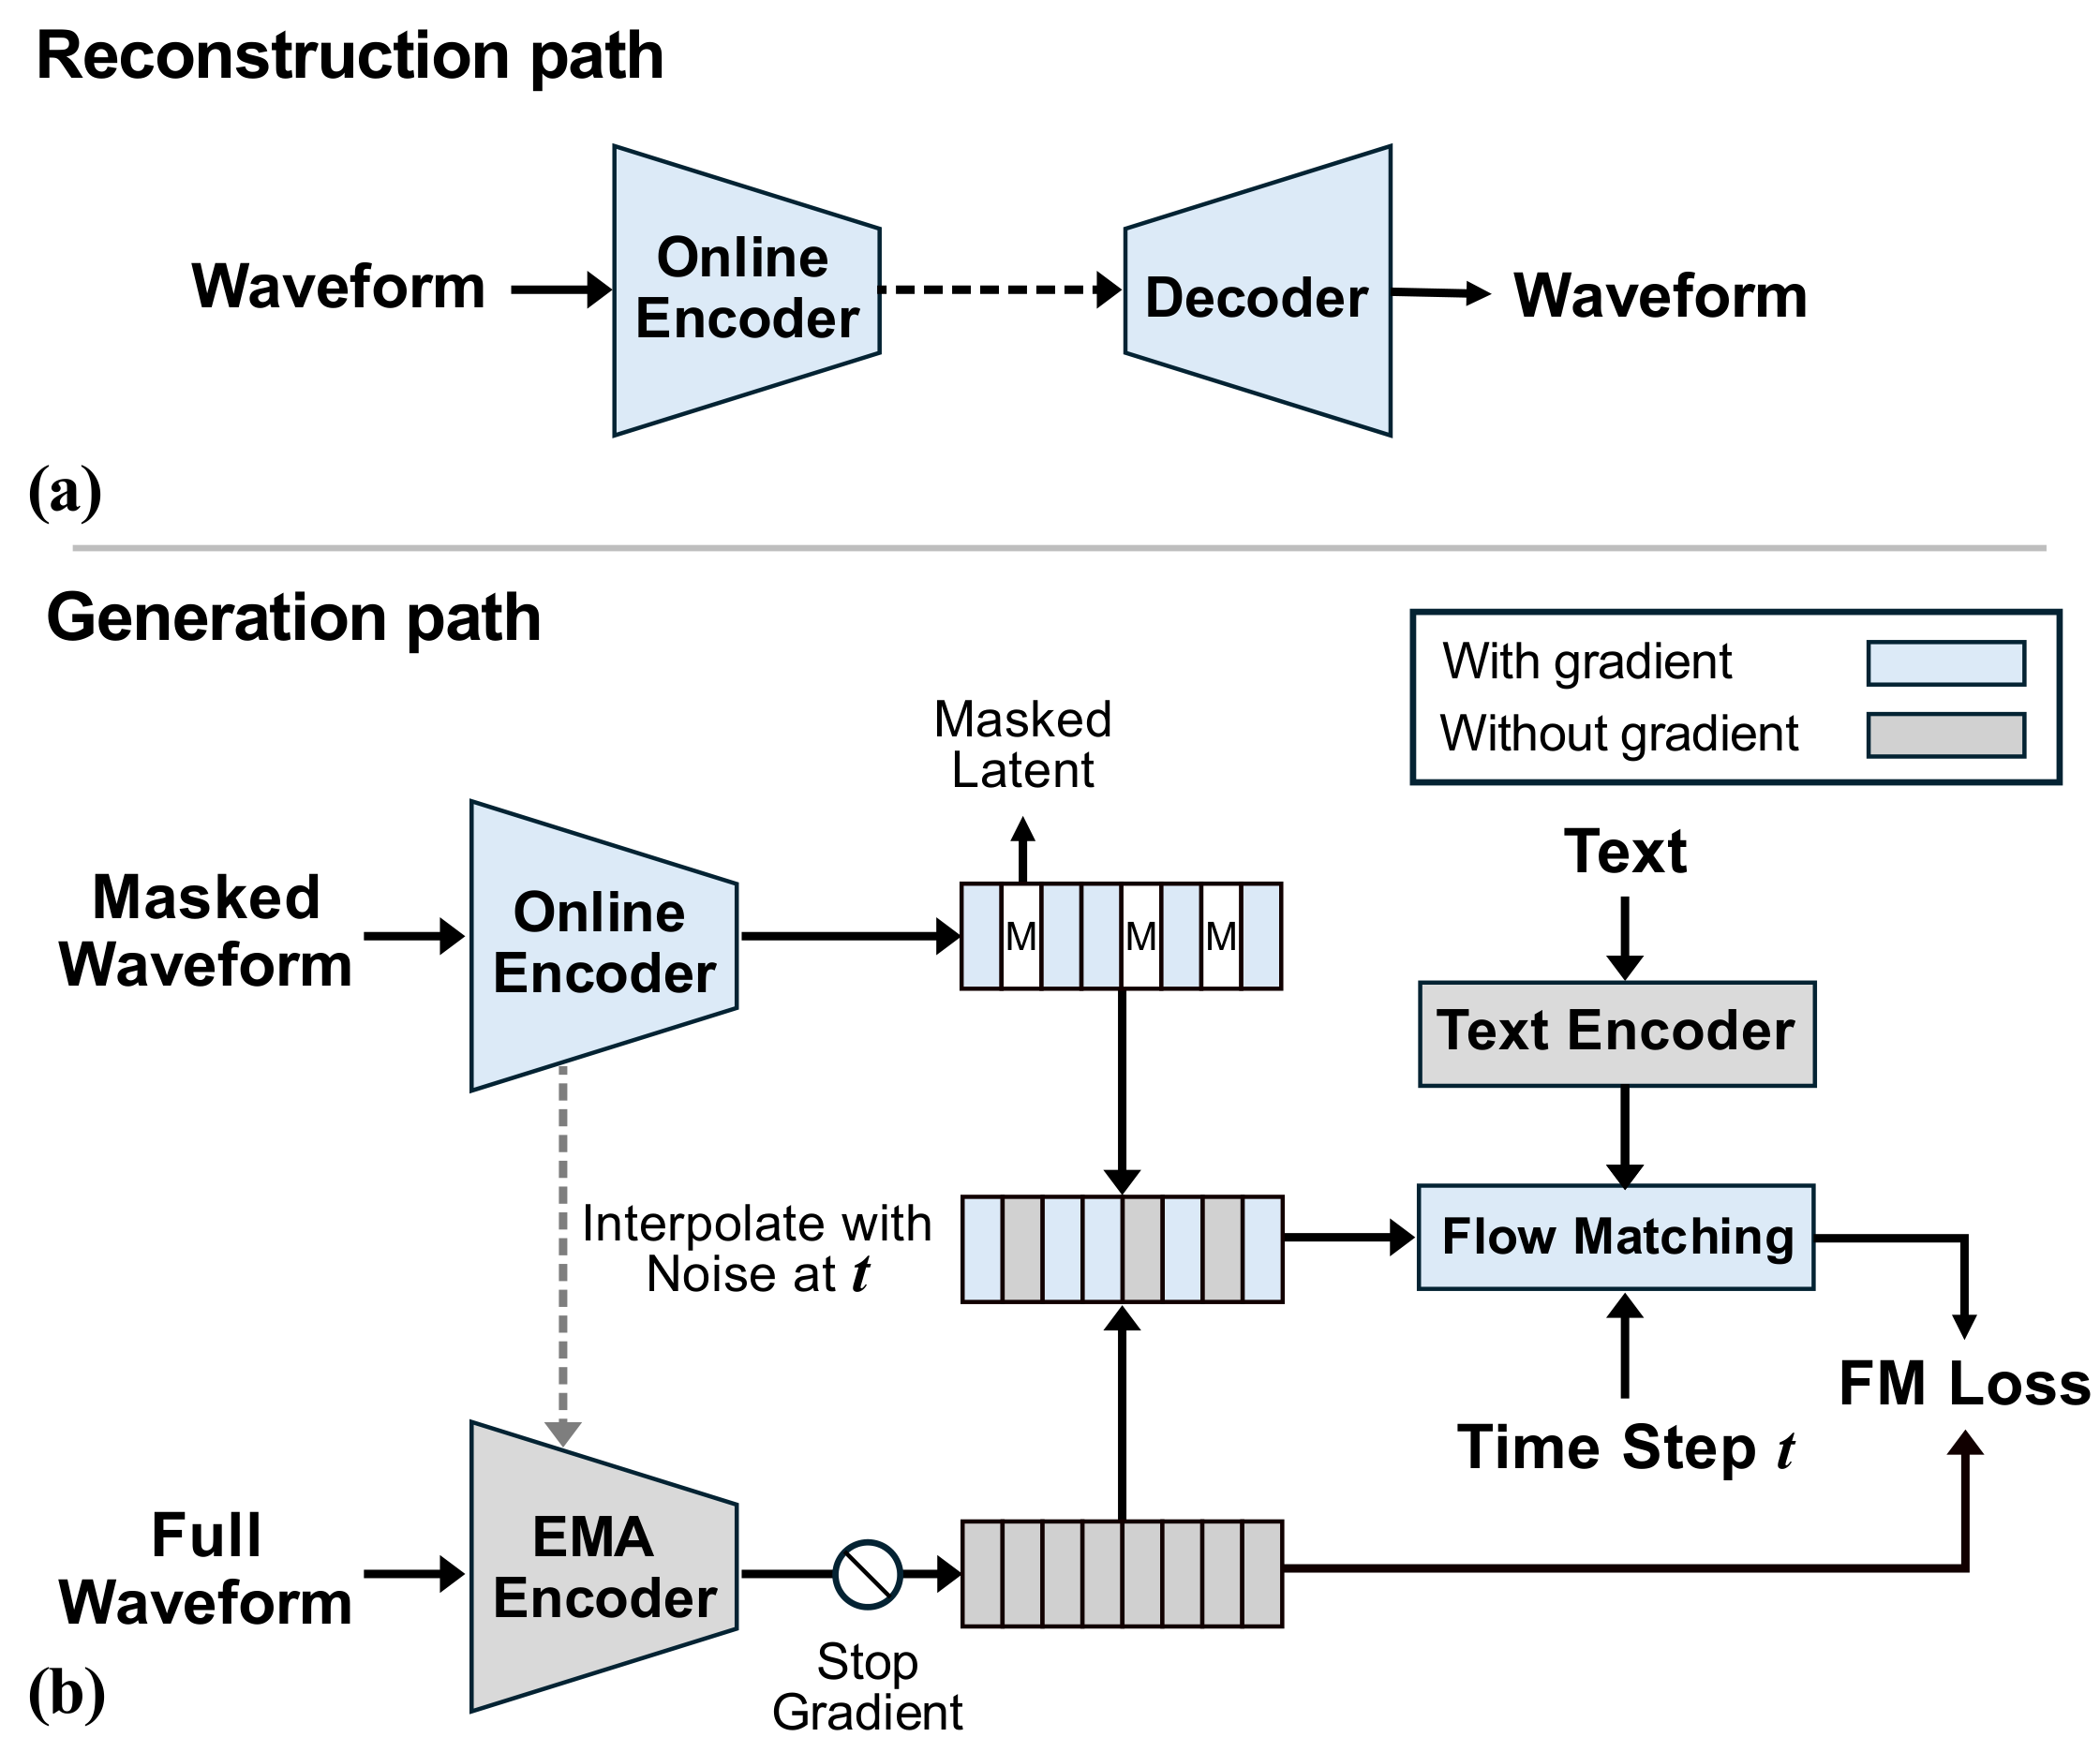
本文贡献 :首个把连续音频表征学习和隐空间 flow matching 联合训练的 TTA 系统:掩码波形过在线编码器,EMA 编码器提供停止梯度的目标特征,重建与自监督生成预测耦合,让生成目标直接塑造隐空间;再用 Flow-GRPO 后训练强化文本条件对齐。
Overview of the proposed framework: (a) the reconstruction path and (b) the generation path. Blue denotes regions with gradient propagation, while gray denotes regions without gradient propagation.
实验效果 :117M 隐空间生成模型(不含编解码器)在 AudioCaps-886 上 CLAP 0.534 全表最高(EzAudio 0.496、TangoFlux-RL 0.480),KL 1.057 最低,RTF 0.062;NFE 压到 4 时 RTF 仅 0.009 仍保 CLAP 0.512。
Comparison between conventional separate tokenizer-generator training and our joint single-stage training.
批判点评 :分布指标难看:FD_OpenL3 84.76 是 EzAudio 38.26 的两倍多,FD_16k 43.25 也落后 GenAU 的 31.94,IS 11.34 不及 TangoFlux-RL 的 12.20——语义对齐赢了,音频分布保真还差得远;首个联合训练的含金量取决于你更看重 CLAP 还是 FD。
4. MotionSpec:频谱轨迹约束视频运动
MotionSpec: Spectral Trajectory Supervision for Motion-Consistent Video Generation | 卡迪夫大学;中国科大;华东师范大学 | arXiv:2609.28095
关键词 :视频生成,运动一致性,傅里叶谱,光流,微调目标
⚠️ 前序问题 :文生视频单帧越来越真,运动却常失真:动作推进不一致、复杂动作下结构崩坏。标准生成目标对运动本身几乎没有专门约束,运动演化处于欠约束状态。
本文贡献 :提出 MotionSpec 运动监督:谱轨迹一致性 STC 构造锚点相对的稠密运动轨迹,经时间傅里叶变换成运动谱体积,对齐幅度与相位同时约束运动强度和时序组织;辅以局部光流一致性 LFC 稳定相邻帧过渡,两者随时间步加权加进微调目标。
Overview of the pipeline. At each training step, the video generative model takes the prompt, timestep, noise level, and real data as inputs.
实验效果 :在 Wan2.1 上微调,VMBench 均分 61.57→65.07,其中物体完整性 OIS 48.34→56.53、时序一致性 TCS 97.09→98.82;VideoJAM-Bench 运动分 85.3→93.61。定性对比里 Wan2.1 的骑车段后半程自行车几乎消失,MotionSpec 保留完整。
Qualitative Results. On the left are the results of Wan2.1, and on the right are the results of ours.
批判点评 :外观分几乎没动:App 仅 81.95→82.20(+0.25);PAS 上单独用 LFC(24.27)反而高于完整版(23.74),说明两个目标存在拉扯。评测全部在 Wan2.1 一个底座上做,换模型的泛化性未知。
5. RecCAR:反向注意力补齐,音画更同步
All modalities are equal, but video is more equal: Closing the Cross-Attention Gap in Joint Video Generation | 巴伊兰大学;NVIDIA | arXiv:2609.27901
关键词 :联合视频生成,跨模态注意力,KL正则,音画同步,人体解剖
⚠️ 前序问题 :联合视频-动作/视频-音频生成的扩散 Transformer 里存在不对称:伴随模态到视频的对应很强,但反过来约束视频生成的对应路始终弱——视频听动作指令的能力远弱于动作看视频的能力,人体解剖崩坏、音画不同步由此而来。
本文贡献 :把两个方向的跨模态对应表示成视频 token 上的分布,定义反向对应差距;提出 RecCAR,KL 正则把弱方向对齐到以视频到模态对应为固定参考的强方向,即插即用地微调 EchoMotion 这类联合生成模型。
Illustration of asymmetric reciprocal cross-modal correspondence. For a motion token corresponding to the head, the VM correspondence correctly localizes the head region in the video, while the reciprocal MV correspondence is dispersed.
实验效果 :视频-动作联合生成 Human Anatomy 0.69→0.75,VMBench 多数指标超 EchoMotion、CoMoVi、FlowMo;视频-音频生成音画失同步从 0.804 降到 0.752。散点图上每个 prompt 的反向差距在微调后一致下降。
Qualitative comparison of RecCAR against EchoMotion, CoMoVi, and FlowMo across three representative scenes.
批判点评 :增益以自家基线为参照:0.75 的解剖分意味着仍有约四分之一样本不达标,音频侧 0.752 的失同步也谈不上小;teaser 里对比的 LTX-2 只做了定性展示,未给出与闭源模型在同一协议下的量化差距。
6. GestureFAR:9.3毫秒每token的流式手势
GestureFAR: Streaming Co-Speech Gesture Generation with Flow Autoregression | 罗切斯特大学;东京大学;加州大学圣克鲁兹分校;加州大学洛杉矶分校;Meta | arXiv:2609.21576
关键词 :手势生成,流式,flow自回归,蒸馏,实时交互
⚠️ 前序问题 :流式陪聊手势生成此前靠离散运动 token 自回归,把高维连续运动压进有限 codebook,真实感和多样性都受损;而连续方法又难以保证逐 token 因果,实时交互卡在延迟上。
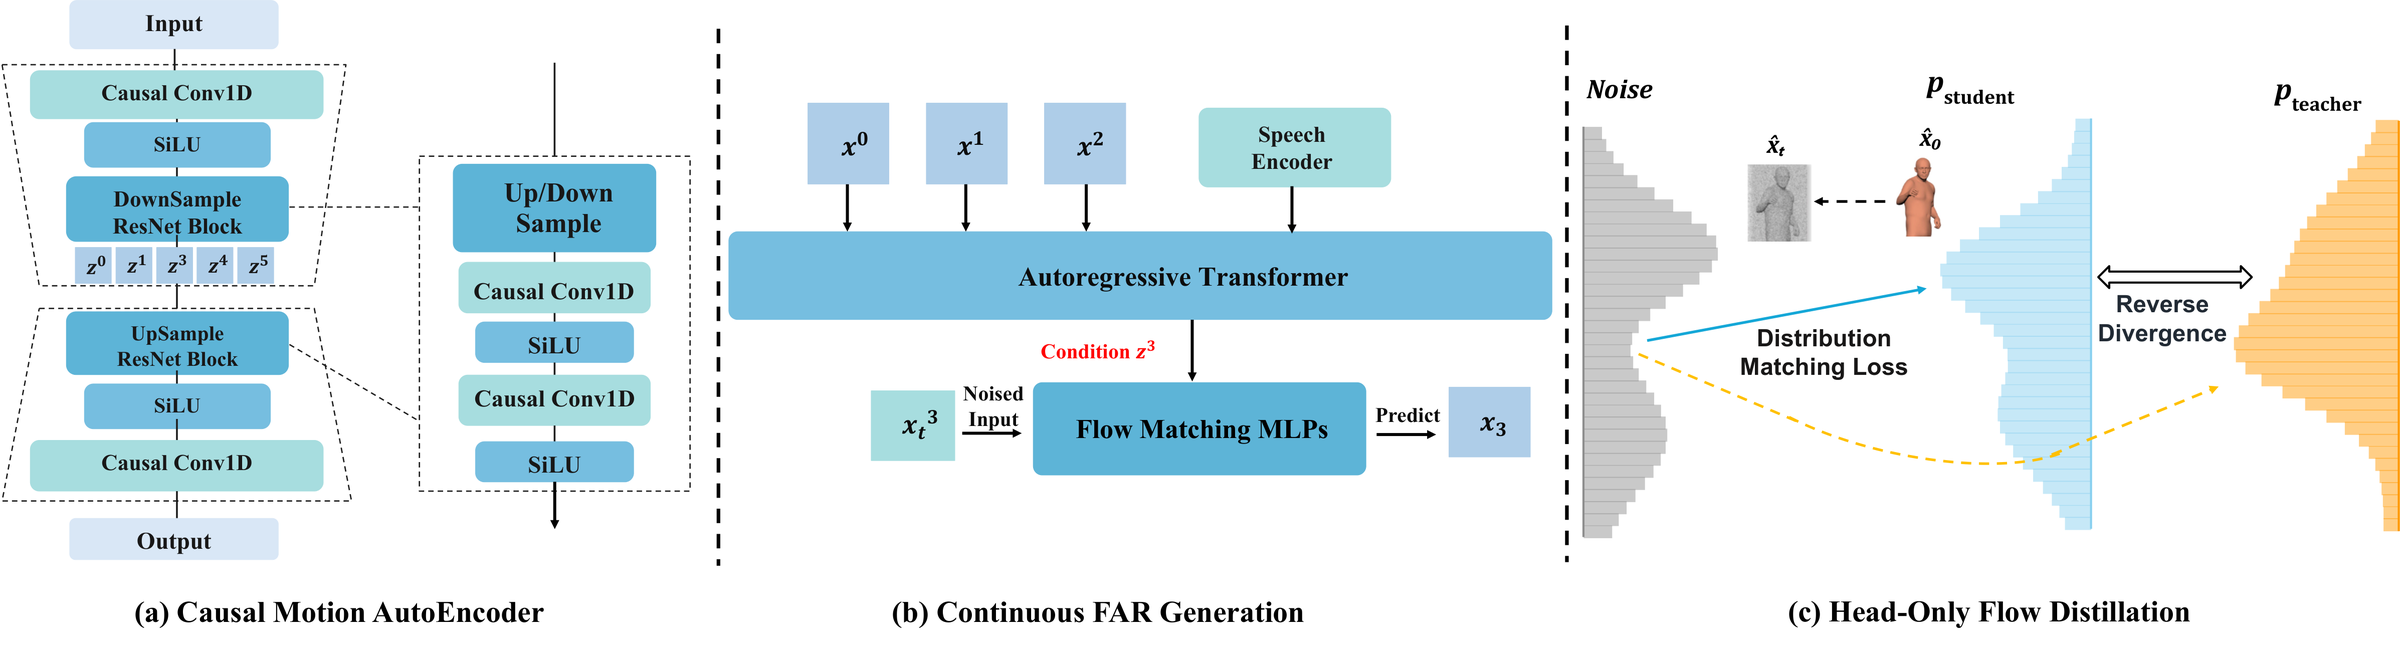
本文贡献 :提出流式手势生成框架 GestureFAR:因果 VAE 把全身动作编码成可流式的连续隐变量,Transformer 对音频-运动上下文自回归,每 token 配 flow-matching 头从连续分布采样下一潜变量;再冻结因果骨干,用一致性加分布匹配目标把多步 flow 头蒸馏成单步前向。
Overview of GestureFAR. GestureFAR generates co-speech gestures from streaming audio by autoregressing over continuous motion latents.
实验效果 :BEAT2 流式组 FGD 3.08 全面最佳(LiveGesture 4.57、MIBURI 8.06),BC 0.741 接近离线最优;1 步蒸馏后每 token 9.3ms,是教师 8 步 24.4ms 的 2.6 倍速、MIBURI 62.9ms 的 6.8 倍速。
Qualitative comparison on BEAT2. We visualize generated full-body gestures from different methods under the same speech inputs, with the semantically salient words highlighted in red.
批判点评 :BC 0.741 仍低于 MIBURI 的 0.790 和 LiveGesture 的 0.794,多样性 13.24 也略逊离线系;单步蒸馏换速度后 FGD 反而比教师还好(3.08 vs 3.17),这个反常更像评测协议的产物而非能力证明,文中未解释。
7. DeltaS:状态漂移选KV,六个基准+2.1
DeltaS: Reading the Gated Linear Attention State for KV Cache Eviction in Streaming Video | Maum AI;首尔大学;延世大学 | arXiv:2609.27470
关键词 :KV缓存淘汰,流式视频,线性注意力,混合架构,训练无关
⚠️ 前序问题 :视频语言模型转向线性/全注意力混合架构后,线性注意力状态固定大小,但全注意力 KV 缓存仍随流式视频无限增长;流式场景下问题还没来就得决定淘汰谁,现有基于位置、注意力或 KV 本身的信号都拿不到这个先验。
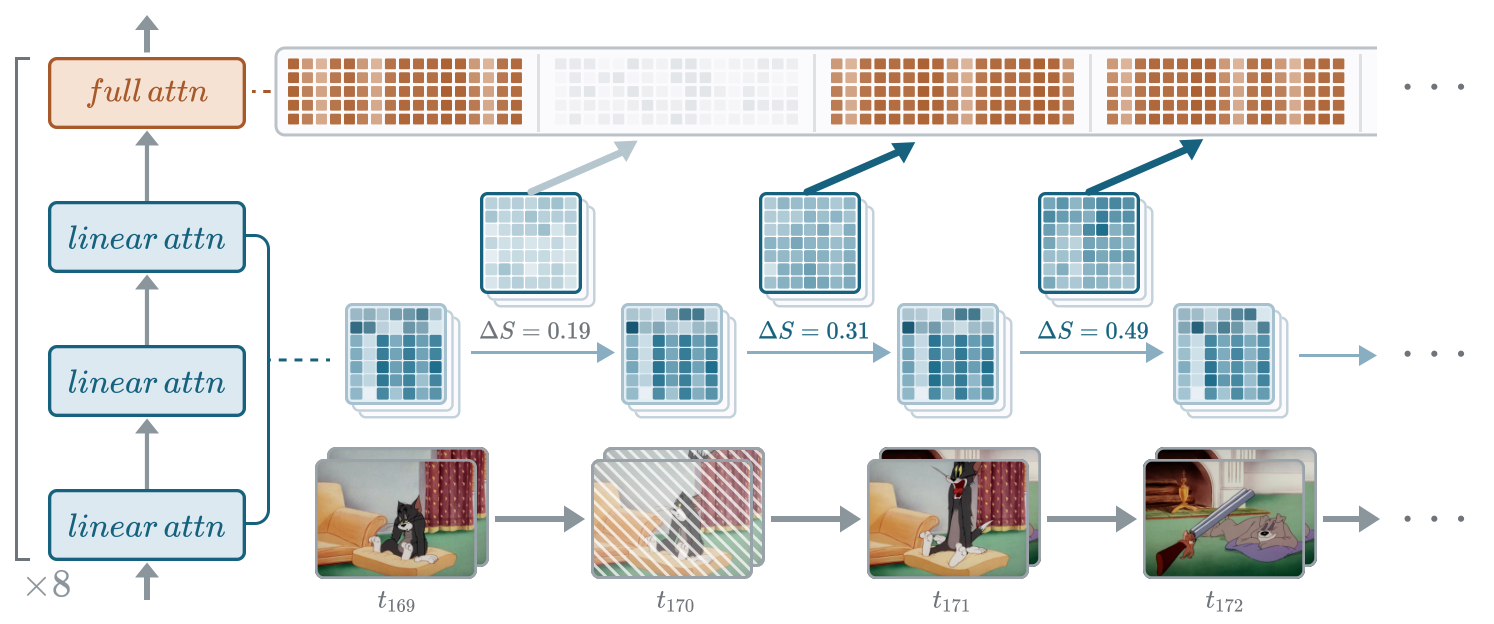
本文贡献 :提出训练无关的 DeltaS:读门控 delta 线性注意力的循环状态,用一块帧内状态的归一化变化量(状态漂移)衡量该块带来多少新信息,漂移大的块对应 KV 留存;信号计算只占前向的 1.9%,无需代理查询。
Overview of DeltaS. Each video chunk updates the recurrent linear-attention states, whose normalized changes yield a shared score for retaining the corresponding KV entries across full-attention layers.
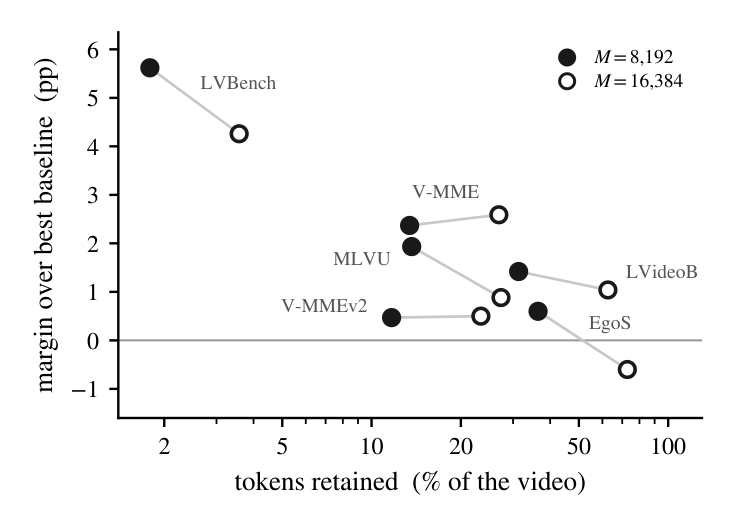
实验效果 :预算与留存策略对齐的受控比较里,状态漂移信号全面胜过位置/注意力/KV 三类基线;六个长视频基准平均超最强无查询基线 2.1 分,最长基准 LVBench 超 5.6 分。
Performance margin as a function of KV retention rate. DeltaS generally shows larger margins at lower retention rates.
批判点评 :增益随留存率升高而收窄:留存 token 超过约四成后在 EgoS 上反而落后基线 0.7 分,高预算场景收益有限;hybrid 架构前提也把它限死在门控 delta 线性注意力这一类骨干上。
8. DriftAudio:一步生成后训练FAD降34%
DriftAudio: Marginal Drifting for Distributional Post-Training of One-Step Text-to-Audio Generators | 悉尼科技大学 | arXiv:2609.27598
关键词 :一步生成,分布后训练,文本生成音频,Drifting,FAD
⚠️ 前序问题 :一步文本生成音频模型把推理成本打下来之后,生成分布仍欠火候;常规后训练依赖逐条件配对的真实样本,自由文本条件下一个 prompt 往往只有一两条真实参考,逐条件 Drifting 根本做不了。
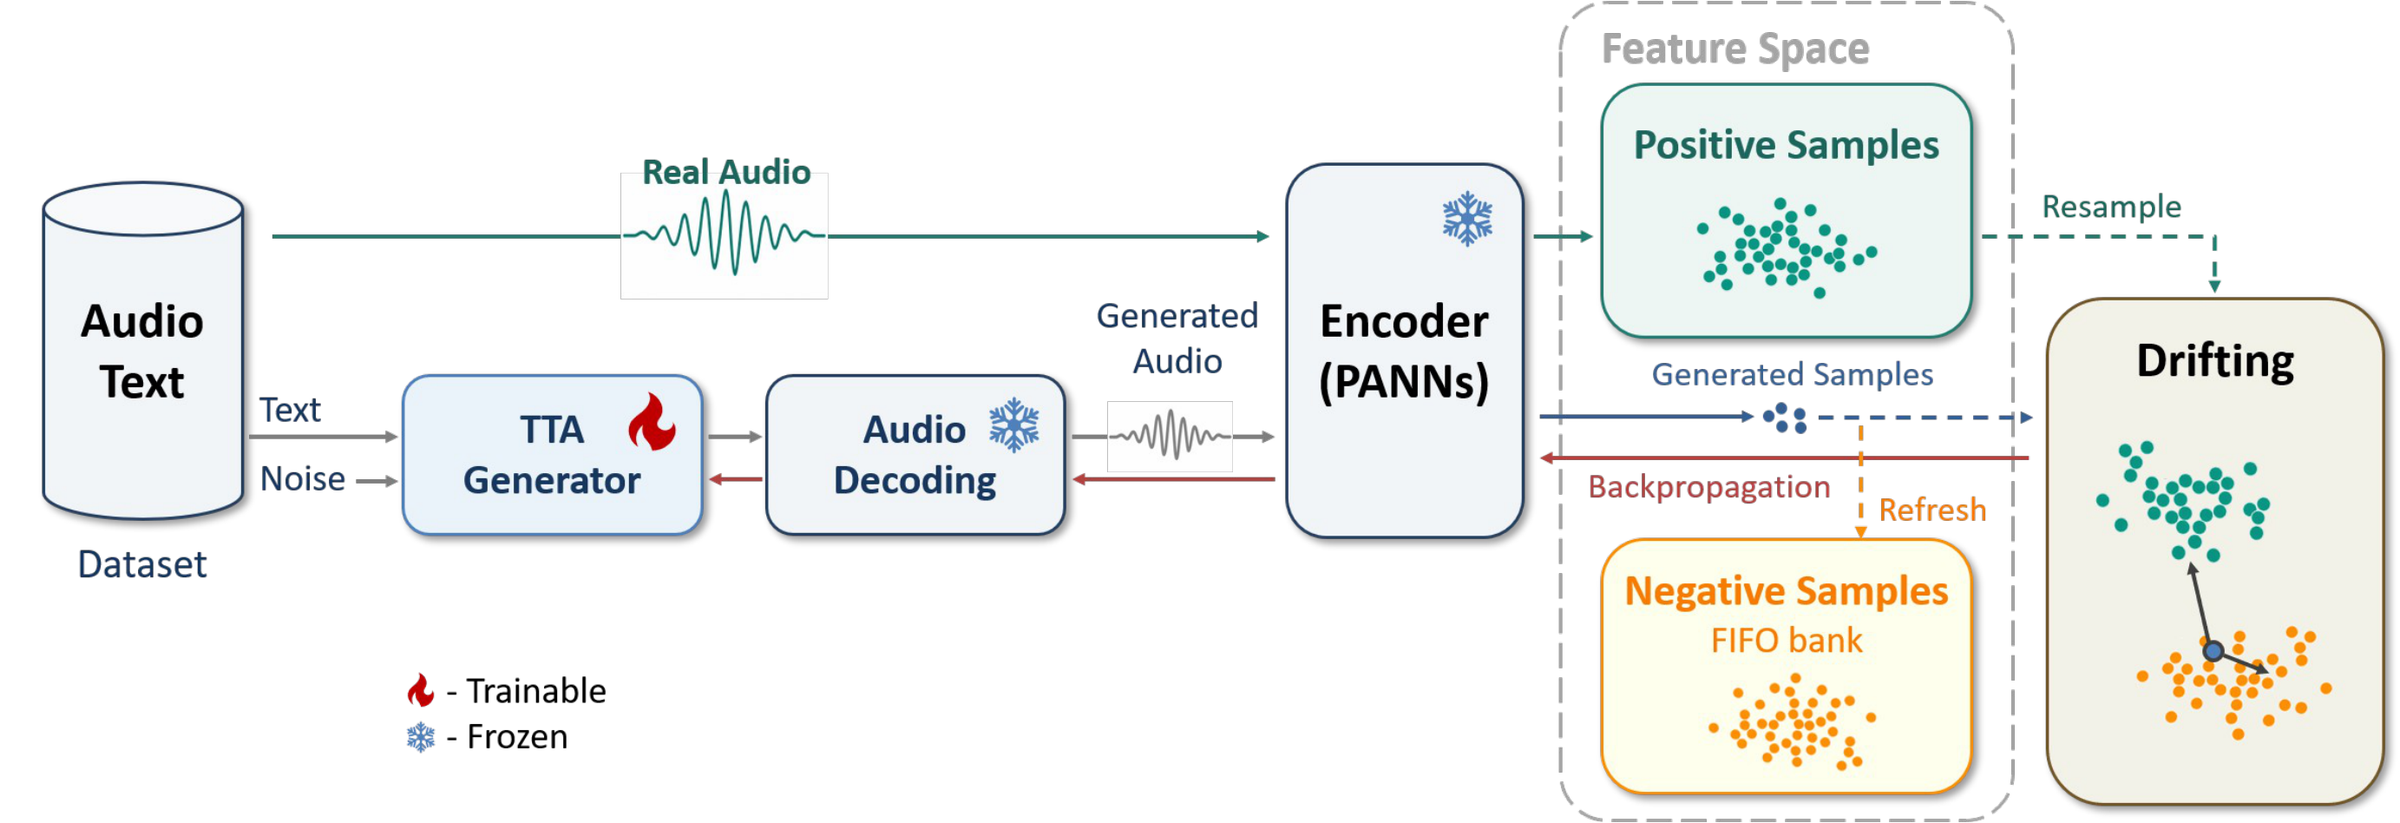
本文贡献 :提出 DriftAudio 边缘分布后训练:把 Drifting 从逐条件搬到边缘音频分布上做,在冻结的 PANNs 特征空间里用重采样真实样本、滚动生成的 FIFO 样本库和当前批次共同估计漂移场,得到 detached 训练目标只更新生成器,一步推理流程原样保留。
Overview of DriftAudio. The one-step generator remains text-conditioned, while Drifting is performed on the marginal audio distribution in feature space.
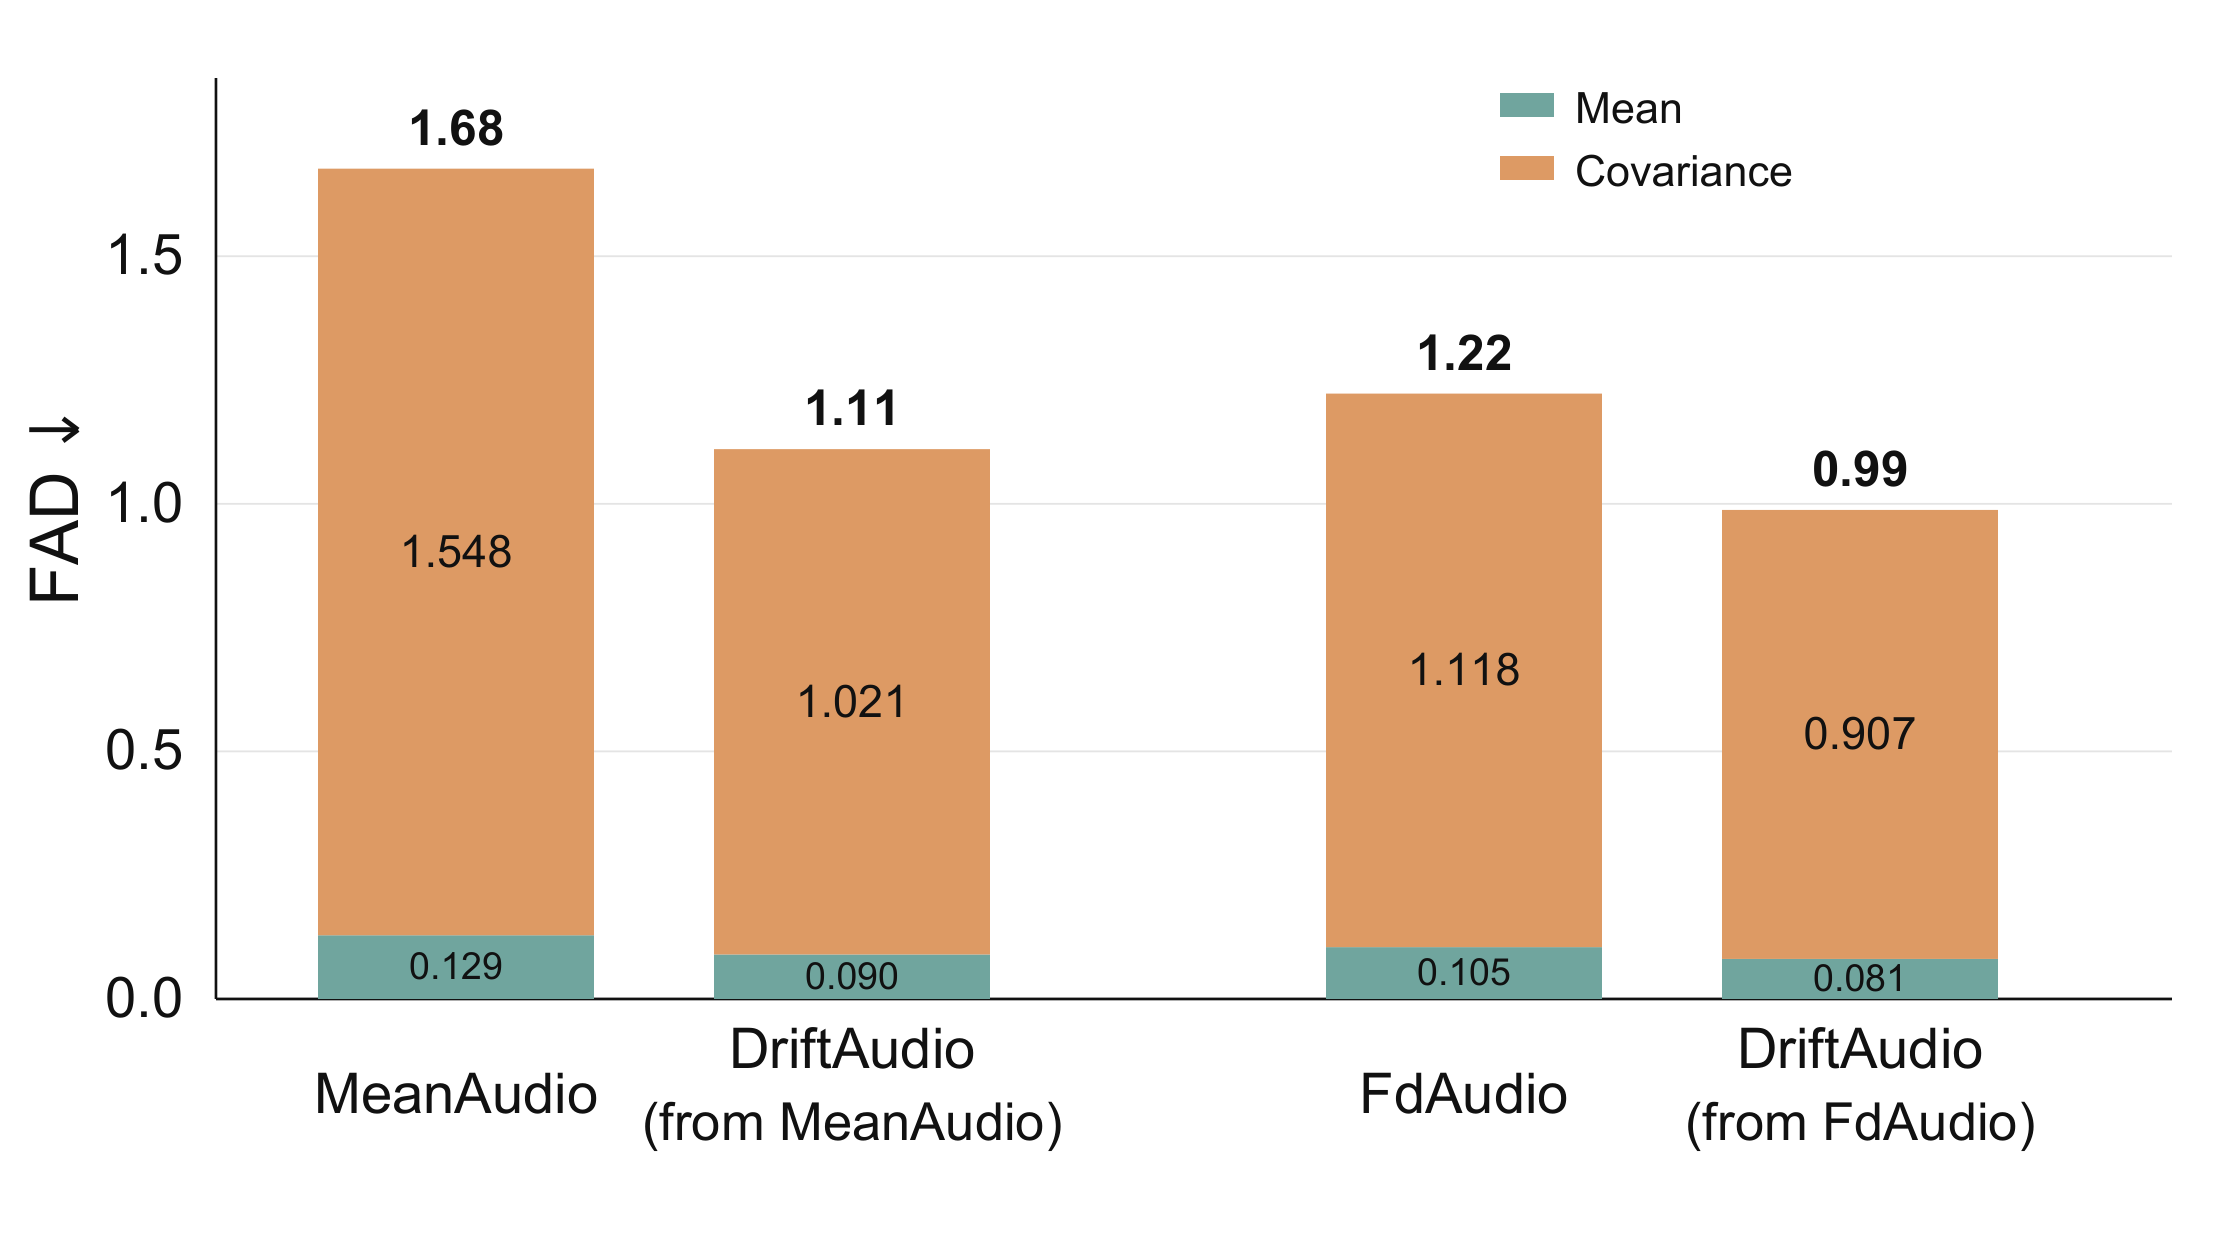
实验效果 :从 MeanAudio 出发 FAD 降 33.9%、FD 降 17.6%,KL 与 CLAP 同步改善;从 FdAudio 出发 FAD 1.22→0.99,一步生成的分布质量明显抬升。
Mean and covariance components of FAD for the four evaluated models. Numbers above the bars denote total FAD.
批判点评 :不是白捡的:从 FdAudio 出发时 IS 和 CLAP 出现回退,说明边缘分布对齐和条件保真之间存在交换;方法绑定冻结的 PANNs 特征空间,换更强的音频评价骨干是否还成立未验证。
9. InGuard:嵌入层安检,省一半去噪步
InGuard: Towards Generalized Inner Guardrail for Safe Text-to-Image Generation | 阿里巴巴 AAIG | arXiv:2609.27620
关键词 :文生图安全,内嵌护栏,嵌入改写,潜空间检测,RevGen
⚠️ 前序问题 :T2I 的安全护栏都装在外面:前置 prompt 分类器加后置图像分类器,两者不用模型自身表征——prompt 检查准头有限,图像检查要等全量去噪烧完才跑,而且违规 prompt 只能一刀切拒绝,本可改写成安全输出的也被扔掉。
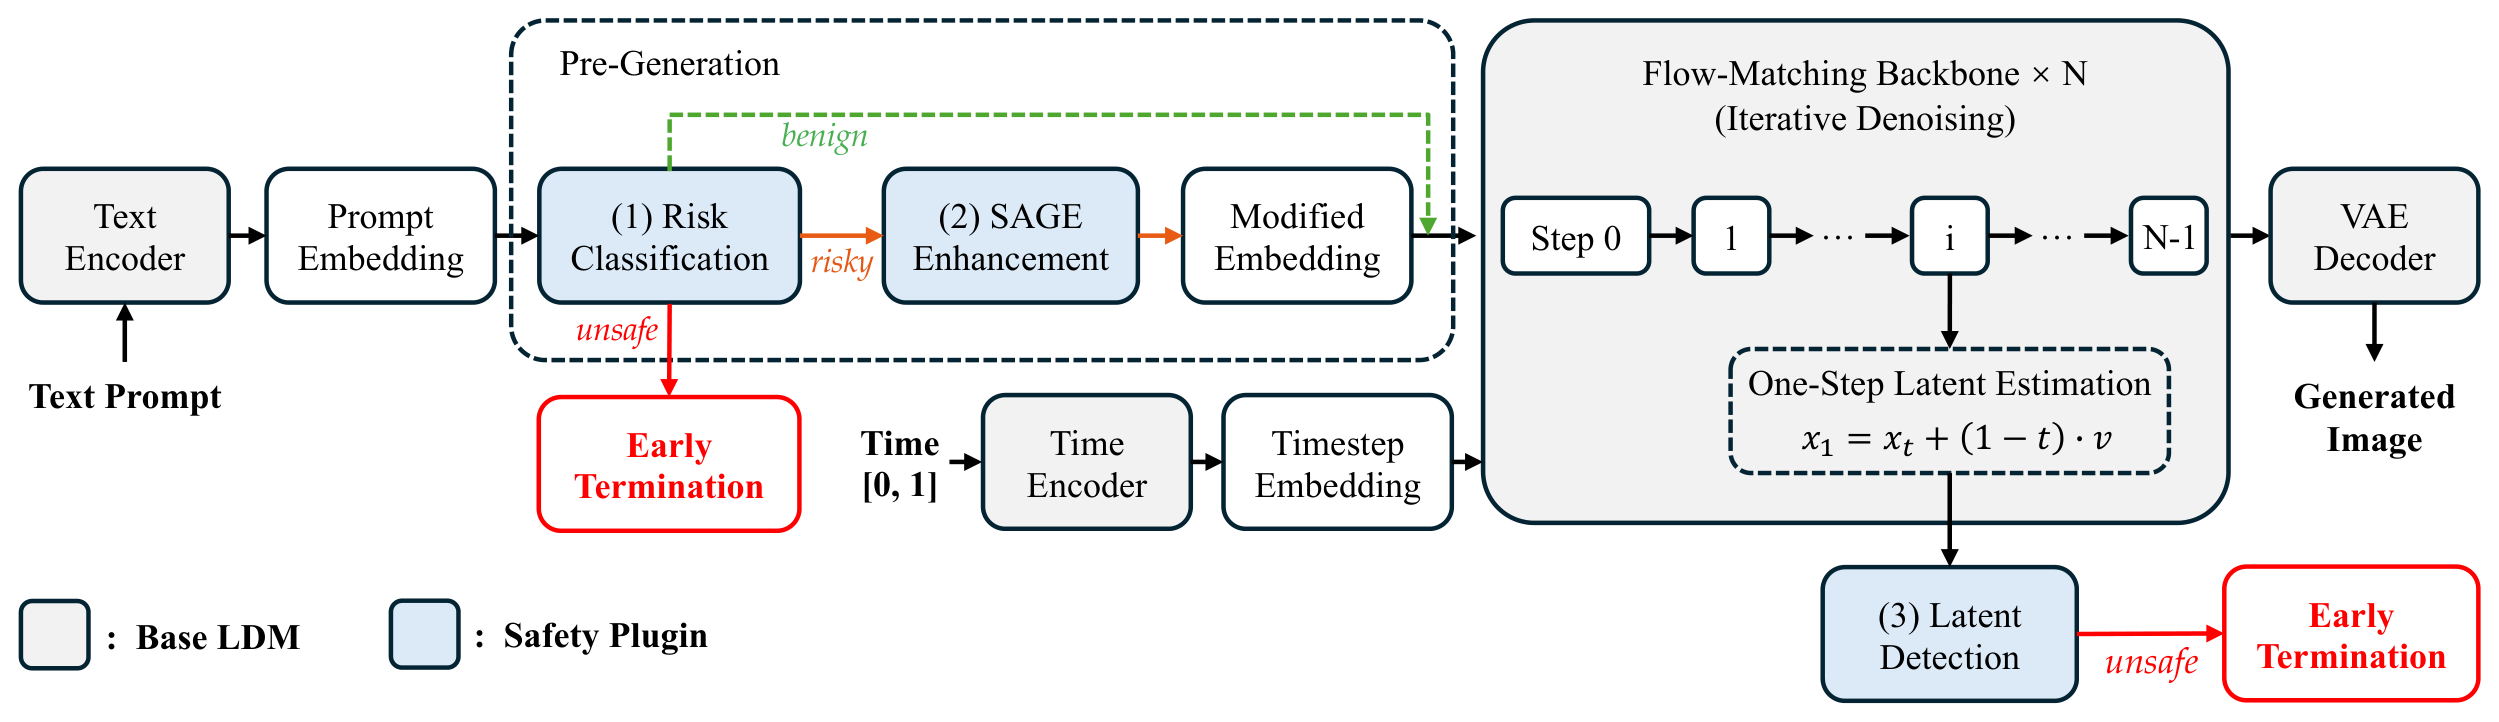
本文贡献 :提出 InGuard 内嵌护栏:文本编码器嵌入上直接做风险三级分类(不安全/风险/良性),SAGE 对风险 prompt 做嵌入空间软门控改写使其输出安全图而非拒答,去噪中途用一步干净潜变量估计做潜空间检测,发现风险即刻提前终止;配套 RevGen Safety 基准,1 万条 prompt 由真实图反生成并注入受控 IP 角色。
Overview of our InGuard framework. Three complementary components work in sequence: prompt embedding risk classification, SAGE embedding-space safety enhancement, and latent detection with early termination.
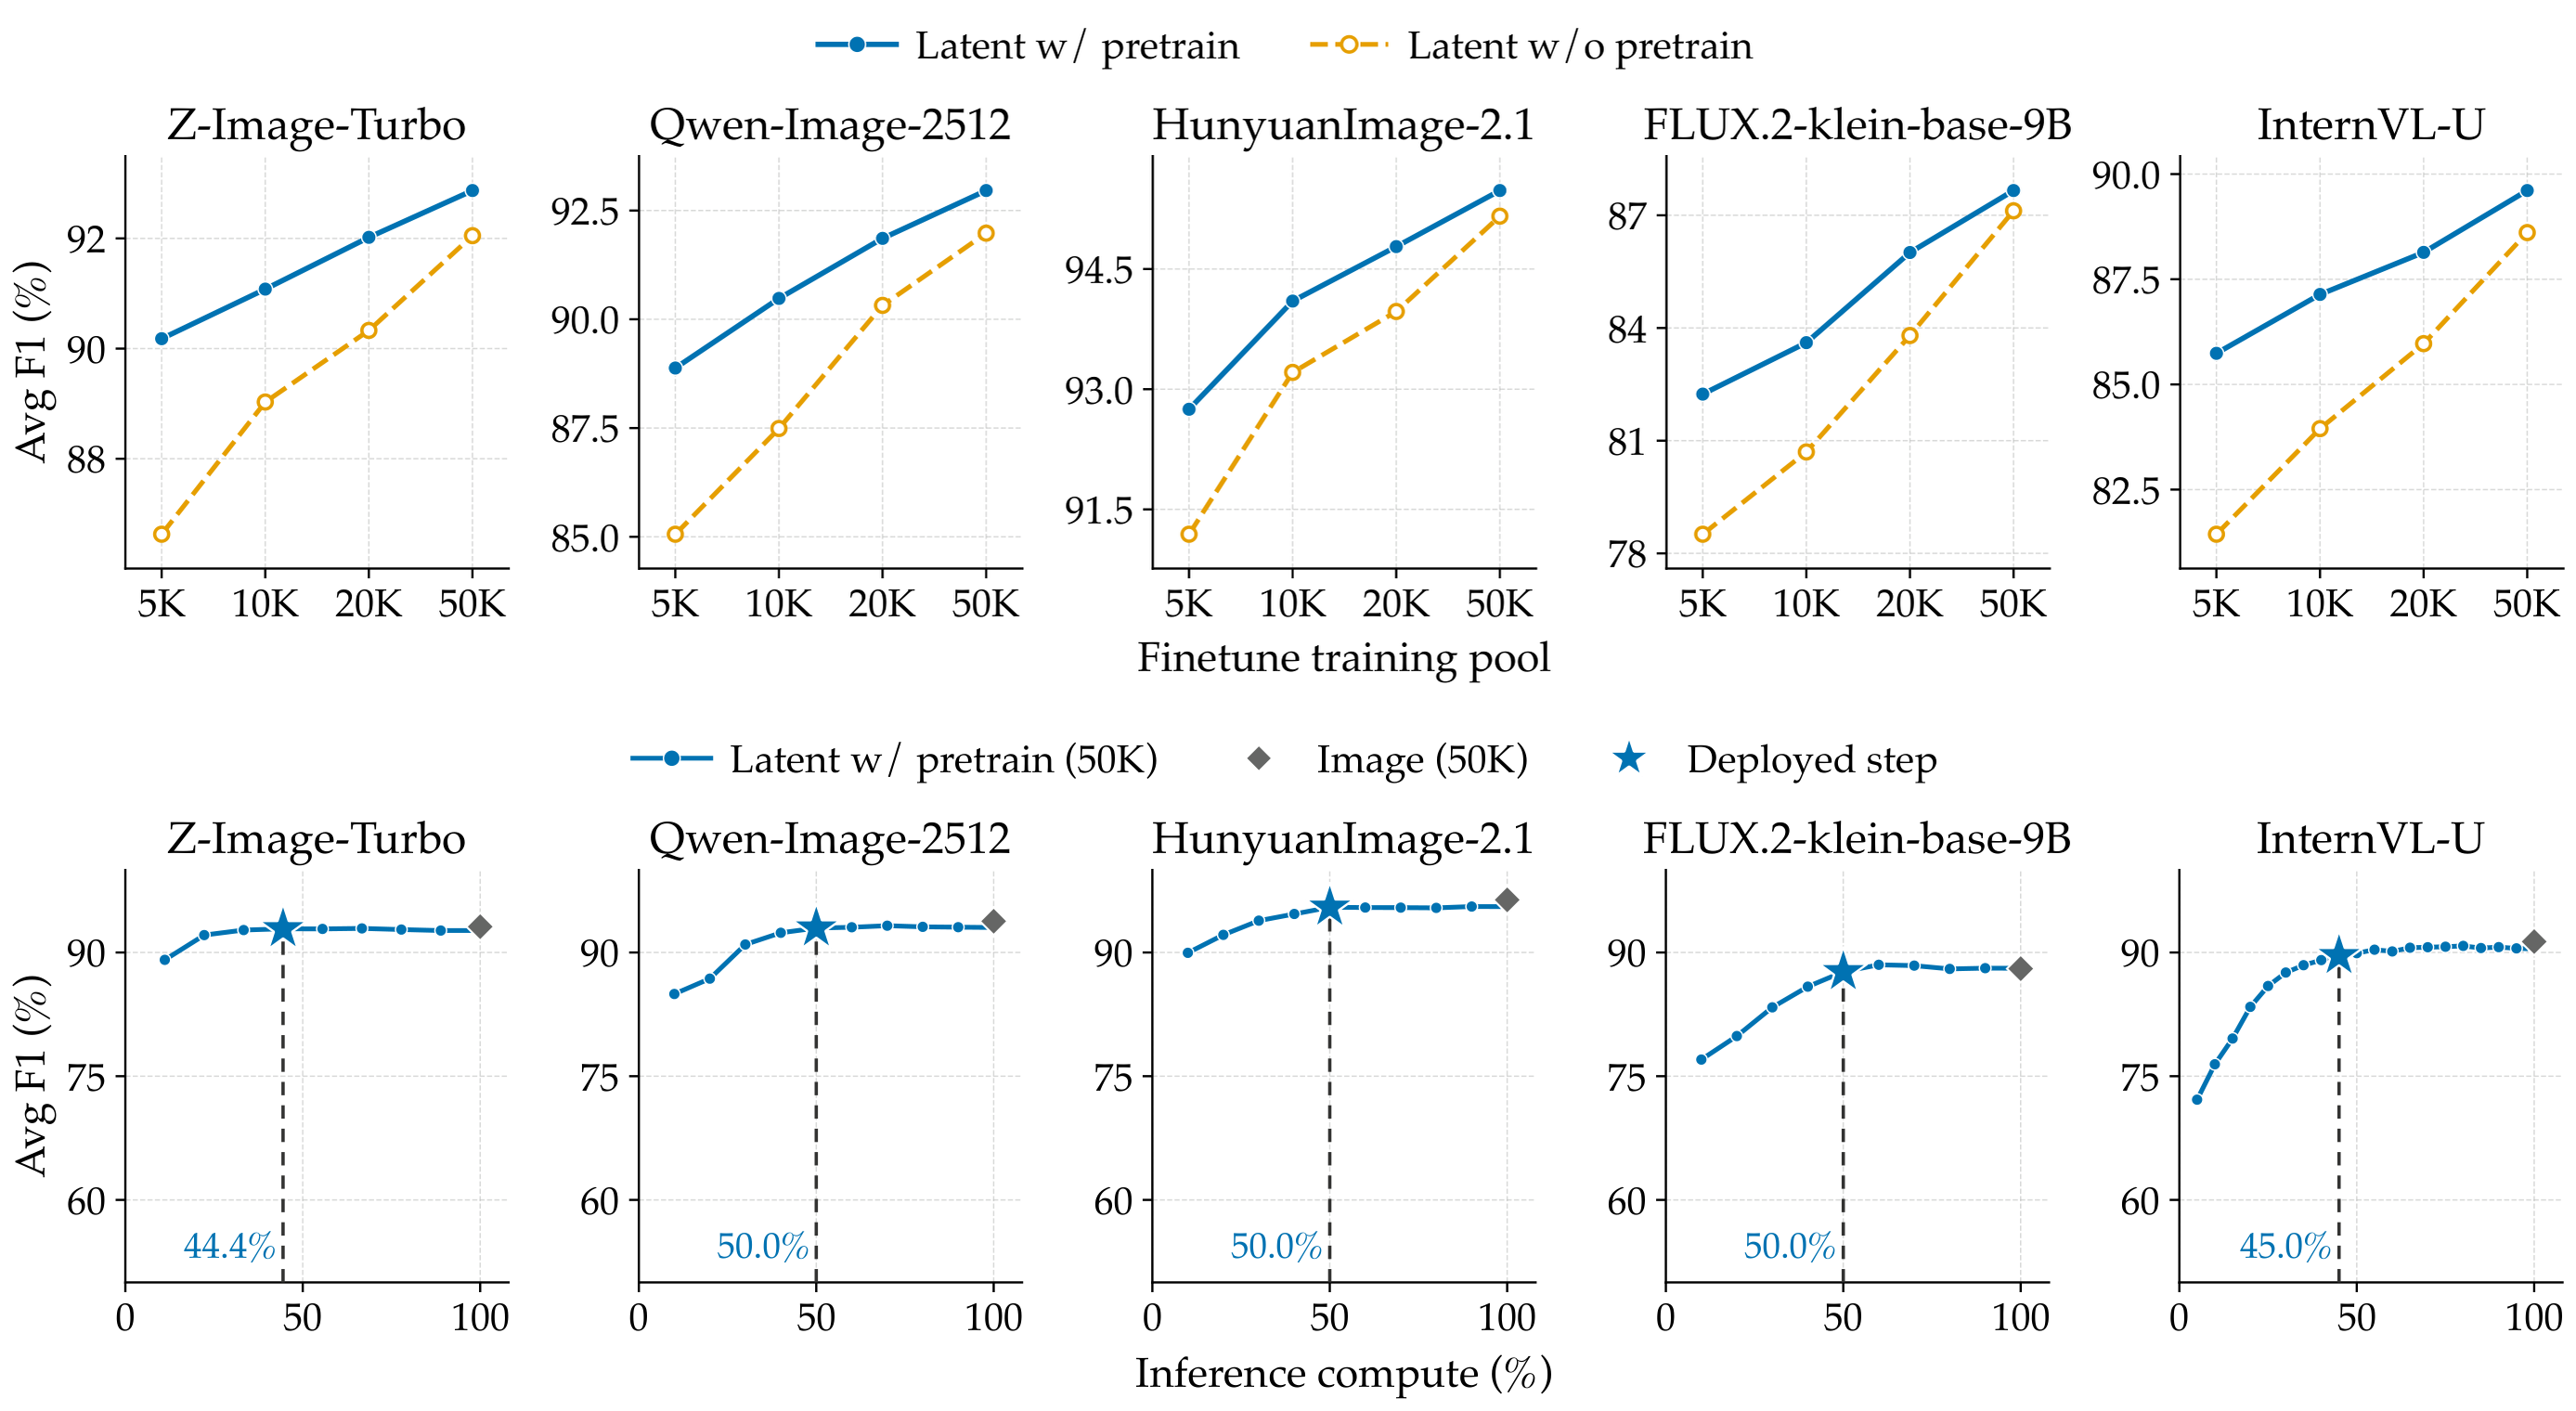
实验效果 :五个开源 T2I 模型上安全率 97.9%-98.8%,追平或超过外置护栏;良性扰动少 57.5%-73.5%,参数少约 3.7 倍,50%-55.6% 的去噪步被跳过;潜空间检测在 44%-50% 计算量处就逼近图像级 F1。
Pretraining effects on Avg F1 across five LDMs; latent detection vs denoising-step fraction used as a compute proxy.
批判点评 :SAGE 改写不是万能的:论文自己承认增强失败时只能靠潜空间检测兜底拦截,等于承认存在漏改样本;RevGen 由自家反生成流水线构造,跨基准的代表性有待第三方复检。
10. CineGuard:11种运镜的抄袭检测
Did You Steal My Shot? Pioneering Camera Motion Plagiarism Detection in Generative Videos | 河海大学 | arXiv:2609.22267
关键词 :运镜抄袭,生成视频,涡度,基准,版权保护
⚠️ 前序问题 :运镜是影视级 IP,但生成视频用一句 prompt 就能复刻高价值运镜;现有相似度检测都盯着画面内容,训练数据把运镜和内容缠在一起,传统光流又表达不了复杂相机运动——运镜抄袭至今无人管。
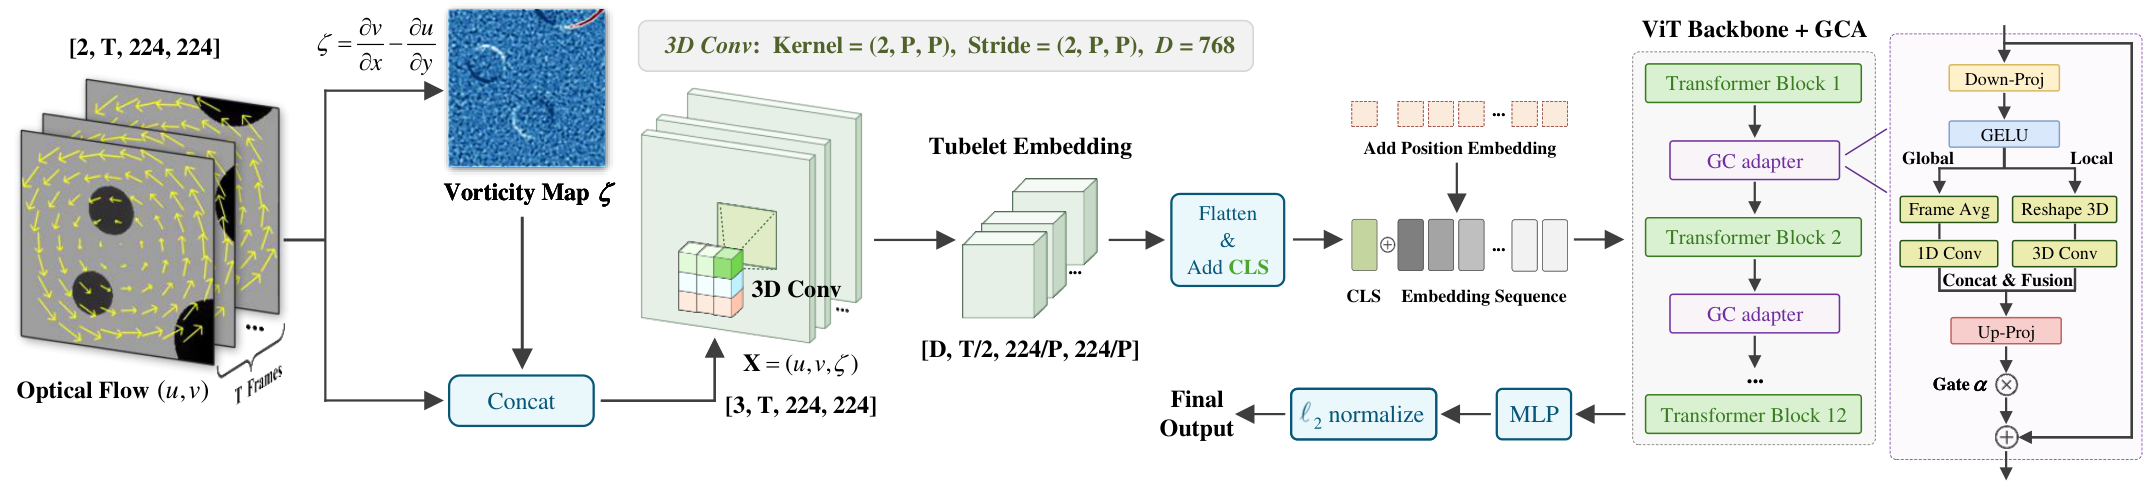
本文贡献 :构建首个运镜分析基准 CineFlow:11 种运镜风格的模拟数据集把运镜与内容解耦;提出 CineGuard 检测网络,在光流上叠加流体力学涡度作为平移不变线索,3D 卷积提 tubelet 嵌入后过 ViT 主干加全局相机适配器,对比学习聚拢同运镜视频。
Architecture of the motion plagiarism detection network. The input flow is first augmented with vorticity, then a 3D convolution extracts tubelet embeddings.
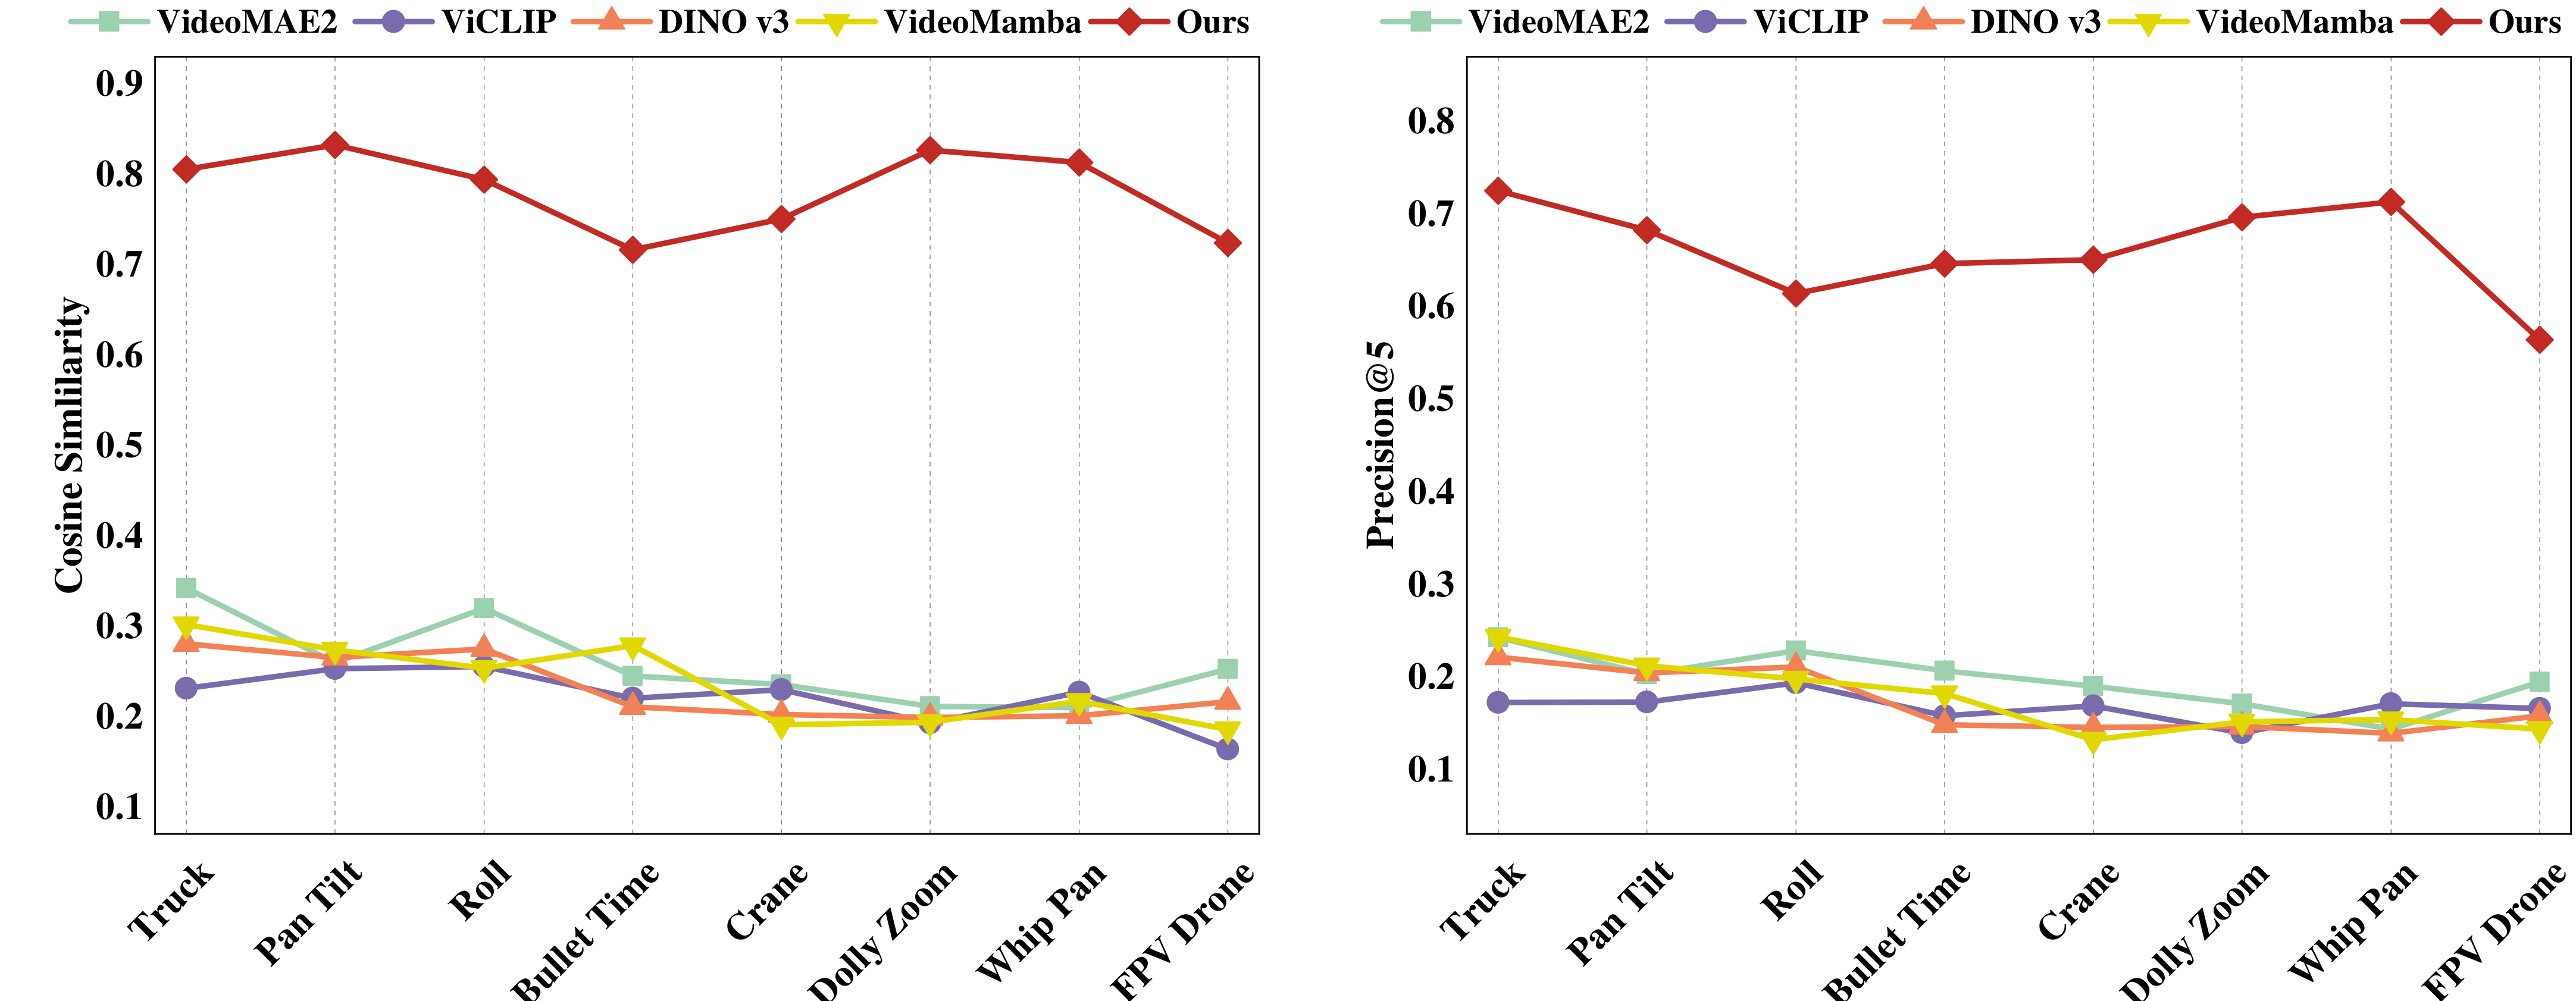
实验效果 :抄袭检测超最强基线 3.02 倍;在 Veo 3.1 与即梦的商业生成视频上,余弦相似度 0.56-0.83,基线全部落在 0.35 以下,Precision@5 最高 0.73 对基线约 0.27。
Performance of plagiarism detection on generative videos. Left: cosine similarity between videos. Right: Precision@5 for retrieving videos with the same motion label.
批判点评 :局限写在图里:FPV Drone 这类复合运镜相似度掉到 0.56,是全表最低,混合运镜仍是软肋;基准是简单几何场景模拟出来的,真实影视素材上的迁移只有商业视频小样本佐证。
趋势观察
编辑模型的主战场从通用能力挪向行业指标
KwaiMind 把 CTR 预测直接做成奖励信号训进编辑模型,线上 A/B 实测 +2.44%;InGuard 则把安全检查搬进生成管线内部,省下一半去噪步。两条线指向同一件事:图像生成的竞争正在从「生成质量」转向「商业约束下的生成质量」,奖励函数和护栏的构造方式开始比骨干网络更值钱。
视觉监督正在从后训练前移到预训练
UVU 用像素级 codebook 把视觉监督直接塞进预训练,RefCOCO 一项涨 7.7 分;MotionSpec 则在视频微调里用频谱约束补上运动监督的缺口。共同逻辑:等表征定型再补监督太晚了,感知质量的上限在预训练阶段就被决定。
一步生成与流式生成进入质量补课期
DriftAudio 给一步 TTA 做边缘分布后训练,FAD 降三分之一;GestureFAR 用单步蒸馏把手势生成压到每 token 9.3ms;Unite-Audio 把去噪步数压到 4 还能保住 CLAP。速度战的下一程是质量战——谁能在一步、几步的预算里把分布差距补回来,谁就拿到实时产品化的门票。
混合架构的两组记忆开始学会协作
DeltaS 证明线性注意力的循环状态可以反过来指挥全注意力 KV 缓存的淘汰,六个长视频基准平均 +2.1;Unite-Audio 则让生成目标直接塑造 tokenizer 隐空间,打破「先冻结表征再训生成」的铁律。两篇都在挑战模块化管线里各训各的默认假设。
人工智能炼丹君 整理 | 2026-09-25
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注














评论 (0)