


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 生成基础范式与高效骨干 2 篇 · 电影叙事与长视频生成 3 篇 · 视频后训练与时间控制 2 篇 · 物理世界建模 2 篇 · 生成式视频编码 1 篇
Chimera: Designing and Chinchilla-Scaling Hybrid Visual Diffusion Transformers | Adobe Research | arXiv:2607.28611
关键词:视觉DiT,混合注意力,MoE,缩放定律,长视频
前序问题:高分辨率图像、长视频和多模态上下文让视觉生成进入高 token 时代,全注意力 DiT 的二次复杂度愈发不可承受;语言模型中的高效结构又不能直接照搬,因为视觉扩散必须保留时空局部性和跨模态双向交互。
本文贡献:提出混合视觉扩散骨干 Chimera:在统一光栅序列中组合 O(N) 的 Kimi Delta Attention 做长上下文状态跟踪、交错的多头潜注意力做全局交互、模态感知短卷积捕捉局部时空结构,并以稀疏 MoE 扩容量而不显著增加激活计算。进一步提出模块级缩放方法 HeteroP,为异构架构拟合 Chinchilla 式最优模型规模、训练 token 数与图像/视频配比规律,最终训练 11B 参数、每次激活 2B 的模型。
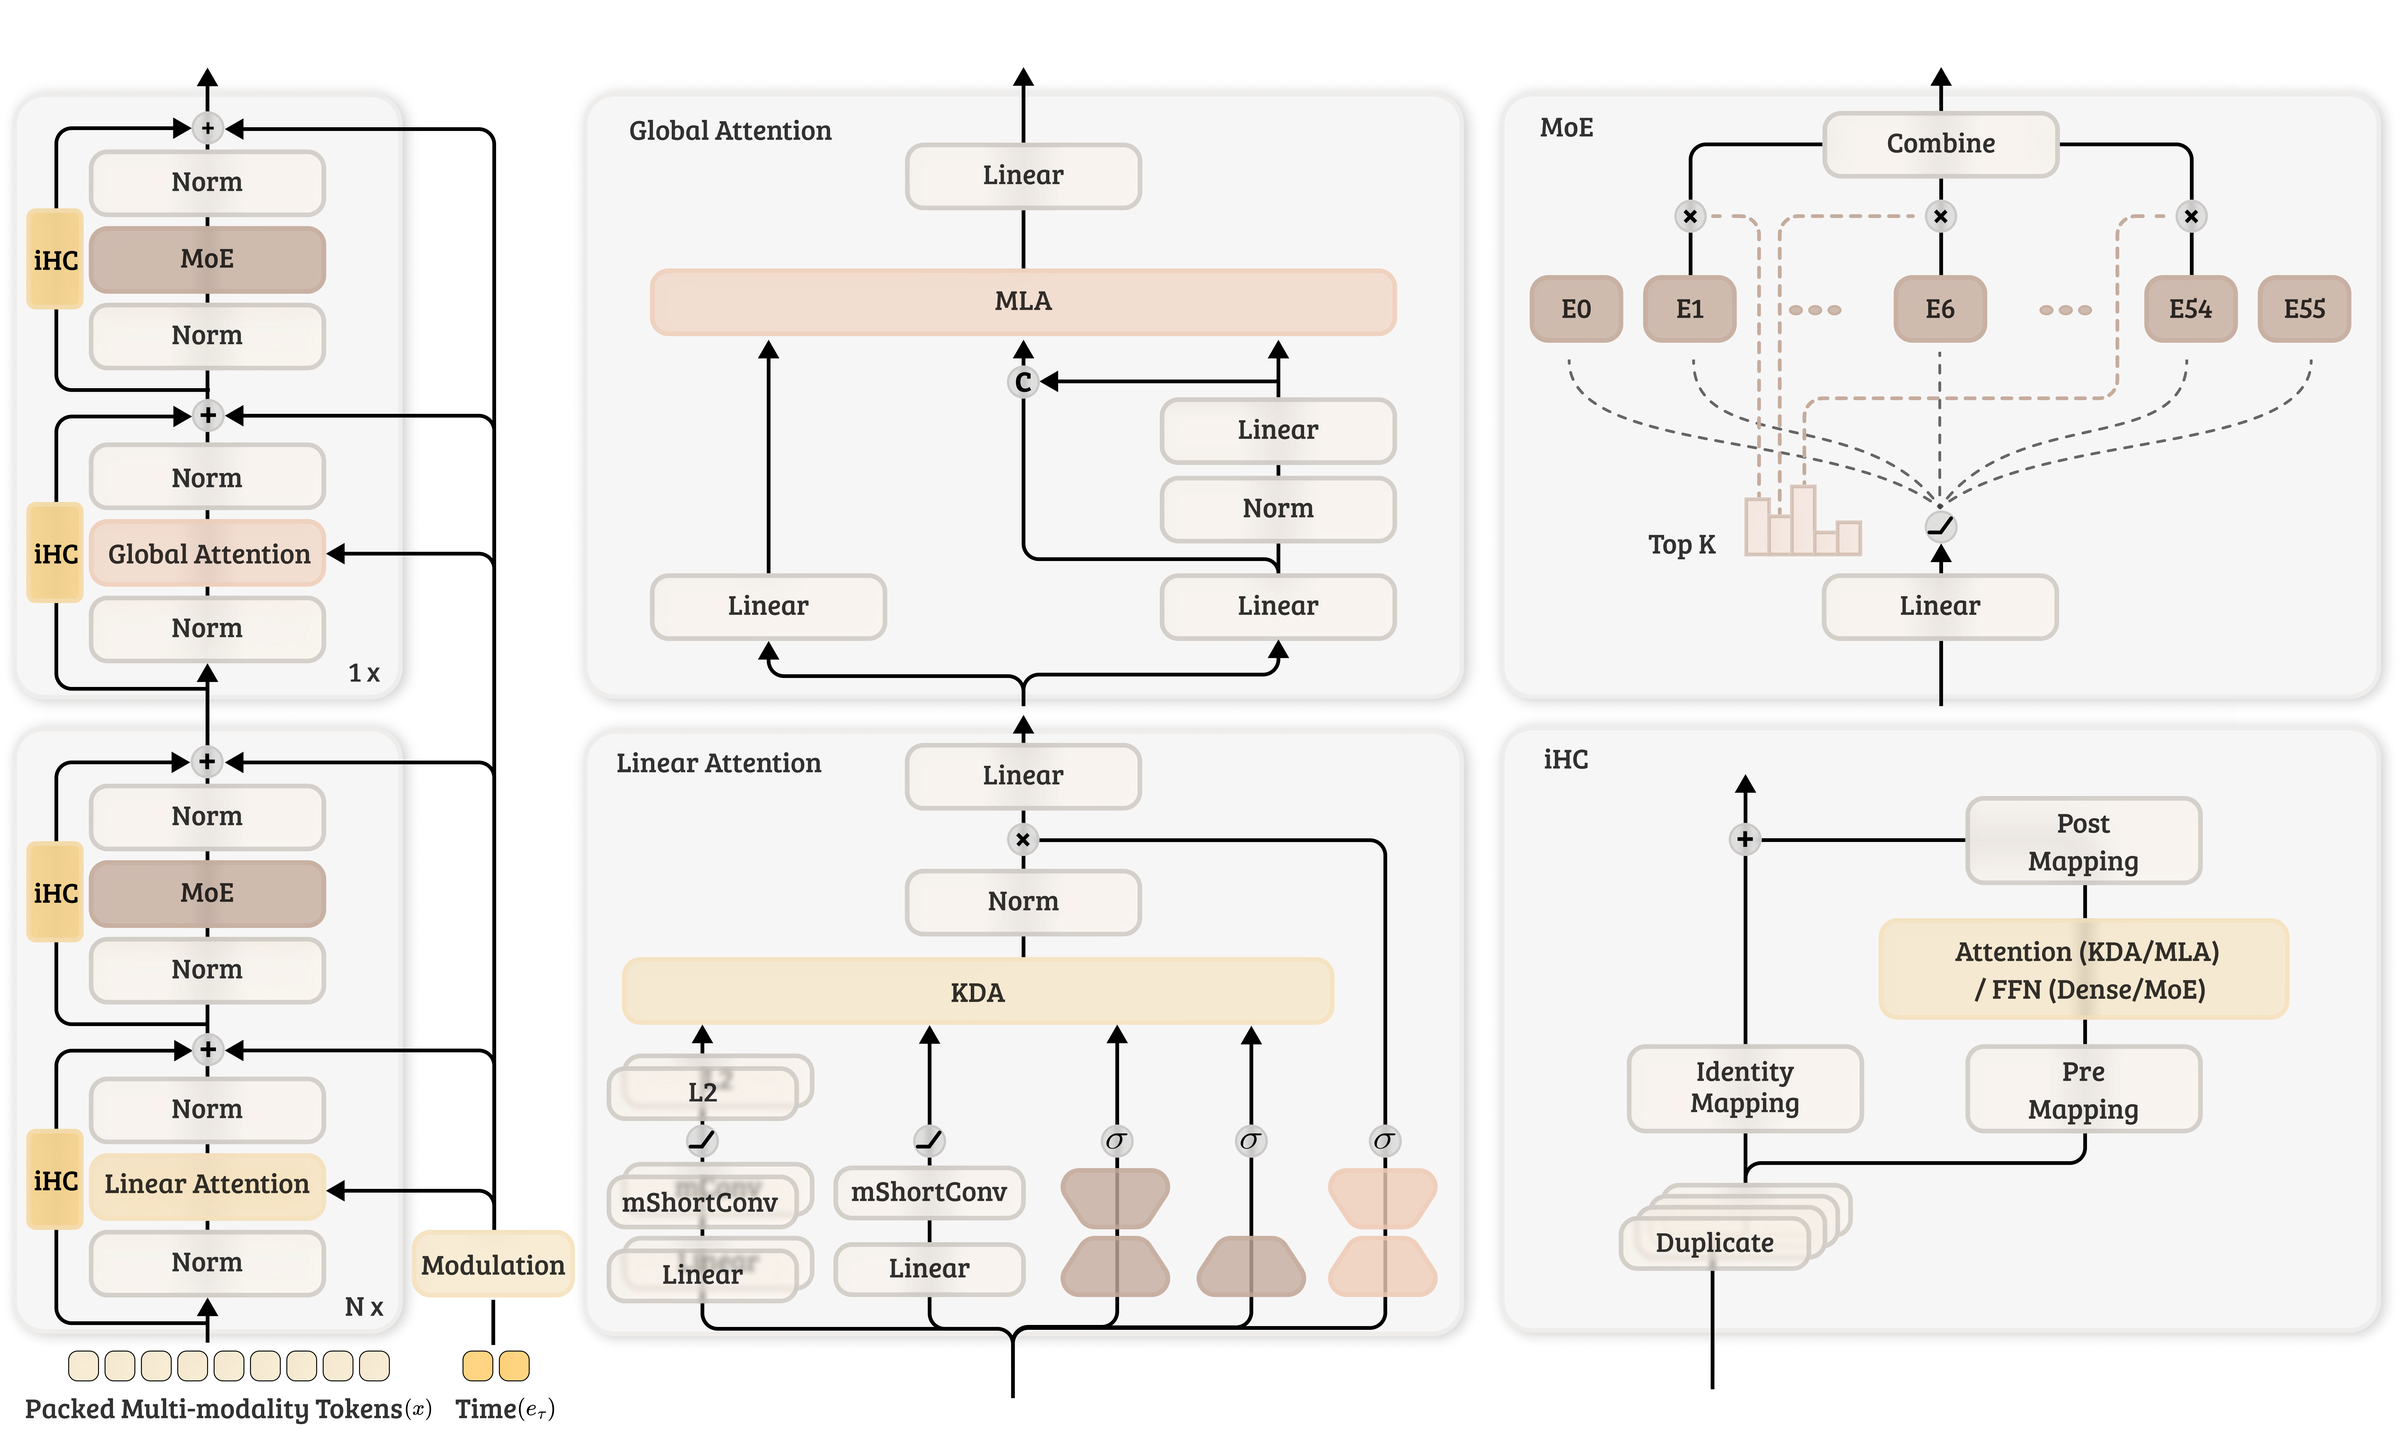
实验效果:稠密骨干相较匹配的全注意力 Wan2.1-2B,预训练计算效率提升 1.7 倍;完整系统提升到 7.3 倍。模型只用 5 秒视频训练,无需长度微调即可零样本生成 30 秒视频,最后 5 秒 FID 仅退化 6.5%。
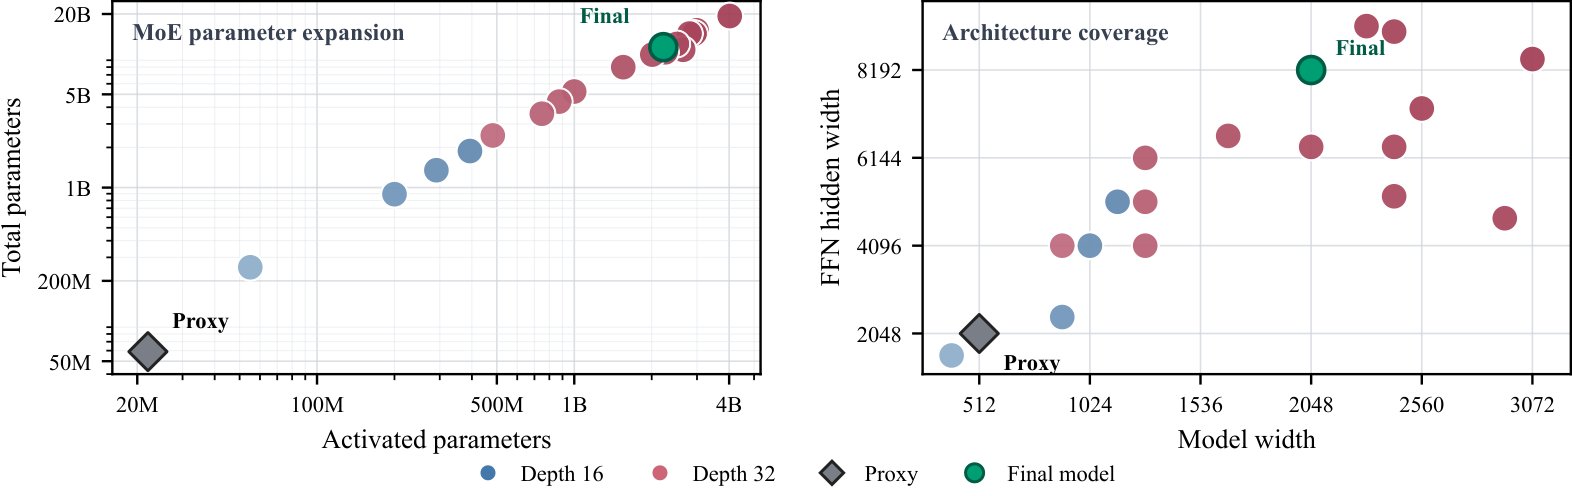
批判点评:Adobe 将线性状态跟踪、全局注意力、局部卷积和 MoE 组合后,再用专门缩放律调参,避免了“高效模块简单拼装”的常见陷阱,7.3 倍算效与 6 倍时长外推都很亮眼。但系统结构复杂、工程优化依赖强,预训练损失和 FID 并不等价于真实指令遵循与长视频观感;11B/2B 激活规模的复现门槛也不低。
CineWeaver: Training-Free Reference-Controllable Multi-Shot Long Video Generation for Cinematic Storytelling | 上交·中国电信TeleAI | arXiv:2607.26529
关键词:多镜头视频,长视频,参考控制,免训练,电影叙事
前序问题:电影级视频生成需要同时满足多镜头切换、人物与场景的逐镜头精细控制,以及跨长时间范围的一致性。现有方法通常针对单项需求定制或重训,难以用一个框架兼顾三者。
本文贡献:提出免训练统一框架 CineWeaver,指出预训练视频扩散模型对时间连续性的结构偏置正是多镜头生成困难的根源。推理时操纵位置编码与注意力模式,主动打破时间连续性以形成清晰转场;设计按镜头路由的参考条件,实现人物和场景的逐镜头控制;再用锚点记忆跨长视频保存全局外观线索。
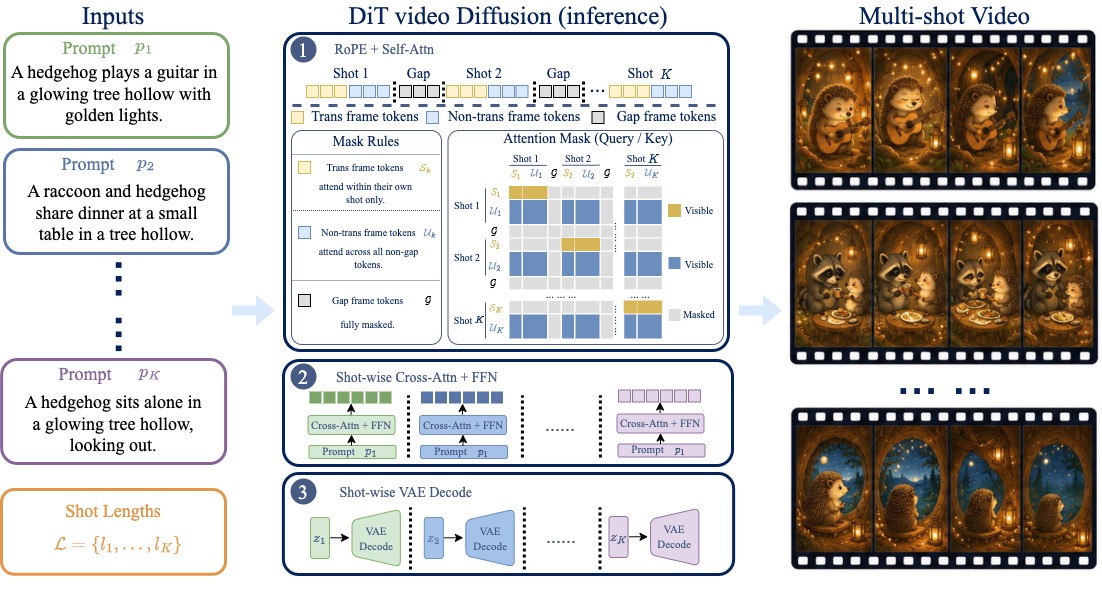
实验效果:据作者所述,这是首个同时支持长视频、参考可控和多镜头生成且无需重训的统一框架。实验可生成身份一致、全局外观稳定、转场清晰的长时电影级视频。

批判点评:把“视频模型过度追求连续”反过来视为多镜头障碍,并仅在推理期改位置编码与注意力,洞察直接且部署成本低。但免训练控制的上限受基础模型约束,复杂叙事中的因果推进、镜头语言和跨镜头表演一致性仍不能只靠外观锚点解决,长片级验证也有待扩大。
Explorative Modeling: Unlocking a Third Pretraining Axis and End-to-End Generation | UIUC·Harvard | arXiv:2607.27372
关键词:生成模型,端到端生成,预训练扩展,探索建模,扩散替代
前序问题:生成模型虽然能力强,却仍不像分类模型那样真正端到端:训练时与推理时的采样过程并不一致。现有可扩展方法通过拆分生成过程处理多峰分布,这种分解既阻碍端到端生成,也让生成能力主要只能沿参数量和数据量两个维度扩展。
本文贡献:提出 Explorative Modeling(XM),不再拆分生成过程,而是拆分训练循环:每次探索模型生成与真实数据之间的 K 个候选匹配,只用最佳匹配训练,使预测主动落在具体模式而非平均模糊。由此把“探索量”建立为参数与数据之外的第三条预训练扩展轴;同时提出端到端重建式生成,让训练采样与推理采样保持一致。
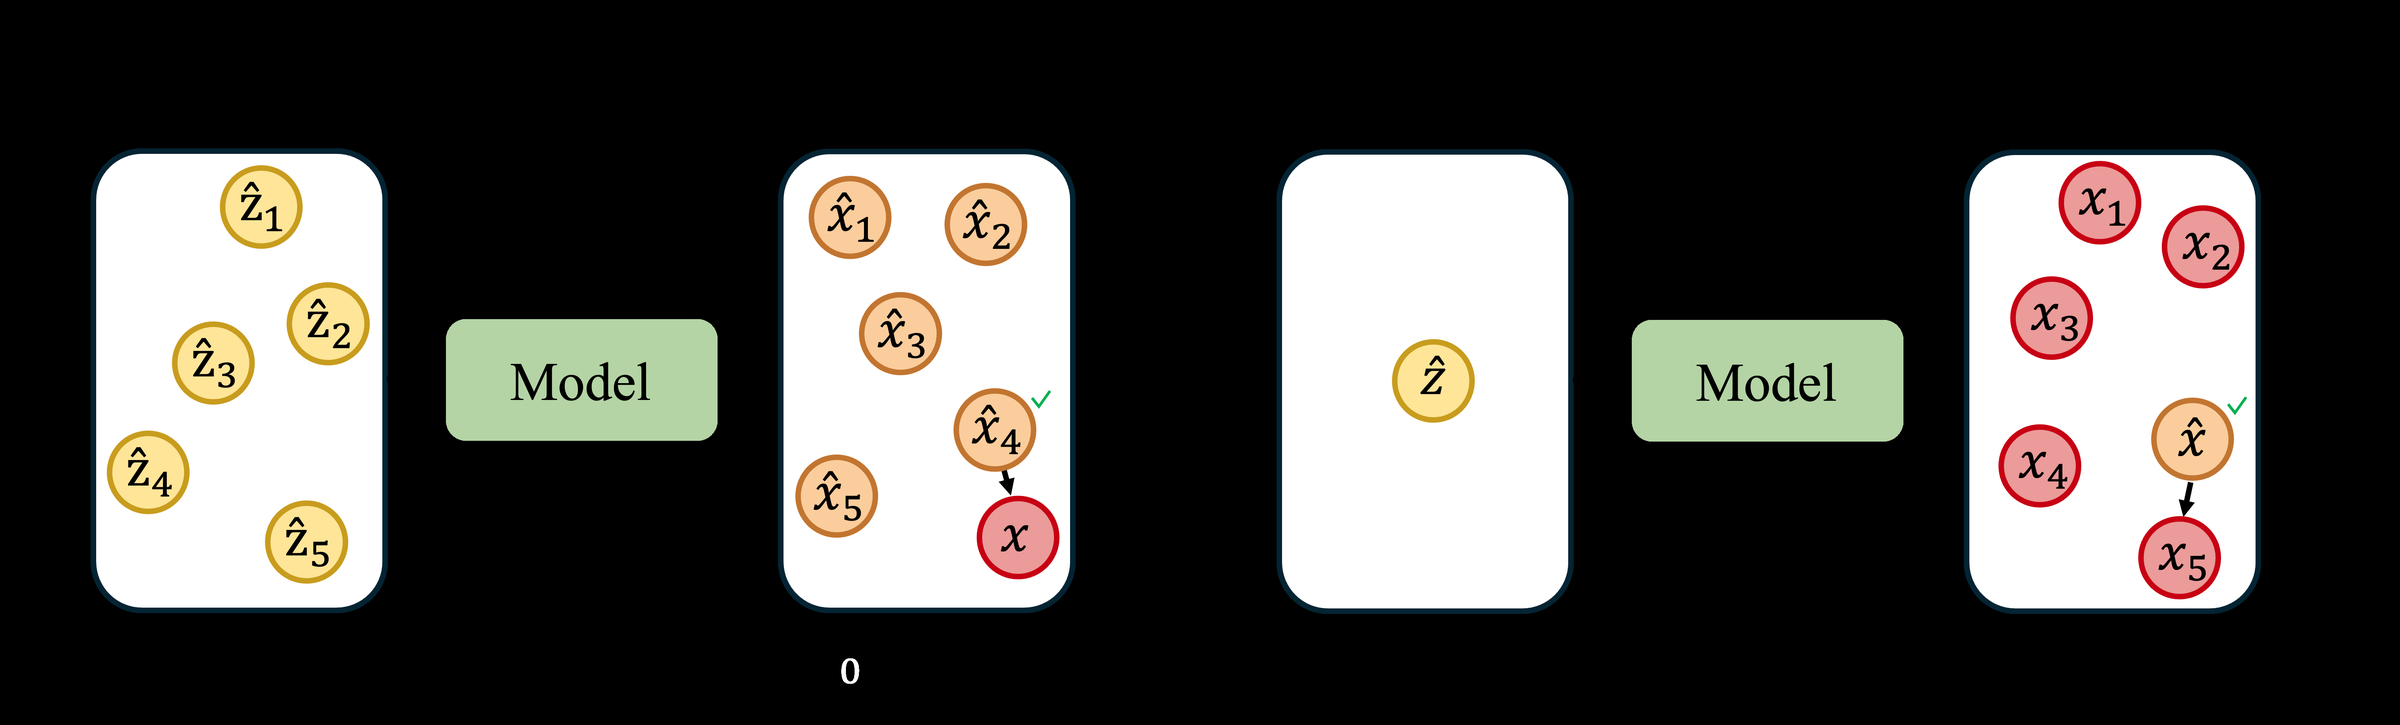
实验效果:扩大探索量在图像、视频、语言等连续与离散领域均单调增益,且规模越大收益越高:随数据规模增长,增益从 7% 升至 36%;随模型增大,从 13% 升至 23%。FLOP 效率提升 4.1 倍、样本效率提升 6.2 倍、参数效率提升 47%;ImageNet 无引导生成达到 1.43 FID,并在控制任务上以少 16–256 倍推理步数匹配扩散模型。
批判点评:“探索量成为第三预训练轴”是今天最具范式意义的结论,也给端到端生成提供了不同于扩散/自回归分解的新路径。但 K 候选探索会把部分成本前移到训练阶段,最佳匹配准则也可能偏向易选模式;目前的规模仍不足以证明它能全面替代成熟扩散路线,大规模文本到视频与真实产品中的稳定性尚待验证。
Temporal Concentration from Rollout Errors: Implicit Preference Optimization for Text-to-Video Diffusion | 清华·快手可灵·中山大学 | arXiv:2607.28058
关键词:视频扩散,偏好优化,自监督,时序一致性,后训练
前序问题:DPO 等偏好对齐虽能提升视频观感,但运动坍缩、物体闪烁、颜色过饱和往往只短暂出现在少数帧。离线人工偏好昂贵且跟不上模型变化,在线奖励又不稳定;对整段视频均匀监督还会把信用分配给无问题的帧。
本文贡献:提出集中式隐式偏好优化 cIPO,不依赖人工标注或外部奖励模型。对真实视频先加噪再让当前模型迭代重建,把原视频视为偏好样本、带有模型 rollout 错误的重建视为非偏好样本,由去噪过程自动产生贴合当前模型的偏好对;再计算逐帧重建误差,把优化集中到高误差的短时片段。

实验效果:在多个数据集和视频扩散模型上持续提升视频真实性与时间连贯性,尤其能更精准地修复只在少量帧中出现的失败区域,同时省去人工偏好标注和外部奖励模型。
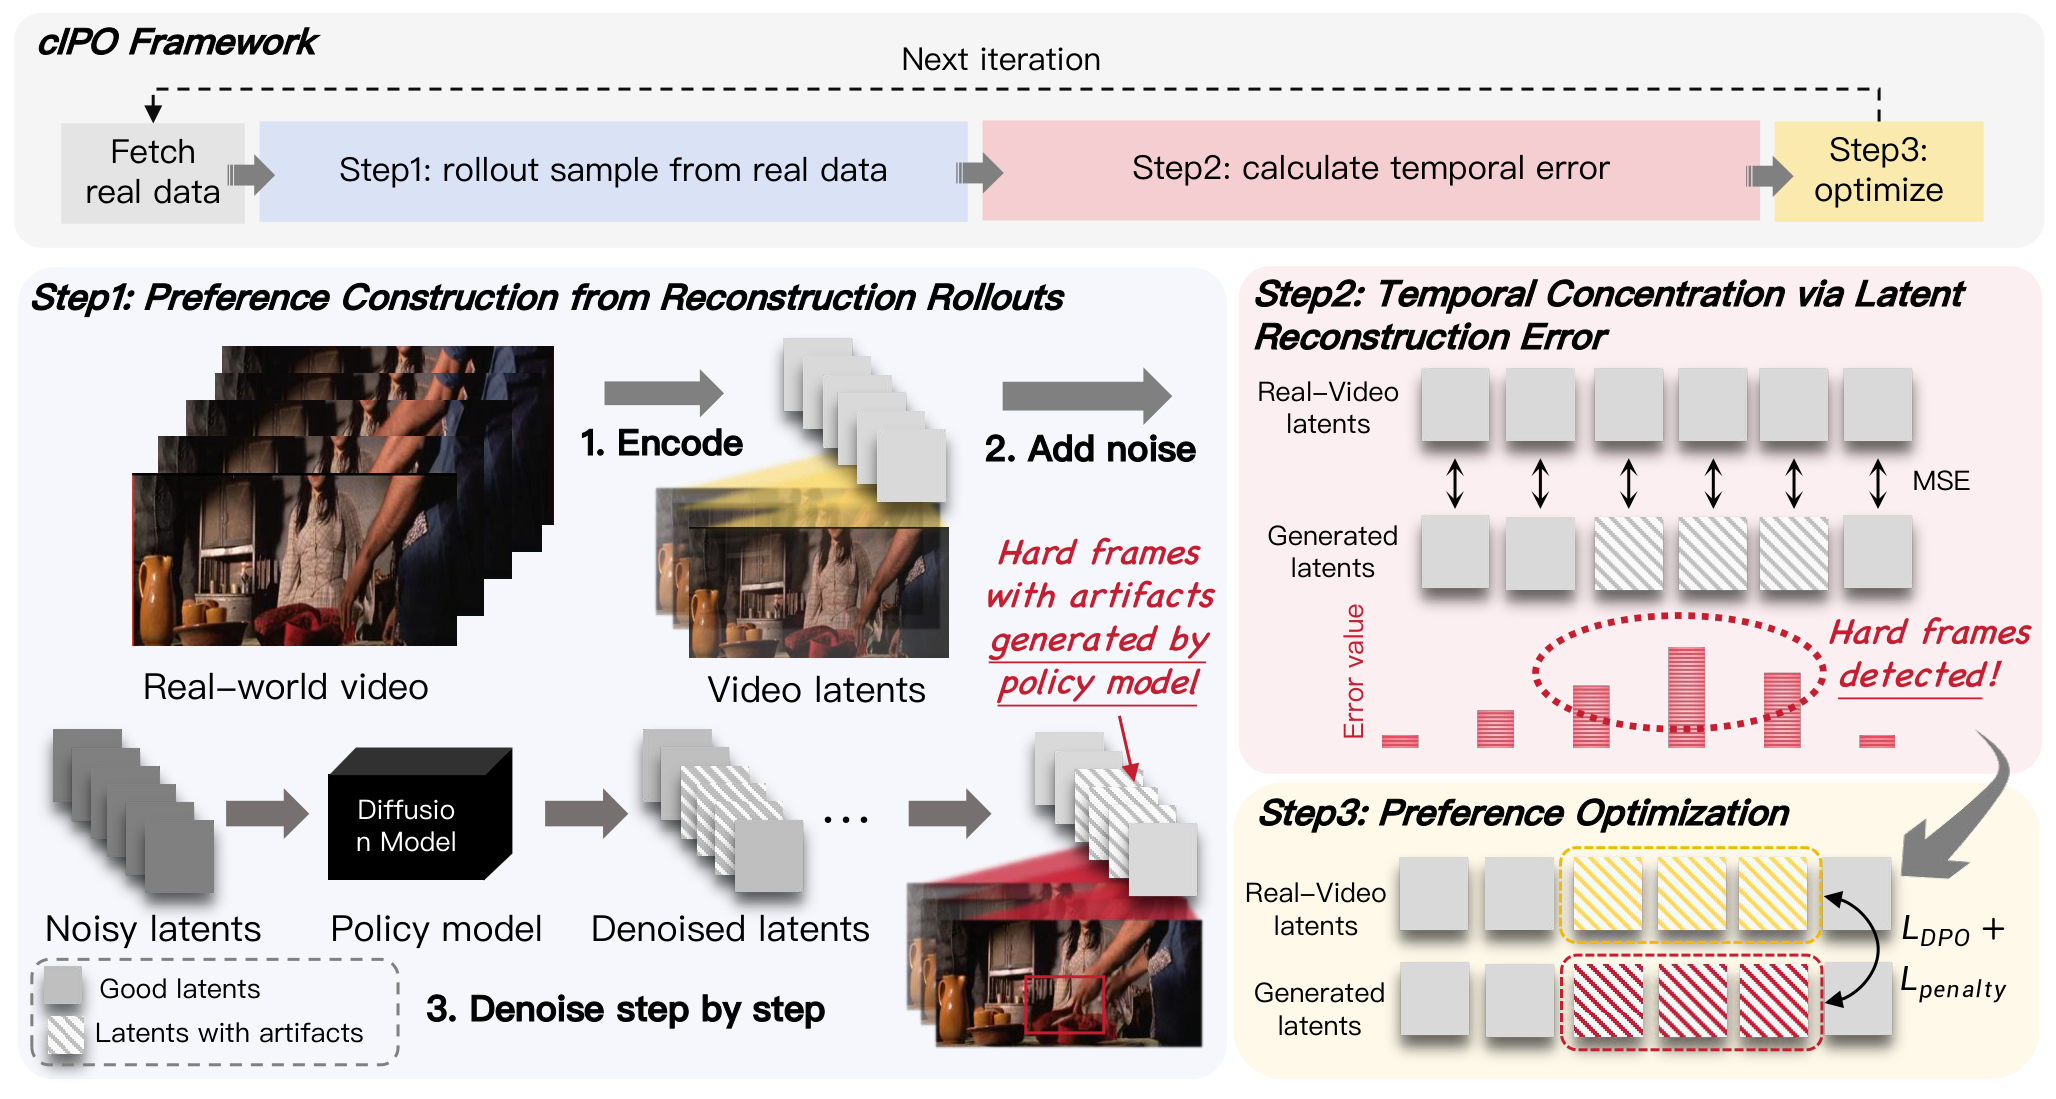
批判点评:可灵团队把模型自己的 rollout 错误变成偏好监督,并按时间集中火力,正面解决视频 DPO 的标注与信用分配瓶颈。不过“真实视频优于重建”主要刻画保真与稳定,不一定等价于用户审美或提示遵循;高误差片段也可能来自困难但合理的运动,需防止优化把动态性一并压平。
PhiZero: A World Model Built Around Physical Language | 中科院自动化所 | arXiv:2607.28624
关键词:世界模型,物理语言,显式推理,视频生成,动作仿真
前序问题:现有物理世界模型通常直接在像素空间预测未来视频,世界动力学被隐式藏在高维视觉预测器中,难以解释、组合和显式推理。
本文贡献:提出围绕“物理语言”构建的世界模型 PhiZero:从野外视频中自监督学习描述世界状态转移的紧凑离散表示,并采用先推理、后渲染范式——先把未来演化推断为物理语言序列,再将这些转移渲染成视频,让动力学从像素预测中解耦出来。
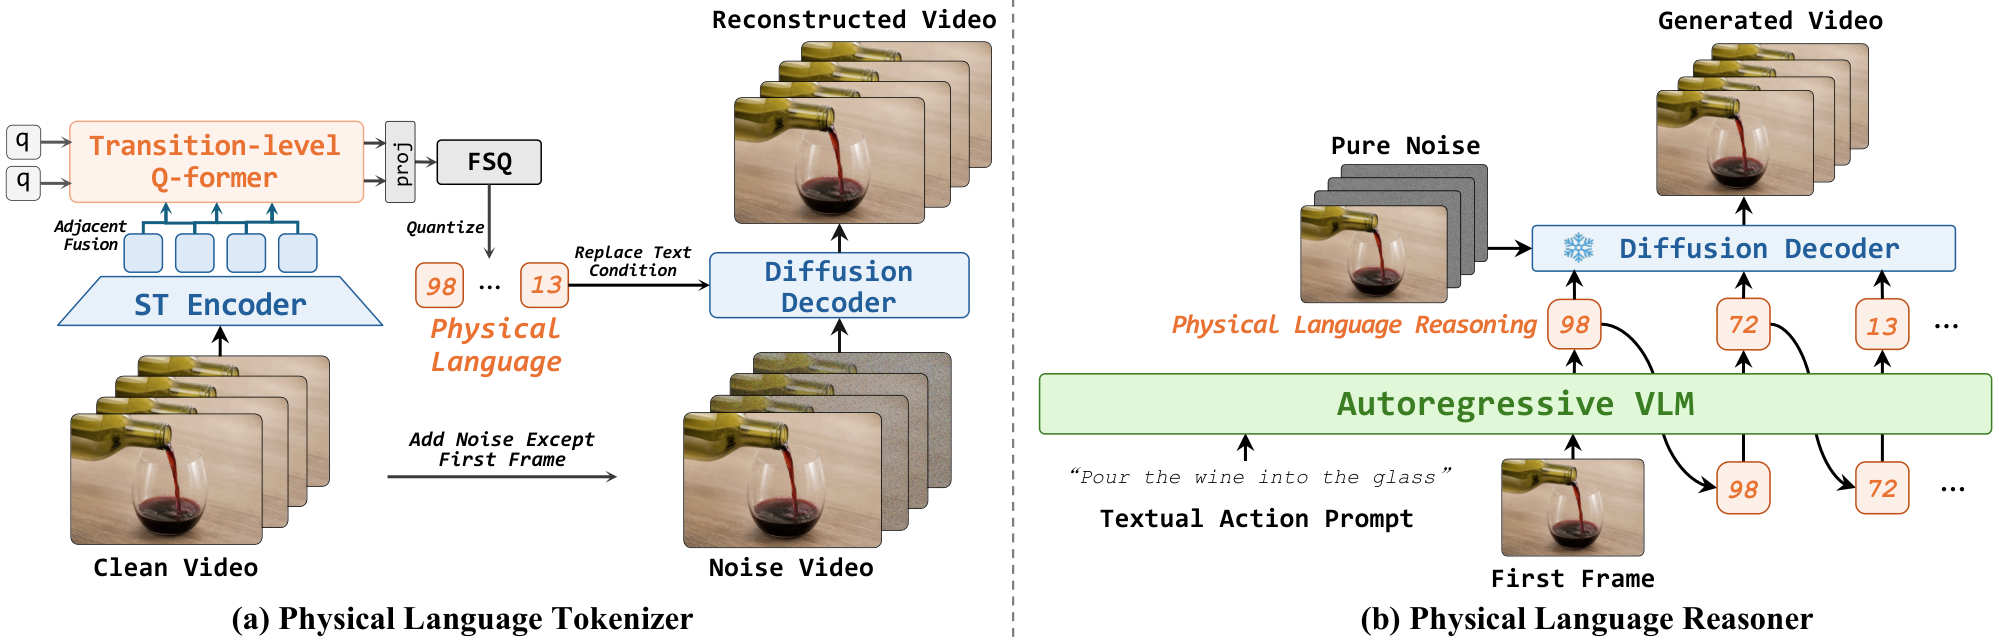
实验效果:在生成与理解基准上验证了物理一致世界演化能力,并展示了在写实交互世界建模、细粒度动作条件仿真和零样本运动迁移上的潜力。
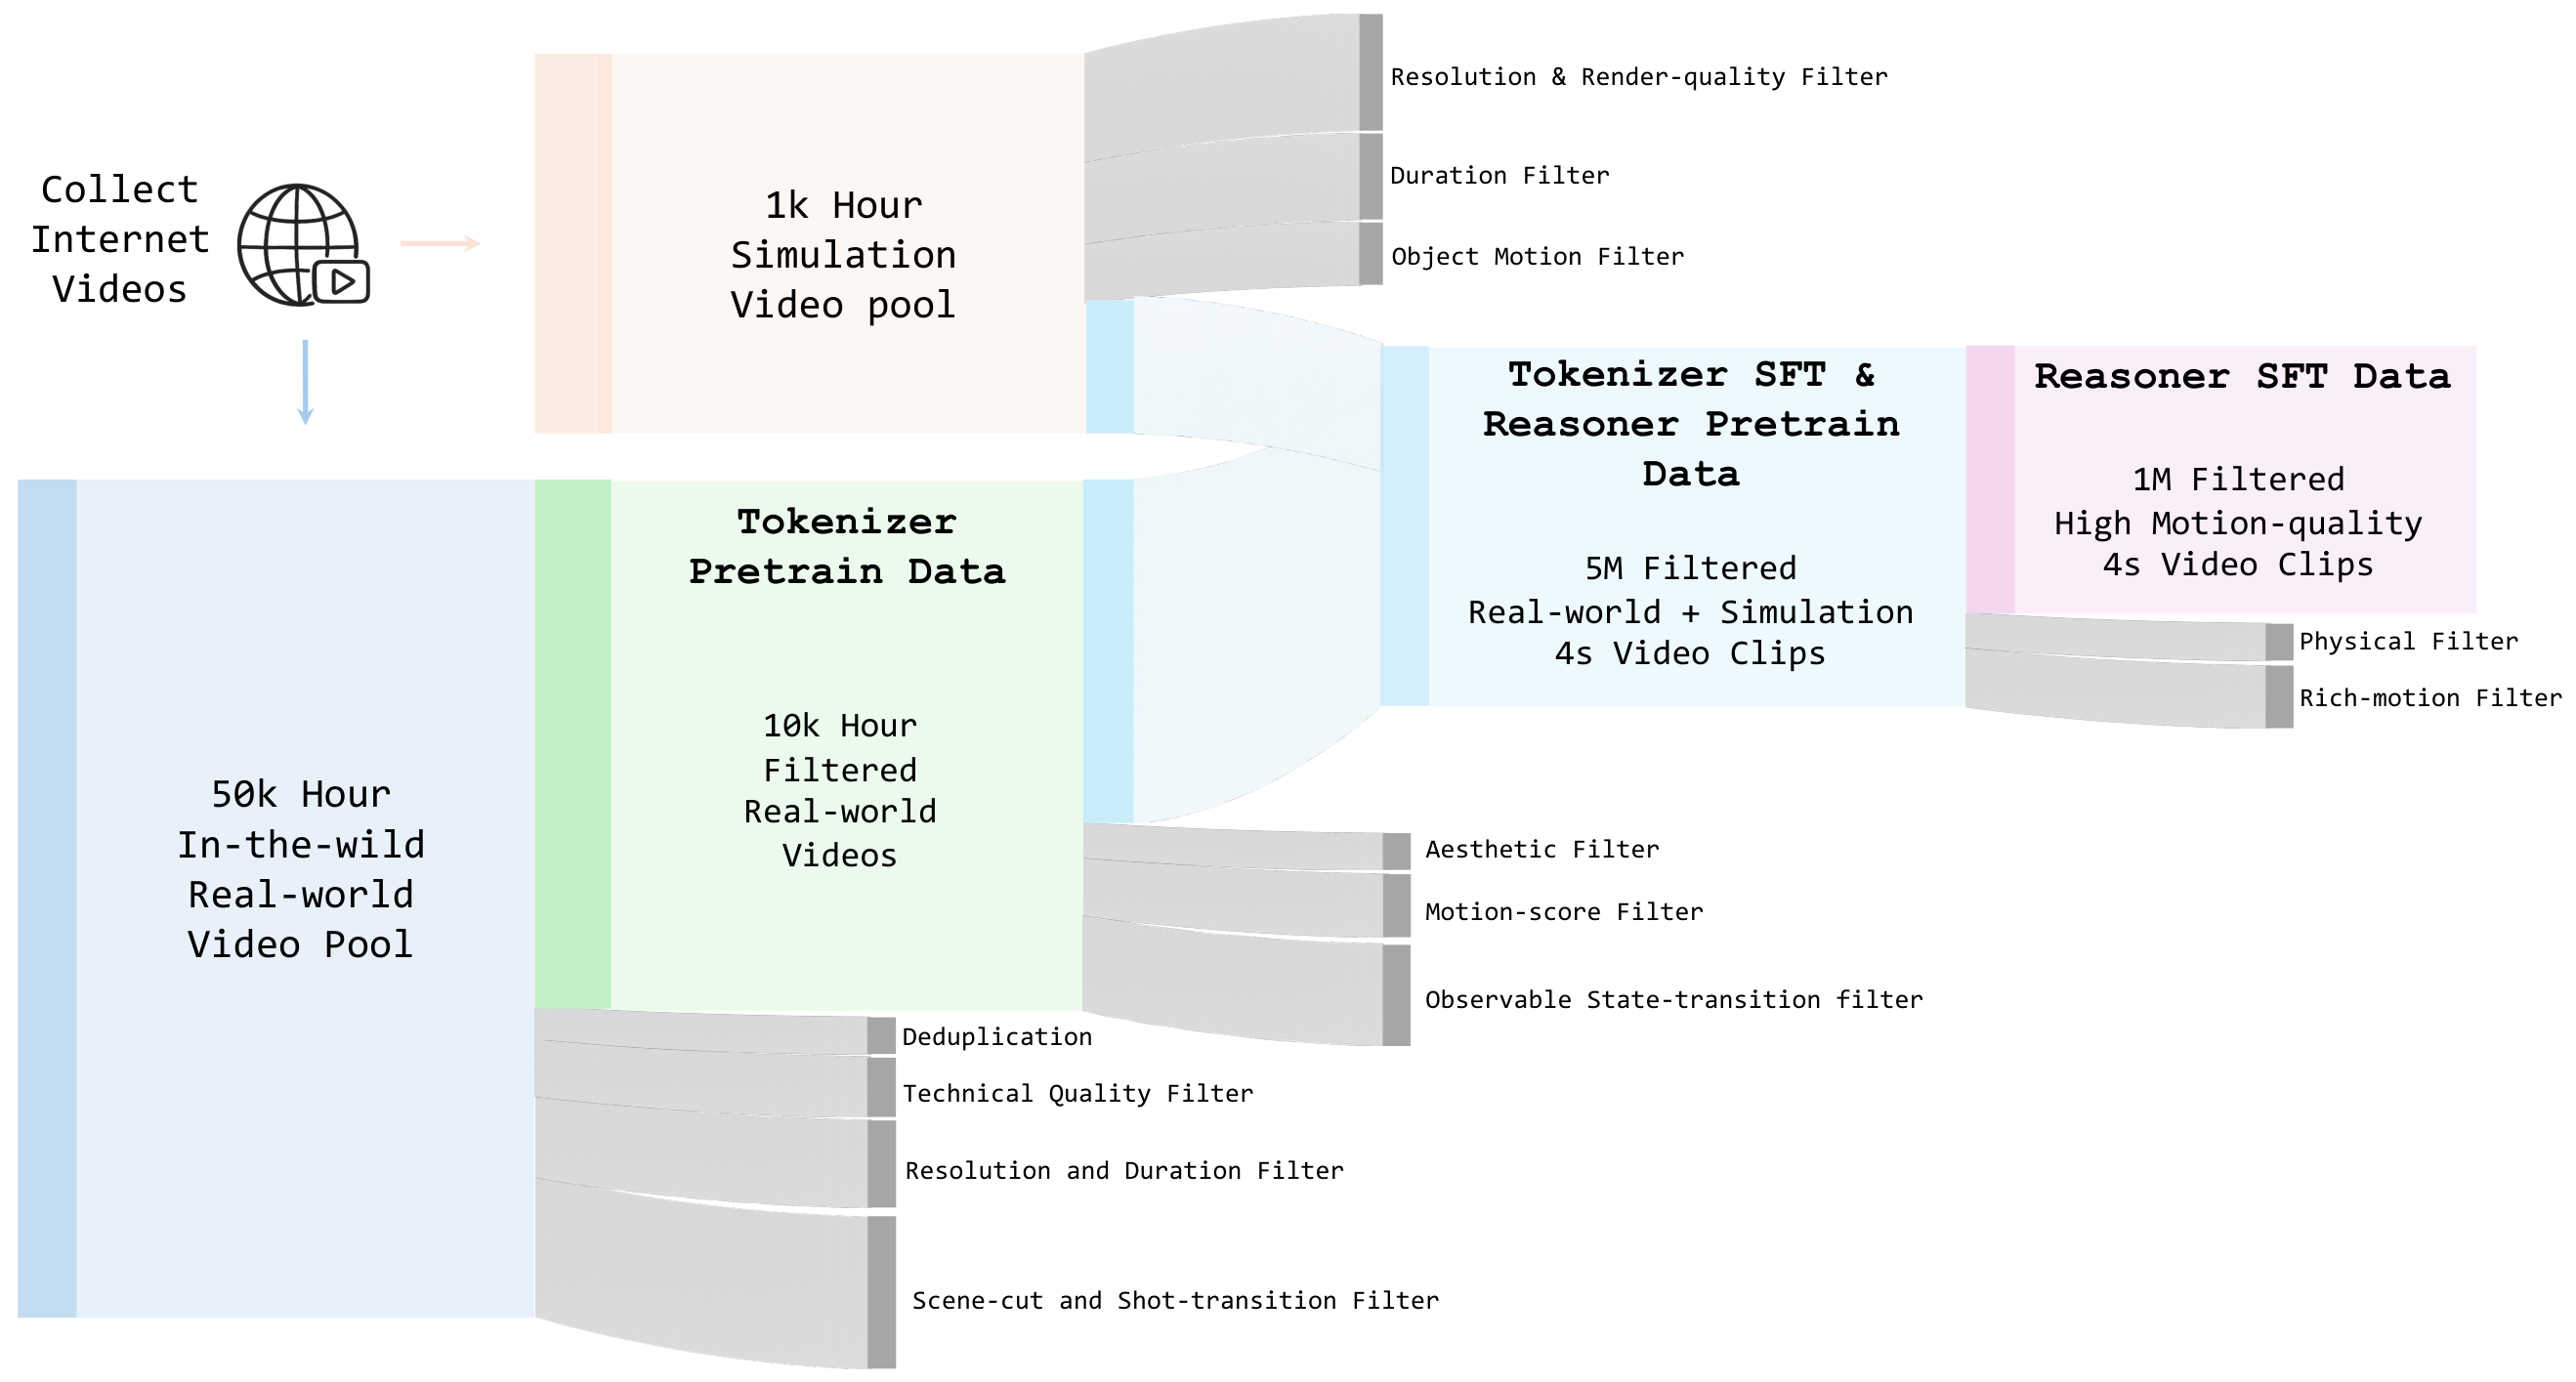
批判点评:“物理语言→视频”的显式中间层让世界模型更可解释、可控,也便于组合长期规划,是比纯像素 rollout 更有想象力的路线。但离散语言可能丢掉接触、形变等连续细节,物理语言是否真正学到因果规律而非运动码本仍需更严格反事实测试,渲染器误差也可能掩盖推理质量。
Visko Orbis 1.0: A Live Model for Real-Time Interactive Long Video Generation | Team Visko | arXiv:2607.26694
关键词:实时视频,长视频,交互生成,4K,流式生成
前序问题:真正的实时视频生成不能只快速吐出短片,还要允许用户在生成过程中随时改变提示,并在持续数十分钟乃至数小时的流式 rollout 中保持主体、场景、风格和颜色稳定。
本文贡献:推出实时交互长视频模型 Visko Orbis 1.0,统一支持文生视频、图生视频、视频续写、多语言提示和生成中切换提示。以有界多尺度记忆跨块保存主体、场景与风格,结合蒸馏后的分块流式生成器、流式视频超分器和优化 GPU 服务引擎。

实验效果:作者报告系统可实时输出 4K、24FPS,并将 rollout 延伸到 1 小时而无明显画质或色偏漂移;在长视频 Arena 中获得最高总体偏好与时间稳定性评分,DOVER 和 VideoAlign 多项指标也领先对比系统。

批判点评:4K/24FPS、实时改提示和小时级生成若能稳定复现,产品信号非常强。但技术报告未在摘要中披露实现该吞吐所需的 GPU 数量、模型规模和端到端延迟,Team Visko 的数据与模型细节也较少;这些亮眼数字应视为作者声明,仍需公开代码或独立测试验证。
VideoCoCo: Code-as-CoT for Physically-Consistent Video Generation via an Agentic Dual-Engine System | 港中文·中科大等11机构 | arXiv:2607.27380
关键词:物理视频,代码思维链,Blender,智能体,双引擎
前序问题:文生视频的视觉质量已很高,但文本把完整时空过程压成一句话,模型只能隐式猜测动力学,容易违反物理规律。已有思维链使用的中间计划或视觉状态不可执行、时间又稀疏,无法精确控制全过程。
本文贡献:提出智能体双引擎框架 VideoCoCo,把可执行 Blender 代码作为过程级思维链。编码智能体先把文本写成显式描述场景和时间演化的 Blender 程序,仿真引擎执行后产出确定性时空草图,再由生成式视频引擎通过草图条件编辑渲染成写实视频;并构建 3K 组“草图-指令-目标”数据适配编辑器。

实验效果:相对 OmniWeaving,PhyGenBench 从 0.475 提升到 0.558,VBench-2.0 从 52.18 提升到 77.88,两项均取得最佳平均分,表明可执行代码能充当可控、可检查的物理过程表示。
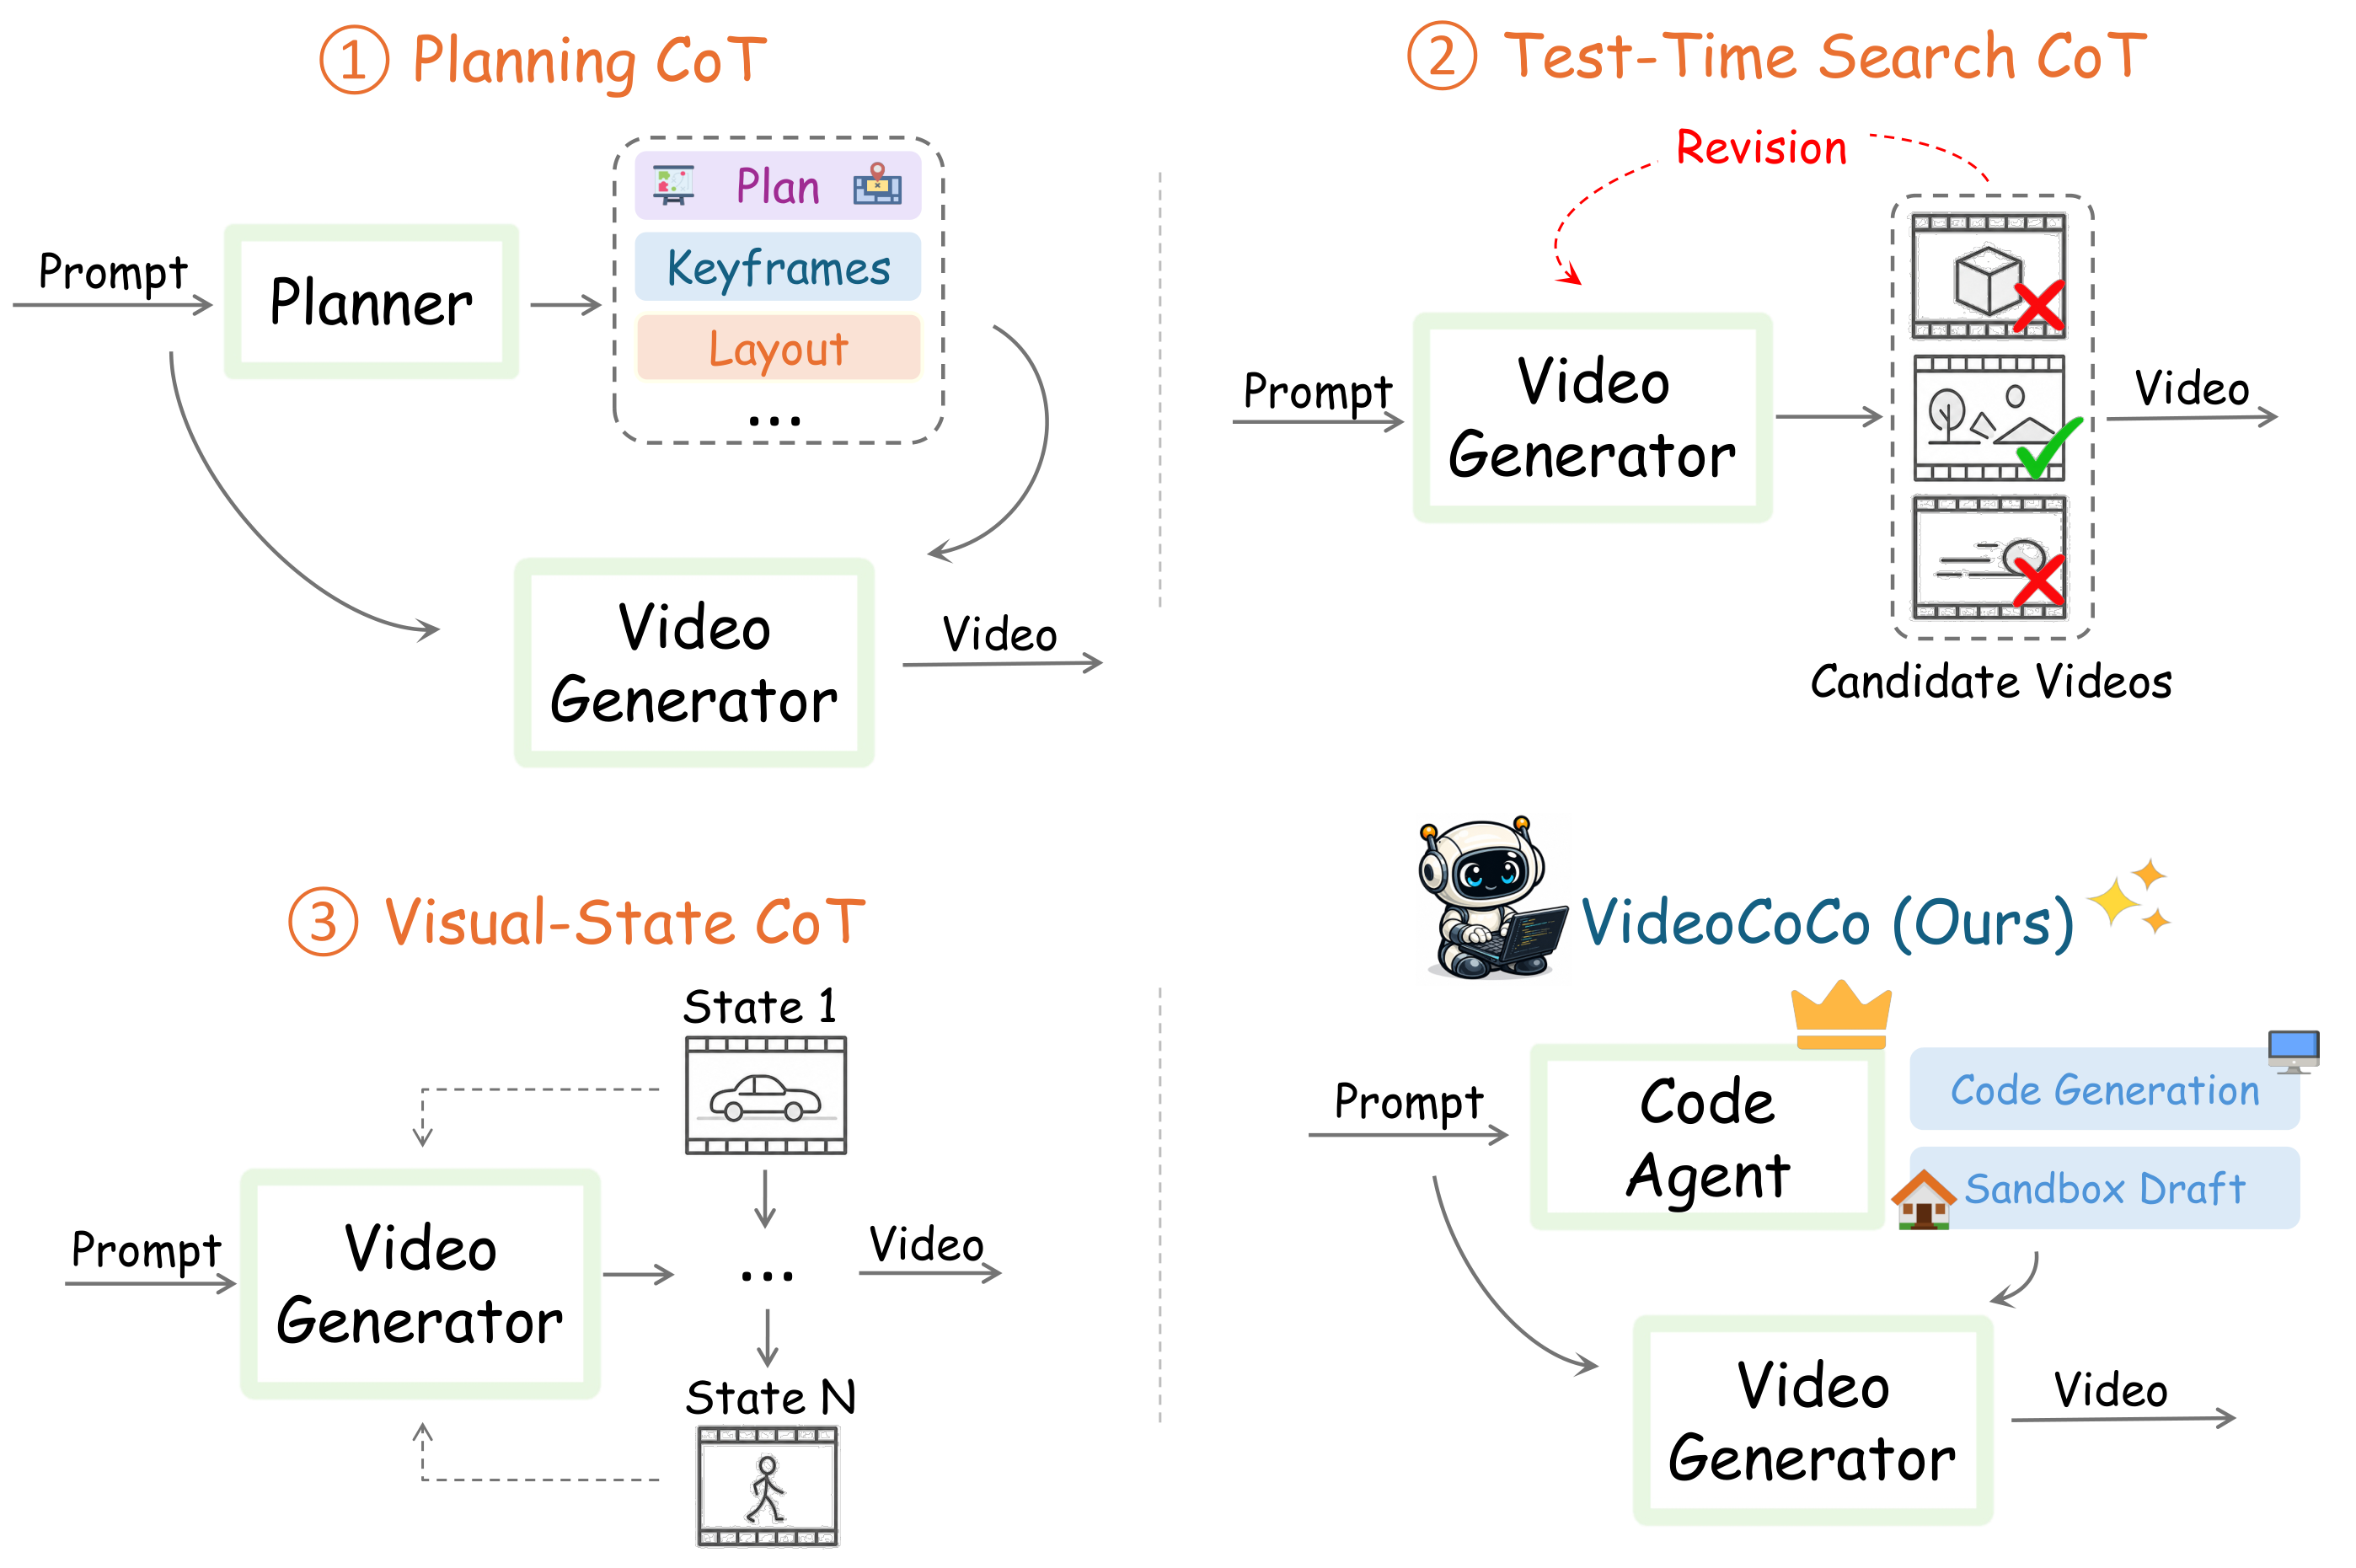
批判点评:将 Blender 代码变成视频 CoT,把物理推理与写实渲染明确拆开,既可检查又可执行,指标增益也明显。但代码智能体受 Blender 可表达对象和规则限制,真实世界的软体、流体、复杂接触难以准确脚本化;双引擎还会累积代码、仿真和渲染三层误差。
ReGenVC: End-to-End Real-Time Generative Video Coding at Ultra-Low Bitrate | Intel | arXiv:2607.28144
关键词:生成式编码,超低码率,实时解码,视频压缩,扩散蒸馏
前序问题:传统视频编码在极低码率下会出现严重块效应;生成式编码能借先验保持清晰,却因扩散 Transformer 与 VAE 多步解码过慢,难以用于直播、弱网通话等交互场景。
本文贡献:提出端到端生成式视频编码器 ReGenVC:编码端只发送神经压缩首帧、逐帧姿态关键点和元数据;解码端以参考帧与姿态为条件,用四步蒸馏 DiT 重建视频。系统再结合 8 GPU 统一序列并行、空间切分 VAE 与三级重叠流水线,并以 CPU 承担编码和一次性条件编码,释放 GPU 显存。

实验效果:77 帧人像视频仅约 26KB,而 x264/x265 达到近乎无瑕疵重建需约 250–280KB;同等极低码率下传统编码出现严重块效应,ReGenVC 仍保持清晰。在 8 GPU 节点上达到 24FPS,每 25 帧窗口 972ms;混合 CPU-GPU 部署把单卡峰值显存从 21.1GB 降至约 7.7GB。

批判点评:Intel 把生成先验真正塞进实时编码链路,在弱网人像通信上用约十分之一数据量维持清晰,方向很实用。但“实时”依赖 8 GPU 节点,而内容又集中于说话人视频;生成式重建可能改变细节,新闻、医疗、取证等强调像素真实性的场景还需明确失真边界。
FreqForcing: Autoregressive Long Video Generation via Spectral Self-Anchoring | 上海交大 | arXiv:2607.27110
关键词:长视频,自回归扩散,频谱锚定,免训练,时长外推
前序问题:自回归视频扩散可实时流式生成,但自 rollout 误差会长期累积,逐渐表现为色偏、运动停滞直至画面崩溃。作者发现其本质特征是低频能量明显漂移,注意力 sink 只能部分缓解。
本文贡献:提出免训练框架 FreqForcing,以频谱自锚定 SSA 解决长视频误差累积:局部注意力保留当前动态,锚点注意力提供高质量历史参照;在频域中融合局部注意力的高频成分与锚点注意力的低频成分,用低频稳定长期外观,同时避免锚定抹掉高频运动。
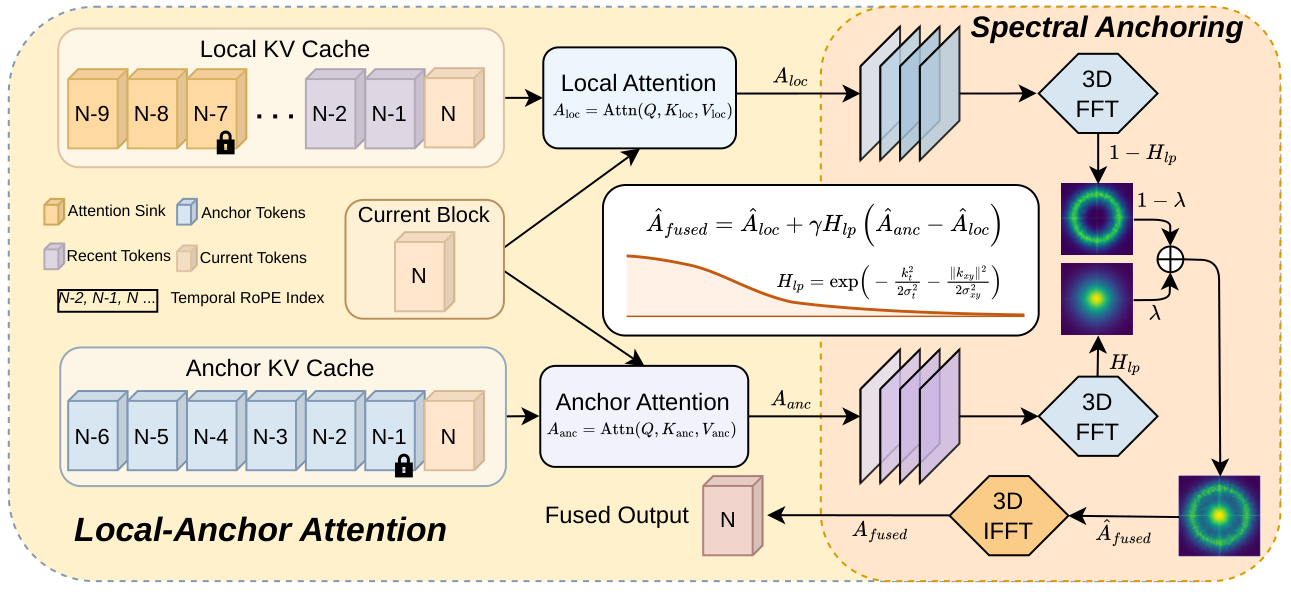
实验效果:无需重新训练,即可把仅在 5 秒片段上训练的 Self-Forcing 扩展到 2 分钟,达到 24 倍时长外推;定量与定性表现超过现有免训练方法,并可与代表性训练式方案竞争。

批判点评:把长视频崩坏定位为低频能量漂移,再让锚点只管低频、局部注意力保高频,是很干净的频域解法,24 倍外推也有说服力。但固定锚点可能限制场景长期演化,频率分解无法替代人物关系与叙事状态记忆;两分钟之后是否仍稳定尚未得到证明。
TPD: Temporal Prior Decoupling for Text-to-Video Diffusion Models | 马里兰大学 | arXiv:2607.26706
关键词:文生视频,时间先验,反事实引导,免训练,事件控制
前序问题:当提示描述一个持续的早期场景、随后才发生新事件时,视频模型常让早期先验支配整条跨时间注意力轨迹,压制后段事件所需的引导信号。例如沙堡一直存在,浪却没有在后半段将其冲毁。
本文贡献:提出时间先验解耦 TPD。仅以早期场景为条件构造时间反事实,将完整提示与反事实轨迹的差定义为被压制的信号方向;不同于以往投影法删除不想要语义,TPD 在扩散步与视频帧上联合求解帧选择的下界约束,保证被压制信号在应出现的后段帧中贡献,同时不破坏早段连贯。

实验效果:完全运行在标准 classifier-free guidance 采样空间,无需重训、与骨干结构无关。多个文生视频骨干上均发现相同压制现象,TPD 显著提升后段概念实现率,同时保持时间连贯与视觉保真。

批判点评:TPD 把“后段事件没发生”明确解释为早期先验压制,并用下界约束恢复信号,诊断与修复逻辑都很清晰。但它需要能从提示中拆出早期条件,复杂并行事件或语义边界模糊时不易构造反事实;额外条件轨迹也会增加推理成本。
人工智能炼丹君 整理 | 2026-07-31
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)