


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 音视频联合生成与修复 2 篇 · 实时与交互视频创作 2 篇 · 多模态Token高效压缩 2 篇 · 生成后训练与条件对齐 2 篇 · 评测与专业可控生成 2 篇
OmniVR: Joint Video-Audio Conditional Generation for Restoring Degraded Historical Films | 中科大·京东探索研究院 | arXiv:2608.04224
关键词:音视频联合修复,历史影像,LTX-2,多模态DiT,京东
前序问题:历史影像往往同时存在模糊、噪声、闪烁、曝光不足,以及嘶声、削波、掉音和带宽缺失。现有修复器通常把视频与音频拆开处理,不仅留下单模态质量短板,还可能破坏口型、动作和声音之间的同步。
本文贡献:提出首个音视频联合生成式老片修复模型 OmniVR。系统从 22B 参数 LTX-2 音视频骨干出发,把低质音频和视频编码成联合条件,在统一多模态 DiT 中同步去噪;以联合退化管线模拟真实老片损伤,用近零初始化通道拼接与提示词退火把 T2AV 平滑改造成 AV2AV,再以首帧锚定、模态损失重加权和波形监督支持跨 121 帧窗口的长视频修复。

实验效果:在 200 段真实历史片组成的 OmniVRBench 上,真实轨 MUSIQ 达 61.87,显著高于次优 RealBasicVSR 的 52.38;DNSMOS 从退化输入的 2.04 提升至 2.43,FAD 从 15.93 降至 8.32。12 名标注者给出 80.0% 综合偏好。模型输出 1920×1088,作者还报告在独立 RTN 老片基准的六项无参考视觉指标上全部第一。

批判点评:把“修画面”和“修声音”变成一次联合条件生成,方向比串联两个修复器更完整,指标和人评也有说服力。但 22B 骨干以 rank-384 LoRA 在 64 张 H200 上训练约 5 天,成本很高;强生成先验可能补出原片不存在的纹理与颜色,历史档案、司法取证等场景仍需要真实性约束。代码和权重目前只是承诺公开。
JoyAI-Video-Edit: Real-Time Open-Ended Video Editing with Autoregressive Diffusion | 京东Joy Future Academy | arXiv:2608.03974
关键词:实时视频编辑,自回归扩散,两步蒸馏,720p,京东
前序问题:直播和视频通话中的编辑必须边接收边输出,不能偷看未来帧,也不能让显存和计算随视频时长不断增长。把离线编辑器简单切成小段会产生边界跳变,自回归地反复使用生成历史又会累积色偏、身份漂移和背景幻觉。
本文贡献:提出 16B 自回归扩散编辑框架:MLLM 条件编码器理解指令和参考,因果 VAE 与分块双向、跨块因果注意力负责流式输出,滑动窗口加首块全局 sink 把历史状态限制在固定预算。Source-Anchored DMD 将多步扩散蒸馏为两步,并用当前源视频块约束教师目标;长程自回归蒸馏则在分段 rollout 上直接学习累积误差。
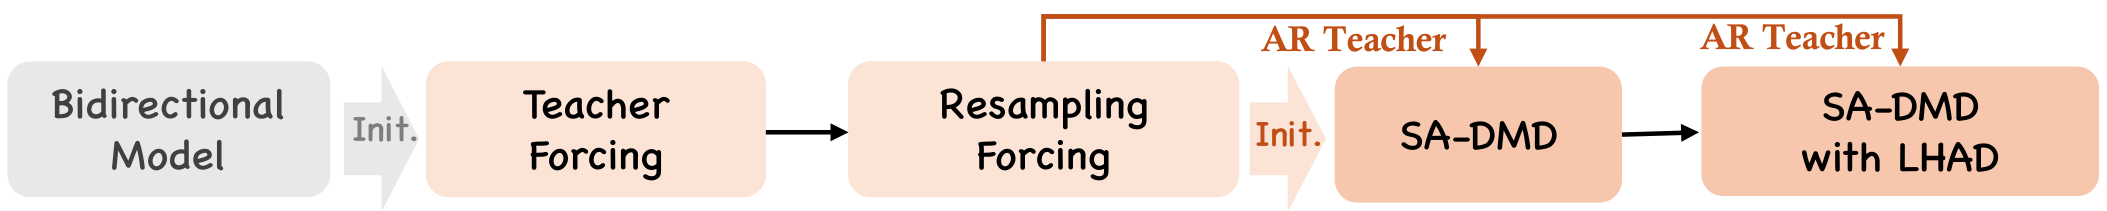
实验效果:结合两步生成、固定历史 KV 缓存、FP8 量化和优化 VAE 管线,完整系统在单张 NVIDIA B200 上实现端到端 720p 约 30 FPS。自动指标和人评均显著超过现有流式编辑器,在短视频与长视频上可与强离线系统竞争;代码已经公开。
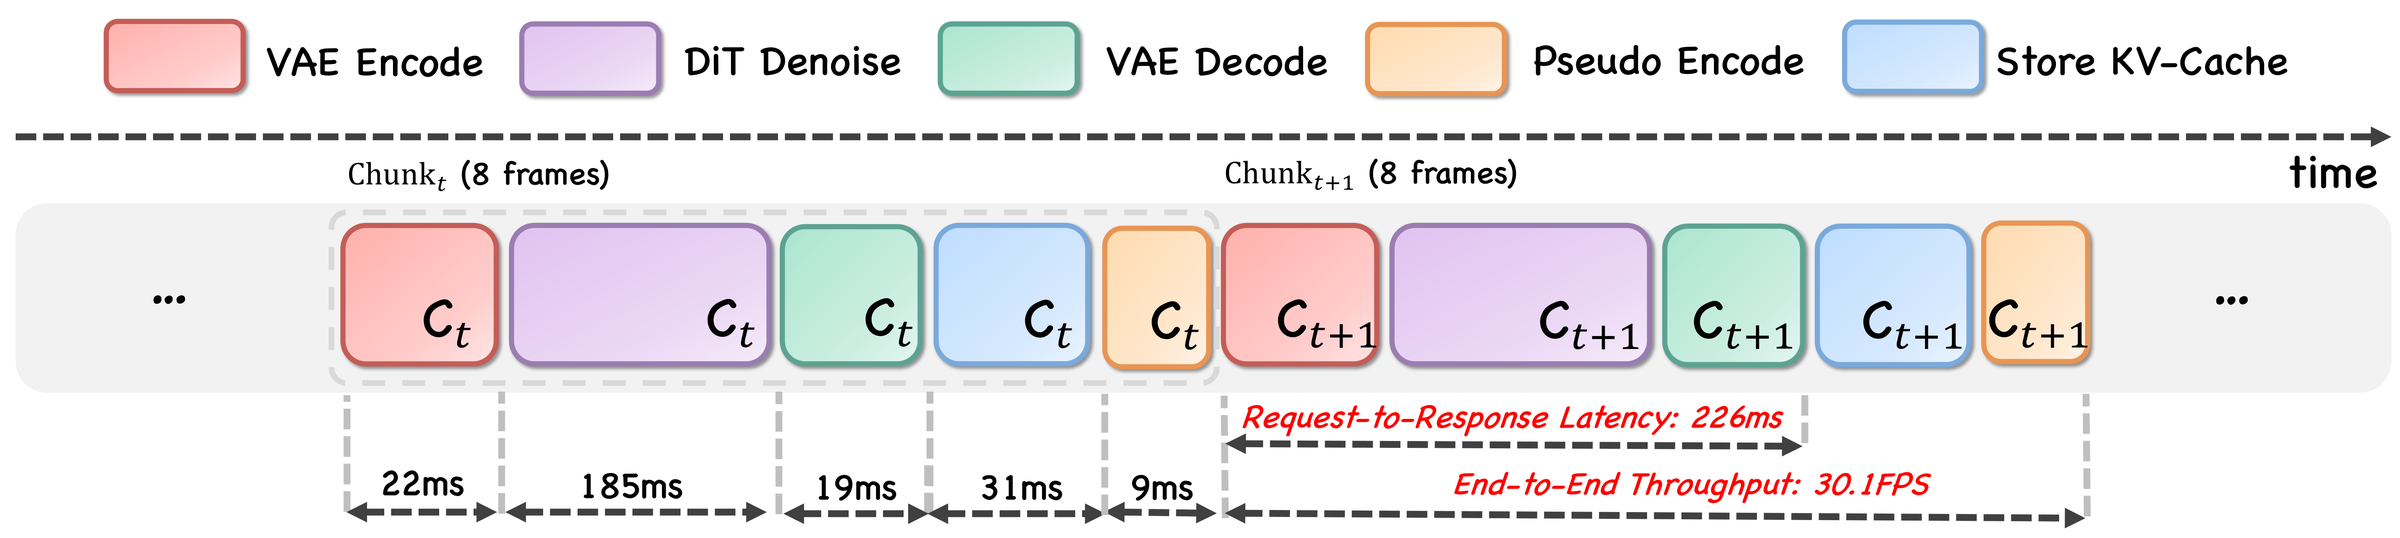
批判点评:这是今日最硬的工业数字:16B 模型把开放式编辑真正推到实时帧率,而且处理时无需预知视频总长度。但单卡指的是昂贵的 B200,30 FPS 不能外推到消费显卡;两步扩散和 FP8 的细节损失、长达数小时的稳定性以及输入输出延迟分布,还需要独立复现。
ContextMaster: Interactive Multi-Shot Video Creation via Fixed-Budget Sparse Context Routing | 清华·南京大学·快手可灵·上科大·港科大 | arXiv:2608.04956
关键词:多镜头视频,交互创作,稀疏路由,上下文缓存,可灵
前序问题:真实视频创作会在多轮中交替生成新镜头、引用人物或场景、编辑已有素材,并持续继承历史。若每个去噪步都密集读取不断增长的上下文,延迟会随会话变长;若只保留短窗口,又会忘掉早期角色与约束。
本文贡献:提出交互式多镜头视频创作 IMVC 与统一模型 ContextMaster。角色感知 RoPE 区分参考图、历史镜头、源视频和待生成目标;可缓存的干净上下文只预填一次,块稀疏路由在固定预算内检索相关历史,ConstraintSink 强制保留参考和逐帧编辑约束。两阶段特权上下文蒸馏先用稠密教师做一致性蒸馏,再用分布匹配修复少步 rollout 的细节。
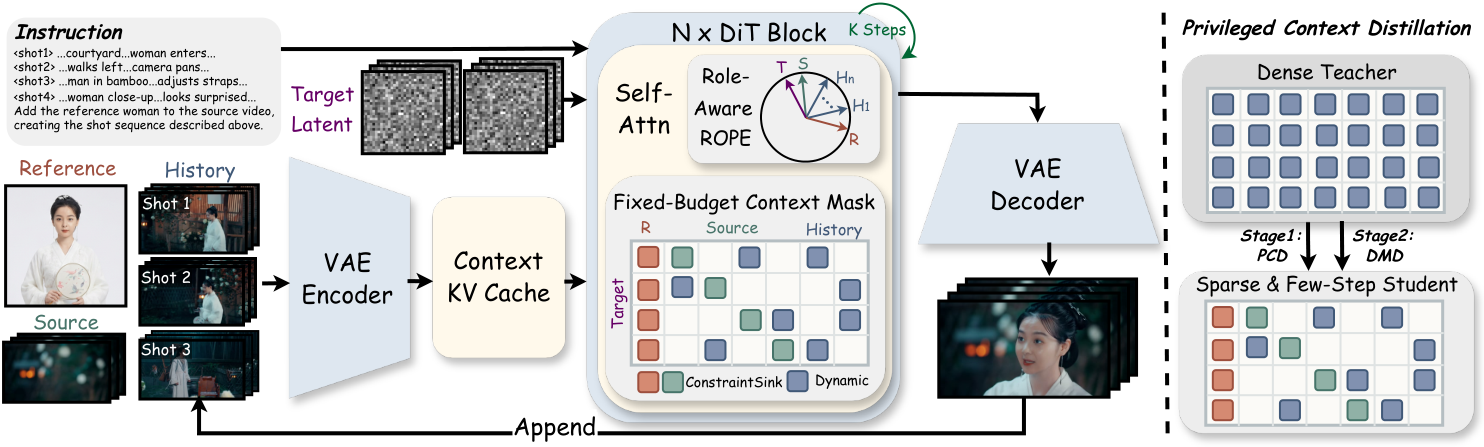
实验效果:在单张 H200、匹配分辨率与帧数的设置下,五镜头任务平均达到 16.74 FPS;跨镜头一致性由强基线的 0.808 提升到 0.836,并在文本生成、参考生成和视频编辑三类任务中取得最强综合表现。固定 6-FE 读取预算接近质量与速度最佳点。

批判点评:这项工作把多镜头创作从一次性提示升级为有状态工作流,并让每轮上下文读取保持定额,产品形态很清晰。但 16.74 FPS 仍依赖 H200;路由器漏掉关键旧镜头会造成不可逆遗忘,角色一致性也不等于剧情因果一致。训练阶段还使用 64 张 H200,复现门槛不低。
OmniPack: Unified Token Compression for Efficient Omni-modal Large Language Models | 西北工业大学·北大·阿里·清华 | arXiv:2608.03812
关键词:全模态大模型,Token压缩,免训练,音视频理解,推理加速
前序问题:全模态大模型同时接收长视频与音频时,视觉和声音 token 数远超文本。现有压缩要么在进入 LLM 前过早丢掉分散在长时间轴上的证据,要么进入 LLM 后只听文本指令,没有充分利用已经对齐的音视频交互。
本文贡献:提出免训练两阶段压缩框架 OmniPack。LLM 前按模态重要性、全局覆盖和相似度合并结构冗余,把被删除信息回收到代表 token;多模态充分交互后,再用文本问题引导和音视频协作做第二次语义压缩。不同阶段分别处理“结构重复”和“任务相关性”,无需改权重。

实验效果:在 Qwen2.5-Omni-7B 上仅用原始 16.7% FLOPs 即保留 98.0% 性能;极限设置只用 6.8% FLOPs 仍保留 92.9%。15%/7.5% 两阶段保留率下,FLOPs 降低 10 倍、prefill 加速 4.5 倍,同时保留 95.6% 性能,并跨三种骨干、五项基准保持最佳效率折中。
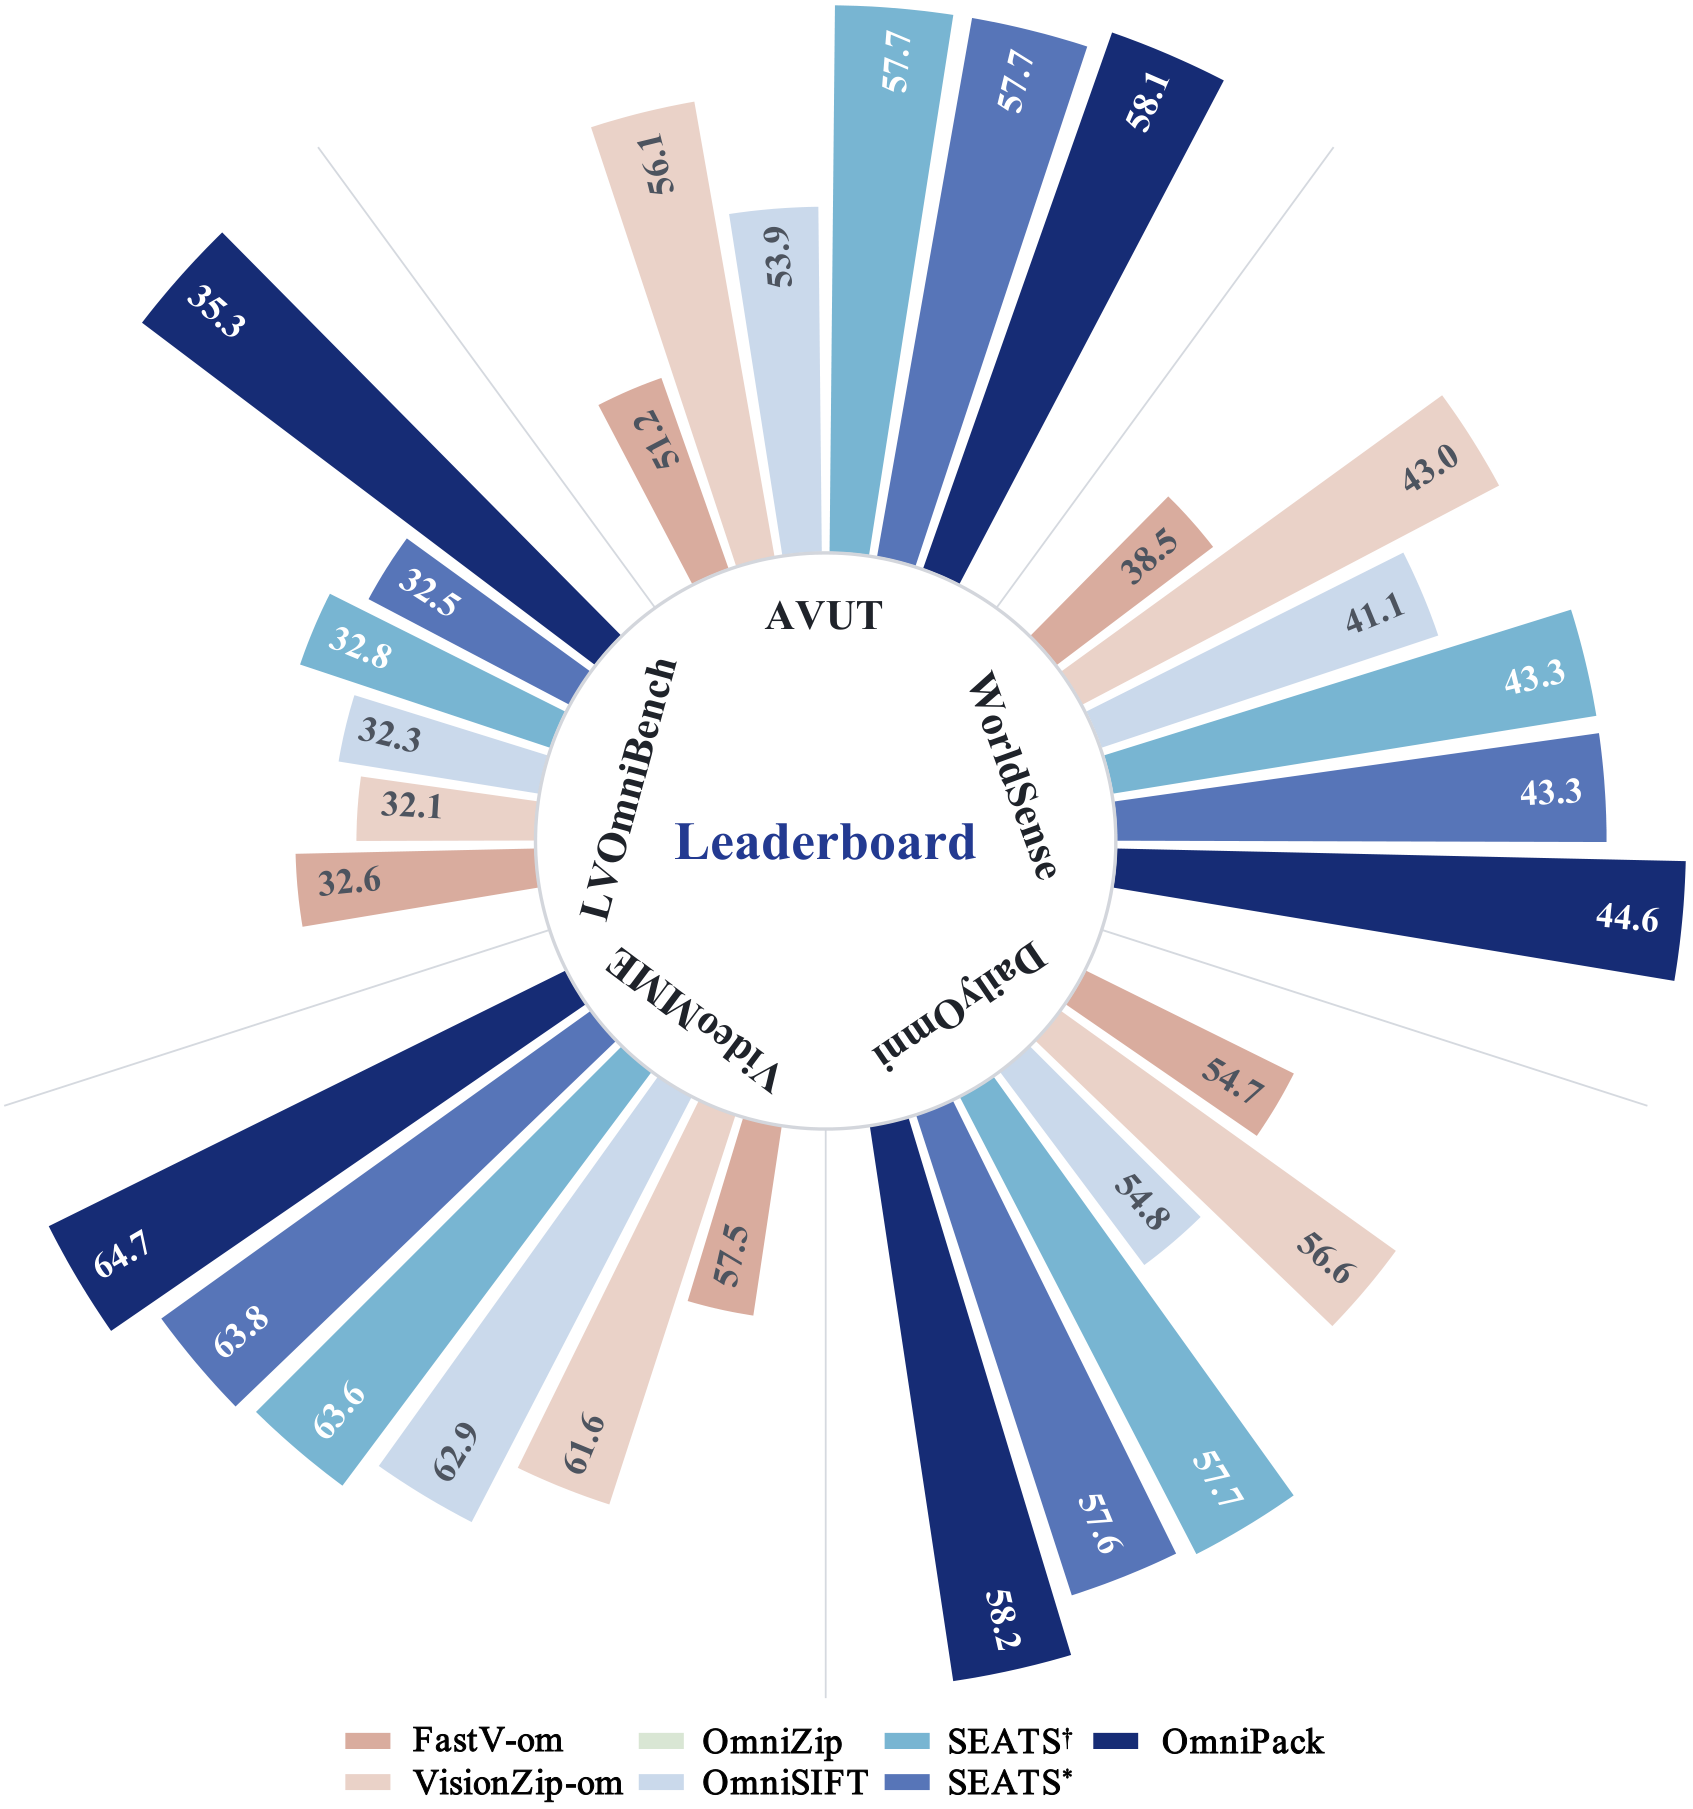
批判点评:无需训练且跨 Qwen 与 MiniCPM 骨干有效,工程接入成本很低;把“先保全局结构、后按问题精炼”拆开也比统一打分更合理。不过结果主要来自 H20 上的 prefill,端到端对话延迟和 KV 缓存收益未完全等同;极低预算仍损失约 7% 综合性能,稀有短暂事件可能最先被压掉。
STEP-OPD: Rethinking Output Targets and Internal Dynamics in On-Policy Distillation for Diffusion Models | 上海交大·阿里 | arXiv:2608.04887
关键词:扩散蒸馏,On-policy,超越教师,表示对齐,图像生成
前序问题:扩散模型的 on-policy 蒸馏通常只让学生在自己的去噪轨迹上拟合教师速度,理论最优点就是“和教师一样”,无法主动超过教师;只看最终输出还会放任各 Transformer Block 的内部表示以错误方式相互抵消。
本文贡献:提出 STEP-OPD:把任务教师相对共享基础模型的速度差视为能力提升方向,将缩放后的差值继续加到教师目标上,构造“教师之外”的输出外推目标;同时不直接硬对齐隐藏状态,而是匹配相邻 Block 表示变化的方向和幅度,让学生学习能力在网络内部如何逐层形成。
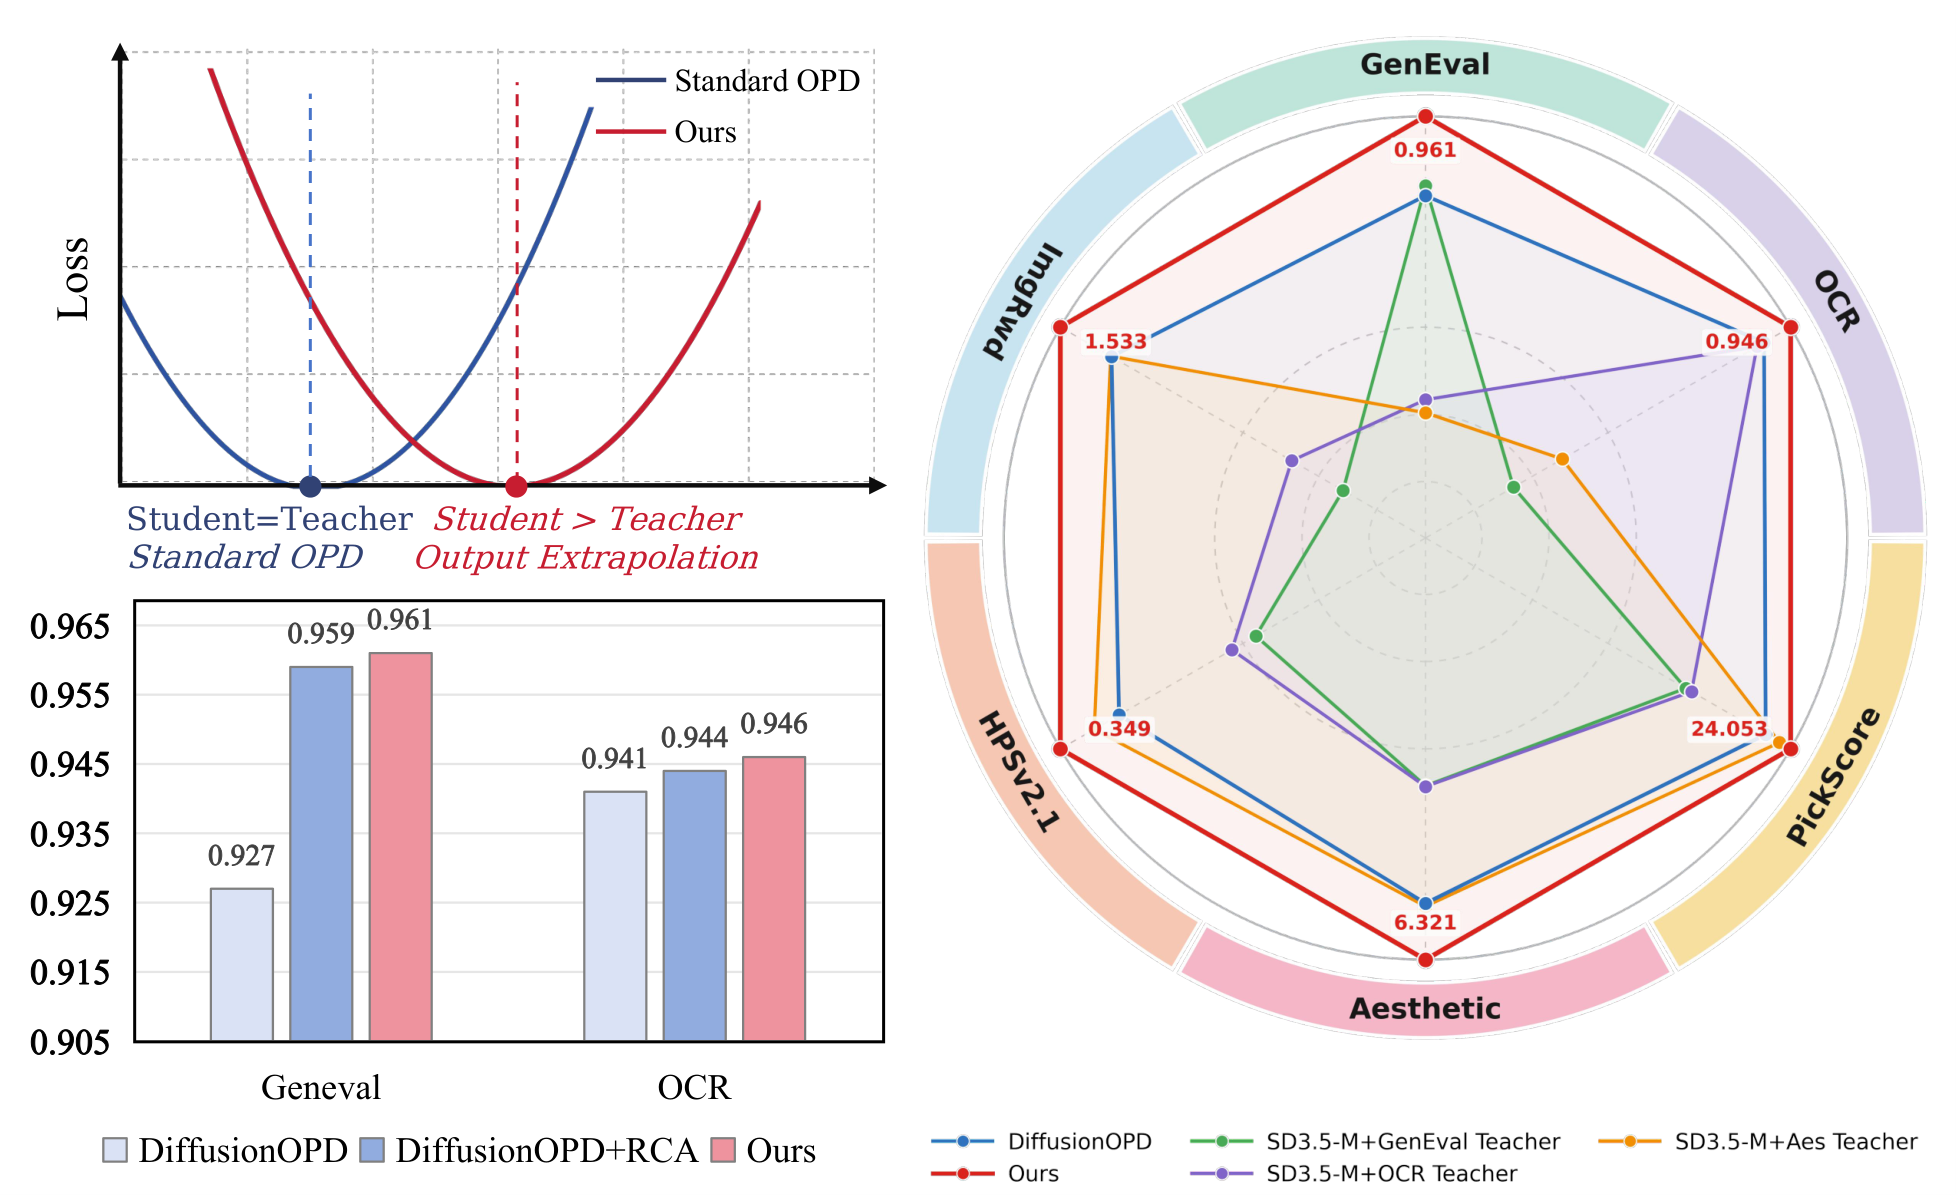
实验效果:在组合对齐、文字渲染与人类偏好三组能力上统一超过标准 DiffusionOPD,并使 GenEval 从 0.927 提升到 0.961;统一学生在三类能力上分别超过对应的单任务教师,证明多教师能力整合不必以教师上限为终点。
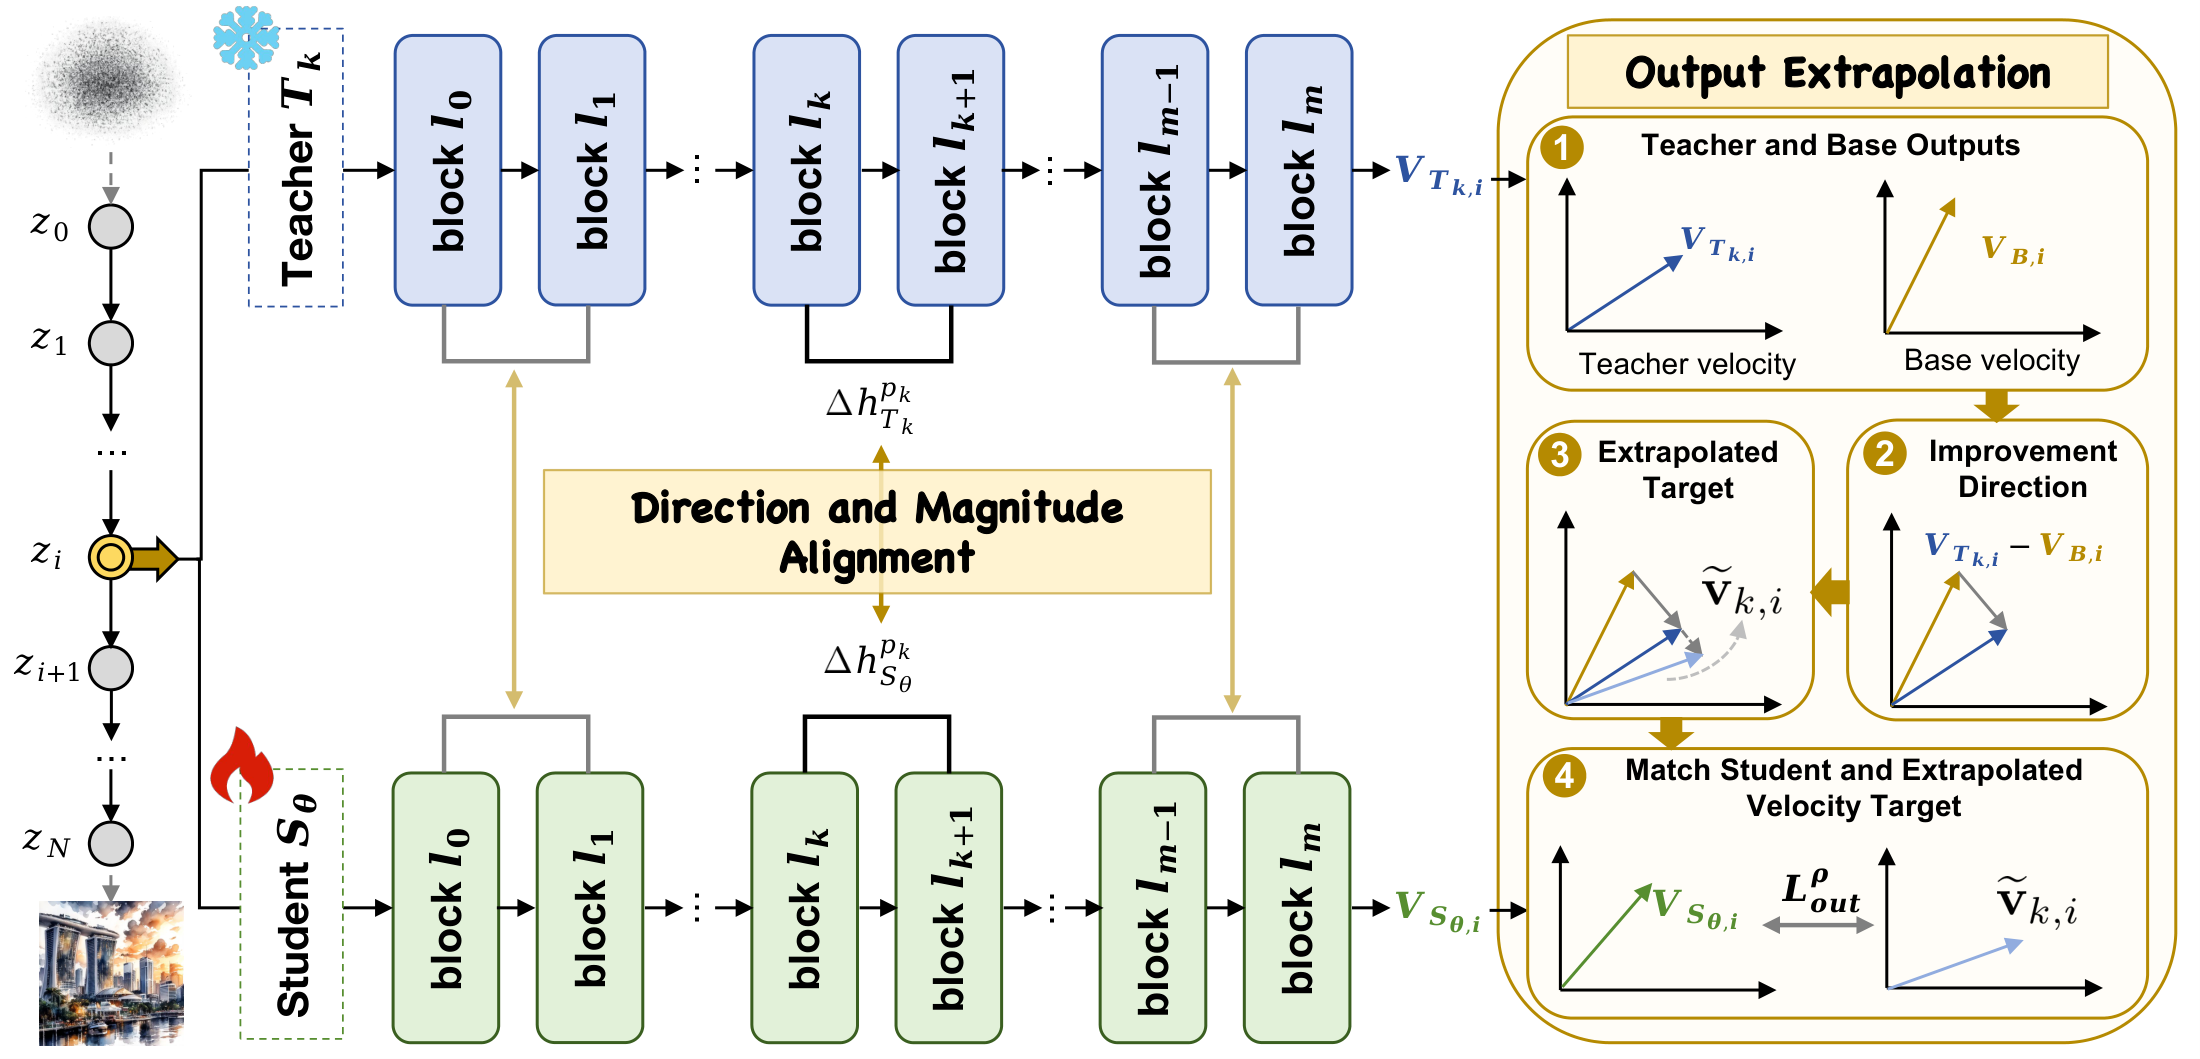
批判点评:“教师减基础模型”的差向量能否稳定代表可继续外推的能力,是很有启发性的假设,内部变化对齐也补上了只看终点的盲区。但外推系数依赖任务调参,走得太远可能放大教师偏差;目前只验证图像生成,扩展到视频等更长序列后,中间层监督的显存和计算成本会更突出。
Visual Representation Matters: Exploiting Temporal Differences in Video-to-Audio Generation | 清华·南洋理工等 | arXiv:2608.04902
关键词:视频配音,帧间差分,音频扩散,时间对齐,视觉表征
前序问题:视频配音区别于看图配音的核心不是多看几张静态图,而是捕捉帧间运动变化。现有方法常外挂音视频对比模型、声学结构预测器或多模态大模型,系统复杂,且可能把真正决定声音时机的低层运动细节压掉。
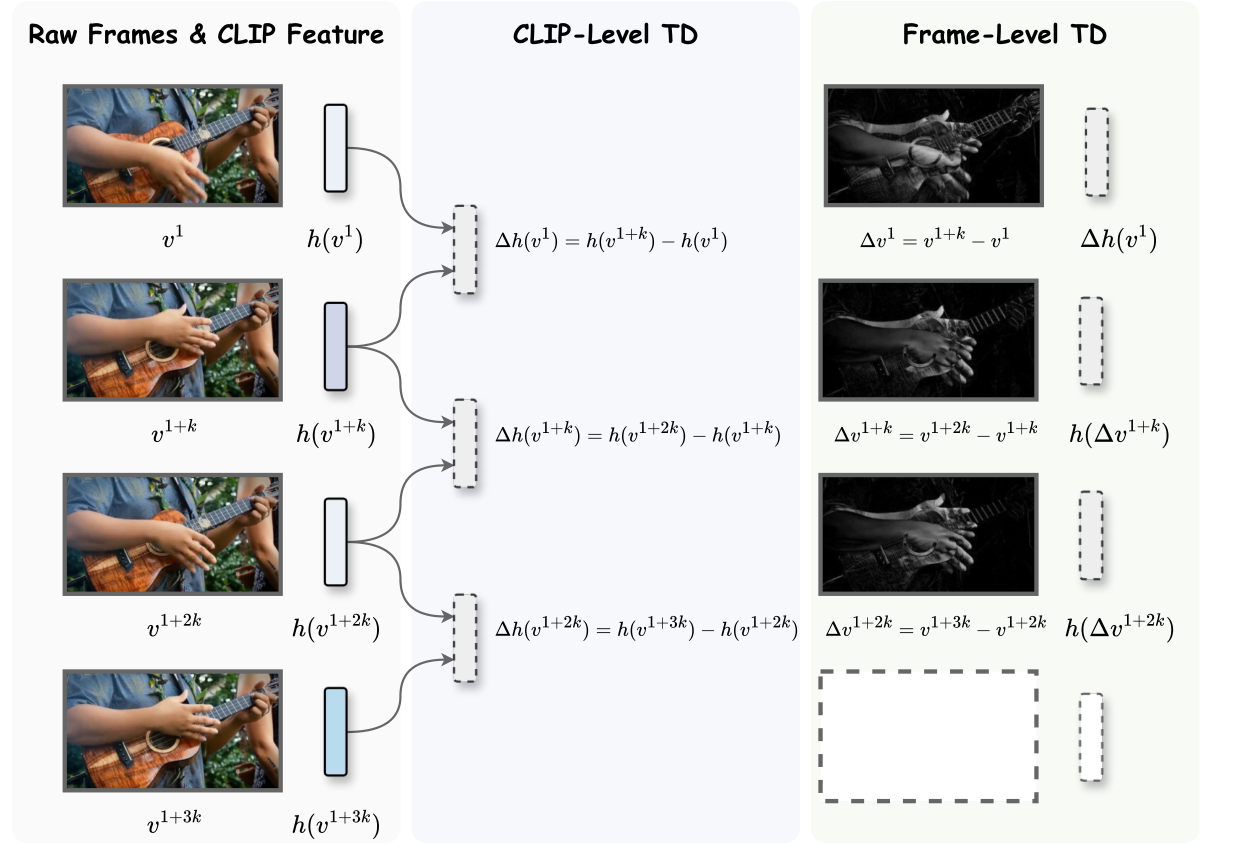
本文贡献:提出 TD-V2A,直接把相邻帧差分作为额外视觉条件。作者比较像素帧差与编码后特征差,发现编码前差分保留的细粒度运动更有效;训练时以文本到音频预训练、原始视频条件、差分增强条件三阶段持续学习,采样时用退火差分引导在早期先确定全局声音动态,后期逐渐回到原始视觉语义。
实验效果:在约 1.5 万段 VGGSound 测试片上,FAD 达 0.53,优于 MMAudio 的 0.81;IS 达 16.9、ImageBind Score 达 33.8,均明显高于对比方法,时间对齐准确率 89.1。它甚至超过需要额外训练的 CAVP 音视频表示,且没有新增预测网络。

批判点评:把“视频比图片多出来的信息”直接定义为帧差,简单而有效,指标也说明低层运动不应过早被语义编码器抹掉。但逐帧差分对镜头切换、抖动和光照闪烁同样敏感,可能把无关变化误当声源;其时间对齐 89.1 仍略低于专门以对齐目标训练的 Diff-Foley 89.9。
CAPE-T2V: Captioner-Anchored Prompt Enhancement toward Two-Sided Conditioning Alignment in Text-to-Video Generation | 复旦·快手可灵 | arXiv:2608.03046
关键词:文生视频,提示增强,训练推理对齐,Caption,可灵
前序问题:视频 DiT 训练时看到的是详尽视频 caption,线上却由 Prompt Enhancer 把用户短句改写后再喂给模型。即使双方使用同一字段模板,细节选择、组织方式、粒度和措辞仍不同,形成残余 PE-Caption 分布缺口。
本文贡献:提出两步 Captioner-Anchored 对齐:先用外部视频描述器产生统一目标,把简短描述、详细描述和伪用户提示都训练成同一种 Anchored PE 输出;再让这个已经冻结的 PE 重写视频训练 caption 并微调 DiT,部署时仍由同一个 PE 改写用户提示,使训练侧与推理侧真正共享同一文本算子。

实验效果:在 Wan2.2 与 LTX-2.3、StoryEval/VBench-2.0/T2V-CompBench 的六个组合上全部超过只做 schema 对齐的基线。Wan2.2 分别提升 1.6、1.12、0.30 分,LTX-2.3 提升 1.4、0.92、0.65 分;caption 到推理改写的 MMD² 从 0.0764 降至 0.0682。
批判点评:工作指出“字段相同不等于分布相同”,并把 Prompt Enhancer 正式视作生成模型接口,诊断很贴近真实部署。但绝对增益多数只有 0.3–1.6 分,StoryEval 又使用 GPT-5.5 判定;一旦线上 PE 更新,就要重新改写训练 caption 并适配 DiT,维护成本仍然存在。
Adaptive Two-Stage Visual Token Pruning for Efficient Inference in Video-Language Models | Amazon | arXiv:2608.03112
关键词:视频语言模型,Token剪枝,免训练,自适应预算,Amazon
前序问题:视频语言模型每帧可产生数百视觉 token,数分钟视频很快进入万 token 区间。现有图像剪枝方法既忽略跨帧重复,又对所有视频使用固定保留率;静态访谈和高速运动显然不该被压成相同预算。
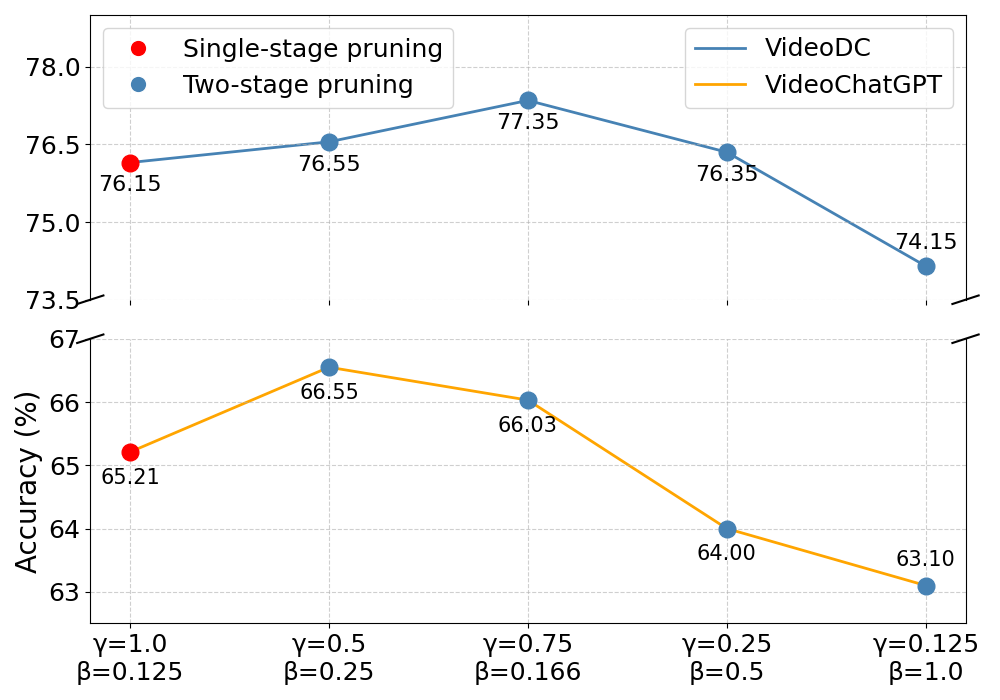
本文贡献:提出完全后处理的两阶段自适应剪枝:先在时间轴选择差异最大的代表帧,再在保留帧内做 token 级裁剪。第二阶段对 token 相关矩阵做特征值分解,用谱衰减速度估计当前视频冗余度,并据此动态决定保留比例,无需训练或微调原模型。
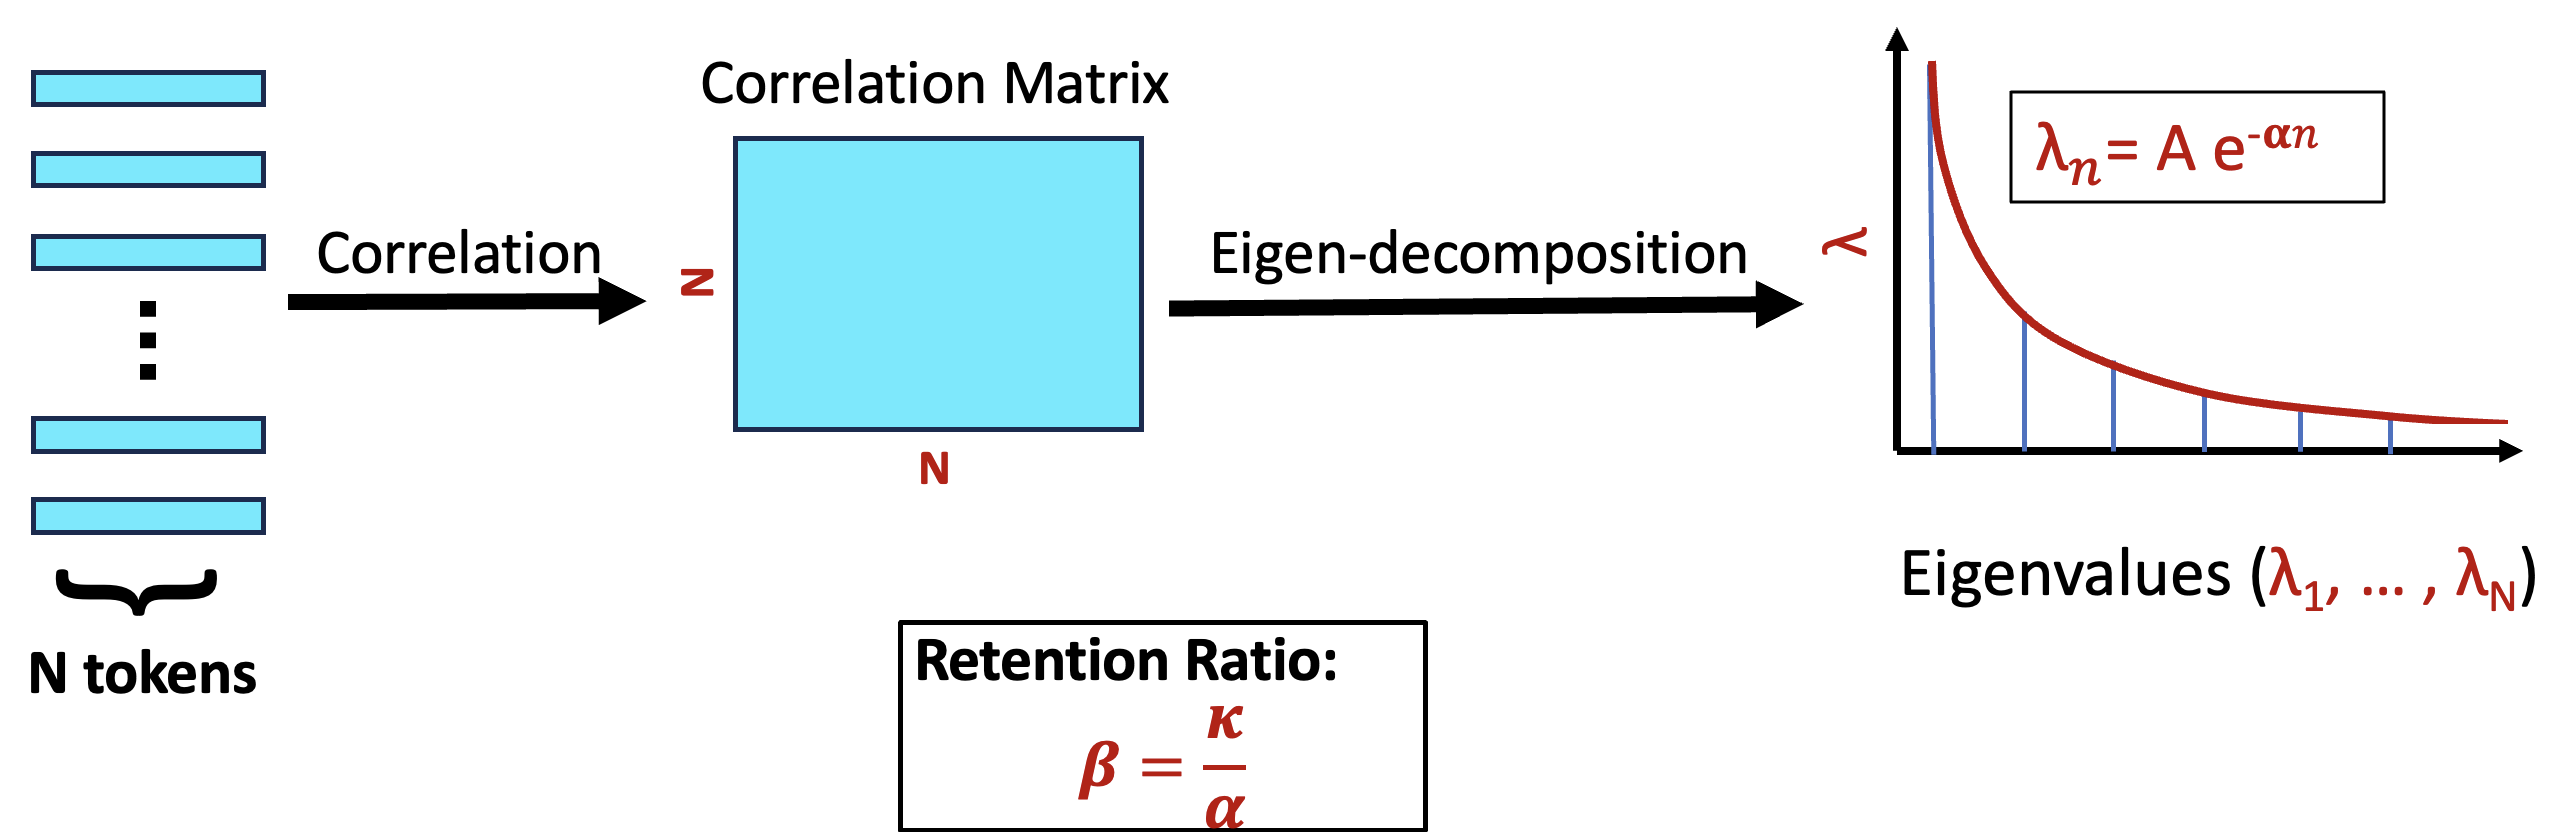
实验效果:在三种 VLM、五项视频基准上持续增益;平均仅保留 10% token 时,VideoDC 准确率达到 76.75%,比同预算 DivPrune 的 68.47% 高 8.28 分,论文摘要按跨设置概括为约 +7%;同时 TFLOPs 降低约 95%,其他问答基准基本保持。
批判点评:把“删哪些帧”和“每帧删多少 token”分开,并让谱结构决定预算,符合视频冗余的实际差异。代价是特征值分解本身有额外开销,当前实验以短视频理解基准为主;突发但关键的一帧或小目标,仍可能在两轮剪枝中被不可逆丢失。
OmniEdit-Bench: A Comprehensive Benchmark for Instruction-based Video Editing | 港大·阿里通义万相·浙大·北大 | arXiv:2608.05049
关键词:视频编辑评测,音频编辑,时间编辑,推理编辑,通义万相
前序问题:很多视频编辑评测沿用图像编辑任务,只看逐帧空间变化;模型即使没有执行指令,只要保留原视频的高画质和一致性,也可能得到高分。音频、时间操作、参考条件和隐式推理因此长期缺席。
本文贡献:构建覆盖空间 240、时间 200、参考 200、音频 100、推理 50 个案例的五赛道基准,并区分显式与隐式指令。评测把质量拆成准确性、保留度、真实感和一致性,再以准确率作为门控缩放后三项,避免“看起来很好但改错了”获得虚高总分。

实验效果:商业与开源模型整体都远未过关:KlingV3-Omni 综合最高也仅 38.3/100,Seedance 2.0 为 37.3;时间赛道最好 Wan2.7-Edit 只有 29.0,推理赛道最好 Seedance 2.0 也只有 29.8。商业模型在空间编辑领先,但优势在音频、时间和推理任务明显收窄。

批判点评:把准确性设为其他质量分的前提,能有效纠正原视频先验造成的假高分;五赛道也比图像式评测更接近真实需求。不过大量评分仍依赖 VLM,门控权重是人为设计;部分商业模型因功能或版权限制没有覆盖全部赛道,横向平均并非完全同条件。
CSGen: A Multi-Domain Curvilinear Structure Generation Model via Hierarchical Multimodal Diffusion | ACM MM 2026·海南大学·广东海洋大学 | arXiv:2608.04655
关键词:可控生成,曲线结构,拓扑保持,专业数据,ACM MM
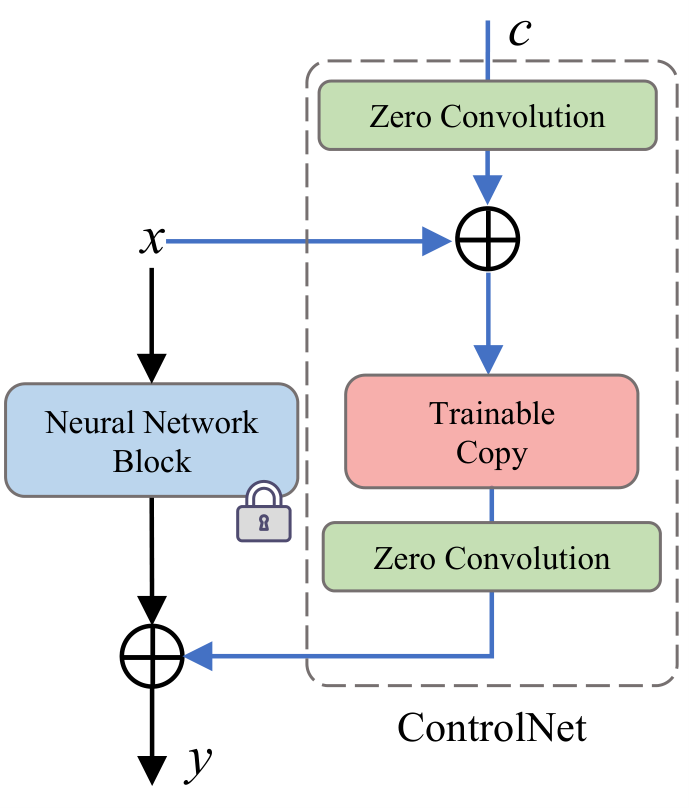
前序问题:血管、道路、叶脉和裂缝只占图像极少像素,却要求细长分支持续连通。通用扩散模型更擅长生成大物体,普通 MSE 又被背景像素主导,容易把这些稀疏结构画断或偏离控制图。
本文贡献:提出基于 SD3.5 的层次多模态扩散模型 CSGen,并汇集 24678 个样本,覆盖血管、冠脉、混凝土裂缝、叶脉和道路五域及七类标注。分阶段注入 CLIP 拓扑属性与 T5 场景描述,先锁定结构再补环境;稀疏感知损失按等效直径提高细小脆弱分支的权重。
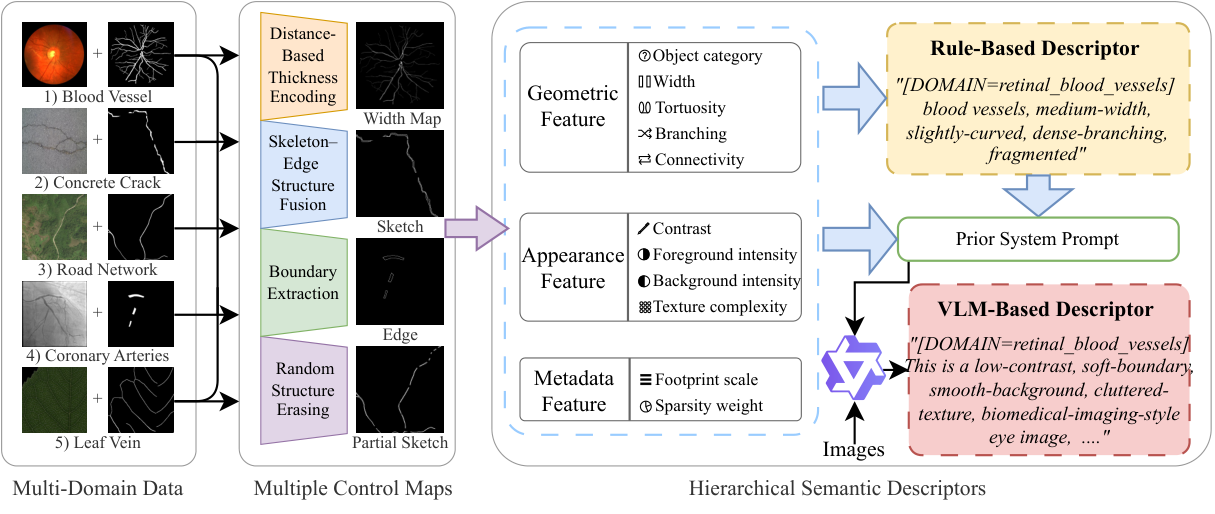
实验效果:相同提示下 FID 达 98.525,优于 SD3.5-ControlNet 的 131.256;完整模型将拓扑 clDice 从基线 0.628 提升到 0.766。合成数据用于下游分割时,道路域 mIoU 最高增加 4.73 分,说明生成结果不只视觉像真,也能补充结构学习。
批判点评:这是 ACM MM 2026 已接收工作,数据、代码和结构指标较完整,说明专业生成不能只看通用审美分。但五个领域仍共享相对简单的二值拓扑先验,跨域统一性有限;合成图提升分割不等于临床或基础设施诊断可靠,专业场景还需真实分布验证。
人工智能炼丹君 整理 | 2026-08-06
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)