


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

模型:MAGI-2 Preview
机构:Sand.ai
发布时间:2026-08-03(权重上传);2026-08-05(技术博客与模型卡定稿)
资料:技术博客 | GitHub 推理代码 | HuggingFace 权重
协议:Apache 2.0,代码与权重都是,可商用
说明:本文分析对象是官方博客、模型卡、configs/配置和inference/全部源码,没有下载 307GB 权重、也没有跑过 8 卡 H100。文中凡是"推算"字样的数字都是我按 config 与源码算出来的,不是官方公布值。
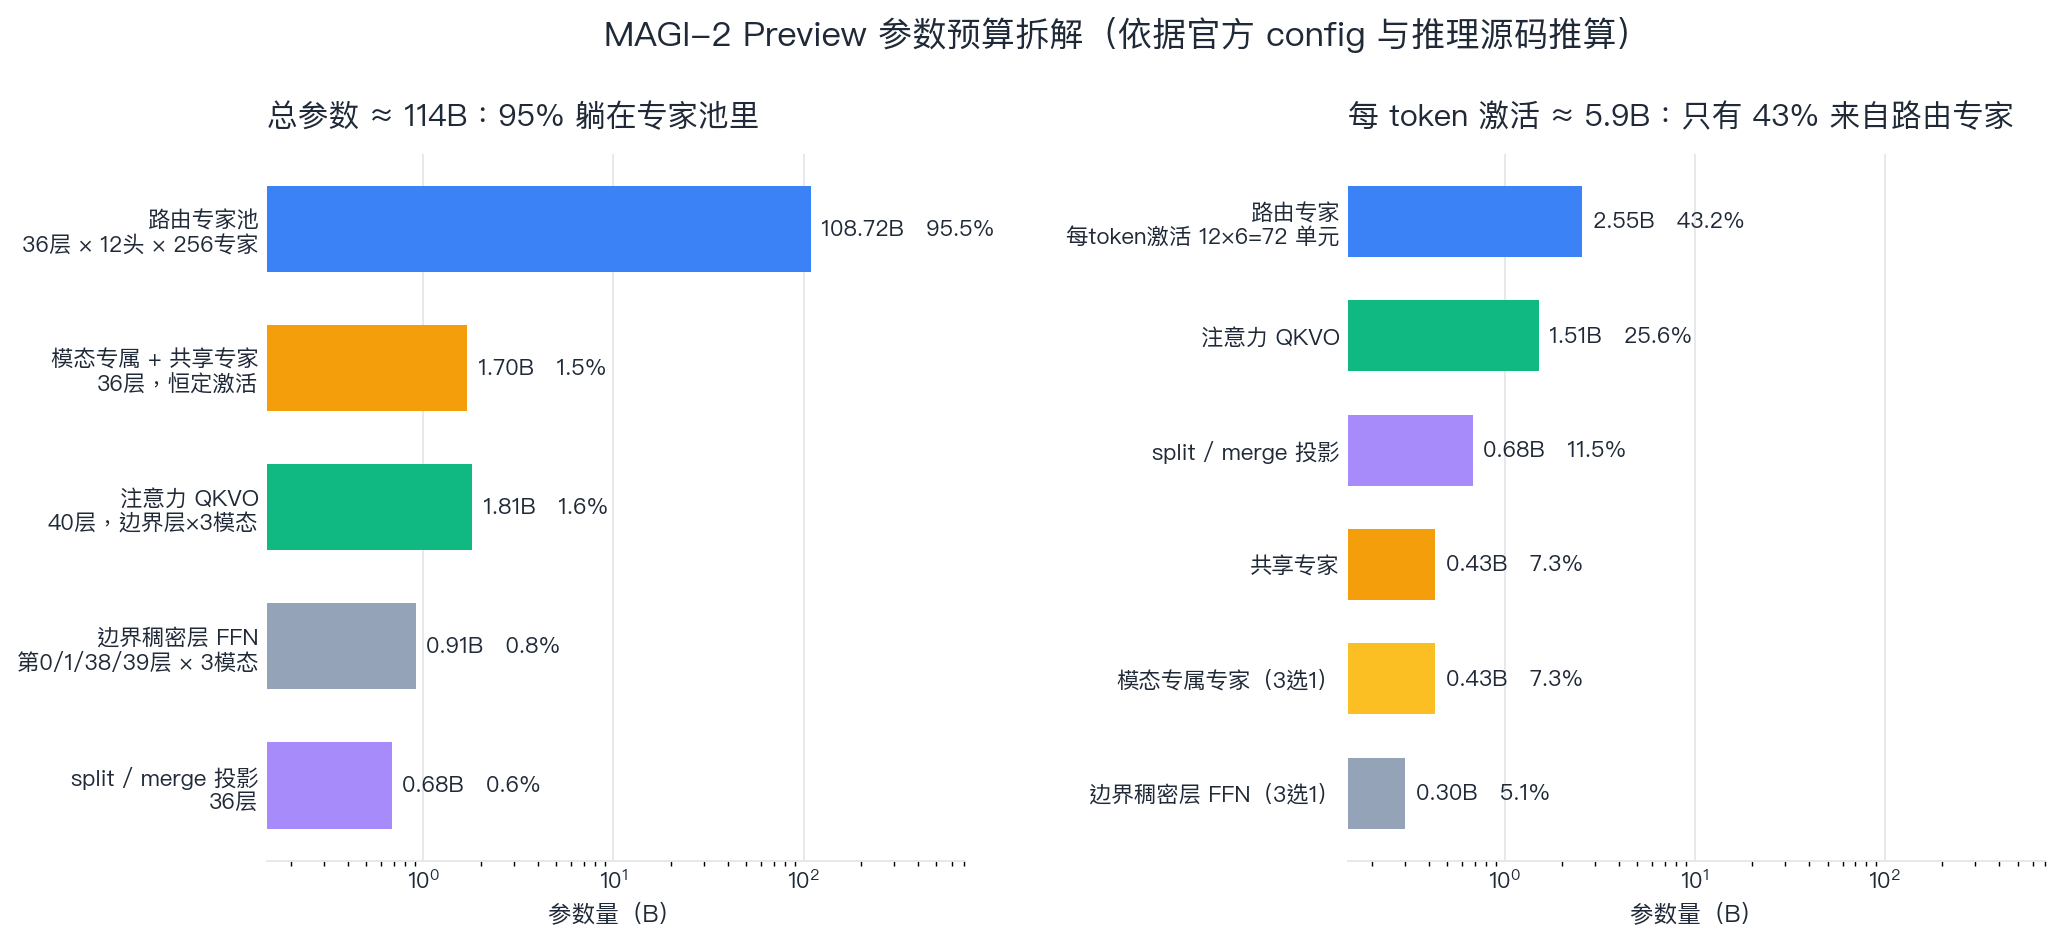
(图片来源:本文根据 configs/magi2_preview.json 与 inference/model/magi2_preview.py 推算绘制)
一句话:Sand.ai 开了一个 114B 总参数、每 token 只激活约 6B 的统一音视频生成模型,权重和推理代码全是 Apache 2.0。
它能干的事其实很窄:
真正值得注意的不是"又一个视频模型",而是它在赛道里的位置:这是目前少数把百亿级 MoE 用在视频生成主干上、并且把权重和训练系统设计一起公开的工作。Sand.ai 自己也把话说得很克制——这是一次 intermediate research release,用来验证"架构、系统、数据能不能一起 scale 到 100B",不是用来宣称画质 SOTA。
所以读这篇东西的正确姿势是:把它当一份系统论文看,而不是当一份效果报告看。
亮点:
MAGI2_DETERMINISTIC=1 可开位级确定性,注释里连"为什么这里必须先 draw 音频噪声"这种 RNG 顺序坑都写了。必须先说清的短板:
2026 年中的音视频联合生成赛道,大致分三层。
闭源第一梯队:字节 Dreamina Seedance 2.0、Google Gemini Omni Flash。这一档拿 API 卖,Elo 在 1190 以上。
开放权重梯队:MiniMax H3(33B 稠密、自定义社区协议)、Wan 系列(阿里,Apache 2.0)、SkyReels、以及现在的 MAGI-2 Preview。
MAGI-2 Preview 的特别之处是它选了一条别人没选的路:别人加参数靠把稠密模型做大(H3 是 33B 稠密),或者做粗粒度 MoE(Wan 2.2 用高噪/低噪两专家切换,27B 总参 14B 激活);MAGI-2 直接把 FFN 拆成三千多个低维小专家。
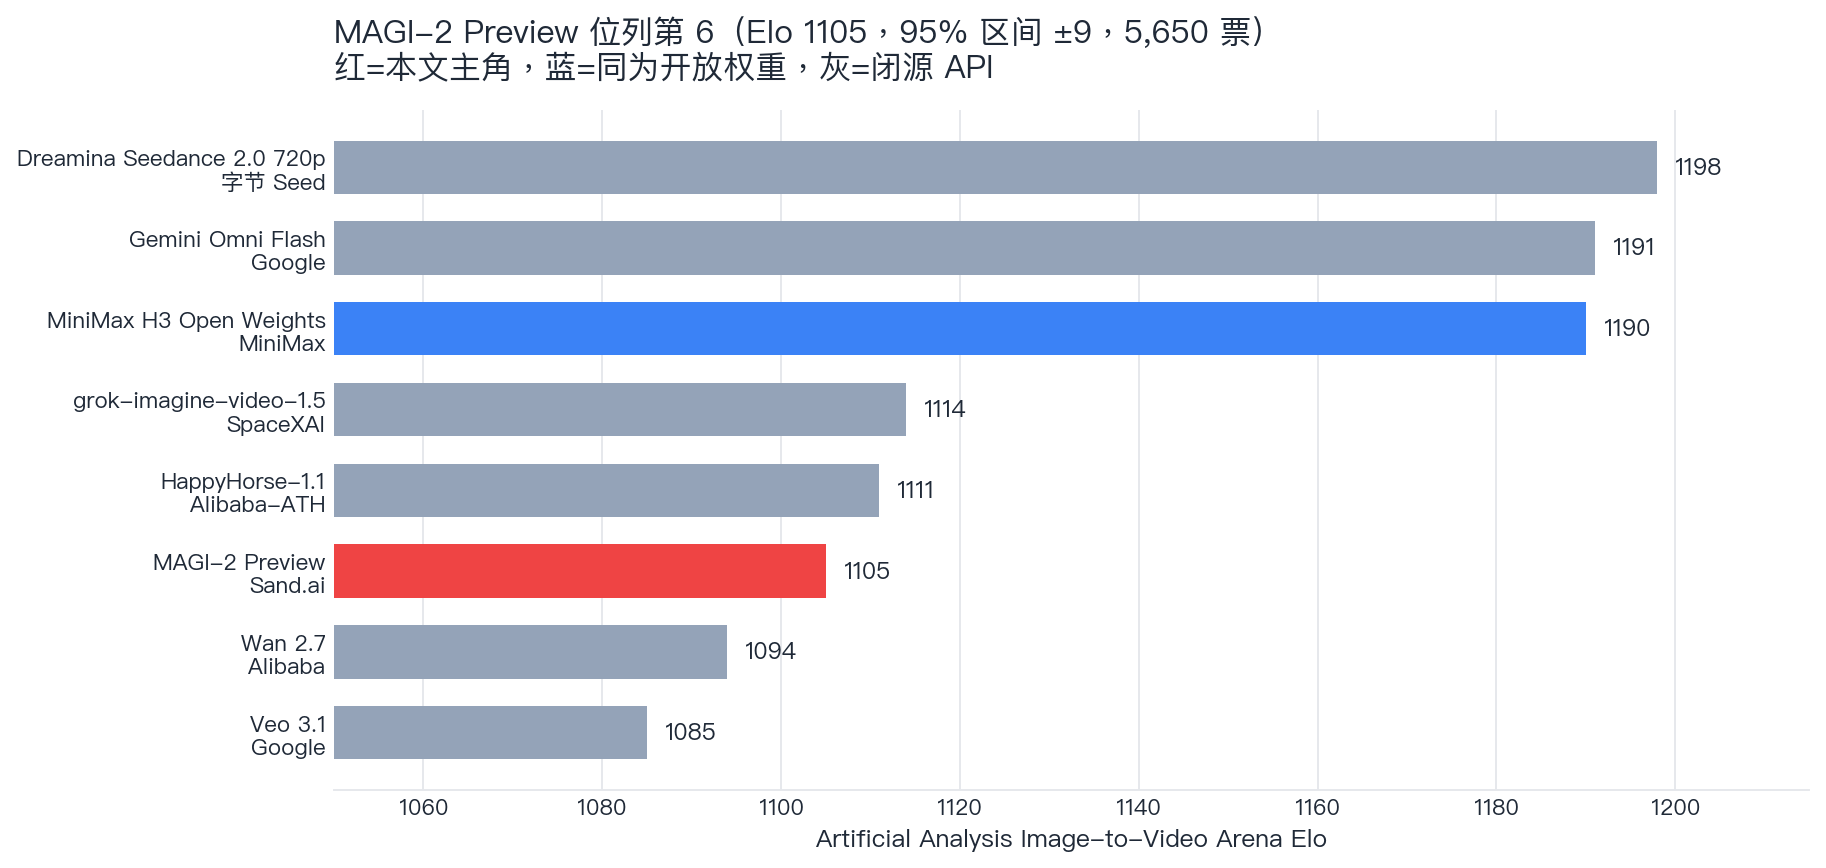
(数据来源:Artificial Analysis Image-to-Video Arena,2026-08-07 快照。盲测投票 Elo,不是逐维度指标)
这张图是全文唯一的第三方数字,值得多看两眼:MAGI-2 Preview 以 1105 排第 6,在 Wan 2.7(1094)和 Veo 3.1(1085)之上,但被同为开放权重的 MiniMax H3(1190)拉开 85 分。
需要给它留的余地也有两条:一是 base 版没蒸馏、100 步硬跑,Arena 用的是哪个配置无从核实;二是 Elo 反映的是"人类更喜欢哪个",而 MAGI-2 的卖点本来就不在这里。
MAGI-1 是 24B 稠密模型,核心卖点是按 24 帧一个 chunk 自回归去噪,噪声水平随时间单调递增,最多 4 个 chunk 并发,因此支持流式生成、视频续写,而且峰值显存与视频总长无关。
MAGI-2 把这套东西整个放弃了。博客给的理由很直白:自回归分块引入额外的时序依赖和更复杂的生成调度,再叠加统一音视频建模和 100B 级分布式训练,系统变量会爆炸。
这个取舍的代价是实打实的:
| MAGI-1 | MAGI-2 Preview | |
|---|---|---|
| 生成方式 | 分块自回归去噪 | 整段一次性去噪 |
| 时长 | 可延长(4M token 上下文) | 固定 10 秒 |
| 流式 / 续写 | 支持 | 不支持 |
| 峰值成本 | 与总长无关 | 与总长成正比 |
| 音频 | 无 | 联合生成 |
所以 MAGI-2 不是 MAGI-1 的功能超集。如果你在用 MAGI-1 做长视频续写,MAGI-2 Preview 替代不了它,Sand.ai 也还在维护 MAGI-1.1-24B。
MAGI-2 保留的是另一篇工作的建模接口——《Speed by Simplicity》里 MagiHuman 的单流架构:文本、视频、音频拼成一条 token 序列,只用 self-attention。理由也讲得通:文本、口型、肢体动作、环境声、音乐、镜头节奏本来就是同一个事件的不同侧面,塞进一条序列可以在整个主干里持续交换信息,而不是只在几个预定义接口上握手。
(这段是全文最技术的一节,不感兴趣可以直接跳到 06 看结论。)
常规 MoE 是这样:路由器看整个 token 的隐藏状态,选出 Top-k 个专家,然后把完整的 H 维表示发到持有这些专家的设备上。每层通信量约为 N·k·H——选的专家越多,通信越贵。
更麻烦的不是量,而是形状不确定:发到哪些设备、每个 rank 收多少 token、收包 buffer 多大,全部由当前 batch 的路由结果决定。于是你会同时吃到三种痛:慢 rank 拖住全局吞吐(straggler)、各 rank 显存峰值不齐导致局部 OOM、以及为了对齐动态 token 数而产生的 GPU-CPU 同步。
视频 latent 的序列比文本长得多,而且一条统一音视频序列里混着不同模态、不同噪声水平、不同空间位置、不同运动状态的 token——异质性更强,动态路由带来的抖动更容易变成一阶系统开销。
Multi-Head LatentMoE 的做法是换掉路由单位。
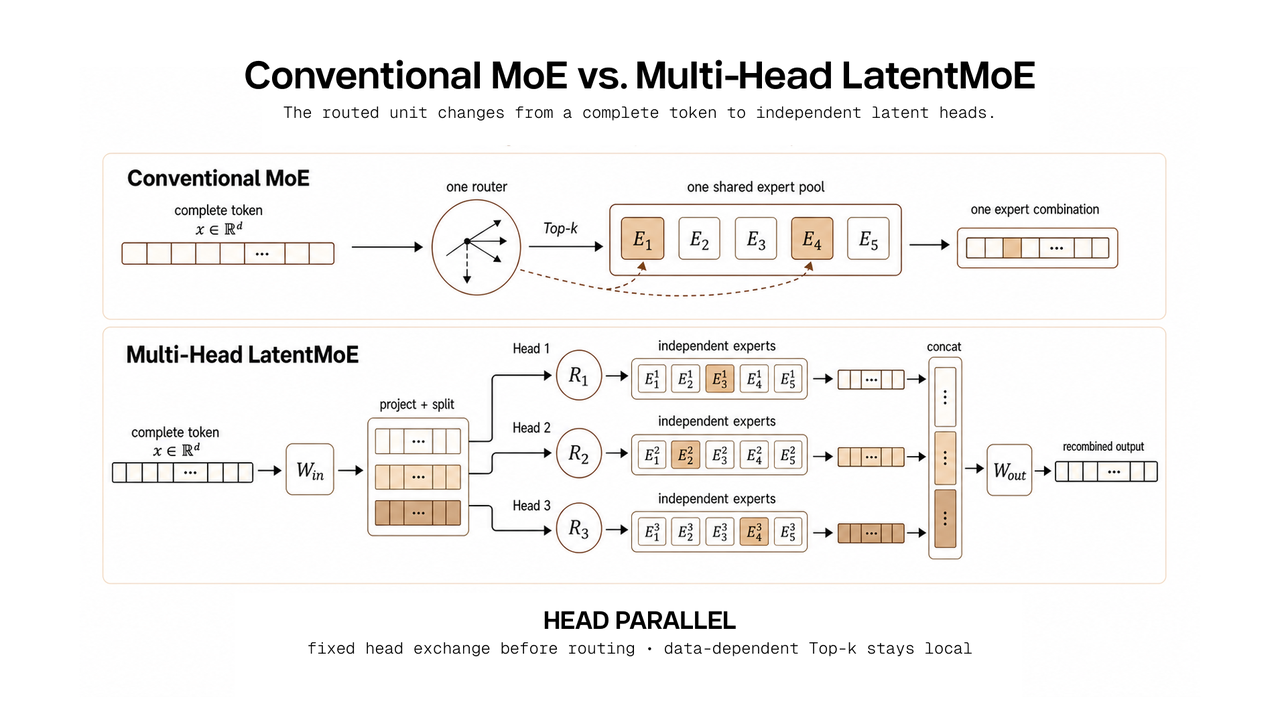
(图片来源:Sand.ai 技术博客 §2.1 配图)
先用一个投影 W_in 把 3072 维隐藏状态映射成"路由表示",再切成 12 个 256 维子空间。每个子空间有自己独立的路由器和独立的专家池,各自从 256 个专家里选 6 个,算完再拼回去、过 W_out 映射回 3072 维。
关键收益在通信:既然要发的是"某几个头的全部子 token",那么通信量是 N·M·H_head = N·H,和每头选几个专家无关,而且跨设备收发形状由头划分静态决定,可以提前分配 buffer。路由依然是数据相关的,但这份不规则性被关在了每个 head owner 内部,不再决定跨设备的通信形状。
代进 MAGI-2 的实际数字,差距很直观:
省下的这个 6 倍恰好就是 Top-k,所以这套方法越是往"超稀疏、多专家、小专家"的方向走,收益越大——而 Ultra-Fine-Grained MoE 正是这个方向的极端。反过来它也有上限:Head Parallel 的并行度被头数卡住,12 个头就意味着这一维最多切 12 份。
有两件事这里需要讲清楚,博客说得比较含蓄:
第一,这不是 Sand.ai 原创。 多头路由的思路来自微软亚研的 Multi-Head Mixture-of-Experts(那一版里不同头还共享路由器和专家池),"每个头独立路由器 + 独立专家集 + Head Parallel"来自亚利桑那州立大学 kerner-lab 的 Multi-Head LatentMoE and Head Parallel。后者在 4B 语言模型上报的数字是:k=4 时通信量降到 EP 的 25%,训练最快 1.61× 加速。Sand.ai 的贡献是把一个 4B 规模验证过的学术方法,扛到 114B 的视频模型上——这个工程量本身很值钱,但署名要说清楚。
第二,那 3072 个"专家"不是 3072 个宽 FFN。 每个专家单元只在一个 256 维子空间上工作,结构是 256 → 1280 → 256 的 SwiGLU。所以 MAGI-2 加的不是一堆必须整体调用的大 FFN,而是一堆可以被独立挑选、自由重组的低维变换。同一个 token 的不同表示子空间可以形成完全不同的专家组合——这是它和常规 MoE 最本质的差别。
官方给的完整配置:
| 组件 | MAGI-2 Preview 配置 |
|---|---|
| 主干层数 | 40 层 |
| 稀疏核心 | 中间 36 层(第 2–37 层)用 Multi-Head MoE,首尾 4 层保持稠密 |
| 模型宽度 | 3072 |
| 路由表示 | 12 头 × 256 维 |
| 专家池 | 每头 256 个专家 |
| 激活专家 | 每头 Top-6 |
| 专家 FFN | 256 → 1280 → 256,融合 SwiGLU7 |
配置文件里还有几个博客没提的参数:路由打分用 sigmoid(不是 softmax),Top-6 概率归一化后再乘 route_scale = 4.9,路由分数在 FP32 下算、专家权重和主计算走 BF16。
博客说 114B 总参、6B 激活,但没给拆解。用 config 里的数字可以自己算,而且算得相当准。
单个稀疏层的路由专家池:12 头 × 256 专家 ×(W_gate 256×1280 + W_up 256×1280 + W_down 1280×256)= 12 × 256 × 983,040 ≈ 3.02B。乘 36 层 = 108.7B。
也就是说,114B 里有 95% 是那 110,592 个(36×12×256)小专家单元,其余全部加起来不到 6B:
| 部分 | 总参数 | 每 token 激活 |
|---|---|---|
| 路由专家池(36 层 × 12 头 × 256) | 108.72B | 2.55B(每层 72 个单元) |
| 模态专属专家 + 共享专家(36 层) | 1.70B | 0.85B |
| 注意力 QKVO(40 层,边界层 ×3 模态) | 1.81B | 1.51B |
| 边界稠密层 FFN(第 0/1/38/39 层) | 0.91B | 0.30B |
| split / merge 投影(36 层) | 0.68B | 0.68B |
| 合计(推算) | ≈113.8B | ≈5.9B |
两个官方数字都对上了,说明这个拆法没跑偏。但拆完会看到一件博客没强调的事:
"每 token 激活 6B"里,只有 43% 来自路由专家,注意力占了 26%,剩下 31% 是恒定激活的稠密件。 稀疏化只作用在 FFN,注意力是全量参与的。而视频生成的瓶颈恰恰在注意力——预览阶段五万多个 token 的全注意力,压根不吃 MoE 的红利。
博客里其实也承认了这点,只是一句话带过:MoE does not remove attention cost, and the number of activated parameters is not equivalent to end-to-end FLOPs。看完这张拆解表,你会明白这句话的分量。
(这段偏基础设施,做应用的可以跳。)
Multi-Head LatentMoE 只定义了路由架构,扛到 114B 要同时解决三个问题。
Hierarchical Head Parallel——把两级网络分开用。
单张 GPU 装不下一个头的完整专家库,而训练集群有两档带宽:节点内 NVLink,跨节点 InfiniBand。MAGI-2 把两件事分别映射到两档网络上。

(图片来源:Sand.ai 技术博客 Figure 2)
跨节点走 InfiniBand,只交换固定形状的头切片——[N, M, H_head] 按头维度分发,收发量由头划分静态推出,和 Top-k 产生的动态 token 拷贝无关。节点内走 NVLink,用 ZeRO/FSDP 式全分片存专家权重、梯度和优化器状态,当前层的参数按需 materialize、算完立刻 reshard。
一句话概括:InfiniBand 只管规整的激活交换,NVLink 管专家状态的高带宽聚合与重分片,负责某个头的 GPU 不需要常驻这个头的整个专家库。
MagiMoE——从路由到输出合并的整条路径都融合。
标准 MoE runtime 会按路由结果重排 token,然后用 Grouped GEMM 跑不同大小的专家矩阵。这套在常规 MoE 上没问题,但 MAGI-2 每个稀疏层有 3072 个窄专家单元:每个单元收到的 token 更少,GEMM 形状更小更不规则,于是排序、kernel launch、中间张量读写反而变成主要开销——足以把稀疏计算省下的算力全吃回去。
MagiMoE 的做法是把 融合路由与 Top-K → 紧凑的按专家 token 布局 → 融合 grouped 专家 FFN → 按路由权重合并输出 整条链一起优化,并把 up、gate 投影和 SwiGLU7 融在一起以减少中间结果落地和显存流量。负载均衡用 DeepSeek 那套 auxiliary-loss-free 专家偏置,不往主目标里塞额外的均衡损失;每个路由头独立应用,专家负载统计放在单独的 CUDA stream 上异步聚合,避免干扰主计算流。
推理仓库里能直接看到这条路径的落地:inference/flash_mh_moe/ 下的 route.py 和 Triton kernel mh_moe_fwd.py。
MagiMuon——让优化器认识 head × expert 结构。
稠密 Transformer 里一个权重就是一个大矩阵;MAGI-2 的专家权重天然是"按 head × expert 索引的一大批小矩阵"。MagiMuon 保留这个结构:路由门按头分组成矩阵批,专家的 up/gate/down 投影把 head 和 expert 展平进 batch 维,Muon 正交化对每个矩阵独立做,矩阵批跨 rank 分布以均衡优化器计算——而不是把所有头和专家拼成一个人造的大矩阵。
不是所有参数都用同一套更新规则:adapter、mHC、attention sink、门控相关参数走 Adam 风格,主矩阵参数走 MagiMuon。
博客还专门提了一句同期工作 Kimi K3 的 Per-Head Muon:那个是沿注意力头维度切 Q/K/V 动量矩阵,和 MagiMuon 针对的结构不同,但体现的是同一个设计原则——模型有显式的 head 结构,优化器就该用上这个结构。
顺手说一个发布配置里的小尴尬:12 个头分不进 8 张卡。
上面那句"并行度被头数卡住"在默认推理配置里就已经咬人了。configs/magi2_preview.json 写的是 ep_size = 8,而路由头是 12 个,12 % 8 ≠ 0。CoreMultiHeadMoE.__init__ 的处理方式是补齐到 8 的倍数:
self.padded_num_heads = math.ceil(self.num_heads / self.ep_size) * self.ep_size  # 16
self.ep_pad_heads = self.padded_num_heads - self.num_heads                       # 4
my_head_start = ep_rank * (self.padded_num_heads // self.ep_size)                # ep_rank * 2
self.has_real_moe_heads = my_head_start < self.num_heads                         # rank 6/7 → False
12 头被补成 16 个槽位,每张卡分 2 个。算下来 rank 0–5 拿到真实的头 0–11,rank 6 和 rank 7 的 has_real_moe_heads 是 False——它们持有全零的 dummy 权重,照样参与 all-to-all,但输出直接丢掉,_forward_impl 里走的是 out = torch.zeros_like(x_heads)。
也就是说,官方 8 卡默认配置下,MoE 层的专家计算只有 6 张卡在干活,另外 2 张纯陪跑(注意力那部分它们还是照常参与,因为走的是 Ulysses 上下文并行)。要让 12 整除,得用 4 卡或 12 卡的 EP,但整个 pipeline 又硬绑在 8 卡上。这不影响正确性,是官方为了兼容才写的 pad 分支,但对着"高效 scaling"的标题看,这个 25% 的槽位浪费还是有点扎眼。
这是我读源码收获最大的一节。有三样东西在 configs/magi2_preview.json 和 magi2_preview.py 里实现得很完整,博客里一个字都没提。
一、mHC:DeepSeek 的流形约束超连接,MAGI-2 全层都在用。
配置里有这么一段:
"mhc_config": { "enable": true, "num_stream": 4, "alpha_init": 0.01 }MHCHandler 的实现里是 num_sk_iters=20 的 Sinkhorn-Knopp 迭代,还配了专门的 Triton 算子 magi2::mhc_sinkhorn_knopp_affine_fwd。这对应的是 mHC: Manifold-Constrained Hyper-Connections(DeepSeek,ICML 2026 Spotlight):Hyper-Connections 把残差流从单股拓宽成多股、连接方式可学,效果有提升但破坏了恒等映射性质,大规模训练会信号发散;mHC 用 Sinkhorn-Knopp 把可学的残差混合矩阵投影到双随机矩阵构成的 Birkhoff 多胞体上,让信号传播变成特征的凸组合,从而在保留多股表达力的同时恢复范数保持性。
MAGI-2 把残差流拓宽成 4 股,每层在 attention 前后、MLP 前后各挂一组 mHC 参数。一篇讲"如何稳定地把模型 scale 上去"的报告,把训练稳定性的关键组件整个漏掉了,这个遗漏挺可惜的。
二、每个稀疏层还有两条恒定激活的稠密通路。
博客把稀疏层描述成"路由 + 专家",但 MultiHeadMoELayer.forward 实际是这样:
moe_out = self.merge_linear(self.moe_mlp(self.split_linear(norm_output)))
return moe_out + self._shared_expert_forward(norm_output, modality_dispatcher)
那个 _shared_expert_forward 里有两个 FFN:一个是所有 token 共用的 shared expert(3072 → 1280 → 3072),另一个是 modality-specific shared expert——视频、音频、文本各有一份独立权重,按 token 的模态选用。加上按模态分组的 MultiModalityRMSNorm,等于每层都留了一条"不经过路由的模态专属通路"。
这解释了一个疑问:既然音频只有 250 个 token、文本只有几百个,混在五万多视频 token 里做 Top-k 路由,凭什么保证音频不被视频专家的分布淹没?答案是——它不完全靠路由,模态差异有一部分是硬编码进权重的。这个设计比博客里"三个模态进同一个主干"的说法要务实得多。
三、注意力侧的两个小改动。
attn_sinks 开启,每层 1 个 sink token;attn_gating 开启。前者是 attention sink 那套(给每个头一个可学的"垃圾桶"logit,缓解 softmax 必须把注意力分配出去导致的伪高激活),后者给注意力输出加了门控。这两个都是 2025-2026 年 LLM 侧被验证有效的稳定性 trick,被搬到了视频 DiT 上。
顺带一个细节:num_query_groups = 24,而 num_heads_q = 3072/128 = 24。两者相等,说明预览阶段没用 GQA,是标准的多头注意力。 首尾 4 层的 QKVO 还是按 3 个模态各存一份。
抛开架构,博客里我觉得最值得抄进笔记本的是"数据过滤陷阱"这个提法。
早期视频生成模型大多在 7B 左右。小模型表达复杂分布的能力有限,而人对视觉错误又极其敏感,于是社区自然形成了一套以过滤为中心的数据策略:保留主体清晰、运动简单、镜头稳定的视频,把模型学不动的样本删掉。
对小模型有效,但会锁死后续 scaling:
当训练数据被持续简化以适配当前模型时,数据本身就成了更强模型的能力上限。
MAGI-2 的转向是从"过滤为中心"改成"高吞吐生产 + 精确标注"。必要的数据治理(安全、合规、隐私、严重损坏、去重)保留,但"当前模型是否容易生成"不再是准入标准。复杂运动、多人交互、镜头切换、长尾主体、字幕、屏幕文字、复杂音频关系——尽可能都留下来。
减少过滤只是第一步。一段复杂视频如果只配一句泛泛的 caption,里面的身份、动作、镜头和音频关系仍然无法变成有效监督。所以新 pipeline 把主体与场景、动作与交互、镜头与时序结构、对白与歌曲、环境声与音乐、屏幕文字与字幕全部纳入可扩展的多模态标注。
这也给"数据质量"换了个定义:先保留有用的复杂度,再把这份复杂度准确描述出来。在这个定义下,标注不再是过滤之后的附加步骤,而是数据 scaling 的核心基础设施。
博客声称的"涌现"是两条:多镜头数据留下后,人物身份跨镜头更容易保持一致;字幕数据留下后,能看到对白/歌曲与对应字幕特效同时出现的样本。但作者自己加了限定——these remain qualitative observations and require more systematic controlled experiments。这个诚实值得肯定,但也意味着这两条目前只是 cherry-picked 样例,不能当结论用。
上面那套数据说法有多少是真的?推理仓库里有一份间接但很强的证据:prompt enhancement 的模板和 JSON schema。
官方明确说模型训练用的 caption 又长又结构化(long and structured),手写短 prompt 会浪费模型能力,所以配了 PE 步骤:拿一个指令模型按模板把用户 prompt 改写成结构化 JSON caption,再喂给 pipeline。那么这份 schema 的形状,就近似等于训练标注的形状。
T2V 模板(prompts/t2v.md,1543 行)要求输出两层结构:
timeline_segment 里带镜头增量(对焦/机位/构图/运镜类型方向强度)、光照增量、物体动态状态、活体主体的动作(主要动作/身体姿态/运动细节/交互/面部表情)、屏幕文字渲染(文字/时间戳/位置/字号/颜色/字体)、因果事件(触发/结果/物理)、音频(对白逐句带 speaker 与 delivery、环境声变化、特殊音效带 visual_sync 说明与画面如何对齐)。I2V 模板则是镜头制的:reference_bank + shot_timeline(每个镜头带时间区间、镜头 caption、镜头光照构图、运动与物理逻辑、引用的参考对象、关联的音频事件)+ audio_event_timeline + visible_text + generation_requirements。
这份 schema 把博客的说法验证得很扎实:
causal_events 里专门有 physics 字段 → 对应"物理合理性"的诉求;text_render 和 visible_text 独立成项 → 字幕和屏幕文字确实没被过滤掉,而且是逐条带时间戳标注的;shot_timeline 允许多个镜头 → 多镜头数据确实保留,跨镜头身份一致靠 reference_bank 的 identifier 串起来;visual_sync 和 synchronization_note → 音画同步是显式标注出来的,不是指望模型自己对齐。顺着这个思路还能看出音画同步的另一半是架构层面做的:配置里 audio_latent_fps = 25.0,视频也是 25fps,一个视频帧配一个音频 latent token。代价是 Stable Audio Open 1.0 的 VAE 原生 latent 频率是 44100/2048 ≈ 21.53Hz,21.53 × 512/441 = 25.0,所以解码之后必须做一次 441/512 的 sinc 重采样把时长掰回来。为了 token 级 1:1 对齐,宁愿在解码端补一次重采样——这个取舍很能说明他们对音画同步的重视程度。
生成分两段,magi2_preview 在低分辨率去噪,magi2_refiner 把结果拉到 1080p。

(图片来源:本文根据两份 config 与 inference/pipeline/inference_engine.py 推算绘制)
预览阶段跑 512×896。按 vae_stride = (8,16,16) 和 10 秒推算,latent 是 32 × 32 × 56 = 57,344 个视频 token,加 250 个音频 token 和文本 token。100 步 UniPC,每步 batch=2 同时算条件与无条件分支(等价 200 次单样本前向),CFG 强度视频 5.0、音频 7.0,负面提示词是一段写死的长串——视觉、音质、播音腔三段拼起来,光"AI voice / synthetic / TTS / 念稿感"就列了十几个词。上下文并行用 Ulysses,cp_size = 8,ep_size = 8。
精修阶段换成一个约 6.7B 的稠密 DiT(30 层、宽 4096、num_query_groups = 8 走 GQA),做的事比"超分"多:
σ[220] 部分加噪,latent × σ + noise × √(1-σ²),是 SDEdit 那个套路;这一阶段的视频 token 是 63 × 68 × 120 = 514,080 个,比预览阶段多 9 倍。50 万 token 显然不能全注意力,所以 30 层全部走滑窗:8×4×4 分块、块半径 2,也就是每个查询块看周围 5×5×5 的块邻域。
有两个数字对不上直觉,值得单独拎出来:
magi2_refiner_audio_noise_scale = -1.0,代码注释写得很直接——the refiner is asked to improve the video and nothing else。音频 token 直接置零,最终音质完全由 512×896 那一阶段决定。解码用的是蒸馏过的 turbo_vae(TurboV3-Wan22-TinyShallow),时间滑窗,每个视频只在一个 rank 上跑。视频 VAE 本身来自 Wan2.2-TI2V-5B,48 通道;文本编码器是 Qwen3.5-27B,56GB,输出 5120 维。
这一节短,因为实在没什么可写。
官方材料里没有任何量化评测。 没有 VBench,没有内部人评,没有和 Wan / Veo / Kling 的对比表,甚至没有 loss 曲线。博客里两处"能力涌现"的描述都标注为 qualitative observations。
唯一可查的第三方数字是上面那张图:Artificial Analysis Image-to-Video Arena,Elo 1105,95% 置信区间 ±9,5650 张盲测投票,排第 6,API 价格栏写着 Coming soon。
所以现在能下的判断只有:
一份标题叫 Scaling Video Generation Models Efficiently 的报告,没有 scaling 曲线——这句吐槽我在第 02 节说过一次,这里还得再说一次。
硬件与环境:
cp_size 和 ep_size 都写成 8,想换卡数得自己改 config 并承担形状对不上的风险;ffmpeg 必须在 PATH 上,否则视频照样出,但是静音的;权重 307GB。按 HuggingFace API 返回的文件大小统计,89 个文件的构成是:preview 228.1GB(56 个 safetensors 分片)、text_encoder 55.6GB、refiner 13.5GB、stable-audio-open-1.0 4.9GB、vae 2.8GB、turbo_vae 1.9GB。
最省事的路是 Docker:
docker pull sandai/magi-2-preview:latest
docker run --gpus all -it -v /path/to/ckpt:/workspace/ckpt sandai/magi-2-preview:latest
顺手提一句官方的好习惯:镜像有 per-commit tag,报告结果时应该写 sandai/magi-2-preview:<commit> 而不是 latest,镜像里 /etc/magi2-build-info 也记着构建来源。
下权重和跑 demo:
hf download sand-ai/MAGI-2-preview --local-dir ckpt
bash scripts/run_demo.sh
单条生成直接调 entry point:
torchrun --nproc_per_node=8 inference/pipeline/entry.py \
--prompt "a red fox in snow" --output output/显存策略要留意:MAGI2_TEXT_ENC_OFFLOAD_MODE、MAGI2_PREVIEW_OFFLOAD_MODE、MAGI2_REFINER_OFFLOAD_MODE、MAGI2_VAE_OFFLOAD_MODE 四个环境变量分别控制四个大组件在阶段之间放哪,取值 cpu / gpu / roundtrip。preview 和 refiner 默认都是 roundtrip——1080p 时这两个模型在 80GB 卡上放不下彼此的激活,只能进出倒腾。这也意味着每次生成都要吃一轮 CPU↔GPU 搬运的时间。
我的建议:
inference/flash_mh_moe/、MultiHeadMoELayer 和两份 config,而不是生成效果。这是目前唯一能读到的百亿级视频 MoE 实现。| 模型 | 参数量 | 架构 | 音频 | 时长 | 分辨率 | 硬件 | 开放程度 | I2V Arena Elo |
|---|---|---|---|---|---|---|---|---|
| MAGI-2 Preview | 114B 总 / 6B 激活 | 单流 Multi-Head MoE + 稠密 refiner | 联合生成,含对白/环境声 | 固定 10s | 1088×1920 | Hopper × 8 | 权重 + 代码 Apache 2.0 | 1105(第 6) |
| MiniMax H3 | 33B 稠密 | 单流 Omni Transformer | 联合生成,32kHz 立体声 | 4–15s | 768p 开放 / 2K 需闭源链路 | — | 权重开放,自定义社区协议 | 1190(第 3) |
| MAGI-1 / 1.1 | 24B 稠密 | 分块自回归去噪 | 无 | 可延长,支持续写 | 720p | H100 × 8(4.5B 版单卡 4090) | Apache 2.0 | — |
| Wan 2.7 | — | DiT(2.2 起用高噪/低噪双专家 MoE) | 部分版本支持 | 5s 起 | 720p/1080p | 消费级可跑小版本 | Apache 2.0 | 1094(第 7) |
| Dreamina Seedance 2.0 | 未公开 | 未公开 | 支持 | — | 720p | 云端 | 闭源,$9.07/min | 1198(第 1) |
| Veo 3.1 | 未公开 | 未公开 | 支持 | — | — | 云端 | 闭源,$24.00/min | 1085(第 10) |
(Elo 与价格取自 Artificial Analysis I2V Arena 2026-08-07 快照;"—"表示官方未公布或该榜未收录。)
这张表里最扎人的一行对比是前两行:114B 总参对 33B 稠密,输了 85 分 Elo。 这不能说明 Ultra-Fine-Grained MoE 路线错,因为 MAGI-2 明说自己是 intermediate release、没蒸馏、没调够;但它确实说明总参数量在这个赛道不是可以直接换成画质的硬通货。
先说我最欣赏的地方:这是一份诚实的技术报告。
Sand.ai 没把 MAGI-2 Preview 包装成"新 SOTA",从标题到结论都在说这是路径验证。博客最后那句话我觉得写得相当好——
模型架构决定容量如何组织,数据决定这份容量能学到什么,系统决定这份容量能否被可靠地训练和部署。
三者必须一起 scale,缺一个都不行。这个框架比"我们把模型做大了"要清晰得多。
然后说我觉得可惜的地方,主要是三条:
第一,最该有的东西没有。 一份讲 scaling 的报告,没有 scaling 曲线、没有受控消融、没有能力边界分析。作者把这三样列进了 next stage 的优先事项,但"下一步会做"和"这次做了"对读者的价值差得很远。现在社区能验证的只有"这套东西跑得起来",验证不了"这套东西比稠密/常规 MoE 更好"。
第二,代码比博客诚实。 mHC、共享专家、模态专属专家、attention sink——这些真正影响训练稳定性和多模态平衡的设计,配置和源码里实现得完完整整,博客里一个字没提。反过来,博客花很大篇幅讲的 Head Parallel 通信优势,其实主要来自一篇 ASU 的 4B 规模工作。该署名的没说清,该自夸的没说出来,这个信息分布挺奇怪的。
第三,能力面收得太紧了。 固定 10 秒、只支持首帧、没有音频编码器、refiner 不管声音、不支持续写——比 MAGI-1 少了流式和长视频,比 MiniMax H3 少了尾帧、音色参考、动作参考。可以理解(要控制系统变量),但这也意味着它现在只能是研究物料,不是生产工具。
最后回到那个真问题:把 token 切成 12 份、每份从 256 个小专家里挑 6 个,这个方向对吗?
我的看法是:方向值得追,但这次没被证明。
值得追的理由是那张参数拆解图——它让人看清了一个反直觉的事实:114B 里 95% 的参数是专家池,可"每 token 激活 6B"里却有 57% 是注意力和恒定稠密件。MoE 把 FFN 的容量-算力解耦做到了极致,但视频生成真正贵的是长序列注意力,那部分一点都没省。 所以在视频上继续堆专家池,边际收益到哪一层会掉下来,这是个必须靠实验回答的问题,而这次没答。
如果 Sand.ai 下一版能补上"同算力预算下,Ultra-Fine-Grained MoE 对稠密、对常规 MoE 的对比曲线",这套东西的分量会完全不同。在那之前,MAGI-2 Preview 最大的价值是:它让一个百亿级视频 MoE 的架构、路由行为和推理特性,第一次可以被外面的人直接读、直接跑、直接质疑。 就一次开源来说,这已经不算小。
本文只依据公开博客、模型卡、配置文件与推理源码分析,未下载权重、未实际运行推理。文中"推算"的参数量与 token 数为作者根据 config 与源码计算所得,可能与官方口径存在差异,欢迎指正。
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)