


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 视频生成与人物编辑 4 篇 · 图像生成与扩散训练范式 1 篇 · 世界模型与 3D 生成 3 篇 · 评测基准与音频编解码 2 篇
Wan-Animate-2: Pushing the Application Boundaries of Character Animation | 阿里巴巴通义实验室 | arXiv:2608.06009
关键词:角色动画,实时流式生成,Self-Forcing蒸馏,视角控制,阿里通义
前序问题:角色图像动画目前有三条路线,每条都有硬伤:基于显式运动表征(骨架、关键点、SMPL)的方法受制于提取误差,一旦姿态估计出错就带着身份一起漂移;基于隐式运动特征的方法把驱动信号压缩成低维向量,手指、微表情这类细粒度动态在压缩里被抹平;上下文学习(in-context learning)路线干脆不要中间表征,直接把驱动视频喂进注意力,质量最好但算力开销高到无法接受。更要命的是,现有系统全部是离线合成,数字人主播、直播换装这类交互场景要求边算边出,而当前方法连准实时都做不到。
本文贡献:端到端重构 DiT,让模型直接消费驱动视频,彻底删掉中间运动提取器。四个部件撑起 Base 版:双分支 DiT 共享 QKV 投影,参考分支锚定在扩散时间步 t=0 提供无噪运动先验,只训共享投影层、主干权重冻结;Time-Align RoPE 把参考视频 token 逐帧前置拼接,用H_t×W_t 的空间偏移避免位置索引撞车;Sparse-Ref Attention 让每个 latent query 只看时间上对应的参考 K/V,把跨分支注意力从 O((N_r+N_l)²) 压到 O(N_l);Viewpoint LoRA 只注入 cross-attention 投影矩阵,用「right 60-degree view」这类自然语言而非旋转矩阵来控视角,把输出机位和驱动视频解耦。Lite 版靠三段式训练做到实时:教师强制预训练把全局去噪模型改造成chunk-wise 因果生成器;Error Buffer 把单步预测与真值latent 的残差以滑动估计维护,训练时加回 clean context 来对冲 exposure bias,不用跑完整自回归 rollout;Self-Forcing 蒸馏为 14B 规模设计分块反向传播,rollout 阶段无梯度算完整序列分数,梯度阶段逐 chunk 累积并 detach,峰值显存从与全序列成正比降到与单 chunk 成正比。
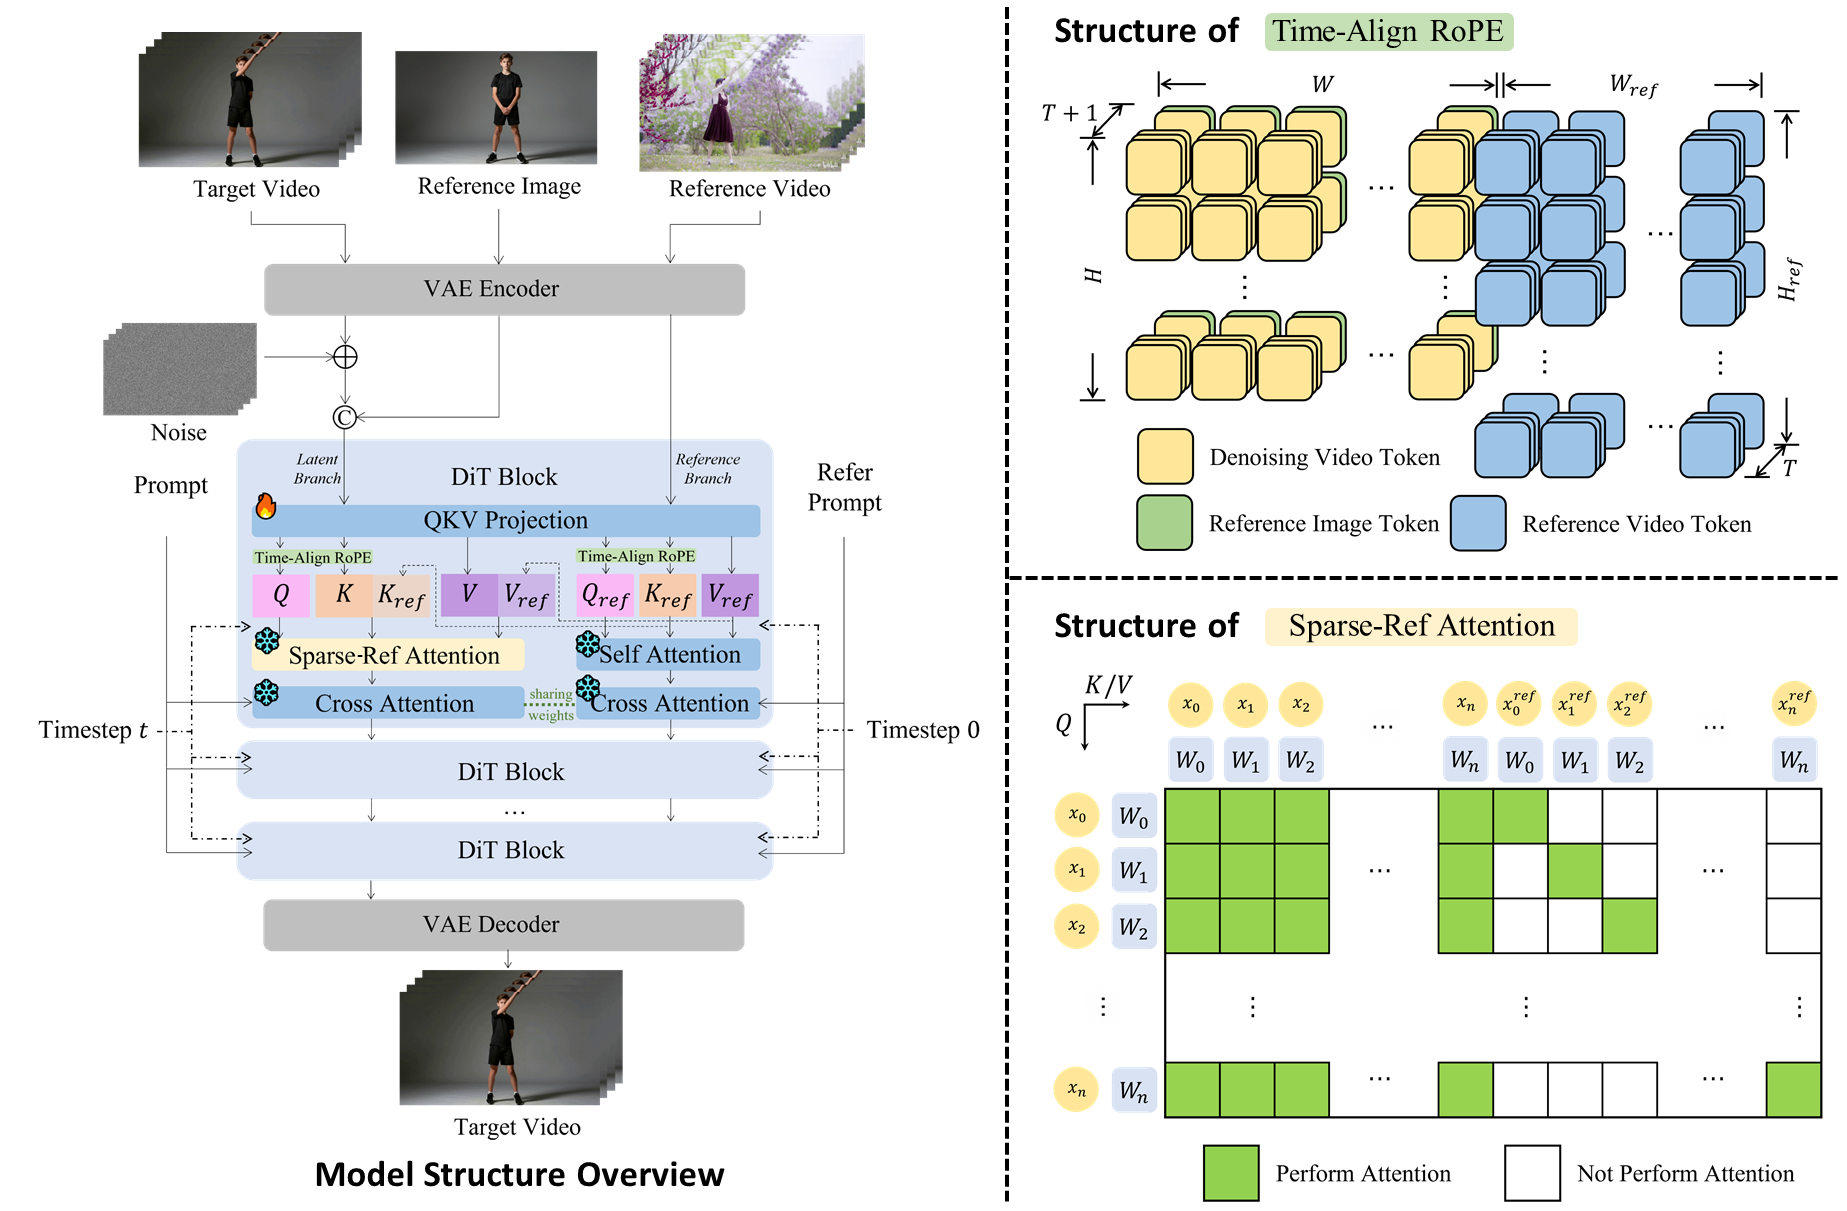
实验效果:Lite 版在 4 张 H100 上以流水线并行(1 卡 VAE 编码、2 卡序列并行跑 3 步 DiT 去噪、1 卡 VAE 解码)达到 400×720 分辨率 24 FPS,推理 chunk 为 8 帧,跨过实时阈值;得益于 error buffer,长时间自回归里观察不到误差累积或质量退化。视角空间离散为 12 个方位角×4 个俯仰角共 48 档,大幅换机位时周围环境仍保持高度一致。盲测用户研究覆盖视觉质量、动态自然度、身份保持、动作准确度、面部表情五维加总体质量:对开源 Wan-Animate 全指标领先,总体质量在超过 70% 的成对比较中被偏好;对闭源商业产品 Dreamina 多数比较中胜出,对可灵 Kling-MotionControl 打成平手——而后两者建立在更大的闭源视频基座上,Wan-Animate-2 完全基于开源基座。训练数据用 Wan-Animate 自动合成配对视频,参考图由 Qwen-Image-Edit / Qwen-Image / Z-Image 生成,覆盖全身/半身/特写;多视角数据由 Unreal Engine 渲染,仅用于训Viewpoint LoRA。团队承诺开源 Base 权重。
批判点评:这篇最扎实的地方不是又一个动画框架,而是把「实时」这件事真正做进了 14B 视频 DiT:Error Buffer 用一次前向的残差近似替代完整 rollout,Self-Forcing 的chunk-wise 反传把显存与序列长度解绑,这两招是可以直接搬去做其他流式视频生成的通用工程手艺。Viewpoint LoRA 用自然语言而非相机参数控视角,也切中了普通用户拿不到标定内参的实际痛点。但要冷静看几处:全文没有一张定量指标表,FVD/FID/身份相似度一个都没报,评估只有定性图和盲测胜率,而用户研究连参与人数、样本量、分维度百分比都没披露,「超过 70% 偏好」这种数字缺乏可复核性;对比只挑了 Wan-Animate、Dreamina、Kling 三家,AnimateAnyone/Champ/UniAnimate 等经典基线全部只在引言里被引用而未实测。所谓 24 FPS 是 4 卡 H100 加 400×720 的成绩,折算成单卡或 1080p 就不再是实时,「开放部署新场景」的说法离消费级还有距离。另外 Lite 是蒸馏产物、Base 才开源,最能落地直播的那一版权重反而没承诺放出。
Vorch-IR: Long-Form Unified Multimodal Identity Replacement Video Generation | 美团 Vorch Team·复旦大学 | arXiv:2608.05648
关键词:视频身份替换,长视频生成,时间重叠推理,LTX2,美团
前序问题:视频身份替换要把一到多个主体的身份换掉,同时保住驱动视频的动作、表情和时序结构。现有方法几乎只做单人,而且普遍依赖任务专属的结构控制——掩码、姿态图之类,这让它们很难塞进一个通用的多模态编辑系统里。多人替换更是被配对训练数据的稀缺卡死:你很难找到「同一段舞蹈、同样的动作、但换了两个人」的真实配对素材。另一个长期痛点是长度,短片段模型要拉长通常靠自回归续写,误差会一路累积成身份漂移。
本文贡献:一个模型同时支持单人替换、双人替换,以及可选的背景替换,四种设置共享同一套参数,没有任务专属分支或输出头。基于 LTX2 的 48 层 DiT,联合条件化于驱动视频、有序参考图集合和一句文本编辑指令;参考图不需要和驱动视频的姿态、布局、空间构型对齐,谁替换谁完全由指令文本说明(比如「参考1换左边的人,参考2换右边的人,参考3换背景」)。密集视觉条件走自注意力融合——驱动视频与目标视频用同时间原点、同帧率的独立 RoPE 网格,每张参考图分配独立位置网格,从而不对参考图与目标施加坐标级对应;语义对应关系则通过 Gemma 视觉语言编码器的 cross-attention 建立,参考-目标的绑定被学成语义关系而非显式定位模块。条件 token 始终保持 clean 并赋时间步 0,只有目标 token 加噪与监督。配套一条全自动数据构建流水线:先编辑首帧身份(合成参考涵盖真人、动漫角色、其他类人形象),可选再编辑背景,由 LLM 生成替换指令,再用运动引导动画模型沿源运动轨迹传播,最后由 VLM 过滤肢体畸形、主体缺失、身份不匹配等失败样本。长视频靠时间重叠推理:8 秒窗口、2 秒重叠、线性 cross-fade 融合,所有窗口读同一份 latent、融合后对整段施加单次 Euler 步,全视频保持单一去噪轨迹,因此不需要自回归续写。
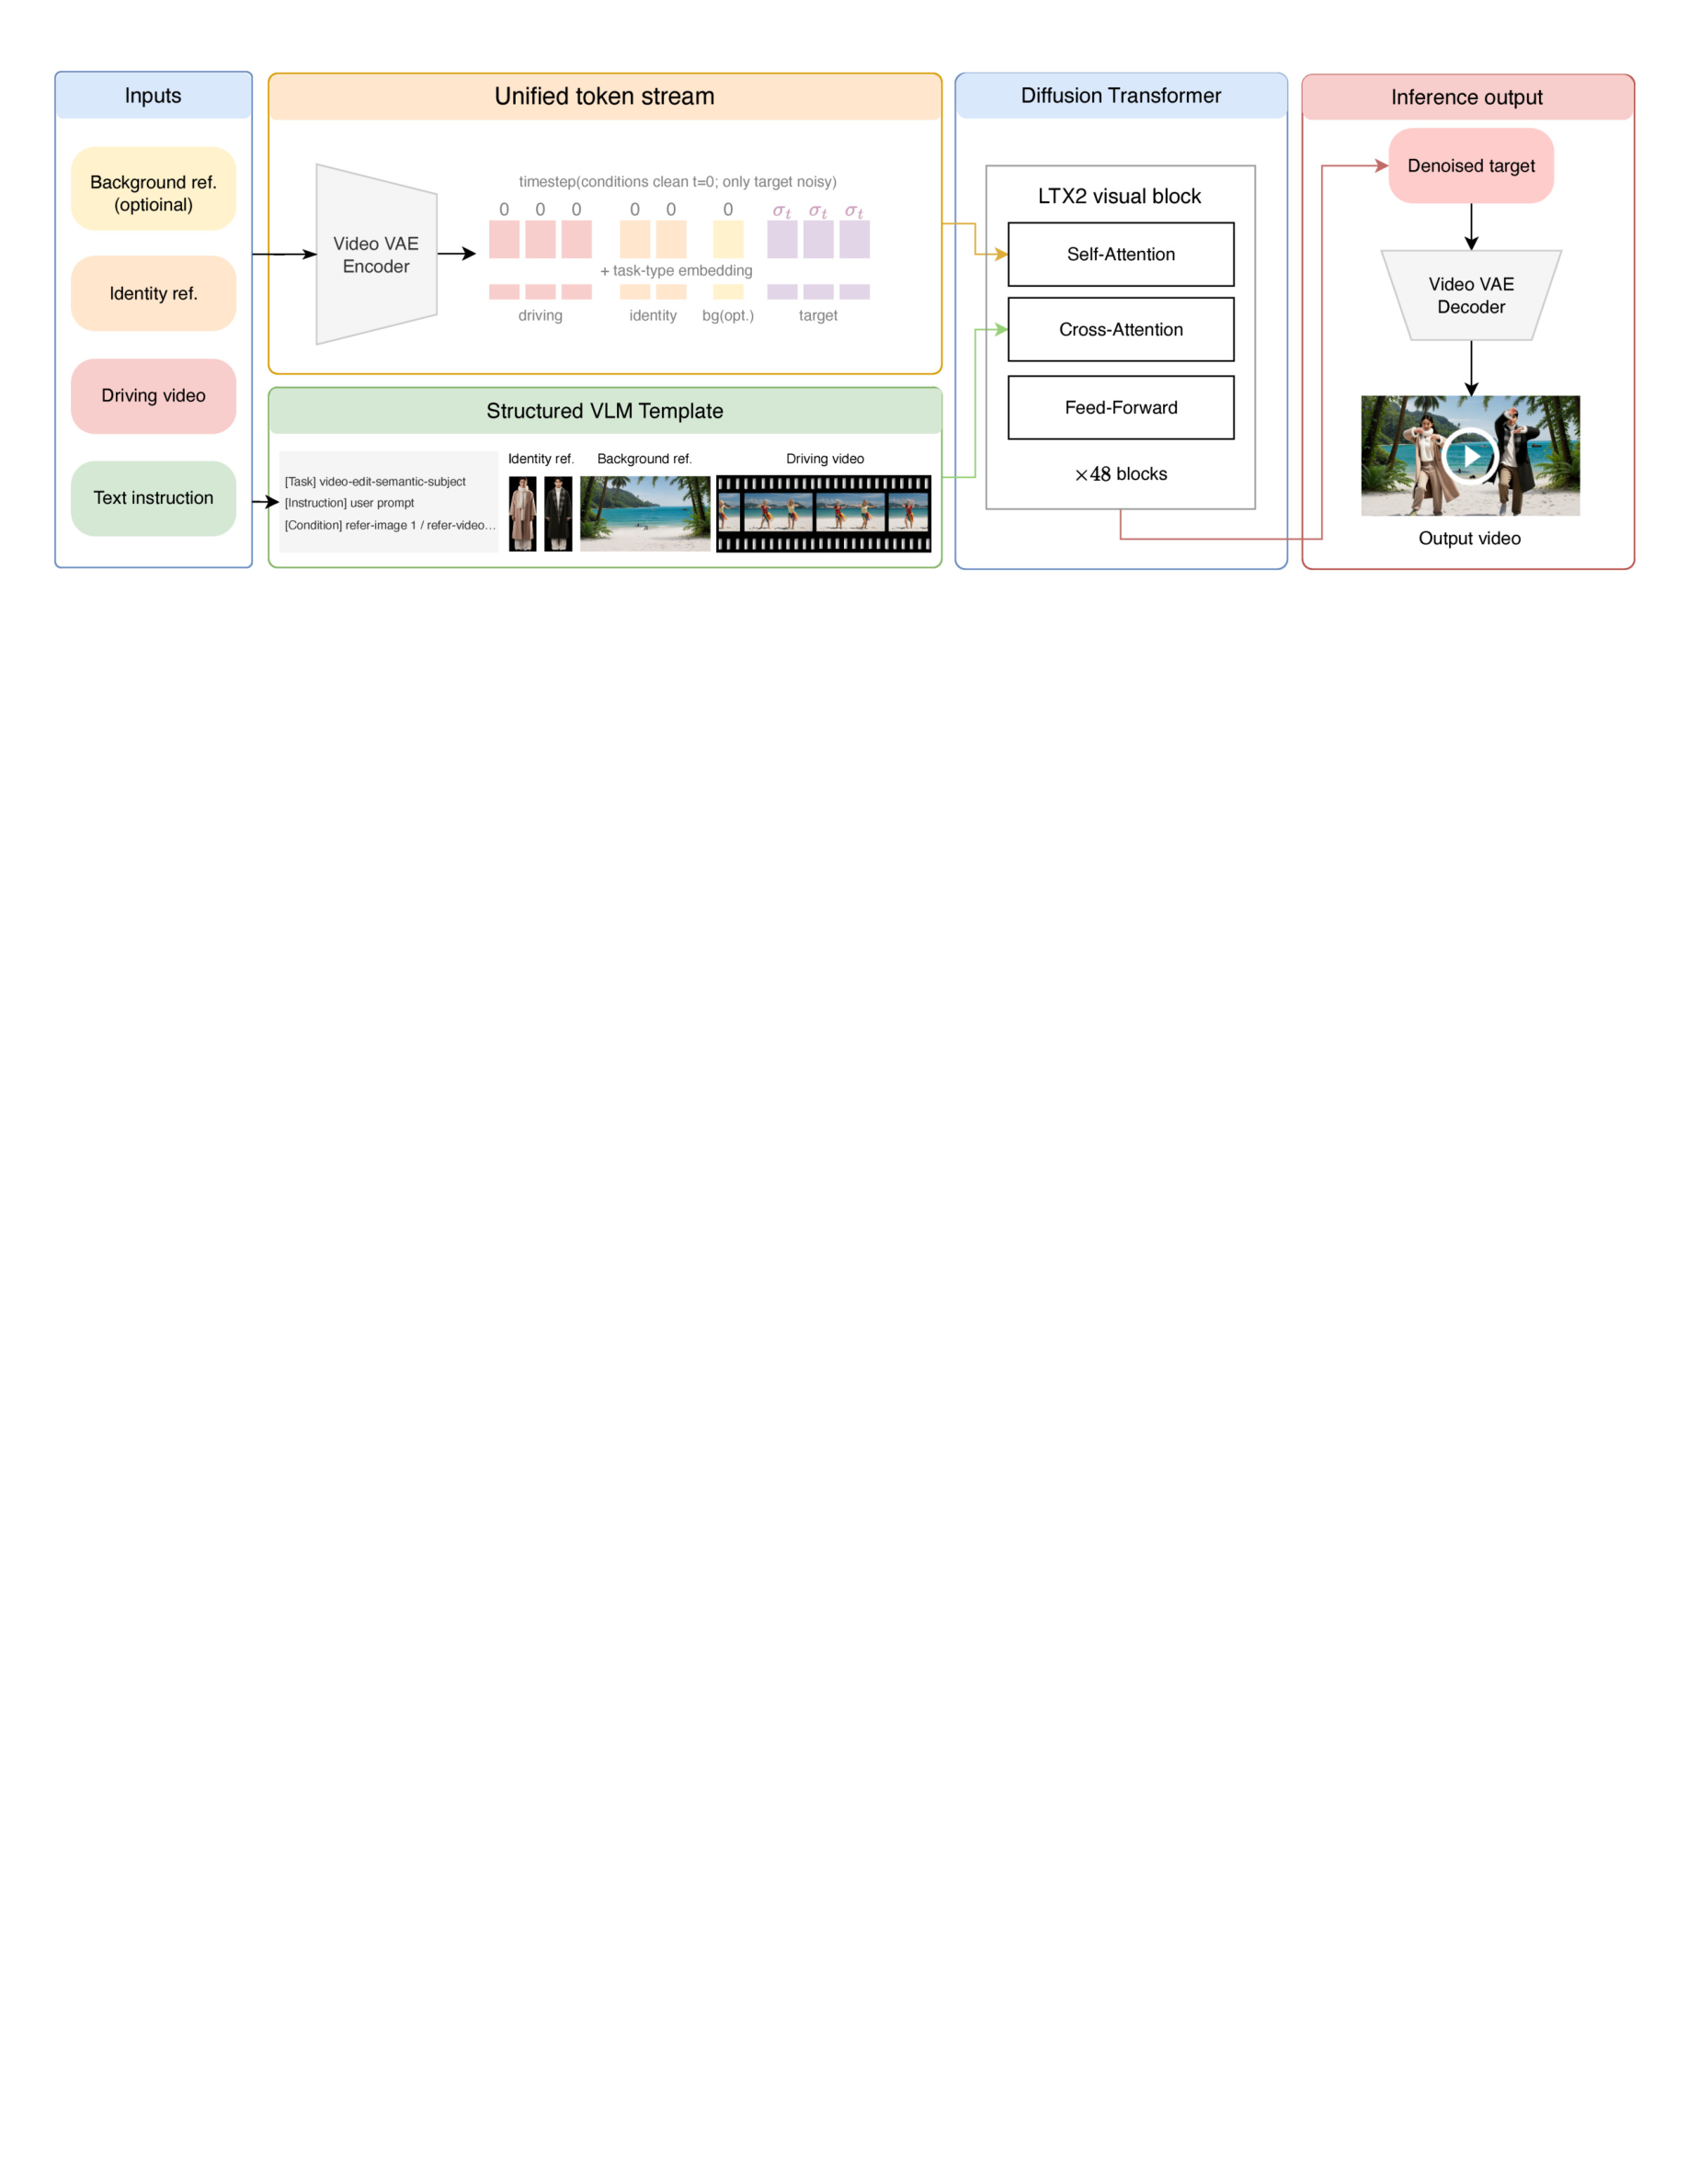
实验效果:训练只用了 15,571 个clip、总时长约 13 小时(91% 的clip 在 2-4 秒),32 张 H20Z、有效 batch 96、2000 次优化步的checkpoint。在自建 benchmark 上主体一致性 0.9096 与背景一致性 0.9332 双项第一,DINOv2 主体相似度 0.5613 第一(次优 SCAIL-2 为 0.5470),CLIP-I 0.7767 第二仅差 0.0068;跨数据集 XDance 上运动平滑度 1.4286 第一,DINOv2 0.6040、CLIP-I 0.7953 均为第二。GSB 人工成对评测覆盖 4 个对手×4 个维度共 16 组,Vorch-IR 在全部 16 组中 Good 占比都高于 Bad:对 Wan-Animate 身份一致性 77.0% Good 对 11.5% Bad,对 MoCha 运动一致性 50.0% Good 对 0.0% Bad、身份一致性 69.2% 对 3.9%,对 HunyuanCustom 身份一致性 65.4% 对 23.1%。推理用 8 步蒸馏采样器单阶段完成,完整驱动视频只编码一次,短片段训练的模型直接扩展到分钟级。

批判点评:这是Vorch 系列本周的第四篇(8 月 7 日那期已推过 Omni、Streamer、Director),从「一套权重覆盖 30 多种音视频配置」走到「一套权重覆盖单人/双人/背景四种替换设置」,路线是连贯的:把任务差异从架构里赶出去,全部推给指令文本和 token 角色分配。最实用的一招是时间重叠推理——用完整驱动视频本身作为稠密逐帧条件,所有窗口共享同一份 latent 再做单次全局 Euler 步,绕开了自回归续写的误差累积,这个思路对任何「有完整条件序列」的长视频任务都能复用。但要看清代价:训练数据只有 13 小时、15,571 个clip,而且监督信号全部由「图像编辑首帧 + 运动传播」合成,本质是在蒸馏现成编辑器与动画模型的能力,天花板受限于那两个工具;论文也没报 FVD,视频级分布距离缺一个公认口径。更关键的是定量对比只在「单人替换」这一共同设置下做——双人和背景替换恰恰是它宣称的核心增量,却只有项目页的定性结果,无法核验。时序闪烁 0.9680 低于 HunyuanCustom 的 0.9781,DWPose 误差 0.0976 也不及 Wan-Animate 的 0.0614,说明身份保真的提升是拿姿态精度和时序平滑换来的。最后,这类换脸能力的滥用风险是实打实的,论文对此几乎没有讨论。
UniVVT: A Unified End-to-End Framework for High-Fidelity Video Virtual Try-on | 清华大学·天津智能创新研究院 | arXiv:2608.05745
关键词:视频虚拟试穿,端到端生成,MLLM语义条件,预处理加速,清华
前序问题:视频虚拟试穿要合成一段「这个人穿上这件目标服装」的视频,同时保住身份、动作和场景动态。主流做法把它当成掩码条件下的视频修补,于是必须挂一串独立模块:人体解析、姿态估计、服装变形。这套多阶段设计不只部署麻烦,更要命的是显式几何先验一旦出错,误差会不可逆地传进生成结果——掩码估计歪了,衣服就换不干净。而且这些预处理开销随视频长度近线性增长,90 帧就要一百多秒。
本文贡献:把视频试穿从「掩码条件视频修补」重新定义为「语义条件视频生成」,推理时彻底不需要掩码、姿态和变形场。核心判断是:「换什么」和「换到哪、怎么换」可以由多模态语义隐式编码,不必显式规定。三个组件:场景-任务感知器用 Qwen3-VL-2B-Instruct 把源视频、目标服装图、文本指令联合编码,前置 512 个可学习 task query 通过自注意力聚合任务信息,取的是 MLLM 的 hidden states 而非解码出的文本,因此同时捕获服装属性、场景上下文、人体-服装对应关系与时序编辑意图;语义桥是个轻量 MLP,只做维度与分布的适配,不学新的生成先验;视频生成模块基于 Wan2.1-Fun-Control 的 DiT,源视频 latent 与噪声沿通道维拼接以保留身份动作背景,服装 latent 沿序列维追加作为静态外观参考,每个 block 通过 cross-attention 注入任务语义与冻结CLIP 的服装外观特征。训练走三阶段渐进:先冻结生成器只对齐语义,再联合端到端适配,最后在256p-1024p 随机分辨率上精调。掩码与 DensePose 只出现在离线数据构建阶段(从真实的服装-视频对反向合成源输入),训练和推理都不吃这些输入。
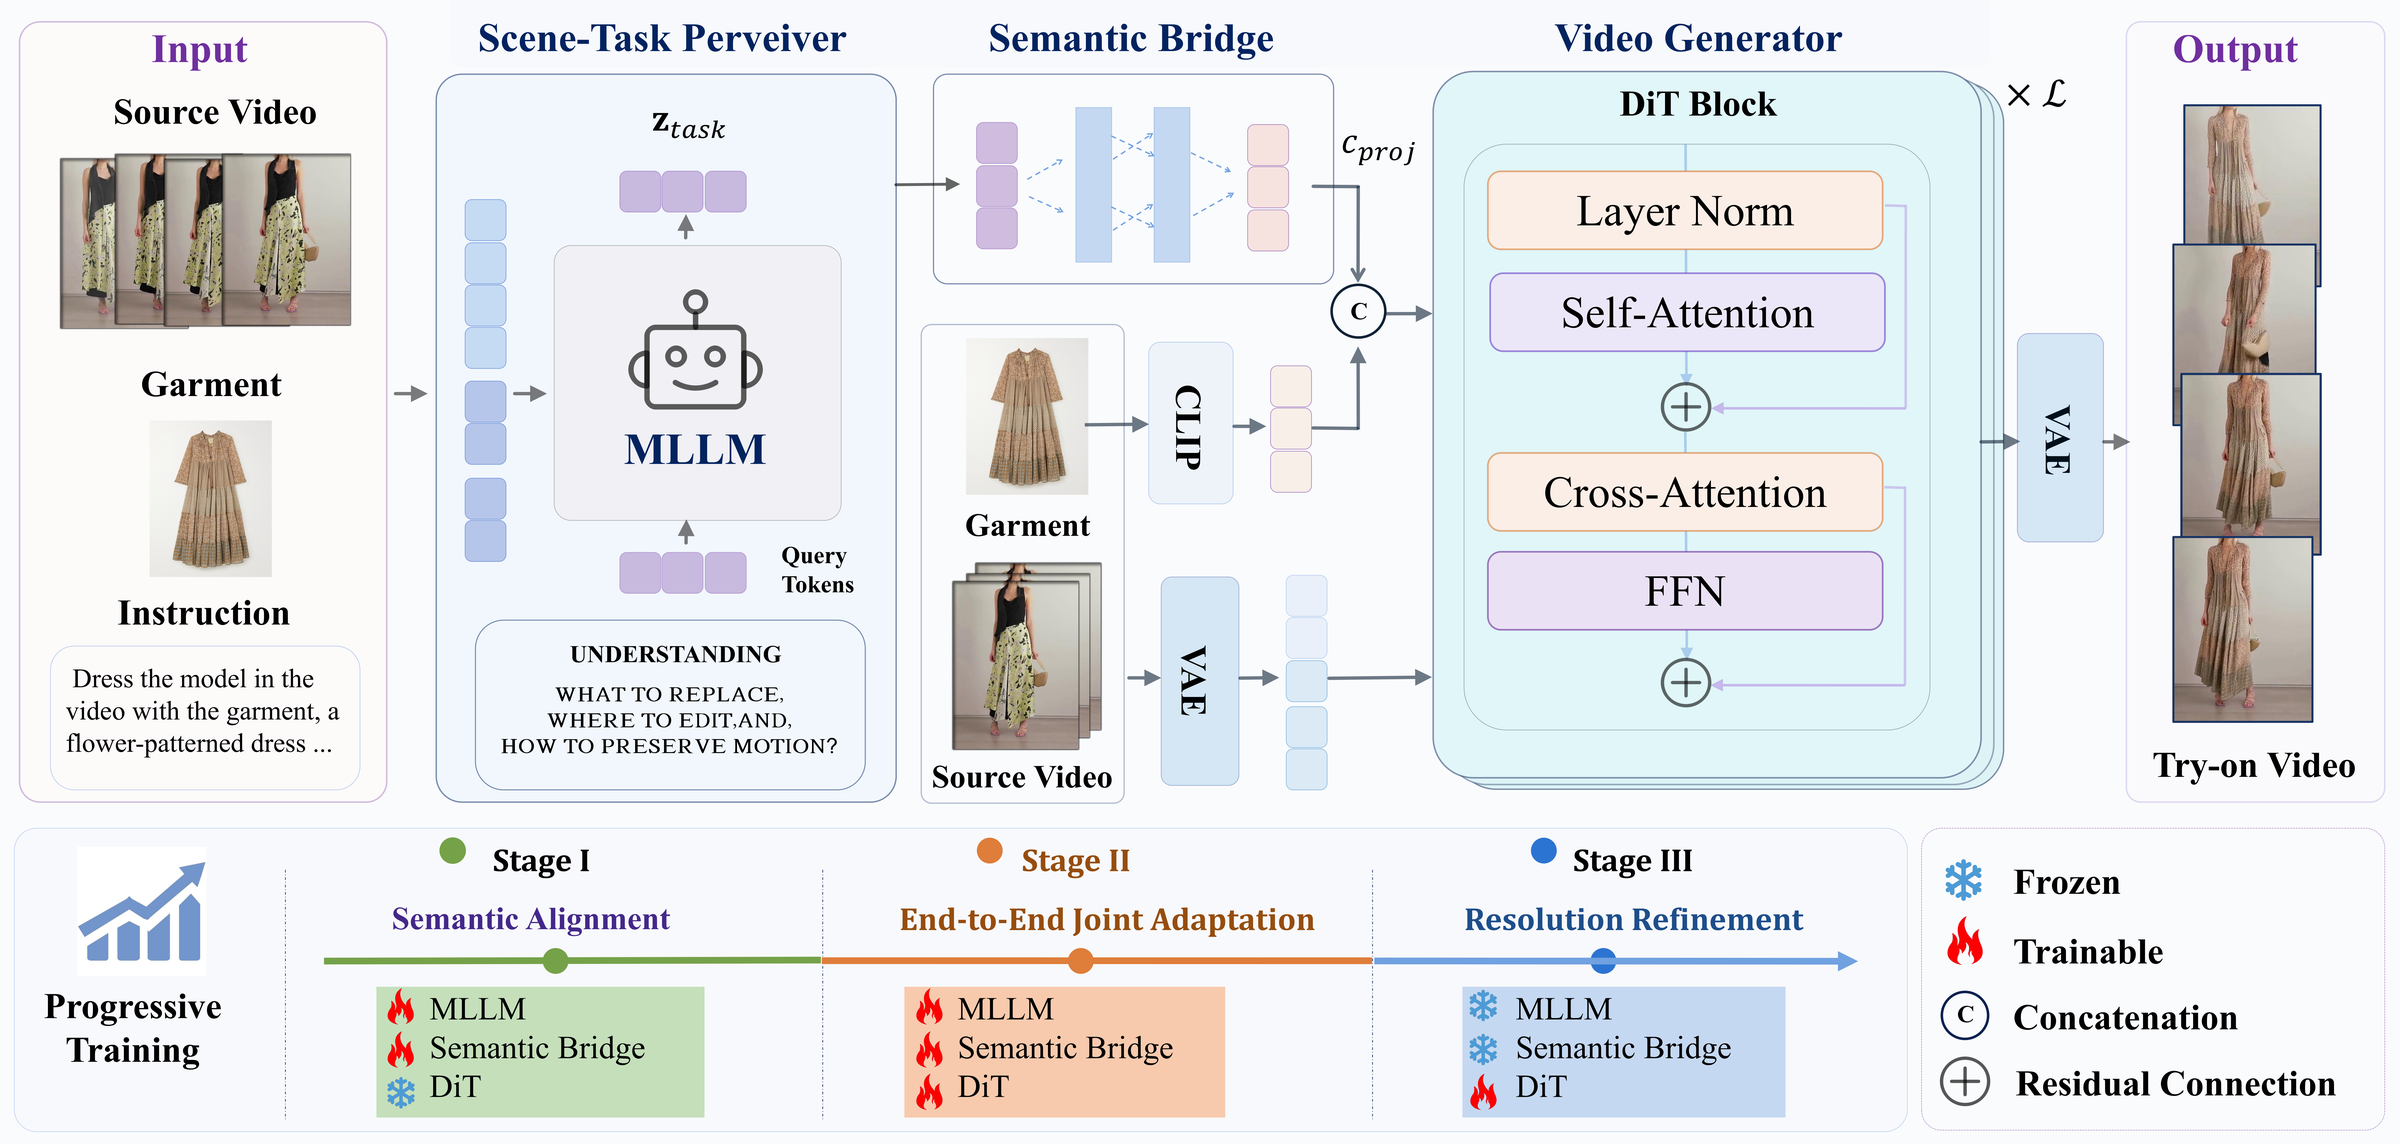
实验效果:最有说服力的是效率:显式几何预处理在 30 帧要 36.36 秒、90 帧要 111.39 秒且近线性增长,UniVVT 的隐式任务编码分别只要 2.06 秒和 2.92 秒,加速 17.7 到 38.1 倍,90 帧场景直接省掉 108.47 秒。质量上也没让步——ViViD-S 视频基准 paired VFID_I 8.3623、VFID_R 0.1934、LPIPS 0.0456、unpaired VFID_I 12.3640、VFID_R 0.1876 五项里四项最优(SSIM 0.8922 次于 MagicTryOn 的 0.9011),unpaired VFID_R 相比次优 DreamVVT 的 0.4285 几乎腰斩。图像基准同样领先:DressCode paired FID 2.734、KID 0.4154、LPIPS 0.0349、unpaired FID 4.900、KID 0.960全为最优;VITON-HD paired FID 5.348、KID 0.3667 也是第一,并明显优于 Qwen-Image-Edit(14.269)与 FLUX.2-klein(11.503)这类通用图像编辑模型。消融很干净:去掉场景-任务感知器后 unpaired VFID_R 从 0.1876 恶化到 0.4424翻倍以上,定性上会把短裙错误地贴到上半身;语义桥若用 12 层 Transformer(1260M 参数、571G FLOPs)反而不如 41.96M 的 MLP,说明这一层只需做紧凑的分布变换。8 张 A100、LoRA rank 32、每阶段 30k 步。

批判点评:这篇给「能不能把一堆预处理模块直接删掉」提供了一个相当有力的答案,而且删的理由讲得通:掩码和姿态本质是在告诉模型「改哪里」,但一个足够强的 MLLM 看完视频和指令后本来就知道该改哪里,交叉注意力可视化也确实显示注意力集中在上半身并沿手臂持续跟随、人脸和背景响应明显更弱。17.7-38.1 倍的预处理加速对电商这种要批量跑的场景是硬收益,比多零点几个 SSIM 实在得多。轻量 MLP 打败重型 Transformer 那组消融也很有价值——提醒大家适配层不该无脑堆容量。但几处需要打折:训练三元组的「源视频」全部是用 inpainting 模型合成出来的,真实数据只提供服装图与目标视频,也就是说模型学的是「从合成劣化态恢复到真实态」,真实用户上传的视频未必落在这个分布里;in-the-wild 只在 TikTok 舞蹈上做了定性展示,没有数值。评测统一在 512×384 这个偏低的分辨率下进行,而试穿最挑剔的恰恰是布料纹理与 logo 这类高频细节,Stage 3 在 832p上 LPIPS 反而退到 0.0586 也暗示高分辨率并非无痛。论文既没有 FVD 也没有用户主观评测,视频级的时序观感缺少直接证据。SSIM 输给 MagicTryOn 也说明「端到端」在结构保真上还有欠账。
Energy-Guided Flow Matching | 京东·中科院自动化所 | arXiv:2608.05811
关键词:像素空间扩散,Flow Matching,频谱调度,收敛加速,京东
前序问题:像素空间生成模型绕开了 VAE 的有损压缩,代价是要在极高维空间里同时学全局结构和细粒度纹理。标准 flow matching 把噪声笔直插值到一个固定的干净图像终点,从低频轮廓到高频细节的整条频谱演化只能由网络隐式摸索,没有任何机制告诉模型「先把大形状定下来,再补纹理」。结果就是收敛慢、epoch 烧得多,像素扩散一直被认为训不动。
本文贡献:把固定终点换成会动的终点。用热核频率响应 R(h,ρ)=exp(−aħρ²) 对干净图做低通滤波,得到随时间平滑演化的终点 y_t(x):h=1 时最强低通只剩轮廓,h=0 时恢复全频谱等于原图,边界条件与标准 FM 完全一致。关键是高频释放节奏不写死,而是按每张图自己的频谱能量自适应:用 Parseval 定理算出总缺失能量与已恢复能量,令所有样本在同一时刻 t 完成相同比例的频谱能量恢复(release clock q(t) 用五次smootherstep),再用 16 次二分求出该图的热时间 h。速度目标因此多出一项终点自身运动项 t·∂_t y_t,通过隐式微分求导,无需对求根器反传。默认 σ₀=3.5,所有频谱运算在 FP32 下执行,t 与 1−t 接近 0 时解析赋值保证端点稳定。不改backbone、不改训练数据、不改采样器。

实验效果:ImageNet 256×256 类条件生成上做成收敛加速器:HyperDiT-H 只训 220 epoch 就拿到 FID 1.51,优于基线 600 epoch 的 1.56,约 2.7 倍加速;DeCo-XL/16 440 epoch 达 1.63 优于基线 600 epoch 的 1.69;PixelDiT-XL 200 epoch 的 1.55 已经超过基线 320 epoch 的 1.61,600 epoch拉到 1.45 优于基线 800 epoch 的 1.54(torch-fidelity 协议下为 1.39)。512×512 上从256 检查点仅微调 40 epoch,240 epoch 得 FID 1.68,而标准 PixelDiT 多训 530 epoch 才 1.81。迁到文生图,1.3B 的 EG-FM-T2I 把 PixelDiT-T2I 的 GenEval 从 0.78 提到 0.85、DPG 83.7→83.9(DPG 为全表最佳),GenEval 分项里Position 0.53→0.72、Color attribute 0.65→0.77 提升最猛。开销几乎为零:额外 FLOPs 最多 +0.026%/样本,每步墙钟时间增幅除 PixelDiT-B/16 的 4.81% 外均在 1% 以内,推理阶段完全零开销(不需 FFT、不需求根,与标准 FM 同 solver 同 NFE)。消融证明「逐样本自适应」是关键:共享线性释放 FID 2.48、数据集级 2.11、类级 2.03、逐样本 1.99。
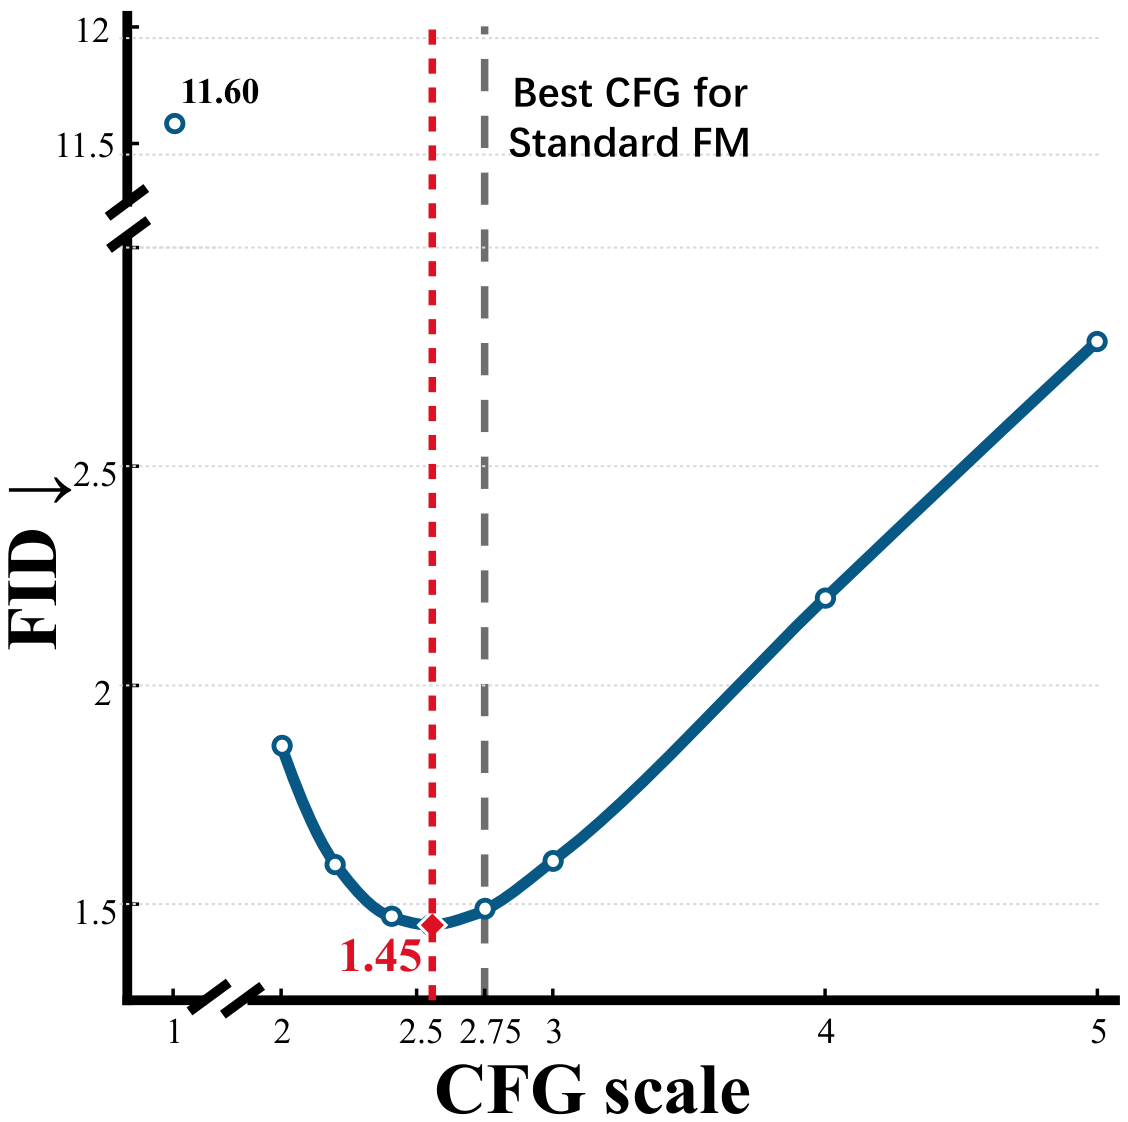
批判点评:在一堆「加个新模块涨点」的论文里,这种改训练目标而不动网络、推理零开销的路子性价比极高,尤其「同一时刻所有样本释放相同比例频谱能量」这个归一化视角很干净——它把粗到细这件一直靠 noise schedule 玄学调的事,变成了可解析求解的能量约束。消融也做得诚实:取消量化、换释放时钟、改热时间粒度都摆了数字,还坦白 x-prediction 扩展在 JiT 上只从 2.37 到 2.33几乎无效,并解释了原因(早期 solver 的 x̃ 频谱不可靠)。不足同样清楚:σ₀ 呈 U 形曲线且最优值 3.5 是搜出来的,换数据分布或分辨率是否还成立没有验证,σ₀=1000 时 FID 崩到 66.08 说明这条路径对超参并不宽容;全部结果限于像素空间 backbone(DeCo/HyperDiT/PixelDiT),latent 空间主流模型上有没有增益完全空白,而作者也承认没在 Flux、Qwen-Image 量级基座上测过;GenEval 0.85 虽亮眼,但 DeCo-XXL/16 用 1.1B 参数拿了 0.86,说明这套增益并非在所有对手面前都成立。视频与跨模态更是明确列为未来工作。
EffectLearner: World-Aware Object-Effect Reasoning for Real-World Video Object Removal | 清华大学深圳国际研究生院 | arXiv:2608.05565
关键词:视频物体移除,效果推理,VLM引导,DiT擦除,清华
前序问题:视频物体移除不只要抹掉目标本身,还要连带清掉它引起的影子、反光、涟漪、尾迹、扬尘这些次生效果,同时保证补出来的背景高保真且时序连贯。现有方法把物体-效果对应关系隐式地从预定义效果类别和固定数据分布里学,一旦遇到真实场景里的组合效果(影子叠反射)、空间上与物体分离或弱相关的效果(远处水面的涟漪)、长尾物理现象、以及随时间演化的动态交互,就统统失效——把人擦了,地上的影子还在。
本文贡献:把语义推理塞进擦除管线:VLM 物体-效果推理器(Qwen2.5-VL-3B-Instruct)接收「目标高亮视频」(红色叠加α=0.15、黄色描边)与结构化效果分析提示,通过可学习效果查询做跨模态推理,聚合目标身份与运动、诱发效果及其时序演化、期望的移除后状态、需保留的场景内容,投影成紧凑的 effect-aware context tokens,直接替换 DiT 交叉注意力里原有的文本条件;DiT 视频擦除器基于 Wan2.2-TI2V-5B(从 Kiwi-Edit 初始化)在通道维拼接源视频 latent 与下采样掩码。两个运动感知机制补最后一公里:时间维掩码并集防止 causal 3D VAE 的时间压缩把快速运动目标的短时位置丢掉,运动一致性损失匹配运动补偿后的潜变量时序残差来压闪烁。配套自建 EffectWorld:Unreal Engine 5 渲染,每个目标 20 条随机化序列、每场景 3 条时空对齐序列(source/target/mask),共 11,092 组有效三元组,加 ROSE 的 16,663 组共 27,711 训练样本,配三阶段渐进课程(基础擦除→提高组合/动态/分离样本比例→长尾物理与快速运动精修)。

实验效果:EffectWorld-Eval 上 5 项指标全线最优:PSNR 29.521(次优 ROSE 25.955,领先 3.57 dB)、SSIM 0.934、LPIPS 0.044(次优 0.111,降 60%)、MAE 6.839、FVD 69.184(次优 EffectErase 238.521,降 71%)。ROSE-Bench 上拿到最佳 LPIPS 0.054 与最佳 FVD 81.866——注意 ROSE 虽然 PSNR 30.468领先,但 FVD 高达 803.722,几乎是本文的 10 倍,说明它的像素分领先建立在视频级不连贯之上。EffectWorld-Wild(70 组无配对真值)的 VBench 指标里背景一致性 0.958 与动态程度 0.400 双项最优。GPT-5.4 作评委的四维打分(1–4)总分 3.389 领先 EffectErase 的 3.270,20 人人工评测总分 3.675 对 3.213,其中效果移除 3.900 对 3.000、背景保持 3.950 对 3.000;人工与 LLM 评测的总分 Pearson r=0.9837。消融显示运动一致性损失最关键:去掉后 PSNR掉 4.818、LPIPS 恶化 3.25 倍、FVD 恶化 4.26 倍。

批判点评:这篇的价值在于把「效果」从枚举类别变成了可推理的语义变量——ROSE 那套预定义五类副作用(阴影/光源/反射/镜面/半透明)在真实视频里根本不够用,而让 VLM 先看一遍再告诉 DiT「哪些像素是这个物体造成的」是很自然的解法,评测设计也难得地把 ROSE 的高 PSNR 低 FVD 矛盾摆出来,说明作者清楚像素指标会骗人。人工与 LLM 评测 r=0.9837 也为 LLM-as-a-Judge 在这个任务上提供了一次有说服力的校验。但几处要打折:训练数据 11,092 组全部来自 Unreal Engine 渲染,虽然规避了肖像权问题,合成到真实的域差距只靠 ROSE 那 16,663 组真数据和课程学习来弥合,EffectWorld-Wild 上的优势主要体现在无参考指标和主观分而非硬指标;评测集规模偏小(Eval 仅 33 对、Wild 70 组、ROSE-Bench 60 组),单个难例就能明显搅动均值;人工评测只有 20 名志愿者且分数密集落在 3.9这种接近满分的区间,区分度有限。作者自己列的失败案例也很实在:大面积遮挡加高纹理背景会补得过度平滑,复杂运动下甚至把本该保留的细杆结构误删——这两类恰好是电商与影视后期最常遇到的。
HelloWorld: Enabling Socially Interactive Characters in Video World Models | 东京大学·Alaya Lab | arXiv:2608.05070
关键词:视频世界模型,社交交互,自蒸馏,时序注意力掩码,东京大学
前序问题:视频世界模型这两年进步很快,但里面的角色始终是「背景板」——你只能看,不能和它们互动。用户按个键让屏幕里的角色转过来朝你挥手、点头、说句问候,这件事目前没有任何世界模型支持。难点有两层:一是要让交互看起来自然,二是要控制交互发生的时机,而不是角色在整段视频里随机做动作。
本文贡献:在 LTX-2.3 基础上做了一个能社交互动的视频世界模型:按一下 F 键,屏幕里的角色就会朝镜头做出回应。关键是不采集任何外部数据、不做人工标注,而是用自蒸馏——先用精心设计的 prompt 让冻结的基座模型自己生成「同时含社交交互和相机运动」的片段,再用 Pi3X 从这些自产片段里恢复首帧点云与逐帧相机轨迹,按轨迹把点云重投影渲染成 warp video作为历史条件。warp video 天然带空洞(遮挡区和视野外),正好只提供几何引导、缺失部分交给模型补全,训练时用 visible-token selection 丢掉无有效源观测的 token,并刻意把相机文本从损失条件里排除,确保相机跟随完全由 warp video 而非文本控制。时机控制则是一个完全免训练的技巧:推理时给 cross-attention 加时序掩码,让交互窗口之外的帧无法 attend 到交互文本token,于是角色只在按键窗口内响应观众、窗口外表现为环境行为,开销可忽略。同时配套 HelloWorldBench,用 120 张图扩成 400 个评测样本、覆盖 264 个角色实例与 101 种交互类型,并设计ActAcc/TimeAcc/GazeDev 三个指标分别回答「做的是不是指定动作、有没有在指定时刻发生、是不是朝着观众」。
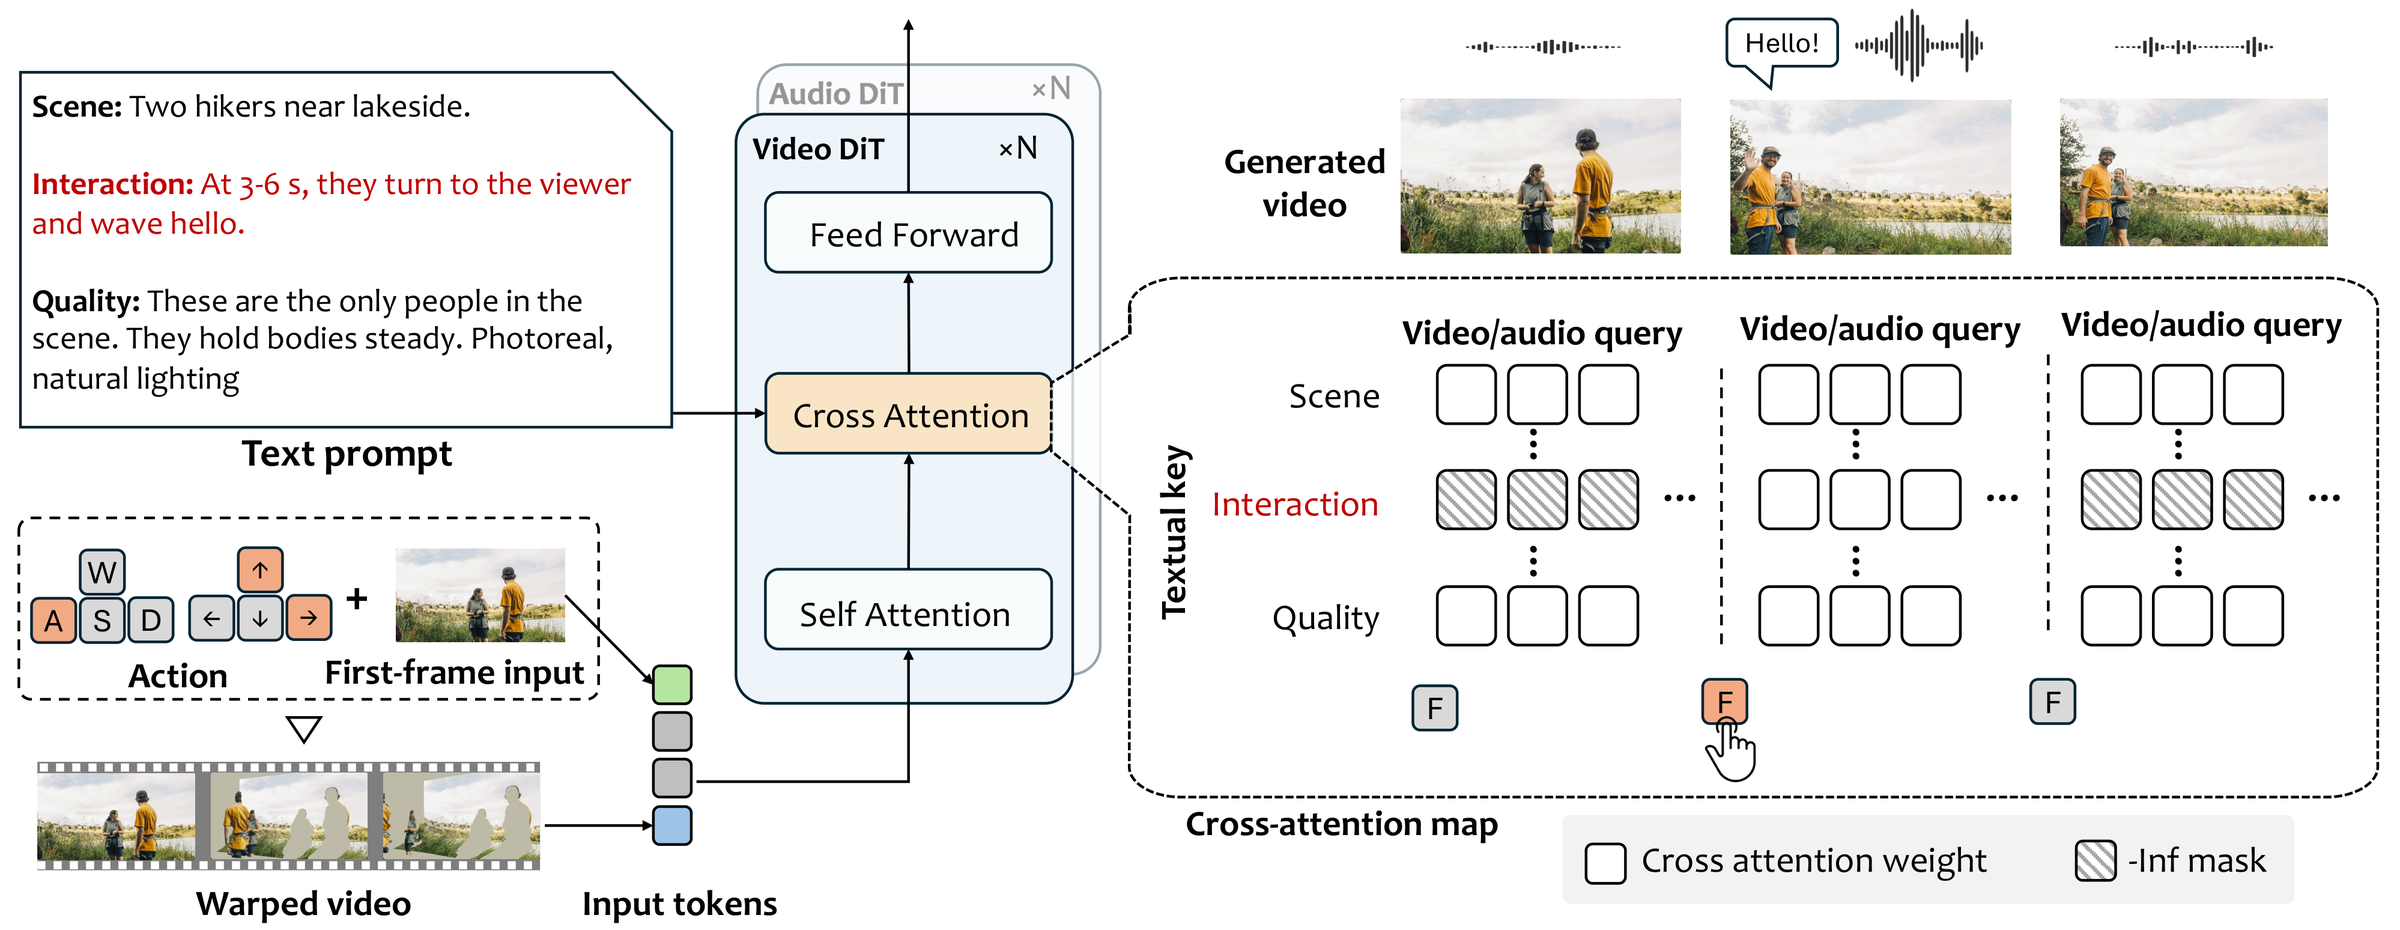
实验效果:训练成本低到有点惊人:156 条自生成视频、2000 步、LoRA rank 32、单张 H200。时机控制是最大增益——TimeAcc 81.7%,而所有基线在 30.9 到 41.2 之间,多数贴近 33.3% 的随机猜测水平,相比最强基线 WorldPlay 的 41.2 提升 40.5 个百分点;消融显示仅加视频流掩码就把 TimeAcc从 36.7拉到 80.9,再加音频流掩码让语音落在窗口内的比例从 52.5% 升到 69.1%。相机可控性 82.9 为全表最优,比次优 SANA-WM 的 70.0 高 12.9、比基座 LTX-2.3 的 31.4 高 51.5,同时背景一致性 96.9 与美学分 5.27 也都是最高,说明自蒸馏没有损伤基座画质。自蒸馏数据的价值也被量化了:相比用真实视频(不含社交交互)训练,ActAcc 从 36.4 升到 41.4、视线偏差从 51.3 度改善到 40.2 度——因为无交互的真实视频只教会模型填warp video 的空洞,角色会做动作但不朝向观众。30 人用户研究覆盖 4 个对手×3 个问题共12 组,偏好率71.7% 到 91.2%,所有置信区间下界都高于 66%。开销为基座的 +20% 时间、+36% FLOPs,10 秒 1280×704 片段耗时 60.2 秒、每帧 0.26 秒。

批判点评:这篇的巧劲在于两处都绕开了「需要更多数据」这个惯性答案:交互能力靠让基座模型自己生成训练数据来激活(156 条视频、2000 步就够),时机控制干脆完全免训练、只加一个 cross-attention 掩码。TimeAcc 从接近随机的 36.7 跳到 80.9 这组数字尤其说明问题——大家一直以为「控制时机」要靠时序建模,实际上只是没人去屏蔽窗口外的文本注意力。三个指标拆成「做什么/何时做/是否朝向观众」也比笼统的偏好分更有诊断力。但最需要说清的是标题里那个「interactive」目前名不副实:论文明确承认尚不支持实时交互,世界生成由预先指定的相机轨迹与交互脚本驱动,也就是说你并不能真的按一下键就看到反应,60.2 秒才出10 秒视频,离交互式体验差着一个数量级,作者把自回归架构列为未来工作。ActAcc 41.4 还输给 LingBot-World 的 50.5,且绝对值只有四成——意味着六成情况下角色做的并不是你指定的那个动作,这个基础准确率撑不起产品化。自蒸馏也有天花板:能被激活的只是基座里本来就有的社交先验,基座不会的动作蒸馏不出来。评测的 VLM 裁判与真人研究都指向同一个模型家族的偏好,跨基座泛化性未验证。
WorldClaw: Agentic 3D Open-World Generation at Scale | 腾讯混元 Hunyuan3D | arXiv:2608.05248
关键词:3D世界生成,Agentic流水线,程序化地形,Hunyuan3D,腾讯
前序问题:从一句开放文本生成能自由漫游的大规模 3D 世界,难点是三件事必须同时成立:全局空间连贯(山脉、河流、聚落的相对关系不能乱)、局部内容丰富(走近了要有细节而不是一块糊墙)、以及产出显式可编辑可复用的资产(下游要能改材质、换模型、接进引擎)。现有路线各缺一角:分块潜变量方法长程组织弱、区域过渡突兀且不暴露独立资产;单视图高保真方法相机一走远就露出离散高斯基元和畸变几何;城市导向方法偏重实例排布而缺大尺度地貌。
本文贡献:全agentic 的粗到细三阶段流水线。规划阶段两个 agent 分工:意图分析 agent 只抽取并归一化 prompt 里显式表达的约束、绝不擅自补内容,场景规划 agent 才按schema 补齐下游必需的缺失字段,输出区域、地形、物体三类结构化规格。全局地形阶段先由地形规划 agent(可调搜索工具、必要时生成概念图)产出布局、资产、材质与世界尺度等参数,再用 GPT-Image-2 生成语义布局图和资产原型图、经 Hunyuan3D 的图生3D 转成可复用原型;核心是区域感知高度场H(x)=Σ_r m̃_r(x)·[h_r+Σk w{r,k}N_{r,k}(x)+Σj α{r,j}G_{r,j}(x)],用区域软权重混合基准高程、多频噪声与山峰/沙丘/阶地/侵蚀四类地貌算子,同一套权重复用于材质分配;地形资产按区域亲和性与目标密度在布局掩码内采样,再用局部高程、坡度、法线过滤,减少悬浮与穿模。区域物体阶段三个可复用 skill:Region Composition 渲染已有地形并生成合成图作为 2D 布局先验,Object Generation 用文本引导 SAM3 分割(全图加重叠滑窗提召回)后 SAM3D 重建网格并做非对称容差的图像空间尺度校准,Object Placement 用双射线对应恢复 3D 放置、以底部体素与地形的接触率为终止条件联合搜索锚点深度与等比尺度。两处渲染驱动精修循环经 BlenderMCP 连回引擎,维护「诊断渲染图+状态报告」任务队列,修区域突变、纹理比例失配、悬浮穿模,并做物体-地形协同变形(修改严格限制在支撑区内以保全全局地貌)。

实验效果:在 4 张 H20 上用 Blender 5.1.1跑通,agent 底座为 Opus 4.8,基础模型套件为 GPT-Image-2 + SAM3 + SAM3D + Hunyuan3D,大物体 PBR 纹理 2048×2048、小物体 1024×1024。正文 4 个加附录 7 个共展示 11 个完整世界,主题跨热带海盗岛、河谷部落聚落、沙漠战场、雪山未来设施、中世纪村庄、日式小镇岛屿、火山巢穴、宝石矿场等,每个都给出全局视图、区域视图、漫游视图,并附实例/深度/法线三种渲染。与 SynCity、Marble、MajutsuCity、WorldGen、GPT-5.6 Sol 五个基线在同一「中世纪村庄」主题下做定性对比:SynCity 长程组织弱且不暴露可控资产,Marble 远移后远处几何不完整并露出离散高斯基元,MajutsuCity 保留可控资产但被规则城市布局强约束,WorldGen 输出显式带纹理网格但展示视图地形平坦均质(作者称其为下游可用性上最接近的基线),GPT-5.6 Sol 能搭出完整布局但地形用简单几何形体、呈 blockout 外观。本文同时给出显式全局地形与独立重建放置的物体网格,兼顾大尺度地貌、局部填充与实例级可编辑性。

批判点评:这篇最有参考价值的不是某个模型,而是它证明了一件事:3D 开放世界生成可以不做成一个端到端大模型,而是拆成「LLM 写程序化地形参数 + 图像模型出布局图 + 分割重建做实例 + 渲染 agent 反复自查」的解耦流水线,且产物天然是引擎可用的显式网格与可编辑实例——这比一坨不可编辑的高斯点云对游戏和影视工业实用得多。区域感知高度场把地貌做成可解析的加权叠加,也让「换个世界尺度重跑」成为改参数而非重训。但必须说清它的实证水准:全文没有任何定量指标,没有 FID、CLIP-Score、几何误差,没有消融,也没有用户研究,全部结论建立在作者挑选的定性图上,这个证据强度撑不起「at Scale」的标题——连场景到底多少平方公里、放了多少资产都没披露。作者自陈的三条局限相当致命:整条链强依赖 Opus 4.8、GPT-Image-2 这类闭源强模型,换开源 LLM 常常生成不可执行的地形程序、换开源图像模型出不了可用布局图;LLM 写 Blender 节点图容易在尺度估计和节点连接上出错,需要多轮渲染-检查-修复;逐物体生成加多轮 agentic 精修导致延迟和成本随物体数与迭代次数增长,简单场景下甚至不如整体式方法。
MASS: Multiplayer World Models with Authoritative Shared State | Alaya Lab·北京大学·东京科学大学 | arXiv:2608.06257
关键词:多人世界模型,类型化状态,权威服务器,可扩展渲染,北大
前序问题:当前视频世界模型在多人场景里必然失效,因为它们把世界状态和依赖视角的视觉潜变量纠缠在一起:同一份共享内容要为每个观看视角独立编码一遍,算力冗余;各视角的循环历史各自漂移,导致跨视图矛盾(同一个位置一个玩家看到食物、另一个看到空地);最要命的是模拟成本被绑死在「有多少人在看」上,视角数一涨算力线性爆炸,根本无法扩展。
本文贡献:把多人在线游戏的权威服务器架构搬进学习式世界模型:世界只模拟一次,与观看人数无关。Game Schema 声明式定义实体种类、字段与实例数,状态是有序 typed record 集合并做规范化序列化(字段固定位置区间、类型标签互斥 token 区间、可选字段显式 present/absent、有界列表带长度与canonical padding、空间桶排序去重)。Logic Engine 是唯一推进共享状态的学习组件,仅 5.66M 参数的 decoder-only Transformer(宽 256、6 层、8 头),自注意力严格限制在单条 record 内部、record 之间无注意力,因此可自由批处理并支撑千实体世界;物体交互靠预测前从共享状态算出的邻域上下文窗口传入;schema 派生 mask 只约束输出位置的合法词表,移动、碰撞、生长、拾取、死亡、奖励全部是学出来的而非写死的规则。Rendering Engine 按需渲染:把相机局部投影成 16 通道张量(可见占据、语义角色、玩家身份、深度、相机几何),经几何感知残差 U-Net 输出 RGB,只读投影后的 typed state 与相机、不读 RGB 历史,因此相机可在rollout 中随意增删移动、分辨率材质光照可变而无需重训动力学。服务端每tick 开销 T_server=T_logic(N)+C·t_sync(S):学习式转移只跑一次,分发对接收方线性,渲染在客户端本地。网络卡顿时客户端用同一个 Logic Engine 从最新权威版本本地推进,新版本到达后直接替换 typed state,不需要单独的纠正网络或隐藏 RGB latent。
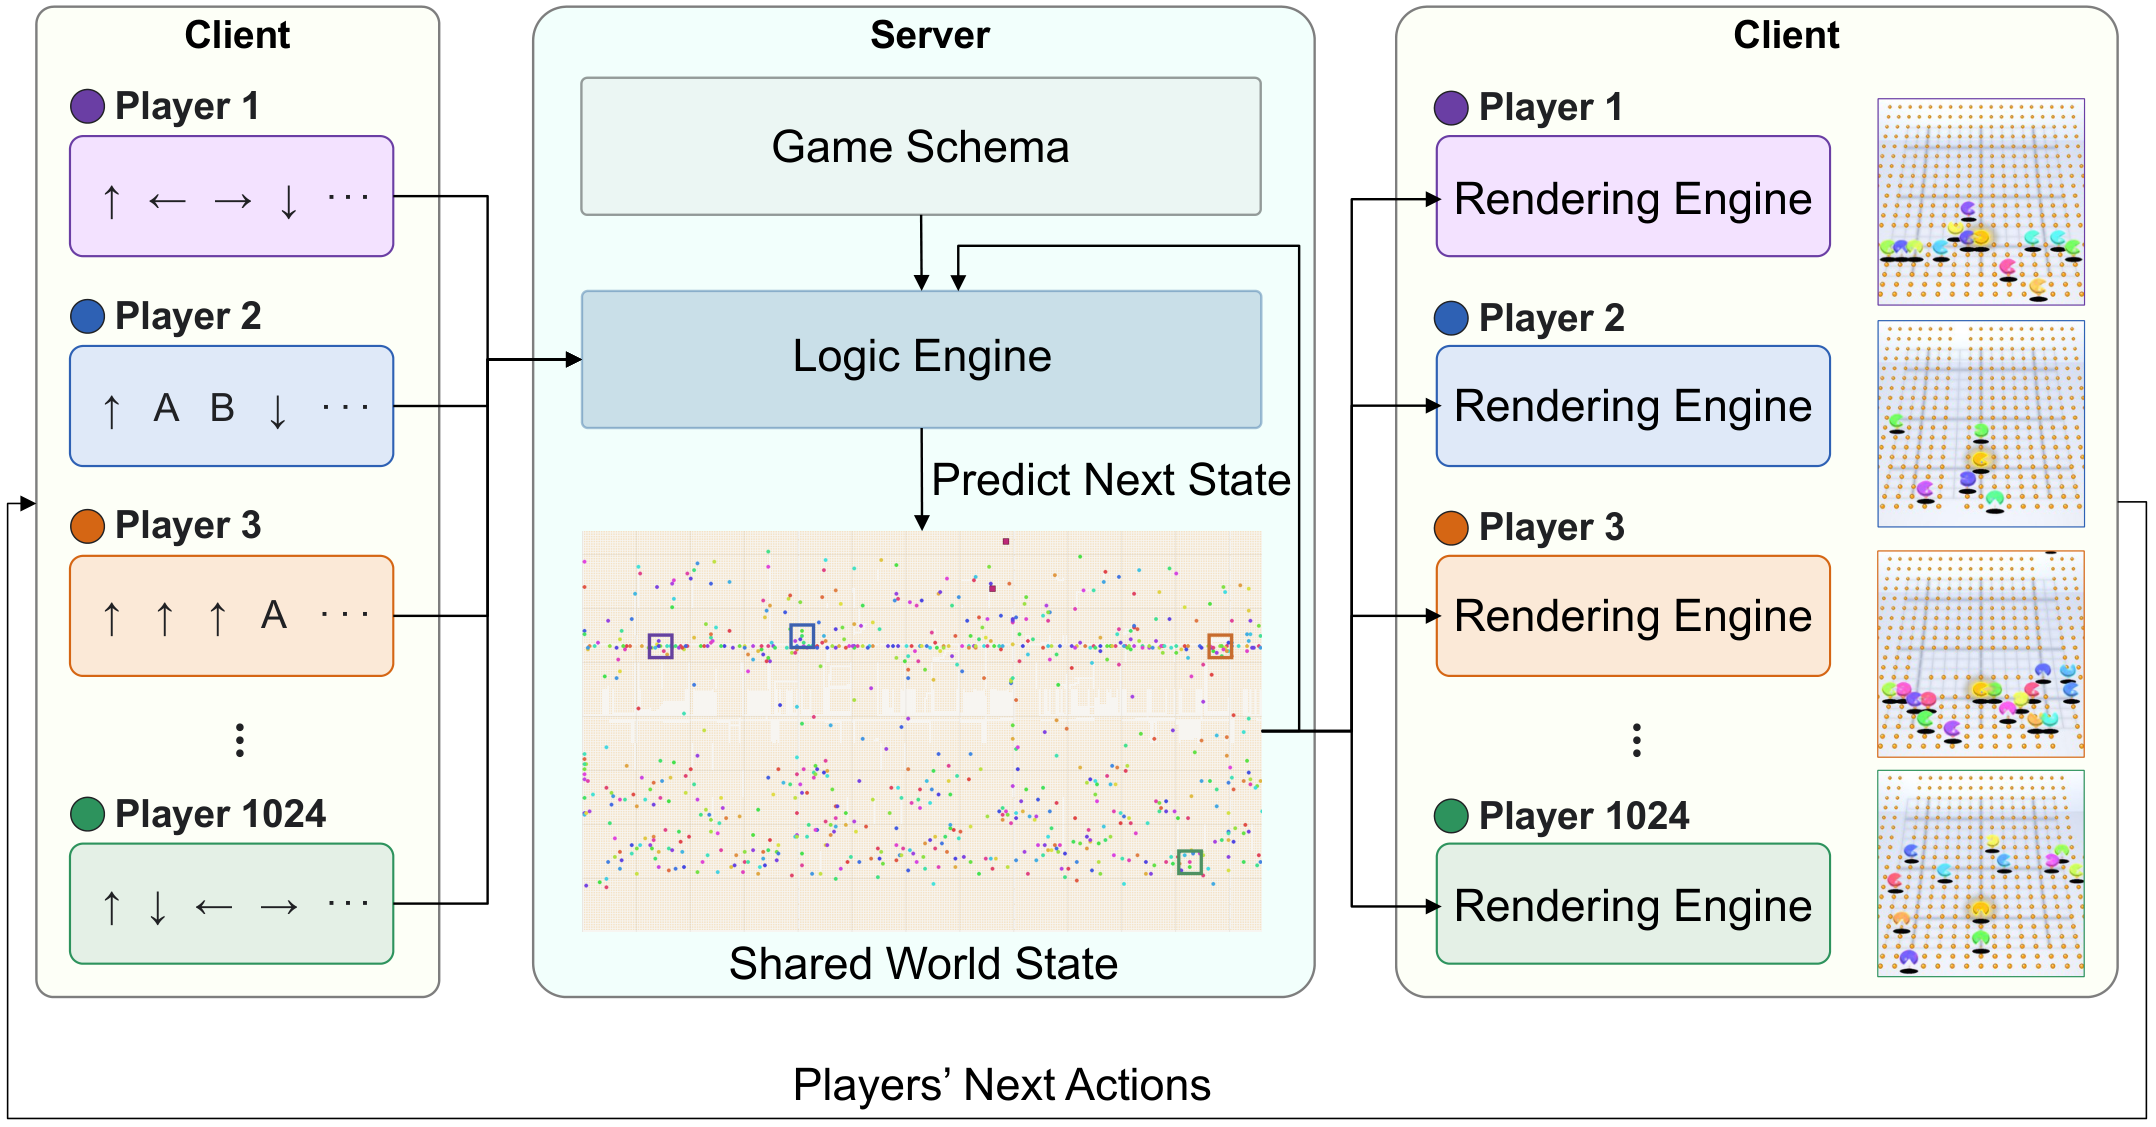
实验效果:matched 多人 Snake(48×48、最多 8 人)上 128 tick、2 路同步相机评测,7 项指标里 6 项领先:LPIPS 0.098(次优 B-UN 0.123、MultiWorld 0.277)、状态恢复 0.764(最强视频基线 B-PV 仅 0.128,约 5.9 倍)、实体计数 0.234、位置 0.355、事件 F1 0.552,而跨视图不一致率为 0.000——所有视图从同一份预测 typed state 解码,一致性是构造性保证,对照 MultiWorld 的 0.984 与 B-PV/B-SL 的 1.000。注意 B-UN 是绝佳反例:LPIPS 有竞争力0.123 但状态恢复归零、事件 F1 仅 0.007,证明像素级好看不等于世界状态可恢复。直接状态预测层面对比更悬殊:所有密集预测器(独立头 CNN、Joint U-Net、RSSM)一步语义准确率都超过 91%,但位置准确率没有一个超过 2.7%、且每个预测 tick 都结构矛盾(100%);typed 载体位置准确率 99.1%、矛盾率 0%,H=32 时位置仍有 90.2%。可扩展性实测 1,024 个玩家 record + 4,096 个食物桶 record 共 5,121 record/tick,推进 10,000 个循环 tick;单张 H100 上渲染请求从 1 个视图 189.6 ms 到 1,024 个视图 842.4 ms,仅 4.4 倍而视图数增加了 1024 倍,世界转移成本完全不变。客户端预测实验中oracle 联合输入下缺失 1–8 次服务器更新的视内一致性恒为 1.000、本地角色位移恒为 0 格,即约 400 ms 窗口内学习式转移不引入任何视内偏差。八个游戏的渲染重建PSNR 五个超过 32 dB(Frogger 40.24),SSIM 全部超过 0.97。
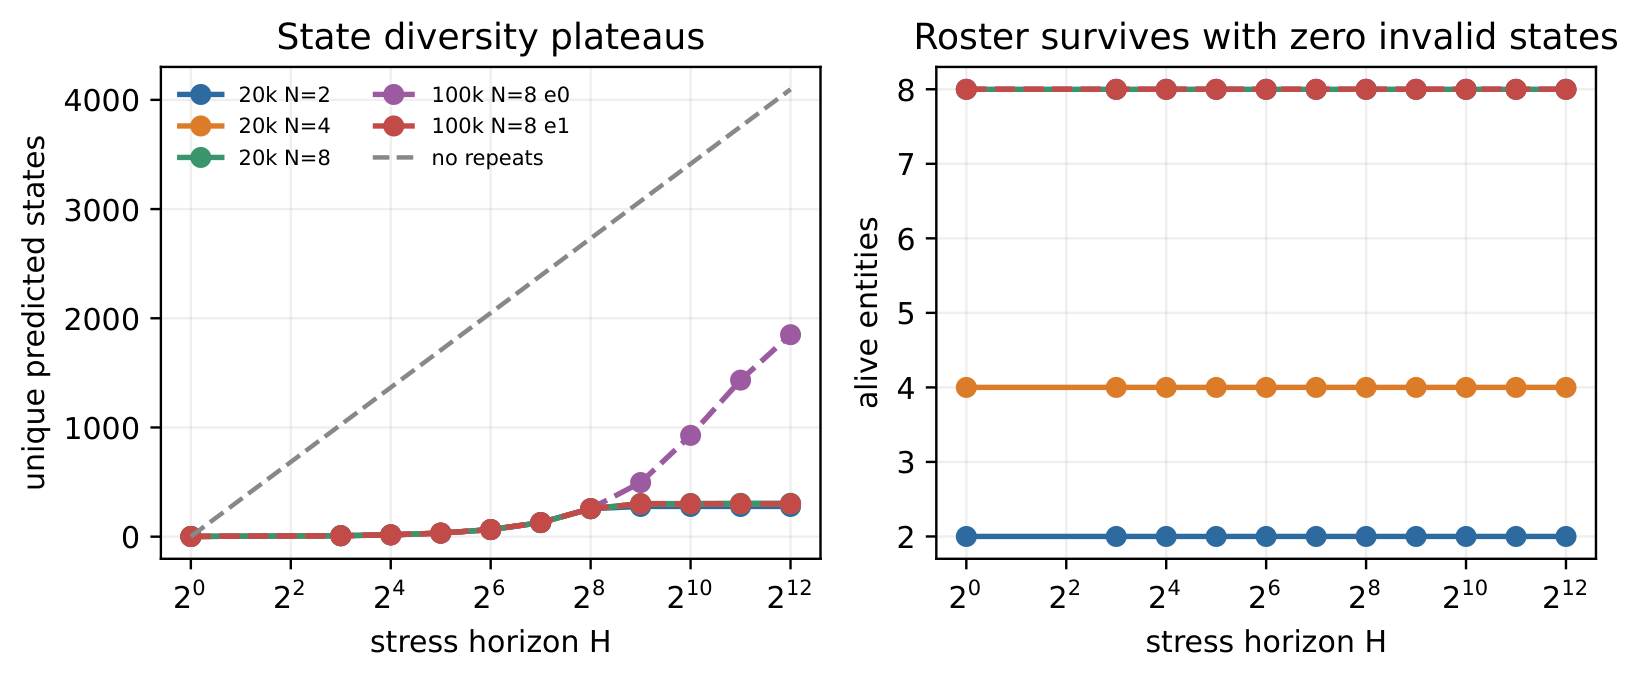
批判点评:这篇的洞察很值钱:多人世界模型真正的瓶颈不是画质而是「循环载体选错了」。密集预测器语义准确率 91% 却位置准确率不到 2.7%、100% 结构矛盾这组对照数据极具说服力——网格表示无法跨 tick 保持实体身份,同一格子在不同步必须编码不同实体,U-Net 没有任何显式追踪机制,所以看起来对但状态全错。把权威状态、状态复制、客户端呈现三者分离,让模拟负载与观众数脱钩,这个架构迁移几乎是把二十年的netcode 经验直接兑换成了世界模型的可扩展性,1024 视图仅 4.4 倍渲染开销的数字很硬。但要注意评测场域的局限:主实验是 48×48 网格的 Snake,附带 Breakout 与 Tile Merger,全部是 2D 离散网格游戏,作者也承认扩展到 3D 环境与更丰富实体交互属未来工作——真实的多人 3D 世界里typed schema 该怎么声明连续几何和物理接触,是完全没碰的难题。延迟上typed-token Transformer 需 45.55 ms,明显高于密集基线的 3–4 ms,虽然刚好卡在 20 Hz tick 预算内但余量很小。Tile Merger 这类随机网格游戏 full-state exact 全程为 0,SRSC 显示 Crate Pusher 的 Logic 分数在 H=100 后跌到 10–17 区间,说明长时程可靠性远未解决。还有一点:MultiWorld 用 5.60B 可训练参数被 5.66M 的MASS 击败,这个对比虽然亮眼,但两者的能力边界本就不同——MASS 需要一份人工声明的 schema,视频世界模型不需要。
VideoArgus: Agentic Rubric-Grounded Unified Evaluation for Video Generation and Editing | 罗切斯特大学 | arXiv:2608.05485
关键词:视频生成评测,动态评分细则,Agentic评估,VideoArgus-Bench,罗切斯特
前序问题:评测生成视频有三个老毛病:评测内容是固定的(一套 prompt 打天下,模型很容易过拟合到榜单)、覆盖面是残缺的(要么只测文生视频、要么只测编辑,五种设置没人统一)、给出的分数是不可追溯的(一个数字下来,你不知道它为什么扣分、也没有证据链)。结果是榜单排名和人类观感经常脱节,尤其文生视频这一档,源基准评测器与人工判断的实例内 Spearman 只有 0.162,图生视频那档甚至是 −0.060,等于负相关。
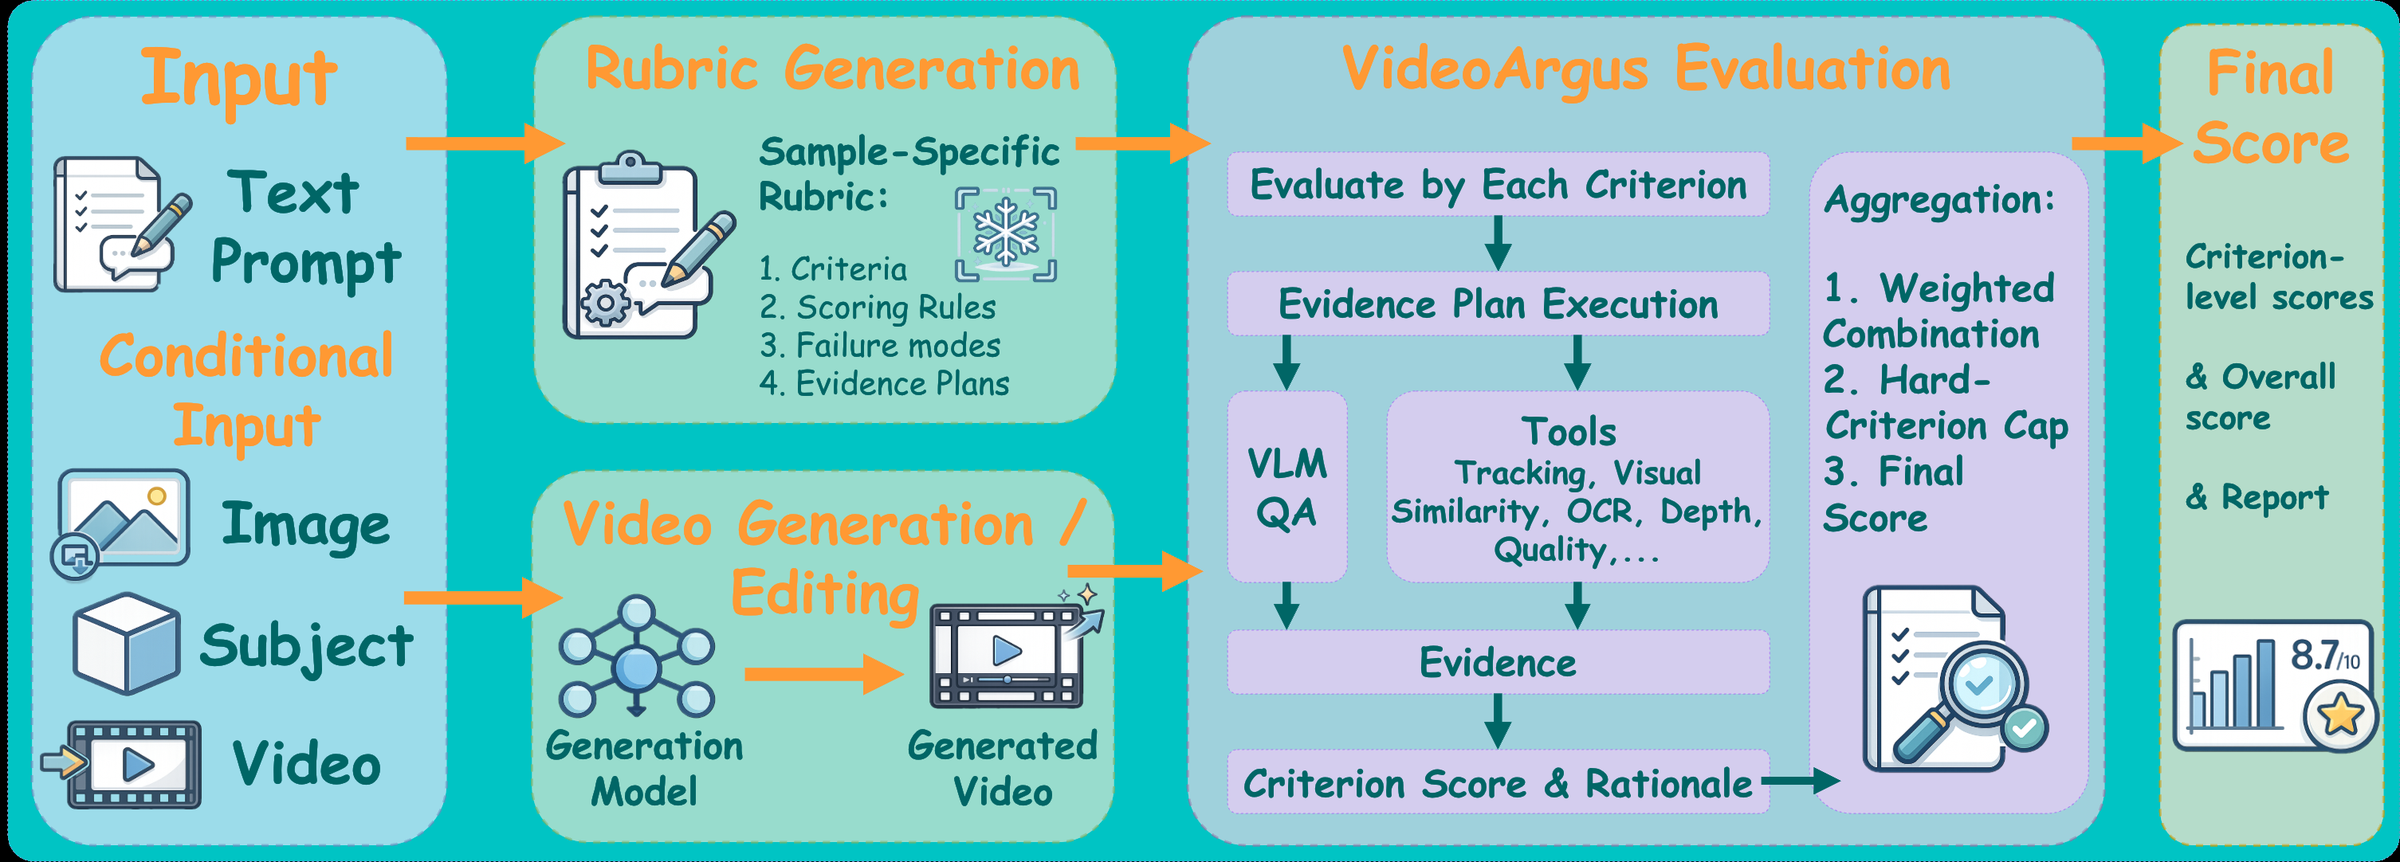
本文贡献:把「固定指标」换成「现场生成的评分细则」。对每条输入实例,先在完全不看任何模型输出的前提下(output-blind)生成一次 sample-specific rubric,然后冻结、复用于该输入的全部候选视频——这样既是样本自适应的,又保证了跨模型的公平。rubric 从统一的 22 个维度池实例化,每条准则包含具体要求、hard/soft 约束类型、三档重要性权重、0–10 整数评分规则、预期失败模式、可选的 hard cap,以及一份evidence plan(目标实体/事件、参考源、有序工具序列)。评估阶段由 evidence plan 驱动工具调用:vlm_qa 做通用语义问答,专用工具负责目标定位跟踪、参考引导裁剪、DINOv3 视觉相似度、OCR、深度与空间关系、时间闪烁检测、感知质量评估,plan-normalization 层会检查工具参数与依赖、把不可用操作映射为替代方案,专用工具失败时回退到 criterion-specific vlm_qa 并把回退决策记进报告。最终分 S=(1−α)B+α·min(B,κ),α=0.5,B 为重要性加权基础分、κ 为最严格 hard cap,且重要性、失败阈值、hard cap 对打分模型隐藏,只在聚合时生效。覆盖 T2V/TI2V/TS2V/TV2V/TSV2V 五种设置。

实验效果:VideoArgus-Bench 含 1,026 条输入实例(653 张图、416 条视频,素材来自 Pixabay 并经质量过滤),指令平均约 26 词,平均 11.9 条准则/实例(范围 6–17),全部 rubric 预生成、冻结并开源,评测了 55 个 model–task 对。在独立的 210 实例、1,260 视频(每输入 6 个模型输出、15 名标注者 0–10 打分)人类对齐集上,实例内 Spearman 与 Kendall 在全部五个任务上都超过源基准评测器:T2V 从 0.162 提到 0.496(+0.334),TI2V 从 −0.060 提到 0.605(+0.665),TS2V 0.524→0.631,TV2V 0.548→0.608,TSV2V 0.686→0.749。骨干鲁棒性上,固定评估 VLM 换 rubric 生成器(Claude Opus 4.8 / GPT 5.6 Sol / Gemini 3.1 Pro)平均排名一致性 0.909,固定 rubric 换评估 VLM(Qwen3.6-27B / Gemma4-31B)平均 0.931。生成 rubric 的准则数是人工标注的 2.33倍(11.68 对 4.98)而 hard 准则数相当(2.09 对 2.27),说明是覆盖更广而非一味更严。成本上 rubric 生成一次性平均 $0.231/case,评估全程本地推理约 0.033 H100 GPU 小时/视频、无按次API 费用。附带榜单里Seedance 2.0 五项任务全冠,可灵 Kling v3 Omni 在四项任务排第二,开源最优分别是 HunyuanVideo-1.5(T2V/TI2V)、OmniWeaving(TS2V)、Kiwi-Edit(TV2V)、Aurora(TSV2V)。
批判点评:这套设计击中了视频评测最尴尬的现实:固定 prompt 集正在被刷榜,而单一维度分数无法解释扣分原因。「output-blind 先出细则、冻结后复用」是很聪明的一步——它同时解决了样本自适应与跨模型公平这对矛盾,而把重要性权重和 hard cap 对打分模型隐藏也有效防止了 judge 顺着权重自我合理化。TI2V 上从负相关 −0.060 翻到 0.605 这个数字尤其说明现有基准的失效程度之深。但要清楚它换来了什么代价:整套流水线依赖闭源 Claude Opus 4.8 生成 rubric、Qwen3.6-27B 做评估,评测本身变成了一个需要 GPU 集群和 API 预算的系统工程,$0.231/case 加0.033 H100 小时/视频,规模化打分并不便宜,而「用大模型评大模型」的循环偏见也没有被真正消解。人类对齐集只有 210 实例且 TSV2V 一档仅 10 条,这一档 0.749 的领先统计意义有限。工具消融显示 Full 相对纯 VLM 在实例内相关性上 5/5 胜出,但 pooled Spearman 在 T2V、TV2V、TSV2V 三项上反而不如纯 VLM 或源基准,说明专用工具的收益并不一致。附带榜单虽然吸引眼球,却只能读作「按VideoArgus 口径」的排名。
LILAC: An Idempotent Neural Speech Codec | 首尔国立大学 | arXiv:2608.05727
关键词:神经语音编解码,幂等性,可逆变换,低码率,首尔国立大学
前序问题:神经音频编解码器已经是语音生成与编辑的标准 token 接口,但它们全都不幂等:把token 解码成音频、再重新编码回 token,token 会变。论文实测的十二个基线配置,单次 decode–re-encode 平均至少重写 15% 的 token,最差的 FocalCodec 重写 89.1%、DualCodec 80.2%。这在任何会发生「重编码解码输出」的管线里都是灾难——级联编辑、迭代生成、多轮处理都会让 token 流不断漂移,100 轮循环后 FocalCodec 与 Mimi 的 token 一致率已趋近于 0,dWER 从 0.07 涨到 1.34。
本文贡献:不靠训练、靠架构把幂等性证出来。设可逆分析变换 A 把输入分成保留坐标 z 与丢弃坐标 f,编码为 E(x)=q(Π_z A(x))、解码为 D(z_q)=A⁻¹(z_q, φ(z_q)),则对任意 z_q 与任意 fill 网络 φ 恒有 E(D(z_q))=z_q,与权重、收敛程度、重建质量完全无关——证明只需三步:可逆性保证投影后取回z_q,FSQ 由 clamp+round 组成故幂等,两者复合即得。工程上用两类可逆基本块:源自 Glow 的可逆 1×1 卷积(正交参数化,逆即转置核)与源自 NICE 的加性耦合块(逆只需减法,对应小波 lifting steps,名字由此而来),f/g 用 ConvNext1D 堆叠、按时间维奇偶索引切分、合并时按通道拼接实现「时间减半通道加倍」。整条路径无任何除法,避免浮点溢出,整体保体积;唯一例外是可逆 1×1 卷积强制全精度执行以保证 round-trip 精确。通道演进为 reshape 到 5 通道 → stem 缓解多相伪影 → 四次 squeeze-and-mix 到 80 通道 → 五次projection 逐步切掉丢弃坐标,最终 20 通道。推论很有意思:证明对 φ 无任何约束,因此可以构造随机解码器 φ(z_q,ω)在保持幂等的同时输出多样结果。

实验效果:24 kHz 全带宽、帧率 9.375 Hz、每通道 4 bit×20 通道 = 80 bits/frame,码率 0.75 kbit/s,总参数 58.5M(分析变换 43.1M 共享 + fill 网络 15.4M)。解码并重编码 LibriSpeech 与 LibriTTS-R 全部 7,457 个测试样本,每一个都重编码为完全相同的 token 流;100 轮循环token 一致率恒为 1.0000,dWER 恒为定值,说话人 EER 恒为 4.00%——而同期DAC 的 EER 从 0.00涨到 46.00、FocalCodec 从 3.00 涨到 41.00。质量上 UTMOS 在 LibriSpeech test-clean 达 4.141、LibriTTS-R 达 4.238,均高于真值音频的 4.072 与 4.194;sub-1 kbit/s 组内 PESQ 2.60、STOI 0.935/0.944、SI-SNR +2.2/+6.0 dB 三项全部第一,且是唯一未在评测集上训练的编解码器(训练用 HiFiTTS-2 并按 reader-ID 排除全部 146 个 LibriSpeech/LibriTTS 说话人)。消融很实在:仅加 anti-imaging stem 会恶化 LibriTTS-R(dWER 0.121→0.252),必须配合带宽衰减增广;解开编解码共享权重、加宽隐层、加深卷积堆叠都无有意义提升;改用连续潜变量(取消量化)每个指标都变差;40 通道×1 bit 的 BSQ 变体 UTMOS 略升但 dWER 崩到 0.46–0.48。
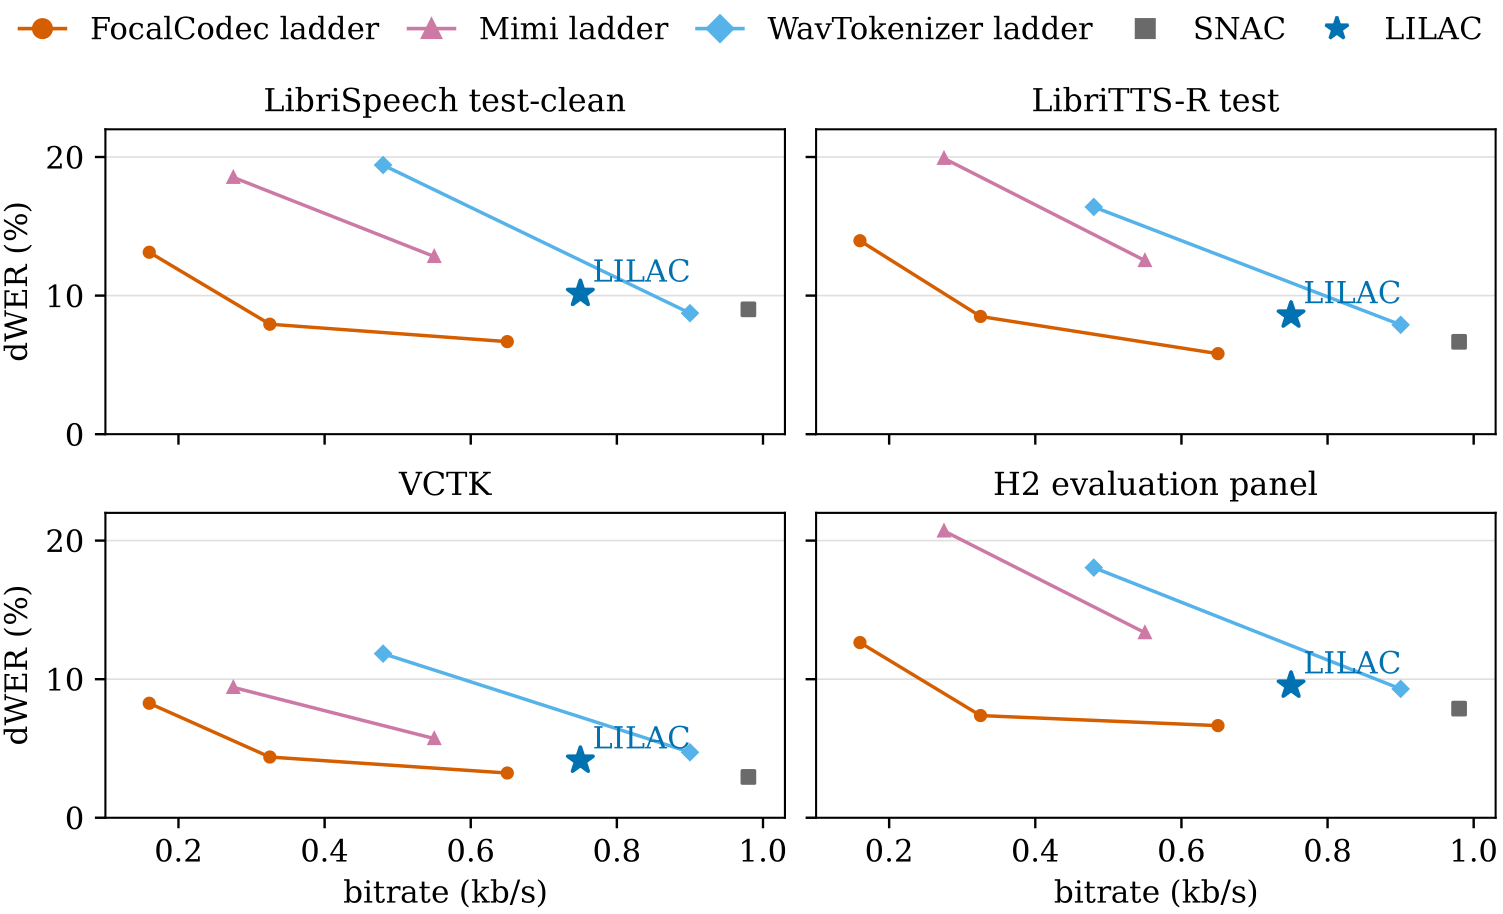
批判点评:这是一篇少见的「先证明、后调参」的 codec 论文:幂等性不是训出来的性质而是构造出来的定理,与权重无关这一点意味着它不会因为换数据、换训练轮次而失效,这种保证在工程上比多零点几个 UTMOS 值钱得多。作者的坦诚也值得记一笔——明确写了「It does not push the pareto frontier」,把单程下游迁移面板里 LILAC dWER 9.90% 在五个学习型 codec 中垫底的数据也照实登出来,MUSHRA 主观分 51.4 落后DualCodec 的 74.8 且相对最接近的 FocalCodec 领先 2.9 分并不显著(p=0.077),这些都没被藏进附录。局限同样明确:dWER 与 SCOREQ 处于中游,纯卷积却因大量小通道卷积导致 GPU 上 RTF 反而落后于其他 codec,「不更好也不更快,只是永不漂移」。最关键的一条作者自己点出来了——幂等性的下游收益(用其 token 训练的生成模型更稳定)目前仍是理论推断,没有任何训练好的下游模型来实证,也就是说这篇提供的是一个有严格保证的接口,但它到底能给TTS 或语音编辑带来多少实际增益,还是空的。另外比特分配消融显示只有真正提高码率才能无副作用地改善性能,说明 0.75 kbit/s 这档已经被榨干。
人工智能炼丹君 整理 | 2026-08-10
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)