


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 世界模型长时一致性与物理保真 2 篇 · 可控图像生成与区域编辑 4 篇 · 生成效率与免训练适配 2 篇 · 语音与数字人生成 2 篇
Addressable Memory for Video World Models | NVIDIA·普林斯顿大学·多伦多大学 | arXiv:2608.07408
关键词:视频世界模型,长时记忆,RoPE外推,KV cache压缩,免训练
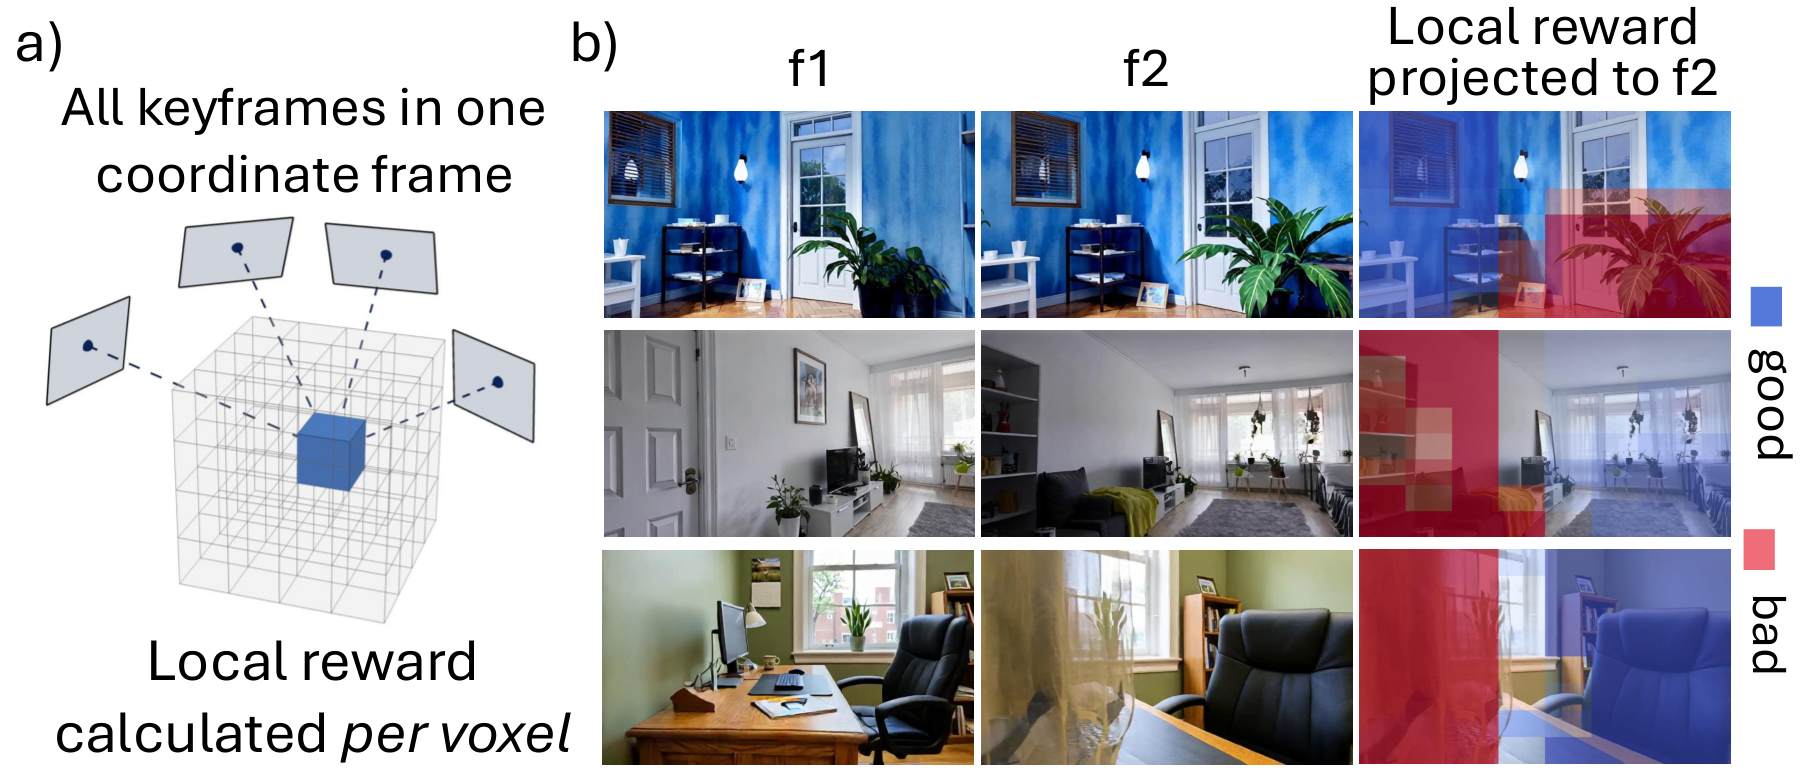
前序问题:交互式视频世界模型依赖不断增长的 KV cache 当视觉记忆,来承接已生成的帧。但作者发现,一旦 rollout 超出训练时长,模型就无法可靠地寻址已存内容——因为时间维度的 RoPE 偏移跑到了训练时从未见过的范围之外,注意力检索不到相关视觉信息。更麻烦的是,天真地在 RoPE 旋转后的空间里压缩 cache 会直接破坏记忆,相当于把互不兼容的位置相位平均在一起。
本文贡献:提出免训练的记忆框架 WorldTrace:给每个摘要槽位分配一个互不相同、且落在训练分布内的虚拟位置,让压缩后的记忆保持「可寻址」。在这个可寻址 cache 之上研究两条压缩路线——WorldTrace-Field 压缩历史以维持时序连贯,WorldTrace-Landmark 在检测到的场景转换处保存原样场景轨迹以支持情节式回忆。同时提出 LoopBench,专门评测「绕一大圈之后能否重建先前访问过的场景」。
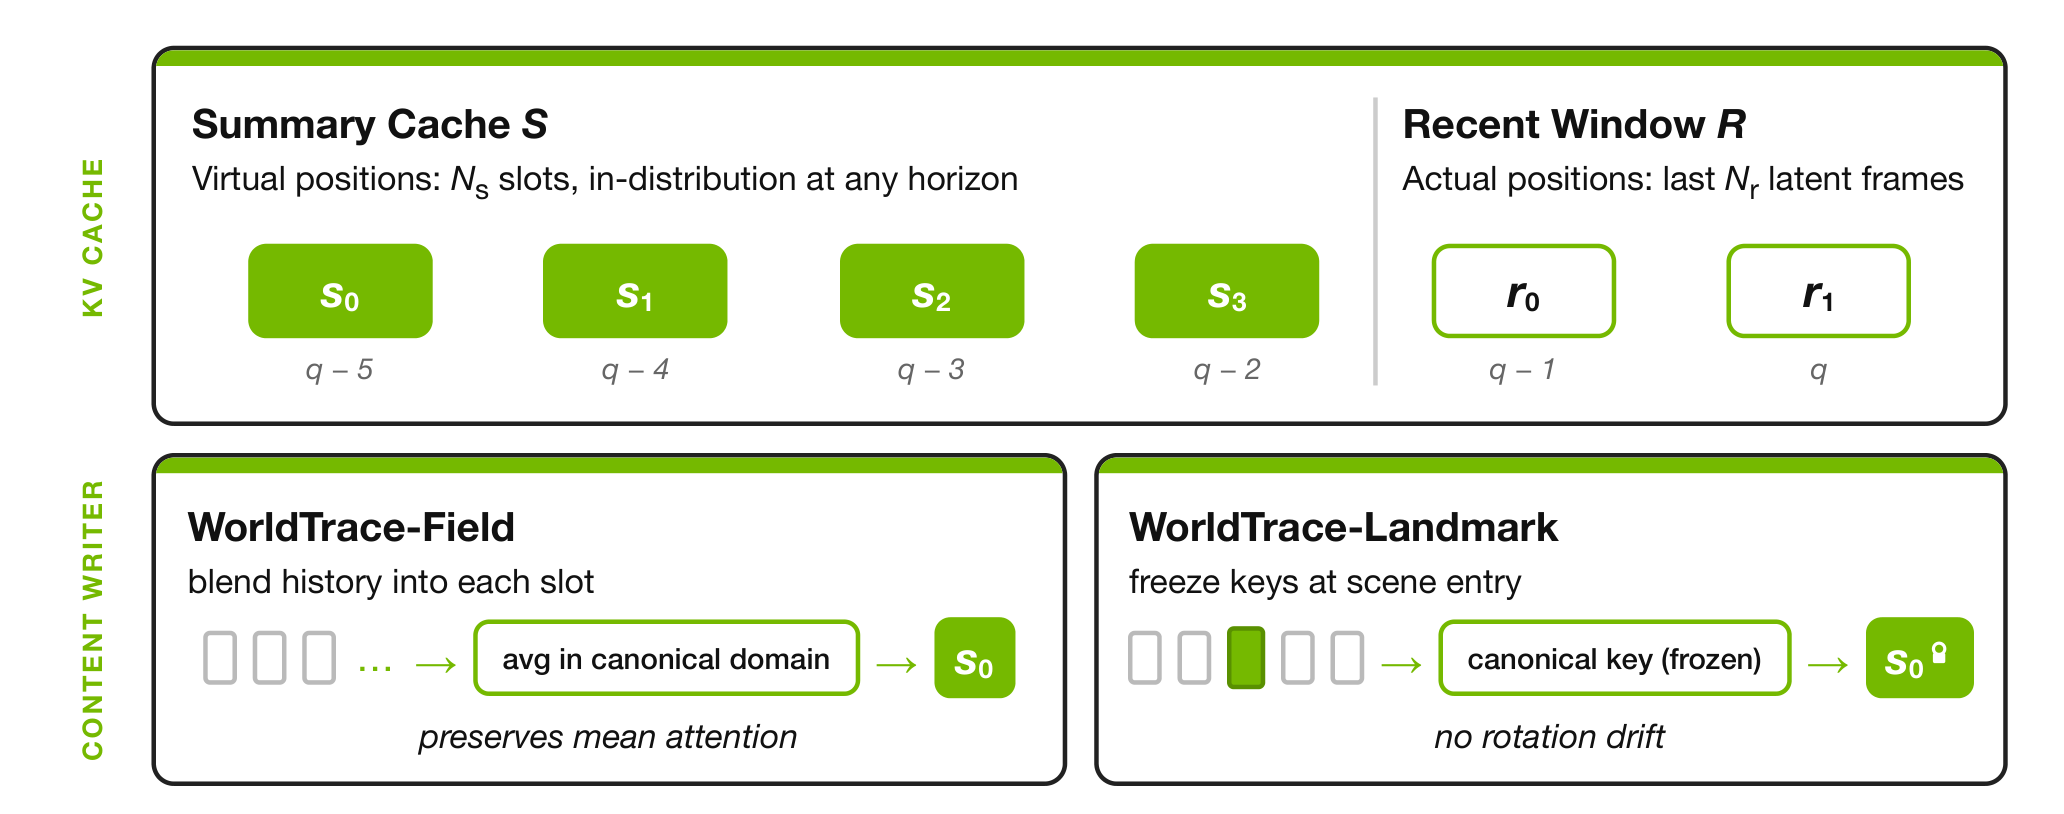
实验效果:WorldTrace-Field 把时序一致性提升 15.5%;WorldTrace-Landmark 在 LoopBench 上把情节式回忆提升 19.5%。全程无需重新训练,即扩展了视觉持久生成的长度。

批判点评:这篇的价值主要在诊断而非方法:把「世界模型跑长了会失忆」从模糊的「容量不够」精确归因到 RoPE 外推越界加旋转空间压缩相位冲突,并指出必须让虚拟位置落回训练分布内,这个洞察干净且可迁移——长上下文语言模型里的同类问题同样适用。免训练、可直接挂到现成模型上,落地成本几乎为零。局限是它本质在给外推能力打补丁而非根治:虚拟位置复用意味着不同时刻的记忆共享位置编码,冲突在更长 rollout 上迟早重现;Field 与 Landmark 两条路线各优化一个指标(时序连贯 vs 情节回忆),说明还没找到统一解;LoopBench 是作者自建的,绝对难度和外部可比性有待其他团队验证。
InsertFuse: A Unified Framework for Multi-Category Reference-Guided Image Insertion | 上海交通大学·上海创智学院·西安交通大学·武汉大学 | arXiv:2608.06490
关键词:图像插入,On-Policy蒸馏,流匹配,区域平衡,参考引导
前序问题:参考引导的图像插入(把一个参考物体自然地放进目标场景)要同时处理人物、服饰、家具、logo 等多种类别,而不同类别的插入行为差异很大。直接联合训练一个通用模型会产生跨类别干扰——学插家具的能力会把插人物的能力带偏;而分别训练多个专用模型又无法统一部署。此外插入区域通常远小于背景,直接做流匹配会让监督信号被背景主导,且对物体尺度敏感。
本文贡献:提出 InsertFuse,核心思路是把「类别专属能力的学习」与「跨类别能力的整合」解耦:先为不同插入类别各训一个专家,再用 Insertion On-Policy Distillation(IOPD)把它们的能力合并进单个学生模型——在学生实际访问到的状态上去查询匹配的那个专家,从而保住类别专属的插入行为,又避免了直接联合训练的跨类别干扰。为改善空间控制,提出 Token 对齐的几何条件(TAGC),把掩码导出的几何线索映射到视觉 token 网格;以及区域平衡流匹配,对插入区域内外的预测误差分别归一化,防止背景主导和尺度依赖的监督失衡。另引入 Reference CFG,在固定场景与几何条件下隔离并强化视觉参考带来的引导,再由 IOPD 把这份增强监督迁移进统一学生。
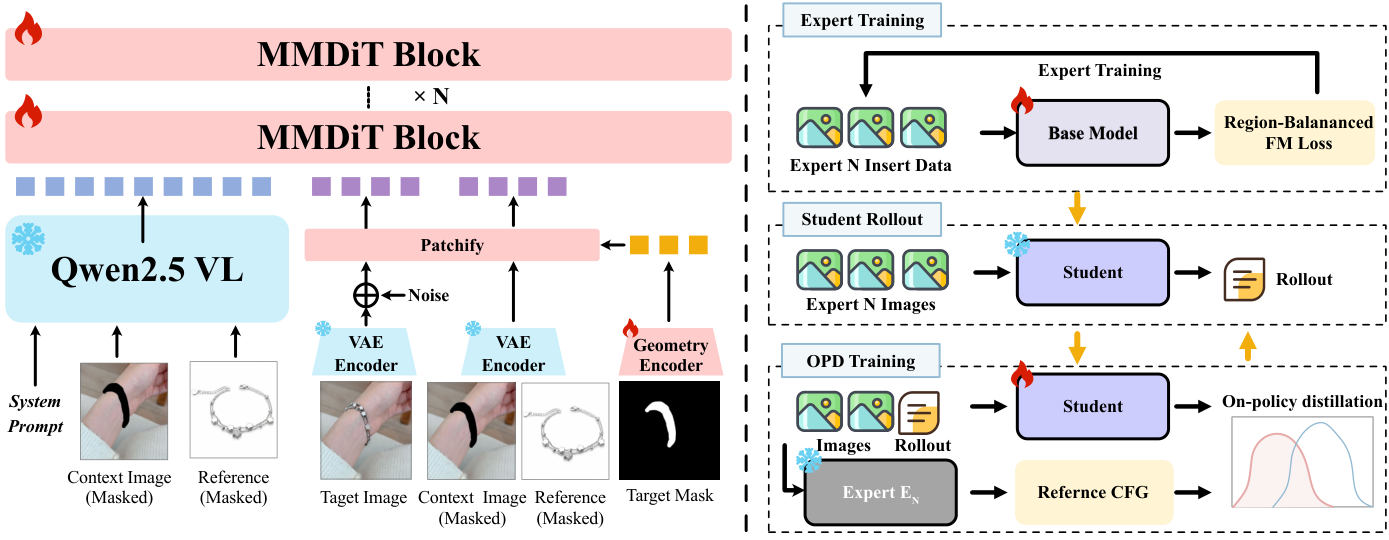
实验效果:在公开的 AnyInsertion benchmark 和作者自建的多类别测试集上,多数指标达到最优,在多样插入类别上都表现出很强的参考保真度与生成质量。
批判点评:「先训专家、再 on-policy 蒸馏成一个」这条路子在大语言模型里已被验证,搬到图像插入上很对症——插入任务的类别差异确实大到会互相拖累,而 IOPD 在学生自己走到的状态上查专家(而非离线蒸馏固定数据),能避免分布错位,这是关键细节。区域平衡流匹配也点出一个容易被忽视的工程真相:插入区域只占画面一小块,不做归一化,损失基本被背景吃掉。不足在于成本:要先训 N 个专家再蒸馏,整体训练开销远高于单模型方案,论文没交代专家数量和总算力,实用性判断打折;「多数指标最优」的措辞意味着有指标不占优,具体哪些没说;此外自建测试集与公开 benchmark 混合汇报,容易掩盖在标准集上的真实位次。
MOSAIK: Multi-Patch Content-Aware Spatial Allocation of Image Tokens for Efficient Generation | 华为加拿大 | arXiv:2608.05450
关键词:像素空间扩散,异构patch,推理加速,token预算,华为
前序问题:像素空间扩散模型避开了潜空间扩散的重建天花板,但 token 数量高得多,在自注意力的二次复杂度下生成成本高昂。已有的效率方法通过在选定的去噪步使用更大 patch 来减少 token,但每一步都在整张图上用同一个 patch 尺寸,忽略了不同区域被粗化时的保真损失其实差别很大。
本文贡献:提出 MOSAIK,一个「损伤引导」的框架,让 patch 尺寸同时随区域和去噪步变化。改造 PixelDiT 骨干使其能生成任意异构的 patch 布局,并用一个轻量预测器基于中间去噪特征估计每个区域被粗化会造成多大保真损失。在给定 token 预算下,损伤引导的布局预测器把细 patch 分给敏感区域、粗 patch 分给其余区域。

实验效果:在 FLOPs 减少 70%、token 数减少 83% 的同时,GenEval 与全算力 PixelDiT 持平,DPG-Bench 仅下降 1.0 分。与包括时序 patch 调度、特征缓存在内的多种效率范式相比,在中等预算下极具竞争力,在算力极度受限的场景下持续超越这些基线。
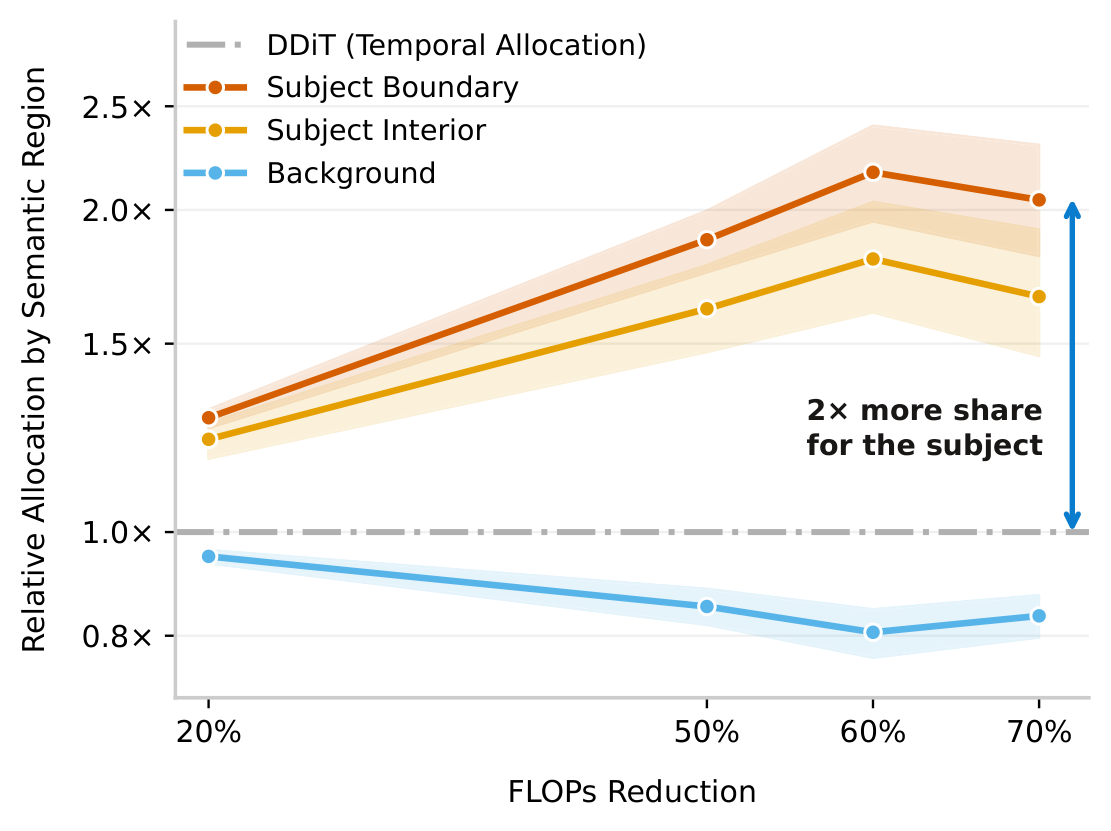
批判点评:「不同区域被粗化的代价不一样」这个观察太朴素了,以至于之前的 patch 调度工作集体忽略——把逐步的时间维调度扩展到空间维,并且用一个学出来的损伤预测器而非手工启发式来分配预算,思路正确且数字漂亮:砍 70% FLOPs 而 GenEval 持平,这个性价比在效率方向里属于第一梯队,尤其在算力受限区间超越特征缓存类方法,说明它不是靠预算宽松堆出来的。风险在于:异构 patch 布局需要改造骨干(PixelDiT),无法像特征缓存那样零成本挂到现成模型;损伤预测器本身要跑,在极小预算下它的开销占比会上升;此外评测集中在 GenEval/DPG 这类文图对齐指标,异构 patch 边界在高频纹理和小字上是否留下可见接缝,摘要没有交代。
ControlRef: Efficient Layout-Guided Multi-Instance Generation via Anchored 4D-RoPE | 中山大学·清华大学·北京理工大学 | arXiv:2608.06878
关键词:布局引导生成,多实例合成,4D-RoPE,MM-DiT,推理加速
前序问题:布局引导的多实例生成对多模态扩散 Transformer(MM-DiT)的可控合成很关键,但要把这个能力整合进统一架构一直很难。此前框架依赖冗余的全分辨率画布填充加 Shifted-RoPE 来管理多张参考图:这套机制在稀疏布局下把计算开销急剧放大,又破坏了关键的低频 RoPE 特征,形成严重的空间-频率折损,把绝对空间对应关系搞模糊。
本文贡献:提出 ControlRef。用统一实例-布局控制(UILC)注意力掩码严格解耦实例间的语义交互,强制精确的区域绑定。为进一步促进区域级空间对齐,提出 Anchored 4D-RoPE:把 token 直接锚定到它们的绝对几何中心——先把参考图预对齐到对应边界框的分辨率,再把布局 token 和参考 token 都物理锚定到绝对几何中心,并让参考沿 z 轴堆叠,从而原生保留空间先验,无需有损位移就缓解了空间-频率折损。
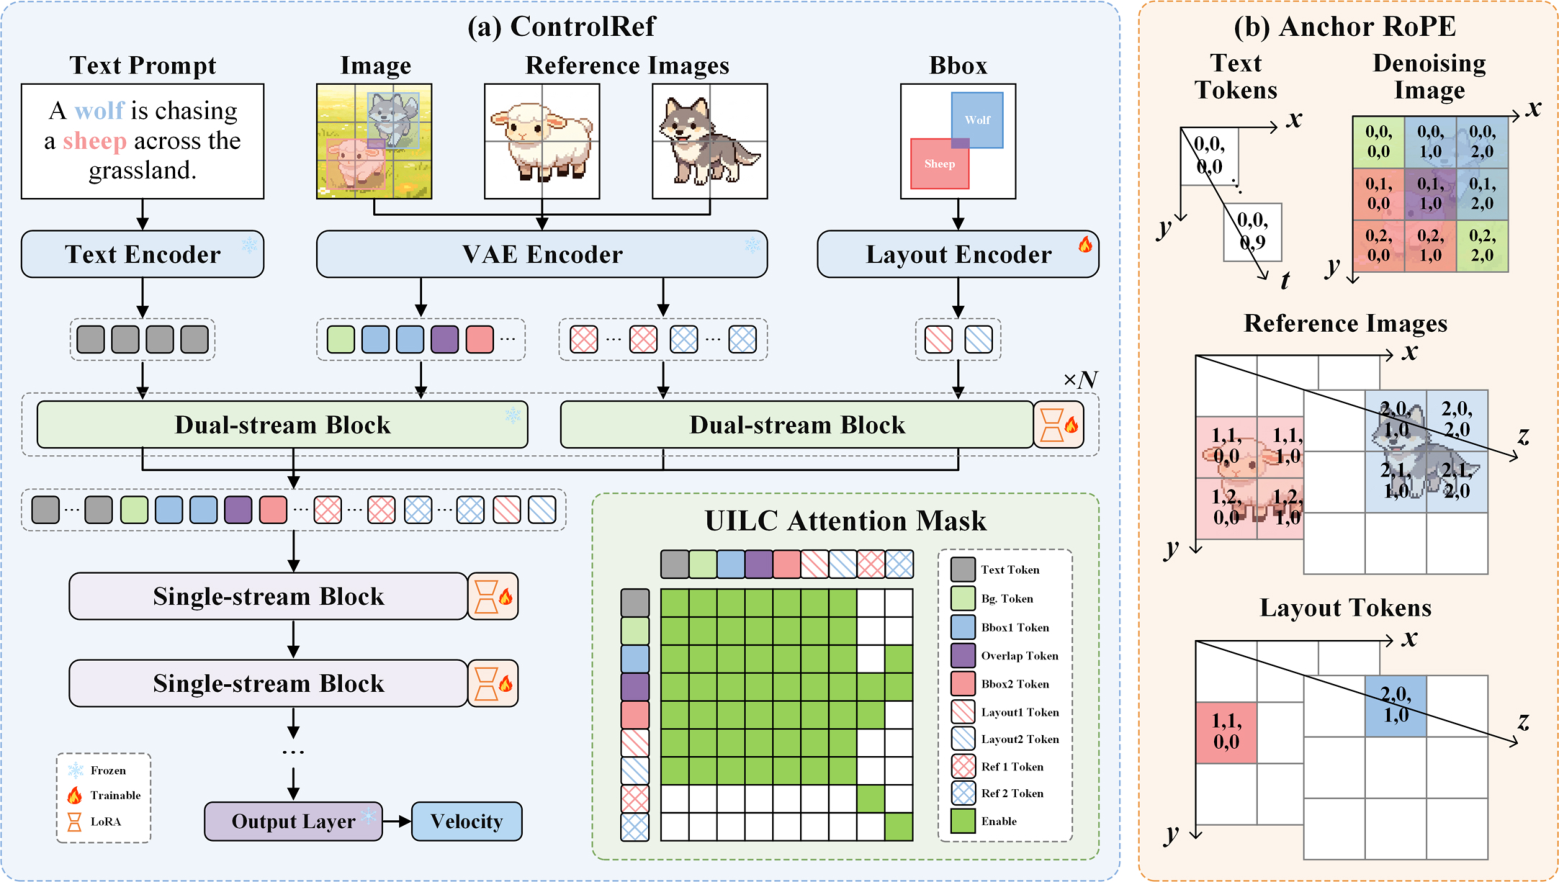
实验效果:在视觉保真度和定位准确率上达到最优,同时把稀疏布局下的推理延迟削减 80% 以上,稠密场景下的显存开销降低 50%。
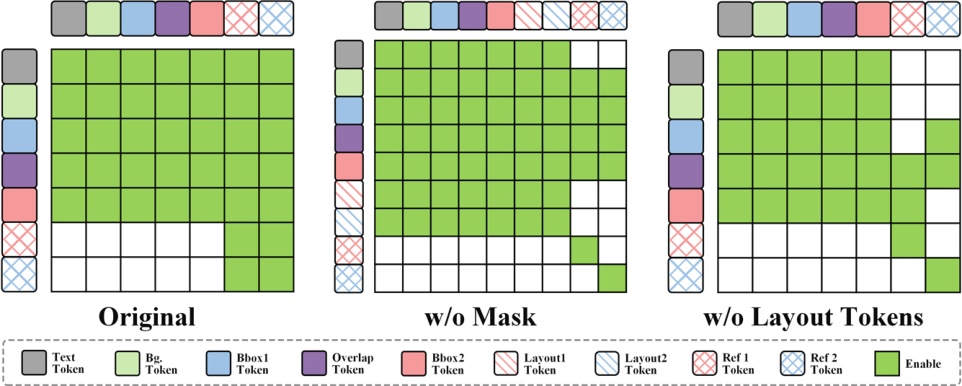
批判点评:这篇把「Shifted-RoPE 用位移换对齐」这个隐性代价揭示得很清楚——位移破坏低频分量,而低频恰恰承载绝对空间信息,于是控制精度和算力两头同时受损。改成把 token 物理锚定到绝对几何中心、参考沿 z 轴堆叠(这也是 4D 的来源),是从坐标系层面而非加约束层面解决问题,延迟降 80%、显存降 50% 属于工程上很实在的收益。需要留意的是:稀疏布局的 80% 提速本质来自不再做全分辨率填充,收益高度依赖布局稀疏程度,稠密场景下只剩 50% 显存收益,宣传口径要打折;把参考预对齐到边界框分辨率意味着参考图会被重采样,小物体的细节保真如何没有交代;此外方法与 MM-DiT 的位置编码强耦合,迁移到其他架构的成本未知。
HRDiT: Training-Free High-Resolution Image Generation with Off-the-Shelf Diffusion Transformer Models (ECCV 2026) | 兰卡斯特大学·华南理工·NVIDIA AI Tech Centre | arXiv:2608.07003
关键词:免训练,高分辨率生成,Diffusion Transformer,空间错乱,ECCV2026
前序问题:免训练的文本到高分辨率图像生成正获得越来越多关注,但已有研究主要集中在把现成的 U-Net 扩散模型适配到高分辨率;对现成 Diffusion Transformer(DiT)的适配进展有限——尽管 DiT 在有限分辨率下的文生图能力本来更强。
本文贡献:指出两个特别阻碍现成 DiT 免训练做高分辨率合成的关键挑战——空间错乱(spatial disorder)与生成时间过长,并针对性提出一套专门适配现成 DiT 的方法。代码已公开。

实验效果:大量实验验证了方法的有效性。论文已被 ECCV 2026 接收。

批判点评:问题定位很到位:社区做免训练超高分辨率的技巧大多是 U-Net 时代的遗产,而主力基座早已换成 DiT,这个空档确实值得补;免训练、直接用现成权重、代码开源,落地门槛几乎为零,ECCV 2026 接收也算一层同行背书。但这条摘要是今天十篇里写得最含糊的:只说「有两个挑战」和「提出一种新方法」,具体机制、能撑到多高分辨率、加速比多少、与 ScaleCrafter/DemoFusion 这类前作差多少,一个数字都没给。即使实验部分扎实,这种写法也会让读者在信息筛选阶段先流失一批——对一篇主打「免训练即插即用」的工作来说,是很可惜的自我设限。
MaskFlow: Precise, Consistent and Seamless Regional Image Editing | 商汤研究院·北京航空航天大学·南洋理工大学 | arXiv:2608.06929
关键词:区域图像编辑,流匹配,掩码条件,边界融合,商汤
前序问题:区域图像编辑因为空间可控性受到关注。但即便基于指令和基于掩码参考的方法都能做到不错的语义对齐,可靠的区域控制仍然困难——编辑必须被准确定位,并且与被保留的上下文自然融合,而现有方法常在边界留下痕迹或污染背景。
本文贡献:提出训练框架 MaskFlow,同时追求精确定位、一致的背景保持和无缝的边界过渡。关键做法是把掩码直接纳入概率路径和流匹配目标,让可编辑区域内的生成与区域外的源保持协同优化,而不是事后拼接。另提出 Soft-Poisson 去缝合模块,在训练和采样两个阶段都对预测的向量场做精修,改善编辑前景与保留背景的平滑融合。同时设计数据合成管线构建 MEData——面向区域图像编辑训练的掩码数据集。
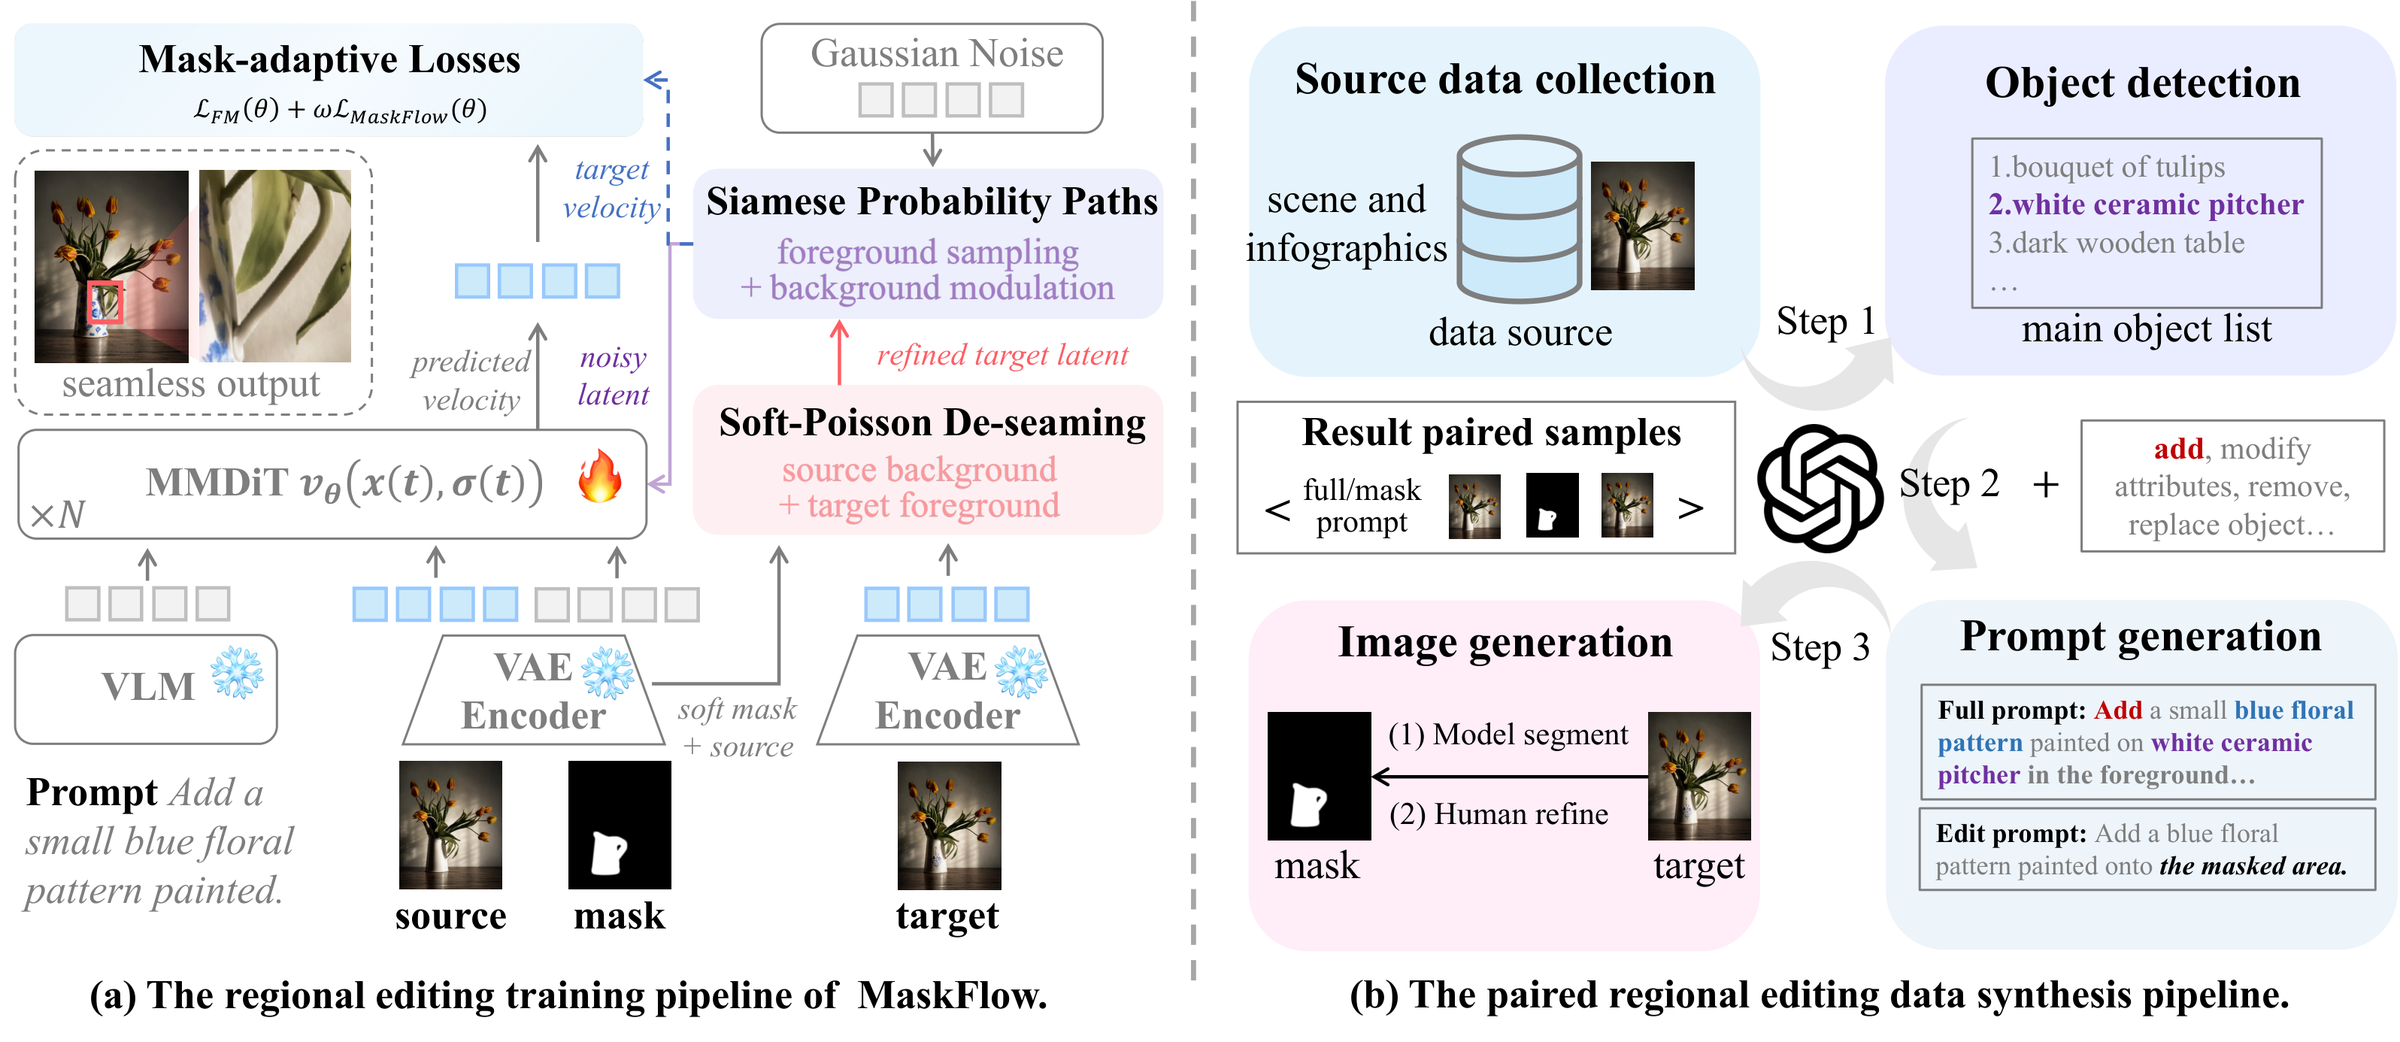
实验效果:在自然场景和信息图(infographic)图像上的实验显示,定量与定性评测均相对竞争方法取得一致提升。

批判点评:把掩码写进概率路径和流匹配目标、而不是当成后处理的贴回操作,这是方法论上的正解——边界不自然的根源就是训练目标里从来没有「区域内外要协同」这一条。Soft-Poisson 在训练和采样两侧都介入也考虑得比较周全;选信息图当评测场景很实用,因为文字和线条对缝合痕迹最不宽容。不足在于它是训练框架而非免训练插件,接入成本比同类高;效果描述停留在「一致提升」,缺具体数字和基线对比,而区域编辑的差异往往只体现在边界几十个像素上,这类主观性强的改进尤其需要量化和用户研究支撑;MEData 由合成管线构造,与真实用户涂抹掩码的分布是否一致也需要验证。
EmoWorld: A Decoupled Affective Field for Controllable Emotional Video Generation | 香港科技大学(广州)等 | arXiv:2608.06231
关键词:情感视频生成,可控生成,冻结DiT,残差操控,Wan2.2
前序问题:情感决定观众如何解读一个场景,但现有视频生成器把全局氛围、承载情感的语义线索、以及情绪的时间推进这三件事全都揉在同一条文本条件里,导致无法分别控制——想调暗氛围就连带改了画面内容,想加一个悲伤的道具又连带改了整体色调。
本文贡献:提出 EmoWorld,在冻结的流匹配视频扩散 Transformer(Video DiT)内部解耦这三个因素。一次性准备阶段从「几何保持的中性全景图」与「情感编辑后的全景图」中提取逐层的情感方向和一个可复用的线索库。推理时:视觉氛围操控(VAS)把氛围方向注入隐藏状态;语义情感操控(SAS)为语义线索单独隔离出一个可独立缩放的 prompt 残差;时间情感操控(TAS)在去噪时间与视频时间两个维度上插值端点残差场。全程不更新生成器参数。
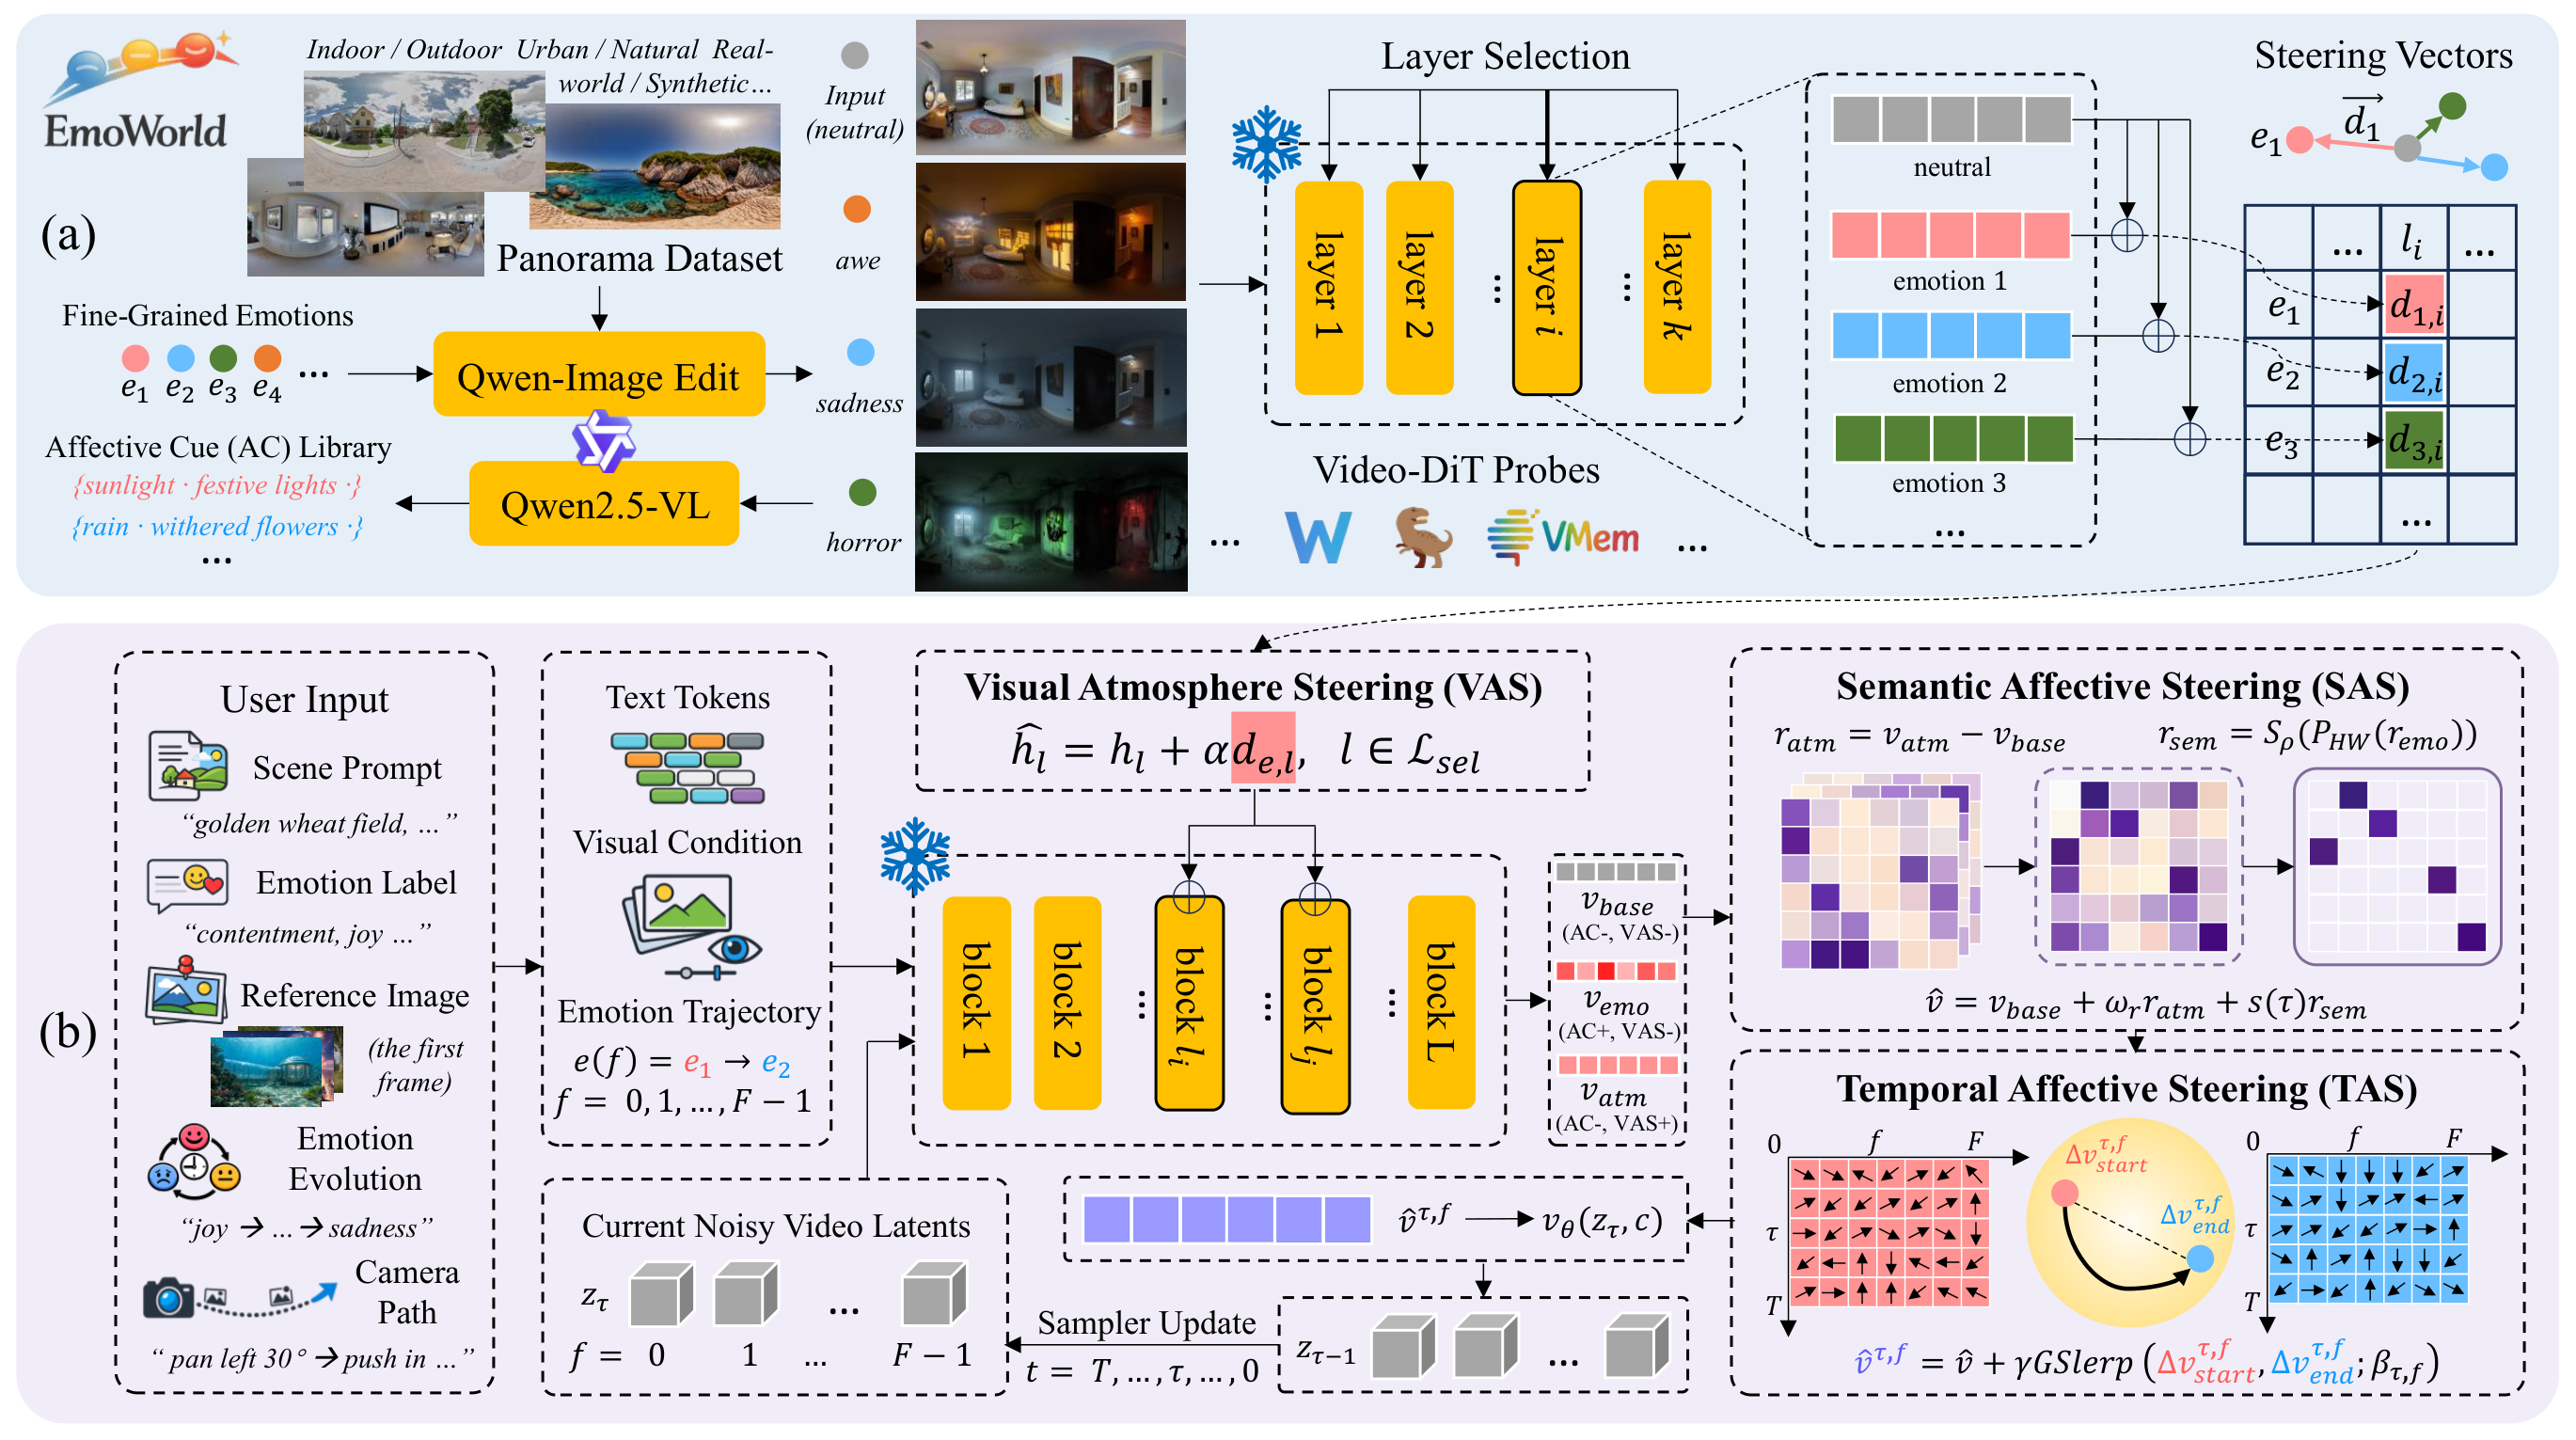
实验效果:在 Wan2.2 上,VAS 把目标情绪对齐度提升 19%、同时把时序波动代理指标降低 48%;SAS 把目标情绪对齐度提升 37%、检测到的承载情感线索增加 36%;TAS 相对最强基线把过渡单调性提升 15%。覆盖 27 个情绪类别的文生视频与图生视频设定,可跨多个 Video-DiT 骨干移植,并支持相机条件下的构图。
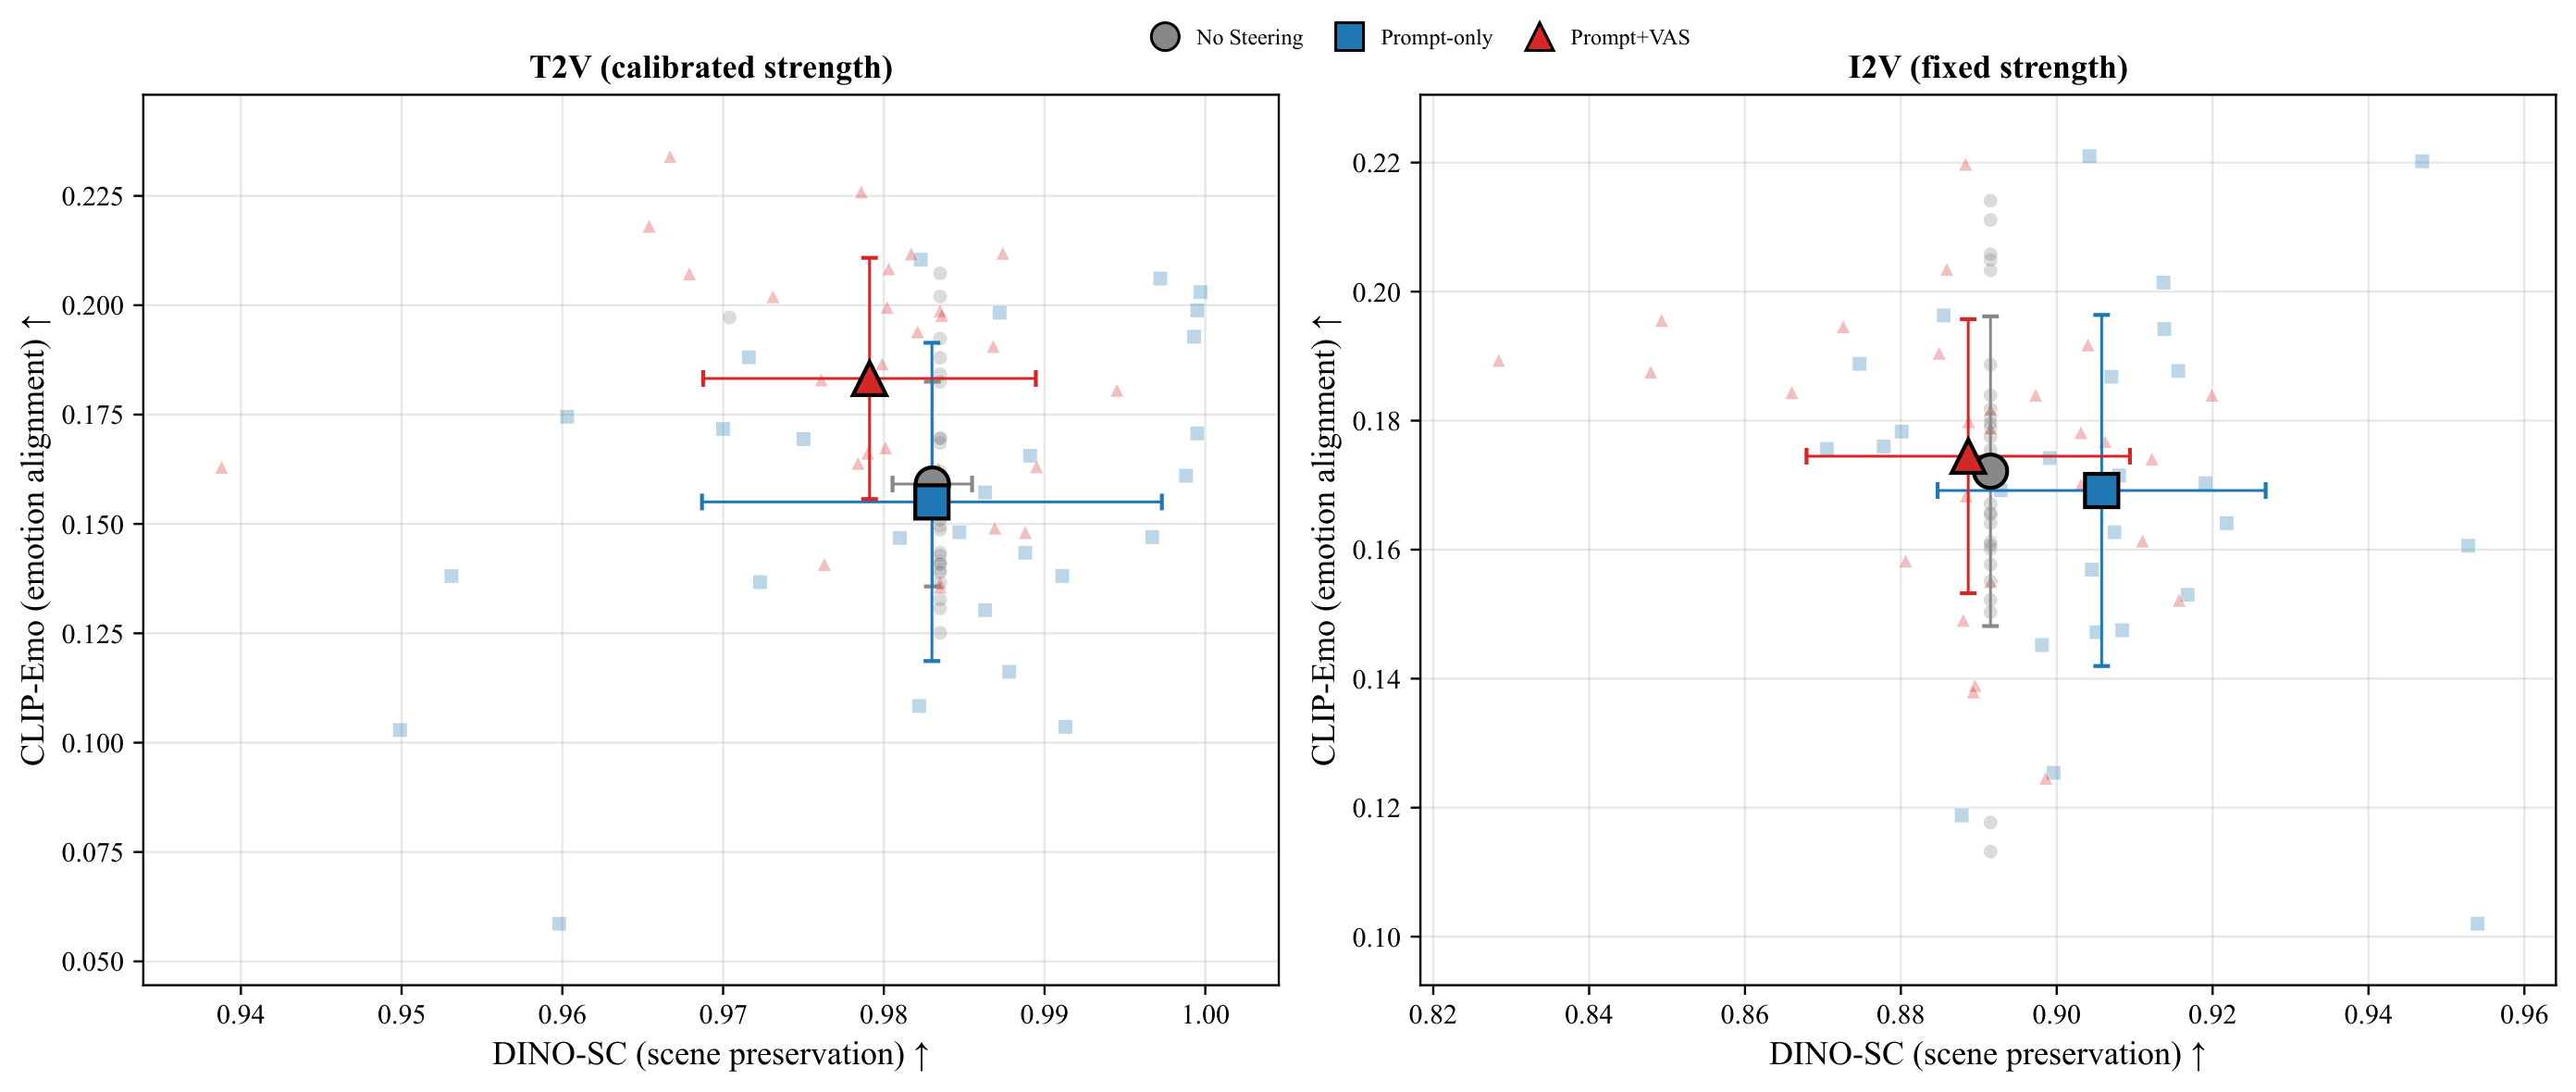
批判点评:把「情感」这个含混的条件拆成氛围、语义线索、时间推进三路分别注入,是这篇最漂亮的地方——它把一个说不清的美学需求变成了三个可分别缩放的旋钮,而且完全不动生成器权重、能跨骨干移植,工程友好度很高;用几何保持的中性/情感全景图对来抽取情感方向,也是个巧妙的构造。要谨慎的是评测指标的自定义程度偏高:「时序波动代理」「过渡单调性」都是作者自拟的量,19%/37%/48% 这些百分比缺少公认基线的对照,跨论文可比性差;情绪这类主观维度最终仍需人类评测,摘要未提及用户研究;此外方法依赖一次性准备阶段产出的线索库,换主题域或换骨干后是否需要重建,成本没有交代。
GAUGE: A Measurement-Grounded Benchmark for Physical Fidelity in Simulation Engines and Video World Models | 上海人工智能实验室·香港大学·上海交通大学·浙江大学 | arXiv:2608.05948
关键词:物理保真度,视频世界模型,物理引擎,诊断基准,上海AI Lab
前序问题:物理引擎支撑着具身智能的大规模训练与评估,而生成式视频世界模型正在成为未来状态与交互的隐式模拟器。但现有的物理保真度评估往往各自孤立进行,且严重依赖感知相似度或人工判断,几乎无法告诉你到底是哪条物理原理、哪个参数被违反了。
本文贡献:提出 GAUGE,一个以真实世界为基准的诊断性 benchmark,联合评估数值模拟器与生成式视频世界模型对真实物理的复现与偏离。包含 22 个受控任务族,覆盖刚体、柔性线缆、织物和体积可变形物体;以真实世界轨迹为基准,配套标定过的物理元数据、不确定性标注和任务专属可观测量,涵盖碰撞、摩擦、动量传递、振荡、自接触、形变等基本物理过程。

实验效果:用广义轨迹误差在 14 个任务族上评测 Isaac Sim、Genesis 与 Newton,并在 5 个刚体任务上评测 6 个图生视频模型的物理定律一致性与推断参数的时序稳定性。结果显示没有任何一个物理引擎在全部任务上保真,最大偏差出现在冲击性接触、织物快速运动和体积形变;更值得警惕的是,视频世界模型能产出「方程形式符合预期」的轨迹,但恢复出的加速度、动量传递和振荡时序全是错的。

批判点评:把物理引擎和生成式视频模型放进同一套以真实轨迹标定的尺子下衡量,这个设计本身就是贡献——此前两个社区各说各话,一边比轨迹误差一边比感知相似度,根本无法对话。最有价值的结论是「方程形式对但加速度错」:这精确刻画了视频模型的物理是表层拟合而非机制正确,对所有把视频世界模型当具身智能模拟器用的团队都是一记警钟,而这种可归因到具体物理量的诊断,是感知相似度指标永远给不出的。局限在于覆盖不平衡:物理引擎评了 14 个任务族,视频模型只评了 5 个刚体任务,柔性和形变这些最难的场景恰恰没测到生成模型;真实轨迹的标定精度与不确定性标注本身也会引入误差上限;22 个任务族的构造和评分细节能否被外部团队稳定复现,要等数据与代码放出后才能判断。
SemBridge: Semantic Token Anchoring for Continuous-Latent Autoregressive Speech Generation | 西北工业大学·Soul AI Lab | arXiv:2608.07462
关键词:自回归语音生成,连续潜表示,语义token监督,零样本TTS,歌声合成
前序问题:连续潜表示的自回归语音生成通过避免量化损失、保留更丰富的声学信息,成为离散 token 建模之外一条有前景的路线。但连续声学目标并不把语言结构暴露成显式的 token 级预测目标,结果自回归语言模型只能通过预测声学来间接获得语言结构,这会损害生成语音的内容保真度——说白了就是音色和韵律很好,但字容易念错。
本文贡献:提出 SemBridge,一个仅在训练阶段生效的语义 token 锚定框架。用离散语义 token 直接监督自回归 LM 的状态,并采用语义对齐的声学 VAE,把连续目标空间组织在同一个语义参照系之下。语义监督只在训练时使用,推理阶段完全保持连续,因此不引入量化损失。在零样本文本转语音(TTS)和乐谱条件的歌声合成(SVS)两个任务上评估。
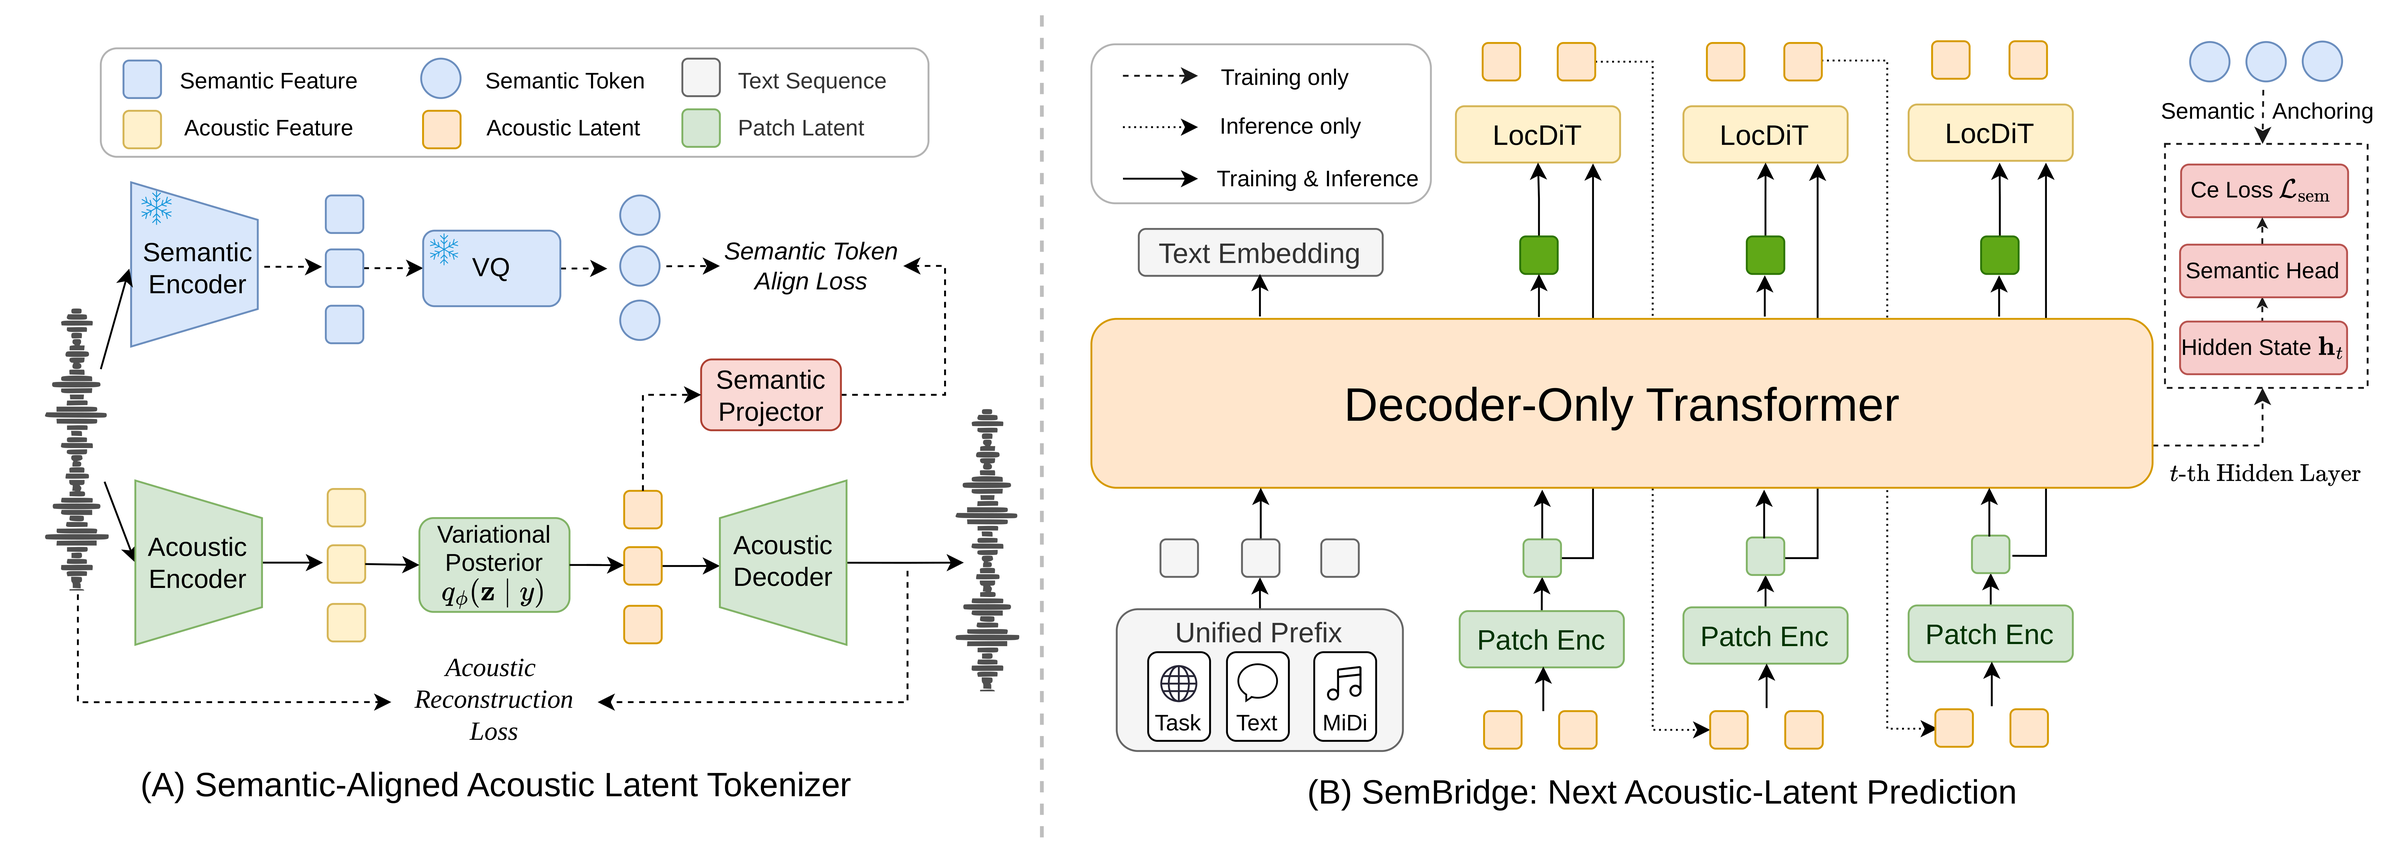
实验效果:在多个基准上,SemBridge 改善了以词错误率和字错误率(WER/CER)衡量的内容准确率,同时保持有竞争力的说话人相似度和感知质量。结果表明,对自回归状态施加显式语义 token 监督,是连续语音生成的一个有效且通用的方向。模型代码与 checkpoint 将开源。
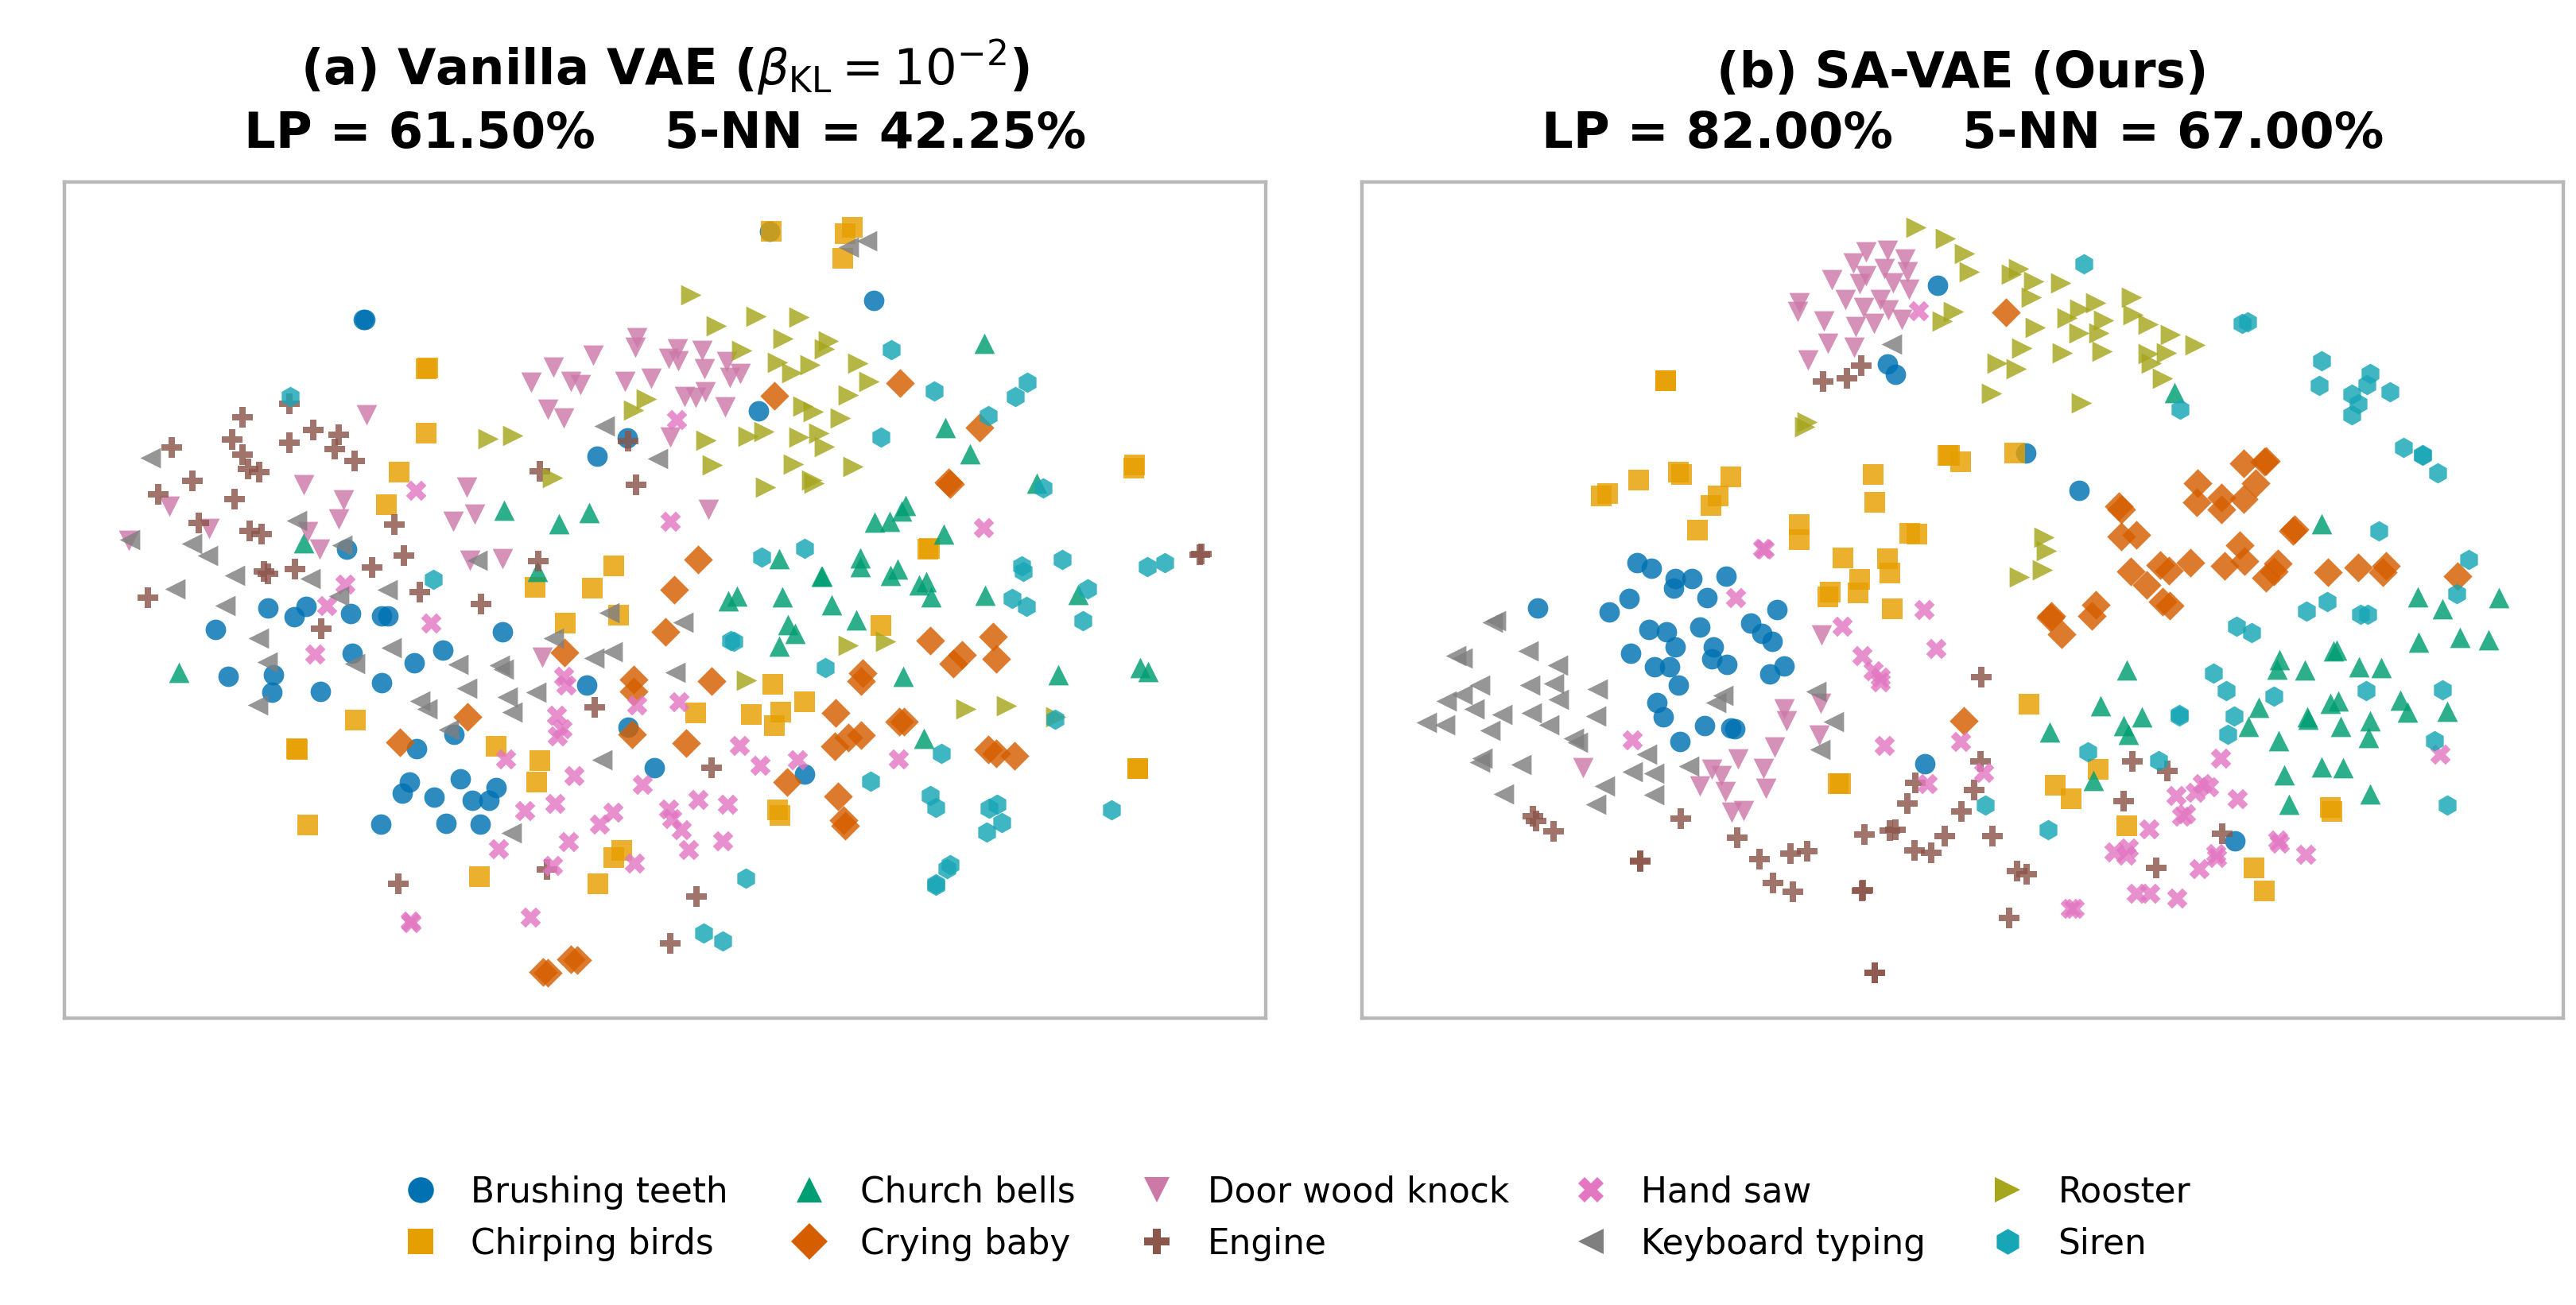
批判点评:「训练时用离散语义 token 当拐杖、推理时完全撤掉」这个设计非常讨巧——它精准命中连续潜表示路线的软肋(音质好但内容易错),又不把量化损失带回推理阶段,属于两头好处都要的正确姿势,而且同时在 TTS 和歌声合成上验证,说明不是针对单一任务的技巧。不足是收益描述偏保守:内容准确率提升、说话人相似度和感知质量「保持有竞争力」,这个措辞通常意味着后两项略有折损,具体折多少要看正文;语义 token 的质量高度依赖所用的语义编码器,换一个编码器结论是否稳定没有交代;此外 16 位作者的大团队工作却只给出相对提升而无绝对 WER 数字,可比性打了折扣。
SubtleTalk: Generating Controllable Weakly-correlated Facial Dynamics for 3D Talking Heads via Residual Flow Matching | 上海交通大学·腾讯 | arXiv:2608.06408
关键词:3D说话人,弱相关动态,残差流匹配,Valence-Arousal,腾讯
前序问题:音频驱动的 3D 面部动画要从语音合成真实且时序连贯的运动。尽管唇形同步已有显著进展,但眉毛运动、眨眼、头部动作这些「弱相关动态」——对照片级真实感恰恰至关重要——仍然难以忠实建模,常常表现得僵死或不自然地重复。作者归因于三点:一是弱相关动态的条件信息不足;二是确定性回归难以捕捉多样的运动模式;三是上半脸伪标签不可靠、数据集多样性有限造成的数据瓶颈。
本文贡献:提出 SubtleTalk,通过多条件建模与残差流匹配生成自然可控的弱相关面部动态。第一,针对单靠语音引导不足,引入可解释的控制信号——韵律、区域强度、Valence-Arousal(效价-唤醒度),显式刻画弱相关动态的时机、幅度和情感变化。第二,针对确定性回归表达力有限,在稳定的语音驱动运动先验之上构建残差流匹配,让模型捕捉超出确定性预测的随机偏差。第三,为缓解数据瓶颈,构建 SubtleTalk-Face 数据集,约 3900 个身份、74 小时数据,通过简单可扩展的伪标注管线构建,改进了上半脸追踪并带有帧级 VA 标注。
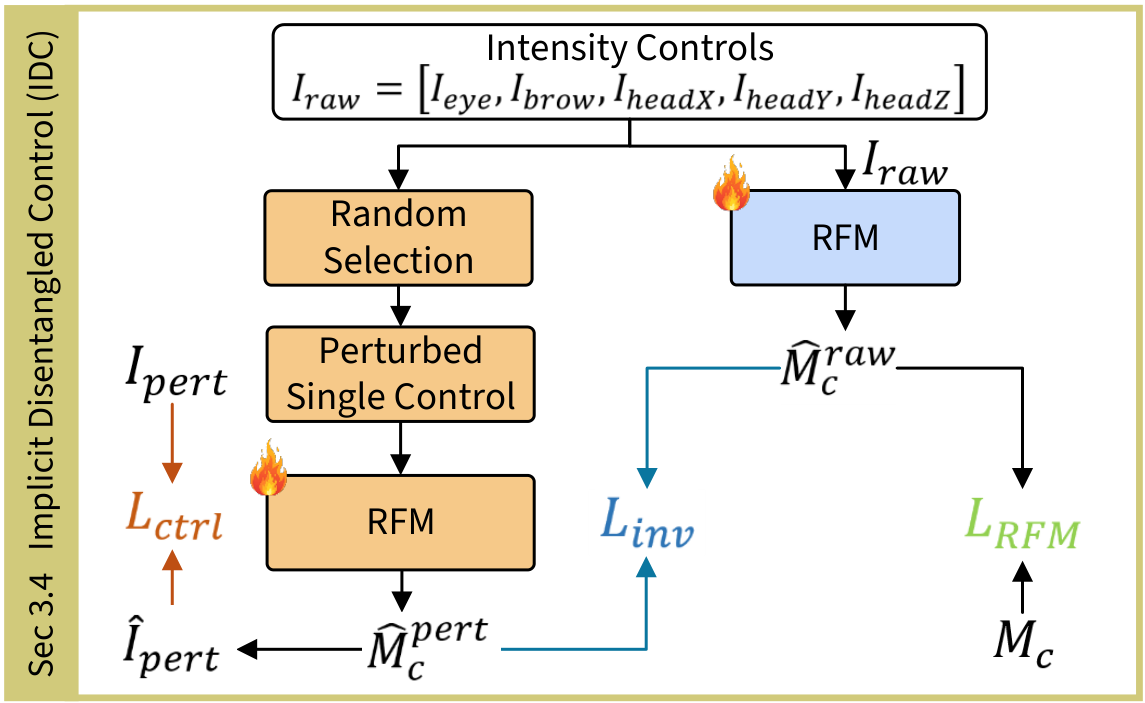
实验效果:大量实验表明,该方法在显著提升弱相关面部动态的真实感和多样性的同时,保持了准确的唇形同步。

批判点评:问题诊断分层很清楚:条件不足、回归表达力不足、数据不足,三条各配一个对策,而不是笼统地上一个更大的模型。「弱相关动态」这个提法本身就抓住了数字人恐怖谷的真正来源——唇形对了但眉眼呆滞,观众立刻觉得假;用残差流匹配在确定性先验之上叠随机偏差,是承认这类动作本质多模态、不该被回归到均值,方向正确;3900 身份、74 小时并带帧级 VA 标注的数据集也是实打实的贡献。局限是上半脸标注仍来自伪标注管线,而上半脸恰恰是原问题里「伪标签不可靠」的部分,这在方法论上有一点自我循环的味道;效果只给了「显著提升真实感和多样性」的定性说法,而多样性和真实感之间通常是权衡(动得多容易动得怪),缺少量化取舍曲线;此外三路控制信号的调参空间不小,实际使用的易用性有待验证。
人工智能炼丹君 整理 | 2026-08-11
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注




评论 (0)