


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

今日共 10 篇 · 统一多模态预训练与Tokenizer 2 篇 · 统一音视频生成 3 篇 · 生成后训练与奖励对齐 3 篇 · 自回归与长视频生成 2 篇
Towards Physics of Multimodal Pretraining: Knowledge Flow, Modality Synergy, Early Unification, and Recipes | Meta FAIR·Reality Labs·牛津大学 | arXiv:2608.05000
关键词:统一多模态预训练,视觉懒惰,MoE,数据配方,Meta FAIR
前序问题:统一多模态预训练已经成为共识路线,但语言、视觉理解、视觉生成三种能力在联合训练时到底怎么互相传递知识、什么时候协同什么时候打架、视觉数据该在训练的哪一刻加入,业界基本靠经验和直觉,公开的对照实验很少。
本文贡献:用严格的单变量控制实验系统拆解统一预训练,给出四条结论:一是知识流动高度不对称,语言是万能助推器、视觉理解是生成的强先验,而生成几乎不反哺前两者;二是数据复杂度决定模态是协同还是竞争,共享注意力与归一化、拆开前馈层的架构最有利于协同,且换视觉 tokenizer 结论不变;三是必须早期统一、同步联训,晚接视觉会触发作者命名的「视觉懒惰」;四是把这些结论合成非对称数据配方 L70/U25/G5(语言 70%、理解 25%、生成 5%)。
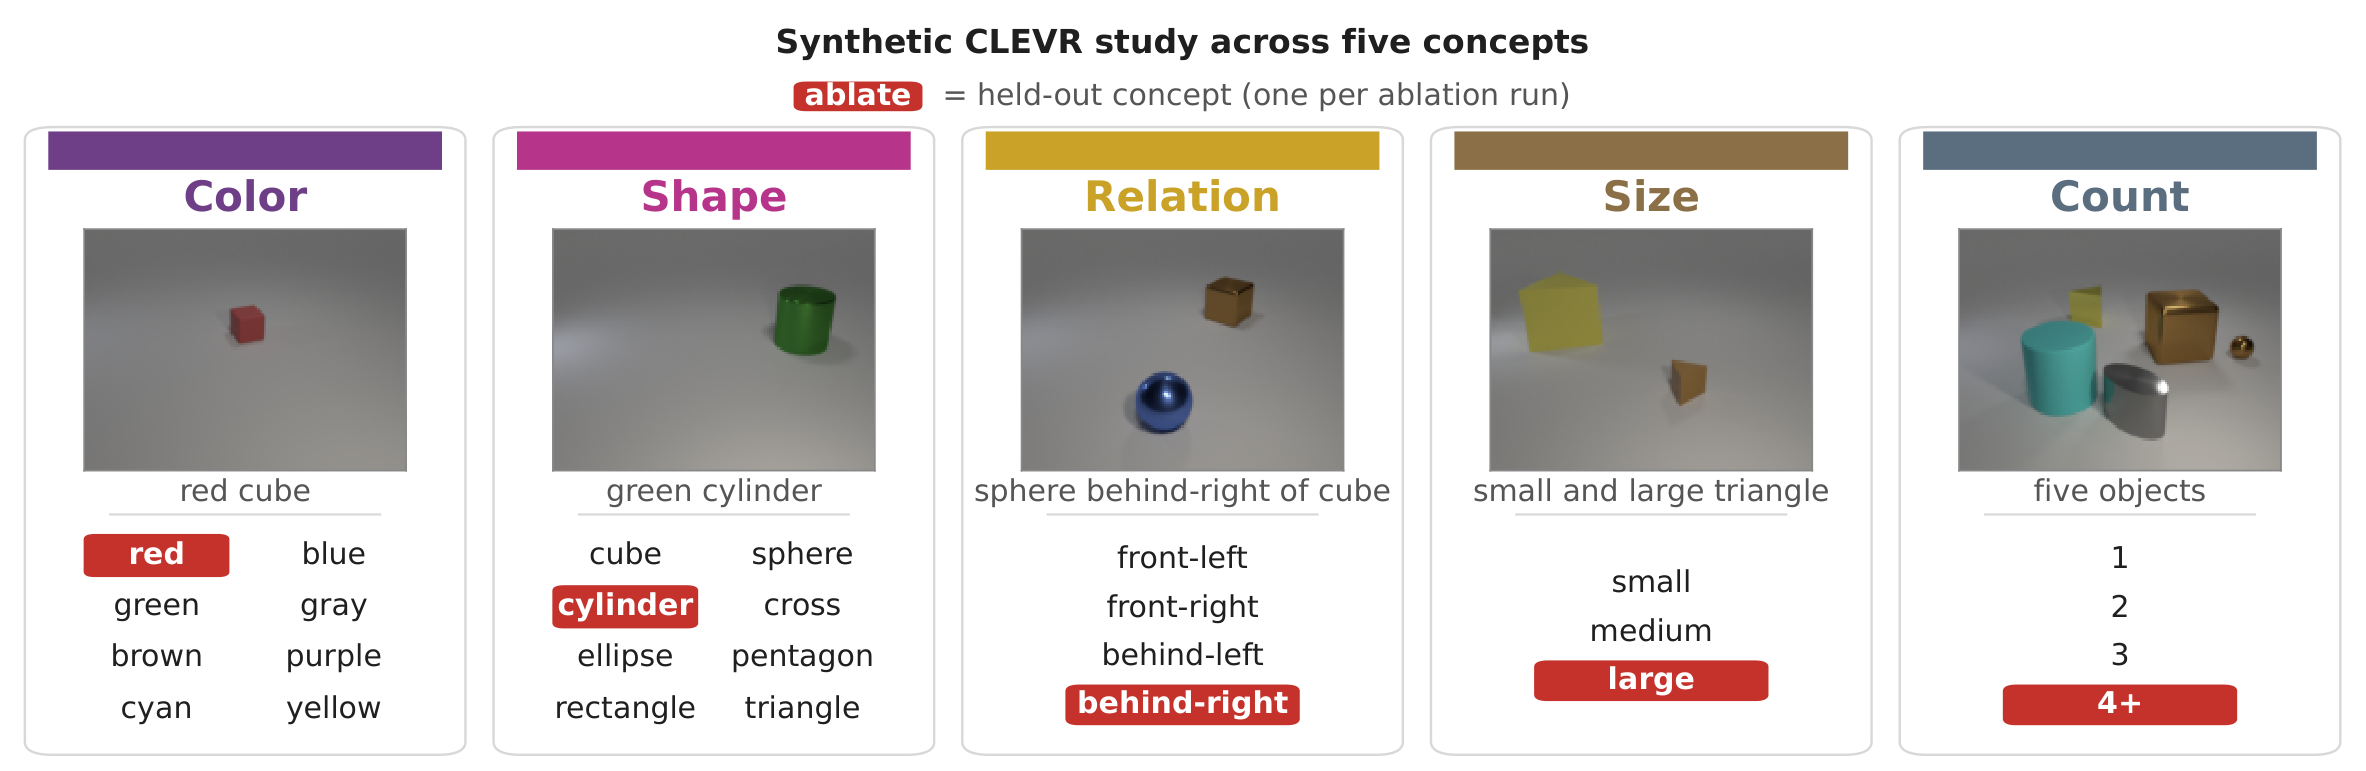
实验效果:在 13.5B MoE(256 专家、每 token 激活 16 个、其中 2 个模态专属,激活参数 1.5B)上用 2T token 做单变量对照:非对称配方相比均衡配方 L50/U25/G25,语言准确率 54.31% 对 52.86%,视觉理解均值 43.08 对 41.42,GenEval 从 0.467 升到 0.482、DPG 从 0.676 升到 0.689——生成 token 少了五倍,文图对齐反而更好,5 万张图的 FID 5.234 与均衡配方的 5.131 基本持平。视觉懒惰有四路机械证据:语言预热从 0B 拉到 800B token 后,视觉 FFN 的训练态与推理态激活幅度、图像包裹 token 的嵌入范数、推理时落在图像 token 上的注意力占比全线下滑。
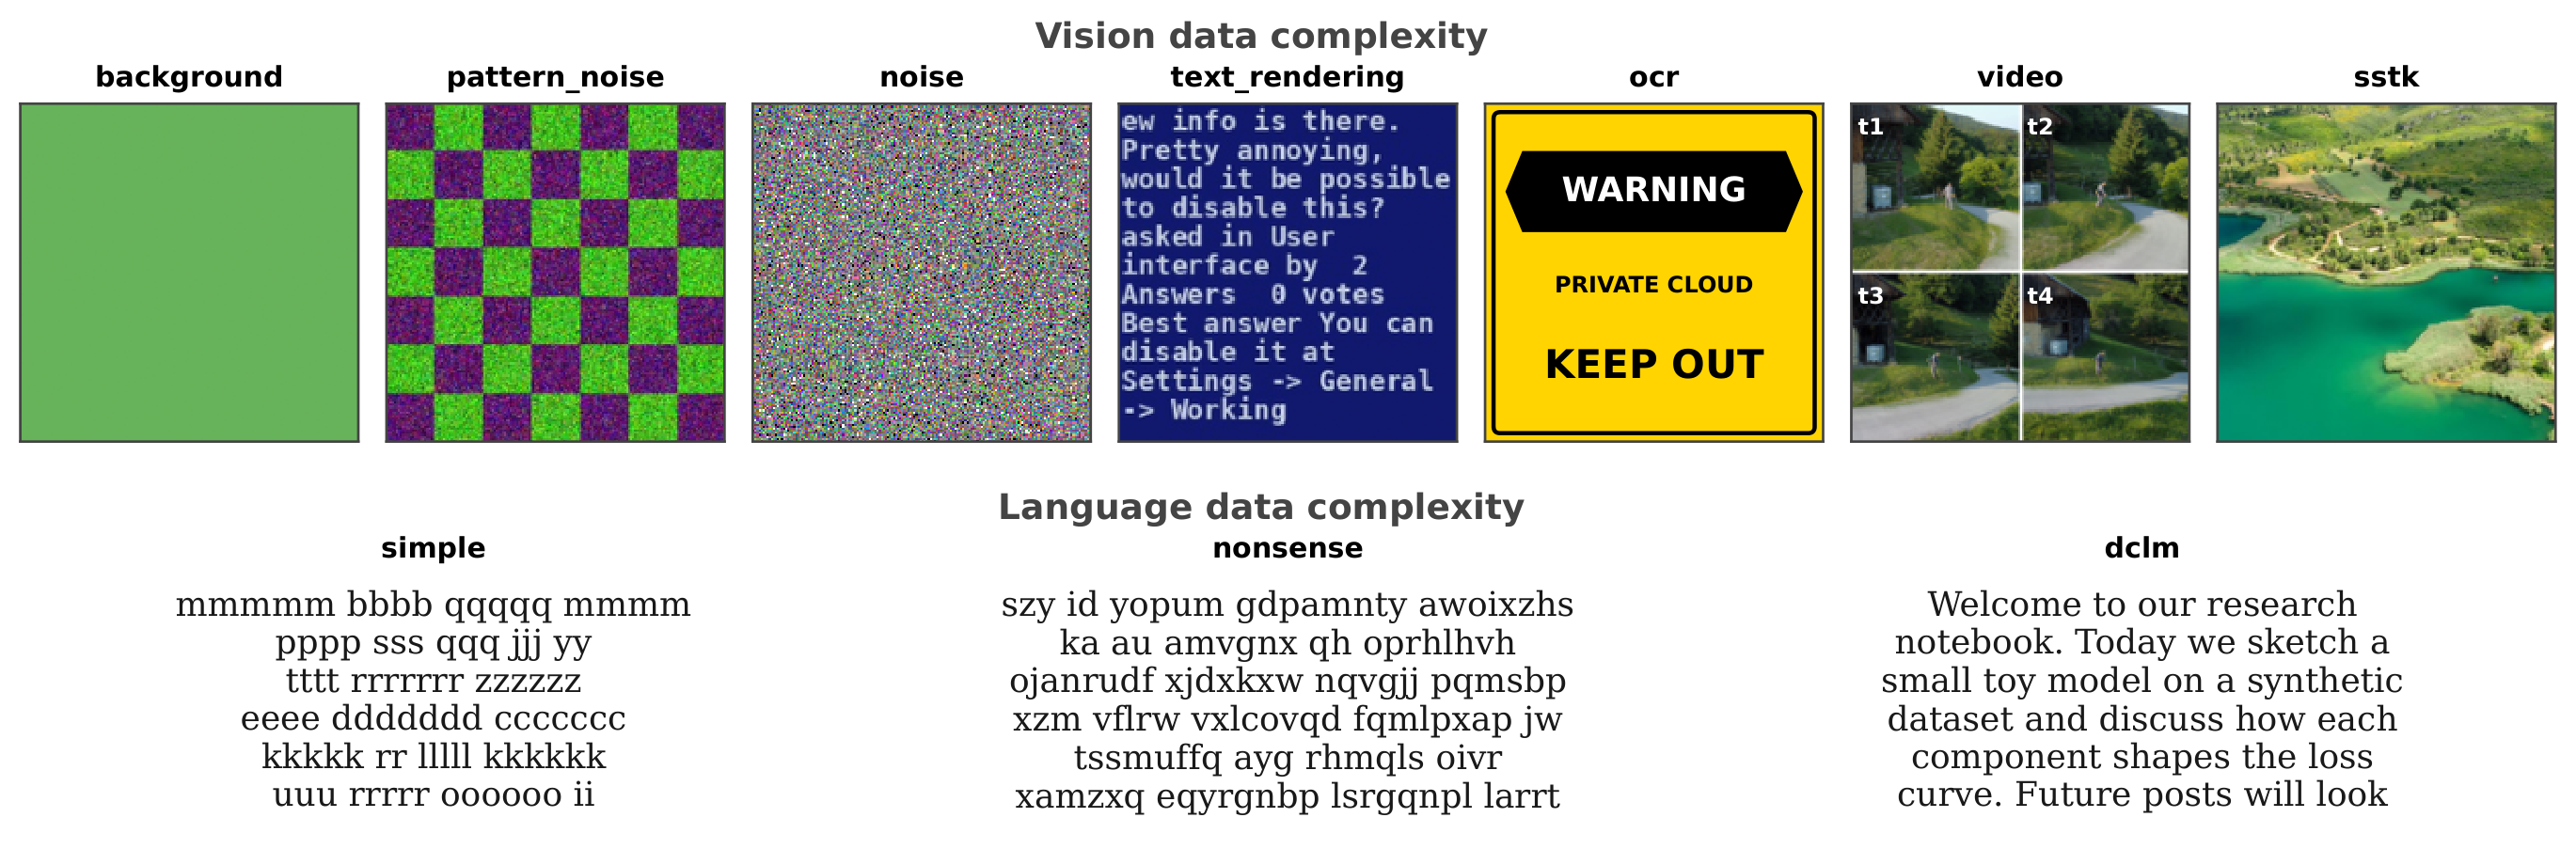
批判点评:这类「控制变量做到底」的实证研究比又一个新架构更稀缺,尤其「生成数据只给 5%、生成指标反而更好」直接冲击了「想让模型会画就多喂图」的直觉,而视觉懒惰给「强 LLM 接视觉后仍然看图犯低级错误」提供了可测量的解释。局限也明显:结论建立在 Meta 自有数据与 RAE 编码器体系上,2T token 的对照跑一次成本极高,外部团队几乎无法复现;L70/U25/G5 是在这套设定下搜出来的,换数据分布未必照搬;GenEval 0.482 本身离商用文生图还有距离,说明配方优化的是预训练起点而非最终生成力。
Vorch-Omni: Multi-Task Orchestration of Sight and Sound | Vorch Team | arXiv:2608.05803
关键词:统一音视频生成,任意条件到任意输出,LTX-2.3,流匹配DiT,多任务
前序问题:文生视频、参考图生成、视频续写、指令编辑、视频配音这些能力今天大多各自训一个模型。一旦把目标视频、源视频、参考图、参考音频塞进同一条序列,模型就分不清哪段该生成、哪段要原样保留、哪段只提供身份或风格;加上音频既可能是条件又可能是输出,任务空间会成倍膨胀。
本文贡献:把所有任务统一成「任意条件到任意输出」的一次条件去噪:每个任务由视频目标、视频条件、音频目标、音频条件四个集合描述,token 级条件掩码决定谁保持干净、谁被去噪,任务标识区分目标/源/主体参考/音频参考/编辑条件,位置类型再区分「与目标共享连续时间轴」(如续写)和「独立参考网格」。视觉条件走两条互补通路——视觉语言模型读采样帧加文本指令给语义,视频 VAE 把完整条件编码成干净 latent 保结构。底座是单个 LTX-2.3 音视频流匹配 DiT(48 层,视频流 32 头×128 维、音频流 32 头×64 维),新任务只改配置不改结构。

实验效果:同一套权重覆盖 10 类以上任务、30 多种条件—输出组合,包括文生视频、文生音视频、图像与参考驱动生成、时间续写、音频驱动生成、视频转换以及单模态和跨模态编辑。人评部分组织 527 组样本、11361 条维度级判断与 Wan 2.7 盲测:81.4% 的判断认为两者相当,Good 与 Bad 各占 7.7% 和 8.0%,总体净胜率 -1.9%;但在最考验统一能力的维度上净胜率为正——音频指令遵循 +7.1%、参考一致性 +6.6%、音画同步 +5.9%、音频质量 +3.3%。
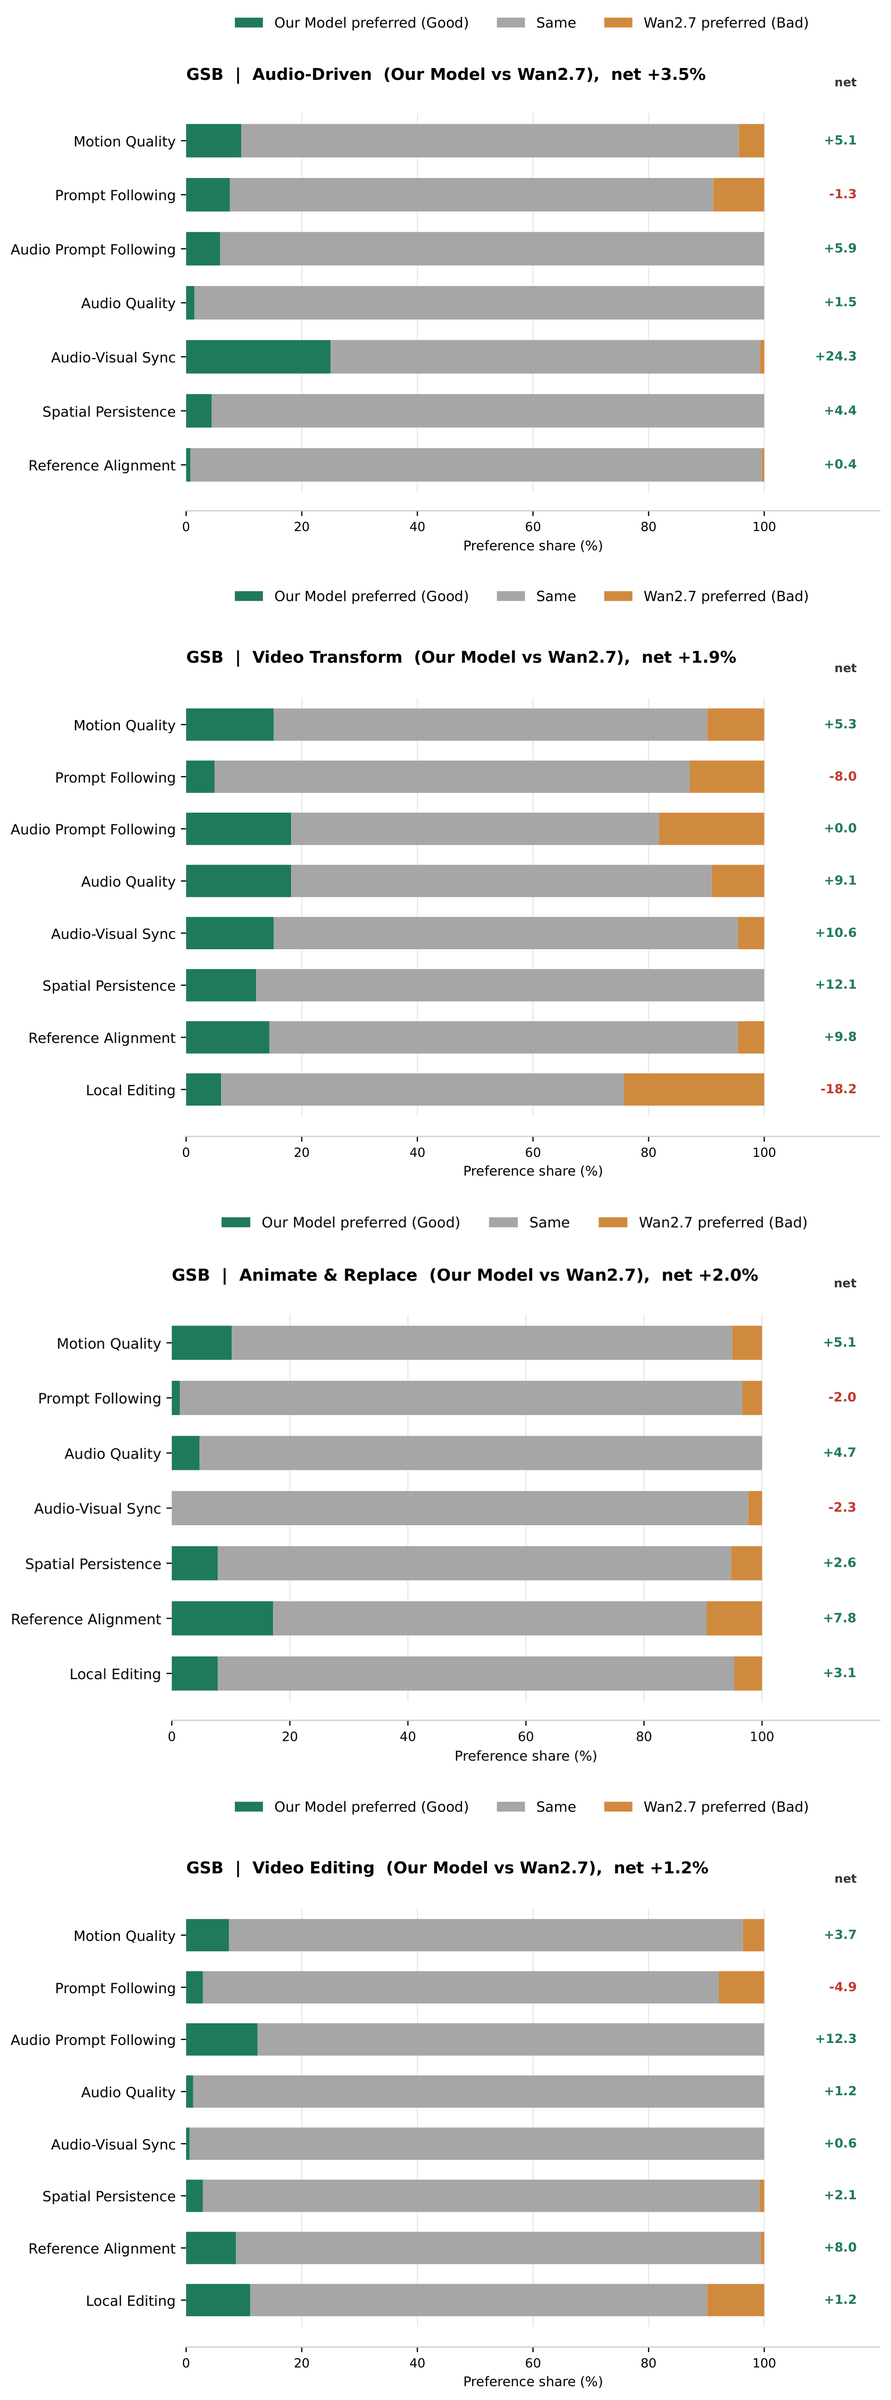
批判点评:把任务差异全部下沉到「token 角色 + 位置类型」的配置层、而不是每个任务加一个分支,是目前统一音视频模型里比较干净的一种抽象,作者也没有粉饰总体净胜率是负的这一点。但代价同样清楚:底座是别人的 LTX-2.3,全参数微调 5 万步,单卡 batch 只有 1;总体 -1.9% 意味着「统一」眼下换来的是特定维度的优势而非全面超越;作者自己也承认长时程一致性、精细局部编辑和多语言多说话人语音仍未解决。Vorch Team 未公开所属机构,权重与代码也没给出时间表。
Vorch-Streamer: Extending Human Audio-Visual Generation to Real-Time Long-Form Streaming | Vorch Team·同济大学·哈工大深圳·上海交大 | arXiv:2608.05663
关键词:实时流式生成,数字人,Self Forcing,DMD蒸馏,语音规划token
前序问题:实时数字人要求边生成边播放,模型只能看历史不能看未来。把预训练的双向音视频扩散模型改成因果流式有两个坎:一是自回归复用自己生成的块会累积曝光偏差,几十秒后身份漂移、画面糊掉;二是给定一整段要说的话,因果生成器在只有局部上下文时并不知道当前这一块该说到哪一句。
本文贡献:在 22B 的 LTX2.3 音视频底座上做三阶段后训练。先用同一个底座合成 8 万条 12–21 秒的数字人音视频语料,保证监督信号与初始化同源;再以样本级混合 Teacher Forcing 与 Diffusion Forcing 训出 20 步因果短流式模型;最后做长时程 Self Forcing,让因果学生在完整 12–21 秒时域上自我 rollout,冻结的原双向模型作为 real-score 教师做 DMD 蒸馏,把双向模型的画质迁移到因果长轨迹上,同时把去噪压到 4 步。语音进度用外部语言模型预测 25 Hz 的离散「说话规划 token」——与 LTX 音频 latent 同频率,因此每个因果块都能拿到属于自己那一秒的语音内容。
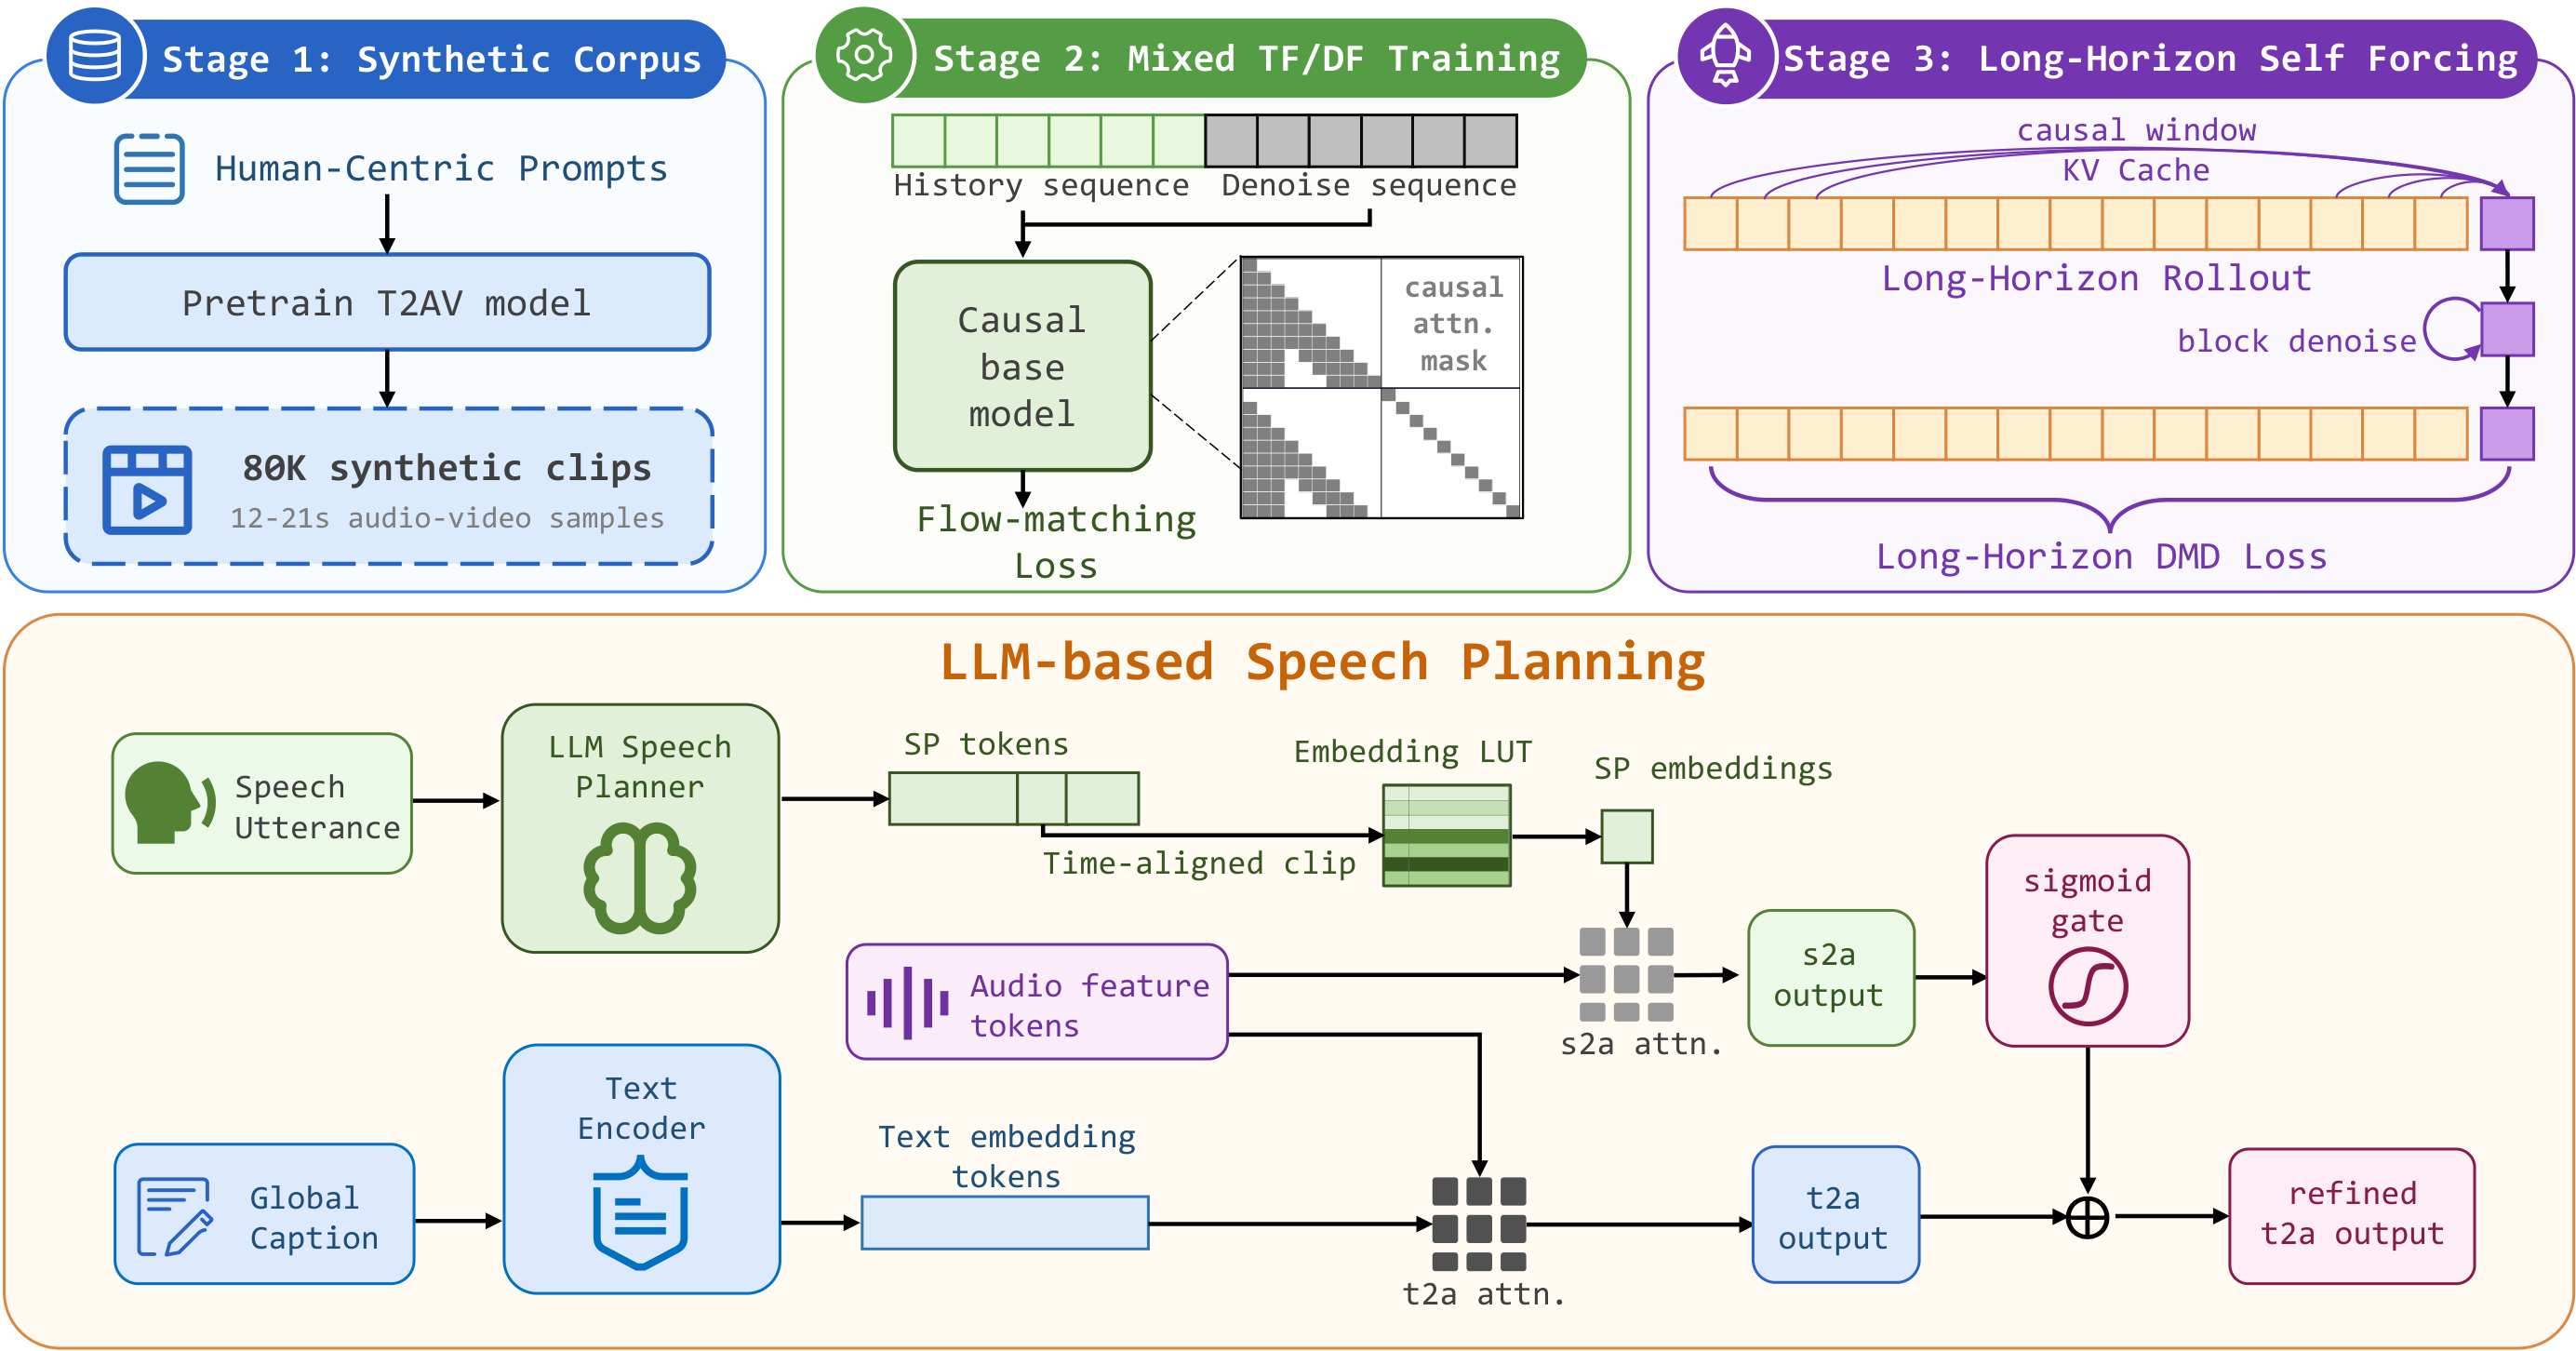
实验效果:768×512、24 FPS 设定下,单张 H200 上端到端 DiT 吞吐 27.12 FPS,是评测中唯一越过 24 FPS 实时播放线的原生 T2AV 方法,且不需要外部音频或参考首帧。约两分钟的连续 rollout 在 0/30/60/90 秒采样帧上仍保持身份与场景一致,音唇同步 Sync-C/Sync-D、词错率、VBench2 身份与人体结构指标均有竞争力。推理用 3+1 因果窗口(三个常驻前缀块加最近一块)。训练侧第二阶段 64 张 H200 跑 6000 步,第三阶段 32 张 H200 跑 1000 步。

批判点评:「实时」这次是有明确定义的:24 FPS 播放线、单卡、四步去噪、有界上下文,比笼统说加速可信得多,25 Hz 说话规划 token 也确实解决了因果生成器不知道该说哪句的具体问题。但 27.12 FPS 建立在 H200 和 768×512 这个不算高的分辨率上,换消费级显卡或上 1080p 结论就不成立;训练语料是底座自己合成的 8 万条,风格和多样性都受限于教师,真人视频上的泛化没有验证;两分钟的 rollout 也还不是「无限长」。
Vorch-Director: Interactive World Story Model via Noise-Aware Error Rectification | Vorch Team·浙江大学 | arXiv:2608.05776
关键词:长视频续写,曝光偏差,噪声感知残差,多镜头故事,ST-Bench
前序问题:分钟级音视频靠自回归续写实现:把长视频切段,第 t 段以前面已生成的画面和声音为条件。但训练时喂的是干净的真值历史,推理时喂的是模型自己带着漂移、模糊和音画错位的输出,误差一段段滚雪球,最终身份跑偏、画面变平、声画不同步。已有做法把预测残差当作合成噪声注入历史来缩小这个落差,但都用一个与噪声水平无关的固定强度。
本文贡献:作者观察到残差修正是否有效,关键取决于残差是在流匹配的哪个噪声水平上产生的。于是把每条残差连同它产生时的噪声水平 σ 一起存下来,训练某个 σ 步时只采样同一噪声区间的残差并缩放到该区间,让注入的错误和去噪过程真正对齐;这样既保留了 teacher forcing 的训练效率,又造出接近推理分布的历史。配套设计包括始终不加噪的干净锚定窗口(clean sink),以及区分历史视频、参考图像、目标视频的任务嵌入,支持多镜头、多主体、参考引导的长时音视频生成。

实验效果:在 30 个用例、每例约 10 个镜头的多镜头故事基准 ST-Bench 上,用统一评测器重跑全部方法(不混用已发表数字),四项跨镜头一致性指标全面领先,ViCLIP 达 0.7887 而最强基线只有 0.5900,两项长程指标 ARC 与 Reappear 同样领先;对比对象包括 StoryDiffusion+Wan、StoryMem、HoloCine、Memento。另在 200 例的 UnityShots 上跑了 T2V 与 R2V 两种设定,并自建带同步语音、音乐和音效的长音视频基准,每例连续 22 个镜头达到分钟级,配套提出质量漂移和锚定相对一致性两个长程退化指标。

批判点评:「残差要按噪声水平配对注入」是个很具体也很容易被忽略的细节,作者还老老实实用同一评测器重跑所有基线,避免了各家用各自设定报数字的常见问题,新增的长程漂移指标也补上了平均分掩盖退化的缺口。但基线的画质与文本一致性其实并不输,领先主要集中在跨镜头一致性这一类指标上;ViCLIP 0.7887 对 0.5900 的巨大差距有多少来自方法本身、多少来自 LTX-2 底座与基线不同,论文没有拆开;自建基准由自己定义、自己评测,说服力要等第三方复现。
KVAE: Family of Tokenizers for Multimodal Generative Models | Kandinsky Lab | arXiv:2608.05798
关键词:视觉tokenizer,VAE,音频编解码,因果压缩,开源
前序问题:潜空间扩散的天花板一半压在 tokenizer 上:压缩率、通道数、因果性直接决定生成模型的学习速度和最终画质。但开源社区里 tokenizer 的训练细节、选型方法和设计取舍几乎都藏在大模型报告的角落,后来者只能反复踩坑。
本文贡献:一次性放出覆盖三种模态的 KVAE 全家桶并开源:KVAE-Audio 是 48 kHz 全带宽连续音频 tokenizer,latent 帧率 50 Hz、64 通道;KVAE-3D 是两个因果视频 tokenizer,压缩率分别为 4×16×16(64 通道)和 4×8×8(16 通道);KVAE-2D 是空间 8 倍压缩、32 通道的图像模型。视频侧刻意做成无注意力的纯 Conv3D 结构,配合缓存机制可以处理任意长序列,归一化用空间 RMSNorm 以便推理时调整分段大小,上下采样把时间和空间操作拆成先后两步。编码器解码器故意不对称:4×8×8 的解码器约为编码器的 1.3 倍,4×16×16 直接做到 5.3 倍,把容量押在需要生成能力的解码侧。
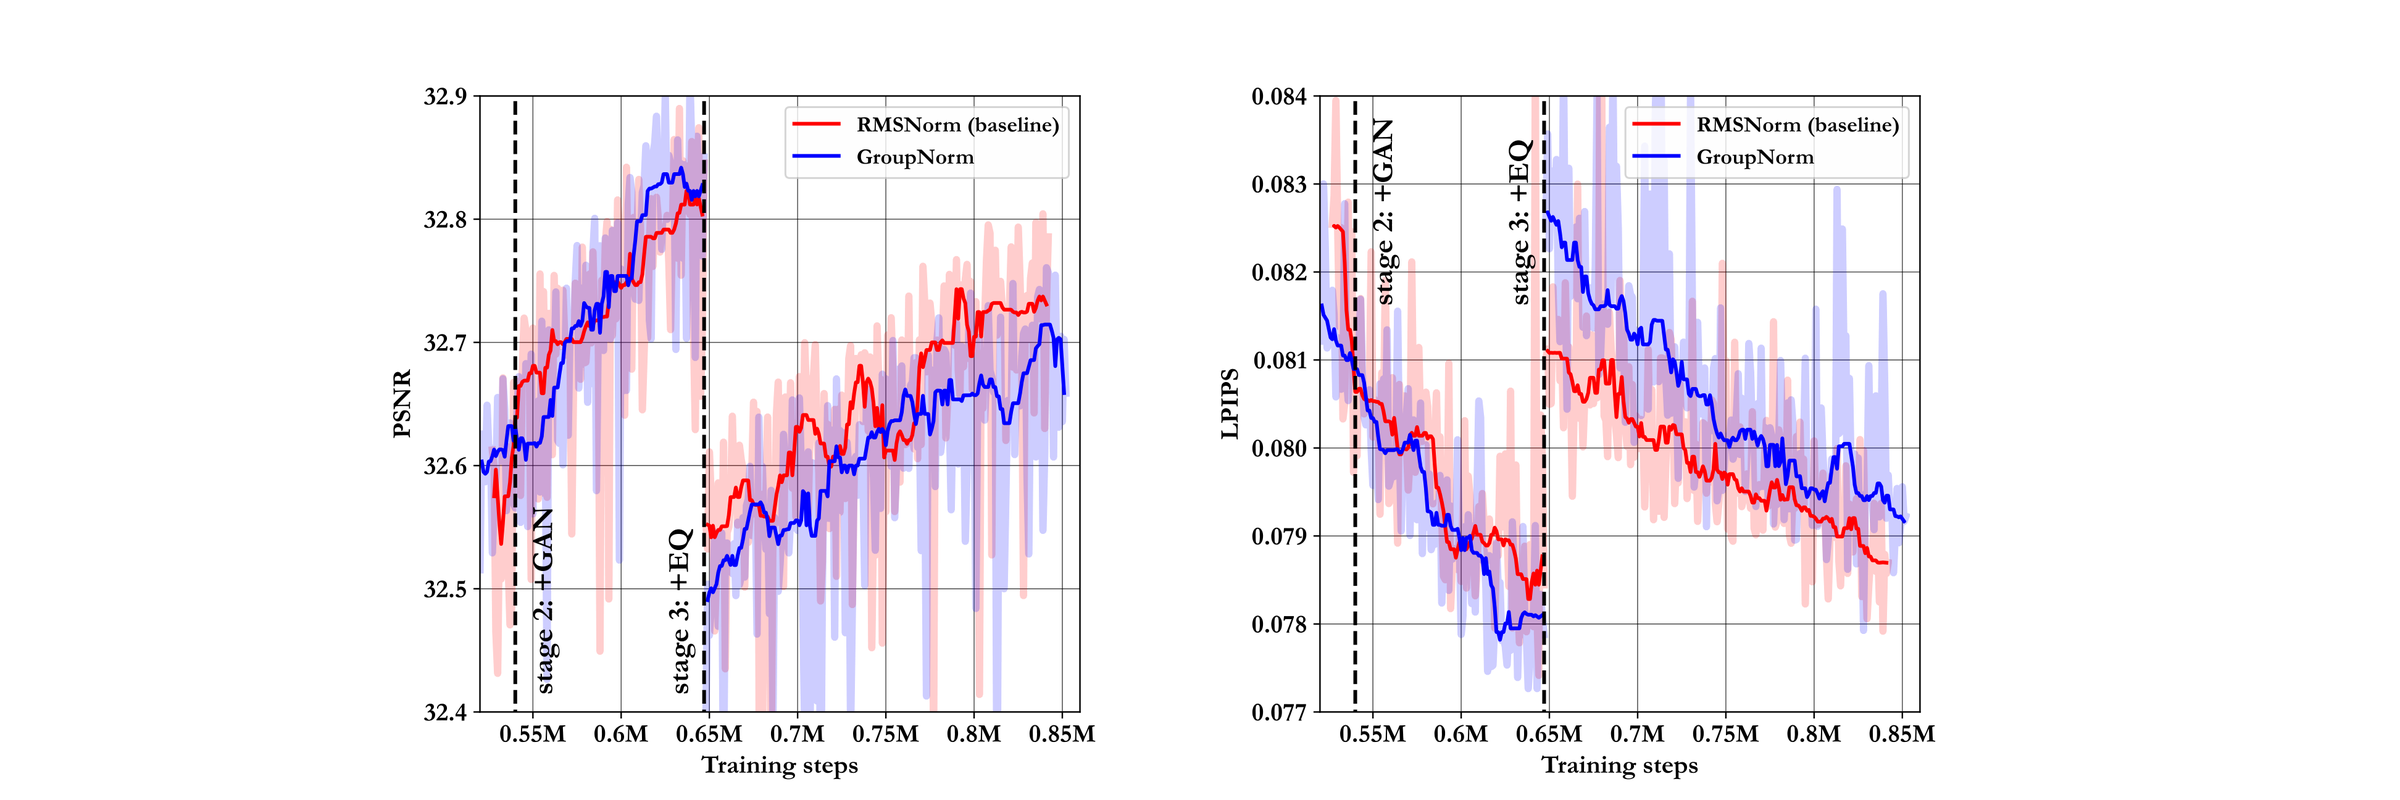
实验效果:在 MCL-JCV 720p 重建评测上,同压缩率分组内平均比 Wan-2.1(PSNR 34.3)、Wan-2.2(34.2)和 HunyuanVideo 高出 1 dB 以上 PSNR,LPIPS 损失可以忽略。生成侧用统一的 2B CrossDiT(Qwen-2.5VL 文本编码器、流匹配损失、同一批数亿图文数据和超参)只换 tokenizer 做对照:KVAE-4×16×16 与指标完全一致,相比 Wan-2.2 让出一点视觉观感换来更好的提示词遵循,对 HunyuanVideo-1.5 则在全部类别上被更多人选中;有意思的是 KVAE-4×8×8 出现客观指标与人评打架的情况——PSNR 不占优,盲测却名列前茅。整体对标 Wan-2.2、HunyuanVideo-1.5、FLUX.2、MovieGen、StableAudio、MMAudio,代码已在 GitHub 公开。
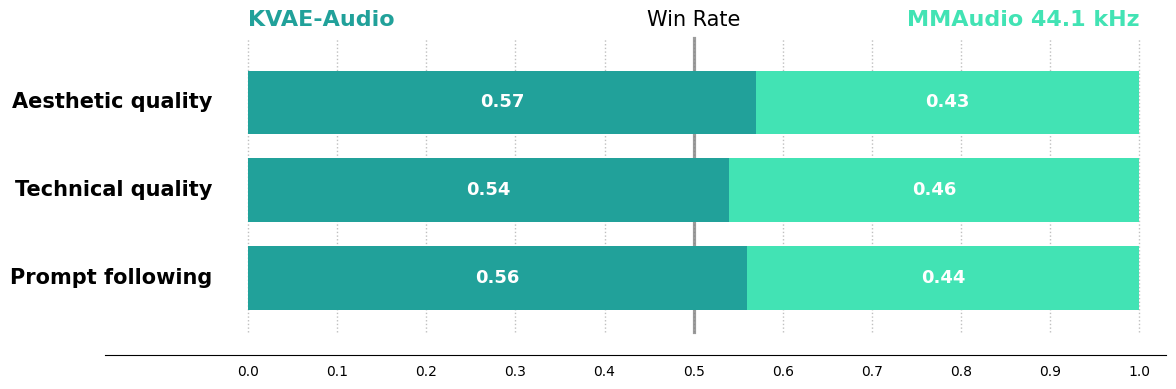
批判点评:肯把训练细节、选型方法和消融一起交出来的 tokenizer 报告非常少,这份等于给中小团队省掉一轮昂贵的试错,「客观指标与人评打架」的坦白也比一味报 PSNR 有价值。但要注意重建指标只在 MCL-JCV 一个数据集上测,生成对照又只用 2B 模型和数亿量级图文数据,能否外推到十亿级视频数据和更大生成骨干是未知数;1 dB PSNR 的领先在下游生成里究竟折算成多少可感知收益,论文自己的人评已经说明关系并不线性。
Latent Reward Registers for Diffusion Preference Alignment | 快手可灵Kling Team·中科大 | arXiv:2608.03929
关键词:偏好对齐,latent奖励模型,寄存器token,on-policy蒸馏,可灵
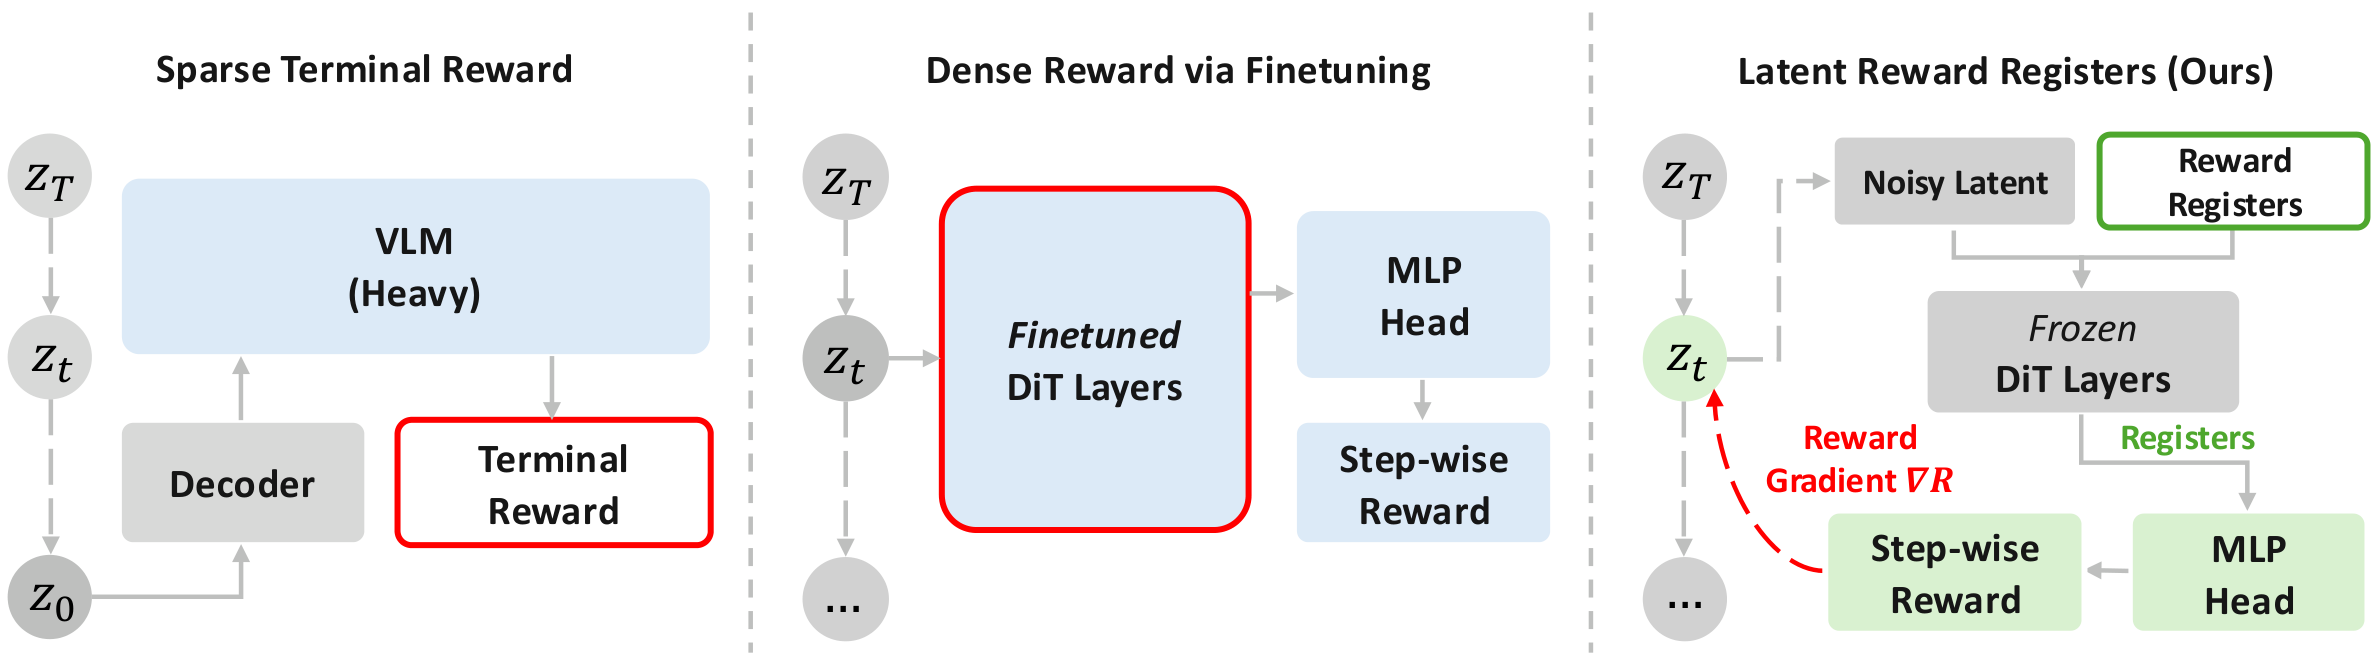
前序问题:扩散模型对齐人类偏好,通常只在最终生成图上算一个稀疏的终点奖励,几十步去噪要共享这一个分数,时序信用分配极其困难。想改成稠密奖励,又绕不开把中间 latent 解码回像素空间的高昂代价。
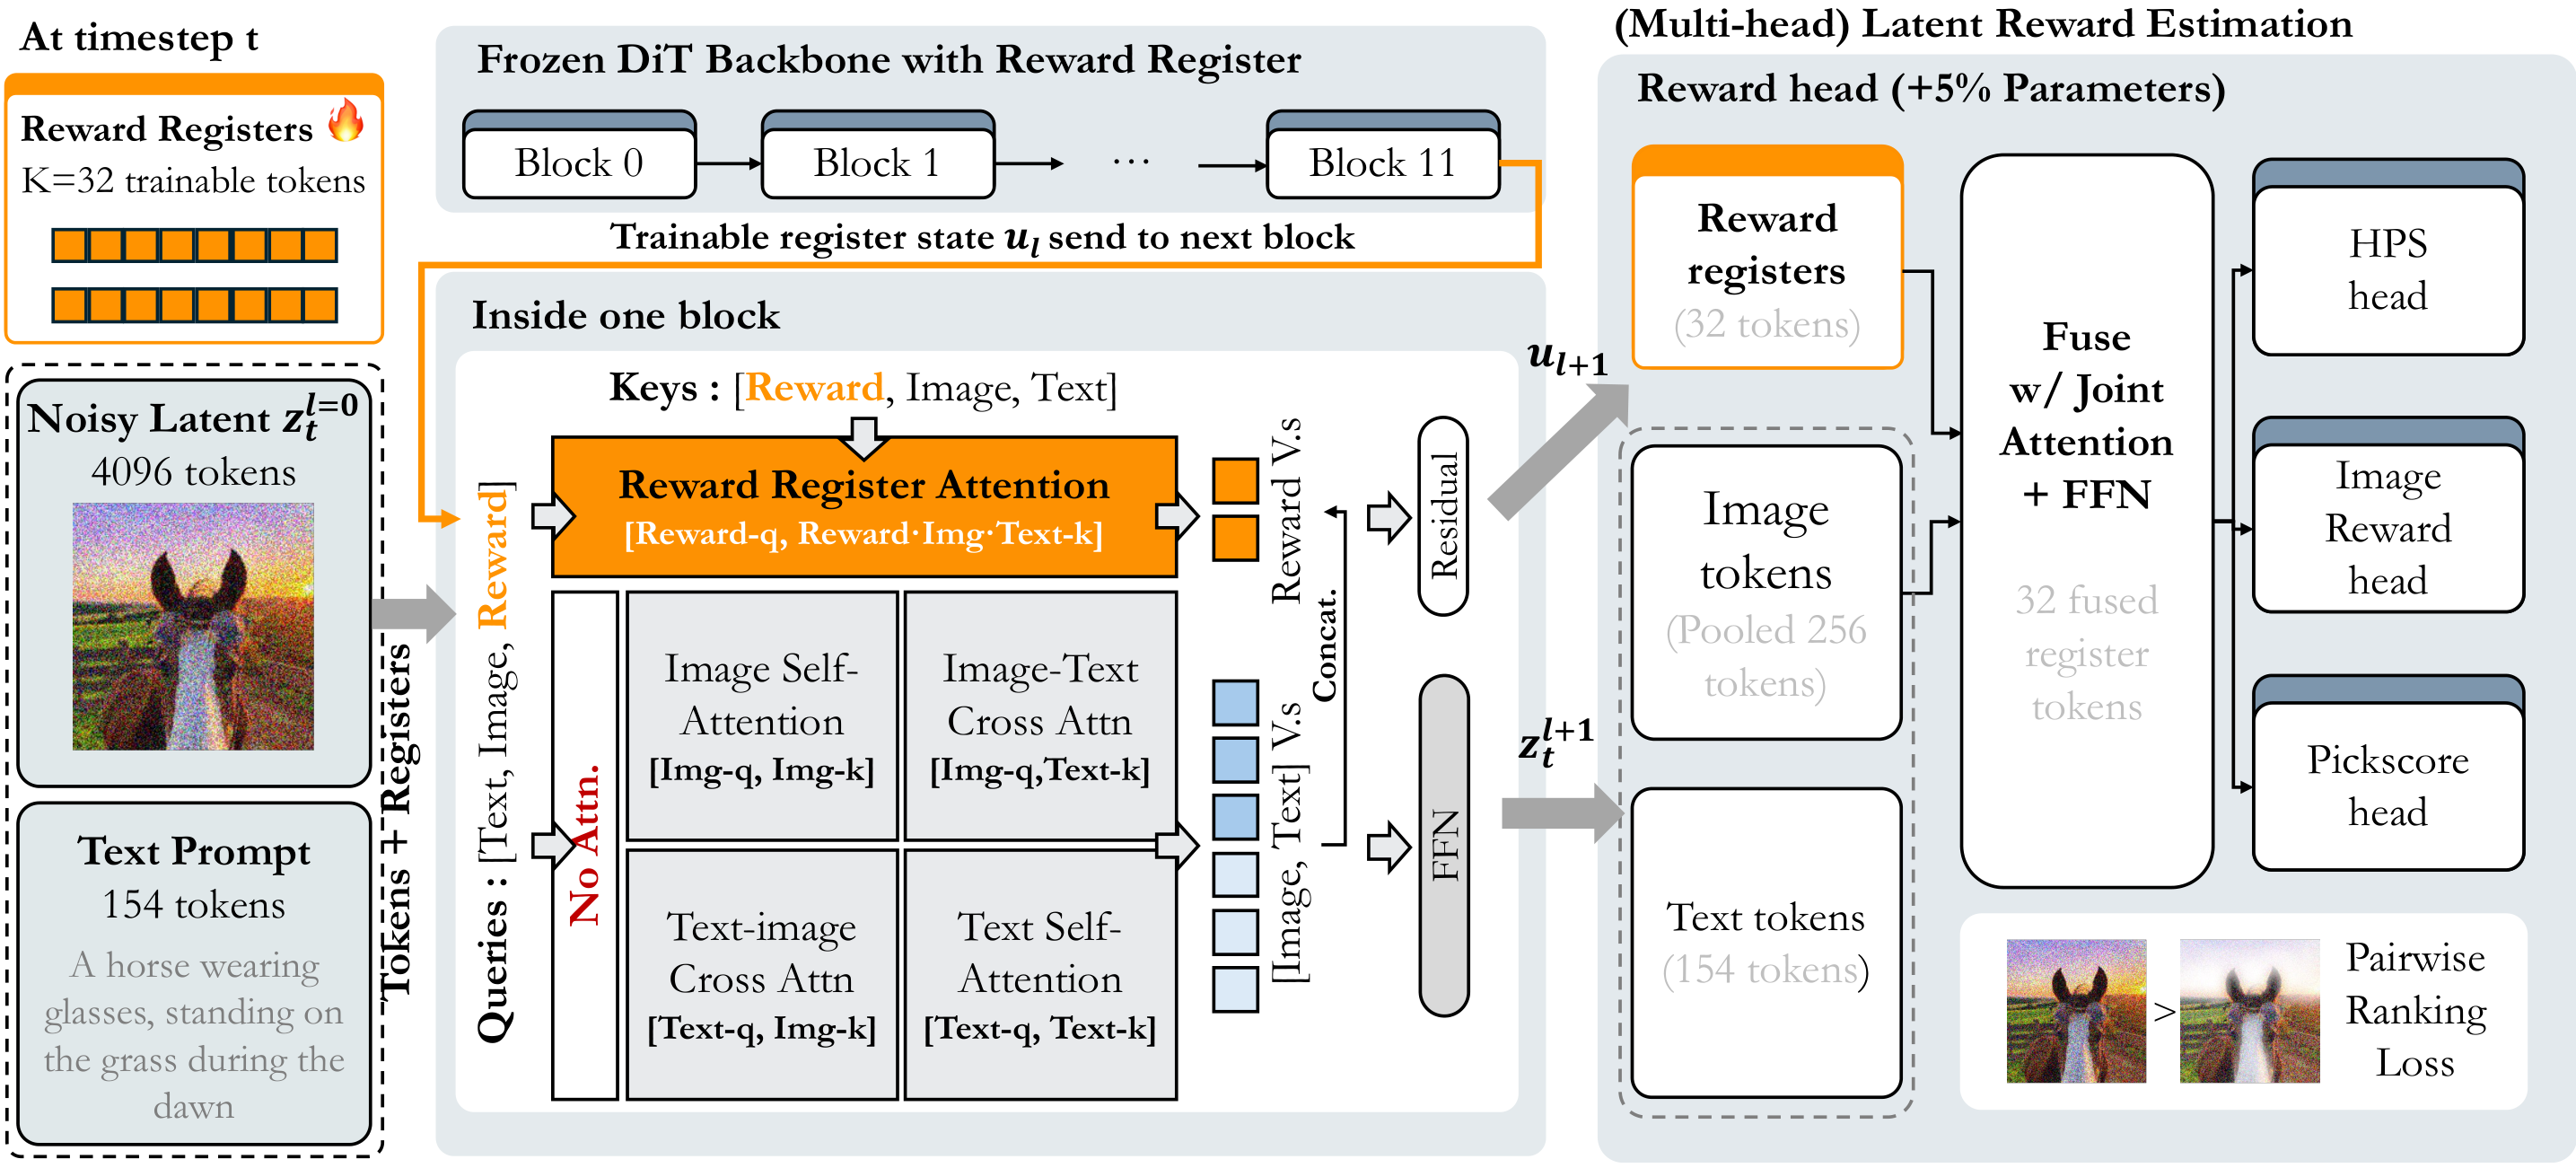
本文贡献:提出 Latent Reward Register:在冻结的 DiT 输入序列前面挂一串可学习、无位置的寄存器 token(实验用 K=32),让它们从中间带噪 latent 里直接读出终点偏好。关键在于这是一条独立读出通路,不改动生成器的隐藏状态和速度场,因此拿到的是贯穿整个去噪过程、可微分的稠密奖励。基于它给出两种用法:训练侧的 RG-OPD 沿 on-policy 轨迹蒸馏奖励引导的更新,绕开标准策略梯度里昂贵的完整 rollout;推理侧的 RGS 用量级匹配的奖励梯度直接引导采样轨迹,一个参数都不用改。
实验效果:在 ImageReward、HPDv2、HPDv3、GenAI-Bench 合计 54170 对样本上,把 latent 前向加噪到高噪声区 u=0.8 打分,寄存器在所有 latent 奖励模型中成对偏好准确率最高。训练侧 SD3-Medium 上 RG-OPD 的 HPSv3 达 11.57,高于 AlignProp 的 11.20、ReFL 的 10.84 和 Flow-GRPO 的 10.26,MUSIQ 74.9、CLIP-IQA 0.726 同时领先,GPU 时最多省到原来的三十三分之一;FLUX.1-dev 上 HPSv3 12.38 同样第一。推理侧 RGS 在免训练方法里刷新 SOTA,SD3-Medium 上 HPSv3 10.70 对 DNO 的 8.85、Demon 的 9.09,且 MUSIQ 与 CLIP-IQA 一并提升而非以画质换分数。代码与权重已开源。
批判点评:「不动生成器、只挂一串寄存器 token 去读奖励」是个很轻的接口设计,33 倍 GPU 时的差距对预算有限的团队几乎是能不能做在线对齐的分水岭,而且训练和免训练两条路复用同一套读出器。需要警惕的是奖励是从生成器自己的特征里读出来的,两者共享盲区时容易一起自我强化,论文报的 MUSIQ 与 CLIP-IQA 都是无参考指标,扛不扛得住长时间优化下的奖励攻击没有给出曲线;实验也集中在 SD3-Medium 和 FLUX.1-dev 两个文生图骨干,视频扩散上还是空白。
Sample-Adaptive Latent Rewards for Uncertainty-Guided Diffusion Post-Training | 中国电信TeleAI·上海交大 | arXiv:2608.06125
关键词:latent奖励,不确定度,奖励攻击,扩散后训练,TeleAI
前序问题:latent 奖励模型能在不解码回像素的前提下监督扩散模型,效率很高,但它们只吐一个标量分数。生成器无从判断这次反馈到底可不可信,一旦在模型本就没把握的样本上照单全收,优化方向就会跑偏,进而演变成奖励攻击。
本文贡献:让奖励模型同时输出「打多少分」和「这个分有多不确定」。SURE-LRM 为每个带噪 latent 预测一个高斯效用:均值是奖励分数,方差是预测的不确定度,且完全从成对偏好中学出来,不需要额外人工标注。SURE-REFL 再把这份不确定度用起来——在选定的去噪转移点上查询冻结的 SURE-LRM,把 detach 后的方差换算成同一转移点内样本之间的可信度权重,每个加权奖励只沿本地转移回传。整条链路留在 latent 空间,既不需要像素解码,也不需要展开完整去噪图。
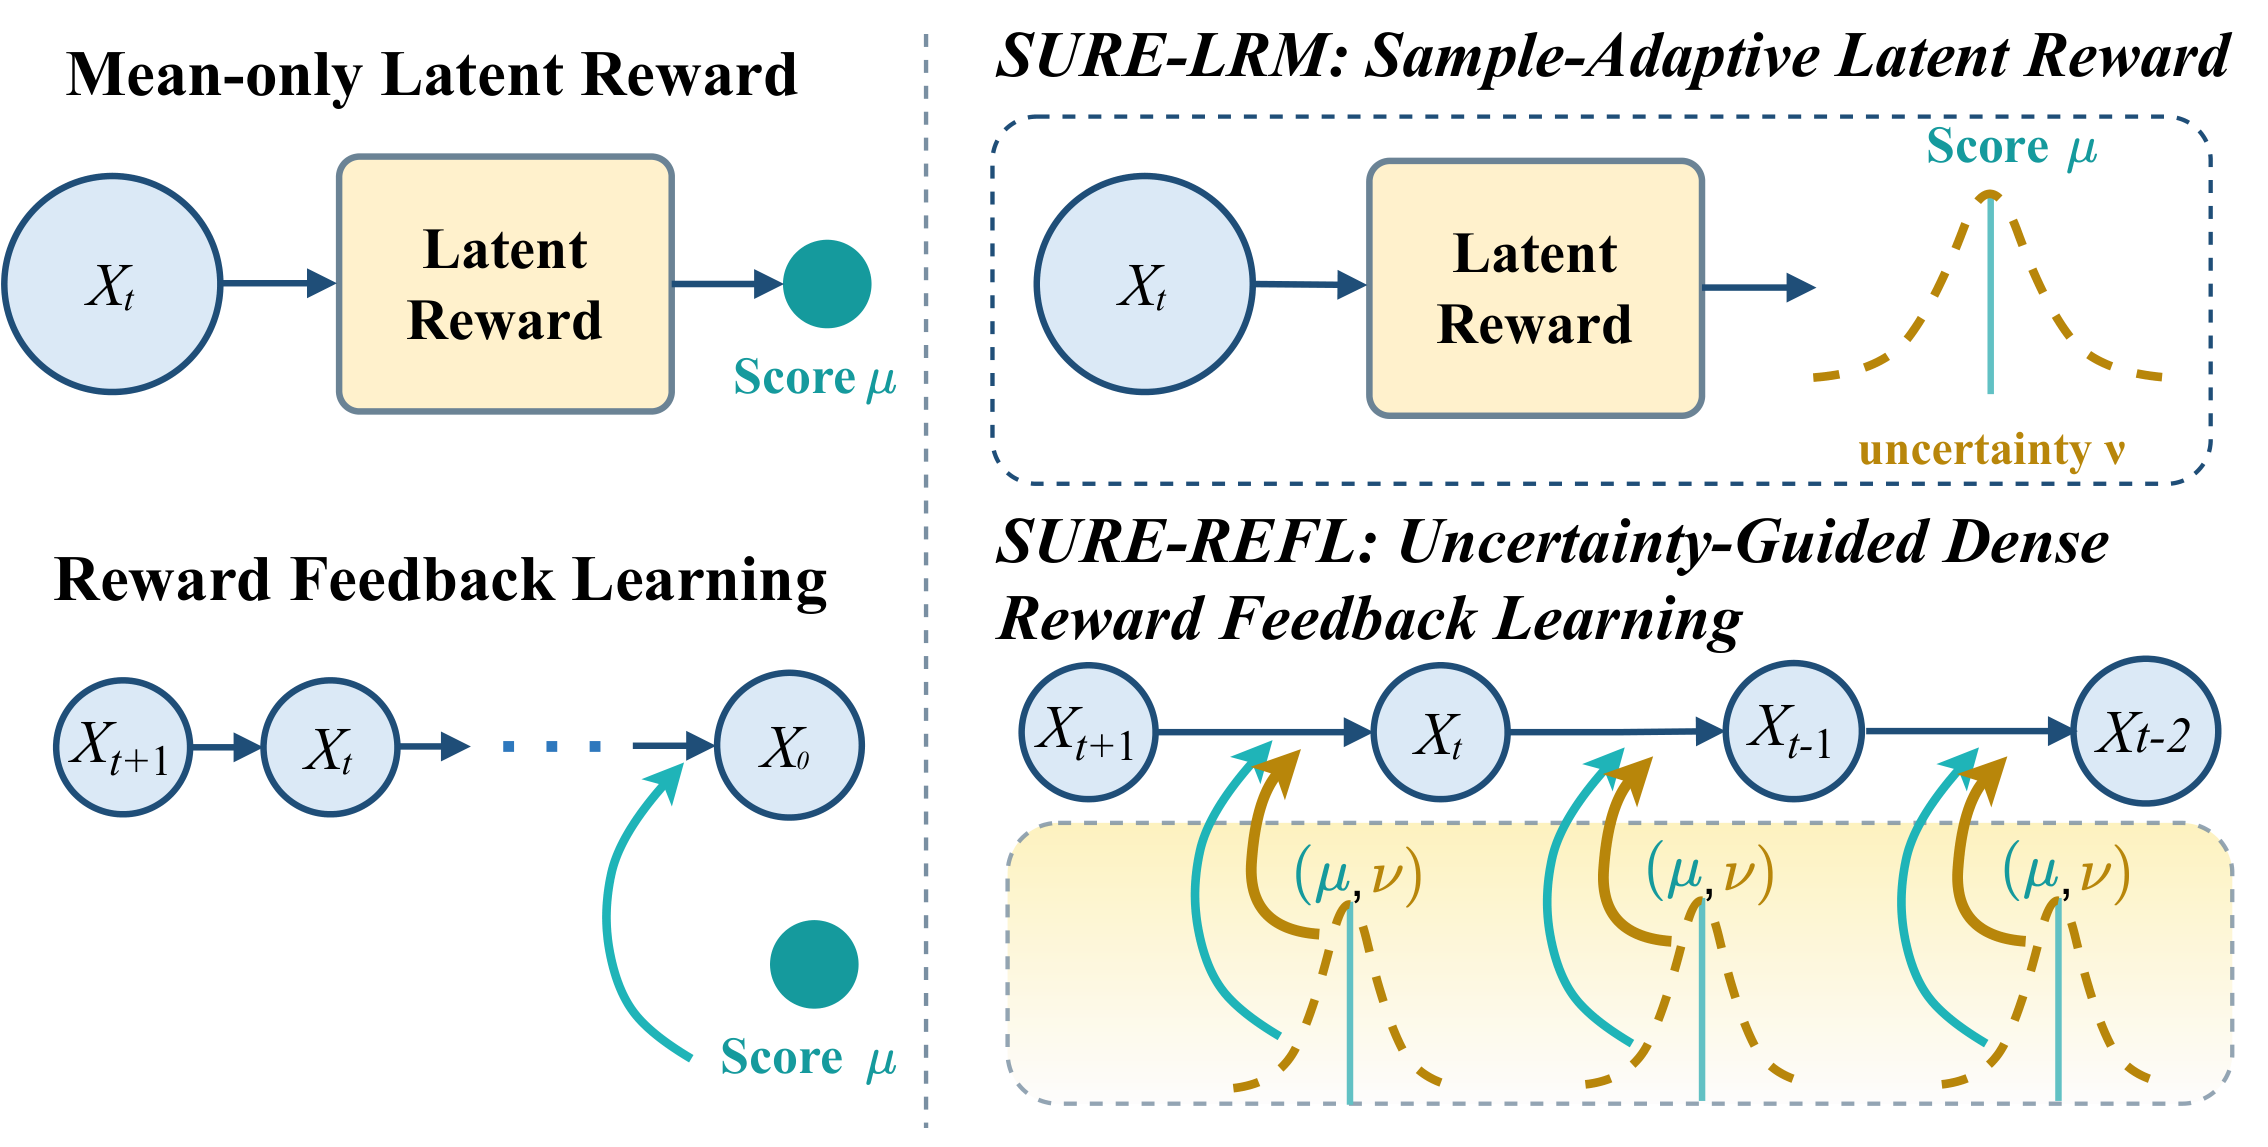
实验效果:偏好预测上跨三个骨干的均值从 DiNa-LRM 的 70.51 提升到 72.14,FLUX.1-dev 上单点最大提升 2.30。不确定度确实有信息量:排错的样本残差方差平均高 24.26%,用方差识别排序错误的 AUROC 为 0.6941,只保留方差最低的一半样本可把成对准确率从 79.40% 抬到 90.10%。视频侧 VisionRewardDB 72.31%、T2V Ranking 71.70%,均为最好。图像后训练在三个生成器、九个骨干—指标组合里拿下八项第一;视频用 Wan2.1-480P-T2V-14B 后训练,VBench 质量、语义、总分均为评测中最高。作者还给出对照曲线:DiNa-LRM-REFL 的优化奖励持续上升而独立的 HPSv3 已经开始下跌(典型奖励攻击),SURE-REFL 两条曲线则能同步更久。
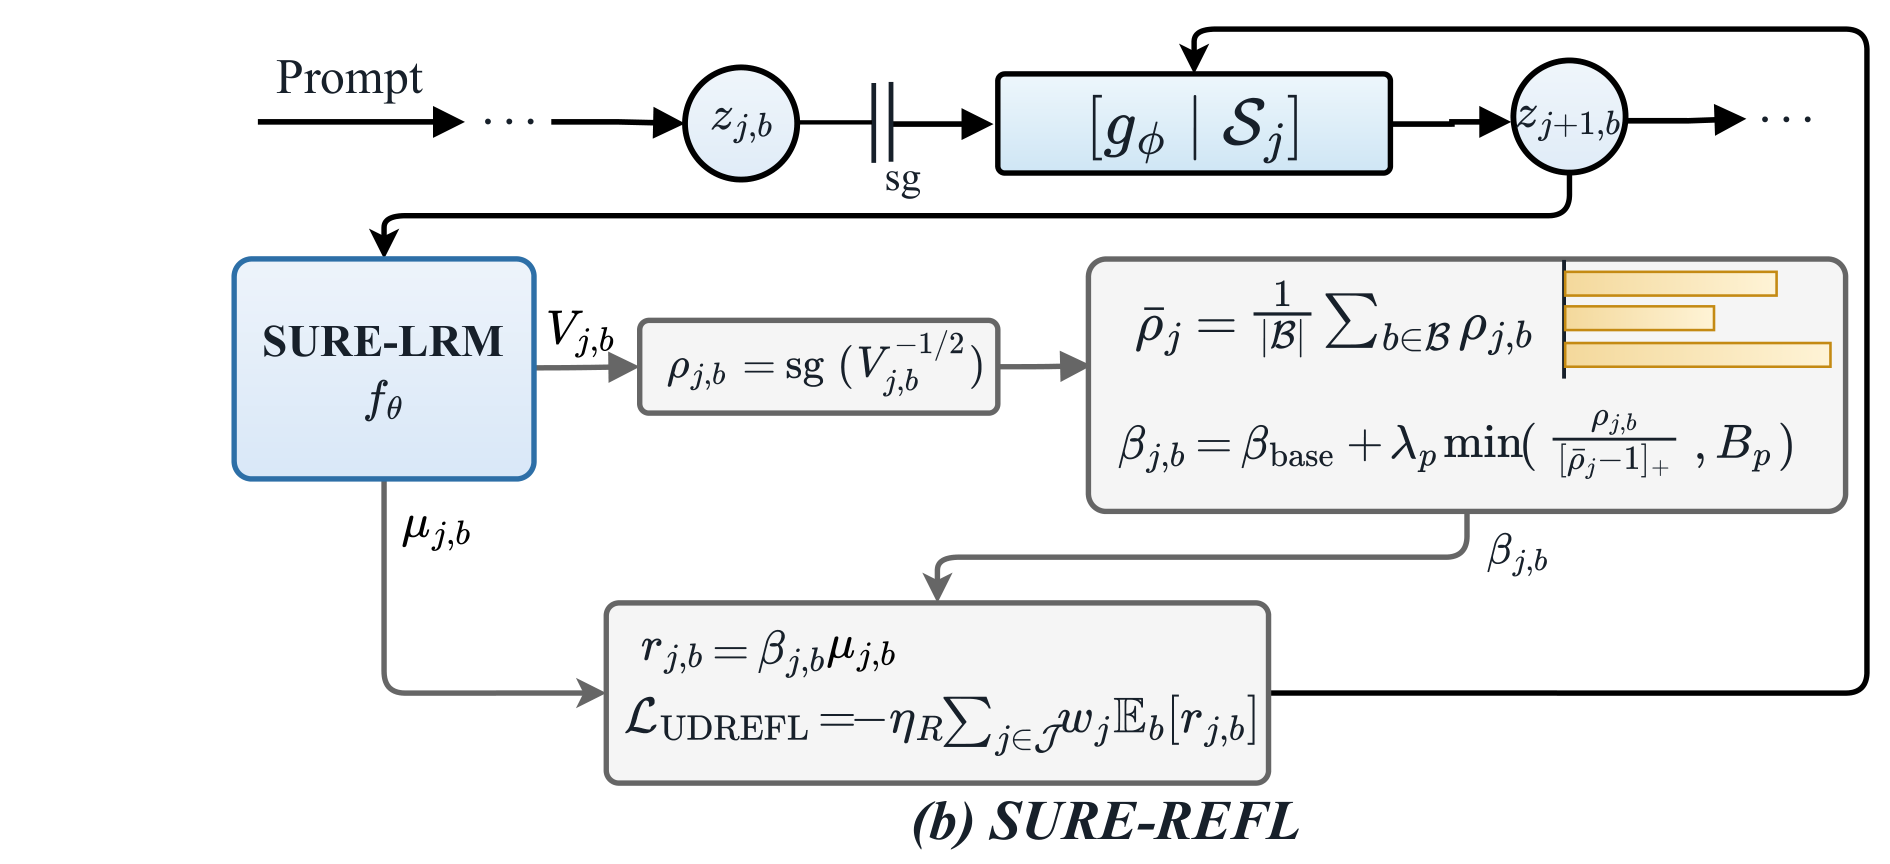
批判点评:把「奖励可不可信」显式建模出来,比事后加正则更对症,方差—错误率的诊断也做得实在。但不确定度是无监督学出来的,AUROC 0.6941 说明它只是弱信号,离可靠的置信度校准还有距离;作者自己也承认「保留低方差一半准确率涨到 90.10%」这组样本训练时见过,属于分布内诊断而非留出校准。更根本的是,可信度只在同一转移点内做相对比较,如果整个时间步的奖励模型集体偏了,加权也救不回来。
LC-GRPO: Bridging Train-Inference Gap for Flow-Based GRPO with Langevin Correction | 普林斯顿大学·加州大学圣地亚哥分校 | arXiv:2608.05600
关键词:Flow-GRPO,Langevin修正,训练推理错配,奖励攻击,强化学习
前序问题:流匹配模型推理时解确定性 ODE,而在线强化学习需要随机 rollout 来探索,于是现有 GRPO 训练时把 ODE 换成 SDE。连续时间下两者边缘分布相同,但有限步离散化后差别很大:探索噪声一大,SDE rollout 就发糊,拿这些糊掉的样本算奖励去训练,和最终 ODE 采样器生成的东西对不上号。
本文贡献:每一步 rollout 先走一步与推理对齐的 ODE Euler,再补一步针对该时刻边缘分布的随机 Langevin 修正。修正需要的 score 直接从流速度里换算出来,不用额外训练 score 模型;修正后的转移仍是各向同性高斯,似然可解析,能直接喂给策略优化。理论上作者证明:在合适条件下一步 Langevin 修正能降低不完美 ODE Euler 步的 Wasserstein 误差;在随机性水平匹配时,该转移比反向 SDE 的标准 Euler–Maruyama 离散更准确。

实验效果:SD3.5-Medium 上文字渲染 OCR 奖励做到 0.960,高于 Flow-GRPO 的 0.914 和 CPS 的 0.935,且 ImageReward 1.00、CLIP 0.291 等旁路质量指标不掉;人类偏好对齐 HPS-v2.1 达 0.393 对 0.381。FLUX.1-Dev 上 HPS-v2.1 0.384、PickScore 23.28 均第一。最刺眼的是视频:HunyuanVideo 用 VideoAlign 视觉质量做奖励,DanceGRPO 把 VBench 动态程度从原模型的 52.8 压到 12.5(画面几乎不动来骗高分),LC-GRPO 保住 45.8,同时 VideoAlign 视觉质量从 -0.205 提到 0.063、VBench 总分 79.10。计算上并不占便宜:Langevin 每步两次前向,作者让基线跑同样和两倍的 rollout 步数取更好结果。

批判点评:指出「训练用 SDE、推理用 ODE」这个人人默认却没人细究的错配,还给了 Wasserstein 误差的理论支撑,而不是纯经验 trick,视频那组动态程度 12.5 对 45.8 更是把奖励攻击拍在明面上——很多 GRPO 的涨分其实是靠画面变静态换来的。要留意每步两次前向的开销是实打实的,作者靠给基线加倍步数来对齐算力,但这不完全等价于同等 wall-clock;实验只覆盖 512×512 分辨率和 HPS、CLIP、OCR 这几类可打分奖励,更主观的美学或叙事奖励是否同样受益尚不清楚。
In-Context Forcing: Uncovering Context Effects in Autoregressive Video Diffusion | 上海科技大学·腾讯优图·浙江大学 | arXiv:2608.05237
关键词:自回归视频扩散,噪声上下文,跨帧并行,推理加速,Self Forcing
前序问题:少步自回归视频扩散在生成当前帧的每一个去噪步时,都拿前面已经彻底去噪的干净帧当上下文。干净帧泄露了太多局部细节,模型顺手抄过来就行,结果时序语义被削弱、画面越生成越静止。而如果简单地给上下文加同样强度的噪声,引导又不够,时序一致性会崩。
本文贡献:借「扩散即掩码」的视角重新设计上下文:让上下文帧带上递减的噪声水平——离得远的帧掩得少、紧挨着的帧掩得多,形成渐进式自回归范式,既保住时序一致性又留出帧间动态。更实际的收益是,一旦不再严格依赖「前面必须是干净帧」,跨帧就能并行去噪,推理不再是一条串行长链。训练上以 Wan2.1-T2V-14B 为教师、其因果版 1.3B 为学生,batch 64 跑 1900 步。

实验效果:VBench 上视觉保真度和推理速度双双超过现有方法。逐帧设定下吞吐从 Self Forcing 的 8.9 FPS 提到 16.2 FPS,相对提速 82%,总推理时间减少 45.1%;即便在本已优化过的分块设定下也还能再省 9.3% 时间。30 秒长视频差距最明显:动态程度 86.40 对 Rolling Forcing 的 40.63——后者训练测试不一致的问题会随着滚动窗口反复传播,越长越静止。盲测 A/B 用户研究中相对 Wan2.1、CausVid、Self Forcing 三个基线均获偏好。
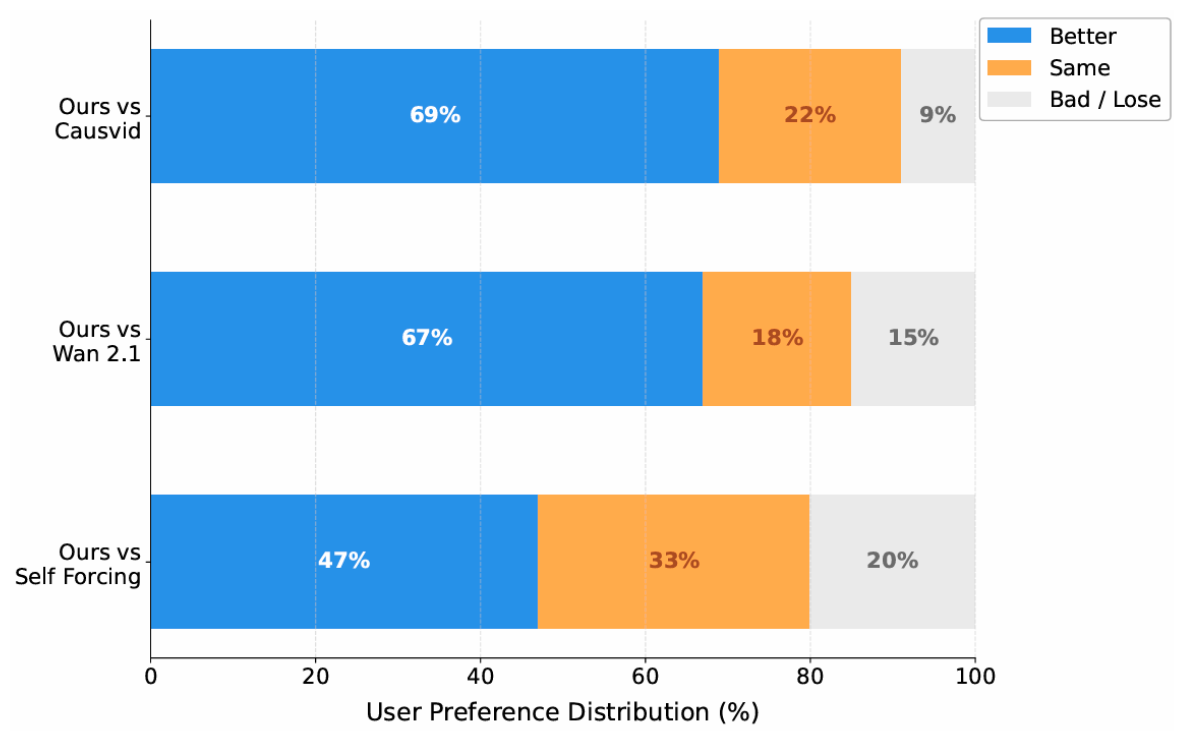
批判点评:「给上下文加噪反而更好」违反直觉但解释得通:干净帧提供的是模型可以偷懒复制的捷径。更漂亮的是解开干净帧依赖后顺带解锁跨帧并行,质量和速度不再是二选一。不过 82% 提速是在逐帧这个本身效率最差的设定下取得的,切到实际常用的分块设定就只剩 9.3%,标题数字有挑好看的成分;学生模型只有 1.3B,是否能迁移到 14B 级别未验证;动态程度高也不等于运动合理,86.40 里有多少是有意义的运动仍需人眼确认。
Diff-VF: Training-free High-quality Long Video Generation via Diffusion Model | 上海交大·上海人工智能实验室 | arXiv:2608.05976
关键词:免训练长视频,窗口融合,噪声初始化,VBench-Long,即插即用
前序问题:现有视频扩散模型基本都用 10 秒以内的短视频训练,直接外推到长视频就会崩:要么长程语义漂移,要么为了保一致性把画面拍成几乎静止。而重新训练长视频模型既缺数据也缺算力。
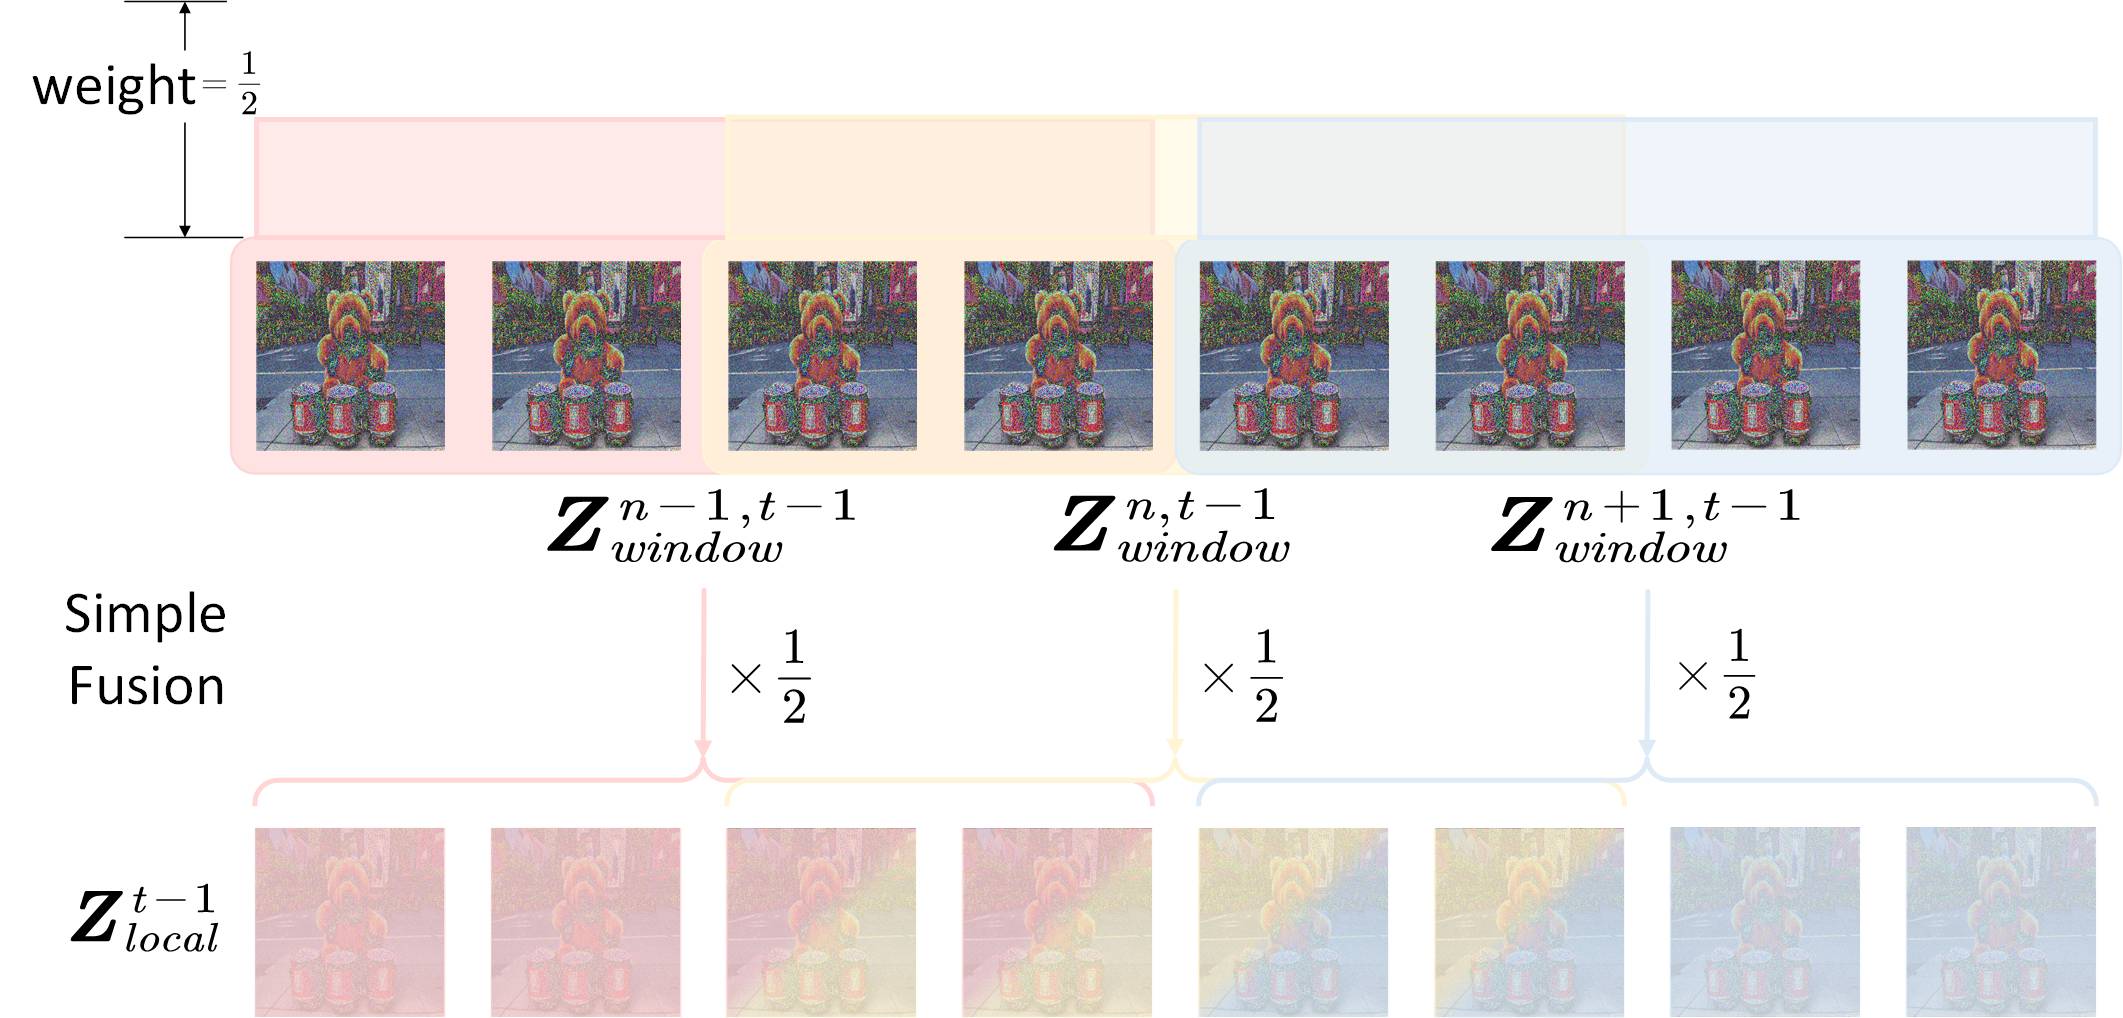
本文贡献:提出免训练、即插即用、与骨干无关的 Diff-VF,全部操作只在噪声 latent 上做,因此不挑空间时间建模方式。三招配合:混合噪声初始化用第一段噪声锚定全局语义、后续段追加噪声补充内容多样性;加权窗口采样给每个窗口内的帧按到窗口中心的距离分配权重,让重叠区平滑过渡而不是简单平均出接缝;时间扩展采样把视频按固定间隔抽成若干等距子片段分别去噪再还原顺序,用随时间步变化的融合建立长程依赖。此外用跳跃残差引导把框架扩展到长视频增强,在保真与真实感之间做时间步相关的平衡。
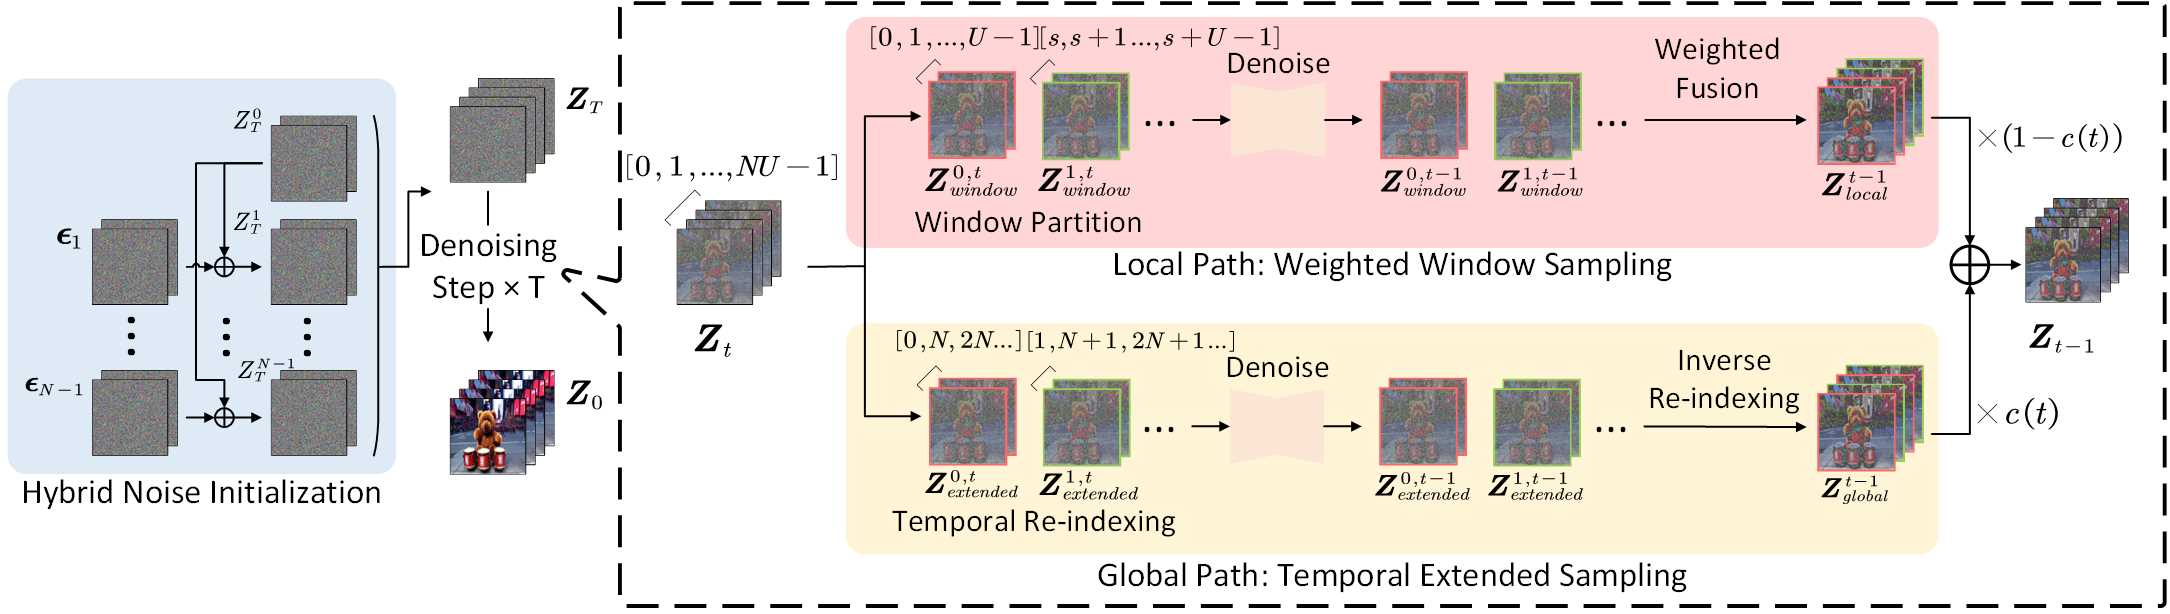
实验效果:在 LaVie 上做 VBench-Long 评测,相比基座模型(主体一致性 0.8546、动态程度 0.9722)和免训练基线,Diff-VF 主体一致性升到 0.9164、动态程度 0.7208,高于 FreeNoise 的 0.6958 和 FreeLong 的 0.5625;整体一致性 0.2795 与人物动作 0.9580 均为最好,运动平滑度 0.9529 也居首。换到 HunyuanVideo 同样有效,说明对 2D+1D 与 3D 注意力两种结构都适用,生成长度是基座原生输出的 4 倍。对比对象包括 FreeNoise、FreeLong 和 RIFLEx。
批判点评:一行权重都不改就把短视频骨干拉长 4 倍,这类方法的部署成本几乎为零,权重函数和等距采样的设计也确实比简单平均更讲究,作者跨两种注意力结构验证了通用性。但要看清代价:基座原本 0.9722 的动态程度被压到 0.7208,只是压得比 FreeLong 的 0.5625 少而已,「一致性—动态性」的跷跷板并没有被打破,只是挪了个位置;评测停在 LaVie 和 HunyuanVideo,没碰 Wan、CogVideoX 这些主流骨干;4 倍长度对分钟级叙事而言仍然偏短。
人工智能炼丹君 整理 | 2026-08-07
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)