


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:对齐与强化学习 | 难度:进阶 | 前置知识:PPO
关键词:DPO、GRPO、偏好优化、组内归一化、免价值网络、参考模型
读者需要会读条件概率、对数概率与期望,理解 PPO 中的策略(给定前缀输出下个 token 的分布)、优势与裁剪。本文把 prompt 记为 $x$、完整回答记为 $y$、回答的第 $t$ 个 token 记为 $y_t$;整句概率按自回归条件概率相乘,整句 logprob 则是有效回答 token 的 logprob 之和。这里讨论的是回答级终局奖励;过程奖励和视觉去噪轨迹只在边界处作区分。
把一个 7B 语言模型接进 PPO-RLHF,训练栈很快会变成四个模型:负责生成的 actor、预测每个 token 未来回报的 critic、限制策略漂移的 reference model,以及把整条回答变成分数的 reward model。真正更新参数的是 actor 和 critic,后两者虽然通常冻结,前向和显存仍要付钱。
critic 是最难解释的一笔成本。语言模型往往只在回答结束时拿到一个总分,但 value head 必须给回答中每个 token 估计未来回报。它不但要和 actor 同量级地跑前向、反向,还要从稀疏的终局信号中学习密集价值。DeepSeekMath 指出,LLM 的 value model 通常与 policy model 规模相当,这正是 GRPO 要删除的部件。
以全参数 AdamW 的粗略账本为例:7B 参数的 BF16 权重约 14 GB,BF16 梯度约 14 GB,FP32 主权重和两份动量约 84 GB,一个可训练模型合计约 112 GB 逻辑状态,实际可被 ZeRO/FSDP 分片。这里的 GB 是十进制字节($10^9$ 字节);112 GB 约为 104.3 GiB,不含激活、通信缓冲、临时张量,且假设保留 FP32 主权重;它是所列精度方案的逻辑状态估算,并非实测峰值。再训练一套同规模 critic,等于再背一次参数、梯度、优化器状态和激活。删掉 critic 的收益很大,但不能机械地说“所有训练都便宜十倍”:GRPO 每个 prompt 要在线生成一组回答,DeepSeekMath 第 4.2 节的 RL 训练每题采 64 条、最大回答长度 1024、每轮探索后仅更新一次;这与摘要中 64 样本 self-consistency 的评测协议是两回事,采样和奖励打分可能成为新的主成本。
DPO 与 GRPO 给了两条不同的减法路线。DPO 把带 KL 约束的 RLHF 目标改写成偏好二分类,训练时不再在线采样,也不需要显式奖励模型;GRPO 保留在线探索和奖励信号,用同一道题的组内相对分数替代 critic。二者名字相邻,解决的却不是同一个问题。
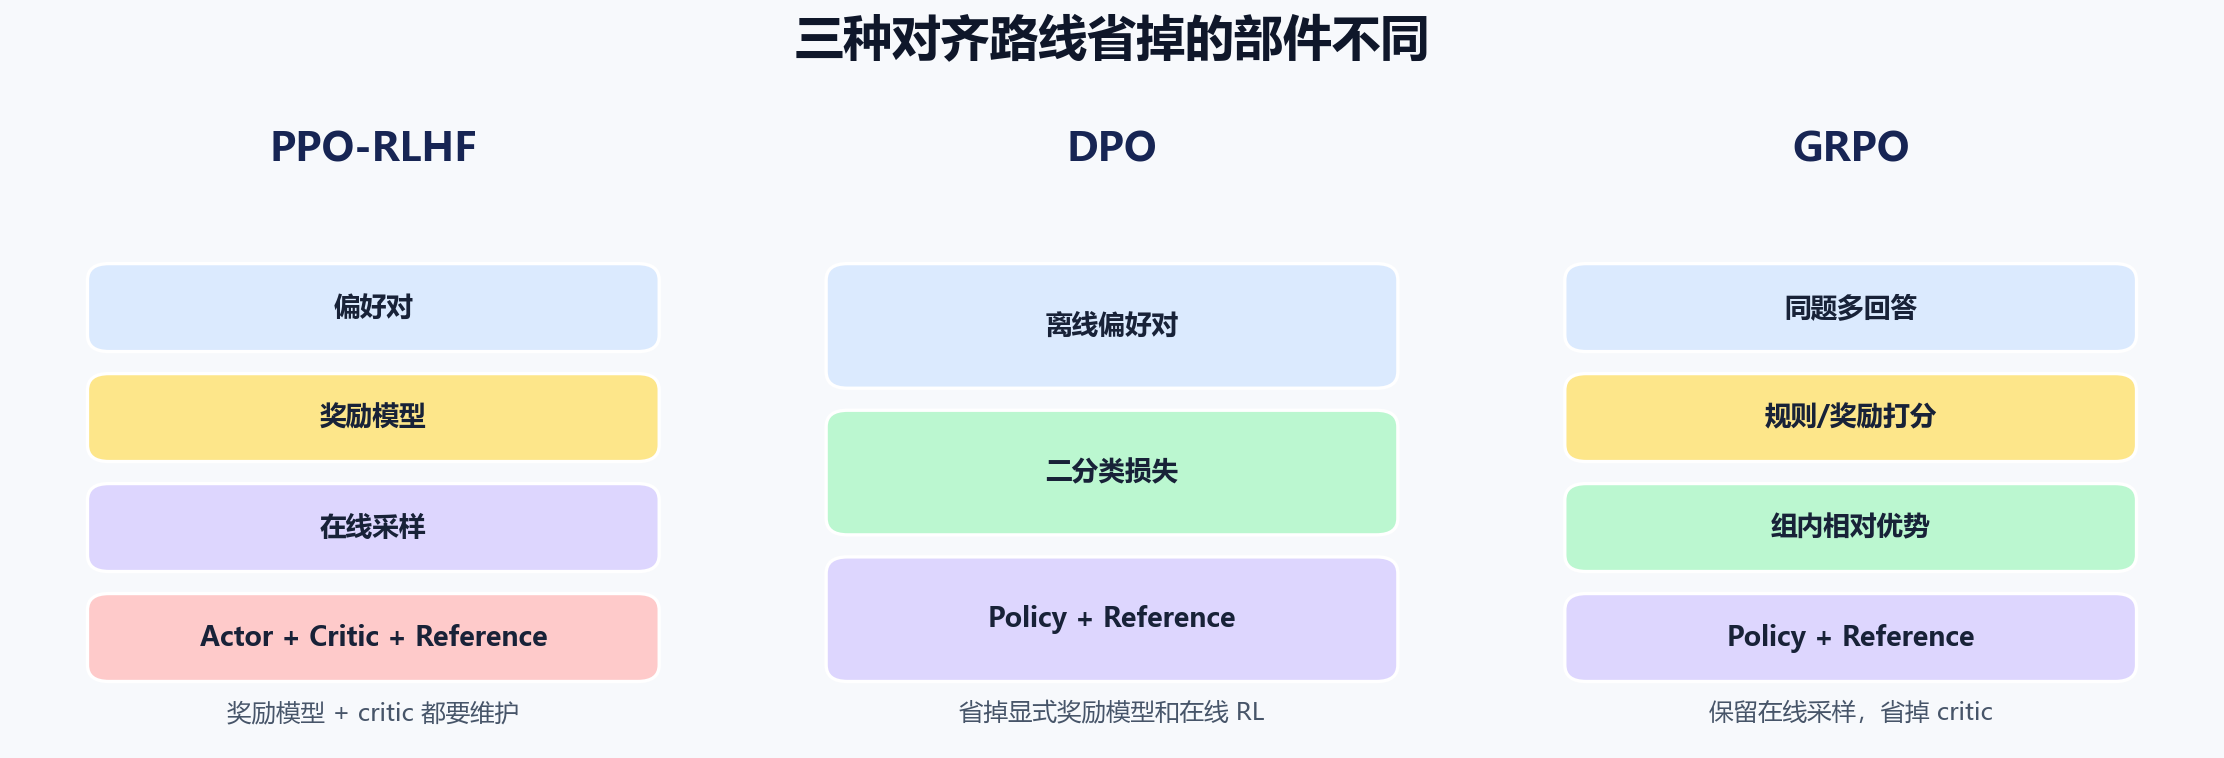
图 1:DPO 省掉显式奖励模型和在线 RL 循环,GRPO 省掉 critic。Policy 与 reference 是否共享底座、reward 是规则还是模型,会继续改变真实成本。
先记住五句话:
因此,从 DPO 到 GRPO 不是把一个损失函数逐项变形为另一个,而是从“离线比较学习”切换到“在线生成、在线评价”。选择算法时先问数据来自哪里,再问显存够不够。
对 prompt $x$ 和回答 $y$,标准 KL 正则化目标可以写成:
$$\max_{\pi}\ \mathbb{E}_{y\sim\pi(\cdot\mid x)}[r(x,y)]-\beta D_{KL}[\pi(\cdot\mid x)\|\pi_{ref}(\cdot\mid x)]$$
$\pi$ 是待训练策略,$\pi_{ref}$ 是在当前优化区间内冻结的参考策略,$r(x,y)$ 是回答奖励,$\beta>0$ 是 KL 权重。这里的 KL 是同一 prompt 下完整回答分布的正向 KL:用策略概率加权,计算对数概率比的期望;后面的 token 代理目标另行定义。PPO 用采样轨迹、critic 优势和裁剪目标近似优化它。这里至少要维护 actor、critic 和 reference;若奖励由神经网络给出,还要运行 reward model。
先固定一个 $x$,把 $\pi(y\mid x)$ 简写为 $p_y$,参考概率写成 $q_y$。假设只在参考策略有正概率的支持集上优化,且归一化常数有限。对有限回答集合,加入约束 $\sum_y p_y=1$ 的拉格朗日乘子 $\lambda$,目标变为:
$$F(p,\lambda)=\sum_y p_y r_y-\beta\sum_y p_y\log(p_y/q_y)+\lambda(\sum_y p_y-1)$$
对每个正概率的 $p_y$ 求偏导并令其为零,得到 $r_y-\beta[\log(p_y/q_y)+1]+\lambda=0$。因此 $p_y=q_y\exp(r_y/\beta)\exp(\lambda/\beta-1)$;最后一项与 $y$ 无关,由概率和为一决定。这才得到闭式最优策略:
$$\pi^*(y\mid x)=\frac{1}{Z(x)}\pi_{ref}(y\mid x)\exp\left(\frac{r(x,y)}{\beta}\right)$$
$Z(x)=\sum_y\pi_{ref}(y\mid x)\exp(r(x,y)/\beta)$。把该解代回目标,可以写成 $\beta\log Z(x)-\beta D_{KL}(\pi\|\pi^*)$;KL 非负,所以闭式解是全局最优。无限回答空间还要求这个和收敛;参考概率为零的回答不能靠这个式子凭空获得概率。把式子移项,可把奖励写成策略与参考策略的对数概率比:
$$r(x,y)=\beta\log\frac{\pi^*(y\mid x)}{\pi_{ref}(y\mid x)}+\beta\log Z(x)$$
偏好数据给出同一 prompt 下的胜者 $y_w$ 与败者 $y_l$。DPO 原论文用 Bradley–Terry(BT)假设,把偏好噪声的尺度吸收到奖励里,令“胜者更好”的概率为两条潜在奖励之差的 sigmoid。这里 $\sigma(u)=1/(1+e^{-u})$:
$$P(y_w\succ y_l\mid x)=\sigma(r(x,y_w)-r(x,y_l))$$
把上一式代入后,同一道题共享的 $\beta\log Z(x)$ 自动相消。用可训练策略 $\pi_\theta$ 代替未知最优策略,得到 DPO 损失:
$$\mathcal{L}_{DPO}=-\mathbb{E}\log\sigma\left(\beta\left[\log\frac{\pi_\theta(y_w\mid x)}{\pi_{ref}(y_w\mid x)}-\log\frac{\pi_\theta(y_l\mid x)}{\pi_{ref}(y_l\mid x)}\right]\right)$$
括号里有两层差。第一层是 chosen 与 rejected 的差;第二层是当前 policy 相对 reference 的差。DPO 鼓励当前策略相对 reference 的 chosen/rejected 间隔增大;它不要求 chosen 的绝对概率单调增加。例如参考分布为 [0.2,0.3,0.5],当前分布从 [0.4,0.4,0.2] 变为 [0.3,0.15,0.55],把前两个动作当 chosen/rejected,chosen 概率下降,但二者比值从 1 增至 2。$\beta=0.1$ 时这对样本的 loss 从 0.673079 降至 0.639724。这是两个归一化分布的目标值反例,不是声称一次 DPO 梯度步必沿这条路径走。
DPO 的省钱来自训练协议:偏好对提前收集好,训练循环只做似然计算和二分类,不需要当前策略在线生成回答,也不需要在循环里调用显式 reward model。但代价也在这里:数据分布被固定。策略更新后会产生哪些新错误,旧偏好集未必覆盖。BT 假设、偏好覆盖和模型可表达性决定了二分类能否恢复所需奖励差;有限、矛盾的偏好对加上受限模型,并不能保证得到原 RLHF 问题的全局最优。DPO 损失中的 $\beta$ 来自上述参数化,调大它会同时改变分类 logit 和梯度,不能只凭“KL 权重更大”推断实际训练必更保守。
PPO 的优势通常来自 critic:
$$A_t=Q(s_t,a_t)-V_\phi(s_t)$$
$V_\phi(s_t)$ 预测从当前 token 前缀继续生成的平均回报。在不引入裁剪等近似时,若 baseline 只依赖状态、与当前动作无关且计算策略梯度时视作常数,减去它不改变期望,因为对该状态所有动作的概率之和求导为零;合适的 baseline 可以降低方差,任意差的 baseline 则未必。问题是,回答只在末尾拿到 $r(x,y)$,critic 却要在每个位置给出估计;它要学习的目标本身就很噪。
如果暂时不追求每个 token 的状态价值,而是对同一道题一次采 $G$ 个完整回答,就能用样本组构造另一种 baseline。
从旧策略 $\pi_{old}$ 对同一 prompt $x$ 采样回答 $\{y_1,\ldots,y_G\}$,奖励为 $\{r_1,\ldots,r_G\}$。Outcome supervision 下,GRPO 定义:
$$\hat A_i=\frac{r_i-\mathrm{mean}(r_1,\ldots,r_G)}{\mathrm{std}(r_1,\ldots,r_G)+\epsilon}$$
这里标准差与防零用 $\epsilon$,裁剪半径则用 $\varepsilon$,二者是不同超参数。本文教学代码固定 $\epsilon=10^{-4}$,默认总体标准差,即平方离差和除以 $G$;固定 TRL 的 nanstd 则除以有效样本数减一。第一组 [0.2,0.8,1.4,0.6] 的总体标准差为 0.433013,样本标准差为 0.5,因此 ddof=1 对照官方时优势幅度会更小。DeepSeekMath 公式只写 std,本文不把教学默认口径冒充论文指定分母。
均值去掉组内共同的加法偏置,标准差调整组内奖励尺度。它不是只保留名次:[0,1,2,10] 和 [0,1,9,10] 的排序相同,标准化优势仍不同,因为相对分差不同。对 $r_i^{\prime}=a r_i+b$、$a>0$,分子乘 $a$、标准差乘 $a$;若 $\epsilon=0$ 才精确抵消,有固定 $\epsilon$ 时新优势等于原中心化奖励除以 $s+\epsilon/a$。负比例会反转方向,非线性单调变换也会改变间距。对一条回答里的每个有效 token,原始 GRPO 都广播同一个 $\hat A_i$:它为高于组均值的采样回答提供正向局部替代梯度、低于均值的提供负向梯度;共享网络参数、clip 和 KL 共同更新后,不能保证每个 token 的最终概率都按该符号变化。
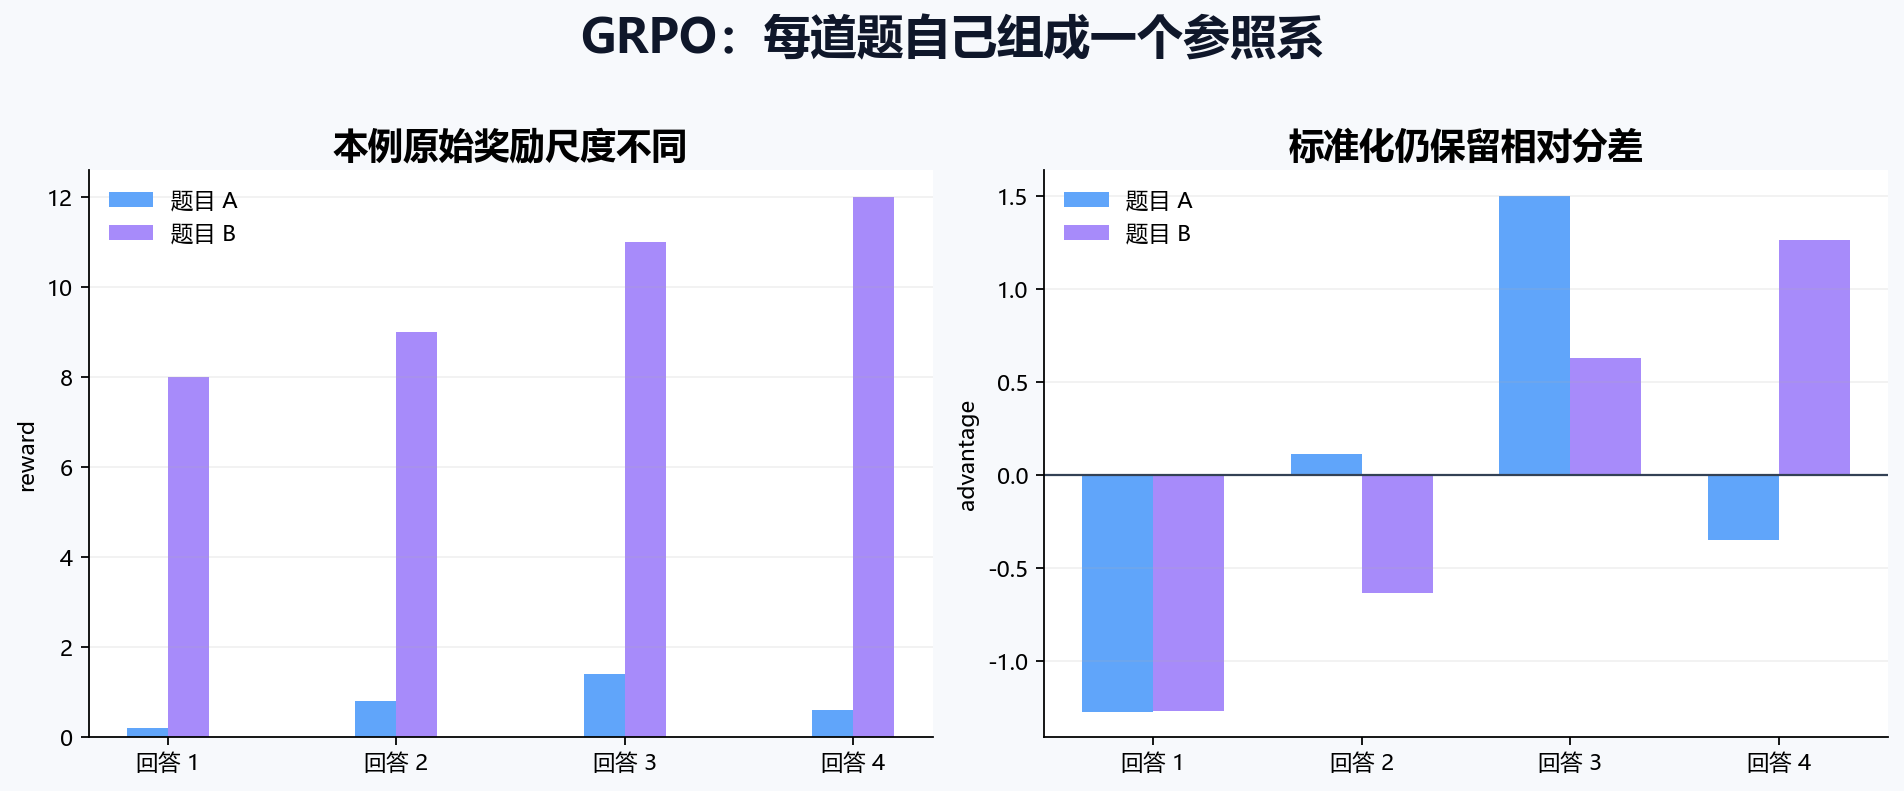
图 2:同原代码的两组奖励和总体标准差、$\epsilon=10^{-4}$。每道题分别中心化;标准化仍保留相对分差,图中的两组也不是精确仿射副本,因此两组柱形无需重合。
组均值包含样本自身,不满足“baseline 与本次动作独立”。把完整回答暂当作一次动作,固定 prompt,令 $s_i=\nabla\log\pi(y_i\mid x)$、$J=E[r_i]$;独立同分布采样且正则性成立时 $E[s_i]=0$。展开组均值项:
$$E[\bar r s_i]=\frac1G E[r_i s_i]+\frac1G\sum_{j\ne i}E[r_j]E[s_i]=\frac1G\nabla J$$
所以 $E[(r_i-\bar r)s_i]=(1-1/G)\nabla J$。改用其余 $G-1$ 条回答的均值(leave-one-out)能去掉这个缩放;$G=1$ 不适用。再除与采样结果相关的随机标准差,一般会改变方向及 prompt 权重,不能只用一个常数纠偏。三动作、$G=3$ 的精确枚举给原奖励梯度 [-0.372,-0.198,0.570]、组中心化梯度 [-0.248,-0.132,0.380],恰为 2/3;标准化后为 [-0.209534,-0.136999,0.346534],三个分量比值不同。这里尚未加入 clip、每条回答长度归一化、旧策略复用和 KL;完整 GRPO 更不能称为原始期望奖励的无偏梯度。
这不是免费午餐。$G$ 太小时,组均值和标准差很不稳定;奖励全相等时,优势全部为零;同一回答的所有 token 共用一个结果优势时,算法知道“整条回答好”,却不知道哪一步推理真正立功。
对回答 $y_i$ 的第 $t$ 个 token,定义新旧策略概率比:
$$\rho_{i,t}(\theta)=\frac{\pi_\theta(y_{i,t}\mid x,y_{i,<t})}{\pi_{old}(y_{i,t}\mid x,y_{i,<t})}$$
GRPO 沿用 PPO-Clip 的保守替代目标,并直接在 loss 上加 reference KL:
$$\mathcal{J}_{GRPO}=\mathbb{E}\left[\frac{1}{G}\sum_i\frac{1}{|y_i|}\sum_t\left(\min\left(\rho_{i,t}\hat A_i,\mathrm{clip}(\rho_{i,t},1-\varepsilon,1+\varepsilon)\hat A_i\right)-\beta D_{KL}(\pi_\theta\|\pi_{ref})\right)\right]$$
$\pi_{old}$ 是本轮 rollout 的采样快照,用于构造旧策略数据上的局部替代目标;单 token 比值并未完整校正所有前缀的分布偏移;$\pi_{ref}$ 是行为锚点,用于限制当前参考区间内的行为漂移;DeepSeekMath 的 iterative RL 会在外层迭代更新 reference,不能一概说它整个训练永久冻结。两者在训练刚开始可能数值相同,但职责不同,不能混用。
DeepSeekMath 使用的固定前缀下单动作的非负 KL 估计量是:
$$D_{KL}=\exp(\Delta)-\Delta-1,\quad \Delta=\log\pi_{ref}-\log\pi_\theta$$
因为对任意实数 $\Delta$ 都有 $e^\Delta\geq1+\Delta$,这个量非负,在两策略对该动作的概率相同时为零。在实现里它可以直接由采到 token 的 policy/reference logprob 计算,不必枚举整个词表。它的期望等于 $D_{KL}(\pi_\theta\|\pi_{ref})$ 的前提是动作从当前 $\pi_\theta$ 采样;实际 rollout 来自 $\pi_{old}$,更新后直接平均得到的是旧采样分布下的代理量,需要相应重要性校正才有同一无偏解释。
还有一个更隐蔽的区别:估计值的期望正确,不代表固定采样后对 $k_\theta=e^\Delta-\Delta-1$ 反向传播就得到真实 KL 的梯度。记当前条件分布为 $p$、reference 为 $q$,则 $k=q/p-\log(q/p)-1$,有:
$$\sum_a p_a k_a=\sum_a[q_a-p_a-p_a\log(q_a/p_a)]=D_{KL}(p\|q)$$
但固定样本只对 $k$ 求导时,$\nabla k=(1-q/p)\nabla\log p$,遗漏了采样概率本身随参数变化的导数。在 softmax logits 上,采样点为当前 $p$ 时这个代理的期望梯度是 $p-q$,真正 KL 的第 $a$ 个分量则为 $p_a[\log(p_a/q_a)-D_{KL}(p\|q)]$。两者一般不同。
可直接核对三动作例子:$p=[0.7,0.2,0.1]$、$q=[0.2,0.3,0.5]$,真实 KL 为 0.634897;若从旧分布 [0.3,0.3,0.4] 采样,裸 $k$ 的期望却是 1.146128。用未 detach 的 $p/\pi_{old}$ 乘 $k$,其值和梯度在这个固定前缀下恢复真实条件 KL;若只乘已 detach 的比值,仍缺一项梯度。序列级分布还包含前缀占用概率,不能由这个单步验证推断整个 GRPO 是精确 KL-RL 优化。固定 TRL 的 use_bias_correction_kl 分支可加入 ratio,本教程 bandit 则有意保留未校正的论文式代理,明确其范围。
同分组只消掉奖励 surrogate。若 $\beta>0$ 且当前策略已偏离 reference,KL 仍可能提供梯度;如果又有熵、辅助损失或 Adam 历史动量,实际参数步也未必为零。“全同分就完全不更新”只在本教程从均匀 reference 初始化、没有其他梯度或动量时成立。
DPO 和 GRPO 都在做“相对比较”,但参照物不同:
| 维度 | DPO | GRPO |
|---|---|---|
| 数据 | 固定的 chosen/rejected 对 | 当前策略在线生成的一组回答 |
| 相对量 | policy 相对 reference 的偏好间隔 | 回答奖励相对同组均值 |
| 删除的部件 | 显式 reward model 与在线 RL 循环 | critic/value model |
| 仍需保留 | policy、reference、偏好数据 | policy、old policy logprob、reference、奖励函数 |
| 主要风险 | 离线数据覆盖不足 | 采样昂贵、组内同分、奖励投机 |
这张表也解释了为什么“DPO 之后再做 GRPO”可以成立:先用便宜的离线偏好对把策略推到合理区域,再用在线 GRPO 探索当前策略真正会生成的回答。但这是一种训练安排,不是数学上必须的前后继关系。
先看 DPO。设第一对样本中,当前 policy 对 chosen 和 rejected 的整句 logprob 分别为 -2.2 和 -2.8,因此 policy 的偏好间隔是 0.6;reference 对二者的 logprob 分别为 -2.0 和 -2.4,偏好间隔是 0.4。当前策略相对 reference 多出来的间隔只有 0.2。当 $\beta=0.1$ 时,送进 sigmoid 的 logit 是 0.02,胜者概率只略高于 0.5,loss 接近随机猜测的 $\log 2$。
这解释了一个常见现象:chosen 的 logprob 即使很低,也不代表 DPO 一定给它很大梯度。DPO 看的是四个 logprob 组成的相对差。若 reference 已经强烈偏爱 chosen,而 policy 只复制了这种偏好,DPO 不会把它误判成新的进步;若 policy 相比 reference 反而缩小了 chosen 的优势,logit 会变负,损失上升。
再看 GRPO。第一组奖励是 [0.2, 0.8, 1.4, 0.6],均值为 0.75,标准差约为 0.433。标准化后得到 [-1.2699, 0.1154, 1.5008, -0.3463]。第二个回答虽然原始分数 0.8 看上去不高,但它略高于同题平均,因此得到很小的正优势;第三个回答比平均高很多,得到最大的正优势。
假设这四条回答更新后的 token ratio 依次是 [1.2840, 1.1052, 0.7788, 0.9048],裁剪区间为 [0.8,1.2]。第一条优势为负,而 ratio 大于 1,说明坏回答变得更可能,目标必须继续惩罚,不能裁掉。第二条优势为正且 ratio 在区间内,正常提供正向梯度。第三条优势为正但 ratio 低于 0.8,说明好回答被错误降权,目标同样继续惩罚。第四条优势为负且 ratio 在区间内,也正常提供降低概率的梯度。
真正被截住的是“已经朝正确方向走过头”的两种情况:正优势回答的 ratio 超过 1.2,或负优势回答的 ratio 低于 0.8。PPO/GRPO 的 clip 从来不是把所有 ratio 强制塞进区间,而是停止奖励过度乐观的改进。只看 np.clip(ratio) 而不把优势符号放进来,几乎一定会误读目标。
code/dpo_grpo_minimal.py 只依赖 NumPy,包含三部分:DPO 二分类损失、GRPO 的组内优势与裁剪损失,以及一个四动作 bandit 的在线训练。本轮在 Windows / Python 3.11.9 / NumPy 2.4.3 的 CPU 环境实际运行,输出如下;无预训练权重、无需 GPU。完整脚本见文末,code/dpo_grpo_checks.py 另外验证闭式解、梯度、mask 与多 seed 边界。
两张解释图由 code/make_figures.py 从文中的固定数值直接生成,图和公式使用同一组奖励,避免手工绘图与代码结果不一致。
=== DPO ===
pair_shape=(2,)
preference_logits=[0.02 0.03]
loss=0.6807

=== GRPO group baseline ===
rewards.shape=(2, 4)
advantages=
[[-1.2699  0.1154  1.5008 -0.3463]
 [-1.2648 -0.6324  0.6324  1.2648]]
row_mean=[-0.  0.]

=== GRPO clipped objective ===
token_logps.shape=(4, 3)
ratio_first_token=[1.284  1.1052 0.7788 0.9048]
mean_kl=0.018550, loss=0.1626
奖励张量形状是 [prompt, generation] = [2, 4]。每行优势的均值都为零,说明每道题自己形成 baseline。裁剪例子里第一条优势为负而 ratio 为 1.284,第三条优势为正而 ratio 为 0.7788:二者都朝错误方向越界,因此 min 保留未裁剪项以继续惩罚。另两条 ratio 在区间内。这四条回答都没有进入裁剪收益的平台分支,与 3.7 节一致。
bandit 有四个回答动作,真实奖励分别是 [-0.2, 0.3, 1.0, 0.0]。脚本不训练 critic,每轮只采 32 个动作、组内标准化奖励,再用两轮 PPO 式更新复用这组样本:
step  P(a0)   P(a1)   P(a2=best)  P(a3)
   1  0.2288  0.2494  0.2883  0.2335
  20  0.0210  0.0346  0.9179  0.0265
  40  0.0048  0.0064  0.9833  0.0055
  80  0.0026  0.0035  0.9906  0.0033
第 80 步时,最优动作概率从 0.25 升到 0.9906。这个实验展示的是此有限 bandit 的组相对代理更新能提高给定奖励较高动作的概率,不代表大模型会如此平滑:真实回答空间巨大,奖励噪声、长度与采样温度都会改变结果。
本文人工核对了 Hugging Face TRL 的 GRPOTrainer,以 2026-09-13 的主分支提交 cd2c528 为准。提交元数据核实日期为 2026-09-13。下述实现选择来自这个固定快照,不能混称为所有 GRPO 的定义;本轮在 Torch 2.10 CPU 上执行其完整 _compute_loss 原始 AST,模型 logprob 回调及单进程 accelerator 用数值夹具提供,24 组损失值与梯度对照通过,不包含 trainer 初始化、分布式生成或大模型训练。生产实现比论文公式多出几层选择:
NaN,从组均值中排除,随后把 NaN 优势置零,避免“不可评分”被误当成零奖励。若一组只剩一个有效奖励,样本标准差不可定义,归一化优势也会被置零;这只保证没有该项奖励梯度,不等于屏蔽 KL。本文 NumPy 教学函数只接受完整有限奖励组,遇到 NaN 明确拒绝,官方的缺失评分路径由独立原代码夹具验证。scale_rewards 支持按 group、batch 或不缩放;多目标奖励还可以“先加权求和再归一化”或“各目标先归一化再求和”。两者表达的偏好并不一样。[2,0.5] 时两者恰好都为 1,但 [2,2] 的整句比值为 4、几何平均仍为 2。名称不能替代实际公式。grpo,还包括 bnpo、dr_grpo、dapo 等不同归一化方式。这里 grpo 先逐序列平均再 batch 平均;bnpo 按当前有效 token 总数平均;dr_grpo 用 batch 大小乘最大回答长度作固定分母。不同形式会改变训练样本权重,不能把它们当完全等价的优化目标。beta=0 会跳过 reference,因而“GRPO 必须保留 reference”也有配置边界;DPO 的 reference logprob 则可在固定偏好集上预计算,不必每步再跑一套模型。最值得监控的日志不是单独一个 reward,而是:组内 reward 标准差为零的比例、clip ratio、KL、回答长度、每种 reward 的均值与方差。如果 reward 上升同时长度暴涨、KL 激增或同分组变多,训练可能在钻评分规则的空子。
本文教学函数还要求每条序列至少有一个有效 token,空 mask 明确报错;指数运算前先把无效位置替换成零,防止 padding 中的 NaN 或无穷通过“乘零”污染 loss。有效位置的非有限 logprob 和指数溢出仍会显式失败,不静默截断以伪造正常结果。
工程上还要区分三种 mask:prompt token 不应进入 completion loss,padding token 不应参与平均,工具调用或环境交互产生的非策略 token 也不该伪装成策略动作。mask 错一个维度,代码仍可能正常运行,但 loss 的分母已经变了。
第一步是挑 prompt。随机抽题看似公平,但大量过易题会产生“全对组”,大量过难题会产生“全错组”,两者都没有组内方差。一种可验证的工程选择是记录题目通过率、奖励方差和最近采样时间,再决定是否调整抽题分布;这不是本文固定 TRL 或 DeepSeekMath 原始 GRPO 的必备步骤。主动选题改变 prompt 分布,需要在独立评测上检验收益,不能把“挑出有分歧的题”直接当作普遍改进。
第二步是冻结采样快照。系统保存 $\pi_{old}$ 的版本标识,并为每个 prompt 生成 $G$ 条 completion。若用独立 vLLM 服务生成,必须记录推理引擎返回的 token id、mask 和 logprob;只保存文本再重新 tokenize,特殊 token、空格或聊天模板差异都可能让动作序列错位。
第三步是评分。规则验证器适合数学答案、代码测试和工具任务;神经 reward model 适合帮助性、风格和主观质量。多个奖励合并时要先决定是“先加权再组内归一化”,还是“每种奖励各自归一化再加权”。前者的各目标相对尺度会影响加权总分,但随后除组标准差会消掉总分的共同尺度;后者先改变各目标尺度,再加权。固定快照的 normalize_then_sum 在逐目标组内标准化后,还对汇总奖励做 batch 标准化,因此不能只凭配置名省略后半段。六组官方 NaN/统计夹具覆盖了两种聚合与三种 scale_rewards 设置。
第四步计算 group statistics。分布式训练里,同一 prompt 的 $G$ 条回答可能散在不同 GPU 上,均值和标准差必须在完整组上聚合。若每张卡只看本地子组,baseline 会随数据切分改变;同一实验换一个 GPU 数就可能得到不同梯度。
第五步计算当前 policy 与 reference 的 token logprob。old_logprob 必须保持 rollout 时的值,不能在每个优化 epoch 重算;reference_logprob 可以预计算并缓存,也可以通过冻结模型或禁用 LoRA adapter 得到。三种 logprob 看着形状相同,来源却完全不同。
第六步形成 per-token loss。Outcome reward 把回答级优势广播到有效 completion token,再乘 ratio、做 clip、加 KL。这里 rollout 的奖励、组统计和 old/reference logprob 都视作固定数据,不对奖励计算或采样反向传播。随后按 mask 归一化。先对每条序列取平均再对 batch 平均,会让长短回答权重相近;直接对全 batch token 求平均,则长回答贡献更多。两种都能运行,但优化目标不同。
第七步更新并监控。一次 rollout 可做有限个优化 epoch,随后必须重新采样。应同时记录 reward、组内标准差、zero-std 比例、KL、clip fraction、回答长度和吞吐量。只有 reward 上升而这些量失控时,不能把结果叫作训练成功。
分组边界错位。 假设 batch 排列本应是“题目 A 的八条回答、题目 B 的八条回答”,数据加载器却在聚合前打乱了 completion,view(-1, G) 仍然合法,均值却混合了不同题目。最可靠的做法是保留 prompt id,计算优势前断言每个连续组的 id 完全相同,分布式 gather 后再断言每题正好有 $G$ 条记录。
把样本标准差和总体标准差混着用。 NumPy 的 std 默认分母是 $G$,PyTorch 某些接口曾默认用 $G-1$。组很大时差别不明显,$G=2$ 或 4 时会明显改变优势幅度。公式、最小实现和训练框架必须约定同一个定义,日志里也应记录原始 reward,而不是只保留标准化后的值。
先逐卡归一化再全局聚合。 数据并行下每张卡只拿到同一题的一部分回答,如果先在本地求均值,结果取决于回答被分到哪张卡。正确顺序是先收集完整组的 reward,再统一计算统计量,最后切回各进程需要的那一段优势。
生成文本与训练 token 不一致。 推理服务可能自动补聊天模板、合并空白、提前截断,训练端重新编码字符串后得到另一串 token。此时旧策略 logprob 与当前策略 logprob 对应的动作不同,ratio 已经失去意义。rollout 应把 token ids 视作主数据,文本只用于评分和审计;恢复训练时也要保留 tokenizer 与 chat template 版本。
长度归一化悄悄改变偏好。 若每条回答先按自身长度求 token loss 均值,短回答和长回答各占一个样本权重;若整个 batch 按 token 总数求均值,长回答天然贡献更多。再叠加“回答越长越可能碰到一次正确步骤”的 reward,模型可能学会延长推理。应同时画 reward 对长度的散点图,并用长度分桶比较通过率。
奖励器和策略一起漂移。 在线迭代训练 reward model 时,今天的 0.8 与上周的 0.8 可能不是同一尺度。组内归一化能消掉部分仿射漂移,却消不掉排序规则改变。需要保留固定校准集和冻结的旧奖励器,周期性比较新旧排序一致率;否则策略看似持续提高,其实只是追着变化的裁判跑。
最后还要保存可恢复状态:policy、optimizer、scheduler、reference 版本、rollout 生成参数、reward 版本和数据游标缺一不可。只保存 actor 权重可以用于推理,却无法保证训练恢复后仍在优化同一个目标。GRPO 少了 critic checkpoint,但并没有把实验追踪简化成一个模型文件。
删掉 critic,省下的是真实成本。 全参数训练时少一套同规模可训练状态和激活;LoRA 或 ZeRO 下绝对节省会变化,但工程链路仍少了 value target、value loss、value clipping 与 critic checkpoint。
组采样把成本转移到生成端。 GRPO 必须对同一 prompt 采多个回答。推理较长、组大小较大或 reward model 很重时,rollout 可能比 critic 更贵。适合有便宜可验证奖励的数学、代码和工具任务;对主观写作、开放式对话,可靠打分本身就是难题。
组内归一化丢掉跨题绝对难度。 一道题的最高分只有 0.2,另一道题四个答案都超过 0.9,标准化后仍可能产生相似幅度的优势。前者也许是奖励器不可靠或题目不可解,却会得到同等更新权重。
同分会让奖励优势项消失。 二值正确性奖励在策略已经很强或很弱时尤其明显:一组全对或全错,标准差为零时完全没有该组奖励优势;标准差虽很小但非零时,是否被抑制取决于它与 $\epsilon$ 的相对大小。这时增加组大小、提高采样温度、设计更细奖励或主动挑选处在学习边界的 prompt,比盲目调学习率更有效。
Outcome reward 的信用分配很粗。 一条 2000-token 推理只拿一个终局优势,每个 token 被同方向推动。过程奖励可以细化信号,但会引入步骤标注、奖励模型偏差与“奖励器教模型写格式”的新问题。
reference KL 不能修复坏奖励。 KL 只限制走多远,不判断方向对不对。奖励函数偏爱冗长、套话或特定格式时,较小 KL 只是让投机变慢。
如果手里已经有高质量 chosen/rejected 数据,生成和人工标注又很贵,DPO 通常是更稳的第一步。它像普通监督训练一样容易批处理,失败时也容易回查是哪一对偏好造成梯度。它尤其适合风格、安全边界、回答格式这类可以提前整理成对的数据。
如果任务能自动验答案,而且策略必须靠探索发现新解法,GRPO 更合适。数学最终答案、代码单元测试、工具调用结果和可执行环境都能提供相对便宜的在线奖励。此时 critic 很难从稀疏终局分数学习每个 token 的价值,组 baseline 的简化更有吸引力。
如果奖励高度主观、每条回答又很长,两者都不会自动解决问题。DPO 受限于离线偏好覆盖,GRPO 受限于奖励模型可靠性和 rollout 成本。常见组合是 SFT 打基础、DPO 吸收稳定的人类偏好、GRPO 在可验证子任务上继续在线探索,最后再用独立评测检查能力回退。
做预算时至少拆成四项:训练模型状态、冻结模型前向、在线生成 token 数、奖励评估次数。只比较“有几个模型”会漏掉 GRPO 的采样账;只比较“每步生成多少 token”又会漏掉 PPO critic 的反向和优化器状态。把四项分别量出来,才能判断删掉 critic 是否真的让当前系统便宜了一个量级。
还有一笔常被忽略的是通信。PPO 的 critic 若与 actor 分开部署,需要在 rollout、价值推理和更新之间搬运 token、mask、value 与 advantage;若与 actor 共卡,又会争夺显存和计算流。GRPO 把 value 请求换成组统计,统计量只是一组标量,通信链更短。可是一旦奖励模型远程部署,$G$ 条回答仍要跨服务传输并等待评分。优化时应测端到端每步墙钟时间,把生成、评分、训练和等待分别打点;单看 GPU 峰值显存,很容易把“省显存”误写成“省总成本”。
评估也要和训练奖励解耦。至少准备一套不参与更新的题目、一个不同实现的验证器,以及人工抽查样本。训练奖励与独立评测同时上升,才说明策略能力可能真的提高;只有训练奖励上涨,最多能证明优化器成功找到了当前评分函数偏爱的输出。对推理模型还应分别统计最终答案、推理有效性、格式合规和长度,避免一个聚合分数掩盖能力回退。
这些记录也是定位回归、比较算法和复现实验的最低证据。
这些数字来自各论文自己的设置,不能跨模型直接比较。DPO 的优势在训练简单,GRPO 的优势在能跟随当前策略在线探索;算法名本身不决定最终能力。
“GRPO 不需要奖励模型。” 错。GRPO 不需要 critic,但必须有奖励信号。奖励可以是神经 reward model、规则验证器、单元测试或多个评分器的组合。
“DPO 和 GRPO 都去掉 value,所以是一回事。” DPO 通过重参数化绕开整套在线 RL;GRPO 仍是 policy-gradient 方法,只把优势 baseline 从 learned value 换成 group statistics。
“组均值就是无偏的真实价值函数。” 组均值只是当前策略、当前 prompt、当前采样温度下的 Monte Carlo baseline。它会随组大小和采样分布变化,不是对所有状态都可查询的 $V(s)$。
“归一化后奖励尺度不重要。” 共同平移精确抵消,正比例缩放仅在忽略防零项时精确抵消,但排序错误、同分、异常值和多目标权重仍会改变梯度。reward design 依然是核心工作。
“去掉 critic 就一定便宜十倍。” 不成立。删掉一个同规模可训练模型可能显著降低显存和通信,但 GRPO 增加了组采样。总成本取决于序列长度、组大小、reward 推理、并行方式和是否使用 LoRA。
“clip 能保证 KL 很小。” clip 只截断采样动作上的替代收益;共享参数更新仍可能让未采到 token 的分布大幅变化,所以工程实现仍单独监控或惩罚 KL。
在仓库目录运行:
python3 outputs/fundamentals_files/dpo_grpo/code/dpo_grpo_minimal.py完整验证脚本 dpo_grpo_checks.py 在固定 80 轮、每组两次更新、学习率 0.18 下,对五种配置分别实际运行 seed 0…9。下表是最终最好动作概率的均值和 seed 范围,比较时只改表中指定配置,reference 均匀:
| 配置 | 均值 | 最小–最大 |
|---|---|---|
| 原设置 G=32 | 0.990830 | 0.987677–0.992312 |
| G=2 | 0.950928 | 0.938407–0.962952 |
| 四奖励全为 1 | 0.250000 | 0.250000–0.250000 |
| 最好奖励改为 0.31 | 0.987225 | 0.983949–0.989418 |
| beta=0.5 | 0.877653 | 0.864133–0.901262 |
小组在这十个 seed 中最终概率更低;这是该 bandit、预算与更新协议的观察,不是对任意任务的收敛率保证。全同分从均匀 reference 出发恰好维持 0.25;若先把策略移开 reference 再给同分,KL 仍可能拉回。
把最好奖励从 1.0 改成 0.31,本例略降到表中数值,不能据此声称奖励差小必然需要更多样本。两样本组 [0,d] 用总体标准差时,正优势为 $d/(d+2\epsilon)$;$d=1,0.01,10^{-5}$ 时分别实测 0.999800、0.980392、0.047619。噪声为零且 $d$ 远大于 $\epsilon$ 时,尺度基本会被抵消;只有与噪声、采样覆盖、防零项一起讨论,才有“更难区分”的具体含义。
DPO 练习先保持 reference 不变,只交换两个 policy logprob,计算新的四项差,不能只凭“交换”断言 logit 必变负(reference 的原始偏好也参与)。本例两个新 logits 为 [-0.10,-0.05],loss 约 0.731428;再尝试 3.2 节 chosen 概率下降而 loss 下降的完整归一化反例。
独立验证还枚举 $3^3=27$ 个采样组,并对 DPO 与完整四动作代理求有限差分:最大梯度误差分别为 $4.31\times10^{-11}$ 与 $8.34\times10^{-12}$;KL 校正梯度误差为 $2.23\times10^{-10}$。两个裁剪平台和两种错误方向均被覆盖。mask 检查确认 padding NaN 不污染有效值、六类非法输入被拒绝。闭式解的 200 组目标恒等式误差不超过 $4.45\times10^{-16}$。这些是有限动作与合成损失的验证,不是 LLM 或视频模型训练复现。
读这篇之前建议先看:
读完这篇可以继续看:
09 节用到的脚本全文如下(dpo_grpo_minimal.py、dpo_grpo_checks.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""DPO 与 GRPO 的最小可运行实现。

运行:python3 dpo_grpo_minimal.py
只依赖 NumPy,不需要模型权重或外部数据。
"""

import numpy as np


def log_sigmoid(x):
    """数值稳定的 log(sigmoid(x))。"""
    return -np.logaddexp(0.0, -x)


def dpo_loss(policy_chosen, policy_rejected, ref_chosen, ref_rejected, beta=0.1):
    """DPO 二分类损失;四个输入都是整条回答的对数概率。"""
    arrays = [np.asarray(x, dtype=np.float64) for x in
              (policy_chosen, policy_rejected, ref_chosen, ref_rejected)]
    if not np.isfinite(beta) or beta <= 0:
        raise ValueError("beta must be positive and finite")
    if not arrays[0].size or any(x.shape != arrays[0].shape or not np.isfinite(x).all() for x in arrays):
        raise ValueError("logprobs need identical nonempty shapes and finite values")
    policy_chosen, policy_rejected, ref_chosen, ref_rejected = arrays
    policy_gap = policy_chosen - policy_rejected
    reference_gap = ref_chosen - ref_rejected
    logits = beta * (policy_gap - reference_gap)
    return -log_sigmoid(logits).mean(), logits


def group_advantages(rewards, eps=1e-4, ddof=0):
    """完整有限奖励组;默认总体标准差,ddof=1 对照固定 TRL。"""
    rewards = np.asarray(rewards, dtype=np.float64)
    if rewards.ndim != 2 or not rewards.size or rewards.shape[1] < 2:
        raise ValueError("rewards must have shape [prompts,G] with G>=2")
    if not np.isfinite(rewards).all() or not np.isfinite(eps) or eps <= 0 or ddof not in (0, 1):
        raise ValueError("finite rewards, positive eps and ddof in {0,1} required")
    mean = rewards.mean(axis=1, keepdims=True)
    std = rewards.std(axis=1, keepdims=True, ddof=ddof)
    return (rewards - mean) / (std + eps)


def grpo_loss(new_logps, old_logps, ref_logps, advantages, mask,
              clip_eps=0.2, beta=0.04):
    """逐序列平均的 token-ratio 代理目标;未加 KL 重要性校正。"""
    arrays = [np.asarray(x, dtype=np.float64) for x in (new_logps, old_logps, ref_logps, mask)]
    new_logps, old_logps, ref_logps, mask = arrays
    advantages = np.asarray(advantages, dtype=np.float64)
    if new_logps.ndim != 2 or not new_logps.size or any(x.shape != new_logps.shape for x in arrays):
        raise ValueError("logprobs and mask require the same nonempty [B,T] shape")
    if advantages.shape != (new_logps.shape[0],) or not np.isfinite(advantages).all():
        raise ValueError("one finite advantage per sequence required")
    if not np.isfinite(mask).all() or not np.isin(mask, [0, 1]).all() or np.any(mask.sum(-1) == 0):
        raise ValueError("binary mask and at least one effective token per sequence required")
    if not np.isfinite(clip_eps) or not 0 < clip_eps < 1 or not np.isfinite(beta) or beta < 0:
        raise ValueError("0<clip_eps<1 and beta>=0 required")
    active = mask.astype(bool)
    if any(not np.isfinite(x[active]).all() for x in arrays[:3]):
        raise ValueError("effective token logprobs must be finite")
    # 在指数运算前遮掉 padding,避免 inf*0 或 NaN*0 污染有效 loss。
    log_ratio = np.where(active, new_logps, 0) - np.where(active, old_logps, 0)
    ref_gap = np.where(active, ref_logps, 0) - np.where(active, new_logps, 0)
    with np.errstate(over="raise", invalid="raise"):
        ratio = np.exp(log_ratio)
        per_token_kl = np.expm1(ref_gap) - ref_gap
    clipped_ratio = np.clip(ratio, 1 - clip_eps, 1 + clip_eps)
    surrogate = np.minimum(ratio * advantages[:, None], clipped_ratio * advantages[:, None])
    per_token_loss = -surrogate + beta * per_token_kl
    sequence_loss = (per_token_loss * mask).sum(axis=-1) / mask.sum(axis=-1)
    return sequence_loss.mean(), ratio, per_token_kl


def softmax(logits):
    shifted = logits - logits.max()
    exp_logits = np.exp(shifted)
    return exp_logits / exp_logits.sum()


def train_group_bandit(steps=80, group_size=32, seed=7, reward_table=None,
                       beta=0.02, lr=0.18, clip_eps=0.2):
    """用 GRPO 训练四选一 bandit,展示无 critic 的在线更新。"""
    if steps < 1 or group_size < 2 or beta < 0 or lr <= 0 or not 0 < clip_eps < 1:
        raise ValueError("invalid training configuration")
    rng = np.random.default_rng(seed)
    logits = np.zeros(4, dtype=np.float64)
    reference_logits = np.zeros(4, dtype=np.float64)
    reward_table = np.asarray([-0.2, 0.3, 1.0, 0.0] if reward_table is None else reward_table, dtype=np.float64)
    if reward_table.shape != (4,) or not np.isfinite(reward_table).all():
        raise ValueError("four finite rewards required")

    snapshots = []
    for step in range(steps):
        old_logits = logits.copy()
        old_probs = softmax(old_logits)
        actions = rng.choice(4, size=group_size, p=old_probs)
        rewards = reward_table[actions]
        advantages = group_advantages(rewards[None, :])[0]
        old_selected = np.log(old_probs[actions])
        ref_probs = softmax(reference_logits)
        ref_selected = np.log(ref_probs[actions])

        # 同一组 rollout 做两轮 PPO 式复用;old_logprob 始终来自采样快照。
        for _ in range(2):
            probs = softmax(logits)
            new_selected = np.log(probs[actions])
            ratio = np.exp(new_selected - old_selected)
            active = ~(((advantages >= 0) & (ratio > 1 + clip_eps)) |
                       ((advantages < 0) & (ratio < 1 - clip_eps)))

            # d[-min(rA, clip(r)A)]/d log pi,以及采样 KL 项的导数。
            coefficient = -active.astype(np.float64) * ratio * advantages
            ref_gap = ref_selected - new_selected
            coefficient += beta * (1 - np.exp(ref_gap))

            one_hot = np.eye(4)[actions]
            grad_logp = one_hot - probs[None, :]
            grad_logits = (coefficient[:, None] * grad_logp).mean(axis=0)
            logits -= lr * grad_logits

        if step in {0, 19, 39, steps - 1}:
            snapshots.append((step + 1, softmax(logits).copy()))
    return snapshots


if __name__ == "__main__":
    np.set_printoptions(precision=4, suppress=True)

    policy_chosen = np.array([-2.2, -1.7])
    policy_rejected = np.array([-2.8, -2.1])
    ref_chosen = np.array([-2.0, -1.9])
    ref_rejected = np.array([-2.4, -2.0])
    loss_dpo, logits_dpo = dpo_loss(
        policy_chosen, policy_rejected, ref_chosen, ref_rejected
    )
    print("=== DPO ===")
    print(f"pair_shape={policy_chosen.shape}")
    print(f"preference_logits={logits_dpo}")
    print(f"loss={loss_dpo:.4f}")

    rewards = np.array([[0.2, 0.8, 1.4, 0.6], [8.0, 9.0, 11.0, 12.0]])
    advantages = group_advantages(rewards)
    print("\n=== GRPO group baseline ===")
    print(f"rewards.shape={rewards.shape}")
    print(f"advantages=\n{advantages}")
    print(f"row_mean={advantages.mean(axis=1)}")

    old_logps = np.log(np.array([
        [0.30, 0.25, 0.20], [0.18, 0.22, 0.20],
        [0.12, 0.16, 0.20], [0.25, 0.20, 0.18],
    ]))
    new_logps = old_logps + np.array([
        [0.25, 0.25, 0.25], [0.10, 0.10, 0.10],
        [-0.25, -0.25, -0.25], [-0.10, -0.10, -0.10],
    ])
    ref_logps = old_logps - 0.05
    mask = np.ones_like(old_logps)
    one_group_adv = group_advantages(np.array([[0.2, 0.8, 1.4, 0.6]]))[0]
    loss_grpo, ratio, kl = grpo_loss(
        new_logps, old_logps, ref_logps, one_group_adv, mask
    )
    print("\n=== GRPO clipped objective ===")
    print(f"token_logps.shape={new_logps.shape}")
    print(f"ratio_first_token={ratio[:, 0]}")
    print(f"mean_kl={kl.mean():.6f}, loss={loss_grpo:.4f}")

    print("\n=== Online group bandit ===")
    print("step  P(a0)   P(a1)   P(a2=best)  P(a3)")
    for step, probs in train_group_bandit():
print(f"{step:>4} " + " ".join(f"{p:.4f}" for p in probs))"""独立检查 DPO 闭式解、组 baseline、KL 代理及原 bandit 的有限差分。
运行:python dpo_grpo_checks.py;只依赖 NumPy,无模型权重。
"""
import itertools
import json
from pathlib import Path
import numpy as np
from dpo_grpo_minimal import dpo_loss, group_advantages, grpo_loss, softmax, train_group_bandit
def finite_difference(fn, x, h=1e-6):
out = np.empty_like(x)
for index in np.ndindex(x.shape):
plus, minus = x.copy(), x.copy()
plus[index] += h
minus[index] -= h
out[index] = (fn(plus) - fn(minus)) / (2 * h)
return out
def run_checks():
result = {}
q = np.array([0.2, 0.3, 0.5])
reward, beta = np.array([-0.5, 0.7, 1.1]), 0.6
z = np.sum(q * np.exp(reward / beta))
optimum = q * np.exp(reward / beta) / z
rng = np.random.default_rng(17)
errors = []
for p in rng.dirichlet(np.ones(3), size=200):
objective = p @ reward - beta * np.sum(p * np.log(p / q))
identity = beta * np.log(z) - beta * np.sum(p * np.log(p / optimum))
errors.append(abs(objective - identity))
assert max(errors) < 2e-15
pairs = np.array([[-2.2, -2.8], [-1.7, -2.1]])
refs = np.array([[-2.0, -2.4], [-1.9, -2.0]])
fn = lambda a: dpo_loss(a[:, 0], a[:, 1], refs[:, 0], refs[:, 1])[0]
loss, margins = dpo_loss(pairs[:, 0], pairs[:, 1], refs[:, 0], refs[:, 1])
coeff = -0.1 / (1 + np.exp(margins)) / len(pairs)
analytic = np.column_stack([coeff, -coeff])
dpo_fd = np.max(np.abs(analytic - finite_difference(fn, pairs)))
assert dpo_fd < 1e-9
before, after = np.array([0.4, 0.4, 0.2]), np.array([0.3, 0.15, 0.55])
compare = lambda p: float(dpo_loss(np.log(p[:1]), np.log(p[1:2]), np.log(q[:1]), np.log(q[1:2]))[0])
assert compare(after) < compare(before) and after[0] < before[0]
swapped_loss, swapped_logits = dpo_loss(pairs[:,1], pairs[:,0], refs[:,0], refs[:,1])
assert np.allclose(swapped_logits, [-0.1,-0.05])
result['dpo'] = dict(loss=float(loss), logits=margins.tolist(), swapped_loss=float(swapped_loss), swapped_logits=swapped_logits.tolist(), fd_max_error=float(dpo_fd),
optimum=optimum.tolist(), objective_identity_max_error=max(errors),
absolute_chosen_counterexample=dict(before=before.tolist(), after=after.tolist(),
loss_before=compare(before), loss_after=compare(after)))
p, r, g = np.array([0.2, 0.3, 0.5]), np.array([-1.0, 0.2, 2.0]), 3
exact_gradient = p * (r - p @ r)
centered, loo, standardized = np.zeros(3), np.zeros(3), np.zeros(3)
for actions in itertools.product(range(3), repeat=g):
a = np.array(actions)
weight = np.prod(p[a])
rr = r[a]
score = np.eye(3)[a] - p
centered += weight * ((rr - rr.mean())[:, None] * score).mean(0)
baseline = (rr.sum() - rr) / (g - 1)
loo += weight * ((rr - baseline)[:, None] * score).mean(0)
standardized += weight * (group_advantages(rr[None, :])[0, :, None] * score).mean(0)
center_error = float(np.max(np.abs(centered - (1 - 1/g) * exact_gradient)))
loo_error = float(np.max(np.abs(loo - exact_gradient)))
assert center_error < 1e-15 and loo_error < 1e-15
normalized = standardized / exact_gradient
assert np.ptp(normalized) > 0.01
gap_adv = [float(group_advantages(np.array([[0.0, gap]]))[0, 1]) for gap in [1.0, 0.01, 1e-5]]
first = group_advantages(np.array([[0.0, 1.0, 2.0, 10.0]]))
second = group_advantages(np.array([[0.0, 1.0, 9.0, 10.0]]))
assert not np.allclose(first, second)
result['baseline'] = dict(group_size=g, exact_reward_gradient=exact_gradient.tolist(),
centered=centered.tolist(), leave_one_out=loo.tolist(),
standardized=standardized.tolist(), standardized_component_ratios=normalized.tolist(),
centered_max_error=center_error, loo_max_error=loo_error,
two_sample_gaps=[1.0, 0.01, 1e-5], positive_advantages=gap_adv,
equal_rank_different_gaps=[first.tolist(), second.tolist()])
p, q, old = np.array([0.7, 0.2, 0.1]), np.array([0.2, 0.3, 0.5]), np.array([0.3, 0.3, 0.4])
k = np.expm1(np.log(q / p)) - np.log(q / p)
exact_kl = float(p @ np.log(p / q))
assert abs(p @ k - exact_kl) < 1e-15 and abs(old @ ((p/old)*k) - exact_kl) < 1e-15
# 固定采样权重 old,分别对裸 k 与未 detach 的 ratio*k 求导。
fn = lambda z: float(old @ (np.expm1(np.log(q / softmax(z))) - np.log(q / softmax(z))))
weighted = lambda z: float(old @ ((softmax(z)/old) * (np.expm1(np.log(q/softmax(z))) - np.log(q/softmax(z)))))
true = lambda z: float(softmax(z) @ np.log(softmax(z)/q))
plain_grad = finite_difference(fn, np.log(p))
weighted_grad = finite_difference(weighted, np.log(p))
true_grad = finite_difference(true, np.log(p))
assert np.max(np.abs(weighted_grad - true_grad)) < 1e-9
# 在 old=p 采样点,裸 k 的期望梯度是 p-q,不等于真正 KL 的梯度。
self_fn = lambda z: float(p @ (np.expm1(np.log(q/softmax(z))) - np.log(q/softmax(z))))
self_grad = finite_difference(self_fn, np.log(p))
assert np.max(np.abs(self_grad - (p-q))) < 1e-9
assert np.max(np.abs(self_grad - true_grad)) > 0.05
result['kl'] = dict(exact=exact_kl, current_sample_expectation=float(p@k),
old_sample_expectation=float(old@k), weighted_old_expectation=float(old@((p/old)*k)),
self_sample_fixed_data_gradient=self_grad.tolist(), true_kl_gradient=true_grad.tolist(),
corrected_gradient_max_error=float(np.max(np.abs(weighted_grad-true_grad))),
old_fixed_surrogate_gradient=plain_grad.tolist())
# 不同长度、padding NaN 与空 mask 的真实边界。
mask = np.array([[1, 0, 0], [1, 1, 1]])
oldlog = np.log(np.full((2, 3), 0.2)); newlog = oldlog + 0.1
adv = np.array([1.0, -1.0])
masked = newlog.copy(); masked[mask == 0] = np.nan
a = grpo_loss(masked, oldlog, oldlog, adv, mask, beta=0)[0]
assert abs(a) < 1e-15
rejected = 0
invalid = [lambda:group_advantages([[1]]), lambda:group_advantages([[1,np.nan]]),
lambda:group_advantages([[1,2]],eps=0), lambda:dpo_loss([1],[2],[3],[4],beta=0),
lambda:grpo_loss(oldlog,oldlog,oldlog,adv,np.zeros_like(mask)),
lambda:grpo_loss(oldlog,oldlog,oldlog,adv,np.full_like(mask,2))]
for fn in invalid:
try:
fn()
except ValueError:
rejected += 1
assert rejected == len(invalid)
result['mask'] = dict(equal_sequence_loss=float(a), invalid_inputs_rejected=rejected, padding_nan_ignored=True)
# 完整 softmax 下的 token surrogate 梯度,含两个裁剪平台和两侧错误方向。
actions = np.array([0,1,2,3]); old_probs = np.array([0.1,0.4,0.3,0.2]); ref_probs=np.full(4,0.25)
new_probs = np.array([0.2,0.2,0.4,0.2]); adv = np.array([1.2,-0.8,-1.1,0.5]); beta=0.04
def f(z):
return grpo_loss(np.log(softmax(z))[actions,None],np.log(old_probs)[actions,None],
np.log(ref_probs)[actions,None],adv,np.ones((4,1)),beta=beta)[0]
ratio = new_probs / old_probs
active = ~(((adv>=0)&(ratio>1.2))|((adv<0)&(ratio<0.8)))
coefficient = -active.astype(float)*ratio*adv + beta*(1-ref_probs/new_probs)
grad = (coefficient[:,None]*(np.eye(4)-new_probs)).mean(0)
err = float(np.max(np.abs(grad-finite_difference(f,np.log(new_probs)))))
assert err < 1e-9
result['surrogate_gradient'] = dict(fd_max_error=err, active=active.tolist())
variants = {'original':{}, 'small_group':{'group_size':2}, 'constant':{'reward_table':[1,1,1,1]},
'near_gap':{'reward_table':[-0.2,0.3,0.31,0.0]}, 'strong_kl':{'beta':0.5}}
rows = {}
for name,kwargs in variants.items():
values=[train_group_bandit(seed=seed,**kwargs)[-1][1][2] for seed in range(10)]
rows[name]=dict(seeds=list(range(10)),steps=80,config=kwargs,prob_best_mean=float(np.mean(values)),
prob_best_min=float(min(values)),prob_best_max=float(max(values)),prob_best_all=[float(x)for x in values])
assert rows['constant']['prob_best_min']==rows['constant']['prob_best_max']==0.25
result['bandit_experiments']=rows
result['original_seed7']=[dict(step=s,probs=p.tolist())for s,p in train_group_bandit()]
result.update(passed=True,errors=[],warnings=[],numpy=np.__version__,scope='Finite categorical and synthetic losses; no language-model training or GPU throughput claim')
return result
if __name__ == '__main__':
result=run_checks()
Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,ensure_ascii=False,indent=2)+'\n',encoding='utf8')
print(json.dumps(result,ensure_ascii=False,indent=2))"""生成 DPO/GRPO 教程的两张解释图。"""
from pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
from dpo_grpo_minimal import group_advantages
from matplotlib.patches import FancyBboxPatch
ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "figures"
OUT.mkdir(exist_ok=True)
plt.rcParams.update({
"font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"],
"axes.unicode_minus": False,
"figure.dpi": 160,
})
def box(ax, x, y, w, h, text, color):
patch = FancyBboxPatch(
(x, y), w, h, boxstyle="round,pad=0.02,rounding_size=0.03",
facecolor=color, edgecolor="white", linewidth=1.5,
)
ax.add_patch(patch)
ax.text(x + w / 2, y + h / 2, text, ha="center", va="center",
fontsize=12, weight="bold", color="#182238")
def method_map():
fig, axes = plt.subplots(1, 3, figsize=(14, 4.6), facecolor="#f7f9fc")
methods = [
("PPO-RLHF", [("偏好对", "#dbeafe"), ("奖励模型", "#fde68a"),
("在线采样", "#ddd6fe"), ("Actor + Critic + Reference", "#fecaca")],
"奖励模型 + critic 都要维护"),
("DPO", [("离线偏好对", "#dbeafe"), ("二分类损失", "#bbf7d0"),
("Policy + Reference", "#ddd6fe")],
"省掉显式奖励模型和在线 RL"),
("GRPO", [("同题多回答", "#dbeafe"), ("规则/奖励打分", "#fde68a"),
("组内相对优势", "#bbf7d0"), ("Policy + Reference", "#ddd6fe")],
"保留在线采样,省掉 critic"),
]
for ax, (title, blocks, note) in zip(axes, methods):
ax.set_xlim(0, 1)
ax.set_ylim(0, 1)
ax.axis("off")
ax.set_title(title, fontsize=18, weight="bold", color="#172554", pad=14)
gap = 0.08
h = (0.72 - gap * (len(blocks) - 1)) / len(blocks)
y = 0.85 - h
for text, color in blocks:
box(ax, 0.12, y, 0.76, h, text, color)
y -= h + gap
ax.text(0.5, 0.03, note, ha="center", va="bottom", fontsize=11,
color="#475569")
fig.suptitle("三种对齐路线省掉的部件不同", fontsize=22, weight="bold",
color="#0f172a", y=1.02)
fig.tight_layout()
fig.savefig(OUT / "alignment_method_map.png", bbox_inches="tight", facecolor=fig.get_facecolor())
plt.close(fig)
def group_relative_plot():
rewards = np.array([[0.2, 0.8, 1.4, 0.6], [8.0, 9.0, 11.0, 12.0]])
advantages = group_advantages(rewards)
fig, axes = plt.subplots(1, 2, figsize=(12, 4.8), facecolor="#f7f9fc")
colors = ["#60a5fa", "#a78bfa", "#34d399", "#fb7185"]
x = np.arange(4)
for row, name in enumerate(["题目 A", "题目 B"]):
axes[0].bar(x + (row - 0.5) * 0.18, rewards[row], width=0.18,
label=name, color=colors[row])
axes[0].set_title("本例原始奖励尺度不同", fontsize=16, weight="bold")
axes[0].set_xticks(x, [f"回答 {i+1}" for i in x])
axes[0].set_ylabel("reward")
axes[0].legend(frameon=False)
width = 0.34
axes[1].bar(x - width / 2, advantages[0], width=width, label="题目 A", color="#60a5fa")
axes[1].bar(x + width / 2, advantages[1], width=width, label="题目 B", color="#a78bfa")
axes[1].axhline(0, color="#334155", linewidth=1)
axes[1].set_title("标准化仍保留相对分差", fontsize=16, weight="bold")
axes[1].set_xticks(x, [f"回答 {i+1}" for i in x])
axes[1].set_ylabel("advantage")
axes[1].legend(frameon=False)
for ax in axes:
ax.spines[["top", "right"]].set_visible(False)
ax.grid(axis="y", alpha=0.18)
fig.suptitle("GRPO:每道题自己组成一个参照系", fontsize=21, weight="bold",
color="#0f172a", y=1.02)
fig.tight_layout()
fig.savefig(OUT / "group_relative_advantage.png", bbox_inches="tight", facecolor=fig.get_facecolor())
plt.close(fig)
if __name__ == "__main__":
method_map()
group_relative_plot()
print(OUT / "alignment_method_map.png")
print(OUT / "group_relative_advantage.png")

评论 (0)