今日 AIGC 论文速览
今日共 10 篇 · 音视频创作评测与安全 2 篇 · 可编程世界与物理视频 2 篇 · 生成后训练与统一多模态 2 篇 · 图像编辑与多视角生成 2 篇 · 设计自动化与合成数据 2 篇
重点论文标题列表
- CutCraft(阿里巴巴、上海交通大学、复旦大学等):13模型不会专业剪辑
- Programmable World Model(Alaya Lab):规则状态准确率98%
- ⚡ DIVA(Peng Li 等(ACM MM 2026)):参考图放大越狱风险
- GGF(上海交通大学、中国电信人工智能研究院、中国科学技术大学):模型用自绘图反哺理解
- FlowCPO(西湖大学、浙江大学、快手可灵团队):离线对齐GenEval达0.84
今日论文速览
1. CutCraft:13模型不会专业剪辑
Beyond Coherence: Benchmarking Professional Editing-Technique Execution in Multi-Shot Audio-Video Generation | 阿里巴巴、上海交通大学、复旦大学等 | arXiv:2609.08275
关键词:音视频生成,多镜头,剪辑评测,生成智能体
- ⚠️ 前序问题:多镜头音视频模型已经能做出连贯、电影感强的片段,但现有评测多看画质、同步和物理合理性,无法判断模型是否真的执行了 J-cut、L-cut、转场时机和蒙太奇等专业剪辑指令。看起来像电影,不代表遵守了剪辑语法。
- 本文贡献:CutCraft 把结构化多镜头提示扩展为显式剪辑规格,并用镜头结构对齐、专家模型指标、工具化多模态判断和规则问答构成分层评测。作者还给出一个生成智能体基线:先规划镜头,再逐镜生成,最后做后期合成,使剪辑语义变成可执行步骤。

- 实验效果:对 13 个闭源与开源音视频生成模型的测试显示,当前系统普遍能维持内容连贯,却经常错过规定镜头数、转场关系和高阶蒙太奇;美学质量与剪辑指令遵循只有弱相关。智能体基线说明把剪辑拆成规划、生成和合成后更容易显式执行专业语法。
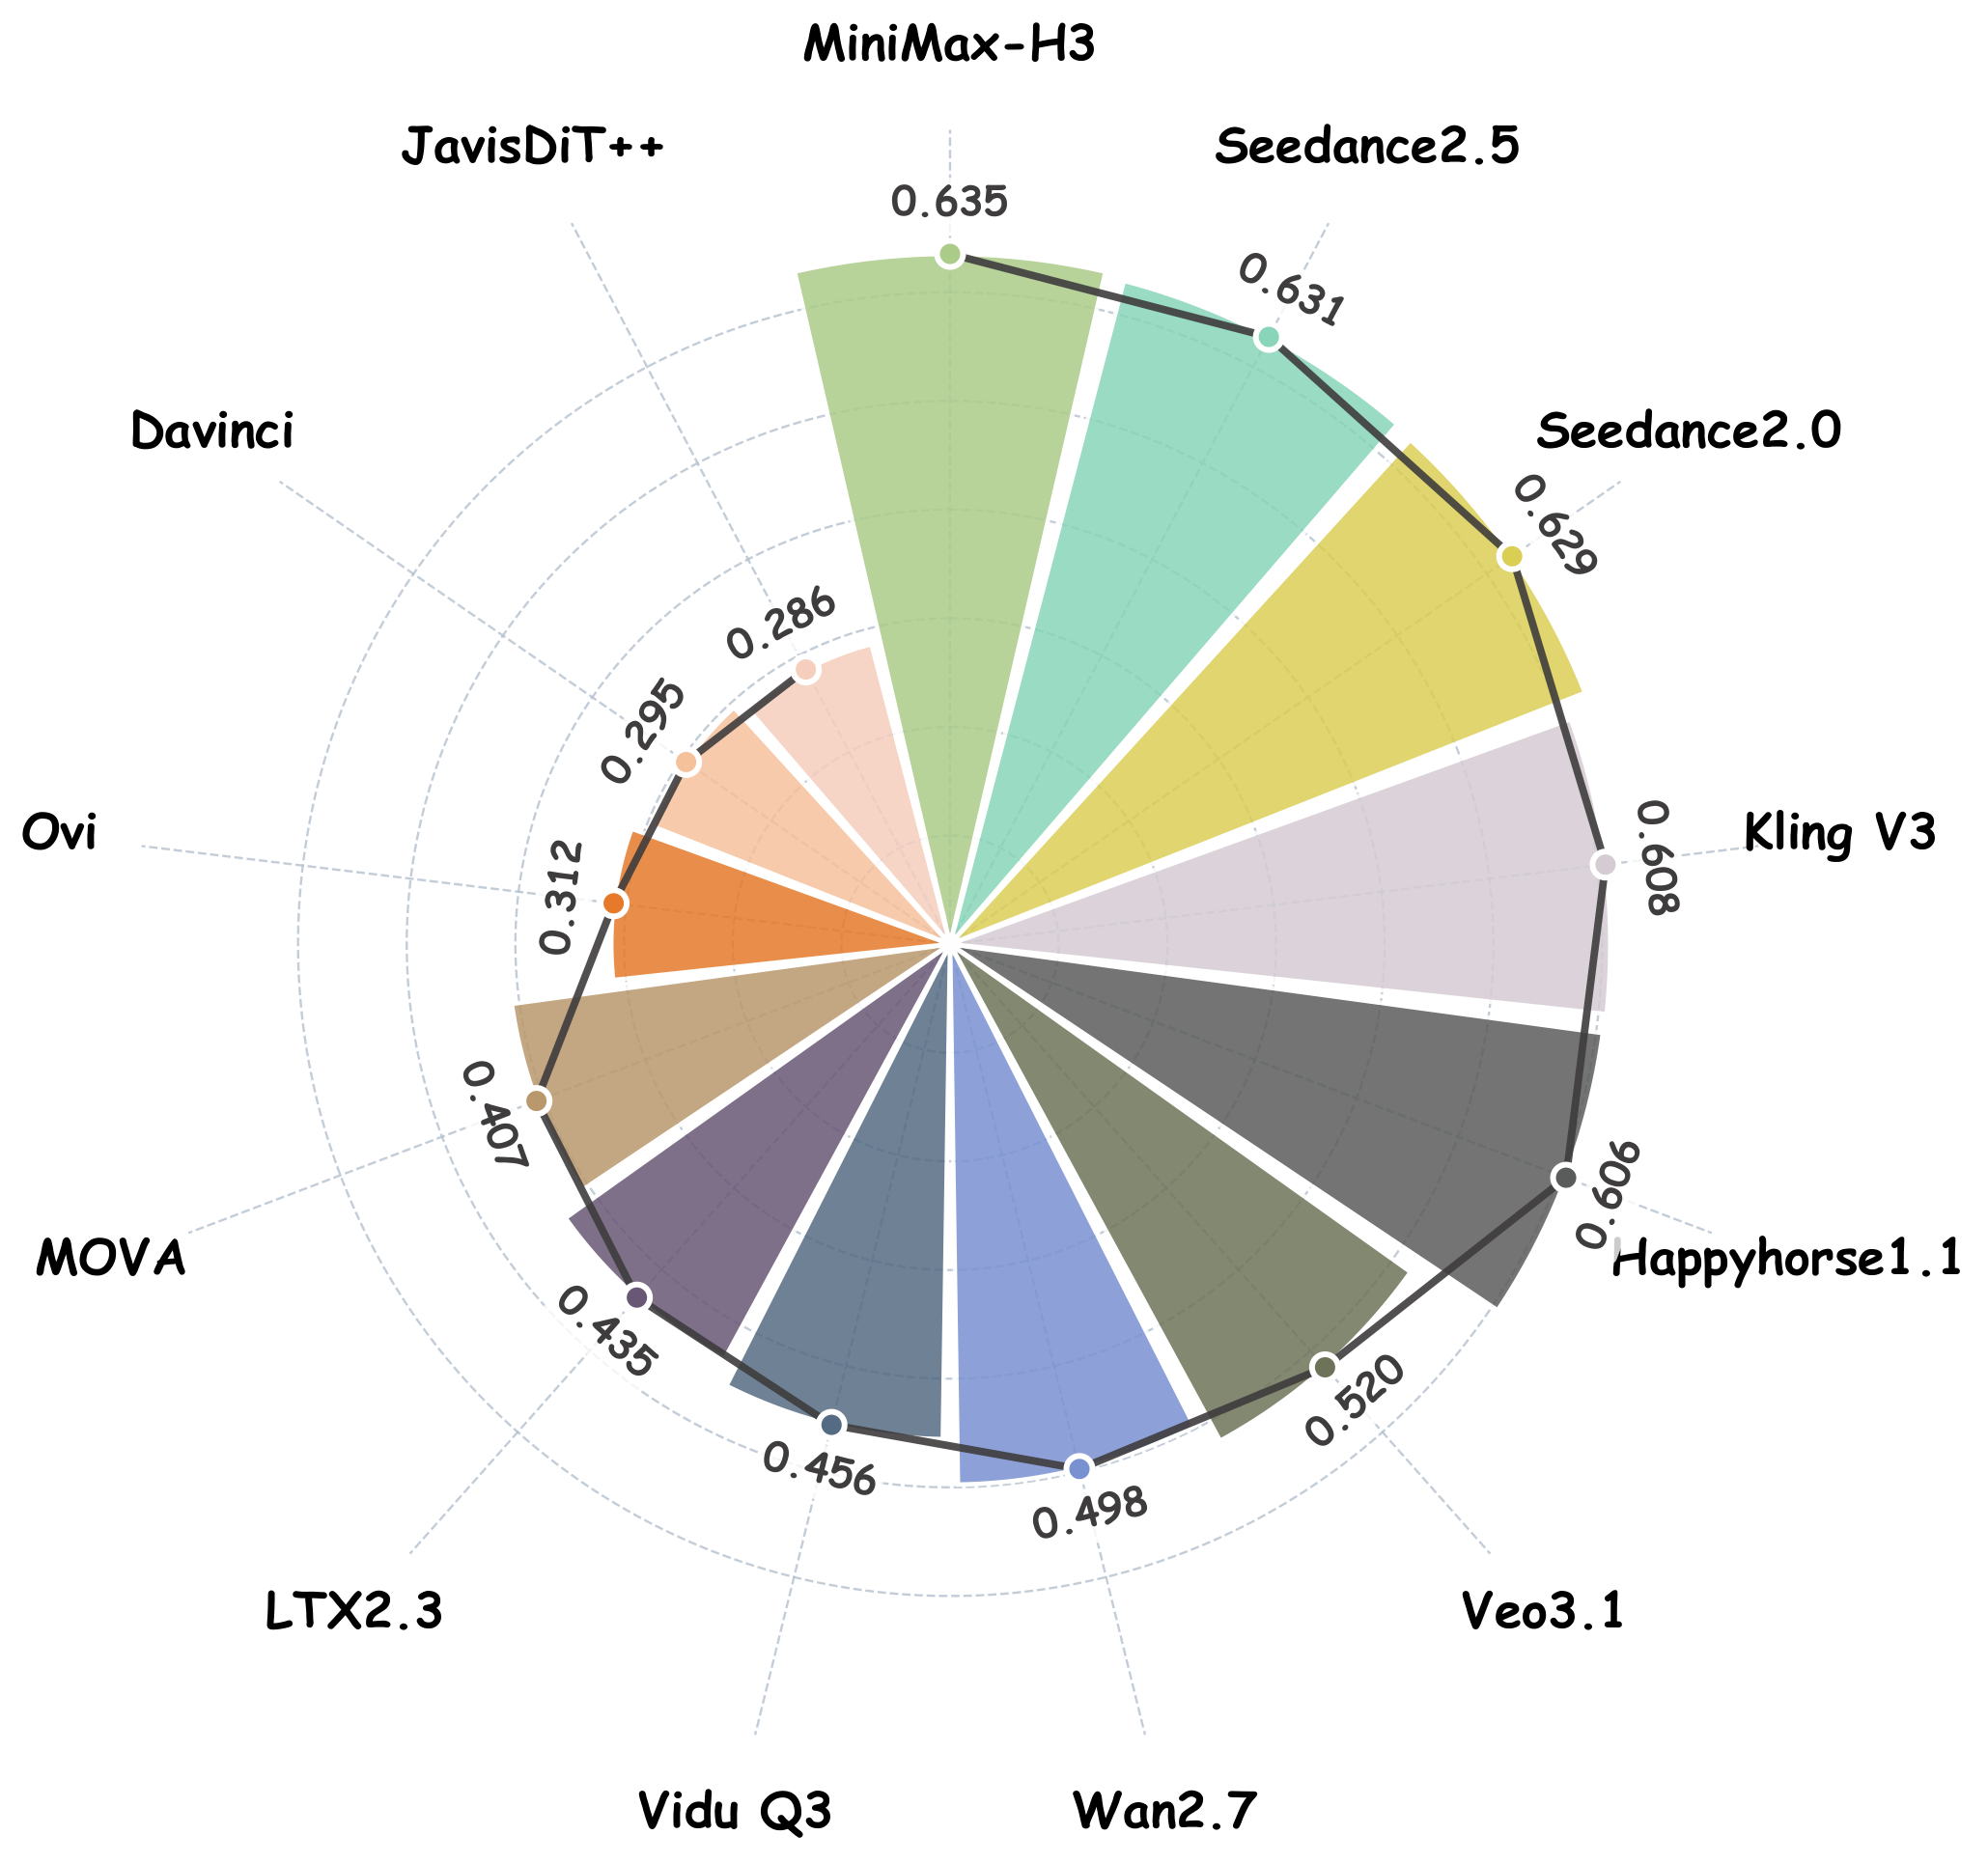
- 批判点评:混合评测仍依赖专家模型和多模态裁判,复杂剪辑意图可能被评分器误读。后期拼接能提升指令遵循,却可能掩盖底层生成模型不会原生控制镜头的问题;基准对真实剪辑师工作流、版权素材和长叙事的覆盖仍有限。
2. Programmable World Model:规则状态准确率98%
Programmable World Model | Alaya Lab | arXiv:2609.10540
关键词:世界模型,视频生成,可编程状态,交互游戏
- ⚠️ 前序问题:交互式视频世界模型能生成逼真的下一帧,却通常把角色生命值、阵营、库存和任务进度隐含在像素历史里。实体离开画面后,模型容易忘记它是否存活;自然语言提示也只能描述结果,无法保证规则在长时间交互中被稳定执行。
- 本文贡献:Programmable World Model 把世界状态演化与视觉生成拆开。编码智能体把自然语言规则写成可执行程序,轻量引擎维护包含屏外实体和非视觉属性的权威状态;状态增强的 3D 定向包围盒再经确定性编译器投影成身份、语义和运动方向控制图,预训练视频模型只负责把状态渲染成画面。
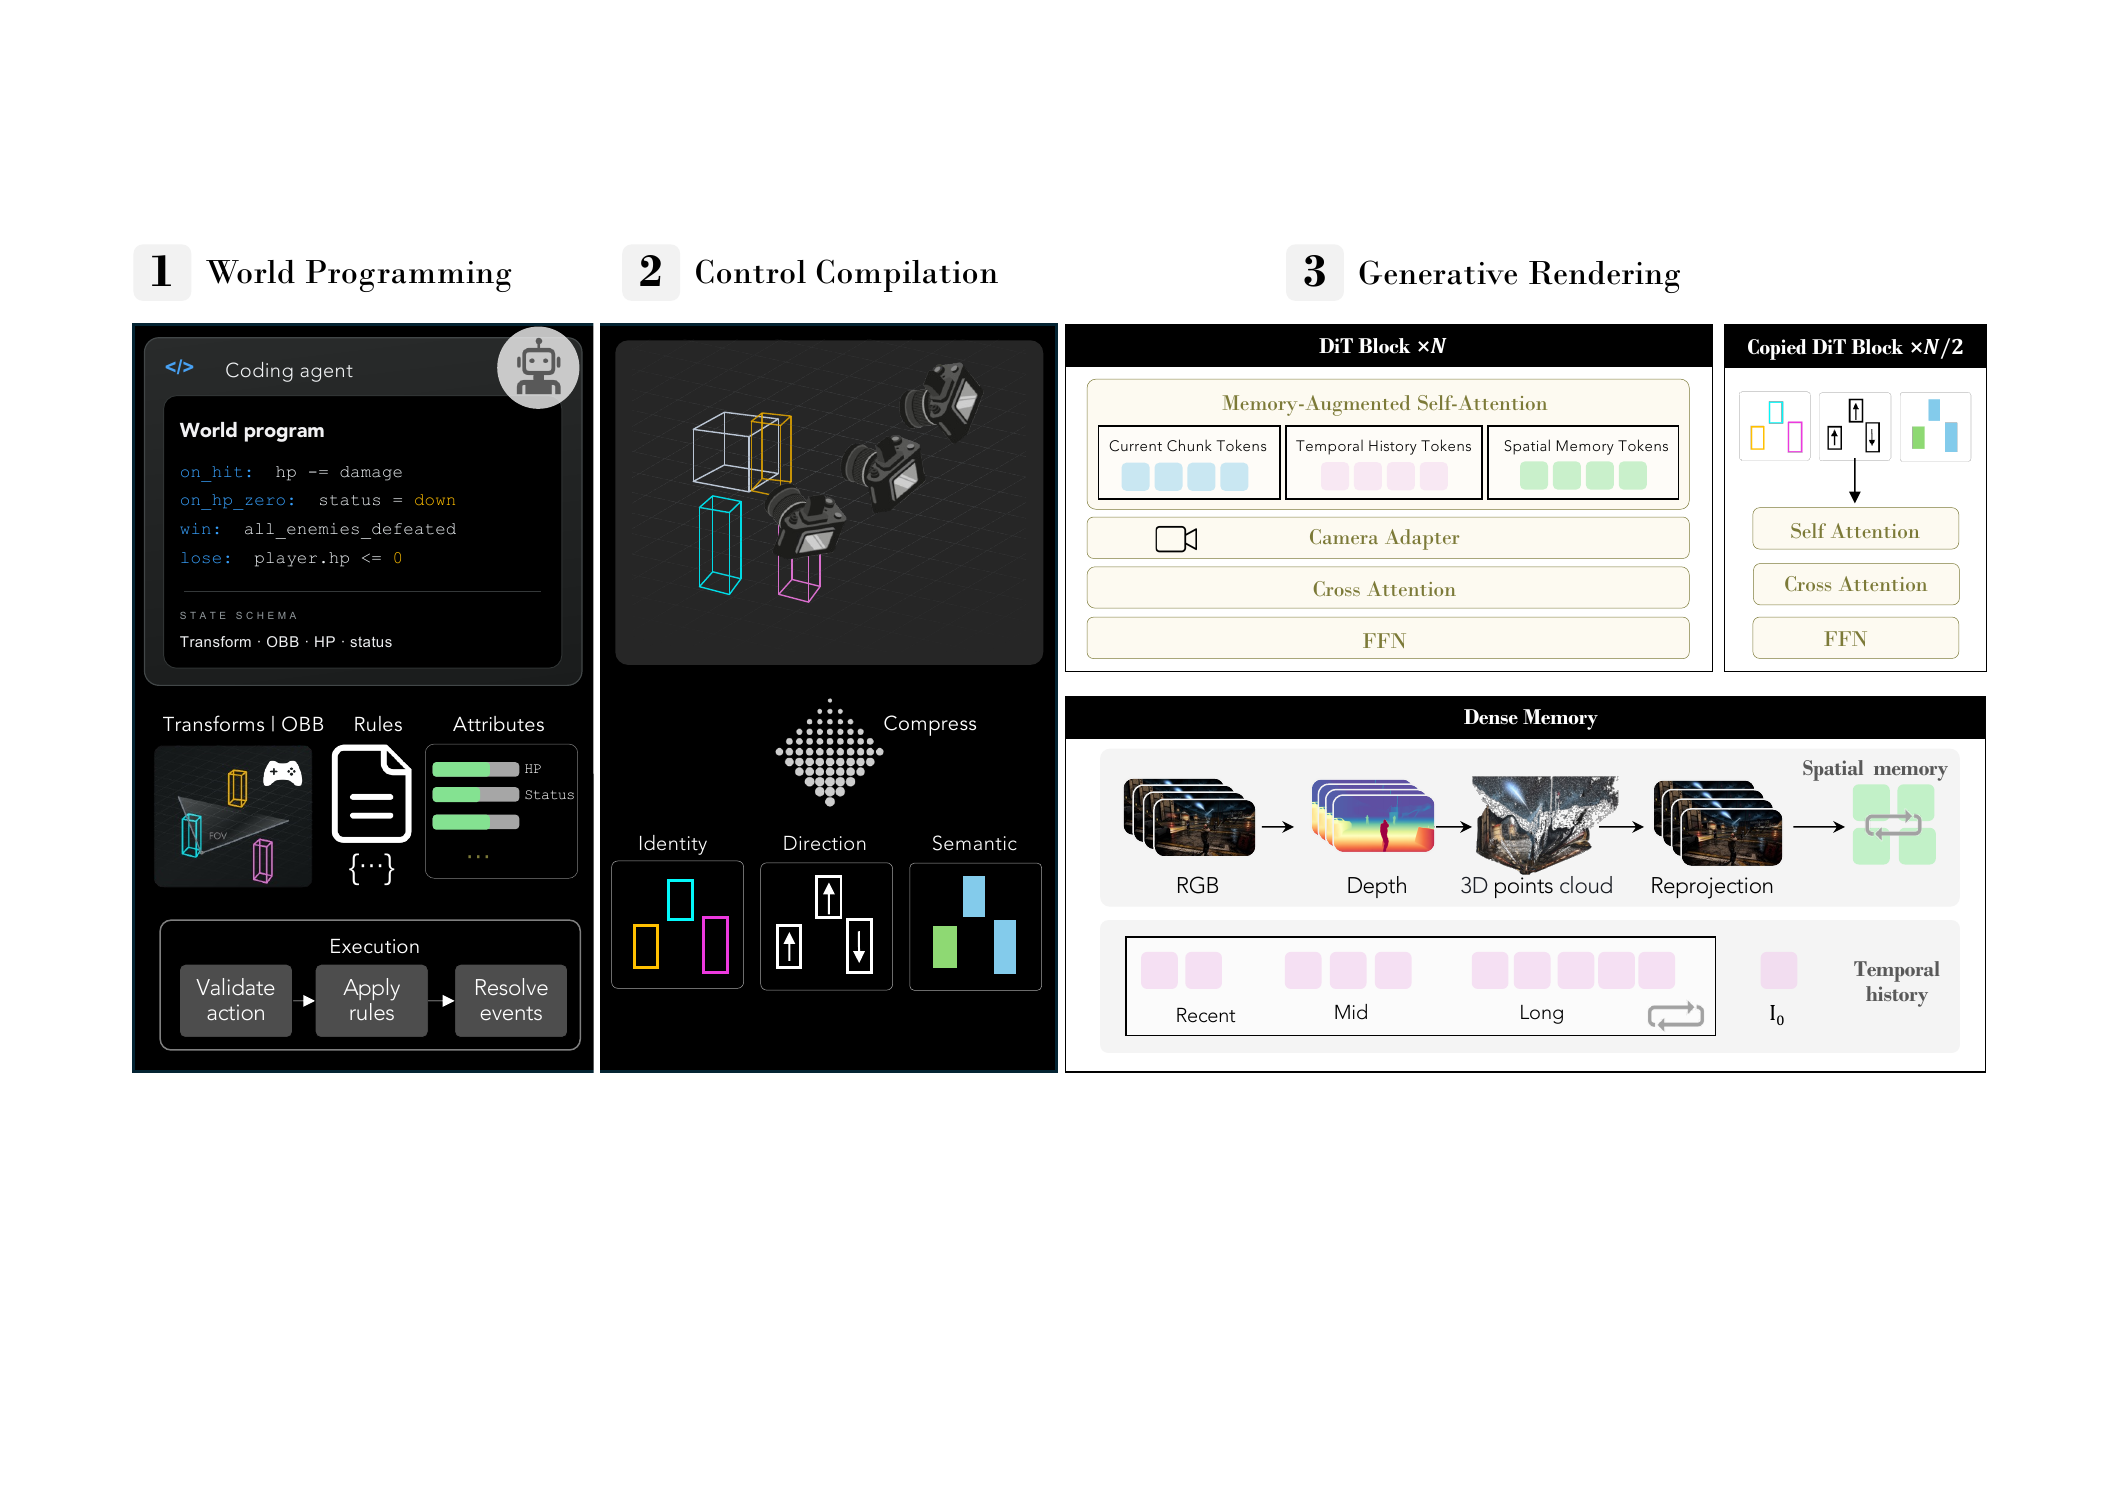
- 实验效果:在作者新建的 CombatStateBench 上,系统的存活角色数量准确率达到 94%,状态准确率达到 98%,并能在长时战斗交互中维持实体状态。它还支持用户预先编写游戏机制、逐个控制实体,并在镜头移开后继续保存世界事实。

- 批判点评:显式引擎让规则可验证,但也把开放世界压缩成包围盒、离散属性和手写转移规则;复杂物理、细粒度姿态与不可预设事件仍交给生成器补全。论文基准集中于战斗场景,面对大规模地图、多玩家并发和长期程序错误时的扩展性仍待验证。
3. DIVA:参考图放大越狱风险
The Price of Consistency: Exploiting Visual Anchors for Multimodal Jailbreaking in Video Generation | Peng Li 等(ACM MM 2026) | arXiv:2609.07216
关键词:视频生成,安全评测,多模态越狱,参考图控制
- ⚠️ 前序问题:图生视频用参考图锁住主体和场景,提高时空一致性,但安全系统往往只重点审查文字。模型原本可能把危险提示漂移成无害内容,视觉锚点却会把生成过程拉回参考图中的危险意图,形成一致性越强、逃逸空间越小的安全悖论。
- 本文贡献:DIVA 是一个免训练多模态越狱框架,把危险意图拆成静态参考图和看似普通的运动提示,并用双重标准筛选兼顾隐蔽性与语义保真度的组合。论文同时提出 TI2VSafetyBench,用于专门评测多条件视频生成中的视觉锚定风险。

- 实验效果:作者在多家主流商业平台和开源视频模型上测试,DIVA 的攻击成功率显著高于纯文本攻击,说明只过滤提示词不足以覆盖图像与运动描述共同表达的风险。论文已被 ACM MM 2026 接收。

- 批判点评:攻击依赖先获得合适的危险参考图,现实系统还可能在上传、编码和输出阶段做二次视觉审核。公开越狱流程有双重用途风险;防御评估需要同时覆盖输入图、运动文本、跨模态组合和生成结果,且必须在平台更新后持续重测。
4. GGF:模型用自绘图反哺理解
Dreaming in Flow: Generative Grounding Feedback for Self-Evolving Unified Multimodal Models | 上海交通大学、中国电信人工智能研究院、中国科学技术大学 | arXiv:2609.08282
关键词:统一多模态,自训练,流模型,图像生成
- ⚠️ 前序问题:统一多模态模型把理解和生成放进同一网络,却仍把两种能力当作独立任务训练。直接用模型自生成图像做自训练又会放大漏物体、属性错误和空间关系失真,缺少一种让生成经验反哺理解、再由理解修正生成的闭环。
- 本文贡献:生成接地反馈 GGF 只使用文本提示和模型自己的视觉梦境。流级反馈在同一噪声潜变量上比较文本、图像与修复条件的预测方向,把图像接地信息传回文本条件;梦境回放则通过描述和再想象,让可验证事实在两次生成间保持一致,并分离无关经验。
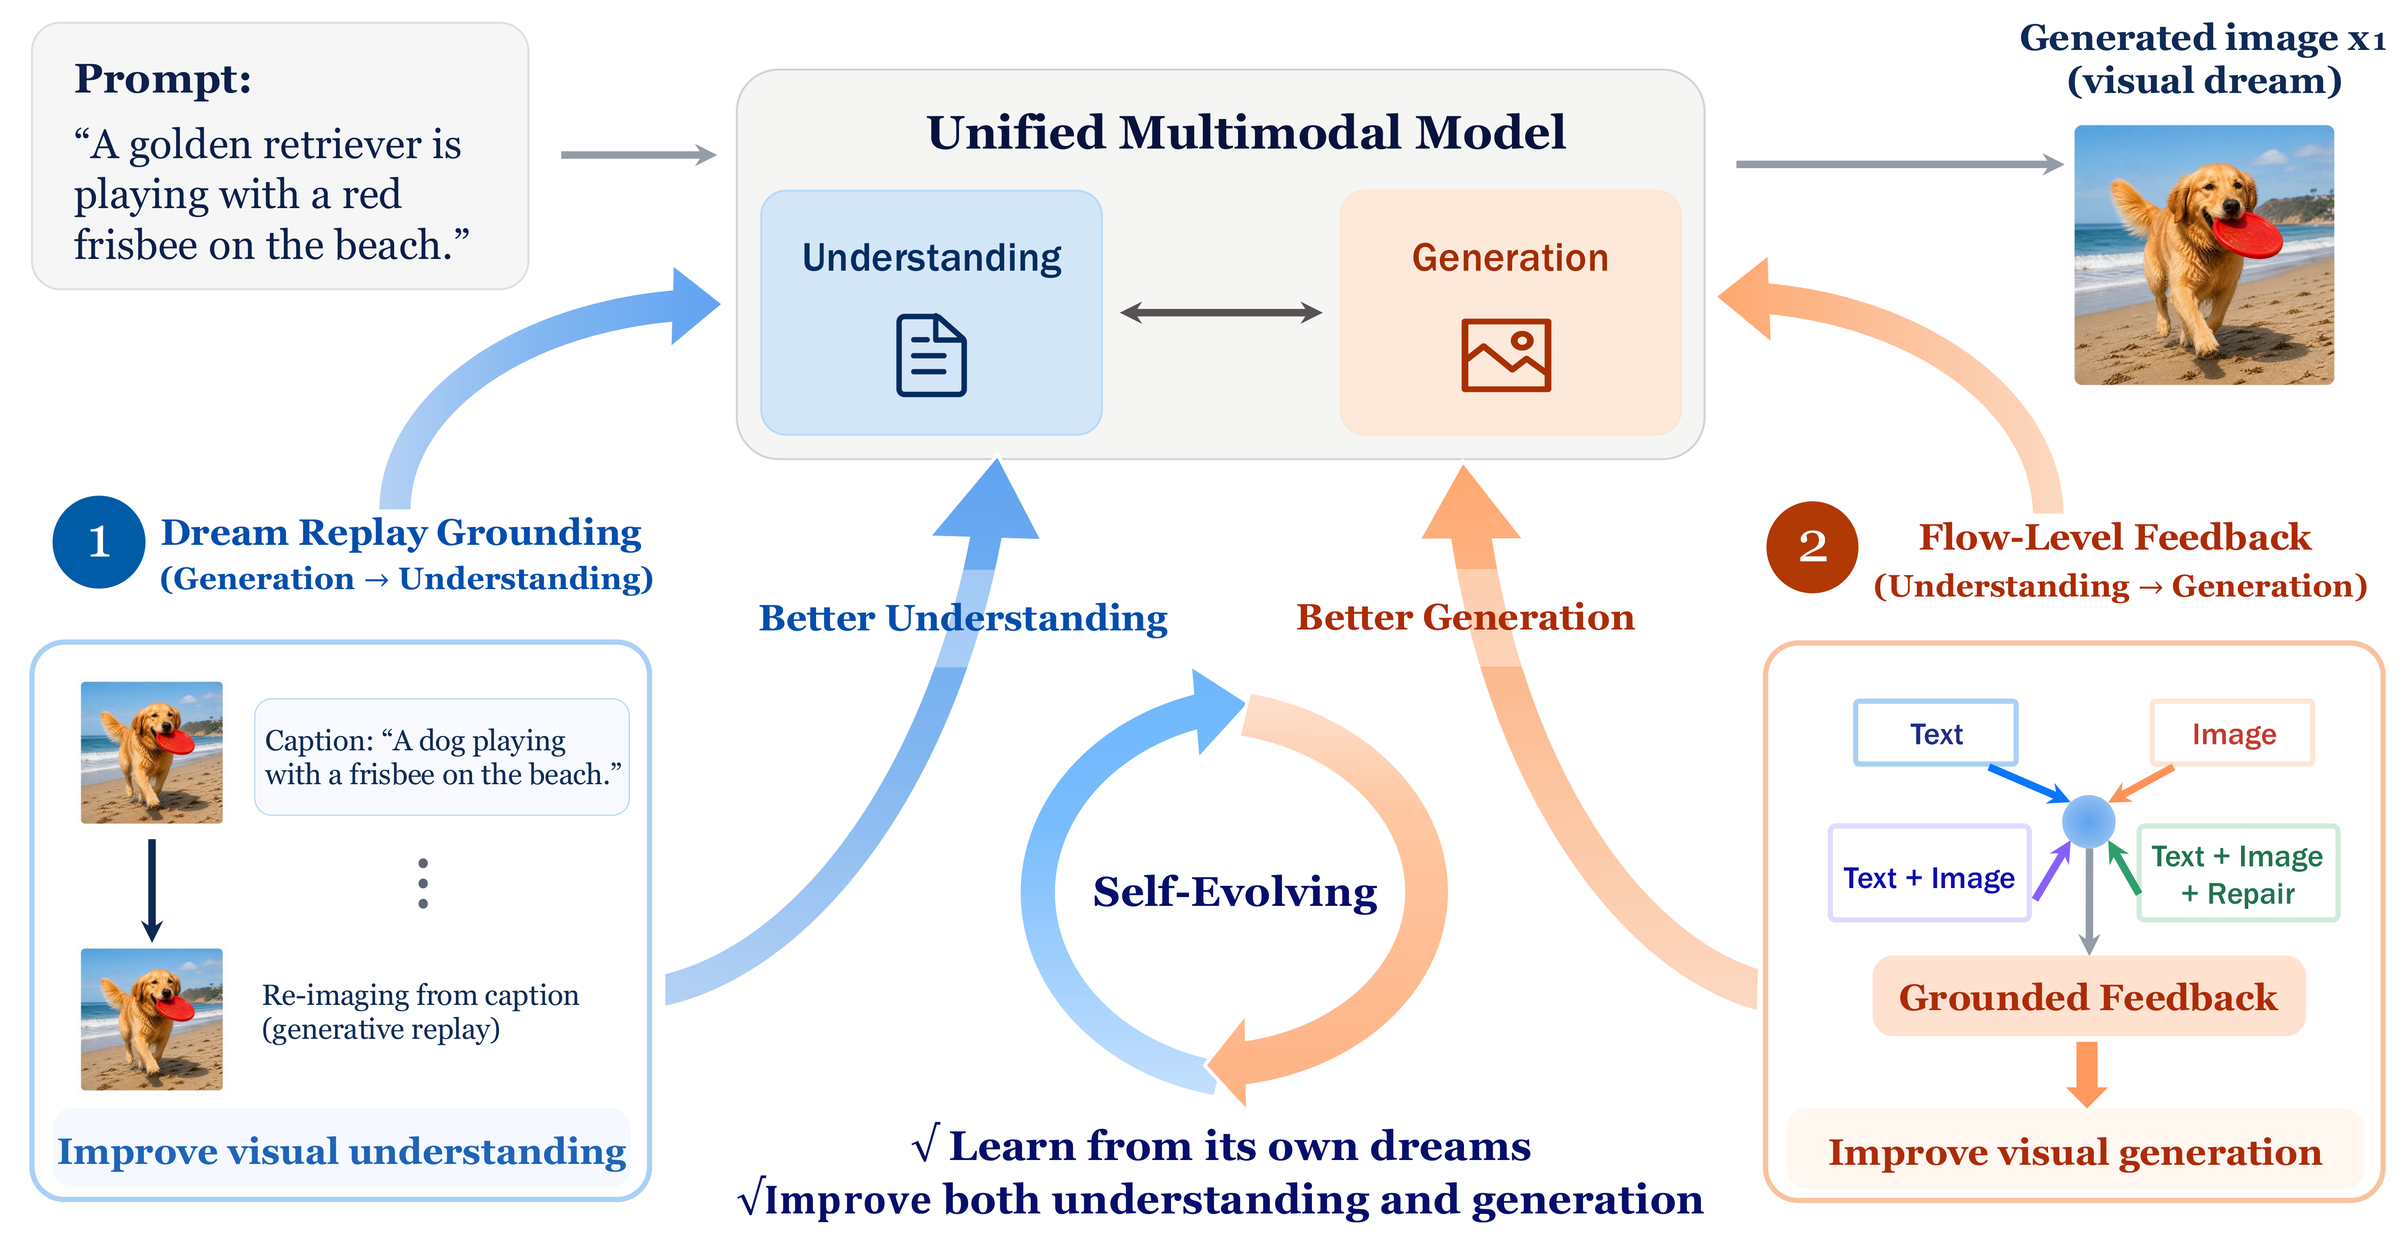
- 实验效果:在采用不同理解—生成融合设计的统一模型上,GGF 都带来一致的文生图提升,同时让视觉理解获得幅度较小但稳定的增益。方法不依赖额外成对图文数据,说明模型自身生成的图像可以成为双向训练信号。
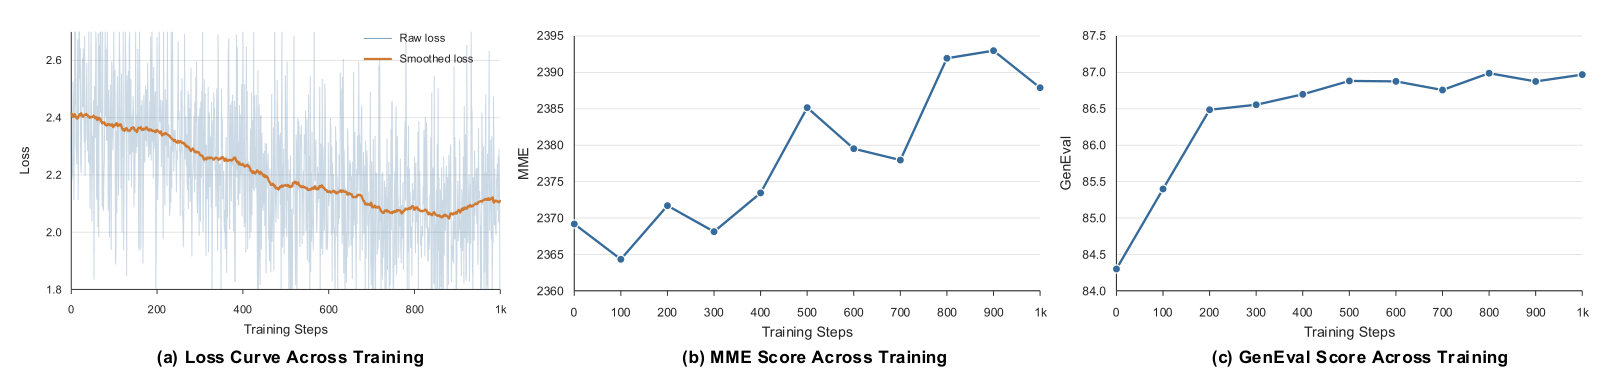
- 批判点评:自生成经验仍受初始模型能力上限约束,流级一致不保证图像事实正确。回放和修复增加训练计算,如何过滤系统性偏见、避免错误闭环以及在闭源生成器上复现,仍是落地障碍。
5. FlowCPO:离线对齐GenEval达0.84
FlowCPO: A Unified Divergence View of Preference Alignment for Flow Models | 西湖大学、浙江大学、快手可灵团队 | arXiv:2609.09905
关键词:流模型,偏好对齐,离线优化,前向KL
- ⚠️ 前序问题:流与扩散模型的偏好对齐分成在线强化学习和离线偏好优化两派:前者必须不断从当前模型采样,成本高;后者常用正样本微调或似然比近似,既难解释与在线目标的关系,简化回归损失还可能无下界。
- 本文贡献:FlowCPO 用散度视角统一这些方法,并提出无需在线回滚的离线前向 KL 目标,同时利用偏好和拒绝样本。在线性插值及明确正则条件下,作者把前向 KL 上界化为可在固定数据上优化的对比流匹配损失,并证明该损失非负。
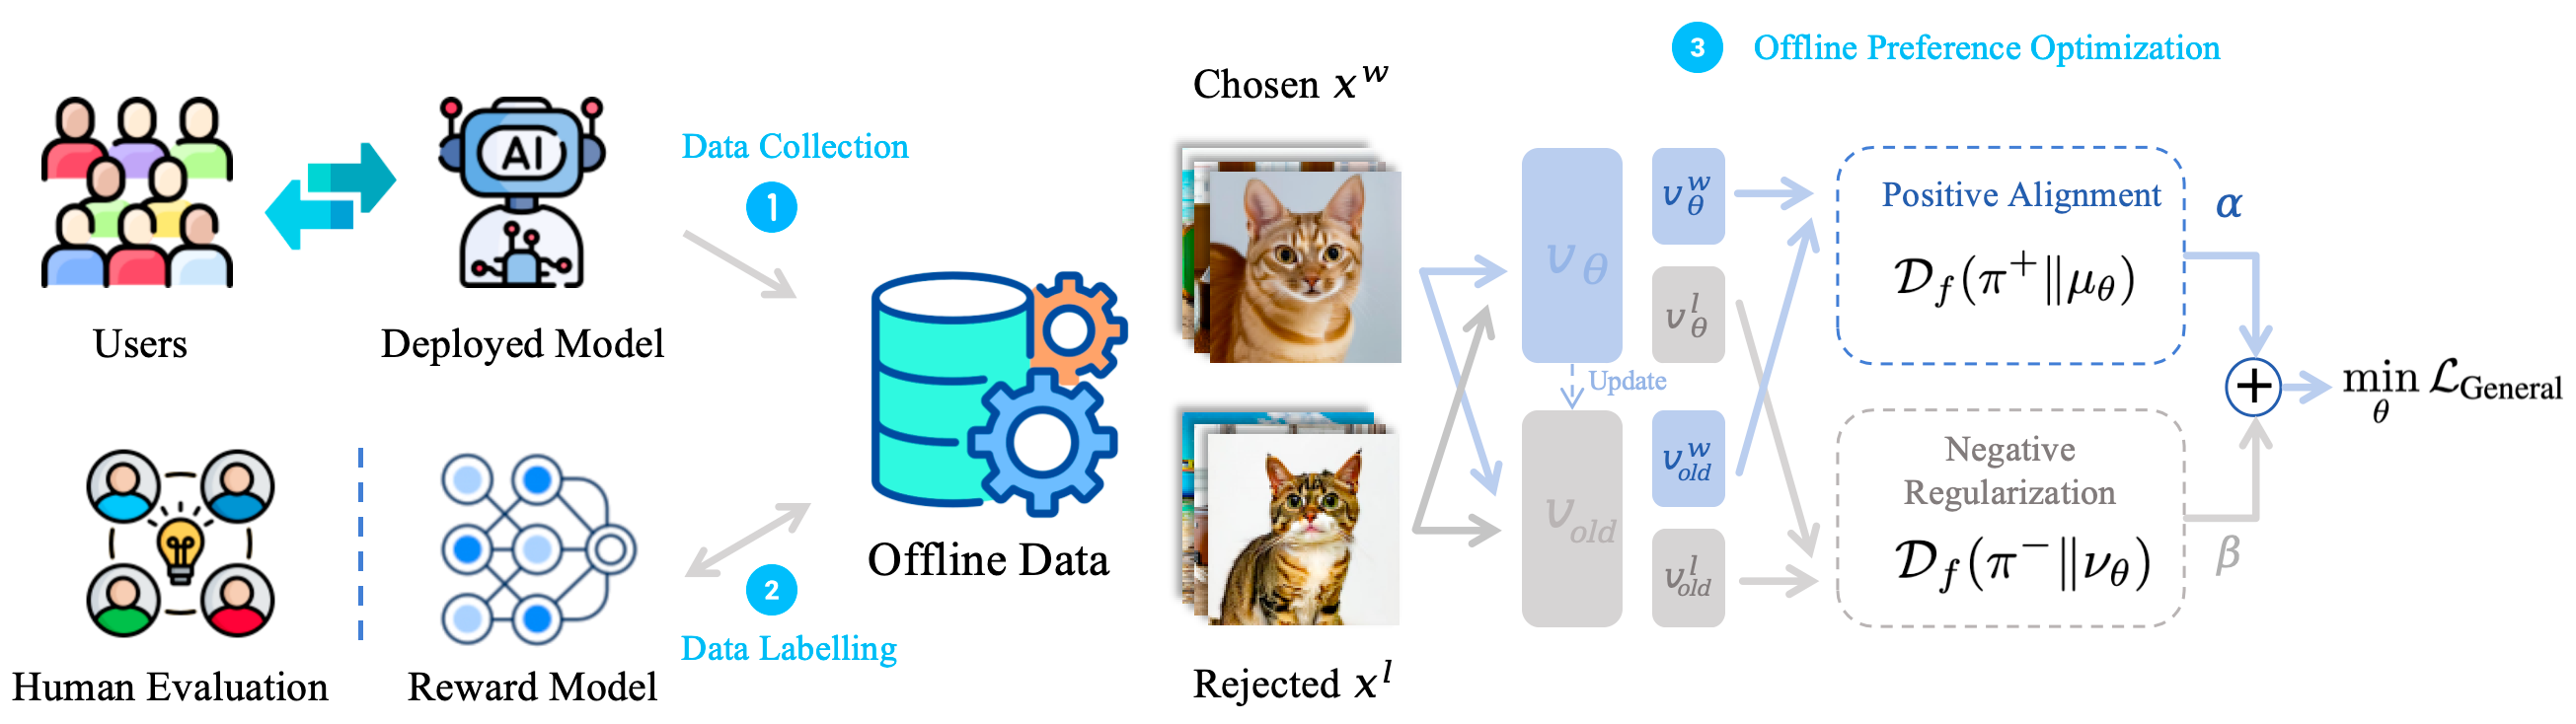
- 实验效果:在域内实验、CFG=3.0 时,FlowCPO 的平均 GenEval 与 OCR 分数分别为 0.84 和 0.87,高于 FlowDPO 的 0.81 和 0.74。域外测试中它取得最佳 GenEval,但多项奖励分数低于 RFT,结果并非全面领先。

- 批判点评:理论上界依赖线性插值和正则条件,真实大模型训练是否满足需要验证。离线数据省掉采样,却继承偏好数据覆盖与标注偏差;负样本权重、参考先验和插值系数也会带来额外调参成本。
6. PhysFlow:5万物理视频教会运动
PhysFlow: Physics-Aware Optical Flow for Motion Controllable Video Generation | 中科院自动化所、中国科学技术大学、北京航空航天大学、中关村学院 | arXiv:2609.08215
关键词:视频生成,物理一致性,光流,运动控制
- ⚠️ 前序问题:视频生成器能做出漂亮纹理,却常出现碰撞错误、非刚体变形失真和前景背景接触不合理。完整物理引擎依赖准确 3D 重建和材料参数,文字或稀疏轨迹又不足以描述像素级形变,需要一种介于模拟状态和最终外观之间的密集运动表示。
- 本文贡献:PhysFlow 把生成拆成两步:PA-Flow 根据速度、加速度、密度和杨氏模量生成物理感知光流,分别建模全局运动与局部形变;FlowRender 再以光流视频为条件合成纹理。配套 PhysVideo 用物理引擎与 3D Gaussian Splatting 构建显式监督。
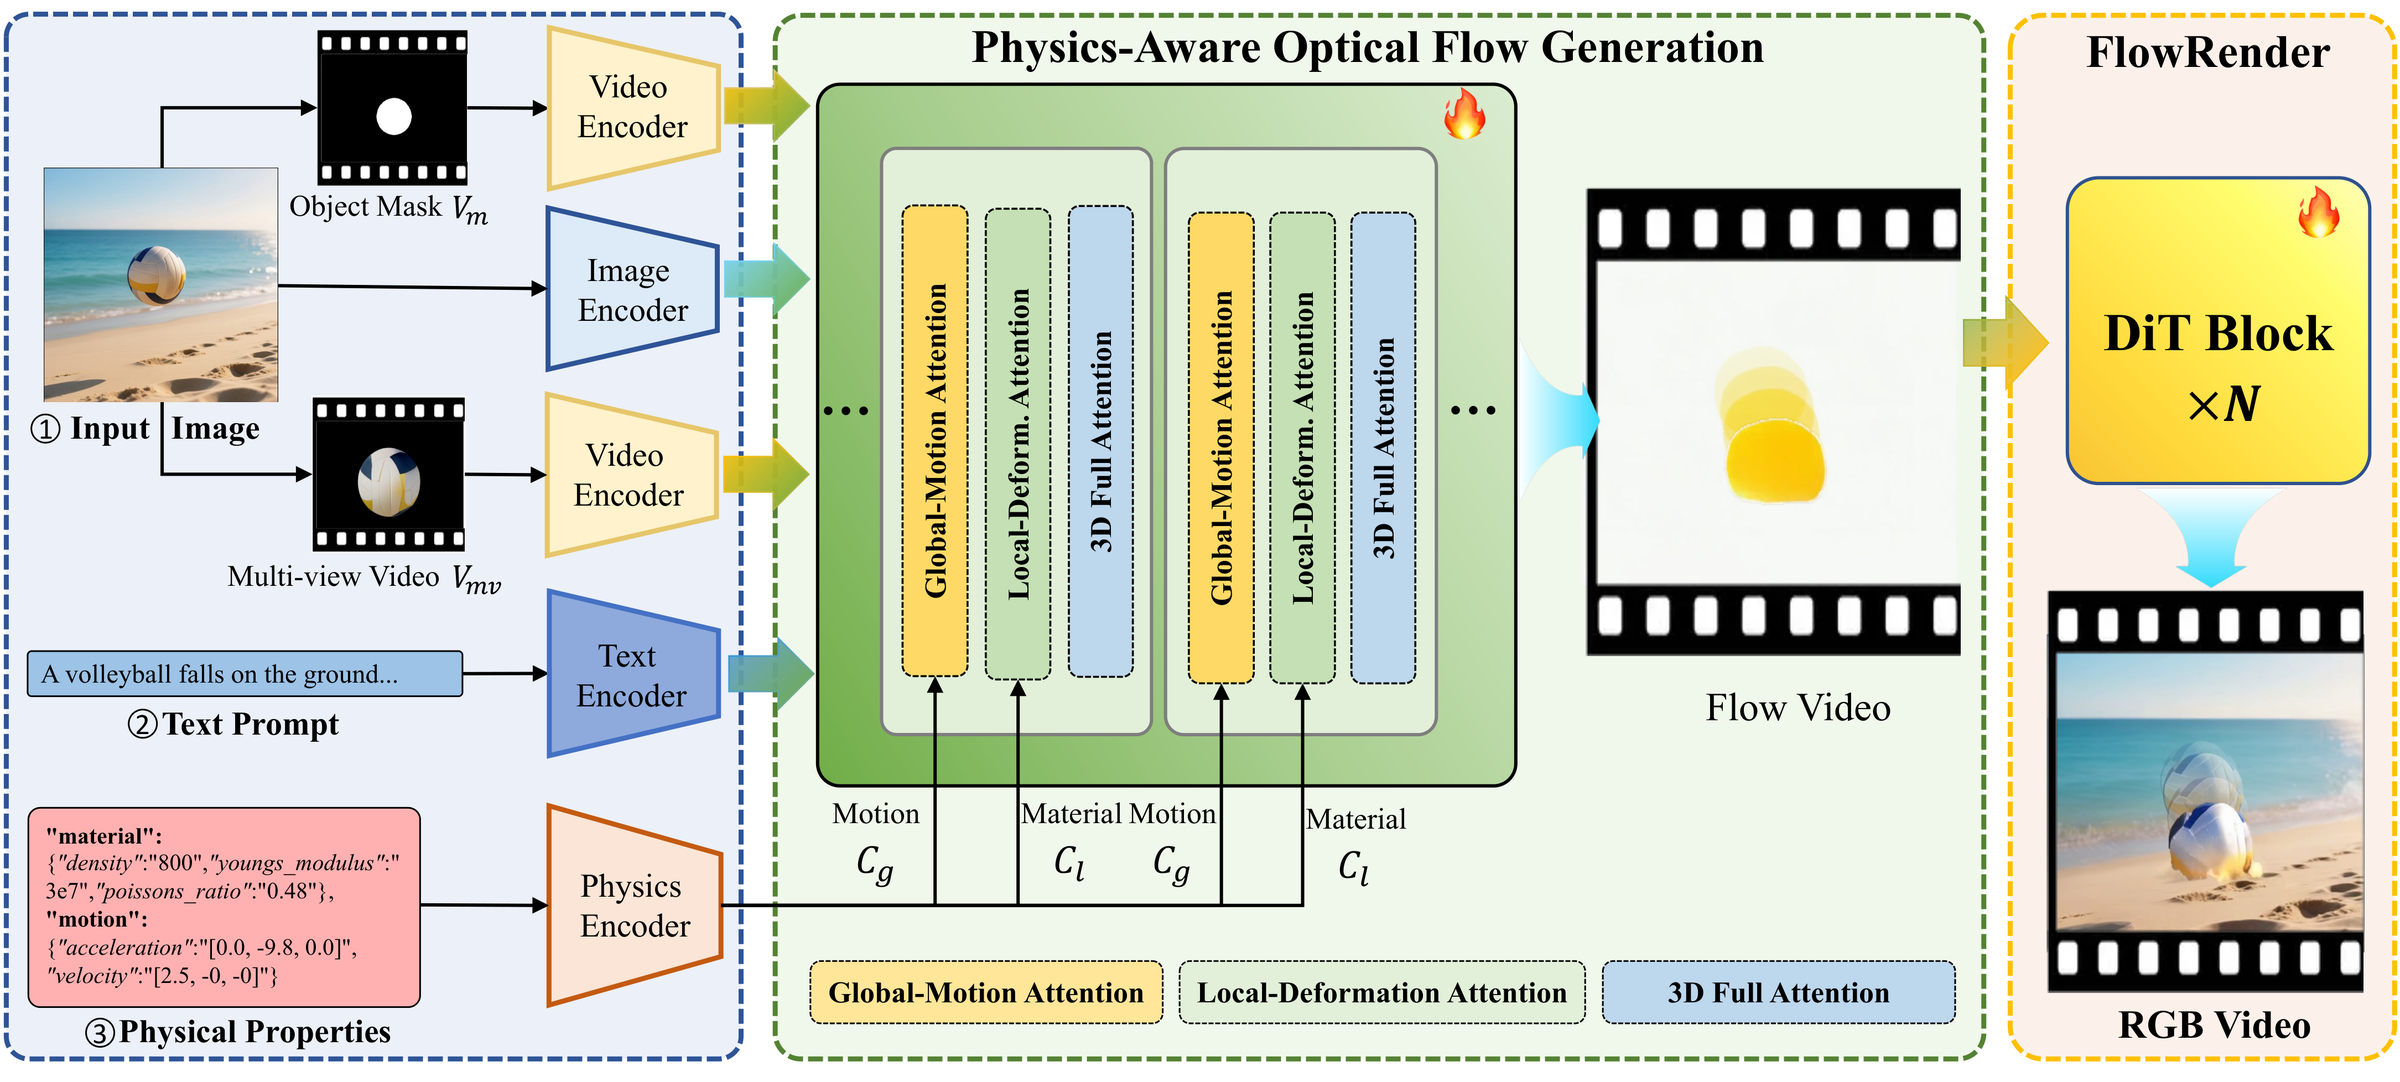
- 实验效果:PhysVideo 包含 1 万个前景物体和 5 万段带运动、材料属性标注的视频。实验显示 PhysFlow 在保持视觉质量的同时提升物理合理性,并能从单图处理非刚体运动、物体交互及前景背景接触。

- 批判点评:光流适合二维位移,却无法显式表达遮挡后的三维结构、拓扑变化和长期守恒量;两阶段误差也会累积。方法仍需用户或数据提供材料与运动属性,开放世界里这些参数通常难以可靠获得。
7. MIEdit:千组编辑基准无需调参
Multi-History-Step SDE Inversion for Image Editing with Superior Regional Awareness | 中科院自动化所、国科大(ECCV 2026) | arXiv:2609.06602
关键词:图像编辑,SDE反演,语义遮罩,免训练
- ⚠️ 前序问题:免训练扩散编辑要在重建原图与服从新提示之间取舍。现有 ODE/SDE 反演步数多、编辑幅度受限,增大 CFG 还可能产生伪影;非编辑区域保护通常需要额外遮罩输入或独立分支。
- 本文贡献:MIEdit 用预测—校正的多历史步 SDE 反演,在每一步复用至少两个历史项,以更少步数提高稳定性和编辑可塑性;同时调整噪声日程缓解大幅编辑冲突。IASM 在反演早期借助 CFG 方向自动生成语义角度遮罩,并贯穿后续采样约束区域。

- 实验效果:作者构建 EditEval++,覆盖 30 个细粒度任务和超过 1,000 组图像—文本—遮罩三元组。实验显示 MIEdit 在无需微调、无需外部遮罩的条件下超过所比较方法,并能把输入重建到数值精度范围。论文已被 ECCV 2026 接收。

- 批判点评:多历史项会增加缓存与实现复杂度,自动遮罩质量仍依赖基础模型的 CFG 响应。论文主要围绕扩散 SDE 编辑,迁移到流匹配模型、超高分辨率和多对象关系编辑时是否稳定还未充分验证。
8. StreetDiff:全景约束街景多视角
StreetDiff: Multi-view Street Scenes Generation via Cross-view Consistent Multi-view Stable Diffusion with Structure Prompts | 深圳大学 | arXiv:2609.09890
关键词:多视角生成,街景,全景图,结构控制
- ⚠️ 前序问题:多视角扩散在室内或简单自然场景表现不错,面对道路、建筑和动态目标密集的城市街景时,镜头旋转后容易重复物体、扭曲建筑和破坏布局。相邻视角注意力缺少球面几何对应,难维持全局结构。
- 本文贡献:StreetDiff 让全景分支负责全局布局、透视分支负责局部细节,并用 Panorama Alignment Module 按球面投影建立跨视角注意力约束。结构提示可来自分割图、轮廓或草图;作者还构建带文本和密集结构标注的 HDR 城市全景数据集 Street360。
- 实验效果:实验显示 StreetDiff 在街景生成质量和多视角几何一致性上超过所比较基线,尤其改善纯文本条件下的建筑与道路结构;它无需修改扩散骨干即可注入几何对齐。
- 批判点评:球面全景是有效的全局脚手架,但真实街区包含强遮挡、动态交通和大范围深度变化,二维投影约束仍可能失效。Street360 的地域与天气覆盖、从合成多视角到可导航 3D 场景的差距也需要检验。
9. LoGAN:少量字形扩展27种语言
LoGAN: Multilingual Font Localization with Generative Agents | Netflix(ECCV 2026) | arXiv:2609.07029
关键词:字体生成,多语言,VLM智能体,扩散模型
- ⚠️ 前序问题:把一个品牌字体或电影 Logo 本地化到新语言,不只是生成单个字形,还要保留笔画风格、纹理、颜色、字距和字偶距。通用生图模型常改乱排版,传统字体生成又难从拉丁字母跨到结构复杂的中日韩字符。
- 本文贡献:LoGAN 用 VLM 智能体协调字形级扩散、少样本风格微调、字距与字偶距迁移以及纹理扩展模块。输入少量原字体字形或 Logo 字母后,系统分别解决结构、排版和材质,再组合成目标语言的完整字符集。
- 实验效果:论文覆盖超过 27 种语言,包括拉丁、希腊、西里尔与中日韩文字;在字体和真实 Logo 数据上,相比字体专用模型及 FLUX、Nano-Banana 等编辑模型取得更高字形保真度,并更好保持风格、纹理和字距。400 个电影 Logo 样本中有 44% 基于字体制作。
- 批判点评:多模块流水线提升可控性,也放大任一环节的误差和运行成本。少数字形可能不足以覆盖复杂脚本的部件组合、书写规范与文化设计语义;字体版权、人工修字和完整字符编码支持仍是商业落地条件。
10. AnomalyCraft-700K:4万异常视频70万标注
AnomalyCraft-700K: Component-Level Controllable and Verifiable Synthetic Anomalies for Fine-Grained Video Anomaly Understanding | 西北工业大学、新加坡管理大学 | arXiv:2609.06978
关键词:视频生成,异常检测,合成数据,多模态理解
- ⚠️ 前序问题:真实异常视频稀少、难控制,已有合成数据通常只按类别或整句提示生成,提示与画面细节不一定一致,也缺少靠近正常—异常边界的困难正常样本,模型容易根据表面线索而非事件语义判断。
- 本文贡献:AnomalyCraft 把异常事件拆成场景、背景、主体、物体和有向交互五类组件,通过三阶段生成逐步放松非关键约束。相同组件同时作为核验单元,定位并人工修正视频—文本偏差;每个异常类别还配套语义接近但实际正常的困难反例。
- 实验效果:数据集包含超过 4 万段视频和 70 万条任务级文本标注,覆盖从异常检测、检索、描述到细粒度推理的六类任务。传统模型和多模态大模型评测都显示,它能为异常检测与理解提供有效监督。
- 批判点评:合成器的视觉偏差可能成为捷径,组件级人工修正也带来高成本和主观性。模型在该数据上提升不代表真实监控、开放场景和未见异常同样受益,需与真实数据混合训练并做跨域验证。
趋势观察
生成评测开始检查专业过程
CutCraft不再只看画质和连贯性,而是逐项检查镜头、转场和音画剪辑语法,说明创作模型的评价对象正在从结果扩展到过程执行。
世界模型从像素记忆走向权威状态
Programmable World Model把规则与实体状态交给可执行引擎,生成模型退回渲染器角色;可验证状态开始成为长期交互的一等公民。
条件越强,跨模态安全面越大
DIVA揭示参考图既提升一致性也会固定危险意图;安全策略需要联合审查图像、文字运动条件与输出,而不能只过滤提示词。
生成模型用结构中间态换取控制
从PhysFlow的光流、StreetDiff的全景几何到MIEdit的语义角度遮罩,低维且可解释的中间表示正在连接高层意图与像素生成。
人工智能炼丹君 整理 | 2026-09-11
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注









评论 (0)