今日 AIGC 论文速览
今日共 10 篇 · 统一视觉理解与生成 1 篇 · 实时视频与世界模型 2 篇 · 多模态智能体评测 3 篇 · 语音识别与压缩 2 篇 · 推理对齐与生成奖励 2 篇
重点论文标题列表
- SenseNova-U1.5(OpenSenseNova 团队):8B原生视觉直出4K
- Vidu S2(清华大学、北京生数科技):720p实时视频25帧起
- World in World(西湖大学 AGI Lab):冻结模型也能自由换镜头
- MindTopo(西北大学、微软研究院、斯坦福大学):拓扑规划远逊人类
- IdeaAMBIG(耶鲁大学、TCS Research):金标准让可实现率到98%
今日论文速览
1. SenseNova-U1.5:8B原生视觉直出4K
SenseNova-U1.5: Towards Native Unified Visual Intelligence | OpenSenseNova 团队 | arXiv:2609.11929
关键词:统一多模态,图像生成,图像编辑,原生像素建模
- 前序问题:理解模型通常依赖视觉编码器,生成模型又依赖 VAE,两条链路使用不同表征,导致理解、推理、生成和编辑难在一个端到端模型里互相迁移;高分辨率生成还会放大局部块之间的不连续。
- 本文贡献:SenseNova-U1.5 用 8B 参数的 Mixture-of-Transformers 直接统一像素与文本,去掉外置视觉编码器和 VAE;空间耦合解码器修补逐块重建的边界,原生分辨率扩展到 4K。后训练分别优化审美、双语文字、信息图和编辑专家,再用多专家在线蒸馏合并能力。

- 实验效果:在作者报告的开放模型对比中,SenseNova-U1.5 的 GenEval 总分达到 0.92,DPG-Bench 为 88.11,CVTG-2K 平均分为 0.948;训练语料新增约 5900 万张图,且有效训练量中 88.2% 超过 1024²、64.4% 超过 2048²。

- 批判点评:原生像素路线减少了模块割裂,却把视觉 token 数量、像素重建和语言建模的竞争都压进同一主干,训练成本并未消失。论文展示大量自有数据与奖励流程,完整数据未开放前,4K稳定性、多语言文字和多参考编辑的复现门槛仍高。
2. Vidu S2:720p实时视频25帧起
Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation | 清华大学、北京生数科技 | arXiv:2609.11638
关键词:实时视频,流式生成,视频编辑,空间视频
- 前序问题:主流扩散视频模型要等整段去噪结束才能播放,用户无法在直播过程中换人物、改衣服或更新参考图;上一代 Vidu S1 也局限于 540p、固定参考和说话头像。
- 本文贡献:Vidu S2 把流式视频扩展为 Avatar 与 Editing 两条实时链路:通过回放式在线蒸馏、块因果时序注意力、高低噪声双阶段缓存、量化与多 GPU 流水线,在生成过程中接收新指令和动态参考;编辑分支支持风格、服装、角色及背景替换,并探索双目空间视频。

- 实验效果:Avatar 在 720p 下维持 25–42 FPS。Editing 在 Sparkle-Bench 获得 3.74 总分,在 OpenVE+RefVIE 联合评测得 4.26;虚拟试穿 VFID-I 为 9.9515,低于 CatV2TON 的 19.5131。长期人评中,对 Runway 的整体质量偏好率达到 85.7%。
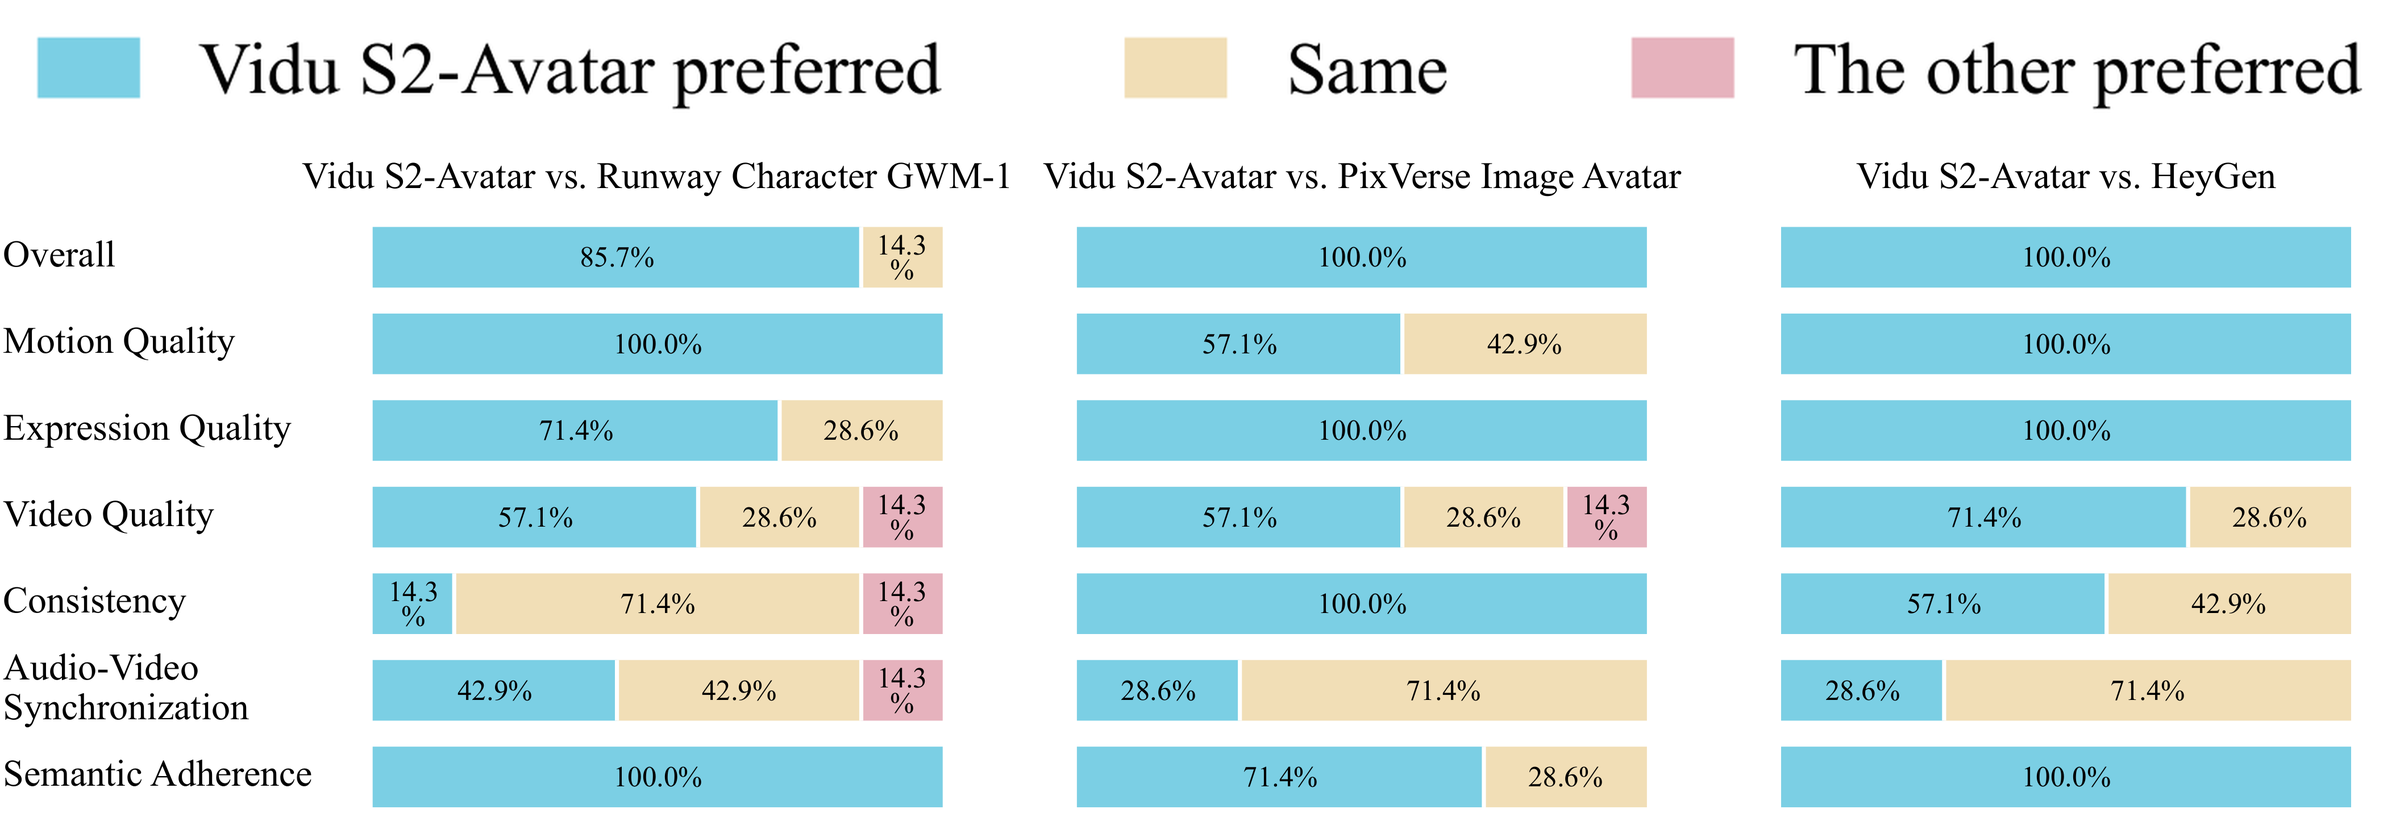
- 批判点评:实时性建立在复杂的缓存、量化和多 GPU 调度上,普通消费级部署能否复现 720p 上限仍需实测。空间视频主要由单目结果与深度后处理构造,快速运动、遮挡边界和长时间身份漂移仍可能影响头显舒适度。
3. World in World:冻结模型也能自由换镜头
World in World: Explore the World with World Models | 西湖大学 AGI Lab | arXiv:2609.11548
关键词:世界模型,相机控制,视频重渲染,免训练控制
- 前序问题:从已有视频换视角时,模型既要跟上原事件的时间线,又要把已见物体放到新视角、补全未见区域,并在镜头返回时恢复先前外观;现有方案通常为每种控制额外训练模块。
- 本文贡献:World in World 把原视频观测、目标视角投影、几何渲染和历史生成帧都编码成带相机、时间与有效区域标签的干净视觉状态,直接送入冻结因果视频模型的原生自注意力。对应路由器建立 token 对应关系,EWA 在同一次去噪前向中分别调节各证据通道。

- 实验效果:在 DAVIS 与 OpenVid-1M 相机重渲染评测中,方法的七项 VBench 平均分为 85.192,优于次高的 84.295;平移误差 0.068622、旋转误差 2.8326°,并取得 23.1511 PSNR。去掉目标视角 warp 后,旋转和平移误差约升至完整方法的 3.4 倍和 10.9 倍。

- 批判点评:免训练接口很实用,但仍依赖深度、相机姿态、点对应和人体几何等外部估计,错误会作为“干净证据”被模型放大。新暴露区域依赖生成先验,几何合理不等于真实世界可恢复。
4. MindTopo:拓扑规划远逊人类
MindTopo: Can Foundation Models Reason in Topological Space? | 西北大学、微软研究院、斯坦福大学 | arXiv:2609.11900
关键词:空间推理,拓扑,多模态模型,智能体规划
- 前序问题:视觉空间评测多考距离、角度和形状,却很少检查连续性、分离、顺序、包围和打结这些在连续形变下保持不变的拓扑关系;看懂静态图也不代表模型能通过动作维持它。
- 本文贡献:MindTopo 用 13 类程序化任务构造 11030 个样本,把五种拓扑性质分别放在单步推理与闭环规划中测试;同时评估 14 个多模态大模型,并让图像或视频生成模型充当规划过程的视觉想象器。
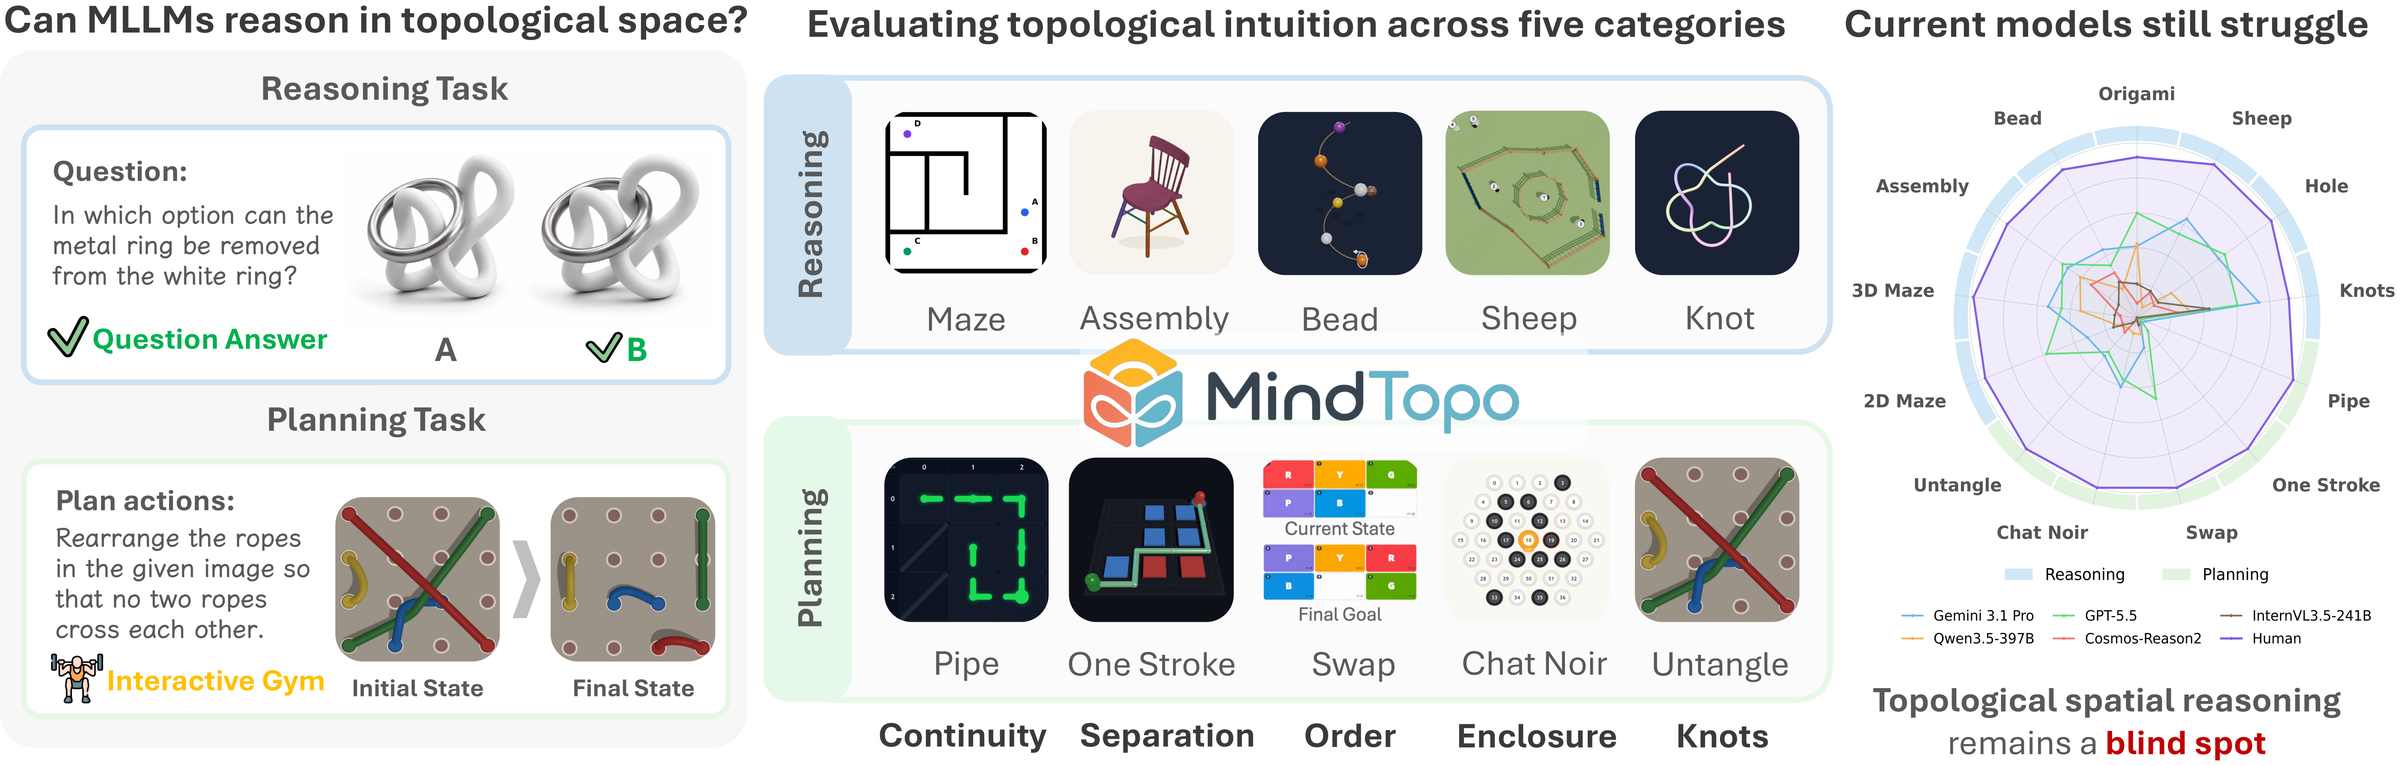
- 实验效果:按任务宏平均,GPT-5.6-Sol 得 61.42%,明显低于人类的 97.87%;其静态推理为 66.83%,闭环规划降到 52.75%。Qwen3-VL-2B 经 SFT 后平均 28.83%,GRPO 为 18.69%;联合训练使推理到 51.53%,规划仍只有 6.33%。
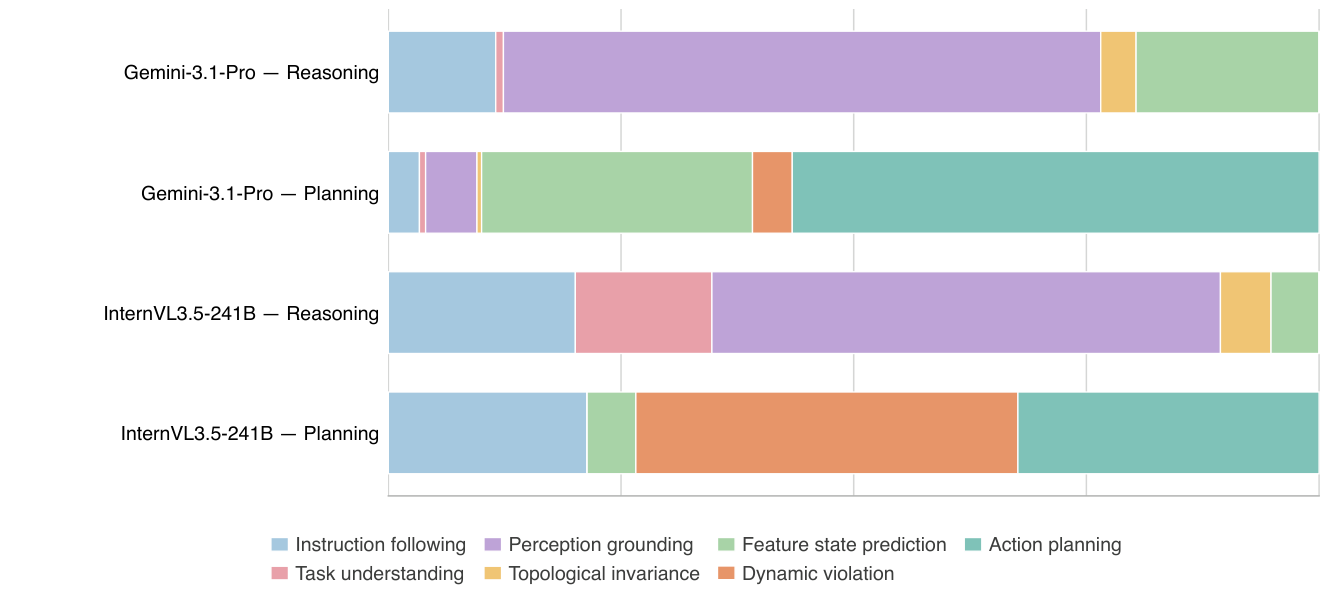
- 批判点评:基准把“识别关系”和“操作关系”的差距量化得很清楚,但渲染风格、动作接口和精确匹配评分可能放大模型失误。生成下一状态有时只是画出合理终点,并未遵守环境动力学,说明视觉想象尚不能替代可执行世界模型。
5. IdeaAMBIG:金标准让可实现率到98%
IdeaAMBIG: Benchmarking Implementation-Critical Gaps in Research-Idea Specifications | 耶鲁大学、TCS Research | arXiv:2609.10539
关键词:研究智能体,代码生成,需求澄清,可复现性
- 前序问题:研究想法可以新颖且逻辑自洽,却遗漏门控方式、损失定义或参数匹配口径;编码智能体若不识别这些关键空白,就会默默补假设,最终实现出另一个方法。
- 本文贡献:IdeaAMBIG 从论文、代码仓库、Issue 和复现记录构造 660 个有证据支撑的样本,其中 163 个是真实缺陷、497 个是受控注入缺陷,分别测试规格是否可编码、缺陷定位和已知缺陷后的澄清问题生成。
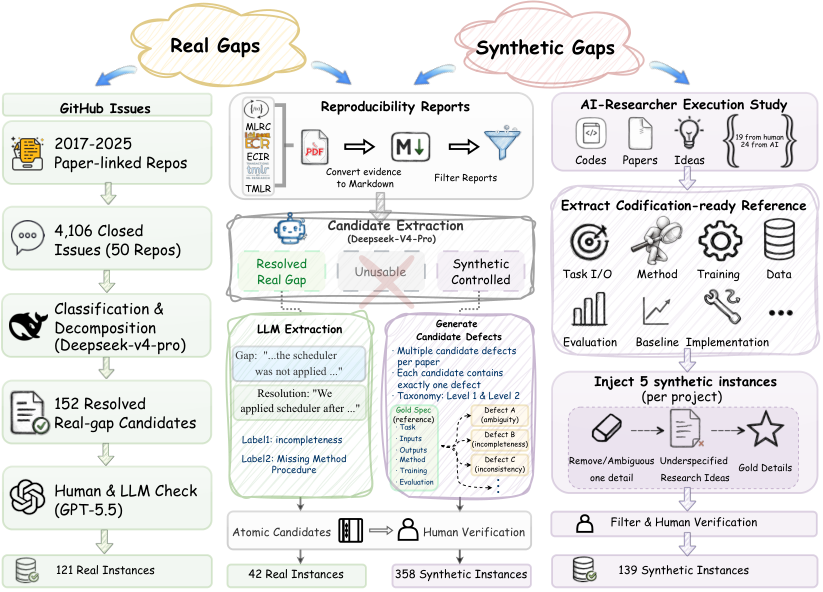
- 实验效果:13 个模型中,真实样本的最佳宏缺陷恢复率仅 9.6%;给出缺陷位置后,最佳宏澄清动作成功率升至 80.6%。在 oracle 实验里直接提供金标准解决方案,可把下游“可编码”率从 14% 提升到 98%。
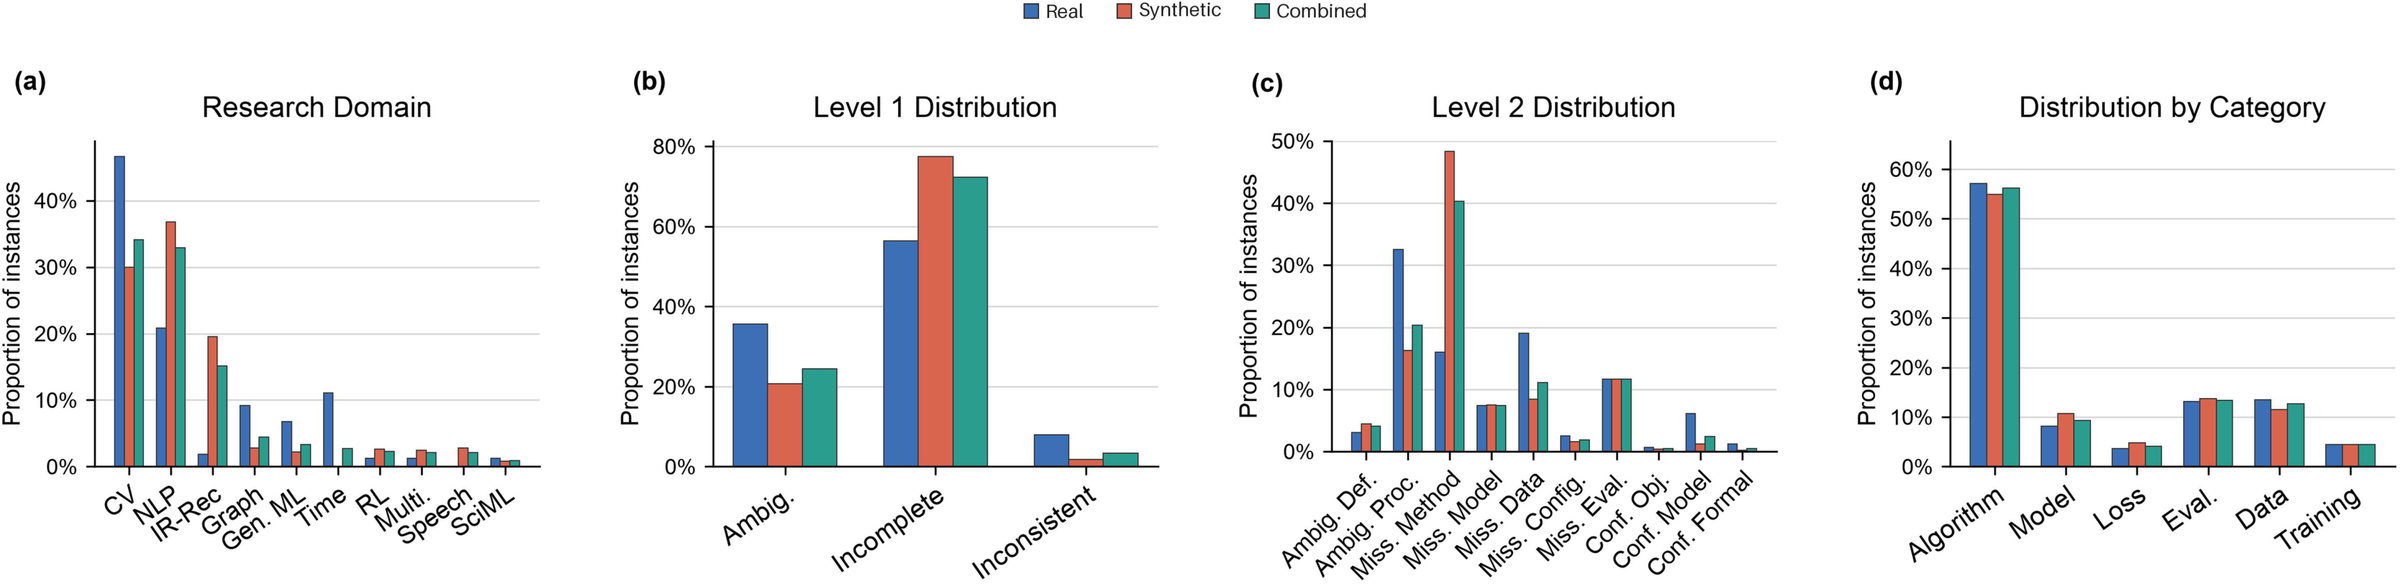
- 批判点评:它抓住了研究自动化中常被忽略的输入质量问题,但真实缺陷只有 163 个,且证据多来自已有复现失败,可能偏向容易留下公开记录的项目。定位失败仍是瓶颈,单纯提高代码模型能力并不能解决规格缺失。
6. Xiaomi-CocktailASR-1:声纹提示直听目标说话
Xiaomi-CocktailASR-1 Technical Report | 小米集团 | arXiv:2609.11274
关键词:语音识别,目标说话人,鸡尾酒会,音频语言模型
- 前序问题:多人同时说话时,普通 ASR 会混写所有声音;传统目标说话人识别通常先分离再转写,误差会累积,而且不少系统在只有一人或目标不在场时容易误删、误认。
- 本文贡献:Xiaomi-CocktailASR-1 把参考语音与混合语音拼接,用 0.6B Data2Vec2 音频编码器同时提取内容和声纹,再接 Qwen3-8B 解码,不需要独立说话人编码器或语音分离。负样本训练让目标缺席时输出空文本,CoT 模式还显式判断人数、性别和声纹相似度。
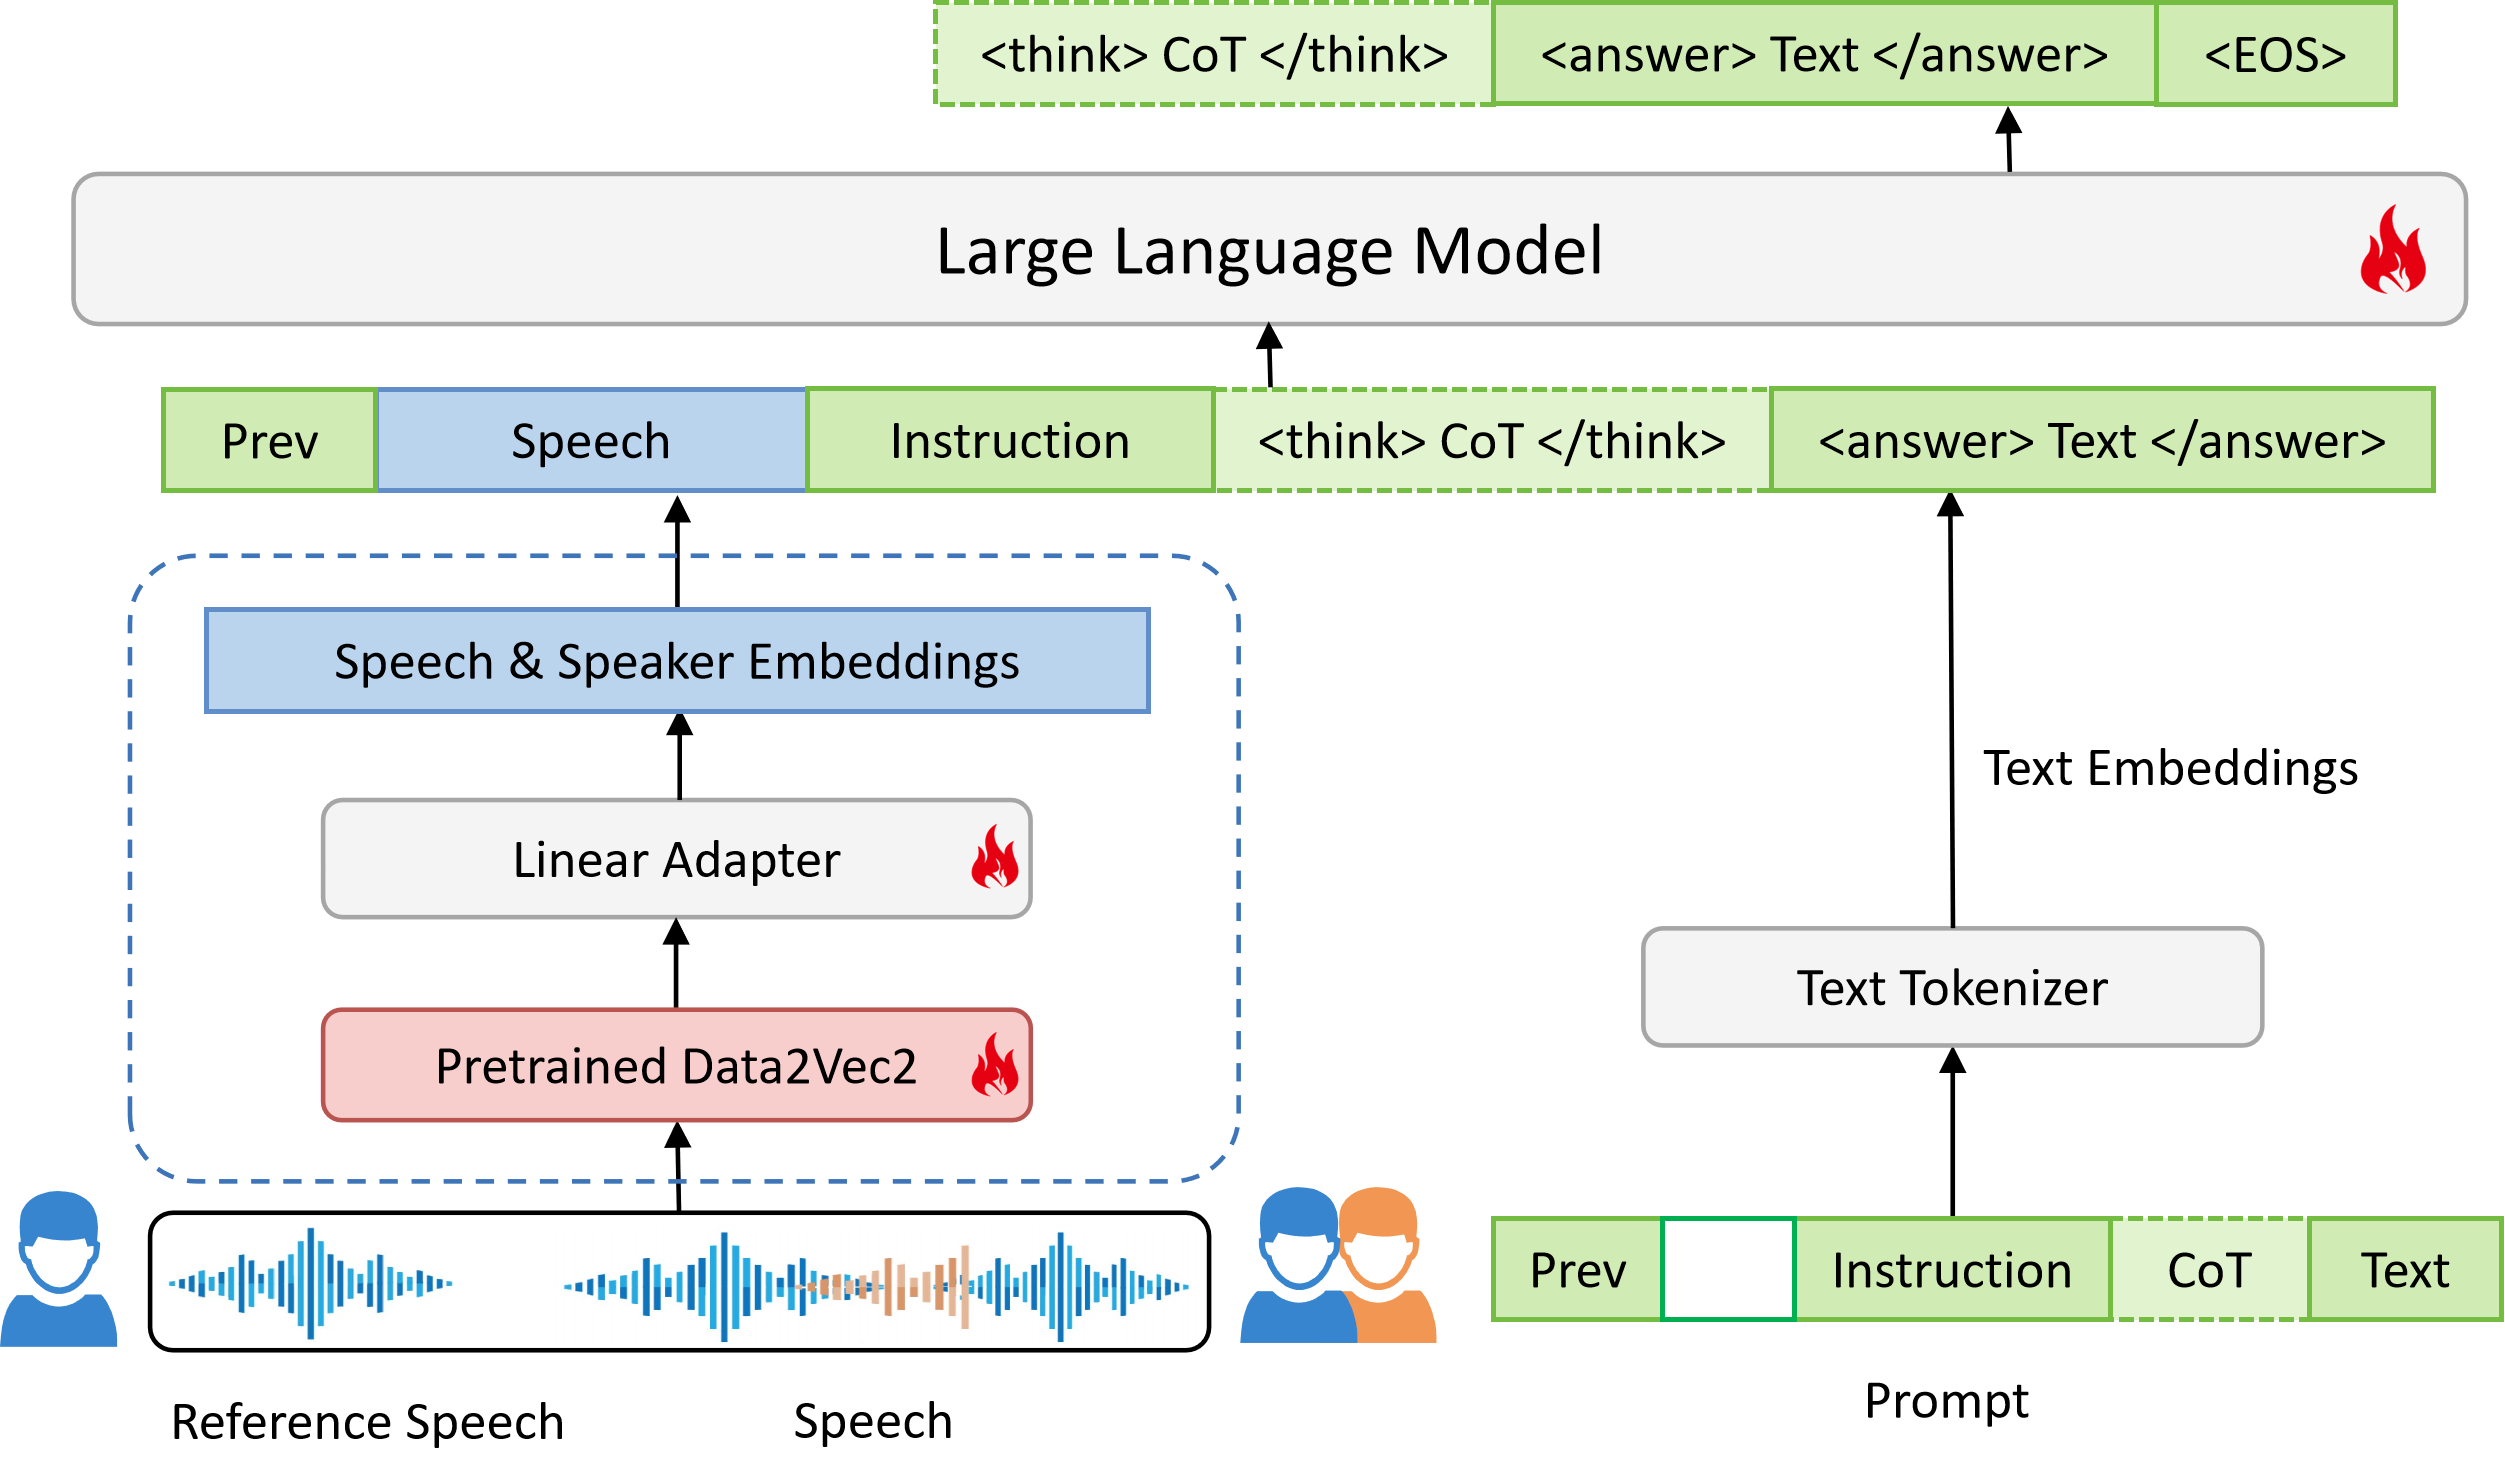
- 实验效果:在 LibriMix 2mix 上,目标说话人 WER 从此前 4.84% 降到 4.11%;真实 AMI-SDM 从此前 22.0% 降到 20.63%。单人 LibriSpeech WER 为 1.73%,目标存在时误拒率 0.36%;AMI-IHM WER 为 8.89%,优于 Qwen3-ASR-1.7B 的 10.56%。

- 批判点评:端到端统一架构减少级联误差,但要额外提供干净参考声纹,且 8B 解码器对边缘设备并不轻。CoT 能给出可读理由,却不保证其人数或声纹判断忠实反映内部决策。
7. Mr.LHDR:深研链越长越容易失真
Mr.LHDR: A Benchmark for Multimodal Real-World Long-Horizon Deep Research Agents | MBZUAI、中国科大、浙江大学、腾讯 | arXiv:2609.11318
关键词:深度研究,多模态智能体,长链推理,评测基准
- 前序问题:现有深度研究基准多在几步检索后只看最终答案,难以判断智能体能否在十几步依赖链中持续保存证据,也会掩盖“答案碰对、过程已错”的情况。
- 本文贡献:Mr.LHDR 用隐藏节点关系图构造八类真实问题,平均要求 12.1 个必要中间结论、依赖深度 10.4;每题至少包含一个会改变推理状态的图像、地图、PDF、图表或视频帧,并同时评分最终答案、检查项和依赖一致性。
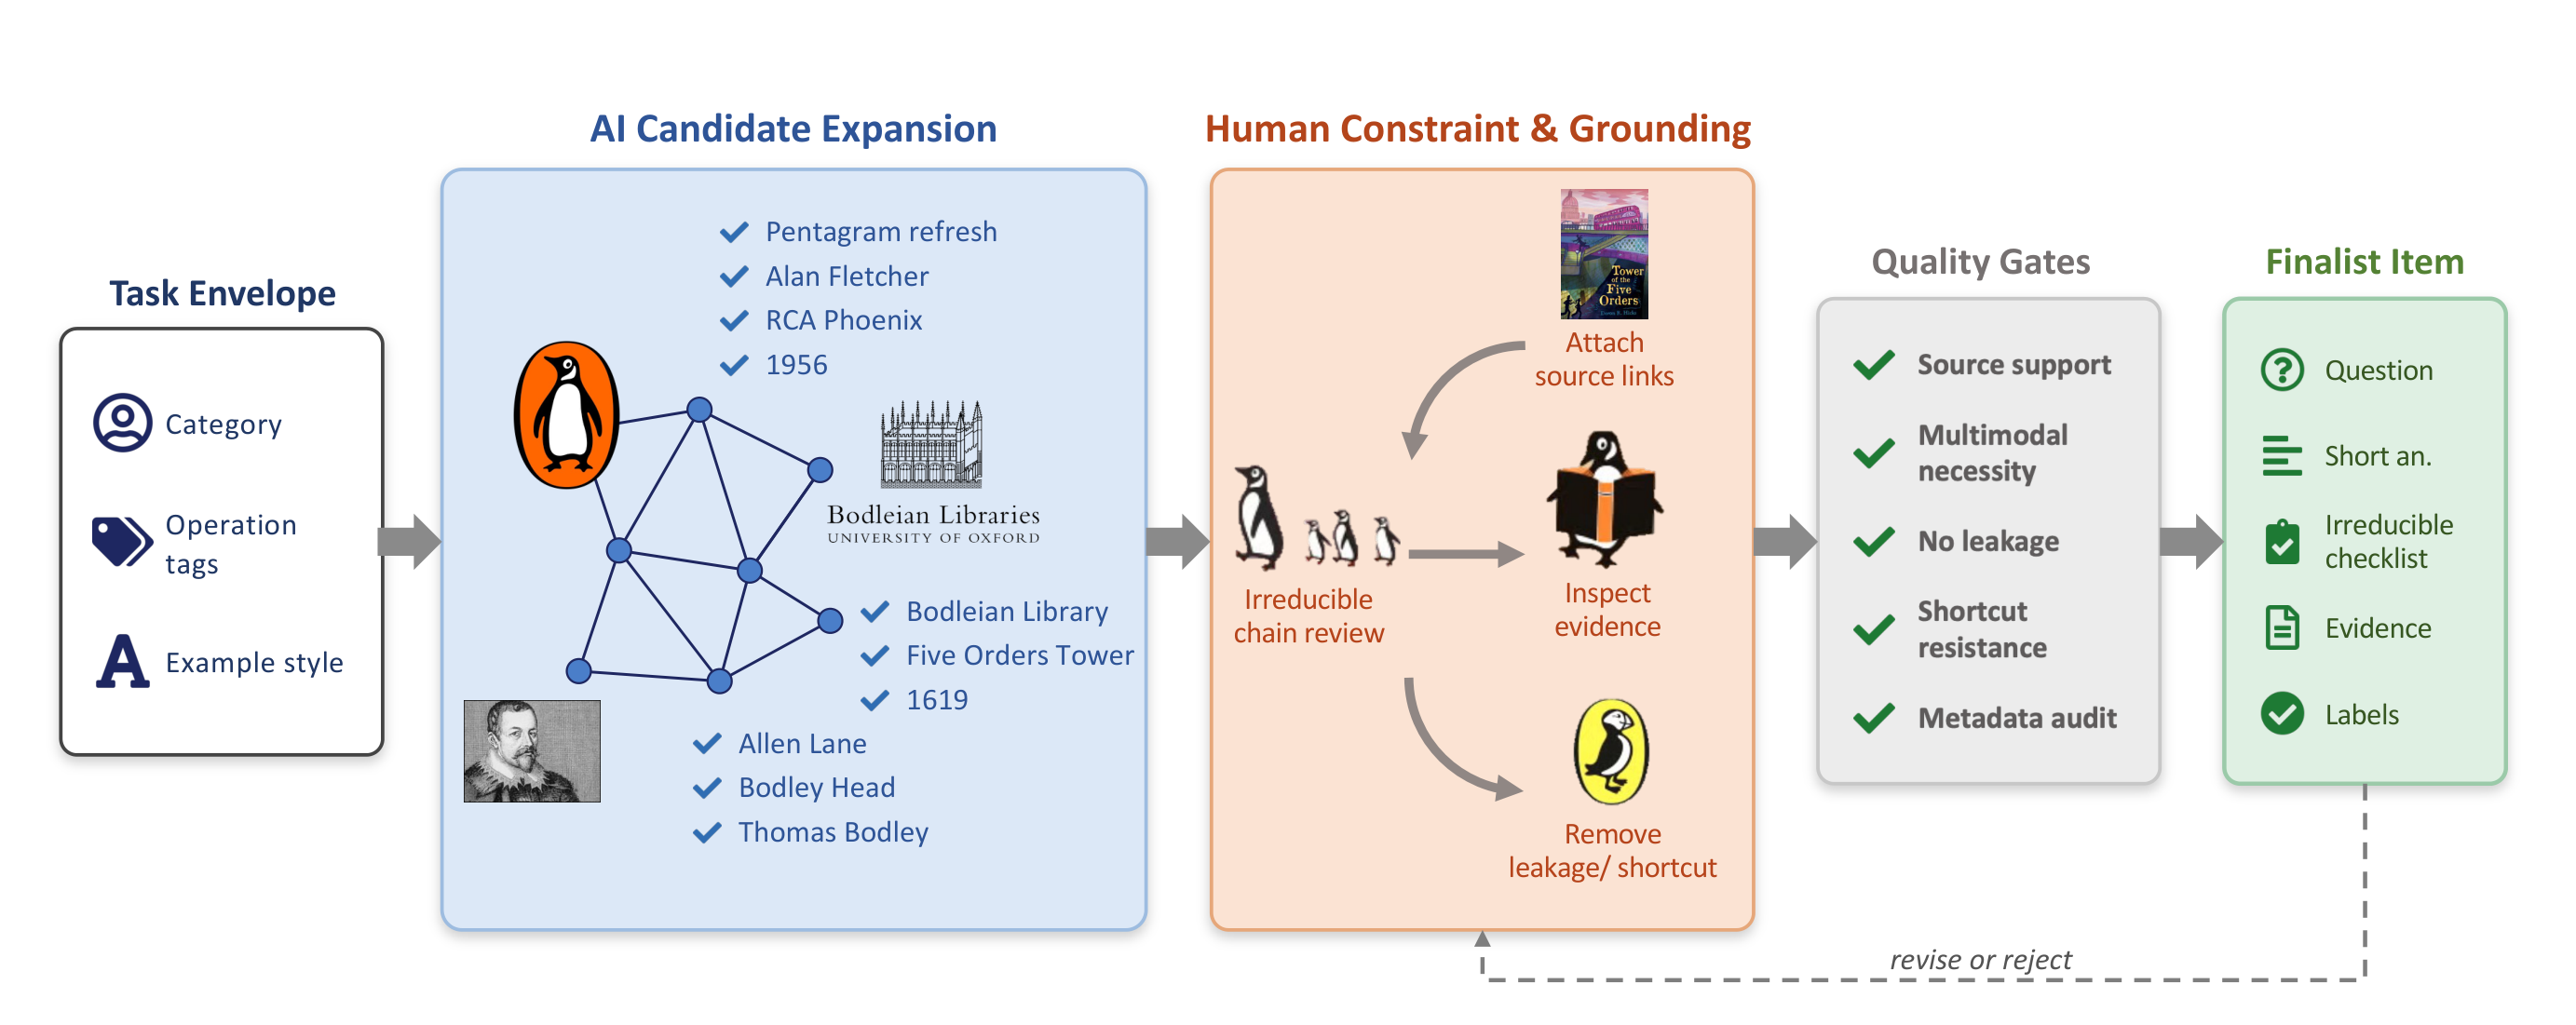
- 实验效果:最终答案最强的一次 GPT-5.5 运行只有 43.1% OA 和 34.3% 严格准确率;专用系统 o3 Deep Research 为 32.4% OA、19.6% 严格准确率。移除图片后,依赖感知检查分下降 12.6 个百分点,且链越长严格准确率越低。
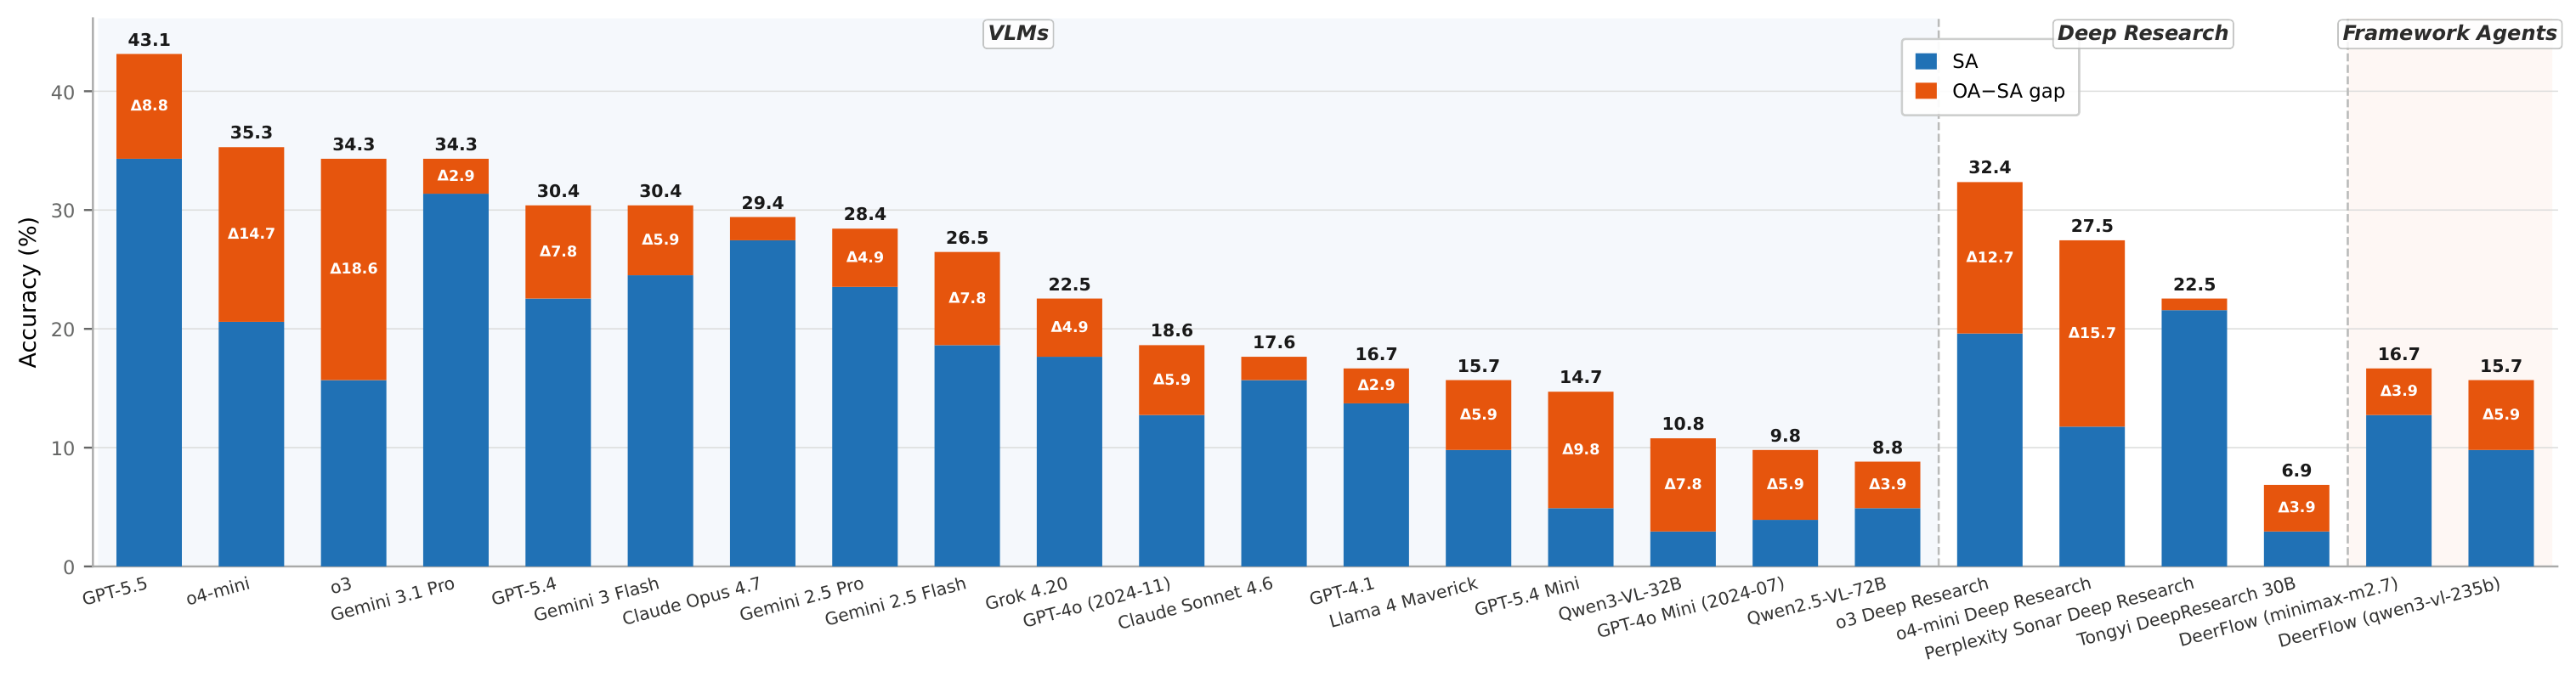
- 批判点评:依赖图让过程评测更可信,但人工构造的唯一答案和必要路径可能排除等价证据链。网页随时间变化会让可复现性持续漂移,真正部署还要处理来源可信度、费用和权限,而不只是链长。
8. Negative Self-Distillation:远离坏推理反超正蒸馏
Negative Self-Distillation: Learning to Reason by Avoiding Flaws | 弗吉尼亚大学、斯坦福大学 | arXiv:2609.11699
关键词:自蒸馏,推理模型,负向教师,对齐训练
- 前序问题:在线自蒸馏让模型模仿带答案提示的高置信轨迹,可能压制不确定表达、探索和自我纠错;直接遗忘错误轨迹又会把普通语言 token 一并惩罚,损坏基础能力。
- 本文贡献:NSD 不模仿“知道答案”的自己,而让模型生成与题目相关的粗心负条件,再推动学生分布远离这个负教师;动态门控只挑出对推理行为关键的 token 更新,减少对标点和通用语言模式的误伤,也不依赖外部教师或标准答案。
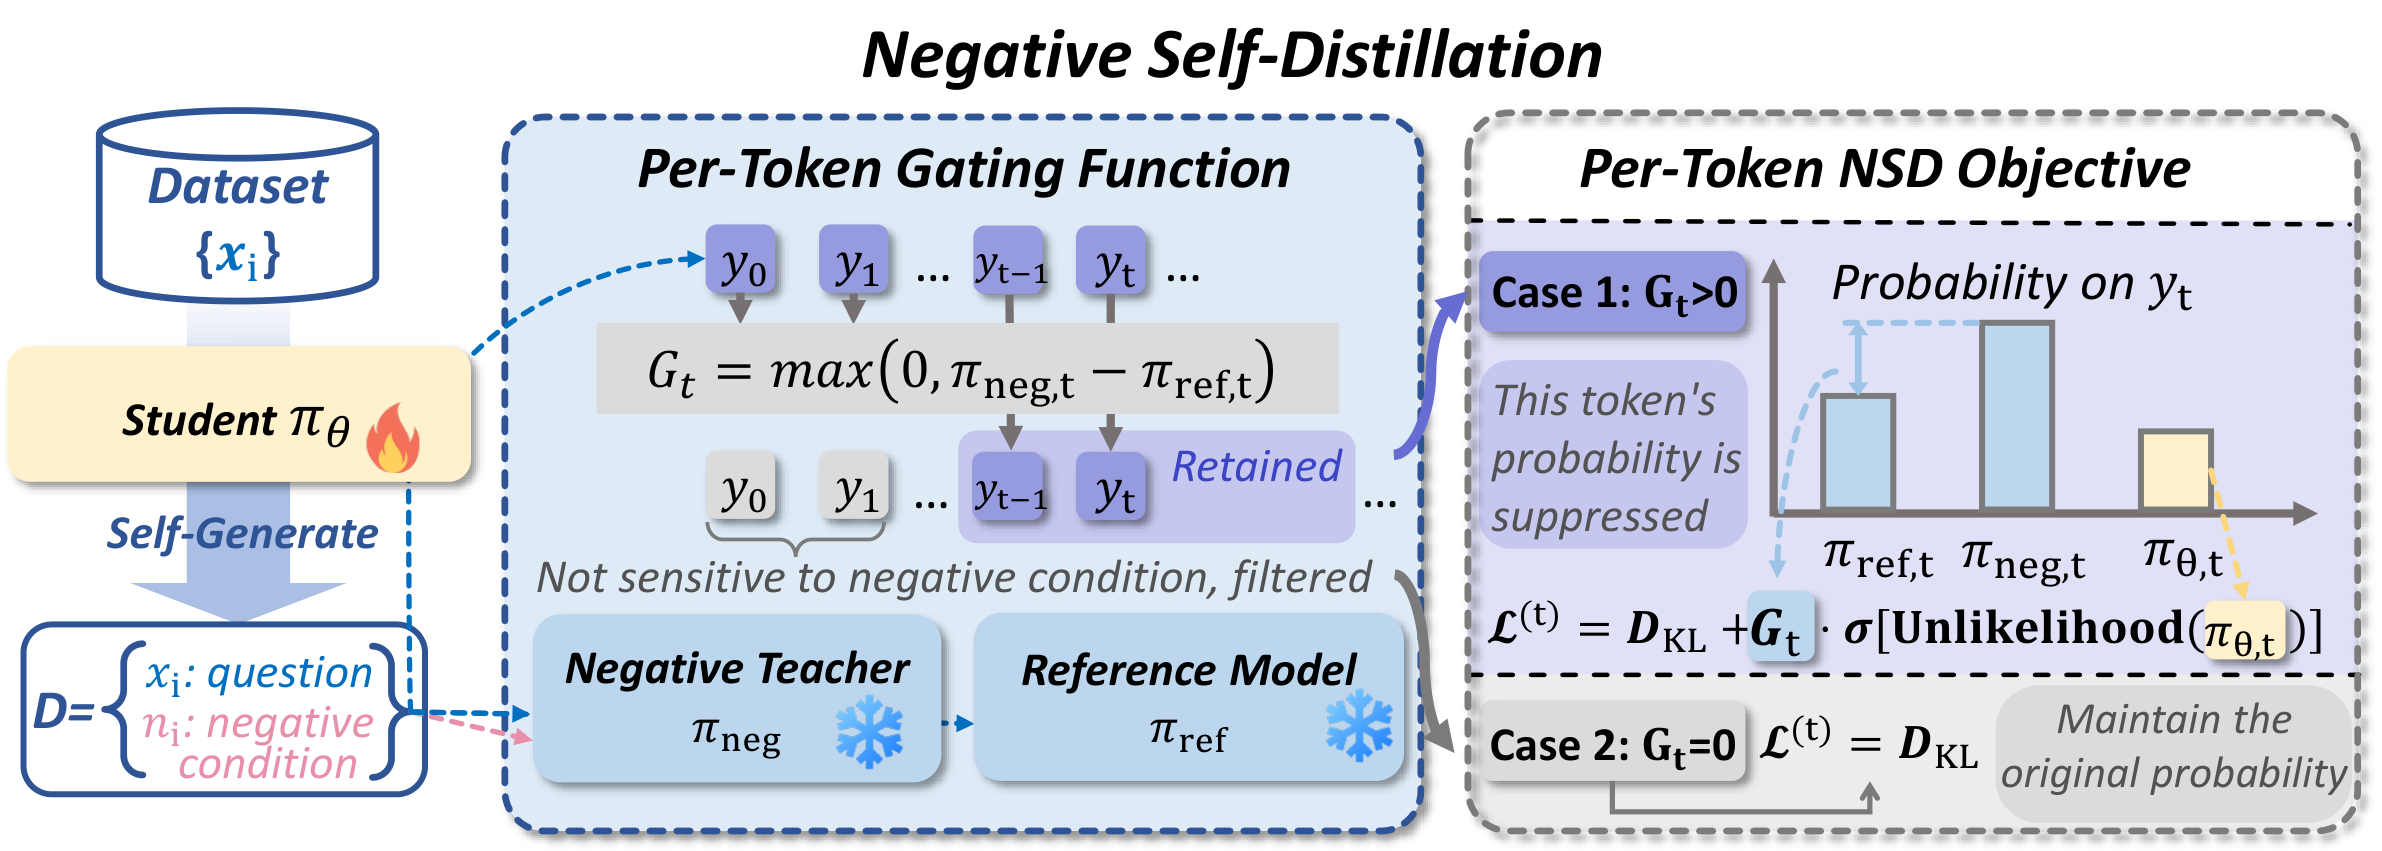
- 实验效果:在 AIME 24/25/26、HMMT、AMC、OlympiadBench 和 MATH 七个数学基准上,NSD 相对基线平均提升:1.7B 模型 2.3%、4B 模型 7.5%、8B 模型 6.0%,并在论文实验中持续超过 OPSD 与其他无标签自举 RL 方法。
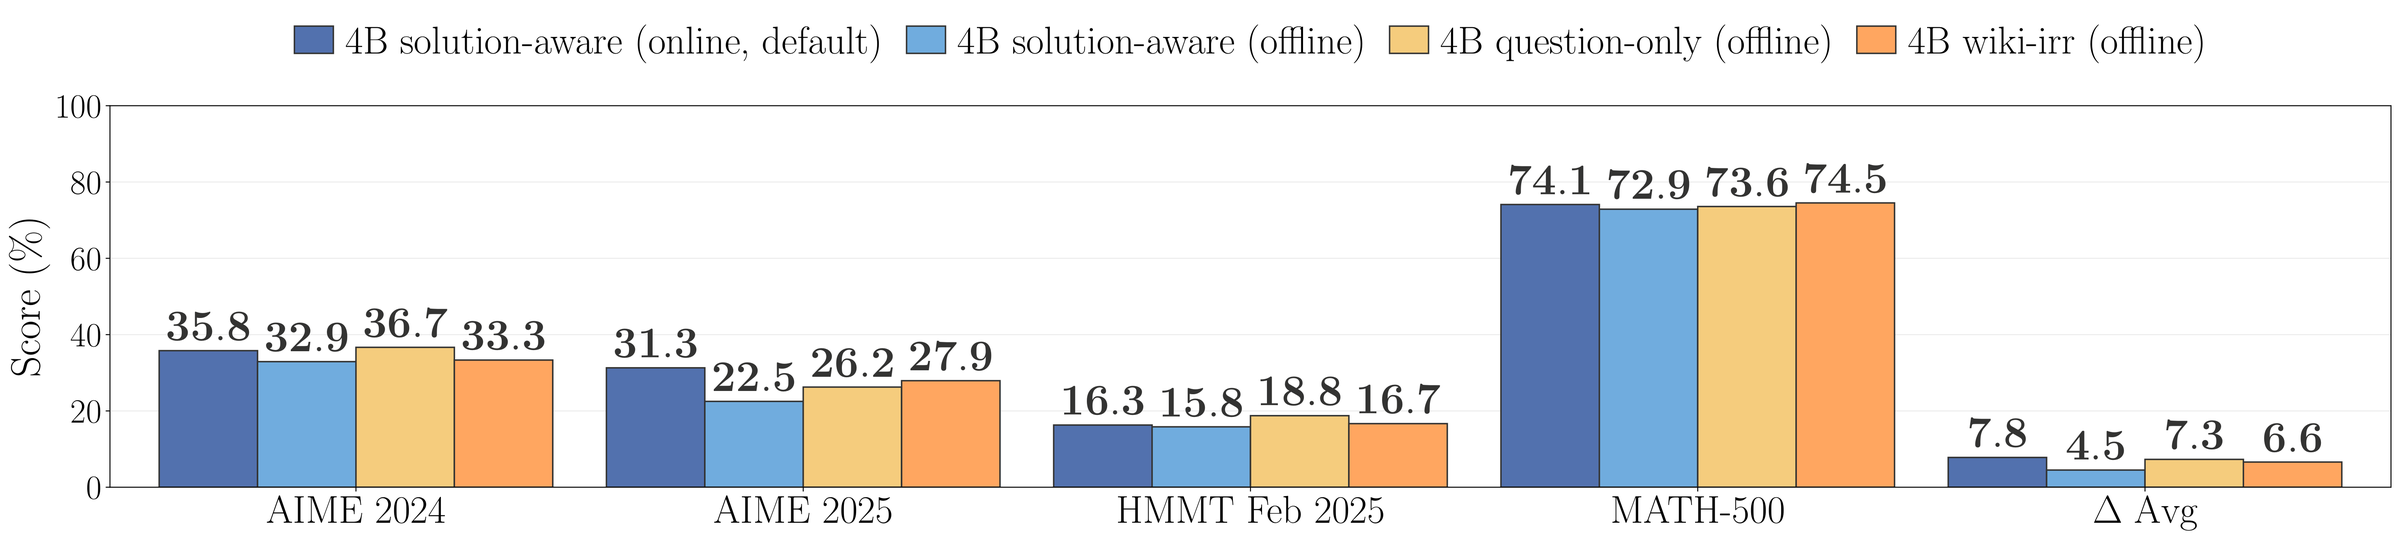
- 批判点评:负教师由模型自己生成,若它不能稳定描述真正的错误模式,训练信号可能只是风格差异。动态门控降低语言退化风险,却新增阈值和梯度设计;数学推理上的收益还需在代码、事实性与开放问答中验证。
9. GenV:生成奖励抓出伪正确
Beyond Solver Verdicts: Generative Reward Models for Autoformalization | 凯斯西储大学、Amazon Web Services | arXiv:2609.11085
关键词:自动形式化,生成奖励模型,Z3,神经符号推理
- 前序问题:Z3 等求解器只能确认给定形式化是否可满足,无法判断它是否忠实翻译了原题;一个写反的不等号仍可能返回同样 verdict,形成“结果正确但形式不等价”的伪正确。
- 本文贡献:GenV 先用离线 Z3 等价性 oracle 挖掘硬负例,再把参考等价判断蒸馏成不需要参考答案的连续生成式分数;它复用语言模型词表读出奖励,并用 logit lens 与稀疏自编码器分析错误坐标如何在内部形成。
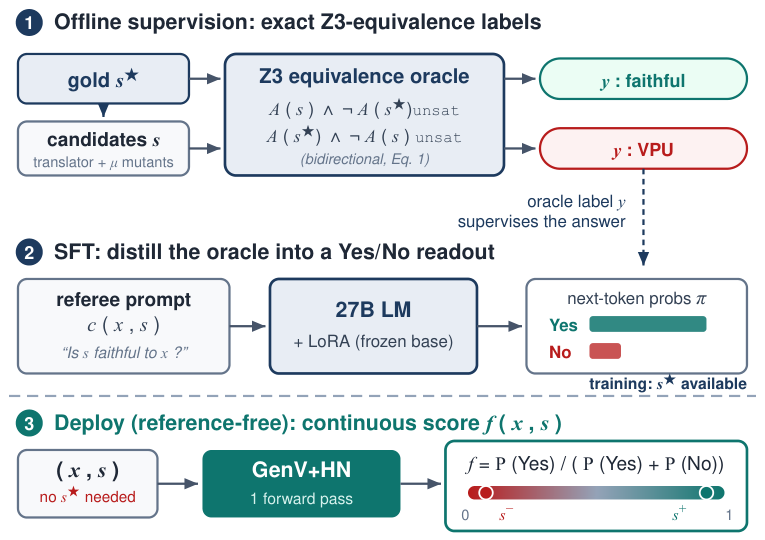
- 实验效果:GenV+HN 在参考等价验证上取得 0.961 AUROC,远高于只看求解器 verdict 的机会水平 0.500;它可零样本迁移到未见翻译器和不同形式风格,并让智能体测试时算力分配的下游准确率提高 11.3 个百分点。

- 批判点评:生成式验证器比二元 verdict 更细,但它把“忠实性”重新交给学习模型,不能替代求解器的形式保证。若参考形式化有误、问题允许多种合理解释,等价性标签本身也会变得含糊。
10. X-AuT:音频塔减20.7%参数
X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation | 小鹏汽车 | arXiv:2609.11412
关键词:语音大模型,模型压缩,跨尺度蒸馏,音频编码器
- 前序问题:直接删除语音大模型的音频编码层虽能降延迟,却会扰动送入语言解码器的表示,造成漏字和过早结束;逐层试错成本又很高。
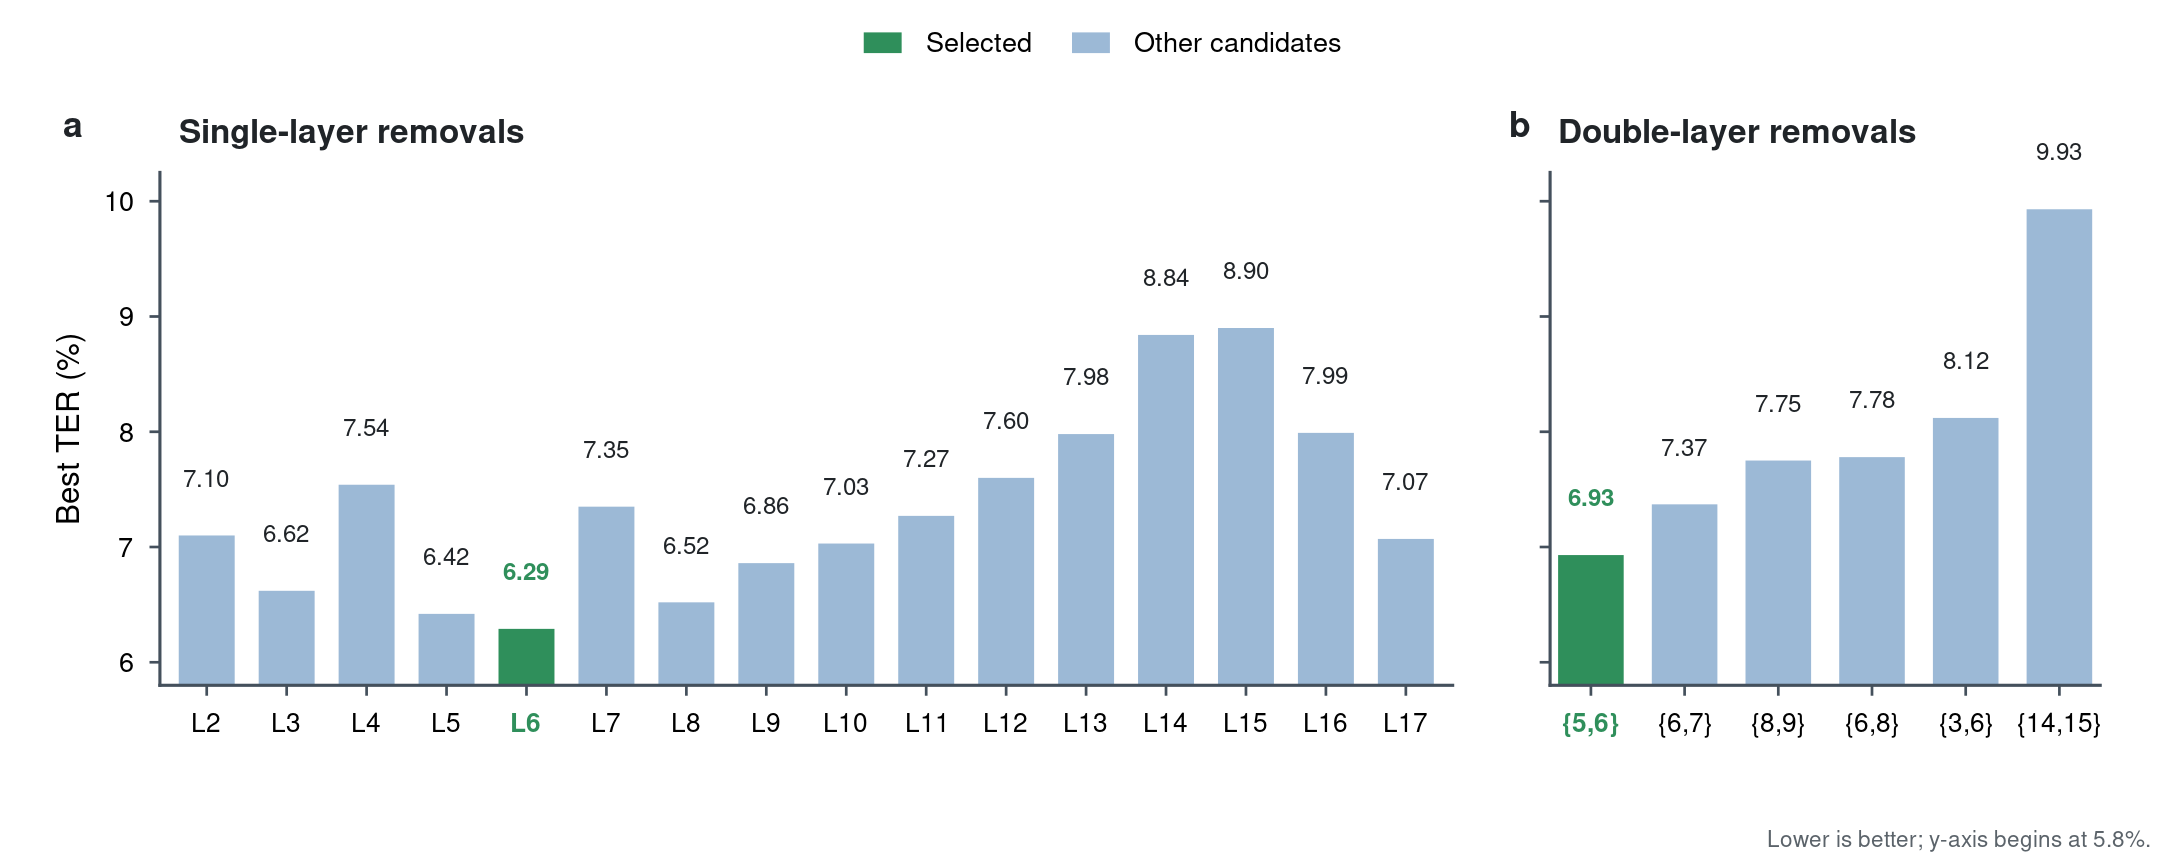
- 本文贡献:X-AuT 先用短行为探针筛选可删层组合,再逐步从 18 层压到目标深度;恢复阶段同时做表示对齐、跨尺度蒸馏、按计划切换学生策略监督和 LoRA 微调,语言主干保持冻结。

- 实验效果:Qwen3-ASR-0.6B 从 18 层压到 16 层后,十个中英基准宏平均错误率从 5.61% 降到 5.27%;14 层模型减少 20.7% 音频塔参数,错误率为 5.75%。渐进式 18→14 优于直接剪枝的 6.73%,1.7B 教师蒸馏为 5.55%,也优于自蒸馏的 8.45%。
- 批判点评:方法给出两个实用压缩点,但流程包含探针、分阶段剪枝、教师蒸馏和 LoRA,训练链条并不轻。语言主干冻结有利于稳定,也限制了模型共同适应严重音频压缩的空间。
趋势观察
生成与理解继续合并底层表征
SenseNova-U1.5去掉视觉编码器和VAE,把像素重建、语言理解、图像生成与编辑放进同一原生主干,统一模型的竞争开始深入到最底层视觉接口。
视频模型从离线片段走向实时世界
Vidu S2把720p Avatar和流式编辑推到25–42 FPS,World in World则用冻结骨干支持任意视角探索;实时交互、换镜头和长时记忆正在合流。
评测开始追踪过程而非只看终点
MindTopo要求动作过程保持拓扑,Mr.LHDR检查依赖链中间结论,IdeaAMBIG定位实现规格缺陷:一个看似正确的最终答案已不足以代表系统可靠。
后训练信号变得更细也更反直觉
NSD让模型远离坏推理,GenV把形式等价性蒸馏成连续奖励;相比简单模仿正确答案,新的对齐方法更关注错误来自哪个token、哪一步和哪种结构。
人工智能炼丹君 整理 | 2026-09-14
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注









评论 (0)