今日 AIGC 论文速览
今日共 10 篇 · 可控与统一音频生成 2 篇 · 长时音视频与可控视频生成 2 篇 · 图像编辑与画质修复 2 篇 · 3D 资产生成 1 篇 · 流式交互与语音评测 2 篇 · 高效长上下文 1 篇
重点论文标题列表
DiffSynth-Music (阿里巴巴集团、上海交通大学):五路音频控制锁住节拍StepAudio 3 Gen (阶跃星辰 StepFun-Audio 团队):一套模型生成所有声音Encore (百度、北京理工大学 · SIGGRAPH Asia 2026):三十秒音画同步不跑偏DIAL (阿里巴巴集团、北京大学):调一个旋钮控人物像不像Omni-Streaming Thinking (香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学):流式多模态会主动改口
今日论文速览
1. DiffSynth-Music:五路音频控制锁住节拍
DiffSynth-Music: Audio-Conditioned KV-Cache Adapters for Controllable Music Generation | 阿里巴巴集团、上海交通大学 | arXiv:2609.12774
关键词 :可控音乐生成,音频条件,KV缓存,扩散Transformer
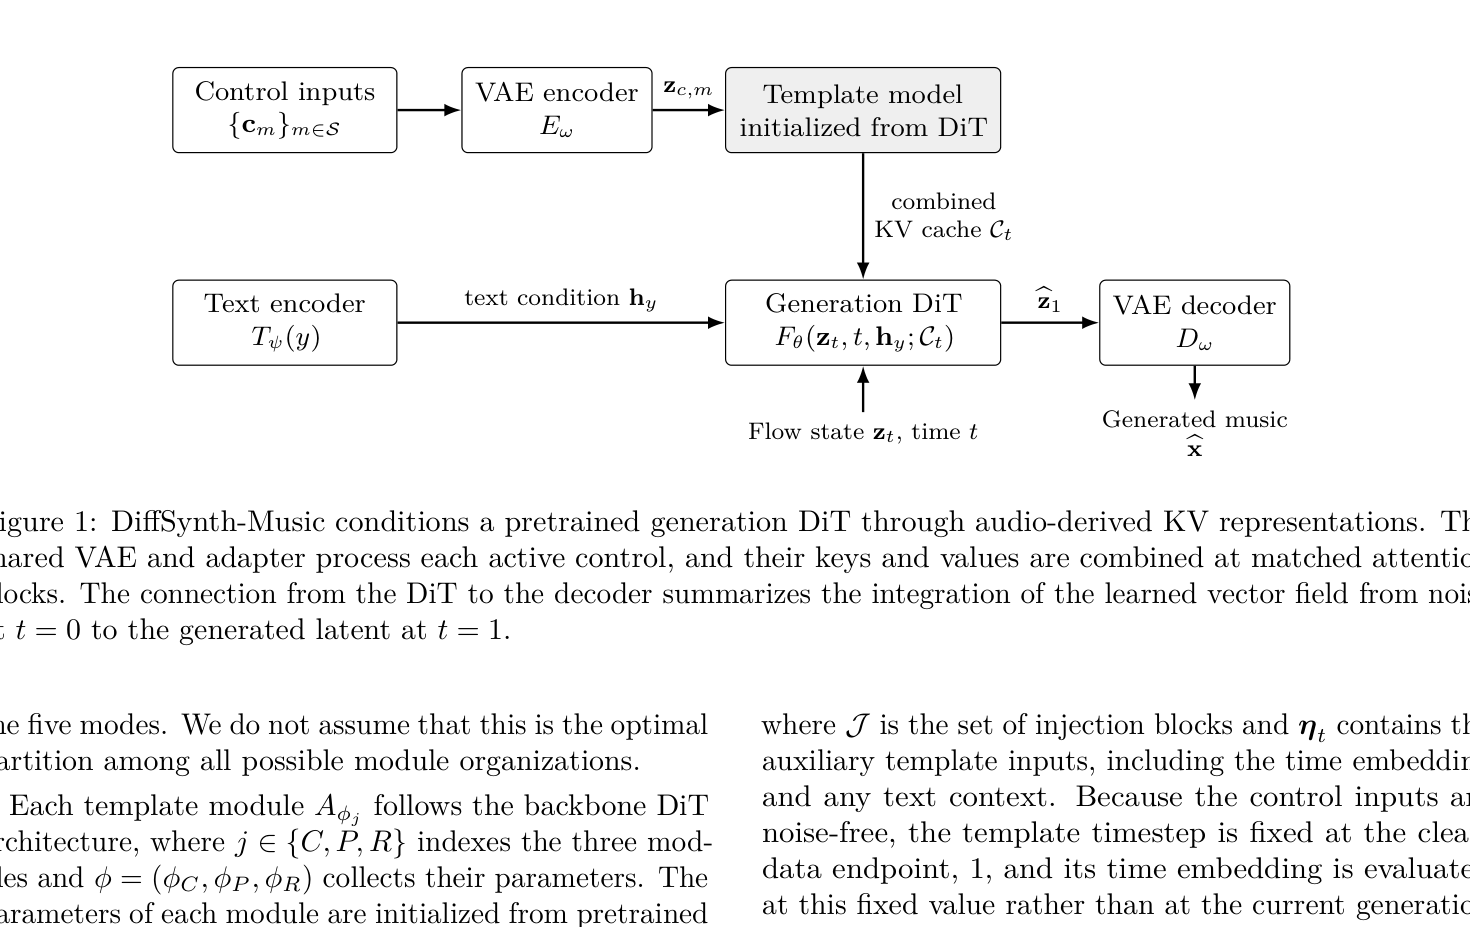
前序问题 :文字与歌词能规定歌曲主题和唱词,却难以精确约束节拍、旋律、伴奏、演唱韵律和参考风格;把多种音频条件逐步送进扩散模型又会反复增加计算。本文贡献 :DiffSynth-Music 从同一音乐 DiT 初始化 Control、Prosody、Reference 三个模板模型,先由共享 VAE 编码控制音频,再把逐层 KV 缓存注入生成主干。模板端固定在干净数据端点,每种控制只前向一次,五类条件还能组合使用。
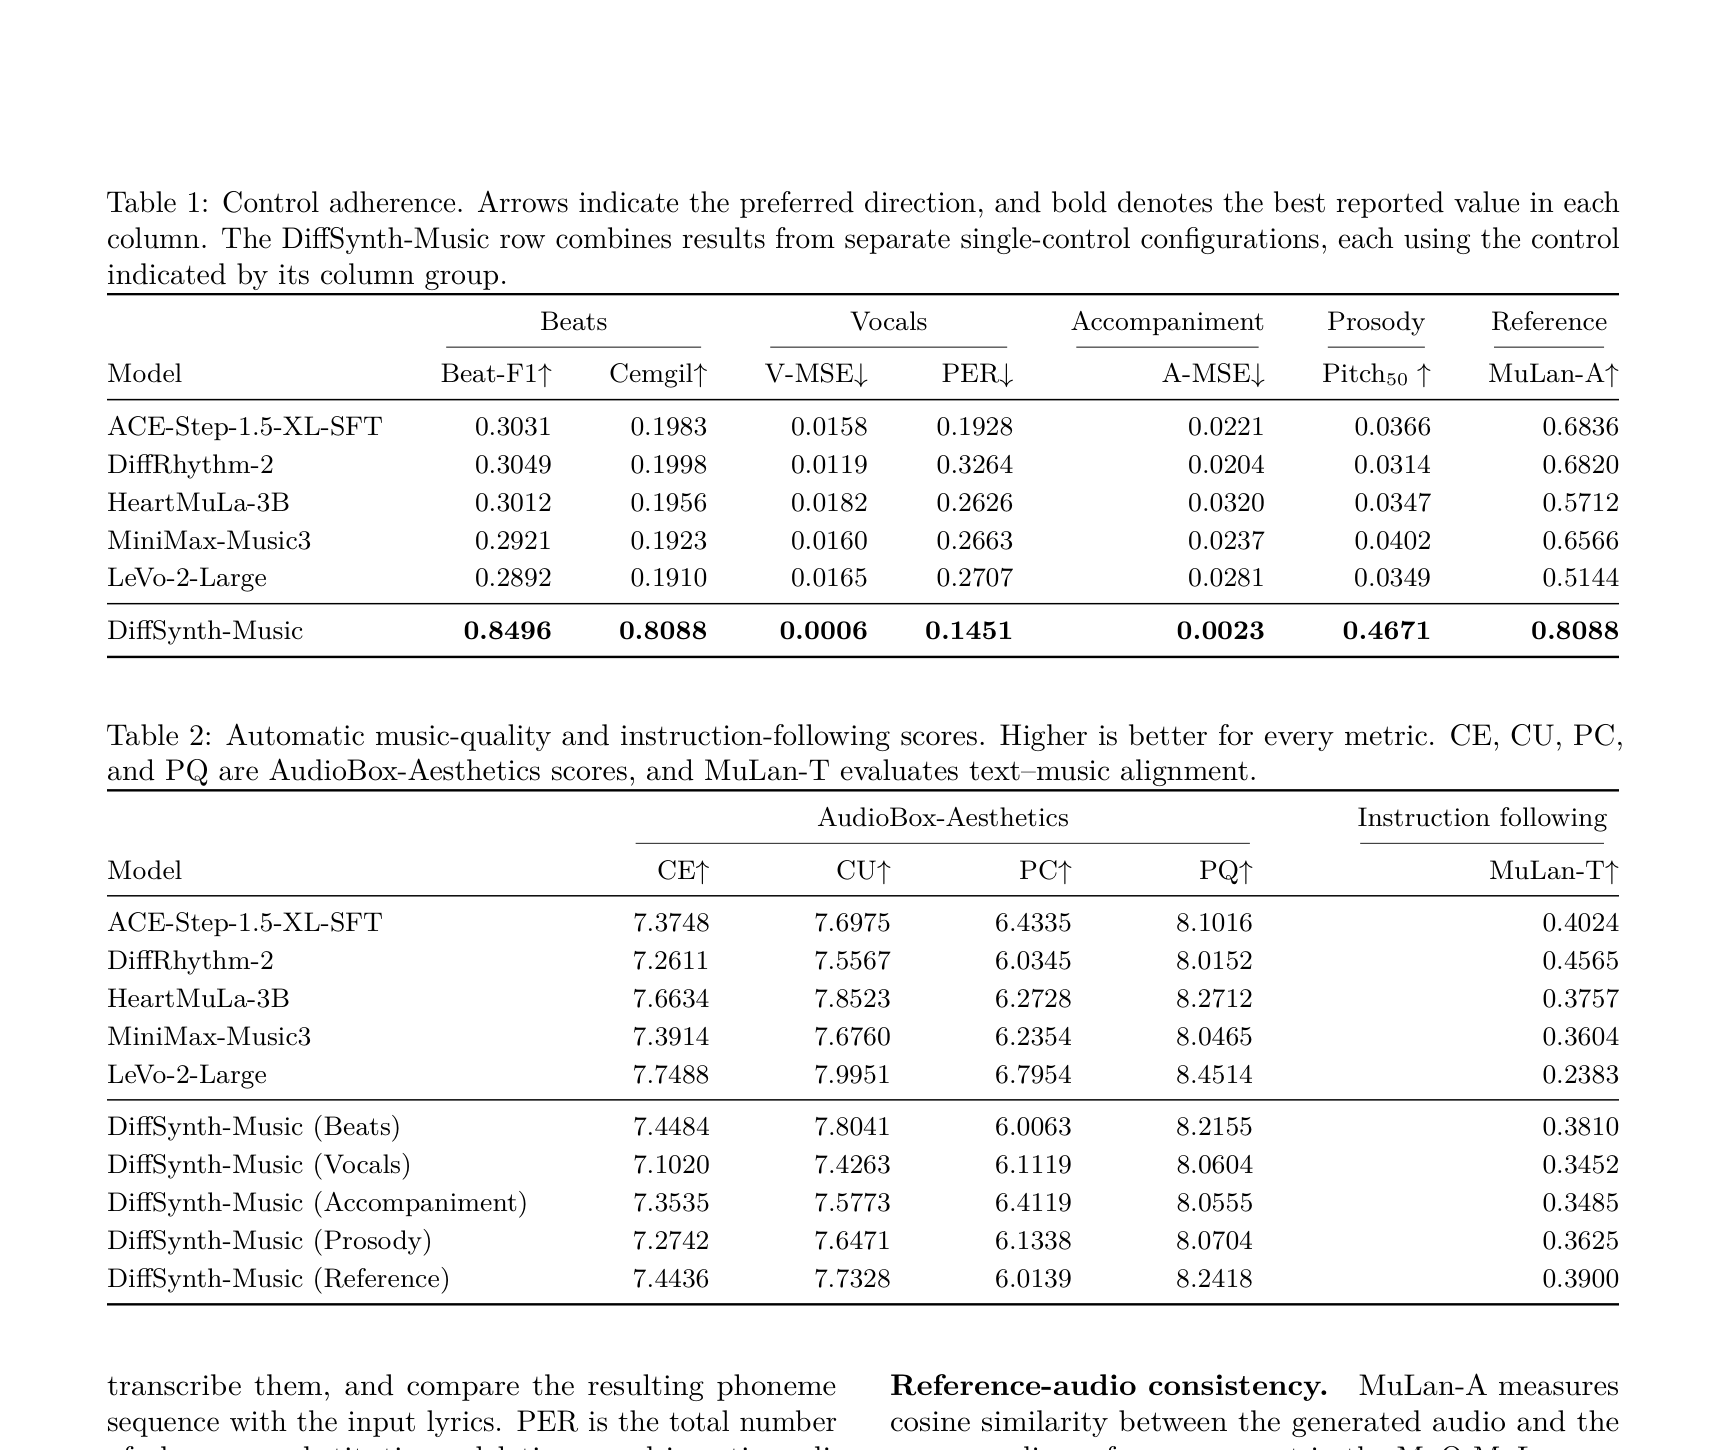
实验效果 :相对冻结主干,节拍条件把 Beat-F1 从 0.3031 提到 0.8496;人声条件把 V-MSE 从 0.0158 降到 0.0006,伴奏条件把 A-MSE 从 0.0221 降到 0.0023;参考条件的 MuLan-A 从 0.6836 升到 0.8088。
批判点评 :一次缓存让多条件控制更便宜,但三个模板模型仍带来额外参数和训练维护成本。实验以单条件为主,真正创作常同时叠加节拍、人声、伴奏与参考音频,组合冲突和听感质量仍需更大规模人评。
2. StepAudio 3 Gen:一套模型生成所有声音
StepAudio 3 Gen Technical Report | 阶跃星辰 StepFun-Audio 团队 | arXiv:2609.12945
关键词 :通用音频生成,语音合成,声音设计,RVQ
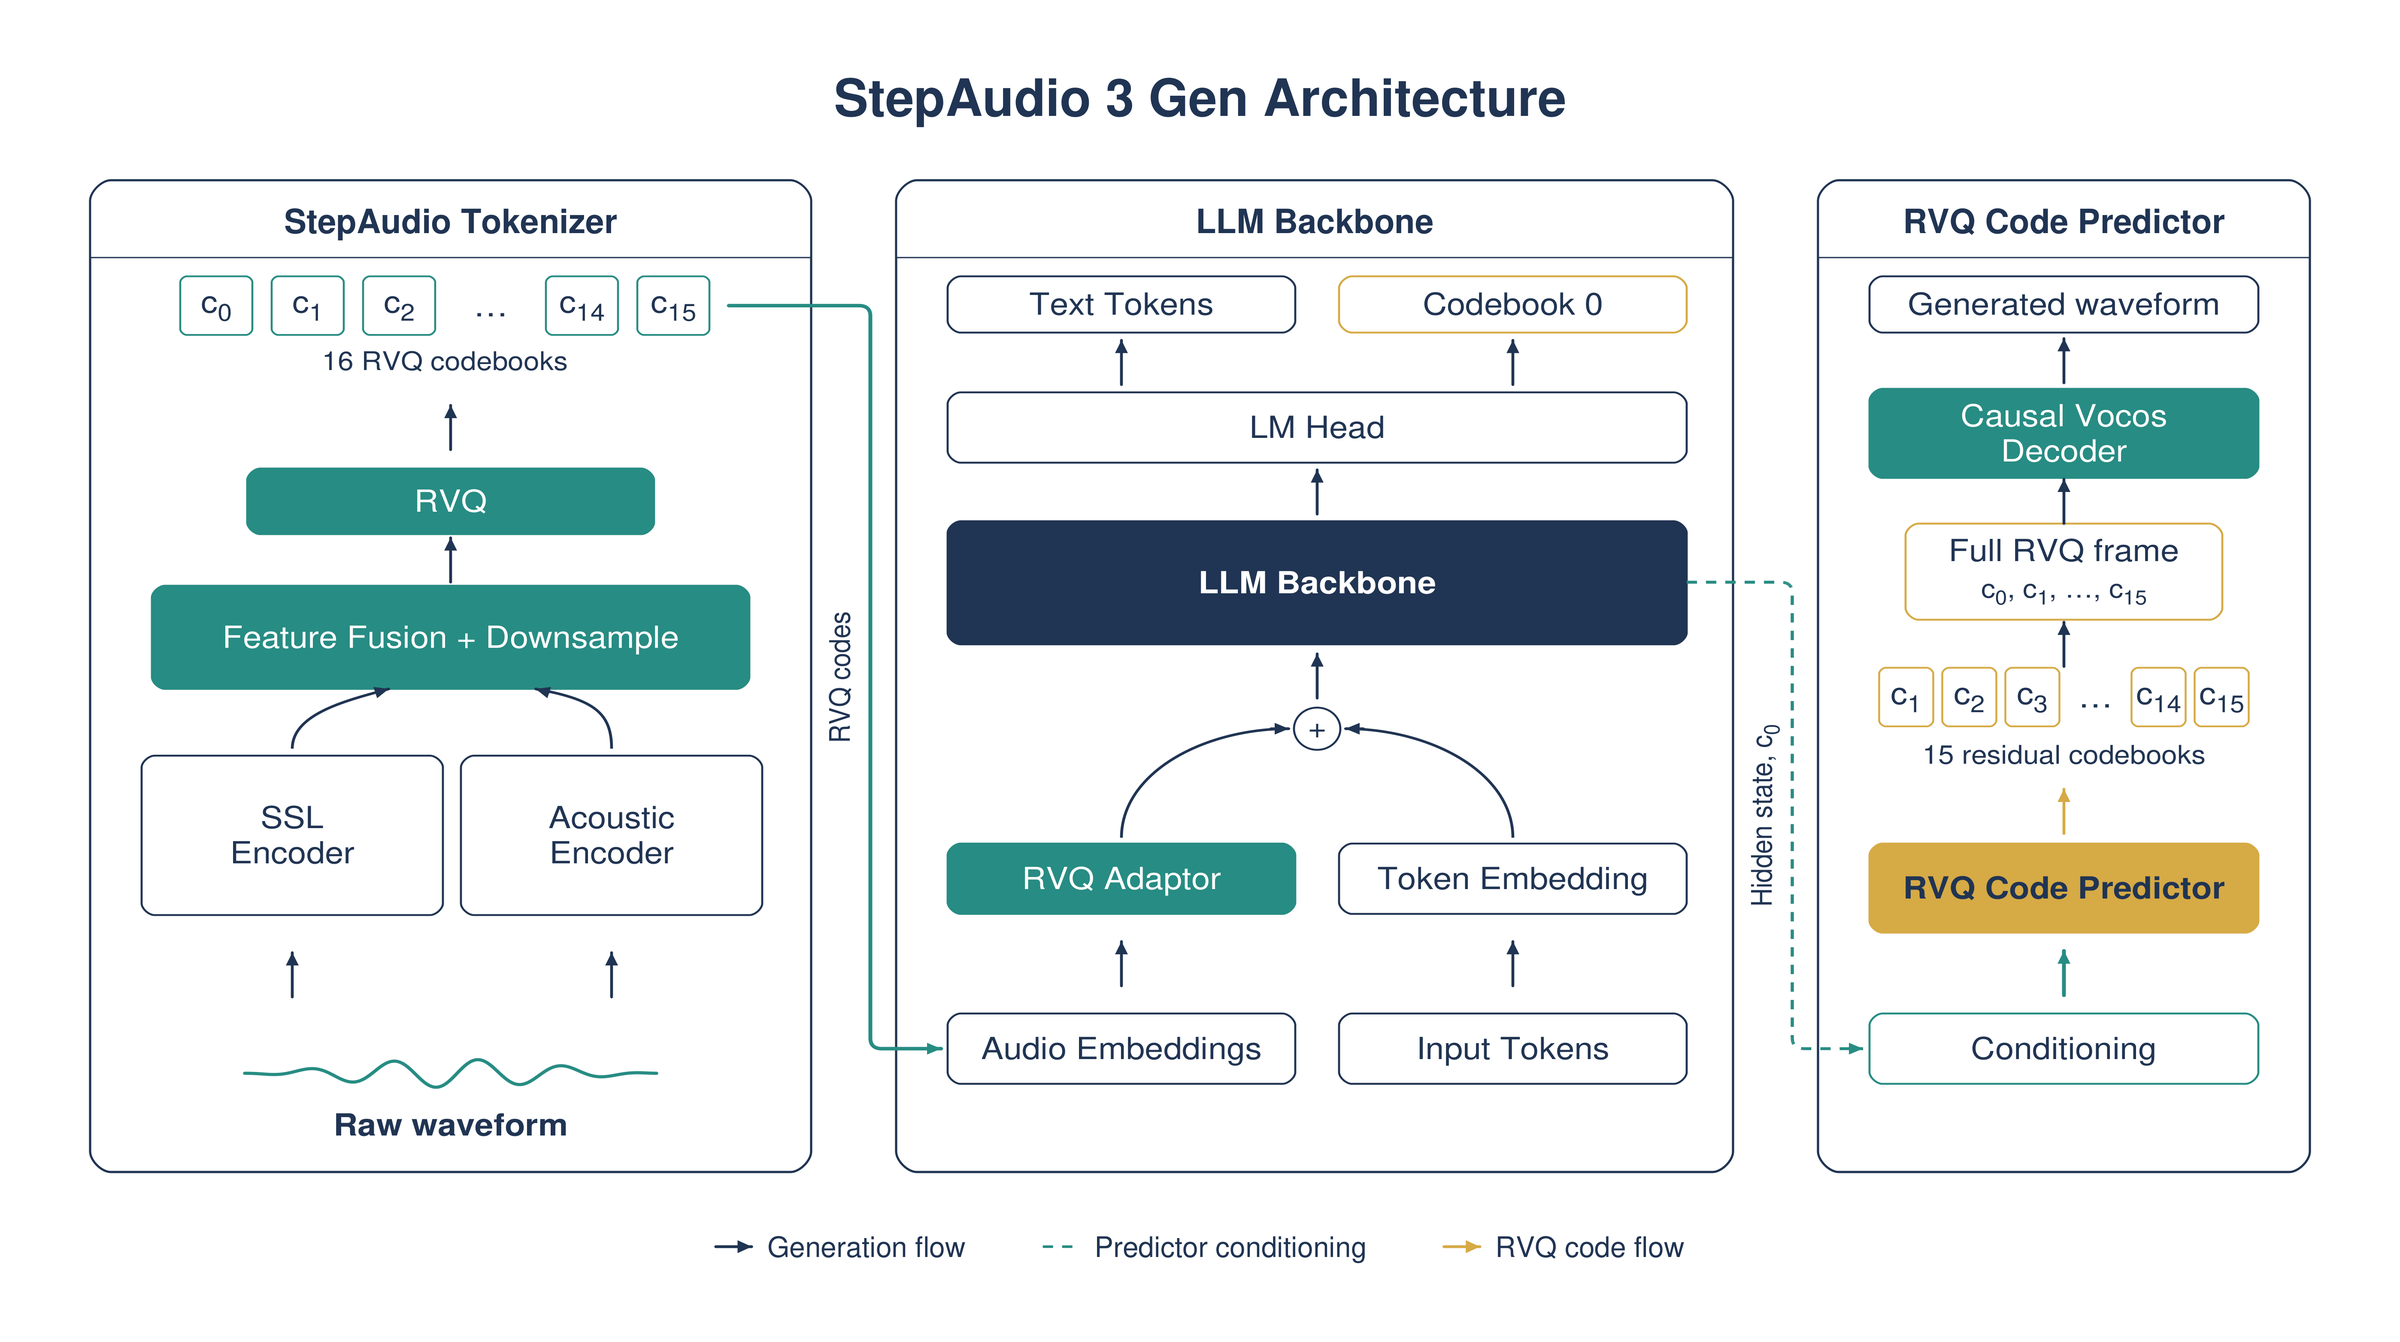
前序问题 :语音、歌声、音乐与音效通常使用不同生成器和离散表示,混合声音任务很难在一套模型里保持文本能力、说话人一致性与声学细节。本文贡献 :StepAudio 3 Gen 以 12.5 Hz 的 16×2048 共享 RVQ 空间直接自回归建模通用音频:主干沿时间预测首码本,轻量因果 Transformer 再沿码本轴补齐其余十五层;渐进预训练与 RVQ Adaptor 缓解音频能力对语言能力的干扰。
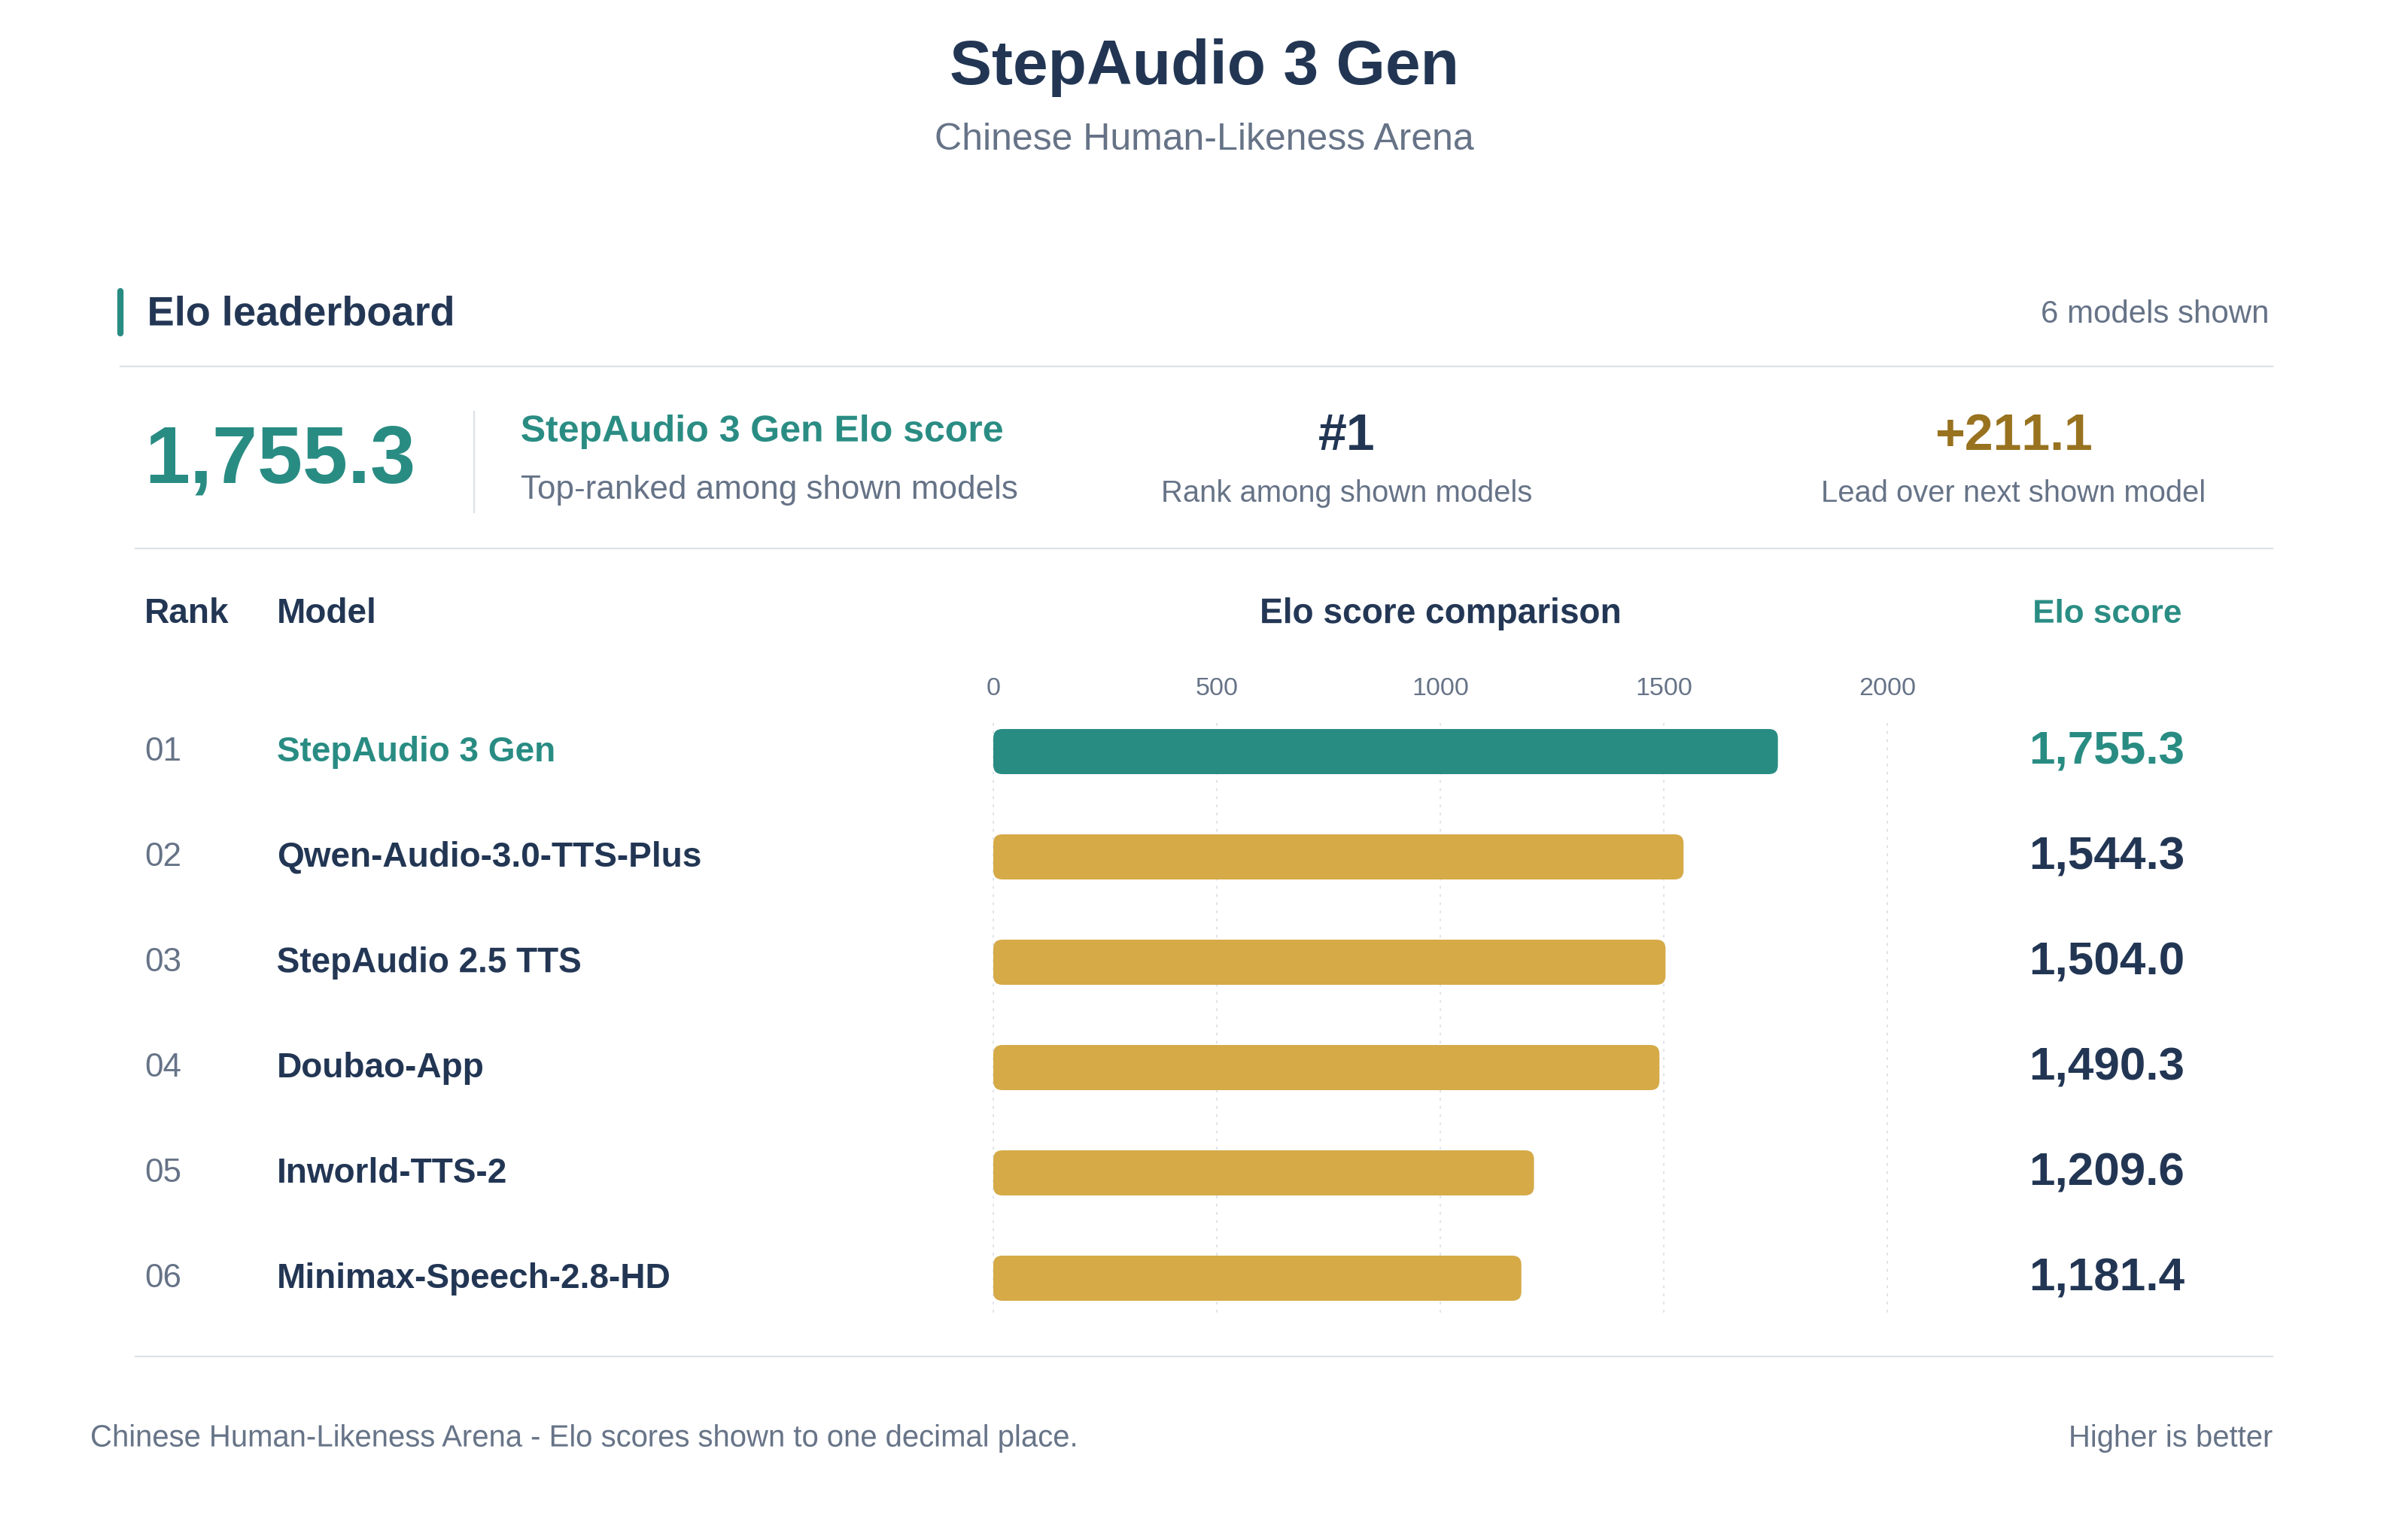
实验效果 :TTS 人类偏好 Elo 达 1755.33,对五个商业系统的汇总胜率为 82.0%;声音设计 Elo 为 1668.5、汇总胜率 75.5%;风格一致性中文平均 85.2%,英文平均 77.7%。
批判点评 :统一离散建模简化了产品管线,但十六层 RVQ 的级联预测仍可能积累误差。报告覆盖多类声音,公开复现仍取决于训练数据、偏好标注与完整模型权重。
3. Encore:三十秒音画同步不跑偏
Encore: Infinite Audio-Video Generation with Adaptive Signal Routing | 百度、北京理工大学 · SIGGRAPH Asia 2026 | arXiv:2609.04249
关键词 :音视频联合生成,长视频生成,自适应信号路由,跨模态同步
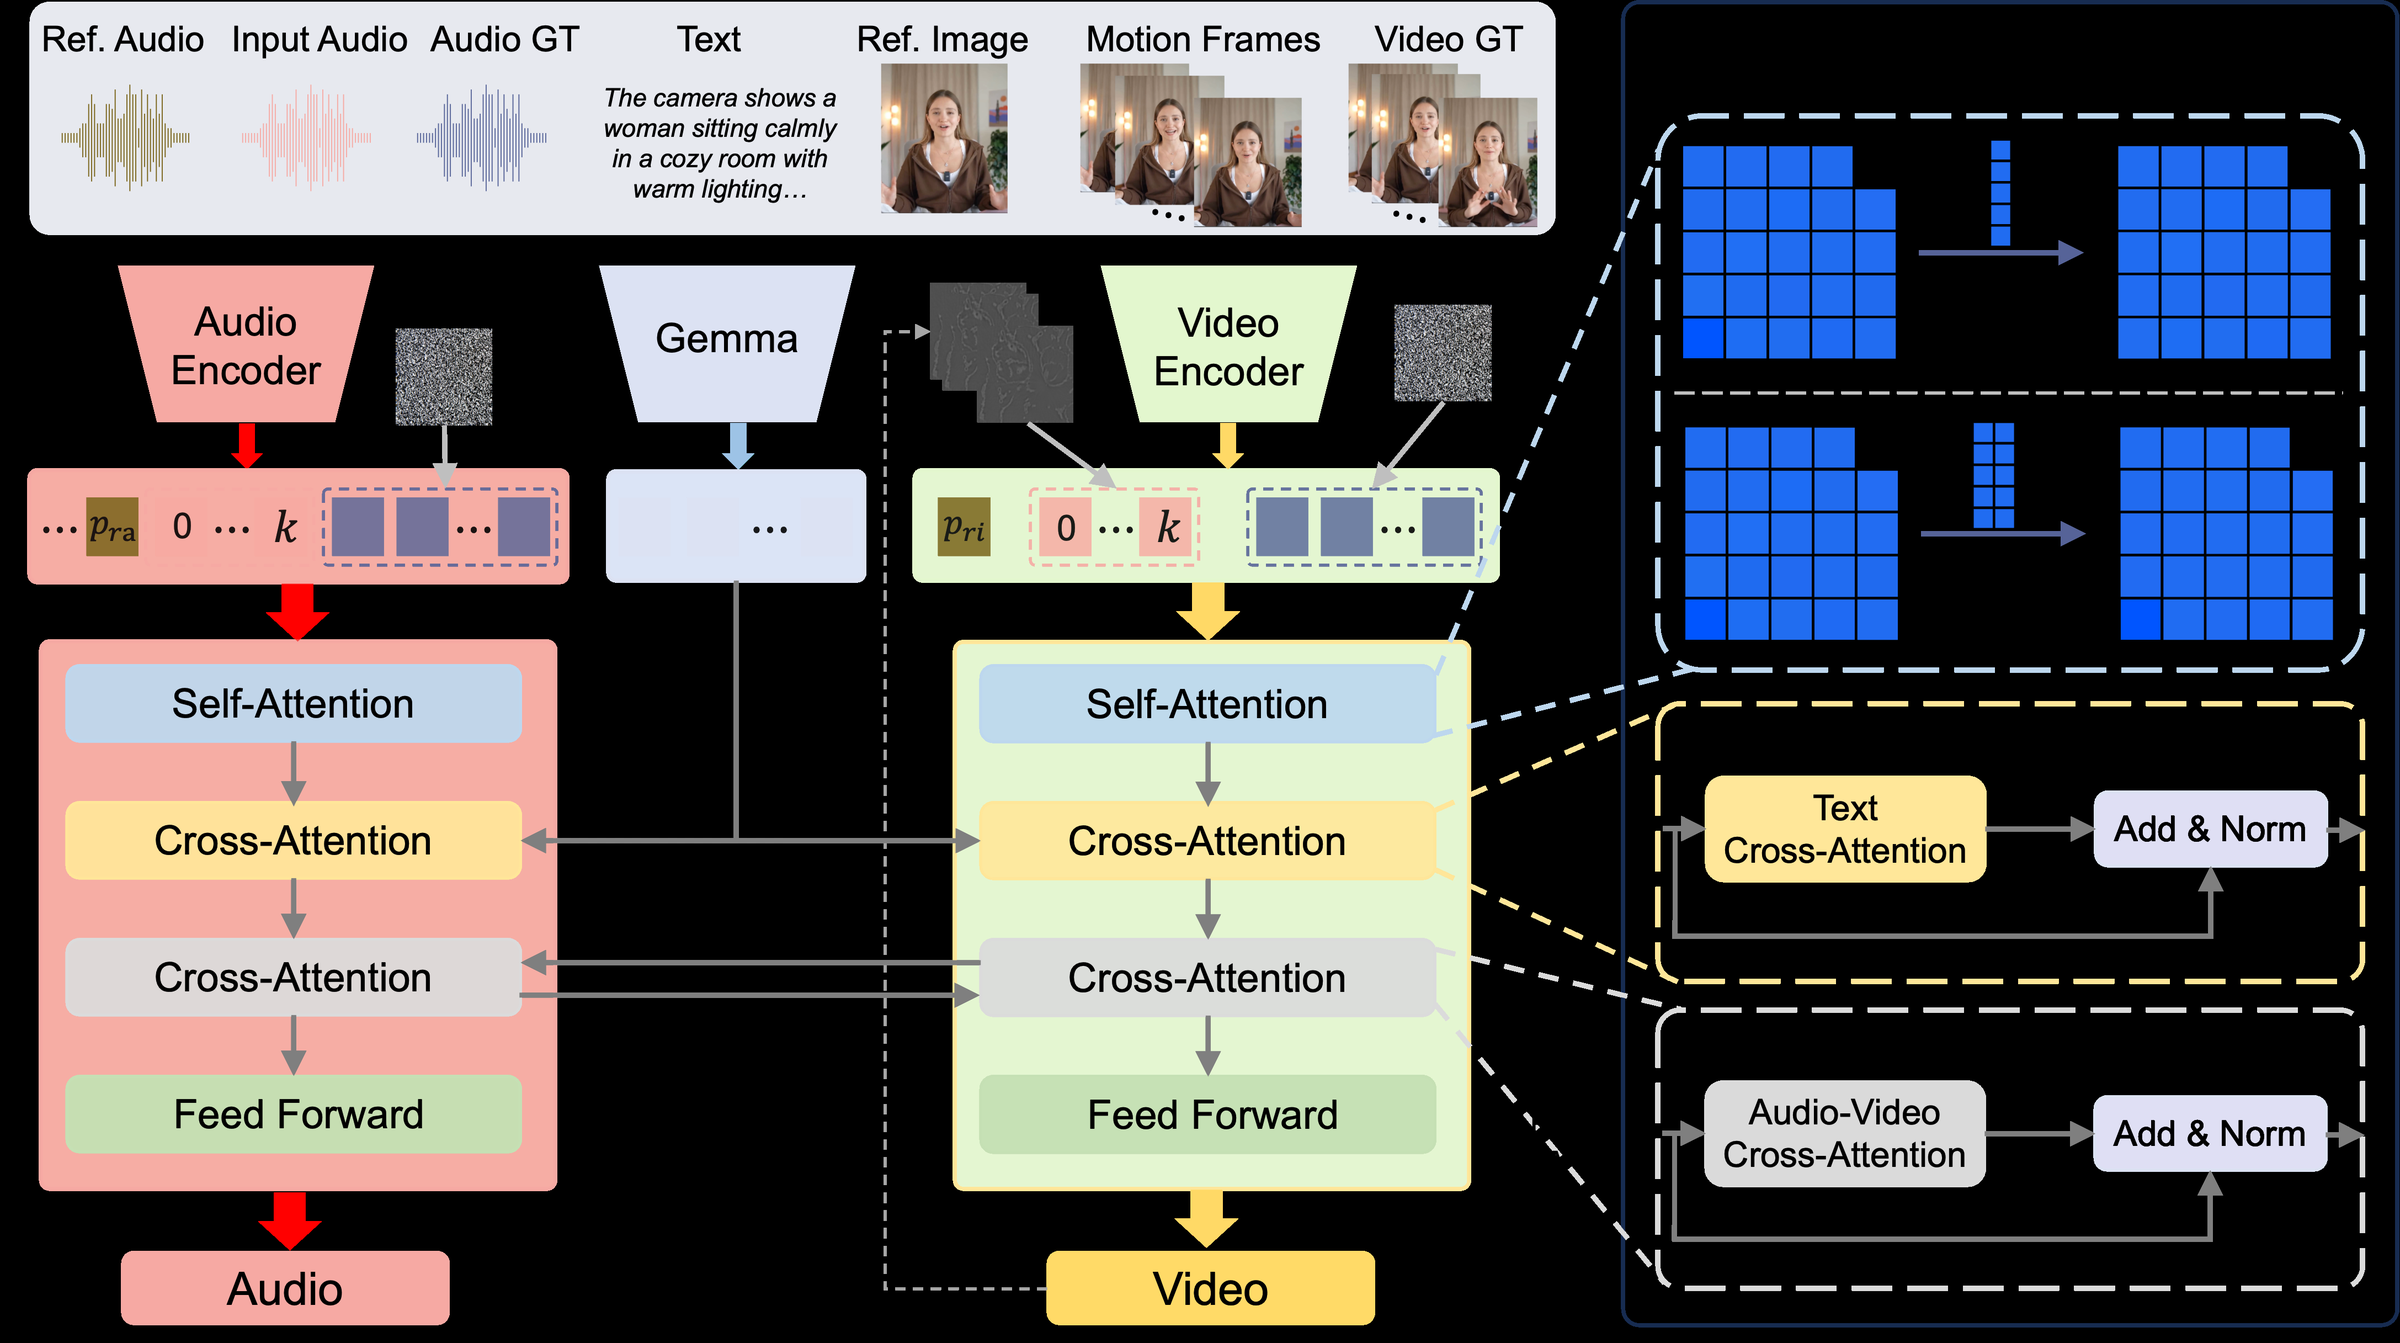
前序问题 :现有音视频生成能做出同步良好的短片,但时长受限;长视频方法靠分块迭代延长时长,却完全没有音频。联合生成长音视频比单做任何一边都难:每一块都要同时保住视频时序连贯、音频时序连贯和跨模态同步,而这三路条件信号进入模型的通路各不相同。本文贡献 :Encore 把难题拆成两层:局部连续性交给带显式跨块上下文传播的迭代生成,全局一致性交给带位移位置编码的参考音视频信号。在此之上提出自适应信号路由(ASR),在自注意力内加逐层逐头可学习偏置、在交叉注意力输出上加可学习缩放,让模型自行调节每路条件信号的影响强度。端到端联合训练后,推理时全程以真值模态为条件即可支持无限长的音频转视频与视频转音频。
实验效果 :扩展后的 VerseBench 长音视频评测上,身份一致性 ID 为 0.86、音画同步 LSE-C 为 2.36、AV-A 为 0.88,三项均为最佳;误差累积 ΔAS 0.02、ΔID 0.07,明显低于次优的 0.06 与 0.22。短片设置下 LSE-C 为 3.46,对 LTX-2.3 的 2.36。
批判点评 :把长音视频拆成局部续接加全局参考,确实压住了 30 秒级的身份漂移与场景突变。但 ASR 的逐层逐头可学习参数把调参负担转移到了训练侧,消融显示去掉任一路缩放都会让同步指标明显掉档。画面美学仍落后于 OVI 与 LTX2.3,且所谓无限长目前只验证到 30 秒量级,更长时长的累积行为没有给出。
4. DIAL:调一个旋钮控人物像不像
Harnessing Intrinsic Subject-Aware Attention for Controllable Multi-Subject Video Generation | 阿里巴巴集团、北京大学 | arXiv:2609.11507
关键词 :多主体视频生成,注意力定位,保真强度控制,偏好优化
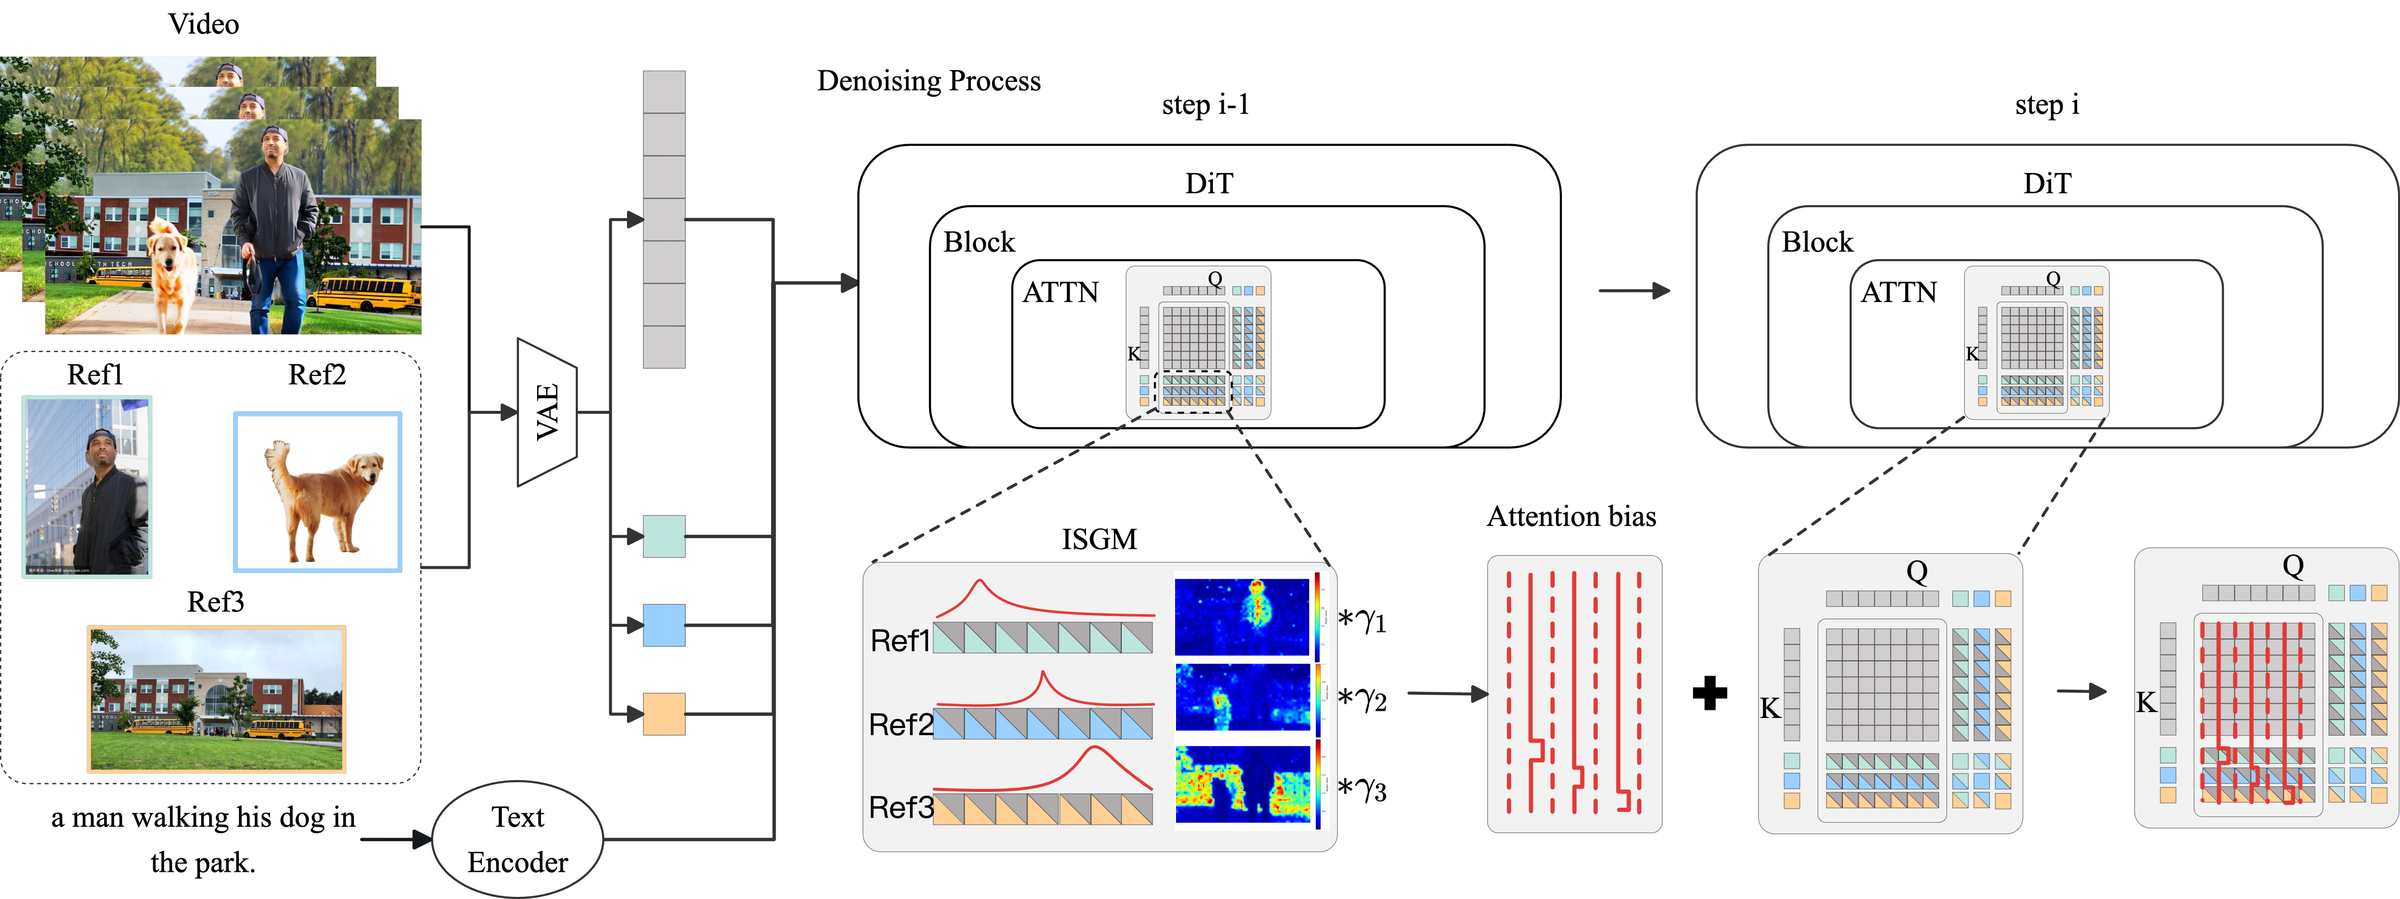
前序问题 :多主体视频生成卡在两件事上:保真强度不可调——模型要么因训练数据偏置产生生硬的贴图感,要么对输入敏感到无法控制;以及语义漂移——主体中途消失、属性出错、多个参考身份互相串味。本文贡献 :作者发现 DiT 内部某些注意力块天然形成内在空间定位图(ISGM),能准确定位参考主体。DIAL 据此双阶段复用这一内部信号:低噪声阶段用 ISGM 构造注意力偏置矩阵,推理时逐主体调节引导强度 γ 即可控制身份保真度,无需重训;高噪声阶段用同一张图零成本构造偏好对做强化学习,把注意力锚定到参考主体上抑制漂移。
实验效果 :OpenS2V-Eval 上,Kaleido 主干总分从 56.00 提到 γ=16 时的 61.14,人脸相似度从 31.81 升到 60.64,双双超过最强通用基线 SkyReels-v3 的 59.26 与 VACE-14B 的 55.09。第二阶段单独作用(γ=0)把主体出现率从 155/320 提到 163/320。
批判点评 :把控制接口接到模型自带的注意力结构上、省掉外挂模块,这个思路很干净。但 ISGM 出现在哪一层依赖对具体主干的经验观察,换骨干要重新找;保真度提升伴随真实感与美学分下滑,γ 给多少仍靠人工判断。第二阶段的偏好对由 ISGM 自评构造,评判标准与被优化对象同源,存在自我确认的风险。
5. Omni-Streaming Thinking:流式多模态会主动改口
Omni-Streaming Thinking | 香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学 | arXiv:2609.15128
关键词 :流式多模态,音视频推理,状态修正,幻觉抑制
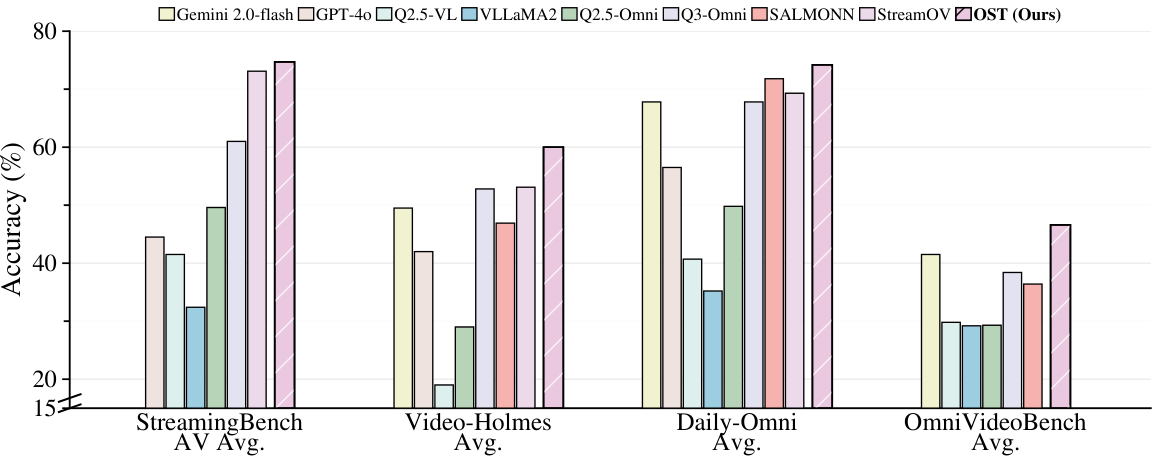
前序问题 :流式音视频模型常在声音尚未说完时依据画面提前下结论;一旦错误判断写入记忆,后续音频即使否定它,模型仍会沿着旧状态回答。本文贡献 :OST 把输出拆成已见证据、未来证据预测和待验证主张,并为主张绑定验证时间窗。音频与视觉证据分开保存;遇到矛盾后,反驳过程削弱旧主张及其依赖状态,回答门控只在关键主张满足条件时放行。主干冻结为 Qwen3-Omni-30B-A3B,仅做轻量适配。
实验效果 :在五个流式与音视频基准上,OST 相对最强开放基线平均提升超过 10%;OST-DiagBench 的 d′ 达 2.95,而开放基线最高 1.38。SOVBench-O 平均准确率由 81.6 提至 87.8,SOVBench-T F1 由 90.5 提至 92.4。
批判点评 :显式状态与反驳链能减少过早承诺,却依赖主张拆分、模态归因和验证时间窗都足够准确。复杂直播中矛盾可能长期不闭合,额外结构化输出也会增加延迟和训练标注成本。
6. Overpainting:灰色地带让模型自己发挥
Overpainting: Localized Context-aware Diffusion Image Editing | Adobe Research、威廉与玛丽学院 | arXiv:2609.10811
关键词 :图像编辑,三值遮罩,扩散模型,注意力dropout
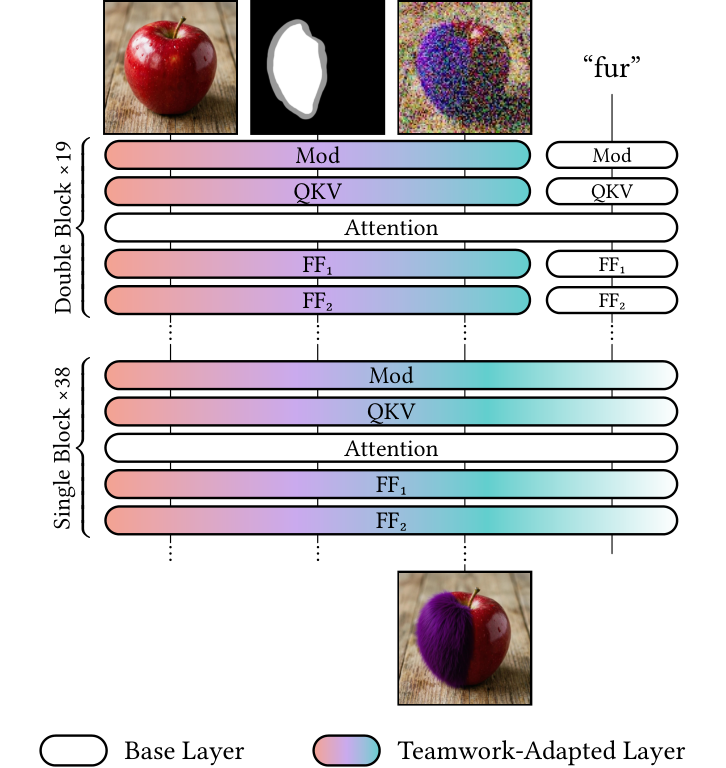
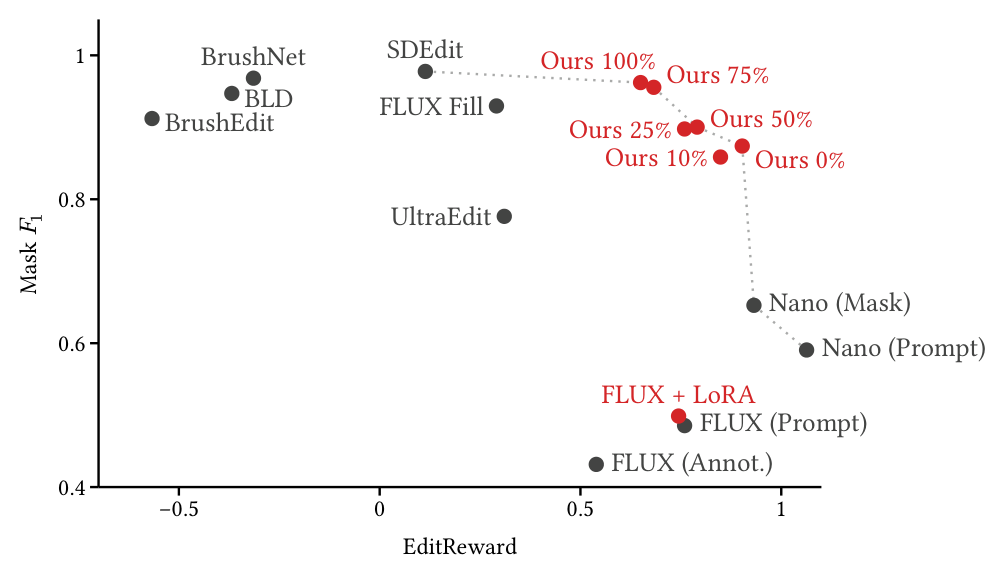
前序问题 :图像编辑要么给定二值遮罩、严格只改框内,结果生硬且边界突兀;要么纯靠文字提示,改哪里完全不受控。用户真正想表达的「这块必须改、这一圈可以顺带调、其余别动」没有对应接口。本文贡献 :Overpainting 用白/灰/黑三值 trimap 表达这三档意图:白色必须编辑、灰色允许编辑、黑色不得改动。实现上在预训练图像编辑扩散模型外挂 LoRA,用联合注意力在源图、遮罩与噪声三路输入间传信息,并以注意力 dropout 平衡信息流。配套的自动数据流水线先用语言编辑模型造候选图像对,筛掉过度编辑、编辑不足与整体偏移的失败样本,再从可用样本反解出 trimap。
实验效果 :遮罩估计网络微调后 F1 达 0.955、IoU 0.916,对比阈值像素差的 0.733 与 0.607。MISATO@1K 补全评测上 LPIPS 0.189、FID 20.58,远好于 FLUX-Kontext 的 0.372 与 92.09。180 个人工整理的例子上,50% 注意力 dropout 在遮罩遵循与编辑质量之间取得平衡点。
批判点评 :三值 trimap 比二值遮罩更贴近真实修图意图,把「顺带调一下」这件事显式化了。但灰区给模型多大自由度只能靠 dropout 率这一个全局参数调,用户画的灰区宽窄也会显著改变结果,论文自己的遮罩变体实验就显示同一提示词能得到差异很大的输出。训练数据由 FLUX.1 Kontext 自动生成再筛选,模型学到的编辑分布因此被上游模型的偏好圈住。
7. PLSR:3D网格切块做超分省显存
PLSR: Progressive and Localized Super-Resolution of 3D Objects via Localized Latent Voxel Diffusion | 香港中文大学、广东工业大学、香港城市大学、莫纳什大学 | arXiv:2609.06436
关键词 :3D资产生成,超分辨率,体素扩散,渐进式生成
前序问题 :扩散式 3D 生成模型被固定分辨率卡住,细节上不去;直接把分辨率整体拉高,显存与算力又会爆掉。本文贡献 :PLSR 在已有 3D 生成基座上做超分,把全局超分拆成关联式的局部子任务:粗网格编码成低分辨率条件,上采样出高分辨率隐变量的稀疏体素骨架后切成固定大小 patch,每个 patch 关联裁剪对应的低分辨率条件与输入图像,逐 patch 去噪再聚合成全局预测。整轮结果还能当作下一轮的低分辨率条件,渐进逼近更高分辨率,基座只需低成本微调。
实验效果 :伪真值几何评测上 LPIPS 0.109、FID 55.89、Chamfer 距离 0.0139、F1 0.145,四项全面优于 TRELLIS.2 在 1536 与 2560 两档分辨率下的结果;纹理评测 LPIPS 0.125、FID 59.89。开放世界 ELO 评分中几何总体质量 1855、纹理 1633,高于 TRELLIS.2(1536) 的 1790 与 1599。
批判点评 :把全局超分拆成局部 patch 换来了显存友好,重叠推理与渐进式两个消融也都验证有效。但逐 patch 去噪要遍历所有 patch,分辨率越高调用次数越多,省的是显存不是时间。接缝主要靠低分辨率条件当锚点加重叠区抑制,论文也承认无重叠时仍有残留。开放世界评测依赖模型打分,与人工审美的一致性没有交叉验证。
8. SAS:稀疏注意力直接听损失
SAS: Simple Attention Sparsification via End-to-End Optimization of Context Ranking | 腾讯混元、香港科技大学(广州)、香港科技大学 | arXiv:2609.13141
关键词 :稀疏注意力,长上下文,上下文排序,端到端优化
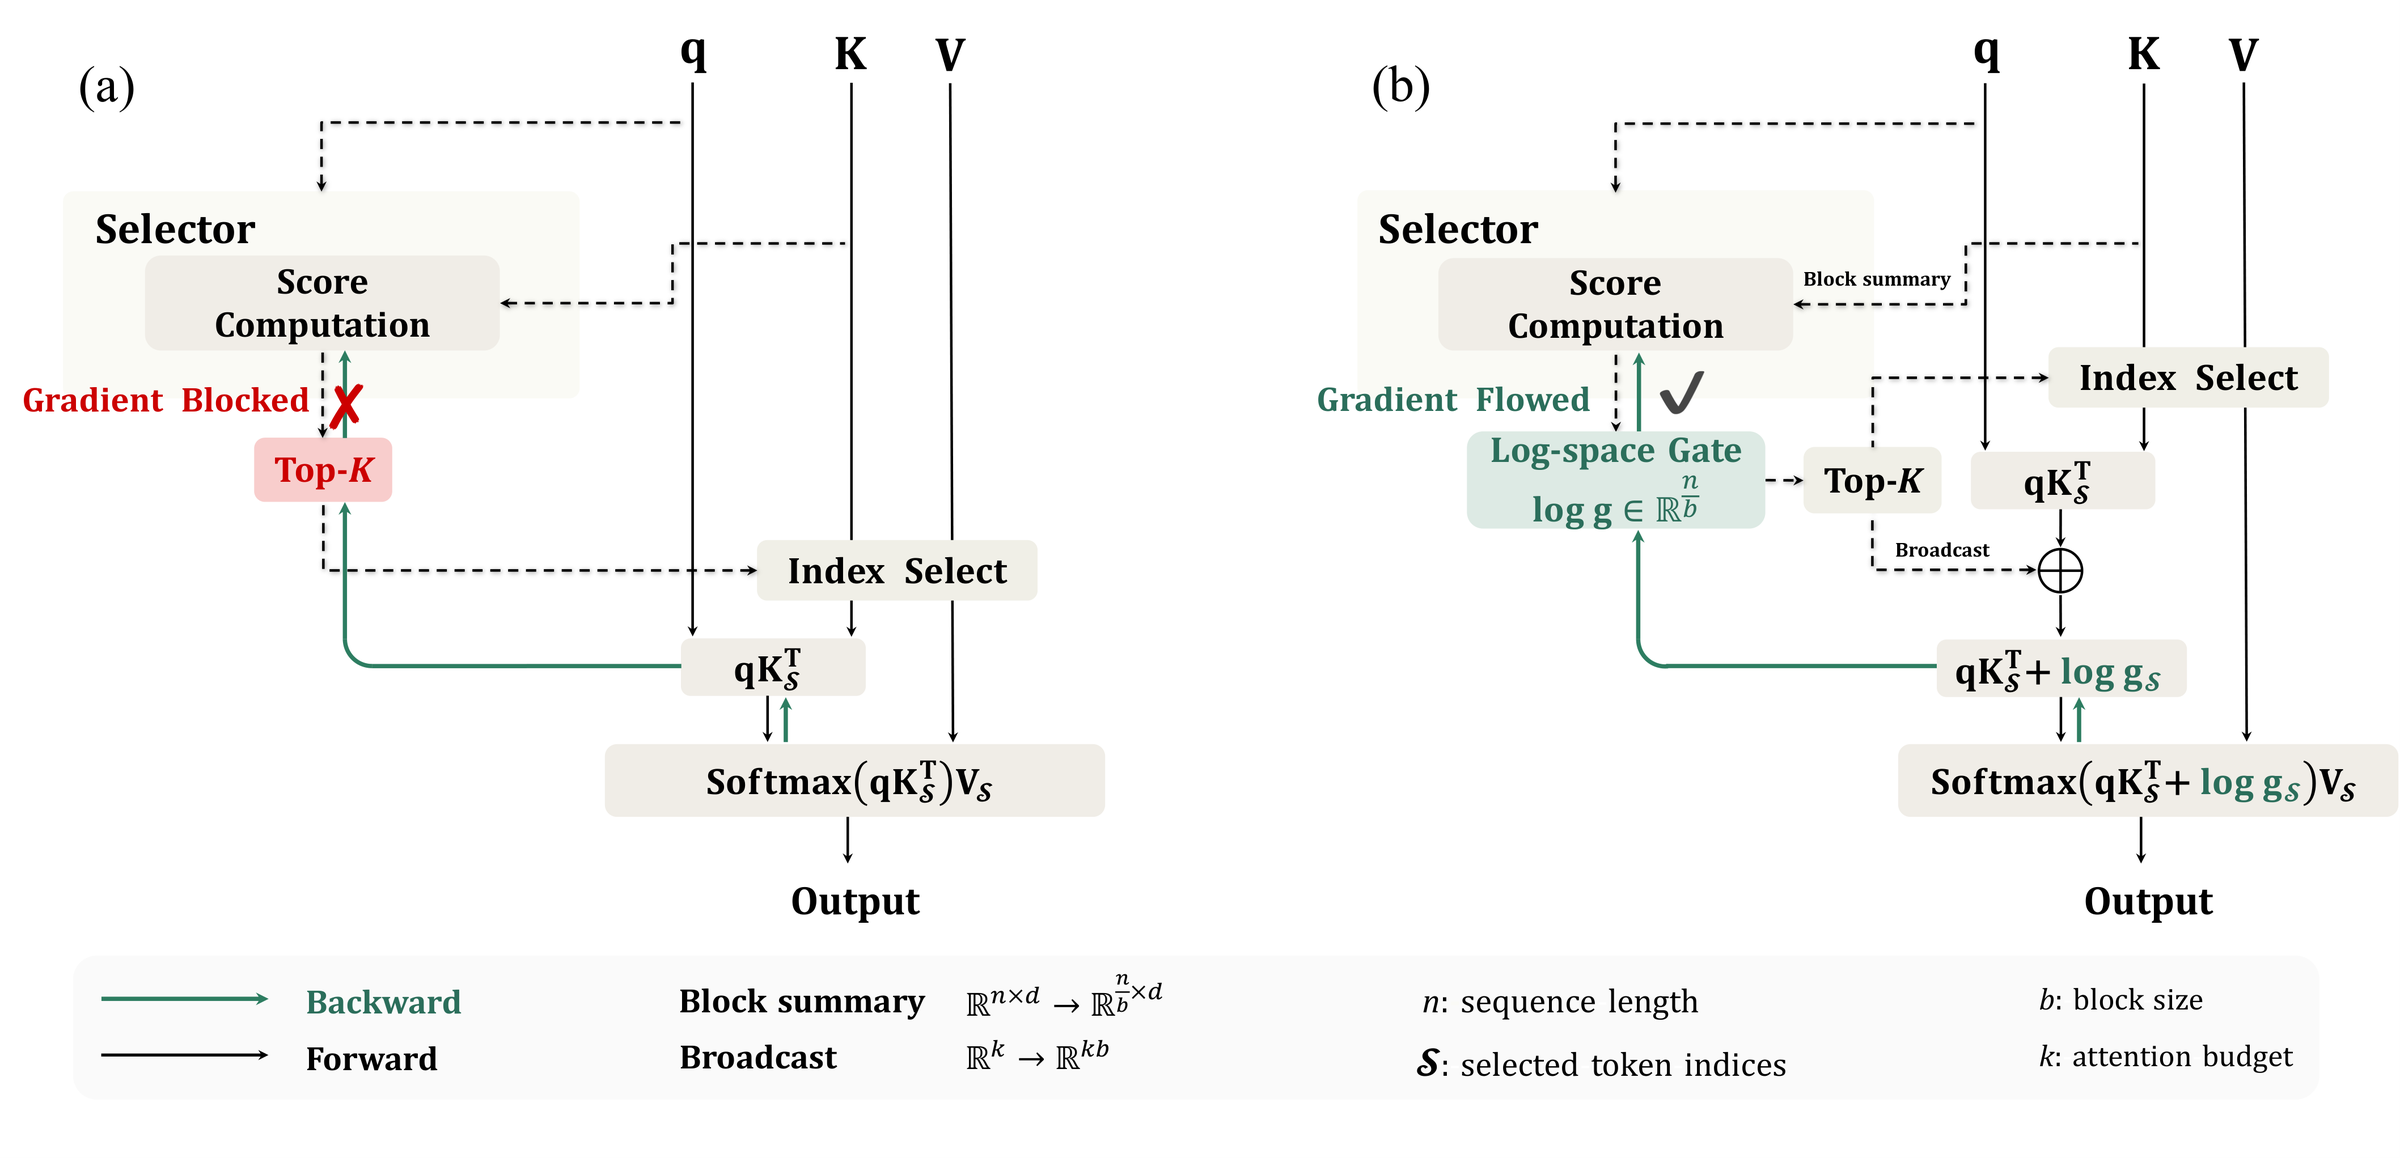
前序问题 :可训练稀疏注意力通常用硬 Top-K 选上下文,语言模型损失无法穿过离散选择,只能蒸馏稠密注意力权重;有限预算因此可能保留“像教师”却不真正影响最终预测的块。本文贡献 :SAS 在训练时把选择器连续分数以对数门的形式注入注意力 softmax,让语言模型损失直接更新上下文排序;归一化门校准历史块与始终保留的当前块,Triton 内核把这一机制嵌入 FlashAttention 风格计算。
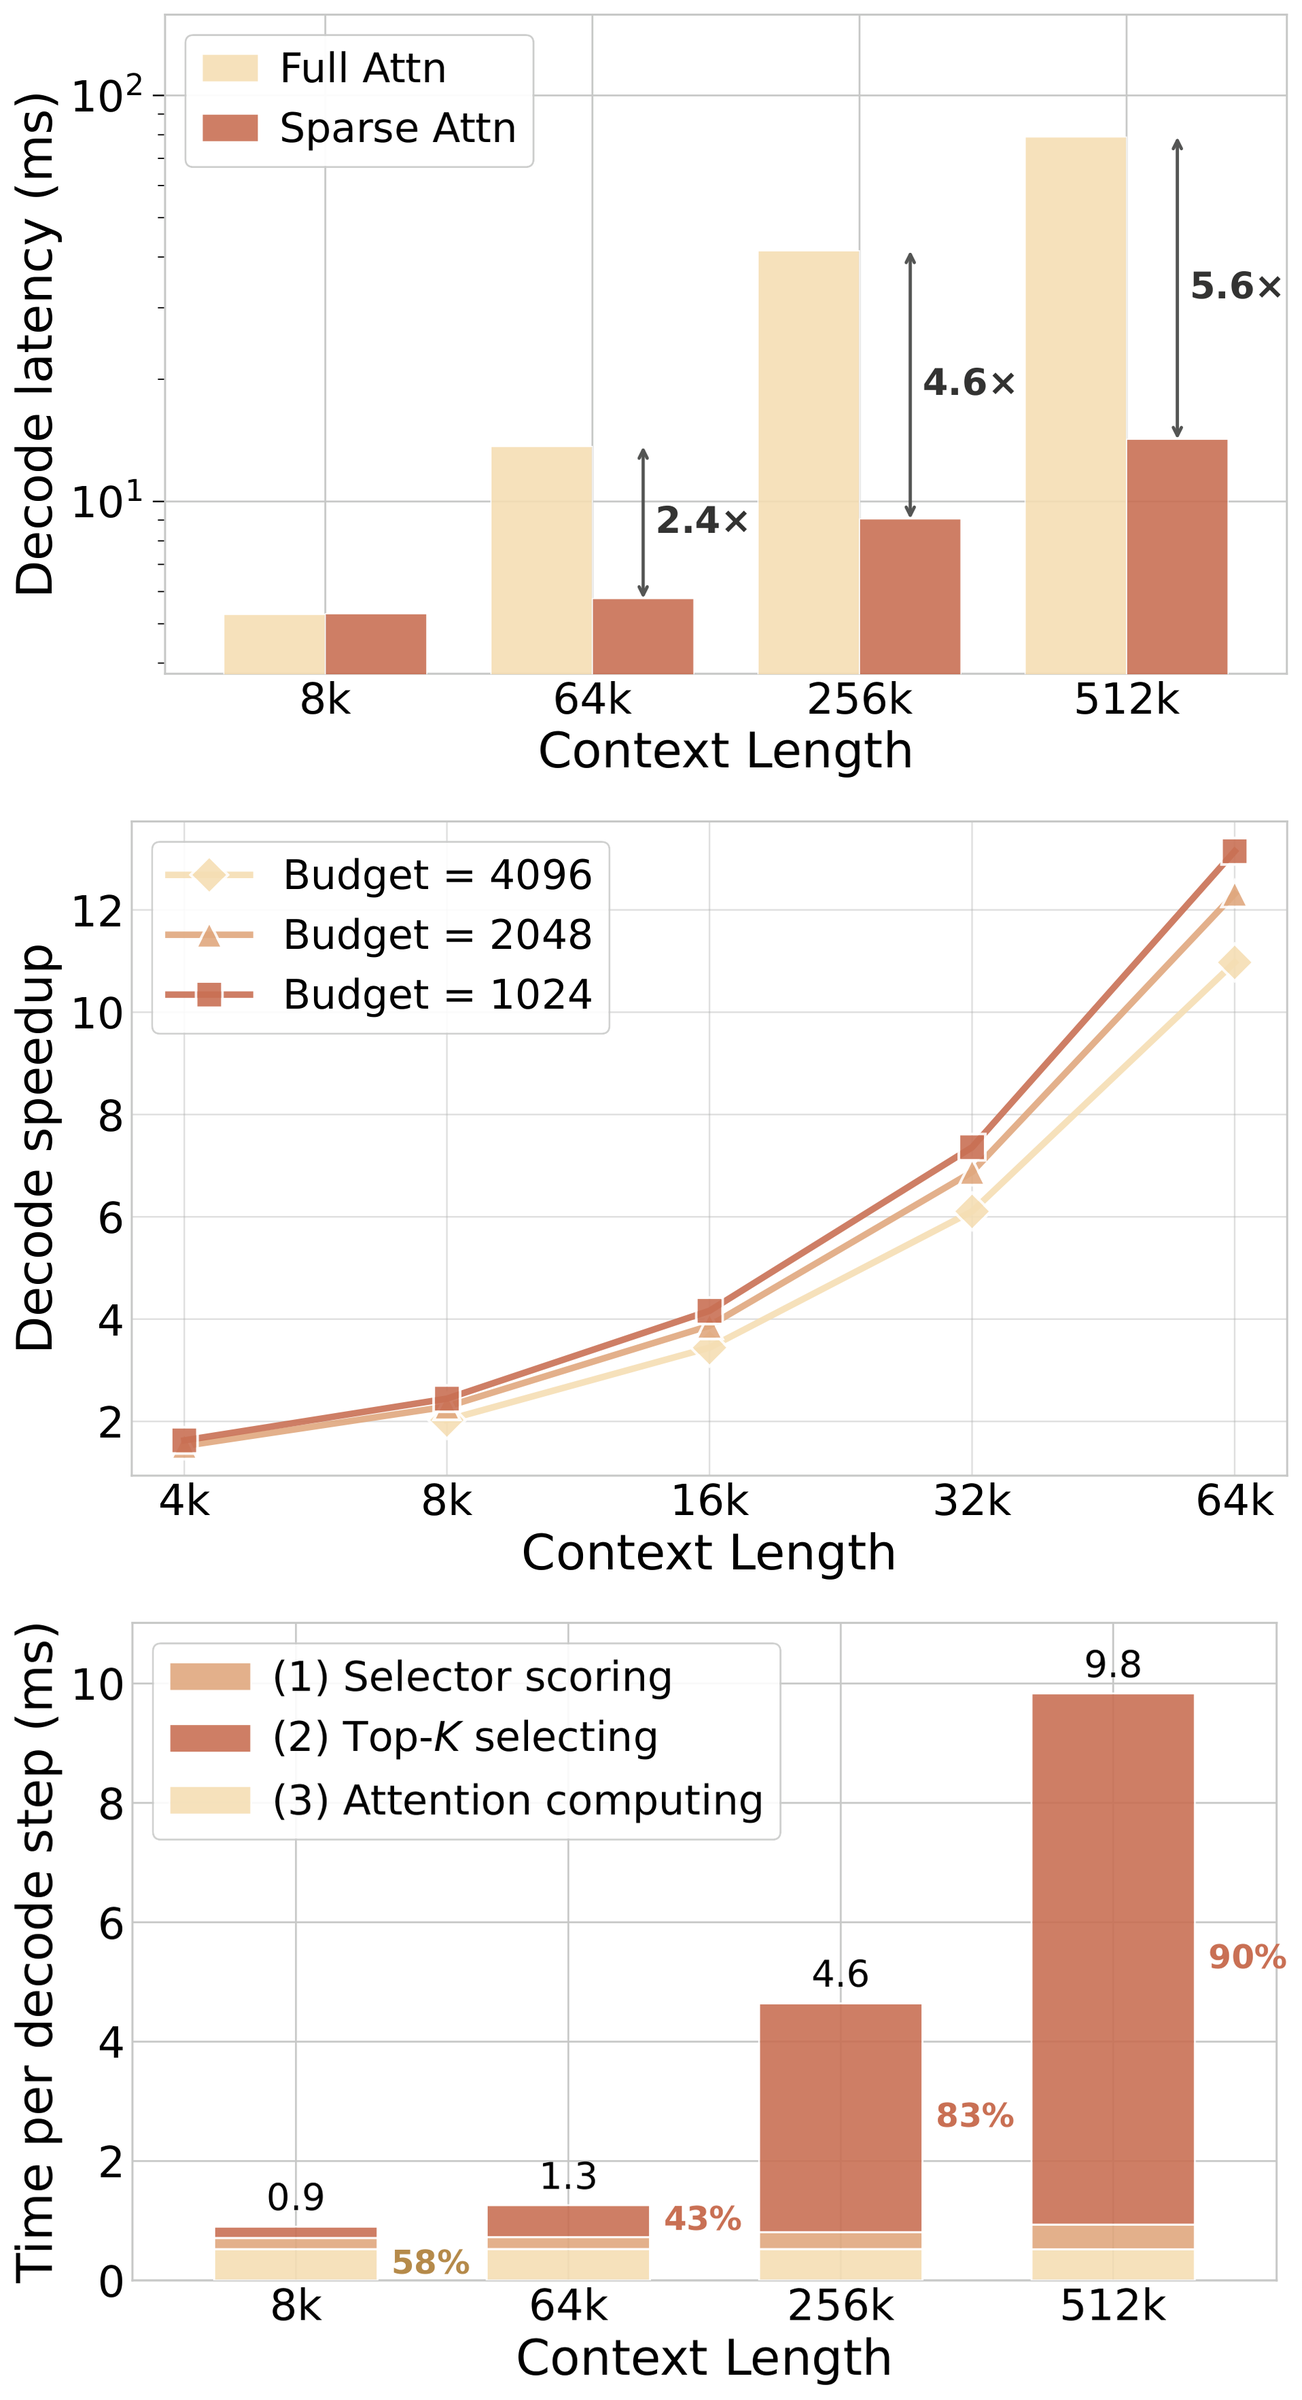
实验效果 :在 2048 token 预算、Qwen3-4B 上,AIME24 比 SeerAttention-R 高 13.02 分(68.85 对 55.83);Qwen3-14B 的 LongBench 8K+ 为 53.9 对 51.5。SGLang 解码在 512K、batch 1 最多降延迟 5.6 倍,batch 8、64K 最多约 13 倍加速。
批判点评 :端到端损失对下游任务更直接,但选择器只在数学数据上训练,跨领域稳定性仍受主干与查询分布影响;预填充仍采用稠密注意力,因此长输入首 token 成本没有同时消失。
9. Mi-Ripple:修掉反复AI编辑的涟漪
Mi-Ripple: Restoring Images Degraded by Iterative AI Editing | 弥阳科技、中国科学院软件研究所、上海交通大学、天津大学 | arXiv:2609.11317
关键词 :图像修复,迭代编辑,频域伪影,配对再生成
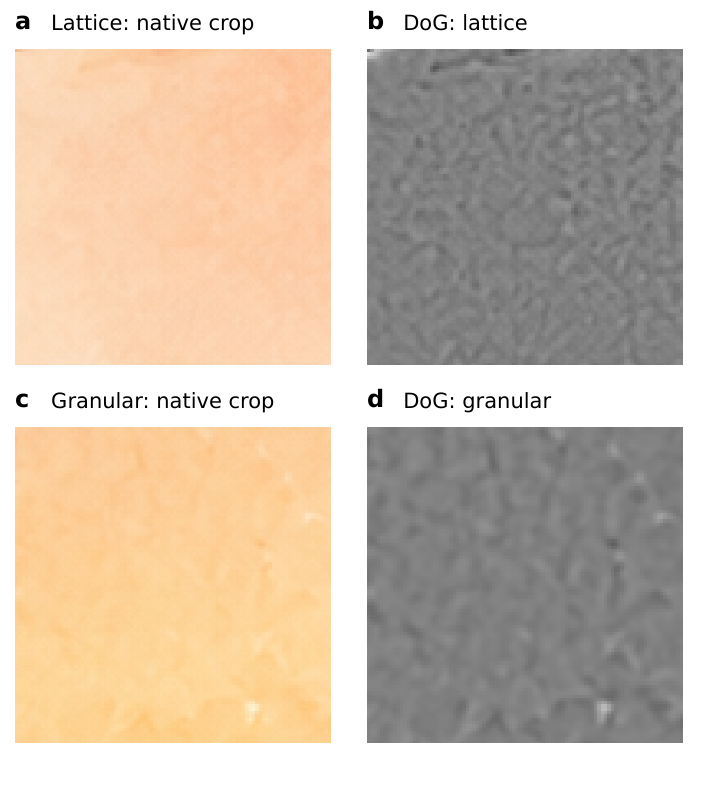
前序问题 :图像被生成模型反复编辑后会积累低频起伏、色带与周期纹理,内容看似正确却越来越“塑料”;普通锐化或去噪可能同时损伤真实边缘。本文贡献 :Mi-Ripple 先在频域用陷波定位并抑制迭代编辑形成的周期分量,再通过配对再生成构造更干净的参考,对剩余伪影做修复;流程把可测量的频谱异常与生成式细节恢复结合。
实验效果 :14 次只做陷波的测试中,整图 CIELAB 亮度残差标准差为 0.08–0.44;配对再生成把参考中的碎屑密度降低 45%。三个示例的尺度纹理指数分别从 25.3%、41.1%、20.0% 降至 11.1%、12.1%、0.0%。
批判点评 :方法针对可见的周期性退化更有解释性,但配对再生成可能改动原图身份与细节。若伪影频率与真实重复纹理重合,陷波也可能误删内容,仍需要区域级保真检查。
10. Duplex Cue:会说会停还要边听边改
Continue, Adapt, or Yield: In-Turn Adaptation to Overlapping Speech in Full-Duplex Agents | Besimple AI | arXiv:2609.13117
关键词 :全双工语音,重叠语音,对话适应,语音评测
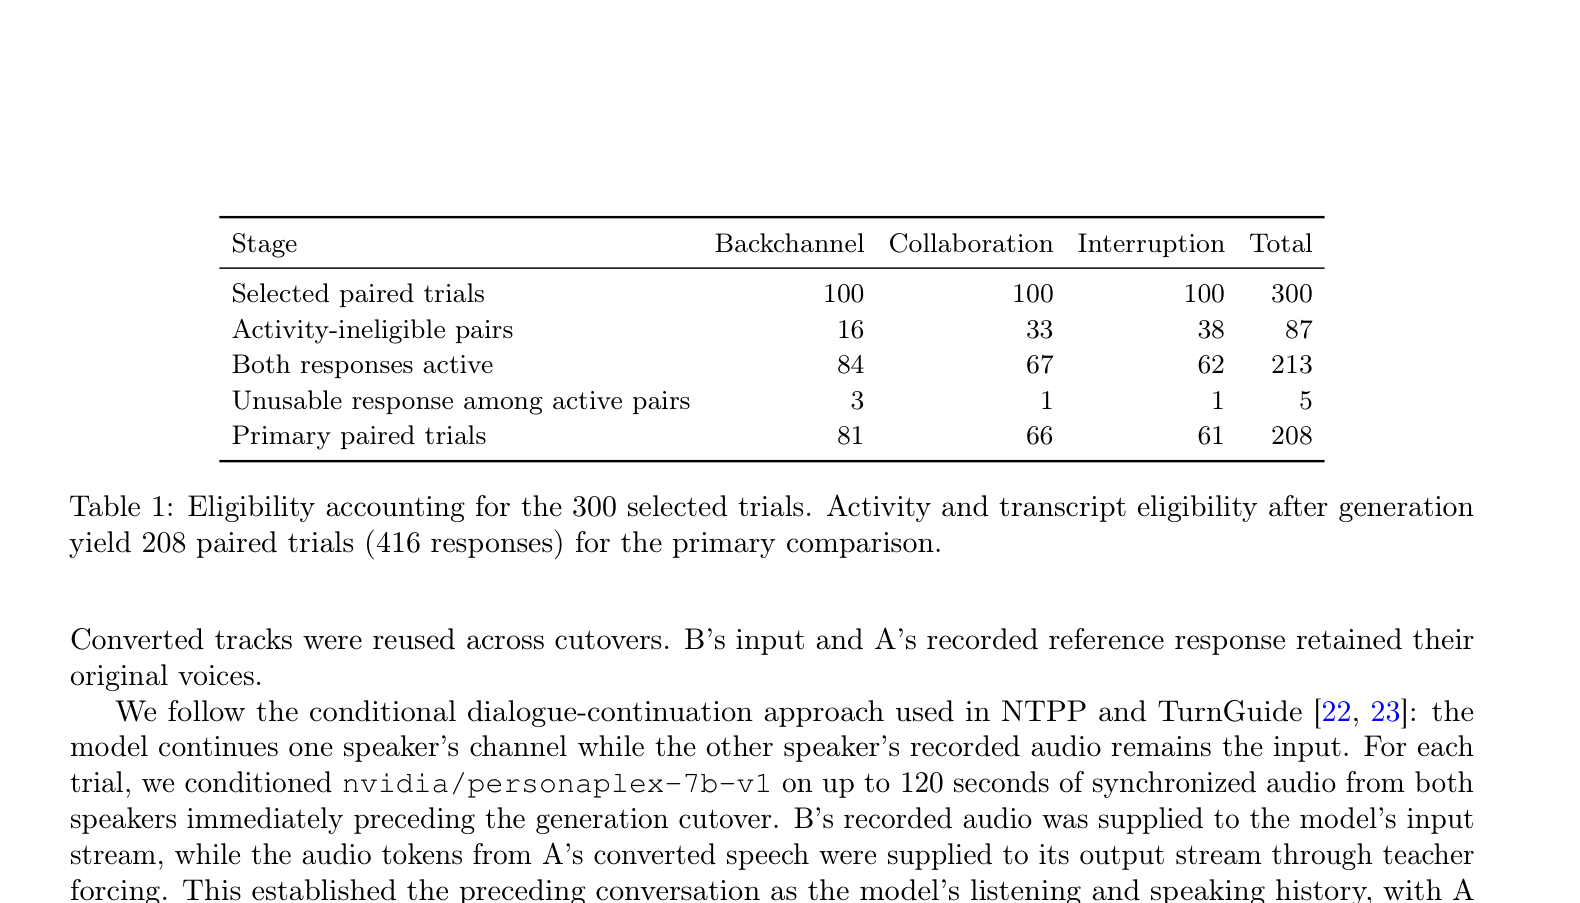
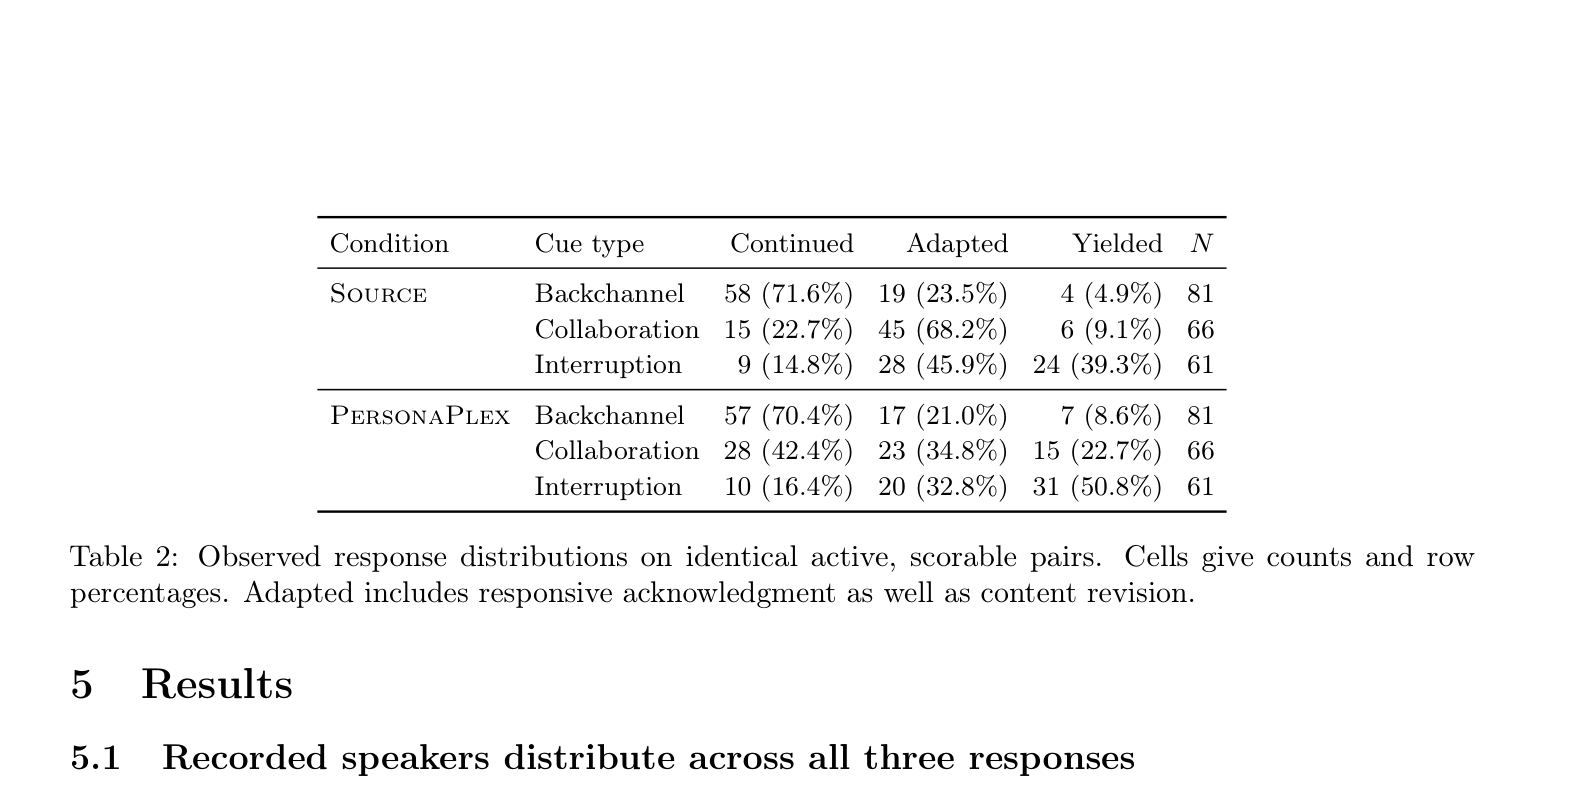
前序问题 :全双工语音评测常把模型行为简化为继续说或停下来,却漏掉人类常用的第三种反应:保留话轮,同时吸收听者补充的词、纠正或澄清。本文贡献 :Duplex Cue 把听者意图区分为回应、协作与打断,把说者行为标成原样继续、话内适应或让出话轮。研究从无脚本英语对话中提取 300 个经人工确认的提示,并在相同提示下比较人类录音与 PersonaPlex 延续。
实验效果 :保留 208 对活跃且可评分样本;66 个协作提示中,人类话内适应率为 68.2%,PersonaPlex 为 34.8%,相差 33.4 个百分点。模型更多原样继续(42.4%)或让出话轮(22.7%);自动评分与人工在 142 项中一致 108 项,κ=0.641。
批判点评 :三分法比“停没停”更接近自然对话,但判断适应需要理解语义依赖,自动评审本身可能偏向表面复述。要成为训练目标,还需扩展语言、说话风格、噪声与真实网络延迟。
趋势观察
控制接口前移到模型内部
控制不再靠外挂模块,而是接到主干已有的结构上:DiffSynth-Music 用可复用 KV 缓存组合五路音频,StepAudio 3 Gen 用共享离散码本统一语音、歌声、音乐与音效,DIAL 干脆直接复用 DiT 自带的注意力定位图。
长时序生成靠显式上下文传播续命
Encore 把长音视频拆成局部连续性与全局一致性两层,用跨块上下文传播加参考信号压住 30 秒后的身份漂移,误差累积指标 ΔID 从次优的 0.22 降到 0.07——长程生成的胜负手不在单帧画质,而在误差累积。
编辑控制从硬遮罩转向软约束
Overpainting 用白灰黑三值 trimap 区分「必须改、可以改、不能改」,Mi-Ripple 用频域陷波只删周期分量,都在回答「哪里该动、动多少」,而不是一刀切地框定编辑区域。
算力不够时预算分配成为核心问题
PLSR 把全局 3D 超分拆成可迭代的局部 patch 去噪换显存,SAS 在固定注意力预算下端到端学上下文排序——两条线都承认资源有限,转而研究怎么把预算花在刀刃上。
人工智能炼丹君 整理 | 2026-09-15
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注















评论 (0)