


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:注意力与核心零件 | 难度:进阶 | 前置知识:RoPE 的原理与实现
关键词:3D RoPE、时空位置编码、视频 DiT、分辨率外推、逐轴位置插值、帧数外推
先看一对位置:视频格点 A=(0,0,0),B=(0,1,0)。B 在 A 的正下方一格。将每帧按行展开,再按时间串接,普通 1D RoPE 看到的序列位置是 m=tHW+hW+w。当每帧宽 W=4 时,A 到 B 的序列距离是 4;仅把宽改为 W=8,距离变成 8。两块仍上下相邻,旋转角却按 1D 的位置差变了。时间上的相邻帧也会受 HW 改变影响。固定画幅下,这种展开次序可以用,模型也可能学到空间规律;问题是在画幅或时长改变时,序列距离不再稳定代表同一种时空关系。这里的 1D RoPE 是为了隔离坐标问题而构造的诊断基线,不是在声称所有早期视频模型都按这一公式编码位置。
3D RoPE 给 A、B 保留 (t,h,w),所以无论宽度是多少,两者都只在高轴相差一格。它解决的是展平编号把画幅尺寸混进位置差的问题;画质外推还涉及训练分辨率、物体尺度和注意力成本。后文用 CogVideoX 的实验 分开讨论位置表直接扩展与逐轴插值,不把“坐标可计算”误当成“视频一定生成得好”。
基础 RoPE 已解释二维旋转与相对位置性质,这里直接看视频新增的两步:
m,相对位移是 Δm;三轴版保留 (t,h,w),相对位移是 (Δt,Δh,Δw)。图 1 的上下邻居在画幅变宽后,只有三轴版仍把它识别为“高轴相差一格”。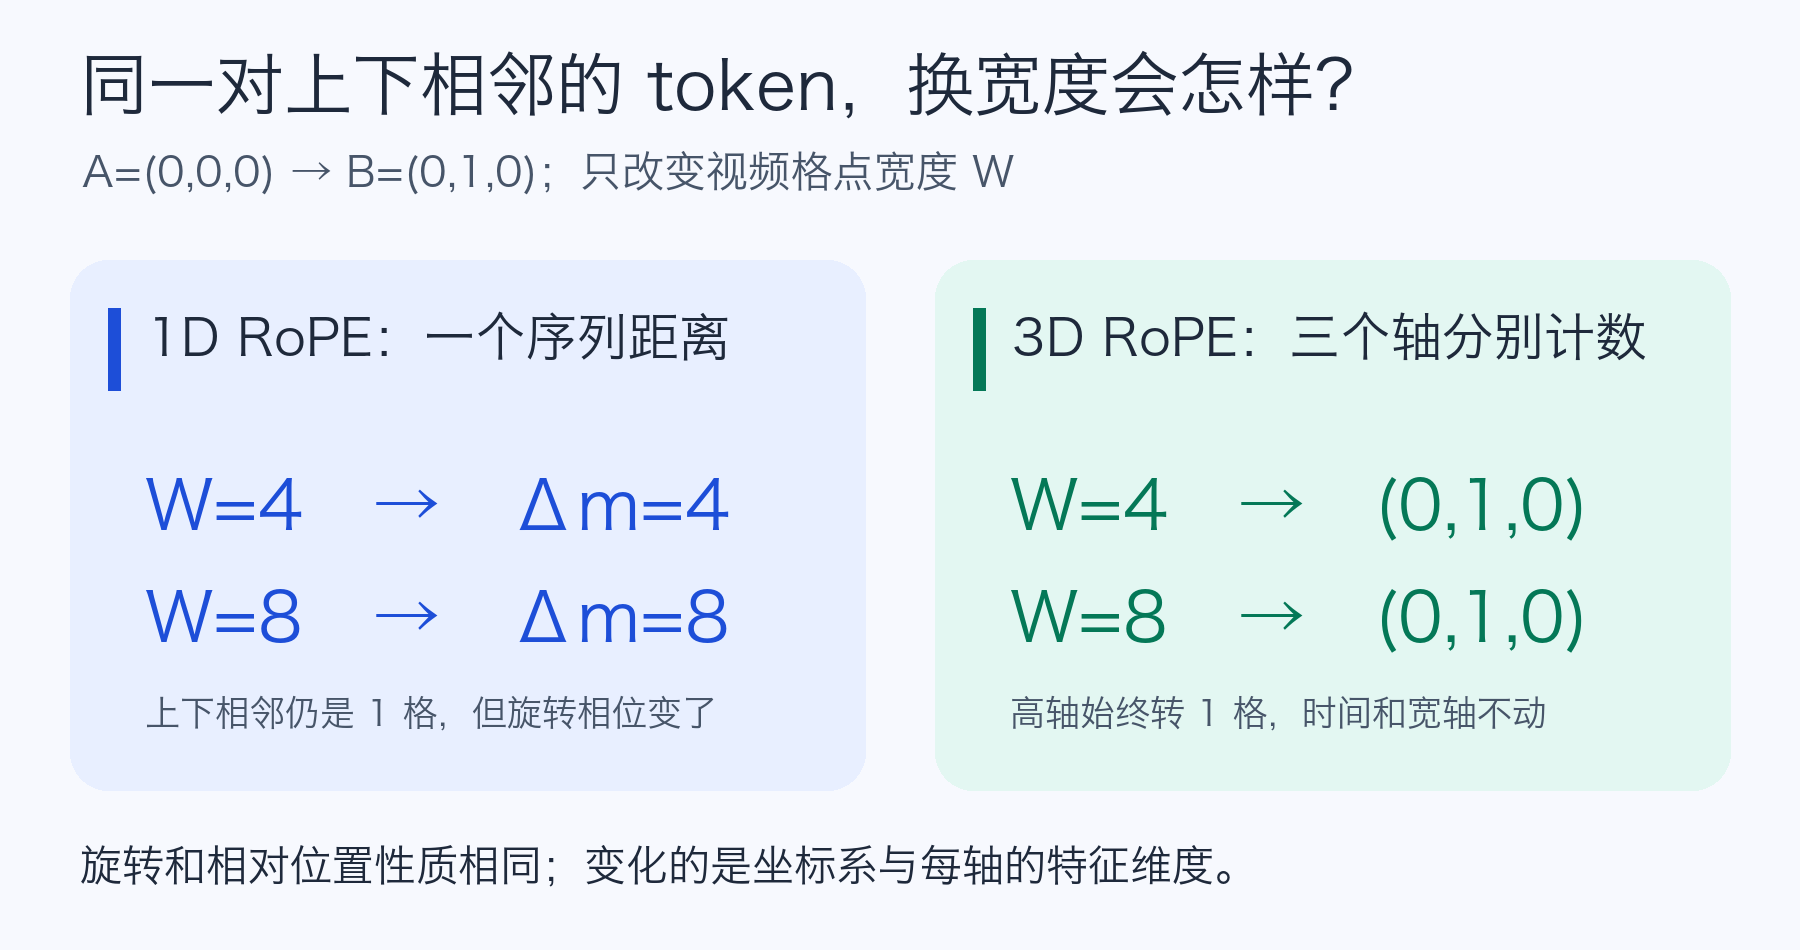
图 1:固定 A、B 的时空坐标,只改每帧格点宽度。展平位置差从 4 变 8,三轴位移始终是 (0,1,0);真实模型的内容特征也会随画幅变化。
具体比例由模型选择。CogVideoX 给时间 1/4、高 3/8、宽 3/8;64 维头对应 (16,24,24),不是所有 3D RoPE 的固定标准。按这个分配,高轴的坐标映射可以单独调整,而时间、宽轴保持原样。实际换模型还要核对每轴维度、坐标单位、频率基数、配对次序和文本 token 的处理,不能只照搬比例。
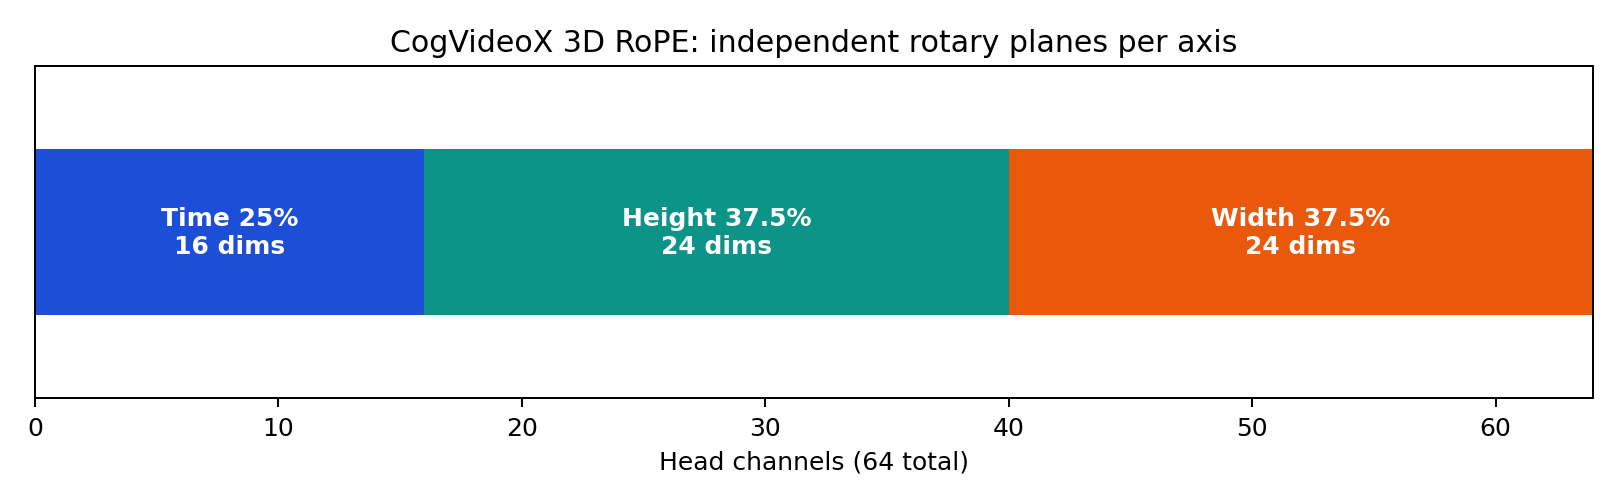
图 2:64 维注意力头的示例。每个轴的维度都成对构成旋转平面;三段共享一个 token,但不会互相混成单一序列编号。图由文末代码生成。
设视频 patch token 为 $z_{t,h,w}$。$t$ 是压缩后的时间格点,$h$ 和 $w$ 是 patch 后的高、宽格点;它们不是原始帧号或像素坐标。以下只讨论注意力打分前,如何给对应的 query/key 构造位置相位。
先写出基础版到底把什么送进旋转。固定一个按行优先展开的视频网格 $(T,H,W)$,位置编号 $m=tHW+hW+w$。任意两格 $p=(t,h,w)$、$r=(t',h',w')$ 的编号差为:
$$m_r-m_p=(t'-t)HW+(h'-h)W+(w'-w)$$
上式说明 1D 并非丢了时空信息:固定 $H,W$ 时,每个格点仍有唯一编号。但同样一个高轴位移会乘上当前的 $W$,同样一个时间位移会乘上当前的 $HW$。换画幅后,“向下 1 格”的位置相位因此变化;这只比较固定内容特征的位置项,不推断整个模型的注意力分数或画质。
令头维度 $d=d_t+d_h+d_w$,每段维度都必须为偶数。把 $q$ 和 $k$ 拆为 $q^{(t)},q^{(h)},q^{(w)}$ 与对应的三段 $k$。对轴 $a\in\{t,h,w\}$ 的第 $i$ 个二维旋转平面,选频率:
$$\omega_{a,i}=\Theta^{-2i/d_a},\qquad i=0,1,\ldots,d_a/2-1$$
$\Theta$ 是频率基数,CogVideoX 的源码默认 10000;$d_a$ 是该轴分到的维度,而不是整个头维度。时间与空间段各自从最高频重新开始,不是把一条 1D 频率数组切成三段。沿用先修文章的旋转记号 $R$,用 $R_a(p_a)$ 表示轴 $a$ 上所有旋转平面的组合。完整位置操作是三个互不混合的块拼接:
$$\widetilde q_{t,h,w}=\operatorname{diag}(R_t(t),R_h(h),R_w(w))q_{t,h,w}$$
key 用同一个位置规则得到 $\widetilde k$。分轴的是位置相位的构造;注意力仍对所有可见视频 token 计算一次打分。
可以把区别压到一行:1D 的相对角是 Δm × 频率,其中 Δm=Δt·HW+Δh·W+Δw;3D 的三组相对角分别是 Δt × 时间频率、Δh × 高频率、Δw × 宽频率。三组贡献在同一次内积里相加。这里的 Δ 都是 token 格点差,不是秒数或像素差。
基础 RoPE 已推过两个旋转角相减的恒等式。这里新增的是:每个轴只用自己的坐标差,整头把三段贡献相加:
$$s(p,r)=\sum_{a\in\{t,h,w\}}\langle q^{(a)},R_a(r_a-p_a)k^{(a)}\rangle$$
$p=(t,h,w)$ 和 $r=(t',h',w')$ 是两个格点。只有高差为 1 时,时间段与宽段的位置差都是零,高段单独改变打分;换宽度不会把这一高差改写成另一个数。公式描述固定 $q,k$ 时的位置作用,文末代码用上下邻居和下一帧两种位移分别检查它。
再看一个跨帧例子:某个物体的投影从 (0,5,5) 到 (1,5,6),位置差是 (1,0,1);时间段和宽段的相位会变,高段不会。但静止物体遇到相机运动也可能产生完全相同的屏幕投影轨迹。对这两个例子,3D RoPE 的位置部分完全一样;它没有标记“这是同一物体”,也没有记录相机姿态或两个时间格点之间的秒数。模型仍可从图像内容、条件和后续层学习运动关系,不能把三轴相位本身当作光流或物理速度。
式子还有一个可检查的边界:三段打分相加,位置操作本身没有 Δt×Δw 这样的跨轴乘积项。这不妨碍注意力通过 $q,k$ 的内容组合时空线索;它只说明“分别编码三个轴”并不等于“直接编码一条物体轨迹”。
假设训练高轴有 $H_0$ 个格点,推理变成 $H_1$ 个格点,零起点时两者的最大坐标分别是 $L_0=H_0-1$、$L_1=H_1-1$。直接外推使用新坐标 $h'=h$,相邻高 token 仍相差 1,角差仍为 $\omega_{h,i}$,但远端坐标超过旧范围。若要让两个端点严格对齐,逐轴位置插值应使用 $h'=h/s_h$、$s_h=L_1/L_0=(H_1-1)/(H_0-1)$;相邻角差变为 $\omega_{h,i}/s_h$,最远坐标正好被压回 $H_0-1$。常见的 $H_1/H_0$ 是大网格下的近似,网格很短时两者不可混写。宽与时间可以分别选择 $s_w,s_t$:
$$\phi_{a,i}(p_a)=\frac{p_a}{s_a}\omega_{a,i},\qquad s_t,s_h,s_w>0$$
这条式子说明“分辨率外推”不是只能一起拉伸三个轴。若只想演示高轴坐标压缩两倍,可以选 $(s_t,s_h,s_w)=(1,2,1)$;若要复现某条真实管线,则应按它的端点、crop 坐标和取样约定计算,不能只看形状比。保持局部细节对应相邻格点的相位差尽量不变;覆盖新范围对应最远端相位别离开已训练的分布。单一全频率插值无法同时严格满足两者。图 3 用 scale=2 隔离这个机制:高度插值后高频振荡慢了一半,低频在这 32 个格点上原本就几乎不动;它不是某个 CogVideoX 推理配置的逐参数复刻。读图时也不要把 cos 的偶然重合当成“两个远处位置相同”。
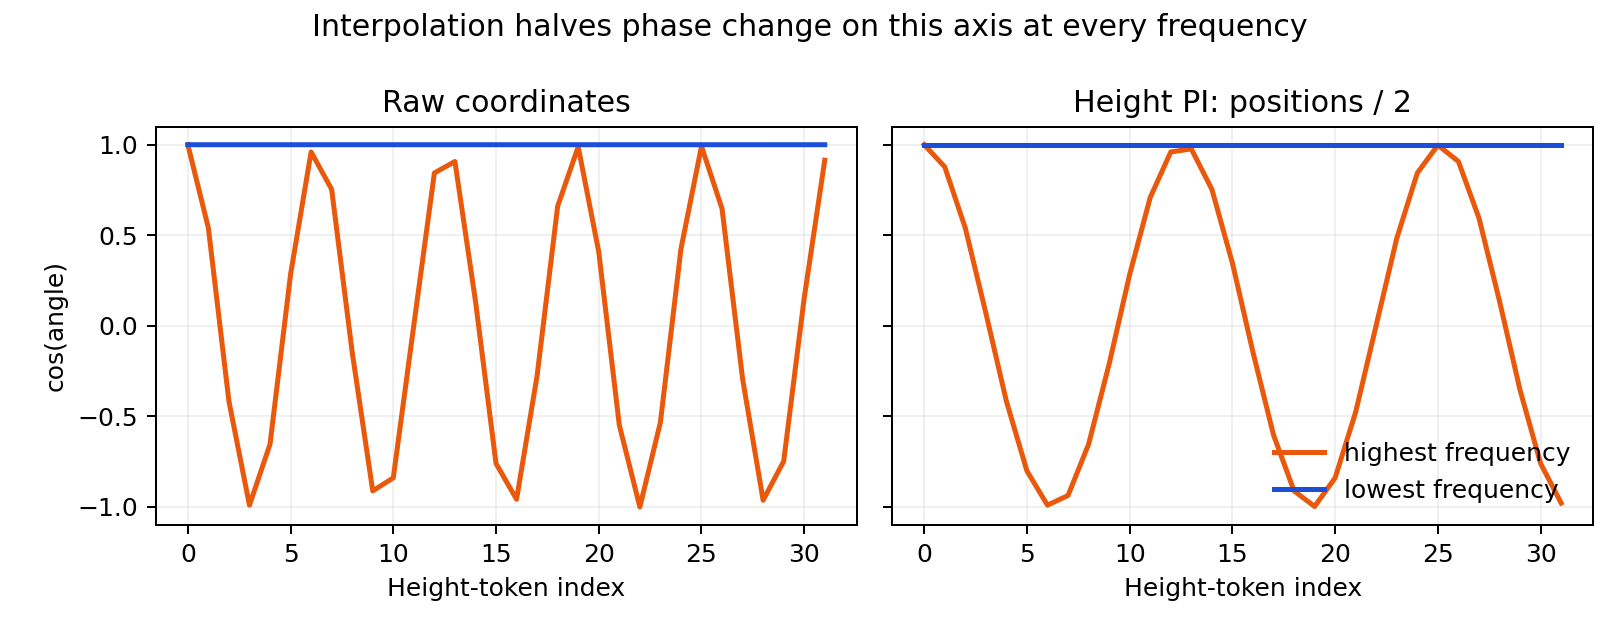
图 3:高维度 24、基数 10000 的示例。左边用原坐标,右边只把高坐标除以 2;时间与宽并未压缩。图中画的是 cos 相位而非生成质量。
为什么 CogVideoX 把时间分到 1/4、两个空间轴各分到 3/8,而不是三等分?论文给出了这个比例与三轴独立 RoPE 的实现,却没有证明它对所有数据和画幅最优。可以从编码需求理解:空间中每一帧都包含大量局部邻接与大范围结构,两个空间轴合计拿到较多旋转平面;压缩后的时间格点通常少于空间格点,但仍需能分辨前后帧。这个解释是设计动机的推断,不能代替原论文消融,更不能据此宣布时间维度永远够用。
64 维示例中,时间 16 维对应 8 个旋转平面,高与宽的 24 维各对应 12 个。最高频平面的角增量都是 1 弧度,因为 $i=0$ 时 $\omega=1$,所以“空间分得多”并不是说高、宽的每一步比时间转得快。区别落在可用的频率层级数量和最慢频率:时间最后一组在坐标 15 的角约 0.004743,高度最后一组约 0.003232。两组数字都很小,它们在短网格上几乎不提供相邻区分,却可能给更长距离提供不同的相位尺度。把更多维度分给某轴,得到的是更丰富的频谱,不是对该轴长度的直接承诺。
还要区分物理帧数与时间 RoPE 格点。假设 VAE 把若干帧压缩到一个 latent 时间格点,视频从 49 帧变成 97 帧,RoPE 的时间长度未必简单从 49 变到 97;VAE 的首帧保留或补帧规则甚至会让两个公式对不上。头维度预算必须在真正进入注意力的 token 网格上讨论。读实现时先打印 patchify 输出和 (T,H,W),再看时间频率有没有被拉伸。
帧率变化不等于时长外推。 同样是把原始帧数翻倍,可能是同一段动作以两倍帧率采样,也可能是原帧率下播放两倍时间。若 VAE 与 patchify 最终都把它们变成两倍的时间格点,整数时间 RoPE 看到的范围一样,却不能仅凭位置角判断“相邻格点代表多少秒”。前者主要考察更密的动作采样,后者还考察更长的主体与场景记忆;测试时间缩放前应固定并记录帧率、实际秒数、latent 时间压缩和条件时间戳。这是视频轴特有的语义问题,空间高宽轴没有对应的播放时钟。
另一类策略不缩坐标,而是逐轴更改频率基数 $\Theta_a$。若 $\Theta_a$ 变大,$i=0$ 的最高频 $\omega_{a,0}=1$ 完全不变,较低频平面转得更慢;于是近邻分辨率较容易保留,远距离相位覆盖可以加宽。它与 $p_a/s_a$ 把所有频率一起压低不同。NTK-aware、YaRN 等方法在语言长上下文中发展,迁移到视频时还要决定给哪个轴、哪些频段用、是否微调和怎样处理训练画幅。仅把 rope_theta 调大,不能替代逐轴分辨率训练或保证画质。
“频率变慢”也不等于“完全不损局部”。注意力打分汇总多个平面,改低频仍会改变其对近处和远处匹配的贡献。任何外推方法都必须用目标模型、目标画幅与目标时长做消融。
code/rope_3d_minimal.py 只依赖 NumPy。核心代码先给时间、高、宽各生成角度表,再广播到 (T,H,W),沿最后一维拼接成每个 token 的角度;rotate 把相邻两维作为一个二维平面旋转。它保留 float64 以让代数测试更容易观察,不模拟工业模型的 BF16 或 CUDA 性能。
dt, dh, dw = axis_dims(head_dim)
at = axis_angles(np.arange(frames), dt, scale=scales[0])[:, None, None, :]
ah = axis_angles(np.arange(height), dh, scale=scales[1])[None, :, None, :]
aw = axis_angles(np.arange(width), dw, scale=scales[2])[None, None, :, :]
angles = np.concatenate(
    [np.broadcast_to(a, (frames, height, width, d // 2))
     for a, d in zip((at, ah, aw), (dt, dh, dw))], axis=-1
).reshape(frames * height * width, head_dim // 2)
cos = np.repeat(np.cos(angles), 2, axis=-1)
sin = np.repeat(np.sin(angles), 2, axis=-1)
这里 angles 的最后一维只有 d/2 个旋转平面;repeat(...,2) 才让 cos/sin 与 d 维特征逐元素相乘。把代码复制到本地运行 python3 rope_3d_minimal.py,本次真实输出如下:
axis_dims= (16, 24, 24)
cache_shape= (24, 64) input_shape= (24, 64)
rotated_shape= (24, 64)
norm_error= 1.78e-15
same_offset_scores= 2.208374 2.208374 difference= 1.33e-15
vertical_neighbor_1d_offsets= 4 8
vertical_neighbor_1d_scores= 1.678217 3.749697
vertical_neighbor_3d_offsets= (0, 1, 0) (0, 1, 0)
vertical_neighbor_3d_scores= 0.419453 0.419453
height_phase_at_15_first_last= [15.        0.003232]
height_PI_x2_first_last= [7.5      0.001616]
time_phase_at_15_first_last= [15.        0.004743]
token_count_13x30x45= 17550
token_count_13x60x90= 70200
dense_attention_ratio= 16.0
naive_score_matrix_fp16_gib_per_head= 0.574 9.179
四条 vertical_neighbor_* 输出固定同一组随机 $q,k$ 与同一对上下相邻 token,只切换展平时的 W=4/8。1D 的 Δm 从 4 变 8,内积分数从 1.678217 变 3.749697;3D 的逐轴距离始终 (0,1,0),位置项分数都为 0.419453。1D 与 3D 的绝对分数本身不该互比:两套频率配置不同;这个小实验只比较各自规则在宽度变化前后是否稳定。模型实际改宽后 $q,k$ 也会变,所以它不是画质或整层注意力不变的证据。
cache_shape=(24,64) 来自 2×3×4=24 个视频格点。旋转前后范数误差接近浮点舍入,因为旋转矩阵保长度。高坐标 15 的最高频角为 15 弧度,插值后变成 7.5;高轴最慢一组角从 0.003232 变 0.001616。时间角仍是 15 和 0.004743,证明只改高轴没有动时间表。最慢高频与最慢时频数值不同,因为两轴拿到的维度数分别是 24 与 16,指数分母不同。
再看代码里一个表面上很普通的选择:scales 被明确写成 (time,height,width) 三元组,而不是一个全局的 scale=2。这个接口让实验可以只改一个轴,也强迫调用者记录每轴真实扩张比例。假如训练网格是 T0×H0×W0、目标网格是 T1×H1×W1,对格点数大于 1 的轴,端点对齐的起点应分别按 (T1-1)/(T0-1)、(H1-1)/(H0-1)、(W1-1)/(W0-1) 计算;只有一个格点的轴没有可缩放的坐标跨度,应单独保持在零点。但这些比例仍不能机械照搬:训练数据往往包含多个时长和长宽比,没有单一的 T0,H0,W0。若宽度原本就见过目标值,宽轴可以维持原坐标;若时间增长跨越训练分布,更慢的低频策略可能更值得先测试。参数名称应表达“坐标映射”,而不是含糊写成“画质增强”。
norm_error、same_offset_scores 和宽度变化前后的 3D 分数在脚本里都有断言;若配对、广播或相对位置性质被改坏,脚本会直接失败,而不是只打印一串看似正常的数字。断言检查的是代数不变量,仍不能判断位置映射对视频是否有用,真实效果还要在固定权重的 DiT 上测。
请注意:示例里的 13×30×45 是格点形状。不能仅凭像素分辨率就猜它。真实模型要逐层根据 VAE 的时空压缩、首帧特殊处理、patch size 和 padding 算出 (T,H,W);错一个维度,位置表和 token 顺序都会错位。
以 2026-09 核对的 CogVideo SAT 源码 Rotary3DPositionEmbeddingMixin 为例,类中 dim_t = hidden_size_head // 4、dim_h = dim_w = hidden_size_head // 8 * 3,每轴各自建立频率与格点,再广播、拼接、取 sin/cos。它在注意力函数中只旋转视频 query/key,先切出 text_length 个文本 token 原样放回;可选 rot_v 才旋转 value,默认并非必要。rope_T/H/W 从预计算的三维表里截取当前视频尺寸,排平为 (T*H*W,D)。这与最小代码的数组顺序一致,也便于逐轴检查实际相位。
一个容易踩的坑是:这个 SAT 类的构造函数虽然接收 height_interpolation、width_interpolation 和 time_interpolation 参数,在本次读取的 main 文件中,角度表仍直接由 torch.arange 计算,这些参数没有参与坐标缩放。因此不能因为配置里写了 height_interpolation=1.875,就声称该 SAT 旋转实现真的进行了高度插值。文章讨论的“逐轴插值”是可选的设计实验,不是这一段 CogVideo SAT 代码的实际行为。作者原论文采用扩表取前段,恰好与这里的原坐标逻辑相符。
Diffusers 的 get_3d_rotary_pos_embed 也有时间 1/4、空间各 3/8 的分配,但它提供 grid_type="linspace" 和 "slice" 两种格点构造。linspace 可把某个目标空间范围映射到当前高宽格点;slice 在最大表上用原索引再取当前尺寸。二者的差别首先是坐标选取,不是旋转公式变化。该函数在本次核对中返回 (cos,sin),供注意力处理器作用在 query/key 上。具体使用哪个 grid_type、裁剪坐标是什么,应沿管线调用栈核对,不能只看函数定义就给整个模型下结论。
写工业调用栈时建议按四个具体问题逐层追:输入是像素帧还是 VAE latent;patchify 后一条样本的 (T,H,W) 分别是多少;三轴坐标从零开始、按最大表切片还是重新映射到训练范围;cos/sin 最后究竟旋转的是视频 query/key、文本 token 是否另有位置处理。单独找到 get_3d_rotary_pos_embed 的名字,只能证明功能存在,不能证明这一模型版本已经启用它。CogVideoX 系列可能根据配置选择旋转位置或学习位置,不同 checkpoint 更不能一概而论。
维度排列也值得实际打印。本文的 rotate 假设相邻两维组成 (实部, 虚部),因此角表用 repeat_interleave(2) 形式复写到两维。若上游先把所有实部放前半、虚部放后半,旋转公式仍可成立,但 rotate_half 与 cos/sin 的广播顺序必须一起换。仅把缓存从另一仓库复制过来,形状同为 [N,D] 也可能在不报错的情况下给完全不同的旋转平面。检查一个位置 1、一个二维平面 (1,0) 的旋转结果应近似 (cos 1,sin 1),比只核对 shape 更可靠。
生产实现还会处理变长视频、文本与视频拼接、packing、缓存、设备和精度。最小脚本只面向一个规则视频网格;真实 batch 如果把不同视频压成一条序列,必须保存每段的起点与独立 (T,H,W),否则第二个视频的时间会错误地延续第一个视频的末帧。cos/sin 表可以复用,但格点顺序和真实 token 排列必须逐项对齐。很多“换分辨率立即崩”其实是这种形状或坐标实现错误,而非外推理论失败。
纯 3D RoPE 本身不引入新的可训练位置参数,换形状时也可以按轴计算新表;具体模型仍可能另外叠加可学习的位置向量。这个性质让多分辨率训练与不同长度输入更自然,但没有把注意力从二次复杂度变成线性。高、宽各两倍时,视频 token 四倍、稠密注意力项十六倍:示例从 13×30×45=17,550 个 token 增至 13×60×90=70,200 个 token,若天真地为单个头物化一张 FP16 分数矩阵,理论容量会从约 0.574 GiB 涨到 9.179 GiB,尚未计梯度、softmax 和其他头。FlashAttention 不必把整张矩阵常驻显存,所以这不是实际峰值预测;它仍准确反映稠密注意力的二次计算量。把空间 RoPE 频率调得再聪明也不会消除这笔账,仍需 VAE 压缩、稀疏或局部注意力、分块计算等手段。
外推的另一重代价是位置区分与训练分布之间的冲突。直接延长表,邻近 token 的相位关系不变,却把远端坐标送到没见过的位置;全部插值,把远端压回旧尺度,却弱化每一步的相位变化。轴越短、分到的旋转平面越少,可用的频率跨度通常越窄。CogVideoX 的时间 16 维并不意味着“时间必然先坏”或“空间必然先坏”:结果还取决于训练长度、VAE 时间压缩、运动跨度与内容建模。
分辨率外推尤其要保住物理尺度解释。同一人物在原图占 10 个 latent 格点,放大画幅后占 20 个,坐标间隔与模型学过的视觉尺度同时变了;只插值位置并不能把纹理、构图与物体大小的分布一起搬过去。长视频类似:更多帧要求模型记住人物、场景和动作因果,位置相位不是记忆网络。若输出失败,先分辨是表索引越界、token 排列错位、局部重复、全局模糊还是跨帧身份漂移,再决定该调位置、数据、注意力或去噪。
相同 token 数也不意味着相同空间外推。 假设训练格点为 (T,H,W)=(8,32,32):目标 (8,64,32) 与 (8,32,64) 都把视频 token 翻倍,但前者只扩高轴,后者只扩宽轴。在 3D RoPE 中,它们分别改变高段或宽段的最远相位;在展平 1D RoPE 中,改宽还会重新标定所有行间与帧间的序列距离。实验可以保持 token 数、权重、prompt 和种子一致,只互换扩张轴,再分别检查竖向重复、横向重复与主体比例。若两个结果不同,先核对训练画幅分布和 VAE/patchify,才讨论是否来自轴频率。
排查失败时可以先做一个不动权重的三步实验。第一步固定 VAE latent 与 patch token,只换位置表构造,在同一坐标对上比较 q·k;若结果突然变化,检查表索引、轴顺序或维度配对。第二步固定画幅和视频内容,单独改变时间格点长度,看主体漂移是否只在跨越训练时长后出现。第三步固定时间格点,单独变高、宽并分别观察全局构图和局部纹理;若高宽都扩大导致局部重复,不能直接断言是 rope_theta 错,还要看是否出现 token 数暴涨引发的注意力截断、分块边界或 VAE tiling 伪影。把这些变量一次全改掉,会失去定位能力。
若比较位置插值与直接外推,评分也至少拆成两类:近邻细节,例如边缘、纹理与细小物体是否保持;远距结构,例如人物是否只有一个、左右场景是否连贯、同一主体跨帧是否一致。CogVideoX 附录里“一张模糊的大画面”与“多个清楚的小画面”的差异正说明:一个单一的美学分数可能掩盖局部与全局朝相反方向变化。画质指标之外还要记录 token 长度、时空网格与推理显存,否则方法之间可能使用了不同计算预算。
这套分轴设计也不表达“这是第 1 帧”这类绝对锚点——它主要编码相对位移。首帧图像条件、相机轨迹和剪辑时间戳需要通过额外条件或掩码表达。多图参考、回放状态与不同视频段拼接时,不同段若都从 (0,0,0) 重启,还需要明确段 ID 或相机等身份信息,免得同坐标误当同内容。
更远一步,镜头绕场景移动后再次拍到同一处墙面,这处墙面的世界位置没变,屏幕上的 (h,w) 却可能不同;反过来,相同 (h,w) 也可能指向另一块墙面。视频 3D RoPE 的“3D”是时间加二维屏幕格点,不是场景的三维坐标。面向相机可控的视频 DiT,SCoPE 将相机视线作为另一种位置线索加入注意力,并保留原有 RoPE;这是研究者针对屏幕坐标局限提出的扩展,不是普通 3D RoPE 自动拥有的几何能力。
误解一:3D RoPE 就是把三个坐标加起来再做 1D RoPE。 若先算 $t+h+w$,(1,0,0) 与 (0,1,0) 就变成同一个位置值,时间变化和上下位移无法区分。正确做法是三段特征独立旋转,最后只在注意力内积里汇总贡献。
误解二:相对位置恒等式成立就证明任意分辨率都能生成。 恒等式对没见过的坐标同样成立;模型从未学过如何在新相位、更多 token 和新物体尺度上使用它。数学可计算性只保证不会因公式本身报错。
误解三:把所有坐标除以两倍没有副作用。 位置插值让新端点回到旧范围,却也让邻近格点的相位差减半,可能伤害局部细节。若目标只换高度,就不要无故压缩时间和宽度。
误解四:调大 rope_theta 等于 Position Interpolation。 更改基数主要影响较低频平面,最高频不动;位置除以缩放因子让所有频率一起慢下来。两者可能组合,作用机制不同。
误解五:CogVideoX 配置里有 height_interpolation 参数,就一定在使用插值。 本次读到的 SAT Rotary3DPositionEmbeddingMixin 接受该参数,却没有用它来计算 grid_h。要按真实执行路径确认;不同实现不能只凭参数名互相代替。
误解六:空间轴拿了 75% 维度,所以换分辨率导致的所有错误都来自空间 RoPE。 维度比例只是一种频率预算,无法排除注意力规模、训练分辨率、VAE 压缩和内容尺度的影响。看输出症状、做逐项消融,才有因果结论。
先运行 python3 rope_3d_minimal.py,看 vertical_neighbor_* 四行。把 lower=(0,1,0) 改成 (1,0,0),即从“下一行”改为“下一帧”:3D 位移由 (0,1,0) 改成 (1,0,0),1D 位移则由 W 改成 H×W。再单独改网格宽度,检查三轴版的下一帧相位是否仍只由时间坐标决定。
调用 rope_3d_cache(2,6,4,64,scales=(1,2,1)) 与 scales=(2,1,1),分别只压缩高、时间坐标;检查同一高坐标的高段相位和同一时间坐标的时间段相位。最后把网格 2×3×4 改成 2×6×4:缓存行数应从 24 变 48,列数仍为 64,只有高坐标的取值范围增加。
如果要评估生成模型的真实外推质量,不能只跑这段 NumPy 脚本。固定模型权重、prompt、种子与去噪设置,比较原训练画幅、直接扩表、逐轴插值和不同频段缩放;同时记录局部纹理、重复图案、全局构图、跨帧主体一致性与实际显存/延迟。只有这样才能分清“位置编码问题”与“高分辨率本来就需要新训练”的差异。
继续向下可以看视频 DiT 的稀疏注意力、3D VAE/patchify 和长视频状态记忆:位置只负责“在哪里”,这几项决定“看哪些 token、用什么尺度和怎样记住内容”。
本篇用到的具体外部依据以 CogVideoX 论文、CogVideo SAT 源码 与 Diffusers 位置编码源码 为准;它们分别支持论文中的训练取舍与两种工程实现,文中的 NumPy 输出仅证明所写公式和示例代码一致。
09 节用到的脚本全文如下(rope_3d_minimal.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""NumPy-only 3D RoPE and per-axis position extrapolation demo."""

import numpy as np


def axis_dims(head_dim):
    """CogVideoX's time/height/width split for a head divisible by sixteen (all three axis sizes must be even)."""
    assert head_dim > 0 and head_dim % 16 == 0
    dims = (head_dim // 4, head_dim * 3 // 8, head_dim * 3 // 8)
    assert all(d % 2 == 0 for d in dims)
    return dims


def axis_angles(positions, dim, base=10000.0, scale=1.0):
    """Angles [positions, dim/2]; scale>1 compresses this axis only."""
    assert dim % 2 == 0 and scale > 0
    inv_freq = base ** (-np.arange(0, dim, 2, dtype=np.float64) / dim)
    return np.asarray(positions, dtype=np.float64)[:, None] * inv_freq[None, :] / scale


def rope_3d_cache(frames, height, width, head_dim=64, scales=(1, 1, 1)):
    """Return interleaved cos/sin, one row per (t,h,w) token."""
    assert frames > 0 and height > 0 and width > 0
    assert len(scales) == 3 and all(scale > 0 for scale in scales)
    dt, dh, dw = axis_dims(head_dim)
    at = axis_angles(np.arange(frames), dt, scale=scales[0])[:, None, None, :]
    ah = axis_angles(np.arange(height), dh, scale=scales[1])[None, :, None, :]
    aw = axis_angles(np.arange(width), dw, scale=scales[2])[None, None, :, :]
    shape = (frames, height, width)
    angles = np.concatenate(
        [np.broadcast_to(a, shape + (d // 2,)) for a, d in zip((at, ah, aw), (dt, dh, dw))],
        axis=-1,
    ).reshape(frames * height * width, head_dim // 2)
    return np.repeat(np.cos(angles), 2, axis=-1), np.repeat(np.sin(angles), 2, axis=-1)


def rotate(x, cos, sin):
    """Rotate adjacent dimension pairs; x and cache both [tokens, head_dim]."""
    paired = x.reshape(x.shape[0], -1, 2)
    quarter_turn = np.stack((-paired[..., 1], paired[..., 0]), axis=-1).reshape(x.shape)
    return x * cos + quarter_turn * sin


def score_for_positions(q, k, pos_q, pos_k, scales=(1, 1, 1)):
    """A single dot product without building an attention matrix."""
    dims = axis_dims(q.size)
    out_q, out_k = [], []
    start = 0
    for axis, dim in enumerate(dims):
        aq = axis_angles([pos_q[axis]], dim, scale=scales[axis])
        ak = axis_angles([pos_k[axis]], dim, scale=scales[axis])
        cq, sq = np.repeat(np.cos(aq), 2, axis=-1), np.repeat(np.sin(aq), 2, axis=-1)
        ck, sk = np.repeat(np.cos(ak), 2, axis=-1), np.repeat(np.sin(ak), 2, axis=-1)
        out_q.append(rotate(q[start:start + dim][None], cq, sq)[0])
        out_k.append(rotate(k[start:start + dim][None], ck, sk)[0])
        start += dim
    return np.dot(np.concatenate(out_q), np.concatenate(out_k))


def flatten_index(pos, height, width):
    """The row-major 1D index of a video token at (time, height, width)."""
    t, h, w = pos
    return t * height * width + h * width + w


def score_for_flattened_positions(q, k, pos_q, pos_k, height, width):
    """Baseline: one 1D RoPE angle table for all head channels."""
    mq = flatten_index(pos_q, height, width)
    mk = flatten_index(pos_k, height, width)
    aq = axis_angles([mq], q.size)
    ak = axis_angles([mk], k.size)
    cq, sq = np.repeat(np.cos(aq), 2, axis=-1), np.repeat(np.sin(aq), 2, axis=-1)
    ck, sk = np.repeat(np.cos(ak), 2, axis=-1), np.repeat(np.sin(ak), 2, axis=-1)
    return float(np.dot(rotate(q[None], cq, sq)[0], rotate(k[None], ck, sk)[0]))


def naive_score_matrix_gib(token_count, bytes_per_element=2):
    """GiB for one materialized dense attention-score matrix of one head."""
    return token_count * token_count * bytes_per_element / 2**30


if __name__ == "__main__":
    np.set_printoptions(precision=6, suppress=True)
    dims = axis_dims(64)
    cos, sin = rope_3d_cache(2, 3, 4, 64)
    rng = np.random.default_rng(7)
    tokens = rng.normal(size=cos.shape)
    rotated = rotate(tokens, cos, sin)
    norm_error = np.max(np.abs(np.linalg.norm(tokens, axis=1) - np.linalg.norm(rotated, axis=1)))
    print("axis_dims=", dims)
    print("cache_shape=", cos.shape, "input_shape=", tokens.shape)
    print("rotated_shape=", rotated.shape)
    print("norm_error=", f"{norm_error:.2e}")

    q, k = rng.normal(size=64), rng.normal(size=64)
    a = score_for_positions(q, k, (0, 1, 2), (1, 2, 3))
    b = score_for_positions(q, k, (5, 6, 7), (6, 7, 8))
    print("same_offset_scores=", f"{a:.6f}", f"{b:.6f}", "difference=", f"{abs(a-b):.2e}")

    upper, lower = (0, 0, 0), (0, 1, 0)
    flat4 = flatten_index(lower, 2, 4) - flatten_index(upper, 2, 4)
    flat8 = flatten_index(lower, 2, 8) - flatten_index(upper, 2, 8)
    one_d4 = score_for_flattened_positions(q, k, upper, lower, 2, 4)
    one_d8 = score_for_flattened_positions(q, k, upper, lower, 2, 8)
    three_d4 = score_for_positions(q, k, upper, lower)
    three_d8 = score_for_positions(q, k, upper, lower)
    three_d_offset = tuple(b - a for a, b in zip(upper, lower))
    print("vertical_neighbor_1d_offsets=", flat4, flat8)
    print("vertical_neighbor_1d_scores=", f"{one_d4:.6f}", f"{one_d8:.6f}")
    print("vertical_neighbor_3d_offsets=", three_d_offset, three_d_offset)
    print("vertical_neighbor_3d_scores=", f"{three_d4:.6f}", f"{three_d8:.6f}")

    # These are algebraic invariants, not video-quality tests. Keeping them as
    # assertions turns the example into a small regression test for pairing,
    # broadcasting and relative-position behavior.
    assert norm_error < 1e-12
    assert abs(a - b) < 1e-12
    assert abs(three_d4 - three_d8) < 1e-12
    assert not np.isclose(one_d4, one_d8)

    raw = axis_angles([15], dims[1])[0]
    pi = axis_angles([15], dims[1], scale=2)[0]
    print("height_phase_at_15_first_last=", np.round(raw[[0, -1]], 6))
    print("height_PI_x2_first_last=", np.round(pi[[0, -1]], 6))
    print("time_phase_at_15_first_last=", np.round(axis_angles([15], dims[0])[0][[0, -1]], 6))
    small_tokens = 13 * 30 * 45
    large_tokens = 13 * 60 * 90
    print("token_count_13x30x45=", small_tokens)
    print("token_count_13x60x90=", large_tokens)
    print("dense_attention_ratio=", (large_tokens / small_tokens) ** 2)
    print(
        "naive_score_matrix_fp16_gib_per_head=",
        f"{naive_score_matrix_gib(small_tokens):.3f}",
        f"{naive_score_matrix_gib(large_tokens):.3f}",
)"""Generate 3D RoPE figures. Requires NumPy, Matplotlib and Pillow."""
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
from PIL import Image, ImageDraw, ImageFont
from rope_3d_minimal import axis_angles, axis_dims
OUT = Path(__file__).resolve().parents[1] / "figures"
OUT.mkdir(exist_ok=True)
def _chinese_font(size):
for path in (
"/System/Library/Fonts/Hiragino Sans GB.ttc",
"/System/Library/Fonts/PingFang.ttc",
"/usr/share/fonts/truetype/noto/NotoSansCJK-Regular.ttc",
):
try:
return ImageFont.truetype(path, size)
except OSError:
pass
raise RuntimeError("请安装中文字体后再生成 1D/3D 对照图")
def one_d_vs_three_d():
"""Show the same vertical neighbor under two video widths."""
image = Image.new("RGB", (1800, 950), "#f7f9fe")
draw = ImageDraw.Draw(image)
ink, muted = "#1e293b", "#475569"
draw.text((80, 50), "同一对上下相邻的 token,换宽度会怎样?", font=_chinese_font(68), fill=ink)
draw.text((82, 150), "A=(0,0,0) → B=(0,1,0);只改变视频格点宽度 W", font=_chinese_font(42), fill=muted)
cards = (
(70, 260, 865, 790, "#e8efff", "#1d4ed8", "1D RoPE:一个序列距离", "W=4 → Δm=4", "W=8 → Δm=8", "上下相邻仍是 1 格,但旋转相位变了"),
(935, 260, 1730, 790, "#e3f7f2", "#047857", "3D RoPE:三个轴分别计数", "W=4 → (0,1,0)", "W=8 → (0,1,0)", "高轴始终转 1 格,时间和宽轴不动"),
)
for x0, y0, x1, y1, bg, accent, title, first, second, note in cards:
draw.rounded_rectangle((x0, y0, x1, y1), radius=38, fill=bg)
draw.rectangle((x0 + 38, y0 + 48, x0 + 50, y0 + 130), fill=accent)
draw.text((x0 + 77, y0 + 51), title, font=_chinese_font(51), fill=ink)
draw.text((x0 + 75, y0 + 210), first, font=_chinese_font(68), fill=accent)
draw.text((x0 + 75, y0 + 322), second, font=_chinese_font(68), fill=accent)
draw.text((x0 + 75, y0 + 435), note, font=_chinese_font(35), fill=muted)
draw.text((80, 844), "旋转和相对位置性质相同;变化的是坐标系与每轴的特征维度。", font=_chinese_font(42), fill=ink)
image.save(OUT / "one_d_vs_three_d.png", optimize=True)
def axis_budget():
dims = axis_dims(64)
fig, ax = plt.subplots(figsize=(9, 2.8))
colors = ["#1d4ed8", "#0d9488", "#ea580c"]
start = 0
for name, dim, color in zip(("Time 25%", "Height 37.5%", "Width 37.5%"), dims, colors):
ax.barh([0], [dim], left=start, color=color, height=0.55)
ax.text(start + dim / 2, 0, f"{name}\n{dim} dims", ha="center", va="center", color="white", weight="bold")
start += dim
ax.set_xlim(0, 64)
ax.set_ylim(-0.55, 0.55)
ax.set_xlabel("Head channels (64 total)")
ax.set_yticks([])
ax.set_title("CogVideoX 3D RoPE: independent rotary planes per axis")
fig.tight_layout()
fig.savefig(OUT / "axis_budget.png", dpi=180)
plt.close(fig)
def phase_tradeoff():
dim_h = axis_dims(64)[1]
pos = np.arange(32)
original = axis_angles(pos, dim_h)
compressed = axis_angles(pos, dim_h, scale=2)
fig, axes = plt.subplots(1, 2, figsize=(9, 3.5), sharey=True)
for ax, values, title in zip(axes, (original, compressed), ("Raw coordinates", "Height PI: positions / 2")):
ax.plot(pos, np.cos(values[:, 0]), color="#ea580c", linewidth=2, label="highest frequency")
ax.plot(pos, np.cos(values[:, -1]), color="#1d4ed8", linewidth=2, label="lowest frequency")
ax.set_title(title)
ax.set_xlabel("Height-token index")
ax.grid(alpha=0.18)
axes[0].set_ylabel("cos(angle)")
axes[1].legend(frameon=False, loc="lower right")
fig.suptitle("Interpolation halves phase change on this axis at every frequency")
fig.tight_layout()
fig.savefig(OUT / "phase_tradeoff.png", dpi=180)
plt.close(fig)
if __name__ == "__main__":
one_d_vs_three_d()
axis_budget()
phase_tradeoff()
for name in ("one_d_vs_three_d.png", "axis_budget.png", "phase_tradeoff.png"):
print(OUT / name)更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注





评论 (0)