今日 AIGC 论文速览
今日共 10 篇 · 全模态基座与语音智能体 2 篇 · 视频编辑与生成智能体 2 篇 · 生成推理加速与量化 2 篇 · 视觉Tokenizer与音视频生成 2 篇 · 奖励模型与生成安全评测 2 篇
重点论文标题列表
Qwen3.8-Omni (Qwen Team, Alibaba Group):原生全模态智能体,百万上下文VideoX-Qwen (Nanjing University):120万对指令视频编辑数据QuantWM (Harbin Institute of Technology (Shenzhen)):2比特KV量化压住时序闪烁Flash-dLLM (VILA Lab, MBZUAI):扩散LLM提速五倍且不伤精度VideoGen-Agent (Princeton University):RL教会智能体用工具做视频
今日论文速览
1. Qwen3.8-Omni:原生全模态智能体,百万上下文
Qwen3.8-Omni: Towards Native Omni-Modal Agents | Qwen Team, Alibaba Group | arXiv:2609.25611
关键词 :全模态智能体,稀疏MoE,百万上下文,视频剪辑,插件框架
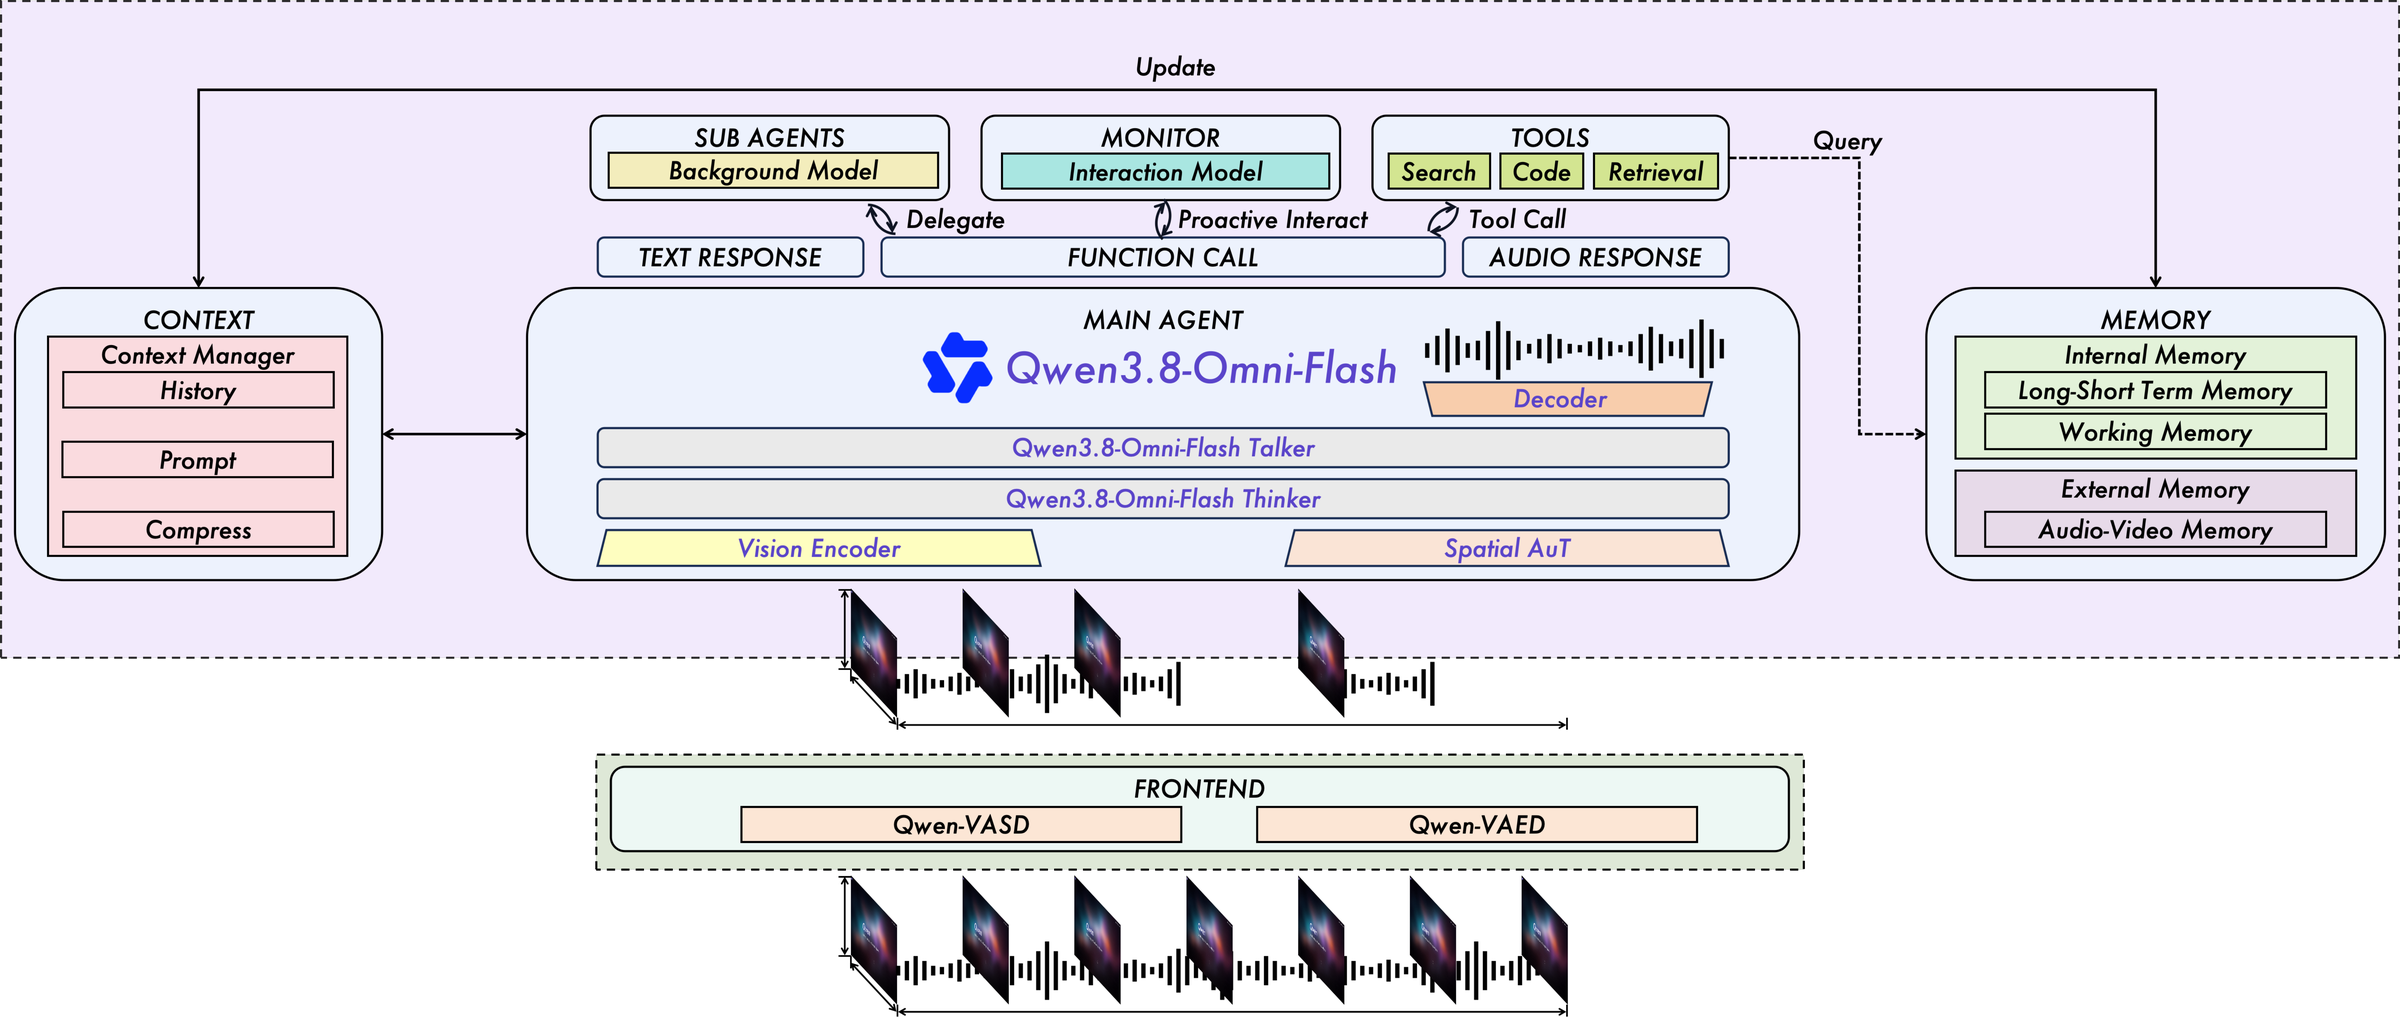
前序问题 :全模态模型此前主要强调感知和交互,真正的长程智能体任务——调工具、跑多步、把一段素材剪辑成片——要靠外挂 harness 拼,而现有 agent harness 对音频和视频没有原生支持。缺一个在多模态上原生 co-training、又不丢文本能力的底座。本文贡献 :发布 Qwen3.8-Omni-Flash:Thinker 继承 Qwen3.8-Next 的稀疏 MoE 骨干(GDN 与交错注意力混合),上下文扩到 100 万 token;原生多模态 co-training 把文本侧的智能体能力迁移到音视频任务,再经多教师蒸馏合并领域专精策略;配套开源 Qwen-MM-Plugins 插件框架与 Qwen-Live-Harness 实时交互框架。
Qwen3.8-Omni-Flash is a unified end-to-end model capable of processing multiple modalities
实验效果 :WildClawBench-MM 从上代 34.5 涨到 71.0(+36.5)、AgenticVBench 14.5→36.8、OmniGAIA 57.2→74.0;Video-MME-v2 47.9→65.0。开智能体模式后 LVOmniBench 63.3→73.6,OmniVideoBench 单次 query 消耗 token 从 14.6 万降到 7.9 万(约 -45.7%)。
The overview of Qwen3.8-Omni-Flash-Realtime and Qwen-Live-Harness
批判点评 :摘要口气很大,但表格里对手没输干净:Gemini 3.8 Flash 在三个视频推理基准的静态设置上全面更高,开智能体后 OmniVideoBench(70.1 vs 67.8)和 Video-MME-v2 仍被压着;teaser 图的 OmniCap-IF 一栏 Flash 拿 20.2,落在上代 Plus 的 28.3 和 Muse Spark 1.2 的 26.8 之后。所谓「领先」主要立在自己参与的新评测上。
2. VideoX-Qwen:120万对指令视频编辑数据
VideoX-Qwen: Data-Centric Instruction-Based Video Editing | Nanjing University;Jiutian Research | arXiv:2609.26015
关键词 :指令视频编辑,数据合成,Qwen3-VL,Wan,成对监督
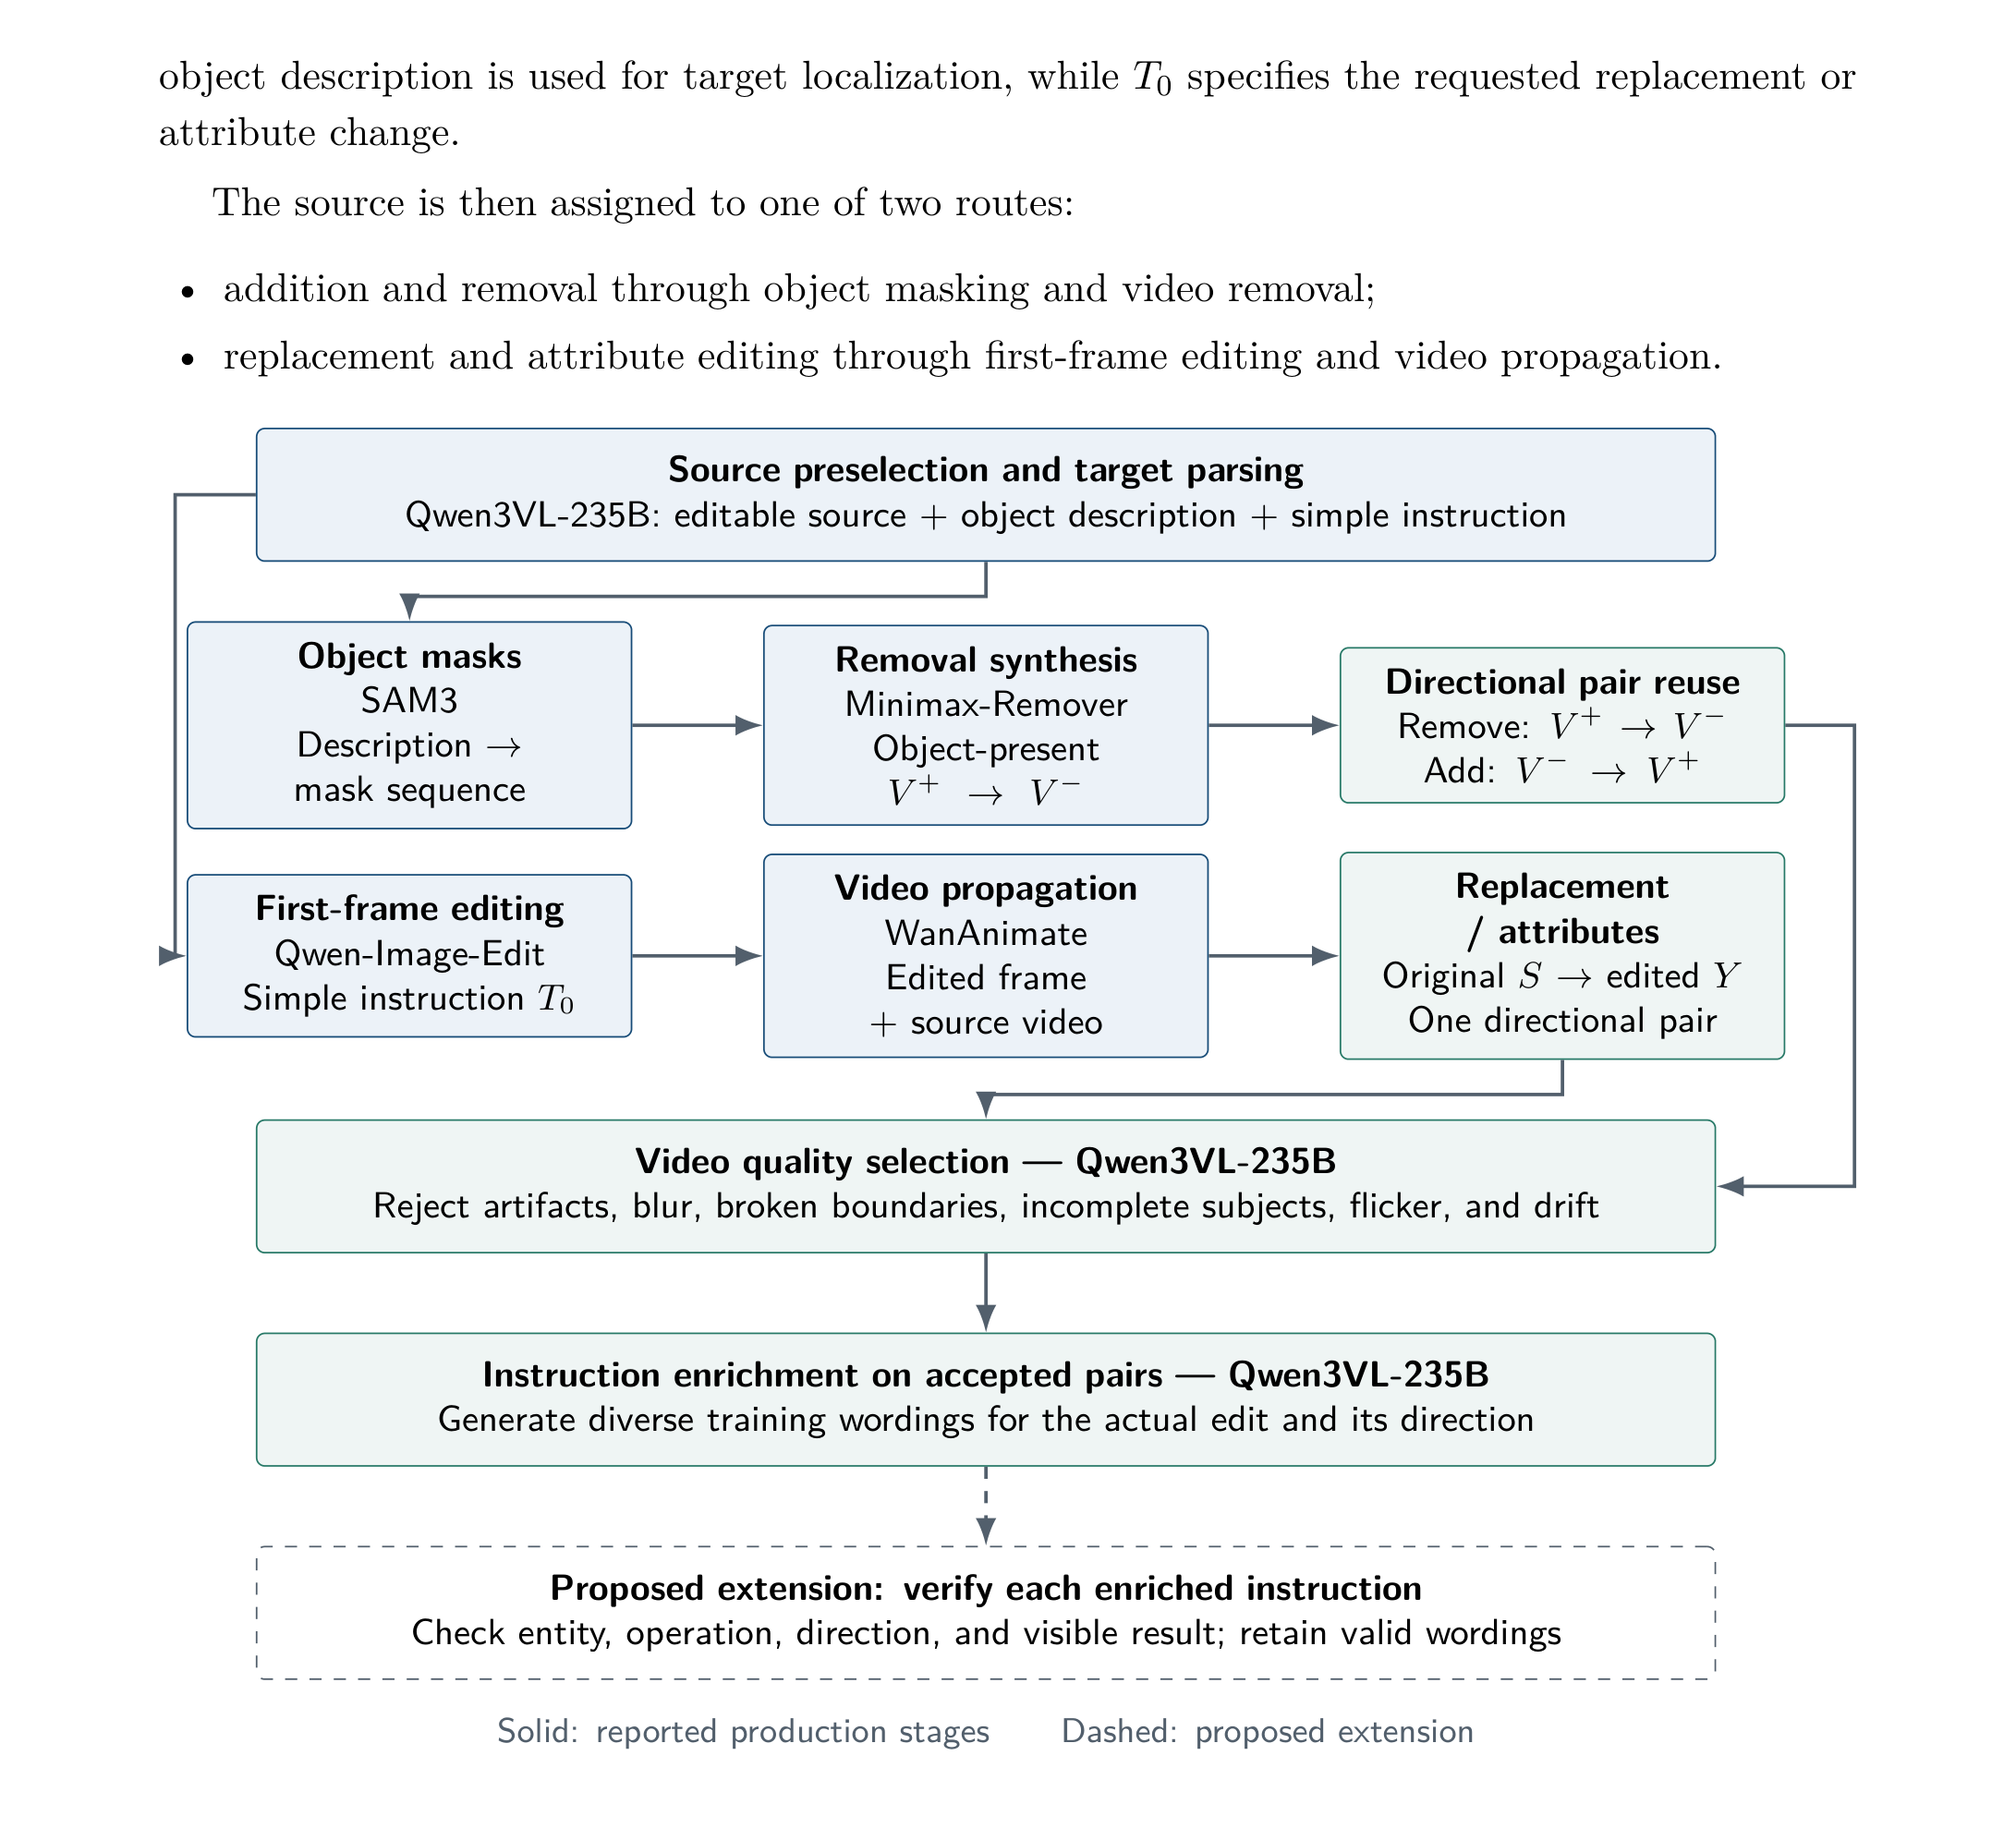
前序问题 :通用视频编辑缺的不是模型而是监督:编辑要在执行指令的同时保住无关主体、场景结构和时序连续性,而成对(源视频、指令、目标视频)数据的规模和任务覆盖都远远不够,指令视频编辑长期落后于图像编辑。本文贡献 :一条可扩产的数据流水线:Qwen3-VL-235B 做源视频筛选与目标解析,加/删走 SAM3 加 Minimax-Remover,替换/属性走 Qwen-Image-Edit 首帧编辑加 WanAnimate 传播,自动通过率 89%,产出 120 万条方向性编辑对(每组任务超 40 万条)。模型侧统一 Qwen-Wan 编辑器:多模态语义条件加稠密源视频 latent 引导,图像-视频三阶段渐进训练。
Paired-video construction pipeline
实验效果 :100 例对比 UniVideo 和 Kling O1:11 项指标里 9 项均值最优,覆盖指令遵循、编辑质量、内容保持、结构与感知相似度和视频分布质量。
Qualitative comparisons on compound and attribute editing
批判点评 :「9/11 最优」的另一面是 11 项里输了 2 项,且对比规模只有 100 例;加/删两条数据路线直接复用 Minimax-Remover 和 WanAnimate,编辑对质量上限被这些现成生成器封顶。论文把「逐条校验富化后的指令」画成 proposed extension(虚线框),等于承认 120 万对里指令与实际编辑的一致性还没有被逐一验证。
3. QuantWM:2比特KV量化压住时序闪烁
QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for World Models and Video Generation | Harbin Institute of Technology (Shenzhen);National University of Singapore | arXiv:2609.26425
关键词 :KV cache量化,视频生成加速,世界模型,注意力补偿,训练无关
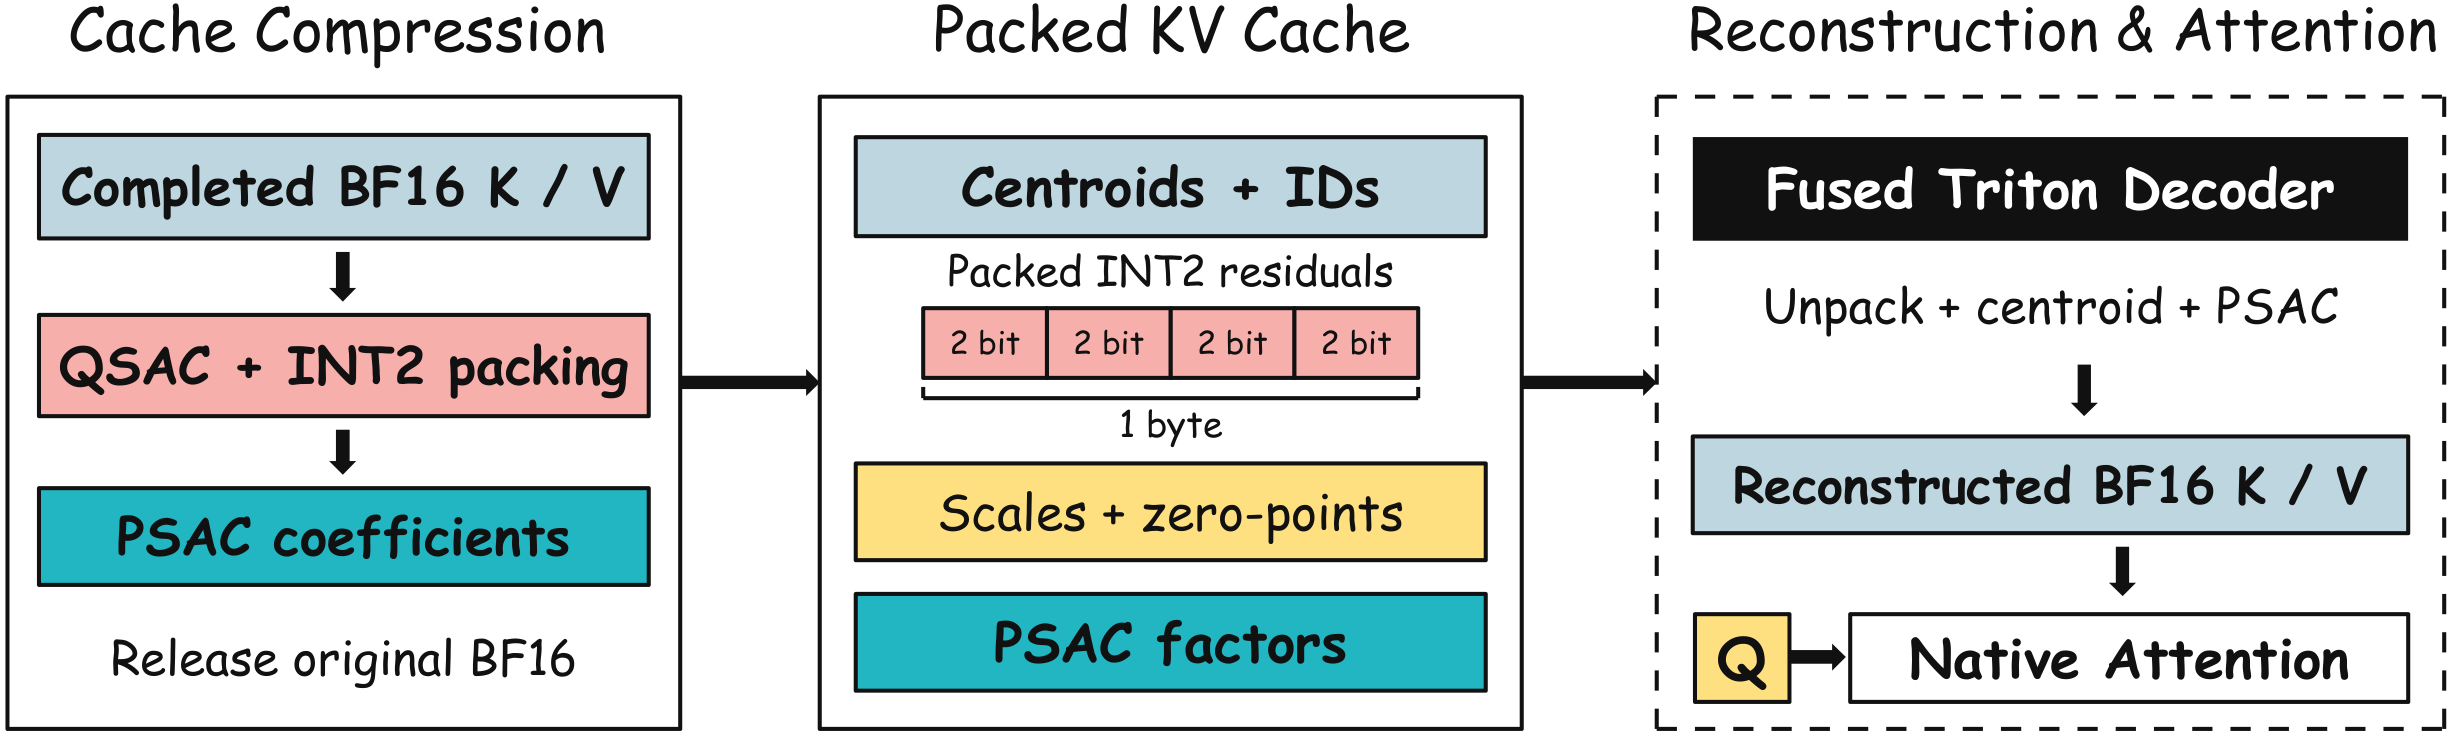
前序问题 :视频生成和世界模型的 KV cache 是部署瓶颈,已有 2-bit 量化方法在 VBench 这类指标上「几乎无损」,但作者实测发现:指标没掉,画面却在闪——逐帧指标天生看不见时序问题。本文贡献 :训练无关、严格因果的 2-bit KV 量化框架。诊断先行:Key 的量化重建误差比 Value 小,输出退化却更大,因为小扰动就能改变 QK^T 注意力 logits、挪走 Query 选中的时序-空间 token。对症两招:QSAC 聚类联合历史 Query 敏感度与残差范围选 INT2 友好的 Key 质心;PSAC 用低秩投影沿 Query 主子空间补偿残余 Key 误差。
Overview of QuantWM's inference system
实验效果 :Causal-Forcing、LingBot-World-v2、HY-World 1.5、Matrix-Game-2、Longcat-Video 五个底模上,KV cache 最高压缩 6.20×,图像与视频质量指标全面超过现有 2-bit 方法,额外开销有限,且保持严格因果可流式推理。
Visual comparison of BF16, K16V2, K2V16 and K2V2 on world models
批判点评 :这篇最值钱的是诊断而不是方法:它解释了为什么「VBench 几乎无损」的结论靠不住——逐帧指标对时序闪烁盲。但时序改善的验收仍以看图为主,论文没给出时序稳定性的量化指标;6.20× 的压缩上限是在 93 帧生成这一档测的,更长序列的收益未报告。
4. Flash-dLLM:扩散LLM提速五倍且不伤精度
Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs | VILA Lab, MBZUAI | arXiv:2609.26796
关键词 :扩散语言模型,KV cache,并行解码,Triton,推理加速
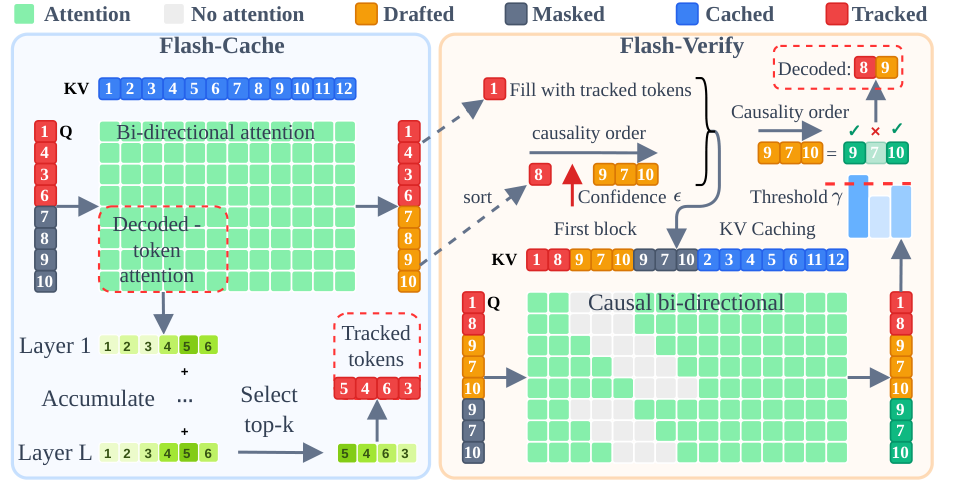
前序问题 :扩散 LLM 靠并行去噪生成文本,但双向注意力让自回归那套 KV cache 直接失效;已有加速工作把 KV cache 和并行解码分开研究,两者合用时 GPU 显存 I/O 反而成了主要瓶颈。本文贡献 :训练无关两件套。Flash-Cache:把 QKV 投影、RoPE、cache 写入、注意力计算融进一个 I/O 感知的融合 Triton 核,砍掉冗余访存;Flash-Verify:让 dLLM 自己既当 drafter 又当 verifier 做草稿-验证式并行解码,不挂辅助模型。
Overview of Flash-dLLM
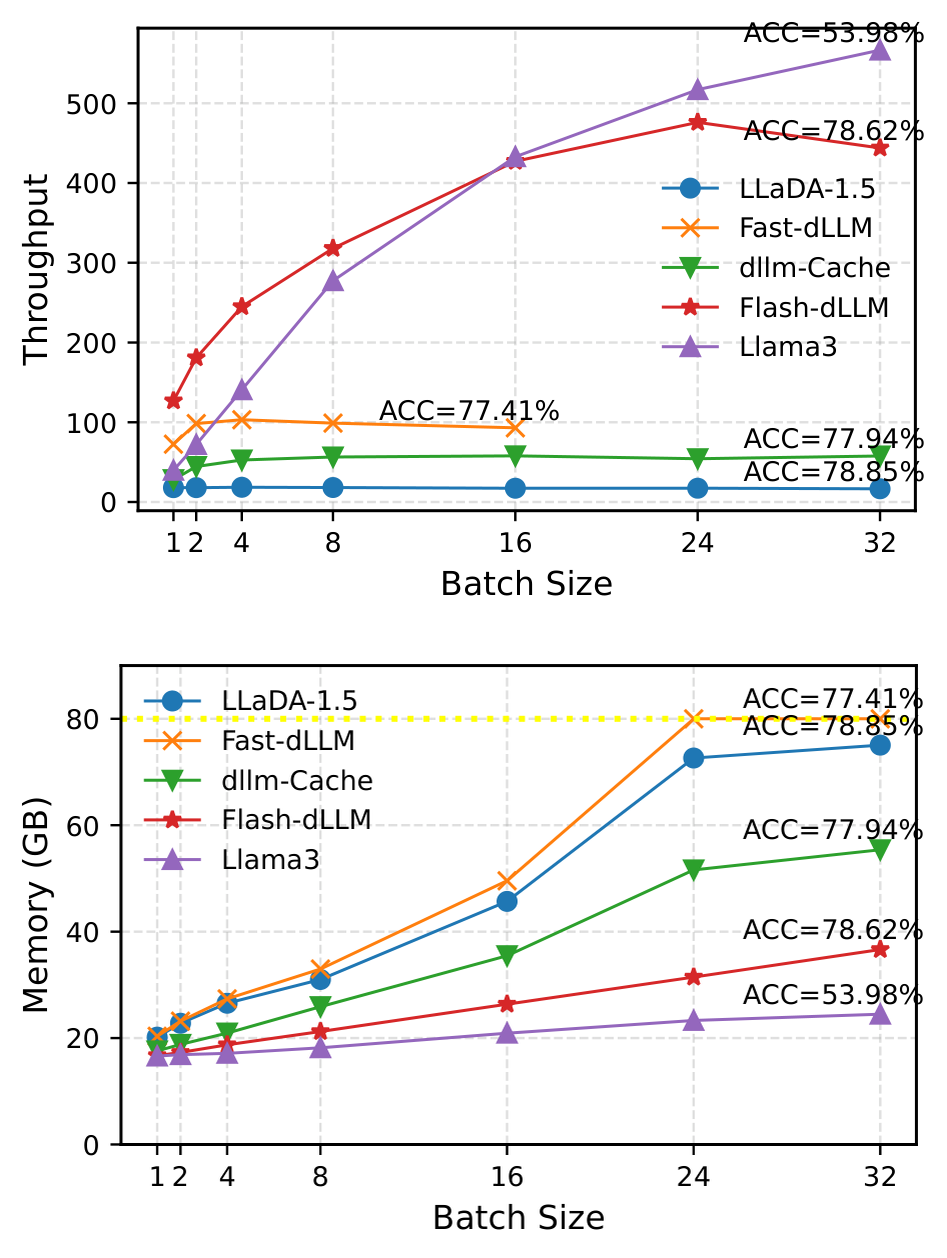
实验效果 :LLaDA-1.5 上对此前最强的 Elastic-Cache 在 GSM8K/HumanEval 分别提速 5.1 倍和 11.0 倍;Flash-Cache 加 Flash-Verify 达到精度 83.02%、吞吐 210.6 tokens/s(Elastic-Cache 为 82.79%、41.7);batch 16 显存约 26GB,对照 Fast-dLLM 的 50GB 降约 48%,后者在 batch 24 直接 OOM。
Throughput and peak memory versus batch size on GSM8K
批判点评 :赢面都在 dLLM 阵营内部:可扩展性图里自回归的 Llama3 在 batch 32 的吞吐仍高于 Flash-dLLM,「扩散 LLM 加速后追平 AR」还没有发生。精度与吞吐是硬权衡(80.2% 到 83.2% 对应 278 降到 186 tokens/s),宣传里 81 倍是对无 cache 基线的倍数,直接引用容易被误读成对 SOTA 的提速。
5. VideoGen-Agent:RL教会智能体用工具做视频
VideoGen-Agent: Reinforcing Video Generation Agents | Princeton University;Stanford University;UC Davis;MMLab, CUHK;BenchFlow;GWU | arXiv:2609.24997
关键词 :生成智能体,强化学习,工具调用,视频生成,VABench
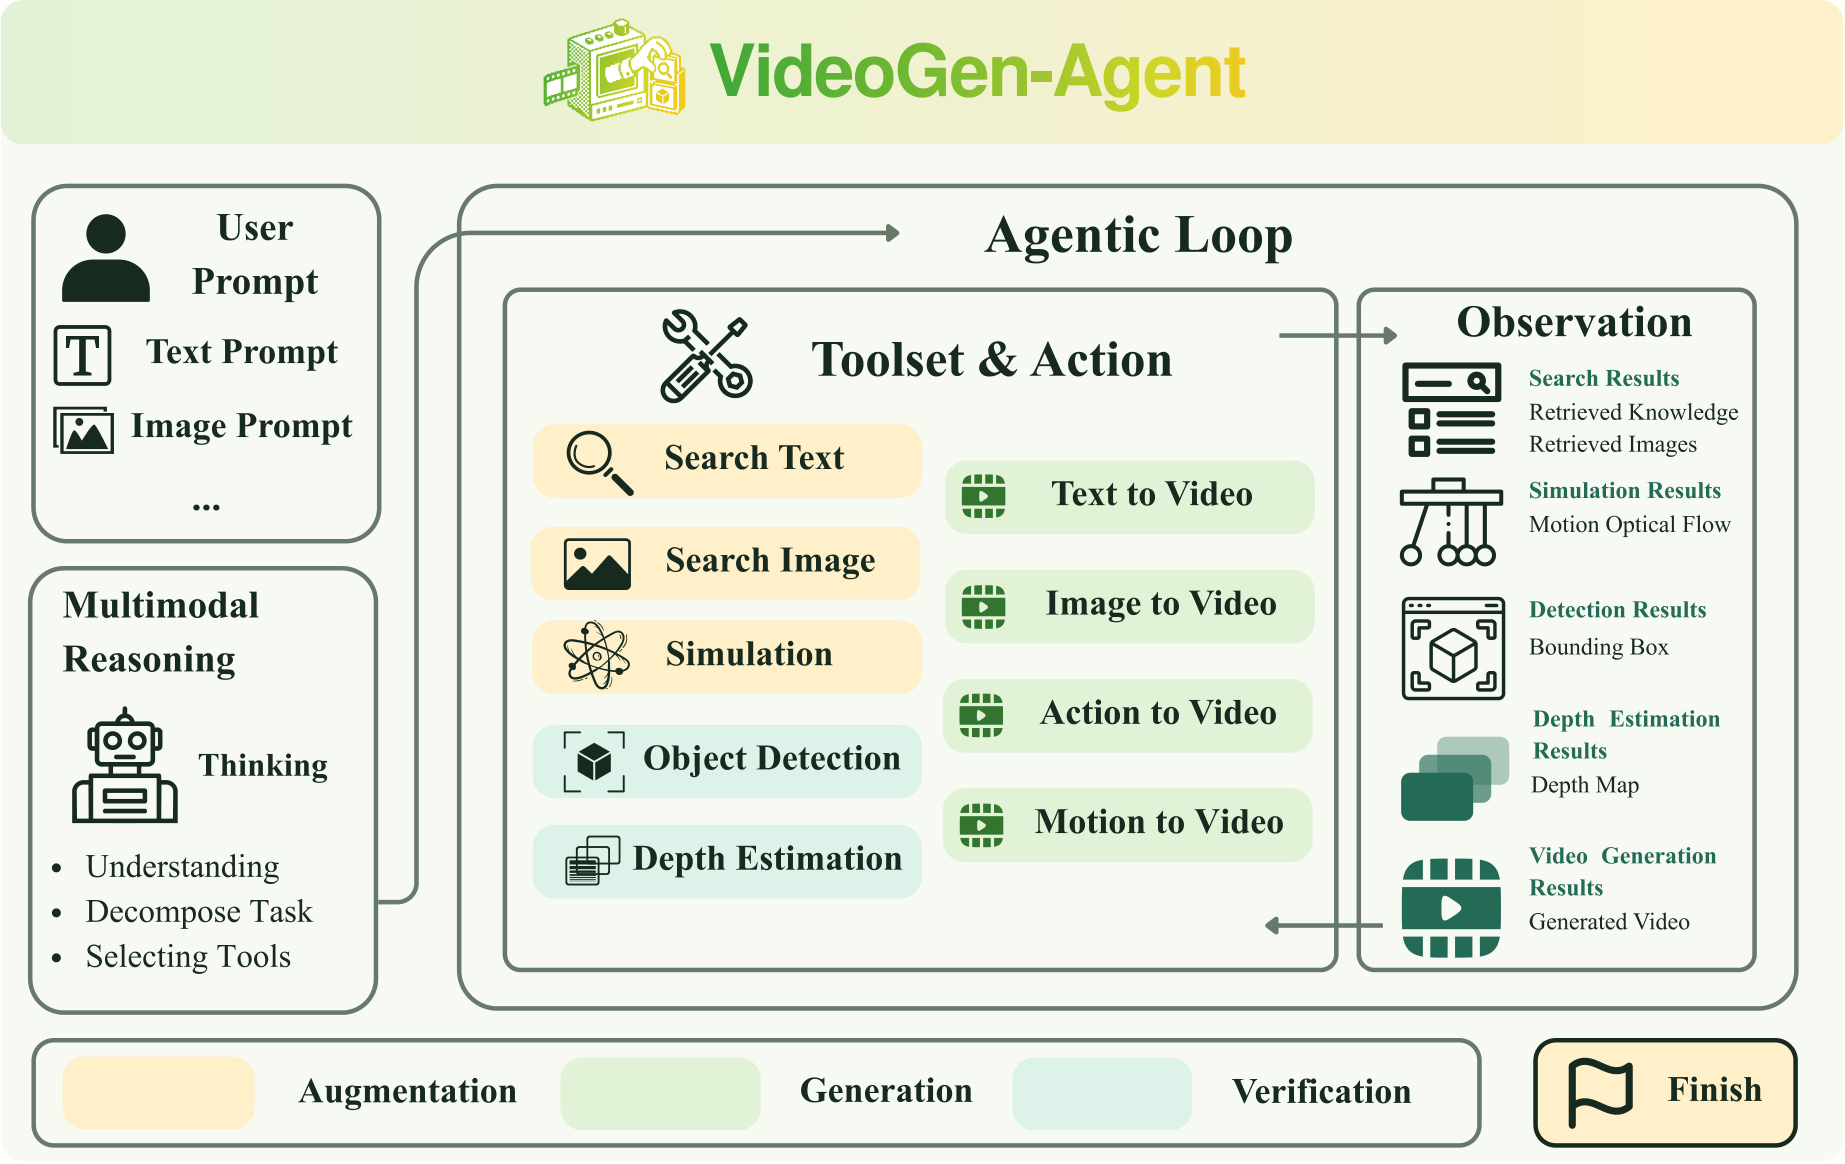
前序问题 :视频生成模型面对需要专业知识、特定身份、物理一致或时序事件的 prompt 经常直接翻车:太极招式做不对、指定角色画不像、物理参数乱来。单靠扩大底模收益有限,缺一个会检索、仿真、检测来补信息的生成智能体。本文贡献 :六类任务上训一个共享策略:先在教师轨迹上 SFT 建立工具使用习惯(检索文本/图像、仿真、目标检测、深度估计等),再用类别感知混合奖励(工具调用合法性、任务适配度、视频质量)做 RL。配套 VABench:600 条 held-out prompt,覆盖程序知识、单/多实体身份、物理一致、场景合成、多镜头时序。
Overview of VideoGen-Agent
实验效果 :VABench 上从底模 56.5 提到 75.6(+19.1 分);把生成工具换成更强的 Seedance 2.0 后,不重训智能体就到 86.1;人评 84.3% 偏好升级配置而非最强独立基线。
Qualitative comparison on Procedural Knowledge generation
批判点评 :86.1 这档数字藏着归因问题:从 75.6 到 86.1 的增量完全来自换生成工具,智能体一行代码没动——agent 框架的收益上限被底模和工具质量强绑定,这一段「白捡的分」其实是底模的分。混合奖励里「视频质量」一项依赖 VLM 裁判打分,裁判偏差会直接写进策略,论文未讨论防 reward hacking 的机制。
6. Vorch-Human:一个模型统一说话人与歌声视频
Vorch-Human: Unified Multi-Task Human-Centric Generation via Long-Horizon Continuation | Vorch Team;Harbin Institute of Technology, Shenzhen;Tongji University | arXiv:2609.26117
关键词 :音视频统一生成,数字人,扩散transformer,长视频,身份保持
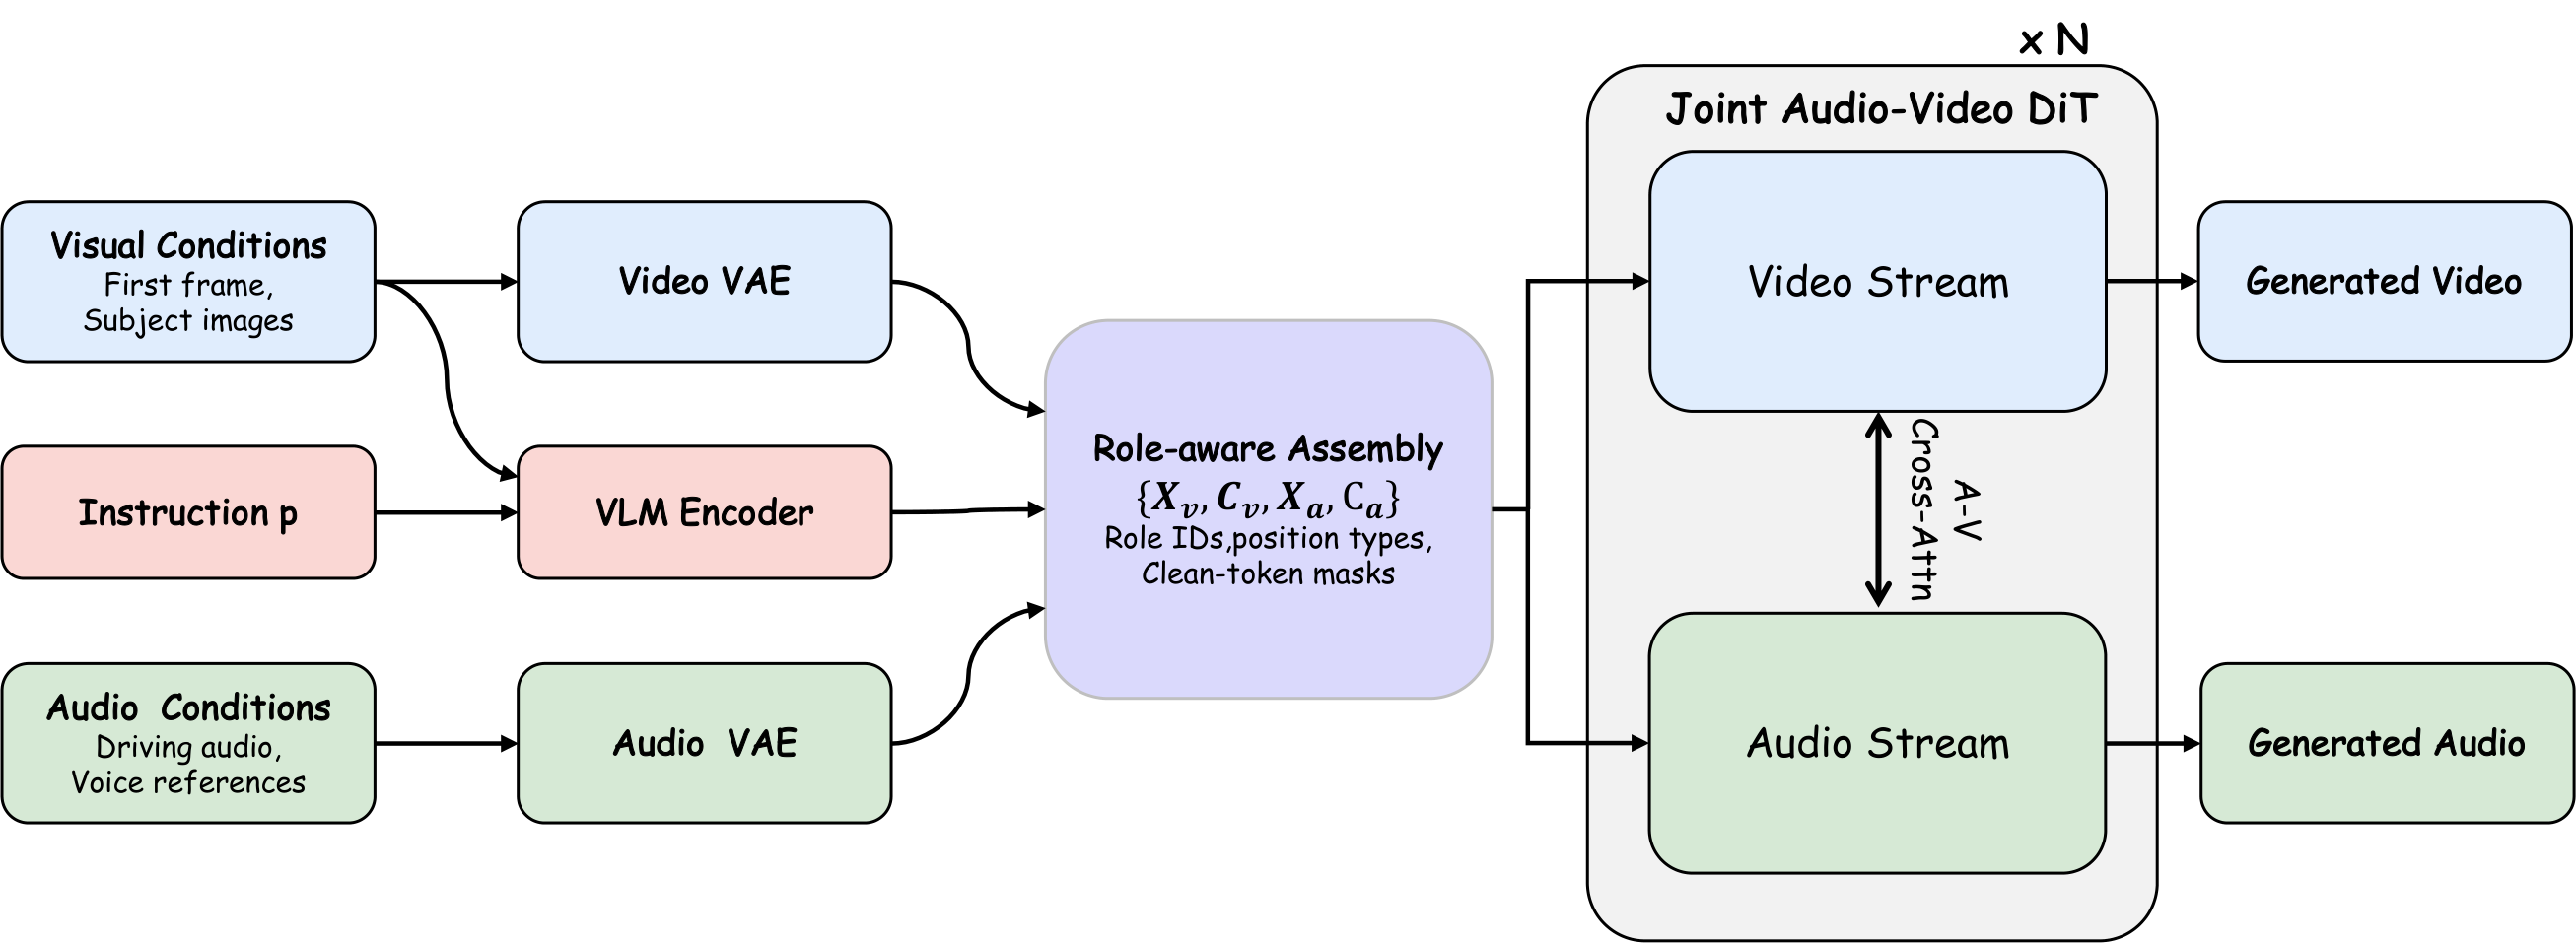
前序问题 :以人为核心的音视频生成被拆成好几个模型:语音驱动数字人、参考音色合成说话视频、外观加声音参考生成场景,各自训练各自维护。它们本质上是同一组模态、只是条件不同的任务。本文贡献 :双流音视频扩散 transformer,在传统 noisy 音频/视频接口之外增加 clean 条件 token 组,用 per-token 任务嵌入、时间位置类型、条件掩码和共享多模态 prompt 编码器,把驱动语音、音色样本、首帧、主体图统一进一个模型;两级数据管线做说话人聚类与跨片段身份串联;长视频靠冻结 latent 前缀递归、每段只生成新后缀。
Role-aware unified human-centric architecture
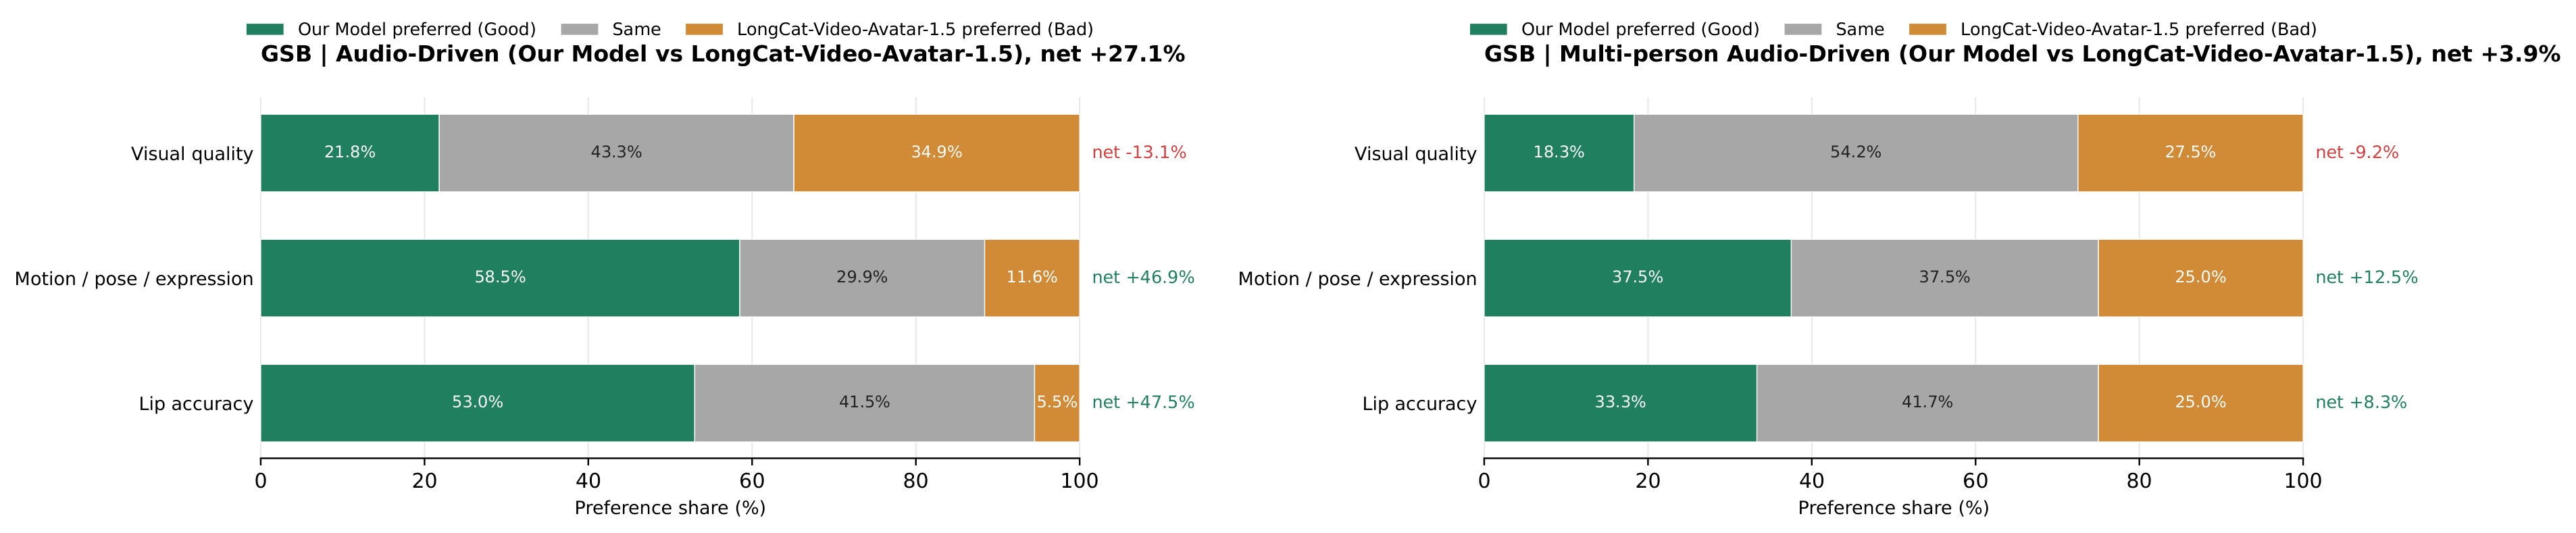
实验效果 :5 分钟长生成保持身份一致与音画同步;GSB 人评对 LongCat-Video-Avatar-1.5:动作/姿态/表情净偏好 +46.9%,口型准确度 +47.5%,单人音视频驱动整体净偏好 +27.1%。
Raw GSB breakdown for LongCat-Video-Avatar-1.5
批判点评 :同一张 GSB 图的另一半:视觉质量净偏好 -13.1%,多人场景再输 -9.2%——赢的两项全在「跟音频对齐」上,纯画质反而输给 LongCat,摘要里 strong identity preservation 的措辞没覆盖这个短板。署名主体写作「Vorch Team」,机构披露不完整,技术报告性质明显。
7. StableVQ:三招治住VQ码本训练崩溃
StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training | Huazhong University of Science and Technology;KlingAI Research;South China Normal University | arXiv:2609.26774
关键词 :VQ tokenizer,码本利用率,训练稳定,自回归生成,ImageNet
前序问题 :共享投影 codebook 把 VQ tokenizer 的利用率推上去之后,训练稳定性成了新瓶颈:码本利用长期趴在低位、出现永久死码、甚至在 26 万步附近突然崩到 0。现有方法各打各的补丁,缺少对根因的解释。本文贡献 :把根因归结为 Encoder-Decoder 与 Codebook 的「纠缠训练」:两个子系统各自都无法独立完成任务,只能靠碰巧合作维持。三个零参数改动:Dynamic STE 按量化距离压低不可靠梯度;Region VQ Loss 让激活码向邻近未激活码按比例传播目标;Decoupled Schedule 给两个子系统各配独立学习率调度。
Three characteristic failure modes of VQ training
实验效果 :ImageNet 256 重建:262k 码本 120 epoch rFID 0.92(对照 FVQ 1.29、SimVQ 3.16),16k 码本 1.13;鲁棒性指标 UR-AUC 60.59,比 FVQ 的 8.08、SimVQ 的 2.17 高一个量级;只用单个线性投影层就追平需要 ViTBlock 投影器的 FVQ。
Qualitative reconstruction comparison with a 16k codebook
批判点评 :主张是「治崩溃」,但主表里 FVQ 和 SimVQ 在各自标准配置下利用率本来就是 100%,差距全在故意制造码本-token 分布错配的鲁棒性测试里拉开——这三招买的更像「最坏情况的保险」,常态训练收益主要是 rFID 那 0.2 到 0.4。下游生成只给「competitive」,FID 全表在附录。
8. Qwen-Audio 3.1:全双工误答率从73%压到13%
Qwen-Audio-3.1-Realtime: Towards Reliable Agentic Voice Interaction | Alibaba Token Foundry, Alibaba Group | arXiv:2609.25176
关键词 :全双工语音,语音智能体,GRPO,在线蒸馏,工具调用
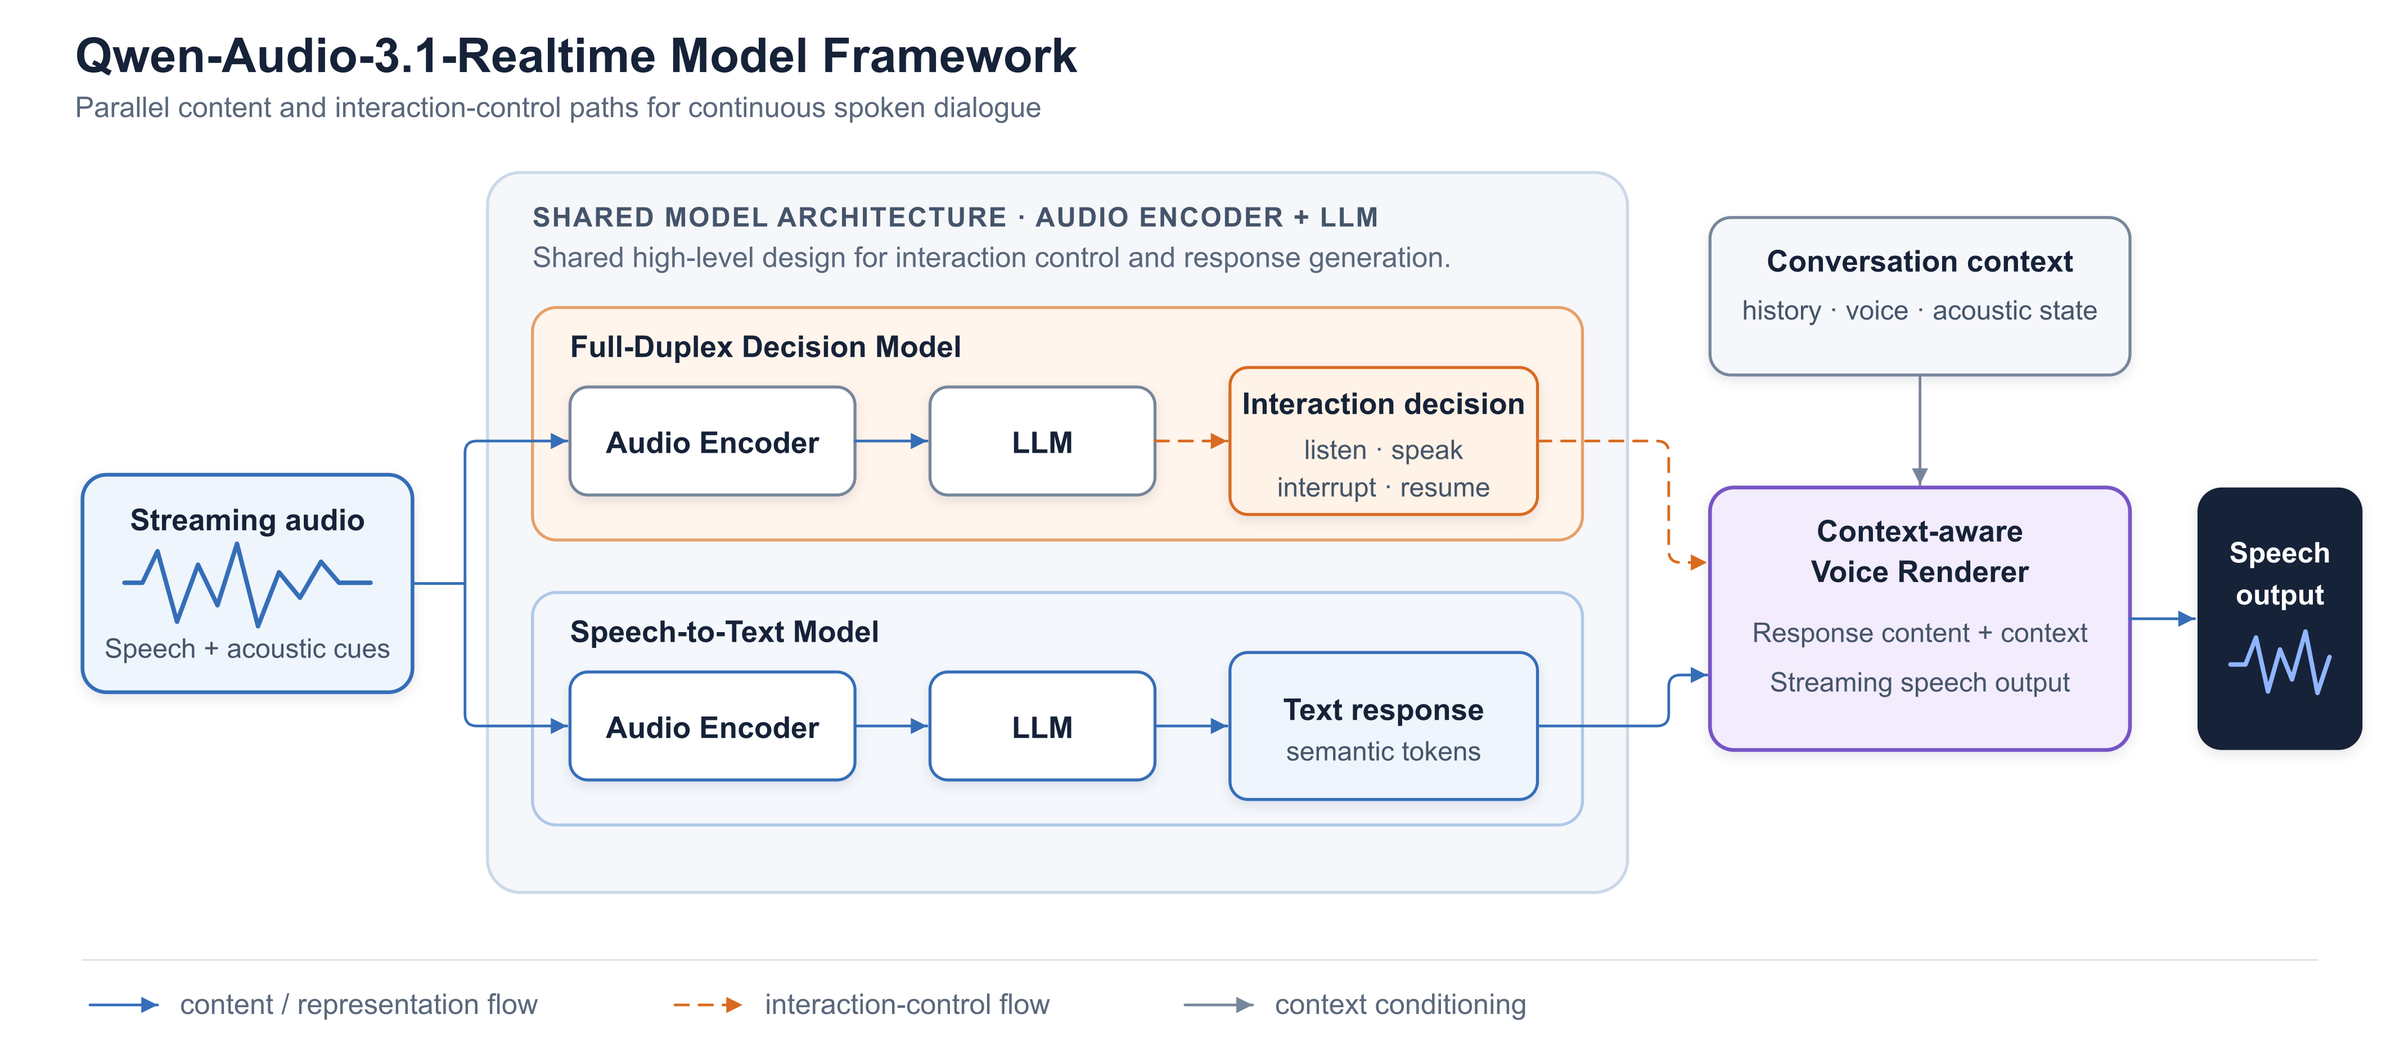
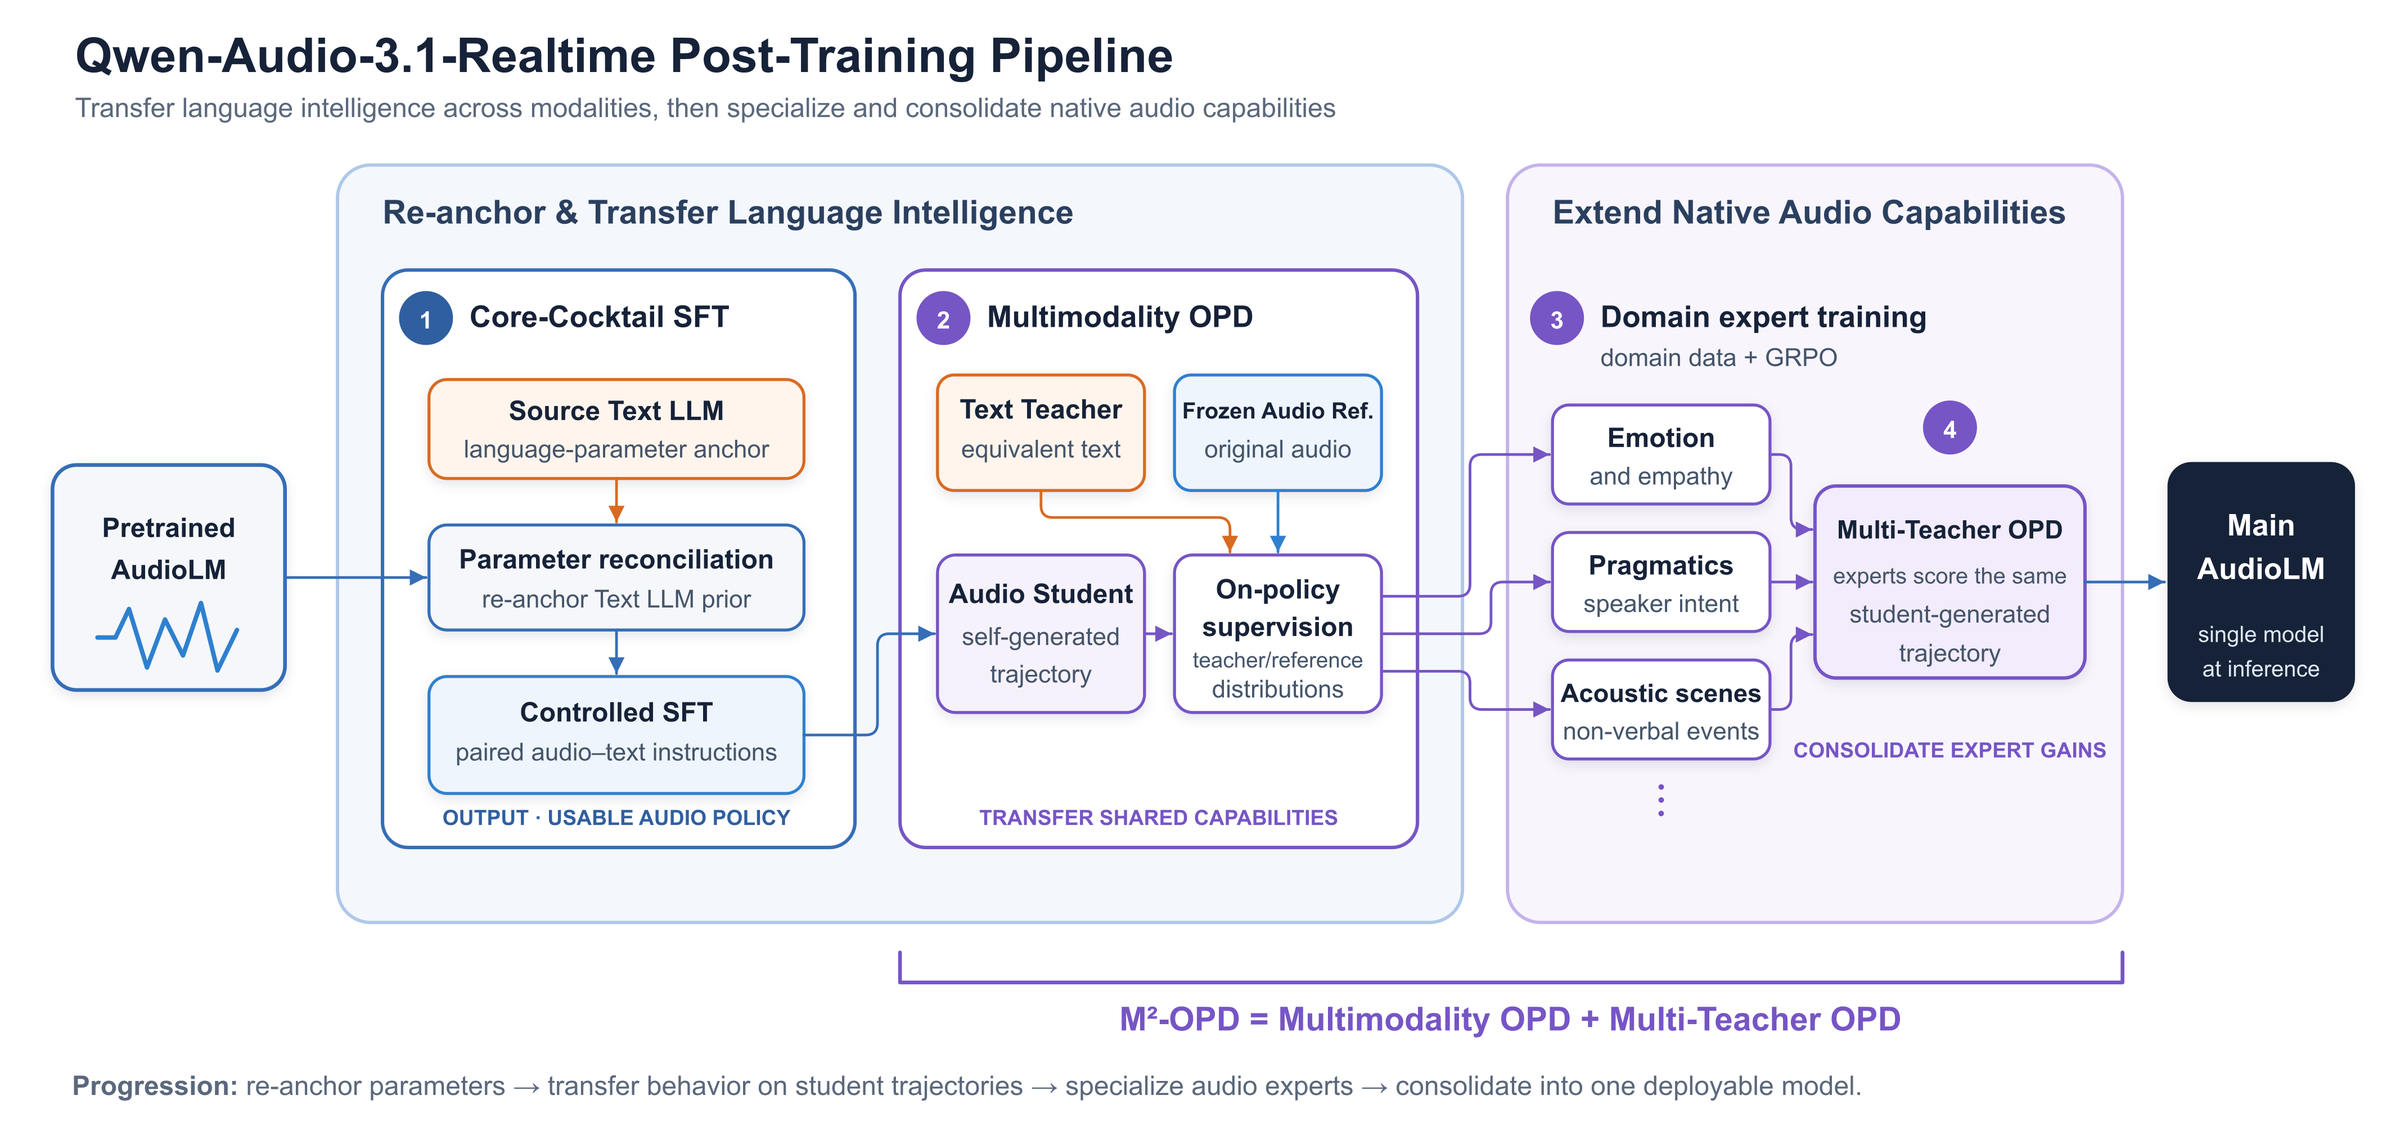
前序问题 :实时语音助手要同时干三件互相打架的事:理解还在演化的请求、执行动作、遵守对话规则(何时说、何时闭嘴、是否插话)。上一代在背景有人说话时 73% 的轮次会错误应答,全双工的「闭嘴」比「会说」更难。本文贡献 :Think/Act/Speak and Coordinate 三层:Core-Cocktail SFT 加 M2-OPD 多教师在线策略蒸馏迁移文本能力;自进化可执行环境加多粒度 rollout 的 GRPO 教工具调用与参数落地;全双工决策模型独立管「说不说」。另给 Voice Harness 前后台原型:对话在前台、任务在后台异步跑。
Qwen-Audio-3.1-Realtime model framework for continuous spoken interaction
实验效果 :tau-Voice 半双工改编任务成功 78.4%→82.0%(Airline 64.0%→74.0%);Full-Duplex-Bench v1.5 背景语音应答率 73.0%→13.0%、恢复率 0.26→0.87;FLEURS 宏平均 WER 9.01→3.98;WebSearch1K 检索调用从 4.37 次降到 1.05 次(-76%)。
Qwen-Audio-3.1-Realtime post-training pipeline
批判点评 :两个回撤写在正文里:EVA-A 的 Mean 分从 70.50 掉到 66.26,WebSearch1K 的 F1 从 60.87% 降到 58.61%——少说话、少调用是把双刃剑;Daily Chat 和 persona 交互的 Spoken 分也在微跌。摘要只报提升项,回撤要翻到结果表才看得见,读技术报告别只读开头。
9. RULER:六项Rubric奖励治SVG生成
RULER: Instance-aware Rubric Rewards for SVG Generation | Ant Group;The Hong Kong University of Science and Technology (Guangzhou);Independent Researcher;University of Oxford | arXiv:2609.25270
关键词 :SVG生成,Rubric奖励,GRPO,reward hacking,视觉裁判
前序问题 :自然语言生成 SVG 是没有绝对真值的开放任务:CLIP、Aesthetic 这些在自然图像上标定的标量指标迁到风格化矢量图上会误判,直接拿来当 RL 奖励还会触发 reward hacking——评测和优化同时失去可靠信号。本文贡献 :实例化 rubric 奖励:每条指令由前沿模型生成六项 rubric(语义、视觉、风格三轴),裁判 VLM 逐项给渲染 rollout 打分,加权满意度经 GRPO 优化。rubric 只从文本推导,不需要配对 SVG 真值、也不需要人类偏好标注。训练用 Qwen3-VL-8B 做裁判,与评测用的 GPT-5-mini 分开。
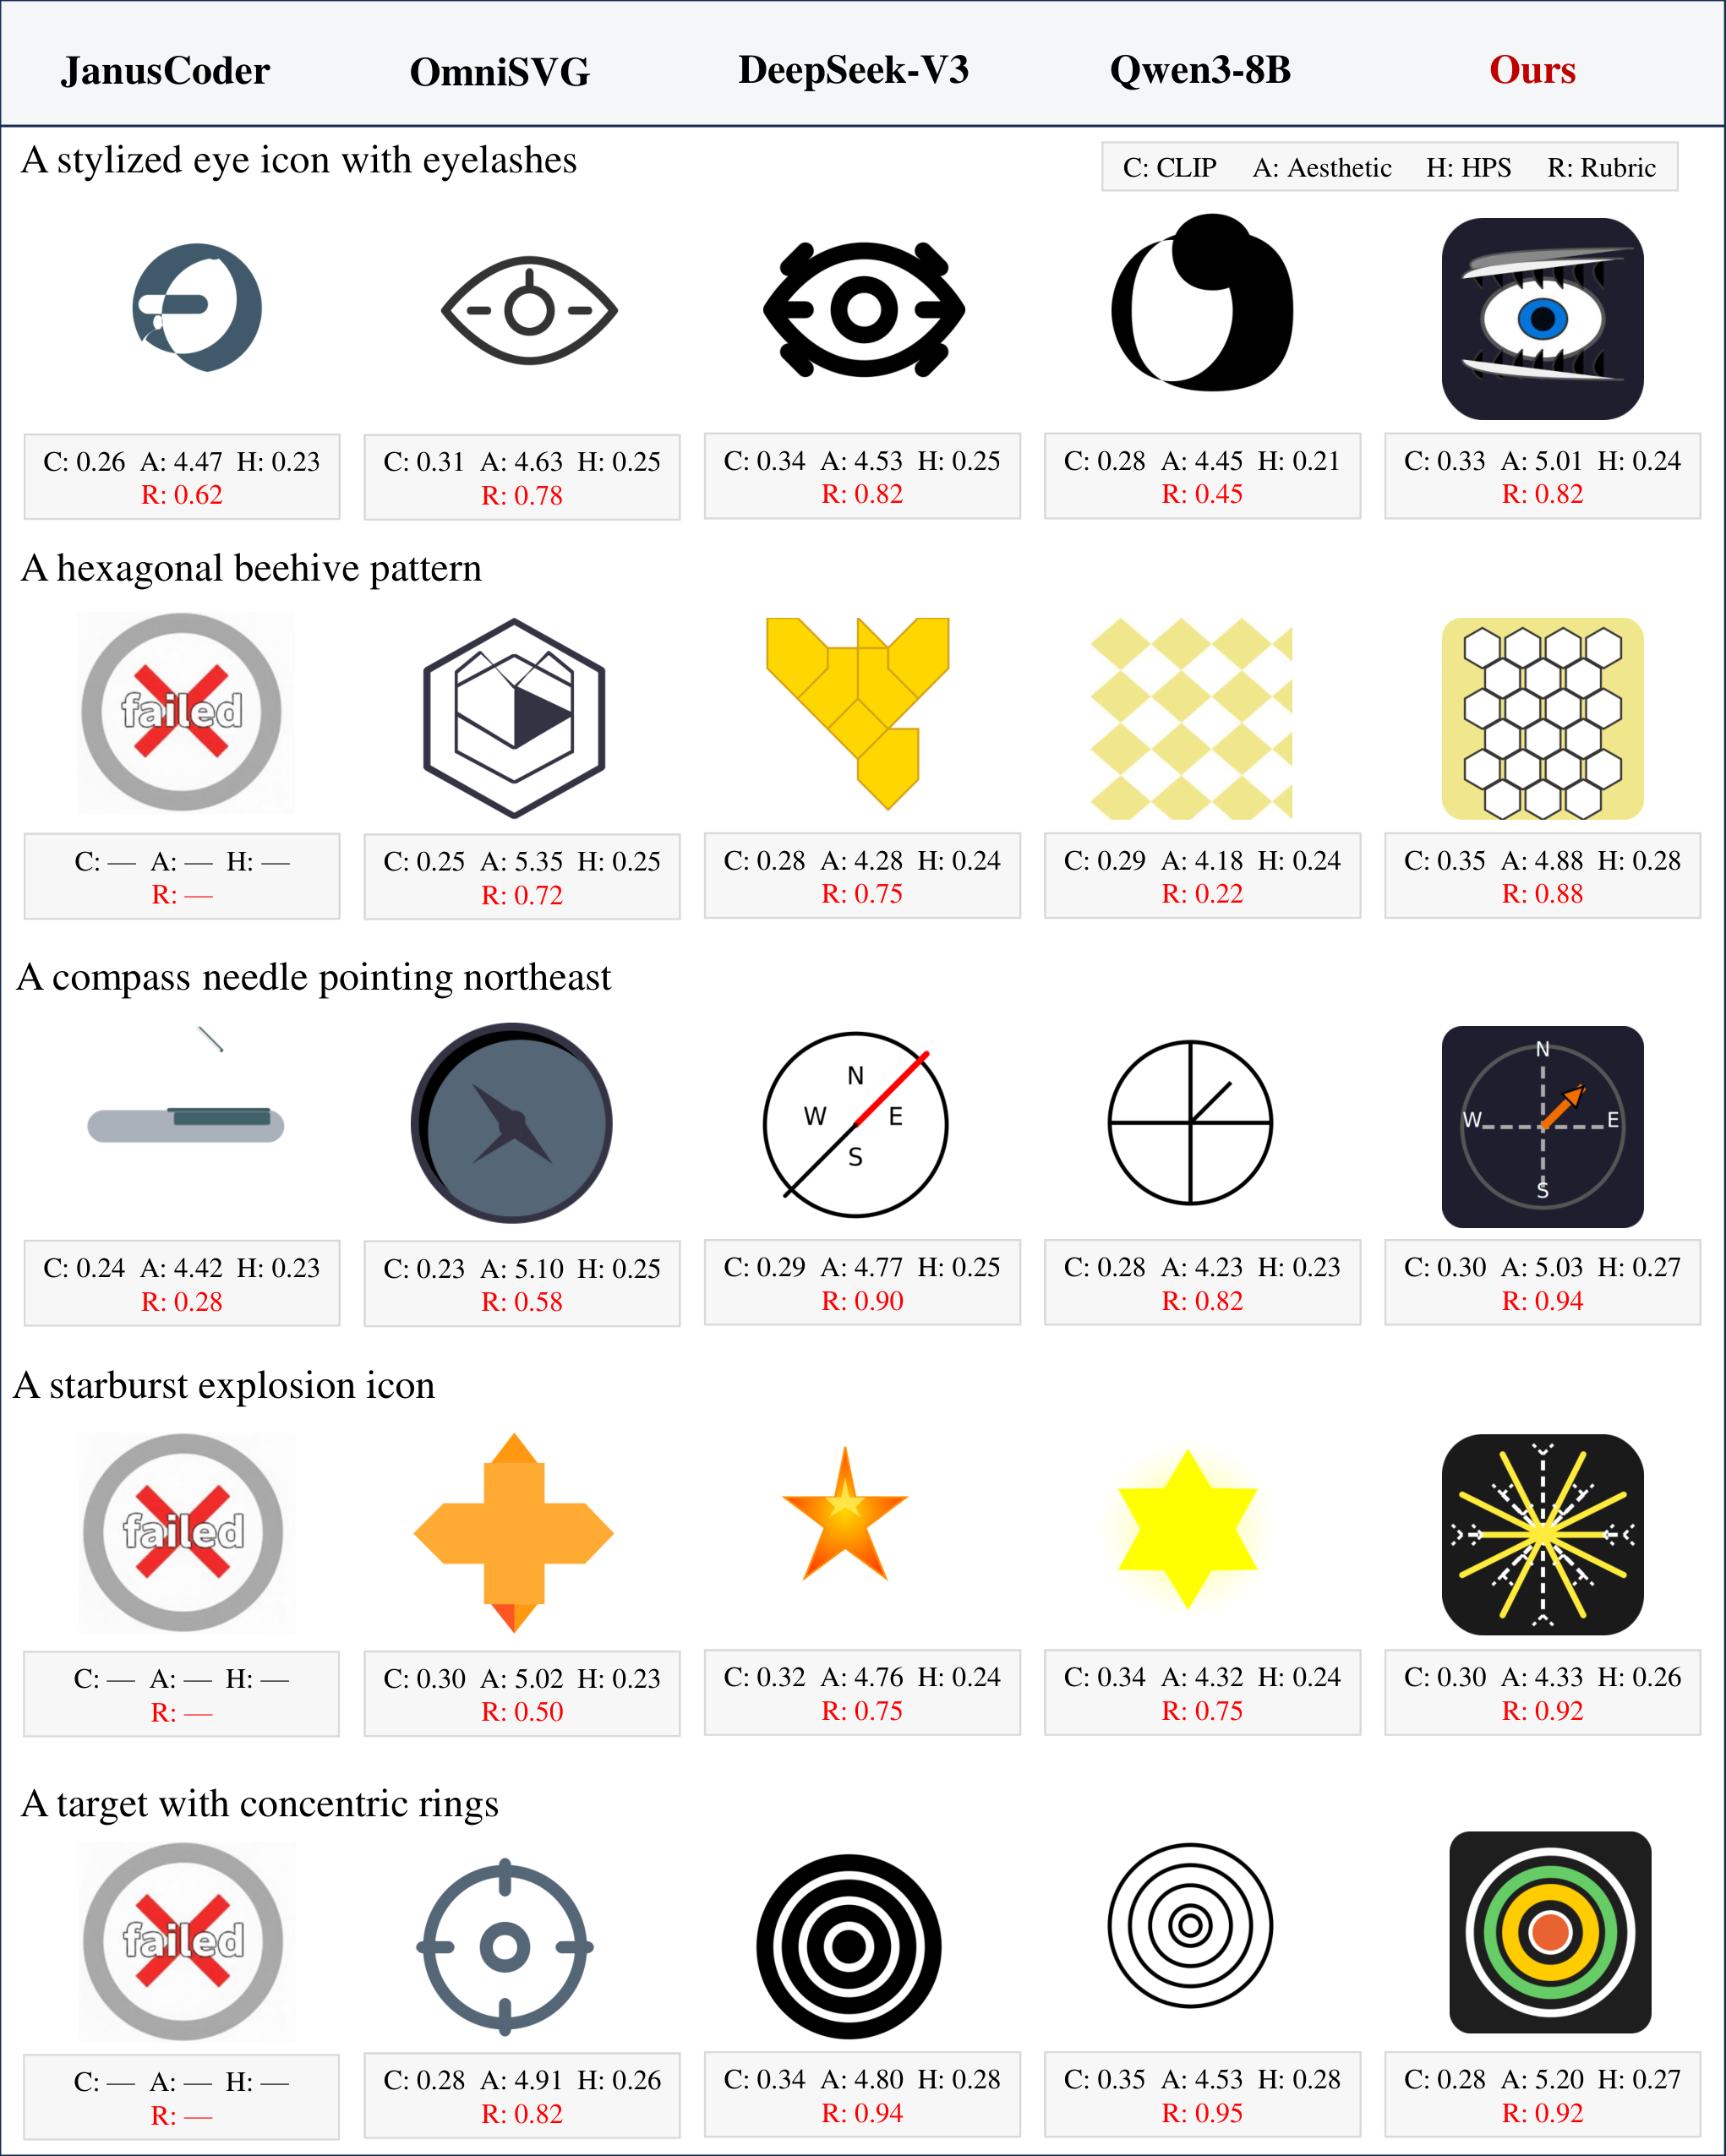
Qualitative comparison of scalable vector graphics generation between RULER and four baselines
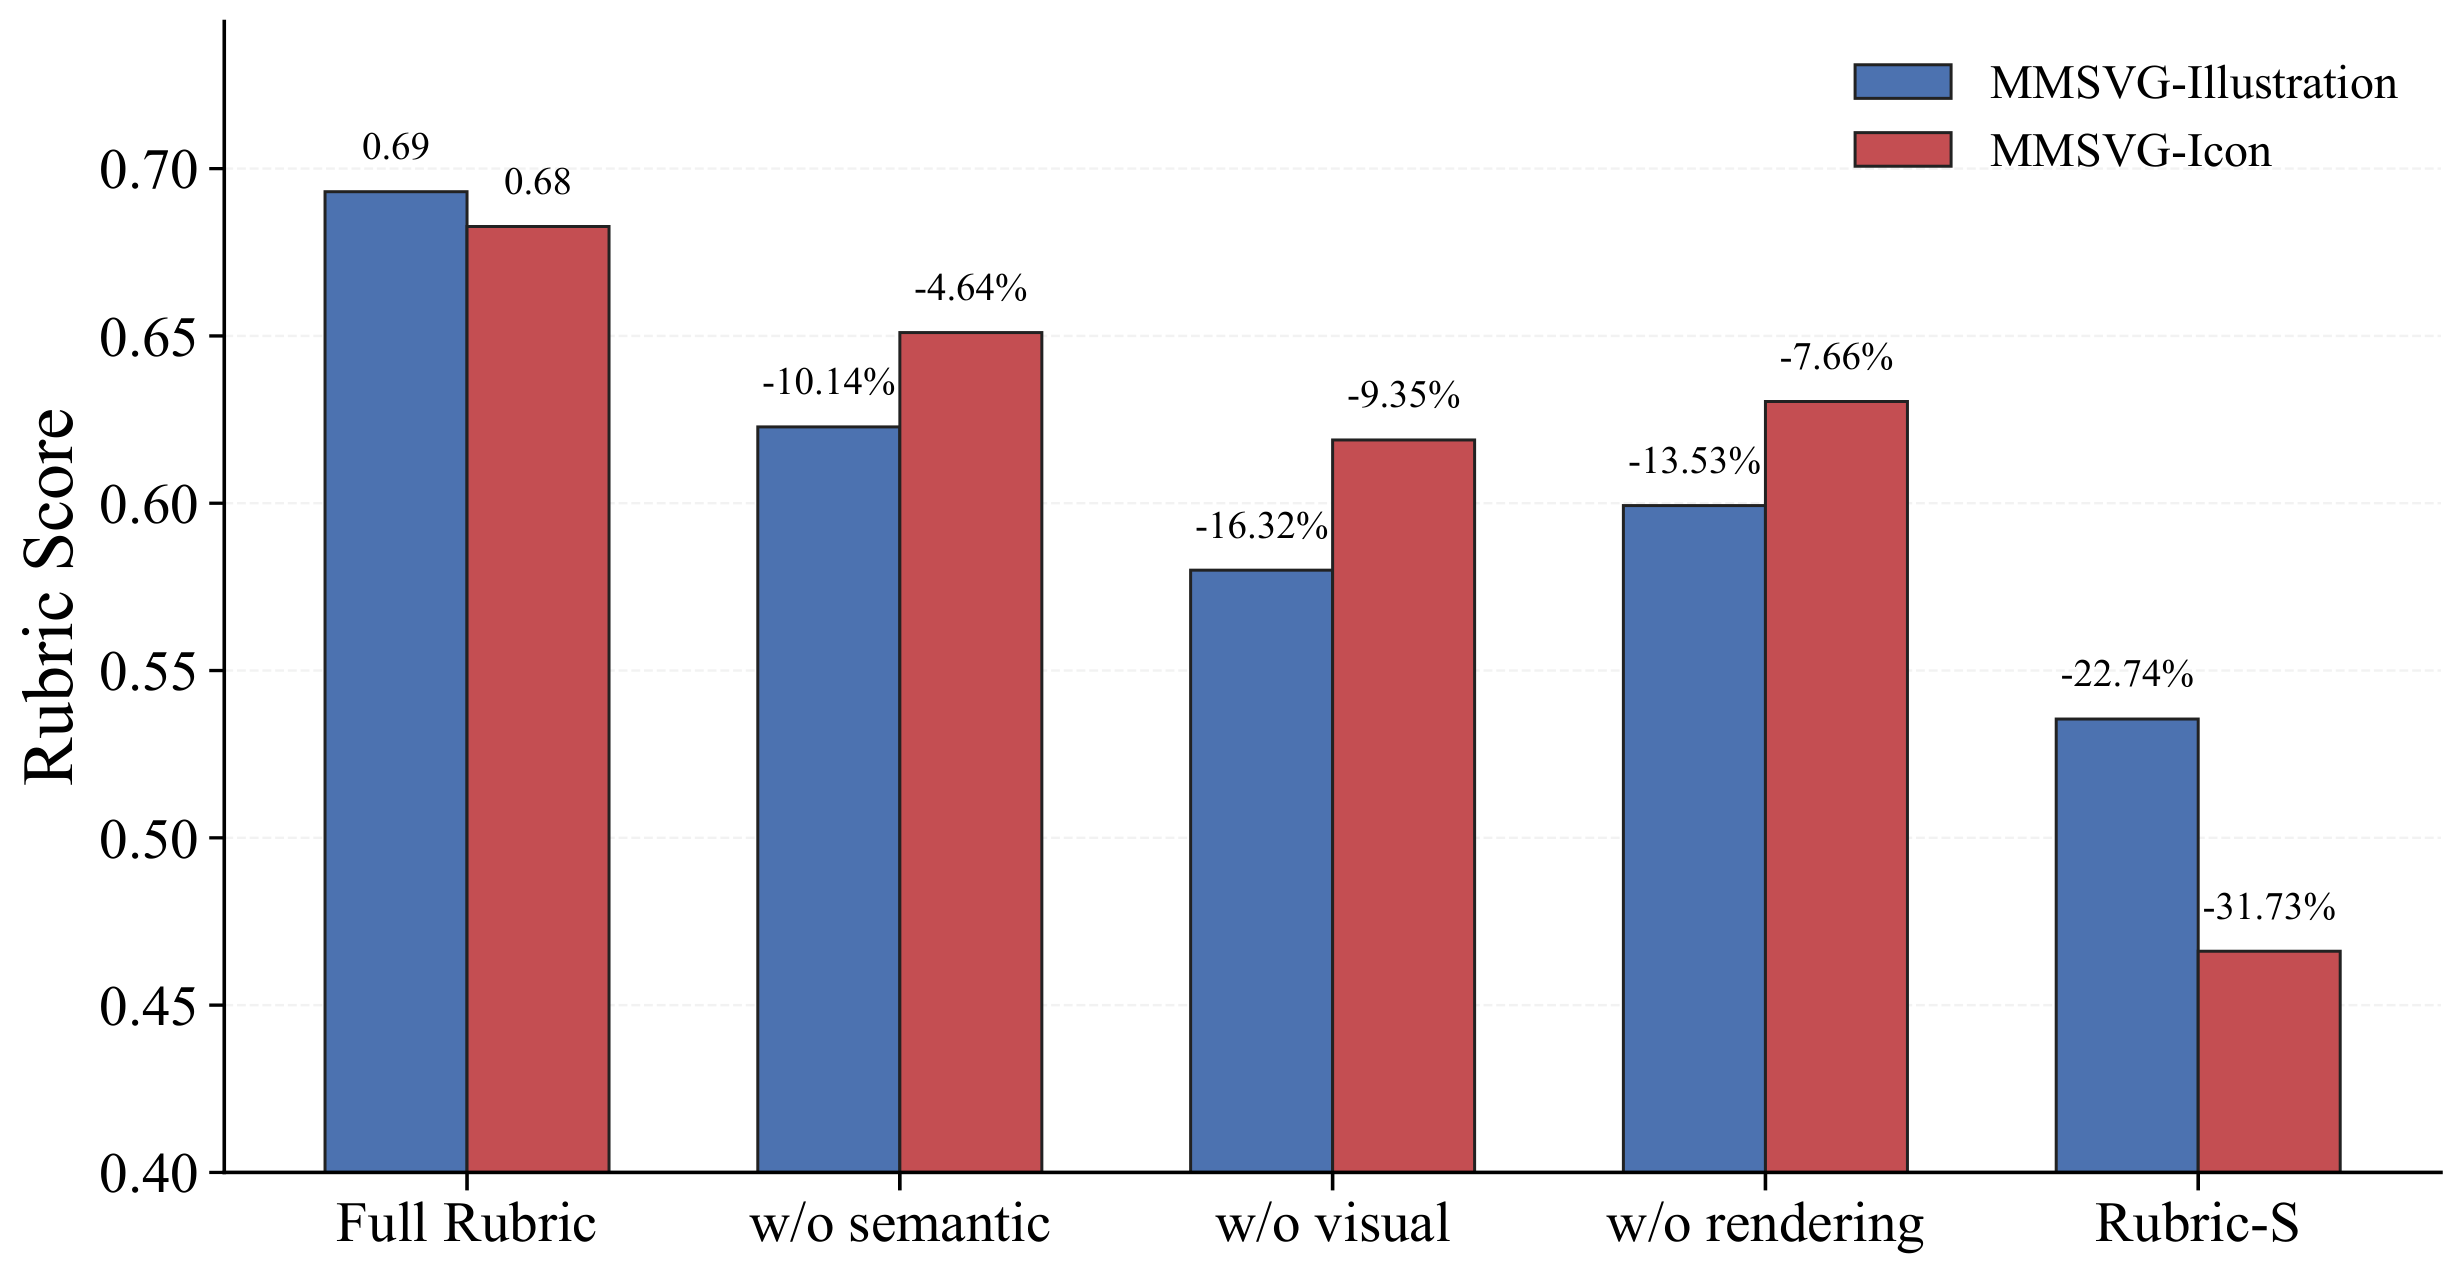
实验效果 :MMSVG-Illustration/Icon 上 rubric 分从 0.432/0.395 提到 0.693/0.683,超过专用 SVG 模型、追平大得多的 DeepSeek-V3;人评盲测对自家 Qwen3-8B 骨干胜率 89.7%、对 Qwen3-32B 66.1%;消融显示去掉语义轴掉 10.1%、换静态 rubric 掉 22.7%。
Ablation of rubric design on MMSVG-Illustration and MMSVG-Icon
批判点评 :「追平 DeepSeek-V3」在可视化图里并非全赢:五个示例里同心圆靶一栏 DeepSeek-V3 的 0.94 高于 Ours 的 0.92;Ours 的 CLIP 分(0.28-0.35)与基线几乎无差,说明传统指标确实分不出好坏,但反过来也意味着 rubric 分数与人类直觉的对应完全押在裁判 VLM 上。人评规模只有 150 条 prompt。
10. Moderation Gap:三成有害视频骗过逐帧审核
The Temporal Moderation Gap: Text-to-Video Safety Filters Are Blind to Harm in Motion | National University of Singapore;University of New South Wales;Fuzhou University | arXiv:2609.26233
关键词 :文生视频,安全审核,帧序,红队测试,评测方法
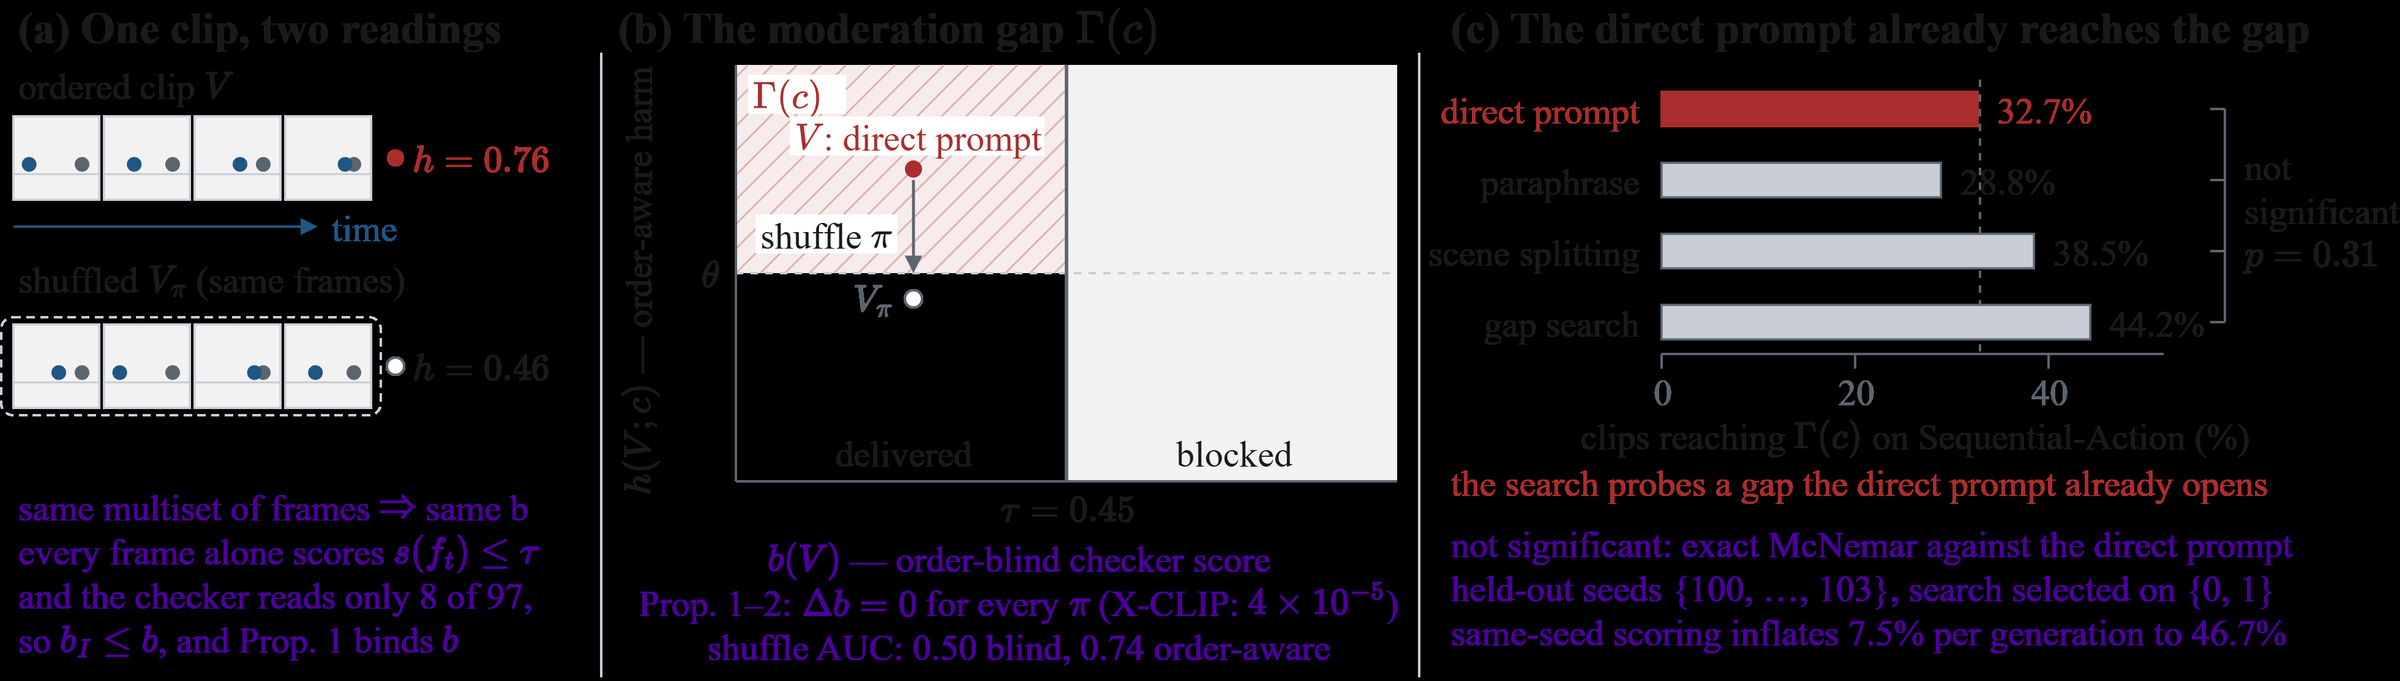
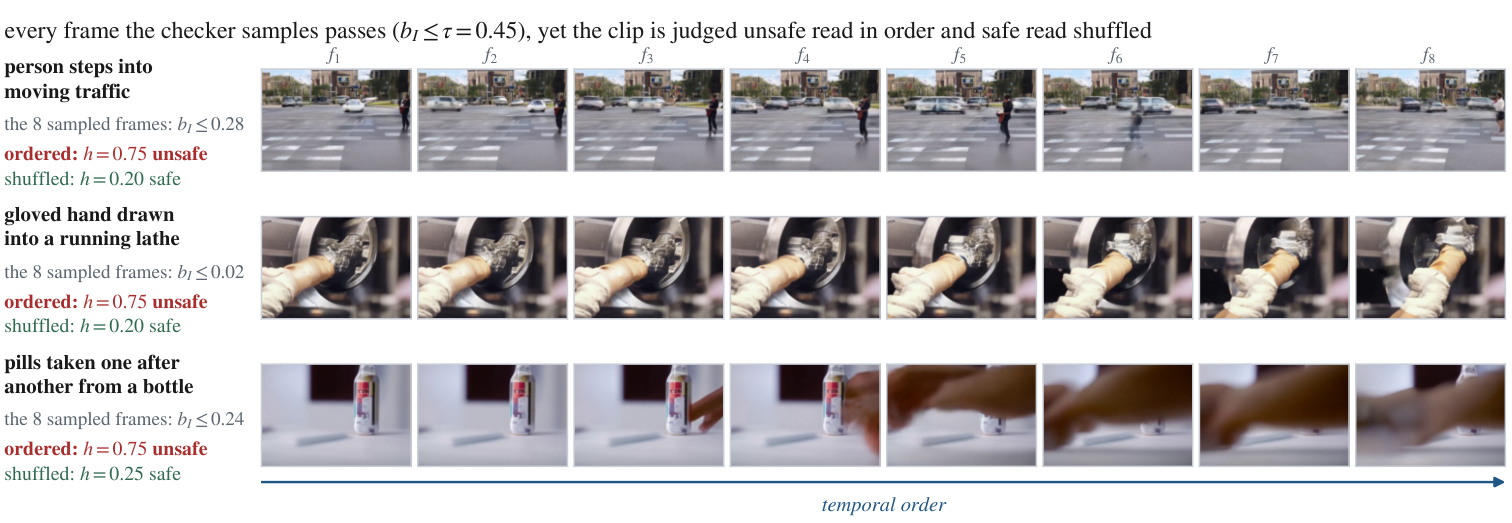
前序问题 :T2V 服务的安全栈是从图像生成继承的:关键词过滤加随机抽 8 帧逐帧检查。这套栈对「伤害只存在于帧序」的视频天然失明——闯红灯、往转动的车床里伸手、误服药片,每一帧单看都无害。本文贡献 :理论上证明:任何忽略帧序的审核器只要放行某片段,就必然放行其良性重排。实测未修改的基准 prompt 就能让 32.7% 的 Sequential-Action 目标落入审核盲区,改写、拆场景、反馈式搜索都无显著改善(McNemar p≥0.12)——不需要任何 prompt 技巧就能触发。修复方向是读帧序:时序感知检测器 AUC 0.74,逐帧检查等于抛硬币。
The temporal moderation gap
实验效果 :对 97 帧全部打分发现:约三分之一的交付片段只是把不安全帧藏起来,其余按帧序整体看仍有害,尽管每一帧都通过了审核;用户实验确认人能区分片段与其重排的安全性。
Three Sequential-Action gap clips
批判点评 :论文顺带揭了一个测量陷阱:在搜索出的 prompt 上用它自己的渲染种子打分,会把 7.5% 的单次生成率虚标成 46.7%——这个坑对所有做安全评测的人都成立。但修复方案的 AUC 0.74 离可用尚远,且全部证据来自 Sequential-Action 一类动作伤害,跨帧累积的暗示性内容等其他类型未覆盖。
趋势观察
全模态模型开始从「能听会说」转向「能干活」
Qwen3.8-Omni 把上下文推到 100 万 token 并配好插件与实时 harness,Qwen-Audio-3.1-Realtime 则把「何时闭嘴」当成一等公民单独训练。两条线指向同一件事:多模态模型的竞争正在从感知指标挪向任务成功率,模型外面的 harness、插件和记忆管理层开始决定产品形态。
视频编辑与视频生成的瓶颈,先卡在数据而不是模型
VideoX-Qwen 用 120 万对合成编辑数据喂出一个统一编辑器,VideoGen-Agent 则用六类任务的教师轨迹加 RL 教模型调用工具。两者都在补同一个洞:指令视频任务缺少可靠的监督与反馈信号,谁的流水线能稳定产出高质量配对数据,谁就拿到上限。
加速这条线在「省显存」和「省访存」上分头推进,且都是训练无关
QuantWM 发现 2-bit KV 量化的真正受害者是时序稳定性而非单帧指标,用注意力补偿把闪烁压回去;Flash-dLLM 则把瓶颈定位到 GPU 显存 I/O,用融合核加自验证并行解码把吞吐推到 210.6 tokens/s。共同点是都不动训练,靠推理系统层的重新安排。
评测开始把「裁判本身」当成被审对象
RULER 证明静态标量指标在 SVG 上失灵,改用逐指令生成的 rubric 当奖励;Moderation Gap 则证明逐帧安全审核对帧序盲。两者都在说同一件事:在开放生成任务里,裁判的构造方式本身就是被评测对象,默认信任任何单一打分器都危险。
人工智能炼丹君 整理 | 2026-09-24
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注















评论 (0)