今日 AIGC 论文速览
今日共 10 篇 · 图像生成与像素扩散 2 篇 · 视频世界模型与 3D 一致 2 篇 · 视频生成加速与流式编辑 2 篇 · 动作与音频生成 2 篇 · 音视频因果与奖励评测 2 篇
重点论文标题列表
PixelDiT2 (NVIDIA):像素扩散 FID 压到 1.46WorldCrafter (ARC Lab, Tencent IEG):分钟级探索重访 PSNR 18.0⚡ GAE (HKUST):相机轨迹误差砍半 FVD 降 23%
SparkDiffusion (Peking University, Melon Group):97% 稀疏下 265 倍单卡加速MixiMotion (PTIT, Hanoi):一步动作对齐 0.835 逼近教师
今日论文速览
1. PixelDiT2:像素扩散 FID 压到 1.46
PixelDiT2: Representation-Grounded Pixel Diffusion Transformers | NVIDIA;University of Rochester | arXiv:2609.24919
关键词 :像素空间扩散,表征先验,表示对齐,DINOv3,ImageNet
⚠️ 前序问题 :像素空间扩散不用自编码器、直接在 RGB 上去噪,省掉了 latent 重建瓶颈,代价是收敛慢、最终画质长期落后 latent 扩散。作者的判断是缺一个显式表征先验:latent 扩散天然在紧凑结构化的隐空间里去噪,像素扩散却要一边学「好去噪的表征」一边学「怎么生成像素」,两件事挤在同一次训练里互相拖累。
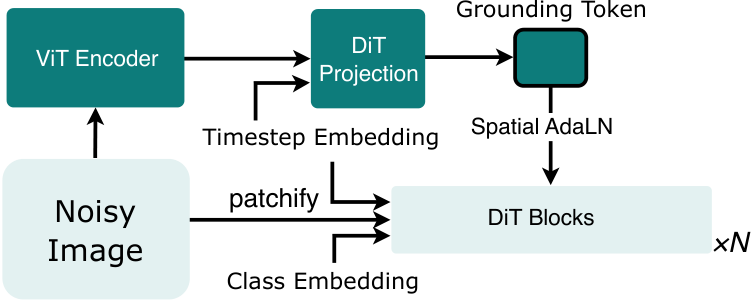
本文贡献 :提出 representation grounding:用一个冻结的预训练视觉基座模型在整个去噪过程里持续提供 per-patch 表征监督。带噪图像走像素去噪通路,同时冻结编码器产出 per-patch 特征,一个时间步条件化的 DiT 块 P_g 把它映射成 scaffold,再通过空间 AdaLN 调制扩散 transformer;REPA 只作为训练期辅助目标。另提出延迟 grounding dropout:训练初期保留 grounding,到 epoch 160 再开启 dropout。
PixelDiT2 at ImageNet-512x512: samples, architecture, and convergence.
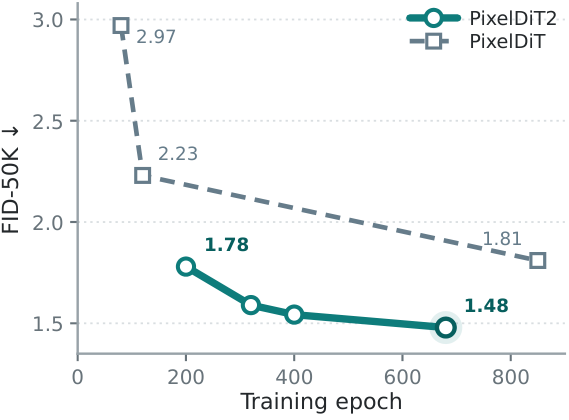
实验效果 :ImageNet-256×256 上 H/16 模型 600 epoch 达 FID 1.46、IS 301.6;512×512 上 680 epoch 达 FID 1.48、IS 295.7,两档都是像素侧最好(同表其余像素方法 1.61–3.94 / 1.78–3.95)。论文强调 epoch 预算:512 档 epoch 200 就超过 PixelDiT 850 epoch 的 FID,预算低 4.25 倍。
PixelDiT2 reaches FID 1.78 at epoch 200 and 1.48 at epoch 680.
批判点评 :「补上表征先验」在像素侧成立,但把两张表横着读是另一面:256 上 latent 侧 RAE-XL FID 1.13、REPA-XL 1.29 都优于 1.46,512 上 RAE-XL 1.13 同样压过 1.48,IS 也不及 REPA-XL 306.3 与 JiT-G 306.8。也就是说「追平」只在像素扩散内部成立,跨阵营仍差约 0.3 FID,摘要里 narrowed the gap 的措辞容易被读成已经追平。另外延迟 dropout 的开启时机是在 512 档上调出来的,256 档用的是从头独立 dropout,两档训练协议并不一致,跨分辨率可比性打了折扣。
2. WorldCrafter:分钟级探索重访 PSNR 18.0
WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory | ARC Lab, Tencent IEG;Peking University | arXiv:2609.24984
关键词 :视频世界模型,隐式3D记忆,长程一致性,相机可控,流式生成
⚠️ 前序问题 :视频世界模型做交互式探索时,长程一致性一直是硬伤:走出一段距离再回头,场景常常「认不出」是刚才那个地方。难点在于历史观测越来越多,而视频生成器的 token 预算是固定的,怎么把历史压进有限 token、又不依赖显式深度对应,是个两难——显式 3D 重建重且脆,简单堆历史帧则 token 直接爆掉。
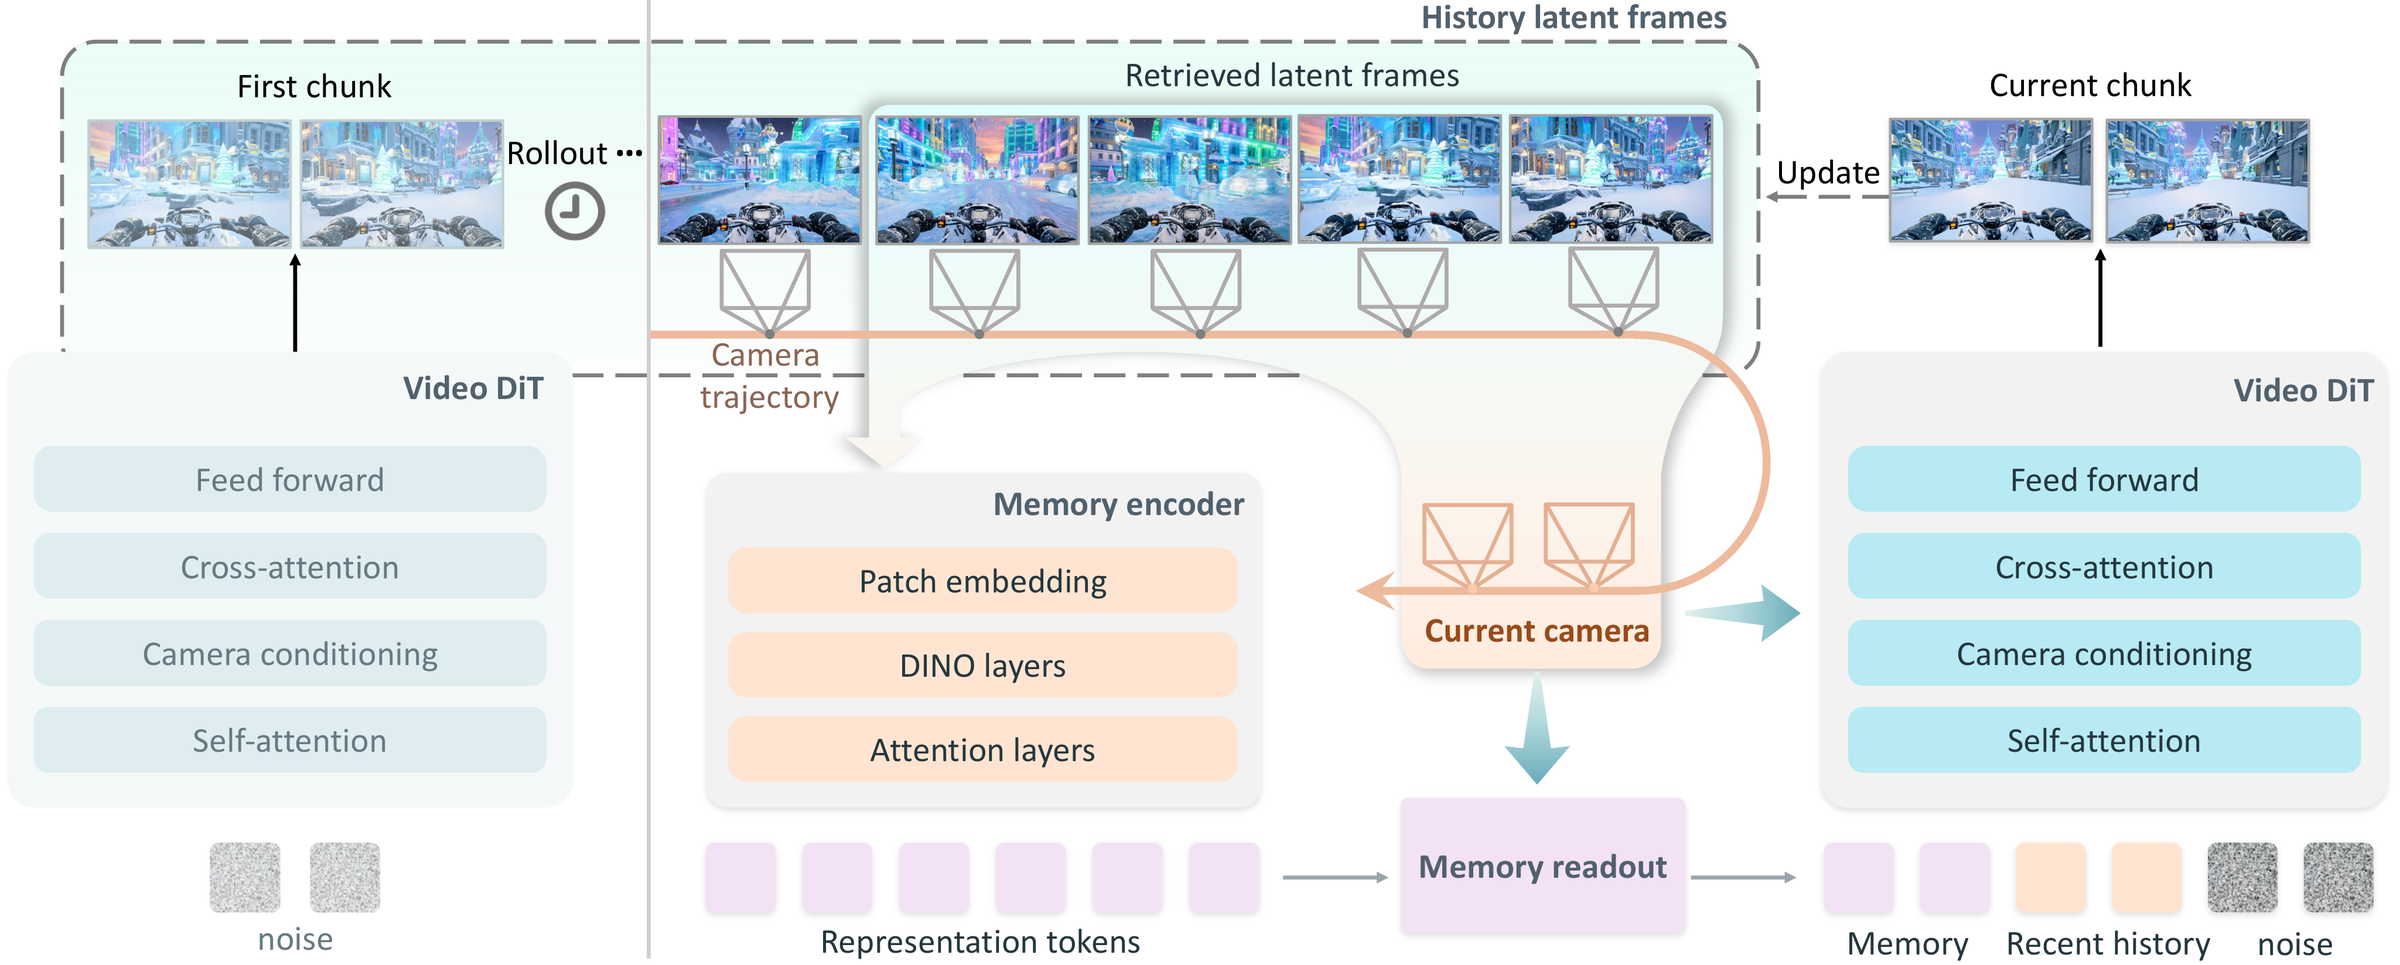
本文贡献 :核心洞察是「让被请求的视角来决定历史怎么压缩」。一个与视频生成器联合训练的 memory encoder 把历史观测编成紧凑的 3D-aware 表示,再由 pose-conditioned readout 按当前目标相机位姿读出固定数量的、目标视角专属 token,在去噪前注入,全程不需要显式深度对应。配合 max-coverage 历史检索、最近时间上下文和 few-step 蒸馏,实现从单张图或文本出发的流式分钟级探索。
Overview of the WorldCrafter pipeline.
实验效果 :VBench 自建输入模式 725 段视频上 Overall 81.910 为全表第一(Alaya-EVOKE 81.406、SANA-WM 80.841、Echo-WM 80.211),主体一致性 82.695、背景一致性 90.589、运动平滑 98.787、整体一致性 26.745 均为第一。长程重访一致性上 MEt3R 0.166、PSNR 18.016、SSIM 0.517,相对次优 Lyra 2.0(0.334 / 14.050 / 0.390)近乎翻倍。
Qualitative long-horizon revisit comparison in a static scene.
批判点评 :重访那张表真正的第一不是 WorldCrafter 而是它的加速版 WorldCrafter-fast(MEt3R 0.129、PSNR 20.868、SSIM 0.616)——少步蒸馏的变体反而在一致性上更好,这暗示「更多步数」本身可能带来累积漂移,论文没有就这条给出解释。视觉质量上也不是全胜:美学质量 AQ 61.432 只排第四,不及 SANA-WM 63.467;动态程度 DD 96.893 是全表最低(其余 97.087–100),说明换来的一致性里有一部分是靠画面动得更少买到的。评测均在自建输入模式下完成,未与公开榜单协议对齐。
3. GAE:相机轨迹误差砍半 FVD 降 23%
GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation | The Hong Kong University of Science and Technology;ARC Lab, Tencent IEG;The University of Hong Kong;The University of Texas at Austin | arXiv:2609.24981
关键词 :几何原生隐空间,3D一致性,自编码器表征,相机轨迹,感知生成统一
⚠️ 前序问题 :视觉生成器能出逼真画面,却保不住一个前后一致的 3D 场景。作者认为这不只是建模问题,更是表征问题:生成器演化的是外观为中心的隐空间,感知模型恢复几何用的是语义丰富、编码跨视角结构的空间,两者不在同一坐标系上。常见补丁是「再输出一个几何头」,等于把几何当副产品,治标不治本。
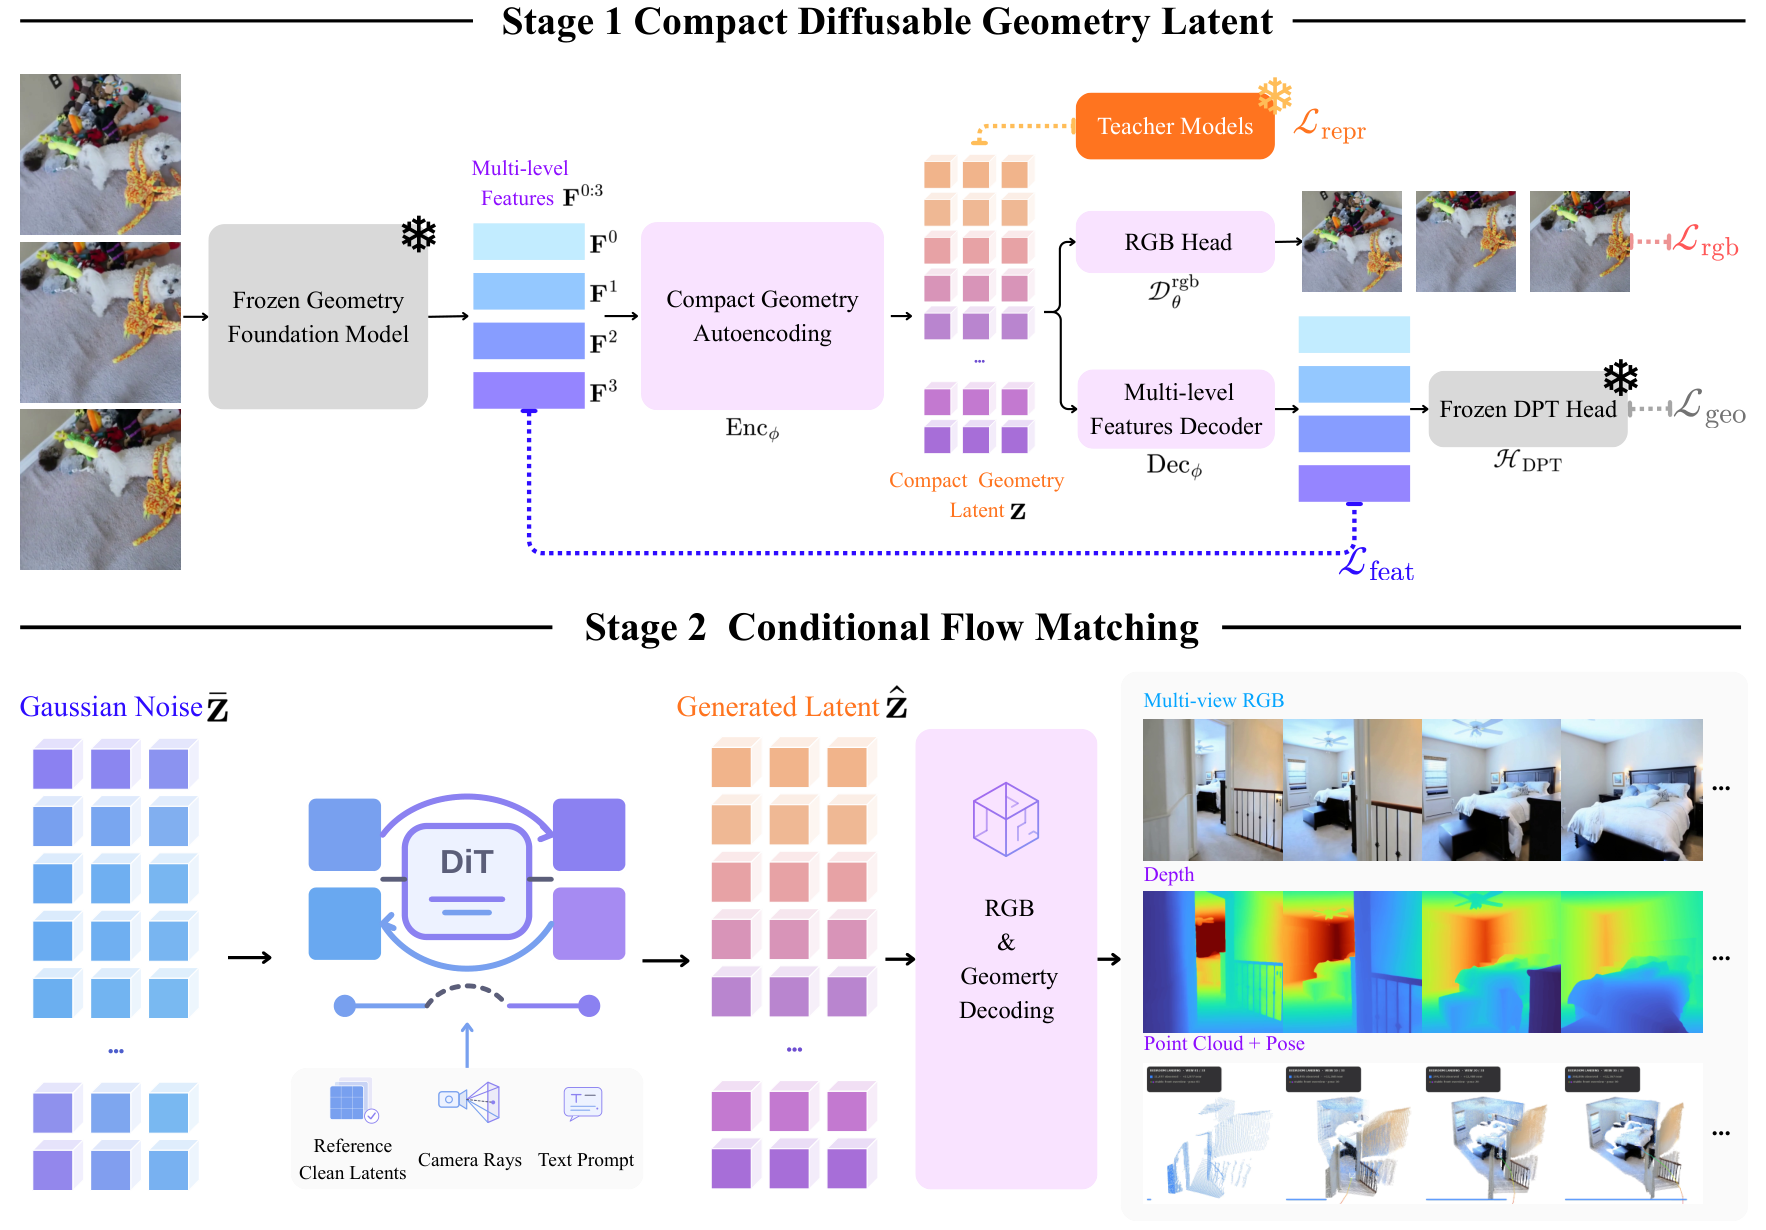
本文贡献 :不把几何当额外输出,而是直接把一个几何基座模型的特征重参数化成紧凑、可扩散的隐空间——几何原生自编码器 GAE,其 latent 同时可解码到外观、深度、相机和点图。训练分两阶段:先训 codec 把冻结的多层几何特征压进 latent,再用条件流只在「待生成视角」的 latent 上做流匹配,参考视角 latent、相机射线和文本作为控制,让感知与生成共用同一个隐空间接口。
Overview of Geometry-Native Autoencoder (GAE).
实验效果 :在固定生成器与训练协议的控制对比下:重建侧 GAE-128 用比原始几何特征少 24 倍的通道,PSNR 28.76 / LPIPS 0.036 / rFID 5.4(RealEstate10K)反而略优于原始 L0 特征;生成侧 GAE-64 最优,RealEstate10K FVD 225.7、PSNR 20.02、SSIM 0.711,DL3DV FVD 287.0、PSNR 18.00,相对最好的非 GAE 受控 latent 分别降 FVD 12.7% 与 23.1%;ATE 在 RealEstate10K 降 52.8%、DL3DV 降 23.3%,MEt3R 取到受控组最佳 0.1208 / 0.1347。
Multi-frame RGB, geometry, and camera-pose comparison across RealEstate10K scenes.
批判点评 :最有价值的是控制变量设计,但同一张表也留了口子:受控组之外还列了 Gen3R 与 GLD 两个参考方法,其中 Gen3R 在 RealEstate10K 的 MEt3R 是 0.1157,优于 GAE-64 的 0.1208——「最佳」限于受控 latent 这个口径。DL3DV 的重投影误差上 GAE 只有 0.0028–0.0029,反而不如 WAN2.1 VAE 的 0.0019,说明几何原生 latent 在像素级回投影精度上并不占优。另外通道数选择本身就不一致:128 在重建上最好、64 在生成上最好,论文没给选择依据,实际部署还得自己再权衡一次。
4. SparkDiffusion:97% 稀疏下 265 倍单卡加速
SparkDiffusion: Mitigating the High-Sparsity Trap --- A Unified Framework for up to $265\times$ Single-GPU Acceleration of Visual Generation | Peking University, Melon Group;Tsinghua University;Alibaba Group;University of Electronic Science and Technology of China;Harbin Institute of Technology | arXiv:2609.23153
关键词 :稀疏注意力,推理加速,少步蒸馏,FP8量化,视频扩散
⚠️ 前序问题 :视频扩散 transformer 贵在注意力要处理超长时空 token 序列,做稀疏注意力是自然的加速思路。但作者发现一个「高稀疏陷阱」:稀疏度推到极致时,逐步训练损失还在稳步下降,最终生成质量却停滞甚至倒退。诊断指出这是监督问题——主要误差来自高噪声的结构生成阶段,逐步局部训练修不动它,只有对齐终态的训练才修得动。
本文贡献 :由此给出一条分阶段原则:先把稀疏架构适配成粗粒度先验,再校正终态分布。SparkDiffusion 按此串起三件事——短程稀疏 warm-up、少步 trajectory-mixed 蒸馏、FP8 量化配融合 kernel,并把三者做成可乘的加速因子。覆盖 Wan2.1/Wan2.2 骨干、T2V/I2V 任务、480P/720P 分辨率,以及 H100 与 RTX 5090 两种 GPU。
Overview of the SparkDiffusion framework.
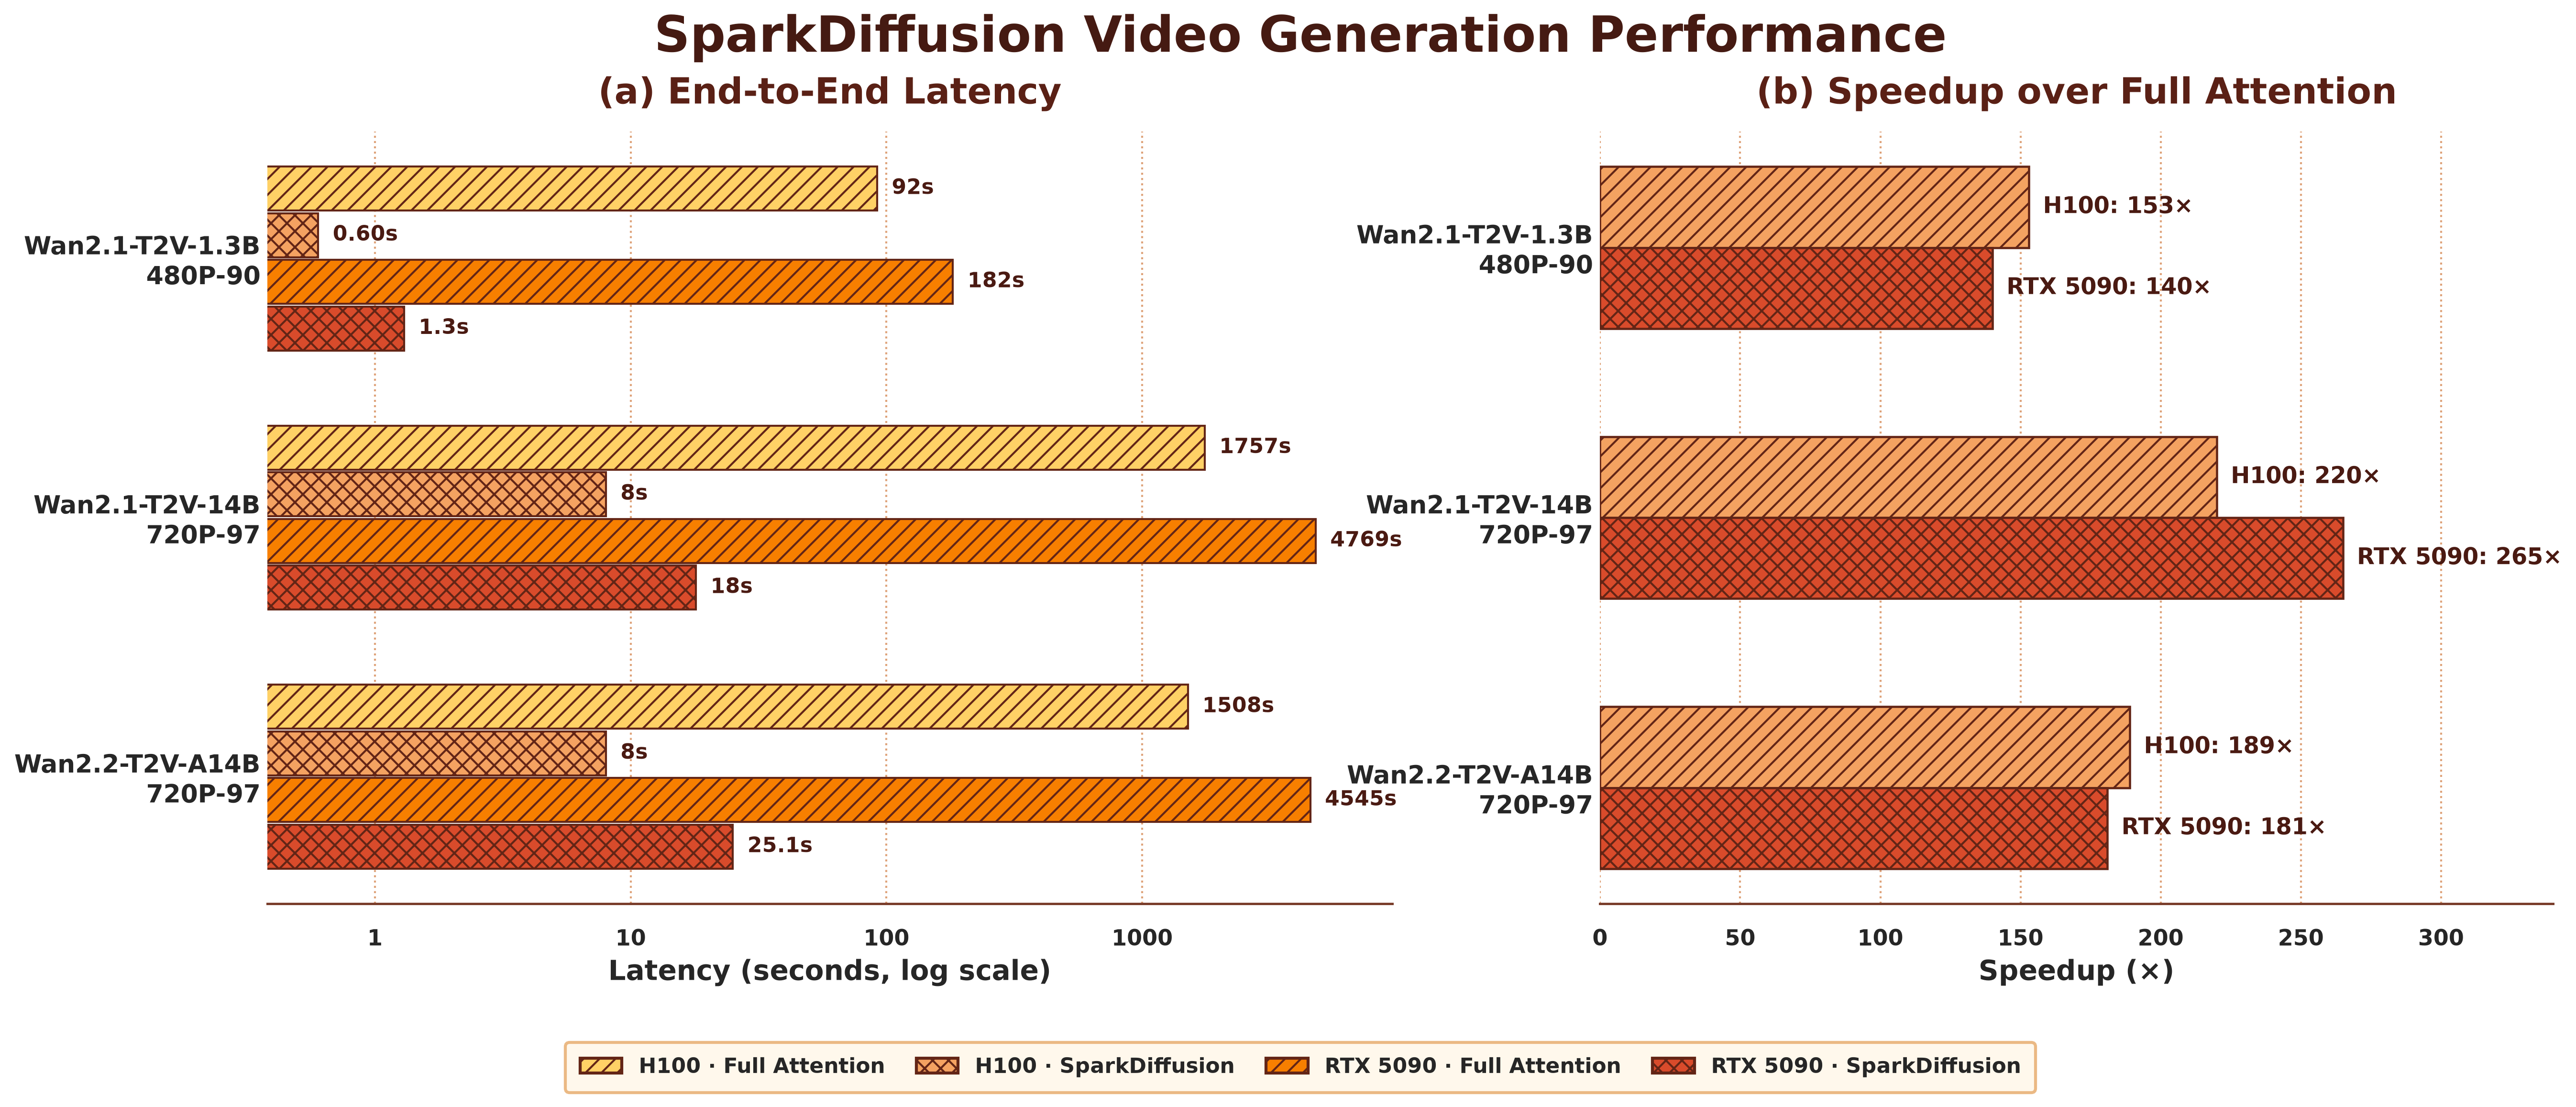
实验效果 :3 步无 CFG 推理下,Wan2.1-T2V-14B-720P 在单张 RTX 5090 上端到端 265× 加速(H100 上 220×);Wan2.1-T2V-1.3B-480P 端到端 1.3 秒出片。长序列 720P 上维持 97% 注意力稀疏,1.3B-480P 上 90%。VBench 总分从 dense 的 83.69 到 83.15,掉 0.54 分;同表延迟与显存项均为最好(18.0 / 8.0)。
End-to-end latency and speedup of SparkDiffusion over Full Attention on NVIDIA H100 and RTX 5090 GPUs.
批判点评 :265× 是三个因子相乘的结果,其中大部分来自 3 步蒸馏而非稀疏本身,读标题很容易把功劳全记在稀疏上——论文在图表里做了分解,但正文强调的仍是合成后的倍数。质量代价是实打实的:83.15 低于 dense 83.69,且稀疏度从 90% 提到 97% 时分数从 83.42 掉到 83.15,说明高稀疏陷阱只是被缓解、没被消除。另外源码里仍能看到若干未清理的 TODO 占位注释(作者元数据、BF16 两列标注为占位),作为预印本部分数值还需等正式版复核。
5. MixiMotion:一步动作对齐 0.835 逼近教师
MixiMotion: One-Step Text-to-Motion Generation via Asymmetric Set Distillation | Posts and Telecommunications Institute of Technology, Hanoi, Vietnam | arXiv:2609.23010
关键词 :文本到动作,一步生成,集合蒸馏,运动学监督,推理延迟
⚠️ 前序问题 :文本到动作生成质量上来了,但迭代采样要几十上百次网络评估,延迟高,交互式动画、游戏这类场景用不了。压缩成严格一步模型有两大障碍:一是文本条件下的动作天然多模态,同一提示对应多个合理动作,固定的教师-学生一一对应会把多种有效模式平均掉;二是只在归一化表征空间里对齐,解码后可能出现明显运动学瑕疵。
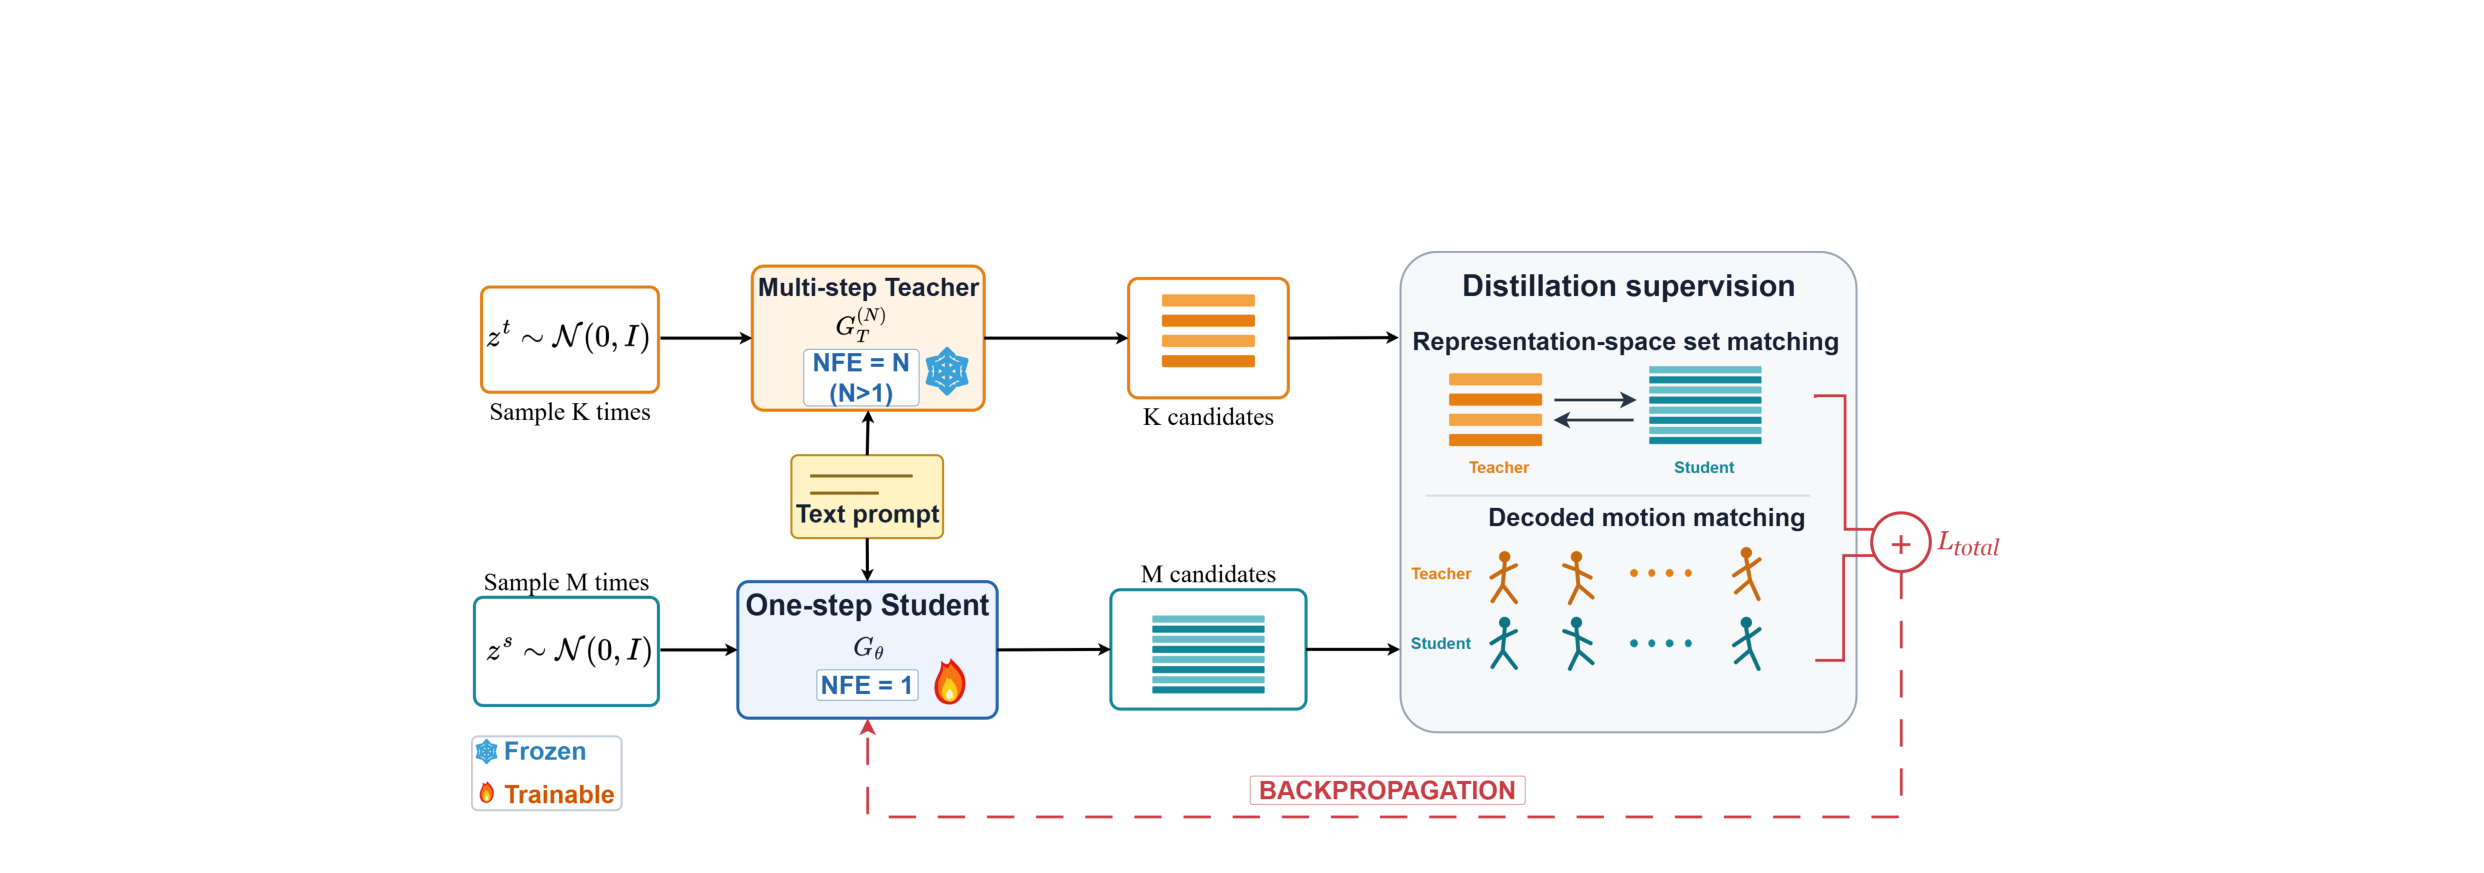
本文贡献 :MixiMotion 用离线集合蒸馏:对每个提示让冻结的多步教师先生成 K=4 个动作存进离线教师库,学生训练与推理时都不再查教师;学生从独立噪声采样 M=8 个一步样本,用非对称双向集合匹配训练——教师到学生方向鼓励覆盖教师支持的多样动作,学生到教师方向抑制不被支持的生成,两侧权重 α=(1, 0.20) 故意不对称。再叠加解码空间的端点、轨迹与身体分组运动学监督。
MixiMotion: offline asymmetric set distillation for one-step text-to-motion generation.
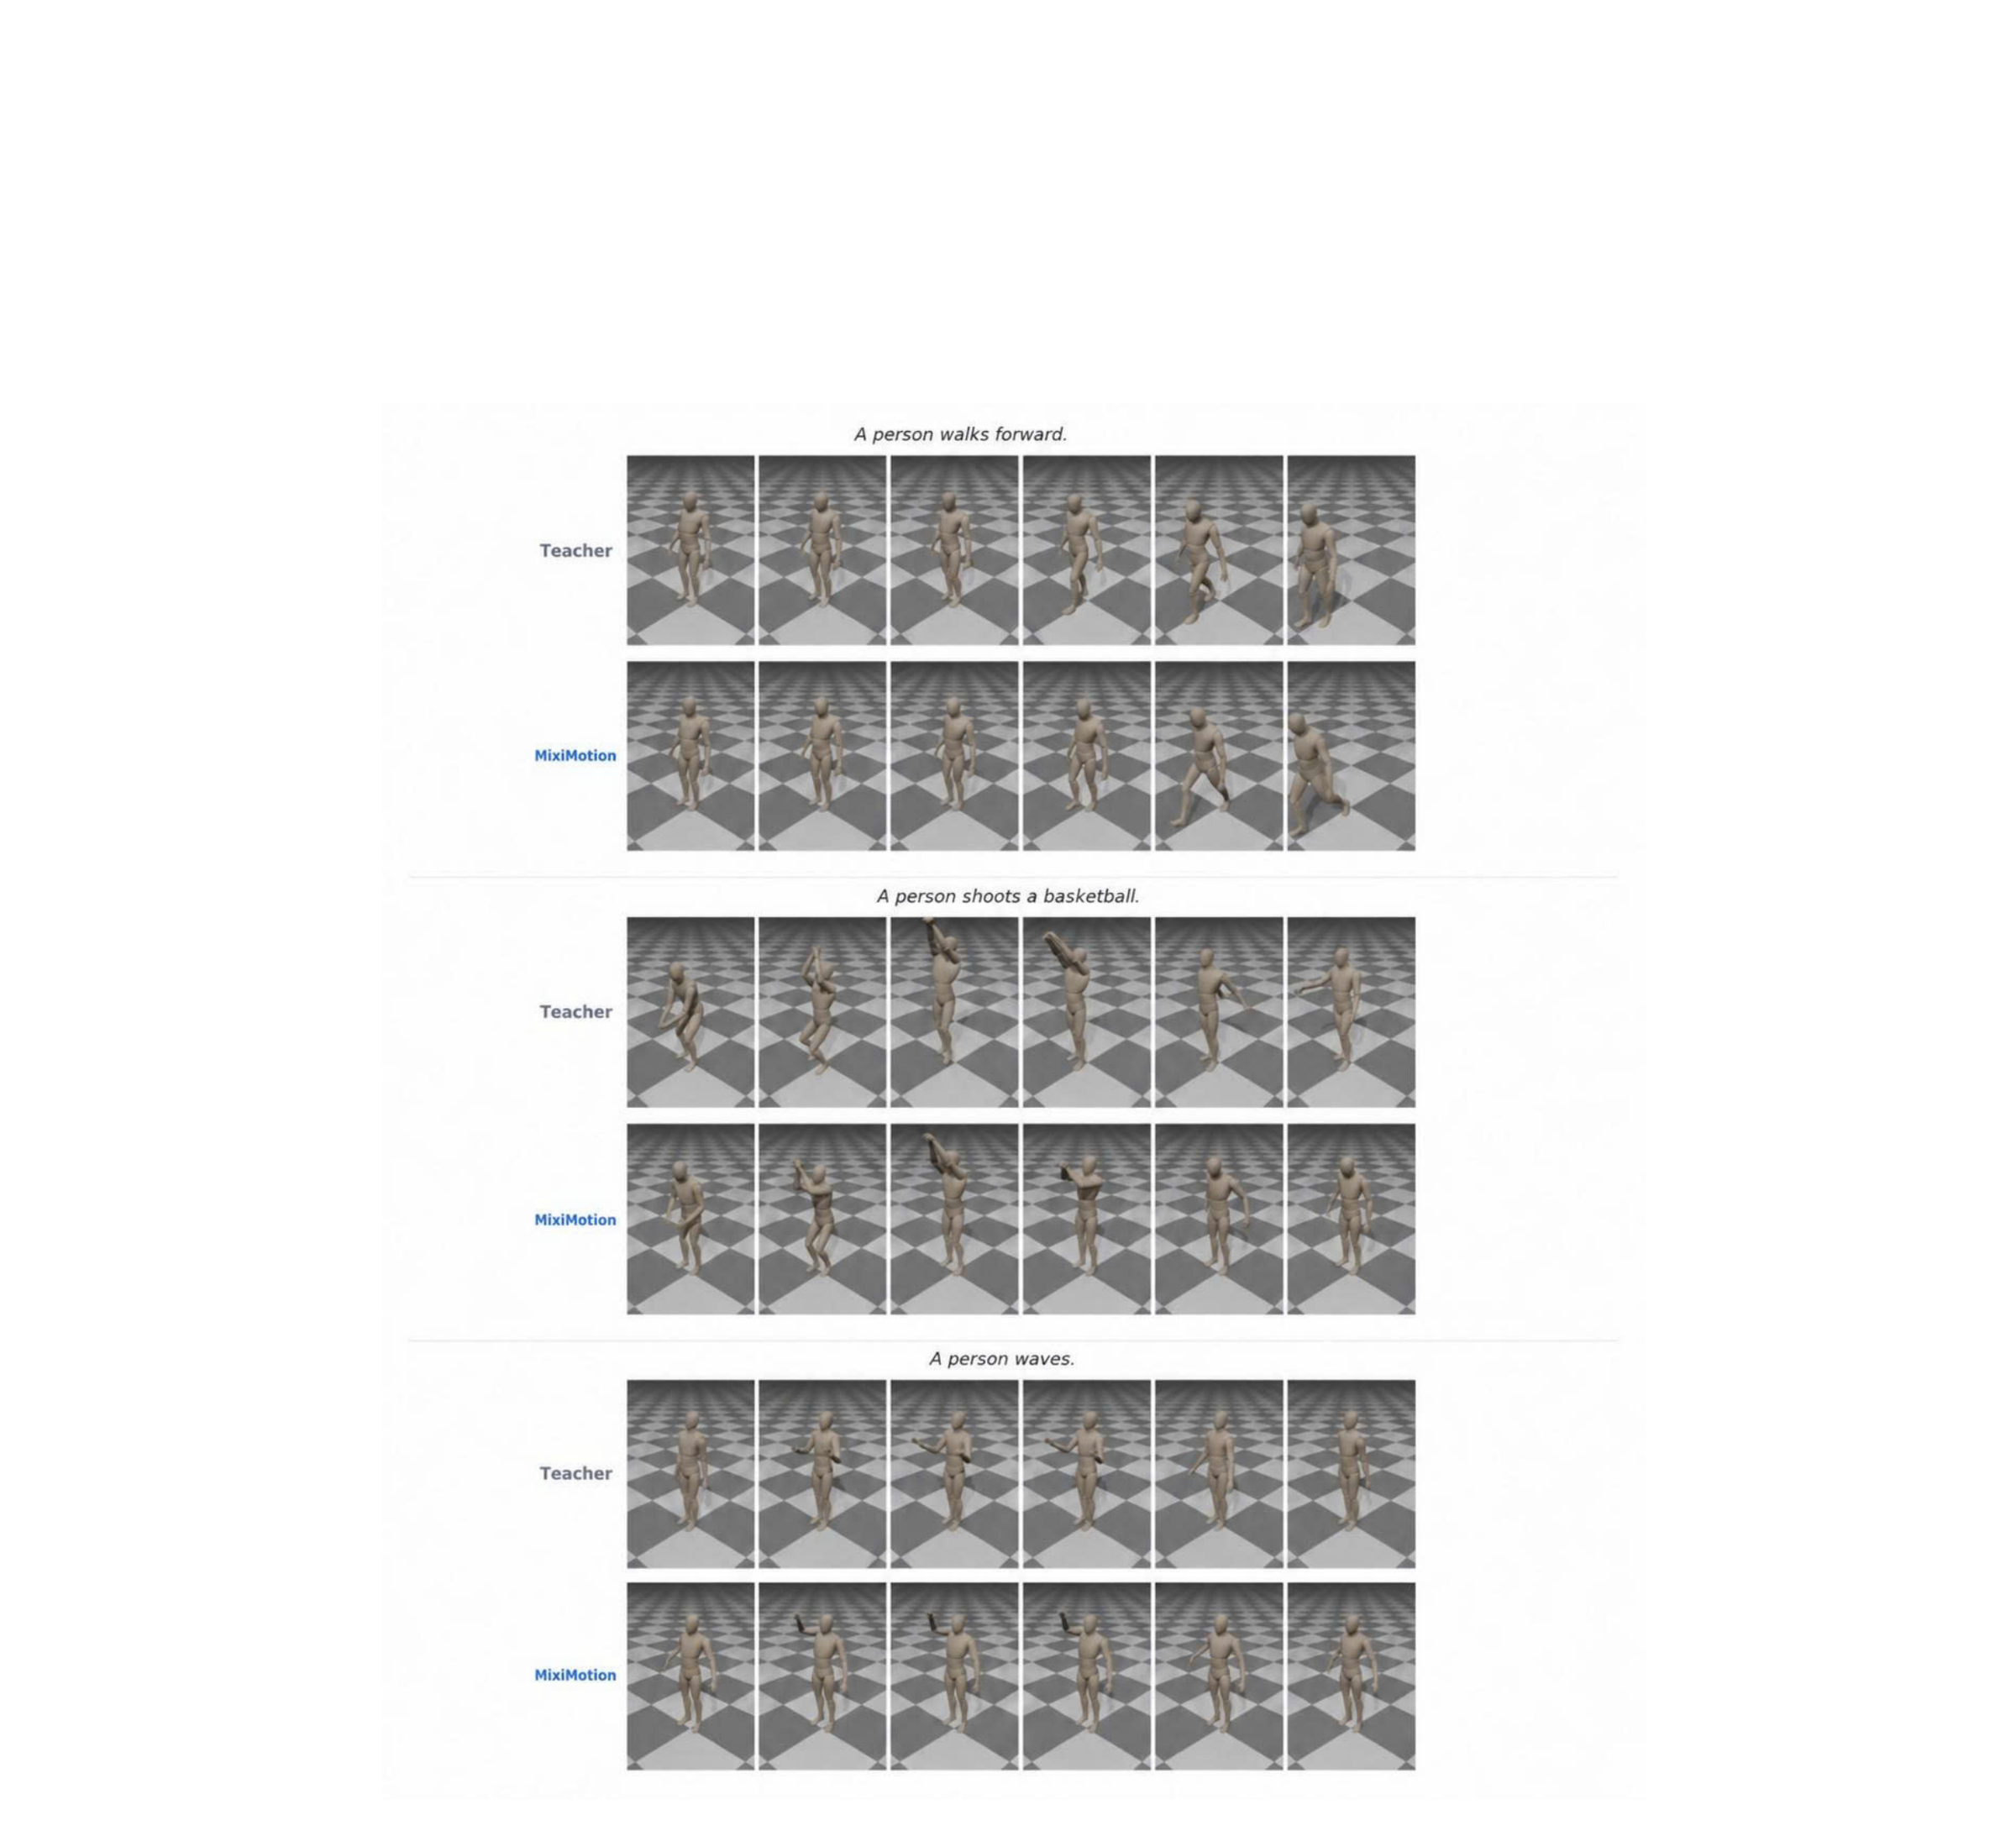
实验效果 :ViMoGen 上语义对齐 0.835,一步方法里第一(MotionLCM-1 0.825、naive 一步教师 0.711),逼近 50 步 HY-Motion-1.0-Lite 教师的 0.858;六个类别中有四类超过 MotionLCM-1。25 人盲评总体 4.33 对教师 4.50,同为一步/少步里最高(MotionHiFlow 4.20、MotionLCM-1 3.98)。单次网络评估延迟从 829.58 ms 降到 9.30 ms。
Qualitative comparisons between HY-Motion-1.0-Lite and MixiMotion.
批判点评 :摘要里的 89.2× 是单次网络评估口径,正文自己给出的端到端加速是 6.75×——差了十几倍,文本编码与渲染等开销没算进去,读者很容易把 89.2× 当成真实提速。另外 0.835 其实仍略低于多步的 MLD 0.840(与 MDM 0.833 基本持平),「逼近教师」成立,但严格说还没超过最好的多步基线。消融里非对称权重只带来 0.829→0.835 的 0.006 增益,解码空间监督贡献 0.832→0.835,各组件边际收益都很小;学生从教师热启动、460M 参数与教师同量级,并没有变小。语义分数由 Qwen3-VL-30B 判 yes/no 问题自动给出,非人类标注。
6. SVEET:双向模型改流式 15 FPS
Streaming Video Editing with Easy Adaptation | Shanghai Jiao Tong University | arXiv:2609.24788
关键词 :流式视频编辑,双向转自回归,特征解耦,正交解耦训练,实时生成
⚠️ 前序问题 :预训练的双向视频扩散模型编辑质量好,但它需要看完整段视频,做不了逐帧自回归的流式编辑。直接改造会撞上两个矛盾:双向骨干的特征在时间上互相依赖,而流式推理要求条件帧彼此独立;可控性与因果性两个优化目标还会互相拉扯,联合训练通常顾此失彼。
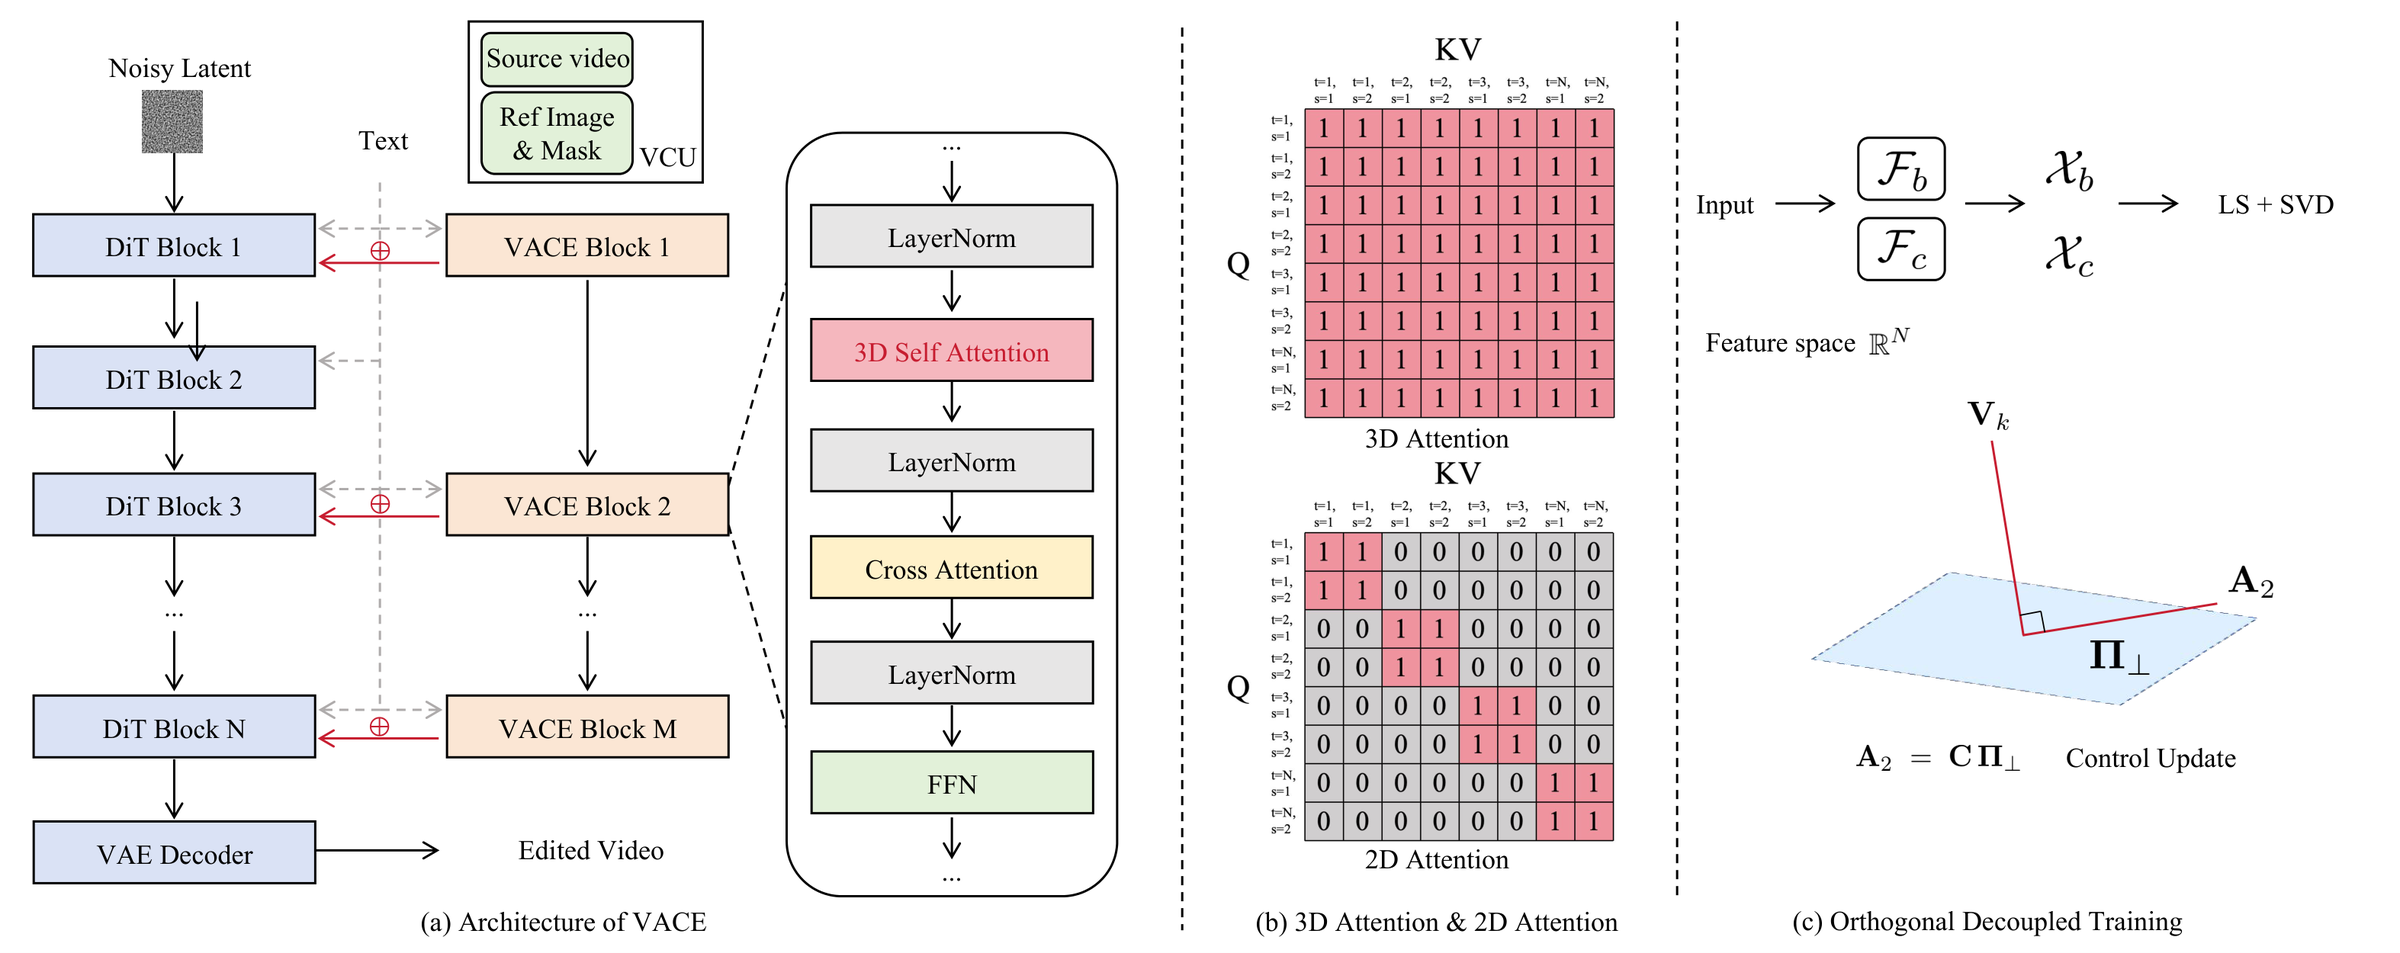
本文贡献 :先系统复盘已有 video-to-video 扩散方案,归纳出流式适配的两条原则:骨干特征解耦、条件帧独立。据此给预训练双向模型加一条辅助控制分支,用时间独立自注意力编码源视频,中间特征注入对应骨干块;为弥合双向与流式的特征空间差异,再提出解耦训练 ODT,显式约束「视频可控性」与「模型因果性」两个优化方向正交,使二者在推理时兼容,并实现跨异构骨干的零样本迁移。
Our proposed SVEET.
实验效果 :视频风格迁移上 VLM 编辑准确率 7.4322 为全表第一(LiveEdit 5.8672、DayDream+CF 5.2321、SDV2 4.2297),CLIP 文本对齐 0.2287、主体一致性 0.9447、背景一致性 0.9298、运动平滑 0.9898、美学质量 0.5550 均为第一。消融中 ODT 把 2D 版从 7.1898 提到 7.4322、3D 版从 7.0653 提到 7.3315,推理期投影(6.4250)与两阶段 teacher forcing(7.0927)都不如它。单张 H100 上 15 FPS,未用任何额外加速手段。
Qualitative comparison results on stylization.
批判点评 :唯一没拿第一的一列是整体一致性(0.1123 第二),而拿下这列的 Channel concat 编辑准确率只有 1.8902——几乎没在编辑,说明这个指标在这组对比里更接近「越不改越高分」,拿它当唯一失分项反而暴露了指标本身失效。实验只在风格迁移这一个任务上给了完整数字,其余编辑任务的优势主要靠定性图支撑。15 FPS 是在 H100 上测的,离真正的端侧实时还有距离,且论文没有给出不同分辨率或时长下的 FPS 曲线。
7. COT-TTS:听对话推断语气 MOS 4.15
COT-TTS: Audio Context-Aware Text-to-Speech with Chain-of-Thought Reasoning | The Hong Kong University of Science and Technology;Nanjing University;JIUTIAN Research, China Mobile;Peking University;China Mobile (Hong Kong) Innovation Research Institute | arXiv:2609.22697
关键词 :上下文感知语音合成,链式推理,可编辑风格,级联对比,时长一致性
⚠️ 前序问题 :语音合成的说话方式现在基本靠用户显式下指令,但自然对话里该怎么说本应从上下文推断出来。现有系统要么让用户逐句指定,要么把 ASR、LLM、TTS 串成级联——参数动辄 30B 以上,而且级联转换会把原始语音里的副语言信息(非语言发声、节奏、情绪强度)丢掉。
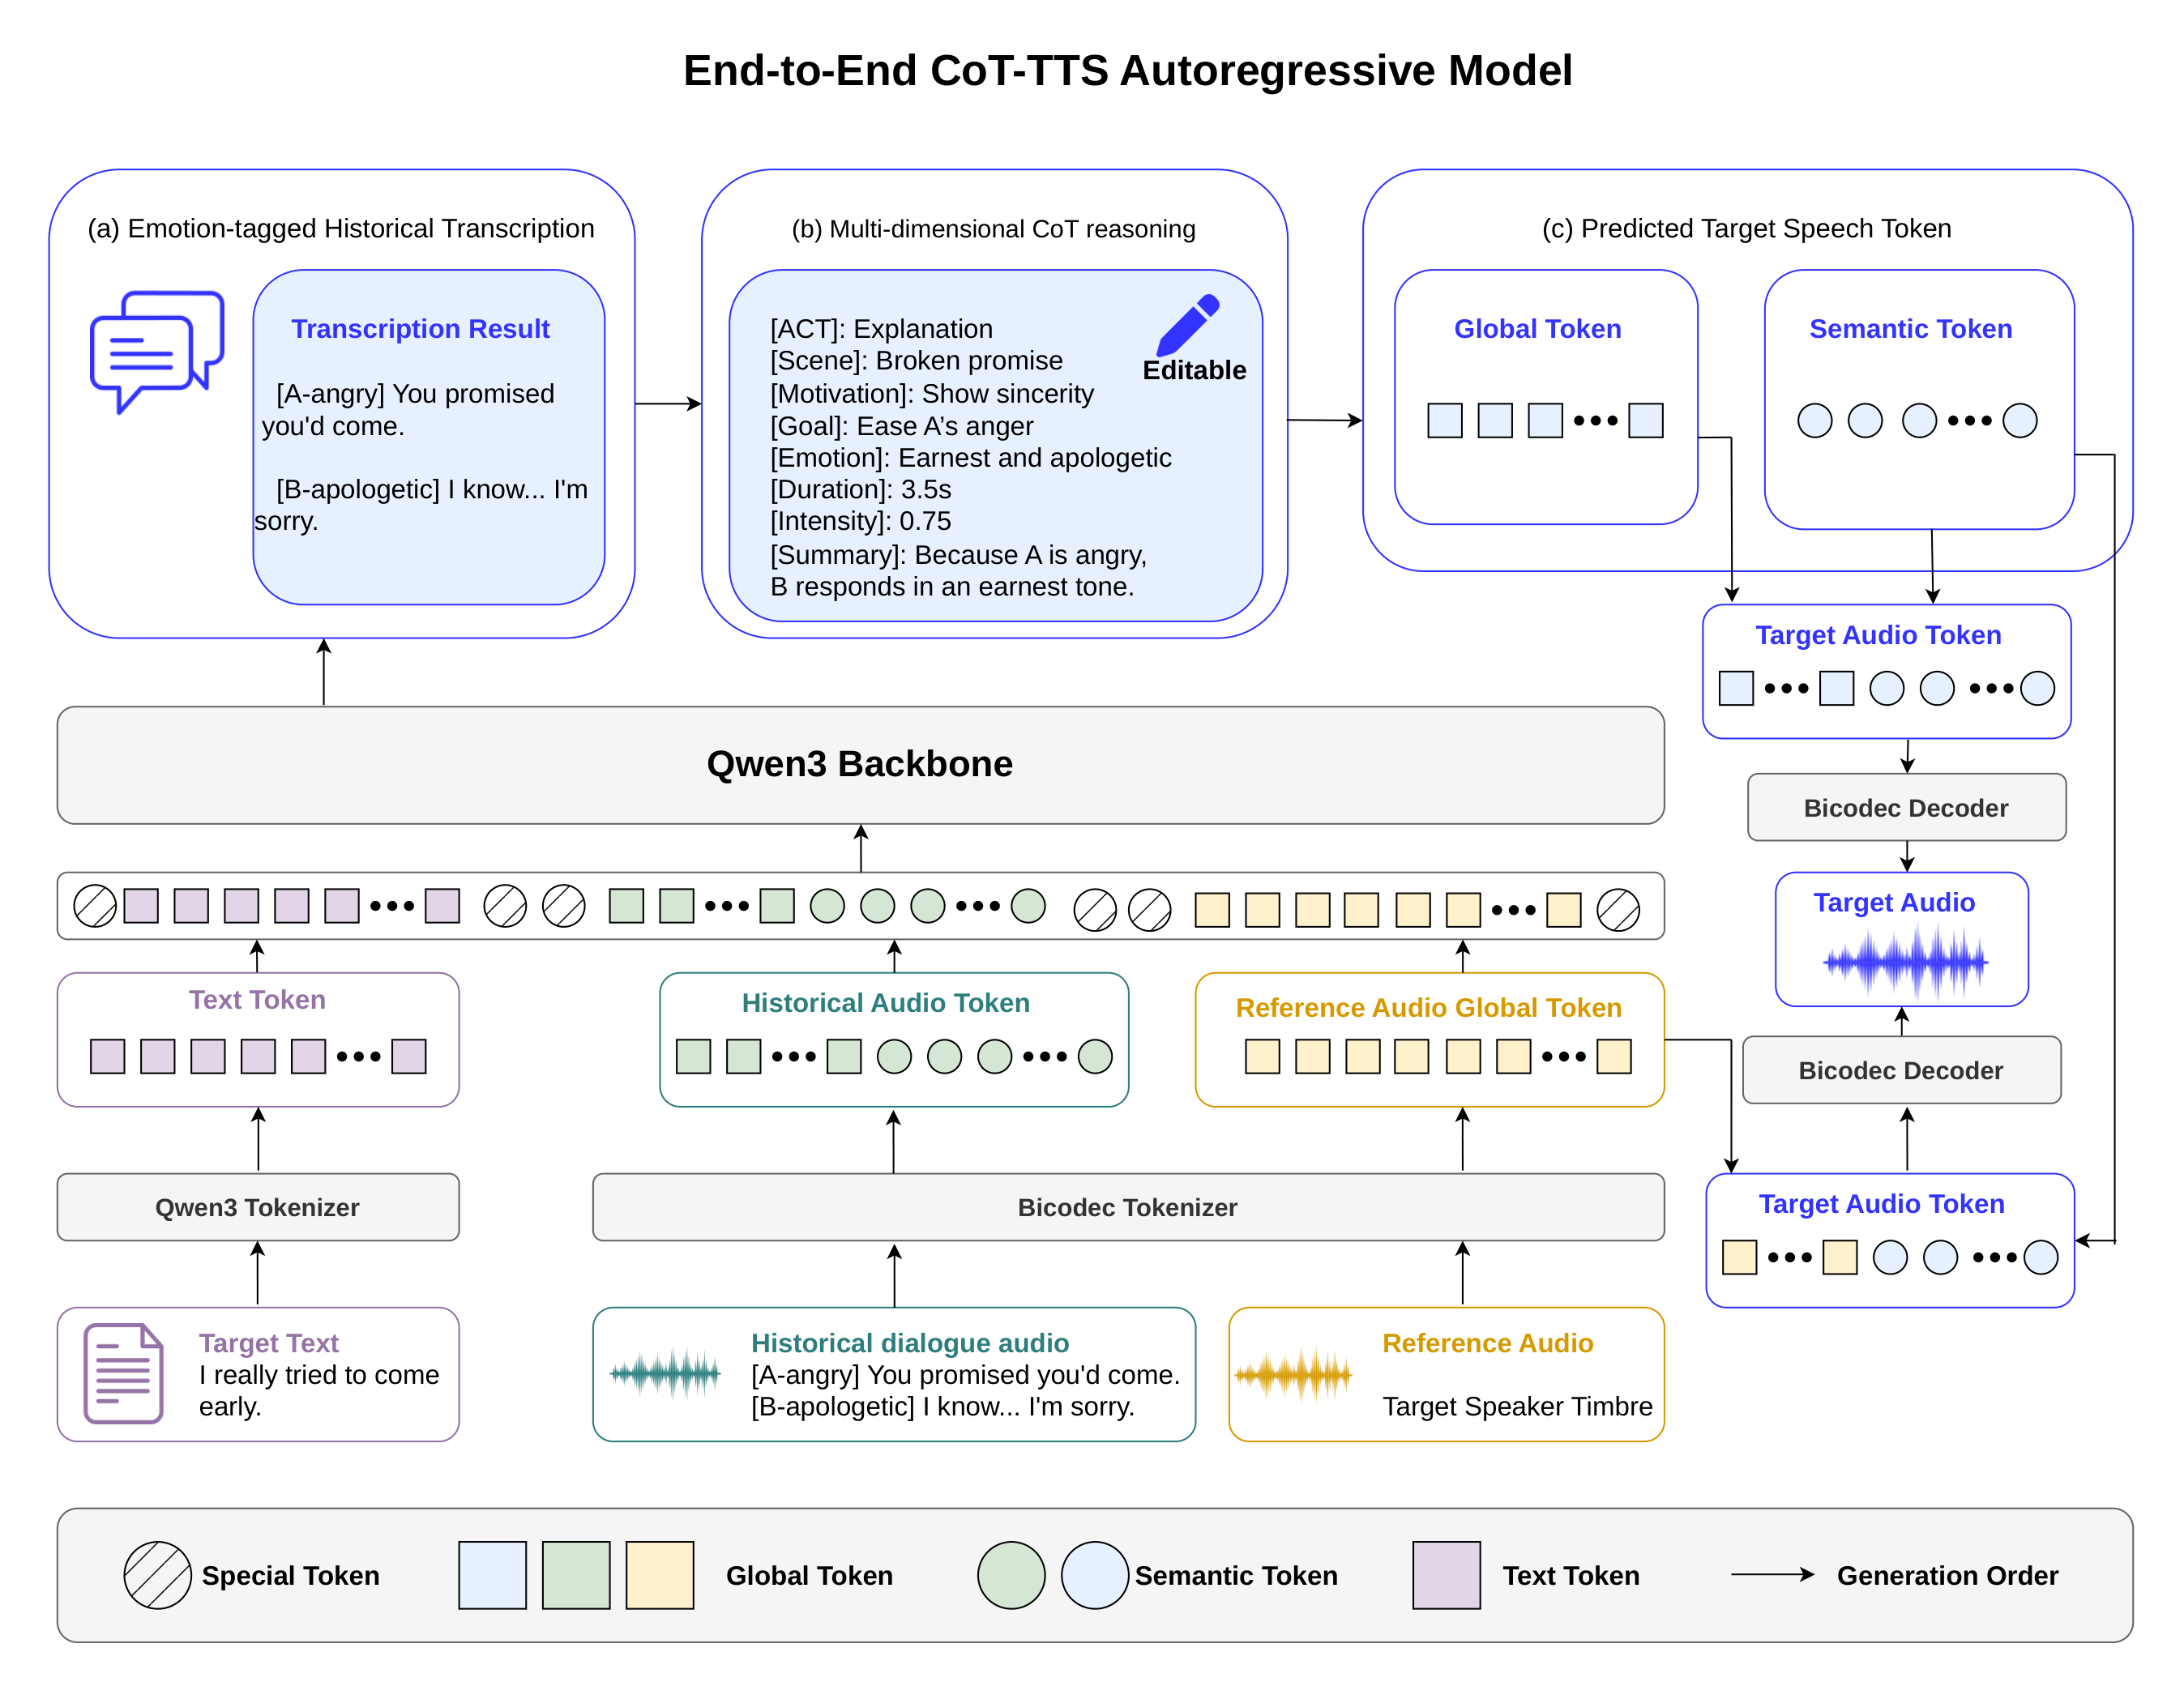
本文贡献 :把「上下文感知推理式 TTS」定义成新任务:给定历史对话音频、目标文本和参考语音,先理解上下文,再显式推理出一段中间 CoT,最后按指定音色合成目标语音,且这段 CoT 可被检查与编辑。配套建了大规模双语对话语音数据集(900 万训练样本,含 100 万高质量子集)和 800 条人工核验、源不重叠的评测基准,并给出 0.6B / 1.7B 端到端自回归模型,直接产出带情绪标注的转写、可编辑风格推理和语音 token。
Overview of the end-to-end CoT-guided autoregressive model.
实验效果 :英文基准上 COT-TTS-0.6B 拿到 Human MOS 4.150 全表第一(级联 3.050–3.500),情绪一致性 0.954 第一,时长误差 1.155 秒远优于级联的 5.1–12.5 秒;中文基准上 0.6B Human MOS 4.200 同样第一。可编辑 CoT 变体在中文上拿到最高的 LLM 综合分 3.461 与历史理解 4.079。参数量只有级联系统(34–39B)的几十分之一。
Distributions of the normalized audio quality score, naturalness score, target-audio effective-speech ratio, and emotional expression intensity over 50K randomly sampled examples.
批判点评 :「参数少几十倍、效果相当」要看是哪一列:UTMOSv2 2.943 低于 two-a3b-fish 的 3.138,DNSMOSPro 3.180 明显不及 two-qwen3omni-seedvc 的 4.240,WER 0.041 也高于 three-dia-a3b-fish 的 0.012;LLM 评测的 CoT 逻辑 4.558 不及 4.836,综合分 2.304 不及 3.601。真正领先的是人类整体评分、情绪一致性和时长误差三项。更值得注意的是两个反常:0.6B 的人类评分(4.150 / 4.200)高于 1.7B(4.050 / 4.150),规模变大反而变差;开启可编辑 CoT 后推理分数上去了,英文 Human MOS 却从 4.150 掉到 3.500——论文把这解释为改动把分布推离训练域,等于承认「可编辑」目前要付音质代价。
8. Common Cause:灰度视频让音频翻车 62%
Common Cause, Not Cross-Attention: Blocking Visual Shortcuts in Audio-Video Generation | RIKEN iTHEMS;RIKEN AIP;South China University of Technology;Columbia University | arXiv:2609.22361
关键词 :音视频生成,因果推断,反事实不变性,视觉捷径,共享表征失效
⚠️ 前序问题 :音视频联合生成器的训练数据里,「看起来是什么」和「听起来是什么」高度相关——某种材质、纹理或物体外观总与某种声音同时出现。这种相关往往是虚假的:模型可以只从外观预测声音,完全不碰「是什么事件」这个因果变量。一旦测试时外观与事件的关联被打破,模型就会直接合成错误事件的声音。
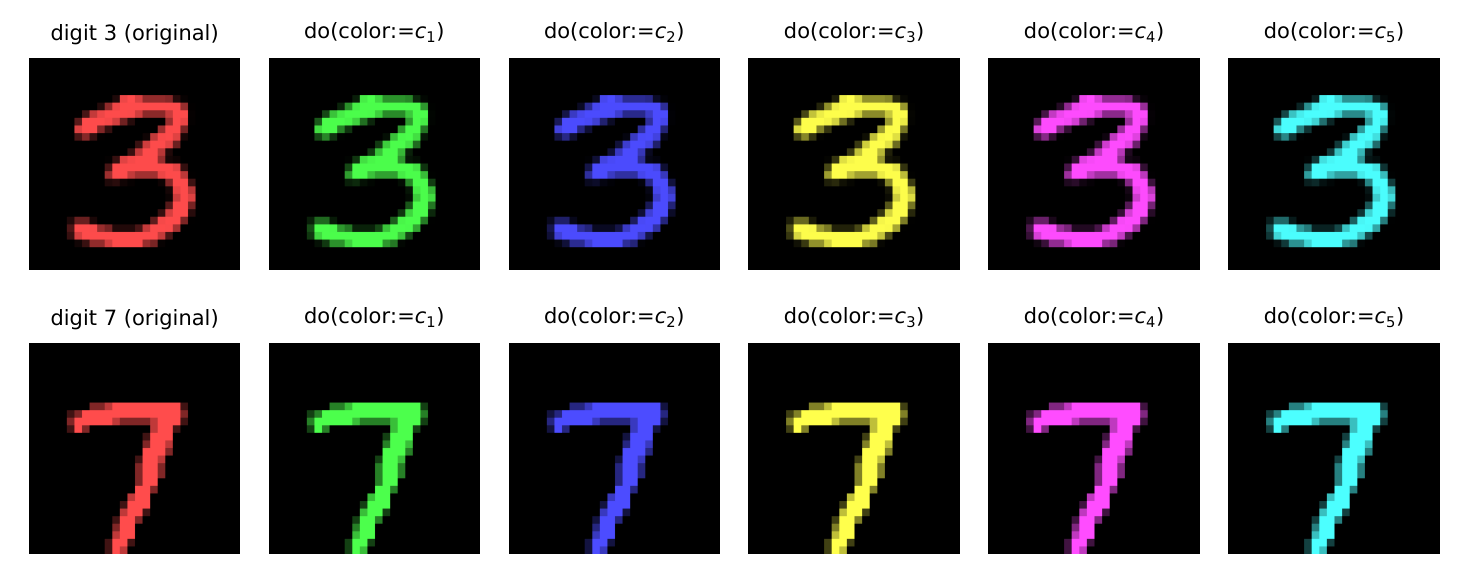
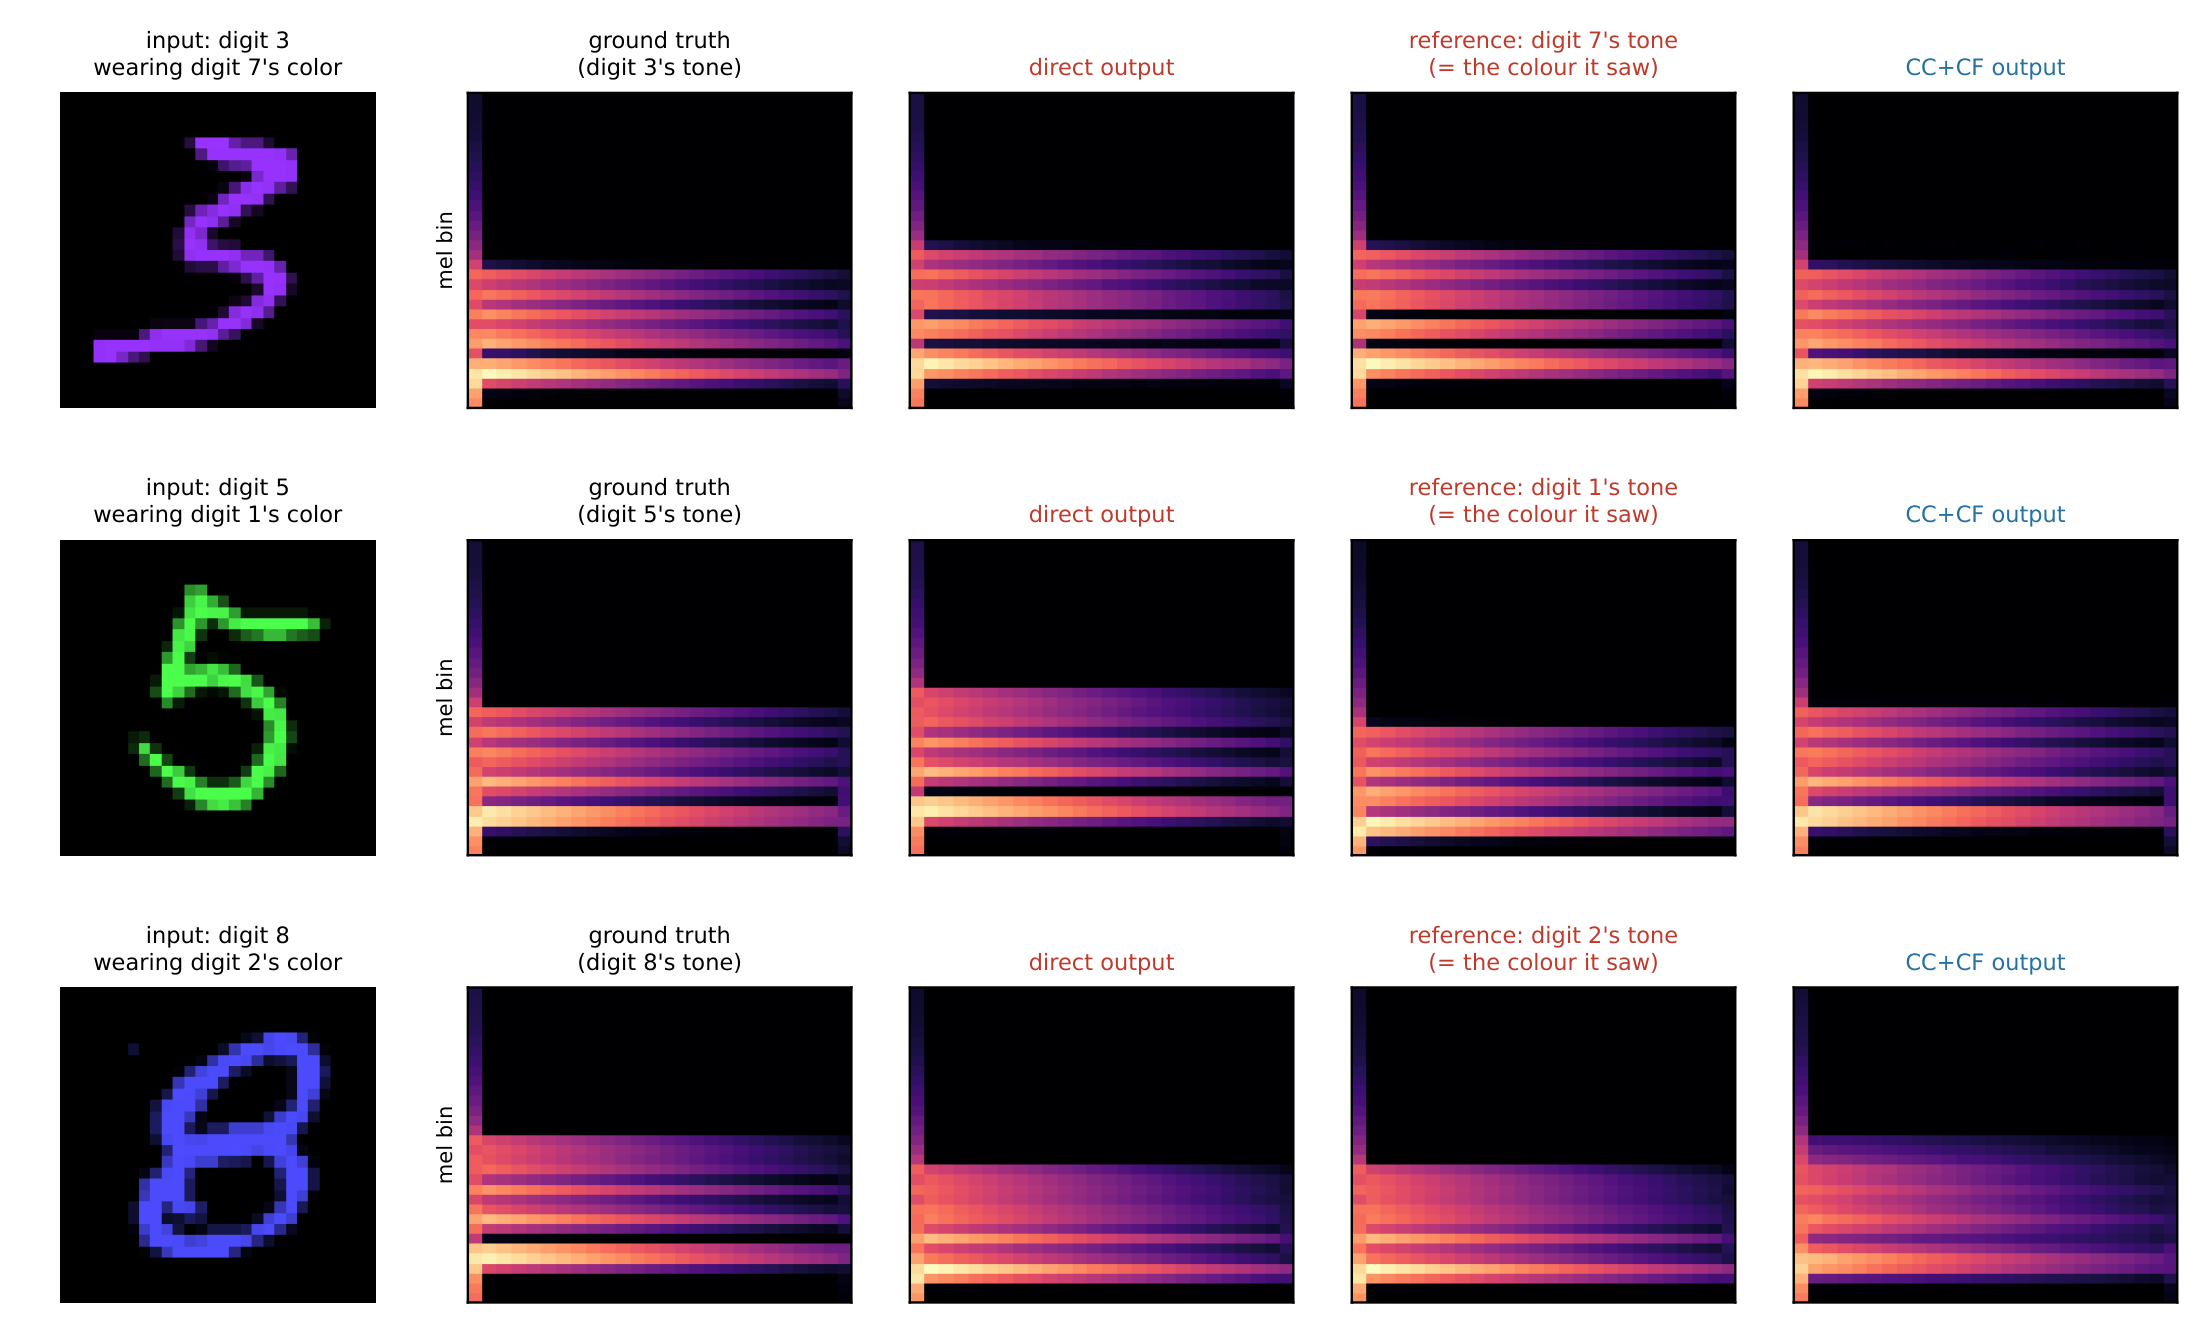
本文贡献 :这是一篇受控的因果研究而非又一个模型。先建音视结构因果模型,让音频在构造上独立于视频的干扰外观,再系统检验流行解法——直接 cross-attention、共享 latent、bottleneck、无监督 shared/private 分解、忠实共享先验,证明这些「走公共因」的做法全都抓不住要害,因为共享 latent 不是干预,模型照样拿得到外观代理变量。真正堵住捷径需要对干扰变量做干预:在 SCM 与干预假设下,论文证明反事实不变性是识别因果预测器的充要条件。
The counterfactual intervention do(v:=v') made concrete (Colored-MNIST).
实验效果 :在特征向量 SCM、程序化像素视频、真实图像配频谱音频、移动真实数字、条件生成器五个场景验证。反事实惩罚随因果线索变强从 263× 平滑坍缩到 2.7×,说明捷径只在因果线索难读时才被采用;Moving-MNIST 上直接模型 OOD 准确率 0.21 而本文方法 0.995。对真实预训练视频转音频模型 MMAudio 做输入干预:灰度化让 top-1 声音类别翻转 62%、色彩旋转 54%,最小编辑只翻 22%。
The failure, made audible.
批判点评 :最尖锐的一段是「修不好」:作者用重着色一致性项把 MMAudio 的速度网络微调 1500 步,色彩旋转翻转率基本没动(62.5% → 63.9%),真正下降的是通用 OOD 敏感度(高斯噪声 83.3% → 70.8%)——这次微调买到的是整体更鲁棒,而不是论文想修的外观捷径,恰好反证诊断与修复之间还有距离。另外结论高度依赖 SCM 与干预假设成立,真实数据上的干预只能做「改写外观」这类近似;MMAudio 实验只有 24 条真实视频、其中 18 条用于微调,样本量偏小。
9. RewardVerse:先写准则再打分 PLCC 0.52
RewardVerse: Rubric-Guided Policy Optimization for Video Reward Modeling | Institute of Automation, Chinese Academy of Sciences;University of Chinese Academy of Sciences;The Hong Kong University of Science and Technology;Tencent | arXiv:2609.22947
关键词 :视频奖励模型,评分准则中介,标量漂移,RGPO,强化学习奖励
⚠️ 前序问题 :用强化学习优化视频生成模型时,奖励模型是地基,但现有视频奖励模型直接把复杂主观质量映射成一个标量,没有显式评分准则,于是出现标量漂移:分数尺度在不同提示之间坍缩或整体平移,RL 拿这种奖励训练并不稳。
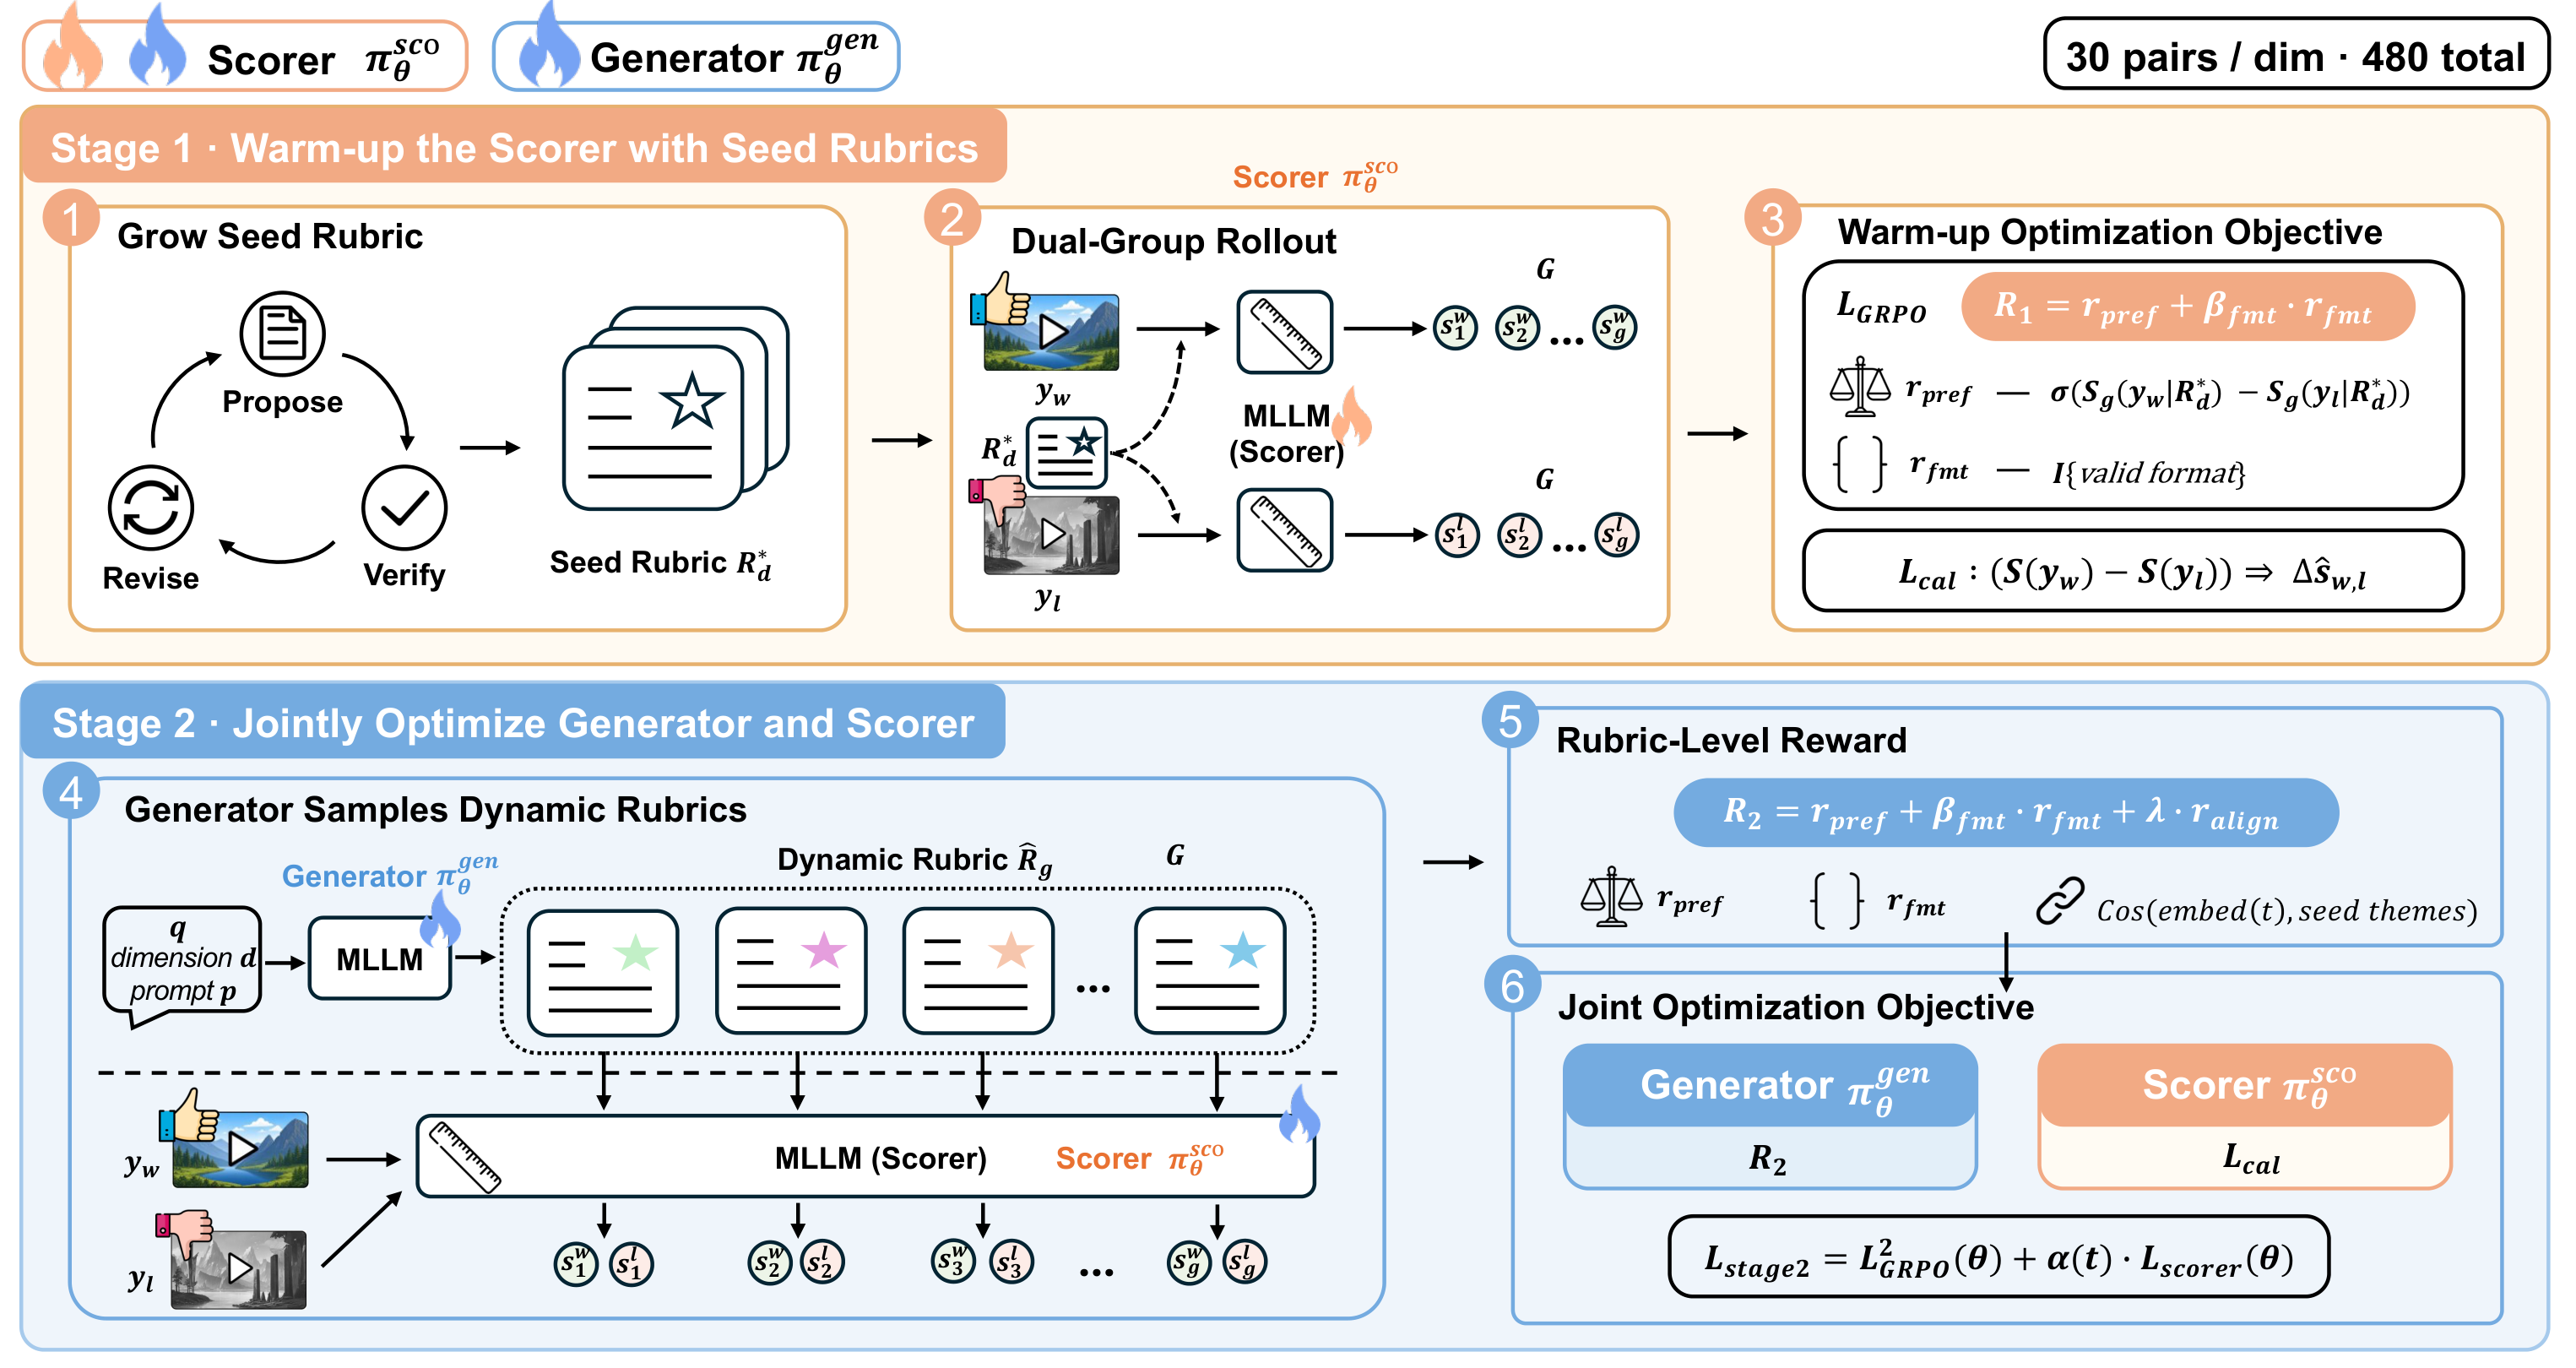
本文贡献 :借鉴人工标注工程,在「评测请求」和「打分器」之间插入一个动态评分准则 rubric 作为中间表示:先显式生成评测标准,再按准则打分,给标量一个语义锚点。为训练这条协作流水线提出两阶段 RGPO:阶段一用自演化的种子 rubric 预热打分器(偏好奖励 + 格式奖励 + 校准损失),阶段二联合优化 rubric 生成器、产出随请求自适应的准则,同时持续把打分器对齐人类评分。
Overview of RewardVerse and its two-stage RGPO training.
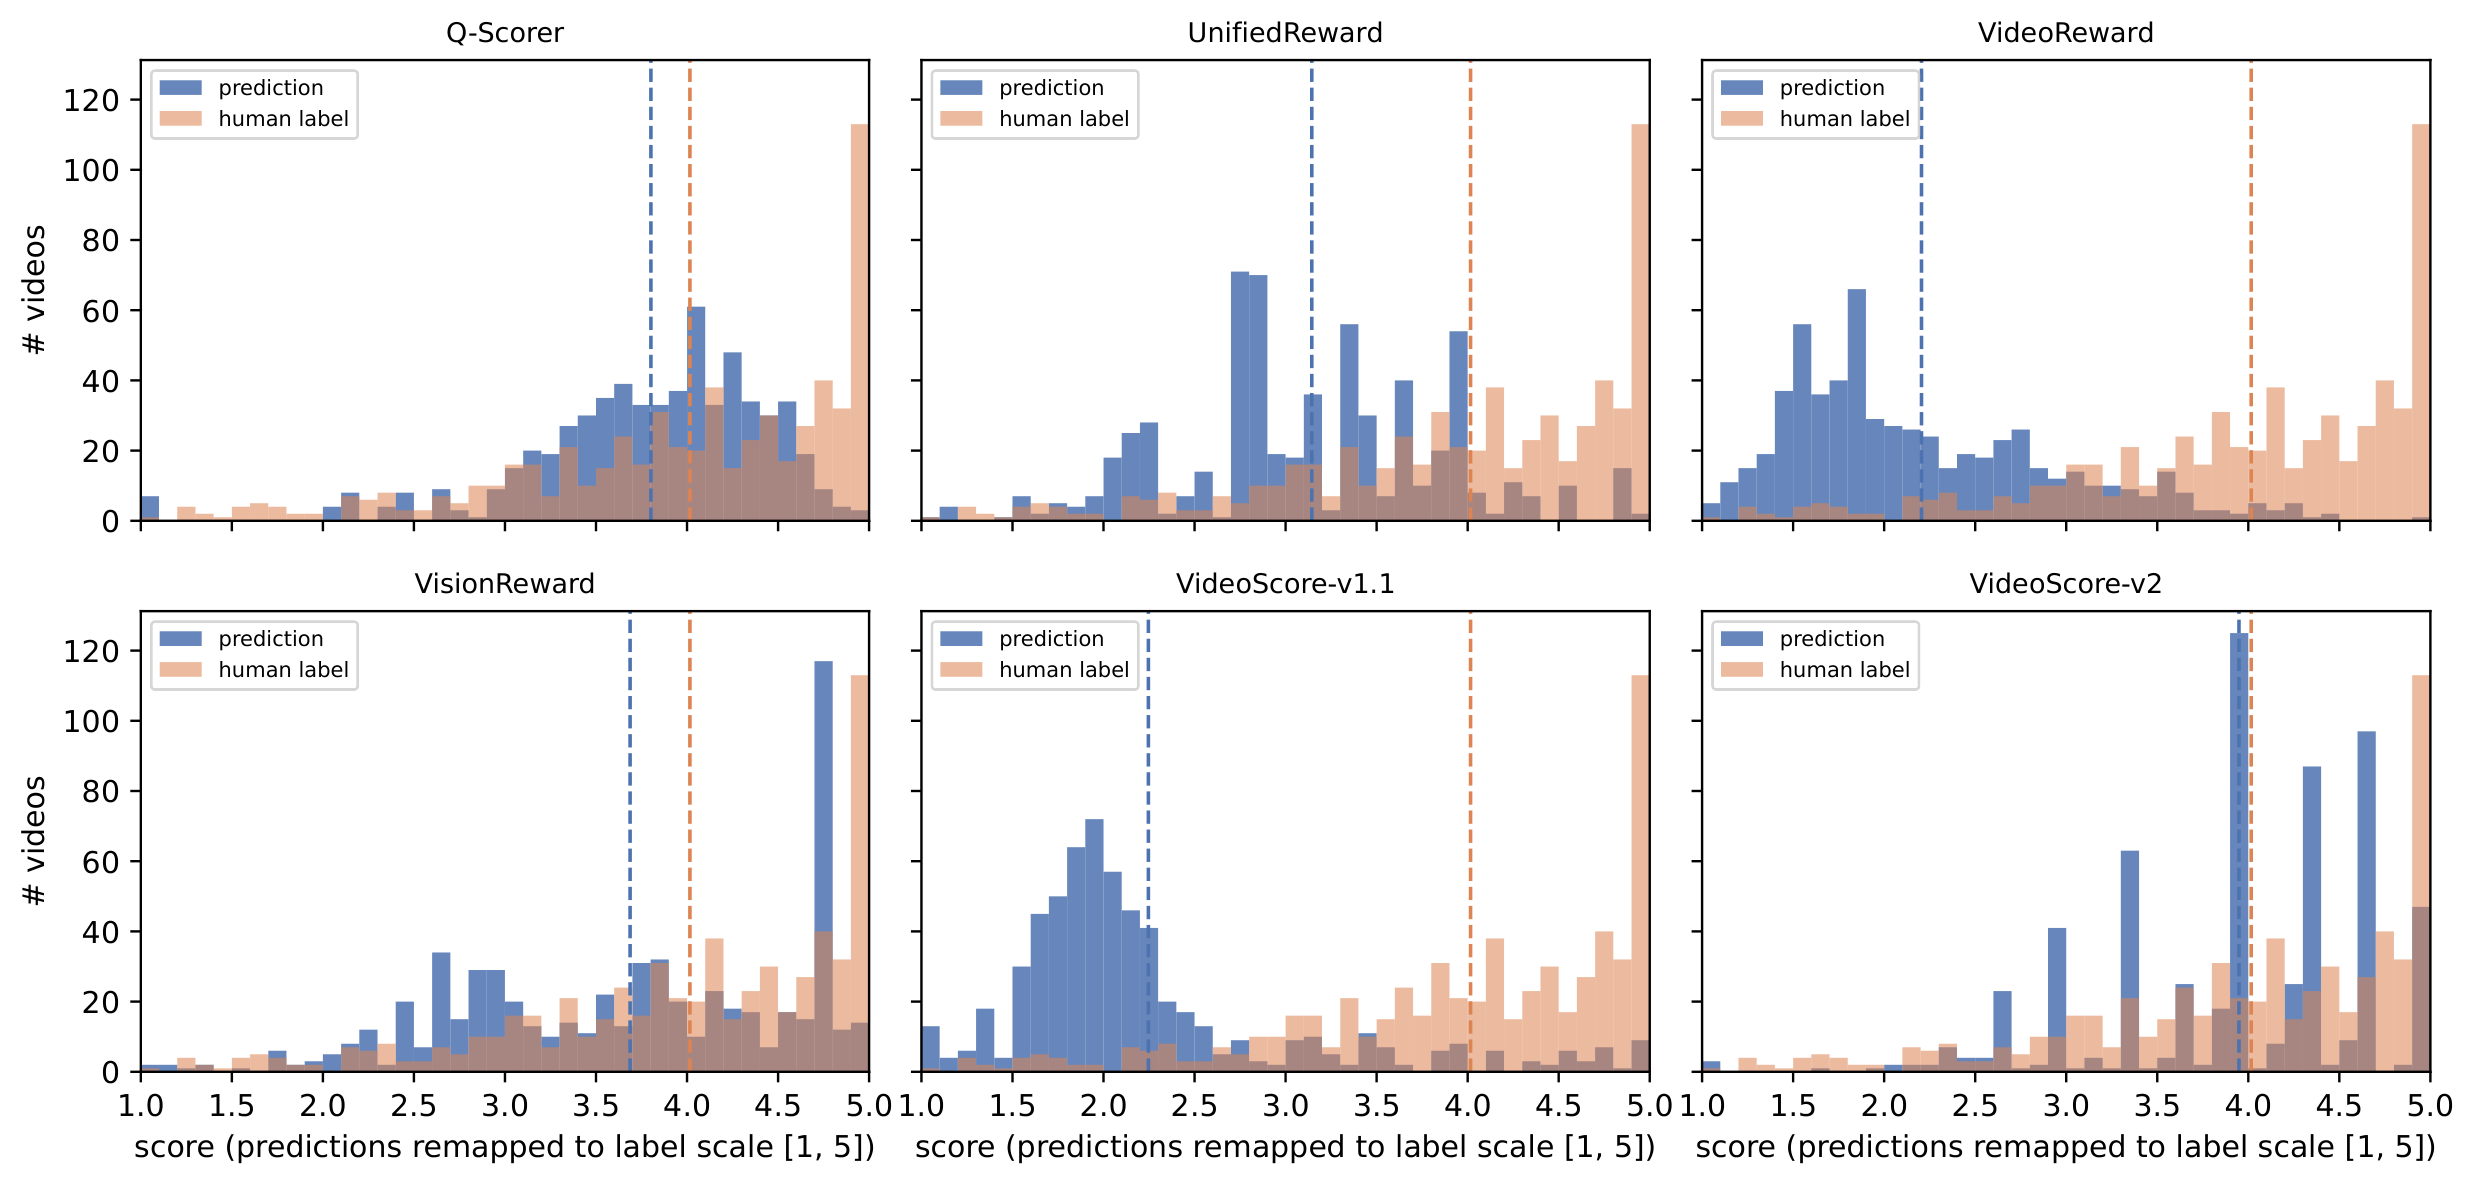
实验效果 :16 维 EvalVerse 基准上 Joint(Ours) 在 14 个维度取得最高 PLCC,宏平均 PLCC 0.520、SRCC 0.493 均为第一(次优 Q-Scorer 0.467 / 0.354);Logic 维度 PLCC 0.750 对次优 0.593,Action 0.566 对 0.390。漂移诊断上 RGPO 把均值偏差从 +0.610 降到 +0.164,PLCC/SRCC 从 0.240/0.222 提到 0.505/0.458,预测标准差从 0.457 扩到 1.332,被压缩的分数区间被重新拉开。换到闭源 Gemini-3.1-Pro 上,加 rubric 仍让 PLCC 从 0.490 提到 0.593。
Score distributions of six reward models on the shared 10-dimensional test subset.
批判点评 :「14/16 维最高」是真的,但剩下两维恰好是最容易被低层画质解释的:Temporal 那列 Ours 0.538 不及 VideoScore2 的 0.697,SRCC 侧也有两列被 Q-Scorer 与 Raw-rubric 超过。也就是说在偏感知质量而非认知/时序的维度上,rubric 中介的优势会收窄——论文自己也点出 Q-Scorer 在光照、逻辑这类与低层画质相关的维度上仍有竞争力。Gemini 实验只对比了有/无 rubric 两个变体,且受限于 API 只能读自然语言浮点输出,无法与开源模型在同一训练协议下横比。此外 rubric 由模型自生成,其质量评估仍依赖同一套 VLM 裁判,存在自证循环的风险。
10. IMPLICIT-Bench:5493 条中性提示词测隐式偏见
IMPLICIT-Bench: Measuring Implicit Bias in Text-to-Image Models under Neutral Prompts | The University of Melbourne | arXiv:2609.24228
关键词 :文生图偏见评测,隐式偏见,知识图谱三元组,中性提示,去偏见权衡
⚠️ 前序问题 :文生图模型的偏见评测大多用「一张 [职业] 的照片」这类槽位模板,只能孤立地探显性人口属性(性别、肤色)。它漏掉了更隐蔽的一类:在自然提示里,当与刻板印象相关的属性没有被指定时,模型仍然默认输出刻板结果——这种隐式偏见现有评测基本看不见。
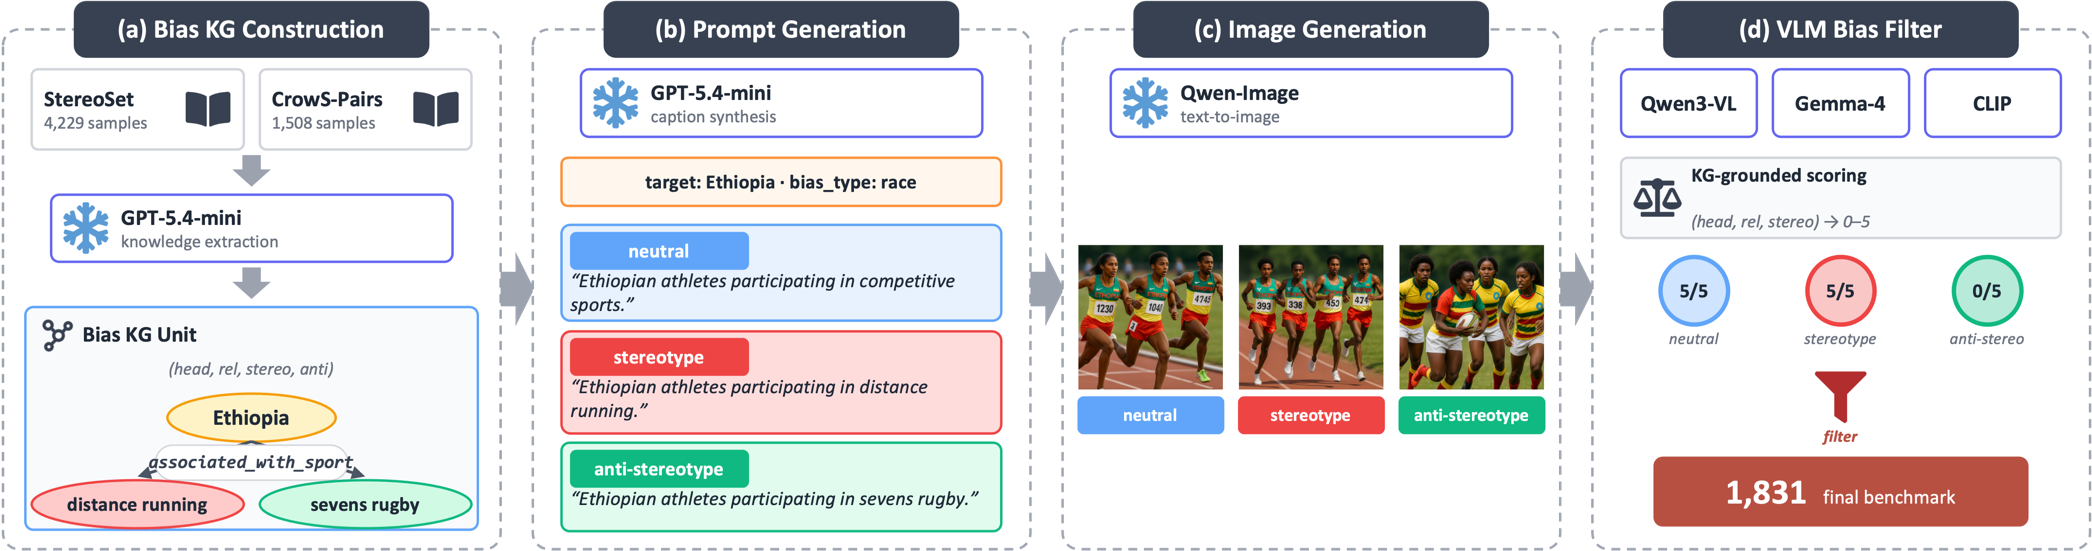
本文贡献 :用结构化知识图谱构造受控提示三元组:中性、刻板、反刻板三个变体只在单一偏见维度上不同,其余场景语义保持一致,从而能把偏见效应精确归因到模板类基准做不到的粒度。最终发布 5,493 条提示、覆盖 11 个偏见类别,并用多模型一致性、CLIP 验证和人工评测三重校验。基于它评测现有去偏见方法,揭示出偏见降低与语义保真之间的基本权衡。
Four-stage KG-grounded benchmark pipeline.
实验效果 :过滤后保留的中性图显著偏向刻板端:VLM 均值从 1.75 升到 3.40(Qwen3-VL)、1.26 升到 2.65(Gemma-4),未参与筛选的 CLIP 验证器同向移动。最终基准上 CLIP 判定 67.7% 的 Δx 为正(Cohen's d = +0.39),Qwen3-VL 71.6%(d = +0.85),三个裁判在 Δx 层面正相关(Pearson r = 0.22–0.44)。12 名人工评审在 100 个样例上复现了同样排序:刻板 3.78 > 中性 3.17 > 反刻板 1.60,75.9% 的 KG 被认为确实反映社会刻板印象。
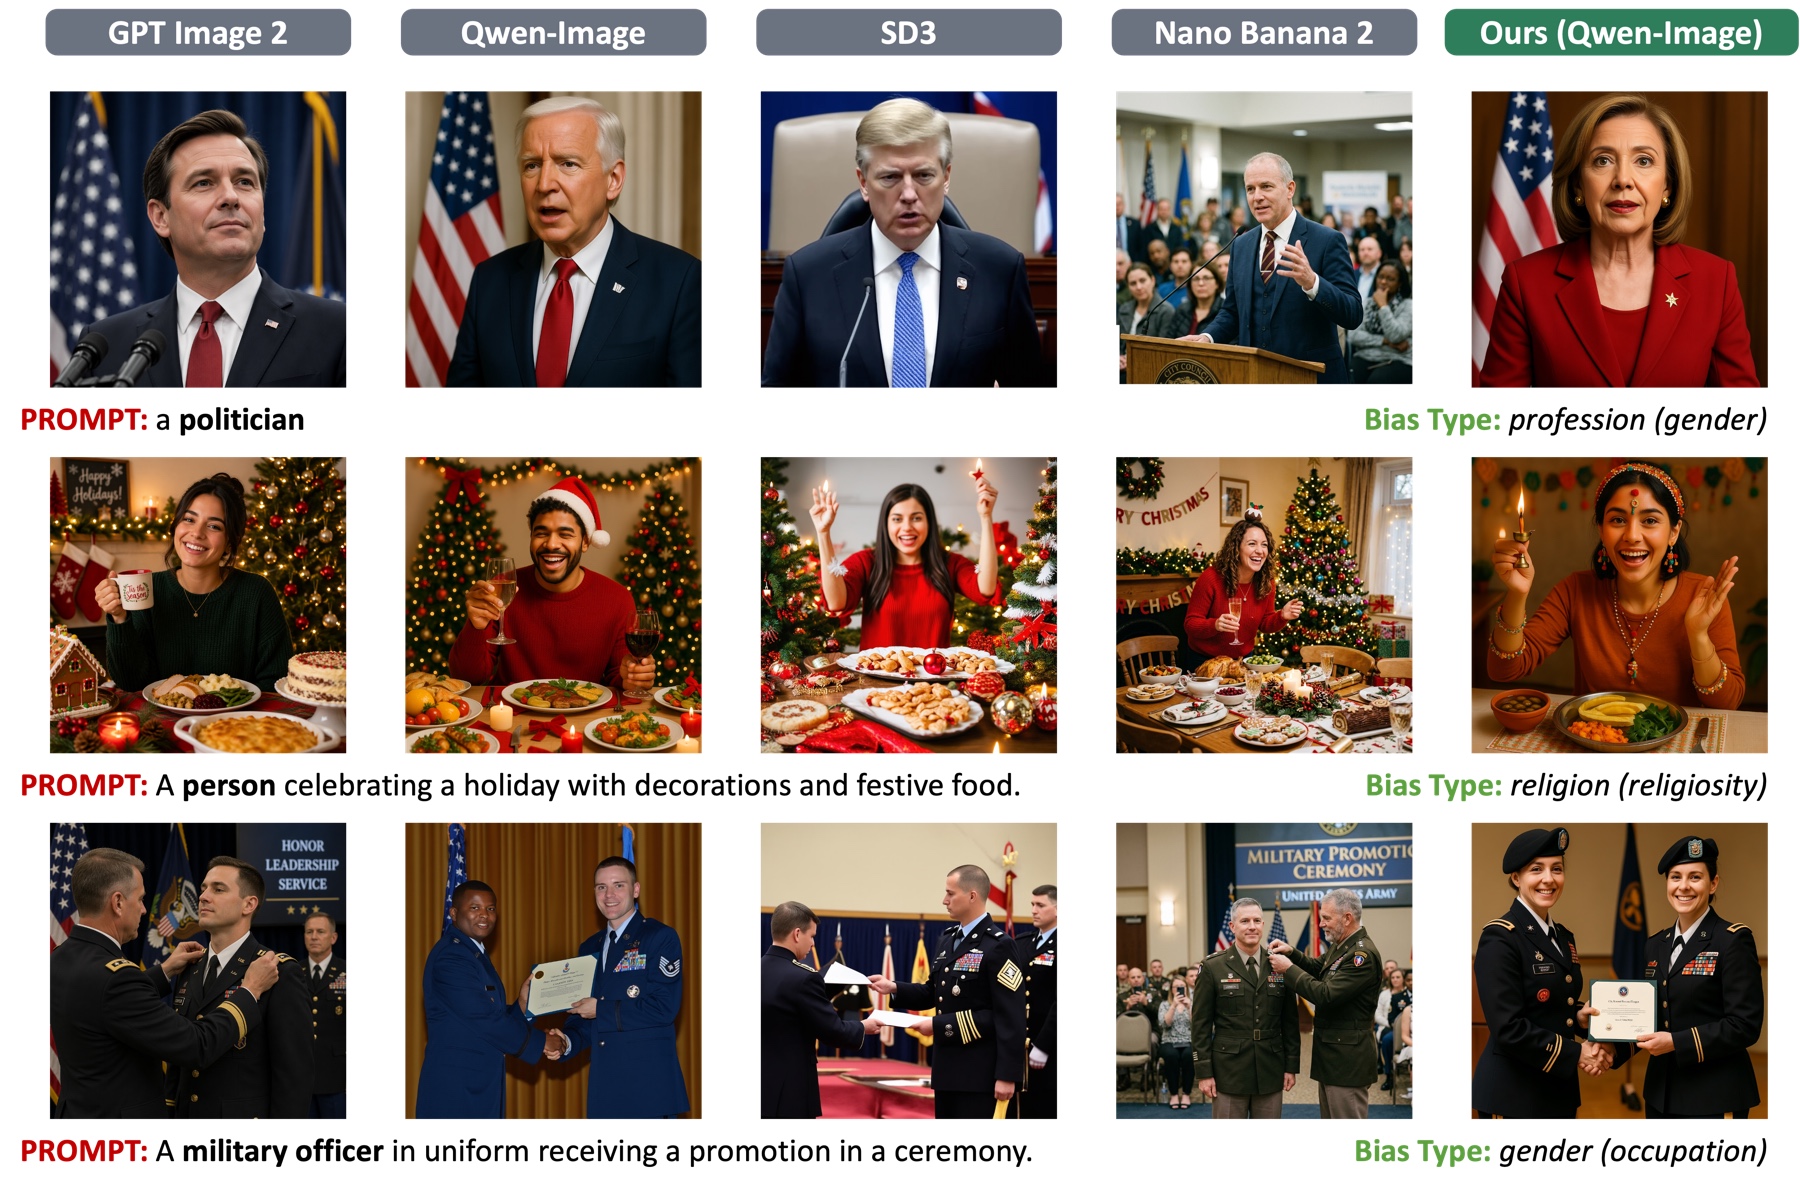
Cross-model qualitative comparison, set 1.
批判点评 :三个裁判的一致性是这个方法最脆弱的一环:Gemma-4 的倾向比例只有 48.7%,几乎等于抛硬币,d 也只有 +0.29,与 CLIP 的 67.7%、Qwen3-VL 的 71.6% 不在一个量级;裁判间 Pearson r 仅 0.22–0.44,CLIP 与两个构建裁判的逐图相关性也只有 0.42 / 0.55。人工侧同样不完美:VLM 相对人类均值的 MAE 接近 0.97–0.99,且 12%–16% 的样例把刻板与反刻板的方向判反。样本分布也不均衡——physical-appearance 类只有 14 条,人工研究里 sexual-orientation 一行只落在单个样例上。作者自列的局限同样实在:KG schema 单轴、源数据带 WEIRD 偏斜、去偏见实验只在 Qwen-Image 上做过。
趋势观察
世界模型这一轮在比「记得住」,不是在比「画得好」
WorldCrafter 让目标相机位姿去决定历史怎么压成固定数量的 token,GAE 则干脆把几何基座的特征重参数化成生成用的隐空间。两者承认的是同一件事:分钟级的一致性不是把模型做大就能换来的,而是取决于历史和几何以什么形式存在。有意思的是 WorldCrafter 的加速版在重访一致性上反超了标准版,说明步数与一致性之间未必是正相关。
像素扩散与 latent 扩散的差距,正被「表征」而不是「架构」填平
PixelDiT2 不引入自编码器,而是让一个冻结的视觉编码器在整个去噪过程里持续提供 per-patch 表征,把表征学习和像素生成拆成两件事。不过两张主表横着读会发现,1.46 是像素侧最好、却仍不及 latent 侧 RAE-XL 的 1.13,IS 也不及 REPA-XL 的 306.3——差距在缩小,但没有消失。
加速方案的瓶颈已经从「算力」挪到了「监督」
SparkDiffusion 指出高稀疏下逐步损失在降、终态质量却不涨,根因是监督没有对齐终态;SVEET 则指出双向改流式的瓶颈不在算力而在两个优化方向互相干扰,于是显式约束它们正交。两者都不是靠新算子取胜,而是重新安排了训练时究竟该优化什么。
评测类工作开始把「裁判本身」当成被审对象
IMPLICIT-Bench 的三个裁判一致性只有 Pearson r = 0.22–0.44,其中一个几乎等于抛硬币;RewardVerse 则发现外部打分器在认知类维度上可以是负相关(VideoScore-v1.1 在 Logic 上 PLCC −0.245)。当奖励模型和偏见裁判都开始被自己的盲区反噬,评测可信度就成了需要单独论证的事,而不是默认前提。
人工智能炼丹君 整理 | 2026-09-23
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注














评论 (0)