搜索到
82
篇与
ai
的结果
-
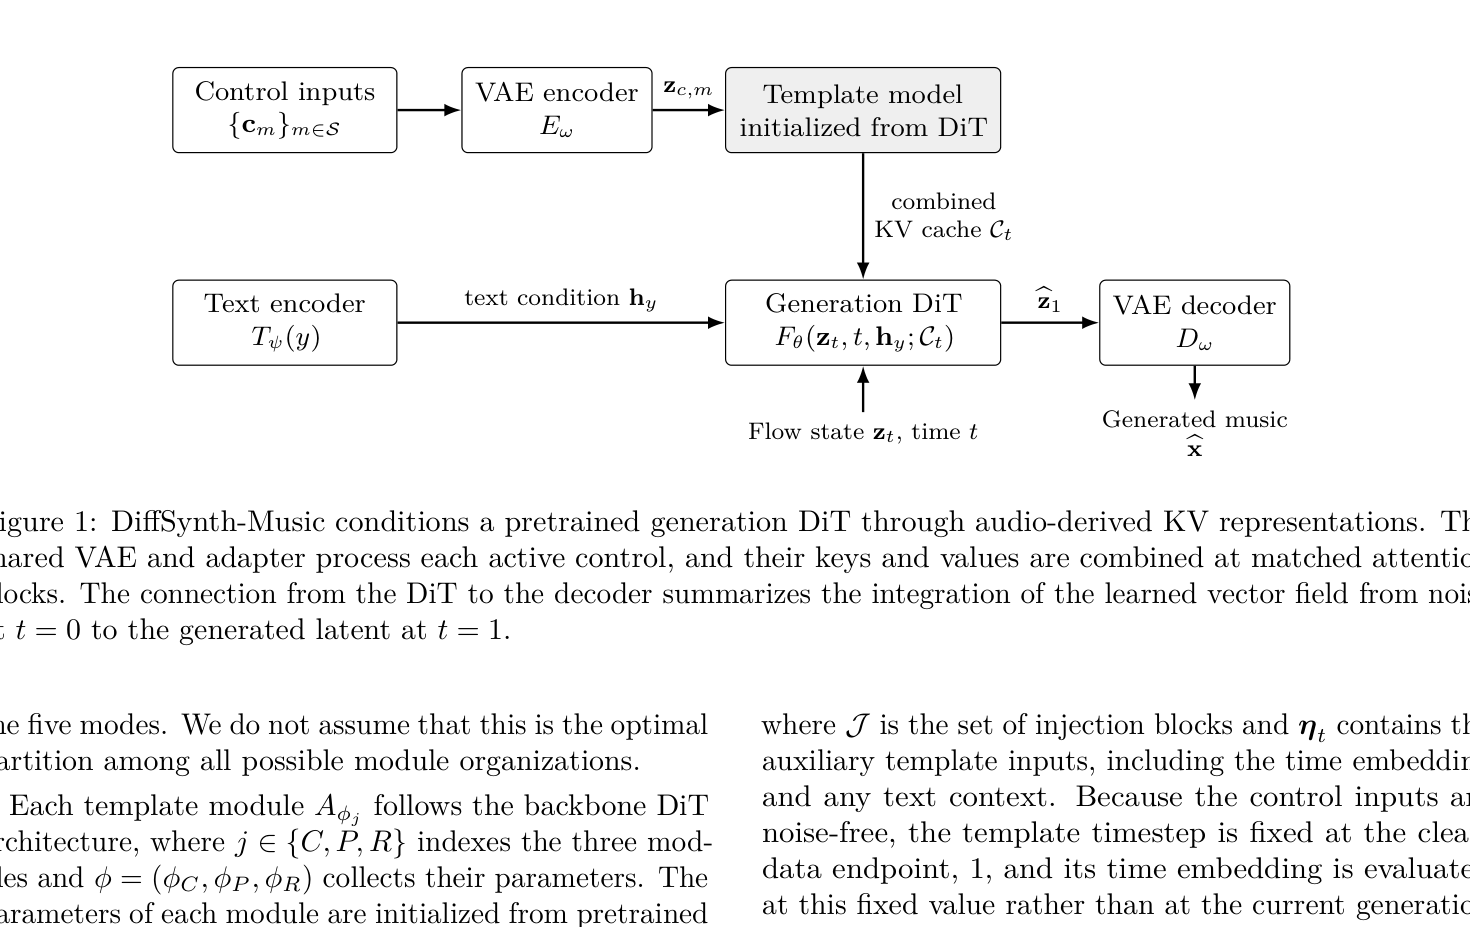
 AIGC 每日速读|2026-09-18|高通揪出长视频KV错配-Recency Forcing 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与长时程一致性 2 篇 · 生成模型评测与审计 2 篇 · 推理与采样加速 2 篇 · 语音与音乐生成 2 篇 · 视频修复与图像应用 2 篇 重点论文标题列表 Recency Forcing(Qualcomm AI Research):按距离衰减注意力救长视频 MiniMax-H3-Reason(National University of Singapore;Fudan University;Tencent):全模态模型物理推理仅四成 ⚡ Diagonal Sparsity(KAIST;Agency for Defense Development;Seoul National University):对角稀疏把吞吐拉到3.1倍 VibeAvatar(Peking University):口型与美感分阶段各管各的 AVR(New York University;University of Technology Sydney):能抄就抄抄不到才让扩散补 今日论文速览 1. Recency Forcing:按距离衰减注意力救长视频 Recency Forcing: Bridging the Long-Horizon Gap in Autoregressive Video Generation | Qualcomm AI Research | arXiv:2609.19729 关键词:自回归视频生成,长时程一致性,KV cache,注意力偏置 ⚠️ 前序问题:自回归视频生成一拉长就退化。论文把根因定位到一处被忽视的训练-推理不一致:训练时短片段的全部上下文帧都在 KV cache 里,推理时显存约束却会把远处帧逐出 cache,等于抽走了模型当初赖以生成的上下文。作者称之为 KV 淘汰错配(KV eviction mismatch)。 本文贡献:思路不是用截断上下文去模拟淘汰——那会连模型仍需要的时间信息一起丢掉、破坏运动连贯——而是保留上下文,同时让远处帧的影响逐步衰减,等它们真被淘汰时影响已可忽略。论文先用扰动式敏感度指标 positional response R(Δ, t_denoise) 量出上下文影响随时间距离陡峭衰减、且在不同去噪步上系统性变化;据此提出 Temporal Response Bias(TRB),把一个非正的、随时间步变化的偏置直接加在 softmax 之前的注意力 logits 上。配套的 Biased Attention Reparameterization(BAR)是个等价改写,把偏置移到 softmax 之外,使 TRB 退化成一次标准 FlashAttention 调用。 实验效果:在 VBench 与 VBench-Long 上取得长时程生成的 state-of-the-art 质量,且不增加推理成本。60 秒视频的定性对比里,Self-Forcing 出现色彩漂移,LongLive 产生场景重复,DeepForcing 引入模糊,Recency Forcing 则保持了画面稳定与运动连贯。方法不改动上下文长度与训练目标,免训练与训练两种模式都能用,BAR 的等价改写让偏置的额外开销为零。 批判点评:把长视频退化归到 KV cache 淘汰这个具体的工程约束上,而不是笼统归因于「误差累积」,定位比多数同类工作清晰,BAR 让它零开销落地也务实。但摘要只给 state-of-the-art 的结论、未披露具体分数,免训练与训练两种模式的增益差距、TRB 偏置形状换骨干后是否还成立,都要看正文;VBench 系列本身偏重视觉质量,长时程的叙事与物体持久性未必能被它完全反映。 2. MiniMax-H3-Reason:全模态模型物理推理仅四成 Can MiniMax-H3 Reason About the Physical World? An Evaluation of Omni-Modal Generative Model | National University of Singapore;Fudan University;Tencent | arXiv:2609.18323 关键词:全模态生成模型,物理世界推理,跨模态整合,评测基准 ⚠️ 前序问题:全模态生成模型把文本、图像、视频、音频统一建模,MiniMax-H3 正是在共享潜空间里同时做多模态理解与音视频联合生成的代表。但多模态对齐到底有没有提升模型的世界推理能力?现有面向视频生成与世界模型的评测大多受限于单一输入模态,且提示词与目标视频内容高度重合,回答不了这个问题。 本文贡献:论文构建了围绕物理世界推理四个互补维度的评测框架,专门为全模态输入设计任务:隐式提示搭配多帧、音频-图像、前缀视频、音频-视频四类场景。关键设计是每一路模态只提供事件的部分证据,模型必须跨模态整合互补线索,才能推断出潜在的事件状态与未来动态。 实验效果:517 个评测实例上,MiniMax-H3 总体成功率 41.97%。分维度看,基于视频的决策推理最高、为 56.00%,基于音频的消歧推理最弱、只有 27.40%。作者据此认为要真正吃到多模态输入的红利,关键仍在有效的跨模态整合。 批判点评:用「每种模态只给部分证据」的设定逼出跨模态整合能力,比提示词与目标高度重合的常规评测更有区分度,音频维度 27.40% 也确实点出了当前全模态模型的短板。但全文只评了 MiniMax-H3 一个模型,没有同代横向对比,41.97% 这个绝对值究竟是模型不行还是任务过难无从判断;517 个实例摊到四个维度上,每个维度的样本量也偏薄。 3. Diagonal Sparsity:对角稀疏把吞吐拉到3.1倍 Understanding and Exploiting Diagonal Attention Sparsity in Autoregressive Image Generation | KAIST;Agency for Defense Development;Seoul National University | arXiv:2609.19702 关键词:自回归图像生成,稀疏注意力,KV cache,推理加速 ⚠️ 前序问题:自回归图像生成因为能直接复用基于 transformer 的 LLM 服务设施而成为多模态系统的一种范式,但每次请求要吐出上千个视觉 token,解码越来越被注意力计算中的 KV cache 访问卡住。稀疏注意力在文本 LLM 推理上已被充分研究,可它的稀疏性假设能不能迁移到自回归图像生成,此前没人说得清。 本文贡献:论文首次系统刻画了自回归图像生成中的注意力稀疏性,覆盖多种负载与代表性开源模型,发现三个和文本场景不一样的性质:prefill 与 decode 阶段存在明显不对称、注意力强烈集中在 prompt token 与局部 token 上、以及视觉 token 的空间局部性带来一种独特的对角稀疏模式。据此提出对角感知稀疏注意力,在最近窗口内沿对角方向选择性跳过 KV 条目。 实验效果:基于 FlexGen、FlashAttention-2 与自定义 kernel 实现在 GPU 服务系统上,相比稠密推理最高取得 3.1 倍吞吐与 1.19 倍延迟改善,质量损失低于 2%。 批判点评:把稀疏模式追到「视觉 token 的空间局部性」这一来源、而不是照搬文本 LLM 的稀疏假设,是这篇最扎实的地方,3.1 倍吞吐也有工程说服力。但「质量损失低于 2%」用的是哪个指标、在哪些负载上成立,摘要没交代;对角模式依赖光栅扫描式的 token 排布,换扫描顺序或改分辨率后是否还成立同样存疑。 4. VibeAvatar:口型与美感分阶段各管各的 VibeAvatar: Aligning Phonetic Kinematics and Human Aesthetics for High-Fidelity Talking Avatar Synthesis | Peking University | arXiv:2609.18632 关键词:说话人视频合成,语音驱动,GRPO,流匹配 ⚠️ 前序问题:多模态说话人视频合成要从一张参考肖像加一段语音生成逼真视频。扩散类方法进步很快,却始终难以同时拿到准确的唇部发音、符合人类偏好的运动美感和高效推理这三样。 本文贡献:论文的判断是:发音准确性和运动美感来自根本不同的源头,应该在互补的阶段分别处理,而不是塞给单个生成器隐式地一起学。VibeAvatar 因此把两个目标解耦——条件阶段用 Phonetic Kinematics Adapter(PKA)把面向识别的语音特征转成发音-运动条件;后训练阶段用 Aesthetic Motion Policy(AMP),以 GRPO 优化一个流一致的随机采样策略。运动生成器本身是轻量流模型,工作在紧凑的一维 warp 潜空间里。 实验效果:客观指标与用户研究上,发音、美感、效率三项均达到 state-of-the-art;生成 10 秒 512px 视频耗时不到 10 秒,显存占用约 3GB。 批判点评:「发音归条件阶段、美感归后训练」是个干净的分工,把 GRPO 用在采样策略而不是生成器权重上也省掉了重训成本,约 3GB 显存意味着消费级显卡能跑。但美感由 GRPO 所对齐的偏好定义,口味会不会过拟合到特定标注群体值得警惕;摘要只给了效率数字,发音与美感的具体分数、以及更长时长下的身份漂移都得看正文。 5. AVR:能抄就抄抄不到才让扩散补 Copy What Is Seen, Generate What Is Not: Training-Free Anomaly-Aware Video Restoration | New York University;University of Technology Sydney | arXiv:2609.18836 关键词:视频修复,异常检测,免训练方法,扩散修补 ⚠️ 前序问题:监控系统检测到异常后往往还得把画面修好,但这两件事一直被分开研究:免训练的异常检测止步于一个分数或标签,免训练的视频编辑则只听用户提示词、不听检测器。 本文贡献:AVR 只用冻结的预训练模型就把两端接上,而且只在画面确实没有证据可抄的地方才生成内容。先由运动证据把开放词表提案收敛成时空掩码;再用片段自身算出的背景先验,填掉异常曾经遮挡过的每一个像素,只把「任何一帧都没出现过」的部分交给扩散合成;最后一个冻结的验证器逐片段决定该信任经典修复、先验锚定修复还是背景条件修复。 实验效果:三个监控数据集上、覆盖全参考异常注入与真实异常两种设定:oracle 掩码下 AVR 的全帧保真度领先,在编辑区域内与三个训练过的视频 inpainting 方法持平,用自己产出的掩码时优于「先检测再生成」的流水线,同时压住了残留异常与自由扩散带来的闪烁。 批判点评:「能抄就抄、抄不到才生成」的取舍很贴监控取证的需求——少生成一分就少一分臆造风险,全程冻结模型也免了训练成本。但它靠运动证据圈定异常,静止或缓慢的异常可能整个漏掉;oracle 掩码下的领先说明上限不错,自产掩码下的成绩才是实际水平,三个监控数据集的场景多样性也仍有限。 6. CPR:作曲演奏精修三段渲染钢琴 CPR: Combining global composing, local performing and full-sequence refining in piano rendering with continuous autoregressive modelling | The Chinese University of Hong Kong, Shenzhen | arXiv:2609.18216 关键词:钢琴渲染,连续自回归,流匹配,音乐生成 ⚠️ 前序问题:提示词条件下的钢琴 MIDI-to-Music 渲染,要在忠实还原目标音符的同时复现参考录音的音色。现有方法分两条路:离散 codec 的自回归模型有因果时序建模能力,但量化会丢掉声学细节;流匹配更能保住声学结构,代价是全序列注意力开销大、语义结构反而更差。 本文贡献:连续自回归模型直接在连续表示上工作,既兼有自回归的条件跟随能力与流匹配的分布建模能力,又绕开量化瓶颈、计算成本更低。CPR 据此拆成三段:Composer 自回归预测连续隐状态,Performer 经局部流匹配生成 24kHz 声学潜变量,Refiner 再把波形上采样到 48kHz。论文另引入 Bottlenecked Representation Alignment(BREPA)与 Modality-Time RoPE(MT-RoPE),分别强化 Composer 隐状态里的音乐语义结构和跨模态时间对齐。 实验效果:P-MUSE-eval 上,CPR 只用 4 步(NFE=4)就输出 48kHz 音频,onset F1 78.4 与 FAD_clap 0.129 均为最佳;音色相似度 89.3 略低于需要 25 步的 P-MUSE(90.6),但明显优于 MIDI-VALLE 的 83.4。另有 13 位听众对 14 个样本的 MOS 主观评测。 批判点评:三段分工把「写什么音」「怎么弹出来」「采样率补齐」拆开,绕过离散量化这个老瓶颈,4 步出 48kHz 相对 P-MUSE 的 25 步是实打实的效率优势。但音色相似度并未超过 P-MUSE,说明连续表示在音色保真上还没占到便宜;MOS 只有 13 位听众评 14 个样本,样本量偏小,评测也集中在钢琴单一乐器上。 7. Self-Distilled TTS:模型自己教自己念生词 Self-Distilled Pronunciation and Accent Control for Neural Text-to-Speech | Independent Researcher;KOWRO Inc. | arXiv:2609.17234 关键词:语音合成,自蒸馏,发音控制,口音标注 ⚠️ 前序问题:直接读原始文本的 TTS 没有词典,碰上生僻词只能靠猜。已有的补救要么拿录音训练一条专门的发音与口音通道,要么从示例里一个词一个词地改。 本文贡献:这篇两样都不做。让冻结的骨干去读一个含有它本来就念得对的常见词的句子,再把它自己的输出当作同一句话的教师——只是把那个词替换成带标注的、指定口音的读法。这一对训练样本就是方法的全部。 实验效果:Sarashina2.2-TTS 上,经筛选的评测者(Fleiss' kappa = 0.85)在 0.89 的未见词上听出了指定口音,而无法表达口音的假名方案只有 0.57、没有赢下任何一组对比,自然度没有可测量的损害。未经调整迁移到自回归、扩散和编码器-解码器骨干后,319 个词上的读法正确率比不做编辑高出 0.25 到 0.47;CosyVoice 2 上三个词里有两个能带上口音,但在 Irodori 上不行,论文分析了原因。 批判点评:用模型自己的输出当教师、只换一个词构成训练对,简洁到几乎没有额外数据成本,跨骨干迁移也说明思路不绑架构。但它天然受限于「骨干本来就念得对的常见词」这个起点,词表外的音素组合未必覆盖得到;Irodori 上失效说明迁移并非无条件成立,日语音高重音之外的语言是否同样奏效也还没有证据。 8. JewelTry:免掩码珠宝试戴还管尺寸 JewelTry: Mask-Free Scale Aware Jewelry Virtual Try-On | Amazon | arXiv:2609.16626 关键词:虚拟试戴,免掩码扩散,尺寸感知,评测基准 ⚠️ 前序问题:虚拟试穿让顾客看到上身效果,已是网购的重要技术。服装类进展很大,珠宝却因为体积小、结构刚性、对细节高度敏感而一直是难啃的品类:既要忠实迁移外观,还得相对佩戴者有正确的尺寸和位置。现有珠宝试戴多依赖掩码引导,而免掩码方法又缺乏建模产品尺寸的显式引导。 本文贡献:论文先建了 JVTO-Bench,提供带真实产品尺寸标注的「参考-源-目标」三元组,覆盖四大珠宝品类。在此之上提出免掩码扩散框架 JewelTry:尺寸适配器把产品实际尺寸编码成一个 scale token,让模型在上下文中学到珠宝与人体解剖结构之间的尺寸关系;再用单向条件注意力与注意力精修损失,同时保住参考珠宝的粗粒度几何与细粒度结构细节。 实验效果:实验显示 JewelTry 在视觉保真度、背景保持、物体一致性与尺寸准确性之间取得平衡,为免掩码、尺寸感知的珠宝虚拟试戴立了一个较强基线。 批判点评:把「尺寸对不对」变成可编码的条件而不是靠掩码兜底,抓住了珠宝区别于服装的真正难点,配套放出带真实尺寸标注的 benchmark 也补上了这一方向的评测空白。但摘要通篇没给量化指标,「取得平衡」这类表述无法判断相对现有方法的实际差距;四个品类对珠宝这种长尾品类而言覆盖面也偏窄。 9. MSR:多张参考图各占一个 slot MSR: Multiple Subject Reference for Video Generation | Licon Studio | arXiv:2609.18393 关键词:多主体视频生成,参考图条件,LoRA,流匹配 ⚠️ 前序问题:让视频生成器同时吃多张参考图时,既要保住每个主体的外观,又要把每张图和它该扮演的角色对上,否则属性就会串到别的对象身上。 本文贡献:MSR 是面向 LTX 视频生成的 slot 感知条件方案:每张参考图被独立编码成一段静态片段、对应一组单独的潜 token;一个紧凑的傅里叶特征 MLP 给它加上数值化的 slot 嵌入,再用随 slot 变化的时间偏移改写这组 token 的旋转位置坐标。这些参考组被前置到带噪的目标 token 之前,在仅针对目标的流匹配训练中充当干净上下文。整套方案用 LoRA 实现,权重与推理工作流已开源。 实验效果:论文给的是定性结果:示例展示了包含不同角色与参考环境的写实及风格化场景组合;开发过程中的观察显示,相对更早的连续参考基线,参考混淆有所减少,但相似服装、复杂衣物和视角变化仍然困难。另有一个补充实验在冻结视觉参数的前提下加入了语音参考条件。 批判点评:用独立 token 组加 slot 嵌入来绑定「哪张图对应哪个角色」,思路直接,靠 LoRA 就能低成本落地,开源权重与工作流对想复现的人友好。但这更像一份技术报告而非完整论文:全文没有定量实验,「参考混淆减少」只是开发观察而非受控对比,缺少与基线的可比指标;作者自己也承认相似服装与视角变化仍未解决。 10. Newer Is Not Fairer:新版文生图并没有更公平 Newer Is Not Fairer: Gender Stereotyping in Text-to-Image AI Across Model Generations | Northeastern University | arXiv:2609.18007 关键词:文生图,性别偏见,模型审计,公平性评测 ⚠️ 前序问题:文生图模型已经在专业与创意场景里广泛使用,但它们如何呈现不同职业的性别、以及更新的模型是不是更公平,跨代际地看仍缺乏系统证据。 本文贡献:论文评测了 20 个职业、5 种提示词模板、4 代 Stable Diffusion(SD 1.5、SD 2.1、SDXL、SD 3 Medium),每个「职业×模型」单元生成 100 张、共 8000 张图,全部用 DeepFace 判定性别,并与美国劳工统计局(BLS)的真实劳动力数据对照,所有显著性检验都做了 Benjamini-Hochberg 多重校正。 实验效果:8000 张开源模型图像中 76.4% 为男性(95% CI [75.1%, 78.7%]);更扎眼的是历史上女性主导的职业里仍有 57.6% 生成男性。相对 BLS 数据,模型平均低估女性 20–46 个百分点,本就接近性别均衡的职业偏差最大——科学家 BLS 女性占 48%、模型输出 82–99% 为男性,清洁工 BLS 女性占 46%、模型输出 80–92% 为男性。代际并非稳步改善:偏差从 SD 1.5 一路恶化到 SDXL,到 SD 3 Medium 才部分回落。与 GPT-image-1 在五个职业上的初步对比显示商业模型偏差更低,但实际效应很小(Cramér's V = 0.080)且属探索性。没有任何一个模型达到性别均衡。 批判点评:8000 张图、多重检验校正、对照 BLS 真实就业数据,这套设计让结论比常见的偏见讨论扎实得多,「更新不等于更公平」的代际发现尤其有价值。但性别判定依赖 DeepFace 的二元分类,本身有误差且无法涵盖非二元表达;20 个职业、5 个模板的提示词空间偏窄,与 GPT-image-1 的对比作者也标注为探索性,撑不起开源与商业模型孰优孰劣的强结论。 趋势观察 长上下文的瓶颈,从「记不记得住」变成「cache 放不放得下」 Recency Forcing 把长视频退化追到 KV cache 淘汰这一工程约束,Diagonal Sparsity 直接冲着自回归图像生成的 KV 访问瓶颈去。两篇都不再泛泛谈误差累积,而是把注意力的显存与访存代价当成一等问题来解。 生成质量的定义权,正在交给后训练与采样策略 VibeAvatar 把运动美感交给 GRPO 在后训练阶段对齐,而不是让生成器隐式地学;CPR 用连续自回归绕开量化,再分三段把语义结构、局部声学与采样率分工。共同前提是承认单个生成器学不好多个互相冲突的目标。 评测开始审问模型「到底懂不懂」,而不只是「像不像」 MiniMax-H3 的评测让每种模态只给部分证据,逼模型跨模态整合才能答对;Newer Is Not Fairer 用 8000 张图对照真实就业数据,把「新版是否更公平」变成可证伪的问题。两者都不满足于保真度分数。 免训练与轻量适配,正在成为落地的默认路径 AVR 全程冻结预训练模型、只在没有证据可抄的地方才生成;MSR 用 LoRA 给现成视频模型加多主体条件;Self-Distilled TTS 让模型自己的输出当教师。共同动机都是避开重训成本。 人工智能炼丹君 整理 | 2026-09-18 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
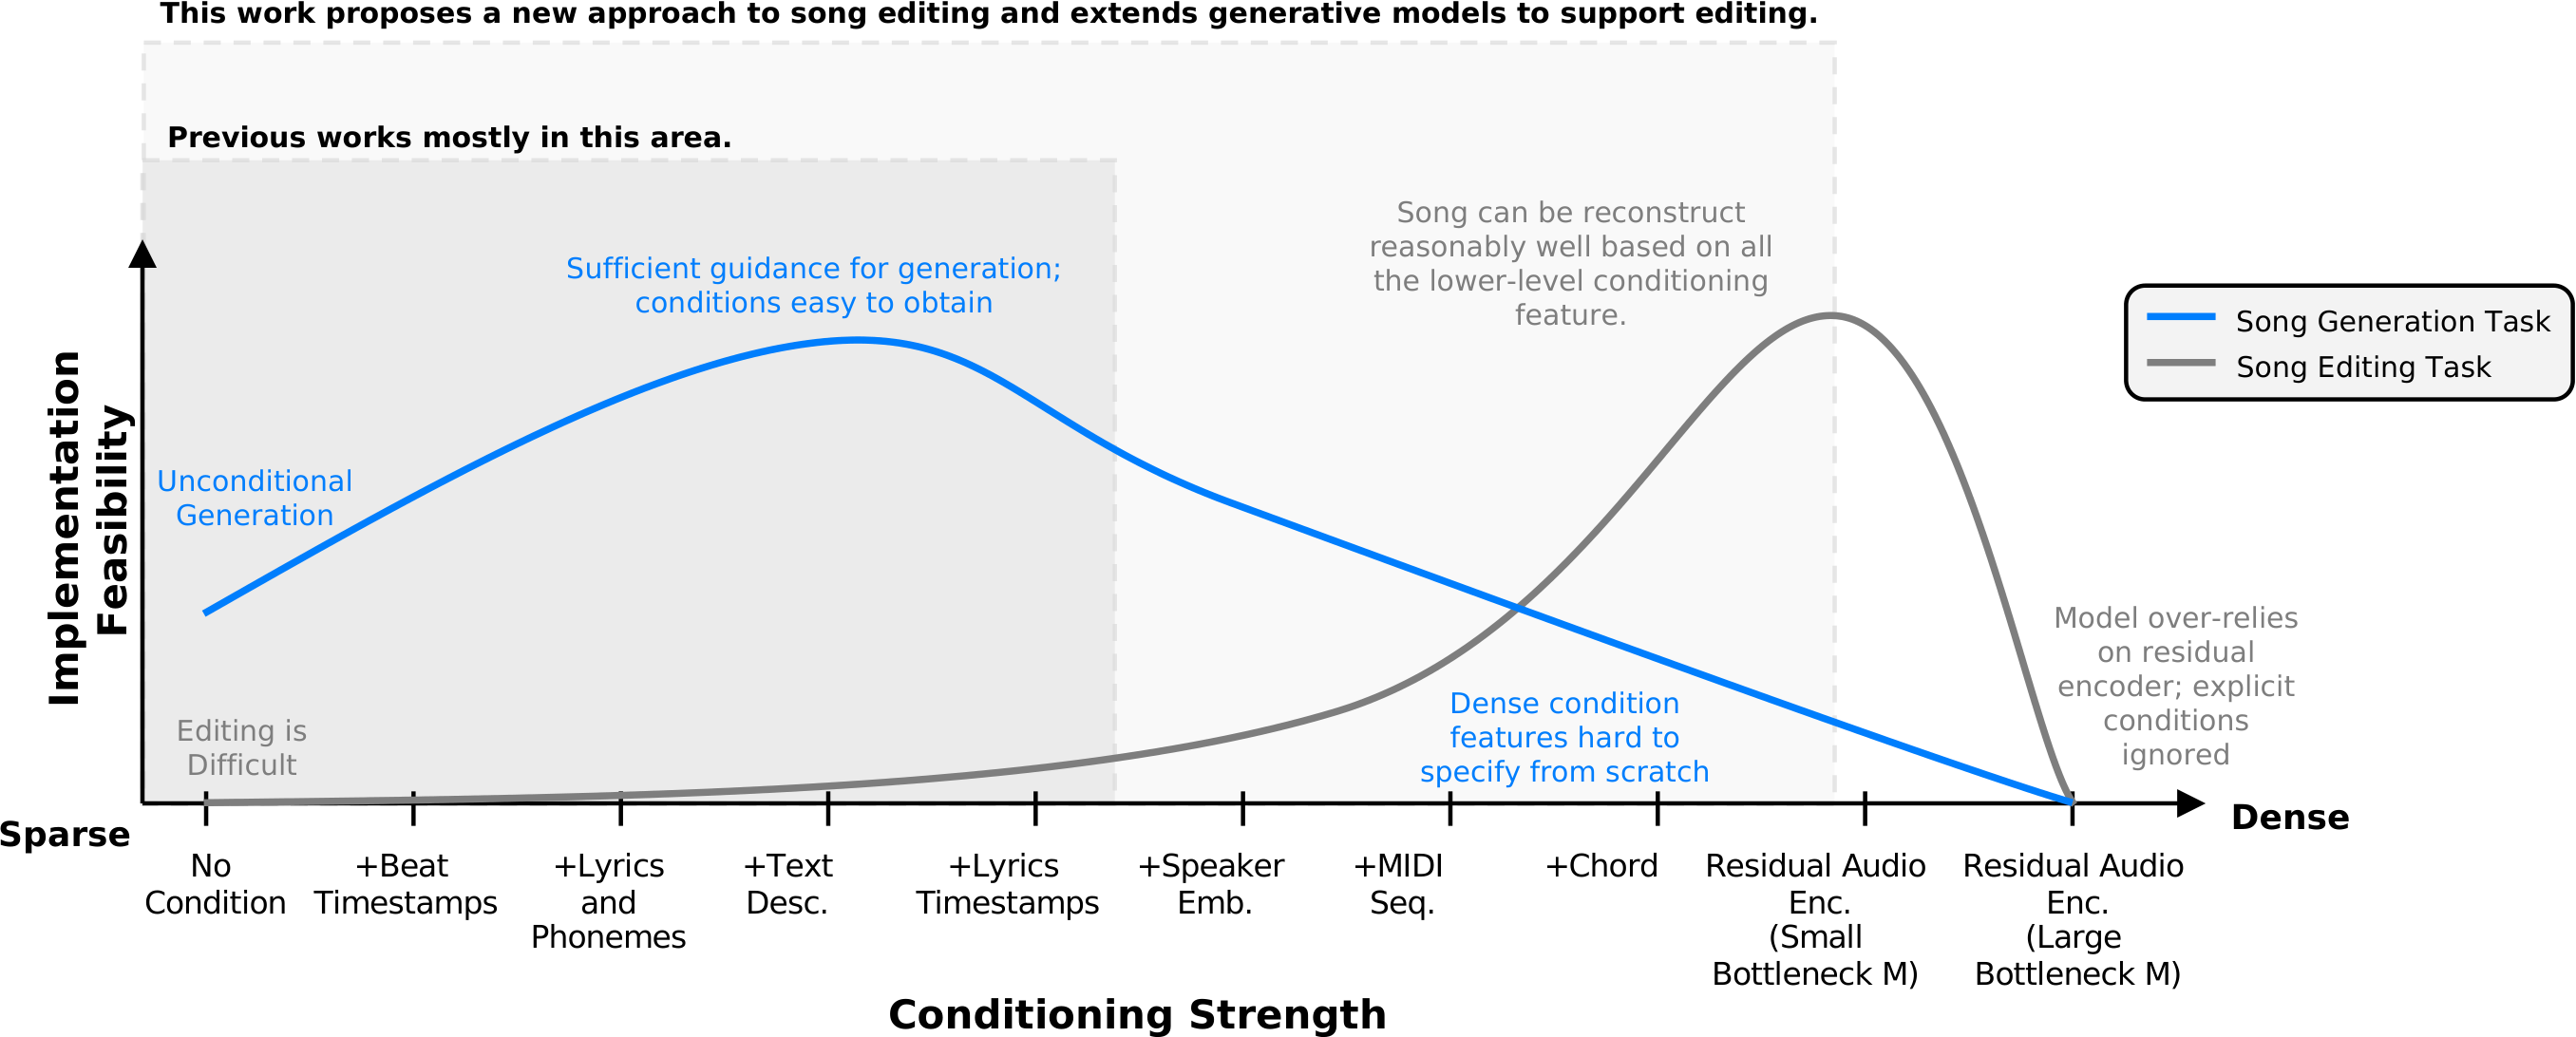
AIGC 每日速读|2026-09-17|Meta一个模型既写歌又改歌-SongCraft 今日 AIGC 论文速览 今日共 10 篇 · 音乐与歌曲生成 2 篇 · 视频生成与世界模型 2 篇 · 视频编辑与采样效率 2 篇 · 长语音稳定生成 2 篇 · 生成评测与溯源 2 篇 重点论文标题列表 SongCraft(Meta AI):一套模型统一歌曲生成编辑 SlotDiT(University of Bonn):用 slot 潜空间省算力提成功率 AlayaVista(Alaya Lab;Beijing Institute of Technology;The University of Tokyo):全景状态驱动流式世界模型 MDN-Control(Wuhan University):掩码深度噪声协同视频编辑 ADSC(SAP;National University of Singapore;A*STAR I2R):按样本收敛动态缩短采样 今日论文速览 1. SongCraft:一套模型统一歌曲生成编辑 SongCraft: Unified Song Generation and Editing with Reconstructive Learning | Meta AI | arXiv:2609.16315 关键词:歌曲生成,音频编辑,流匹配,重建预训练 前序问题:歌曲生成与歌曲编辑通常由两套系统完成:生成只接收歌词等稀疏条件,编辑却需要保留人声、旋律和结构等稠密属性,分别训练会重复成本且难共享能力。 本文贡献:SongCraft用重建式预训练随机切换稀疏生成分支和稠密编辑分支,共享潜空间流匹配主干;编辑时抽取歌词时间戳、MIDI、和弦、歌手等属性并只改目标条件,生成时仅保留歌词、节拍和描述。 实验效果:统一模型的歌词WER为0.133;主观A4平均分7.45、SongEval为3.62。它的可懂度领先,但SongEval整体质量仍低于Levo的3.95;瓶颈加长还会同时降低音高、歌手和歌词可编辑性。 批判点评:统一生成与属性级编辑是实用方向,重建预训练减少成对编辑数据依赖;但质量与可编辑性存在明显折中,当前主要针对有限时长与条件类型,更长歌曲和复杂编曲仍是后续工作。 2. SlotDiT:用 slot 潜空间省算力提成功率 SlotDiT: Object-Centric Representations for Diffusion Transformers | University of Bonn | arXiv:2609.17414 关键词:扩散Transformer,对象中心表示,潜空间设计,机器人控制 前序问题:视频DiT通常在像素或稠密视觉潜空间中预测,容易把大量算力花在背景纹理上,也难以显式跟踪承担动作的对象;机器人控制真正关心的是对象状态及其随指令发生的变化。 本文贡献:SlotDiT 让文本条件 DiT 直接在 slot 潜空间里工作:先把场景分解成一组对象级的 slot,再依据指令与已观测上下文自回归去噪未来的 slot 轨迹。论文的落点是系统性比较潜空间设计——在统一 DiT 框架下把 slot 表示与 VAE 式、语义对齐式潜空间放在一起对照。 % Overview of SlotDiT. % (a) Given a reference image $\ImageT{1}$ and text instruction $\Caption$, SlotDiT parses the scene into an object-centric slot representation $\SlotsT{1}$. % Conditioned on the encoded instruction and context slots, an object-centric diffusion transformer (DiT) autoregressively denoises future slot trajectories $\PredSlotsT{2}, \ldots, \PredSlotsT{T+1}$, % optionally decoded into future video frames $\PredImageT{2},\, \ldots,\, \PredImageT{T+1}$. % % (b) Comparison of SlotDiT's slot-based latent space against established representation spaces used in DiTs. % % (c) Across four robotic datasets, SlotDiT achieves higher task-completion rates while remaining substantially more efficient than the baselines. 实验效果:每帧只需 10 个 token(VAE 类基线为 256)。CLIPort 的 PutInBowl 任务上成功率 73.0%,次优的 TextOCVP 为 50.0%,VAE 类基线仅 0.5%–10.0%;LT-syn 的六种设置下为 17.0%–74.5%,均居首。生成 39 帧的吞吐 9.33 FPS,快于最快基线的 6.71 FPS,相对 SD-VAE 基准提速 5.68 倍(单卡 A6000)。 % Overview of SlotDiT. % (a) Given a reference image $\ImageT{1}$ and text instruction $\Caption$, SlotDiT parses the scene into an object-centric slot representation $\SlotsT{1}$. % Conditioned on the encoded instruction and context slots, an object-centric diffusion transformer (DiT) autoregressively denoises future slot trajectories $\PredSlotsT{2}, \ldots, \PredSlotsT{T+1}$, % optionally decoded into future video frames $\PredImageT{2},\, \ldots,\, \PredImageT{T+1}$. % % (b) Comparison of SlotDiT's slot-based latent space against established representation spaces used in DiTs. % % (c) Across four robotic datasets, SlotDiT achieves higher task-completion rates while remaining substantially more efficient than the baselines. 批判点评:论文自己点明了一个反直觉结论:视觉质量指标好不等于任务能完成——VAE 基线的感知分更高,指令跟随与任务成功率却大幅落后。代价是 slot 数量固定、外观细节受限,视频生成质量只能算与基线持平而非更优;评测也集中在 CLIPort 与 LT-syn 两类机器人环境,开放世界泛化尚无证据。 3. AlayaVista:全景状态驱动流式世界模型 AlayaVista: Streaming World Modeling from Panoramic States to Perspective Video | Alaya Lab;Beijing Institute of Technology;The University of Tokyo | arXiv:2609.14462 关键词:世界模型,视频生成,相机控制,全景状态 前序问题:相机连续移动时,普通视频生成模型只看局部视口,离开画面的区域容易被遗忘,重新转回时场景会漂移;直接维护高分辨率全景又会让生成和渲染成本过高。 本文贡献:AlayaVista把360度全景作为持续演化的全局状态,再按相机轨迹选择视口、渲染低分辨率透视潜变量,并用局部视频细化器恢复高清画面;全景状态和当前视角因此分离更新,支持流式相机控制。 实验效果:在 MUGEN-HQ 上,AlayaVista 的跨视角一致性 0.9240、旋转误差 2.132 均为最优,平移误差 0.03312 优于 HY-World 2.0 的 0.03885,但仍高于带显式 3D 高斯支架的 MoVerse(0.02746);动态性 0.9200 偏低,作者认为是长时漫游中局部运动被衰减所致。 批判点评:全景记忆能减少回看漂移,但系统包含全景生成、潜空间渲染和局部细化三段,训练与部署都较重;评测集中在合成式或精选全景数据,长时间真实街景中的几何稳定性仍需验证。 4. MDN-Control:掩码深度噪声协同视频编辑 MDN-Control: Mask-Depth-Noise Guided Region Control for Multi-Subject Video Editing | Wuhan University | arXiv:2609.16475 关键词:视频编辑,多主体控制,遮挡建模,免训练方法 前序问题:多主体视频编辑时,目标人物常被邻近主体或遮挡区域干扰,属性会串到无关对象;只靠文本和掩码也难以同时保持身份、边界与背景。 本文贡献:MDN-Control不再训练新模型,而是组合掩码引导定位、深度感知遮挡软门控和噪声潜变量检索:前者锁定主体,中间模块随去噪阶段调整遮挡约束,后者从候选噪声中选择更匹配指令的初始化。 实验效果:在MSVBench上,方法取得Warp-Err 2.87、CLIP-T 27.09、CLIP-F 95.72、Q-Edit 9.43与CM-Err 2.75;实验在单张NVIDIA L40上完成,并包含20段视频的用户研究。 Overview of MDN-Control. Mask-guided localization localizes the target, depth-aware occlusion control guides editing near occlusions, and noise latent prompting initializes appearance generation. Denoising uses mask-depth guidance at early steps and mask-only guidance thereafter. 批判点评:免训练组合便于迁移到现有DiT,但噪声检索的增益不大,部分固定随机种子甚至更好;20段主观测试规模也偏小,复杂相机运动和长遮挡下的稳定性还未充分覆盖。 5. ADSC:按样本收敛动态缩短采样 Efficient Text-to-Image Generation: An Adaptive Step Schedule Controller for Diffusion Models | SAP;National University of Singapore;A*STAR I2R | arXiv:2609.16572 关键词:文生图,扩散采样,自适应步数,推理加速 前序问题:文生图扩散模型通常给所有提示词使用同一去噪步数,但简单样本早已收敛仍继续计算,复杂样本又可能因固定短计划而欠采样。 本文贡献:ADSC 准备一组步长不同的采样日程,在每个时间步评估误差项的差异,据此在日程之间动态切换,让简单提示词早收敛早停、复杂提示词保留更多步数;控制器无需额外训练,也不改动基础扩散模型。 Effect of text prompt and seed combinations on diffusion steps for generating visually sufficient images. Step counts shown are examples; optimal steps may vary. 实验效果:在COCO的DDIM实验中平均18.89步、0.79秒/图;与固定19步的0.78秒几乎相同,但CLIP-I为95.70,高于固定19步的92.40,CLIP-T均为31.4,优势主要来自按样本分配步数。 The denoising process begins with the longest schedule (e.g. 40 steps in the example) and transitions to shorter schedules (20 followed by 10) upon detecting convergence. 批判点评:方法实现简单且可插拔,不过同等平均步数下墙钟时间没有加速,控制器判断还增加少量开销;论文比较的不同基线并非始终严格等算力,效率结论应区分步数、质量和实际延迟。 6. LACI:回滚重生成压住长语音失败 Taming Long-form Text-to-Speech | Argmax, Inc.;University of Virginia;Bilkent University | arXiv:2609.16989 关键词:长文本语音合成,推理期干预,错误回滚,语音克隆可靠性 前序问题:自回归TTS在超长文本上会突然跳过整段内容或重复、幻觉;平均WER掩盖了少数灾难性失败,而重新训练模型对已有开源系统成本很高。 本文贡献:LACI(Localized Attention-Constrained Inference,局部注意力约束推理)是纯推理期方法,不改动模型权重:近实时检测 TTS 生成错误,回滚到错误起点,再施加临时护栏重新生成,额外开销可忽略。论文另提出滑窗版说话人相似度 wSIM,用来暴露常规 SIM measure 不到的失败模式。 实验效果:Qwen3-TTS-0.6B 在超过 1500 词的提示上,10 个随机种子里的最差 WER 从 35.2% 降到 3.4%,甚至优于它在 500 词以内短文本上 5.4% 的可靠性;120 秒参考音频下最差 wSIM 从 0.01 升到 0.47;WER 超过 30% 的灾难性生成比例从 26% 降到 1% 以下。 批判点评:推理期干预能给现成开源模型直接止损,不必重训,这是它最实用的地方;但前提是错误可被近实时检出,回滚重生成也会推高长文本的尾部延迟。更值得注意的是超过 1300 词之后失败开始抗拒重生成,LACI 只把失败比例从 70% 压到 57%,反而不及对照方法 ACI 的 34%,作者认为这是模型自身的连贯性上限而非检测不到。 7. DiTAR+:扩张上下文抑制长语音漂移 DiTAR+: Dual Optimization for Robust Autoregressive Diffusion Speech Synthesis | ASLP@NPU, Northwestern Polytechnical University | arXiv:2609.13909 关键词:语音生成,扩散Transformer,长上下文,说话人一致性 前序问题:连续潜变量自回归扩散语音模型在长序列中会逐块积累误差,出现说话人漂移、重复或无法终止;简单扩大历史上下文又让局部声学细节成为捷径。 本文贡献:DiTAR+用扩张上下文采样跨更远的历史块建模宏观一致性,同时在浅层对历史声学块做分层掩码,把语义对齐与声学渲染分开,减少模型复制局部声学模式。 The overall architecture of the proposed DiTAR+ framework. (a) The standard two-stage DiTAR baseline. (b) Hierarchical Acoustic Masking (HAM), which masks historical acoustic context in shallow layers to decouple semantic alignment and acoustic rendering. (c) Dilated Context Sampling (DCS), which expands the macro-receptive field via dilated sampling while preserving temporal continuity. 实验效果:在SeedTTS评测中,DiTAR+的Seed-EN WER为1.672、Seed-ZH为0.985;中文困难集WER为9.893,低于DiTAR的12.478;25至35秒长语音WER从2.778降至2.173,说话人相似度从0.741升至0.759。 Chunk-level speaker similarity over continuous generation steps (3.0,s per chunk). The standard baseline experiences severe speaker drift in the long tail, whereas DCS effectively stabilizes the temporal coherence. 批判点评:DCS与HAM直接针对长尾漂移,消融也显示两者互补;但困难集和长语音集为内部构造,论文没有充分量化扩张上下文带来的吞吐、显存和首音延迟成本。 8. CMA-OT:课程式多尺度舞蹈配乐对齐 CMA-OT: Hierarchical Expert Supervision for Dance-to-Music Generation | HKUST(GZ);Tencent | arXiv:2609.13118 关键词:舞蹈配乐,多尺度对齐,最优传输,音乐生成 前序问题:舞蹈配乐既要踩准局部节拍,又要匹配段落级风格;单尺度动作特征或固定对齐损失容易顾此失彼,尤其在动作与音乐结构非一一对应时。 本文贡献:CMA-OT从预训练Jukebox专家提取底层、中层和高层音乐知识,课程式地由局部节奏过渡到全局语义,并用尺度感知的Fused Gromov-Wasserstein最优传输对齐舞蹈与音乐表示。 实验效果:在AIST++上,CMA-OT取得BCS 99.14、BHS 99.12、F1 99.12、FADp 12.50、FADc 0.26;MotionComposer的FADp/FADc为27.52/0.49。TikTok上FADp/FADc为27.53/0.38,也优于30.61/0.81。 批判点评:多尺度课程把节拍和风格监督组织得较清楚,但系统依赖Jukebox专家与额外最优传输计算;AIST++和TikTok仍是较窄的数据分布,指标提升不等同于真实音乐审美或版权可用性。 9. VOR-Bench:细粒度评测视频对象移除 VOR-Bench: A Human Perception-Driven Benchmark for Video Object Removal | Beijing University of Posts and Telecommunications;China Telecom AI Technology;Xi'an Jiaotong University | arXiv:2609.16878 关键词:视频对象移除,评测基准,视觉语言模型,主观一致性 前序问题:视频对象移除常用有缺陷的参考视频或逐帧图像指标,既可能把错误参考当真值,也难以判断对象是否删净、背景是否连续以及结果是否符合常识。 本文贡献:VOR-Bench 由三部分组成:VORD 数据集提供 150 对配对编辑视频与涂鸦式掩码,覆盖模型生成、工具渲染与相机实拍三类来源,另构建 300 对的扩展集验证规模是否足够;rMPAF 流程把图像级对象移除与微调后的视频生成模型结合,自动产出运动连贯的配对视频;VOR-MDSM 则是按三个评价维度微调的 VLM 打分模型。 实验效果:论文报告VOR-MDSM三项偏好判断与人工评分的Spearman相关系数均超过0.9,整体高于VideoLLaMA3、Qwen3-VL-8B和Gemini-3.1-Pro;基准覆盖相机采集、模型生成和工具渲染三类视频。 批判点评:细粒度维度比单一PSNR更接近真实观感,但150/300对数据仍小,VLM裁判也在相近任务分布上训练和验证;论文中的数据与模型发布仍带未来时态,可复现性要看正式开放程度。 10. RAIN:区域感知一跳提取语义水印 RAIN: Region-Aware Inversion Network for Semantic Watermark Extraction | Independent Researcher | arXiv:2609.14856 关键词:生成水印,扩散反演,鲁棒提取,模型归属 前序问题:Gaussian Shading等语义水印把信息埋在扩散初始噪声里,传统提取要多步反演大模型,代价高且在压缩、裁剪、噪声等失真后容易累积误差。 本文贡献:RAIN把终端噪声恢复改写为高信噪比端点上的条件回归,用小型双分支NAFNet一次预测水印决策所需的噪声区域;训练时加入有限集合的最坏失真样本,强化区域边界而非逐点精确重建。 Extraction pipeline used in our implementation. 实验效果:在1000条COCO样本的SD 2.1匹配评测中,干净图比特准确率99.99%;JPEG Q=25为98.15%,缩放到0.25为98.93%。其一次提取仅14.394 GFLOPs、15.468M参数,FARI为682.675 GFLOPs、868.469M参数。 Redrawn from Tables 3 and 4 of RAIN: extraction backbone cost and bit accuracy under matched SD 2.1 distortions. 批判点评:把目标从精确噪声恢复改成区域判别很契合水印任务,但盐椒噪声下93.11%的比特准确率低于OSI的99.71%,极端亮度下也非最优;当前证据绑定Gaussian Shading与特定Stable Diffusion设置。 趋势观察 生成系统开始压缩“状态”而非只压缩网络 SlotDiT 把视频压成少量 slot,AlayaVista把漫游场景压成持续全景状态,MDN-Control则把编辑约束拆成掩码、深度与噪声。共同方向是先确定任务真正需要保存的状态,再把DiT算力集中到这些变量。 推理时控制器成为低成本升级路径 ADSC按样本切换去噪日程,LACI检测跳读后回滚,MDN-Control组合现成控制信号。三者都尽量不重训主模型,把可靠性或效率问题移到可观测、可干预的推理环节。 评测从单一保真度转向任务与失败尾部 VOR-Bench用三维主观语义评分替代单一图像指标;LACI报告最差采样和灾难性失败率;SlotDiT直接看机器人完成率。平均分仍重要,但能否解释具体失败正成为更强的证据。 音频生成继续争夺长程结构控制 DiTAR+扩张历史上下文,SongCraft统一稀疏生成与稠密编辑条件,CMA-OT以多尺度音乐专家监督舞蹈配乐。不同任务都在处理局部声学质量与长程语义结构之间的矛盾。 人工智能炼丹君 整理 | 2026-09-17 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
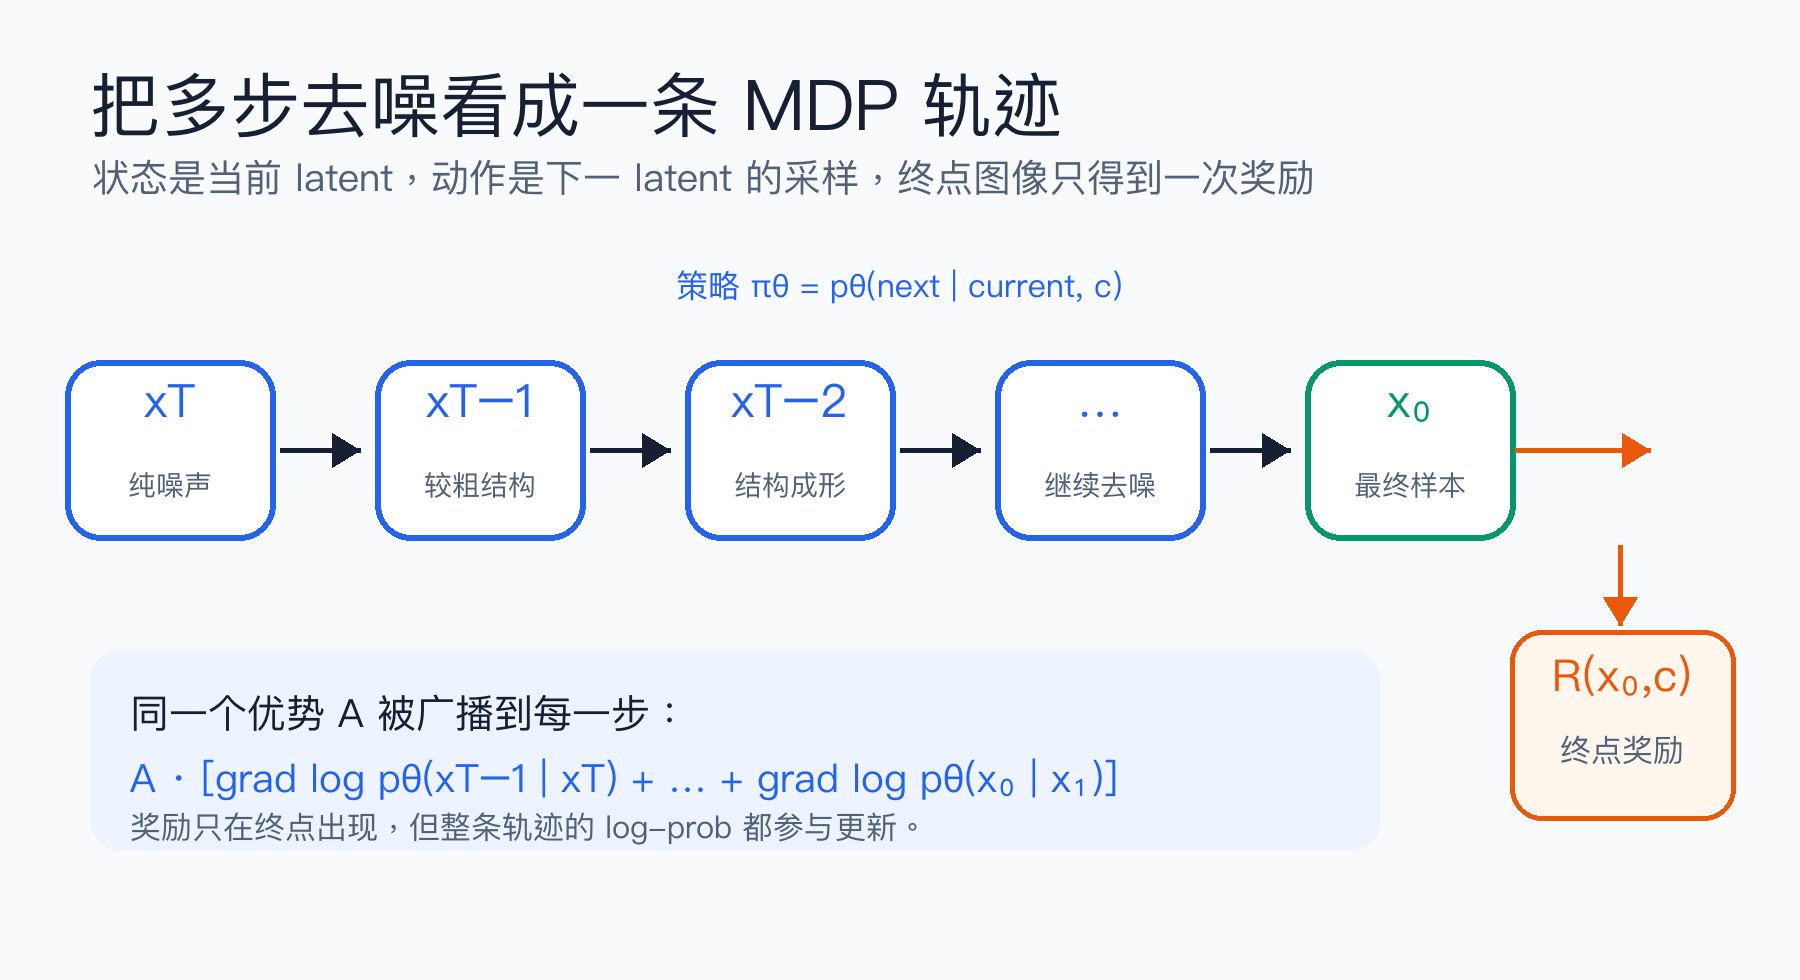
AIGC 基本功|把 RL 用到扩散模型上-DiffusionRL 把 RL 用到扩散模型上:从一张图的奖励到整条去噪轨迹的梯度 所属方向:对齐与强化学习 | 难度:前沿 | 前置知识:GRPO、DDIM 采样 关键词:DiffusionRL、DDPO、去噪轨迹、终点奖励、信用分配、DPOK、DRaFT 01. 为什么需要它 扩散模型通常先学习“像训练数据”,但产品真正关心的目标往往不是训练集似然:文字有没有正确渲染、人物是不是多了一根手指、构图是否讨喜、生成物能不能被某个下游系统识别、视频运动是否自然。这些目标可能来自人工打分、视觉语言模型、OCR、物理模拟器,甚至一段只能返回分数的业务程序。它们大多不可微,也不一定有成对偏好数据,却都能回答同一个问题:这张最终样本值多少分? 直接把最终图片当成一次普通动作,会丢掉扩散模型最重要的结构:图片不是一次生成的,而是从纯噪声开始,经过几十次随机去噪才得到的。假设采样有 50 步,最后的文字错了,到底是哪一步需要改?如果只对最终结果拟合,模型既看不到每一步在旧策略下出现的概率,也无法使用 PPO 的重要性比率约束更新;如果硬把 50 个概率相乘成一个轨迹比率,数值又很容易趋近 0 或爆炸。 DiffusionRL 的关键不是发明一种新的扩散网络,而是换一个观察角度: 把一次完整采样视为一条有限时域 MDP 轨迹;当前 latent 是状态,下一 latent 的随机采样是动作,最终图片的评分是终点奖励。 这样,奖励虽然只在最后出现,整条轨迹的 log-prob 仍然可以参与策略梯度。DDPO(Denoising Diffusion Policy Optimization)正是把这个视角变成了可训练算法:它允许我们用 JPEG 可压缩性、目标检测器、审美模型或人工反馈等黑盒奖励微调扩散模型,而不要求对奖励函数求导。 这也是理解视频生成 RL 的统一入口。图片去噪已经有“时间步 × latent”的信用分配;到了视频,还会再叠加帧间运动、时序一致性和长时奖励。先把图像版的轨迹与概率比率看清,后面的算法名字就不再是一堆孤立缩写。 02. 最小可用理解 给定提示词 $c$,采样从 $x_T\sim\mathcal N(0,I)$ 开始;每个去噪步骤都由模型定义一个策略 $p_\theta(x_{t-1}\mid x_t,c)$。 完整轨迹的概率是所有步骤概率的乘积,所以它的 log-prob 是逐步 log-prob 之和;终点奖励 $R(x_0,c)$ 因而能乘到每一步的 score function 上。 实际训练不直接做无约束 REINFORCE,而是像 PPO 一样保存旧策略的逐步 log-prob、重新计算新策略 log-prob、裁剪概率比率,并用基线或组内标准化降低方差。 图里有一个必须说准的细节:网络通常输出噪声、velocity 或转移均值的参数,但在 MDP 记号中,“动作”是实际采样出来的 $x_{t-1}$。也就是说,网络参数化动作分布,采样器从这个分布中抽出动作;不要把“网络输出”和“环境中发生的动作”混成一件事。 03. 数学推导 3.1 先把一次随机去噪写成概率分布 为避免被不同预测参数化淹没,先只保留采样器真正需要的形式。对当前 latent $x_t$,模型根据时间步 $t$ 和条件 $c$ 预测噪声,再由调度器算出一个转移均值: $$\mu_\theta(x_t,t,c).$$ 带随机性的 DDIM 步可以统一写成: $$x_{t-1}=\mu_\theta(x_t,t,c)+\sigma_t z_t,\qquad z_t\sim\mathcal N(0,I).$$ 因此条件转移是一个高斯策略: $$\pi_\theta(a_t\mid s_t)=p_\theta(x_{t-1}\mid x_t,t,c)=\mathcal N\!\left(x_{t-1};\mu_\theta(x_t,t,c),\sigma_t^2 I\right).$$ DDIM 中的随机强度由 $\eta$ 控制。训练 DDPO 时通常必须让 $\eta>0$,这样被纳入似然目标的随机步骤才有普通高斯密度可用于 log-prob 和重要性比率。注意 $\eta>0$ 仍不保证所有步骤 $\sigma_t>0$:落到干净端的终步可能方差为零,需排除该步或显式采用非零方差,不能直接算高斯 log-prob。若 $\eta=0$,转移退化为确定性映射,$\sigma_t=0$,直接套高斯 log-prob 会除以零;确定性采样仍可用于可微奖励反传,但不能不加处理地套用这套随机策略梯度。 3.2 MDP 的四个元素 把扩散采样改写成 MDP 时,可使用下面的对应关系: RL 概念 扩散采样中的对象 状态 $s_t$ 当前 latent、时间步和条件:$(x_t,t,c)$ 动作 $a_t$ 从模型给出的分布中采样下一 latent:$x_{t-1}$ 策略 $\pi_\theta$ 反向去噪转移 $p_\theta(x_{t-1}\mid x_t,t,c)$ 奖励 中间步骤通常为 0;解码 $x_0$ 后得到 $R(x_0,c)$ 这里的“环境”几乎没有额外动力学:动作 $x_{t-1}$ 本身就成为下一状态的一部分,时间步从 $t$ 减到 $t-1$。文本编码器、VAE 解码器和奖励模型通常不属于策略参数;真正更新的是 UNet、DiT 或其 LoRA 适配器。 3.3 终点一个分数,为什么每一步都有梯度 给定提示词,一条轨迹记作 $\tau=(x_T,x_{T-1},\ldots,x_0)$。因为初始噪声不依赖模型参数,轨迹概率可分解为: $$p_\theta(\tau\mid c)=p(x_T)\prod_{t=T}^{1}p_\theta(x_{t-1}\mid x_t,t,c).$$ 取对数后,乘积变为求和: $$\log p_\theta(\tau\mid c)=\log p(x_T)+\sum_{t=T}^{1}\log p_\theta(x_{t-1}\mid x_t,t,c).$$ 目标是最大化期望终点奖励: $$J(\theta)=\mathbb E_{c,\tau\sim p_\theta}[R(x_0,c)].$$ 应用 likelihood-ratio trick: $$\nabla_\theta J(\theta)=\mathbb E\!\left[R(x_0,c)\nabla_\theta\log p_\theta(\tau\mid c)\right]=\mathbb E\!\left[R(x_0,c)\sum_{t=T}^{1}\nabla_\theta\log p_\theta(x_{t-1}\mid x_t,t,c)\right].$$ 这就是“奖励只在终点,梯度覆盖全轨迹”的来源。实践中会减去不依赖当前动作的基线 $b(c)$,得到优势: $$A=R(x_0,c)-b(c).$$ 减基线不会改变期望梯度,却能显著降低采样方差。若同一个 prompt 一次生成多张图,可以用组内均值和标准差做归一化: $$A_i=\frac{R_i-\operatorname{mean}(R_{1:G})}{\operatorname{std}(R_{1:G})+\epsilon}.$$ 组均值包含自身时,未标准化的中心化 score 估计在独立采样条件下有 $(1-1/G)$ 的缩放;随机标准差还会改变各组权重。因此上面的无偏基线证明不能直接套到组内标准化。它和 GRPO 的“组内相对分数”很相似,不过动作空间从 token 变成了高维 latent 转移。 3.4 每一步的 log-prob 到底怎么算 设动作 $x_{t-1}$ 有 $D$ 个独立高斯坐标、固定方差为 $\sigma_t^2>0$。真实联合 log-prob 必须对坐标求和: $$\ell_\theta=-\frac{\|x_{t-1}-\mu_\theta\|^2}{2\sigma_t^2}-D\log\sigma_t-\frac D2\log(2\pi).$$ 真实逐步联合概率比为 $r_t=\exp(\ell_\theta-\ell_{old})$。DDPO 作者实现 则把逐坐标 log-prob 取平均,即 $\bar\ell=\ell/D$,再计算 $$\bar r_t=\exp(\bar\ell_\theta-\bar\ell_{old})=r_t^{1/D}.$$ 这是一种控制高维数值尺度的工程替代比率,不再是严格的联合重要性权重;它也改变了 clip 的尺度。本文一维玩具 $D=1$ 时二者相同,多维复现时必须明确采用哪个约定。下式的 $r_t$ 应按所选约定解释。 PPO 风格的裁剪目标是: $$L_t(\theta)=\min\!\left(r_t A,\operatorname{clip}(r_t,1-\epsilon,1+\epsilon)A\right).$$ 训练代码通常最小化 $-L_t$。关键是先按转移计算比率再裁剪,不是先把所有 $r_t$ 相乘成一个轨迹比率。后者会随步数快速积累方差,也让某一步的异常比率拖垮整条样本。 3.5 同一个优势,不代表每一步得到同样的梯度 优势 $A$ 可以广播给每一步,但 score function 不同。对固定方差的高斯策略,有: $$\nabla_\theta\log p_\theta(x_{t-1}\mid x_t,c)=\frac{x_{t-1}-\mu_\theta}{\sigma_t^2}\nabla_\theta\mu_\theta.$$ 时间步的噪声尺度、采样残差、网络 Jacobian 都不同,因此各步的梯度贡献不会相等。终点附近通常对最终结果影响更直接,但并不存在“最后一步天然包办所有学习”的定理;调度器与模型参数化会改变信用在各步之间的分布。 04. 代码实现 下面的玩具过程只有一个可训练标量 $\theta$,但保留了 DDPO 的核心结构:8 步高斯去噪、只在终点计算奖励、保存逐步 log-prob、用中心化优势做 REINFORCE,并在最后演示新旧策略的 PPO 比率。 状态转移是: $$x_{t-1}=0.72x_t+0.18\theta+0.45z_t,\qquad z_t\sim\mathcal N(0,1).$$ 终点目标为 1.5,奖励为: $$R(x_0)=-(x_0-1.5)^2.$$ 完整代码见文末。直接运行: python3 ddpo_minimal.py 真实输出如下: trajectory_shape= (4096, 9) transition_log_prob_shape= (4096, 8) before_terminal_mean= 0.0052 before_reward_mean= -2.6513 after_theta= 2.2677 after_terminal_mean= 1.3577 after_reward_mean= -0.4370 per_step_gradient= [0.0088 0.0085 0.014 0.024 0.0358 0.0435 0.0578 0.0883] gradient_sample_std_raw_centered= 1.6981 1.3899 ppo_ratio_mean_min_max= 1.0010 0.4051 2.2337 ppo_clip_fraction= 0.3108 history_first= [ 0. -0.0165 -2.7295] history_last= [ 2.2677 1.3601 -0.4503] 几个 shape 很重要:4096 条轨迹、每条 8 个转移,所以状态数组有 9 个点,而 log-prob 只有 8 个。训练前 $x_0$ 均值约为 0;40 次更新后移到 1.36,接近目标 1.5,平均奖励从 -2.65 提升到约 -0.44。奖励是负平方误差,所以“更大”意味着更接近 0,而不是数值绝对值更大。 中心化前后,单样本梯度估计的标准差从 1.70 降到 1.39。这只是最简单的 batch baseline;工业实现还会按 prompt 维护统计量,避免一个本来就容易拿高分的 prompt 主导更新。 最后把参数轻微扰动,逐步比率均值仍约为 1,但极端值已经到 0.41 和 2.23,有约 31% 的转移落到裁剪区间之外。这说明“平均比率看起来正常”不足以判断更新是否安全,还要看 clip fraction、KL 和比率分位数。 右图里越靠近终点的转移贡献越大,是这个线性玩具过程的收缩系数 0.72 造成的:早期扰动经过多次收缩后影响变小。真实扩散模型不会总呈现这种单调形状,但它直观说明了:即使每一步共享同一个终点优势,信用仍由每一步的局部概率结构决定。 05. 工业级实现对照 截至 2026 年 9 月,DDPO 论文作者维护的参考实现 kvablack/ddpo-pytorch 仍是理解训练循环最直接的代码入口。其 scripts/train.py 和带 log-prob 的 ddim_step_with_logprob 展示了完整数据流: 采样 rollout:从 prompt 和初始噪声出发,保存形状近似为 [batch, steps + 1, C, H, W] 的 latents,以及 [batch, steps] 的旧策略 log-prob。 只给终点打分:将 $x_0$ 经 VAE 解码成图片,用 JPEG 可压缩性、审美分数、目标检测、视觉语言模型或业务规则计算奖励。慢奖励可以并发执行,但返回时必须和样本一一对齐。 构造优势:对全批次奖励标准化,或用 per-prompt statistics tracker 做条件化标准化。同一条轨迹的优势广播到各去噪时间步。 打乱样本与时间步:实现不仅 shuffle 样本,还可对每个样本打乱时间步顺序,降低相邻去噪步相关性对小批次更新的影响。 重算 log-prob:把保存的 $(x_t,x_{t-1},t,c)$ 喂给当前模型,通过 patched DDIM step 得到新策略 log-prob,而不是重新采样一个 $x_{t-1}$。 PPO 裁剪更新:计算逐步新旧比率,应用 clipped surrogate loss;通常只训练 LoRA,以降低显存、通信和策略漂移。 这个实现细节解释了为什么训练内存明显大于普通推理:rollout 阶段要保存整条 latent 轨迹和旧 log-prob,更新阶段又要为当前时间步建立反向图。若 rollout batch 为 $B$、去噪步数为 $T$,一轮采样至少处理 $B\times T$ 次 UNet/DiT 前向;若每批 rollout 做 $K$ 个 inner epochs,更新成本还会近似再乘 $K$。梯度累积只改变峰值显存,不会凭空消除总计算量。 早期 Hugging Face TRL 版本曾提供 DDPOTrainer,但当前上游目录与公开 API 已发生重构。读旧教程时应锁定对应版本,不要假设 trl/trainer/ddpo_trainer.py 在最新版仍是稳定入口;本文因此把论文作者仓库作为代码锚点。 从 rollout 到 update 的数据契约 工程里最值得先写清的不是 Trainer 类,而是一条样本在两个阶段之间必须携带什么。rollout 结束后,每条样本至少要保存 prompt 或其编码、全部时间步、从初始噪声到终点的 latents、旧策略逐步 log-prob、最终图片、原始奖励和经过标准化的优势。若使用 classifier-free guidance,还必须固定无条件分支、guidance scale 和文本编码方式;否则更新阶段重算出来的均值并不是采样时那条策略的均值。 update 阶段只取保存的当前 latent 和下一 latent,调用当前模型重算同一个已发生动作的 log-prob。这里绝对不能重新抽噪声:PPO 问的是“新策略对旧动作给出多大概率”,不是“新策略这次随机采到了什么”。这个区别在 token PPO 中很直观——不会在更新时重采一句回答——换成连续 latent 后却很容易藏在调度器接口里。 还应给 rollout 批次分配不可变的 sample id,并把 prompt、随机种子、reward 版本、模型 checkpoint 和 scheduler 配置写进元数据。这样一旦某个 batch 的 ratio 或奖励异常,能够重放出同一条轨迹并定位问题。只记录最后的 PNG 不够,因为不同 latent 轨迹可能解码成肉眼相近的图片,而策略梯度依赖的是当时每一步的概率。 多卡训练时,全局优势标准化也必须基于所有进程聚合后的奖励,而不是每张卡各算各的。否则不同卡的 prompt 难度稍有偏差,就会得到不同的零点和尺度;随后再做梯度平均,相当于混合了多套不一致的目标。相反,若采用 per-prompt 统计器,应明确冷启动策略:某个 prompt 样本太少时回退到全局统计,避免标准差接近零导致优势被放大。 DPOK:为什么还要加 KL 纯奖励最大化很容易把模型推离预训练分布。DPOK(Diffusion Policy Optimization with KL regularization)在在线策略梯度中加入参考模型约束,可抽象为: $$J_{\text{DPOK}}(\theta)=\mathbb E[R(x_0,c)]-\beta\,D_{\mathrm{KL}}(p_\theta\|p_{\text{ref}}).$$ $\beta$ 越大,模型越保守;越小,越容易快速追逐奖励,也越容易丢失多样性或出现奖励投机。PPO clipping 约束的是一次更新相对旧策略的变化,reference KL 约束的是长期相对基座模型的漂移,两者作用并不相同。 DRaFT:奖励可微时,可以不走 score function 如果奖励模型对像素可微,且采样器的整条计算图可以保留,就能把梯度从奖励直接穿过 VAE 与采样步骤反传到扩散模型。DRaFT 将这一路线系统化,并提出截断反传等变体来控制内存与梯度不稳定。 两条路线的选择很清楚: DDPO / DPOK:奖励可以是完全黑盒,只需要返回标量;代价是策略梯度方差较高,需要大量 on-policy 样本。 DRaFT 类方法:能利用奖励的路径导数,梯度通常更直接;但奖励必须可微,且跨很多采样步骤保存或重算计算图,显存与稳定性是主要问题。 它们可以共享同一个奖励定义,却不能把“对奖励求导”和“用奖励乘 log-prob”混写成一套推导。 06. 代价与边界 6.1 它省下了什么 不需要奖励函数可微,外部 API、人工评分和离散程序都能接入。 不需要为每个目标重新制作大规模成对偏好数据;在线采样能探索当前策略真正会生成的区域。 能复用 PPO 的裁剪、KL、优势归一化和诊断工具,把更新幅度控制在可观察范围内。 6.2 它付出了什么 on-policy 成本高:策略一更新,旧 rollout 很快过期;数据复用能力弱于离线偏好优化。 终点信用粗糙:所有步骤共享终点优势,方差高;步数越多、latent 越高维,问题越明显。 奖励调用可能成为瓶颈:大型 VLM 或人工评分比去噪本身还慢,异步队列与缓存很重要。 探索与画质有冲突:增大 DDIM 的 $\eta$ 有利于随机策略探索,却可能改变原有采样质量与分布。 奖励投机不会自动消失:OCR 奖励可能鼓励巨大文字,审美分数可能压低多样性,检测器奖励可能诱导模型画出分类器偏爱的纹理。 6.3 上线前至少记录这些指标 不要只看 mean reward。最低限度还应记录: 奖励均值、标准差和分位数,按 prompt 类别拆分; 新旧策略的 approximate KL、ratio 分位数与 clip fraction; 每个时间步的 loss、KL 或梯度范数,检查是否只剩少数步在学习; 多样性指标和基础画质指标,防止奖励提高但模式坍缩; 人工盲评或独立奖励模型的 holdout 分数,防止只攻破训练用 reward; 无效图片、NaN、全黑/过曝和安全过滤命中率。 如果奖励模型本身正在更新,还要给 reward 版本打快照。否则同一条训练曲线纵轴含义会变化,前后 reward 数字不可直接比较。 6.4 奖励怎么配,往往比优化器更重要 真实系统几乎不会只用一个分数。以文字生成图片为例,可以同时有提示词一致性、OCR 正确率、审美、人体结构和安全性五类信号。最直接的做法是加权求和: $$R=w_{\text{prompt}}R_{\text{prompt}}+w_{\text{ocr}}R_{\text{ocr}}+w_{\text{aesthetic}}R_{\text{aesthetic}}-w_{\text{safety}}C_{\text{safety}}.$$ 但“都放进来”不等于问题解决了。不同奖励的量纲与波动范围可能差几个数量级:OCR 是 0 或 1,审美模型可能落在 1 到 10,安全惩罚可能只有极少数样本非零。若不先校准,权重看似相近,实际梯度却会被方差最大的那一项占满。稳妥做法是先在固定基座模型上采一批校准集,观察每项分布,再做裁剪、标准化或分位数映射;训练期间同时画出每个子奖励,不能只保存加权总分。 还要区分“软目标”和“硬约束”。图片里文字少一个字,通常是可连续改进的软目标;生成违法内容则不应靠一个可被其他高分抵消的负权重处理。硬约束更适合在采样前后用过滤器、拒绝策略或拉格朗日约束单独处理。否则模型可能发现:只要审美分足够高,安全惩罚也值得承受。 多目标之间还会发生真实冲突。把 OCR 权重拉高,模型可能把文字做得巨大而破坏构图;只奖励检测器置信度,可能得到边缘锐利但不自然的目标。应当用 Pareto 视角看结果:同一批 checkpoints 同时比较各子目标和人工偏好,选择没有被某一维明显支配的方案,而不是盯着一条总 reward 曲线挑最高点。 6.5 三个能快速定位实现错误的不变量 第一,rollout 保存的状态数必须比转移 log-prob 数多 1;若二者相等,通常漏了初始噪声或终点 latent。第二,当新旧模型参数完全相同时,逐步 ratio 应非常接近 1,approximate KL 应接近 0;否则多半是调度器、CFG 分支、时间步索引或 log-prob 归约维度不一致。第三,打乱 batch 顺序不应改变同一个样本的 reward、prompt、latents 与 log-prob 对齐关系。异步奖励最容易在这里悄悄错位:训练仍会运行,均值甚至会上升,但模型学到的是别人的分数。 调试时先用一个可以解析求解的低维过程,就像本文代码;确认梯度方向、ratio 和 baseline 都符合预期,再接入大模型。直接在多卡图像训练里找符号错误,通常会把昂贵计算浪费在最便宜的 bug 上。 这些不变量也适合写进自动化测试:用固定随机种子的十几条轨迹做快速回归,每次升级 diffusers、调度器或混合精度设置后先跑它,再启动昂贵的正式训练。 07. 经典论文脉络 Training Diffusion Models with Reinforcement Learning / DDPO(arXiv:2305.13301)把扩散去噪正式改写为多步决策过程,给出基于 likelihood ratio 的 DDPO,并展示了不可微奖励下的微调能力。它奠定了“去噪轨迹就是策略轨迹”的主框架。 DPOK: Reinforcement Learning for Fine-tuning Text-to-Image Diffusion Models(arXiv:2305.16381)把在线策略梯度与 KL 正则结合,强调奖励提升和预训练分布保持之间的平衡。 DRaFT: Directly Fine-tuning Diffusion Models on Differentiable Rewards(arXiv:2309.17400)转向可微奖励,通过采样链直接反传,并研究 full、截断和低方差版本,形成与 DDPO 互补的路线。 Reward-Directed Conditional Diffusion(arXiv:2307.07055)从 reward-conditioned / reward-directed 角度研究如何把黑盒目标引入扩散生成,说明“训练一个条件生成器”和“在线策略优化”是相关但不同的解法。 Diffusion Models for Reinforcement Learning: A Survey(arXiv:2311.01223)覆盖的是更宽的交叉方向:既包括用 RL 对齐扩散生成,也包括把扩散模型当作策略或规划器。阅读时要先辨认“RL 优化 diffusion”还是“diffusion 服务 RL”。 论文名称很像时,先看梯度从哪里来:若公式里是 $R\nabla\log p_\theta$,属于 score-function 策略梯度;若是 $\nabla_{x_0}R$ 沿采样链反传,则属于可微奖励路线;若训练数据是静态偏好对,通常又是离线偏好优化问题。 08. 常见误解 误解 1:模型预测的噪声就是 RL 动作 噪声预测是策略的参数化中间量。DDPO 的动作通常记为实际采样出的下一 latent $x_{t-1}$,策略概率才是 $p_\theta(x_{t-1}\mid x_t,c)$。只有这样,保存动作、重算 log-prob 和构造新旧比率才是一致的。 误解 2:奖励在最后,所以只有最后一步能更新 轨迹 log-prob 是逐步 log-prob 的和。终点奖励乘的是整条和,因此每个去噪转移都有 score-function 梯度。最后一步可能贡献较大,但不是唯一有梯度的一步。 误解 3:确定性 DDIM 也能原样计算 DDPO log-prob $\eta=0$ 时 $\sigma_t=0$,普通高斯 log-prob 不再成立。要么使用非零随机性,要么换成适合确定性路径的可微反传或其他估计器,不能简单给分母加一个 epsilon 就宣称理论等价。 误解 4:把所有逐步比率相乘,才是最“严格”的 PPO 轨迹比率在长链上方差巨大。DDPO 实践通常按去噪转移计算和裁剪 ratio;这是一种稳定的 surrogate,而不是把一个 50 步连乘数硬塞进普通 PPO 公式。 误解 5:同一奖励广播到每一步,所以每步学到的一样 优势相同,不等于 score function 相同。噪声方差、预测残差、网络敏感度和调度器权重都随时间步变化,逐步梯度自然不同。 误解 6:奖励不可微就无法优化扩散模型 DDPO 只需要采样结果和标量奖励,不需要奖励梯度。不可微带来的问题是估计方差和样本成本,而不是“没有任何梯度”。 误解 7:训练 reward 上升就代表模型全面变好 模型可能只学会利用 reward 的盲点。必须同时看独立评估、人工盲评、多样性、prompt 遵循和安全指标;最好用不同架构的 holdout reward 检查泛化。 09. 动手验证:四个改动看懂算法 文末代码只依赖 NumPy,建议依次改四个参数,每次固定随机种子并比较输出。 实验 A:把 steps 从 8 改为 16 预期状态 shape 从 (4096, 9) 变成 (4096, 17),log-prob shape 从 (4096, 8) 变成 (4096, 16)。更长轨迹会增加梯度求和项;在不调整学习率与归一化时,训练波动通常更明显。 实验 B:把 noise_std 从 0.45 降到 0.10 探索减弱,采样更集中;但 score function 含 $1/\sigma^2$,数值会更尖锐。过小噪声并不等于更稳定,极限到 0 反而失去这套高斯策略梯度的基础。 实验 C:删掉优势中心化 把 advantage = (reward - reward.mean()) / ... 改成直接使用 reward。gradient_sample_std_raw_centered 的第二个值会失去优势,训练曲线更抖。这个实验直观看到 baseline 改变方差而不改变目标最优点。 实验 D:增大新旧参数差 在 PPO 诊断部分增大 new_theta - old_theta。你会看到 ratio_min/max 更极端,clip_fraction 上升。工程上这对应学习率过大、inner epochs 过多或 KL 约束过弱。 进一步可把终点奖励改成离散黑盒:例如 reward = (abs(x0-target) < 0.25)。代码仍能训练,但由于奖励更稀疏,往往需要更大 batch、分层采样或更好的 baseline。这正是从玩具例子走向 OCR 成功率、目标检测命中和人工反馈时遇到的现实问题。 10. 延伸阅读 这篇位于“对齐与强化学习”路径的第三段: 策略梯度与 PPO 基础:理解 advantage、ratio、clipping 和 KL; 从 DPO 到 GRPO:去掉价值网络:理解组内相对优势; 本文 DiffusionRL:把 token 轨迹换成 latent 去噪轨迹; 视频生成中的强化学习与奖励模型:在去噪信用之外,再处理画质、运动与指令遵循的多目标奖励。 如果 DDIM 还不熟,先记住本文真正依赖的最小事实:它把 $x_t$ 和网络预测组合成下一步均值,并可用 $\eta$ 注入高斯随机性。从 DDIM 到高阶采样器 已展开采样公式、ODE/SDE 视角与高阶求解器。 最后用一句话收束: DiffusionRL 不是把一个 PPO 套在图片外面,而是把每次去噪转移变成可计概率的动作,再让终点奖励沿整条轨迹分配信用。 附录:完整代码 09 节用到的脚本全文如下(ddpo_minimal.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 ddpo_minimal.py """NumPy-only toy DDPO: treat iterative denoising as a stochastic policy. This is an algebra demo, not an image generator. A scalar latent follows a short Gaussian reverse process. One parameter shifts every denoising mean, and a terminal reward teaches the process to end near a target value. """ from dataclasses import dataclass import numpy as np @dataclass(frozen=True) class ToyConfig: steps: int = 8 batch_size: int = 4096 contraction: float = 0.72 action_scale: float = 0.18 noise_std: float = 0.45 target: float = 1.5 def gaussian_log_prob(value, mean, std): """Elementwise log N(value; mean, std^2).""" return -0.5 * ((value - mean) / std) ** 2 - np.log(std * np.sqrt(2.0 * np.pi)) def rollout(theta, cfg, rng): """Sample x_T -> ... -> x_0 and retain every transition. Array index 0 stores x_T; index cfg.steps stores x_0. The transition mean is mu_theta = contraction * x_t + action_scale * theta. """ latents = np.empty((cfg.batch_size, cfg.steps + 1), dtype=np.float64) means = np.empty((cfg.batch_size, cfg.steps), dtype=np.float64) log_probs = np.empty((cfg.batch_size, cfg.steps), dtype=np.float64) latents[:, 0] = rng.normal(size=cfg.batch_size) for j in range(cfg.steps): mean = cfg.contraction * latents[:, j] + cfg.action_scale * theta next_latent = mean + cfg.noise_std * rng.normal(size=cfg.batch_size) latents[:, j + 1] = next_latent means[:, j] = mean log_probs[:, j] = gaussian_log_prob(next_latent, mean, cfg.noise_std) terminal = latents[:, -1] rewards = -(terminal - cfg.target) ** 2 return latents, means, log_probs, rewards def score_function(latents, means, cfg): """d log pi_theta(x_{t-1}|x_t) / d theta for every transition.""" residual = latents[:, 1:] - means return residual * cfg.action_scale / (cfg.noise_std**2) def policy_gradient(rewards, per_step_scores): """REINFORCE with a batch baseline; terminal advantage is broadcast to T steps.""" centered = rewards - rewards.mean() advantages = centered / (rewards.std() + 1e-8) trajectory_scores = per_step_scores.sum(axis=1) gradient = np.mean(advantages * trajectory_scores) per_step_gradient = np.mean(advantages[:, None] * per_step_scores, axis=0) return gradient, per_step_gradient, advantages def evaluate(theta, cfg, seed): rng = np.random.default_rng(seed) latents, means, log_probs, rewards = rollout(theta, cfg, rng) return { "terminal_mean": float(latents[:, -1].mean()), "reward_mean": float(rewards.mean()), "latents": latents, "means": means, "log_probs": log_probs, "rewards": rewards, } def train(cfg, updates=40, learning_rate=0.08, seed=7): theta = 0.0 history = [] rng = np.random.default_rng(seed) for update in range(updates + 1): latents, means, _, rewards = rollout(theta, cfg, rng) scores = score_function(latents, means, cfg) gradient, per_step_gradient, advantages = policy_gradient(rewards, scores) history.append((update, theta, latents[:, -1].mean(), rewards.mean(), gradient)) if update < updates: theta += learning_rate * gradient return theta, np.asarray(history), per_step_gradient, advantages, scores, rewards def ppo_diagnostics(theta_old, theta_new, cfg, seed=123, clip_range=0.2): """Re-evaluate old transitions under a candidate new policy.""" rng = np.random.default_rng(seed) latents, old_means, old_log_probs, rewards = rollout(theta_old, cfg, rng) new_means = cfg.contraction * latents[:, :-1] + cfg.action_scale * theta_new new_log_probs = gaussian_log_prob(latents[:, 1:], new_means, cfg.noise_std) ratios = np.exp(new_log_probs - old_log_probs) clipped = np.abs(ratios - 1.0) > clip_range return rewards, ratios, clipped if __name__ == "__main__": np.set_printoptions(precision=6, suppress=True) cfg = ToyConfig() before = evaluate(theta=0.0, cfg=cfg, seed=2026) theta, history, per_step_gradient, advantages, scores, rewards = train(cfg) after = evaluate(theta=theta, cfg=cfg, seed=2026) raw_gradient_samples = rewards * scores.sum(axis=1) centered_gradient_samples = (rewards - rewards.mean()) * scores.sum(axis=1) ppo_rewards, ratios, clipped = ppo_diagnostics( theta_old=0.0, theta_new=0.5, cfg=cfg ) print("trajectory_shape=", before["latents"].shape) print("transition_log_prob_shape=", before["log_probs"].shape) print("before_terminal_mean=", f"{before['terminal_mean']:.4f}") print("before_reward_mean=", f"{before['reward_mean']:.4f}") print("after_theta=", f"{theta:.4f}") print("after_terminal_mean=", f"{after['terminal_mean']:.4f}") print("after_reward_mean=", f"{after['reward_mean']:.4f}") print("per_step_gradient=", np.round(per_step_gradient, 4)) print( "gradient_sample_std_raw_centered=", f"{raw_gradient_samples.std():.4f}", f"{centered_gradient_samples.std():.4f}", ) print( "ppo_ratio_mean_min_max=", f"{ratios.mean():.4f}", f"{ratios.min():.4f}", f"{ratios.max():.4f}", ) print("ppo_clip_fraction=", f"{clipped.mean():.4f}") print("history_first=", np.round(history[0, 1:4], 4)) print("history_last=", np.round(history[-1, 1:4], 4)) assert before["latents"].shape == (cfg.batch_size, cfg.steps + 1) assert before["log_probs"].shape == (cfg.batch_size, cfg.steps) assert after["reward_mean"] > before["reward_mean"] assert abs(after["terminal_mean"] - cfg.target) < abs(before["terminal_mean"] - cfg.target) assert np.all(np.isfinite(ratios)) make_figures.py """Generate the explanatory figures for the DiffusionRL article. Requires NumPy, Matplotlib and Pillow. The numerical chart reuses the exact toy process from ddpo_minimal.py so the article and figure cannot drift apart. """ from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from PIL import Image, ImageDraw, ImageFont from ddpo_minimal import ToyConfig, train OUT = Path(__file__).resolve().parents[1] / "figures" OUT.mkdir(exist_ok=True) def _font(size, bold=False): candidates = ( "/System/Library/Fonts/PingFang.ttc", "/System/Library/Fonts/Hiragino Sans GB.ttc", "/usr/share/fonts/opentype/noto/NotoSansCJK-Bold.ttc" if bold else "/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc", ) for path in candidates: try: return ImageFont.truetype(path, size) except OSError: pass raise RuntimeError("请安装中文字体后再生成 DiffusionRL 示意图") def trajectory_mdp(): image = Image.new("RGB", (1800, 980), "#f8fafc") draw = ImageDraw.Draw(image) ink, blue, green, orange, muted = "#172033", "#2563eb", "#059669", "#ea580c", "#526078" draw.text((90, 55), "把多步去噪看成一条 MDP 轨迹", font=_font(70, True), fill=ink) draw.text((92, 150), "状态是当前 latent,动作是下一 latent 的采样,终点图像只得到一次奖励", font=_font(38), fill=muted) draw.text((900, 285), "策略 πθ = pθ(next | current, c)", font=_font(32), fill=blue, anchor="mm") xs = [170, 480, 790, 1100, 1410] labels = ["xT", "xT−1", "xT−2", "…", "x₀"] subtitles = ["纯噪声", "较粗结构", "结构成形", "继续去噪", "最终样本"] for i, (x, label, subtitle) in enumerate(zip(xs, labels, subtitles)): color = blue if i < len(xs) - 1 else green draw.rounded_rectangle((x - 105, 360, x + 105, 540), radius=36, fill="#ffffff", outline=color, width=6) draw.text((x, 400), label, font=_font(46, True), fill=color, anchor="mm") draw.text((x, 485), subtitle, font=_font(28), fill=muted, anchor="mm") if i < len(xs) - 1: draw.line((x + 110, 450, xs[i + 1] - 120, 450), fill=ink, width=5) draw.polygon( [(xs[i + 1] - 120, 450), (xs[i + 1] - 148, 433), (xs[i + 1] - 148, 467)], fill=ink, ) draw.line((1515, 450, 1650, 450), fill=orange, width=5) draw.polygon([(1650, 450), (1622, 433), (1622, 467)], fill=orange) draw.rounded_rectangle((1510, 630, 1735, 820), radius=32, fill="#fff7ed", outline=orange, width=5) draw.text((1622, 675), "R(x₀,c)", font=_font(44, True), fill=orange, anchor="mm") draw.text((1622, 750), "终点奖励", font=_font(31), fill=muted, anchor="mm") draw.line((1620, 545, 1620, 625), fill=orange, width=5) draw.polygon([(1620, 625), (1603, 597), (1637, 597)], fill=orange) draw.rounded_rectangle((90, 650, 1380, 850), radius=30, fill="#eef4ff") draw.text((130, 685), "同一个优势 A 被广播到每一步:", font=_font(39, True), fill=ink) draw.text((130, 750), "A · [grad log pθ(xT−1 | xT) + … + grad log pθ(x₀ | x₁)]", font=_font(39), fill=blue) draw.text((130, 805), "奖励只在终点出现,但整条轨迹的 log-prob 都参与更新。", font=_font(31), fill=muted) image.save(OUT / "diffusion_rl_mdp.png", optimize=True) def cover(): image = Image.new("RGB", (1280, 720), "#081225") draw = ImageDraw.Draw(image) # A denoising trajectory that gradually changes from noise-like dots into a # clean latent. Keeping this code-native makes the cover deterministic. rng = np.random.default_rng(7) stages = [190, 400, 610, 820, 1030] palette = ["#60a5fa", "#38bdf8", "#2dd4bf", "#34d399", "#f59e0b"] for i, x in enumerate(stages): radius = 62 draw.ellipse((x - radius, 258 - radius, x + radius, 258 + radius), outline=palette[i], width=5) spread = 47 - i * 7 for _ in range(38 - i * 4): px = x + int(rng.normal(0, spread)) py = 258 + int(rng.normal(0, spread)) dot = 2 + i draw.ellipse((px - dot, py - dot, px + dot, py + dot), fill=palette[i]) if i < len(stages) - 1: draw.line((x + 72, 258, stages[i + 1] - 75, 258), fill="#94a3b8", width=4) draw.polygon( [(stages[i + 1] - 75, 258), (stages[i + 1] - 96, 246), (stages[i + 1] - 96, 270)], fill="#94a3b8", ) draw.rounded_rectangle((1068, 190, 1222, 326), radius=26, fill="#431407", outline="#f59e0b", width=4) draw.text((1145, 258), "+R", font=_font(48, True), fill="#fbbf24", anchor="mm") draw.text((92, 415), "把 RL 用到扩散模型上", font=_font(64, True), fill="#f8fafc") draw.text((96, 507), "DiffusionRL · DDPO · 去噪轨迹 · 信用分配", font=_font(34), fill="#93c5fd") draw.rounded_rectangle((94, 603, 426, 659), radius=25, fill="#1d4ed8") draw.text((260, 631), "AIGC 基本功", font=_font(28, True), fill="#ffffff", anchor="mm") image.save(OUT / "wechat_cover_diffusion_rl.png", optimize=True) def training_and_credit(): cfg = ToyConfig() _, history, per_step_gradient, _, _, _ = train(cfg) updates = history[:, 0] fig, axes = plt.subplots(1, 2, figsize=(11, 4.3)) ax = axes[0] ax.plot(updates, history[:, 3], color="#2563eb", linewidth=2.5, label="mean terminal reward") ax.set_xlabel("policy updates") ax.set_ylabel("reward (higher is better)") ax.grid(alpha=0.2) ax2 = ax.twinx() ax2.plot(updates, history[:, 2], color="#059669", linewidth=2.2, label="mean x0") ax2.axhline(cfg.target, color="#059669", linestyle="--", alpha=0.45, label="target") ax2.set_ylabel("terminal latent mean") lines = ax.get_lines() + ax2.get_lines() ax.legend(lines, [line.get_label() for line in lines], frameon=False, loc="center right") ax.set_title("Toy DDPO learns from terminal reward") ax = axes[1] steps = np.arange(cfg.steps) ax.bar(steps, per_step_gradient, color=plt.cm.Blues(np.linspace(0.45, 0.95, cfg.steps))) ax.set_xticks(steps, [f"{cfg.steps-i}→{cfg.steps-i-1}" for i in steps], rotation=40) ax.set_xlabel("denoising transition") ax.set_ylabel("estimated gradient contribution") ax.grid(axis="y", alpha=0.2) ax.set_title("Same reward, different credit per step") fig.suptitle("Terminal reward becomes a trajectory-level policy gradient", fontsize=15, weight="bold") fig.tight_layout() fig.savefig(OUT / "diffusion_rl_training_credit.png", dpi=190) plt.close(fig) if __name__ == "__main__": trajectory_mdp() training_and_credit() cover() for name in ( "diffusion_rl_mdp.png", "diffusion_rl_training_credit.png", "wechat_cover_diffusion_rl.png", ): print(OUT / name) 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
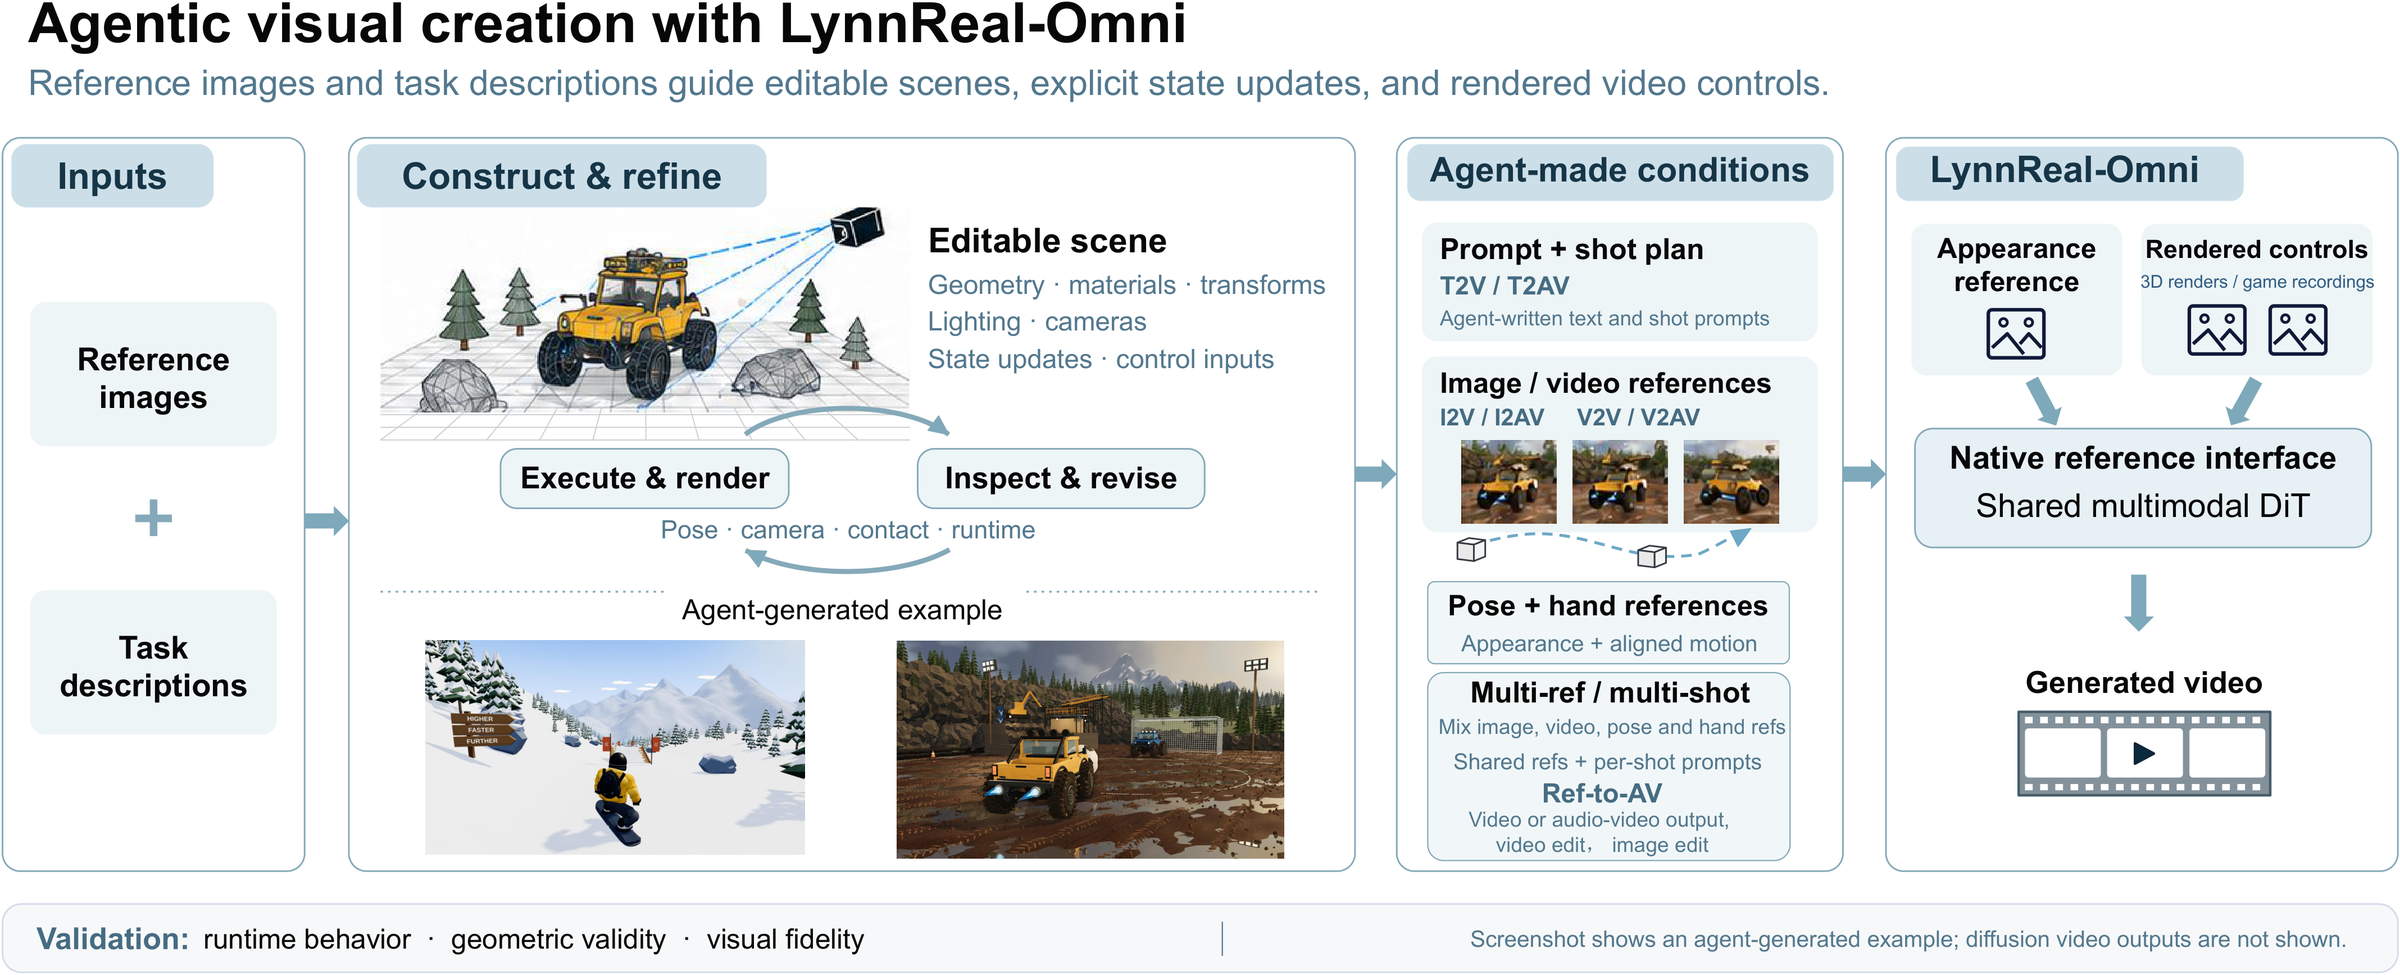
AIGC 每日速读|2026-09-16|22帧视频377毫秒-LynnReal-Omni 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与交互 2 篇 · 视频算子与少步蒸馏 2 篇 · 图像生成、编辑与超分 3 篇 · 视频重建评测与动作建模 2 篇 · 语音合成与文本对齐 1 篇 重点论文标题列表 LynnReal-Omni(LynnReal AI):22帧视频377毫秒生成 VC-Attention(Nunchux AI、MIT、NVIDIA):低位注意力提速视频生成 Logit Refiner(CompVis @ LMU Munich · ECCV 2026):补回同尺度token依赖 BVB(罗切斯特大学、Sony、卡内基梅隆大学、华盛顿大学):让智能体用Blender复刻视频 CrossDistill(北京大学、清华大学、阿里巴巴集团):分段蒸馏兼顾画质与多样性 今日论文速览 1. LynnReal-Omni:22帧视频377毫秒生成 LynnReal-Omni: Native multi-modal Video Generation for Agentic Visual Workflows | LynnReal AI | arXiv:2609.15863 关键词:多模态视频生成,可控视频,实时渲染,智能体创作 前序问题:扩散视频采样具有随机性,人物外观和长场景连续性难以精确控制;代理提供3D场景、游戏录像等明确约束,但单靠这些结构化输入又不足以保证真实感。 本文贡献:LynnReal-Omni 用32B共享多模态扩散Transformer统一文生视频、参考图驱动、结构控制、编辑与长视频;另训练27B Flash版本,接收3D渲染和游戏录像等异构条件,并以轻量VAE加速解码。 Agent workflows. Image-based scene reconstruction and agent-written low-poly games produce distinct visual-control streams. Prompt refinement, image generation, and first-frame editing provide appearance controls. The video model receives these controls through its native reference interface. 实验效果:论文报告在单张H100上,预热状态下生成并解码22帧540p视频,标准版需843毫秒,Flash版需377毫秒;这是特定帧数、分辨率和硬件条件的延迟,不代表任意长视频都可实时生成。 An example of generated-video artifact repair with LynnReal-Omni. Top: corrupted candle video. Bottom: independently repaired frames at identical timestamps, including both endpoints. Full frames are displayed at the same scale. Each source-frame edit uses four denoiser evaluations, for 480 evaluations across this 120-frame example. The accompanying demo plays both complete videos synchronously. 批判点评:统一的控制接口便于代理组合素材,但32B/27B模型的训练与部署成本很高;公开的22帧预热延迟也不能直接推出长片段的端到端吞吐或多轮主体一致性。 2. VC-Attention:低位注意力提速视频生成 VC-Attention: Value Smoothing and Softmax Casting for Low-bit Attention | Nunchux AI、MIT、NVIDIA | arXiv:2609.15810 关键词:视频生成,低比特注意力,FP8,算子优化 前序问题:视频DiT的时空token序列很长,低比特乘法虽快,V值离群点使量化误差扩大,softmax的高精度指数计算又成了新的延迟瓶颈。 本文贡献:VC-Attention 无需重新训练模型:V-Smooth先在线聚类并重排V token,减去块均值后量化残差;ExpCast-FP8把对数域分数直接编码为E4M3概率,替代FP32指数与格式转换。 VC-Attention writes the byte the conventional path writes. (a) Both paths take the same log-domain score $z$. The standard path evaluates an FP32 exponential and casts the result to E4M3; VC-Attention replaces both steps with one fused multiply-add, because an E4M3 byte is an affine function of the log of the value it stores. Reading the result as E4M3 costs no instruction: those bits already are the byte the $PV$ matrix multiply consumes. (b) The byte each path writes, and the relative error of the probability it decodes to. The two write the same byte on most of the interval and are one code apart on the rest. Every unit interval of $z$ looks the same, so one is enough. 实验效果:在所测B200/B300/H200上,注意力核相对BF16 FlashAttention-4快1.46–1.59倍,工作站卡快2.3–3.6倍;所测视频模型端到端加速为1.13–1.19倍或1.36–1.70倍,核加速不能当作整段视频加速。 Video diffusion leaves two bottlenecks that QK-centric low-bit attention does not touch. (a) Output error on Wan2.2. A Hadamard rotation of $QK$ shrinks the probability term, but leaves the larger value term exactly where it was: the value quantizer, not the $QK$ quantizer, is what bounds fidelity. (b) Even once both matrix products are low-bit, softmax's FP32 exponentiation and its cast still sit on the critical path between them. 批判点评:需要专门融合算子和在线token分组,不同GPU、序列长度及模型分布会影响收益;重排与量化误差应在具体视频模型上逐一核验。 3. Logit Refiner:补回同尺度token依赖 Logit Refiner: Improving Visual Autoregressive Models via Intra-Scale Dependency Modeling | CompVis @ LMU Munich · ECCV 2026 | arXiv:2609.11804 关键词:视觉自回归,图像生成,同尺度依赖,解码优化 前序问题:视觉自回归模型在每个尺度内并行采样token,忽略它们彼此的空间依赖;即便增大主干参数,也可能产生局部不连贯的图像。 本文贡献:Logit Refiner 冻结预训练VAR主干,增加轻量自回归模块,依次采样同尺度token并利用主干特征恢复局部联合依赖;接到已有checkpoint时无需重训主干。 Logit Refiner Overview. (a) The VAR backbone processes all previous scales and produces hidden states for the current scale in a single parallel forward pass, finally sampling from pointwise posteriors in parallel. As sampling is done independently within each scale, this can lead to mismatched tokens, affecting generation quality. (b) Our logit refiner takes these hidden states and samples tokens autoregressively within the scale, conditioning each prediction on previously sampled tokens. The refiner is a lightweight causal transformer, incurring only a small overhead during generation, while significantly improving sample quality. 实验效果:论文称新增参数约为主干的10%,训练计算不足主干的5%;在ImageNet 256×256类别条件实验中,1.1B参数的加装模型质量超过约两倍规模的对照主干,且在文生图设置中仍有提升。 VAR Failure Cases vs. Refiner. Our Logit Refiner can address a range of typical failures of VAR. Each column shows a paired sample (same class, same seed). Top: samples covering various failure modes from VAR-d30. Bottom: with refiner. 批判点评:顺序采样补回依赖也可能增加推理时的串行开销;论文中的参数和质量比较限定于所测VAR主干与任务,不能直接外推到所有生成架构。 4. BVB:让智能体用Blender复刻视频 BVB: Benchmarking Agentic Video Understanding via Programmatic Reconstruction in Blender | 罗切斯特大学、Sony、卡内基梅隆大学、华盛顿大学 | arXiv:2609.15478 关键词:视频理解,Blender,程序化重建,智能体评测 前序问题:现有视频理解基准多靠问答;模型即使答对部分问题,也不一定能生成同时保留动作、镜头和对象关系的可执行场景。 本文贡献:BVB要求智能体在统一沙箱与成本上限内编写Blender动画,渲染后分别用Dual VQA评价时空事实保留率、用Latent Similarity评价视觉相似度,并以平方根均值综合评分。 Controlled reconstruction and evaluation. A model alternates between viewing source frames and running Python code in a Docker sandbox under a cost limit, then saves an animated Blend scene. Dual VQA measures how well the rendered video retains answers the judge gets right on the source, and Latent Similarity compares layout and motion using frozen V-JEPA features. 实验效果:论文测试10个模型家族的51种配置;最优配置的潜空间相似度达到88.6,但仅保留源视频中53.7%的正确时空问答,说明看起来像与事实还原之间仍有差距。 BVB reveals shared task difficulty and model-specific variation. The left panel shows retention across eleven representative configurations. The right panel shows the full range, interquartile range, and mean over all 51 configurations for each task. Purple boxes mark the best shown value in each task. 批判点评:程序化重建比问答更能暴露空间和时间推理缺陷,但Blender建模、工具调用预算及渲染质量也会影响分数;不能把结果简单当作通用视频理解能力排名。 5. CrossDistill:分段蒸馏兼顾画质与多样性 CrossDistill: Balancing Quality and Diversity via Trajectory-Level Hybrid Few-Step Distillation | 北京大学、清华大学、阿里巴巴集团 | arXiv:2609.14725 关键词:扩散蒸馏,少步采样,视频生成,多样性 前序问题:扩散模型少步蒸馏常在画质与多样性之间取舍:轨迹蒸馏保留模式覆盖,分布匹配提升细节却可能让不同随机种子收敛到相似画面。 本文贡献:CrossDistill 沿噪声轴设置交叉点:高噪声阶段保持教师轨迹以保留全局分支,低噪声阶段做分布匹配以锐化局部细节,再用交叉状态耦合两段目标。 2D toy manifold distillation setting. From left to right: original teacher, trajectory-based distillation (TD), distribution matching (DM), loss-level mixture of TD and DM, and trajectory-level hybrid distillation (CrossDistill; ours). All models are trained on the same gray data manifold, and each student is trained to convergence. Colored curves denote denoising trajectories of 12 seeds, and black dots denote final generated samples. 实验效果:文生视频实验与图生视频定性展示显示,方法在少步设置下保留种子级差异,同时获得有竞争力的视觉质量;摘要没有给出可跨基准引用的统一加速倍数。 Diversity--quality trade-off. For each of three prompts (rows) we sample four independent initial noise seeds (columns) and show the same frame per generated video. AnyFlow and DMD show reduced seed-level variation, while rCM is diverse but lower in visual quality. In these examples, CrossDistill improves the trade-off, maintaining competitive diversity and visual quality. 批判点评:交叉点选择与两类目标的平衡需要按模型、任务调整;目前的图生视频证据以定性结果为主,读者应区分画质展示与可复现的综合指标。 6. DiVA:锚点续接让数字角色多轮互动 DiVA: Enabling Interactive Digital Life Simulation via Video Models | 蚂蚁集团、南洋理工大学、A*STAR | arXiv:2609.13830 关键词:交互视频,数字人,视频续接,多轮生成 前序问题:数字角色连续互动时,等待、动作与下一轮切换容易造成姿态跳变、镜头抖动和身份漂移;只拼接长视频难以稳定维持可交互状态。 本文贡献:DiVA 用多模态语言模型路由动作和语音响应,再把等待视频、动作视频和两者过渡拆成耦合模块;Anchored Video Continuation根据前一动作返回稳定锚点状态,支持语音与空间点击输入。 Given a text prompt defining the character's role, an MLLM acts as a router, processing user inputs (e.g. clicks and dialogue) and translating them into character responses and behavioral prompts for the audio-text conditional action model. Our video generation component starts with a waiting video, followed by iterative action videos based on the MLLM output. Finally, the anchored video continuation (AVC) module, conditioned on the prior action, targets preset, high-quality anchor frames that represent distinct character states (e.g. sitting or leaning back). Guided by the MLLM state assessment, AVC transitions to the appropriate anchor state. This mechanism smoothly restores the sequence to a stable, high-quality condition and enables expressive transitions between states, significantly expanding the character's motion range. 实验效果:论文对长视频、续接和插帧替代方案做比较,并报告多轮视觉质量与真实感的改善;摘要未给出统一的绝对延迟或显著性数字,因此不宜宣称“无限无衰减”。 Qualitative comparison on long-term digital life simulation. Our method successfully generates high-quality, expressive, and drift-free results, accurately performing state transitions (e.g. the 3rd to 4th transition in both examples). In contrast, all baselines suffer from severe drift and fail to execute precise state transitions; for instance, InfiniteTalk's subject only partially stands up in the second example. Notably, all baselines exhibit severe drift in fewer than 10 interaction rounds (marked in the bottom-right of each image), whereas our method remains stable indefinitely. Best viewed zoomed in. 批判点评:锚点策略对角色常见姿态有效,但复杂、非周期动作可能难找合适状态;实时交互还依赖生成延迟、音视频同步和对用户点击的空间理解。 7. Open-UniMo:64K动作token接入语言模型 Open-UniMo: Towards Unified Motion-Language Understanding and Generation in the Open World | 清华大学、香港中文大学(深圳)、南洋理工大学 | arXiv:2609.14615 关键词:动作生成,动作理解,具身智能,统一token 前序问题:动作语言模型往往把动作当作文本的辅助输入,跨模态互动不足;长动作序列逐token生成还容易积累误差。 本文贡献:Open-UniMo 在约150K文本token之外增加64K动作token,用一致的动作思维链连接语言语义与动作动态;先监督微调建立双向映射,再用GRPO提高语义对齐。 Overview of the Open-UniMo framework. Open-UniMo is trained in two stages with CoT reasoning. In the SFT stage, the model learns CoT-guided bidirectional motion-language mappings for both T2M and M2T tasks. In the GRPO stage, reinforcement learning further refines format compliance and motion-language alignment through multiple reward signals. 实验效果:论文在传统指标和自建Open-MoBench上报告领先结果,并通过消融指出动作到文本理解的瓶颈不主要在词表大小;没有单一数字可以概括所有动作任务。 Qualitative comparison on Open-MoBench for the T2M task. Compared with existing representative approaches, Open-UniMo generates motions that better capture semantic details and natural dynamics. 批判点评:64K动作词表与大规模开放数据意味着训练和部署成本;自建基准依赖VLM评判,实际机器人动作与物理环境中的泛化还需独立测试。 8. IABEdit:语义梯度教编辑器只改该改处 Semantically Aligned Gradient-Driven Context-Preserving Image Editing | 印度理工学院焦特布尔分校 | arXiv:2609.12691 关键词:图像编辑,语义对齐,视觉语言模型,局部保持 前序问题:指令式图像编辑的训练通常只看重建和文字条件,没有显式检查生成结果是否完成指令,因此容易漏改目标或波及无关区域。 本文贡献:IABEdit 用冻结的视觉语言模型提取目标编辑图的空间语义描述,再由可训练对齐器从生成图重建描述,利用残差梯度教生成器同时判断改什么、改哪里;推理时无需VLM。 IABEdit enables instruction-based image editing through a semantic-supervised distillation mechanism. A frozen Descriptive Anchor extracts rich guidance from the instruction and ground-truth edit, while an Instruction Aligner learns to align the generated image with this guidance. The alignment is enforced via backpropagation, guiding the diffusion model toward faithful and controllable edits. 实验效果:在MagicBrush上,DINO-I相对最佳扩散基线提高3.49、相对最佳总体基线提高1.26;在遮挡较重的D-LORD设置中,DINO-P比论文比较的Gemini代理高5.13。 Qualitative results on RealEdit dataset showing comparisons across various editing methods. The instruction adherence can be visualized at the fine-grained level. The non-targeted regions remain preserved, showcasing precise instruction-aligned editing generations. 批判点评:指标提升反映所测数据集的结构和语义保持,不等于所有编辑指令都能被精准执行;训练额外依赖VLM表征,需警惕其偏差与评测模型重合。 9. DNF-SR:双输入保住一步超分细节 DNF-SR: Dual-Input and Negative-Aware Feature Fine-Tuning for Real-World Image Super-Resolution | 南开大学 · CVPR 2026 | arXiv:2609.15120 关键词:真实图像超分,一步扩散,双输入,负样本微调 前序问题:低清图直接送入一步扩散模型会与其训练输入分布错位;只给低清图加噪虽能缩小分布差异,却可能抹掉原始内容。 本文贡献:DNF-SR 把原始低清图与加噪低清图一起送入Flux-Kontext编辑主干:噪声提供生成先验,原图维持内容条件;随后把多次生成结果分为正负样本,在图像和特征空间做负样本感知微调。 Overview of the DNF-SR framework. (a) The model structure adopts a dual-input design: noisy LR latents ($z_{mix}$) and original LR latents ($z_{LR}$) are concatenated with text tokens (encoded from image captions) and fed into fine-tuned DiT blocks of the Flux-Kontext pretrained model. We employed multiple loss functions to ensure the performance of the model. (b) The post-training process of Negative-aware Feature Fine-Tuning: multiple restored results are generated with different input noises, evaluated by combined full-reference (FR) and no-reference (NR) IQA metrics to obtain reward scores, and divided into positive and negative subsets. By constructing positive and negative optimization directions within both the image and the feature spaces, the quality of the restored images is improved. 实验效果:论文报告在真实图像超分实验中优于所比方法,并强调一步推理;arXiv摘要没有统一的绝对速度或画质数字,具体收益取决于论文内各数据集和指标。 Visual comparisons of different Real-ISR methods. Please zoom in for a better view. 批判点评:一次前向降低采样步数,但双输入增加token和内存;负样本分组依赖奖励模型,细节“更好看”时也可能偏离真实纹理。 10. AlignDPO:严重语音幻觉率降至0.6% AlignDPO: Preference-Gated Alignment for Reducing Hallucination in Decoder-Only TTS | ConnexAI · IEEE SLT 2026 | arXiv:2609.12855 关键词:语音合成,文本语音对齐,DPO,内容幻觉 前序问题:纯解码器语音合成在自回归输出时可能漏词、重复或编造内容;注意力对齐过弱不行,但一味把对齐压得很尖也会降低鲁棒性。 本文贡献:AlignDPO 在DPO偏好优化中只对被选中的语音样本加入轻量CTC对齐项,引导少数承担文本语音对齐的注意力头到适度锐化区间,推理时无需改模型结构。 Per-head $L_{CTC}$ distribution (log scale, teacher-forced over 100 utterances) for the four systems, sharing the x-axis. Colored dots are the identified AEAMs ($L_{CTC} < 2$); gray dots are the remaining heads. 实验效果:在Seed-TTS-Eval英语集上,论文报告严重内容幻觉率由4.4%降到约0.6%;正文还给出相对强DPO基线的幻觉率15.0%降至11.3%,两种统计口径不能混为一个数字。 ACI's effect is non-monotone (U-shaped) in attention sharpness, on both an in-domain and a hard out-of-domain set: hallucination vs. free-running entropy $C_E$ for five models. Left to right (soft to sharp): Base ($C_E{=}1.01$), DPO ($0.84$), DPO+M ($0.48$), Base+M ($0.08$), and DPO+M from Base+M ($0.07$). Seed-TTS reports HAL ($n{=}706$); Hard-500 reports SEV-HAL. 批判点评:结果基于特定英语语音数据和纯声学单码本主干;多语言、长句及噪声输入能否维持相同收益仍需独立验证,CTC权重过大会过度锐化。 趋势观察 视频模型走向可组合控制 LynnReal-Omni统一参考图、3D渲染和游戏录像等条件,DiVA把角色等待、动作与过渡拆开管理。可控生成的重点正从单段采样转到素材接口和跨轮状态保持。 加速要拆解真实瓶颈 VC-Attention同时处理V值离群点和softmax成本,LynnReal-Omni-Flash以独立模型和轻量解码器压缩短片段延迟;核提速、模型延迟和长片段吞吐需分别衡量。 生成质量不只是增加参数 Logit Refiner补回同尺度token依赖,CrossDistill按噪声阶段分别保多样性与细节,DNF-SR用原图条件减少一步超分的内容漂移;三者都调整了生成过程中的信息流。 评测从单一画质走向任务事实 BVB用程序化重建拆分视觉相似和时空事实,IABEdit显式检查编辑语义与局部保持,Open-UniMo同时评估动作生成和理解;分项指标比一个综合分更容易定位失败。 人工智能炼丹君 整理 | 2026-09-16 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
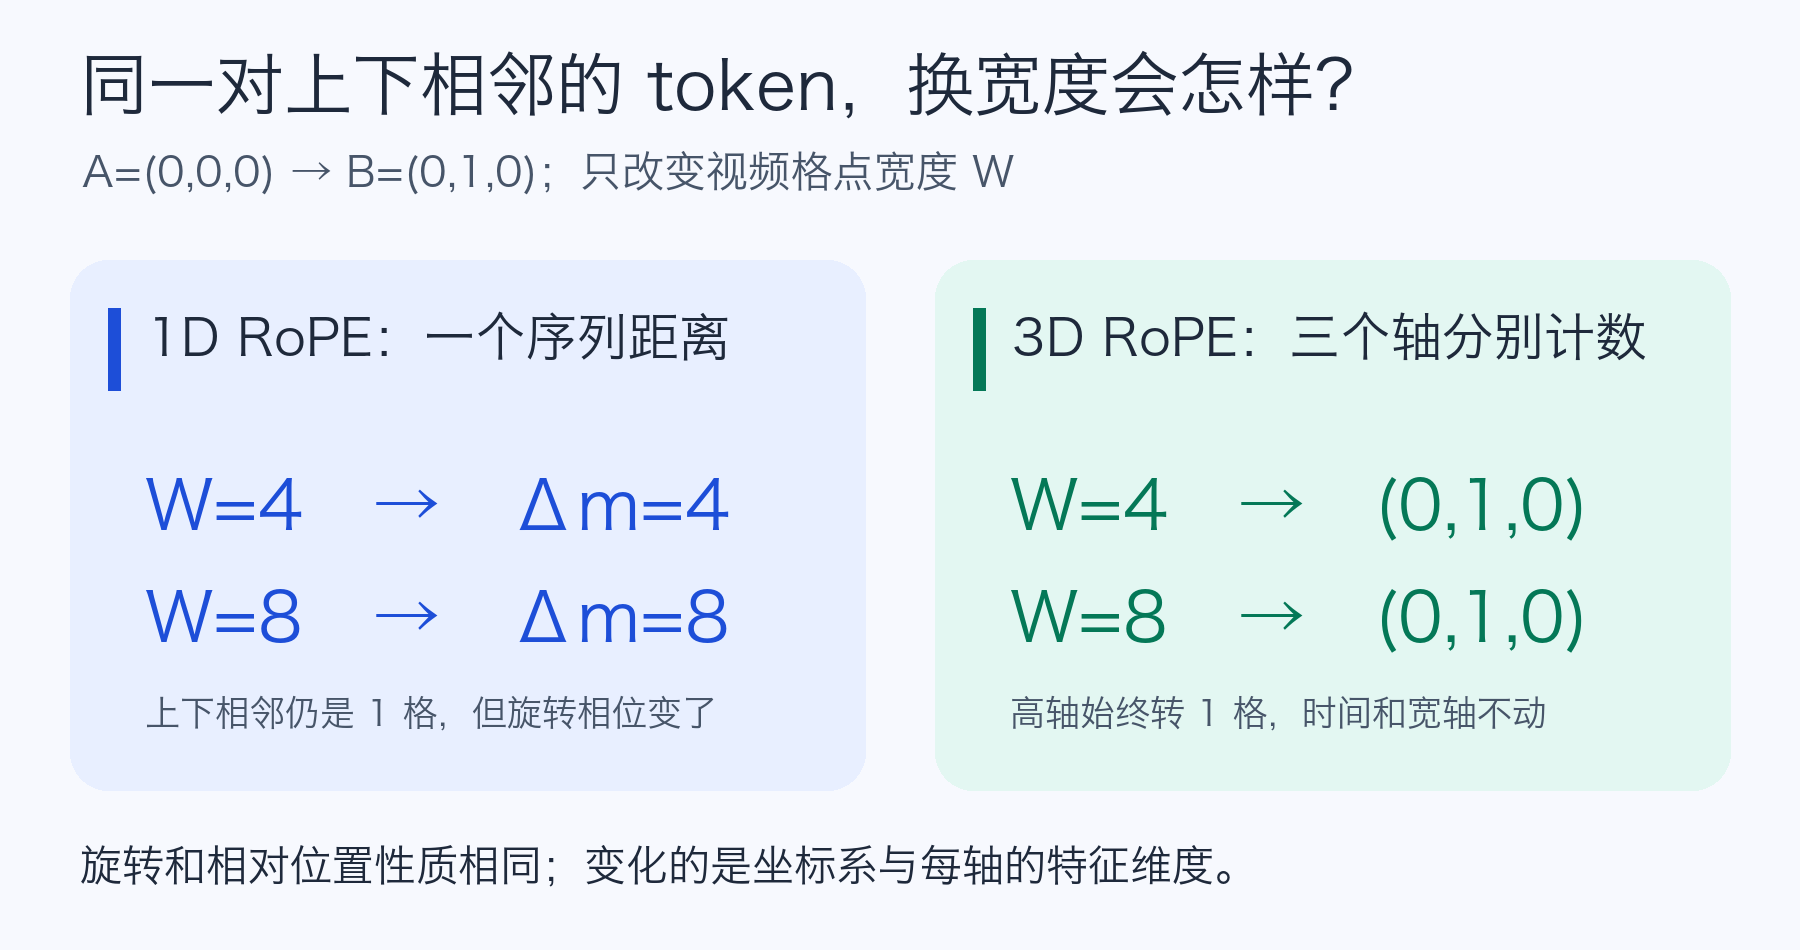
AIGC 基本功|视频 DiT 里的 3D RoPE 与分辨率外推-3D-RoPE 视频 DiT 里的 3D RoPE 与分辨率外推 所属方向:注意力与核心零件 | 难度:进阶 | 前置知识:RoPE 的原理与实现 关键词:3D RoPE、时空位置编码、视频 DiT、分辨率外推、逐轴位置插值、帧数外推 01. 为什么需要它 先看一对位置:视频格点 A=(0,0,0),B=(0,1,0)。B 在 A 的正下方一格。将每帧按行展开,再按时间串接,普通 1D RoPE 看到的序列位置是 m=tHW+hW+w。当每帧宽 W=4 时,A 到 B 的序列距离是 4;仅把宽改为 W=8,距离变成 8。两块仍上下相邻,旋转角却按 1D 的位置差变了。时间上的相邻帧也会受 HW 改变影响。固定画幅下,这种展开次序可以用,模型也可能学到空间规律;问题是在画幅或时长改变时,序列距离不再稳定代表同一种时空关系。这里的 1D RoPE 是为了隔离坐标问题而构造的诊断基线,不是在声称所有早期视频模型都按这一公式编码位置。 3D RoPE 给 A、B 保留 (t,h,w),所以无论宽度是多少,两者都只在高轴相差一格。它解决的是展平编号把画幅尺寸混进位置差的问题;画质外推还涉及训练分辨率、物体尺度和注意力成本。后文用 CogVideoX 的实验 分开讨论位置表直接扩展与逐轴插值,不把“坐标可计算”误当成“视频一定生成得好”。 02. 最小可用理解 基础 RoPE 已解释二维旋转与相对位置性质,这里直接看视频新增的两步: 换坐标:展平版给每个 token 一个 m,相对位移是 Δm;三轴版保留 (t,h,w),相对位移是 (Δt,Δh,Δw)。图 1 的上下邻居在画幅变宽后,只有三轴版仍把它识别为“高轴相差一格”。 分特征与频率:一个注意力头的特征分为时间、高、宽三段,每段用自己的坐标和频率表生成位置角。三段随后仍在同一次注意力内积里汇总;“3D”说的是坐标轴数,不是把视频物体在欧氏空间旋转。 图 1:固定 A、B 的时空坐标,只改每帧格点宽度。展平位置差从 4 变 8,三轴位移始终是 (0,1,0);真实模型的内容特征也会随画幅变化。 具体比例由模型选择。CogVideoX 给时间 1/4、高 3/8、宽 3/8;64 维头对应 (16,24,24),不是所有 3D RoPE 的固定标准。按这个分配,高轴的坐标映射可以单独调整,而时间、宽轴保持原样。实际换模型还要核对每轴维度、坐标单位、频率基数、配对次序和文本 token 的处理,不能只照搬比例。 图 2:64 维注意力头的示例。每个轴的维度都成对构成旋转平面;三段共享一个 token,但不会互相混成单一序列编号。图由文末代码生成。 03. 数学推导 3.1 从视频格点到三组旋转 设视频 patch token 为 $z_{t,h,w}$。$t$ 是压缩后的时间格点,$h$ 和 $w$ 是 patch 后的高、宽格点;它们不是原始帧号或像素坐标。以下只讨论注意力打分前,如何给对应的 query/key 构造位置相位。 先写出基础版到底把什么送进旋转。固定一个按行优先展开的视频网格 $(T,H,W)$,位置编号 $m=tHW+hW+w$。任意两格 $p=(t,h,w)$、$r=(t',h',w')$ 的编号差为: $$m_r-m_p=(t'-t)HW+(h'-h)W+(w'-w)$$ 上式说明 1D 并非丢了时空信息:固定 $H,W$ 时,每个格点仍有唯一编号。但同样一个高轴位移会乘上当前的 $W$,同样一个时间位移会乘上当前的 $HW$。换画幅后,“向下 1 格”的位置相位因此变化;这只比较固定内容特征的位置项,不推断整个模型的注意力分数或画质。 令头维度 $d=d_t+d_h+d_w$,每段维度都必须为偶数。把 $q$ 和 $k$ 拆为 $q^{(t)},q^{(h)},q^{(w)}$ 与对应的三段 $k$。对轴 $a\in\{t,h,w\}$ 的第 $i$ 个二维旋转平面,选频率: $$\omega_{a,i}=\Theta^{-2i/d_a},\qquad i=0,1,\ldots,d_a/2-1$$ $\Theta$ 是频率基数,CogVideoX 的源码默认 10000;$d_a$ 是该轴分到的维度,而不是整个头维度。时间与空间段各自从最高频重新开始,不是把一条 1D 频率数组切成三段。沿用先修文章的旋转记号 $R$,用 $R_a(p_a)$ 表示轴 $a$ 上所有旋转平面的组合。完整位置操作是三个互不混合的块拼接: $$\widetilde q_{t,h,w}=\operatorname{diag}(R_t(t),R_h(h),R_w(w))q_{t,h,w}$$ key 用同一个位置规则得到 $\widetilde k$。分轴的是位置相位的构造;注意力仍对所有可见视频 token 计算一次打分。 可以把区别压到一行:1D 的相对角是 Δm × 频率,其中 Δm=Δt·HW+Δh·W+Δw;3D 的三组相对角分别是 Δt × 时间频率、Δh × 高频率、Δw × 宽频率。三组贡献在同一次内积里相加。这里的 Δ 都是 token 格点差,不是秒数或像素差。 3.2 三个位移怎样汇入一次打分 基础 RoPE 已推过两个旋转角相减的恒等式。这里新增的是:每个轴只用自己的坐标差,整头把三段贡献相加: $$s(p,r)=\sum_{a\in\{t,h,w\}}\langle q^{(a)},R_a(r_a-p_a)k^{(a)}\rangle$$ $p=(t,h,w)$ 和 $r=(t',h',w')$ 是两个格点。只有高差为 1 时,时间段与宽段的位置差都是零,高段单独改变打分;换宽度不会把这一高差改写成另一个数。公式描述固定 $q,k$ 时的位置作用,文末代码用上下邻居和下一帧两种位移分别检查它。 再看一个跨帧例子:某个物体的投影从 (0,5,5) 到 (1,5,6),位置差是 (1,0,1);时间段和宽段的相位会变,高段不会。但静止物体遇到相机运动也可能产生完全相同的屏幕投影轨迹。对这两个例子,3D RoPE 的位置部分完全一样;它没有标记“这是同一物体”,也没有记录相机姿态或两个时间格点之间的秒数。模型仍可从图像内容、条件和后续层学习运动关系,不能把三轴相位本身当作光流或物理速度。 式子还有一个可检查的边界:三段打分相加,位置操作本身没有 Δt×Δw 这样的跨轴乘积项。这不妨碍注意力通过 $q,k$ 的内容组合时空线索;它只说明“分别编码三个轴”并不等于“直接编码一条物体轨迹”。 3.3 直接外推与逐轴插值到底改了什么 假设训练高轴有 $H_0$ 个格点,推理变成 $H_1$ 个格点,零起点时两者的最大坐标分别是 $L_0=H_0-1$、$L_1=H_1-1$。直接外推使用新坐标 $h'=h$,相邻高 token 仍相差 1,角差仍为 $\omega_{h,i}$,但远端坐标超过旧范围。若要让两个端点严格对齐,逐轴位置插值应使用 $h'=h/s_h$、$s_h=L_1/L_0=(H_1-1)/(H_0-1)$;相邻角差变为 $\omega_{h,i}/s_h$,最远坐标正好被压回 $H_0-1$。常见的 $H_1/H_0$ 是大网格下的近似,网格很短时两者不可混写。宽与时间可以分别选择 $s_w,s_t$: $$\phi_{a,i}(p_a)=\frac{p_a}{s_a}\omega_{a,i},\qquad s_t,s_h,s_w>0$$ 这条式子说明“分辨率外推”不是只能一起拉伸三个轴。若只想演示高轴坐标压缩两倍,可以选 $(s_t,s_h,s_w)=(1,2,1)$;若要复现某条真实管线,则应按它的端点、crop 坐标和取样约定计算,不能只看形状比。保持局部细节对应相邻格点的相位差尽量不变;覆盖新范围对应最远端相位别离开已训练的分布。单一全频率插值无法同时严格满足两者。图 3 用 scale=2 隔离这个机制:高度插值后高频振荡慢了一半,低频在这 32 个格点上原本就几乎不动;它不是某个 CogVideoX 推理配置的逐参数复刻。读图时也不要把 cos 的偶然重合当成“两个远处位置相同”。 图 3:高维度 24、基数 10000 的示例。左边用原坐标,右边只把高坐标除以 2;时间与宽并未压缩。图中画的是 cos 相位而非生成质量。 3.4 维度预算不是按视频长宽直接分蛋糕 为什么 CogVideoX 把时间分到 1/4、两个空间轴各分到 3/8,而不是三等分?论文给出了这个比例与三轴独立 RoPE 的实现,却没有证明它对所有数据和画幅最优。可以从编码需求理解:空间中每一帧都包含大量局部邻接与大范围结构,两个空间轴合计拿到较多旋转平面;压缩后的时间格点通常少于空间格点,但仍需能分辨前后帧。这个解释是设计动机的推断,不能代替原论文消融,更不能据此宣布时间维度永远够用。 64 维示例中,时间 16 维对应 8 个旋转平面,高与宽的 24 维各对应 12 个。最高频平面的角增量都是 1 弧度,因为 $i=0$ 时 $\omega=1$,所以“空间分得多”并不是说高、宽的每一步比时间转得快。区别落在可用的频率层级数量和最慢频率:时间最后一组在坐标 15 的角约 0.004743,高度最后一组约 0.003232。两组数字都很小,它们在短网格上几乎不提供相邻区分,却可能给更长距离提供不同的相位尺度。把更多维度分给某轴,得到的是更丰富的频谱,不是对该轴长度的直接承诺。 还要区分物理帧数与时间 RoPE 格点。假设 VAE 把若干帧压缩到一个 latent 时间格点,视频从 49 帧变成 97 帧,RoPE 的时间长度未必简单从 49 变到 97;VAE 的首帧保留或补帧规则甚至会让两个公式对不上。头维度预算必须在真正进入注意力的 token 网格上讨论。读实现时先打印 patchify 输出和 (T,H,W),再看时间频率有没有被拉伸。 帧率变化不等于时长外推。 同样是把原始帧数翻倍,可能是同一段动作以两倍帧率采样,也可能是原帧率下播放两倍时间。若 VAE 与 patchify 最终都把它们变成两倍的时间格点,整数时间 RoPE 看到的范围一样,却不能仅凭位置角判断“相邻格点代表多少秒”。前者主要考察更密的动作采样,后者还考察更长的主体与场景记忆;测试时间缩放前应固定并记录帧率、实际秒数、latent 时间压缩和条件时间戳。这是视频轴特有的语义问题,空间高宽轴没有对应的播放时钟。 3.5 NTK 变基数为什么不是“插值”的同义词 另一类策略不缩坐标,而是逐轴更改频率基数 $\Theta_a$。若 $\Theta_a$ 变大,$i=0$ 的最高频 $\omega_{a,0}=1$ 完全不变,较低频平面转得更慢;于是近邻分辨率较容易保留,远距离相位覆盖可以加宽。它与 $p_a/s_a$ 把所有频率一起压低不同。NTK-aware、YaRN 等方法在语言长上下文中发展,迁移到视频时还要决定给哪个轴、哪些频段用、是否微调和怎样处理训练画幅。仅把 rope_theta 调大,不能替代逐轴分辨率训练或保证画质。 “频率变慢”也不等于“完全不损局部”。注意力打分汇总多个平面,改低频仍会改变其对近处和远处匹配的贡献。任何外推方法都必须用目标模型、目标画幅与目标时长做消融。 04. 代码实现 code/rope_3d_minimal.py 只依赖 NumPy。核心代码先给时间、高、宽各生成角度表,再广播到 (T,H,W),沿最后一维拼接成每个 token 的角度;rotate 把相邻两维作为一个二维平面旋转。它保留 float64 以让代数测试更容易观察,不模拟工业模型的 BF16 或 CUDA 性能。 dt, dh, dw = axis_dims(head_dim) at = axis_angles(np.arange(frames), dt, scale=scales[0])[:, None, None, :] ah = axis_angles(np.arange(height), dh, scale=scales[1])[None, :, None, :] aw = axis_angles(np.arange(width), dw, scale=scales[2])[None, None, :, :] angles = np.concatenate( [np.broadcast_to(a, (frames, height, width, d // 2)) for a, d in zip((at, ah, aw), (dt, dh, dw))], axis=-1 ).reshape(frames * height * width, head_dim // 2) cos = np.repeat(np.cos(angles), 2, axis=-1) sin = np.repeat(np.sin(angles), 2, axis=-1) 这里 angles 的最后一维只有 d/2 个旋转平面;repeat(...,2) 才让 cos/sin 与 d 维特征逐元素相乘。把代码复制到本地运行 python3 rope_3d_minimal.py,本次真实输出如下: axis_dims= (16, 24, 24) cache_shape= (24, 64) input_shape= (24, 64) rotated_shape= (24, 64) norm_error= 1.78e-15 same_offset_scores= 2.208374 2.208374 difference= 1.33e-15 vertical_neighbor_1d_offsets= 4 8 vertical_neighbor_1d_scores= 1.678217 3.749697 vertical_neighbor_3d_offsets= (0, 1, 0) (0, 1, 0) vertical_neighbor_3d_scores= 0.419453 0.419453 height_phase_at_15_first_last= [15. 0.003232] height_PI_x2_first_last= [7.5 0.001616] time_phase_at_15_first_last= [15. 0.004743] token_count_13x30x45= 17550 token_count_13x60x90= 70200 dense_attention_ratio= 16.0 naive_score_matrix_fp16_gib_per_head= 0.574 9.179 四条 vertical_neighbor_* 输出固定同一组随机 $q,k$ 与同一对上下相邻 token,只切换展平时的 W=4/8。1D 的 Δm 从 4 变 8,内积分数从 1.678217 变 3.749697;3D 的逐轴距离始终 (0,1,0),位置项分数都为 0.419453。1D 与 3D 的绝对分数本身不该互比:两套频率配置不同;这个小实验只比较各自规则在宽度变化前后是否稳定。模型实际改宽后 $q,k$ 也会变,所以它不是画质或整层注意力不变的证据。 cache_shape=(24,64) 来自 2×3×4=24 个视频格点。旋转前后范数误差接近浮点舍入,因为旋转矩阵保长度。高坐标 15 的最高频角为 15 弧度,插值后变成 7.5;高轴最慢一组角从 0.003232 变 0.001616。时间角仍是 15 和 0.004743,证明只改高轴没有动时间表。最慢高频与最慢时频数值不同,因为两轴拿到的维度数分别是 24 与 16,指数分母不同。 再看代码里一个表面上很普通的选择:scales 被明确写成 (time,height,width) 三元组,而不是一个全局的 scale=2。这个接口让实验可以只改一个轴,也强迫调用者记录每轴真实扩张比例。假如训练网格是 T0×H0×W0、目标网格是 T1×H1×W1,对格点数大于 1 的轴,端点对齐的起点应分别按 (T1-1)/(T0-1)、(H1-1)/(H0-1)、(W1-1)/(W0-1) 计算;只有一个格点的轴没有可缩放的坐标跨度,应单独保持在零点。但这些比例仍不能机械照搬:训练数据往往包含多个时长和长宽比,没有单一的 T0,H0,W0。若宽度原本就见过目标值,宽轴可以维持原坐标;若时间增长跨越训练分布,更慢的低频策略可能更值得先测试。参数名称应表达“坐标映射”,而不是含糊写成“画质增强”。 norm_error、same_offset_scores 和宽度变化前后的 3D 分数在脚本里都有断言;若配对、广播或相对位置性质被改坏,脚本会直接失败,而不是只打印一串看似正常的数字。断言检查的是代数不变量,仍不能判断位置映射对视频是否有用,真实效果还要在固定权重的 DiT 上测。 请注意:示例里的 13×30×45 是格点形状。不能仅凭像素分辨率就猜它。真实模型要逐层根据 VAE 的时空压缩、首帧特殊处理、patch size 和 padding 算出 (T,H,W);错一个维度,位置表和 token 顺序都会错位。 05. 工业级实现对照 以 2026-09 核对的 CogVideo SAT 源码 Rotary3DPositionEmbeddingMixin 为例,类中 dim_t = hidden_size_head // 4、dim_h = dim_w = hidden_size_head // 8 * 3,每轴各自建立频率与格点,再广播、拼接、取 sin/cos。它在注意力函数中只旋转视频 query/key,先切出 text_length 个文本 token 原样放回;可选 rot_v 才旋转 value,默认并非必要。rope_T/H/W 从预计算的三维表里截取当前视频尺寸,排平为 (T*H*W,D)。这与最小代码的数组顺序一致,也便于逐轴检查实际相位。 一个容易踩的坑是:这个 SAT 类的构造函数虽然接收 height_interpolation、width_interpolation 和 time_interpolation 参数,在本次读取的 main 文件中,角度表仍直接由 torch.arange 计算,这些参数没有参与坐标缩放。因此不能因为配置里写了 height_interpolation=1.875,就声称该 SAT 旋转实现真的进行了高度插值。文章讨论的“逐轴插值”是可选的设计实验,不是这一段 CogVideo SAT 代码的实际行为。作者原论文采用扩表取前段,恰好与这里的原坐标逻辑相符。 Diffusers 的 get_3d_rotary_pos_embed 也有时间 1/4、空间各 3/8 的分配,但它提供 grid_type="linspace" 和 "slice" 两种格点构造。linspace 可把某个目标空间范围映射到当前高宽格点;slice 在最大表上用原索引再取当前尺寸。二者的差别首先是坐标选取,不是旋转公式变化。该函数在本次核对中返回 (cos,sin),供注意力处理器作用在 query/key 上。具体使用哪个 grid_type、裁剪坐标是什么,应沿管线调用栈核对,不能只看函数定义就给整个模型下结论。 写工业调用栈时建议按四个具体问题逐层追:输入是像素帧还是 VAE latent;patchify 后一条样本的 (T,H,W) 分别是多少;三轴坐标从零开始、按最大表切片还是重新映射到训练范围;cos/sin 最后究竟旋转的是视频 query/key、文本 token 是否另有位置处理。单独找到 get_3d_rotary_pos_embed 的名字,只能证明功能存在,不能证明这一模型版本已经启用它。CogVideoX 系列可能根据配置选择旋转位置或学习位置,不同 checkpoint 更不能一概而论。 维度排列也值得实际打印。本文的 rotate 假设相邻两维组成 (实部, 虚部),因此角表用 repeat_interleave(2) 形式复写到两维。若上游先把所有实部放前半、虚部放后半,旋转公式仍可成立,但 rotate_half 与 cos/sin 的广播顺序必须一起换。仅把缓存从另一仓库复制过来,形状同为 [N,D] 也可能在不报错的情况下给完全不同的旋转平面。检查一个位置 1、一个二维平面 (1,0) 的旋转结果应近似 (cos 1,sin 1),比只核对 shape 更可靠。 生产实现还会处理变长视频、文本与视频拼接、packing、缓存、设备和精度。最小脚本只面向一个规则视频网格;真实 batch 如果把不同视频压成一条序列,必须保存每段的起点与独立 (T,H,W),否则第二个视频的时间会错误地延续第一个视频的末帧。cos/sin 表可以复用,但格点顺序和真实 token 排列必须逐项对齐。很多“换分辨率立即崩”其实是这种形状或坐标实现错误,而非外推理论失败。 06. 代价与边界 纯 3D RoPE 本身不引入新的可训练位置参数,换形状时也可以按轴计算新表;具体模型仍可能另外叠加可学习的位置向量。这个性质让多分辨率训练与不同长度输入更自然,但没有把注意力从二次复杂度变成线性。高、宽各两倍时,视频 token 四倍、稠密注意力项十六倍:示例从 13×30×45=17,550 个 token 增至 13×60×90=70,200 个 token,若天真地为单个头物化一张 FP16 分数矩阵,理论容量会从约 0.574 GiB 涨到 9.179 GiB,尚未计梯度、softmax 和其他头。FlashAttention 不必把整张矩阵常驻显存,所以这不是实际峰值预测;它仍准确反映稠密注意力的二次计算量。把空间 RoPE 频率调得再聪明也不会消除这笔账,仍需 VAE 压缩、稀疏或局部注意力、分块计算等手段。 外推的另一重代价是位置区分与训练分布之间的冲突。直接延长表,邻近 token 的相位关系不变,却把远端坐标送到没见过的位置;全部插值,把远端压回旧尺度,却弱化每一步的相位变化。轴越短、分到的旋转平面越少,可用的频率跨度通常越窄。CogVideoX 的时间 16 维并不意味着“时间必然先坏”或“空间必然先坏”:结果还取决于训练长度、VAE 时间压缩、运动跨度与内容建模。 分辨率外推尤其要保住物理尺度解释。同一人物在原图占 10 个 latent 格点,放大画幅后占 20 个,坐标间隔与模型学过的视觉尺度同时变了;只插值位置并不能把纹理、构图与物体大小的分布一起搬过去。长视频类似:更多帧要求模型记住人物、场景和动作因果,位置相位不是记忆网络。若输出失败,先分辨是表索引越界、token 排列错位、局部重复、全局模糊还是跨帧身份漂移,再决定该调位置、数据、注意力或去噪。 相同 token 数也不意味着相同空间外推。 假设训练格点为 (T,H,W)=(8,32,32):目标 (8,64,32) 与 (8,32,64) 都把视频 token 翻倍,但前者只扩高轴,后者只扩宽轴。在 3D RoPE 中,它们分别改变高段或宽段的最远相位;在展平 1D RoPE 中,改宽还会重新标定所有行间与帧间的序列距离。实验可以保持 token 数、权重、prompt 和种子一致,只互换扩张轴,再分别检查竖向重复、横向重复与主体比例。若两个结果不同,先核对训练画幅分布和 VAE/patchify,才讨论是否来自轴频率。 排查失败时可以先做一个不动权重的三步实验。第一步固定 VAE latent 与 patch token,只换位置表构造,在同一坐标对上比较 q·k;若结果突然变化,检查表索引、轴顺序或维度配对。第二步固定画幅和视频内容,单独改变时间格点长度,看主体漂移是否只在跨越训练时长后出现。第三步固定时间格点,单独变高、宽并分别观察全局构图和局部纹理;若高宽都扩大导致局部重复,不能直接断言是 rope_theta 错,还要看是否出现 token 数暴涨引发的注意力截断、分块边界或 VAE tiling 伪影。把这些变量一次全改掉,会失去定位能力。 若比较位置插值与直接外推,评分也至少拆成两类:近邻细节,例如边缘、纹理与细小物体是否保持;远距结构,例如人物是否只有一个、左右场景是否连贯、同一主体跨帧是否一致。CogVideoX 附录里“一张模糊的大画面”与“多个清楚的小画面”的差异正说明:一个单一的美学分数可能掩盖局部与全局朝相反方向变化。画质指标之外还要记录 token 长度、时空网格与推理显存,否则方法之间可能使用了不同计算预算。 这套分轴设计也不表达“这是第 1 帧”这类绝对锚点——它主要编码相对位移。首帧图像条件、相机轨迹和剪辑时间戳需要通过额外条件或掩码表达。多图参考、回放状态与不同视频段拼接时,不同段若都从 (0,0,0) 重启,还需要明确段 ID 或相机等身份信息,免得同坐标误当同内容。 更远一步,镜头绕场景移动后再次拍到同一处墙面,这处墙面的世界位置没变,屏幕上的 (h,w) 却可能不同;反过来,相同 (h,w) 也可能指向另一块墙面。视频 3D RoPE 的“3D”是时间加二维屏幕格点,不是场景的三维坐标。面向相机可控的视频 DiT,SCoPE 将相机视线作为另一种位置线索加入注意力,并保留原有 RoPE;这是研究者针对屏幕坐标局限提出的扩展,不是普通 3D RoPE 自动拥有的几何能力。 07. 经典论文脉络 RoFormer、Position Interpolation 与 YaRN 的旋转及语言长上下文扩展已在先修文章讲过;对视频的问题是哪一轴、哪一频段需要缩放,语言模型结果不能直接当画质证据。 CogVideoX 将三维相对位置用于视频 DiT,并用多分辨率 Frame Pack 与渐进训练支持不同尺寸;论文附录展示的初始生成状态对比揭示了“局部清晰”与“全局成形”的矛盾。它是该模型上的定性证据,不是所有视频 RoPE 的通用胜负结论。 Diffusers 的 CogVideoX 实现 提供可核对的三轴维度分配、格点生成和注意力接口;论文、SAT 与 Diffusers 版本未必走同一坐标路径。 SCoPE 在视频 DiT 中保留时空格点 RoPE,另加相机视线线索以改善相机轨迹下的场景一致性;它讨论的是屏幕位置之外的几何信息,并非改写基础 RoPE 的旋转恒等式。 08. 常见误解 误解一:3D RoPE 就是把三个坐标加起来再做 1D RoPE。 若先算 $t+h+w$,(1,0,0) 与 (0,1,0) 就变成同一个位置值,时间变化和上下位移无法区分。正确做法是三段特征独立旋转,最后只在注意力内积里汇总贡献。 误解二:相对位置恒等式成立就证明任意分辨率都能生成。 恒等式对没见过的坐标同样成立;模型从未学过如何在新相位、更多 token 和新物体尺度上使用它。数学可计算性只保证不会因公式本身报错。 误解三:把所有坐标除以两倍没有副作用。 位置插值让新端点回到旧范围,却也让邻近格点的相位差减半,可能伤害局部细节。若目标只换高度,就不要无故压缩时间和宽度。 误解四:调大 rope_theta 等于 Position Interpolation。 更改基数主要影响较低频平面,最高频不动;位置除以缩放因子让所有频率一起慢下来。两者可能组合,作用机制不同。 误解五:CogVideoX 配置里有 height_interpolation 参数,就一定在使用插值。 本次读到的 SAT Rotary3DPositionEmbeddingMixin 接受该参数,却没有用它来计算 grid_h。要按真实执行路径确认;不同实现不能只凭参数名互相代替。 误解六:空间轴拿了 75% 维度,所以换分辨率导致的所有错误都来自空间 RoPE。 维度比例只是一种频率预算,无法排除注意力规模、训练分辨率、VAE 压缩和内容尺度的影响。看输出症状、做逐项消融,才有因果结论。 09. 动手验证 先运行 python3 rope_3d_minimal.py,看 vertical_neighbor_* 四行。把 lower=(0,1,0) 改成 (1,0,0),即从“下一行”改为“下一帧”:3D 位移由 (0,1,0) 改成 (1,0,0),1D 位移则由 W 改成 H×W。再单独改网格宽度,检查三轴版的下一帧相位是否仍只由时间坐标决定。 调用 rope_3d_cache(2,6,4,64,scales=(1,2,1)) 与 scales=(2,1,1),分别只压缩高、时间坐标;检查同一高坐标的高段相位和同一时间坐标的时间段相位。最后把网格 2×3×4 改成 2×6×4:缓存行数应从 24 变 48,列数仍为 64,只有高坐标的取值范围增加。 如果要评估生成模型的真实外推质量,不能只跑这段 NumPy 脚本。固定模型权重、prompt、种子与去噪设置,比较原训练画幅、直接扩表、逐轴插值和不同频段缩放;同时记录局部纹理、重复图案、全局构图、跨帧主体一致性与实际显存/延迟。只有这样才能分清“位置编码问题”与“高分辨率本来就需要新训练”的差异。 10. 延伸阅读 继续向下可以看视频 DiT 的稀疏注意力、3D VAE/patchify 和长视频状态记忆:位置只负责“在哪里”,这几项决定“看哪些 token、用什么尺度和怎样记住内容”。 本篇用到的具体外部依据以 CogVideoX 论文、CogVideo SAT 源码 与 Diffusers 位置编码源码 为准;它们分别支持论文中的训练取舍与两种工程实现,文中的 NumPy 输出仅证明所写公式和示例代码一致。 附录:完整代码 09 节用到的脚本全文如下(rope_3d_minimal.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 rope_3d_minimal.py """NumPy-only 3D RoPE and per-axis position extrapolation demo.""" import numpy as np def axis_dims(head_dim): """CogVideoX's time/height/width split for a head divisible by sixteen (all three axis sizes must be even).""" assert head_dim > 0 and head_dim % 16 == 0 dims = (head_dim // 4, head_dim * 3 // 8, head_dim * 3 // 8) assert all(d % 2 == 0 for d in dims) return dims def axis_angles(positions, dim, base=10000.0, scale=1.0): """Angles [positions, dim/2]; scale>1 compresses this axis only.""" assert dim % 2 == 0 and scale > 0 inv_freq = base ** (-np.arange(0, dim, 2, dtype=np.float64) / dim) return np.asarray(positions, dtype=np.float64)[:, None] * inv_freq[None, :] / scale def rope_3d_cache(frames, height, width, head_dim=64, scales=(1, 1, 1)): """Return interleaved cos/sin, one row per (t,h,w) token.""" assert frames > 0 and height > 0 and width > 0 assert len(scales) == 3 and all(scale > 0 for scale in scales) dt, dh, dw = axis_dims(head_dim) at = axis_angles(np.arange(frames), dt, scale=scales[0])[:, None, None, :] ah = axis_angles(np.arange(height), dh, scale=scales[1])[None, :, None, :] aw = axis_angles(np.arange(width), dw, scale=scales[2])[None, None, :, :] shape = (frames, height, width) angles = np.concatenate( [np.broadcast_to(a, shape + (d // 2,)) for a, d in zip((at, ah, aw), (dt, dh, dw))], axis=-1, ).reshape(frames * height * width, head_dim // 2) return np.repeat(np.cos(angles), 2, axis=-1), np.repeat(np.sin(angles), 2, axis=-1) def rotate(x, cos, sin): """Rotate adjacent dimension pairs; x and cache both [tokens, head_dim].""" paired = x.reshape(x.shape[0], -1, 2) quarter_turn = np.stack((-paired[..., 1], paired[..., 0]), axis=-1).reshape(x.shape) return x * cos + quarter_turn * sin def score_for_positions(q, k, pos_q, pos_k, scales=(1, 1, 1)): """A single dot product without building an attention matrix.""" dims = axis_dims(q.size) out_q, out_k = [], [] start = 0 for axis, dim in enumerate(dims): aq = axis_angles([pos_q[axis]], dim, scale=scales[axis]) ak = axis_angles([pos_k[axis]], dim, scale=scales[axis]) cq, sq = np.repeat(np.cos(aq), 2, axis=-1), np.repeat(np.sin(aq), 2, axis=-1) ck, sk = np.repeat(np.cos(ak), 2, axis=-1), np.repeat(np.sin(ak), 2, axis=-1) out_q.append(rotate(q[start:start + dim][None], cq, sq)[0]) out_k.append(rotate(k[start:start + dim][None], ck, sk)[0]) start += dim return np.dot(np.concatenate(out_q), np.concatenate(out_k)) def flatten_index(pos, height, width): """The row-major 1D index of a video token at (time, height, width).""" t, h, w = pos return t * height * width + h * width + w def score_for_flattened_positions(q, k, pos_q, pos_k, height, width): """Baseline: one 1D RoPE angle table for all head channels.""" mq = flatten_index(pos_q, height, width) mk = flatten_index(pos_k, height, width) aq = axis_angles([mq], q.size) ak = axis_angles([mk], k.size) cq, sq = np.repeat(np.cos(aq), 2, axis=-1), np.repeat(np.sin(aq), 2, axis=-1) ck, sk = np.repeat(np.cos(ak), 2, axis=-1), np.repeat(np.sin(ak), 2, axis=-1) return float(np.dot(rotate(q[None], cq, sq)[0], rotate(k[None], ck, sk)[0])) def naive_score_matrix_gib(token_count, bytes_per_element=2): """GiB for one materialized dense attention-score matrix of one head.""" return token_count * token_count * bytes_per_element / 2**30 if __name__ == "__main__": np.set_printoptions(precision=6, suppress=True) dims = axis_dims(64) cos, sin = rope_3d_cache(2, 3, 4, 64) rng = np.random.default_rng(7) tokens = rng.normal(size=cos.shape) rotated = rotate(tokens, cos, sin) norm_error = np.max(np.abs(np.linalg.norm(tokens, axis=1) - np.linalg.norm(rotated, axis=1))) print("axis_dims=", dims) print("cache_shape=", cos.shape, "input_shape=", tokens.shape) print("rotated_shape=", rotated.shape) print("norm_error=", f"{norm_error:.2e}") q, k = rng.normal(size=64), rng.normal(size=64) a = score_for_positions(q, k, (0, 1, 2), (1, 2, 3)) b = score_for_positions(q, k, (5, 6, 7), (6, 7, 8)) print("same_offset_scores=", f"{a:.6f}", f"{b:.6f}", "difference=", f"{abs(a-b):.2e}") upper, lower = (0, 0, 0), (0, 1, 0) flat4 = flatten_index(lower, 2, 4) - flatten_index(upper, 2, 4) flat8 = flatten_index(lower, 2, 8) - flatten_index(upper, 2, 8) one_d4 = score_for_flattened_positions(q, k, upper, lower, 2, 4) one_d8 = score_for_flattened_positions(q, k, upper, lower, 2, 8) three_d4 = score_for_positions(q, k, upper, lower) three_d8 = score_for_positions(q, k, upper, lower) three_d_offset = tuple(b - a for a, b in zip(upper, lower)) print("vertical_neighbor_1d_offsets=", flat4, flat8) print("vertical_neighbor_1d_scores=", f"{one_d4:.6f}", f"{one_d8:.6f}") print("vertical_neighbor_3d_offsets=", three_d_offset, three_d_offset) print("vertical_neighbor_3d_scores=", f"{three_d4:.6f}", f"{three_d8:.6f}") # These are algebraic invariants, not video-quality tests. Keeping them as # assertions turns the example into a small regression test for pairing, # broadcasting and relative-position behavior. assert norm_error < 1e-12 assert abs(a - b) < 1e-12 assert abs(three_d4 - three_d8) < 1e-12 assert not np.isclose(one_d4, one_d8) raw = axis_angles([15], dims[1])[0] pi = axis_angles([15], dims[1], scale=2)[0] print("height_phase_at_15_first_last=", np.round(raw[[0, -1]], 6)) print("height_PI_x2_first_last=", np.round(pi[[0, -1]], 6)) print("time_phase_at_15_first_last=", np.round(axis_angles([15], dims[0])[0][[0, -1]], 6)) small_tokens = 13 * 30 * 45 large_tokens = 13 * 60 * 90 print("token_count_13x30x45=", small_tokens) print("token_count_13x60x90=", large_tokens) print("dense_attention_ratio=", (large_tokens / small_tokens) ** 2) print( "naive_score_matrix_fp16_gib_per_head=", f"{naive_score_matrix_gib(small_tokens):.3f}", f"{naive_score_matrix_gib(large_tokens):.3f}", ) make_figures.py """Generate 3D RoPE figures. Requires NumPy, Matplotlib and Pillow.""" from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from PIL import Image, ImageDraw, ImageFont from rope_3d_minimal import axis_angles, axis_dims OUT = Path(__file__).resolve().parents[1] / "figures" OUT.mkdir(exist_ok=True) def _chinese_font(size): for path in ( "/System/Library/Fonts/Hiragino Sans GB.ttc", "/System/Library/Fonts/PingFang.ttc", "/usr/share/fonts/truetype/noto/NotoSansCJK-Regular.ttc", ): try: return ImageFont.truetype(path, size) except OSError: pass raise RuntimeError("请安装中文字体后再生成 1D/3D 对照图") def one_d_vs_three_d(): """Show the same vertical neighbor under two video widths.""" image = Image.new("RGB", (1800, 950), "#f7f9fe") draw = ImageDraw.Draw(image) ink, muted = "#1e293b", "#475569" draw.text((80, 50), "同一对上下相邻的 token,换宽度会怎样?", font=_chinese_font(68), fill=ink) draw.text((82, 150), "A=(0,0,0) → B=(0,1,0);只改变视频格点宽度 W", font=_chinese_font(42), fill=muted) cards = ( (70, 260, 865, 790, "#e8efff", "#1d4ed8", "1D RoPE:一个序列距离", "W=4 → Δm=4", "W=8 → Δm=8", "上下相邻仍是 1 格,但旋转相位变了"), (935, 260, 1730, 790, "#e3f7f2", "#047857", "3D RoPE:三个轴分别计数", "W=4 → (0,1,0)", "W=8 → (0,1,0)", "高轴始终转 1 格,时间和宽轴不动"), ) for x0, y0, x1, y1, bg, accent, title, first, second, note in cards: draw.rounded_rectangle((x0, y0, x1, y1), radius=38, fill=bg) draw.rectangle((x0 + 38, y0 + 48, x0 + 50, y0 + 130), fill=accent) draw.text((x0 + 77, y0 + 51), title, font=_chinese_font(51), fill=ink) draw.text((x0 + 75, y0 + 210), first, font=_chinese_font(68), fill=accent) draw.text((x0 + 75, y0 + 322), second, font=_chinese_font(68), fill=accent) draw.text((x0 + 75, y0 + 435), note, font=_chinese_font(35), fill=muted) draw.text((80, 844), "旋转和相对位置性质相同;变化的是坐标系与每轴的特征维度。", font=_chinese_font(42), fill=ink) image.save(OUT / "one_d_vs_three_d.png", optimize=True) def axis_budget(): dims = axis_dims(64) fig, ax = plt.subplots(figsize=(9, 2.8)) colors = ["#1d4ed8", "#0d9488", "#ea580c"] start = 0 for name, dim, color in zip(("Time 25%", "Height 37.5%", "Width 37.5%"), dims, colors): ax.barh([0], [dim], left=start, color=color, height=0.55) ax.text(start + dim / 2, 0, f"{name}\n{dim} dims", ha="center", va="center", color="white", weight="bold") start += dim ax.set_xlim(0, 64) ax.set_ylim(-0.55, 0.55) ax.set_xlabel("Head channels (64 total)") ax.set_yticks([]) ax.set_title("CogVideoX 3D RoPE: independent rotary planes per axis") fig.tight_layout() fig.savefig(OUT / "axis_budget.png", dpi=180) plt.close(fig) def phase_tradeoff(): dim_h = axis_dims(64)[1] pos = np.arange(32) original = axis_angles(pos, dim_h) compressed = axis_angles(pos, dim_h, scale=2) fig, axes = plt.subplots(1, 2, figsize=(9, 3.5), sharey=True) for ax, values, title in zip(axes, (original, compressed), ("Raw coordinates", "Height PI: positions / 2")): ax.plot(pos, np.cos(values[:, 0]), color="#ea580c", linewidth=2, label="highest frequency") ax.plot(pos, np.cos(values[:, -1]), color="#1d4ed8", linewidth=2, label="lowest frequency") ax.set_title(title) ax.set_xlabel("Height-token index") ax.grid(alpha=0.18) axes[0].set_ylabel("cos(angle)") axes[1].legend(frameon=False, loc="lower right") fig.suptitle("Interpolation halves phase change on this axis at every frequency") fig.tight_layout() fig.savefig(OUT / "phase_tradeoff.png", dpi=180) plt.close(fig) if __name__ == "__main__": one_d_vs_three_d() axis_budget() phase_tradeoff() for name in ("one_d_vs_three_d.png", "axis_budget.png", "phase_tradeoff.png"): print(OUT / name) 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-15|阿里五路音频控制-DiffSynth-Music 今日 AIGC 论文速览 今日共 10 篇 · 可控与统一音频生成 2 篇 · 长时音视频与可控视频生成 2 篇 · 图像编辑与画质修复 2 篇 · 3D 资产生成 1 篇 · 流式交互与语音评测 2 篇 · 高效长上下文 1 篇 重点论文标题列表 DiffSynth-Music(阿里巴巴集团、上海交通大学):五路音频控制锁住节拍 StepAudio 3 Gen(阶跃星辰 StepFun-Audio 团队):一套模型生成所有声音 Encore(百度、北京理工大学 · SIGGRAPH Asia 2026):三十秒音画同步不跑偏 DIAL(阿里巴巴集团、北京大学):调一个旋钮控人物像不像 Omni-Streaming Thinking(香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学):流式多模态会主动改口 今日论文速览 1. DiffSynth-Music:五路音频控制锁住节拍 DiffSynth-Music: Audio-Conditioned KV-Cache Adapters for Controllable Music Generation | 阿里巴巴集团、上海交通大学 | arXiv:2609.12774 关键词:可控音乐生成,音频条件,KV缓存,扩散Transformer 前序问题:文字与歌词能规定歌曲主题和唱词,却难以精确约束节拍、旋律、伴奏、演唱韵律和参考风格;把多种音频条件逐步送进扩散模型又会反复增加计算。 本文贡献:DiffSynth-Music 从同一音乐 DiT 初始化 Control、Prosody、Reference 三个模板模型,先由共享 VAE 编码控制音频,再把逐层 KV 缓存注入生成主干。模板端固定在干净数据端点,每种控制只前向一次,五类条件还能组合使用。 实验效果:相对冻结主干,节拍条件把 Beat-F1 从 0.3031 提到 0.8496;人声条件把 V-MSE 从 0.0158 降到 0.0006,伴奏条件把 A-MSE 从 0.0221 降到 0.0023;参考条件的 MuLan-A 从 0.6836 升到 0.8088。 批判点评:一次缓存让多条件控制更便宜,但三个模板模型仍带来额外参数和训练维护成本。实验以单条件为主,真正创作常同时叠加节拍、人声、伴奏与参考音频,组合冲突和听感质量仍需更大规模人评。 2. StepAudio 3 Gen:一套模型生成所有声音 StepAudio 3 Gen Technical Report | 阶跃星辰 StepFun-Audio 团队 | arXiv:2609.12945 关键词:通用音频生成,语音合成,声音设计,RVQ 前序问题:语音、歌声、音乐与音效通常使用不同生成器和离散表示,混合声音任务很难在一套模型里保持文本能力、说话人一致性与声学细节。 本文贡献:StepAudio 3 Gen 以 12.5 Hz 的 16×2048 共享 RVQ 空间直接自回归建模通用音频:主干沿时间预测首码本,轻量因果 Transformer 再沿码本轴补齐其余十五层;渐进预训练与 RVQ Adaptor 缓解音频能力对语言能力的干扰。 实验效果:TTS 人类偏好 Elo 达 1755.33,对五个商业系统的汇总胜率为 82.0%;声音设计 Elo 为 1668.5、汇总胜率 75.5%;风格一致性中文平均 85.2%,英文平均 77.7%。 批判点评:统一离散建模简化了产品管线,但十六层 RVQ 的级联预测仍可能积累误差。报告覆盖多类声音,公开复现仍取决于训练数据、偏好标注与完整模型权重。 3. Encore:三十秒音画同步不跑偏 Encore: Infinite Audio-Video Generation with Adaptive Signal Routing | 百度、北京理工大学 · SIGGRAPH Asia 2026 | arXiv:2609.04249 关键词:音视频联合生成,长视频生成,自适应信号路由,跨模态同步 前序问题:现有音视频生成能做出同步良好的短片,但时长受限;长视频方法靠分块迭代延长时长,却完全没有音频。联合生成长音视频比单做任何一边都难:每一块都要同时保住视频时序连贯、音频时序连贯和跨模态同步,而这三路条件信号进入模型的通路各不相同。 本文贡献:Encore 把难题拆成两层:局部连续性交给带显式跨块上下文传播的迭代生成,全局一致性交给带位移位置编码的参考音视频信号。在此之上提出自适应信号路由(ASR),在自注意力内加逐层逐头可学习偏置、在交叉注意力输出上加可学习缩放,让模型自行调节每路条件信号的影响强度。端到端联合训练后,推理时全程以真值模态为条件即可支持无限长的音频转视频与视频转音频。 实验效果:扩展后的 VerseBench 长音视频评测上,身份一致性 ID 为 0.86、音画同步 LSE-C 为 2.36、AV-A 为 0.88,三项均为最佳;误差累积 ΔAS 0.02、ΔID 0.07,明显低于次优的 0.06 与 0.22。短片设置下 LSE-C 为 3.46,对 LTX-2.3 的 2.36。 批判点评:把长音视频拆成局部续接加全局参考,确实压住了 30 秒级的身份漂移与场景突变。但 ASR 的逐层逐头可学习参数把调参负担转移到了训练侧,消融显示去掉任一路缩放都会让同步指标明显掉档。画面美学仍落后于 OVI 与 LTX2.3,且所谓无限长目前只验证到 30 秒量级,更长时长的累积行为没有给出。 4. DIAL:调一个旋钮控人物像不像 Harnessing Intrinsic Subject-Aware Attention for Controllable Multi-Subject Video Generation | 阿里巴巴集团、北京大学 | arXiv:2609.11507 关键词:多主体视频生成,注意力定位,保真强度控制,偏好优化 前序问题:多主体视频生成卡在两件事上:保真强度不可调——模型要么因训练数据偏置产生生硬的贴图感,要么对输入敏感到无法控制;以及语义漂移——主体中途消失、属性出错、多个参考身份互相串味。 本文贡献:作者发现 DiT 内部某些注意力块天然形成内在空间定位图(ISGM),能准确定位参考主体。DIAL 据此双阶段复用这一内部信号:低噪声阶段用 ISGM 构造注意力偏置矩阵,推理时逐主体调节引导强度 γ 即可控制身份保真度,无需重训;高噪声阶段用同一张图零成本构造偏好对做强化学习,把注意力锚定到参考主体上抑制漂移。 实验效果:OpenS2V-Eval 上,Kaleido 主干总分从 56.00 提到 γ=16 时的 61.14,人脸相似度从 31.81 升到 60.64,双双超过最强通用基线 SkyReels-v3 的 59.26 与 VACE-14B 的 55.09。第二阶段单独作用(γ=0)把主体出现率从 155/320 提到 163/320。 批判点评:把控制接口接到模型自带的注意力结构上、省掉外挂模块,这个思路很干净。但 ISGM 出现在哪一层依赖对具体主干的经验观察,换骨干要重新找;保真度提升伴随真实感与美学分下滑,γ 给多少仍靠人工判断。第二阶段的偏好对由 ISGM 自评构造,评判标准与被优化对象同源,存在自我确认的风险。 5. Omni-Streaming Thinking:流式多模态会主动改口 Omni-Streaming Thinking | 香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学 | arXiv:2609.15128 关键词:流式多模态,音视频推理,状态修正,幻觉抑制 前序问题:流式音视频模型常在声音尚未说完时依据画面提前下结论;一旦错误判断写入记忆,后续音频即使否定它,模型仍会沿着旧状态回答。 本文贡献:OST 把输出拆成已见证据、未来证据预测和待验证主张,并为主张绑定验证时间窗。音频与视觉证据分开保存;遇到矛盾后,反驳过程削弱旧主张及其依赖状态,回答门控只在关键主张满足条件时放行。主干冻结为 Qwen3-Omni-30B-A3B,仅做轻量适配。 实验效果:在五个流式与音视频基准上,OST 相对最强开放基线平均提升超过 10%;OST-DiagBench 的 d′ 达 2.95,而开放基线最高 1.38。SOVBench-O 平均准确率由 81.6 提至 87.8,SOVBench-T F1 由 90.5 提至 92.4。 批判点评:显式状态与反驳链能减少过早承诺,却依赖主张拆分、模态归因和验证时间窗都足够准确。复杂直播中矛盾可能长期不闭合,额外结构化输出也会增加延迟和训练标注成本。 6. Overpainting:灰色地带让模型自己发挥 Overpainting: Localized Context-aware Diffusion Image Editing | Adobe Research、威廉与玛丽学院 | arXiv:2609.10811 关键词:图像编辑,三值遮罩,扩散模型,注意力dropout 前序问题:图像编辑要么给定二值遮罩、严格只改框内,结果生硬且边界突兀;要么纯靠文字提示,改哪里完全不受控。用户真正想表达的「这块必须改、这一圈可以顺带调、其余别动」没有对应接口。 本文贡献:Overpainting 用白/灰/黑三值 trimap 表达这三档意图:白色必须编辑、灰色允许编辑、黑色不得改动。实现上在预训练图像编辑扩散模型外挂 LoRA,用联合注意力在源图、遮罩与噪声三路输入间传信息,并以注意力 dropout 平衡信息流。配套的自动数据流水线先用语言编辑模型造候选图像对,筛掉过度编辑、编辑不足与整体偏移的失败样本,再从可用样本反解出 trimap。 实验效果:遮罩估计网络微调后 F1 达 0.955、IoU 0.916,对比阈值像素差的 0.733 与 0.607。MISATO@1K 补全评测上 LPIPS 0.189、FID 20.58,远好于 FLUX-Kontext 的 0.372 与 92.09。180 个人工整理的例子上,50% 注意力 dropout 在遮罩遵循与编辑质量之间取得平衡点。 批判点评:三值 trimap 比二值遮罩更贴近真实修图意图,把「顺带调一下」这件事显式化了。但灰区给模型多大自由度只能靠 dropout 率这一个全局参数调,用户画的灰区宽窄也会显著改变结果,论文自己的遮罩变体实验就显示同一提示词能得到差异很大的输出。训练数据由 FLUX.1 Kontext 自动生成再筛选,模型学到的编辑分布因此被上游模型的偏好圈住。 7. PLSR:3D网格切块做超分省显存 PLSR: Progressive and Localized Super-Resolution of 3D Objects via Localized Latent Voxel Diffusion | 香港中文大学、广东工业大学、香港城市大学、莫纳什大学 | arXiv:2609.06436 关键词:3D资产生成,超分辨率,体素扩散,渐进式生成 前序问题:扩散式 3D 生成模型被固定分辨率卡住,细节上不去;直接把分辨率整体拉高,显存与算力又会爆掉。 本文贡献:PLSR 在已有 3D 生成基座上做超分,把全局超分拆成关联式的局部子任务:粗网格编码成低分辨率条件,上采样出高分辨率隐变量的稀疏体素骨架后切成固定大小 patch,每个 patch 关联裁剪对应的低分辨率条件与输入图像,逐 patch 去噪再聚合成全局预测。整轮结果还能当作下一轮的低分辨率条件,渐进逼近更高分辨率,基座只需低成本微调。 实验效果:伪真值几何评测上 LPIPS 0.109、FID 55.89、Chamfer 距离 0.0139、F1 0.145,四项全面优于 TRELLIS.2 在 1536 与 2560 两档分辨率下的结果;纹理评测 LPIPS 0.125、FID 59.89。开放世界 ELO 评分中几何总体质量 1855、纹理 1633,高于 TRELLIS.2(1536) 的 1790 与 1599。 批判点评:把全局超分拆成局部 patch 换来了显存友好,重叠推理与渐进式两个消融也都验证有效。但逐 patch 去噪要遍历所有 patch,分辨率越高调用次数越多,省的是显存不是时间。接缝主要靠低分辨率条件当锚点加重叠区抑制,论文也承认无重叠时仍有残留。开放世界评测依赖模型打分,与人工审美的一致性没有交叉验证。 8. SAS:稀疏注意力直接听损失 SAS: Simple Attention Sparsification via End-to-End Optimization of Context Ranking | 腾讯混元、香港科技大学(广州)、香港科技大学 | arXiv:2609.13141 关键词:稀疏注意力,长上下文,上下文排序,端到端优化 前序问题:可训练稀疏注意力通常用硬 Top-K 选上下文,语言模型损失无法穿过离散选择,只能蒸馏稠密注意力权重;有限预算因此可能保留“像教师”却不真正影响最终预测的块。 本文贡献:SAS 在训练时把选择器连续分数以对数门的形式注入注意力 softmax,让语言模型损失直接更新上下文排序;归一化门校准历史块与始终保留的当前块,Triton 内核把这一机制嵌入 FlashAttention 风格计算。 实验效果:在 2048 token 预算、Qwen3-4B 上,AIME24 比 SeerAttention-R 高 13.02 分(68.85 对 55.83);Qwen3-14B 的 LongBench 8K+ 为 53.9 对 51.5。SGLang 解码在 512K、batch 1 最多降延迟 5.6 倍,batch 8、64K 最多约 13 倍加速。 批判点评:端到端损失对下游任务更直接,但选择器只在数学数据上训练,跨领域稳定性仍受主干与查询分布影响;预填充仍采用稠密注意力,因此长输入首 token 成本没有同时消失。 9. Mi-Ripple:修掉反复AI编辑的涟漪 Mi-Ripple: Restoring Images Degraded by Iterative AI Editing | 弥阳科技、中国科学院软件研究所、上海交通大学、天津大学 | arXiv:2609.11317 关键词:图像修复,迭代编辑,频域伪影,配对再生成 前序问题:图像被生成模型反复编辑后会积累低频起伏、色带与周期纹理,内容看似正确却越来越“塑料”;普通锐化或去噪可能同时损伤真实边缘。 本文贡献:Mi-Ripple 先在频域用陷波定位并抑制迭代编辑形成的周期分量,再通过配对再生成构造更干净的参考,对剩余伪影做修复;流程把可测量的频谱异常与生成式细节恢复结合。 实验效果:14 次只做陷波的测试中,整图 CIELAB 亮度残差标准差为 0.08–0.44;配对再生成把参考中的碎屑密度降低 45%。三个示例的尺度纹理指数分别从 25.3%、41.1%、20.0% 降至 11.1%、12.1%、0.0%。 批判点评:方法针对可见的周期性退化更有解释性,但配对再生成可能改动原图身份与细节。若伪影频率与真实重复纹理重合,陷波也可能误删内容,仍需要区域级保真检查。 10. Duplex Cue:会说会停还要边听边改 Continue, Adapt, or Yield: In-Turn Adaptation to Overlapping Speech in Full-Duplex Agents | Besimple AI | arXiv:2609.13117 关键词:全双工语音,重叠语音,对话适应,语音评测 前序问题:全双工语音评测常把模型行为简化为继续说或停下来,却漏掉人类常用的第三种反应:保留话轮,同时吸收听者补充的词、纠正或澄清。 本文贡献:Duplex Cue 把听者意图区分为回应、协作与打断,把说者行为标成原样继续、话内适应或让出话轮。研究从无脚本英语对话中提取 300 个经人工确认的提示,并在相同提示下比较人类录音与 PersonaPlex 延续。 实验效果:保留 208 对活跃且可评分样本;66 个协作提示中,人类话内适应率为 68.2%,PersonaPlex 为 34.8%,相差 33.4 个百分点。模型更多原样继续(42.4%)或让出话轮(22.7%);自动评分与人工在 142 项中一致 108 项,κ=0.641。 批判点评:三分法比“停没停”更接近自然对话,但判断适应需要理解语义依赖,自动评审本身可能偏向表面复述。要成为训练目标,还需扩展语言、说话风格、噪声与真实网络延迟。 趋势观察 控制接口前移到模型内部 控制不再靠外挂模块,而是接到主干已有的结构上:DiffSynth-Music 用可复用 KV 缓存组合五路音频,StepAudio 3 Gen 用共享离散码本统一语音、歌声、音乐与音效,DIAL 干脆直接复用 DiT 自带的注意力定位图。 长时序生成靠显式上下文传播续命 Encore 把长音视频拆成局部连续性与全局一致性两层,用跨块上下文传播加参考信号压住 30 秒后的身份漂移,误差累积指标 ΔID 从次优的 0.22 降到 0.07——长程生成的胜负手不在单帧画质,而在误差累积。 编辑控制从硬遮罩转向软约束 Overpainting 用白灰黑三值 trimap 区分「必须改、可以改、不能改」,Mi-Ripple 用频域陷波只删周期分量,都在回答「哪里该动、动多少」,而不是一刀切地框定编辑区域。 算力不够时预算分配成为核心问题 PLSR 把全局 3D 超分拆成可迭代的局部 patch 去噪换显存,SAS 在固定注意力预算下端到端学上下文排序——两条线都承认资源有限,转而研究怎么把预算花在刀刃上。 人工智能炼丹君 整理 | 2026-09-15 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-14|SenseNova 8B原生视觉直出4K-SN-U15 今日 AIGC 论文速览 今日共 10 篇 · 统一视觉理解与生成 1 篇 · 实时视频与世界模型 2 篇 · 多模态智能体评测 3 篇 · 语音识别与压缩 2 篇 · 推理对齐与生成奖励 2 篇 重点论文标题列表 SenseNova-U1.5(OpenSenseNova 团队):8B原生视觉直出4K Vidu S2(清华大学、北京生数科技):720p实时视频25帧起 World in World(西湖大学 AGI Lab):冻结模型也能自由换镜头 MindTopo(西北大学、微软研究院、斯坦福大学):拓扑规划远逊人类 IdeaAMBIG(耶鲁大学、TCS Research):金标准让可实现率到98% 今日论文速览 1. SenseNova-U1.5:8B原生视觉直出4K SenseNova-U1.5: Towards Native Unified Visual Intelligence | OpenSenseNova 团队 | arXiv:2609.11929 关键词:统一多模态,图像生成,图像编辑,原生像素建模 前序问题:理解模型通常依赖视觉编码器,生成模型又依赖 VAE,两条链路使用不同表征,导致理解、推理、生成和编辑难在一个端到端模型里互相迁移;高分辨率生成还会放大局部块之间的不连续。 本文贡献:SenseNova-U1.5 用 8B 参数的 Mixture-of-Transformers 直接统一像素与文本,去掉外置视觉编码器和 VAE;空间耦合解码器修补逐块重建的边界,原生分辨率扩展到 4K。后训练分别优化审美、双语文字、信息图和编辑专家,再用多专家在线蒸馏合并能力。 实验效果:在作者报告的开放模型对比中,SenseNova-U1.5 的 GenEval 总分达到 0.92,DPG-Bench 为 88.11,CVTG-2K 平均分为 0.948;训练语料新增约 5900 万张图,且有效训练量中 88.2% 超过 1024²、64.4% 超过 2048²。 批判点评:原生像素路线减少了模块割裂,却把视觉 token 数量、像素重建和语言建模的竞争都压进同一主干,训练成本并未消失。论文展示大量自有数据与奖励流程,完整数据未开放前,4K稳定性、多语言文字和多参考编辑的复现门槛仍高。 2. Vidu S2:720p实时视频25帧起 Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation | 清华大学、北京生数科技 | arXiv:2609.11638 关键词:实时视频,流式生成,视频编辑,空间视频 前序问题:主流扩散视频模型要等整段去噪结束才能播放,用户无法在直播过程中换人物、改衣服或更新参考图;上一代 Vidu S1 也局限于 540p、固定参考和说话头像。 本文贡献:Vidu S2 把流式视频扩展为 Avatar 与 Editing 两条实时链路:通过回放式在线蒸馏、块因果时序注意力、高低噪声双阶段缓存、量化与多 GPU 流水线,在生成过程中接收新指令和动态参考;编辑分支支持风格、服装、角色及背景替换,并探索双目空间视频。 实验效果:Avatar 在 720p 下维持 25–42 FPS。Editing 在 Sparkle-Bench 获得 3.74 总分,在 OpenVE+RefVIE 联合评测得 4.26;虚拟试穿 VFID-I 为 9.9515,低于 CatV2TON 的 19.5131。长期人评中,对 Runway 的整体质量偏好率达到 85.7%。 批判点评:实时性建立在复杂的缓存、量化和多 GPU 调度上,普通消费级部署能否复现 720p 上限仍需实测。空间视频主要由单目结果与深度后处理构造,快速运动、遮挡边界和长时间身份漂移仍可能影响头显舒适度。 3. World in World:冻结模型也能自由换镜头 World in World: Explore the World with World Models | 西湖大学 AGI Lab | arXiv:2609.11548 关键词:世界模型,相机控制,视频重渲染,免训练控制 前序问题:从已有视频换视角时,模型既要跟上原事件的时间线,又要把已见物体放到新视角、补全未见区域,并在镜头返回时恢复先前外观;现有方案通常为每种控制额外训练模块。 本文贡献:World in World 把原视频观测、目标视角投影、几何渲染和历史生成帧都编码成带相机、时间与有效区域标签的干净视觉状态,直接送入冻结因果视频模型的原生自注意力。对应路由器建立 token 对应关系,EWA 在同一次去噪前向中分别调节各证据通道。 实验效果:在 DAVIS 与 OpenVid-1M 相机重渲染评测中,方法的七项 VBench 平均分为 85.192,优于次高的 84.295;平移误差 0.068622、旋转误差 2.8326°,并取得 23.1511 PSNR。去掉目标视角 warp 后,旋转和平移误差约升至完整方法的 3.4 倍和 10.9 倍。 批判点评:免训练接口很实用,但仍依赖深度、相机姿态、点对应和人体几何等外部估计,错误会作为“干净证据”被模型放大。新暴露区域依赖生成先验,几何合理不等于真实世界可恢复。 4. MindTopo:拓扑规划远逊人类 MindTopo: Can Foundation Models Reason in Topological Space? | 西北大学、微软研究院、斯坦福大学 | arXiv:2609.11900 关键词:空间推理,拓扑,多模态模型,智能体规划 前序问题:视觉空间评测多考距离、角度和形状,却很少检查连续性、分离、顺序、包围和打结这些在连续形变下保持不变的拓扑关系;看懂静态图也不代表模型能通过动作维持它。 本文贡献:MindTopo 用 13 类程序化任务构造 11030 个样本,把五种拓扑性质分别放在单步推理与闭环规划中测试;同时评估 14 个多模态大模型,并让图像或视频生成模型充当规划过程的视觉想象器。 实验效果:按任务宏平均,GPT-5.6-Sol 得 61.42%,明显低于人类的 97.87%;其静态推理为 66.83%,闭环规划降到 52.75%。Qwen3-VL-2B 经 SFT 后平均 28.83%,GRPO 为 18.69%;联合训练使推理到 51.53%,规划仍只有 6.33%。 批判点评:基准把“识别关系”和“操作关系”的差距量化得很清楚,但渲染风格、动作接口和精确匹配评分可能放大模型失误。生成下一状态有时只是画出合理终点,并未遵守环境动力学,说明视觉想象尚不能替代可执行世界模型。 5. IdeaAMBIG:金标准让可实现率到98% IdeaAMBIG: Benchmarking Implementation-Critical Gaps in Research-Idea Specifications | 耶鲁大学、TCS Research | arXiv:2609.10539 关键词:研究智能体,代码生成,需求澄清,可复现性 前序问题:研究想法可以新颖且逻辑自洽,却遗漏门控方式、损失定义或参数匹配口径;编码智能体若不识别这些关键空白,就会默默补假设,最终实现出另一个方法。 本文贡献:IdeaAMBIG 从论文、代码仓库、Issue 和复现记录构造 660 个有证据支撑的样本,其中 163 个是真实缺陷、497 个是受控注入缺陷,分别测试规格是否可编码、缺陷定位和已知缺陷后的澄清问题生成。 实验效果:13 个模型中,真实样本的最佳宏缺陷恢复率仅 9.6%;给出缺陷位置后,最佳宏澄清动作成功率升至 80.6%。在 oracle 实验里直接提供金标准解决方案,可把下游“可编码”率从 14% 提升到 98%。 批判点评:它抓住了研究自动化中常被忽略的输入质量问题,但真实缺陷只有 163 个,且证据多来自已有复现失败,可能偏向容易留下公开记录的项目。定位失败仍是瓶颈,单纯提高代码模型能力并不能解决规格缺失。 6. Xiaomi-CocktailASR-1:声纹提示直听目标说话 Xiaomi-CocktailASR-1 Technical Report | 小米集团 | arXiv:2609.11274 关键词:语音识别,目标说话人,鸡尾酒会,音频语言模型 前序问题:多人同时说话时,普通 ASR 会混写所有声音;传统目标说话人识别通常先分离再转写,误差会累积,而且不少系统在只有一人或目标不在场时容易误删、误认。 本文贡献:Xiaomi-CocktailASR-1 把参考语音与混合语音拼接,用 0.6B Data2Vec2 音频编码器同时提取内容和声纹,再接 Qwen3-8B 解码,不需要独立说话人编码器或语音分离。负样本训练让目标缺席时输出空文本,CoT 模式还显式判断人数、性别和声纹相似度。 实验效果:在 LibriMix 2mix 上,目标说话人 WER 从此前 4.84% 降到 4.11%;真实 AMI-SDM 从此前 22.0% 降到 20.63%。单人 LibriSpeech WER 为 1.73%,目标存在时误拒率 0.36%;AMI-IHM WER 为 8.89%,优于 Qwen3-ASR-1.7B 的 10.56%。 批判点评:端到端统一架构减少级联误差,但要额外提供干净参考声纹,且 8B 解码器对边缘设备并不轻。CoT 能给出可读理由,却不保证其人数或声纹判断忠实反映内部决策。 7. Mr.LHDR:深研链越长越容易失真 Mr.LHDR: A Benchmark for Multimodal Real-World Long-Horizon Deep Research Agents | MBZUAI、中国科大、浙江大学、腾讯 | arXiv:2609.11318 关键词:深度研究,多模态智能体,长链推理,评测基准 前序问题:现有深度研究基准多在几步检索后只看最终答案,难以判断智能体能否在十几步依赖链中持续保存证据,也会掩盖“答案碰对、过程已错”的情况。 本文贡献:Mr.LHDR 用隐藏节点关系图构造八类真实问题,平均要求 12.1 个必要中间结论、依赖深度 10.4;每题至少包含一个会改变推理状态的图像、地图、PDF、图表或视频帧,并同时评分最终答案、检查项和依赖一致性。 实验效果:最终答案最强的一次 GPT-5.5 运行只有 43.1% OA 和 34.3% 严格准确率;专用系统 o3 Deep Research 为 32.4% OA、19.6% 严格准确率。移除图片后,依赖感知检查分下降 12.6 个百分点,且链越长严格准确率越低。 批判点评:依赖图让过程评测更可信,但人工构造的唯一答案和必要路径可能排除等价证据链。网页随时间变化会让可复现性持续漂移,真正部署还要处理来源可信度、费用和权限,而不只是链长。 8. Negative Self-Distillation:远离坏推理反超正蒸馏 Negative Self-Distillation: Learning to Reason by Avoiding Flaws | 弗吉尼亚大学、斯坦福大学 | arXiv:2609.11699 关键词:自蒸馏,推理模型,负向教师,对齐训练 前序问题:在线自蒸馏让模型模仿带答案提示的高置信轨迹,可能压制不确定表达、探索和自我纠错;直接遗忘错误轨迹又会把普通语言 token 一并惩罚,损坏基础能力。 本文贡献:NSD 不模仿“知道答案”的自己,而让模型生成与题目相关的粗心负条件,再推动学生分布远离这个负教师;动态门控只挑出对推理行为关键的 token 更新,减少对标点和通用语言模式的误伤,也不依赖外部教师或标准答案。 实验效果:在 AIME 24/25/26、HMMT、AMC、OlympiadBench 和 MATH 七个数学基准上,NSD 相对基线平均提升:1.7B 模型 2.3%、4B 模型 7.5%、8B 模型 6.0%,并在论文实验中持续超过 OPSD 与其他无标签自举 RL 方法。 批判点评:负教师由模型自己生成,若它不能稳定描述真正的错误模式,训练信号可能只是风格差异。动态门控降低语言退化风险,却新增阈值和梯度设计;数学推理上的收益还需在代码、事实性与开放问答中验证。 9. GenV:生成奖励抓出伪正确 Beyond Solver Verdicts: Generative Reward Models for Autoformalization | 凯斯西储大学、Amazon Web Services | arXiv:2609.11085 关键词:自动形式化,生成奖励模型,Z3,神经符号推理 前序问题:Z3 等求解器只能确认给定形式化是否可满足,无法判断它是否忠实翻译了原题;一个写反的不等号仍可能返回同样 verdict,形成“结果正确但形式不等价”的伪正确。 本文贡献:GenV 先用离线 Z3 等价性 oracle 挖掘硬负例,再把参考等价判断蒸馏成不需要参考答案的连续生成式分数;它复用语言模型词表读出奖励,并用 logit lens 与稀疏自编码器分析错误坐标如何在内部形成。 实验效果:GenV+HN 在参考等价验证上取得 0.961 AUROC,远高于只看求解器 verdict 的机会水平 0.500;它可零样本迁移到未见翻译器和不同形式风格,并让智能体测试时算力分配的下游准确率提高 11.3 个百分点。 批判点评:生成式验证器比二元 verdict 更细,但它把“忠实性”重新交给学习模型,不能替代求解器的形式保证。若参考形式化有误、问题允许多种合理解释,等价性标签本身也会变得含糊。 10. X-AuT:音频塔减20.7%参数 X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation | 小鹏汽车 | arXiv:2609.11412 关键词:语音大模型,模型压缩,跨尺度蒸馏,音频编码器 前序问题:直接删除语音大模型的音频编码层虽能降延迟,却会扰动送入语言解码器的表示,造成漏字和过早结束;逐层试错成本又很高。 本文贡献:X-AuT 先用短行为探针筛选可删层组合,再逐步从 18 层压到目标深度;恢复阶段同时做表示对齐、跨尺度蒸馏、按计划切换学生策略监督和 LoRA 微调,语言主干保持冻结。 实验效果:Qwen3-ASR-0.6B 从 18 层压到 16 层后,十个中英基准宏平均错误率从 5.61% 降到 5.27%;14 层模型减少 20.7% 音频塔参数,错误率为 5.75%。渐进式 18→14 优于直接剪枝的 6.73%,1.7B 教师蒸馏为 5.55%,也优于自蒸馏的 8.45%。 批判点评:方法给出两个实用压缩点,但流程包含探针、分阶段剪枝、教师蒸馏和 LoRA,训练链条并不轻。语言主干冻结有利于稳定,也限制了模型共同适应严重音频压缩的空间。 趋势观察 生成与理解继续合并底层表征 SenseNova-U1.5去掉视觉编码器和VAE,把像素重建、语言理解、图像生成与编辑放进同一原生主干,统一模型的竞争开始深入到最底层视觉接口。 视频模型从离线片段走向实时世界 Vidu S2把720p Avatar和流式编辑推到25–42 FPS,World in World则用冻结骨干支持任意视角探索;实时交互、换镜头和长时记忆正在合流。 评测开始追踪过程而非只看终点 MindTopo要求动作过程保持拓扑,Mr.LHDR检查依赖链中间结论,IdeaAMBIG定位实现规格缺陷:一个看似正确的最终答案已不足以代表系统可靠。 后训练信号变得更细也更反直觉 NSD让模型远离坏推理,GenV把形式等价性蒸馏成连续奖励;相比简单模仿正确答案,新的对齐方法更关注错误来自哪个token、哪一步和哪种结构。 人工智能炼丹君 整理 | 2026-09-14 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|从 DPO 到 GRPO:去掉价值网络-GRPO 从 DPO 到 GRPO:去掉价值网络 所属方向:对齐与强化学习 | 难度:进阶 | 前置知识:PPO 关键词:DPO、GRPO、偏好优化、组内归一化、免价值网络、参考模型 01. 为什么需要它 把一个 7B 语言模型接进 PPO-RLHF,训练栈很快会变成四个模型:负责生成的 actor、预测每个 token 未来回报的 critic、限制策略漂移的 reference model,以及把整条回答变成分数的 reward model。真正更新参数的是 actor 和 critic,后两者虽然通常冻结,前向和显存仍要付钱。 critic 是最难解释的一笔成本。语言模型往往只在回答结束时拿到一个总分,但 value head 必须给回答中每个 token 估计未来回报。它不但要和 actor 同量级地跑前向、反向,还要从稀疏的终局信号中学习密集价值。DeepSeekMath 指出,LLM 的 value model 通常与 policy model 规模相当,这正是 GRPO 要删除的部件。 以全参数 AdamW 的粗略账本为例:7B 参数的 BF16 权重约 14 GB,BF16 梯度约 14 GB,FP32 主权重和两份动量约 84 GB,一个可训练模型合计约 112 GB 逻辑状态,实际会被 ZeRO/FSDP 分片。再训练一套同规模 critic,等于再背一次参数、梯度、优化器状态和激活。删掉 critic 的收益很大,但不能机械地说“所有训练都便宜十倍”:GRPO 每个 prompt 要在线生成一组回答,DeepSeekMath 的实验组大小是 64,采样和奖励打分可能成为新的主成本。 DPO 与 GRPO 给了两条不同的减法路线。DPO 把带 KL 约束的 RLHF 目标改写成偏好二分类,训练时不再在线采样,也不需要显式奖励模型;GRPO 保留在线探索和奖励信号,用同一道题的组内相对分数替代 critic。二者名字相邻,解决的却不是同一个问题。 图 1:DPO 省掉显式奖励模型和在线 RL 循环,GRPO 省掉 critic。Policy 与 reference 是否共享底座、reward 是规则还是模型,会继续改变真实成本。 02. 最小可用理解 先记住五句话: DPO 吃离线偏好对:同一 prompt 下给一个 chosen 和一个 rejected,直接提高 chosen 相对 reference 的概率优势。 GRPO 吃在线样本组:同一 prompt 采样 $G$ 个回答,打分后用组均值当 baseline,不训练 value model。 GRPO 沿用 PPO 的概率比与 clip:它只换了优势估计,没有丢掉“旧策略采样、新策略更新”这套框架。 reference 不是 critic:reference 负责限制长期漂移,critic 负责估计当前状态的未来回报;删掉 critic 后 reference 通常还在。 组内相对分数只回答谁更好:如果一组答案同分,GRPO 在这道题上没有方向;如果奖励尺度跨题不一致,组内归一化反而能消掉尺度差。 因此,从 DPO 到 GRPO 不是把一个损失函数逐项变形为另一个,而是从“离线比较学习”切换到“在线生成、在线评价”。选择算法时先问数据来自哪里,再问显存够不够。 03. 数学推导 3.1 PPO-RLHF 的起点 对 prompt $x$ 和回答 $y$,标准 KL 正则化目标可以写成: $$\max_{\pi}\ \mathbb{E}_{y\sim\pi(\cdot\mid x)}[r(x,y)]-\beta D_{KL}[\pi(\cdot\mid x)\|\pi_{ref}(\cdot\mid x)]$$ $\pi$ 是待训练策略,$\pi_{ref}$ 是固定参考策略,$r(x,y)$ 是回答奖励,$\beta$ 控制策略离参考模型多远。PPO 用采样轨迹、critic 优势和裁剪目标近似优化它。这里至少要维护 actor、critic 和 reference;若奖励由神经网络给出,还要运行 reward model。 3.2 DPO 如何把奖励塞回策略 上面的目标对每个 $x$ 都有闭式最优策略: $$\pi^*(y\mid x)=\frac{1}{Z(x)}\pi_{ref}(y\mid x)\exp\left(\frac{r(x,y)}{\beta}\right)$$ $Z(x)$ 是归一化常数。把式子移项,可把奖励写成策略与参考策略的对数概率比: $$r(x,y)=\beta\log\frac{\pi^*(y\mid x)}{\pi_{ref}(y\mid x)}+\beta\log Z(x)$$ 偏好数据给出同一 prompt 下的胜者 $y_w$ 与败者 $y_l$。用 Bradley-Terry 模型表示“胜者更好”的概率: $$P(y_w\succ y_l\mid x)=\sigma(r(x,y_w)-r(x,y_l))$$ 把上一式代入后,同一道题共享的 $\beta\log Z(x)$ 自动相消。用可训练策略 $\pi_\theta$ 代替未知最优策略,得到 DPO 损失: $$\mathcal{L}_{DPO}=-\mathbb{E}\log\sigma\left(\beta\left[\log\frac{\pi_\theta(y_w\mid x)}{\pi_{ref}(y_w\mid x)}-\log\frac{\pi_\theta(y_l\mid x)}{\pi_{ref}(y_l\mid x)}\right]\right)$$ 括号里有两层差。第一层是 chosen 与 rejected 的差;第二层是当前 policy 相对 reference 的差。只让 policy 提高 chosen 概率还不够,它提高的幅度必须超过 reference 原本已有的偏好。 DPO 的省钱来自训练协议:偏好对提前收集好,训练循环只做似然计算和二分类,不需要当前策略在线生成回答,也不需要在循环里调用显式 reward model。但代价也在这里:数据分布被固定。策略更新后会产生哪些新错误,旧偏好集未必覆盖。 3.3 PPO 的 critic 到底提供了什么 PPO 的优势通常来自 critic: $$A_t=Q(s_t,a_t)-V_\phi(s_t)$$ $V_\phi(s_t)$ 预测从当前 token 前缀继续生成的平均回报。减去它不会改变策略梯度的期望,却能降低方差。问题是,回答只在末尾拿到 $r(x,y)$,critic 却要在每个位置给出估计;它要学习的目标本身就很噪。 如果暂时不追求每个 token 的状态价值,而是对同一道题一次采 $G$ 个完整回答,就能用样本组构造另一种 baseline。 3.4 GRPO 的组内相对优势 从旧策略 $\pi_{old}$ 对同一 prompt $x$ 采样回答 $\{y_1,\ldots,y_G\}$,奖励为 $\{r_1,\ldots,r_G\}$。Outcome supervision 下,GRPO 定义: $$\hat A_i=\frac{r_i-\mathrm{mean}(r_1,\ldots,r_G)}{\mathrm{std}(r_1,\ldots,r_G)+\epsilon}$$ $\epsilon$ 防止标准差为零时除零。均值把“这道题本来容易还是难”扣掉,标准差把不同题目的奖励尺度拉到接近一致。对一条回答里的每个有效 token,原始 GRPO 都广播同一个 $\hat A_i$:得分高于组均值的回答整体增概率,低于均值的整体降概率。 图 2:两道题的原始 reward 尺度相差很大,组内标准化后各自在零均值参照系里比较。被保留的是同题回答间的相对好坏。 组均值包含样本自身,并不满足“baseline 与本次动作独立”的条件。对固定 prompt 的独立同分布样本,若只减组均值而不除标准差,有 $E[(r_i-\bar r)\nabla\log\pi(y_i)]=(1-1/G)\nabla J$;leave-one-out 均值可去掉这项缩放。再除随机组标准差会改变样本及 prompt 权重,因此完整 GRPO 不能宣称是原始期望奖励梯度的无偏估计。 这不是免费午餐。$G$ 太小时,组均值和标准差很不稳定;奖励全相等时,优势全部为零;同一回答的所有 token 共用一个结果优势时,算法知道“整条回答好”,却不知道哪一步推理真正立功。 3.5 GRPO 仍然是 PPO 家族 对回答 $y_i$ 的第 $t$ 个 token,定义新旧策略概率比: $$\rho_{i,t}(\theta)=\frac{\pi_\theta(y_{i,t}\mid x,y_{i,<t})}{\pi_{old}(y_{i,t}\mid x,y_{i,<t})}$$ GRPO 沿用 PPO-Clip 的保守替代目标,并直接在 loss 上加 reference KL: $$\mathcal{J}_{GRPO}=\mathbb{E}\left[\frac{1}{G}\sum_i\frac{1}{|y_i|}\sum_t\left(\min\left(\rho_{i,t}\hat A_i,\mathrm{clip}(\rho_{i,t},1-\varepsilon,1+\varepsilon)\hat A_i\right)-\beta D_{KL}(\pi_\theta\|\pi_{ref})\right)\right]$$ $\pi_{old}$ 是本轮 rollout 的采样快照,用于纠正同一批数据被重复更新后的分布偏移;$\pi_{ref}$ 是行为锚点,用于限制训练全过程的长期漂移。两者在训练刚开始可能数值相同,但职责不同,不能混用。 DeepSeekMath 使用的单样本 KL 正值估计器是: $$D_{KL}=\exp(\Delta)-\Delta-1,\quad \Delta=\log\pi_{ref}-\log\pi_\theta$$ 因为对任意实数 $\Delta$ 都有 $e^\Delta\geq1+\Delta$,这个量非负。在实现里它可以直接由采到 token 的 policy/reference logprob 计算,不必枚举整个词表。它的期望等于 $D_{KL}(\pi_\theta\|\pi_{ref})$ 的前提是动作从当前 $\pi_\theta$ 采样;实际 rollout 来自 $\pi_{old}$,更新后直接平均得到的是旧采样分布下的代理量,需要相应重要性校正才有同一无偏解释。 3.6 DPO 与 GRPO 的统一观察 DPO 和 GRPO 都在做“相对比较”,但参照物不同: 维度 DPO GRPO 数据 固定的 chosen/rejected 对 当前策略在线生成的一组回答 相对量 policy 相对 reference 的偏好间隔 回答奖励相对同组均值 删除的部件 显式 reward model 与在线 RL 循环 critic/value model 仍需保留 policy、reference、偏好数据 policy、old policy logprob、reference、奖励函数 主要风险 离线数据覆盖不足 采样昂贵、组内同分、奖励投机 这张表也解释了为什么“DPO 之后再做 GRPO”可以成立:先用便宜的离线偏好对把策略推到合理区域,再用在线 GRPO 探索当前策略真正会生成的回答。但这是一种训练安排,不是数学上必须的前后继关系。 3.7 手算一组 DPO 和 GRPO 先看 DPO。设第一对样本中,当前 policy 对 chosen 和 rejected 的整句 logprob 分别为 -2.2 和 -2.8,因此 policy 的偏好间隔是 0.6;reference 对二者的 logprob 分别为 -2.0 和 -2.4,偏好间隔是 0.4。当前策略相对 reference 多出来的间隔只有 0.2。当 $\beta=0.1$ 时,送进 sigmoid 的 logit 是 0.02,胜者概率只略高于 0.5,loss 接近随机猜测的 $\log 2$。 这解释了一个常见现象:chosen 的 logprob 即使很低,也不代表 DPO 一定给它很大梯度。DPO 看的是四个 logprob 组成的相对差。若 reference 已经强烈偏爱 chosen,而 policy 只复制了这种偏好,DPO 不会把它误判成新的进步;若 policy 相比 reference 反而缩小了 chosen 的优势,logit 会变负,损失上升。 再看 GRPO。第一组奖励是 [0.2, 0.8, 1.4, 0.6],均值为 0.75,标准差约为 0.433。标准化后得到 [-1.2699, 0.1154, 1.5008, -0.3463]。第二个回答虽然原始分数 0.8 看上去不高,但它略高于同题平均,因此得到很小的正优势;第三个回答比平均高很多,得到最大的正优势。 假设这四条回答更新后的 token ratio 依次是 [1.2840, 1.1052, 0.7788, 0.9048],裁剪区间为 [0.8,1.2]。第一条优势为负,而 ratio 大于 1,说明坏回答变得更可能,目标必须继续惩罚,不能裁掉。第二条优势为正且 ratio 在区间内,正常提供正向梯度。第三条优势为正但 ratio 低于 0.8,说明好回答被错误降权,目标同样继续惩罚。第四条优势为负且 ratio 在区间内,也正常提供降低概率的梯度。 真正被截住的是“已经朝正确方向走过头”的两种情况:正优势回答的 ratio 超过 1.2,或负优势回答的 ratio 低于 0.8。PPO/GRPO 的 clip 从来不是把所有 ratio 强制塞进区间,而是停止奖励过度乐观的改进。只看 np.clip(ratio) 而不把优势符号放进来,几乎一定会误读目标。 04. 代码实现 code/dpo_grpo_minimal.py 只依赖 NumPy,包含三部分:DPO 二分类损失、GRPO 的组内优势与裁剪损失,以及一个四动作 bandit 的在线训练。实际运行输出如下: 两张解释图由 code/make_figures.py 从文中的固定数值直接生成,图和公式使用同一组奖励,避免手工绘图与代码结果不一致。 === DPO === pair_shape=(2,) preference_logits=[0.02 0.03] loss=0.6807 === GRPO group baseline === rewards.shape=(2, 4) advantages= [[-1.2699 0.1154 1.5008 -0.3463] [-1.2648 -0.6324 0.6324 1.2648]] row_mean=[-0. 0.] === GRPO clipped objective === token_logps.shape=(4, 3) ratio_first_token=[1.284 1.1052 0.7788 0.9048] mean_kl=0.018550, loss=0.1626 奖励张量形状是 [prompt, generation] = [2, 4]。每行优势的均值都为零,说明每道题自己形成 baseline。裁剪例子里第一条优势为负而 ratio 为 1.284,第三条优势为正而 ratio 为 0.7788:二者都朝错误方向越界,因此 min 保留未裁剪项以继续惩罚。另两条 ratio 在区间内。这四条回答都没有进入裁剪收益的平台分支,与 3.7 节一致。 bandit 有四个回答动作,真实奖励分别是 [-0.2, 0.3, 1.0, 0.0]。脚本不训练 critic,每轮只采 32 个动作、组内标准化奖励,再用两轮 PPO 式更新复用这组样本: step P(a0) P(a1) P(a2=best) P(a3) 1 0.2288 0.2494 0.2883 0.2335 20 0.0210 0.0346 0.9179 0.0265 40 0.0048 0.0064 0.9833 0.0055 80 0.0026 0.0035 0.9906 0.0033 第 80 步时,最优动作概率从 0.25 升到 0.9906。这个实验展示的是组 baseline 能提供正确梯度,不代表大模型会如此平滑:真实回答空间巨大,奖励噪声、长度与采样温度都会改变结果。 05. 工业级实现对照 本文人工核对了 Hugging Face TRL 的 GRPOTrainer,以 2026-09-13 的主分支提交 cd2c528 为准。生产实现比论文公式多出几层防护: 奖励函数全返回空值的回答会标成 NaN,从组均值中排除,随后把优势置零,避免“不可评分”被误当成零奖励。 scale_rewards 支持按 group、batch 或不缩放;多目标奖励还可以“先加权求和再归一化”或“各目标先归一化再求和”。两者表达的偏好并不一样。 importance sampling 可以按 token 或 sequence 计算。长回答里 token 级 ratio 连乘会很不稳定,序列级方案则改变了权重粒度。 loss 已不止原始 grpo,还包括 bnpo、dr_grpo、dapo 等不同归一化方式。它们主要在回答长度和 batch/token 归一化上修补偏差。 使用 vLLM 生成时,推理引擎与训练模型的 logprob 可能有数值差异,框架提供额外 importance-sampling correction。 PEFT 场景可在同一底座上挂训练 adapter 与 reference adapter,减少复制完整模型的显存。 最值得监控的日志不是单独一个 reward,而是:组内 reward 标准差为零的比例、clip ratio、KL、回答长度、每种 reward 的均值与方差。如果 reward 上升同时长度暴涨、KL 激增或同分组变多,训练可能在钻评分规则的空子。 工程上还要区分三种 mask:prompt token 不应进入 completion loss,padding token 不应参与平均,工具调用或环境交互产生的非策略 token 也不该伪装成策略动作。mask 错一个维度,代码仍可能正常运行,但 loss 的分母已经变了。 5.1 一次工业 GRPO update 的数据流 第一步是挑 prompt。随机抽题看似公平,但大量过易题会产生“全对组”,大量过难题会产生“全错组”,两者都没有组内方差。生产系统通常会维护题目通过率、奖励方差和最近采样时间,让训练 batch 更多覆盖当前策略刚好有分歧的区域。 第二步是冻结采样快照。系统保存 $\pi_{old}$ 的版本标识,并为每个 prompt 生成 $G$ 条 completion。若用独立 vLLM 服务生成,必须记录推理引擎返回的 token id、mask 和 logprob;只保存文本再重新 tokenize,特殊 token、空格或聊天模板差异都可能让动作序列错位。 第三步是评分。规则验证器适合数学答案、代码测试和工具任务;神经 reward model 适合帮助性、风格和主观质量。多个奖励合并时要先决定是“先加权再组内归一化”,还是“每种奖励各自归一化再加权”。前者保留权重指定的绝对尺度,后者让每种奖励先取得相近话语权。 第四步计算 group statistics。分布式训练里,同一 prompt 的 $G$ 条回答可能散在不同 GPU 上,均值和标准差必须在完整组上聚合。若每张卡只看本地子组,baseline 会随数据切分改变;同一实验换一个 GPU 数就可能得到不同梯度。 第五步计算当前 policy 与 reference 的 token logprob。old_logprob 必须保持 rollout 时的值,不能在每个优化 epoch 重算;reference_logprob 可以预计算并缓存,也可以通过冻结模型或禁用 LoRA adapter 得到。三种 logprob 看着形状相同,来源却完全不同。 第六步形成 per-token loss。Outcome reward 把回答级优势广播到有效 completion token,再乘 ratio、做 clip、加 KL。随后按 mask 归一化。先对每条序列取平均再对 batch 平均,会让长短回答权重相近;直接对全 batch token 求平均,则长回答贡献更多。两种都能运行,但优化目标不同。 第七步更新并监控。一次 rollout 可做有限个优化 epoch,随后必须重新采样。应同时记录 reward、组内标准差、zero-std 比例、KL、clip fraction、回答长度和吞吐量。只有 reward 上升而这些量失控时,不能把结果叫作训练成功。 5.2 六个不会报错却会训歪的实现细节 分组边界错位。 假设 batch 排列本应是“题目 A 的八条回答、题目 B 的八条回答”,数据加载器却在聚合前打乱了 completion,view(-1, G) 仍然合法,均值却混合了不同题目。最可靠的做法是保留 prompt id,计算优势前断言每个连续组的 id 完全相同,分布式 gather 后再断言每题正好有 $G$ 条记录。 把样本标准差和总体标准差混着用。 NumPy 的 std 默认分母是 $G$,PyTorch 某些接口曾默认用 $G-1$。组很大时差别不明显,$G=2$ 或 4 时会明显改变优势幅度。公式、最小实现和训练框架必须约定同一个定义,日志里也应记录原始 reward,而不是只保留标准化后的值。 先逐卡归一化再全局聚合。 数据并行下每张卡只拿到同一题的一部分回答,如果先在本地求均值,结果取决于回答被分到哪张卡。正确顺序是先收集完整组的 reward,再统一计算统计量,最后切回各进程需要的那一段优势。 生成文本与训练 token 不一致。 推理服务可能自动补聊天模板、合并空白、提前截断,训练端重新编码字符串后得到另一串 token。此时旧策略 logprob 与当前策略 logprob 对应的动作不同,ratio 已经失去意义。rollout 应把 token ids 视作主数据,文本只用于评分和审计;恢复训练时也要保留 tokenizer 与 chat template 版本。 长度归一化悄悄改变偏好。 若每条回答先按自身长度求 token loss 均值,短回答和长回答各占一个样本权重;若整个 batch 按 token 总数求均值,长回答天然贡献更多。再叠加“回答越长越可能碰到一次正确步骤”的 reward,模型可能学会延长推理。应同时画 reward 对长度的散点图,并用长度分桶比较通过率。 奖励器和策略一起漂移。 在线迭代训练 reward model 时,今天的 0.8 与上周的 0.8 可能不是同一尺度。组内归一化能消掉部分仿射漂移,却消不掉排序规则改变。需要保留固定校准集和冻结的旧奖励器,周期性比较新旧排序一致率;否则策略看似持续提高,其实只是追着变化的裁判跑。 最后还要保存可恢复状态:policy、optimizer、scheduler、reference 版本、rollout 生成参数、reward 版本和数据游标缺一不可。只保存 actor 权重可以用于推理,却无法保证训练恢复后仍在优化同一个目标。GRPO 少了 critic checkpoint,但并没有把实验追踪简化成一个模型文件。 06. 代价与边界 删掉 critic,省下的是真实成本。 全参数训练时少一套同规模可训练状态和激活;LoRA 或 ZeRO 下绝对节省会变化,但工程链路仍少了 value target、value loss、value clipping 与 critic checkpoint。 组采样把成本转移到生成端。 GRPO 必须对同一 prompt 采多个回答。推理较长、组大小较大或 reward model 很重时,rollout 可能比 critic 更贵。适合有便宜可验证奖励的数学、代码和工具任务;对主观写作、开放式对话,可靠打分本身就是难题。 组内归一化丢掉跨题绝对难度。 一道题的最高分只有 0.2,另一道题四个答案都超过 0.9,标准化后仍可能产生相似幅度的优势。前者也许是奖励器不可靠或题目不可解,却会得到同等更新权重。 同分会让梯度消失。 二值正确性奖励在策略已经很强或很弱时尤其明显:一组全对或全错,标准差接近零。这时增加组大小、提高采样温度、设计更细奖励或主动挑选处在学习边界的 prompt,比盲目调学习率更有效。 Outcome reward 的信用分配很粗。 一条 2000-token 推理只拿一个终局优势,每个 token 被同方向推动。过程奖励可以细化信号,但会引入步骤标注、奖励模型偏差与“奖励器教模型写格式”的新问题。 reference KL 不能修复坏奖励。 KL 只限制走多远,不判断方向对不对。奖励函数偏爱冗长、套话或特定格式时,较小 KL 只是让投机变慢。 6.1 什么时候选 DPO,什么时候选 GRPO 如果手里已经有高质量 chosen/rejected 数据,生成和人工标注又很贵,DPO 通常是更稳的第一步。它像普通监督训练一样容易批处理,失败时也容易回查是哪一对偏好造成梯度。它尤其适合风格、安全边界、回答格式这类可以提前整理成对的数据。 如果任务能自动验答案,而且策略必须靠探索发现新解法,GRPO 更合适。数学最终答案、代码单元测试、工具调用结果和可执行环境都能提供相对便宜的在线奖励。此时 critic 很难从稀疏终局分数学习每个 token 的价值,组 baseline 的简化更有吸引力。 如果奖励高度主观、每条回答又很长,两者都不会自动解决问题。DPO 受限于离线偏好覆盖,GRPO 受限于奖励模型可靠性和 rollout 成本。常见组合是 SFT 打基础、DPO 吸收稳定的人类偏好、GRPO 在可验证子任务上继续在线探索,最后再用独立评测检查能力回退。 做预算时至少拆成四项:训练模型状态、冻结模型前向、在线生成 token 数、奖励评估次数。只比较“有几个模型”会漏掉 GRPO 的采样账;只比较“每步生成多少 token”又会漏掉 PPO critic 的反向和优化器状态。把四项分别量出来,才能判断删掉 critic 是否真的让当前系统便宜了一个量级。 还有一笔常被忽略的是通信。PPO 的 critic 若与 actor 分开部署,需要在 rollout、价值推理和更新之间搬运 token、mask、value 与 advantage;若与 actor 共卡,又会争夺显存和计算流。GRPO 把 value 请求换成组统计,统计量只是一组标量,通信链更短。可是一旦奖励模型远程部署,$G$ 条回答仍要跨服务传输并等待评分。优化时应测端到端每步墙钟时间,把生成、评分、训练和等待分别打点;单看 GPU 峰值显存,很容易把“省显存”误写成“省总成本”。 评估也要和训练奖励解耦。至少准备一套不参与更新的题目、一个不同实现的验证器,以及人工抽查样本。训练奖励与独立评测同时上升,才说明策略能力可能真的提高;只有训练奖励上涨,最多能证明优化器成功找到了当前评分函数偏爱的输出。对推理模型还应分别统计最终答案、推理有效性、格式合规和长度,避免一个聚合分数掩盖能力回退。 这些记录也是定位回归、比较算法和复现实验的最低证据。 07. 经典论文脉络 Proximal Policy Optimization Algorithms(arXiv:1707.06347,2017)提出可多轮复用 rollout 的裁剪替代目标,是 GRPO 概率比与 clip 的直接来源。 Direct Preference Optimization(arXiv:2305.18290,2023)利用 KL 正则化 RLHF 的闭式最优策略,把偏好学习变成二分类,训练阶段绕开在线 RL。 DeepSeekMath(arXiv:2402.03300,2024)正式提出 GRPO,用同题多回答的组分数替代 value model;7B 实验中 GSM8K 从 82.9% 提升到 88.2%,MATH 从 46.8% 提升到 51.7%。 DeepSeek-R1(arXiv:2501.12948,2025)把大规模 GRPO 推到长链推理与可验证奖励场景,也让组内相对优化成为推理模型训练的常用基线。 这些数字来自各论文自己的设置,不能跨模型直接比较。DPO 的优势在训练简单,GRPO 的优势在能跟随当前策略在线探索;算法名本身不决定最终能力。 08. 常见误解 “GRPO 不需要奖励模型。” 错。GRPO 不需要 critic,但必须有奖励信号。奖励可以是神经 reward model、规则验证器、单元测试或多个评分器的组合。 “DPO 和 GRPO 都去掉 value,所以是一回事。” DPO 通过重参数化绕开整套在线 RL;GRPO 仍是 policy-gradient 方法,只把优势 baseline 从 learned value 换成 group statistics。 “组均值就是无偏的真实价值函数。” 组均值只是当前策略、当前 prompt、当前采样温度下的 Monte Carlo baseline。它会随组大小和采样分布变化,不是对所有状态都可查询的 $V(s)$。 “归一化后奖励尺度不重要。” 组内仿射变换会被抵消,但排序错误、同分、异常值和多目标权重仍会改变梯度。reward design 依然是核心工作。 “去掉 critic 就一定便宜十倍。” 不成立。删掉一个同规模可训练模型可能显著降低显存和通信,但 GRPO 增加了组采样。总成本取决于序列长度、组大小、reward 推理、并行方式和是否使用 LoRA。 “clip 能保证 KL 很小。” clip 只截断采样动作上的替代收益;共享参数更新仍可能让未采到 token 的分布大幅变化,所以工程实现仍单独监控或惩罚 KL。 09. 动手验证 在仓库目录运行: python3 outputs/fundamentals_files/dpo_grpo/code/dpo_grpo_minimal.py 可以做四个改动观察边界: 把 group_size=32 改成 2,多换几个 seed。预期收敛抖动明显增大,有时一组采不到最优动作。 把 reward_table 改成四个相同值。预期标准差为零,优势接近零,策略不再学习。 把最好动作奖励从 1.0 改成 0.31,使它只比第二名高 0.01。预期需要更多样本才能稳定区分。 把 beta 从 0.02 提到 0.5。预期策略更贴近均匀 reference,最优动作概率上升更慢、上限更低。 再做一个 DPO 对照:交换 policy_chosen 与 policy_rejected,观察 preference logit 变负、loss 变大。它说明 DPO 优化的是相对 reference 的 chosen/rejected 间隔,而不是 chosen 的绝对 logprob。 10. 延伸阅读 读这篇之前建议先看: 策略梯度与 PPO 基础:优势估计、概率比和 clip 的完整推导。 读完这篇可以继续看: 把 RL 用到扩散模型上(DiffusionRL):把多步去噪改写成 MDP 轨迹。 视频生成中的强化学习与奖励模型:GRPO 进入视觉生成后,采样成本、时序奖励与 reward hacking 如何变化。 附录:完整代码 09 节用到的脚本全文如下(dpo_grpo_minimal.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 dpo_grpo_minimal.py """DPO 与 GRPO 的最小可运行实现。 运行:python3 dpo_grpo_minimal.py 只依赖 NumPy,不需要模型权重或外部数据。 """ import numpy as np def log_sigmoid(x): """数值稳定的 log(sigmoid(x))。""" return -np.logaddexp(0.0, -x) def dpo_loss(policy_chosen, policy_rejected, ref_chosen, ref_rejected, beta=0.1): """DPO 二分类损失;四个输入都是整条回答的对数概率。""" policy_gap = policy_chosen - policy_rejected reference_gap = ref_chosen - ref_rejected logits = beta * (policy_gap - reference_gap) return -log_sigmoid(logits).mean(), logits def group_advantages(rewards, eps=1e-4): """对同一 prompt 的 G 个奖励做组内中心化和标准化。""" mean = rewards.mean(axis=1, keepdims=True) std = rewards.std(axis=1, keepdims=True) return (rewards - mean) / (std + eps) def grpo_loss(new_logps, old_logps, ref_logps, advantages, mask, clip_eps=0.2, beta=0.04): """Outcome-supervision GRPO:一条回答的优势广播给它的全部 token。""" log_ratio = new_logps - old_logps ratio = np.exp(log_ratio) clipped_ratio = np.clip(ratio, 1 - clip_eps, 1 + clip_eps) advantage_per_token = advantages[:, None] surrogate = np.minimum( ratio * advantage_per_token, clipped_ratio * advantage_per_token, ) # DeepSeekMath 使用的正值 KL 估计器:exp(x) - x - 1,其中 x=log pi_ref-log pi。 ref_gap = ref_logps - new_logps per_token_kl = np.exp(ref_gap) - ref_gap - 1 per_token_loss = -surrogate + beta * per_token_kl sequence_loss = (per_token_loss * mask).sum(axis=-1) / mask.sum(axis=-1) return sequence_loss.mean(), ratio, per_token_kl def softmax(logits): shifted = logits - logits.max() exp_logits = np.exp(shifted) return exp_logits / exp_logits.sum() def train_group_bandit(steps=80, group_size=32, seed=7): """用 GRPO 训练四选一 bandit,展示无 critic 的在线更新。""" rng = np.random.default_rng(seed) logits = np.zeros(4, dtype=np.float64) reference_logits = np.zeros(4, dtype=np.float64) reward_table = np.array([-0.2, 0.3, 1.0, 0.0]) lr, clip_eps, beta = 0.18, 0.2, 0.02 snapshots = [] for step in range(steps): old_logits = logits.copy() old_probs = softmax(old_logits) actions = rng.choice(4, size=group_size, p=old_probs) rewards = reward_table[actions] advantages = (rewards - rewards.mean()) / (rewards.std() + 1e-4) old_selected = np.log(old_probs[actions]) ref_probs = softmax(reference_logits) ref_selected = np.log(ref_probs[actions]) # 同一组 rollout 做两轮 PPO 式复用;old_logprob 始终来自采样快照。 for _ in range(2): probs = softmax(logits) new_selected = np.log(probs[actions]) ratio = np.exp(new_selected - old_selected) active = ~(((advantages >= 0) & (ratio > 1 + clip_eps)) | ((advantages < 0) & (ratio < 1 - clip_eps))) # d[-min(rA, clip(r)A)]/d log pi,以及采样 KL 项的导数。 coefficient = -active.astype(np.float64) * ratio * advantages ref_gap = ref_selected - new_selected coefficient += beta * (1 - np.exp(ref_gap)) one_hot = np.eye(4)[actions] grad_logp = one_hot - probs[None, :] grad_logits = (coefficient[:, None] * grad_logp).mean(axis=0) logits -= lr * grad_logits if step in {0, 19, 39, 79}: snapshots.append((step + 1, softmax(logits).copy())) return snapshots if __name__ == "__main__": np.set_printoptions(precision=4, suppress=True) policy_chosen = np.array([-2.2, -1.7]) policy_rejected = np.array([-2.8, -2.1]) ref_chosen = np.array([-2.0, -1.9]) ref_rejected = np.array([-2.4, -2.0]) loss_dpo, logits_dpo = dpo_loss( policy_chosen, policy_rejected, ref_chosen, ref_rejected ) print("=== DPO ===") print(f"pair_shape={policy_chosen.shape}") print(f"preference_logits={logits_dpo}") print(f"loss={loss_dpo:.4f}") rewards = np.array([[0.2, 0.8, 1.4, 0.6], [8.0, 9.0, 11.0, 12.0]]) advantages = group_advantages(rewards) print("\n=== GRPO group baseline ===") print(f"rewards.shape={rewards.shape}") print(f"advantages=\n{advantages}") print(f"row_mean={advantages.mean(axis=1)}") old_logps = np.log(np.array([ [0.30, 0.25, 0.20], [0.18, 0.22, 0.20], [0.12, 0.16, 0.20], [0.25, 0.20, 0.18], ])) new_logps = old_logps + np.array([ [0.25, 0.25, 0.25], [0.10, 0.10, 0.10], [-0.25, -0.25, -0.25], [-0.10, -0.10, -0.10], ]) ref_logps = old_logps - 0.05 mask = np.ones_like(old_logps) one_group_adv = group_advantages(np.array([[0.2, 0.8, 1.4, 0.6]]))[0] loss_grpo, ratio, kl = grpo_loss( new_logps, old_logps, ref_logps, one_group_adv, mask ) print("\n=== GRPO clipped objective ===") print(f"token_logps.shape={new_logps.shape}") print(f"ratio_first_token={ratio[:, 0]}") print(f"mean_kl={kl.mean():.6f}, loss={loss_grpo:.4f}") print("\n=== Online group bandit ===") print("step P(a0) P(a1) P(a2=best) P(a3)") for step, probs in train_group_bandit(): print(f"{step:>4} " + " ".join(f"{p:.4f}" for p in probs)) make_figures.py """生成 DPO/GRPO 教程的两张解释图。""" from pathlib import Path import matplotlib.pyplot as plt import numpy as np from matplotlib.patches import FancyBboxPatch ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, }) def box(ax, x, y, w, h, text, color): patch = FancyBboxPatch( (x, y), w, h, boxstyle="round,pad=0.02,rounding_size=0.03", facecolor=color, edgecolor="white", linewidth=1.5, ) ax.add_patch(patch) ax.text(x + w / 2, y + h / 2, text, ha="center", va="center", fontsize=12, weight="bold", color="#182238") def method_map(): fig, axes = plt.subplots(1, 3, figsize=(14, 4.6), facecolor="#f7f9fc") methods = [ ("PPO-RLHF", [("偏好对", "#dbeafe"), ("奖励模型", "#fde68a"), ("在线采样", "#ddd6fe"), ("Actor + Critic", "#fecaca")], "奖励模型 + critic 都要维护"), ("DPO", [("离线偏好对", "#dbeafe"), ("二分类损失", "#bbf7d0"), ("Policy + Reference", "#ddd6fe")], "省掉显式奖励模型和在线 RL"), ("GRPO", [("同题多回答", "#dbeafe"), ("规则/奖励打分", "#fde68a"), ("组内相对优势", "#bbf7d0"), ("Policy + Reference", "#ddd6fe")], "保留在线采样,省掉 critic"), ] for ax, (title, blocks, note) in zip(axes, methods): ax.set_xlim(0, 1) ax.set_ylim(0, 1) ax.axis("off") ax.set_title(title, fontsize=18, weight="bold", color="#172554", pad=14) gap = 0.08 h = (0.72 - gap * (len(blocks) - 1)) / len(blocks) y = 0.85 - h for text, color in blocks: box(ax, 0.12, y, 0.76, h, text, color) y -= h + gap ax.text(0.5, 0.03, note, ha="center", va="bottom", fontsize=11, color="#475569") fig.suptitle("三种对齐路线省掉的部件不同", fontsize=22, weight="bold", color="#0f172a", y=1.02) fig.tight_layout() fig.savefig(OUT / "alignment_method_map.png", bbox_inches="tight", facecolor=fig.get_facecolor()) plt.close(fig) def group_relative_plot(): rewards = np.array([[0.2, 0.8, 1.4, 0.6], [8.0, 9.0, 11.0, 12.0]]) advantages = (rewards - rewards.mean(1, keepdims=True)) / rewards.std(1, keepdims=True) fig, axes = plt.subplots(1, 2, figsize=(12, 4.8), facecolor="#f7f9fc") colors = ["#60a5fa", "#a78bfa", "#34d399", "#fb7185"] x = np.arange(4) for row, name in enumerate(["题目 A", "题目 B"]): axes[0].bar(x + (row - 0.5) * 0.18, rewards[row], width=0.18, label=name, color=colors[row]) axes[0].set_title("原始奖励不可跨题直接比较", fontsize=16, weight="bold") axes[0].set_xticks(x, [f"回答 {i+1}" for i in x]) axes[0].set_ylabel("reward") axes[0].legend(frameon=False) width = 0.34 axes[1].bar(x - width / 2, advantages[0], width=width, label="题目 A", color="#60a5fa") axes[1].bar(x + width / 2, advantages[1], width=width, label="题目 B", color="#a78bfa") axes[1].axhline(0, color="#334155", linewidth=1) axes[1].set_title("组内标准化只保留相对名次", fontsize=16, weight="bold") axes[1].set_xticks(x, [f"回答 {i+1}" for i in x]) axes[1].set_ylabel("advantage") axes[1].legend(frameon=False) for ax in axes: ax.spines[["top", "right"]].set_visible(False) ax.grid(axis="y", alpha=0.18) fig.suptitle("GRPO:每道题自己组成一个参照系", fontsize=21, weight="bold", color="#0f172a", y=1.02) fig.tight_layout() fig.savefig(OUT / "group_relative_advantage.png", bbox_inches="tight", facecolor=fig.get_facecolor()) plt.close(fig) if __name__ == "__main__": method_map() group_relative_plot() print(OUT / "alignment_method_map.png") print(OUT / "group_relative_advantage.png") 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-11|阿里13模型不会专业剪辑-CutCraft 今日 AIGC 论文速览 今日共 10 篇 · 音视频创作评测与安全 2 篇 · 可编程世界与物理视频 2 篇 · 生成后训练与统一多模态 2 篇 · 图像编辑与多视角生成 2 篇 · 设计自动化与合成数据 2 篇 重点论文标题列表 CutCraft(阿里巴巴、上海交通大学、复旦大学等):13模型不会专业剪辑 Programmable World Model(Alaya Lab):规则状态准确率98% ⚡ DIVA(Peng Li 等(ACM MM 2026)):参考图放大越狱风险 GGF(上海交通大学、中国电信人工智能研究院、中国科学技术大学):模型用自绘图反哺理解 FlowCPO(西湖大学、浙江大学、快手可灵团队):离线对齐GenEval达0.84 今日论文速览 1. CutCraft:13模型不会专业剪辑 Beyond Coherence: Benchmarking Professional Editing-Technique Execution in Multi-Shot Audio-Video Generation | 阿里巴巴、上海交通大学、复旦大学等 | arXiv:2609.08275 关键词:音视频生成,多镜头,剪辑评测,生成智能体 ⚠️ 前序问题:多镜头音视频模型已经能做出连贯、电影感强的片段,但现有评测多看画质、同步和物理合理性,无法判断模型是否真的执行了 J-cut、L-cut、转场时机和蒙太奇等专业剪辑指令。看起来像电影,不代表遵守了剪辑语法。 本文贡献:CutCraft 把结构化多镜头提示扩展为显式剪辑规格,并用镜头结构对齐、专家模型指标、工具化多模态判断和规则问答构成分层评测。作者还给出一个生成智能体基线:先规划镜头,再逐镜生成,最后做后期合成,使剪辑语义变成可执行步骤。 实验效果:对 13 个闭源与开源音视频生成模型的测试显示,当前系统普遍能维持内容连贯,却经常错过规定镜头数、转场关系和高阶蒙太奇;美学质量与剪辑指令遵循只有弱相关。智能体基线说明把剪辑拆成规划、生成和合成后更容易显式执行专业语法。 批判点评:混合评测仍依赖专家模型和多模态裁判,复杂剪辑意图可能被评分器误读。后期拼接能提升指令遵循,却可能掩盖底层生成模型不会原生控制镜头的问题;基准对真实剪辑师工作流、版权素材和长叙事的覆盖仍有限。 2. Programmable World Model:规则状态准确率98% Programmable World Model | Alaya Lab | arXiv:2609.10540 关键词:世界模型,视频生成,可编程状态,交互游戏 ⚠️ 前序问题:交互式视频世界模型能生成逼真的下一帧,却通常把角色生命值、阵营、库存和任务进度隐含在像素历史里。实体离开画面后,模型容易忘记它是否存活;自然语言提示也只能描述结果,无法保证规则在长时间交互中被稳定执行。 本文贡献:Programmable World Model 把世界状态演化与视觉生成拆开。编码智能体把自然语言规则写成可执行程序,轻量引擎维护包含屏外实体和非视觉属性的权威状态;状态增强的 3D 定向包围盒再经确定性编译器投影成身份、语义和运动方向控制图,预训练视频模型只负责把状态渲染成画面。 实验效果:在作者新建的 CombatStateBench 上,系统的存活角色数量准确率达到 94%,状态准确率达到 98%,并能在长时战斗交互中维持实体状态。它还支持用户预先编写游戏机制、逐个控制实体,并在镜头移开后继续保存世界事实。 批判点评:显式引擎让规则可验证,但也把开放世界压缩成包围盒、离散属性和手写转移规则;复杂物理、细粒度姿态与不可预设事件仍交给生成器补全。论文基准集中于战斗场景,面对大规模地图、多玩家并发和长期程序错误时的扩展性仍待验证。 3. DIVA:参考图放大越狱风险 The Price of Consistency: Exploiting Visual Anchors for Multimodal Jailbreaking in Video Generation | Peng Li 等(ACM MM 2026) | arXiv:2609.07216 关键词:视频生成,安全评测,多模态越狱,参考图控制 ⚠️ 前序问题:图生视频用参考图锁住主体和场景,提高时空一致性,但安全系统往往只重点审查文字。模型原本可能把危险提示漂移成无害内容,视觉锚点却会把生成过程拉回参考图中的危险意图,形成一致性越强、逃逸空间越小的安全悖论。 本文贡献:DIVA 是一个免训练多模态越狱框架,把危险意图拆成静态参考图和看似普通的运动提示,并用双重标准筛选兼顾隐蔽性与语义保真度的组合。论文同时提出 TI2VSafetyBench,用于专门评测多条件视频生成中的视觉锚定风险。 实验效果:作者在多家主流商业平台和开源视频模型上测试,DIVA 的攻击成功率显著高于纯文本攻击,说明只过滤提示词不足以覆盖图像与运动描述共同表达的风险。论文已被 ACM MM 2026 接收。 批判点评:攻击依赖先获得合适的危险参考图,现实系统还可能在上传、编码和输出阶段做二次视觉审核。公开越狱流程有双重用途风险;防御评估需要同时覆盖输入图、运动文本、跨模态组合和生成结果,且必须在平台更新后持续重测。 4. GGF:模型用自绘图反哺理解 Dreaming in Flow: Generative Grounding Feedback for Self-Evolving Unified Multimodal Models | 上海交通大学、中国电信人工智能研究院、中国科学技术大学 | arXiv:2609.08282 关键词:统一多模态,自训练,流模型,图像生成 ⚠️ 前序问题:统一多模态模型把理解和生成放进同一网络,却仍把两种能力当作独立任务训练。直接用模型自生成图像做自训练又会放大漏物体、属性错误和空间关系失真,缺少一种让生成经验反哺理解、再由理解修正生成的闭环。 本文贡献:生成接地反馈 GGF 只使用文本提示和模型自己的视觉梦境。流级反馈在同一噪声潜变量上比较文本、图像与修复条件的预测方向,把图像接地信息传回文本条件;梦境回放则通过描述和再想象,让可验证事实在两次生成间保持一致,并分离无关经验。 实验效果:在采用不同理解—生成融合设计的统一模型上,GGF 都带来一致的文生图提升,同时让视觉理解获得幅度较小但稳定的增益。方法不依赖额外成对图文数据,说明模型自身生成的图像可以成为双向训练信号。 批判点评:自生成经验仍受初始模型能力上限约束,流级一致不保证图像事实正确。回放和修复增加训练计算,如何过滤系统性偏见、避免错误闭环以及在闭源生成器上复现,仍是落地障碍。 5. FlowCPO:离线对齐GenEval达0.84 FlowCPO: A Unified Divergence View of Preference Alignment for Flow Models | 西湖大学、浙江大学、快手可灵团队 | arXiv:2609.09905 关键词:流模型,偏好对齐,离线优化,前向KL ⚠️ 前序问题:流与扩散模型的偏好对齐分成在线强化学习和离线偏好优化两派:前者必须不断从当前模型采样,成本高;后者常用正样本微调或似然比近似,既难解释与在线目标的关系,简化回归损失还可能无下界。 本文贡献:FlowCPO 用散度视角统一这些方法,并提出无需在线回滚的离线前向 KL 目标,同时利用偏好和拒绝样本。在线性插值及明确正则条件下,作者把前向 KL 上界化为可在固定数据上优化的对比流匹配损失,并证明该损失非负。 实验效果:在域内实验、CFG=3.0 时,FlowCPO 的平均 GenEval 与 OCR 分数分别为 0.84 和 0.87,高于 FlowDPO 的 0.81 和 0.74。域外测试中它取得最佳 GenEval,但多项奖励分数低于 RFT,结果并非全面领先。 批判点评:理论上界依赖线性插值和正则条件,真实大模型训练是否满足需要验证。离线数据省掉采样,却继承偏好数据覆盖与标注偏差;负样本权重、参考先验和插值系数也会带来额外调参成本。 6. PhysFlow:5万物理视频教会运动 PhysFlow: Physics-Aware Optical Flow for Motion Controllable Video Generation | 中科院自动化所、中国科学技术大学、北京航空航天大学、中关村学院 | arXiv:2609.08215 关键词:视频生成,物理一致性,光流,运动控制 ⚠️ 前序问题:视频生成器能做出漂亮纹理,却常出现碰撞错误、非刚体变形失真和前景背景接触不合理。完整物理引擎依赖准确 3D 重建和材料参数,文字或稀疏轨迹又不足以描述像素级形变,需要一种介于模拟状态和最终外观之间的密集运动表示。 本文贡献:PhysFlow 把生成拆成两步:PA-Flow 根据速度、加速度、密度和杨氏模量生成物理感知光流,分别建模全局运动与局部形变;FlowRender 再以光流视频为条件合成纹理。配套 PhysVideo 用物理引擎与 3D Gaussian Splatting 构建显式监督。 实验效果:PhysVideo 包含 1 万个前景物体和 5 万段带运动、材料属性标注的视频。实验显示 PhysFlow 在保持视觉质量的同时提升物理合理性,并能从单图处理非刚体运动、物体交互及前景背景接触。 批判点评:光流适合二维位移,却无法显式表达遮挡后的三维结构、拓扑变化和长期守恒量;两阶段误差也会累积。方法仍需用户或数据提供材料与运动属性,开放世界里这些参数通常难以可靠获得。 7. MIEdit:千组编辑基准无需调参 Multi-History-Step SDE Inversion for Image Editing with Superior Regional Awareness | 中科院自动化所、国科大(ECCV 2026) | arXiv:2609.06602 关键词:图像编辑,SDE反演,语义遮罩,免训练 ⚠️ 前序问题:免训练扩散编辑要在重建原图与服从新提示之间取舍。现有 ODE/SDE 反演步数多、编辑幅度受限,增大 CFG 还可能产生伪影;非编辑区域保护通常需要额外遮罩输入或独立分支。 本文贡献:MIEdit 用预测—校正的多历史步 SDE 反演,在每一步复用至少两个历史项,以更少步数提高稳定性和编辑可塑性;同时调整噪声日程缓解大幅编辑冲突。IASM 在反演早期借助 CFG 方向自动生成语义角度遮罩,并贯穿后续采样约束区域。 实验效果:作者构建 EditEval++,覆盖 30 个细粒度任务和超过 1,000 组图像—文本—遮罩三元组。实验显示 MIEdit 在无需微调、无需外部遮罩的条件下超过所比较方法,并能把输入重建到数值精度范围。论文已被 ECCV 2026 接收。 批判点评:多历史项会增加缓存与实现复杂度,自动遮罩质量仍依赖基础模型的 CFG 响应。论文主要围绕扩散 SDE 编辑,迁移到流匹配模型、超高分辨率和多对象关系编辑时是否稳定还未充分验证。 8. StreetDiff:全景约束街景多视角 StreetDiff: Multi-view Street Scenes Generation via Cross-view Consistent Multi-view Stable Diffusion with Structure Prompts | 深圳大学 | arXiv:2609.09890 关键词:多视角生成,街景,全景图,结构控制 ⚠️ 前序问题:多视角扩散在室内或简单自然场景表现不错,面对道路、建筑和动态目标密集的城市街景时,镜头旋转后容易重复物体、扭曲建筑和破坏布局。相邻视角注意力缺少球面几何对应,难维持全局结构。 本文贡献:StreetDiff 让全景分支负责全局布局、透视分支负责局部细节,并用 Panorama Alignment Module 按球面投影建立跨视角注意力约束。结构提示可来自分割图、轮廓或草图;作者还构建带文本和密集结构标注的 HDR 城市全景数据集 Street360。 实验效果:实验显示 StreetDiff 在街景生成质量和多视角几何一致性上超过所比较基线,尤其改善纯文本条件下的建筑与道路结构;它无需修改扩散骨干即可注入几何对齐。 批判点评:球面全景是有效的全局脚手架,但真实街区包含强遮挡、动态交通和大范围深度变化,二维投影约束仍可能失效。Street360 的地域与天气覆盖、从合成多视角到可导航 3D 场景的差距也需要检验。 9. LoGAN:少量字形扩展27种语言 LoGAN: Multilingual Font Localization with Generative Agents | Netflix(ECCV 2026) | arXiv:2609.07029 关键词:字体生成,多语言,VLM智能体,扩散模型 ⚠️ 前序问题:把一个品牌字体或电影 Logo 本地化到新语言,不只是生成单个字形,还要保留笔画风格、纹理、颜色、字距和字偶距。通用生图模型常改乱排版,传统字体生成又难从拉丁字母跨到结构复杂的中日韩字符。 本文贡献:LoGAN 用 VLM 智能体协调字形级扩散、少样本风格微调、字距与字偶距迁移以及纹理扩展模块。输入少量原字体字形或 Logo 字母后,系统分别解决结构、排版和材质,再组合成目标语言的完整字符集。 实验效果:论文覆盖超过 27 种语言,包括拉丁、希腊、西里尔与中日韩文字;在字体和真实 Logo 数据上,相比字体专用模型及 FLUX、Nano-Banana 等编辑模型取得更高字形保真度,并更好保持风格、纹理和字距。400 个电影 Logo 样本中有 44% 基于字体制作。 批判点评:多模块流水线提升可控性,也放大任一环节的误差和运行成本。少数字形可能不足以覆盖复杂脚本的部件组合、书写规范与文化设计语义;字体版权、人工修字和完整字符编码支持仍是商业落地条件。 10. AnomalyCraft-700K:4万异常视频70万标注 AnomalyCraft-700K: Component-Level Controllable and Verifiable Synthetic Anomalies for Fine-Grained Video Anomaly Understanding | 西北工业大学、新加坡管理大学 | arXiv:2609.06978 关键词:视频生成,异常检测,合成数据,多模态理解 ⚠️ 前序问题:真实异常视频稀少、难控制,已有合成数据通常只按类别或整句提示生成,提示与画面细节不一定一致,也缺少靠近正常—异常边界的困难正常样本,模型容易根据表面线索而非事件语义判断。 本文贡献:AnomalyCraft 把异常事件拆成场景、背景、主体、物体和有向交互五类组件,通过三阶段生成逐步放松非关键约束。相同组件同时作为核验单元,定位并人工修正视频—文本偏差;每个异常类别还配套语义接近但实际正常的困难反例。 实验效果:数据集包含超过 4 万段视频和 70 万条任务级文本标注,覆盖从异常检测、检索、描述到细粒度推理的六类任务。传统模型和多模态大模型评测都显示,它能为异常检测与理解提供有效监督。 批判点评:合成器的视觉偏差可能成为捷径,组件级人工修正也带来高成本和主观性。模型在该数据上提升不代表真实监控、开放场景和未见异常同样受益,需与真实数据混合训练并做跨域验证。 趋势观察 生成评测开始检查专业过程 CutCraft不再只看画质和连贯性,而是逐项检查镜头、转场和音画剪辑语法,说明创作模型的评价对象正在从结果扩展到过程执行。 世界模型从像素记忆走向权威状态 Programmable World Model把规则与实体状态交给可执行引擎,生成模型退回渲染器角色;可验证状态开始成为长期交互的一等公民。 条件越强,跨模态安全面越大 DIVA揭示参考图既提升一致性也会固定危险意图;安全策略需要联合审查图像、文字运动条件与输出,而不能只过滤提示词。 生成模型用结构中间态换取控制 从PhysFlow的光流、StreetDiff的全景几何到MIEdit的语义角度遮罩,低维且可解释的中间表示正在连接高层意图与像素生成。 人工智能炼丹君 整理 | 2026-09-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-09|阿里两步口型配音跑到7.13FPS-TBDub 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 TBDub(阿里巴巴淘天集团 TaoLive AIGC):两步口型配音跑到7.13FPS AlignGraft(新南威尔士大学):弱模型一次对齐全家复用 ⚡ SeRV(俄克拉荷马大学、佐治亚大学、马萨诸塞大学阿默斯特分校):375小时数据生成3D手语 PAI-Actor(Utopai Studios、加州大学尔湾分校、南洋理工大学、新加坡国立大学 Show Lab):1080P多角色电影替换 MVWeaver(中国科学院自动化研究所、快手可灵 KlingAI、上海戏剧学院、北京电影学院、康斯坦茨大学):1861支MV教会歌曲转镜头 今日论文速览 1. TBDub:两步口型配音跑到7.13FPS TBDub: Production-Oriented Visual Dubbing | 阿里巴巴淘天集团 TaoLive AIGC | arXiv:2609.06144 关键词:视频编辑,视觉配音,少步蒸馏,口型同步 ⚠️ 前序问题:把原视频语音替换为新音频时,嘴形必须同步,同时还要保住身份、牙齿、光照、遮挡与背景。X-Dub 在干净数据上有效,但面对直播压缩、绿幕素材和上游生成视频时,容易出现嘴部粘连、身份漂移、边界闪烁,并且 30 步采样难以投入生产。 本文贡献:TBDub 先用生产域数据、失败规则、非对称条件退化、干净口腔先验和多层 HuBERT 音频特征,对完整视频 DiT 做任务自适应后训练,得到 30 步教师;再把 DMD/DMD2 改造为条件视频编辑蒸馏,对完整两步轨迹反向传播,并用分区重建监督稳定身份和口腔细节,得到两步学生。 编辑依据论文方法章节重绘;原论文未提供方法框架图。 实验效果:在 38 段 TalkVid 视频上,教师相对 X-Dub 的口型同步、身份一致性和视觉质量 MOS 分别提高 0.14、0.95 和 0.90 分。两步学生在单张 NVIDIA H20、512×512 的端到端计时中达到 7.13 FPS,总延迟降低 13.93 倍,DiT 阶段加速 42.49 倍,同时大体保留教师的画质与音画同步。 论文 Table 4:单张 NVIDIA H20、512×512、VAE-to-VAE 计时边界下的端到端生成吞吐量。 批判点评:38 段视频与单一 H20 配置仍不足以覆盖真实直播中的语言、脸型、遮挡和码率变化;音频前端使用英语 HuBERT,也需要跨语言检验。方法继承 Wan 与 X-Dub 的大部分能力,训练数据和生产过滤规则对结果贡献很大,不能只归因于两步蒸馏。 2. AlignGraft:弱模型一次对齐全家复用 Test-Time Weak-to-Strong Alignment: Transferring Implicit Rewards from Weak to Strong Flow Models | 新南威尔士大学 | arXiv:2609.05968 关键词:测试时对齐,流模型,弱到强迁移,偏好优化 ⚠️ 前序问题:每个新生成模型、检查点和奖励目标都重新做强化学习或偏好优化,成本高且把奖励强度永久写死。现有测试时对齐又常要求奖励函数梯度或另训价值模型,部署仍需保留奖励基础设施。 本文贡献:AlignGraft 保存一个弱模型的“基础版与已对齐版”模型对,把两者在每个采样步的速度差视为隐式奖励方向,再将这段差值加到同潜空间、同前向加噪核的强模型速度上。强模型保持冻结,测试时只用一个标量调节对齐强度,不需要奖励评估、反向传播或新的微调。 实验效果:把 SD3.5-Medium 的 GenEval 对齐迁移到 SD3.5-Large 后,强模型总分从 0.68 升到 0.90,接近源对齐模型的 0.93;位置关系从 0.28 升到 0.91,计数从 0.67 升到 0.84。相同思路也在 FLUX 同族模型和 Wan 1.3B 到 14B 视频模型间提升了多项偏好与对齐指标。 批判点评:迁移要求源模型对能在强模型状态上给出分布内信号,并共享潜空间和噪声过程;跨完全不同架构并非自动成立。弱模型学到的奖励偏差也会被一起移植,强度外推过大可能损害保真度。 3. SeRV:375小时数据生成3D手语 SeRV: Semantic-Aligned Residual Vector Quantization for American Sign Language Generation | 俄克拉荷马大学、佐治亚大学、马萨诸塞大学阿默斯特分校 | arXiv:2609.05742 关键词:手语生成,残差向量量化,动作生成,语义对齐 ⚠️ 前序问题:手语动作令牌器通常只追求姿态重建,未必把文本语义组织进离散空间;后续生成器即使能复原大动作,也可能把承载词义的手形和细粒度关节做错。配对的文本与三维手语动作数据又很稀缺。 本文贡献:SeRV 在残差向量量化器中同时加入句子级动作文本对齐和令牌级文本条件监督,让粗到细的多层码本既可重建动作又可预测语义;随后用分层 GPT 逐级生成身体和手部令牌。团队还从 YouTube-ASL 视频恢复三维动作,构建 375 小时的动作文本基准。 实验效果:在 YouTube-ASL 上,身体与手部 DTW-JPE 分别为 4.98 和 6.70,优于 SOKE 的 5.42 和 7.44;SiBLEU-4 从 2.18 提升到 3.13。在 How2Sign 上身体与手部误差也最低,不过 MaDiS 的 SiBLEU-4 为 4.47,仍高于 SeRV 的 4.12。 批判点评:训练数据来自二维视频重建的三维动作,手指遮挡与视角误差可能被写进码本。DTW-JPE 与 SiBLEU 不能完全代表手语可理解性,仍需由聋人和专业手语者做语义、自然度与文化适切性评测;结论目前也只覆盖美国手语。 4. PAI-Actor:1080P多角色电影替换 PAI-Actor: Cinematic Multi-Character Replacement in Dynamic Scenes | Utopai Studios、加州大学尔湾分校、南洋理工大学、新加坡国立大学 Show Lab | arXiv:2609.05918 关键词:角色动画,视频编辑,多角色生成,自回归蒸馏 ⚠️ 前序问题:角色替换系统多围绕单张人物或单主体展开,面对电影中的多人互动、遮挡、手持物、相机运动和动态光影时,容易改坏背景或让身份漂移;双向视频模型画质高,却难扩展到长片段。 本文贡献:PAI-Actor 把多角色替换改写为结构引导的人体恢复:从电影中抹去原演员,以身体与人脸关联后的骨架和每个角色参考图作为条件,在约 3 万段电影片段上训练 1080P 双向 DiT。随后通过因果适配与 on-policy self-forcing,把双向教师蒸馏为可使用 KV 缓存的自回归视频到视频模型。 实验效果:论文在角色动画子集的大多数指标上优于对比方法,并展示多人身份、背景与姿态一致性。自回归学生可生成约 417 帧、17 秒的 1920×1056 视频,而双向教师因全局注意力不能扩展到该长度。 批判点评:训练三个阶段合计数百 GPU 小时,峰值显存约 114 至 136 GB,生产门槛很高。电影数据还涉及演员肖像、版权与合成滥用风险;失败案例中极端像素位移、复杂遮挡和长时身份漂移仍未解决。 5. MVWeaver:1861支MV教会歌曲转镜头 MVWeaver: A Hierarchical Music Video Generation Agent with a Learned Song-to-Visual Bridge | 中国科学院自动化研究所、快手可灵 KlingAI、上海戏剧学院、北京电影学院、康斯坦茨大学 | arXiv:2609.06478 关键词:音乐视频,生成智能体,分层规划,音画生成 ⚠️ 前序问题:自动音乐视频系统可以拼出漂亮镜头,却常停留在歌词字面联想:整首歌的情绪、人物动机和反复意象没有发展,镜头之间也缺少可追踪的概念与状态。 本文贡献:MVWeaver 先做结构化歌曲分析,再由视觉规划器生成全局概念、段落计划和可执行镜头,最后调用图像与视频模型渲染。关键的 song-to-visual bridge 来自 1861 组真实歌曲与 MV,包含歌曲侧、MV 侧以及教师推导的转译理由,并用 LoRA 微调大语言模型学习从听歌理解到视觉设计的中间桥。 实验效果:在 1 至 5 分评测中,MVWeaver 的歌曲解释、视觉发展、概念连贯和镜头连续得分分别为 4.08、3.63、4.30、4.10,均高于 AutoMV 和去掉桥接模块的版本;与所有对比方法成对比较后的总体用户偏好率为 67.06%,AutoMV 为 30.59%。 批判点评:1861 组真实 MV 的规模、文化分布和版权来源会影响桥接模型学到的视觉惯例。长视频一致性评分仍难覆盖完整观影体验;若歌曲分析出错,层级规划会把错误系统性传播到所有镜头。 6. ToPO:把整图偏好路由到词和像素 ToPO: Token-Conditioned Preference Routing for Attention-Based Latent Diffusion Models | 清华大学、电子科技大学、斯坦福大学 | arXiv:2609.03688 关键词:偏好优化,扩散模型,注意力,空间时间路由 ⚠️ 前序问题:一条成对偏好只说明整张图谁更好,却没有指出哪个提示词、空间位置和去噪时刻该更新。Diffusion-DPO 把全局信号铺到大量局部坐标,容易浪费梯度或修错区域。 本文贡献:ToPO 用冻结参考去噪器比较优选与劣选分支的局部平方残差,构造与小批次相关、停止梯度的可分空间时间路由;再用优选分支交叉注意力把内容词映射回空间,并加入像素中点排序项。整个过程不需要局部标签或另训奖励模型。 实验效果:在 SD-1.5 上,ToPO 的 GenEval 与 T2I-CompBench 平均分为 0.5092 和 0.4123,高于 Diffusion-DPO 的 0.4591 和 0.3521;在 SDXL 上 GenEval 为 0.6168,T2I-CompBench 为 0.4975,与 Diffusion-DPO 的 0.4974 近似持平。300 提示盲测的六组问题中,ToPO 均获得更多原始选择。 批判点评:路由依赖参考模型残差和交叉注意力的可解释性,未证明可直接迁移到所有 DiT 或无交叉注意力架构。盲测只公开聚合计数,不能进行参与者层面的显著性推断;部分 SDXL 自动指标也没有全面领先。 7. Diffuse2Seg:扩散模型零训练造分割标签 Diffuse2Seg: Diffusion Models Can Segment Anything Without Supervision | 柏林工业大学、CARIAD SE(大众汽车集团) | arXiv:2609.06491 关键词:开放世界分割,扩散特征,伪标签,无监督学习 ⚠️ 前序问题:SAM 的开放世界分割能力依赖 1100 万图像和超过 10 亿人工掩码,继续扩大标注极其昂贵。自监督视觉特征生成的伪标签又常偏向前景物体,难覆盖天空、道路等无定形区域。 本文贡献:Diffuse2Seg 不训练扩散模型,而是从文生图模型的自注意力中提取对象结构,将密集点网格通过保边的非线性 p-Laplacian 传播为软掩码,再合并为从部件到完整物体的多粒度实例图,去重后用于训练开放世界分割器。 实验效果:生成伪标签在五个领域的 AR1000 比此前最佳标签生成器高 4.3 至 7.1 个百分点。用这些标签训练的无检测器分割模型在 things 与 stuff+things 上分别提升 7.4 和 7.7 个百分点,并在后者超过检测器式 UnSAM 2.1 个百分点。 批判点评:伪标签会继承文生图训练数据的类别偏差,对小目标、透明物、医学或机器人极端域未必可靠。评测以平均召回为主,边界精度和错误标签对下游安全任务的影响仍需单独检查。 8. OAVC:只改目标不带跑背景 Object-Aware Background-Controlled Editing via Weighted Velocity Guidance | 卡内基梅隆大学、中国科学院计算技术研究所、中国科学院大学 | arXiv:2609.06288 关键词:图像编辑,视频编辑,免训练控制,整流流 ⚠️ 前序问题:免训练编辑通常把源提示与目标提示的速度差全局加到潜空间。目标之外的小残差虽然单步很弱,却会在多步积分中累积,最终带跑背景纹理、反射和物体边界。 本文贡献:OAVC 把“语义残差能在哪里生效”和“如何注入动力学”拆开:先在源提示下建立背景锚点和对象支持区,再用受约束的投影抑制会引发漂移的速度分量,并按时间和边界置信度加权注入目标语义。它不训练或修改预训练模型参数,可接到 SD3.5、FLUX 和视频流编辑器上。 实验效果:在 PIE-Bench 上,FLUX 版本相对 DNAEdit 将结构距离从 18.87 降至 4.07,背景 PSNR 从 24.99 dB 提升到 33.30 dB;SD3.5 版本也从 14.19 降至 4.11、从 26.66 dB 升到 32.64 dB。100 例盲测中,OAVC 赢下 94 个有明确结果的背景保持比较中的 74 个,占 78.7%。 批判点评:默认依赖 SAM3 提供对象支持区,分割遗漏或膨胀会直接限制编辑。它在背景保持上更强,但 CLIP 编辑性分数较低;人工评测也显示编辑实现偏好差异未达 0.05 显著水平,存在保真与改动强度的权衡。 9. AngelFingerprint:水印直接藏进编辑模型权重 AngelFingerprint: A Traceable, Explainable, and White-Box Stealthy Watermark for Text-Guided Image Editing | 台湾大学、日本国立信息学研究所 | arXiv:2609.04709 关键词:生成水印,图像溯源,文本引导编辑,白盒安全 ⚠️ 前序问题:常见生成水印只携带固定 ID,能说明图像来自哪个模型,却无法解释改了什么;水印若由独立编码器或后处理模块写入,在开源白盒场景中又容易被定位和移除。 本文贡献:AngelFingerprint 用 LoRA 把编辑提示的 CLIP 文本嵌入写进扩散模型权重,专用提取器再从像素恢复语义载荷。速度对齐锚点限制水印对编辑结果的扰动,仿照 JPEG 的 DCT 中频掩码避开显眼低频和脆弱高频,让架构、推理代码与计算图保持不变。 实验效果:在 MagicBrush 的 200 候选提示检索中,SD3-Medium 版本 Top-1 为 86.0%、MRR 为 0.917,而提示反演 Top-1 为 20%;UltraEdit 版本 Top-1 为 65.5%。中频滤波版本在水印开关之间得到 PSNR 22.91 dB、SSIM 0.704。 批判点评:把 LoRA 融入权重提高了隐蔽性,却没有证明能抵抗模型再训练、合并、剪枝或蒸馏等强白盒攻击。200 路封闭检索和单一编辑数据集规模有限;语义载荷也会带来隐私与滥用提示暴露问题。 10. Srijika:生成66套可安装印度字体 Srijika: OpenType-Layout-Reusing Font Restyling for Nine Indic Scripts | Loopdesk Technologies LLP | arXiv:2609.05661 关键词:字体生成,扩散模型,OpenType,印度文字 ⚠️ 前序问题:印度婆罗米系文字包含大量合字、半形和元音附标。只生成漂亮字形位图并不能得到可用字体,因为 cmap、GSUB 替换闭包、GPOS 定位和锚点关系必须共同满足排版引擎契约。 本文贡献:Srijika 不从零生成字体,而是保留完整模板字体的字符映射与替换闭包,用约 650 个开放许可字体族的检索系统 Lipika 将自然语言风格落到参考字体,再由参考条件潜扩散逐字重绘轮廓。内容门控、风格协调和排版簇验证会自动回退失败字形,最终重建为 TTF。 实验效果:系统产出 66 个 TTF,包含 57 个预设和 9 个开放词汇示例;全部通过 OpenType Sanitizer,HarfBuzz 与 CoreText 在高难合字探针上复现模板字形 ID 序列,并审计 80,915 个字形与 54,812 个锚点。 批判点评:论文只与无学习基线比较,缺少独立风格指标、人类研究和完整 GPOS 视觉质量审计。检索编码器与评测嵌入的数据并非完全独立,风格提升可能被高估;工程上的回退机制保证可安装,却可能留下大量未真正重绘的字形。 趋势观察 少步与长视频开始接受完整系统计时 TBDub把视觉配音压到两步并报告VAE到VAE的端到端速度,PAI-Actor则诚实披露17秒视频仍需95分钟;生产可用性正在从采样步数口号转向全链路成本。 对齐信号从整图分数走向可迁移局部场 AlignGraft把弱模型对的速度差跨规模移植,ToPO把整图偏好分配到词元、空间和时间,说明生成对齐正从重复微调转向复用和精确分配。 生成系统更重视可验证的结构契约 SeRV用语义码本约束手语,OAVC显式限定对象区域,AngelFingerprint嵌入可恢复提示,Srijika复用OpenType闭包;输出是否可编辑、可追溯、可执行,正与视觉质量同样重要。 人工智能炼丹君 整理 | 2026-09-09 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-08|蚂蚁从零训6B开源生图-LLaDA-Image 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 LLaDA-Image(Inclusion AI AGI Research Center):从零训练开放生图模型 DSAQuant(Robbyant、浙江大学、香港理工大学、香港科技大学):按去噪阶段做视频量化 ⚡ DM-Align(清华大学、快手科技、哈尔滨工业大学(深圳)、北京邮电大学):四步视频同时对齐与蒸馏 RA-GRPO(清华大学、快手科技):用反思轨迹稳定生成对齐 VoRTeC(清华大学深圳国际研究生院、哈尔滨工业大学(深圳)、北京大学):用生成流做一步视频解码 今日论文速览 1. LLaDA-Image:从零训练开放生图模型 LLaDA-Image: Building Strong Image Generators with Fully Open Training Recipes | Inclusion AI AGI Research Center | arXiv:2609.03796 关键词:图像生成,开放模型,扩散语言模型,模型蒸馏 ⚠️ 前序问题:高质量图像生成模型常依赖不透明的数据配方、训练细节或已有模型权重,研究者难以复现从零训练过程;把理解、生成和编辑统一起来也容易牺牲其中一项能力。 本文贡献:作者从零训练一个 6B 参数 DiT,并接入冻结的 LLaDA2.0-Mini 视觉语言理解模块。训练先用纯图像预训练建立视觉先验,再做中期训练和图文统一训练;全流程使用 2.2 亿样本,其中 98% 为真实图像,并公开权重、代码和训练配方。团队还用 TwinFlow 将模型蒸馏为 2 至 4 步推理的 Turbo 版本。 实验效果:LLaDA-Image 在 Qwen-Image-Bench 英文与中文轨分别得到 53.53 和 53.38,领先当时其余开源模型;LongText-Bench 英文、中文得分为 0.923 和 0.913。编辑基准 GEdit-Bench 的英文、中文总分为 7.336 和 7.294,说明统一模型已具备较强的生成、文字渲染与编辑能力。 批判点评:2.2 亿样本的收集、清洗和训练成本仍然很高,公开配方也不会自动解决数据授权与可追溯性问题。报告覆盖模块很多,但部分组件的独立贡献和跨架构可迁移性仍需更多消融验证。 2. DSAQuant:按去噪阶段做视频量化 DSAQuant: Denoising-Stage-Aligned Quantization-Aware Training for Video Generation | Robbyant、浙江大学、香港理工大学、香港科技大学 | arXiv:2609.04031 关键词:视频生成,量化感知训练,低比特推理,部署优化 ⚠️ 前序问题:视频扩散模型压到 W4A4 或 W3A3 后,通常还能保住提示词语义、构图与粗粒度运动,却会明显丢失纹理、锐度和局部细节。传统量化训练把所有去噪时刻一视同仁,没有利用早期规划结构、后期补细节的分工。 本文贡献:DSAQuant 按去噪阶段切换监督目标:早期保持教师蒸馏以稳定全局结构与运动,后期逐渐转向目标驱动的细节重建;推理时在最后阶段关闭分类器自由引导,避免量化误差被 CFG 放大为高频伪影。方法同时覆盖 Wan 与 CogVideoX 系列。 实验效果:在 Wan2.1-1.3B 的 W4A4 设置下,DSAQuant 的 VBench 平均分为 67.21,高于 BF16 模型的 66.28 和 QVGen 对称量化的 63.56;在更激进的 W3A3 下,相对当时量化训练基线最高提升 6.60 分。 批判点评:论文重点验证生成质量,没有把端到端延迟、显存、能耗和不同硬件内核的实际收益放在同等位置;量化感知训练本身也有额外成本。后期关闭 CFG 可能改变文本对齐,需要在更广的提示与长视频任务上验证。 3. DM-Align:四步视频同时对齐与蒸馏 Joint Alignment and Distillation for Video Generation via Sample-Guided Distribution Matching | 清华大学、快手科技、哈尔滨工业大学(深圳)、北京邮电大学 | arXiv:2609.04283 关键词:视频生成,偏好对齐,分布匹配,少步蒸馏 ⚠️ 前序问题:视频生成的偏好对齐与少步蒸馏通常分成两段:先强化学习再蒸馏计算昂贵,先蒸馏再做强化学习又容易让模型坍塌。两段流程还要重复运行多步奖励评估,并在 ODE 与 SDE 轨迹间转换。 本文贡献:DM-Align 在一次分布匹配训练中同时叠加两种梯度:DMD2 梯度缩小真实模型与学生模型的分布差距,偏好梯度则利用成对偏好或组内探索,把生成分布推向人类偏好的样本。它把类似 DPO 与 GRPO 的信号写进同一训练目标,直接产出 4 次函数评估的视频模型。 实验效果:在 Wan2.1-T2V-1.3B、5 秒 832×480 视频上,组内模式以 4 NFE 得到 VBench 平均分 84.40、动态度 80.19;成对模式为 82.78。人工比较中,成对模式相对原模型净偏好提升 48%,相对单独 DMD2 提升 32%。 批判点评:实验集中在 1.3B 基模、5 秒 480p 视频,尚不足以说明长视频与更大模型也能稳定受益。样本引导仍依赖奖励或偏好数据,奖励偏差与奖励投机只是减轻,不能视为消失。 4. RA-GRPO:用反思轨迹稳定生成对齐 Step Back to Move Forward: Reflection-Aware Preference Optimization for Visual Generation | 清华大学、快手科技 | arXiv:2609.04282 关键词:偏好对齐,扩散模型,强化学习,奖励投机 ⚠️ 前序问题:生成模型用策略梯度对齐人类偏好时,探索常被局部最优牵引:奖励上升了,语义忠实度或真实感却可能下降。常规 GRPO 只从当前前向采样学习,很难主动修复已经偏离高概率数据流形的中间状态。 本文贡献:RA-GRPO 在训练中加入“向后反思”。Diffusion Reflection 在随机中间时刻用较弱估计器反演并校正潜变量,再由 Counterfactual Path Synthesis 把校正后的路径蒸馏回策略。反思只发生在优化阶段,因此部署时没有额外采样开销。 实验效果:在 FLUX.1-dev 与 HPSv2.1 提示集上,以 HPS 为奖励时,RA-GRPO 的 HPSv2.1、ImageReward、HPSv3 分别为 0.378、1.417、15.324,均高于论文复现的 DanceGRPO 与 MixGRPO;多目标 HPS+CLIP 训练也取得更均衡的自动指标。 批判点评:验证主要围绕 FLUX.1-dev、HPS 提示和自动奖励模型。弱估计器、指导强度与反思时刻的选择会影响稳定性;只看自动奖励仍可能漏掉新的投机模式,需要更大规模人工偏好与跨模型复核。 5. VoRTeC:用生成流做一步视频解码 VoRTeC: Taming Foundation Flow for One-step Real time Video Compression | 清华大学深圳国际研究生院、哈尔滨工业大学(深圳)、北京大学 | arXiv:2609.02291 关键词:视频压缩,流模型,实时解码,超低码率 ⚠️ 前序问题:传统神经视频压缩在超低码率下容易模糊,而扩散式生成压缩通常需要多步采样,难以实时运行。如何借用强视频生成模型的先验,又不复制其昂贵迭代过程,是部署瓶颈。 本文贡献:VoRTeC 冻结 Wan2.1 流模型,只训练紧凑潜码与轨迹位置预测器,用多尺度先验把一次解码对齐到生成流。跨帧组复用尾帧,并缓存生成先验,以降低连续视频的重复计算;训练不需要访问基础流模型的参数或梯度,可在单张 A6000 上完成。 实验效果:论文报告在相近感知质量下可节省 58.12% 至 73.25% 码率,并达到低于 0.01 bpp;推理相对多步生成压缩加速 3 至 197 倍,720p 达 13 fps、480p 达 32 fps。 批判点评:速度依赖具体显卡、分辨率与缓存条件,不能直接外推到移动设备。对取证、医疗、遥感等要求像素真实性的场景,生成先验可能引入不可接受的幻觉,需要独立的保真约束与错误标记。 6. Editable Visual Design:让视觉设计真正可编辑 Editable Visual Design | 腾讯混元、中山大学、清华大学、香港中文大学、上海交通大学 | arXiv:2609.04034 关键词:视觉设计,智能体,图像生成,HTML CSS ⚠️ 前序问题:文生图可以快速给出海报或信息图,但输出通常是一张扁平位图,文字、图标和布局无法继续精确编辑;纯代码生成又容易缺少视觉想象与审美反馈。 本文贡献:该系统让视觉语言模型充当创意大脑、图像生成器充当视觉世界模拟器,先想象整体效果,再把素材隔离为独立资产并用原生 HTML/CSS 重建文字、层级与布局。Agent Design Replay 学习专业设计轨迹,智能体通过截图反馈持续比较和修改。 实验效果:论文用海报、信息图、营销物料和长文本版式等案例展示:输出中的文字保留为真实文本,元素可以用鼠标拖动,图层与样式可继续修改。论文当前以定性案例证明可编辑工作流,没有给出可横向比较的统一量化分数。 批判点评:缺少大规模用户研究、任务完成时间和跨基线量化评测,使“更专业”仍难精确判断。流程依赖图像生成和代码智能体的能力,素材版权、网页代码安全与复杂版式的兼容性也需要产品级约束。 7. Temporal Context Routing:把脚本精确路由到时间轴 The Missing Temporal Link: Temporal Context Routing for Script-Driven Audio-Video Generation | 北京大学、Qwen Applications、香港科技大学、香港中文大学、上海交通大学 | arXiv:2609.02367 关键词:音视频生成,时间控制,脚本驱动,多模态生成 ⚠️ 前序问题:脚本驱动的音视频生成会同时处理镜头、对白、动作和音效,但全局文本条件不知道某条指令应该在哪一秒生效,常出现切镜过早、对白错位或动作与声音不同步。 本文贡献:Temporal Context Routing 先把脚本事件映射到音频与视频共享的时间轴,再将每段提示的引导信号只路由到匹配的时空位置。它给现有联合音视频模型补上显式时间链接,而不用让所有帧共同接受整段脚本。 实验效果:在 200 条测试脚本上,镜头边界平均绝对误差从 1.11 秒降到 0.042 秒,下降约 96%;对白在 0.5 秒容差内的准确率从 28.3% 提升到 84.1%,同时视觉质量与音画同步指标保持相近。 批判点评:实验规模仍有限,长叙事、重叠对白、快速多事件和镜头外音源会让路由更复杂。用户研究偏好不能替代对叙事连贯性与错误恢复的长期评估。 8. Unreal Engine World Data:用虚幻引擎规模化造数据 Building Pretraining Data for World Models: An Unreal Engine-Based Pipeline for Action-Conditioned Video Generation | Joy Future Academy、京东、清华大学、香港科技大学 | arXiv:2609.03557 关键词:世界模型,合成数据,虚幻引擎,动作条件视频 ⚠️ 前序问题:动作条件世界模型需要既有可控动作轨迹、又有高质量画面的长视频数据。直接在游戏引擎中边运行物理、边实时渲染,容易因帧率波动破坏动作与画面对齐,也难在数百 GPU 上稳定扩展。 本文贡献:作者把流程拆成两段:PIE 先按真实物理运行并记录角色、控制和相机状态,MRQ 再离线重放轨迹并高质量渲染。系统加入缓存感知的任务分片、节点槽位、场景筛选、亮度与审美过滤,以及失败恢复、上传和健康检查。 实验效果:在 25 台服务器、共 200 张 RTX 5090 上,系统从 2384 个资产包整理出 429 个关卡与 40 个类人角色,生成 2691 小时 1080p 和 6076 小时 720p 动作条件视频,并用于 EchoWM 数据建设。 批判点评:合成场景仍有引擎域偏差,审美和亮度过滤可能进一步删掉困难样本;资产许可、人物动作覆盖和 200 GPU 的成本也决定了复现门槛。数据规模不能替代真实世界验证。 9. Structured-Prior Inpainting:给交通标志注入物理先验 Structured-Prior-Guided Diffusion Inpainting with Physical Consistency for Traffic Sign Augmentation | 高德地图、阿里巴巴集团 | arXiv:2609.02348 关键词:图像修复,合成数据,交通标志,物理一致性 ⚠️ 前序问题:稀有交通标志样本不足,但普通文生图或修复模型容易生成错误文字、色彩和边缘。视觉上“像标志”还不够,训练检测器需要类别语义、模板几何与法规颜色都准确。 本文贡献:方法把三类结构先验送入扩散修复:JSON 语义提示描述类别,正视矢量图通过 IP-Adapter 提供测量颜色,仿射对齐的矢量模板通过 ControlNet 约束几何;训练再加入 CIELAB 颜色 L1 损失和 Sobel 边缘损失,强化物理一致性。 实验效果:在 TT100K2021 零样本测试中,OCR 完全匹配率为 91.1%,而 12B 参数 FLUX.1 Fill 为 44.2%;基于 SD1.5 的方案推理时间约为其十四分之一。把合成图加入训练后,稀有类别 AP50 提升到原来的 1.23 至 7.40 倍。 批判点评:公开验证集中在一种交通标志数据源,检测增益会受合成比例、地区法规、拍摄距离和天气影响。用于道路安全前,还需跨国家模板、夜间、遮挡和极端退化测试,并保留可审计的生成记录。 10. Pitch-class Steering:用潜空间探针控制旋律 Pitch-class Steering for Diffusion-based Music Generation via Latent-space Probes | 卡内基梅隆大学、独立研究者 | arXiv:2609.04516 关键词:音乐生成,扩散模型,旋律控制,潜空间探针 ⚠️ 前序问题:文本能描述音乐风格,却很难要求扩散音乐模型严格跟随指定旋律。重新训练完整模型或改架构成本高,而 MIDI 条件又不一定能直接接入现有生成器。 本文贡献:作者用配对音频与 MIDI 训练一个 12.5 万参数卷积探针,从 Stable Audio Open 的 VAE 潜变量逐帧解码音高类别。生成时冻结基础模型,把探针的可微损失作为引导信号,在每步去噪中推动潜变量靠近目标旋律,不修改生成模型结构。 实验效果:在 9 个提示词与 3 条旋律组成的 27 次试验中,引导生成的旋律一致性相对无引导基线提升 2.4 倍;Wilcoxon 检验给出 p<1e-5。论文已被 IEEE MLSP 2026 接收。 批判点评:27 次试验规模很小,统计显著不等于覆盖多样音乐风格。每步反向传播引导会增加推理开销,配对 MIDI 数据的偏差也可能限制泛化;还需听感盲测和更长曲目验证。 趋势观察 生成训练开始公开到数据与优化器层级 LLaDA-Image不仅开放权重,还披露2.2亿样本、纯图像预训练、Muon与少步蒸馏配方,竞争焦点正从模型接口转向可复现的完整训练系统。 视频部署优化必须贴合去噪阶段 DSAQuant按阶段分配量化监督,DM-Align把偏好对齐和少步蒸馏并成一次训练,VoRTeC则预测生成流位置完成一步解码;三者都在利用生成轨迹的内部结构减少成本。 显式控制信号重新进入生成链路 时间路由、交通标志模板与音高探针分别把时间、物理几何和旋律注入生成过程,显示开放式文本提示正在与可验证、可定位的结构条件结合。 人工智能炼丹君 整理 | 2026-09-08 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|策略梯度与 PPO 基础-PPO 策略梯度与 PPO 基础 所属方向:对齐与强化学习 | 难度:核心必修 | 前置知识:无 关键词:策略梯度、REINFORCE、优势函数、GAE、PPO、裁剪、KL 约束 01. 为什么需要它 先看一个很容易把模型训坏的场景。 你有一个已经做过监督微调的语言模型,给同一个问题采样了若干回答,奖励模型认为其中一条更好。最直接的想法是:让模型提高这条回答的概率。于是你把它的对数概率乘上奖励,连续更新十轮。训练日志里的 reward 不断上升,重新采样时却发现模型开始反复输出奖励模型偏爱的句式,内容变长,语言能力下降,最后连原来会答的问题也答不好。 问题不只在奖励。至少有三笔账同时失控了: 信用分配:一个回答只得到一个总分,到底哪些 token 值得鼓励? 估计噪声:这条回答得 8 分,是动作真的好,还是题目本来就容易? 更新幅度:数据由旧策略采出,新策略反复使用同一批数据后已经变了,为什么还能继续把旧结论当真? 策略梯度解决第一笔账:把“提高期望奖励”变成对可采样策略的梯度。价值函数和优势估计解决第二笔账:把状态本身的难易扣掉,只保留“这个动作比预期好多少”。PPO 的裁剪目标处理第三笔账:允许一批昂贵样本做多轮更新,同时阻止单个样本把新旧概率比推得过远。 这三层关系决定了后面的算法谱系。DPO 改写优化问题,GRPO 换掉价值网络,RLOO 换基线,很多 RLHF 系统再加入参考模型 KL、奖励归一化和长度处理。名字不断变,问题仍可追溯到三个量:优势怎么估、概率比怎么算、策略走多远。 02. 最小可用理解 先记住四句话: 策略梯度会提高“优势为正”的动作概率,降低“优势为负”的动作概率。 优势 $A(s,a)$ 是采取动作 $a$ 后的回报,相对状态 $s$ 下平均预期的超额部分。 GAE 用参数 $\lambda$ 在低方差但依赖 critic 的一步 TD,与高方差但依赖较少的完整回报之间插值。 PPO-Clip 比较新旧策略的动作概率比 $r_t$;一旦更新已经朝有利方向超过 $1\pm\epsilon$,该样本不再继续提供奖励。 把一次语言模型生成看成一条轨迹也很直观:状态是 prompt 加已经生成的 token,动作是下一个 token,策略是词表上的概率分布,终局奖励来自奖励模型。critic 预测“从当前前缀继续生成,平均还能拿多少分”,优势则问“刚才选的这个 token,让结局比平均预期好还是差”。 PPO 的 clip 不是把梯度值裁小,也不是保证 KL 一定不超过某个阈值。它裁的是替代目标里的概率比收益。这个区别是理解所有变体的入口。 03. 数学推导 3.1 从期望回报到策略梯度 考虑一个马尔可夫决策过程。$s_t$ 是时刻 $t$ 的状态,$a_t$ 是动作,$r_t$ 是环境在这一步给出的奖励,$\gamma\in[0,1]$ 是折扣因子。策略 $\pi_\theta(a_t\mid s_t)$ 由参数 $\theta$ 控制。一条长度为 $T$ 的轨迹记作 $\tau=(s_0,a_0,r_0,\ldots,s_T)$,折扣回报为: $$R(\tau)=\sum_{t=0}^{T-1}\gamma^t r_t$$ 训练目标是让轨迹的期望回报最大: $$J(\theta)=\mathbb{E}_{\tau\sim\pi_\theta}[R(\tau)]$$ 轨迹概率由初始状态分布 $p(s_0)$、策略和环境转移 $p(s_{t+1}\mid s_t,a_t)$ 连乘得到: $$p_\theta(\tau)=p(s_0)\prod_{t=0}^{T-1}\pi_\theta(a_t\mid s_t)p(s_{t+1}\mid s_t,a_t)$$ 对 $J$ 求梯度,并使用恒等式 $\nabla p=p\nabla\log p$: $$\nabla_\theta J(\theta)=\mathbb{E}_{\tau\sim\pi_\theta}[R(\tau)\nabla_\theta\log p_\theta(\tau)]$$ 环境转移不依赖 $\theta$,因此它在对数梯度中消失,只剩策略项: $$\nabla_\theta J(\theta)=\mathbb{E}\left[R(\tau)\sum_{t=0}^{T-1}\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]$$ 这就是 REINFORCE 的骨架。还可以利用“未来动作不能影响过去奖励”,把整条轨迹回报换成从 $t$ 开始的 reward-to-go: $$G_t=\sum_{l=0}^{T-t-1}\gamma^l r_{t+l}$$ 于是每个动作只为它之后的结果负责: $$\nabla_\theta J(\theta)=\mathbb{E}\left[\sum_{t=0}^{T-1}\gamma^t G_t\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]$$ 这里的 $\gamma^t$ 不能漏:本文从固定初始状态、折扣总回报 $J$ 出发,$G_t$ 的折扣却从当前步重新计起。只有 $\gamma=1$,或把该权重吸收到折扣状态访问分布时,才能省略显式 $\gamma^t$。实际 PPO 常把 rollout 的时间步均匀平均,这是常用替代目标,不应与上面的精确有限时域梯度混同。 如果 $G_t$ 总为正,采到的每个动作都会被提高概率,区别只是力度大小。这种估计虽然无偏,方差却很大。我们需要一个不改变期望梯度的参照物。 3.2 基线为什么可以减 从回报减去任何只依赖状态、不依赖本次动作的基线 $b(s_t)$,期望梯度不变。因为对固定状态 $s$: $$\mathbb{E}_{a\sim\pi_\theta}[b(s)\nabla_\theta\log\pi_\theta(a\mid s)]=b(s)\nabla_\theta\sum_a\pi_\theta(a\mid s)=0$$ 最常见的基线是状态价值函数: $$V^\pi(s_t)=\mathbb{E}_\pi[G_t\mid s_t]$$ 动作价值函数把本次动作也作为条件: $$Q^\pi(s_t,a_t)=\mathbb{E}_\pi[G_t\mid s_t,a_t]$$ 两者之差就是优势函数: $$A^\pi(s_t,a_t)=Q^\pi(s_t,a_t)-V^\pi(s_t)$$ $A>0$ 表示这个动作比该状态下的平均动作好,$A<0$ 表示更差。Actor 通过优势更新策略,critic 通过回归回报学习 $V$,所以这类方法叫 actor-critic。 3.3 从 TD 残差到 GAE 真实 $Q$ 和 $V$ 都不知道,只能估计。最短视的估计是一步 TD 残差: $$\delta_t=r_t+\gamma(1-d_t)V_\phi(s_{t+1})-V_\phi(s_t)$$ $V_\phi$ 是参数为 $\phi$ 的 critic,$d_t\in\{0,1\}$ 表示这一步后轨迹是否真正终止。若 $d_t=1$,就不能再 bootstrap 到下一个状态。critic 准确时,$\delta_t$ 是优势的低方差估计;critic 有系统误差时,它也会把误差直接传给 actor。 把未来多个 TD 残差加进来,会得到不同步数的优势估计。GAE 用指数权重把它们合在一起: $$\hat A_t^{\mathrm{GAE}(\gamma,\lambda)}=\sum_{l=0}^{T-t-1}(\gamma\lambda)^l\delta_{t+l}$$ 实际代码不需要为每个 $t$ 再套一层求和。由上式直接得到从后向前的递推: $$\hat A_t=\delta_t+\gamma\lambda(1-d_t)\hat A_{t+1}$$ 两个极端很关键。$\lambda=0$ 时,$\hat A_t=\delta_t$,只看一步,方差小但强依赖 critic。$\lambda=1$ 且轨迹正确终止时,TD 项会望远镜式相消,得到 $G_t-V(s_t)$,对未来 critic 误差不再敏感,但把后续所有随机奖励都带了进来。常见的 $\gamma=0.99,\lambda=0.95$ 是经验起点,不是定律。 训练 critic 时通常使用 value target: $$\hat V_t^{\mathrm{target}}=\hat A_t+V_\phi(s_t)$$ 实现时要区分 terminated 和因时间上限触发的 truncated。真正终止的状态没有未来价值;时间截断通常仍应 bootstrap。把两者都当 done=1,会在每段 rollout 尾部制造系统性低估。 3.4 为什么需要新旧策略概率比 采样成本高,所以 PPO 会冻结采样策略 $\pi_{\theta_{\mathrm{old}}}$,用同一批轨迹对当前策略 $\pi_\theta$ 做多轮小批量更新。数据来自旧策略,目标却要描述新策略,动作重要性比在固定旧策略状态上校正动作分布;它不校正整条轨迹的状态访问分布,所以以下是局部替代目标: $$r_t(\theta)=\frac{\pi_\theta(a_t\mid s_t)}{\pi_{\theta_{\mathrm{old}}}(a_t\mid s_t)}=\exp(\log\pi_\theta-\log\pi_{\theta_{\mathrm{old}}})$$ 未裁剪的替代目标是: $$L^{\mathrm{PG}}(\theta)=\mathbb{E}_t[r_t(\theta)\hat A_t]$$ 刚开始新旧策略相同,$r_t=1$。如果 $\hat A_t>0$,增大该动作概率会使目标变大;如果 $\hat A_t<0$,减小概率会使目标变大。但在同一批数据上更新多轮后,某些比率可能冲到 1.8、0.2,旧数据已不能可靠描述新策略附近的行为。 3.5 PPO-Clip 的 min 到底裁了哪一边 PPO-Clip 的核心目标只有一行: $$L^{\mathrm{CLIP}}(\theta)=\mathbb{E}_t\left[\min\left(r_t\hat A_t,\mathrm{clip}(r_t,1-\epsilon,1+\epsilon)\hat A_t\right)\right]$$ 这里的 min 取较悲观的收益。它必须与优势的符号一起看: 当 $\hat A_t>0$,把好动作的概率比推到 $1+\epsilon$ 以上不再得分;但若概率比跌到 $1-\epsilon$ 以下,损失仍继续变差,算法不会保护错误方向。 当 $\hat A_t<0$,把坏动作的概率比压到 $1-\epsilon$ 以下不再得分;但若坏动作反而变得更可能,惩罚仍继续加重。 所以 clip 是单侧的乐观收益上限。它不会把所有比率强行夹回区间,也不会保证一次优化后每个样本都满足区间约束。一个 batch 内不同样本共享参数,更新某个样本可能把另一个样本推得更远。 PPO 通常最小化总损失,因此策略项前面带负号,再加 critic 的均方误差和熵奖励: $$\mathcal{L}_{\mathrm{total}}=-L^{\mathrm{CLIP}}+c_v\mathbb{E}_t[(V_\phi(s_t)-\hat V_t^{\mathrm{target}})^2]-c_e\mathbb{E}_t[\mathcal{H}(\pi_\theta(\cdot\mid s_t))]$$ $c_v$ 控制价值损失权重,$c_e$ 控制探索强度,$\mathcal H$ 是策略熵。LLM 对齐还常加入相对参考模型 $\pi_{\mathrm{ref}}$ 的 KL 惩罚: $$r_t^{\mathrm{RLHF}}=r_t^{\mathrm{task}}-\beta\left(\log\pi_\theta(a_t\mid s_t)-\log\pi_{\mathrm{ref}}(a_t\mid s_t)\right)$$ 注意这里有两个不同的“旧模型”。$\pi_{\theta_{\mathrm{old}}}$ 是本轮采样快照,用来计算 PPO ratio;$\pi_{\mathrm{ref}}$ 通常是固定的 SFT 参考模型,用来限制长期漂移。把两者混成一个模型,会把更新稳定性和行为保持两个问题混在一起。 3.6 把公式还原成一轮训练 一轮 PPO 可以按下面的顺序执行。顺序很重要,因为每个张量对应的策略版本不同。 第一步,冻结当前 actor 为 $\pi_{\theta_{\mathrm{old}}}$,用它与环境交互,保存每一步的状态、动作、奖励、old_logprob、critic value、终止标记。语言模型场景还要保存 completion mask,明确哪些位置真的是策略采出的动作。 第二步,在 rollout 末端决定是否 bootstrap。若轨迹真正终止,next_value=0;若只是采样窗口用完,则由 critic 估计最后状态价值。然后从后向前计算 $\delta_t$ 和 GAE。此时优势应视作固定训练标签,actor 更新不能反向穿过 GAE 进入旧 value。 第三步,用 $\hat V_t^{\mathrm{target}}=\hat A_t+V_{\mathrm{old}}(s_t)$ 构造 critic 目标。这里加的是采样时保存的旧 value。如果一边更新 critic 一边用新 value 重算 target,目标本身会追着模型移动。 第四步,打乱 rollout,切成 minibatch。当前 actor 对已经采过的动作重新计算 new_logprob,然后用对数概率之差求 ratio。直接先算概率再做除法容易在大词表和低概率动作上出现下溢。 第五步,分别计算未裁剪和裁剪后的 policy surrogate,逐样本取 min,再按有效动作 mask 求平均。同时计算 value loss、entropy bonus,以及可选的 reference KL。 第六步,反向传播并做梯度范数裁剪。一个 rollout 通常会被重复使用若干 epoch;每轮都用同一份 old_logprob,但 new_logprob 随参数更新而变化。若 approximate KL 超阈值,就提前结束剩余 epoch。 第七步,丢弃这批 on-policy 数据,用更新后的 actor 重新采样。此时新策略成为下一轮的 old policy。PPO 能复用的是“一轮之内的有限次数”,并没有把数据永久变成离线训练集。 用张量形状检查这套流程也很有效。经典控制任务常见 reward/value/advantage/logprob 都是 [T, N],其中 $T$ 是 rollout 长度,$N$ 是并行环境数;语言模型常见 [B, L],其中 $B$ 是回答数,$L$ 是序列长度。只要其中一个量偷偷变成 [B] 并发生广播,训练可能不会报错,却会让整条回答的每个 token 共享一个本不该共享的系数。 3.7 手算一条两步轨迹 用一个最小数字例子把 GAE 和 clip 接起来。设两步奖励为 $[0,1]$,critic 预测为 $[0.4,0.7]$,第二步后真正终止,$\gamma=0.9$。最后一步的 TD 残差是 $\delta_1=1-0.7=0.3$;第一步是 $\delta_0=0+0.9\times0.7-0.4=0.23$。当 $\lambda=0.95$ 时: $$\hat A_0=0.23+0.9\times0.95\times0.3=0.4865$$ 对应的 value target 为 $0.4865+0.4=0.8865$,接近完整 Monte Carlo 回报 $0+0.9\times1=0.9$。若 $\lambda=0$,target 只有 $0.23+0.4=0.63$,它完全相信 critic 对下一状态的 0.7 估计。这几个数把“依赖 critic”和“纳入远期真实奖励”的差别直接展开了。 再设旧策略给第一步动作的概率是 0.25,新策略更新后变为 0.30,则 ratio 为 $0.30/0.25=1.2$。若该动作优势为 0.4865,正好到 $\epsilon=0.2$ 的上边界;继续把概率推到 0.35 时,未裁剪收益会按 ratio=1.4 计算,裁剪收益仍只按 1.2 计算,min 选择后者。若优势改为负数,1.4 一侧不会被保护,因为提高坏动作概率应该继续受到惩罚。 这个例子也说明两个超参数并不独立。$\lambda$ 改变优势的大小和噪声,进而改变样本多久撞上 clip;$\epsilon$ 决定同一批优势可以推动概率多远。只调其中一个而不观察 ratio 分布,往往解释不了训练曲线。 04. 代码实现 4.1 逐步算 GAE code/gae_minimal.py 只依赖 NumPy。它先对一条长度为 4 的固定轨迹从后向前递推,再模拟 20000 条随机轨迹,比较不同 $\lambda$ 下 value target 对真实 $V(s_0)$ 的偏差和方差。固定轨迹的真实输出是: rewards.shape=(4,), values.shape=(4,) lambda=0.00 delta=[0.1445 0.143 0.597 0.2 ] A=[0.1445 0.143 0.597 0.2 ] lambda=0.50 delta=[0.1445 0.143 0.597 0.2 ] A=[0.3858 0.4875 0.696 0.2 ] lambda=0.95 delta=[0.1445 0.143 0.597 0.2 ] A=[0.9734 0.8814 0.7851 0.2 ] lambda=1.00 delta=[0.1445 0.143 0.597 0.2 ] A=[1.0652 0.93 0.795 0.2 ] 同一行的 delta 不随 $\lambda$ 变化,因为它只由一步奖励和 critic 决定;$\lambda$ 改变的是未来残差往前传播的强度。最后一步已经终止,所以四组优势都等于 0.2。 随机实验故意给 critic 加入固定误差,结果是: episodes=20000, true_V0=4.2083, critic_V0=4.5083 lambda mean bias std mse 0.00 3.3133 -0.8950 0.7941 1.4315 0.50 3.8265 -0.3818 0.9201 0.9924 0.95 4.1767 -0.0316 1.8754 3.5181 1.00 4.2130 0.0048 2.2029 4.8529 $\lambda$ 从 0 增大到 1,偏差从 -0.8950 降到接近 0,标准差却从 0.7941 增至 2.2029。这个设定里 $\lambda=0.5$ 的均方误差最低;换一个 critic 误差和奖励噪声,最优点也会移动。这正是“偏差—方差折中”的可观测含义。 图 1:同一随机环境与 critic 误差下,$\lambda$ 改变了偏差和方差的配比。曲线由 make_figures.py 根据 20000 条固定随机种子轨迹生成。 4.2 看懂裁剪的符号 code/ppo_clip_minimal.py 先列出单样本裁剪表。下面四行足以解释 min: ratio A ratio*A clip(ratio)*A min clipped? 1.35 1.0 1.350 1.200 1.200 yes 0.65 1.0 0.650 0.800 0.650 no 1.35 -1.0 -1.350 -1.200 -1.350 no 0.65 -1.0 -0.650 -0.800 -0.800 yes 第一行是好动作已经涨太多,因此收益停在 1.2。第二行是好动作被错误地下调,目标仍取更差的 0.65。第三行是坏动作被错误地上调,惩罚保留 -1.35。第四行才是坏动作下降过多后停止继续奖励。clip 只截断“继续沿正确方向冲得更远”的激励。 图 2:蓝色阴影是 $[1-\epsilon,1+\epsilon]$。正优势在右侧形成平台,负优势在左侧形成平台,另一侧继续保留惩罚。 脚本还构造了一个两臂老虎机:旧策略给好、坏动作各 0.5 概率,同一批数据更新 40 轮。不裁剪时,好动作概率一路升到 0.9492,新旧策略 KL 达 0.8231;PPO-Clip 在第三轮越过 1.2 附近后梯度归零,停在 0.6097,KL 为 0.0246: mode epoch p(good) ratio_good grad KL(old||new) unclipped 3 0.6097 1.2193 0.4890 0.0246 unclipped 40 0.9492 1.8984 0.0990 0.8231 PPO-Clip 3 0.6097 1.2193 0.4890 0.0246 PPO-Clip 40 0.6097 1.2193 0.0000 0.0246 为什么停在 1.2193 而不是精确的 1.2?因为脚本用有限学习率做离散更新,第三步从区间内跨到了区间外,跨过以后才失去梯度。真实神经网络也会出现这种越界,所以还要监控 approximate KL,并在过大时提前停止 epoch。 05. 工业级实现对照 参考实现以 2026-09-08 的上游主分支为准。知识树原来记录的 huggingface/trl/trl/trainer/ppo_trainer.py 已经不在 TRL 当前主分支;当前 TRL 的 trainer 目录以 GRPO、DPO、RLOO 等实现 为主。因此本文把仍在维护、能直接核对 PPO 细节的 Stable-Baselines3 PPO.train 作为代码锚点,同时用 TRL GRPOTrainer 观察 LLM 对齐算法如何改写这些组件。 最小脚本与工业实现的差别主要有六处: rollout buffer:工业实现保存 observation、action、old log-prob、value、reward、termination mask,并在采样结束后统一算 GAE。old log-prob 必须冻结,不能在每个 epoch 重算。 优势标准化:常见实现按 minibatch 或整批做 $(A-\mu)/(\sigma+\varepsilon)$。它通常改善数值尺度,却会让一个样本的梯度依赖同批其他样本;batch 太小还可能产生不稳定统计量。 多轮 minibatch:Stable-Baselines3 的默认参数明确包含 n_epochs=10、gamma=0.99、gae_lambda=0.95、clip_range=0.2。这些是基准默认值,不应脱离任务直接复制。 价值函数处理:actor 与 critic 常共享 backbone,并用 vf_coef 合并损失;一些实现还裁剪 value 更新。value clipping 的尺度受奖励缩放影响,不能把 policy clip 的 $\epsilon$ 无脑复用。 额外护栏:除了 ratio clip,还会使用梯度范数裁剪、熵正则、approximate KL、target KL early stop、学习率退火和数值异常检查。Stable-Baselines3 的参数说明也明确指出,clip 本身不足以保证更新一定很小。 LLM 的 token mask:prompt token、padding 和 completion token 必须分开。策略损失通常只落在生成 token 上;序列末端奖励要变成 token 级回报,KL 往往逐 token 计算。错误的 mask 会把 padding 当动作,或者让 prompt 本身参与优化。 在 RLHF 里还要额外记录 reward/score、reward/non_score_reward、policy/approxkl、policy/clipfrac、loss/value、熵、响应长度和终止比例。只看总 reward 上升无法判断是任务能力提高、KL 惩罚变化,还是模型学会钻奖励与长度的空子。 5.1 指标应该怎样联读 clipfrac 必须先确认实现口径:常见日志统计 $|r_t-1|>\epsilon$,但真正进入目标平台还要满足“正优势且 ratio 过大”或“负优势且 ratio 过小”。越界比例不等于梯度被截断比例。它长期接近 0,可能说明学习率过小、epoch 太少、优势太弱,也可能只是策略已经接近局部平稳;它突然接近 1,说明新旧动作概率已大幅偏离,应结合优势符号与 KL 判断;错误方向的越界样本仍有纠正梯度。单独追求某个“漂亮”的 clipfrac 没有意义,应与 KL、entropy 和 reward 一起看。 approximate KL 快速增大而 reward 没有改善,通常先检查学习率、更新 epoch、优势尺度和 mask。如果 KL 很小、entropy 很快下降,则可能是分布变化集中在少数关键 token,平均 KL 把局部坍缩稀释了,需要再看 token 级分位数或最大值。 critic loss 下降也不一定是好消息。若 explained_variance 仍接近 0,critic 可能只学会了回报均值;若训练 loss 很低而新 rollout 上的 value error 很高,critic 在记忆同批噪声。此时 actor 收到的优势基线并不可靠。可以检查优势均值、标准差、与 return 的相关性,并把 value 网络的学习轮数与 actor 分开调节。 语言模型还有一个常见组合信号:任务 reward 上升、KL 惩罚绝对值变大、回答长度持续增加、人工质量不升。它常意味着奖励模型偏好长度或某种格式,策略在用分布漂移换分。解决顺序应是先按长度和题型切片评估奖励,再检查 EOS 奖励与 truncation,最后才调整 $\beta$。只增大 KL 系数会把症状压住,却不能修复有偏的反馈。 5.2 一个最小验收清单 正式放大训练前,可以用小 batch 做四个不依赖最终 reward 的验收。新旧模型完全一致时,所有有效位置的 ratio 应接近 1,approximate KL 应接近 0;把优势全设为 0 后,policy loss 对 actor 的梯度应为 0;交换优势正负号后,选中动作的更新方向应反转;只改变 padding 内容而保持 mask 不变时,损失应不变。这四项能抓住大部分 silent broadcasting、旧概率未冻结和 mask 泄漏问题。 06. 代价与边界 PPO 的优点是实现直接、可对 actor 和 critic 使用普通一阶优化器、同一批 rollout 可以复用多个 epoch。它的代价也很具体。 第一,PPO 仍是 on-policy 算法。ratio 能容忍有限的策略变化,却不能把很久以前的 replay data 变成可靠的当前策略数据。生成模型的 rollout 很贵,这也是许多对齐算法试图绕开在线 PPO 的原因。 第二,critic 会占显存、计算和调参预算。GAE 的质量由奖励噪声、value 误差、终止处理共同决定。critic 拟合得太慢,优势带偏;拟合得太快,又可能记住同一批高噪声回报。 第三,clip 是代理目标的启发式约束。它不等价于 TRPO 的显式 trust region,也不保证真实期望回报单调上升。大 batch、较小学习率、较少 epoch 和 target KL 能降低风险,仍需用新 rollout 验证。 第四,奖励尺度会渗透到整个系统。优势标准化能消除一部分尺度问题,critic loss、value clipping、梯度竞争和终止奖励仍受影响。LLM 的序列长度还会改变 token 级 KL 总量,导致长回答受到更大惩罚或获得更多优化机会。 以下情况不适合直接上 PPO:没有可信在线奖励或无法持续采样;动作空间可枚举且能直接做监督式偏好优化;离线数据远多于在线交互预算;安全约束必须严格满足而不能只靠软惩罚;环境极端稀疏奖励且 critic 没有可学习信号。此时应先解决反馈、数据或约束建模,而不是把希望寄托在 clip 上。 调试时也应先分清“估计坏了”还是“优化走远了”。前者常表现为优势高噪声、critic 解释方差差、不同随机种子更新方向不稳定,应检查奖励、bootstrap 和 GAE;后者常表现为前几个 minibatch 正常,随后 ratio、KL、clipfrac 一起升高,应减少学习率、epoch 或启用 KL early stop。两类问题都会造成 reward 抖动,但修复手段完全不同。 还要保留旧策略下的原始 rollout 指标。只比较更新后的 loss 无法回答“策略是否真的更好”;每轮更新后用新策略重新采样,并按任务、长度和难度切片比较回报,才能排除同一批数据上的代理目标过拟合。至少运行多个随机种子,因为一次 rollout 的偶然高分足以让小样本实验得出相反结论。 07. 经典论文脉络 REINFORCE:Williams 在 1992 年的 Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning 给出基于采样回报和 log-derivative 的经典策略梯度形式,优点是通用,主要问题是方差高。 TRPO:Trust Region Policy Optimization(2015)用 KL 约束和二阶近似限制策略更新,为“旧数据上走多远”给出更严格的处理,但实现复杂。 GAE:High-Dimensional Continuous Control Using Generalized Advantage Estimation(2015)把 TD($\lambda$) 思想用于优势估计,明确控制 bias 与 variance。 PPO:Proximal Policy Optimization Algorithms(2017)用 clip 或 KL penalty 构造易实现的一阶替代目标,让同一批数据可做多轮 minibatch 更新。 InstructGPT:Training language models to follow instructions with human feedback(2022)展示了 SFT、奖励模型和 PPO 组合成语言模型 RLHF 流水线的代表性实践,也让参考模型 KL 成为对齐工程中的常见组件。 这条演进线并不是“新论文淘汰旧论文”。REINFORCE 给出梯度来源,GAE 改善估计,TRPO/PPO 限制更新,RLHF 再把状态、动作、奖励和约束映射到序列模型。后续算法通常只替换其中一到两块。 08. 常见误解 误解一:优势为正就说明奖励为正 优势是相对量。一个回答奖励为 -2,如果当前 prompt 下平均只能拿 -5,它的优势仍可能为正;一个回答奖励为 9,如果该状态平均是 9.5,它的优势反而为负。策略更新比较的是条件基线,不是绝对分数。 误解二:把优势乘常数不会影响训练 纯策略梯度方向不变,但真实 PPO 还有固定学习率、clip、value loss、熵和 KL 项。优势尺度改变后,各损失的相对权重、越过 clip 边界的速度都会改变。优势标准化是训练定义的一部分,不能只当日志美化。 误解三:ratio 超出区间后一定没有梯度 只有“超出区间且方向有利”的样本会被截断。好动作概率下降得太多、坏动作概率上升得太多时,目标仍保留梯度去纠正。04 节的四行表比背公式更可靠。 误解四:PPO clip 就是 KL trust region clip 在采样动作上限制替代收益,KL 衡量整个动作分布的变化。一个低概率 token 的概率可以相对变化很多而对平均 KL 贡献有限;许多小变化也可能累积出较大 KL。工程实现常同时监控 ratio、clip fraction 和 KL。 误解五:episode 截断等于终止 死亡、成功等真实终止意味着后续价值为零;时间上限只是观察窗口结束,底层状态可能仍有价值。两者都清零 bootstrap 会使 rollout 尾部的 value target 偏低。在固定最大生成长度的 LLM 训练中,这一点对应 EOS 与被长度上限截断的区别。 误解六:old policy 和 reference policy 是同一个概念 old policy 是一轮 PPO 的行为策略快照,几轮 minibatch 后就会更新;reference policy 是长期锚点,通常在 RL 开始时冻结。前者服务于重要性采样,后者服务于行为约束。 09. 动手验证 先在仓库根目录运行: python3 outputs/fundamentals_files/policy_gradient/code/gae_minimal.py python3 outputs/fundamentals_files/policy_gradient/code/ppo_clip_minimal.py 接着做三个小改动,每次只改一个变量并记录输出。 把 gae_minimal.py 的 critic_error 全部设为 0。你会看到 $\lambda=0$ 的偏差大幅下降;奖励噪声不变时,小 $\lambda$ 的低方差优势变得更有吸引力。 把奖励噪声标准差从 0.8 改为 0.1。完整 Monte Carlo target 的方差会明显下降,$\lambda=1$ 的代价随之减小。 把 ppo_clip_minimal.py 的学习率从 0.3 改为 0.03。PPO-Clip 会更接近 ratio=1.2 后才停住,说明 clip 边界不是参数投影,离散优化仍会跨界。 最后给脚本加入 target_kl=0.02 的提前停止条件:每轮更新后计算 KL(old||new),超过阈值就停止。比较它与 ratio clip 的停止轮数。你会看到两种护栏观察的是不同量,也会理解工业实现为什么常把它们同时保留。 10. 延伸阅读 读完这篇可以继续看: 从 DPO 到 GRPO:去掉价值网络:比较偏好优化、组内相对优势与 PPO critic,追踪它们分别改了哪一项。 RLHF 工程实践:继续研究 token mask、参考模型 KL、奖励白化、长度偏置与分布式 rollout。 视频生成中的强化学习与奖励模型:把策略梯度和相对优势迁移到扩散与 flow matching 生成过程,观察奖励黑客如何出现。 回到开头那三个问题,现在可以逐项检查任何新对齐算法:它用什么分配信用,用什么基线或优势降低噪声,用什么机制约束策略变化。只要这三项说清楚,新名词就不会遮住算法真正改变的地方。 附录:完整代码 09 节用到的脚本全文如下(gae_minimal.py、make_figures.py、ppo_clip_minimal.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 gae_minimal.py #!/usr/bin/env python3 """用 NumPy 展示 GAE 递推,以及 lambda 的偏差—方差折中。 依赖:numpy。运行:python3 gae_minimal.py """ import numpy as np def generalized_advantage_estimate(rewards, values, dones, next_value, gamma, lam): """返回 TD 残差、GAE 优势和 value target,输入均为 shape [T]。""" rewards = np.asarray(rewards, dtype=np.float64) values = np.asarray(values, dtype=np.float64) dones = np.asarray(dones, dtype=np.float64) advantages = np.zeros_like(rewards) deltas = np.zeros_like(rewards) gae = 0.0 for t in reversed(range(len(rewards))): value_next = next_value if t == len(rewards) - 1 else values[t + 1] not_done = 1.0 - dones[t] deltas[t] = rewards[t] + gamma * not_done * value_next - values[t] gae = deltas[t] + gamma * lam * not_done * gae advantages[t] = gae return deltas, advantages, advantages + values def fixed_trajectory_demo(): rewards = np.array([0.0, 0.0, 1.0, 0.5]) values = np.array([0.40, 0.55, 0.70, 0.30]) dones = np.array([0, 0, 0, 1]) gamma = 0.99 print("=== 固定轨迹 ===") print(f"rewards.shape={rewards.shape}, values.shape={values.shape}") for lam in (0.0, 0.5, 0.95, 1.0): deltas, advantages, targets = generalized_advantage_estimate( rewards, values, dones, next_value=0.0, gamma=gamma, lam=lam ) print( f"lambda={lam:>4.2f} delta={np.round(deltas, 4)} " f"A={np.round(advantages, 4)} target={np.round(targets, 4)}" ) def bias_variance_demo(seed=7, episodes=20000): """比较 GAE value target 对真实 V(s_0) 的偏差、标准差和均方误差。""" rng = np.random.default_rng(seed) gamma = 0.99 reward_means = np.linspace(0.2, 0.9, 8) horizon = len(reward_means) dones = np.zeros(horizon) dones[-1] = 1.0 true_values = np.zeros(horizon) for t in reversed(range(horizon)): future = 0.0 if t == horizon - 1 else true_values[t + 1] true_values[t] = reward_means[t] + gamma * future # 故意给 critic 加一组固定误差,使短视的 TD target 有偏。 critic_error = np.array([0.30, -0.90, 0.35, -0.25, 0.20, -0.15, 0.10, -0.05]) approx_values = true_values + critic_error rewards_batch = rng.normal(reward_means, 0.8, size=(episodes, horizon)) print("\n=== lambda 的偏差—方差折中(估计 V(s_0))===") print(f"episodes={episodes}, true_V0={true_values[0]:.4f}, critic_V0={approx_values[0]:.4f}") print("lambda mean bias std mse") for lam in (0.0, 0.5, 0.95, 1.0): estimates = np.empty(episodes) for i, rewards in enumerate(rewards_batch): _, advantages, targets = generalized_advantage_estimate( rewards, approx_values, dones, next_value=0.0, gamma=gamma, lam=lam ) estimates[i] = targets[0] bias = estimates.mean() - true_values[0] mse = np.mean((estimates - true_values[0]) ** 2) print(f"{lam:>6.2f} {estimates.mean():>8.4f} {bias:>8.4f} {estimates.std():>8.4f} {mse:>8.4f}") if __name__ == "__main__": fixed_trajectory_demo() bias_variance_demo() make_figures.py #!/usr/bin/env python3 """生成本文的 GAE 偏差—方差图与 PPO 裁剪曲线。 依赖:numpy、matplotlib。运行:python3 make_figures.py 图片写入相邻的 figures/ 目录。 """ from pathlib import Path import matplotlib.pyplot as plt import numpy as np from gae_minimal import generalized_advantage_estimate from ppo_clip_minimal import clipped_surrogate OUT_DIR = Path(__file__).resolve().parent.parent / "figures" def gae_tradeoff_figure(seed=7, episodes=20000): rng = np.random.default_rng(seed) gamma = 0.99 means = np.linspace(0.2, 0.9, 8) dones = np.zeros(len(means)) dones[-1] = 1.0 true_values = np.zeros(len(means)) for t in reversed(range(len(means))): true_values[t] = means[t] + gamma * (0.0 if t == len(means) - 1 else true_values[t + 1]) approx_values = true_values + np.array([0.30, -0.90, 0.35, -0.25, 0.20, -0.15, 0.10, -0.05]) reward_batch = rng.normal(means, 0.8, size=(episodes, len(means))) lambdas = np.array([0.0, 0.25, 0.5, 0.75, 0.95, 1.0]) bias, std, mse = [], [], [] for lam in lambdas: estimates = [] for rewards in reward_batch: _, _, targets = generalized_advantage_estimate( rewards, approx_values, dones, 0.0, gamma, lam ) estimates.append(targets[0]) estimates = np.asarray(estimates) bias.append(estimates.mean() - true_values[0]) std.append(estimates.std()) mse.append(np.mean((estimates - true_values[0]) ** 2)) fig, ax = plt.subplots(figsize=(10, 5.3)) ax.plot(lambdas, np.abs(bias), "o-", linewidth=2.5, label="Absolute bias") ax.plot(lambdas, std, "s-", linewidth=2.5, label="Standard deviation") ax.plot(lambdas, mse, "^-", linewidth=2.5, label="Mean squared error") ax.set(xlabel="GAE lambda", ylabel="Error scale", title="GAE: less bias usually costs more variance") ax.grid(alpha=0.25) ax.legend(frameon=False) fig.tight_layout() path = OUT_DIR / "gae_bias_variance.png" fig.savefig(path, dpi=180, facecolor="white") plt.close(fig) return path def ppo_clip_figure(): ratio = np.linspace(0.4, 1.6, 500) fig, axes = plt.subplots(1, 2, figsize=(11, 4.8), sharex=True) for ax, advantage in zip(axes, (1.0, -1.0)): raw, clipped, objective = clipped_surrogate(ratio, np.full_like(ratio, advantage)) ax.plot(ratio, raw, linestyle="--", linewidth=2, label="Unclipped") ax.plot(ratio, objective, linewidth=3, label="PPO objective") ax.axvspan(0.8, 1.2, color="#2f6df6", alpha=0.08) ax.axvline(1.0, color="black", linewidth=1, alpha=0.5) ax.set_title(f"Advantage = {advantage:+.0f}") ax.set_xlabel("new / old probability ratio") ax.grid(alpha=0.2) axes[0].set_ylabel("Per-sample surrogate") axes[0].legend(frameon=False) fig.suptitle("PPO-Clip is one-sided and depends on the advantage sign", fontsize=14) fig.tight_layout() path = OUT_DIR / "ppo_clip_sign.png" fig.savefig(path, dpi=180, facecolor="white") plt.close(fig) return path if __name__ == "__main__": OUT_DIR.mkdir(parents=True, exist_ok=True) for output in (gae_tradeoff_figure(), ppo_clip_figure()): print(f"saved: {output} ({output.stat().st_size / 1024:.1f} KiB)") ppo_clip_minimal.py #!/usr/bin/env python3 """用 NumPy 拆解 PPO-Clip,并在两臂老虎机上复用同一批数据更新多轮。 依赖:numpy。运行:python3 ppo_clip_minimal.py """ import numpy as np def clipped_surrogate(ratio, advantage, epsilon=0.2): ratio = np.asarray(ratio, dtype=np.float64) advantage = np.asarray(advantage, dtype=np.float64) unclipped = ratio * advantage clipped = np.clip(ratio, 1.0 - epsilon, 1.0 + epsilon) * advantage objective = np.minimum(unclipped, clipped) return unclipped, clipped, objective def clipping_table(): ratios = np.array([1.35, 0.65, 1.35, 0.65, 1.10, 0.90]) advantages = np.array([1.0, 1.0, -1.0, -1.0, 0.5, -0.5]) raw, clipped, objective = clipped_surrogate(ratios, advantages) print("=== 单样本裁剪表 ===") print(" ratio A ratio*A clip(ratio)*A min clipped?") for r, a, u, c, o in zip(ratios, advantages, raw, clipped, objective): flag = "yes" if not np.isclose(u, o) else "no" print(f" {r:>4.2f} {a:>4.1f} {u:>7.3f} {c:>7.3f} {o:>6.3f} {flag}") def sigmoid(x): return 1.0 / (1.0 + np.exp(-x)) def bandit_objective(theta, clipped): """旧策略两动作概率各 0.5;动作 1 优势 +1,动作 0 优势 -1。""" p_good = sigmoid(theta) ratios = np.array([p_good / 0.5, (1.0 - p_good) / 0.5]) advantages = np.array([1.0, -1.0]) if clipped: return clipped_surrogate(ratios, advantages)[2].mean() return np.mean(ratios * advantages) def finite_difference_gradient(theta, clipped, h=1e-5): return (bandit_objective(theta + h, clipped) - bandit_objective(theta - h, clipped)) / (2 * h) def bernoulli_kl(old_p, new_p): return old_p * np.log(old_p / new_p) + (1.0 - old_p) * np.log((1.0 - old_p) / (1.0 - new_p)) def optimize_same_batch(clipped, steps=40, learning_rate=0.3): theta = 0.0 snapshots = [] watch = {0, 1, 2, 5, 10, 20, 39} for step in range(steps): grad = finite_difference_gradient(theta, clipped) theta += learning_rate * grad if step in watch: p_good = sigmoid(theta) ratio_good = p_good / 0.5 snapshots.append((step + 1, p_good, ratio_good, grad, bernoulli_kl(0.5, p_good))) return snapshots def repeated_update_demo(): print("\n=== 在同一批旧策略数据上更新 40 轮 ===") print("mode epoch p(good) ratio_good grad KL(old||new)") for mode, clipped in (("unclipped", False), ("PPO-Clip", True)): for epoch, p_good, ratio, grad, kl in optimize_same_batch(clipped): print(f"{mode:<10} {epoch:>5d} {p_good:>7.4f} {ratio:>7.4f} {grad:>7.4f} {kl:>7.4f}") if __name__ == "__main__": clipping_table() repeated_update_demo() 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注