搜索到
38
篇与
AIGC Fundamentals
的结果
-
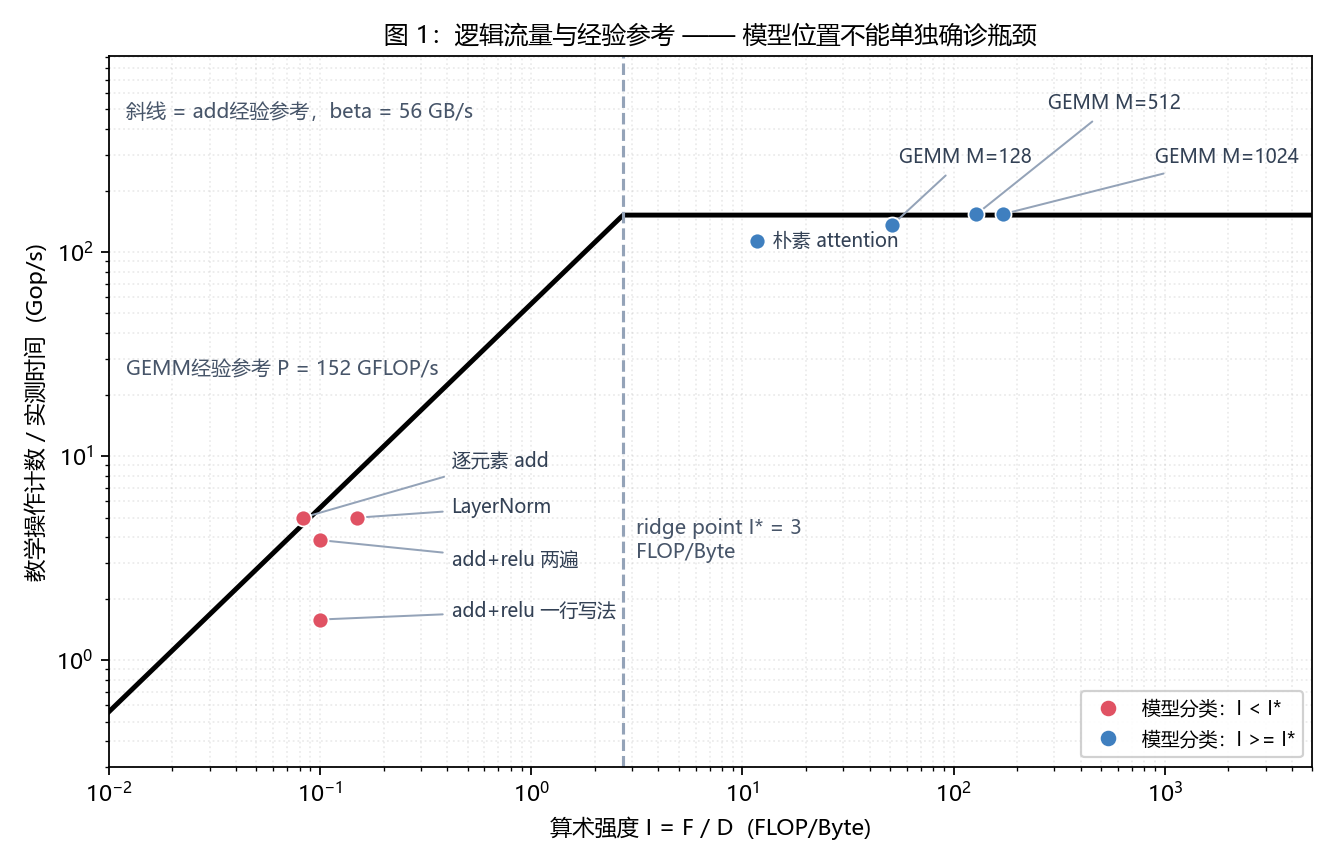
 AIGC 基本功|性能建模与 Profiling:算力、带宽与显存账本-Roofline AIGC 基本功|性能建模与 Profiling:算力、带宽与显存账本-Roofline 所属方向:推理加速 | 难度:进阶 | 前置知识:混合精度与数值稳定性、自注意力机制的计算与显存账本 关键词:性能建模、Profiling、Roofline、算术强度、memory bandwidth、FLOPs、MFU、PyTorch Profiler、Nsight 01. 为什么需要它 先看本次 CPU 复核得到的两段计算:GEMM 约 98.57 MFLOP,逐元素 add 约 100 MFLOP;二者运算量相近,最短耗时却分别为 1.029 ms 和 23.623 ms,差 22.9 倍。环境为 Windows / AMD64、NumPy 2.4.6、OpenBLAS,线程请求值为 1。machine_probe.py 会记录实际 NumPy 构建配置和全部计时样本。 这里 add 复用 200 万元素的三份 fp32 数组,工作集 24 MB,重复 50 轮;累计逻辑流量 1200 MB,并不等于实测 DRAM 搬运量。GEMM 通过矩阵复用获得更高逻辑算术强度,但本实验没有硬件计数器,不能把 22.9 倍差距全部归因于 DRAM 带宽。它足以提醒我们:只比较 FLOPs,不能预测耗时。 再看一个优化评审:想把 LayerNorm 换成更快的低精度计算单元。若一行数据确实能驻留片上、只读输入并写输出,本文简化账本的强度约为 1.5 个教学操作/Byte;是否由带宽主导,还要核对标量、归约、平方根的执行资源,不能直接与 BF16 Tensor Core 的 ridge point 比较。只有在已确认流量主导、其他资源不变的模型里,单独提高计算峰值的收益才是 1.00。 小 batch GEMM 的权重量化常能减少字节,但反量化、格式元数据和内核效率也要记账。 这篇的目的就是把这套「先算账再动手」的方法补齐:两个账本——速度账(算力 vs 带宽)和容量账(显存四项)——加上一套实测手段(profiler)。量化、算子融合、KV cache 管理、并行切分,所有推理优化节点的收益判断都站在这篇的地基上。 02. 最小可用理解 阅读前只需会矩阵形状、乘加计数和单位换算;混合精度一篇解释 dtype 与字节数,注意力一篇解释 Q/K/V。本篇会补足异步计时、缓存层级与活跃 token 的必要背景,不要求先懂 CUDA 内核。 三句话讲完核心: 任何算子的耗时有一个下界,由两种资源里更慢的那个决定:$T \ge \max(F/P_{\text{peak}},\ D/\beta)$。$F$ 是算子要做的浮点运算数,$P_{\text{peak}}$ 是硬件与该指令类型匹配的峰值算力;$D$ 是算子要搬运的字节数,$\beta$ 是带宽。算得再快也快不过「数据没到」。 算术强度 $I = F/D$ 决定卡在哪:与 ridge point $I^{\ast} = P_{\text{peak}}/\beta$ 比较,$I \lt I^{\ast}$ 表示该二资源模型的流量项主导,优先检查少搬字节的机会(融合、量化、FlashAttention);$I \gt I^{\ast}$ 表示计算项主导,再检查少算或提高同口径吞吐的机会。两种分类都须用实际流量和热点执行资源核验。 显存容量是另一本独立的账:权重 + KV cache + 激活 + 额外开销四项加总,才决定一张卡能塞多少并发。「权重放得下就能跑」只覆盖了四项里的第一项。 03. 数学推导 3.1 时间下界为什么取 max 一个算子要做 $F$ 个浮点运算(FLOP,口径:一次乘加记 2 个 FLOP),硬件每秒最多做 $P_{\text{peak}}$ 个——就算计算单元一刻不停,也至少要 $F/P_{\text{peak}}$ 秒。同理,算子要把 $D$ 字节的数据在内存和计算单元之间搬个来回,总线每秒最多搬 $\beta$ 字节——至少要 $D/\beta$ 秒。无论计算和搬运是否重叠,总时间都不能短于这两个最低时间,所以可取 max 作为下界。若进一步用等号近似真实时间,才需要充分重叠和接近峰值利用率等假设: $$T \ge \max\left(\frac{F}{P_{\text{peak}}},\ \frac{D}{\beta}\right)$$ 注意这是下界:真实 kernel 还有 kernel launch、同步、缓存未命中、TLB miss 等额外开销,只要 $F$、$D$ 和对应物理峰值口径正确,实际耗时不能突破这个下界。后面的实验用经验标定值和逻辑数组流量代入,此时算出的只是参考模型估计;计时波动或缓存会产生超过 100% 的达成率,并不违反物理下界。差距也不能全算成可消除的优化空间。 3.2 算术强度与 ridge point 定义算术强度: $$I = \frac{F}{D}$$ 物理含义:每从内存搬 1 字节数据,能换来多少次浮点运算。它取决于实现与所选存储层级;实际缓存命中和重复加载又与硬件有关,不能视为完全与机器无关。再定义机器的 ridge point: $$I^{\ast} = \frac{P_{\text{peak}}}{\beta}$$ 物理含义:给定指令资源与存储层级下,「算」和「搬」模型时间一样长的分界点,单位都是 FLOP/Byte,所以可以比。把 $I$ 与 $I^{\ast}$ 代回 3.1 的下界: $I \lt I^{\ast}$(模型流量项主导):$D/\beta$ 那一项更大,$T \approx D/\beta$,模型性能上界 $F/T \le I \cdot \beta$——性能与算力峰值无关,只跟 $I$ 成正比,这就是 roofline 图上那条斜线; $I \ge I^{\ast}$(模型计算项主导):$T \approx F/P_{\text{peak}}$,性能封顶在 $P_{\text{peak}}$,这就是平顶。 $P_{\text{peak}}$ 必须匹配运算类型。本文采用 A100 40GB SXM 白皮书 Table 1的 BF16 dense Tensor Core 312 TFLOP/s、HBM2 带宽 1555 GB/s,得到 $I^{\ast}=200.6$;同表 FP32 CUDA core 只有 19.5 TFLOP/s,对应 12.5 FLOP/Byte。A100 的表中没有原生 FP8 Tensor Core。保留这些旧卡作为易复算例子,数字不是对所有算子的统一峰值。 H100 SXM 官方规格给带稀疏脚注的 BF16 1979、FP8 3958 TFLOP/s;除去结构化稀疏的二倍口径后约为 989.5、1979。代码取 BF16 的约数 989、带宽 3.35 TB/s。下面若对 add、LayerNorm、softmax 统一代入 $P=312$ TFLOP/s,只是在演示一个假想统一操作吞吐的教学模型,不能据此诊断 A100 上的标量算子。真实不同资源的写法见 3.6。 3.3 给几类算子记账 GEMM:$A[M,K] \times B[K,N] \to C[M,N]$。每个输出元素要做 $K$ 次乘加,共 $M N K$ 次,乘加各记一次: $$F_{\text{gemm}} = 2MNK,\qquad D_{\text{gemm}} = b\,(MK + KN + MN)$$ $b$ 是每元素字节数(bf16 取 2)。这是每份输入读一次、输出写一次且不读取旧 C 的最低流量示例,未计分块重读、write allocate 与输出累加。固定 K/N 时增大 M 可摊薄权重读取,提高模型 I;大 batch 更可能接近计算侧、小 batch 更可能受流量影响,但缓存命中、矩阵布局和内核调度可能改变实际瓶颈。 逐元素算子:$n$ 个元素各做 1 次运算,读 2 份写 1 份: $$F = n,\qquad D = 3 b n,\qquad I = \frac{1}{3b}$$ $I$ 是常数(fp32 下约 0.083,bf16 下约 0.17),与 $n$ 无关。在固定 dtype 与访存模型下,增大 n 本身不会提高 I,因而不会像增加 GEMM 的复用维度那样跨越 roofline 分界。 简化 LayerNorm:共 n 行、每行 d 个元素(本节不加偏置,只保留 gamma),先求均值、减均值、平方后再求均值,最后除标准差并乘 gamma;忽略每行 eps 加法/平方根等小量,按教学规则每个元素约六次操作。若整行及统计量能复用、gamma 读取等小量忽略,最低流量示例为一次读与一次写: $$F_{\text{ln}}\approx6nd,\qquad D_{\text{ln,min}}\approx2bnd,\qquad I_{\text{ln,min}}\approx\frac{3}{b}$$ bf16 时得到约1.5个教学操作/Byte。本文 NumPy 分步实现会反复读写大数组,共约10遍,fp32 下 $I\approx6/(10\times4)=0.15$;广播 gamma 和行统计量按可复用小数组另计。两种流量口径不同,不应把最低流量模型冒充 NumPy 的物理实测流量。 softmax 的读写口径:本文的三阶段教学实现先读 X 求 max,再读 X、计算并保存指数数组 E(同时归约求和),最后读 E、归一化并写 P。因此是 3 读 2 写,约 $D=5bnd$;这里假设“保存 E 与求和”已融合,并不是第 4.2 节 NumPy 各语句的完整流量。若整行能驻留片上存储,融合实现可约 1 读 1 写,二者的理想流量比为 2.5。 在线归一化原论文 Algorithm 2的 Safe softmax 不保存 E,输出时重新计算 exp,因此是 3 读 1 写;Algorithm 3 的 online 版本先流式求归一化量,再重读输入写概率,为 2 读 1 写,其对照是 4/3 的流量比。它们与本文保存 E 的基线不同,也与 Triton 整行融合示例的驻留前提不同,不能混用这些比值。 本文与 roofline_model.softmax 对保存 E 或整行驻留的模型统一用约 $5nd$ 作为教学操作计数(max、减法、exp、求和、除法各按一次,忽略每行的小量);它不是五类操作都拥有相同吞吐的物理断言。max、exp 与除法并非都能跑在 Tensor Core 上;重新计算 exp 的 Safe 版本、online 递推及实际分块内核都需另数操作。 单头注意力($N$ 是 token 数,$D_{h}$ 是每头维度):两次 $N \times N \times D_{h}$ 的矩阵乘加 softmax: $$F_{\text{attn}} = 4N^{2}D_{h} + 5N^{2}$$ 朴素实现的分数矩阵 $S$ 和概率矩阵 $P$ 都要落显存,二次项访存约 $4N^{2}$;FlashAttention 原论文 Algorithm 1 与 IO 分析只让当前分数/概率瓦片驻留片上,不保存完整 $N^{2}$ 矩阵;若仅统计每份输入读取一次与输出写回一次,可得到不可避免的数据流量下界;真实分块内核会反复读入 K/V 或 Q 等数据: $$D_{\text{朴素}} = b\,(4N^{2} + 4ND_{h}),\qquad D_{\text{flash,min}} = b \cdot 4ND_{h}$$ 代入 $N=4096$、$D_{h}=128$、bf16(脚本 roofline_model.py 实算):朴素 $D = 138.41\ \text{MB}$、$I = 62.7$,落在 A100($I^{\ast} = 200.6$)的带宽受限区;理想最低流量 $D_{\mathrm{flash,min}} = 4.19\ \text{MB}$、$I = 2068$,跳进算力受限区。教学函数令两种路径使用相同操作计数(×1.000),参考模型从 0.089 ms 降到 0.028 ms(×3.2);真实 online softmax 有额外归约/重缩放操作,不能据此说实际 FLOPs 完全不变。这是按最低流量与假想统一吞吐计算的理想示例,33 倍不是实际 FlashAttention 访存或速度的测量;有限片上存储下还需分块 IO 模型。FlashAttention 那篇的完整递推在知识树的下一节点展开,这里先用 roofline 把它的收益定位清楚。 图 1:这张图要看三样——散点的横坐标是各算子的算术强度 $I$,点越靠右越「算得过来」;按 I 与 I 的相对位置给点作模型分类;点到经验参考折线的距离并不能单独证明真实瓶颈;FlashAttention 会改变访存量和横坐标,无法直接把这段垂直差距视为它的加速收益。* 3.4 模型估计随资源改变的比值 把算力翻倍($P_{\text{peak}} \to 2P_{\text{peak}}$),加速比是: $$S_{\text{算力}} = \frac{\max(F/P_{\text{peak}},\ D/\beta)}{\max(F/(2P_{\text{peak}}),\ D/\beta)}$$ 若模型流量项主导,分子分母都是 $D/\beta$,$S_{\text{算力}} = 1$。算力受限时加速至多为 2;当 $1\lt I/I^{\ast}\lt 2$ 时,算力翻倍会遇到带宽上限,加速为 $I/I^{\ast}$。带宽翻倍对称地反一次。roofline_model.py 第四节用统一教学计数代入 $P=312$ TFLOP/s、$\beta=1555$ GB/s,下面是该假想二资源模型的结果;只有 BF16 dense GEMM 的计算峰值与 A100 规格直接匹配,其他行仍需 3.6 的资源区分: 算子 I/I* 算力×2 的加速 带宽×2 的加速 逐元素 add [16M] 0.001 1.00x 2.00x LayerNorm [4096, 3072] 0.007 1.00x 2.00x softmax 朴素三遍 [4096, 4096] 0.002 1.00x 2.00x GEMM 512x4096x4096 2.041 2.00x 1.00x attention 朴素 [N=4096,D=128] 0.312 1.00x 2.00x attention ideal-min [N=4096,D=128] 10.307 2.00x 1.00x 这些是模型估计时间的比值,不是对真实优化加速比的无条件上限。一个实现若同时消除了调度开销、缓存重读或中间分配,实际加速可以大于单独改变 P 或 beta 的模型比值;反过来,开销不降也可能达不到该比值。图 2 用于提出测量假设,不能代替 profile。 图 2:这张图要看什么——横轴 $I/I^{\ast}=1$ 那条竖线就是分界线:线左边算力翻倍的理想收益为 1,带宽翻倍收益在 1 到 2 之间;只有 I/I≤0.5 时完整得到 2 倍。线右边对称,I/I≥2 才完整得到算力翻倍的 2 倍。投入硬件或投入算子融合之前,先看自己在哪一侧。 3.5 显存的容量账 速度账之外另有一本容量账。下面以未分块 prefill、同时处理 BS 个 token 为例,显存分四项: $$M_{\text{total}} = N_{\text{params}} \cdot b_{w} + 2BSLd_{\text{kv}}b_{\text{kv}} + N_{\text{active}}a + \rho M_{\text{sum}}$$ 逐项说物理含义:$N_{\text{params}}$ 是参数量、$b_{w}$ 是每参数字节数(fp16 为 2)——这一项与并发无关,是常数;$B$ 是并发序列数、$S$ 是序列长度、$L$ 是层数、$d_{\text{kv}}$ 是每层 KV 总维度(GQA 模型用实际的 KV head 数乘头维度)——KV cache 每个 token 每层都要存一份 K 和一份 V,所以是 $2BSLd_{\text{kv}}b_{\text{kv}}$ 字节;$b_{\text{kv}}$ 是 KV 的每元素字节数,与权重 dtype 独立;KV 总容量随并发线性增长;$a$ 是每 token 的激活峰值(推理不保留整层中间结果,但当前层十几份临时张量要同时活着,$d_{\text{model}}=4096$、fp16 时假设同时存活 16 份这种张量得到 128 KiB/token;这是容量练习的显式假设,未做模型显存峰值测量,不能视为经验通用常数);$\rho$ 是额外开销率,$M_{\text{sum}}$ 是前三项之和。这里 $N_{\text{active}}$ 是同时处理的活跃 token 数:未分块 prefill 取 BS,逐 token decode 通常取 B,分块 prefill 取本轮实际 chunk token 数。KV cache 仍按已保存上下文 token 数计。变长序列应把 BS 换成各序列实际长度之和;权重 fp16 并不要求 KV 也用 fp16,代码显式支持 kv_b 和 active_tokens。第 04 节把未分块 prefill 的教学账本代进一个 7B 模型。 3.6 同一 kernel 的运算可能不走同一资源 把不同工作量分开:$F_{\text{tc}}$ 为 Tensor Core 的乘加 FLOP,$F_{\text{scalar}}$ 为普通浮点管线 FLOP,$N_{\exp}$ 为指数次数,$D_{\ell}$ 为存储层级 $\ell$ 的实测字节数。分别匹配峰值 $P_{\text{tc}}$、$P_{\text{scalar}}$、指数吞吐 $R_{\exp}$ 和该层带宽 $\beta_{\ell}$,仍可逐项取最大: $$T\ge\max\left(\frac{F_{\text{tc}}}{P_{\text{tc}}},\frac{F_{\text{scalar}}}{P_{\text{scalar}}},\frac{N_{\exp}}{R_{\exp}},\max_{\ell}\frac{D_{\ell}}{\beta_{\ell}}\right)$$ 这是更细的乐观下界;如果操作有依赖或共享执行资源,还可能需要把某些时间相加。没有 $R_{\exp}$ 实测或明确规格时,就不能从 $5nd$ 推出 softmax 的硬件计算时间。Hierarchical Roofline 原文解释为什么每一级存储都需要自己的流量与带宽,不能拿逻辑数组流量直接配 DRAM 带宽。 一个纯算术反例(单位为教学单位,非任何GPU规格):Tensor工作量10、吞吐100,标量工作量90、吞吐10,搬100字节、带宽100。误把100次操作全除以100得到计算时间1;分资源后下界为 max(0.1,9,1)=9。resource_time 实跑验证了这个9倍差距。这说明“运算数少”与“该类资源能做多快”必须一起定义。 04. 代码实现 保留原来的三个数值脚本与四幅图,并增加可独立运行的 profiler_probe.py。数值实验只需 Python 3.10+ 与 NumPy;图表另外需要 matplotlib,Profiler 对照另需 PyTorch(本次 2.10.0+cpu)。依次运行 machine_probe.py、roofline_model.py、memory_ledger.py、profiler_probe.py、make_figures.py,文末附录包含完整代码。 原稿的大工作集默认占用较多内存,尤其十亿元素 add 还曾通过 float64 临时数组初始化。本版默认用有界工作集;machine_probe.py --large 和 memory_ledger.py --large 保留原 32M 向量、4096 方阵与 64 MiB batch 权重实验,运行前需确认资源。默认模式不能证明 DRAM 流量、GPU 内核瓶颈或服务吞吐。 本次快照时间 2026-10-10 09:12:57;Windows / AMD64、NumPy 2.4.6、OpenBLAS、fp32,BLAS/OpenMP线程请求值均为 1(只设置本次进程)。经验参考 $\beta=55.74$ GB/s、$P=151.75$ GFLOP/s、$I^{\ast}=2.72$ FLOP/Byte。它们是所选 shape 的最短样本结果,不是设备峰值。 4.1 标定两个经验参考 add 标定用 200 万个 fp32 元素、三份数组,总工作集 24 MB,累计每轮逻辑读写也是 24 MB;是否触及 DRAM,取决于缓存层级与系统状态。方阵乘用 1024×1024,三份数组工作集 12 MiB,$F=2n^{3}$,不能将这个 shape 的经验参考视作所有矩阵形状的可达峰值。 预热一次后,add 测 8 次,GEMM 测 5 次;代码同时保存全部样本、min、median、max。参考折线采用最短时间,以观察接近最佳状态的实现;端到端延迟应另测典型请求、并发和分位数,不能套用这个 min。 add:最短 0.431 ms,中位数 0.612 ms GEMM:最短 14.152 ms,中位数 14.367 ms 经验 P = 151.75 GFLOP/s,add 逻辑字节率 beta = 55.74 GB/s,I* = 2.72 比值超过 100% 不代表违反物理定律:逻辑 D 未用硬件计数器测量,而基线 P/beta 只来自一个 shape 和访问模式。本机算子若运行得比参考更好,也会超过这条经验折线。 4.2 把真实算子打上 roofline 关键测试对象是 matmul-softmax-matmul 微基准;此处省略 1/√D 缩放,不是完整的生产 attention。下面按 NumPy 语句累计逻辑读写:右侧 1~10 是分数/概率矩阵的累计访问遍数;它不包含 Q/K/V/O 的线性项,也不是十次完整 DRAM 扫描的测量。实际 BLAS 分块、CPU缓存、write allocate 都可能改变物理流量: def attention_naive(): np.matmul(q, kt, out=S) # 写 S 1 遍 np.max(S, axis=-1, keepdims=True, out=rowmax) # 读 S 2 遍 np.subtract(S, rowmax, out=S) # 读写 S 4 遍 np.exp(S, out=S) # 读写 S 6 遍 np.sum(S, axis=-1, keepdims=True, out=rowsum) # 读 S 7 遍 np.divide(S, rowsum, out=S) # 读写 S 9 遍 np.matmul(S, v, out=O) # 读 S 写 O 10 遍 本次默认模式的真实输出(经验 $I^{\ast}=2.72$;“模型位置”只指该参考折线): 算子 | I | 模型位置 | 估计 ms | 最短 ms | 中位 ms | 参考比值 逐元素 add(1 遍) | 0.08 | 带宽 | 0.431 | 0.400 | 0.511 | 108% add+relu 两遍(预分配) | 0.10 | 带宽 | 0.718 | 1.032 | 1.465 | 70% add+relu 写成一行(有中间数组) | 0.10 | 带宽 | 0.718 | 2.530 | 2.970 | 28% LayerNorm [1024,1024] 预分配 | 0.15 | 带宽 | 0.753 | 1.261 | 1.290 | 60% attention 朴素 [N=512,D=128] | 11.75 | 算力 | 0.893 | 1.191 | 1.211 | 75% GEMM 128x1024x1024 | 51.20 | 算力 | 1.769 | 1.978 | 2.116 | 89% GEMM 512x1024x1024 | 128.00 | 算力 | 7.076 | 7.020 | 7.320 | 101% GEMM 1024x1024x1024 | 170.67 | 算力 | 14.152 | 14.017 | 14.306 | 101% 逐元素、LayerNorm 与注意力的 exp/max 被各按一个教学操作计数,因此表中的参考 P 只可作粗略标尺,不能认为这些指令都能达到 GEMM 吞吐。分配与归约是否主导,还需更细的 profile。 本次朴素 attention 的模型位置是“算力”,参考比值 75%;原稿 arm64、大 shape 快照的位置曾是“带宽”。这正好构成反例:同一个算法换 shape、BLAS、线程和经验参考,模型分类便可能改变;仅凭这张总计时表无法确证哪级缓存、哪类指令才是瓶颈。 图 1 画全部 8 行,图文使用同一快照。 4.3 显存账本与 batch 拐点 未分块 prefill 的容量教学账代一个 7B 模型(32 层、$d_{\text{kv}} = 4096$、权重和 KV 都取 fp16): 模型:7B,fp16 权重 = 13.0 GiB,32 层,d_kv = 4096 KV cache 单价:512 KiB / token (一条 4096 长的序列 = 2.00 GiB) batch 权重 KV cache 激活 额外开销 合计 假设 78 GiB 可用预算 1 13.0G 2.00G 0.50G 4.66G 20.20G 装得下 8 13.0G 16.00G 4.00G 9.91G 42.95G 装得下 16 13.0G 32.00G 8.00G 15.91G 68.95G 装得下 24 13.0G 48.00G 12.00G 21.91G 94.95G OOM 32 13.0G 64.00G 16.00G 27.91G 120.95G OOM 两个读数:权重是常数,batch 再大都是 13.0 GiB;KV cache 按 512 KiB/token 线性涨,batch 16 时(32 GiB)已经是权重的 2.5 倍。此处 30% 是人为设定的额外开销/前三项总量比率,不是实测额外开销率;它也不同于 PagedAttention 论文中 KV cache 已分配容量的浪费比例。同一张卡只把本教学模型的额外开销率改成 4%,batch 24 从 94.95 GiB 降到 75.96 GiB,从 OOM 变装得下:不换卡、不改模型,这个假设账本跨过一个 batch 档位;真实分页收益需只对可优化的 KV 分配项建模,并检查实际可用显存。例如 batch=24 若只把“KV 额外开销/有效KV”从 30% 改为 4%,而权重、激活不加该比例,合计从 87.44 GiB 降到 74.96 GiB;这是另一个显式教学账本,仍不是 PagedAttention 实测复现。 容量账决定“能开多大”,速度账用于比较吞吐与延迟。默认 batch 微基准固定 1024×1024 的 fp32 权重,只有 4 MiB;原稿 4096×4096、64 MiB 可通过 --large 恢复。本次每个 B 预热一次后测 15 次,吞吐是 B 除以最短 GEMM 时间,不包含请求排队、前后处理或完整模型: B | F MFLOP | D MB | I | 模型位置 | 最短 ms | 中位 ms | 吞吐 K token/s 1 | 2.097 | 4.202 | 0.50 | 带宽 | 0.059 | 0.065 | 16.9 2 | 4.194 | 4.211 | 1.00 | 带宽 | 0.382 | 0.391 | 5.2 4 | 8.389 | 4.227 | 1.98 | 带宽 | 0.346 | 0.347 | 11.6 8 | 16.777 | 4.260 | 3.94 | 算力 | 0.406 | 0.416 | 19.7 16 | 33.554 | 4.325 | 7.76 | 算力 | 0.502 | 0.512 | 31.9 32 | 67.109 | 4.456 | 15.06 | 算力 | 0.711 | 0.802 | 45.0 64 | 134.218 | 4.719 | 28.44 | 算力 | 1.107 | 1.138 | 57.8 128 | 268.435 | 5.243 | 51.20 | 算力 | 1.939 | 2.043 | 66.0 256 | 536.871 | 6.291 | 85.33 | 算力 | 3.604 | 3.722 | 71.0 B=1 到 256,最短延迟增长 61.0 倍,GEMM-only 吞吐增长 4.2 倍;没有理由预设“batch 越大延迟就一定平坦”。B=1 的参考比值 128% 也证明经验折线不是硬件上界。4 MiB 权重可能被缓存复用,D 表只记逻辑流量,不能直接把 D/时间当成 DRAM 带宽。 另作两个容量反例:在 batch=24、4096上下文下,把 KV 从 2 字节改成 1 字节,KV 项从 48 GiB 降至 24 GiB;仅改变权重 dtype 并不会自动改变 KV dtype。相同 KV 上下文做逐 token decode,激活项若按 128 KiB/活跃token 的假设计数,则从 prefill 的 12 GiB 变为约 0.00293 GiB;实际 attention workspace、分配器和运行库仍要另计。memory_ledger.ledger 支持这两种参数,见 09 节。 图 3:这张图要看什么——左边是实测延迟,右边是实测吞吐,曲线不保证出现理想平坦段;竖虚线是首个跨过经验 ridge point 的采样 B,模型边界在它与前一采样值之间;延迟变化可能有多个原因,不能从该图猜测具体库路径。 图 4:这张图要看什么——左图是显存四项的堆叠:蓝色权重是常数,红色 KV cache 随并发线性涨,越过黑色可用线就是 OOM;右图是只改一个参数(额外开销率 30%→4%)的效果,batch 24 从 OOM 变装得下。 05. 工业级实现对照 PyTorch v2.10.0 torch/profiler/profiler.py#profile是本次核验的固定源码版本。附录 profiler_probe.py 定义了完整 x/w,CPU 也能运行;若 CUDA 可用,才加 CUDA activity 并在独立计时前后同步。预热与延迟测量放在采集区外,减少把初始化和采集成本当作 kernel 时间的风险。它和本文账本的对应关系是: key_averages 聚合算子事件,不等于直接聚合 GPU kernel;嵌套事件的总时间可能重复包含子调用,不能把所有行的 total time 简单相加。CPU 本次按 self_cpu_time_total 排序;CUDA 分支按 self_device_time_total 排序,该分支尚未在本次 CPU 机器实测。 with_flops=True 在该版本只估计支持的矩阵乘与二维卷积等算子;本次 aten::mm 报 524288,与 $2\times16\times128\times128$ 一致,输出 shape 为 [16,128]。它不是全模型完整 FLOPs 计数,也不是实测指令数。 profile_memory=True 跟踪张量分配/释放。本次 mm 的 self CPU memory 为 8192 字节,恰好等于输出大小;这是该事件的分配增量,不是 CPU RSS 或设备显存峰值,也不涵盖预先创建的权重、KV、allocator reserve 与所有 workspace。 record_shapes 等开关会增加开销并保留张量引用,可能影响优化;定位后应关闭采集单独计时。代码导出 Chrome trace,后续才能分析热点、子事件与时间线。 PaLM §4.1 与 Appendix B定义的训练 MFU 排除激活重算 FLOPs,只计模型所需前向与反向运算。使用 MFU(Model FLOPs Utilization)时应先定义模型理论运算量、时间窗口、卡数与匹配硬件峰值,典型形式为 $\mathrm{MFU}=F_{\text{model}}/(T_{\text{wall}}N_{\text{gpu}}P_{\text{peak}})$。本文不从这一次 mm 采集计算模型 MFU;分布式通信、并发重叠和计时范围都可能改变分母。 Nsight 工具的分工:Nsight Systems 官方 User Guide对应 kernel 空隙、同步和通信时间线;Nsight Compute 官方 Profiling Guide给热点 kernel 的指令吞吐、缓存层级、occupancy 与 stall 等指标。Speed Of Light 的两个百分比是利用率摘要,不能只比较它们便确证瓶颈。先用时间线选热点,再用与该 kernel 指令/存储层级相匹配的计数器检验模型。本次没有 NVIDIA GPU,不宣称完成 nsys/ncu 实测。 SDPA 会按输入和硬件选择后端,不能断言所有 diffusers/transformers 默认用某个 FlashAttention 实现。本文 2068 个教学操作/Byte 来自理想一次读写与统一计数,真实 FlashAttention 仍有分块重读、标量归约和有限片上容量约束。 06. 代价与边界 roofline 是模型,模型有假设。四条主要假设和不成立时的样子: 把下界当时间近似时,假设计算与访存充分重叠。真实 kernel 在算和搬之间来回切换,还有 launch 和同步的开销。小工作集与短 kernel 常会受这些开销影响,但总计时不足以定量区分每一项,本次 B=1 结果也不能单独证明 launch 开销主导。 假设峰值算力是一个数。实际有 fp16/bf16/fp8/稀疏好几档,差 6 倍以上;按 BF16 dense 口径,H100 SXM 相比 A100 40GB SXM 的 ridge point 从约 201 升到 295——在同一 GEMM 逻辑流量与指令口径的模型里,更多强度值会落进带宽侧,拿旧卡的直觉做判断会错。 假设 $D$ 与缓存无关。本文数组账本的 $D$ 是逻辑读写,缓存命中会让逻辑 D/时间大于 DRAM 标称带宽;这并不代表物理DRAM超速,必须先测相应层级流量。锚点论文 Hierarchical Roofline(arXiv:2009.05257)就是把单一 roofline 扩展成每级缓存一条,用于定位数据移动发生在哪一层。 假设算子孤立。decode 阶段 GEMM 的「权重」每层都要重新读一遍,全局账(整个模型、整个请求)和单算子账结论可能不同;通信算子(allreduce)的账本里延迟和消息数占大头,照搬本文公式会算错。 什么时候不用它:动态 shape、算子间强耦合(融合边界在变)、通信密集的分布式场景——这些先上 profiler 看时间线,先选热点与明确测量口径,再用 roofline;分层、分资源模型也可以帮助分析这些复杂负载,只是本文简单二资源式不够。坦诚标注:本文当前数值实测来自 Windows CPU 的 NumPy 与一个 PyTorch CPU 小矩阵;原大工作集形状保留为可选模式,数字本身不可迁移,理想分段趋势也可能被缓存、内核选择和调度打破。 07. 经典论文脉络 Roofline: An Insightful Visual Performance Model for Multicore Architectures(Williams et al., CACM 2009;2008 Berkeley 技术报告版本):提出算术强度与 ridge point,一根折线把「算力受限/带宽受限」变成可判定的题。一切性能建模的原点。 Hierarchical Roofline Performance Analysis for Deep Learning Applications(Yang et al., 2020):把 roofline 按缓存层级展开,回答「多搬的字节发生在哪一级存储」,是本文锚点论文,也补了单一 roofline 在深度学习负载上最大的盲区。 FlashAttention(Dao et al., 2022):IO-aware 的代表作——保持精确注意力的数学结果与主导矩阵乘量级,靠 tiling + online softmax 避免完整 N×N 中间量落 HBM;标量重缩放和重复读取仍有代价,是否改变实际瓶颈须看形状与内核。roofline 视角下「优化带宽」的教科书案例。 Mixed Precision Training(Micikevicius et al., 2017):换 dtype 同时改两本账——$b$ 变小省字节,算力单元换挡提峰值。哪半边有收益取决于受限类型(已发长文专门讲数值稳定那半)。 Efficient Memory Management with PagedAttention(Kwon et al., 2023):在论文比较的服务负载中显著减少 KV cache 分配浪费;这些比例不能直接乘到权重、激活和所有显存上,虚拟内存的分页思想搬进显存管理。知识树里 KV cache 一篇的主角。 五篇连起来是一条线:先有判定工具(roofline),再按受限类型各给一把钥匙——算力侧(混合精度)、带宽侧(FlashAttention)、容量侧(PagedAttention)。 08. 常见误解 “FLOPs 少就更快”。本次开头的约100MFLOP实验已给出反例;它支持“只数运算不够”,不能单独证明DRAM带宽造成了全部时间差。 “显存够放权重就能跑”。未分块 prefill 的显式教学参数给 batch=24 的 94.95 GiB,超过假设78 GiB预算;KV、活跃激活与额外分配都需记账。模型没有实际在GPU上运行,OOM是容量模型预测。 “新卡算力翻倍,推理就必定提速”。仅当匹配的计算资源主导且可利用新增吞吐才有希望;量化还会改变字节、反量化成本和数值误差,不能把它等同于只改P。 “MFU低说明实现差”。小batch、长上下文、通信或排队可能限制吞吐;模型理论FLOPs、每步时间和硬件峰值口径不同,也会改变MFU。先拆测量窗口与资源,才能评价实现。 “图上的带宽分类就是硬件瓶颈证明”。经验GEMM P和逻辑D只构成参考模型;本次4MiB权重可被缓存反复用,不能把表里的D直接当HBM/DRAM流量。换工作集大小、读取硬件计数器和时间线后,再检验假设。 “FlashAttention把整个N²放进SRAM”。它保留瓦片和行统计量;有限片上存储导致分块重读,理想4ND字节只是一次读写的下界。 09. 动手验证 依次执行五个完整脚本,比较快照的最短值、中位数和全部样本;不预设某行参考比值必须低于50%或接近100%。改变工作集、shape与线程设置,每次重新标定并重画四图。若观察到分类或延迟变化,先记录变化,再用工具确认原因。 先运行 machine_probe.py,再用 ledger(..., kv_b=1) 对照 kv_b=2;KV项应分别24/48 GiB。再加 active_tokens=24 比较decode激活,注意它没有改变已保存的KV上下文。 memory_ledger.ledger( 7e9, 2, 32, 4096, 24, 4096, 131072, 0.30, kv_b=1) 在 roofline_model.py 中只把例子的P改为1979e12、保留beta和字节数,观察模型边界右移;这是控制变量练习,不能称为真实H100换卡结果。真实换卡需要同时核对带宽、指令类型、dtype、缓存和内核。 运行 profiler_probe.py,核对 [16,128]×[128,128]、524288 FLOP和8192字节输出,打开trace查看算子事件;CPU结果不能用来证明CUDA分支或GPU显存表现。 10. 延伸阅读 按知识树的依赖关系,从这篇出发有三个方向: 往上游:自注意力机制的计算与显存账本——本文 3.3 节那笔注意力账的完整推导;混合精度与数值稳定性——换 dtype 的另一本账(数值范围与累加精度)。 往下游(受限类型各一把钥匙):FlashAttention(带宽侧)、KV Cache 与自回归视频生成(容量侧)、算子融合与 CUDA Graph(launch/中间量侧)、量化(字节/计算侧)。 目录:完整知识树见博客目录页 AIGC 基本功知识树,按依赖顺序排好了先修课。 继续阅读 FlashAttention 为什么不需要存下注意力矩阵:本文 3.3 节的最低流量示例省略了真实分块重读,那篇把 online softmax 的递推式一步步推出来。 附录:完整代码 09 节用到的脚本全文如下(machine_probe.py、roofline_model.py、profiler_probe.py、memory_ledger.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 machine_probe.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """在同一台机器上把 roofline 的「峰值」和「落点」都实测出来。 只依赖 numpy。直接 `python machine_probe.py` 即可运行,约 20 秒。 为什么要自己测一遍 ------------------ roofline_model.py 里的 A100/H100 峰值是厂商标称值,读者手边不一定有 GPU。 本脚本统一记录教学操作数和逻辑数组流量;GEMM乘加按2计数,exp/max各按1。 add有效字节率与GEMM经验算力只构成参考折线,不是所有算子的硬件物理下界。 同一台机器、BLAS和线程设置可以比较本次结果,但仍须硬件计数器才能诊断瓶颈。 每个算子的 D 都按实现里实际的读写遍数来数: LayerNorm 预分配版 10 遍(mean / 减均值 / 平方 / 再 mean / 除 / 乘 gamma) attention 朴素预分配 10 遍(写 S / max / 减 / exp / sum / 除 / 读 S 写 O) 遍数不是拍脑袋来的,是照着下面每一行 numpy 数出来的。 输出的每个数字都来自 `time.perf_counter()` 的真实计时。 """ import argparse import io import os import statistics from contextlib import redirect_stdout import json import platform import time from pathlib import Path import numpy as np FP32 = 4 # 本机跑 fp32,BLAS 后端在快照 environment 中实际记录 _LAST_TIMING = {} SNAPSHOT = Path(__file__).resolve().parent / "probe_results.json" def _best(fn, repeat: int): """预热后取repeat次最短值,另存全部样本和中位数;不代表请求延迟分位数。""" fn() # 预热:第一次要分配 / 触发缺页 samples = [] for _ in range(repeat): t = time.perf_counter() fn() samples.append(time.perf_counter() - t) _LAST_TIMING.clear() _LAST_TIMING.update(samples_seconds=samples, median_seconds=statistics.median(samples), min_seconds=min(samples), max_seconds=max(samples), repeats=repeat) return min(samples) # ── 一、标定可达带宽:二元 add 模式(读两份写一份)─────────────────── def measure_bandwidth(n: int = 2_000_000, repeat: int = 8) -> float: """返回实测可达带宽(Byte/s)。 默认每份 fp32 数组 8 MB;large模式128 MB;应核对目标机器缓存大小,这里测量此访问模式的有效带宽。 z = x + y:读 2n、写 n,共 3n 个元素。 """ x = np.ones(n, dtype=np.float32) y = np.ones(n, dtype=np.float32) z = np.empty(n, dtype=np.float32) dt = _best(lambda: np.add(x, y, out=z), repeat) return 3 * n * FP32 / dt # ── 二、标定峰值算力:大矩阵乘 ──────────────────────────────────── def measure_matmul_peak(n: int = 1024, repeat: int = 5) -> float: """返回实测可达算力(FLOP/s)。 大方阵乘能摊薄访存;测得的是此shape/BLAS/线程数的经验参考,非物理峰值。 FLOPs = 2·n³(口径同 roofline_model.py:一次乘加记 2 个浮点运算)。 """ rng = np.random.default_rng(0) a = rng.standard_normal((n, n), dtype=np.float32) b = rng.standard_normal((n, n), dtype=np.float32) c = np.empty((n, n), dtype=np.float32) dt = _best(lambda: np.matmul(a, b, out=c), repeat) return 2 * n ** 3 / dt def calibrate(verbose: bool = True, large: bool = False): n = 32_000_000 if large else 2_000_000 side = 4096 if large else 1024 bw = measure_bandwidth(n=n) bw_timing = dict(_LAST_TIMING) fl = measure_matmul_peak(n=side) peak = dict(peak_flops=fl, peak_bw=bw, vector_elements=n, matrix_side=side, bandwidth_timing=bw_timing, matmul_timing=dict(_LAST_TIMING)) if verbose: print("=" * 80) print(f"本机标定({platform.machine()},numpy {np.__version__},fp32)") print("=" * 80) print(f" 实测可达带宽 beta = {bw / 1e9:8.2f} GB/s") print(f" 实测可达算力 P = {fl / 1e9:8.2f} GFLOP/s") print(f" ridge point I* = {fl / bw:8.1f} FLOP/Byte") print(" 注:这是该shape下的经验参考,不是所有算子的物理上限;") print(" 换 BLAS 后端、换 dtype、换线程数都会变。口径一致才有可比性。") return peak def build_ops(large: bool = False): """构造待实测的算子。每个元素 = (名字, F, D, 函数, repeat)。""" rng = np.random.default_rng(0) ops = [] # ── 逐元素:1 遍 vs 2 遍 vs「看起来融合了」 ── n = 32_000_000 if large else 2_000_000 a = rng.standard_normal(n, dtype=np.float32) b = rng.standard_normal(n, dtype=np.float32) o1 = np.empty(n, dtype=np.float32) tmp = np.empty(n, dtype=np.float32) def add_relu_two_pass(): # 5n 个元素:tmp 读写各一次 np.add(a, b, out=tmp) np.maximum(tmp, 0, out=o1) def add_relu_one_line(): # 写法像融合了,numpy 照样分配中间数组 np.maximum(np.add(a, b), 0, out=o1) ops.append(("逐元素 add(1 遍)", 1.0 * n, FP32 * 3 * n, lambda: np.add(a, b, out=o1), 8)) ops.append(("add+relu 两遍(预分配)", 2.0 * n, FP32 * 5 * n, add_relu_two_pass, 8)) ops.append(("add+relu 写成一行(有中间数组)", 2.0 * n, FP32 * 5 * n, add_relu_one_line, 8)) # ── LayerNorm:预分配的 10 遍版 ── ln_n, ln_d = (8192, 4096) if large else (1024, 1024) x = rng.standard_normal((ln_n, ln_d), dtype=np.float32) g = rng.standard_normal(ln_d, dtype=np.float32) mu = np.empty((ln_n, 1), dtype=np.float32) var = np.empty((ln_n, 1), dtype=np.float32) xc = np.empty_like(x) xc2 = np.empty_like(x) def layernorm_buffered(): np.mean(x, axis=-1, keepdims=True, out=mu) # 读 x 1 遍 np.subtract(x, mu, out=xc) # 读 x 写 xc 3 遍 np.multiply(xc, xc, out=xc2) # 读 xc 写 xc2 5 遍 np.mean(xc2, axis=-1, keepdims=True, out=var) # 读 xc2 6 遍 np.sqrt(var + 1e-5, out=var) # 小量 np.divide(xc, var, out=xc) # 读 xc 写 xc 8 遍 np.multiply(xc, g, out=xc) # 读 xc 写 xc 10 遍 ops.append((f"LayerNorm [{ln_n},{ln_d}] 预分配", 6.0 * ln_n * ln_d, FP32 * 10 * ln_n * ln_d, layernorm_buffered, 5)) # ── 朴素注意力:S 落盘,10 遍 N² 访存 ── N, D = (2048 if large else 512), 128 q = rng.standard_normal((N, D), dtype=np.float32) k = rng.standard_normal((N, D), dtype=np.float32) v = rng.standard_normal((N, D), dtype=np.float32) kt = np.ascontiguousarray(k.T) S = np.empty((N, N), dtype=np.float32) O = np.empty((N, D), dtype=np.float32) rowmax = np.empty((N, 1), dtype=np.float32) rowsum = np.empty((N, 1), dtype=np.float32) def attention_naive(): # 本微基准省略 1/sqrt(D) 缩放,只测 matmul-softmax-matmul 的执行开销。 np.matmul(q, kt, out=S) # 写 S 1 遍 np.max(S, axis=-1, keepdims=True, out=rowmax) # 读 S 2 遍 np.subtract(S, rowmax, out=S) # 读写 S 4 遍 np.exp(S, out=S) # 读写 S 6 遍 np.sum(S, axis=-1, keepdims=True, out=rowsum) # 读 S 7 遍 np.divide(S, rowsum, out=S) # 读写 S 9 遍 np.matmul(S, v, out=O) # 读 S 写 O 10 遍 ops.append((f"attention 朴素 [N={N},D={D}]", 4.0 * N * N * D + 5.0 * N * N, FP32 * (10 * N * N + 4 * N * D), attention_naive, 5)) # ── GEMM 三个规模 ── side = 4096 if large else 1024 for m in ((512, 2048, 4096) if large else (128, 512, 1024)): ma = rng.standard_normal((m, side), dtype=np.float32) mb = rng.standard_normal((side, side), dtype=np.float32) mc = np.empty((m, side), dtype=np.float32) ops.append((f"GEMM {m}x{side}x{side}", 2.0 * m * side * side, FP32 * (m * side + side * side + m * side), lambda ma=ma, mb=mb, mc=mc: np.matmul(ma, mb, out=mc), 5)) return ops def probe(peak: dict, verbose: bool = True, large: bool = False): ops = build_ops(large=large) I_star = peak["peak_flops"] / peak["peak_bw"] if verbose: print("\n" + "=" * 80) print("三、真实算子打到这张 roofline 上:模型估计 vs 实测") print("=" * 80) hdr = (f"{'算子':<32s}{'I':>9s}{'受限':>8s}{'T估计':>10s}{'T实测':>10s}" f"{'达成率':>9s}{'实测算力':>14s}") print(hdr) print("-" * len(hdr)) rows = [] for name, F, D, fn, repeat in ops: dt = _best(fn, repeat) I = F / D bound = "算力" if I >= I_star else "带宽" t_pred = max(F / peak["peak_flops"], D / peak["peak_bw"]) eff = t_pred / dt rows.append(dict(name=name, I=I, bound=bound, t_pred=t_pred, t_real=dt, eff=eff, flops=F, bytes=D, gflops=F / dt / 1e9, timing=dict(_LAST_TIMING))) if verbose: print(f"{name:<32s}{I:>9.2f}{bound:>8s}{t_pred * 1e3:>8.2f}ms" f"{dt * 1e3:>8.2f}ms{eff * 100:>8.0f}%" f"{F / dt / 1e9:>11.1f} GF/s") if verbose: print("\n 参考比值 = 模型估计 / 实测,回答的是「这个实现离 roofline 还有多远」。") print(" 低达成率可能来自指令、缓存、调度或同步;单凭此比值不能诊断额外访存。") return rows def demo_same_flops(): """约100MFLOP,有限工作集重复访问对比,不是DRAM压力测试。""" print("\n" + "=" * 80) print("四、约100MFLOP,两种算子在有限工作集上差多少时间") print("=" * 80) rng = np.random.default_rng(3) target = 1.0e8 # GEMM:2·M·K·N = target,取 K=N=1024 M = int(target / (2 * 1024 * 1024)) ma = rng.standard_normal((M, 1024)).astype(np.float32) mb = rng.standard_normal((1024, 1024)).astype(np.float32) mc = np.empty((M, 1024), dtype=np.float32) t_gemm = _best(lambda: np.matmul(ma, mb, out=mc), 10) f_gemm = 2.0 * M * 1024 * 1024 # 逐元素:n 个元素各算 1 次,F = n # 复用有限工作集,避免十亿元素及float64临时数组造成多GB瞬时分配。 chunk, rounds = 2_000_000, 50 n_elem = chunk * rounds a = rng.standard_normal(chunk, dtype=np.float32) b = rng.standard_normal(chunk, dtype=np.float32) o = np.empty(chunk, dtype=np.float32) def chunked_add(): for _ in range(rounds): np.add(a, b, out=o) t_elem = _best(chunked_add, 5) print(f" GEMM : F = {f_gemm / 1e9:.3f} GFLOP, " f"D = {FP32 * (M * 1024 + 1024 * 1024 + M * 1024) / 1e6:.1f} MB, " f"实测 {t_gemm * 1e3:.3f} ms({f_gemm / t_gemm / 1e9:.0f} GFLOP/s)") print(f" 逐元素 : F = {n_elem / 1e9:.3f} GFLOP, " f"D = {FP32 * 3 * n_elem / 1e6:.1f} MB, " f"实测 {t_elem * 1e3:.3f} ms({n_elem / t_elem / 1e9:.0f} GFLOP/s)") print(f" → FLOPs 基本相同,耗时差 {t_elem / t_gemm:.0f} 倍。") print(" 同样运算量不代表同样时间:这里逐元素算子的运算数并未") print(f" 减少;逻辑 I={1 / (FP32 * 3):.2f} FLOP/Byte,24MB工作集反复访问,不能确证DRAM瓶颈。") return dict(gemm_flops=f_gemm, gemm_seconds=t_gemm, add_flops=n_elem, add_seconds=t_elem, add_working_set_bytes=3 * chunk * FP32, add_logical_bytes=FP32 * 3 * n_elem, chunk=chunk, rounds=rounds, ratio=t_elem / t_gemm) def main(): parser = argparse.ArgumentParser() parser.add_argument("--large", action="store_true", help="恢复原大shape实验;先确认可用内存") args = parser.parse_args() peak = calibrate(large=args.large) rows = probe(peak, large=args.large) demo = demo_same_flops() config = io.StringIO() with redirect_stdout(config): np.show_config() environment = dict(platform=platform.platform(), numpy=np.__version__, thread_settings={k: os.environ.get(k) for k in ("OPENBLAS_NUM_THREADS", "OMP_NUM_THREADS", "MKL_NUM_THREADS")}, numpy_config=config.getvalue(), preset="large" if args.large else "bounded") # 把这次标定存成快照:make_figures / memory_ledger 直接读它, # 保证「图上的数字」和「正文引用的数字」来自同一次运行。 SNAPSHOT.write_text(json.dumps( dict(peak=peak, rows=rows, demo=demo, environment=environment, note=f"{platform.machine()} / numpy {np.__version__} / fp32", timestamp=time.strftime("%Y-%m-%d %H:%M:%S")), ensure_ascii=False, indent=1), encoding="utf-8") print(f"\n标定快照已存到 {SNAPSHOT.name},make_figures / memory_ledger 会复用它。") print(f"这台机器的 roofline:P = {peak['peak_flops'] / 1e9:.0f} GFLOP/s, " f"beta = {peak['peak_bw'] / 1e9:.1f} GB/s, " f"I* = {peak['peak_flops'] / peak['peak_bw']:.1f} FLOP/Byte") if __name__ == "__main__": main() roofline_model.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """Roofline 模型的最小实现:把「算力账」和「带宽账」合成一条上界曲线。 只依赖 numpy(其实只是用来排版,算法本身是纯标量运算)。 直接 `python roofline_model.py` 即可运行,约 1 秒。 符号与文章第 03 节一一对应 -------------------------- F 浮点运算数(FLOP)。口径:一次乘加(MAC)记 2 FLOP D 教学逻辑流量(Byte):按数组读写计;并非硬件DRAM计数器 I 算术强度 I = F / D,单位 FLOP/Byte P_peak 峰值算力(FLOP/s) beta 峰值带宽(Byte/s) I_star ridge point = P_peak / beta,只判定所给模型的主导资源 关键结论(代码算完会打印): T >= max(F / P_peak, D / beta) 把 F 降为一半或把 D 降为一半时的模型比值,见 optimize_headroom() """ import json from pathlib import Path def _local_spec(): """本机实测峰值:优先读 machine_probe.py 存下的标定快照。 快照不存在时明确要求先运行 machine_probe.py。 这样 SPECS 里的「本机实测」永远是同一次标定,不会和正文引用的数字分叉。 """ snap = Path(__file__).resolve().parent / "probe_results.json" if snap.exists(): p = json.loads(snap.read_text(encoding="utf-8"))["peak"] return dict(peak_flops=p["peak_flops"], peak_bw=p["peak_bw"]) raise FileNotFoundError("请先运行 machine_probe.py 生成本机快照;不能用别人的峰值兜底") # ── BF16/FP8 dense GEMM 厂商峰值;不能视为逐元素/exp吞吐。 # A100 40GB SXM: https://images.nvidia.com/aem-dam/en-zz/Solutions/data-center/nvidia-ampere-architecture-whitepaper.pdf # H100 SXM: https://www.nvidia.com/en-us/data-center/h100/ (带*稀疏值除2) # 注意 H100 BF16 dense 算力增幅大于带宽增幅,ridge point 比 A100 高: # 带宽涨 2.15 倍、bf16 算力涨约 3.17 倍 → 更多 kernel 落在带宽受限区。 SPECS = { "A100-40GB SXM (bf16)": dict(peak_flops=312e12, peak_bw=1555e9), "H100-80GB SXM (bf16)": dict(peak_flops=989e12, peak_bw=3350e9), "H100-80GB SXM (fp8)": dict(peak_flops=1979e12, peak_bw=3350e9), # 下面这一条不是标称值,是 machine_probe.py 在同一台机器上实测出来的 "本机实测(见 machine_probe.py)": _local_spec(), } BF16 = 2 # bytes per element def roofline_time(F: float, D: float, peak_flops: float, peak_bw: float): """roofline 时间下界:算力时间与带宽时间取 max(假设两者完美重叠)。""" t_compute = F / peak_flops t_memory = D / peak_bw return max(t_compute, t_memory), t_compute, t_memory def resource_time(terms, moved_bytes, bandwidth): """按不同资源给下界,terms 为 [(工作量, 同口径峰值), ...]。 例:Tensor Core FLOP、FP32 CUDA-core FLOP、exp次数分别使用对应吞吐。 只取max仍是假定资源可完美重叠的乐观下界,不能冒充实测耗时。 """ if moved_bytes < 0 or bandwidth <= 0: raise ValueError("字节数非负、带宽为正") if any(work < 0 or rate <= 0 for work, rate in terms): raise ValueError("工作量非负、同口径吞吐为正") return max([moved_bytes / bandwidth] + [work / rate for work, rate in terms]) def bound_of(F: float, D: float, peak_flops: float, peak_bw: float) -> str: I = F / D I_star = peak_flops / peak_bw return "算力受限" if I >= I_star else "带宽受限" def optimize_headroom(F: float, D: float, peak_flops: float, peak_bw: float): """把运算量 F 或搬运量 D 减半,理想模型可快多少? 答案与算术强度有关:带宽受限时只减少运算量的模型收益为 0,算力受限时最多 2 倍。 返回 (F 减半的加速比, D 减半的加速比),分别等价于只将峰值算力或带宽翻倍。 """ def speedup(F2, D2): t0, _, _ = roofline_time(F, D, peak_flops, peak_bw) t1, _, _ = roofline_time(F2, D2, peak_flops, peak_bw) return t0 / t1 return speedup(F / 2, D), speedup(F, D / 2) # ── 几类算子的 F / D 账本 ────────────────────────────────────────── def gemm(M: int, K: int, N: int, b: int = BF16): """矩阵乘 [M,K] @ [K,N] -> [M,N]。读 A、读 B、写 C。""" F = 2.0 * M * K * N D = b * (M * K + K * N + M * N) return F, D def elementwise(n: int, b: int = BF16, n_pass: int = 1, n_read: int = 1): """逐元素算子:读 n_read 份、写 1 份;n_pass 表示这样读写几轮。 二元运算(如 add)是 n_read=2:读两份输入、写一份输出。 """ F = 1.0 * n * n_pass # 每个元素算 1 次 D = b * (n_read + 1) * n * n_pass return F, D def layernorm(n: int, d: int, b: int = BF16): """简化 LayerNorm(无 beta):两次归约、减均值、平方、除标准差、乘 gamma,约 6 次/元素。 访存 = 读 x 一遍 + 写 y 一遍(统计量是 O(n) 的小量,忽略)。""" F = 6.0 * n * d D = b * 2 * n * d return F, D def softmax(n: int, d: int, b: int = BF16, fused: bool = True): """softmax:exp / 减最大值 / 归一化,约 5 次运算/元素。 fused=True 假设整行可驻留片上存储,读 1 遍写 1 遍;不是独立 online normalizer 的通用 IO fused=False 保存 E 的三阶段模型:读X求max;读X写E同时归约和;读E写P,共3读2写 不是原论文 Algorithm 2 的重算 exp、3读1写版本;F=5nd不适用于后者或online递推 """ F = 5.0 * n * d D = b * 2 * n * d if fused else b * (3 * n * d + 2 * n * d) return F, D def attention(N: int, D: int, b: int = BF16, flash: bool = False): """单头注意力。N 是 token 数,D 是每头维度。 flash=False(朴素):分数矩阵 S 和权重 P 都要落 HBM S = Q K^T 写 N^2 P = softmax(S) 读 N^2 写 N^2 O = P V 读 N^2 → 二次项访存 ≈ 4 N^2 b flash=True(强缓存假设下的最低流量,不是真实 FlashAttention IO):Q/K/V 读进来、O 写出去,只保留一块分数/概率瓦片,不分配完整 N^2 矩阵 → 访存 ≈ 4 N D b """ F = 4.0 * N * N * D + 5.0 * N * N # 两个 N×N×D 的矩阵乘 + softmax if flash: D_bytes = b * (3 * N * D + N * D) # 读 Q K V,写 O else: D_bytes = b * (4 * N * N + 4 * N * D) # 上面再加 S/P 的读写 return F, D_bytes def fmt(x: float, unit: str = "") -> str: for u, s in (("T", 1e12), ("G", 1e9), ("M", 1e6), ("K", 1e3)): if x >= s: return f"{x / s:.2f} {u}{unit}" return f"{x:.2f} {unit}" def main(): print("=" * 78) print("一、三组 GEMM 规格与本机经验标定(不是所有算子的统一物理峰值)") print("=" * 78) print(f"{'设备':<28s}{'P_peak':>14s}{'beta':>14s}{'I* = P/beta':>16s}") ridges = {} for name, s in SPECS.items(): I_star = s["peak_flops"] / s["peak_bw"] ridges[name] = (s, I_star) print(f"{name:<28s}{fmt(s['peak_flops'], 'FLOP/s'):>16s}" f"{fmt(s['peak_bw'], 'B/s'):>14s}{I_star:>12.1f} FLOP/B") a100 = SPECS["A100-40GB SXM (bf16)"] h100 = SPECS["H100-80GB SXM (bf16)"] print(f"\n A100 -> H100:带宽 ×{h100['peak_bw'] / a100['peak_bw']:.2f}," f"算力 ×{h100['peak_flops'] / a100['peak_flops']:.2f}," f"ridge point {a100['peak_flops'] / a100['peak_bw']:.0f} -> " f"{h100['peak_flops'] / h100['peak_bw']:.0f}(更高 = 更多算子落入带宽受限区)") # ── 二、算子账本 ──────────────────────────────────────────────── N, D = 4096, 128 # 一个典型的 DiT / LLM 单头规模 cases = [ ("逐元素 add [16M]", elementwise(16_000_000, n_read=2)), ("LayerNorm [4096, 3072]", layernorm(4096, 3072)), ("softmax fused [4096, 4096]", softmax(4096, 4096, fused=True)), ("softmax 朴素三遍 [4096, 4096]", softmax(4096, 4096, fused=False)), ("GEMM 512x4096x4096", gemm(512, 4096, 4096)), ("GEMM 4096x4096x4096", gemm(4096, 4096, 4096)), ("attention 朴素 [N=4096,D=128]", attention(N, D, flash=False)), ("attention ideal-min [N=4096,D=128]", attention(N, D, flash=True)), ] print("\n" + "=" * 78) print("二、统一操作计数的教学模型(b=2,P=312T,beta=1555G)") print("=" * 78) hdr = (f"{'算子':<32s}{'F (教学操作)':>14s}{'D (Byte)':>14s}" f"{'I':>10s}{'受限':>10s}{'T_roof':>12s}") print(hdr) print("-" * len(hdr)) for name, (F, Db) in cases: I = F / Db T, tc, tm = roofline_time(F, Db, a100["peak_flops"], a100["peak_bw"]) print(f"{name:<32s}{fmt(F):>14s}{fmt(Db, 'B'):>14s}" f"{I:>10.2f}{bound_of(F, Db, a100['peak_flops'], a100['peak_bw']):>10s}" f"{T * 1e3:>10.3f} ms") # ── 三、FlashAttention 把算术强度抬了多少 ──────────────────────── print("\n" + "=" * 78) print("三、物化 S/P 与理想最低 IO 对比(单头 N=4096, D=128, bf16)") print("=" * 78) F_naive, D_naive = attention(N, D, flash=False) F_flash, D_flash = attention(N, D, flash=True) T_naive, _, _ = roofline_time(F_naive, D_naive, a100["peak_flops"], a100["peak_bw"]) T_flash, _, _ = roofline_time(F_flash, D_flash, a100["peak_flops"], a100["peak_bw"]) print(f" FLOPs : {fmt(F_naive)} -> {fmt(F_flash)} " f"(×{F_flash / F_naive:.3f},几乎没变)") print(f" 访存 : {fmt(D_naive, 'B')} -> {fmt(D_flash, 'B')} " f"(×{D_flash / D_naive:.4f},省 {D_naive / D_flash:.1f} 倍)") print(f" 算术强度 : {F_naive / D_naive:.1f} -> {F_flash / D_flash:.1f} FLOP/B " f"(×{(F_flash / D_flash) / (F_naive / D_naive):.1f})") print(f" 受限类型 : {bound_of(F_naive, D_naive, **a100)} -> " f"{bound_of(F_flash, D_flash, **a100)}") print(f" roofline : {T_naive * 1e3:.3f} ms -> {T_flash * 1e3:.3f} ms " f"(×{T_naive / T_flash:.2f})") print(f" 注意:模型比值来自「少搬 {D_naive / D_flash:.0f} 倍字节」," "此处给各运算统一计数和统一P,仅为教学模型;真实内核的标量吞吐、exp及重读需另计。") # ── 四、砍算力 vs 砍带宽,谁的收益大 ──────────────────────────── print("\n" + "=" * 78) print("四、教学资源模型中,只翻倍 P 或 beta 的时间估计比值") print("=" * 78) print(f"{'算子':<32s}{'I/I*':>10s}{'算力×2 的加速':>16s}{'带宽×2 的加速':>16s}") I_star = a100["peak_flops"] / a100["peak_bw"] for name, (F, Db) in cases: s_flops, s_bw = optimize_headroom(F, Db, a100["peak_flops"], a100["peak_bw"]) print(f"{name:<32s}{(F / Db) / I_star:>10.3f}" f"{s_flops:>14.2f}x{s_bw:>14.2f}x") print("\n 读法:带宽受限的行(I/I* < 1)里「算力×2」那一列几乎都是 1.00——" "\n 在只改变计算峰值且访存不变的理想模型里,该列为 1。") # ── 五、GEMM 什么时候从带宽受限翻到算力受限 ───────────────────── print("\n" + "=" * 78) print("五、GEMM [M,4096] x [4096,4096]:M 多大才开始算力受限") print("=" * 78) K = Nout = 4096 print(f"{'M':>8s}{'I (FLOP/B)':>14s}{'受限':>12s}") prev = None for M in (1, 2, 4, 8, 16, 32, 64, 128, 256, 512, 1024, 4096): F, Db = gemm(M, K, Nout) b = bound_of(F, Db, a100["peak_flops"], a100["peak_bw"]) print(f"{M:>8d}{F / Db:>14.2f}{b:>12s}") if prev == "带宽受限" and b == "算力受限": print(f" ↑ 拐点:M 在 ({M // 2}, {M}] 之间," f"I 越过 ridge point {I_star:.0f}") prev = b print("\n 推论:小 batch 推理(M=1~8)里的 GEMM 是带宽受限的," "这时候做 fp8 量化省的是字节、不是算力。") if __name__ == "__main__": main() profiler_probe.py """最小 PyTorch Profiler 对照:无需模型权重;默认CPU,可选CUDA。""" import json import statistics import time from pathlib import Path import torch from torch.profiler import ProfilerActivity, profile, record_function def main(): torch.manual_seed(7) torch.set_num_threads(1) device = torch.device("cuda" if torch.cuda.is_available() else "cpu") x = torch.randn(16, 128, device=device) w = torch.randn(128, 128, device=device) activities = [ProfilerActivity.CPU] if device.type == "cuda": activities.append(ProfilerActivity.CUDA) def synchronize(): if device.type == "cuda": torch.cuda.synchronize() with torch.inference_mode(): for _ in range(5): torch.mm(x, w) synchronize() samples = [] for _ in range(10): synchronize() start = time.perf_counter() torch.mm(x, w) synchronize() samples.append(time.perf_counter() - start) # profiler区域用于观察事件;上面单独计时用于延迟,避免混入采集开销。 with profile(activities=activities, record_shapes=True, profile_memory=True, with_flops=True, acc_events=True) as prof: with record_function("one_matmul"): y = torch.mm(x, w) synchronize() events = prof.key_averages() sort = "self_device_time_total" if device.type == "cuda" else "self_cpu_time_total" print(events.table(sort_by=sort, row_limit=8)) mm = next(event for event in events if event.key == "aten::mm") expected = 2 * 16 * 128 * 128 assert mm.flops == expected assert y.shape == (16, 128) and torch.isfinite(y).all() result = dict(torch_version=torch.__version__, device=str(device), x_shape=list(x.shape), w_shape=list(w.shape), y_shape=list(y.shape), estimated_mm_flops=mm.flops, expected_mm_flops=expected, mm_self_cpu_memory_bytes=mm.self_cpu_memory_usage, y_bytes=y.numel() * y.element_size(), standalone_seconds=samples, median_seconds=statistics.median(samples), event_keys=[event.key for event in events], note="CPU实跑时不宣称CUDA内核验证;算子分配增量不是设备显存总占用") here = Path(__file__).resolve().parent prof.export_chrome_trace(str(here / "profiler_trace.json")) (here / "profiler_results.json").write_text(json.dumps(result, ensure_ascii=False, indent=2), encoding="utf-8") print(json.dumps(result, ensure_ascii=False, indent=2)) if __name__ == "__main__": main() memory_ledger.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """显存账本 + batch 扫描:容量这本账怎么算,以及它怎么反过来决定速度。 只依赖 numpy(第二部分要真跑计时)。直接 `python memory_ledger.py` 即可运行,约 10 秒。 第一部分是「容量账」:权重 / KV cache / 激活 / 额外开销四项加总,看 假设 78 GiB 可用预算 能塞多少条并发请求。第二部分是「速度账」:batch 变大之后,同一份权重被更多 token 摊薄,算术强度抬上去。I与I*仅标记模型分类交界,计时曲线不一定出现相同拐点。 """ import argparse import statistics import json import time from pathlib import Path import numpy as np GIB = 1024 ** 3 def _load_peak(): """优先读 machine_probe.py 存下的标定快照(保证口径一致); 未运行时明确报错,避免误用另一台机器的峰值。""" snap = Path(__file__).resolve().parent / "probe_results.json" if snap.exists(): peak = json.loads(snap.read_text(encoding="utf-8"))["peak"] return peak["peak_flops"], peak["peak_bw"] raise FileNotFoundError("请先运行 machine_probe.py;不使用其他机器标定兜底") P_PEAK, BETA = _load_peak() I_STAR = P_PEAK / BETA def kv_cache_bytes(n_tokens: int, n_layers: int, d_kv: int, b: int = 2) -> int: """KV cache 字节数:每个 token 每层都要存一份 K 和一份 V。 n_tokens 序列长度(或并发请求的总 token 数) n_layers 层数 L d_kv 每层的 KV 总维度 = n_kv_heads × d_head(GQA 时用实际的 KV head 数) b 每个元素的字节数(fp16/bf16 = 2,fp8 = 1) """ return 2 * n_tokens * n_layers * d_kv * b def ledger(n_params: float, b_w: int, n_layers: int, d_kv: int, batch: int, seq: int, act_per_token: int, overhead_rate: float, kv_b: int = 2, active_tokens: int | None = None): """推理显存账本的四项,单位 GiB。 act_per_token 每个 token 的激活峰值(字节)。推理不保留整层的中间结果, 但当前层的十几份临时张量要同时活着:d_model=4096、fp16 时 一份 [d] 张量 8 KiB,取 16 份 ≈ 128 KiB / token。 这是16份张量的教学假设,不是实测或通用经验值。 overhead_rate 教学额外开销 / (权重 + KV + 激活),不是实测碎片率。 本函数按未分块 prefill 计 batch*seq 个活跃 token; 逐 token decode 的激活应改为 batch*act_per_token,KV 仍取 batch*seq。 """ w = n_params * b_w if min(n_params, b_w, n_layers, d_kv, batch, seq, act_per_token, overhead_rate, kv_b) < 0: raise ValueError("容量输入不得为负") active = batch * seq if active_tokens is None else active_tokens if active < 0: raise ValueError("活跃token数不得为负") kv = kv_cache_bytes(batch * seq, n_layers, d_kv, b=kv_b) act = active * act_per_token frag = (w + kv + act) * overhead_rate return dict(weights=w / GIB, kv=kv / GIB, act=act / GIB, frag=frag / GIB, total=(w + kv + act + frag) / GIB) def part1(): print("=" * 80) print("一、显存账本:一张 假设 78 GiB 可用预算,能塞多少条并发请求") print("=" * 80) # Llama-2-7B 的配置:32 层、32 个 KV head、d_head=128 → d_kv = 4096 N_PARAMS, N_LAYERS, D_KV = 7e9, 32, 4096 SEQ = 4096 per_token = kv_cache_bytes(1, N_LAYERS, D_KV) print(f" 模型:7B,fp16 权重 = {N_PARAMS * 2 / GIB:.1f} GiB," f"{N_LAYERS} 层,d_kv = {D_KV}") print(f" KV cache 单价:{per_token / 1024:.0f} KiB / token " f"(一条 {SEQ} 长的序列 = {per_token * SEQ / GIB:.2f} GiB)") print() hdr = (f"{'batch':>6s}{'权重':>9s}{'KV cache':>10s}{'激活':>9s}" f"{'额外开销':>9s}{'合计':>9s}{'78GiB预算':>10s}") print(hdr) print("-" * len(hdr)) for batch in (1, 4, 8, 16, 24, 32): # 朴素预分配:按最大长度全预留,教学假设:以权重+KV+激活总和的 30% 估计额外开销,不是实测碎片比例 naive = ledger(N_PARAMS, 2, N_LAYERS, D_KV, batch, SEQ, act_per_token=131072, overhead_rate=0.30) ok = "装得下" if naive["total"] < 78 else "OOM" print(f"{batch:>6d}{naive['weights']:>8.1f}G{naive['kv']:>9.2f}G" f"{naive['act']:>8.2f}G{naive['frag']:>8.2f}G" f"{naive['total']:>8.2f}G{ok:>10s}") # 换成低开销假设(教学假设,非 PagedAttention 实测):额外开销率降到 4% print("\n 同一张卡,把额外开销率从 30% 降到 4%(低开销假设):") print(f"{'batch':>6s}{'朴素合计':>11s}{'低开销假设':>11s}{'多出来的并发':>16s}") for batch in (8, 16, 24, 32): naive = ledger(N_PARAMS, 2, N_LAYERS, D_KV, batch, SEQ, 131072, 0.30) low_overhead = ledger(N_PARAMS, 2, N_LAYERS, D_KV, batch, SEQ, 131072, 0.04) extra = "" if naive["total"] > 78 >= low_overhead["total"]: extra = "从 OOM 变装得下" print(f"{batch:>6d}{naive['total']:>10.2f}G{low_overhead['total']:>10.2f}G" f"{extra:>16s}") print("\n 读法:权重那一项是常数,batch 再大也不变;KV cache 才是随并发") print(" 线性增长的那一项,batch 16 时它已经比权重还大。") print(" 「显存够放权重就能跑」这句话漏掉了后面三项。") # 用 roofline_model 里同款口径:下界 = max(F/P, D/beta)。 # P_PEAK / BETA / I_STAR 已在文件顶部从标定快照读出,这里不再覆盖, # 否则快照刷新后正文引用的数字会和实际跑出来的对不上。 def batch_sweep(repeats: int = 15, d: int = 1024): """固定一份「权重」,扫 batch,返回每一档的实测延迟/吞吐/算术强度。""" rng = np.random.default_rng(0) W = rng.standard_normal((d, d), dtype=np.float32) # 默认4 MiB,large模式64 MiB的权重 W_bytes = W.nbytes FP32 = 4 def run(B): x = rng.standard_normal((B, d), dtype=np.float32) y = np.empty((B, d), dtype=np.float32) np.matmul(x, W, out=y) # 预热 samples = [] for _ in range(repeats): t = time.perf_counter() np.matmul(x, W, out=y) samples.append(time.perf_counter() - t) return min(samples), samples rows = [] for B in (1, 2, 4, 8, 16, 32, 64, 128, 256): F = 2.0 * B * d * d D = W_bytes + 2 * B * d * FP32 I = F / D dt, samples = run(B) rows.append(dict(B=B, F=F, D=D, I=I, lat=dt, thr=B / dt, bound="算力" if I >= I_STAR else "带宽", t_pred=max(F / P_PEAK, D / BETA), eff=max(F / P_PEAK, D / BETA) / dt, matrix_side=d, median_seconds=statistics.median(samples), samples_seconds=samples)) return rows, W_bytes def part2(d=1024): """batch 扫描实测:延迟、吞吐、算术强度,以及拐点在哪。""" print("\n" + "=" * 80) print("二、batch 扫描实测:吞吐什么时候不再涨") print("=" * 80) rows, W_bytes = batch_sweep(d=d) (Path(__file__).resolve().parent / "batch_results.json").write_text( json.dumps(dict(rows=rows, weight_bytes=W_bytes, peak=dict(peak_flops=P_PEAK, peak_bw=BETA), matrix_side=d), indent=2), encoding="utf-8") print(f" 固定「权重」W 形状 [{d}, {d}],fp32 = {W_bytes / 2 ** 20:.0f} MiB;" f"batch B 就是一次喂进去的 token 数") print(f" 经验参考(来自 machine_probe 的标定快照):" f"P = {P_PEAK / 1e9:.0f} GFLOP/s,beta = {BETA / 1e9:.1f} GB/s," f"I* = {I_STAR:.1f}") print() hdr = (f"{'B':>6s}{'F (GFLOP)':>12s}{'D (MB)':>10s}{'I':>9s}{'受限':>8s}" f"{'延迟 ms':>10s}{'吞吐 K/s':>11s}{'估计 ms':>10s}{'达成率':>9s}") print(hdr) print("-" * len(hdr)) prev_bound = None for r in rows: print(f"{r['B']:>6d}{r['F'] / 1e9:>12.3f}{r['D'] / 1e6:>10.2f}" f"{r['I']:>9.2f}{r['bound']:>8s}{r['lat'] * 1e3:>10.3f}" f"{r['thr'] / 1e3:>9.1f}K{r['t_pred'] * 1e3:>10.3f}" f"{r['eff'] * 100:>8.0f}%") if prev_bound == "带宽" and r["bound"] == "算力": print(f" ↑ 拐点:B 从 {r['B'] // 2} 到 {r['B']} 之间" f"越过 ridge point {I_STAR:.1f}") prev_bound = r["bound"] # 只标记延迟变化;不从总计时猜测库实现路径或实际硬件瓶颈。 for r0, r1 in zip(rows, rows[1:]): if r1["B"] == 2 * r0["B"] and r1["lat"] > r0["lat"] * 1.5: print(f" ! 反常:B={r0['B']} 只要 {r0['lat'] * 1e3:.2f} ms," f"B={r1['B']} 却要 {r1['lat'] * 1e3:.2f} ms") base = rows[0] top = rows[-1] print(f"\n 延迟:B=1 时 {base['lat'] * 1e3:.3f} ms,B={top['B']} 时 " f"{top['lat'] * 1e3:.3f} ms(涨 {top['lat'] / base['lat']:.1f} 倍)") print(f" 吞吐:B=1 时 {base['thr'] / 1e3:.1f} K/s,B={top['B']} 时 " f"{top['thr'] / 1e3:.1f} K/s(涨 {top['thr'] / base['thr']:.1f} 倍)") print(f" 单样本成本:B={top['B']} 时把 {W_bytes / 2 ** 20:.0f} MiB 权重的逻辑读取摊薄到 {top['B']} 个样本," f"每个样本只摊 {W_bytes / top['B'] / 2 ** 20:.2f} MiB") print(" → 增大 batch 可摊薄权重访问;延迟是否平坦、吞吐能增加多少仍需实测。") print(" → 上面标 ! 的行是 roofline 看不见的东西:同样的公式、更大的 batch," "可能涉及内核选择、调度或计时波动,单凭本表不能确诊。") if __name__ == "__main__": parser = argparse.ArgumentParser() parser.add_argument("--large", action="store_true", help="batch权重恢复4096x4096") args = parser.parse_args() part1() part2(d=4096 if args.large else 1024) make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「性能建模与 Profiling」一文的四张解释图。 图里的计时优先读取已保存的实测快照,避免重绘时图文使用不同测量: * roofline.png 峰值与落点来自 machine_probe.calibrate() / probe() * batch_scaling.png 来自 memory_ledger.batch_sweep() * memory_ledger.png 来自 memory_ledger.ledger() * opt_gain.png 来自 roofline_model.optimize_headroom() 只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行,约 40 秒。 改了另外三个脚本,这里要重跑,避免图与正文数字对不上。 """ import json import sys from pathlib import Path import matplotlib.pyplot as plt import numpy as np HERE = Path(__file__).resolve().parent sys.path.insert(0, str(HERE)) import machine_probe as MP # noqa: E402 import memory_ledger as ML # noqa: E402 import roofline_model as RM # noqa: E402 OUT = HERE.parent / "figures" try: # exist_ok=True 是必须的:目录已存在时 pathlib 会抛 FileExistsError, # 少数沙箱环境连 exist_ok=True 的 mkdir 也一并拦,这里再兜一层。 OUT.mkdir(exist_ok=True) except PermissionError: if not OUT.is_dir(): raise plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "SimHei", "PingFang SC", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, "savefig.dpi": 160, }) C_MEM = "#e05263" # 带宽受限:红 C_CMP = "#3f7fbf" # 算力受限:蓝 C_ACC = "#2f9e6f" # 好结果:绿 C_GREY = "#94a3b8" # ── 图 1:roofline 曲线 + 实测落点 ──────────────────────────────── def fig_roofline(peak, rows): P = peak["peak_flops"] / 1e9 # GFLOP/s beta = peak["peak_bw"] / 1e9 # GB/s I_star = P / beta # 因为两个都除过 1e9,比值不变 I = np.logspace(-2, 4, 400) perf = np.minimum(P, beta * I) fig, ax = plt.subplots(figsize=(8.4, 5.4)) ax.loglog(I, perf, color="k", lw=2.2) ax.axvline(I_star, color=C_GREY, ls="--", lw=1.4) ax.text(I_star * 1.15, 3, f"ridge point I* = {I_star:.0f}\nFLOP/Byte", color="#475569", fontsize=9, va="bottom") ax.text(0.012, 25, f"GEMM经验参考 P = {P:.0f} GFLOP/s", fontsize=9, color="#475569") ax.text(0.012, P * 3, "斜线 = add经验参考,beta = " f"{beta:.0f} GB/s", fontsize=9, color="#475569") # 落点:用实测时间反推实际性能 short = { "逐元素 add(1 遍)": "逐元素 add", "add+relu 两遍(预分配)": "add+relu 两遍", "add+relu 写成一行(有中间数组)": "add+relu 一行写法", "LayerNorm [8192,4096] 预分配": "LayerNorm", "attention 朴素 [N=2048,D=128]": "朴素 attention", "GEMM 512x4096x4096": "GEMM M=512", "GEMM 2048x4096x4096": "GEMM M=2048", "GEMM 4096x4096x4096": "GEMM M=4096", } offsets = { # 手工调过:右边缘和重叠的标签让位 "GEMM M=4096": (-10, 10), "GEMM M=2048": (10, -4), "GEMM M=512": (12, -14), "朴素 attention": (7, -3), } # 左下角四个点挤在一起,用箭头把标签拉到右边的空地上 arrows = { "逐元素 add": (0.42, 9.5), "LayerNorm": (0.42, 5.6), "add+relu 两遍": (0.42, 3.1), "add+relu 一行写法": (0.42, 1.75), } for r in rows: name = short.get(r["name"], r["name"]) if r["name"].startswith("GEMM "): name = "GEMM M=" + r["name"].split()[1].split("x")[0] elif r["name"].startswith("LayerNorm"): name = "LayerNorm" elif r["name"].startswith("attention"): name = "朴素 attention" y = r["gflops"] ax.scatter([r["I"]], [y], s=52, color=C_MEM if r["bound"] == "带宽" else C_CMP, zorder=5, edgecolor="white", linewidth=0.8) if name.startswith("GEMM M="): m = int(name.split("=")[1]) target = {128: (55, P * 1.8), 512: (280, P * 3.3), 1024: (900, P * 1.8)}.get(m) if target: ax.annotate(name, (r["I"], y), xytext=target, fontsize=8.5, color="#334155", arrowprops=dict(arrowstyle="-", color=C_GREY, lw=0.9)) continue if name in arrows: tx, ty = arrows[name] ax.annotate(name, (r["I"], y), xytext=(tx, ty), fontsize=8.5, color="#334155", arrowprops=dict(arrowstyle="-", color=C_GREY, lw=0.9), va="center") continue dx, dy = offsets.get(name, (7, -3)) ha = "right" if dx < 0 else "left" ax.annotate(name, (r["I"], y), textcoords="offset points", xytext=(dx, dy), fontsize=8.5, color="#334155", ha=ha) ax.set_xlabel("算术强度 I = F / D (FLOP/Byte)") ax.set_ylabel("教学操作计数 / 实测时间 (Gop/s)") ax.set_title("图 1:逻辑流量与经验参考 —— 模型位置不能单独确诊瓶颈", fontsize=11) ax.set_xlim(0.01, 5000) ax.set_ylim(0.3, max(600, P * 6)) ax.grid(alpha=0.25, which="both", ls=":") handles = [plt.Line2D([], [], marker="o", ls="", color=C_MEM, label="模型分类:I < I*"), plt.Line2D([], [], marker="o", ls="", color=C_CMP, label="模型分类:I >= I*")] ax.legend(handles=handles, loc="lower right", fontsize=8.5, framealpha=0.9) fig.tight_layout() fig.savefig(OUT / "roofline.png") plt.close(fig) # ── 图 3:batch 扫描的延迟与吞吐 ────────────────────────────────── def fig_batch(rows): B = [r["B"] for r in rows] lat = [r["lat"] * 1e3 for r in rows] thr = [r["thr"] / 1e3 for r in rows] fig, ax1 = plt.subplots(figsize=(8.4, 5.0)) ax1.plot(B, lat, "o-", color=C_CMP, lw=2, label="延迟(左轴)") ax1.set_xscale("log", base=2) ax1.set_xlabel("batch B(一次喂进去的 token 数)") ax1.set_ylabel("延迟 (ms)", color=C_CMP) ax1.tick_params(axis="y", labelcolor=C_CMP) ax2 = ax1.twinx() ax2.plot(B, thr, "s--", color=C_ACC, lw=2, label="吞吐(右轴)") ax2.set_ylabel("吞吐 (K token/s)", color=C_ACC) ax2.tick_params(axis="y", labelcolor=C_ACC) # 拐点:I 越过 ridge point 的地方 cross = next((r for r in rows if r["bound"] == "算力"), None) if cross: ax1.axvline(cross["B"], color=C_GREY, ls=":", lw=1.5) ax1.text(cross["B"] * 1.05, max(lat) * 0.92, f"越过 ridge point\nB ≈ {cross['B']}", fontsize=9, color="#475569") # 库的反常:延迟不随 batch 单调 b8 = next((r["lat"] for r in rows if r["B"] == 8), None) spike = next((r for r in rows if r["B"] in (2, 4) and b8 is not None and r["lat"] > 1.5 * b8), None) if spike: ax1.annotate(f"B={spike['B']} 延迟为 B=8 的 {spike['lat']/b8:.1f} 倍\n(原因需 profile)", (spike["B"], spike["lat"] * 1e3), textcoords="offset points", xytext=(14, -6), fontsize=8.5, color=C_MEM) ax1.set_title("图 3:batch 扫描 —— 实测延迟、吞吐与 roofline 模型交界", fontsize=11) ax1.grid(alpha=0.25, ls=":") lines1, lab1 = ax1.get_legend_handles_labels() lines2, lab2 = ax2.get_legend_handles_labels() ax1.legend(lines1 + lines2, lab1 + lab2, loc="upper left", fontsize=9) fig.tight_layout() fig.savefig(OUT / "batch_scaling.png") plt.close(fig) # ── 图 4:显存账本 ──────────────────────────────────────────────── def fig_ledger(): batches = [1, 4, 8, 16, 24, 32] naive = [ML.ledger(7e9, 2, 32, 4096, b, 4096, 131072, 0.30) for b in batches] low_overhead = [ML.ledger(7e9, 2, 32, 4096, b, 4096, 131072, 0.04) for b in batches] fig, (ax, ax2) = plt.subplots(1, 2, figsize=(11.2, 4.8), gridspec_kw={"width_ratios": [1.35, 1]}) x = np.arange(len(batches)) keys = [("weights", "权重", "#3f7fbf"), ("kv", "KV cache", "#e05263"), ("act", "激活", "#e8a33d"), ("frag", "额外开销", "#94a3b8")] bottom = np.zeros(len(batches)) for k, label, color in keys: vals = np.array([d[k] for d in naive]) ax.bar(x, vals, bottom=bottom, label=label, color=color, width=0.62, edgecolor="white", linewidth=0.6) bottom += vals ax.axhline(78, color="k", ls="--", lw=1.3) ax.text(len(batches) - 0.4, 79, "教学假设:78 GiB 可用预算", fontsize=8.5, ha="right", color="#334155", bbox=dict(facecolor="white", alpha=0.85, edgecolor="none", pad=1)) for i, d in enumerate(naive): if d["total"] > 78: ax.text(i, d["total"] + 2, "OOM", ha="center", fontsize=9, color=C_MEM, fontweight="bold") ax.set_xticks(x) ax.set_xticklabels(batches) ax.set_xlabel("并发序列数 batch") ax.set_ylabel("显存 (GiB)") ax.set_title("图 4a:未分块 prefill 教学账本(额外开销率 30%)", fontsize=10.5) ax.legend(fontsize=8.5, ncol=2) ax.grid(axis="y", alpha=0.25, ls=":") w_naive = [d["total"] for d in naive] w_low_overhead = [d["total"] for d in low_overhead] ax2.bar(x - 0.2, w_naive, width=0.4, label="额外开销率30%", color="#e05263") ax2.bar(x + 0.2, w_low_overhead, width=0.4, label="低开销假设", color="#2f9e6f") ax2.axhline(78, color="k", ls="--", lw=1.3) ax2.set_xticks(x) ax2.set_xticklabels(batches) ax2.set_xlabel("并发序列数 batch") ax2.set_ylabel("合计显存 (GiB)") ax2.set_title("图 4b:只把额外开销率从 30% 降到 4%", fontsize=10.5) ax2.legend(fontsize=8.5) ax2.grid(axis="y", alpha=0.25, ls=":") fig.suptitle("图 4:显存账本的四项 —— 权重是常数,KV cache 随并发线性增长", fontsize=11) fig.tight_layout() fig.savefig(OUT / "memory_ledger.png") plt.close(fig) # ── 图 2:砍算力 vs 砍带宽,各有多少钱 ──────────────────────────── def fig_opt_gain(): a100 = RM.SPECS["A100-40GB SXM (bf16)"] ratio = np.logspace(-2, 1.2, 300) sp_flops, sp_bw = [], [] for r in ratio: # 造一个算术强度恰好是 r × I* 的算子:固定 D,F 由 r 决定 D = 1e8 F = r * (a100["peak_flops"] / a100["peak_bw"]) * D s_f, s_b = RM.optimize_headroom(F, D, a100["peak_flops"], a100["peak_bw"]) sp_flops.append(s_f) sp_bw.append(s_b) fig, ax = plt.subplots(figsize=(8.4, 4.8)) ax.semilogx(ratio, sp_flops, color=C_CMP, lw=2.2, label="算力翻 2 倍能拿到的加速") ax.semilogx(ratio, sp_bw, color=C_MEM, lw=2.2, label="带宽翻 2 倍能拿到的加速") ax.axvline(1.0, color=C_GREY, ls="--", lw=1.4) ax.text(1.05, 1.02, "I = I*:分界线", fontsize=9, color="#475569") ax.fill_between(ratio, 0.98, 2.02, where=np.array(ratio) < 1, color=C_MEM, alpha=0.07) ax.fill_between(ratio, 0.98, 2.02, where=np.array(ratio) >= 1, color=C_CMP, alpha=0.07) ax.text(0.05, 1.9, "带宽受限区:\n换更快的算力单元 = 0 收益", fontsize=9, color=C_MEM) ax.text(6, 1.9, "算力受限区:\n加带宽 = 0 收益", fontsize=9, color=C_CMP) ax.set_xlabel("算术强度 / ridge point (I / I*)") ax.set_ylabel("教学模型时间估计比值") ax.set_ylim(0.95, 2.1) ax.set_title("图 2:只改变一个资源的教学模型 —— 实际收益需验证", fontsize=11) ax.grid(alpha=0.25, ls=":") ax.legend(fontsize=9, loc="center right") fig.tight_layout() fig.savefig(OUT / "opt_gain.png") plt.close(fig) def main(): # --only <图名>:只重画指定一张(roofline / batch / ledger / gain), # 避免为了改一张图的标签把所有实测算子重跑一遍、数字跟正文引用分叉。 only = None if "--only" in sys.argv: only = sys.argv[sys.argv.index("--only") + 1] # 优先读 machine_probe.py 存的标定快照,保证图上数字与正文引用同源 if MP.SNAPSHOT.exists(): snap = json.loads(MP.SNAPSHOT.read_text(encoding="utf-8")) peak = snap["peak"] print(f"读取标定快照({snap['timestamp']},{snap['note']}):") else: print("没找到标定快照,现场标定一遍…") peak = MP.calibrate(verbose=False) MP.SNAPSHOT.write_text(json.dumps( dict(peak=peak, rows=MP.probe(peak, verbose=False), note="fresh", timestamp=""))) print(f" P = {peak['peak_flops'] / 1e9:.0f} GFLOP/s, " f"beta = {peak['peak_bw'] / 1e9:.1f} GB/s, " f"I* = {peak['peak_flops'] / peak['peak_bw']:.1f}") if only in (None, "roofline"): rows = snap.get("rows") if MP.SNAPSHOT.exists() and "snap" in locals() else None if not rows: rows = MP.probe(peak, verbose=False) fig_roofline(peak, rows) if only in (None, "batch"): batch_snap = HERE / "batch_results.json" if batch_snap.exists(): sweeps = json.loads(batch_snap.read_text(encoding="utf-8"))["rows"] else: sweeps, weight_bytes = ML.batch_sweep() batch_snap.write_text(json.dumps(dict(rows=sweeps, weight_bytes=weight_bytes, peak=peak), indent=2)) fig_batch(sweeps) if only in (None, "ledger"): fig_ledger() if only in (None, "gain"): fig_opt_gain() if only and only not in ("roofline", "batch", "ledger", "gain"): raise ValueError("unknown figure: " + only) print(f"\n图已写入 {OUT}") if __name__ == "__main__": main()
-
AIGC 基本功|自注意力机制的计算与显存账本-MHA AIGC 基本功|自注意力机制的计算与显存账本-MHA 所属方向:注意力与位置编码 | 难度:入门 | 前置知识:无(这是知识树注意力方向的根节点) 关键词:自注意力、multi-head attention、QKV、复杂度、显存账本、缩放因子 01. 为什么需要它 先看一个真实会撞上的场景:你拿到一个约 3.62B 参数的简化 Transformer(批量 B=1、宽度 d=3072、头数 H=24、层数 L=32,权重和下面的教学张量均按 bf16 两字节),想在 1024×1024 的图生视频任务上训练,并保留各层激活供反向使用。VAE 八倍下采样、patch size 为 2 之后,单帧 latent 是 128×128、patch 网格是 64×64,单帧序列长度 N=4096(视频若联合多个潜帧,N 还要乘潜帧数)。模型权重 bf16 约 6.75 GiB,80 GB 的 A100/H100 看起来还装得下;但若用下面的显式中间量账本、无激活重算地保留 32 层,权重加注意力激活已经超过容量,还没算 FFN、梯度和优化器状态。这里是解释 OOM 风险的教学构造,不是某张 GPU 的峰值测量。 把账摊开看(怎么算出来的见第 03、04 节):一层注意力在 N=4096 时按下述教学账本计为 2.39 GiB 激活,32 层就是 76.5 GiB——是权重的 11 倍;这个乘法还假设这些层的相应中间量同时为反向传播保留。这说明只看权重大小无法判断是否 OOM;在这套训练存储假设下,激活已经超过预算,而且爆的是其中三个特定张量:分数矩阵、softmax 权重、浮点 dropout 乘子,各占 31.4%,三项合计吃掉单层激活的 94%。 按本文简化层结构,N=4096 时两个 N×N 矩阵乘只占整层前向 FLOPs 的 18.2%;它们与线性项之比在 N=18432 达到 1,只看 attention 投影则交叉点为 6144。这是运算量比例,不是运行时间比例;IO、kernel 形状与融合可能让 FLOPs 较少的部分反而更慢。 因此应同时记录 FLOPs、激活存储假设和实际时间线。N=32768 时,本文教学账本的一层存储为 145 GiB,二次项 FLOPs 占 64%;这些值用于理解增长趋势,不能替代实际框架的显存测量。 02. 最小可用理解 三句话讲完核心思想: 每个 token 经三组可学习的线性投影得到 Query、Key、Value;它们不是输入向量的三份原样拷贝。每个 token 再拿自己的 Query 和所有 token(包括自己)的 Key 做内积打分,分数过 softmax 变成权重,再对所有 Value 加权求和,得到这个 token 的新表示。权重由 Q/K、位置编码和掩码共同决定,输出内容还依赖 V。 计算和显存都分两笔:一笔随 N 线性(QKV 投影、输出投影、FFN),一笔随 N 二次(分数矩阵 S、softmax 权重 P、浮点 dropout 乘子各一份 B×H×N×N)。显存爆炸的几乎都是第二笔,这是显式保存中间量的教学实现假设;融合、重算或不使用 dropout 会改变这笔账。 「O(N²) 是瓶颈」有适用条件:二次项与线性项的比值是 N/(6d),占总量的比例是 N/(6d+N),N 小于 2d 时它连 attention 模块内部的一半都不到。在本例朴素存储方案下,N² 项先成为显存大头;实际耗时瓶颈仍需测量。 两 token 先走一遍。 暂取单头 D=1,某个 query 的数值为 1,两枚 key 分别为 1 和 0,两枚 value 分别为 10 和 0。缩放因子 √D=1,分数为 [1, 0],softmax 权重约 [0.731, 0.269],因此输出是 0.731×10+0.269×0≈7.31。若把两枚 key 都改成 1,分数同为 1,权重各 0.5,输出变成 5。这个反例说明:权重由 Q/K 的相对打分决定,而输出还取决于 V;注意力不是「把 Query 复制出来」,也不是看单个分数的绝对大小。 这张图要看什么:多头切的是 d_model 这个维度(H·D 拆成 H 份),不是把注意力复制 H 份;切分本身零算术开销,但分数矩阵从 1 个 N×N 变成 H 个 N×N,显存乘上 H。 03. 数学推导 3.1 单头:打分、归一化、加权求和 设输入序列 $X \in \mathbb{R}^{N \times d}$,N 是 token 数,d 是每个 token 的向量维度(d_model)。三个投影矩阵 $W_q, W_k, W_v \in \mathbb{R}^{d \times d}$ 把每个 token 映射成查询、键、值: $$Q = X W_q, \quad K = X W_k, \quad V = X W_v$$ 每个 token 的 Query 要和所有 token 的 Key 算相似度,写成矩阵形式就是一次 $N \times D$ 对 $D \times N$ 的矩阵乘,得到分数矩阵 $S \in \mathbb{R}^{N \times N}$,其中 $S_{ij}$ 是第 i 个 token 对第 j 个 token 的打分: $$S = \frac{Q K^{\top}}{\sqrt{D}}$$ 本小节是单头,H=1、D=d,所以 Q/K/V 都是 N×D;下一小节切成 H 头后才有 D=d/H。除以 $\sqrt{D}$ 不是装饰,推导一下就知道:为解释尺度,暂假设每个坐标上的 $q_i$ 与 $k_i$ 相互独立、均值为 0、方差为 1,而且不同坐标的乘积不相关,那么点积的方差是 $$\mathrm{Var}(q \cdot k) = \sum_{i=1}^{D} \mathrm{Var}(q_i k_i) = D$$ 点积的标准差随 $\sqrt{D}$ 线性增长。D=128 时分数的摆动幅度是 D=1 的 11 倍,softmax 拿到这么大的输入会直接饱和:最大的那个分数吃掉几乎全部权重,输出逼近 one-hot。接近 one-hot 时,softmax Jacobian 的多数项会很小;有限 logits 的精确 softmax 通常并非严格 one-hot,浮点舍入可能进一步使梯度消失。在这些假设下,除以 $\sqrt{D}$ 把分数方差归一回 1。训练后的 Q/K 未必满足独立与单位方差,同一 token 的 Q 与 K 也可能相关,所以这不是对所有模型 logits 的精确分布定理;它是控制初始化时维度增长效应的动机。第 04 节 D 从 8 扫到 256 的随机实验只检验这个动机。 分数过 softmax 变成权重(每行归一化,行内竞争): $$P_{ij} = \frac{\exp(S_{ij})}{\sum_{j'} \exp(S_{ij'})}$$ 最后对 Value 加权求和得到输出 $O = P V$,形状和输入一样是 $N \times d$。工程实现里 softmax 前要先减去每行最大值再取指数,防止 $\exp$ 上溢——这不改变结果,因为分子分母同乘了一个常数。 3.2 多头:切的是维度,不是份数 把 d 维切成 H 段,每段 D = d/H 维当作一个独立的「头」,各算各的注意力,最后拼回来过一个输出投影: $$\mathrm{MHA}(X) = \mathrm{Concat}(\mathrm{head}_1, \dots, \mathrm{head}_H)\, W_o, \qquad \mathrm{head}_h = \mathrm{softmax}\!\left(\frac{Q_h K_h^{\top}}{\sqrt{D}}\right) V_h$$ $Q_h$ 是 $Q$ 的第 h 段 D 列。两个常被搞错的点: 固定 d 时,多头不改变两次矩阵乘的主导 FLOPs。H 个头各做 $N^2 D$ 次乘加,总共 $H \cdot N^2 D = N^2 d$,和不切头(一个 D=d 的单头)一样;softmax、调度等开销仍随头数变化。多头改的是「在多少个独立子空间里同时做注意力」,是表达能力的再分配,不是算力的加倍。 多头增加显存。分数矩阵是按头存的:H 个 $N \times N$。显存里 显式分数存储的 N² 项系数是 H 而不是 1。 3.3 算力账:二次项什么时候过半 一层 transformer 的前向 FLOPs(一次 $[M,K] \times [K,N]$ 矩阵乘算 $2MKN$ 个浮点运算): 四个 d×d 投影(Q、K、V 输入投影 + 输出投影):$8 N d^2$ FFN(升维 4d 再降回):$16 N d^2$ 注意力内部两个 N×N 矩阵乘($QK^{\top}$ 与 $PV$):$4 N^2 d$ 线性项合计 $24 N d^2$,二次项是 $4 N^2 d$,比值等于 $N / (6d)$。令比值等于 1: $$4 N^2 d = 24 N d^2 \quad \Longrightarrow \quad N^{\star} = 6d$$ d=3072 时 $N^{\star} = 18432$。如果只看 attention 模块内部(4 个投影对 2 个 N×N 乘),交叉点是 $N^{\star} = 2d = 6144$。你日常跑的 N=4096 在两条线之下——二次项占整层算力 18.2%,占模块内 40.0%。 3.4 显存账:三个 B×H×N×N 下面采用一个刻意显式的教学分配模型:B 是批量、H 是头数、N 是 token 数、d 是总通道宽度;同时计入 X/Q/K/V/ctx/O,以及 S、P 和一份浮点 dropout 乘子,全部按 bf16 两字节估算。它只数某一层注意力中指定张量的字节总和,不是框架峰值,也不是反向传播的最低存储要求;未计权重、梯度、优化器、FFN、临时工作区及分配器开销。bool mask 通常只占一字节,dropout=0 时可省掉该项,S 也通常不必与 P 同时保留。 线性项:X、Q、K、V、加权和、输出,共 6 个 $[B, N, d]$ 张量(不含 FFN 的话); 二次项:分数矩阵 S、softmax 权重 P、浮点 dropout 乘子,各 $[B, H, N, N]$。 $$\text{单层激活} \approx 6 B N d \cdot 2 + 3 B H N^2 \cdot 2 \;\; \text{字节}$$ 两笔相等解得 $N^{\star} = 2d/H$,d=3072、H=24 时 *N=256**——序列长度刚过几百,显存就已经被 N² 项主导了。算力和显存的交叉点差 72 倍(18432 对 256),这就是「算力瓶颈来得晚、显存瓶颈来得早」的定量出处。 这张图要看什么:左边 N=4096 的堆叠条里红色三个格子(S、P、浮点 dropout 乘子)占 94%,线性项挤在边上几乎看不见;右边是对数轴,两条教学模型的比值随 N 近似线性增长,N=32768 时为 129 倍。融合侧统一按六份线性张量 6BNd·bytes 计,忽略小的 LSE 与内核工作区;这不是具体框架的峰值比。 04. 代码实现 完整脚本在文末附录(mha_minimal.py、attention_memory.py、flops_ledger.py、make_figures.py),只依赖 numpy。下面按执行顺序拆核心片段。形状、随机种子下的数值及静态账本已用附录脚本复跑;CPU 耗时随机器和运行条件变化,后面的表保留原稿 Linux 环境的一次样例,并给出本次复跑作对照。 4.1 前向:六行写完 MHA def mha(X, W_q, W_k, W_v, W_o, H, causal=False): B, N, d_model = X.shape D = d_model // H Q = split_heads(X @ W_q, H) # [B, H, N, D] K = split_heads(X @ W_k, H) # [B, H, N, D] V = split_heads(X @ W_v, H) # [B, H, N, D] S = Q @ K.transpose(0, 1, 3, 2) / np.sqrt(D) # [B, H, N, N] if causal: mask = np.triu(np.ones((N, N), dtype=bool), k=1) S = np.where(mask, -np.inf, S) P = softmax(S, axis=-1) # [B, H, N, N] return merge_heads(P @ V) @ W_o, P # [B, N, d_model] 切头函数值得单独看一眼——对这里连续的输入,它是 reshape 加 transpose 的视图变换;非连续输入的 reshape 可能触发拷贝: def split_heads(t, H): B, N, d_model = t.shape D = d_model // H return t.reshape(B, N, H, D).transpose(0, 2, 1, 3) 配置 B=2、N=8、d_model=32、H=4 时各张量的真实形状: [1] 各张量形状 X (2, 8, 32) 输入 Q/K/V (2, 4, 8, 8) 切头后 [B, H, N, D] S (2, 4, 8, 8) 分数矩阵,N×N 是显存爆炸的源头 O (2, 8, 32) 输出,和输入同形 4.2 验证四条性质 脚本跑出来的校验结果: [3] 性质校验 (a) 权重行和为 1 : max|sum(P)-1| = 2.22e-16 (b) 向量化 vs 四重循环 : max|O - O_loop| = 2.22e-16 allclose=True (c) 因果掩码上三角全 0 : max = 0.00e+00 且下三角行和仍为 1 : max|sum-1| = 2.22e-16 (d) 各头权重并不相同 : 头 0 与 H 头平均的平均绝对差 = 0.0223 头之间的平均离散度 : 0.0206(0 表示所有头完全一样) (b) 是最值得做的一次校验:把公式照定义抄成四重循环(一个 token 一个 token 地打分、归一、加权),结果和向量化版本在浮点精度内完全一致。下标搞反、transpose 方向写错这类 bug,靠肉眼很难发现,靠一个慢十倍但显然正确的对照实现能当场抓住。 4.3 缩放因子的实测 D 扫描表(固定 scale=1,看 softmax 最大权重): 固定 scale=1,扫一遍 D 看 softmax 最大权重怎么变: D 分数标准差 最大权重(未缩放) 最大权重(缩放后) 8 2.8587 0.9089 0.2711 16 3.9246 0.9970 0.1718 32 5.6569 1.0000 0.2427 64 8.0203 1.0000 0.1547 128 11.3903 1.0000 0.1322 256 16.0367 1.0000 0.1619 和 3.1 节的推导对上了:分数标准差就是 $\sqrt{D}$(2.8587 ≈ √8,16.0367 ≈ √256)。本次随机样本在 D=16 时最大权重为 0.9970,之后若干行四舍五入显示 1.0000;这说明可能接近饱和,不能证明所有 token 的梯度严格为零。缩放后最大权重回落到 0.13~0.27,分布活着。另外注意主配置(D=8)下的对比:未缩放最大权重 0.5948,缩放后 0.2589——D 小的时候不缩放也能活,缩放用于控制点积随维度增长的方差;这组随机样本不构成某个 D 阈值的通用结论。 4.4 显存账本实跑 attention_memory.py 在 d_model=3072、H=24、B=1、bf16 下逐项清点: [1] 逐项账本 B=1 N=4096 bf16(2 字节) 分数矩阵 S [B, H, N, N] 805,306,368 31.4% softmax 权重 P [B, H, N, N] 805,306,368 31.4% 浮点 dropout 乘子 [B, H, N, N] 805,306,368 31.4% 输入 X / Q / K / V / ctx / O 各 25,165,824 1.0% 合计 2,566,914,048 2.39 GiB → N² 项共 2.25 GiB,线性项共 144.00 MiB,N² 项占 94.1% 随 N 的增长(一层,不含 FFN): [2] N 增长时一层 MHA 的激活显存(B=1, bf16, 含 浮点 dropout 乘子) N 线性项 N² 项 合计 融合侧教学值 倍数 1024 36.00 MiB 144.00 MiB 180.00 MiB 36.00 MiB 5.0x 2048 72.00 MiB 576.00 MiB 648.00 MiB 72.00 MiB 9.0x 4096 144.00 MiB 2.25 GiB 2.39 GiB 144.00 MiB 17.0x 8192 288.00 MiB 9.00 GiB 9.28 GiB 288.00 MiB 33.0x 16384 576.00 MiB 36.00 GiB 36.56 GiB 576.00 MiB 65.0x 32768 1.12 GiB 144.00 GiB 145.12 GiB 1.12 GiB 129.0x 若训练时按同一教学假设保留每层中间量,且不做重算,才可再乘层数:L=32 层时,N=2048 的激活是 20.25 GiB(权重的 3.0 倍),N=8192 是 297 GiB(权重的 44 倍)。推理时不应把当前层临时激活直接乘 L;需要缓存历史的自回归推理另计 KV cache 随 N 和并发数 B 都线性涨:B=32、N=32768、L=80 时光 KV cache 就要 960 GiB,这就是为什么长上下文服务都把 GQA/MLA 当标配。 4.5 算力账本实跑 flops_ledger.py 的占比表(d=3072,含 FFN): N 线性项 二次项 二次项占比 4096 927.71 GFLOPs 206.16 GFLOPs 18.2% 16384 3.71 TFLOPs 3.30 TFLOPs 47.1% 32768 7.42 TFLOPs 13.19 TFLOPs 64.0% 65536 14.84 TFLOPs 52.78 TFLOPs 78.0% 脚本末尾有一段 CPU 微基准。下表是原稿 Linux 环境的一次实测(numpy float32,d_t=1024、16 头);这不是性能保证,也不能和新环境的时延逐项混用: N 投影 (ms) QK^T (ms) 实测比 FLOPs 比 256 1.64 2.36 1.44 0.25 1024 6.64 60.80 9.16 1.00 4096 21.36 1148.15 53.75 4.00 在原稿样例的 N=256 行,QK^T 的算术量只有投影的四分之一,耗时比却是 1.44。2026-10-08 在 Windows 上重跑同一脚本得到投影 3.39 ms、QK^T 12.37 ms,耗时比 3.65;N=4096 则为 27.13 ms 和 1257.98 ms。两组数值不同,恰好说明时延不是 FLOPs 公式能单独预测的。脚本给出的简化算术强度(AI = FLOPs / 估算访存字节)提示了一种原因:投影约 85~228,QK^T 约 21~31,后者还要写出 H·N² 项。但这些是模型估算,不是 CPU 硬件访存计数;一组耗时不足以排除 BLAS 实现、线程数、缓存命中和矩阵布局。应把它当作 profiler 要验证的假说,而不是由时延表证明的因果结论。FlashAttention 原论文则明确以减少 HBM 与片上 SRAM 之间的 IO 为目标,避免把完整 N×N 权重矩阵落到 HBM;它仍需计算全局注意力的二次项。 这张图要看什么:两条曲线是二次项算力占比随 N 的爬升,红蓝两条竖虚线分别是 N=2d=6144(只算 attention 模块)和 N=6d=18432(算上 FFN);你常用的 N=4096 在两条线左边很远的位置。 05. 工业级实现对照 参考实现(以 2026-09 的 main 分支为准,上游重构频繁): huggingface/transformers → modeling_llama.py:LlamaAttention.forward huggingface/transformers → masking_utils.py / integrations/flash_attention.py:attention 实现分发 生产代码和第 04 节的最小实现有五处不一样,每一处都有理由。 5.1 不落地 N×N:eager / sdpa / flash 三条路 HF 的 attention 实现 attn_implementation 有三档: eager:与本文显式计算 S/P 的思路相同;最小代码没有 dropout,也不代表训练账本的全部分配。好处是 P 可访问,代价是二次存储;具体峰值取决于 dtype、存活期与 dropout。 sdpa:调 PyTorch 的 scaled_dot_product_attention,由 PyTorch 按硬件、dtype、mask 等选择 flash、memory-efficient 或 math 后端;不能仅凭 sdpa 名称断言没有 N×N 中间量。 flash_attention_2:在线 softmax + 分块计算,显存 O(N·d),本文统一教学账本在 N=32768 时两者为 129 倍,真实节省比例需实测。 长序列训练通常优先评估可用的融合后端,但要检查硬件、dtype、掩码形式和是否需要显式注意力权重;不能把 sdpa 这个名字等同于必走 Flash kernel。融合实现常不返回完整 P;可视化注意力图或对 P 加自定义正则时,可能需要 eager、专门的导出路径或改变算法,收益与成本都要实测。 5.2 因果掩码不是加 −inf 的稠密矩阵 最小实现里我建了一个 $N \times N$ 的 bool 矩阵,这本身就又是一笔 N² 显存。支持的融合后端可以用 is_causal=True 或滑动窗口等结构化信息在内核内判断位置关系,从而避免显式的 N×N 因果掩码;但 eager、某些 padding/自定义 mask 或后端回退仍可能构造稠密掩码。是否落地要看实际分发路径,不能仅凭 API 名称保证。自己无条件创建 N×N causal mask,会额外消耗显存。 5.3 QKV 合并成一个投影 三个 $d \times d$ 投影合并成一个 $d \times 3d$(或直接 qkv_proj),一次 GEMM 出 Q、K、V。算术量不变,但少起两次 kernel、权重读取更连续。代价是 PyTorch 里要自己 chunk(3, dim=-1) 拆回来——本次核对的 modeling_llama.py 仍保留独立的 q_proj/k_proj/v_proj;融合 QKV 是另一些架构或执行后端的选择。 5.4 KV 头数可以比 Q 头少:GQA 多头切分时 K、V 的头数用 $H_{kv} < H$(比如 8 对 32),多个 Query 头共享一组 KV。公式的改动只是把 $K_h$ 换成 $K_{\lfloor h/(H/H_{kv})\rfloor}$。它不改变 attention 核心两次矩阵乘的主导 FLOPs,但可以减少 K/V 投影的 FLOPs,省的是 KV cache 和 KV 的显存与带宽——推理时 KV cache 缩到 $H_{kv}/H$(LLaMA-3 70B 的 8/64 为 1/8)。这是在固定 Query 宽度时减少 KV 头数、压缩线性 KV 项的优化,而 FlashAttention 优化的是 N² 那一笔,两者正交,经常一起用。 5.5 buffer 化与 position_ids 无位置编码且无位置相关掩码的自注意力对 token 排列是等变的。位置信息可通过正弦表、可学习嵌入、RoPE 或掩码注入,其中 RoPE 的旋转点积体现相对位移,不应统称绝对位置编码。不同实现对 RoPE 的缓存策略并不相同。以 本次核对的 Hugging Face Llama 源码(2026-10-08)为例,LlamaRotaryEmbedding 把逆频率 inv_freq 存为非持久 buffer,而 forward 用 position_ids 计算当次的 cos/sin;不能把它描述成预先缓存整张 cos/sin 表。LlamaModel.forward 在未提供位置时按已缓存 token 数生成 position_ids,外部也能传入位置,例如 packed 序列需要明确处理段内位置。位置如何进入 Q/K,是 RoPE 那一篇的主题。 06. 代价与边界 把 N² 落地换来了什么,又赔了什么。 朴素实现唯一的优点是 S、P 全程可见:可视化注意力图、或使用依赖完整 P 的蒸馏损失,需要访问相应权重。加到 logits 上的结构化 bias 则不必先物化 P;若内核支持其形式,可在分块时应用。导出完整 P 仍需相应的二次输出存储。工程上常见的折中是:训练用 sdpa/flash,分析时用小 N 的 eager 导出注意力图。 二次项的 FLOPs 收益要按序列长度评估。 若各项运行时间恰好与 FLOPs 成正比,N=4096 时消除占比 18.2% 的二次项,整层理想加速约为 1.22 倍;现实中的 IO 和融合会改变时间占比,因此这不是 FlashAttention 的实测加速上限。 多头的账要两头看。 头数 H 越大,每个头的 D = d/H 越小:每头维度 D 改变会影响子空间容量,但不存在这里能够证明的 D<32 通用质量阈值;固定 d=H·D 时,标准 MHA 的 KV cache 与 KV 投影参数量不因增加 H 而线性增长;若固定 D 则另当别论。所以现代模型反而从「H 越多越好」退到「适度头数 + GQA」:LLaMA-3 70B 用 64 个 Query 头配 8 个 KV 头。 什么时候根本不该用全局自注意力。 像素级 self-attention(把 H×W 个像素当 token)在中等分辨率下 N 就上了万,N² 显存直接不可行——这是 latent diffusion 在压缩空间里计算更经济的原因之一;卷积等其他算子的成本也同时下降。高分辨率密集预测里,窗口注意力、局部注意力是常态而不是妥协。 别只优化注意力。 N 小于 2d 时(d=3072 即 N<6144),attention 模块内部的算力大头是投影;FFN 属于整层的另一部分;显存侧倒是早就归 N² 管。所以「 profiling 之前先改结构」是赌博——performance_profiling 那一篇讲的账本方法就是为此准备的。 07. 经典论文脉络 Attention Is All You Need(Vaswani et al., 2017)——本文锚点。把缩放点积注意力 + 多头定型成今天的形态,丢掉循环结构,端到端只靠注意力。 Neural Machine Translation by Jointly Learning to Align and Translate(Bahdanau et al., 2014)——注意力的史前史:注意力最初是翻译里的一组对齐权重,softmax 那一行的「分布」语义就是从这来的。 Generating Long Sequences with Sparse Transformers(Child et al., 2019)——处理长序列 N² 成本的一条代表性稀疏路线:限制每个位置可看的位置集合,减少需要计算和保存的格子;具体节省取决于稀疏模式与实现。 FlashAttention(Dao et al., 2022)——不动公式、只改执行:在线 softmax + 分块,让 N×N 不落地。精确注意力,不是近似——这一点和稀疏/线性路线有本质区别。 GQA: Training Generalized Multi-Query Transformer Models(Ainslie et al., 2023)——把矛头从 N² 转向 KV cache:KV 头数变少、Q 头分组共享,是许多现代模型降低 KV cache 成本的重要设计。 五篇连起来读的线索:注意力先是「一种对齐手段」(2014),再是「唯一的序列算子」(2017),然后 N² 账单到期,在这五篇代表作里,2019 年的路线砍格子,2022 年的路线改执行而保持精确注意力,2023 年的路线则着眼于自回归推理时线性增长的 KV cache。不同成本可以并存,后出现的方案不意味着前一笔账已消失。 08. 常见误解 「注意力是 O(N²),所以序列不长时它也是最慢的部分。」 N=4096、d=3072 时二次项只占本文层结构前向 FLOPs 的 18.2%,但不能据此猜测热点。应结合算术强度、硬件与 profiler 判断。 「多头注意力算 H 遍,所以比单头慢 H 倍。」 H·N²·D = N²·d,多头和全维单头的算术量完全相同;多的是 H 份 N×N 显存和 H 份小矩阵乘的调度开销,不是 H 倍算力。 「显存不够就是模型太大,换个更小的模型。」 d=3072、L=32 的模型权重 6.75 GiB,N=8192 时仅激活就 297 GiB。先算激活账(6B·N·d·bytes + 3B·H·N²·bytes 乘层数),再决定动不动模型。这套无重算训练账本提示应先比较开 gradient checkpointing、换 sdpa/flash、或降分辨率。 「除以 √D 是可要可不要的数值技巧。」 本次样本中未缩放 logits 更容易接近饱和;D=16 的最大权重实际为 0.9970,显示 1.0000 也不等于数学上梯度严格为零。它控制点积方差随维度增长;其他归一化或初始化设计也能缓解饱和,不能据此宣称不缩放就一定无法训练。 「浮点 dropout 乘子不占显存。」 bool mask 通常每元素一字节,而 bf16 为两字节;本文账本计的是两字节的浮点 dropout 乘子,两者不能混称。使用逐元素 dropout 的 eager 训练通常还需保留随机掩码或等价信息;占用取决于表示与实现,不一定恰好是一份 bf16 张量。FlashAttention 可以保存随机数状态并在分块反向时重建掩码。 09. 动手验证 把附录里的 mha_minimal.py 存下来直接跑(python mha_minimal.py),对照三处输出: 形状链:X (2,8,32) → Q/K/V (2,4,8,8) → S (2,4,8,8) → O (2,8,32)。确认分数矩阵是按头存的 4 个 8×8,不是 1 个。 缩放对照:未缩放最大权重 0.5948,缩放后 0.2589;再把 D 扫描表看一遍,本次 D=16 的未缩放值是 0.9970,后续多行显示值接近 1。 等价性:向量化实现与四重循环实现的 max 误差应为 1e-16 量级(你机器上具体数字可能略有不同,但 allclose 一定是 True)。 然后做两个改动观察变化: 把 H 从 4 改成 1 再改成 8,跑性质校验 (d):在 H=1 时头间离散度按定义为 0(没有第二个头);H=8 的数值要以实际重跑为准。这个随机初始化实验只展示不同投影可产生不同权重,不证明训练后各头必然学到互补功能,也不保证头数越多质量越高。 跑 flops_ledger.py 的 CPU 实测段,找到你机器上「实测比」超过「FLOPs 比」的 N 拐点,和理论交叉点 N*=2d 对一下差多少。 预期最容易误判的是第二个:原稿样例在 N=256 的耗时比是 1.44,本次复跑是 3.65,而 FLOPs 比都是 0.25。这只说明两次运行里时延都没有跟着算术量成比例变化;是否由访存、调度或其他因素主导,还需用 profiler 在目标硬件上验证。 10. 延伸阅读 按知识树的依赖顺序,下一步建议这么走: 旋转位置编码 RoPE 的原理与实现——注意力对位置是盲的,RoPE 是视觉/语言模型目前的主流注入方式;本文的 Q、K 在那里会被旋转一次。 视频 DiT 里的 3D RoPE 与分辨率外推——RoPE 在时间/高/宽三组频率上的拆分,视频生成的位置问题。 性能建模与 Profiling:算力、带宽与显存账本——把本文的两本账变成系统方法,roofline 分析。 序列并行——N² 显存装不下时的横向切分方案。 策略梯度与 PPO 基础 等 RL 方向的文章与本篇无直接依赖,可随时穿插。 附录:完整代码 09 节用到的脚本全文如下(mha_minimal.py、attention_memory.py、flops_ledger.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 mha_minimal.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """多头自注意力(MHA)的最小可运行实现:把公式逐行翻译成 numpy。 只依赖 numpy,直接 `python mha_minimal.py` 即可运行。 刻意不用 PyTorch:讲原理时框架的抽象反而是噪声,而且 numpy 谁都能跑。 生产实现见文章第 05 节对 transformers 的引用。 公式符号与代码变量名的对应关系 ------------------------------ X 输入序列 形状 [B, N, d_model] W_q/W_k/W_v 三个输入投影矩阵 形状 [d_model, d_model] W_o 输出投影矩阵 形状 [d_model, d_model] Q, K, V 查询 / 键 / 值 形状 [B, H, N, D] S 缩放后的注意力分数 形状 [B, H, N, N],S = Q K^T / sqrt(D) P softmax 后的权重 形状 [B, H, N, N] O 注意力输出 形状 [B, N, d_model] 运行后你会看到:每一层的真实 shape、注意力权重的数值范围、 以及四条性质校验(行和为 1 / 与循环实现等价 / 缩放系数的影响 / 因果掩码)。 """ import numpy as np rng = np.random.default_rng(0) def split_heads(t: np.ndarray, H: int) -> np.ndarray: """[B, N, H*D] -> [B, H, N, D]。 多头不是「复制 H 份再算」,而是把 d_model 这个维度切成 H 段, 每段独立算一次注意力,最后再拼回去。这一步只是 reshape + transpose, 本身不做任何算术,但它决定了后面所有矩阵乘的形状。 """ B, N, d_model = t.shape D = d_model // H return t.reshape(B, N, H, D).transpose(0, 2, 1, 3) def merge_heads(t: np.ndarray) -> np.ndarray: """[B, H, N, D] -> [B, N, H*D],split_heads 的逆操作。""" B, H, N, D = t.shape return t.transpose(0, 2, 1, 3).reshape(B, N, H * D) def softmax(x: np.ndarray, axis: int = -1) -> np.ndarray: """数值稳定的 softmax:先减去最大值再取指数,避免 exp 溢出。""" x = x - x.max(axis=axis, keepdims=True) e = np.exp(x) return e / e.sum(axis=axis, keepdims=True) def mha(X: np.ndarray, W_q, W_k, W_v, W_o, H: int, causal: bool = False): """完整的多头自注意力前向。返回 (输出, 注意力权重 P)。""" B, N, d_model = X.shape D = d_model // H # ① 三个投影:每个 token 独立地把自己映射成 query / key / value Q = split_heads(X @ W_q, H) # [B, H, N, D] K = split_heads(X @ W_k, H) # [B, H, N, D] V = split_heads(X @ W_v, H) # [B, H, N, D] # ② 打分:每个 query 和所有 key 做内积,得到 N×N 的分数矩阵 S = Q @ K.transpose(0, 1, 3, 2) / np.sqrt(D) # [B, H, N, N] # ③ 因果掩码:第 i 个 query 只能看 0..i 的 key if causal: mask = np.triu(np.ones((N, N), dtype=bool), k=1) S = np.where(mask, -np.inf, S) # ④ 归一化成权重,再对 V 做加权求和 P = softmax(S, axis=-1) # [B, H, N, N] ctx = P @ V # [B, H, N, D] # ⑤ 拼回 d_model,过输出投影 O = merge_heads(ctx) @ W_o # [B, N, d_model] return O, P def mha_naive_loop(X, W_q, W_k, W_v, W_o, H): """完全不用矩阵乘的「照着定义抄」版本:四重循环。 用来验证上面的向量化实现没有把下标搞反。逻辑等价但慢得多(O(B·H·N²·D))。 """ B, N, d_model = X.shape D = d_model // H Q = (X @ W_q).reshape(B, N, H, D).transpose(0, 2, 1, 3) K = (X @ W_k).reshape(B, N, H, D).transpose(0, 2, 1, 3) V = (X @ W_v).reshape(B, N, H, D).transpose(0, 2, 1, 3) out = np.zeros((B, H, N, D)) for b in range(B): for h in range(H): for i in range(N): # 先逐个算出这一行 N 个分数,再 softmax,再加权求和 s = np.array([float(Q[b, h, i] @ K[b, h, j]) / np.sqrt(D) for j in range(N)]) p = softmax(s) out[b, h, i] = p @ V[b, h] return merge_heads(out) @ W_o def main(): B, N, d_model, H = 2, 8, 32, 4 D = d_model // H print(f"配置: B={B} N={N} d_model={d_model} H={H} D={D}") X = rng.normal(size=(B, N, d_model)) * 0.5 W_q, W_k, W_v, W_o = (rng.normal(size=(d_model, d_model)) / np.sqrt(d_model) for _ in range(4)) # ── 1. 每一层的真实形状 ────────────────────────────────── Q = split_heads(X @ W_q, H) K = split_heads(X @ W_k, H) S = Q @ K.transpose(0, 1, 3, 2) / np.sqrt(D) print("\n[1] 各张量形状") print(f" X {X.shape} 输入") print(f" Q/K/V {Q.shape} 切头后 [B, H, N, D]") print(f" S {S.shape} 分数矩阵,N×N 是显存爆炸的源头") print(f" O {mha(X, W_q, W_k, W_v, W_o, H)[0].shape} 输出,和输入同形") # ── 2. 分数的量级:为什么要除以 sqrt(D) ────────────────── raw = Q @ K.transpose(0, 1, 3, 2) # 不除以 sqrt(D) print("\n[2] 缩放系数 sqrt(D) 的作用") print(f" D = {D}, sqrt(D) = {np.sqrt(D):.4f}") print(f" 未缩放分数的标准差 : {raw.std():.4f} 分布范围 [{raw.min():.2f}, {raw.max():.2f}]") print(f" 缩放后分数的标准差 : {S.std():.4f} 分布范围 [{S.min():.2f}, {S.max():.2f}]") print(f" 未缩放 softmax 的最大权重: {softmax(raw).max():.4f}") print(f" 缩放后 softmax 的最大权重: {softmax(S).max():.4f}") # D 越大,不缩放的分数方差越大,softmax 越容易塌成 one-hot print(" 固定 scale=1,扫一遍 D 看 softmax 最大权重怎么变:") print(" D 分数标准差 最大权重(未缩放) 最大权重(缩放后)") for D_test in (8, 16, 32, 64, 128, 256): q = rng.normal(size=(256, D_test)) k = rng.normal(size=(256, D_test)) s_raw = q @ k.T s_scaled = s_raw / np.sqrt(D_test) print(f" {D_test:4d} {s_raw.std():9.4f} " f"{softmax(s_raw).max():14.4f} {softmax(s_scaled).max():15.4f}") # ── 3. 性质校验 ──────────────────────────────────────── print("\n[3] 性质校验") O, P = mha(X, W_q, W_k, W_v, W_o, H) print(f" (a) 权重行和为 1 : max|sum(P)-1| = " f"{np.abs(P.sum(axis=-1) - 1).max():.2e}") O_loop = mha_naive_loop(X, W_q, W_k, W_v, W_o, H) print(f" (b) 向量化 vs 四重循环 : max|O - O_loop| = " f"{np.abs(O - O_loop).max():.2e} allclose=" f"{np.allclose(O, O_loop)}") _, P_causal = mha(X, W_q, W_k, W_v, W_o, H, causal=True) upper = np.triu(P_causal, k=1) print(f" (c) 因果掩码上三角全 0 : max = {upper.max():.2e}") print(f" 且下三角行和仍为 1 : max|sum-1| = " f"{np.abs(P_causal.sum(axis=-1) - 1).max():.2e}") # 随机初始化的不同投影产生不同权重;这不是训练后头功能分化的证据 P_mean = P.mean(axis=1) # [B, N, N],把 H 个头的权重平均 diff = np.abs(P[0, 0] - P_mean[0]).mean() spread = np.abs(P[0] - P[0].mean(axis=0, keepdims=True)).mean() print(f" (d) 各头权重并不相同 : 头 0 与 H 头平均的平均绝对差 = {diff:.4f}") print(f" 头之间的平均离散度 : {spread:.4f}(0 表示所有头完全一样)") # ── 4. 不看自己的极端情形:注意力塌缩成「复制」 ────────── print("\n[4] 极端情形:把 K 设成和 Q 完全一样(自注意力且 W_q=W_k)") X2 = rng.normal(size=(1, 4, d_model)) Q2 = split_heads(X2 @ W_q, H) S2 = Q2 @ Q2.transpose(0, 1, 3, 2) / np.sqrt(D) P2 = softmax(S2) diag_share = np.trace(P2[0, 0]) / 4 print(f" 对角线权重占比 = {diag_share:.4f}(1.0 表示每个 token 只关注自己)") if __name__ == "__main__": main() attention_memory.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """自注意力的显存账本:把一层 attention 的每一笔开销都算成字节。 只依赖 numpy(其实只用到它做格式化,核心就是整数乘除)。 直接 `python attention_memory.py` 即可运行。 算的是「训练时一层 MHA 需要为反向传播留下来的激活」, 这是显式保留中间量的保守教学模型,并非框架实测或反向所需最小值。默认的模型尺寸 采用简化 Transformer:d_model=3072、H=24、D=128。 """ import numpy as np BYTES = {"fp32": 4, "fp16": 2, "bf16": 2, "fp8": 1} MIB = 1024 ** 2 GIB = 1024 ** 3 def fmt(nbytes: float) -> str: if nbytes >= GIB: return f"{nbytes / GIB:8.2f} GiB" if nbytes >= MIB: return f"{nbytes / MIB:8.2f} MiB" return f"{nbytes / 1024:8.2f} KiB" def ledger(B: int, N: int, d_model: int, H: int, dtype: str = "bf16", dropout: bool = True): """返回一层 MHA 的逐项激活显存(字节)。 N² 项有三个:分数矩阵 S、softmax 后的 P、以及与所选 dtype 同宽的浮点 dropout 乘子(非 bool mask)。 这三项就是 O(N²) 显存的真身——不是「注意力复杂度是 N²」这句话, 而是本教学模型假设同时保存的三个 B×H×N×N 张量;框架可复用或省略它们。 """ b = BYTES[dtype] linear = B * N * d_model * b # 每个 [B, N, d_model] 的张量 square = B * H * N * N * b # 每个 [B, H, N, N] 的张量 return { "输入 X": linear, "Q": linear, "K": linear, "V": linear, "分数矩阵 S": square, "softmax 权重 P": square, "浮点 dropout 乘子": square if dropout else 0, "加权和 ctx": linear, "输出 O": linear, } def main(): d_model, H, D = 3072, 24, 128 print(f"模型尺寸: d_model={d_model} H={H} D={D} (H*D = {H * D})") # ── 1. 单个 N 下的逐项账本 ────────────────────────────── B, N = 1, 4096 items = ledger(B, N, d_model, H, "bf16") total = sum(items.values()) print(f"\n[1] 逐项账本 B={B} N={N} bf16(2 字节)") print(f" {'项目':<16}{'形状':<22}{'字节数':>14} 占比") for name, nb in items.items(): shape = "[B, N, d_model]" if nb == B * N * d_model * 2 else "[B, H, N, N]" print(f" {name:<16}{shape:<22}{nb:>14,} {nb / total:6.1%}") print(f" {'合计':<16}{'':<22}{total:>14,} {fmt(total)}") quad = sum(v for k, v in items.items() if "S" in k or "P" in k or "乘子" in k) lin = total - quad print(f" → N² 项共 {fmt(quad)},线性项共 {fmt(lin)},N² 项占 {quad / total:.1%}") # ── 2. N 增长时账本怎么变 ─────────────────────────────── print("\n[2] N 增长时一层 MHA 的激活显存(B=1, bf16, 含 浮点 dropout 乘子)") print(f" {'N':>7}{'线性项':>12}{'N² 项':>12}{'合计':>12} " f"{'融合侧教学值':>15} 倍数") for N in (1024, 2048, 4096, 8192, 16384, 32768): it = ledger(1, N, d_model, H, "bf16") q = it["分数矩阵 S"] + it["softmax 权重 P"] + it["浮点 dropout 乘子"] l = sum(it.values()) - q # 与 FlashAttention 文统一:六份线性量的教学预算,忽略小的 LSE 与工作区 flash = 6 * 1 * N * d_model * 2 print(f" {N:>7}{fmt(l):>12}{fmt(q):>12}{fmt(l + q):>12} " f"{fmt(flash):>15} {(l + q) / flash:5.1f}x") # ── 3. 交叉点:从哪个 N 开始 N² 项压过线性项 ──────────── # 3·B·H·N² = 6·B·N·d → N* = 2d / H N_star = 2 * d_model / H print("\n[3] 交叉点") print(f" 3·B·H·N²·bytes = 6·B·N·d·bytes 解得 N* = 2d/H = {N_star:.0f}") print(f" 也就是说 N 超过 {N_star:.0f} 之后,一层 attention 的激活显存") print(f" 就由 N² 项主导;N=4096 时已经超出 {(4096 / N_star):.0f} 倍。") # ── 4. 乘上层数:为什么 L 层比 N 更狠 ──────────────────── print("\n[4] 乘上层数 L(无重算训练,按上述教学模型保留各层中间量)") print(f" {'L':>4}{'N=2048':>12}{'N=4096':>12}{'N=8192':>12} 说明") for L in (12, 24, 32, 48): row = [] for N in (2048, 4096, 8192): tot = sum(ledger(1, N, d_model, H, "bf16").values()) row.append(fmt(tot * L)) print(f" {L:>4}{row[0]:>12}{row[1]:>12}{row[2]:>12}") print(" 以上均未计入模型权重与优化器状态;梯度检查点减少内部保存量,但仍需保留边界激活,并非通用的 1/L。") # ── 5. 推理侧的另一种账本:KV cache ───────────────────── print("\n[5] 推理侧:KV cache 的账本(随 N 线性增长,但随并发数 B 线性增长)") print(" 公式: 2 · B · N · L · H · D · bytes") print(f" {'B':>4}{'N':>7}{'L=32':>12}{'L=80':>12}") for B in (1, 8, 32): for N in (4096, 32768): r = [] for L in (32, 80): nb = 2 * B * N * L * H * D * 2 r.append(fmt(nb)) print(f" {B:>4}{N:>7}{r[0]:>12}{r[1]:>12}") # ── 6. 权重和激活谁更大 ──────────────────────────────── print("\n[6] 权重 vs 激活:别只盯着模型大小") L = 32 # 一层 transformer 的权重:4 个 d×d 投影 + 2 个 FFN 的 4d×d w_per_layer = (4 * d_model * d_model + 2 * d_model * 4 * d_model) * 2 print(f" 一层权重(4 个 d×d + FFN 的 2×4d×d,bf16): {fmt(w_per_layer)}") print(f" L={L} 层总权重 : {fmt(w_per_layer * L)}") for N in (2048, 8192): act = sum(ledger(1, N, d_model, H, "bf16").values()) * L print(f" N={N} 时 L={L} 层激活 : {fmt(act)} " f"(是权重的 {act / (w_per_layer * L):.1f} 倍)") if __name__ == "__main__": main() flops_ledger.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """自注意力的算力账本:把一层 attention 拆成「线性项」和「二次项」两笔。 只依赖 numpy。直接 `python flops_ledger.py` 即可运行。 最后有一段 CPU 实测,耗时约 10 秒;不同机器数值会不同,看趋势即可。 FLOPs 口径:一次矩阵乘 [M,K] @ [K,N] 需要 M·K·N 次乘加(MAC), 一次乘加算 2 个浮点运算,所以 FLOPs = 2·M·K·N。全文统一用这个口径。 """ import time import numpy as np def layer_flops(N: int, d: int, with_ffn: bool = True): """一层 transformer 的前向 FLOPs,拆成线性项和二次项。""" # 4 个 d×d 投影:Q、K、V 三个输入投影 + 1 个输出投影 proj = 4 * 2 * N * d * d # FFN:升到 4d 再降回来,两个矩阵乘 ffn = 2 * 2 * N * d * 4 * d if with_ffn else 0.0 # 注意力内部两个 N×N 的矩阵乘:QK^T 与 P·V attn = 2 * 2 * N * N * d return proj + ffn, attn def fmt_flops(f: float) -> str: for unit, scale in (("P", 1e15), ("T", 1e12), ("G", 1e9), ("M", 1e6)): if f >= scale: return f"{f / scale:7.2f} {unit}FLOPs" return f"{f:7.2f} FLOPs" def main(): d, H = 3072, 24 print(f"模型尺寸: d_model={d} H={H}") # ── 1. 一层里两笔账各是多少 ───────────────────────────── print("\n[1] 一层 transformer 的前向 FLOPs(N=4096, 含 FFN)") linear, quad = layer_flops(4096, d) print(f" 线性项(QKV 投影 + O 投影 + FFN): {fmt_flops(linear)}") print(f" 二次项(QK^T 与 P·V) : {fmt_flops(quad)}") print(f" 二次项占比 : {quad / (linear + quad):.1%}") # 只看 attention 内部:4 个投影 vs 2 个 N×N 矩阵乘 l_attn_only, q_attn_only = layer_flops(4096, d, with_ffn=False) print(f" 只算 attention 模块本身(去掉 FFN): 二次项占 " f"{q_attn_only / (l_attn_only + q_attn_only):.1%}") # ── 2. 交叉点:二次项什么时候超过线性项 ────────────────── # 4N²d = 24Nd² → N* = 6d print("\n[2] 交叉点") print(f" 含 FFN : 4N²d = 24Nd² → N* = 6d = {6 * d}") print(f" 只含投影: 4N²d = 8Nd² → N* = 2d = {2 * d}") print(f" 结论:N 小于 {2 * d} 时,二次项的 FLOPs 少于 attention 投影,") print(f" 这只比较运算量;是否为耗时瓶颈仍取决于访存、内核与硬件。") # ── 3. 占比怎么随 N 变化 ─────────────────────────────── print("\n[3] 二次项占比随 N 变化(d=3072,含 FFN)") print(f" {'N':>7}{'线性项':>16}{'二次项':>16}{'二次项占比':>10}") for N in (512, 1024, 2048, 4096, 8192, 16384, 32768, 65536): l, q = layer_flops(N, d) print(f" {N:>7}{fmt_flops(l):>16}{fmt_flops(q):>16}{q / (l + q):>10.1%}") # ── 4. 训练总算力:前向的三倍 ─────────────────────────── print("\n[4] 训练一个 token 的 FLOPs(前向 + 反向 ≈ 3 倍前向)") for N in (2048, 4096, 8192): l, q = layer_flops(N, d) print(f" N={N:<6} 每 token 前向 {fmt_flops((l + q) / N)}" f" 训练 {fmt_flops(3 * (l + q) / N)}") # ── 5. CPU 实测:二次项的增长是不是真的更快 ────────────── print("\n[5] CPU 实测(本机一次运行,看趋势不看绝对值;numpy float32)") d_t, H_t = 1024, 16 rng = np.random.default_rng(0) X = rng.normal(size=(4096, d_t)).astype(np.float32) W = rng.normal(size=(d_t, d_t)).astype(np.float32) / np.sqrt(d_t) def bench(fn, repeat=3): best = float("inf") for _ in range(repeat): t0 = time.perf_counter() fn() best = min(best, time.perf_counter() - t0) return best * 1000.0 print(f" {'N':>6}{'投影 (ms)':>12}{'QK^T (ms)':>12}{'实测比':>9}" f"{'FLOPs 比':>10}") measured = {} for N in (256, 512, 1024, 2048, 4096): x = X[:N] t_proj = bench(lambda: x @ W) D_t = d_t // H_t Q = (x @ W)[:, :].reshape(N, H_t, D_t).transpose(1, 0, 2) t_qk = bench(lambda: Q @ Q.transpose(0, 2, 1)) # 理论 FLOPs 比:二次项 / 一个投影 ratio_flops = (2 * N * N * d_t) / (2 * N * d_t * d_t) measured[N] = t_qk / t_proj print(f" {N:>6}{t_proj:>12.2f}{t_qk:>12.2f}" f"{t_qk / t_proj:>9.2f}{ratio_flops:>10.2f}") print(f" 注意看 N=256 那一行:QK^T 的算术量只有投影的 0.25 倍,") print(f" 本次 QK^T / 投影耗时比为 {measured[256]:.2f}。耗时比不必等于 FLOPs 比。") # ── 6. 算术强度:FLOPs 回答不了「为什么慢」 ─────────────── print("\n[6] 算术强度 AI = FLOPs / 访存字节(float32,4 字节/元素)") print(" 估算 AI 较低提示应检查访存;是否实际受限需测硬件计数器。") print(f" {'算子':<22}{'N=256':>12}{'N=1024':>12}{'N=4096':>12}") rows = [] for N in (256, 1024, 4096): # 投影 X[N,d] @ W[d,d]:读 X 与 W,写输出 f_proj = 2 * N * d_t * d_t m_proj = (N * d_t + d_t * d_t + N * d_t) * 4 # QK^T:读 Q 与 K,写 N×N 的分数矩阵(H 份) f_qk = 2 * N * N * d_t m_qk = (2 * N * d_t + H_t * N * N) * 4 rows.append((N, f_proj / m_proj, f_qk / m_qk)) print(f" {'投影 X@W_q':<22}" + "".join(f"{r[1]:>12.1f}" for r in rows)) print(f" {'注意力 QK^T':<22}" + "".join(f"{r[2]:>12.1f}" for r in rows)) print(f" {'(投影 / QK^T)':<22}" + "".join(f"{r[1] / r[2]:>12.1f}" for r in rows)) print(" 投影的 AI 高出 4~7 倍:权重矩阵被整批 token 复用,读一次能做 N 次乘加。") print(" QK^T 的 AI 低:输出是 H·N²,写完就走,数据复用少。") print(" 该估算不能解释本机时延;FlashAttention 原论文通过分块减少 HBM IO,") print(" 避免显式落地完整 N×N 权重矩阵,但算术量仍是二次。") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「自注意力机制的计算与显存账本」的三张解释图。 数值全部来自同目录下的 attention_memory.py 与 flops_ledger.py, 改了那两个脚本的话这里要跟着重跑,避免图与正文数字不一致。 只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行。 """ from pathlib import Path import matplotlib.pyplot as plt import numpy as np from matplotlib.patches import FancyBboxPatch ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, }) C_QUAD = "#e05263" # N² 项:红 C_LIN = "#3f7fbf" # 线性项:蓝 C_FLASH = "#2f9e6f" # FlashAttention:绿 C_GREY = "#94a3b8" INK = "#182238" MIB = 1024 ** 2 GIB = 1024 ** 3 def _style(ax, title, xlabel, ylabel): ax.set_title(title, fontsize=14, weight="bold", color=INK, pad=10) ax.set_xlabel(xlabel, fontsize=11, color="#475569") ax.set_ylabel(ylabel, fontsize=11, color="#475569") ax.tick_params(colors="#475569", labelsize=10) for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#cbd5e1") ax.grid(axis="y", color="#eef2f7", linewidth=1) ax.set_axisbelow(True) # ──────────────────────────────────────────────────────────── # 图 1:显存账本的构成 # ──────────────────────────────────────────────────────────── def fig_memory_ledger(): d_model, H = 3072, 24 b = 2 # bf16 fig, axes = plt.subplots(1, 2, figsize=(13.2, 4.9), facecolor="#fbfcfe") # 左:N=4096 时的逐项占比(一根堆叠条) ax = axes[0] N = 4096 lin_item = 1 * N * d_model * b quad_item = 1 * H * N * N * b labels = ["输入 X", "Q", "K", "V", "分数矩阵 S", "softmax 权重 P", "浮点 dropout 乘子", "加权和 ctx", "输出 O"] sizes = [lin_item, lin_item, lin_item, lin_item, quad_item, quad_item, quad_item, lin_item, lin_item] colors = [C_LIN] * 4 + [C_QUAD] * 3 + [C_LIN] * 2 total = sum(sizes) left = 0.0 for lab, s, c in zip(labels, sizes, colors): ax.barh([0], [s / GIB], left=left / GIB, color=c, edgecolor="white", linewidth=1.2, height=0.55) if s / total > 0.05: ax.text(left / GIB + s / GIB / 2, 0, f"{lab}\n{s / total:.1%}", ha="center", va="center", fontsize=9.5, color="white", weight="bold") left += s ax.set_xlim(0, total / GIB) ax.set_yticks([]) for s in ("left", "top", "right"): ax.spines[s].set_visible(False) ax.set_xlabel("单层 MHA 的教学激活存储(GiB)", fontsize=11, color="#475569") ax.set_title(f"N={N} 时,三个 N² 项吃掉 94%", fontsize=14, weight="bold", color=INK, pad=10) ax.text(0, -0.42, f"合计 {total / GIB:.2f} GiB | 模型 d_model={d_model}, " f"H={H}, bf16", ha="left", fontsize=10, color="#64748b") # 右:随 N 增长,朴素实现 vs FlashAttention ax = axes[1] Ns = np.array([1024, 2048, 4096, 8192, 16384, 32768]) lin = 6 * Ns * d_model * b # 与逐项账本相同:6 个 [B,N,d] 张量 quad = 3 * H * Ns ** 2 * b # 3 个 [B,H,N,N] 张量 naive = (lin + quad) / GIB flash = (6 * Ns * d_model * b) / GIB # 统一教学线性预算,忽略小的 LSE ax.plot(Ns, naive, "o-", color=C_QUAD, linewidth=2.4, markersize=6, label="朴素实现(落 N² 到显存)") ax.plot(Ns, flash, "s-", color=C_FLASH, linewidth=2.4, markersize=6, label="融合侧教学值(6Nd)") ax.fill_between(Ns, flash, naive, color=C_QUAD, alpha=0.10) ax.set_yscale("log") ax.set_xscale("log") ax.set_xticks(Ns) ax.set_xticklabels([f"{n:,}" for n in Ns], fontsize=9) ax.legend(fontsize=10, frameon=False, loc="upper left") _style(ax, "两者比值随 N 近似线性增长", "序列长度 N(token 数)", "单层教学激活存储(GiB,对数轴)") ax.text(0.98, 0.06, f"N=32768 时相差 {naive[-1] / flash[-1]:.0f} 倍", transform=ax.transAxes, ha="right", fontsize=10, color=C_QUAD, weight="bold") fig.suptitle("自注意力的显存账本:钱花在哪一笔", fontsize=17, weight="bold", color="#0f172a", y=1.03) fig.tight_layout() fig.savefig(OUT / "memory_ledger.png", bbox_inches="tight", facecolor=fig.get_facecolor()) plt.close(fig) # ──────────────────────────────────────────────────────────── # 图 2:算力账本里二次项的占比 # ──────────────────────────────────────────────────────────── def fig_flops_ratio(): d = 3072 Ns = np.logspace(9, 16.5, 300, base=2) # 512 ~ 92682 quad = 4 * Ns ** 2 * d lin_proj = 8 * Ns * d * d # 只含 4 个投影 lin_all = lin_proj + 16 * Ns * d * d # 再算上 FFN fig, ax = plt.subplots(figsize=(8.6, 5.0), facecolor="#fbfcfe") r_only = quad / (quad + lin_proj) r_all = quad / (quad + lin_all) ax.plot(Ns, r_only, "-", color=C_QUAD, linewidth=2.6, label="只算 attention 模块(4 个投影 vs 2 个 N×N 乘)") ax.plot(Ns, r_all, "-", color=C_LIN, linewidth=2.6, label="算上 FFN(整层的线性项)") ax.axhline(0.5, color=C_GREY, linestyle="--", linewidth=1.2) ax.text(Ns[0], 0.52, "50% 线", fontsize=10, color=C_GREY) for N_star, color, tag in ((2 * d, C_QUAD, "N* = 2d = 6,144"), (6 * d, C_LIN, "N* = 6d = 18,432")): ax.axvline(N_star, color=color, linestyle=":", linewidth=1.6) ax.text(N_star * 1.05, 0.06, tag, fontsize=10.5, color=color, weight="bold", rotation=90, va="bottom") ax.set_xscale("log", base=2) ax.set_xticks([512, 1024, 2048, 4096, 8192, 16384, 32768, 65536]) ax.set_xticklabels(["512", "1K", "2K", "4K", "8K", "16K", "32K", "64K"]) ax.set_ylim(0, 1) ax.legend(fontsize=10.5, frameon=False, loc="upper left") _style(ax, "二次项的 FLOPs 占比随 N 增长(不等于耗时占比)", "序列长度 N(token 数)", "二次项占该层前向 FLOPs 的比例") ax.text(0.98, 0.30, "常用的 N=4096:\n只算 attention 时二次项占 40%,\n算上 FFN 后只占 18%", transform=ax.transAxes, ha="right", fontsize=10, color="#475569", bbox=dict(boxstyle="round,pad=0.4", facecolor="#f1f5f9", edgecolor="#e2e8f0")) fig.suptitle("算力账本:二次项什么时候才是主角", fontsize=16, weight="bold", color="#0f172a", y=1.00) fig.tight_layout() fig.savefig(OUT / "flops_ratio.png", bbox_inches="tight", facecolor=fig.get_facecolor()) plt.close(fig) # ──────────────────────────────────────────────────────────── # 图 3:多头到底切了什么 # ──────────────────────────────────────────────────────────── def fig_head_split(): fig, ax = plt.subplots(figsize=(11.4, 5.0), facecolor="#fbfcfe") ax.set_xlim(0, 1) ax.set_ylim(0, 1) ax.axis("off") def block(x, y, w, h, title, lines, color, fs=11): ax.add_patch(FancyBboxPatch( (x, y), w, h, boxstyle="round,pad=0.01,rounding_size=0.02", facecolor=color, edgecolor="white", linewidth=1.6)) ax.text(x + w / 2, y + h * 0.74, title, ha="center", va="center", fontsize=fs + 2, weight="bold", color=INK) ax.text(x + w / 2, y + h * 0.33, "\n".join(lines), ha="center", va="center", fontsize=fs, color="#334155", linespacing=1.5) def arrow(x1, y, x2, label): ax.annotate("", xy=(x2, y), xytext=(x1, y), arrowprops=dict(arrowstyle="-|>", color=C_GREY, linewidth=2.0, mutation_scale=16)) ax.text((x1 + x2) / 2, y + 0.045, label, ha="center", fontsize=11, color="#475569", weight="bold") # X block(0.02, 0.30, 0.16, 0.42, "X", ["[B, N, d_model]", "d_model = H · D"], "#dbeafe") arrow(0.185, 0.51, 0.245, "三个投影") # Q/K/V 未切头 block(0.25, 0.30, 0.17, 0.42, "Q, K, V", ["各 [B, N, H·D]", "仍是完整宽度"], "#e0e7ff") arrow(0.425, 0.51, 0.485, "切头") # 切头后 block(0.49, 0.30, 0.17, 0.42, "切头之后", ["[B, H, N, D]", "reshape + transpose"], "#ede9fe") arrow(0.665, 0.51, 0.725, r"$QK^\top/\sqrt{D}$") # 分数矩阵 block(0.73, 0.22, 0.25, 0.58, "分数矩阵 S", ["[B, H, N, N]", "H 个 N×N,不是 1 个", "← 显存就花在这里"], "#fecaca", fs=11) # 底部说明 ax.text(0.5, 0.10, "每个头只用自己的 D = d_model / H 维去做内积,H 个头各算各的 N×N;\n" "最后把 H 份 D 维结果拼回 d_model,再过一次输出投影 W_o。", ha="center", va="center", fontsize=11.5, color="#475569", linespacing=1.6) ax.text(0.5, 0.02, "关键:分头不改变总算术量(H · N² · D = N² · d_model),它改变的是每个子空间的表达能力。", ha="center", va="center", fontsize=11, color=C_QUAD, weight="bold") fig.suptitle("多头注意力切的是 d_model 这一维,不是复制 H 份", fontsize=16, weight="bold", color="#0f172a", y=0.99) fig.tight_layout() fig.savefig(OUT / "head_split.png", bbox_inches="tight", facecolor=fig.get_facecolor()) plt.close(fig) if __name__ == "__main__": fig_memory_ledger() fig_flops_ratio() fig_head_split() print(f"已生成 3 张图到 {OUT}") for p in sorted(OUT.glob("*.png")): print(f" {p.name} {p.stat().st_size / 1024:.0f} KiB")
-
AIGC 基本功|音频质量评测:MOS、PESQ 与 FAD 各测什么-AudioEval 音频质量评测:MOS、PESQ 与 FAD 各测什么 所属方向:评测与指标 | 难度:工程实战 | 前置知识:无 关键词:音频质量、音频评测、MOS、PESQ、STOI、SI-SDR、FAD、Fréchet Audio Distance、感知评测、语音合成、音频codec、无参考评测 01. 为什么需要它 先看一个教学假设:团队比较两个音频 codec 版本,一个版本对齐更准,SI-SDR 更高,却同时新增了低能量的高频纯音。波形误差下降和听感变差可以同时发生。第 04 节用可复现合成信号展示这个指标盲区;本文没有受试者听测,因此不把「刺耳」或「无差别」写成测得的事实。7~7.5 kHz 的窄带成分可能可闻,其显著程度取决于响度、掩蔽、设备和听者;不能把这一段称为人耳最敏感频段。 这个问题不是「评测做少了」,而是指标回答的问题和团队想问的问题不是同一个。SI-SDR 回答的是「输出波形和参考波形逐采样点对得上吗」,团队想问的是「用户听着难受吗」。这两个问题之间的距离,就是这篇要讲的东西。 更麻烦的是,音频指标的「鄙视链」比图像指标更长、更碎:PESQ 面向语音质量,含窄带与宽带版本;STOI 面向语音可懂度,音乐生成用的是分布级的 FAD,而人工 MOS 需要组织听测,并报告受试者、协议与置信区间。没有一个指标是免费的午餐——先搞清楚每个指标在测什么,再决定用哪个,比记住任何一行数字都重要。 02. 最小可用理解 先把这篇要用的缩写认全——音频圈的缩写比图像圈更碎,不先对齐名词,后面每个数字都容易理解错: 缩写 全称 中文 一句话 MOS Mean Opinion Score 平均意见分 找一群人听、打分取平均。按指定听测协议汇总主观评分,有成本和统计不确定性 PESQ Perceptual Evaluation of Speech Quality 语音质量感知评估 语音有参考质量指标,P.862 为窄带、P.862.2 为宽带扩展 STOI Short-Time Objective Intelligibility 短时客观可懂度 只测「内容听不听得清」,不测好不好听 SI-SDR Scale-Invariant Signal-to-Distortion Ratio 尺度不变信号失真比 允许整体缩放后再比波形,衡量逐采样点对齐程度 FAD Fréchet Audio Distance Fréchet 音频距离 不需逐条配对参考,仍需参考音频集合,比较两堆特征分布,思想来自图像的 FID STFT Short-Time Fourier Transform 短时傅里叶变换 把波形切帧做 FFT,得到随时间变化的频谱 SSL Self-Supervised Learning 自监督学习 UTMOS 这类 MOS 预测器用来提特征的预训练模型 DNSMOS / UTMOS — — 用模型预测 MOS 的两种常见方案(前者微软、后者东京大学 SaruLab) 三句话讲完框架: 每个指标只回答一个具体的问题:「波形逐点对齐了吗」(SI-SDR/SNR)、「频谱形状像吗」(对数梅尔距离)、「这两堆音频听起来像同一个世界来的吗」(FAD)、「人听着舒服吗」(MOS,以及预测它的 UTMOS/DNSMOS)。问题不同,答案就不同——不存在「最好的指标」,只存在「问对了问题的指标」。 有参考和无参考是两大阵营。有参考指标(SI-SDR、PESQ、梅尔距离)需要对应的参考信号,适合 codec、增强、分离等任务;逐条无参考指标(UTMOS、DNSMOS)不需要对应参考;FAD 不需要逐条配对,但需要代表目标分布的参考集合。是否适合音乐或音效仍取决于训练域和特征器。 客观指标是 人耳的代理,代理就有失真。失真最大的地方往往是「在部分听测条件下不显著、指标却敏感」的维度(波形相位、时移、整体音量),和「人耳一耳朵就听出来、指标却毫无反应」的维度(高频毛刺、音色瑕疵)。第 04 节会用一张表把这两类失真都造出来给你看。 03. 数学推导 3.1 SI-SDR:为什么它对音量不敏感、对时移却如此脆弱 信号处理里的「失真」最朴素的定义是信噪比: $$\mathrm{SNR} = 10 \log_{10} \frac{\| s \|^{2}}{\| \hat{s} - s \|^{2}}$$ 其中 $s$ 是参考信号、$\hat{s}$ 是待测信号,范数就是逐采样点的能量。它有一个明显的不合理之处:如果输出和参考只差一个整体音量($\hat{s} = 0.95\,s$),按理说听感几乎没差别,但 SNR 会把它记成 $20\log_{10}(1/0.05) \approx 26$ dB 的「失真」。 SI-SDR 的解法是先做最优缩放,再算残差——这也是它名字里 Scale-Invariant 的来历: $$\alpha = \frac{\langle \hat{s}, s \rangle}{\langle s, s \rangle}$$ $$\mathrm{SI\text{-}SDR} = 10 \log_{10} \frac{\| \alpha s \|^{2}}{\| \hat{s} - \alpha s \|^{2}}$$ $\alpha$ 是把待测信号投影到参考方向上的最小二乘系数:分子是内积 $\langle \hat{s}, s \rangle$(两个波形逐点相乘再求和,衡量「同相程度」),分母是参考信号的能量,用来归一化。缩放完再算残差,整体音量的差异就被精确抵消了。 但这个设计同时埋了雷。SI-SDR 衡量的是逐采样点的对齐程度,而波形对齐对时间平移极端敏感:把信号往后挪 8 个采样点(16 kHz 采样率下只有 0.5 毫秒,单独播放时通常不易觉察),波形的峰谷就全部错开了,内积 $\langle \hat{s}, s \rangle$ 急剧下降、残差急剧上升,SI-SDR 可以从正几十分贝直接掉到负值——第 04 节的实验里,0.5 毫秒的时移让 SI-SDR 掉到了 $-6.25$ dB。 所以使用 SI-SDR 前要确认与参考的对齐约定(降噪、回声消除、codec 重建),并且要明白它测的是去掉全局增益后的波形误差,对齐只是影响因素之一。 顺带回答一个高频疑问:为什么叫 SDR 不叫 SNR? 因为这个指标不是从「信噪比」这棵树上长出来的,而是从盲源分离那套评价体系里长出来的。2006 年的 BSS_eval 工具箱(Vincent / Gribonval / Févotte,Performance measurement in blind audio source separation)把估计信号相对参考的总误差拆成四类: 残留干扰(interference):别的声源串进来多少 加性噪声(noise):环境噪声剩多少 算法伪影(artifacts):算法自己制造出来的人工痕迹 通道误差(channel errors):增益、滤波这类整体偏差 对应地给出 SIR / SAR / ISR 三个分项,以及一个总指标——SDR(Signal-to-Distortion Ratio)。 关键就在 Distortion 这个词:它涵盖上面四类,而 SNR 的「噪声」只对应其中一类。在盲源分离里,最伤听感的往往不是噪声,而是别的源串进来的干扰和算法自己的伪影,叫「信噪比」会名不副实。 后来 2019 年 Le Roux 等人在 SDR – half-baked or well done?(arXiv:1811.02508)里指出 BSS_eval 版 SDR 有两个致命问题:bss_eval_sources 允许用 512 阶滤波器去「修改参考信号」来拟合估计值,于是把某些频段直接置零也能拿到近乎无穷的 SDR;bss_eval_images 的 SDR 又退化成了普通 SNR,不允许全局缩放,反被一些算法无意间靠调音量刷了分。他们给出的修法就是本文用的 SI-SDR——误差项与参考信号严格正交,彻底去掉对幅度缩放的依赖,命名沿袭 SDR 保持与社区的连续性。 SDR 的 distortion 可以包括噪声、串扰和伪影等误差。SNR 与 SI-SDR 是否数值相等还取决于缩放、投影和预处理约定,不能仅凭「只有加性噪声」判定。工程上 SI-SNR 常用于同类投影指标,比较实现时须检查是否先去均值、如何处理静音。 3.2 对数梅尔距离:把「人耳怎么听」写进公式 梅尔刻度近似描述感知音高与频率的非线性关系,不能据此断言某两个高频纯音「人耳几乎分不清」。本文采用 HTK 风格的映射: $$m(f) = 2595 \log_{10}\left(1 + \frac{f}{700}\right)$$ 其中 $f$ 的单位为 Hz。短时傅里叶变换(STFT)得到幅度谱后,用三角滤波器聚合到梅尔频带,再取对数。本文的最小实现是梅尔幅度谱,不是常见的梅尔功率谱;两者必须区分。令 $M(k,t)$ 为第 $k$ 带、第 $t$ 帧的幅度,以每条音频的谱峰值 $M_{\max}$ 归一化,定义: $$L(k,t)=\ln\max\left(M(k,t)/M_{\max},10^{-4}\right)$$ $$D_{\mathrm{mel}} = \frac{1}{KT}\sum_{k,t}\left|L(k,t)-\hat L(k,t)\right|$$ $K,T$ 分别为梅尔带数和帧数。这里的单位是自然对数幅度差,不是 dB;换成 dB 要乘 $20/\ln 10$。独立归一化是为了在本实验里忽略整体增益,若任务关心响度,就不能先把这类差异消掉。幅度下限 $10^{-4}$ 对应峰值下 80 dB,防止对接近零的值取对数;若使用功率谱,同样的 80 dB 下限应是 $10^{-8}$。窗口、hop、滤波器、幅度/功率约定、floor 和归一化都会改变数值,需完整报告。 3.3 Fréchet Audio Distance:从「两条音频」到「两堆音频」 前面两个指标都需要一条参考音频。但音乐生成、音效生成没有「正确答案」——你没法说这段生成的钢琴曲应该长什么样。这类任务需要无参考指标,FAD 是其中最常用的一个。 FAD 的思路借自图像领域的 FID:不比较单条音频,而是比较两堆音频的分布。把每条音频过一个特征提取器(原论文用 VGGish,得到 128 维特征),每堆音频的特征就变成了高维空间里的一团点云,然后近似成高斯分布,问:这两个高斯离得多远? FAD 使用两个拟合高斯之间的 2-Wasserstein 距离平方(沿用 Fréchet distance 名称): $$\mathrm{FD} = \left\| \mu_{r} - \mu_{t} \right\|^{2} + \mathrm{Tr}\left( \Sigma_{r} + \Sigma_{t} - 2 \left( \Sigma_{r} \Sigma_{t} \right)^{1/2} \right)$$ $\mu_{r}, \mu_{t}$ 是参考集和测试集的特征均值(每维上特征的平均),$\Sigma_{r}, \Sigma_{t}$ 是协方差矩阵(特征之间的联合波动结构),$\mathrm{Tr}$ 是矩阵的迹(对角线元素之和)。直觉上:均值差衡量「两团云的中心差多远」,协方差项衡量「两团云的形状差多远」。 样本量会影响均值和协方差的估计。当样本数不超过特征维度时,中心化样本协方差必然秩亏;但秩亏不表示距离无法计算。更关键的是估计偏差和方差,其大小取决于特征谱、独立样本数和参考集,而非单由维度决定。第 04 节的 16 维合成例子中,同分布两组的距离从 8 个样本时的 13.1390 降到 300 个样本时的 0.1844;这是一组随机种子的结果,不是通用阈值。 实战里怎么检查样本量的影响 报告同分布基线及其波动。按原始音频为单位反复随机分组,让组大小与真正的比较一致,观察距离分布。不能拿一次基线的「2 倍」当显著性阈值;应结合效应量、重采样区间或预先设计的置换检验。 不要把切片数当独立样本数。0.96 秒窗口是 VGGish 常见的输入单位。帧级统计与 clip 级统计评价的对象不同,同一条音频的窗口又高度相关。切片可以提供局部信息,但不会凭空产生同等数量的独立录音;bootstrap 应按音频或更高层级成组抽样,不能把相关帧当成独立样本。 固定评测协议。报告参考集、生成集规模、总时长、窗口步长、特征器和归一化。更换这些条件后,旧 FAD 数字不再是同一把尺子。 原始 FAD 论文 与 后续 FAD 评测研究 讨论了特征器和样本量偏差。本次修订移除了缺少原始音频与评测脚本的历史「真实案例」图表;下面保留可由附录完整复现的合成实验,避免把不可复核的数值当作结论依据。 04. 代码实现 完整脚本在文末附录,这里只看核心片段与真实输出。数值脚本只用 numpy;配图脚本另需 matplotlib,不依赖音频模型权重。 第一段:构造三种不同机制的退化(metric_disagreement.py)。干净信号用「基频 + 6 个谐波 + 慢包络」合成;三种退化分别是音量 ×0.95、叠 7/7.5 kHz 纯音、循环时移 0.5 ms: def degrade(x, kind, sr=SR): if kind == "A": return 0.95 * x # 音量差 5% if kind == "B": # 7/7.5 kHz 纯音,均低于 16 kHz 采样率的 Nyquist 频率 t = np.arange(len(x)) / sr buzz = 0.02 * ( np.sin(2 * np.pi * 7000 * t) + np.sin(2 * np.pi * 7500 * t) ) return x + buzz if kind == "C": return np.roll(x, 8) # 时移 8 采样 = 0.5ms raise ValueError(kind) 第二段:SI-SDR 的最小实现(缩放抵消就三行): def si_sdr(ref, est): """Scale-Invariant SDR。 先把 est 投影到 ref 上(找一个最优缩放 alpha),剩下的残差才算失真。 所以「整体音量变了」在 SI-SDR 里被完全抵消——这是设计意图, 但也意味着它测不出增益错误。 """ if np.dot(ref, ref) <= 0 or np.dot(est, est) <= 0: raise ValueError("SI-SDR needs non-silent reference and estimate") alpha = np.dot(est, ref) / np.dot(ref, ref) e_target = alpha * ref e_res = est - e_target num = np.dot(e_target, e_target) den = np.dot(e_res, e_res) if den <= 1e-24 * num: return float("inf"), alpha return 10 * np.log10(num / den), alpha 真实运行输出(16 kHz、1 秒合成乐音): 操作 SI-SDR(dB) SNR(dB) 梅尔距离(ln幅度) 高频占比 高频谱平坦度 A 音量×0.95 inf 26.02 0.0000 3.808e-14 0.3256 B 7/7.5kHz纯音 26.58 26.58 0.3472 2.188e-03 近0 C 循环时移0.5ms -6.25 -0.51 0.0187 3.836e-14 0.3272 A 的全局增益在 SI-SDR 和独立归一化的梅尔谱里被消除;SNR 仍会计入它。$\alpha=0.95$ 表示待测信号为参考的 0.95 倍,并不是把 0.95「倒过来」。 B 的 SI-SDR 为 26.58 dB,但它不是主观音质的合格线。高频能量占比明显上升,说明多了高频成分;这些成分是否不悦耳,需要听测。 C 在波形上错位,SI-SDR 大幅下降,梅尔距离较小。这里 np.roll 是循环时移,会把尾部搬到开头;它只是对齐敏感性的演示,真实系统延迟应在共同有效区间评测。 谱平坦度描述所选频带的谱能量是否集中。纯音通常低、平坦噪声通常高,但音乐本来就含纯音,白噪声也可能是缺陷,因此不能用统一的 0.05 阈值判好坏。本实验干净信号的高频能量约为 $10^{-14}$ 量级,已几乎为空;此时平坦度主要由窗函数泄漏和数值 floor 决定,0.3256 不是「健康音频标准」。高频能量占比与平坦度在理想非零计算下都对全局增益不变,实际小能量频带则应先做绝对能量门控。 第三段:FAD 与样本量(fad_sample_size.py)。没有 VGGish,就用 16 维归一化对数梅尔幅度均值当特征——Fréchet 距离这一步的数学完全一样。核心实现采用对称半正定夹心矩阵。不能把一般非对称的 $\Sigma_r\Sigma_t$ 直接交给只处理对称矩阵的 eigh;通用矩阵平方根算法可以处理乘积,但不是这里的最小实现。附录检查非半正定输入,并仅把容差内的负舍入误差截为零。 真实运行输出(每行重新抽取样本,固定随机种子): 每堆样本数 同分布距离 带纯音距离 8 13.1390 47.5224 16 3.8499 49.1996 32 1.6452 46.6619 64 0.9992 46.3322 128 1.1044 45.4964 300 0.1844 45.4057 总体分布相同才有理论距离零,两个有限样本的估计值不必为零,也不必随样本量严格单调下降。这里是自定义 16 维梅尔特征的高斯距离演示,不是标准 VGGish FAD。 配图由 mel_spectrogram.py 重绘,单位为 dB,和表中自然对数单位相差固定倍数。B 的两条纯音均低于 Nyquist 频率;旧实现的 sin(2π·8000t) 在 16 kHz 采样时落在零点,不能用它模拟一个存在的 8 kHz 纯音。 图要看什么:B 在高频多出亮带;A 因独立归一化与参考重合;C 的谱形状变化较小。色谱只能证实频谱结构变化,不能代替主观听测。 05. 工业级实现对照 最小实现是为了讲清原理,生产里的实现多出的主要是「工程鲁棒性」: FAD:TorchEval 的 FrechetAudioDistance 的 FrechetAudioDistance(以 2026-09 的实现为准)把特征提取抽象成 preproc + model 两个可插拔组件,with_vggish() 一行构建官方配置;Microsoft 的 fadtk 则把 CLAP、MERT、HuBERT、Whisper 等十来种特征提取器都接了进来——FAD 的数值和特征提取器强绑定,换提取器等于换了一把尺子,不同论文的 FAD 数字不能直接比。另外它用流式更新(update/compute 两段式),避免一次把全部音频载入内存。 编解码器:facebookresearch/encodec/encodec/model.py 的 EncodecModel 提供 encode/decode 与可调目标码率的残差量化器,评测 codec 时要用它官方的 24 kHz / 48 kHz 配置,因为不同采样率下量化器的带宽分配不同,失真谱型也不同。 PESQ / STOI:两者来源不同。PESQ 对应 ITU-T P.862 系列,P.862.2 是宽带扩展;ITU 已于 2024-01-05 撤回该系列,并指向 P.863 系列。历史 benchmark 仍可报告 PESQ,但要写清版本、带宽和采样率。STOI 则来自 Taal 等人的可懂度研究,不是 P.862 标准;作者资料与代码 给出来源。常用实现为 pesq / pystoi,使用时仍须核对模式与预处理。 MOS 预测:UTMOS/DNSMOS 可以对单条样本输出预测分,适合筛选和回归测试。域内和域外的绝对值、排序都应在目标数据上验证,不能保证域内排序必然正确。人工听测也并非不可复现,可按 ITU-T P.800 等协议固定设计并报告评分分布和置信区间。 06. 代价与边界 指标 适合的问题 什么时候会骗你 SI-SDR 时间严格对齐的重建任务 对时移和相位差敏感;对单个全局增益不敏感 SNR 同上,且关心音量 对感知无感的相位问题同样过敏 对数梅尔距离 音色/频谱保真度 归一化会消除整体增益;逐帧比较仍对时序变化敏感,时间聚合又会丢失结构 PESQ / STOI 语音质量 / 语音可懂度 需按版本匹配带宽;不能直接推广为音乐或音效质量指标 FAD 生成系统的分布级评价 样本量不足时严重虚高;绑定特征提取器;对单条样本没有意义 MOS(人工) 指定协议下的主观评价 有采样不确定性;跨批次比较需要协议、样本与评分锚点控制 UTMOS / DNSMOS MOS 的廉价代理 排序与绝对值都需校准,域外泛化尤其容易失败 两条总原则: 任何单一指标都可能给出与听感相反的结论。开头的教学场景说明,波形误差变小并不排除感知缺陷。多指标交叉 + 小规模人工抽听,是底线配置。 指标回答「像不像」,不回答「好不好」。一个模型可以无限逼近参考(各种距离都趋近 0),同时毫无创造力;生成类任务的最终评价一定要留人工的位置。 (具体缺陷怎么查、该看哪个数字,见下面「诊断手册:按症状选指标」。) 07. 诊断手册:按症状选指标与读图 前面几节讲的是「每个指标测什么」,这一节反过来——从你听到或收到的问题出发,倒推该看哪个数字。(它和上面的边界表是一体两面:表说「指标会骗你」,这里说「那该看谁」。) 7.1 先区分配对参考、参考分布与无参考预测 有对应参考波形时,可算 SI-SDR、SNR、谱距离以及适用的语音指标。没有逐条参考时,MOS 预测器仍可逐条打分,文本条件模型也可以计算文本与音频相似度。经典 FAD 是集合统计,不直接定位单条缺陷;研究中的单样本扩展有另外的定义与边界。 比较两个生成器时,优先固定 prompt 分布、后处理、时长和测试规模。若确实有一一对应的 prompt 与样本,可以做配对分析;非配对设计同样可以成立,但需要匹配设计的统计方法。报告效应量和置信区间,必要时使用置换检验或按独立音频单位重采样;多指标检验还要考虑多重比较。p=0.02 不能因为只有 24 条样本就改称「勉强」,p=0.2 也不能证明没有差异。单个集合级 FAD 更不能直接塞进逐条配对 t 检验。 7.2 按症状安排检查 持续高音、电流声:先看谱图确认是否存在额外窄带峰,再看该频带能量与逐帧平坦度。嘶声可能是宽带噪声,平坦度反而较高;蜂鸣、鸟叫、乐器泛音也可能是正常窄带成分。阈值必须由正常/异常验证集校准。 发闷或带宽不足:检查绝对电平、高频能量、频谱质心和相对参考的带宽。贝斯、鼓等低频内容天然窄带,不能由质心低直接判缺陷。 金属声或音乐噪声:沿时间看瞬态谱峰、带宽和谱距离变化,避免全段平均掩盖短时问题。有参考时可结合分离任务的伪影指标,再人工确认。 相位或通道异常:明确是否允许补偿全局延迟,检查通道间相关和对齐后的波形误差。低 SI-SDR 加小谱距离只能提示对齐问题,不能唯一证明根因。 整体增益偏差:用 RMS、LUFS 或参考增益比。SI-SDR 对单个全局非零增益不变,对随时间变化的增益并不不变;响度泵动需要逐窗观察。 可懂度不足:语音任务可结合 STOI 与人工转写;WER/CER 还依赖 ASR 本身,不能把识别器错误全部算成生成缺陷。 内容跑偏或多样性不足:在一致协议下看 FAD、条件一致性和多样性统计。特征方差变大也可能只是噪声,不能以「方差越大越好」替代覆盖度分析。 7.3 排查顺序和判定边界 先检查格式、采样率、声道、时长、绝对电平,再检查相对谱、局部异常和整体统计。接近静音时,按自身峰值归一化会把噪声放大得像正常内容,平坦度也可能很高;此时应单独报告静音比例及条件质量,不能默默删掉静音样本来提高总分。 浮点信号超过 0 dBFS 说明超出常见满刻度约定,但尚不能证明已发生硬削波。真峰值与采样峰值也要区分,是否压限应依据目标交付规范;不能假设流媒体平台的响度归一化会自动修复过载。THD+N 通常需要规定的测试信号,不是对任意音乐直接测 50/60 Hz 哼声的万能工具,后者应在谱上检查基频、谐波与背景的相对强度。 最后把可疑样本与 prompt、参考和听测对照:可视化说明信号发生了什么,不能单独决定这种变化是否符合内容要求。附录实验能验证增益、时移和新增纯音如何影响指标;实际产品的合格线需要自己的数据与听测来确定。 08. 经典论文脉络 PESQ(ITU-T P.862,2001):通信时代的遗产。把心理声学掩蔽模型塞进了客观指标,第一次让「机器预测听感」在窄带语音上有了可信度——也把「只适用语音」的边界刻进了骨子里。 SDR – half-baked or well done? (arXiv:1811.02508)(ICASSP 2019):指出 BSS_eval 那版 SDR 在单通道场景下会被滥用(改参考信号、靠调音量刷分),给出本文用的 SI-SDR 定义——误差与参考正交、不依赖幅度缩放。读它是理解「为什么偏偏叫 SDR」的最短路径。 Fréchet Audio Distance: A Metric for Evaluating Music Enhancement Algorithms (arXiv:1812.08466):把 FID 的思想搬到音频,提出基于背景集特征统计的音乐质量指标,解决了生成式音乐「没有正确答案可比」的问题;留下的问题是 FAD 数值绑定特征提取器、且强依赖样本量。 High Fidelity Neural Audio Compression (arXiv:2210.13438)(EnCodec):神经音频 codec 的代表作,结合客观指标与主观听测评价低码率重建。不能由这篇论文推导出「SI-SDR + PESQ + 梅尔距离」是所有 codec 的固定验收标准。 UTMOS: UTokyo-SaruLab System for VoiceMOS Challenge 2022 (arXiv:2204.02152):用 SSL 特征 + 集成学习预测 MOS,拿了 VoiceMOS Challenge 2022 多项第一。它代表的方向是「用模型替代昂贵的人工听测」——可行,但域外泛化仍是软肋。 一条暗线贯穿始终:指标的演进一直在追赶生成能力的演进。信号指标管不了感知,感知指标管不了分布,分布指标管不了单条样本——每一代生成技术把旧指标逼失效一次,然后逼出下一代指标。 09. 常见误解 「SI-SDR 高就是音质好」。它衡量去掉全局增益后的波形误差,对齐、相位、噪声和伪影都会影响它,但影响权重并非人耳感知权重。 「FAD 低说明每条音频都好」。均值与协方差相近不保证所有样本合格,也不保证更高阶分布一致、文本匹配或内容多样性。 「FAD 数字可以跨论文直接比」。特征器、参考集、时长、分帧、样本量、预处理一致,比较才有明确含义。本例是自定义梅尔特征距离,不应混称标准分数。 「MOS 不可复现」。MOS 是按协议收集的主观统计量,可以复做实验估计误差;跨批次须控制听测设计,报告不确定性。VoiceMOS 也评价 MSE 等指标,并非只比相关系数而完全不看绝对误差。 「无参考模型可替代人工验收」。MOS 预测器有域和数据偏差,即使在训练域也可能错排;发布标准需要经过人工标注或听测校准。 10. 动手验证 先安装 numpy matplotlib,把文末三个脚本存到同一目录,分别运行。它们不下载音频或权重;可复现的结论来自数值输出,不包括主观听感结论。 把 metric_disagreement.py 的 7000/7500 Hz 改成 200/250 Hz,重跑。高频占比应基本不变,但低频梅尔谱会改变。记录实际距离,不能预设「一定更小」或「一定同样刺耳」。这说明频带指标有明确的观测范围。 把 np.roll(x, 8) 改成 np.roll(x, 1),比较 SI-SDR 与谱距离。变化取决于波形自相关,不存在通用于所有音频的固定分数;真实延迟应在共同有效区间对齐,避免循环边界干扰。 在 FAD 脚本的循环中加入样本量 4,并多换几个种子。16 维协方差的秩最多为 3,估计很不稳定,但仍可计算;单次结果也可能偶然小。观察分布而非某一次抽样,才是样本量实验的正确读法。 11. 延伸阅读 FID / CLIP Score 到底测了什么(image_metrics):FAD 的直系前身。FID 的样本量陷阱、特征提取器绑定问题在图像侧一模一样,先读它再看本文会有「同一个故事换了个领域」的感觉。 视频生成评测:VBench 与人工验收(video_metrics):评测的维度从音频扩展到视频,多维度分解 + 人工验收的思路一脉相承。 离散化表征:VQ-VAE 与 VQGAN(vq_tokenizer):音频 codec(EnCodec、SoundStream)就是 VQ-VAE 思想在波形上的应用,想理解被评测的对象,从这篇进。 官方工具:fadtk(多种特征提取器的 FAD 工具箱)、torcheval 的 FrechetAudioDistance、ITU-T P.862.2(历史宽带 PESQ 与撤回说明)。 附录:完整代码 09 节用到的脚本全文如下(metric_disagreement.py、fad_sample_size.py、mel_spectrogram.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 metric_disagreement.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """同一个音频退化,四个指标给出四种排名。 这篇文章的核心论点就是这张表:指标不是「音质分数」,每个指标只回答一个 很具体的问题。用错了就会得到自欺欺人的结论。 三种退化分别是整体增益、窄带纯音和循环时移。 表中听感仅是待验证的假设,本文没有执行受试者听测。 干净的语音/音乐可以看成「基频 + 一串谐波」,这里就按这个造, 省得读者还要去找音频文件。只用 numpy。 """ import numpy as np SR = 16000 DUR = 1.0 N = int(SR * DUR) rng = np.random.default_rng(0) def make_clean(n=N, sr=SR): """基频 220Hz + 前 6 个谐波,加一点慢包络,听起来像有起伏的乐音。""" t = np.arange(n) / sr x = np.zeros(n) for k in range(1, 7): x += (1.0 / k) * np.sin(2 * np.pi * 220 * k * t) # 慢包络:2.5Hz 的轻微起伏,避免信号看起来像死板的稳态正弦 x *= 0.75 + 0.25 * np.sin(2 * np.pi * 2.5 * t) return x / np.abs(x).max() def degrade(x, kind, sr=SR): if kind == "A": return 0.95 * x # 音量差 5% if kind == "B": # 7/7.5 kHz 的窄带纯音:是否刺耳需听测,且两者均低于 Nyquist 频率 t = np.arange(len(x)) / sr buzz = 0.02 * ( np.sin(2 * np.pi * 7000 * t) + np.sin(2 * np.pi * 7500 * t) ) return x + buzz if kind == "C": return np.roll(x, 8) # 时移 8 采样 = 0.5ms raise ValueError(kind) def si_sdr(ref, est): """Scale-Invariant SDR。 先把 est 投影到 ref 上(找一个最优缩放 alpha),剩下的残差才算失真。 所以「整体音量变了」在 SI-SDR 里被完全抵消——这是设计意图, 但也意味着它测不出增益错误。 """ if np.dot(ref, ref) <= 0 or np.dot(est, est) <= 0: raise ValueError("SI-SDR needs non-silent reference and estimate") alpha = np.dot(est, ref) / np.dot(ref, ref) e_target = alpha * ref e_res = est - e_target num = np.dot(e_target, e_target) den = np.dot(e_res, e_res) if den <= 1e-24 * num: return float("inf"), alpha return 10 * np.log10(num / den), alpha def snr(ref, est): """不做缩放对齐的信噪比。音量差会被算成失真。""" res = est - ref den = np.dot(res, res) if den == 0: return float("inf") return 10 * np.log10(np.dot(ref, ref) / den) def stft_mag(x, n_fft=512, hop=128): win = np.hanning(n_fft) n_frames = 1 + (len(x) - n_fft) // hop frames = np.stack([x[i * hop:i * hop + n_fft] * win for i in range(n_frames)]) return np.abs(np.fft.rfft(frames, n_fft, axis=1)).T # [freq, time] def hz_to_mel(f): return 2595.0 * np.log10(1.0 + f / 700.0) def mel_to_hz(m): return 700.0 * (10 ** (m / 2595.0) - 1.0) def mel_filterbank(sr=SR, n_fft=512, n_mels=64, fmin=20.0, fmax=8000.0): n_freqs = n_fft // 2 + 1 hz = mel_to_hz(np.linspace(hz_to_mel(fmin), hz_to_mel(fmax), n_mels + 2)) bins = np.floor(hz * n_fft / sr).astype(int) fb = np.zeros((n_mels, n_freqs)) for i in range(n_mels): left, center, right = bins[i], bins[i + 1], bins[i + 2] if center <= left: center = left + 1 if right <= center: right = center + 1 for k in range(left, min(center, n_freqs)): fb[i, k] = (k - left) / (center - left) for k in range(center, min(right, n_freqs)): fb[i, k] = (right - k) / (right - center) return fb def log_mel(x, sr=SR, n_fft=512, hop=128, n_mels=64): """归一化梅尔幅度谱的自然对数,单位为 ln 幅度(不是 dB)。 每条样本独立归一化是本实验为了忽略整体增益所作的选择, 不是所有音频评测的必需步骤。幅度 floor=1e-4 对应峰值下 80 dB。 """ fb = mel_filterbank(sr=sr, n_fft=n_fft, n_mels=n_mels) mel = fb @ stft_mag(x, n_fft=n_fft, hop=hop) mel = mel / (mel.max() + 1e-12) return np.log(np.maximum(mel, 1e-4)) # floor 在 log(1e-4) ≈ -9.2 def log_mel_distance(ref, est): """对数梅尔谱的平均绝对误差(单位为自然对数幅度差)。""" return float(np.mean(np.abs(log_mel(est) - log_mel(ref)))) def hf_energy_ratio(x, sr=SR, n_fft=512, hop=128, f_lo=6000.0): """6kHz 以上能量占总能量的比例——高频毛刺会把它顶起来。""" mag = stft_mag(x, n_fft=n_fft, hop=hop) freqs = np.fft.rfftfreq(n_fft, 1.0 / sr) power = (mag ** 2).mean(axis=1) return float(power[freqs >= f_lo].sum() / power.sum()) def spectral_flatness(x, sr=SR, n_fft=512, hop=128, f_lo=4000.0, f_hi=9000.0): """高频平均功率谱的几何均值/算术均值,范围 0~1。 小值表示谱能量集中,不等价于存在缺陷;纯乐音也会很低。 只在该频带有足够能量时解释,阈值必须按任务和频带校准。 与高频能量占比一样,理想计算对非零全局增益不变。 """ mag = stft_mag(x, n_fft=n_fft, hop=hop) freqs = np.fft.rfftfreq(n_fft, 1.0 / sr) band = mag[(freqs >= f_lo) & (freqs <= f_hi)] power = (band ** 2).mean(axis=1) + 1e-20 geo = np.exp(np.mean(np.log(power))) ari = np.mean(power) return float(geo / ari) def main(): ref = make_clean() print(f"参考信号: {len(ref)} 采样 = {len(ref) / SR:.2f}s @ {SR}Hz") print(f"参考信号高频能量占比: {hf_energy_ratio(ref):.3e}") print() header = (f"{'退化':<18}{'操作':<12}{'SI-SDR(dB)':>12}{'SNR(dB)':>10}" f"{'梅尔距离':>10}{'高频占比':>12}{'高频谱平坦度':>14}") print(header) print("-" * len(header)) rows = {} for kind, feel in (("A", "增益变化"), ("B", "新增纯音"), ("C", "循环时移")): est = degrade(ref, kind) s, alpha = si_sdr(ref, est) d = { "si_sdr": s, "snr": snr(ref, est), "mel": log_mel_distance(ref, est), "hf": hf_energy_ratio(est), "flat": spectral_flatness(est), "alpha": alpha, } rows[kind] = d print(f"{kind + ' ' + {'A': '音量×0.95', 'B': '高频毛刺', 'C': '时移0.5ms'}[kind]:<18}" f"{feel:<12}{s:>12.2f}{d['snr']:>10.2f}{d['mel']:>10.4f}" f"{d['hf']:>12.3e}{d['flat']:>14.4f}") print() print("读数(这才是重点):") print(f" A 音量小 5%:SI-SDR = {rows['A']['si_sdr']:.2f} dB(缩放被抵消,几乎满分)," f"SNR = {rows['A']['snr']:.2f} dB(老老实实记了一笔)") print(f" → 最优缩放 alpha = {rows['A']['alpha']:.4f},表示估计波形为参考的 0.95 倍") print(f" B 高频毛刺:SI-SDR = {rows['B']['si_sdr']:.2f} dB 看着还行," f"高频占比却从 {hf_energy_ratio(ref):.3e} 涨到 {rows['B']['hf']:.3e}") print(f" C 时移 0.5ms:SI-SDR 掉到 {rows['C']['si_sdr']:.2f} dB," f"但梅尔距离只有 {rows['C']['mel']:.4f} —— 谱几乎没动") print() print("结论:SI-SDR 衡量的是「波形对不对齐」,梅尔距离衡量的是「频谱像不像」,") print(" 高频占比描述频带能量分配,是否刺耳还需要听测。") if __name__ == "__main__": main() fad_sample_size.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """FAD 到底在比什么,以及为什么样本量不够时它根本不可信。 FAD(Fréchet Audio Distance)是 FID 的音频版:不问「这两条音频像不像」, 而是问「这两堆音频的分布像不像」。这个区别决定了它有两个反直觉的性质: 1. 它不配对。不需要参考音频和测试音频一一对应, 所以能评测「凭空生成」的音乐/音效——这是 PESQ 之类做不到的。 2. 它对样本量极其敏感。协方差是从样本里估的,样本不够时估出来的协方差 本身就是歪的,算出来的 FAD 跟真实值差得离谱。 这里用 16 维归一化对数梅尔幅度均值当特征(真正的 FAD 用 VGGish 的 128 维 embedding, 我们没有那个模型,但 Fréchet 距离这一步的数学完全一样)。 """ import numpy as np SR = 16000 N_FFT = 512 HOP = 128 N_MELS = 16 rng = np.random.default_rng(7) def stft_mag(x, n_fft=N_FFT, hop=HOP): win = np.hanning(n_fft) n_frames = 1 + (len(x) - n_fft) // hop frames = np.stack([x[i * hop:i * hop + n_fft] * win for i in range(n_frames)]) return np.abs(np.fft.rfft(frames, n_fft, axis=1)).T def hz_to_mel(f): return 2595.0 * np.log10(1.0 + f / 700.0) def mel_to_hz(m): return 700.0 * (10 ** (m / 2595.0) - 1.0) def mel_filterbank(sr=SR, n_fft=N_FFT, n_mels=N_MELS, fmin=20.0, fmax=8000.0): n_freqs = n_fft // 2 + 1 hz = mel_to_hz(np.linspace(hz_to_mel(fmin), hz_to_mel(fmax), n_mels + 2)) bins = np.floor(hz * n_fft / sr).astype(int) fb = np.zeros((n_mels, n_freqs)) for i in range(n_mels): left, center, right = bins[i], bins[i + 1], bins[i + 2] if center <= left: center = left + 1 if right <= center: right = center + 1 for k in range(left, min(center, n_freqs)): fb[i, k] = (k - left) / (center - left) for k in range(center, min(right, n_freqs)): fb[i, k] = (right - k) / (right - center) return fb FB = mel_filterbank() def embed(x): """一段音频 → 16 维特征:各梅尔带的平均对数幅度。""" mel = FB @ stft_mag(x) mel = mel / (mel.max() + 1e-12) return np.log(np.maximum(mel, 1e-4)).mean(axis=1) def make_tone(f0, n=8000, buzz=False, snr_db=None): """一个乐音:基频 f0 + 谐波。buzz=True 时叠高频毛刺。""" t = np.arange(n) / SR x = np.zeros(n) for k in range(1, 6): x += (1.0 / k) * np.sin(2 * np.pi * f0 * k * t) if buzz: x += 0.05 * (np.sin(2 * np.pi * 7000 * t) + np.sin(2 * np.pi * 7500 * t)) if snr_db is not None: x = x + rng.normal(0, np.sqrt(np.mean(x ** 2) / (10 ** (snr_db / 10))), n) return x / (np.abs(x).max() + 1e-12) def sqrtm_psd(A): """对称半正定阵的平方根;仅裁掉舍入级负特征值。""" A = (A + A.T) / 2 w, V = np.linalg.eigh(A) if w.min() < -1e-10 * max(1.0, np.abs(w).max()): raise ValueError("matrix is not positive semidefinite") w = np.clip(w, 0.0, None) return (V * np.sqrt(w)) @ V.T def frechet_distance(X, Y): """两个特征集合的 Fréchet 距离。 把每堆特征当成一个高斯(只关心均值和协方差),再算这两个高斯之间的 2-Wasserstein 距离的平方。闭式解: FD = ||mu_x - mu_y||^2 + Tr(S_x + S_y - 2 (S_x S_y)^{1/2}) """ mu_x, mu_y = X.mean(axis=0), Y.mean(axis=0) S_x = np.cov(X, rowvar=False) S_y = np.cov(Y, rowvar=False) diff = mu_x - mu_y # 不可把一般非对称的 S_x @ S_y 直接交给 eigh。 # 使用对称半正定夹心矩阵,平方根的迹与原式相同。 s_x_sqrt = sqrtm_psd(S_x) covmean = sqrtm_psd(s_x_sqrt @ S_y @ s_x_sqrt) fd = diff @ diff + np.trace(S_x) + np.trace(S_y) - 2 * np.trace(covmean) tol = 1e-7 * max(1.0, np.trace(S_x) + np.trace(S_y)) if fd < -tol: raise ArithmeticError("negative distance exceeds numerical tolerance") return float(max(fd, 0.0)) # 仅容差内的负舍入误差截到 0 def main(): # 参考集:干净乐音,基频在 200~400Hz 之间随机 # 测试集 A:同分布(只是另一批采样)→ FAD 应该接近 0 # 测试集 B:带高频毛刺 → FAD 应该明显大于 0 def make_set(n, buzz=False): return np.stack([ embed(make_tone(rng.uniform(200, 400), buzz=buzz)) for _ in range(n) ]) print("特征维度: 16(各梅尔带的平均对数幅度)") print() print("样本量对 FAD 的影响(同一个分布对,只是抽的样本数不同):") print(f"{'每堆样本数':>10}{'同分布 FAD':>14}{'带毛刺 FAD':>14}{'相对基线':>10}") print("-" * 50) big_ref = make_set(600) for n in (8, 16, 32, 64, 128, 300): ref = big_ref[:n] same = np.stack([ embed(make_tone(rng.uniform(200, 400))) for _ in range(n) ]) buzz = make_set(n, buzz=True) fd_same = frechet_distance(ref, same) fd_buzz = frechet_distance(ref, buzz) ok = f"{fd_buzz / max(fd_same, 1e-6):.1f}x" print(f"{n:>10}{fd_same:>14.4f}{fd_buzz:>14.4f}{ok:>10}") print() print("注意最上面几行:样本只有 8 或 16 个时,「同分布」的 FAD 就已经不是 0 了,") print("这是均值与协方差估计误差;16 维、16 个样本的中心化协方差必然奇异。") print("真实 VGGish 特征为 128 维,但所需样本数还取决于谱结构、独立性和精度——") print("这就是为什么论文里报的 FAD 必须同时报样本数,否则数字不可比。") print() print("另一面:") print(f" 300 个样本时,同分布 FAD 与带毛刺 FAD 差了 " f"{frechet_distance(big_ref[:300], make_set(300, buzz=True)) / max(frechet_distance(big_ref[:300], np.stack([embed(make_tone(rng.uniform(200, 400))) for _ in range(300)])), 1e-9):.1f} 倍") print(" → 倍数只是描述量,不是统计检验;需多次抽样或按音频做 bootstrap。") if __name__ == "__main__": main() mel_spectrogram.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """把「指标打架」画出来看:三种退化的梅尔谱。 波形指标(SI-SDR)分不清的三件事,在谱上一眼就能看出来: 音量 ×0.95 —— 本图每条单独归一化,整体增益被抵消 高频毛刺 —— 谱的中上部多出一条亮带(听感需另行验证) 时移 0.5ms —— 几乎看不出差别(但 SI-SDR 可能明显下降) 产出 figures/mel_compare.png,文章里用  引用。 """ import os import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt from matplotlib import font_manager # matplotlib 默认字体没有中文,标题会渲染成一排豆腐块。 # 按 macOS / Linux 常见字体逐个试,找一个系统里真有的。 _AVAILABLE = {f.name for f in font_manager.fontManager.ttflist} for _cand in ["PingFang SC", "Heiti SC", "Arial Unicode MS", "Songti SC", "STHeiti", "Noto Sans CJK SC", "WenQuanYi Zen Hei"]: if _cand in _AVAILABLE: plt.rcParams["font.sans-serif"] = [_cand] break plt.rcParams["axes.unicode_minus"] = False # 负号不要用中文缺字替代 SR = 16000 N_FFT = 512 HOP = 128 N_MELS = 64 OUT_DIR = os.path.join(os.path.dirname(os.path.abspath(__file__)), "..", "figures") def make_clean(n=16000, sr=SR): t = np.arange(n) / sr x = np.zeros(n) for k in range(1, 7): x += (1.0 / k) * np.sin(2 * np.pi * 220 * k * t) x *= 0.75 + 0.25 * np.sin(2 * np.pi * 2.5 * t) return x / np.abs(x).max() def degrade(x, kind, sr=SR): t = np.arange(len(x)) / sr if kind == "A": return 0.95 * x if kind == "B": return x + 0.02 * (np.sin(2 * np.pi * 7000 * t) + np.sin(2 * np.pi * 7500 * t)) if kind == "C": return np.roll(x, 8) raise ValueError(kind) def stft_mag(x, n_fft=N_FFT, hop=HOP): win = np.hanning(n_fft) n_frames = 1 + (len(x) - n_fft) // hop frames = np.stack([x[i * hop:i * hop + n_fft] * win for i in range(n_frames)]) return np.abs(np.fft.rfft(frames, n_fft, axis=1)).T def hz_to_mel(f): return 2595.0 * np.log10(1.0 + f / 700.0) def mel_to_hz(m): return 700.0 * (10 ** (m / 2595.0) - 1.0) def mel_filterbank(sr=SR, n_fft=N_FFT, n_mels=N_MELS, fmin=20.0, fmax=8000.0): n_freqs = n_fft // 2 + 1 hz = mel_to_hz(np.linspace(hz_to_mel(fmin), hz_to_mel(fmax), n_mels + 2)) bins = np.floor(hz * n_fft / sr).astype(int) fb = np.zeros((n_mels, n_freqs)) for i in range(n_mels): left, center, right = bins[i], bins[i + 1], bins[i + 2] if center <= left: center = left + 1 if right <= center: right = center + 1 for k in range(left, min(center, n_freqs)): fb[i, k] = (k - left) / (center - left) for k in range(center, min(right, n_freqs)): fb[i, k] = (right - k) / (right - center) return fb FB = mel_filterbank() def log_mel_db(x): mel = FB @ stft_mag(x) mel = mel / (mel.max() + 1e-12) return 20 * np.log10(np.maximum(mel, 1e-4)) # 归一化后取 dB,floor 在 -80dB def main(): ref = make_clean() cases = [ ("参考(干净)", ref), ("A 音量 ×0.95", degrade(ref, "A")), ("B 高频毛刺", degrade(ref, "B")), ("C 时移 0.5ms", degrade(ref, "C")), ] specs = [log_mel_db(x) for _, x in cases] # 每条谱已独立按峰值归一化,共用色标只用于比较相对谱形状。 vmin = min(s.min() for s in specs) vmax = max(s.max() for s in specs) fig, axes = plt.subplots(1, 4, figsize=(15, 3.6), constrained_layout=True) for ax, (name, _), s in zip(axes, cases, specs): im = ax.imshow(s, origin="lower", aspect="auto", vmin=vmin, vmax=vmax, cmap="magma") ax.set_title(name, fontsize=12) ax.set_xlabel("帧") ax.set_ylabel("梅尔带") fig.colorbar(im, ax=axes, shrink=0.8, label="dB(相对峰值)") fig.suptitle("同一个音频的四种形态:梅尔谱", fontsize=13) os.makedirs(OUT_DIR, exist_ok=True) out = os.path.join(OUT_DIR, "mel_compare.png") fig.savefig(out, dpi=150, bbox_inches="tight", facecolor="white") plt.close(fig) print(f"图已保存: {out}") print() print("每张谱的动态范围与「和参考谱的平均绝对差」:") print(f"{'形态':<16}{'最小值(dB)':>12}{'最大值(dB)':>12}{'与参考的平均差(dB)':>20}") print("-" * 62) base = specs[0] for (name, _), s in zip(cases, specs): print(f"{name:<16}{s.min():>12.2f}{s.max():>12.2f}" f"{np.mean(np.abs(s - base)):>20.3f}") if __name__ == "__main__": main()
-
AIGC 基本功|视频 VAE 的常见 loss 组合-VAELoss 视频 VAE 的常见 loss 组合 所属方向:表征与压缩 | 难度:工程实战 | 前置知识:视频 VAE 的时空压缩结构(本文第 02 节另补最小背景) 关键词:重建损失、KL 损失、LPIPS、感知损失、GAN 损失、判别器、loss 权重 01. 为什么需要它 训练一个视频 VAE,最朴素的想法是「编码器压缩、解码器还原,加个 L1 或 KL 就够了」。不同目标可能暴露不同问题,效果取决于瓶颈、数据和训练配方: 只用 L1/L2 + KL:画面是稳的,但像蒙了一层猪油 —— 头发丝、文字、树叶这种高频纹理全被抹掉,人脸带着一层「塑料感」。在存在重建不确定性时,这与逐像素回归的性质有关,但不能断言 L1/L2 + KL 必然不可用(L2 的最优解是条件期望,天然倾向平均、发糊)。 加上 GAN 想救清晰度:判别器一旦过早发力或过强,解码器立刻走样 —— 出现棋盘格、闪烁、甚至凭空捏造纹理;训练损失曲线看起来在降,重建却越来越假。 把图像那套搬到视频上:每一帧单独看 PSNR 都不错,连起来播放却疯狂闪烁,相邻帧的纹理在抖动。单帧指标根本测不出时间维的失真。 这不是三个孤立的 bug,而是三类不同的失真,需要三种不同的尺子去量。视频 VAE 的训练目标因此通常是四项的组合:像素重建、KL 正则、感知损失、对抗损失,有时再加一项时间一致性约束。玄学的地方从来不是「用哪几项」—— 这几项高度趋同 —— 而是权重配比:为什么 HunyuanVideo 的 KL 权重能小到 $10^{-6}$,而感知项是 $0.1$、对抗项是 $0.05$?这些数字不是拍脑袋,是被各项的量纲、归一化口径和训练阶段逼出来的。 本文把每一项「在管什么失真、数学上长什么样、量级有多大、什么时候帮倒忙」逐一拆开,所有关键数字都来自随文可跑的脚本(只依赖 numpy)。 02. 最小可用理解 最小背景(前置 VideoVAE):视频 VAE 用 3D 因果卷积把一段视频 $x\in\mathbb{R}^{B\times C\times T\times H\times W}$ 压成低维潜变量 $z$(典型压缩率:时间 $4\times$、空间 $8\times$),解码器再从 $z$ 重建出 $r$。编码器输出一个高斯后验 $q(z\mid x)=\mathcal{N}(\mu,\sigma^2)$,训练目标要同时满足三件事:重建要像、潜变量分布要规整(好让后面的扩散模型去建模)、压缩率要够高。loss 就是在这三者之间做权衡的旋钮。 三句话讲清四项损失: 像素损失(L1/L2)和 KL 是「保正确」的:前者逐像素对齐内容与结构,后者把潜变量摁在标准正态附近、防止它为了重建而无限膨胀。 LPIPS 感知损失和 GAN 对抗损失是「保好看」的:LPIPS 在预训练深度网络的特征空间里比较,惩罚人眼在意的语义 / 纹理差异;GAN 让一个判别器去挑刺,逼着解码器还原高频细节。 这四项量纲完全不同,必须加权配平,GAN 常用「晚启动 + 自适应权重」来控制训练平衡:先让重建项把解码器教到成形,再让判别器入场,并按两项在最后一层上的梯度范数之比动态调权。视频还要额外盯时间维(时空判别器或帧间一致性项)。 03. 数学推导 3.1 从 ELBO 到「重建 + KL」两项 VAE 最大化证据下界(ELBO)。写成「最小化负 ELBO」,目标天然裂成两项: $$\mathcal{L} = \underbrace{-\mathbb{E}_{q_\phi(z\mid x)}[\log p_\theta(x\mid z)]}_{\text{重建项}} + \underbrace{D_{\mathrm{KL}}\big(q_\phi(z\mid x)\,\|\,p(z)\big)}_{\text{KL 正则项}}$$ 逐项解释符号:$\phi$ 是编码器参数、$\theta$ 是解码器参数;$q_\phi(z\mid x)$ 是编码器给出的后验分布;$p_\theta(x\mid z)$ 是解码器的似然;$p(z)=\mathcal{N}(0,I)$ 是标准正态先验。重建项要求「从采样出的 $z$ 能还原 $x$」,KL 项要求「后验别离先验太远」—— 它是潜变量的正则项,鼓励与先验对齐;它不保证感知空间的平滑或连通,也不是所有 latent 扩散能够学习的必要条件。 当后验取对角高斯 $q_\phi(z\mid x)=\mathcal{N}(\mu_\phi(x),\,\mathrm{diag}(\sigma_\phi(x)^2))$、先验取标准正态时,KL 有解析解(不用采样、不用估计)。令 $\ell_j=\log\sigma_j^2$(工程上网络直接预测 $\ell$,数值更稳): $$D_{\mathrm{KL}} = -\frac{1}{2}\sum_{j=1}^{d_z}\Big(1+\ell_j-\mu_j^2-\exp(\ell_j)\Big)$$ 这里求和下标 $j$ 跑遍所有潜变量维度。直觉:$\tfrac12\mu_j^2$ 惩罚均值偏离 0,$-(1+\ell_j-e^{\ell_j})$ 惩罚方差偏离 1($\ell=0$ 即 $\sigma^2=1$ 时该项为 0)。 第一个容易被忽略的坑是「求和 vs 平均」。教科书公式对 $d_z$ 个维度求和;而像素损失通常对全部像素求平均。两者元素个数差着几个数量级,直接相加 KL 会凭「项数多」碾压重建。随文脚本 vaeloss_terms.py 在一个合成视频上实测: # 解析 KL,logvar 是网络直接预测的 log(sigma^2) kl_per_element = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar)) kl_sum, kl_mean = kl_per_element.sum(), kl_per_element.mean() l1 = np.mean(np.abs(x - r)) print("L1 = %.5f" % l1) # 0.03158 print("KL(sum) = %.3f KL(mean) = %.4f" % (kl_sum, kl_mean)) print("KL(sum)/L1 = %.0f 倍" % (kl_sum / l1)) 输出(视频 $2\times3\times8\times32\times32$,latent $2\times4\times2\times4\times4$,像素 49152 个、全 batch 的 latent 共 256 个数值(每样本 128 个)): L1 重建 (mean) 0.03158 KL (全 batch sum,教学口径) 57.66490 KL (mean,换口径) 0.22525 KL(sum)/L1 的量级倍数 : 1826.0x 归约口径是开源视频 VAE 的 KL 权重有时出现 $10^{-6}$ 这种「看着离谱」的数字 —— 的原因之一,但不能由这个 toy 直接反推实际系数。通常应先对每样本 latent 求和,再对 batch 平均;这里为演示求和效应,57.66 是整个 batch 的和,batch=2 时常见口径为 28.83。抄权重之前先对齐归一化口径,这句话后面还会强调。 这张图要看什么:左图是四项损失在同一个合成视频上的原始数值(对数轴)——KL(sum) 一根柱子顶到 57.66,是 L1 的 1826 倍;右图套上 HunyuanVideo 的配方权重之后,各项贡献变为不同数量级,不能称为完全配平,最矮的 KL 贡献只有 $5.8\times10^{-5}$。权重同时反映口径、梯度和重建目标,不能仅按标量 loss 大小配平(图由 code/make_figures.py 生成,下同)。 3.2 像素损失:为什么多用 L1 而不是 L2 $$\mathcal{L}_{\mathrm{pix}} = \frac{1}{N}\sum_{n=1}^{N}\big\|x_n-r_n\big\|_1$$ L2(MSE)对大误差平方加权,其逐点最优解是给定 $z$ 下所有可能输出的条件均值—— 面对「这块纹理可能是 A 也可能是 B」的不确定性,它选择把 A、B 平均掉,结果就是模糊。L1 在非零残差处的梯度为 $\pm1$,其逐点最优解是条件中位数,不会因为误差大就给出更强的「往平均靠」的驱动力,对异常值通常更稳健,但条件中位数也可能模糊,不能保证所有纹理更锐利。代价是 L1 在零点不可导、对小误差的梯度恒定,容易留下颗粒感 —— 这正是要靠感知 / 对抗项补的地方。也有工作(如 LTX-Video)在像素项里混用 MSE 与小波域 L1(Video-DWT),在多尺度上约束。 3.3 感知损失 LPIPS:换一把「人眼的尺子」 像素距离有个致命问题:同样大小的像素误差,人眼感受天差地别。一个全局亮度偏移,MSE 不小但人眼几乎无感;一团等量的逐点噪声,MSE 相同却把纹理毁了。LPIPS(Learned Perceptual Image Patch Similarity)改用在 ImageNet 上预训练的分类网络(VGG/Alex,参数冻结)提特征,再在特征空间量距离: $$\mathcal{L}_{\mathrm{LPIPS}}(x,r) = \sum_{k}\frac{1}{H_kW_k}\Big\|\,w_k\odot\big(\hat{y}_x^{k}-\hat{y}_r^{k}\big)\Big\|_2^2$$ 符号:$y_x^k$、$y_r^k$ 是第 $k$ 层(LPIPS 用 VGG 的 relu1_2 到 relu5_3 共 5 层)对真实图和重建图提的特征图;$\hat{y}$ 表示沿通道做了归一化(除以通道维 L2 范数);公式中的 $w_k^2$ 对应实现里作用在平方特征差上的 $1\times1$ 非负通道权重;$w_k$ 可理解为它的平方根,而非直接把卷积权重再平方。该权重在人类主观偏好数据集 BAPPS 上学出来、之后冻结;最后空间平均、跨层求和。两个细节缺一不可:逐通道归一化让比较不被某些高幅值通道主导,学习权重 $w_k$ 让「哪些层的差异人眼更在意」由数据决定。它天然偏向语义 / 结构 / 纹理,而对整体明暗、轻微色偏不敏感。 pixel_vs_perceptual.py 用一个免权重的多尺度高通特征(高斯差分 DoG)复现 LPIPS 的结构,对比三种退化: # A:全局亮度偏移;B:同等 L2 能量的逐点噪声;C:高斯模糊 rA = x + delta # delta = 0.12 rB = x + rng.normal(0, delta, x.shape) # 标准差同为 0.12 # 像素 MSE:A 约等于 B;特征距离:B 远大于 A 真实输出: 重建方式 像素MSE 感知距离 感知/像素 A 亮度偏移(整体+0.12) 0.01440 0.00008 0.01 B 逐点噪声(σ=0.12) 0.01426 0.64084 44.93 C 高斯模糊 0.00508 0.50163 98.69 A、B 的像素 MSE 只差 0.95%,但特征距离里 B 是 A 的约 $8\times10^3$ 倍;模糊 C 的像素误差最小,感知距离却很高。高通教学代理天然抑制直流亮度,因此本例差距尤其大;真实 LPIPS 使用学习特征和权重,不能据此断言它对亮度或颜色变化不敏感。 3.4 对抗损失:雇一个判别器专挑高频毛病 GAN 引入一个判别器 $D$,训练它区分真实帧与重建帧;解码器(生成器)则努力骗过它。视频 / 图像重建里几乎都用 PatchGAN 式判别器:不输出整图真假,而是对每个空间 patch 打分,主要约束其感受野内的统计,常改善局部纹理,但并非数学上只看高频。最常用的 hinge 形式: $$\mathcal{L}_{D} = \tfrac{1}{2}\Big(\mathbb{E}_{\text{real}}[\max(0,\,1-D(x))]+\mathbb{E}_{\text{recon}}[\max(0,\,1+D(r))]\Big)$$ $$\mathcal{L}_{G}^{\mathrm{adv}} = -\mathbb{E}_{r}[D(r)]$$ 判别器希望真帧打分大于 1、重建打分小于 -1;生成器希望重建打分尽量大(为正)。gan_schedule.py 用合成 logits 算了判别器在三种强弱下的损失: 起步:判别器分不清 D(hinge)=1.0126 G(hinge)=-0.0312 real≈ 0.01 fake≈ 0.03 健康:适度拉开 D(hinge)=0.0767 G(hinge)= 1.2067 real≈ 1.21 fake≈-1.21 过强:margin 已饱和 D(hinge)=0.0000 G(hinge)= 5.9713 real≈ 6.02 fake≈-5.97 注意判别器 hinge loss 为 0 只说明这些样本的 margin 已满足,此时判别器对应损失的梯度为 0;不意味着生成器梯度消失。这里 $\mathcal L_G=-\mathbb E[D(r)]$ 对 fake logit 的导数仍是 −1,传回解码器的梯度还取决于判别器对输入的导数。仅看 +6/−6 logits 无法判断梯度是否健康。 其一,GAN 晚启动(warm-up)。重建项还没把解码器教出基本形状时,判别器挑的「毛病」没有意义,甚至会把训练带偏。taming 的做法是一个开关 adopt_weight,在第 $t_{\mathrm{start}}$ 步前把对抗权重置 0: $$\delta(t)=\begin{cases}0,&t<t_{\mathrm{start}}\\ \lambda_{\mathrm{adv}},&t\ge t_{\mathrm{start}}\end{cases}$$ 脚本实测 disc_start=2000 时,step 0 和 1999 的权重为 0,step 2000 起跳到 0.05。 其二,自适应对抗权重。固定 $\lambda_{\mathrm{adv}}$ 的两难:训练早期重建梯度很大、GAN 抢不过;后期重建收敛、梯度变小,同样的 GAN 梯度又会相对越来越强甚至压过重建。VQGAN 的解法是让两项在解码器最后一层权重 $w_L$ 上的梯度范数之比来决定权重: $$\lambda_{\mathrm{adv}}(t)=\mathrm{clip}\left(\frac{\|\nabla_{w_L}\mathcal{L}_{\mathrm{rec}}\|}{\|\nabla_{w_L}\mathcal{L}_{G}^{\mathrm{adv}}\|+\epsilon},\ 0,\ 10^4\right)\cdot\delta(t)$$ 直觉:它动态地让「对抗项在最后一层上产生的梯度量级」与「重建项的梯度量级」匹配,重建没收敛时比值大、收敛后比值自动变小。adaptive_weight.py 用一个可解析求导的迷你线性解码器精确计算两个梯度范数,并用中心差分验证(解析 0.012371 对差分 0.012371;0.255913 对 0.255913): 训练早期(未收敛) L_rec=0.73740 ||∇rec||=0.4071 ||∇gan||=4.2840 d_weight=0.0950 训练后期(近收敛) L_rec=0.00071 ||∇rec||=0.0127 ||∇gan||=4.2840 d_weight=0.0030 重建收敛后自适应权重从 0.095 掉到 0.003(约 32 倍),GAN 项被自动调小 —— 这正是固定权重给不了的能力。 这张图要看什么:横轴是合成出来的训练进程(从「解码器还没学会」到「重建已收敛」),三条曲线分别是重建损失、重建项在最后一层上的梯度范数、以及据此算出的 $\lambda_{\mathrm{adv}}$。要点是 $\lambda_{\mathrm{adv}}$ 不是人为排的衰减计划,而是被 $\|\nabla\mathcal{L}_{\mathrm{rec}}\|$ 拖着走的:早期 0.095、后期 0.003。对照上面的 warm-up 开关看更清楚——$\delta(t)$ 负责「第 2000 步之前完全不启用」,这条曲线负责「启用之后给多大」,两者相乘才是最终权重。 3.5 总目标,以及视频多出的时间维 把四项合起来,连续潜变量视频 VAE 的生成器目标是: $$\mathcal{L}_{G} = \lambda_{\mathrm{pix}}\mathcal{L}_{\mathrm{pix}}+\lambda_{\mathrm{p}}\mathcal{L}_{\mathrm{LPIPS}}+\lambda_{\mathrm{kl}}\mathcal{L}_{\mathrm{KL}}+\lambda_{\mathrm{adv}}(t)\,\mathcal{L}_{G}^{\mathrm{adv}}$$ (VQGAN 是离散码本,没有 KL,对应位置换成 codebook/commitment 损失;连续 KL-VAE 才是上面这版。)判别器另用 $\mathcal{L}_D$ 单独更新,二者交替。 视频比图像多一维,单帧损失管不到帧间。temporal_consistency.py 构造了一段运动视频,给两种重建:A 加逐帧独立噪声(播放时闪烁),B 加跨帧恒定的退化(不闪),两者单帧空间 L1 几乎相同: 重建 单帧空间L1 时序差分L1 时序差分MSE A 逐帧独立噪声(闪) 0.06393 0.09018 0.01275 B 跨帧恒定退化(稳) 0.06340 0.00455 0.00003 单帧 L1 几乎相等(0.0639 对 0.0634),时序差分 MSE 却差了约 393 倍。 这张图要看什么:上半部是同一个像素点随帧走的亮度轨迹。A(逐帧独立噪声)和 B(跨帧恒定退化)的逐帧平均误差几乎一样,但 A 的轨迹在真值附近高频锯齿抖动,B 的轨迹只是整体平移——前者播放起来就是闪烁,后者只是画质差一点。下半部把这件事量化:单帧空间 L1 两根柱子几乎齐平(0.0639 / 0.0634),时序差分 L1 差 20 倍,时序差分 MSE 差到 393 倍。所以「视频 VAE 的重建指标好看但看着闪」,根因是指标选错了:空间指标对时间频率不敏感。 补救有两条路:一是把判别器从 2D 扩到时空(3D/PatchGAN、混合外观 - 运动判别器),让它直接看片段;二是显式加时间一致性损失,用光流把相邻帧 warp 过来再比(静止区域退化成帧差): $$\mathcal{L}_{\mathrm{temp}}=\frac{1}{T-1}\sum_{t=1}^{T-1}\big\|r_t-\mathcal{W}(r_{t-1},\,F_{t\to t-1})\big\|_1$$ 其中 $\mathcal{W}$ 是 warp 算子、$F$ 是估计的光流;没有光流时可用相邻帧差分近似 $\mathcal{L}_{\Delta}=\frac{1}{T-1}\sum_t\|(r_t-r_{t-1})-(x_t-x_{t-1})\|_1$。 04. 代码实现 随文 5 个脚本只依赖 numpy,python 脚本名.py 即可运行,完整版在文末附录;另有 make_figures.py 需要 matplotlib,负责本文三张配图。这里串起主干。 (1)四项损失与量级对照(vaeloss_terms.py):在合成视频上算 L1、解析 KL(sum/mean 两种口径)、感知代理、GAN,核心是 KL 解析式: kl_per_element = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar)) kl_sum = kl_per_element.sum() # 教科书口径:对 latent 维求和 l1 = np.mean(np.abs(x - r)) # 工程口径:对像素求平均 print("KL(sum)/L1 = %.0f 倍" % (kl_sum / l1)) # 1826 倍 (2)像素 vs 感知(pixel_vs_perceptual.py):多尺度高斯差分特征加逐通道归一化,复现 LPIPS「在特征空间量距离」的结构。再次强调这是教学代理:本体用的是在 BAPPS 上学过权重的 VGG(见第 05 节真实代码)。 (3)GAN 损失与 warm-up(gan_schedule.py): def hinge_d(real, fake): return 0.5 * (np.mean(np.maximum(0.0, 1.0 - real)) + np.mean(np.maximum(0.0, 1.0 + fake))) def adopt_weight(weight, step, threshold=0, value=0.0): return value if step < threshold else weight (4)自适应权重(adaptive_weight.py):对迷你线性解码器用解析梯度(并用中心差分校验)算范数比: d_weight = np.clip(np.linalg.norm(g_rec) / (np.linalg.norm(g_gan) + 1e-4), 0.0, 1e4) print("早期 %.3f -> 后期 %.4f" % (w_early, w_late)) # 0.095 -> 0.003 (5)时间一致性(temporal_consistency.py):比较单帧空间 L1 与相邻帧差分误差,证明只有后者能抓到闪烁。 这些脚本的真实输出已散落在第 03 节,文末附录给出可直接运行的完整源码。 05. 工业级实现对照 最小实现是为了讲清原理,生产代码有几处关键的工程化。最权威的参照是 VQGAN 的损失模块(知识树锚点): CompVis/taming-transformers/taming/modules/losses/vqperceptual.py → VQLPIPSWithDiscriminator.forward(以 2026-09 的实现为准) 对照本文的四项,它的生成器一步几乎是公式的逐行翻译: rec_loss = torch.abs(inputs - reconstructions) # L1 像素 if self.perceptual_weight > 0: p_loss = self.perceptual_loss(inputs, reconstructions) # LPIPS rec_loss = rec_loss + self.perceptual_weight * p_loss nll_loss = torch.mean(rec_loss) logits_fake = self.discriminator(reconstructions) g_loss = -torch.mean(logits_fake) # hinge 生成损失 d_weight = self.calculate_adaptive_weight(nll_loss, g_loss, last_layer) loss = nll_loss + d_weight * disc_factor * g_loss \ + self.codebook_weight * codebook_loss.mean() # VQ:codebook;连续 VAE 换成 KL 与最小实现的差异,每一处都有来由: 重建与感知合并成 nll_loss 一起算梯度:自适应权重需要对「合并后的重建项」和「GAN 项」分别在最后一层求梯度(torch.autograd.grad(..., retain_graph=True)),所以 LPIPS 不是独立加权、而是并进重建项。 双优化器、两次前向:optimizer_idx==0 更新生成器(含重建、LPIPS、codebook、GAN),==1 才更新判别器;判别器那一路对输入 .detach(),不让梯度流回解码器。 LPIPS 本体(taming/modules/losses/lpips.py):先过一个 ScalingLayer(把通常约定为 $[-1,1]$ 的输入变到 VGG 的归一化统计,shift/scale 是写死的常数),再取 VGG16 的 5 个 relu 特征,逐通道归一化、过学来的 $1\times1$ 卷积、空间平均、跨层求和 —— 正是公式 3.3 的完整实现,权重从 BAPPS 预训练 ckpt 加载且全程冻结。 连续视频 VAE 用 KL 约束替代离散码本损失,但具体实现还可能改变重建项归约、学习似然尺度、判别器和时序结构,不能机械替换一行就认为目标完全相同。 当代视频 VAE 的公开配方(权重都来自各自技术报告,不要跨项目照抄,口径不同): 模型 损失组合与权重(论文原文) HunyuanVideo (2412.03603) $\mathrm{L_1}+0.1\,\mathrm{L_{lpips}}+0.05\,\mathrm{L_{adv}}+10^{-6}\,\mathrm{L_{kl}}$;判别器做随机缩放加时间维扩展,视频与图像从零联合训练 LTX-Video (2501.00103) 像素 MSE 加 Video-DWT(小波域 L1)加 LPIPS 加 Reconstruction-GAN;并讨论 causal /non-causal VAE 的取舍 Seedance 1.0 (2506.09113) L1 加 KL 加 LPIPS 加对抗损失;用类 PatchGAN 的混合判别器同时约束外观与运动 H3AE (2504.10567) 反方证据:判别类损失收益小却显著拖慢训练,主张先用 L1+KL 收敛、再用潜空间一致性损失微调 表中只有 HunyuanVideo 给出了这里列出的明确系数,其他项目采用不同目标或归一化,不能据此称权重“高度趋同”。toy 的数值只解释口径为何重要,不能从 1826 倍损失比推导出真实训练必需的 $10^{-6}$ 权重。 06. 代价与边界 每一项都在解决一类失真,也都引入新的代价: L1/L2:稳、好训,但 L2 糊、L1 颗粒重;它们只能保证「像素对」,保证不了「看着真」。 KL:去掉它可能使后验更确定、尺度约束变弱,但没有 KL 的自编码器或 VQ latent 也可以训练扩散模型;但权重过大、瓶颈太紧,重建细节会被牺牲。$10^{-6}$ 这种小权重是「弱正则」,依赖特定归一化口径,换套实现可能就要重新定标。 LPIPS:贴人眼,但它的「审美」被冻结在 VGG 的自然图像特征里 —— 对医学影像、动画、线稿等域外数据可能偏置;它偏纹理,有时会鼓励「看起来有细节」的伪纹理。 GAN:是清晰度和真实感的主要来源,也几乎是所有训练不稳的来源:需要 warm-up、谱归一化、限制判别器更新次数、自适应权重;并且提升感知质量往往以 PSNR 下降为代价(感知 — 失真权衡,perception–distortion tradeoff),这不是没训好,而是规律。 视频时间项 / 3D 判别器:能压闪烁,但显著增算力、增训练时长;光流估计本身在遮挡和大运动处会出错,warp 损失可能误伤真实运动。 边界也要讲清:H3AE 等近期工作指出,在高压缩 VAE 上判别类损失的边际收益可能撑不起它的训练成本,先用重建加 KL、后期再针对性微调是更划算的路线。四项全开不是政治正确—— 数据域、压缩率、训练阶段不同,最优组合也不同,应当用消融实验决定。 07. 经典论文脉络 Auto-Encoding Variational Bayes(VAE,arXiv:1312.6114,2013):提出 ELBO、重参数化与连续高斯潜变量,KL 正则的源头。 Neural Discrete Representation Learning(VQ-VAE,arXiv:1711.00937,2017):改走离散码本,用 codebook/commitment 损失替代 KL,是 VQGAN 的前身。 Image-to-Image Translation with Conditional Adversarial Networks(pix2pix / PatchGAN,arXiv:1611.07004,2017):把判别器做成局部 patch 判定器,确立了「局部对抗项与像素重建互补」的分工。 The Unreasonable Effectiveness of Deep Features as a Perceptual Metric(LPIPS,arXiv:1801.03924,CVPR 2018):用 BAPPS 人类偏好数据证明深度特征距离远胜 PSNR/SSIM,并学出逐层权重。 Taming Transformers for High-Resolution Image Synthesis(VQGAN,arXiv:2012.09841,2021):L1、LPIPS、PatchGAN、codebook 四件套定型,配套自适应 GAN 权重与 warm-up,是本文工业对照的母本。 CogVideoX(arXiv:2408.06072)与 HunyuanVideo(arXiv:2412.03603):把这套组合搬到 3D 因果视频 VAE,后者给出明确的四项权重和时空判别器设计。 H3AE(arXiv:2504.10567,2025):对「判别损失是否值得」提出反方证据,代表这条线仍在演进。 08. 常见误解 「KL 权重抄 HunyuanVideo 的 $10^{-6}$ 就行」:错。权重取决于你的 KL 是 sum 还是 mean、latent 与像素各有多少元素、有没有做 loss balancing。本文实测同一组数据 sum 口径 KL 是 mean 口径 L1 的 1826 倍;换个压缩率或归一化,$10^{-6}$ 可能过大或过小。先统一口径,再谈数字。 「LPIPS 就是拿 VGG 特征算 L2」:漏了两个关键件 —— 沿通道的归一化和在 BAPPS 上学出来的 $1\times1$ 权重;输入还要先过 scaling layer 换到 VGG 的数值域。少了归一化,距离会被少数高响应通道主导。 「生成器 GAN 损失算出来是负数,训练崩了」:hinge 生成器目标下 $\mathcal{L}_G=-\mathbb{E}[D(r)]$(logistic non-saturating 常写成 $\mathbb E[\mathrm{softplus}(-D(r))]$,是另一种公式),为负恰恰说明重建帧已经把判别器骗到打正分,是预期现象;该盯的是梯度和平衡,不是损失正负。 「判别器越强,重建越清晰」:hinge margin 饱和会让判别器损失梯度为 0,但生成器目标对 fake logit 的导数仍为 −1,不能把 D loss=0 当成生成器梯度消失的证据。正确姿势是晚启动、谱归一化、限制判别器更新次数、用自适应权重。 「L1/L2 越低画面越好」:L2 的最优解是条件均值,越低往往越糊;清晰度是用 GAN / 感知项换来的,并伴随 PSNR 下降。要同时看像素指标和感知 / 对抗指标。 「视频 VAE 把图像四项 loss 直接套到 3D 卷积上就行」:单帧损失测不出帧间闪烁(实测单帧 L1 几乎相同、时序误差差 393 倍)。应额外评估时序误差,按消融结果决定是否需要时空判别器、Video-DWT 或显式帧间约束;时间网络结构本身也能学习一致性。 「四项应该从头一起训」:主流做法是重建加 KL(有时加 LPIPS)先预热,第 disc_start 步才开 GAN;H3AE 甚至主张慎用判别损失。晚启动是一种稳定训练的办法,是否必需以及何时启动需依据具体实验。 09. 动手验证 5 个脚本都在本文附录,仅需 numpy(pip install numpy);第 6 个 make_figures.py 额外需要 matplotlib,用来重画本文配图。预期关键结果如下(随机种子已固定): 运行 vaeloss_terms.py:看到 L1 约 0.0316、KL (sum) 约 57.7、KL (mean) 约 0.225,以及「KL (sum)/L1 约 1826 倍」和 HunyuanVideo 权重配方下各项贡献 —— 建立「权重是在配平量纲」的直觉。 运行 pixel_vs_perceptual.py:亮度偏移与同能量噪声的像素 MSE 几乎相等(差小于 1%),但感知距离相差约三个数量级(噪声约为偏移的 $8\times10^3$ 倍)。 运行 gan_schedule.py:warm-up 在 step 2000 起跳;判别器「过强」时 D (hinge)=0.0000 而 G 约 5.97,同时检查脚本新增的 logit 导数:D margin 梯度归零,G 对 fake logit 的导数仍非零。 运行 adaptive_weight.py:先看有限差分与解析梯度完全一致,再看 d_weight 从训练早期 0.095 降到近收敛 0.003(约 32 倍)。 运行 temporal_consistency.py:闪烁与稳定两种重建的单帧 L1 约 0.063 几乎相同,时序 MSE 却差约 393 倍 —— 理解视频为何要单独约束时间维。 运行 make_figures.py(这个需要额外装 pip install matplotlib):重新生成本文三张配图 —— 量级账本(加权前 vs 加权后)、闪烁轨迹与指标对比、自适应权重随收敛下降的曲线。把 vaeloss_terms.py 里的 KL 权重从 $10^{-6}$ 调大两个数量级再看图 1,KL 项由约 $5.8\times10^{-5}$ 升到 $5.8\times10^{-3}$,仍低于这里约 0.0316 的 L1,不能声称已经压过所有项。 建议进一步动手:把 vaeloss_terms.py 里的 KL 从 sum() 改成 mean(),观察 HunyuanVideo 配方里 KL 项的相对权重需要相应放大多少倍,就能切身体会「权重不能跨口径照抄」。 10. 延伸阅读 读这篇之前建议先看已发布的前置: 变分下界与重参数化:KL 解析式与重参数化技巧的完整推导。 VAE 结构与训练目标:编码器 / 解码器、scaling factor、后验坍缩。 视频 VAE 的时空压缩结构:3D 因果卷积、时间 / 空间压缩比与分块解码。 读完这篇可以继续看: 视频生成评测:VBench 与人工验收(还没写):学会在分维度指标上看出「总分没变、时序一致性掉了」这类压缩副作用。 FID / CLIP Score 到底测了什么:感知与分布距离指标的适用边界,与本文 LPIPS/GAN 的质量观互补。 离散化表征:VQ-VAE 与 VQGAN(还没写):本文连续 KL-VAE 的「离散码本」对照版本,codebook 损失替代 KL。 附录:完整代码 09 节用到的脚本全文如下(vaeloss_terms.py、make_figures.py、pixel_vs_perceptual.py、gan_schedule.py、adaptive_weight.py、temporal_consistency.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 vaeloss_terms.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """视频 VAE 四类损失的最小可运行对照:L1 / KL / 感知 / GAN。 只依赖 numpy,直接 `python vaeloss_terms.py` 复现。 这一步不训练任何网络,只把四项损失放到同一个合成视频张量上算一遍, 回答一个最容易把人带沟里的问题:它们的「数值量级」根本不在一个频道上, 为什么工业配方里 KL 的权重会小到 1e-6。 """ import numpy as np rng = np.random.default_rng(0) # ---------------------------------------------------------------------- # 一个迷你的多尺度「特征提取器」,用来演示感知损失的*结构*。 # 注意:它不是 LPIPS 本体——LPIPS 用的是在 BAPPS 上学过权重的 VGG/Alex # 特征(见工业对照一节的 taming/lpips.py)。这里用可分离高斯 + 差分(DoG) # 构造确定性的多尺度边缘特征,目的是让「在特征空间而非像素空间比较」 # 这件事可以离线、免权重地跑起来。 # ---------------------------------------------------------------------- def _gauss_kernel(size=5, sigma=1.0): ax = np.arange(size) - (size - 1) / 2.0 k = np.exp(-(ax ** 2) / (2 * sigma ** 2)) return k / k.sum() def _conv_separable(img, k): """对最后两轴(H, W)做可分离卷积;img 形状 [..., H, W],边界 reflect。""" pad = len(k) // 2 x = np.pad(img, ((0, 0),) * (img.ndim - 2) + ((pad, pad), (0, 0)), mode="reflect") acc = np.zeros_like(img) for i, w in enumerate(k): acc += w * x[..., i:i + img.shape[-2], :] x = np.pad(acc, ((0, 0),) * (img.ndim - 2) + ((0, 0), (pad, pad)), mode="reflect") acc = np.zeros_like(img) for j, w in enumerate(k): acc += w * x[..., :, j:j + img.shape[-1]] return acc def _normalize_channels(feat, eps=1e-10): # 对应 LPIPS 的 normalize_tensor:沿通道维归一化 norm = np.sqrt(np.sum(feat ** 2, axis=1, keepdims=True)) return feat / (norm + eps) def feature_stack(x): """x: [B, C, T, H, W] -> 多尺度边缘特征列表(先把 T 折叠进 batch)。""" B, C, T, H, W = x.shape f = x.transpose(0, 2, 1, 3, 4).reshape(B * T, C, H, W) k = _gauss_kernel(5, 1.0) b1 = _conv_separable(f, k) b2 = _conv_separable(_conv_separable(b1, k), k) dog1 = f - b1 # 高频细节 dog2 = b1 - b2 # 中频边缘 feats = [_normalize_channels(f), _normalize_channels(dog1), _normalize_channels(dog2)] return feats def perceptual_proxy(x, y): """结构对齐 LPIPS:逐层归一化特征差的平方,空间平均后跨层求和。""" total = 0.0 for fx, fy in zip(feature_stack(x), feature_stack(y)): total += np.mean((fx - fy) ** 2) return total def make_video(B=2, T=8, H=32, W=32): """合成一段有运动内容的视频:移动的亮圆 + 网格背景,取值[0,1]。""" x = np.zeros((B, 3, T, H, W), dtype=np.float64) yy, xx = np.mgrid[0:H, 0:W] for b in range(B): for t in range(T): cx = W * (0.3 + 0.5 * t / (T - 1)) cy = H * (0.3 + 0.15 * np.sin(2 * np.pi * t / T)) circle = ((xx - cx) ** 2 + (yy - cy) ** 2) < (H * 0.12) ** 2 grid = ((xx // 8 + yy // 8) % 2) * 0.15 frame = 0.2 + grid frame[circle] = 0.95 x[b, 0, t] = frame x[b, 1, t] = frame * 0.9 x[b, 2, t] = frame * 0.7 return x def degrade(x): """重建结果:轻微模糊 + 小噪声 + 偏色,模拟一个训练中段的解码器。""" B, C, T, H, W = x.shape flat = x.transpose(0, 2, 1, 3, 4).reshape(B * T, C, H, W) k = _gauss_kernel(3, 0.8) out = _conv_separable(flat, k) out = out + rng.normal(0, 0.02, out.shape) out[:, 0] += 0.03 # 轻微红色偏置 return np.clip(out, 0, 1).reshape(B, T, C, H, W).transpose(0, 2, 1, 3, 4) def main(): x = make_video() r = degrade(x) print("视频张量 x / r :", x.shape, " 取值范围 %.2f~%.2f" % (x.min(), x.max())) # 编码器输出的后验 q(z|x):latent 在时间压缩4x、空间压缩8x B, C, T, H, W = x.shape Cz, Tz, Hz, Wz = 4, T // 4, H // 8, W // 8 mu = 0.3 * rng.standard_normal((B, Cz, Tz, Hz, Wz)) logvar = -1.0 + 0.2 * rng.standard_normal((B, Cz, Tz, Hz, Wz)) n_pix = B * C * T * H * W n_lat = mu.size print("latent 形状 :", mu.shape, " 像素数=%d latent数=%d\n" % (n_pix, n_lat)) # ① 像素重建 L1(对全部元素求平均,量纲与像素一致,O(0.01~0.1)) l1 = np.mean(np.abs(x - r)) # ② KL 解析式(标准正态先验)。注意它天然是「求和」式 kl_per_element = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar)) kl_sum = kl_per_element.sum() kl_mean = kl_per_element.mean() # ③ 感知损失(多尺度特征距离,量级被归一化压在 O(0.01)) l_p = perceptual_proxy(x, r) # ④ GAN 生成器损失。这里直接喂一组判别器对假图的打分 logits # hinge 生成损失 = -mean(logits_fake);先假设判别器刚起步、打分偏正 logits_fake = rng.normal(0.3, 0.5, size=64) g_loss = -np.mean(logits_fake) print("%-28s %10s" % ("损失项", "原始数值")) print("-" * 40) print("%-28s %10.5f" % ("L1 重建 (mean)", l1)) print("%-28s %10.5f" % ("KL (sum,常见写法)", kl_sum)) print("%-28s %10.5f" % ("KL (mean,换口径)", kl_mean)) print("%-28s %10.5f" % ("感知 proxy", l_p)) print("%-28s %10.5f" % ("GAN g=-mean(D(r))", g_loss)) print("\n--- 为什么 KL 权重能小到 1e-6 ---") # 若直接把 sum 口径的 KL 与 mean 口径的 L1 相加,KL 会凭元素数量碾压: print("KL(sum)/L1 的量级倍数 : %.1fx" % (kl_sum / l1)) print("HunyuanVideo 配方 L1 + 0.1*LPIPS + 0.05*GAN + 1e-6*KL :") total = l1 + 0.1 * l_p + 0.05 * g_loss + 1e-6 * kl_sum print(" 各项贡献: L1=%.5f LPIPS=%.5f GAN=%.5f KL=%.6f" % (l1, 0.1 * l_p, 0.05 * g_loss, 1e-6 * kl_sum)) print(" 合计 = %.5f" % total) print("\n结论:权重不是玄学,是在给「不同口径、不同元素数、不同量纲」的项找平。") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「视频 VAE 的常见 loss 组合」的三张解释图。 数值一律从同目录的三个脚本里取(vaeloss_terms / temporal_consistency / adaptive_weight),这里只负责画——改了那边这里要重跑,免得图和正文数字打架。 三张图分别回答: 1. 四项损失的原始量级差着几个数量级,工业配方加权后为什么能凑到一起 2. 单帧指标完全分不开的两种重建,时间维损失一眼看穿 3. 自适应 GAN 权重为什么随训练自动变小 只依赖 numpy + matplotlib。跑法:python make_figures.py """ import textwrap from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np import adaptive_weight as AW import temporal_consistency as TC import vaeloss_terms as VT ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(parents=True, exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, "savefig.bbox": "tight", }) INK = "#1f2937" MUTE = "#6b7280" C_PIX = "#2f6fb0" # 像素项:蓝 C_PERC = "#8b5cf6" # 感知项:紫 C_GAN = "#e0a03c" # 对抗项:橙 C_KL = "#d1495b" # KL:红 C_A = "#d1495b" # 闪烁重建 C_B = "#2f9e6f" # 稳定重建 C_GT = "#1f2937" # 真值 def style(ax, title, xlabel=None, ylabel=None): ax.set_title(title, fontsize=11.5, color=INK, pad=10, loc="left") if xlabel: ax.set_xlabel(xlabel, fontsize=10, color=MUTE) if ylabel: ax.set_ylabel(ylabel, fontsize=10, color=MUTE) ax.tick_params(colors=MUTE, labelsize=9) for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#d1d5db") ax.grid(alpha=0.25, linewidth=0.6, axis="y") ax.set_axisbelow(True) def footer(fig, text, width=118): """把「这张图要看什么」放到坐标轴下方。 必须放在 y<0 的位置:bbox_inches="tight" 会把负坐标的 artist 一起收进来, 放在 0~0.05 之间的话会和 x 轴标签叠在一起。 """ wrapped = "\n".join(textwrap.wrap(text, width=width)) fig.text(0.012, -0.13, wrapped, fontsize=8.5, color=MUTE, va="top", ha="left", linespacing=1.6) # ────────────────────────────────────────────────────────────────────── # 图 1:四项损失的量级账本 # ────────────────────────────────────────────────────────────────────── def fig_magnitudes(): x, r = VT.make_video(), VT.degrade(VT.make_video()) # 与 vaeloss_terms.main 完全同口径重算一遍(rng 序列一致) B, C, T, H, W = x.shape Cz, Tz, Hz, Wz = 4, T // 4, H // 8, W // 8 mu = 0.3 * VT.rng.standard_normal((B, Cz, Tz, Hz, Wz)) logvar = -1.0 + 0.2 * VT.rng.standard_normal((B, Cz, Tz, Hz, Wz)) l1 = float(np.mean(np.abs(x - r))) kl_el = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar)) kl_sum, kl_mean = float(kl_el.sum()), float(kl_el.mean()) lp = float(VT.perceptual_proxy(x, r)) gan = abs(float(-np.mean(VT.rng.normal(0.3, 0.5, size=64)))) fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.4)) ax = axes[0] names = ["L1 重建", "感知 proxy", "KL(mean)", "KL(sum)", "|GAN|"] vals = [l1, lp, kl_mean, kl_sum, gan] cols = [C_PIX, C_PERC, C_KL, C_KL, C_GAN] bars = ax.bar(names, vals, color=cols, width=0.62) ax.set_yscale("log") ax.set_ylim(1e-3, 3e2) for b, v in zip(bars, vals): ax.text(b.get_x() + b.get_width() / 2, v * 1.25, f"{v:.4g}", ha="center", fontsize=8.5, color=INK) style(ax, "加权前:同一视频上四项损失的原始数值", None, "损失值(对数轴)") ax = axes[1] wnames = ["1.0 × L1", "0.1 × 感知", "0.05 × GAN", "1e-6 × KL(sum)"] wvals = [l1, 0.1 * lp, 0.05 * gan, 1e-6 * kl_sum] wcols = [C_PIX, C_PERC, C_GAN, C_KL] bars = ax.bar(wnames, wvals, color=wcols, width=0.62) ax.set_yscale("log") ax.set_ylim(1e-6, 1e-1) for b, v in zip(bars, wvals): ax.text(b.get_x() + b.get_width() / 2, v * 1.6, f"{v:.4g}", ha="center", fontsize=8.5, color=INK) ax.axhline(l1, color=MUTE, ls=":", lw=1.0) ax.text(2.6, l1 * 1.5, "L1 的量级", fontsize=8, color=MUTE) style(ax, "加权后:HunyuanVideo 配方下各项的真实贡献", None, "对总损失的贡献(对数轴)") fig.suptitle("图 1 损失归约口径与加权贡献:标量大小不等于梯度大小", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "要看什么:左图是四项损失在同一个合成视频上的原始数值——KL 按教科书口径对 latent 维" "求和,一上来就是 L1 的 1826 倍;右图是套上工业权重之后各项的真实贡献," "贡献仍不同量级(KL 约5.8e-5,而L1约0.0316);这些权重不能由toy损失比唯一推导。" "KL 权重小到 1e-6 不是不重要,是在补偿「求和口径 vs 平均口径」的元素数之差。") fig.savefig(OUT / "loss_magnitudes.png") plt.close(fig) print(f"[图1] L1={l1:.5f} KL_sum={kl_sum:.5f} 倍数={kl_sum / l1:.0f}x;" f"加权后贡献 L1={l1:.5f} KL={1e-6 * kl_sum:.2e}") # ────────────────────────────────────────────────────────────────────── # 图 2:单帧指标看不见的闪烁 # ────────────────────────────────────────────────────────────────────── def fig_temporal(): x = TC.make_sequence() # [T,1,H,W] fixed = TC.SIGMA * TC.rng.standard_normal(x.shape[1:])[None] rA = x + TC.SIGMA * TC.rng.standard_normal(x.shape) rB = x + fixed + 0.05 * TC.SIGMA * TC.rng.standard_normal(x.shape) # 取一条穿过运动边缘的水平线上的一个像素,看它随帧的取值 t_axis = np.arange(TC.T) y0, x0 = TC.H // 2, 30 gt = x[:, 0, y0, x0] a = rA[:, 0, y0, x0] b = rB[:, 0, y0, x0] fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.3)) ax = axes[0] ax.plot(t_axis, gt, lw=2.6, color=C_GT, label="真值", zorder=3) ax.plot(t_axis, a, lw=1.2, color=C_A, alpha=0.9, label="A 逐帧独立噪声(闪)") ax.plot(t_axis, b, lw=1.2, color=C_B, alpha=0.9, label="B 跨帧恒定退化(稳)") ax.set_ylim(gt.min() - 4 * TC.SIGMA, gt.max() + 4 * TC.SIGMA) ax.legend(fontsize=8.5, frameon=False, loc="upper left") style(ax, "同一个像素随帧的变化:A 在真值附近抖,B 整体平移但不抖", "帧 t", "像素值") ax = axes[1] mets = ["单帧空间 L1", "时序差分 L1", "时序差分 MSE"] va = [TC.spatial_l1(rA, x), TC.temporal_error(rA, x), TC.temporal_mse(rA, x)] vb = [TC.spatial_l1(rB, x), TC.temporal_error(rB, x), TC.temporal_mse(rB, x)] xg = np.arange(len(mets)) w = 0.36 ba = ax.bar(xg - w / 2, va, w, color=C_A, label="A 闪") bb = ax.bar(xg + w / 2, vb, w, color=C_B, label="B 稳") ax.set_yscale("log") ax.set_ylim(1e-5, 1) for bars in (ba, bb): for b_ in bars: ax.text(b_.get_x() + b_.get_width() / 2, b_.get_height() * 1.5, f"{b_.get_height():.4g}", ha="center", fontsize=8, color=INK) ax.set_xticks(xg) ax.set_xticklabels(mets) ax.legend(fontsize=8.5, frameon=False, loc="upper left") style(ax, "三种指标下 A、B 的差距:第一列分不开,第三列差 393 倍", None, "误差(对数轴)") fig.suptitle("图 2 单帧 L1 完全分不开的两种重建,时序差分 MSE 差了 393 倍", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "要看什么:左图是同一个像素在 12 帧上的取值——A(红)每一帧都在真值附近独立抖动," "连起来播放就是闪烁;B(绿)带一个恒定偏移但帧间几乎不动。" "右图是量化结论:单帧空间 L1 下 A=0.0639、B=0.0634,指标根本分不出谁好谁坏;" "换时序差分 MSE,A 是 B 的 393 倍。只看单帧指标,闪烁是隐形的。") fig.savefig(OUT / "temporal_flicker.png") plt.close(fig) print(f"[图2] 单帧L1 A={va[0]:.5f}/B={vb[0]:.5f};时序MSE A={va[2]:.5f}/B={vb[2]:.5f}" f"({va[2] / max(vb[2], 1e-12):.0f}x)") # ────────────────────────────────────────────────────────────────────── # 图 3:自适应 GAN 权重随训练自动变小 # ────────────────────────────────────────────────────────────────────── def fig_adaptive(): b = np.zeros(AW.D) # 先按 adaptive_weight.main 的抽随机顺序取两个阶段点,保证与正文数字一致 W_early = AW.rng.standard_normal((AW.dz, AW.D)) * 0.05 W_late = AW.W_star + AW.rng.standard_normal((AW.dz, AW.D)) * 0.01 g_rec, g_gan = AW.grads(W_early, b) w_early = AW.adaptive_weight(g_rec, g_gan) g_rec2, g_gan2 = AW.grads(W_late, b) w_late = AW.adaptive_weight(g_rec2, g_gan2) # 扫描曲线用独立的 rng,不扰动上面的阶段点 sweep_rng = np.random.default_rng(7) scales = np.logspace(-4, -0.3, 14) weights = [] for s in scales: W = AW.W_star + s * sweep_rng.standard_normal((AW.dz, AW.D)) g_rec, g_gan = AW.grads(W, b) weights.append(AW.adaptive_weight(g_rec, g_gan)) weights = np.array(weights) fig, ax = plt.subplots(figsize=(7.8, 4.4)) ax.plot(scales, weights, marker="o", ms=4.5, lw=2.0, color=C_GAN, label=r"自适应权重 $d_{\mathrm{weight}}$") ax.axvline(0.05, color=MUTE, ls=":", lw=1.0) ax.text(0.055, w_early * 2.2, "训练早期\n(初始化附近)", fontsize=8.5, color=MUTE) ax.axvline(0.01, color=MUTE, ls=":", lw=1.0) ax.text(0.0105, w_late * 0.06, "训练后期\n(近收敛)", fontsize=8.5, color=MUTE) for s, w_ in [(0.05, w_early), (0.01, w_late)]: ax.plot([s], [w_], marker="s", ms=7, color=C_PIX, zorder=5) ax.annotate(f"{w_early:.3f}", xy=(0.05, w_early), xytext=(0.075, w_early * 1.6), fontsize=9, color=C_PIX) ax.annotate(f"{w_late:.4f}", xy=(0.01, w_late), xytext=(0.0125, w_late * 0.4), fontsize=9, color=C_PIX) ax.set_xscale("log") ax.set_yscale("log") ax.legend(fontsize=9, frameon=False, loc="upper right") style(ax, "重建越接近收敛,GAN 项被自动调得越小", "解码器离最优解的距离(权重扰动幅度,对数轴)", r"自适应权重 $d_{\mathrm{weight}}$(对数轴)") fig.suptitle("图 3 固定 λ 会两头翻车:早期压不住重建、后期压不住 GAN", fontsize=12, color=INK, x=0.012, ha="left", y=1.03) footer(fig, "要看什么:横轴是解码器离最优解有多远(越靠左越接近收敛),纵轴是 VQGAN 的" "自适应权重 ||∇L_rec|| / ||∇L_GAN||。它随残差缩小近似线性下降——重建收敛后" f"从 {w_early:.3f} 掉到 {w_late:.4f}(约 {w_early / max(w_late, 1e-12):.0f} 倍),GAN 项被同步调小。" "若用固定权重,早期 GAN 抢不过巨大的重建梯度,后期重建梯度变小、GAN 又反过来" "压过重建——这条斜线就是在消除这个漂移。") fig.savefig(OUT / "adaptive_weight_curve.png") plt.close(fig) print(f"[图3] d_weight: 早期 {w_early:.4f} -> 后期 {w_late:.4f}" f"({w_early / max(w_late, 1e-12):.0f}x)") def main(): fig_magnitudes() fig_temporal() fig_adaptive() print(f"[OK] 三张图已写入 {OUT}") for f in sorted(OUT.glob("*.png")): print(f" {f.name} {f.stat().st_size / 1024:.0f} KB") if __name__ == "__main__": main() pixel_vs_perceptual.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """复现 LPIPS 论文最核心的观察:相同的像素误差,感知质量可以天差地别。 只依赖 numpy,直接 `python pixel_vs_perceptual.py` 复现。 我们构造三种「重建」,让其中两种的像素 MSE 完全相等: A. 全局亮度偏移 —— 人眼对缓慢的整体明暗变化相当不敏感; B. 同等 L2 能量的逐点噪声 —— 直接污染纹理与细节,观感很差; C. 高斯模糊 —— 抹掉高频细节。 然后分别在「像素空间」和一个多尺度特征空间里比较距离。 """ import numpy as np rng = np.random.default_rng(1) def _gauss_kernel(size=5, sigma=1.0): ax = np.arange(size) - (size - 1) / 2.0 k = np.exp(-(ax ** 2) / (2 * sigma ** 2)) return k / k.sum() def _conv_separable(img, k): pad = len(k) // 2 x = np.pad(img, ((0, 0),) * (img.ndim - 2) + ((pad, pad), (0, 0)), mode="reflect") acc = np.zeros_like(img) for i, w in enumerate(k): acc += w * x[..., i:i + img.shape[-2], :] x = np.pad(acc, ((0, 0),) * (img.ndim - 2) + ((0, 0), (pad, pad)), mode="reflect") acc = np.zeros_like(img) for j, w in enumerate(k): acc += w * x[..., :, j:j + img.shape[-1]] return acc def _norm(feat, eps=1e-10): return feat / (np.sqrt(np.sum(feat ** 2, axis=1, keepdims=True)) + eps) def perceptual_proxy(x, y): """多尺度高通特征上的归一化距离(LPIPS 的结构代理,非本体)。""" def feats(z): k = _gauss_kernel(5, 1.0) b1 = _conv_separable(z, k) b2 = _conv_separable(_conv_separable(b1, k), k) return [_norm(z), _norm(z - b1), _norm(b1 - b2)] return sum(np.mean((a - b) ** 2) for a, b in zip(feats(x), feats(y))) def make_textured_image(H=64, W=64): """一张同时含锐边、细密纹理和平滑区域的图。""" yy, xx = np.mgrid[0:H, 0:W].astype(np.float64) img = 0.5 + 0.25 * np.sin(xx / 2.0) * np.sin(yy / 2.0) # 细密纹理 img += 0.3 * (xx > W / 2) # 一条锐边 checker = ((xx // 4 + yy // 4) % 2) * 0.15 # 棋盘格 img += checker img = np.clip(img, 0, 1) return np.stack([img, img * 0.92, img * 0.8], axis=0)[None] # [1,C,H,W] def mse(a, b): return float(np.mean((a - b) ** 2)) def main(): x = make_textured_image() delta = 0.12 # 统一的 L2 误差能量 rA = x + delta # A:全局亮度偏移(不 clip,保证误差严格等于 delta) rB = x + rng.normal(0, delta, x.shape) # B:零均值逐点噪声,标准差=delta rC = _conv_separable(x, _gauss_kernel(7, 1.6)) # C:模糊 rows = [ ("A 亮度偏移(整体+%.2f)" % delta, rA), ("B 逐点噪声(σ=%.2f)" % delta, rB), ("C 高斯模糊", rC), ] print("%-26s %12s %12s %14s" % ("重建方式", "像素MSE", "感知距离", "感知/像素 比")) print("-" * 68) for name, r in rows: pm = mse(x, r) pp = perceptual_proxy(x, r) print("%-26s %12.5f %12.5f %14.2f" % (name, pm, pp, pp / (pm + 1e-12))) mseA, mseB = mse(x, rA), mse(x, rB) pA, pB = perceptual_proxy(x, rA), perceptual_proxy(x, rB) print("\n关键对照:A 与 B 的像素 MSE 相差仅 %.2f%%," % (100 * abs(mseA - mseB) / mseA)) print("但特征空间里 B(噪声)的感知距离是 A(亮度偏移)的 %.1f 倍。" % (pB / pA)) print("高通/多尺度特征天然滤掉直流亮度、放大纹理污染——这正是 LPIPS 比 MSE 更贴人眼的原因。") if __name__ == "__main__": main() gan_schedule.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """GAN 两项的最小演示:hinge / vanilla 损失,以及判别器的 warm-up 调度。 只依赖 numpy,直接 `python gan_schedule.py` 复现。 视频 VAE 里对抗损失通常不是从头开:先用 L1+KL+LPIPS 把解码器训到大致成形, 第 disc_start 步才把判别器权重从 0 抬起来(taming 里的 adopt_weight)。 本脚本同时给出两种常见判别损失的数值,并展示「判别器过强」时的失衡信号。 """ import numpy as np rng = np.random.default_rng(3) def adopt_weight(weight, global_step, threshold=0, value=0.0): """taming-transformers 里的原逻辑:threshold 之前强制为 value(通常是0)。""" return value if global_step < threshold else weight def hinge_d(real, fake): return 0.5 * (np.mean(np.maximum(0.0, 1.0 - real)) + np.mean(np.maximum(0.0, 1.0 + fake))) def hinge_g(fake): return float(-np.mean(fake)) def vanilla_d(real, fake): softplus = lambda z: np.log1p(np.exp(-np.abs(z))) + np.maximum(z, 0.0) return 0.5 * (np.mean(softplus(-real)) + np.mean(softplus(fake))) def evaluate(real, fake, tag): print("%-28s D(hinge)=%.4f D(vanilla)=%.4f G(hinge)=%.4f 均值打分 real=%.2f fake=%.2f" % (tag, hinge_d(real, fake), vanilla_d(real, fake), hinge_g(fake), real.mean(), fake.mean())) def main(): # ① warm-up 调度:disc_start=2000 print("== adopt_weight 调度(disc_start=2000, 目标权重 0.05) ==") for step in (0, 1999, 2000, 5000): w = adopt_weight(0.05, step, threshold=2000) print(" step=%5d -> 对抗权重 = %.3f" % (step, w)) # ② 判别器在三种强弱下的损失 print("\n== 判别器强弱与损失信号 ==") # 平衡初期:真假打分都在 0 附近 real0 = rng.normal(0.0, 0.3, 256) fake0 = rng.normal(0.0, 0.3, 256) evaluate(real0, fake0, "起步:判别器分不清") # 健康:真≈+1,假≈-1,仍留梯度 real1 = rng.normal(1.2, 0.4, 256) fake1 = rng.normal(-1.2, 0.4, 256) evaluate(real1, fake1, "健康:适度拉开") # 过强:真≈+6,假≈-6,判别器 hinge 梯度为 0,但生成器对 fake logit 仍有梯度 real2 = rng.normal(6.0, 0.5, 256) fake2 = rng.normal(-6.0, 0.5, 256) evaluate(real2, fake2, "过强:margin 已饱和") d_fake_grad = 0.5 * (fake2 > -1.0) / fake2.size g_fake_grad = -np.ones_like(fake2) / fake2.size print("\nD 对 fake logit 梯度范数 = %.6f" % np.linalg.norm(d_fake_grad)) print("G 对 fake logit 梯度范数 = %.6f" % np.linalg.norm(g_fake_grad)) print("D margin 饱和不表示 G 梯度消失;参数梯度还取决于判别器输入雅可比。") if __name__ == "__main__": main() adaptive_weight.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """复现 VQGAN 的自适应 GAN 权重 calculate_adaptive_weight。 只依赖 numpy,直接 `python adaptive_weight.py` 复现。 固定 GAN 权重的痛点:训练早期解码器很烂,重建梯度很大;训练后期重建收敛、 梯度变小。若 λ 固定,GAN 梯度在后期会相对越来越强,甚至把重建带偏。 VQGAN 的做法是让两项在「最后一层」上的梯度范数之比来决定权重: d_weight = ||∇_last L_rec|| / (||∇_last L_gan|| + 1e-4),再 clamp 到 [0,1e4] 我们用一个可解析求导的迷你线性解码器,精确算出两个梯度范数, 并用有限差分抽查一个分量,证明数值不是凑出来的。 """ import numpy as np rng = np.random.default_rng(2) N, D, dz = 16, 24, 8 # 样本数、像素维、latent 维 Z = rng.standard_normal((N, dz)) W_star = rng.standard_normal((dz, D)) * 0.3 X = Z @ W_star # 真实数据:线性可完美拟合 # 一个固定的微型判别器打分函数 s(x)=x @ a(教学用,参数冻结) a = rng.standard_normal((D,)) def decode(W, b): return Z @ W + b def rec_loss(W, b): """重建项:L2(L1 同理,范数比机制不变)。""" return float(np.mean((decode(W, b) - X) ** 2)) def gan_g_loss(W, b): """生成器 hinge 损失 -mean(D(r))。""" s = decode(W, b) @ a return float(-np.mean(s)) def grads(W, b): R = decode(W, b) - X g_rec = (2.0 / (N * D)) * Z.T @ R # ∂L_rec/∂W(mean 对 N*D) # g=-mean_n(s_n),s_n=Σ_d xhat_nd·a_d:mean 只对 N,分母是 N,不是 N*D s_coef = -(1.0 / N) * Z.sum(axis=0) # ∂g/∂W_kd = -(1/N)(Σ_n z_nk) a_d g_gan = np.outer(s_coef, a) return g_rec, g_gan def adaptive_weight(g_rec, g_gan, cap=1e4): w = np.linalg.norm(g_rec) / (np.linalg.norm(g_gan) + 1e-4) return float(np.clip(w, 0.0, cap)) def finite_diff_check(W, b, eps=1e-6): """用中心差分抽查 W[0,0] 上的两个梯度,验证解析解。""" out = [] for fn in (rec_loss, gan_g_loss): Wp, Wm = W.copy(), W.copy() Wp[0, 0] += eps Wm[0, 0] -= eps out.append((fn(Wp, b) - fn(Wm, b)) / (2 * eps)) return out def stage(W, b, name): lrec = rec_loss(W, b) lgan = gan_g_loss(W, b) g_rec, g_gan = grads(W, b) w = adaptive_weight(g_rec, g_gan) print("%-22s L_rec=%8.5f L_gan=%8.4f ||∇rec||=%8.4f ||∇gan||=%7.4f d_weight=%7.4f" % (name, lrec, lgan, np.linalg.norm(g_rec), np.linalg.norm(g_gan), w)) return w def main(): b = np.zeros(D) # 阶段一:解码器刚初始化,离最优很远(重建残差大) W_early = rng.standard_normal((dz, D)) * 0.05 # 阶段二:接近收敛(在最优解上加很小扰动,残差小) W_late = W_star + rng.standard_normal((dz, D)) * 0.01 print("== 有限差分校验(W[0,0]) ==") fd_rec, fd_gan = finite_diff_check(W_early, b) g_rec, g_gan = grads(W_early, b) print("解析 ∂Lrec/∂W00=%.6f 差分=%.6f" % (g_rec[0, 0], fd_rec)) print("解析 ∂Lgan/∂W00=%.6f 差分=%.6f\n" % (g_gan[0, 0], fd_gan)) print("== 自适应权重随训练阶段变化 ==") w_early = stage(W_early, b, "训练早期(未收敛)") w_late = stage(W_late, b, "训练后期(近收敛)") print("\n重建收敛后 d_weight 从 %.3f 降到 %.4f(约 %.0f 倍),GAN 项被自动调小。" % (w_early, w_late, w_early / max(w_late, 1e-12))) print("若用固定 λ:早期 GAN 抢不过重建、后期 GAN 又可能压过重建——自适应权重就是在消除这个漂移。") if __name__ == "__main__": main() temporal_consistency.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """视频 VAE 为什么必须额外盯「时间维」:同样的单帧画质,闪烁程度可以天差地别。 只依赖 numpy,直接 `python temporal_consistency.py` 复现。 构造一段运动视频,再给两种重建: A. 逐帧独立噪声 —— 每一帧单独看误差不大,连起来播放却疯狂闪烁; B. 跨帧恒定的退化(同一固定纹理噪声)—— 单帧误差与 A 相同,但不闪。 单帧空间 L1 完全分不清 A、B;相邻帧差分的时序一致性损失一眼区分。 """ import numpy as np rng = np.random.default_rng(4) T, H, W = 12, 48, 64 SIGMA = 0.08 def make_sequence(): yy, xx = np.mgrid[0:H, 0:W].astype(np.float64) x = np.zeros((T, H, W)) for t in range(T): cx = 8 + 4 * t # 一条匀速移动的竖边 frame = 0.25 + 0.5 * (xx >= cx) frame += 0.1 * ((xx // 6 + yy // 6) % 2) x[t] = frame return np.clip(x, 0, 1)[:, None] # [T,1,H,W] def spatial_l1(r, x): return float(np.mean(np.abs(r - x))) def frame_diff(v): return v[1:] - v[:-1] def temporal_error(r, x): """相邻帧差分一致性:||Δr - Δx||(静止背景上 GT 帧差为0,闪烁直接显现)。""" return float(np.mean(np.abs(frame_diff(r) - frame_diff(x)))) def temporal_mse(r, x): return float(np.mean((frame_diff(r) - frame_diff(x)) ** 2)) def main(): x = make_sequence() fixed_noise = SIGMA * rng.standard_normal(x.shape[1:])[None] # [1,1,H,W] 跨帧恒定 rA = x + SIGMA * rng.standard_normal(x.shape) # 逐帧独立噪声 -> 闪烁 # 稳定退化:以跨帧恒定噪声为主,只掺 5% 的逐帧抖动(更贴近真实解码器) rB = x + fixed_noise + 0.05 * SIGMA * rng.standard_normal(x.shape) print("退化能量相同(σ=%.2f),比较单帧空间误差与时间维误差:\n" % SIGMA) print("%-22s %14s %16s %16s" % ("重建", "单帧空间L1", "时序差分L1", "时序差分MSE")) print("-" * 72) for name, r in (("A 逐帧独立噪声(闪)", rA), ("B 跨帧恒定退化(稳)", rB)): print("%-22s %14.5f %16.5f %16.5f" % (name, spatial_l1(r, x), temporal_error(r, x), temporal_mse(r, x))) print("\n单帧空间 L1 几乎相等(A=%.4f vs B=%.4f),但时序 MSE 上 A 约为 B 的 %.0f 倍。" % (spatial_l1(rA, x), spatial_l1(rB, x), temporal_mse(rA, x) / max(temporal_mse(rB, x), 1e-12))) print("这解释了视频 VAE 为何要在 2D 的 L1/LPIPS/GAN 之外:") print(" · 把判别器扩到时空(3D/PatchGAN、LTX 的 Video-DWT);") print(" · 或加相邻帧/warp 一致性损失,专门惩罚帧间抖动与闪烁。") if __name__ == "__main__": main()
-
AIGC 基本功|把 RL 用到扩散模型上-DiffusionRL 把 RL 用到扩散模型上:从一张图的奖励到整条去噪轨迹的梯度 所属方向:对齐与强化学习 | 难度:前沿 | 前置知识:GRPO、DDIM 采样 关键词:DiffusionRL、DDPO、去噪轨迹、终点奖励、信用分配、DPOK、DRaFT 01. 为什么需要它 扩散模型通常先学习“像训练数据”,但产品真正关心的目标往往不是训练集似然:文字有没有正确渲染、人物是不是多了一根手指、构图是否讨喜、生成物能不能被某个下游系统识别、视频运动是否自然。这些目标可能来自人工打分、视觉语言模型、OCR、物理模拟器,甚至一段只能返回分数的业务程序。它们大多不可微,也不一定有成对偏好数据,却都能回答同一个问题:这张最终样本值多少分? 直接把最终图片当成一次普通动作,会丢掉扩散模型最重要的结构:图片不是一次生成的,而是从纯噪声开始,经过几十次随机去噪才得到的。假设采样有 50 步,最后的文字错了,到底是哪一步需要改?如果只对最终结果拟合,模型既看不到每一步在旧策略下出现的概率,也无法使用 PPO 的重要性比率约束更新;如果硬把 50 个概率相乘成一个轨迹比率,数值又很容易趋近 0 或爆炸。 DiffusionRL 的关键不是发明一种新的扩散网络,而是换一个观察角度: 把一次完整采样视为一条有限时域 MDP 轨迹;当前 latent 是状态,下一 latent 的随机采样是动作,最终图片的评分是终点奖励。 这样,奖励虽然只在最后出现,整条轨迹的 log-prob 仍然可以参与策略梯度。DDPO(Denoising Diffusion Policy Optimization)正是把这个视角变成了可训练算法:它允许我们用 JPEG 可压缩性、目标检测器、审美模型或人工反馈等黑盒奖励微调扩散模型,而不要求对奖励函数求导。 这也是理解视频生成 RL 的统一入口。图片去噪已经有“时间步 × latent”的信用分配;到了视频,还会再叠加帧间运动、时序一致性和长时奖励。先把图像版的轨迹与概率比率看清,后面的算法名字就不再是一堆孤立缩写。 02. 最小可用理解 给定提示词 $c$,采样从 $x_T\sim\mathcal N(0,I)$ 开始;每个去噪步骤都由模型定义一个策略 $p_\theta(x_{t-1}\mid x_t,c)$。 完整轨迹的概率是所有步骤概率的乘积,所以它的 log-prob 是逐步 log-prob 之和;终点奖励 $R(x_0,c)$ 因而能乘到每一步的 score function 上。 实际训练不直接做无约束 REINFORCE,而是像 PPO 一样保存旧策略的逐步 log-prob、重新计算新策略 log-prob、裁剪概率比率,并用基线或组内标准化降低方差。 图里有一个必须说准的细节:网络通常输出噪声、velocity 或转移均值的参数,但在 MDP 记号中,“动作”是实际采样出来的 $x_{t-1}$。也就是说,网络参数化动作分布,采样器从这个分布中抽出动作;不要把“网络输出”和“环境中发生的动作”混成一件事。 03. 数学推导 3.1 先把一次随机去噪写成概率分布 为避免被不同预测参数化淹没,先只保留采样器真正需要的形式。对当前 latent $x_t$,模型根据时间步 $t$ 和条件 $c$ 预测噪声,再由调度器算出一个转移均值: $$\mu_\theta(x_t,t,c).$$ 带随机性的 DDIM 步可以统一写成: $$x_{t-1}=\mu_\theta(x_t,t,c)+\sigma_t z_t,\qquad z_t\sim\mathcal N(0,I).$$ 因此条件转移是一个高斯策略: $$\pi_\theta(a_t\mid s_t)=p_\theta(x_{t-1}\mid x_t,t,c)=\mathcal N\!\left(x_{t-1};\mu_\theta(x_t,t,c),\sigma_t^2 I\right).$$ DDIM 中的随机强度由 $\eta$ 控制。训练 DDPO 时通常必须让 $\eta>0$,这样被纳入似然目标的随机步骤才有普通高斯密度可用于 log-prob 和重要性比率。注意 $\eta>0$ 仍不保证所有步骤 $\sigma_t>0$:落到干净端的终步可能方差为零,需排除该步或显式采用非零方差,不能直接算高斯 log-prob。若 $\eta=0$,转移退化为确定性映射,$\sigma_t=0$,直接套高斯 log-prob 会除以零;确定性采样仍可用于可微奖励反传,但不能不加处理地套用这套随机策略梯度。 3.2 MDP 的四个元素 把扩散采样改写成 MDP 时,可使用下面的对应关系: RL 概念 扩散采样中的对象 状态 $s_t$ 当前 latent、时间步和条件:$(x_t,t,c)$ 动作 $a_t$ 从模型给出的分布中采样下一 latent:$x_{t-1}$ 策略 $\pi_\theta$ 反向去噪转移 $p_\theta(x_{t-1}\mid x_t,t,c)$ 奖励 中间步骤通常为 0;解码 $x_0$ 后得到 $R(x_0,c)$ 这里的“环境”几乎没有额外动力学:动作 $x_{t-1}$ 本身就成为下一状态的一部分,时间步从 $t$ 减到 $t-1$。文本编码器、VAE 解码器和奖励模型通常不属于策略参数;真正更新的是 UNet、DiT 或其 LoRA 适配器。 3.3 终点一个分数,为什么每一步都有梯度 给定提示词,一条轨迹记作 $\tau=(x_T,x_{T-1},\ldots,x_0)$。因为初始噪声不依赖模型参数,轨迹概率可分解为: $$p_\theta(\tau\mid c)=p(x_T)\prod_{t=T}^{1}p_\theta(x_{t-1}\mid x_t,t,c).$$ 取对数后,乘积变为求和: $$\log p_\theta(\tau\mid c)=\log p(x_T)+\sum_{t=T}^{1}\log p_\theta(x_{t-1}\mid x_t,t,c).$$ 目标是最大化期望终点奖励: $$J(\theta)=\mathbb E_{c,\tau\sim p_\theta}[R(x_0,c)].$$ 应用 likelihood-ratio trick: $$\nabla_\theta J(\theta)=\mathbb E\!\left[R(x_0,c)\nabla_\theta\log p_\theta(\tau\mid c)\right]=\mathbb E\!\left[R(x_0,c)\sum_{t=T}^{1}\nabla_\theta\log p_\theta(x_{t-1}\mid x_t,t,c)\right].$$ 这就是“奖励只在终点,梯度覆盖全轨迹”的来源。实践中会减去不依赖当前动作的基线 $b(c)$,得到优势: $$A=R(x_0,c)-b(c).$$ 减基线不会改变期望梯度,却能显著降低采样方差。若同一个 prompt 一次生成多张图,可以用组内均值和标准差做归一化: $$A_i=\frac{R_i-\operatorname{mean}(R_{1:G})}{\operatorname{std}(R_{1:G})+\epsilon}.$$ 组均值包含自身时,未标准化的中心化 score 估计在独立采样条件下有 $(1-1/G)$ 的缩放;随机标准差还会改变各组权重。因此上面的无偏基线证明不能直接套到组内标准化。它和 GRPO 的“组内相对分数”很相似,不过动作空间从 token 变成了高维 latent 转移。 3.4 每一步的 log-prob 到底怎么算 设动作 $x_{t-1}$ 有 $D$ 个独立高斯坐标、固定方差为 $\sigma_t^2>0$。真实联合 log-prob 必须对坐标求和: $$\ell_\theta=-\frac{\|x_{t-1}-\mu_\theta\|^2}{2\sigma_t^2}-D\log\sigma_t-\frac D2\log(2\pi).$$ 真实逐步联合概率比为 $r_t=\exp(\ell_\theta-\ell_{old})$。DDPO 作者实现 则把逐坐标 log-prob 取平均,即 $\bar\ell=\ell/D$,再计算 $$\bar r_t=\exp(\bar\ell_\theta-\bar\ell_{old})=r_t^{1/D}.$$ 这是一种控制高维数值尺度的工程替代比率,不再是严格的联合重要性权重;它也改变了 clip 的尺度。本文一维玩具 $D=1$ 时二者相同,多维复现时必须明确采用哪个约定。下式的 $r_t$ 应按所选约定解释。 PPO 风格的裁剪目标是: $$L_t(\theta)=\min\!\left(r_t A,\operatorname{clip}(r_t,1-\epsilon,1+\epsilon)A\right).$$ 训练代码通常最小化 $-L_t$。关键是先按转移计算比率再裁剪,不是先把所有 $r_t$ 相乘成一个轨迹比率。后者会随步数快速积累方差,也让某一步的异常比率拖垮整条样本。 3.5 同一个优势,不代表每一步得到同样的梯度 优势 $A$ 可以广播给每一步,但 score function 不同。对固定方差的高斯策略,有: $$\nabla_\theta\log p_\theta(x_{t-1}\mid x_t,c)=\frac{x_{t-1}-\mu_\theta}{\sigma_t^2}\nabla_\theta\mu_\theta.$$ 时间步的噪声尺度、采样残差、网络 Jacobian 都不同,因此各步的梯度贡献不会相等。终点附近通常对最终结果影响更直接,但并不存在“最后一步天然包办所有学习”的定理;调度器与模型参数化会改变信用在各步之间的分布。 04. 代码实现 下面的玩具过程只有一个可训练标量 $\theta$,但保留了 DDPO 的核心结构:8 步高斯去噪、只在终点计算奖励、保存逐步 log-prob、用中心化优势做 REINFORCE,并在最后演示新旧策略的 PPO 比率。 状态转移是: $$x_{t-1}=0.72x_t+0.18\theta+0.45z_t,\qquad z_t\sim\mathcal N(0,1).$$ 终点目标为 1.5,奖励为: $$R(x_0)=-(x_0-1.5)^2.$$ 完整代码见文末。直接运行: python3 ddpo_minimal.py 真实输出如下: trajectory_shape= (4096, 9) transition_log_prob_shape= (4096, 8) before_terminal_mean= 0.0052 before_reward_mean= -2.6513 after_theta= 2.2677 after_terminal_mean= 1.3577 after_reward_mean= -0.4370 per_step_gradient= [0.0088 0.0085 0.014 0.024 0.0358 0.0435 0.0578 0.0883] gradient_sample_std_raw_centered= 1.6981 1.3899 ppo_ratio_mean_min_max= 1.0010 0.4051 2.2337 ppo_clip_fraction= 0.3108 history_first= [ 0. -0.0165 -2.7295] history_last= [ 2.2677 1.3601 -0.4503] 几个 shape 很重要:4096 条轨迹、每条 8 个转移,所以状态数组有 9 个点,而 log-prob 只有 8 个。训练前 $x_0$ 均值约为 0;40 次更新后移到 1.36,接近目标 1.5,平均奖励从 -2.65 提升到约 -0.44。奖励是负平方误差,所以“更大”意味着更接近 0,而不是数值绝对值更大。 中心化前后,单样本梯度估计的标准差从 1.70 降到 1.39。这只是最简单的 batch baseline;工业实现还会按 prompt 维护统计量,避免一个本来就容易拿高分的 prompt 主导更新。 最后把参数轻微扰动,逐步比率均值仍约为 1,但极端值已经到 0.41 和 2.23,有约 31% 的转移落到裁剪区间之外。这说明“平均比率看起来正常”不足以判断更新是否安全,还要看 clip fraction、KL 和比率分位数。 右图里越靠近终点的转移贡献越大,是这个线性玩具过程的收缩系数 0.72 造成的:早期扰动经过多次收缩后影响变小。真实扩散模型不会总呈现这种单调形状,但它直观说明了:即使每一步共享同一个终点优势,信用仍由每一步的局部概率结构决定。 05. 工业级实现对照 截至 2026 年 9 月,DDPO 论文作者维护的参考实现 kvablack/ddpo-pytorch 仍是理解训练循环最直接的代码入口。其 scripts/train.py 和带 log-prob 的 ddim_step_with_logprob 展示了完整数据流: 采样 rollout:从 prompt 和初始噪声出发,保存形状近似为 [batch, steps + 1, C, H, W] 的 latents,以及 [batch, steps] 的旧策略 log-prob。 只给终点打分:将 $x_0$ 经 VAE 解码成图片,用 JPEG 可压缩性、审美分数、目标检测、视觉语言模型或业务规则计算奖励。慢奖励可以并发执行,但返回时必须和样本一一对齐。 构造优势:对全批次奖励标准化,或用 per-prompt statistics tracker 做条件化标准化。同一条轨迹的优势广播到各去噪时间步。 打乱样本与时间步:实现不仅 shuffle 样本,还可对每个样本打乱时间步顺序,降低相邻去噪步相关性对小批次更新的影响。 重算 log-prob:把保存的 $(x_t,x_{t-1},t,c)$ 喂给当前模型,通过 patched DDIM step 得到新策略 log-prob,而不是重新采样一个 $x_{t-1}$。 PPO 裁剪更新:计算逐步新旧比率,应用 clipped surrogate loss;通常只训练 LoRA,以降低显存、通信和策略漂移。 这个实现细节解释了为什么训练内存明显大于普通推理:rollout 阶段要保存整条 latent 轨迹和旧 log-prob,更新阶段又要为当前时间步建立反向图。若 rollout batch 为 $B$、去噪步数为 $T$,一轮采样至少处理 $B\times T$ 次 UNet/DiT 前向;若每批 rollout 做 $K$ 个 inner epochs,更新成本还会近似再乘 $K$。梯度累积只改变峰值显存,不会凭空消除总计算量。 早期 Hugging Face TRL 版本曾提供 DDPOTrainer,但当前上游目录与公开 API 已发生重构。读旧教程时应锁定对应版本,不要假设 trl/trainer/ddpo_trainer.py 在最新版仍是稳定入口;本文因此把论文作者仓库作为代码锚点。 从 rollout 到 update 的数据契约 工程里最值得先写清的不是 Trainer 类,而是一条样本在两个阶段之间必须携带什么。rollout 结束后,每条样本至少要保存 prompt 或其编码、全部时间步、从初始噪声到终点的 latents、旧策略逐步 log-prob、最终图片、原始奖励和经过标准化的优势。若使用 classifier-free guidance,还必须固定无条件分支、guidance scale 和文本编码方式;否则更新阶段重算出来的均值并不是采样时那条策略的均值。 update 阶段只取保存的当前 latent 和下一 latent,调用当前模型重算同一个已发生动作的 log-prob。这里绝对不能重新抽噪声:PPO 问的是“新策略对旧动作给出多大概率”,不是“新策略这次随机采到了什么”。这个区别在 token PPO 中很直观——不会在更新时重采一句回答——换成连续 latent 后却很容易藏在调度器接口里。 还应给 rollout 批次分配不可变的 sample id,并把 prompt、随机种子、reward 版本、模型 checkpoint 和 scheduler 配置写进元数据。这样一旦某个 batch 的 ratio 或奖励异常,能够重放出同一条轨迹并定位问题。只记录最后的 PNG 不够,因为不同 latent 轨迹可能解码成肉眼相近的图片,而策略梯度依赖的是当时每一步的概率。 多卡训练时,全局优势标准化也必须基于所有进程聚合后的奖励,而不是每张卡各算各的。否则不同卡的 prompt 难度稍有偏差,就会得到不同的零点和尺度;随后再做梯度平均,相当于混合了多套不一致的目标。相反,若采用 per-prompt 统计器,应明确冷启动策略:某个 prompt 样本太少时回退到全局统计,避免标准差接近零导致优势被放大。 DPOK:为什么还要加 KL 纯奖励最大化很容易把模型推离预训练分布。DPOK(Diffusion Policy Optimization with KL regularization)在在线策略梯度中加入参考模型约束,可抽象为: $$J_{\text{DPOK}}(\theta)=\mathbb E[R(x_0,c)]-\beta\,D_{\mathrm{KL}}(p_\theta\|p_{\text{ref}}).$$ $\beta$ 越大,模型越保守;越小,越容易快速追逐奖励,也越容易丢失多样性或出现奖励投机。PPO clipping 约束的是一次更新相对旧策略的变化,reference KL 约束的是长期相对基座模型的漂移,两者作用并不相同。 DRaFT:奖励可微时,可以不走 score function 如果奖励模型对像素可微,且采样器的整条计算图可以保留,就能把梯度从奖励直接穿过 VAE 与采样步骤反传到扩散模型。DRaFT 将这一路线系统化,并提出截断反传等变体来控制内存与梯度不稳定。 两条路线的选择很清楚: DDPO / DPOK:奖励可以是完全黑盒,只需要返回标量;代价是策略梯度方差较高,需要大量 on-policy 样本。 DRaFT 类方法:能利用奖励的路径导数,梯度通常更直接;但奖励必须可微,且跨很多采样步骤保存或重算计算图,显存与稳定性是主要问题。 它们可以共享同一个奖励定义,却不能把“对奖励求导”和“用奖励乘 log-prob”混写成一套推导。 06. 代价与边界 6.1 它省下了什么 不需要奖励函数可微,外部 API、人工评分和离散程序都能接入。 不需要为每个目标重新制作大规模成对偏好数据;在线采样能探索当前策略真正会生成的区域。 能复用 PPO 的裁剪、KL、优势归一化和诊断工具,把更新幅度控制在可观察范围内。 6.2 它付出了什么 on-policy 成本高:策略一更新,旧 rollout 很快过期;数据复用能力弱于离线偏好优化。 终点信用粗糙:所有步骤共享终点优势,方差高;步数越多、latent 越高维,问题越明显。 奖励调用可能成为瓶颈:大型 VLM 或人工评分比去噪本身还慢,异步队列与缓存很重要。 探索与画质有冲突:增大 DDIM 的 $\eta$ 有利于随机策略探索,却可能改变原有采样质量与分布。 奖励投机不会自动消失:OCR 奖励可能鼓励巨大文字,审美分数可能压低多样性,检测器奖励可能诱导模型画出分类器偏爱的纹理。 6.3 上线前至少记录这些指标 不要只看 mean reward。最低限度还应记录: 奖励均值、标准差和分位数,按 prompt 类别拆分; 新旧策略的 approximate KL、ratio 分位数与 clip fraction; 每个时间步的 loss、KL 或梯度范数,检查是否只剩少数步在学习; 多样性指标和基础画质指标,防止奖励提高但模式坍缩; 人工盲评或独立奖励模型的 holdout 分数,防止只攻破训练用 reward; 无效图片、NaN、全黑/过曝和安全过滤命中率。 如果奖励模型本身正在更新,还要给 reward 版本打快照。否则同一条训练曲线纵轴含义会变化,前后 reward 数字不可直接比较。 6.4 奖励怎么配,往往比优化器更重要 真实系统几乎不会只用一个分数。以文字生成图片为例,可以同时有提示词一致性、OCR 正确率、审美、人体结构和安全性五类信号。最直接的做法是加权求和: $$R=w_{\text{prompt}}R_{\text{prompt}}+w_{\text{ocr}}R_{\text{ocr}}+w_{\text{aesthetic}}R_{\text{aesthetic}}-w_{\text{safety}}C_{\text{safety}}.$$ 但“都放进来”不等于问题解决了。不同奖励的量纲与波动范围可能差几个数量级:OCR 是 0 或 1,审美模型可能落在 1 到 10,安全惩罚可能只有极少数样本非零。若不先校准,权重看似相近,实际梯度却会被方差最大的那一项占满。稳妥做法是先在固定基座模型上采一批校准集,观察每项分布,再做裁剪、标准化或分位数映射;训练期间同时画出每个子奖励,不能只保存加权总分。 还要区分“软目标”和“硬约束”。图片里文字少一个字,通常是可连续改进的软目标;生成违法内容则不应靠一个可被其他高分抵消的负权重处理。硬约束更适合在采样前后用过滤器、拒绝策略或拉格朗日约束单独处理。否则模型可能发现:只要审美分足够高,安全惩罚也值得承受。 多目标之间还会发生真实冲突。把 OCR 权重拉高,模型可能把文字做得巨大而破坏构图;只奖励检测器置信度,可能得到边缘锐利但不自然的目标。应当用 Pareto 视角看结果:同一批 checkpoints 同时比较各子目标和人工偏好,选择没有被某一维明显支配的方案,而不是盯着一条总 reward 曲线挑最高点。 6.5 三个能快速定位实现错误的不变量 第一,rollout 保存的状态数必须比转移 log-prob 数多 1;若二者相等,通常漏了初始噪声或终点 latent。第二,当新旧模型参数完全相同时,逐步 ratio 应非常接近 1,approximate KL 应接近 0;否则多半是调度器、CFG 分支、时间步索引或 log-prob 归约维度不一致。第三,打乱 batch 顺序不应改变同一个样本的 reward、prompt、latents 与 log-prob 对齐关系。异步奖励最容易在这里悄悄错位:训练仍会运行,均值甚至会上升,但模型学到的是别人的分数。 调试时先用一个可以解析求解的低维过程,就像本文代码;确认梯度方向、ratio 和 baseline 都符合预期,再接入大模型。直接在多卡图像训练里找符号错误,通常会把昂贵计算浪费在最便宜的 bug 上。 这些不变量也适合写进自动化测试:用固定随机种子的十几条轨迹做快速回归,每次升级 diffusers、调度器或混合精度设置后先跑它,再启动昂贵的正式训练。 07. 经典论文脉络 Training Diffusion Models with Reinforcement Learning / DDPO(arXiv:2305.13301)把扩散去噪正式改写为多步决策过程,给出基于 likelihood ratio 的 DDPO,并展示了不可微奖励下的微调能力。它奠定了“去噪轨迹就是策略轨迹”的主框架。 DPOK: Reinforcement Learning for Fine-tuning Text-to-Image Diffusion Models(arXiv:2305.16381)把在线策略梯度与 KL 正则结合,强调奖励提升和预训练分布保持之间的平衡。 DRaFT: Directly Fine-tuning Diffusion Models on Differentiable Rewards(arXiv:2309.17400)转向可微奖励,通过采样链直接反传,并研究 full、截断和低方差版本,形成与 DDPO 互补的路线。 Reward-Directed Conditional Diffusion(arXiv:2307.07055)从 reward-conditioned / reward-directed 角度研究如何把黑盒目标引入扩散生成,说明“训练一个条件生成器”和“在线策略优化”是相关但不同的解法。 Diffusion Models for Reinforcement Learning: A Survey(arXiv:2311.01223)覆盖的是更宽的交叉方向:既包括用 RL 对齐扩散生成,也包括把扩散模型当作策略或规划器。阅读时要先辨认“RL 优化 diffusion”还是“diffusion 服务 RL”。 论文名称很像时,先看梯度从哪里来:若公式里是 $R\nabla\log p_\theta$,属于 score-function 策略梯度;若是 $\nabla_{x_0}R$ 沿采样链反传,则属于可微奖励路线;若训练数据是静态偏好对,通常又是离线偏好优化问题。 08. 常见误解 误解 1:模型预测的噪声就是 RL 动作 噪声预测是策略的参数化中间量。DDPO 的动作通常记为实际采样出的下一 latent $x_{t-1}$,策略概率才是 $p_\theta(x_{t-1}\mid x_t,c)$。只有这样,保存动作、重算 log-prob 和构造新旧比率才是一致的。 误解 2:奖励在最后,所以只有最后一步能更新 轨迹 log-prob 是逐步 log-prob 的和。终点奖励乘的是整条和,因此每个去噪转移都有 score-function 梯度。最后一步可能贡献较大,但不是唯一有梯度的一步。 误解 3:确定性 DDIM 也能原样计算 DDPO log-prob $\eta=0$ 时 $\sigma_t=0$,普通高斯 log-prob 不再成立。要么使用非零随机性,要么换成适合确定性路径的可微反传或其他估计器,不能简单给分母加一个 epsilon 就宣称理论等价。 误解 4:把所有逐步比率相乘,才是最“严格”的 PPO 轨迹比率在长链上方差巨大。DDPO 实践通常按去噪转移计算和裁剪 ratio;这是一种稳定的 surrogate,而不是把一个 50 步连乘数硬塞进普通 PPO 公式。 误解 5:同一奖励广播到每一步,所以每步学到的一样 优势相同,不等于 score function 相同。噪声方差、预测残差、网络敏感度和调度器权重都随时间步变化,逐步梯度自然不同。 误解 6:奖励不可微就无法优化扩散模型 DDPO 只需要采样结果和标量奖励,不需要奖励梯度。不可微带来的问题是估计方差和样本成本,而不是“没有任何梯度”。 误解 7:训练 reward 上升就代表模型全面变好 模型可能只学会利用 reward 的盲点。必须同时看独立评估、人工盲评、多样性、prompt 遵循和安全指标;最好用不同架构的 holdout reward 检查泛化。 09. 动手验证:四个改动看懂算法 文末代码只依赖 NumPy,建议依次改四个参数,每次固定随机种子并比较输出。 实验 A:把 steps 从 8 改为 16 预期状态 shape 从 (4096, 9) 变成 (4096, 17),log-prob shape 从 (4096, 8) 变成 (4096, 16)。更长轨迹会增加梯度求和项;在不调整学习率与归一化时,训练波动通常更明显。 实验 B:把 noise_std 从 0.45 降到 0.10 探索减弱,采样更集中;但 score function 含 $1/\sigma^2$,数值会更尖锐。过小噪声并不等于更稳定,极限到 0 反而失去这套高斯策略梯度的基础。 实验 C:删掉优势中心化 把 advantage = (reward - reward.mean()) / ... 改成直接使用 reward。gradient_sample_std_raw_centered 的第二个值会失去优势,训练曲线更抖。这个实验直观看到 baseline 改变方差而不改变目标最优点。 实验 D:增大新旧参数差 在 PPO 诊断部分增大 new_theta - old_theta。你会看到 ratio_min/max 更极端,clip_fraction 上升。工程上这对应学习率过大、inner epochs 过多或 KL 约束过弱。 进一步可把终点奖励改成离散黑盒:例如 reward = (abs(x0-target) < 0.25)。代码仍能训练,但由于奖励更稀疏,往往需要更大 batch、分层采样或更好的 baseline。这正是从玩具例子走向 OCR 成功率、目标检测命中和人工反馈时遇到的现实问题。 10. 延伸阅读 这篇位于“对齐与强化学习”路径的第三段: 策略梯度与 PPO 基础:理解 advantage、ratio、clipping 和 KL; 从 DPO 到 GRPO:去掉价值网络:理解组内相对优势; 本文 DiffusionRL:把 token 轨迹换成 latent 去噪轨迹; 视频生成中的强化学习与奖励模型:在去噪信用之外,再处理画质、运动与指令遵循的多目标奖励。 如果 DDIM 还不熟,先记住本文真正依赖的最小事实:它把 $x_t$ 和网络预测组合成下一步均值,并可用 $\eta$ 注入高斯随机性。从 DDIM 到高阶采样器 已展开采样公式、ODE/SDE 视角与高阶求解器。 最后用一句话收束: DiffusionRL 不是把一个 PPO 套在图片外面,而是把每次去噪转移变成可计概率的动作,再让终点奖励沿整条轨迹分配信用。 附录:完整代码 09 节用到的脚本全文如下(ddpo_minimal.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 ddpo_minimal.py """NumPy-only toy DDPO: treat iterative denoising as a stochastic policy. This is an algebra demo, not an image generator. A scalar latent follows a short Gaussian reverse process. One parameter shifts every denoising mean, and a terminal reward teaches the process to end near a target value. """ from dataclasses import dataclass import numpy as np @dataclass(frozen=True) class ToyConfig: steps: int = 8 batch_size: int = 4096 contraction: float = 0.72 action_scale: float = 0.18 noise_std: float = 0.45 target: float = 1.5 def gaussian_log_prob(value, mean, std): """Elementwise log N(value; mean, std^2).""" return -0.5 * ((value - mean) / std) ** 2 - np.log(std * np.sqrt(2.0 * np.pi)) def rollout(theta, cfg, rng): """Sample x_T -> ... -> x_0 and retain every transition. Array index 0 stores x_T; index cfg.steps stores x_0. The transition mean is mu_theta = contraction * x_t + action_scale * theta. """ latents = np.empty((cfg.batch_size, cfg.steps + 1), dtype=np.float64) means = np.empty((cfg.batch_size, cfg.steps), dtype=np.float64) log_probs = np.empty((cfg.batch_size, cfg.steps), dtype=np.float64) latents[:, 0] = rng.normal(size=cfg.batch_size) for j in range(cfg.steps): mean = cfg.contraction * latents[:, j] + cfg.action_scale * theta next_latent = mean + cfg.noise_std * rng.normal(size=cfg.batch_size) latents[:, j + 1] = next_latent means[:, j] = mean log_probs[:, j] = gaussian_log_prob(next_latent, mean, cfg.noise_std) terminal = latents[:, -1] rewards = -(terminal - cfg.target) ** 2 return latents, means, log_probs, rewards def score_function(latents, means, cfg): """d log pi_theta(x_{t-1}|x_t) / d theta for every transition.""" residual = latents[:, 1:] - means return residual * cfg.action_scale / (cfg.noise_std**2) def policy_gradient(rewards, per_step_scores): """REINFORCE with a batch baseline; terminal advantage is broadcast to T steps.""" centered = rewards - rewards.mean() advantages = centered / (rewards.std() + 1e-8) trajectory_scores = per_step_scores.sum(axis=1) gradient = np.mean(advantages * trajectory_scores) per_step_gradient = np.mean(advantages[:, None] * per_step_scores, axis=0) return gradient, per_step_gradient, advantages def evaluate(theta, cfg, seed): rng = np.random.default_rng(seed) latents, means, log_probs, rewards = rollout(theta, cfg, rng) return { "terminal_mean": float(latents[:, -1].mean()), "reward_mean": float(rewards.mean()), "latents": latents, "means": means, "log_probs": log_probs, "rewards": rewards, } def train(cfg, updates=40, learning_rate=0.08, seed=7): theta = 0.0 history = [] rng = np.random.default_rng(seed) for update in range(updates + 1): latents, means, _, rewards = rollout(theta, cfg, rng) scores = score_function(latents, means, cfg) gradient, per_step_gradient, advantages = policy_gradient(rewards, scores) history.append((update, theta, latents[:, -1].mean(), rewards.mean(), gradient)) if update < updates: theta += learning_rate * gradient return theta, np.asarray(history), per_step_gradient, advantages, scores, rewards def ppo_diagnostics(theta_old, theta_new, cfg, seed=123, clip_range=0.2): """Re-evaluate old transitions under a candidate new policy.""" rng = np.random.default_rng(seed) latents, old_means, old_log_probs, rewards = rollout(theta_old, cfg, rng) new_means = cfg.contraction * latents[:, :-1] + cfg.action_scale * theta_new new_log_probs = gaussian_log_prob(latents[:, 1:], new_means, cfg.noise_std) ratios = np.exp(new_log_probs - old_log_probs) clipped = np.abs(ratios - 1.0) > clip_range return rewards, ratios, clipped if __name__ == "__main__": np.set_printoptions(precision=6, suppress=True) cfg = ToyConfig() before = evaluate(theta=0.0, cfg=cfg, seed=2026) theta, history, per_step_gradient, advantages, scores, rewards = train(cfg) after = evaluate(theta=theta, cfg=cfg, seed=2026) raw_gradient_samples = rewards * scores.sum(axis=1) centered_gradient_samples = (rewards - rewards.mean()) * scores.sum(axis=1) ppo_rewards, ratios, clipped = ppo_diagnostics( theta_old=0.0, theta_new=0.5, cfg=cfg ) print("trajectory_shape=", before["latents"].shape) print("transition_log_prob_shape=", before["log_probs"].shape) print("before_terminal_mean=", f"{before['terminal_mean']:.4f}") print("before_reward_mean=", f"{before['reward_mean']:.4f}") print("after_theta=", f"{theta:.4f}") print("after_terminal_mean=", f"{after['terminal_mean']:.4f}") print("after_reward_mean=", f"{after['reward_mean']:.4f}") print("per_step_gradient=", np.round(per_step_gradient, 4)) print( "gradient_sample_std_raw_centered=", f"{raw_gradient_samples.std():.4f}", f"{centered_gradient_samples.std():.4f}", ) print( "ppo_ratio_mean_min_max=", f"{ratios.mean():.4f}", f"{ratios.min():.4f}", f"{ratios.max():.4f}", ) print("ppo_clip_fraction=", f"{clipped.mean():.4f}") print("history_first=", np.round(history[0, 1:4], 4)) print("history_last=", np.round(history[-1, 1:4], 4)) assert before["latents"].shape == (cfg.batch_size, cfg.steps + 1) assert before["log_probs"].shape == (cfg.batch_size, cfg.steps) assert after["reward_mean"] > before["reward_mean"] assert abs(after["terminal_mean"] - cfg.target) < abs(before["terminal_mean"] - cfg.target) assert np.all(np.isfinite(ratios)) make_figures.py """Generate the explanatory figures for the DiffusionRL article. Requires NumPy, Matplotlib and Pillow. The numerical chart reuses the exact toy process from ddpo_minimal.py so the article and figure cannot drift apart. """ from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from PIL import Image, ImageDraw, ImageFont from ddpo_minimal import ToyConfig, train OUT = Path(__file__).resolve().parents[1] / "figures" OUT.mkdir(exist_ok=True) def _font(size, bold=False): candidates = ( "/System/Library/Fonts/PingFang.ttc", "/System/Library/Fonts/Hiragino Sans GB.ttc", "/usr/share/fonts/opentype/noto/NotoSansCJK-Bold.ttc" if bold else "/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc", ) for path in candidates: try: return ImageFont.truetype(path, size) except OSError: pass raise RuntimeError("请安装中文字体后再生成 DiffusionRL 示意图") def trajectory_mdp(): image = Image.new("RGB", (1800, 980), "#f8fafc") draw = ImageDraw.Draw(image) ink, blue, green, orange, muted = "#172033", "#2563eb", "#059669", "#ea580c", "#526078" draw.text((90, 55), "把多步去噪看成一条 MDP 轨迹", font=_font(70, True), fill=ink) draw.text((92, 150), "状态是当前 latent,动作是下一 latent 的采样,终点图像只得到一次奖励", font=_font(38), fill=muted) draw.text((900, 285), "策略 πθ = pθ(next | current, c)", font=_font(32), fill=blue, anchor="mm") xs = [170, 480, 790, 1100, 1410] labels = ["xT", "xT−1", "xT−2", "…", "x₀"] subtitles = ["纯噪声", "较粗结构", "结构成形", "继续去噪", "最终样本"] for i, (x, label, subtitle) in enumerate(zip(xs, labels, subtitles)): color = blue if i < len(xs) - 1 else green draw.rounded_rectangle((x - 105, 360, x + 105, 540), radius=36, fill="#ffffff", outline=color, width=6) draw.text((x, 400), label, font=_font(46, True), fill=color, anchor="mm") draw.text((x, 485), subtitle, font=_font(28), fill=muted, anchor="mm") if i < len(xs) - 1: draw.line((x + 110, 450, xs[i + 1] - 120, 450), fill=ink, width=5) draw.polygon( [(xs[i + 1] - 120, 450), (xs[i + 1] - 148, 433), (xs[i + 1] - 148, 467)], fill=ink, ) draw.line((1515, 450, 1650, 450), fill=orange, width=5) draw.polygon([(1650, 450), (1622, 433), (1622, 467)], fill=orange) draw.rounded_rectangle((1510, 630, 1735, 820), radius=32, fill="#fff7ed", outline=orange, width=5) draw.text((1622, 675), "R(x₀,c)", font=_font(44, True), fill=orange, anchor="mm") draw.text((1622, 750), "终点奖励", font=_font(31), fill=muted, anchor="mm") draw.line((1620, 545, 1620, 625), fill=orange, width=5) draw.polygon([(1620, 625), (1603, 597), (1637, 597)], fill=orange) draw.rounded_rectangle((90, 650, 1380, 850), radius=30, fill="#eef4ff") draw.text((130, 685), "同一个优势 A 被广播到每一步:", font=_font(39, True), fill=ink) draw.text((130, 750), "A · [grad log pθ(xT−1 | xT) + … + grad log pθ(x₀ | x₁)]", font=_font(39), fill=blue) draw.text((130, 805), "奖励只在终点出现,但整条轨迹的 log-prob 都参与更新。", font=_font(31), fill=muted) image.save(OUT / "diffusion_rl_mdp.png", optimize=True) def cover(): image = Image.new("RGB", (1280, 720), "#081225") draw = ImageDraw.Draw(image) # A denoising trajectory that gradually changes from noise-like dots into a # clean latent. Keeping this code-native makes the cover deterministic. rng = np.random.default_rng(7) stages = [190, 400, 610, 820, 1030] palette = ["#60a5fa", "#38bdf8", "#2dd4bf", "#34d399", "#f59e0b"] for i, x in enumerate(stages): radius = 62 draw.ellipse((x - radius, 258 - radius, x + radius, 258 + radius), outline=palette[i], width=5) spread = 47 - i * 7 for _ in range(38 - i * 4): px = x + int(rng.normal(0, spread)) py = 258 + int(rng.normal(0, spread)) dot = 2 + i draw.ellipse((px - dot, py - dot, px + dot, py + dot), fill=palette[i]) if i < len(stages) - 1: draw.line((x + 72, 258, stages[i + 1] - 75, 258), fill="#94a3b8", width=4) draw.polygon( [(stages[i + 1] - 75, 258), (stages[i + 1] - 96, 246), (stages[i + 1] - 96, 270)], fill="#94a3b8", ) draw.rounded_rectangle((1068, 190, 1222, 326), radius=26, fill="#431407", outline="#f59e0b", width=4) draw.text((1145, 258), "+R", font=_font(48, True), fill="#fbbf24", anchor="mm") draw.text((92, 415), "把 RL 用到扩散模型上", font=_font(64, True), fill="#f8fafc") draw.text((96, 507), "DiffusionRL · DDPO · 去噪轨迹 · 信用分配", font=_font(34), fill="#93c5fd") draw.rounded_rectangle((94, 603, 426, 659), radius=25, fill="#1d4ed8") draw.text((260, 631), "AIGC 基本功", font=_font(28, True), fill="#ffffff", anchor="mm") image.save(OUT / "wechat_cover_diffusion_rl.png", optimize=True) def training_and_credit(): cfg = ToyConfig() _, history, per_step_gradient, _, _, _ = train(cfg) updates = history[:, 0] fig, axes = plt.subplots(1, 2, figsize=(11, 4.3)) ax = axes[0] ax.plot(updates, history[:, 3], color="#2563eb", linewidth=2.5, label="mean terminal reward") ax.set_xlabel("policy updates") ax.set_ylabel("reward (higher is better)") ax.grid(alpha=0.2) ax2 = ax.twinx() ax2.plot(updates, history[:, 2], color="#059669", linewidth=2.2, label="mean x0") ax2.axhline(cfg.target, color="#059669", linestyle="--", alpha=0.45, label="target") ax2.set_ylabel("terminal latent mean") lines = ax.get_lines() + ax2.get_lines() ax.legend(lines, [line.get_label() for line in lines], frameon=False, loc="center right") ax.set_title("Toy DDPO learns from terminal reward") ax = axes[1] steps = np.arange(cfg.steps) ax.bar(steps, per_step_gradient, color=plt.cm.Blues(np.linspace(0.45, 0.95, cfg.steps))) ax.set_xticks(steps, [f"{cfg.steps-i}→{cfg.steps-i-1}" for i in steps], rotation=40) ax.set_xlabel("denoising transition") ax.set_ylabel("estimated gradient contribution") ax.grid(axis="y", alpha=0.2) ax.set_title("Same reward, different credit per step") fig.suptitle("Terminal reward becomes a trajectory-level policy gradient", fontsize=15, weight="bold") fig.tight_layout() fig.savefig(OUT / "diffusion_rl_training_credit.png", dpi=190) plt.close(fig) if __name__ == "__main__": trajectory_mdp() training_and_credit() cover() for name in ( "diffusion_rl_mdp.png", "diffusion_rl_training_credit.png", "wechat_cover_diffusion_rl.png", ): print(OUT / name) 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|视频 DiT 里的 3D RoPE 与分辨率外推-3D-RoPE AIGC 基本功|视频 DiT 里的 3D RoPE 与分辨率外推-3D-RoPE 所属方向:注意力与核心零件 | 难度:进阶 | 前置知识:RoPE 的原理与实现 关键词:3D RoPE、时空位置编码、视频 DiT、分辨率外推、逐轴位置插值、帧数外推 01. 为什么需要它 先看一对位置:视频格点 A=(0,0,0),B=(0,1,0)。B 在 A 的正下方一格。将每帧按行展开,再按时间串接,普通 1D RoPE 看到的序列位置是 m=tHW+hW+w。当每帧宽 W=4 时,A 到 B 的序列距离是 4;仅把宽改为 W=8,距离变成 8。两块仍上下相邻,旋转角却按 1D 的位置差变了。时间上的相邻帧也会受 HW 改变影响。固定画幅下,这种展开次序可以用,模型也可能学到空间规律;问题是在画幅或时长改变时,序列距离不再稳定代表同一种时空关系。这里的 1D RoPE 是为了隔离坐标问题而构造的诊断基线,不是在声称所有早期视频模型都按这一公式编码位置。 3D RoPE 给 A、B 保留 (t,h,w),所以无论宽度是多少,两者都只在高轴相差一格。它解决的是展平编号把画幅尺寸混进位置差的问题;画质外推还涉及训练分辨率、物体尺度和注意力成本。后文用 CogVideoX 的实验 分开讨论位置表直接扩展与逐轴插值,不把“坐标可计算”误当成“视频一定生成得好”。 02. 最小可用理解 基础 RoPE 已解释二维旋转与相对位置性质,这里直接看视频新增的两步: 换坐标:展平版给每个 token 一个 m,相对位移是 Δm;三轴版保留 (t,h,w),相对位移是 (Δt,Δh,Δw)。图 1 的上下邻居在画幅变宽后,只有三轴版仍把它识别为“高轴相差一格”。 分特征与频率:一个注意力头的特征分为时间、高、宽三段,每段用自己的坐标和频率表生成位置角。三段随后仍在同一次注意力内积里汇总;“3D”说的是坐标轴数,不是把视频物体在欧氏空间旋转。 图 1:固定 A、B 的时空坐标,只改每帧格点宽度。展平位置差从 4 变 8,三轴位移始终是 (0,1,0);真实模型的内容特征也会随画幅变化。 具体比例由模型选择。CogVideoX 给时间 1/4、高 3/8、宽 3/8;64 维头对应 (16,24,24),不是所有 3D RoPE 的固定标准。按这个分配,高轴的坐标映射可以单独调整,而时间、宽轴保持原样。实际换模型还要核对每轴维度、坐标单位、频率基数、配对次序和文本 token 的处理,不能只照搬比例。 图 2:64 维注意力头的示例。每个轴的维度都成对构成旋转平面;三段共享一个 token,但不会互相混成单一序列编号。图由文末代码生成。 03. 数学推导 3.1 从视频格点到三组旋转 设视频 patch token 为 $z_{t,h,w}$。$t$ 是压缩后的时间格点,$h$ 和 $w$ 是 patch 后的高、宽格点;它们不是原始帧号或像素坐标。以下只讨论注意力打分前,如何给对应的 query/key 构造位置相位。 先写出基础版到底把什么送进旋转。固定一个按行优先展开的视频网格 $(T,H,W)$,位置编号 $m=tHW+hW+w$。任意两格 $p=(t,h,w)$、$r=(t',h',w')$ 的编号差为: $$m_r-m_p=(t'-t)HW+(h'-h)W+(w'-w)$$ 上式说明 1D 并非丢了时空信息:固定 $H,W$ 时,每个格点仍有唯一编号。但同样一个高轴位移会乘上当前的 $W$,同样一个时间位移会乘上当前的 $HW$。换画幅后,“向下 1 格”的位置相位因此变化;这只比较固定内容特征的位置项,不推断整个模型的注意力分数或画质。 令头维度 $d=d_t+d_h+d_w$,每段维度都必须为偶数。把 $q$ 和 $k$ 拆为 $q^{(t)},q^{(h)},q^{(w)}$ 与对应的三段 $k$。对轴 $a\in\{t,h,w\}$ 的第 $i$ 个二维旋转平面,选频率: $$\omega_{a,i}=\Theta^{-2i/d_a},\qquad i=0,1,\ldots,d_a/2-1$$ $\Theta$ 是频率基数,CogVideoX 的源码默认 10000;$d_a$ 是该轴分到的维度,而不是整个头维度。时间与空间段各自从最高频重新开始,不是把一条 1D 频率数组切成三段。沿用先修文章的旋转记号 $R$,用 $R_a(p_a)$ 表示轴 $a$ 上所有旋转平面的组合。完整位置操作是三个互不混合的块拼接: $$\widetilde q_{t,h,w}=\operatorname{diag}(R_t(t),R_h(h),R_w(w))q_{t,h,w}$$ key 用同一个位置规则得到 $\widetilde k$。分轴的是位置相位的构造;注意力仍对所有可见视频 token 计算一次打分。 可以把区别压到一行:1D 的相对角是 Δm × 频率,其中 Δm=Δt·HW+Δh·W+Δw;3D 的三组相对角分别是 Δt × 时间频率、Δh × 高频率、Δw × 宽频率。三组贡献在同一次内积里相加。这里的 Δ 都是 token 格点差,不是秒数或像素差。 3.2 三个位移怎样汇入一次打分 先把先修结论接到三轴上。一个平面的旋转矩阵满足正交性与角度相加: $$R(\alpha)^\top R(\beta)=R(-\alpha)R(\beta)=R(\beta-\alpha).$$ 因此,第 $i$ 个平面的两维内容向量在内积中的贡献为: $$q_i^\top R(\delta_i)k_i=(q_{i,1}k_{i,1}+q_{i,2}k_{i,2})\cos\delta_i+(q_{i,2}k_{i,1}-q_{i,1}k_{i,2})\sin\delta_i.$$ 这里 $q_i,k_i\in\mathbb{R}^2$,$\delta_i=(r_a-p_a)\omega_{a,i}$;先在每个轴内求和,再把三轴相加,就得到下面的式子。它依赖内容方向,不能只根据坐标距离预测分数大小。 基础 RoPE 已推过两个旋转角相减的恒等式。这里新增的是:每个轴只用自己的坐标差,整头把三段贡献相加: $$s(p,r)=\sum_{a\in\{t,h,w\}}\langle q^{(a)},R_a(r_a-p_a)k^{(a)}\rangle$$ $p=(t,h,w)$ 和 $r=(t',h',w')$ 是两个格点。只有高差为 1 时,时间段与宽段的位置差都是零,高段单独改变打分;换宽度不会把这一高差改写成另一个数。公式描述固定 $q,k$ 时的位置作用,文末代码用上下邻居和下一帧两种位移分别检查它。此处 $s$ 是未缩放内积。普通单头注意力还要除以 $\sqrt d$、加入可见性掩码 $M$,然后逐行归一化: $$A_{p,r}=\operatorname{softmax}_{r}\left(\frac{s(p,r)}{\sqrt d}+M_{p,r}\right).$$ $M$ 对允许位置取零,对禁止位置取负无穷;它决定某个视频、帧或文本是否可见。不能把内积不变直接推成整个模型不变:其他 key 的数量、掩码或内容变了,softmax 的分母也会变。 再看一个跨帧例子:某个物体的投影从 (0,5,5) 到 (1,5,6),位置差是 (1,0,1);时间段和宽段的相位会变,高段不会。但静止物体遇到相机运动也可能产生完全相同的屏幕投影轨迹。对这两个例子,3D RoPE 的位置部分完全一样;它没有标记“这是同一物体”,也没有记录相机姿态或两个时间格点之间的秒数。模型仍可从图像内容、条件和后续层学习运动关系,不能把三轴相位本身当作光流或物理速度。 式子还有一个可检查的边界:三段打分相加,位置操作本身没有 Δt×Δw 这样的跨轴乘积项。这不妨碍注意力通过 $q,k$ 的内容组合时空线索;它只说明“分别编码三个轴”并不等于“直接编码一条物体轨迹”。 3.3 直接外推与逐轴插值到底改了什么 假设训练高轴有 $H_0$ 个格点,推理变成 $H_1$ 个格点,零起点时两者的最大坐标分别是 $L_0=H_0-1$、$L_1=H_1-1$。直接外推使用新坐标 $h'=h$,相邻高 token 仍相差 1,角差仍为 $\omega_{h,i}$,但远端坐标超过旧范围。若要让两个端点严格对齐,逐轴位置插值应使用 $h'=h/s_h$、$s_h=L_1/L_0=(H_1-1)/(H_0-1)$;相邻角差变为 $\omega_{h,i}/s_h$,最远坐标正好被压回 $H_0-1$。例如从 4 格扩到 8 格,严格端点尺度是 $7/3$,新末端 7 映到 3;用形状比 2 则映到 3.5。两者都是可选坐标约定,不能混写成同一映射。上述端点推导要求 $H_0,H_1>1$:训练只有一个格点时,没有非零跨度可供线性缩放;若强制所有新格点回到零点,就会完全丢掉该轴的位置区分。目标只有一个格点时直接选坐标零,不使用分母为零的尺度。宽与时间可以分别选择 $s_w,s_t$: $$\phi_{a,i}(p_a)=\frac{p_a}{s_a}\omega_{a,i},\qquad s_t,s_h,s_w>0$$ 若采用一般坐标映射 $g_a$,第 3.2 节对应的相位差应写成 $[g_a(r_a)-g_a(p_a)]\omega_{a,i}$。只有固定线性或仿射映射时,它才只由原坐标差决定;非线性映射不能直接沿用原始格点的平移不变性。 这条式子说明“分辨率外推”不是只能一起拉伸三个轴。若只想演示高轴坐标压缩两倍,可以选 $(s_t,s_h,s_w)=(1,2,1)$;若要复现某条真实管线,则应按它的端点、crop 坐标和取样约定计算,不能只看形状比。保持局部细节对应相邻格点的相位差尽量不变;覆盖新范围对应最远端相位别离开已训练的分布。对同一线性坐标映射,端点严格对齐与保留原相邻角差在扩张时不能同时满足。这里比较的是坐标和相位范围;即使范围落回旧区间,也不代表相位组合、内容和整条注意力分布与训练时相同。图 3 用 scale=2 隔离这个机制:高度插值后高频振荡慢了一半,低频在这 32 个格点上原本就几乎不动;它不是某个 CogVideoX 推理配置的逐参数复刻。读图时也不要把 cos 的偶然重合当成“两个远处位置相同”。 图 3:高维度 24、基数 10000 的示例。左边用原坐标,右边只把高坐标除以 2;时间与宽并未压缩。图中画的是 cos 相位而非生成质量。 3.4 维度预算不是按视频长宽直接分蛋糕 为什么 CogVideoX 把时间分到 1/4、两个空间轴各分到 3/8,而不是三等分?论文给出了这个比例与三轴独立 RoPE 的实现,却没有证明它对所有数据和画幅最优。可以从编码需求理解:空间中每一帧都包含大量局部邻接与大范围结构,两个空间轴合计拿到较多旋转平面;压缩后的时间格点通常少于空间格点,但仍需能分辨前后帧。这个解释是设计动机的推断,不能代替原论文消融,更不能据此宣布时间维度永远够用。 64 维示例中,时间 16 维对应 8 个旋转平面,高与宽的 24 维各对应 12 个。最高频平面的角增量都是 1 弧度,因为 $i=0$ 时 $\omega=1$,所以“空间分得多”并不是说高、宽的每一步比时间转得快。区别落在可用的频率层级数量和最慢频率:时间最后一组在坐标 15 的角约 0.004743,高度最后一组约 0.003232。两组数字都很小,它们在短网格上几乎不提供相邻区分,却可能给更长距离提供不同的相位尺度。把更多维度分给某轴,得到的是更丰富的频谱,不是对该轴长度的直接承诺。 还要区分物理帧数与时间 RoPE 格点。假设 VAE 把若干帧压缩到一个 latent 时间格点,视频从 49 帧变成 97 帧,RoPE 的时间长度未必简单从 49 变到 97;VAE 的首帧保留或补帧规则甚至会让两个公式对不上。头维度预算必须在真正进入注意力的 token 网格上讨论。读实现时先打印 patchify 输出和 (T,H,W),再看时间频率有没有被拉伸。 帧率变化不等于时长外推。 同样是把原始帧数翻倍,可能是同一段动作以两倍帧率采样,也可能是原帧率下播放两倍时间。若 VAE 与 patchify 最终都把它们变成两倍的时间格点,整数时间 RoPE 看到的范围一样,却不能仅凭位置角判断“相邻格点代表多少秒”。前者主要考察更密的动作采样,后者还考察更长的主体与场景记忆;测试时间缩放前应固定并记录帧率、实际秒数、latent 时间压缩和条件时间戳。这是视频轴特有的语义问题,空间高宽轴没有对应的播放时钟。 3.5 NTK 变基数为什么不是“插值”的同义词 另一类策略不缩坐标,而是逐轴更改频率基数 $\Theta_a$。若 $\Theta_a$ 变大,$i=0$ 的最高频 $\omega_{a,0}=1$ 完全不变,较低频平面转得更慢;于是近邻分辨率较容易保留,远距离相位覆盖可以加宽。它与 $p_a/s_a$ 把所有频率一起压低不同。NTK-aware、YaRN 等方法在语言长上下文中发展,迁移到视频时还要决定给哪个轴、哪些频段用、是否微调和怎样处理训练画幅。仅把 rope_theta 调大,不能替代逐轴分辨率训练或保证画质。 “频率变慢”也不等于“完全不损局部”。注意力打分汇总多个平面,改低频仍会改变其对近处和远处匹配的贡献。任何外推方法都必须用目标模型、目标画幅与目标时长做消融。 04. 代码实现 code/rope_3d_minimal.py 只依赖 NumPy。核心代码先给时间、高、宽各生成角度表,再广播到 (T,H,W),沿最后一维拼接成每个 token 的角度;rotate 把相邻两维作为一个二维平面旋转。它保留 float64 以让代数测试更容易观察,不模拟工业模型的 BF16 或 CUDA 性能。 dt, dh, dw = axis_dims(head_dim) at = axis_angles(np.arange(frames), dt, scale=scales[0])[:, None, None, :] ah = axis_angles(np.arange(height), dh, scale=scales[1])[None, :, None, :] aw = axis_angles(np.arange(width), dw, scale=scales[2])[None, None, :, :] angles = np.concatenate( [np.broadcast_to(a, (frames, height, width, d // 2)) for a, d in zip((at, ah, aw), (dt, dh, dw))], axis=-1 ).reshape(frames * height * width, head_dim // 2) cos = np.repeat(np.cos(angles), 2, axis=-1) sin = np.repeat(np.sin(angles), 2, axis=-1) 这里 angles 的最后一维只有 d/2 个旋转平面;repeat(...,2) 才让 cos/sin 与 d 维特征逐元素相乘。把代码复制到本地运行 python3 rope_3d_minimal.py,本次真实输出如下: axis_dims= (16, 24, 24) cache_shape= (24, 64) input_shape= (24, 64) rotated_shape= (24, 64) norm_error= 1.78e-15 same_offset_scores= 2.208374 2.208374 difference= 2.66e-15 vertical_neighbor_1d_offsets= 4 8 vertical_neighbor_1d_scores= 1.678217 3.749697 vertical_neighbor_3d_offsets= (0, 1, 0) (0, 1, 0) vertical_neighbor_3d_scores= 0.419453 0.419453 height_phase_at_15_first_last= [15. 0.003232] height_PI_x2_first_last= [7.5 0.001616] time_phase_at_15_first_last= [15. 0.004743] token_count_13x30x45= 17550 token_count_13x60x90= 70200 dense_attention_ratio= 16.0 naive_score_matrix_fp16_gib_per_head= 0.574 9.179 四条 vertical_neighbor_* 输出固定同一组随机 $q,k$ 与同一对上下相邻 token,只切换展平时的 W=4/8。1D 的 Δm 从 4 变 8,内积分数从 1.678217 变 3.749697;3D 的逐轴距离始终 (0,1,0),位置项分数都为 0.419453。1D 与 3D 的绝对分数本身不该互比:两套频率配置不同;这个小实验只比较各自规则在宽度变化前后是否稳定。模型实际改宽后 $q,k$ 也会变,所以它不是画质或整层注意力不变的证据。 cache_shape=(24,64) 来自 2×3×4=24 个视频格点。旋转前后范数误差接近浮点舍入,因为旋转矩阵保长度。高坐标 15 的最高频角为 15 弧度,插值后变成 7.5;高轴最慢一组角从 0.003232 变 0.001616。时间角仍是 15 和 0.004743,证明只改高轴没有动时间表。高轴和时间轴的最低频角数值不同,因为两轴拿到的维度数分别是 24 与 16,指数分母不同。 再看代码里一个表面上很普通的选择:scales 被明确写成 (time,height,width) 三元组,而不是一个全局的 scale=2。这个接口让实验可以只改一个轴,也强迫调用者记录每轴真实扩张比例。假如训练网格是 T0×H0×W0、目标网格是 T1×H1×W1,对格点数大于 1 的轴,端点对齐的起点应分别按 (T1-1)/(T0-1)、(H1-1)/(H0-1)、(W1-1)/(W0-1) 计算;训练只有一个格点、目标却有多个格点时,必须另选扩展规则,不能用一个有限缩放因子把非零跨度变成零;目标只有一个格点则可直接选零坐标。但这些比例仍不能机械照搬:训练数据往往包含多个时长和长宽比,没有单一的 T0,H0,W0。若宽度原本就见过目标值,宽轴可以维持原坐标;若时间增长跨越训练分布,更慢的低频策略可能更值得先测试。参数名称应表达“坐标映射”,而不是含糊写成“画质增强”。 norm_error、same_offset_scores 和宽度变化前后的 3D 分数在脚本里都有断言;原示例的两次三轴分数调用使用同一组坐标,适合展示接口,却不足以检查真实网格的索引。新增 rope3d_checks.py 会分别构建宽 4/8 的两张完整表,按各自的展平下标取出 A、B 再旋转,两个分数均为 -2.593254501463;若配对、广播或相对位置性质被改坏,脚本会直接失败,而不是只打印一串看似正常的数字。断言检查的是代数不变量,仍不能判断位置映射对视频是否有用,真实效果还要在固定权重的 DiT 上测。 请注意:示例里的 13×30×45 是格点形状。不能仅凭像素分辨率就猜它。真实模型要逐层根据 VAE 的时空压缩、首帧特殊处理、patch size 和 padding 算出 (T,H,W);错一个维度,位置表和 token 顺序都会错位。 05. 工业级实现对照 以本次固定提交 7a1af7154511(2026-10-23 核对)的 CogVideo SAT 源码 Rotary3DPositionEmbeddingMixin 为例,类中 dim_t = hidden_size_head // 4、dim_h = dim_w = hidden_size_head // 8 * 3,每轴各自建立频率与格点,再广播、拼接、取 sin/cos。它在注意力函数中只旋转视频 query/key,先切出 text_length 个文本 token 原样放回;可选 rot_v 才旋转 value,默认并非必要。rope_T/H/W 从预计算的三维表里截取当前视频尺寸,排平为 (T*H*W,D)。这与最小代码的数组顺序一致,也便于逐轴检查实际相位。本文采用能被 16 整除的头维度,保证这套整数分配的三段都是偶数;其他分配规则应独立校验。 一个容易踩的坑是:这个 SAT 类的构造函数虽然接收 height_interpolation、width_interpolation 和 time_interpolation 参数,在这个固定提交中,角度表仍直接由 torch.arange 计算,这些参数没有参与坐标缩放。因此不能因为配置里写了 height_interpolation=1.875,就声称该 SAT 旋转实现真的进行了高度插值。文章讨论的“逐轴插值”是可选的设计实验,不是这一段 CogVideo SAT 代码的实际行为。作者原论文采用扩表取前段,恰好与这里的原坐标逻辑相符。 Diffusers 的 get_3d_rotary_pos_embed 也有时间 1/4、空间各 3/8 的分配,但它提供 grid_type="linspace" 和 "slice" 两种格点构造。linspace 可把某个目标空间范围映射到当前高宽格点;slice 在最大表上用原索引再取当前尺寸。二者的差别首先是坐标选取,不是旋转公式变化。该函数在本次核对中返回 (cos,sin),供注意力处理器作用在 query/key 上。具体使用哪个 grid_type、裁剪坐标是什么,应沿管线调用栈核对,不能只看函数定义就给整个模型下结论。 把格点约定落到具体数值。 以下均指 Diffusers v0.35.1。linspace 分支对高轴实际执行: $$g_h=\operatorname{linspace}\left(c_0,c_1\frac{H-1}{H},H\right).$$ $c_0,c_1$ 是 crop 的高轴起止值,$H$ 是目标高格点数。零起点时它等于排除右端点的等距取样:H=4, crop=(0,4) 得到 0,1,2,3。但起点非零时,该版源码不是一般形式的半开区间取样:H=4, crop=(2,6) 实跑得到 2,2.833333,3.666667,4.5,而常见半开区间规则给 2,3,4,5。这不是第 3.3 节严格端点插值的公式;复现这个版本就按其实际行为核对,不能根据参数名自动换成另一个实现。slice 分支按 max_size 建表再截取,目标高宽超过最大表会在组合张量时形状失败,不能无限取新尺寸。 沿固定管线源码继续追:patch_size_t=None 的 1.0 分支计算 crop 并用 linspace;1.5 分支设置 grid_type="slice",时间 RoPE 格点数取 latent 帧数除以时间 patch size 后向上取整。这里传入辅助函数的 num_frames 已是 latents.size(1),不是用户请求的原始帧数。管线先按 (F-1)//r_t+1 得到 latent 帧数,$F$ 为原始帧数、$r_t$ 为 VAE 时间压缩率;需要时补到时间 patch 的整数倍。比如 $F=49,r_t=4,p_t=2$ 时,13 个 latent 时间格点先补到 14,再形成 7 个时间 patch;只把 49 直接填给 RoPE 会错。我们还实跑原始 CogVideoXPatchEmbed 的卷积与时间 patch 两条路径,逐格验证 token 排列,避免只看表的 shape。 SAT 与 Diffusers 的旋转算术也不同:SAT 把 FP32 cos/sin 表转成输入 dtype 再运算;Diffusers 的 apply_rotary_emb 将特征提升到 FP32 旋转,最后转回输入 dtype。本文 float64 范数恒等式不能保证 BF16 路径逐位保范数;大坐标应先在足够精度下生成角表,再转换。若在长视频缓存方案里改变基数、尺度或 crop,已旋转 key 必须与新 query 使用同一映射;不能保留旧 key 相位只切换新表。这个要求针对缓存扩展设计,不是在说此 CogVideoX 双向去噪管线默认采用自回归 KV cache。 写工业调用栈时建议按四个具体问题逐层追:输入是像素帧还是 VAE latent;patchify 后一条样本的 (T,H,W) 分别是多少;三轴坐标从零开始、按最大表切片还是重新映射到训练范围;cos/sin 最后究竟旋转的是视频 query/key、文本 token 是否另有位置处理。单独找到 get_3d_rotary_pos_embed 的名字,只能证明功能存在,不能证明这一模型版本已经启用它。CogVideoX 系列可能根据配置选择旋转位置或学习位置,不同 checkpoint 更不能一概而论。 维度排列也值得实际打印。本文的 rotate 假设相邻两维组成 (实部, 虚部),因此角表用 repeat_interleave(2) 形式复写到两维。若上游先把所有实部放前半、虚部放后半,旋转公式仍可成立,但 rotate_half 与 cos/sin 的广播顺序必须一起换。仅把缓存从另一仓库复制过来,形状同为 [N,D] 也可能在不报错的情况下给完全不同的旋转平面。检查一个位置 1、一个二维平面 (1,0) 的旋转结果应近似 (cos 1,sin 1),比只核对 shape 更可靠。 生产实现还会处理变长视频、文本与视频拼接、packing、缓存、设备和精度。最小脚本只面向一个规则视频网格。把多个视频 packing 到一条序列时,先保存每段的网格、token 排列与可见性边界。重置坐标不能代替隔离掩码:不同视频即使都从零计数,没有掩码仍会互相读取 value;若共用文本条件,还要明确各视频与文本的可见关系。 “第二段时间必须重置”也不是无条件定理。对固定线性映射、仅有视频内部注意力且掩码完全隔离的片段,把该段所有 query/key 的时间共同加常数,常数会在相对位移中抵消;所以不重置也可能给出相同结果。可是有未旋转文本、绝对条件、非线性坐标映射或跨段连接时,不能沿用这个结论。坐标约定要匹配模型训练和实际注意力图。cos/sin 表可以复用,但格点顺序和真实 token 排列必须逐项对齐。形状、坐标与掩码是可先排除的实现问题;本文没有统计它们在实际生成失败中的占比。 06. 代价与边界 纯 3D RoPE 本身不引入新的可训练位置参数,换形状时也可以按轴计算新表;具体模型仍可能另外叠加可学习的位置向量。这个性质让多分辨率训练与不同长度输入更自然,但没有把注意力从二次复杂度变成线性。高、宽各两倍时,视频 token 四倍、稠密注意力项十六倍:示例从 13×30×45=17,550 个 token 增至 13×60×90=70,200 个 token,若天真地为单个头物化一张 FP16 分数矩阵,理论容量会从约 0.574 GiB 涨到 9.179 GiB,尚未计梯度、softmax 和其他头。FlashAttention 不必把整张矩阵常驻显存,所以这不是实际峰值预测;它仍准确反映稠密注意力的二次计算量。把空间 RoPE 频率调得再聪明也不会消除这笔账,仍需 VAE 压缩、稀疏或局部注意力、分块计算等手段。 外推的另一重代价是位置区分与训练分布之间的冲突。直接延长表,邻近 token 的相位关系不变,却把远端坐标送到没见过的位置;全部插值,把远端压回旧尺度,却弱化每一步的相位变化。轴越短、分到的旋转平面越少,可用的频率跨度通常越窄。CogVideoX 的时间 16 维并不意味着“时间必然先坏”或“空间必然先坏”:结果还取决于训练长度、VAE 时间压缩、运动跨度与内容建模。 分辨率外推尤其要保住物理尺度解释。同一人物在原图占 10 个 latent 格点,放大画幅后占 20 个,坐标间隔与模型学过的视觉尺度同时变了;只插值位置并不能把纹理、构图与物体大小的分布一起搬过去。长视频类似:更多帧要求模型记住人物、场景和动作因果,位置相位不是记忆网络。若输出失败,先分辨是表索引越界、token 排列错位、局部重复、全局模糊还是跨帧身份漂移,再决定该调位置、数据、注意力或去噪。 相同 token 数也不意味着相同空间外推。 假设训练格点为 (T,H,W)=(8,32,32):目标 (8,64,32) 与 (8,32,64) 都把视频 token 翻倍,但前者只扩高轴,后者只扩宽轴。在 3D RoPE 中,它们分别改变高段或宽段的最远相位;在展平 1D RoPE 中,改宽还会重新标定所有行间与帧间的序列距离。实验可以保持 token 数、权重、prompt 和种子一致,只互换扩张轴,再分别检查竖向重复、横向重复与主体比例。若两个结果不同,先核对训练画幅分布和 VAE/patchify,才讨论是否来自轴频率。 排查失败时可以先做一个不动权重的三步实验。第一步固定 VAE latent 与 patch token,只换位置表构造,在同一坐标对上比较 q·k;在坐标映射相同、只换等价的建表方式时,若同一坐标对的分数变化,检查表索引、轴顺序或维度配对;有意改变缩放则本来就会改变相位。第二步固定画幅和视频内容,单独改变时间格点长度,看主体漂移是否只在跨越训练时长后出现。第三步固定时间格点,单独变高、宽并分别观察全局构图和局部纹理;若高宽都扩大导致局部重复,不能直接断言是 rope_theta 错,还要看是否出现 token 数暴涨引发的注意力截断、分块边界或 VAE tiling 伪影。把这些变量一次全改掉,会失去定位能力。 若比较位置插值与直接外推,评分也至少拆成两类:近邻细节,例如边缘、纹理与细小物体是否保持;远距结构,例如人物是否只有一个、左右场景是否连贯、同一主体跨帧是否一致。CogVideoX 附录里“一张模糊的大画面”与“多个清楚的小画面”的差异正说明:一个单一的美学分数可能掩盖局部与全局朝相反方向变化。画质指标之外还要记录 token 长度、时空网格与推理显存,否则方法之间可能使用了不同计算预算。 三轴旋转没有自动提供首帧语义、秒数或段身份,但也不能因此断言模型无法感知绝对相位。相对位移的抵消仅适用于两端都按同一规则旋转的 query/key。CogVideoX 的联合注意力把文本保留原样;视频 query 对未旋转文本 key 的内积是: $$s_{\mathrm{v,txt}}(p)=\langle R(p)q,k_{\mathrm{txt}}\rangle.$$ 这里没有第二个视频位置角可相减,因此平移视频坐标一般会改变交叉模态打分。最简单的反例是只启用时间最高频平面、两端内容都是 (1,0):视频时间为 0/1/2 时,分数分别是 1/0.540302/-0.416147。所以“纯视频相对不变”不等于“整个文本—视频模型没有绝对锚点”。首帧内容、可见性边界和额外条件还会进一步打破对称性。不同视频重启同坐标也不等于相同内容;是否添加段 ID 要由训练、掩码和跨段交互需求决定。 更远一步,镜头绕场景移动后再次拍到同一处墙面,这处墙面的世界位置没变,屏幕上的 (h,w) 却可能不同;反过来,相同 (h,w) 也可能指向另一块墙面。视频 3D RoPE 的“3D”是时间加二维屏幕格点,不是场景的三维坐标。面向相机可控的视频 DiT,SCoPE 将相机视线作为另一种位置线索加入注意力,并保留原有 RoPE;这是研究者针对屏幕坐标局限提出的扩展,不是普通 3D RoPE 自动拥有的几何能力。 07. 经典论文脉络 RoFormer、Position Interpolation 与 YaRN 的旋转及语言长上下文扩展已在先修文章讲过;对视频的问题是哪一轴、哪一频段需要缩放,语言模型结果不能直接当画质证据。 CogVideoX 将三维相对位置用于视频 DiT,并用多分辨率 Frame Pack 与渐进训练支持不同尺寸;论文附录展示的初始生成状态对比揭示了“局部清晰”与“全局成形”的矛盾。它是该模型上的定性证据,不是所有视频 RoPE 的通用胜负结论。 Diffusers 的 CogVideoX 实现 提供可核对的三轴维度分配、格点生成和注意力接口;论文、SAT 与 Diffusers 版本未必走同一坐标路径。 SCoPE 在视频 DiT 中保留时空格点 RoPE,另加相机视线线索以改善相机轨迹下的场景一致性;它讨论的是屏幕位置之外的几何信息,并非改写基础 RoPE 的旋转恒等式。 08. 常见误解 误解一:3D RoPE 就是把三个坐标加起来再做 1D RoPE。 若先算 $t+h+w$,(1,0,0) 与 (0,1,0) 就变成同一个位置值,时间变化和上下位移无法区分。正确做法是三段特征独立旋转,最后只在注意力内积里汇总贡献。 误解二:相对位置恒等式成立就证明任意分辨率都能生成。 恒等式对没见过的坐标同样成立;模型从未学过如何在新相位、更多 token 和新物体尺度上使用它。数学可计算性只保证不会因公式本身报错。 误解三:把所有坐标除以两倍没有副作用。 位置插值让新端点回到旧范围,却也让邻近格点的相位差减半,可能伤害局部细节。若目标只换高度,就不要无故压缩时间和宽度。 误解四:调大 rope_theta 等于 Position Interpolation。 更改基数主要影响较低频平面,最高频不动;位置除以缩放因子让所有频率一起慢下来。两者可能组合,作用机制不同。 误解五:CogVideoX 配置里有 height_interpolation 参数,就一定在使用插值。 本次读到的 SAT Rotary3DPositionEmbeddingMixin 接受该参数,却没有用它来计算 grid_h。要按真实执行路径确认;不同实现不能只凭参数名互相代替。 误解六:空间轴拿了 75% 维度,所以换分辨率导致的所有错误都来自空间 RoPE。 维度比例只是一种频率预算,无法排除注意力规模、训练分辨率、VAE 压缩和内容尺度的影响。看输出症状、做逐项消融,才有因果结论。 09. 动手验证 先运行 python3 rope_3d_minimal.py,看 vertical_neighbor_* 四行。把 lower=(0,1,0) 改成 (1,0,0),即从“下一行”改为“下一帧”:3D 位移由 (0,1,0) 改成 (1,0,0),1D 位移则由 W 改成 H×W。再单独改网格宽度,检查三轴版的下一帧相位是否仍只由时间坐标决定。 调用 rope_3d_cache(2,6,4,64,scales=(1,2,1)) 与 scales=(2,1,1),分别只压缩高、时间坐标;检查同一高坐标的高段相位和同一时间坐标的时间段相位。最后把网格 2×3×4 改成 2×6×4:缓存行数应从 24 变 48,列数仍为 64,只有高坐标的取值范围增加。 再运行 python rope3d_checks.py。独立块矩阵覆盖 27 组头维度、格点与缩放组合,网格旋转最大差为零;相对内积误差约 $2.66\times10^{-15}$,128 个 query/key 分量的中心差分梯度最大差约 $1.93\times10^{-10}$。它还给出三个反例:没有隔离掩码时,value 为 1/100 的两段都会读出 50.5;只平移隔离的视频片段时,内部打分仍相同,但对未旋转文本的分数改变;新 query 用时间尺度 2、旧 key 仍用尺度 1 时,分数 -5.383380 与统一映射的 -2.268360 不同。它们证明边界和实现关系,不是生成质量实验。 原始脚本新增有限值、正整数格点、成对维度和形状校验,8 组非法输入明确抛出 ValueError;这些输入约束不会随 python -O 消失。代数测试断言仍用于正常模式运行,不能把它们当生产输入验证。完整代码均见附录。 如果要评估生成模型的真实外推质量,不能只跑这段 NumPy 脚本。固定模型权重、prompt、种子与去噪设置,比较原训练画幅、直接扩表、逐轴插值和不同频段缩放;同时记录局部纹理、重复图案、全局构图、跨帧主体一致性与实际显存/延迟。只有这样才能分清“位置编码问题”与“高分辨率本来就需要新训练”的差异。 10. 延伸阅读 继续向下可以看稀疏注意力、视频 VAE及线性递推记忆。分别理解可见关系、压缩格点和状态容量后,再判断位置缩放能解决哪部分失败。 本篇用到的具体外部依据以 CogVideoX 论文、CogVideo SAT 源码 与 Diffusers 位置编码源码 为准;它们分别支持论文中的训练取舍与两种工程实现,文中的 NumPy 输出仅证明所写公式和示例代码一致。 附录:完整代码 09 节用到的脚本全文如下(rope_3d_minimal.py、rope3d_checks.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 rope_3d_minimal.py """NumPy-only 3D RoPE and per-axis position extrapolation demo.""" import numpy as np def axis_dims(head_dim): """CogVideoX's time/height/width split for a head divisible by sixteen (all three axis sizes must be even).""" if not isinstance(head_dim, (int, np.integer)) or isinstance(head_dim, bool) or head_dim <= 0 or head_dim % 16: raise ValueError("head_dim must be a positive integer divisible by 16") dims = (head_dim // 4, head_dim * 3 // 8, head_dim * 3 // 8) assert all(d % 2 == 0 for d in dims) return dims def axis_angles(positions, dim, base=10000.0, scale=1.0): """Angles [positions, dim/2]; scale>1 compresses this axis only.""" if not isinstance(dim, (int, np.integer)) or dim <= 0 or dim % 2: raise ValueError("dim must be a positive even integer") if not np.isfinite(base) or base <= 1 or not np.isfinite(scale) or scale <= 0: raise ValueError("base must exceed 1 and scale must be finite and positive") positions = np.asarray(positions, dtype=np.float64) if positions.ndim != 1 or not np.all(np.isfinite(positions)): raise ValueError("positions must be a finite one-dimensional array") inv_freq = base ** (-np.arange(0, dim, 2, dtype=np.float64) / dim) return np.asarray(positions, dtype=np.float64)[:, None] * inv_freq[None, :] / scale def rope_3d_cache(frames, height, width, head_dim=64, scales=(1, 1, 1)): """Return interleaved cos/sin, one row per (t,h,w) token.""" if any(not isinstance(n, (int, np.integer)) or isinstance(n, bool) or n <= 0 for n in (frames, height, width)): raise ValueError("grid sizes must be positive integers") if len(scales) != 3 or not all(np.isfinite(v) and v > 0 for v in scales): raise ValueError("three finite positive scales are required") dt, dh, dw = axis_dims(head_dim) at = axis_angles(np.arange(frames), dt, scale=scales[0])[:, None, None, :] ah = axis_angles(np.arange(height), dh, scale=scales[1])[None, :, None, :] aw = axis_angles(np.arange(width), dw, scale=scales[2])[None, None, :, :] shape = (frames, height, width) angles = np.concatenate( [np.broadcast_to(a, shape + (d // 2,)) for a, d in zip((at, ah, aw), (dt, dh, dw))], axis=-1, ).reshape(frames * height * width, head_dim // 2) return np.repeat(np.cos(angles), 2, axis=-1), np.repeat(np.sin(angles), 2, axis=-1) def rotate(x, cos, sin): """Rotate adjacent dimension pairs; x and cache both [tokens, head_dim].""" if x.ndim != 2 or x.shape[1] % 2 or x.shape != cos.shape or x.shape != sin.shape: raise ValueError("x/cos/sin must have identical [tokens, even_head_dim] shapes") paired = x.reshape(x.shape[0], -1, 2) quarter_turn = np.stack((-paired[..., 1], paired[..., 0]), axis=-1).reshape(x.shape) return x * cos + quarter_turn * sin def score_for_positions(q, k, pos_q, pos_k, scales=(1, 1, 1)): """A single dot product without building an attention matrix.""" if q.ndim != 1 or k.shape != q.shape or len(pos_q) != 3 or len(pos_k) != 3 or len(scales) != 3: raise ValueError("matching vectors and three coordinates/scales are required") dims = axis_dims(q.size) out_q, out_k = [], [] start = 0 for axis, dim in enumerate(dims): aq = axis_angles([pos_q[axis]], dim, scale=scales[axis]) ak = axis_angles([pos_k[axis]], dim, scale=scales[axis]) cq, sq = np.repeat(np.cos(aq), 2, axis=-1), np.repeat(np.sin(aq), 2, axis=-1) ck, sk = np.repeat(np.cos(ak), 2, axis=-1), np.repeat(np.sin(ak), 2, axis=-1) out_q.append(rotate(q[start:start + dim][None], cq, sq)[0]) out_k.append(rotate(k[start:start + dim][None], ck, sk)[0]) start += dim return np.dot(np.concatenate(out_q), np.concatenate(out_k)) def flatten_index(pos, height, width): """The row-major 1D index of a video token at (time, height, width).""" t, h, w = pos return t * height * width + h * width + w def score_for_flattened_positions(q, k, pos_q, pos_k, height, width): """Baseline: one 1D RoPE angle table for all head channels.""" mq = flatten_index(pos_q, height, width) mk = flatten_index(pos_k, height, width) aq = axis_angles([mq], q.size) ak = axis_angles([mk], k.size) cq, sq = np.repeat(np.cos(aq), 2, axis=-1), np.repeat(np.sin(aq), 2, axis=-1) ck, sk = np.repeat(np.cos(ak), 2, axis=-1), np.repeat(np.sin(ak), 2, axis=-1) return float(np.dot(rotate(q[None], cq, sq)[0], rotate(k[None], ck, sk)[0])) def naive_score_matrix_gib(token_count, bytes_per_element=2): """GiB for one materialized dense attention-score matrix of one head.""" return token_count * token_count * bytes_per_element / 2**30 if __name__ == "__main__": np.set_printoptions(precision=6, suppress=True) dims = axis_dims(64) cos, sin = rope_3d_cache(2, 3, 4, 64) rng = np.random.default_rng(7) tokens = rng.normal(size=cos.shape) rotated = rotate(tokens, cos, sin) norm_error = np.max(np.abs(np.linalg.norm(tokens, axis=1) - np.linalg.norm(rotated, axis=1))) print("axis_dims=", dims) print("cache_shape=", cos.shape, "input_shape=", tokens.shape) print("rotated_shape=", rotated.shape) print("norm_error=", f"{norm_error:.2e}") q, k = rng.normal(size=64), rng.normal(size=64) a = score_for_positions(q, k, (0, 1, 2), (1, 2, 3)) b = score_for_positions(q, k, (5, 6, 7), (6, 7, 8)) print("same_offset_scores=", f"{a:.6f}", f"{b:.6f}", "difference=", f"{abs(a-b):.2e}") upper, lower = (0, 0, 0), (0, 1, 0) flat4 = flatten_index(lower, 2, 4) - flatten_index(upper, 2, 4) flat8 = flatten_index(lower, 2, 8) - flatten_index(upper, 2, 8) one_d4 = score_for_flattened_positions(q, k, upper, lower, 2, 4) one_d8 = score_for_flattened_positions(q, k, upper, lower, 2, 8) three_d4 = score_for_positions(q, k, upper, lower) three_d8 = score_for_positions(q, k, upper, lower) three_d_offset = tuple(b - a for a, b in zip(upper, lower)) print("vertical_neighbor_1d_offsets=", flat4, flat8) print("vertical_neighbor_1d_scores=", f"{one_d4:.6f}", f"{one_d8:.6f}") print("vertical_neighbor_3d_offsets=", three_d_offset, three_d_offset) print("vertical_neighbor_3d_scores=", f"{three_d4:.6f}", f"{three_d8:.6f}") # These are algebraic invariants, not video-quality tests. Keeping them as # assertions turns the example into a small regression test for pairing, # broadcasting and relative-position behavior. assert norm_error < 1e-12 assert abs(a - b) < 1e-12 assert abs(three_d4 - three_d8) < 1e-12 assert not np.isclose(one_d4, one_d8) raw = axis_angles([15], dims[1])[0] pi = axis_angles([15], dims[1], scale=2)[0] print("height_phase_at_15_first_last=", np.round(raw[[0, -1]], 6)) print("height_PI_x2_first_last=", np.round(pi[[0, -1]], 6)) print("time_phase_at_15_first_last=", np.round(axis_angles([15], dims[0])[0][[0, -1]], 6)) small_tokens = 13 * 30 * 45 large_tokens = 13 * 60 * 90 print("token_count_13x30x45=", small_tokens) print("token_count_13x60x90=", large_tokens) print("dense_attention_ratio=", (large_tokens / small_tokens) ** 2) print( "naive_score_matrix_fp16_gib_per_head=", f"{naive_score_matrix_gib(small_tokens):.3f}", f"{naive_score_matrix_gib(large_tokens):.3f}", ) rope3d_checks.py """Independent 3D RoPE invariants and counterexamples; run with NumPy only.""" import json from pathlib import Path import numpy as np from rope_3d_minimal import axis_dims, axis_angles, rope_3d_cache, rotate, score_for_positions, flatten_index def rotation_matrix(position, dim, scales=(1, 1, 1)): matrix = np.zeros((dim, dim)) start = 0 for coordinate, width, scale in zip(position, axis_dims(dim), scales): for j in range(width // 2): angle = coordinate * 10000.0 ** (-2 * j / width) / scale c, s = np.cos(angle), np.sin(angle) k = start + 2 * j matrix[k:k + 2, k:k + 2] = [[c, -s], [s, c]] start += width return matrix def validate(): rng = np.random.default_rng(23) worst = dict(grid=0.0, relative=0.0, orthogonal=0.0, gradient=0.0) cases = 0 for dim in (16, 32, 64): for shape in ((1, 1, 1), (2, 3, 4), (3, 2, 5)): for scales in ((1, 1, 1), (1, 2, 1), (2, 1, 3)): cos, sin = rope_3d_cache(*shape, dim, scales) x = rng.normal(size=cos.shape) y = rotate(x, cos, sin) for p in np.ndindex(shape): idx = flatten_index(p, shape[1], shape[2]) R = rotation_matrix(p, dim, scales) worst['grid'] = max(worst['grid'], float(np.max(abs(y[idx] - R @ x[idx])))) worst['orthogonal'] = max(worst['orthogonal'], float(np.max(abs(R.T @ R - np.eye(dim))))) q, k = rng.normal(size=(2, dim)) p, r = (2, 3, 5), (7, 1, 9) delta = tuple(b - a for a, b in zip(p, r)) value = score_for_positions(q, k, p, r, scales) ref = q @ rotation_matrix(delta, dim, scales) @ k worst['relative'] = max(worst['relative'], float(abs(value - ref))) cases += 1 # True grid lookups under two different widths, not two identical function calls. q, k = rng.normal(size=(2, 64)) scores = [] for width in (4, 8): c, s = rope_3d_cache(2, 3, width) i, j = flatten_index((0, 0, 0), 3, width), flatten_index((0, 1, 0), 3, width) qr = rotate(q[None], c[i:i+1], s[i:i+1])[0] kr = rotate(k[None], c[j:j+1], s[j:j+1])[0] scores.append(float(qr @ kr)) assert abs(scores[0] - scores[1]) < 1e-12 # Direct gradient versus coordinatewise central differences for both inputs. p, r = (1, 2, 3), (4, 2, 1) A = rotation_matrix(p, 64).T @ rotation_matrix(r, 64) exact = np.concatenate((A @ k, A.T @ q)) joint = np.concatenate((q, k)); eps = 1e-5 def objective(v): return score_for_positions(v[:64], v[64:], p, r) approx = [] for j in range(joint.size): bump = np.zeros_like(joint); bump[j] = eps approx.append((objective(joint + bump) - objective(joint - bump)) / (2 * eps)) worst['gradient'] = float(np.max(abs(exact - approx))) # Video-video shifts cancel; an unrotated text key is a fixed phase anchor. unit = np.zeros(64); unit[0] = 1 anchor = {str(t): float((rotation_matrix((t, 0, 0), 64) @ unit) @ unit) for t in (0, 1, 2)} assert abs(anchor['1'] - np.cos(1)) < 1e-14 packing = [score_for_positions(q, k, (t, 0, 0), (t + 1, 0, 0)) for t in (0, 10)] assert abs(packing[0] - packing[1]) < 1e-12 # Resetting positions does not isolate clips: a missing attention mask leaks V. logits = np.zeros((4, 4)); values = np.array([1., 1., 100., 100.]) unmasked = np.full((4, 4), .25) @ values mask = np.equal.outer([0, 0, 1, 1], [0, 0, 1, 1]) masked = (mask / mask.sum(axis=1, keepdims=True)) @ values assert np.all(masked == values) and unmasked[0] == 50.5 # New frequency/crop maps must also apply to already rotated keys. p, r = (10, 3, 4), (11, 4, 5) mixed = (rotation_matrix(p, 64, (2, 1, 1)) @ q) @ (rotation_matrix(r, 64) @ k) consistent = score_for_positions(q, k, p, r, (2, 1, 1)) assert abs(mixed - consistent) > .01 # Endpoint-aligned teaching PI versus a zero-start half-open size rule. endpoint_scale = (8 - 1) / (4 - 1) assert 7 / endpoint_scale == 3 and 7 / (8 / 4) == 3.5 invalid = [lambda: axis_dims(24), lambda: axis_angles([1], 0), lambda: axis_angles([np.inf], 16), lambda: axis_angles([1], 16, scale=np.nan), lambda: axis_angles([1], 16, base=1), lambda: rope_3d_cache(2.5, 3, 4), lambda: rope_3d_cache(2, 3, 4, scales=(1, np.inf, 1)), lambda: rotate(np.ones((2, 4)), np.ones((1, 4)), np.ones((1, 4)))] rejected = 0 for call in invalid: try: call() except ValueError: rejected += 1 assert rejected == len(invalid) assert worst['grid'] < 1e-12 and worst['relative'] < 1e-12 assert worst['orthogonal'] < 1e-14 and worst['gradient'] < 1e-8 return dict(passed=True, grid_cases=cases, max_errors=worst, actual_grid_width_scores=scores, unrotated_text_anchor=anchor, masked_clip_values=masked.tolist(), unmasked_clip_values=unmasked.tolist(), video_only_shift_scores=packing, mixed_key_score=float(mixed), consistent_key_score=float(consistent), endpoint_scale=endpoint_scale, invalid_inputs_rejected=rejected, errors=[], warnings=[]) if __name__ == '__main__': result = validate() Path(__file__).with_name('validation_results.json').write_text(json.dumps(result, indent=2), encoding='utf8') print(json.dumps(result, indent=2)) make_figures.py """Generate 3D RoPE figures. Requires NumPy, Matplotlib and Pillow.""" from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from PIL import Image, ImageDraw, ImageFont from rope_3d_minimal import axis_angles, axis_dims OUT = Path(__file__).resolve().parents[1] / "figures" OUT.mkdir(exist_ok=True) def _chinese_font(size): for path in ( "C:/Windows/Fonts/msyh.ttc", "C:/Windows/Fonts/simhei.ttf", "/System/Library/Fonts/Hiragino Sans GB.ttc", "/System/Library/Fonts/PingFang.ttc", "/usr/share/fonts/truetype/noto/NotoSansCJK-Regular.ttc", ): try: return ImageFont.truetype(path, size) except OSError: pass raise RuntimeError("请安装中文字体后再生成 1D/3D 对照图") def one_d_vs_three_d(): """Show the same vertical neighbor under two video widths.""" image = Image.new("RGB", (1800, 950), "#f7f9fe") draw = ImageDraw.Draw(image) ink, muted = "#1e293b", "#475569" draw.text((80, 50), "同一对上下相邻的 token,换宽度会怎样?", font=_chinese_font(68), fill=ink) draw.text((82, 150), "A=(0,0,0) → B=(0,1,0);只改变视频格点宽度 W", font=_chinese_font(42), fill=muted) cards = ( (70, 260, 865, 790, "#e8efff", "#1d4ed8", "1D RoPE:一个序列距离", "W=4 → Δm=4", "W=8 → Δm=8", "上下相邻仍是 1 格,但旋转相位变了"), (935, 260, 1730, 790, "#e3f7f2", "#047857", "3D RoPE:三个轴分别计数", "W=4 → (0,1,0)", "W=8 → (0,1,0)", "高轴始终转 1 格,时间和宽轴不动"), ) for x0, y0, x1, y1, bg, accent, title, first, second, note in cards: draw.rounded_rectangle((x0, y0, x1, y1), radius=38, fill=bg) draw.rectangle((x0 + 38, y0 + 48, x0 + 50, y0 + 130), fill=accent) draw.text((x0 + 77, y0 + 51), title, font=_chinese_font(51), fill=ink) draw.text((x0 + 75, y0 + 210), first, font=_chinese_font(68), fill=accent) draw.text((x0 + 75, y0 + 322), second, font=_chinese_font(68), fill=accent) draw.text((x0 + 75, y0 + 435), note, font=_chinese_font(35), fill=muted) draw.text((80, 844), "旋转和相对位置性质相同;变化的是坐标系与每轴的特征维度。", font=_chinese_font(42), fill=ink) image.save(OUT / "one_d_vs_three_d.png", optimize=True) def axis_budget(): dims = axis_dims(64) fig, ax = plt.subplots(figsize=(9, 2.8)) colors = ["#1d4ed8", "#0d9488", "#ea580c"] start = 0 for name, dim, color in zip(("Time 25%", "Height 37.5%", "Width 37.5%"), dims, colors): ax.barh([0], [dim], left=start, color=color, height=0.55) ax.text(start + dim / 2, 0, f"{name}\n{dim} dims", ha="center", va="center", color="white", weight="bold") start += dim ax.set_xlim(0, 64) ax.set_ylim(-0.55, 0.55) ax.set_xlabel("Head channels (64 total)") ax.set_yticks([]) ax.set_title("CogVideoX 3D RoPE: independent rotary planes per axis") fig.tight_layout() fig.savefig(OUT / "axis_budget.png", dpi=180) plt.close(fig) def phase_tradeoff(): dim_h = axis_dims(64)[1] pos = np.arange(32) original = axis_angles(pos, dim_h) compressed = axis_angles(pos, dim_h, scale=2) fig, axes = plt.subplots(1, 2, figsize=(9, 3.5), sharey=True) for ax, values, title in zip(axes, (original, compressed), ("Raw coordinates", "Height PI: positions / 2")): ax.plot(pos, np.cos(values[:, 0]), color="#ea580c", linewidth=2, label="highest frequency") ax.plot(pos, np.cos(values[:, -1]), color="#1d4ed8", linewidth=2, label="lowest frequency") ax.set_title(title) ax.set_xlabel("Height-token index") ax.grid(alpha=0.18) axes[0].set_ylabel("cos(angle)") axes[1].legend(frameon=False, loc="lower right") fig.suptitle("Interpolation halves phase change on this axis at every frequency") fig.tight_layout() fig.savefig(OUT / "phase_tradeoff.png", dpi=180) plt.close(fig) if __name__ == "__main__": one_d_vs_three_d() axis_budget() phase_tradeoff() for name in ("one_d_vs_three_d.png", "axis_budget.png", "phase_tradeoff.png"): print(OUT / name)
-
AIGC 基本功|从 DPO 到 GRPO:去掉价值网络-GRPO AIGC 基本功|从 DPO 到 GRPO:去掉价值网络-GRPO 所属方向:对齐与强化学习 | 难度:进阶 | 前置知识:PPO 关键词:DPO、GRPO、偏好优化、组内归一化、免价值网络、参考模型 读者需要会读条件概率、对数概率与期望,理解 PPO 中的策略(给定前缀输出下个 token 的分布)、优势与裁剪。本文把 prompt 记为 $x$、完整回答记为 $y$、回答的第 $t$ 个 token 记为 $y_t$;整句概率按自回归条件概率相乘,整句 logprob 则是有效回答 token 的 logprob 之和。这里讨论的是回答级终局奖励;过程奖励和视觉去噪轨迹只在边界处作区分。 01. 为什么需要它 把一个 7B 语言模型接进 PPO-RLHF,训练栈很快会变成四个模型:负责生成的 actor、预测每个 token 未来回报的 critic、限制策略漂移的 reference model,以及把整条回答变成分数的 reward model。真正更新参数的是 actor 和 critic,后两者虽然通常冻结,前向和显存仍要付钱。 critic 是最难解释的一笔成本。语言模型往往只在回答结束时拿到一个总分,但 value head 必须给回答中每个 token 估计未来回报。它不但要和 actor 同量级地跑前向、反向,还要从稀疏的终局信号中学习密集价值。DeepSeekMath 指出,LLM 的 value model 通常与 policy model 规模相当,这正是 GRPO 要删除的部件。 以全参数 AdamW 的粗略账本为例:7B 参数的 BF16 权重约 14 GB,BF16 梯度约 14 GB,FP32 主权重和两份动量约 84 GB,一个可训练模型合计约 112 GB 逻辑状态,实际可被 ZeRO/FSDP 分片。这里的 GB 是十进制字节($10^9$ 字节);112 GB 约为 104.3 GiB,不含激活、通信缓冲、临时张量,且假设保留 FP32 主权重;它是所列精度方案的逻辑状态估算,并非实测峰值。再训练一套同规模 critic,等于再背一次参数、梯度、优化器状态和激活。删掉 critic 的收益很大,但不能机械地说“所有训练都便宜十倍”:GRPO 每个 prompt 要在线生成一组回答,DeepSeekMath 第 4.2 节的 RL 训练每题采 64 条、最大回答长度 1024、每轮探索后仅更新一次;这与摘要中 64 样本 self-consistency 的评测协议是两回事,采样和奖励打分可能成为新的主成本。 DPO 与 GRPO 给了两条不同的减法路线。DPO 把带 KL 约束的 RLHF 目标改写成偏好二分类,训练时不再在线采样,也不需要显式奖励模型;GRPO 保留在线探索和奖励信号,用同一道题的组内相对分数替代 critic。二者名字相邻,解决的却不是同一个问题。 图 1:DPO 省掉显式奖励模型和在线 RL 循环,GRPO 省掉 critic。Policy 与 reference 是否共享底座、reward 是规则还是模型,会继续改变真实成本。 02. 最小可用理解 先记住五句话: DPO 吃离线偏好对:同一 prompt 下给一个 chosen 和一个 rejected,直接优化 chosen/rejected 相对 reference 的对数概率间隔;chosen 的绝对概率未必增加。 GRPO 吃在线样本组:同一 prompt 采样 $G$ 个回答,打分后用组均值当 baseline,不训练 value model。 GRPO 沿用 PPO 的概率比与 clip:它只换了优势估计,没有丢掉“旧策略采样、新策略更新”这套框架。 reference 不是 critic:reference 负责限制长期漂移,critic 负责估计当前状态的未来回报;删掉 critic 后 reference 通常还在。 组内相对分数只回答谁更好:如果一组答案同分,奖励优势项没有方向;KL 正则仍可能更新策略。正比例缩放和共同平移会被标准化大体抵消,但固定 $\epsilon$、排序变化和非线性变换仍会影响结果。 因此,从 DPO 到 GRPO 不是把一个损失函数逐项变形为另一个,而是从“离线比较学习”切换到“在线生成、在线评价”。选择算法时先问数据来自哪里,再问显存够不够。 03. 数学推导 3.1 PPO-RLHF 的起点 对 prompt $x$ 和回答 $y$,标准 KL 正则化目标可以写成: $$\max_{\pi}\ \mathbb{E}_{y\sim\pi(\cdot\mid x)}[r(x,y)]-\beta D_{KL}[\pi(\cdot\mid x)\|\pi_{ref}(\cdot\mid x)]$$ $\pi$ 是待训练策略,$\pi_{ref}$ 是在当前优化区间内冻结的参考策略,$r(x,y)$ 是回答奖励,$\beta>0$ 是 KL 权重。这里的 KL 是同一 prompt 下完整回答分布的正向 KL:用策略概率加权,计算对数概率比的期望;后面的 token 代理目标另行定义。PPO 用采样轨迹、critic 优势和裁剪目标近似优化它。这里至少要维护 actor、critic 和 reference;若奖励由神经网络给出,还要运行 reward model。 3.2 DPO 如何把奖励塞回策略 先固定一个 $x$,把 $\pi(y\mid x)$ 简写为 $p_y$,参考概率写成 $q_y$。假设只在参考策略有正概率的支持集上优化,且归一化常数有限。对有限回答集合,加入约束 $\sum_y p_y=1$ 的拉格朗日乘子 $\lambda$,目标变为: $$F(p,\lambda)=\sum_y p_y r_y-\beta\sum_y p_y\log(p_y/q_y)+\lambda(\sum_y p_y-1)$$ 对每个正概率的 $p_y$ 求偏导并令其为零,得到 $r_y-\beta[\log(p_y/q_y)+1]+\lambda=0$。因此 $p_y=q_y\exp(r_y/\beta)\exp(\lambda/\beta-1)$;最后一项与 $y$ 无关,由概率和为一决定。这才得到闭式最优策略: $$\pi^*(y\mid x)=\frac{1}{Z(x)}\pi_{ref}(y\mid x)\exp\left(\frac{r(x,y)}{\beta}\right)$$ $Z(x)=\sum_y\pi_{ref}(y\mid x)\exp(r(x,y)/\beta)$。把该解代回目标,可以写成 $\beta\log Z(x)-\beta D_{KL}(\pi\|\pi^*)$;KL 非负,所以闭式解是全局最优。无限回答空间还要求这个和收敛;参考概率为零的回答不能靠这个式子凭空获得概率。把式子移项,可把奖励写成策略与参考策略的对数概率比: $$r(x,y)=\beta\log\frac{\pi^*(y\mid x)}{\pi_{ref}(y\mid x)}+\beta\log Z(x)$$ 偏好数据给出同一 prompt 下的胜者 $y_w$ 与败者 $y_l$。DPO 原论文用 Bradley–Terry(BT)假设,把偏好噪声的尺度吸收到奖励里,令“胜者更好”的概率为两条潜在奖励之差的 sigmoid。这里 $\sigma(u)=1/(1+e^{-u})$: $$P(y_w\succ y_l\mid x)=\sigma(r(x,y_w)-r(x,y_l))$$ 把上一式代入后,同一道题共享的 $\beta\log Z(x)$ 自动相消。用可训练策略 $\pi_\theta$ 代替未知最优策略,得到 DPO 损失: $$\mathcal{L}_{DPO}=-\mathbb{E}\log\sigma\left(\beta\left[\log\frac{\pi_\theta(y_w\mid x)}{\pi_{ref}(y_w\mid x)}-\log\frac{\pi_\theta(y_l\mid x)}{\pi_{ref}(y_l\mid x)}\right]\right)$$ 括号里有两层差。第一层是 chosen 与 rejected 的差;第二层是当前 policy 相对 reference 的差。DPO 鼓励当前策略相对 reference 的 chosen/rejected 间隔增大;它不要求 chosen 的绝对概率单调增加。例如参考分布为 [0.2,0.3,0.5],当前分布从 [0.4,0.4,0.2] 变为 [0.3,0.15,0.55],把前两个动作当 chosen/rejected,chosen 概率下降,但二者比值从 1 增至 2。$\beta=0.1$ 时这对样本的 loss 从 0.673079 降至 0.639724。这是两个归一化分布的目标值反例,不是声称一次 DPO 梯度步必沿这条路径走。 DPO 的省钱来自训练协议:偏好对提前收集好,训练循环只做似然计算和二分类,不需要当前策略在线生成回答,也不需要在循环里调用显式 reward model。但代价也在这里:数据分布被固定。策略更新后会产生哪些新错误,旧偏好集未必覆盖。BT 假设、偏好覆盖和模型可表达性决定了二分类能否恢复所需奖励差;有限、矛盾的偏好对加上受限模型,并不能保证得到原 RLHF 问题的全局最优。DPO 损失中的 $\beta$ 来自上述参数化,调大它会同时改变分类 logit 和梯度,不能只凭“KL 权重更大”推断实际训练必更保守。 3.3 PPO 的 critic 到底提供了什么 PPO 的优势通常来自 critic: $$A_t=Q(s_t,a_t)-V_\phi(s_t)$$ $V_\phi(s_t)$ 预测从当前 token 前缀继续生成的平均回报。在不引入裁剪等近似时,若 baseline 只依赖状态、与当前动作无关且计算策略梯度时视作常数,减去它不改变期望,因为对该状态所有动作的概率之和求导为零;合适的 baseline 可以降低方差,任意差的 baseline 则未必。问题是,回答只在末尾拿到 $r(x,y)$,critic 却要在每个位置给出估计;它要学习的目标本身就很噪。 如果暂时不追求每个 token 的状态价值,而是对同一道题一次采 $G$ 个完整回答,就能用样本组构造另一种 baseline。 3.4 GRPO 的组内相对优势 从旧策略 $\pi_{old}$ 对同一 prompt $x$ 采样回答 $\{y_1,\ldots,y_G\}$,奖励为 $\{r_1,\ldots,r_G\}$。Outcome supervision 下,GRPO 定义: $$\hat A_i=\frac{r_i-\mathrm{mean}(r_1,\ldots,r_G)}{\mathrm{std}(r_1,\ldots,r_G)+\epsilon}$$ 这里标准差与防零用 $\epsilon$,裁剪半径则用 $\varepsilon$,二者是不同超参数。本文教学代码固定 $\epsilon=10^{-4}$,默认总体标准差,即平方离差和除以 $G$;固定 TRL 的 nanstd 则除以有效样本数减一。第一组 [0.2,0.8,1.4,0.6] 的总体标准差为 0.433013,样本标准差为 0.5,因此 ddof=1 对照官方时优势幅度会更小。DeepSeekMath 公式只写 std,本文不把教学默认口径冒充论文指定分母。 均值去掉组内共同的加法偏置,标准差调整组内奖励尺度。它不是只保留名次:[0,1,2,10] 和 [0,1,9,10] 的排序相同,标准化优势仍不同,因为相对分差不同。对 $r_i^{\prime}=a r_i+b$、$a>0$,分子乘 $a$、标准差乘 $a$;若 $\epsilon=0$ 才精确抵消,有固定 $\epsilon$ 时新优势等于原中心化奖励除以 $s+\epsilon/a$。负比例会反转方向,非线性单调变换也会改变间距。对一条回答里的每个有效 token,原始 GRPO 都广播同一个 $\hat A_i$:它为高于组均值的采样回答提供正向局部替代梯度、低于均值的提供负向梯度;共享网络参数、clip 和 KL 共同更新后,不能保证每个 token 的最终概率都按该符号变化。 图 2:同原代码的两组奖励和总体标准差、$\epsilon=10^{-4}$。每道题分别中心化;标准化仍保留相对分差,图中的两组也不是精确仿射副本,因此两组柱形无需重合。 组均值包含样本自身,不满足“baseline 与本次动作独立”。把完整回答暂当作一次动作,固定 prompt,令 $s_i=\nabla\log\pi(y_i\mid x)$、$J=E[r_i]$;独立同分布采样且正则性成立时 $E[s_i]=0$。展开组均值项: $$E[\bar r s_i]=\frac1G E[r_i s_i]+\frac1G\sum_{j\ne i}E[r_j]E[s_i]=\frac1G\nabla J$$ 所以 $E[(r_i-\bar r)s_i]=(1-1/G)\nabla J$。改用其余 $G-1$ 条回答的均值(leave-one-out)能去掉这个缩放;$G=1$ 不适用。再除与采样结果相关的随机标准差,一般会改变方向及 prompt 权重,不能只用一个常数纠偏。三动作、$G=3$ 的精确枚举给原奖励梯度 [-0.372,-0.198,0.570]、组中心化梯度 [-0.248,-0.132,0.380],恰为 2/3;标准化后为 [-0.209534,-0.136999,0.346534],三个分量比值不同。这里尚未加入 clip、每条回答长度归一化、旧策略复用和 KL;完整 GRPO 更不能称为原始期望奖励的无偏梯度。 这不是免费午餐。$G$ 太小时,组均值和标准差很不稳定;奖励全相等时,优势全部为零;同一回答的所有 token 共用一个结果优势时,算法知道“整条回答好”,却不知道哪一步推理真正立功。 3.5 GRPO 仍然是 PPO 家族 对回答 $y_i$ 的第 $t$ 个 token,定义新旧策略概率比: $$\rho_{i,t}(\theta)=\frac{\pi_\theta(y_{i,t}\mid x,y_{i,<t})}{\pi_{old}(y_{i,t}\mid x,y_{i,<t})}$$ GRPO 沿用 PPO-Clip 的保守替代目标,并直接在 loss 上加 reference KL: $$\mathcal{J}_{GRPO}=\mathbb{E}\left[\frac{1}{G}\sum_i\frac{1}{|y_i|}\sum_t\left(\min\left(\rho_{i,t}\hat A_i,\mathrm{clip}(\rho_{i,t},1-\varepsilon,1+\varepsilon)\hat A_i\right)-\beta D_{KL}(\pi_\theta\|\pi_{ref})\right)\right]$$ $\pi_{old}$ 是本轮 rollout 的采样快照,用于构造旧策略数据上的局部替代目标;单 token 比值并未完整校正所有前缀的分布偏移;$\pi_{ref}$ 是行为锚点,用于限制当前参考区间内的行为漂移;DeepSeekMath 的 iterative RL 会在外层迭代更新 reference,不能一概说它整个训练永久冻结。两者在训练刚开始可能数值相同,但职责不同,不能混用。 DeepSeekMath 使用的固定前缀下单动作的非负 KL 估计量是: $$D_{KL}=\exp(\Delta)-\Delta-1,\quad \Delta=\log\pi_{ref}-\log\pi_\theta$$ 因为对任意实数 $\Delta$ 都有 $e^\Delta\geq1+\Delta$,这个量非负,在两策略对该动作的概率相同时为零。在实现里它可以直接由采到 token 的 policy/reference logprob 计算,不必枚举整个词表。它的期望等于 $D_{KL}(\pi_\theta\|\pi_{ref})$ 的前提是动作从当前 $\pi_\theta$ 采样;实际 rollout 来自 $\pi_{old}$,更新后直接平均得到的是旧采样分布下的代理量,需要相应重要性校正才有同一无偏解释。 还有一个更隐蔽的区别:估计值的期望正确,不代表固定采样后对 $k_\theta=e^\Delta-\Delta-1$ 反向传播就得到真实 KL 的梯度。记当前条件分布为 $p$、reference 为 $q$,则 $k=q/p-\log(q/p)-1$,有: $$\sum_a p_a k_a=\sum_a[q_a-p_a-p_a\log(q_a/p_a)]=D_{KL}(p\|q)$$ 但固定样本只对 $k$ 求导时,$\nabla k=(1-q/p)\nabla\log p$,遗漏了采样概率本身随参数变化的导数。在 softmax logits 上,采样点为当前 $p$ 时这个代理的期望梯度是 $p-q$,真正 KL 的第 $a$ 个分量则为 $p_a[\log(p_a/q_a)-D_{KL}(p\|q)]$。两者一般不同。 可直接核对三动作例子:$p=[0.7,0.2,0.1]$、$q=[0.2,0.3,0.5]$,真实 KL 为 0.634897;若从旧分布 [0.3,0.3,0.4] 采样,裸 $k$ 的期望却是 1.146128。用未 detach 的 $p/\pi_{old}$ 乘 $k$,其值和梯度在这个固定前缀下恢复真实条件 KL;若只乘已 detach 的比值,仍缺一项梯度。序列级分布还包含前缀占用概率,不能由这个单步验证推断整个 GRPO 是精确 KL-RL 优化。固定 TRL 的 use_bias_correction_kl 分支可加入 ratio,本教程 bandit 则有意保留未校正的论文式代理,明确其范围。 同分组只消掉奖励 surrogate。若 $\beta>0$ 且当前策略已偏离 reference,KL 仍可能提供梯度;如果又有熵、辅助损失或 Adam 历史动量,实际参数步也未必为零。“全同分就完全不更新”只在本教程从均匀 reference 初始化、没有其他梯度或动量时成立。 3.6 DPO 与 GRPO 的统一观察 DPO 和 GRPO 都在做“相对比较”,但参照物不同: 维度 DPO GRPO 数据 固定的 chosen/rejected 对 当前策略在线生成的一组回答 相对量 policy 相对 reference 的偏好间隔 回答奖励相对同组均值 删除的部件 显式 reward model 与在线 RL 循环 critic/value model 仍需保留 policy、reference、偏好数据 policy、old policy logprob、reference、奖励函数 主要风险 离线数据覆盖不足 采样昂贵、组内同分、奖励投机 这张表也解释了为什么“DPO 之后再做 GRPO”可以成立:先用便宜的离线偏好对把策略推到合理区域,再用在线 GRPO 探索当前策略真正会生成的回答。但这是一种训练安排,不是数学上必须的前后继关系。 3.7 手算一组 DPO 和 GRPO 先看 DPO。设第一对样本中,当前 policy 对 chosen 和 rejected 的整句 logprob 分别为 -2.2 和 -2.8,因此 policy 的偏好间隔是 0.6;reference 对二者的 logprob 分别为 -2.0 和 -2.4,偏好间隔是 0.4。当前策略相对 reference 多出来的间隔只有 0.2。当 $\beta=0.1$ 时,送进 sigmoid 的 logit 是 0.02,胜者概率只略高于 0.5,loss 接近随机猜测的 $\log 2$。 这解释了一个常见现象:chosen 的 logprob 即使很低,也不代表 DPO 一定给它很大梯度。DPO 看的是四个 logprob 组成的相对差。若 reference 已经强烈偏爱 chosen,而 policy 只复制了这种偏好,DPO 不会把它误判成新的进步;若 policy 相比 reference 反而缩小了 chosen 的优势,logit 会变负,损失上升。 再看 GRPO。第一组奖励是 [0.2, 0.8, 1.4, 0.6],均值为 0.75,标准差约为 0.433。标准化后得到 [-1.2699, 0.1154, 1.5008, -0.3463]。第二个回答虽然原始分数 0.8 看上去不高,但它略高于同题平均,因此得到很小的正优势;第三个回答比平均高很多,得到最大的正优势。 假设这四条回答更新后的 token ratio 依次是 [1.2840, 1.1052, 0.7788, 0.9048],裁剪区间为 [0.8,1.2]。第一条优势为负,而 ratio 大于 1,说明坏回答变得更可能,目标必须继续惩罚,不能裁掉。第二条优势为正且 ratio 在区间内,正常提供正向梯度。第三条优势为正但 ratio 低于 0.8,说明好回答被错误降权,目标同样继续惩罚。第四条优势为负且 ratio 在区间内,也正常提供降低概率的梯度。 真正被截住的是“已经朝正确方向走过头”的两种情况:正优势回答的 ratio 超过 1.2,或负优势回答的 ratio 低于 0.8。PPO/GRPO 的 clip 从来不是把所有 ratio 强制塞进区间,而是停止奖励过度乐观的改进。只看 np.clip(ratio) 而不把优势符号放进来,几乎一定会误读目标。 04. 代码实现 code/dpo_grpo_minimal.py 只依赖 NumPy,包含三部分:DPO 二分类损失、GRPO 的组内优势与裁剪损失,以及一个四动作 bandit 的在线训练。本轮在 Windows / Python 3.11.9 / NumPy 2.4.3 的 CPU 环境实际运行,输出如下;无预训练权重、无需 GPU。完整脚本见文末,code/dpo_grpo_checks.py 另外验证闭式解、梯度、mask 与多 seed 边界。 两张解释图由 code/make_figures.py 从文中的固定数值直接生成,图和公式使用同一组奖励,避免手工绘图与代码结果不一致。 === DPO === pair_shape=(2,) preference_logits=[0.02 0.03] loss=0.6807 === GRPO group baseline === rewards.shape=(2, 4) advantages= [[-1.2699 0.1154 1.5008 -0.3463] [-1.2648 -0.6324 0.6324 1.2648]] row_mean=[-0. 0.] === GRPO clipped objective === token_logps.shape=(4, 3) ratio_first_token=[1.284 1.1052 0.7788 0.9048] mean_kl=0.018550, loss=0.1626 奖励张量形状是 [prompt, generation] = [2, 4]。每行优势的均值都为零,说明每道题自己形成 baseline。裁剪例子里第一条优势为负而 ratio 为 1.284,第三条优势为正而 ratio 为 0.7788:二者都朝错误方向越界,因此 min 保留未裁剪项以继续惩罚。另两条 ratio 在区间内。这四条回答都没有进入裁剪收益的平台分支,与 3.7 节一致。 bandit 有四个回答动作,真实奖励分别是 [-0.2, 0.3, 1.0, 0.0]。脚本不训练 critic,每轮只采 32 个动作、组内标准化奖励,再用两轮 PPO 式更新复用这组样本: step P(a0) P(a1) P(a2=best) P(a3) 1 0.2288 0.2494 0.2883 0.2335 20 0.0210 0.0346 0.9179 0.0265 40 0.0048 0.0064 0.9833 0.0055 80 0.0026 0.0035 0.9906 0.0033 第 80 步时,最优动作概率从 0.25 升到 0.9906。这个实验展示的是此有限 bandit 的组相对代理更新能提高给定奖励较高动作的概率,不代表大模型会如此平滑:真实回答空间巨大,奖励噪声、长度与采样温度都会改变结果。 05. 工业级实现对照 本文人工核对了 Hugging Face TRL 的 GRPOTrainer,以 2026-09-13 的主分支提交 cd2c528 为准。提交元数据核实日期为 2026-09-13。下述实现选择来自这个固定快照,不能混称为所有 GRPO 的定义;本轮在 Torch 2.10 CPU 上执行其完整 _compute_loss 原始 AST,模型 logprob 回调及单进程 accelerator 用数值夹具提供,24 组损失值与梯度对照通过,不包含 trainer 初始化、分布式生成或大模型训练。生产实现比论文公式多出几层选择: 奖励函数全返回空值的回答会标成 NaN,从组均值中排除,随后把 NaN 优势置零,避免“不可评分”被误当成零奖励。若一组只剩一个有效奖励,样本标准差不可定义,归一化优势也会被置零;这只保证没有该项奖励梯度,不等于屏蔽 KL。本文 NumPy 教学函数只接受完整有限奖励组,遇到 NaN 明确拒绝,官方的缺失评分路径由独立原代码夹具验证。 scale_rewards 支持按 group、batch 或不缩放;多目标奖励还可以“先加权求和再归一化”或“各目标先归一化再求和”。两者表达的偏好并不一样。 importance sampling 可以按 token 或 sequence 计算。这个快照的 sequence 模式先对有效 token 的 log-ratio 取平均再求指数,即 token ratio 的几何平均,并非整句概率比(整句比值对应 log-ratio 求和)。例如两 token 比值 [2,0.5] 时两者恰好都为 1,但 [2,2] 的整句比值为 4、几何平均仍为 2。名称不能替代实际公式。 loss 已不止原始 grpo,还包括 bnpo、dr_grpo、dapo 等不同归一化方式。这里 grpo 先逐序列平均再 batch 平均;bnpo 按当前有效 token 总数平均;dr_grpo 用 batch 大小乘最大回答长度作固定分母。不同形式会改变训练样本权重,不能把它们当完全等价的优化目标。 使用 vLLM 生成时,推理引擎与训练模型的 logprob 可能有数值差异,框架提供额外 importance-sampling correction。 PEFT 场景可在同一底座上挂训练 adapter 与 reference adapter,减少复制完整模型的显存。此固定实现若 beta=0 会跳过 reference,因而“GRPO 必须保留 reference”也有配置边界;DPO 的 reference logprob 则可在固定偏好集上预计算,不必每步再跑一套模型。 最值得监控的日志不是单独一个 reward,而是:组内 reward 标准差为零的比例、clip ratio、KL、回答长度、每种 reward 的均值与方差。如果 reward 上升同时长度暴涨、KL 激增或同分组变多,训练可能在钻评分规则的空子。 本文教学函数还要求每条序列至少有一个有效 token,空 mask 明确报错;指数运算前先把无效位置替换成零,防止 padding 中的 NaN 或无穷通过“乘零”污染 loss。有效位置的非有限 logprob 和指数溢出仍会显式失败,不静默截断以伪造正常结果。 工程上还要区分三种 mask:prompt token 不应进入 completion loss,padding token 不应参与平均,工具调用或环境交互产生的非策略 token 也不该伪装成策略动作。mask 错一个维度,代码仍可能正常运行,但 loss 的分母已经变了。 5.1 一次工业 GRPO update 的数据流 第一步是挑 prompt。随机抽题看似公平,但大量过易题会产生“全对组”,大量过难题会产生“全错组”,两者都没有组内方差。一种可验证的工程选择是记录题目通过率、奖励方差和最近采样时间,再决定是否调整抽题分布;这不是本文固定 TRL 或 DeepSeekMath 原始 GRPO 的必备步骤。主动选题改变 prompt 分布,需要在独立评测上检验收益,不能把“挑出有分歧的题”直接当作普遍改进。 第二步是冻结采样快照。系统保存 $\pi_{old}$ 的版本标识,并为每个 prompt 生成 $G$ 条 completion。若用独立 vLLM 服务生成,必须记录推理引擎返回的 token id、mask 和 logprob;只保存文本再重新 tokenize,特殊 token、空格或聊天模板差异都可能让动作序列错位。 第三步是评分。规则验证器适合数学答案、代码测试和工具任务;神经 reward model 适合帮助性、风格和主观质量。多个奖励合并时要先决定是“先加权再组内归一化”,还是“每种奖励各自归一化再加权”。前者的各目标相对尺度会影响加权总分,但随后除组标准差会消掉总分的共同尺度;后者先改变各目标尺度,再加权。固定快照的 normalize_then_sum 在逐目标组内标准化后,还对汇总奖励做 batch 标准化,因此不能只凭配置名省略后半段。六组官方 NaN/统计夹具覆盖了两种聚合与三种 scale_rewards 设置。 第四步计算 group statistics。分布式训练里,同一 prompt 的 $G$ 条回答可能散在不同 GPU 上,均值和标准差必须在完整组上聚合。若每张卡只看本地子组,baseline 会随数据切分改变;同一实验换一个 GPU 数就可能得到不同梯度。 第五步计算当前 policy 与 reference 的 token logprob。old_logprob 必须保持 rollout 时的值,不能在每个优化 epoch 重算;reference_logprob 可以预计算并缓存,也可以通过冻结模型或禁用 LoRA adapter 得到。三种 logprob 看着形状相同,来源却完全不同。 第六步形成 per-token loss。Outcome reward 把回答级优势广播到有效 completion token,再乘 ratio、做 clip、加 KL。这里 rollout 的奖励、组统计和 old/reference logprob 都视作固定数据,不对奖励计算或采样反向传播。随后按 mask 归一化。先对每条序列取平均再对 batch 平均,会让长短回答权重相近;直接对全 batch token 求平均,则长回答贡献更多。两种都能运行,但优化目标不同。 第七步更新并监控。一次 rollout 可做有限个优化 epoch,随后必须重新采样。应同时记录 reward、组内标准差、zero-std 比例、KL、clip fraction、回答长度和吞吐量。只有 reward 上升而这些量失控时,不能把结果叫作训练成功。 5.2 六个不会报错却会训歪的实现细节 分组边界错位。 假设 batch 排列本应是“题目 A 的八条回答、题目 B 的八条回答”,数据加载器却在聚合前打乱了 completion,view(-1, G) 仍然合法,均值却混合了不同题目。最可靠的做法是保留 prompt id,计算优势前断言每个连续组的 id 完全相同,分布式 gather 后再断言每题正好有 $G$ 条记录。 把样本标准差和总体标准差混着用。 NumPy 的 std 默认分母是 $G$,PyTorch 某些接口曾默认用 $G-1$。组很大时差别不明显,$G=2$ 或 4 时会明显改变优势幅度。公式、最小实现和训练框架必须约定同一个定义,日志里也应记录原始 reward,而不是只保留标准化后的值。 先逐卡归一化再全局聚合。 数据并行下每张卡只拿到同一题的一部分回答,如果先在本地求均值,结果取决于回答被分到哪张卡。正确顺序是先收集完整组的 reward,再统一计算统计量,最后切回各进程需要的那一段优势。 生成文本与训练 token 不一致。 推理服务可能自动补聊天模板、合并空白、提前截断,训练端重新编码字符串后得到另一串 token。此时旧策略 logprob 与当前策略 logprob 对应的动作不同,ratio 已经失去意义。rollout 应把 token ids 视作主数据,文本只用于评分和审计;恢复训练时也要保留 tokenizer 与 chat template 版本。 长度归一化悄悄改变偏好。 若每条回答先按自身长度求 token loss 均值,短回答和长回答各占一个样本权重;若整个 batch 按 token 总数求均值,长回答天然贡献更多。再叠加“回答越长越可能碰到一次正确步骤”的 reward,模型可能学会延长推理。应同时画 reward 对长度的散点图,并用长度分桶比较通过率。 奖励器和策略一起漂移。 在线迭代训练 reward model 时,今天的 0.8 与上周的 0.8 可能不是同一尺度。组内归一化能消掉部分仿射漂移,却消不掉排序规则改变。需要保留固定校准集和冻结的旧奖励器,周期性比较新旧排序一致率;否则策略看似持续提高,其实只是追着变化的裁判跑。 最后还要保存可恢复状态:policy、optimizer、scheduler、reference 版本、rollout 生成参数、reward 版本和数据游标缺一不可。只保存 actor 权重可以用于推理,却无法保证训练恢复后仍在优化同一个目标。GRPO 少了 critic checkpoint,但并没有把实验追踪简化成一个模型文件。 06. 代价与边界 删掉 critic,省下的是真实成本。 全参数训练时少一套同规模可训练状态和激活;LoRA 或 ZeRO 下绝对节省会变化,但工程链路仍少了 value target、value loss、value clipping 与 critic checkpoint。 组采样把成本转移到生成端。 GRPO 必须对同一 prompt 采多个回答。推理较长、组大小较大或 reward model 很重时,rollout 可能比 critic 更贵。适合有便宜可验证奖励的数学、代码和工具任务;对主观写作、开放式对话,可靠打分本身就是难题。 组内归一化丢掉跨题绝对难度。 一道题的最高分只有 0.2,另一道题四个答案都超过 0.9,标准化后仍可能产生相似幅度的优势。前者也许是奖励器不可靠或题目不可解,却会得到同等更新权重。 同分会让奖励优势项消失。 二值正确性奖励在策略已经很强或很弱时尤其明显:一组全对或全错,标准差为零时完全没有该组奖励优势;标准差虽很小但非零时,是否被抑制取决于它与 $\epsilon$ 的相对大小。这时增加组大小、提高采样温度、设计更细奖励或主动挑选处在学习边界的 prompt,比盲目调学习率更有效。 Outcome reward 的信用分配很粗。 一条 2000-token 推理只拿一个终局优势,每个 token 被同方向推动。过程奖励可以细化信号,但会引入步骤标注、奖励模型偏差与“奖励器教模型写格式”的新问题。 reference KL 不能修复坏奖励。 KL 只限制走多远,不判断方向对不对。奖励函数偏爱冗长、套话或特定格式时,较小 KL 只是让投机变慢。 6.1 什么时候选 DPO,什么时候选 GRPO 如果手里已经有高质量 chosen/rejected 数据,生成和人工标注又很贵,DPO 通常是更稳的第一步。它像普通监督训练一样容易批处理,失败时也容易回查是哪一对偏好造成梯度。它尤其适合风格、安全边界、回答格式这类可以提前整理成对的数据。 如果任务能自动验答案,而且策略必须靠探索发现新解法,GRPO 更合适。数学最终答案、代码单元测试、工具调用结果和可执行环境都能提供相对便宜的在线奖励。此时 critic 很难从稀疏终局分数学习每个 token 的价值,组 baseline 的简化更有吸引力。 如果奖励高度主观、每条回答又很长,两者都不会自动解决问题。DPO 受限于离线偏好覆盖,GRPO 受限于奖励模型可靠性和 rollout 成本。常见组合是 SFT 打基础、DPO 吸收稳定的人类偏好、GRPO 在可验证子任务上继续在线探索,最后再用独立评测检查能力回退。 做预算时至少拆成四项:训练模型状态、冻结模型前向、在线生成 token 数、奖励评估次数。只比较“有几个模型”会漏掉 GRPO 的采样账;只比较“每步生成多少 token”又会漏掉 PPO critic 的反向和优化器状态。把四项分别量出来,才能判断删掉 critic 是否真的让当前系统便宜了一个量级。 还有一笔常被忽略的是通信。PPO 的 critic 若与 actor 分开部署,需要在 rollout、价值推理和更新之间搬运 token、mask、value 与 advantage;若与 actor 共卡,又会争夺显存和计算流。GRPO 把 value 请求换成组统计,统计量只是一组标量,通信链更短。可是一旦奖励模型远程部署,$G$ 条回答仍要跨服务传输并等待评分。优化时应测端到端每步墙钟时间,把生成、评分、训练和等待分别打点;单看 GPU 峰值显存,很容易把“省显存”误写成“省总成本”。 评估也要和训练奖励解耦。至少准备一套不参与更新的题目、一个不同实现的验证器,以及人工抽查样本。训练奖励与独立评测同时上升,才说明策略能力可能真的提高;只有训练奖励上涨,最多能证明优化器成功找到了当前评分函数偏爱的输出。对推理模型还应分别统计最终答案、推理有效性、格式合规和长度,避免一个聚合分数掩盖能力回退。 这些记录也是定位回归、比较算法和复现实验的最低证据。 07. 经典论文脉络 Proximal Policy Optimization Algorithms(arXiv:1707.06347,2017)提出可多轮复用 rollout 的裁剪替代目标,是 GRPO 概率比与 clip 的直接来源。 Direct Preference Optimization: Your Language Model is Secretly a Reward Model(arXiv:2305.18290,2023)利用 KL 正则化 RLHF 的闭式最优策略,把偏好学习变成二分类,训练阶段绕开在线 RL。 DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models(arXiv:2402.03300,2024)正式提出 GRPO,用同题多回答的组分数替代 value model;Table 5 的 chain-of-thought 条件下,DeepSeekMath-Instruct 7B 到 DeepSeekMath-RL 7B,GSM8K 为 82.9%→88.2%,MATH 为 46.8%→51.7%;它们是单条推理回答评测,不能与 64 样本投票的 60.9% MATH 混比。 DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning(arXiv:2501.12948,2025)把大规模 GRPO 推到长链推理与可验证奖励场景,也让组内相对优化成为推理模型训练的常用基线。 这些数字来自各论文自己的设置,不能跨模型直接比较。DPO 的优势在训练简单,GRPO 的优势在能跟随当前策略在线探索;算法名本身不决定最终能力。 08. 常见误解 “GRPO 不需要奖励模型。” 错。GRPO 不需要 critic,但必须有奖励信号。奖励可以是神经 reward model、规则验证器、单元测试或多个评分器的组合。 “DPO 和 GRPO 都去掉 value,所以是一回事。” DPO 通过重参数化绕开整套在线 RL;GRPO 仍是 policy-gradient 方法,只把优势 baseline 从 learned value 换成 group statistics。 “组均值就是无偏的真实价值函数。” 组均值只是当前策略、当前 prompt、当前采样温度下的 Monte Carlo baseline。它会随组大小和采样分布变化,不是对所有状态都可查询的 $V(s)$。 “归一化后奖励尺度不重要。” 共同平移精确抵消,正比例缩放仅在忽略防零项时精确抵消,但排序错误、同分、异常值和多目标权重仍会改变梯度。reward design 依然是核心工作。 “去掉 critic 就一定便宜十倍。” 不成立。删掉一个同规模可训练模型可能显著降低显存和通信,但 GRPO 增加了组采样。总成本取决于序列长度、组大小、reward 推理、并行方式和是否使用 LoRA。 “clip 能保证 KL 很小。” clip 只截断采样动作上的替代收益;共享参数更新仍可能让未采到 token 的分布大幅变化,所以工程实现仍单独监控或惩罚 KL。 09. 动手验证 在仓库目录运行: python3 outputs/fundamentals_files/dpo_grpo/code/dpo_grpo_minimal.py 完整验证脚本 dpo_grpo_checks.py 在固定 80 轮、每组两次更新、学习率 0.18 下,对五种配置分别实际运行 seed 0…9。下表是最终最好动作概率的均值和 seed 范围,比较时只改表中指定配置,reference 均匀: 配置 均值 最小–最大 原设置 G=32 0.990830 0.987677–0.992312 G=2 0.950928 0.938407–0.962952 四奖励全为 1 0.250000 0.250000–0.250000 最好奖励改为 0.31 0.987225 0.983949–0.989418 beta=0.5 0.877653 0.864133–0.901262 小组在这十个 seed 中最终概率更低;这是该 bandit、预算与更新协议的观察,不是对任意任务的收敛率保证。全同分从均匀 reference 出发恰好维持 0.25;若先把策略移开 reference 再给同分,KL 仍可能拉回。 把最好奖励从 1.0 改成 0.31,本例略降到表中数值,不能据此声称奖励差小必然需要更多样本。两样本组 [0,d] 用总体标准差时,正优势为 $d/(d+2\epsilon)$;$d=1,0.01,10^{-5}$ 时分别实测 0.999800、0.980392、0.047619。噪声为零且 $d$ 远大于 $\epsilon$ 时,尺度基本会被抵消;只有与噪声、采样覆盖、防零项一起讨论,才有“更难区分”的具体含义。 DPO 练习先保持 reference 不变,只交换两个 policy logprob,计算新的四项差,不能只凭“交换”断言 logit 必变负(reference 的原始偏好也参与)。本例两个新 logits 为 [-0.10,-0.05],loss 约 0.731428;再尝试 3.2 节 chosen 概率下降而 loss 下降的完整归一化反例。 独立验证还枚举 $3^3=27$ 个采样组,并对 DPO 与完整四动作代理求有限差分:最大梯度误差分别为 $4.31\times10^{-11}$ 与 $8.34\times10^{-12}$;KL 校正梯度误差为 $2.23\times10^{-10}$。两个裁剪平台和两种错误方向均被覆盖。mask 检查确认 padding NaN 不污染有效值、六类非法输入被拒绝。闭式解的 200 组目标恒等式误差不超过 $4.45\times10^{-16}$。这些是有限动作与合成损失的验证,不是 LLM 或视频模型训练复现。 10. 延伸阅读 读这篇之前建议先看: 策略梯度与 PPO 基础:优势估计、概率比和 clip 的完整推导。 读完这篇可以继续看: 把 RL 用到扩散模型上(DiffusionRL):把多步去噪改写成 MDP 轨迹。 视频生成中的强化学习与奖励模型:GRPO 进入视觉生成后,采样成本、时序奖励与 reward hacking 如何变化。 附录:完整代码 09 节用到的脚本全文如下(dpo_grpo_minimal.py、dpo_grpo_checks.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 dpo_grpo_minimal.py """DPO 与 GRPO 的最小可运行实现。 运行:python3 dpo_grpo_minimal.py 只依赖 NumPy,不需要模型权重或外部数据。 """ import numpy as np def log_sigmoid(x): """数值稳定的 log(sigmoid(x))。""" return -np.logaddexp(0.0, -x) def dpo_loss(policy_chosen, policy_rejected, ref_chosen, ref_rejected, beta=0.1): """DPO 二分类损失;四个输入都是整条回答的对数概率。""" arrays = [np.asarray(x, dtype=np.float64) for x in (policy_chosen, policy_rejected, ref_chosen, ref_rejected)] if not np.isfinite(beta) or beta <= 0: raise ValueError("beta must be positive and finite") if not arrays[0].size or any(x.shape != arrays[0].shape or not np.isfinite(x).all() for x in arrays): raise ValueError("logprobs need identical nonempty shapes and finite values") policy_chosen, policy_rejected, ref_chosen, ref_rejected = arrays policy_gap = policy_chosen - policy_rejected reference_gap = ref_chosen - ref_rejected logits = beta * (policy_gap - reference_gap) return -log_sigmoid(logits).mean(), logits def group_advantages(rewards, eps=1e-4, ddof=0): """完整有限奖励组;默认总体标准差,ddof=1 对照固定 TRL。""" rewards = np.asarray(rewards, dtype=np.float64) if rewards.ndim != 2 or not rewards.size or rewards.shape[1] < 2: raise ValueError("rewards must have shape [prompts,G] with G>=2") if not np.isfinite(rewards).all() or not np.isfinite(eps) or eps <= 0 or ddof not in (0, 1): raise ValueError("finite rewards, positive eps and ddof in {0,1} required") mean = rewards.mean(axis=1, keepdims=True) std = rewards.std(axis=1, keepdims=True, ddof=ddof) return (rewards - mean) / (std + eps) def grpo_loss(new_logps, old_logps, ref_logps, advantages, mask, clip_eps=0.2, beta=0.04): """逐序列平均的 token-ratio 代理目标;未加 KL 重要性校正。""" arrays = [np.asarray(x, dtype=np.float64) for x in (new_logps, old_logps, ref_logps, mask)] new_logps, old_logps, ref_logps, mask = arrays advantages = np.asarray(advantages, dtype=np.float64) if new_logps.ndim != 2 or not new_logps.size or any(x.shape != new_logps.shape for x in arrays): raise ValueError("logprobs and mask require the same nonempty [B,T] shape") if advantages.shape != (new_logps.shape[0],) or not np.isfinite(advantages).all(): raise ValueError("one finite advantage per sequence required") if not np.isfinite(mask).all() or not np.isin(mask, [0, 1]).all() or np.any(mask.sum(-1) == 0): raise ValueError("binary mask and at least one effective token per sequence required") if not np.isfinite(clip_eps) or not 0 < clip_eps < 1 or not np.isfinite(beta) or beta < 0: raise ValueError("0<clip_eps<1 and beta>=0 required") active = mask.astype(bool) if any(not np.isfinite(x[active]).all() for x in arrays[:3]): raise ValueError("effective token logprobs must be finite") # 在指数运算前遮掉 padding,避免 inf*0 或 NaN*0 污染有效 loss。 log_ratio = np.where(active, new_logps, 0) - np.where(active, old_logps, 0) ref_gap = np.where(active, ref_logps, 0) - np.where(active, new_logps, 0) with np.errstate(over="raise", invalid="raise"): ratio = np.exp(log_ratio) per_token_kl = np.expm1(ref_gap) - ref_gap clipped_ratio = np.clip(ratio, 1 - clip_eps, 1 + clip_eps) surrogate = np.minimum(ratio * advantages[:, None], clipped_ratio * advantages[:, None]) per_token_loss = -surrogate + beta * per_token_kl sequence_loss = (per_token_loss * mask).sum(axis=-1) / mask.sum(axis=-1) return sequence_loss.mean(), ratio, per_token_kl def softmax(logits): shifted = logits - logits.max() exp_logits = np.exp(shifted) return exp_logits / exp_logits.sum() def train_group_bandit(steps=80, group_size=32, seed=7, reward_table=None, beta=0.02, lr=0.18, clip_eps=0.2): """用 GRPO 训练四选一 bandit,展示无 critic 的在线更新。""" if steps < 1 or group_size < 2 or beta < 0 or lr <= 0 or not 0 < clip_eps < 1: raise ValueError("invalid training configuration") rng = np.random.default_rng(seed) logits = np.zeros(4, dtype=np.float64) reference_logits = np.zeros(4, dtype=np.float64) reward_table = np.asarray([-0.2, 0.3, 1.0, 0.0] if reward_table is None else reward_table, dtype=np.float64) if reward_table.shape != (4,) or not np.isfinite(reward_table).all(): raise ValueError("four finite rewards required") snapshots = [] for step in range(steps): old_logits = logits.copy() old_probs = softmax(old_logits) actions = rng.choice(4, size=group_size, p=old_probs) rewards = reward_table[actions] advantages = group_advantages(rewards[None, :])[0] old_selected = np.log(old_probs[actions]) ref_probs = softmax(reference_logits) ref_selected = np.log(ref_probs[actions]) # 同一组 rollout 做两轮 PPO 式复用;old_logprob 始终来自采样快照。 for _ in range(2): probs = softmax(logits) new_selected = np.log(probs[actions]) ratio = np.exp(new_selected - old_selected) active = ~(((advantages >= 0) & (ratio > 1 + clip_eps)) | ((advantages < 0) & (ratio < 1 - clip_eps))) # d[-min(rA, clip(r)A)]/d log pi,以及采样 KL 项的导数。 coefficient = -active.astype(np.float64) * ratio * advantages ref_gap = ref_selected - new_selected coefficient += beta * (1 - np.exp(ref_gap)) one_hot = np.eye(4)[actions] grad_logp = one_hot - probs[None, :] grad_logits = (coefficient[:, None] * grad_logp).mean(axis=0) logits -= lr * grad_logits if step in {0, 19, 39, steps - 1}: snapshots.append((step + 1, softmax(logits).copy())) return snapshots if __name__ == "__main__": np.set_printoptions(precision=4, suppress=True) policy_chosen = np.array([-2.2, -1.7]) policy_rejected = np.array([-2.8, -2.1]) ref_chosen = np.array([-2.0, -1.9]) ref_rejected = np.array([-2.4, -2.0]) loss_dpo, logits_dpo = dpo_loss( policy_chosen, policy_rejected, ref_chosen, ref_rejected ) print("=== DPO ===") print(f"pair_shape={policy_chosen.shape}") print(f"preference_logits={logits_dpo}") print(f"loss={loss_dpo:.4f}") rewards = np.array([[0.2, 0.8, 1.4, 0.6], [8.0, 9.0, 11.0, 12.0]]) advantages = group_advantages(rewards) print("\n=== GRPO group baseline ===") print(f"rewards.shape={rewards.shape}") print(f"advantages=\n{advantages}") print(f"row_mean={advantages.mean(axis=1)}") old_logps = np.log(np.array([ [0.30, 0.25, 0.20], [0.18, 0.22, 0.20], [0.12, 0.16, 0.20], [0.25, 0.20, 0.18], ])) new_logps = old_logps + np.array([ [0.25, 0.25, 0.25], [0.10, 0.10, 0.10], [-0.25, -0.25, -0.25], [-0.10, -0.10, -0.10], ]) ref_logps = old_logps - 0.05 mask = np.ones_like(old_logps) one_group_adv = group_advantages(np.array([[0.2, 0.8, 1.4, 0.6]]))[0] loss_grpo, ratio, kl = grpo_loss( new_logps, old_logps, ref_logps, one_group_adv, mask ) print("\n=== GRPO clipped objective ===") print(f"token_logps.shape={new_logps.shape}") print(f"ratio_first_token={ratio[:, 0]}") print(f"mean_kl={kl.mean():.6f}, loss={loss_grpo:.4f}") print("\n=== Online group bandit ===") print("step P(a0) P(a1) P(a2=best) P(a3)") for step, probs in train_group_bandit(): print(f"{step:>4} " + " ".join(f"{p:.4f}" for p in probs)) dpo_grpo_checks.py """独立检查 DPO 闭式解、组 baseline、KL 代理及原 bandit 的有限差分。 运行:python dpo_grpo_checks.py;只依赖 NumPy,无模型权重。 """ import itertools import json from pathlib import Path import numpy as np from dpo_grpo_minimal import dpo_loss, group_advantages, grpo_loss, softmax, train_group_bandit def finite_difference(fn, x, h=1e-6): out = np.empty_like(x) for index in np.ndindex(x.shape): plus, minus = x.copy(), x.copy() plus[index] += h minus[index] -= h out[index] = (fn(plus) - fn(minus)) / (2 * h) return out def run_checks(): result = {} q = np.array([0.2, 0.3, 0.5]) reward, beta = np.array([-0.5, 0.7, 1.1]), 0.6 z = np.sum(q * np.exp(reward / beta)) optimum = q * np.exp(reward / beta) / z rng = np.random.default_rng(17) errors = [] for p in rng.dirichlet(np.ones(3), size=200): objective = p @ reward - beta * np.sum(p * np.log(p / q)) identity = beta * np.log(z) - beta * np.sum(p * np.log(p / optimum)) errors.append(abs(objective - identity)) assert max(errors) < 2e-15 pairs = np.array([[-2.2, -2.8], [-1.7, -2.1]]) refs = np.array([[-2.0, -2.4], [-1.9, -2.0]]) fn = lambda a: dpo_loss(a[:, 0], a[:, 1], refs[:, 0], refs[:, 1])[0] loss, margins = dpo_loss(pairs[:, 0], pairs[:, 1], refs[:, 0], refs[:, 1]) coeff = -0.1 / (1 + np.exp(margins)) / len(pairs) analytic = np.column_stack([coeff, -coeff]) dpo_fd = np.max(np.abs(analytic - finite_difference(fn, pairs))) assert dpo_fd < 1e-9 before, after = np.array([0.4, 0.4, 0.2]), np.array([0.3, 0.15, 0.55]) compare = lambda p: float(dpo_loss(np.log(p[:1]), np.log(p[1:2]), np.log(q[:1]), np.log(q[1:2]))[0]) assert compare(after) < compare(before) and after[0] < before[0] swapped_loss, swapped_logits = dpo_loss(pairs[:,1], pairs[:,0], refs[:,0], refs[:,1]) assert np.allclose(swapped_logits, [-0.1,-0.05]) result['dpo'] = dict(loss=float(loss), logits=margins.tolist(), swapped_loss=float(swapped_loss), swapped_logits=swapped_logits.tolist(), fd_max_error=float(dpo_fd), optimum=optimum.tolist(), objective_identity_max_error=max(errors), absolute_chosen_counterexample=dict(before=before.tolist(), after=after.tolist(), loss_before=compare(before), loss_after=compare(after))) p, r, g = np.array([0.2, 0.3, 0.5]), np.array([-1.0, 0.2, 2.0]), 3 exact_gradient = p * (r - p @ r) centered, loo, standardized = np.zeros(3), np.zeros(3), np.zeros(3) for actions in itertools.product(range(3), repeat=g): a = np.array(actions) weight = np.prod(p[a]) rr = r[a] score = np.eye(3)[a] - p centered += weight * ((rr - rr.mean())[:, None] * score).mean(0) baseline = (rr.sum() - rr) / (g - 1) loo += weight * ((rr - baseline)[:, None] * score).mean(0) standardized += weight * (group_advantages(rr[None, :])[0, :, None] * score).mean(0) center_error = float(np.max(np.abs(centered - (1 - 1/g) * exact_gradient))) loo_error = float(np.max(np.abs(loo - exact_gradient))) assert center_error < 1e-15 and loo_error < 1e-15 normalized = standardized / exact_gradient assert np.ptp(normalized) > 0.01 gap_adv = [float(group_advantages(np.array([[0.0, gap]]))[0, 1]) for gap in [1.0, 0.01, 1e-5]] first = group_advantages(np.array([[0.0, 1.0, 2.0, 10.0]])) second = group_advantages(np.array([[0.0, 1.0, 9.0, 10.0]])) assert not np.allclose(first, second) result['baseline'] = dict(group_size=g, exact_reward_gradient=exact_gradient.tolist(), centered=centered.tolist(), leave_one_out=loo.tolist(), standardized=standardized.tolist(), standardized_component_ratios=normalized.tolist(), centered_max_error=center_error, loo_max_error=loo_error, two_sample_gaps=[1.0, 0.01, 1e-5], positive_advantages=gap_adv, equal_rank_different_gaps=[first.tolist(), second.tolist()]) p, q, old = np.array([0.7, 0.2, 0.1]), np.array([0.2, 0.3, 0.5]), np.array([0.3, 0.3, 0.4]) k = np.expm1(np.log(q / p)) - np.log(q / p) exact_kl = float(p @ np.log(p / q)) assert abs(p @ k - exact_kl) < 1e-15 and abs(old @ ((p/old)*k) - exact_kl) < 1e-15 # 固定采样权重 old,分别对裸 k 与未 detach 的 ratio*k 求导。 fn = lambda z: float(old @ (np.expm1(np.log(q / softmax(z))) - np.log(q / softmax(z)))) weighted = lambda z: float(old @ ((softmax(z)/old) * (np.expm1(np.log(q/softmax(z))) - np.log(q/softmax(z))))) true = lambda z: float(softmax(z) @ np.log(softmax(z)/q)) plain_grad = finite_difference(fn, np.log(p)) weighted_grad = finite_difference(weighted, np.log(p)) true_grad = finite_difference(true, np.log(p)) assert np.max(np.abs(weighted_grad - true_grad)) < 1e-9 # 在 old=p 采样点,裸 k 的期望梯度是 p-q,不等于真正 KL 的梯度。 self_fn = lambda z: float(p @ (np.expm1(np.log(q/softmax(z))) - np.log(q/softmax(z)))) self_grad = finite_difference(self_fn, np.log(p)) assert np.max(np.abs(self_grad - (p-q))) < 1e-9 assert np.max(np.abs(self_grad - true_grad)) > 0.05 result['kl'] = dict(exact=exact_kl, current_sample_expectation=float(p@k), old_sample_expectation=float(old@k), weighted_old_expectation=float(old@((p/old)*k)), self_sample_fixed_data_gradient=self_grad.tolist(), true_kl_gradient=true_grad.tolist(), corrected_gradient_max_error=float(np.max(np.abs(weighted_grad-true_grad))), old_fixed_surrogate_gradient=plain_grad.tolist()) # 不同长度、padding NaN 与空 mask 的真实边界。 mask = np.array([[1, 0, 0], [1, 1, 1]]) oldlog = np.log(np.full((2, 3), 0.2)); newlog = oldlog + 0.1 adv = np.array([1.0, -1.0]) masked = newlog.copy(); masked[mask == 0] = np.nan a = grpo_loss(masked, oldlog, oldlog, adv, mask, beta=0)[0] assert abs(a) < 1e-15 rejected = 0 invalid = [lambda:group_advantages([[1]]), lambda:group_advantages([[1,np.nan]]), lambda:group_advantages([[1,2]],eps=0), lambda:dpo_loss([1],[2],[3],[4],beta=0), lambda:grpo_loss(oldlog,oldlog,oldlog,adv,np.zeros_like(mask)), lambda:grpo_loss(oldlog,oldlog,oldlog,adv,np.full_like(mask,2))] for fn in invalid: try: fn() except ValueError: rejected += 1 assert rejected == len(invalid) result['mask'] = dict(equal_sequence_loss=float(a), invalid_inputs_rejected=rejected, padding_nan_ignored=True) # 完整 softmax 下的 token surrogate 梯度,含两个裁剪平台和两侧错误方向。 actions = np.array([0,1,2,3]); old_probs = np.array([0.1,0.4,0.3,0.2]); ref_probs=np.full(4,0.25) new_probs = np.array([0.2,0.2,0.4,0.2]); adv = np.array([1.2,-0.8,-1.1,0.5]); beta=0.04 def f(z): return grpo_loss(np.log(softmax(z))[actions,None],np.log(old_probs)[actions,None], np.log(ref_probs)[actions,None],adv,np.ones((4,1)),beta=beta)[0] ratio = new_probs / old_probs active = ~(((adv>=0)&(ratio>1.2))|((adv<0)&(ratio<0.8))) coefficient = -active.astype(float)*ratio*adv + beta*(1-ref_probs/new_probs) grad = (coefficient[:,None]*(np.eye(4)-new_probs)).mean(0) err = float(np.max(np.abs(grad-finite_difference(f,np.log(new_probs))))) assert err < 1e-9 result['surrogate_gradient'] = dict(fd_max_error=err, active=active.tolist()) variants = {'original':{}, 'small_group':{'group_size':2}, 'constant':{'reward_table':[1,1,1,1]}, 'near_gap':{'reward_table':[-0.2,0.3,0.31,0.0]}, 'strong_kl':{'beta':0.5}} rows = {} for name,kwargs in variants.items(): values=[train_group_bandit(seed=seed,**kwargs)[-1][1][2] for seed in range(10)] rows[name]=dict(seeds=list(range(10)),steps=80,config=kwargs,prob_best_mean=float(np.mean(values)), prob_best_min=float(min(values)),prob_best_max=float(max(values)),prob_best_all=[float(x)for x in values]) assert rows['constant']['prob_best_min']==rows['constant']['prob_best_max']==0.25 result['bandit_experiments']=rows result['original_seed7']=[dict(step=s,probs=p.tolist())for s,p in train_group_bandit()] result.update(passed=True,errors=[],warnings=[],numpy=np.__version__,scope='Finite categorical and synthetic losses; no language-model training or GPU throughput claim') return result if __name__ == '__main__': result=run_checks() Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,ensure_ascii=False,indent=2)+'\n',encoding='utf8') print(json.dumps(result,ensure_ascii=False,indent=2)) make_figures.py """生成 DPO/GRPO 教程的两张解释图。""" from pathlib import Path import matplotlib.pyplot as plt import numpy as np from dpo_grpo_minimal import group_advantages from matplotlib.patches import FancyBboxPatch ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, }) def box(ax, x, y, w, h, text, color): patch = FancyBboxPatch( (x, y), w, h, boxstyle="round,pad=0.02,rounding_size=0.03", facecolor=color, edgecolor="white", linewidth=1.5, ) ax.add_patch(patch) ax.text(x + w / 2, y + h / 2, text, ha="center", va="center", fontsize=12, weight="bold", color="#182238") def method_map(): fig, axes = plt.subplots(1, 3, figsize=(14, 4.6), facecolor="#f7f9fc") methods = [ ("PPO-RLHF", [("偏好对", "#dbeafe"), ("奖励模型", "#fde68a"), ("在线采样", "#ddd6fe"), ("Actor + Critic + Reference", "#fecaca")], "奖励模型 + critic 都要维护"), ("DPO", [("离线偏好对", "#dbeafe"), ("二分类损失", "#bbf7d0"), ("Policy + Reference", "#ddd6fe")], "省掉显式奖励模型和在线 RL"), ("GRPO", [("同题多回答", "#dbeafe"), ("规则/奖励打分", "#fde68a"), ("组内相对优势", "#bbf7d0"), ("Policy + Reference", "#ddd6fe")], "保留在线采样,省掉 critic"), ] for ax, (title, blocks, note) in zip(axes, methods): ax.set_xlim(0, 1) ax.set_ylim(0, 1) ax.axis("off") ax.set_title(title, fontsize=18, weight="bold", color="#172554", pad=14) gap = 0.08 h = (0.72 - gap * (len(blocks) - 1)) / len(blocks) y = 0.85 - h for text, color in blocks: box(ax, 0.12, y, 0.76, h, text, color) y -= h + gap ax.text(0.5, 0.03, note, ha="center", va="bottom", fontsize=11, color="#475569") fig.suptitle("三种对齐路线省掉的部件不同", fontsize=22, weight="bold", color="#0f172a", y=1.02) fig.tight_layout() fig.savefig(OUT / "alignment_method_map.png", bbox_inches="tight", facecolor=fig.get_facecolor()) plt.close(fig) def group_relative_plot(): rewards = np.array([[0.2, 0.8, 1.4, 0.6], [8.0, 9.0, 11.0, 12.0]]) advantages = group_advantages(rewards) fig, axes = plt.subplots(1, 2, figsize=(12, 4.8), facecolor="#f7f9fc") colors = ["#60a5fa", "#a78bfa", "#34d399", "#fb7185"] x = np.arange(4) for row, name in enumerate(["题目 A", "题目 B"]): axes[0].bar(x + (row - 0.5) * 0.18, rewards[row], width=0.18, label=name, color=colors[row]) axes[0].set_title("本例原始奖励尺度不同", fontsize=16, weight="bold") axes[0].set_xticks(x, [f"回答 {i+1}" for i in x]) axes[0].set_ylabel("reward") axes[0].legend(frameon=False) width = 0.34 axes[1].bar(x - width / 2, advantages[0], width=width, label="题目 A", color="#60a5fa") axes[1].bar(x + width / 2, advantages[1], width=width, label="题目 B", color="#a78bfa") axes[1].axhline(0, color="#334155", linewidth=1) axes[1].set_title("标准化仍保留相对分差", fontsize=16, weight="bold") axes[1].set_xticks(x, [f"回答 {i+1}" for i in x]) axes[1].set_ylabel("advantage") axes[1].legend(frameon=False) for ax in axes: ax.spines[["top", "right"]].set_visible(False) ax.grid(axis="y", alpha=0.18) fig.suptitle("GRPO:每道题自己组成一个参照系", fontsize=21, weight="bold", color="#0f172a", y=1.02) fig.tight_layout() fig.savefig(OUT / "group_relative_advantage.png", bbox_inches="tight", facecolor=fig.get_facecolor()) plt.close(fig) if __name__ == "__main__": method_map() group_relative_plot() print(OUT / "alignment_method_map.png") print(OUT / "group_relative_advantage.png")
-
AIGC 基本功|策略梯度与 PPO 基础-PPO AIGC 基本功|策略梯度与 PPO 基础-PPO 所属方向:对齐与强化学习 | 难度:核心必修 | 前置知识:无 关键词:策略梯度、REINFORCE、优势函数、GAE、PPO、裁剪、KL 约束 本文不要求先读其他树节点,但需要知道:条件概率描述给定状态时各动作的分布;期望是按概率加权平均;梯度给出参数的局部变化方向。$\pi_\theta(a\mid s)$ 对所有动作归一化为 1,$\nabla_\theta$ 表示对参数求导。后文从有限时域、离散动作推导,再说明连续动作与语言模型的接口边界。 01. 为什么需要它 先看一个很容易把模型训坏的场景。 设想一个调试场景,而非本文做过的模型训练实验:你有一个已经做过监督微调的语言模型,给同一个问题采样了若干回答,奖励模型认为其中一条更好。最直接的想法是:让模型提高这条回答的概率。于是你把它的对数概率乘上奖励,连续更新十轮。训练日志里的 reward 不断上升,重新采样时却发现模型开始反复输出奖励模型偏爱的句式,内容变长,语言能力下降,最后连原来会答的问题也答不好。 问题不只在奖励。至少有三笔账同时失控了: 信用分配:一个回答只得到一个总分,到底哪些 token 值得鼓励? 估计噪声:这条回答得 8 分,是动作真的好,还是题目本来就容易? 更新幅度:数据由旧策略采出,新策略反复使用同一批数据后已经变了,为什么还能继续把旧结论当真? 策略梯度解决第一笔账:把“提高期望奖励”变成对可采样策略的梯度。价值函数和优势估计解决第二笔账:把状态本身的难易扣掉,只保留“这个动作比预期好多少”。PPO 的裁剪目标处理第三笔账:允许一批昂贵样本做多轮更新,减少单个样本继续把新旧概率比往有利方向推远的激励;它并不施加硬约束。 这三层关系决定了后面的算法谱系。DPO 改写优化问题,GRPO 换掉价值网络,RLOO 换基线,很多 RLHF 系统再加入参考模型 KL、奖励归一化和长度处理。名字不断变,问题仍可追溯到三个量:优势怎么估、概率比怎么算、策略走多远。 02. 最小可用理解 先记住四句话: 单样本策略梯度中,正优势沿提高该动作对数概率的方向贡献梯度,负优势反向贡献;共享参数下,合并更新并不保证每个样本的概率都按各自优势变化。 优势 $A(s,a)$ 是采取动作 $a$ 后的回报,相对状态 $s$ 下平均预期的超额部分。 GAE 用参数 $\lambda$ 混合不同长度的 TD 残差。它能调节对 critic 与后续采样的依赖,偏差和方差是否单调变化取决于误差结构。 PPO-Clip 比较新旧策略的动作概率比 $\rho_t$;一旦更新已经朝有利方向超过 $1\pm\epsilon$,该样本的 surrogate 对 ratio 进入平台,不再提供继续沿此方向更新的激励。 把一次语言模型生成看成一条轨迹也很直观:状态是 prompt 加已经生成的 token,动作是下一个 token,策略是词表上的概率分布,终局奖励来自奖励模型。critic 预测“从当前前缀继续生成,平均还能拿多少分”,优势则问“刚才选的这个 token,让结局比平均预期好还是差”。 PPO 的 clip 不是把梯度值裁小,也不是保证 KL 一定不超过某个阈值。它裁的是替代目标里的概率比收益。这个区别是理解所有变体的入口。 03. 数学推导 3.1 从期望回报到策略梯度 考虑一个马尔可夫决策过程。$s_t$ 是时刻 $t$ 的状态,$a_t$ 是动作,$r_t$ 是环境在这一步给出的奖励,$\gamma\in[0,1]$ 是折扣因子。策略 $\pi_\theta(a_t\mid s_t)$ 由参数 $\theta$ 控制。有限时域下,状态还应包含时刻或剩余步数,使 $V(s)$ 不会把不同时域混在一起;初始分布、环境转移与奖励在本节不显式依赖 $\theta$。一条长度为 $T$ 的轨迹记作 $\tau=(s_0,a_0,r_0,\ldots,s_T)$,折扣回报为: $$R(\tau)=\sum_{t=0}^{T-1}\gamma^t r_t$$ 训练目标是让轨迹的期望回报最大: $$J(\theta)=\mathbb{E}_{\tau\sim\pi_\theta}[R(\tau)]$$ 轨迹概率由初始状态分布 $p(s_0)$、策略和环境转移 $p(s_{t+1}\mid s_t,a_t)$ 连乘得到: $$p_\theta(\tau)=p(s_0)\prod_{t=0}^{T-1}\pi_\theta(a_t\mid s_t)p(s_{t+1}\mid s_t,a_t)$$ 假设可以交换求导与期望、策略在被考虑动作上可微且有正概率;连续动作时把求和换成积分,并保持支持集等必要正则条件。对 $J$ 求梯度,并使用恒等式 $\nabla p=p\nabla\log p$: $$\nabla_\theta J(\theta)=\mathbb{E}_{\tau\sim\pi_\theta}[R(\tau)\nabla_\theta\log p_\theta(\tau)]$$ 环境转移不依赖 $\theta$,因此它在对数梯度中消失,只剩策略项: $$\nabla_\theta J(\theta)=\mathbb{E}\left[R(\tau)\sum_{t=0}^{T-1}\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]$$ 这就是 REINFORCE 的骨架。还可以利用“未来动作不能影响过去奖励”,把整条轨迹回报换成从 $t$ 开始的 reward-to-go: $$G_t=\sum_{l=0}^{T-t-1}\gamma^l r_{t+l}$$ 于是每个动作只为它之后的结果负责: $$\nabla_\theta J(\theta)=\mathbb{E}\left[\sum_{t=0}^{T-1}\gamma^t G_t\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]$$ 这里的 $\gamma^t$ 不能漏:本文从固定初始状态、折扣总回报 $J$ 出发,$G_t$ 的折扣却从当前步重新计起。只有 $\gamma=1$,或把该权重吸收到折扣状态访问分布时,才能省略显式 $\gamma^t$。实际 PPO 常把 rollout 的时间步均匀平均,这是常用替代目标,不应与上面的精确有限时域梯度混同。 若 $G_t$ 总为正,每个样本都对其所选动作贡献正向 score 梯度,但样本共享参数,梯度可能互相抵消,不能断言所有动作概率同时提高。这样的回报加权估计在上述条件下无偏,方差却可能很大。我们需要一个不改变期望梯度的参照物。 3.2 基线为什么可以减 从回报减去任何只依赖状态、不依赖本次动作的基线 $b(s_t)$,期望梯度不变。因为对固定状态 $s$: $$\mathbb{E}_{a\sim\pi_\theta}[b(s)\nabla_\theta\log\pi_\theta(a\mid s)]=b(s)\nabla_\theta\sum_a\pi_\theta(a\mid s)=0$$ 最常见的基线是状态价值函数: $$V^\pi(s_t)=\mathbb{E}_\pi[G_t\mid s_t]$$ 动作价值函数把本次动作也作为条件: $$Q^\pi(s_t,a_t)=\mathbb{E}_\pi[G_t\mid s_t,a_t]$$ 两者之差就是优势函数: $$A^\pi(s_t,a_t)=Q^\pi(s_t,a_t)-V^\pi(s_t)$$ $A>0$ 表示这个动作比该状态下的平均动作好,$A\lt0$ 表示更差。Actor 通过优势更新策略,critic 通过回归回报学习 $V$,所以这类方法叫 actor-critic。 这里的“不依赖动作”是条件于状态的统计要求。固定的 $b_\theta(s)$ 即使共享网络参数,也必须在 actor 的乘法项中停止梯度;否则还会多出对基线求导的项。用本条动作的回报拟合后立刻当作其基线,可能引入样本依赖偏差;例如单样本直接取 $b=G$,估计恒为零。独立旧数据或适当的留一法可以避免这种直接依赖,不能只靠 detach 修复它。 价值基线也不保证在所有参数化下方差最小。令 $g=\nabla_\theta\log\pi(a\mid s)$,对 $\mathbb E[\|(G-b)g\|^2\mid s]$ 关于标量 $b$ 求导,得到: $$b^*(s)=\frac{\mathbb E[G\|g\|^2\mid s]}{\mathbb E[\|g\|^2\mid s]}$$ 分母非零时这才是该单步 score 向量的最小方差基线;它不一定等于 $V(s)$,也不直接给出整条轨迹、跨时刻协方差下的最优基线。ppo_checks.py 的 Bernoulli 例子取好动作概率 0.8、奖励 $[1,0]$:不减基线、减 $V=0.8$、减 $b^*=0.2$ 的梯度期望都为 0.16,方差分别为 0.0064、0.0576、0。这个反例不否定 critic 的实用性,而是限定“减价值一定降方差”的说法。 3.3 从 TD 残差到 GAE 真实 $Q$ 和 $V$ 都不知道,只能估计。最短视的估计是一步 TD 残差: $$\delta_t=r_t+\gamma(1-d_t)V_\phi(s_{t+1})-V_\phi(s_t)$$ $V_\phi$ 是参数为 $\phi$ 的 critic,$d_t\in\{0,1\}$ 表示这一步后轨迹是否真正终止。若 $d_t=1$,就不能再 bootstrap 到下一个状态。若 critic 等于真实价值,条件于 $(s_t,a_t)$ 的 $\delta_t$ 期望是优势,但方差仍由即时奖励和转移噪声决定;critic 有系统误差时,它也会把误差直接传给 actor。 把未来多个 TD 残差加进来,会得到不同步数的优势估计。先对不含中途 reset 的单段轨迹,GAE 用指数权重把它们合在一起: $$\hat A_t^{\mathrm{GAE}(\gamma,\lambda)}=\sum_{l=0}^{T-t-1}(\gamma\lambda)^l\delta_{t+l}$$ 实际代码不需要为每个 $t$ 再套一层求和。由上式直接得到从后向前的递推: $$\hat A_t=\delta_t+\gamma\lambda c_t\hat A_{t+1}$$ 这里有两个不同掩码:$1-d_t$ 决定 TD 的未来价值能否 bootstrap,$c_t$ 决定能否继续传播同一 episode 的后续残差。真正终止时两者都是 0;时间上限截断并 reset 时,$d_t=0,c_t=0$,TD 使用 reset 前真实下一状态 的价值,却不能接上新 episode 的残差。普通中间步两者都是 1。仅因 rollout 窗口结束时也保留末状态价值,但有限递推设 $\hat A_T=0$,不借用尚未采到的残差。 两个极端很关键。$\lambda=0$ 时,$\hat A_t=\delta_t$,只看一步,通常减少长程采样噪声,但强依赖 critic,不能无条件保证方差更小。$\lambda=1$ 且轨迹正确终止时,TD 项会望远镜式相消,得到 $G_t-V(s_t)$,对未来 critic 误差不再敏感,但仍含当前状态基线误差,且把后续所有随机奖励都带了进来。若窗口在 $H$ 步后结束而非真正终止,望远镜相消只得到: $$\hat A_t=\sum_{l=0}^{H-1}\gamma^l r_{t+l}+\gamma^H V_\phi(s_{t+H})-V_\phi(s_t)$$ 因此仍依赖尾部 bootstrap。常见的 $\gamma=0.99,\lambda=0.95$ 是经验起点,不是定律。 训练 critic 时通常使用 value target: $$\hat V_t^{\mathrm{target}}=\hat A_t+V_\phi(s_t)$$ 实现时要区分 terminated 和因时间上限触发的 truncated。真正终止的状态没有未来价值;时间截断通常仍应 bootstrap。若真实后续价值为正,把截断也清零会造成低估;若它为负则会高估。反过来,仅保留 bootstrap 却继续跨 reset 递推,会混入下一条 episode 的奖励。本文旧接口 generalized_advantage_estimate 适合单段轨迹或真正终止边界;新增 gae_transitions 显式接收每条转移的 next_values、terminated、episode_ends,处理截断。 3.4 为什么需要新旧策略概率比 采样成本高,所以 PPO 会冻结采样策略 $\pi_{\theta_{\mathrm{old}}}$,用同一批轨迹对当前策略 $\pi_\theta$ 做多轮小批量更新。数据来自旧策略,目标却要描述新策略,动作重要性比在固定旧策略状态上校正动作分布;它不校正整条轨迹的状态访问分布,所以以下是局部替代目标: $$\rho_t(\theta)=\frac{\pi_\theta(a_t\mid s_t)}{\pi_{\theta_{\mathrm{old}}}(a_t\mid s_t)}=\exp(\log\pi_\theta-\log\pi_{\theta_{\mathrm{old}}})$$ 未裁剪的替代目标是: $$L^{\mathrm{PG}}(\theta)=\mathbb{E}_t[\rho_t(\theta)\hat A_t]$$ 刚开始新旧策略相同,$\rho_t=1$。如果 $\hat A_t>0$,增大该动作概率会使目标变大;如果 $\hat A_t<0$,减小概率会使目标变大。但在同一批数据上更新多轮后,某些比率可能冲到 1.8、0.2,旧数据已不能可靠描述新策略附近的行为。 3.5 PPO-Clip 的 min 到底裁了哪一边 PPO-Clip 的核心目标只有一行: $$L^{\mathrm{CLIP}}(\theta)=\mathbb{E}_t\left[\min\left(\rho_t\hat A_t,\mathrm{clip}(\rho_t,1-\epsilon,1+\epsilon)\hat A_t\right)\right]$$ 这里的 min 取较悲观的收益。它必须与优势的符号一起看: 当 $\hat A_t>0$,把好动作的概率比推到 $1+\epsilon$ 以上不再得分;但若概率比跌到 $1-\epsilon$ 以下,损失仍继续变差,算法不会保护错误方向。 当 $\hat A_t<0$,把坏动作的概率比压到 $1-\epsilon$ 以下不再得分;但若坏动作反而变得更可能,惩罚仍继续加重。 所以 clip 是单侧的乐观收益上限。它不会把所有比率强行夹回区间,也不会保证一次优化后每个样本都满足区间约束。一个 batch 内不同样本共享参数,更新某个样本可能把另一个样本推得更远。 PPO 通常最小化总损失,因此策略项前面带负号,再加 critic 的均方误差和熵奖励: $$\mathcal{L}_{\mathrm{total}}=-L^{\mathrm{CLIP}}+c_v\mathbb{E}_t[(V_\phi(s_t)-\hat V_t^{\mathrm{target}})^2]-c_e\mathbb{E}_t[\mathcal{H}(\pi_\theta(\cdot\mid s_t))]$$ $c_v$ 控制价值损失权重,$c_e$ 控制探索强度,$\mathcal H$ 是策略熵。LLM 对齐还常加入相对参考模型 $\pi_{\mathrm{ref}}$ 的 KL 惩罚: $$\tilde r_t^{\mathrm{rollout}}=r_t^{\mathrm{task}}-\beta\left(\log\pi_{\theta_{\mathrm{old}}}(a_t\mid s_t)-\log\pi_{\mathrm{ref}}(a_t\mid s_t)\right)$$ 上式写的是一轮 PPO 已采样并冻结的奖励:动作来自 $\pi_{\theta_{\mathrm{old}}}$,用采样时的 actor 与 reference log-prob 算 KL 奖励,再固定 GAE 和 value target。序列任务可把任务分数放在终步,KL 项逐有效生成 token 累加。不能在 minibatch 内偷偷把 old 换成不断变化的 current,再把它当成同一份固定训练标签;若另加可微 KL loss,应单独定义其采样分布与梯度路径。 单个 token 的 log-ratio 可能为负。对固定状态、动作按 old policy 采样且 reference 在其支持集上概率为正时,其期望才是 $D_{\mathrm{KL}}(\pi_{\mathrm{old}}\|\pi_{\mathrm{ref}})$。例子 $\pi_{\mathrm{old}}=[0.8,0.2]$、reference=$[0.5,0.5]$ 的两项为 0.4700 与 -0.9163,期望为 0.1927;把每个负项截成零会改变目标。沿轨迹累加还涉及 old policy 的状态访问分布与长度,不能把两个模型之间任意方向、任意归约的 KL 都叫同一约束。 注意这里有两个不同的“旧模型”。$\pi_{\theta_{\mathrm{old}}}$ 是本轮采样快照,用来计算 PPO ratio;$\pi_{\mathrm{ref}}$ 通常是固定的 SFT 参考模型,用来限制长期漂移。把两者混成一个模型,会把更新稳定性和行为保持两个问题混在一起。 3.6 把公式还原成一轮训练 一轮 PPO 可以按下面的顺序执行。顺序很重要,因为每个张量对应的策略版本不同。 第一步,冻结当前 actor 为 $\pi_{\theta_{\mathrm{old}}}$,用它与环境交互,保存每一步的状态、动作、奖励、old_logprob、critic value、终止标记。语言模型场景还要保存 completion mask,明确哪些位置真的是策略采出的动作。 第二步,在 rollout 末端决定是否 bootstrap。若轨迹真正终止,next_value=0;若只是采样窗口用完,则由 critic 估计最后状态价值。然后从后向前计算 $\delta_t$ 和 GAE。此时优势应视作固定训练标签,actor 更新不能反向穿过 GAE 进入旧 value。 第三步,用 $\hat V_t^{\mathrm{target}}=\hat A_t+V_{\mathrm{old}}(s_t)$ 构造 critic 目标。这里加的是采样时保存的旧 value。如果一边更新 critic 一边用新 value 重算 target,目标本身会追着模型移动。 第四步,打乱 rollout,切成 minibatch。当前 actor 对已经采过的动作重新计算 new_logprob,然后用对数概率之差求 ratio。直接先算概率再做除法容易在大词表和低概率动作上出现下溢。 第五步,分别计算未裁剪和裁剪后的 policy surrogate,逐样本取 min,再按有效动作 mask 求平均。同时计算 value loss、entropy bonus,以及可选的 reference KL。 第六步,反向传播并做梯度范数裁剪。一个 rollout 通常会被重复使用若干 epoch;每轮都用同一份 old_logprob,但 new_logprob 随参数更新而变化。若 approximate KL 超阈值,可以提前结束剩余更新。具体检查发生在 optimizer step 前还是后、阈值是否带倍率,要看实现;它不是投影,也不会自动回滚前一步。 第七步,丢弃这批 on-policy 数据,用更新后的 actor 重新采样。此时新策略成为下一轮的 old policy。PPO 能复用的是“一轮之内的有限次数”,并没有把数据永久变成离线训练集。 用张量形状检查这套流程也很有效。经典控制任务常见 reward/value/advantage/logprob 都是 [T, N],其中 $T$ 是 rollout 长度,$N$ 是并行环境数;语言模型常见 [B, L],其中 $B$ 是回答数,$L$ 是序列长度。若其中一个量形状不符,既可能报错,也可能在碰巧可广播时静默改变含义;例如 [B,1] 被扩到 [B,L]。后者,训练可能不会报错,却会让整条回答的每个 token 共享一个本不该共享的系数。 3.7 手算一条两步轨迹 用一个最小数字例子把 GAE 和 clip 接起来。设两步奖励为 $[0,1]$,critic 预测为 $[0.4,0.7]$,第二步后真正终止,$\gamma=0.9$。最后一步的 TD 残差是 $\delta_1=1-0.7=0.3$;第一步是 $\delta_0=0+0.9\times0.7-0.4=0.23$。当 $\lambda=0.95$ 时: $$\hat A_0=0.23+0.9\times0.95\times0.3=0.4865$$ 对应的 value target 为 $0.4865+0.4=0.8865$,接近完整 Monte Carlo 回报 $0+0.9\times1=0.9$。若 $\lambda=0$,target 只有 $0.23+0.4=0.63$,它完全相信 critic 对下一状态的 0.7 估计。这几个数把“依赖 critic”和“纳入远期真实奖励”的差别直接展开了。 再设旧策略给第一步动作的概率是 0.25,新策略更新后变为 0.30,则 ratio 为 $0.30/0.25=1.2$。若该动作优势为 0.4865,正好到 $\epsilon=0.2$ 的上边界;继续把概率推到 0.35 时,未裁剪收益会按 ratio=1.4 计算,裁剪收益仍只按 1.2 计算,min 选择后者。若优势改为负数,1.4 一侧不会被保护,因为提高坏动作概率应该继续受到惩罚。 这个例子也说明两个超参数的作用会通过优化过程耦合。$\lambda$ 改变优势的大小和噪声,进而改变样本多久撞上 clip;$\epsilon$ 决定同一批优势可以推动概率多远。只调其中一个而不观察 ratio 分布,往往解释不了训练曲线。 04. 代码实现 4.1 逐步算 GAE code/gae_minimal.py 只依赖 NumPy。它先对一条长度为 4 的固定轨迹从后向前递推,再模拟 20000 条随机轨迹,比较不同 $\lambda$ 下 value target 对真实 $V(s_0)$ 的偏差和方差。固定轨迹的真实输出是: rewards.shape=(4,), values.shape=(4,) lambda=0.00 delta=[0.1445 0.143 0.597 0.2 ] A=[0.1445 0.143 0.597 0.2 ] lambda=0.50 delta=[0.1445 0.143 0.597 0.2 ] A=[0.3858 0.4875 0.696 0.2 ] lambda=0.95 delta=[0.1445 0.143 0.597 0.2 ] A=[0.9734 0.8814 0.7851 0.2 ] lambda=1.00 delta=[0.1445 0.143 0.597 0.2 ] A=[1.0652 0.93 0.795 0.2 ] 同一行的 delta 不随 $\lambda$ 变化,因为它只由一步奖励和 critic 决定;$\lambda$ 改变的是未来残差往前传播的强度。最后一步已经终止,所以四组优势都等于 0.2。 随机实验故意给 critic 加入固定误差,结果是: episodes=20000, true_V0=4.2083, critic_V0=4.5083 lambda mean bias std mse 0.00 3.3133 -0.8950 0.7941 1.4315 0.50 3.8265 -0.3818 0.9201 0.9924 0.95 4.1767 -0.0316 1.8754 3.5181 1.00 4.2130 0.0048 2.2029 4.8529 $\lambda$ 从 0 增大到 1,本次有限样本偏差从 -0.8950 降到接近 0,标准差从 0.7941 增至 2.2029。这里比较的是固定状态的 value target,不直接等于 actor 梯度估计的偏差或方差。在正文列出的四个候选中,$\lambda=0.5$ 的均方误差最低;换一个 critic 误差和奖励噪声,最优点也会移动。这展示了一个具体折中,不是任意环境下的单调定律。 这个实验的状态按时间确定,八步奖励彼此独立,均值 $\mu_k$ 从 0.2 到 0.9,标准差 $\sigma=0.8$;critic 固定,不参与拟合。设 $q=\gamma\lambda$,真正终止时尾部价值为零,展开递推可得: $$\hat V_0^{\mathrm{target}}=\sum_{k=0}^{7}q^k r_k+\gamma(1-\lambda)\sum_{k=1}^{7}q^{k-1}V_\phi(s_k)$$ 因此其期望把 $r_k$ 换成 $\mu_k$ 即可,方差为 $\sigma^2\sum_{k=0}^{7}q^{2k}$。这也解释了当前状态 $V_\phi(s_0)$ 在 target 中相消。脚本给出的解析偏差依次为 -0.8910、-0.3814、-0.0348、0,解析标准差为 0.8000、0.9207、1.8617、2.1857;20000 样本均值的标准误分别为 0.0057、0.0065、0.0132、0.0155。末行样本偏差 0.0048 小于一个标准误,不是 $\lambda=1$ 的结构性偏差。若奖励相关、状态随机或尾部截断,上面的独立噪声方差公式就需要重写。 图 1:同一随机环境与 critic 误差下,$\lambda$ 改变了偏差和方差的配比。曲线由 make_figures.py 根据 seed=7、20000 条轨迹生成,并叠加解析矩;左图是奖励单位,右图 MSE 是奖励平方单位,不共用纵轴。 4.2 看懂裁剪的符号 code/ppo_clip_minimal.py 先列出单样本裁剪表。下面四行足以解释 min: ratio A ratio*A clip(ratio)*A min clipped? 1.35 1.0 1.350 1.200 1.200 yes 0.65 1.0 0.650 0.800 0.650 no 1.35 -1.0 -1.350 -1.200 -1.350 no 0.65 -1.0 -0.650 -0.800 -0.800 yes 第一行是好动作已经涨太多,因此收益停在 1.2。第二行是好动作被错误地下调,目标仍取更差的 0.65。第三行是坏动作被错误地上调,惩罚保留 -1.35。第四行才是坏动作下降过多后停止继续奖励。clip 只截断“继续沿正确方向冲得更远”的激励。 图 2:蓝色阴影是 $[1-\epsilon,1+\epsilon]$。正优势在右侧形成平台,负优势在左侧形成平台,另一侧继续保留惩罚。 脚本还构造了一个两臂老虎机:旧策略给好、坏动作各 0.5 概率,用两动作的精确旧分布期望更新 40 轮,没有实际采样一批动作。这里把优势直接固定为 $[+1,-1]$,用于隔离目标与优化的关系,不包含 critic、rollout 噪声或完整 PPO 训练。不裁剪时,好动作概率一路升到 0.9492,新旧策略 KL 达 0.8231;PPO-Clip 在第三轮越过 1.2 附近后梯度归零,停在 0.6097,KL 为 0.0246: mode epoch p(good) ratio_good grad KL(old||new) unclipped 3 0.6097 1.2193 0.4890 0.0246 unclipped 40 0.9492 1.8984 0.0990 0.8231 PPO-Clip 3 0.6097 1.2193 0.4890 0.0246 PPO-Clip 40 0.6097 1.2193 0.0000 0.0246 为什么停在 1.2193 而不是精确的 1.2?因为脚本用有限学习率做离散更新,第三步从区间内跨到了区间外,跨过以后才失去梯度。真实神经网络也会出现这种越界,所以还要监控 approximate KL,并在过大时提前停止 epoch。 05. 工业级实现对照 工业对照固定到 Stable-Baselines3 v2.7.0,不随主分支漂移。主要锚点是 PPO.train、RolloutBuffer 的 GAE 方法 和 OnPolicyAlgorithm.collect_rollouts。这是经典环境 PPO 的参考,不能直接当作 LLM trainer 的完整实现。最小脚本与工业实现的差别主要有六处: rollout buffer:工业实现保存 observation、action、old log-prob、value、reward、termination mask,并在采样结束后统一算 GAE。old log-prob 必须冻结,不能在每个 epoch 重算。 优势标准化:常见实现按 minibatch 或整批做 $(A-\mu)/(\sigma+\varepsilon)$。它通常改善数值尺度,却会让一个样本的梯度依赖同批其他样本;batch 太小还可能产生不稳定统计量。 多轮 minibatch:Stable-Baselines3 的默认参数明确包含 n_epochs=10、gamma=0.99、gae_lambda=0.95、clip_range=0.2。这些是基准默认值,不应脱离任务直接复制。 价值函数处理:actor 与 critic 常共享 backbone,并用 vf_coef 合并损失;一些实现还裁剪 value 更新。value clipping 的尺度受奖励缩放影响,不能把 policy clip 的 $\epsilon$ 无脑复用。 额外护栏:v2.7.0 的 max_grad_norm=0.5、ent_coef=0.0、target_kl=None、clip_range_vf=None。因此熵 bonus、KL early stop、value clipping 都不是默认开启;学习率可用 schedule,不能把默认常数叫作自动退火。ratio clip 本身不足以保证更新很小。 LLM 的 token mask:prompt token、padding 和 completion token 必须分开。策略损失通常只落在生成 token 上;序列末端奖励要变成 token 级回报,KL 往往逐 token 计算。错误的 mask 会把 padding 当动作,或者让 prompt 本身参与优化。 本轮实际把上述三个未改写的源码方法或代码块抽出,在最小 CPU policy、buffer、logger 夹具中执行;不是安装整套 SB3 后训练环境。使用 PyTorch 2.10.0+cpu,单个 minibatch、离散两动作、SGD 学习率 0.1:未标准化优势 $[1,-1,0.5,-0.5]$ 时 logits 从 $[0,0]$ 变为 $[0.0375,-0.0375]$,value 从 0 变为 0.075;打开标准化后 logits 为 $[0.041079,-0.041079]$。另验证 value clip、截断修正和 KL 提前停止。教学 NumPy 脚本的数值梯度与解析梯度最大差 $1.69\times10^{-11}$;GAE 递推与直接有限求和最大差 $8.89\times10^{-16}$。这些是实现一致性证据,不是任务学习效果或 GPU 性能复现。 在 RLHF 里还要额外记录 reward/score、reward/non_score_reward、policy/approxkl、policy/clipfrac、loss/value、熵、响应长度和终止比例。只看总 reward 上升无法判断是任务能力提高、KL 惩罚变化,还是模型学会钻奖励与长度的空子。 5.1 指标应该怎样联读 clipfrac 必须先确认实现口径:常见日志统计 $|\rho_t-1|>\epsilon$,但真正进入目标平台还要满足“正优势且 ratio 过大”或“负优势且 ratio 过小”。越界比例不等于梯度被截断比例。它长期接近 0,可能说明学习率过小、epoch 太少、优势太弱,也可能只是策略已经接近局部平稳;它突然接近 1,说明新旧动作概率已大幅偏离,应结合优势符号与 KL 判断;错误方向的越界样本仍有纠正梯度。单独追求某个“漂亮”的 clipfrac 没有意义,应与 KL、entropy 和 reward 一起看。 SB3 v2.7.0 令 $\ell_t=\log\pi_\theta-\log\pi_{\mathrm{old}}$,使用 $\widehat K=\mathrm{mean}(\exp(\ell_t)-1-\ell_t)$。固定旧状态、动作按 old policy 精确平均且支持一致时,$\mathbb E_{\mathrm{old}}[\exp(\ell)-1]=0$,于是期望等于 $D_{\mathrm{KL}}(\pi_{\mathrm{old}}\|\pi_\theta)$;有限 minibatch 只是估计,也不是相对 reference 的 KL。该版本在 当前 optimizer step 之前 检查是否超过 $1.5\,\texttt{target\_kl}$,触发后停止后续训练,不回滚已有更新。本轮大步长夹具中,第一步已把 logits 推到 $[1.875,-1.875]$,第二次检查才停止;这直接说明 early stop 也不是硬 KL 保证。 approximate KL 快速增大而 reward 没有改善,通常先检查学习率、更新 epoch、优势尺度和 mask。如果 KL 很小、entropy 很快下降,则可能是分布变化集中在少数关键 token,平均 KL 把局部坍缩稀释了,需要再看 token 级分位数或最大值。 critic loss 下降也不一定是好消息。若 explained_variance 仍接近 0,critic 可能只学会了回报均值;若训练 loss 很低而新 rollout 上的 value error 很高,critic 在记忆同批噪声。此时 actor 收到的优势基线并不可靠。可以检查优势均值、标准差、与 return 的相关性,并把 value 网络的学习轮数与 actor 分开调节。 语言模型还有一个常见组合信号:任务 reward 上升、KL 惩罚绝对值变大、回答长度持续增加、人工质量不升。它常意味着奖励模型偏好长度或某种格式,策略在用分布漂移换分。解决顺序应是先按长度和题型切片评估奖励,再检查 EOS 奖励与 truncation,最后才调整 $\beta$。只增大 KL 系数会把症状压住,却不能修复有偏的反馈。 5.2 一个最小验收清单 正式放大训练前,可以用小 batch 做四个不依赖最终 reward 的验收。新旧模型完全一致时,所有有效位置的 ratio 应接近 1,approximate KL 应接近 0;把优势全设为 0 后,policy loss 对 actor 的梯度应为 0;交换优势正负号后,选中动作的更新方向应反转;只改变 padding 内容而保持 mask 不变时,损失应不变。这些是必要的局部检查,不能宣称抓住“大部分”错误。零优势只保证纯 policy surrogate 的梯度为零:总损失的熵、KL 或共享 critic 仍可改变 actor;翻转优势的方向测试应在 ratio=1、未 clip 的局部执行。padding 不变性测试必须让有效 token 的上下文与位置也保持不变,不能任意改动可被模型关注的上下文。 06. 代价与边界 PPO 的优点是实现直接、可对 actor 和 critic 使用普通一阶优化器、同一批 rollout 可以复用多个 epoch。它的代价也很具体。 第一,PPO 仍是 on-policy 算法。ratio 能容忍有限的策略变化,却不能把很久以前的 replay data 变成可靠的当前策略数据。生成模型的 rollout 很贵,这也是许多对齐算法试图绕开在线 PPO 的原因。 第二,critic 会占显存、计算和调参预算。GAE 的质量由奖励噪声、value 误差、终止处理共同决定。critic 拟合得太慢,优势带偏;拟合得太快,又可能记住同一批高噪声回报。 第三,clip 是代理目标的启发式约束。它不等价于 TRPO 的显式 trust region,也不保证真实期望回报单调上升。大 batch、较小学习率、较少 epoch 和 target KL 能降低风险,仍需用新 rollout 验证。 第四,奖励尺度会渗透到整个系统。优势标准化能消除一部分尺度问题,critic loss、value clipping、梯度竞争和终止奖励仍受影响。LLM 的序列长度还会改变 token 级 KL 总量,导致长回答受到更大惩罚或获得更多优化机会。 以下情况不适合直接上 PPO:没有可信在线奖励或无法持续采样;若只有离线偏好对且目标适合偏好优化;离线数据远多于在线交互预算;约束必须严格满足而当前方案只有软惩罚;环境极端稀疏奖励且 critic 没有可学习信号。此时应先解决反馈、数据或约束建模,而不是把希望寄托在 clip 上。 调试时也应先分清“估计坏了”还是“优化走远了”。前者常表现为优势高噪声、critic 解释方差差、不同随机种子更新方向不稳定,应检查奖励、bootstrap 和 GAE;后者常表现为前几个 minibatch 正常,随后 ratio、KL、clipfrac 一起升高,应减少学习率、epoch 或启用 KL early stop。两类问题都会造成 reward 抖动,但修复手段完全不同。 还要保留旧策略下的原始 rollout 指标。只比较更新后的 loss 无法回答“策略是否真的更好”;每轮更新后用新策略重新采样,并按任务、长度和难度切片比较回报,才能排除同一批数据上的代理目标过拟合。至少运行多个随机种子,因为一次 rollout 的偶然高分足以让小样本实验得出相反结论。 07. 经典论文脉络 REINFORCE:Williams 在 1992 年的 Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning 给出基于采样回报和 log-derivative 的经典策略梯度形式,优点是通用,主要问题是方差高。 TRPO:Trust Region Policy Optimization(2015)用 KL 约束和二阶近似限制策略更新,为“旧数据上走多远”给出更严格的处理,但实现复杂。 GAE:High-Dimensional Continuous Control Using Generalized Advantage Estimation(2015)把 TD($\lambda$) 思想用于优势估计,明确控制 bias 与 variance。 PPO:Proximal Policy Optimization Algorithms(2017)用 clip 或 KL penalty 构造易实现的一阶替代目标,让同一批数据可做多轮 minibatch 更新。 InstructGPT:Training language models to follow instructions with human feedback(2022)展示了 SFT、奖励模型和 PPO 组合成语言模型 RLHF 流水线的代表性实践,也让参考模型 KL 成为对齐工程中的常见组件。 这条演进线并不是“新论文淘汰旧论文”。REINFORCE 给出梯度来源,GAE 改善估计,TRPO/PPO 限制更新,RLHF 再把状态、动作、奖励和约束映射到序列模型。后续算法通常只替换其中一到两块。 08. 常见误解 误解一:优势为正就说明奖励为正 优势是相对量。一个回答奖励为 -2,如果当前 prompt 下平均只能拿 -5,它的优势仍可能为正;一个回答奖励为 9,如果该状态平均是 9.5,它的优势反而为负。策略更新比较的是条件基线,不是绝对分数。 误解二:把优势乘常数不会影响训练 纯策略梯度方向不变,但真实 PPO 还有固定学习率、clip、value loss、熵和 KL 项。优势尺度改变后,各损失的相对权重、越过 clip 边界的速度都会改变。优势标准化是训练定义的一部分,不能只当日志美化。 误解三:ratio 超出区间后一定没有梯度 只有“超出区间且方向有利”的样本会被截断。好动作概率下降得太多、坏动作概率上升得太多时,目标仍保留梯度去纠正。04 节的四行表比背公式更可靠。 误解四:PPO clip 就是 KL trust region clip 在采样动作上限制替代收益,KL 衡量固定状态下整个动作分布的变化。ppo_checks.py 取旧分布 $[0.5,0.25,0.25]$、新分布 $[0.6,0.4-10^{-10},10^{-10}]$:只观测第一动作时 ratio 为 1.2,但全分布 $D_{\mathrm{KL}}(\pi_{\mathrm{old}}\|\pi_\theta)=5.2012$。未观测动作可发生很大变化,目标平台无法给它们施加硬限制。一个低概率 token 的概率可以相对变化很多而对平均 KL 贡献有限;许多小变化也可能累积出较大 KL。工程实现常同时监控 ratio、clip fraction 和 KL。 误解五:episode 截断等于终止 死亡、成功等真实终止意味着后续价值为零;时间上限只是观察窗口结束,底层状态可能仍有价值。两者都清零 bootstrap 会使 rollout 尾部的 value target 偏低。LLM 的最大长度是否 bootstrap 取决于任务定义:若上限本身就是任务终局,应按有限时域终止;若只是外部采样窗口,才考虑尾部价值。EOS 也要按具体奖励任务的终局语义处理,不能只按一个 token 名称机械判断。 误解六:old policy 和 reference policy 是同一个概念 old policy 是一轮 PPO 的行为策略快照,几轮 minibatch 后就会更新;reference policy 是长期锚点,通常在 RL 开始时冻结。前者服务于重要性采样,后者服务于行为约束。 09. 动手验证 先在仓库根目录运行: python3 outputs/fundamentals_files/policy_gradient/code/gae_minimal.py python3 outputs/fundamentals_files/policy_gradient/code/ppo_clip_minimal.py 再运行: python3 outputs/fundamentals_files/policy_gradient/code/ppo_checks.py 检查双掩码、有限窗口、解析矩、基线方差、共享参数与 KL 反例。两步截断例的 reward=$[1,100]$、value=$[2,50]$;第一步 reset 前末状态 value=3,$\gamma=0.9$。正确第一步 target 是 $1+0.9\times3=3.7$,不能用 reset 后的 value=50,也不能接上第二条 episode 的 residual。 接着做三个小改动,每次只改一个变量并记录输出。 调用 bias_variance_demo,设置 critic_scale=0.0。本实验的全部 $\lambda$ 解析偏差都变为零,样本均值仍会有误差;奖励独立且 critic 固定时,较小 $\lambda$ 的 target 方差较小。 调用 bias_variance_demo(sigma=0.1),把奖励噪声标准差从 0.8 改为 0.1。完整 Monte Carlo target 的方差会明显下降,$\lambda=1$ 的代价随之减小。 把 ppo_clip_minimal.py 的学习率从 0.3 改为 0.03。PPO-Clip 会更接近 ratio=1.2 后才停住,说明 clip 边界不是参数投影,离散优化仍会跨界。 最后给脚本加入 target_kl=0.02 的提前停止条件:每轮更新后计算 KL(old||new),超过阈值就停止。比较它与 ratio clip 的停止轮数。你会看到两种护栏观察的是不同量,也会理解工业实现为什么常把它们同时保留。 10. 延伸阅读 读完这篇可以继续看: 从 DPO 到 GRPO:去掉价值网络:这是本节点的直接后继;比较偏好优化、组内相对优势与 PPO critic,追踪各自改变的目标或估计器。 把 RL 用到扩散模型上:继续分清生成过程的采样分布与重要性比。 视频生成中的强化学习与奖励模型:观察奖励定义、长度和任务评测之间的关系。回到开头那三个问题,现在可以逐项检查任何新对齐算法:它用什么分配信用,用什么基线或优势降低噪声,用什么机制约束策略变化。只要这三项说清楚,新名词就不会遮住算法真正改变的地方。 附录:完整代码 09 节用到的脚本全文如下(ppo_checks.py、gae_minimal.py、make_figures.py、ppo_clip_minimal.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 ppo_checks.py """Independent numerical checks for the PPO article; no environment training.""" import json from pathlib import Path import numpy as np from gae_minimal import gae_transitions, generalized_advantage_estimate, analytic_target_stats from ppo_clip_minimal import clipped_surrogate, bandit_objective, finite_difference_gradient, optimize_same_batch def main(): rng = np.random.default_rng(71) gamma, lam = .9, .95 d, a, target = gae_transitions([1, 100], [2, 50], [3, 0], [0, 1], [1, 1], gamma, lam) assert np.allclose(a, [1.7, 50]) and np.allclose(target, [3.7, 100]) d2, a2, t2 = gae_transitions([0, 1], [.4, .7], [.7, 2], [0, 0], [0, 0], .9, 1) assert np.allclose(t2, [2.52, 2.8]) old = generalized_advantage_estimate([0, 0, 1, .5], [.4, .55, .7, .3], [0, 0, 0, 1], 0, .99, .95) general = gae_transitions([0, 0, 1, .5], [.4, .55, .7, .3], [.55, .7, .3, 0], [0, 0, 0, 1], [0, 0, 0, 1], .99, .95) assert all(np.array_equal(x, y) for x, y in zip(old, general)) # Direct residual summation, independently of reverse recursion. error = 0. for _ in range(50): n = 7 rew, val, nxt = rng.normal(size=(3, n)) ends = rng.integers(0, 2, n) terms = ends * rng.integers(0, 2, n) delta, adv, _ = gae_transitions(rew, val, nxt, terms, ends, .93, .71) direct = np.zeros(n) for t in range(n): weight = 1. for k in range(t, n): direct[t] += weight * delta[k] weight *= .93 * .71 * (1 - ends[k]) error = max(error, float(np.max(np.abs(direct - adv)))) assert error < 2e-15 # Exact finite-action policy gradient; environment rewards do not depend on theta. sigmoid = lambda x: 1 / (1 + np.exp(-x)) theta, discount = .37, .9 def objective(x): return sigmoid(x) + discount * 2 * sigmoid(2 * x) exact = 0. ps = [sigmoid(theta), sigmoid(2 * theta)] for x in (0, 1): for y in (0, 1): prob = (ps[0] if x else 1-ps[0]) * (ps[1] if y else 1-ps[1]) exact += prob * ((x + discount*2*y) * (x-ps[0]) + discount * (2*y) * 2*(y-ps[1])) fd = (objective(theta+1e-5)-objective(theta-1e-5))/2e-5 assert abs(exact-fd) < 1e-9 # A value baseline is unbiased, but is not necessarily variance minimizing. p = np.array([.8, .2]); rewards = np.array([1., 0.]); scores = np.array([.2, -.8]) stats = {} for label, base in [('zero', 0.), ('value', .8), ('optimal', .2)]: samples = (rewards-base)*scores mean = p @ samples stats[label] = dict(baseline=base, mean=float(mean), variance=float(p @ (samples-mean)**2)) assert np.isclose(stats['optimal']['variance'], 0) and stats['value']['variance'] > stats['zero']['variance'] # Two positive advantages share theta but opposing feature gradients. direction = (.5 - 5.) / 2 new_p = sigmoid(.02*direction) assert new_p < .5 # Clip derivative away from the nondifferentiable boundaries. clip_error = 0. for ratio in [.65, .95, 1.1, 1.35]: for adv in [-2., 1.]: step = 1e-6 fun = lambda r: float(clipped_surrogate(r, adv)[2]) got = (fun(ratio+step)-fun(ratio-step))/(2*step) expected = 0 if (adv>0 and ratio>1.2) or (adv<0 and ratio<.8) else adv clip_error = max(clip_error, abs(got-expected)) assert clip_error < 1e-9 bandit_errors = [] for x in [-2., -.1, .1, .2, .8, 2.]: prob = sigmoid(x) for clip in [False, True]: expect = 0 if clip and prob > .6 else 2*prob*(1-prob) bandit_errors.append(abs(finite_difference_gradient(x, clip)-expect)) assert max(bandit_errors) < 1e-9 # Unobserved actions: observed ratio alone cannot bound full KL. old_probs = np.array([.5, .25, .25]); new_probs = np.array([.6, .4-1e-10, 1e-10]) kl = float(old_probs @ np.log(old_probs/new_probs)) ratio = new_probs/old_probs approx = float(old_probs @ ((ratio-1)-np.log(ratio))) assert abs(kl-approx) < 1e-14 and kl > 5 ref = np.array([.5, .5]); cur = np.array([.8, .2]); terms = np.log(cur/ref) assert terms[1]<0 and cur@terms>0 # Gaussian reward moments and Monte Carlo standard errors. means=np.linspace(.2,.9,8); true_values=np.array([sum(.99**k*means[t+k] for k in range(8-t)) for t in range(8)]) val=true_values+np.array([.3,-.9,.35,-.25,.2,-.15,.1,-.05]) noise=np.random.default_rng(7).normal(means,.8,size=(20000,8)); rows=[] for l in [0.,.5,.95,1.]: weights=(.99*l)**np.arange(8) estimates=noise@weights+.99*(1-l)*(weights[:-1]@val[1:]) mean,bias,var=analytic_target_stats(means,val,.8,.99,l) se=np.sqrt(var/len(noise)); assert abs(estimates.mean()-mean)<4*se rows.append(dict(lam=l,mean=float(estimates.mean()),bias=float(estimates.mean()-true_values[0]),std=float(estimates.std()),mse=float(np.mean((estimates-true_values[0])**2)),theory_bias=bias,theory_std=float(np.sqrt(var)),mean_se=float(se))) # Exact-value critic has zero expectation bias for every lambda in this setup. assert max(abs(analytic_target_stats(means,true_values,.8,.99,l)[1]) for l in [0,.5,.95,1]) < 2e-15 out=dict(passed=True,gae_direct_sum_max_error=error,truncation_advantages=a.tolist(),truncation_targets=target.tolist(),window_lambda1_targets=t2.tolist(),exact_policy_gradient=exact,finite_difference_gradient=fd,policy_gradient_error=abs(exact-fd),baseline_examples=stats,shared_positive_advantage_first_probability=float(new_p),clip_derivative_max_error=clip_error,bandit_gradient_max_error=max(bandit_errors),unobserved_action_kl=kl,exact_kl_estimator_error=abs(kl-approx),reference_sample_logratios=terms.tolist(),reference_forward_kl=float(cur@terms),moments=rows,bandit_clipped_snapshots=optimize_same_batch(True),errors=[],warnings=[]) dest=Path(__file__).with_name('validation_results.json');dest.write_text(json.dumps(out,indent=2,ensure_ascii=False),encoding='utf8') print(json.dumps(out,indent=2,ensure_ascii=False)) if __name__ == '__main__': main() gae_minimal.py #!/usr/bin/env python3 """用 NumPy 展示 GAE 递推,以及 lambda 的偏差—方差折中。 依赖:numpy。运行:python3 gae_minimal.py """ import numpy as np def gae_transitions(rewards, values, next_values, terminated, episode_ends, gamma, lam): """Each transition supplies its actual next-state value, before any auto-reset. terminated stops bootstrap; episode_ends stops GAE across a reset, including time-limit truncation. A rollout window end alone needs no terminal flag. All inputs have shape [T]; this routine does not batch or broadcast inputs. """ arrays = [np.asarray(x, dtype=np.float64) for x in (rewards, values, next_values, terminated, episode_ends)] rewards, values, next_values, terminated, episode_ends = arrays if rewards.ndim != 1 or not len(rewards) or any(x.shape != rewards.shape for x in arrays): raise ValueError("Inputs must share a nonempty shape [T]") if not (0 <= gamma <= 1 and 0 <= lam <= 1): raise ValueError("gamma and lambda must be in [0, 1]") if any(np.any((x != 0) & (x != 1)) for x in (terminated, episode_ends)): raise ValueError("Flags must be binary") if np.any(terminated > episode_ends): raise ValueError("A termination must also end the episode") deltas = rewards + gamma * (1 - terminated) * next_values - values advantages = np.zeros_like(rewards) carry = 0.0 for t in reversed(range(len(rewards))): carry = deltas[t] + gamma * lam * (1 - episode_ends[t]) * carry advantages[t] = carry return deltas, advantages, advantages + values def analytic_target_stats(reward_means, values, sigma, gamma, lam): """Exact moments for independent rewards, fixed values, terminal V_T=0.""" means = np.asarray(reward_means, dtype=np.float64) weights = (gamma * lam) ** np.arange(len(means)) mean = weights @ means mean += gamma * (1 - lam) * np.dot(weights[:-1], values[1:]) variance = sigma ** 2 * np.dot(weights, weights) truth = gamma ** np.arange(len(means)) @ means return float(mean), float(mean - truth), float(variance) def generalized_advantage_estimate(rewards, values, dones, next_value, gamma, lam): """单段旧接口;dones 仅表示真正终止,不支持中途截断后 auto-reset。""" rewards = np.asarray(rewards, dtype=np.float64) values = np.asarray(values, dtype=np.float64) dones = np.asarray(dones, dtype=np.float64) advantages = np.zeros_like(rewards) deltas = np.zeros_like(rewards) gae = 0.0 for t in reversed(range(len(rewards))): value_next = next_value if t == len(rewards) - 1 else values[t + 1] not_done = 1.0 - dones[t] deltas[t] = rewards[t] + gamma * not_done * value_next - values[t] gae = deltas[t] + gamma * lam * not_done * gae advantages[t] = gae return deltas, advantages, advantages + values def fixed_trajectory_demo(): rewards = np.array([0.0, 0.0, 1.0, 0.5]) values = np.array([0.40, 0.55, 0.70, 0.30]) dones = np.array([0, 0, 0, 1]) gamma = 0.99 print("=== 固定轨迹 ===") print(f"rewards.shape={rewards.shape}, values.shape={values.shape}") for lam in (0.0, 0.5, 0.95, 1.0): deltas, advantages, targets = generalized_advantage_estimate( rewards, values, dones, next_value=0.0, gamma=gamma, lam=lam ) print( f"lambda={lam:>4.2f} delta={np.round(deltas, 4)} " f"A={np.round(advantages, 4)} target={np.round(targets, 4)}" ) def bias_variance_demo(seed=7, episodes=20000, sigma=0.8, critic_scale=1.0): """比较 GAE value target 对真实 V(s_0) 的偏差、标准差和均方误差。""" rng = np.random.default_rng(seed) gamma = 0.99 reward_means = np.linspace(0.2, 0.9, 8) horizon = len(reward_means) dones = np.zeros(horizon) dones[-1] = 1.0 true_values = np.zeros(horizon) for t in reversed(range(horizon)): future = 0.0 if t == horizon - 1 else true_values[t + 1] true_values[t] = reward_means[t] + gamma * future # 故意给 critic 加一组固定误差,使短视的 TD target 有偏。 critic_error = np.array([0.30, -0.90, 0.35, -0.25, 0.20, -0.15, 0.10, -0.05]) approx_values = true_values + critic_scale * critic_error rewards_batch = rng.normal(reward_means, sigma, size=(episodes, horizon)) print("\n=== lambda 的偏差—方差折中(估计 V(s_0))===") print(f"episodes={episodes}, true_V0={true_values[0]:.4f}, critic_V0={approx_values[0]:.4f}") print("lambda mean bias std mse theory_bias theory_std mean_SE") for lam in (0.0, 0.5, 0.95, 1.0): estimates = np.empty(episodes) for i, rewards in enumerate(rewards_batch): _, advantages, targets = generalized_advantage_estimate( rewards, approx_values, dones, next_value=0.0, gamma=gamma, lam=lam ) estimates[i] = targets[0] bias = estimates.mean() - true_values[0] mse = np.mean((estimates - true_values[0]) ** 2) theory_mean, theory_bias, variance = analytic_target_stats(reward_means, approx_values, sigma, gamma, lam) print(f"{lam:>6.2f} {estimates.mean():>8.4f} {bias:>8.4f} {estimates.std():>8.4f} {mse:>8.4f} {theory_bias:>10.4f} {np.sqrt(variance):>10.4f} {np.sqrt(variance / episodes):>7.4f}") if __name__ == "__main__": fixed_trajectory_demo() bias_variance_demo() make_figures.py #!/usr/bin/env python3 """生成本文的 GAE 偏差—方差图与 PPO 裁剪曲线。 依赖:numpy、matplotlib。运行:python3 make_figures.py 图片写入相邻的 figures/ 目录。 """ from pathlib import Path import matplotlib.pyplot as plt import numpy as np from gae_minimal import generalized_advantage_estimate, analytic_target_stats from ppo_clip_minimal import clipped_surrogate OUT_DIR = Path(__file__).resolve().parent.parent / "figures" def gae_tradeoff_figure(seed=7, episodes=20000): rng = np.random.default_rng(seed) gamma = 0.99 means = np.linspace(0.2, 0.9, 8) dones = np.zeros(len(means)) dones[-1] = 1.0 true_values = np.zeros(len(means)) for t in reversed(range(len(means))): true_values[t] = means[t] + gamma * (0.0 if t == len(means) - 1 else true_values[t + 1]) approx_values = true_values + np.array([0.30, -0.90, 0.35, -0.25, 0.20, -0.15, 0.10, -0.05]) reward_batch = rng.normal(means, 0.8, size=(episodes, len(means))) lambdas = np.array([0.0, 0.25, 0.5, 0.75, 0.95, 1.0]) bias, std, mse = [], [], [] for lam in lambdas: estimates = [] for rewards in reward_batch: _, _, targets = generalized_advantage_estimate( rewards, approx_values, dones, 0.0, gamma, lam ) estimates.append(targets[0]) estimates = np.asarray(estimates) bias.append(estimates.mean() - true_values[0]) std.append(estimates.std()) mse.append(np.mean((estimates - true_values[0]) ** 2)) fig, axes = plt.subplots(1, 2, figsize=(11, 4.8)) theory = [analytic_target_stats(means, approx_values, 0.8, gamma, lam) for lam in lambdas] axes[0].plot(lambdas, np.abs(bias), "o-", label="Empirical absolute bias") axes[0].plot(lambdas, std, "s-", label="Empirical standard deviation") axes[0].plot(lambdas, np.abs([x[1] for x in theory]), ":", label="Analytic absolute bias") axes[0].plot(lambdas, np.sqrt([x[2] for x in theory]), ":", label="Analytic standard deviation") axes[0].set_ylabel("Reward units") axes[1].plot(lambdas, mse, "^-", label="Empirical MSE") axes[1].plot(lambdas, [x[1]**2+x[2] for x in theory], ":", label="Analytic MSE") axes[1].set_ylabel("Squared reward units") for ax in axes: ax.set_xlabel("GAE lambda") ax.grid(alpha=0.25) ax.legend(frameon=False, fontsize=8) fig.suptitle("Fixed critic errors and independent reward noise (seed 7, n=20000)") fig.tight_layout() path = OUT_DIR / "gae_bias_variance.png" fig.savefig(path, dpi=180, facecolor="white") plt.close(fig) return path def ppo_clip_figure(): ratio = np.linspace(0.4, 1.6, 500) fig, axes = plt.subplots(1, 2, figsize=(11, 4.8), sharex=True) for ax, advantage in zip(axes, (1.0, -1.0)): raw, clipped, objective = clipped_surrogate(ratio, np.full_like(ratio, advantage)) ax.plot(ratio, raw, linestyle="--", linewidth=2, label="Unclipped") ax.plot(ratio, objective, linewidth=3, label="PPO objective") ax.axvspan(0.8, 1.2, color="#2f6df6", alpha=0.08) ax.axvline(1.0, color="black", linewidth=1, alpha=0.5) ax.set_title(f"Advantage = {advantage:+.0f}") ax.set_xlabel("new / old probability ratio") ax.grid(alpha=0.2) axes[0].set_ylabel("Per-sample surrogate") axes[0].legend(frameon=False) fig.suptitle("PPO-Clip is one-sided and depends on the advantage sign", fontsize=14) fig.tight_layout() path = OUT_DIR / "ppo_clip_sign.png" fig.savefig(path, dpi=180, facecolor="white") plt.close(fig) return path if __name__ == "__main__": OUT_DIR.mkdir(parents=True, exist_ok=True) for output in (gae_tradeoff_figure(), ppo_clip_figure()): print(f"saved: {output} ({output.stat().st_size / 1024:.1f} KiB)") ppo_clip_minimal.py #!/usr/bin/env python3 """用 NumPy 拆解 PPO-Clip,并在两臂老虎机旧动作分布的精确求和上更新多轮。 依赖:numpy。运行:python3 ppo_clip_minimal.py """ import numpy as np def clipped_surrogate(ratio, advantage, epsilon=0.2): ratio = np.asarray(ratio, dtype=np.float64) advantage = np.asarray(advantage, dtype=np.float64) unclipped = ratio * advantage clipped = np.clip(ratio, 1.0 - epsilon, 1.0 + epsilon) * advantage objective = np.minimum(unclipped, clipped) return unclipped, clipped, objective def clipping_table(): ratios = np.array([1.35, 0.65, 1.35, 0.65, 1.10, 0.90]) advantages = np.array([1.0, 1.0, -1.0, -1.0, 0.5, -0.5]) raw, clipped, objective = clipped_surrogate(ratios, advantages) print("=== 单样本裁剪表 ===") print(" ratio A ratio*A clip(ratio)*A min clipped?") for r, a, u, c, o in zip(ratios, advantages, raw, clipped, objective): flag = "yes" if not np.isclose(u, o) else "no" print(f" {r:>4.2f} {a:>4.1f} {u:>7.3f} {c:>7.3f} {o:>6.3f} {flag}") def sigmoid(x): return 1.0 / (1.0 + np.exp(-x)) def bandit_objective(theta, clipped): """旧策略两动作概率各 0.5;动作 1 优势 +1,动作 0 优势 -1。精确期望,不采样。""" p_good = sigmoid(theta) ratios = np.array([p_good / 0.5, (1.0 - p_good) / 0.5]) advantages = np.array([1.0, -1.0]) if clipped: return clipped_surrogate(ratios, advantages)[2].mean() return np.mean(ratios * advantages) def finite_difference_gradient(theta, clipped, h=1e-5): return (bandit_objective(theta + h, clipped) - bandit_objective(theta - h, clipped)) / (2 * h) def bernoulli_kl(old_p, new_p): return old_p * np.log(old_p / new_p) + (1.0 - old_p) * np.log((1.0 - old_p) / (1.0 - new_p)) def optimize_same_batch(clipped, steps=40, learning_rate=0.3): theta = 0.0 snapshots = [] watch = {0, 1, 2, 5, 10, 20, 39} for step in range(steps): grad = finite_difference_gradient(theta, clipped) theta += learning_rate * grad if step in watch: p_good = sigmoid(theta) ratio_good = p_good / 0.5 snapshots.append((step + 1, p_good, ratio_good, grad, bernoulli_kl(0.5, p_good))) return snapshots def repeated_update_demo(): print("\n=== 在旧策略动作分布精确期望上更新 40 轮 ===") print("mode epoch p(good) ratio_good grad KL(old||new)") for mode, clipped in (("unclipped", False), ("PPO-Clip", True)): for epoch, p_good, ratio, grad, kl in optimize_same_batch(clipped): print(f"{mode:<10} {epoch:>5d} {p_good:>7.4f} {ratio:>7.4f} {grad:>7.4f} {kl:>7.4f}") if __name__ == "__main__": clipping_table() repeated_update_demo()
-
AIGC 基本功|序列并行与 Ring Attention-SP 序列并行与 Ring Attention 所属方向:分布式训练 | 难度:高阶 | 前置知识:张量并行与流水线并行、注意力显存账本、FlashAttention 关键词:序列并行、Ring Attention、长序列、通信与计算重叠、Ulysses 01. 为什么需要它 一个视频或长文被编码成 131072 个 token,hidden size 为 8192,仅一个 BF16 的 $[L,d]$ 张量就占 2 GiB。Transformer 每层不只保存一个这样的张量,还要保存归一化输入、Q/K/V、MLP 中间量、dropout 状态等;标准 attention 若显式保存 $[L,L]$ 分数矩阵,单头 BF16 就是 32 GiB,根本无法进入反向。 数据并行沿 batch 切,每个 rank 仍要处理完整序列;张量并行沿 hidden/head 切,序列长度 $L$ 仍完整复制;流水线并行沿层切,某一层的长序列峰值仍在。长上下文把瓶颈推到第四个维度:必须沿 sequence 切 token。 但“每卡拿一段 token”并不自动成立。MLP 和 LayerNorm 对每个 token 独立,本地就能算;self-attention 中,每个 query 必须看到所有 key/value。若 rank 0 只拿前 1/8 的 K/V,它算出的就成了局部 attention,数学结果已经改变。序列并行的核心问题,是怎样在不复制全部长序列、不近似 attention 的前提下交换必要信息。 目前最常见的两类答案是 Ulysses 与 Ring Attention。Ulysses 先按 sequence 分片,再用 all-to-all 把布局变成按 attention head 分片,让每个 rank 在少量 head 上看到完整 sequence;算完后再 all-to-all 变回来。Ring Attention 则让每个 rank 保留本地 query,K/V block 沿环传递,经过 $P$ 轮后本地 query 恰好见过全序列。 即使尚未阅读FlashAttention 文章,因此先补最小背景:FlashAttention 并不近似 softmax,它把 Q/K/V 分块,并用在线 softmax 的最大值、分母和加权和递推,避免把完整 $L\times L$ 注意力矩阵写回 HBM。Ring Attention 把同一个分块思想扩展到多设备:块不只从显存搬到片上 SRAM,也沿网络搬到下一个 rank。 本文预算脚本给出:$L=131072,d=8192,P=8$ 时,一个 BF16 序列张量从每卡 2 GiB 降到 0.25 GiB,理想降低 8 倍;每层每 rank 绕环接收 K/V 的单向数据约 3.5 GiB。显存不是白省的,它被换成了通信与 $P$ 轮依赖。 02. 最小可用理解 三句话建立框架: 序列并行把 $[B,L,d]$ 沿 $L$ 切成 $P$ 份,使 LayerNorm、dropout、MLP 等序列形激活每卡近似降为 $1/P$。 Ulysses 用 all-to-all 在 sequence shard 与 head shard 间转置;Ring Attention 让 K/V block 绕环流动,本地 Q 用在线 softmax逐块累积精确结果。 两者没有把全注意力的 $O(L^2d)$ 算术复杂度变成线性,只是把计算与内存分散到多卡,并用通信重叠争取接近线性扩展。 如果只记一个区别:Megatron 风格的 sequence parallel 主要切 LayerNorm/dropout 等非 TP 区域的激活;Ulysses/Ring Attention 属于长上下文的 attention 并行,真正处理完整 sequence 上的全局注意力。很多系统把后者称为 context parallel,以免名称混淆。 03. 数学推导 3.1 标准 attention 的账本 令 $Q,K,V\in\mathbb{R}^{L\times d}$,为简洁省略 batch 与 head 维。scaled dot-product attention: $$O=\operatorname{softmax}\left(\frac{QK^\top}{\sqrt d}\right)V$$ 分数矩阵 $S=QK^\top/\sqrt d$ 有 $L^2$ 个元素,算力约为 $O(L^2d)$。若将序列均分到 $P$ 个 rank,每卡持有 $Q_r,K_r,V_r\in\mathbb{R}^{L/P\times d}$。逐 token 的 MLP 可以直接本地算,但 attention 的本地输出需要: $$O_r=\operatorname{softmax}\left(\frac{Q_r[K_0;K_1;\ldots;K_{P-1}]^\top}{\sqrt d}\right)[V_0;V_1;\ldots;V_{P-1}]$$ 也就是说,本地 query 仍必须与所有 rank 的 K/V 相遇。区别只在“把所有 K/V 一次聚齐”还是“逐块流过”。 3.2 在线 softmax:Ring 的数学底座 对一行 query,把 key/value 分成若干块。处理前 $t$ 个块后,保存行最大值 $m_t$、指数和 $\ell_t$ 与未归一化加权和 $u_t$。新块分数为 $s$,块内最大值为 $m_b=\max(s)$,更新全局最大值: $$m_{t+1}=\max(m_t,m_b)$$ 为了把旧累计量换到新的指数基准,定义 $\alpha=\exp(m_t-m_{t+1})$,则: $$\ell_{t+1}=\alpha\ell_t+\sum_j\exp(s_j-m_{t+1})$$ $$u_{t+1}=\alpha u_t+\sum_j\exp(s_j-m_{t+1})v_j$$ 处理完所有块后: $$o=\frac{u_T}{\ell_T}$$ 每次最大值变大时,旧分母与旧分子同时乘 $\alpha$,所以比值语义不变。算法只需保存 $m,\ell,u$ 和当前 score tile,不需保存全矩阵。它与减最大值的稳定 softmax 完全等价,而不是近似。 3.3 Ring Attention 的 $P$ 轮 第 $r$ 个 rank 固定本地 $Q_r$,初始持有 $K_r,V_r$。第 0 轮计算本地块,第 1 轮把 K/V 发给下一个 rank并接收上一个 rank 的块,如此循环。第 $t$ 轮 rank $r$ 处理来源 $(r-t)\bmod P$ 的 K/V;$P$ 轮后每个 $Q_r$ 看过所有块。 本地计算量近似: $$C_{\mathrm{rank}}=O\left(\frac{L}{P}\cdot L\cdot d\right)=O\left(\frac{L^2d}{P}\right)$$ 每 rank 需要接收 $P-1$ 次大小约 $2(L/P)d\,b$ 的 K/V,其中 $b$ 是每元素字节数: $$V_{\mathrm{ring}}=2\frac{P-1}{P}Ldb$$ 当 $L$ 与 $P$ 同比例增长、每卡本地 token 数保持不变时,单轮的 Q/KV block 大小、计算量和传输量近似不变,增长的是轮数和每卡总计算量。是否能覆盖通信取决于单轮 block 是否足够大、有效算力与链路带宽;弱扩展本身不会自动改善单轮的重叠条件。若本地 block 太小、网络慢或 kernel 没有异步双缓冲,通信会裸露出来。 训练反向不能只把前向环倒放那么简单:每个 rank 还要计算对本地 Q、流动 K/V 的梯度,并把属于原拥有者的 dK/dV 沿环累积或归还。checkpoint 与重计算还能减少保存量,但增加计算。 3.4 因果 mask 如何穿过环 自回归 attention 要求 query 位置 $i$ 只能看 key 位置 $j\le i$。分块后,根据全局位置判断: K/V block 完全位于 Q block 未来:整块跳过; 完全位于过去:无需 mask; 与 Q block 重叠:块内施加三角 mask。 跳过未来块可省计算,但不同 rank 的有效工作量会不均。某些实现使用 zigzag 或重新排列 token,使每卡同时持有前后位置,平衡 causal attention 工作量。若只看非因果公式估算吞吐,部署到 causal LLM 时可能偏差很大。 3.5 Ulysses 的 all-to-all 转置 设输入布局是 sequence-sharded: $$[B,L/P,H,D_h]$$ $H$ 是 head 数,$D_h$ 是每头维度。Ulysses all-to-all 把它转成: $$[B,L,H/P,D_h]$$ 每卡序列完整、head 只剩 $H/P$,于是能在本地执行普通 attention;输出再 all-to-all 回 sequence shard。它通常要求 $H$ 能被 $P$ 整除,若 GQA 只有很少 KV heads,约束会更紧。Ring 不要求按 head 数切,但要经历 $P$ 个顺序环步骤。 Ulysses 的 collective 容易利用成熟 all-to-all,但跨节点 all-to-all 对网络争用敏感;Ring 只与邻居点对点通信,更贴合环形拓扑,也更容易细粒度重叠。没有一种方法在所有硬件和 head 配置上恒优。 3.6 Megatron Sequence Parallel 不等于长上下文 attention 传统 TP 的 column/row parallel 边界往往让某些激活在 TP rank 上复制。Megatron sequence parallel 把 LayerNorm、dropout 等逐 token 操作沿 sequence 切分,并用 reduce-scatter 与 all-gather 衔接 TP 区域,使这些激活内存近似降为 $1/P$。它与 TP process group 绑定,主要减少非 TP 区域的重复激活。 但 attention 若仍按 head 做 TP,每个 head 仍可能看到完整 sequence。因此配置项 sequence_parallel=true 并不等于已经支持百万 token。需要进一步的 context parallel、Ulysses 或 Ring Attention 才能沿 attention 的上下文维扩展。 一个序列张量的每卡存储随 P 下降,而完整前向绕环接收的 K/V 字节增加并趋于上限。右图是接收量,不重复计发送量,尚未包含反向通信。 04. 代码实现 ring_attention_sim.py 只用标准库,实现完整 softmax attention 与分块在线递推。Q/K/V 均为 $[4,2]$,每个 K/V block 两行,相当于两轮 ring: Q=K=V shape=(4, 2), kv_block=2, ring_steps=2 full[0]=[1.713718770, 1.717687378] ring[0]=[1.713718770, 1.717687378] max_abs_diff=0.000e+00 本组小样本在打印精度内相同;算法等价性来自第 3.2 节的不变式,浮点实现一般仍存在求和顺序引起的舍入差异。脚本没有真正启动多进程;它把 K/V block 依次喂给同一递推器,模拟每个 rank 收到环上块后的本地数学。生产实现还要异步 send/recv、双缓冲、causal mask 与 backward。 sp_budget.py 对 $L=131072,d=8192,H=64,P=8$ 输出: L=131072, d=8192, heads=64, sp=8, dtype_bytes=2 one [L,d] tensor: replicated=2.00 GiB, sequence-sharded/rank=0.25 GiB ideal memory reduction for sequence-shaped activations=8.0x Ulysses head-divisible=True (64//8=8 heads/rank) Ring Attention rounds=8, local query tokens=16384 Ring K/V traffic per rank per layer (one direction, ideal)=3.50 GiB 2 GiB 只是一个张量,不是整层总显存;0.25 GiB 是理想静态 shard,也没算当前通信块、输出、梯度与工作区。3.5 GiB 对应 $2(P-1)Ldb/P$,是每层、每 rank、单方向的 K/V 接收量。实际网络还包含反向与协议开销。 05. 工业级实现对照 以 2026-09 为准,DeepSpeed 的 deepspeed/sequence/layer.py 中 DistributedAttention 用自定义 all-to-all 在 scatter 轴与 gather 轴间转换 Q/K/V,调用 local_attention 后再变回去。源码明确检查总 head 数必须能被 sequence parallel size 整除,并提供 stream 与 overlap handle 管理通信重叠。 这个工业实现比最小公式多处理 batch 维位置、不同 Q/K/V 布局、rotary position embedding、异步 stream、autograd 的反向 all-to-all 与进程组。布局索引错一位可能 shape 仍合法但语义错误,所以系统必须统一采用明确的张量维约定。 Megatron-LM 的模型并行配置中 sequence_parallel 用于并行 LayerNorm 与 dropout;context_parallel_size 则面向上下文切分。当前 Megatron Core 还支持多种 context parallel 通信方式。读配置时不要只看“SP”缩写,要追到具体张量在哪个轴分片以及 attention 内部采取哪种交换。 Ring Attention 的工业 kernel 通常建立两个 K/V buffer:当前块参与计算时,下一个块在独立通信 stream 接收;计算结束交换 buffer。要真正隐藏通信,必须满足: $$T_{\mathrm{attention\ block}}\ge T_{\mathrm{send/recv}}$$ 此外还要确保计算与 NCCL 没争抢同一资源到互相拖慢。仅在代码里使用 async op 不代表 timeline 上已经重叠,必须用 profiler 验证。 FlashAttention 提供单卡块级 IO 优化,Ring/Ulysses 提供多卡数据布局。两者不是竞争关系:每个 rank 的 local attention 往往正由 FlashAttention kernel 完成。前者减少 HBM 读写,后者减少单卡需要常驻的全局序列。 checkpoint 也必须保存并行元数据。若训练时改变 SP/CP 度,参数本身或许未沿 sequence 切,但 optimizer、随机数状态和位置相关缓存可能变化。恢复前应由框架的 distributed checkpoint 层重新映射,而不是直接让每个 rank 读取旧编号文件。 06. 代价与边界 序列并行省的是序列形激活,不一定省参数和优化器状态;它通常要与 ZeRO/FSDP、TP、PP 组合。完整世界规模可能写成 $W=d_p t_p p_p c_p$,其中 $c_p$ 是 context parallel 度。每多一根轴,都新增 process group、拓扑映射与整除约束。 Ring Attention 保留全注意力的二次计算量。卡数增加能把每卡计算降到 $1/P$,但集群总 FLOPs 仍为 $O(L^2d)$;当上下文翻倍、卡数不变时,总计算约四倍。它突破的是单卡内存和 wall-clock 可扩展性,不是算法复杂度。 通信也不是“免费”。Ring 的每 rank 字节量随 $L$ 线性增长且有 $P$ 轮延迟链;Ulysses 有前后 all-to-all,容易受跨节点网络与并发任务干扰。若 $L$ 尚短,通信与布局转换可能比 attention 本身更贵,普通 TP 更合适。 常见边界包括: Ulysses 的 head 或 KV head 不能被 SP 度整除,GQA/MQA 尤其容易受限; causal mask 造成各 block 计算不均,需要 load-balanced ring; position encoding 必须使用全局位置,不能把每 rank 的局部 token 从 0 重新编号; dropout 的随机数要在切分前后保持统计与重算一致,否则并行度改变会造成难解释的差异; variable-length packed sequence 需要携带边界,不能让不同样本互相 attention; 视频 token 在时间、空间上的排列会影响 causal 或局部结构,切块策略不能只按连续内存方便决定。 在低带宽以太网集群上,增加 context parallel 度可能只是把 OOM 变成通信瓶颈。应先用 activation checkpoint、FlashAttention、减小 microbatch 等单机方法,确认仍由单卡序列容量限制,再引入跨设备 SP。 6.1 从单张量扩展到整层激活账本 一个 $[L,d]$ BF16 张量占 $2Ld$ 字节,但训练层内可能同时存在 residual、norm 输入、Q/K/V、attention output 与 MLP 中间值。设所有与序列线性相关且必须保存到反向的张量合计为 $cLd$ 个元素,序列分片后的理想每卡保存: $$M_{\mathrm{linear/rank}}\approx\frac{cLdb}{P}$$ $c$ 由架构、融合 kernel 与 checkpoint 策略决定,不能用固定常数套所有模型。SwiGLU 会产生门控与 value 两个支路;视频 DiT 还可能有条件分支、cross-attention 与调制参数。最可靠方法是从 profiler 的 allocation timeline 识别跨 backward 存活的张量。 attention tile 与通信 buffer 是额外峰值。Ring 双缓冲至少需要当前和下一份 K/V block;FlashAttention kernel 还需要 score tile、softmax statistic 和 workspace。于是: $$M_{\mathrm{peak/rank}}=M_{\mathrm{linear/rank}}+M_{\mathrm{local\ attention}}+M_{\mathrm{double\ buffer}}+M_{\mathrm{runtime}}$$ 当 $P$ 继续增加时,第一项下降,但 buffer、runtime 和最小 kernel workspace 不会等比下降,显存收益逐渐偏离 $1/P$。用总 allocated 除卡数预测极限会过于乐观。 6.2 反向为何比前向更难 前向中,本地 Q 只需依次看过所有 K/V block。反向要得到 $dQ_r$、$dK_j$ 与 $dV_j$。当来源 $j$ 的 K/V 到达 rank $r$ 时,本地可计算它对 $dQ_r$ 的贡献,也会产生属于来源 rank $j$ 的 $dK_j,dV_j$ 部分。后两者必须跨所有 query shard 求和并归还拥有者。 因此每个块需要身份信息,环中既可能传 K/V,也可能传对应梯度累计。为了减少前向保存,backward 常重算局部 score 与概率,依赖前向保存的行最大值和归一化分母。若随机 dropout 参与 attention,重算还必须恢复相同随机 mask。 理论通信量必须同时列前向与反向。只用 $2(P-1)Ldb/P$ 报告 K/V 前向流量会低估训练网络负担;真实实现还包括 dK/dV、可能的 dQ 归约、控制同步和其他模块的 collective。性能分析应以 profiler 中每层总通信字节与裸露时间为准。 6.3 通信重叠需要满足哪些条件 把一个本地 query block 与一个 K/V block 的 attention 计算时间记为 $T_c$,邻居传输一个 K/V block 的时间记为 $T_n=\alpha+S/\beta$,其中 $\alpha$ 是链路延迟,$\beta$ 是有效带宽,$S$ 是消息字节。双缓冲后的理想每轮时间: $$T_{\mathrm{round}}\approx\max(T_c,T_n)$$ 只有 $T_c\ge T_n$,网络才大部分隐藏。减小 block 能降低临时显存,却增加轮数和延迟占比;增大 block 提高 GEMM 效率,却增大 buffer。block size 是计算、带宽、延迟与显存的共同旋钮。 实现还需避免隐式同步。例如在循环中把 GPU 标量取回 CPU、过早 wait 通信 handle、复用尚未完成接收的 buffer,都会把异步流水串行化。正确做法是独立 stream、event 依赖与 ping-pong buffer,并在 GPU timeline 上确认 send/recv 与 attention kernel 真正重叠。 环的物理顺序同样重要。逻辑 rank 相邻却跨交换机,会让每轮走慢链路;合理 ring 应优先沿 NVLink 域,再通过少量跨节点边连接。多维集群还可以分层:节点内用 Ulysses all-to-all,节点间用 Ring,或反过来根据硬件选择,这正是统一序列并行方法的动机。 6.4 长度、head 与并行轴的联合约束 设 context parallel 度为 $c_p$、tensor parallel 度为 $t_p$。若 TP 已把 head 切为 $H/t_p$,Ulysses 再沿 head 分 $c_p$,就需要本地可见 head 数继续可分: $$H\ \bmod\ (t_pc_p)=0$$ 具体约束取决于框架是在同一 head 轴叠加还是采用不同布局。GQA 中应将 $H_{KV}$ 单独代入;只有 8 个 KV head 的模型很难做大 head-parallel。某些系统复制 K/V 以放松整除,但通信和显存模型随之改变。 sequence length 通常也要求能被 $c_p$ 与 block size 整除。不整除时可以 padding 或不等长 shard。padding 实现简单但会浪费二次 attention 计算;不等长 shard 又使通信消息与计算不均。对长度差异大的数据,先按 token 数分桶往往比依赖动态不等长 ring 更稳定。 TP 与 CP 同时使用还会出现多种 collective。attention 投影可能在 TP 组 all-reduce,context attention 在 CP 组 send/recv,层外梯度还在 DP 组 reduce-scatter。若各组在不同 rank 上以不一致顺序发起 collective,可能死锁。框架必须给跨组通信建立确定顺序或独立 stream 依赖。 6.5 视频与多模态序列的特殊问题 视频 token 常按时间、空间高、空间宽展平。连续切 sequence 可能让每个 rank 持有若干完整帧,也可能持有同一帧的空间条带;两种布局对位置编码、局部 attention、数据增强和负载平衡影响不同。若模型有 temporal attention 与 spatial attention 分解结构,最优切分轴也可能随层变化。 全局位置必须从原始坐标生成。RoPE 若把每个 rank 的局部索引重新从 0 开始,不会报 shape 错,却让不同块位置混叠。二维或三维 RoPE 更要携带时间与空间坐标,而不是只传一个线性 offset。跨模态序列还要保持文本、图像、视频 segment 的 mask 与边界。 视频长度和分辨率经常动态变化。同一 global batch 内若 token 数差异大,padding 使最长样本决定所有 rank 工作量;packed sequence 可减少浪费,却要求 block 不跨样本做 attention。调度系统最好按总 token 数而非样本数组 batch,并把实际有效 token 纳入 loss normalization。 因果结构也不总是标准下三角。视频生成可能使用双向视觉 attention、文本到视频 cross-attention 或分块因果时间 mask。Ring 优化中“未来块可跳过”的判断必须来自真实 mask 结构,不能硬编码 LLM 假设。 6.6 正确性验收与故障定位 第一层验收是 shape:每个边界记录 global shape、local shape、分片轴、global offset、padding 与拥有者。第二层是数学:小尺寸 FP64 单卡作为 oracle,逐项比较 forward 和 dQ/dK/dV。第三层是随机性:开启 dropout 与 checkpoint 后,在固定 seed 下比较统计和可复现范围。 输出不一致时,可按轮 dump 每个 rank 处理的 K/V 来源编号。若少一个或重复一个,是 ring 调度;若所有来源齐全但数值错,检查在线 softmax 的旧累计重标定;若仅 causal 错,检查全局位置与块分类;若 forward 对而 backward 错,检查 dK/dV 归还与跨 query shard 求和。 OOM 时不要只减 block。先区分 persistent activation、通信双 buffer、kernel workspace 与碎片。若 activation 占主导,提高 CP 或 checkpoint 有效;若 buffer 占主导,减 block 才有效;若碎片主导,可调分配器或稳定 shape。错误手段可能降低吞吐却完全不改变峰值来源。 性能验收同时做 strong scaling 与 weak scaling。strong scaling 固定全局 $L$,增加卡数,观察端到端时间能否下降;容量弱扩展固定每卡 local token,令 $L\propto P$:精确全注意力的每卡计算 $L^2/P$ 此时随 $P$ 线性增长,不能期望每卡时间不变;应比较实测时间与这一增长基线,以及通信隐藏率。Ring Attention 可随设备数扩展可处理上下文,但总计算也随之增加。 最后把精度也纳入验收。在线 softmax 很稳定,但不同 block 顺序改变浮点加法;BF16、FP8 attention 更明显。应比较最终任务指标、loss 轨迹和梯度,而不是要求多卡输出 bitwise 等同。若误差远超单纯归约顺序,再排查 scale、mask 与布局。 6.7 Ulysses、Ring 与混合方案如何选 先看 head 约束。若本地 Q head 与 KV head 都能被目标 SP 度整除,且集群 all-to-all 带宽高,Ulysses 路径直接,local attention 可复用成熟 kernel。若 KV head 很少、SP 度很大,Ring 不沿 head 切,通常更容易扩展。再看拓扑:全连接高速交换更适合 all-to-all;邻接带宽强、跨组带宽弱时,环形点对点更自然。 再看本地块计算。长序列、大 head dimension 使每轮计算足以隐藏 K/V 传输,Ring 受益;较短序列或大量小 head 时,$P$ 轮延迟可能突出。Ulysses collective 次数少,但消息全局交换可能造成拥塞。决策依据应是每轮计算时间、有效链路带宽和 collective 实测,不是理论总字节一项。 混合方案把设备组织成二维网格。例如节点内 8 卡做 Ulysses,节点间若干组做 Ring;这样 head 整除只限制节点内度数,跨节点使用邻接通信。代价是布局更复杂、process group 更多,Q/K/V 需要在两个维度间保持一致顺序。只有单一方案确实受限时才值得引入。 还要把 TP 纳入考虑。如果 TP 已经切 head,Ulysses 可用 head 更少;有时降低 TP、提高 CP 更适合长序列,有时模型单层容量又要求 TP 不能降。最优并行度会随训练长度变化,短序列预训练与长序列继续训练未必使用同一布局。 6.8 推理场景与训练不同 prefill 处理整段 prompt,计算形态接近训练前向,序列并行能分摊长 prompt attention。decode 每步只有少量新 query,却要读取不断增长的 KV cache;此时瓶颈常是 KV 带宽与跨卡延迟,而非大块 GEMM。训练中优秀的 Ring block,在逐 token decode 里可能太细、同步轮数太多。 推理还涉及请求级并发。可以把不同请求分给数据并行副本,也可把一个超长请求沿 context 分片。前者吞吐高、单请求受单卡长度限制;后者支持超长上下文、占用多个设备。调度器应根据请求长度动态选择,而不是所有请求固定占一个 CP 组。 KV cache 的拥有关系必须稳定。若每 rank 保存一段 sequence,新增 token 的 K/V 放在哪一段、何时重平衡、beam search 如何复制,都要定义。Paged KV cache 与 context parallel 叠加时,逻辑页、物理 GPU 与全局位置形成三层映射,错误可能表现为偶发内容质量下降而非崩溃。 因此本文通信公式主要用于训练或 prefill,不能直接拿来预测 decode tokens/s。推理基准要分别报告 time-to-first-token、inter-token latency、并发吞吐、KV cache 容量和长短请求混合表现。 6.9 上线前检查清单 上线前确认:sequence、head、KV head 与 block 的整除或 padding 规则明确;每个 shard 保存全局位置;causal/packed mask 按全局索引生成;每轮 K/V 来源不重不漏;在线 softmax 保存并正确重标定最大值、分母与分子;backward 的 dK/dV 回到原拥有者;dropout 重算保持随机一致。 系统侧确认 ring 物理顺序符合拓扑,通信与计算 timeline 真重叠,buffer 生命周期无覆盖,所有 rank collective 顺序一致,checkpoint 记录分片元数据,变更 CP 度可以恢复。性能侧同时做 strong/weak scaling,并在真实长度分布而非单一最大长度上测试。 最后保留小尺寸 oracle。每次升级 attention kernel、通信库、RoPE 或 mask 实现,都自动生成随机 Q/K/V,与 FP64 单卡结果比较 forward 和全部梯度;再跑包含因果、变长、GQA、极端分数和非整除长度的边界集。长序列错误代价很高,小 oracle 是最便宜的保险。 6.10 最后的边界:更长不等于更有用 系统能够处理百万 token,只说明容量与运行时间可接受,不保证模型会利用远距离信息。长上下文实验还要检查位置外推、训练长度分布、检索准确率与有效注意范围。并行系统解决“算得出来”,数据与模型设计决定“学得会不会”。 因此扩展长度时同时保留短上下文质量基线,按距离分桶评估信息召回,并报告有效 token 而非 padding 后长度。否则可能用大量 GPU 计算模型并未使用的上下文。 07. 经典论文脉络 FlashAttention(arXiv:2205.14135):用 IO-aware tiling 与在线 softmax 实现精确 attention,避免物化完整分数矩阵,是多卡分块 attention 的本地 kernel 基础。 Reducing Activation Recomputation in Large Transformer Models(arXiv:2205.05198):提出 Megatron sequence parallel 与选择性重计算,减少 TP 区域之外的重复激活。 DeepSpeed Ulysses(arXiv:2309.14509):用 all-to-all 在 sequence 与 head 布局间转换,使超长序列 attention 可扩展。 Ring Attention with Blockwise Transformers(arXiv:2310.01889):让 K/V 块沿环流动并与分块计算重叠,把可处理上下文随设备数扩展。 USP(arXiv:2405.07719):统一 Ulysses 与 Ring 两类序列并行,针对模型结构与网络拓扑组合两者。 这条演进线从“单卡不保存 $L^2$ 矩阵”,走到“多卡不复制 $L$ 激活”,再走到按 head 结构和网络拓扑组合通信方式。算法、kernel 与系统三层缺一不可。 08. 常见误解 误解一:序列并行把 attention 复杂度从二次降成线性。 精确全注意力的集群总计算仍为 $O(L^2d)$;它只把工作分摊,并让内存近似随本地 token 数增长。 误解二:每卡切一段 token 后直接做本地 attention。 那只允许 token 看同一分片,会改变模型。必须让 query 见到全局 K/V,或明确接受局部/稀疏近似。 误解三:Ring Attention 是近似注意力。 在线 softmax 递推在精确算术下与完整 softmax 等价;差别来自浮点归约顺序,不是丢弃连接。 误解四:开启 Megatron sequence_parallel 就解决长上下文。 它主要减少 LayerNorm、dropout 等激活复制;长上下文 attention 通常还需 context parallel。 误解五:异步 send/recv 就等于通信被隐藏。 只有计算时间覆盖传输、stream 真能并发且无资源争抢,timeline 上才会重叠。 误解六:Ulysses 的 SP 度只受 GPU 数限制。 head 数、KV head 数与 tensor layout 必须可切;GQA 模型常比标准 MHA 更早碰到上限。 09. 动手验证 先运行 ring_attention_sim.py,把 block_size 改成 1、2、4。预期 max_abs_diff 始终接近机器精度;再把 score 全部加 1000,稳定递推仍有限,而直接 exp(score) 会溢出。这同时验证精确性与减最大值的重要性。 为脚本加入 causal mask,使用 query/key 的全局索引屏蔽 $j>i$。预期分块结果与完整下三角 attention 一致。然后故意用局部索引 mask,会发现后续 rank 错误允许关注未来或错误屏蔽过去,这是真实分布式实现中很隐蔽的 bug。 运行 sp_budget.py,固定每卡 token 为 16384,让 $L$ 与 ranks 同比例从 1、2、4、8 增长。每卡序列张量保持 0.25 GiB,而 ring K/V 流量与全局 $L$ 增长。这个弱扩展实验说明“可放下更长序列”并不等于“通信不增长”,只是计算增长可能覆盖通信。 在真实集群比较 FlashAttention 单卡、Ulysses、Ring/context parallel:固定模型与 global sequence,记录峰值显存、attention kernel 时间、collective/点对点时间、重叠率与 MFU。分别在节点内和跨节点运行;预期最佳方法随 NVLink、InfiniBand、head 数和 local block 大小变化。 最后做数值验收:关闭 dropout,用同一 Q/K/V 比较单卡与多卡输出及 dQ/dK/dV。BF16 下用合理容差,同时单独检查每个 rank 拼接后的全局顺序。输出对而梯度错,通常说明 backward 中流动 K/V 梯度没有正确归还拥有者。 10. 延伸阅读 读懂本文的完整前置路径是: 数据并行与 ZeRO 显存切分:先区分状态分片与计算分片(已发布)。 张量并行与流水线并行:理解 process group、collective、microbatch 与拓扑(已发布)。 自注意力机制的计算与显存账本:理解 $L^2$ 分数矩阵从哪里来。 FlashAttention 为什么不需要存下注意力矩阵:深入单卡在线 softmax 与 IO 复杂度。 DDPM 训练目标与采样流程和 DiT:用 Transformer 替掉 UNet:理解视频 DiT 的时空 token 为何迅速推高注意力成本。 选 Ulysses 还是 Ring,不应从名字出发。先列出 $L,H,H_{KV},d$、网络拓扑、每卡内存与 causal 结构;再计算 local shape、通信字节、轮数和可重叠窗口;最后用 profiler 验证。长上下文系统真正的能力,是让数学等价、内存边界和物理网络三者同时对齐。 附录:完整代码 09 节用到的脚本全文如下(ring_attention_sim.py、sp_budget.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 ring_attention_sim.py #!/usr/bin/env python3 """Exact blockwise attention recurrence used by ring-style attention; stdlib only.""" import math def dot(a, b): return sum(x * y for x, y in zip(a, b)) def full_attention(q, k, v): outputs = [] scale = math.sqrt(len(q[0])) for query in q: scores = [dot(query, key) / scale for key in k] peak = max(scores) weights = [math.exp(score - peak) for score in scores] denom = sum(weights) outputs.append([sum(w * value[j] for w, value in zip(weights, v)) / denom for j in range(len(v[0]))]) return outputs def blockwise_attention(q, k, v, block_size): scale = math.sqrt(len(q[0])) peak = [-math.inf] * len(q) denom = [0.0] * len(q) numer = [[0.0] * len(v[0]) for _ in q] for start in range(0, len(k), block_size): kb, vb = k[start:start + block_size], v[start:start + block_size] for row, query in enumerate(q): scores = [dot(query, key) / scale for key in kb] new_peak = max(peak[row], max(scores)) correction = math.exp(peak[row] - new_peak) if peak[row] != -math.inf else 0.0 weights = [math.exp(score - new_peak) for score in scores] denom[row] = correction * denom[row] + sum(weights) numer[row] = [correction * old + sum(w * value[j] for w, value in zip(weights, vb)) for j, old in enumerate(numer[row])] peak[row] = new_peak return [[x / denom[row] for x in numer[row]] for row in range(len(q))] q = [[1.0, 0.0], [0.0, 1.0], [1.0, 1.0], [-1.0, 1.0]] k = [[1.0, 0.0], [0.0, 1.0], [1.0, 1.0], [1.0, -1.0]] v = [[1.0, 2.0], [2.0, 0.0], [0.0, 3.0], [4.0, 1.0]] full = full_attention(q, k, v) streamed = blockwise_attention(q, k, v, block_size=2) max_diff = max(abs(a - b) for ra, rb in zip(full, streamed) for a, b in zip(ra, rb)) print("Q=K=V shape=(4, 2), kv_block=2, ring_steps=2") print("full[0]=[" + ", ".join(f"{x:.9f}" for x in full[0]) + "]") print("ring[0]=[" + ", ".join(f"{x:.9f}" for x in streamed[0]) + "]") print(f"max_abs_diff={max_diff:.3e}") sp_budget.py #!/usr/bin/env python3 """Compare idealized per-rank sequence-memory and method constraints.""" import argparse parser = argparse.ArgumentParser() parser.add_argument("--tokens", type=int, default=131072) parser.add_argument("--hidden", type=int, default=8192) parser.add_argument("--heads", type=int, default=64) parser.add_argument("--ranks", type=int, default=8) args = parser.parse_args() if args.tokens % args.ranks: parser.error("tokens must be divisible by ranks") tensor_gib = args.tokens * args.hidden * 2 / 1024**3 local_gib = tensor_gib / args.ranks print(f"L={args.tokens}, d={args.hidden}, heads={args.heads}, sp={args.ranks}, dtype_bytes=2") print(f"one [L,d] tensor: replicated={tensor_gib:.2f} GiB, sequence-sharded/rank={local_gib:.2f} GiB") print(f"ideal memory reduction for sequence-shaped activations={args.ranks:.1f}x") print(f"Ulysses head-divisible={args.heads % args.ranks == 0} ({args.heads}//{args.ranks}={args.heads // args.ranks} heads/rank)") print(f"Ring Attention rounds={args.ranks}, local query tokens={args.tokens // args.ranks}") print(f"Ring K/V traffic per rank per layer (one direction, ideal)={2*tensor_gib*(args.ranks-1)/args.ranks:.2f} GiB") make_figures.py """Regenerate this article's deterministic teaching figure (numpy + matplotlib).""" from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np OUT=Path(__file__).resolve().parents[1]/"figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({"font.sans-serif":["PingFang SC","Arial Unicode MS","DejaVu Sans"],"axes.unicode_minus":False}) p=np.array([1,2,4,8,16,32]); L=131072;d=8192;b=2;g=1024**3 fig,axes=plt.subplots(1,2,figsize=(10,4.4)) axes[0].plot(p,np.full(p.shape,L*d*b/g),"--",label="Replicated") axes[0].plot(p,L*d*b/p/g,"o-",label="Sequence shard") axes[0].set(xscale="log",xlabel="Ranks P",ylabel="One tensor per rank (GiB)");axes[0].legend() axes[1].plot(p,2*(p-1)/p*L*d*b/g,"o-") axes[1].set(xscale="log",xlabel="Ranks P",ylabel="Forward K/V received per rank (GiB)") for ax in axes:ax.grid(alpha=.25) fig.suptitle("Ring attention budget: L=131072, d=8192, BF16");fig.tight_layout() fig.savefig(OUT/'ring_budget.png',dpi=170) plt.close(fig) print(OUT/'ring_budget.png') 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|张量并行与流水线并行-TP-PP AIGC 基本功|张量并行与流水线并行-TP-PP 所属方向:分布式训练 | 难度:高阶 | 前置知识:数据并行与 ZeRO 显存切分 关键词:张量并行、流水线并行、Megatron-LM、GPipe、通信开销、并行策略 先读数据并行与 ZeRO,掌握矩阵乘法、链式求导和梯度累积即可。rank 指进程编号,process group 是参加同一次通信的一组进程;GEMM 是通用矩阵乘,all-gather 把各片拼齐到每个 rank,all-reduce 把各份逐元素求和并把结果交给每个 rank。本文按每进程使用一张设备讲解,集合通信的“求和”与 DP 中约定的“平均梯度”要分清。 01. 为什么需要它 ZeRO-3 能把参数、梯度和优化器状态切到数据并行 rank 上,但计算某个模块时仍需取得所需的完整参数。聚合粒度未必是整层 Transformer,可细化到子模块;如果一个实际执行的巨大 Linear 连同必需输入输出和临时空间仍放不进一张卡,单纯增加数据并行度并不把这次矩阵乘拆开,此时需要 TP、算子分块或卸载等办法;若层能放下,但整网常驻状态或激活放不下,也可考虑沿网络深度切开;能否仅靠 ZeRO-3 和重计算解决,需要先算峰值。 这对应两把不同的刀。张量并行(Tensor Parallelism,TP)在一层内部切矩阵,让多张卡共同完成同一个 GEMM;流水线并行(Pipeline Parallelism,PP)沿层切模型,让不同设备各自保存连续或交错的一段层。前者解决“这一层太宽”,后者解决“模型太深”。普通数据并行沿 batch 分样本、复制模型计算;ZeRO/FSDP 另对状态分片,三者可以组合,切的轴与状态拥有者必须分别标明。 先看一个浪费现场:4 个 pipeline stage 处理 1 个 microbatch。第 0 段前向时其余三段都空闲;数据流到第 3 段后,前几段又空闲。若把一个 global batch 切成 8 个 microbatch,让不同样本在各 stage 重叠,把总计 $4\times8=32$ 份 stage 工作分摊到 4 台设备,理想 forward sweep 用 11 个时间槽完成,但仍有填充和排空的“气泡”。本文脚本算出 4 段、8 个 microbatch 的单向 sweep 的理想利用率为 $32/(4\times11)=72.73\%$,空闲槽占 27.27%。在均衡 GPipe 训练中也会得到这一比例;其他调度不能只凭这一个公式推断实测效率。 再看 TP:若一个 MLP 的第一层权重为 $[d,4d]$,可沿输出维切成 $p$ 份,每卡算 $[d,4d/p]$;第二层 $[4d,d]$ 再沿输入维与中间激活匹配切分。这样两次 GEMM 都不需要在中间把完整 $4d$ 激活拼回每张卡,只在必要边界做集合通信。这正是 Megatron-LM 的 column-parallel 与 row-parallel 配对。 难点不在“切成几份”,而在切后保持数学等价,并让通信落在高带宽拓扑上。TP 频繁同步,通常限制在 NVLink/NVSwitch 节点内;PP 在相邻 stage 前向传激活、反向传对应梯度,更适合跨节点。这是基于通信频率的配置起点;若链路、消息量或层划分不同,需用实际 trace 比较,不能仅凭并行轴名称判定哪种拓扑一定更快。 02. 最小可用理解 三句话建立框架: TP 切一层的隐藏维、输出通道或 attention head,每层都会通信,换来单层权重、激活和计算分摊。 PP 把层分给不同 stage,再把 batch 切成 microbatch 以重叠各段计算;在均衡调度模型中 microbatch 越多,气泡占比越小,但调度和激活管理更复杂;固定 global batch 与 DP 度时,这通常意味着减小每个 microbatch。 生产系统通常组成 DP×TP×PP 的三维网格:TP 放在最快链路内,PP 穿过较慢边界,剩余设备做 DP 与 ZeRO/FSDP。 如果只记一句:TP 是“同一个样本的一层由多卡一起算”,PP 是“同一个样本依次经过多卡上的不同层”。它们都属于模型并行,但通信模式完全不同。 设世界规模 $W$,数据并行度为 $d_p$、张量并行度为 $t_p$、流水线段数为 $p_p$,若没有其他并行轴: $$W=d_p\,t_p\,p_p$$ 这不是越均匀越好。TP 度受矩阵维度、head 数、KV head 数和高速互联限制;PP 度受层数、切分均衡与 microbatch 数限制;最后再用 DP 提升全局吞吐。 03. 数学推导 3.1 Column Parallel:沿输出维切 将 batch 与 token 两维合成行数 $n=B L$。线性层输入 $X\in\mathbb{R}^{n\times d_{\mathrm{in}}}$,权重 $A\in\mathbb{R}^{d_{\mathrm{in}}\times d_{\mathrm{out}}}$,输出为: $$Y=XA$$ 把 $A$ 沿列切为 $p$ 份: $$A=[A_0,A_1,\ldots,A_{p-1}],\qquad A_i\in\mathbb{R}^{d_{\mathrm{in}}\times d_{\mathrm{out}}/p}$$ 第 $i$ 个 rank 计算: $$Y_i=XA_i$$ 完整结果只是拼接: $$Y=[Y_0,Y_1,\ldots,Y_{p-1}]$$ 前向不必通信,只要输入 $X$ 在 TP 组内复制。若下一层能直接消费分片 $Y_i$,连 all-gather 都可省。反向时,每个 rank 产生一份输入梯度贡献 $dX_i=dY_iA_i^\top$,完整 $dX$ 要求和: $$dX=\sum_{i=0}^{p-1}dX_i$$ 因此,在输入与其梯度都要复制、未启用 sequence parallel 的约定下,column-parallel 的关键通信落在反向输入梯度 all-reduce。令标量 loss 对 $Y_i$ 的梯度为 $G_i$,则本地权重梯度为 $X^\top G_i$;若加分片偏置 $c_i$,其梯度是对所有行求和的 $\sum_{k=1}^{n}G_i[k,:]$,而非再对不同特征 shard 求和。 3.2 Row Parallel:沿输入维切 把输入和权重的匹配维切开: $$X=[X_0,X_1,\ldots,X_{p-1}],\qquad A=\begin{bmatrix}A_0\\A_1\\ \vdots\\A_{p-1}\end{bmatrix}$$ 每卡先算局部部分和 $Z_i=X_iA_i$,完整输出是: $$Y=XA=\sum_{i=0}^{p-1}X_iA_i=\sum_{i=0}^{p-1}Z_i$$ 所以 row-parallel 前向需要 reduce 或 all-reduce,反向则能从复制的 $dY$ 本地得到 $dX_i=dYA_i^\top$。Megatron 把 MLP 的第一层做 column parallel,激活函数逐元素地作用在本地 shard;第二层做 row parallel,最后只求和一次。attention 的 QKV 投影与输出投影也能形成类似配对。注意 row-parallel 的输出偏置应在求和后加一次:每片先加同一 $b$ 再归约会得到 $p b$。列并行的偏置则随输出特征切分,各片在自己的激活前相加。 为看清非线性和反向,写一个 MLP:第一层分片权重为 $A_i$、偏置 $c_i$,第二层分片权重为 $B_i$、完整输出偏置为 $b$,$\phi$ 是逐元素激活,如 GELU 或本文验证用的 tanh: $$U_i=XA_i+c_i,\qquad H_i=\phi(U_i),\qquad Y=\sum_iH_iB_i+b$$ 逐元素函数不会混合不同特征,所以可以留在各片计算;若换成跨隐藏维归一化等操作,这一步需要另设计通信。令 $G=\partial\mathcal{L}/\partial Y$,先由第二层反传,再乘激活导数($\odot$ 表示逐元素乘): $$D_i=(GB_i^\top)\odot\phi^{\prime}(U_i)$$ $$\nabla_{B_i}\mathcal{L}=H_i^\top G,\quad\nabla_{A_i}\mathcal{L}=X^\top D_i,\quad\nabla_X\mathcal{L}=\sum_iD_iA_i^\top$$ $$\nabla_{c_i}\mathcal{L}=\sum_{k=1}^{n}D_i[k,:],\qquad\nabla_b\mathcal{L}=\sum_{k=1}^{n}G[k,:]$$ 这些式子也解释了两个容易重复归约的地方:每片的 $A_i,B_i,c_i$ 是不同参数;复制的输出偏置 $b$ 各副本看到同一 $G$,不能再无条件相加 $p$ 次。框架还会为 DP、sequence parallel 等情况另定义梯度同步。本文权重按数学右乘写成 [in,out];PyTorch/Megatron Linear 把 weight 存成 [out,in],forward 用其转置,因此源码里“列并行”切的是存储权重的第 0 维。 这种设计的精髓不是“每个 Linear 都随便切”,而是让相邻层的分片布局衔接,从而避免在每个算子后都 all-gather。若一个自定义层偷偷需要完整 hidden,通信会突然增加。 3.3 TP 的通信账本 设传输张量有 $N$ 个元素、每元素 $b$ 字节,按 ring 的 reduce-scatter 加 all-gather 计算,前一阶段有 $p-1$ 次发送、每次 $Nb/p$ 字节,后一阶段相同;故一次 all-reduce 的每 rank 发送字节为: $$V_{\mathrm{AR}}=2\frac{p-1}{p}Nb$$ $p$ 是 TP 组大小,$b$ 是实际通信 dtype 的字节数。每 rank 接收量与发送量相等;若把发送加接收合计,数值再乘 2;集群全部 rank 的发送总量则乘 $p$,不能混着比较。对不启用 sequence parallel 的经典 Megatron Transformer block,attention 和 MLP 的 row-parallel 输出各做一次前向 all-reduce,两个 column-parallel 的输入梯度各做一次反向 all-reduce,共四次。这不含 DP 同步、embedding/loss、重算和通信元数据。 例如 $B=1,L=131072,d=8192,p=8$,假设四个边界均传输 BF16 的 $[B,L,d]$:单张量为 2 GiB,一次 all-reduce 每 rank 发 3.5 GiB,整个 block 一次 microbatch 前后向合计发 14 GiB,另收 14 GiB。这是按所列假设的逻辑字节账本,不是实测网络吞吐。FP32 通信会翻倍,$p=1$ 时该通信为零。真实实现可用 reduce-scatter、all-gather 与 sequence parallel 改写,fused kernel 和通信算法也会改变调用形态。TP 每层同步,所以延迟不能忽略:小矩阵、多层和大 TP 度会让消息切得太碎,算力利用率反而下降。 TP 对参数显存理想降为 $1/p$,但并非所有东西都跟着切。LayerNorm 参数很小,可能复制;embedding 与 LM head 有词表切分规则;激活是否分片取决于 sequence-parallel 配置;通信临时 buffer 还会增加峰值。因此应从真实 module state 和 profiler 测量,不可把全显存直接除以 TP 度。 3.4 PP 气泡从哪里来 设有 $p$ 个等耗时 stage,每个 DP 副本在一次 optimizer step 内处理 $m$ 个 microbatch,每个 stage 处理一个 microbatch 的单向计算耗时为一格。第一个 microbatch 需要 $p$ 格到达尾部,之后每格完成一个。完成一个 forward sweep 共: $$T_{\mathrm{sweep}}=m+p-1$$ 其中每个 stage 真正工作 $m$ 格,所以理想效率与气泡比例: $$\eta_{\mathrm{pipe}}=\frac{m}{m+p-1},\qquad f_{\mathrm{bubble}}=\frac{p-1}{m+p-1}$$ 当 $p=4,m=8$,效率 $8/11=72.73\%$。当 $p>1$,要达到至少 90%,由 $10m\ge9(m+p-1)$ 得 $m\ge9(p-1)$;若要严格超过 90%,则需 $m>9(p-1)$。例如 4 段、27 个 microbatch 恰好 90%,28 个才超过;$p=1$ 且 $m\ge1$ 时没有这种填充气泡。这也解释了为什么 stage 很多却只有几个 microbatch 时 PP 很差。 这个比例先由单向 sweep 推出。均衡 GPipe 训练若每段前向时间为 $t_f$、反向为 $t_b$,先全前向再全反向,总时长为 $(m+p-1)(t_f+t_b)$;每设备有效工作为 $m(t_f+t_b)$,所以比例不变,不要求前反向等长。论文中气泡相对理想有效工作时长的开销比为 $(p-1)/m$,与本文用总时长作分母的空闲比例是不同口径。这里假设各段分别等耗时、通信完全隐藏、忽略优化器和同步等其他开销。真实训练的气泡还包括 stage 不均衡、点对点传输、参数同步、数据加载与尾 batch。最后一段若有巨大词表投影,前面切得再平均也会被它卡住。 3.5 GPipe、1F1B 与交错调度 GPipe 先把所有 microbatch 前向跑完,再统一反向,调度简单但要保存更多未反向的激活。1F1B 在 warmup 后交替执行一次 forward 和一次 backward,优先释放较早完成反向的计算图;同步更新语义仍要求一次 optimizer step 所需梯度累积完再更新权重。非交错 1F1B 的 stage $s$(从 0 开始)先做 $w_s=\min(p-s-1,m)$ 个 warmup forward,然后每次做一个新 forward 与一个旧 microbatch 的 backward,最后排空剩余 backward。 tp_pp_checks.py 按 stage 资源和跨段前反向依赖做最早启动事件模拟。$p=4,m=8$、每次 F/B 都耗时 1、无通信时,GPipe 与非交错 1F1B 均为 22 个时间单位,利用率均为 72.73%;按“F 完成后持有一份图,B 完成后释放”计数,GPipe 四段峰值为 [8,8,8,8],1F1B 为 [4,3,2,1]。因此这个理想例子主要省激活驻留,并没有把气泡自动减半。它不是物理显存的测量:forward/backward 的临时存储、重算和通信 buffer 尚未计入。 将最后一段 F/B 各改成 3、其他段仍为 1,同一个 1F1B 模拟总时长变成 54,设备时间利用率为 44.44%。这是具体的失衡反例;改变调度、时长或异步资源后要重算,不能把 72.73% 当任意流水的上限或预报。 交错 1F1B 让每个物理设备承载多个 virtual stage,把一个大气泡拆细。它可改善负载与气泡,却增加更多通信边界、依赖和调度复杂度。Pipeline 并行的优化对象不只是公式里的 bubble,还包括峰值激活、通信重叠和 kernel 连续性。 均衡同步流水线的理想利用率,按 m/(m+p−1) 计算。增加 microbatch 能摊薄填充与排空气泡;它首先描述均衡 forward sweep,也适用于上述均衡 GPipe;图中不含通信、stage 失衡与小 GEMM 效率变化,不能据此直接预测 tokens/s。 04. 代码实现 tp_linear_sim.py 只用标准库,构造 $X:[2,4]$、$W_1:[4,6]$、$W_2:[6,3]$。先完整计算,再把第一层按列、第二层按行切到两个虚拟 rank: X shape=(2, 4), W1 shape=(4, 6), W2 shape=(6, 3), tp=2 column shards: W1=(4, 3) each, hidden=(2, 3) each row shards: W2=(3, 3) each, partial output=(2, 3) each full output=[[52, 42, 72], [132, 114, 180]] max hidden diff=0, max output diff=0 该整数例子的输出差为 0,验证无偏置、无激活时“按列拼接、按行求和”的实现;一般实数情形的代数等价性来自第 03 节推导,不能仅靠一组样本证明。脚本现在支持 --parts 1/2/3/6,非整除及错误矩阵形状会拒绝,避免 zip 静默截断。完整的非线性、偏置与梯度验证在下面的检查脚本中。真实浮点并行的归约顺序不同,通常会出现末位误差,不能要求 bitwise 一致,而应设置与 dtype 相称的容差。 pipeline_bubble.py 默认模拟 4 段、8 个 microbatch: stages=4, microbatches=8, ideal_slots_per_sweep=11 pipeline_efficiency=72.73%, bubble_fraction=27.27% forward schedule (slot -> active stage:microbatch) 00: S0:M0 01: S0:M1 S1:M0 02: S0:M2 S1:M1 S2:M0 03: S0:M3 S1:M2 S2:M1 S3:M0 04: S0:M4 S1:M3 S2:M2 S3:M1 05: S0:M5 S1:M4 S2:M3 S3:M2 06: S0:M6 S1:M5 S2:M4 S3:M3 07: S0:M7 S1:M6 S2:M5 S3:M4 08: S1:M7 S2:M6 S3:M5 09: S2:M7 S3:M6 10: S3:M7 前 3 格在填充、后 3 格在排空,第 3 到第 7 格这 5 格四段都忙碌;11 格总容量为 44 个设备槽,实际使用 32 个。这里打印的是前向时间表,没有实现训练反向。用参数改变 stages 与 microbatches,就能看到增加 microbatch 如何摊薄固定气泡。 额外运行 tp_pp_checks.py(需要 NumPy),固定 seed=27、FP64:TP=1/2/3/6 的 tanh+双偏置两层网络,输出与五类梯度(输入、两权重、两偏置)的最大差均不超过 $8.89\times10^{-16}$;全部 71 个输入/参数分量的中心差分最大差为 $2.44\times10^{-9}$。TP=3 时故意重复加输出偏置,最大输出差为 3.169615;倒置第二层 shard,差为 4.447151。64 组 GPipe/1F1B 事件模拟核对了依赖、任务数和均衡时长;不等 batch 的正确加权梯度为 5.533333,错把两个 microbatch 均值等权平均则为 4.3。这里没有启动多 GPU 或 NCCL。 四份脚本均在 Windows、Python 3.11.9、NumPy 2.4.3、matplotlib 3.10.7 下实际运行;前两份仅用标准库,画图另需 matplotlib,检查脚本另需 NumPy。附录含完整代码;运行当前目录的脚本即可复算 JSON 与配图。 05. 工业级实现对照 本次核对日期为 2026-10-27,固定使用 NVIDIA Megatron-LM 的 core_v0.14.0,不把该版本称为最新。张量并行源码 提供 ColumnParallelLinear 与 RowParallelLinear。工业实现除切权重外,还管理参数初始化、bias、是否 gather 输出、异步梯度 all-reduce、梯度累积融合、sequence parallel、专家并行组和通信 buffer。前两份最小脚本只展示代数和调度账本;新增检查脚本独立核对解析梯度与事件依赖,也没有模拟真实 NCCL。 ColumnParallelLinear 的 gather_output 决定输出是否立刻汇总;RowParallelLinear 的 input_is_parallel 表示输入是否已经按最后一维切好。skip_bias_add=True 会把 bias 作为第二个返回值交给调用者,供后续融合;忽略它就漏掉偏置,重复添加则又算一遍。row-parallel 正常分支先归约无偏置的局部输出,再加完整 bias;sequence parallel 分支改为 reduce-scatter。错置布局可能触发 shape 错,也可能多做 gather 或静默算错。审计并行模型时,应给每个边界标清 global shape、local shape、分片轴、复制轴和预期 collective。 PP 代码位于同版本的流水线调度模块。非交错路径在源码中明确分 warmup、1F1B 和 cooldown;交错路径还涉及 virtual stage、microbatch 分组和通信重叠,不能只套非交错的 warmup 公式。配置中的 pipeline_model_parallel_size 切物理 stage,virtual_pipeline_model_parallel_size 启用交错。系统必须传递前向激活和反向梯度,处理 tied embedding、首尾 stage 特殊 loss、不同张量 shape、激活释放与通信重叠。 为了让对照可核验,本轮保留原始源码并逐字保留 AST 中的两类完整 forward 方法,在 PyTorch 2.10.0+cpu 上运行 48 个 rank/dtype/bias 夹具:TP=1/2/3/6、FP32/FP64、两种 bias 返回模式,以及 gather/scatter 分支,前向与本地 autograd 参考差均为 0。另执行三个原调度辅助函数:60 个非交错 rank 配置的 warmup/remaining 与公式一致,交错示例的 20 项操作序列与源码文档逐项相符。PyTorch autograd 对 NumPy 的五类解析梯度最大差为 $1.61\times10^{-15}$。 这次用 CPU 线性算子与数学集合通信回调替代 CUDA 构造、NCCL 及融合内核,验证的是原 forward 的布局/偏置分支与调度表。它没有验证多卡反向通信、完整 Megatron 模型、通信重叠、GPU 显存或吞吐;这些仍需在真实集群跑下一节的验收。 Megatron 2021 展示了 TP、PP 与 DP 的组合,并提出交错流水调度。工程上的常见布局是:同一节点内组成 TP 组,邻接节点组成 PP 链,跨副本组成 DP 组。原因是 TP 每层通信而 PP 只在 stage 边界传输;把频繁 collective 放在更快互联上更划算。 生产配置还要做 layer partition。按层数平均只在每层耗时相同才合理;MoE 层、cross-attention、视觉模块、embedding 与词表 head 的成本差异很大。应先 profile 单层前后向时间和激活尺寸,再按时间而不是按层数切 stage。 06. 代价与边界 TP 的主要代价是高频 collective。TP 度增加后,每卡 GEMM 变小,计算效率下降,通信延迟占比上升;跨节点 TP 尤其敏感。维度还必须能合理整除:attention head、KV head、MLP intermediate size、词表分片与低精度 tile 对齐都会形成约束。 PP 的主要代价是气泡、激活驻留与调度复杂度。microbatch 增多能降气泡,却让每次 GEMM 的 batch 更小,可能降低算力利用率;还会增加调度次数。梯度累积数也受 global batch、DP 度与 microbatch size 约束: $$B_{\mathrm{global}}=B_{\mathrm{micro}}\,m\,d_p$$ 为了把 $m$ 调大而偷偷改变 global batch,会连学习率与收敛语义一起改变。更稳妥的做法是减小 microbatch size、保持 global batch,再检查小 GEMM 是否仍高效。 PP stage 之间有顺序依赖,在每条样本路径都经过所有 stage 的假设下,单个慢 stage 会拖住全链。设备故障、动态 shape、条件分支和 MoE 路由也比普通 DP 难处理。推理时 batch 与请求长度动态变化,训练得到的均衡切分未必仍均衡。 TP 与 ZeRO/FSDP 并非天然可任意叠加。两者可能切同一参数的不同轴,process group、参数初始化、checkpoint layout 和 optimizer state 都需协调。首先建立二维或三维 rank 映射,再启用框架明确支持的组合,避免自行套两层 wrapper。 什么时候不该用?模型单卡能放下且吞吐受数据不足或 CPU 限制时,TP/PP 只会增加同步;单层很小而层很多时,优先 PP 或 FSDP;单层巨大而层数不多时,TP 更直接;超长序列导致激活爆炸时,还要引入下一篇的序列/上下文并行。 6.1 从模型形状反推 TP 度 假设 decoder hidden size 为 $d$,MLP expansion 为 $4d$,attention head 数为 $H$,每头维度为 $d_h=d/H$。采用 $t_p$ 路 TP 时,至少希望 $H/t_p$ 与 $4d/t_p$ 为整数,且本地矩阵维度满足 Tensor Core tile 对齐。GQA 还要检查 KV head 数 $H_{KV}$;若 Q head 可整除而 KV head 不可整除,框架可能复制 K/V 或根本拒绝配置。 参数容量只是下界。以 MLP 两个权重为例,忽略 bias: $$P_{\mathrm{MLP}}=d(4d)+(4d)d=8d^2$$ 理想 TP 后每卡为 $8d^2/t_p$ 个参数。然而输入 $X$、残差、LayerNorm 与某些输出仍可能复制。是否启用 sequence parallel,会决定 $[B,L,d]$ 激活是每 TP rank 一份还是沿 token 切开。评估 TP 度时要分别列参数、可分片激活、复制激活和通信 buffer,不能只用总显存除 $t_p$。 性能上,增大 $t_p$ 会改变本地 GEMM 的形状与数据复用;是否降低算术强度或耗时要看哪一维被切、缓存及 kernel。若局部矩阵太窄,GPU 的流式多处理器(SM)可能利用不足,计算缩小也未必换来相应加速。实际选型一般从“能放下的最小 TP 度”起步,再尝试少数相邻值;不是卡越多 TP 越大。 6.2 三维 rank 映射为什么决定速度 有 2 个节点、每节点 8 卡,总计 16 卡。假设 TP=8、PP=2、DP=1,合理映射是每个节点内部构成一个 TP 组,两个节点作为相邻 PP stage。这样每层 TP collective 走 NVLink/NVSwitch,只有 stage 边界激活跨节点。 若 rank 编号错误,使每个 TP 组横跨两节点,那么每个 Transformer 层的 all-reduce 都经过网络;PP 反而在节点内。数学结果完全正确,吞吐却可能大幅下降。这类问题从配置数字看不出来,必须导出每个 process group 的物理 GPU、主机名、PCIe/NVLink 路径和 NIC 亲和性。 当 DP>1 时,DP 组应从相同 TP/PP 坐标上取不同副本。例如把 rank 写成坐标 $(r_d,r_p,r_t)$,模型同一 shard 的梯度只在 $r_d$ 维同步;层内 tensor collective 只改变 $r_t$;pipeline 点对点只沿 $r_p$ 邻接。把坐标语义明确下来,checkpoint 分片和故障定位才不会依赖偶然 rank 编号。 多 NIC 节点还要关注通信并发。TP all-reduce、PP send/recv、DP reduce-scatter 可能同时争同一链路。单独 benchmark 每个 collective 很快,不代表组合后仍快;应在真实 schedule 上看每条 stream 和 NIC 的时间线。 6.3 Pipeline 内存不是简单除以段数 PP 将参数按层分段,参数内存近似降为 $1/p_p$,但激活取决于 schedule。GPipe 前向完所有 $m$ 个 microbatch 才反向,每 stage 可能保留 $O(m)$ 份边界与层内激活。1F1B warmup 后尽早反向,可显著减少同时存活的 microbatch 数;不同 stage 的 warmup 长度又不同,峰值不完全一致。 activation checkpoint 将层内保存换成反向重算,但 stage 边界张量通常仍要保留或重新通信。若 PP 与 ZeRO-3 叠加,重算还可能再次触发参数 all-gather;如果 prefetch 与 release 时机不匹配,理论显存节省会被临时完整参数覆盖。 一个更实用的峰值模型是: $$M_s^{\mathrm{peak}}=\max_t[M_{\mathrm{state},s}(t)+M_{\mathrm{act},s}(t)+M_{\mathrm{comm},s}(t)+M_{\mathrm{workspace},s}(t)]$$ $s$ 是 stage,$t$ 是时间,state 含权重、梯度与优化器状态;各项应为同一时刻互不重复计数的存储。若每份图大小接近,激活项可近似为当时存活图数乘单份大小,但不能把各项在不同时刻的最大值当成真实同时峰值。选切分点的目标应是控制 $\max_s M_s^{\mathrm{peak}}$ 并平衡每段时间,而不是让每段层数相同。首段 embedding、尾段 vocab projection 和 loss 往往需要单独计量。 6.4 Schedule 的一致性与权重版本 同步 GPipe 或 1F1B 中,一个 global batch 的所有 microbatch 应使用同一版参数,梯度累积后再统一 optimizer step。若 loss 能按样本或有效 token 相加,所有 microbatch 使用同一版权重、对应计算相同且累积权重正确,则在精确算术下得到同一批的梯度。BatchNorm 训练态按 microbatch 计算均值/方差,改变切分会改变 forward;共享可变状态或跨样本操作同样需要单独处理,不能无条件称等价。检查脚本中 [1,2,4] 整批与按 1+2 拆分的 BatchNorm 型归一化,最大输出差为 1.069042。随机 dropout 若要严格比较,还需保证不同 schedule 消耗一致的随机数流。 异步 pipeline 为减少 flush 可能允许某些 microbatch 使用旧权重,产生 weight staleness。PipeDream 的权重暂存与调度就是为管理这个问题。吞吐更高不等于优化轨迹相同;对需要可复现或大规模预训练的任务,同步 schedule 通常更容易验收。 梯度累积的 loss normalization 也常出错。若每个 microbatch loss 已取 mean,再把 $m$ 份梯度直接相加,最终梯度比全局 mean 大 $m$ 倍;框架可能在 loss、backward 或 optimizer wrapper 某处除 $m$。迁移实现时必须确认缩放发生在哪里,特别是最后一个不完整 microbatch。若第 $j$ 片包含 $n_j$ 个有效单元(例如未被 mask 的 token),片内 mean loss 为 $\bar\ell_j$,需要先明确整批目标: $$\mathcal{L}_{\mathrm{mean}}=\frac{\sum_jn_j\bar\ell_j}{\sum_jn_j},\qquad\nabla\mathcal{L}_{\mathrm{mean}}=\sum_j\frac{n_j}{\sum_kn_k}\nabla\bar\ell_j$$ 只有所有 $n_j$ 相等时才是简单除以 $m$。还要考虑 DP 默认梯度平均的除数;不能同时在 loss 和 wrapper 各除一遍。目标若本来定义为每样本均值,应按有效样本数加权,而非擅自换成 token 均值。 6.5 如何系统调优而不是枚举所有组合 第一步做容量约束:根据参数、优化器、激活和临时 buffer,排除会 OOM 的 TP/PP。第二步做整除约束:检查层数、head、KV head、MLP width、词表与 microbatch。第三步按拓扑放组:TP 留在最快域,PP 穿过节点,DP 使用余下副本。第四步才短跑候选方案。 短跑至少记录每个 stage 的 forward/backward 时间、TP collective、PP send/recv、DP collective、bubble、MFU 和峰值显存。若 stage 时间方差大,先重切层;若 collective 裸露,检查异步与 bucket;若 GEMM 利用率低,减少 TP 或增大 microbatch;若 bubble 大,增加 microbatch 或 virtual stage。 还要避免只优化稳态。训练中 checkpoint、评估、数据切换、动态 loss scale 与长短样本混合会改变节拍。视频模型的序列长度可能随分辨率和帧数变化,固定层切分在不同 batch 上会失衡。可以按长度分桶、限制每批 token 数,或使用能处理动态 shape 的 schedule,但都要重新验证 global batch 语义。 6.6 Checkpoint 与并行度变更 TP checkpoint 的一个权重可能沿行或列分片,PP checkpoint 又只在拥有该层的 stage 上出现。保存时应记录全局 shape、分片轴、offset、replica group 与 tied-weight 关系。仅按 rank 存文件却没有布局元数据,会显著增加从 TP=8 改成 TP=4 的恢复难度;若完整掌握原切分约定仍可转换,但必须验证。 成熟 distributed checkpoint 会把逻辑参数名与物理 shard 解耦,加载时重新规划切片。验证转换不能只看“文件读完”,应抽样 all-gather 后与原始全参数比较,并跑一个确定性 forward。optimizer state 也必须按相同参数布局重分片,特别是 Adam 的 m、v 与 FP32 主权重。 PP 的 tied embedding 是典型边界:输入 embedding 在首段,输出投影在尾段,但两者可能共享参数。系统要么在两个 stage 间同步梯度,要么采用明确的复制与更新协议。忽略它会让模型能跑、loss 也下降,却不再是原架构。 最后为每个组合保留机器可读配置:world size、各轴度数、rank 坐标映射、global/micro batch、累积数、schedule、virtual stage、precision 与 checkpoint schema。没有这份清单,性能回归时很难判断是代码变化还是并行布局变化。 6.7 一个具体的 64 卡选型例子 假设 8 个节点、每节点 8 卡,模型单层在 4 卡上能放下,96 层在单节点放不下,目标 global batch 又允许 4 个数据副本。可先试 TP=4、PP=4、DP=4,乘积正好 64。每个节点容纳两个 TP 组,相邻两个节点组成一条四段 pipeline;相同 TP/PP 坐标跨四个副本形成 DP 组。 为什么不直接 TP=8、PP=2、DP=4?它减少 PP 气泡,但本地 GEMM 变小、每层 collective 参与卡数翻倍。为什么不 TP=2、PP=8、DP=4?单层可能放不下,而且 PP 段更多,要求更多 microbatch 才能摊薄气泡。三个方案都满足乘积约束,只有容量、profile 和拓扑能决定赢家。 设 PP=4、microbatch 数 $m=16$,理想气泡为 $3/19=15.79\%$;若为配合 DP=4,global batch 满足 $B_{\mathrm{global}}=B_{\mathrm{micro}}\times16\times4$。当目标 global batch 固定时,microbatch size 可能被压得太小。此时交错 PP 可在不继续增加 $m$ 的情况下缩小气泡,但要多传 stage 边界。 选定后再检查每卡峰值。若尾段词表 head 使 stage 3 明显更慢,可把少量 Transformer 层从尾段移到前段;若 stage 0 embedding 占显存而计算很少,切分目标应同时满足容量与时间,而不是追求参数量绝对相等。 6.8 故障现象与定位路径 若所有 GPU 利用率呈周期性锯齿且空白集中在迭代首尾,优先看 PP bubble;若每层 GEMM 后都有长 NCCL 条带,优先看 TP 通信或 rank 跨节点;若只有某一个 stage 长期满载、其他 stage 等待,是层切分失衡;若迭代末尾集中等待,是 DP 梯度同步没有充分 overlap。 出现 hang 时,先核对各 rank collective 调用序列。条件分支导致某些 rank 少调用一次 all-reduce,或 PP 两端 send/recv shape 不一致,都会永久等待。为通信操作记录 group、sequence number、peer、shape 与 dtype,比只看 Python stack 更有用。设置超时只能让错误更快暴露,不能修复顺序。 数值不一致时,从一个微型模型开始,关闭 dropout 和 fused kernel,分别测试 TP、PP,再测试组合。TP 常见错误是切分轴、bias 重复相加、输出误 gather;PP 常见错误是 loss 缩放、跨段激活 requires-grad、共享参数同步。一次只启用一根并行轴,能把搜索空间从三维降为一维。 OOM 若只发生在第一步,往往是 optimizer state 首次建立或通信 bucket 惰性分配;若在若干步后发生,可能是 graph retention、动态 shape 缓存或碎片;若只在某个 PP stage,先看该段真实 activation 与临时 buffer。不要看到 OOM 就统一减 microbatch,这可能掩盖泄漏却降低所有卡效率。 6.9 上线验收清单 发布配置前确认:世界规模等于各并行轴乘积;每个 rank 坐标唯一;TP group 位于预期高速域;head、KV head、MLP 与词表可整除;各 stage 时间和峰值接近;global batch 算术正确;loss normalization 不依赖 microbatch 数;tied weight 有同步协议;checkpoint 能跨目标并行度恢复。 性能门禁同时保存 tokens/s、MFU、bubble、每类 collective 的裸露时间、峰值显存和最慢 stage。只保存总迭代时间无法解释回归。集群拓扑或通信库升级后,即使模型代码未变,也要重跑基准,因为并行策略本质上是对物理系统的映射。 最后预留降级方案:某节点高速链路异常时能否减少 TP、增加 PP;某个 checkpoint 是否可重分片;global batch 是否仍保持;恢复后数值是否连续。真正稳健的并行配置,不只是峰值最快,也要能在硬件变化和断点恢复时保持语义清楚。 6.10 理论通信量为什么不等于训练时间 同样传 1 GiB,一个大 all-reduce 与数百个小 collective 的耗时不同。常用模型 $T=\alpha n+\beta V$ 中,$n$ 是消息次数,$V$ 是字节量,$\alpha$ 表示每次启动延迟,$\beta$ 表示每字节时间。TP 在每层频繁通信,尤其受 $\alpha$ 影响;PP 消息次数少,但单次边界激活可能很大。 通信是否裸露还取决于依赖。梯度 all-reduce 可与更早层 backward 重叠,PP send 可与下一份本地计算重叠;位于关键路径上的 collective 即使字节少也会直接延长 step。性能报告应区分总 NCCL 时间与 exposed communication time。 bucket 太小会增加消息次数,太大又推迟通信启动,减少 overlap。最优 bucket 与层大小、网络延迟和反向节奏有关。框架默认值是通用折中,不一定适合视频 DiT 的大激活或 MoE 的不均匀参数。 最后还要观察尾延迟。一个 rank 因热降频、ECC、数据抖动或网络拥塞变慢,collective 会让整个组等待。平均 GPU 时间看似健康,最慢 rank 才决定训练。按 rank 记录分位数,并把异常节点与拓扑关联,是大规模并行调优的基本动作。 理论模型最终要由 trace 校准。为每次实验保存并行配置、网络拓扑、逐 stage 时间线与通信矩阵,下一次才能定位回归。若只留一行 tokens/s,既无法判断瓶颈是 GEMM、气泡还是慢 rank,也无法安全迁移到另一代 GPU。并行策略不是模型的附属启动参数,而是计算图和硬件共同组成的一部分,理应像模型结构一样接受版本管理和回归测试。 07. 经典论文脉络 GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism(arXiv:1811.06965v5;arXiv 元数据题名如此,v5 PDF 首页题名为 GPipe: Easy Scaling with Micro-Batch Pipeline Parallelism):用 microbatch 流水化跨加速器的模型分段,并以同步 mini-batch 语义训练巨型网络。 PipeDream: Fast and Efficient Pipeline Parallel DNN Training(arXiv:1806.03377v1):探索 1F1B 与异步流水,揭示吞吐、权重版本和一致性之间的权衡。 Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism(arXiv:1909.08053v4):提出 Transformer 内高效的 tensor model parallel 切法,用少量 collective 支撑数十亿参数。 Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM(arXiv:2104.04473v5):系统组合 TP、PP、DP,并以交错流水减少气泡,扩展到千卡与万亿参数。 论文演进说明:单一并行轴只能解决一种容量瓶颈,规模继续增长后,真正的问题变成如何把多个轴映射到硬件拓扑并共同调度。 08. 常见误解 误解一:TP 就是把每层平均切开。 切分轴决定通信。Megatron 的 column-row 配对是为了让中间分片直接衔接,不是机械地切一半权重。 误解二:PP 段数越多,显存越省且速度越快。 参数容量会下降,但固定气泡随 $p-1$ 增长;若 microbatch 不够,更多 stage 反而更闲。 误解三:microbatch 越多越好。 它降低理想气泡,却减小 GEMM、增加调度,并可能扩大激活队列。要联动测 MFU 与显存。 误解四:1F1B 是异步优化。 常用同步 1F1B 只是改变前后向顺序,仍在一个 global batch 梯度完成后统一更新;PipeDream 式异步才涉及权重陈旧。 误解五:TP 能把所有显存除以 TP 度。 小参数、复制激活、通信 buffer 与 runtime 不会理想均分。必须看逐项账本。 误解六:三维并行度乘起来等于卡数就配置正确。 整除只是必要条件。拓扑、矩阵 tile、head 数、stage 均衡、global batch 都可能让配置不可用。 09. 动手验证 先运行 tp_linear_sim.py,使用 python tp_linear_sim.py --parts 3,把 $W_1$ 的输出与 $W_2$ 的输入切成 3 片。预期完整输出仍一致。然后故意让第二层 shard 顺序交换,结果会静默错误;这说明 distributed tensor layout 必须携带明确语义。 运行 pipeline_bubble.py,固定 stages=8,分别取 microbatches=1、8、32、72。理论效率依次为 $1/8$、$8/15$、$32/39$、$72/79$。脚本当前只实现均衡 stage 的闭式公式;扩展成事件调度模拟后,用 tp_pp_checks.py 中已实现的事件模拟比较 GPipe、非交错 1F1B 与最后一段变慢的案例,检查 makespan、每段存活图峰值和全部任务的依赖。平衡 64 组与不均衡 54 时间单位反例都能复算,观察均分层数为何不等于均分时间。 在真实集群做 TP=1/2/4/8 对照,固定 global batch 和模型,记录每层 GEMM 时间、collective 时间、MFU、峰值显存。观察容量是否解除、吞吐是否改善,以及更大 TP 是否因小 GEMM 或通信而退化;这些是待测假设,不是保证出现的曲线。用拓扑工具确认 TP rank 是否真的落在 NVLink 域内。 对 PP 做相同实验:固定 PP 度,逐步增加 microbatch 数;再固定 microbatch,增加 virtual stage。记录 bubble、激活峰值与端到端 tokens/s。不要只看 framework 打印的理论 bubble,GPU timeline 中的空白才是真实气泡。 最后做一次等价性验收:单卡、TP、PP、TP+PP 使用相同初始化和样本,关闭 dropout,比较一个 step 的 loss 和若干参数梯度。低精度与归约顺序会造成小差异,但若误差随层爆炸,优先检查 shard 顺序、bias、loss 归一化与 tied weight。 10. 延伸阅读 读完这篇可以继续看: 数据并行与 ZeRO 显存切分:DP 沿 batch 分样本、ZeRO 沿 DP 组切状态,是三维并行的第一根轴。 序列并行与 Ring Attention:当瓶颈从模型宽度转向超长 token,沿 sequence 切激活与 attention。 混合精度与数值稳定性:低精度改变 TP/PP 通信字节与归约误差,配置并行前要先明确累加精度。 选型时先问容量瓶颈在哪里:单层太宽选 TP,层总数太深选 PP,副本吞吐选 DP,超长激活选 SP。随后才是把这些轴映射到实际互联。公式给出上限,profile 决定最终配置。 附录:完整代码 09 节用到的脚本全文如下(tp_pp_checks.py、tp_linear_sim.py、pipeline_bubble.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 tp_pp_checks.py """CPU teaching checks: NumPy only; python tp_pp_checks.py. No GPU cluster benchmark.""" from pathlib import Path import json import numpy as np from tp_linear_sim import matmul, split_columns, split_rows def stage_order(p, m, schedule): if p < 1 or m < 1 or schedule not in ("gpipe", "1f1b"): raise ValueError("positive stages/microbatches and gpipe/1f1b required") orders = [] for s in range(p): if schedule == "gpipe": ops = [("F", i) for i in range(m)] + [("B", i) for i in reversed(range(m))] else: warm = min(p - s - 1, m) ops = [("F", i) for i in range(warm)] for i in range(m - warm): ops.extend([("F", i + warm), ("B", i)]) ops += [("B", i) for i in range(m - warm, m)] orders.append(ops) return orders def schedule_events(p, m, schedule, forward=None, backward=None): """Earliest-start DAG simulation; one nonpreemptive compute resource per stage.""" orders = stage_order(p, m, schedule) forward = [1.] * p if forward is None else list(forward) backward = [1.] * p if backward is None else list(backward) if len(forward) != p or len(backward) != p or not all(np.isfinite(x) and x > 0 for x in forward + backward): raise ValueError("positive finite per-stage times required") done, next_op, events = {}, [0] * p, [] while sum(next_op) < 2 * p * m: progress = False for s, ops in enumerate(orders): if next_op[s] == len(ops): continue kind, i = ops[next_op[s]] deps = [] if next_op[s]: last = ops[next_op[s] - 1] deps.append((s, *last)) if kind == "F" and s: deps.append((s - 1, "F", i)) if kind == "B": deps.append((s, "F", i)) if s < p - 1: deps.append((s + 1, "B", i)) if not all(d in done for d in deps): continue start = max([done[d] for d in deps], default=0.) end = start + (forward[s] if kind == "F" else backward[s]) done[(s, kind, i)] = end events.append(dict(stage=s, kind=kind, microbatch=i, start=start, end=end)) next_op[s] += 1 progress = True if not progress: raise RuntimeError("schedule dependency cycle") peak = [] for s in range(p): # Count one graph after F completion until B completion; tie releases first. changes = [(e['end'], 1 if e['kind'] == 'F' else -1) for e in events if e['stage'] == s] live = high = 0 for _, delta in sorted(changes): live += delta high = max(high, live) assert live == 0 peak.append(high) total = max(done.values()) busy = m * sum(forward + backward) return dict(schedule=schedule, stages=p, microbatches=m, makespan=total, utilization=busy / (p * total), peak_graphs=peak, events=events) def main(): rng = np.random.default_rng(27) x, a, b = rng.normal(size=(5, 4)), rng.normal(size=(4, 6)), rng.normal(size=(6, 3)) c, d, g = rng.normal(size=6), rng.normal(size=3), rng.normal(size=(5, 3)) h = np.tanh(x @ a + c) y = h @ b + d dz = (g @ b.T) * (1 - h * h) reference = [dz @ a.T, x.T @ dz, h.T @ g, dz.sum(0), g.sum(0)] rows = [] for p in (1, 2, 3, 6): aa, bb, cc = np.split(a, p, 1), np.split(b, p, 0), np.split(c, p) hh = [np.tanh(x @ ai + ci) for ai, ci in zip(aa, cc)] partials = [hi @ bi for hi, bi in zip(hh, bb)] out = sum(partials) + d zz = [(g @ bi.T) * (1 - hi * hi) for hi, bi in zip(hh, bb)] actual = [sum(zi @ ai.T for zi, ai in zip(zz, aa)), np.concatenate([x.T @ zi for zi in zz], axis=1), np.concatenate([hi.T @ g for hi in hh]), np.concatenate([zi.sum(0) for zi in zz]), g.sum(0)] err = max(float(np.max(abs(u-v))) for u, v in zip(reference, actual)) assert np.max(abs(out-y)) < 1e-12 and err < 1e-12 wrong_bias = sum(pi + d for pi in partials) wrong_layout = sum(hi @ bi for hi, bi in zip(hh, list(reversed(bb)))) + d rows.append(dict(parts=p, output_error=float(np.max(abs(out-y))), gradient_error=err, repeated_bias_error=float(np.max(abs(wrong_bias-y))), reversed_shard_error=float(np.max(abs(wrong_layout-y))))) # Independent central finite differences over all input/weight/bias elements. fd = 0. for z, grad in zip([x, a, b, c, d], reference): for idx in np.ndindex(z.shape): old = z[idx];eps = 1e-6 z[idx] = old + eps;plus = np.sum((np.tanh(x @ a + c) @ b + d) * g) z[idx] = old - eps;minus = np.sum((np.tanh(x @ a + c) @ b + d) * g) z[idx] = old fd = max(fd, float(abs((plus-minus)/(2*eps)-grad[idx]))) assert fd < 1e-7 balanced = [] for p in (1, 2, 4, 8): for m in (1, 2, 8, 27): for method in ('gpipe', '1f1b'): z = schedule_events(p, m, method) assert z['makespan'] == 2 * (m + p - 1), (p, m, method) assert abs(z['utilization'] - m/(m+p-1)) < 1e-14 assert len(z['events']) == 2*p*m balanced.append({k:v for k,v in z.items() if k!='events'}) demos = [schedule_events(4, 8, v) for v in ('gpipe', '1f1b')] unbalanced = schedule_events(4, 8, '1f1b', [1, 1, 1, 3], [1, 1, 1, 3]) assert unbalanced['makespan'] > 22 # Unequal microbatch mean example: scalar squared-error derivative 2*(w*x-y)*x. xx, yy, w = np.array([1., 2., 4.]), np.array([0., 1., -1.]), .3 grad = 2*(w*xx-yy)*xx full = grad.mean();weighted = (grad[:1].mean()+2*grad[1:].mean())/3 wrong = (grad[:1].mean()+grad[1:].mean())/2 assert abs(full-weighted) < 1e-14 and abs(full-wrong) > .1 batchnorm = lambda z:(z-z.mean())/np.sqrt(z.var()+1e-5) bn_error = float(np.max(abs(batchnorm(xx)-np.concatenate([batchnorm(xx[:1]),batchnorm(xx[1:])])))) assert bn_error > .1 invalid = 0 for func, args in [(split_columns, ([[1,2,3]], 2)), (split_rows, ([[1],[2],[3]], 2)), (split_columns, ([[1]], 0)), (matmul, ([[1,2]], [[3]])), (matmul, ([[1],[2,3]], [[4]])), (stage_order, (0, 1, 'gpipe')), (schedule_events, (2, 2, 'gpipe', [1,-1]))]: try:func(*args) except ValueError:invalid += 1 else:raise AssertionError('invalid input accepted') result = dict(passed=True,seed=27,numpy=np.__version__,shapes=dict(X=list(x.shape),A=list(a.shape),B=list(b.shape),c=list(c.shape),b=list(d.shape),Y=list(y.shape)),tp=rows,finite_difference_max=fd, balanced_cases=balanced,demo_schedules=demos,unbalanced=unbalanced, unequal_microbatch=dict(global_mean=float(full),weighted=float(weighted),wrong_equal=float(wrong)), batchnorm_split_difference=bn_error,invalid_inputs_rejected=invalid, limits='In-process CPU algebra and dependency simulation; no NCCL, GPU memory, latency or throughput measurements.') Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,indent=2)+'\n',encoding='utf8') print(json.dumps({k:v for k,v in result.items() if k not in ('balanced_cases','demo_schedules','unbalanced')},indent=2)) for z in demos+[unbalanced]:print(z['schedule'],z['makespan'],z['utilization'],z['peak_graphs']) if __name__ == '__main__':main() tp_linear_sim.py #!/usr/bin/env python3 """Verify column- and row-parallel linear algebra without any framework.""" def matmul(a, b): if not a or not b or not a[0] or not b[0] or any(len(r) != len(a[0]) for r in a) or any(len(r) != len(b[0]) for r in b): raise ValueError("nonempty rectangular matrices required") if len(a[0]) != len(b): raise ValueError("inner dimensions must match") return [[sum(x * y for x, y in zip(row, col)) for col in zip(*b)] for row in a] def split_columns(a, parts): if not isinstance(parts, int) or isinstance(parts, bool) or parts < 1 or not a or not a[0] or any(len(r) != len(a[0]) for r in a) or len(a[0]) % parts: raise ValueError("positive parts must divide rectangular matrix width") width = len(a[0]) // parts return [[row[i * width:(i + 1) * width] for row in a] for i in range(parts)] def split_rows(a, parts): if not isinstance(parts, int) or isinstance(parts, bool) or parts < 1 or not a or not a[0] or any(len(r) != len(a[0]) for r in a) or len(a) % parts: raise ValueError("positive parts must divide rectangular matrix height") height = len(a) // parts return [a[i * height:(i + 1) * height] for i in range(parts)] def add(a, b): if len(a) != len(b) or any(len(ra) != len(rb) for ra, rb in zip(a, b)): raise ValueError("addition shapes must match") return [[x + y for x, y in zip(ra, rb)] for ra, rb in zip(a, b)] x = [[1, 2, 3, 4], [5, 6, 7, 8]] # [tokens=2, hidden=4] w1 = [[1, 0, 2, 0, 3, 0], [0, 1, 0, 2, 0, 3], [1, 1, 1, 1, 1, 1], [2, 1, 0, 1, 2, 1]] # [4, 6] w2 = [[1, 0, 1], [0, 1, 1], [1, 1, 0], [2, 0, 1], [0, 2, 1], [1, 0, 2]] # [6, 3] full_hidden = matmul(x, w1) full_output = matmul(full_hidden, w2) # Column parallel W1: every rank computes a slice of output features. w1_shards = split_columns(w1, 2) hidden_shards = [matmul(x, shard) for shard in w1_shards] column_joined = [left + right for left, right in zip(*hidden_shards)] # Row parallel W2: input features and W2 rows use matching shards, then sum. w2_shards = split_rows(w2, 2) partials = [matmul(h, w) for h, w in zip(hidden_shards, w2_shards)] row_reduced = [[sum(part[r][c] for part in partials) for c in range(len(partials[0][0]))] for r in range(len(x))] max_hidden_diff = max(abs(a - b) for ra, rb in zip(full_hidden, column_joined) for a, b in zip(ra, rb)) max_output_diff = max(abs(a - b) for ra, rb in zip(full_output, row_reduced) for a, b in zip(ra, rb)) print("X shape=(2, 4), W1 shape=(4, 6), W2 shape=(6, 3), tp=2") print("column shards: W1=(4, 3) each, hidden=(2, 3) each") print("row shards: W2=(3, 3) each, partial output=(2, 3) each") print(f"full output={full_output}") print(f"max hidden diff={max_hidden_diff}, max output diff={max_output_diff}") if __name__ == "__main__": import argparse parser = argparse.ArgumentParser() parser.add_argument("--parts", type=int, default=2) args = parser.parse_args() try: hs = [matmul(x, w) for w in split_columns(w1, args.parts)] ps = [matmul(h, w) for h, w in zip(hs, split_rows(w2, args.parts))] except ValueError as exc: parser.error(str(exc)) reduced = [[sum(part[r][c] for part in ps) for c in range(3)] for r in range(2)] assert reduced == full_output print(f"requested_tp={args.parts}, shards={len(hs)}, output={reduced}") pipeline_bubble.py #!/usr/bin/env python3 """Idealized GPipe bubble calculator; stdlib only.""" import argparse parser = argparse.ArgumentParser() parser.add_argument("--stages", type=int, default=4) parser.add_argument("--microbatches", type=int, default=8) args = parser.parse_args() if args.stages < 1 or args.microbatches < 1: parser.error("stages and microbatches must be positive") p, m = args.stages, args.microbatches slots = m + p - 1 efficiency = m / slots print(f"stages={p}, microbatches={m}, ideal_slots_per_sweep={slots}") print(f"pipeline_efficiency={efficiency:.2%}, bubble_fraction={1-efficiency:.2%}") print("forward schedule (slot -> active stage:microbatch)") for t in range(slots): active = [f"S{s}:M{t-s}" for s in range(p) if 0 <= t - s < m] print(f"{t:02d}: " + " ".join(active)) make_figures.py """Regenerate this article's deterministic teaching figure (numpy + matplotlib).""" from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np OUT=Path(__file__).resolve().parents[1]/"figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({"font.sans-serif":["Microsoft YaHei","DejaVu Sans"],"axes.unicode_minus":False}) m=np.arange(1,129) fig,ax=plt.subplots(figsize=(8,4.8)) for p in [2,4,8,16]:ax.plot(m,m/(m+p-1),label=f"{p} stages") ax.set(xlabel="Microbatches per DP replica per optimizer step",ylabel="Ideal utilization",ylim=(0,1.02),title="Balanced forward sweep / GPipe: m / (m + p - 1)") ax.legend();ax.grid(alpha=.25);fig.tight_layout() fig.savefig(OUT/'pipeline_utilization.png',dpi=170) plt.close(fig) print(OUT/'pipeline_utilization.png')
-
AIGC 基本功|混合精度与数值稳定性-AMP AIGC 基本功|混合精度与数值稳定性-AMP 所属方向:分布式训练 | 难度:进阶 | 前置知识:无节点级先修;需要向量范数、导数与梯度的基本概念 关键词:混合精度、FP16、BF16、FP8、loss scaling、溢出、数值稳定 01. 为什么需要它 同一份训练代码,把 BF16 改成 FP16,吞吐可能更高,也可能几十步后 loss 直接变成 NaN。另一个常见现场是:模型看起来正常收敛,但某些参数长期没有变化;检查梯度才发现,一些绝对值不超过 $2^{-25}\approx2.98\times10^{-8}$ 的梯度在 round-to-nearest-even 写回 FP16 时已经变成了 0。 这不是“半精度不准”一句话能解释的。训练里的风险至少有三种:数太大,越过该转换路径的舍入溢出边界而成为 inf;数太小,舍入后落到 0(或硬件将次正规数 flush-to-zero);数虽然在范围内,却因为有效位太少,在加法里被大数吞掉。三者的修复手段不同:loss scaling 能救小梯度,却救不了激活溢出;换 BF16 能扩展动态范围,却不会自动改善尾数精度;把归约留在 FP32 能减小累加误差,却不代表所有输入和权重都要回到 FP32。 为什么还要承担这些麻烦?因为 Transformer 的大头通常是矩阵乘(GEMM,通用矩阵乘法)。现代加速器对低精度矩阵乘提供更高吞吐,权重和激活每元素从 4 字节降到 2 字节也能减小显存与带宽压力。Mixed Precision Training 给出的核心配方是:低精度做大部分前后向,保留 FP32 主权重进行更新,并对 loss 缩放以防小梯度消失;其特定模型与实验保持了精度。低精度张量本身的字节可减半,总训练显存是否下降还取决于主权重、梯度和优化器状态,6.1 节给出两套账本。 “混合”的重点不是选一个统一 dtype,而是给不同数值角色分工。大 GEMM 适合低精度输入,softmax、归一化、loss 和长归约通常需要更大的范围或更高精度,优化器状态又有自己的要求。自动混合精度(Automatic Mixed Precision,AMP)的价值正是把逐算子的 dtype 路由表和梯度缩放流程标准化。 一个数字能说明 FP16 与 BF16 的性格差异:FP16 最大有限值只有 65504,而 BF16 与 FP32 一样有 8 位指数,最大值约 $3.39\times10^{38}$。反过来,FP16 有 10 位小数尾数,1 附近的间隔约 $9.77\times10^{-4}$;BF16 只有 7 位尾数,间隔约 $7.81\times10^{-3}$。BF16 更不容易炸,FP16 在可表示范围内更细;“更稳定”与“更精确”不是同一维度。 02. 最小可用理解 三句话先建立框架: autocast 按设备与算子选择 dtype:例如 PyTorch 2.10 的 CUDA 矩阵乘可用 FP16,CUDA softmax、MSE 等用 FP32;CPU 的 BF16 策略表不同,不能把这句话当作所有设备和归约的保证。 FP16 训练通常用 loss scale $S$ 把反向梯度整体放大,更新前再除回去;发现 inf/NaN 时跳过这一步并缩小 $S$。 BF16 动态范围接近 FP32,通常不需要 GradScaler,但尾数更短;FP8 则必须进一步管理张量尺度、绝对最大值历史和累加精度。 如果只记一个检查顺序:先问异常发生在前向还是反向,再区分 overflow、underflow 与 rounding,最后才决定换 dtype、调 scale,还是把局部算子提升到 FP32。 AMP 中常见的四种角色也要分开:参数存储 dtype、算子输入 dtype、乘法累加 dtype、优化器状态 dtype。日志打印“BF16 training”并不能证明四者都是 BF16。很多 GEMM 是 BF16 输入、FP32 累加;Adam 的一阶矩和二阶矩仍为 FP32;某些框架还会保存 FP32 主权重。 03. 数学推导 3.1 浮点数到底牺牲了什么 对非零正规数,一个二进制浮点数可写成(次正规数没有隐含的前导 1): $$x=(-1)^s(1.f)_2\,2^{e-\mathrm{bias}}$$ $s$ 是符号位,$e$ 是指数域,$f$ 是小数域。指数位数决定动态范围,尾数位数决定相邻可表示数的间距。FP16 是 1 位符号、5 位指数、10 位小数;BF16 是 1、8、7;FP32 是 1、8、23。这里的“小数位”不含正规数隐含的前导 1,所以有效二进制位分别为 11、8、24;指数全 0/全 1 留给边界及特殊值。于是: FP16:最小正规数 $2^{-14}=6.1035\times10^{-5}$,最小次正规数 $2^{-24}=5.9605\times10^{-8}$,最大有限值 65504; BF16:最小正规数 $2^{-126}\approx1.1755\times10^{-38}$,最小次正规数 $2^{-133}$,最大有限值约 $3.3895\times10^{38}$; FP32:动态范围与 BF16 同阶,但 23 位小数显著降低舍入误差。 机器 epsilon 是 1 与下一个可表示数的间隔;下面列的是 epsilon。在 round-to-nearest 模式下,通常定义的 unit roundoff 为这些值的一半: $$\epsilon_{\mathrm{FP16}}=2^{-10},\qquad \epsilon_{\mathrm{BF16}}=2^{-7},\qquad \epsilon_{\mathrm{FP32}}=2^{-23}$$ epsilon 描述的是 1 向上的间距,不是所有数的固定绝对误差。对没有溢出或下溢的正规结果,最近舍入常用模型为 $\operatorname{fl}(x)=x(1+\delta)$,$|\delta|\le u$,其中 $u=\epsilon/2$;次正规区应使用绝对误差界,不能直接套相对界。这个界可以从间距看出:设 $p$ 是小数位数、$E$ 是实际二进制指数。在区间 $[2^E,2^{E+1})$,相邻数间距为 $2^{E-p}$,最近舍入误差至多半个间距;除以至少 $2^E$ 的输入幅值,就得到 $u=2^{-p-1}$。相应推导只描述单次舍入,不包含前序算子误差。 因此 $1+10^{-4}$ 写入 FP16 或 BF16 都舍入为 1。更危险的是参数更新:若权重 $w=1$,学习率乘梯度只有 $10^{-5}$,直接在低精度权重上做 $w-\eta g$,变化会被舍掉。FP32 主权重就是在高精度副本上累计细小更新,再把结果舍入给低精度前后向。 在 round-to-nearest-even 且保留次正规数时,绝对值不超过 $2^{-25}$ 的 FP16 输入舍入为零;介于这个阈值和 $2^{-24}$ 之间的数可能舍入为最小次正规数,而非一律为零。支持 flush-to-zero 的执行路径还需另查硬件与算子规则。 3.2 为什么 loss scaling 不改梯度 设损失为 $L(\theta)$,参数为 $\theta$,真实梯度为 $g=\nabla_\theta L$。取与参数无关、同一次累积期间固定的正常数 $S$。在精确算术下,把 loss 乘常数 $S$ 后反向: $$g_s=\nabla_\theta(SL)=S\nabla_\theta L=Sg$$ 只要在优化器读取梯度前除以 $S$,就恢复原梯度: $$g=\frac{g_s}{S}$$ 关键是量化顺序。若 $g=10^{-8}$,先写入 FP16 会变 0,之后再乘任何数都救不回来;若先由链式法则得到 $Sg=1.024\times10^{-5}$,它能被 FP16 表示,写回后再用 FP32 除以 1024,就能保留接近 $10^{-8}$ 的非零值。浮点计算实际得到的是 $Q(Sg)/S$,一般不恰等于 $g$;而真实反向还包含中间张量的舍入,不能把单次梯度量化模拟当成完整训练误差模型。 能否用一个 scale 同时容纳所有梯度?设需要保留的最小非零幅值为 $g_{\min}$,最大幅值为 $g_{\max}$。在 FP16 最近偶数舍入且保留次正规数的简单写回模型下,非零所需条件和一个避免溢出的充分条件是: $$Sg_{\min}>2^{-25},\qquad Sg_{\max}\le65504$$ 因此必须寻找两者交集。65504 是保守安全上界;真正向 inf 的最近舍入边界是 65520。若梯度同时有 $10^{-8}$ 和 $10^5$,下界要求 $S>2.98023224$,安全上界却是 $S\le0.65504$;即使使用 65520 边界也无交集。任何动态策略都不能用一个标量消除这个范围冲突。若路径将 FP16 次正规数清零,保留到正规区约需 $Sg_{\min}\ge2^{-14}$,限制更强。这里尚未计入中间反向的溢出。 静态 scale 要人工选 $S$。太小救不了下溢,太大会让大梯度越过 FP16 的安全范围,甚至舍入成 inf。动态 GradScaler 维护随训练变化的 $S_t$: $$S_{t+1}=\begin{cases}\beta S_t,&g_s\text{ 含 inf/NaN}\\ \gamma S_t,&\text{连续 }K\text{ 步有限}\\ S_t,&\text{其他情况}\end{cases}$$ $\beta<1$ 是回退因子,$\gamma>1$ 是增长因子,$K$ 是增长间隔。出现非有限梯度时必须跳过 optimizer step,否则坏更新会污染权重和 Adam 状态。PyTorch 文档还提醒:scale 不保证始终大于 1,BF16 预训练模型强转 FP16 时可能因数值过大而一路回退。 3.3 为什么 softmax 和归约容易出事 直接计算 softmax: $$p_i=\frac{e^{x_i}}{\sum_j e^{x_j}}$$ 若 $x_i$ 很大,指数会溢出。稳定写法先减最大值 $m=\max_jx_j$: $$p_i=\frac{e^{x_i-m}}{\sum_j e^{x_j-m}}$$ 对一行至少有一个有效有限 logit、其余有限或被遮罩为负无穷的输入,最大指数为 1,分母至少为 1;对有限有效 logits,分子分母同除 $e^m$ 证明结果不变。它避免了 exp 的正向溢出,却不能保证所有小概率非零,也不能挽回输入先变成 inf 的损失。全行被 mask 为负无穷时,$-\infty-(-\infty)$ 是 NaN,必须明确选择报错、跳行或该算子的零输出约定。若输入已有正 inf,同样不能直接套减 max 公式。LayerNorm 方差也不宜用 $E[x^2]-E[x]^2$ 的低精度朴素形式:两个接近的大数相减会灾难性消减。长向量求和误差还会随项数累积,不能由此推出所有归约都自动在 FP32 完成:先检查设备策略、输出与累加 dtype。 numeric_stability.py 给出两个不依赖 GPU 的反例。把 256 与 256 个 1 逐项相加,BF16 每步舍入得到 256,而高精度求和后只量化一次得到 512:在 256 这个区间,BF16 相邻值差 2,256+1 恰在中点并向偶数舍回 256。这里模拟顺序加法,不能用来估计厂商 GEMM 的误差。 对数据 9999、10001,真实总体方差为 1;模拟 FP32 的 $E[x^2]-E[x]^2$ 得到 0。用中心化形式可避免这次大数相减,但若先写成 BF16,两个输入都成 9984,之后即使用 FP32 中心化也只能得到 0。稳定算法和输入信息完整性是两件事。 还要区分“算子输出 dtype”和“内部累加 dtype”。矩阵乘输入、输出可以是 BF16,但硬件乘积常进入 FP32 accumulator,最终再舍入回 BF16。若自定义 kernel 把 accumulator 也降成 16 位,它不再与常规 AMP 拥有同样数值性质。 3.4 FP8 为什么不只是再少 8 位 FP8 常见 E4M3 与 E5M2。FP8 Formats for Deep Learning 用 E4M3 提供较多有效位,用 E5M2 提供较大范围。本文具体指该论文的 E4M3(常标为 E4M3FN)和 E5M2:前者最大有限值 448、最小次正规数 $2^{-9}$,不编码无穷;后者最大有限值 57344、最小次正规数 $2^{-16}$,包含 inf/NaN。不能把这些范围推广到所有名为 E4M3 的变体。格式定义与转换策略也要分开:有限大值是饱和、报错还是转特殊值,由具体转换模式决定。 原始张量很难恰好落进狭窄范围,通常给每个张量或块维护正的反量化尺度 $a$: $$q=Q_{\mathrm{FP8}}(x/a),\qquad x_{\mathrm{deq}}=a\,q$$ 这里 $Q$ 是选定舍入及越界策略的 FP8 转换,$x_{\mathrm{deq}}$ 是还原到高精度的近似值。若格式上限为 $F$,对非零有限张量可取 $a=\operatorname{amax}(|x|)/F$,于是最大幅值映到 $F$;全零张量应另取安全尺度,不能除以零。很多库把 $1/a$ 称作 scale,符号恰好相反。 例如使用 E4M3 的 $F=448$,向量中若出现 44800 的异常值,张量尺度 $a=100$;普通值 1 被映成 0.01,在该格式最近舍入下约为 0.009765625,还原后是 0.9765625。没有该异常值时所需尺度不同;这说明 amax 选取改变误差分配,不证明任何块缩放必定改善最终任务。若每步都同步全局 amax,又会引入开销;不同方案会用历史窗口、延迟缩放或块缩放。例如 TE 2.13 delayed scaling 利用历史 amax 预测下一次 scale,减少额外读张量;突然增大的异常值可能超出历史预测,因此还要检查饱和比例,不能把历史尺度当作当步最大值保证。FP8 的正确性同时依赖格式、粒度、尺度更新、异常值分布和高精度累加,不能机械替换 dtype 字符串。 图要比较动态范围与精度:输入先转成 FP32,再分别转换为 FP16/BF16;这是脚本实际比较的路径。小数值端 FP16 可能舍入为零(相对误差 1),超过最大有限值后溢出;BF16 的范围更宽,但正规数的尾数精度更低。精确可表示点的误差为零,图中作绘图下限处理;非有限溢出点被省略而非画成零误差,FP16 上限用竖线标出。 04. 代码实现 float_formats.py、loss_scaling_sim.py、numeric_stability.py 只依赖 Python 标准库;amp_probe.py 需要 PyTorch,配图脚本需要 NumPy/matplotlib。文末附录提供全部五个文件。 float_formats.py 用 IEEE 二进制打包模拟 FP16;BF16 路径先转 FP32,再按舍入位和保留位奇偶加偏置,截去低 16 位,且单独保留 NaN 分类。这是 FP32→BF16 的最近偶数舍入,不是任意 Python 双精度数直接到 BF16 的转换。反例 $1+2^{-8}+2^{-26}$ 高于 BF16 中点:直接最近舍入应为 1.0078125,先转 FP32 却恰落中点,再转 BF16 得 1。不同输入精度必须写明。 真实输出: format exp frac min_normal max_finite epsilon_at_1 FP16 5 10 6.1035e-05 6.5504e+04 9.7656e-04 BF16 8 7 1.1755e-38 3.3895e+38 7.8125e-03 FP32 8 23 1.1755e-38 3.4028e+38 1.1921e-07 value -> FP16 | BF16 1.0001 -> 1 | 1 1e-05 -> 1.00136e-05 | 1.00136e-05 100000 -> inf | 99840 100000 在 FP16 变成 inf,在 BF16 仍有限;1.0001 在两种 16 位格式里都舍入成 1。动态范围与精度的区别由此可见。 loss_scaling_sim.py 把五个小梯度直接量化,再先乘 1024、量化、最后除回去: shape=(5,), loss_scale=1024 gradient direct_fp16 scaled_fp16/unscaled 1.000e-08 0.000e+00 1.001e-08 3.000e-08 5.960e-08 2.998e-08 1.000e-07 1.192e-07 1.000e-07 1.000e-06 1.013e-06 1.000e-06 1.000e-05 1.001e-05 9.999e-06 nonzero: direct=4/5, scaled=5/5 $10^{-8}$ 直接写 FP16 已为 0,缩放路径却保留为 $1.001\times10^{-8}$。这不是凭空增加精度:量化误差仍在,只是把数搬进可表示区间。 实际 AMP 流程用 amp_probe.py 复现:固定 seed 7,FP32 参数的线性层接收形状 [6,4] 的输入,输出 [6,2],CPU FP16 autocast 前向,MSE 与参数梯度为 FP32。这里故意用 CPU 支持的路径检查控制流程;它不是 CUDA Tensor Core 吞吐或完整 DiT 收敛实验。运行: python amp_probe.py 关键顺序是 autocast 包住前向/loss,退出后 scale(loss).backward,再 unscale、裁剪、scaler.step、update;完整可执行循环在附录,包含 model、数据和 optimizer 的定义。第三步在梯度中注入 inf,这一步不做无意义的非有限 norm 裁剪,仍由 scaler.step 检查并跳过更新。实际结果: step loss(前向) update 后 scale 参数最大变化 0 1.087817 8 0.055877 1 0.930182 16 0.105419 2(注入 inf) 0.675444 8 0 3 0.675444 8 0.147829 4 0.412640 16 0.168862 增长间隔设为 2,因此前两次有限 step 后 scale 翻倍;inf step 跳过且回退,下一次前向 loss 仍相同。另从 scale=1 注入 inf,真实回退到 0.5。脚本在完整 step 1 后保存/恢复 model、带 momentum 的 optimizer 和 scaler,续跑后三步与不断点结果逐位相同。这里无 dropout 且数据预先生成;一般训练仍要保存 RNG、数据游标和分布式状态。BF16 autocast 的另一分支实际得到 BF16 输出、FP32 MSE 和 FP32 参数梯度,无 scaler。 实跑环境为 Windows、Python 3.11.9、PyTorch 2.10.0+cpu,单 CPU 线程;图使用 NumPy 2.4.6、matplotlib 3.10.7。环境复用项目已有局部依赖,未改系统安装。不同版本/kernel 的末位或阈值不要求逐位相同,本次验收的是上述有限性、跳步、scale 与恢复关系。 梯度裁剪必须在 unscale 之后,若对放大后的梯度仍用阈值 C 裁剪,反缩放后的有效阈值会变成 C/S。令梯度范数为 4、$S=1024$、阈值为 1,先裁 scaled grad 再除 S 只剩 0.0009765625;先反缩放再裁才得到 1。证明是 $\operatorname{clip}_C(Sg)/S=g\min(1,C/(S\|g\|))$,与 $\operatorname{clip}_C(g)$ 不同(库实现还可能加入小的稳定常数)。若用 BF16,通常保留 autocast 而不用 GradScaler;是否省略仍应由实际梯度分布验证。 05. 工业级实现对照 本文对照固定 PyTorch v2.10.0 的 torch/amp/grad_scaler.py#GradScaler 中 GradScaler.scale 把 loss 乘当前尺度;unscale 按 device 与 dtype 分组检查并反缩放梯度;step 只在没有 inf/NaN 时调用优化器;update 再根据各 optimizer 的 found-inf 状态调整尺度。它还处理稀疏梯度、多设备、多优化器、checkpoint state dict 和惰性初始化,这些都是最小模拟没有覆盖的工程边界。 官方 PyTorch 2.10 AMP 文档 推荐统一使用 torch.autocast 与 torch.amp.GradScaler;旧的 torch.cuda.amp 接口已标记弃用。autocast 只包前向和 loss,backward 放在上下文外。不要启用 autocast 后再全局 model.half,否则会绕开逐算子的安全策略。 本次还把下载的 v2.10.0 GradScaler 整份原始模块直接加载到 CPU,使用与第 04 节相同数据执行五个 step;输出、scale、inf 跳步与最终参数均与安装的 2.10.0+cpu 完全一致。原源码文件和 SHA256、独立边界验证见本篇审计证据;不声称执行了分布式或 GPU 分支。 算子策略不是“白名单里全降精度”。线性层、卷积通常进入 lower-precision;例如 CUDA 表中的 softmax、sum 和 MSE 使用 FP32,但 CPU BF16 表中未列入的 softmax 会沿输入 dtype 运行;多输入算子可能提升到最宽输入类型。显式 dtype、原地算子或 out 版本可能不参与 autocast,自定义代码要检查实际 dtype 流。 FP8 方面,NVIDIA Transformer Engine 2.13 的 delayed-scaling 文档 描述 E4M3/E5M2 recipe、amax 历史与 delayed scaling,并在支持硬件上让 Transformer 层进入 FP8 路径。它仍以 BF16/FP16 保存部分张量并用高精度累加;分布式训练还可能跨 rank 归约 amax。“开启 FP8”是引入量化运行时,不是把参数永久存成单一 8 位格式。 生产监控至少记录当前 scale、增长和回退次数、跳过的 step 数、梯度范数、参数与激活 amax、NaN 首次出现的层、关键算子 dtype。只看总 loss 会把静默下溢藏很久。 06. 代价与边界 混合精度常能节省参与低精度计算的张量带宽,但原生 autocast 不一定降低参数和梯度的持久存储 dtype,但不保证总显存恰好减半。若使用独立 FP32 主权重与两个 FP32 moment,仅这三项就占 12 字节/参数;原生 FP32 参数 autocast 通常没有额外独立主权重,不能重复计账;部分算子保存 FP32 中间量;通信 buffer、cast buffer、workspace 与碎片也增加峰值。 吞吐提升也有条件。矩阵尺寸太小、CPU 或数据加载受限、频繁转换、未使用低精度加速单元,都会让 AMP 几乎不加速。小 batch 下,kernel launch 与 cast 成本甚至抵消收益。正确基准应同时报告 tokens/s、峰值显存、收敛曲线和最终指标。 以下情况尤其要谨慎: 模型源自 BF16 预训练且激活常超过 65504,FP16 loss scaling 只能处理梯度,救不了前向溢出; 长归约、概率、指数、对数、方差或很小正则项的自定义算子没有 autocast 策略; 梯度累积时各 microbatch 使用不同 scale,或反缩放前裁剪梯度; 多 optimizer 共用计算图,却在所有梯度就绪前更新 scale; FP8 中异常值主导 amax,张量级缩放让普通值量化过粗,可评估块缩放或高精度旁路,仍需任务实验验证。 调试时先用 FP32 建立可复现基线,再开 BF16,然后才是 FP16/FP8。每步只改一个变量,并比较前若干 step 的 loss、梯度范数和权重更新。数值问题最怕同时调整学习率、并行度、batch 与 dtype。 6.1 一次更新里究竟有哪些精度 以 AdamW 为例,要先分清框架是否真的创建低精度参数及主副本。常见的原生 autocast 方案保持参数 FP32,.grad 通常随参数为 FP32,两个 FP32 moment:持久参数状态约为 $4+4+8=16$ 字节/参数;临时 cast 权重缓存和激活另算。另一种“低精度模型+FP32 主副本”若参数与梯度各 2 字节,主副本 4、moment 8,共 16 字节/参数;若另有 FP32 master gradient,还需再加 4。这里忽略 step 标量、workspace、通信、分片和张量生命周期,不能直接当峰值显存。这两套结构不能相加。 下面的更新式只描述第二种方案。一次更新至少涉及前向激活、反向梯度、参数、副本和两个动量。低精度 GEMM 只覆盖其中一部分。设低精度参数为 $\theta_{16}$,FP32 主参数为 $\theta_{32}$,反缩放后的梯度为 $g_{32}$,则更新链条可以写成: $$\theta_{32}^{t+1}=\operatorname{AdamW}(\theta_{32}^{t},g_{32}^{t},m_t,v_t),\qquad \theta_{16}^{t+1}=Q_{16}(\theta_{32}^{t+1})$$ $m_t,v_t$ 是 FP32 一阶、二阶矩,$Q_{16}$ 表示舍入到前后向 dtype。若框架没有主参数副本,而直接更新 BF16 参数,许多小于当前参数 ULP 的更新会消失。是否保留主权重是优化器实现细节,不能仅从模型参数 dtype 推断。 梯度累积又多一层顺序。假设一个 optimizer step 包含 $A$ 个 microbatch,先定义 $g_a$ 已包含所需的 batch 权重:若每个 microbatch 大小相同且各自 loss 是均值,应先除以 $A$;若大小不同,应按样本数加权(token loss 按有效 token 计)。它们必须使用同一 scale $S$,先把已缩放梯度累加: $$g_s=\sum_{a=1}^{A}Sg_a=S\sum_{a=1}^{A}g_a$$ 等所有 microbatch 完成后只反缩放一次。若中途 update scale,累加 buffer 中不同 microbatch 带有不同倍数,最后无法用一个 $S$ 恢复。例如两段真实梯度为 1、3,分别乘 8、16 后统一除 16,得到 3.5 而非 4。amp_probe.py 用大小 2 与 4 的两个 microbatch,把各自平方误差的 sum 除以同一总元素数,再用 scale=8 累积;反缩放后的梯度与完整 batch FP32 基线最大差 $5.96046448\times10^{-8}$。这个实验只隔离累积与缩放,不含低精度前向误差。完整顺序见 官方累积示例。若某个 microbatch 产生 inf,这一整个 optimizer step 都应跳过,而不是只丢掉坏 microbatch,否则有效 batch 和采样权重已变化。这是保持当前 accumulation 窗口语义的策略,scaler 不会替用户恢复或重放丢失的 microbatch。 6.2 分布式训练里的非有限值共识 数据并行中,每个 rank(参与通信的一份进程副本)只看到本地样本。rank 3 出现 inf 而其他 rank 有限时,所有副本仍必须对“是否更新”达成一致;否则 rank 3 跳步、其余 rank 更新,参数立即分叉。普通 torch.amp.GradScaler 只在当前进程内按设备/优化器汇总 found-inf,不自动执行跨 rank all-reduce。 常规 DDP 同步的梯度若包含 inf,往往会把非有限值传到各副本;这依赖实际梯度同步路径,不能当作 scaler 的跨进程协议。存在 no_sync、分片、局部参数或自定义通信时必须另查一致性。固定版本 分片梯度缩放器源码 中的 ShardedGradScaler.unscale_ 显式调用 dist.all_reduce 同步 found-inf。这里已逐行核对两份原源码,未执行多机实验,也不建议在现有封装外盲加一次 collective(调用组和次序必须一致)。 梯度裁剪也有全局语义。ZeRO/FSDP 把梯度分片后,每卡只能算局部平方和: $$\|g\|_2=\sqrt{\sum_{r=0}^{P-1}\sum_{i\in\mathcal{S}_r}g_i^2}$$ 若这些集合是互不重叠、合起来恰好覆盖全梯度的分片,必须对局部平方和做 sum all-reduce 才得到全局范数;若每卡已有完整复制梯度,再这样相加会多乘 $P$,范数错放大为 $\sqrt P$ 倍。应调用并行框架提供的全局裁剪接口,并核对副本与分片组。正确顺序通常是:完成梯度同步,反缩放,检查非有限值,计算全局 norm,裁剪,执行 optimizer step,最后更新 scale。任一步调换都可能让“裁剪阈值 1.0”失去原含义。 混合精度还会改变 collective 的数值误差。BF16 梯度 all-reduce 比 FP32 少一半字节,但不同归约树改变加法顺序;卡数越多、梯度尺度跨度越大,末位差异越明显。若训练对归约误差敏感,可使用 FP32 梯度通信或分块高精度累加,但要接受带宽代价。排查时应分开比较“本地梯度生成精度”与“跨 rank 归约精度”。 6.3 一张可执行的 dtype 选型表 选 FP16 还是 BF16,不应只看硬件宣传峰值。可按四步判断: 第一,确认硬件原生路径。某些设备对 BF16 与 FP16 吞吐相同,某些旧设备没有 BF16 Tensor Core;软件模拟 BF16 可能更慢。第二,检查模型来源。BF16 预训练 checkpoint 的激活范围未必适合 FP16,直接转换容易前向溢出。第三,检查数值敏感区域。softmax、归一化、概率 loss、长归约优先保留 FP32。第四,跑短程 A/B,比较吞吐、峰值、跳步率和收敛,而非只确认“能启动”。 可以把训练方案分成四档: FP32 基线:通常有较大内存与算术成本,但小矩阵或低精度路径不理想时可能更快;它适合建立 loss 与梯度参照; BF16 AMP:大范围、无需常规 loss scaling,是现代大模型训练的常见起点; FP16 AMP:尾数稍细,但指数窄,必须认真监控动态 scaling 与前向溢出; FP8 混合精度:只把适合的 GEMM 张量降到 FP8,保留 16/32 位旁路,并维护尺度元数据。 所谓“纯 BF16”或“纯 FP8”常是营销简写。softmax、norm statistic、optimizer state、某些 residual 累加和 master gradient 仍可能更高精度。真正有意义的配置描述,应列出 input、weight、output、accumulator 和 optimizer 五个维度。 6.4 从第一个 NaN 反推根因 排查顺序应尽量靠近异常源。先在每个模块前后记录有限值比例、绝对最大值、绝对非零最小值与 dtype;找到第一个从有限变非有限的边界。若 attention score 在 softmax 前已经 inf,检查 Q/K 范数、缩放因子与位置编码;若 loss 有限而 backward 首先 inf,检查导数奇点、自定义 backward 和 loss scale;若梯度有限但 step 后参数异常,检查 optimizer state、权重衰减和反缩放顺序。 静默下溢比 NaN 更难发现。建议记录零梯度比例,并按参数组看更新比率: $$r_{\mathrm{update}}=\frac{\|\Delta\theta\|_2}{\|\theta\|_2+\varepsilon}$$ 若某些层长期为 0 而 FP32 基线非零,应把低精度存储或 scale 窗口列为候选原因;还需排除冻结参数、mask、稀疏路由、断开的计算图或真实零梯度,不能只凭零比例完成归因。若所有层的比例突然增大,则更像学习率、loss normalization 或跳步恢复后的 scale 问题。 不要看到 NaN 就立即降低学习率。学习率过大确实可能导致发散,但 dtype overflow、错误 mask 产生全负无穷、空 batch 的除零、坏数据和通信错误都可能表现为同一个 NaN。先定位首次非有限张量,才能选择对应修复。 6.5 Checkpoint、编译与自定义算子的坑 恢复训练时必须保存 GradScaler 状态。若只恢复模型和 optimizer,却把 scale 重置为很大初值,前几步可能反复溢出并被跳过;重置太小则产生额外下溢。保存点最好位于完整 optimizer step 之后,避免记录到一半累积的混合状态。 activation checkpoint 会在 backward 重跑前向。重算应保持与原前向兼容的 autocast 上下文;PyTorch v2.10.0 自带 checkpoint 会保存并重入相应状态,自定义重算仍需核实。若保存路径是 BF16、重算路径变 FP32 或 FP16,梯度对不上。torch.compile、CUDA Graph 和 fused optimizer 还可能改变 autocast 边界或引入 CPU-GPU 同步,升级版本后要重新做数值与性能回归。 自定义 autograd Function 不能假定输入永远 FP32。前向若内部要求 FP32,应显式关闭 autocast 并转换输入;反向要返回与调用约定兼容的梯度。写自定义 CUDA kernel 时,明确 accumulator 类型、饱和或 inf 行为、次正规数处理以及随机舍入。一个算子“支持 half”只代表能执行,不代表适合训练。 最后,评估数值稳定不能只跑几十步。动态 scale 的增长周期可能是数千步,某些罕见 batch 才触发极端值。至少保留一次覆盖学习率峰值、warmup 结束和验证阶段的长程对照,并把跳步数作为训练产物记录;否则断点续训后出现指标差异,很难追溯是数据还是精度状态造成。 6.6 性能基准该怎样设计 AMP 基准应先预热到 kernel 编译、缓存和分配行为稳定,再做多次迭代。三次 warmup 只能作为起点,不能作为稳定保证。计时前后做设备同步;否则异步 kernel 会让 CPU 提交时间冒充 GPU 执行时间。显存要同时报告 allocated 与 reserved 峰值,前者是活跃张量,后者包含分配器缓存。对比方案必须使用同一 batch、相同梯度累积与相同 checkpoint 策略。 吞吐最好报告有效 token/s,而不是 batch/s。变长序列下,一个 batch 的 padding 比例不同,batch/s 会误导。质量侧至少比较训练 loss、验证指标、梯度范数和被跳过 step 数。若 AMP 每秒更快却需要更多 step 才到相同验证指标,最终 time-to-quality 未必更优。 对 FP8 还应增加量化覆盖率:多少 GEMM 真正走 FP8,多少因 shape、算子或 recipe 回退到 BF16;记录每层 amax、饱和比例和 scale 更新。仅看配置显示 FP8 无法证明加速路径被命中。kernel trace 能确认实际指令与 cast 开销。 建立门禁时,不必要求低精度与 FP32 每步完全相同。可先规定前 100 步 loss 相对误差、梯度 cosine、最终指标容差与最大跳步率,再用多个随机种子评估。数值差异是浮点并行的正常现象,持续偏向、层级爆炸或指标显著退化才是故障信号。 6.7 一份上线前检查清单 上线前逐项回答:硬件是否原生支持目标 dtype;矩阵尺寸是否对齐加速 tile;敏感算子是否保持 FP32;FP16 是否启用动态 scaling;裁剪是否在 unscale 后;所有 DP rank 是否共享跳步决策;梯度累积期间 scale 是否不变;checkpoint 是否保存 scaler;自定义算子是否声明 autocast 与 accumulator;监控是否能定位第一处非有限值。 然后做三个故障注入。人为把 scale 调得极大,确认系统发现 inf、跳过更新并回退;给输入加入一个幅值异常样本,确认前向监控能定位层;从 checkpoint 恢复,确认 scale、optimizer 与随机数状态连续。没有做过故障注入的告警,往往只在真正长跑失败后才发现无效。 最后保留 FP32 或 BF16 安全开关。生产训练发生异常时,能在不改数据顺序和并行布局的条件下提升精度复现,定位效率远高于临时改一堆超参。安全路径不一定长期运行,但必须定期测试,避免代码演进后早已失效。 这些流程看似比设置一个 autocast 开关繁琐,却能把“偶尔 NaN”“换卡就掉点”“断点后不收敛”变成有指标、有复现实验、有回退方案的普通工程问题。 6.8 如何判断变化来自精度而不是随机性 一次训练 A 比 B 的 loss 高,并不能证明精度方案更差。数据顺序、dropout、并行归约顺序和非确定 kernel 都会制造波动。公平实验要固定数据索引与初始化,尽可能使用确定算法,并运行多个随机种子。先比较同一步同一层的输出、梯度与更新,再比较长程最终指标。 可用 FP32 输出 $y_{32}$ 作为局部参照,计算相对误差与余弦相似度: $$e_{\mathrm{rel}}=\frac{\|y_{\mathrm{low}}-y_{32}\|_2}{\|y_{32}\|_2+\varepsilon}$$ 单层误差略大未必影响训练,但若误差沿深度单调放大,往往说明 residual 累加、归一化或某个敏感算子精度不足。把统计按层绘制比只比较最终 logits 更容易定位。 还应区分可复现性与正确性。集合通信改变加法顺序后,bitwise 结果可能不同,但两条训练曲线仍落在相同统计分布。反之,两次运行逐位一致也可能稳定地实现了错误缩放。验收既要有小规模数学 oracle,也要有多种子任务指标。 混合精度上线后,持续监控跳步比例和 scale 分布。数据配方变化、序列变长、加入新 loss 或更换初始化,都可能改变数值范围;一次验证通过不意味着未来配置永久安全。把 precision 当成模型配置的一部分进行版本化,才能复现每次训练。 一个实用原则是把所有隐式转换显式化到观测层:训练启动时抽样打印关键模块的参数、输入、输出与归约 dtype,同时保存硬件、驱动、框架版本。低精度 kernel 与 autocast 策略会随版本更新,旧实验结论不能无条件外推。版本升级后的第一件事应是重跑短程数值基线与吞吐基线,而不是直接续跑昂贵训练。这样才能知道速度变化来自 kernel,精度变化来自策略,还是数据本身发生了变化。 还应把这些元数据写进 checkpoint 清单,使恢复任务能够拒绝不兼容的精度配置,而不是在数小时后以 NaN 形式暴露。可诊断性本身就是混合精度系统的一项能力。 07. 经典论文脉络 Mixed Precision Training(arXiv:1710.03740):提出低精度前后向、FP32 主权重与 loss scaling,奠定现代 AMP。 A Study of BFLOAT16 for Deep Learning Training(arXiv:1905.12322):说明 BF16 用 FP32 相同指数范围换取更短尾数,使训练更少依赖 loss scaling。 FP8 Formats for Deep Learning(arXiv:2209.05433):提出 E4M3/E5M2 两种互补编码,并用数值模拟训练实验验证其精度;不能把格式论文的模拟结果当成本篇的 FP8 硬件实测。 FP8-LM: Training FP8 Large Language Models(arXiv:2310.18313):处理 FP8 大语言模型训练的精度、通信与优化器环节,说明端到端 FP8 不只是替换 GEMM dtype。 共同主题是:硬件格式越窄,软件越需要知道张量的数值角色。格式提供可能性,尺度管理、累加方式和回退路径才决定能否稳定训练。 08. 常见误解 误解一:BF16 比 FP16 精度更高。 BF16 指数范围更大,更少 overflow;但尾数只有 7 位,1 附近分辨率更粗。应说通常更稳定,不是处处更精确。 误解二:loss scaling 能修复所有 NaN。 它主要防 FP16 小梯度下溢。前向激活溢出、除零、softmax 不稳定、学习率过大,都不会被它根治。 误解三:scale 越大越好,而且一定大于 1。 scale 太大会溢出。PyTorch 允许动态 scale 降到 1 以下;应观察 found-inf 和跳步频率。 误解四:用了 autocast 就无需关心 dtype。 自定义算子、显式 dtype、原地运算和策略表外 op 可能保持输入 dtype。关键归约与 loss 仍需审计。 误解五:AMP 会把训练显存直接砍半。 激活可能下降,FP32 优化器状态仍在。账本还包括梯度、通信 buffer、workspace 与碎片。 误解六:FP8 是 BF16 的无痛升级。 FP8 依赖尺度、amax 历史、格式选择和硬件 kernel;错误配置可能不 NaN,却悄悄降低收敛质量。 09. 动手验证 先运行文末脚本,修改 loss_scaling_sim.py 中 scale 为 1、128、1024、65536。本次对 [1e-8,100] 的实际输出:scale=1 时小梯度为 0;128 时为 9.77888703e-9 且大梯度仍为 100;1024 时小梯度约 1.00117177e-8,但大梯度已为 inf;65536 仍溢出。并非 scale 越大越接近真实训练梯度。这正是动态 scale 在 underflow 与 overflow 之间寻找窗口的原因。 在支持 BF16/FP16 的 GPU 上做四组短跑:FP32、BF16 autocast、FP16 autocast 不带 scaler、FP16 autocast 带 scaler。固定随机种子和 batch,记录 200 步吞吐、峰值显存、loss、全局梯度范数、跳步数。这四组是建议读者执行的 GPU 实验,本次未执行,也不给出速度或最终指标排名。先用脚本定位 dtype 与跳步,再比较同一任务的多 seed 长程质量;不能由本篇 CPU 结果推出 GPU 模型中哪组必然更准。 定位首个异常层时,给模块注册 hook,输出有限值比例、绝对最大值和 dtype。若前向先出现 inf,优先检查指数、归一化、attention score 与输入范围;若反向先异常,再检查 scale、梯度裁剪顺序和自定义 backward。 最后验证累加精度:构造一个大数和大量小数的向量,用 FP32、模拟 BF16 顺序累加、分块 FP32 累加分别求和。预期低精度顺序加法吞掉更多小项;这解释为什么 GEMM 输入低精度不等于 accumulator 也该低精度。 10. 延伸阅读 读完这篇可以继续看: 量化:从 INT8 到 FP4:区分训练混合精度与推理量化的目标、校准和误差模型。 数据并行与 ZeRO 显存切分:混合精度改变每项状态字节数,ZeRO 决定状态在哪些 rank 上复制或分片。 张量并行与流水线并行:低精度减少通信字节,但集合通信次数、拓扑与同步点仍由并行策略决定。 可靠的 AMP 心智模型不是“半精度开关”,而是一张数值预算表:每个张量需要多大范围、多少有效位,在何处累加、何时舍入、出现异常如何回退。把这张表画清楚,NaN 就从玄学变成可以定位的工程问题。 附录:完整代码 09 节用到的脚本全文如下(numeric_stability.py、float_formats.py、loss_scaling_sim.py、amp_probe.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 numeric_stability.py """Arithmetic counterexamples, stdlib only; no hardware FTZ/GEMM simulation.""" import json import math import struct from pathlib import Path from float_formats import fp16, bf16 def q32(x): return struct.unpack('f', struct.pack('f', x))[0] def sequential(values, quantize): total = 0.0 for v in values: total = quantize(total + quantize(v)) return total def softmax(values): m = max(values) if not math.isfinite(m): raise ValueError('finite nonempty logits or an explicit masked-row policy required') e = [math.exp(v - m) for v in values] return [v / sum(e) for v in e] def main(): values = [256.0] + [1.0] * 256 results = dict(bf16_sequential=sequential(values, bf16), fp16_sequential=sequential(values, fp16), fp32_sequential=sequential(values, q32), quantize_once=bf16(math.fsum(values)), exact=math.fsum(values)) assert results == dict(bf16_sequential=256.0, fp16_sequential=512.0, fp32_sequential=512.0, quantize_once=512.0, exact=512.0) # Squaring rounded inputs; this models one poor algorithm, not a fused norm kernel. x = [9999.0, 10001.0] qx = [bf16(v) for v in x] mean = math.fsum(qx) / len(qx) stable_after_cast = math.fsum((v - mean)**2 for v in qx) / len(qx) var32_naive = q32(q32(sum(q32(v*v) for v in x) / 2) - q32(q32(sum(x)/2)**2)) results.update(input_bf16=qx, true_variance=1.0, fp32_naive_variance=var32_naive, centered_bf16_input_variance=stable_after_cast, shifted_softmax=softmax([1000.0, 1001.0]), raw_exp_fp16=fp16(math.exp(12)), scaled_grad_clip_wrong=1/1024, scaled_grad_clip_correct=1.0, mixed_scale_unscale=(8*1 + 16*3)/16, desired_sum=4.0) assert var32_naive == 0 and stable_after_cast == 0 for name, v in results.items(): print(name, v) (Path(__file__).with_name('numeric_results.json')).write_text( json.dumps(results, indent=2, allow_nan=True), encoding='utf8') if __name__ == '__main__': main() float_formats.py #!/usr/bin/env python3 """FP16 and FP32-to-BF16 nearest-even conversion; standard library only.""" import math import struct def fp16(x: float) -> float: try: return struct.unpack('e', struct.pack('e', x))[0] except OverflowError: return math.copysign(math.inf, x) def bf16(x: float) -> float: """Round FP64 input to FP32 first, then BF16; preserve NaN classification.""" try: bits = struct.unpack('>I', struct.pack('>f', x))[0] except OverflowError: return math.copysign(math.inf, x) if (bits & 0x7F800000) == 0x7F800000: if bits & 0x007FFFFF: bits = (bits & 0xFFFF0000) | 0x00400000 else: bits += 0x7FFF + ((bits >> 16) & 1) return struct.unpack('>f', struct.pack('>I', bits & 0xFFFF0000))[0] FORMATS = ( ('FP16', 5, 10, 2.0**-14, (2 - 2.0**-10) * 2.0**15, 2.0**-10), ('BF16', 8, 7, 2.0**-126, (2 - 2.0**-7) * 2.0**127, 2.0**-7), ('FP32', 8, 23, 2.0**-126, (2 - 2.0**-23) * 2.0**127, 2.0**-23), ) def main(): print('format exp frac min_normal max_finite epsilon_at_1') for name, exp, frac, low, high, eps in FORMATS: print(f'{name:5s} {exp:3d} {frac:4d} {low:.4e} {high:.4e} {eps:.4e}') print('\nvalue -> FP16 | BF16') for value in (1.0001, 0.00001, 100000.0): print(f'{value:g} -> {fp16(value):g} | {bf16(value):g}') print('\nFP16 ties:') for x in (2**-25, math.nextafter(2**-25, math.inf), 65519.0, 65520.0): print(f'{x:.17g} -> {fp16(x):.17g}') # This value lies above the exact BF16 midpoint but rounds to it in FP32. x = 1 + 2**-8 + 2**-26 print(f'double rounding: x={x:.17g}, FP32->BF16={bf16(x)}, direct BF16 nearest={1 + 2**-7}') if __name__ == '__main__': main() loss_scaling_sim.py #!/usr/bin/env python3 """FP16 gradient quantization and scale tradeoffs; standard library only.""" import math from float_formats import fp16 def main(): gradients = [1e-8, 3e-8, 1e-7, 1e-6, 1e-5] scale = 1024.0 direct = [fp16(g) for g in gradients] rescued = [fp16(g * scale) / scale for g in gradients] print(f'shape=({len(gradients)},), loss_scale={scale:g}') print('gradient direct_fp16 scaled_fp16/unscaled') for g, raw, value in zip(gradients, direct, rescued): print(f'{g:11.3e} {raw:11.3e} {value:11.3e}') print(f'nonzero: direct={sum(x != 0 for x in direct)}/5, scaled={sum(x != 0 for x in rescued)}/5') print('\nscale sweep: [1e-8, 100]') for scale in (1.0, 128.0, 1024.0, 65536.0): result = [fp16(g * scale) / scale for g in (1e-8, 100.0)] print(f'S={scale:g}: tiny={result[0]:.9g}, large={result[1]:g}, finite={all(map(math.isfinite, result))}') low = 2**-25 / 1e-8 high = 65504 / 1e5 print(f'no safe scalar window for [1e-8,1e5]: S>{low:.8f}, sufficient upper S<={high:.5f}') if __name__ == '__main__': main() amp_probe.py """Real CPU AMP, nonfinite injection and resume; requires PyTorch 2.10.0 CPU. Run: python amp_probe.py. No GPU or distributed benchmark is performed. """ import copy import json from pathlib import Path import torch def run(scaler_class=torch.amp.GradScaler, restore_at=None): torch.manual_seed(7) model = torch.nn.Linear(4, 2) opt = torch.optim.SGD(model.parameters(), lr=0.1, momentum=0.9) scaler = scaler_class('cpu', init_scale=8, growth_interval=2) x = torch.randn(6, 4) y = torch.randn(6, 2) rows = [] for step in range(5): opt.zero_grad(set_to_none=True) with torch.autocast('cpu', dtype=torch.float16): pred = model(x) loss = torch.nn.functional.mse_loss(pred, y) scaler.scale(loss).backward() if step == 2: next(model.parameters()).grad[0, 0] = float('inf') before = [p.detach().clone() for p in model.parameters()] scaler.unscale_(opt) grad_dtype = str(next(model.parameters()).grad.dtype) # Skip clipping the deliberately nonfinite step: scaler.step still checks it. if step != 2: torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0) scaler.step(opt) scaler.update() delta = max(float((p.detach()-b).abs().max()) for p, b in zip(model.parameters(), before)) rows.append(dict(step=step, loss=float(loss.detach()), scale=scaler.get_scale(), max_update=delta, parameter_dtype=str(next(model.parameters()).dtype), output_dtype=str(pred.dtype), loss_dtype=str(loss.dtype), gradient_dtype=grad_dtype)) assert (delta == 0) == (step == 2) if restore_at == step: checkpoint = copy.deepcopy(dict(model=model.state_dict(), optimizer=opt.state_dict(), scaler=scaler.state_dict())) model = torch.nn.Linear(4, 2) model.load_state_dict(checkpoint['model']) opt = torch.optim.SGD(model.parameters(), lr=0.1, momentum=0.9) opt.load_state_dict(checkpoint['optimizer']) scaler = scaler_class('cpu') scaler.load_state_dict(checkpoint['scaler']) assert [r['scale'] for r in rows] == [8, 16, 8, 8, 16] return rows, torch.cat([p.detach().flatten() for p in model.parameters()]) def accumulation(): torch.manual_seed(11) model = torch.nn.Linear(4, 2) x = torch.randn(6, 4) y = torch.randn(6, 2) torch.nn.functional.mse_loss(model(x), y).backward() reference = [p.grad.clone() for p in model.parameters()] model.zero_grad(set_to_none=True) scaler = torch.amp.GradScaler('cpu', init_scale=8) opt = torch.optim.SGD(model.parameters(), lr=0.1) # Unequal microbatches: divide each sum by the SAME total element count. for a, b in ((0, 2), (2, 6)): loss = torch.nn.functional.mse_loss(model(x[a:b]), y[a:b], reduction='sum') / y.numel() scaler.scale(loss).backward() scaler.unscale_(opt) error = max(float((p.grad-g).abs().max()) for p, g in zip(model.parameters(), reference)) assert error < 1e-6 return error def main(): torch.set_num_threads(1) rows, final = run() resumed_rows, resumed = run(restore_at=1) assert rows == resumed_rows and torch.equal(final, resumed) torch.manual_seed(5) model = torch.nn.Linear(4, 2) with torch.autocast('cpu', dtype=torch.bfloat16): output = model(torch.randn(3, 4)) loss = torch.nn.functional.mse_loss(output, torch.zeros(3, 2)) loss.backward() p = torch.nn.Parameter(torch.tensor(1.0)) opt = torch.optim.SGD([p], lr=0.1) scaler = torch.amp.GradScaler('cpu', init_scale=1) scaler.scale(p).backward() p.grad.fill_(float('inf')) scaler.step(opt) scaler.update() assert scaler.get_scale() == 0.5 and p.item() == 1 result = dict(torch_version=torch.__version__, device='cpu', threads=1, rows=rows, resume_bitwise_equal=True, accumulation_max_abs=accumulation(), bf16_output_dtype=str(output.dtype), bf16_loss_dtype=str(loss.dtype), bf16_grad_dtype=str(next(model.parameters()).grad.dtype), backoff_below_one=scaler.get_scale(), gpu_tested=False, distributed_tested=False) print(json.dumps(result, indent=2)) Path(__file__).with_name('amp_results.json').write_text(json.dumps(result, indent=2), encoding='utf8') if __name__ == '__main__': main() make_figures.py """Regenerate this article's deterministic teaching figure (numpy + matplotlib).""" from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np OUT=Path(__file__).resolve().parents[1]/"figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({"font.sans-serif":["DejaVu Sans"],"axes.unicode_minus":False}) from float_formats import fp16,bf16 x=np.geomspace(1e-9,1e5,1500).astype(np.float32).astype(np.float64) y16=np.array([fp16(float(v)) for v in x]);yb=np.array([bf16(float(v)) for v in x]) fig,ax=plt.subplots(figsize=(8,4.8)) for name,y in [("FP16",y16),("BF16",yb)]: err=np.abs(y-x)/x;err[~np.isfinite(err)]=np.nan ax.loglog(x,np.maximum(err,1e-12),label=name,alpha=.75) ax.axvline(65504,color="grey",ls=":",label="FP16 max finite") ax.set(xlabel="Positive input value",ylabel="Relative rounding error",title="FP32 input to FP16 / BF16: nearest-even rounding",ylim=(1e-8,2)) ax.text(0.03,0.06,"FP16 overflow points omitted; finite relative errors only.",transform=ax.transAxes,fontsize=9) ax.legend();ax.grid(alpha=.25);fig.tight_layout() fig.savefig(OUT/'precision_error.png',dpi=170) plt.close(fig) print(OUT/'precision_error.png')
-
AIGC 基本功|数据并行与 ZeRO 显存切分-ZeRO AIGC 基本功|数据并行与 ZeRO 显存切分-ZeRO 所属方向:分布式训练 | 难度:进阶 | 前置知识:梯度、向量范数与 Adam;本文会补齐加权平均、集体通信和优化器状态的必要定义 关键词:数据并行、DDP、ZeRO、优化器状态切分、FSDP、显存占用估算 01. 为什么需要它 先算一笔会让很多人意外的账:训练一个 75 亿参数模型,模型权重明明只有 15 GB,为什么放进 80 GB 显存的 GPU 还会爆? 假设用混合精度 Adam 训练。每个参数除了 2 字节的 FP16/BF16 权重,还要留下 2 字节梯度、4 字节 FP32 主权重、4 字节一阶动量和 4 字节二阶动量。合计不是 2 字节,而是 16 字节/参数: $$7.5\times10^9\times16\ \mathrm{bytes}=120\ \mathrm{GB}$$ 这 120 GB 还没有算激活、临时通信缓冲区、CUDA context 和显存碎片。换句话说,模型甚至没开始处理一帧视频,单是“为了训练而保存的状态”就已经放不下。 自然的反应是:“那我上 64 张卡。”可如果只用普通数据并行,每张卡都会保留完整的参数、完整的梯度和完整的 Adam 状态。64 张卡只是把不同 mini-batch 同时算得更快,每张卡看到的仍然是同一份 120 GB。总显存从 80 GB 变成 5120 GB,但单卡瓶颈一点没松,模型照样启动不了。 这就是 ZeRO 要解决的矛盾:数据并行已经拥有整个集群的总显存,却因为每张卡都复制同样的训练状态,只能使用其中一张卡的容量。ZeRO 不改变模型的数学计算,而是按顺序切掉三种冗余副本: ZeRO-1 切优化器状态; ZeRO-2 再切梯度; ZeRO-3 连参数也切,只在某一层即将计算时临时拼回来。 把刚才的 75 亿参数模型放到 64 个数据并行 rank 上,三阶段的模型状态显存分别是 31.41 GB、16.64 GB 和 1.88 GB。最后一个数字正好是 $120/64$。这些数字不是宣传页上的模糊“最高节省多少”,而是本文后面会逐项推出来、再用代码复现的结果。 对视频生成尤其要补一句:视频 DiT 的 token 数很长,激活往往比模型状态还大。ZeRO 能拆掉模型状态冗余,但不会自动消灭激活。先分清是哪一类显存爆了,再决定用 ZeRO、激活重计算还是序列并行,比盲目把配置改成 stage 3 更重要。 02. 最小可用理解 三句话先建立框架: 数据并行让每个 rank 保存同一个模型、读取不同数据,反向后把局部梯度求平均,在下文列出的损失可分解、样本权重及同步条件下,数学上等价于对合并后的大 batch 做一次更新。 既然所有 rank 最终拿到相同梯度,它们各自保存一整套 Adam 状态并重复做同一份更新就是冗余;ZeRO 把状态分片,每个 rank 只负责其中 $1/N$。 切得越彻底,常驻显存越少,但参数就越需要“用前聚合、用后释放”,因此省下的显存会转化成通信、调度和峰值控制问题。 如果只记一件事:DDP 在不同数据上复制模型,ZeRO 再切分训练状态;在同一全局目标和正确归约下,切分本身不改变梯度的数学值。 这里的 rank 可以先理解为一个独立训练进程,通常一个 rank 独占一张 GPU。$N$ 表示数据并行进程数,world_size 就是 $N$。每个 rank 处理本地 batch,DDP 的参数副本在同步更新后应一致;ZeRO-3 则让不同 rank 持有同一个全局参数向量的不同分片,不能要求它们的本地张量相同。 03. 数学推导 3.1 为什么平均梯度等价于一个大 batch 设全局 batch 有 $B$ 个样本,均匀切给 $N$ 个 rank,每个 rank 得到 $b=B/N$ 个样本。模型参数记作 $w$,第 $i$ 个样本的损失是 $\ell(x_i;w)$。 第 $r$ 个 rank 的局部平均损失为: $$L_r(w)=\frac{1}{b}\sum_{i\in\mathcal{B}_r}\ell(x_i;w)$$ 其中 $\mathcal{B}_r$ 是 rank $r$ 拿到的样本集合,$b$ 是本地 batch size。对参数求导,得到局部梯度: $$g_r=\nabla_w L_r(w)=\frac{1}{b}\sum_{i\in\mathcal{B}_r}\nabla_w\ell(x_i;w)$$ 同步数据并行对所有局部梯度取平均: $$g=\frac{1}{N}\sum_{r=1}^{N}g_r=\frac{1}{Nb}\sum_{r=1}^{N}\sum_{i\in\mathcal{B}_r}\nabla_w\ell(x_i;w)=\frac{1}{B}\sum_{i=1}^{B}\nabla_w\ell(x_i;w)$$ 右边正是把所有样本放在一张卡上算全局平均损失所得到的梯度。等价成立依赖四个前提:损失能按样本分解且样本计算不因分组改变(如本地 BatchNorm 统计会破坏这一条件);各 rank 从同一个参数 $w$ 出发;样本权重一致;更新前完成同步。若最后一个 batch 在各 rank 上不等长,仍然机械地“先本地平均再按 rank 平均”,样本就会被赋予错误权重。这也是分布式数据加载器必须谨慎处理尾 batch 的原因。 DDP 的核心任务由此非常明确:它不替你切输入,而是在 autograd 产生梯度后,把各 rank 的 $g_r$ 聚合成相同的 $g$。 不等长时要把“按 rank 平均”改成“按目标中的有效元素加权”。记 rank $r$ 有 $b_r$ 个样本,总数 $B=\sum_r b_r$,则: $$L=\sum_r\frac{b_r}{B}L_r,\qquad g=\sum_r\frac{b_r}{B}g_r$$ 默认 DDP 对梯度按 $N$ 平均;因此把每个本地平均损失乘以 $Nb_r/B$,归约后才等于全局样本均值。若目标是有效 token 的平均,$b_r$ 就应换成有效 token 数,并在同一个累计更新窗口内求总分母;每条回答平均再平均,是另一个目标。自定义通信 hook 或 DDP join 的除数可能改变,不能继续套默认 $N$。 一个可手算的反例:两个 rank 的局部梯度均值为 2 和 8,分别代表 2 和 1 个样本。rank 平均是 5,样本平均是 $(2\times2+8)/3=4$。下文真实 CPU MSE 例子中,错误 rank 平均的最大梯度误差为 0.4166667,正确加权误差仅 $2.22\times10^{-16}$。 DistributedSampler 让各 rank 迭代数相同,不能自动保持原始数据集的严格样本均值。固定 PyTorch v2.10.0 源码实跑:5 个样本、2 个 rank、不打乱时,默认得到 [0,2,4] 与 [1,3,0],样本 0 被补一次;drop_last=True 得 [0,2] 与 [1,3],样本 4 被丢掉。它们各自定义了实际处理的数据多重集。要对原始 5 个样本严格平均,仍需显式处理重复/丢弃和有效权重,并保持各 rank 集体调用顺序一致;只改本地权重而让某 rank 提前退出可能挂起。 3.2 先把 16 字节拆明白 设模型有 $P$ 个可训练参数,采用低精度前后向和 FP32 Adam 更新。每个参数对应: 低精度参数:2 字节; 低精度梯度:2 字节; FP32 主参数:4 字节; Adam 一阶矩 $m$:4 字节; Adam 二阶矩 $v$:4 字节。 后面三项统称优化器状态,共 12 字节。普通 DDP 每个 rank 的模型状态显存是: $$M_{\mathrm{DDP}}=(2+2+12)P=16P$$ 注意这是该训练状态布局的理想常驻账本,没有包含激活等剩余显存;它不是所有混合精度实现的通用下界。它的价值不是预测 nvidia-smi 到个位数,而是先回答“哪一类状态值得切”。 实际套公式时,$P$ 应取需要优化器更新的参数量,不是配置文件里笼统写出的模型总参数量。冻结的视觉编码器通常仍要保存推理权重,却不产生梯度和 Adam 状态;共享 embedding 在参数统计中也只能算一次。优化器同样会改常数:SGD 无动量时几乎没有 $m,v$,8-bit Adam 会压缩这两份状态,某些纯 BF16 配置也不保留 FP32 主参数。所以正确动作不是背住“训练恒等于 16 字节/参数”,而是先列出当前训练栈真正持有的张量,再把每一项的元素数乘 dtype 字节数。本文使用 16 字节,是为了与 ZeRO 原论文的混合精度 Adam 假设严格对齐。 原生 PyTorch autocast 的另一种常见布局是 FP32 参数 4 字节、FP32 梯度 4 字节、两个 FP32 矩 8 字节,也可能合计 16 字节,但没有另算一份 FP32 主权重。把两种布局混在一起,会重复计算主参数。Adam 的状态通常在首次产生梯度并更新时才创建,初始化后直接读显存也会低估训练稳定阶段。 若有 $P_f$ 个冻结参数,还要加其实际权重字节 $d_fP_f$;它们没有梯度和 Adam 状态,不代表权重不占空间。只有确实参加相同分片方案的冻结权重才能除以 $N$。共享权重按底层存储去重,分片填充、对齐、桶和副本则单列;小模型和不能整除的分片不一定恰好达到 $1/N$。 3.3 ZeRO 三阶段到底切了什么 ZeRO-1:只切优化器状态。 参数和梯度仍然每卡各有一份,12 字节的 FP32 主参数与 Adam 两个矩按 $N$ 份切开: $$M_{\mathrm{Z1}}=4P+\frac{12P}{N}$$ 当 $N$ 很大,第二项趋近于 0,但第一项中的 2 字节参数和 2 字节梯度仍然复制,所以 ZeRO-1 的极限是 $4P$,相对 $16P$ 最多节省 4 倍。 ZeRO-2:再切梯度。 常驻的完整副本只剩 2 字节低精度参数;梯度与优化器状态合计 14 字节一起分片: $$M_{\mathrm{Z2}}=2P+\frac{14P}{N}$$ 当 $N$ 很大,极限是 $2P$,相对普通 DDP 最多节省 8 倍。这里的常驻值不包含反向产生和归约中的临时梯度。所谓“切梯度”不是说某个 rank 永远见不到别人的梯度,而是 reduce-scatter 聚合后,每个 rank 只保留自己负责更新的那一片结果,其余梯度用完即释放。 ZeRO-3:参数也切。 参数、梯度和优化器状态全部只保留 $1/N$: $$M_{\mathrm{Z3}}=\frac{16P}{N}$$ 这时单卡模型状态随卡数线性下降,理论上终于可以使用整个数据并行组的聚合显存。代价是某层计算前必须 all-gather 出完整参数,计算后再 reshard。这里的“完整”通常只针对一个 FSDP unit 或若干层,而不是一次把全模型永远拼回显存;包装粒度如果选错,峰值仍然可能爆掉。 代入 $P=7.5\times10^9$、$N=64$: DDP:$16P=120.00$ GB; ZeRO-1:$4P+12P/64=31.41$ GB; ZeRO-2:$2P+14P/64=16.64$ GB; ZeRO-3:$16P/64=1.875$ GB。 这与 ZeRO 原论文表 1中的 120、31.4、16.6、1.88 GB 对上了。论文使用十进制 GB;如果监控工具显示 GiB,同一字节数的 GiB 数值会比 GB 数值小约 6.9%,比较数字前先统一单位。 3.4 显存省了,通信为什么没有立刻爆炸 先固定口径:$W$ 是完整参数的通信字节数,$G$ 是完整梯度的通信字节数,$a=(N-1)/N$。以下数值是理想 ring 每个 rank 的发送字节;接收量相同,若把发送和接收相加要再乘 2。它既不是整个集群的字节总和,也不是实测网卡流量。 ring reduce-scatter 有 $N-1$ 轮,每轮发送张量的 $1/N$,所以每 rank 发送 $aG$;all-gather 同理发送 $aW$。DDP 的 all-reduce 可拆成梯度 reduce-scatter 与梯度 all-gather: $$V_{\mathrm{DDP}}=2aG$$ ZeRO 论文的理想 Stage 1/2 调度把平均梯度送到状态所有者,再让所有者更新参数,最后聚合参数片: $$V_{\mathrm{Z1/Z2}}=a(G+W)$$ Stage 1 可在这一调度下不长期释放梯度,Stage 2 进一步释放非所属梯度;二者的通信账不因此翻倍。Stage 3 在前向后释放完整参数,反向前再聚合一次,然后归约梯度: $$V_{\mathrm{Z3}}=a(G+2W)$$ 若参数、梯度通信都为两字节,$W=G=2P$,Stage 3/DDP 比为 $3/2$;但 7.5B/64 卡的精确发送量为 DDP/Stage 1/2 29.53125 GB、Stage 3 44.296875 GB。30/45 GB 是省略 $a$ 的大 $N$ 近似。1.5B/8 卡则为 5.25/7.875 GB,直接用 6/9 GB 会高估约 14.3%。$N=1$ 时所有通信量应为零。 通信 dtype 不同会改变比例。保持两字节参数,改用四字节梯度,7.5B/64 卡下 $W=15$ GB、$G=30$ GB,DDP/Stage 1或2/Stage 3 分别发送 59.0625/44.296875/59.0625 GB;此时 Stage 3 相对 DDP 为 1,而非 1.5。驻留梯度与通信梯度在真实框架中也可能不同,脚本为简单起见让它们共用一个 dtype 参数。 实现名不能代替通信时间轴。 PyTorch v2.10.0 的 DDP + ZeroRedundancyOptimizer 默认先执行 DDP 完整梯度 all-reduce,再由各状态所有者广播更新后的参数。它不能直接套上述 Stage 1 的 $a(G+W)$;若把参数广播理想化为相同带宽的分片聚合,应另算 $2aG+aW$。实际广播树、NCCL 算法、融合及 overlap 路径均会改变流量与时间。这些式子只比较指定调度的带宽项,不是训练时间预测。 3.5 别把模型状态公式当成整机显存公式 实际峰值更接近: $$M_{\mathrm{peak}}=\max_t\left[S(t)+A(t)+U(t)+R(t)+F(t)\right]$$ 这里 $t$ 是训练时间,$S,A,U,R,F$ 分别是同一时刻的模型状态、激活、临时物化/通信/算子空间、运行时和未被前项计入的分配器开销。它们必须按底层存储互不重复;不能把各类在不同时间的峰值直接相加当作实测峰值。 第一项是前面推导的参数、梯度和优化器状态。激活由 batch、序列长度、空间分辨率、层数和 checkpoint 策略决定;临时项包含 all-gather bucket、梯度 bucket 和算子工作区;runtime 包含 CUDA context、通信库等;碎片则取决于张量生命周期和分配器状态。 例如上面的 ZeRO-3 常驻状态是 1.875 GB。若一个 unit 就包含全部 7.5B 参数,完整两字节参数缓冲本身为 15 GB;当它与常驻分片共存时,仅这两项就约 16.875 GB。若实现复用存储,增量需按实际存活缓冲重算;预取下一个 unit 还可能让两个完整缓冲共存。用 $16P/N$ 断言“2 GB 就能训练”会漏掉决定能否启动的窗口。 ZeRO 原论文给过一个很有提醒意义的例子:15 亿参数 GPT-2 的模型状态至少 24 GB;序列长度 1024、batch 32 时,激活约 60 GB,即使用激活重计算降到约 8 GB,临时 FP32 扁平缓冲还可能再占 6 GB。只看 $16P$ 判断“32 GB 正好能放下”会直接翻车。 模型状态随数据并行卡数的变化。固定 FP16 参数/梯度与 FP32 主权重及 Adam 状态,纵轴为十进制 GB;不含激活、临时聚合缓冲和运行时。 04. 代码实现 本节保留两个标准库脚本,并增加一份 NumPy/PyTorch CPU 参考脚本。第一个复现论文显存表;第二个把 DDP all-reduce 与 ZeRO-2 的 reduce-scatter + all-gather 拆开,先验证一次更新,再用混合正负梯度验证连续 12 次 Adam 更新及恢复。完整代码在文末附录。 4.1 用公式生成显存账本 zero_memory_ledger.py 把每个阶段写成“每卡复制多少字节 + 分片多少字节”: STAGES = ( Stage("DDP", 16.0, 0.0), Stage("ZeRO-1", 4.0, 12.0), Stage("ZeRO-2", 2.0, 14.0), Stage("ZeRO-3", 0.0, 16.0), ) def bytes_per_parameter(self, world_size: int) -> float: return self.replicated_bytes + self.sharded_bytes / world_size replicated_bytes 是每个 rank 必须完整保留的部分,sharded_bytes 是可以除以 $N$ 的部分。默认参数就是论文的 7.5B/64 卡案例。实际运行: model=7.5B, world_size=64 assumption: params 2B + grads 2B + fp32 master/m/v 12B = 16 bytes/parameter stage bytes/param model-state GB vs DDP comm/step GB DDP 16.0000 120.00 1.00x 29.53 ZeRO-1 4.1875 31.41 3.82x 29.53 ZeRO-2 2.2188 16.64 7.21x 29.53 ZeRO-3 0.2500 1.88 64.00x 44.30 note: activation, temporary buffers and fragmentation are excluded 为什么 64 卡的 ZeRO-1 只有 3.82 倍而不是宣传里的 4 倍?因为 4 倍是 $N\to\infty$ 的上限,有限卡数下 $12P/N$ 还没有消失。ZeRO-2 的 7.21 倍同理。ZeRO-3 没有复制项,所以恰好获得 64 倍。通信列已包含 $(N-1)/N$,是每 rank 发送的理论 GB;表格保留两位小数,精确值见 3.4。用 --grad-bytes 4 可重算四字节梯度的账本;参数通信仍为两字节。 再换成 1.5B/8 卡: model=1.5B, world_size=8 assumption: params 2B + grads 2B + fp32 master/m/v 12B = 16 bytes/parameter stage bytes/param model-state GB vs DDP comm/step GB DDP 16.0000 24.00 1.00x 5.25 ZeRO-1 5.5000 8.25 2.91x 5.25 ZeRO-2 3.7500 5.62 4.27x 5.25 ZeRO-3 2.0000 3.00 8.00x 7.88 note: activation, temporary buffers and fragmentation are excluded 这组数字揭示一个选型习惯:模型状态只差几 GB 时,ZeRO-1/2 往往已经够用;不必为了追求最低常驻显存直接承担 Stage 3 的参数聚合。 4.2 ZeRO 为什么没有改掉优化结果 zero_update_simulator.py 构造 4 个 rank、8 个参数。每个 rank 看见不同数据,因此产生不同局部梯度。DDP 路径先得到完整平均梯度,再完整执行 Adam;ZeRO-2 路径只把平均梯度对应的两元素分片交给各 rank,每个 rank 维护自己的 $m,v$,更新后再把四个参数片聚合起来。 核心区别只有分片发生的位置: reduced_full_grad = average_columns(local_grads) ddp_params, ddp_m, ddp_v = adam_first_step(PARAMS, reduced_full_grad) param_shards = shard(PARAMS, WORLD_SIZE) grad_shards = shard(reduced_full_grad, WORLD_SIZE) updated_shards = [] for params_for_rank, grads_for_rank in zip(param_shards, grad_shards): updated, local_m, local_v = adam_first_step(params_for_rank, grads_for_rank) updated_shards.append(updated) zero_params = [value for part in updated_shards for value in part] 真实运行输出: world_size=4, parameter_count=8, shard_width=2 local gradient matrix shape=(4, 8) reduce-scatter result shape=(4, 2) averaged gradient: [0.02, 0.045, 0.07, 0.095, 0.12, 0.145, 0.17, 0.195] DDP updated params: [0.099, -0.201, 0.299, -0.401, 0.499, -0.601, 0.699, -0.801] ZeRO-2 gathered params: [0.099, -0.201, 0.299, -0.401, 0.499, -0.601, 0.699, -0.801] max_abs_diff=0.000000000000 Adam m/v scalars per rank: DDP=16, ZeRO-2=4, reduction=4.00x max_abs_diff=0 是本文最重要的代码结果:同一份平均梯度、同一优化器规则下,把参数更新分给不同 rank 并不会改变更新后的模型。每卡 Adam 的 $m,v$ 元素数则从 16 降到 4,正好是 4 倍。真实系统还需要 bucket、异步通信、混合精度和异常恢复,但数学骨架就是这几十行。 不过,Adam 第一步不是足够强的聚合验收。初始 $m=v=0$ 时,偏差修正后更新为: $$\Delta w=-\eta\frac{g}{|g|+\varepsilon}$$ 若梯度全同号且远大于 $\varepsilon$,把 $g$ 错乘一个正数,参数改变量仍几乎只是 $-\eta$。因此保留上面例子作入门,不把它当完整正确性证据。 新补的 multistep() 连续 12 步改变梯度符号与幅度,并直接按目标分片聚合,避免先算全量平均再切片的同源验证。它在每一步分别比较参数、一阶矩和二阶矩;从第 5 步保存的参数、两个矩和全局 step 恢复,再续跑到第 12 步。实跑最大参数/m/v 差和恢复参数差均为 0。故意让 rank 0 漏除以 4,一阶矩最大差为 0.0807017083,验收能够抓住故障。 Adam 每一步的规则是 $m_t=\beta_1m_{t-1}+(1-\beta_1)g_t$、$v_t=\beta_2v_{t-1}+(1-\beta_2)g_t^2$,然后用 $m_t/(1-\beta_1^t)$ 与 $v_t/(1-\beta_2^t)$ 更新对应参数。$m,v$ 都按参数元素独立计算,所以同一归约梯度下可分别更新分片;保存矩却丢掉 $t$,也会改掉偏差修正。这里的 $\eta$ 是学习率,$\varepsilon$ 是开方之后的稳定项,$\beta_1=0.9,\beta_2=0.999$。脚本不使用 weight decay。 两个反例说明哪些操作不能随便交换顺序: 四 rank 梯度分别为 1、1、1、-2。先平均梯度得到 0.25,再做 Adam 第一步;若各自先做 Adam 再平均参数,更新量约少一半。本例两结果最大差为 0.000499999966,学习率为 0.001。 两个无重复分片的梯度为 3 与 4,全局二范数为 5,阈值 1 时应统一乘 1/5,得到 0.6 与 0.8。每片各自裁到 1 得到 1 与 1,全局范数反而为 1.41421356。正确全局范数应先把各片平方和归约再开方;有复制或混合分片时还要去重、选对进程组。 4.3 用真实 CPU 参考检查模拟器 zero_reference.py 在 Python 3.11.9、NumPy 2.4.6、PyTorch 2.10.0+cpu 下实跑。它把同样 12 步梯度送给真实 torch.optim.Adam,逐步检查参数和两个矩,最大误差 $4.16\times10^{-17}$;保存并恢复优化器状态后,后七步结果逐位一致。再对真实线性模型的 MSE 做 autograd,验证 3.1 的不等 batch 加权。 审核时还通过脚本可选参数加载了下载的 PyTorch v2.10.0 原始 Adam 源码与原始采样器源码,整份加载,没有改写函数;原始 Adam 与安装版本结果完全一致。读者日常运行只需 python zero_reference.py,不需要下载目录、GPU、模型权重或进程组。源码下载属于额外审阅证据,不是基本运行的前提。 这是单进程 CPU 的数值与 API 参考核验。没有执行真实 DDP 集体通信、DeepSpeed、FSDP GPU 分片,也没有实测 NCCL 带宽或模型显存;不能把脚本的 0 误差换算成多机吞吐或浮点归约逐位一致的保证。 05. 工业级实现对照 最小实现为了看懂“切什么”,生产实现要解决的则是“什么时候切、什么时候聚合、怎么让网络传输藏在计算后面”。本轮核对固定 PyTorch v2.10.0 文档/源码与 DeepSpeed v0.18.0 配置定义(2026-10-17 审阅);原理与这些版本的默认调度分开讨论。 5.1 PyTorch DDP:复制参数,反向时同步梯度 PyTorch 的 DistributedDataParallel 常见 GPU 用法是一进程一卡,也支持 CPU 模型;本文的数值验证在 CPU 上完成。它不会自动切分输入;应用通常用 DistributedSampler 保证不同 rank 读取不同样本。模型参数在每卡完整复制,autograd hook 在反向过程中把就绪梯度装进 bucket,并尽早发起 all-reduce,以便通信和后续层反向计算重叠。 这解释了两个常见现象:第一,DDP 通常比单进程 DataParallel 快,因为没有主卡收集和 Python 线程瓶颈;第二,DDP 加卡能缩短时间,却不会降低模型状态的单卡显存。它首先是一种吞吐扩展方案,不是大模型装载方案。 5.2 ZeroRedundancyOptimizer:最小改动的 Stage 1 思路 PyTorch 的 ZeroRedundancyOptimizer 可以和 DDP 组合。每个 rank 只为大约 $1/N$ 的参数维护本地优化器状态,更新自己负责的参数后广播结果,让所有 DDP 副本重新一致。这对应 ZeRO-1 的核心思想;参数仍完整复制,所以不能把它当成 FSDP 的替代品。 官方文档还标记该 API 为 experimental,并提示启用 overlap_with_ddp=True 时,最初若干迭代可能因为梯度 bucket 尚未稳定而不做参数更新。工程上不能只看“少了多少 GB”,还要读清 API 的更新时序、checkpoint 聚合和版本状态。 5.3 DeepSpeed ZeRO:三个阶段直接写进配置 DeepSpeed 官方 ZeRO 教程把三个阶段定义得很直接:Stage 1 切优化器状态,Stage 2 再切梯度,Stage 3 再切参数。一个典型配置是: { "zero_optimization": { "stage": 2, "contiguous_gradients": true, "overlap_comm": true, "reduce_bucket_size": 500000000 } } contiguous_gradients 针对碎片与通信连续性,overlap_comm 尝试把通信藏进计算,reduce_bucket_size 在“消息大到能吃满带宽”和“临时 bucket 不要撑爆显存”之间取舍。这些开关没有脱离前面的公式,只是在控制公式之外的临时项和时间轴。固定 DeepSpeed v0.18.0 配置源码把 reduce_bucket_size 定义为元素数;500000000 是五亿个元素,不是五亿字节:两字节缓冲约 1 GB、四字节约 2 GB,重叠时还可能同时存活多个缓冲。这个教学配置不是对任意显存容量的推荐值。 如果 GPU 显存仍不够,ZeRO-Offload 可以把优化器状态与计算移到 CPU,ZeRO-Infinity 进一步使用 CPU 和 NVMe。但 官方 ZeRO-Offload 教程 展示的 10B 单 V100 案例并不意味着 offload 免费:PCIe 传输、CPU Adam 吞吐、NUMA 与磁盘带宽会变成新的瓶颈。 5.4 PyTorch FSDP:Stage 2/3 的框架化实现 知识树里的代码锚点 FullyShardedDataParallel 类 在固定 PyTorch v2.10.0 中存在,已实际读取该类源码;下列为 FSDP1 策略。FSDP1 的 ShardingStrategy 可以这样理解: NO_SHARD:参数、梯度、优化器状态都复制,行为接近 DDP; SHARD_GRAD_OP:梯度和优化器状态分片,参数在计算窗口内保持完整,接近 ZeRO-2; FULL_SHARD:参数、梯度和优化器状态全分片,接近 ZeRO-3; HYBRID_SHARD:节点内全分片、节点间复制,减少低带宽跨节点通信。 另一个代际是 PyTorch 2.10 FSDP2 API 的 fully_shard:FSDP2 以 DTensor 做逐参数分片,不再依赖 FSDP1 的扁平参数;reshard_after_forward=True 对应 FULL_SHARD,设为 False 则更像 SHARD_GRAD_OP。文章或配置里只写“用了 FSDP”已经不够,必须同时说明代际和策略。在本版默认 reshard_after_forward=None 下,非根 unit 通常前向后重新分片,根 unit 默认保留完整参数到反向以省一次聚合;显式布尔值可以覆盖这一行为。因此下面七步生命周期对应显式前向后 reshard 的 full-shard unit,不能宣称所有默认 FSDP2 unit 都反向前再 all-gather。只包装根模块也容易把全模型聚在一起,应从各 block 到根模块逐层应用;优化器须在完成分片后创建。 5.5 一层参数在 FSDP 中的生命周期 以 full shard 为例,一个 FSDP unit 在一次训练步里大致经历: 常驻状态只有本 rank 的参数分片; pre-forward hook 发起 all-gather,临时物化完整参数; 执行该 unit 的前向; 释放完整参数,恢复分片; 反向前再次 all-gather 参数; 计算梯度后执行 reduce-scatter,每个 rank 只留下本地梯度片; 本地优化器只更新本 rank 的参数与状态分片。 真正决定峰值的不是“最终只存 $1/N$”,而是同一时刻有多少 unit 正在 all-gather、预取队列有多深、最大 unit 有多大。如果把整个模型只包成一个巨型 unit,那么计算前仍要暂时物化全模型;如果把每个很小的算子都单独包起来,又会制造大量小消息,延迟和调度开销反而吞掉吞吐。Transformer 常按 block 包装,就是在这两端之间折中。 FSDP2 的公开契约仍是同一个时间逻辑:前向/反向前由 hook unshard,之后 reshard,梯度用 reduce-scatter 汇聚。实现细节从 flat parameter 变成 DTensor,不代表 ZeRO 的“按需物化”思想变了。 5.6 一个实用的选择顺序 先测量,再逐级加复杂度: 模型状态能放下,只想提吞吐:先用 DDP; Adam 状态是主要缺口:DDP + ZeRO-1/ZeroRedundancyOptimizer; 梯度也造成明显压力:ZeRO-2 或 FSDP 的 shard-grad 策略; 单卡连参数副本都放不下:ZeRO-3/FSDP full shard; 模型状态已经很小但长视频仍 OOM:处理激活重计算、micro-batch、FlashAttention 或序列并行,而不是继续折腾 ZeRO stage; 网络太慢:优先让分片组留在节点内,再用张量/流水线或混合分片扩到节点间。 06. 代价与边界 切分不省去同一全局 batch 的模型前向与反向。 集群仍要完成这些数学运算,但原 DDP 在每 rank 重复的完整 Adam 更新可改成各 rank 只更新所属片,因而不能笼统说所有优化器计算也完全不减少。它让每个 rank 少存状态,并通过通信在需要时恢复视图。若模型原本就能舒适放下,Stage 3 很可能只是增加通信和 hook 调度,吞吐反而下降。 通信字节相同,不代表时间相同。 ZeRO-2 与 DDP 在论文模型里都是约 $2G$,但一次大 all-reduce 和许多 layer-wise reduce-scatter/all-gather 的延迟特征不同。NVLink 节点内、InfiniBand 节点间、普通以太网的最优 bucket 大小不会一样;跨节点带宽不足时,1.5 倍 Stage 3 通信尤其明显。 平均显存很低,峰值仍可能 OOM。 参数 all-gather、预取、梯度归约、算子 workspace 可能同时在场。只看稳定阶段的 memory_allocated 会漏掉峰值;要记录 max_memory_allocated,并逐步调 wrap 粒度、prefetch 和 bucket。 ZeRO 解决不了激活随序列长度增长。 视频 DiT 中,时间、宽、高一起扩张,token 数可能成倍增加,注意力和 MLP 保存的激活随之增长。参数切到 1 GB 后仍然爆显存,并不说明 ZeRO 失效,而是瓶颈已经从模型状态转移到激活。 checkpoint 变复杂。 每个 rank 手里只有一片状态,保存时要选择 full、sharded 或 local state dict。把完整 checkpoint 聚合到 rank 0 可能让 CPU 内存瞬间成为瓶颈;只保存分片又要求恢复时正确处理 world size 和布局。训练能跑并不等于容灾链路可用,上线前至少做一次“保存—退出—换步数恢复”的演练。 全局操作必须认识分片。 梯度范数裁剪、参数检查、EMA、冻结部分参数、权重共享都不能默认“当前 rank 能看到完整张量”。例如 FSDP1 提供自己的 clip_grad_norm_,就是因为全局范数需要跨分片归约。绕开框架直接遍历本地 .grad,算到的只是局部值。 offload 是拿带宽换容量。 CPU 内存比显存大,NVMe 又比 CPU 内存大,但层级越远,带宽越低、延迟越高。小模型或计算密度不够的模型会被数据搬运压垮;只有“不 offload 根本跑不了”或计算足以覆盖传输时,这个交换才划算。 大 batch 会改变优化问题。 增加数据并行度时,如果每卡 batch 不变,全局 batch 会随 $N$ 增长。ZeRO 保证同一全局 batch 下更新等价,却不保证扩大 batch 后收敛曲线不变。学习率、warmup、梯度累计和数据采样仍要一起调整。 什么时候不该用 ZeRO-3:模型与激活在单卡尚有充足余量、网络较慢、模型由大量极小模块组成且难以形成高效 bucket,或者你更看重最低延迟和调试简单性。此时 DDP 或 ZeRO-1/2 往往是更好的工程答案。 07. 经典论文脉络 这条路线不是“突然发明一种分布式训练”,而是一步步把数据并行里的冗余拆掉: Horovod(arXiv:1802.05799,2018)把 ring all-reduce 做成易接入的训练抽象,提供了可用的“各算各的、梯度集体归约”工程方案;这不是 ring all-reduce 的最早发明声明;它解决吞吐扩展,但每个 worker 仍保存完整模型状态。 ZeRO(arXiv:1910.02054,2019)指出数据并行浪费的不是总显存,而是参数、梯度和优化器状态的重复副本;三阶段切分在保持数据并行计算粒度的同时,把模型状态显存从 $16P$ 推到 $16P/N$。 ZeRO-Offload(arXiv:2101.06840,2021)把优化器状态与计算搬到 CPU,并针对 CPU Adam 优化,让单张 32 GB V100 训练 10B 模型成为论文展示案例;留下的新问题是主机带宽和异构调度。 ZeRO-Infinity(arXiv:2104.07857,2021)继续把 CPU 与 NVMe 纳入内存层级,用带宽感知的分区和预取突破 GPU 内存墙;容量继续扩大,但 I/O 调度成为系统的核心。 PyTorch FSDP(arXiv:2304.11277,2023)总结了把 fully sharded data parallelism 纳入 PyTorch eager 训练栈的实践,让 ZeRO-3 类思想不再只属于单一外部训练引擎,并推动后续 FSDP2 的逐参数分片。 主线可以压缩成一句话:all-reduce 证明“计算可以复制、结果可以同步”,ZeRO 进一步问“既然结果会同步,状态为什么还要复制”。 后续 Offload、Infinity、FSDP 都是在回答状态放在哪、何时出现、以什么粒度搬运。 08. 常见误解 “数据并行会把模型切到多张卡上。” 不会。普通 DDP 是每卡一个完整模型,只切数据。能把吞吐从一张卡扩到八张,不代表能装下超过单卡容量的参数。 “ZeRO-3 后每卡永远只有 $1/N$ 参数。” 常驻状态是 $1/N$,计算某个 FSDP unit 前仍需临时 all-gather 完整参数。忽略这个瞬时窗口,就会得到理论显存能放、实际 forward 前仍 OOM 的配置。 “ZeRO-2 比 DDP 少传一半梯度,所以一定更快。” ZeRO-2 用 reduce-scatter 只留下梯度片,但更新后还要 all-gather 参数片。按论文的理想字节模型,总通信量与 DDP all-reduce 相同;快慢来自重叠、bucket、拓扑与实现,而非简单少一半。 “用了 ZeRO 就不用 activation checkpointing。” 两者切的是不同账本。ZeRO 处理模型状态冗余;activation checkpointing 用额外重算减少前向激活保存。长视频训练经常需要两者同时用。 “参数是 BF16,所以 Adam 也只占 2 字节。” 常见混合精度训练会保留 FP32 主参数与 FP32 的 $m,v$,优化器部分仍是 12 字节/参数。不同优化器、8-bit optimizer 或纯 BF16 更新会改变常数,因此使用 $16P$ 前必须先列出真实 dtype 与状态。 “64 卡 ZeRO-1 就一定省 4 倍。” 4 倍是 $N$ 很大时的渐近上限。64 卡的精确值是 $16/(4+12/64)=3.82$ 倍;8 卡只有 2.91 倍。宣传中的“up to”不能替代自己的显存账本。 “只要 loss 一样,所有数据并行更新都严格一致。” 浮点归约顺序会改变末位误差,随机数、dropout、数据尾 batch 和非确定性 kernel 也会影响复现。数学上等价不等于 bitwise identical;本文模拟得到 0 误差,是因为使用同一确定性顺序与双精度标量。 09. 动手验证 下面前四项可在没有 GPU 的机器上完成,第五项需要你自己的真实训练日志。三个数值脚本及配图脚本全文在附录,标准库例子直接用 Python 3 运行;真实参考脚本需安装 NumPy 和 PyTorch,配图另需 matplotlib。 实验一:复现原论文表格。 python zero_memory_ledger.py 预期看到 7.5B/64 卡下 DDP、ZeRO-1/2/3 分别为 120.00、31.41、16.64、1.88 GB。如果结果差约 7%,检查自己是不是把 GiB 和十进制 GB 混用了。 实验二:观察有限卡数离理论上限有多远。 python zero_memory_ledger.py --params-b 1.5 --world-size 8 预期 ZeRO-1 只省 2.91 倍,ZeRO-2 只省 4.27 倍,ZeRO-3 才精确省 8 倍。再把 world-size 改成 2、4、16、64,观察 Stage 1 向 4 倍、Stage 2 向 8 倍收敛。 实验三:验证更新等价性。 python zero_update_simulator.py 预期 DDP 与 ZeRO-2 的八个新参数完全相同,max_abs_diff=0;每 rank 的 Adam $m,v$ 标量数从 16 降为 4。把 local_gradient() 的公式改掉,只要两条路径仍使用同一平均梯度,完整平均与直接分片聚合的更新、两个矩应继续一致;再运行脚本自带的 12 步检查和故障注入,避免只检查第一步。 实验四:核对不等 batch 与真实优化器。 运行 python zero_reference.py,应看到正确加权梯度误差约 2.22e-16、错误 rank 平均误差约 0.4167、12 步 Adam 参数/状态最大误差约 4.16e-17,以及恢复后逐位相同。也可以在标准库模拟器中修改 rank 代表的样本数,观察 5 与 4 的反例。采样器的补齐/丢弃决定实际数据多重集,不能把 drop_last 当成无损修复。 实验五:给自己的模型补全账本。 从训练日志记录参数量、每种状态 dtype、峰值激活与临时 buffer。先用脚本算指定布局的常驻状态,再结合 profiler、分配器快照及 all-gather 时间轴定位额外存储。随序列长度或分辨率增长的差值可能来自激活,也可能来自 attention workspace 和算法选择;输入无关的峰值还可能是参数聚合。改变一个因素再复测,峰值相减只能提供线索,不能单独确定因果。 10. 延伸阅读 读完这篇可以沿分布式训练知识树继续: 混合精度与数值稳定性:本文的 16 字节常数建立在混合精度 Adam 上;理解 FP16、BF16、FP8 的动态范围后,才能判断哪些状态可以继续降精度。 张量并行与流水线并行:当单个算子或单层连临时 all-gather 都放不下时,需要切计算本身;下一步要算 TP 通信量和 PP 气泡率。 序列并行与 Ring Attention:模型状态已经切完,长视频仍被激活卡住时,才轮到沿序列维度切注意力计算。 本文的核心资料均来自原始论文与官方实现:ZeRO 的显存和通信公式以 ZeRO 原论文为准;三阶段配置参考 DeepSpeed ZeRO 官方教程;DDP、优化器分片和 FSDP 策略分别核对了 PyTorch DDP 文档、ZeroRedundancyOptimizer 文档 与 FSDP 文档。代码路径和 API 会随上游重构,工业实现部分注明的日期就是版本边界。 附录:完整代码 09 节用到的脚本全文如下(zero_memory_ledger.py、zero_update_simulator.py、zero_reference.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 zero_memory_ledger.py #!/usr/bin/env python3 """复现 ZeRO 论文中的混合精度 Adam 模型状态显存账本。 这里只计算参数、梯度和优化器状态,不包含激活、临时通信缓冲区、 CUDA context 与内存碎片。单位同时使用十进制 GB,便于和论文表格对照。 """ from __future__ import annotations import argparse import math from dataclasses import dataclass @dataclass(frozen=True) class Stage: name: str replicated_bytes: float sharded_bytes: float def bytes_per_parameter(self, world_size: int) -> float: return self.replicated_bytes + self.sharded_bytes / world_size STAGES = ( Stage("DDP", 16.0, 0.0), Stage("ZeRO-1", 4.0, 12.0), Stage("ZeRO-2", 2.0, 14.0), Stage("ZeRO-3", 0.0, 16.0), ) def gb(byte_count: float) -> float: """转为十进制 GB;ZeRO 原论文的 120 GB 使用这个口径。""" return byte_count / 1_000_000_000 def communication_bytes(stage: str, params: float, world_size: int, grad_bytes: int = 2) -> float: """理想 ring:每 rank 发送字节数;不再加一份接收,未算延迟。""" alpha = (world_size - 1) / world_size weights, grads = 2 * params, grad_bytes * params if stage == "DDP": return alpha * 2 * grads if stage in ("ZeRO-1", "ZeRO-2"): return alpha * (grads + weights) return alpha * (grads + 2 * weights) def main() -> None: parser = argparse.ArgumentParser() parser.add_argument("--params-b", type=float, default=7.5, help="参数量,单位十亿;默认复现论文的 7.5B 示例") parser.add_argument("--world-size", type=int, default=64, help="数据并行进程数") parser.add_argument("--grad-bytes", type=int, choices=(2, 4), default=2, help="驻留及通信梯度的每元素字节数;参数通信固定2字节") args = parser.parse_args() if not math.isfinite(args.params_b) or args.params_b <= 0 or args.world_size <= 0: raise ValueError("params-b 与 world-size 必须为正数") params = args.params_b * 1_000_000_000 print(f"model={args.params_b:g}B, world_size={args.world_size}") print(f"assumption: params 2B + grads {args.grad_bytes}B + " f"fp32 master/m/v 12B = {14 + args.grad_bytes} bytes/parameter") print("stage bytes/param model-state GB vs DDP comm/step GB") ddp_bytes = 14 + args.grad_bytes for stage in STAGES: extra = args.grad_bytes - 2 bpp = stage.bytes_per_parameter(args.world_size) bpp += extra if stage.name in ("DDP", "ZeRO-1") else extra / args.world_size state_gb = gb(params * bpp) saving = ddp_bytes / bpp comm_gb = gb(communication_bytes(stage.name, params, args.world_size, args.grad_bytes)) print(f"{stage.name:<8} {bpp:>10.4f} {state_gb:>17.2f} " f"{saving:>9.2f}x {comm_gb:>15.2f}") print("note: activation, temporary buffers and fragmentation are excluded") print("comm: ideal ZeRO schedule, per-rank sent bytes, finite-N ring factor included") print("not measured network traffic; PyTorch ZRO+DDP may use a different schedule") if __name__ == "__main__": main() zero_update_simulator.py #!/usr/bin/env python3 """用单进程模拟 DDP 与 ZeRO-2 的单步及多步 Adam 更新。 脚本不依赖 GPU、PyTorch 或分布式运行时。四个“rank”先各自产生一份局部 梯度,再比较两条路径:DDP 对完整梯度做 all-reduce;ZeRO-2 对梯度做 reduce-scatter、每个 rank 只更新自己的参数片,最后 all-gather 参数。 """ from __future__ import annotations import math import copy import json WORLD_SIZE = 4 PARAMS = [0.10, -0.20, 0.30, -0.40, 0.50, -0.60, 0.70, -0.80] LEARNING_RATE = 1e-3 BETA1 = 0.9 BETA2 = 0.999 EPSILON = 1e-8 def local_gradient(rank: int, width: int) -> list[float]: """构造确定性的局部梯度,模拟每个 rank 看见不同数据。""" return [((rank + 1) * (index + 2) - 3) / 100.0 for index in range(width)] def average_columns(rows: list[list[float]]) -> list[float]: return [sum(column) / len(rows) for column in zip(*rows)] def shard(vector: list[float], world_size: int) -> list[list[float]]: if len(vector) % world_size: raise ValueError("为了让示例清楚,参数量必须能被 world_size 整除") width = len(vector) // world_size return [vector[rank * width:(rank + 1) * width] for rank in range(world_size)] def adam_first_step(params: list[float], grads: list[float]) -> tuple[list[float], list[float], list[float]]: """执行 Adam 的第 1 步,并返回新参数、m、v。""" new_params: list[float] = [] m_state: list[float] = [] v_state: list[float] = [] for value, grad in zip(params, grads): m = (1.0 - BETA1) * grad v = (1.0 - BETA2) * grad * grad m_hat = m / (1.0 - BETA1) v_hat = v / (1.0 - BETA2) updated = value - LEARNING_RATE * m_hat / (math.sqrt(v_hat) + EPSILON) new_params.append(updated) m_state.append(m) v_state.append(v) return new_params, m_state, v_state def adam_step(params, grads, m, v, step): """逐元素 Adam,无weight decay;epsilon在开方之后,使用全局step。""" m = [BETA1 * a + (1 - BETA1) * g for a, g in zip(m, grads)] v = [BETA2 * a + (1 - BETA2) * g * g for a, g in zip(v, grads)] p = [a - LEARNING_RATE * (mi / (1 - BETA1 ** step)) / (math.sqrt(vi / (1 - BETA2 ** step)) + EPSILON) for a, mi, vi in zip(params, m, v)] return p, m, v def mixed_gradients(step): return [[math.sin((r + 1) * (j + 1) * 0.73 + step * 0.47) + 0.2 * math.cos(j + step) for j in range(len(PARAMS))] for r in range(WORLD_SIZE)] def reduce_scatter_direct(rows): """直接聚合每个目标分片;不先构造完整平均梯度。""" width = len(rows[0]) // WORLD_SIZE return [[sum(row[j] for row in rows) / WORLD_SIZE for j in range(r * width, (r + 1) * width)] for r in range(WORLD_SIZE)] def multistep(steps=12): p = PARAMS[:]; m = [0.] * len(p); v = m[:] parts = shard(p, WORLD_SIZE); ms = shard(m, WORLD_SIZE); vs = shard(v, WORLD_SIZE) wrong_parts = copy.deepcopy(parts); wrong_ms = copy.deepcopy(ms); wrong_vs = copy.deepcopy(vs) max_p = max_m = max_v = resume_error = 0. saved = None for t in range(1, steps + 1): rows = mixed_gradients(t) p, m, v = adam_step(p, average_columns(rows), m, v, t) gs = reduce_scatter_direct(rows) for r in range(WORLD_SIZE): parts[r], ms[r], vs[r] = adam_step(parts[r], gs[r], ms[r], vs[r], t) # 故障注入:某rank漏了平均中的除以world_size。 bad = [g * WORLD_SIZE for g in gs[r]] if r == 0 else gs[r] wrong_parts[r], wrong_ms[r], wrong_vs[r] = adam_step( wrong_parts[r], bad, wrong_ms[r], wrong_vs[r], t) flat = lambda xs: [a for x in xs for a in x] diff = lambda a, b: max(abs(x - y) for x, y in zip(a, b)) max_p = max(max_p, diff(p, flat(parts))) max_m = max(max_m, diff(m, flat(ms))) max_v = max(max_v, diff(v, flat(vs))) if t == 5: saved = json.loads(json.dumps(dict(step=t,params=parts,m=ms,v=vs))) # 从第5步保存的参数、矩和全局step恢复;继续到同一第12步。 for t in range(saved['step'] + 1, steps + 1): gs = reduce_scatter_direct(mixed_gradients(t)) for r in range(WORLD_SIZE): saved['params'][r],saved['m'][r],saved['v'][r] = adam_step( saved['params'][r],gs[r],saved['m'][r],saved['v'][r],t) resume_error = diff(p, flat(saved['params'])) bad_m = diff(m, flat(wrong_ms)) # 先各rank做本地Adam再平均参数,与先平均梯度再Adam不交换。 rows = [[1.] * 8, [1.] * 8, [1.] * 8, [-2.] * 8] correct = adam_first_step(PARAMS, average_columns(rows))[0] local = average_columns([adam_first_step(PARAMS,g)[0] for g in rows]) local_adam_error = diff(correct, local) # 两分片梯度[3,4],阈值1。全局裁剪为[.6,.8];分别裁剪为[1,1]。 local_clip_norm = math.sqrt(2.) # rank平均2与8,各代表2和1样本。 unweighted, weighted = (2 + 8) / 2, (2 * 2 + 8) / 3 result=dict(steps=steps,max_parameter_error=max_p,max_m_error=max_m,max_v_error=max_v, resume_parameter_error=resume_error,wrong_reduce_m_error=bad_m, local_adam_then_average_error=local_adam_error, independently_clipped_global_norm=local_clip_norm, uneven_rank_mean=unweighted,uneven_sample_mean=weighted) assert max(max_p,max_m,max_v,resume_error) < 1e-14 assert bad_m > 0.01 and local_adam_error > 0.0004 and unweighted != weighted return result def main() -> None: local_grads = [local_gradient(rank, len(PARAMS)) for rank in range(WORLD_SIZE)] # DDP:每个 rank 经 all-reduce 得到同一份完整平均梯度,并完整更新参数。 reduced_full_grad = average_columns(local_grads) ddp_params, ddp_m, ddp_v = adam_first_step(PARAMS, reduced_full_grad) # ZeRO-2:reduce-scatter 的结果等价于先平均,再只保留所属分片。 param_shards = shard(PARAMS, WORLD_SIZE) grad_shards = shard(reduced_full_grad, WORLD_SIZE) updated_shards: list[list[float]] = [] state_sizes: list[int] = [] for params_for_rank, grads_for_rank in zip(param_shards, grad_shards): updated, local_m, local_v = adam_first_step(params_for_rank, grads_for_rank) updated_shards.append(updated) state_sizes.append(len(local_m) + len(local_v)) # all-gather 后每个 rank 都能拿到同一份新参数;这里拼接一次代表该结果。 zero_params = [value for part in updated_shards for value in part] max_abs_diff = max(abs(a - b) for a, b in zip(ddp_params, zero_params)) shard_width = len(PARAMS) // WORLD_SIZE print(f"world_size={WORLD_SIZE}, parameter_count={len(PARAMS)}, " f"shard_width={shard_width}") print(f"local gradient matrix shape=({WORLD_SIZE}, {len(PARAMS)})") print(f"reduce-scatter result shape=({WORLD_SIZE}, {shard_width})") print("averaged gradient:", [round(x, 4) for x in reduced_full_grad]) print("DDP updated params:", [round(x, 6) for x in ddp_params]) print("ZeRO-2 gathered params:", [round(x, 6) for x in zero_params]) print(f"max_abs_diff={max_abs_diff:.12f}") print(f"Adam m/v scalars per rank: DDP={len(ddp_m) + len(ddp_v)}, " f"ZeRO-2={state_sizes[0]}, reduction={WORLD_SIZE:.2f}x") print("multistep:", json.dumps(multistep(), sort_keys=True)) if __name__ == "__main__": main() zero_reference.py """真实CPU Adam/梯度加权对照:Python3.11、NumPy、PyTorch2.10。 不启动进程组、不需要GPU;不声称测量了DDP/ZeRO网络或显存。 可选 --official-dir 指向已下载的v2.10.0官方adam.py与sampler源码目录。 """ import argparse import copy import importlib.util import json from pathlib import Path import numpy as np import torch from zero_update_simulator import PARAMS, average_columns, mixed_gradients, multistep, adam_step def load_original(name, file): spec = importlib.util.spec_from_file_location(name, file) module = importlib.util.module_from_spec(spec) spec.loader.exec_module(module) return module def probe(adam_class): p = torch.tensor(PARAMS, dtype=torch.float64, requires_grad=True) optimizer = adam_class([p], lr=1e-3, betas=(.9,.999), eps=1e-8, foreach=False, fused=False) q=PARAMS[:]; m=[0.] * 8; v=m[:]; saved=None; error=0. for step in range(1,13): g=average_columns(mixed_gradients(step)) p.grad=torch.tensor(g,dtype=torch.float64); optimizer.step() q,m,v=adam_step(q,g,m,v,step) state=optimizer.state[p] for actual,expected in [(p.detach().tolist(),q),(state['exp_avg'].tolist(),m), (state['exp_avg_sq'].tolist(),v)]: error=max(error,max(abs(a-b)for a,b in zip(actual,expected))) if step==5:saved=(p.detach().clone(),copy.deepcopy(optimizer.state_dict())) p2=saved[0].clone().requires_grad_(True) o2=adam_class([p2],lr=1e-3,foreach=False,fused=False) o2.load_state_dict(saved[1]) for step in range(6,13): p2.grad=torch.tensor(average_columns(mixed_gradients(step)),dtype=torch.float64);o2.step() assert torch.equal(p,p2) return dict(max_state_parameter_error=error,resume_bitwise_equal=True,final_parameters=p.detach().tolist()) def weighted_gradients(): x=torch.tensor([[1.,0.],[0.,1.],[2.,1.]],dtype=torch.float64) y=torch.tensor([1.,-2.,.5],dtype=torch.float64) w=torch.tensor([.2,-.3],dtype=torch.float64,requires_grad=True) full=torch.autograd.grad(((x@w-y)**2).mean(),w)[0] gs=[] for indices in [slice(0,2),slice(2,3)]: gs.append(torch.autograd.grad(((x[indices]@w-y[indices])**2).mean(),w)[0]) correct=(2*gs[0]+gs[1])/3;wrong=(gs[0]+gs[1])/2 # DDP默认按rank平均:每个rank的局部mean乘 N*b_r/B。 ddp_scaled=(gs[0]*(2*2/3)+gs[1]*(2*1/3))/2 return dict(global_gradient=full.tolist(),correct_max_error=float((full-correct).abs().max()), ddp_scaled_max_error=float((full-ddp_scaled).abs().max()), wrong_max_error=float((full-wrong).abs().max())) def main(): parser=argparse.ArgumentParser();parser.add_argument('--official-dir',type=Path);a=parser.parse_args() torch.set_num_threads(1) result=dict(torch=torch.__version__,numpy=np.__version__,device='cpu',simulator=multistep(), installed_adam=probe(torch.optim.Adam),weighted_mse=weighted_gradients()) if a.official_dir: original=load_original('torch.optim.reviewed_adam',a.official_dir/'adam_v2.10.0.py') result['official_adam']=probe(original.Adam) assert result['official_adam']==result['installed_adam'] sampler=load_original('reviewed_sampler',a.official_dir/'sampler_v2.10.0.py') dataset=list(range(5)) result['sampler']={} for drop in [False,True]: parts=[list(sampler.DistributedSampler(dataset,num_replicas=2,rank=r, shuffle=False,drop_last=drop))for r in range(2)] result['sampler'][str(drop)]=parts assert result['sampler']=={'False':[[0,2,4],[1,3,0]],'True':[[0,2],[1,3]]} assert result['installed_adam']['max_state_parameter_error']<1e-14 assert result['weighted_mse']['correct_max_error']<1e-14 assert result['weighted_mse']['wrong_max_error']>0.1 output='reference_official_results.json' if a.official_dir else 'reference_results.json' Path(__file__).with_name(output).write_text(json.dumps(result,indent=2),encoding='utf8') print(json.dumps(result,indent=2)) if __name__=='__main__': main() make_figures.py """Regenerate this article's deterministic teaching figure (numpy + matplotlib).""" from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np OUT=Path(__file__).resolve().parents[1]/"figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({"font.sans-serif":["Microsoft YaHei","DejaVu Sans"],"axes.unicode_minus":False}) n=np.array([1,2,4,8,16,32,64]); p=7.5e9 fig,ax=plt.subplots(figsize=(8,4.8)) for name,y in [("DDP",np.full(n.shape,16.)),("ZeRO-1",4+12/n),("ZeRO-2",2+14/n),("ZeRO-3",16/n)]: ax.plot(n,y*p/1e9,"o-",label=name) ax.set(xscale="log",yscale="log",xlabel="Data-parallel ranks",ylabel="Model states per rank (GB)",title="7.5B model: FP16 weights/grads + FP32 master/m/v") ax.legend();ax.grid(alpha=.25);fig.tight_layout() fig.savefig(OUT/'zero_states.png',dpi=170) plt.close(fig) print(OUT/'zero_states.png')